
Лента новостей
|
22.10.2026 [17:25], Павел Котов
Nebius привлекла $3,5 млрд от Citi на развитие сети ЦОДОблачный провайдер Nebius объявил о получении кредитной линии в размере $3,5 млрд от банка Citi. Средства будут направлены на дальнейшее развитие ЦОД и закупку GPU — компания стремится нарастить свои вычислительные мощности максимально быстро. Это сообщение появилось на фоне недавнего массового падения акций компаний, связанных с инфраструктурой для ИИ, напоминает Reuters. Инцидент был спровоцирован резко подешевевшими облигациями CoreWeave — конкурента Nebius. CoreWeave, как и Nebius, относят к числу ведущих представителей сегмента неооблачных провайдеров, которые специализируются на создании ЦОД для нужд ИИ. Срок погашения новой кредитной линии составляет 364 дня, а процентная ставка установлена на уровне 2,75 % от уровня базовой SOFR. 
Источник изображения: Nebius Финансирование обеспечит гибкость в выборе сроков и структуры привлечения капитала для обеспечения роста в 2027 году и в дальнейшем, отметили в компании. Другими источниками финансирования выступают предоплата от клиентов и операционный денежный поток. У Nebius есть и другие возможности для привлечения средств, в том числе получение кредитов под обеспечение будущими поступлениями по долгосрочным контрактам с заказчиками, у которых высокий кредитный рейтинг, отметил операционный директор Nebius Офир Наве (Ophir Nave). Общая сумма таких контрактов составляет $40 млрд, среди заказчиков значатся Microsoft и Meta✴. Nebius выступает приоритетным облачным провайдером у Palantir. Оператор ЦОД выпустил облигации на $5 млрд для расширения парка дата-центров и ИИ-ускорителей. Компания активно расширяется в Европе, строя и арендуя ЦОД в Эстонии, Финляндии и Великобритании.
22.10.2026 [17:05], Владимир Мироненко
GitHub перевела 99,99999 % репозиториев в облако AzureGitHub объявила о переносе 99,99999 % репозиториев в Azure. «За последний год, на фоне экспоненциального роста трафика Git, 99,99999 % репозиториев GitHub стали размещаться одновременно в двух местах: в наших собственных дата-центрах и в Azure. Оставшиеся репозитории — одни из самых активно используемых на платформе, и их переносу мешает лишь один фактор: задержка в 25 мс при обмене данными (round trip)», — сообщила компания. Компания объяснила сроки и формат перехода «агентным сдвигом» (agentic shift): стремительным ростом трафика, жёсткими ограничениями по энергопотреблению в её дата-центрах и прилегающих регионах, а также физическими трудностями в цепочках поставок. Рост трафика, генерируемого программными агентами, повысил нагрузку на критически важные сервисы (уровень Tier 0), обеспечивающие основные операции с репозиториями. 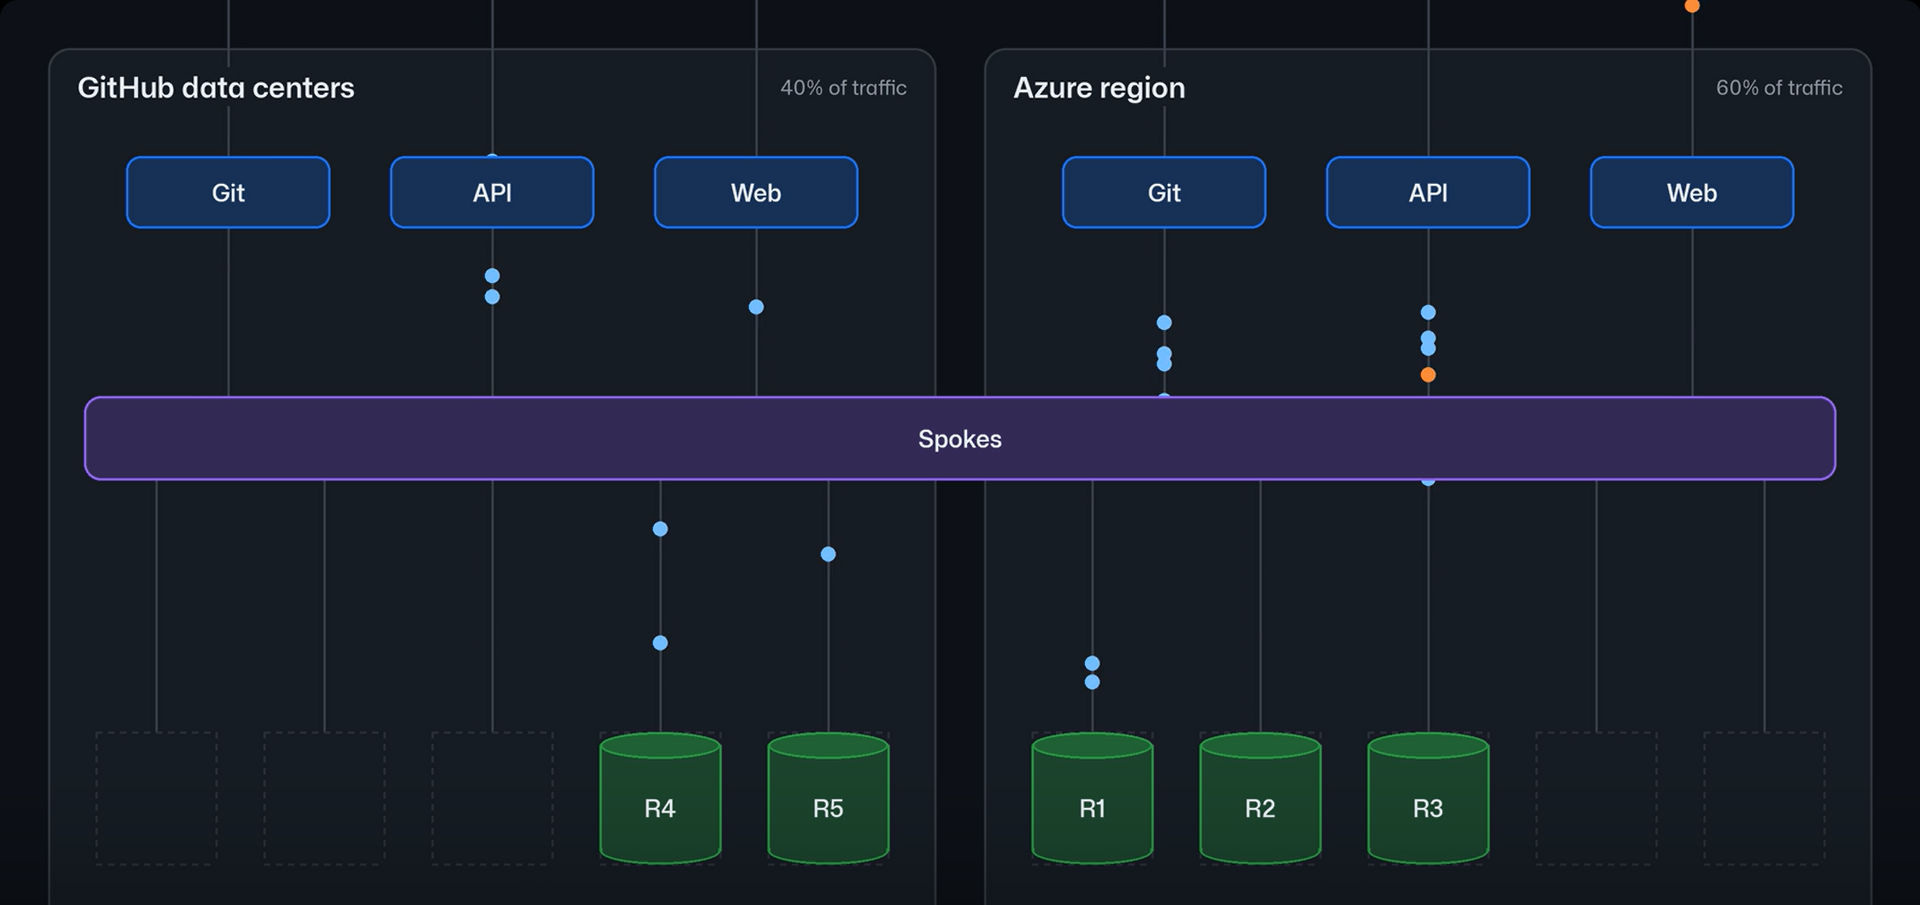
Источник изображения: GitHub Учитывая масштаб системы и её критическую важность для сообщества, GitHub тщательно выстроила последовательность действий, решив сначала перенести данные, сервисы и все сопутствующие зависимости, а затем, после их перемещения, развивать архитектуру. Первая копия репозитория была размещена в регионе Azure Central US в августе 2025 года. На данный момент у большинства репозиториев две из пяти реплик находятся в Azure, и на долю этой платформы приходится около половины всего трафика Git. На протяжении большей части этого периода Azure брала на себя растущую нагрузку, в то время как собственные дата-центры GitHub сохраняли стабильные показатели. При этом GitHub опиралась на два принципа: минимизацию координации и отделение хранилища от вычислительных ресурсов. В GitHub описывают эту работу как «мост» между текущей архитектурой (системой Spokes) и следующей моделью хранения данных. Для большинства репозиториев GitHub создаёт пять реплик, распределнных по разным регионам и зонам доступности. Сервис Spokes использует механизм предпочтительной маршрутизации, направляя каждый запрос к реплике, находящейся в том же регионе и зоне доступности, что и источник запроса. По мере переноса реплик в Azure доля трафика, обслуживаемого этой платформой, увеличивается — до тех пор, пока не будет перемещена последняя реплика, после чего старый регион полностью перестает получать запросы. В текущей архитектуре репозиторий, размещённый более чем в одном регионе, имеет более низкий предел пропускной способности для операций записи. Для их подтверждения системе Spokes требуется большинство реплик, при этом кворум ожидает ответа от каждой исправной реплики вплоть до истечения времени ожидания (тайм-аута). Задержка при записи определяется самой медленной из исправных реплик. Поскольку на время выполнения записи накладывается блокировка всего репозитория, эта задержка также ограничивает максимальную пропускную способность репозитория. Если одна из реплик оказывается в целевом регионе Azure — на расстоянии около 1600 км от дата-центров GitHub, — каждый цикл обмена данными по сети (round trip) занимает примерно 25 мс, а для выполнения записи требуется несколько таких циклов. Если репозиторий уже работает на пределе своей пропускной способности, он не сможет «поглотить» эти дополнительные временные затраты при каждой записи, в результате чего очередь операций push начнёт расти. Здесь вступает в силу принцип минимизации координации. В данном случае это означает: не стоит сериализовать (выполнять строго последовательно) те операции, которые в этом не нуждаются. В связи с этим меняется область действия кворума: теперь он распространяется не на весь репозиторий целиком, а на отдельные ссылки. Запись с привязкой к конкретной ссылке (ref) сохраняет порядок операций, требуемый Git. Git предполагает наличие опредёленной последовательности событий для каждой ссылки (ветки или тега): как только сервер принимает новое значение, клиент видит либо это значение, либо более позднее. Между независимыми ссылками требования к согласованности отсутствуют. При сериализации на уровне отдельных ссылок (per-reference serialization) ожидание репозитория, то есть его временная блокировка, требуется только в тех случаях, когда операции записи затрагивают одну и ту же общую ссылку. На практике большинство операций записи в репозиторий направлено на разные ссылки. Когда агенты и разработчики работают с разными ветками, их операции больше не блокируют друг друга. Хотя каждая операция записи по-прежнему подвержена задержкам, связанным с передачей данных между регионами, операции с разными ссылками могут выполняться параллельно. Такой подход устраняет необходимость в единой очереди для всего репозитория, сохраняя при этом гарантии согласованности, на которые полагаются клиенты Git. По данным внутреннего тестирования было зафиксировано, что при записи в разные ссылки пропускная способность возрастает в 3–4 раза, а задержки при этом снижаются. В большинстве репозиториев соотношение операций чтения к записи составляет от 100:1 до 1000:1. В текущей архитектуре реплик GitHub чтение и запись выполняются на одних и тех же вычислительных ресурсах, из-за чего они конкурируют за память и процессорное время, что исключает возможность их независимого масштабирования. Новая архитектура предусматривает разделение мощностей для чтения и записи, благодаря чему для каждой задачи можно задать собственную конфигурацию. На первом этапе объектное хранилище включается в состав кворума в качестве «виртуальной реплики записи» (virtual write replica) — временного узла, который передаёт входящие данные записи в Azure Blob Storage, но не обслуживает запросы на чтение. Spokes включает этот узел в кворум и отправляет подтверждение записи клиенту после того, как данные будут надёжно сохранены в объектном хранилище. Виртуальная реплика записи также объединяет транзакции, затрагивающие независимые ссылки, в единый пакет сетевых операций ввода-вывода при обращении к объектному хранилищу. Благодаря этому для активно используемого репозитория вместо отдельного сетевого запроса на каждую операцию записи выполняется лишь один запрос для целого ряда одновременных операций. На текущем этапе виртуальная реплика записи также отвечает за процесс уплотнения данных (compaction), а реплики чтения (read replicas) получают уже уплотнённое состояние. Использование виртуальных реплик записи позволяет по мере необходимости масштабировать систему, создавая любое количество виртуальных реплик чтения. Каждая такая реплика наполняет свой кеш данными из Azure Blob Storage и начинает обслуживать запросы на чтение, не становясь участником кворума. Единственным достоверным источником данных выступает объектное хранилище, с которым реплика в фоновом режиме согласовывает своё локальное состояние. Поскольку синхронизация проходит в фоновом режиме, реплики подходят не для всех типов рабочих нагрузок, связанных с чтением. Для поддержки любых видов операций чтения процесс синхронизации должен быть переведён в синхронный режим (in-line): реплика должна запрашивать только те данные и состояния, которые изменились с момента её последней синхронизации. Компания отметила, что, несмотря на эти изменения, кворум по-прежнему остаётся ограничивающим фактором для дальнейшего роста. GitHub утверждает, что Spokes обрабатывает более 100 млрд операций в день, и предупреждает, что его протокол фиксации изменений (commit protocol) не сможет обеспечить работу сервиса с миллиарда репозиториев до следующего миллиарда. Сегодня Spokes представляет собой интеллектуальный уровень маршрутизации и балансировки нагрузки, единый API, через который внутренние сервисы получают доступ к данным репозиториев, а также набор фоновых процессов — так называемых «чистильщиков» (sweepers), — которые управляют размещением репозиториев, их восстановлением и перераспределением между узлами хранения. Компания отметила, что после реализации этих шагов следующим ограничивающим фактором станет пропускная способность операций записи. Каждая операция записи по-прежнему зависит от реплик, каждая из которых хранит полную копию репозитория, хотя лишь малая часть данных, записываемых в репозиторий, требует строгого упорядочивания. Объекты Git неизменяемы и идентифицируются по своему содержимому, поэтому их можно сохранять без необходимости достижения консенсуса между узлами. Остаётся лишь небольшой объём данных, и самая сложная задача — упорядочить их максимально быстро, не создавая при этом «узкого места» в другом звене системы. Как ожидается, подробности о финальной версии архитектуры платформы компания сообщит на GitHub Universe.
22.10.2026 [15:14], Руслан Авдеев
Горсовет Мемфиса отклонил 18-месячный мораторий на строительство ЦОД — ограничения ввели на 135 днейПредложение ввести мораторий на строительство дата-центров в Мемфисе (Memphis, штат Теннесси) на 18 месяцев было отклонено местным городским советом. Вместо этого власти приняли решение ввести 135-дневную «паузу» в рассмотрении новых заявок на строительство ЦОД, сообщает Datacenter Dynamics. Такое ограничение по времени отчасти совпадает с 90-дневным исследованием, заказанным в начале октября мэром Полом Янгом (Paul Young). Оно призвано оценить влияние проектов цифровой инфраструктуры на Мемфис. Возможность введения 18-месячного моратория обсуждалась несколько недель. Ранее в октябре сообщалось, что местные законодатели отложили голосование по этому вопросу после заседания с участием общественности, завершившегося протестами и драками возле зала заседаний совета. В итоге голоса разделились поровну, хотя один из членов совета отсутствовал. Вместо предложенного моратория был поддержан альтернативный вариант, предусматривающий запрет на строительство на более короткий срок. По результатам исследования предполагается выработать «чёткие практические рекомендации» по регулированию деятельности крупных и сверхкрупных дата-центров в Мемфисе. Местные СМИ сообщали, что на заключительном заседании присутствовали сотни жителей города, в том числе те, кому ранее запретили присутствовать на заседаниях из-за нарушений правил во время встречи 6 октября. Суд счёл такой запрет необоснованным. 
Источник изображения: Joshua J. Cotten/unsplash.com Хотя рынок ЦОД в Мемфисе относительно небольшой, на территории города есть несколько крупных объектов xAI Илона Маска (Elon Musk), влившейся в SpaceXAI/SpaceXSI. Данные ЦОД, обеспечивающие работу ИИ Grok и облачных сервисов, в т.ч. для Anthropic, строились на протяжении последних двух лет. Объекты неоднократно становились предметом судебных исков. Например, НКО и экологи заявляли, что компания нарушила условия выданных на использование газовых турбин разрешений. Эти турбины в своё время позволили компании быстро ввести ЦОД в эксплуатацию, а позже она «исправилась», хотя по существу изменилось немногое. Хотя в Мемфисе растёт противодействие строительству ЦОД, некоторые члены городского совета утверждают, что введение моратория нанесёт ущерб экономическому развитию региона: операторы дата-центров перенаправят инвестиции в другие места, где и будут платить налоги. Один из ЦОД Маска уже разместили в соседнем штате Миссисипи (Mississippi), в непосредственной близости от административной границы с Теннесси. Моратории на новые ЦОД всё чаще вводят в США на фоне усиления общественного недовольства новыми ИИ-проектам и строительству инфраструктуры дата-центров. В некоторых случаях моратории вводятся на уровне штатов, а порой общественное недовольство выливается не только в потасовки и не обходится без стрельбы.
22.10.2026 [15:07], Павел Котов
Red Hat и NVIDIA расширили партнёрство для обеспечения безопасности ИИ-агентовRed Hat объявила о расширении сотрудничества с NVIDIA. Цель партнёрства — обеспечить клиентам безопасность ИИ-агентов, контроль доступа к ИИ-моделям и развёртывание рабочих нагрузок на инфраструктуре Vera Rubin, пишет SiliconANGLE. В центре внимания — решение Red Hat AI Factory with NVIDIA, которое объединяет средства управления средой выполнения агентов, ПО для инференса моделей и аппаратную поддержку в гибридных облачных средах. Red Hat работает над интеграцией эталонной архитектуры NVIDIA OpenShell в свои ИИ-платформы как встроенной функциональности. Предложенный подход к безопасности направлен на устранение двух основных рисков: выхода ИИ-агентов за пределы установленных для них границ, а также их компрометации злоумышленниками — например, посредством внедрения вредоносных запросов или атак на цепочку поставок. Компании стремятся вынести механизмы контроля безопасности за пределы ИИ-агентов, а в ряде случаев и за пределы ОС на хосте. OpenShell выступает в качестве песочницы — изолированной среды выполнения для ИИ-агентов. На более низком уровне работает система безопасности NVIDIA Sentry на базе DPU BlueField; для мониторинга рабочих нагрузок используется ПО DOCA Argus на отдельном устройстве. Argus анализирует определённые структуры памяти хоста, определяя, какие процессы запущены, с какими файлами производится работа, и какие используются сетевые соединения. При обнаружении угрозы система безопасности может инициировать применение политик BlueField, которые изолируют скомпрометированную рабочую нагрузку. 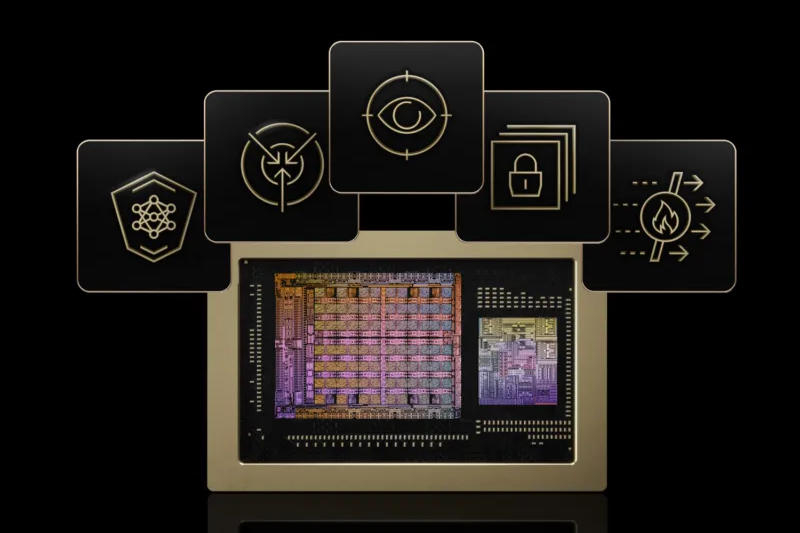
Источник изображения: NVIDIA Эта архитектура опирается на реализованную в Red Hat OpenShift 4.22 поддержку платформы BlueField-3. Она позволяет отделить рабочие нагрузки ИИ на CPU серверов от сетевых функций и сервисов безопасности, работающих на Arm-процессорах модулей BlueField. Таким образом, если злоумышленник скомпрометирует хост, элементы управления инфраструктурой останутся защищёнными. Sentry может изолировать скомпрометированный ИИ-агент за считанные миллисекунды. Перенос функций мониторинга и управления сетью на DPU снижает нагрузку на основные процессоры сервера, высвобождая ресурсы для выполнения ИИ-задач. Партнёрство также связано с вопросами инфраструктуры моделей, необходимых агентам для принятия решения и выполнения действий. Эталонный проект включает средства контроля доступа в рамках схемы «модель как услуга» (Model-as-a-Service) и ИИ-шлюз с технологиями инференса, такими как vLLM, llm-d, NVIDIA Dynamo и микросервисы NVIDIA NIM. Основанное на NVIDIA Inference Hub решение поддерживает самостоятельный выбор моделей пользователями, возможности задавать политики доступа, ограничивать частоту запросов и разграничивать возможности по подписке. Функции управления доступом и выполнения моделей разделены — это даёт клиентам возможность контролировать квоты, распределять затраты и поддерживать производительность в гибридных средах. Компании объявили о совместной поддержке моделей NVIDIA Nemotron, в том числе Nemotron 3.5 Super VL, в среде инференса и обслуживания vLLM. В Red Hat отметили механизмы квантования и спекулятивного декодирования, позволяющие снижать задержку при запуске моделей без потери точности. Версия Red Hat Enterprise Linux for NVIDIA теперь поддерживает процессоры Vera и готова к работе с платформой Vera Rubin. Партнёры стремятся обеспечить совместимость ОС и платформы к моменту выхода нового оборудования. В RHEL for NVIDIA 26.03 для поддержки новой платформы внесены изменения в набор базовых пакетов; при этом сохранены стандартное пользовательское окружение и средства безопасности, включая Security-Enhanced Linux. Когда поддержка оборудования будет включена в основное ядро Linux, клиенты смогут перейти на стандартную версию RHEL без переустановки системы. Сценарии использования, эталонные решения и функции работы с агентами доступны у партнёров, в том числе Cisco, Dell и Lenovo; продолжается работа по нативной интеграции OpenShell. Ранее процессор NVIDIA Vera продемонстрировал превосходство над чипами Intel и AMD. Компания передала в OCP спецификации стоек Vera Rubin и вычислительных узлов в рамках открытой архитектуры MGХ. В инфраструктуре Google Cloud инстансы на базе Vera Rubin NVL72 заработают в ноябре.
22.10.2026 [12:36], Владимир Мироненко
IBM увеличила прогноз по выручке от ПО — акции выросли на 4 %IBM опубликовала финансовые результаты за III квартал 2026 года, завершившийся 30 сентября. Финансовый директор IBM Джеймс Кавано (James Kavanaugh) сообщил, что задержки в заключении сделок в сфере ПО — фактор, обеспокоивший инвесторов в прошлом квартале, — начали преодолеваться. В связи с этим компания повысила прогноз по выручке от ПО. Результаты по этому сегменту за прошедший квартал также превзошли ожидания аналитиков, отметило агентство Reuters. Выручка IBM в III квартале увеличилась на 4,7 %, до $17,10 млрд, превысив средний прогноз аналитиков в размере $16,82 млрд, опрошенных LSEG (по данным CNBC). Скорректированная прибыль на акцию (Non-GAAP) составила $2,95 при прогнозе $2,86. Чистая прибыль (GAAP) составила $2,19 млрд или $2,30 на акцию, превысив показатели аналогичного периода годом ранее, — $1,74 млрд и $1,84 на акцию соответственно. 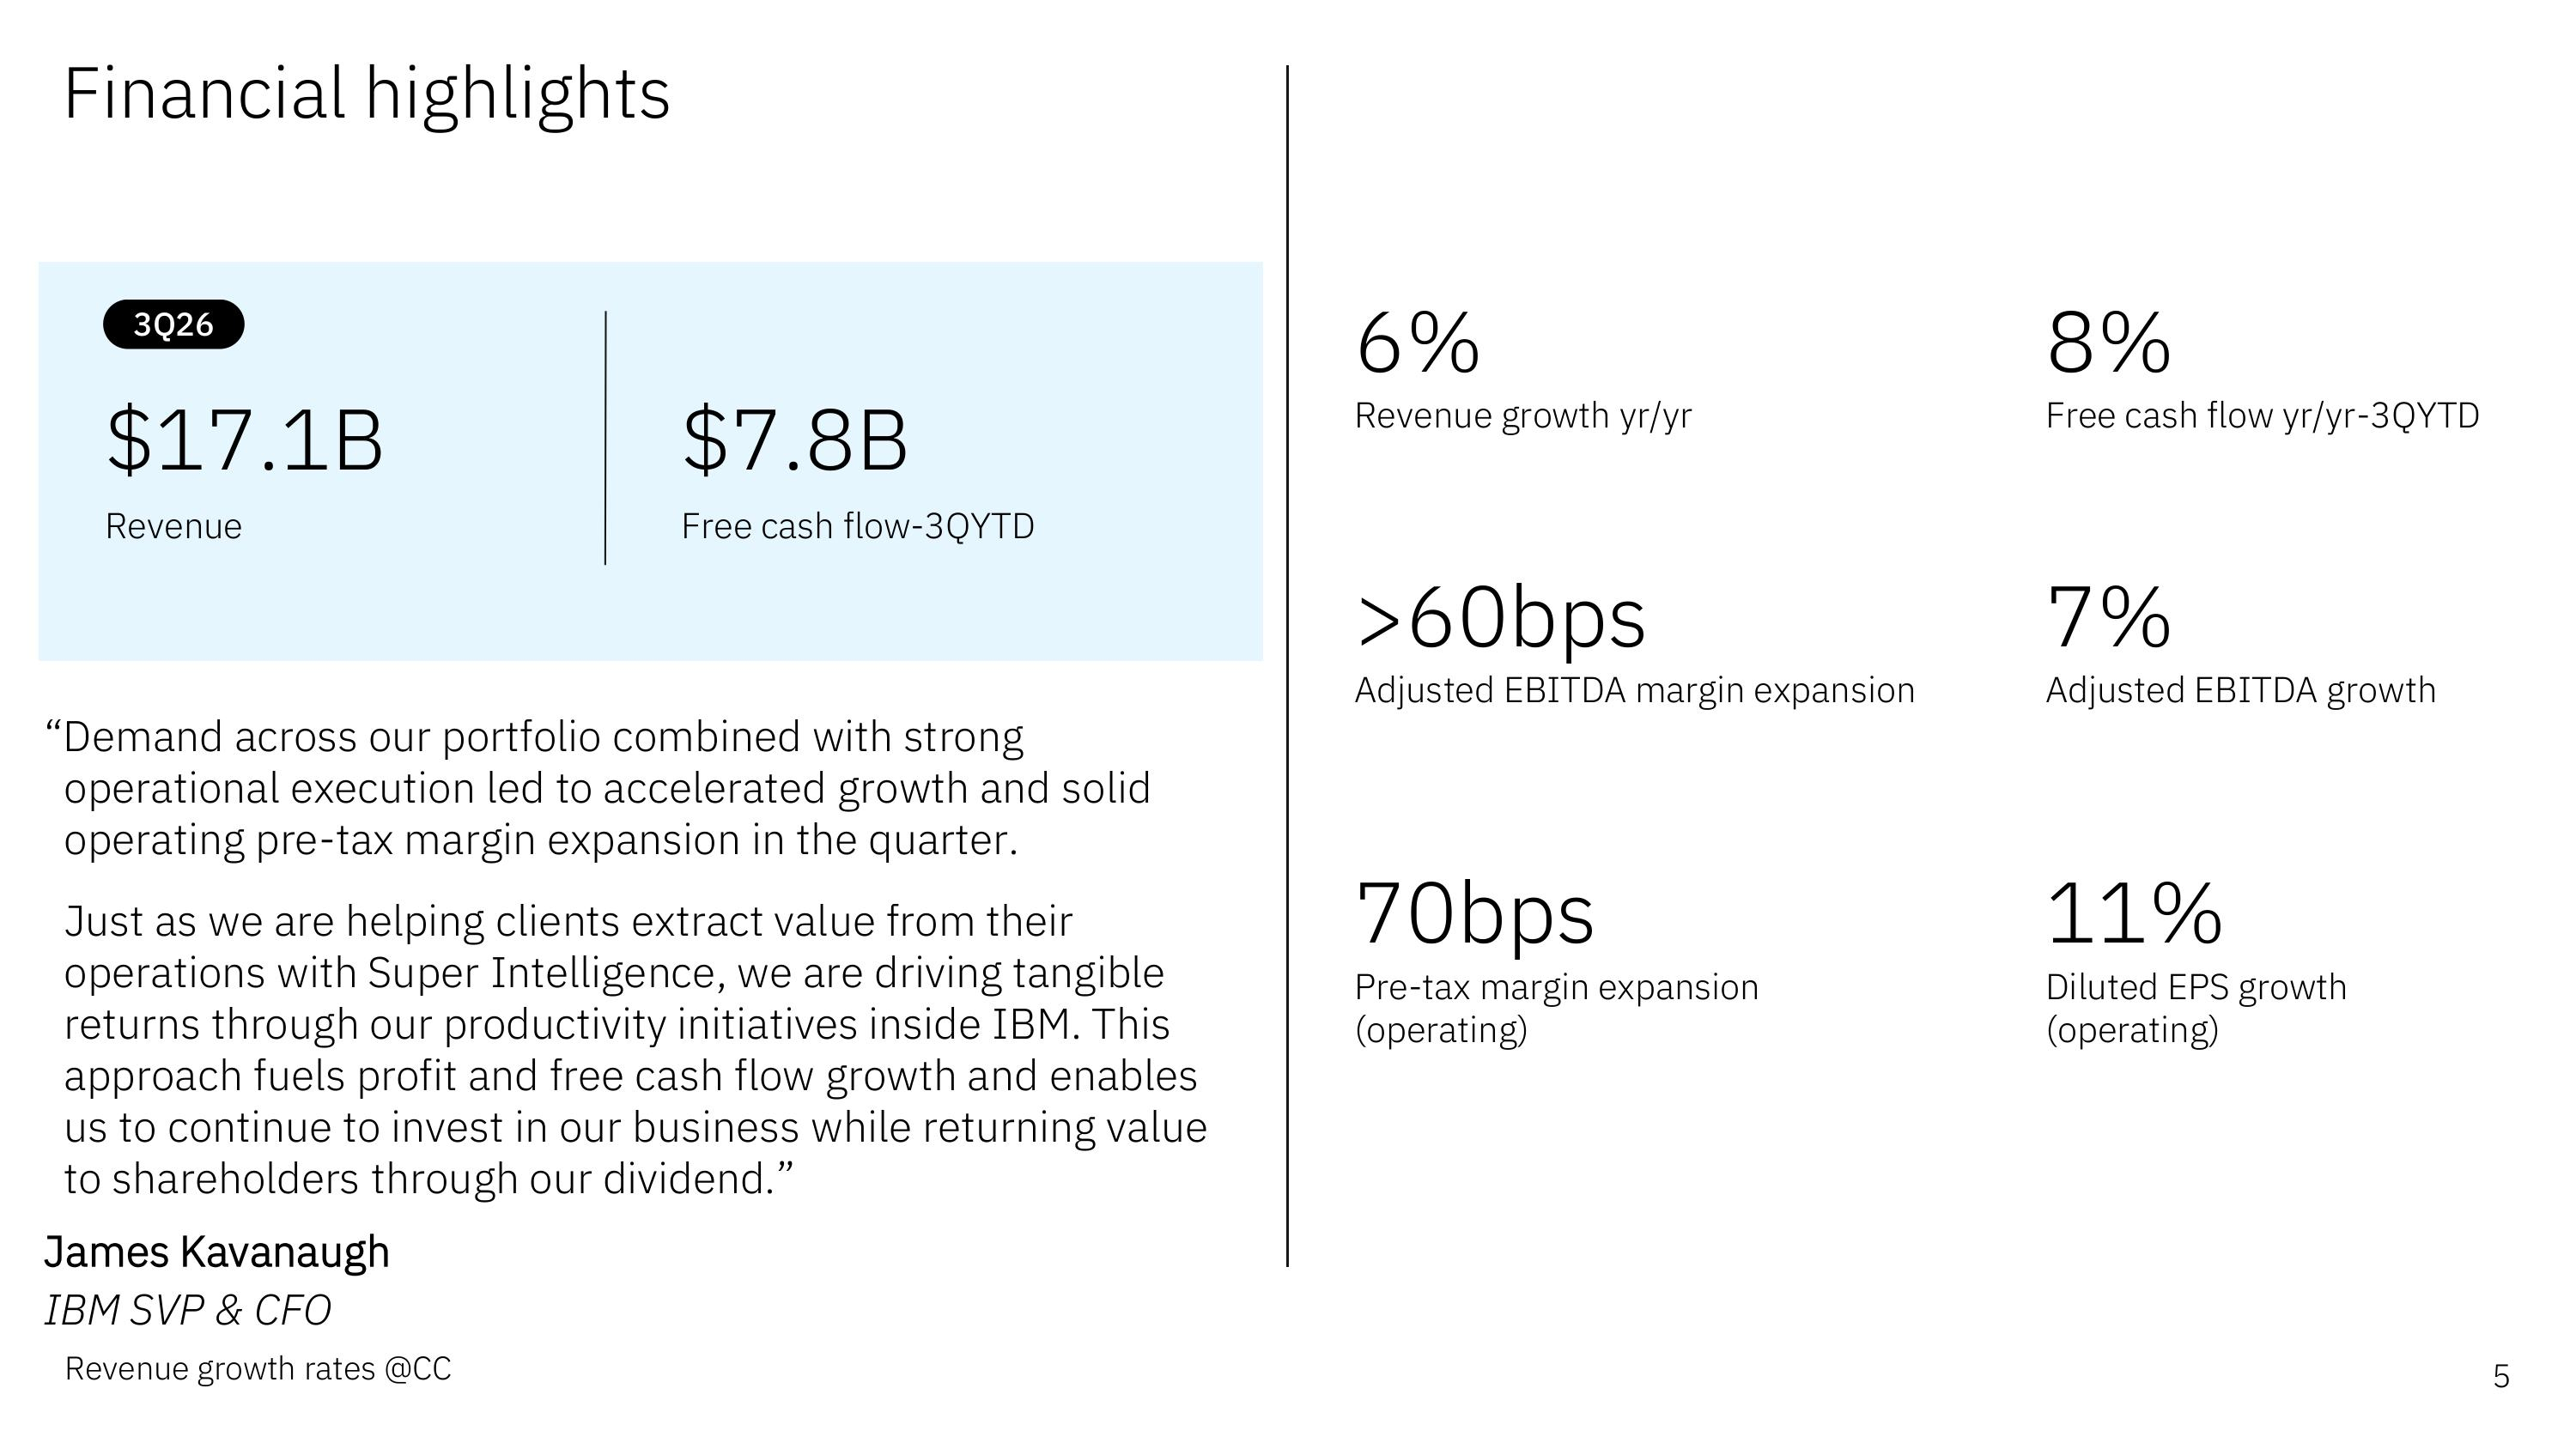
Источник изображений: IBM Выручка от ПО увеличилась на 8 % до $7,80 млрд, превысив консенсус-прогноз аналитиков, опрошенных StreetAccount ($7,66 млрд). Гибридные облачные решения (Hybrid Cloud, включая Red Hat) принесли больше выручки на 11 %. Выручка подразделения по автоматизации упала на 3 %, выручка подразделения по обработке данных и ИИ выросла на 19 %, выручка от обработки транзакций — на 9 %. 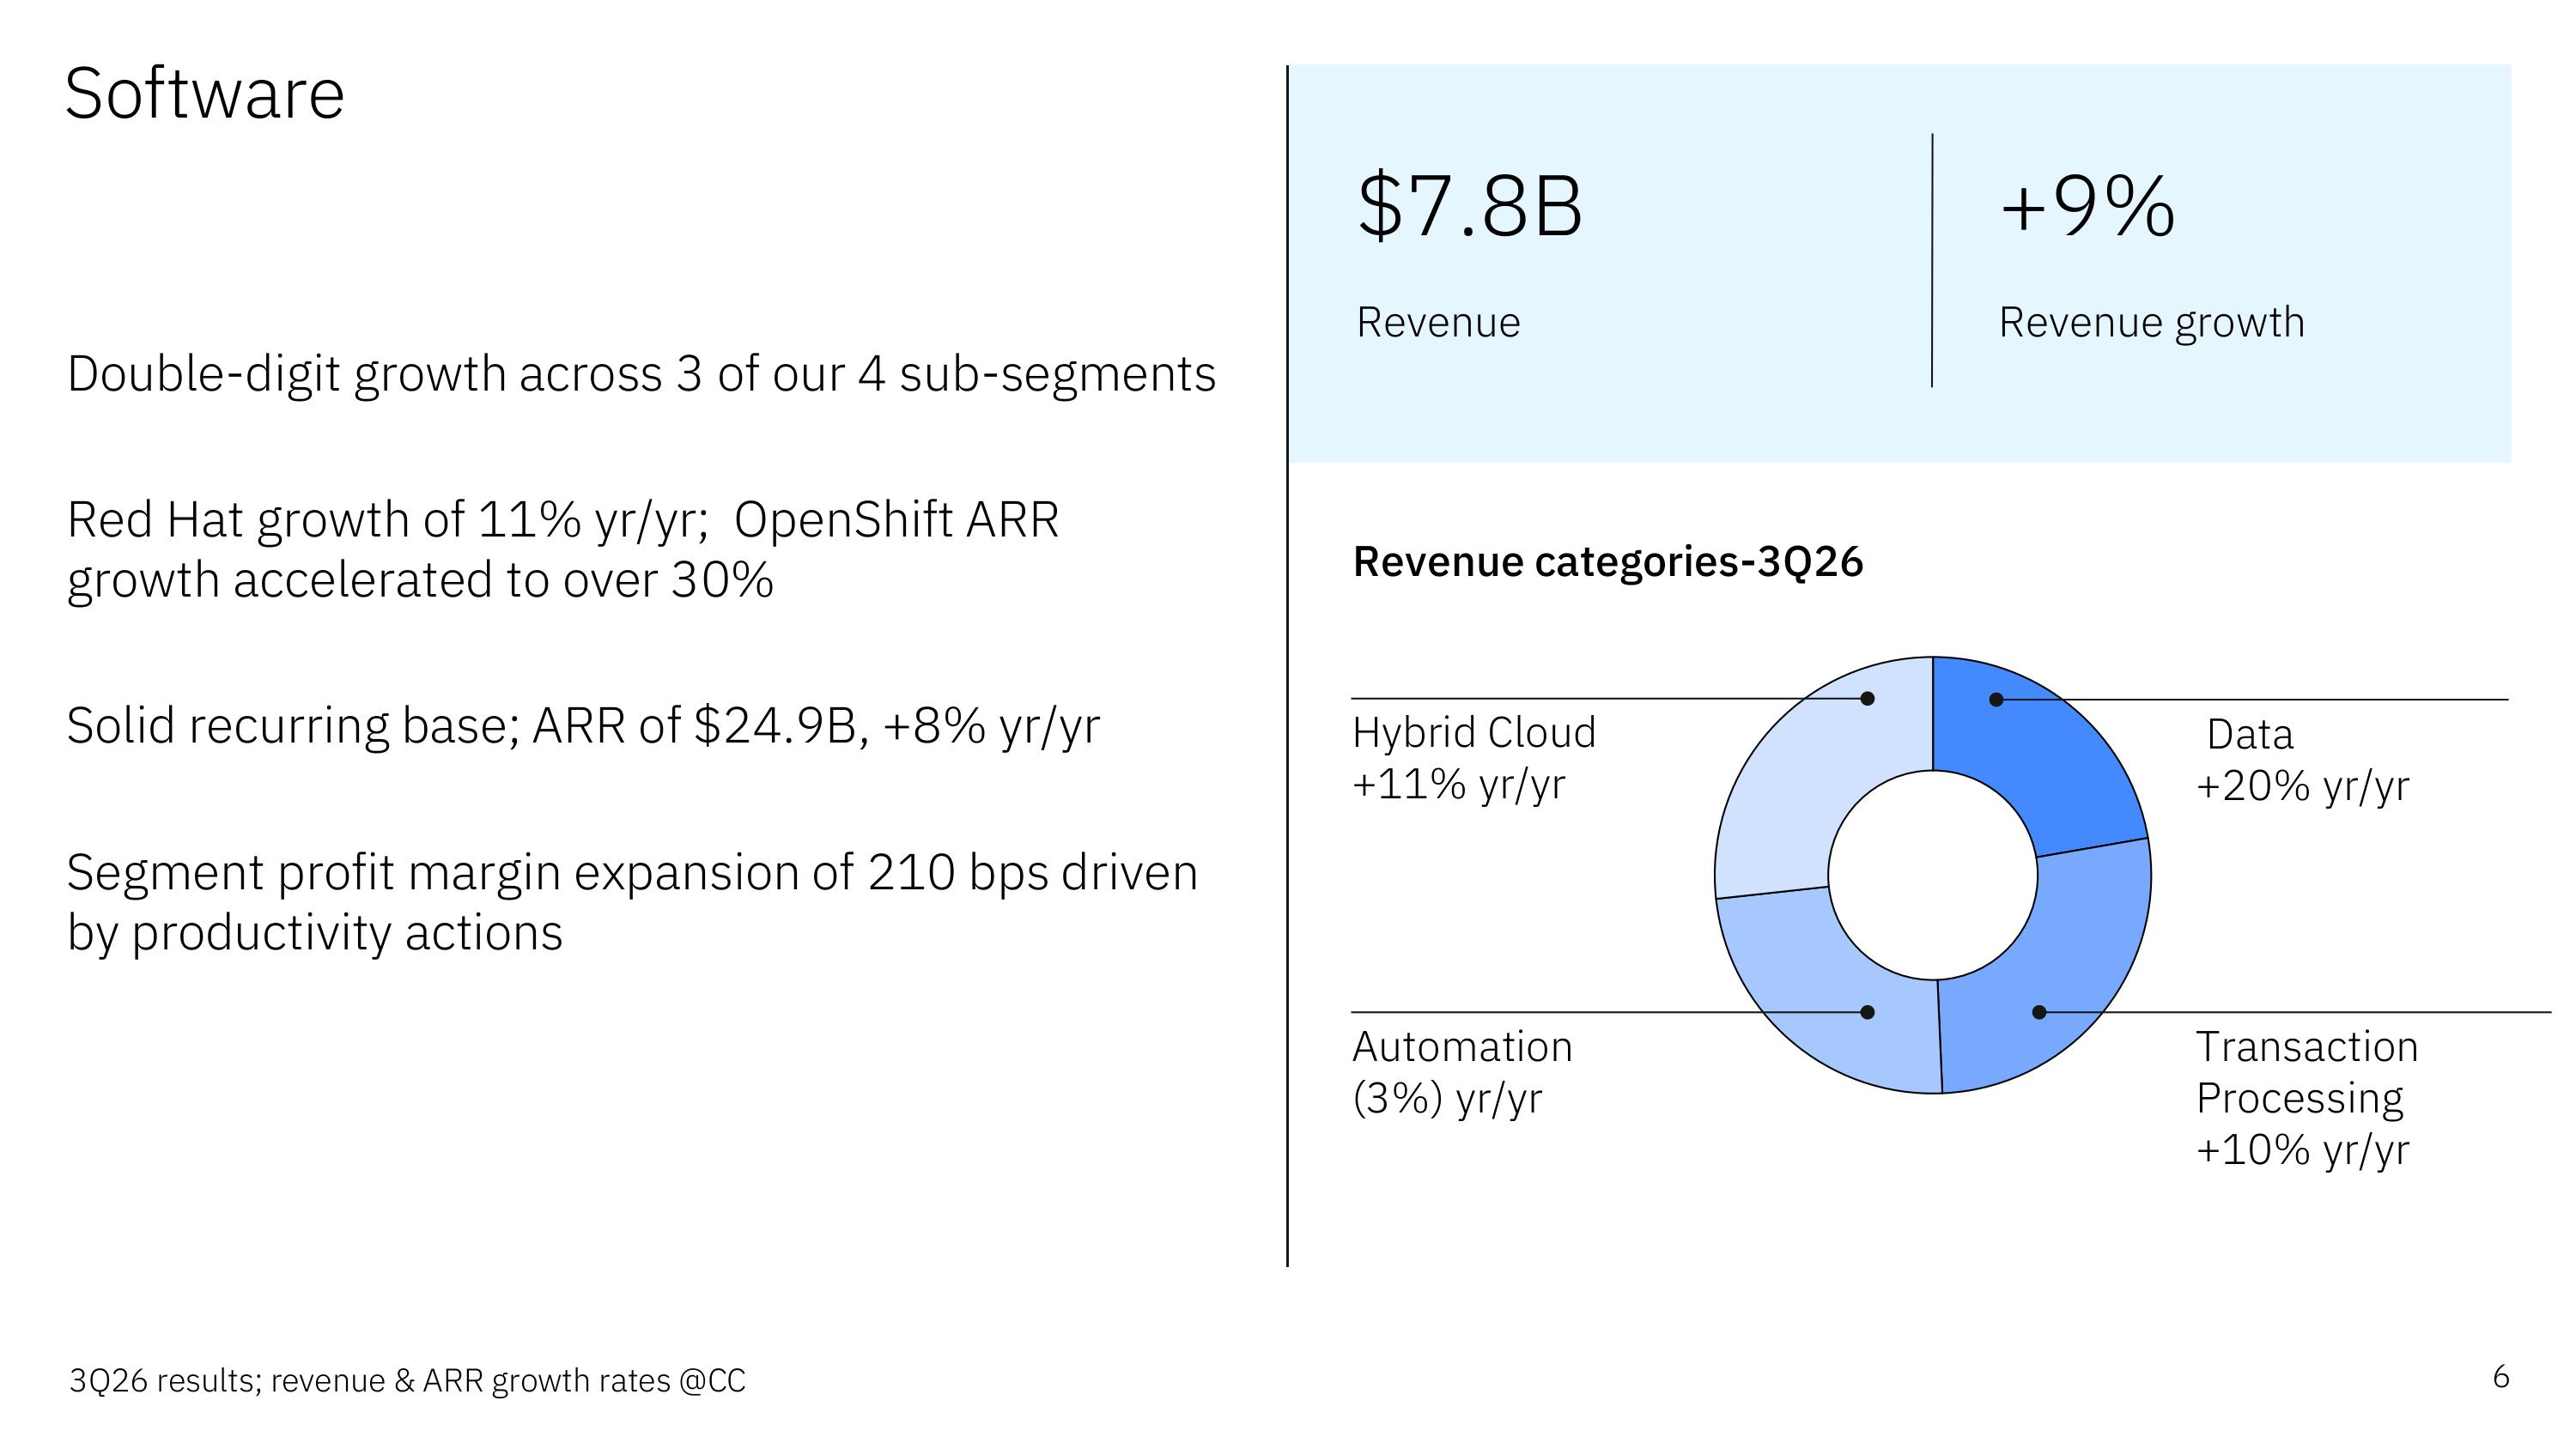 По словам Кавано, около 25 % выручки в сегменте обработки транзакций обеспечили сделки, перенесенные со II квартала, а «остальные 75 % — это полностью новый бизнес». Кавано заявил агентству Reuters, что теперь IBM ожидает роста годовой выручки от продажи ПО на уровне 7–8 % (ранее прогнозировался рост в диапазоне 6–8 %). На фоне этих новостей акции IBM выросли примерно на 4 % на расширенных торгах. 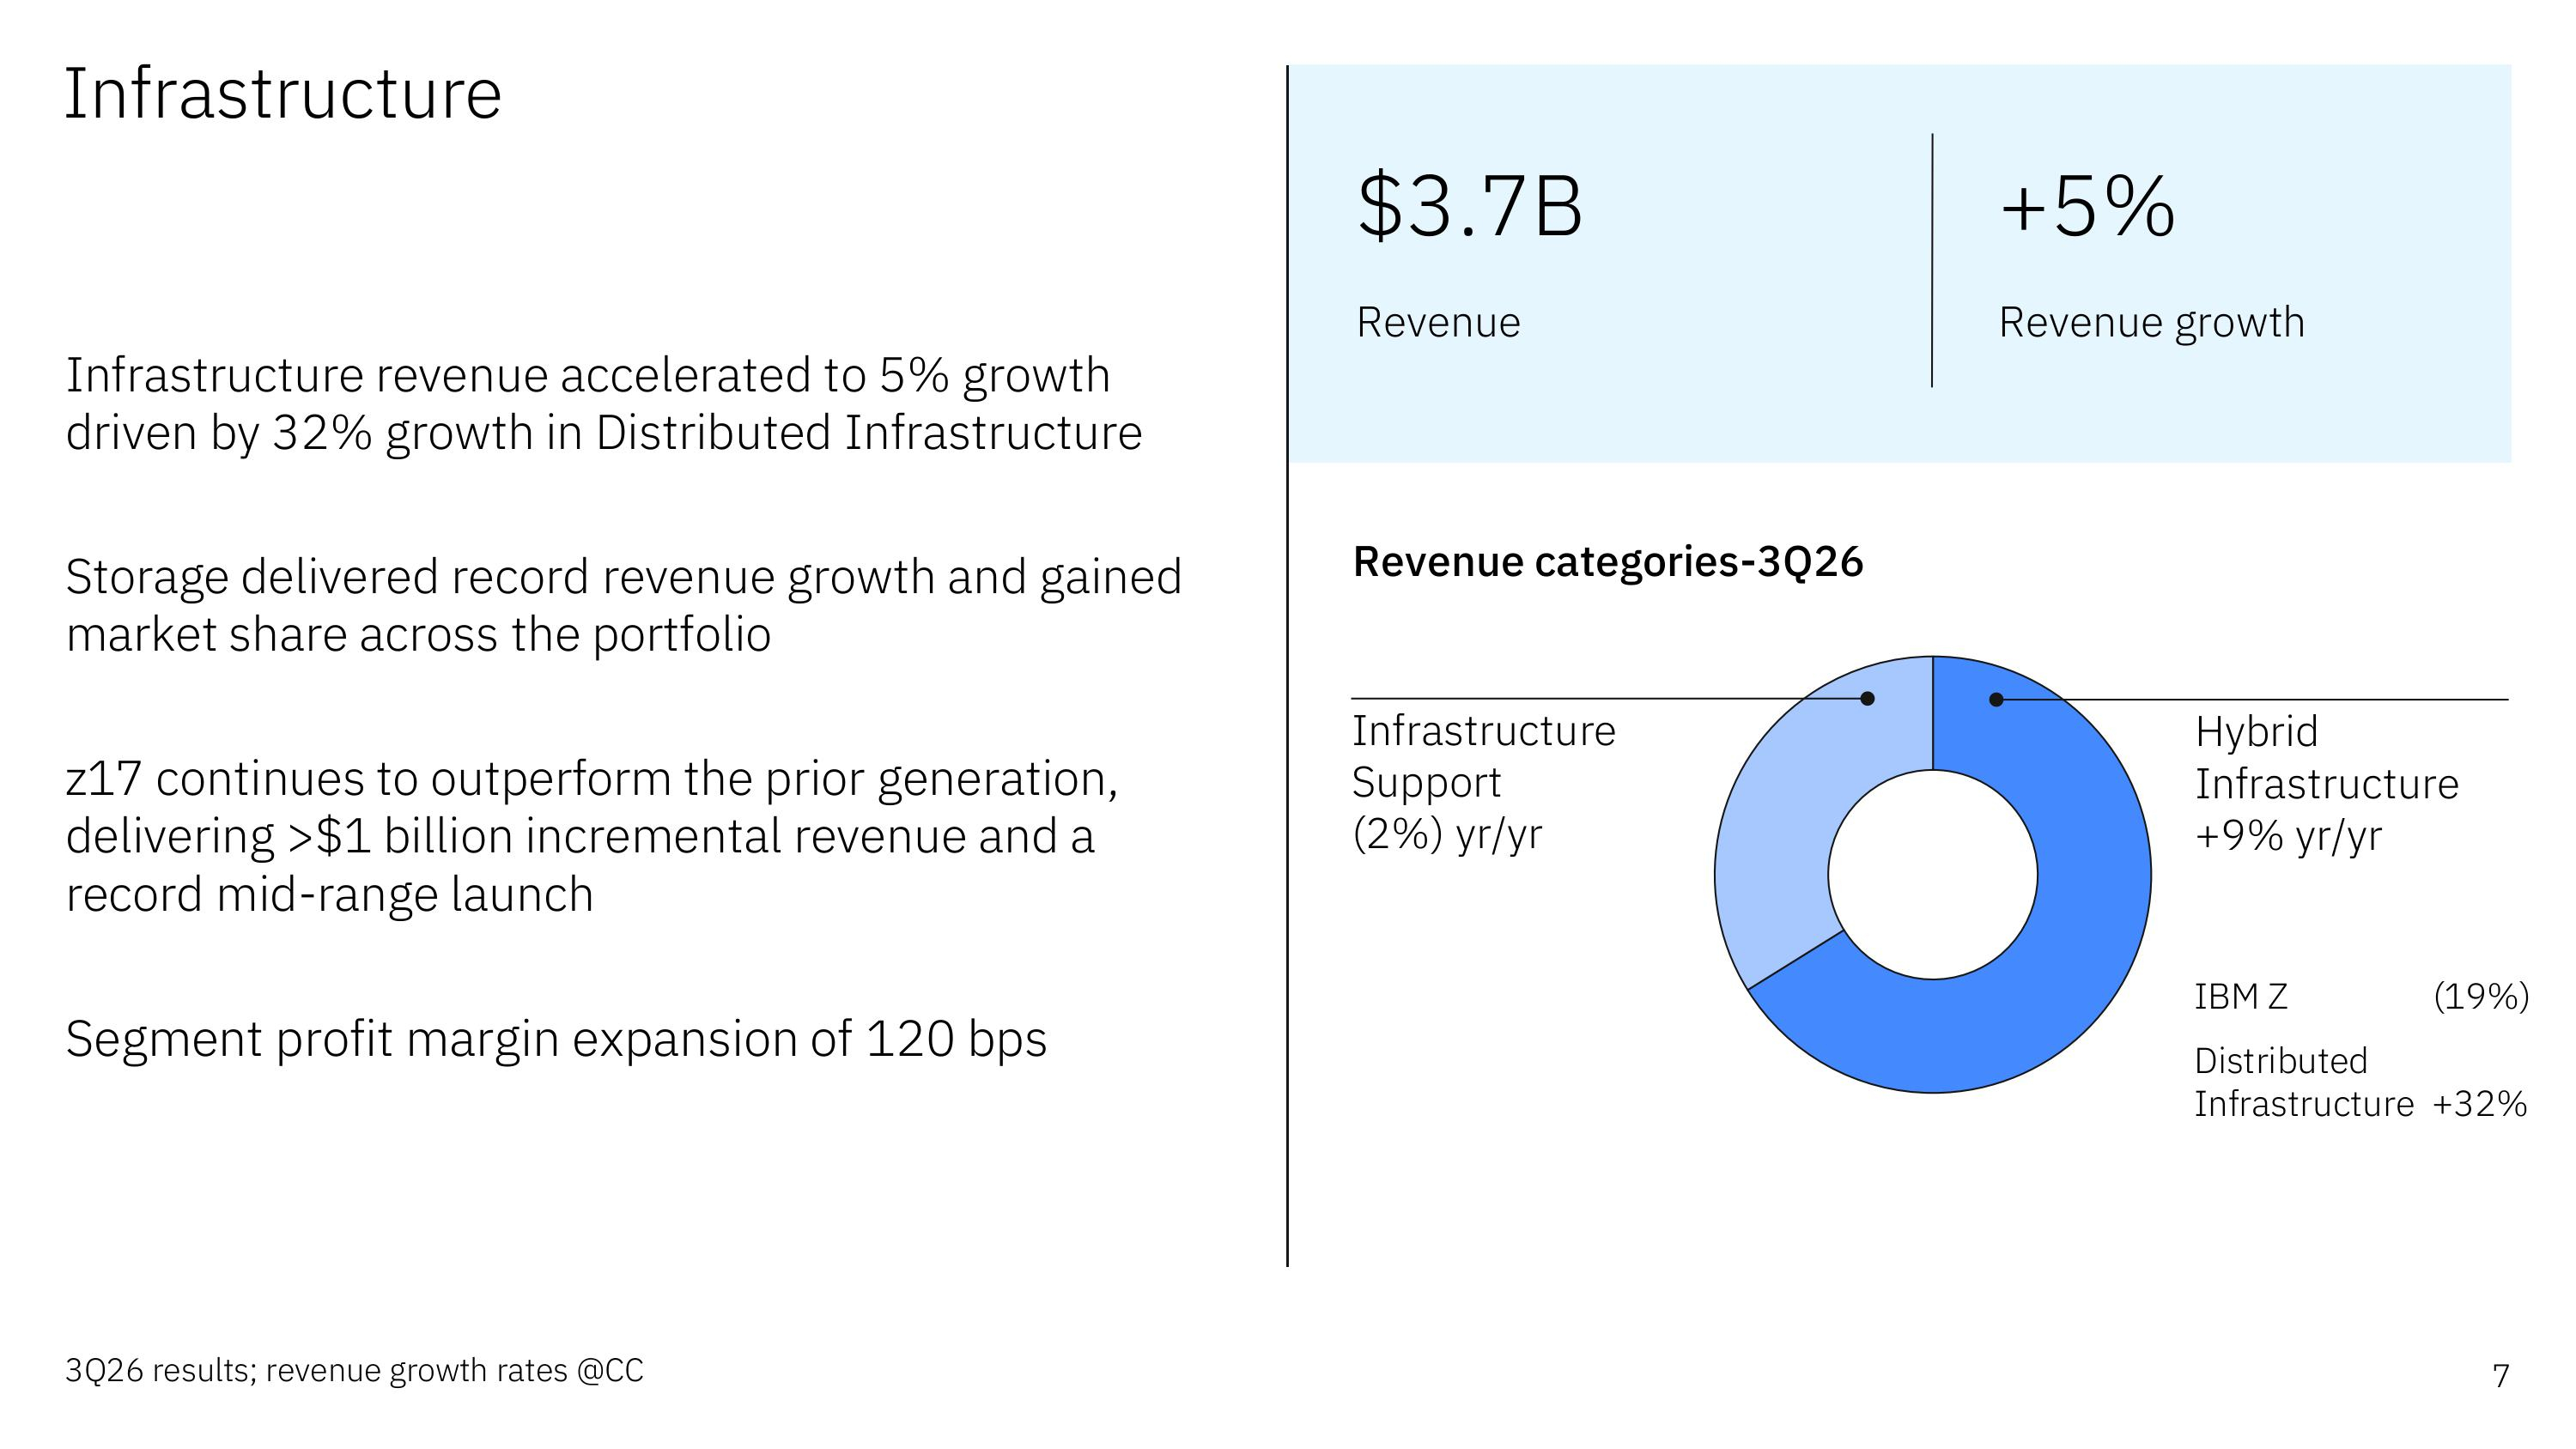 Выручка от консалтинга осталась на прежнем уровне, составив $5,3 млрд. Выручка инфраструктурного подразделения (IBM Infrastructure), занимающегося продажей серверов, СХД, коммутаторов и системного ПО, составила $3,7 млрд (рост — 4 %). При этом выручка от продаж аппаратного обеспечения мейнфреймов z упала на 20 %. Что касается прогноза, то компания по-прежнему ожидает, что по итогам года рост выручки составит от 4 до 5 %.
22.10.2026 [10:56], Сергей Карасёв
Gartner: мировые затраты на дата-центры в 2026 году взлетят более чем на 70 %Компания Gartner опубликовала свежий прогноз по глобальному IT-рынку на текущий и следующий годы. Отрасль демонстрирует быстрый рост, а ключевым драйвером остается ИИ, который стимулирует инвестиции в вычислительные инфраструктуры, облачные платформы и передовые программные экосистемы. По оценкам, в 2026-м объём рынка достигнет $6,39 трлн, увеличившись на 14,5 % по отношению к предыдущему году. В эту сумму включены расходы на дата-центры, электронные устройства, ПО корпоративного класса, IT-сервисы, телекоммуникационные сервисы и решения IaaS. Наибольший рост ожидается в области ЦОД — плюс 73,8 % в годовом исчислении с итоговым результатом около $879 млрд в 2026-м. Аналитики подчёркивают, что за последние 12 месяцев огромный спрос на оборудование со стороны операторов дата-центров привёл к более чем двукратному росту цен на память: это вызвало цепную реакцию в каналах поставок СХД, серверов, сетевого оборудования, ПК и прочих устройств. Как следствие, цены пошли вверх. Эксперты полагают, что наблюдающаяся тенденция сохранится до 2027 года, после чего стоимость оборудования начнёт стабилизироваться. 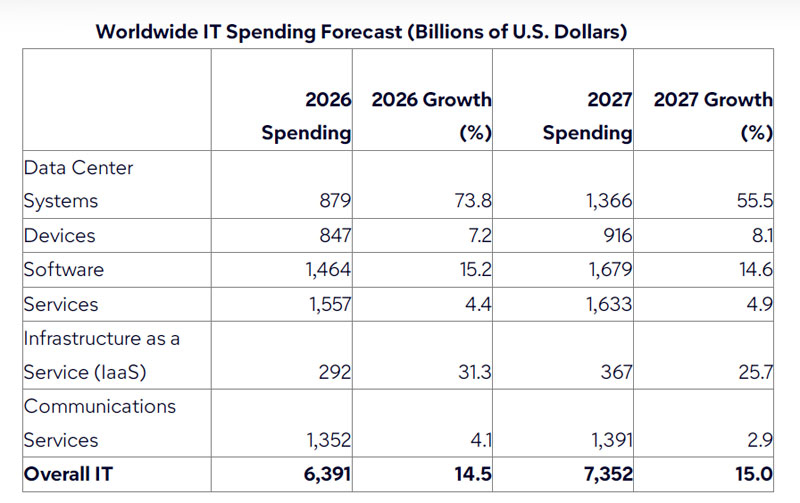
Источник изображения: Gartner Самый существенный вклад в общий объём рынка вносят IT-сервисы с прогнозируемым результатом $1,56 трлн в 2026 году и ростом на 4,4 %. Программные продукты, по оценкам, обеспечат $1,46 трлн (плюс 15,2 % по отношению к 2025-му), телекоммуникационные сервисы — $1,35 трлн (плюс 4,1 %). Ещё $847 млрд придётся на электронные устройств (плюс 7,2 %), $292 млрд — на платформы IaaS (плюс 31,3 %). В 2027 году объём глобального IT-рынка, по мнению экспертов Gartner, впервые в истории превысит отметку в $7 трлн, составив $7,35 трлн. Это будет соответствовать росту на 15 % по сравнению с предыдущим годом. В сегменте дата-центров затраты поднимутся на 55,5 % — до $1,37 трлн. Софт корпоративного класса принесёт $1,68 трлн, IT-сервисы — $1,63 трлн, телекоммуникационные сервисы — $1,39 трлн, электронные устройства — $916 млрд, решения IaaS — $367 млрд.
22.10.2026 [00:36], Владимир Мироненко
Google Cloud и NVIDIA запустят в ноябре инстансы на базе Vera Rubin NVL72Google Cloud и NVIDIA объявили, что в следующем месяце в Европе станут общедоступны инстансы Google Cloud A5X на базе систем NVIDIA Vera Rubin NVL72. Они предоставят клиентам комплексную платформу для обучения моделей, инференса и масштабного обучения с подкреплением. A5X используют системы NVIDIA Vera Rubin NVL72, сетевые адаптеры NVIDIA ConnectX-9 SuperNIC, сеть Virgo Network и передовую технологию жидкостного охлаждения четвертого поколения от Google Cloud. Сообщается, что Google Cloud планирует расширить инфраструктуру на базе архитектуры Vera Rubin, доведя количество ускорителей Rubin до 960 тыс. единиц, размещённых на различных площадках. 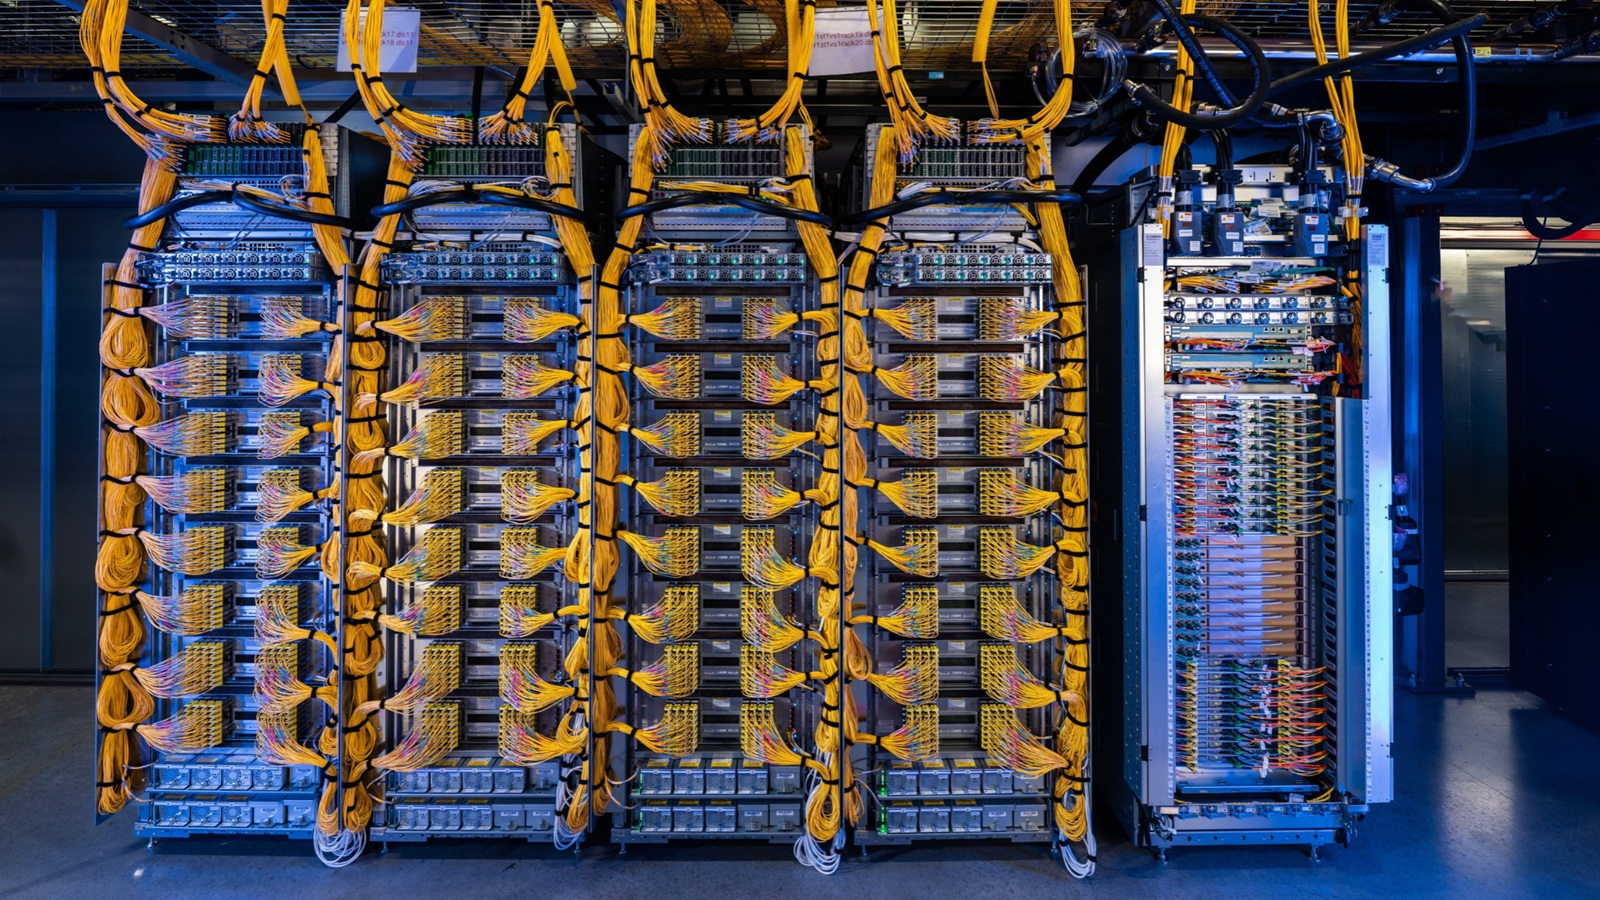
Источник изображения: NVIDIA Обучение с подкреплением требует непрерывного цикла: накопления опыта, оценки результатов и обновления моделей. Для этого необходима инфраструктура, способная поддерживать весь процесс в больших масштабах. A5X интегрирует архитектуру Vera Rubin в систему Google Cloud AI Hypercomputer, объединяя вычислительные мощности, сетевые ресурсы и системы хранения данных для поддержки обучения на основе опыта. По мере развёртывания агентских систем компаниям необходимо обеспечивать защиту проприетарных моделей и конфиденциальных данных, лежащих в основе этих систем, даже при использовании инфраструктуры сторонней организации. Google Cloud станет одним из первых облачных провайдеров, предлагающих NVIDIA Confidential Computing в масштабе стойки на bare-metal-инстансах, таких как A4X Max на базе NVIDIA GB300 NVL72. Кроме того, Google Cloud делает конфиденциальные вычисления (Confidential Computing) общедоступными на виртуальных машинах G4 на базе ускорителей NVIDIA RTX PRO 6000 Blackwell Server Edition, предлагая гибкую платформу для конфиденциального инференса и тонкой настройки. Клиенты, включая Vertebrae, Polaris Cloud и Confidential Core AI, используют ВМ Confidential G4 для обеспечения конфиденциальности разговоров, проверяемой работы агентов и корпоративного ИИ, управляемого в рамках заданных политик. Google Cloud и NVIDIA также изучают возможности комплекса технологий NVIDIA DSX MaxLPS для инфраструктуры на базе Vera Rubin, чтобы оптимизировать производительность на ватт и расширить возможности в рамках доступного бюджета электропитания ЦОД.
22.10.2026 [00:33], Руслан Авдеев
К 2030 году доходы рынка малых ЦОД в России достигнут 14,2 млрд рублейСогласно новому отчёту аналитической группы J’son & Partners Consulting, посвящённому динамике развития российского рынка малых ЦОД вместимостью до 50 стоек, доходы этого рынка к 2030 году достигнут 14,2 млрд руб. при среднегодовых темпах роста 26,8 %. Малые ЦОД активно используются государственными структурами, крупными корпорациями, а также средним и малым бизнесом. Такие объекты подходят как для построения геораспределённых сетей, так и для реализации приложений в отдельных локациях удалённых регионов России. По оценкам экспертов, в 2025 году объём мирового рынка малых ЦОД составил $7,8 млрд, а к 2035 году достигнет $53,6 млрд при среднегодовых темпах роста 21,8 %. На такие дата-центры будет приходиться 6,6 % общемировых доходов от ЦОД (в 2025 году этот показатель составлял лишь 2,6 %). Сегодня в России насчитывается более 450 действующих малых ЦОД. Доходы российского рынка малых ЦОД в 2025 году составили 4,4 млрд руб., а к 2030 году, как ожидается, вырастут до 14,2 млрд руб. При этом около 40 % объёма рынка приходится на дополнительные услуги, включая проектно-изыскательские и строительно-монтажные работы, транспортировку, поддержку и сервис. Другими словами, в цепочке продаж значительную роль играют интеграторы, выступающие непрямым каналом сбыта для производителей малых ЦОД и их собственных фронт-офисов. 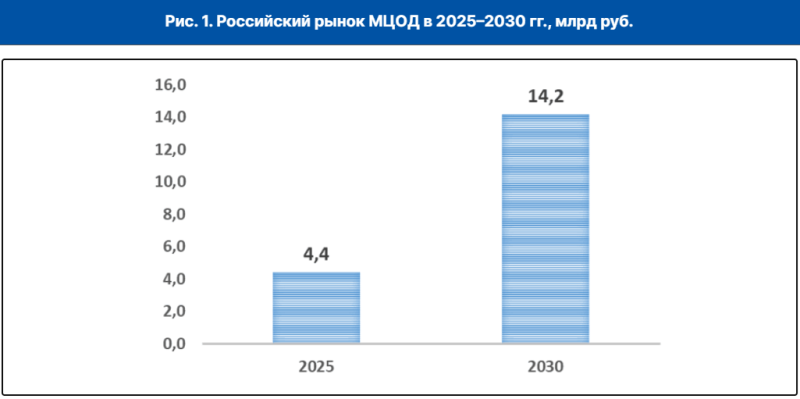
Источник изображения: J’son & Partners Consulting Крупнейшими потребительскими сегментами по числу малых ЦОД являются:
К преимуществам малых ЦОД относится универсальность базовых решений, подходящих для удалённых подразделений крупных компаний, малого и среднего бизнеса, государственных учреждений, систем здравоохранения и образования, а также городских служб. В формате малых ЦОД обычно предлагаются модульные решения, позволяющие последовательно наращивать вычислительные ресурсы и объём инвестиций по мере роста потребностей. Также малые дата-центры, по словам авторов доклада, можно подключать «в любой точке магистральных, региональных и локальных сетей ВОЛС», формируя геораспределённые системы передачи и обработки данных как национального, так и местного масштаба с возможностью интеграции с крупными дата-центрами головных офисов компаний. Наконец, в России реализуется национальный проект «Экономика данных и цифровая трансформация государства», рассчитанный на 2025–2030 годы. Кроме того, в стране действуют отраслевые программы цифровизации в различных сферах. Например, как заявил заместитель президента — председателя правления ПАО «Ростелеком» Валерий Ермаков на форуме РБК Tech, в нынешних условиях российским компаниям необходимы резервные ЦОД «судного дня» для быстрого восстановления сервисов.
22.10.2026 [00:19], Павел Котов
DeepSeek открыла исходный код DeepInfer — фреймворка для инференса своего ИИКитайская ИИ-лаборатория DeepSeek открыла исходный код DeepInfer — фреймворка для инференса, на базе которого работают собственные сервисы компании, сообщает SiliconANGLE. Ключевой задачей продукта разработчик называет обеспечение работы с большой пользовательской базой при сохранении приемлемой стоимости. Один кластер, по заявлению DeepSeek, обрабатывает 155 трлн токенов в сутки, а доход при использовании тарифов в периоды низкой нагрузки составляет $38 в час на один GPU. На данный момент DeepInfer поддерживает только модель DeepSeek-V4.1-Flash — по умолчанию загружается версия 1017, вышедшая в минувшие выходные. Фреймворк совместим с GPU NVIDIA на архитектуре Blackwell (SM100) и ускорителями Huawei Ascend 950; поддержка архитектуры NVIDIA Hopper и более старых поколений не предусмотрена. В DeepInfer есть две функции, гарантирующие получение идентичных результатов при повторном запуске с одинаковыми исходными данными. Они работают только на ускорителях NVIDIA. Быстродействие DeepInfer DeepSeek проверяла только на ускорителях NVIDIA, поэтому приведённые результаты бенчмарков получены исключительно в ходе собственных испытаний компании. 
Источник изображения: DeepSeek В DeepInfer предусмотрены два способа ускорения работы модели. Спекулятивное декодирование с помощью системы DSpark предполагает генерацию сразу пяти токенов вспомогательной моделью; модуль оценки уверенности прогнозирует, какие из них будут приняты основной моделью. Вычислительные ресурсы для проверки затрачиваются только на наиболее вероятные варианты, благодаря чему количество проверяемых «черновых» токенов на каждом шаге сокращается на 30 %. В реальных рабочих нагрузках это обеспечивает прирост производительности на 4–7 %. Второй механизм почти вдвое сокращает объём вычислений при первичной обработке запроса: через слои декодера модели повторно пропускаются только последние 128 токенов, а не весь запрос целиком. Код для управления KV-кэшем и балансировки нагрузки DeepSeek пока не опубликовала, пояснив, что эти компоненты тесно связаны с внутренней инфраструктурой компании. DeepInfer преимущественно ориентирован на разделение нагрузки между первичной обработкой запросов и генерацией ответов, но реализовывать этот механизм пользователям придётся самостоятельно. В качестве минимальной эффективной конфигурации указываются 128 GPU: по 64 для первичной обработки запросов и генерации ответов. Фреймворк DeepInfer доступен на GitHub под лицензией Apache 2.0. В комплект входит библиотека deepseek-recipe, которая преобразует запросы в последовательности токенов, используя ту же логику, что и официальный API DeepSeek. В этом же репозитории будет размещаться код для инференса и будущих моделей. Поддержка платформы Ascend в DeepInfer появилась вслед за релизом от 30 сентября, в рамках которого DeepSeek при содействии Huawei обеспечила поддержку TileLang — китайского аналога NVIDIA CUDA. Во Внутренней Монголии ИИ-лаборатория намерена построить кампус ИИ ЦОД мощностью 1 ГВт и развернуть там не менее 160 000 ускорителей Huawei Ascend 950DT. Ранее стало известно, что DeepSeek занимается разработкой и собственного ИИ-ускорителя для инференса, чтобы снизить свою зависимость как от NVIDIA, так и от Huawei.
21.10.2026 [21:22], Руслан Авдеев
Десятки тысяч ускорителей NVIDIA простаивают в суперкластере Meta✴, ожидая отказа рабочих чиповБолее 11 % ИИ-ускорителей в суперкластере Meta✴ Prometheus в Нью-Олбани (New Albany, штат Огайо), либо уже вышли из строя, либо простаивают. Последние ожидают, когда перестанет функционировать ещё один из уже активных чипов, сообщает The Register со ссылкой на информацию самой компании. Такой резерв ускорителей — лишь одна из мер, принимаемых гиперскейлером для обеспечения бесперебойного обучения ИИ-моделей. Prometheus представляет собой один из крупнейших вычислительных проектов Meta✴, оснащённый стоечными системами Grace Blackwell и в будущем Vera Rubin. Meta✴ рассчитывает масштабировать комплекс до 1 ГВт с использованием порядка миллиона ускорителей. При этом увеличение количества ускорителей обычно ведёт к росту числа проблем. В узле с восемью ускорителями вероятность отказа невелика, но в кластере из 100 тыс. ускорителей отказы неизбежны. Масштаб проекта Meta✴ значительно больше, причём распределённые вычисления осуществляются сразу в нескольких ЦОД. Поэтому поддержание бесперебойной работы инфраструктуры до следующей контрольной точки обучения — непростая задача. В корпоративном блоге Meta✴ рассказала о мерах, принимаемых для защиты обучения моделей, таких как Muse Spark и последняя версия Muse Wonder, от аппаратных сбоев. 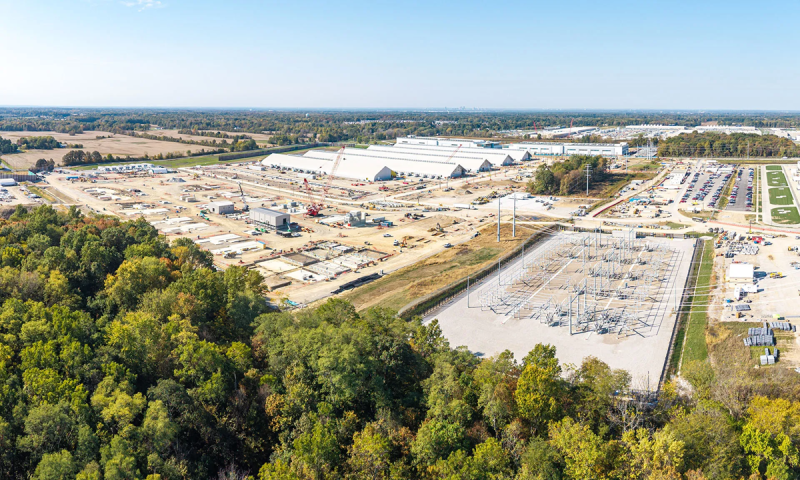
Источник изображения: Meta✴ На первом этапе развёртывания Prometheus в Нью-Олбани происходило порядка 1 тыс. прерываний вычислений в сутки на каждые 8 тыс. ускорителей. Прерывания не обязательно означают отказ ускорителя. Речь идёт практически о любом сбое, в результате которого процесс приходится останавливать и «откатываться» к последней успешно сохранённой контрольной точке. По данным Meta✴, за последовавший год компания сократила количество таких прерываний на 99 %, до порядка 11 на каждые 8 тыс. ускорителей. Один из способов — постоянно держать часть из них в резерве. Кластер работает на основе комбинации систем GB200 и GB300, каждая из которых включает 72 ускорителя в каждом домене NVLink, объединяющем ускорители высокоскоростными соединениями. В каждый отдельный момент работают только 64 из них, а оставшиеся восемь находятся в «горячем резерве». Такую схему внедрили, поскольку даже отказ одного ускорителя мог прервать процесс обучения во всей стойке. Теперь в случае отказа сразу задействуется резервный экземпляр, что позволяет сэкономить время. Прерывание вычислений по-прежнему происходит, но затраты времени на восстановление значительно сокращаются. Чтобы уменьшить последствия подобных сбоев, Meta✴ использует принцип параллелизма данных, при котором в одном кластере одновременно работают несколько копий модели. В случае сбоя неисправность локализуется в одной из копий, а остальные продолжают обучение, повторно выполняя соответствующий этап. В результате совокупная производительность лишь ненадолго снижается, а обучение не приходится начинать с нуля. Распределённая архитектура сохранения контрольных точек тем временем обеспечивает запись состояния модели в многоуровневую систему хранения. По данным Meta✴, одной из сложнейших задач стало обеспечение с помощью NVLink работы 72 ускорителей как единого целого. В системах на NVIDIA H100 и H200 использовалось всего по восемь чипов на домен, поэтому соединения были значительно короче, а их количество — меньше. Для поколения Blackwell масштаб домена по числу ускорителей увеличился в девять раз. Как заявили в компании, при наличии более 600 тыс. соединений даже небольшое падение качества сигнала приводит к частым циклам восстановления соединений NVLink. 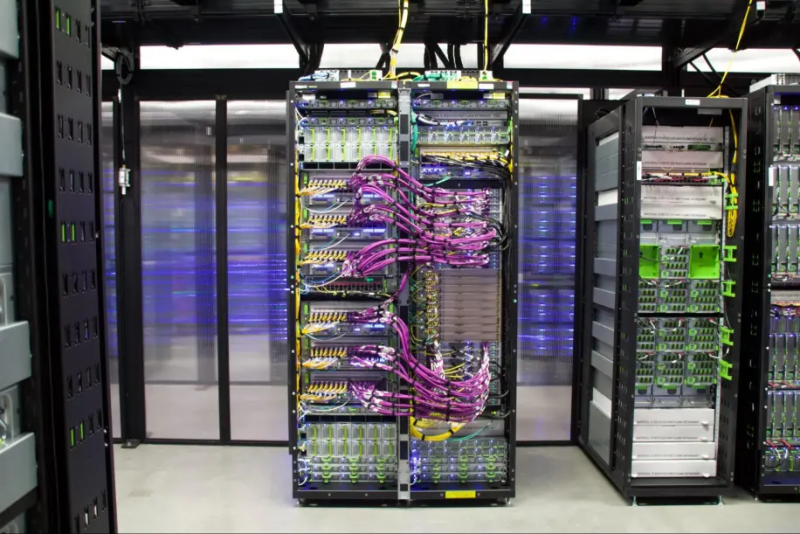
Источник изображения: Meta✴ Для решения проблемы пришлось внедрить систему непрерывного телеметрического мониторинга, а также проводить стресс-тесты уровня L11, позволяющие выявлять ненадёжные соединения до начала эксплуатации систем. Ещё одна проблема связана с обеспечением электропитания. Одновременное включение и выключение десятков тысяч ускорителей при запуске и завершении задач может вызывать скачки энергопотребления, перегружающие оборудование, отвечающее за электропитание. По данным Meta✴, меры по повышению стабильности и надёжности кластера позволили добиться доли полезной вычислительной работы (так называемого goodput) на уровне более 85 % при предварительном обучении и более 90 % при обучении с подкреплением последней модели Muse Wonder. На этом амбиции Meta✴ не заканчиваются: компания по-прежнему стремится создать инфраструктуру на миллион ускорителей. Частоту прерываний предполагается снизить до двух в сутки на каждые 8 тыс. ускорителей. Также компания рассчитывает обеспечить среднее время между прерываниями на уровне 100 тыс. GPU-часов. |
|

