Материалы по тегу: x
|
22.03.2022 [18:40], Игорь Осколков
NVIDIA анонсировала 4-нм ускорители Hopper H100 и самый быстрый в мире ИИ-суперкомпьютер EOS на базе DGX H100На GTC 2022 компания NVIDIA анонсировала ускорители H100 на базе новой архитектуры Hopper. Однако NVIDIA уже давно говорит о себе как создателе платформ, а не отдельных устройств, так что вместе с H100 были представлены серверные Arm-процессоры Grace, в том числе гибридные, а также сетевые решения и обновления наборов ПО. 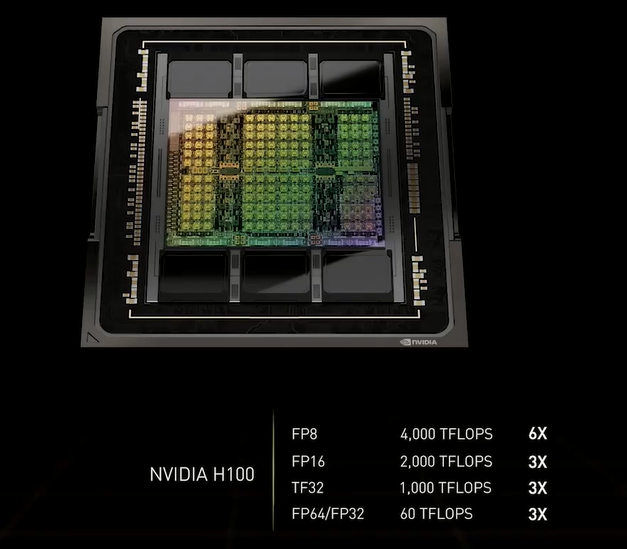
NVIDIA H100 (Изображения: NVIDIA) NVIDIA H100 использует мультичиповую 2.5D-компоновку CoWoS и содержит порядка 80 млрд транзисторов. Но нет, это не самый крупный чип компании на сегодняшний день. Кристаллы новинки изготавливаются по техпроцессу TSMC N4, а сопровождают их — впервые в мире, по словам NVIDIA — сборки памяти HBM3 суммарным объёмом 80 Гбайт. Объём памяти по сравнению с A100 не вырос, зато в полтора раза увеличилась её скорость — до рекордных 3 Тбайт/с. 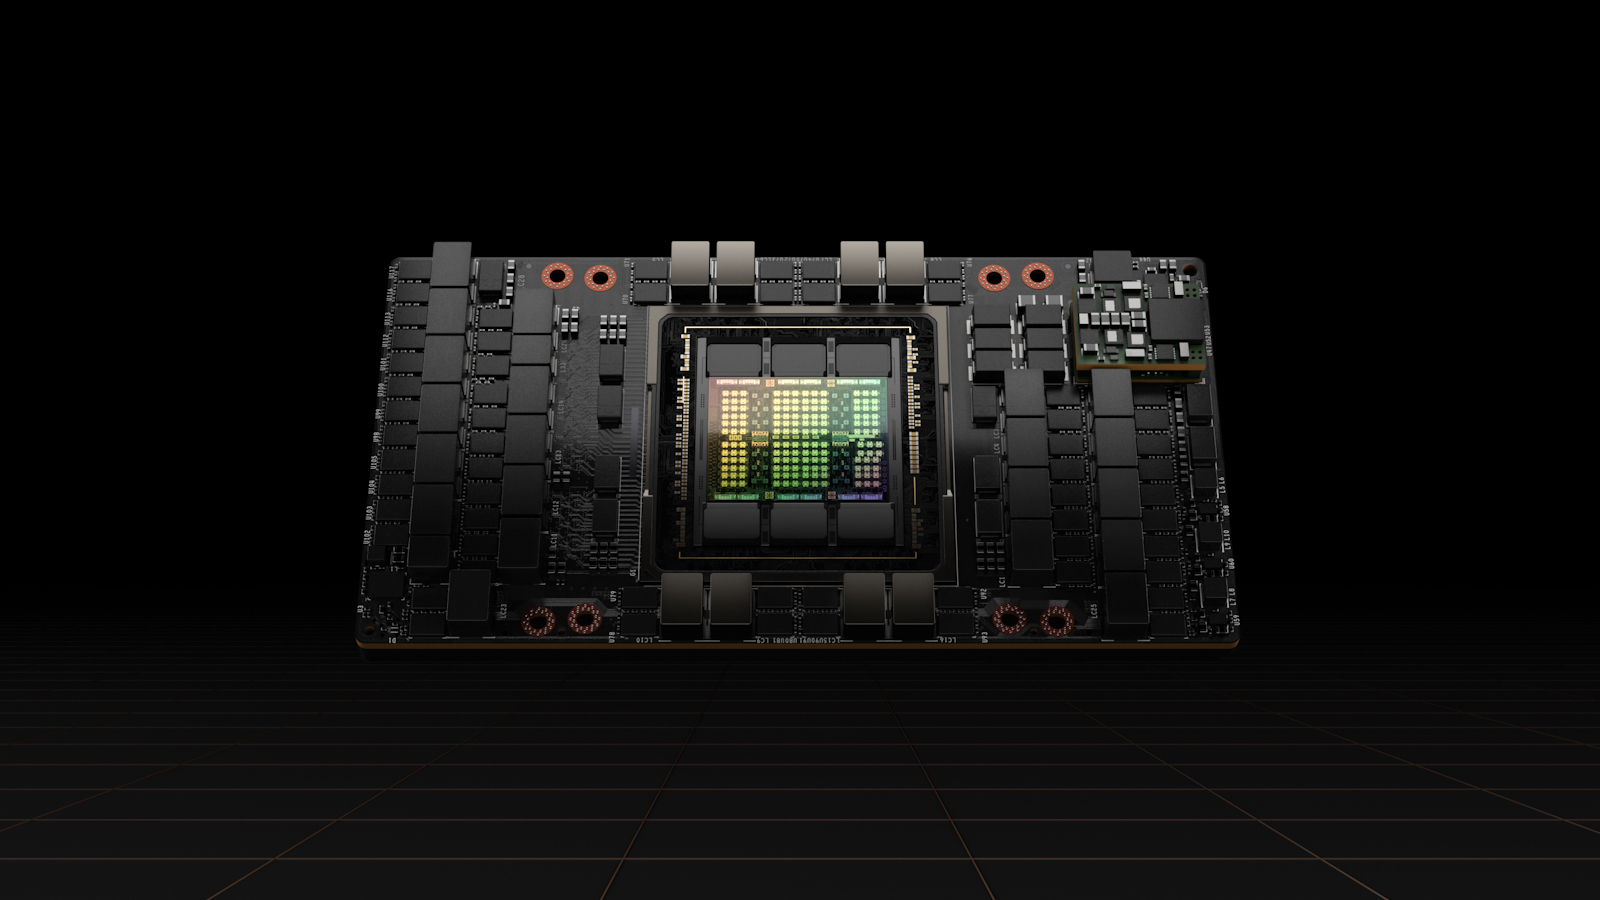
NVIDIA H100 (SXM) Подробности об архитектуре Hopper будут представлены чуть позже. Пока что NVIDIA поделилась некоторыми сведениями об особенностях новых чипов. Помимо прироста производительности от трёх (для FP64/FP16/TF32) до шести (FP8) раз в сравнении с A100 в Hopper появилась поддержка формата FP8 и движок Transformer Engine. Именно они важны для достижения высокой производительности, поскольку само по себе четвёртое поколение ядер Tensor Core стало втрое быстрее предыдущего (на всех форматах). 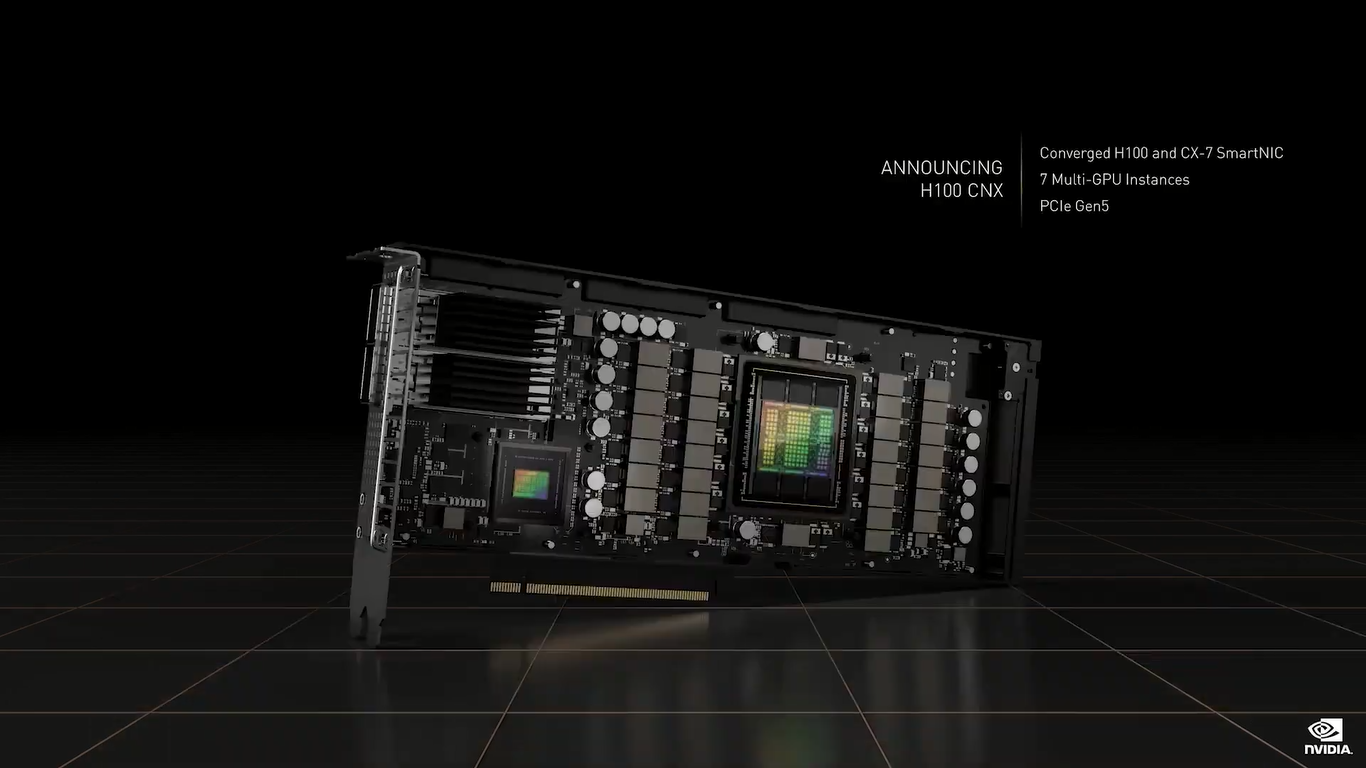
NVIDIA H100 CNX (PCIe) TF32 останется форматом по умолчанию при работе с TensorFlow и PyTorch, но для ускорения тренировки ИИ-моделей NVIDIA предлагает использовать смешанные FP8/FP16-вычисления, с которыми Tensor-ядра справляются эффективно. Хитрость в том, что Transformer Engine на основе эвристик позволяет динамически переключаться между ними при работе, например, с каждым отдельным слоем сети, позволяя таким образом добиться повышения скорости обучения без ущерба для итогового качества модели.  На больших моделях, а именно для таких H100 и создавалась, сочетание Transformer Engine с другими особенностями ускорителей (память и интерконнект) позволяет получить девятикратный прирост в скорости обучения по сравнению с A100. Но Transformer Engine может быть полезен и для инференса — готовые FP8-модели не придётся самостоятельно конвертировать в INT8, движок это сделает на лету, что позволяет повысить пропускную способность от 16 до 30 раз (в зависимости от желаемого уровня задержки). 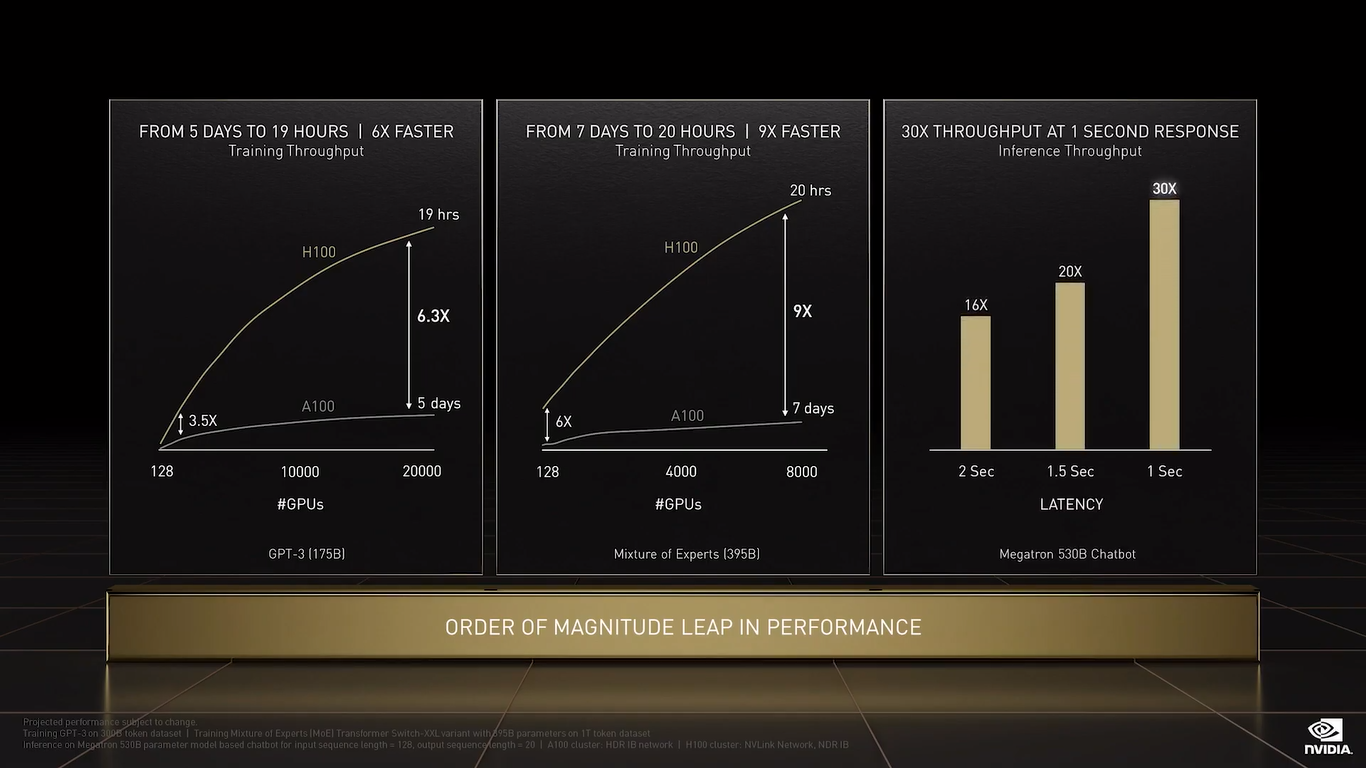 Другое любопытное нововведение — специальные DPX-инструкции для динамического программирования, которые позволят ускорить выполнение некоторых алгоритмов до 40 раз в задачах, связанных с поиском пути, геномикой, квантовыми системами и при работе с большими объёмами данных. Кроме того, H100 получили дальнейшее развитие виртуализации. В новых ускорителях всё так же поддерживается MIG на 7 инстансов, но уже второго поколения, которое привнесло больший уровень изоляции благодаря IO-виртуализации, выделенным видеоблокам и т.д. 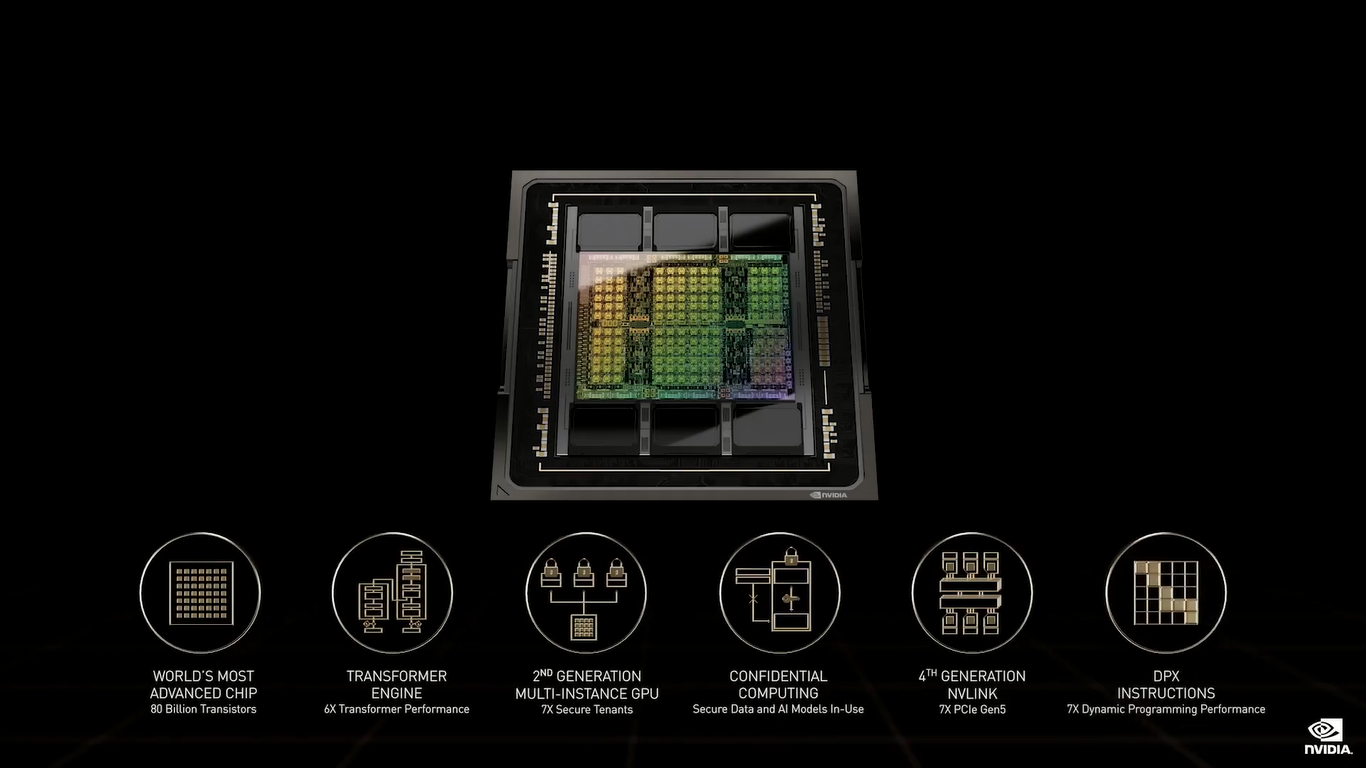 Так что MIG становится ещё более предпочтительным вариантом для облачных развёртываний. Непосредственно к MIG примыкает и технология конфиденциальных вычислений, которая по словам компании впервые стала доступна не только на CPU. Программно-аппаратное решение позволяет создавать изолированные ВМ, к которым нет доступа у ОС, гипервизора и других ВМ. Поддерживается сквозное шифрование при передаче данных от CPU к ускорителю и обратно, а также между ускорителями. 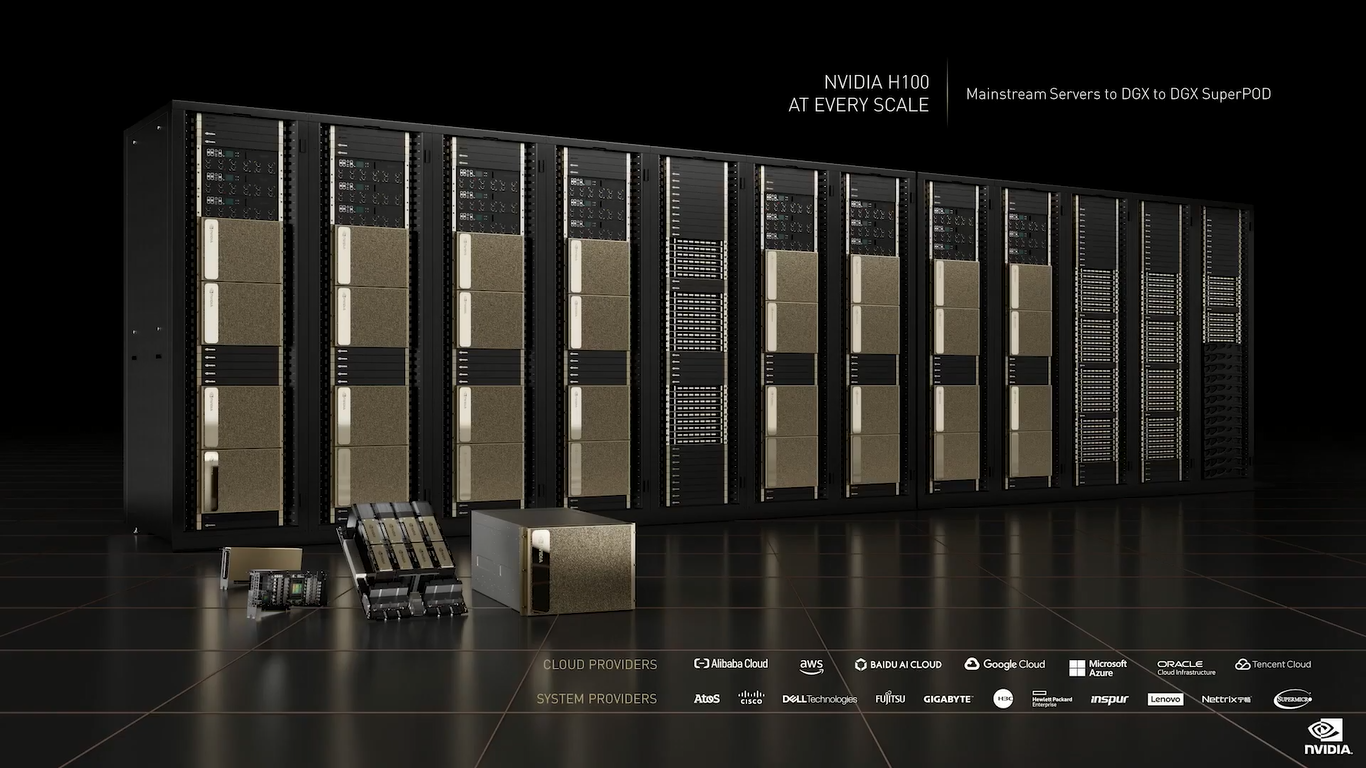 Память внутри GPU также может быть изолирована, а сам ускоритель оснащается неким аппаратным брандмауэром, который отслеживает трафик на шинах и блокирует несанкционированный доступ даже при наличии у злоумышленника физического доступа к машине. Это опять-таки позволит без опаски использовать H100 в облаке или в рамках колокейшн-размещения для обработки чувствительных данных, в том числе для задач федеративного обучения. 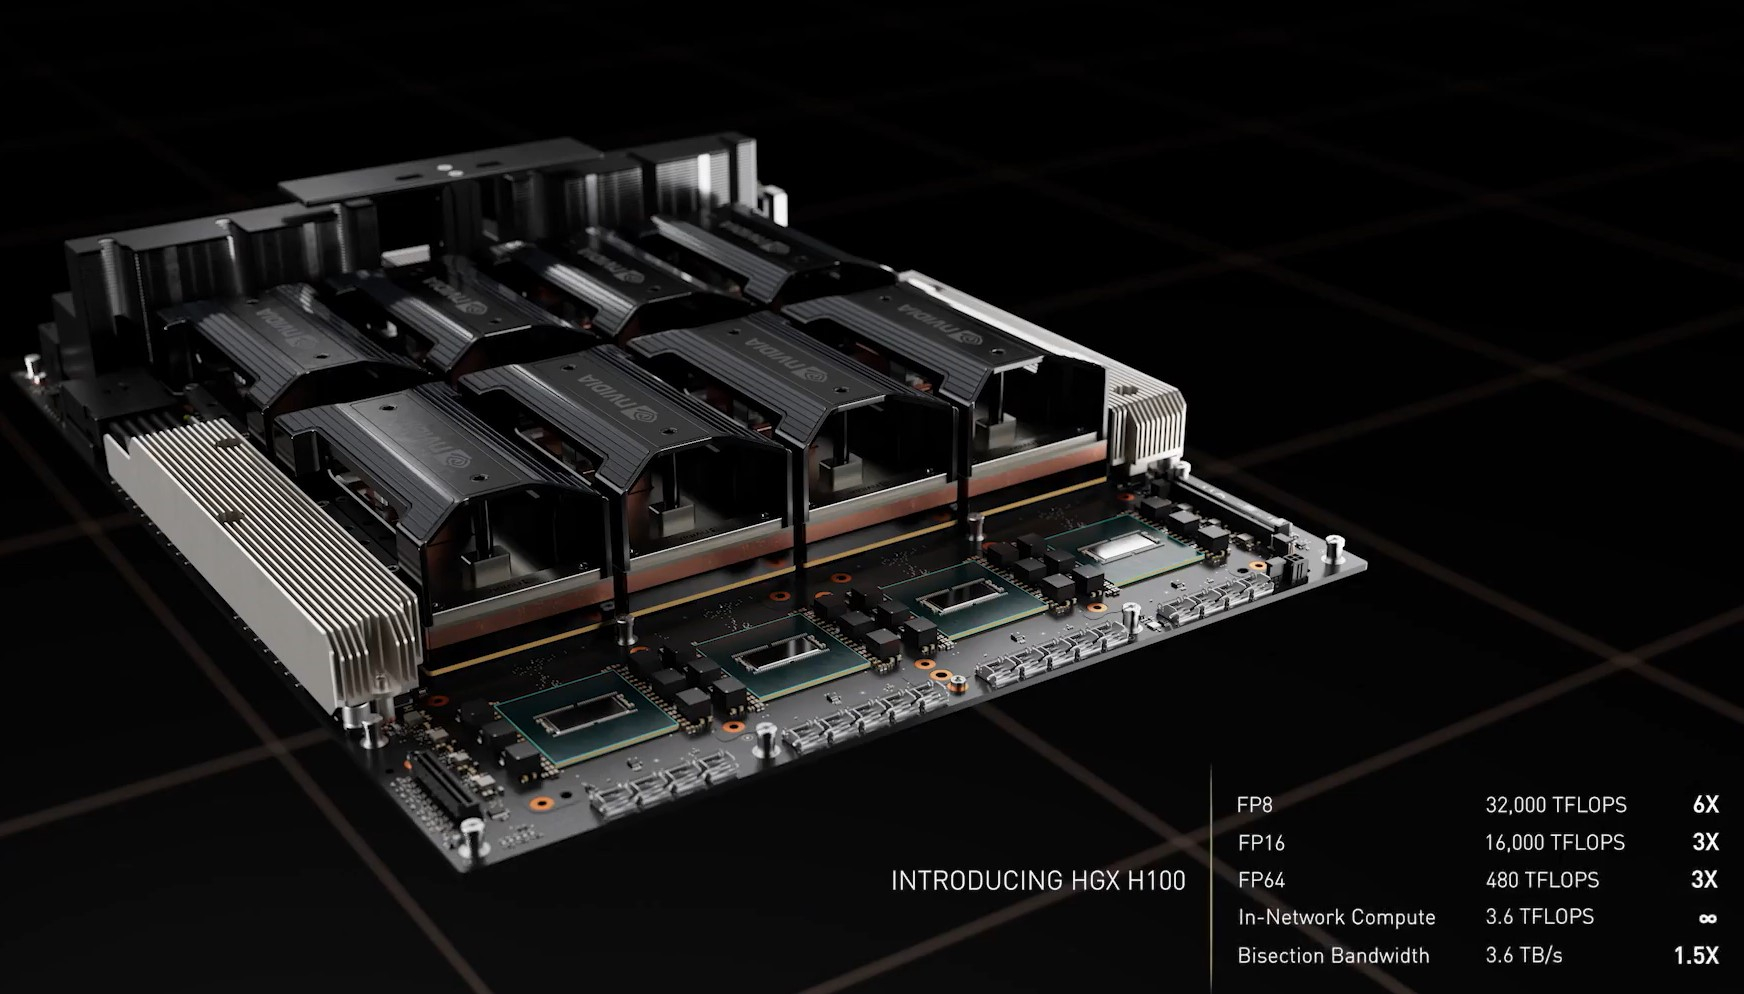 NVIDIA HGX H100 Но главная инновация — это существенное развитие интерконнекта по всем фронтам. Суммарная пропускная способность внешних интерфейсов чипа H100 составляет 4,9 Тбайт/с. Да, у H100 появилась поддержка PCIe 5.0, тоже впервые в мире, как утверждает NVIDIA. Однако ускорители получили не только новую шину NVLink 4.0, которая стала в полтора раза быстрее (900 Гбайт/с), но и совершенно новый коммутатор NVSwitch, который позволяет напрямую объединить между собой до 256 ускорителей! Пропускная способность «умной» фабрики составляет до 70,4 Тбайт/с. 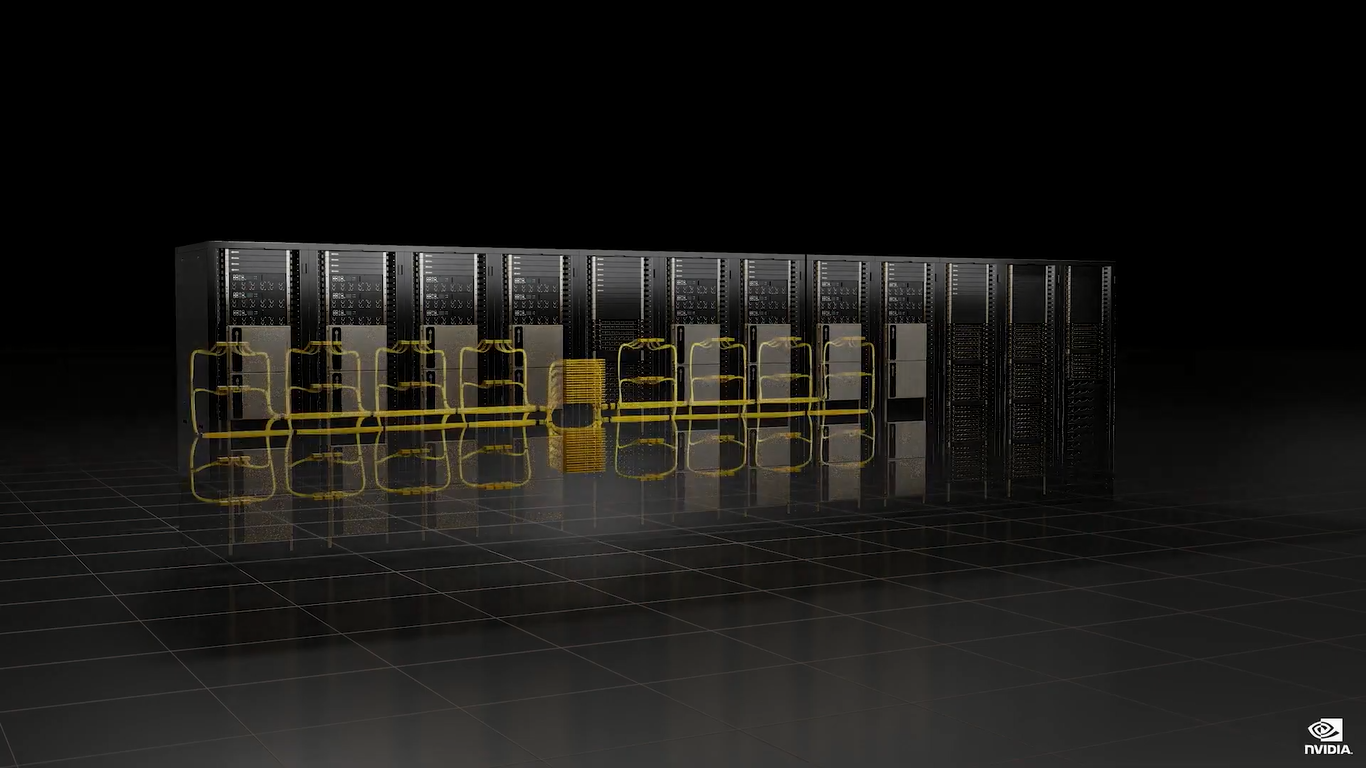 Сама NVIDIA предлагает как новые системы DGX H100 (8 × H100, 2 × BlueField-3, 8 × ConnectX-7), так и SuperPOD-сборку из 32-х DGX, как раз с использованием NVLink и NVSwitch. Партнёры предложат HGX-платформы на 4 или 8 ускорителей. Для дальнейшего масштабирования SuperPOD и связи с внешним миром используются 400G-коммутаторы Quantum-2 (InfiniBand NDR). Сейчас NVIDIA занимается созданием своего следующего суперкомпьютера EOS, который будет состоять из 576 DGX H100 и получит FP64-производительность на уровне 275 Пфлопс, а FP16 — 9 Эфлопс. 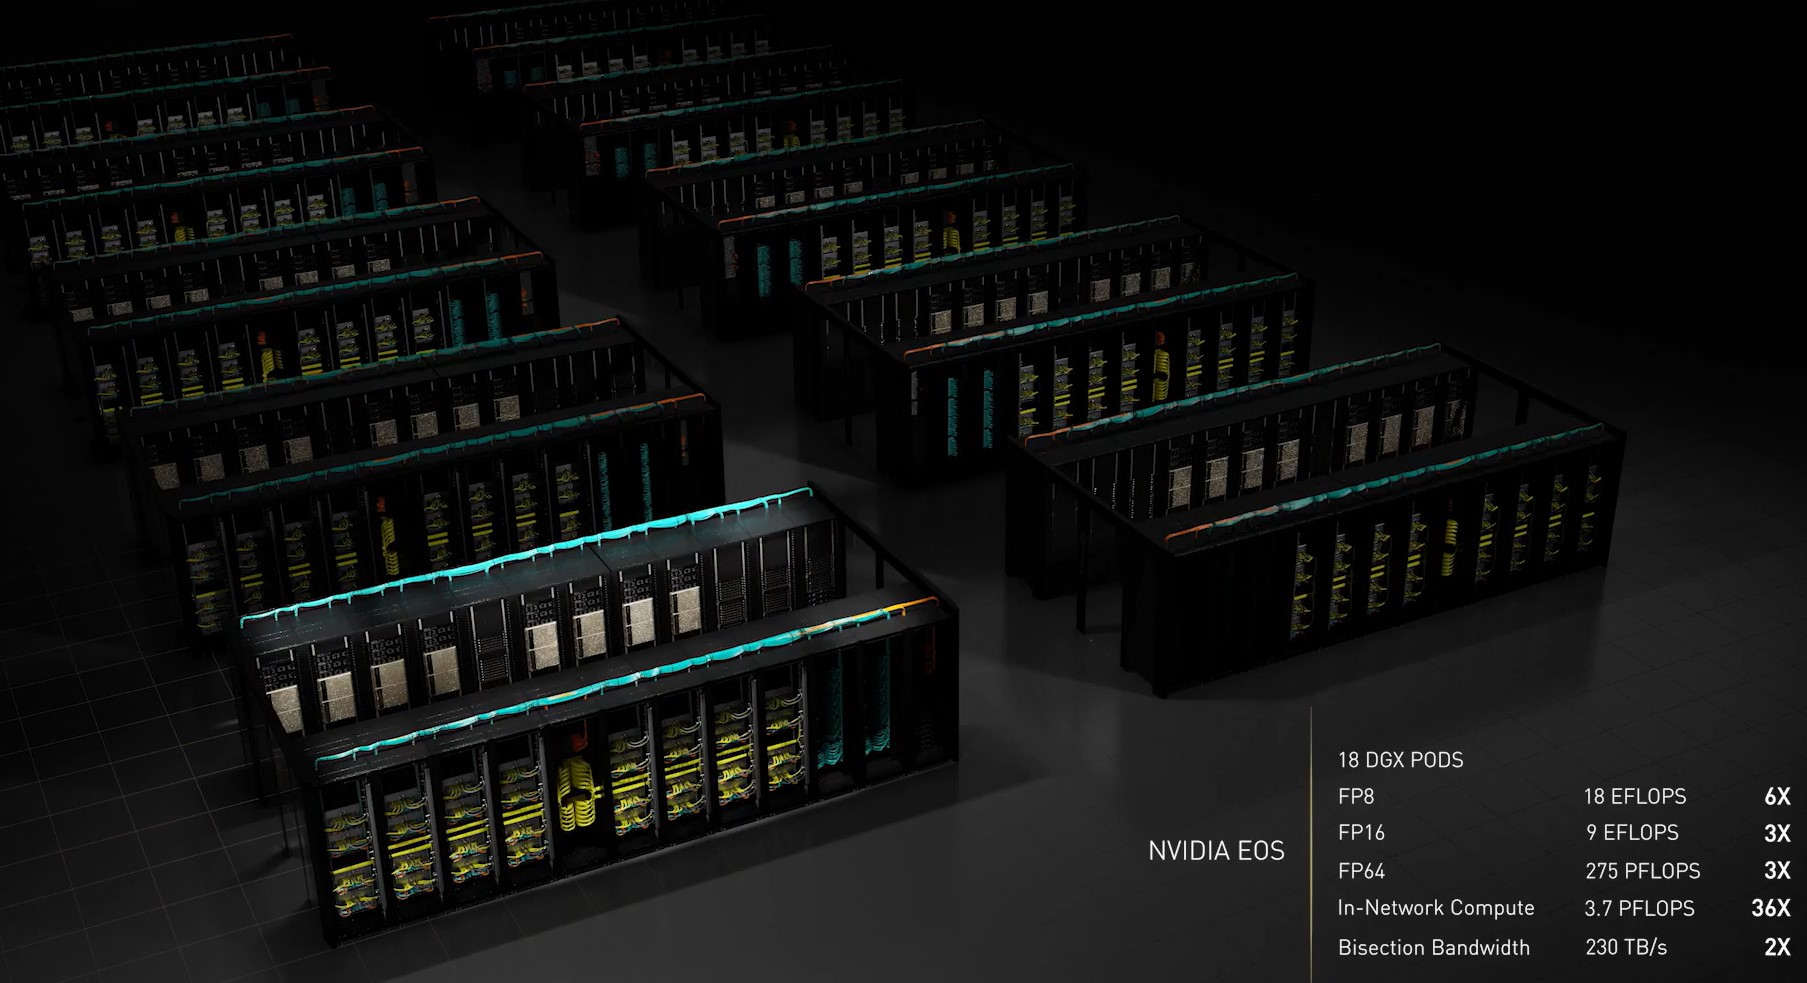 Компания надеется, что EOS станет самой быстрой ИИ-машиной в мире. Появится она чуть позже, как и сами ускорители, выход которых запланирован на III квартал 2022 года. NVIDIA представит сразу три версии. Две из них стандартные, в форм-факторах SXM4 (700 Вт) и PCIe-карты (350 Вт). А вот третья — это конвергентный ускоритель H100 CNX со встроенными DPU Connect-X7 класса 400G (подключение PCIe 5.0 к самому ускорителю) и интерфейсом PCIe 4.0 для хоста. Компанию ей составят 400G/800G-коммутаторы Spectrum-4.
11.03.2022 [20:59], Алексей Степин
Ростелеком и Мегафон отлучили от лондонской точки обмена интернет-трафиком LINXЛондонская точка обмена интернет-трафиком LINX (London Internet Exchange Network), объединяющая сети более 950 различных операторов, хотя и не является коммерческой компанией, тем не менее, как сообщают зарубежные источники, тоже оказалась вынуждена применить санкции — совет директоров LINX принял решение отключить две крупные телекоммуникационные компании: Мегафон (AS 1133) и Ростелеком (AS 12389). В приводимом источником письме из внутренней рассылки для клиентов LINX говорится, что решение вступило в силу сразу после принятия и что LINX продолжит проверку в отношении других российских клиентов, которые могут быть связаны с владельцами двух вышеназванных компаний. Пока неясно, как это скажется на функционировании сетей, принадлежащих Ростелеком и Мегафону, но предполагается, что эффект будет более мягким, чем отключение от магистральных сетей Cogent и Lumen. Среди других крупных российских клиентов LINX есть, к примеру, Вымпелком, МТС и ТрансТелеКом. 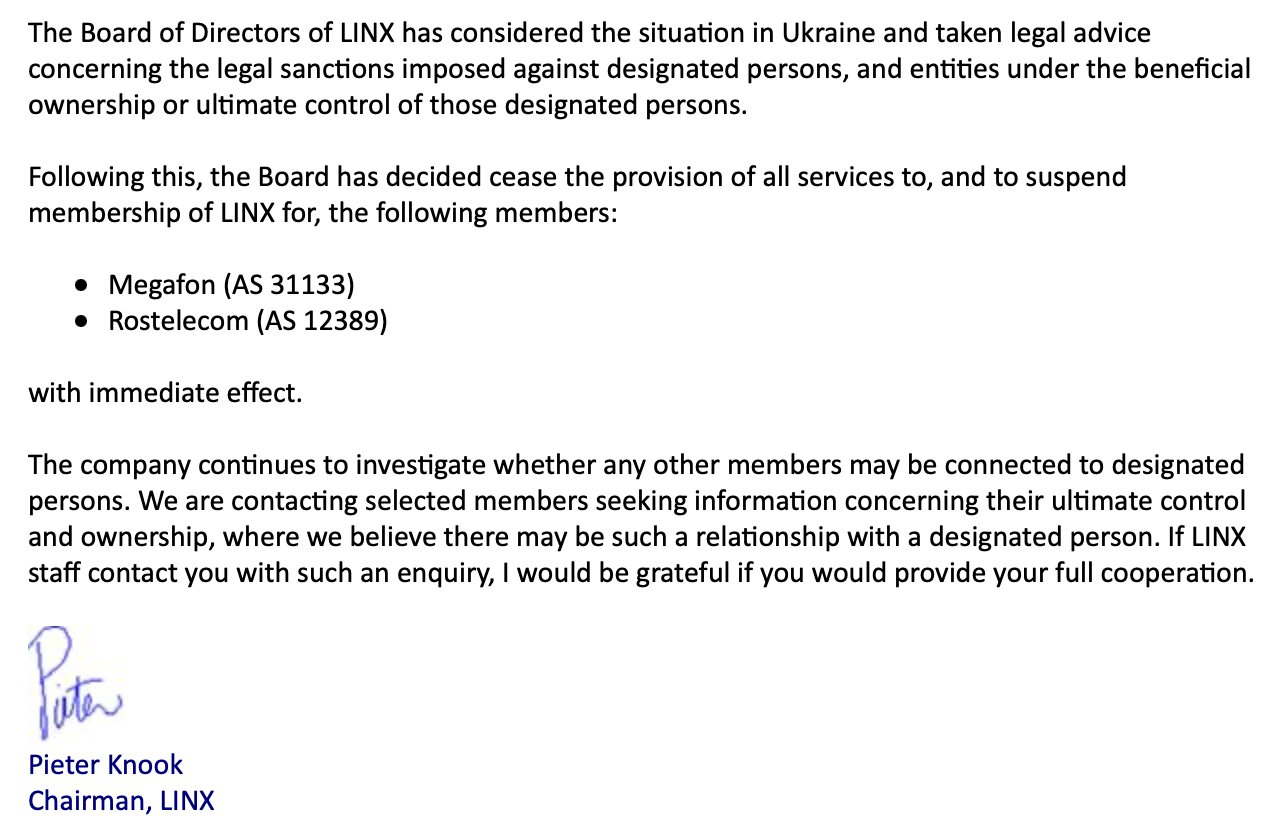
Источник: Twitter/woodyatpch Публичного подтверждения LINX о принятых мерах пока получено не было. Сейчас LINX является одним из крупнейших в Европе сетевым хабом с пиковым на текущий момент трафиком 6,89 Тбит/с. Напомним, что в 2017 году LINX стала участником скандала, приняв инициативу, позволяющую руководителям организации не сообщать клиентам об установке следящего оборудования несмотря на то, что законы ряда стран компаний-участников LINX запрещают массовую слежку за пользователями всемирной сети. UPD: «Мегафон» и «Ростелеком» подтвердили отключение от LINX, но уточнили, что обмен трафиком с этой точкой и так был невелик, поэтому отключение не скажется на абонентах.
27.02.2022 [01:01], Владимир Мироненко
Облако ждёт: к 2030 году Fujitsu откажется от мейнфреймов и UNIX-системFujitsu подтвердила, что выпуску её мейнфреймов и серверных систем c Unix подходит конец. Согласно новым планам компании, она прекратит производство и продажу мейнфреймов к 2030 году, а выпуск серверных систем UNIX — к концу 2029 года. Сопровождение обоих продуктов продлится в течение ещё пяти лет и закончится в 2035 году и в 2034 году соответственно. Как надеется компания, к тому времени пользователи подобных систем окончательно перейдут в облако. 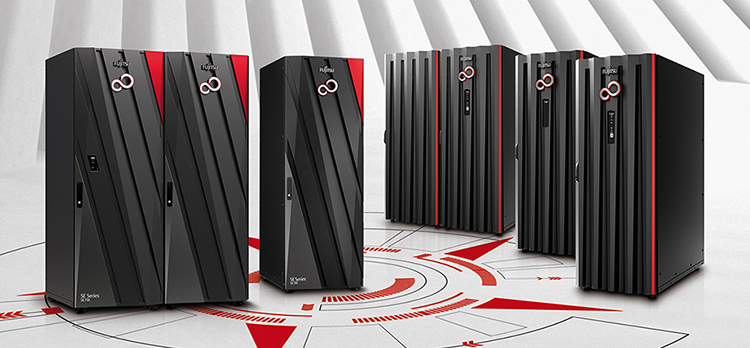
Источник изображений: Fujitsu Тем не менее, Fujitsu по-прежнему планирует выпустить в 2024 году новую модель в серии мейнфреймов GS21. Также планируется обновление семейства UNIX-серверов Fujitsu SPARC M12 в конце этого года и в 2026 году. Впрочем, это пока предварительные планы. Компания уже составила график перехода с мейнфреймов и UNIX-серверов в облако в рамках нового бизнес-бренда Fujitsu Uvance. Теперь у пользователей мейнфреймов Fujitsu есть чётко обозначенный срок, к которому они должны перенести свои приложения на другую платформу или воспользоваться возможностью создать их с нуля в рамках более современной инфраструктуры. 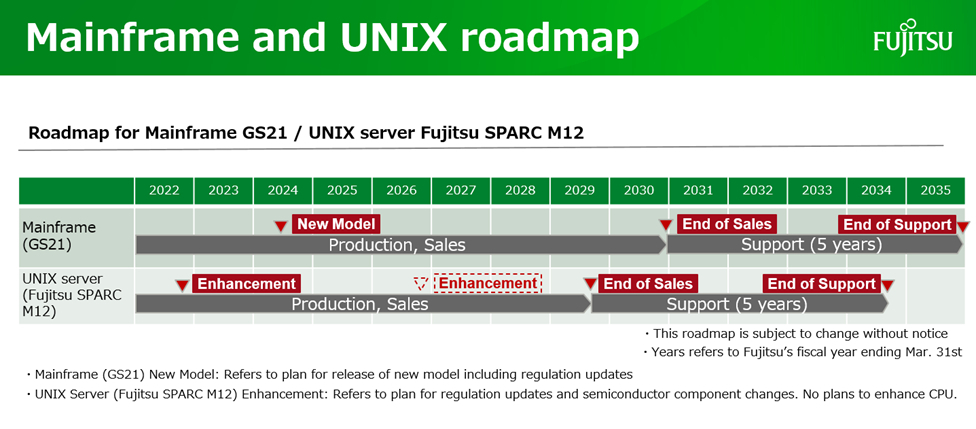 Сомнительной альтернативой может быть уход на платформу IBM z. Филип Доусон (Philip Dawson), вице-президент Gartner Research сообщил The Register, что отказ от UNIX пройдёт менее болезненно, так как рабочие нагрузки могут быть относительно легко перенесены на Linux: «По сути, Linux заменил UNIX. Но такой замены нет для мейнфреймов. Когда аппаратное обеспечение исчезнет, что вы будете делать с приложениями?». Фактически Fujitsu в наследство достались две разные серии мейнфреймов от Amdahl Corporation (GS21) и Siemens (BS2000), если не считать старые решения ICL.
31.08.2021 [00:56], Владимир Мироненко
Судебная тяжба 18-летней давности между IBM и SCO закончена, но противостояние по поводу прав на Linux продолжаетсяПохоже, что затянувшийся судебный спор между компаниями Santa Cruz Operation (SCO) и IBM по поводу прав на код ядра Linux может закончиться в ближайшее время. Суд США по делам о банкротстве округа Делавэр объявил, что TSG Group, которая представляет интересы должников обанкротившейся SCO, урегулировала все оставшиеся претензии с IBM. «В соответствии с Мировым соглашением стороны договорились разрешить все споры между собой по выплате Доверительному управляющему [TLD] от имени IBM в размере $14 250 000», — указано в постановлении суда. В свою очередь, TLD отказывается от всех прав и интересов по всем судебным искам, находящимся на рассмотрении или которые могут быть предъявлены в будущем против IBM и Red Hat, а также по любым обвинениям в том, что Linux нарушает интеллектуальную собственность SCO Unix или Unixware. Как пояснил представитель TLD, даже если бы SCO удалось доказать суду присяжных, что около 20 лет назад действительно были нарушены права и была нечестная конкуренция, размер ущерба всё было бы нельзя определить. И выплаты, вероятно, были бы значительно меньше, чем при мировом соглашении. 
Источник изображения: SCO Впрочем, речь идёт о завершении лишь части судебного противостояния, длящегося 18 лет. Дело в том, что Xinuos, которая купила продукты SCO Unix и её интеллектуальную собственность в 2011 году, подала в суд на IBM и Red Hat в связи с «незаконным копированием программного кода Xinuos для своих серверных операционных систем». Хотя во время сделки она обещала, что не намерена вести какие-либо судебные разбирательства, связанные с активами группы SCO. Во-первых, Xinuos утверждает, что IBM украла её интеллектуальную собственность, которую использовала для создания и продажи продукта, чтобы конкурировать с самой Xinuos. Во-вторых, по её мнению, IBM и Red Hat незаконно договорились разделить соответствующий рынок и использовать свои растущие силы на рынке для преследования конкурентов и подавления инноваций. И, наконец, в-третьих, по версии Xinuos, IBM приобрела Red Hat, чтобы укрепить положение на рынке и использовать незаконную схему на постоянной основе.
28.06.2021 [13:22], Алексей Степин
Обновление NVIDIA HGX: PCIe-вариант A100 с 80 Гбайт HBM2e, InfiniBand NDR и Magnum IO с GPUDirect StorageНа суперкомпьютерной выставке-конференции ISC 2021 компания NVIDIA представила обновление платформы HGX A100 для OEM-поставщиков, которая теперь включает PCIe-ускорители NVIDIA c 80 Гбайт памяти, InfiniBand NDR и поддержку Magnum IO с GPUDirect Storage. В основе новинки лежат наиболее продвинутые на сегодняшний день технологии, имеющиеся в распоряжении NVIDIA. В первую очередь, это, конечно, ускорители на базе архитектуры Ampere, оснащённые процессорами A100 с производительностью почти 10 Тфлопс в режиме FP64 и 624 Топс в режиме тензорных вычислений INT8. 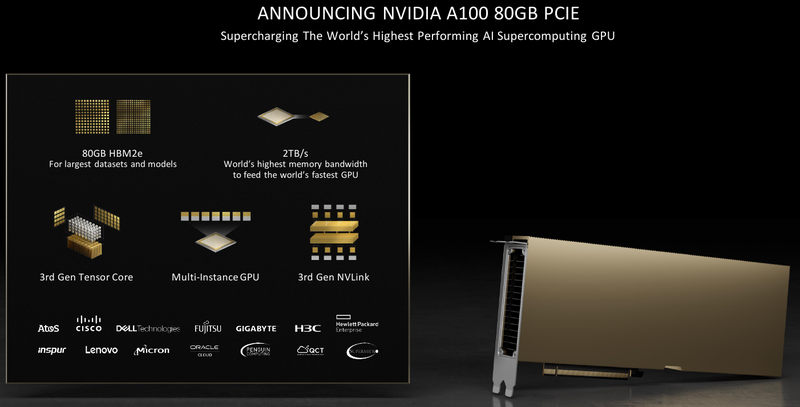 HGX A100 предлагает 300-Вт версию ускорителей с PCIe 4.0 x16 и удвоенным объёмом памяти HBM2e (80 Гбайт). Увеличена и пропускная способность (ПСП), в новой версии ускорителя она достигла 2 Тбайт/с. И если по объёму и ПСП новинки догнали SXM-версию A100, то в отношении интерконнекта они всё равно отстают, так как позволяют напрямую объединить посредством NVLink только два ускорителя. 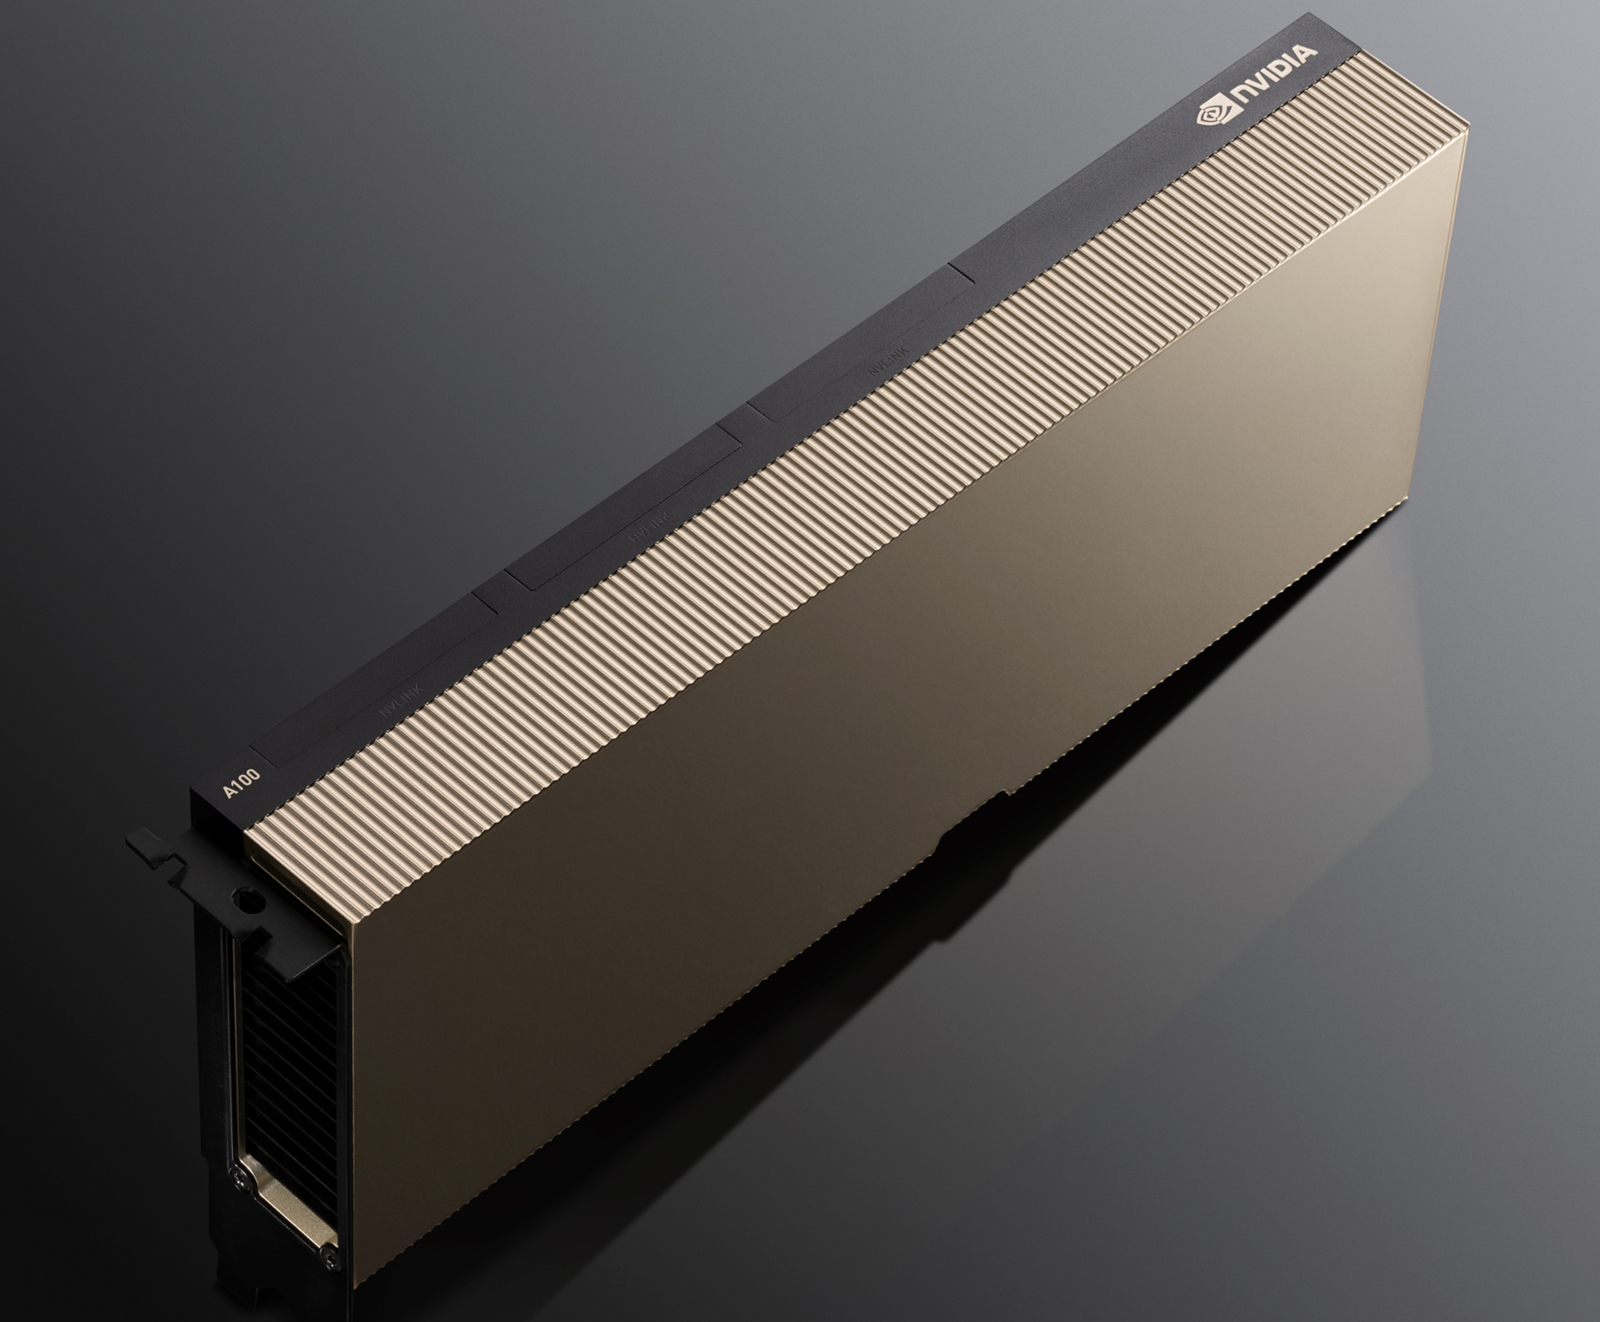 В качестве сетевой среды в новой платформе NVIDIA применена технология InfiniBand NDR со скоростью 400 Гбит/с. Можно сказать, что InfiniBand догнала Ethernet, хотя не столь давно её потолком были 200 Гбит/с, а в плане латентности IB по-прежнему нет равных. Сетевые коммутаторы NVIDIA Quantum 2 поддерживают до 64 портов InfiniBand NDR и вдвое больше для скорости 200 Гбит/с, а также имеют модульную архитектуру, позволяющую при необходимости нарастить количество портов NDR до 2048. Пропускная способность при этом может достигать 1,64 Пбит/с. 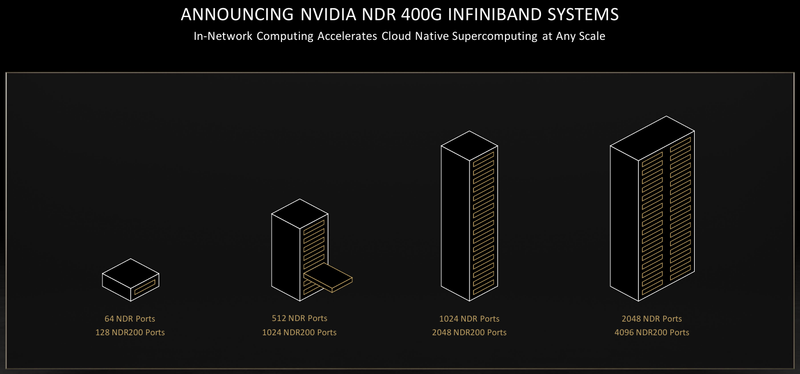 Технология NVIDIA SHARP In-Network Computing позволяет компании заявлять о 32-крантом превосходстве над системами предыдущего поколения именно в области сложных задач машинного интеллекта для индустрии и науки. Естественно, все преимущества машинной аналитики используются и внутри самого продукта — технология UFM Cyber-AI позволяет новой платформе исправлять большинство проблем с сетью на лету, что минимизирует время простоя. 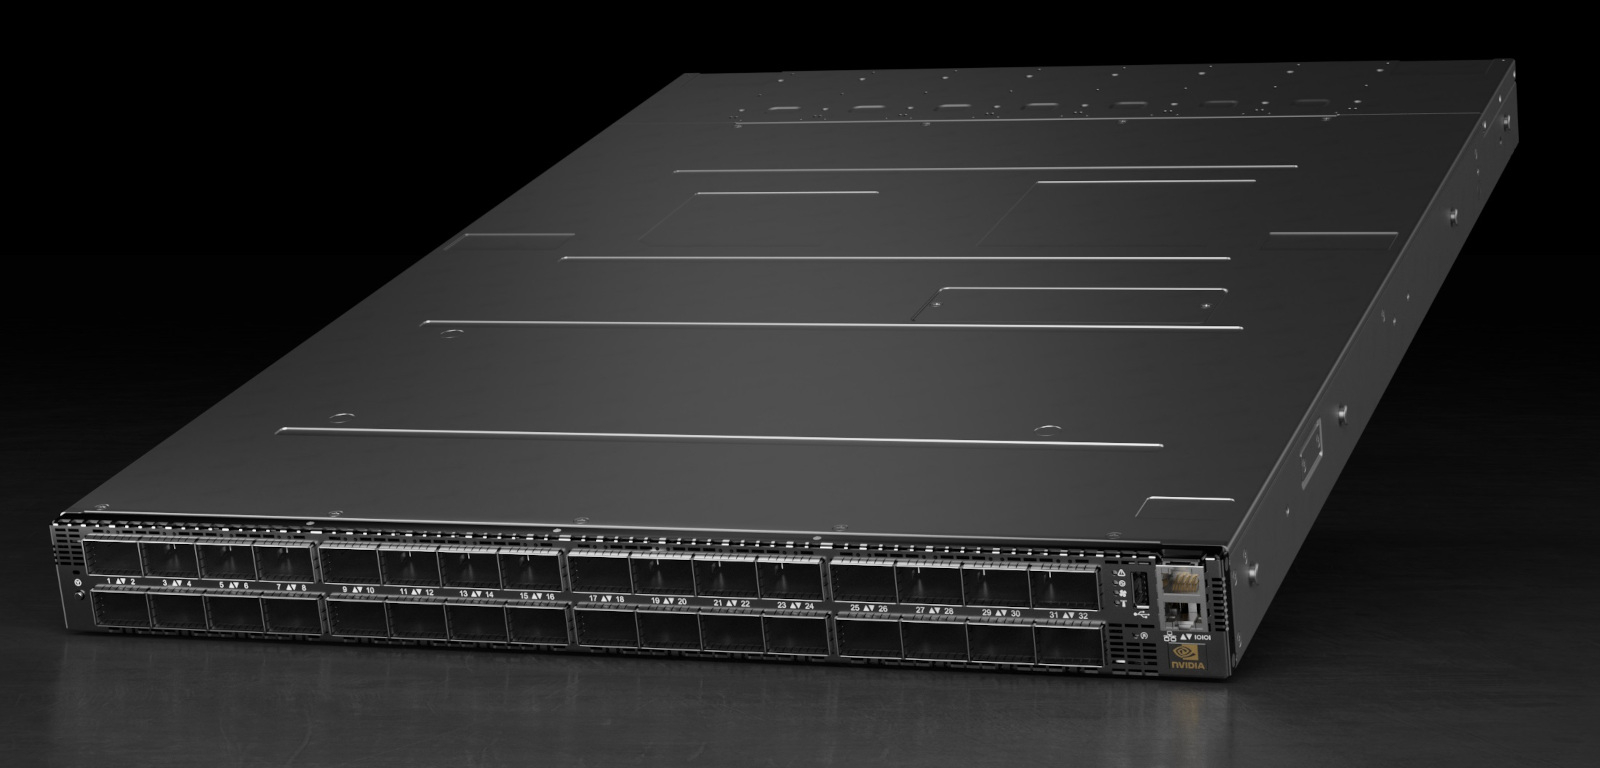 Отличным дополнением к новым сетевым возможностями является технология GPUDirect Storage, которая позволяет NVMe-накопителям общаться напрямую с GPU, минуя остальные компоненты системы. В качестве программной прослойки для обслуживания СХД новая платформа получила систему Magnum IO с поддержкой вышеупомянутой технологии, обладающую низкой задержкой ввода-вывода и по максимуму способной использовать InfiniBand NDR. 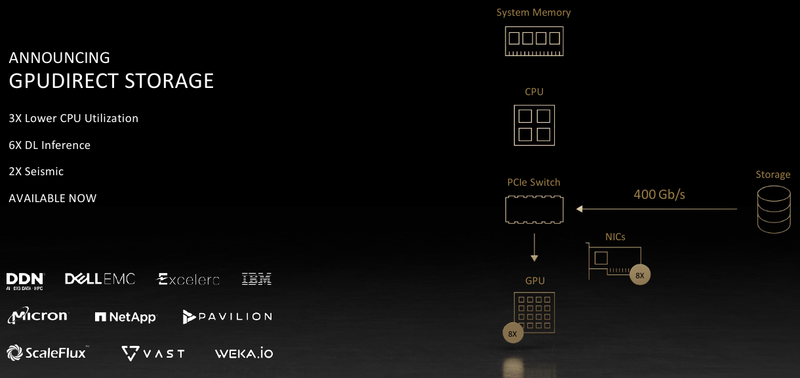 Три новых ключевых технологии NVIDIA помогут супервычислениям стать ещё более «супер», а суперкомпьютерам следующего поколения — ещё более «умными» и производительными. Достигнуты договорённости с такими крупными компаниями, как Atos, Dell Technologies, HPE, Lenovo, Microsoft Azure и NetApp. Решения NVIDIA используются как в индустрии — в качестве примера можно привести промышленный суперкомпьютер Tesla Automotive, так и в ряде других областей. 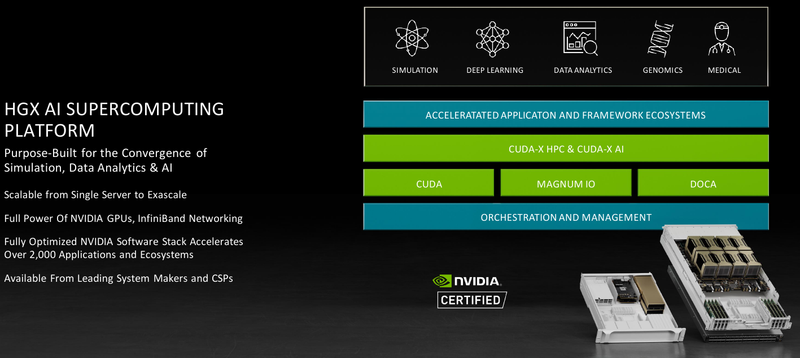 В частности, фармакологическая компания Recursion использует наработки NVIDIA в области машинного обучения для поиска новых лекарств, а национальный научно-исследовательский центр энергетики (NERSC) применяет ускорители A100 в суперкомпьютере Perlmutter при разработке новых источников энергии. И в дальнейшем NVIDIA продолжит своё наступление на рынок HPC, благо, она может предложить заказчикам как законченные аппаратные решения, так и облачные сервисы, также использующие новейшие технологии компании.
29.01.2021 [17:17], Андрей Галадей
Itanium забыт и заброшен: Линус Торвальдс констатировал смерть архитектурыОдной из проблем и в то же время достоинств Linux является поддержка многих старых архитектур процессоров. Это увеличивает размеры ядра и усложняет сопровождение. Но теперь, похоже, на одну архитектуру станет меньше. В ядре Linux 5.11, как выяснилось, оказалась нарушена поддержка Itanium IA-64. После исправления выяснилось, что это не единственная проблема такого рода, однако истинную причину выяснить не удалось из-за отсутствия доступа к «железу». Так что Линус Торвальдс (Linus Torvalds) в итоге принял решение пометить данную архитектуру как orphaned, то есть заброшенную, и прямо заявил, что она мертва. А это первый шаг к полному исключению её из ядра, как это уже случилось с другим продуктом Intel — Xeon Phi. 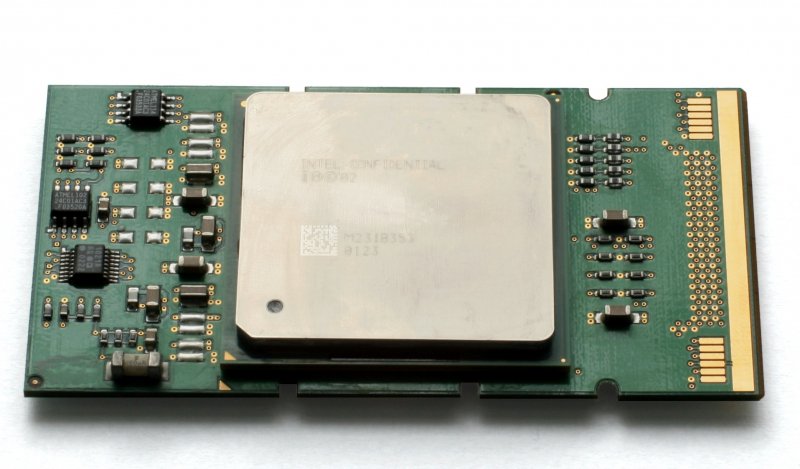
Изображения: wikipedia.org Два последних крупных игрока на рынке Itanium-систем — сама Intel и её клиент HPE — уже давно забросили поддержку этой архитектуры в Linux, да и энтузиасты к ней охладели. И это объяснимо. Последнее поколение Itanium 9700 Kittson вышло в 2017 году, а приём заказов на них прекратился год назад. Поставки формально будут свёрнуты 29 июля 2021 года, но эти CPU с высокой степенью вероятности практически никто не закупил хоть в сколько-то значимых объёмах. 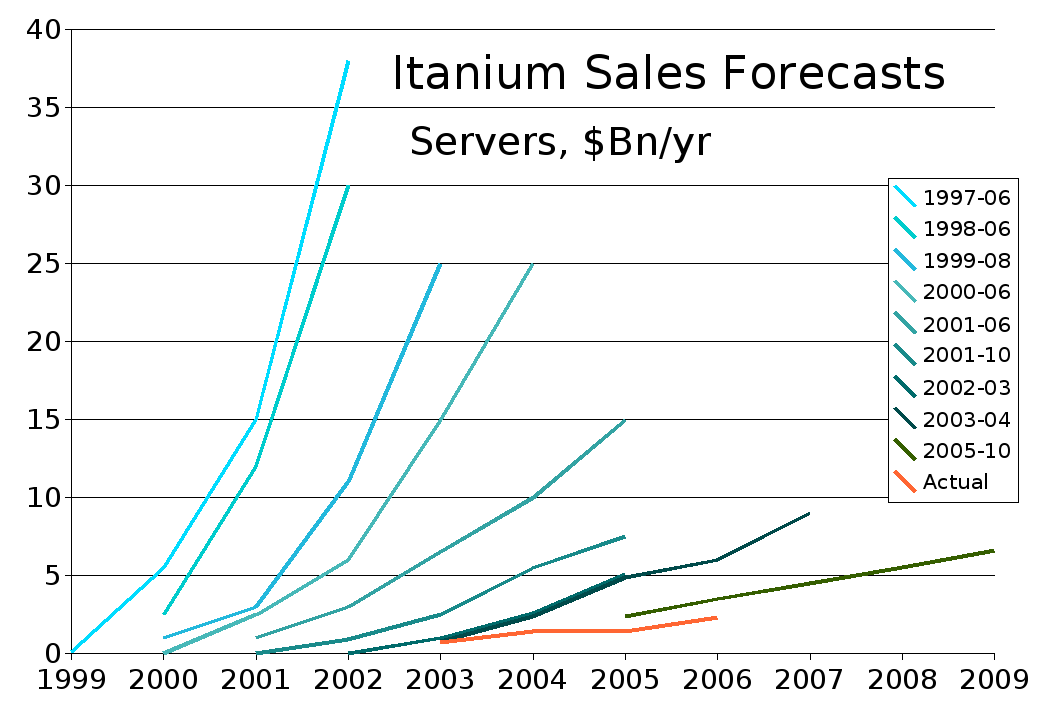
Несбывшиеся надежды В дистрибутивах же поддержку процессоров убрали давно. Red Hat не поддерживает чипы с RHEL 5, SUSE перестала поддерживать после SUSE Linux 11. Так что теперь поддержка будет осуществляться лишь теми компаниями, которые явно заинтересованы в этом. Разумеется, если такие остались. В своё время спор между Oracle и HPE подорвал репутацию платформы. Впрочем, Linux не является единственным вариантом — поддержка HP-UX, наследника классических UNIX, версии 11i v3 для ряда продуктов HPE будет осуществляться до 31 декабря 2025. Аналогичная ситуация сложилась и вокруг SPARC c Solaris, так как большую часть разработчиков обоих продуктов Oracle уволила ещё в 2017 году. Oracle обязалась сопровождать Solaris 11 максимум до 2034 года. В частности, на днях она выпустила патч безопасности для sudo и восстановила некоторые старые материалы. Однако Solaris 12 мы вряд ли когда-либо увидим. Сейчас компании гораздо более интересны облака, Linux и Arm-процессоры Ampere.
08.12.2020 [23:24], Андрей Галадей
Место CentOS займёт CentOS Stream, вечная бета-версия RHELВ конце 2021 года Red Hat прекратит разработку привычного дистрибутива CentOS в пользу проекта CentOS Stream, так что CentOS 9 ждать не стоит. Новая версия представляет собой rolling-релиз Red Hat Enterpise Linux (RHEL), предназначенный для формирования следующего промежуточного выпуска RHEL. Фактически CentOS Stream станет «вечной бета-версией», за счёт чего будет упрощено тестирование конечного продукта, ведь теперь в релизе будет один дистрибутив, а не два. Впрочем, Red Hat продолжит выкладывать исходные коды в общий доступ, поэтому есть шанс на появление некоей альтернативы CentOS. Напомним, что сам проект перешёл под крыло Red Hat почти сем лет назад. На текущий момент единственным совместимым с актуальной веткой RHEL альтернативным дистрибутивом от крупных игроков, похоже, является только Oracle Linux. 
youtube.com Что касается поставки обновлений для CentOS 8, то она прекратится 31 декабря 2021 года, хотя поддержка CentOS 7 продлится до 2024 года. Пользователям рекомендуется с 2022 года перейти на CentOS Stream. Разработчики утверждают, что новый дистрибутив будет мало отличаться от RHEL, а патчи будут выходить регулярно. Напомним, что ранее мы писали о росте роли CentOS в развитии Red Hat Enterprise Linux. Похоже, именно переход на CentOS Stream и станет таким шагом. Однако сама природа Stream-версии вряд ли придётся по душе всем, кто использует CentOS в рабочем окружении. Red Hat подготовила FAQ и предлагает обратиться к ней, если возникнут какие-то сомнения или вопросы. Можно предположить, что компания таким образом пытается подтолкнуть пользователей к переходу на платные подписки и, быть может, будет готова предложить особые условия для перехода. На текущий момент акутальной является версия CentOS 8.3 (2011). Этот дистрибутив полностью бинарно совместим с RHEL 8.3. Он поддерживает архитектуры x86_64, Aarch64 (ARM64) и ppc64le.
02.11.2020 [17:56], Илья Коваль
Прощание с Xeon Phi: ядро Linux лишится поддержки MIC-архитектурыФинальная партия Intel Xeon Phi была отгружена летом этого года, хотя сам закат продуктов на базе архитектуры MIC (Many Integrated Core) начался за несколько лет до этого. Теперь же можно сказать, что в их истории поставлена последняя точка — из основной ветки ядра Linux 5.10 поддержка этих процессоров убрана уже в rc2. В ядре Linux поддержка MIC появилась в 2013 году, и Intel очень активно развивала её, почти втрое увеличив объём кодовой базы. Однако в последние годы развитие прекратилось и код остался фактически заброшенным. Связано это, понятное дело, с уходом ускорителей с рынка, где они не стали массовыми, проиграв конкуренцию NVIDIA как в HPC, так и в остальных сегментах. 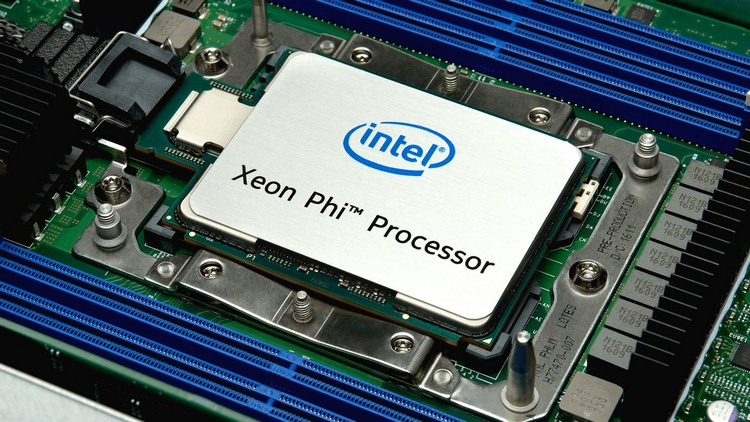 Intel последовательно отменила выпуск следующего поколения MIC и продуктов всех прошлых поколений Xeon Phi, переключившись на создание универсальной архитектуры GPU. HPC-ускорители на её базе должны появиться в скором времени. Шине Intel Omni-Path, которая была непосредственно интегрирована в некоторые поздние модели Xeon Phi, повезло больше — после отказа Intel разработки были переданы свежесозданной Cornelis Networks. Тем не менее, кое-какое наследие MIC в ядре всё же может сохраниться. Речь идёт подсистеме VOP (VirtIO over PCIe), которая решает некоторые проблемы виртуализации PCI Express и для устройств других вендоров. Однако в текущем она ориентирована только на поддержку продуктов и драйверов Intel, и сможет вернуться в ядро Linux лишь после доработки.
18.08.2020 [22:16], Алексей Степин
Серверные ARM-процессоры Marvell ThunderX3: 60 ядер в SCM, 96 ядер в MCM, SMT4 в подарокПоследние дни оказались богатыми на анонсы новых процессоров. Компания IBM представила новейшие POWER10 с поддержкой памяти OMI DDR5 и PCI Express 5.0, Intel анонсировала Xeon Ice Lake-SP, которые, наконец, получили поддержку PCIe 4.0. Третьей в этом списке можно назвать Marvell, которая на мероприятии Hot Chips 32 рассказала подробности о последнем, третьем поколении ARM-процессоров ThunderX, формально анонсированном ещё весной этого года. 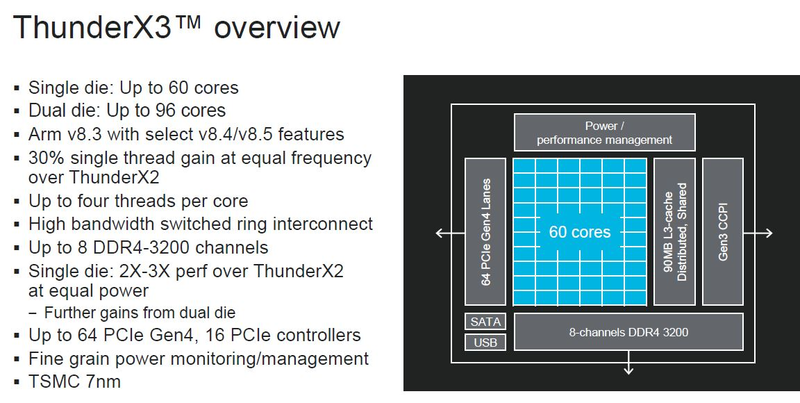
Источник изображений: ServeTheHome Процессоры с архитектурой ARM покорили сегмент мобильных устройств, но в последние несколько лет интереснее другая тенденция — данная архитектура ложится в основу всё новых и новых «крупных» процессоров, предназначенных для серверного применения. И как показывает практика, когда-то считавшаяся «слабой» архитектура оказывается вовсе не такой. 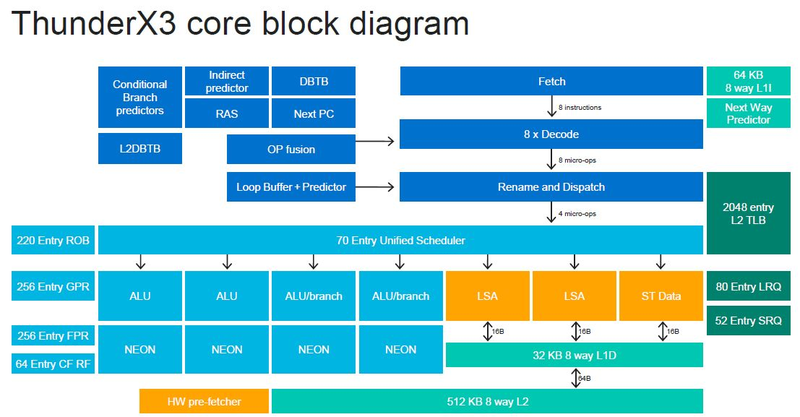 Она успешно соперничает с x86, особенно там, где необходима высокая плотность упаковки вычислительных мощностей и высокая энергоэффективность. Примеры AWS Graviton2 и кастомных процессоров Google тому доказательством, а разработка Fujitsu, процессор A64FX, и вовсе лежит в основе мощнейшего суперкомпьютера планеты, японского кластера Fugaku. 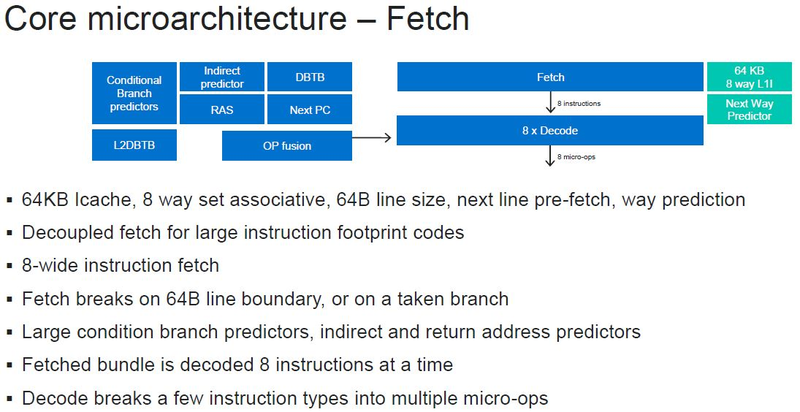 Одной из компаний, прилагающих серьёзные усилия к освоению серверного рынка с помощью архитектуры ARM, является Marvell. Если первые процессоры ThunderX, доставшиеся в наследство от Broadcom, сложно назвать успешным, то уже второе поколение показало себя неплохо, и, судя по всему, третье, наконец, готово к массовому внедрению. Напомним, в отличие от домашних проектов AWS и Google, процессоры ThunderX3 должны получить развитую поддержку многопоточности, на уровне SMT4, что больше, чем у x86, но меньше, чем у POWER10. 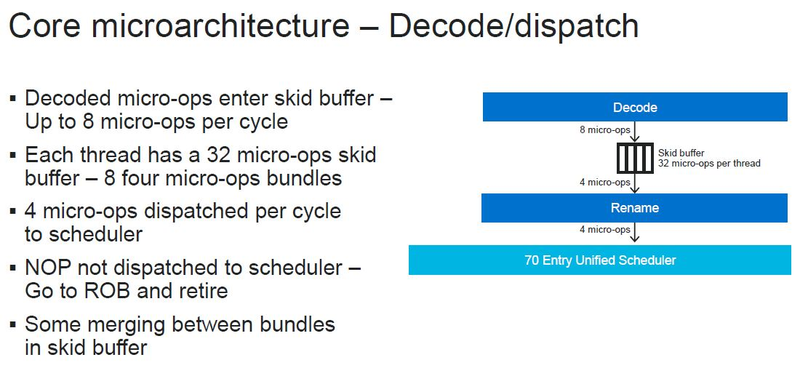 При этом максимальное количество ядер у ThunderX3 впечатляет. Теперь известно, что о 96 ядрах речь идёт только в двухкристалльной компоновке (этим подход Marvell напоминает IBM POWER10, также существующий в двух вариантах). Один кристалл может нести до 60 ядер, что меньше, чем у Graviton2, но, во-первых, ненамного, а во-вторых, с лихвой компенсируется наличием SMT. SMT4 может дать 240 или 384 потока в зависимости от версии, и наверняка это понравится крупным облачным провайдерам, поскольку позволит разместить беспрецедентное количество VM в рамках одного сокета. 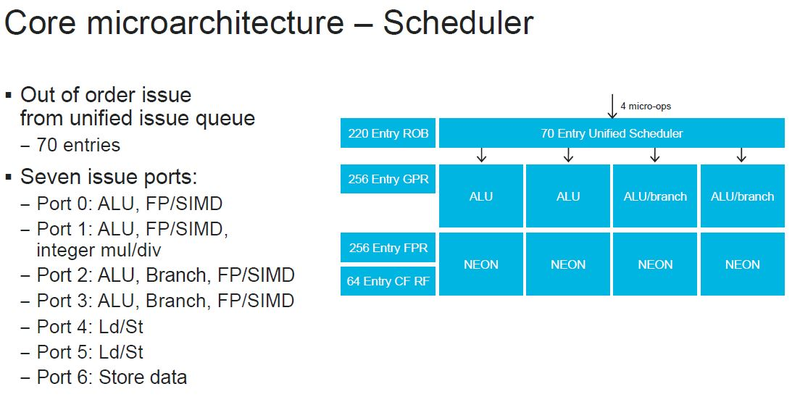 Однопоточная производительность не осталась без внимания. Компания заявила о 30% превосходстве над ThunderX2 в пересчёте на поток. В целом же, третье поколение ThunderX должно быть в 2-3 раза быстрее второго. Архитектурно процессор основывается на наборе инструкций ARM v8.3, однако сказано о частичной поддержке ARM v8.4/8.5. 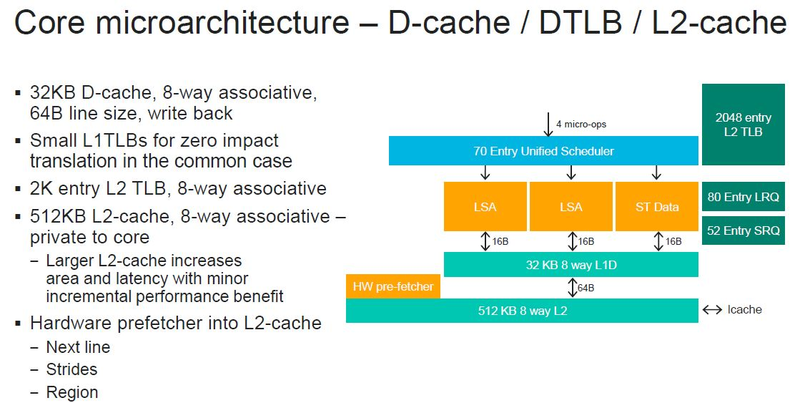 В споре о том, что эффективнее для связи ядер между собой, кольцевые шины или единая mesh-сеть, единого мнения нет. Intel предпочитает первый подход, но Marvell остановила свой выбор на втором. Как обычно, на внешнем кольце расположены кеш (80 Мбайт L3 на кристалл), блоки управление питанием, а также контроллеры памяти, PCI Express и межпроцессорной шины (в данном случае CCPI). 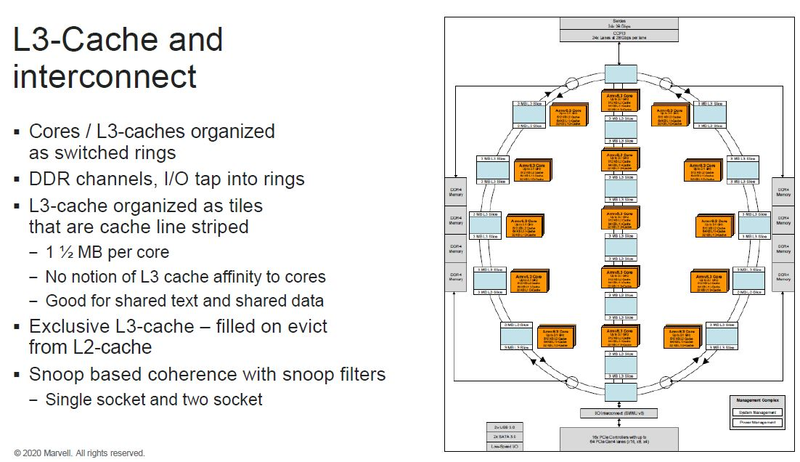 Поддержка SMT4 реализована полностью аппаратно. С точки зрения операционной системы каждый поток ThunderX3 выглядит, как обычный процессор с архитектурой ARM. При этом реализация столь развитой многопоточности привела всего лишь к 5% увеличению площади кристалла в сравнении с однопоточной реализацией. 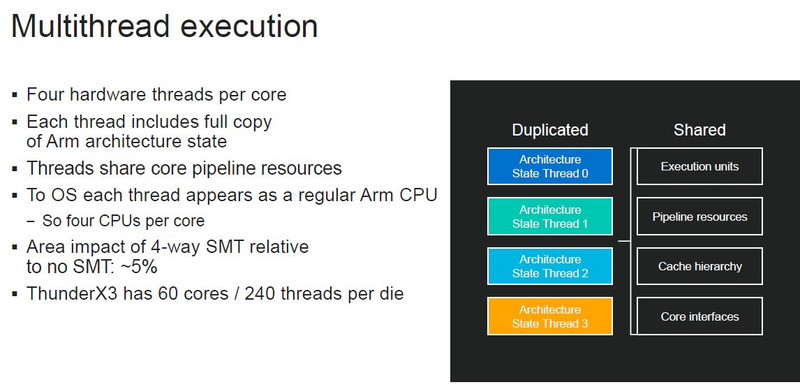 Разделение ресурсов ядра у нового процессора динамическое, осуществляется оно в четырёх точках: выборка, когда потока с меньшим количеством инструкций получают более высокий приоритет; выполнение, работающее по такому же принципу; планирование, которое базируется на «возрасте» потока; наконец, «отставка» — здесь приоритет получают потоки с наибольшим количеством инструкций. Оптимизация многопоточности позволяет Marvell говорить о практически линейной масштабируемости новых процессоров, по крайней мере, в пределах одного разъёма. В зависимости от числа инструкций на ядро коэффициент прироста может варьироваться от x1,28 до 2,21. 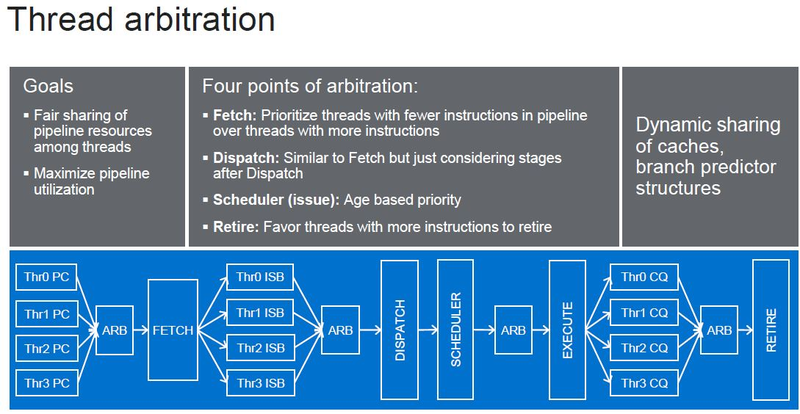 Подсистема ввода-вывода у новинок достаточно развитая. Контроллер памяти имеет 8 каналов и поддерживает DDR4-3200. За поддержку PCI Express отвечают 16 раздельных контроллеров, поддерживающих четвёртую версию стандарта. Это должно обеспечивать высокий уровень производительности при подключении 16 NVMe-накопителей, на каждый из которых придётся по четыре линии PCIe. 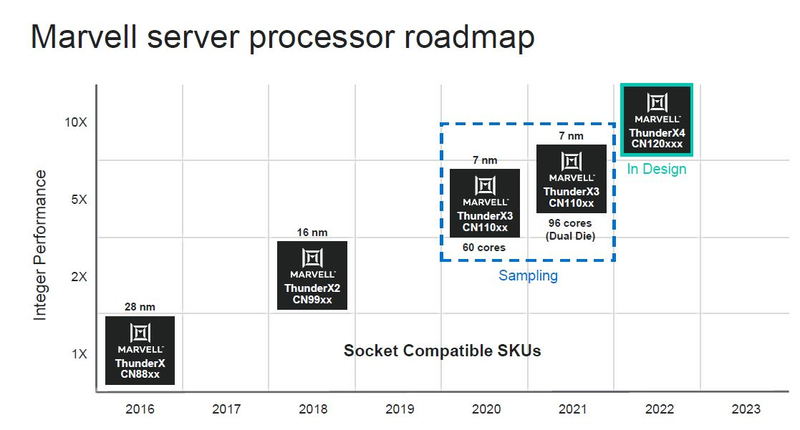 Заявлено о «тонком» управлении питанием, но деталей Marvell не приводит и остаётся только догадываться, насколько эта подсистема ThunderX3 продвинута. Производится новый процессор на мощностях TSMC с использованием техпроцесса 7 нм. Версия с одним 60-ядерным кристаллом выйдет на рынок уже в этом году, а вариант с двумя кристаллами и большим общим количеством ядер начнет поставляться позже, в 2021 году. Компания уже работает над ThunderX4, ожидается что эти процессоры будут использовать техпроцесс 5 нм и увидят свет в 2022 году.
14.05.2020 [18:52], Рамис Мубаракшин
NVIDIA представила ускорители A100 с архитектурой Ampere и систему DGX A100 на их основеNVIDIA официально представила новую архитектуру графических процессоров под названием Ampere, которая является наследницей представленной осенью 2018 года архитектуры Turing. Основные изменения коснулись числа ядер — их теперь стало заметно больше. Кроме того, новинки получили больший объём памяти, поддержку bfloat16, возможность разделения ресурсов (MIG) и новые интерфейсы: PCIe 4.0 и NVLink третьего поколения. NVIDIA A100 выполнен по 7-нанометровому техпроцессу и содержит в себе 54 млрд транзисторов на площади 826 мм2. По словам NVIDIA, A100 с архитектурой Ampere позволяют обучать нейросети в 40 раз быстрее, чем Tesla V100 с архитектурой Turing. 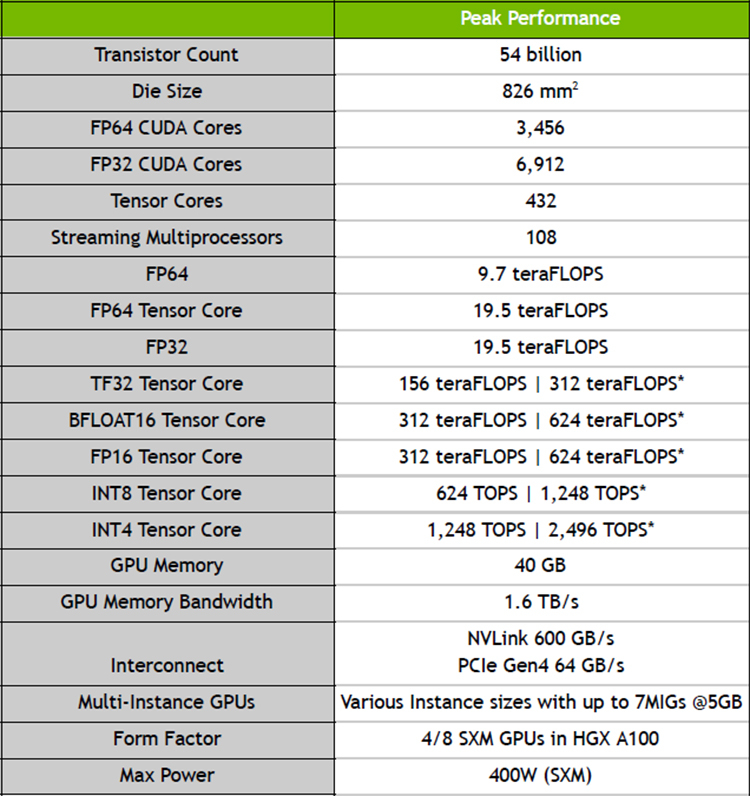
Характеристики A100 Первой основанной на ней вычислительной системой стала фирменная DGX A100, состоящая из восьми ускорителей NVIDIA A100 с NVSwitch, имеющих суммарную производительность 5 Пфлопс. Стоимость одной системы DGX A100 равна $199 тыс., они уже начали поставляться некоторым клиентам. Известно, что они будут использоваться в Аргоннской национальной лаборатории для поддержания работы искусственного интеллекта, изучающего COVID-19 и ищущего от него лекарство. Так как некоторые группы исследователей не могут себе позволить покупку системы DGX A100 из-за ее высокой стоимости, их планируют купить поставщики услуг по облачным вычислений и предоставлять удалённый доступ к высоким мощностям. На данный момент известно о 18 провайдерах, готовых к использованию систем и ускорителей на основе архитектуры Ampere, и среди них есть Google, Microsoft и Amazon. 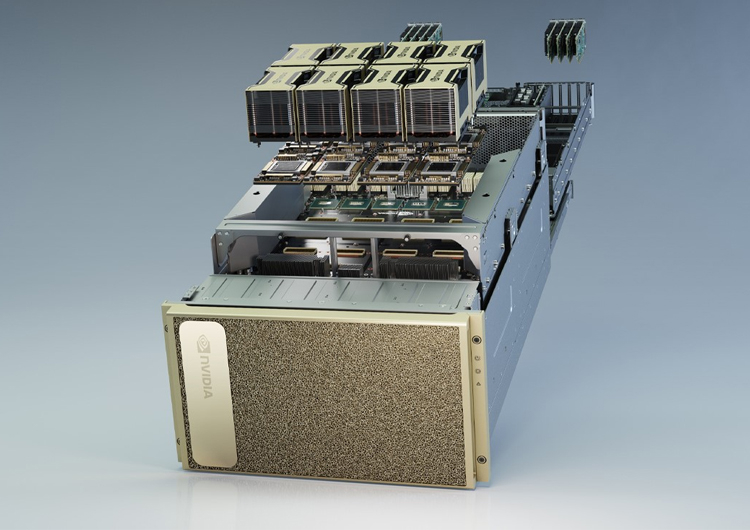
Система NVIDIA DGX A100 Помимо системы DGX A100, компания NVIDIA анонсировала ускорители NVIDIA EGX A100, предназначенная для периферийных вычислений. Для сегмента интернета вещей компания предложила плату EGX Jetson Xavier NX размером с банковскую карту. |
|

