Материалы по тегу: x
|
21.03.2023 [20:45], Владимир Мироненко
NVIDIA запустила облачный сервис DGX Cloud — доступ к ИИ-супервычислениям прямо в браузереNVIDIA запустила сервис ИИ-супервычислений DGX Cloud, предоставляющий предприятиям доступ к инфраструктуре и программному обеспечению, необходимым для обучения передовых моделей для генеративного ИИ и других приложений. DGX Cloud предлагает выделенные ИИ-кластеры NVIDIA DGX в сочетании с фирменным набором ПО NVIDIA. С его помощью предприятие сможет получить доступ к облачному ИИ-суперкомпьютеру, используя веб-браузер и без надобности в приобретении, развёртывании и управлении собственной HPC-инфраструктурой. Правда, удовольствие это всё равно не из дешёвых — стоимость инстансов DGX Cloud начинается от $36 999/мес., причём деньги получает в первую очередь сама NVIDIA. Для сравнения — полностью укомплектованная система DGX A100 в Microsoft Azure обойдётся примерно в $20 тыс. Облачные кластеры DGX предлагаются предприятиям на условиях ежемесячной аренды, что гарантирует им возможность быстро масштабировать разработку больших рабочих нагрузок. «DGX Cloud предоставляет клиентам мгновенный доступ к супервычислениям NVIDIA AI в облаках глобального масштаба», — сообщил Дженсен Хуанг (Jensen Huang), основатель и генеральный директор NVIDIA. 
Источник изображения: NVIDIA Развёртыванием инфраструктуры DGX Cloud компания NVIDIA будет заниматься в сотрудничестве с ведущими поставщиками облачных услуг. Первым среди них стала платформа Oracle Cloud Infrastructure (OCI), предлагающая суперкластер (SuperCluster) с объединёнными RDMA-сетью (в том числе на базе BlueField-3 и Connect-X7) системами DGX (bare metal), которые дополняет высокопроизводительное локальное и блочное хранилище. Cуперкластер может включать до 32 768 ускорителей, но этот рекорд был поставлен с использованием DGX A100, а вот предложение DGX H100 пока что ограничено. В следующем квартале похожее решение появится в Microsoft Azure, а потом в Google Cloud и у других провайдеров. 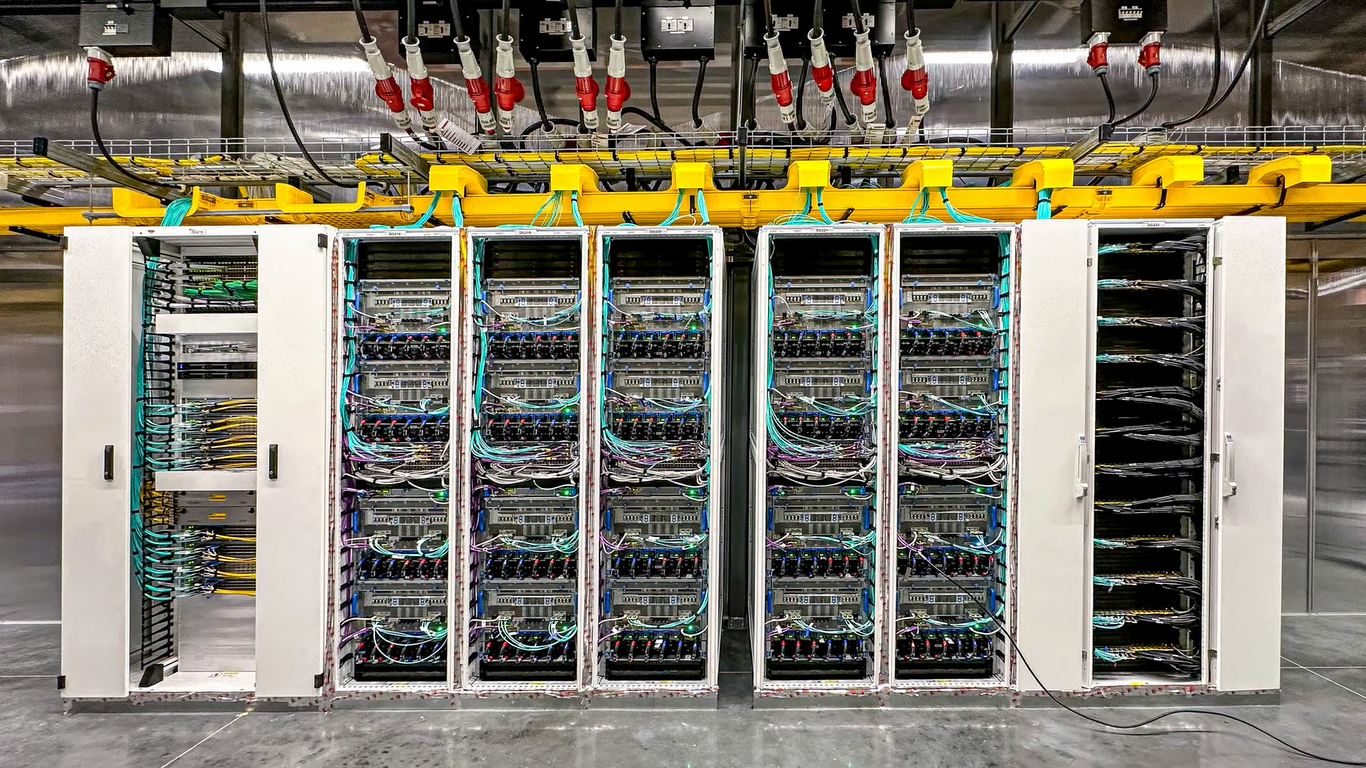
Источник изображения: NVIDIA Первыми пользователями DGX Cloud стали Amgen, одна из ведущих мировых биотехнологических компаний, лидер рынка страховых технологий CCC Intelligent Solutions (CCC) и провайдер цифровых бизнес-платформ ServiceNow. «Мощные вычислительные и многоузловые возможности DGX Cloud позволили нам в 3 раза ускорить обучение белковых LLM с помощью BioNeMo и до 100 раз ускорить анализ после обучения с помощью NVIDIA RAPIDS по сравнению с альтернативными платформами», — сообщил представитель Amgen. Для управления нагрузками в DGX Cloud предлагается NVIDIA Base Command. Также DGX Cloud включает в себя набор инструментов NVIDIA AI Enterprise для создания и запуска моделей, который предоставляет комплексные фреймворки и предварительно обученные модели для ускорения обработки данных и оптимизации разработки и развёртывания ИИ. DGX Cloud предоставляет поддержку экспертов NVIDIA на всех этапах разработки ИИ. Клиенты смогут напрямую работать со специалистами NVIDIA, чтобы оптимизировать свои модели и быстро решать задачи разработки с учётом сценариев отраслевого использования.
21.03.2023 [19:15], Сергей Карасёв
NVIDIA представила систему DGX Quantum для гибридных квантово-классических вычисленийКомпания NVIDIA в партнёрстве с Quantum Machines анонсировала DGX Quantum — первую систему, объединяющую GPU и квантовые вычисления. Решение использует новую открытую программную платформу CUDA Quantum. Утверждается, что система предоставляет революционно архитектуру для исследователей, работающими с гибридными вычислениями с низкой задержкой. NVIDIA DGX Quantum объединяет средства ускоренных вычислений на базе Grace Hopper (Arm-процессор + ускоритель H100), модели программирования с открытым исходным кодом CUDA Quantum и передовую квантовую управляющую платформу Quantum Machines OPX+. Такая комбинация позволяет создавать ресурсоёмкие приложения, сочетающие квантовые вычисления с современными классическими вычислениями. При этом в числе прочего обеспечивается работа гибридных алгоритмов и коррекция ошибок. 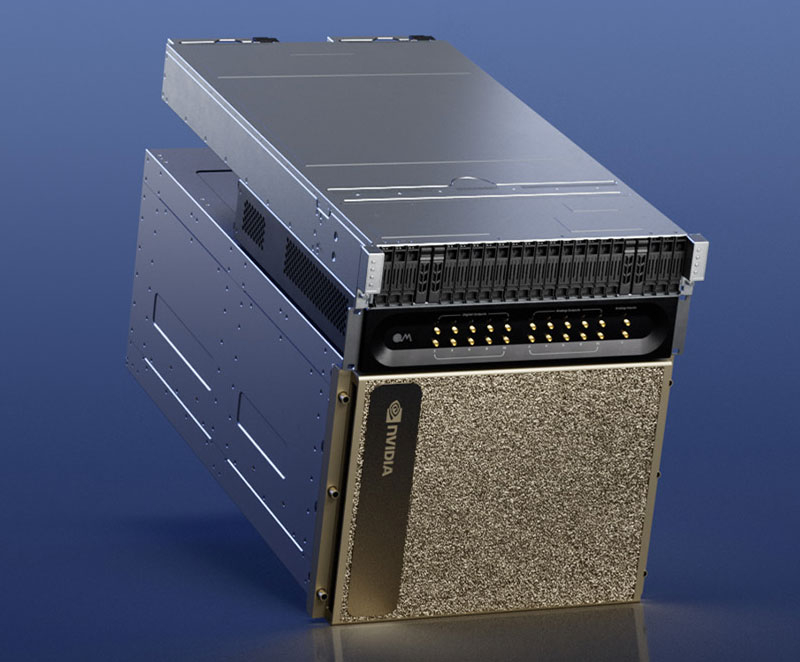
Источник изображения: NVIDIA Представленное решение предполагает соединение Grace Hopper и Quantum Machines OPX+ посредством интерфейса PCIe. Это обеспечивает задержку менее микросекунды между ускорителем и блоками квантовой обработки (QPU). Отмечается, что OPX+ — это универсальная система квантового управления. Таким образом, можно максимизировать производительность QPU и предоставить разработчикам новые возможности при использовании квантовых алгоритмов. Системы Grace Hopper и OPX+ можно масштабировать в соответствии с потребностями — от QPU с несколькими кубитами до суперкомпьютера с квантовым ускорением. 
Источник изображения: NVIDIA О намерении интегрировать CUDA Quantum в свои платформы уже заявили компании по производству квантового оборудования Anyon Systems, Atom Computing, IonQ, ORCA Computing, Oxford Quantum Circuits и QuEra, разработчики ПО Agnostiq и QMware, а также некоторые суперкомпьютерные центры.
17.03.2023 [14:10], Сергей Карасёв
Разработчики Linux отказались принимать апдейты от «Байкал Электроникс»Сообщество разработчиков ядра Linux отказалось принимать от российской компании «Байкал Электроникс» патчи для ядра. О запрете, как отмечает ресурс Phoronix, сообщил Якуб Кичиньский (Jakub Kicinski), занимающийся поддержкой сетевой подсистемы Linux. «Нам некомфортно принимать патчи от вашей организации или обновления, связанные с произведённым вами оборудованием», — заявил господин Кичиньский в переписке с Сергеем Сёминым, сотрудником «Байкал Электроникс». Дело в том, что российский разработчик процессоров и SoC с архитектурами MIPS и Arm находится под европейскими и американскими санкциями. В этой связи Якуб Кичиньский посоветовал «Байкал Электроникс» воздержаться от внесения изменений в сетевую подсистему ядра Linux «до дальнейшего уведомления». Отметим, что именно благодаря «Байкал Электроникс» в ядре Linux появилась полноценная поддержка Warrior P5600 — именно это решение лежит в основе чипа «Байкал-Т1». 
Источник изображения: «Байкал Электроникс» Как уточняет Phoronix, отказ принимать патчи последовал после того, как «Байкал Электроникс» предложила ряд исправлений для сетевого драйвера STMMAC. Он предназначен для Ethernet-контроллеров Synopsys, которые используются в решениях российской компании. «Серия исправлений, о которой идёт речь, не относится непосредственно к решениям "Байкал Электроникс", а представляет собой всего лишь исправления для сетевого драйвера Synopsys, используемого несколькими различными аппаратными платформами/организациями», — подчёркивается в публикации.
07.02.2023 [15:15], Сергей Карасёв
IBM продолжит развитие AIX как минимум до 2030 годаКорпорация IBM, как сообщает ресурс Network World, опровергла предположения о том, что разработка операционной системы AIX отошла на второй план. Компания заявляет, что по-прежнему привержена данному проекту, а развитие платформы и внедрение в неё новых функций рассчитано как минимум до 2030 года. В начале 2023 года стало известно, что IBM полностью передала разработку Unix-платформы AIX своему индийскому подразделению. Тогда говорилось, что разработчикам AIX в США было предложено подыскать другую работу в компании, но некоторые оказались в «подвешенном состоянии». Высказывались предположения, что данная мера нацелена на то, чтобы избавиться от пожилых сотрудников. Кроме того, появились слухи, что проект AIX теряет приоритет. 
Источник изображения: IBM IBM теперь заявляет, что разработка AIX уже велась в Индии, тогда как специалисты в США работали над платформой POWER, на которой функционирует AIX. Отмечается, что компания решила сосредоточить дальнейшее развитие AIX в Индии по многим причинам, а не исключительно из соображений экономии средств. В компании говорят, что осенью 2023 года будет выпущено очередное обновление AIX 7.3. Компания намерена и дальше придерживаться цикла ежегодного обновления платформы. «Мы продолжим совершенствовать систему. Ни одно из действий по оптимизации ресурсов, которые мы предприняли, не повлияло на наш план развития ОС или кого-либо из сотрудников, которые вовлечены в проект», — отмечают в корпорации. Более того, по словам IBM, которой теперь принадлежит Red Hat, бывают даже случаи переноса рабочих нагрузок с Linux на AIX. Сейчас AIX является фактически единственным активно развивающимся наследником UNIX System V Release 4.
13.01.2023 [23:24], Владимир Мироненко
IBM полностью передала разработку ОС AIX своему индийскому офисуIBM полностью передала разработку платформы AIX своему индийскому офису. Об этом сообщил ресурс The Register. До этой передачи, которая, по данным The Register, произошла в III квартале 2022 года, разработка AIX, согласно его источнику, была равномерно распределена между специалистами IBM в США и Индии. С наступлением 2023 года все работы были перемещены в Индию. Согласно данным The Register, пострадало порядка 80 разработчиков AIX в США, которым было предложено подыскать другую работу в компании, выделив на решение вопроса неограниченное время. Сообщается, что большая часть программистов перешла на другие должности в IBM, хотя некоторые оказались в «подвешенном состоянии». По словам собеседника The Register, это в основном пожилые сотрудники, имеющие право на получение пенсии. 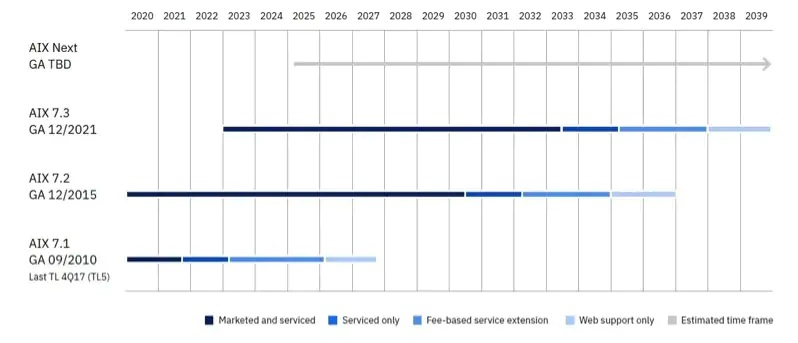
Изображения: IBM «Среди моих коллег общее мнение состоит в том, что перераспределение используется для того, чтобы вытолкнуть пожилых сотрудников из компании и сделать это таким образом, чтобы избежать проверки, которая проводится при увольнениях», — говорит источник. При увольнении работника обычно выплачивается выходное пособие, что отражается в отчётности. Перераспределение (направление работников на поиск другой должности внутри компании, возможно, с переездом) позволяет избежать этих затрат и заполнения лишних бумаг. Кроме того, это может побудить работника уволиться по собственному желанию.  Известно, что против IBM было подано множество исков с обвинением компании в дискриминации пожилых сотрудников и неправомерном их увольнении. IBM намеренно усложнила проверку таких обвинений, перестав в 2014 году раскрывать возрастные демографические данные об уволенных сотрудниках. Имея доступ к таким данным было бы проще оценить средний возраст тех, кого подвергают перераспределению. В феврале 2022 года директор по персоналу IBM директор по работе с персоналом IBM Никль Ламоро (Nickle LaMoreaux) выступила с опровержением «ложных утверждений о возрастной дискриминации в компании». В последнее время многие из исков против IBM были урегулированы компанией на условиях конфиденциальности, нередко без признания своей вины и без возможности формирования коллективных исков.
11.01.2023 [03:00], Игорь Осколков
Асимметричный ответ: Intel официально представила процессоры Xeon Sapphire RapidsIntel официально представила серверные процессоры Xeon семейства Sapphire Rapids (SPR), выход которых изрядно задержался, а также ускорители ранее известные как Ponte Vecchio и теперь объединённые вместе с HBM-версиями SPR в отдельную HPC-серию Max. В этом поколении Intel не смогла догнать AMD EPYC Genoa по числу ядер, числу каналов памяти и линий PCIe, но заготовила ассиметричный, хотя и очень странно реализованный ответ. Всего представлено 52 модели с числом P-ядер от 8 до 60 и с TDP от 125 до 350 Вт. По числу ядер это существенный апгрейд по сравнению с Ice Lake-SP (до 40 ядер), да и IPC вырос у Golden Cove на 15 % в сравнении с Sunny Cove. Но это существенный проигрыш в сравнении с Genoa (до 96 ядер), особенно если учитывать их максимальный TDP в 360 Вт (cTDP до 400 Вт). Правда, у Sapphire Rapids есть ещё и экономичный режим работы, в котором энергопотребление снижается на 20 %, а производительность для некоторых нагрузок — всего на 5 %. 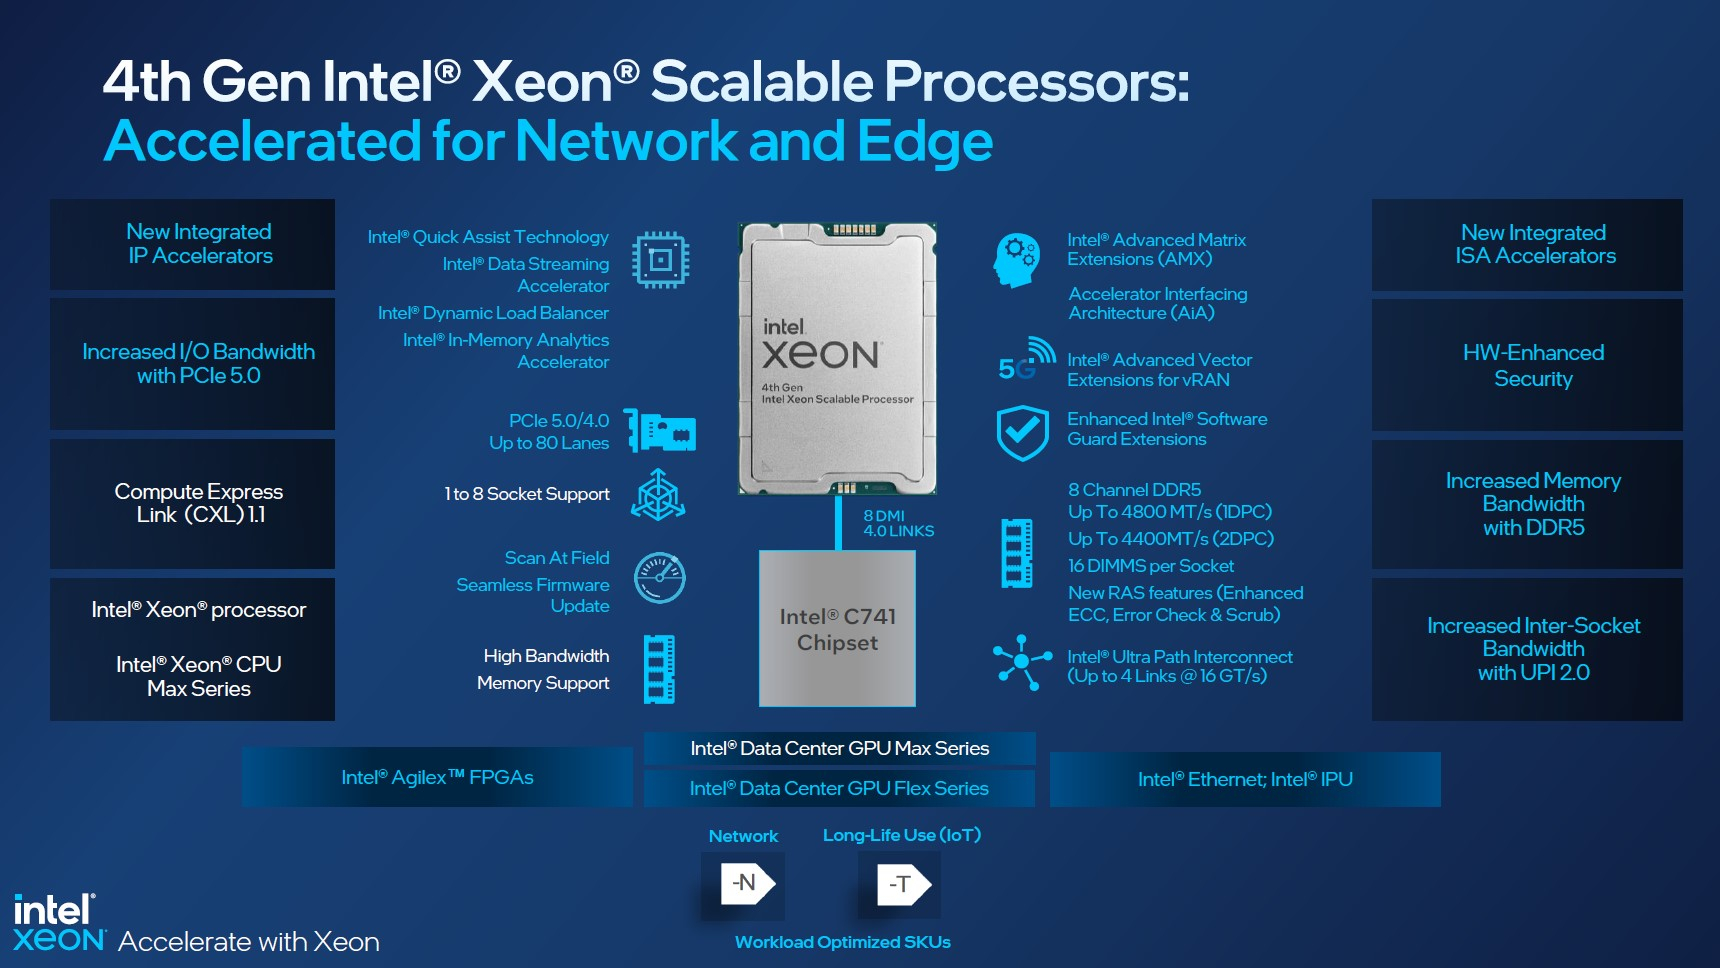
Изображения: Intel Sapphire Rapids предлагают 8 каналов памяти DDR5-4800 (1DPC) и DDR5-4400 (2DPC). 2DPC у Genoa пока что нет. Кроме того, контроллеры поддерживают и модули Optane PMem 300 (Crow Pass), но с учётом того, что производство 3D XPoint прекращено, достаться они могут не всем (впрочем, не всем они и нужны). Ну а маленькая серия Max также включает 64 Гбайт набортной HBM2e-памяти (1,2 Тбайт/с). Остались и отличия в максимальном объёме SGX-анклавов в зависимости от модели CPU. 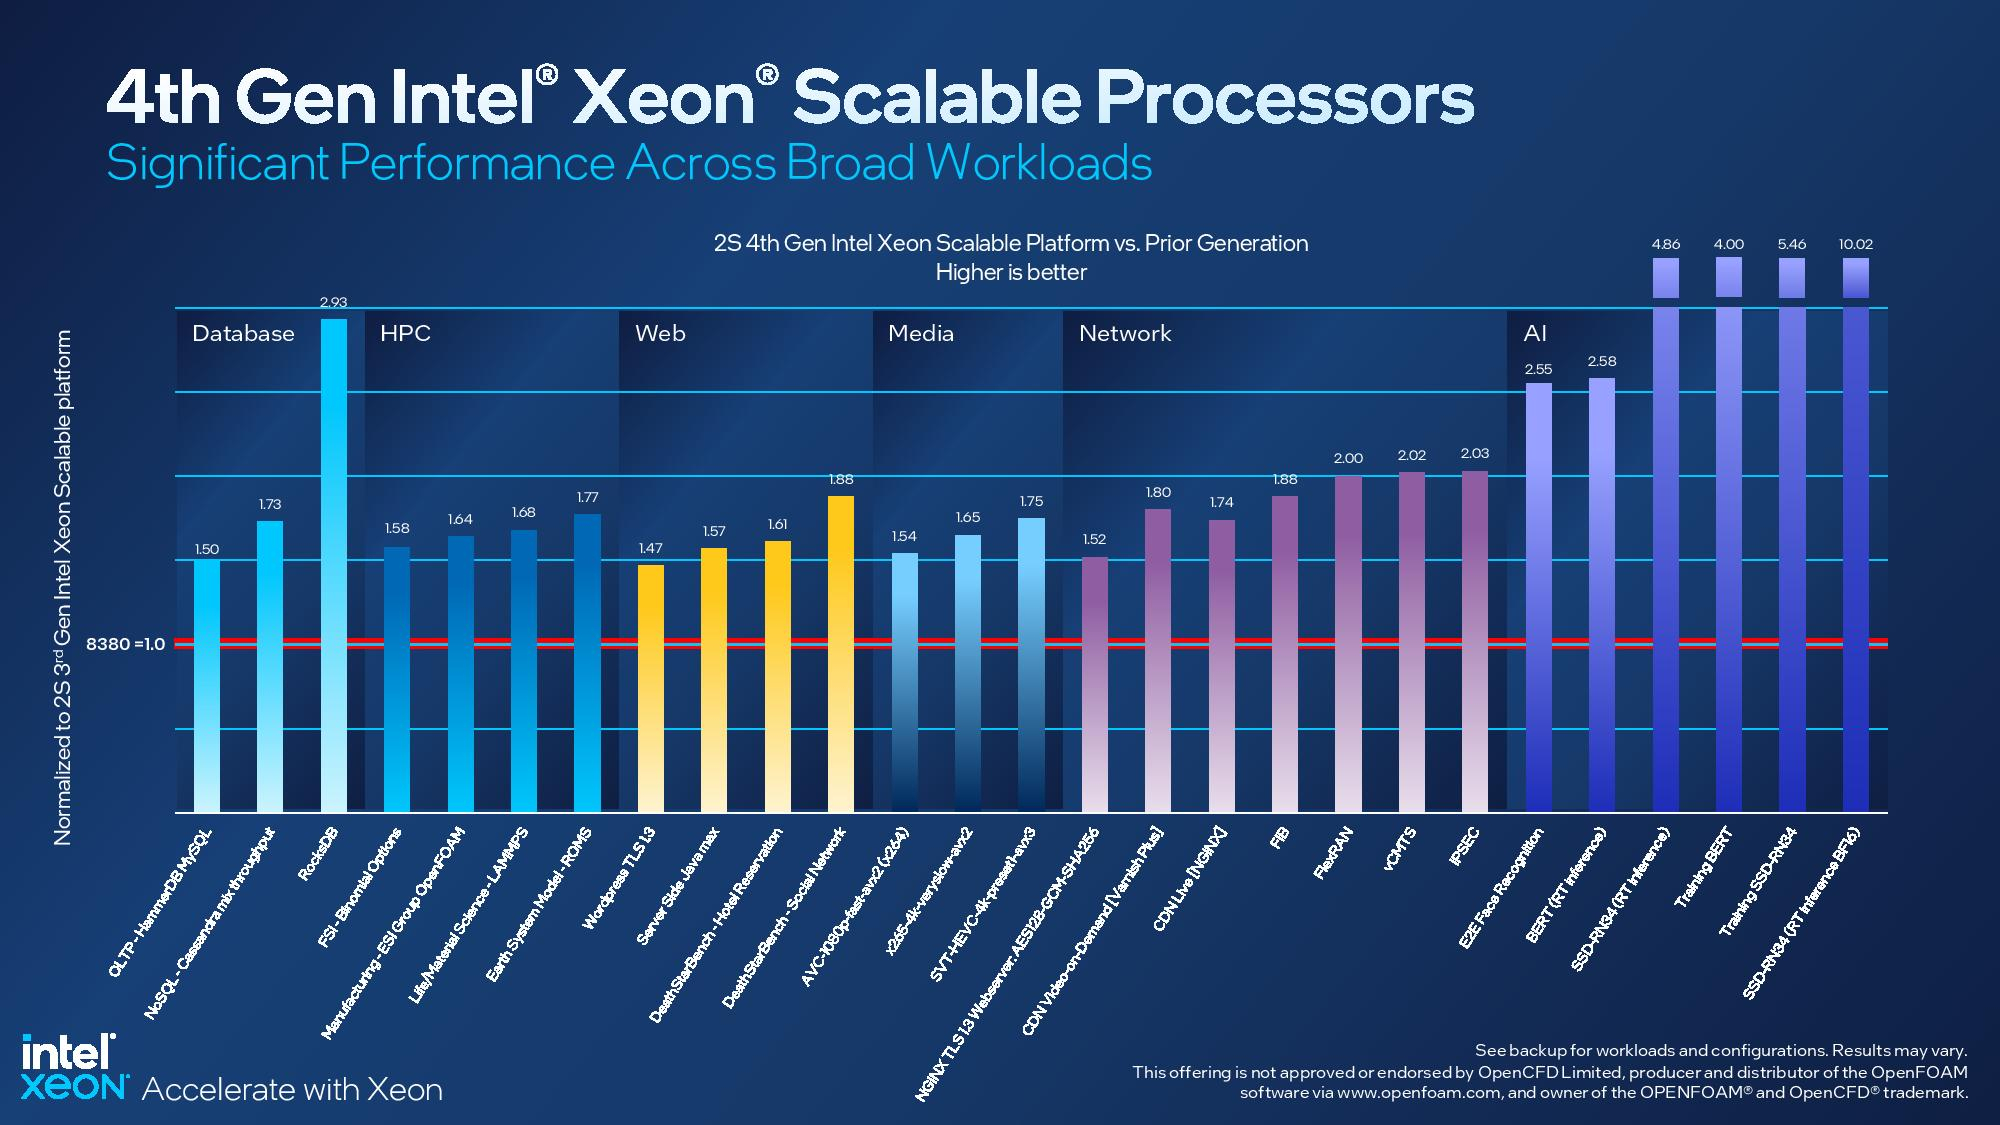 Однако по числу ядер на узел всё равно лидирует Intel. Если AMD поддерживает только 2S-конфигурации, то Intel снова предлагает и 4S, и 8S (а с момента выхода Cooper Lake-SP прошло немало времени) — на процессор доступно до 4 линий UPI 2.0 (16 ГТ/с в сравнении с 11,2 ГТ/с у Ice Lake-SP). В 2S-платформах Sapphire Rapids также формально обгоняет Genoa по числу линий PCIe 5.0, которых тут по 80 шт. на сокет. Формально потому, что в случае Genoa при желании всё же можно получить 160 линий, пожертвовав скоростью шины между CPU, но в односокетном варианте EPYC в любом случае интереснее Xeon. 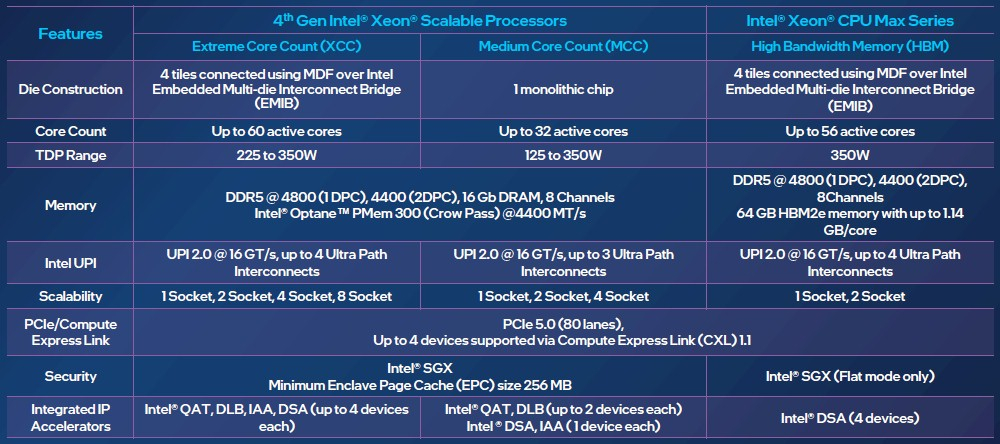 Без нюансов тут не обошлось. Так, при бифуркации до 8 x2 скорость падает до PCIe 4.0. Зато каждый root-комплекс поддерживает CXL 1.1, тогда как у Genoa CXL есть только у половины! Впрочем, поддержка всё равно ограничена 4x CXL-устройствами на CPU. Что ещё более странно, официально заявлена поддержка только устройств Type 1 и Type 2, но не Type 3, хотя последние весьма пригодились бы в ряде конфигураций, где требуется больше относительно недорогой, пусть и несколько более медленной, RAM. 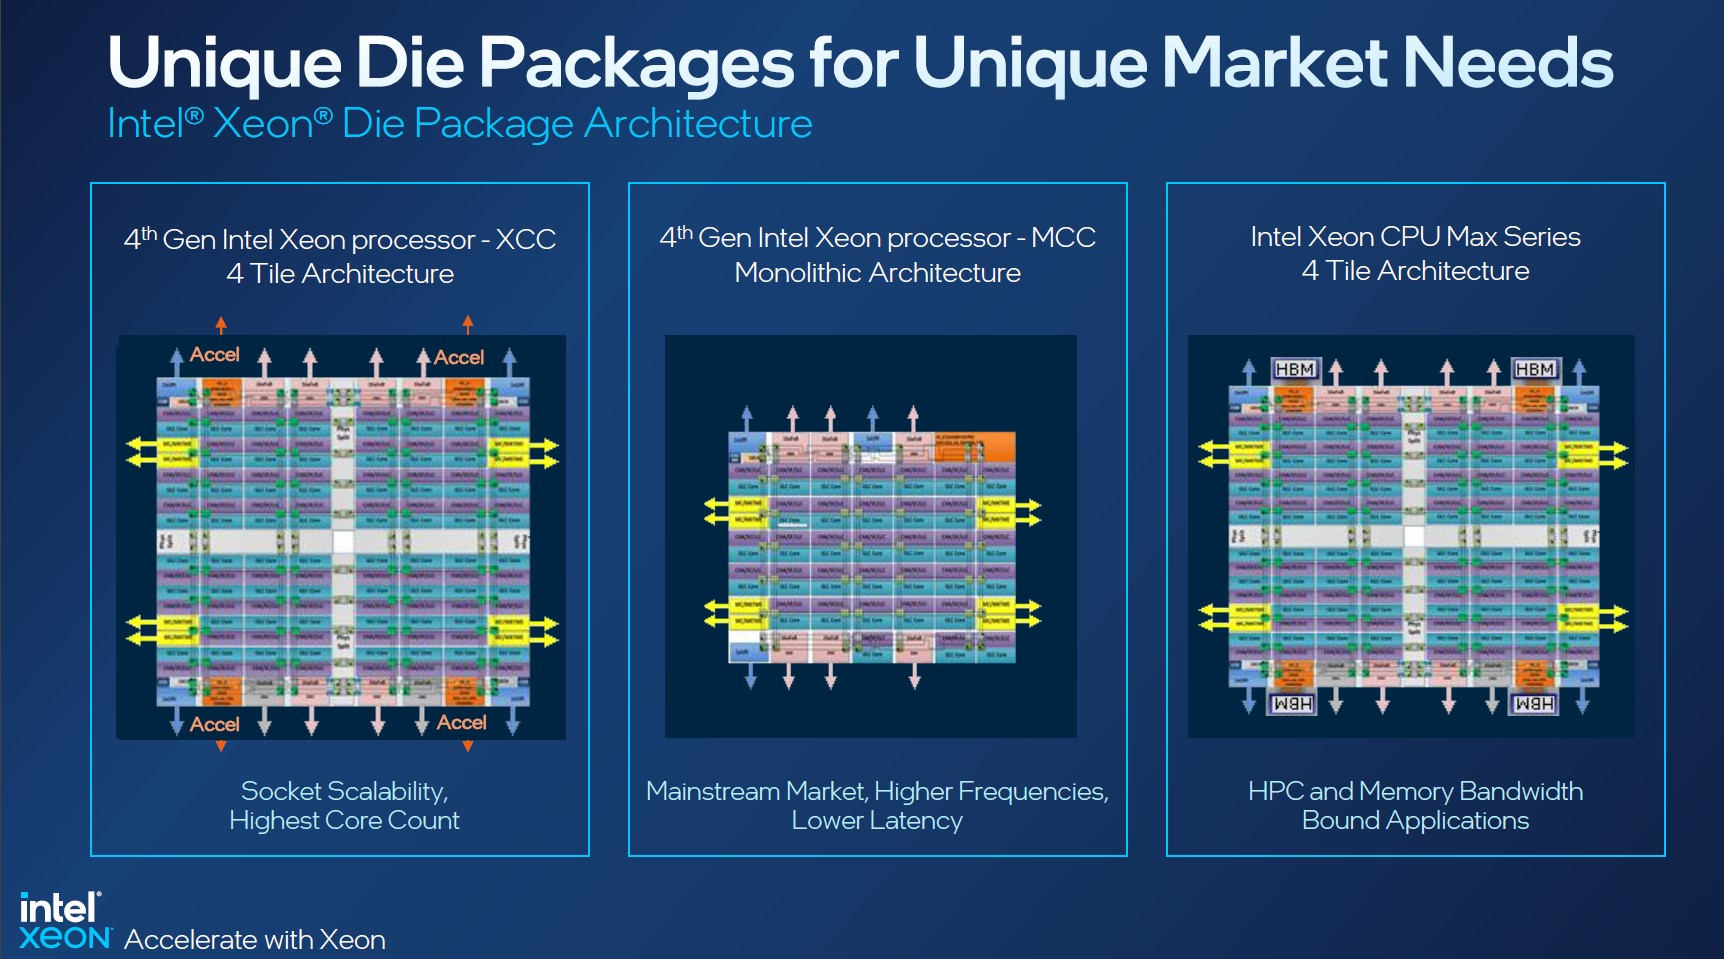 Сохранилось традиционное разделение на серии Platinum (8000), Gold (6000/5000), Silver (4000) и Bronze (3000), к которым теперь добавилась серия Max (9400). Список суффиксов, означающих оптимизацию под те или иные задачи и наличие каких-то особенностей, стал чуть шире: Y (SST-PP 2.0), Q (рассчитаны на работу с СЖО), U (односокетные общего назначения), T (увеличенный жизненный цикл), H (in-memory СУБД, аналитика, виртуализация), N (сетевые решения, в том числе для 5G), облачные P/V/M (IaaS/Paa/медиа), S (СХД и HCI). 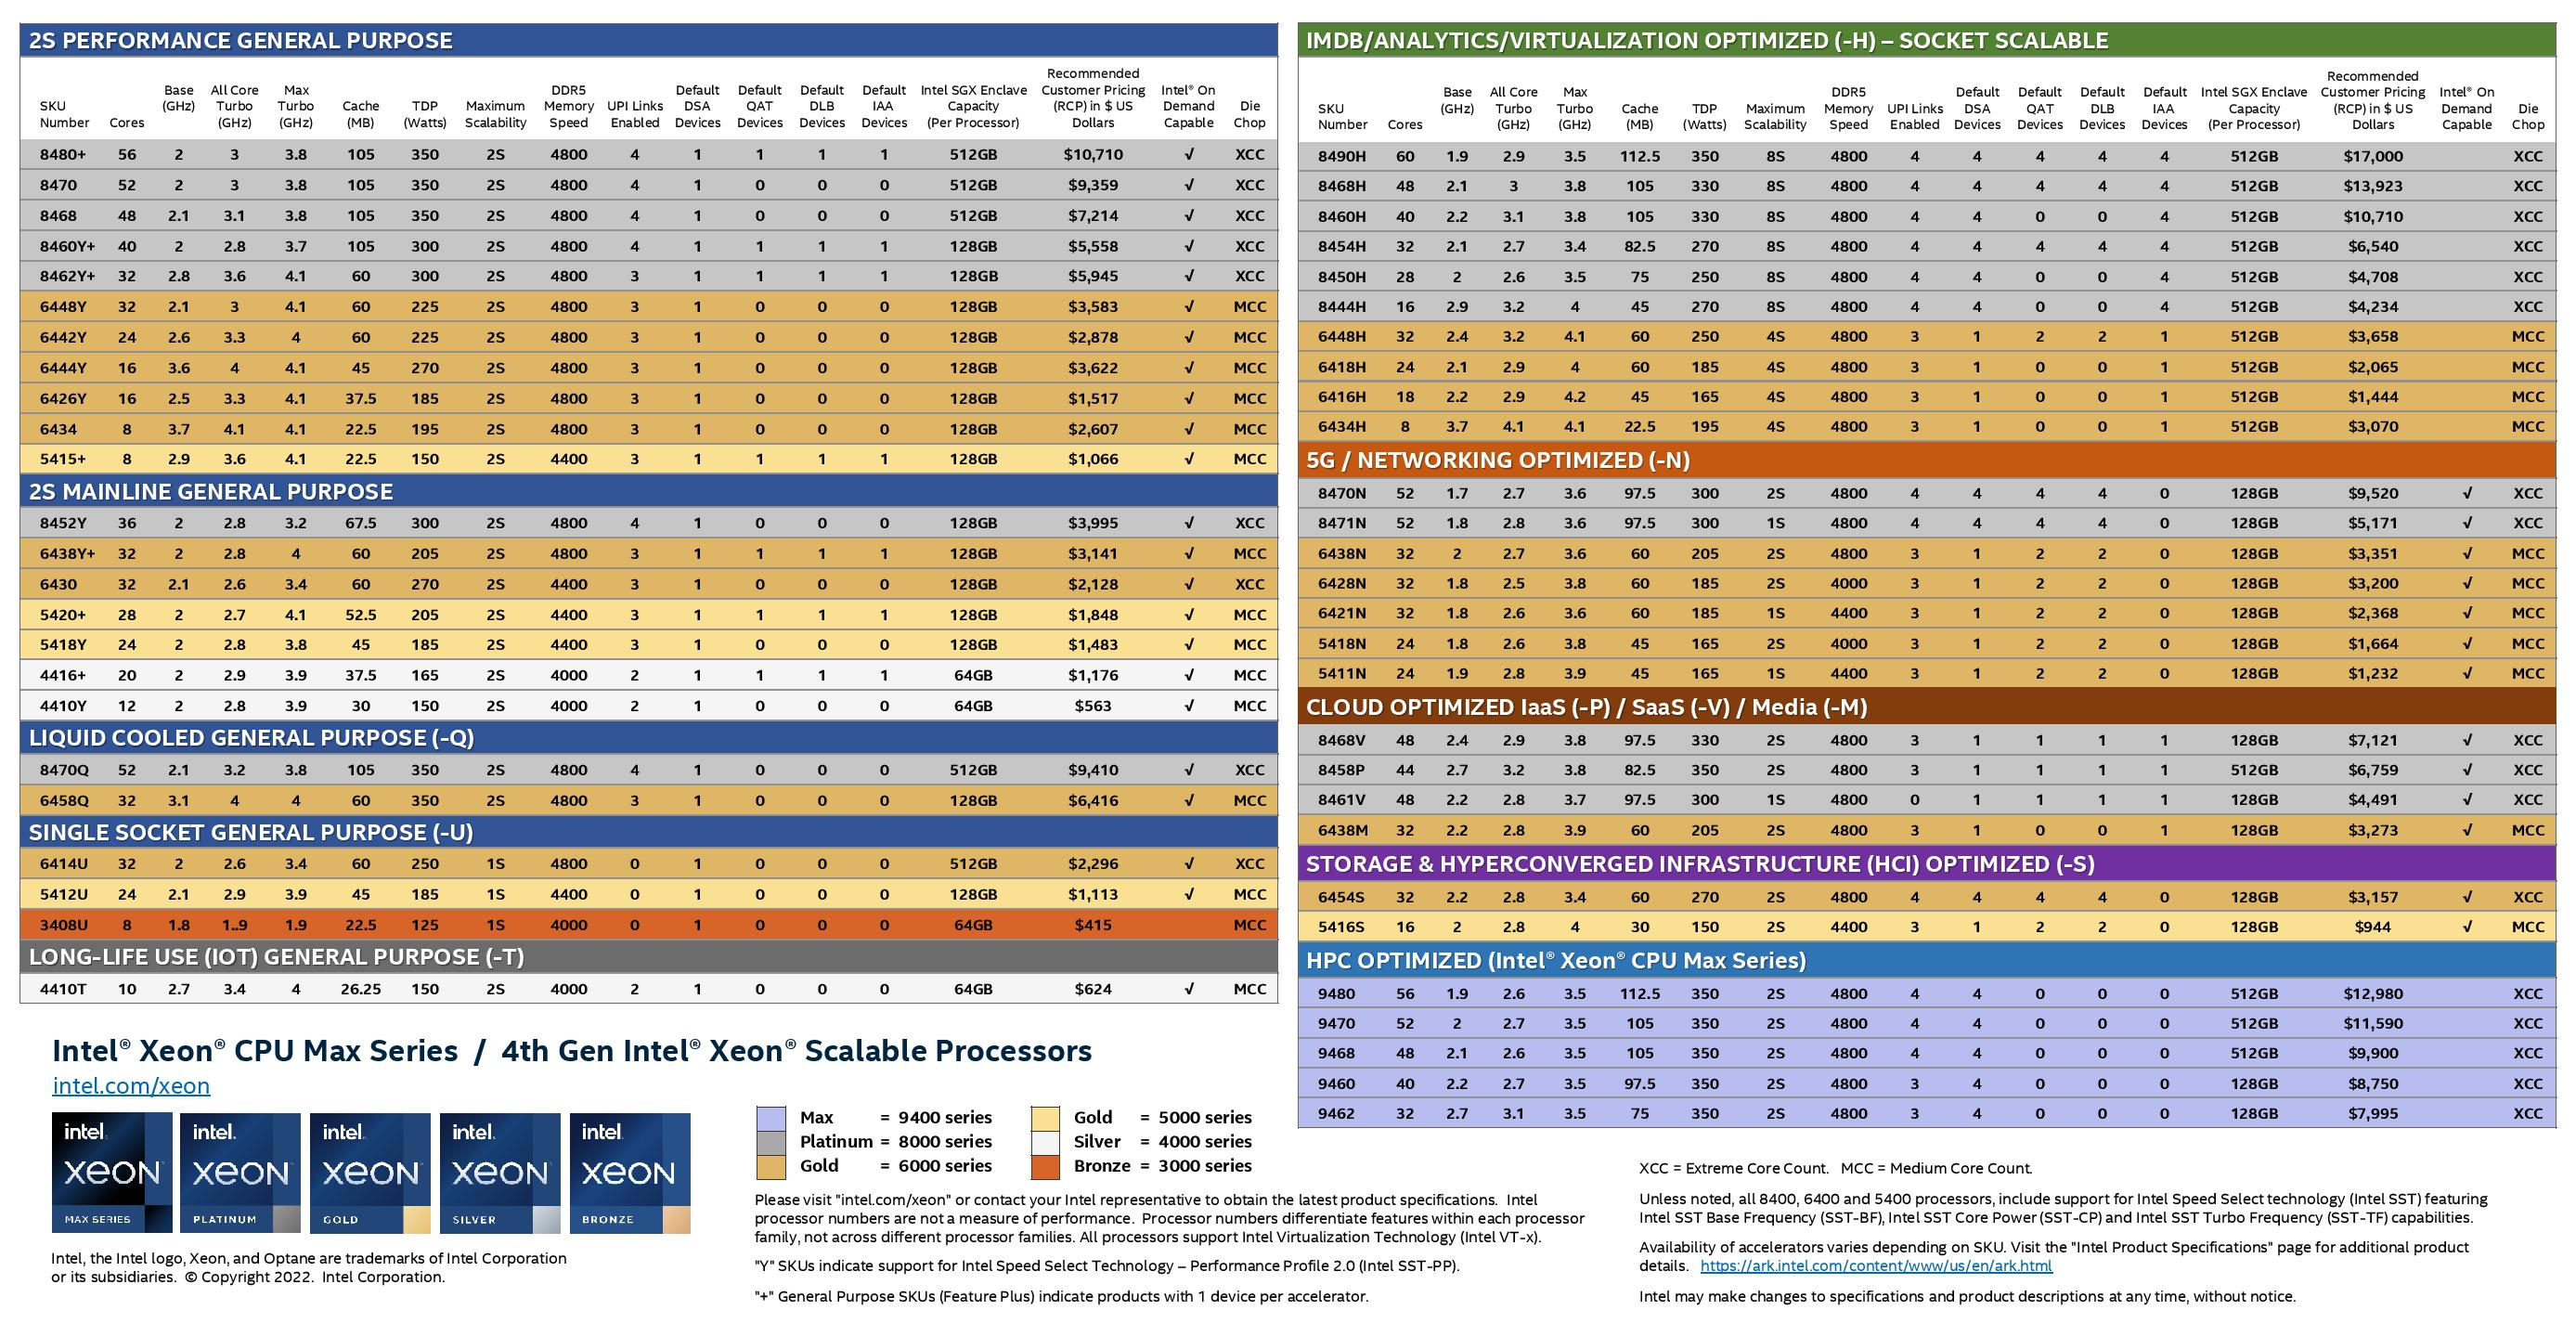 Но некоторые модели также имеют в названии «+». И вот тут начинается самое интересное! Все процессоры получили «традиционную» (в сравнении с Genoa) реализацию AVX-512, включая DL Boost, а также целый новый набор ИИ-инструкций AMX (до 10 раз быстрее обучение и инференс в сравнении с Ice Lake-SP). Есть и всяческие Speed Select, DDIO, TDX, CET и т.д. Но Sapphire Rapids также получили четыре отдельных ускорителя:
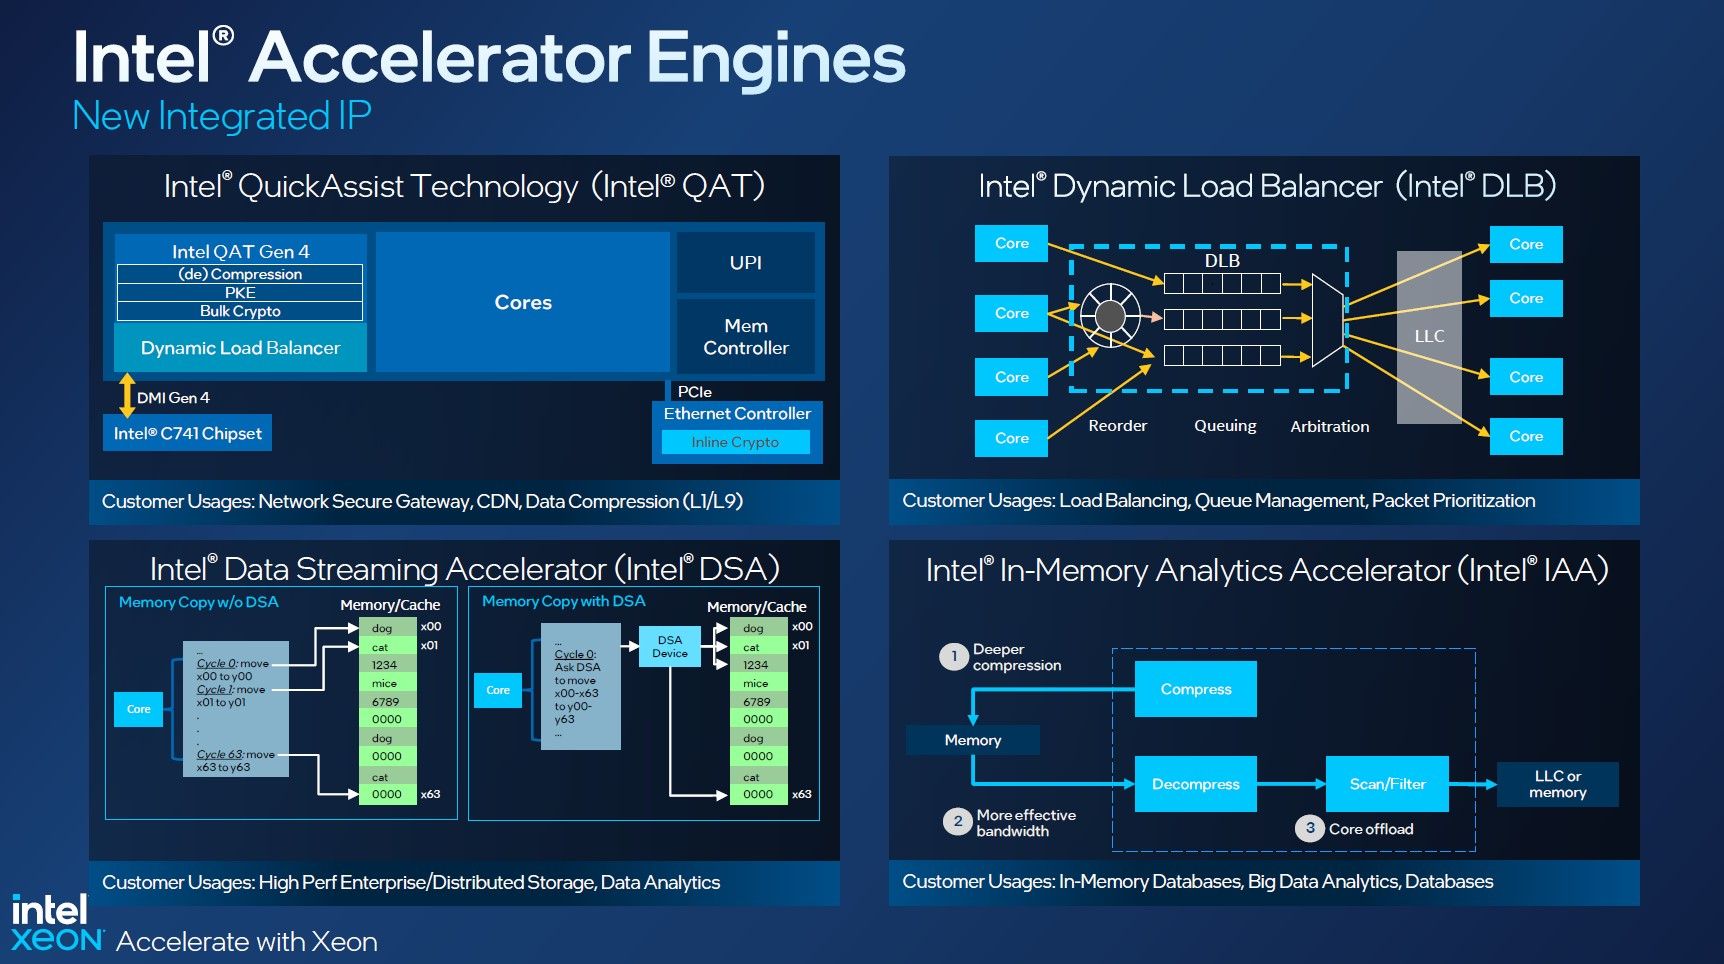 Intel заявляет, что средний прирост производительности Sapphire Rapids в сравнении с Ice Lake-SP составил 1,53 раза. А вот для ряда нагрузок, которые могут задействовать новые ускорители прирост производительности на Вт составляет уже до 2,9 раз! То есть Intel продолжает придерживаться стратегии создания максимально универсальных CPU для различных нагрузок. И действительно, спорить с гибкостью Sapphire Rapids трудно. Но какой ценой это достигается? Т.е. буквально: во сколько это обойдётся заказчику? Ответа пока нет. 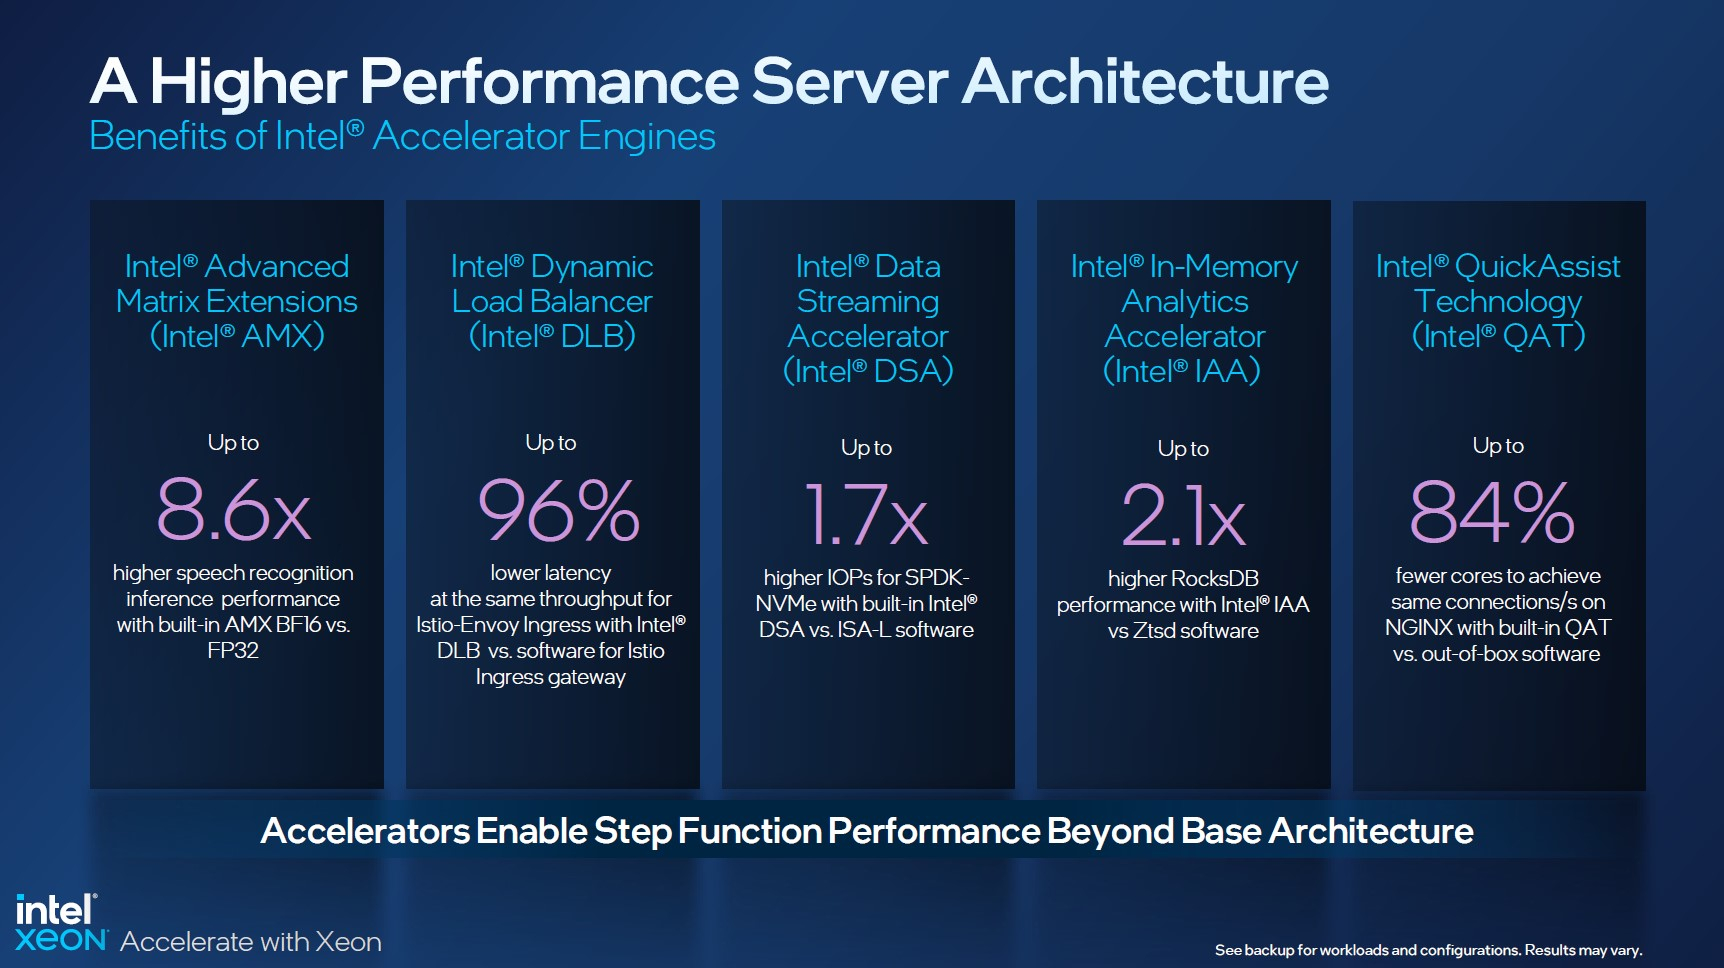 Дело в том, что в зависимости от модели отличается число доступных и число активированных ускорителей. Фактически в новом поколении используется два вида кристаллов: XCC, «сшитые» из четырёх отдельных тайлов, и монолитные MCC (до 32 ядер, причём 32-ядерных моделей в серии большинство). У каждого тайла в XCC есть по одному блоку QAT, DSA, DLB и IAA, т.е. суммарно на CPU приходится до четырёх ускорителей каждого типа. В случае MCC может быть по два QAT и DLB и по одному DSA и IAA на процессор. Например, у тех моделей, что помечены «+», активно по одному блоку каждого типа, а минимум один DSA активен есть вообще у всех CPU. 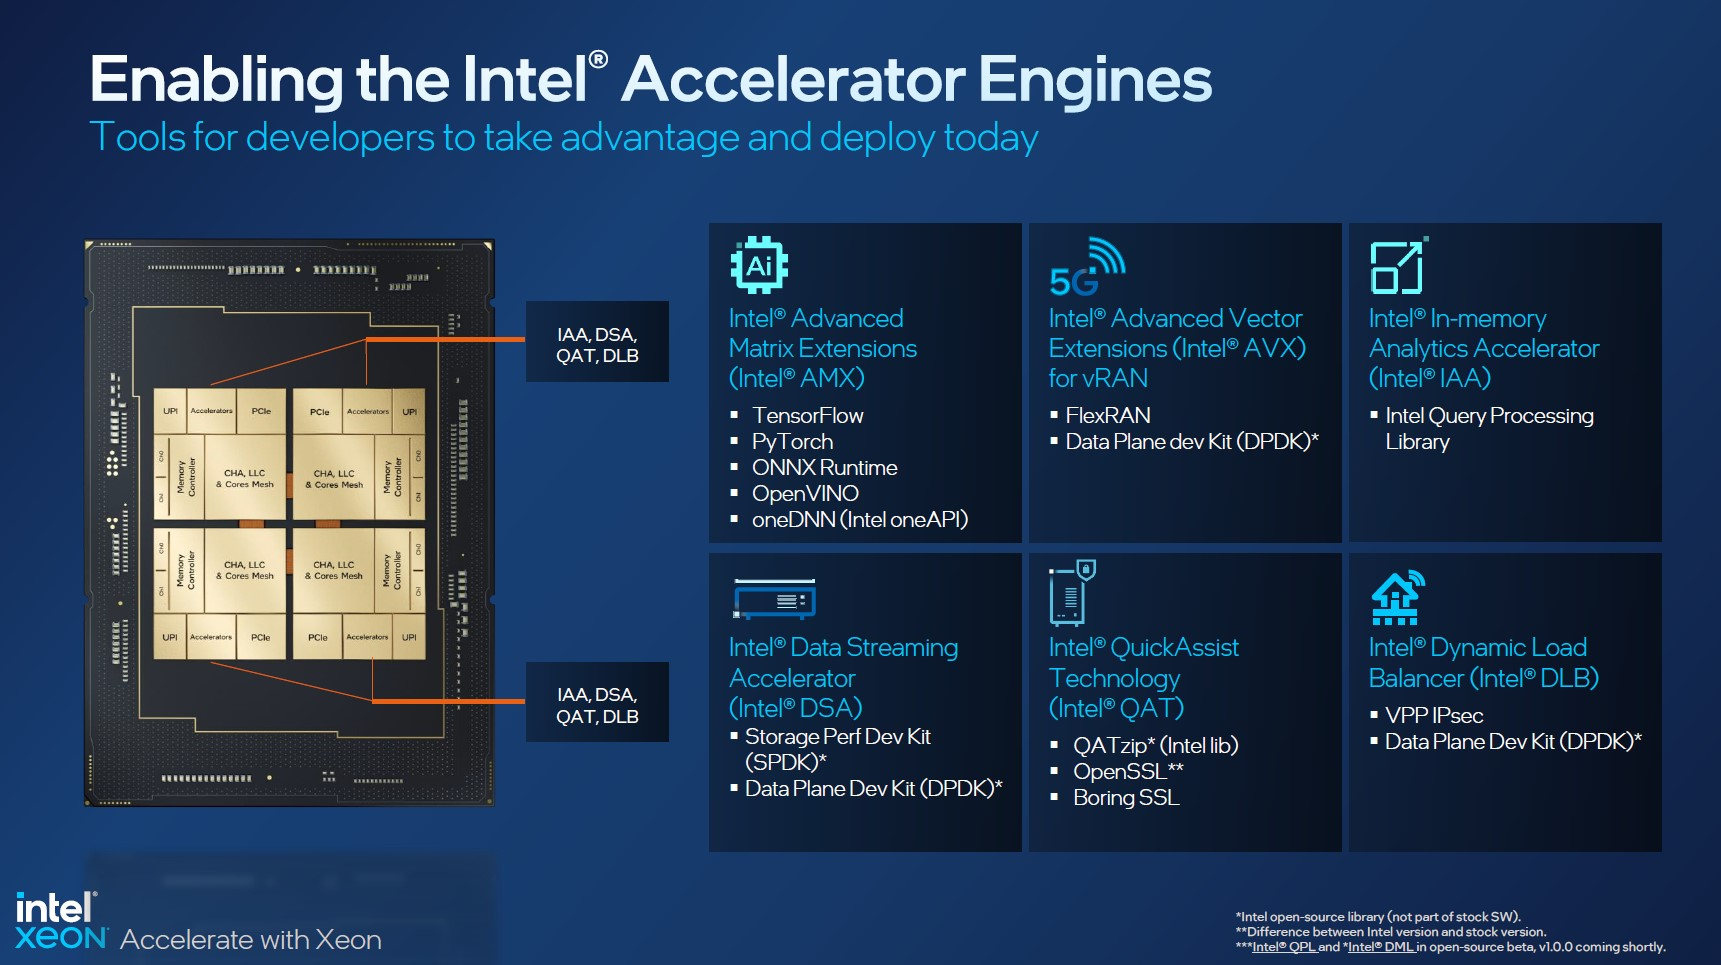 За не активированные по умолчанию ускорители придётся заплатить в рамках программы Intel On Demand (SDSi), причём есть опции как с единовременным платежом за постоянную активацию, так и с оплатой по факту использования (это удобно в случае облаков и платформ по типу HPE Greenlake). Исключением являются H-модели, куда входит и самый дорогой ($17000) 60-ядерный процессор 8490H с полностью разблокированными ускорителями и поддержкой 8S-конфигураций, а также процессоры Max, которым доступно только четыре DSA-блока и 2S-платформы, например, 56-ядерный 9480 ($12980). 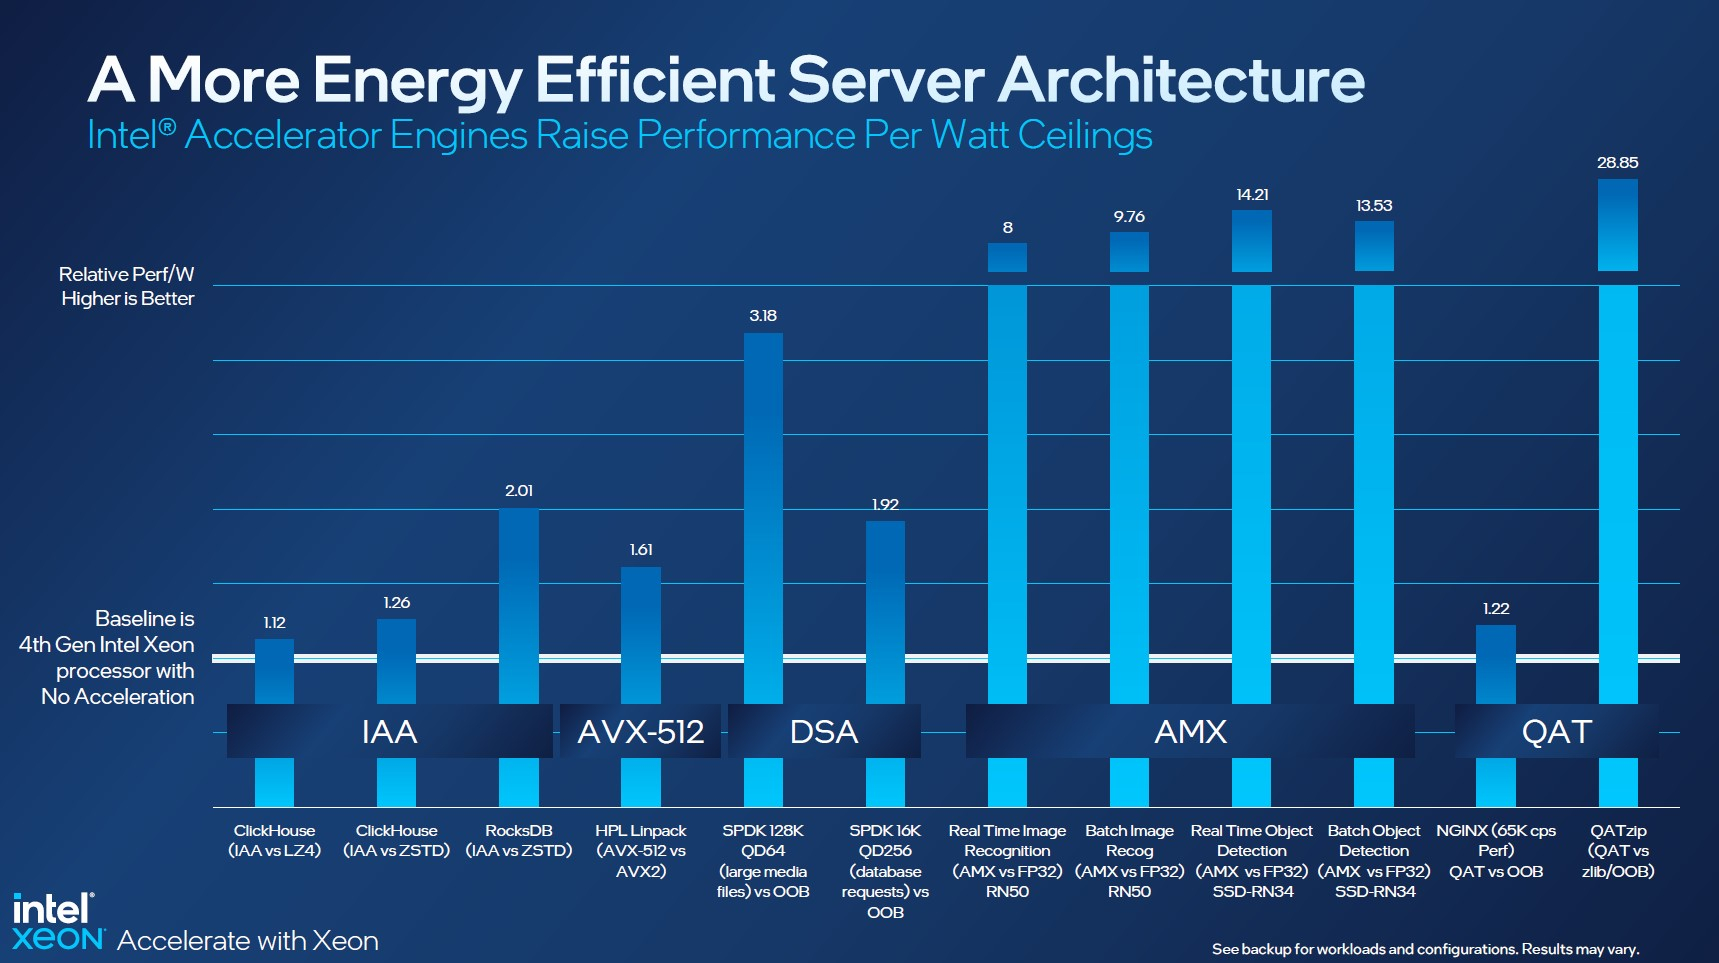 С одной стороны, желание Intel предоставить больше гибкости заказчикам, а заодно чуть увеличить выход годных к продаже процессоров, понятно. С другой — не очень-то и похоже, что CPU без «лишних» ускорителей отдаются с какой-то существенной скидкой. При этом транзисторный бюджет на них всё равно расходуется. Кроме того, есть ещё момент востребованности этих ускорителей и готовности ПО. У Intel есть и опыт ресурсы для помощи разработчикам, но процесс адаптации в любом случае не мгновенен. 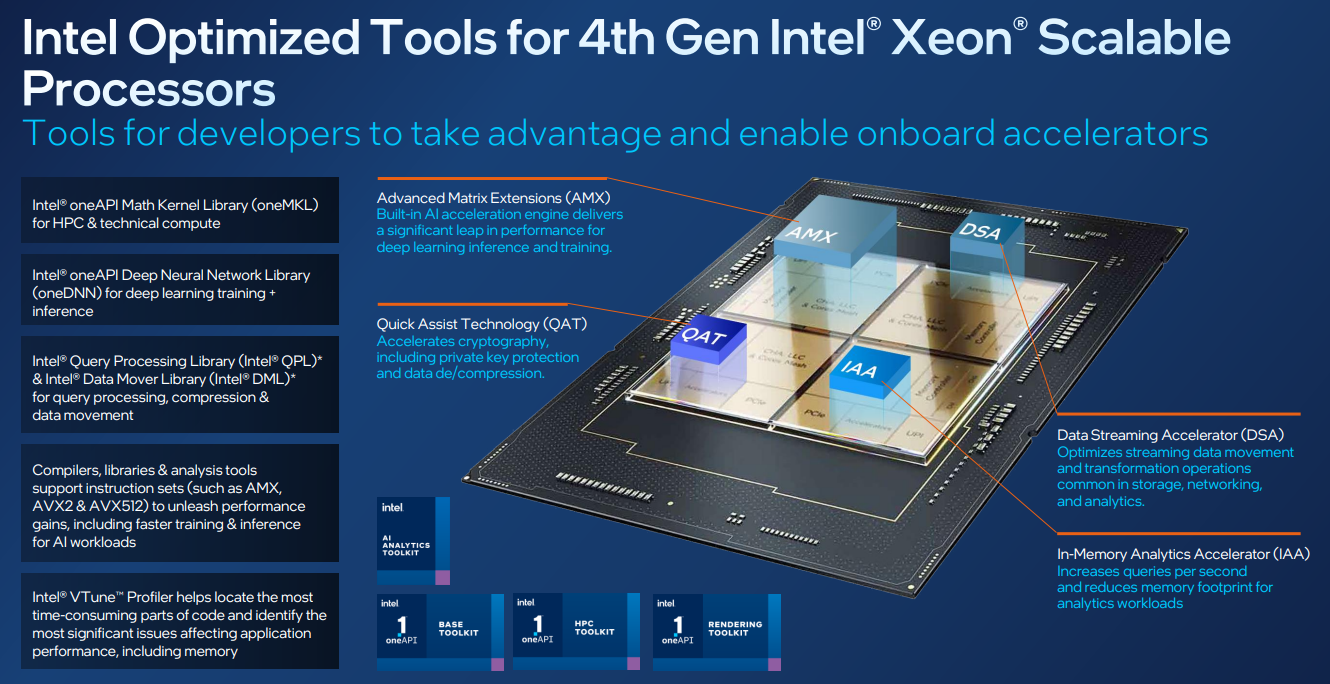 Впрочем, у Intel по сравнению с AMD есть и ещё одно важное преимущество — в среднем более высокая доступность процессоров для большинства заказчиков. Так что с Sapphire Rapids может повториться та же история, что с Ice Lake-SP, когда вендоры здесь и сейчас готовы были предложить Intel-платформы. 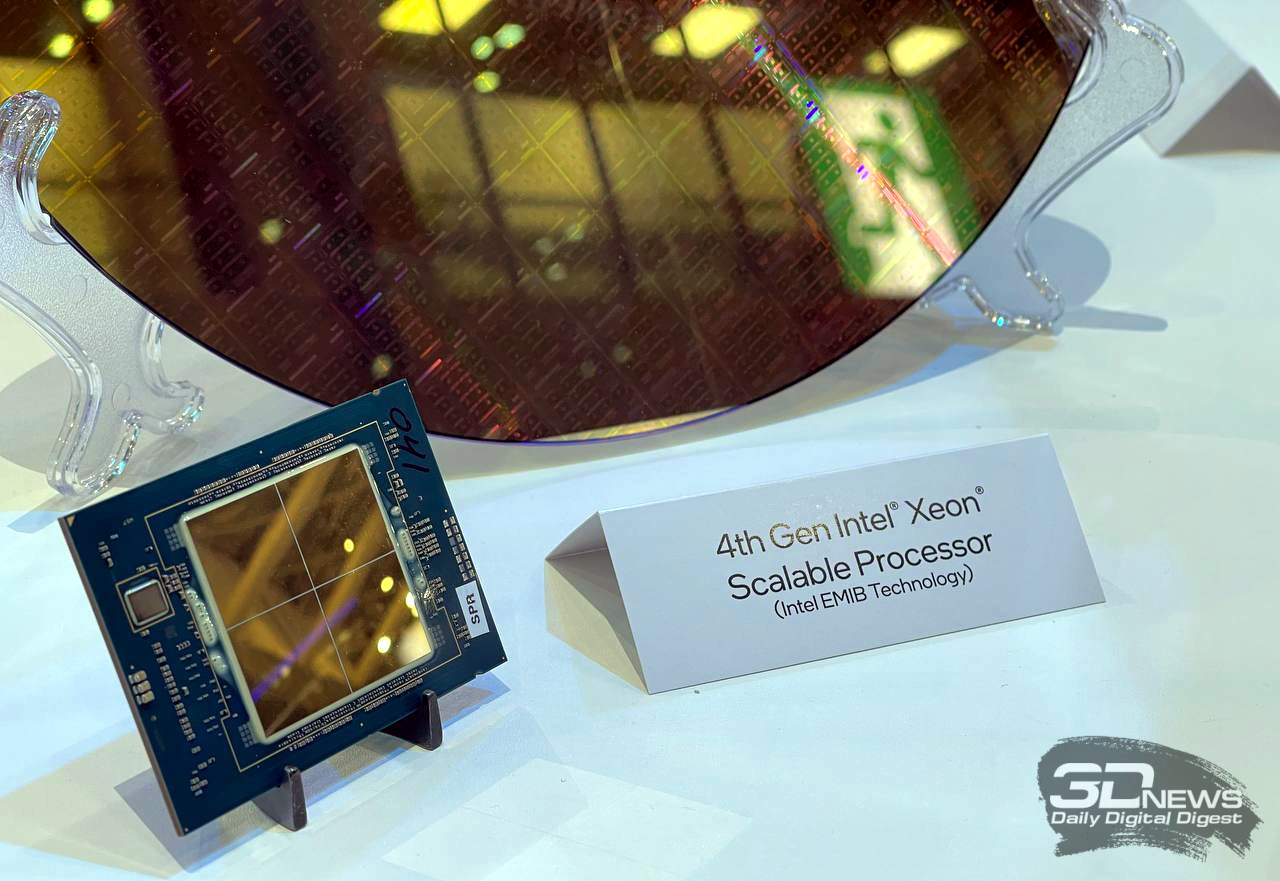 В целом же, в новом семействе наиболее любопытны Xeon Max, которые, по словам Intel, по сравнению с прошлым поколением в 3,7 раз производительнее в задачах, завязанных на пропускную способность памяти (а это целый пласт HPC-нагрузок), и которые не так уж дороги. Правда, и здесь без приключений не обошлось — несчастный суперкомпьютер Aurora ожидает утомительный апгрейд его 10 тыс. узлов c простых Xeon Sapphire Rapids на Xeon Max — по полчаса на каждый узел.
10.11.2022 [01:55], Игорь Осколков
Intel объединила HBM-версии процессоров Xeon Sapphire Rapids и ускорители Xe HPC Ponte Vecchio под брендом MaxВ преддверии SC22 и за день до официального анонса AMD EPYC Genoa компания Intel поделилась некоторыми подробностями об HBM-версии процессоров Xeon Sapphire Rapids и ускорителях Ponte Vecchio, которые теперь входят в серию Intel Max. 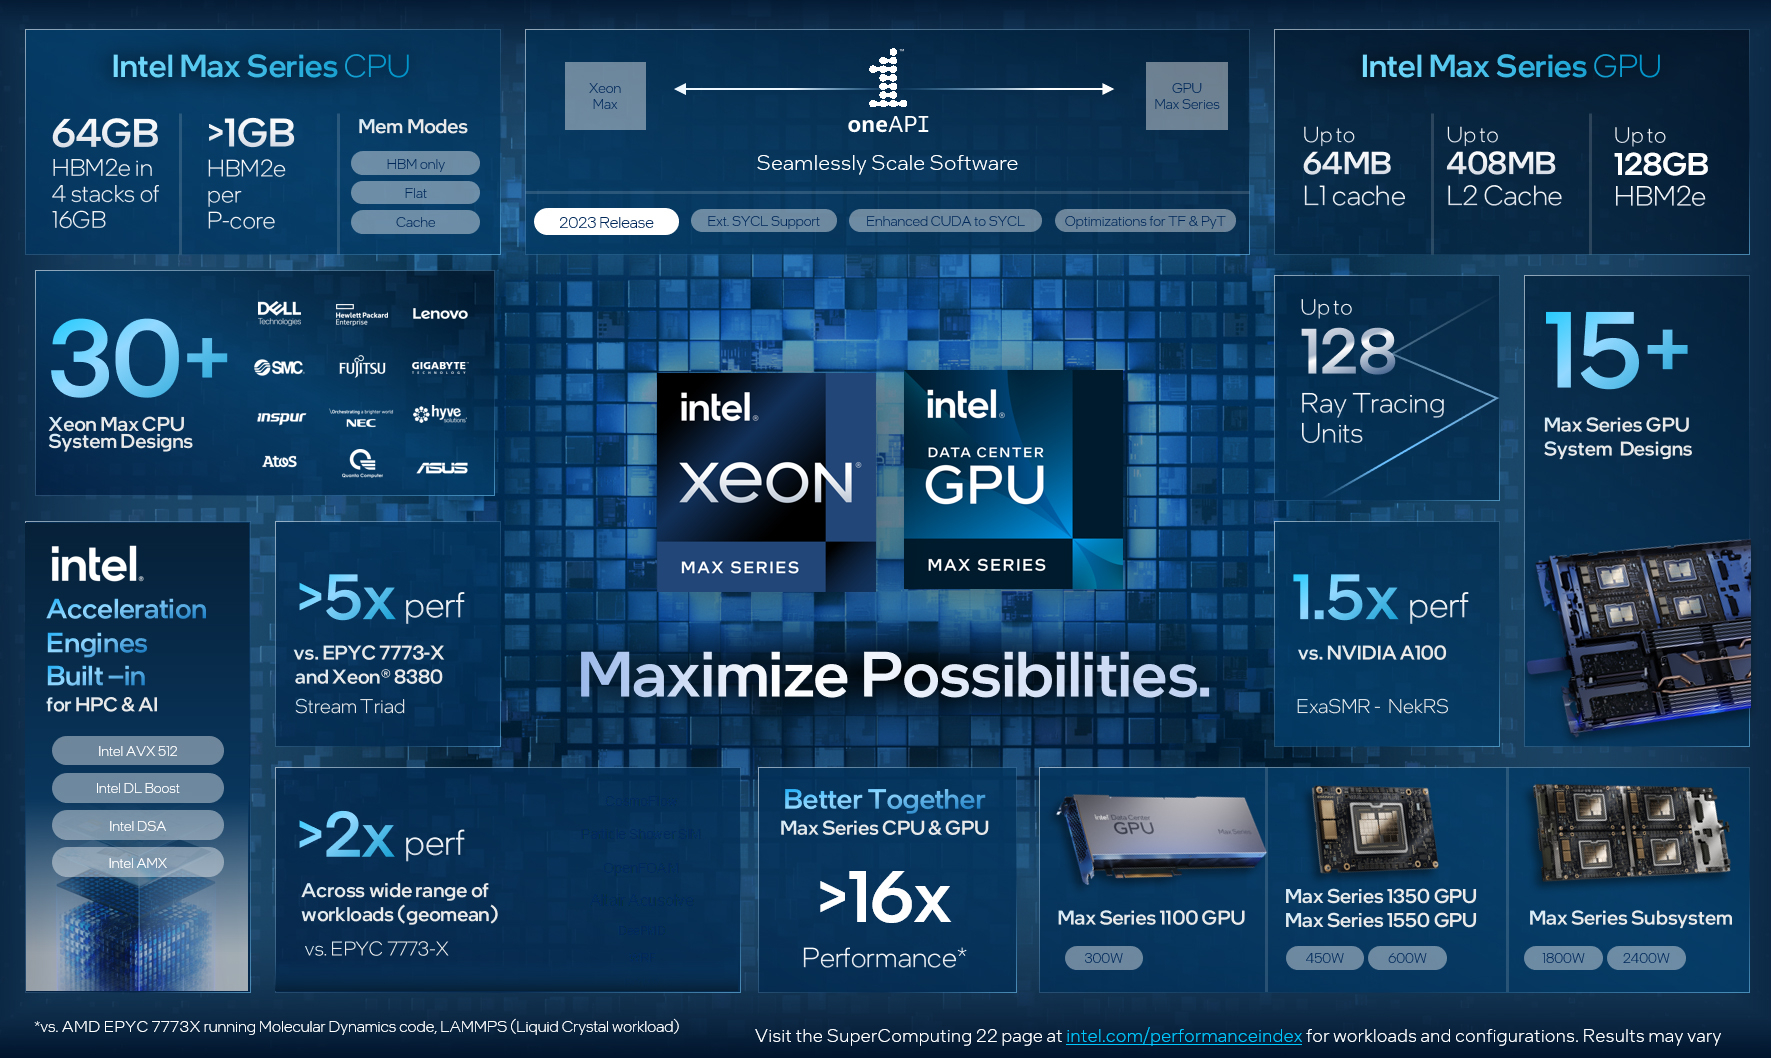
Изображения: Intel Intel Xeon Max предложат до 56 P-ядер, 112,5 Мбайт L3-кеша, 64 Гбайт HBM2e-памяти (четыре стека) с пропускной способностью порядка 1 Тбайт/с, 8 каналов памяти (DDR5-4800 в случае 1DPC, суммарно до 6 Тбайт), а также интерфейсы PCIe 5.0, CXL 1.1, UPI 2.0 и целый ряд различных технологий ускорения для задач HPC и ИИ: AVX-512, DL Boost, AMX, DSA, QAT и т.д. Заявленный уровень TDP составляет 350 Вт. 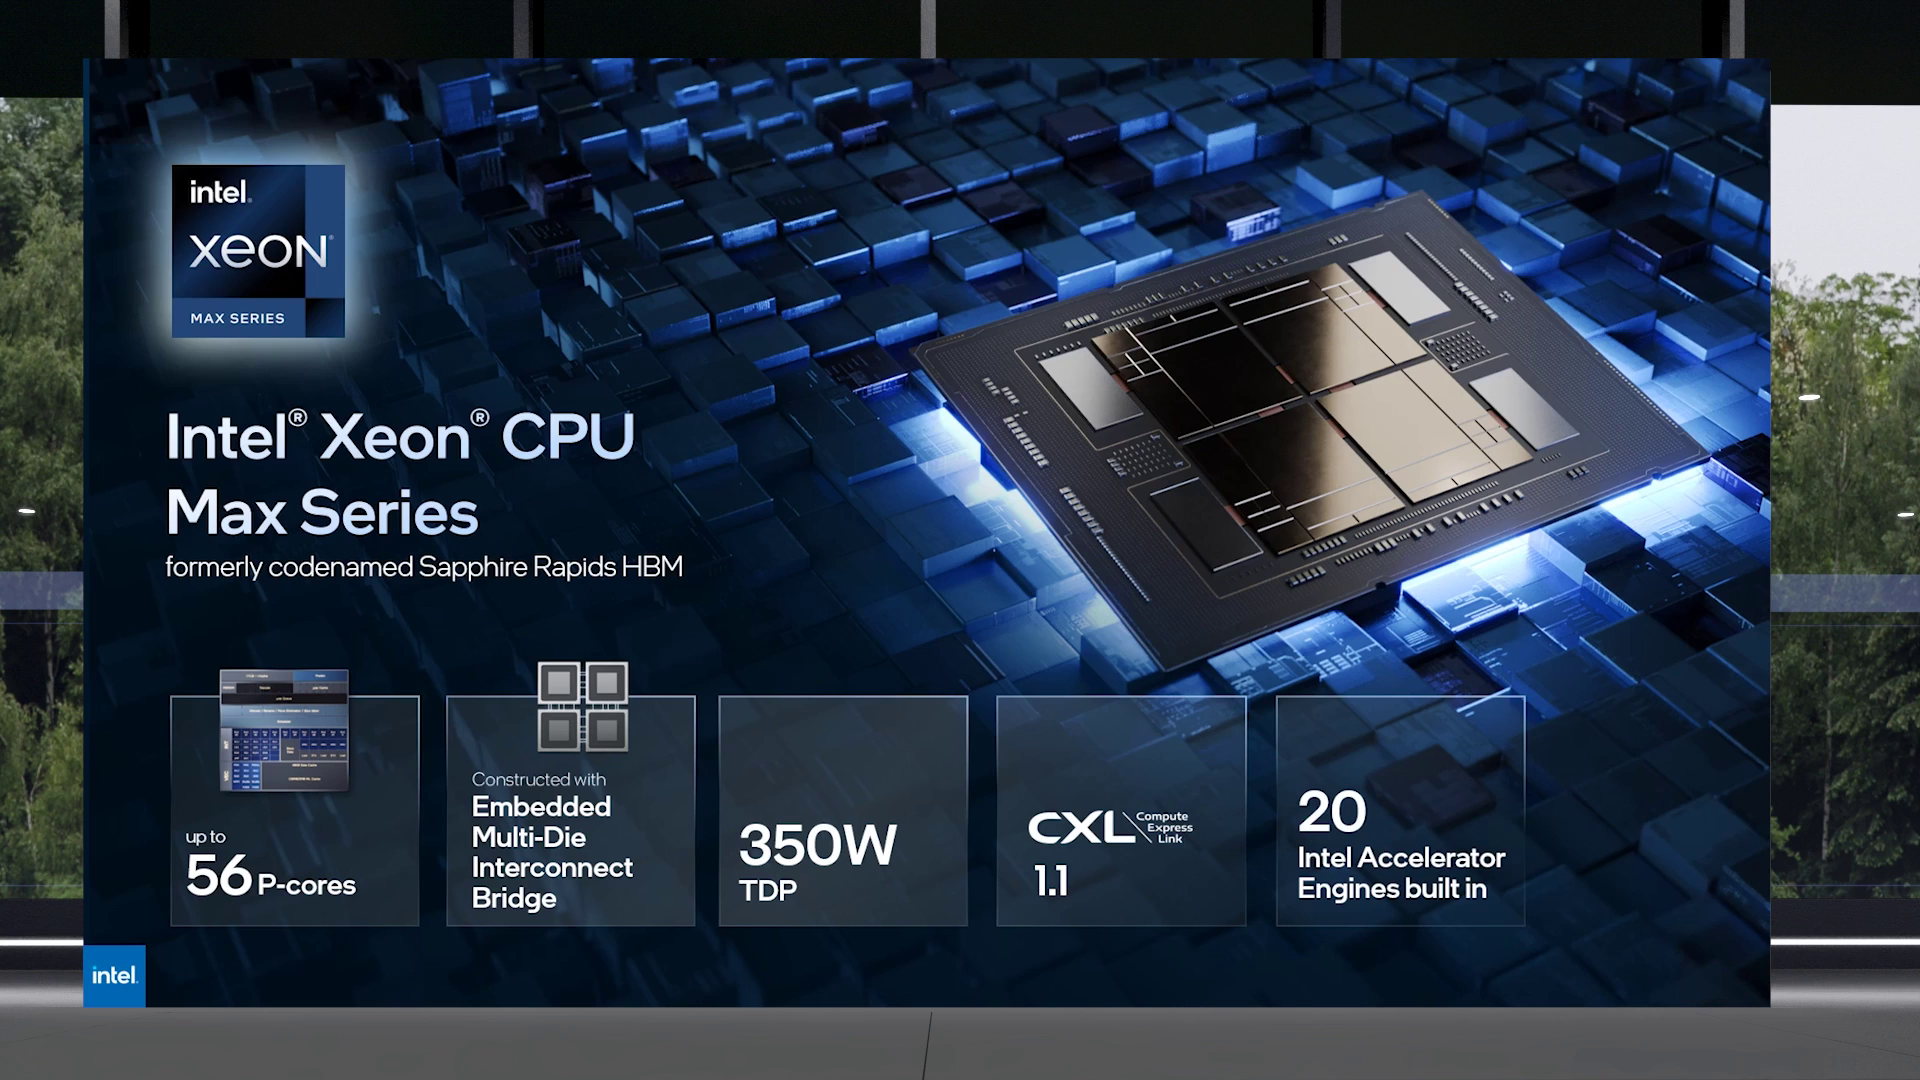 Первым процессором с набортной HBM-памятью был Arm-чип Fujitsu A64FX (48 ядер, 32 Гбайт HBM2), лёгший в основу суперкомпьютера Fugaku. Intel поднимает планку, давая более 1 Гбайт быстрой памяти на каждое ядро. А поскольку процессор состоит из четырёх отдельных чиплетов, возможно создание четырёх NUMA-доменов с выделенными HBM- и DDR-контроллерами. Но и монолитный режим тоже имеется. А поддержка CXL даёт возможность задействовать RAM-экспандеры. 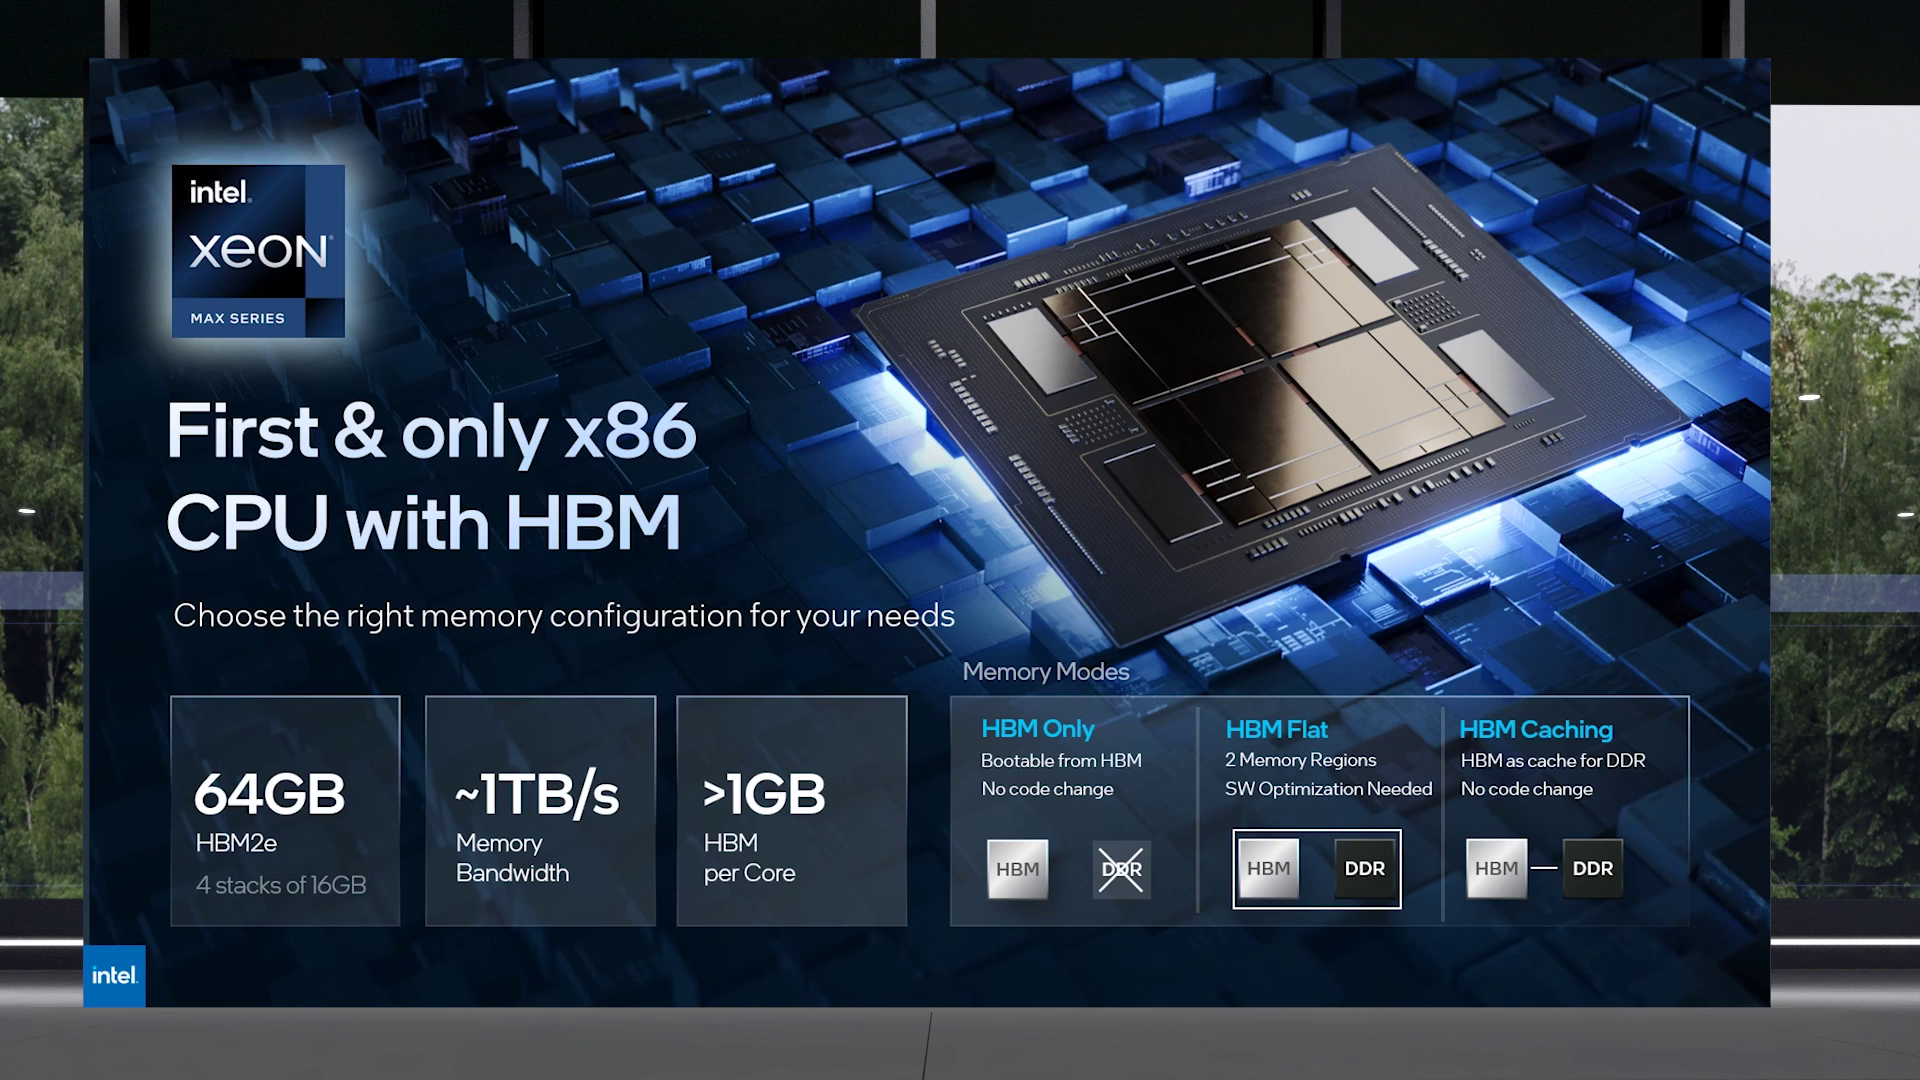 Intel Xeon Max поддерживают 2S-платформы, что суммарно даёт уже 128 Гбайт HBM-памяти, которых вполне хватит для целого ряда задач. Новые процессоры действительно могут обходиться без DIMM. Но есть и два других режима. В первом HBM-память работает в качестве кеша для обычной памяти, и для системы это происходит прозрачно, так что никаких модификаций для ПО (как в случае отсутствия DIMM вообще) не требуется. Во втором режиме HBM и DDR представлены как отдельные пространства, так что тут дорабатывать ПО придётся, зато можно добиться более эффективного использования обоих типов памяти.
В презентации Intel сравнивает новые Xeon Max с AMD EPYC Milan-X – в зависимости от задачи прирост составляет от +20 % до 4,8 раз. Но, во-первых, уже сегодня эти тесты потеряют всякий смысл в связи с презентацией EPYC Genoa (которые, к слову, должны получить AVX-512), а во-вторых, в следующем году AMD обещает представить Genoa-X с 3D V-Cache. Intel же явно не оставляет попытки создать как можно более универсальный процессор. 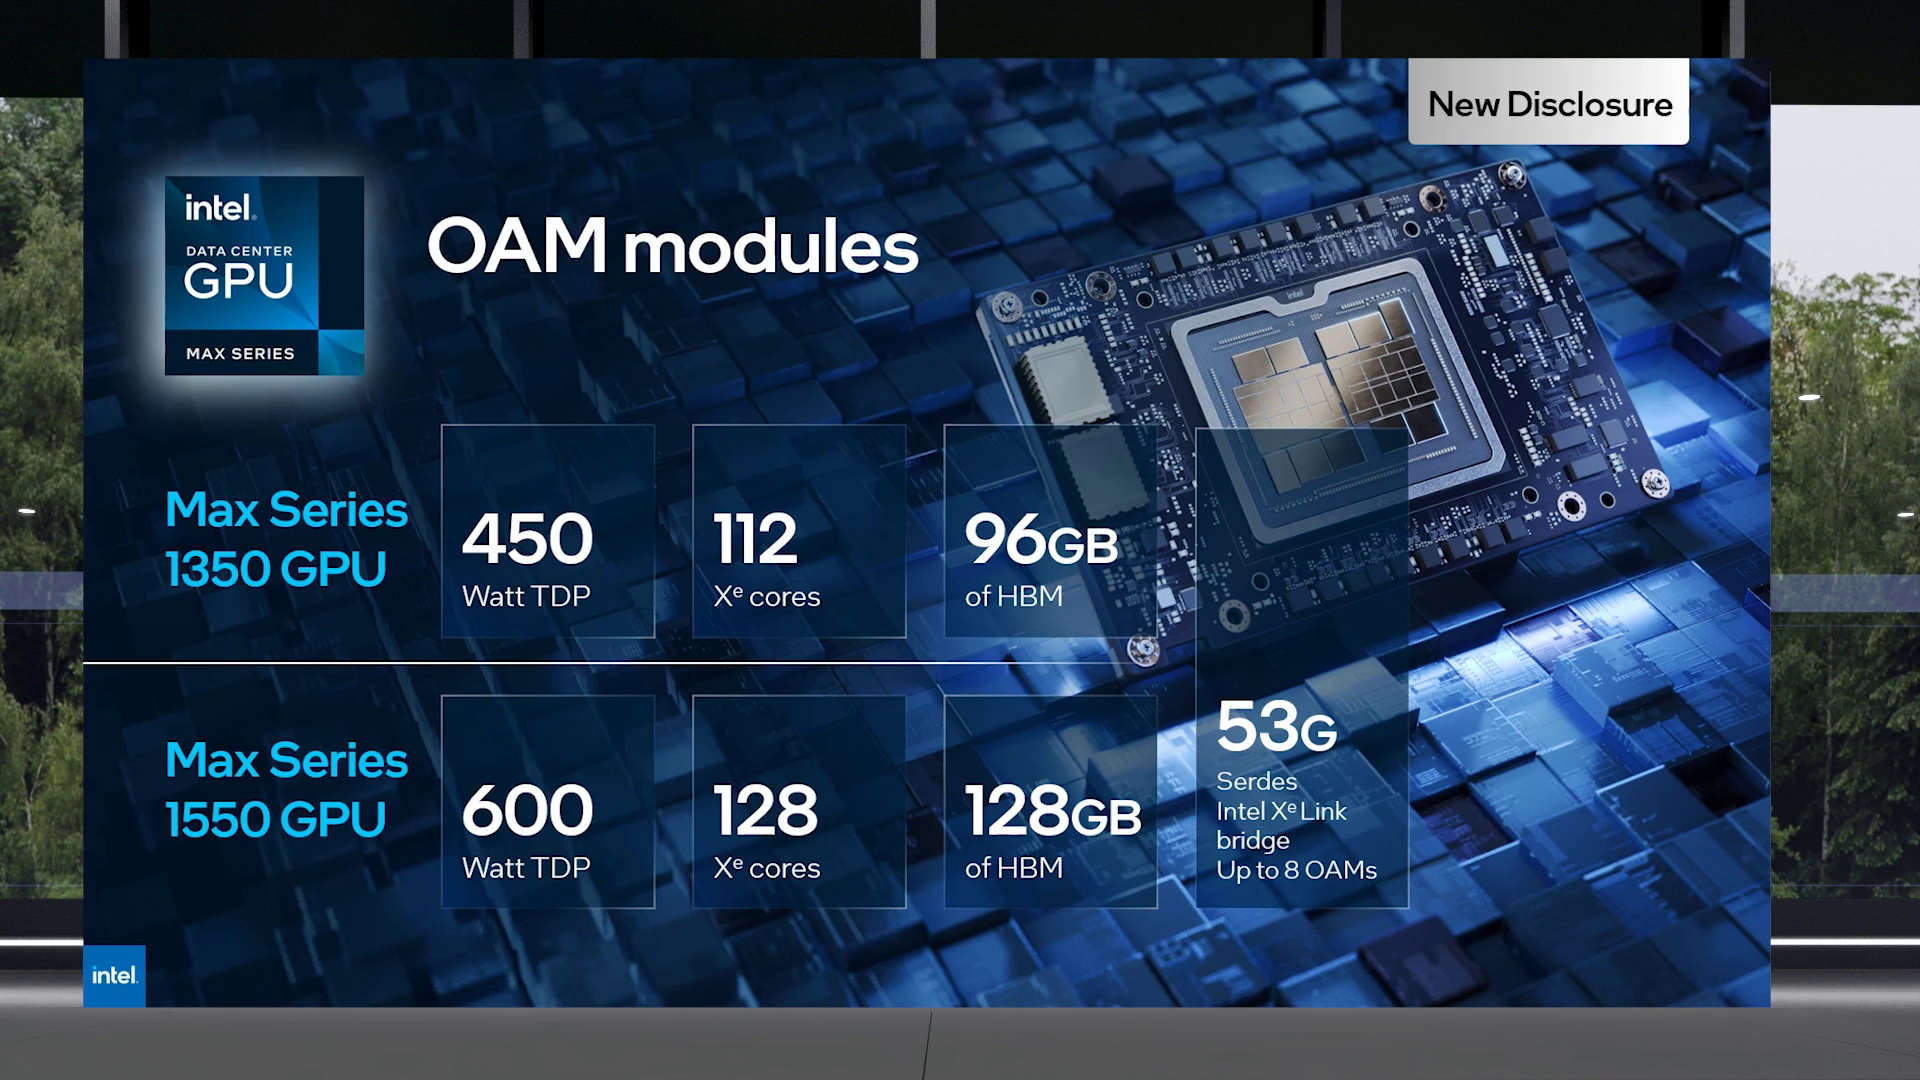 Что касается Ponte Vecchio, которые теперь называются Max GPU, то практически ничего нового относительно строения и особенностей данных ускорителей Intel не сказала: до 128 ядер Xe (только теперь стало известно об аппаратном ускорении трассировки лучей, что важно для визуализации), 64 Мбайт L1-кеша и аж 408 Мбайт L2-кеша (из них 120 Мбайт приходится на Rambo-кеш в двух стеках), 16 линий Xe Link, 8 HBM2e-контроллеров на 128 Гбайт памяти и пиковая FP64-производительность на уровне 52 Тфлопс. Все эти характеристики относятся к старшей модели Max Series 1550 в OAM-исполнении с TDP в 600 Вт. 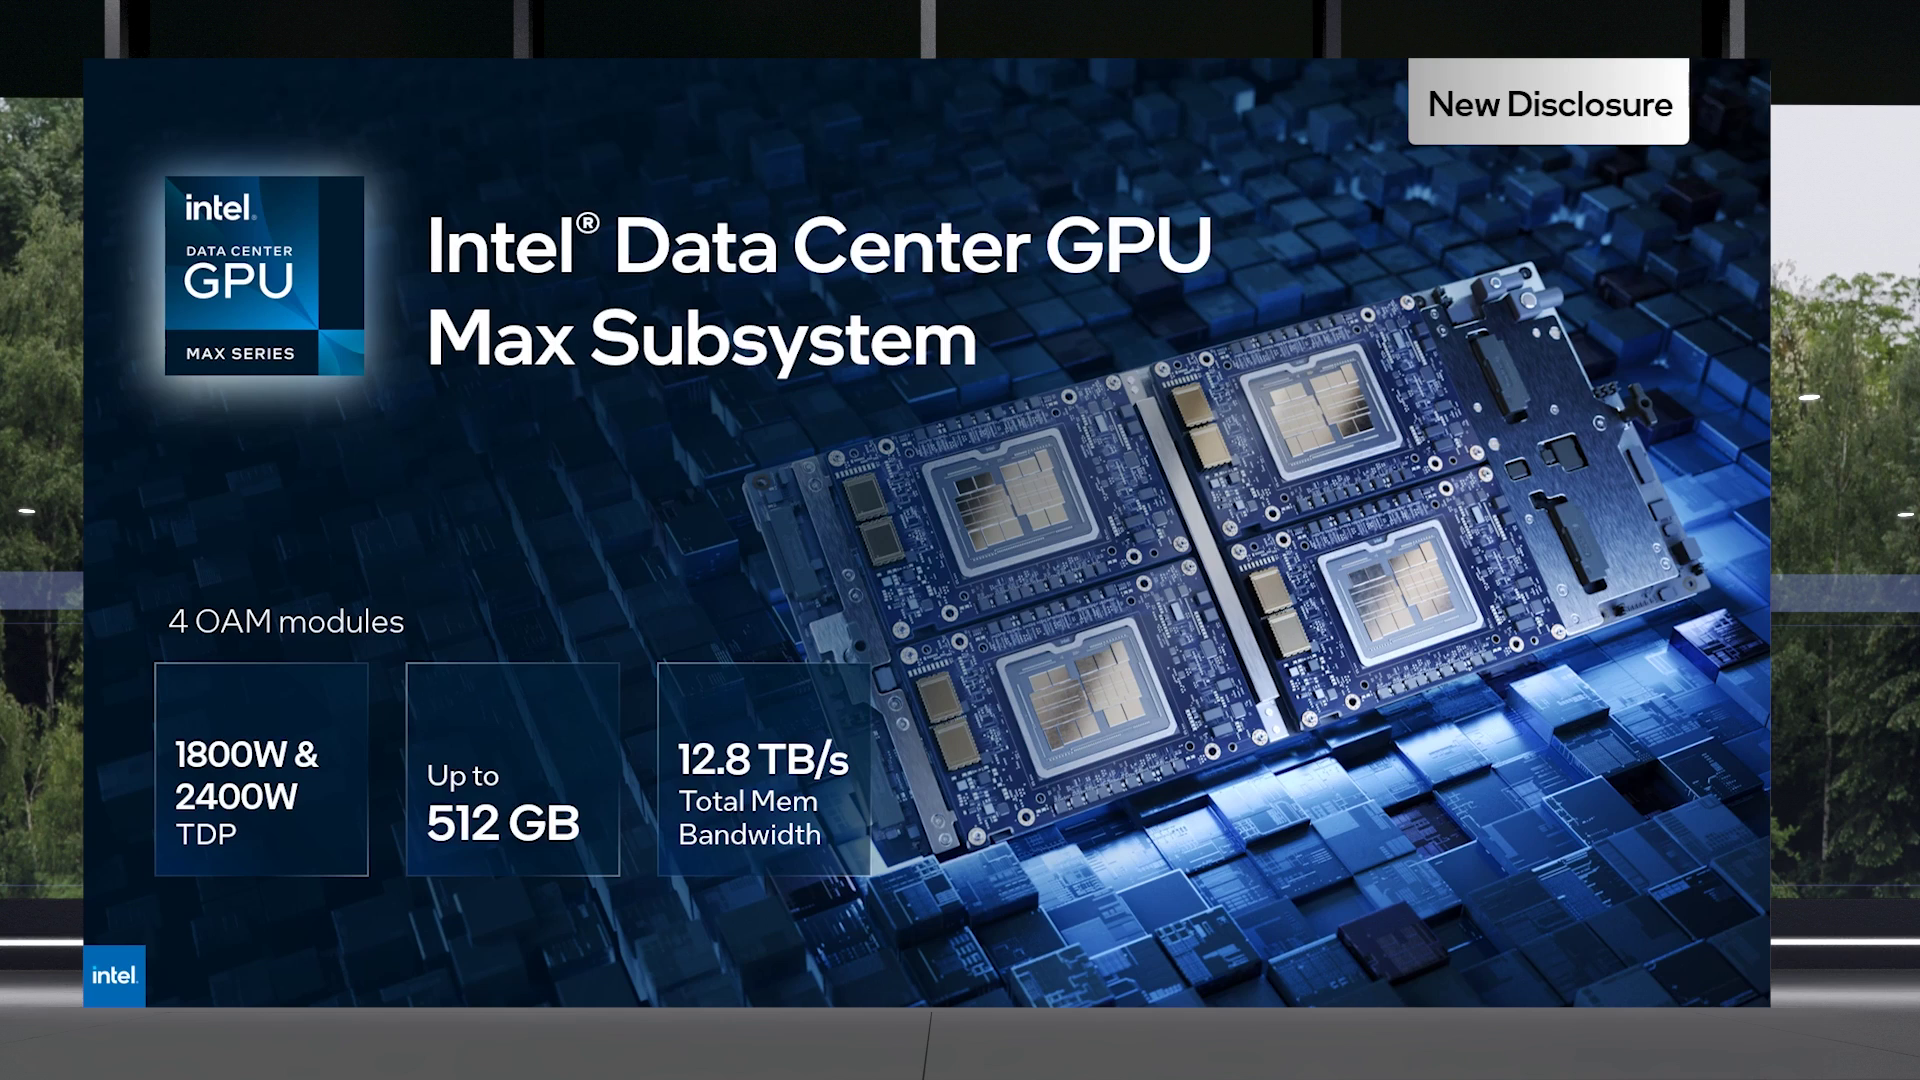 Max Series 1350 предложит 112 ядер Xe и 96 Гбайт HBM2e, но и TDP у этой модели составит всего 450 Вт. Для обеих OAM-версий также будут доступны готовые блоки из четырёх ускорителей (по примеру NVIDIA RedStone), объединённых по схеме «каждый с каждым», так что в сумме можно получить 512 Гбайт HBM2e с ПСП в 12,8 Тбайт/с. Ну а самый простой ускоритель в серии называется Max Series 1100. Это 300-Вт PCIe-плата с 56 Xe-ядрами, 48 Гбайт HBM2e и мостиками Xe Link. 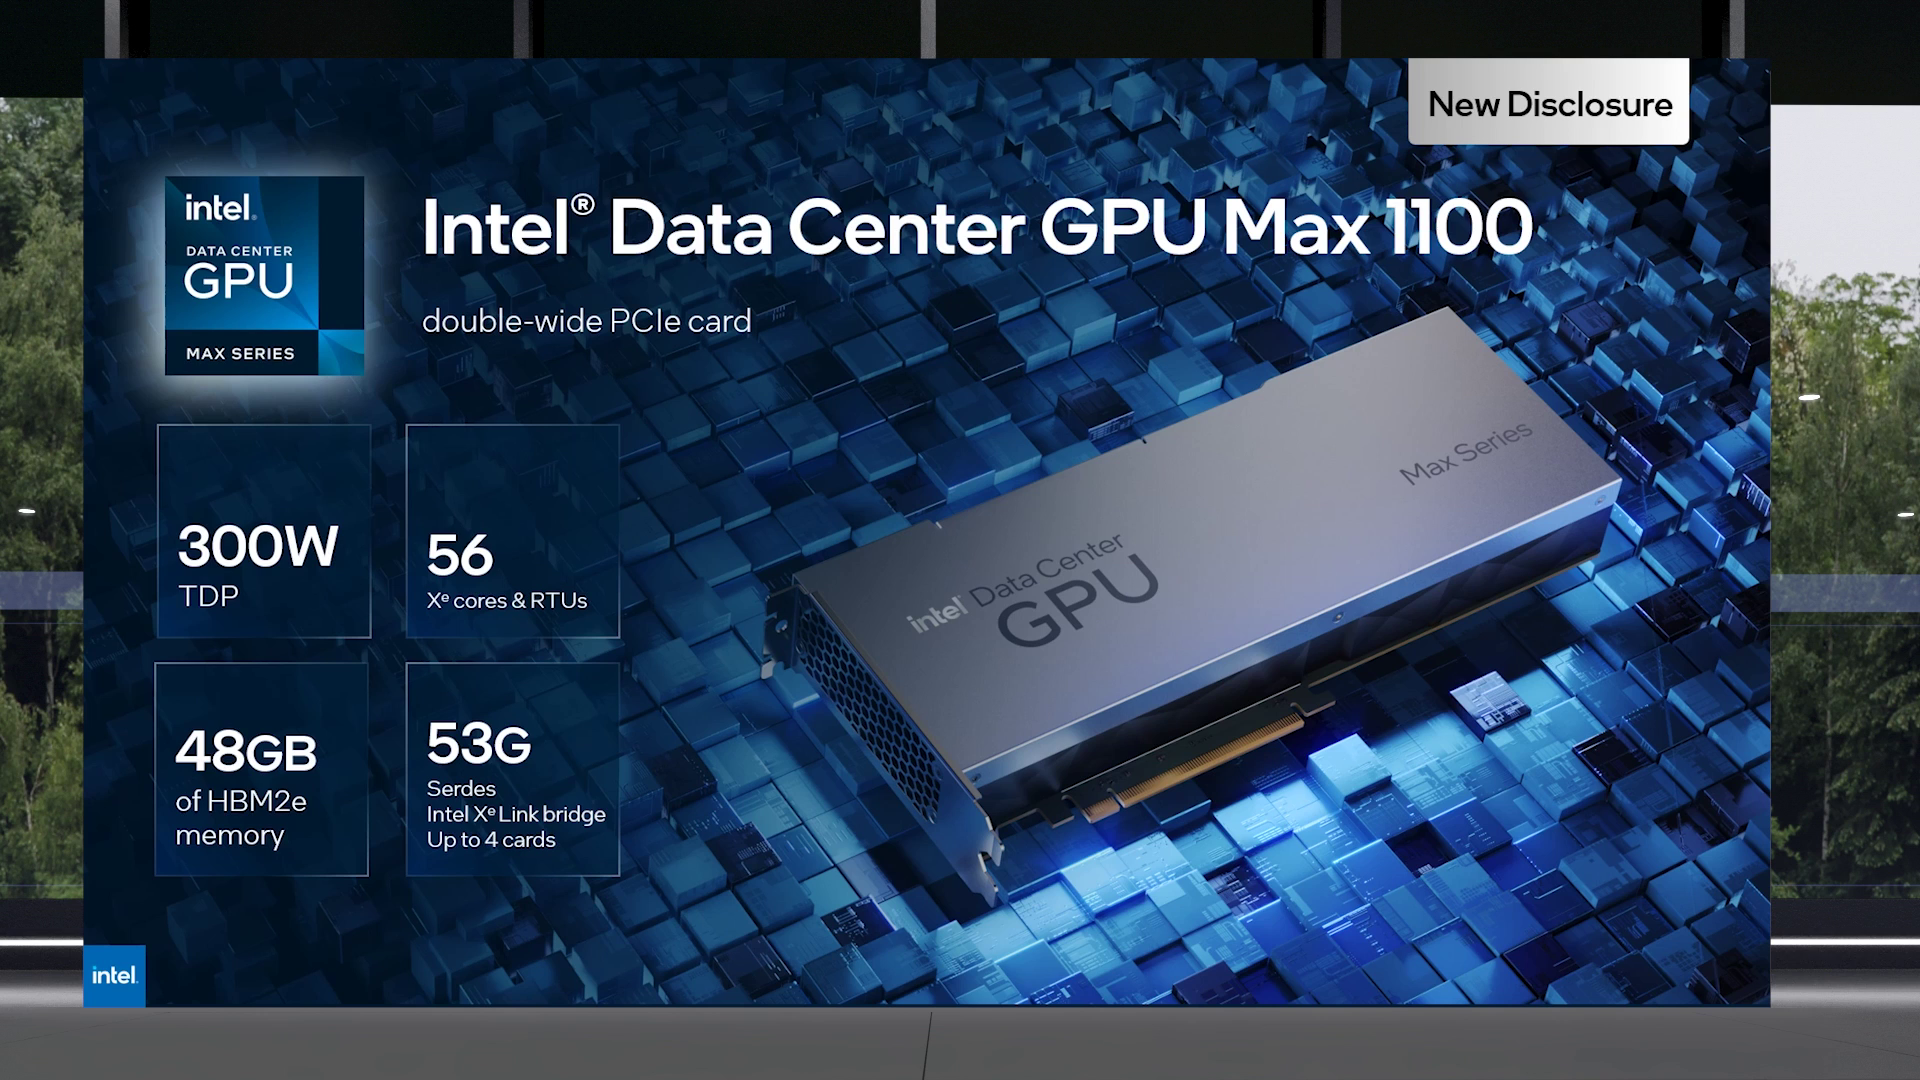 Intel утверждает, что ускорители Max до двух раз быстрее NVIDIA A100 в некоторых задачах, но и здесь история повторяется — нет сравнения с более современными H100. Хотя предварительный доступ к этим ускорителям у Intel есть, поскольку именно Sapphire Rapids являются составной частью платформы DGX H100. В целом, Intel прямо говорит, что наибольшей эффективности вычислений позволяет добиться связка CPU и GPU серии Max в сочетании с oneAPI. Всего на базе решений данной серии готовится более 40 продуктов.
Пока что приоритетным для Intel проектом является 2-Эфлопс суперкомпьютер Aurora, для которого пока что создан тестовый кластер Sunspot со 128 узлами, содержащими ускорители Max. Следующим ускорителем Intel станет Rialto Bridge, который появится в 2024 году. Также компания готовит гибридные (XPU) чипы Falcon Shores, сочетающие CPU, ускорители и быструю память. Аналогичный подход применяют AMD и NVIDIA.
21.09.2022 [19:32], Алексей Степин
NVIDIA представила ускорители L40 и новую Omniverse-платформу OVX на их основеНа конференции GTC 2022 NVIDIA анонсировала второе поколение систем для симуляции и запуска «цифровых двойников» OVX. Это вовсе не развлечение: использование точных моделей реальных физических объектов, пространств и устройств потенциально весьма выгодно, поскольку симуляция городского квартала для обучения автопилотов или фабрики для оценки взаимодействия роботов с живыми работниками априори будет стоить намного меньше, нежели проведение натурных испытаний. Зачастую такие симуляции используют тензорные и матричные вычисления, поэтому основой новой платформы OVX стали новые ускорители NVIDIA L40 с архитектурой Ada Lovelace, располагающие ядрами трассировки лучей третьего поколения и тензорными ядрами четвёртого поколения. Они поддерживают как классический трассировку лучей (ray tracing), так и трассировку путей (path tracing), что важно для корректной симуляции поведения различных материалов. 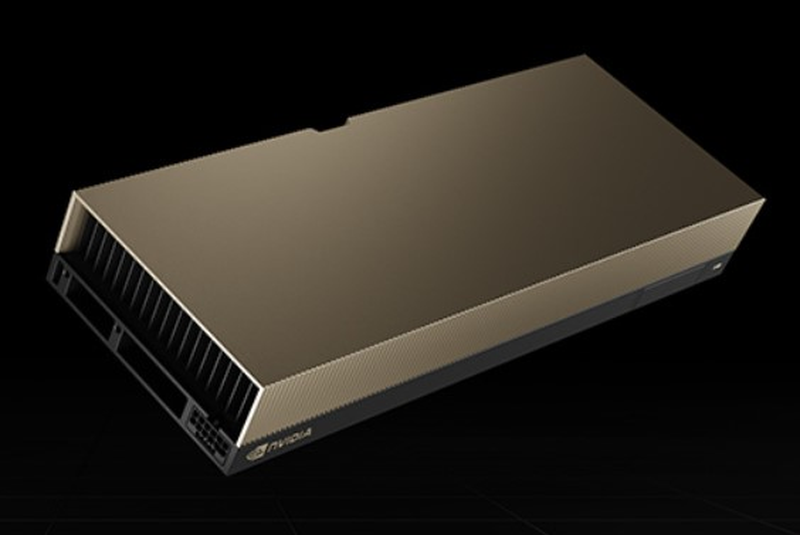
NVIDIA L40. Здесь и далее источник изображений: NVIDIA Физически L40 представляют собой двухслотовую FHFL-плату расширения PCIe с пассивным охлаждением — теплопакет новинки ограничен рамками 300 Вт. Объём оперативной памяти GDDR6 составляет 48 Гбайт, вдвое больше, нежели у игровых GeForce RTX 4090, и, в отличие от последних, поддерживается совместная работа двух карт в режиме NVLink, что может оказаться полезным в симуляциях с большим объёмом данных. Для вывода изображения служат четыре порта DP 1.4a. 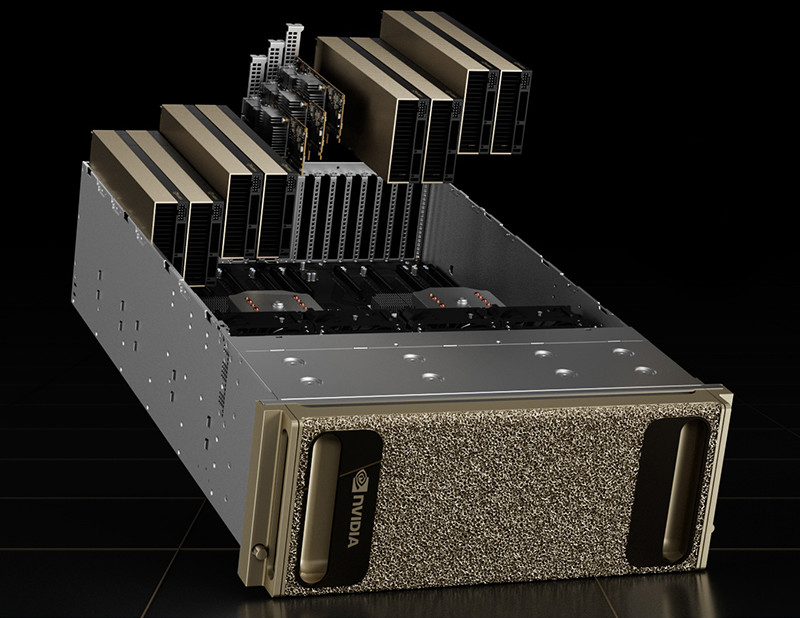
NVIDIA OVX Server Каждый сервер NVIDIA OVX будет содержать 8 ускорителей L40 и три сетевых адаптера ConnectX-7 с портами класса 200GbE и поддержкой шифрования сетевого трафика на лету. От 4 до 16 таких серверов составят OVX POD, а 32 или более —кластер SuperPOD. Такие кластеры станут домом для новой облачной платформы NVIDIA Omniverse Cloud, услуги которой компания планирует предоставлять робототехникам, создателям автономных транспортных средств, «умной инфраструктуры» и вообще всем, кому нужна точная симуляция сложных объектов и систем с качественной визуализацией результатов.
21.09.2022 [01:10], Алексей Степин
NVIDIA представила платформу IGX для «умной» промышленности и медициныПомимо новых GPU с архитектурой Ada компания NVIDIA на конференции GTC 2022 анонсировала множество новинок и не последней из них стала новая периферийная платформа IGX, призванная вывести «умную» промышленность на новый уровень. Главный упор в IGX сделан на обеспечении повышенной безопасности, причём как информационной, так и физической. Использовать совместный труд роботов в промышленности пытаются уже давно, но до недавних пор такие решения были нестандартными и весьма дорогостоящими. IGX призвана обеспечить безопасность, стандартизацию и высокий уровень производительности, достаточный для современной робототехники. Сердцем платформы IGX являются высокоинтегрированные модули серии Jetson AGX Orin, сочетающие в себе достаточно мощный процессор общего назначения, GPU-ускоритель, ускорители ИИ, машинного зрения, а также отдельный сопроцессор sMCU, отвечающий за обеспечение безопасности в проактивном режиме. Последний работает в комплексе с новыми программными расширениями, легко интегрируемыми в большинство коммерческих ОС благодаря сопутствующему программному стеку NVIDIA AI Enterprise. 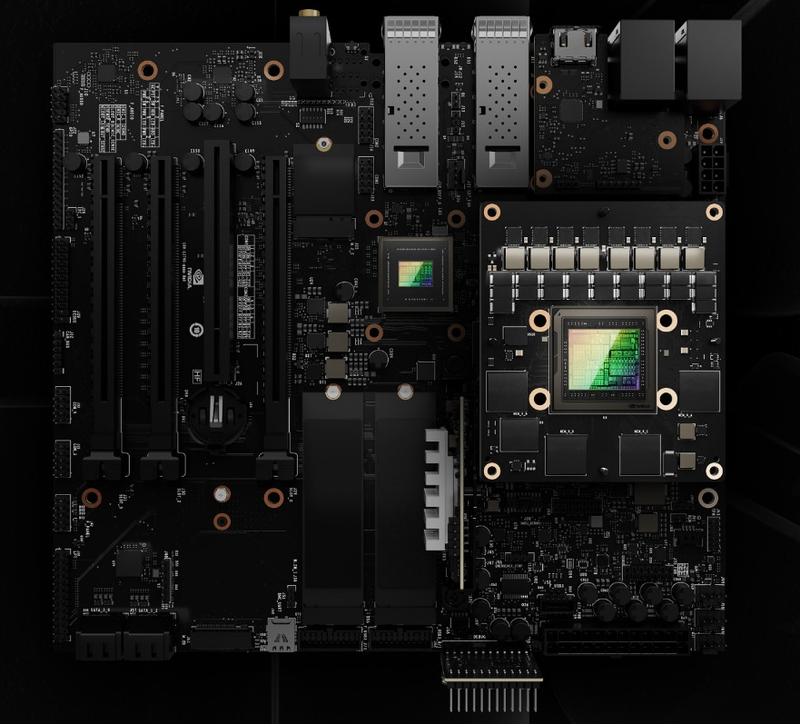
NVIDIA IGX. Здесь и далее источник изображений: NVIDIA Что касается проактивной защиты, то, к примеру, получив сигнал с видеокамер о том, что человек приближается к «зоне ответственности» роботов, система автоматически изменит траекторию движения последних, предупредит сотрудников, а также на основании полученных данных скорректирует поведение роботов в дальнейшем. Также с помощью технологии «цифровых двойников» можно будет провести симуляцию, дабы заранее выяснить возможные точки потенциально опасных столкновений машин и людей. 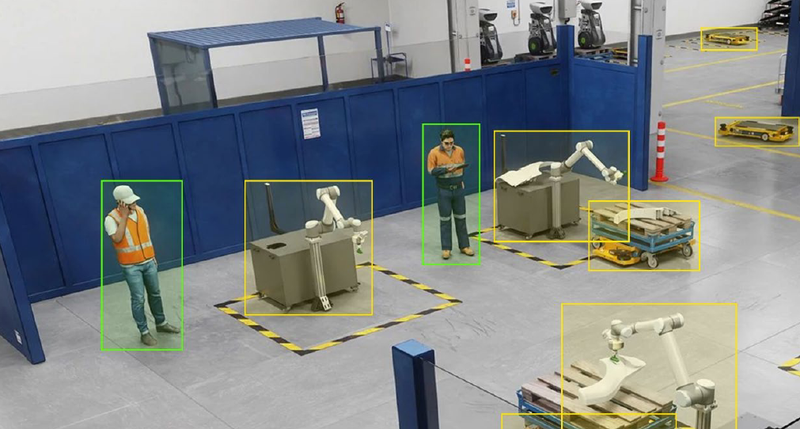
NVIDIA IGX сделает подобные сценарии безопасными Производительность центрального модуля IGX составляет 275 Топс в режиме INT8. Обеспечение сетевых возможностей возложено на плечи современного сетевого адаптера ConnectX-7, гарантирующего прецизионные тайминги, позволяющие использовать платформу не только в промышленности, но и в медицине, где вопросы безопасности и точности жизненно важны. Естественно, индустрия нового поколения не может обойтись без унифицированных средств управления и обеспечения кибербезопасности. Весь комплекс решений на базе новой платформы IGX может развёртываться и управляться с единой консоли с помощью облачной системы NVIDIA Fleet Command. За безопасность при этом отвечает выделенный контроллер. На более высоком уровне за интеграцию новой платформы в единую экосистему отвечает фреймворк NVIDIA Metropolis, с помощью которого можно создавать по-настоящему крупномасштабные комплексы, включая целые «умные города». 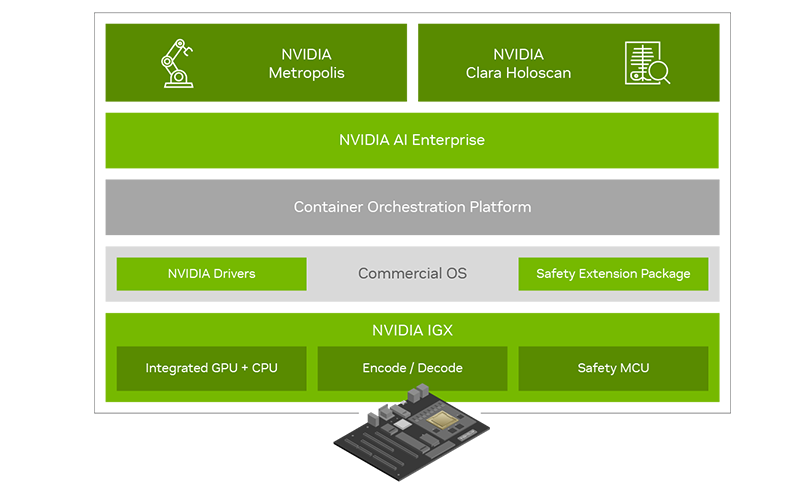
Программно-аппаратный состав новой платформы Отдельного упоминания заслуживает то, что новая платформа NVIDIA IGX избрана в качестве основы разработчиками медицинских систем, в частности, цифровой и робо-хирургии, такими как Activ Surgical, Moon Surgical и Proximie. Это стало возможным как благодаря аппаратным свойствам платформы, таким как низкая латентность и гарантированное время отклика, так и сочетанию фреймворков MONAI и Clara Holoscan. 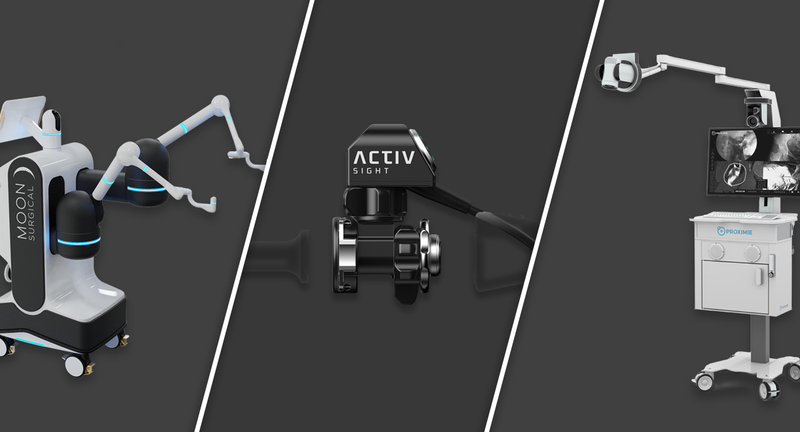 Первый позволяет обучать специфические ИИ-модели на основании массивов медицинских данных. Эти модели затем могут интегрироваться с помощью Clara Holoscan SDK в реальные системы ультразвукового сканирования, эндоскопии или робохирургии. Помимо встроенных средств ускорения IGX, Clara Holoscan поддерживает и внешние ускорители NVIDIA RTX A6000, а технология Rivermax обеспечит передачу видеоданных для робота-хирурга на скорости 100 Гбит/с прямо в набортную память GPU. 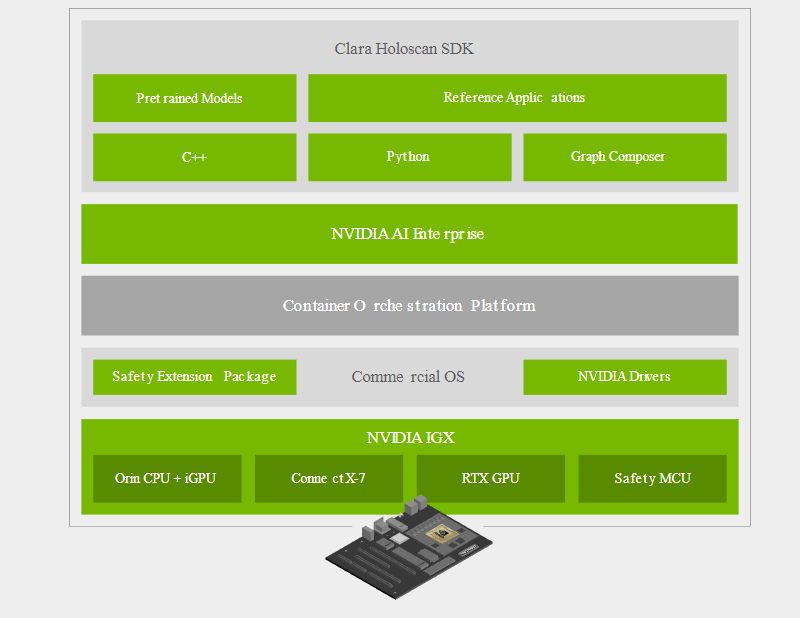 Комплекты разработчика IGX Orin будут доступны заказчикам в начале следующего года. Уже достигнуты соглашения с производителями встраиваемого оборудования ADLINK, Advantech, Dedicated Computing, Kontron, Leadtek, MBX, Onyx, Portwell, Prodrive Technologies и YUAN; уже испытывает новинку в деле Siemens. Также NVIDIA сотрудничает с Canonical, Red Hat и SUSE в целях обеспечения долговременной поддержки платформы, срок которой составит не менее 10 лет.
24.05.2022 [07:00], Игорь Осколков
NVIDIA представила референсные платформы CGX, OVX и HGX на базе собственных Arm-процессоров GraceНа весенней конференции GTC 2022 NVIDIA поделилась подробностями о грядущих серверных Arm-процессорах Grace Superchip и гибридах Grace Hopper Superchip, а на Computex 2022 представила первые референсные платформы на базе этих чипов для OEM-производителей и объявила о расширении программы NVIDIA Certified. Последнее, впрочем, не означает отказ от x86-систем, поскольку программа будет просто расширена. Да и портирование стороннего и собственного ПО займёт некоторое время. Первые несколько десятков моделей серверов от ASUS, Foxconn, GIGABYTE, QCT, Supermicro и Wiwynn появятся в первой половине 2023 года. Представлены они будут в трёх категориях, причём все, за исключением одной, базируются на «сдвоенных» процессорах Grace Superchip, насчитывающих до 144 ядер. 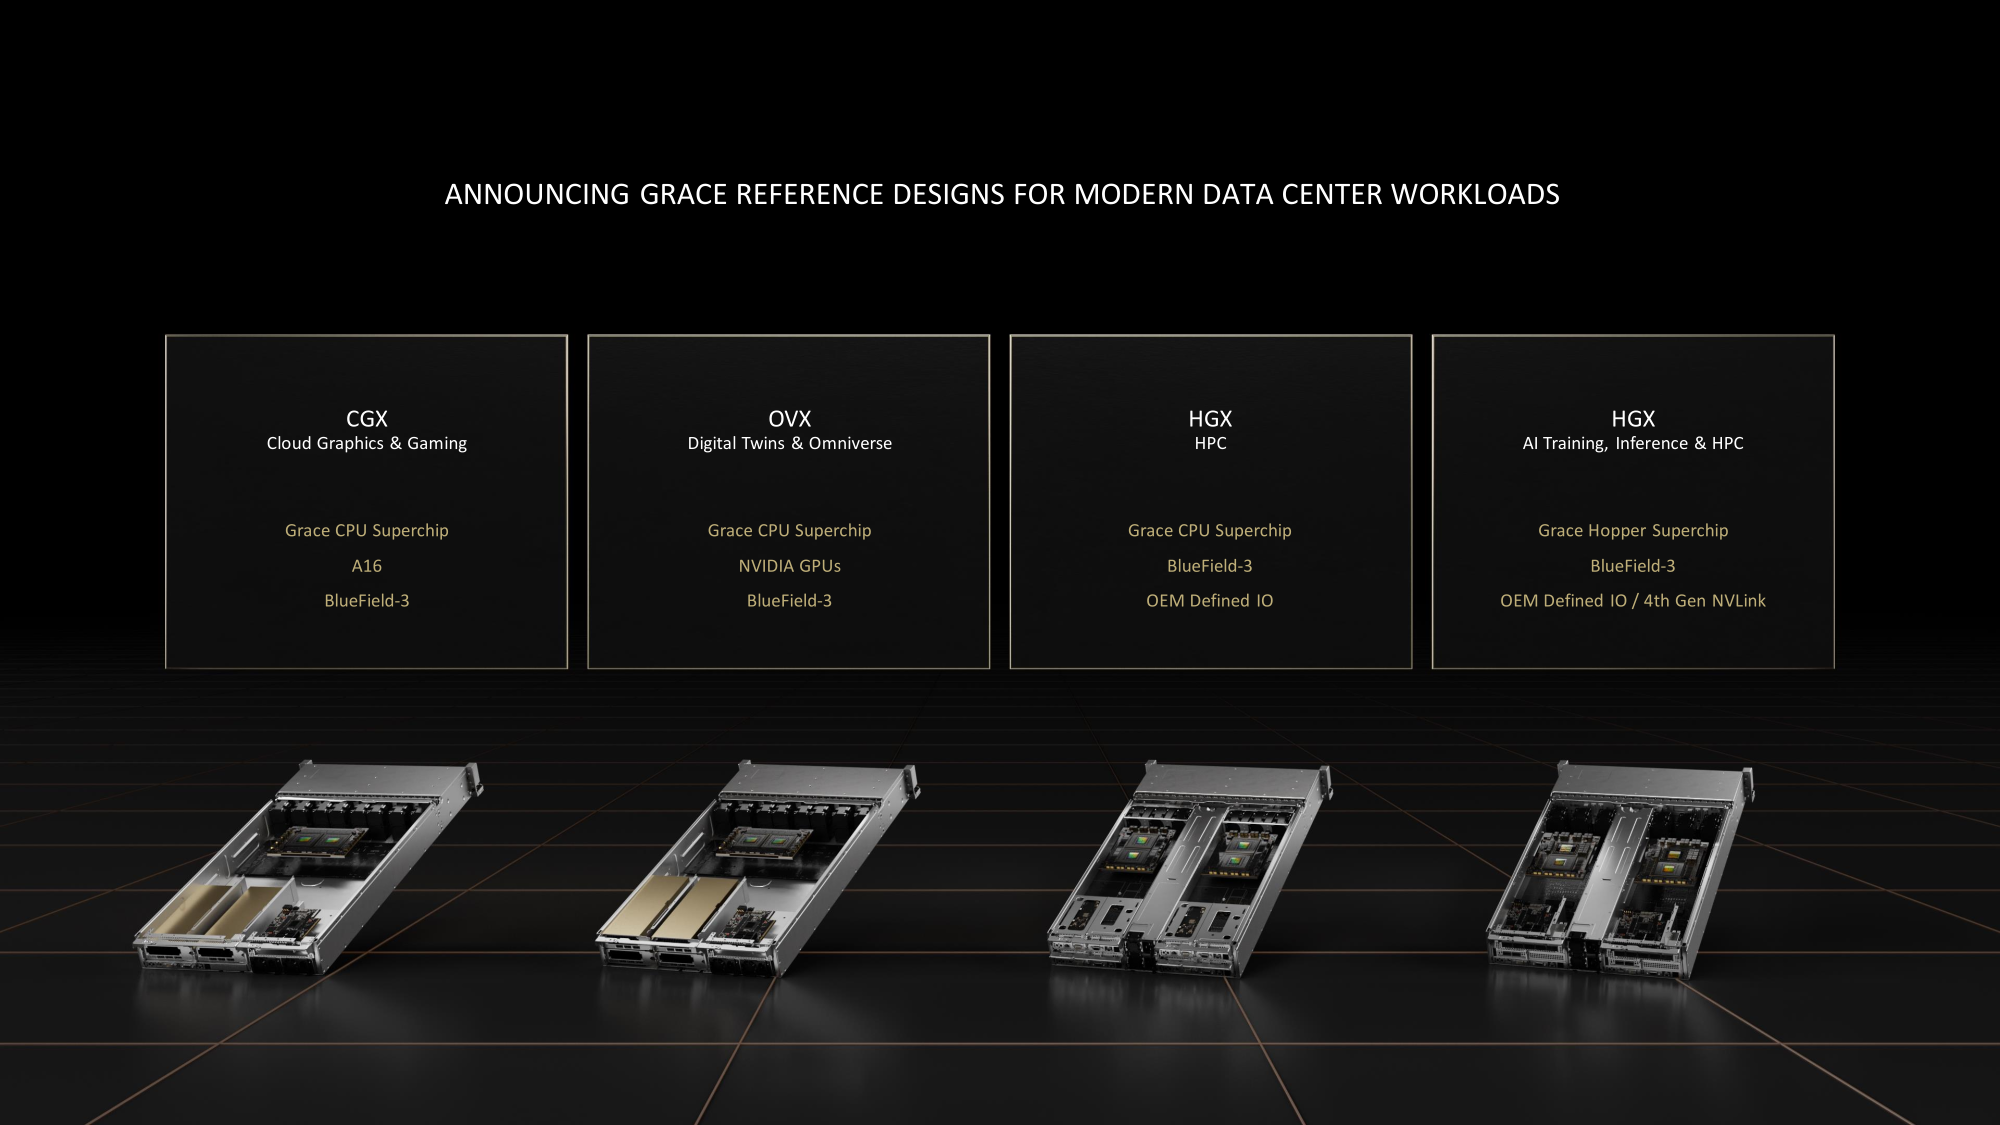
Источник: NVIDIA Системы серии OVX, представленной ранее, всё так же будут предназначены для цифровых двойников и Omniverse — NVIDIA продолжает наставить на том, что любое современное производство или промышленное предприятие должно быть интеллектуальным. Arm-версия OVA получит неназванные ускорители NVIDIA и DPU Bluefield-3. Новая платформа NVIDIA CGX очень похожа на OVX — она тоже получит DPU Bluefield-3 и до четырёх ускорителей NVIDIA A16. CGX создана специального для облачных гейминга и работы с графикой. А вот новое поколение платформы NVIDIA HGX гораздо интереснее. Оно заметно отличается от предыдущих, которые в основном представляли собой различные комбинации базовых плат NVIDIA с четырьмя или восемью ускорителями, вокруг которых OEM-партнёры строили системы в меру своих умений и фантазий. Нынешняя инкарнация NVIDIA HGX всё же несколько более комплексная, поскольку сейчас предлагается два варианта узлов, специально спроектированных для высокоплотных систем и явно ориентированных на высокопроизводительные вычисления (HPC). 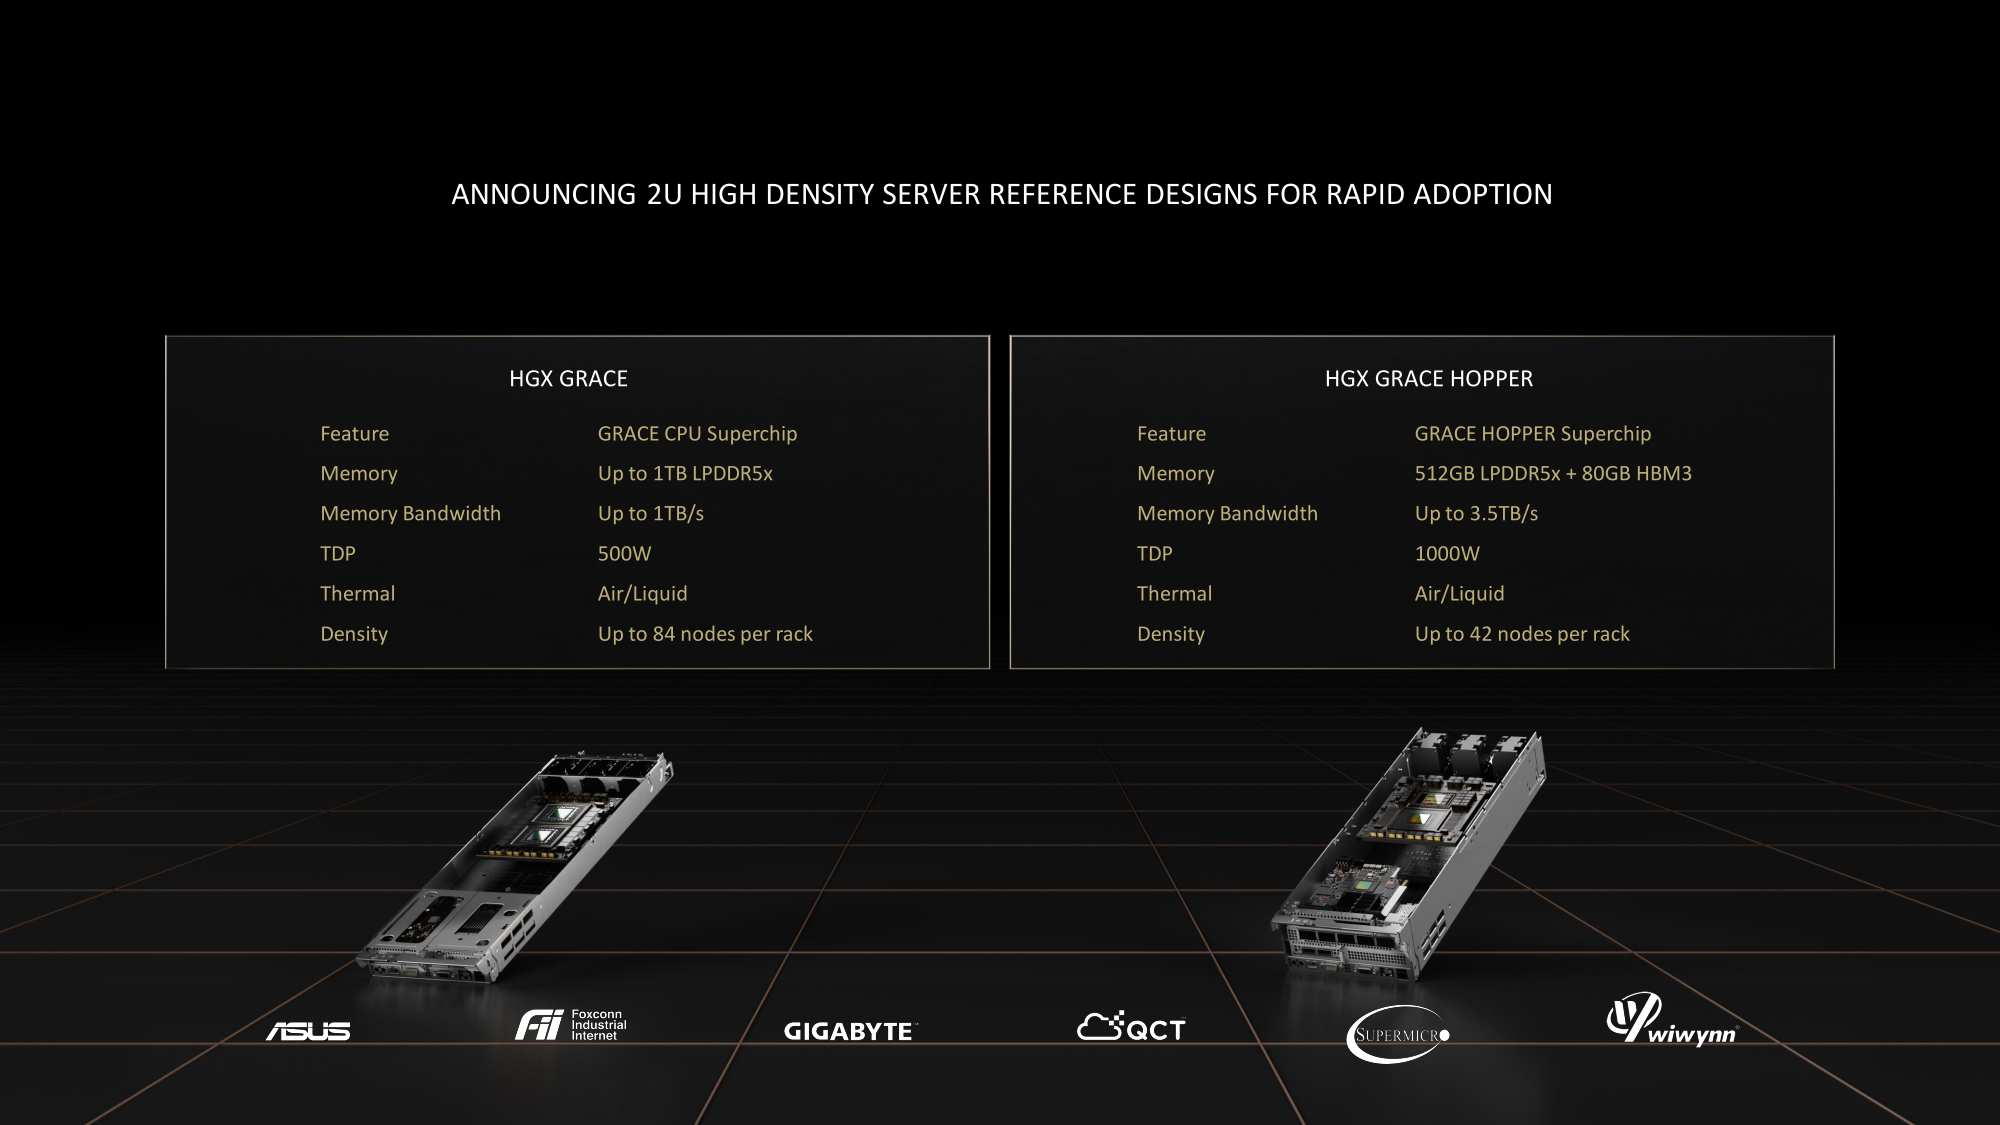
Источник: NVIDIA Первый вариант — это 1U-лезвие (до 84 шт. в стандартной стойке), которое включает один процессор Grace Superchip, до 1 Тбайт LPDDR5x-памяти с пропускной способностью (ПСП) до 1 Тбайт/с и DPU BlueField-3. Иные варианты сетевого подключения оставлены на усмотрение конечного производителя. Заявленный уровень TDP составляет 500 Вт, так что на выбор доступны системы с воздушным и жидкостным охлаждением. Второй вариант базируется на гибридных чипах Grace Hopper Superchip, объединяющих в себе посредством шины NVLink-C2C процессорную часть с 512 Гбайт LPDDR5x-памяти и ускоритель NVIDIA H100 c 80 Гбайт HBM3-памяти (ПСП до 3,5 Тбайт/с). Помимо DPU BlueField-3 опционально доступен и интерконнект NVLink 4.0, но и здесь вендору оставлена свобода выбора. Уровень TDP для данной платформы составляет 1 кВт, но вот обойтись одним только воздушным охлаждением (а такой вариант есть) при полном заполнении стойки всеми 42-мя 2U-лезвиями будет трудно. |
|


