
Материалы по тегу: x
|
24.11.2024 [09:54], Сергей Карасёв
AIC и ScaleFlux представили JBOF-массив на основе NVIDIA BlueField-3Компании AIC и ScaleFlux анонсировали систему F2026 Inference AI для ресурсоёмких приложений ИИ с интенсивным использованием данных. Решение выполнено в форм-факторе 2U. В оснащение входят два DPU NVIDIA BlueField-3, которые могут работать на скорости до 400 Гбит/с. Эти изделия способны ускорять различные сетевые функции, а также операции, связанные с передачей и обработкой больших массивов информации. Во фронтальной части F2026 Inference AI расположены 26 отсеков для высокопроизводительных вычислительных SSD семейства ScaleFlux CSD5000 (U.2). Накопители с интерфейсом PCIe 5.0 (NVMe 2.0b) имеют вместимость 3,84, 7,68, 15,36, 30,72, 61,44 и 122,88 Тбайт, а с учётом компрессии эффективная ёмкость может достигать приблизительно 256 Тбайт. Реализована поддержка TCG Opal 2.02 и шифрования AES-256, NVMe Thin Provisioned Namespaces Virtualization (48PF/32VF), ZNS, FDP. Платформа F2026 Inference AI представляет собой JBOF-массив, способный на сегодняшний день хранить 1,6 Пбайт информации (эффективный объём). В следующем году показатель будет доведён до 6,6 Пбайт. Утверждается, что сочетание BlueField-3 и энергоэффективной технологии хранения ScaleFlux помогает минимизировать энергопотребление, а также повысить долговечность и надёжность. Результаты проведённого тестирования F2026 Inference AI демонстрируют пропускную способность при чтении до 59,49 Гбайт/с, при записи — более 74,52 Гбайт/с. Благодаря объединению средств хранения, сетевых функций и инструментов безопасности в одну систему достигается снижение эксплуатационных расходов, что позволяет оптимизировать совокупную стоимость владения (TCO). 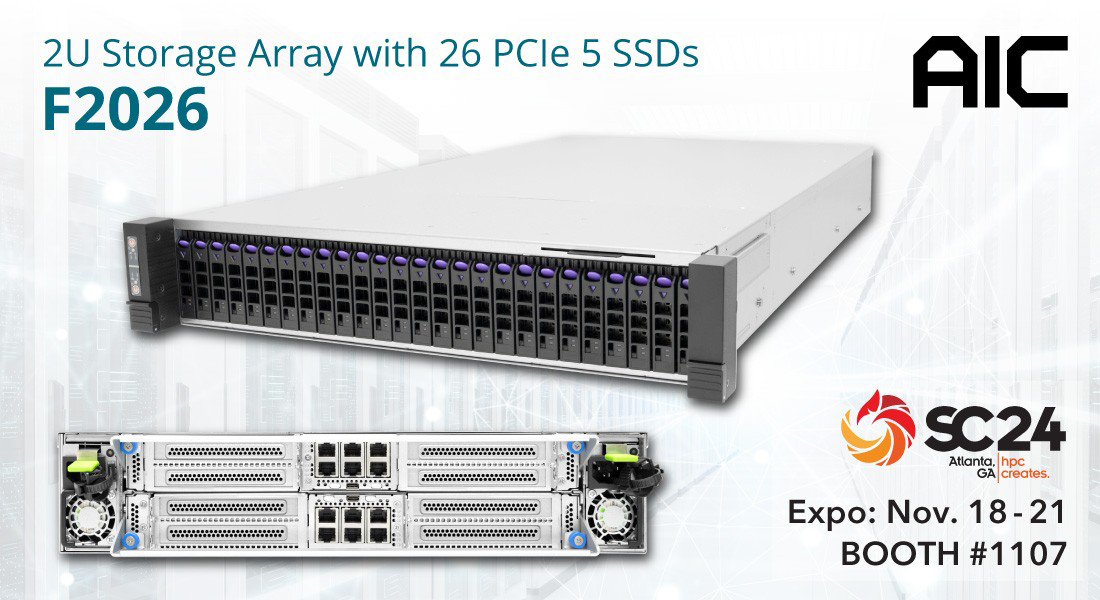
Источник изображения: AIC Новинка является лишь одной из вариаций решений на базе F2026. Платформа, в частности, поддерживает работу других DPU, включая Kalray 200 и Chelsio T7. Также упоминается вариант шасси на 32 накопителя EDSFF E3.S/E3.L.
23.11.2024 [12:26], Сергей Карасёв
«Аквариус» и «Группа Астра» представили ПАК облачной инфраструктуры Aquarius AICКомпания «Аквариус» и «Группа Астра» объявили о разработке российского программно-аппаратного комплекса (ПАК) облачной инфраструктуры Aquarius AIC. Решение, как ожидается, заинтересует предприятия из различных отраслей, включая электроэнергетику, нефтегазовый сектор, промышленное производство и пр. По заявлениям разработчиков, Aquarius AIC — это высокоадаптивное и безопасное облачное решение, предназначенное для создания программно-определяемого инфраструктурного слоя. Все аппаратные компоненты для платформы предоставляются «Аквариусом»: в их число входят серверы, СХД и коммутационное оборудование. Программная часть базируется на платформе Astra Infrastructure Cloud (AIC), разработанной «Группой Астра». Она предназначена для построения защищённого частного облака с возможностью предоставления различных услуг. Среди её ключевых характеристик названы:
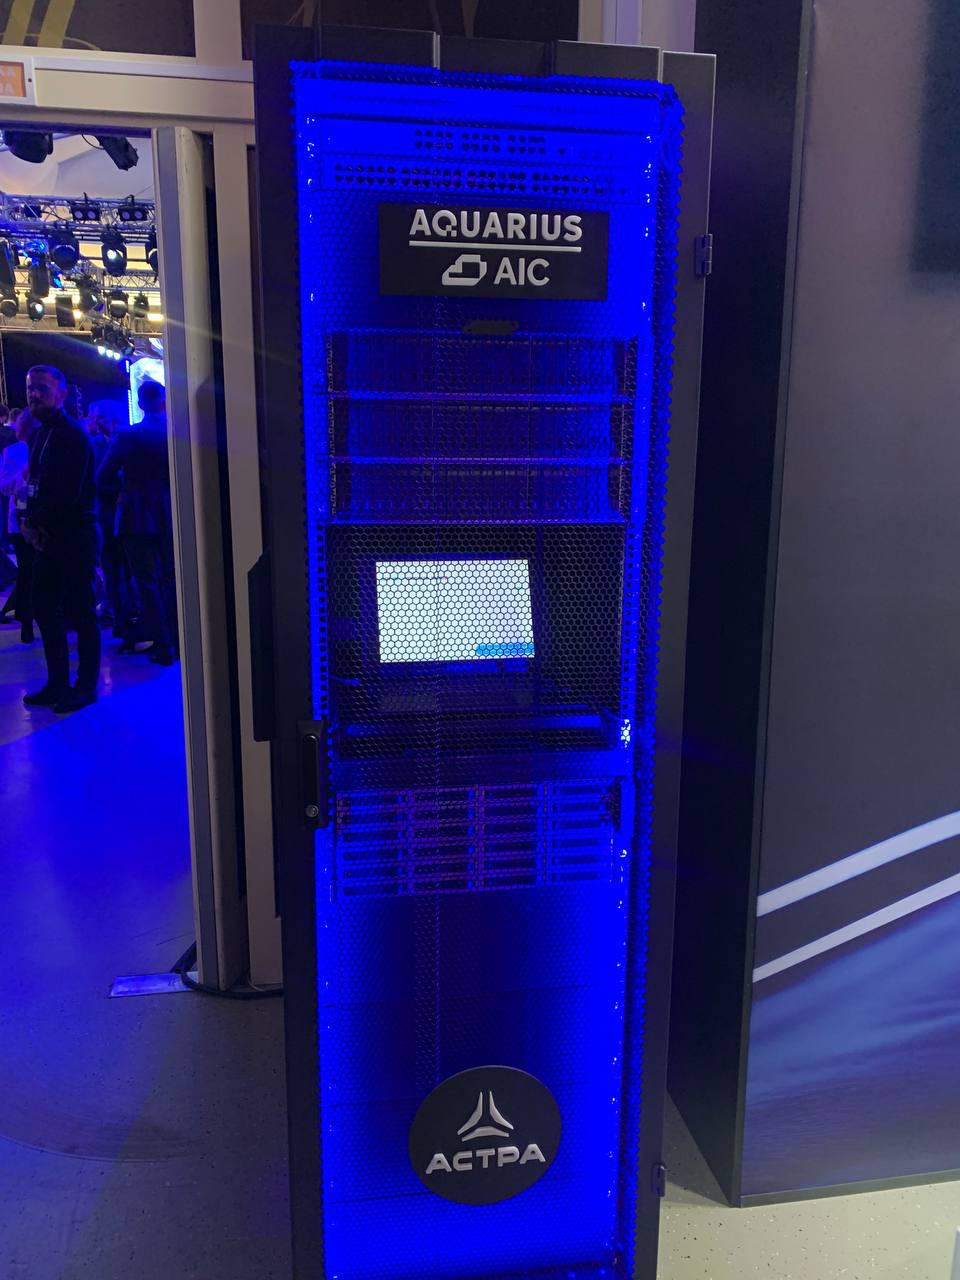
Источник изображения: «Аквариус» Отмечается, что на основе ПАК Aquarius AIC может предоставляться полный набор сервисов: аренда вычислительных ресурсов (IaaS), готовая платформа с определёнными настройками под различные задачи (PaaS), полностью готовое решение (SaaS) для обеспечения соответствия корпоративным стандартам как для крупных предприятий, так и для малого и среднего бизнеса. ПАК успешно протестирован в лаборатории Центра разработок «Аквариус» командами разработчиков, архитекторов и инженеров обеих компаний. В частности, проведены функциональные и нагрузочные испытания. Нужно отметить, что «Аквариус» и «Группа Астра» предлагают и другие совместные решения. Ранее компании представили ПАК системы резервного копирования AQ_ServRuBackup. Кроме того, «Аквариус» и «Тантор Лабс» (входит в «Группу Астра») развивают ПАК Tantor XData, предназначенный для обслуживания СУБД Tantor.
18.11.2024 [15:29], Андрей Крупин
Selectel объявил о доступности серверной операционной системы SelectOSРоссийский провайдер сервисов IT-инфраструктуры Selectel сообщил о коммерческом запуске SelectOS — серверной операционной системы корпоративного класса на базе Debian GNU/Linux. SelectOS характеризуется внушительным набором преднастроенного и оптимизированного для работы серверного программного обеспечения. В состав дистрибутива ОС включены веб-серверы Apache, Nginx, балансировщики HAProxy, DPVS, серверы баз данных MariaDB, PostgreSQL, LDAP-системы FreeIPA, Samba, сервисы резервного копирования Bacula, Rsnapshot, средства виртуализации KVM, QEMU, Libvirt, приложения для контейнеризации Docker, Podman, средства аутентификации Kerberos, средства мониторинга Zabbix, Prometheus, а также сервисные пакеты. Платформа интегрирована с облачными сервисами и хранилищем S3 Selectel. 
Источник изображения: selectel.ru Операционная система построена с использованием фреймворка DPDK (Data Plane Development Kit), предоставляющего средства для создания высокопроизводительных сетевых приложений, напрямую работающих с сетевым оборудованием и обрабатывающих пакеты минуя сетевой стек ядра. Отдельное внимание уделено безопасности ОС: благодаря собственному репозиторию Selectel обеспечивает оперативное обновление ПО и критически важных компонентов платформы. Регулярный мониторинг и устранение уязвимостей через базы данных CVE обеспечивает высокий уровень безопасности SelectOS. ОС может быть установлена как на новых, так и на существующих серверах, включая те, что находятся вне инфраструктуры Selectel. Обслуживание SelectOS осуществляется по модели SLA — клиенты могут выбрать наиболее подходящий для бизнеса уровень технической поддержки: от базового, доступного только в рабочие часы, до премиального в формате 24/7. В планах компании — дальнейшее развитие операционной системы за счет расширения репозитория приложений, адаптированных под технологию DPDK, внедрение SPDK (Storage Performance Development Kit) для виртуальных дисков и продвинутой системы резервного копирования.
18.11.2024 [13:55], Руслан Авдеев
Flex покупает производителя СЖО JetCoolПроизводитель электроники и инфраструктуры для ЦОД Flex объявил о покупке производителя СЖО для ЦОД JetCool. Приобретение позволит Flex расширить портфолио продуктов для дата-центров, сообщает HPC Wire. Сделка позволит объединить передовые технологии охлаждения JetCool и опыт Flex, связанный с IT-решениями, энергетической инфраструктурой, производством и вертикальной интеграцией для клиентов, нацеленных на масштабное внедрение ИИ-серверов. Как заявляют во Flex, передовые технологии жидкостного охлаждения усиливают возможности компании решать проблемы клиентов с возрастающей энергетической и тепловой плотностью, а также соответствовать требованиям к охлаждению при решении любых задач в области ИИ и HPC. В JetCool уверены, что присоединение к Flex позволит компании добиться новых высот, нарастить производственные возможности и расширить продуктовую номенклатуру. 
Источник изображения: JetCool Основанная в 2019 году компания JetCool из Массачусетса предоставляет СЖО на базе т.н. «микроконвективного охлаждения». Компания предлагает широкий спектр продуктов, от водоблоков и систем прямого жидкостного охлаждения чипов до интегрированных систем точечного отвода тепла и комплексных систем охлаждения «под ключ». Не так давно компания представлена CDU для отвода до 300 кВт. Систему можно масштабировать, общая охлаждающая способность увеличивается до более 2 МВт. Около года назад сообщалось, что JetCool в ходе раунда финансирования серии А получила $17 млн на развитие бизнеса. До этого компания в рамках программы COOLERCHIPS получила $1 млн от Агентства передовых исследований в области энергетики (ARPA-E) при Министерстве энергетики США (DOE).
14.11.2024 [08:17], Владимир Мироненко
SoftBank построит в Японии первый в мире ИИ-суперкомпьютер на базе NVIDIA DGX B200NVIDIA объявила о серии совместных проектов с SoftBank, направленных на ускорение суверенных инициатив Японии в области ИИ, которые также обеспечат возможность получения дохода от ИИ для поставщиков телекоммуникационных услуг по всему миру. В выступлении на саммите NVIDIA AI Summit Japan генеральный директор NVIDIA Дженсен Хуанг (Jensen Huang) объявил, что SoftBank создаёт самый мощный в Японии ИИ-суперкомпьютер с использованием платформы NVIDIA DGX SuperPOD B200 и интерконнекта Quantum-2 InfiniBand. Эта система станет первой в мире, которая получит системы DGX B200. Она будет использоваться компанией для разработки генеративного ИИ и развития других бизнес-решений, а также для предоставления вычислительных услуг университетам, научно-исследовательским институтам и предприятиям в стране. Суперкомпьютер идеально подойдёт для разработки больших языковых моделей (LLM), говорится в пресс-релизе. Пока что на звание самого мощного ИИ-суперкомьютера Японии претендует система ABCI 3.0 на базе NVIDIA H200. Впрочем, Softbank не сидит сложа руки и планирует построить ещё один суперкомпьютер, на этот раз на базе суперускорителей GB200 NVL72. Они же будут использоваться в проекте Sharp, KDDI и Supermicro по созданию «крупнейшего в Азии» ИИ ЦОД. 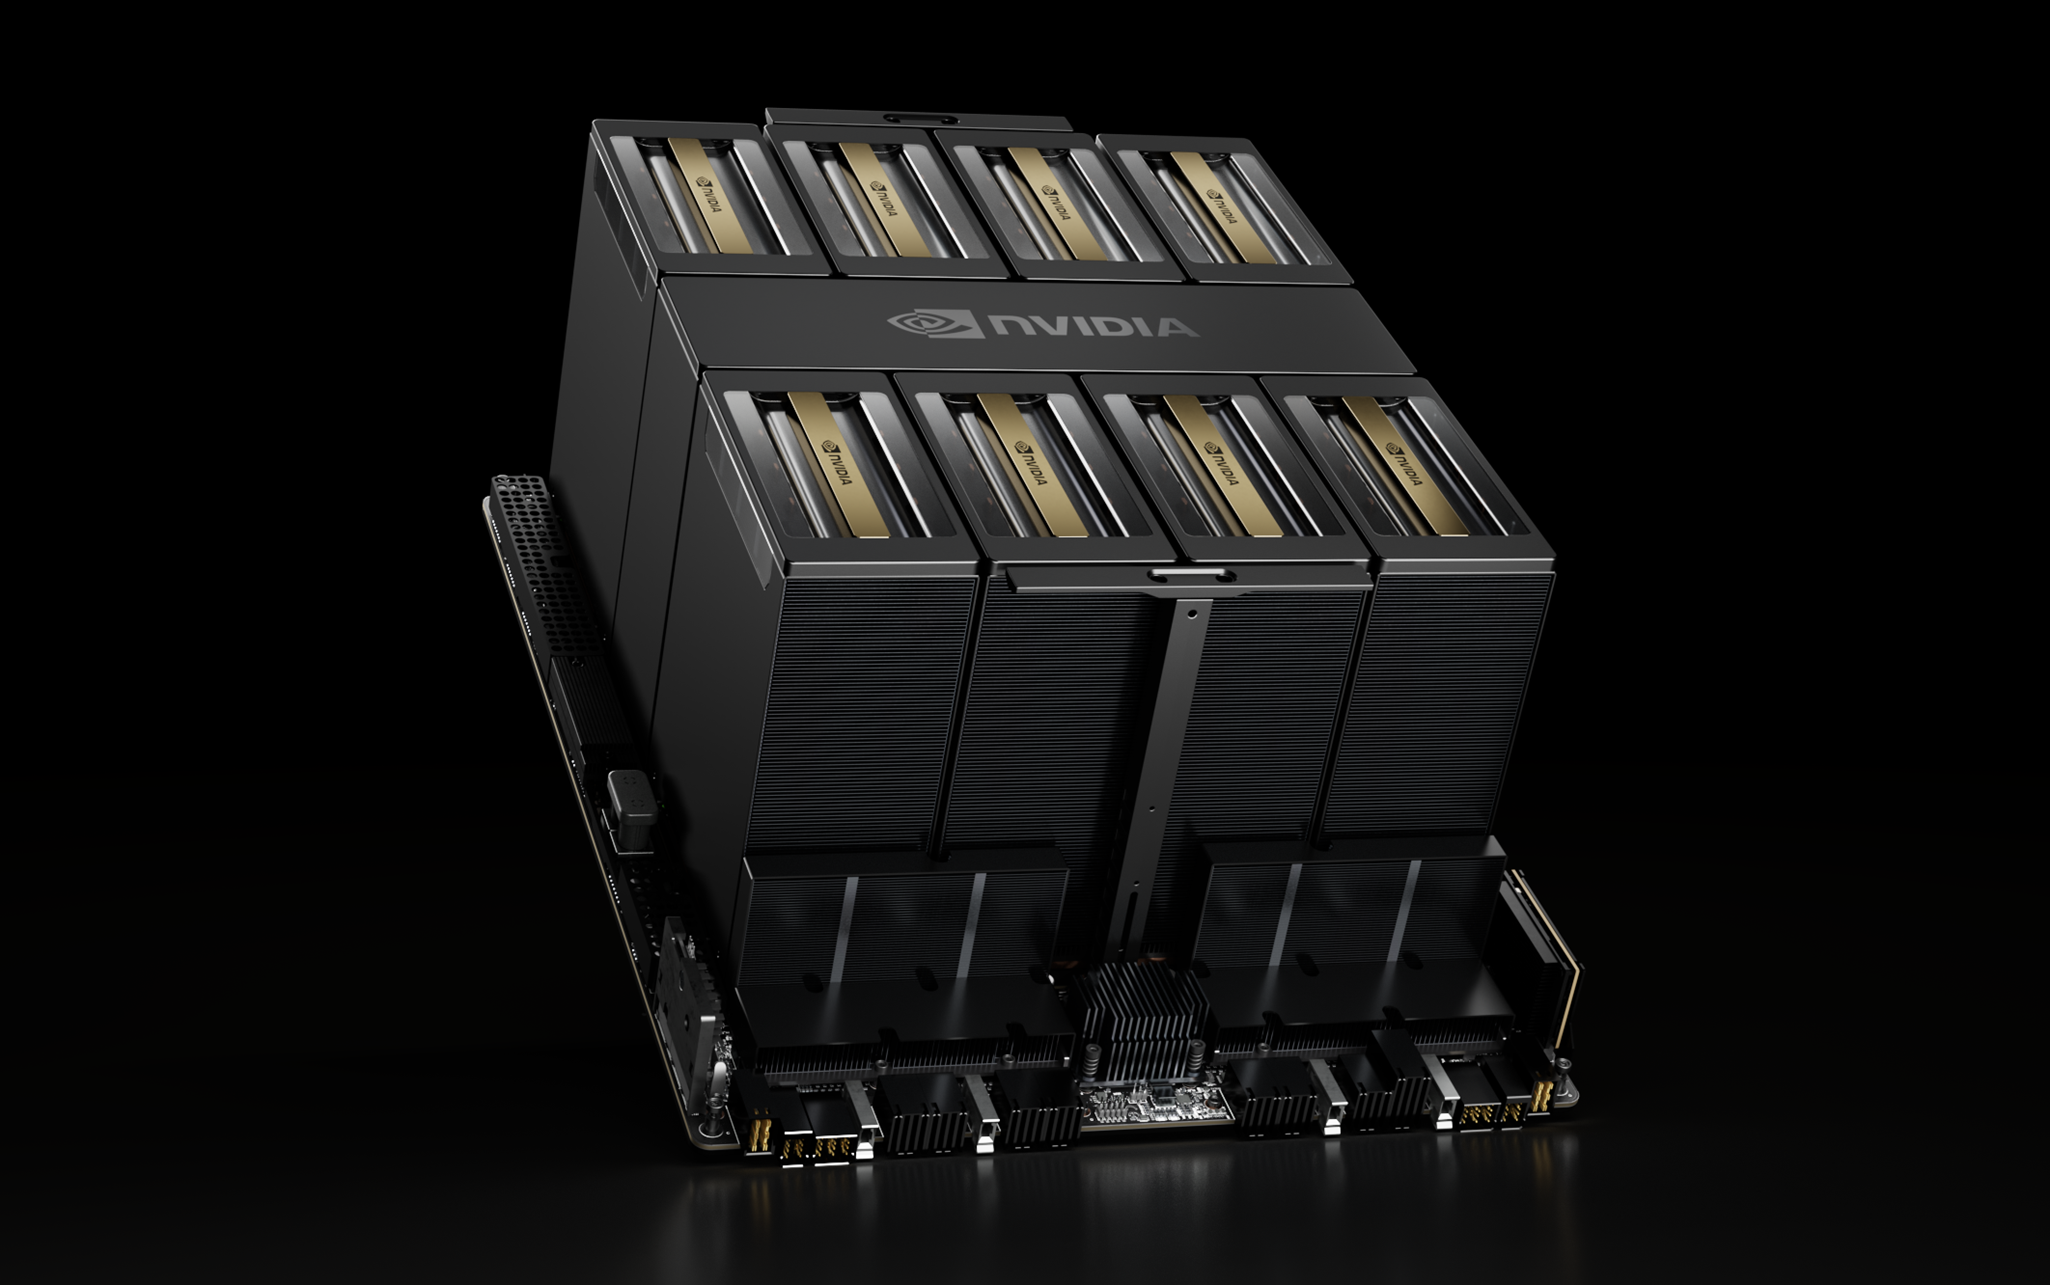
Источник изображения: NVIDIA Также в ходе саммита было объявлено, что SoftBank, используя платформу ускоренных вычислений NVIDIA AI Aerial, успешно запустил первую в мире телекоммуникационную сеть, объединяющую возможности ИИ и 5G. В ходе испытаний, проведенных в префектуре Канагава, SoftBank продемонстрировала, что решение AI-RAN достигло производительности 5G операторского класса, используя ресурсы ускорителя для одновременной обработки сетевого трафика и инференса. Отмечается, что мобильные сети традиционно рассчитаны на обработку пиковых нагрузок и в среднем задействуют только треть аппаратных ресурсов, что позволяет монетизировать оставшиеся две трети путём предоставления ИИ-сервисов. NVIDIA и SoftBank также сообщили, что с помощью ПО NVIDIA AI Enterprise японская компания будет создавать локализованные безопасные ИИ-сервисы.
08.11.2024 [12:51], Сергей Карасёв
Axiomtek выпустила плату MMB541 формата Micro ATX для Intel Core Raptor LakeКомпания Axiomtek анонсировала материнскую плату MMB541 на платформе Intel, предназначенную, по словам создателей, для создания ИИ-систем, платформ промышленной автоматизации и других индустриальных решений. Новинка выполнена в форм-факторе Micro ATX с размерами 244 × 244 мм. В основу положен набор логики Intel H610; допускается установка процессоров Core 14-го поколения (Raptor Lake) в исполнении LGA 1700 с показателем TDP до 125 Вт. Предусмотрены два слота для модулей DDR4-3200 non-ECC; максимально поддерживаемый объём ОЗУ составляет 64 Гбайт. Плата получила один коннектор M.2 Key M 2280/2242 для SSD с интерфейсом SATA-3, а также три стандартных порта SATA-3 без поддержки RAID. Для карт расширения доступны один разъём PCIe 4.0 x16, два слота PCIe 3.0 x2, а также один 32-битный слот PCI. В оснащение входят сетевые адаптеры Intel I226-V (один порт 2.5GbE) и Intel I210-AT (два порта 1GbE). 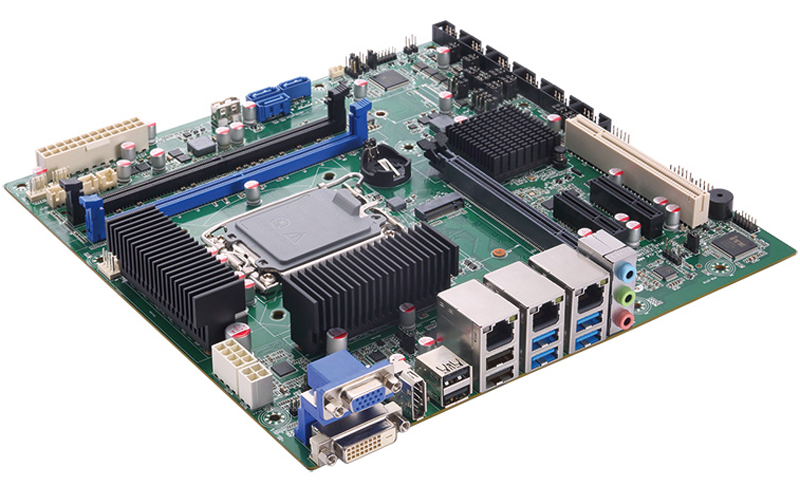
Источник изображения: Axiomtek Изображение может выводиться на три монитора через интерфейсы DisplayPort (до 4096 × 2160 пикселей; 30 Гц), DVI-D (1920 × 1200 точек; 60 Гц) и D-Dub (до 1920 × 1200 пикселей; 60 Гц). В набор разъёмов входят по четыре порта USB 3.2 Gen1x1 (USB 3.0) Type-A и USB 2.0 Type-A, три гнезда RJ45 для сетевых кабелей и набор аудиогнёзд на 3,5 мм. Через коннекторы на плате можно задействовать ряд последовательных портов (4 × RS-232, 1 × RS-232/RS-485/RS-422 и 1 × RS-232/RS-485), а также пять портов USB 2.0. Опционально может быть добавлен модуль TPM 2.0. Диапазон рабочих температур простирается от 0 до +60 °C.
22.09.2024 [00:58], Владимир Мироненко
Linux запустили на Intel 4004 — загрузка заняла пять днейКак передаёт OpenNet, разработчик Дмитрий Гринберг сумел запустить ядро Linux с rootfs-окружением из Debian на 10-мкм 4-бит процессоре Intel 4004, вышедшем в конце 1971 года и считающемся первым в мире коммерчески доступным однокристалльным микропроцессором. У Intel 4004 всего 2300 транзисторов. Процессор имел всего 46 инструкций, а его пиковая производительность достигала примерно 93 тыс. операций в секунду. Из-за невозможности напрямую портировать ядро на Intel 4004 и из-за ограничений самого CPU автор решил написать эмулятор процессора MIPS R3000, внутри которого уже запускался Linux. Для запуска процессора автор в несколько подходов создал плату Linux/4004 на базе компонентов 1970-х годов, которые, как выяснилось, не так уж дёшевы. Естественно, плата содержит и гораздо более современные компоненты, позволяющие, к примеру, использовать SD-карту в качестве постоянной памяти. 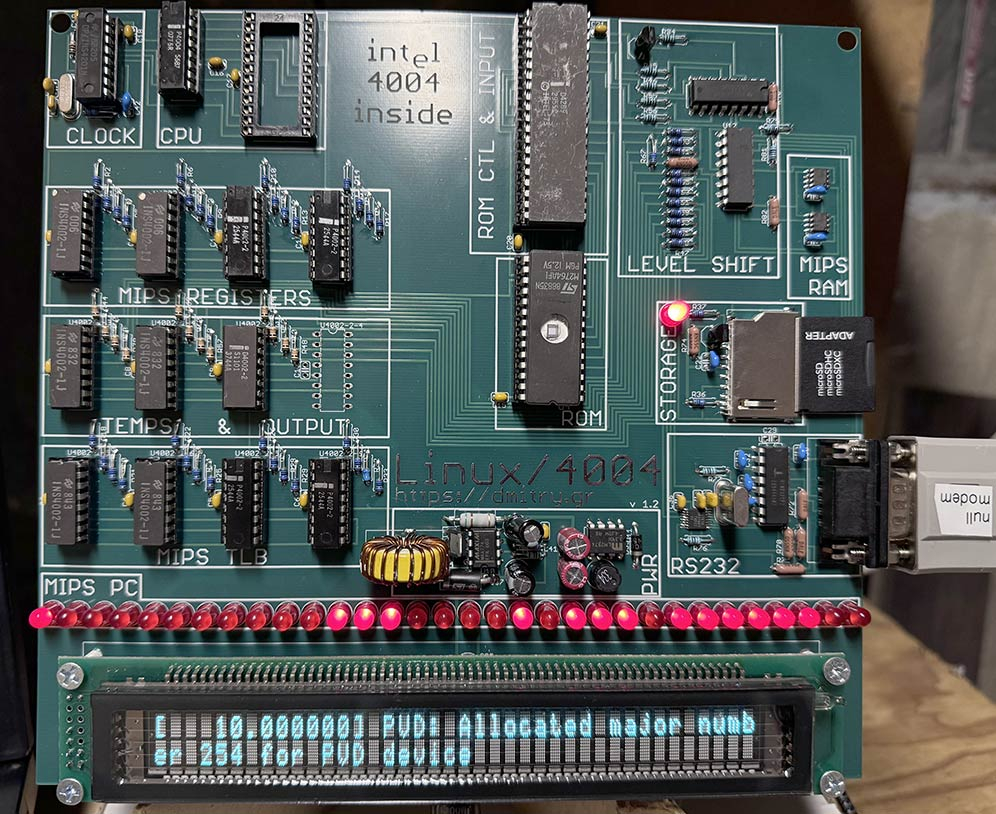
Источник изображения: dmitry.gr Из-за малой производительности Intel 4004 эмулятор работал медленно — на обработку каждой виртуальной секунды в эмулируемом окружении уходило почти 4 часа реального времени. После усовершенствования платы и ПО загрузка Linux сократилась с почти 9 дней до примерно 5 дней. Автор даже смог разогнать CPU с базовых 740 кГц до 790 кГц. Желающие повторить эксперимент могут воспользоваться опубликованными спецификациями и схемой платы, а также ПО.
07.04.2024 [23:52], Руслан Авдеев
Утром — деньги, вечером — SMR: Equinix заплатила $25 млн за право получить до 500 МВт от малых модульных реакторов OkloEquinix заключила предварительное соглашение с создателем малых модульных реакторов (SMR) Oklo, поддерживаемым главой OpenAI Сэмом Альтманом (Sam Altman). По данным Datacenter Dynamics, это первый договор, подписанный оператором, предусматривающий использование SMR. В заявлении по форме S4, поданном AltC Acquisition Corp в Комиссию по ценным бумагам и биржам США (SEC), раскрываются некоторые детали сделки. В частности, Equinix внесла в качестве предоплаты $25 млн. Считается, что в данном случае речь идёт о финансировании акционерного капитала — Equinix получает возможность купить долю в 1,5-1,9 % в бизнесе Oklo. Сейчас разработчик реакторов находится в стадии обратного слияния со SPAC-компанией AltC Acquisition, намеренной вывести специалистов по атомной энергетике на IPO в июле 2024 года. Вместо акций Equinix также может получить дисконт на приобретение энергии. 
Источник изображения: Oklo Модульные реакторы Oklo на быстрых нейтронах способны генерировать до 15 МВт каждый и работать до 10 лет без перезарядки. Equinix будет получать энергию от SMR Oklo в США в течение 20 лет. Конкретные объёмы будут оговариваться в будущих соглашениях о покупке энергии (PPA), а в будущем Equinix сможет обновить и расширить PPA ещё на 20 лет. Оператор ЦОД также получил право преимущественной покупки энергии, вырабатываемой определёнными реакторами, сроком на 36 месяцев — выкупаемая мощность составит 100–500 МВт. SMR, разрабатываемые также NuScale, Rolls-Royce и другими компаниями, предлагаются в качестве источника «низкоуглеродного» экобезопасного питания для ЦОД — это позволит дата-центрам работать без подключения к магистральным электросетям. В прошлом году Standard Power анонсировала планы приобрести 24 SMR у NuScale, хотя позже его назвали фейковым.
19.03.2024 [01:00], Игорь Осколков
NVIDIA B200, GB200 и GB200 NVL72 — новые ускорители на базе архитектуры BlackwellNVIDIA представила сразу несколько ускорителей на базе новой архитектуры Blackwell, названной в честь американского статистика и математика Дэвида Блэквелла. На смену H100/H200, GH200 и GH200 NVL32 на базе архитектуры Hopper придут B200, GB200 и GB200 NVL72. Все они, как говорит NVIDIA, призваны демократизировать работу с большими языковыми моделями (LLM) с триллионами параметров. В частности, решения на базе Blackwell будут до 25 раз энергоэффективнее и экономичнее в сравнении с Hopper. В разреженных FP4- и FP8-вычислениях производительность B200 достигает 20 и 10 Пфлопс соответственно. Но без толики технического маркетинга не обошлось — показанные результаты достигнуты не только благодаря аппаратным улучшениям, но и программным оптимизациям. Это ни в коей мере не умаляет их важности и полезности, но затрудняет прямое сравнение с конкурирующими решениями. В общем, появление Blackwell стоит рассматривать не как очередное поколение ускорителей, а как расширение всей экосистемы NVIDIA. В Blackwell компания использует тайловую (чиплетную) компоновку — два тайла объединены 2,5D-упаковкой CoWoS-L и на двоих имеют 208 млрд транзисторов, изготовленных по техпроцессу TSMC 4NP. В одно целое со всех точек зрения их объединяет новый интерконнект NV-HBI с пропускной способностью 10 Тбайт/с, а дополняют их восемь стеков HBM3e-памяти ёмкостью до 192 Гбайт с агрегированной пропускной способностью до 8 Тбайт/с. Такой же объём памяти предлагает и Instinct MI300X, но с меньшей ПСП (5,3 Тбайт/с), хотя это скоро изменится. FP8-производительность в разреженных вычислениях у решения AMD составляет 5,23 Пфлопс, но зато компания не забывает и про FP64 в отличие от NVIDIA. 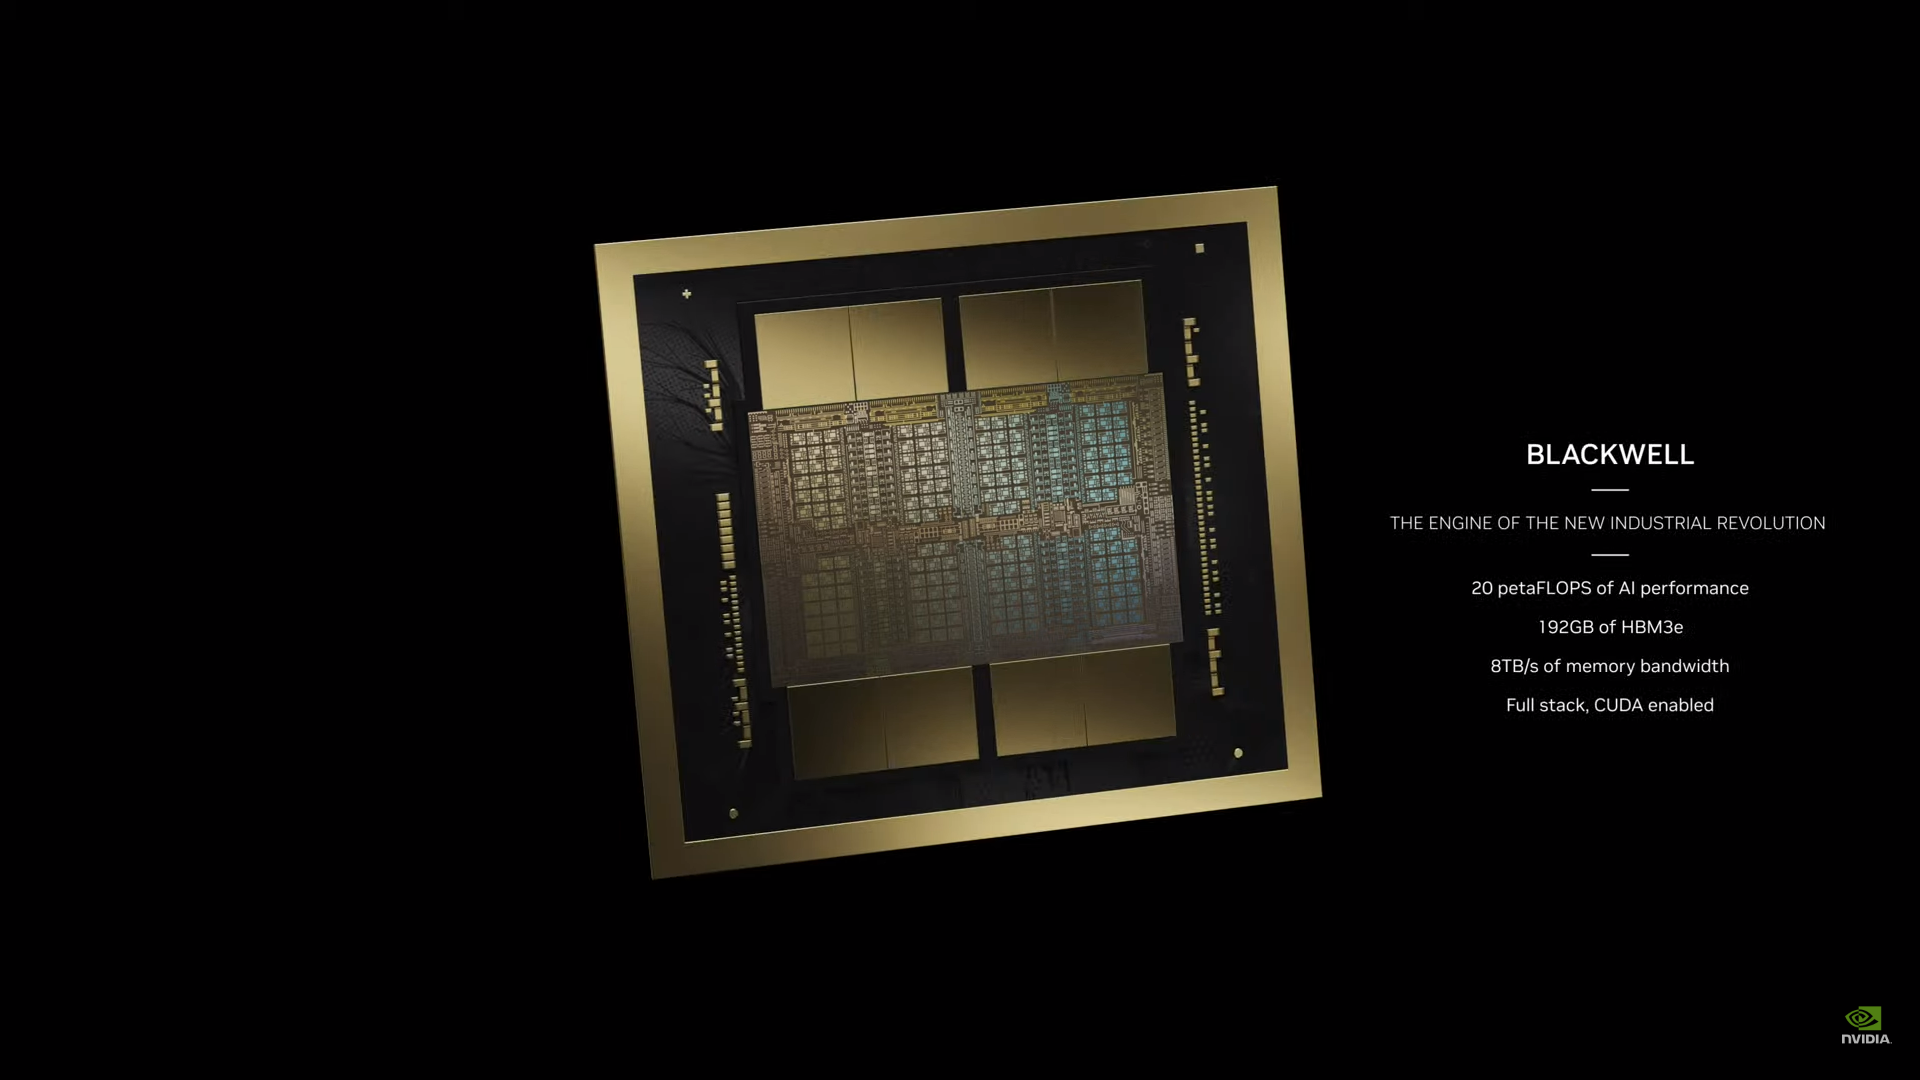
Источник изображений: NVIDIA Одними из ключевых нововведений, отвечающих за повышение производительности, стали новые Tensor-ядра и второе поколение механизма Transformer Engine, который научился заглядывать внутрь тензоров, ещё более тонко подбирая необходимую точность вычислений, что влияет и на скорость обучения с инференсом, и на максимальный объём модели, умещающейся в памяти ускорителя. 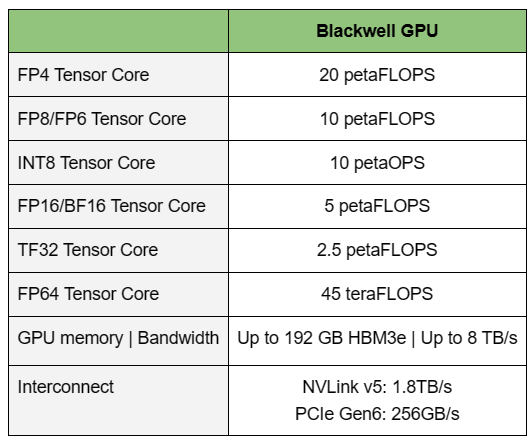 Теперь NVIDIA намекает на то, что обучение можно делать в FP8-формате, а для инференса хватит и FP4. Всё это без потери качества. Но вообще Blackwell поддерживает FP4/FP6/FP8, INT8, BF16/FP16, TF32 и FP64. И только для последнего нет поддержки разреженных вычислений. 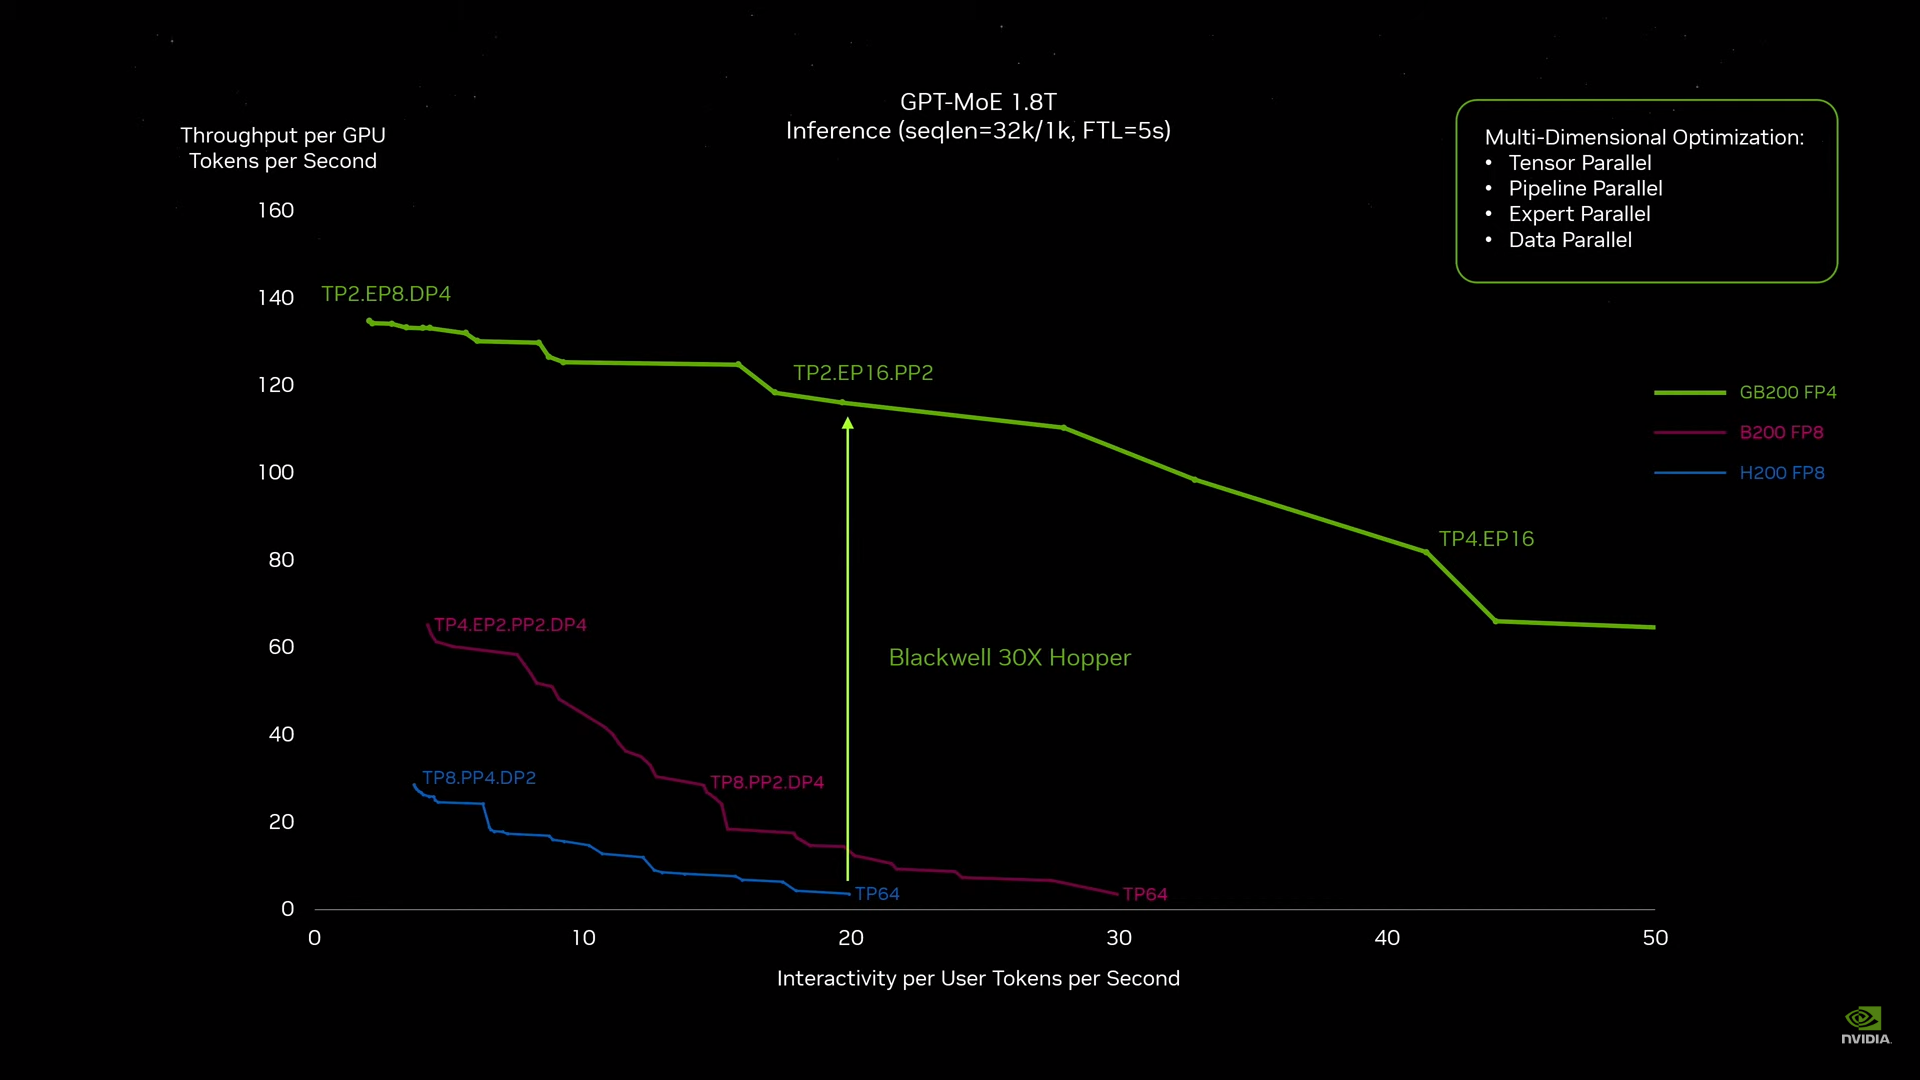 Дополнительно Blackwell обзавёлся движком для декомпрессии (в первую очередь LZ4, Deflate, Snappy) входящих данных со скоростью до 800 Гбайт/с, что тоже должно повысить производительность, т.к. теперь распаковкой будет заниматься не CPU и, соответственно, ускоритель не будет «голодать». Эта функция рассчитана в основном на Apache Spark и другие системы для аналитики больших данных. Также есть по семь движков NVDEC и NVJPEG. 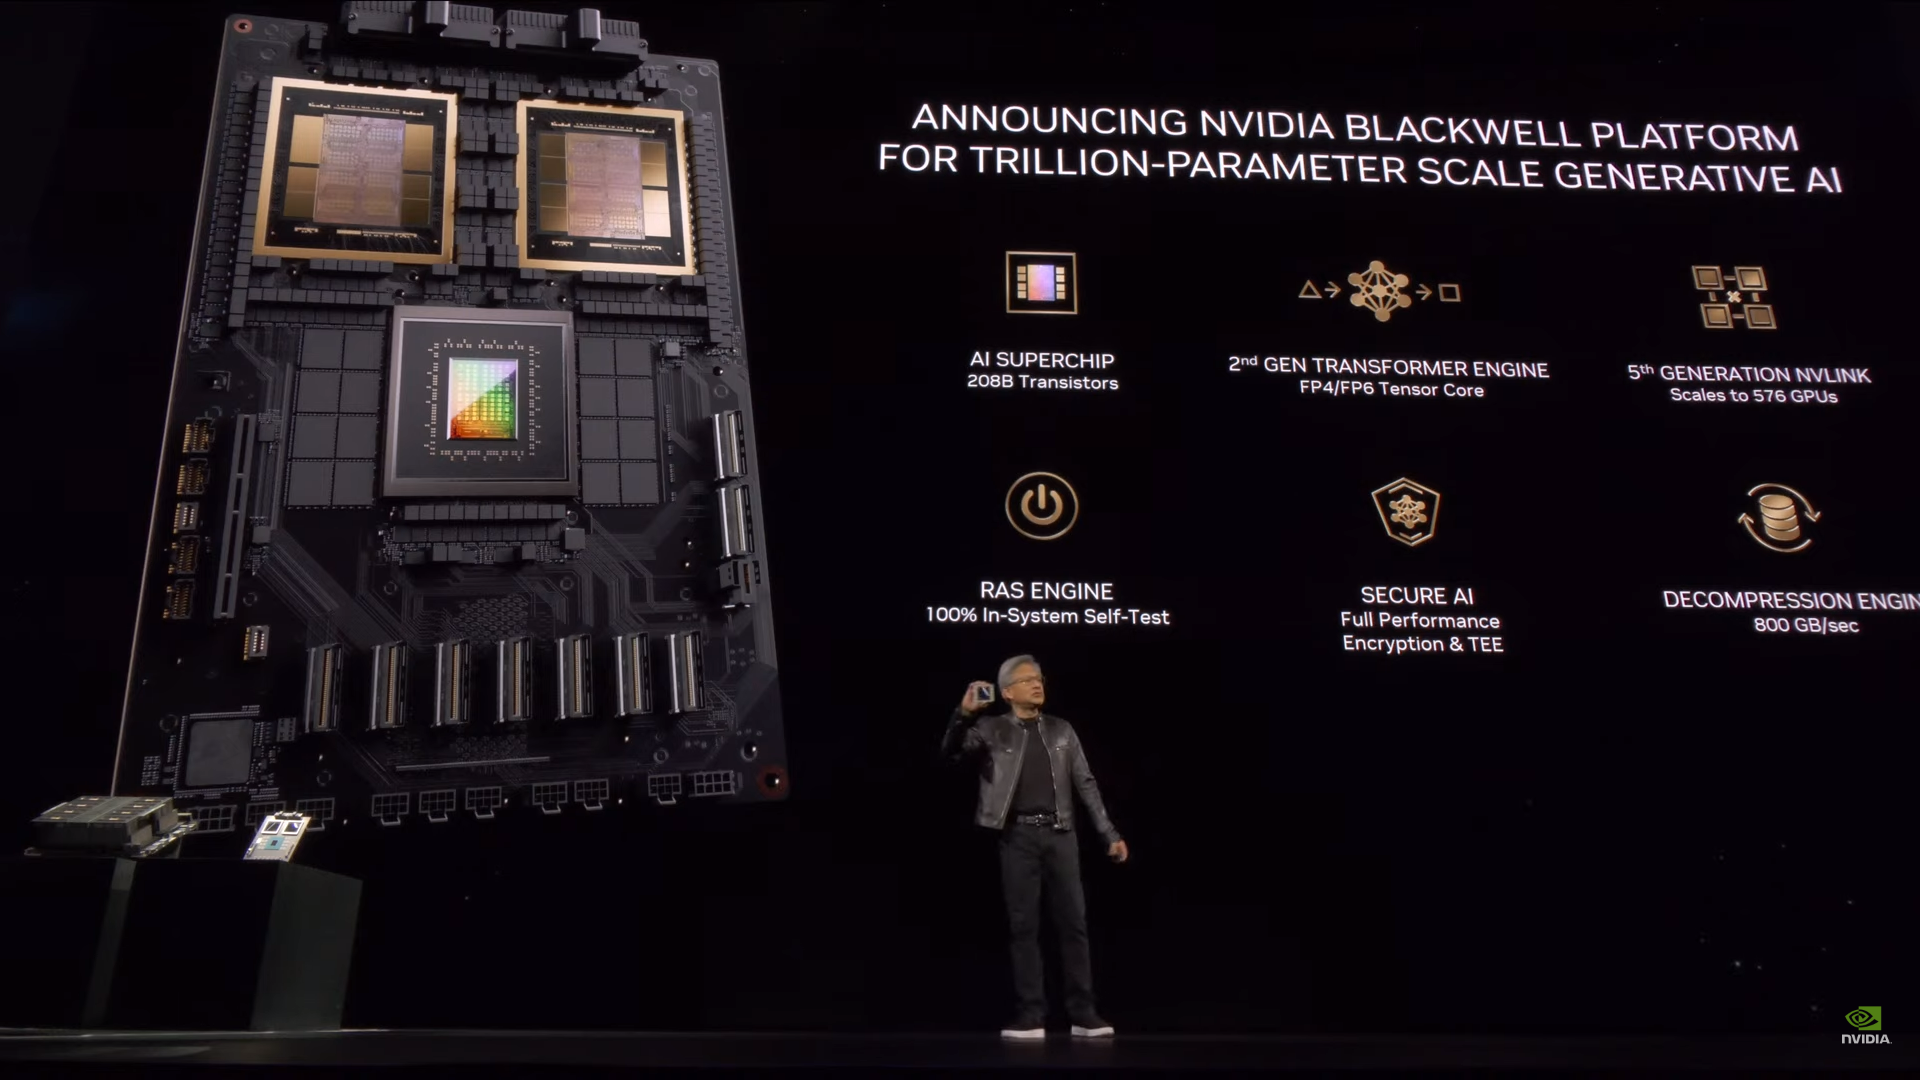 Наконец, NVIDIA упоминает ещё две новых возможности Blackwell: шифрование данных в памяти и RAS-функции. В первом случае речь идёт о защите конфиденциальности обрабатываемых данных, что важно в целом ряде областей. Причём формирование TEE-анклава возможно в рамках группы из 128 ускорителей. MIG-доменов по-прежнему семь. В случае RAS говорится о телеметрии и предиктивной аналитике (естественно, на базе ИИ), которые помогут заранее выявить возможные сбои и снизить время простоя. Это важно, поскольку многие модели могут обучаться неделями и месяцами, так что потеря даже относительно небольшого куска данных крайне неприятна и финансово затратна. 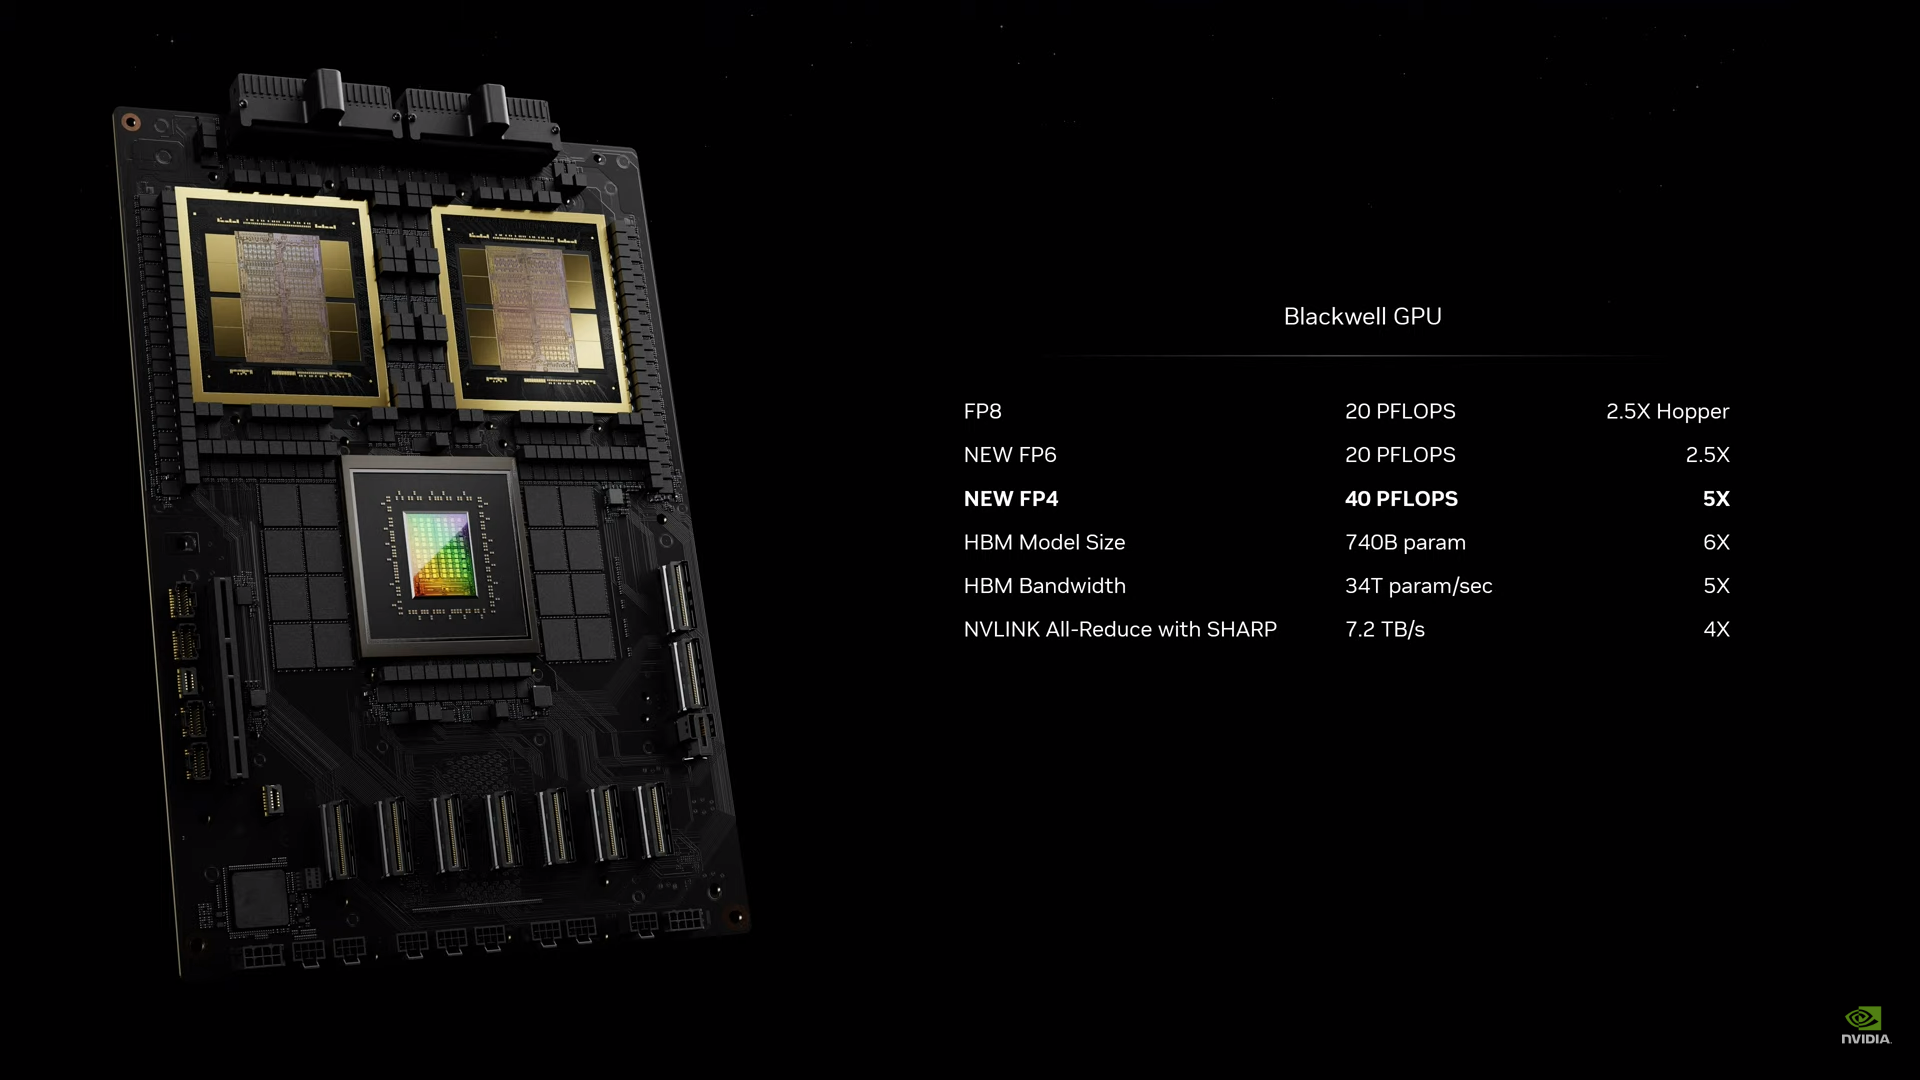 Однако всё эти инновации не имеют смысла без возможности масштабирования, поэтому NVIDIA оснастила Blackwell не только интерфейсом PCIe 6.0 (32 линии), который играет всё меньшую роль, но и пятым поколением интерконнекта NVLink. NVLink 5 по сравнению с NVLink 4 удвоил пропускную способность до 1,8 Тбайт/с (по 900 Гбайт/с в каждую сторону), а соответствующий коммутатор NVSwitch 7.2T позволяет объединить до 576 ускорителей в одном домене. SHARP-движки с поддержкой FP8 дополнительно помогут ускорить обработку моделей, избавив ускорители от части работ по предобработке и трансформации данных. Чип коммутатора тоже изготавливается по техпроцессу TSMC N4P и содержит 50 млрд транзисторов. 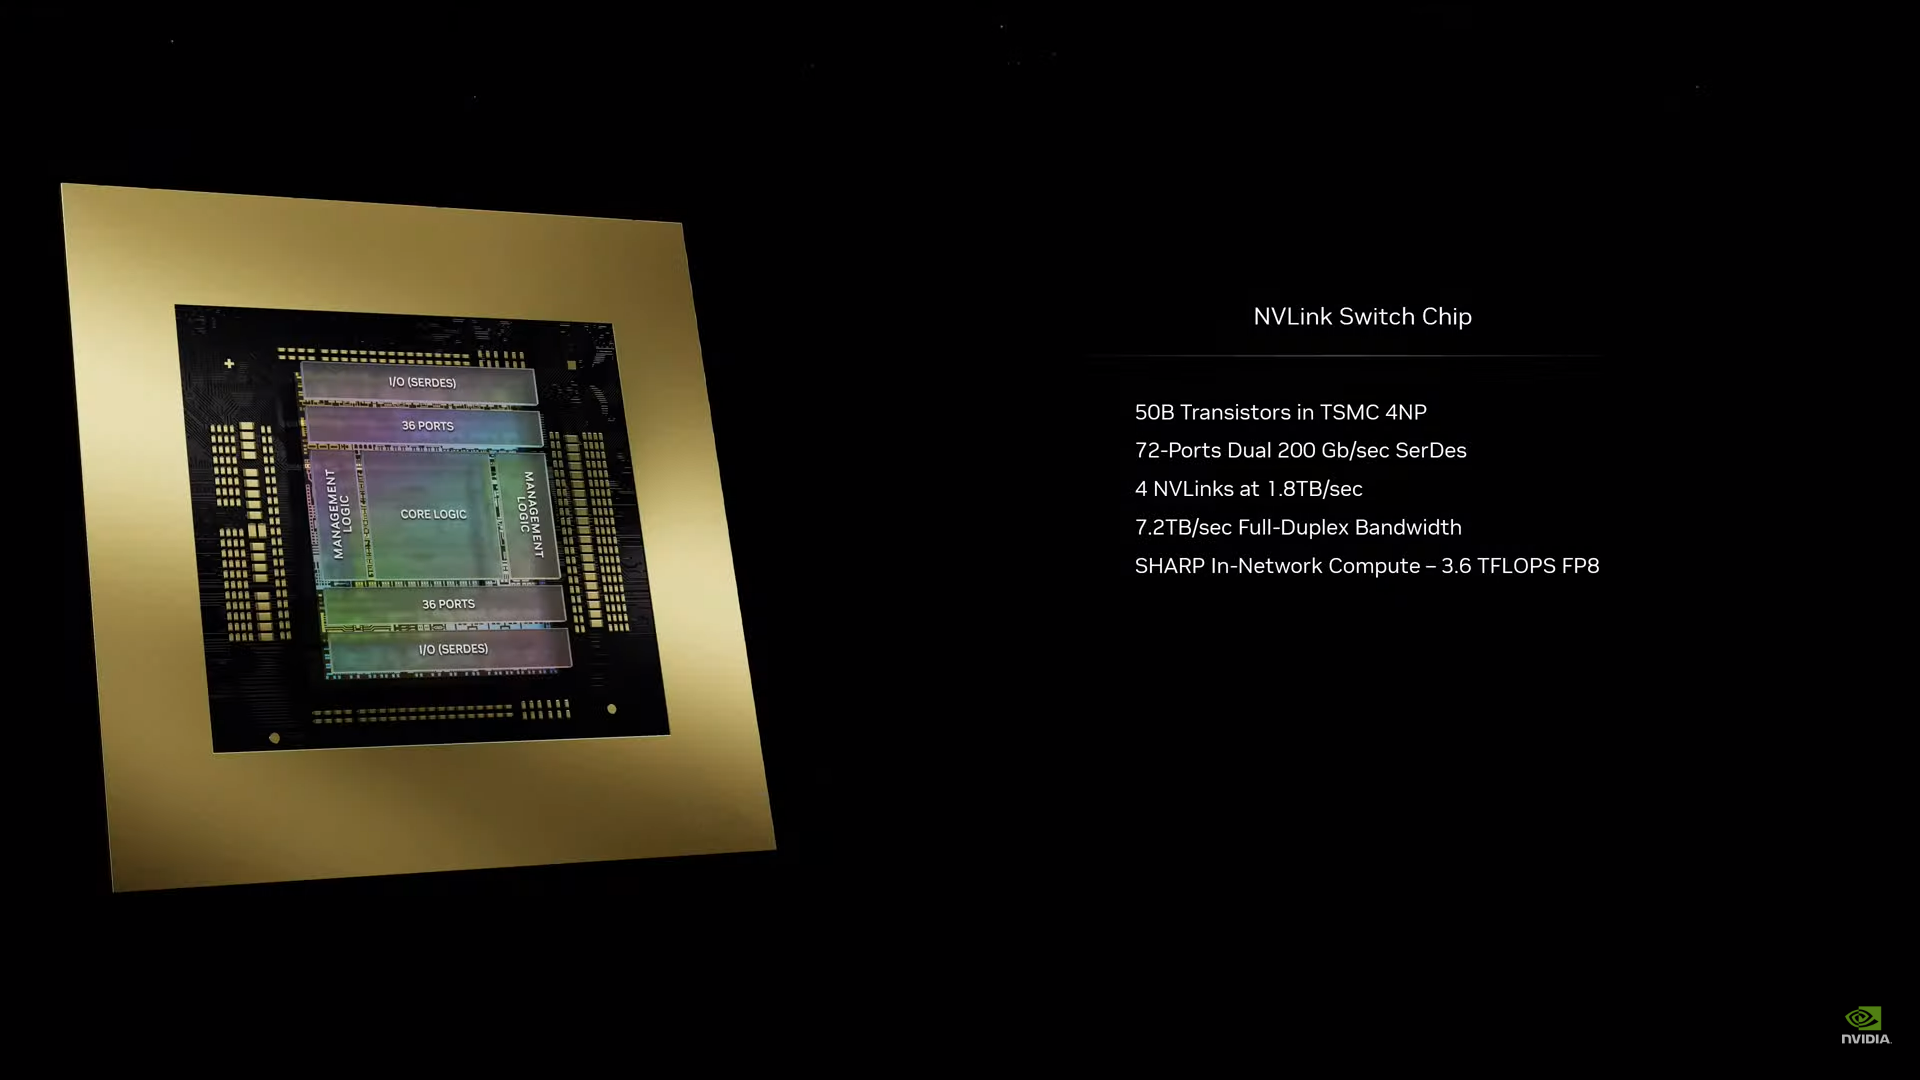 Для дальнейшего масштабирования и формирования кластеров из 10 тыс. ускорителей и более, вплоть до 100 тыс. ускорителей на уровне ЦОД, NVIDIA предлагает 800G-коммутаторы Quantum-X800 InfiniBand XDR и Spectrum-X800 Ethernet, имеющие соответственно 144 и 64 порта. Узлам же полагаются DPU ConnectX-8 SuperNIC и BlueField-3. Правда, последний предлагает только 400G-порты в отличие от первого. От InfiniBand компания отказываться не собирается. 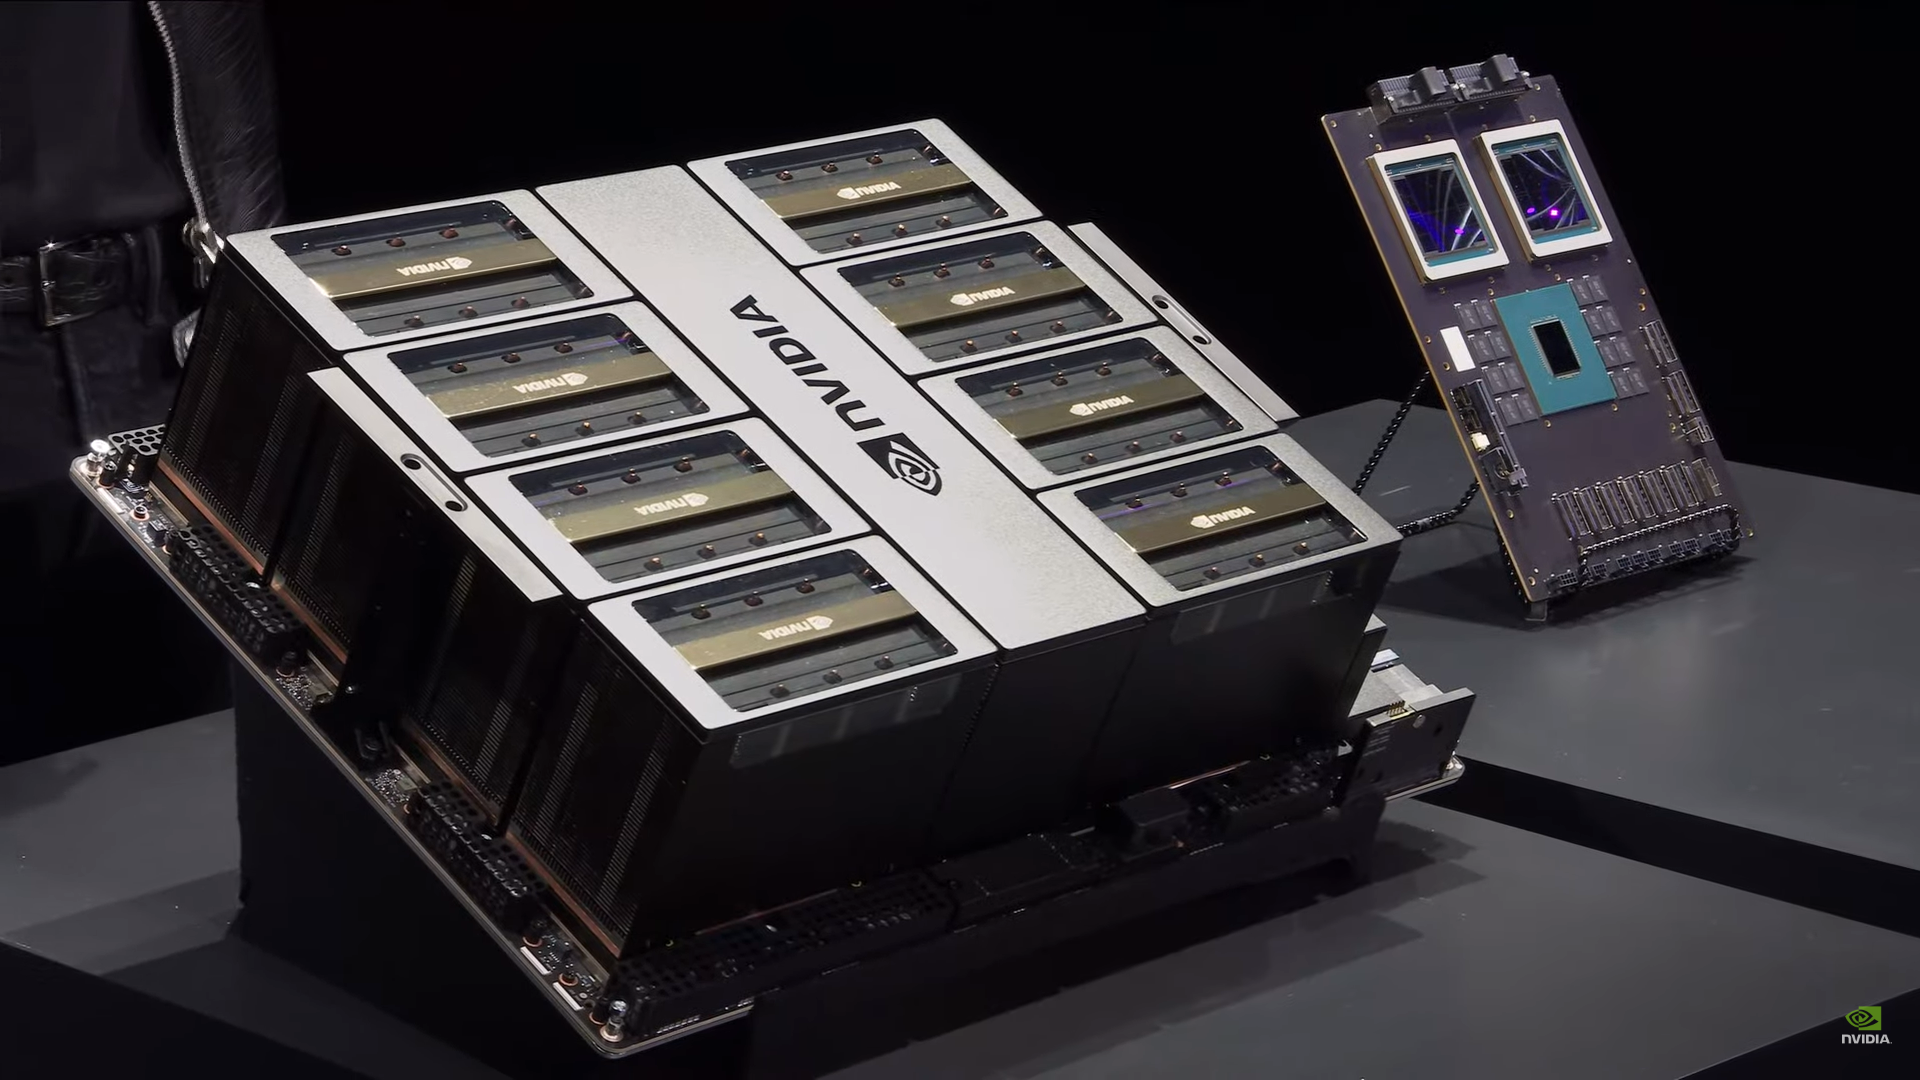 С базовыми кирпичиками разобрались, пора переходить к конструированию продуктов. Первым идёт HGX B100, в основе которой всё та же базовая плата с восемью ускорителями Blackwell, точно так же провязанных между собой NVLink 5 с агрегированной скоростью 14,4 Тбайт/с. Для связи с внешним миром предлагается пара интерфейсов PCIe 6.0 x16. HGX B100 предназначена для простой замены HGX H100, поэтому ускорители имеют TDP не более 700 Вт, что ограничивает пиковую производительность в разреженных FP4- и FP8/FP6/INT8-вычислениях до 14 и 7 Пфлопс соответственно, а для всей системы — 112 и 56 Пфлопс соответственно. 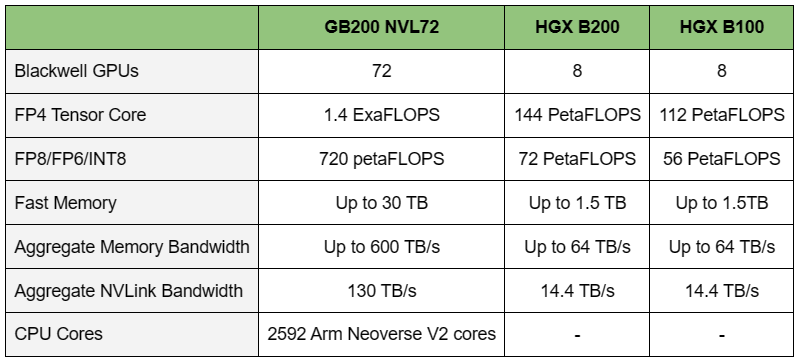 У HGX B200 показатель TDP ограничен уже 1 кВт, причём возможность воздушного охлаждения по-прежнему сохраняется. Производительность одного B200 в разреженных FP4- и FP8/FP6/INT8-вычислениях достигает уже 18 и 9 Пфлопс, а для всей системы — 144 и 72 Пфлопс соответственно. DGX B200 повторяет HGX B200 в плане производительности и является готовой системой от NVIDIA, тоже с воздушным охлаждением. В системе используются два чипа Intel Xeon Emerald Rapids. По словам NVIDIA, DGX B200 до 15 раз быстрее в задачах инференса «триллионных» моделей по сравнению с DGX-узлами прошлого поколения. 800G-интерконнект Ethernet/InfiniBand этим трём платформам не достался, только 400G. 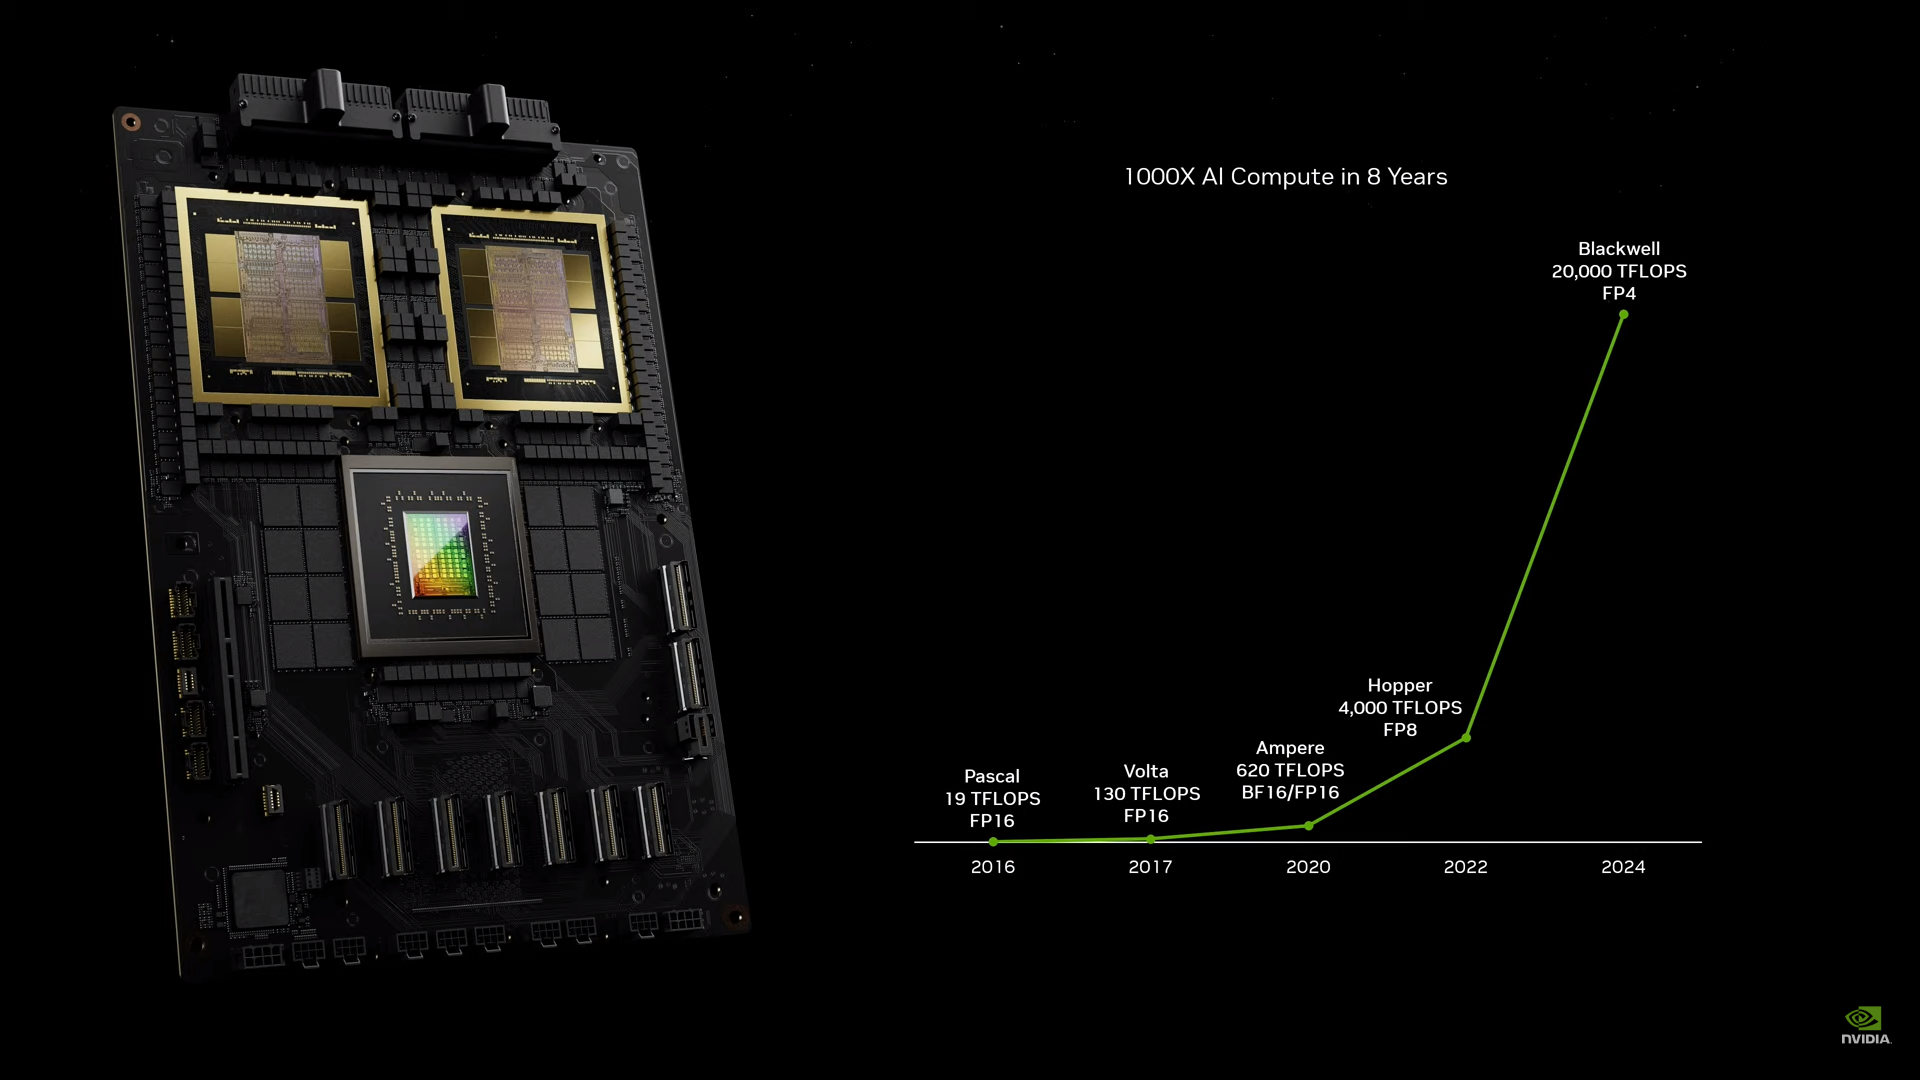 Основным же строительным блоком сама компания явно считает гибридный суперчип GB200, объединяющий уже имеющийся у неё Arm-процессор Grace сразу с двумя ускорителями Blackwell B200. CPU-часть включает 72 ядра Neoverse V2 (по 64 Кбайт L1-кеша для данных и инструкций, L2-кеш 1 Мбайт), 144 Мбайт L3-кеша и до 480 Гбайт LPDDR5x-памяти с ПСП до 512 Гбайт/с. С двумя B200 процессор связан 900-Гбайт/с шиной NVLink-C2C — по 450 Гбайт/с на каждый ускоритель. Между собой B200 напрямую подключены уже по полноценной 1,8-Тбайт/с шине NVLink 5. 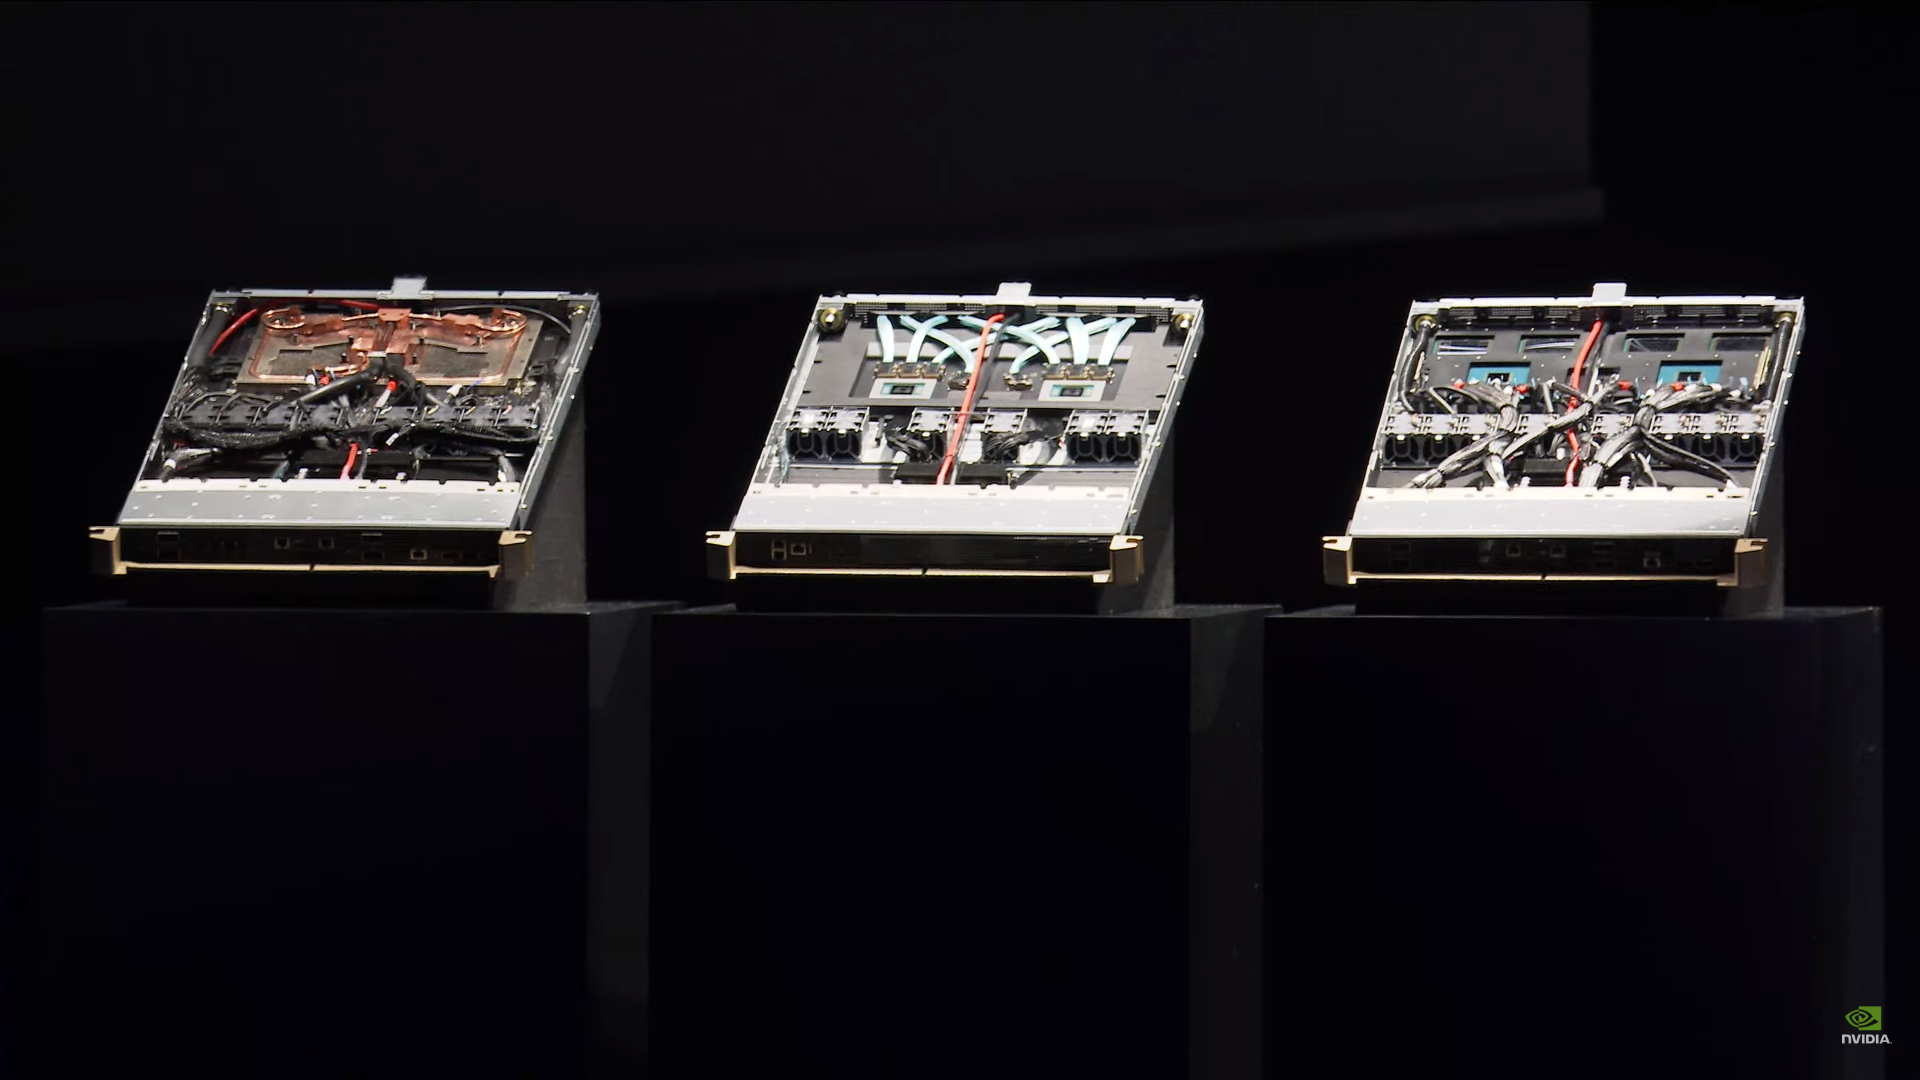 Вся эта немаленькая конструкция шириной в половину стойки имеет TDP до 2,7 кВт. 1U-узел с парой чипов GB200, каждый из которых может отъедать до 1,2 кВт, уже требует жидкостное охлаждение. FP4- и FP8/FP6/INT8-производительность (речь всё ещё о разреженных вычислениях) GB200 достигает 40 и 20 Пфлопс. И именно эти цифры NVIDIA нередко использует для сравнения новинок со старыми решениями. 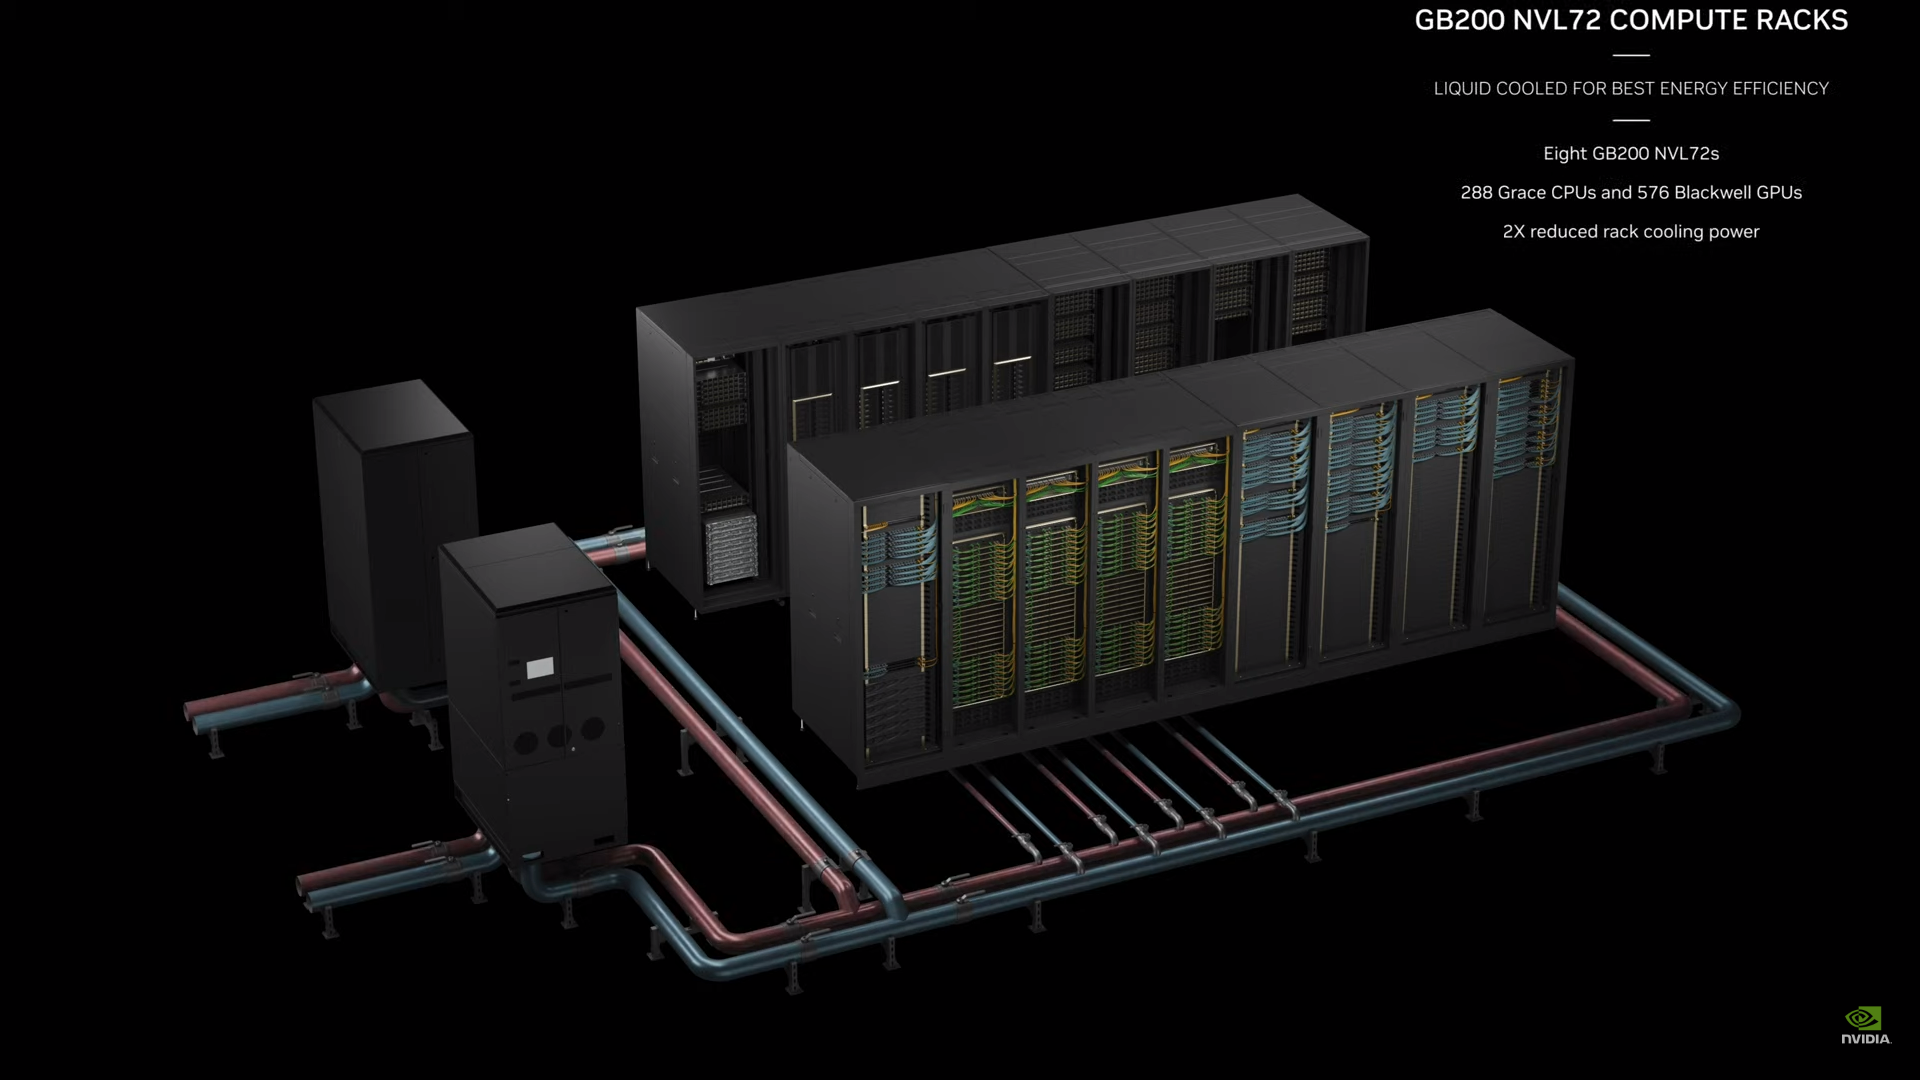 18 узлов с парой GB200 (суммарно 72 шт.) и 9 узлов с парой коммутаторов NVSwitch 7.2T, которые провязывают все ускорители по схеме каждый-с-каждым (агрегированно 130 Тбайт/с, более 3 км соединений), формируют 120-кВт суперускоритель GB200 NVL72 размером со стойку (Oberon), оснащённый СЖО и единой DC-шиной питания. Всё это даёт до 1,44 Эфлопс в FP4-вычислениях и до 720 Пфлопс в FP8, а также до 13,5 Тбайт HBM3e с агрегированной ПСП до 576 Тбайт/с. Ну а общий объём памяти составляет порядка 30 Тбайт. GB200 NVL72 одновременно является и узлом DGX GB200. Восемь DGX GB200 формируют DGX SuperPOD. Впрочем, будет доступен и SuperPOD попроще, на базе DGX B200. 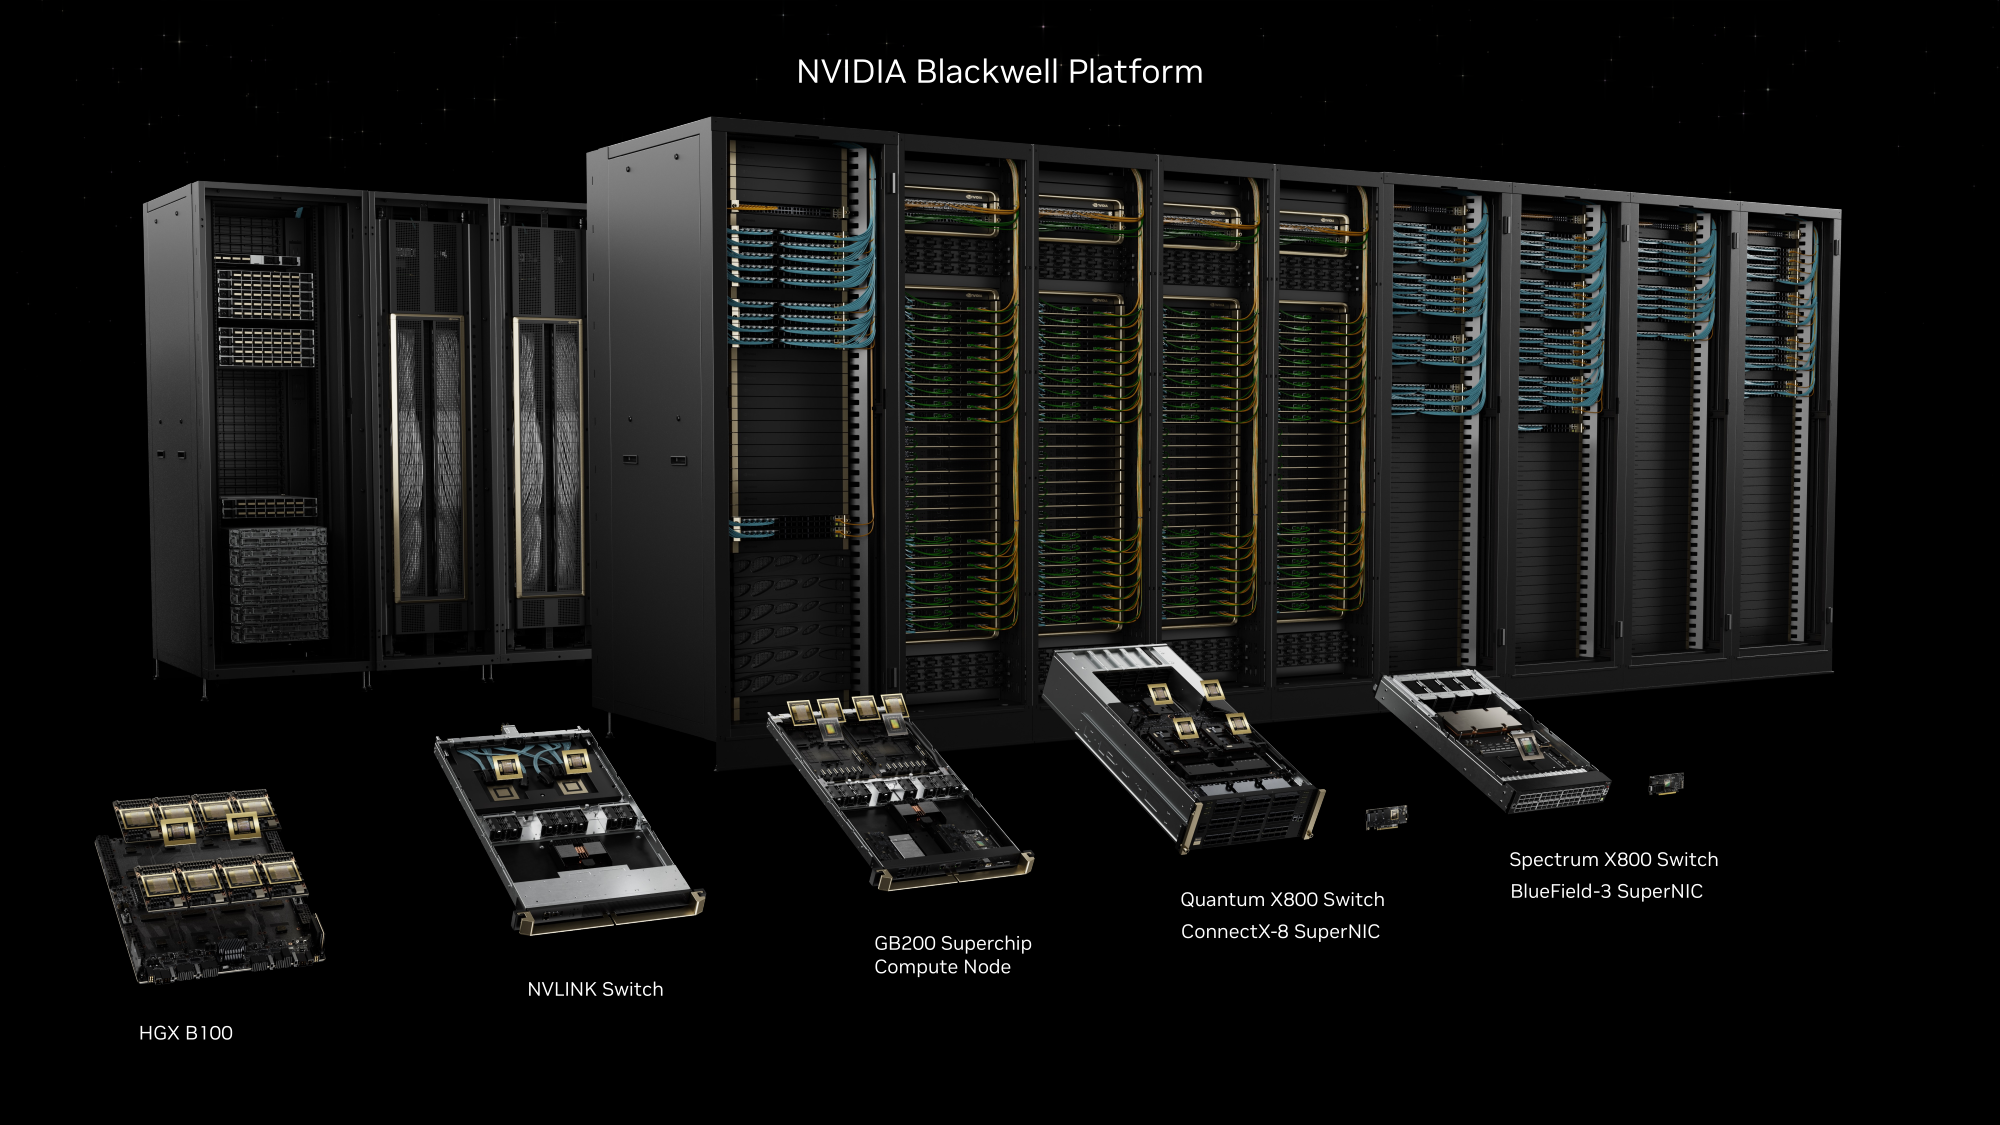 Ускорители B200 появятся в этом году и будут стоить в диапазоне $30–$40 тыс., что ненамного больше начальной цены Hopper в диапазоне $25–$40 тыс. Глава NVIDIA уже предупредил, что Blackwell сразу будут в дефиците. Вероятно, получить доступ к ним проще всего будет в облаках Amazon, Google, Microsoft и Oracle.
23.12.2023 [02:11], Владимир Мироненко
В Испании официально запустили 314-Пфлопс суперкомпьютер MareNostrum 5, который вскоре объединится с двумя квантовыми компьютерами21 декабря в Суперкомпьютерном центре Барселоны — Centro Nacional de Supercomputación (BSC-CNS) — в торжественной обстановке официально запустили европейский суперкомпьютер MareNostrum 5 производительностью 314 Пфлопс. В церемонии, посвящённой машине, созданной в рамках проекта European High Performance Computing Joint Undertaking (EuroHPC JU), принял участие председатель правительства Испании. MareNostrum 5 представляет собой крупнейшую инвестицию, когда-либо сделанную Европой в научную инфраструктуру Испании — суммарно €202 млн, из которых €151,4 млн ушло на приобретение суперкомпьютера. Финансирование было проведено EuroHPC JU через Фонд ЕС «Соединение Европы» и программу исследований и инноваций «Горизонт 2020», а также государствами-участниками: Испанией (через Министерство науки, инноваций и университетов и правительство Каталонии), Турцией и Португалией. С запуском MareNostrum 5 заметно укрепились позиции BSC в качестве одного из ведущих суперкомпьютерных центров мира с более чем 900 сотрудниками, занимающимися исследования в области информатики, наук о жизни и о Земле, а также вычислительных систем для науки и техники. Обладая максимальной общей производительностью 314 Пфлопс, MareNostrum 5 присоединяется к двум другим системам EuroHPC: Lumi (Финляндия) и Leonardo (Италия), тоже являющихся суперкомпьютерами предэкзафлопсного класса, единственными системами такого уровня в Европе. 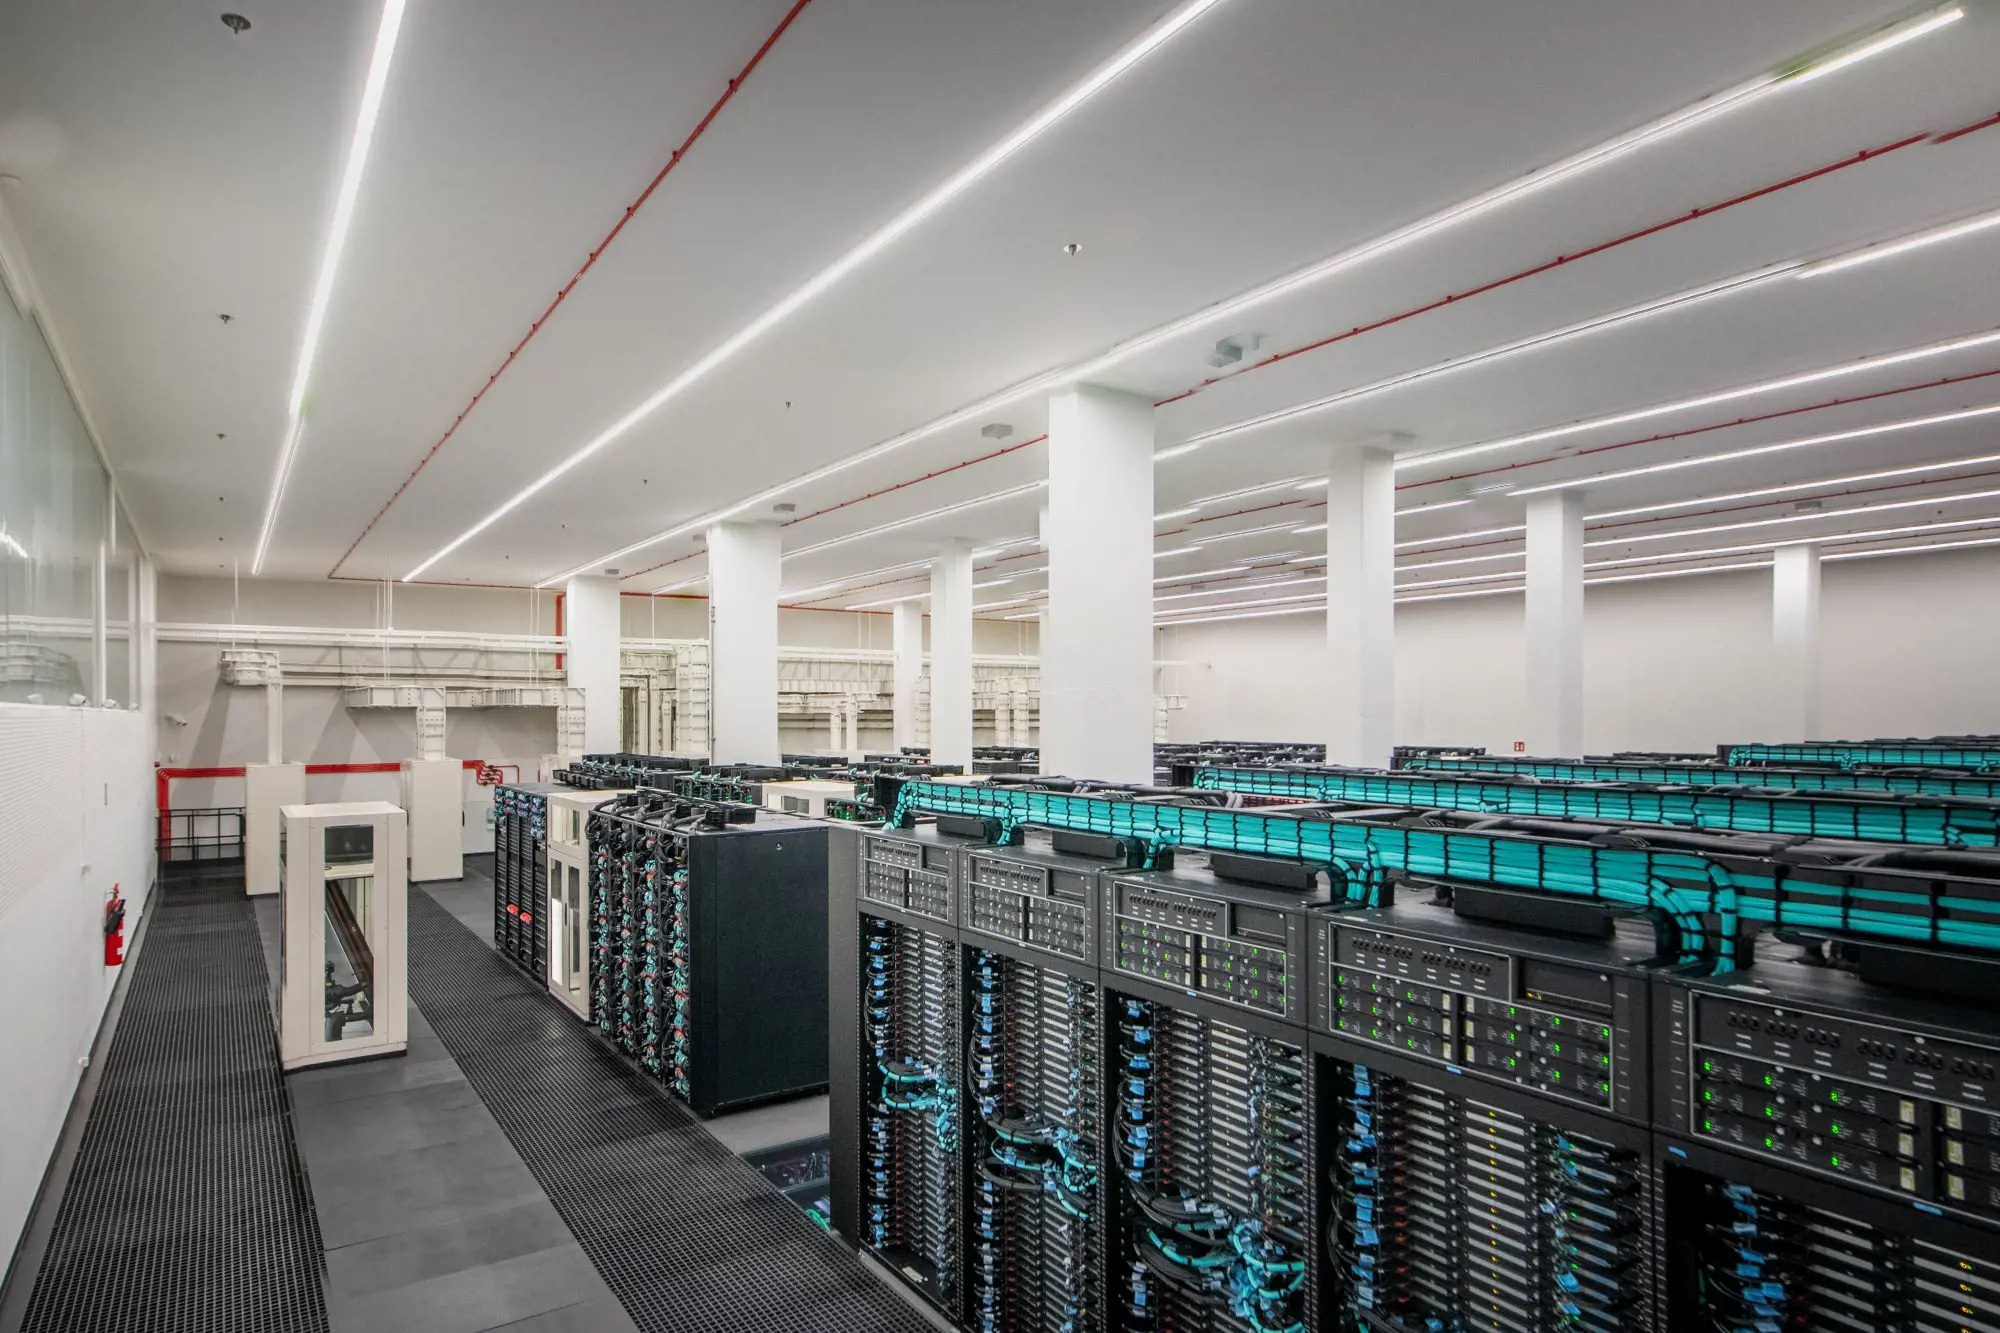
Источник изображений: BSC Eviden (Atos) была выбрана в качестве основного поставщика, но в создании машины приняли участие Lenovo, IBM, Intel и NVIDIA, а также Partec. Как отмечено в пресс-релизе, уникальная архитектура MareNostrum 5 была создана для того, чтобы предоставить исследователям лучшие из доступных технологий. Это гетерогенная машина, сочетающая в себе две отдельные системы: раздел общего назначения (GPP), предназначенный для классических вычислений, и GPU-раздел (ACC), ориентированный на ИИ. Обе системы по отдельности входят в первую двадцатку TOP500, занимая 19-е и 8-е места соответственно. Раздел общего назначения (GPP) является крупнейшим в мире x86-кластером на базе Intel Xeon Sapphire Rapids. Эта часть суперкомпьютера имеет пиковую производительность 45,9 Пфлопс. Система, произведённая Lenovo, специально разработана для решения сложных научных задач с разделением ресурсов, что обеспечивает большую гибкость и повышает эффективность системы, поскольку разные пользователи или проекты могут использовать её одновременно. GPP имеет 6408 стандарных узлов следующей конфигурации:
Дополнительно система имеет 72 узла с двумя 56-ядерными Xeon Max (1,7 ГГц) и набортной памятью HBM2e объёмом 128 Гбайт. 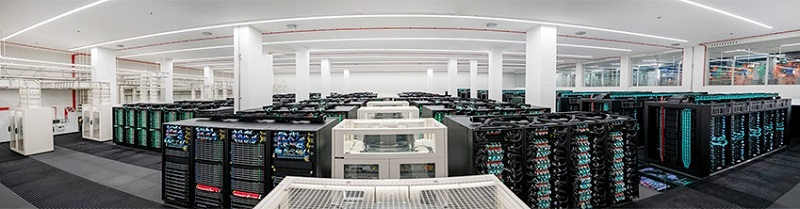 GPU-раздел (ACC) производства Eviden является третьим по мощности в Европе и восьмым в мире по версии TOP500, с пиковой производительностью 260 Пфлопс. Он основан на 4480 ускорителях NVIDIA H100. Раздел имеет 1120 узлов, каждый из которых включает:
Общая ёмкость хранилища MareNostrum 5 составляет 650 Пбайт, из которых, 402 Пбайт приходятся на LTO, 248 Пбайт — на HDD, а остальное — на NVMe SSD. Задействована ФС IBM Spectrum Scale. Машина использует интерконнект InfiniBand NDR200, объединяющий более 8000 узлов. Можно заметить, что NVIDIA предоставила BSC не совсем стандартные решения. В будущем ожидается появление ещё одного GPP-раздела на базе NVIDIA Grace, а вот расширение ACC узлами с Xeon Emerald Rapids и Rialto Bridge не состоится. 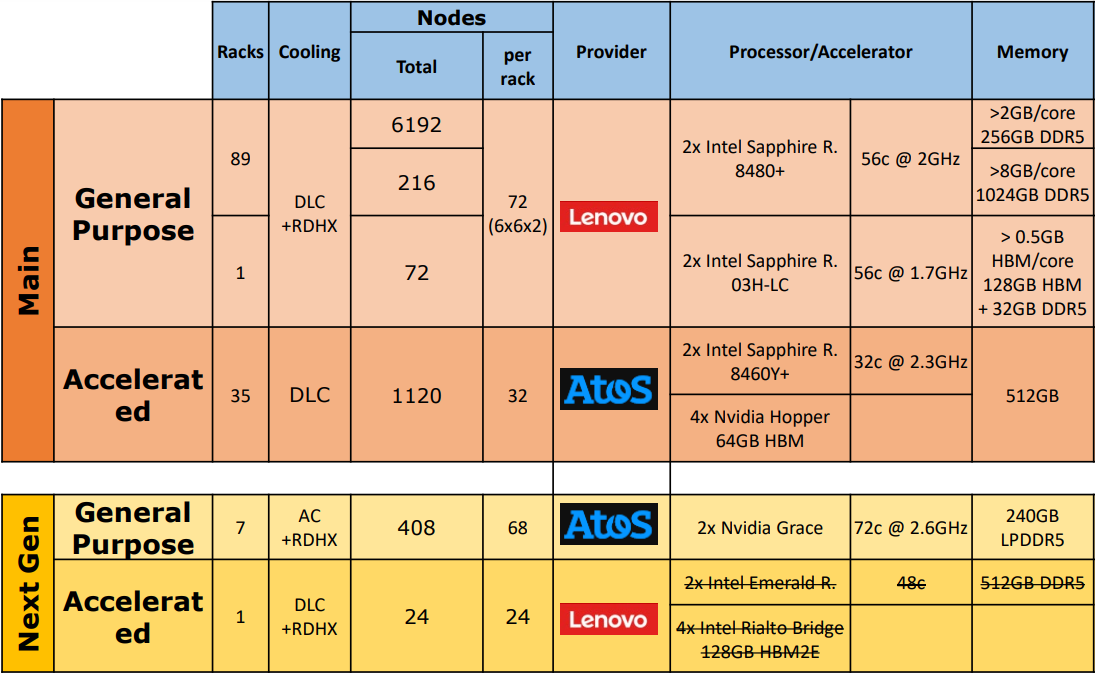 Благодаря увеличенной вычислительной мощности MareNostrum 5 позволяет решать всё более сложные задачи. Например, климатические модели получат более высокое разрешение, что сделает прогнозы гораздо более точными и надёжными. Также появится возможность решать гораздо более сложные проблемы в области ИИ и Big Data. Отдельное внимание уделено поддержке европейских медицинских исследований в области создания новых лекарств, разработки вакцин и моделирования распространения вирусов. Суперкомпьютер также станет важнейшим инструментом для материаловедения и инженерии, включая проектирование и оптимизацию самолётов, развитие более безопасной, экологически чистой и эффективной авиации. Аналогичным образом, машина будет использоваться для моделирования процессов энергогенерации, включая ядерный синтез. В ближайшие месяцы MareNostrum 5 объединится с двумя квантовыми компьютерами: первой системой испанской суперкомпьютерной сети (RES), которая является частью инициативы Quantum Spain, и одним из первых европейских квантовых компьютеров EuroHPC JU. Оба квантовых компьютера будут одними из первых, которых запустили в Южной Европе. |
|

