
Материалы по тегу: nvidia
|
14.11.2024 [08:17], Владимир Мироненко
SoftBank построит в Японии первый в мире ИИ-суперкомпьютер на базе NVIDIA DGX B200NVIDIA объявила о серии совместных проектов с SoftBank, направленных на ускорение суверенных инициатив Японии в области ИИ, которые также обеспечат возможность получения дохода от ИИ для поставщиков телекоммуникационных услуг по всему миру. В выступлении на саммите NVIDIA AI Summit Japan генеральный директор NVIDIA Дженсен Хуанг (Jensen Huang) объявил, что SoftBank создаёт самый мощный в Японии ИИ-суперкомпьютер с использованием платформы NVIDIA DGX SuperPOD B200 и интерконнекта Quantum-2 InfiniBand. Эта система станет первой в мире, которая получит системы DGX B200. Она будет использоваться компанией для разработки генеративного ИИ и развития других бизнес-решений, а также для предоставления вычислительных услуг университетам, научно-исследовательским институтам и предприятиям в стране. Суперкомпьютер идеально подойдёт для разработки больших языковых моделей (LLM), говорится в пресс-релизе. Пока что на звание самого мощного ИИ-суперкомьютера Японии претендует система ABCI 3.0 на базе NVIDIA H200. Впрочем, Softbank не сидит сложа руки и планирует построить ещё один суперкомпьютер, на этот раз на базе суперускорителей GB200 NVL72. Они же будут использоваться в проекте Sharp, KDDI и Supermicro по созданию «крупнейшего в Азии» ИИ ЦОД. 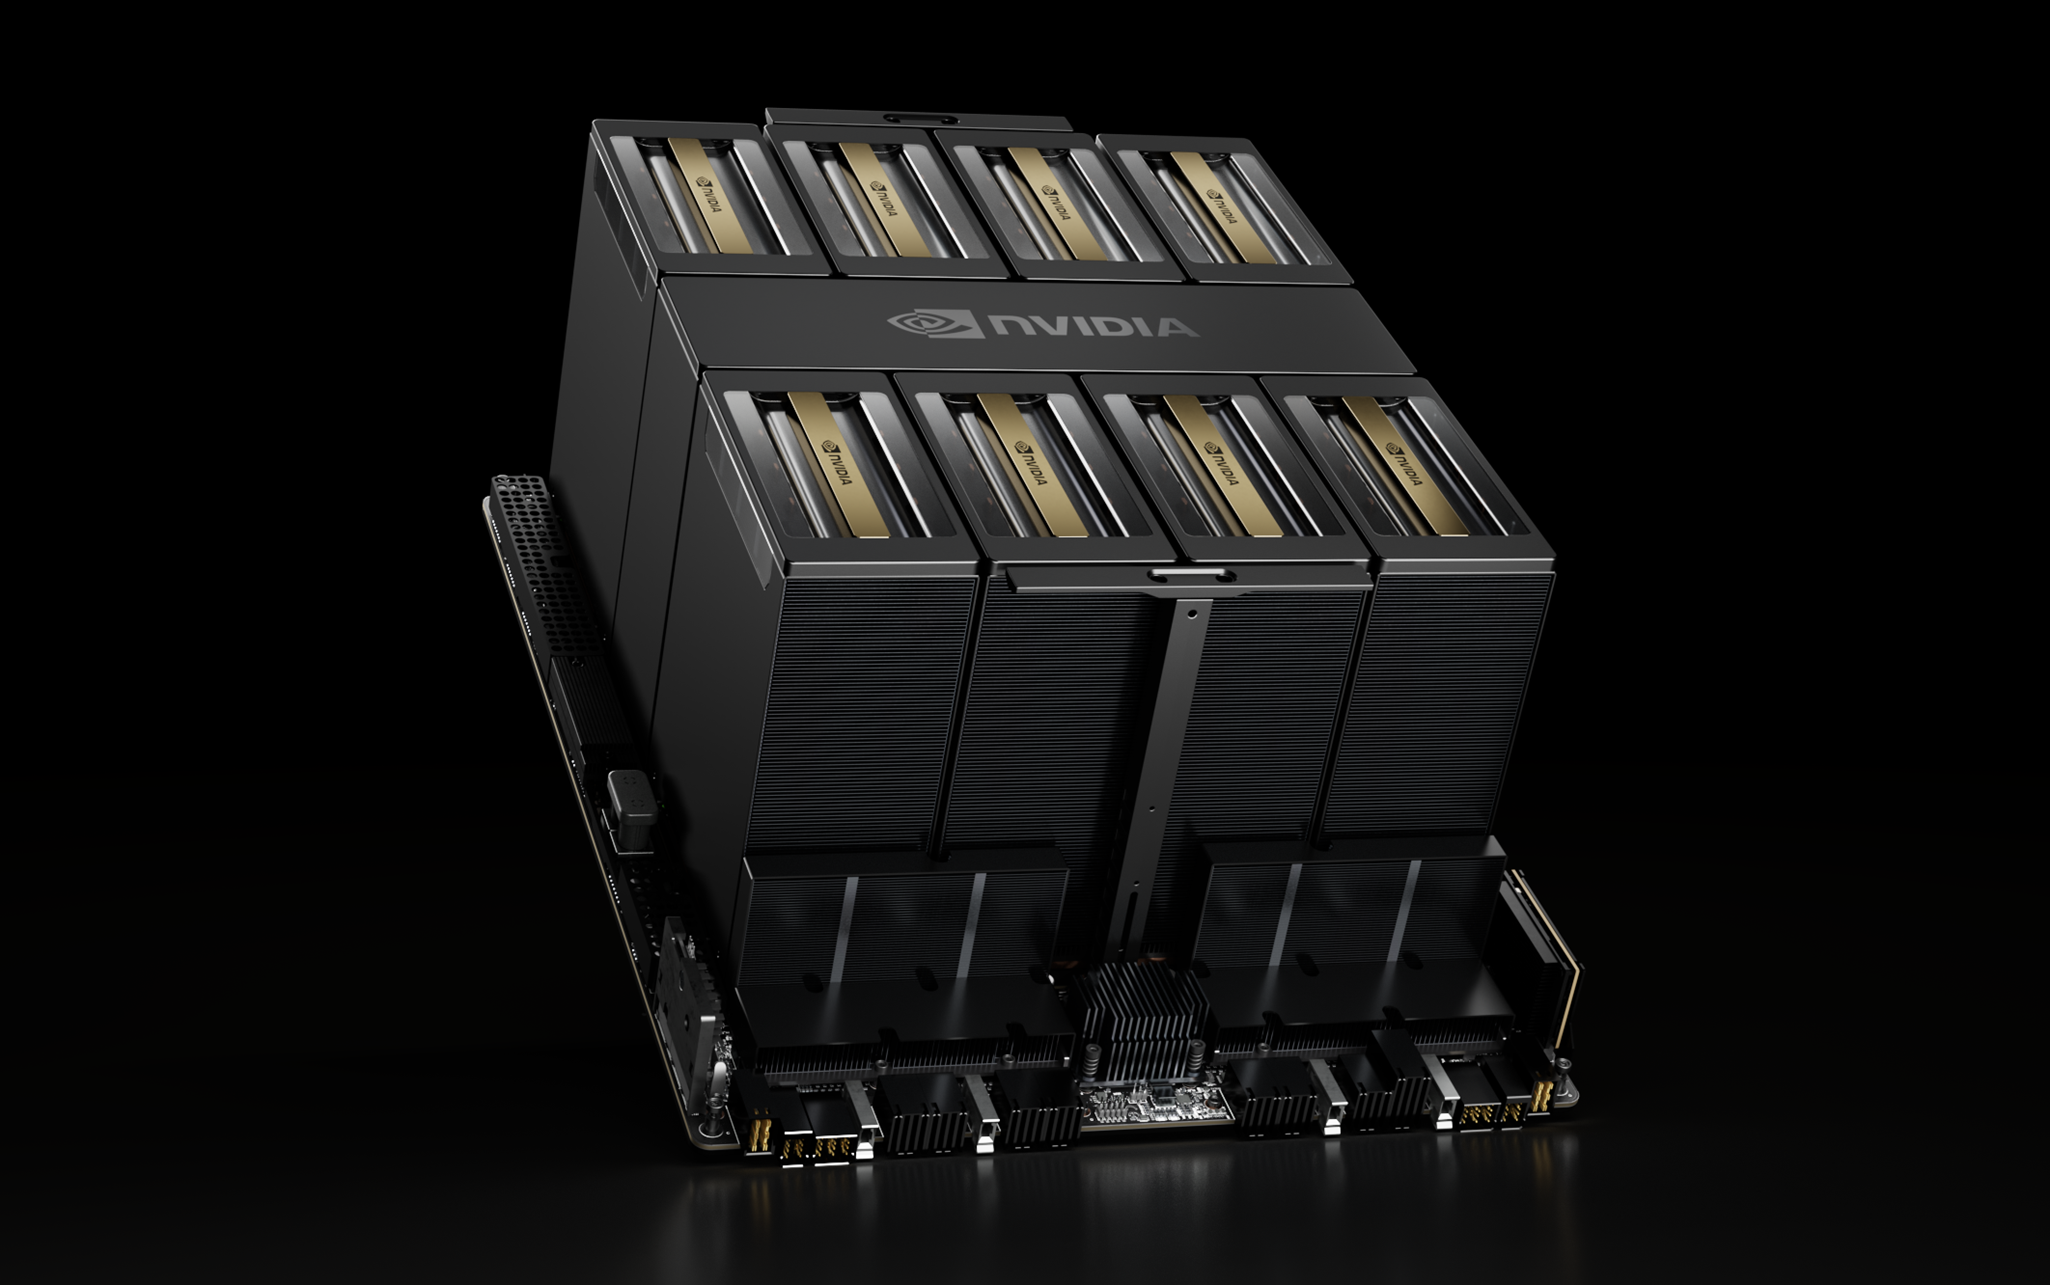
Источник изображения: NVIDIA Также в ходе саммита было объявлено, что SoftBank, используя платформу ускоренных вычислений NVIDIA AI Aerial, успешно запустил первую в мире телекоммуникационную сеть, объединяющую возможности ИИ и 5G. В ходе испытаний, проведенных в префектуре Канагава, SoftBank продемонстрировала, что решение AI-RAN достигло производительности 5G операторского класса, используя ресурсы ускорителя для одновременной обработки сетевого трафика и инференса. Отмечается, что мобильные сети традиционно рассчитаны на обработку пиковых нагрузок и в среднем задействуют только треть аппаратных ресурсов, что позволяет монетизировать оставшиеся две трети путём предоставления ИИ-сервисов. NVIDIA и SoftBank также сообщили, что с помощью ПО NVIDIA AI Enterprise японская компания будет создавать локализованные безопасные ИИ-сервисы.
12.11.2024 [14:31], Руслан Авдеев
Supermicro лишилась огромного заказа на NVIDIA GB200 NVL72, который был передан WiwynnSupermicro, по данным UDN, лишилась заказа от индонезийской YTL Group (YTLP) на поставку новейших суперускорителей NVIDIA GB200 NVL72 для одного из крупнейших в Юго-Восточной Азии ИИ-суперкомпьютеров. Изначально заказ YTL был поделен между Supermicro и Wiwynn (Wistron), но теперь поставками будет заниматься только Wiwynn. В начале ноября появилась информация о том, что NVIDIA начала менять цепочку поставок, перенаправляя чипы, предназначавшиеся Supermicro, другим вендорам. В последнее время Supermicro была третьим по величине партнёром NVIDIA по объёму закупок чипов. Supermicro, по слухам, остановила расширение двух заводов в Малайзии, которые должны были удвоить её производственные мощности до 10 тыс. полностью укомплектованных стоек с СЖО в месяц. Остановка строительства заводов негативно сказалась на планах YTL Group, крупного покупателя ИИ-серверов NVIDIA и одного из крупнейших клиентов Supermicro. YTL намерена за $4,3 млрд построить кампус ЦОД площадью более 660 га в Джохоре (Малайзия) и разместить там самый производительный в стране или даже регионе ИИ-суперкомпьютер (300 Эфлопс). По данным UDN, YTL вынужденно передала заказ тайваньской Wywinn. Последняя также владеет современным производством в Малайзии, которое недавно было расширено.  Крупные неприятности у Supermicro начались в августе, когда Hindenburg Research обвинила компанию в различных злоупотреблениях, включая манипуляции с бухгалтерской отчётностью. Впоследствии собственное расследование открыло Министерства юстиции США. Ernst & Young отказалась от аудита Supermicro, а сама компания уже несколько раз откладывала публикацию финансовой отчётности. Всё это привело к резкому падению стоимости акций компании. А сейчас ей и вовсе грозит делистинг с Nasdaq.
20.10.2024 [11:01], Сергей Карасёв
NVIDIA передаст OCP спецификации компонентов суперускорителя GB200 NVL72Некоммерческая организация Open Compute Project Foundation (OCP), специализирующаяся на создании открытых спецификаций оборудования для ЦОД, сообщила о том, что для её инициативы Open Systems for AI собственные разработки предоставят NVIDIA и Meta✴. Проект Open Systems for AI был анонсирован в январе 2024 года при участии Intel, Microsoft, Google, Meta✴, NVIDIA, AMD, Arm, Ampere, Samsung, Seagate, SuperMicro, Dell и Broadcom. Цель инициативы заключается в разработке открытых стандартов для кластеров ИИ и дата-центров, в которых размещаются такие системы. Предполагается, что Open Systems for AI поможет повысить эффективность и устойчивость ИИ-платформ, а также обеспечит возможность формирования цепочек поставок оборудования от нескольких производителей. В рамках инициативы NVIDIA предоставит OCP спецификации элементы электромеханической конструкции суперускорителей GB200 NVL72, включая архитектуры стойки и жидкостного охлаждения, механические части вычислительного и коммутационного лотков. 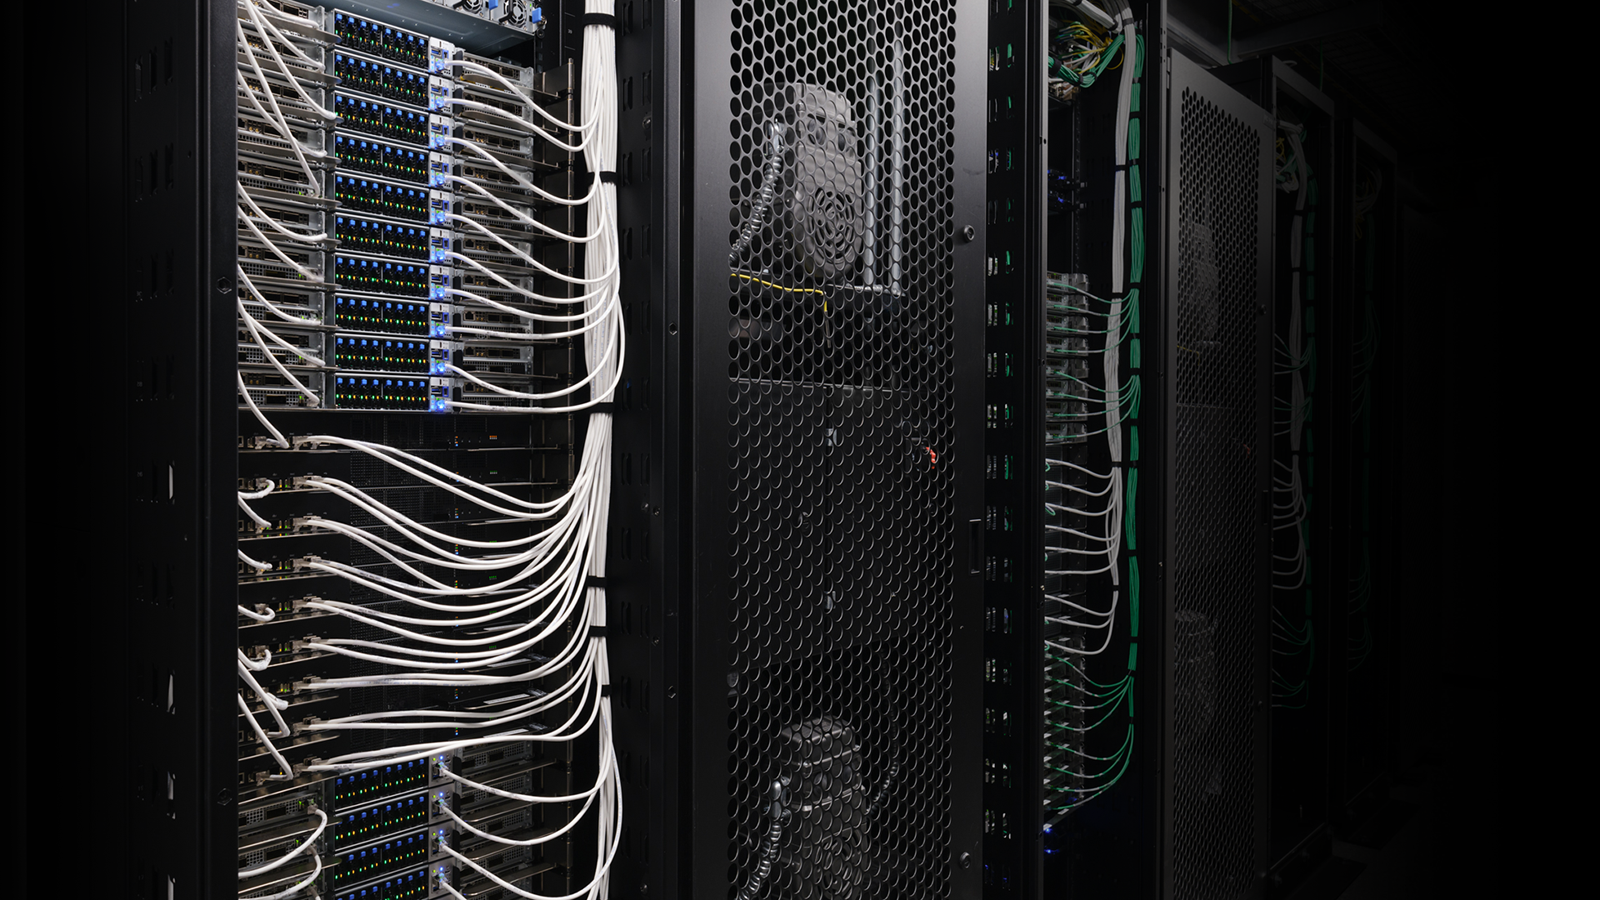
Источник изображения: NVIDIA Кроме того, NVIDIA расширит поддержку стандартов OCP в своей сетевой инфраструктуре Spectrum-X. Речь идёт об обеспечении совместимости со стандартами OCP Switch Abstraction Interface (SAI) и Software for Open Networking in the Cloud (SONiC). Это позволит клиентам использовать адаптивную маршрутизацию Spectrum-X и управление перегрузками на основе телеметрии для повышения производительности Ethernet-соединений в составе масштабируемой инфраструктуры ИИ. Адаптеры ConnectX-8 SuperNIC с поддержкой OCP 3.0 появятся в 2025 году. В свою очередь, Meta✴ передаст проекту Open Systems for AI свою архитектуру Catalina AI Rack, которая специально предназначена для создания ИИ-систем высокой плотности с поддержкой GB200. Это, как ожидается, позволит организации OCP «внедрять инновации, необходимые для создания более устойчивой экосистемы ИИ».
18.10.2024 [00:10], Алексей Степин
Meta✴ представила свой вариант суперускорителя NVIDIA GB200 NVL72Meta✴ поделилась своими новинками в области аппаратной инфраструктуры и рассказала, каким именно видит будущее открытых ИИ-платформ. В своей презентации Meta✴ рассказала о новой ИИ-платформе, новых дизайнах стоек, включая варианты с повышенной мощностью питания, а также о новинках в области сетевой инфраструктуры. 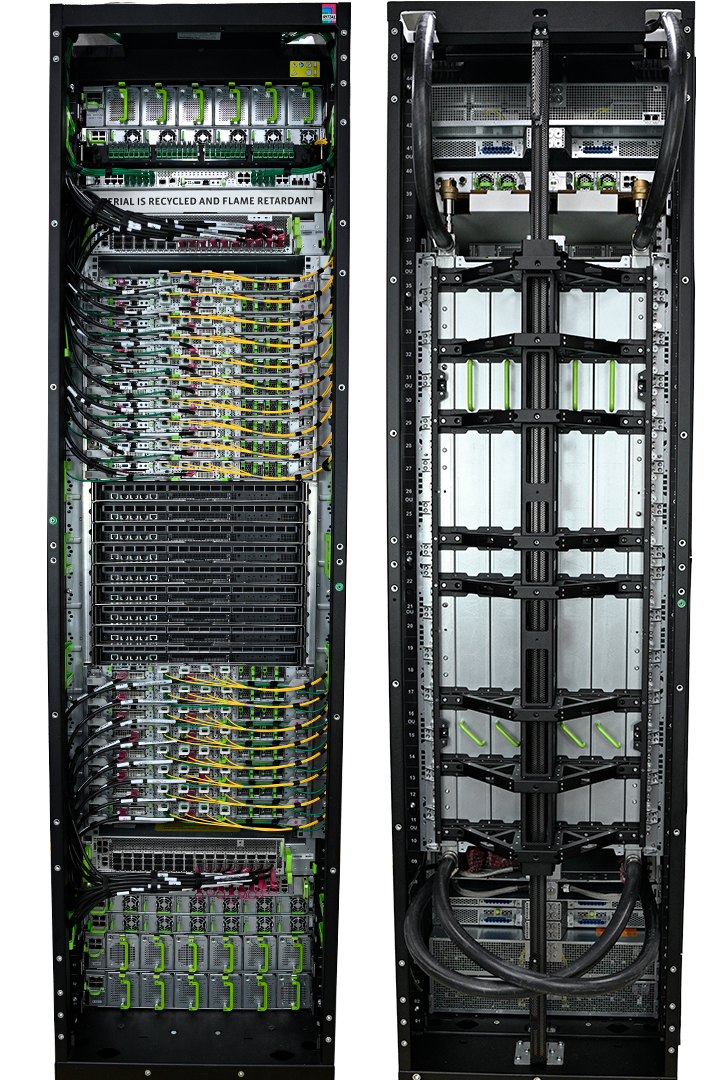
Источник изображений: Meta✴ В настоящее время компания использует нейросеть Llama 3.1 405B. Контекстное окно у этой LLM достигает 128 тыс. токенов, всего же токенов свыше 15 трлн. Чтобы обучать такие модели, требуются очень серьёзные ресурсы и глубокая оптимизация всего программно-аппаратного стека. В обучении базовой модели Llama 3.1 405B участвовал кластер 16 тыс. ускорителей NVIDIA H100, один из первых такого масштаба. Но уже сейчас для обучения ИИ-моделей Meta✴ использует два кластера, каждый с 24 тыс. ускорителей. Проекты такого масштаба зависят не только от ускорителей. На передний план выходят проблемы питания, охлаждения и, главное, интерконнекта. В течение нескольких следующих лет Meta✴ ожидает скоростей в районе 1 Тбайт/с на каждый ускоритель. Всё это потребует новой, ещё более плотной архитектуры, которая, как считает Meta✴, должна базироваться на открытых аппаратных стандартах. 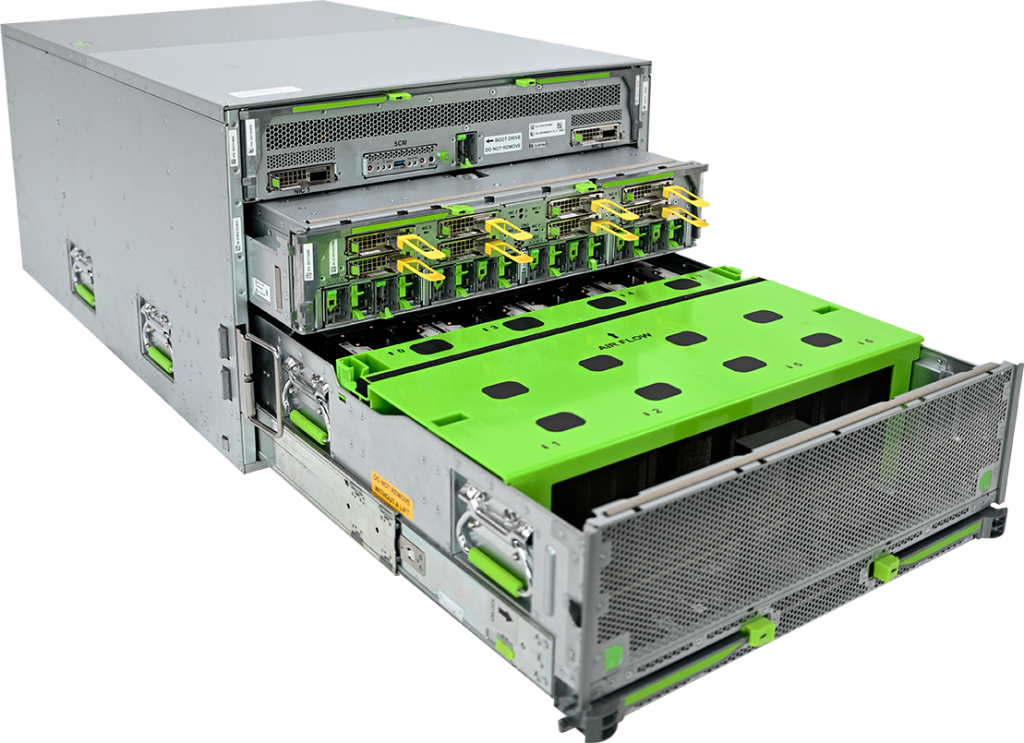 Одной из новинок стала платформа Catalina. Это Orv3-стойка, сердцем которой являются гибридные процессоры NVIDIA GB200. Стойка относится к классу HPR (High Power Rack) и рассчитана на 140 КВт. Сейчас Microsoft и Meta✴ ведут работы над модульной и масштабируемой системой питания Mount Diablo. Свой вариант GB200 NVL72 у Microsoft тоже есть. Также Meta✴ обновила ИИ-серверы Grand Teton, впервые представленные в 2022 году. Это по-прежнему монолитные системы, но теперь они поддерживают не только ускорители NVIDIA, но и AMD Instinct MI300X и будущие MI325X. 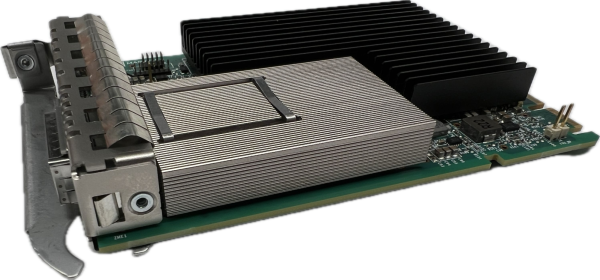 Интерконнектом будущих платформ станет сеть DSF (Disaggregated Scheduled Fabric). Благодаря переходу на открытые стандарты компания планирует избежать ограничений, связанных с масштабированием, зависимостью от вендоров аппаратных компонентов и плотностью подсистем питания. В основе DSF лежит стандарт OCP-SAI и ОС Meta✴ FBOSS для коммутаторов. Аппаратная часть базируется на стандартном интерфейсе Ethernet/RoCE. Meta✴ уже разработала и воплотила в металл новые коммутаторы класса 51Т на базе кремния Broadcom и Cisco, а также сетевые адаптеры FBNIC, созданные при поддержке Marvell. FBNIC может иметь до четырёх 100GbE-портов. Используется интерфейс PCIe 5.0, причём могущий работать как четыре отдельных слайса. Новинка соответствует открытому стандарту OCP NIC 3.0 v1.2.0.
27.07.2024 [23:44], Алексей Степин
Не так просто и не так быстро: учёные исследовали особенности работы памяти и NVLink C2C в NVIDIA Grace HopperГибридный ускоритель NVIDIA Grace Hopper объединяет CPU- и GPU-модули, которые связаны интерконнектом NVLink C2C. Но, как передаёт HPCWire, в строении и работе суперчипа есть некоторые нюансы, о которых рассказали шведские исследователи. Им удалось замерить производительность подсистем памяти Grace Hopper и интерконнекта NVLink в реальных сценариях, дабы сравнить полученные результаты с характеристиками, заявленными NVIDIA. Напомним, для интерконнекта изначально заявлена скорость 900 Гбайт/с, что в семь раз превышает возможности PCIe 5.0. Память HBM3 в составе GPU-части имеет ПСП до 4 Тбайт/с, а вариант с HBM3e предлагает уже до 4,9 Тбайт/с. Процессорная часть (Grace) использует LPDDR5x с ПСП до 512 Гбайт/с. В руках исследователей оказалась базовая версия Grace Hopper с 480 Гбайт LPDDR5X и 96 Гбайт HBM3. Система работала под управлением Red Hat Enterprise Linux 9.3 и использовала CUDA 12.4. В бенчмарке STREAM исследователям удалось получить следующие показатели ПСП: 486 Гбайт/с для CPU и 3,4 Тбайт/с для GPU, что близко к заявленным характеристиками. Однако результат скорость NVLink-C2C составила всего 375 Гбайт/с в направлении host-to-device и лишь 297 Гбайт/с в обратном направлении. Совокупно выходит 672 Гбайт/с, что далеко от заявленных 900 Гбайт/с (75 % от теоретического максимума). 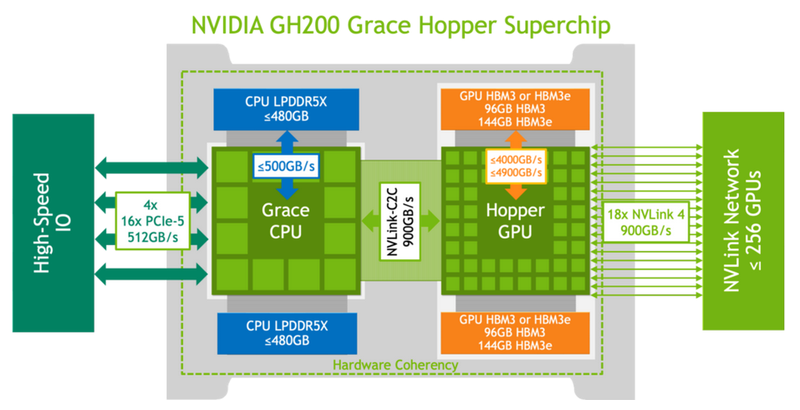
Источник: NVIDIA Grace Hopper в силу своей конструкции предлагает два вида таблицы для страниц памяти: общесистемную (по умолчанию страницы размером 4 Кбайт или 64 Кбайт), которая охватывает CPU и GPU, и эксклюзивную для GPU-части (2 Мбайт). При этом скорость инициализации зависит от того, откуда приходит запрос. Если инициализация памяти происходит на стороне CPU, то данные по умолчанию помещаются в LPDDR5x, к которой у GPU-части есть прямой доступ посредством NVLink C2C (без миграции), а таблица памяти видна и GPU, и CPU. 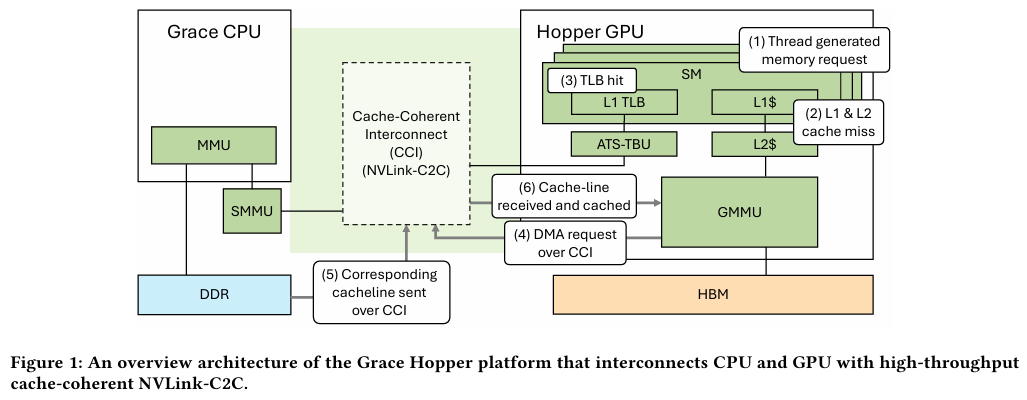
Источник: arxiv.org Если же памятью управляет не ОС, а CUDA, то инициализацию можно сразу организовать на стороне GPU, что обычно гораздо быстрее, а данные поместить в HBM. При этом предоставляется единое виртуальное адресное пространство, но таблиц памяти две, для CPU и GPU, а сам механизм обмена данными между ними подразумевает миграцию страниц. Впрочем, несмотря на наличие NVLink C2C, идеальной остаётся ситуация, когда GPU-нагрузке хватает HBM, а CPU-нагрузкам достаточно LPDDR5x. 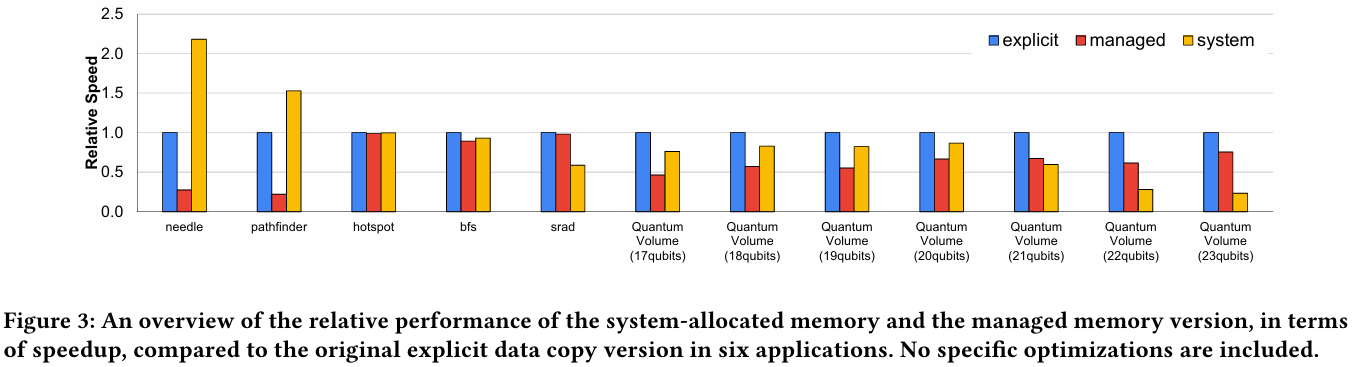
Источник: arxiv.org Также исследователи затронули вопрос производительности при использовании страниц памяти разного размера. 4-Кбайт страницы обычно используются процессорной частью с LPDDR5X, а также в тех случаях, когда GPU нужно получить данные от CPU через NVLink-C2C. Но как правило в HPC-нагрузках оптимальнее использовать 64-Кбайт страницы, на управление которыми расходуется меньше ресурсов. Когда же доступ в память хаотичен и непостоянен, страницы размером 4 Кбайт позволяют более тонко управлять ресурсами. В некоторых случаях возможно двукратное преимущество в производительности за счёт отсутствия перемещения неиспользуемых данных в страницах объёмом 64 Кбайт. В опубликованной работе отмечается, что для более глубокого понимания механизмов работы унифицированной памяти у гетерогенных решений, подобных Grace Hopper, потребуются дальнейшие исследования.
17.07.2024 [23:33], Игорь Осколков
Суперускоритель по суперцене — NVIDIA GB200 NVL72, вероятно, будет стоить $3 млнКомпания NVIDIA значительно увеличила заказ на ускорители Blackwell у TSMC, сообщает TrendForce со ссылкой на United Daily News (UDN). По данным источника, NVIDIA намерена получить уже не 40 тыс., а 60 тыс. суперускорителей нового поколения, причём 50 тыс. из них придётся на стоечные системы GB200 NVL36. При этом Blackwell всё равно будут в дефиците, как и обещал ещё зимой глава NVIDIA Дженсен Хуанг (Jensen Huang). B200 включает два тайла, объединённых 2,5D-упаковкой CoWoS-L и соединённых интерконнектом NV-HBI. Чип имеет 208 млрд транзисторов, изготовленных по кастомному техпроцессу TSMC 4NP. GB200 объединяет два ускорителя B200 и один 72-ядерный Arm-процессор Grace. А суперускоритель GB200 NVL72, в свою очередь, объединяет в рамках одной стойки Oberon сразу 18 1U-узлов с парой GB200 в каждом (плата Bianca, 72 × B200 и 36 × Grace), провязанных шиной NVLink 5. Вся эта система потребляет порядка 120 кВт, оснащена СЖО и единой DC-шиной питания. Однако у GB200 NVL72 довольно специфические требования к окружению, поэтому NVIDIA предлагает суперускоритель попроще — GB200 NVL36, который как раз и должен стать наиболее массовым в данной серии. Эта платформа точно так же занимает целую стойку, но использует 2U-узлы с теми же платами Bianca (суммарно 36 × B200 и 18 × Grace), потребляя всего 66 кВт. При этом всё равно подразумевается использование двух стоек GB200 NVL36, объединённых интерконнектом, так что GB200 NVL72 всё равно получается более энергоэффективным решением. 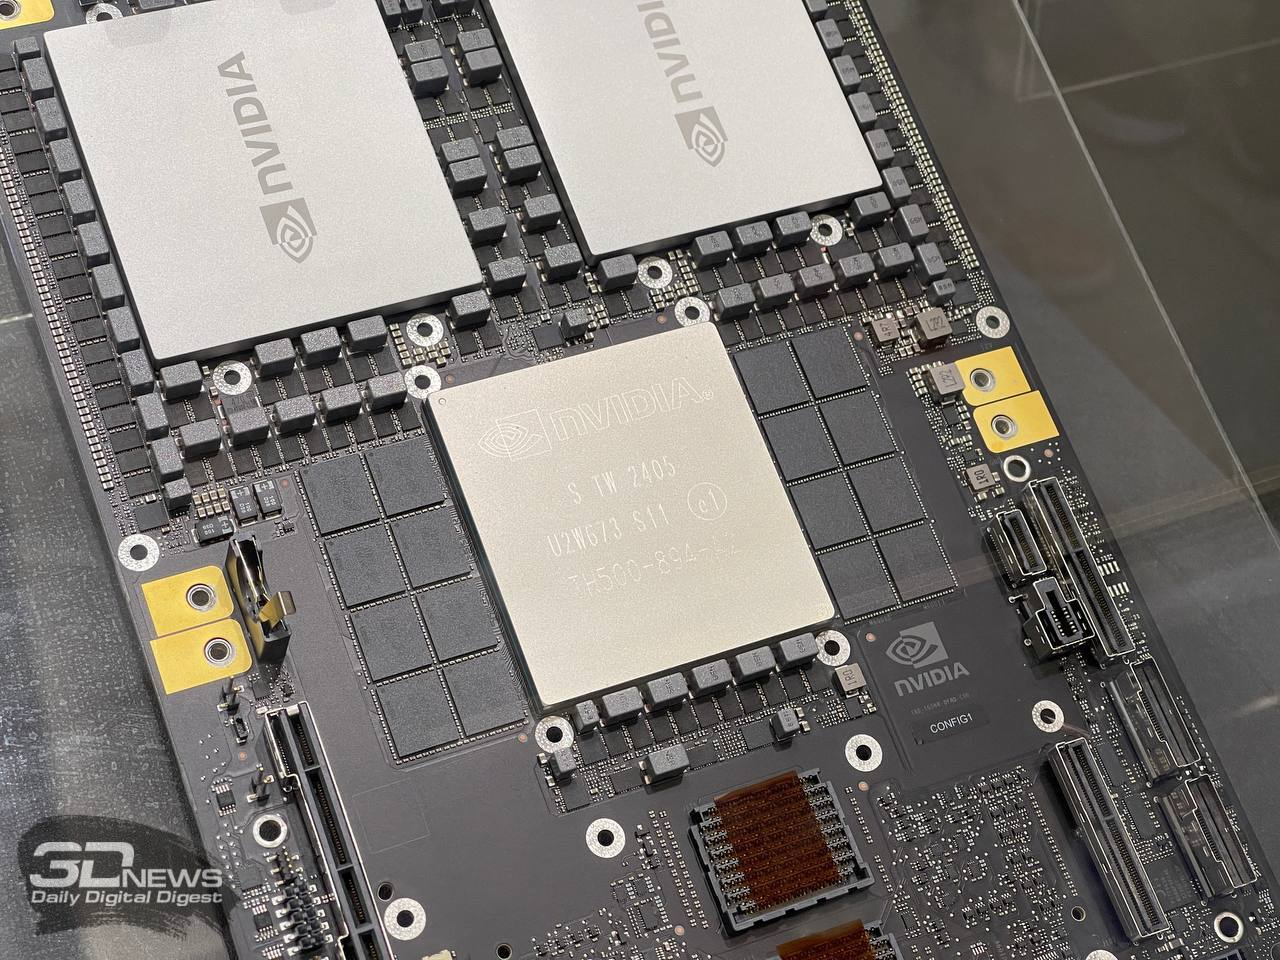
NVIDIA GB200 Как отмечает SemiAnalysis, GB200 NVL36 также будет доступен в варианте с платами Ariel, имеющими по одному чипу B200 и Grace. Наконец, во II квартале 2025 года появятся системы B200 NVL72 и B200 NVL36 с x86-процессорами (Miranda). Кроме того, NVIDIA представила и отдельные MGX-узлы GB200 NVL2 с парой GB200. В общем, ускорителей B200 компании понадобится много, чтобы наверняка удержать лидерство на рынке. 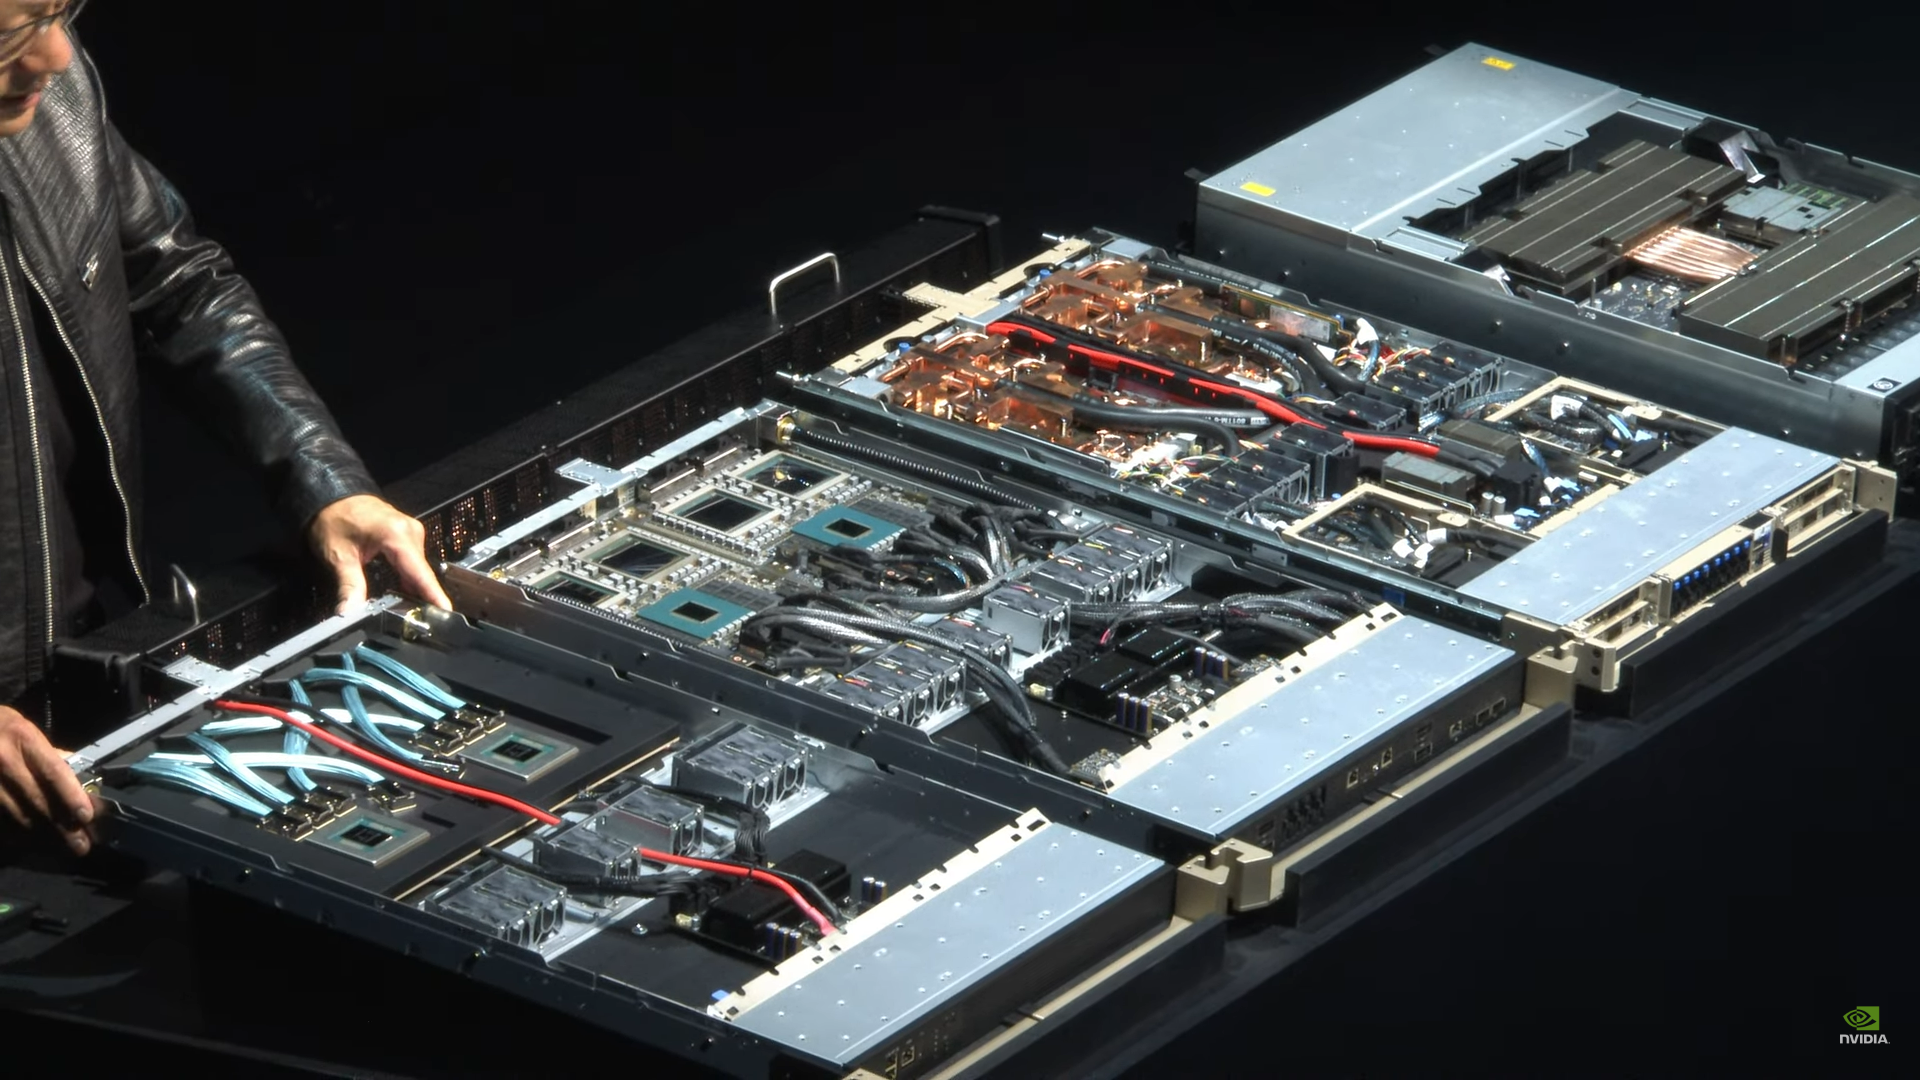
Источник изображения: NVIDIA По словам UDN, GB200 NVL36 будет стоить порядка $1,8 млн, а GB200 NVL72 обойдётся уже в $3 млн. Одиночный GB200 будет стоить $60–$70 тыс., а самый простой ускоритель B100 оценён в $30–$35 тыс. Нужно подчеркнуть, что это оценки сторонних аналитиков. Сама компания официально не раскрывает стоимость своих продуктов. Это устоявшаяся практика на данном рынке, против которой пошла только Intel, публично назвавшая стоимость ИИ-ускорителей Gaudi. Впрочем, ранее глава NVIDIA намекнул, что B200 будет стоить приблизительно $30–$40 тыс.
27.05.2024 [22:20], Алексей Степин
Тридцать на одного: Liqid UltraStack 30 позволяет подключить десятки GPU к одному серверуКомпания Liqid сотрудничает с Dell довольно давно — ещё в прошлом году она смогла добиться размещения 16 ускорителей в своей платформе UltraStack L40S. Но на этом компания не остановилась и представила новую композитную платформу UltraStack 30, в которой смогла довести число одновременно доступных хост-системе ускорителей до 30. Для подключения, конфигурации и управления ресурсами ускорителей Liqid использует комбинацию фирменного программного обеспечения Matrix CDI и интерконнекта Liqid Fabric. В основе последнего лежит PCI Express. Это позволяет динамически конфигурировать аппаратную инфраструктуру с учётом конкретных задач с её возвратом в общий пул ресурсов по завершению работы. Сами «капсулы» с ресурсами подключены к единственному хост-серверу, что упрощает задачу масштабирования, минимизирует потери производительности, повышает энергоэффективность и позволяет добиться наиболее плотной упаковки вычислительных ресурсов, нежели это возможно в классическом варианте с раздельными серверами. А благодаря гибкости конфигурирования буквально «на лету» исключается простой весьма дорогостоящих аппаратных ресурсов. 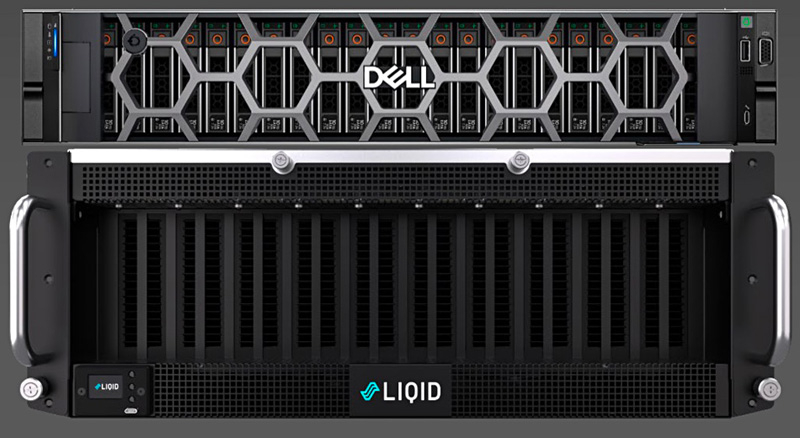
Источник здесь и далее: Liqid В случае UltraStack 30 основой по умолчанию является сервер серии Dell PowerEdge R760 с двумя Xeon Gold 6430 и 1 Тбайт оперативной памяти, однако доступен также вариант на базе Dell R7625, оснащённый процессорами AMD EPYC 9354. Опционально можно укомплектовать систему NVMe-хранилищем объёмом 30 Тбайт, в качестве сетевых опций доступны либо пара адаптеров NVIDIA ConnectX-7, либо один DPU NVIDIA Bluefield-3. 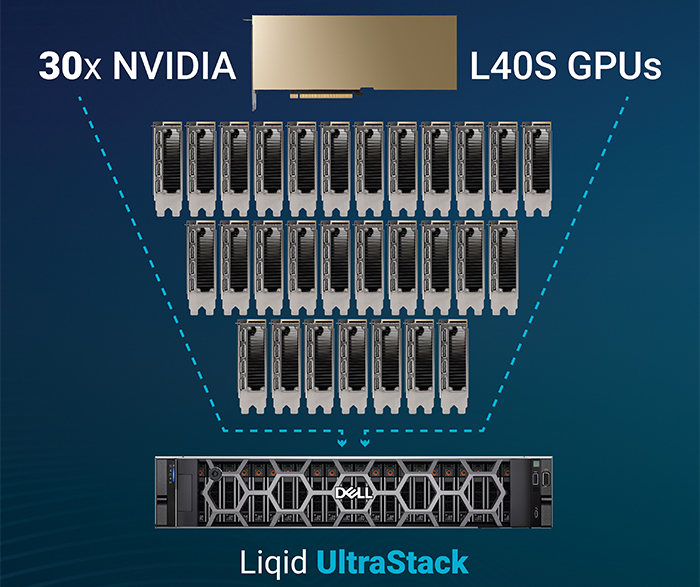 За общение с ускорительными модулями отвечает 48-портовой коммутатор PCI Express 4.0 вкупе с фирменными хост-адаптерами Liqid. Технология ioDirect позволяет ускорителям общаться друг с другом и хранилищем данных напрямую, без посредничества CPU. В трёх модулях расширения установлено по 10 ускорителей NVIDIA L40S, каждый несет на борту 48 Гбайт памяти GDDR6. Такая конфигурация теоретически способна развить 7,3 Пфлопс на вычислениях FP16, вдвое больше на FP8, и почти 1,1 Пфлопс на тензорных ядрах в формате TF32. 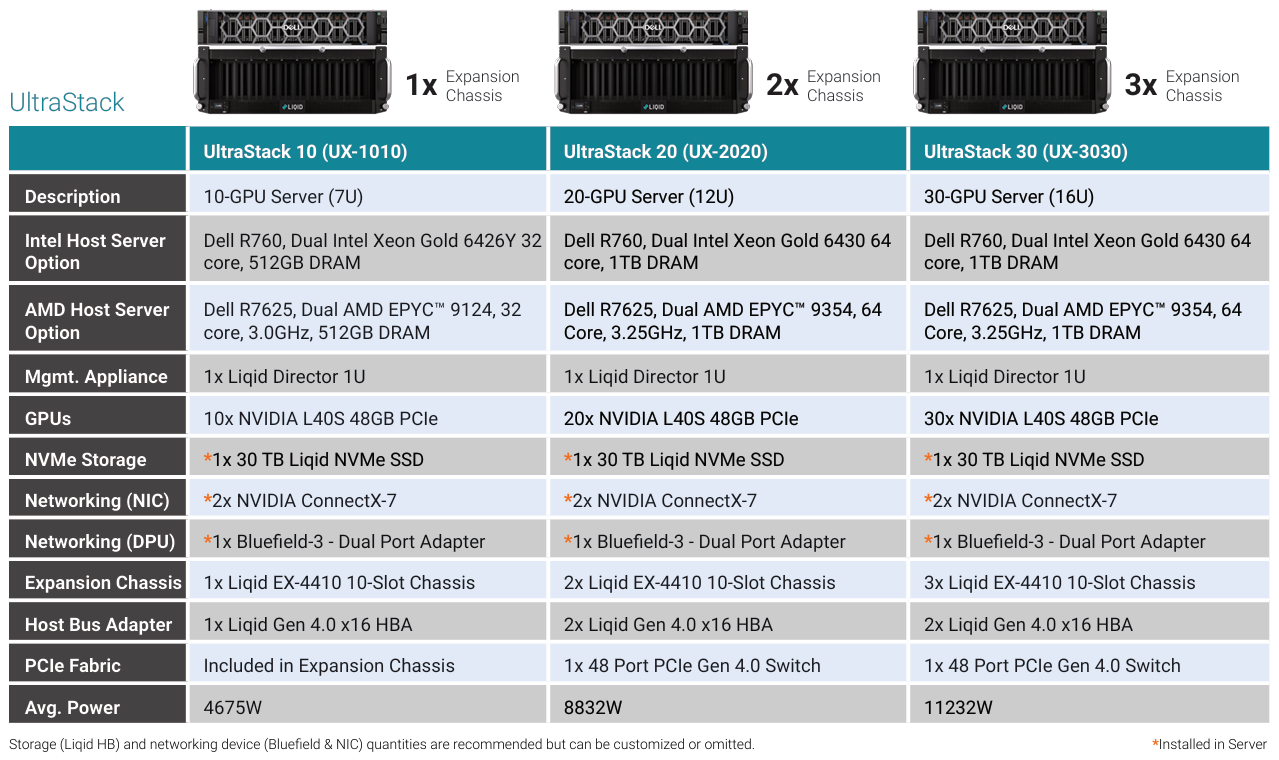 Платформа UltraStack 30 предназначена в первую очередь для быстрого развёртывания достаточно мощной ИИ-инфраструктуры там, где требуется тонкая подстройка и дообучение уже «натасканных» больших моделей. При этом стоит учитывать довольно солидное энергопотребление, составляющее более 11 кВт. Также в арсенале компании есть решения SmartStack на базе модульных систем Dell PowerEdge C-Series, позволяющие подключать к каждому из лезвийных модулей MX760c, MX750с и MX740c до 20 ускорителей. Модульные решения Liqid поддерживают также ускорители других производителей, включая достаточно экзотические, такие как Groq.
15.05.2024 [14:18], Руслан Авдеев
PUE у вас неправильный: NVIDIA призывает пересмотреть методы оценки энергоэффективности ЦОД и суперкомпьютеровОператорам дата-центров и суперкомпьютеров не хватает инструментов для корректного измерения энергоэффективности их оборудования и оценки прогресса на пути к экоустойчивым вычислениям. Как утверждает NVIDIA, нужна новая система оценки показателей при использовании оборудования в реальных задачах. Для оценки эффективности ЦОД существует как минимум около трёх десятков стандартов, некоторые уделяют внимание весьма специфическим критериям вроде расхода воды или уровню безопасности. Сегодня чаще всего используется показатель PUE (power usage effectiveness), т.е. отношение энергопотребления всего объекта к потреблению собственно IT-инфраструктуры. В последние годы многие операторы достигли практически идеальных значений PUE, поскольку, например, на преобразование энергии и охлаждение нужно совсем мало энергии. В эпоху роста облачных сервисов оценка PUE показала довольно высокую эффективность, но в эру ИИ-вычислений этот индекс уже не вполне соответствует запросам отрасли ЦОД — оборудование заметно изменилось. NVIDIA справедливо отмечает, что PUE не учитывает эффективность инфраструктуры в реальных нагрузках. С таким же успехом можно измерять расход автомобилем бензина без учёта того, как далеко он может проехать без дозаправки. При этом среднемировой показатель PUE дата-центров остаётся неизменным уже несколько лет, а улучшать его всё дороже. 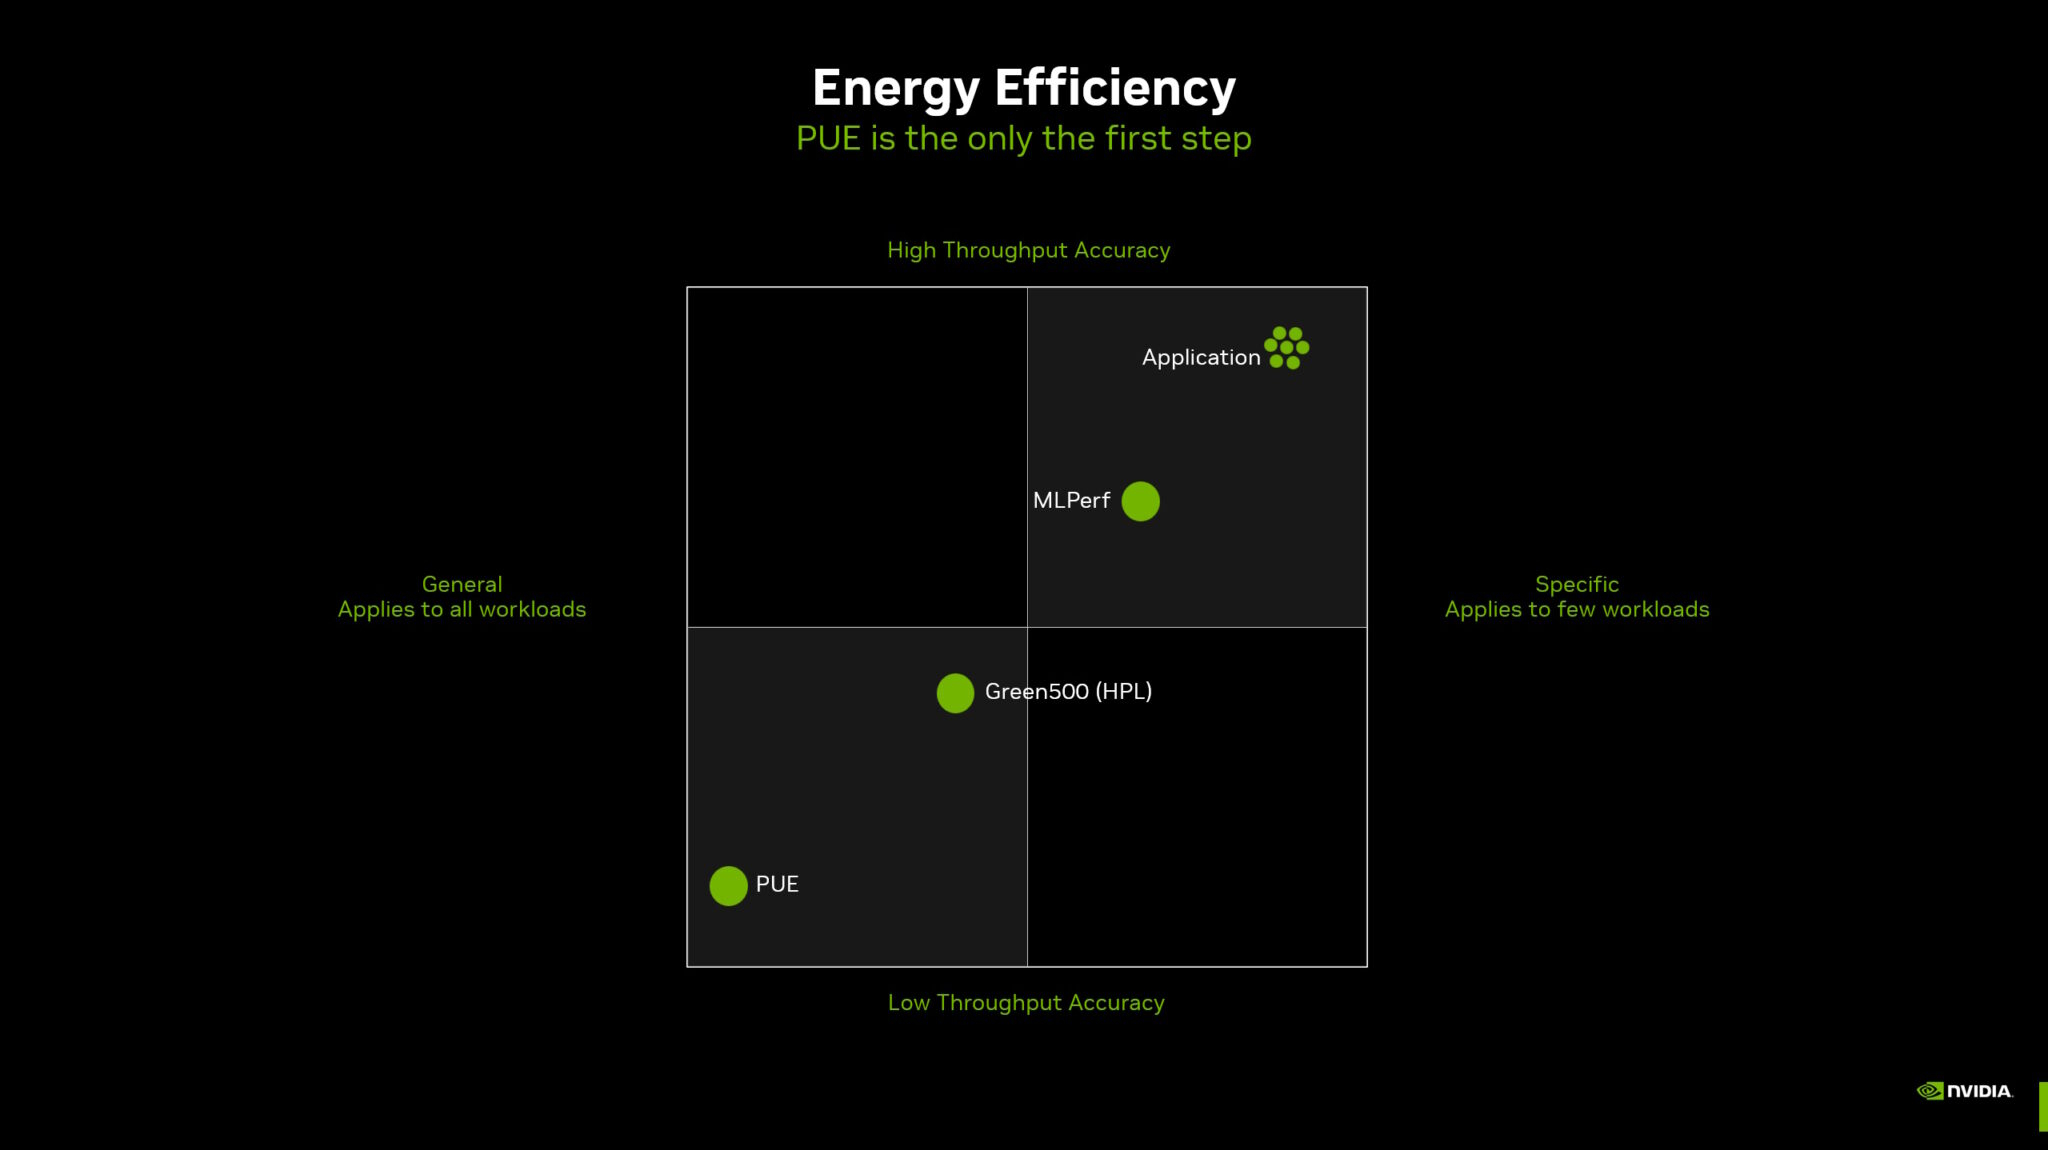
Источник изображений: NVIDIA Что касается энергопотребления, разное оборудование при одинаковых затратах может давать самые разные результаты. Другими словами, если современные ускорители потребляют больше энергии, это не значит, что они менее эффективны, поскольку они дают несопоставимо лучший результат в сравнении со старыми решениями. NVIDIA неоднократно приводила подобные сравнения и между своими GPU с обычными CPU, а теперь предлагает распространить этот подход на ЦОД целиком, что справедливо, учитывая стремление NVIDIA сделать минимальной единицей развёртывания целую стойку. 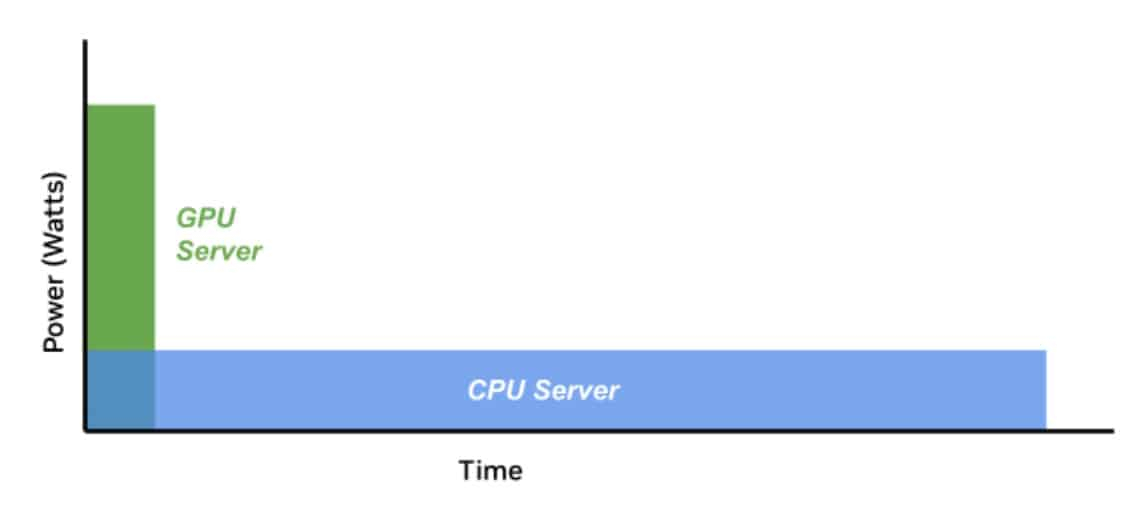 Как считают в NVIDIA, оценивать качество ЦОД можно только с учётом того, сколько энергии тратится для получения результата. Так, ЦОД для ИИ могут полагаться на MLPerf-бенчмарки, суперкомпьютеры для научных исследований могут требовать измерения других показателей, а коммерческие дата-центры для стриминговых сервисов — третьих. В идеале бенчмарки должны измерять прогресс в ускоренных вычислениях с использованием специализированных сопроцессоров, ПО и методик. Например, в параллельных вычислениях GPU намного энергоэффективнее обычных процессоров Отмечается, что с 2003 года производительность ускорителей выросла приблизительно в 7 тыс. раз, а соотношение цены и производительности стало в 5,6 тыс. раз лучше. А с учётом того, что современные ЦОД достигли PUE на уровне приблизительно 1,2, подобная метрика практически исчерпала себя, теперь стоит ориентироваться на другие показатели, релевантные актуальным проблемам. Хотя напрямую сравнить некоторые аспекты невозможно, сегментировав деятельность ЦОД на типы рабочих нагрузок, возможно, удалось бы получить некоторые результаты. В частности, операторам ЦОД нужен пакет бенчмарков, измеряющих показатели при самых распространённых рабочих ИИ-нагрузках. Например, неплохой метрикой может стать Дж/токен. Впрочем, NVIDIA грех жаловаться на недостойные оценки — в последнем рейтинге Green500 именно её системы заняли лидерские позиции.
29.03.2024 [21:54], Сергей Карасёв
Eviden увеличит производительность французского суперкомпьютера Jean Zay более чем втроеФранцузское национальное агентство по высокопроизводительным вычислениям (GENCI) и Национальный центр научных исследований (CNRS) заключили соглашение с компанией Eviden (дочерняя структура Atos) о модернизации НРС-комплекса Jean Zay. Ожидается, что производительность этого суперкомпьютера увеличится приблизительно в 3,5 раза. В рамках проекта Eviden оборудует комплекс 1456 ускорителями NVIDIA H100 в дополнение к 416 ускорителям NVIDIA A100 и 1832 ускорителям NVIDIA V100, которые задействованы в настоящее время. Модернизация предполагает использование 14 стоек суперкомпьютерной платформы Eviden BullSequana XH3000. В общей сложности будут задействованы 364 двухпроцессорных узла на базе Intel Xeon Sapphire Rapids с 48 ядрами. Каждый сервер получит 512 Гбайт оперативной памяти и четыре ускорителя NVIDIA H100 SXM5. Говорится об использовании адаптеров NVIDIA ConnectX-7. 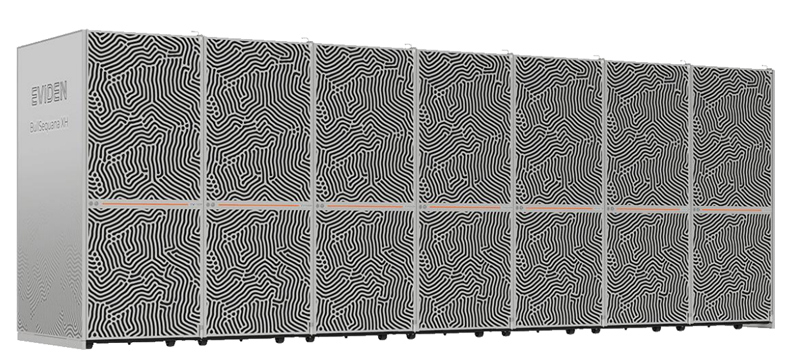
Источник изображения: Eviden Проект также предусматривает комплексное обновление подсистемы хранения данных. Она будет состоять из флеш-массива вместимостью 4,3 Пбайт со скоростями чтения/записи свыше 1 Тбайт/с и дискового массива ёмкостью 39 Пбайт со скоростями чтения/записи более 300 Гбайт/с. Компоненты СХД поставит компания DataDirect Networks (DDN). Для обоих уровней хранения предусмотрено использование файловой системы Lustre. 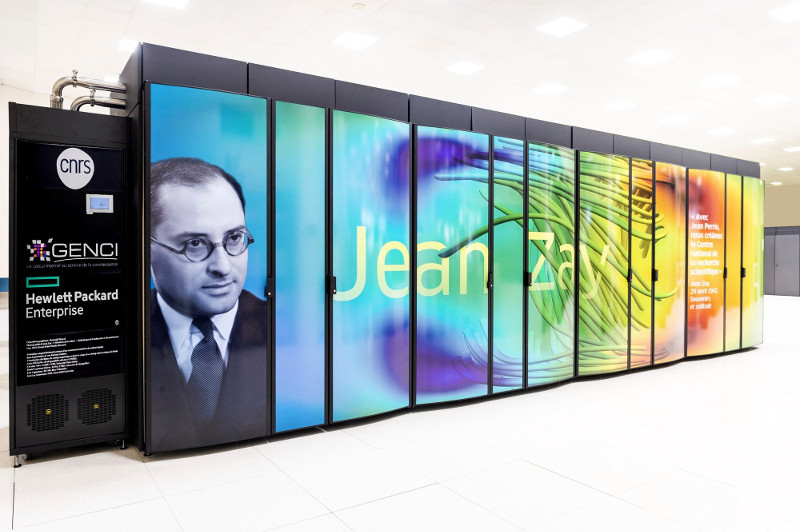
Фото: Photothèque CNRS/Cyril Frésillon Ожидается, что модернизация позволит увеличить пиковую производительность Jean Zay с 36,85 до 125,9 Пфлопс. Проект получил финансирование в рамках национальной инвестиционной программы «Франция 2030». Усовершенствованный суперкомпьютер будет использоваться для решения ресурсоёмких задач, в том числе в области ИИ. Отмечается, что Jean Zay — это один из наиболее экологичных суперкомпьютеров в Европе. Отчасти это достигается благодаря использованию генерируемого машиной тепла для обогрева более 1000 зданий в кампусе Париж-Сакле.
22.03.2024 [09:09], Алексей Степин
NVIDIA представила 800G-платформы Quantum-X800 и Spectrum-X800 для InfiniBand- и Ethernet-фабрик нового поколенияДополнением к только что представленным ИИ-ускорителям NVIDIA Blackwell станут новые сетевые 800G-платформы Quantum-X800 и Spectrum-X800, а также сетевые адаптеры ConnectX-8. Именно они позволят вывести масштабирование ИИ-кластеров на новый уровень и позволят «прокормить» гигантские массивы ускорителей в дата-центрах гиперскейлеров. Платформа NVIDIA Quantum-X800 ориентирована на наиболее производительные ИИ- и HPC-кластеры. Она использует новое поколение технологии InfiniBand, всё ещё обладающей рядом преимуществ в сравнении с Ethernet, и включает в себя обновлённые SHARP-движки. Технология SHARPv4 реализует «вычисления в сети» (In-Network Computing), что позволяет не только существенно разгрузить вычислительные узлы и серверы, но и обеспечить более высокую пропускную способность интерконнекта вкупе с более серьёзными возможностями его масштабирования. 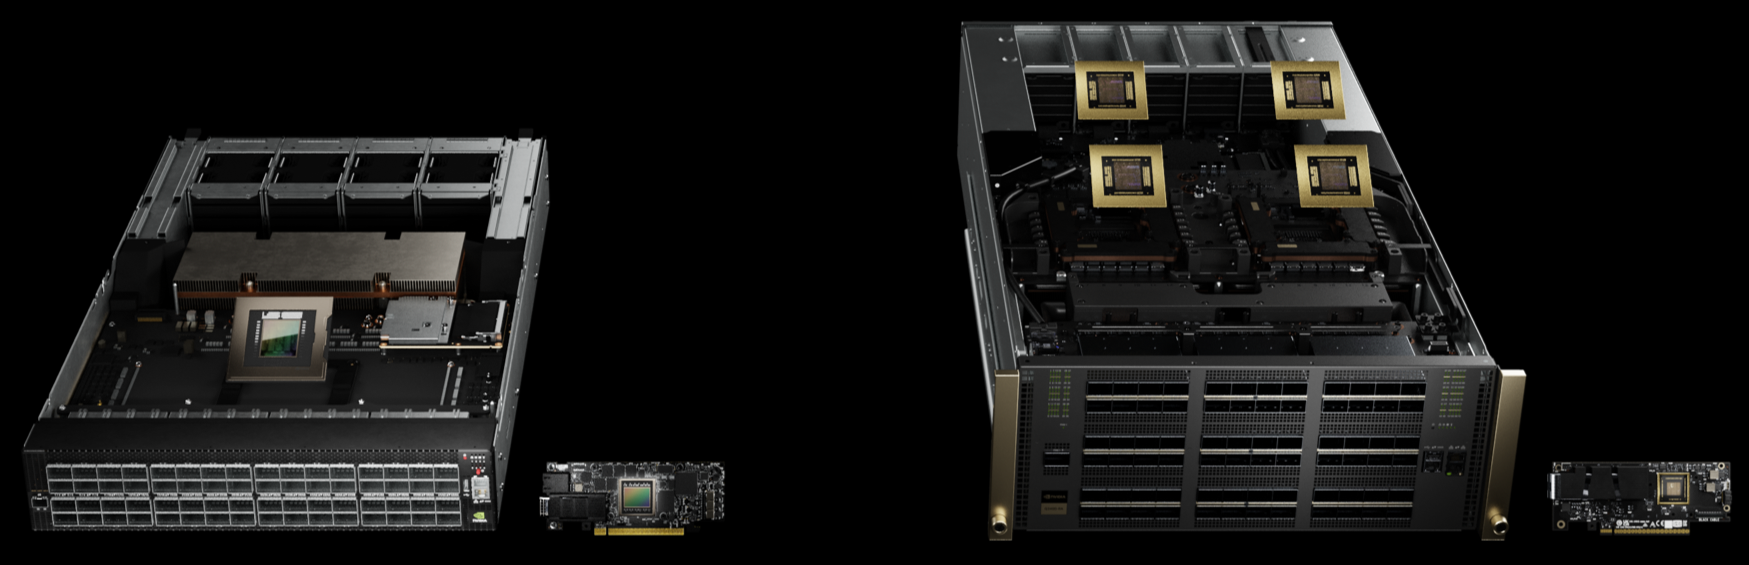
NVIDIA Q3400-RA 4U (справа) и SN5600. Источник изображений здесь и далее: NVIDIA Основой платформы Quantum-X800 стал 4U-коммутатор Q3400-RA, впервые в индустрии, как говорит компания, использующий 200G-блоки SerDes для каждой линии InfiniBand. Коммутатор располагает 144 портами 800G в 72 OSFP-модулях и выделенным портом для Unified Fabric Manager. Новинка имеет стандартное 19″ исполнение с воздушным охлаждением, но есть и вариант Q3400-LD с жидкостным охлаждением, предназначенный для 21″ OCP-стоек. В двухуровневом варианте fat tree коммутаторы позволят объединить 10 368 NIC. 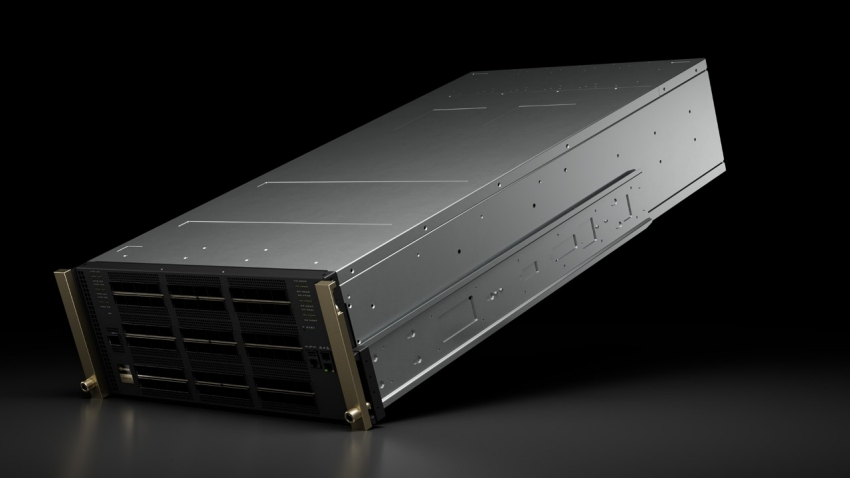 Основным адаптером для новой платформы InfiniBand является ConnectX-8 SuperNIC с интерфейсом PCIe 6.0. Он является частью SHARPv4 и предлагается в однопортовом (OSFP224) и двухпортовом (QSFP112) вариантах и в нескольких форм-факторах, включая OCP 3.0. На платах также имеется разъём SocketDirect на 16 линий PCIe. Также компания представила компоненты NVIDIA LinkX: оптические трансиверы 2xDR4/2xFR4 и активные медные кабели (LACC). 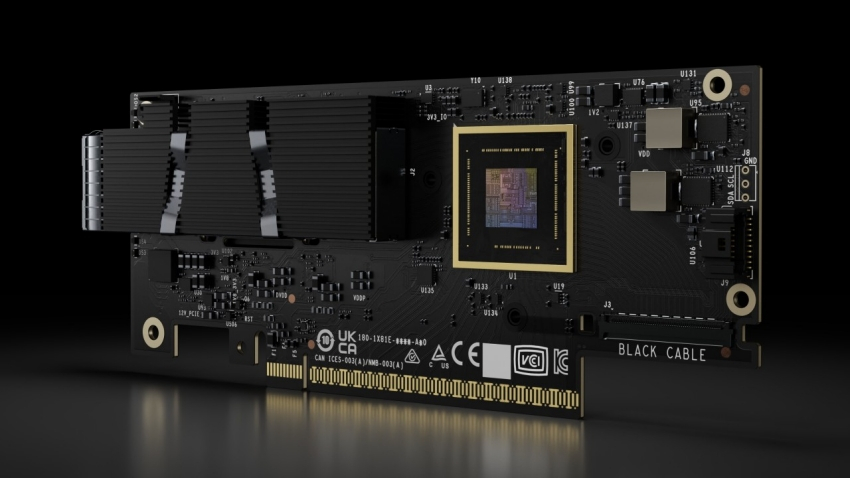 Не забыла NVIDIA и про Ethernet: здесь вывести производительность сети на новый уровень должна платформа Spectrum-X800. Её основой служит новейший коммутатор SN5600 — это, по словам NVIDIA, первый в мире Ethernet-коммутатор класса 800GbE, специально разработанный для применения гиперскейлерами в крупных облачных ИИ-комплексах. Применяемая архитектура позволяет гарантировать каждому клиенту оптимальный и постоянный уровень производительности, а потоковая телеметрия позволит находить и ликвидировать возможные «бутылочные горлышки» в сети буквально на лету. 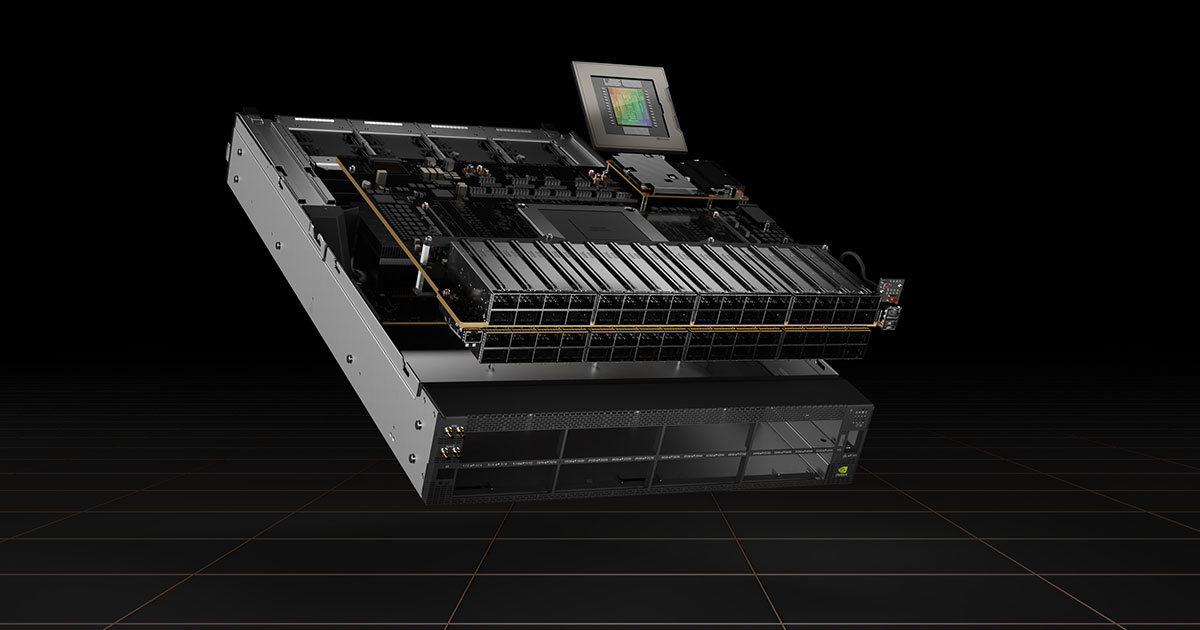 Общая пропускная способность SN5600 составляет 51,2 Тбит/с. Коммутатор располагает 64 портами 800GbE в формате OSFP. В нём используется ASIC пятого поколения на базе архитектуры Spectrum-4. В качестве основного адаптера предлагается SuperNIC на базе DPU BlueField-3 с двумя 400GbE-портами. 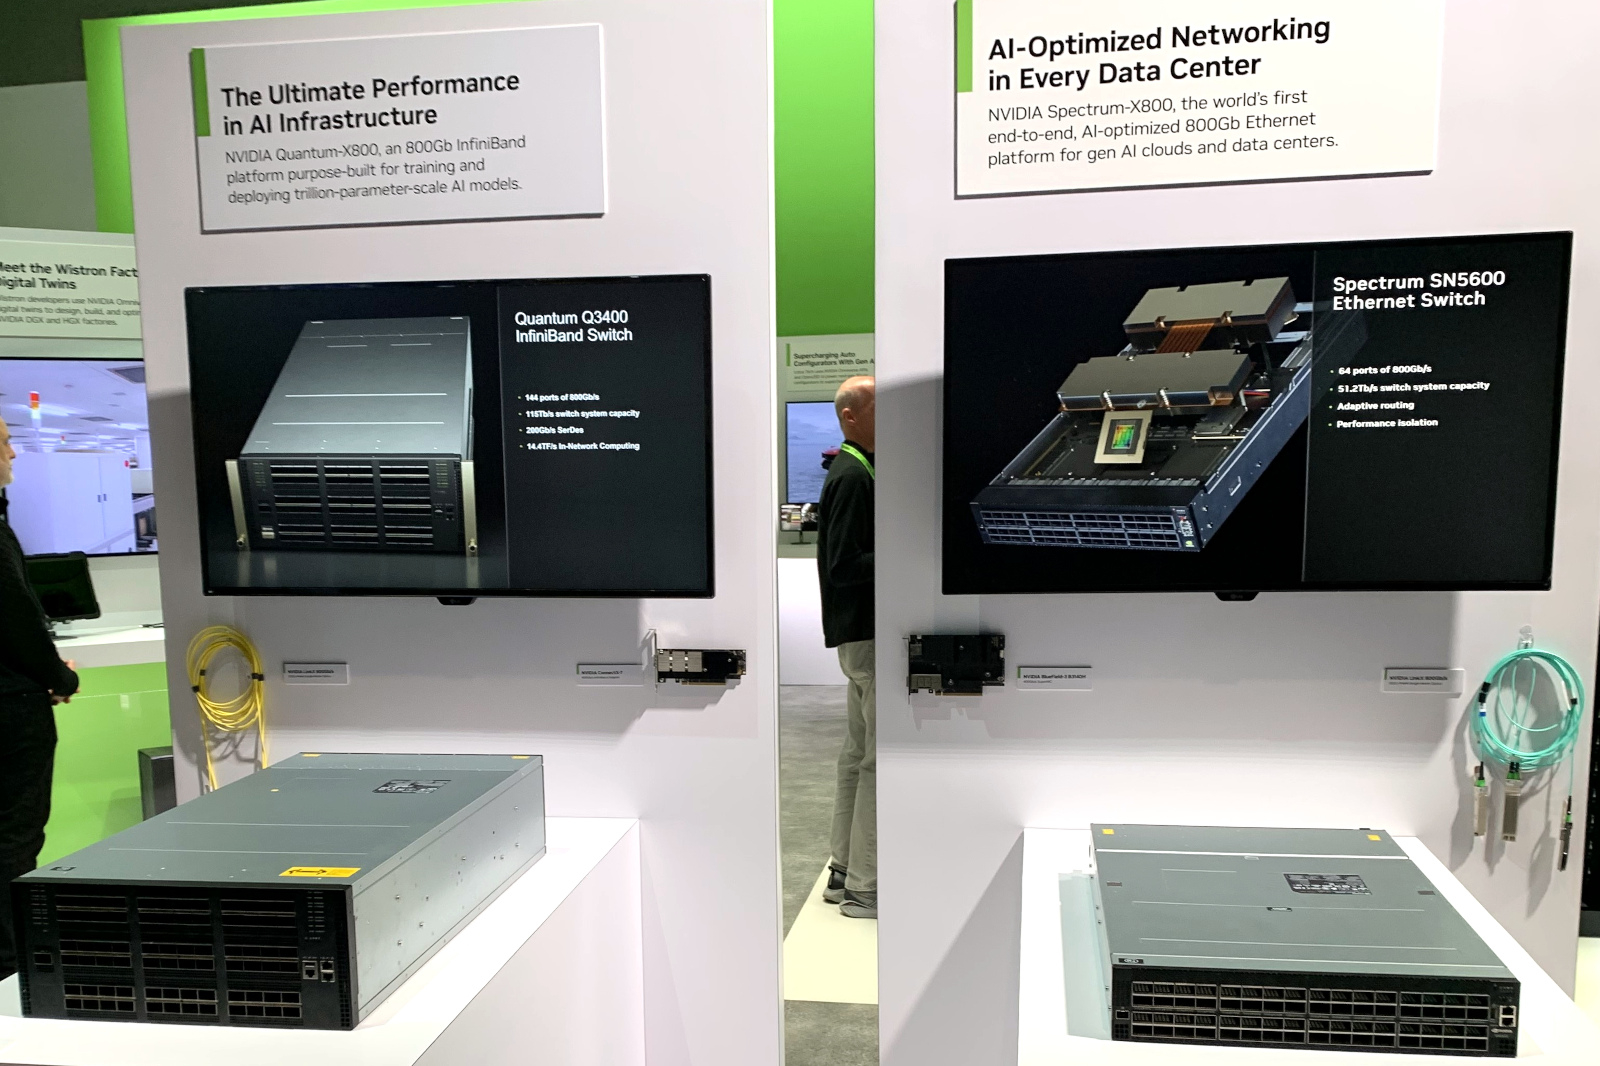
Фото: Twitter/NVIDIANetworkng Spectrum-X800 сопровождает полноценный спектр инфраструктурных компонентов, включая кабели DAC и LACC. С оптическими трансиверами длина соединения 800GbE может достигать двух километров. Начиная со следующего года, решения на базе новых сетевых платформ NVIDIA будут доступны от широкого круга поставщиков оборудования, включая Aivres, DDN, Dell Technologies, Eviden, Hitachi Vantara, HPE, Lenovo, Supermicro и VAST Data. |
|

