
Материалы по тегу: nvidia
|
03.10.2024 [10:51], Сергей Карасёв
NVIDIA отказалась от выпуска двухстоечных суперускорителей GB200 NVL36×2Компания NVIDIA, по информации аналитика Минг-Чи Куо (Ming-Chi Kuo), приняла решение отказаться от выпуска двухстоечных ИИ-систем NVL36×2 на основе ускорителей GB200 в пользу одностоечных машин NVL72 и NVL36. Объясняется это ограниченностью ресурсов и предпочтениями клиентов. Изначально планировалось выпустить три суперсистемы GB200 на базе ускорителей Blackwell для рабочих нагрузок ИИ и HPC — NVL72, NVL36 и NVL36×2. Первая объединяет в одной стойке 18 узлов 1U, каждый из которых содержит два ускорителя GB200. В сумме это даёт 72 чипа B200 и 36 процессоров Grace. Задействована шина NVLink 5, а энергопотребление системы находится на уровне 120 кВт. В свою очередь, NVL36 насчитывает 36 чипов B200, тогда как NVL36×2 объединяет две такие системы. 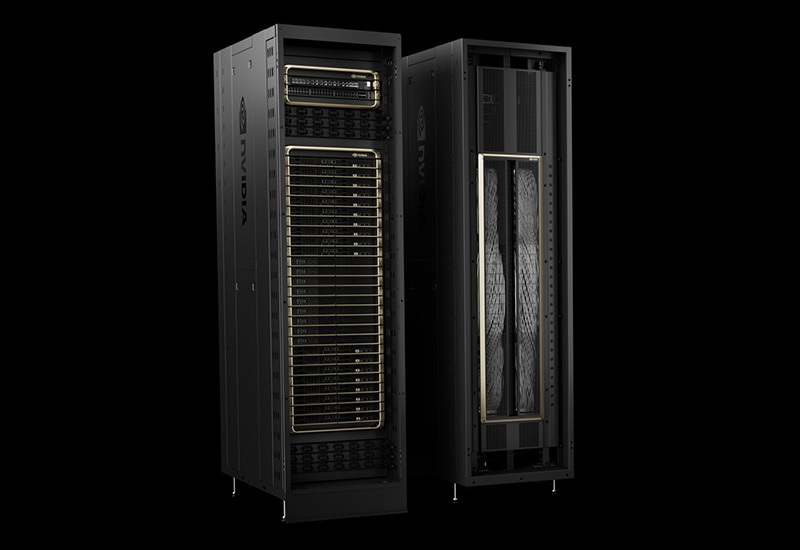
Источник изображения: NVIDIA Ожидалось, что конфигурация NVL36×2 получит более широкое распространение, нежели NVL72. Дело в том, что дата-центры большинства клиентов NVIDIA не могут удовлетворить требования NVL72 в плане питания и охлаждения. С этой точки зрения NVL36×2 представляет собой компромиссное решение. С другой стороны, NVL72 требует меньше пространства для установки и обладает меньшим суммарным энергопотреблением: каждая из стоек NVL36×2 требует 66 кВт, что в сумме даёт 132 кВт. При этом обеспечивается несколько меньшая производительность. По сведениям Минг-Чи Куо, некоторые заказчики (в частности, Microsoft) отдали предпочтение NVL72 перед NVL36×2. При этом между компании ещё на этапе обсуждения возникли разногласия по поводу конфигурации стоек. Кроме того, для NVIDIA управление тремя разными проектами по созданию суперускорителей на базе GB200 стало сложной задачей. Поэтому от двухстоечной машины решено отказаться. Отмечается также, что массовое производство NVL72 может быть отложено до II половины 2025-го, хотя ранее называлось I полугодие следующего года. Впрочем, отдельные заказчики, включая Microsoft, начнут получать эти системы уже в декабре.
28.09.2024 [23:24], Сергей Карасёв
Индия запустила сразу пять суперкомпьютеров за два дня
a100
amd
atos
cascade lake-sp
epyc
eviden
hardware
hpc
intel
milan
nvidia
xeon
индия
метео
суперкомпьютер
Премьер-министр Индии Нарендра Моди, по сообщению The Register, объявил о вводе в эксплуатацию трёх новых высокопроизводительных вычислительных комплексов PARAM Rudra. Запуск этих суперкомпьютеров, как отмечается, является «символом экономической, социальной и промышленной политики» страны. Вдаваться в подробности о технических характеристиках машин Моди во время презентации не стал. Однако некоторую информацию раскрыли организации, которые займутся непосредственной эксплуатацией этих НРС-систем. Один из суперкомпьютеров располагается в Национальном центре радиоастрофизики Индии (NCRA). Данная машина оснащена «несколькими тысячами процессоров Intel» и 90 ускорителями NVIDIA A100, 35 Тбайт памяти и хранилищем вместимостью 2 Пбайт. Ещё один НРС-комплекс смонтирован в Центре фундаментальных наук имени С. Н. Бозе (SNBNCBS): известно, что он обладает быстродействием 838 Тфлопс. Оператором третьей системы является Межуниверситетский центр ускоренных вычислений (IUAC): этот суперкомпьютер с производительностью на уровне 3 Пфлопс использует 24-ядерные чипы Intel Xeon Cascade Lake-SP. Ёмкость хранилища составляет 4 Пбайт. Упомянут интерконнект с пропускной способностью 240 Гбит/с. The Register отмечает, что указанные характеристики в целом соответствуют описанию суперкомпьютеров Rudra первого поколения. Согласно имеющейся документации, такие машины используют:
Ожидается, что машины Rudra второго поколения получат поддержку процессоров Xeon Sapphire Rapids и четырёх GPU-ускорителей. Суперкомпьютеры третьего поколения будут использовать 96-ядерные Arm-процессоры AUM, разработанные индийским Центром развития передовых вычислений: эти изделия будут изготавливаться по 5-нм технологии TSMC. 
Источник изображения: pixabay.com Между тем компания Eviden (дочерняя структура Atos) сообщила о поставках в Индию двух новых суперкомпьютеров. Один из них установлен в Индийском институте тропической метеорологии (IITM) в Пуне, второй — в Национальном центре среднесрочного прогнозирования погоды (NCMRWF) в Нойде. Эти системы, построенные на платформе BullSequana XH2000, предназначены для исследования погоды и климата. В создании комплексов приняли участие AMD, NVIDIA и DDN. Система IITM, получившая название ARKA, обладает быстродействием 11,77 Пфлопс: 3021 узел с AMD EPYC 7643 (Milan), 26 узлов с NVIDIA A100, NVIDIA Quantum InfiniBand и хранилище на 33 Пбайт (ранее говорилось о 3 Пбайт SSD + 29 Пбайт HDD). В свою очередь, суперкомпьютер NCMRWF под названием Arunika обладает производительностью 8,24 Пфлопс: 2115 узлов с AMD EPYC 7643 (Milan), NVIDIA Quantum InfiniBand и хранилище DDN EXAScaler ES400NVX2 (2 Пбайт SSD + 22 Пбайт HDD). Кроме того, эта система включает выделенный блок для приложений ИИ и машинного обучения с быстродействием 1,9 Пфлопс (точность не указана), состоящий из 18 узлов с NVIDIA A100.
27.09.2024 [11:54], Сергей Карасёв
Плата reServer Industrial J501 на базе NVIDIA Jetson AGX Orin предназначена для создания ИИ-устройствКомпания Seeed Studio, по сообщению CNX-Software, представила плату reServer Industrial J501, рассчитанную на подключение вычислительного модуля NVIDIA Jetson AGX Orin. Новинка предназначена для создания периферийных устройств с ИИ-функциями, таких как роботы, всевозможные встраиваемые решения и пр. Может быть задействовано изделие Jetson AGX Orin с 32 и 64 Гбайт памяти LPDDR5. В первом случае используется GPU с 1792 ядрами Ampere и 56 тензорными ядрами, во втором — с 2048 ядрами Ampere и 64 тензорными ядрами. ИИ-производительность достигает соответственно 200 и 275 TOPS. Плата reServer Industrial J501 располагает двумя портами SATA-3 и коннектором M.2 Key M (PCIe 4.0; NVMe) для SSD. Есть слот Mini PCIe для модуля LoRaWAN/4G, разъём M.2 Key B (3042/3052) для сотового модема 4G/5G (есть слот Nano SIM) и разъём M.2 Key E для адаптера Wi-Fi/Bluetooth. Реализованы сетевые порты 1GbE и 10GbE на базе коннекторов RJ-45. 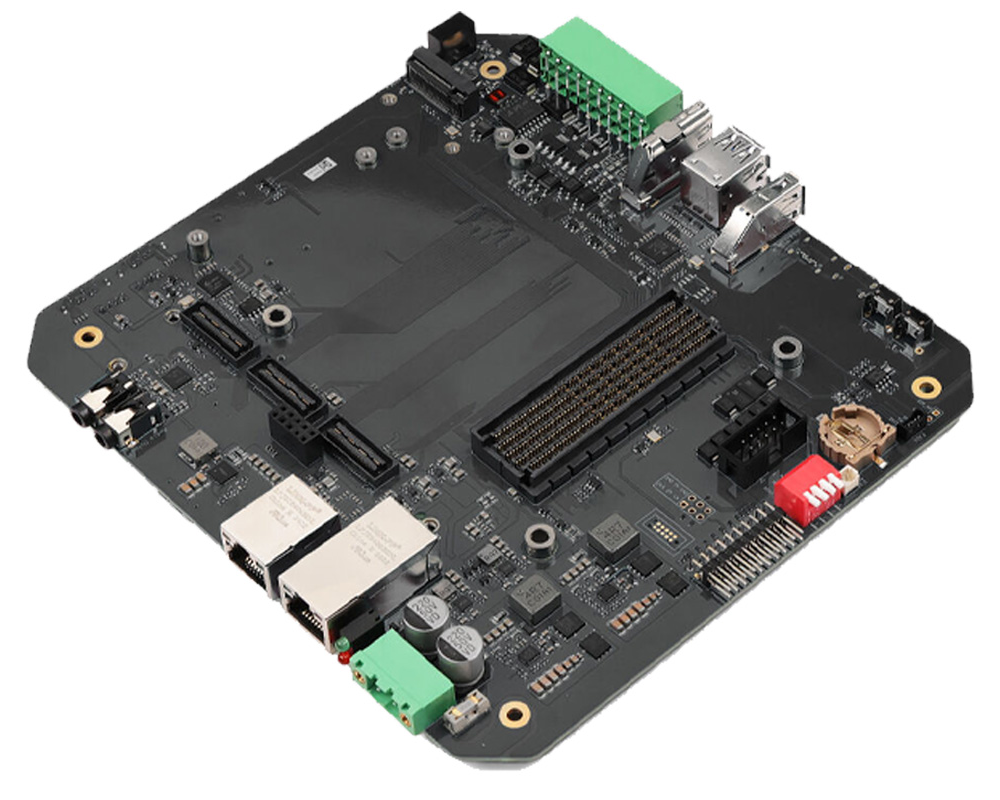
Источник изображения: Seeed Studio В набор доступных интерфейсов входят: HDMI 2.1 Type-A с поддержкой разрешения до 7680 × 4320 пикселей, по одному порту USB 3.1 Type-C (Host Mode) и USB 2.0 Type-C (Device Mode), три порта USB 3.1 Type-A, последовательный порт RS-232/422/485, колодка GPIO/DIO (4 × DI, 4 × DO, 3 × GND_DI, 2 × GND_DO, 1 × GND_ISO, 1 × CAN). Возможно подключение опциональных плат расширения с поддержкой восьми камер GMSL (Gigabit Multimedia Serial Link). Размеры reServer Industrial J501 составляют 176 × 163 мм, масса — 225 г (без вычислительного модуля). Диапазон рабочих температур простирается от -25 до +60 °C. Питание подаётся от сетевого адаптера на 24 В / 5 A. Новинка предлагается по ориентировочной цене $379.
27.07.2024 [23:44], Алексей Степин
Не так просто и не так быстро: учёные исследовали особенности работы памяти и NVLink C2C в NVIDIA Grace HopperГибридный ускоритель NVIDIA Grace Hopper объединяет CPU- и GPU-модули, которые связаны интерконнектом NVLink C2C. Но, как передаёт HPCWire, в строении и работе суперчипа есть некоторые нюансы, о которых рассказали шведские исследователи. Им удалось замерить производительность подсистем памяти Grace Hopper и интерконнекта NVLink в реальных сценариях, дабы сравнить полученные результаты с характеристиками, заявленными NVIDIA. Напомним, для интерконнекта изначально заявлена скорость 900 Гбайт/с, что в семь раз превышает возможности PCIe 5.0. Память HBM3 в составе GPU-части имеет ПСП до 4 Тбайт/с, а вариант с HBM3e предлагает уже до 4,9 Тбайт/с. Процессорная часть (Grace) использует LPDDR5x с ПСП до 512 Гбайт/с. В руках исследователей оказалась базовая версия Grace Hopper с 480 Гбайт LPDDR5X и 96 Гбайт HBM3. Система работала под управлением Red Hat Enterprise Linux 9.3 и использовала CUDA 12.4. В бенчмарке STREAM исследователям удалось получить следующие показатели ПСП: 486 Гбайт/с для CPU и 3,4 Тбайт/с для GPU, что близко к заявленным характеристиками. Однако результат скорость NVLink-C2C составила всего 375 Гбайт/с в направлении host-to-device и лишь 297 Гбайт/с в обратном направлении. Совокупно выходит 672 Гбайт/с, что далеко от заявленных 900 Гбайт/с (75 % от теоретического максимума). 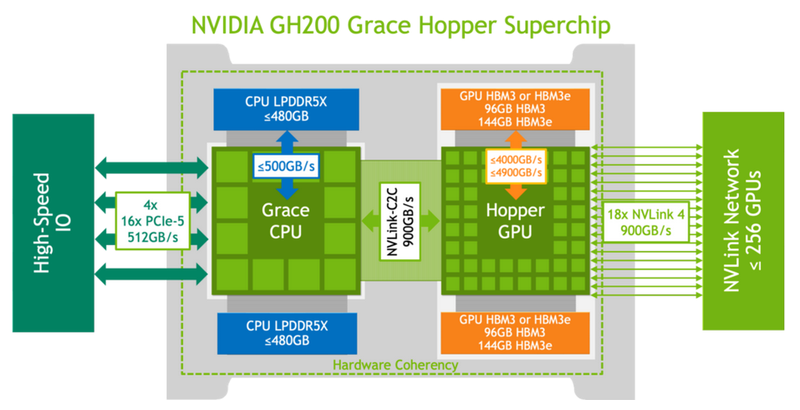
Источник: NVIDIA Grace Hopper в силу своей конструкции предлагает два вида таблицы для страниц памяти: общесистемную (по умолчанию страницы размером 4 Кбайт или 64 Кбайт), которая охватывает CPU и GPU, и эксклюзивную для GPU-части (2 Мбайт). При этом скорость инициализации зависит от того, откуда приходит запрос. Если инициализация памяти происходит на стороне CPU, то данные по умолчанию помещаются в LPDDR5x, к которой у GPU-части есть прямой доступ посредством NVLink C2C (без миграции), а таблица памяти видна и GPU, и CPU. 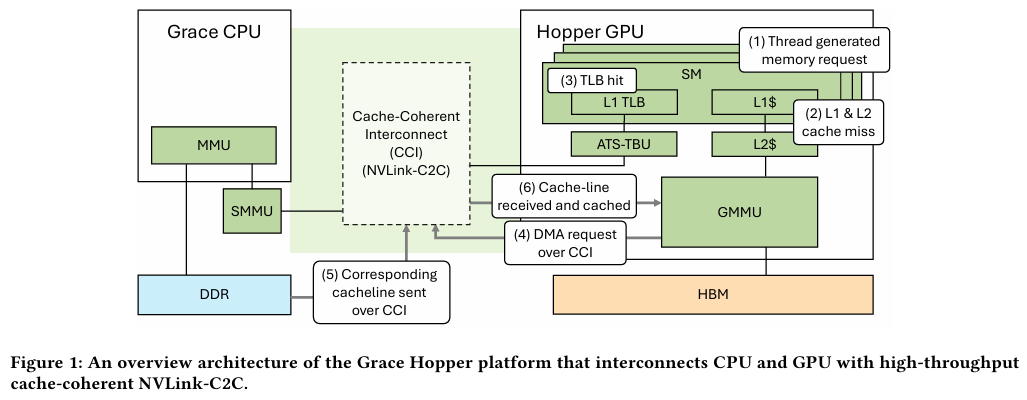
Источник: arxiv.org Если же памятью управляет не ОС, а CUDA, то инициализацию можно сразу организовать на стороне GPU, что обычно гораздо быстрее, а данные поместить в HBM. При этом предоставляется единое виртуальное адресное пространство, но таблиц памяти две, для CPU и GPU, а сам механизм обмена данными между ними подразумевает миграцию страниц. Впрочем, несмотря на наличие NVLink C2C, идеальной остаётся ситуация, когда GPU-нагрузке хватает HBM, а CPU-нагрузкам достаточно LPDDR5x. 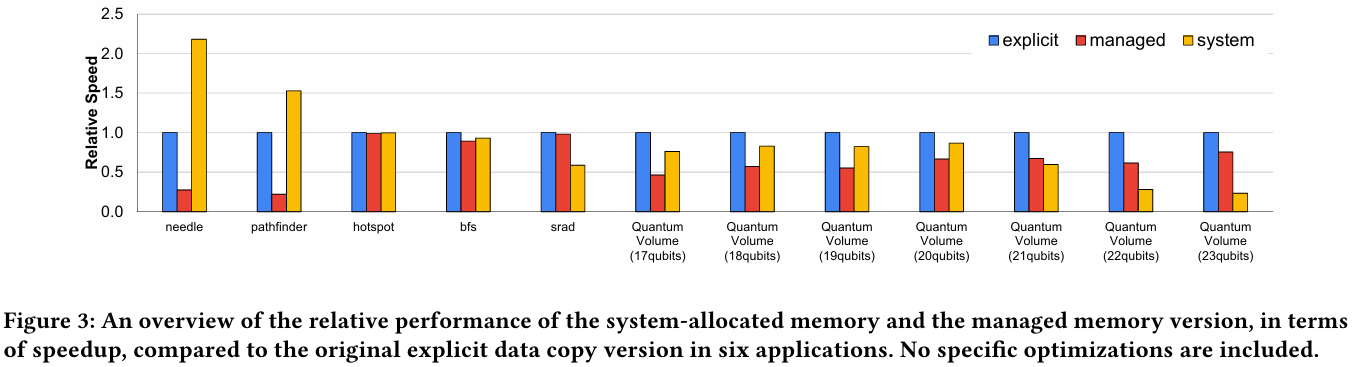
Источник: arxiv.org Также исследователи затронули вопрос производительности при использовании страниц памяти разного размера. 4-Кбайт страницы обычно используются процессорной частью с LPDDR5X, а также в тех случаях, когда GPU нужно получить данные от CPU через NVLink-C2C. Но как правило в HPC-нагрузках оптимальнее использовать 64-Кбайт страницы, на управление которыми расходуется меньше ресурсов. Когда же доступ в память хаотичен и непостоянен, страницы размером 4 Кбайт позволяют более тонко управлять ресурсами. В некоторых случаях возможно двукратное преимущество в производительности за счёт отсутствия перемещения неиспользуемых данных в страницах объёмом 64 Кбайт. В опубликованной работе отмечается, что для более глубокого понимания механизмов работы унифицированной памяти у гетерогенных решений, подобных Grace Hopper, потребуются дальнейшие исследования.
17.07.2024 [23:33], Игорь Осколков
Суперускоритель по суперцене — NVIDIA GB200 NVL72, вероятно, будет стоить $3 млнКомпания NVIDIA значительно увеличила заказ на ускорители Blackwell у TSMC, сообщает TrendForce со ссылкой на United Daily News (UDN). По данным источника, NVIDIA намерена получить уже не 40 тыс., а 60 тыс. суперускорителей нового поколения, причём 50 тыс. из них придётся на стоечные системы GB200 NVL36. При этом Blackwell всё равно будут в дефиците, как и обещал ещё зимой глава NVIDIA Дженсен Хуанг (Jensen Huang). B200 включает два тайла, объединённых 2,5D-упаковкой CoWoS-L и соединённых интерконнектом NV-HBI. Чип имеет 208 млрд транзисторов, изготовленных по кастомному техпроцессу TSMC 4NP. GB200 объединяет два ускорителя B200 и один 72-ядерный Arm-процессор Grace. А суперускоритель GB200 NVL72, в свою очередь, объединяет в рамках одной стойки Oberon сразу 18 1U-узлов с парой GB200 в каждом (плата Bianca, 72 × B200 и 36 × Grace), провязанных шиной NVLink 5. Вся эта система потребляет порядка 120 кВт, оснащена СЖО и единой DC-шиной питания. Однако у GB200 NVL72 довольно специфические требования к окружению, поэтому NVIDIA предлагает суперускоритель попроще — GB200 NVL36, который как раз и должен стать наиболее массовым в данной серии. Эта платформа точно так же занимает целую стойку, но использует 2U-узлы с теми же платами Bianca (суммарно 36 × B200 и 18 × Grace), потребляя всего 66 кВт. При этом всё равно подразумевается использование двух стоек GB200 NVL36, объединённых интерконнектом, так что GB200 NVL72 всё равно получается более энергоэффективным решением. 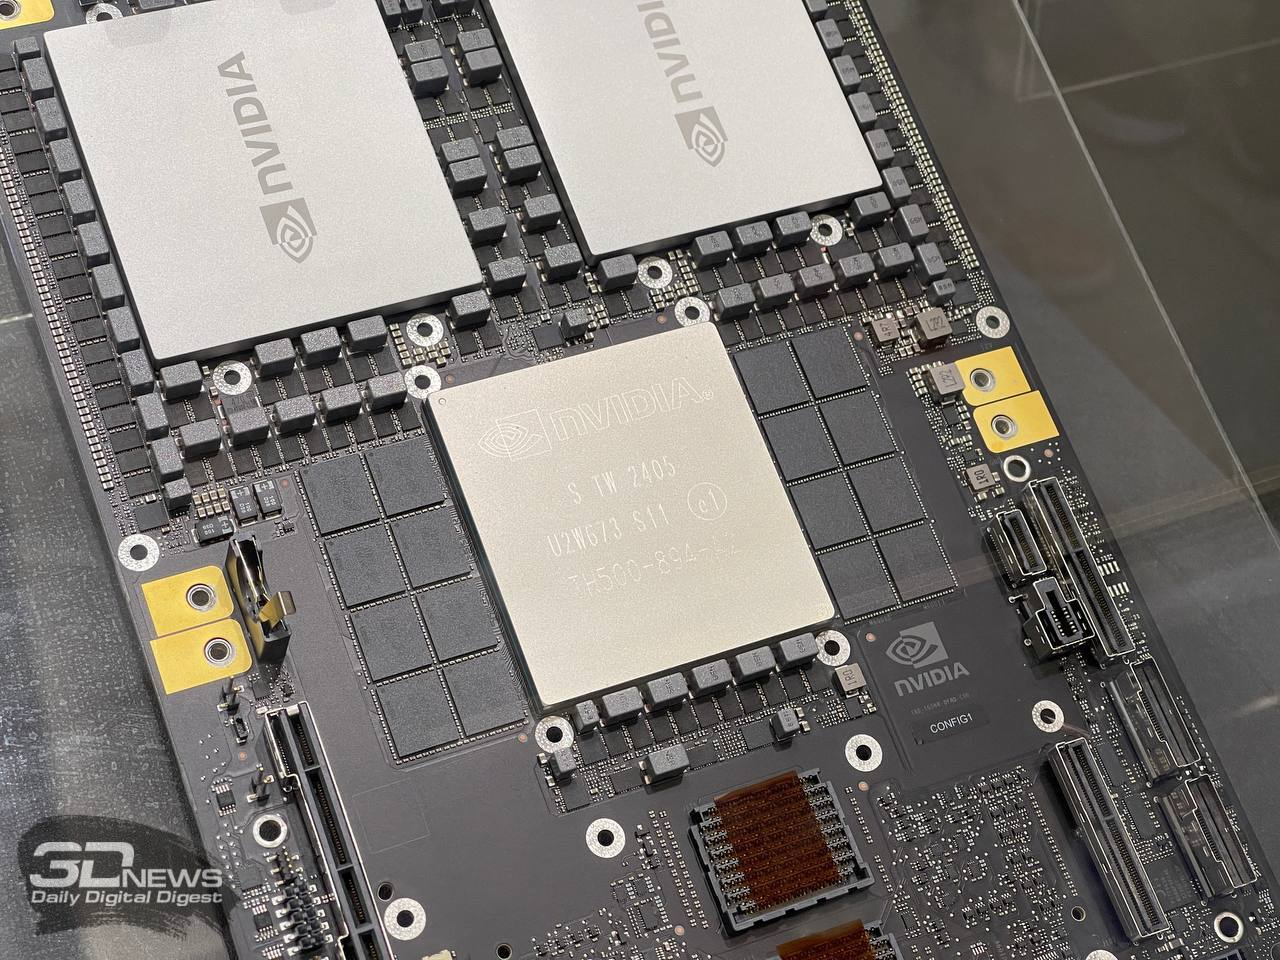
NVIDIA GB200 Как отмечает SemiAnalysis, GB200 NVL36 также будет доступен в варианте с платами Ariel, имеющими по одному чипу B200 и Grace. Наконец, во II квартале 2025 года появятся системы B200 NVL72 и B200 NVL36 с x86-процессорами (Miranda). Кроме того, NVIDIA представила и отдельные MGX-узлы GB200 NVL2 с парой GB200. В общем, ускорителей B200 компании понадобится много, чтобы наверняка удержать лидерство на рынке. 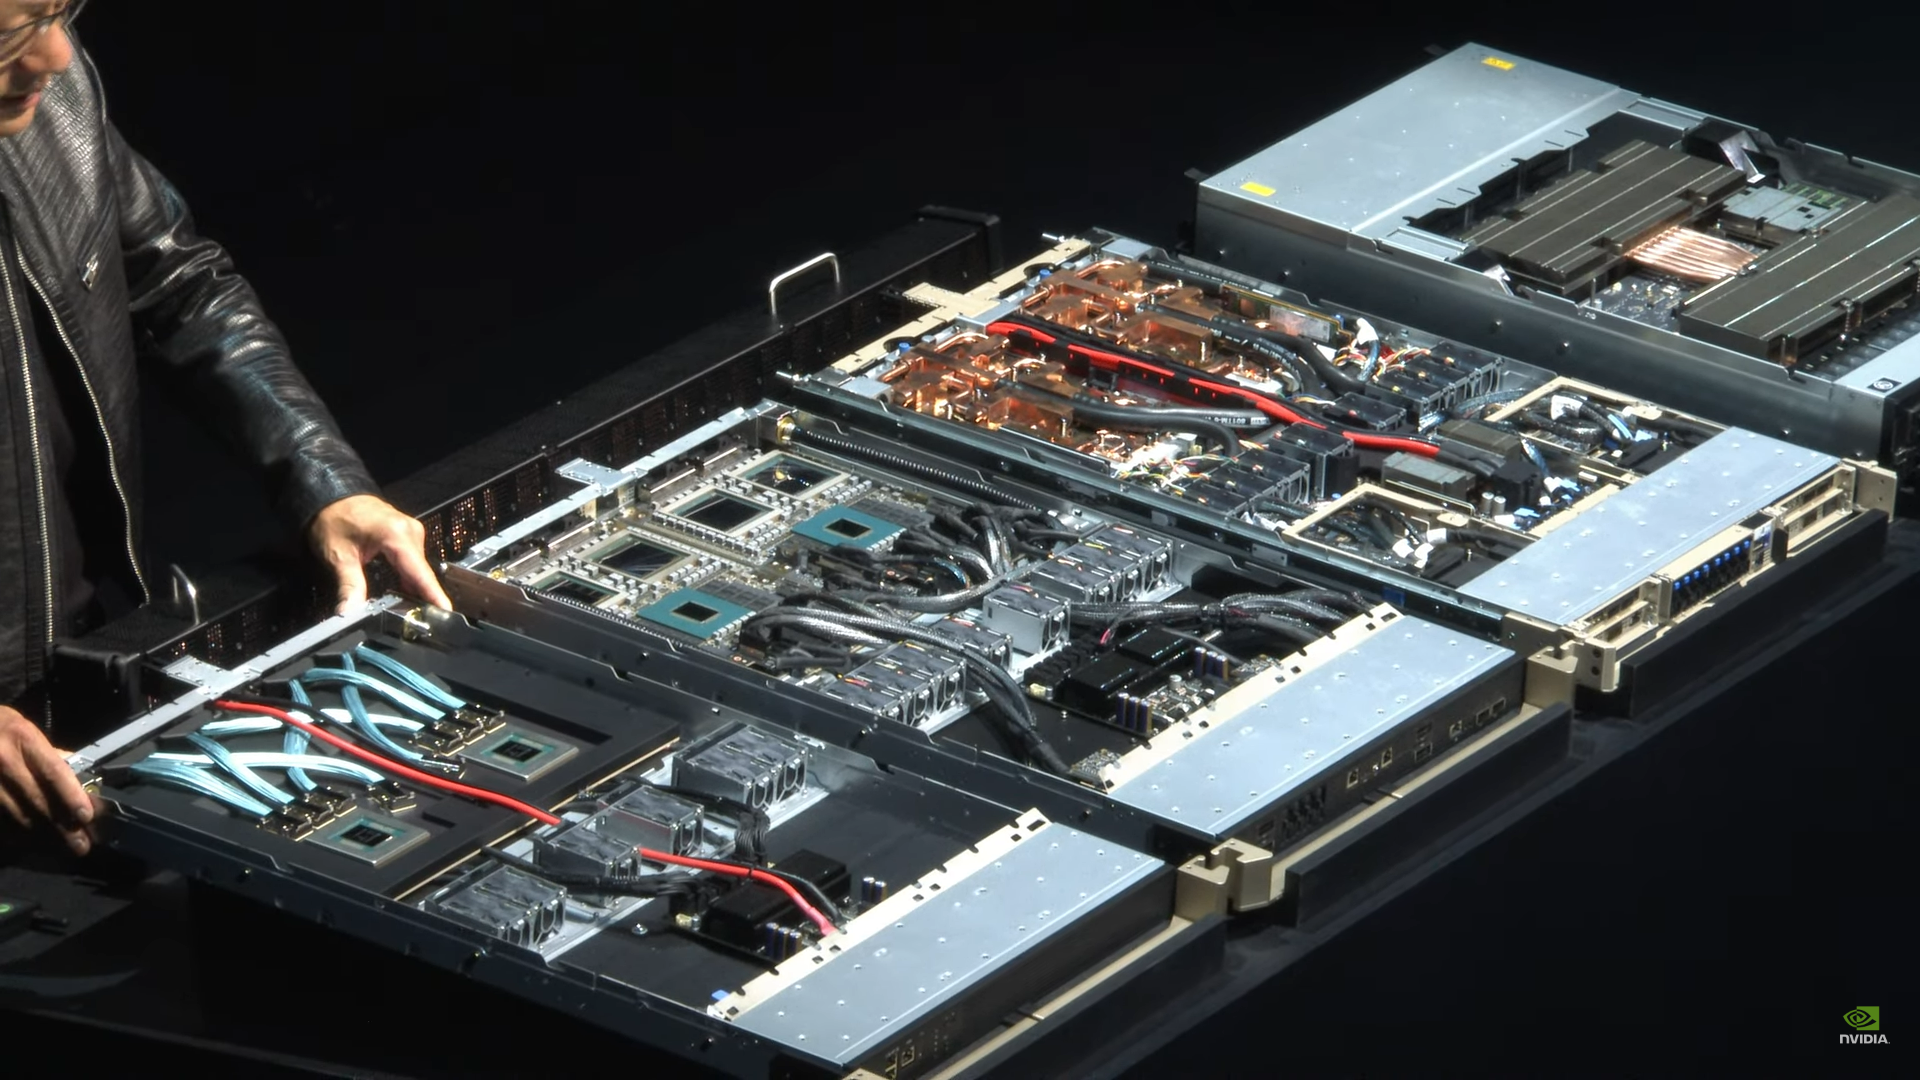
Источник изображения: NVIDIA По словам UDN, GB200 NVL36 будет стоить порядка $1,8 млн, а GB200 NVL72 обойдётся уже в $3 млн. Одиночный GB200 будет стоить $60–$70 тыс., а самый простой ускоритель B100 оценён в $30–$35 тыс. Нужно подчеркнуть, что это оценки сторонних аналитиков. Сама компания официально не раскрывает стоимость своих продуктов. Это устоявшаяся практика на данном рынке, против которой пошла только Intel, публично назвавшая стоимость ИИ-ускорителей Gaudi. Впрочем, ранее глава NVIDIA намекнул, что B200 будет стоить приблизительно $30–$40 тыс.
27.05.2024 [22:20], Алексей Степин
Тридцать на одного: Liqid UltraStack 30 позволяет подключить десятки GPU к одному серверуКомпания Liqid сотрудничает с Dell довольно давно — ещё в прошлом году она смогла добиться размещения 16 ускорителей в своей платформе UltraStack L40S. Но на этом компания не остановилась и представила новую композитную платформу UltraStack 30, в которой смогла довести число одновременно доступных хост-системе ускорителей до 30. Для подключения, конфигурации и управления ресурсами ускорителей Liqid использует комбинацию фирменного программного обеспечения Matrix CDI и интерконнекта Liqid Fabric. В основе последнего лежит PCI Express. Это позволяет динамически конфигурировать аппаратную инфраструктуру с учётом конкретных задач с её возвратом в общий пул ресурсов по завершению работы. Сами «капсулы» с ресурсами подключены к единственному хост-серверу, что упрощает задачу масштабирования, минимизирует потери производительности, повышает энергоэффективность и позволяет добиться наиболее плотной упаковки вычислительных ресурсов, нежели это возможно в классическом варианте с раздельными серверами. А благодаря гибкости конфигурирования буквально «на лету» исключается простой весьма дорогостоящих аппаратных ресурсов. 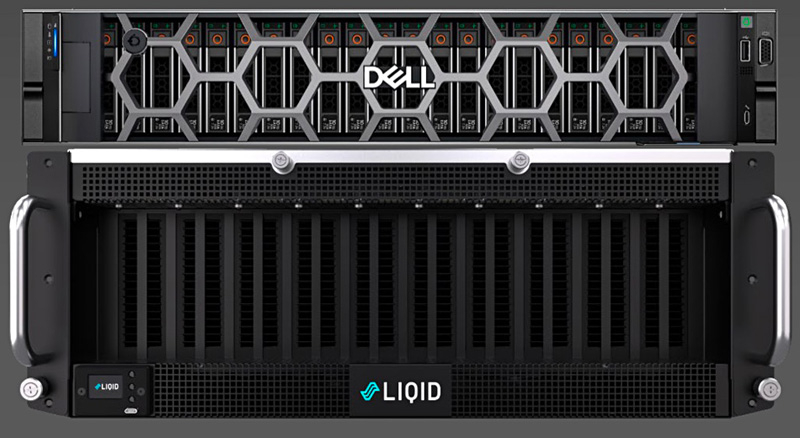
Источник здесь и далее: Liqid В случае UltraStack 30 основой по умолчанию является сервер серии Dell PowerEdge R760 с двумя Xeon Gold 6430 и 1 Тбайт оперативной памяти, однако доступен также вариант на базе Dell R7625, оснащённый процессорами AMD EPYC 9354. Опционально можно укомплектовать систему NVMe-хранилищем объёмом 30 Тбайт, в качестве сетевых опций доступны либо пара адаптеров NVIDIA ConnectX-7, либо один DPU NVIDIA Bluefield-3. 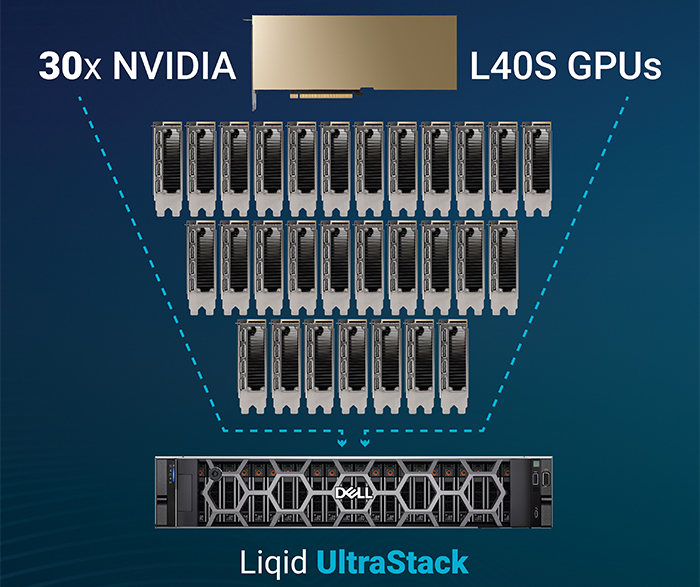 За общение с ускорительными модулями отвечает 48-портовой коммутатор PCI Express 4.0 вкупе с фирменными хост-адаптерами Liqid. Технология ioDirect позволяет ускорителям общаться друг с другом и хранилищем данных напрямую, без посредничества CPU. В трёх модулях расширения установлено по 10 ускорителей NVIDIA L40S, каждый несет на борту 48 Гбайт памяти GDDR6. Такая конфигурация теоретически способна развить 7,3 Пфлопс на вычислениях FP16, вдвое больше на FP8, и почти 1,1 Пфлопс на тензорных ядрах в формате TF32. 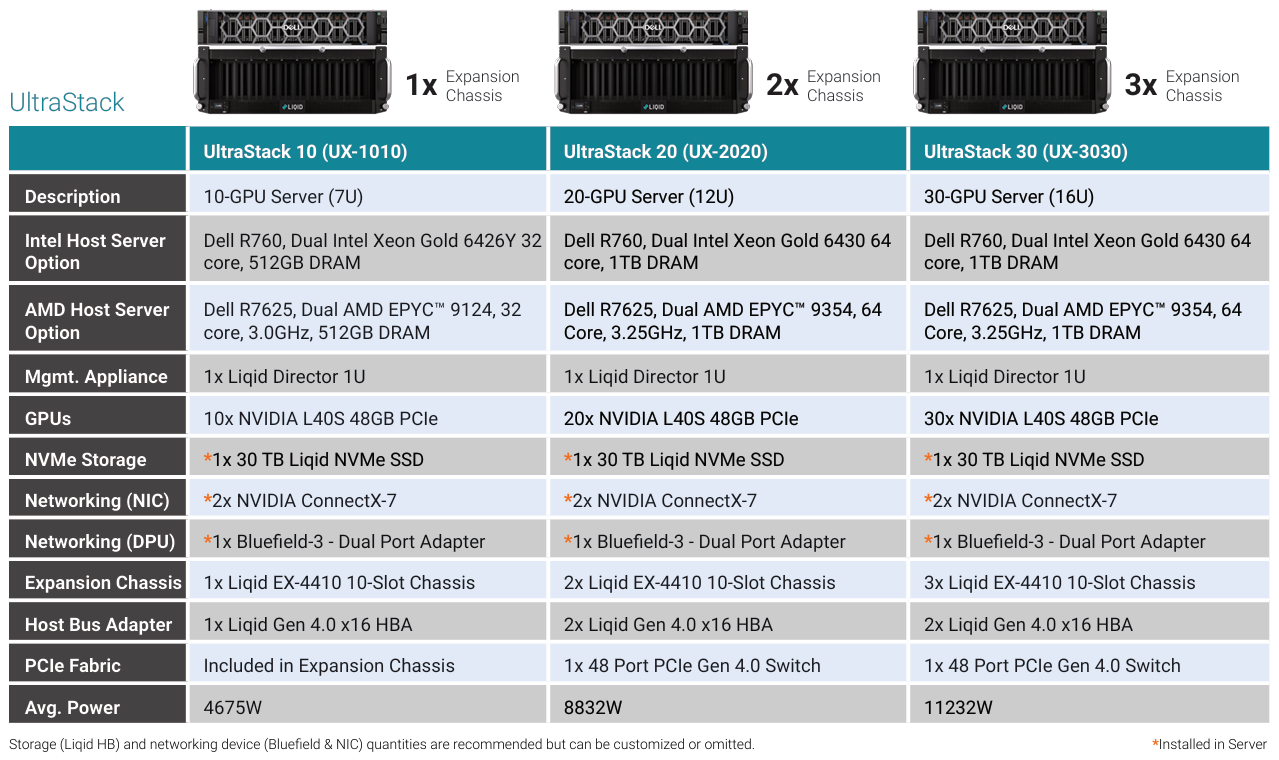 Платформа UltraStack 30 предназначена в первую очередь для быстрого развёртывания достаточно мощной ИИ-инфраструктуры там, где требуется тонкая подстройка и дообучение уже «натасканных» больших моделей. При этом стоит учитывать довольно солидное энергопотребление, составляющее более 11 кВт. Также в арсенале компании есть решения SmartStack на базе модульных систем Dell PowerEdge C-Series, позволяющие подключать к каждому из лезвийных модулей MX760c, MX750с и MX740c до 20 ускорителей. Модульные решения Liqid поддерживают также ускорители других производителей, включая достаточно экзотические, такие как Groq.
15.05.2024 [14:18], Руслан Авдеев
PUE у вас неправильный: NVIDIA призывает пересмотреть методы оценки энергоэффективности ЦОД и суперкомпьютеровОператорам дата-центров и суперкомпьютеров не хватает инструментов для корректного измерения энергоэффективности их оборудования и оценки прогресса на пути к экоустойчивым вычислениям. Как утверждает NVIDIA, нужна новая система оценки показателей при использовании оборудования в реальных задачах. Для оценки эффективности ЦОД существует как минимум около трёх десятков стандартов, некоторые уделяют внимание весьма специфическим критериям вроде расхода воды или уровню безопасности. Сегодня чаще всего используется показатель PUE (power usage effectiveness), т.е. отношение энергопотребления всего объекта к потреблению собственно IT-инфраструктуры. В последние годы многие операторы достигли практически идеальных значений PUE, поскольку, например, на преобразование энергии и охлаждение нужно совсем мало энергии. В эпоху роста облачных сервисов оценка PUE показала довольно высокую эффективность, но в эру ИИ-вычислений этот индекс уже не вполне соответствует запросам отрасли ЦОД — оборудование заметно изменилось. NVIDIA справедливо отмечает, что PUE не учитывает эффективность инфраструктуры в реальных нагрузках. С таким же успехом можно измерять расход автомобилем бензина без учёта того, как далеко он может проехать без дозаправки. При этом среднемировой показатель PUE дата-центров остаётся неизменным уже несколько лет, а улучшать его всё дороже. 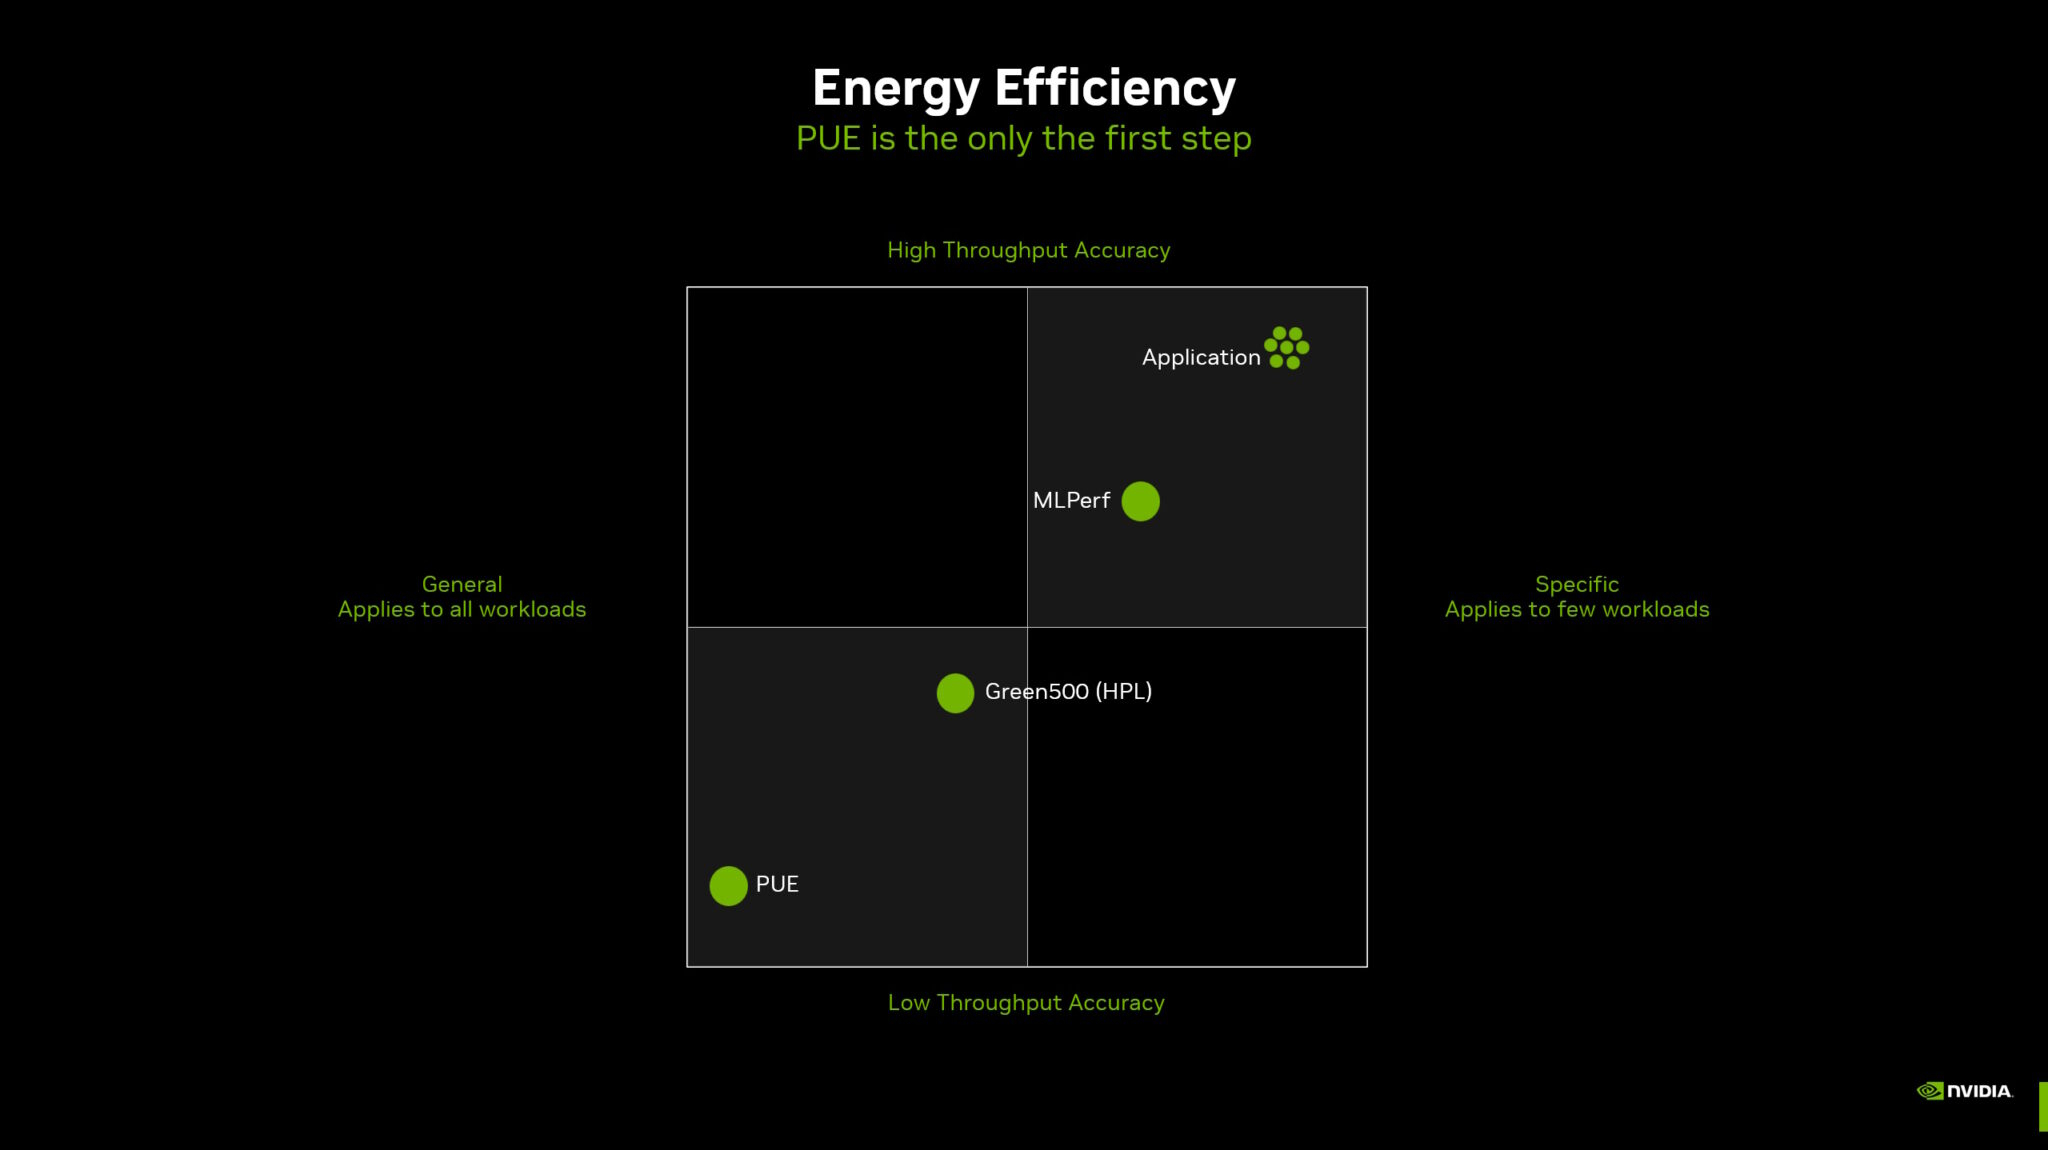
Источник изображений: NVIDIA Что касается энергопотребления, разное оборудование при одинаковых затратах может давать самые разные результаты. Другими словами, если современные ускорители потребляют больше энергии, это не значит, что они менее эффективны, поскольку они дают несопоставимо лучший результат в сравнении со старыми решениями. NVIDIA неоднократно приводила подобные сравнения и между своими GPU с обычными CPU, а теперь предлагает распространить этот подход на ЦОД целиком, что справедливо, учитывая стремление NVIDIA сделать минимальной единицей развёртывания целую стойку. 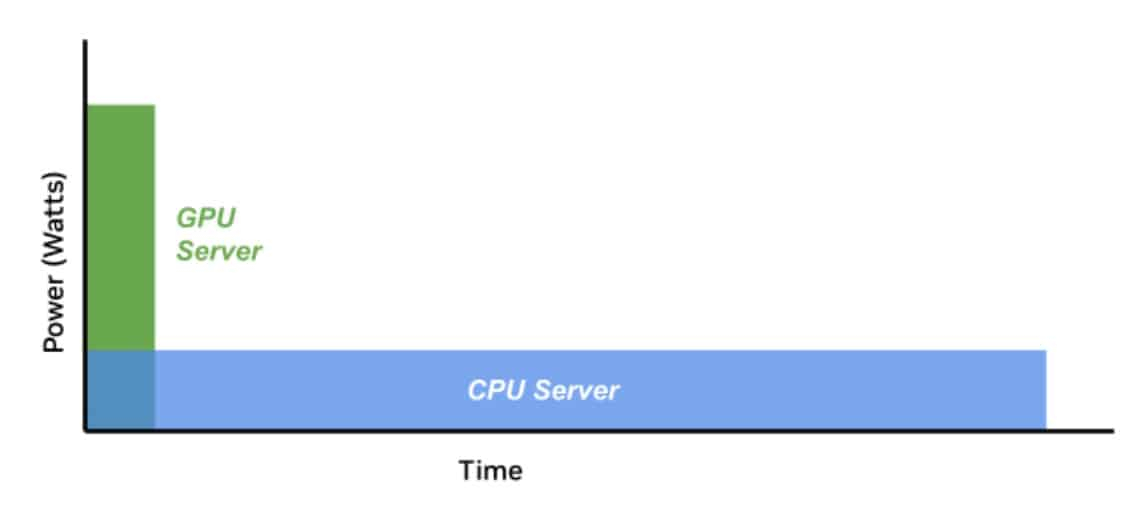 Как считают в NVIDIA, оценивать качество ЦОД можно только с учётом того, сколько энергии тратится для получения результата. Так, ЦОД для ИИ могут полагаться на MLPerf-бенчмарки, суперкомпьютеры для научных исследований могут требовать измерения других показателей, а коммерческие дата-центры для стриминговых сервисов — третьих. В идеале бенчмарки должны измерять прогресс в ускоренных вычислениях с использованием специализированных сопроцессоров, ПО и методик. Например, в параллельных вычислениях GPU намного энергоэффективнее обычных процессоров Отмечается, что с 2003 года производительность ускорителей выросла приблизительно в 7 тыс. раз, а соотношение цены и производительности стало в 5,6 тыс. раз лучше. А с учётом того, что современные ЦОД достигли PUE на уровне приблизительно 1,2, подобная метрика практически исчерпала себя, теперь стоит ориентироваться на другие показатели, релевантные актуальным проблемам. Хотя напрямую сравнить некоторые аспекты невозможно, сегментировав деятельность ЦОД на типы рабочих нагрузок, возможно, удалось бы получить некоторые результаты. В частности, операторам ЦОД нужен пакет бенчмарков, измеряющих показатели при самых распространённых рабочих ИИ-нагрузках. Например, неплохой метрикой может стать Дж/токен. Впрочем, NVIDIA грех жаловаться на недостойные оценки — в последнем рейтинге Green500 именно её системы заняли лидерские позиции.
29.03.2024 [21:54], Сергей Карасёв
Eviden увеличит производительность французского суперкомпьютера Jean Zay более чем втроеФранцузское национальное агентство по высокопроизводительным вычислениям (GENCI) и Национальный центр научных исследований (CNRS) заключили соглашение с компанией Eviden (дочерняя структура Atos) о модернизации НРС-комплекса Jean Zay. Ожидается, что производительность этого суперкомпьютера увеличится приблизительно в 3,5 раза. В рамках проекта Eviden оборудует комплекс 1456 ускорителями NVIDIA H100 в дополнение к 416 ускорителям NVIDIA A100 и 1832 ускорителям NVIDIA V100, которые задействованы в настоящее время. Модернизация предполагает использование 14 стоек суперкомпьютерной платформы Eviden BullSequana XH3000. В общей сложности будут задействованы 364 двухпроцессорных узла на базе Intel Xeon Sapphire Rapids с 48 ядрами. Каждый сервер получит 512 Гбайт оперативной памяти и четыре ускорителя NVIDIA H100 SXM5. Говорится об использовании адаптеров NVIDIA ConnectX-7. 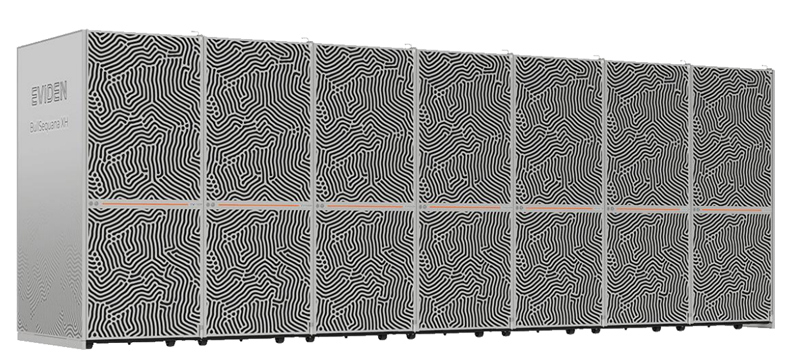
Источник изображения: Eviden Проект также предусматривает комплексное обновление подсистемы хранения данных. Она будет состоять из флеш-массива вместимостью 4,3 Пбайт со скоростями чтения/записи свыше 1 Тбайт/с и дискового массива ёмкостью 39 Пбайт со скоростями чтения/записи более 300 Гбайт/с. Компоненты СХД поставит компания DataDirect Networks (DDN). Для обоих уровней хранения предусмотрено использование файловой системы Lustre. 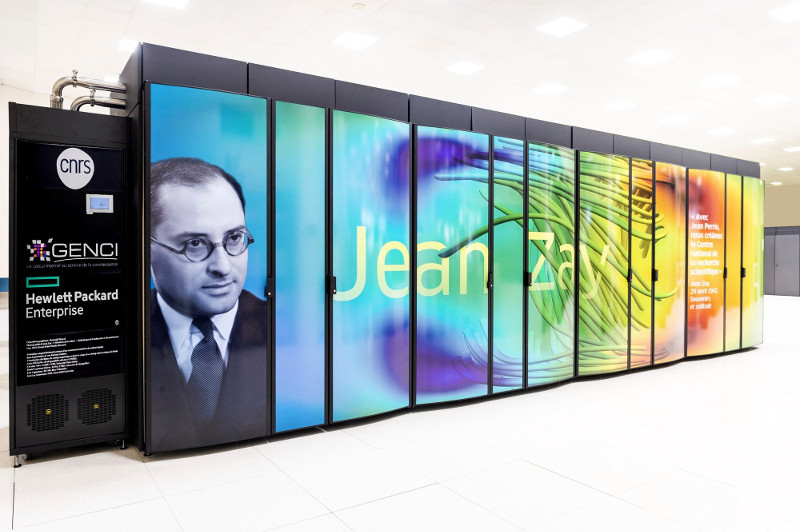
Фото: Photothèque CNRS/Cyril Frésillon Ожидается, что модернизация позволит увеличить пиковую производительность Jean Zay с 36,85 до 125,9 Пфлопс. Проект получил финансирование в рамках национальной инвестиционной программы «Франция 2030». Усовершенствованный суперкомпьютер будет использоваться для решения ресурсоёмких задач, в том числе в области ИИ. Отмечается, что Jean Zay — это один из наиболее экологичных суперкомпьютеров в Европе. Отчасти это достигается благодаря использованию генерируемого машиной тепла для обогрева более 1000 зданий в кампусе Париж-Сакле.
22.03.2024 [09:09], Алексей Степин
NVIDIA представила 800G-платформы Quantum-X800 и Spectrum-X800 для InfiniBand- и Ethernet-фабрик нового поколенияДополнением к только что представленным ИИ-ускорителям NVIDIA Blackwell станут новые сетевые 800G-платформы Quantum-X800 и Spectrum-X800, а также сетевые адаптеры ConnectX-8. Именно они позволят вывести масштабирование ИИ-кластеров на новый уровень и позволят «прокормить» гигантские массивы ускорителей в дата-центрах гиперскейлеров. Платформа NVIDIA Quantum-X800 ориентирована на наиболее производительные ИИ- и HPC-кластеры. Она использует новое поколение технологии InfiniBand, всё ещё обладающей рядом преимуществ в сравнении с Ethernet, и включает в себя обновлённые SHARP-движки. Технология SHARPv4 реализует «вычисления в сети» (In-Network Computing), что позволяет не только существенно разгрузить вычислительные узлы и серверы, но и обеспечить более высокую пропускную способность интерконнекта вкупе с более серьёзными возможностями его масштабирования. 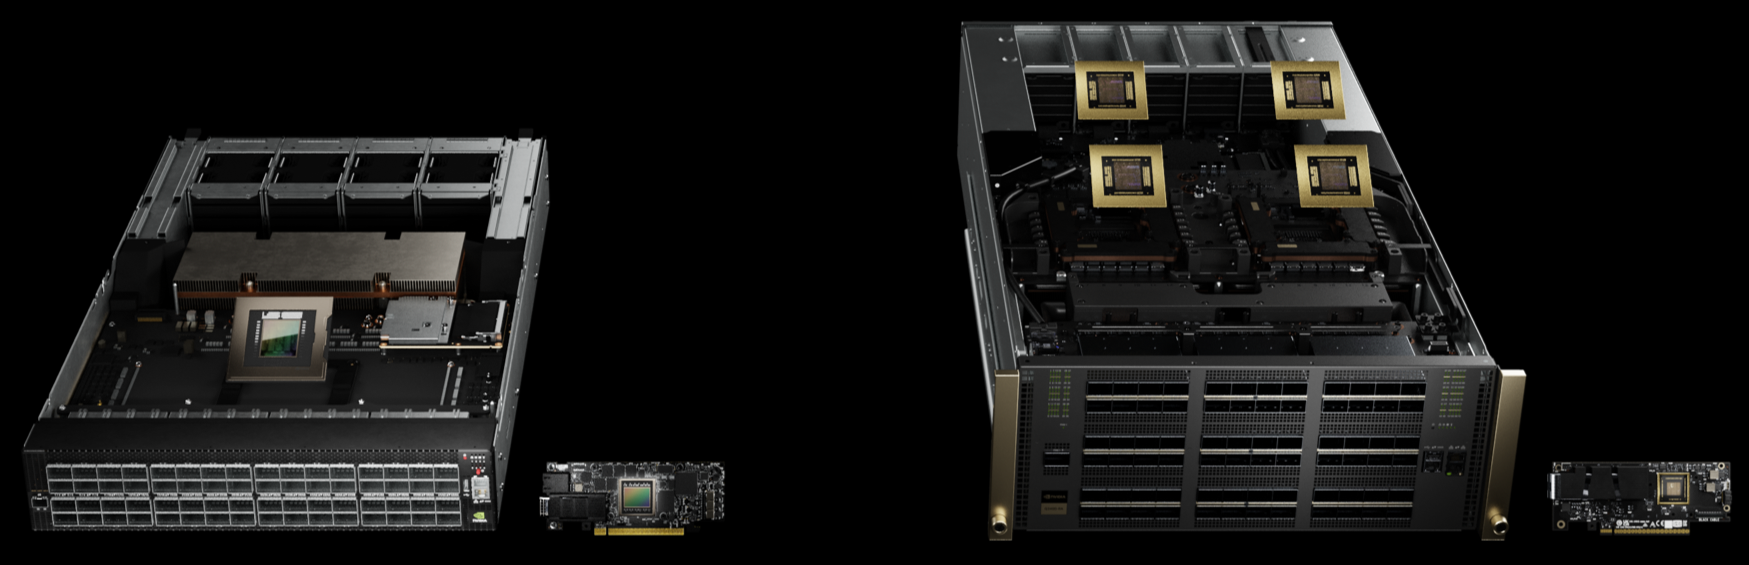
NVIDIA Q3400-RA 4U (справа) и SN5600. Источник изображений здесь и далее: NVIDIA Основой платформы Quantum-X800 стал 4U-коммутатор Q3400-RA, впервые в индустрии, как говорит компания, использующий 200G-блоки SerDes для каждой линии InfiniBand. Коммутатор располагает 144 портами 800G в 72 OSFP-модулях и выделенным портом для Unified Fabric Manager. Новинка имеет стандартное 19″ исполнение с воздушным охлаждением, но есть и вариант Q3400-LD с жидкостным охлаждением, предназначенный для 21″ OCP-стоек. В двухуровневом варианте fat tree коммутаторы позволят объединить 10 368 NIC. 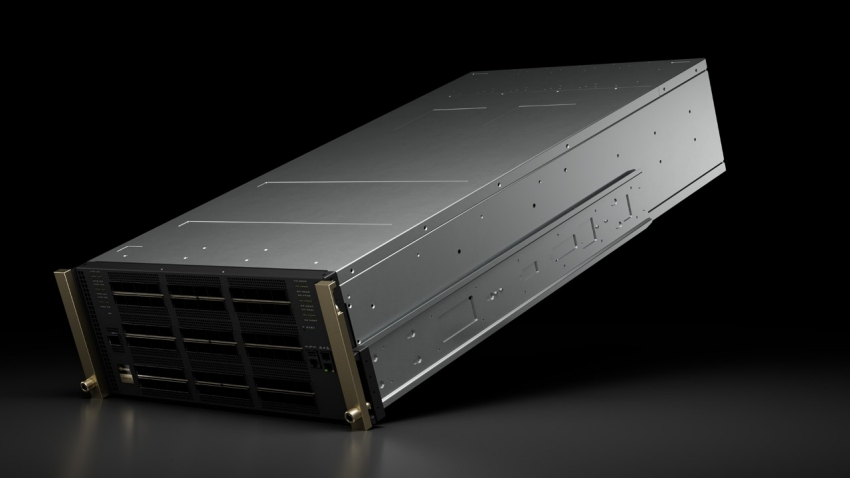 Основным адаптером для новой платформы InfiniBand является ConnectX-8 SuperNIC с интерфейсом PCIe 6.0. Он является частью SHARPv4 и предлагается в однопортовом (OSFP224) и двухпортовом (QSFP112) вариантах и в нескольких форм-факторах, включая OCP 3.0. На платах также имеется разъём SocketDirect на 16 линий PCIe. Также компания представила компоненты NVIDIA LinkX: оптические трансиверы 2xDR4/2xFR4 и активные медные кабели (LACC). 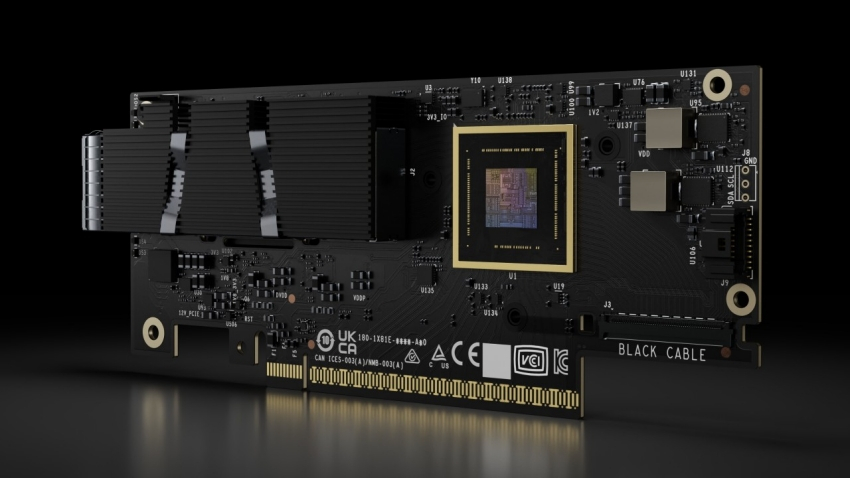 Не забыла NVIDIA и про Ethernet: здесь вывести производительность сети на новый уровень должна платформа Spectrum-X800. Её основой служит новейший коммутатор SN5600 — это, по словам NVIDIA, первый в мире Ethernet-коммутатор класса 800GbE, специально разработанный для применения гиперскейлерами в крупных облачных ИИ-комплексах. Применяемая архитектура позволяет гарантировать каждому клиенту оптимальный и постоянный уровень производительности, а потоковая телеметрия позволит находить и ликвидировать возможные «бутылочные горлышки» в сети буквально на лету. 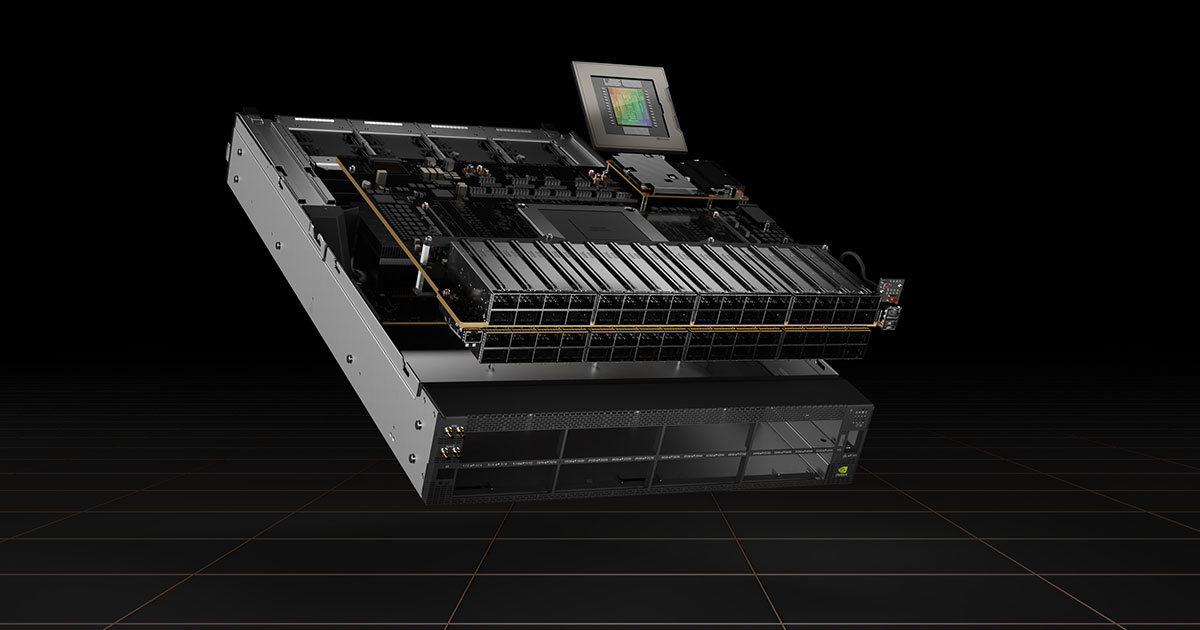 Общая пропускная способность SN5600 составляет 51,2 Тбит/с. Коммутатор располагает 64 портами 800GbE в формате OSFP. В нём используется ASIC пятого поколения на базе архитектуры Spectrum-4. В качестве основного адаптера предлагается SuperNIC на базе DPU BlueField-3 с двумя 400GbE-портами. 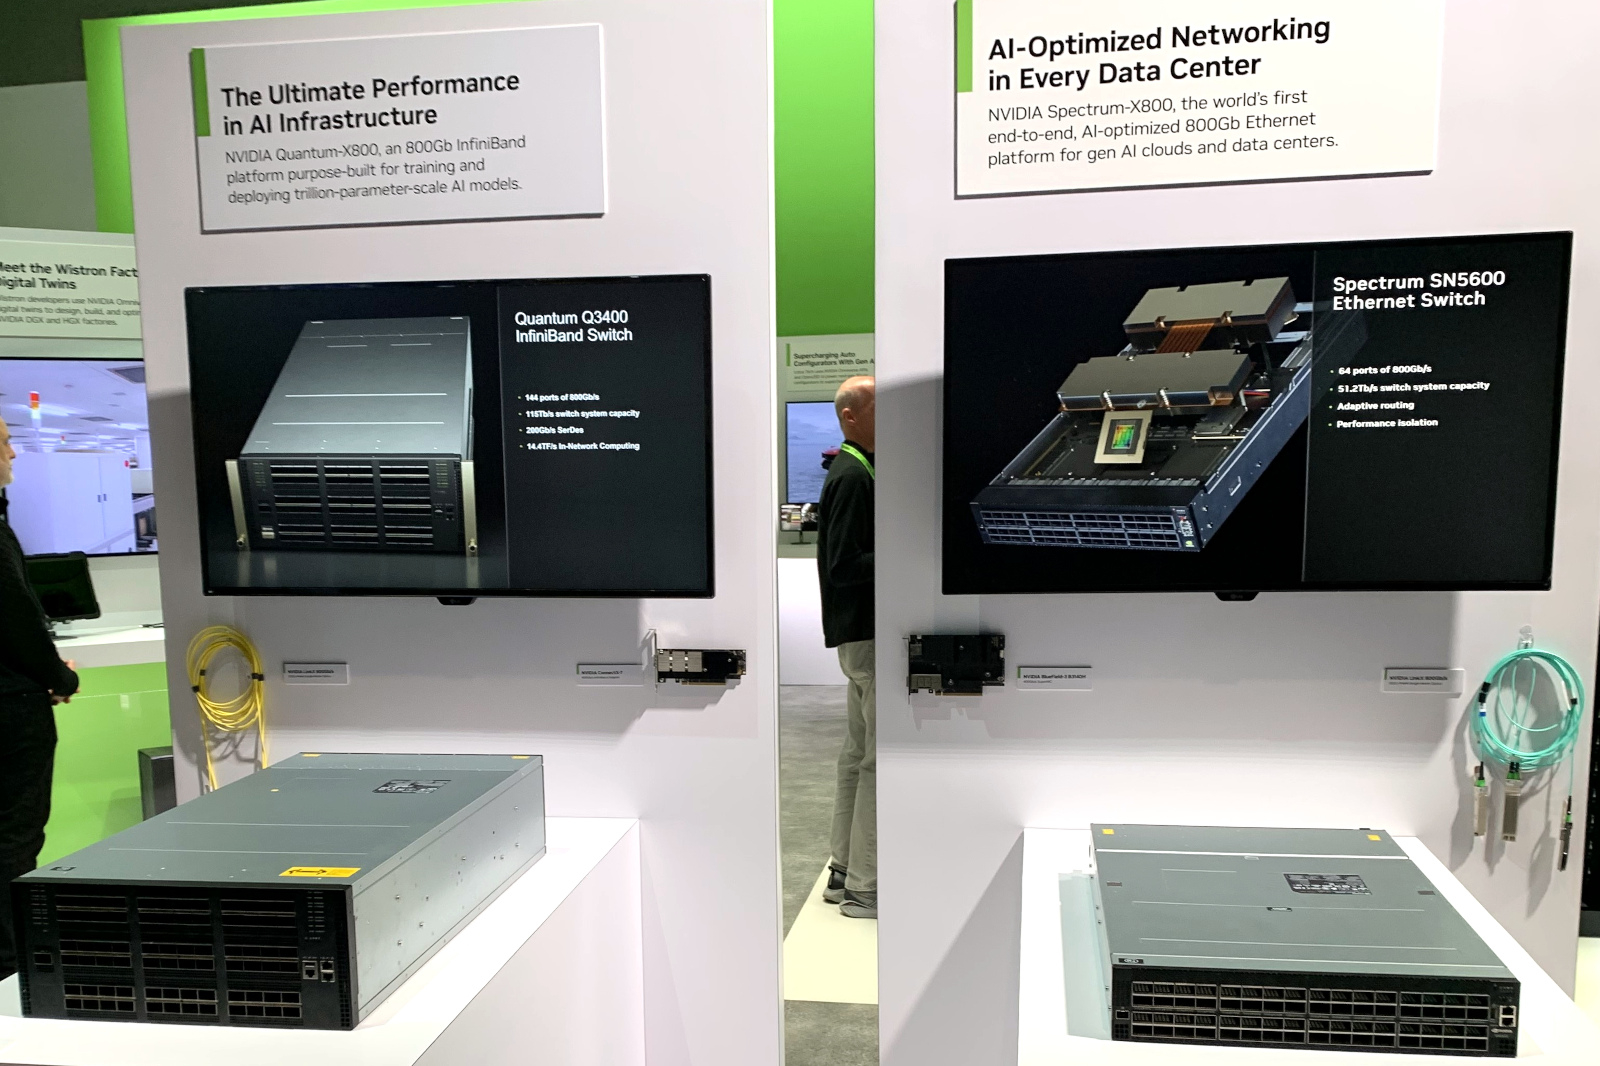
Фото: Twitter/NVIDIANetworkng Spectrum-X800 сопровождает полноценный спектр инфраструктурных компонентов, включая кабели DAC и LACC. С оптическими трансиверами длина соединения 800GbE может достигать двух километров. Начиная со следующего года, решения на базе новых сетевых платформ NVIDIA будут доступны от широкого круга поставщиков оборудования, включая Aivres, DDN, Dell Technologies, Eviden, Hitachi Vantara, HPE, Lenovo, Supermicro и VAST Data.
19.03.2024 [01:00], Игорь Осколков
NVIDIA B200, GB200 и GB200 NVL72 — новые ускорители на базе архитектуры BlackwellNVIDIA представила сразу несколько ускорителей на базе новой архитектуры Blackwell, названной в честь американского статистика и математика Дэвида Блэквелла. На смену H100/H200, GH200 и GH200 NVL32 на базе архитектуры Hopper придут B200, GB200 и GB200 NVL72. Все они, как говорит NVIDIA, призваны демократизировать работу с большими языковыми моделями (LLM) с триллионами параметров. В частности, решения на базе Blackwell будут до 25 раз энергоэффективнее и экономичнее в сравнении с Hopper. В разреженных FP4- и FP8-вычислениях производительность B200 достигает 20 и 10 Пфлопс соответственно. Но без толики технического маркетинга не обошлось — показанные результаты достигнуты не только благодаря аппаратным улучшениям, но и программным оптимизациям. Это ни в коей мере не умаляет их важности и полезности, но затрудняет прямое сравнение с конкурирующими решениями. В общем, появление Blackwell стоит рассматривать не как очередное поколение ускорителей, а как расширение всей экосистемы NVIDIA. В Blackwell компания использует тайловую (чиплетную) компоновку — два тайла объединены 2,5D-упаковкой CoWoS-L и на двоих имеют 208 млрд транзисторов, изготовленных по техпроцессу TSMC 4NP. В одно целое со всех точек зрения их объединяет новый интерконнект NV-HBI с пропускной способностью 10 Тбайт/с, а дополняют их восемь стеков HBM3e-памяти ёмкостью до 192 Гбайт с агрегированной пропускной способностью до 8 Тбайт/с. Такой же объём памяти предлагает и Instinct MI300X, но с меньшей ПСП (5,3 Тбайт/с), хотя это скоро изменится. FP8-производительность в разреженных вычислениях у решения AMD составляет 5,23 Пфлопс, но зато компания не забывает и про FP64 в отличие от NVIDIA. 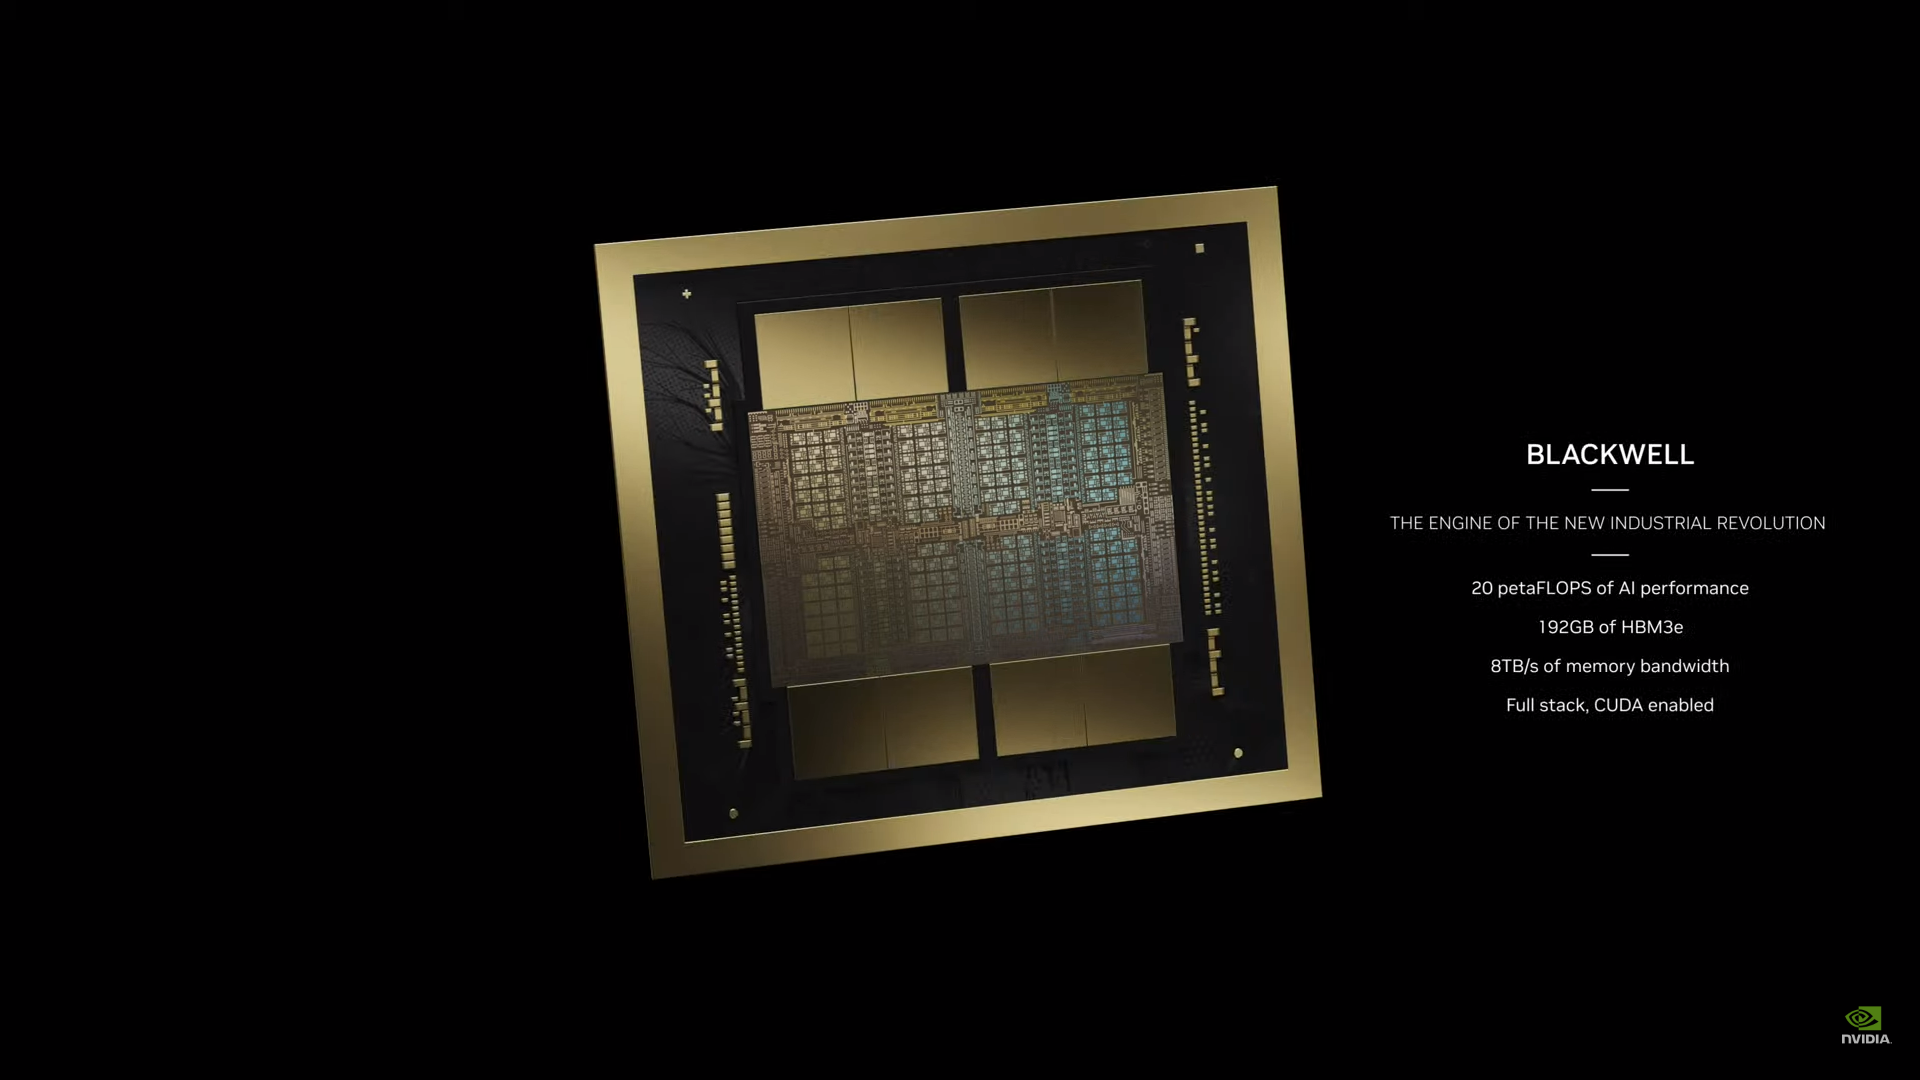
Источник изображений: NVIDIA Одними из ключевых нововведений, отвечающих за повышение производительности, стали новые Tensor-ядра и второе поколение механизма Transformer Engine, который научился заглядывать внутрь тензоров, ещё более тонко подбирая необходимую точность вычислений, что влияет и на скорость обучения с инференсом, и на максимальный объём модели, умещающейся в памяти ускорителя. 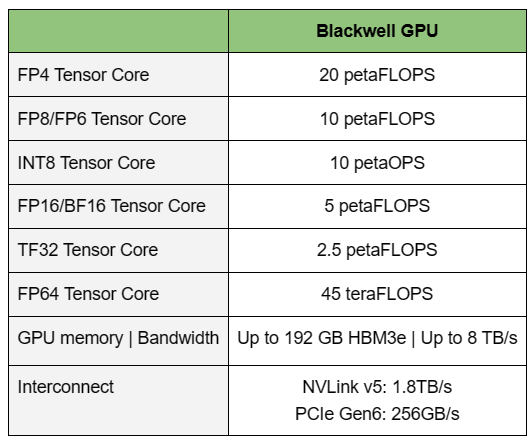 Теперь NVIDIA намекает на то, что обучение можно делать в FP8-формате, а для инференса хватит и FP4. Всё это без потери качества. Но вообще Blackwell поддерживает FP4/FP6/FP8, INT8, BF16/FP16, TF32 и FP64. И только для последнего нет поддержки разреженных вычислений. 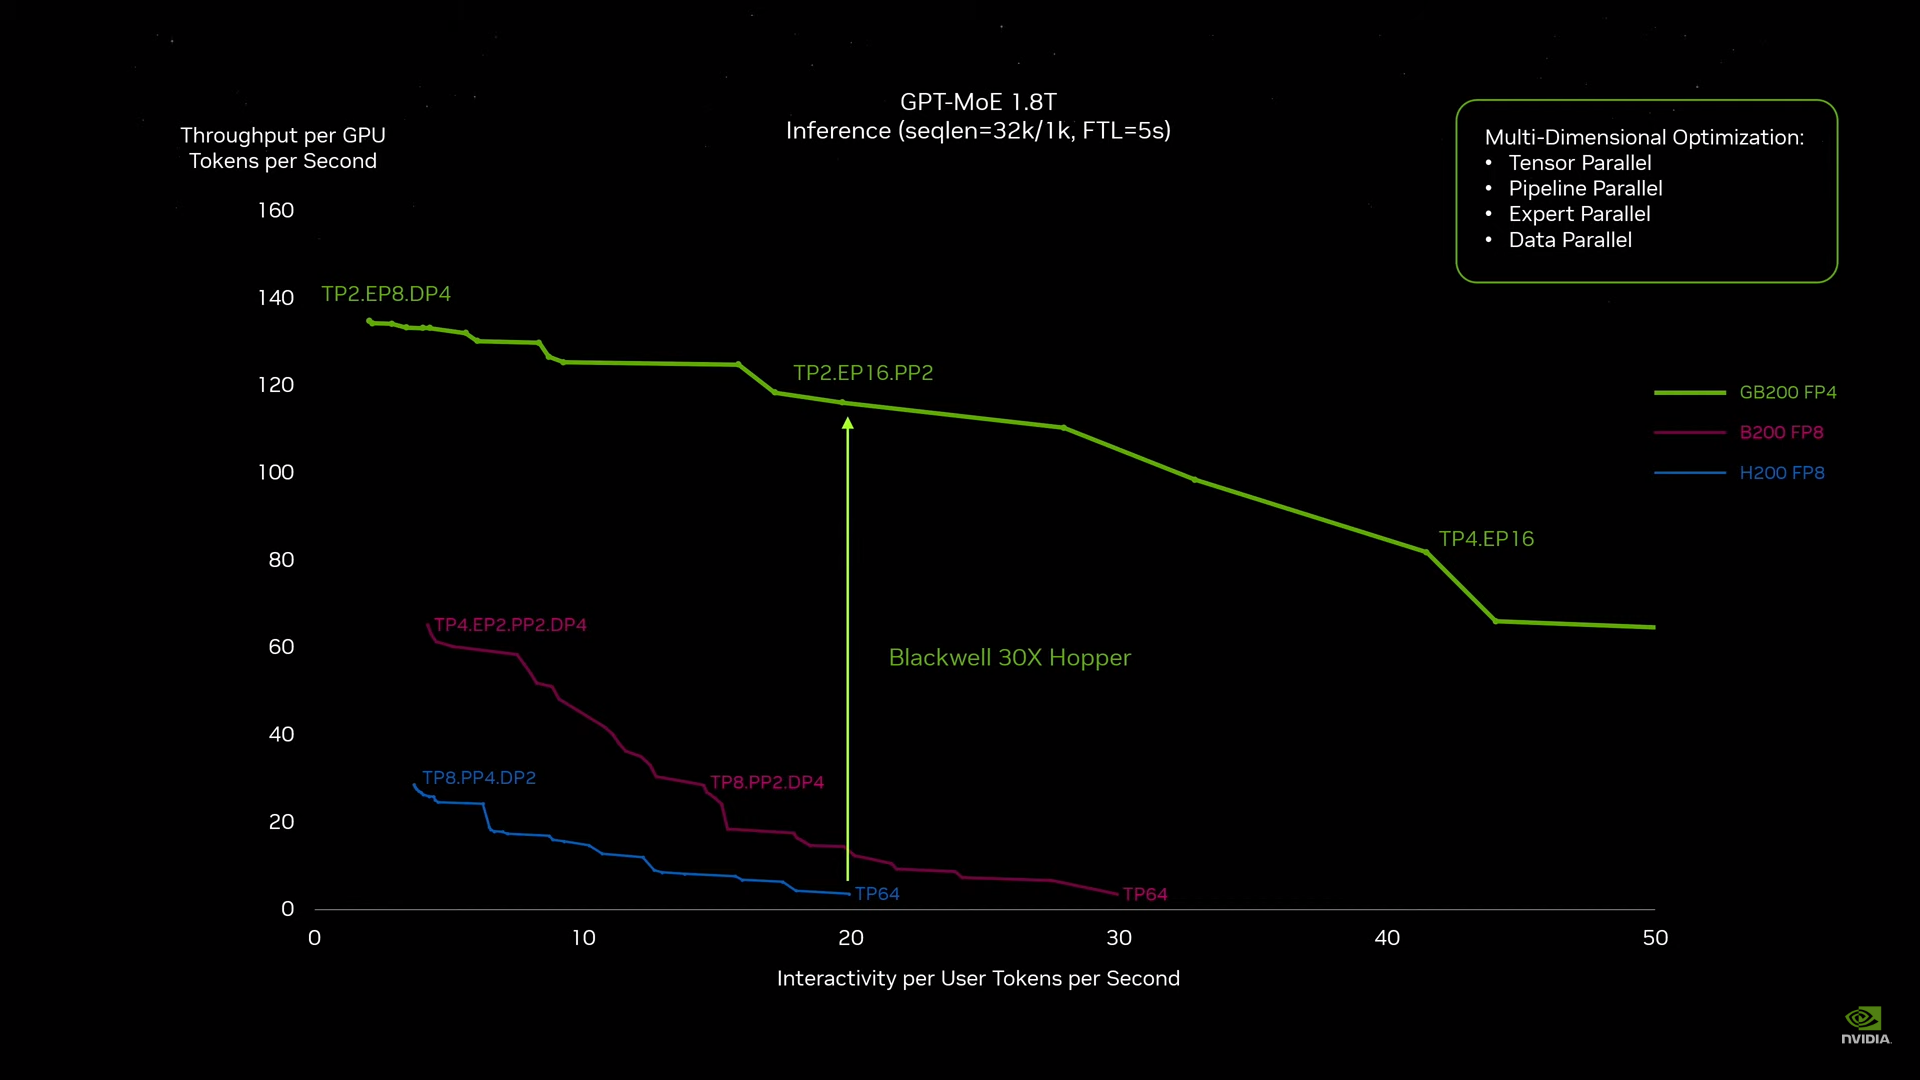 Дополнительно Blackwell обзавёлся движком для декомпрессии (в первую очередь LZ4, Deflate, Snappy) входящих данных со скоростью до 800 Гбайт/с, что тоже должно повысить производительность, т.к. теперь распаковкой будет заниматься не CPU и, соответственно, ускоритель не будет «голодать». Эта функция рассчитана в основном на Apache Spark и другие системы для аналитики больших данных. Также есть по семь движков NVDEC и NVJPEG. 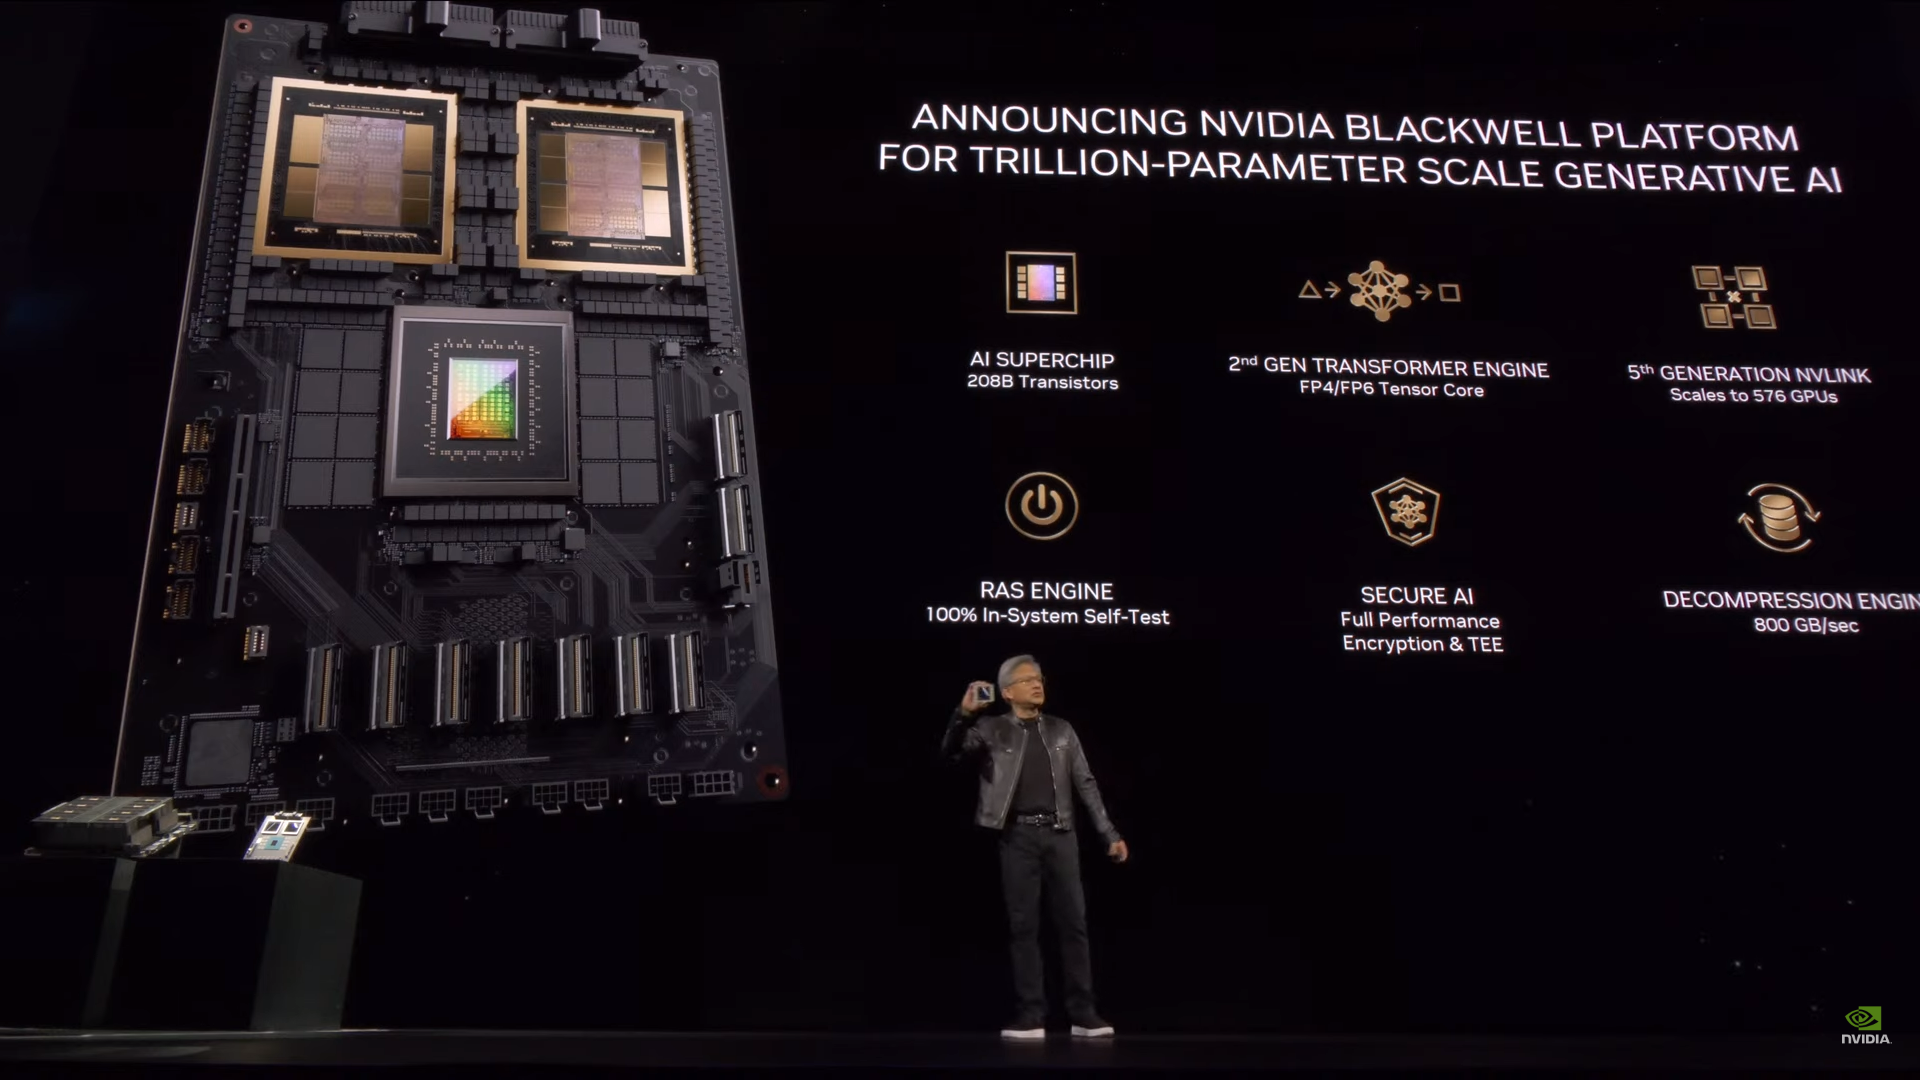 Наконец, NVIDIA упоминает ещё две новых возможности Blackwell: шифрование данных в памяти и RAS-функции. В первом случае речь идёт о защите конфиденциальности обрабатываемых данных, что важно в целом ряде областей. Причём формирование TEE-анклава возможно в рамках группы из 128 ускорителей. MIG-доменов по-прежнему семь. В случае RAS говорится о телеметрии и предиктивной аналитике (естественно, на базе ИИ), которые помогут заранее выявить возможные сбои и снизить время простоя. Это важно, поскольку многие модели могут обучаться неделями и месяцами, так что потеря даже относительно небольшого куска данных крайне неприятна и финансово затратна. 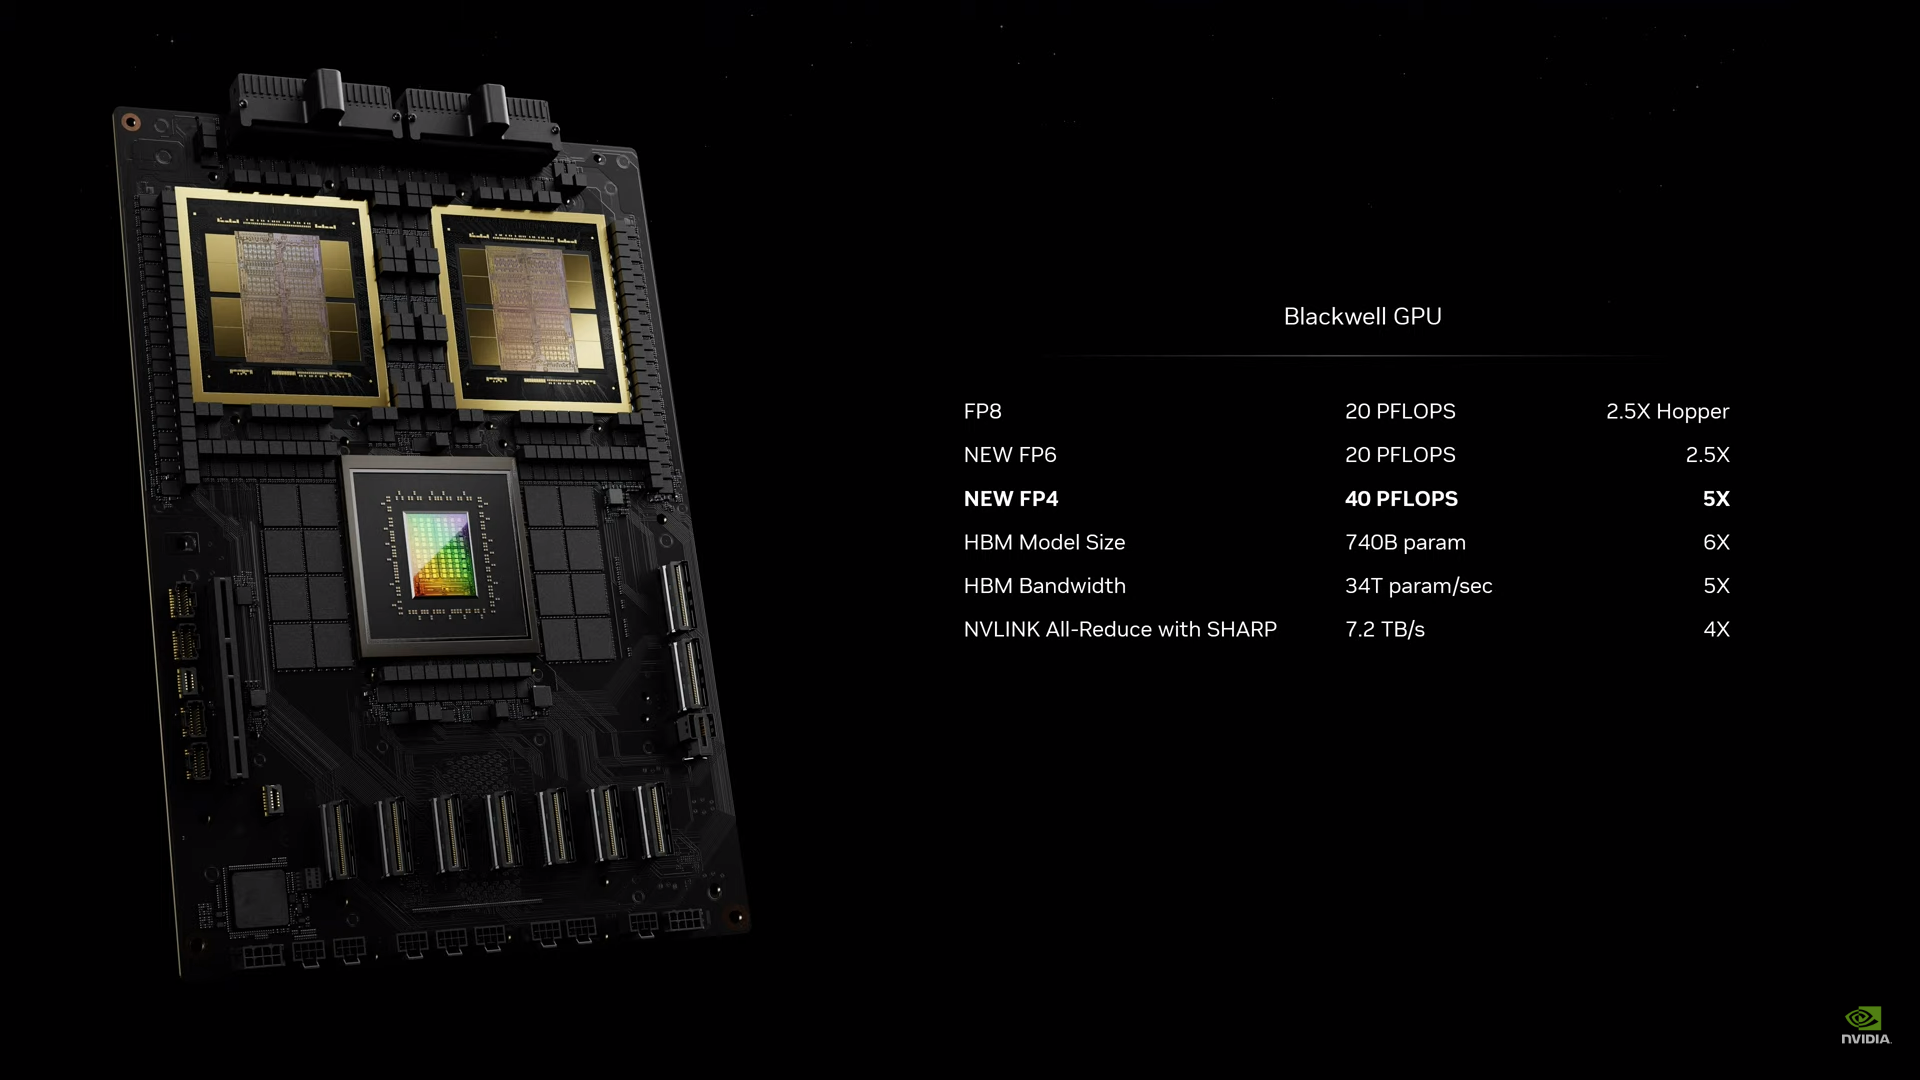 Однако всё эти инновации не имеют смысла без возможности масштабирования, поэтому NVIDIA оснастила Blackwell не только интерфейсом PCIe 6.0 (32 линии), который играет всё меньшую роль, но и пятым поколением интерконнекта NVLink. NVLink 5 по сравнению с NVLink 4 удвоил пропускную способность до 1,8 Тбайт/с (по 900 Гбайт/с в каждую сторону), а соответствующий коммутатор NVSwitch 7.2T позволяет объединить до 576 ускорителей в одном домене. SHARP-движки с поддержкой FP8 дополнительно помогут ускорить обработку моделей, избавив ускорители от части работ по предобработке и трансформации данных. Чип коммутатора тоже изготавливается по техпроцессу TSMC N4P и содержит 50 млрд транзисторов. 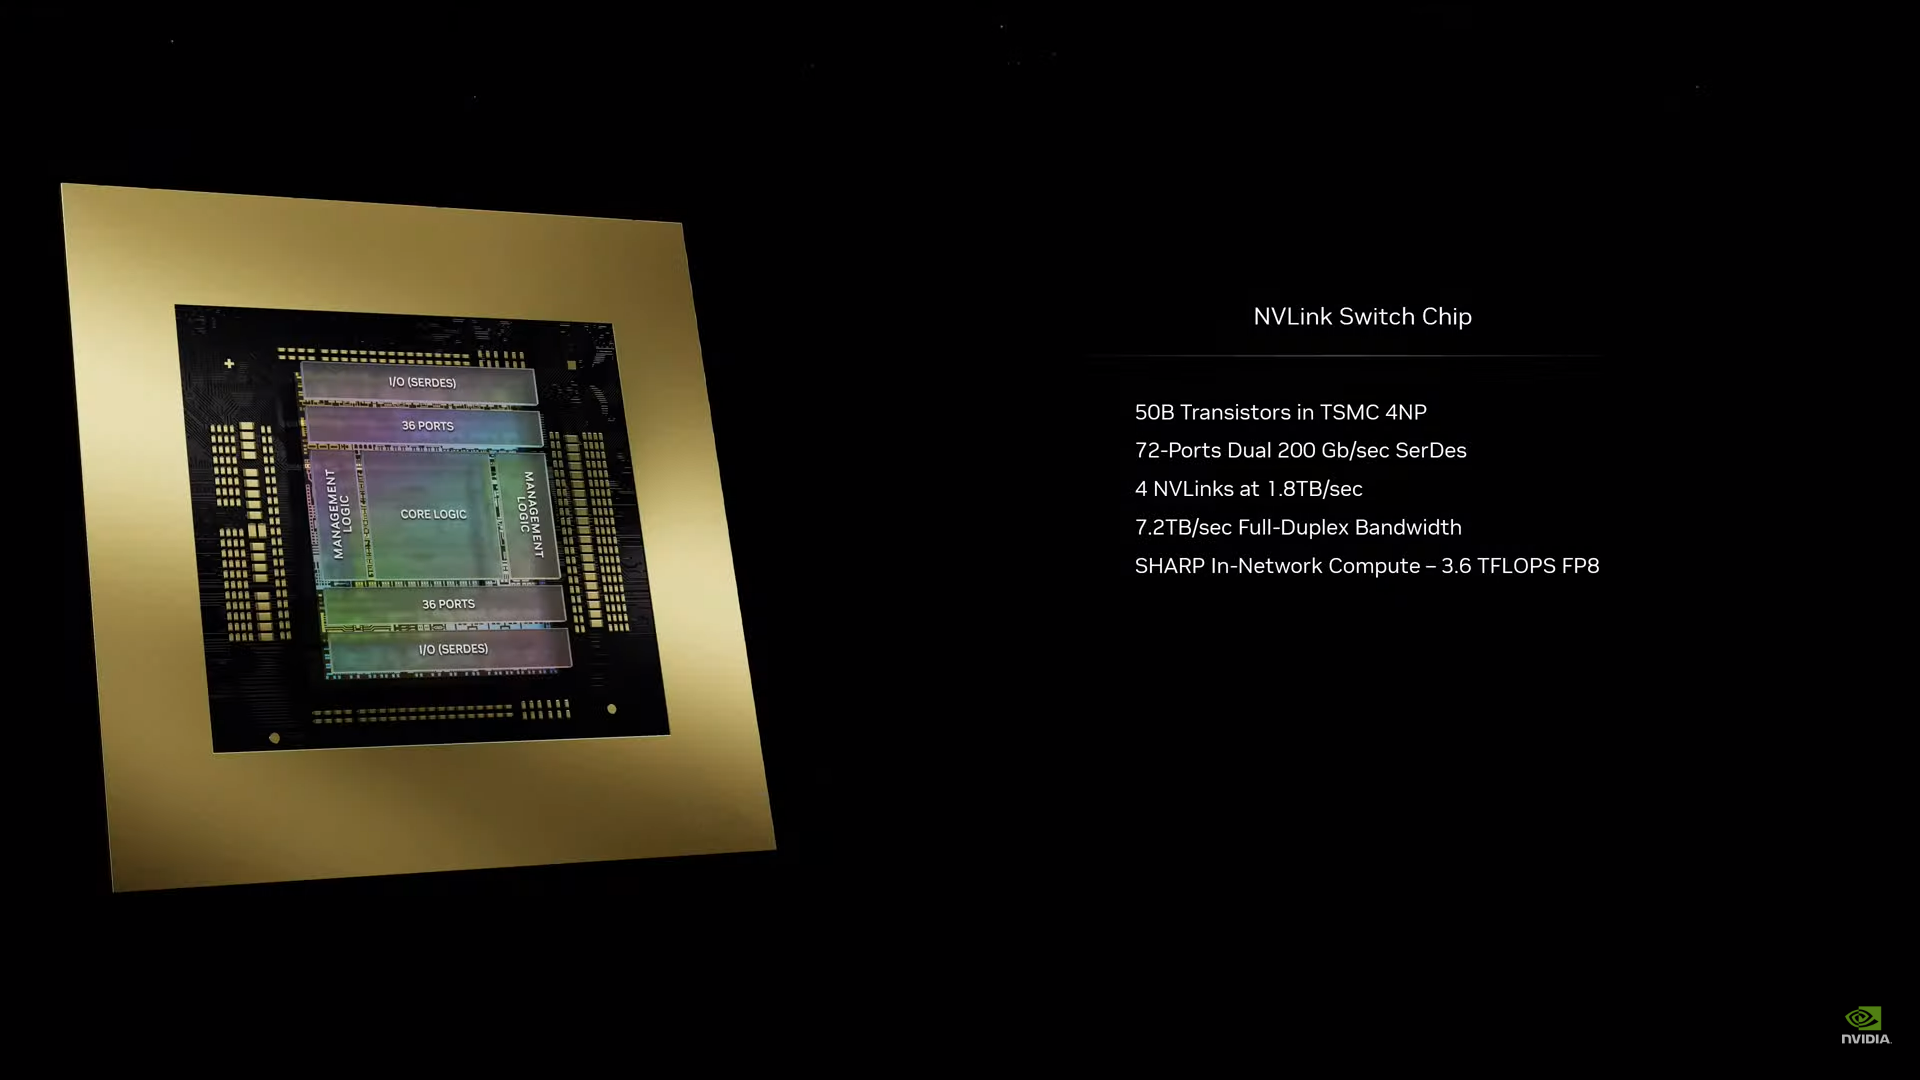 Для дальнейшего масштабирования и формирования кластеров из 10 тыс. ускорителей и более, вплоть до 100 тыс. ускорителей на уровне ЦОД, NVIDIA предлагает 800G-коммутаторы Quantum-X800 InfiniBand XDR и Spectrum-X800 Ethernet, имеющие соответственно 144 и 64 порта. Узлам же полагаются DPU ConnectX-8 SuperNIC и BlueField-3. Правда, последний предлагает только 400G-порты в отличие от первого. От InfiniBand компания отказываться не собирается. 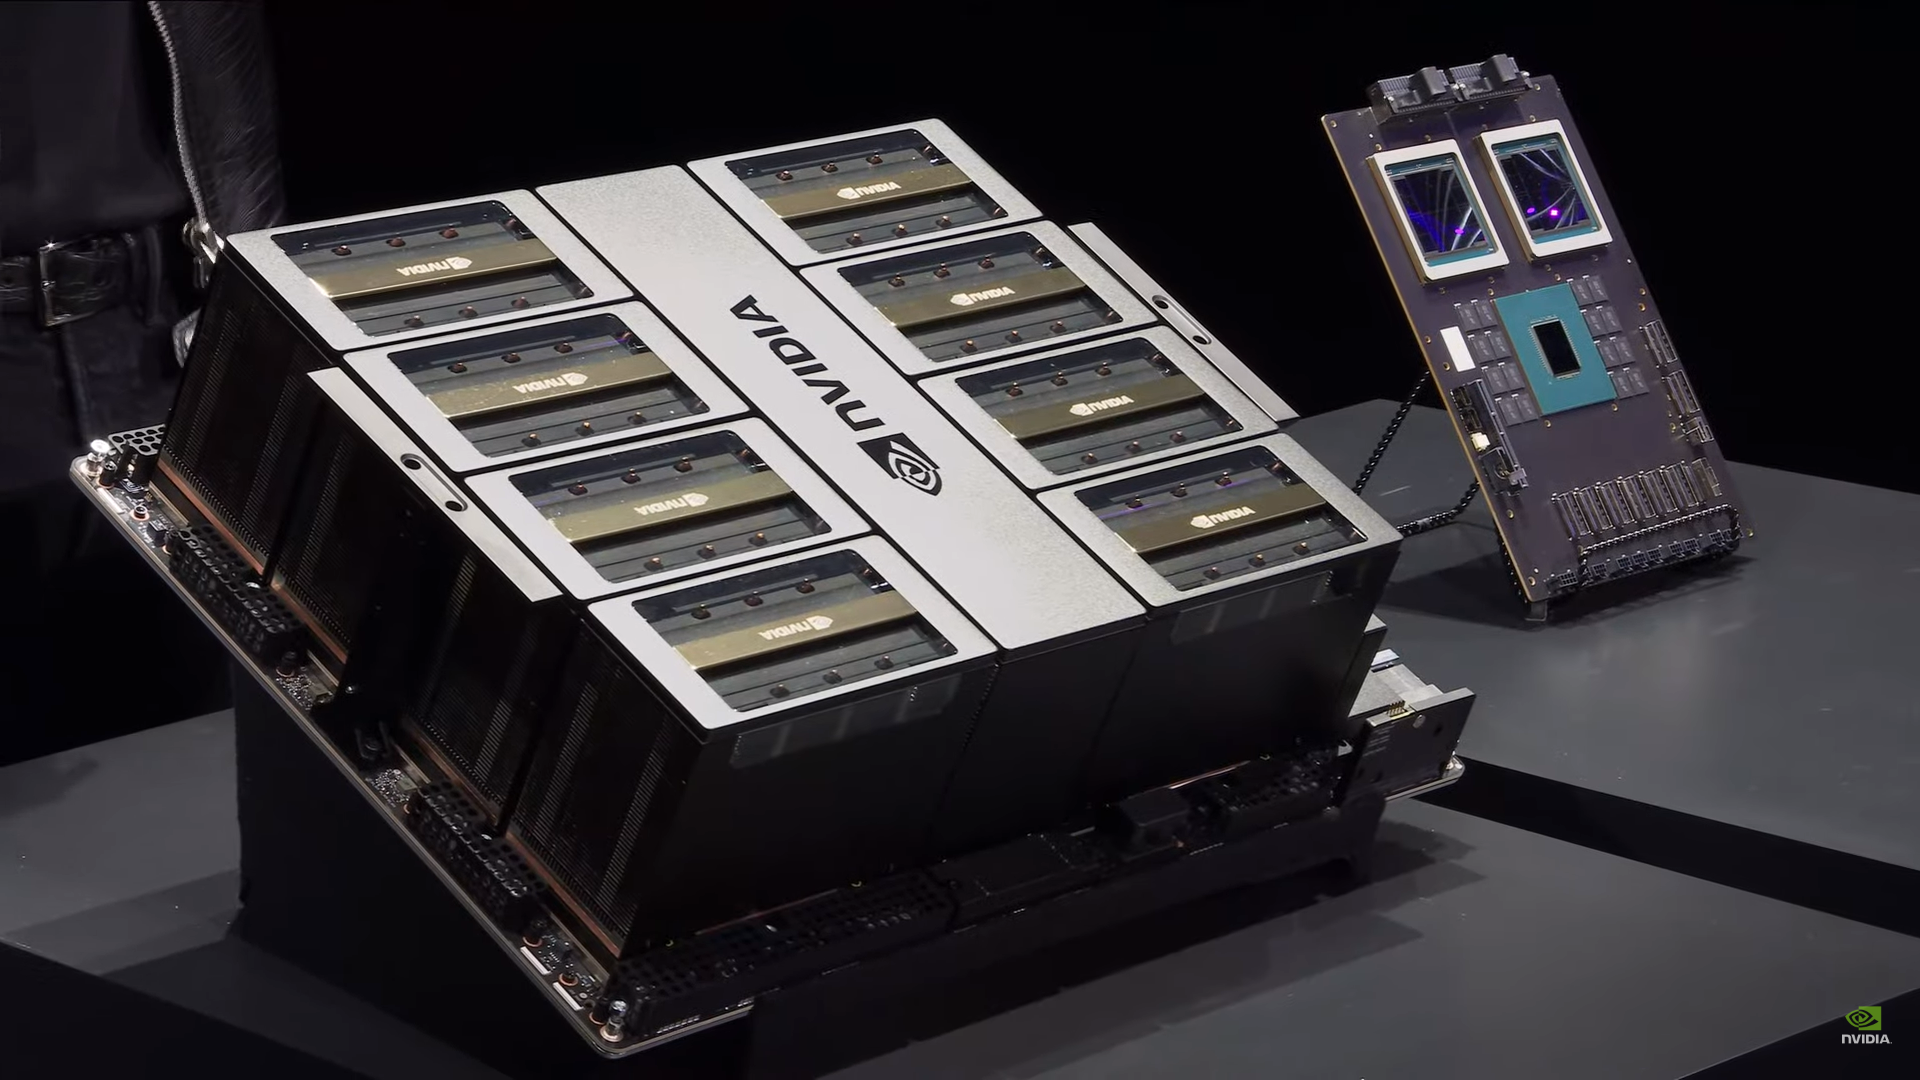 С базовыми кирпичиками разобрались, пора переходить к конструированию продуктов. Первым идёт HGX B100, в основе которой всё та же базовая плата с восемью ускорителями Blackwell, точно так же провязанных между собой NVLink 5 с агрегированной скоростью 14,4 Тбайт/с. Для связи с внешним миром предлагается пара интерфейсов PCIe 6.0 x16. HGX B100 предназначена для простой замены HGX H100, поэтому ускорители имеют TDP не более 700 Вт, что ограничивает пиковую производительность в разреженных FP4- и FP8/FP6/INT8-вычислениях до 14 и 7 Пфлопс соответственно, а для всей системы — 112 и 56 Пфлопс соответственно. 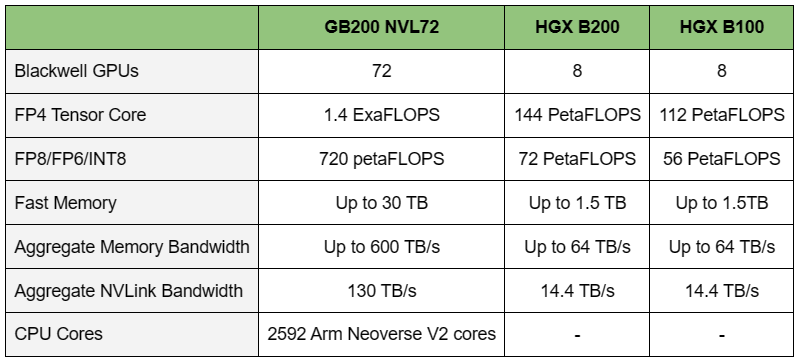 У HGX B200 показатель TDP ограничен уже 1 кВт, причём возможность воздушного охлаждения по-прежнему сохраняется. Производительность одного B200 в разреженных FP4- и FP8/FP6/INT8-вычислениях достигает уже 18 и 9 Пфлопс, а для всей системы — 144 и 72 Пфлопс соответственно. DGX B200 повторяет HGX B200 в плане производительности и является готовой системой от NVIDIA, тоже с воздушным охлаждением. В системе используются два чипа Intel Xeon Emerald Rapids. По словам NVIDIA, DGX B200 до 15 раз быстрее в задачах инференса «триллионных» моделей по сравнению с DGX-узлами прошлого поколения. 800G-интерконнект Ethernet/InfiniBand этим трём платформам не достался, только 400G. 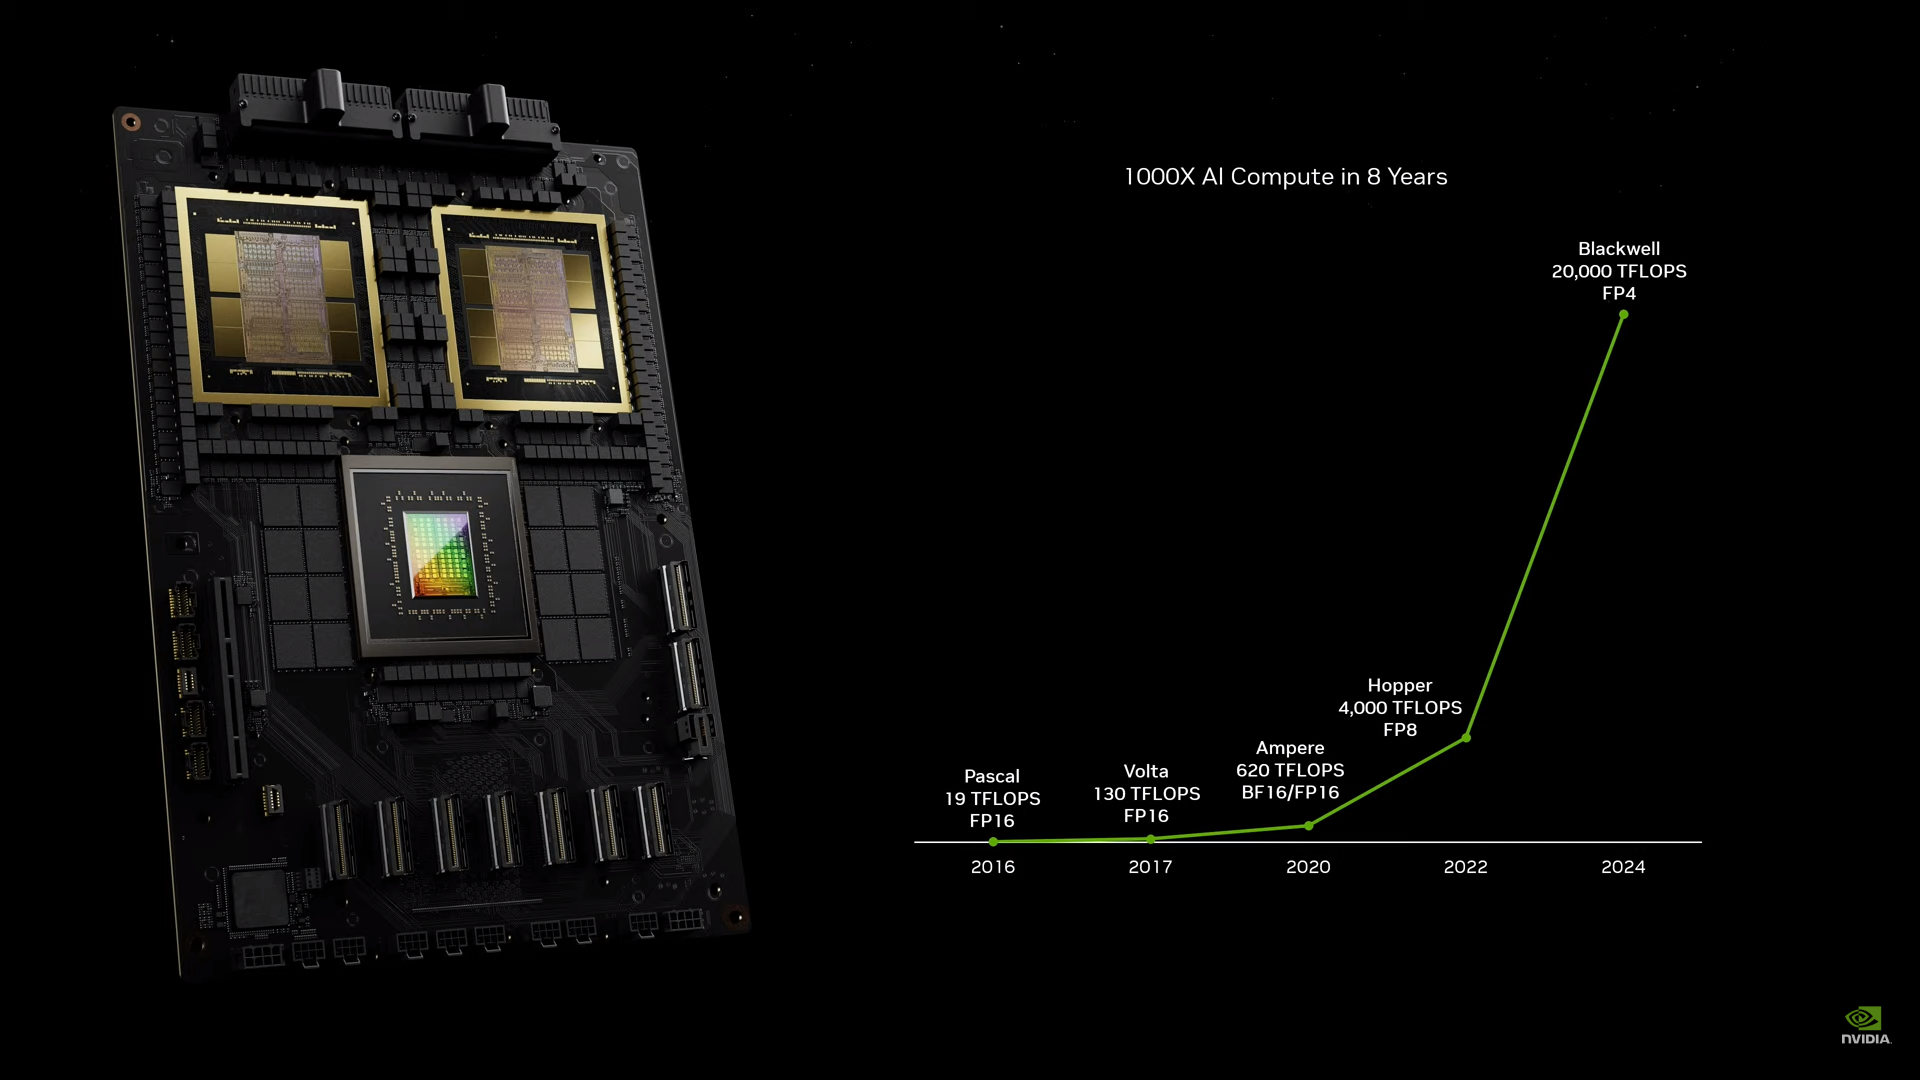 Основным же строительным блоком сама компания явно считает гибридный суперчип GB200, объединяющий уже имеющийся у неё Arm-процессор Grace сразу с двумя ускорителями Blackwell B200. CPU-часть включает 72 ядра Neoverse V2 (по 64 Кбайт L1-кеша для данных и инструкций, L2-кеш 1 Мбайт), 144 Мбайт L3-кеша и до 480 Гбайт LPDDR5x-памяти с ПСП до 512 Гбайт/с. С двумя B200 процессор связан 900-Гбайт/с шиной NVLink-C2C — по 450 Гбайт/с на каждый ускоритель. Между собой B200 напрямую подключены уже по полноценной 1,8-Тбайт/с шине NVLink 5. 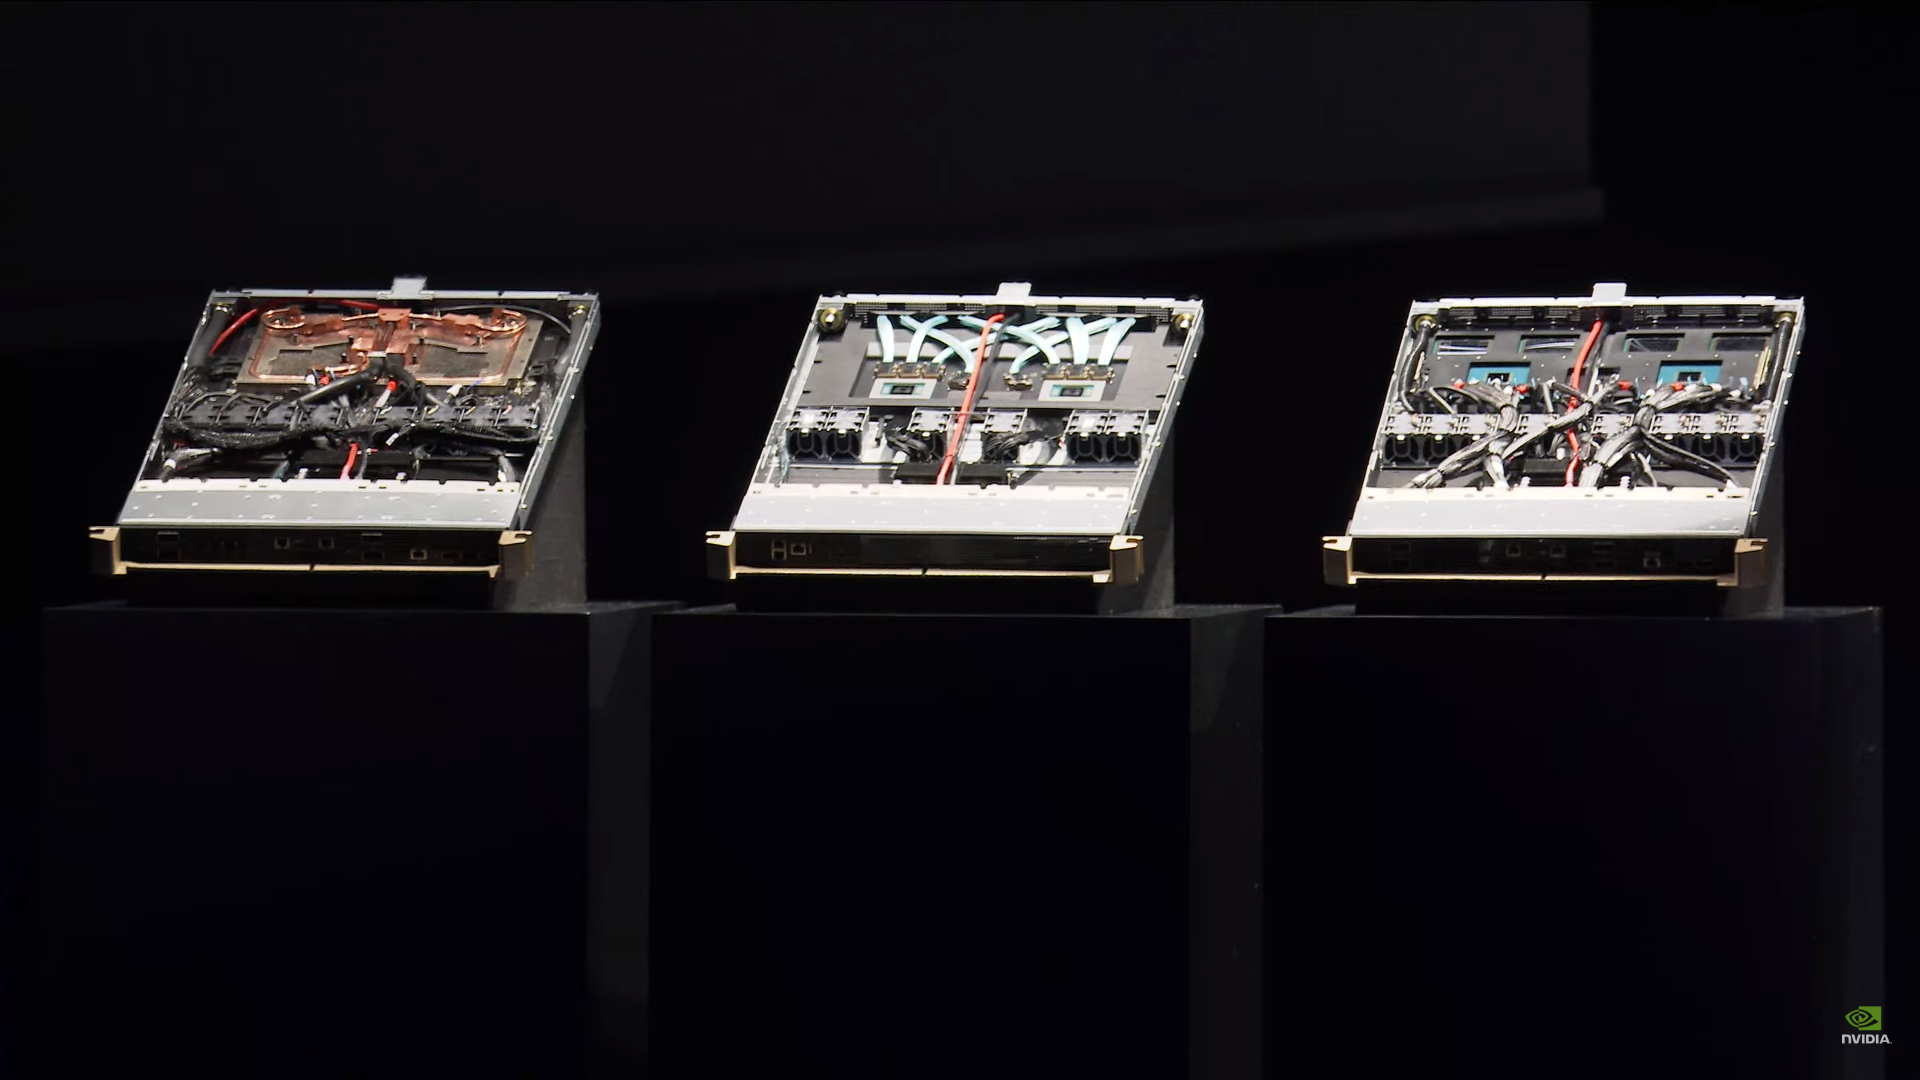 Вся эта немаленькая конструкция шириной в половину стойки имеет TDP до 2,7 кВт. 1U-узел с парой чипов GB200, каждый из которых может отъедать до 1,2 кВт, уже требует жидкостное охлаждение. FP4- и FP8/FP6/INT8-производительность (речь всё ещё о разреженных вычислениях) GB200 достигает 40 и 20 Пфлопс. И именно эти цифры NVIDIA нередко использует для сравнения новинок со старыми решениями. 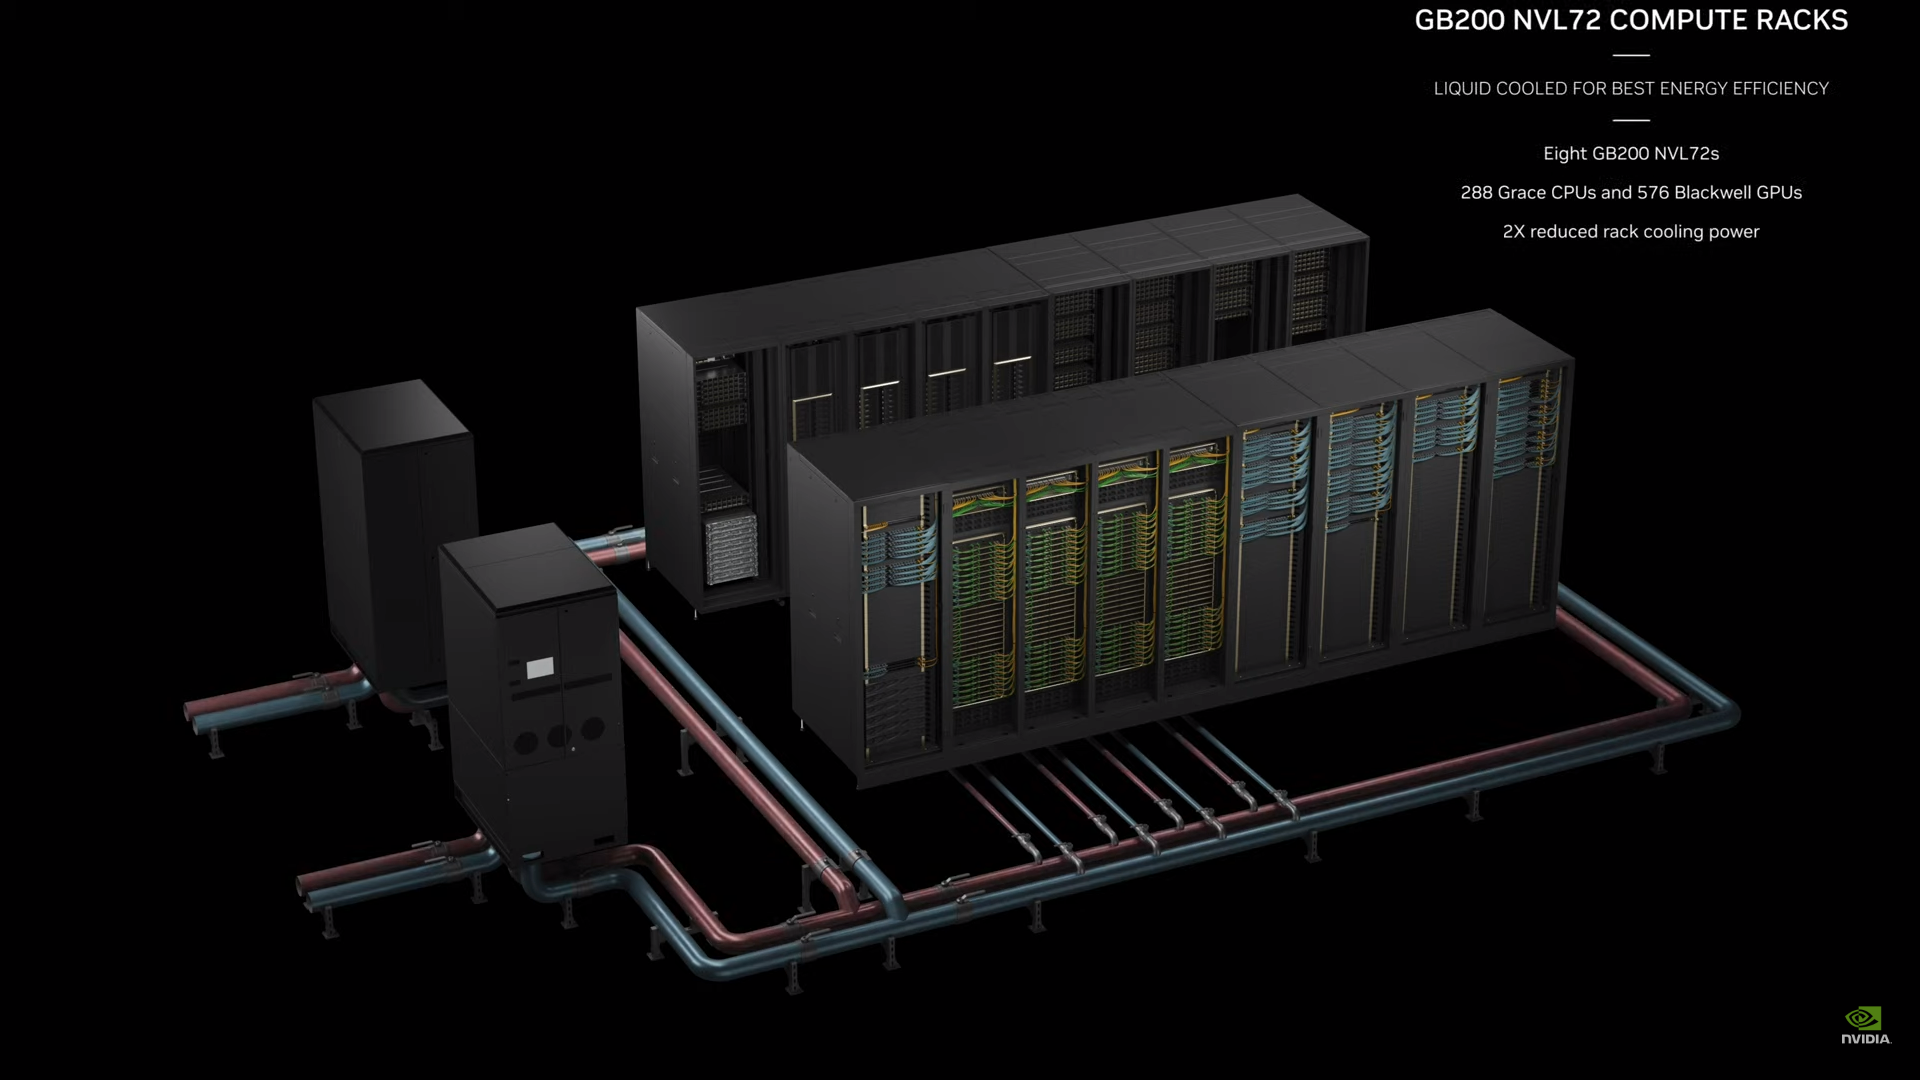 18 узлов с парой GB200 (суммарно 72 шт.) и 9 узлов с парой коммутаторов NVSwitch 7.2T, которые провязывают все ускорители по схеме каждый-с-каждым (агрегированно 130 Тбайт/с, более 3 км соединений), формируют 120-кВт суперускоритель GB200 NVL72 размером со стойку (Oberon), оснащённый СЖО и единой DC-шиной питания. Всё это даёт до 1,44 Эфлопс в FP4-вычислениях и до 720 Пфлопс в FP8, а также до 13,5 Тбайт HBM3e с агрегированной ПСП до 576 Тбайт/с. Ну а общий объём памяти составляет порядка 30 Тбайт. GB200 NVL72 одновременно является и узлом DGX GB200. Восемь DGX GB200 формируют DGX SuperPOD. Впрочем, будет доступен и SuperPOD попроще, на базе DGX B200. 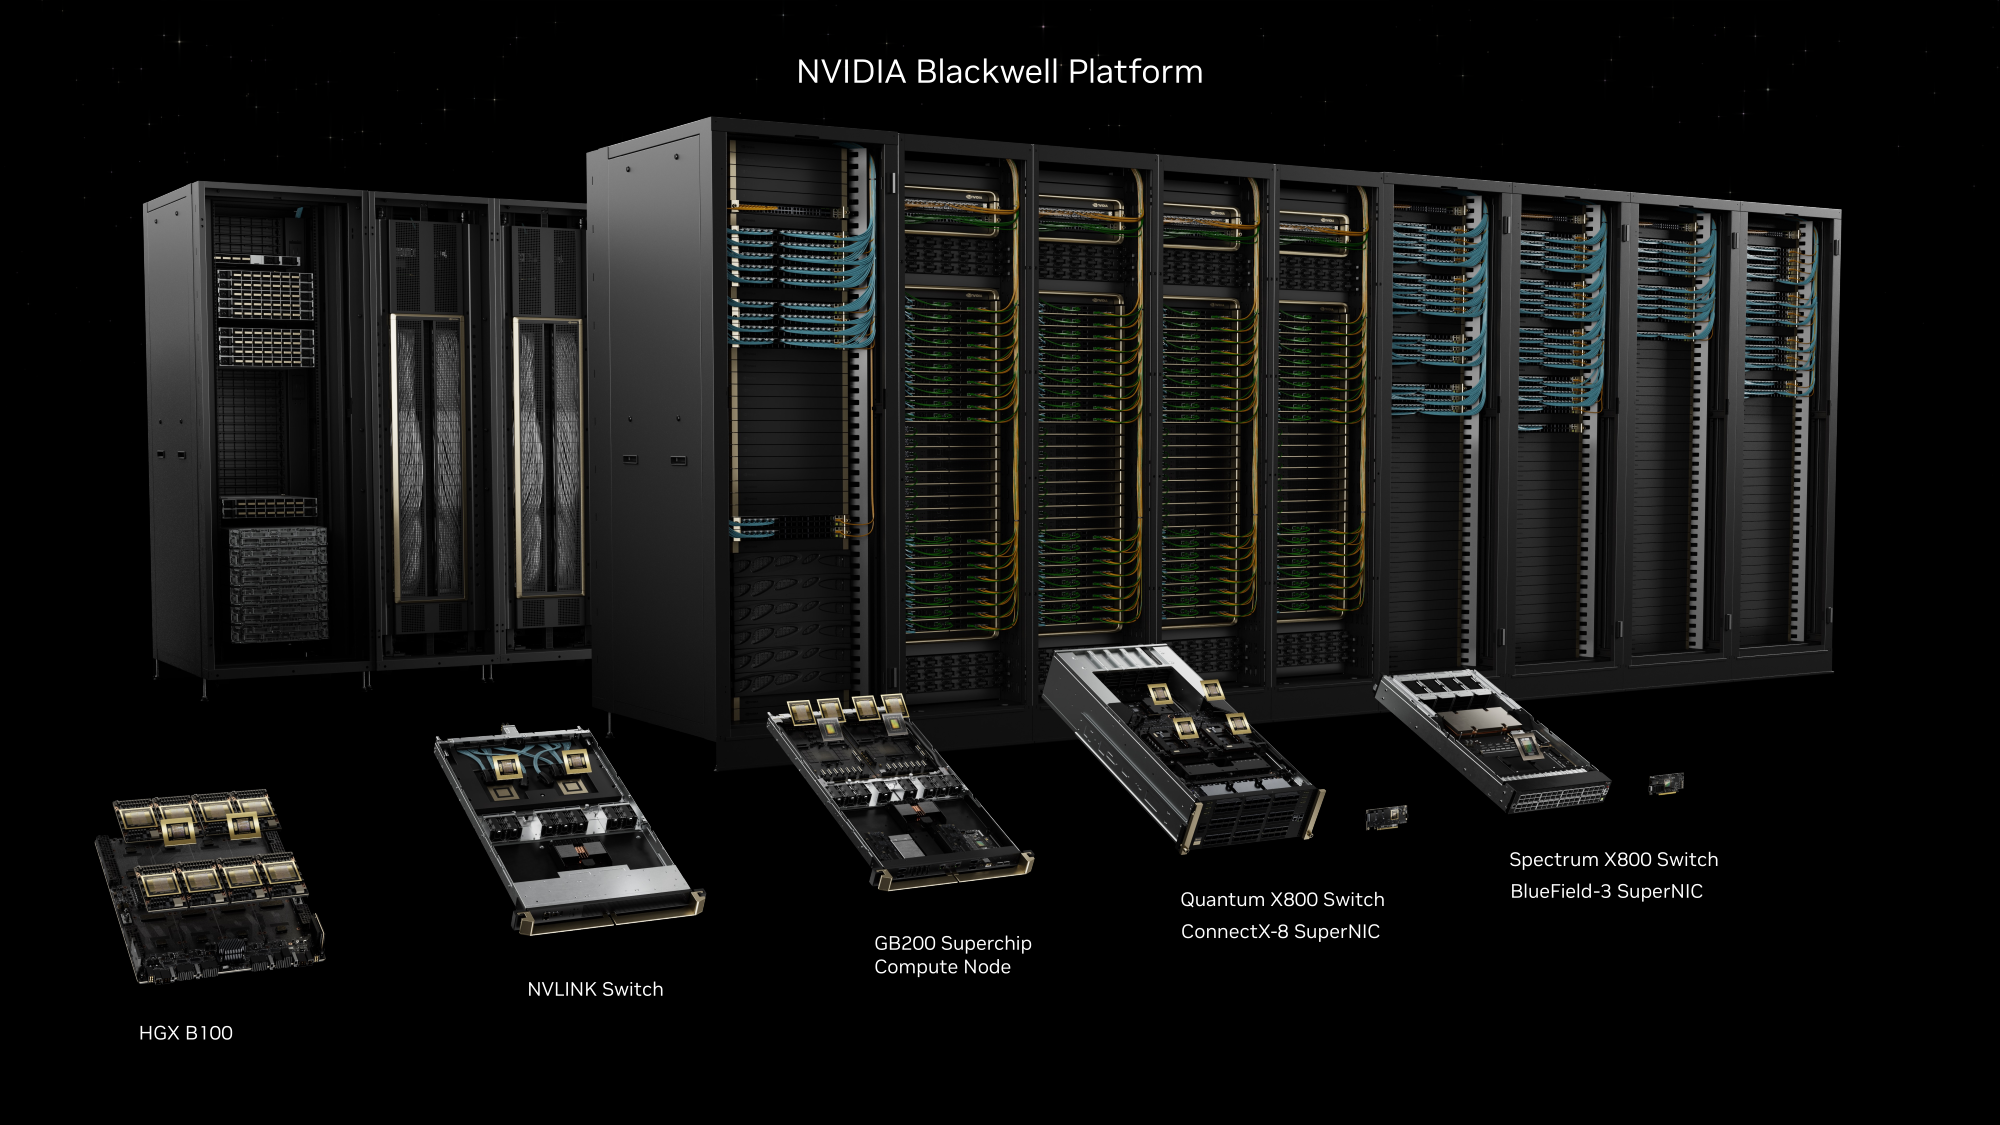 Ускорители B200 появятся в этом году и будут стоить в диапазоне $30–$40 тыс., что ненамного больше начальной цены Hopper в диапазоне $25–$40 тыс. Глава NVIDIA уже предупредил, что Blackwell сразу будут в дефиците. Вероятно, получить доступ к ним проще всего будет в облаках Amazon, Google, Microsoft и Oracle. |
|

