
Материалы по тегу: инференс
|
07.11.2026 [00:30], Владимир Мироненко
Tesla сообщила о планах по выпуску ИИ-ускорителей SI и Dojo 3Tesla представила обновлённые планы выпуска ИИ-ускорителей, включающие чипы SI пятого и шестого поколения, предназначенные для инференса, и чип Dojo 3 (D3) для обучения моделей. Компания изменила брендинг чипов AI на SI, поскольку вместо термина «искусственный интеллект» (artificial intelligence) теперь использует «суперинтеллект» (super intelligence), соответственно AI4 (ранее HW4), AI5 и AI6 теперь называются SI4, SI5 и SI6. Dojo 3 будет существенно отличаться от своих предшественников — Dojo D1 и Dojo D2. Он описывается компанией как решение на базе чиплетов, объединяющее технологии 2.5D- и 3D-компоновки со стековой памятью HBM. Это знаменует собой значительный отход от архитектуры Dojo D1, которая представляла собой систему на кремниевой пластине (system-on-wafer), где 25 процессоров D1 были объединены в единую структуру с использованием памяти SRAM объёмом 11 Гбайт. 
Источник изображения: Prometheus/unsplash.com Tesla не стала вдаваться в подробности о вычислительной мощности, объёме памяти, техпроцессе или сроках разработки D3, заявив, что система Dojo D3 будет оптимизирована с точки зрения «занимаемого пространства, обучения моделей и масштабируемости». Также предполагается, что D3, по всей видимости, будет оптимизирован для работы в условиях космоса, что означает радиационную стойкость (по крайней мере, для отдельных модификаций устройства). Как сообщается, чип SI6 в 80 раз превосходи SI4/AI4/HW4 по производительности, и в 9 раз по объёму памяти. В зависимости от того, как именно измеряется производительность SI4, речь идёт о показателях в диапазоне 17 280–46 080 TOPS или 17,28–46,08 POPS, подсчитал ресурс Tom's Hardware. Он привёл для сравнения данные NVIDIA Rubin — 50 Пфлопс (NVFP4) для задач инференса, 35 Пфлопс (NVFP4) — для обучения нейросетей, а также 17,5 Пфлопс при использовании форматов FP8/FP6. При этом ресурс отметил, что Rubin уже поставляется заказчикам, тогда как выход SI6 ожидается в 2029–2030 гг. Илон Маск (Elon Musk) ранее сообщил, что разработка чипа Tesla AI5 (теперь SI5) почти завершена, а чип AI6 (SI6) находится на «ранней стадии» разработки, добавив, что компания также планирует создать чипы AI7, AI8 и AI9 (SI7, SI8 и SI9). Выпуском автомобильного чипа SI5 будут заниматься TSMC (3 нм) и Samsung Foundry (2 нм), которые создадут разные версии чипа. Сообщается, что он получит 40-кратный прирост производительности по сравнению с SI4. Контракт по поводу выпуска SI6 заключён с Samsung Foundry. Он будет продлён до 2033 года. Для производства чипа будет использоваться 2-на техпроцесс.
06.11.2026 [16:37], Сергей Карасёв
Supermicro, IBM и NVIDIA представили хранилище для работы с KV-кешемКомпания Supermicro в партнёрстве с IBM и NVIDIA анонсировала специализированную аппаратно-программную платформу, предназначенную для работы с KV-кешем. Система позволяет значительно сократить время, необходимое ИИ-моделям для начала генерации ответа по запросу пользователя. Аппаратной основой платформы служат серверы хранения Supermicro Petascale класса All-Flash. Такие устройства выполнены в форм-факторе 1U на процессоре AMD EPYC Turin (до 96 ядер). Поддерживается до 9 Тбайт DDR5-4400 в виде 24 модулей. Упомянуто применение сетевых технологий NVIDIA Spectrum-X. Питание обеспечивают два блока мощностью 1600 Вт с резервированием и сертификатом 80 Plus Titanium. Во фронтальной части узлов хранения расположены 16 отсеков для накопителей E3.S 1T с интерфейсом PCIe 5.0 x4 (NVMe). Кроме того, есть два внутренних коннектора M.2 M-key 2280/22110 для SSD с интерфейсами PCIe 3.0 x2 и PCIe 3.0 x4. Предусмотрены два слота PCIe 5.0 x16 для карт FHHL и два разъёма OCP 3.0 (PCIe 5.0 x16). Устройство оборудовано сетевым портом управления 1GbE (RJ45), коннектором D-Sub и четырьмя портами USB 3.0 Type-A (по два спереди и сзади). Используется воздушное охлаждение с восемью вентиляторами диаметром 40 мм. Программная часть включает софт IBM Storage Scale, а также фреймворк NVIDIA Dynamo. В тестах новой платформы на модели со 120 млрд параметров при длине промпта в 130 тыс. токенов время до выдачи первого ответа оказалось в 56 раз меньше по сравнению с обычными системами. Кроме того, при увеличении длины запроса с 30 тыс. до 130 тыс. токенов задержка поднялась всего на 0,377 с. 
Источник изображения: Supermicro
31.10.2026 [23:11], Павел Котов
Орбитальный ЦОД Google Suncatcher вышел на связь и написал хайкуСпутник Google Suncatcher, выступающий прототипом космического ЦОД, начал работу и установил связь с Землёй, сообщает TechCrunch. Он отправился на орбиту в начале октября вместе более чем с сотней других космических аппаратов на ракете SpaceX Falcon 9. Suncatcher, оснащённый четырьмя ИИ-ускорителями Google TPU, вырабатывает до 1 кВт электроэнергии. Проект призван проложить путь к созданию целых группировок спутников, работающих в тесной связке и выполняющих масштабные задачи инференса прямо на орбите. Пока из-за высокого энергопотребления спутник может задействовать только один TPU за раз — и то не более чем на 20 минут, что усложняет и без того непростую задачу обмена данными между космосом и Землёй. Пусконаладочные работы заняли три недели: все системы аппарата протестировали, и спутник стал готов к эксплуатации. На этой неделе инженеры с Земли отправили первый запрос, попросив заранее загруженную на борт модель Google Gemma 4 написать хайку о пребывании в космосе. Ответ был таким: «Голубой шар внизу, В Google также протестировали модель, поставив ей задачу написать несколько лимериков на космическую тематику. Компания также поручила аппарату собрать данные об условиях на орбите в месте его нахождения. 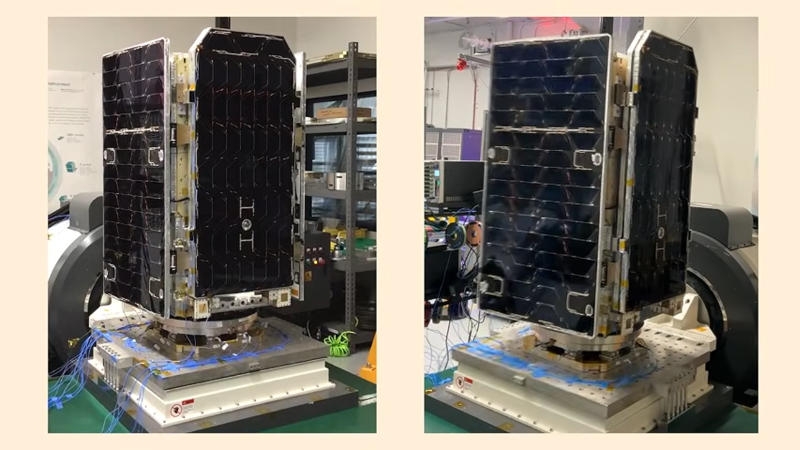
Источник изображений: Google В ходе текущей серии испытаний специалисты изучат, как чипы ведут себя в условиях тепловых нагрузок и космической радиации. До этого компания проводила масштабные проверки TPU на наземных ускорителях частиц, и теперь ей предстоит выяснить, как в реальных космических условиях на оборудование влияет радиация. Она может вызывать инверсию битов — самопроизвольное изменение значений в памяти, которое способно привести к искажению данных и остаться незамеченным для стандартных систем мониторинга. Радиация должна оказывать минимальное влияние на инференс, но она может создать некоторые сложности на этапе обучения моделей. Если установленные на борту TPU подтвердят свою эффективность, в 2027 году компания запустить ещё два спутника с ИИ-ускорителями. Новые аппараты смогут вырабатывать больше электроэнергии, они также продемонстрируют работу оптических каналов связи между спутниками. 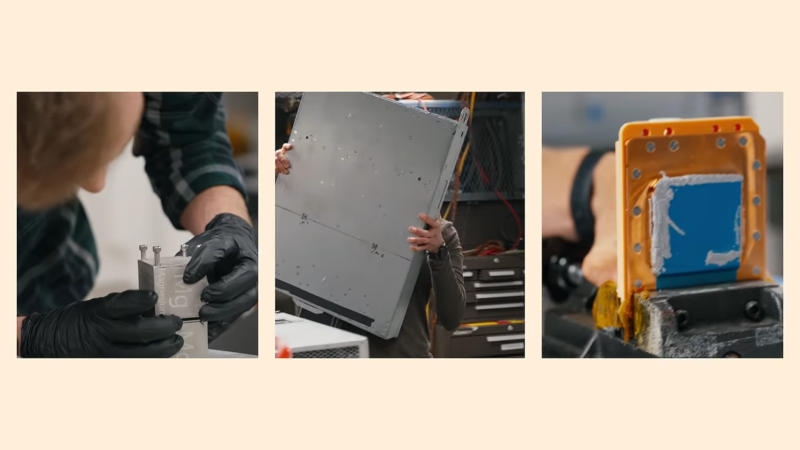 Сейчас Google Suncatcher является едва ли не единственным проектом ЦОД, предусматривающим создание высокоскоростных каналов связи между спутниками для поддержки согласованных распределённых вычислительных сред. В проектах орбитальных ЦОД SpaceX лазерную связь предполагают использовать на слишком больших расстояниях, чтобы аппараты производили совместные вычисления. Starcloud и Cowboy Space планируют выполнять инференс на отдельных спутниках. В остальном концепции Google и SpaceX тесно связаны: холдинг Alphabet владеет значительной долей в SpaceX. И для полномасштабного развёртывания орбитальных ЦОД потребуется ракета класса Starship. Чтобы добиться такого же снижения затрат путём накопления опыта, какое наблюдалось при эксплуатации предыдущих моделей ракет SpaceX, компании потребуется произвести 1800 запусков Starship, подсчитали авторы проекта Suncatcher. Инфраструктура Suncatcher станет экономически выгодной лишь к следующему десятилетию. Но успех начинания может зависеть от того, как остальная часть корпорации в ближайшей перспективе отреагирует на вызовы и возможности, связанные с развитием ИИ. Ранее SpaceX подала заявку на развёртывание 1 млн аппаратов — орбитальных ЦОД. Blue Origin хочет запустить 51 тыс. таких спутников, Cowboy Space — 20 тыс., подобные проекты разрабатывают индийские NeevCloud и Agnikul Cosmos. А российская RuVDS запустила спутник-платформу ещё в феврале.
28.10.2026 [18:52], Павел Котов
В Oracle Cloud Infrastructure появятся ускорители CerebrasНа платформе Oracle Cloud Infrastructure (OCI) будет организован доступ к технологиям высокоскоростного ИИ-инференса Cerebras. Решение предназначено для исследовательских лабораторий в сфере ИИ, корпораций и разработчиков, которые создают интерактивные интеллектуальные приложения. Партнёрство затрагивает существующую инфраструктуру Oracle и её возможности в области ИИ-инференса, включая специализированные кластеры (Dedicated AI Clusters) в составе сервиса OCI Enterprise AI. Царь-чип Cerebras Wafer-Scale Engine (WSE), разработанный специально для высокоскоростного ИИ-инференса, объединяет вычислительные мощности и память на одном кристалле размером с целую кремниевую пластину. Такая архитектура сокращает перемещение данных и необходимость обмена информацией между отдельными чипами, в результате чего обеспечивается быстрая генерация токенов даже в длинных цепочках рассуждений и многоэтапных процессах, которые выполняют ИИ-агенты. 
Источник изображения: cerebras.ai Решение Cerebras Inference станет доступным в OCI в 2027 году — клиенты облачной платформы Oracle получат новый инструмент для создания ИИ-приложений, в которых скорость имеет решающее значение. Ранее AMD и Cerebras представили платформу для ИИ-инференса со сверхнизкой задержкой. Разработчик царь-чипов к концу года намерен развернуть в Европе 200 МВт ИИ-мощностей. Только в Финляндии компания получит объект на 165 МВт.
28.10.2026 [16:14], Владимир Мироненко
Oracle станет первым гиперскейлером, предлагающим Google TPUOracle и Google объявили о расширении партнёрства, в рамках которого тензорные процессоры Google TPU станут доступны через облачную инфраструктуру Oracle Cloud Infrastructure (OCI). Таким образом Oracle станет первым гиперскейлером, предлагающим Google TPU за пределами экосистемы Google. Сообщается, что TPU появятся на платформе OCI, начиная с 2027 года. «Различные задачи в сфере ИИ требуют разных вычислительных мощностей, — отметил Махеш Тиагараджан (Mahesh Thiagarajan), президент OCI. — Доступ к TPU от Google в среде OCI позволяет клиентам использовать несколько передовых архитектур для вычислений в области ИИ в рамках одного облака. Такая свобода выбора дает возможность подобрать оптимальную инфраструктуру с точки зрения производительности, пропускной способности и экономической эффективности для каждой конкретной задачи ИИ». В настоящее время Google предлагает TPU восьмого поколения. Модель TPU 8t предназначена для обучения нейросетей, TPU 8i — это чип для инференса (выполнения вычислений в обученных моделях), оптимизированный для решения итеративных задач, характерных для работы специализированных ИИ-агентов. 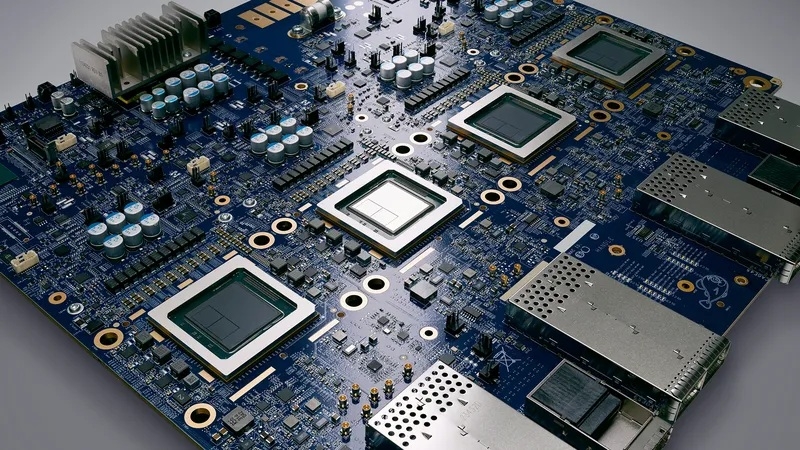
Источник изображения: Google На прошедшей на прошлой неделе конференции PyTorch Conference 2026 Google объявила, что TorchTPU — нативный стек PyTorch для TPU Google — теперь доступен в формате открытого исходного кода на платформе GitHub. Это позволяет обучать, обслуживать и развёртывать модели на TPU, используя привычные инструменты, такие как vLLM, SGLang, llm-d, TorchTitan, Ray, TorchRec, Hugging Face и LiteRT. Как отметила Google, такая переносимость даёт командам возможность выбирать для каждой задачи тот ускоритель, который обеспечивает минимальную стоимость одного токена или максимальную скорость обучения — и всё это без необходимости переписывать код модели. А благодаря нынешнему анонсу вскоре можно будет запускать такие задачи на TPU как в Google Cloud, так и в инфраструктуре Oracle. Кроме того, Google сотрудничает с компанией Blackstone в создании облачной платформы на территории США, которая также будет предоставлять доступ к TPU, отметил ресурс Data Center Dynamics. Не исключено, что эта платформа может опередить Oracle и раньше её начнёт предлагать TPU клиентам.
28.10.2026 [01:08], Павел Котов
Akamai расширила платформу AI Cloud средами для инференса и работы ИИ-агентовAkamai расширила свою инфраструктурную платформу AI Cloud двумя базовыми компонентами: Akamai Inference и Akamai Agent Sandbox, сообщает SiliconANGLE. Они обеспечат корпоративных клиентов управляемой средой с широкими возможностями настройки, из которой можно выполнять и обслуживать нагрузки ИИ-инференса и запуска агентных приложений в любой инфраструктуре, от облачных ЦОД до периферийных серверов. Akamai Inference представляет собой управляемый сервис, обеспечивающий клиентам доступ к нескольким десяткам открытых и кастомизированных ИИ-моделей через OpenAI-совместимые API. Преимуществом Akamai Inference является возможность развёртывать новые приложения и ИИ-агенты на периферийном оборудовании без переписывания кода. При запуске доступен выбор из 12 моделей с открытыми весами размером от 8 млрд до 2,8 трлн параметров, в том числе NVIDIA Nemotron 3 Ultra, OpenAI gpt-oss-120b и Google Gemma 4. Доступен ассортимент специализированных встраиваемых моделей для RAG-конвейеров. Они предназначаются для подключения моделей с открытыми весами к службам управляемых БД Akamai для получения ответов на основе корпоративных данных. 
Источник изображения: Markus Stickling / unsplash.com Основная задача Akamai Agent Sandbox — безопасное выполнение. Это изолированная среда для запуска ИИ-агентов, работающих в автономном режиме от имени пользователей. В песочнице ИИ-агенты работают на базе бессерверной вычислительной платформы Akamai Functions; их код содержится в изолированных средах WebAssembly под управлением открытого фреймворка Spin. Эти песочницы обеспечивают предприятиям полный контроль над ИИ-агентами: от вычислений и памяти до системных API и исходящего доступа к Сети, гарантируя, что они не выйдут за установленные границы. Akamai также расширила парк платформ GPU в Akamai AI Cloud: предлагается доступ к кластерам NVIDIA Blackwell Ultra, в том числе к RTX PRO 6000 Blackwell Server Edition. В следующем году компания намерена также развернуть платформу Vera Rubin. Ранее Akamai заключила с Anthropic соглашение на $11,6 млрд, обеспечив ИИ-лаборатории доступ к своей инфраструктуре, а также была вынуждена отказаться от своих CDN-сервисов в Китае. Компания также сообщала о намерении развернуть несколько тысяч ускорителей RTX Blackwell для распределённого инференса.
23.10.2026 [17:26], Павел Котов
Dell представила системы на NVIDIA Vera и первую стойку для инференса на чипах Groq 3 LPUDell расширила ассортимент решений серии Dell AI Factory with NVIDIA — производитель представил серверы и стойки на процессорах NVIDIA Vera, а также стоечную систему для инференса с ускорителями Groq 3 LPU. Система Dell PowerEdge M9882 включает 256 процессоров NVIDIA Vera в одной стойке формата 48U — решение призвано более эффективно использовать ресурсы питания и охлаждения в ЦОД за счёт отделения вычислительных мощностей CPU от кластеров GPU. Стойка, отметили в Dell, разрабатывалась специально для поддержки агентного ИИ; система может работать параллельно с инфраструктурой на базе GPU, ориентированной на инференс моделей. Сервер Dell PowerEdge R8822 представляет собой двухпроцессорное решение на базе NVIDIA Vera с воздушным охлаждением, совместимое со стандартными 19″ стойками. Как и стоечный вариант, модель R8822 оптимизирована для агентного ИИ: на ней можно запускать задачи обучения с подкреплением, обработки данных и аналитики; поддерживается установка до четырёх двухслотовых GPU. 
Источник изображения: dell.com Dell также представила PowerEdge XE9810 — свой первый продукт с ускорителями Groq 3 LPU. Система состоит из 16 вычислительных модулей с прямым жидкостным охлаждением. Точное число LPU в каждом модуле не уточняется, но в Dell отмечают, что решение служит «идеальным дезагрегированным дополнением к существующим GPU-кластерам». Система разрабатывалась для обеспечения высокой пропускной способности, необходимой для массового выполнения задач агентного ИИ в реальных условиях. Сервер Dell PowerEdge R8822 станет доступным уже в октябре; модели M9882 и XE9810 появятся в I квартале 2027 года. Ранее компания рассказала о расширении возможностей Dell AI Data Platform. Производитель анонсировал первую в мире СХД PowerEdge R7725 с поддержкой SSD на 245 Гбайт; в ассортименте Dell также значится сервер PowerEdge XE8812 на архитектуре NVIDIA Vera Rubin NVL4.
22.10.2026 [00:19], Павел Котов
DeepSeek открыла исходный код DeepInfer — фреймворка для инференса своего ИИКитайская ИИ-лаборатория DeepSeek открыла исходный код DeepInfer — фреймворка для инференса, на базе которого работают собственные сервисы компании, сообщает SiliconANGLE. Ключевой задачей продукта разработчик называет обеспечение работы с большой пользовательской базой при сохранении приемлемой стоимости. Один кластер, по заявлению DeepSeek, обрабатывает 155 трлн токенов в сутки, а доход при использовании тарифов в периоды низкой нагрузки составляет $38/час на один GPU. На данный момент DeepInfer поддерживает только модель DeepSeek-V4.1-Flash — по умолчанию загружается версия 1017, вышедшая в минувшие выходные. Фреймворк совместим с NVIDIA Blackwell (SM100) и Huawei Ascend 950; поддержка архитектуры NVIDIA Hopper и более старых поколений не предусмотрена. В DeepInfer есть две функции, гарантирующие получение идентичных результатов при повторном запуске с одинаковыми исходными данными. Они работают только на ускорителях NVIDIA. Быстродействие DeepInfer DeepSeek проверяла только на ускорителях NVIDIA, поэтому приведённые результаты бенчмарков получены исключительно в ходе собственных испытаний компании. 
Источник изображения: DeepSeek В DeepInfer предусмотрены два способа ускорения работы модели. Спекулятивное декодирование с помощью системы DSpark предполагает генерацию сразу пяти токенов вспомогательной моделью; модуль оценки прогнозирует, какие из них будут приняты основной моделью. Вычислительные ресурсы для проверки затрачиваются только на наиболее вероятные варианты, благодаря чему количество проверяемых «черновых» токенов на каждом шаге сокращается на 30 %. В реальных рабочих нагрузках это обеспечивает прирост производительности на 4–7 %. Второй механизм почти вдвое сокращает объём вычислений при первичной обработке запроса: через слои декодера модели повторно пропускаются только последние 128 токенов, а не весь запрос целиком. Код для управления KV-кешем и балансировки нагрузки DeepSeek пока не опубликовала, пояснив, что эти компоненты тесно связаны с внутренней инфраструктурой. DeepInfer преимущественно ориентирован на разделение нагрузки между первичной обработкой запросов и генерацией ответов, но реализовывать этот механизм пользователям придётся самостоятельно. В качестве минимальной эффективной конфигурации указываются 128 GPU: по 64 для первичной обработки и генерации ответов. Фреймворк DeepInfer доступен на GitHub под лицензией Apache 2.0. В комплект входит библиотека deepseek-recipe, которая преобразует запросы в последовательности токенов, используя ту же логику, что и официальный API DeepSeek. В этом же репозитории будет размещаться код для инференса будущих моделей. Поддержка платформы Ascend в DeepInfer появилась вслед за релизом от 30 сентября, в рамках которого DeepSeek при содействии Huawei обеспечила поддержку TileLang — китайского аналога NVIDIA CUDA. Во Внутренней Монголии ИИ-лаборатория намерена построить кампус ИИ ЦОД мощностью 1 ГВт и развернуть там не менее 160 тыс. ускорителей Huawei Ascend 950DT. Ранее стало известно, что DeepSeek занимается разработкой и собственного ИИ-ускорителя для инференса, чтобы снизить свою зависимость как от NVIDIA, так и от Huawei.
15.10.2026 [16:31], Владимир Мироненко
Лучше меньше да лучше: Intel верит, что развитие агентного ИИ вернёт CPU значимость в инфраструктуре ЦОДIntel заявила, что следующий этап развития ИИ будет определять не обучение моделей, а их использование (инференс), и что развитие агентного ИИ вернёт CPU в центр инфраструктуры дата-центров, сообщил SiliconANGLE. Сейчас по умолчанию любой запрос как правило отправляется в компаниях к самой мощной модели — независимо от того, требует ли этого сама задача. Intel предлагает альтернативу: уровень оркестрации, который анализирует каждый запрос, оценивая необходимый уровень «интеллекта», объём контекста, допустимую задержку, требования к конфиденциальности и суверенитету данных, а также затраты и энергопотребление. «Для каждого запроса — своё решение», — подчеркнул Николас Дюбе (Nicolas Dubé), корпоративный вице-президент Intel. Если для глубоких исследований использование передовой модели может быть оправдано, то для рутинных задач — написание кода, составление резюме или операционные процессы — могут использоваться более компактные открытые моделей, что обходится значительно дешевле. Дюбе отметил, что open source модели расширяют возможности компаний по внедрению ИИ. «Чтобы полностью раскрыть их потенциал, организациям необходима инфраструктура, способная подобрать для каждой конкретной задачи оптимальный уровень интеллектуальных возможностей, вычислительных ресурсов и экономических затрат», — говорит он. 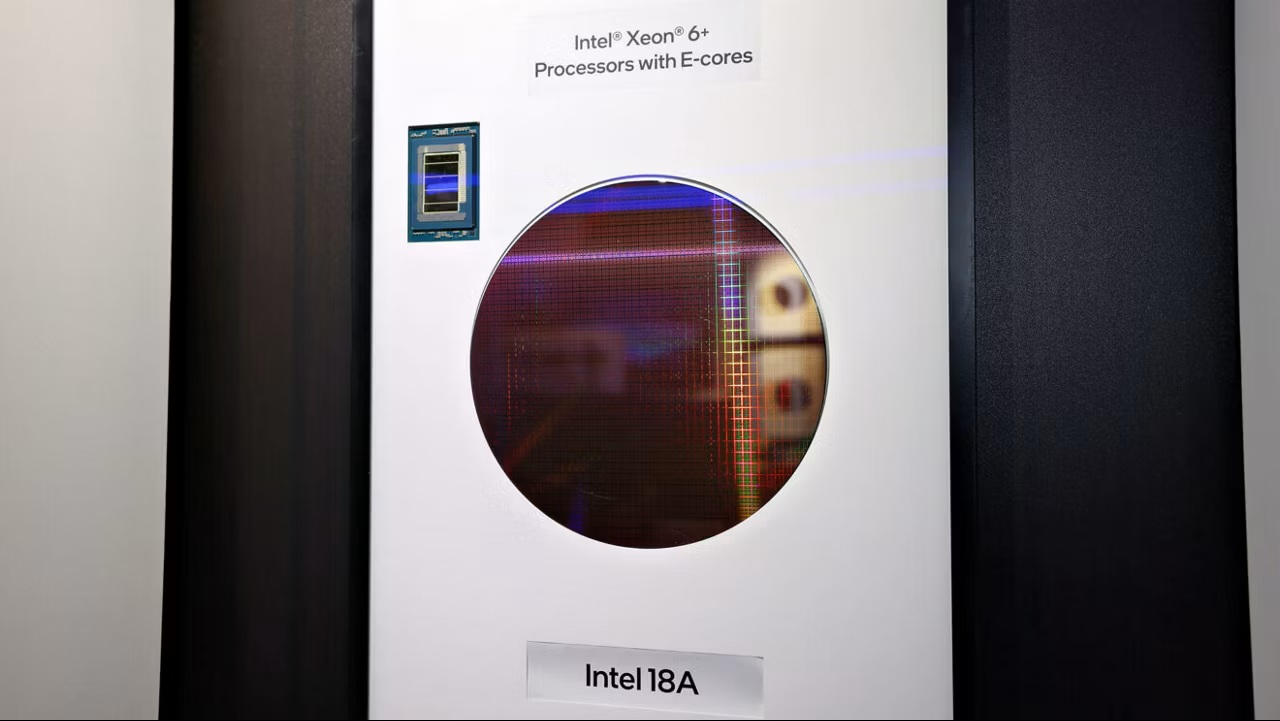
Источник изображения: Intel Только что представленный 350-Вт ускоритель Intel GPU D270 (Crescent Island), совместимый со стандартными серверами с воздушным охлаждением, позволяет компании начать с одного устройства, затем перейти к серверу с восемью ускорителями и масштабировать инфраструктуру до уровня целой стойки только тогда, когда этого потребует рабочая нагрузка. Инференс становится ключевой задачей в сфере ИИ, и корпорациям необходима инфраструктура, которая сделает переход к нему более простым и экономически выгодным. Опционально GPU можно дополнить ускорителями RDU SambaNova. Также компания продемонстрировала разработанные партнёрами стоечные системы (в том числе ORv3) на базе Xeon. Например, доступные конфигурации с Xeon 6+ (Clearwater Forest), масштабируемыми до более чем 46 тыс. ядер на стойку при мощности 133,45 кВт. Высокоплотные Xeon 6+ с E-ядрами ориентированы на высокопроизводительные агентские нагрузки, в то время как Xeon 6 (Granite Rapids-SP) с P-ядрами справляются с задачами, зависящими от скорости однопоточного выполнения. Intel утверждает, что теперь следует исходить не из количества ядер, а количества одновременно работающих агентов, которые может поддерживать стойка при целевой задержке. В результате формируется гетерогенная система: Xeon используется для оркестрации, обработки данных и запуска вспомогательных инструментов, а GPU серии D и RDU — для инференса открытых моделей. При этом Дюбе пояснил, что Intel объединяет систему с помощью программной архитектуры, разрабатываемой совместно с сообществом. Она является открытой, доступной для загрузки уже сегодня и спроектированной для работы на самых разных аппаратных платформах. 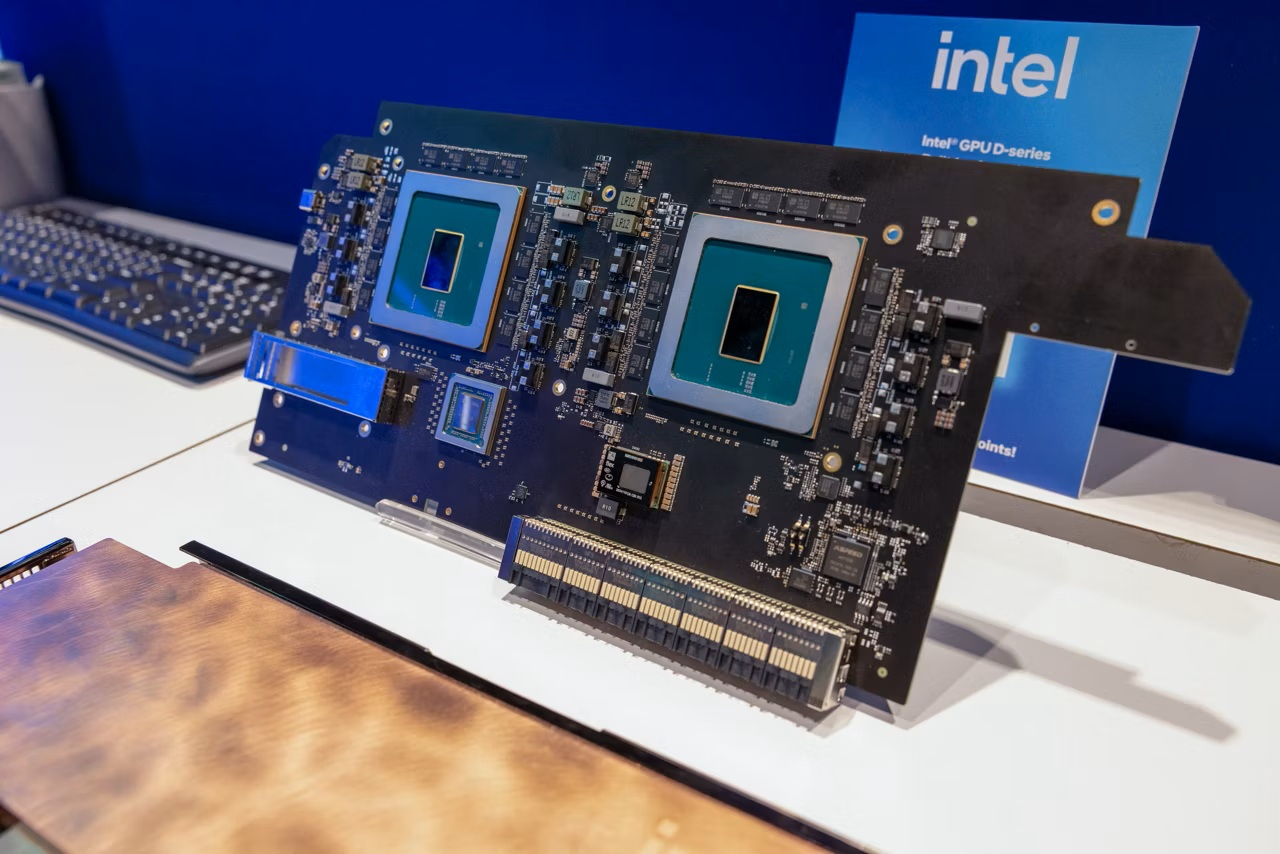
Источник изображения: Intel Как отметил SiliconANGLE, разработки в области «агентных стоек» (agentic racks) подстегивают спрос на Xeon — ключевой драйвер текущих показателей, — позиционируя Intel не просто как традиционного поставщика оборудования, а как важнейшего провайдера инфраструктуры для ИИ-агентов. А Crescent Island даёт Intel возможность предложить решения для ускорения вычислений, где компании не обязательно превосходить NVIDIA по пиковой производительности. Это может стать наиболее практичным и энергоэффективным способом запуска открытых ИИ-моделей в уже существующих ЦОД. Именно такую стратегию выбрал гендиректор Intel Лип-Бу Тан (Lip-Bu Tan): перестать пытаться выиграть в каждой битве и сосредоточиться на тех направлениях, где у Intel есть структурное преимущество. Intel не обязательно доминировать в сфере обучения передовых моделей. Ей следует занять нишу в корпоративном сегменте — это гораздо более масштабная возможность, чем принято считать. ZK Research предлагает ИТ-руководителям провести аудит используемых промптов и классифицировать их по типам задач, объёму контекста, требования к конфиденциальности и т.п., а затем настроить маршрутизацию запросов к наиболее подходящим моделям. Кроме того, рекомендуется пересмотреть подход к оценке инфраструктуры, перестав ориентироваться на «голые» цифры вроде FLOPS или количества ядер и начав требовать от вендоров соблюдения целевых показателей задержки, стоимости обработки миллиона токенов и энергоэффективности для конкретных используемых моделей, промптов и контекста.
14.10.2026 [18:07], Владимир Мироненко
Эскадрон ИИ-агентов шальных: d-Matrix анонсировала мегаваттные кластеры Squadron для инференсаd-Matrix анонсировала d-Matrix Squadron — вычислительный комплекс из многостоечных систем, обеспечивающий мощность порядка мегаватт для выполнения задач ИИ-инференса. По словам компании, благодаря вычислительной архитектуре d-Matrix, ориентированной на работу с памятью (memory-centric), кластеры Squadron идеально подходят для исследовательских лабораторий в сфере ИИ, корпораций и государственных организаций. Они оптимальны для приложений, критически чувствительных к задержкам, включая инструменты для написания кода, персональных ИИ-агентов, системы кибербезопасности и платформы для высокочастотного трейдинга (HFT). Система Squadron, разработанная в партнёрстве с компаниями Arista, Broadcom и Supermicro, уже задействована в дата-центре d-Matrix в Аризоне для внутренних исследований и разработок. Компания начала её поставки приоритетным клиентам для внедрения в их ЦОД. Кроме того, в свободную продажу поступили отдельные компоненты системы: серверы и стойки d-Matrix Corsair SquadRack. 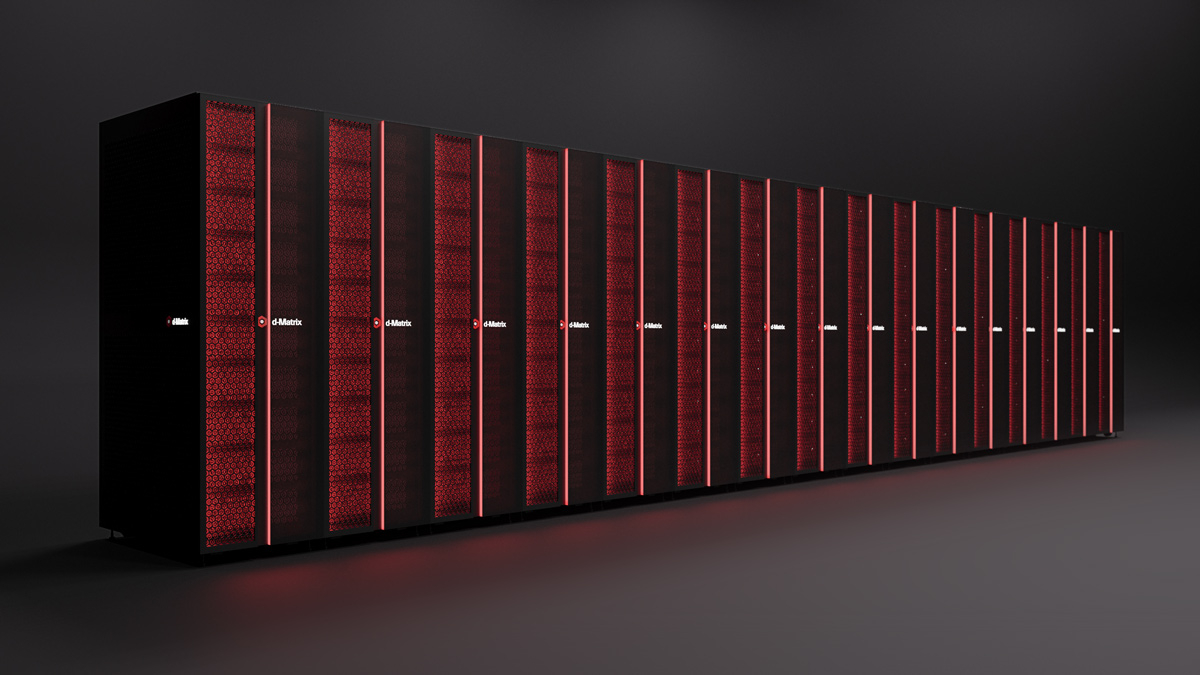
Источник изображения: d-Matrix Система Squadron предлагается в различных конфигурациях: от отдельных стоек d-SquadRack (в каждой — восемь серверов) до полномасштабных интегрированных вычислительных кластеров, включающих до 1024 ускорителей Corsair. Кластеры объединяются в единую сеть с помощью 400G-адаптеров JetStream, а ПО d-Matrix Aviator упрощает их развёртывание. Поскольку кластеры Squadron используют воздушное охлаждение и созданы на базе отраслевых стандартов, заказчики могут интегрировать их в уже существующие ЦОД без необходимости внедрения СЖО или реконструкции инфраструктуры. Кластеры Squadron, оптимизированные для быстрого и эффективного развёртывания ИИ-систем, способны обеспечиваать работу моделей исключительно на чипах Corsair. Они рассчитаны на работу в гетерогенных средах с использованием дезагрегированных вычислений. Генеральный директор и соучредитель d-Matrix сообщил, что компания успешно реализовала технологию дезагрегации Attention-FFN (AFD), используя собственную систему Squadron в связке с серверами на базе GPU. При переносе вычислений компонентов Experts/FFN на стойки Corsair гетерогенная система обеспечила генерацию 845 т/с на одного пользователя. При одновременной работе 64 пользователей такая гетерогенная конфигурация с поддержкой AFD продемонстрировала общую пропускную способность 20 415 т/с. d-Matrix уверяет, что первой в отрасли продемонстрировала реализацию концепции AFD на реальном «железе», доступном уже сегодня. |
|

