
Материалы по тегу: cpu
|
23.09.2026 [15:54], Владимир Мироненко
SiPearl поставила первые образцы европейского серверного процессора Rhea1 для суперкомпьютера JUPITERФранцузский разработчик процессоров SiPearl предоставил образцы своего первого процессора Rhea1 компании Bull, которая приступила к интеграции чипа в свою платформу BullSequana XH3000 для первого в Европе суперкомпьютера экзафлопсного класса JUPITER (Joint Undertaking Pioneer for Innovative and Transformative Exascale Research) в суперкомпьютерном центре Forschungszentrum Juelich (FZJ) в Юлихе (Jülich, Германия). На данном этапе производятся работы по созданию процессорного блейд-модуля для JUPITER, дополняющего GPU-сегмент, что открывает возможность полноценной модульной интеграции всего комплекса. Поставка оборудования для JUPITER стала первым заказом на серверные процессоры Rhea1 для компании SiPearl. Процессор включает 80 ядер Arm Neoverse V1 (Zeus), четыре стека памяти HBM2e (64 Гбайт), а также четыре канала памяти DDR5 (2DPC). Поддерживаются 104 линии PCIe 5.0 в виде шести комплексов x16 и двух x4. Благодаря этим ключевым характеристикам Rhea1 идеально подходит для выполнения самых ресурсоёмких HPC-задач, обеспечивая при этом безопасность без бэкдоров и «выключателей», энергоэффективность и гибкость, отмечено в пресс-релизе. Выход Rhea1 на рынок запланирован на конец 2026 года. 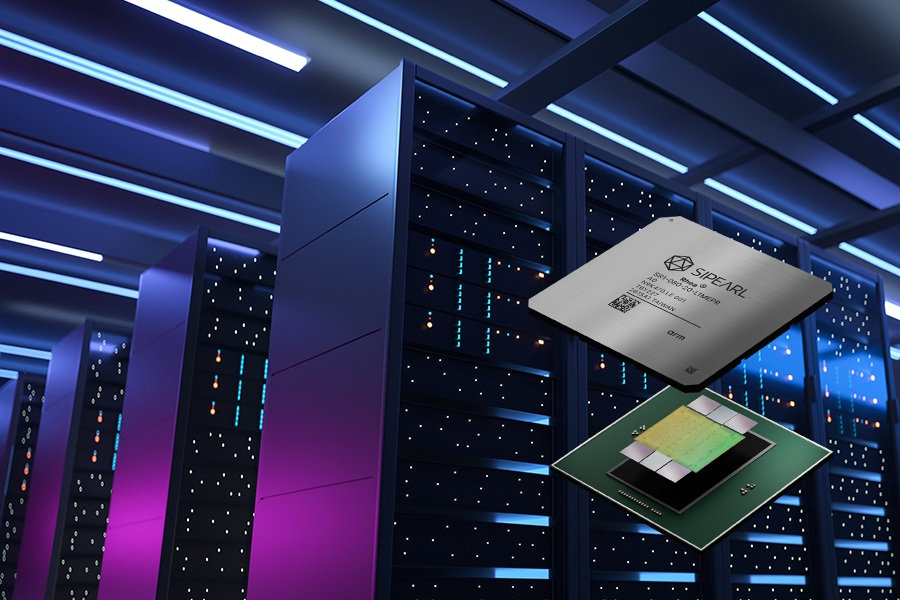
Источник изображения: SiPearl «Благодаря высокой пропускной способности памяти этот процессор особенно хорошо подходит для приложений, которым необходим эффективный доступ к большим объёмам данных», — отметил директор Юлихского суперкомпьютерного центра Исследовательского центра Юлиха, а исполнительный директор EuroHPC JU назвал поставку образцов «важной вехой на пути к суверенитету Европы в области суперкомпьютерных технологий». Вторая европейская система экзафлопсного уровня Alice Recoque, будет установлена в центре CEA/DAM к югу от Парижа. В ней будет использоваться процессор Rhea2. Генеральный директор и основатель SiPearl сообщил, что компания сейчас ведёт переговоры с предприятиями оборонного сектора по поводу поставок ещё одного продукта — Athena1 — специализированной версии Rhea1 для приложений двойного назначения.
22.09.2026 [19:23], Владимир Мироненко
Alibaba представила новый ИИ-ускоритель Zhenwu V900 — самый мощный в Китае, и заявила о планах увеличить мощность ЦОД до 20 ГВтКомпания Alibaba Group представила ИИ-ускоритель Zhenwu V900, разработанный её подразделением T-Head Semiconductor (Pingtouge Semiconductor), пишет SCMP. Кампания заявила, что это «самый мощный чип для ИИ в Китае на сегодняшний день». По данным Alibaba, Zhenwu V900 в три раза превосходит по производительности своего предшественника — Zhenwu M890, но точные показатели не приводятся. Сообщается, что Zhenwu V900 оснащён 216 Гбайт HBM, поддерживает вычисления в формате FP32–FP4 и обладает усовершенствованным тензорным вычислительным блоком Tensor Core, который значительно повышает точность выполнения инструкций в форматах FP8/FP4. Также сообщается о пропускной способности межчипового интерконнекта 1,2 Тбайт/с. Конфигурации размеров блока в форматах MXFP8 и MXFP4 позволяют стабилизировать производительность при масштабировании вычислений в ходе обучения и инференса, пишет The Register. Как сообщил Гао Хуэй (Gao Hui), вице-президент T-Head, серийное производство что Zhenwu V900 запустят в I квартале 2027 года. Вычислительные ИИ-кластеры на базе V900 могут объединять до 500 тыс. ускорителей с использованием коммутаторов ICN Switch собственной разработки, обеспечивая достаточно вычислительной мощности для обучения и инференса моделей с 5–10 трлн параметров. 
Источник изображения: T-Head Также на I квартал 2027 года намечен выход суперускорителя Panjiu, оснащенного чипами Zhenwu V900, коммутаторами ICN Switch, картами SmartNIC Panmai и контроллерами Zhenyue. Заодно T-Head представила предварительную версию ИИ-ускорителя нового поколения Zhenwu J900, в основе которого лежит архитектура параллельных вычислений собственной разработки. Его выпуск запланирован на III квартал 2028 года. Компания сообщила о планах по созданию собственных центральных процессоров (CPU) нового поколения, оптимизированных для задач агентного ИИ — Yitian 720 и Yitian 730, выпуск которых стартует в 2027 году. При этом Yitian 730 станет первым процессором T-Head, созданным на базе собственной микроархитектуры, возможно, RISC-V. Yitian 710 использовал архитектуру Arm. 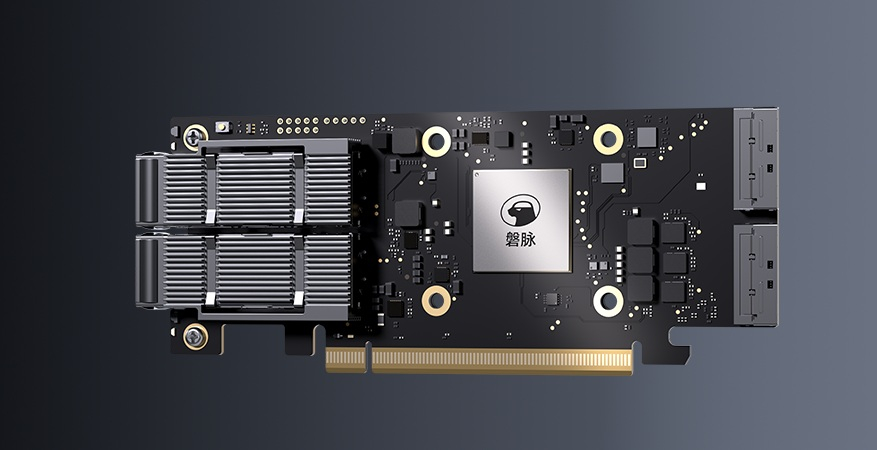
Источник изображения: T-Head Глава Alibaba У Юнмин (Wu Yongming) представил план развития компании, выделив «ИИ-модели, ИИ-чипы и ИИ-облако» в качестве трёх краеугольных камней «машинного интеллекта». Сообщается, что подразделение T-Head завершило разработку полной линейки основных микросхем для ЦОД, охватывающей четыре основные категории: ускорители Zhenwu, CPU Yitian, SmartNIC Panmai и интерконнект ICN. При этом все основные микросхемы, необходимые для формирования сверхбольших ИИ-кластеров, были разработаны самостоятельно. Юнмин заявил о планах компании увеличить мощность глобальных дата-центров Alibaba Cloud до более чем 20 ГВт к 2032 году, что примерно в 10 раз превышает их мощность до появления генеративного ИИ. Для реализации проекта компания инвестирует более $53 млрд в ближайшие три года в строительство ИИ-инфраструктуры. Также компания намерена значительно увеличить поставки чипов для ИИ. И всё же, если сравнивать с ИИ-индустрией США, цифры выглядят не столь впечатляюще. Например, компания Cushman & Wakefield, занимающаяся коммерческой недвижимостью, на прошлой неделе сообщила, что только в США в настоящее время ведётся строительство ЦОД общей мощностью 37,7 ГВт. Часть из них будет задействована в проекте Stargate, в рамках которого к 2029 году планируется ввести в эксплуатацию 10 ГВт.
16.09.2026 [01:35], Владимир Мироненко
144-ядерные Arm-процессоры Fujitsu MONAKA станут доступны в ноябреFujitsu объявила о предстоящем старте глобальных продаж процессора нового поколения Fujitsu MONAKA, намеченном на ноябрь 2026 года. Также компания выпустит на базе новинок сервер Fujitsu MONAKA Server для суверенной ИИ-инфраструктуры, который станет доступен для заказа с ноября 2026 года операторам ЦОД, предприятиям, академическим учреждениями и HPC-центрам в Японии и Европе, и оборонному сектору. Массовые поставки начнутся в апреле следующего года. В процессоре Fujitsu MONAKA используется 3D-стековая архитектура с 2-нм техпроцессом для Arm-ядер и 5-нм техпроцессом для кеша и I/O-блоков. Чип имеет до 144 ядер, работает на частоте до 3,8 ГГц и поддерживает память DDR5-8800. Также сообщалось, что процессоры MONAKA получат продвинутую упаковку Broadcom 3.5D XDSiP. Использование собственной технологии Ultra Low Voltage обеспечивает высокую энергоэффективность процессора. MONAKA обеспечивает аппаратное ускорение матричных операций, используя специальные инструкции, которое в сочетании с поддержкой векторных вычислений SVE2 и программной оптимизацией позволяет ускорять ИИ-инференс непосредственно на уровне CPU. Как сообщает Fujitsu, чип обеспечивает вдвое большую пропускную способность для ИИ-инференса по сравнению с другими процессорами. 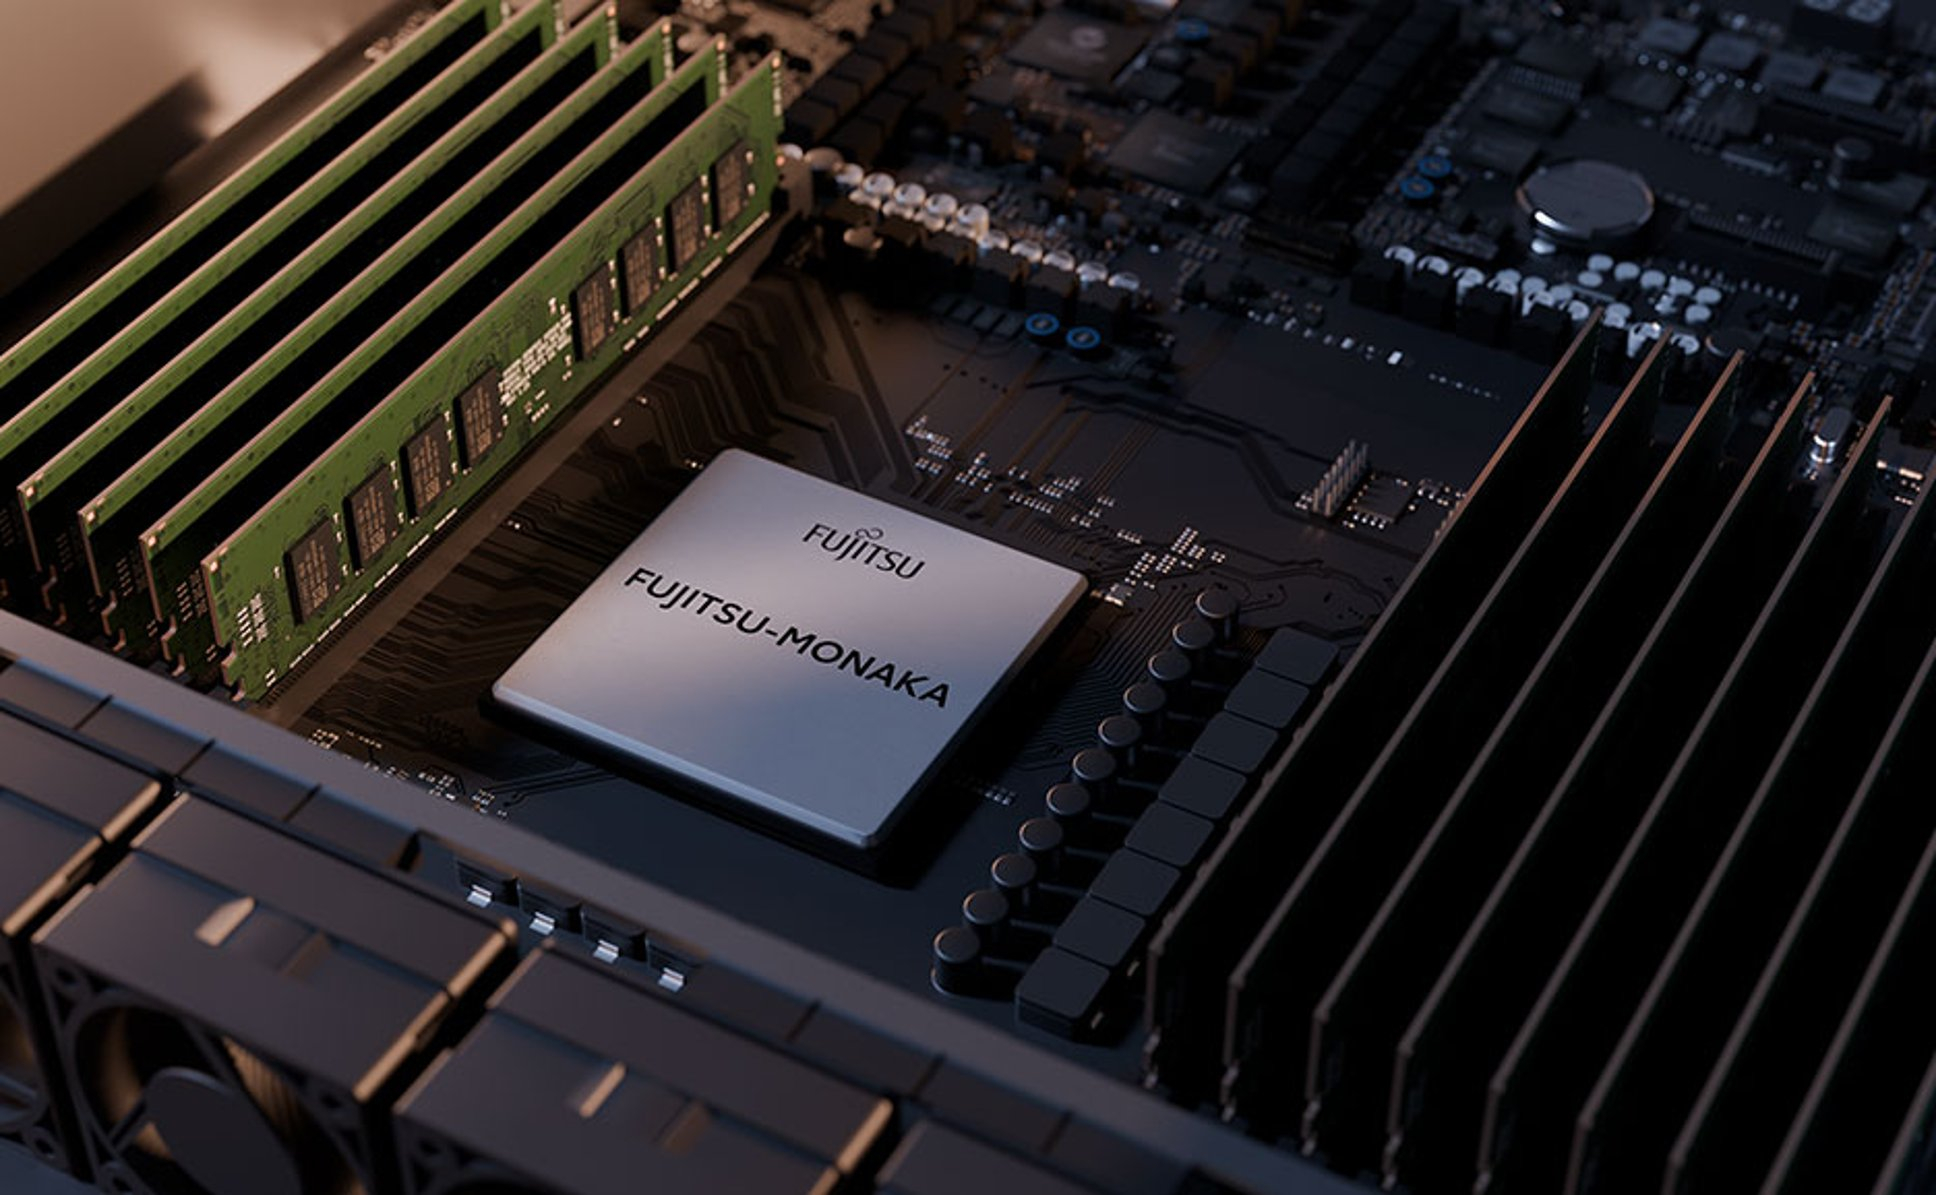
Источник изображений: Fujitsu Кроме того, MONAKA поддерживает конфиденциальные вычисления для защиты данных и приложений на аппаратном уровне с помощью технологии Arm CCA, которая обеспечивает шифрование приложений и данных непосредственно во время их выполнения в оперативной памяти, в том числе при работе в многопользовательских облачных средах с разделением ресурсов. 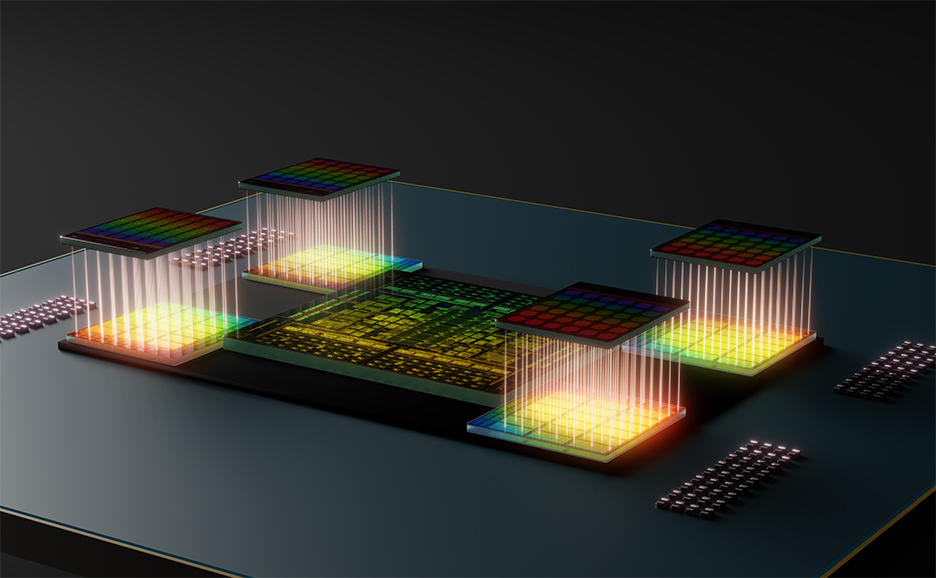 Первоначально серверы на базе MONAKA будут доступны в конфигурациях 1U (один или два сокета) и 2U (два сокета) для задач ИИ-инференса и работы ИИ-агентов. Также планируется выпуск отдельной многоузловой системы формата 2U4N (два сокета на узел) для академических целей и HPC. В частности, эта система подходит для создания суррогатных моделей и CFD-расчётов. 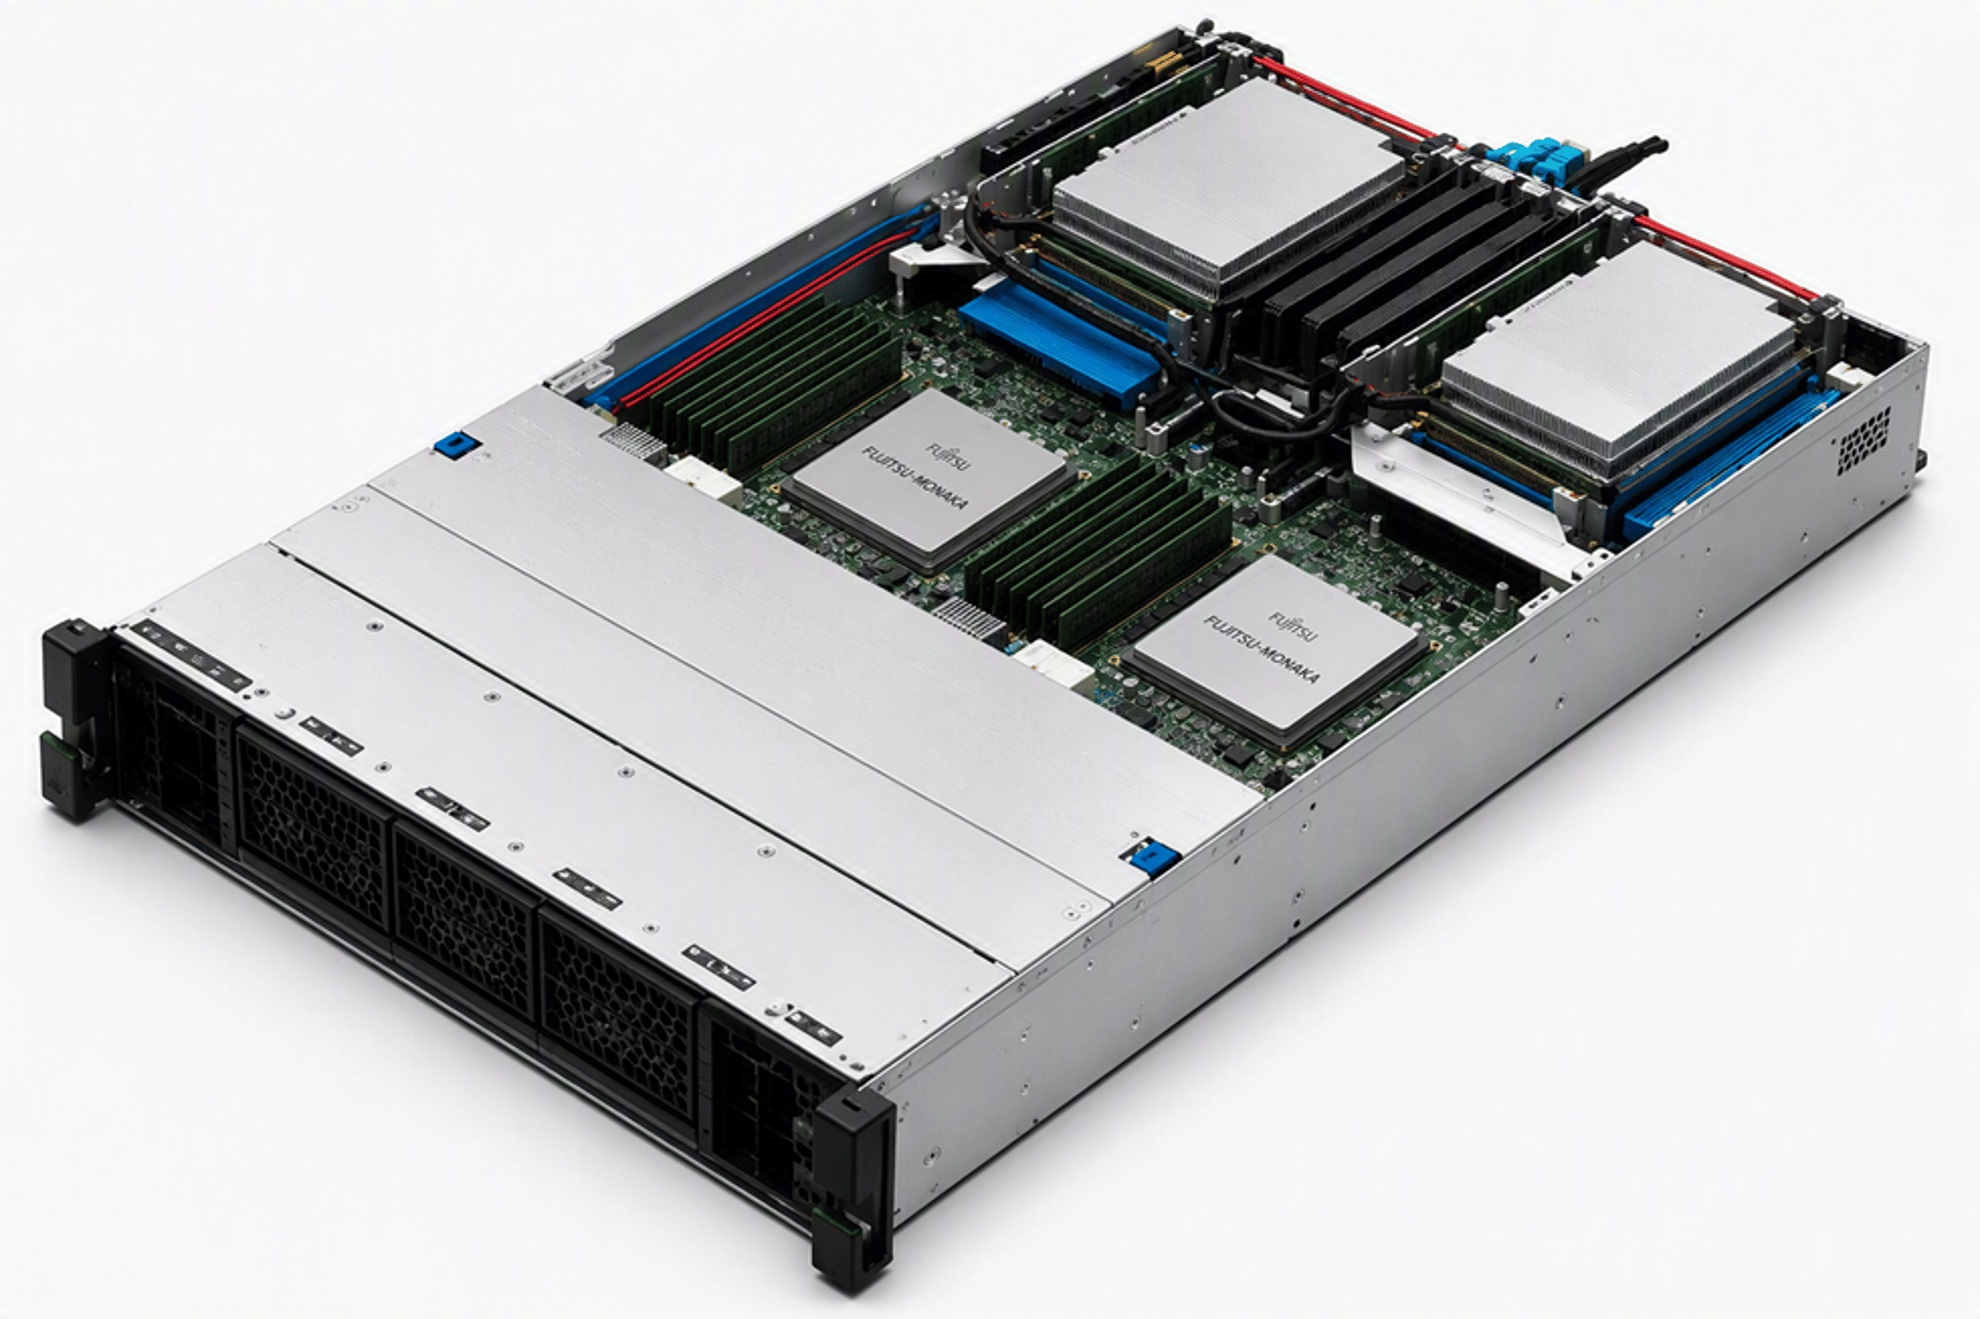 1U-версия поддерживает воздушное охлаждение с температурой окружающей среды до +40 °C (базовая частота ядер — 2,1 ГГц) и СЖО с температурой воды до +45 °C (базовая частота ядер — 2,9 ГГц) без необходимости в специализированной инфраструктуре охлаждения. Согласно Fujitsu, фирменная технология охлаждения серверов позволяет снизить энергопотребление систем охлаждения до 80 %. Каждому процессору полагается 12 слотов памяти. Подсистема хранения включает восемь слотов E3.S и два слота M.2. Основная шина — PCIe 6.0, но поддержка GPU не заявлена. 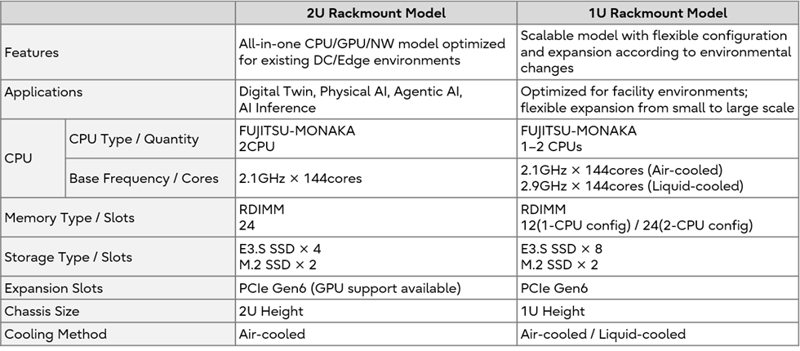 Кроме того, доступная память 1U-версии может быть расширена путём использования дезагеграции и CXL. Речь, вероятно, о внешних разделяемых пулах памяти. Такой подход решает проблему нехватки памяти — распространённую при ИИ-инференсе — и максимизирует эффективность использования ресурсов, обеспечивая гибкую адаптацию к будущим крупномасштабным ИИ-моделям и изменениям рабочих нагрузок, говорит Fujitsu. 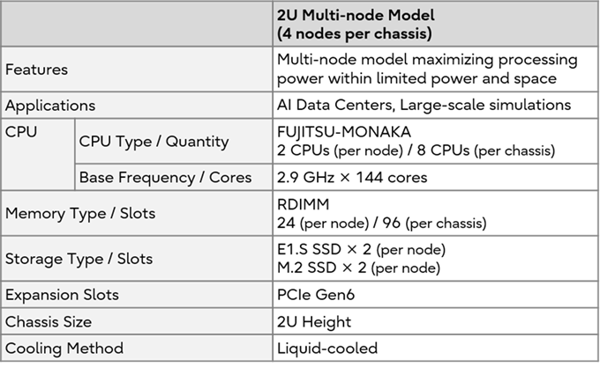 2U-сервер включает два процессора с базовой частотой 2,1 ГГц, 24 слота для памяти RDIMM, четыре слота для E.3 SSD и два — для M.2. Он поддерживает только воздушное охлаждение. Доступна установка GPU. Наконец, многоузловой 2U-сервер с СЖО включает восемь процессоров MONAKA с частотой 2,9 ГГц и 96 слотов для RDIMM. На каждый узел приходится лишь по паре E.3 и M.2 SSD, зато с PCIe 6.0. Разработкой серверов для новых CPU также занимается Supermicro.  Сервер Fujitsu MONAKA Server спроектирован, разработан и произведен в Японии для использования в системах, обеспечивающих технологический суверенитет. Производство осуществляется на заводе Fujitsu в Касашиме (Kasashima), где на всех этапах производства можно отследить происхождение компонентов и историю изготовления. На базе Fujitsu MONAKA Server строится вертикально интегрированная модель «суверенного ИИ», объединяющая ИИ-технологии Fujitsu (такие как платформа Fujitsu Kozuchi и корпоративный генеративный ИИ Takane) со специализированными отраслевыми моделями, что создает безопасную среду для предприятий и госучреждений.
08.09.2026 [19:29], Владимир Мироненко
Arm анонсировала платформу Neoverse CSS N4 для 128-ядерных серверных процессоров для ИИ ЦОДArm представила платформу нового поколения Neoverse Compute Subsystems (CSS) N4 для разработки серверных процессоров для ИИ ЦОД. Как сообщает компания, ИИ-инфраструктура становится всё более разнородной: для некоторых развёртываний требуются микросхемы, адаптированные под определённую системную архитектуру или функцию — от специализированных вычислительных платформ до цифровых сигнальных процессоров, сетевых и других специализированных решений. Новая платформа позволяет внедрить технологии Arm в эти решения, предоставляя партнёрам возможность адаптировать её под свои нужды, сокращая при этом трудозатраты на разработку, риски, связанные с интеграцией, и время, необходимое для создания микросхемы. По словам компании, Neoverse CSS N4 (Ranger) — это самая гибкая вычислительная подсистема Arm, обеспечивающая самый быстрый способ создания кастомных процессоров для ИИ ЦОД. Arm Compute Subsystems или CSS — это программа создания полукастомных решений, которая позволяет клиентам разрабатывать чипы на основе IP-ядер Arm, настраивая количество ядер, размер кеша, I/O-блоки и возможности подключения в соответствии со своими потребностями. Neoverse CSS N4 поддерживает от 8 до 128 ядер Neoverse N4 с тактовой частотой до 3,8 ГГц (первые в серии N с такой частотой), изготовленных по техпроцессу N3P от TSMC, с поддержкой мультичиплетной и мультисокетной архитектуры. 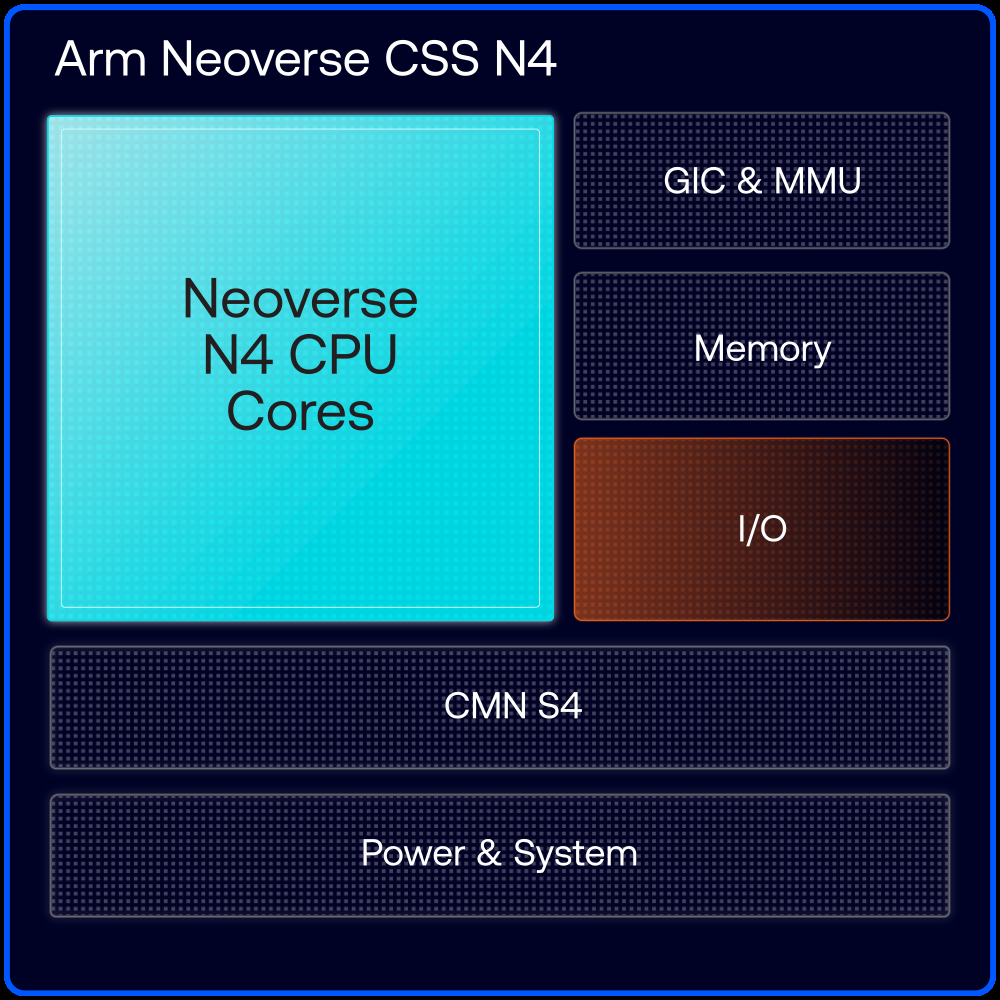
Источник изображения: Arm Платформа поддерживает память DDR5/LPDDR6, обеспечивает до 256 Мбайт L3-кеша с ECC на кристалл, до 2 Мбайт L2-кеша с ECC на ядро и по 64 Кбайт L1d/L1i-кеша на ядро. Также платформа поддерживает до 128 линий PCIe 6.0/7.0 (блоки по x16 с бифуркацией до x4) с CXL 4.0, интерфейсы AMBA CHI/AXI и UCIe. Для BMC предполагается использование ASPEED AST2600. По данным компании, Neoverse CSS N4 обеспечивает в 2 раза более высокую производительность, в 1,25 раза более высокую производительность на ватт и в 1,75 раза более высокую пропускную способность памяти по сравнению с Neoverse N3 (Hermes). Идея состоит в том, чтобы позволить разработчикам чипов тратить больше времени на добавление своих собственных элементов и меньше времени на то, чтобы разбираться, почему предположительно совместимые блоки перестали взаимодействовать друг с другом. CSS поставляется в виде RTL (Register-Transfer Level), который может быть интегрирован в современные EDA-процессы, с руководством по внедрению, поддержкой совместимости с IP-блоками сторонних производителей и интегрированным стеком ПО. Arm заявляет, что клиенты могут развернуть Linux для проверки и разработки ПО до того, как появится готовый чип. Компания также предложила клиентам, которые не хотят заниматься разработкой собственных чипов, объединить CSS N4 с процессором Arm AGI. Это уже готовый чип для рабочих нагрузок, требующих высокой скорости обработки данных, а CSS N4 позволяет гиперскейлерам и разработчикам чипов адаптировать его под конкретные стойки. По словам компании, OpenAI, Meta✴, Cloudflare, Oracle, SAP, Lenovo, Supermicro и Verda уже разрабатывают системы и сервисы на базе процессора AGI.
08.09.2026 [13:30], Сергей Карасёв
К выпуску готовится загадочный x86-процессор с поддержкой APX, AMX, FRED и x86SВ распоряжении сетевых источников оказалась новая порция технической информации о загадочном процессоре с архитектурой x86, который проектируется неназванной компанией. Чип может получить поддержку ряда технологий, работу над которыми Intel либо отложила, либо вовсе свернула, передаёт Phoronix. В частности, готовящийся CPU использует концепцию x86S (x86 Simplification) — это исключительно 64-бит процессор, из которого полностью исключена поддержка старых 16-бит и 32-бит режимов на аппаратном уровне. Intel ранее рассматривала идею x86S, но в декабре 2024 года решила прекратить единоличную разработку данной архитектуры. Ещё одной особенностью загадочного изделия является технология FRED (Flexible Return and Event Delivery), предназначенная для обработки системных событий и прерываний. Она заменяет старые, медленные механизмы переключения привилегий на новые — с низкой задержкой. Intel и AMD объединили усилия в рамках консультативной группы x86 Ecosystem Advisory Group (EAG) для стандартизации FRED, чтобы сделать решение общеотраслевым стандартом. 
Источник изображения: unsplash.com / Brecht Corbeel Кроме того, для нового чипа предусмотрена система APX (Advanced Performance Extensions), ориентированная на увеличение производительности ядер. Она предполагает использование 32 регистров общего назначения вместо прежних 16. Упомянуты также расширенные варианты аппаратной архитектуры матричных вычислений Intel AMX (Advanced Matrix Extensions), содержащие 16 или 32 тайловых регистра вместо стандартных 8. В целом, чип реализован как исключительно 64-разрядный (PM64-only) с пятиуровневой адресацией (PML5-only). Кто стоит за созданием процессора, пока не ясно. Высказываются предположения, что это может быть китайская компания Zhaoxin или Hygon. Другая версия — стартап RosaicLabs, который, как сообщается, получил доступ к наработкам Intel в области изделий Atom и продолжил улучшать архитектуру этих чипов. Однако чипу уровня Atom вряд ли нужны APX и AMX.
27.08.2026 [08:00], Сергей Карасёв
До 136 ядер, 96 линий PCIe 6.0 и 12 каналов DDR5-8800: Arm раскрыла характеристики серверных процессоров AGIКомпания Arm раскрыла дополнительные подробности о процессорах AGI, официальная презентация которых состоялась в марте нынешнего года. Эти чипы предназначены для использования в дата-центрах, ориентированных на ИИ-нагрузки. Чипы выполнены на платформе Arm Neoverse CSS V3. Конструкция включает два чиплета, каждый из которых насчитывает свыше 50 млрд транзисторов. При производстве применяется технология TSMC N3P (3 нм). Процессоры AGI будут предлагаться в модификациях с 64, 128 и 136 ядрами Armv9.2, распределёнными между двумя чиплетами. Номинальная тактовая частота составляет 3,2 ГГц, частота с ускорением — до 3,7 ГГц. Каждое ядро содержит 2 Мбайт кеша L2 (от 128 до 272 Мбайт на чип) и два 128-бит блока SVE2, предназначенных для ускорения задач ИИ и машинного обучения. Поддерживаются форматы BF16 и INT8. Общий объём кеша на уровне системы (SLC) равен 128 Мбайт. 
Источник изображений: Arm Каждый из чиплетов содержит шесть каналов оперативной памяти (12 на процессор) с поддержкой 3 Тбайт DDR5-8800 (6 Тбайт на процессор). Суммарная пропускная способность памяти достигает 845 Гбайт/с, пропускная способность в пересчёте на ядро — от 6 до 13 Гбайт/с в зависимости от их количества. В то время как AMD, Intel и NVIDIA используют гетерогенный многочиплетный подход для увеличения вычислительных мощностей и повышения производительности, решение Arm основано на сочетании высокой пропускной способности памяти и небольшой задержки (менее 100 нс). Благодаря отсутствию необходимости передачи данных на отдельный чиплет с контроллером памяти повышается быстродействие в задачах, чувствительных к задержкам. Внутри каждого чиплета AGI используется интерконнект CMN-S3 с топологией 8 × 9, которая связывает вычислительные ядра, память, IO-блоки и ускорители. Упомянуты фильтрация запросов к памяти (snoop filtering) и иерархическое кеширование на основе HN-S (Super Home Node) — логического блока, выполняющего функции распределительного центра. Он управляет трафиком и данными внутри чипа, чтобы ускорить обмен информацией. 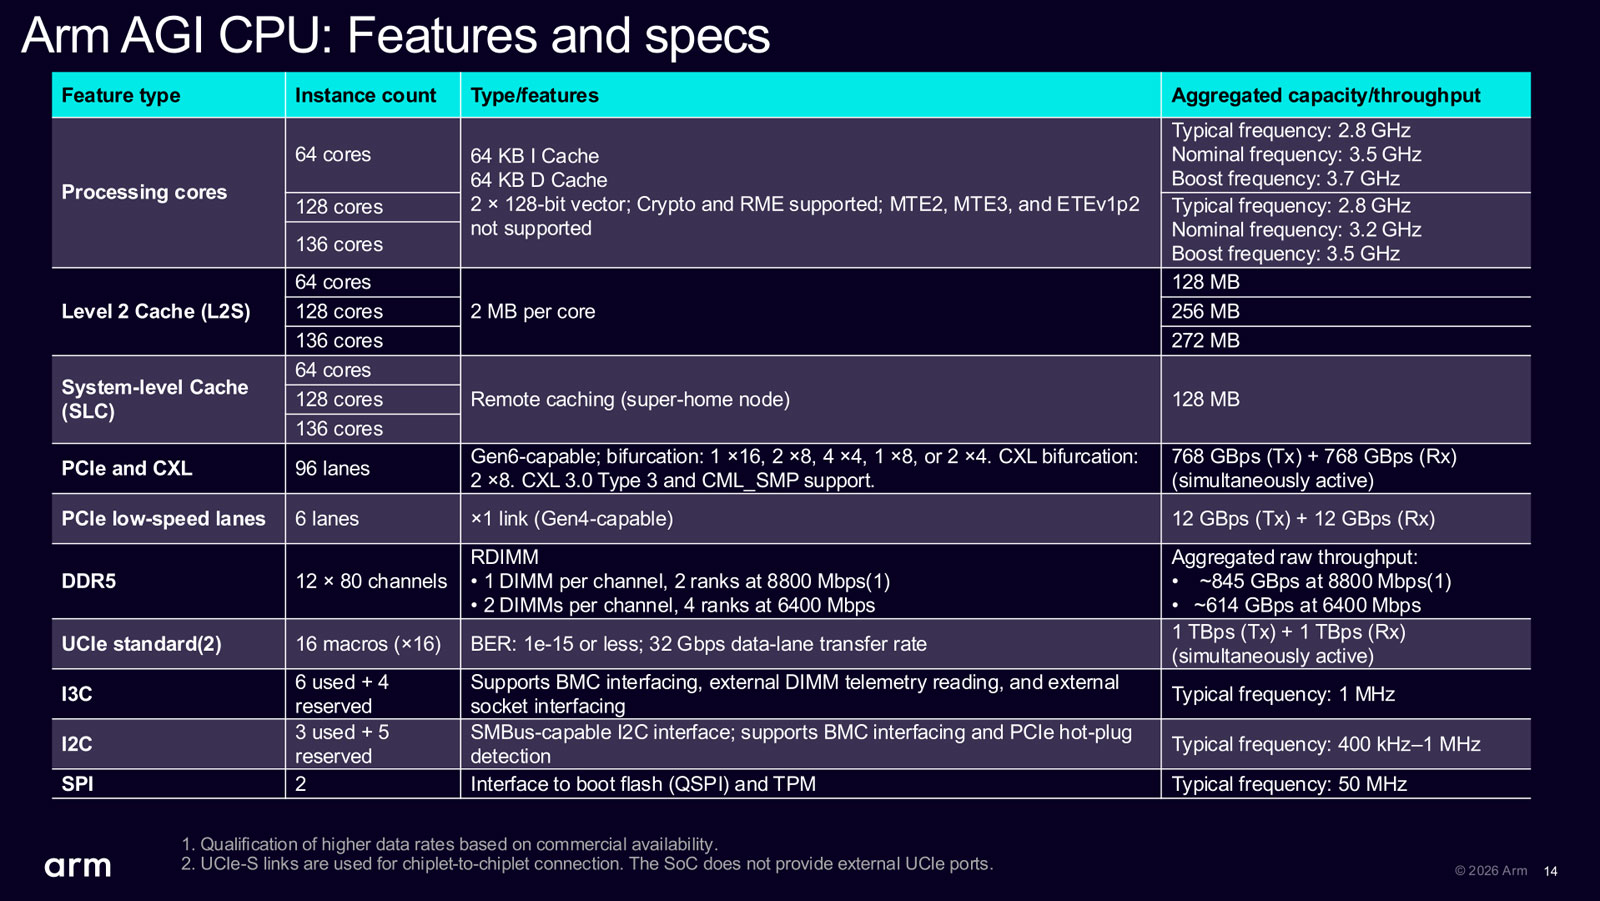 Если CPU-ядру требуется обратиться к памяти на другом чиплете, запрос передаётся по когерентному межчиповому интерконнекту, но при этом задержка увеличивается. Контроллеры DDR5 поддерживают ряд функций для достижения максимальной производительности в реальных рабочих нагрузках, включая полностью внеочередное планирование команд, оптимизированное отображение адресов и программируемые политики страничной адресации. Кроме того, реализован контроль и мониторинг пропускной способности памяти на основе технологии Memory Partitioning and Monitoring (MPAM). В сочетании с приоритизацией (QoS) и обратной связью о перегрузках это позволяет управлять конфликтами, когда множеству ядер и IO-устройствам требуется пропускная способность DRAM.
Процессор имеет 96 линий PCIe 6.0 с поддержкой CXL 3.0, четыре линии PCIe 4.0, а также интерфейсы I3C, I2C и SPI. Показатель TDP находится на уровне 300 Вт. Архитектура изделия рассчитана на стандартные воздушные системы охлаждения и позволяет эффективно использовать доступный лимит мощности. Утверждается, что в стандартной стойке на 36 кВт могут быть задействованы до 8160 вычислительных ядер AGI. В целом, решения AGI оптимизированы под сценарии, в которых CPU берёт на себя значительную часть ИИ-нагрузки. Это могут быть задачи инференса, координация вычислений в гетерогенных средах (CPU + GPU/TPU и т. п.), оркестрация ИИ-агентов и т. д. Реализована встроена аппаратная защита для мультитенантных сред: Runtime Security Engine (RSE), Pointer Authentication, Branch Target Identification.
25.08.2026 [18:35], Владимир Мироненко
IBM объединила архитектуры z и Arm в одном CPU для будущих мейнфреймовIBM анонсировала первый двухархитектурный процессор для мейнфреймов, который позволит запускать операционные системы и приложения на вычислительных платформах IBM (s390x) и Arm (AArch64) в будущих системах IBM z и LinuxONE. Компания отметила, что это первый этап в разработке процессора, достигнутый в рамках сотрудничества с Arm, стартовавшего в апреле 2026 года. 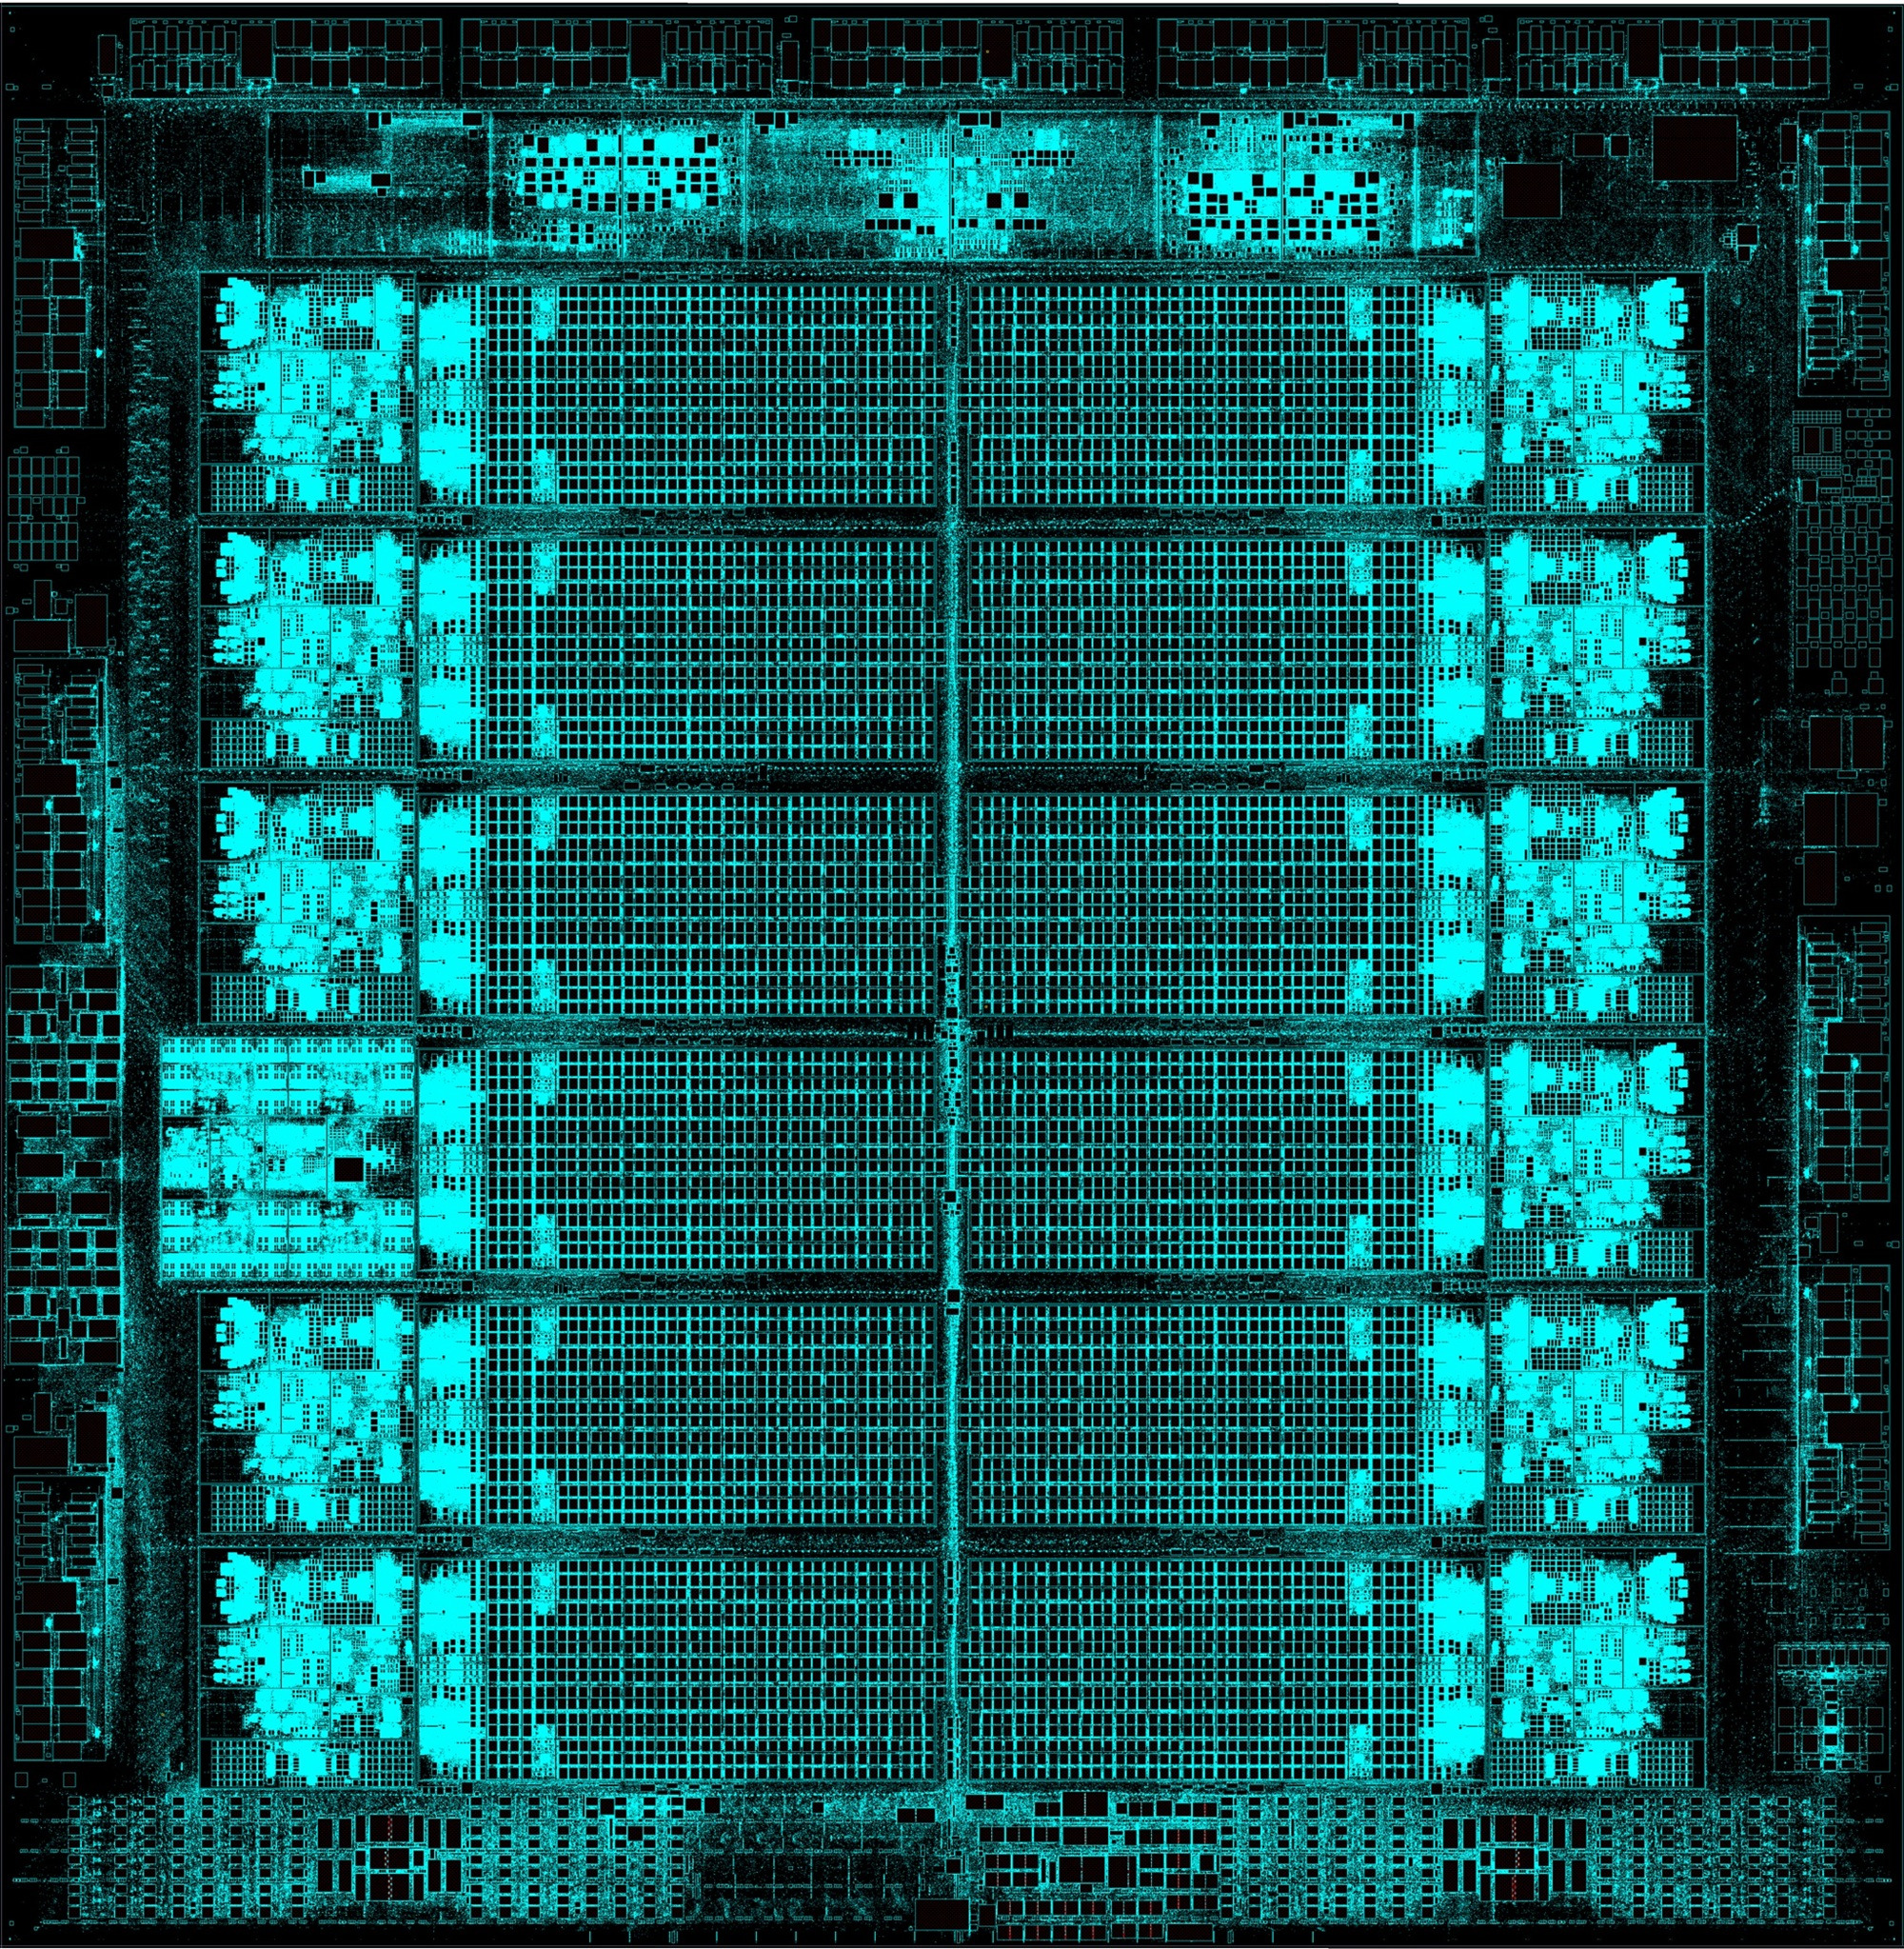
Источник изображения: IBM 2-нм процессор будет содержать 11 доступных двухпоточных (SMT 2) ядер, работающих на частоте более 5,7 ГГц, ускорители ИИ-инференса, специально разработанные для обнаружения мошенничества в финансовых транзакциях в режиме реального времени, выделенный встроенный DPU для ускорения I/O и большую кеш-архитектуру для ресурсоёмких корпоративных рабочих нагрузок с большими частными кешами L2 объёмом по 36 Мбайт, из которых формируются виртуальные L3/L4-кеши. Как отметил ресурс ServeTheHome, виртуальный L3 даёт 432 Мбайт, в то время как L4, объединяя все кеши всех ядер, обеспечит до 3,5 Гбайт памяти с очень низкой задержкой, что полезно для корпоративных рабочих нагрузок, таких как обработка транзакций и обслуживание баз данных. 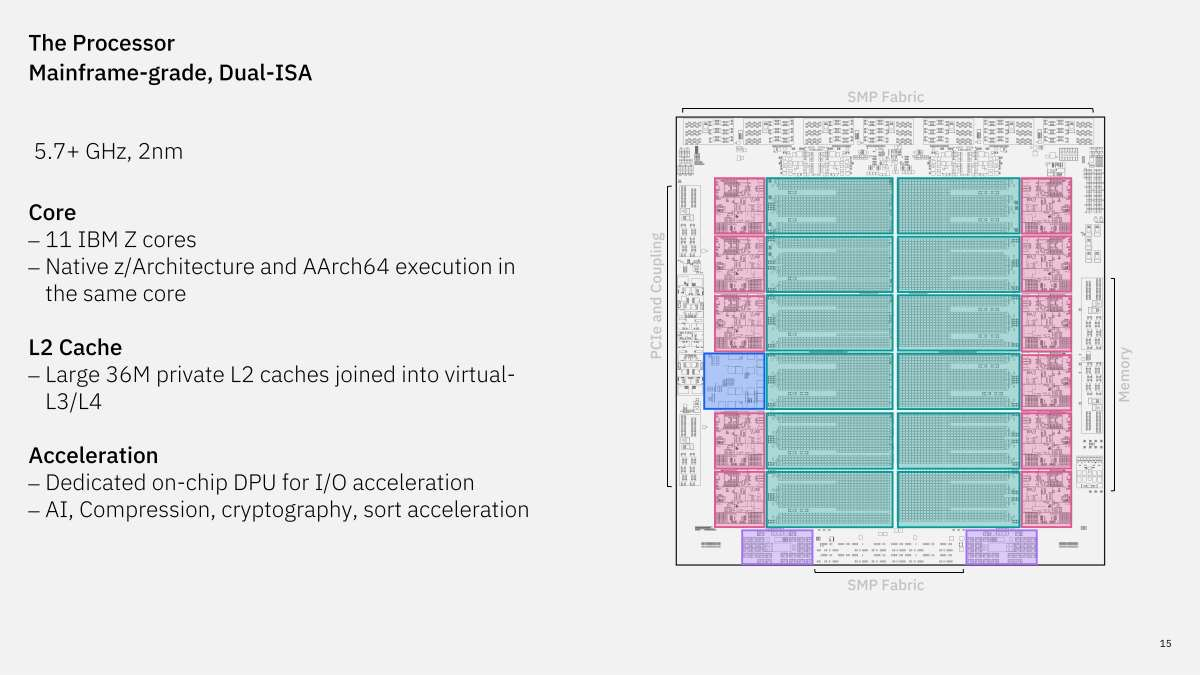
Источник изображений: IBM/ServeTheHome Компания отметила, что архитектура чипа не предусматривает отдельных ядер Arm и IBM: каждое процессорное ядро может одновременно выполнять инструкции Arm и IBM Z, или Arm и LinuxONE, отдавая приоритет установленным характеристикам платформы: производительности, безопасности, шифрования и доступности. Платформы IBM Z и LinuxONE способны масштабироваться до сотен ядер и десятков терабайт памяти. Подчёркивается, что ключевым моментом является то, что IBM реализовала AArch64 на аппаратном уровне, а не путём трансляции. В этом проекте используется реализация Arm с порядком байтов little-endian поверх архитектуры z/Architecture с порядком байтов big-endian. Заявлена поддержка Armv9.3, SVE и SVE2 — всего 2792 инструкции, что более чем в два раза больше, чем z-инструкций. IBM также заявляет о соответствии стандарту Arm SystemReady, что важно для совместимости с имеющимся ПО. Приложения Arm видят собственный полноценный процессор Arm, работая без изменений «из коробки». 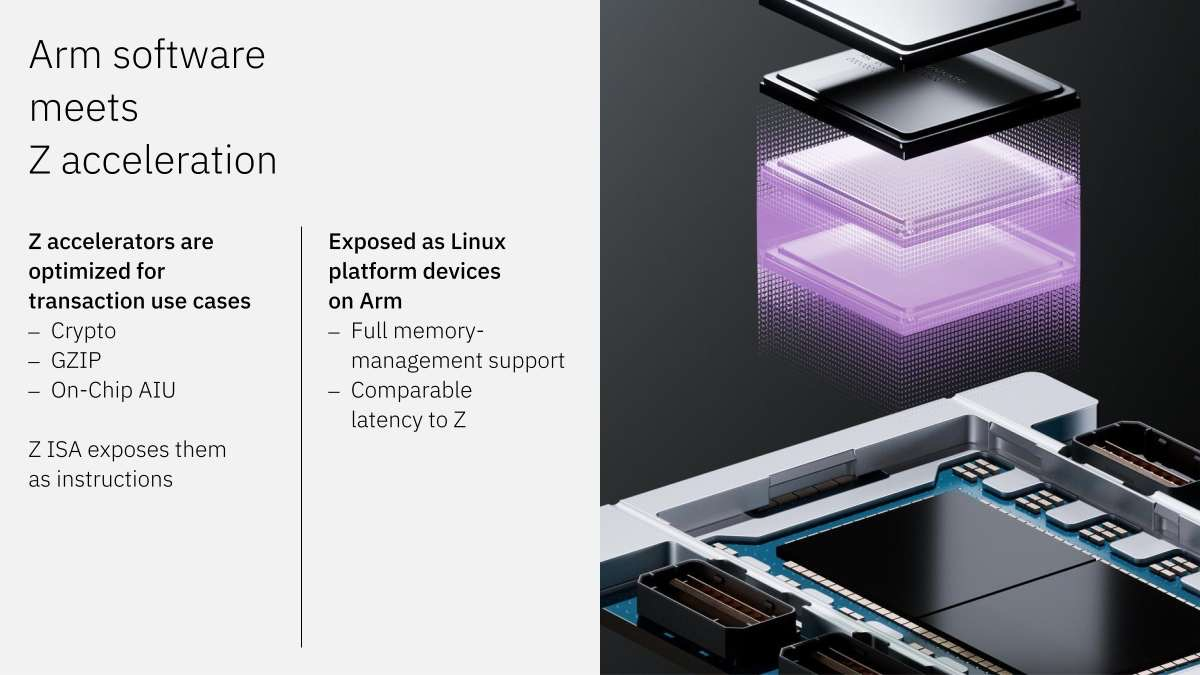 IBM говорит, что новый чип эффективно объединит две крупнейшие в мире вычислительные экосистемы, которые до сих пор были изолированы друг от друга. Мейнфреймы IBM z и системы LinuxONE составляют основу мировой экономики, обрабатывая, по оценкам аналитиков, около 70 % всех финансовых транзакций в мире, а также огромные объёмы данных в сфере здравоохранения. В свою очередь, программную экосистему Arm поддерживает более 22 млн разработчиков по всему миру. Она охватывает широкий и постоянно растущий спектр облачных и периферийных приложений, включая облачное ПО и ПО для ИИ. Предсказатель ветвлений демонстрирует, как существующая конструкция ядра IBM z может использоваться и для AArch64. Используется XML-описание архитектуры Arm для автоматического декодирования инструкций, диспетчеризации и отправки на исполнение. Переиспользуется возможность переименования регистров и основные пути исполнения инструкций, а также некоторые CISC-решения вроде копирования и очистки памяти. Но разработчиком всё равно пришлось добавить новые элементы управления для SVE, а также пути исполнения для FP16/Bfloat16 и криптографических функций. 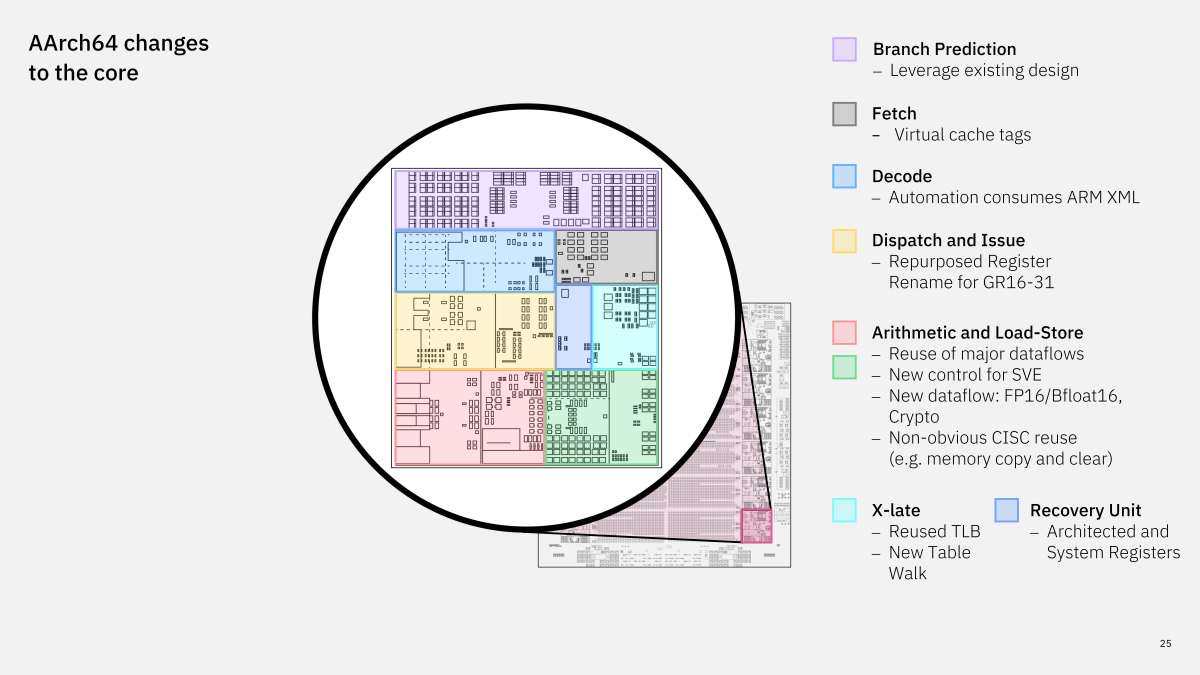 Встроенные ускорителям для криптографии, сжатия и инференса отображаются для Arm ПО представляются в качестве платформенных устройств в Linux на Arm. При этом процессор способен одновременно выполнять инструкции обеих ISA с сохранением сквозной проверки массивов и потоков данных/управления, прозрачного восстановления после нерегулярных сбоев, резервирования/замещения ядер при постоянных сбоях, параллельного восстановления и технологии аппаратной защиты оперативной памяти RAIM. Эта конструкции обеспечивает надёжность с целевым показателем доступности 99,999999 %. 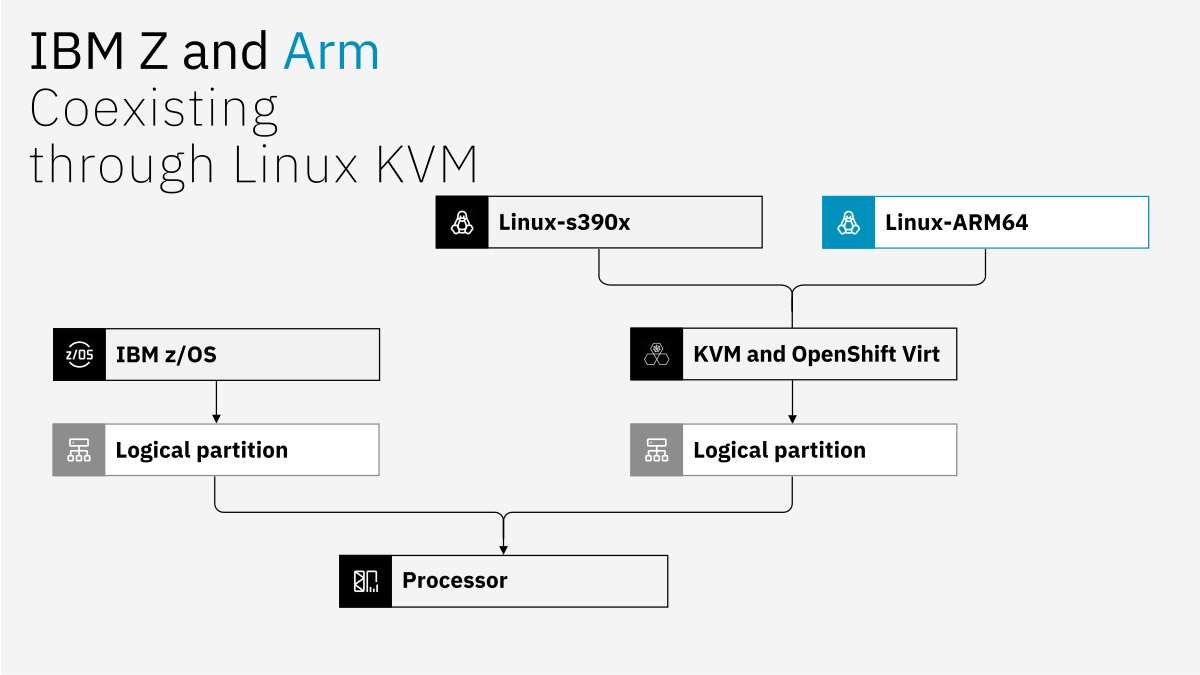 На программном уровне для запуска Linux-приложений для обеих архитектур используются KVM и OpenShift, которые, как нативные приложения z/OS, используют логически разделы, работающие на одном физическом процессоре. А каждый поток может работать как с инструкциями s390x, так и с Arm, при этом переключение занимает наносекунды. Такое сосуществование является залогом получения наилучших результатов от обеих программных экосистем, позволяя клиентам сохранять код для мейнфреймов, одновременно используя широкую базу ПО Arm, пишет SiliconANGLE. Дополнит новый CPU ускоритель ИИ-инференса второго поколения, который ориентирован на более крупные корпоративные рабочие нагрузки. Он содержит 16 активных ИИ-ядер (и одно резервное) с поддержкой FP4 и MXFP4, которые, по словам IBM, могут обеспечить четырёхкратное увеличение TOPS. Он получит 96 Гбайт HBM3e с ПСП до 4 Тбайт/с и PCIe 6.0 в качестве интерфейса одноранговой сети с низкой задержкой. IBM позиционирует чип как компонент для критически важных ИИ-систем, обеспечивающий надёжные вычисления, защищающие данные и модели в состоянии покоя, при передаче и использовании, в том числе с использованием криптографии с квантовой защитой. 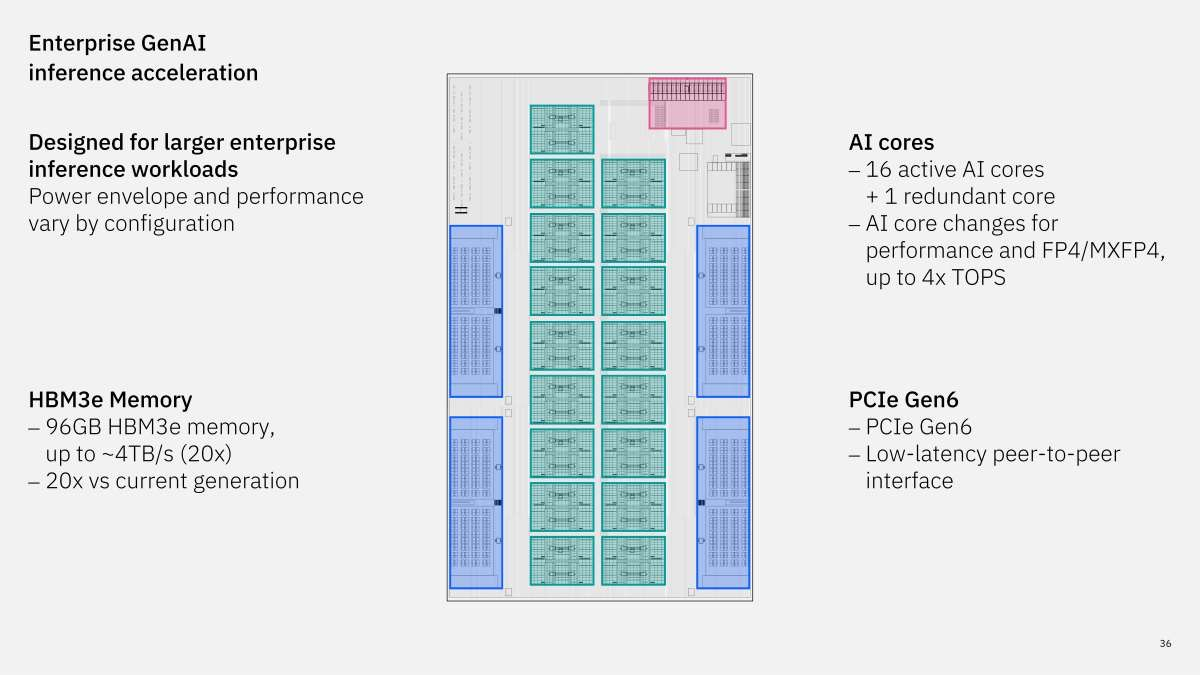 Как пишет SiliconANGLE, финансовые компании, работающие в условиях жёсткого регулирования, не могут отказаться от использования мейнфреймов и LinuxONE, известных своей исключительной безопасностью и надёжностью. Но для доступа к программной экосистеме Arm им приходилось отказываться от систем IBM. Новый чип меняет положение дел. «Этот процессор представляет собой значительный архитектурный прогресс для IBM z и LinuxONE, — сказал Кристиан Якоби (Christian Jacobi), главный технический директор и научный сотрудник IBM Systems Development. — Внедряя Arm непосредственно в наши платформы, мы объединяем доступ к одной из самых быстрых программных экосистем в отрасли с качествами, которые сделали системы IBM основой для ведения бизнеса». Двухпроцессорная архитектура IBM и Arm потенциально может способствовать новой волне внедрения ИИ компаниями в отраслях с жёстким регулированием. Вскоре разработчики смогут писать код для Arm и развёртывать его непосредственно на мейнфреймах, так что устаревшие аппаратные системы IBM останутся актуальными ещё долгие годы. Сообщается, что новый процессор будет доступен для клиентов в 2028 году. Это не первая попытка IBM скрестить две ISA в одном чипе. В 1994 году компания анонсировала процессор PowerPC 615, который объединил бы x86 и PPC, причём на уровне сокета он был совместим именно с Pentium-платформами, что, как ожидала IBM, привлечёт многочисленных производителей ПК. На деле чип поддерживался только Minix и особой версией OS/2, тогда как Microsoft отказалась участвовать в развитии ПО для него, а MacOS на нём, по-видимому, никто запускать и не собирался. В результате чип так и остался прототипом.
25.08.2026 [15:17], Сергей Карасёв
256 P-ядер, 16 каналов DDR5-8000, 1,28 Гбайт L3-кеша и 128 линий PCIe 6.0: Intel рассказала о процессорах Xeon 7 Diamond RapidsКорпорация Intel на конференции Hot Chips 2026 поделилась подробностями о серверных процессорах следующего поколения Xeon 7 Diamond Rapids, которые проектируются с прицелом на высокопроизводительные ИИ-системы. Эти чипы, как ожидается, появятся на рынке в следующем году. Процессоры Diamond Rapids построены по принципу дезагрегированной компоновки, схожей с подходом, реализованным в изделиях AMD EPYC: вычислительные ядра группируются в небольшие узлы и соединяются с централизованным блоком ввода-вывода и системной логикой. Отдельные функциональные блоки производятся по разным технологическим процессам и объединяются в систему. Подобный подход повышает гибкость конфигурации, снижает процент брака и упрощает масштабирование платформы под разные нагрузки. 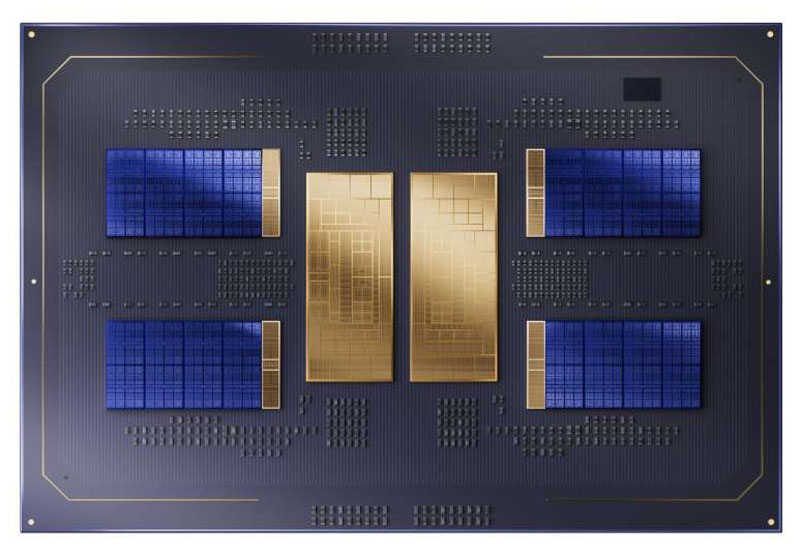
Источник изображений: Intel Конструкция Diamond Rapids предполагает использование многочиповой упаковки MCP (Multi-Chip Package). В основу положены два блока Fabric Hub Tiles (FHT) и четыре базовых тайла для вычислительных ядер (Base Tile). В состав каждого узла FHT входят восемь каналов памяти DDR5, что в сумме даёт 16 каналов на процессор. Поддерживаются модули RDIMM-8000 и MRDIMM-12800. Кроме того, каждый узел FHT обеспечивает 64 линии PCIe 6.0, которые могут конфигурироваться как CXL 3.0 или UPI 3 (в общей сложности 128 линий). Дополнительно предусмотрены по 8 линий PCIe 4.0. В состав FHT входит набор аппаратных ускорителей (TDX, SGX, QAT, DSA). 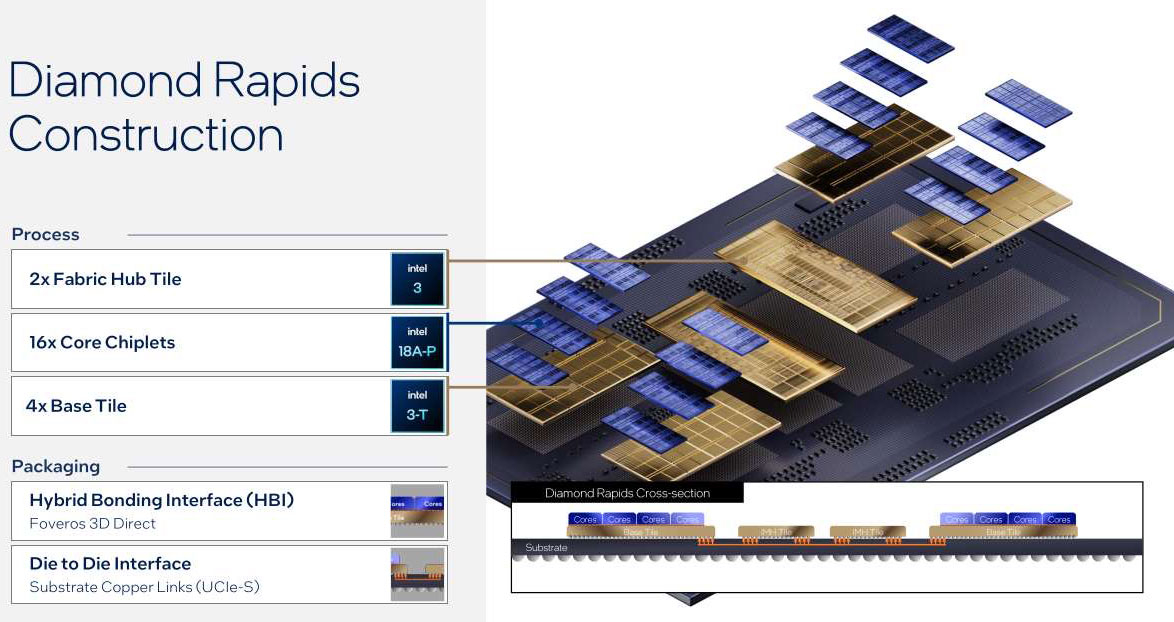 В свою очередь, блоки Base Tile объединяют по четыре чиплета с 16 Р-ядрами каждый. Таким образом, каждый из блоков включает 64 ядра — это даёт 256 ядер на процессор. Чиплеты располагают только выделенным L2-кешем, но не имеют общего кеша L3. Вместе с тем блоки Base Tile содержат 320 Мбайт L3-кеша, или 1,28 Гбайт на процессор. В рамках базового тайла чиплеты ядер соединяются через интерфейс Foveros 3D Direct.
В составе Diamond Rapids применяются ядра Panther Cove с поддержкой AMX, AVX 10.2, а также форматов FP8, FP16 и BF16. Для компонентов предусмотрены разные технологии производства: так, чиплеты вычислительных ядер изготавливаются по техпроцессу Intel 18A-P, сами Base Tile — по Intel 3-T, а FHT — по техпроцессу Intel 3. Такая архитектура обеспечивает оптимальные показатели производительности, энергоэффективности и надёжности для каждого из функциональных модулей. Управление питанием реализовано на уровне вычислительных блоков и позволяет гибко балансировать между пиковым быстродействием и потреблением энергии. Выход процессоров Diamond Rapids ожидается во II половине 2027 года. Благодаря сочетанию передовых технологий и модульной архитектуры чипы, как ожидается, выведут на новый уровень вычислительные возможности в области ИИ и других ресурсоёмких приложений.
31.07.2026 [17:42], Сергей Карасёв
Openchip представила европейский 2-нм процессор BER10 с архитектурой RISC-VКомпания Openchip анонсировала суверенный европейский процессор BER10, построенный на открытой архитектуре RISC-V. Изделие ориентировано на различные устройства, функционирующие под управлением Linux. Это могут быть серверы, периферийные платформы и пр. Чип BER10 получил четыре 64-бит вычислительных ядра с внеочередным исполнением инструкций. Тактовая частота и размер кеш-памяти пока не раскрываются. Но отмечается, что при производстве применяется передовая технология Gate-All-Around (GAA) с нормами «менее 2 нм». Таким образом, можно предположить, что решение обладает высокой энергетической эффективностью. 
Источник изображения: Openchip В процессоре реализована поддержка многоканальной оперативной памяти и высокоскоростных интерфейсов, таких как PCIe и AXI (Advanced eXtensible Interface). Кроме того, имеется аппаратный векторный блок, предназначенный для ускорения операций, связанных с ИИ, научными расчётами, обработкой изображений и другими ресурсоёмкими задачами. Openchip подчёркивает, что BER10 — это не исследовательский прототип, а чип, рассчитанный на серийное производство. Иными словами, изделие готово для работы с реальными операционными системами и прикладным софтом. Впрочем, о начале массовых поставок процессоров разработчик умалчивает. Европейская безфабричная компания Openchip была основана в Барселоне в 2021 году. В настоящее время она ведёт деятельность в Испании, Италии, Франции, Польше, Германии и Ирландии. В штат входят более 200 специалистов — в основном в области исследований и разработок. Ключевым направлением деятельности является проектирование энергоэффективных «систем на кристалле» (SoC) на основе архитектуры RISC-V.
25.07.2026 [21:20], Сергей Карасёв
В семейство AMD Ryzen AI Embedded X100 вошли процессоры с 8–16 ядрамиВ январе нынешнего года компания AMD формально анонсировала процессоры Ryzen AI Embedded X100 для встраиваемых и автономных систем с ИИ-функциями. Теперь раскрыты технические характеристики этих изделий. Кроме того, представлены вычислительный модуль Kria AI SoM на базе чипа X100 и платформа для разработчиков Kria AI Robotics Developer Platform. В семейство Ryzen AI Embedded X100 вошли шесть моделей — X168i, X168, X188i, X188, X199i и X199. У изделий с суффиксом «i» в обозначении диапазон рабочих температур простирается от -40 до +105 °C, у других — от 0 до +105 °C. Процессоры X168i и X168 получили восемь ядер с частотой до 5 ГГц и GPU с 32 вычислительными блоками (CU). Решения X188i и X188 имеют аналогичные характеристики, но содержат 12 ядер CPU. Чипы X199i и X199 объединяют 16 ядер с частотой 5,1 ГГц и GPU с 40 вычислительными блоками. 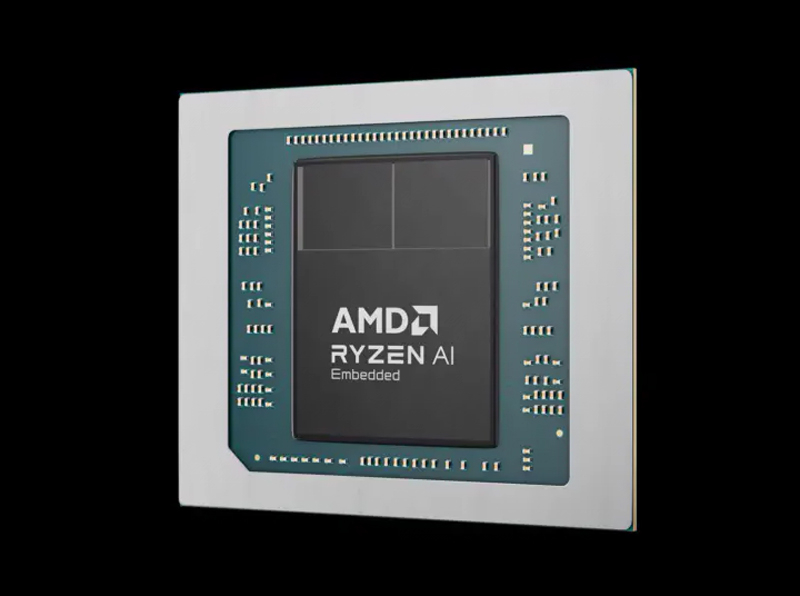
Источник изображений: CNX Software Все процессоры поддерживают оперативную память LPDDR5x-8533 (до 8 каналов) и 16 линий PCIe 4.0. Реализованы интерфейсы HDMI 2.1, DP 2.0, eDP v1.4, DVI, USB4 (×2), USB 3.2 (×2), USB 2.0 (×3), I2C, SMBus, SPI, UART. Изделия выполнены в корпусе с размерами 45 × 37,5 мм. 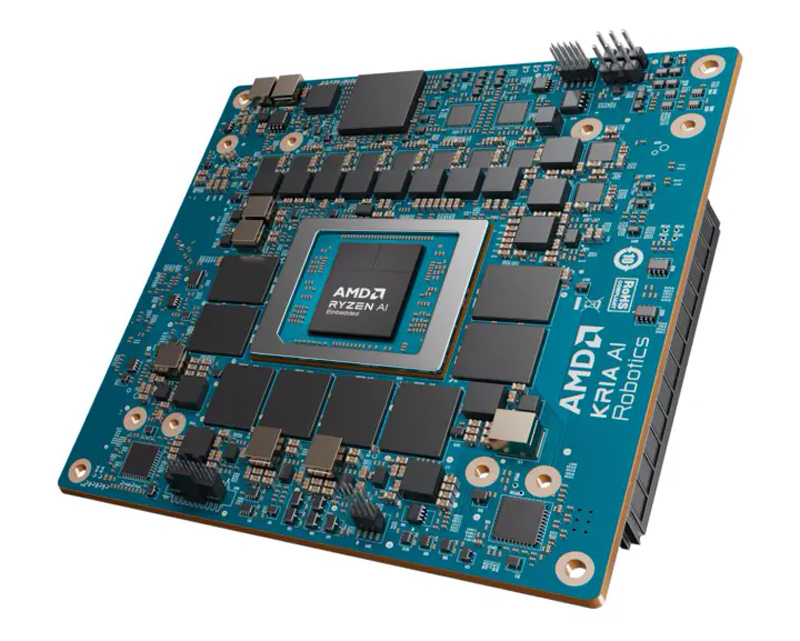 Утверждается, что по сравнению с аналогичными процессорами Intel Core Ultra Series 3 чипы Ryzen AI Embedded X100 обеспечивают прирост производительности в 2,1 раза в многопоточном режиме (CoreMark). Графический блок при этом демонстрирует 1,7-кратную прибавку (OpenGL, GFXBench 5.0.0). По сравнению с платформой NVIDIA Jetson Thor T5000 процессоры Ryzen AI Embedded X100 Series демонстрируют 3-кратный рост пиковой производительности в формате FP32. Вычислительный блок AMD Kria AI SoM, по информации ресурса CNX Software, несёт на борту 64 или 128 Гбайт памяти LPDDR5x. Возможно подключение до восьми камер через коннекторы FAKRA. Упомянуты интерфейсы CAN-FD, RS485, 10GbE QSFP. 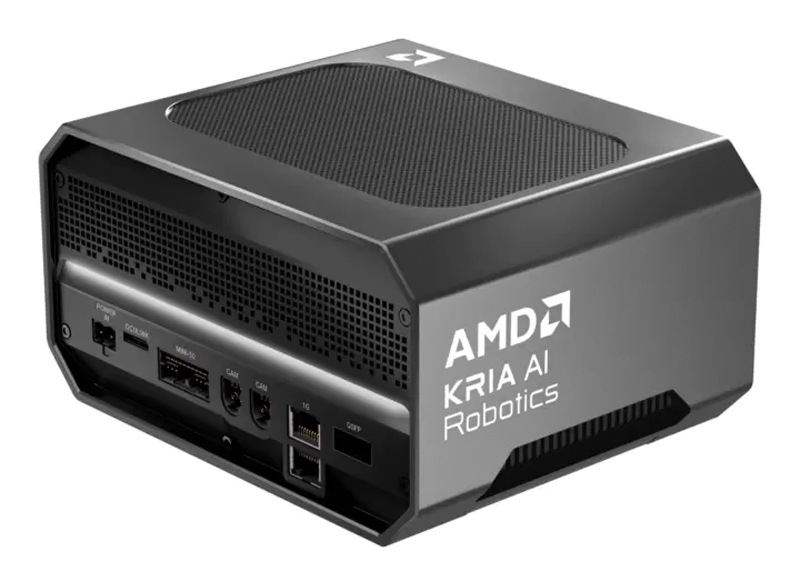 В свою очередь, платформа для разработчиков Kria AI Robotics Developer Platform оснащена модулем Kria AI SoM и FPGA Spartan UltraScale+. Предусмотрены коннектор Oculink PCIe, разъём M.2 2280 Key-M для NVMe SSD и слот M.2 2230 Key-E для комбинированного адаптера Wi-Fi/Bluetooth. В оснащение входят два интерфейса Mini DisplayPort, по одному коннектору FAKRA x4 (GMSL2/3) и FAKRA x4 (GMSL1/2), 3,5-мм аудиогнездо, по два сетевых порта 5GbE RJ45 и 1GbE RJ45 (EtherCAT/TSN), порт 10GbE QFSP, интерфейсы USB4 Type-C (×2), USB 3.2 Type-C (×3) и USB 2.0 Type-A (×2), два последовательных порта CAN-FD/RS485. |
|


