
Материалы по тегу: интерконнект
|
12.10.2026 [17:48], Сергей Карасёв
Медь и оптика: Astera Labs представила ретаймеры и редрайверы PCIe 7.0Astera Labs представила изделия семейства Aries 7 — первые в отрасли ретаймеры и редрайверы, поддерживающие стандарт PCIe 7.0 как по медным, так и по оптическим линиям связи. Эти чипы ориентированы на применение в высокопроизводительных ИИ-системах. Новинки призваны решить проблему затухания и искажения сигналов при переходе дата-центров на стандарт PCIe 7.0. Изделия обеспечивают возможность подключения устройств на расстояниях от нескольких сантиметров по печатной плате до более чем 50 м в пределах нескольких стоек. Ретаймеры и редрайверы поддерживают стандарт OCP Signal Conditioner Standard Footprint, предоставляя разработчикам возможность менять преобразователи сигналов без необходимости перепроектирования печатной платы. Иными словами, одна и та же платформа допускает установку медных или оптических модулей — в зависимости от конкретных требований. 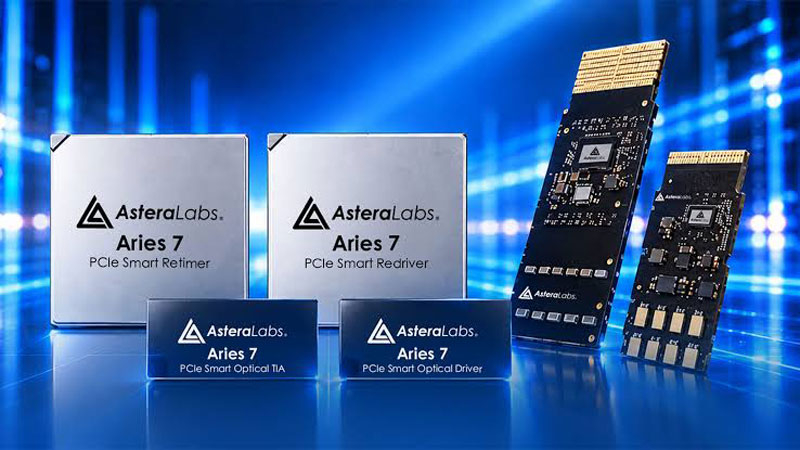
Источник изображения: Astera Labs В новое семейство также вошли интеллектуальные оптические драйверы и оптические трансимпедансные усилители (TIA), предназначенные для оборудования LPO и NPO. Сопутствующие программные инструменты Astera COSMOS обеспечивают централизованный мониторинг состояния соединений в реальном времени, диагностику и динамическую настройку каналов связи на базе медных и оптических компонентов. Корме того, Astera Labs анонсировала семейство специализированных умных контроллеров Leo X-Series, предназначенных для оптимизации работы ИИ-платформ. Они позволяют подключать дополнительную память напрямую к сетевому слою ИИ-ускорителей на базе GPU, полностью исключая CPU из цепочки передачи данных. Устройства берут на себя разгрузку KV-кеша и контекста агентов ИИ. Наконец, дебютировали контроллеры Leo 2 E-Series и Leo 2 P-Series на базе стандартов CXL 3.2 и PCIe 6.0. Изделия Leo 2 E-Series дают возможность расширять объём памяти, напрямую подключённой к одному CPU: в этом случае нет необходимости задействовать дополнительные процессорные разъёмы. В свою очередь, решения Leo 2 P-Series обеспечивает динамическое объединение и создание пулов памяти для нескольких хостов.
12.10.2026 [09:37], Владимир Мироненко
Upscale AI представил архитектуру Token Fabric для ИИ-фабрикСтартап Upscale AI представил архитектуру Token Fabric, призванную объединить вертикальное и горизонтальное масштабирование в рамках одной сетевой платформы. Решение сочетает в себе фирменный чип SkyFabriX (scale-up), NVIDIA Spectrum-X Ethernet (scale-out) и единый программный уровень для управления. Система, построенная на открытых стандартах, должна обеспечить непрерывную работу ИИ-чипов, чтобы они не простаивали в ожидании данных, тем самым помогая клиентам повысить отдачу от своих инвестиций. Token Fabric включает:
Клиенты могут внедрять Token Fabric, выбирая отдельные компоненты (чипы, системы, ПО) или весь стек целиком. Вариант с полным стеком рассчитан на неооблака и корпоративных клиентов, не располагающих сетевыми командами масштаба гиперскейлеров. Вариант с интегрированными системами предназначен для производителей XPU, которым требуется проверенное оборудование без необходимости самостоятельной разработки сетевого стека. Третий вариант предусматривает поставку чипов или специализированных систем вместе с SDK/SAI от Upscale, поверх которых работает собственная NOS заказчика. 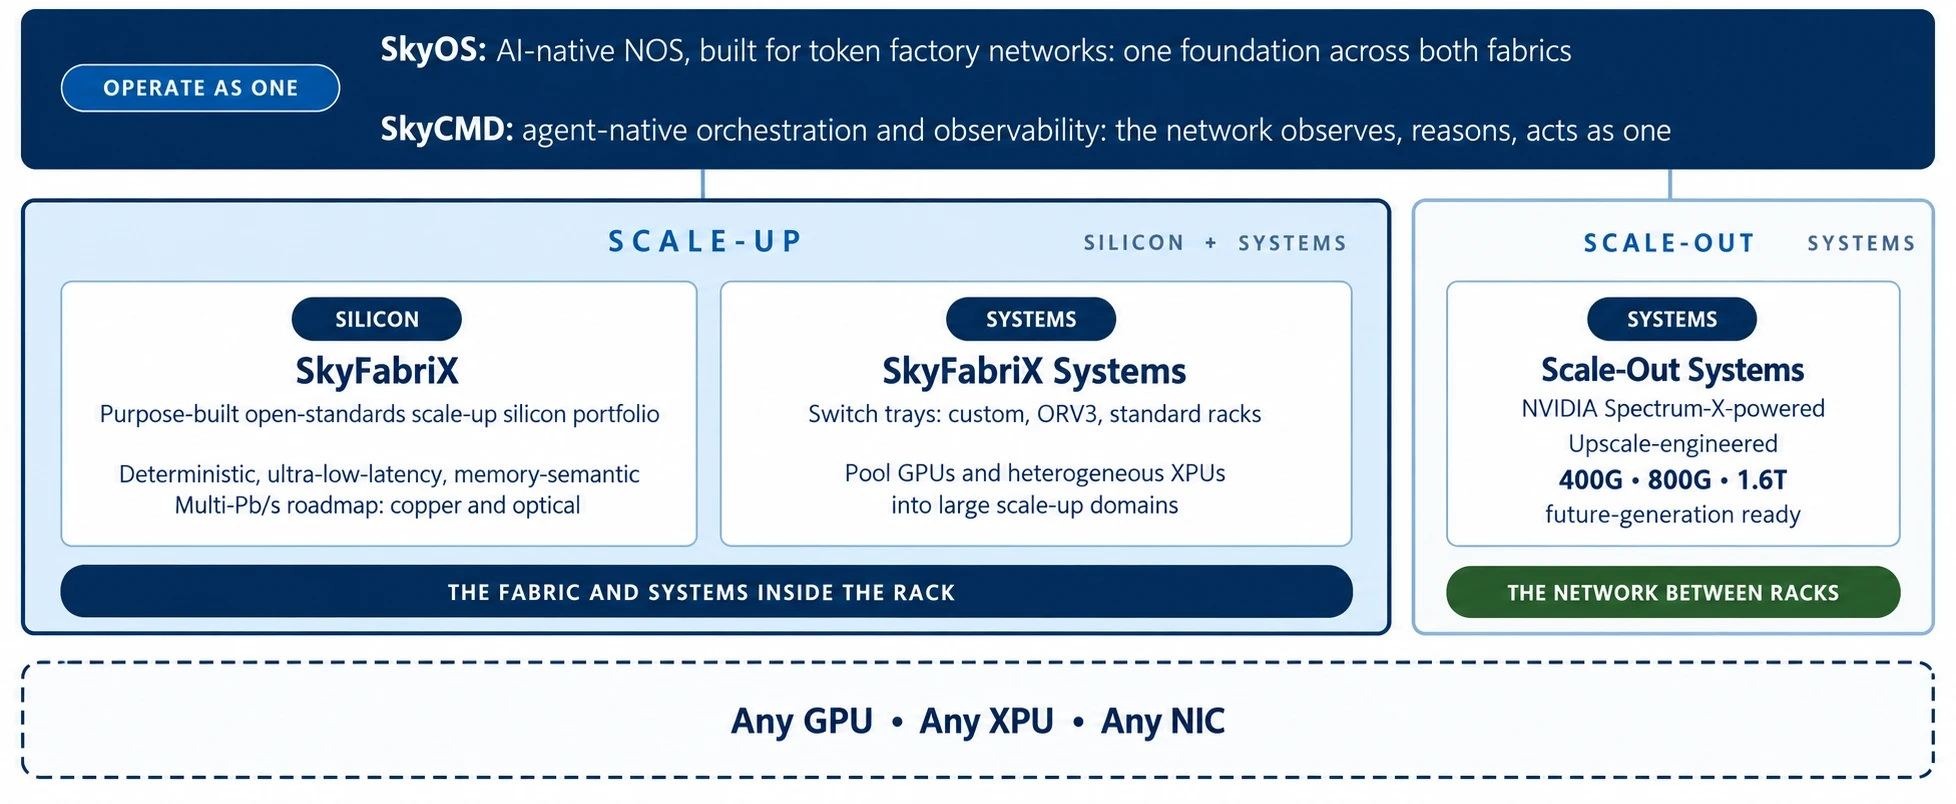
Источник изображения: Upscale AI Upscale AI расширяет существующие протоколы, а не заменяет их, говорит компания. Upscale AI также вносит вклад в открытые проекты, лежащие в основе стека. К ним относятся SONiC, расширения интерфейса абстракции коммутатора (SAI) для поддержки ESUN, а также инициативы Ultra Ethernet Consortium (UEC) и UALink. SkyOS абстрагирует нижележащее оборудование и обеспечивает единую плоскость управления для всего кластера, а SkyCMD унифицирует управление. Любая вычислительная платформа в гетерогенном кластере может использовать этот интерфейс для управления сетью. «Операционная система должна быть компактной и эффективной, чтобы обеспечивать быстродействие, гибкость и безопасность, — сообщил изданию Network World Барун Кар (Barun Kar), генеральный директор Upscale AI. — Кроме того, поверх неё необходим уровень оркестрации, позволяющий поддерживать такие возможности, как гетерогенные вычисления». Полномасштабный выпуск Token Fabric запланирован на начало 2027 года; в настоящее время действуют программы раннего доступа и совместного тестирования. Компания Upscale AI вышла из скрытого (stealth) режима в сентябре 2025 года. Она привлекла $100 млн в рамках посевного раунда финансирования, потом — $200 млн в раунде A, а затем — ещё $190 млн, при оценке капитализации в $2 млрд. В результате общий объём инвестиций составил $500 млн. Стартап поддерживают как NVIDIA, Salesforce и сингапурский государственный инвестиционный фонд Temasek. Главный инвестор — фонд Premji Invest. Штат компании превышает 300 сотрудников.
12.10.2026 [08:53], Сергей Карасёв
Arista представила интерконнект Etherlink SU-144 для кластеров ИИ и НРСКомпания Arista Networks анонсировала сетевую архитектуру Etherlink SU-144, призванную перенести стандарт Ethernet в ту область, в которой ранее превалировали такие технологии, как NVIDIA NVLink и InfiniBand. Новое решение ориентировано на масштабные кластеры ИИ и НРС. Arista отмечает, что рынок ИИ стремительно расширяется. По мере усложнения больших языковых моделей (LLM) и появления нагрузок, которым необходима тесная синхронизация данных между огромными пулами ускорителей, возможностей интерфейсов PCIe, CXL и проприетарных интерконнектов становится недостаточно для эффективного масштабирования ресурсов. Такие технология хорошо работают внутри серверов, но создают определённые трудности на уровне кластеров из-за применения ускорителей разных поколений и конструктивных особенностей систем, объединяющих сотни и тысячи XPU. В такой ситуации сеть больше не является просто связующим звеном между серверами — она становится частью самой вычислительной системы. Архитектура Etherlink SU-144, как ожидается, поможет в удовлетворении растущих потребностей в высокоскоростном обмене данными. 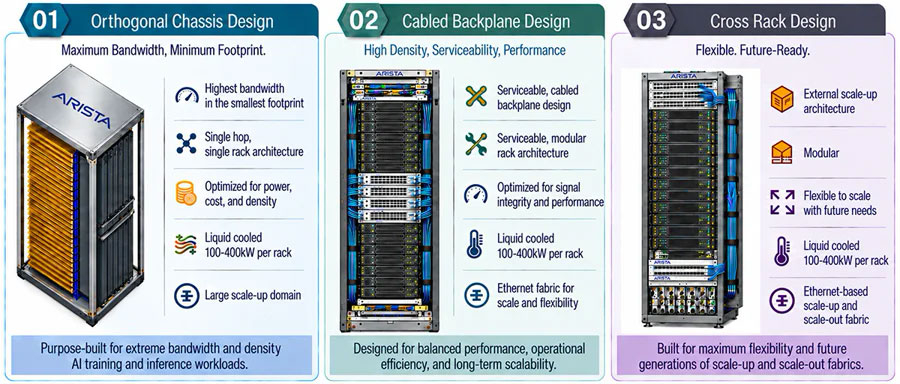
Источник изображения: Arista Networks Новая технология разработана в рамках инициативы Ethernet for Scale-Up Networks (ESUN). В проекте также принимают участие AMD, Arm, Broadcom, d-Matrix, Meta✴, Microsoft и Qualcomm. Благодаря Etherlink SU-144 в пределах одной стойки могут быть объединены до 144 ускорителей, а в массиве из нескольких стоек — до 1024. Расчётная мощность при этом может варьироваться от 100 до 400 кВт на стойку, что требует применения исключительно жидкостного охлаждения. Для Etherlink SU-144 предусмотрены три физических форм-фактора под разные сценарии. Это, в частности, ортогональное шасси, когда серверы располагаются спереди, а коммутационные карты — сзади. Такое исполнение обеспечивает максимальную плотность компоновки и высокую пропускную способность при интенсивных нагрузках обучения и инференса ИИ-моделей. Ещё один вариант — шасси с бэкплейном: решение обеспечивает оптимальное сочетание производительности, операционной эффективности и долгосрочной масштабируемости. Наконец, третий подход предполагает формирование межстоечной связи — для максимальной гибкости и будущих развёртываний. Для архитектуры Etherlink SU-144 заявлена поддержка динамической балансировки нагрузки, а также оптических технологий XPO и CPO/NPO с перспективой повышения пропускной способности до 6,5 Пбит/с на стойку.
05.10.2026 [13:40], Руслан Авдеев
Разработчик «неубиваемого» оптического интерконнекта CScale вышел из «стелс-режима», получив $145 млн от NVIDIA и IntelЗанимающийся разработкой оптических интерконнектов стартап CScale вышел из «стелс-режима» после раунда финансирования серии C. Компания привлекла $145 млн, участие в раунде приняли NVIDIA и Intel Capital, сообщает Datacenter Dynamics. Раунд совместно возглавили Atreides Management, Valor Equity Partners и Premji Invest, также в нём приняли участие Sutter Hill Ventures и Maverick Silicon. Общая сумма привлечённых средств достигла $188 млн. Они помогут ускорить разработку и коммерческое внедрение дебютного оптического интерконнекта. Основанная в 2023 году компания разрабатывает оптические интерконнекты для масштабирования ИИ-систем. Пока подробностей о технологии компании немного, но в официальном заявлении CScale объявила, что занимается проектированием интерконнекта по принципу, в соответствии с которым оптические сбои «локализуются без прерывания вычислений». 
Источник изображения: CScale По словам компании, на фоне того, как ИИ-системы начинают занимать десятки стоек, оптические интерконнекты становятся необходимостью для создания сетевой инфраструктуры для масштабирования ИИ-систем. Надёжная связь имеет решающее значение для экономической эффективности системы. Упрощённая замена компонентов при этом делает обслуживание более удобным, но не обеспечивает бесперебойности работы системы. Компания работает именно над вариантом интерконнекта, с расчётом на обеспечение непрерывной работы. В Atreides Management отметили, что масштабируемые ИИ-системы приближаются к гигаваттному уровню и пропускная способность интерконнектов ничего не даёт без обеспечения бесперебойной работы. При этом, с учётом масштаба проектов, отказы — не гипотетическая возможность, а неизбежность, поэтому CScale разрабатывает надёжные оптические продукты для нового поколения ИИ-фабрик. Судя по описанию вакансии на сайте компании, технология CScale будет интегрирована в SoC, оснащённый CPU. Последний может понадобиться для работы сетевого ПО для автоматизации. Компания описывает свой продукт как «интегрированный световой модуль» (integrated light engine).
22.09.2026 [19:23], Владимир Мироненко
Alibaba представила новый ИИ-ускоритель Zhenwu V900 — самый мощный в Китае, и заявила о планах увеличить мощность ЦОД до 20 ГВтКомпания Alibaba Group представила ИИ-ускоритель Zhenwu V900, разработанный её подразделением T-Head Semiconductor (Pingtouge Semiconductor), пишет SCMP. Кампания заявила, что это «самый мощный чип для ИИ в Китае на сегодняшний день». По данным Alibaba, Zhenwu V900 в три раза превосходит по производительности своего предшественника — Zhenwu M890, но точные показатели не приводятся. Сообщается, что Zhenwu V900 оснащён 216 Гбайт HBM, поддерживает вычисления в формате FP32–FP4 и обладает усовершенствованным тензорным вычислительным блоком Tensor Core, который значительно повышает точность выполнения инструкций в форматах FP8/FP4. Также сообщается о пропускной способности межчипового интерконнекта 1,2 Тбайт/с. Конфигурации размеров блока в форматах MXFP8 и MXFP4 позволяют стабилизировать производительность при масштабировании вычислений в ходе обучения и инференса, пишет The Register. Как сообщил Гао Хуэй (Gao Hui), вице-президент T-Head, серийное производство что Zhenwu V900 запустят в I квартале 2027 года. Вычислительные ИИ-кластеры на базе V900 могут объединять до 500 тыс. ускорителей с использованием коммутаторов ICN Switch собственной разработки, обеспечивая достаточно вычислительной мощности для обучения и инференса моделей с 5–10 трлн параметров. 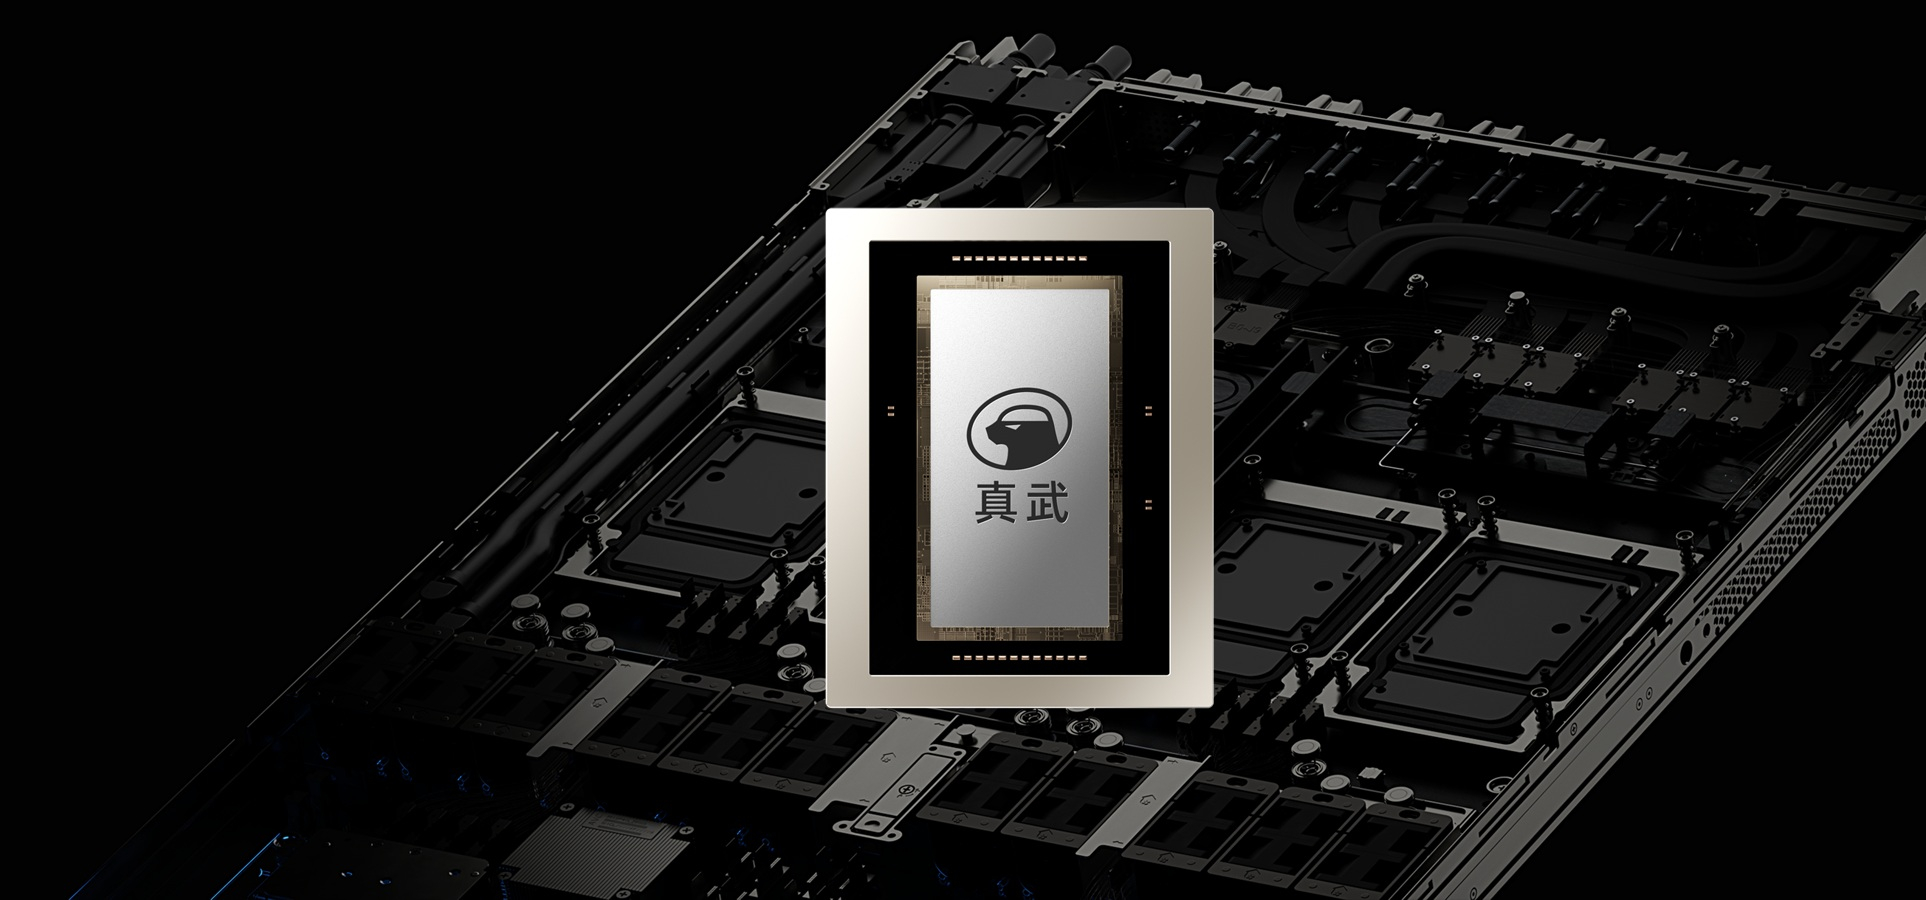
Источник изображения: T-Head Также на I квартал 2027 года намечен выход суперускорителя Panjiu, оснащенного чипами Zhenwu V900, коммутаторами ICN Switch, картами SmartNIC Panmai и контроллерами Zhenyue. Заодно T-Head представила предварительную версию ИИ-ускорителя нового поколения Zhenwu J900, в основе которого лежит архитектура параллельных вычислений собственной разработки. Его выпуск запланирован на III квартал 2028 года. Компания сообщила о планах по созданию собственных центральных процессоров (CPU) нового поколения, оптимизированных для задач агентного ИИ — Yitian 720 и Yitian 730, выпуск которых стартует в 2027 году. При этом Yitian 730 станет первым процессором T-Head, созданным на базе собственной микроархитектуры, возможно, RISC-V. Yitian 710 использовал архитектуру Arm. 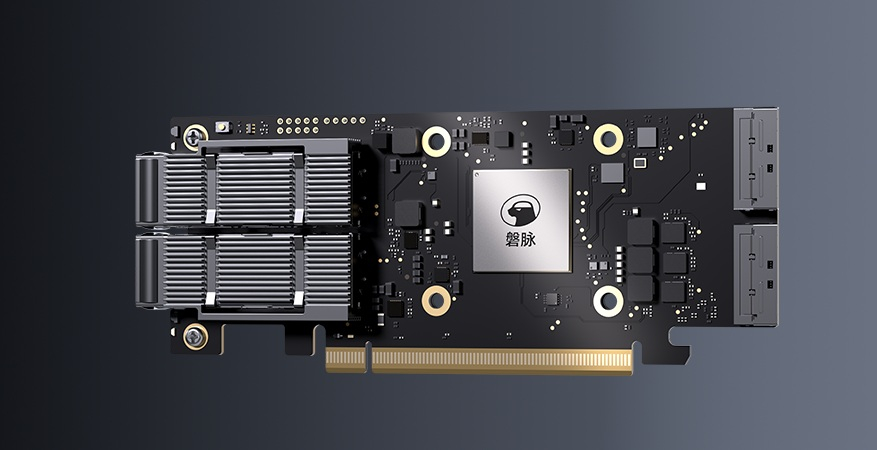
Источник изображения: T-Head Глава Alibaba У Юнмин (Wu Yongming) представил план развития компании, выделив «ИИ-модели, ИИ-чипы и ИИ-облако» в качестве трёх краеугольных камней «машинного интеллекта». Сообщается, что подразделение T-Head завершило разработку полной линейки основных микросхем для ЦОД, охватывающей четыре основные категории: ускорители Zhenwu, CPU Yitian, SmartNIC Panmai и интерконнект ICN. При этом все основные микросхемы, необходимые для формирования сверхбольших ИИ-кластеров, были разработаны самостоятельно. Юнмин заявил о планах компании увеличить мощность глобальных дата-центров Alibaba Cloud до более чем 20 ГВт к 2032 году, что примерно в 10 раз превышает их мощность до появления генеративного ИИ. Для реализации проекта компания инвестирует более $53 млрд в ближайшие три года в строительство ИИ-инфраструктуры. Также компания намерена значительно увеличить поставки чипов для ИИ. И всё же, если сравнивать с ИИ-индустрией США, цифры выглядят не столь впечатляюще. Например, компания Cushman & Wakefield, занимающаяся коммерческой недвижимостью, на прошлой неделе сообщила, что только в США в настоящее время ведётся строительство ЦОД общей мощностью 37,7 ГВт. Часть из них будет задействована в проекте Stargate, в рамках которого к 2029 году планируется ввести в эксплуатацию 10 ГВт.
21.09.2026 [13:53], Сергей Карасёв
Huawei представила архитектуру UnifiedBus для повышения производительности ИИ-кластеровHuawei объявила о разработке архитектуры интерконнекта нового поколения UnifiedBus (UB). Технология призвана решить проблемы скорости передачи данных в крупномасштабных вычислительных кластерах, ориентированных на ресурсоёмкие задачи ИИ. В традиционных системах для ЦОД эффективность использования ресурсов снижается по мере масштабирования платформы. Так, в кластере из 100 тыс. NPU фактически задействуется всего около 20 % доступной вычислительной мощности, в то время как оставшиеся ресурсы простаивают в ожидании данных, утверждает Huawei. Обучение модели с триллионами параметров требует передачи колоссальных объёмов промежуточных сведений, а современные ИИ-агенты регулярно генерируют запросы, создавая постоянную нагрузку на коммуникационные линии. Всё это приводит к необходимости гибкого перераспределения меняющейся нагрузки между CPU и NPU. Кроме того, резко возрастают требования к хранению данных на всех уровнях вычислительных платформ. В результате, недостаточная пропускная способность интерконнекта становится главным узким местом, ограничивающим производительность современных ИИ-кластеров. 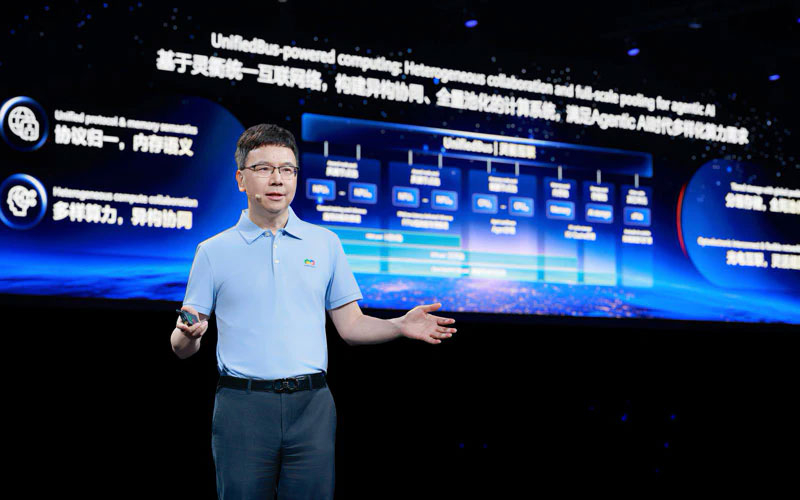
Источник изображения: Huawei Архитектура UnifiedBus позволяет устранить существующие недостатки, объединив более десяти различных протоколов и увеличив общую пропускную способность интерконнекта с примерно 100 Гбайт/с до уровня в несколько Тбайт/с, тогда как задержка (RTT) уменьшается с 7 до 2 мкс. Новая архитектура также предусматривает единую глобальную адресацию памяти внутри ИИ-узлов SuperPoD. Помимо этого, UnifiedBus напрямую соединяет CPU, NPU, RAM и SSD, обеспечивая децентрализованную одноранговую связь между ними и гибкое распределение имеющихся ресурсов. В рамках концепции UnifiedBus чипы DDR выступают в качестве альтернативной памяти для NPU, снижая задержки для поисковых, рекомендательных и других сервисов, а также удваивая производительность векторного поиска. При этом сокращаются требования к ёмкости HBM в составе ИИ-ускорителей. В целом, UnifiedBus служит глобальной «магистралью данных» со сверхвысокой пропускной способностью и малой задержкой, обеспечивая гибкое масштабирование вычислительных ресурсов. Специальный модуль интерконнекта UnifiedBus LinkBlade с бескабельным дизайном обеспечивает высокоскоростную связь внутри стоек вычислительного кластера. Утверждается, что в составе SuperPoD с 4096 NPU применение LinkBlade позволяет сэкономить около 196 км медных соединений. Для обмена данными между отдельными стойками решение UnifiedBus LinkDevice предлагает 176 портов с пропускной способностью 1,6 Тбит/с каждый, обеспечивая полностью оптическое соединение со скоростью 280 Тбит/с. При этом могут формироваться кластеры с миллионами NPU. Huawei продемонстрировала суперкластер для работы с агентным ИИ на базе UnifiedBus, который состоит из узлов SuperPoD TaiShan 950 и Atlas 960, хранилища данных OceanStor M900 и коммутатора Xinghe UBG. Эта платформа поддерживает многоуровневое объединение ресурсов, обеспечивая эффективную работу с различными нагрузками.
21.09.2026 [08:32], Сергей Карасёв
Huawei разработала модуль NPO с пропускной способностью до 7,2 Тбит/сКомпания Huawei, по сообщению The Register, продемонстрировала оптические модули NPO (Near-Packaged Optics), предназначенные для организации высокоскоростного интерконнекта в дата-центрах для ИИ-задач. В традиционных коммутаторах оптические блоки обычно располагаются на передней панели, а длина соединения от собственно чипа до собственно оптических компонентов довольно велика. Энергопотребление и тепловыделение таких решений увеличиваются с ростом скоростей передачи данных, что становится серьезной проблемой в свете активного внедрения стандартов 800 Гбит/с и 1,6 Тбит/с. Кроме того, длинные электрические трассы и интенсивная обработка сигналов в DSP приводят к увеличению задержек. 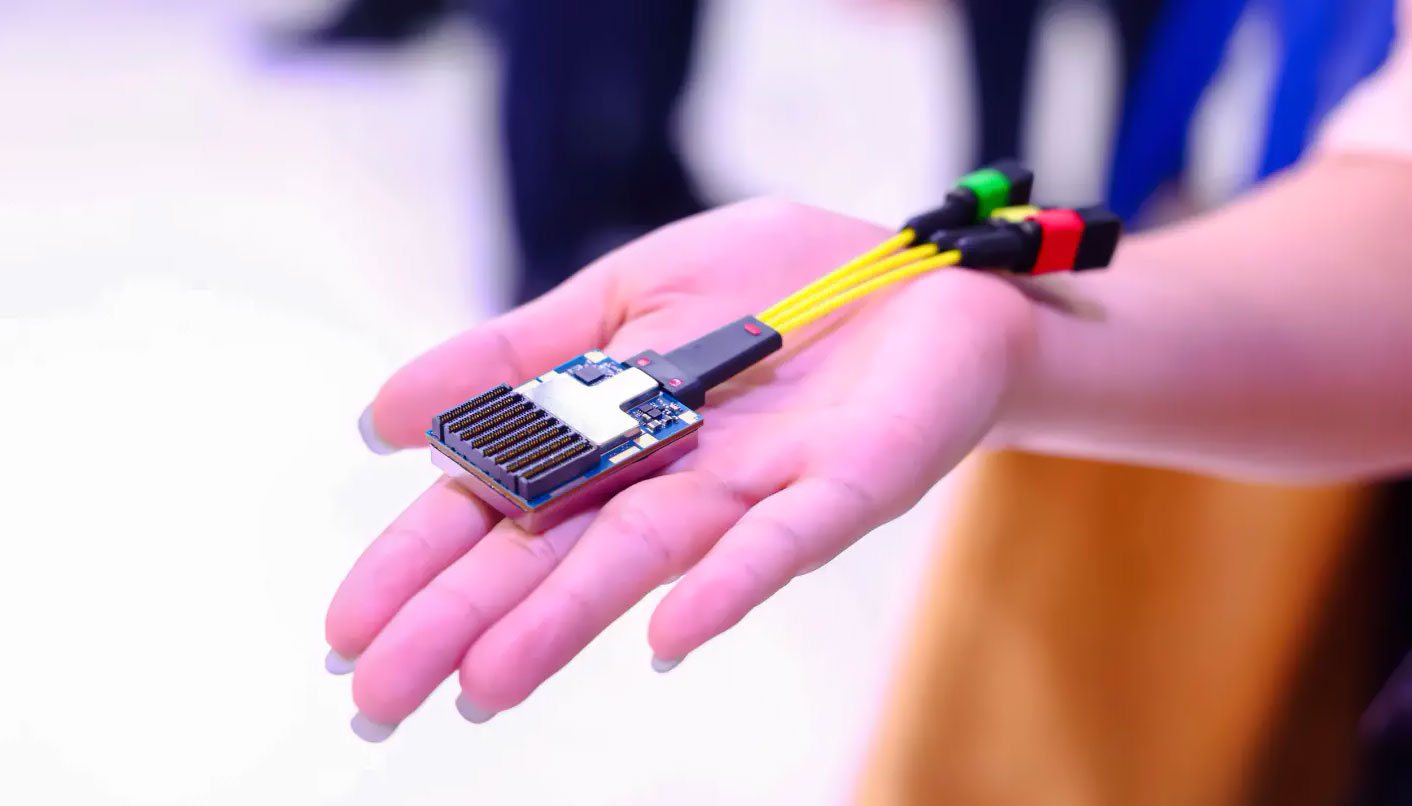
Источник изображения: The Register Одним из способов повышения эффективности является применение технологии CPO (Co-Packaged Optics). Она предполагает размещение оптического модуля на той же подложке, что и ASIC. Такой подход обеспечивает небольшие задержки и низкое энергопотребление, однако затрудняет замену вышедших из строя оптических модулей и значительно удорожает производство. В результате, возрастают эксплуатационные затраты в ЦОД. Платформа NPO, предложенная компанией Huawei, предусматривает монтаж оптического движка в виде отдельного компонента на плате рядом с ASIC. При этом конструкция NPO исключает необходимость в отдельном DSP-чипе — соответствующие функции интегрируются в ASIC. Таким образом, сохраняется возможность замены оптического модуля в случае его выхода из строя, тогда как задержки по сравнению с традиционными решениями снижаются со 100 до 10 нс, а энергопотребление уменьшается примерно на 60 %. В NPO-решении Huawei используются 36 линий 200G, что в сумме даёт 7,2 Тбит/с. Предполагается, что предложенная технология будет использоваться в следующих поколениях ИИ-узлов SuperPoD.
18.09.2026 [17:40], Владимир Мироненко
Вглубь и вширь: Cornelis анонсировала архитектуру Active Compute FabricCornelis представила Active Compute Fabric — открытую архитектуру, охватывающую сетевые системы класса scale-up (вертикальное масштабирование) и scale-out (горизонтальное масштабирование) и включающую встроенные средства программируемых вычислений. В настоящее время ИИ-кластеры выросли до многих тысяч GPU. Количество параметров в моделях увеличилось с миллиардов до триллионов. Однако фундаментальное поведение большинства сетей ЦОД не эволюционировало так быстро — они в основном перемещают данные из точки А в точку Б, обеспечивая максимально надёжную передачу. Современные рабочие ИИ-нагрузки не всегда ведут себя как традиционные HPC и другие распределённые приложения. В них доминируют синхронизация, коллективные операции и зависимости, а также значительный трафик между серверами (east-west). Когда сеть не справляется с огромными требованиями к пропускной способности таких рабочих нагрузок, ускорители часто простаивают, иногда в течение длительного времени. Проблему простоя поставщики пытаются решить преимущественно за счёт увеличения пропускной способности, а не изменения принципов работы самой сетевой инфраструктуры. «ИИ-инфраструктура достигла того этапа, когда одного лишь повышения быстродействия конечных узлов уже недостаточно. Сетевая фабрика должна стать активным компонентом вычислительной системы», — заявила Лиза Спелман (Lisa Spelman), генеральный директор Cornelis. 
Источник изображений: Cornelis Networks Архитектура Active Compute Fabric переносит программируемые вычислительные функции непосредственно на уровень сети. Сетевая фабрика может производить манипуляции над данными прямо во время передачи: собирать данные KV-кеша для дезагрегированного инференса, координировать распределение экспертов для моделей MoE, ускорять коллективные операции, такие как AllReduce, и сжимать градиенты при передаче, разгружая вычислительные узлы, уменьшая накладные расходы на синхронизацию и отвечая за целостность передачи данных. При этом она может брать на себя новые функции по мере развития алгоритмов ИИ и ПО. Нечто похожее, например, NVIDIA начала предлагать в InfiniBand несколько поколений назад (SHARP), но, по слухам, данная функциональность особой популярностью не пользуется. Cornelis опирается на открытые Ethernet-стандарты UALink для вертикального масштабирования и Ultra Ethernet — для горизонтального, что даёт поддержку широкого спектра ускорителей. Это важный фактор, поскольку компании всё больше диверсифицируют оборудование и технологии, используемые в своих ЦОД. Клиенты, использующие решения для ИИ, всё чаще обращаются к решениям стоечного масштаба, сталкиваясь при этом с проблемой привязки к конкретному поставщику, а Cornelis позиционирует себя как нейтральная, открытая альтернатива. Это явный кивок в сторону NVIDIA, хотя тот же UALink пока трудно назвать действительно зрелой технологией. 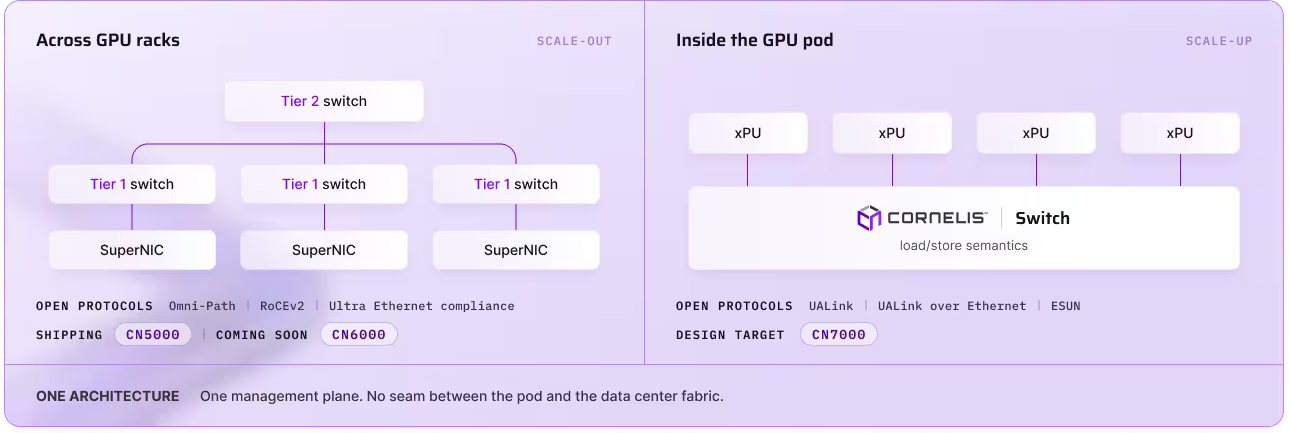 Видение Cornelis по поводу открытых и эффективных сетей, масштабируемых по принципу «масштабирование и расширение», разделяет Qualcomm, которая присоединилась к Cornelis на конференции AI Infra Summit. Cornelis отметила, что обе компании разделяют общее видение проблем, стоящих перед ИИ-инфраструктурой: использование пассивных сетевых архитектур, обеспечивающих лишь передачу данных, приводит к недогрузке вычислительных ускорителей, что напрямую сказывается на экономической эффективности процессов инференса. По мере перехода к созданию ИИ-систем стоечного масштаба, обе компании рассматривают сеть как ключевой элемент проектирования, а не как второстепенный компонент. Лиза Спелман отдельно отметила в интервью CRN схожесть подходов с Qualcomm: «Мы видим много общего в отношении проблем инфраструктуры ИИ, проблем, с которыми сталкиваются клиенты, и множество возможностей и потенциала для объединения наших технологий и решения этих проблем для клиентов <…> Мы считаем, что сейчас идеальное время для выхода на этот рынок. Ещё многое предстоит решить», — сказала Спелман. Как отметил CRN, проблема для Cornelis заключается в том, что NVIDIA более года продвигает свою собственную технологию интерконнекта NVLink Fusion как де-факто интерконнект для вертикального масштабирования. К альянсу уже присоединились Qualcomm, Arm, Marvell, Amazon, Fujitsu, Ayar, SiFive, Intel, d-Matrix и MediaTek. Это позволяет NVIDIA оставаться важнейшим поставщиком для рынка ИИ-инфраструктуры и открывает новый источник дохода. 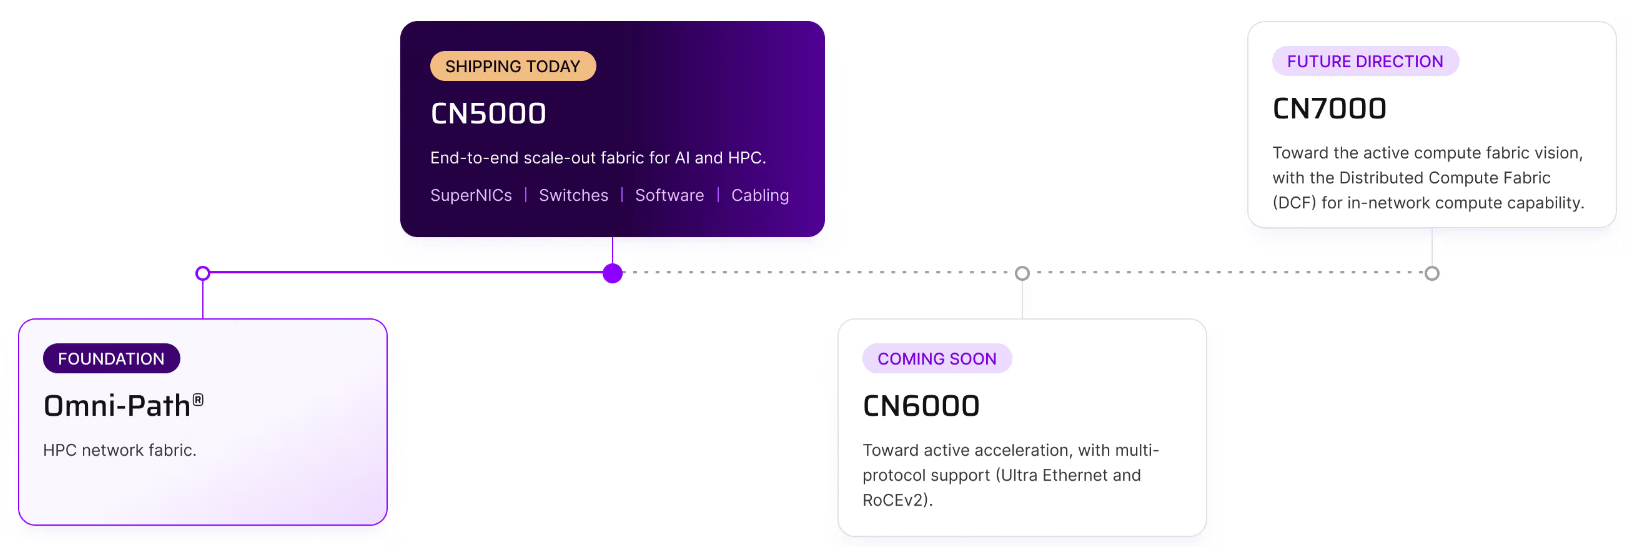 Cornelis также объявила о привлечении финансирования в размере $205 млн. Средства будут направлены на масштабирование производства, укрепление партнёрских отношений с клиентами и ускорение реализации планов по выводу продукции на рынок. Ресурс Forbes считает, что для компании в сегменте HPC-сетей такой уровень инвестиций значителен и свидетельствует о том, что рынок считает проблему узкого места в сетевых технологиях реальной, и что Cornelis продемонстрировала достаточный прогресс благодаря текущим внедрениям в ЦОД для ИИ и HPC, чтобы оправдать дальнейшее расширение. «Потенциал рынка сетевых решений на базе открытых стандартов для масштабирования ИИ (как вертикального, так и горизонтального) к 2030 году превысит $55 млрд. Мы убеждены, что именно сетевая инфраструктура будет определять, какая часть инвестиций в развёртывание систем ИИ принесёт реальную отдачу», — заявили в IAG Capital Partners.
11.09.2026 [09:44], Владимир Мироненко
d-Matrix присоединилась к альянсу NVLink Fusion, чтобы интегрировать свои ИИ-ускорители в экосистему NVIDIAРазработчик ИИ-ускорителей d-Matrix пополнил растущий список производителей чипов, лицензировавших технологию NVLink Fusion и эталонные стоечные решения компании NVIDIA. Стартап объявил, что новое соглашение о сотрудничестве позволит интегрировать его XPU в широко распространённую экосистему NVIDIA AI Factory. Финансовые условия сделки не раскрываются. В числе тех, кто также полагается на NVLink, уже есть Qualcomm, Arm, Marvell, Amazon, Fujitsu, Ayar, SiFive, Intel и MediaTek. В качестве партнёра по программе NVLink Fusion компания d-Matrix будет сотрудничать с NVIDIA для интеграции своих XPU нового поколения для задач инференса (начиная с Raptor) непосредственно в новейшую эталонную стоечную архитектуру NVIDIA, которая включает CPU Vera, коммутаторы NVLink, адаптеры ConnectX-9 SuperNIC/DPU BlueField-4 и решения Spectrum-X Ethernet. d-Matrix также сотрудничает с компанией Astera Labs — специализирующейся в области решений для межкомпонентных соединений в экосистеме NVIDIA NVLink Fusion, — для создания специализированных решений, обеспечивающих высокую пропускную способность и бесперебойную передачу данных. Стоечные решения d-Matrix на базе платформы MGX будут оснащены модульными бескабельными узлами, разработанными с использованием экосистемы и цепочки поставок NVIDIA, что обеспечит их быстрое беспроблемное развёртывание. 
Источник изображения: NVIDIA Как отметила d-Matrix, развёртывание автономных ИИ-агентов вызвало резкий рост спроса на инференс, и провайдеры ИИ-сервисов всё чаще выбирают системы со смешанной архитектурой, способные обеспечить экономическую эффективность, необходимую их клиентам. Система d-Matrix MGX разработана для ИИ-приложений, чувствительных к задержке: ИИ-помощников для написания кода, чат-ботов реального времени и голосовых агентов, для которых имеют большое значение интерактивность и высокая скорость работы. Система, созданная на базе NVIDIA MGX, расширяет возможности унифицированной архитектуры стоек, позволяя ИИ-фабрикам гибко подбирать вычислительные ресурсы под конкретную задачу. Используя принцип гетерогенной дезагрегации, операторы могут распределять нагрузку между XPU d-Matrix Raptor и CPU NVIDIA Vera Rubin, оптимизируя каждый этап инференса. Например, при генерации кода с помощью ИИ — GPU могут брать на себя ресурсоёмкий этап предварительного заполнения, тогда как XPU d-Matrix ускоряют критически важный для задержки этап декодирования (decode). Ожидается, что первые образцы XPU d-Matrix Raptor в составае MGX-стоек станут доступны в IV квартале 2027 года, а разработка самих Raptor должна завершиться к концу текущего года. 
Источник изображения: NVIDIA Новые системы будут объединять до 144 XPU Raptor в единую сеть NVLink с топологией «каждый с каждым» (All-to-All). Как сообщает The Register, на конференции Hot Chips в прошлом месяце компания сообщила, что каждая карта Raptor будет оснащена 32 Гбайт сверхбыстрой памяти DRAM с 3D-компоновкой (3D-stacked), обеспечивающей пропускную способность 100 Тбайт/с — это примерно в 4,5 раза больше, чем у ускорителя NVIDIA Rubin. Также есть возможность использовать стойку Raptor в качестве дополнения к стойкам NVIDIA Vera Rubin. «Прелесть этого решения в том, что мы берем узлы Raptor, подключаем их к той же архитектуре стойки NVL144 MGX, которая широко используется во многих ЦОД, и получаем мгновенный доступ к этим площадкам», — отметил Сид Шет (Sid Sheth), генеральный директор и соучредитель d-Matrix, о чём сообщил ресурс The Next Platform. Строго говоря, гибридные системы инференса на базе ASIC d-Matrix и традиционных GPU уже анонсировали Parasail и Gimlet Labs. 
Источник изображения: d-Matrix The Register сообщил, что XPU для d-Matrix NVL144 будут примерно вдвое меньше обычных карт Raptor, показанных на Hot Chips. Они получат 16 Гбайт памяти 3D-DRAM и с пропускной способностью около 50 Тбайт/с. При размещении 144 таких чипов в одной стойке общий объём памяти составит около 2,3 Тбайт, чего достаточно для моделей с более 4 трлн параметров при 4-бит точности, а пиковая агрегированная пропускная способность памяти (ПСП) достигнет примерно 7,2 Пбайт/с. ПСП является главным «узким местом» при выполнении инференса. Архитектура чипа Groq LPU, ориентированная на интенсивное использование SRAM, позволяет достичь скорости передачи данных 150 Тбайт/с на один чип, однако обратной стороной медали является низкая плотность размещения SRAM: на одном кристалле удаётся разместить лишь порядка 500 Мбайт памяти. Raptor обеспечивает схожий уровень ПСП при несоизмеримо большем объёме RAM. Это позволит использовать гораздо меньше чипов для работы одной модели. Если для модели с 1 трлн параметров при 8-бит точности может потребоваться более 2 тыс. Groq LPU, то системе d-Matrix будет достаточно всего 64 Raptor (или 32 при 4-бит точности). Как и LPU от Groq, чипы d-Matrix могут использоваться как автономно, так и в составе гетерогенных вычислительных систем. Чипы d-Matrix могут стать более доступным вариантом выхода на рынок для корпоративных клиентов, заинтересованных в сверхнизкой задержке при инференсе, поскольку для работы системы требуется меньшее количество вычислительных модулей (XPU). Как отметил The Register, NVIDIA настолько стремится привлечь клиентов в свою закрытую экосистему, что тратит для этого миллиарды долларов. MediaTek она заплатила $3,5 млрд, а привлечение Marvell обошлось ей в $2 млрд.
11.09.2026 [08:51], Владимир Мироненко
ЦОД как чип: Meta✴ и Panmnesia предложили CXL-фабрику размером с целый дата-центрКомпания Meta✴ и южнокорейский стартап Panmnesia, специализирующийся на разработке интерконнекта для ИИ-инфраструктур, представили архитектуру ИИ ЦОД нового поколения, в которой весь дата-центр функционирует как единый чип. Описание архитектуры опубликовано в журнале Nature Reviews Electrical Engineering (NREE), входящем в портфолио издательства Nature. В исследовании отмечено, что в современных дата-центрах ускорители внутри одной стойки могут взаимодействовать через высокоскоростные интерфейсы для вертикального масштабирования (scale-up), тогда как трафик, выходящий за пределы стойки, обычно опирается на более медленные сети с горизонтальным масштабированием (scale-out), такие как Ethernet или InfiniBand. 
Источник изображений: Panmnesia Компании отметили, что для эффективной работы ИИ ЦОД необходимы контроль и координация как внутри стоек с GPU, памятью и СХД, так и между ними. В масштабной ИИ-инфраструктуре снижение вариативности задержек (джиттера) между устройствами — чтобы весь ЦОД функционировал предсказуемо — имеет такое же значение, как и повышение производительности отдельных устройств или скорости каналов связи.  Meta✴ и Panmnesia предлагают взять за основу стандарт CXL, дополнив его новыми возможностями по объединению нескольких стоек с GPU для минимизации колебаний задержки при передаче данных за пределы каждой отдельной стойки. Конечная цель — создать дата-центр, работающий столь же предсказуемо, как отдельный чип. В этой схеме расширенный CXL обеспечивает когерентность кеш-памяти между стойками ускорителей, поддерживая большее количество устройств по сравнению со стоечными решениями NVIDIA уровня GB200 NVL72 (на базе NVLink) и UALink. Для минимизации и ограничения вариативности задержек предлагается использовать три специализированных аппаратных компонента: неблокирующий коммутатор с высокой плотностью портов, блок ускорения передачи данных и контроллер сетевой фабрики.  Неблокирующий коммутатор с большим количеством портов (high-fan-out) обеспечивает одновременное подключение множества устройств, сокращая количество переходов (hop) и выравнивая длину путей прохождения сигнала независимо от источника. Блок ускорения передачи (Link Acceleration Unit, LAU) переносит повторяющиеся операции обработки протокола в каждой точке соединения на специализированный аппаратный конвейер, обеспечивая стабильность системы на уровне отдельных этапов передачи и ограничивая колебания задержки.  Контроллер фабрики (Fabric Controller) применяет единую политику упорядочивания запросов во всей системе, обеспечивая согласованную обработку транзакций через все устройства. Для преодоления физических ограничений дальности передачи электрических сигналов рассматривается использование оптических каналов связи (CXL-over-optics) для увеличения радиуса действия фабрики CXL. Консорциум PCI-SIG уже работает над оптической версией PCIe, да и первые чипы тоже уже были анонсированы.  По словам Panmnesia, комбинированный контроллер фабрики CXL/PCIe и блок LAU уже прошли проверку работоспособности на кремниевых чипах; также изготовлен коммутатор фабрики, и начаты поставки предсерийных образцов. Архитектура решения предусматривает группировку CPU, ускорителей, памяти и коммутаторов по функциональному признаку в модули (узлы), объединение модулей в группы (поды) и объединение подов посредством коммутационной фабрики. Такая упорядоченная иерархия призвана обеспечить стабильные пути передачи данных с фиксированным количеством сетевых переходов и предсказуемыми временными характеристиками.  По сравнению с NVIDIA GB200 NVL72 данная схема:
«Объединение устройств такого масштаба в единую среду выполнения позволит обучать гораздо более крупные ИИ-модели без прерывания процесса или одновременно запускать несколько сервисов на общей инфраструктуре, исключая взаимное замедление их работы», — отметили компании. При этом платформы с PCIe/CXL-интерконнектом уровня стойки уже есть — например, Liqid UltraStack. |
|

