
Материалы по тегу: x
|
20.01.2025 [07:53], Владимир Мироненко
SRAM, да и только: d-Matrix готовит ИИ-ускоритель CorsairСтартап d-Matrix создал ИИ-ускоритель Corsair, оптимизированный для быстрого пакетного инференса больших языковых моделей (LLM). Архитектура ускорителя основана на модифицированных ячейках SRAM для вычислений в памяти (DIMC), работающих на скорости порядка 150 Тбайт/с. Новинка, по словам компании, отличается производительностью и энергоэффективностью, пишет EE Times. Массовое производство Corsair начнётся во II квартале. Среди инвесторов d-Matrix — Microsoft, Nautilus Venture Partners, Entrada Ventures и SK hynix. d-Matrix фокусируется на пакетном инференсе с низкой задержкой. В случае Llama3-8B сервер d-Matrix (16 четырёхчиплетных ускорителей в составе восьми карт) может производить 60 тыс. токенов/с с задержкой 1 мс/токен. Для Llama3-70B стойка d-Matrix (128 чипов) может производить 30 тыс. токенов в секунду с задержкой 2 мс/токен. Клиенты d-Matrix могут рассчитывать на достижение этих показателей для размеров пакетов порядка 48–64 (в зависимости от длины контекста), сообщила EE Times руководитель отдела продуктов d-Matrix Шри Ганесан (Sree Ganesan). 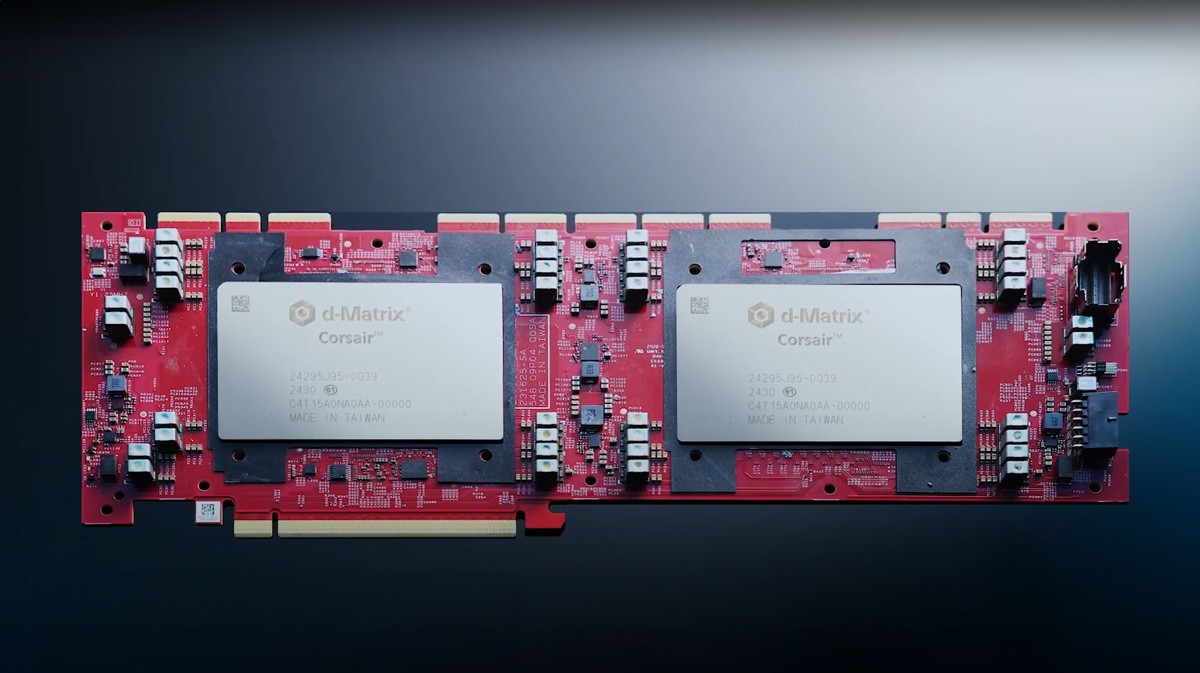
Источник изображений: d-Matrix Производительность оптимизирована для исполнения моделей в расчёте до 100 млрд параметров на одну стойку. По словам Ганесан, это реалистичный сценарий использования LLM. В таких сценариях решение d-Matrix обеспечивает 10-кратное преимущество в интерактивности (время до получения токена) по сравнению с решениями на базе традиционных ускорителей, таких как NVIDIA H100. Corsair ориентирован на модели размером менее 70 млрд параметров, подходящих для генерации кода, интерактивной генерации видео или агентского ИИ, которые требуют высокой интерактивности в сочетании с пропускной способностью, энергоэффективностью и низкой стоимостью.  Ранние версии архитектуры d-Matrix использовали MAC-блоки на базе SRAM-ячеек, дополненных большим количеством транзисторов для операций умножения. Сложение же выполнялось в аналоговом виде с использованием разрядных линий, измерения тока и аналого-цифрового преобразования. В 2020 году компания выпустила чиплетную платформу Nighthawk на основе этой архитектуры. «[Nighthawk] продемонстрировал, что мы можем значительно повысить точность по сравнению с традиционными аналоговыми решениями, но мы всё ещё отстаем на пару процентных пунктов от традиционных решений типа GPU», — сказал EE Times генеральный директор d-Matrix Сид Шет (Sid Sheth). 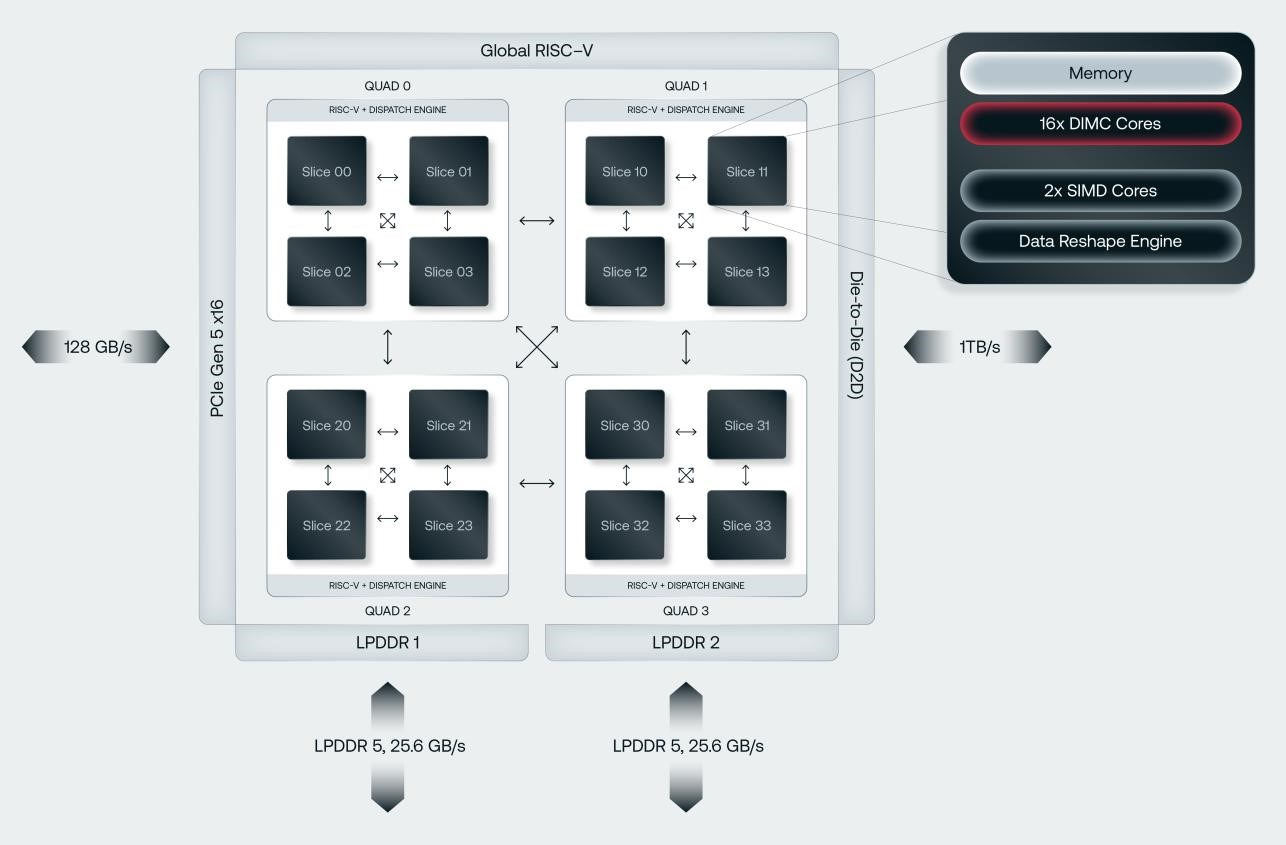 Однако потенциальным клиентам не понравилось, что при таком подходе возможно снижение точности, так что в Corsair компания вынужденно сделала выбор в пользу полностью цифрового сумматора. ASIC d-Matrix включает четыре чиплета, каждый из которых содержит по четыре вычислительных блока, объединённых посредством DMX Link по схеме каждый-с-каждым, и по одному планировщику и RISC-V ядру. Внутри каждого вычислительного блока есть 16 DIMC-ядер, состоящих из наборов SRAM-ячеек (64×64), а также два SIMD-ядра и движок преобразования данных. Суммарно доступен 1 Гбайт SRAM с пропускной способностью 150 Тбайт/с. 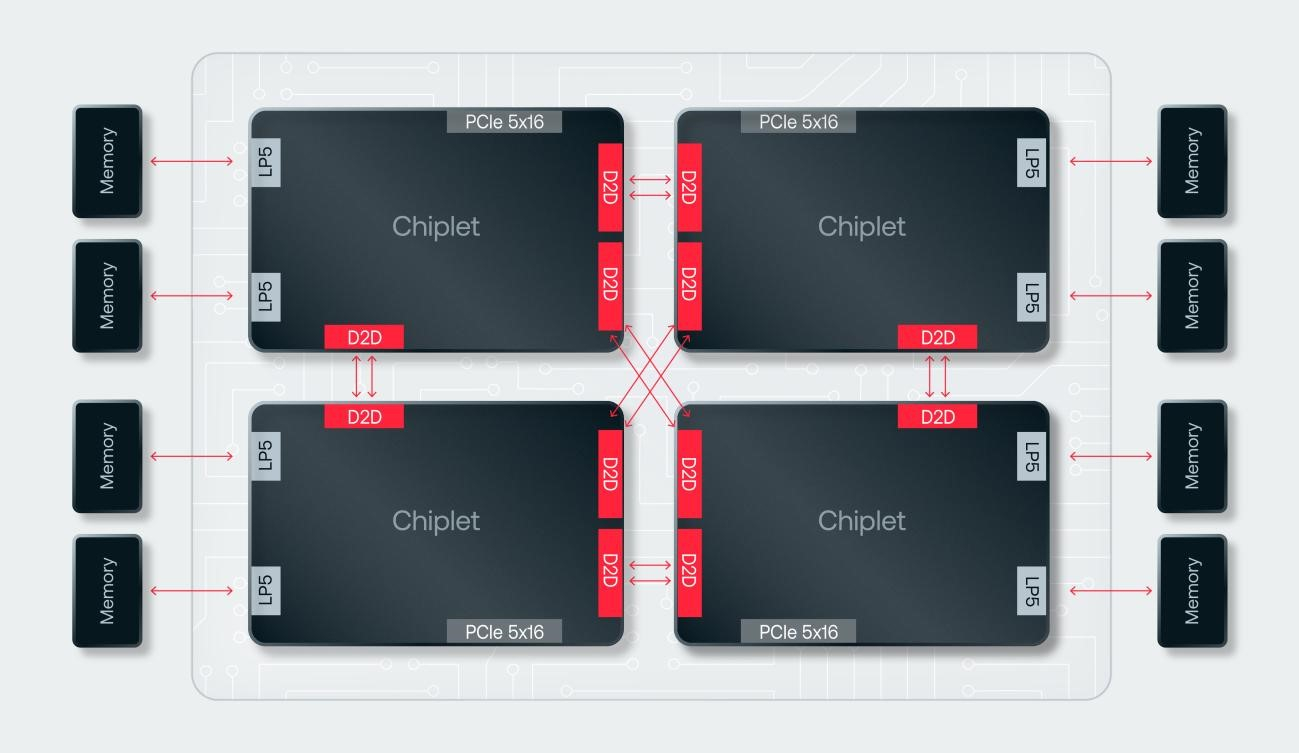 ASIC объединён со 128 Гбайт LPDDR5 (до 400 Гбайт/с) посредством органической подложки (без дорогостоящего кремниевого интерпозера). Хотя текущее поколение ASIC включает только четыре чиплета именно из-за ограничений подложки, в будущем их количество увеличится. Внешние интерфейсы ASIC представлены стандартным PCIe 5.0 x16 (128 Гбайт/с) и фирменным интерконнектом DMX Link (1 Тбайт/с) для объединения чиплетов. 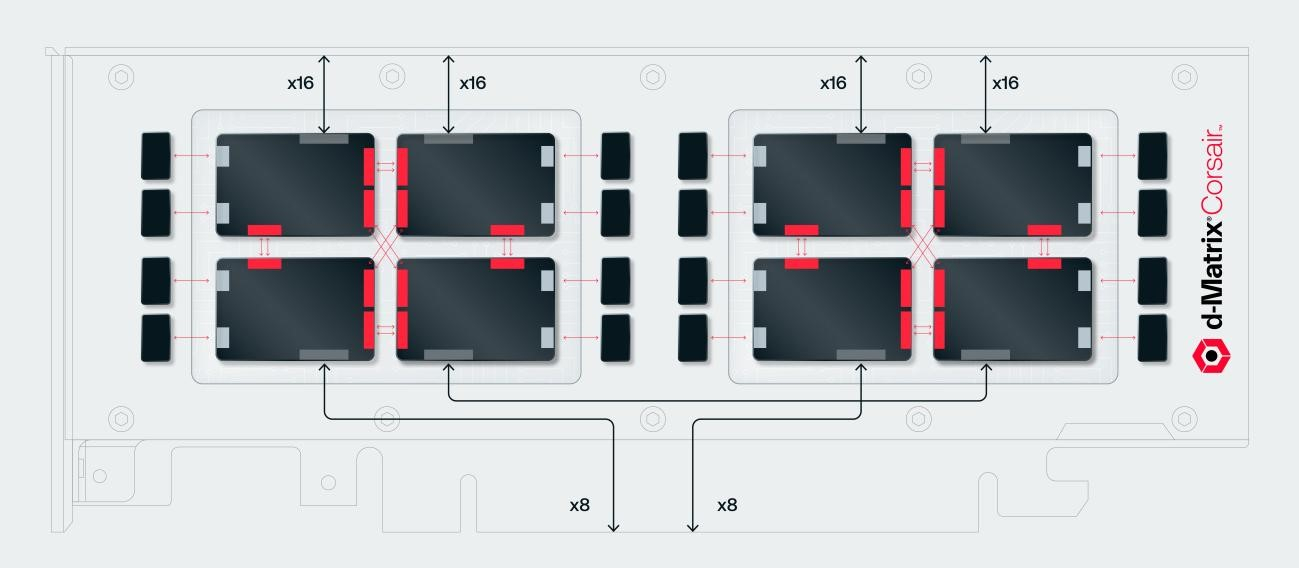 FHFL-карта Corsair включает два ASIC d-Matrix (т.е. всего восемь чиплетов) и имеет TDP на уровне 600 Вт. Ускоритель работает с форматами данных OCP MX (Microscaling Formats) и обеспечивает до 2400 Тфлопс в MXINT8-вычислениях или 9600 Тфолпс в случае MXINT4. Две карты Corsair можно объединить посредством 512-Гбайт/с мостика DMX Bridge. Их, по словам компании, достаточно для задействования тензорного параллелизма. Дальнейшее масштабирование возможно посредством PCIe-коммутации. Именно поэтому d-Matrix работает с GigaIO и Liqid. В одно шасси можно поместить восемь карт Corsair, а в стойку, которая будет потреблять порядка 6–7 кВт — 64 карты. 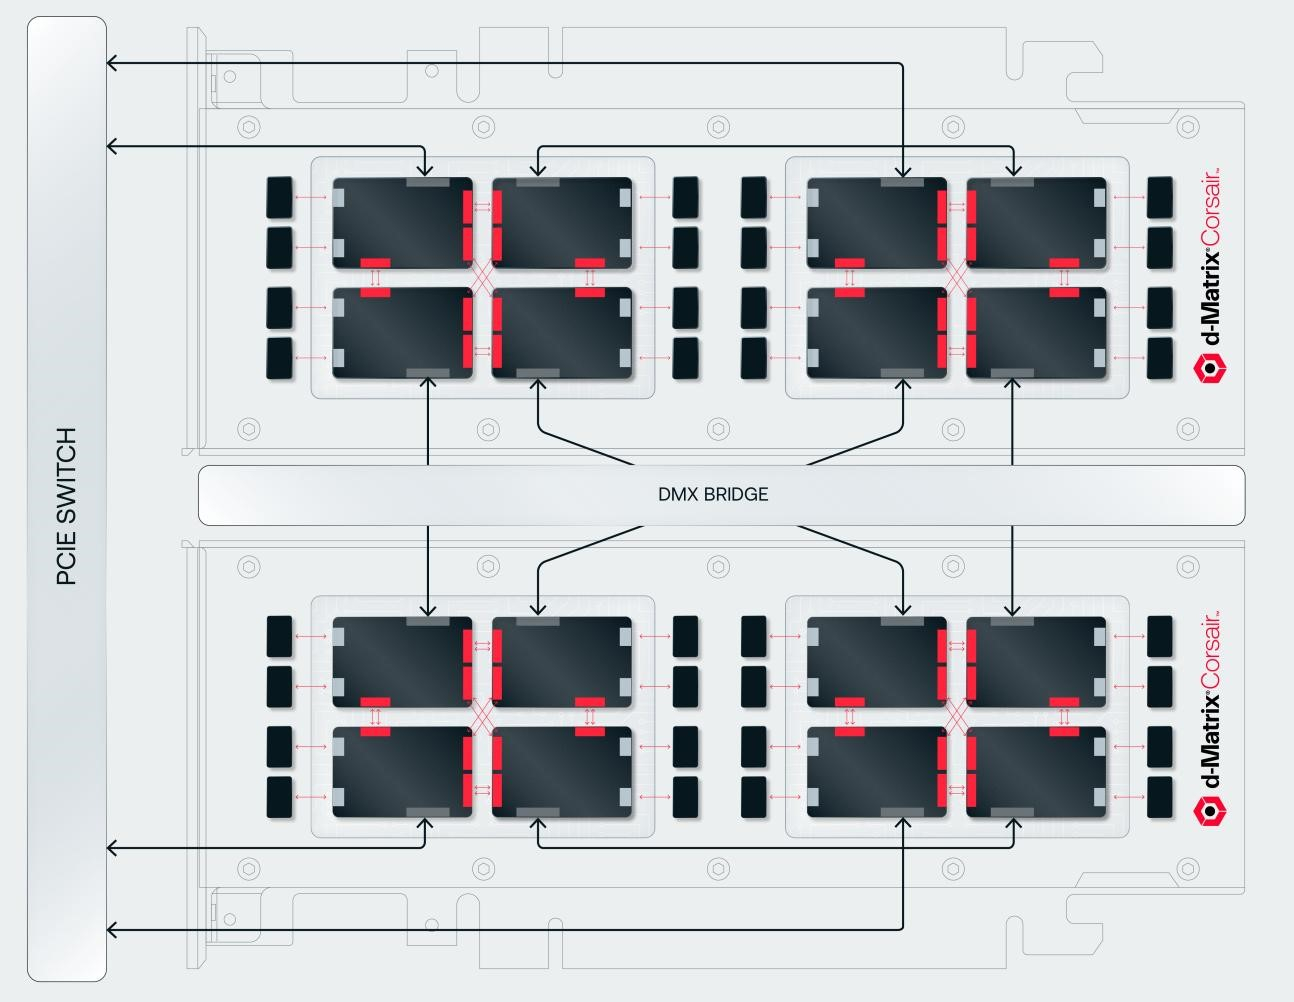 d-Matrix уже разрабатывает ASIC следующего поколения Raptor, который должен выйти в 2026 году. Raptor будет ориентирован на «думающие» модели и получит ещё больше памяти за счёт размещения DRAM непосредственно поверх вычислительных чиплетов. SRAM-чиплеты Raptor также перейдут с 6-нм техпроцесса TSMC, который используется при изготовлении Corsair, к 4 нм без существенных изменений микроархитектуры. По словам компании, она потратила два года на работу с TSMC, чтобы создать 3D-упаковку для нового поколения ASIC. 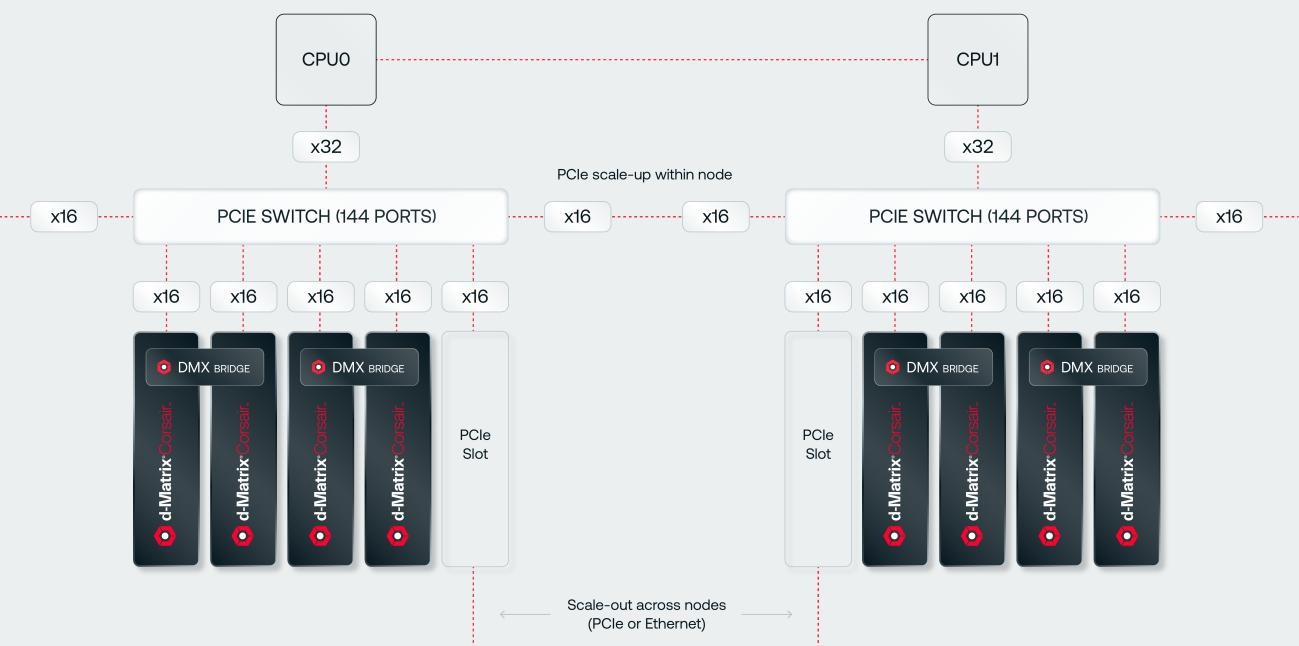 Как отмечает EETimes, команда разработчиков ПО d-Matrix в два раза больше команды разработчиков оборудования (120 против 60). Стратегия компании в области ПО заключается в максимальном использовании open source экосистемы, включая PyTorch, OpenAI Triton, MLIR, OpenBMC и т.д. Вместе они образуют программный стек Aviator, который отвечает за конвертацию моделей в числовые форматы d-Matrix, применяет к ним фирменные методы разрежения, компилирует их, распределяет нагрузку по картам и серверам, а также управляет исполнением моделей, включая обслуживание большого количества запросов.
16.01.2025 [13:10], Сергей Карасёв
Плата Jetway MTX-MTH1 формата Thin Mini-ITX получила чип Intel Core Ultra 5/7, три порта 2.5GbE и слот PCIe 5.0 x8Компания Jetway анонсировала плату MTX-MTH1 типоразмера Thin Mini-ITX, предназначенную для создания встраиваемых систем, периферийного оборудования, устройств промышленной автоматизации, ИИ-платформ и пр. Новинка имеет широкий диапазон рабочих температур — от -20 до +60 °C. Плата изначально комплектуется процессором Intel поколения Meteor Lake: это может быть чип Core Ultra 7 155H или Core Ultra 5 125H с графикой Intel Arc Graphics. Установлен кулер с довольно крупным радиатором и вентилятором. Доступны два слота SO-DIMM для модулей DDR5-5600 суммарным объёмом до 96 Гбайт. Новинка располагает полноразмерным слотом PCIe 5.0 x8, разъёмом M.2 M-Key 2242 (PCIe 4.0 x4) для NVMe SSD, коннектором M.2 M-Key 2242/2280 (PCIe 4.0 x4 / SATA-3) для ещё одного SSD (NVMe или SATA), разъёмом M.2 B-Key 3042/3052 (PCIe 3.0 x1 / USB 3.2 Gen2 / USB 2.0 плюс Nano SIM) для модема 4G/5G, а также коннектором M.2 E-Key 2230 (USB 2.0 / PCIe x1) для адаптера Wi-Fi/Bluetooth. Накопитель также может быть подключён к порту SATA-3. 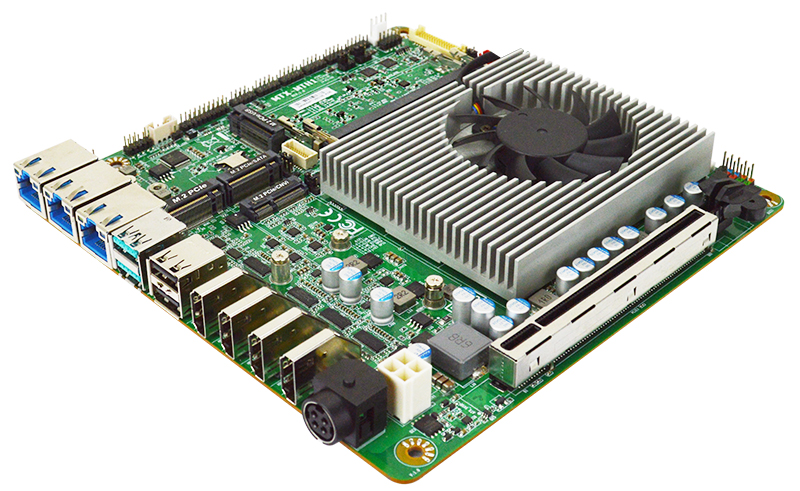
Источник изображения: Jetway Плата получила три сетевых порта 2.5GbE, один из которых реализован на контроллере Intel I226-LM, два других — на базе Intel I226-V. В основу аудиосистемы положен кодек Realtek Audio. Допускается вывод изображения одновременно на четыре дисплея через порты HDMI 2.1 (до 7680 × 4320 точек, 60 Гц). Кроме того, присутствует интерфейс LVDS (1920 × 1200 пикселей, 60 Гц). Предусмотрены по два порта USB 3.2 Gen 2×1 Type-A (10Gbps) и USB 2.0 Type-A. Через коннекторы на плате можно задействовать два порта USB 3.2 и четыре порта USB 2.0, четыре последовательных порта RS-232 и два RS-232/422/485. Имеется колодка GPIO. Питание (12–36 В) подаётся через разъём DC. Размеры платы составляют 170 × 170 мм. Говорится о совместимости с Windows 10/11 и Linux.
28.12.2024 [01:55], Владимир Мироненко
Дороже, но втрое эффективнее: NVIDIA готовит ускорители GB300 с 288 Гбайт HBM3E и TDP 1,4 кВтNVIDIA выпустила новые ускорители GB300 и B300 всего через шесть месяцев после выхода GB200 и B200. И это не минорное обновление, как может показаться на первый взгляд — появление (G)B300 приведёт к серьёзной трансформации отрасли, особенно с учётом значительных улучшений в инференсе «размышляющих» моделей и обучении, пишет SemiAnalysis. При этом с переходом на B300 вся цепочка поставок меняется, и от этого кто-то выиграет, а кто-то проиграет. Конструкция вычислительного кристалла B300 (ранее известного как Blackwell Ultra), изготавливаемого с использованием кастомного техпроцесса TSMC 4NP. Благодаря этому он обеспечивает на 50 % больше Флопс (FP4) по сравнению с B200 на уровне продукта в целом. Часть прироста производительности будет получена за счёт увеличения TDP, достигающим 1,4 кВт и 1,2 кВт для GB300 и B300 HGX соответственно (по сравнению с 1,2 кВт и 1 кВт для GB200 и B200). Остальное повышение производительности связано с архитектурными улучшениями и оптимизациями на уровне системы, такими как динамическое распределение мощности между CPU и GPU. Кроме того, в B300 применяется память HBM3E 12-Hi, а не 8-Hi, ёмкость которой выросла до 288 Гбайт. Однако скорость на контакт осталась прежней, так что суммарная пропускная способность памяти (ПСП) по-прежнему составляет 8 Тбайт/с. В качестве системной памяти будут применяться модули LPCAMM. Разница в производительности и экономичности из-за увеличения объёма HBM намного больше, чем кажется. Усовершенствования памяти имеют решающее значение для обучения и инференса больших языковых моделей (LLM) в стиле OpenAI O3, поскольку более длинные последовательности токенов негативно влияют на скорость обработки и задержку. 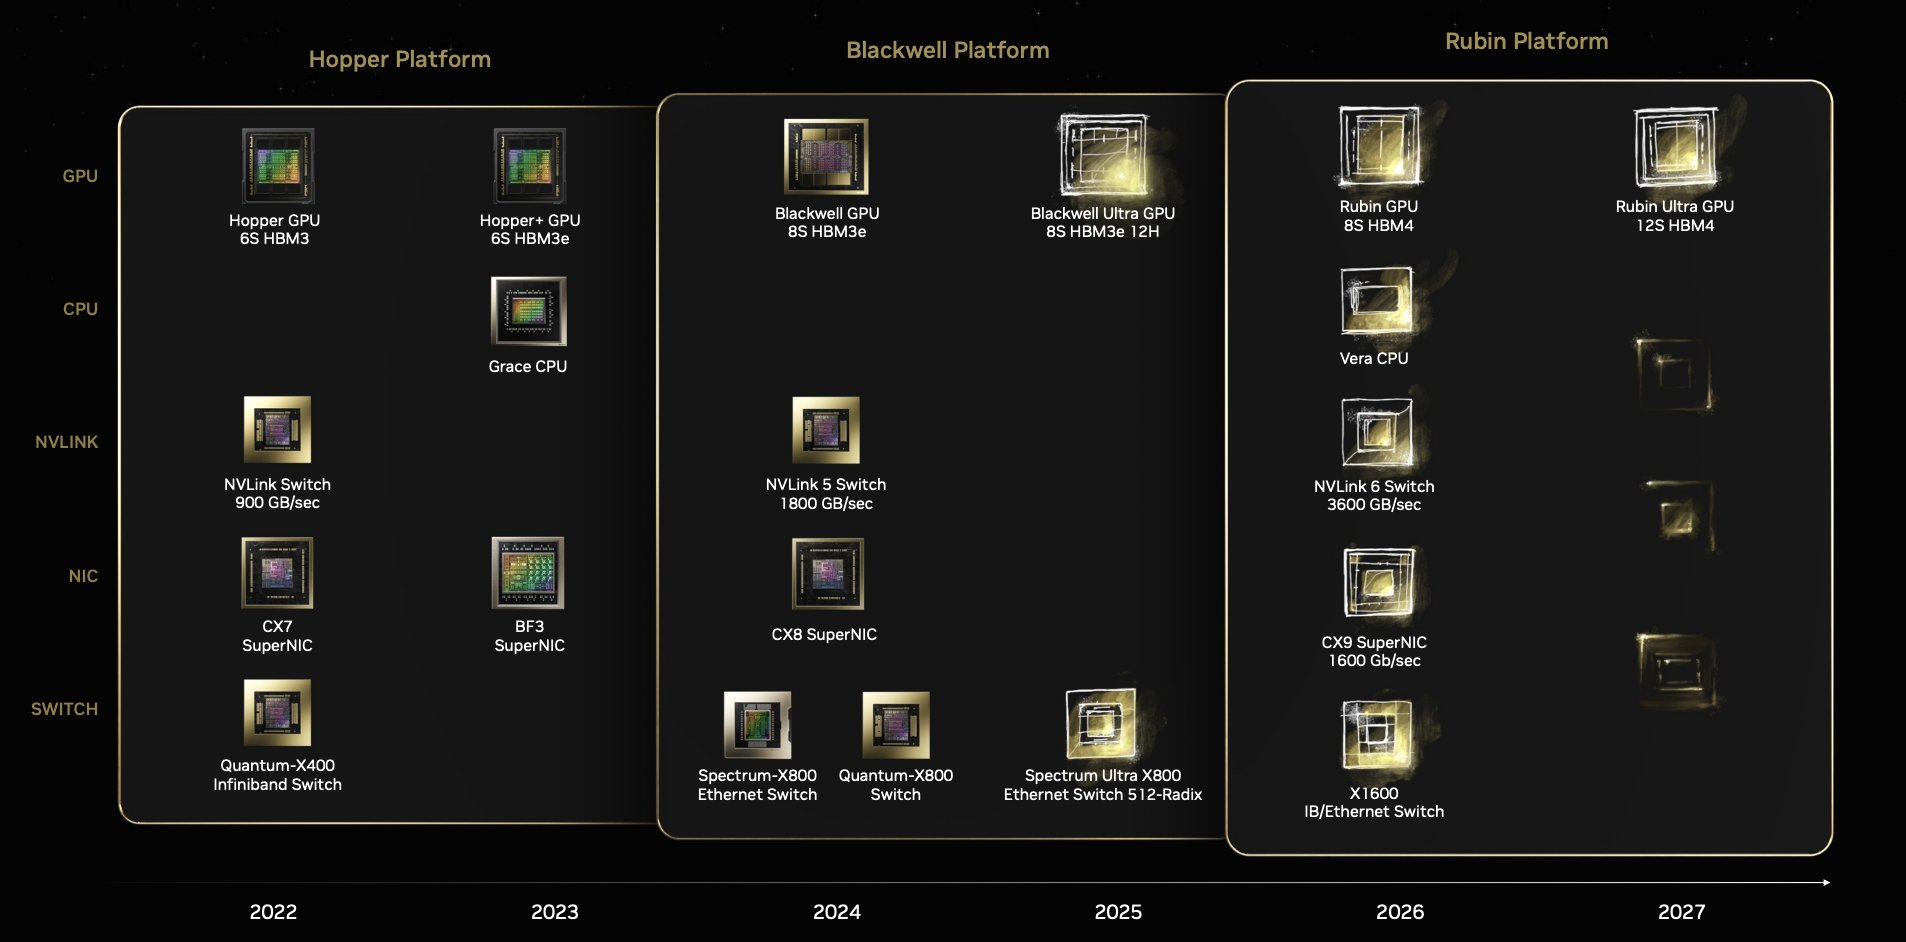
Источник изображения: NVIDIA На примере обновления H100 до H200 хорошо видно, как память влияет на производительность ускорителя. Более высокая ПСП (H200 — 4,8 Тбайт/с, H100 — 3,35 Тбайт/с) в целом улучшила интерактивность в инференсе на 43 %. А большая ёмкость памяти снизила объём перемещаемых данных и увеличила допустимый размер KVCache, что увеличило количество генерируемых токенов в секунду втрое. Это положительно сказывается на пользовательском опыте, что особенно важно для всё более сложных и «умных» моделей, которые могут приносить больше дохода с каждого ускорителя. Валовая прибыль от использования передовых моделей превышает 70 %, тогда как для отстающих моделей в конкурентной open source среде она составляет менее 20 %. 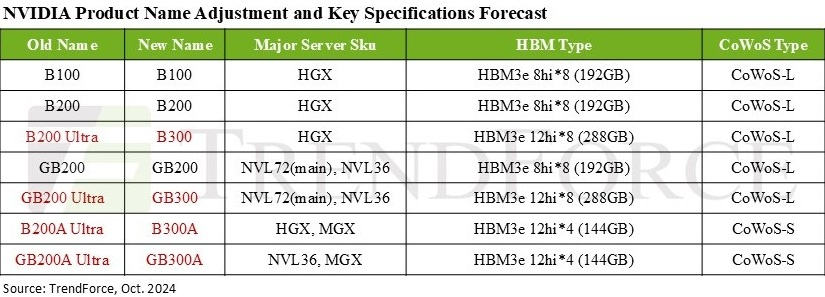
Источник изображения: TrendForce Однако одного наращивания скорости и памяти, как это делает AMD в Instinct MI300X (192 Гбайт), MI325X и MI355X (256 Гбайт и 288 Гбайт соответственно), мало. И дело не в том, что забагованное ПО компании не позволяет раскрыть потенциал ускорителей, а в особенности общения ускорителей между собой. Только NVIDIA может предложить коммутируемое соединение «все ко всем» посредством NVLink. В GB200 NVL72 все 72 ускорителя могут совместно работать над одной и той же задачей, что повышает интерактивность, снижая задержку для каждой цепочки размышлений и в то же время увеличивая их максимальную длину. На практике NVL72 — единственный способ увеличить длину инференса до более чем 100 тыс. токенов и при этом экономически эффективный, говорит SemiAnalysis. По оценкам, GB300 NVL72 обойдётся заказчиками минимум в $7,5 млн, тогда как GB200 NVL72 стоил порядка $3 млн.
27.12.2024 [12:40], Сергей Карасёв
Плата lowRISC Sonata v1.0 с системой защиты памяти CHERIoT объединяет FPGA AMD Artix-7 и микроконтроллер Raspberry Pi RP2040Участники проекта lowRISC по созданию 64-бит чипов RISC-V, как сообщает ресурс CNX Software, анонсировали аппаратную платформу Sonata v1.0 для разработчиков встраиваемых систем и всевозможных устройств Интернета вещей (IoT). Новинка поддерживает технологию CHERIoT (Capability Hardware Extension to RISC-V for IoT). Напомним, летом уходящего года lowRISC, а также Capabilities Limited, Codasip, FreeBSD Foundation, SCI Semiconducto и Кембриджский университет создали альянс CHERI для продвижения средств надёжной защиты памяти от атак. Специальные механизмы исключают ряд потенциальных уязвимостей, таких как переполнение буфера или некорректная работа с указателями. Отмечалось, что первыми новую технологию могут получить процессоры RISC-V. В основе платформы Sonata v1.0 лежит FPGA AMD Xilinx Artix-7 (XC7A35T-1CSG324C). Изделие содержит Soft-процессорное ядро AMD MicroBlaze с архитектурой RISC и 400 Кбайт распределённой памяти RAM. Ещё одной составляющей платы является микроконтроллер Raspberry Pi RP2040 (два ядра Cortex-M0+ с частотой 133 МГц), который отвечает за IO-функции. Есть 64 Мбит памяти HyperRAM (Winbond W956D8MBYA5I), 256 Мбит памяти SPI-флеш (Winbond W25Q256JVEIQ) для FPGA AMD Artix-7 или Raspberry Pi RP2040, ещё 64 Мбит SPI-флеш (Winbond W25Q64JVZEIQ) для RP2040 и 256 Мбит памяти SPI-флеш (Winbond W25Q256JVEIQ) для FPGA. 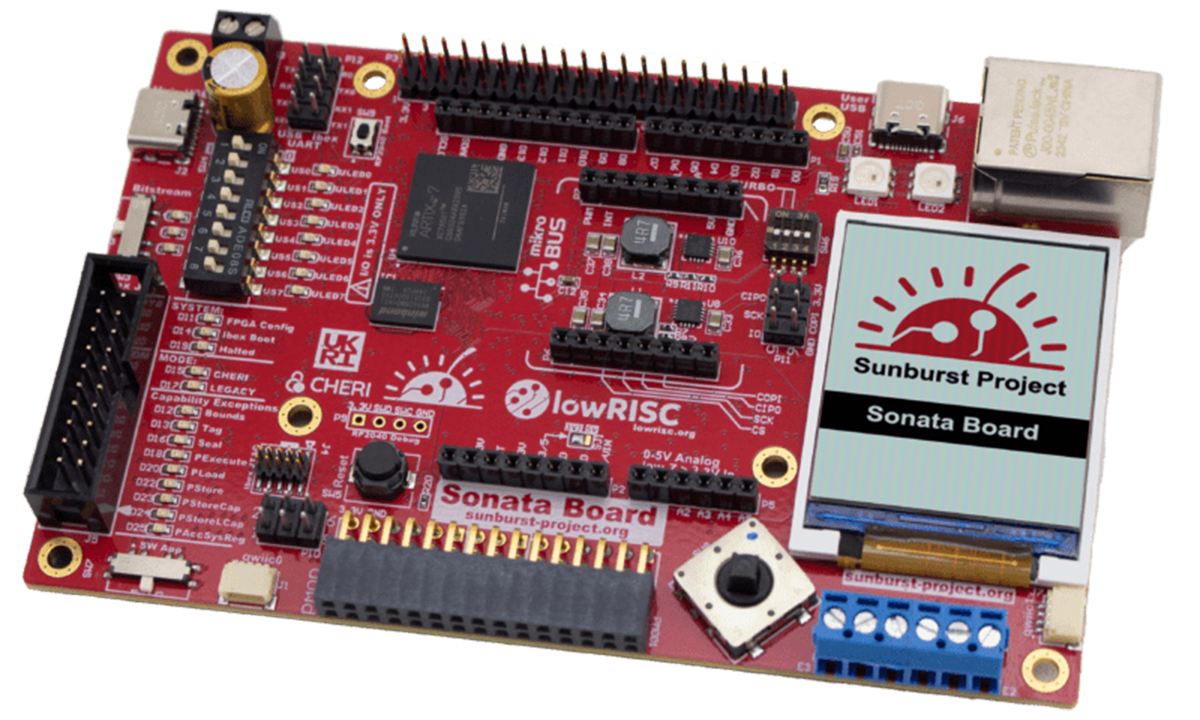
Источник изображения: lowRISC В арсенале Sonata v1.0 — встроенный цветной ЖК-дисплей с диагональю 1,8″, сетевой порт 10/100MbE, два разъёма USB Type-C (для программирования и подачи питания) и слот microSD. Реализованы последовательные интерфейсы RS-232 и RS-485, 40-контактный разъём Raspberry Pi, две 10-контактные колодки Ibex JTAG, две 4-контактные колодки Ibex UART и пр. Размеры составляют 125 × 80 мм. Разработчики могут получить доступ к подробной документации и дополнительным ресурсам на сайтах lowRISC и GitHub, чтобы в полной мере использовать возможности платформы Sonata v1.0. Цена новинки — примерно $413.
26.12.2024 [16:50], Руслан Авдеев
Equinix предложил ИИ-фабрики на базе систем Dell с ускорителями NVIDIAОператор ЦОД Equinix совместно с Dell Technologies предложил частные ИИ-облака на базе Dell AI Factory. Использование комплекса Dell AI Factory with NVIDIA в ЦОД IBX позволяет комбинировать различные продукты, решения и сервисы на нейтральной площадке, где клиенты смогут безопасно и экономически эффективно объединить ресурсы публичных облаков, колокейшн-объектов, а также собственных облачных и локальных инфраструктур. Dell AI Factory with NVIDIA включает серверы Dell PowerEdge XE9680 с ускорителями NVIDIA, Ethernet-решения NVIDIA Spectrum-X и BlueField-3, а также СХД Dell PowerScale F710. Кроме того, будут доступны и 4U-серверы PowerEdge XE9680L, поддерживающие до восьми новейших ускорителей NVIDIA Blackwell. Решение будет доступно в более чем 260 ЦОД Equinix IBX. В Equinix объявили, что намерены обеспечить клиентов передовой ИИ-инфраструктурой, отвечающей самым высоким стандартам производительности, безопасности и надёжности, а сотрудничество с Dell и NVIDIA позволит использовать максимум ресурсов систем генеративного ИИ, сохраняя контроль над данными и поддерживая собственные корпоративные цели достижения экоустойчивости. 
Источнки изображения: Dell Наличие площадок Equinix в более 70 мегаполисах мира, время бесперебойной работы 99,999 %, масштабируемость проектов и сотрудничество с тысячами сетей и провайдеров, а также обеспечение ЦОД на 96 % возобновляемой энергией (100 % на ключевых рынках) в сочетании с платформой Dell AI Factory with NVIDIA, которая уже доступна в ЦОД Equinix в большинстве регионов мира, позволит заказчикам повысить удобство, безопасность и экологичность работы с генеративным ИИ.
25.12.2024 [14:00], Владимир Мироненко
Linux Foundation сократила расходы на разработку ядра Linux до $6,8 млнОрганизация Foundation опубликовала отчёт за 2024 год. Всего за отчётный период организация получила $292,2 млн (год назад — $263,6 млн). Почти половина (43 % или $125,1 млн) полученных средств приходится на пожертвования и взносы участников организации. В прошлом году по этой статье было получено $118,2 млн. 25,1 % ($73,6 млн, год назад — $67 млн) было выделено организации в качестве целевой поддержка проектов; 18,6 % ($54,5 млн, год назад — $49,5 млн) приходится на поддержку мероприятий, а также регистрационные взносы на конференциях; 12,3 % ($36,1 млн, год назад — $27,2 млн) получено в качестве оплаты за обучающие курсы и получение сертификатов. Организация отметила, что доля затрат, связанных с разработкой ядра, в общем объёме расходов снизилась до 2,3 % с 2,9 % в 2023 году. В 2022 доля составляла 3,2 %, в 2021 году — 3,4 %. На разработку ядра Linux в этом году было израсходовано $6,8 млн, что на $1 млн меньше, чем в прошлом году и на $1,4 млн меньше, чем в позапрошлом году. 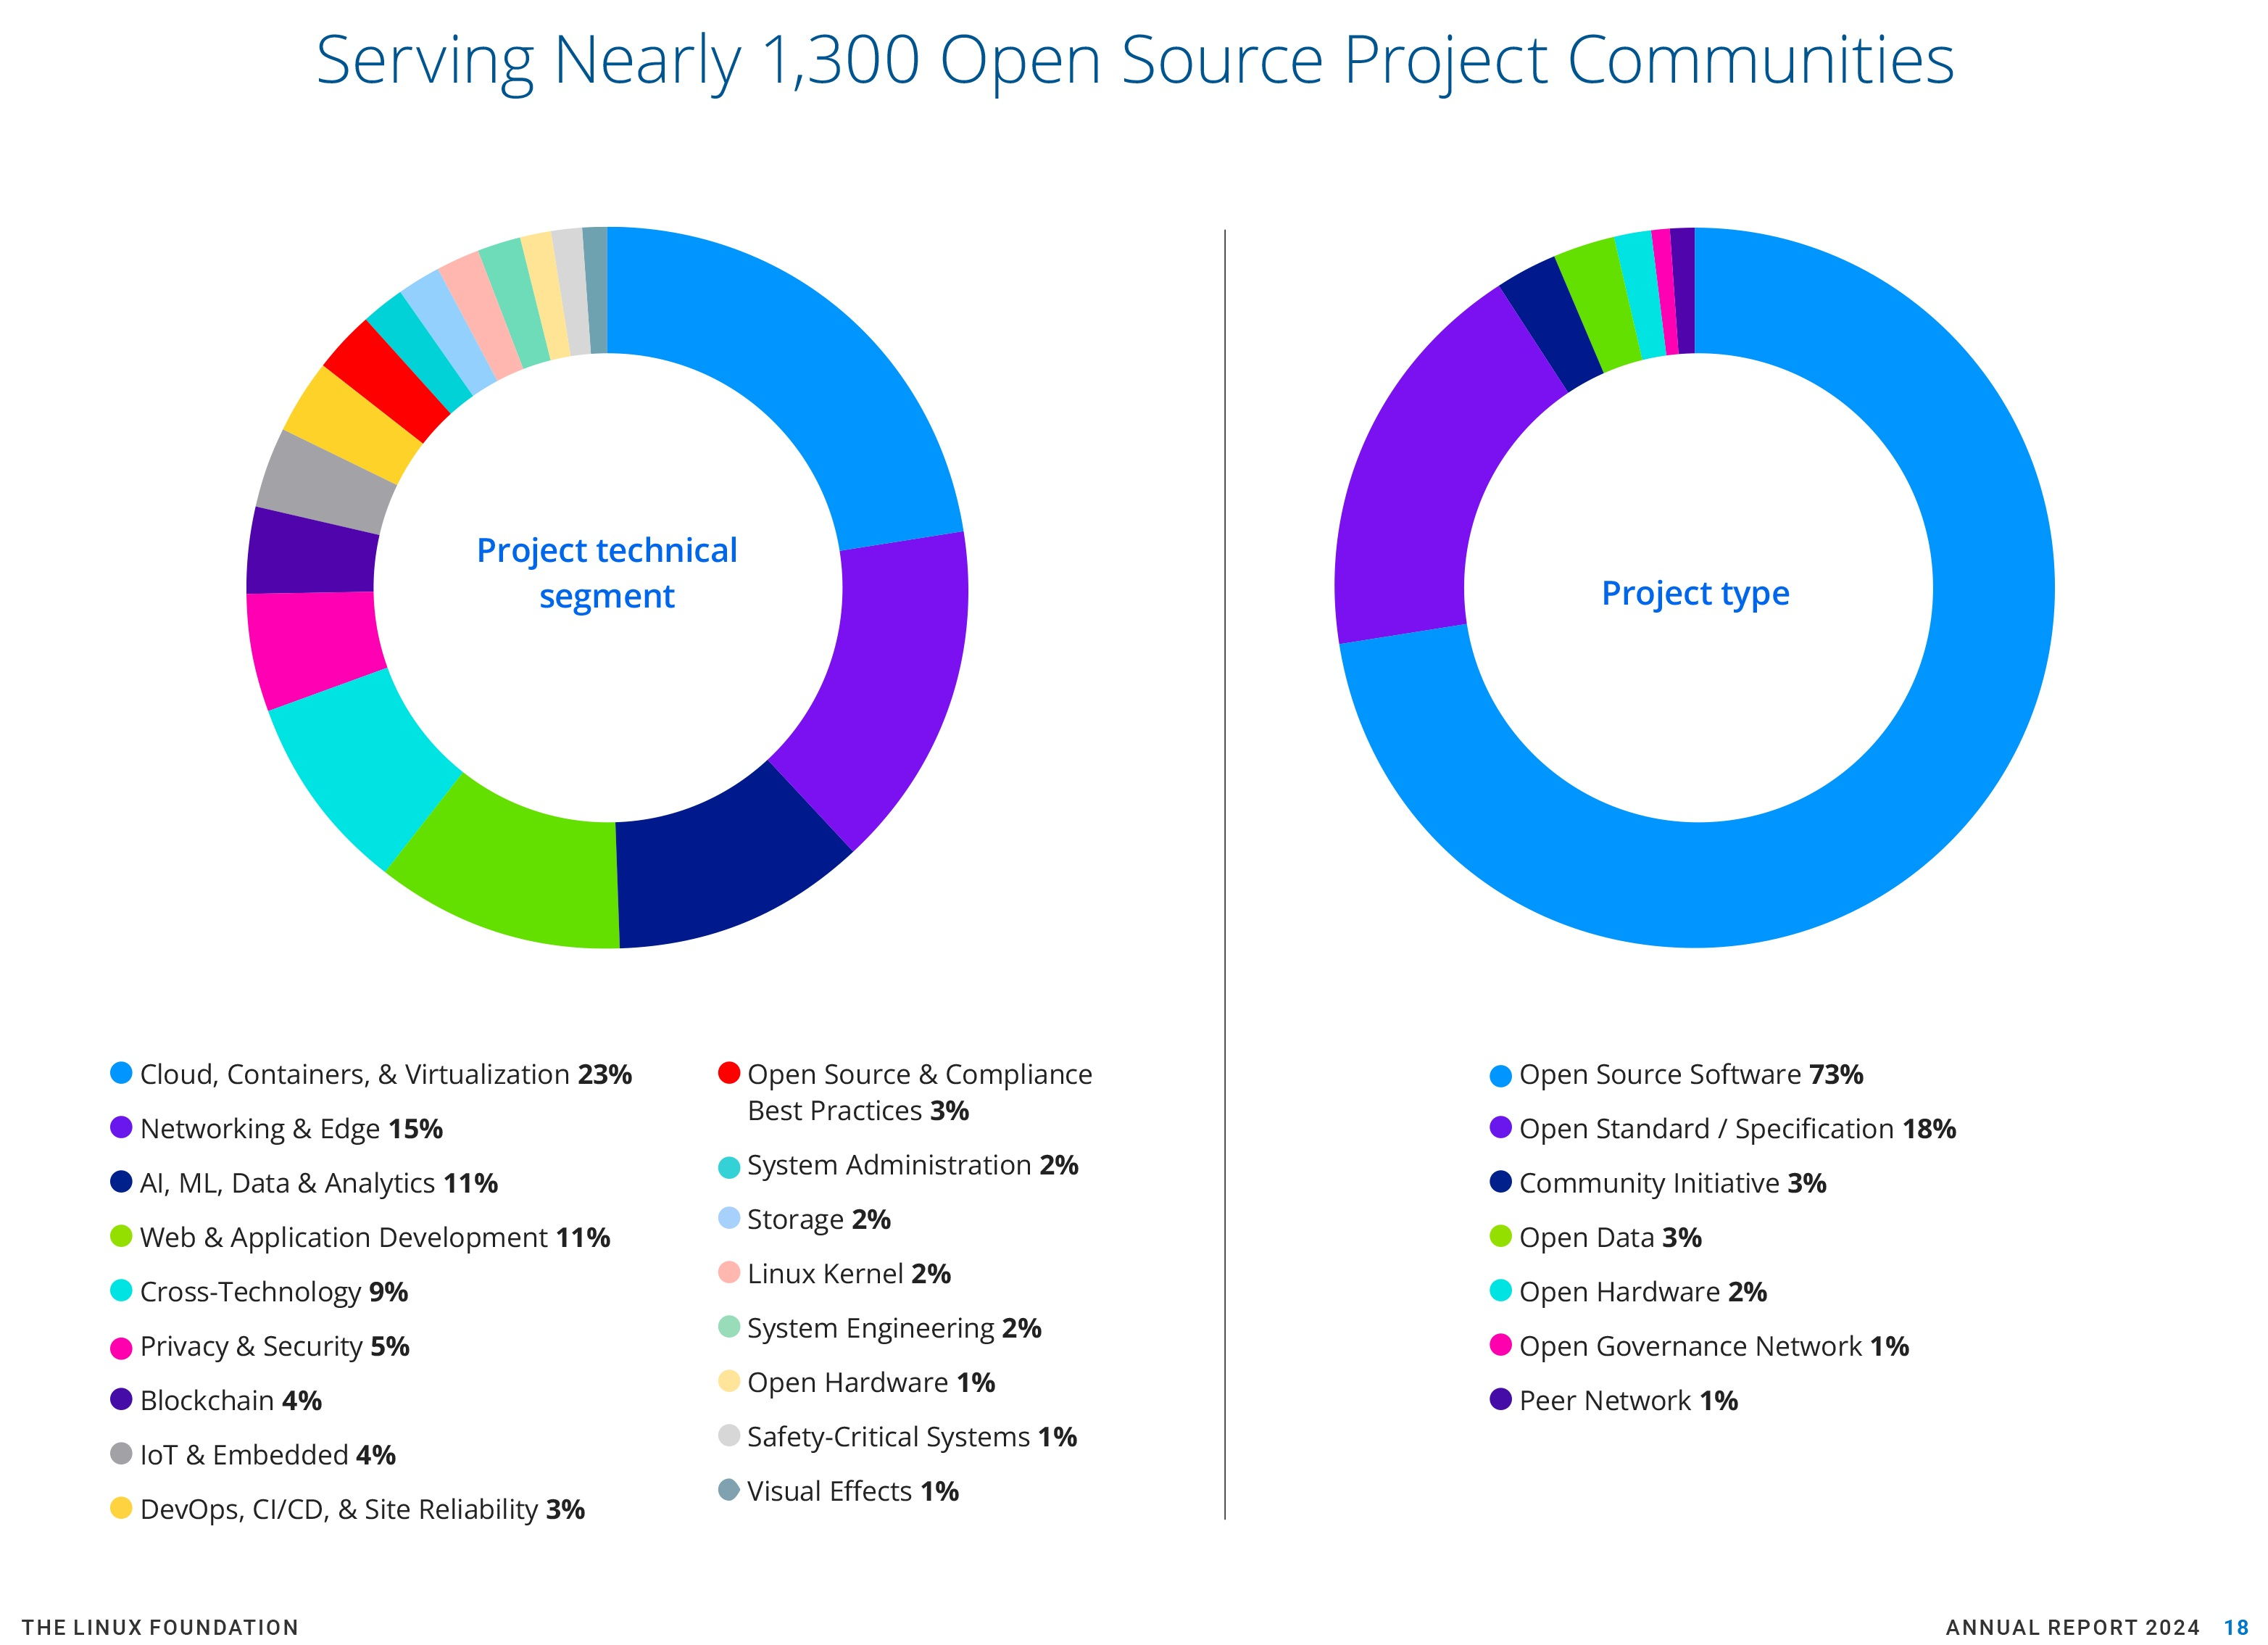
Источник изображений: Linux Foundation Общая сумма расходов за 2024 год равняется 299,7 млн (в 2023 году — $269 млн). Расходы на не связанные с ядром проекты увеличились с $171,8 млн в прошлом году до $193,7 млн (64,6 % всех расходов). Расходы на поддержание инфраструктуры составили $22,69 млн (7,6 %, в прошлом году — $22,58 млн), затраты на программы обучения и сертификации — $23,1 млн (7,7 %, в прошлом году — $18,57 млн), затраты на корпоративные операции — $18,9 млн (6,3 %, в прошлом году — $17,1 млн), расходы на проведение мероприятий — $15,2 млн (5,0 %, в прошлом году — $14,61 млн), затраты на сопровождение сообщества — $13,7 млн (4,5 %, год назад — $13,5 млн). Расходы на международные операции выросли с $2,96 млн до $5,6 млн (1,8 %). 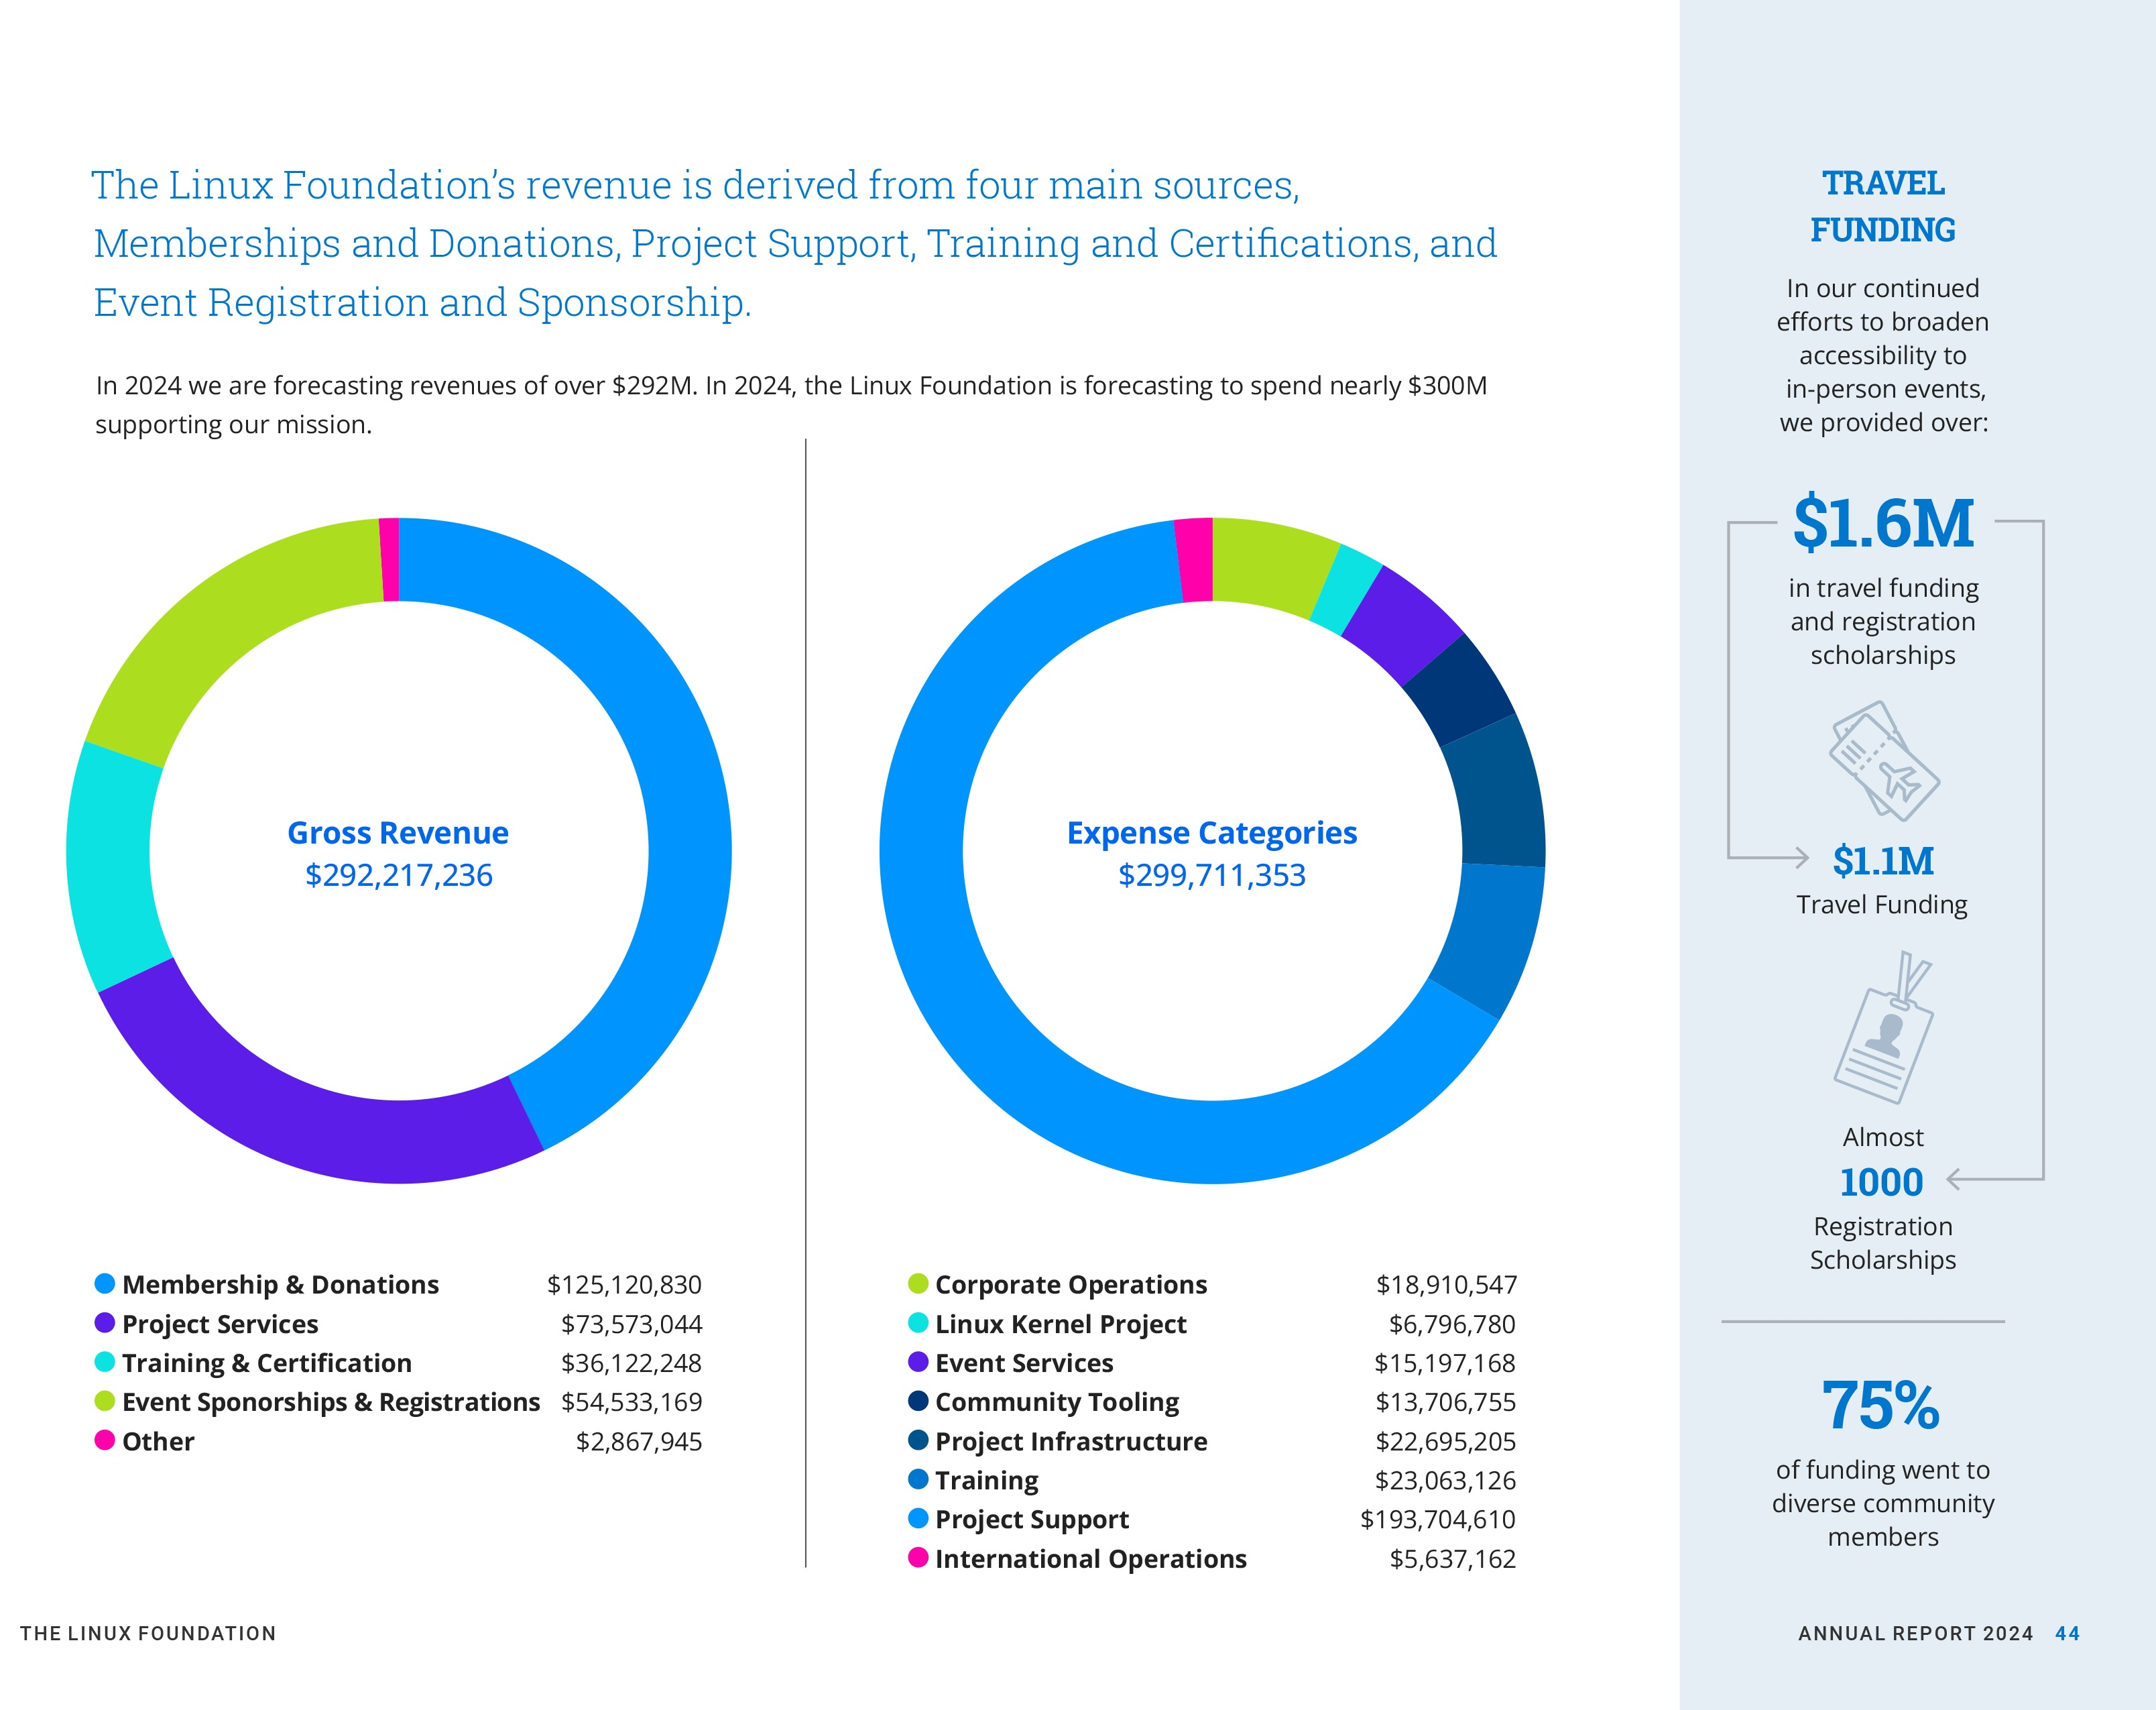 Сообщается, что количество курируемых Linux Foundation проектов приблизилось к 1300, тогда как год назад их насчитывалось около 1100. Наибольшее число проектов Linux Foundation связано с облачными технологиями, контейнерами и виртуализацией (23 %), с сетевыми технологиями (15 %), ИИ (11 %), web-разработкой (11 %), cross-technology (9 %), безопасностью (5 %), Интернетом вещей (4 %) и блокчейном (4 %).
25.12.2024 [00:55], Владимир Мироненко
Netflix подал в суд на Broadcom, заявив, что VMware нарушает его патенты в области виртуализацииСтриминговый гигант Netflix подал в понедельник иск к Broadcom в окружной суд США по Северному округу Калифорнии с обвинением принадлежащего ей дочернего предприятия VMware в нарушении пяти патентов, связанных с работой виртуальных машин («патент 424», «патент 707», «патент 891», «патент 893» и «патент 122»). Как сообщает SiliconANGLE, три из этих патентов касаются использования CPU в виртуальных машинах, а два — запуска по крайней мере одной виртуальной машины с использованием балансировщика нагрузки. Согласно иску, нарушения патентов были допущены в VMware vSphere Foundation, VMware Cloud Foundation, VMware Cloud on AWS и облачных решениях, предлагаемых Microsoft, Google, Oracle, IBM и Alibaba. В частности, в вышеуказанных продуктах, по словам Netflix, допущены нарушения «патента 424». Netflix заявил, что VMware умышленно нарушает авторские права с 2012 года, когда она узнала об этом патенте. «Патент 424 был процитирован экспертом Бюро по патентам и товарным знакам США при отклонении заявки VMware, которая в конечном итоге была оформлена как патент США № 8 650 564», — указал Netflix в иске. 
Источник изображения: Broadcom Учитывая осведомлённость VMware об этом патенте, Netflix утверждает, что Broadcom и VMware занимались «умышленным нарушением», и попросила суд обязать Broadcom возместить убытки, размер которых в иске не указан. Патентная война Netflix и Broadcom началась в 2018 году, когда Broadcom подала в суд на Netflix, обвинив его в нарушении своих патентов на технологию потокового видео. Дела были возбуждены в Калифорнии, Германии и Нидерландах. Судебное разбирательство по иску Netflix запланировано на июнь 2025 года.
19.12.2024 [10:27], Сергей Карасёв
Одноплатный компьютер Radxa Orion O6 формата mini-ITX получил 12-ядерный Arm-процессор с ИИ-ускорителемКомпания Radxa пополнила ассортимент одноплатных компьютеров моделью Orion O6, особенность которой заключается в использовании процессора Cix P1 с 12 вычислительными ядрами Armv9. Новинка выполнена в форм-факторе mini-ITX с габаритами 170 × 170 мм. Чип Cix P1 с архитектурой DynamIQ объединяет квартеты ядер Cortex-A720 с частотой до 2,8 ГГц, Cortex-A720 с частотой до 2,4 ГГц и Cortex-A520 с частотой до 1,8 ГГц. Присутствует GPU-блок Arm Immortalis G720 MC10 с поддержкой Vulkan 1.3, OpenGL ES 3.2, OpenCL 3.0. Возможно декодирование видео 8Kp60 (AV1, H.265, H.264, VP9, VP8, H.263, MPEG4, MPEG2), а также кодирование 8Kp30 (H.265, H.264, VP9, VP8). Встроенный нейропроцессорный движок (NPU) обладает производительностью до 30 TOPS с возможностью работы в режимах INT4/INT8/INT16, FP16/BF16 и TF32. 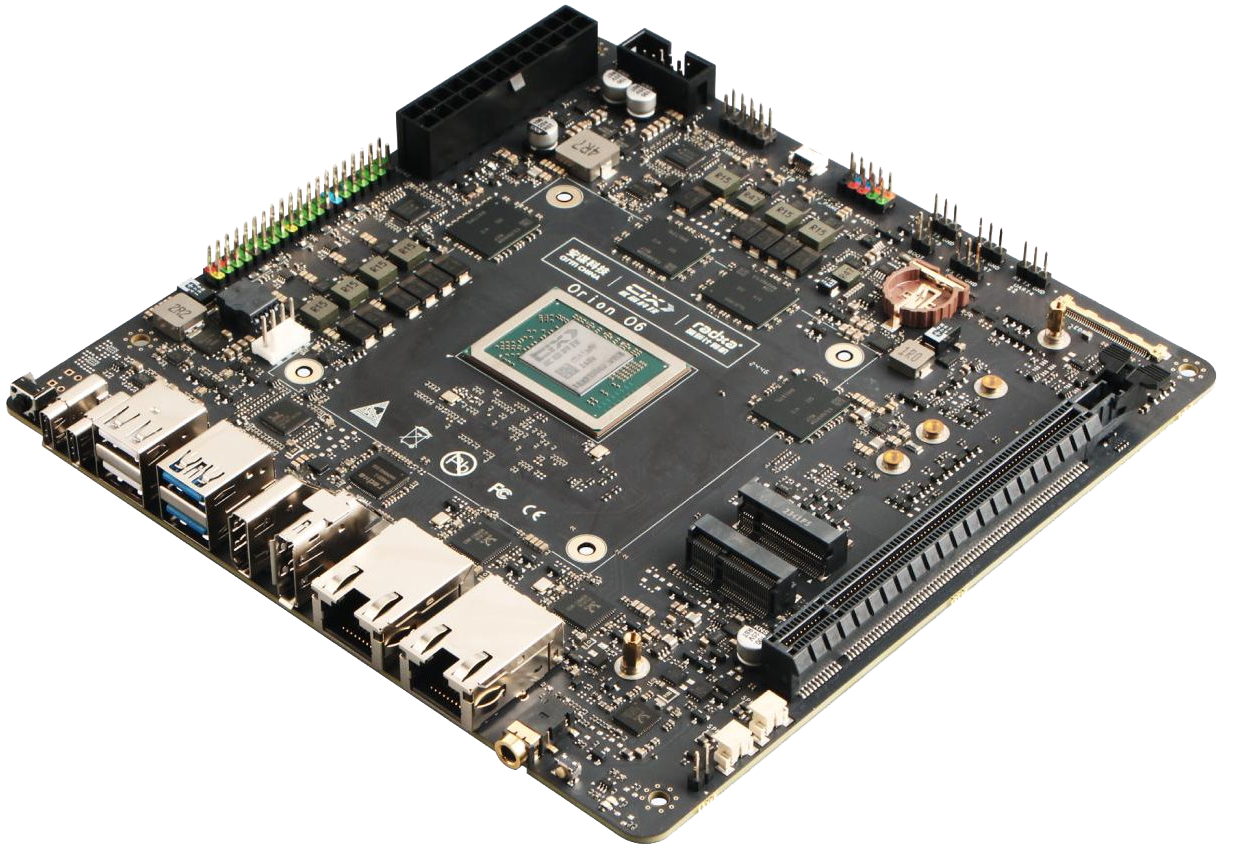
Источник изображения: Radxa Объём оперативной памяти LPDDR5-5500 может составлять 8, 16, 32 или 64 Гбайт. Есть слот M.2 Key-M (PCIe 4.0 x4) для NVMe SSD, разъём M.2 Key-E (PCIe 4.0 x2; USB) для адаптера Wi-Fi (Wi-Fi 7/6E + Bluetooth) и слот PCIe x16 (PCIe 4.0 x8) для карты расширения. Присутствует сетевой адаптер 5GbE. Допускается вывод изображения на четыре монитора через интерфейсы HDMI 2.0 (4Kp60), DisplayPort 1.4 (4Kp120), USB Type-C (DisplayPort Alt Mode) и eDP (4Kp60). В оснащение входят по два порта USB 3.2 Gen2 (10 Гбит/с) Type-A и USB 2.0 Type-A, дополнительный порт USB 3.2 Gen2 Type-C с поддержкой Power Delivery, гнездо RJ-45 для сетевого кабеля, 40-контактная колодка GPIO (3 × UART, 2 × I2C, 2 × I2S, 2 × PWM, 1 × SPI, 10 × GPIO), 4-контактный коннектор для вентилятора с ШИМ-управлением. Питание может подаваться через порт USB Type-C (минимум 65 Вт) или АТХ-коннектор. Говорится о совместимости с Debian и Fedora, а в дальнейшем — с Ubuntu, Android, Deepin, Windows и OpenKylin. Цена варьируется от $200 до $450 в зависимости от объёма ОЗУ. Доступность платы гарантирована как минимум до сентября 2029 года.
18.12.2024 [13:00], Сергей Карасёв
SK hynix анонсировала 61-Тбайт U.2 SSD серии PS1012 с интерфейсом PCIe 5.0 и QLC-памятьюКомпания SK hynix анонсировала SSD семейства PS1012, выполненные в форм-факторе U.2 SFF. Эти накопители большой ёмкости рассчитаны на современные дата-центры, спроектированные для ИИ-нагрузок. Пробные поставки новинок начнутся до конца текущего месяца. В основу изделий PS1012 положены микрочипы флеш-памяти QLC NAND. Для обмена данными служит интерфейс PCIe 5.0. Заявленная скорость последовательного чтения информации достигает 13 Гбайт/с, что, как утверждается, вдвое больше по сравнению с продуктами предыдущего поколения. Вместимость новинки составляет 61,44 Тбайт. В разработке также находится вариант ёмкостью 122 Тбайт, который планируется представить в III квартале следующего года. Кроме того, SK hynix намерена вывести на рынок SSD, способные хранить 244 Тбайт информации. В основу этих устройств лягут 321-слойные чипы флеш-памяти 4D NAND. 
Источник изображения: SK hynix «По мере стремительного развития ИИ спрос на высокопроизводительные твердотельные накопители корпоративного класса быстро растёт, а технология QLC , обеспечивающая высокую ёмкость, становится отраслевым стандартом. SK hynix следует этой тенденции и представляет новый продукт на 61 Тбайт», — говорится в заявлении компании. Отмечается, что накопители PS1012 соответствуют стандарту Open Compute Project (OCP) 2.0. Прочие технические характеристики пока не раскрываются. Образцы SSD планируется предоставить ведущим мировым производителям серверов для оценки.
14.12.2024 [15:15], Сергей Карасёв
Представлен ПАК Tantor XData 2.0 на основе СУБД Tantor 16.6 и серверов «Аквариус»Компания «Тантор Лабс», входящая в «Группу Астра», анонсировала программно-аппаратный комплекс (ПАК) Tantor XData 2.0 для поддержания работы СУБД Tantor. По сравнению с платформой предыдущего поколения новинка, как утверждается, демонстрирует более высокую производительность, а также обладает улучшенным интерфейсом. Оригинальная версия Tantor XData дебютировала в феврале нынешнего года: в разработке решения приняли участие специалисты группы компаний «Аквариус». Говорилось о применении серверов на процессорах Intel Xeon Cascade Lake-SP, AMD EPYC, Baikal-S или Kunpeng 920, а также ОС Astra Linux Special Edition. А в апреле 2024-го «Группа Астра» создала компанию «Иксдата» по выпуску ПАК для высоконагруженных СУБД. Говорится, что в Tantor XData 2.0 применяется аппаратно-программное RAID-решение собственной разработки, которое обеспечивает трёхкратное сжатие данных и увеличивает производительность подсистемы хранения до 102 тыс. TPS (транзакций в секунду) в тестах pgbench (операции чтения/записи). Это на 25 % больше по сравнению с ПАК предыдущей версии. 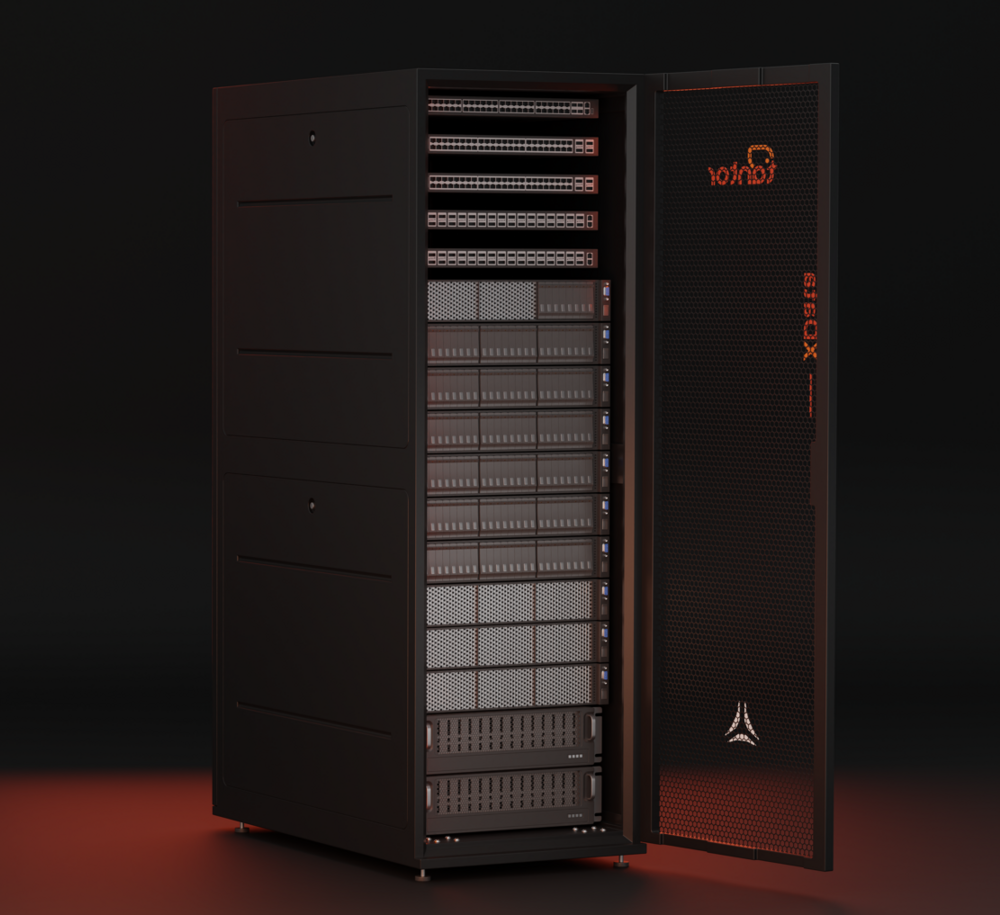
Источник изображения: «Тантор Лабс» В состав комплекса включено S3-совместимое хранилище, позволяющее гибко масштабировать ресурсы. При этом обеспечивается высокая доступность данных благодаря возможности дублирования и распределения между разными узлами. Реализована новая встроенная система резервного копирования на основе WAL-G: благодаря использованию объектного хранилища S3 упрощается восстановление информации из резервных копий. Кроме того, возможна миграция резервных копий баз данных между различными площадками или регионами. Применяется СУБД Tantor 16.6. Усовершенствованный графический интерфейс с модулем управления и мониторинга аппаратных ресурсов DCImanager позволяет централизованно взаимодействовать как с программной, так и с аппаратной частью ПАК в режиме «одного окна»: это повышает удобство и прозрачность административных операций. В Tantor XData 2.0 улучшены возможности работы с кластерами баз данных: остановка и запуск для планового обслуживания, ведение реестра задействованных ресурсов, автоматизированное выделение сетевых и дисковых ресурсов при формировании кластера, усиленный механизм работы с секретами для повышения уровня безопасности. Интерфейс для проведения полного цикла инсталляции/обновления и конфигурирования ПАК XData 2.0 обеспечивает автоматизацию ключевых этапов: монтажа, коммутации и первичной настройки аппаратного комплекса, установки и конфигурации операционной системы на управляющие и вычислительные серверы, на серверы хранения данных, установку, настройку, диагностику и обновление компонентов ПАК, предварительную проверку перед вводом в промышленную эксплуатацию. |
|

