
Материалы по тегу: ff
|
27.08.2026 [09:25], Владимир Мироненко
MTIA 300: первый ИИ-чип Meta✴ со встроенными 800GbE-адаптерами и механизмами разгрузки коммуникацийMeta✴ сообщила новые подробности о 667-Вт ИИ-ускорителе MTIA 300 — своём первом чипе, оптимизированном для обучения DLRM-моделей. В отличие от LLM, требующих огромной пропускной способности вычислений с плавающей запятой, рекомендательные модели сталкиваются с проблемой необходимости быстрого и эффективного взаимодействия ускорителей в сочетании с большой ёмкостью памяти и высокой пропускной способностью интерконнекта. Их таблицы эмбеддингов могут содержать более 99 % параметров модели, что требует гибридного параллелизма, генерирующего частые коллективные операции AllReduce, AllToAll и AllGather на сотнях ускорителей. На таких чипах, как GPU, эти коммуникационные операции конкурируют с вычислениями за одни и те же ресурсы, часто приводя к неэффективному использованию дорогостоящего оборудования. Для решения этой проблемы разработчики, используя совместную разработку MTIA 300 с HCCL, библиотекой коммуникационных интерфейсов, созданной на основе разработанного с нуля оборудования, сделали коммуникацию первостепенной задачей в проектировании микросхем. На практике HCCL обеспечивает пропускную способность передачи данных до 940 Гбайт/с в пределах одной стойки. На модели со 150 млрд параметров, работающей на 40 ускорителях, общее время обмена данными при использовании MTIA 300 в 3,9 раза меньше, чем у эквивалентного кластера на базе GPU. 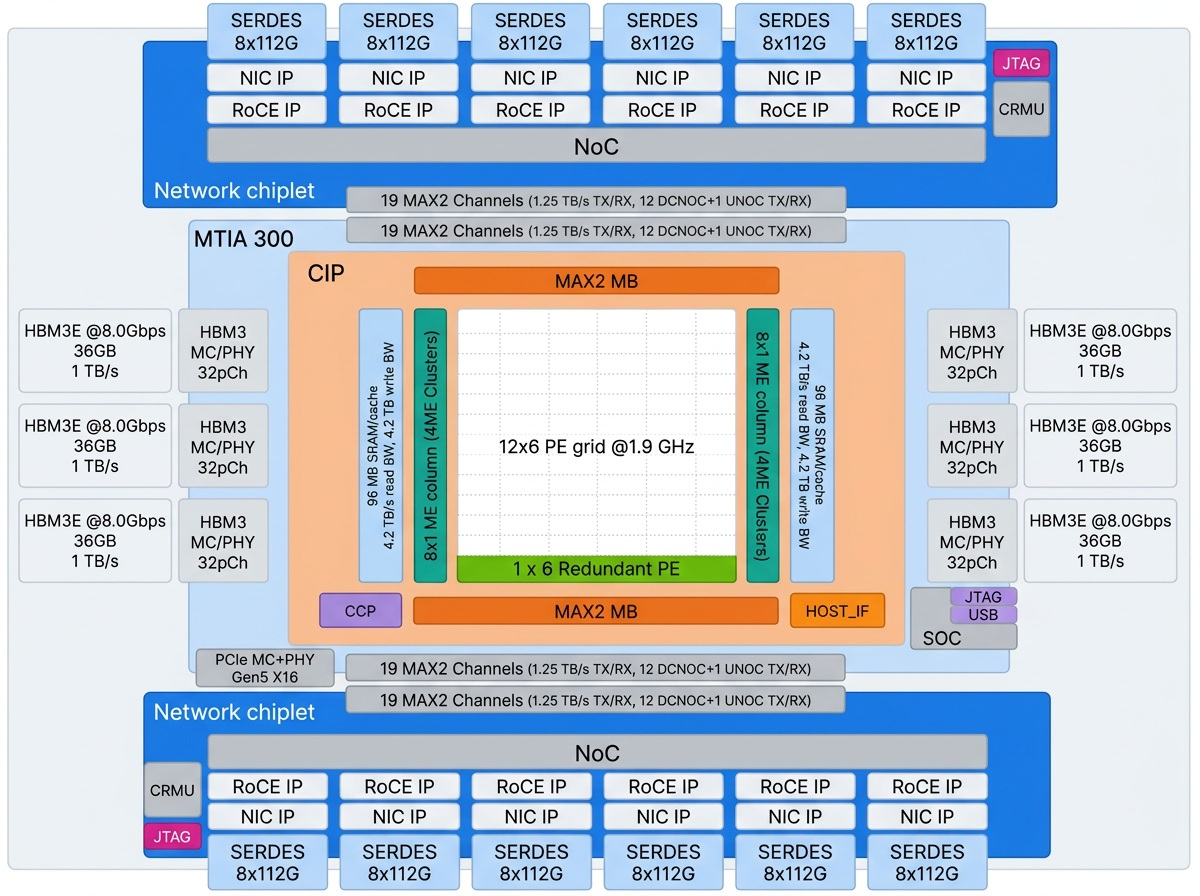
Источник изображения: Meta✴ В MTIA 300 сетевой интерфейс находится внутри самой упаковки микросхемы. Два 5-нм сетевых чиплета, каждый из которых содержит по шесть специализированных 800GbE RoCE-адаптеров, обеспечивают общую пропускную способность I/O 1,2 Тбайт/с без пересечения c шиной PCIe. Это устраняет узкое место в цепочке «хост-устройство-NIC», присутствующей в традиционных архитектурах GPU, где CPU должен выступать посредником между ускорителем и сетью, и позволяет избежать перегрузки PCIe между ускорителем и NIC. При этом NIC можно гибко использовать для масштабирования. Поскольку используются одни и те же 12 NIC на базе Ethernet для вертикального масштабирования (внутри стойки из 16 узлов, до 1 Тбайт/с) и горизонтального масштабирования (между стойками, до 200 Гбайт/с), можно гибко распределять NIC в соответствии с меняющимися потребностями. По мере изменения требований модели можно переконфигурировать сеть, а не само оборудование. Для минимизации задержки транзакций разработчики внедрили экспресс-оповещения (doorbell). Сама запись запроса на выполнение служит оповещением, исключая дополнительное чтение из памяти и экономя около 800 нс на операцию. 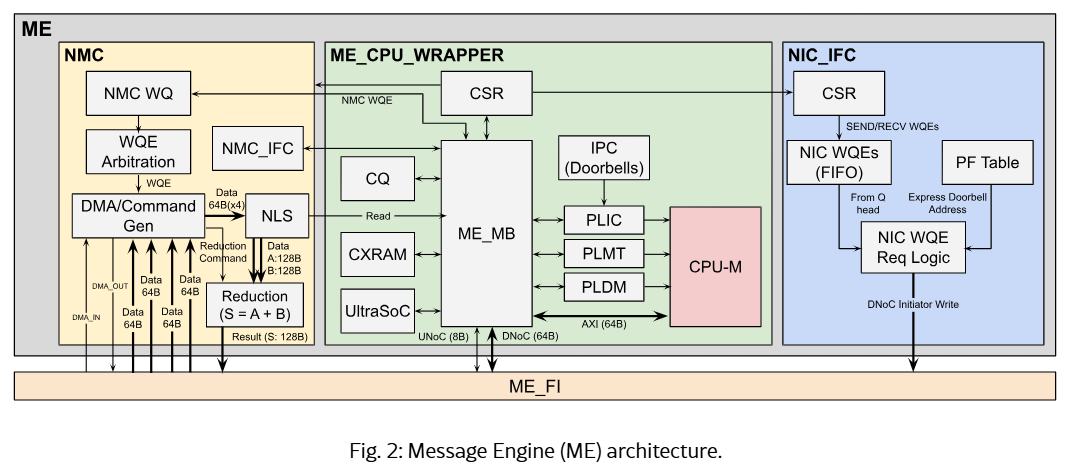
Источник изображения: Meta✴ В случае GPU библиотеки вроде NCCL реализуют операции коллективных коммуникаций в виде вычислительных ядер (kernel), которые используют те же ресурсы, что нужны для вычислений при обучении. Пересечение коллективных операций и операций обучения приводит к замедлению обоих и того, и другого. В MTIA 300 использовали другой подход. Наряду с матрицей из 72 3-нм вычислительных элементов (PE), чип включает 16 выделенных механизмов обработки сообщений (ME), которые обрабатывают всю коммуникацию независимо. ME содержит ядро RISC-V для оркестрации; сетевой интерфейс, который направляет запросы к нужному NIC; вычислительный блок Near-Memory Computing (NMC), который выполняет операции редукции со скоростью 128 байт/цикл. Расположенные по краям чипа, рядом с HBM и кешем, NMC в совокупности обеспечивают пропускную способность редукции более 2,8 Тбайт/с — более чем вдвое превышающую пропускную способность I/O. Это позволяет выполнять коллективные операции AllReduce и ReduceScatter на линейной скорости NIC без использования ресурсов PE. 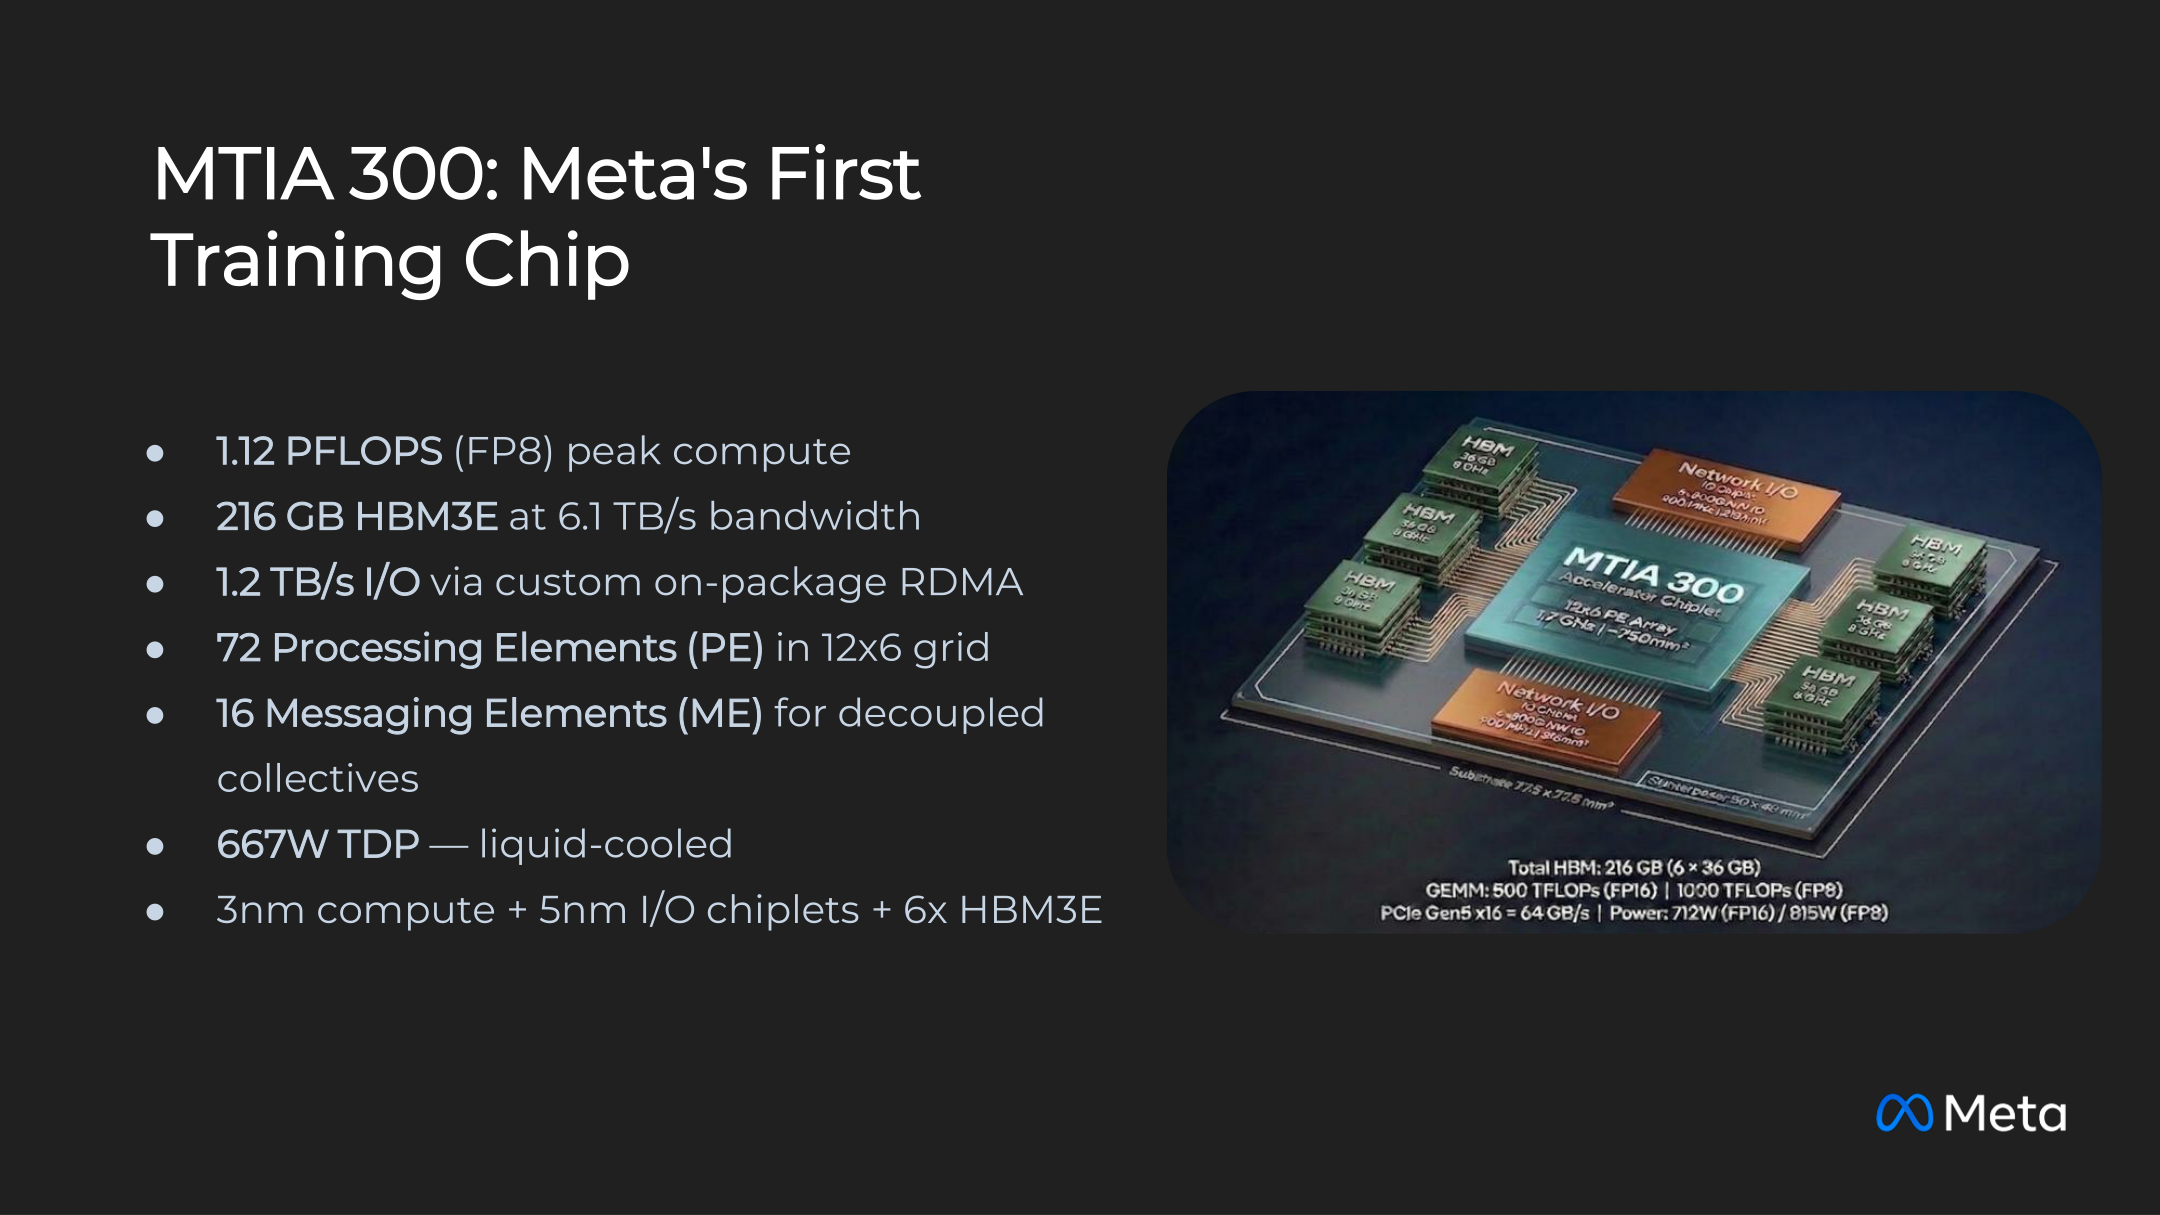
Источник изображения: Meta✴ В результате обеспечивается практически идеальная изоляция операций. Одновременное выполнение больших GEMM-операций с коллективными операциями приводит к снижению вычислительной пропускной способности менее чем на 0,5 %, в отличие от традиционных GPU, где снижение может превышать 20 % из-за использования одних и тех же ресурсов на обмен данными и вычисления. Разработанная совместно с MTIA 300 библиотека HCCL вместо управления обменом данными с хостом во время выполнения компилирует каждую коллективную операцию в полный набор подграфов (массивы очередей задач с явным указанием зависимостей), которые отправляются на ME для полностью автономного выполнения. Таким образом, хост лишь единожды отправляет ускорителю набор сетевых инструкций и более не вмешивается в работу сети. 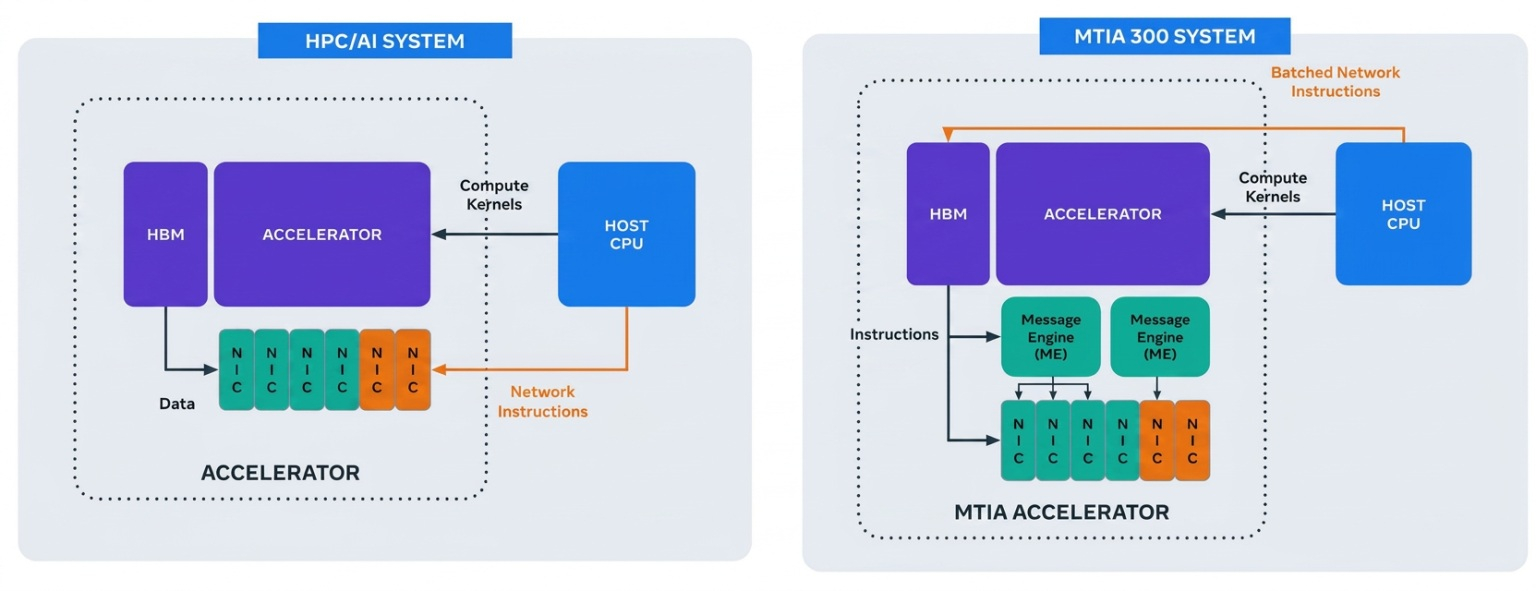
Источник изображения: Meta✴ По словам Meta✴, такая архитектура естественным образом интегрируется с PyTorch. Коллективные операции компилируются в единый граф вместе с вычислительными задачами. HCCL сама выбирает алгоритмы, учитывающие топологию сети и асимметричность полос пропускания, по возможности минимизируя межстоечный трафик. Для инференса были разработаны дополнительные пути: односторонняя коммуникация, когда PE используют экспресс-оповещения, и параллельный запуск коллективных операций по сигналу от kernel'а без прерывания работы последнего. Компания отметила, что MTIA 300 имеет и другие плюсы 216 Гбайт HBM3E (6,1 Тбайт/с) позволяют разместить больше данных на одном чипе, а не загружать их лишний раз извне; на каждый ускоритель приходится всего один CPU, что позволяет нагружать его интенсивными вычислениями на некоторых этапах; высокая пропускная способность сети позволяет при необходимости использовать форматы данных с более высокой точностью. Хотя сочетание умеренной FP-производительности с ёмкой и быстрой HBM в MTIA 300 изначально было оптимизировано для обучения DLRM, эти качества позволяет эффективно использовать чипа для более широкого спектра нагрузок, включая инференс моделей генеративного ИИ. Стоит отметить, что подход Meta✴ с внедрением NIC непосредственно в чип не нов сам по себе. Например, чипы Intel/Habana Gaudi2, представленные в 2022 году, использовали 24 100GbE-интерфейса RoCE для вертикального и горизонтального масштабирования.
24.08.2026 [08:46], Руслан Авдеев
Meta✴ подала заявку на прокладку 497-Тбит/с интернет-кабеля Aurora между США и ДаниейMeta✴ Platforms планирует строительство ещё одной подводной кабельной системы — Aurora. При посредничестве Edge Cable Holdings USA она подала заявку в Федеральную комиссию по связи (FCC) заявку на лицензию для посадочных станций, связывающих США и Данию, сообщает Datacenter Dynamics. Согласно документам, поданным в FCC 17 августа 2026 года, «посадку» кабеля должны осуществить в Манаскуане (Manasquan, Нью-Джерси) и Блобьерге (Blaabjerg, Дания). Фактически посадочные станции уже существуют, площадка в Нью-Джерси принадлежит NJFX, а в Дании — Arelion. Речь идёт о создании открытой кабельной системы, позволяющей разным владельцам оптоволоконных пар отдельно управлять ими и контролировать оконечное оборудование на посадочных станциях. Протяжённость кабеля составит 7268 км, он будет состоять из 24 оптоволоконных пар, каждая с пропускной способностью 20,7 Тбит/с, совокупная ёмкость должна составить порядка 497 Тбит/с. В заявке не упоминается, какая именно пропускная способность будет активирована на момент ввода кабеля в эксплуатацию. Заработать система должна 15 января 2028 года. Для того, чтобы уложиться в расписание, лицензию на посадочные станции просят выдать к ноябрю 2026 года. 
Источник изображения: Matt Hardy/unsplash.com В документе уточняется, что Edge USA может предоставить сторонним заказчиками доступ к «тёмному» волокну, обеспечив новые возможности для передовых сервисов ЦОД в США и за рубежом. Также отмечается, что система усилит конкуренцию среди операторов инфраструктуры, проложенной между США и Данией, а также на других трансатлантических направлениях: AEC-1, Amitié/Dunant, Apollo, Atlantic Crossing-1, EXA North and South, FLAG Atlantic-1, Grace Hopper, Marea, TGN Atlantic, Yellow и запланированные Nuvem, Fastnet и Sol. У Meta✴ имеются многочисленные действующие кабели, а также проекты в стадии прокладки. Реализация осуществляется компанией как самостоятельно, так и в составе консорциумов. В феврале 2025 года компания подала заявку на прокладку кабеля протяжённостью 50 тыс. км, связывающего пять континентов и известного как Project Waterworth. Meta✴ стоит и за известным кабелем 2Africa протяжённостью 45 тыс. км (33 страны и 46 посадочных станций), который ранее считался самым длинными в мире.
12.08.2026 [18:15], Сергей Карасёв
Smart IOPS и H3 Platform представили All-Flash СХД с производительностью до 1 млрд IOPSКомпании Smart IOPS и H3 Platform, по сообщению ресурса Storage Review, разработали высокопроизводительную систему хранения данных, ориентированную на наиболее требовательные рабочие нагрузки в области ИИ. Платформа обеспечивает показатель IOPS на уровне 1 млрд при произвольном чтении. В основу СХД положены накопители Smart IOPS Unobtanium T50 в форм-факторе E3.S 2T. Эти SSD выполнены на чипах флеш-памяти TLC NAND, которые функционируют в режиме pseudo-SLC. Для подключения служит интерфейс PCIe 6 x4 (NVMe 2.0). Вместимость составляет 9, 18 и 36 Тбайт. Заявленная скорость передачи информации достигает 28 Гбайт/с при последовательном чтении и 24 Гбайт/с при последовательной записи. Величина IOPS при произвольном чтении данных блоками по 512 байт составляет до 50 млн, при произвольной записи — до 10 млн. Собственно СХД несёт на борту четыре ускорителя NVIDIA RTX PRO 6000 Blackwell Server Edition с 96 Гбайт GDDR7 и четыре сетевых адаптера NVIDIA ConnectX-8. Доступны 20 посадочных мест для накопителей E3.S 2T с бюджетом питания 60 Вт на каждый слот. Задействовано воздушно охлаждение. При установке 20 изделий семейства Unobtanium T50 достигается суммарное значение IOPS до 1 млрд. 
Источник изображения: Storage Review Платформа ориентирована на такие рабочие нагрузки, как графовые нейронные сети, векторный поиск, рекомендательные системы, генерация с дополненной выборкой (RAG) и аналитические задачи, при которых формируются огромные объёмы случайных запросов небольшого размера. Пробные поставки новых SSD и самой платформы хранения начнутся в I квартале 2027-го, а массовое производство намечено на II четверть следующего года.
12.08.2026 [17:12], Владимир Мироненко
OpenAI, Amazon, Google и Meta✴ обязались выполнять новые требования Техаса к строительству ЦОДАмериканские технологические гиганты выразили готовность соблюдать новые стандарты и руководящие принципы, установленные для ЦОД губернатором Техаса Грегом Эбботтом (Greg Abbott), который поручил Комиссии по коммунальным услугам Техаса (PUC) и Совету по надёжности электроснабжения Техаса (ERCOT) принять меры, чтобы рост дата-центров не приводил к увеличению затрат для обычных потребителей, не создавал дополнительной нагрузки на местных жителей и не перекладывал на них инфраструктурные расходы. «Я установил чёткие ограничения, чтобы гарантировать, что ЦОД защищают нашу электросеть, экономят воду, уважают наши районы и покрывают свои расходы», — указал Эбботт в пресс-релизе. Директива губернатора предусматривает, что все новые ЦОД должны строиться с использованием водосберегающих технологий, таких как системы охлаждения замкнутого цикла. Также Эбботт ввёл мораторий на подключение к энергосети новых ЦОД, потребовав от регуляторов коммунальных услуг проводить до выдачи разрешения всесторонние проверки всех проектов ЦОД. Также предлагается обязать крупные ЦОД ежегодно предоставлять данные об использовании электроэнергии и воды в PUC. Кроме того, директивой предлагается обязательное снижение воздействия ЦОД на жилую застройку путём внедрения передовых методов, таких как отступы от границ участка, технологии снижения шума и другие меры, учитывающие интересы соседей. При этом новые правила могут затормозить развитие рынка ЦОД в штате, который имеет шансы стать крупнейшим в мире. 
Источник изображения: Lightsaber Collection/unsplash.com OpenAI заявила, что готова сотрудничать с Техасом для выполнения этих требований. «OpenAI стремится к созданию необходимой инфраструктуры, чтобы предоставить преимущества ИИ всем жителям Техаса, обеспечивая при этом, чтобы наш рост укреплял сообщества Техаса, поддерживал надёжность энергосистемы, защищал водные ресурсы и не перекладывал затраты на наши проекты на частных лиц или малые предприятия», — сообщила компания. Аналогичное заявление опубликовала Meta✴, сообщившая, что «поддерживает стремление губернатора к ответственному развитию ЦОД». «Мы полностью оплачиваем затраты на электроэнергию и воду в наших ЦОД, чтобы они не перекладывались на потребителей», — подчеркнула компания. Как сообщает ресурс yahoo.com, поддержку требований губернатора Техаса также выразили Amazon, Google и QTS. В свою очередь, Diode сообщила, что её проект по строительству ЦОД в округе Хендерсон (Henderson County) не соответствует установленным стандартам и потому будет закрыт. По оценкам Bloomberg NEF, новые правила штата могут привести к задержке примерно пятой части проектов ЦОД в США. По оценкам аналитиков, под угрозой находятся почти 49,8 ГВт мощностей, что обойдётся потерей примерно $8 млрд к I кварталу 2027 года. Дальнейшие задержки обойдутся в намного более значительные суммы.
11.08.2026 [09:11], Сергей Карасёв
DapuStor анонсировала 512-Тбайт SSD серии R6060DapuStor анонсировала передовые твердотельные накопители корпоративного класса, предназначенные для работы с ИИ. Представлены решения разных типов с воздушным и жидкостным охлаждением. В частности, дебютировали первые, по словам компании, в отрасли SSD вместимостью 512 Тбайт — изделия серии R6060. Они выполнены на основе чипов флеш-памяти QLC и оснащены интерфейсом PCIe 5.0. Заказчикам будут предлагаться модификации в форм-факторах EDSFF нового поколения, включая E3.L и E2. Большая ёмкость упрощает масштабирование, снижает энергопотребление и общую стоимость владения высоконагруженных систем хранения, рассчитанных на работу с огромными массивами информации. В число новинок DapuStor вошёл накопитель R6 типоразмера E1.S ёмкостью 8 Тбайт. Особенностью этого изделия является жидкостное охлаждение. В устройстве применяются чипы флеш-памяти TLC, а для подключения к серверу служит интерфейс PCIe 5.0. Решение ориентировано на ИИ-системы высокой плотности с большим количеством GPU. 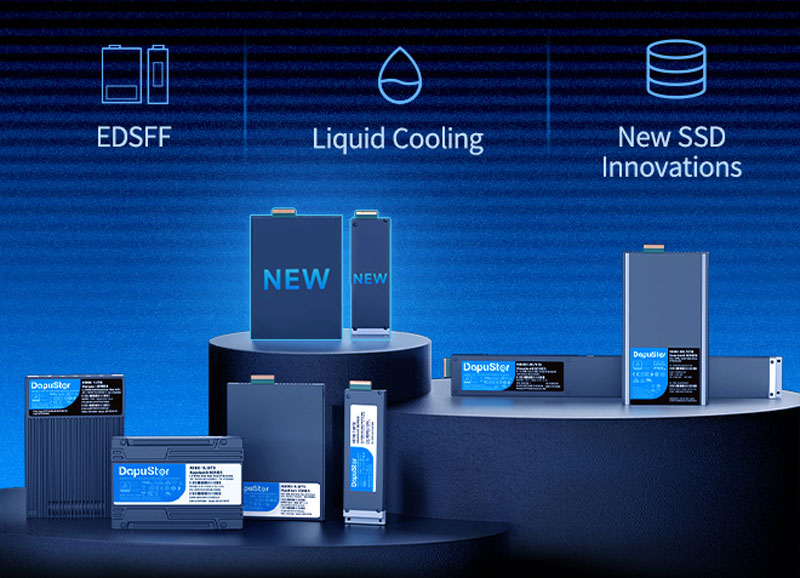
Источник изображения: DapuStor Кроме того, представлены SSD серии J5060 на базе чипов QLC. Они ориентированы на применение в составе платформ с несколькими уровнями флеш-хранения, включая SLC. Это даёт улучшенную гибкость для ИИ-нагрузок, которым требуются одновременно быстрый доступ к данным и значительная вместимость. При таких конфигурациях SLC-накопители обеспечат высокую скорость и существенный ресурс, а QLC — большую вместимость. DapuStor также демонстрирует двухпортовые SSD семейства R6 в форм-факторе E3.S. Изделия будут выпускаться в конфигурациях TLC и QLC. В первом случае вместимость достигает 30,72 Тбайт, во втором — 61,44 Тбайт. При этом наличие двух портов повышает отказоустойчивость корпоративных ИИ-систем.
04.08.2026 [12:20], Сергей Карасёв
10 млн IOPS и 50 DWPD: Kioxia представила SSD серии GP1 для ИИ-приложенийКомпания Kioxia анонсировала SSD семейства GP1, спроектированные с прицелом на ИИ-системы. Новинки будут предлагаться в различных вариантах исполнения, включая E3.S и E1.S с толщиной корпуса 9,5 и 15 мм. Устройства используют флеш-память Kioxia XL-Flash второго поколения с низкой задержкой и улучшенной производительностью. Для обмена данными служит интерфейс PCIe 6.0 (NVMe 2.2). Накопители, как утверждается, выдерживают до 50 полных перезаписей в сутки (значение DWPD). Изделия GP1 стали первыми продуктами серии Super High IOPS SSD. Их особенностью является то, что графический ускоритель в составе системы может получать прямой доступ к SSD. Таким образом, флеш-память используется для расширения встроенной памяти HBM. В результате, улучшается быстродействие на операциях ИИ и повышается эффективность использования имеющихся вычислительных ресурсов. «Устройства Kioxia GP1 — это прорывной продукт, который позволит создать новую, передовую топологию памяти для ИИ-систем», — отмечает Невилл Ичхапория (Neville Ichhaporia), старший вице-президент и генеральный директор подразделения твердотельных накопителей Kioxia America. 
Источник изображения: Kioxia Решения GP1 обеспечивают показатель IOPS (количество операций ввода-вывода в секунду) до 10 млн при произвольном чтении данных блоками по 512 байт. Более того, применённая в устройствах архитектура предусматривает возможность повышения значения до 100 млн IOPS в будущих поколениях SSD. Новые накопители будут предлагаться в вариантах с воздушным и жидкостным (только у версий толщиной 9,5 мм) охлаждением. Вместимость и прочие технические характеристики пока не раскрываются. Поставки опытных образцов отдельным заказчикам будут организованы к концу текущего года.
31.07.2026 [11:09], Сергей Карасёв
Форматы E3.S, E1.S, SFF и ёмкость до 61,44 Тбайт: Kioxia представила свои первые корпоративные SSD с интерфейсом PCIe 6.0Компания Kioxia анонсировала SSD семейства CM10 — свои первые твердотельные накопители корпоративного класса, оснащённые интерфейсом PCIe 6.0. Устройства, спроектированные для ресурсоёмких нагрузок, включая ИИ-инференс, будут предлагаться в различных вариантах исполнения, в том числе E3.S, E1.S и SFF. Изделия выполнены на основе чипов Kioxia BiCS FLASH 10-го поколения (332 слоя) в соответствии со спецификациями NVMe 2.1, OCP Datacenter NVMe SSD 2.7 и NVMe Flexible Data Placement (FDP). Говорится о поддержке различных средств обеспечения безопасности — SIE, SED, SED FIPS 140-3 и постквантовой криптографии. Вместимость в зависимости от варианта исполнения варьируется от 1,6 до 61,44 Тбайт. Накопители типоразмера E3.S и E1.S толщиной 9,5 мм будут выпускаться в модификациях с жидкостным охлаждением, тогда как все другие решения довольствуются традиционным воздушным охлаждением. Предусмотрены версии для интенсивного чтения с возможностью одной полной перезаписи в сутки (1 DWPD) и смешанного использования с показателем 3 DWPD. 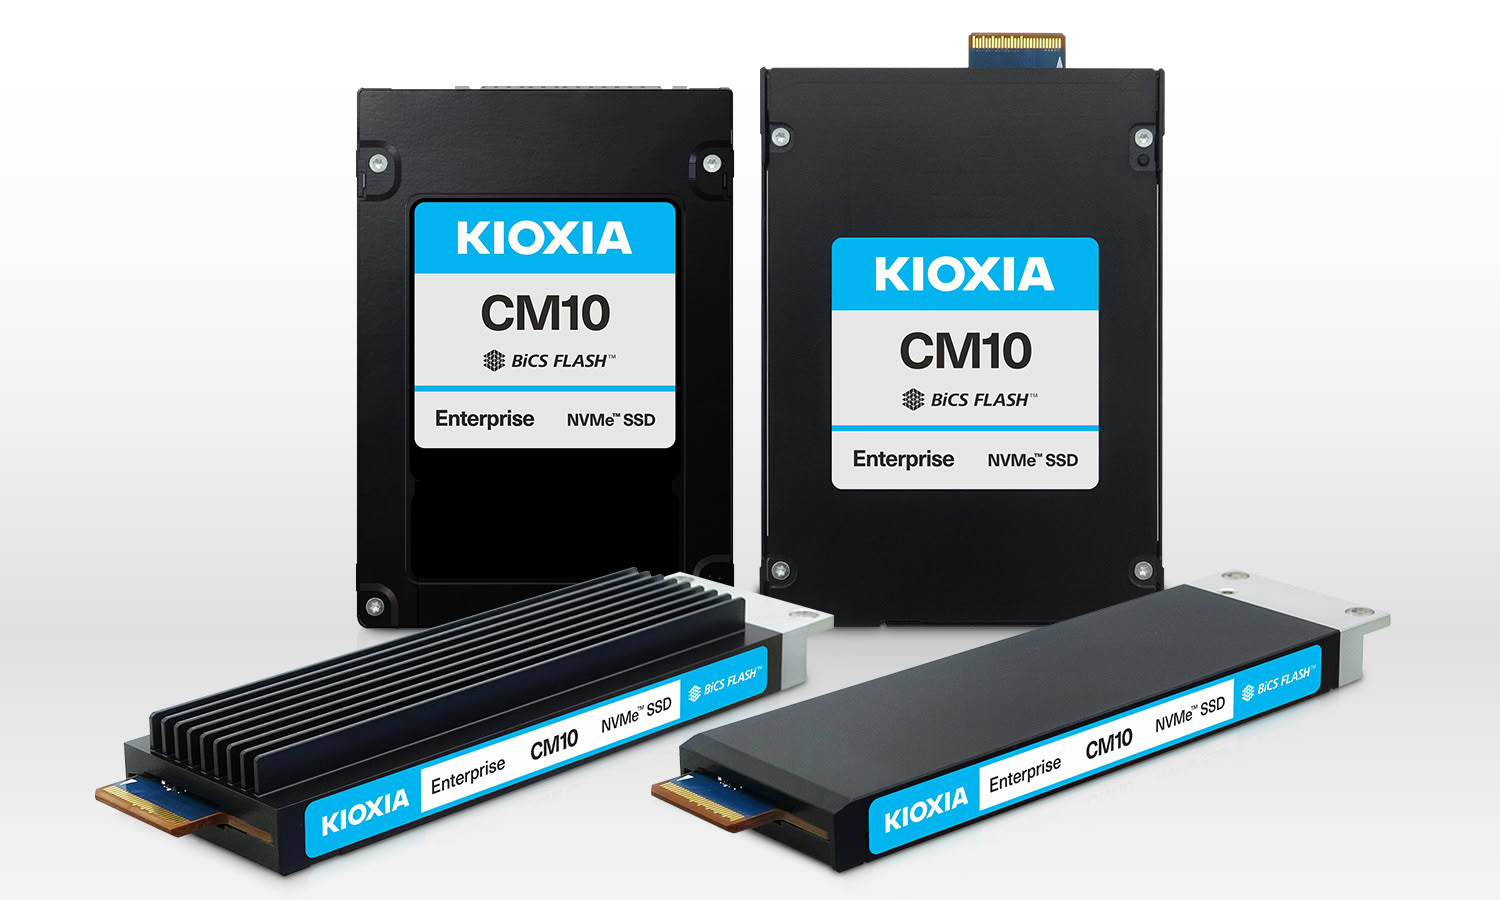
Источник изображения: Kioxia По заявлениям Kioxia, устройства серии CM10 по быстродействию значительно превосходят накопители предыдущего поколения CM9, которые дебютировали весной 2025 года. Эти SSD наделены интерфейсом PCIe 5.0, а ёмкость достигает 61,44 Тбайт. Утверждается, что по сравнению с предшественниками решения CM10 обеспечивают на 92 % более высокую производительность в режиме последовательного чтения и примерно на 85 % большую скорость на операциях случайного чтения. Пробные поставки новинок уже начались.
29.07.2026 [17:05], Руслан Авдеев
Meta✴ совместно с BlackRock построит в Техасе ИИ ЦОД стоимостью $14 млрдMeta✴ анонсировала строительство кампуса ИИ ЦОД в Эль-Пасо (El Paso, Техас) при поддержке BlackRock. В проект планируется вложить $14 млрд, сообщает Silicon Angle. Закрытие сделки планируется в ближайшие дни. После подписания договора Meta✴ намерена внести «физические активы» стоимостью $2,3 млрд, включая уже строящиеся на площадке объекты. BlackRock инвестирует в проект $4,9 млрд и выплатит Meta✴ $1 млрд. Доля BlackRock в кампусе составит 80 %, Meta✴ получит 20 %. При этом IT-гигант станет единственным пользователем 1-ГВт кампуса, когда тот заработает в 2028 году. Аренда заключена на четыре года с возможностью продления действия договора четыре раза. При этом Meta✴ обязалась минимизировать риски BlackRock, гарантировав последней компенсацию падения остаточной рыночной стоимости (residual value guarantees, RVG). Сумма гарантий составит до $13 млрд в первые 16 лет. В Meta✴ полагают, что $14 млрд позволят покрыть общие затраты на строительство, расходы на электроснабжение, охлаждение и сетевую инфраструктуру. При этом компания не уточняет стоимости чипов, поэтому итоговые затраты на проект могут оказаться выше. Кампус войдёт в число гигаватных проектов, уже представленных Meta✴ в последние два года, в т.ч. в Огайо, Индиане и Канаде. Согласно расчётам Meta✴, три последних проекта обойдутся по $10 млрд. Бюджет площадки в Эль-Пасо косвенно указывает на применение более передовых решения. Не исключено, что кампус предназначен для собственного облака Meta✴. 
Источник изображения: Meta✴ Ранее в июле Meta✴ сообщила о намерении потратить более $50 млрд на кампус Hyperion в Луизиане. По мнению экспертов, общшая стоимость проекта с учётом чипов и оборудования составит до $250 млрд. Финансовая структура проектов в Луизиане и Техасе аналогичны. В 2025 году 80-% доля кампуса Hyperion досталась компании Blue Owl Capital, взамен та внесла $7 млрд наличными средствами. Meta✴ завершила 2025 год с капитальными затратами в объёме $72 млрд. Ожидается, что в 2026 году они составят $125–$145 млрд. Не исключается, что облачный бизнес будет способствовать окупаемости инвестиций.
29.07.2026 [10:06], Сергей Карасёв
Kioxia представила SSD серии NX1 с поддержкой СЖОКомпания Kioxia анонсировала SSD корпоративного класса семейства NX1, выполненные в форм-факторе E1.S. Накопители рассчитаны на высокопроизводительные GPU-серверы, которые применяются на площадках гиперскейлеров и в крупных дата-центрах, ориентированных в том числе на задачи ИИ. NX1 — это первые изделия Kioxia, поддерживающие DLC СЖО. Такая опция в дополнение к традиционному воздушному охлаждению доступна для устройств в корпусе толщиной 9,5 мм. В семейство также входят варианты толщиной 15 мм: они оснащаются исключительно воздушным охлаждением. Для подключения к серверу служит интерфейс PCIe 5.0 (NVMe 2.0). Говорится о поддержке стандартов OCP Datacenter NVMe SSD 2.6 и NVMe Flexible Data Placement (FDP), а также опционального шифрования данных (SED). В основу накопителей положены чипы флеш-памяти Kioxia BiCS Flash 8-го поколения типа TLC и фирменный контроллер с «уникальными возможностями». Задействована технология CBA (CMOS directly Bonded to Array), которая обеспечивает повышение энергоэффективности, производительности, плотности и стабильности по сравнению с решениями предыдущих поколений. 
Источник изображения: Kioxia В серию NX1 входят модели вместимостью от 1,92 до 15,36 Тбайт. Устройства способны выдерживать одну полную перезапись в сутки (1 DWPD). По сравнению с SSD серии Kioxia XD8 типоразмера E1.S, которые дебютировали в октябре 2024 года, новинки обеспечивают прирост производительности до 38 % в режиме последовательной записи и до 20 % на операциях произвольной записи. Пробные поставки изделий NX1 уже начались.
28.07.2026 [16:45], Руслан Авдеев
ИИ оказался важнее экологии: Meta✴ покинула климатическую инициативу RE100 из-за роста закупок газаКомпания Meta✴ отказалась принимать дальнейшее участие в инициативе RE100 по переходу на закупки электричества исключительно из возобновляемых источников, сообщает Datacenter Dynamics. Уход связан с увеличением закупок энергии, вырабатываемой за счёт природного газа. Это поможет покрыть потребности её разросшегося портфолио ИИ ЦОД. В The Climate Group сообщают, что после ряда бесед Meta✴ с представителями НКО техногигант вышел из курируемой ей инициативы RE100, поскольку более не способен соответствовать техническим критериям — компания инвестирует в новые проекты газовой энергетики. Возглавляемая The Climate Group и CDP инициатива поощряет бизнесы ставить прозрачные цели по использованию «зелёной» энергетики и докладывать о своих достижениях в этой сфере. В числе ключевых участников — Apple, Google, Microsoft, Amazon, Adobe, Salesforce, SAP, HP, Dell Technologies, Intel и Equinix. Meta✴ присоединилась к RE100 в 2016 году, а с 2021 года утверждала, что её операции по всему миру в полной мере покрываются за счёт «зелёной» энергетики. Решение отказаться от участия, вероятно, связано с «небезупречным» в экологическом контексте кампусом ИИ ЦОД Hyperion в Луизиане, который будет снабжаться энергией в основном за счёт газовой генерации — для него Meta✴ построит семь новых электростанций. 
Источник изображения: He Junhui/unsplash.com Выход Meta✴ — лишь часть более обширного тренда. В последнее время крупнейшие девелоперы ЦОД вынуждены переходить на традиционные источники энергии, в первую очередь обеспечивающие электричество за счёт тепловых электростанций, в т.ч. на газе. Большинство гиперскейлеров уже отметили рост энергопотребления из-за масштабирования ИИ-инфраструктуры. Так, в 2025 году только Google нарастила расход энергии на 37 %. В результате зарегистрирован рост углеродных выбросов, связанный с деятельностью гиперскейлеров. Так, в 2025 году Amazon увеличила их на 16 %, а Microsoft — на 25 %. Последняя сообщила в июне, что планируемый ЦОД в Пекосе (Pecos, Техас) будет снабжаться энергией газовой электростанции мощностью 2,67 ГВт. |
|

