Лента новостей
|
25.11.2022 [16:33], Алексей Степин
Meta✴ переходит на использование протокола синхронизации времени PTPВ отличие от широко известного протокола сетевой координации времени NTP, разработанный изначально для локальных сетей, PTP (Precision Time Protocol, IEEE 1588) способен обеспечивать точность синхронизации в пределах десятков наносекунд, тогда как у NTP это значение находится в диапазоне единиц или десятков миллисекунд. С точки зрения владельцев крупных ЦОД возможность повысить точность синхронизации может представлять существенный интерес, поскольку позволяет точнее привести серверы к единому времени. И такой возможностью заинтересовалась компания Meta✴, которая в течение некоторого времени тестировала PTP локально, а в настоящее время заявила о переводе всех серверов на новый стандарт синхронизации. 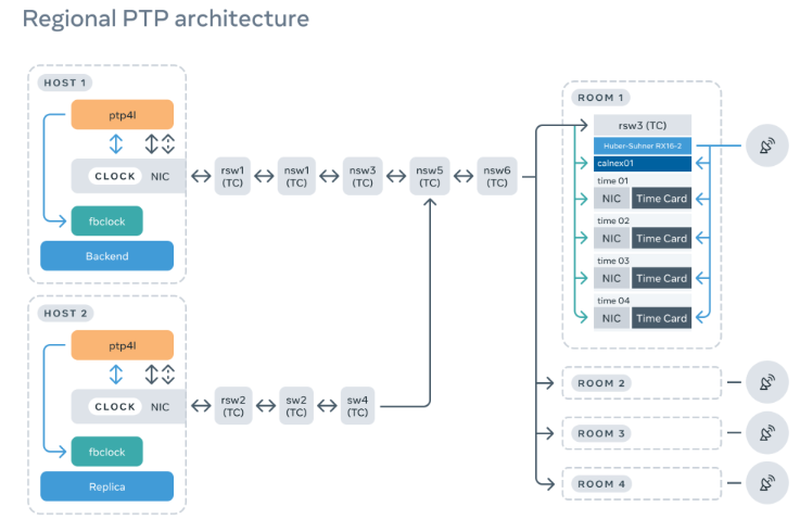 Поскольку масштабы сети серверов Meta✴ действительно велики, влияние неточностей при использовании NTP может накапливаться и приводить к задержкам, сбоям или даже сетевым отказам. Тем более сверхточная синхронизация важна для проекта метавселенной, в котором огромная виртуальная вселенная должна функционировать как единое целое. Однако внедрение PTP требует поддержки со стороны не только программного, но и аппаратного обеспечения, поэтому компания разработала в рамках OCP систему Open Time Server, в основе которой лежит плата точного времени Facebook✴ Time Card с приёмником сигналов GNSS. Требований со стороны сервера немного: использование сетевых интерфейсов с поддержкой PPS и Hardware Timestamps и процессоров с VT-d. 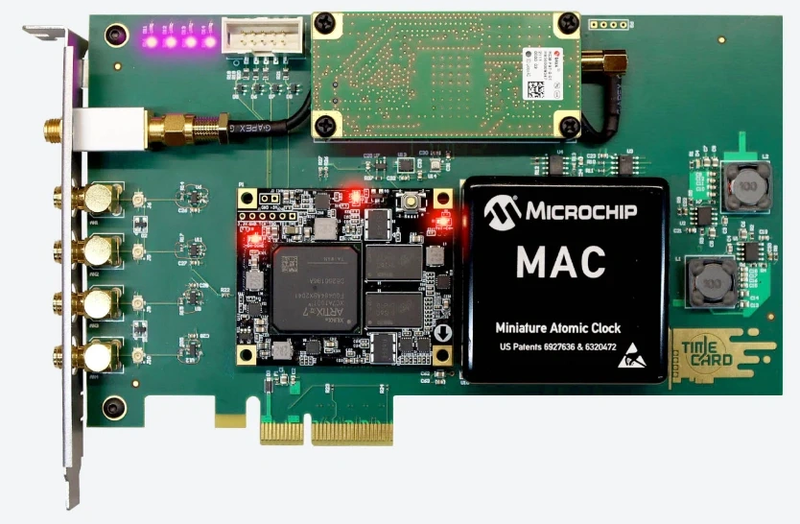
Facebook✴ Time Card Программная часть состоит из ОС Linux с драйвером ocp_ptp и демонов Chrony/NTPd и ptp4u/ptp4l, работающих с устройствами dev/ptpX карты времени и сетевого адаптера. В официальном репозитории Open Time Server приведена подробная информация на этот счёт. На уровне ЦОД это означает появление выделенных стоек PTP, оснащённых соответствующим оборудованием. Подчёркивается также важность наличия качественной антенны для приёма GNSS-сигналов, гарантирующей точность позиционирования менее 10 м — лишь при такой точности можно вести речь о наносекундном уровне синхронизации. Каждая стойка PTP также содержит устройство Calnex Sentinel 2.0, ответственное за мониторинг состояния системы: расхождение между Time Card и сетевым адаптером должно укладываться в окно размером не более 50 нс.
17.11.2022 [00:56], Руслан Авдеев
Сухо и комфортно: для экономии воды в ЦОД Meta✴ подняла температуру и снизила влажность в машинных залахНа мероприятии 7×24 Exchange Fall Conference Meta✴ поделилась секретами сбережения воды при эксплуатации дата-центров. Компания повысила температуру в серверных до +32,2 °C, а влажность, наоборот, снизила — до 13 %. Ожидается, что это позволит сэкономить миллиарды литров воды ежегодно. Попутно компания также внедряет передовую систему обработки и фильтрации воды, а в перспективе Meta✴ намерена «восстанавливать» больше воды для окружающей среды, чем потребляет. Для оптимизации работы собственных площадок Meta✴ прибегла к эксперименту — на половине территории некоторых ЦОД задавались различные значения температуры и влажности, после чего оценивались и сравнивались различные показатели, включая, например, процент отказов оборудования. Делается это всё ради уменьшение затрат энергии и воды на охлаждение. Поскольку у Meta✴ площадь ЦОД составляет более 3,7 млн м2, даже небольшие улучшения ведут к большой экономии. 
Источник изображения: Erda Estremera/unsplash.com Это не первое повышение температуры и понижение влажности в дата-центрах компании. Ранее Meta✴ увеличила температуру до +29,4 °C, а влажность вообще планировалось поддерживать на уровне 20–30 %. Однако практические испытания показали, что оборудованию достаточно комфортно в новых условиях, и нет проблем, например, со статическими разрядами. Изначально все эти меры были предприняты для снижения энергопотребления, но они заодно помогают экономить и воду. Также в компании обновили процессы промышленной обработки воды, используемой в ЦОД — от фильтрации до «смягчения». Одним из важных изменений стал процесс оптимизации т.н. «обратной промывки» загрязнённых фильтров — в Meta✴ смогли организовать его таким образом, что фильтрационные системы стали использовать намного меньше воды. Помогла и оптимизация процесса смягчения воды в некоторых ЦОД. 
Источник изображения: Stephen Dawson/unsplash.com Всего компания использовала 2,57 млрд литров воды в 2021 году, но водные затраты на электроэнергию составили ещё 3,31 млрд литров. Проекты по восстановлению воды позволили «компенсировать» 2,33 млрд литров, а новые технологии, как ожидается, в перспективе обеспечат «возврат» более 3,2 млрд литров воды ежегодно, так что в Meta✴ рассчитывают стать «водно-положительной» к 2030 году — заявление сделали после критики нового ЦОД в одном из засушливых штатов США.
15.11.2022 [19:08], Сергей Карасёв
Cerebras построила ИИ-суперкомпьютер Andromeda с 13,5 млн ядерКомпания Cerebras Systems сообщила о запуске уникального вычислительного комплекса Andromeda для выполнения «тяжёлых» ИИ-нагрузок. В основу Andromeda положен кластер из 16 блоков Cerebras CS-2, объединённых 96,8-Тбит/с фабрикой. Каждый из них содержит чип WSE-2, насчитывающий 850 тыс. ядер. Таким образом, общее число ядер достигает 13,5 млн. Кроме того, непосредственно в состав каждого чипа входят 40 Гбайт сверхбыстрой памяти. Система уже доступна коммерческим заказчикам, а также различным научным организациям. 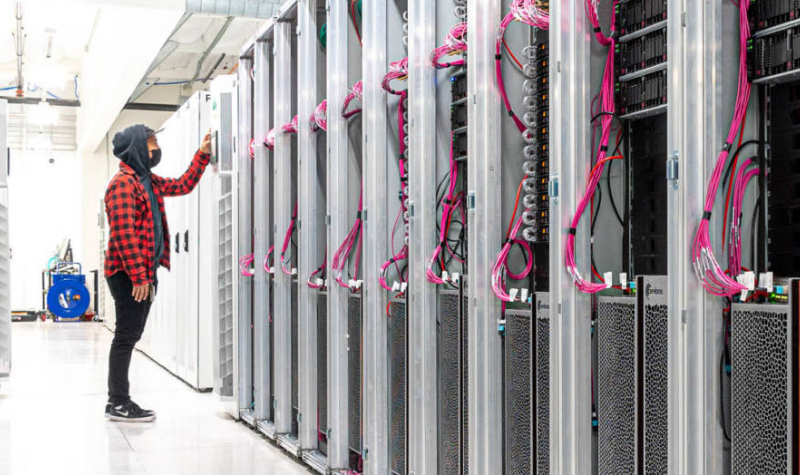
Источник изображения: Cerebras Systems Суперкомпьютер также использует 284 односокетных сервера с процессорами AMD EPYC 7713. Суммарное количество вычислительных ядер общего назначения составляет 18 176. Каждый из этих серверов несёт на борту 128 Гбайт оперативной памяти, NVMe-накопитель вместимостью 1,92 Тбайт и две сетевые карты 100GbE. Эти узлы отвечают за предварительную обработку информации. 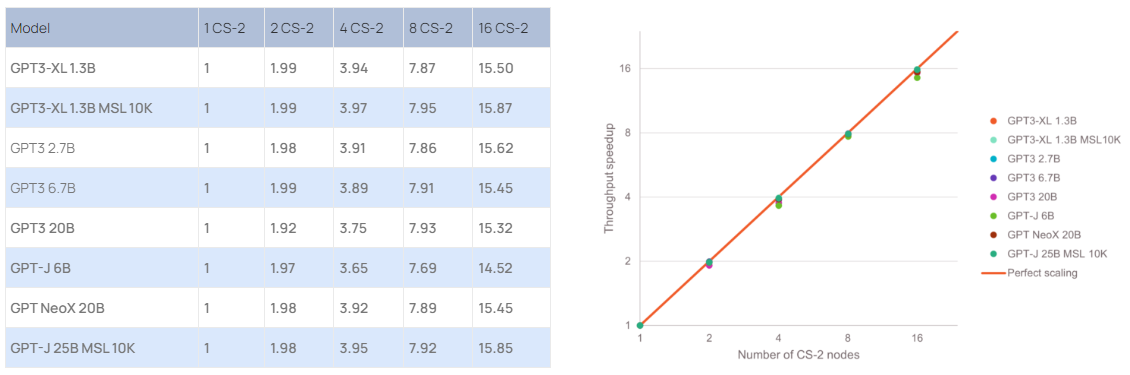
Источник: Cerebras Systems По заявлениям Cerebras, производительность системы превышает 1 Эфлопс на т.н. разреженных вычислениях и достигает 120 Пфлопс при обычных FP16-вычислениях. Это первый в мире суперкомпьютер, который обеспечивает практически идеальное линейное масштабирование при работе с GPT-моделями, в частности, GPT-3, GPT-J и GPT-NeoX. Иначе говоря, при каждом удвоении числа комплексов CS-2 время обучения моделей сокращается почти в два раза. 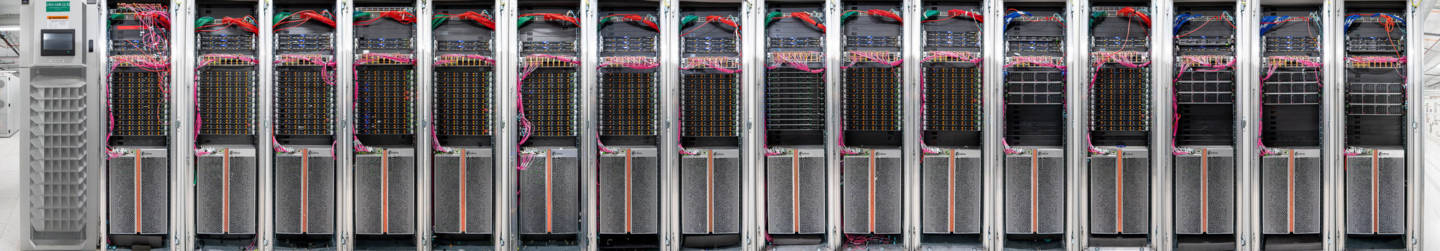 Суперкомпьютер смонтирован в дата-центре Colovore в Санта-Кларе (Калифорния, США). Стоимость системы составила приблизительно $30 млн, а на её развёртывание потребовалось всего три дня. Использовать ресурсы Andromeda могут одновременно несколько клиентов.
14.11.2022 [17:45], Сергей Карасёв
SiPearl и AMD создадут экзафлопсные суперкомпьютеры для Европы на Arm-процессорах и ускорителях InstinctSiPearl, европейский разработчик высокопроизводительных и энергоэффективных процессоров для суперкомпьютеров, и компания AMD объявили о сотрудничестве. Цель инициативы — ускорение создания HPC-систем экзафлопсного класса для Европы. На первом этапе стороны оценят совместимость ПО AMD ROCm с Arm-процессорами SiPearl Rhea. На основе полученных результатов будет создан оптимизированный софт, который расширит возможности названных чипов в сочетании с ускорителями AMD Instinct. Данная работа направлена на портирование и оптимизацию компонентов AMD HIP, компиляторов и библиотек OpenMP. На следующем этапе сотрудничество будет расширено за счёт привлечения сторонних европейских институтов, использующих инструменты моделирования исследований. Это позволит ключевым европейским разработчикам и владельцам кода переносить свои приложения на платформу SiPearl/AMD. Кроме того, планируется взаимодействовать с OEM-производителями, использующими чипы SiPearl Rhea вместе с ускорителями AMD Instinct. 
Источник изображения: SiPearl Предполагается, что сотрудничество поможет в создании экзафлопсных суперкомпьютеров для Европы, нацеленных на широкий спектр НРС-задач: это научные проекты, искусственный интеллект, здравоохранение, климат, энергетика, инженерия, геология и правительство. Стартап SiPearl начал операционную деятельность в январе 2020 года. В руководящий состав входят специалисты Atos, Intel, Marvell, MediaTek и STMicroelectronics. Ранее SiPearl сообщила о партнёрстве с HPE, а также о сотрудничестве с Intel и NVIDIA.
14.11.2022 [00:00], Игорь Осколков
Игра по новым правилам: AMD представила Genoa, четвёртое поколение серверных процессоров EPYCВсего за десять лет AMD совершила почти невозможное — практически полностью потеряла серверный рынок, а теперь не просто успешно его отвоёвывает, но и предлагает комплексное портфолио решений. Анонс четвёртого поколения процессоров EPYC под кодовым именем Genoa — это не технологическая победа над Intel, поскольку AMD даже не думала бороться с Sapphire Rapids и уж тем более с Ice Lake-SP, а ориентировалась на Granite Rapids. Но годовая задержка с выпуском Sapphire Rapids позволила AMD не только в более спокойном темпе доделывать чипы Genoa, которые вышли на полгода позже, чем задумывалось ранее, но и поработать с разработчиками и заказчиками. Компании удалось вернуть их доверие — победа в умах гораздо важнее, чем просто технологическое превосходство. А оно неоспоримо. 
Источник: AMD EPYC Genoa заключены в корпус 72×75 мм, содержат до 90 млрд транзисторов и состоят из 13 чиплетов: 12 CCD, изготовленных по 5-нм техпроцессу TSMC плюс один, изрядно увеличившийся в размерах, IO-блок, сделанный там же, но уже по 6-нм нормам. Отказ от услуг GlobalFoundries, которая так и не смогла освоить тонкие техпроцессы, случился как нельзя кстати, поскольку IO-блок становится крайне важным компонентом при таком количестве ядер, которые необходимо вовремя накормить данными. И Genoa интересны в первую очередь с точки зрения полноты и разнообразия IO, а не рекордного количества ядер. IO-чиплет оснащён новыми SerDes-блоками, которые обслуживают и PCIe 5.0, и Infinity Fabric 3.0 (IF/GMI3). Формально каждому чипу полагается 128 линий PCIe 5.0, но реальная конфигурация чуть сложнее. Во-первых, у каждого чипа есть ещё восемь (2 x4) бонусных линий PCIe 3.0 для подключения нетребовательных устройств и обвязки, но в 2S-конфигурации таких линий будет только 12. Во-вторых, для 2S можно задействовать три (3Link) или четыре (4Link) IF-подключения, получив 160 или 128 свободных линий PCIe 5.0 соответственно. 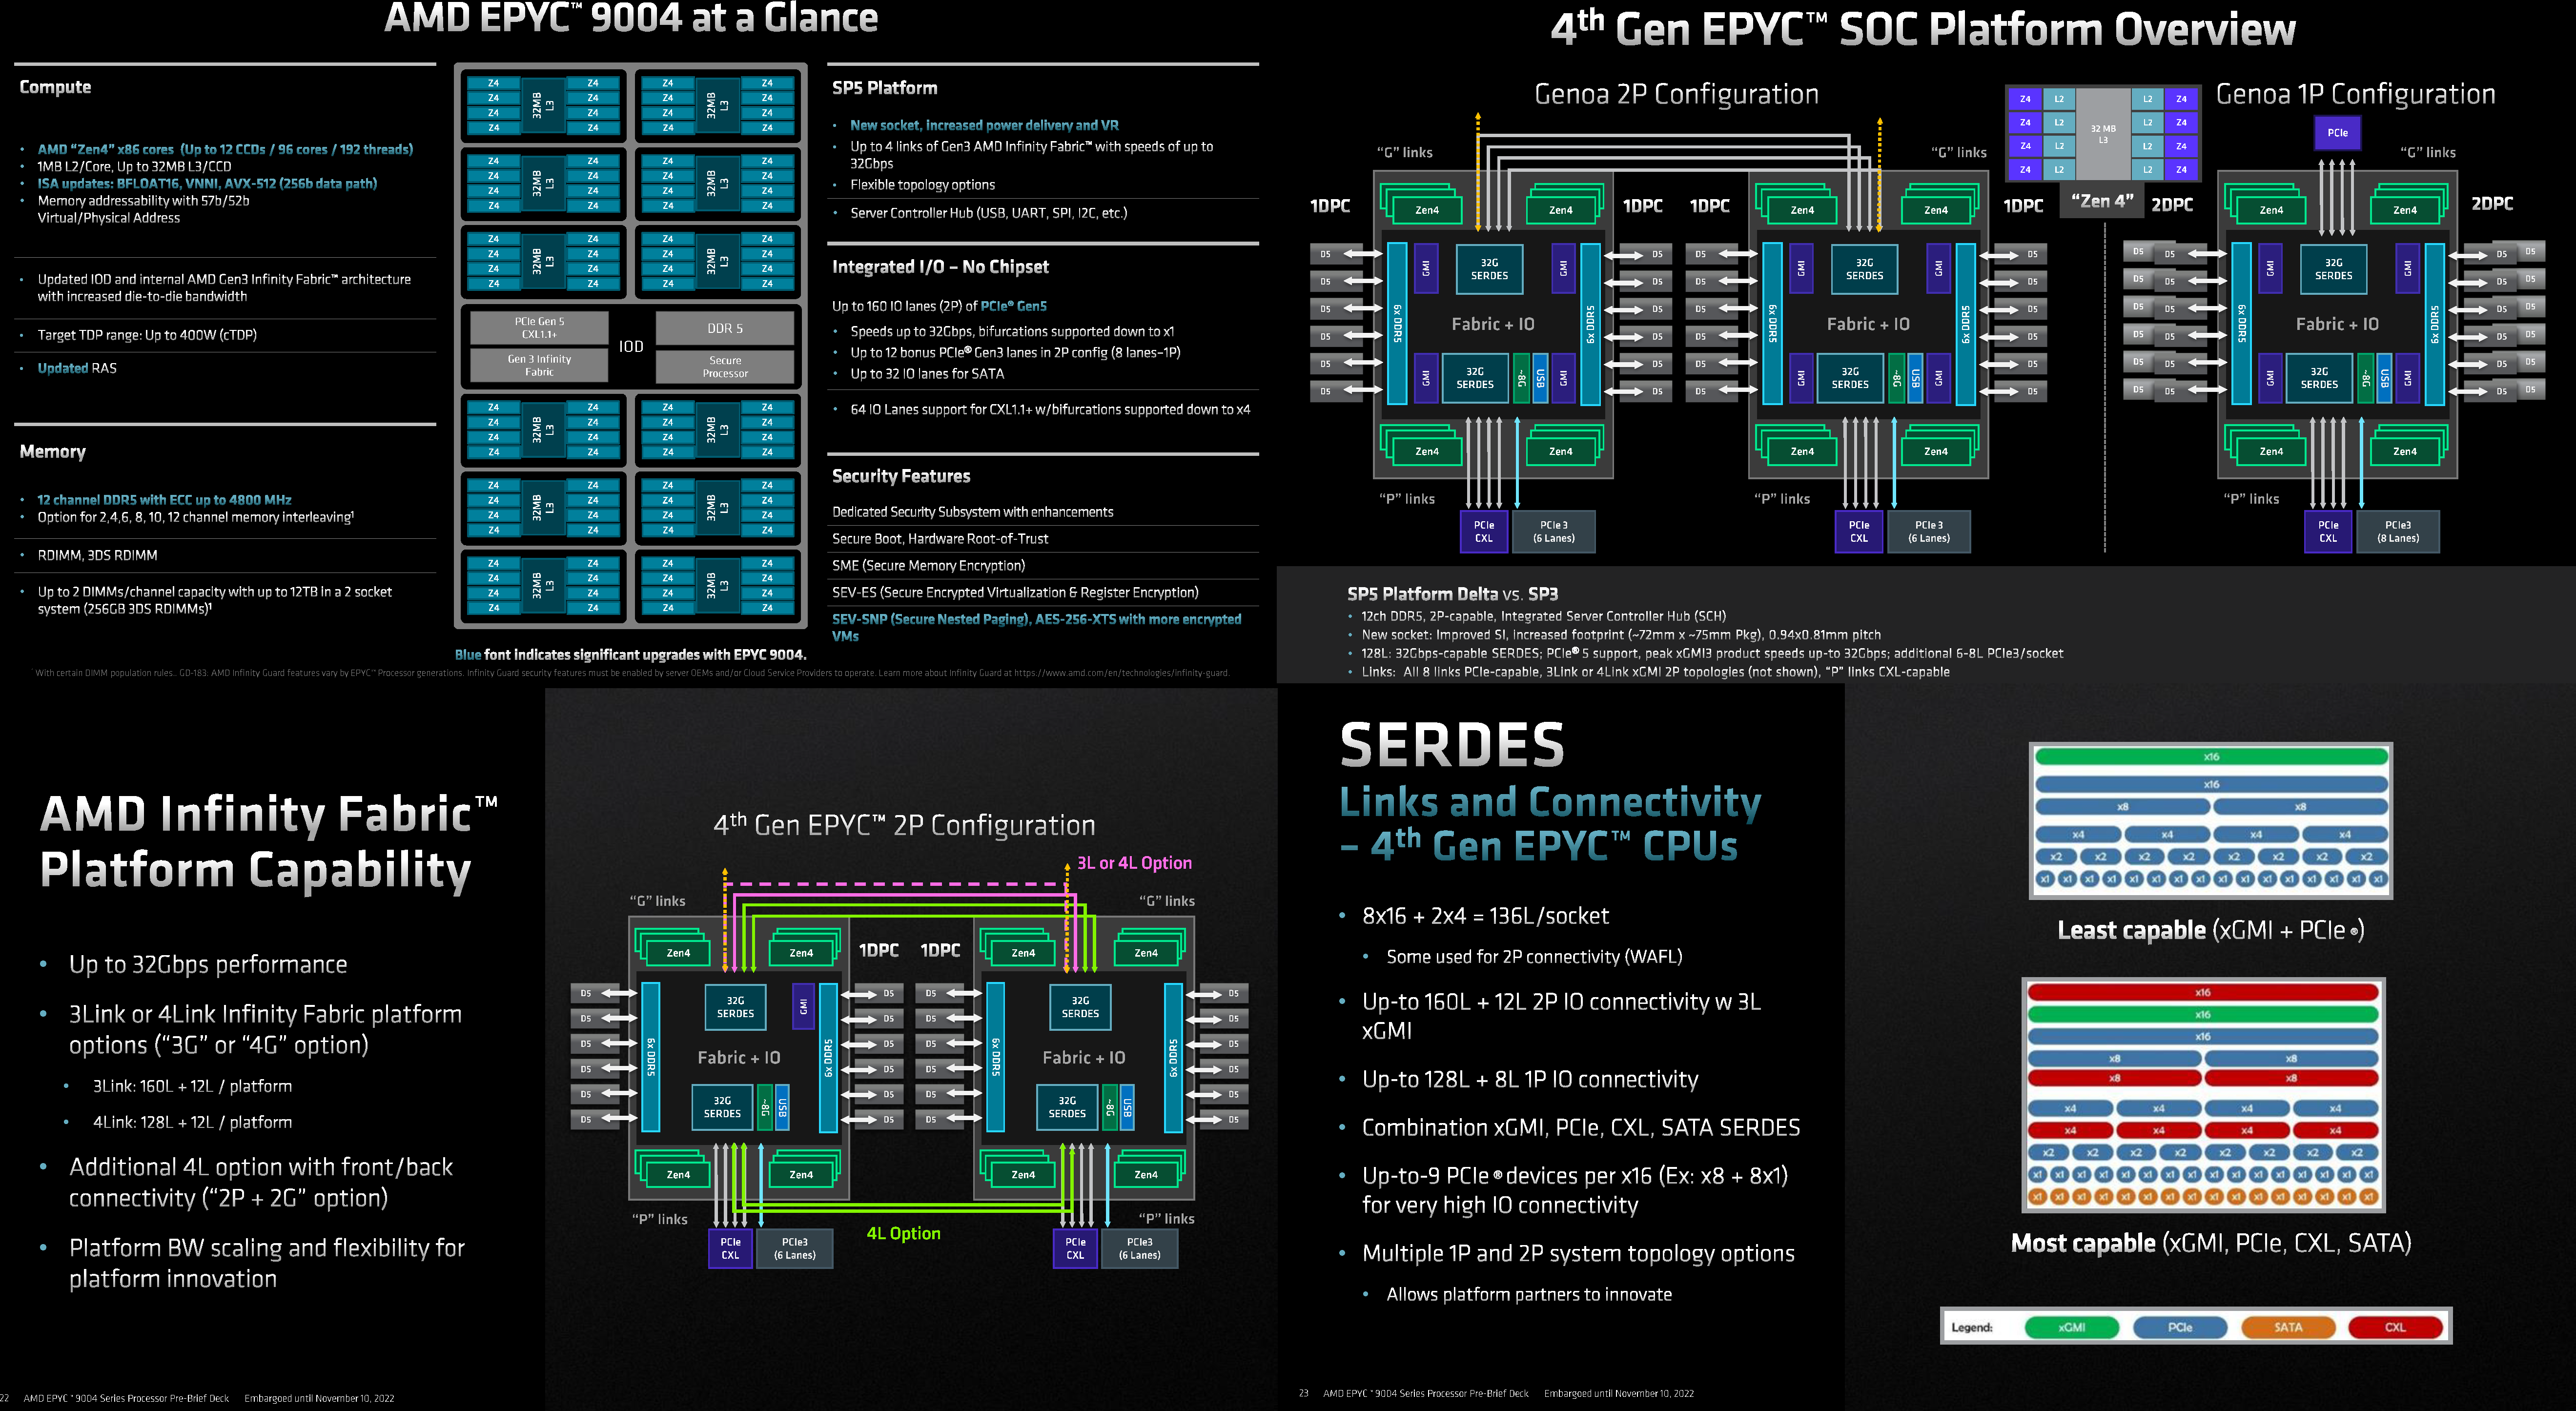
Изображения: AMD (via SemiAnalysis) В-третьих, каждый root-комплекс x16 может быть поделён между девятью устройствами (вплоть до x8 + восемь x1). Часть линий можно отдать на SATA (до 32 шт.), хотя это довольно расточительно. Но главное не это! Из 128 линий 64 поддерживают в полном объёме CXL 1.1 и частично CXL 2.0 Type 3, причём возможна бифуркация вплоть до x4. Ради такой поддержки CXL выход Genoa задержался на два квартала, но оно того определённо стоило — к процессору можно подключать RAM-экспандеры. И решения SK Hynix уже валидированы для новой платформы. CXL-память будет выглядеть как NUMA-узел (без CPU) — задержки обещаны примерно те же, что и при обращении к памяти в соседнем сокете, а пропускная способность одного CXL-подключения x16 почти эквивалентна двум каналам DDR5. При этом для CXL-памяти прозрачно поддерживаются всё те же функции безопасности, включая SME/SEV/SNP (теперь ключей стало аж 1006, а алгоритм обновлён до 256-бит AES-XTS). Отдельно для CXL-памяти внедрена поддержка SMKE (secure multi-key encryption), с помощью которой гипервизор может оставлять зашифрованными выбранные области SCM-устройств (до 64 ключей) между перезагрузками. 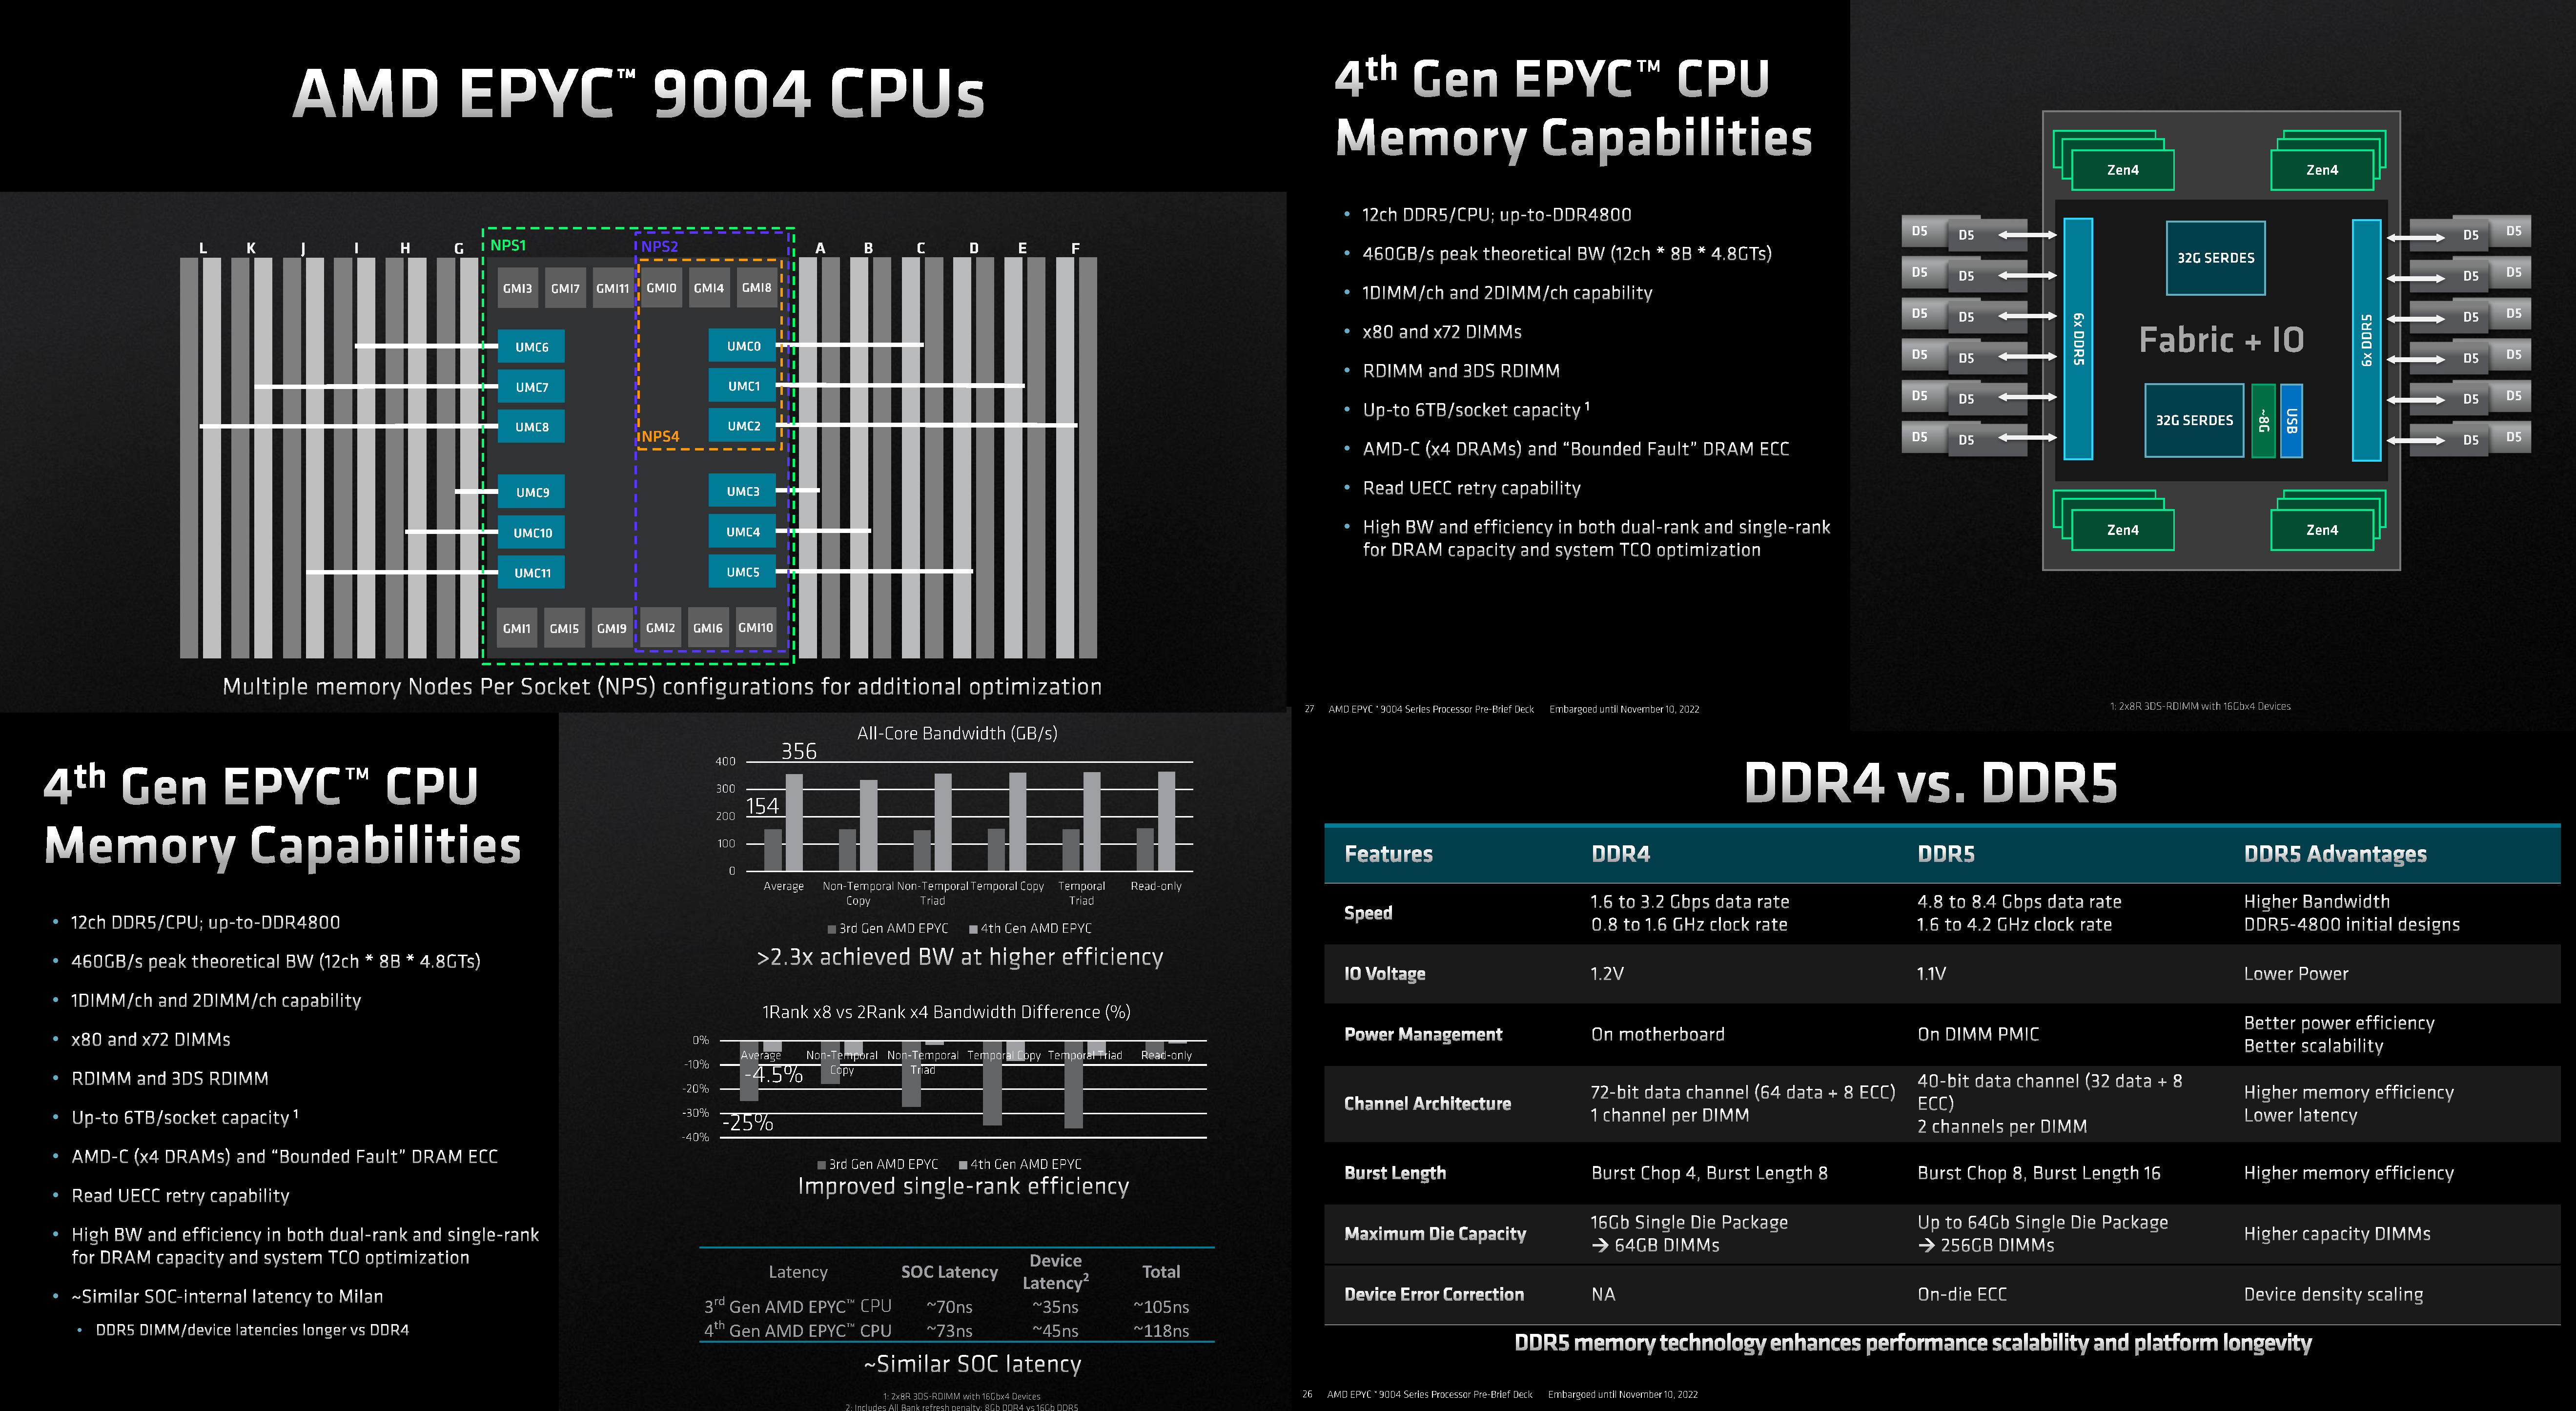
Изображения: AMD (via SemiAnalysis) Такая гибкость при работе с памятью крайне важна для тех же гиперскейлеров. DDR5 по сравнению с DDR4 вчетверо плотнее, вполовину быстрее и… пока значительно дороже. И здесь AMD снова пошла им навстречу, добавив поддержку 72-бит памяти, а не только стандартной 80-бит, сохранив и расширив механизмы коррекции ошибок. 10-% разница в количестве DRAM-чипов при сохранении той же ёмкости на масштабах в десятки и сотни тысяч серверов выливается в круглую сумму. Кроме того, в Genoa сглажена разница в производительности между одно- и двухранговыми модулями с 25 % (в случае Milan) до 4,5 %. Что примечательно, AMD удалось сохранить сопоставимый уровень задержки обращений к памяти между поколениями CPU: 118 нс против 108 нс, из которых только 3 нс приходится на IO-блок, а 10 нс уже на саму память. Теоретическая пиковая пропускная способность памяти составляет 460,8 Гбайт/с на сокет. Однако тут есть нюансы. Genoa имеет 12 каналов памяти DDR5-4800, которые способны вместить до 6 Тбайт RAM. Однако сейчас фактически доступен только режим 1DPC, а вот 2DPC, судя по всему, появится только в следующем году. Genoa поддерживает модули (3DS) RDIMM и предлагает чередование с шагом в 2, 4, 6, 8, 10 или 12 каналов. 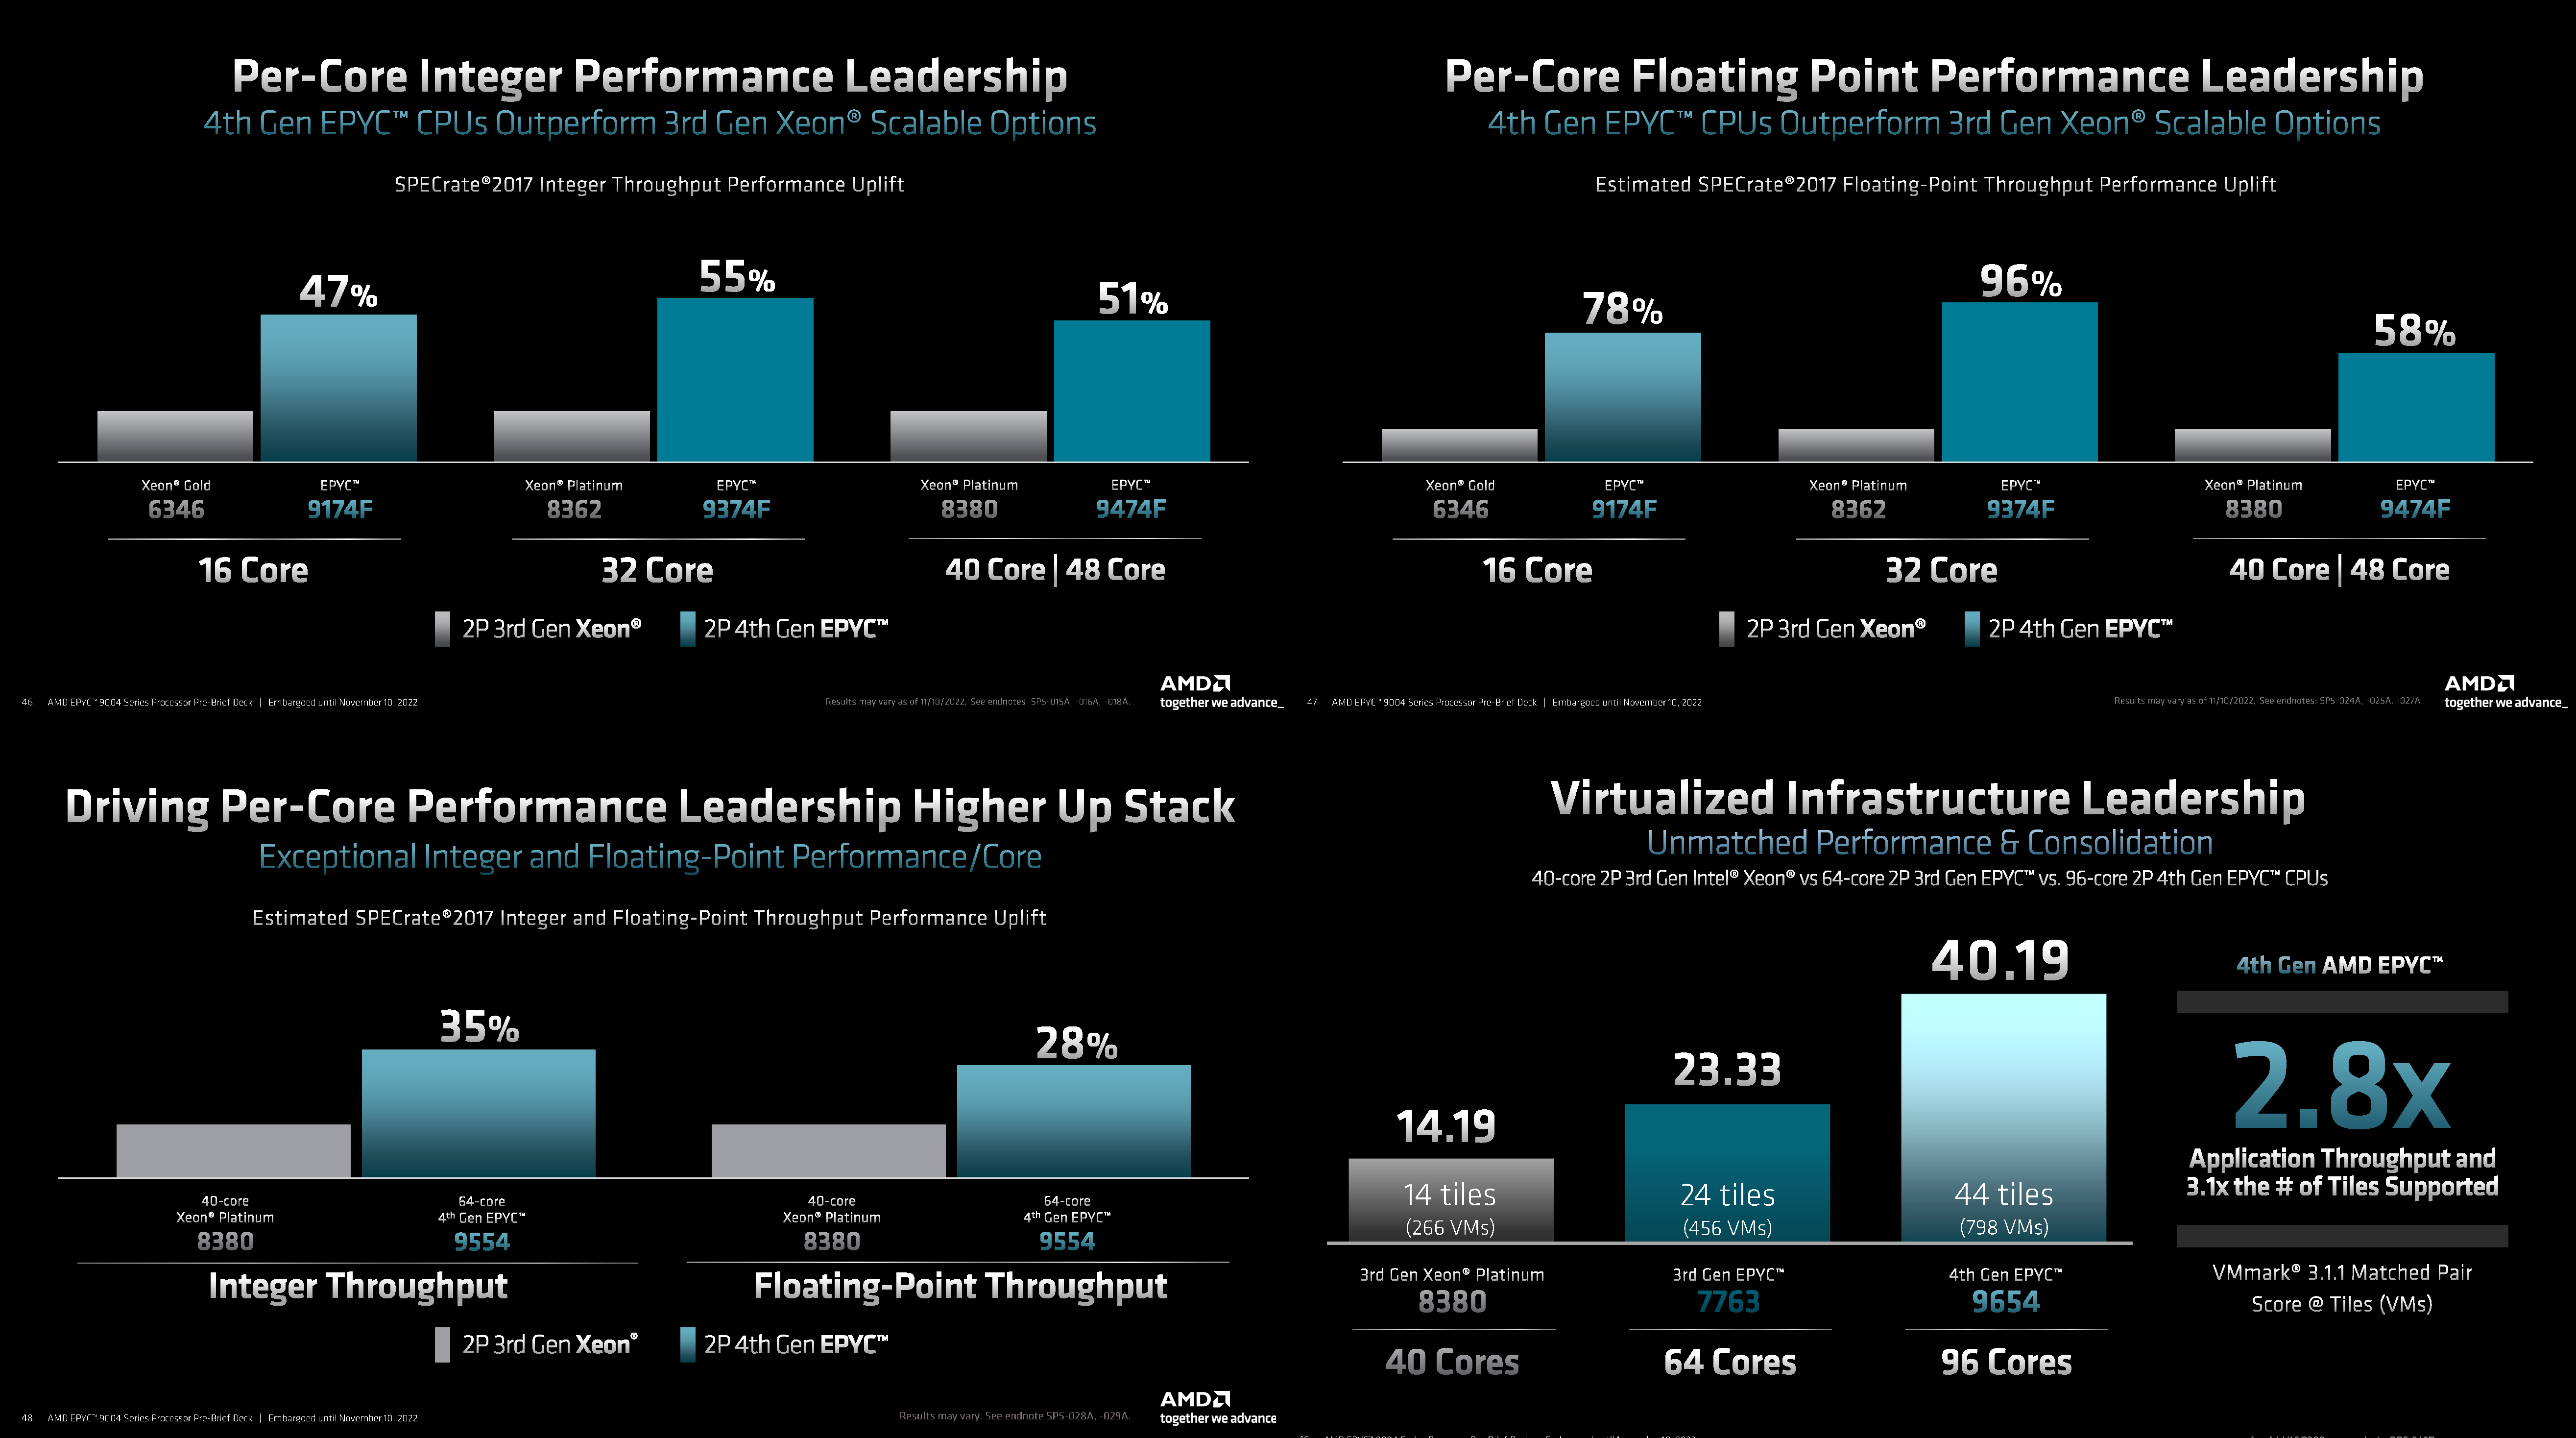
Изображения: AMD (via SemiAnalysis)
Каждый чип можно разбить на два (NPS2) или четыре (NPS4) равных NUMA-домена, а при большом желании и «прибить» L3-кеш к ядрам в том же CCD, получив уже 12 доменов. Но, по словам AMD, это нужно лишь в редких случаях, чтобы выжать ещё несколько процентов производительности. И это снова возвращает нас к особенностям IO-блока. Дело в том, что у каждого CCD есть сразу два GMI-порта. Но в конфигурациях с 8 и 12 CCD используется только один из них, а вот в случае 4 CCD — оба. Интересно, задействует ли AMD «лишние» порты для подключения других блоков. Впрочем, AMD, имея столь гибкие возможности конфигурации моделей, ограничилась относительно скромным начальным набором CPU, которые включает всего 18 моделей с числом ядер от 16 до 96, из которых четыре имеют индекс P (односокетные, чуть дешевле) и четыре — F (выше частота, больше объём L3-кеша). Модельный ряд условно делится на три группы: повышенная производительность на ядро (F-серия), повышенная плотность ядер и повышенный показатель TCO (с относительно малым количеством ядер). 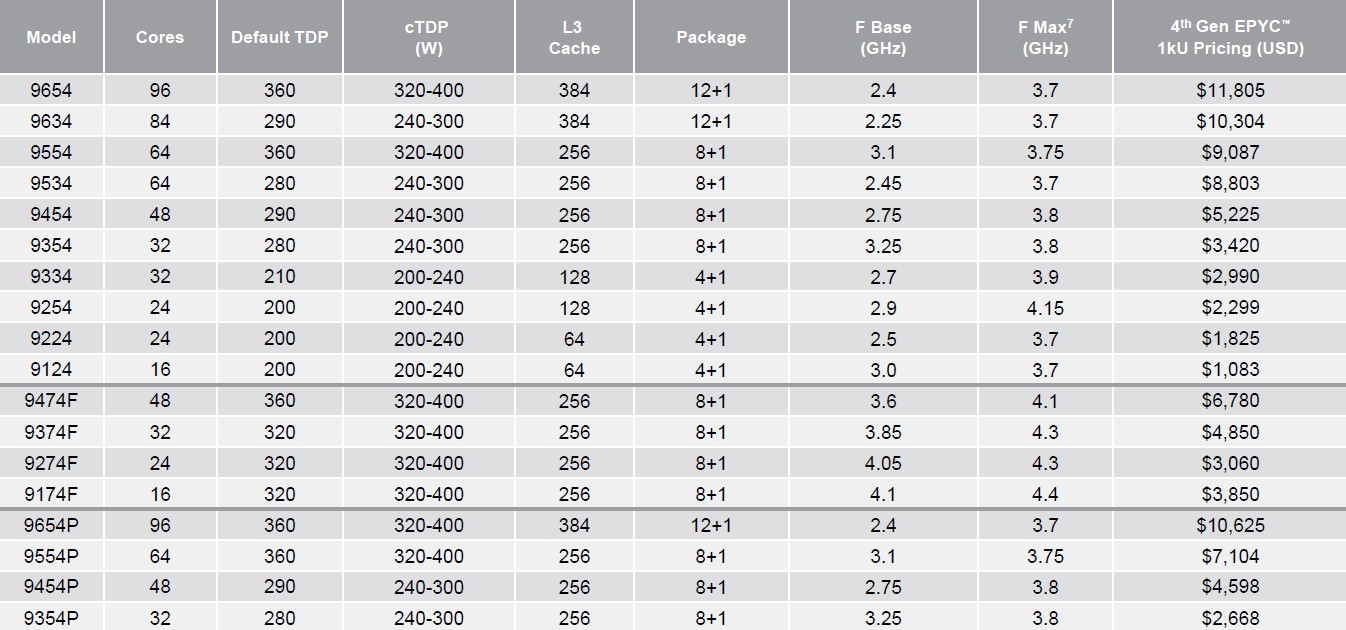
Источник: AMD (via ServeTheHome) На первый взгляд может показаться, что и цены на новинки заметно выросли, но это не совсем так. Например, у топовых моделей условная стоимость одного ядра (а их стала в полтора раза больше) так и крутится около «магического» значения в $123. Но с учётом возросшей производительности на ценовую политику AMD просто грех жаловаться. Прирост IPC между Zen3 и Zen4 составил 14 %, в том числе благодаря увеличению L2-кеша до 1 Мбайт на ядро (L1 и L3 остались без изменений), но не только. Есть и другие улучшения. Например, обновлённый контроллер прерываний AVIC позволяет практически полностью насытить не только 200G, но 400G NIC. С учётом чуть возросших частот и просто катастрофической разнице в количестве ядер топовый вариант Genoa не только значительно обгоняет Milan, но и в два-три раза быстрее старшего Ice Lake-SP. Дело ещё в и том, что Genoa обзавелись поддержкой AVX-512, в том числе инструкций VNNI (DL Boost), которыми так долго хвасталась Intel, а также BF16. Но реализация сделана иначе. У Intel используются «полноценные» 512-бит блоки, дорогие с точки зрения энергопотребления и затрат кремния. AMD же пошла по старому пути, используя 256-бит операции и несколько циклов, что позволяет не так агрессивно сбрасывать частоты. 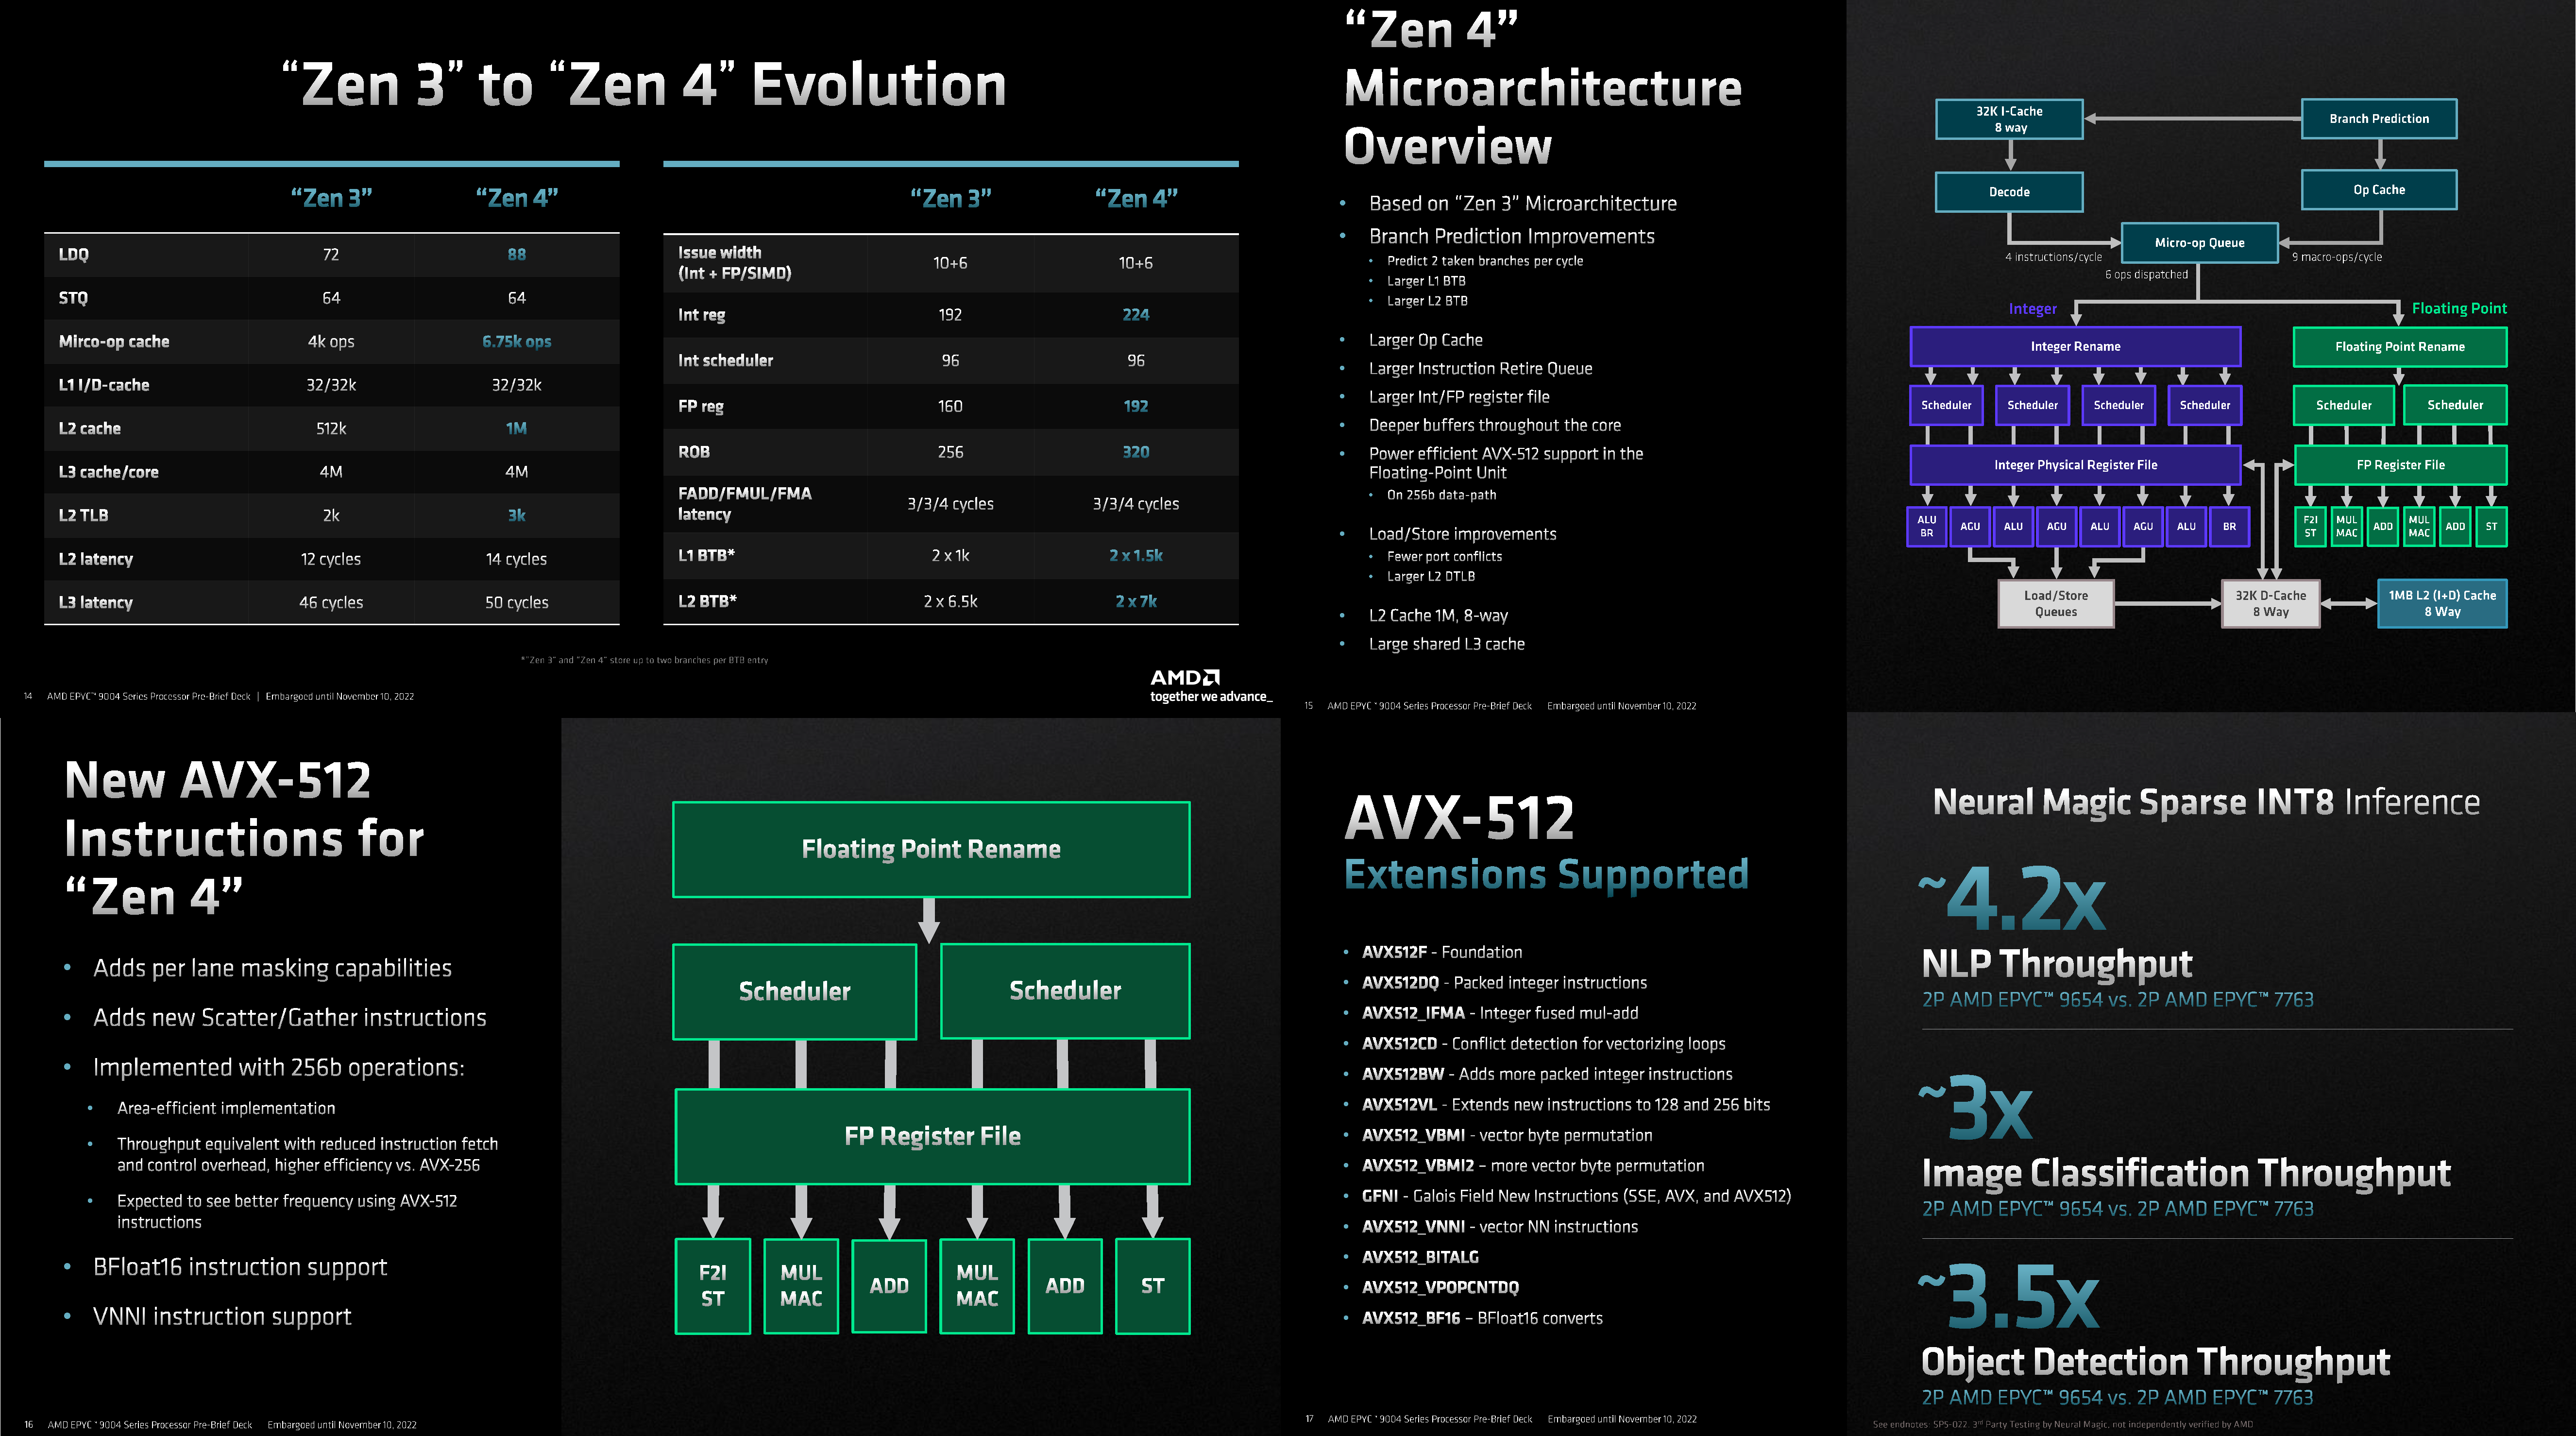
Изображения: AMD (via SemiAnalysis) Переход на новый техпроцесс, а также обновлённые подсистемы мониторинга и управления питанием позволили сохранить TDP в разумных пределах от 200 Вт до 360 Вт (cTDP до 400 Вт), что всё ещё позволяет обойтись воздушным охлаждением — всего + 80 Вт для старших процессоров при полуторакратном росте числа ядер. Таким образом, AMD имеет полное право заявлять, что Genoa лидирует по производительности, плотности размещения вычислительных мощностей, энергоэффективности и, в целом, по уровню TCO. У Intel же пока преимущество в более высокой доступности продукции в сложившейся геополитической обстановке. Отдельный вопрос, как AMD будет распределять имеющиеся мощности по выпуску Genoa между гиперскейлерами, корпоративным сектором и HPC-сегментом. Впрочем, компания в любом случае меняет рынок, иногда неожиданным образом. В частности, VMware, которая когда-то из-за EPYC изменила политику лицензирования, была вынуждена дополнительно оптимизировать свои продукты для Genoa. В конце концов, где вы раньше видели 2S-платформу со 192 ядрами и 384 потоками?
10.11.2022 [17:15], Владимир Мироненко
HPE анонсировала недорогие, энергоэффективные и компактные суперкомпьютеры Cray EX2500 и Cray XD2000/6500Hewlett Packard Enterprise анонсировала суперкомпьютеры HPE Cray EX и HPE Cray XD, которые отличаются более доступной ценой, меньшей занимаемой площадью и большей энергоэффективностью по сравнению с прошлыми решениями компании. Новинки используют современные технологии в области вычислений, интерконнекта, хранилищ, питания и охлаждения, а также ПО. 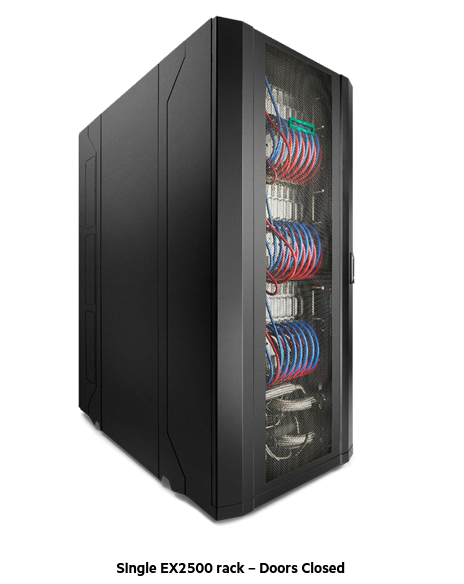
Изображение: HPE Суперкомпьютеры HPE обеспечивают высокую производительность и масштабируемость для выполнения ресурсоёмких рабочих нагрузок с интенсивным использованием данных, в том числе задач ИИ и машинного обучения. Новинки, по словам компании, позволят ускорить вывода продуктов и сервисов на рынок. Решения HPE Cray EX уже используются в качестве основы для больших машин, включая экзафлопсные системы, но теперь компания предоставляет возможность более широкому кругу организаций задействовать супервычисления для удовлетворения их потребностей в соответствии с возможностями их ЦОД и бюджетом. В семейство HPE Cray вошли следующие системы:
Все три системы задействуют те же технологии, что и их старшие собратья: интерконнект HPE Slingshot, хранилище Cray Clusterstor E1000 и пакет ПО HPE Cray Programming Environment и т.д. Система HPE Cray EX2500 поддерживает процессоры AMD EPYC Genoa и Intel Xeon Sapphire Rapids, а также ускорители AMD Instinct MI250X. Модель HPE Cray XD6500 поддерживает чипы Sapphire Rapids и ускорители NVIDIA H100, а для XD2000 заявлена поддержка AMD Instinct MI210. 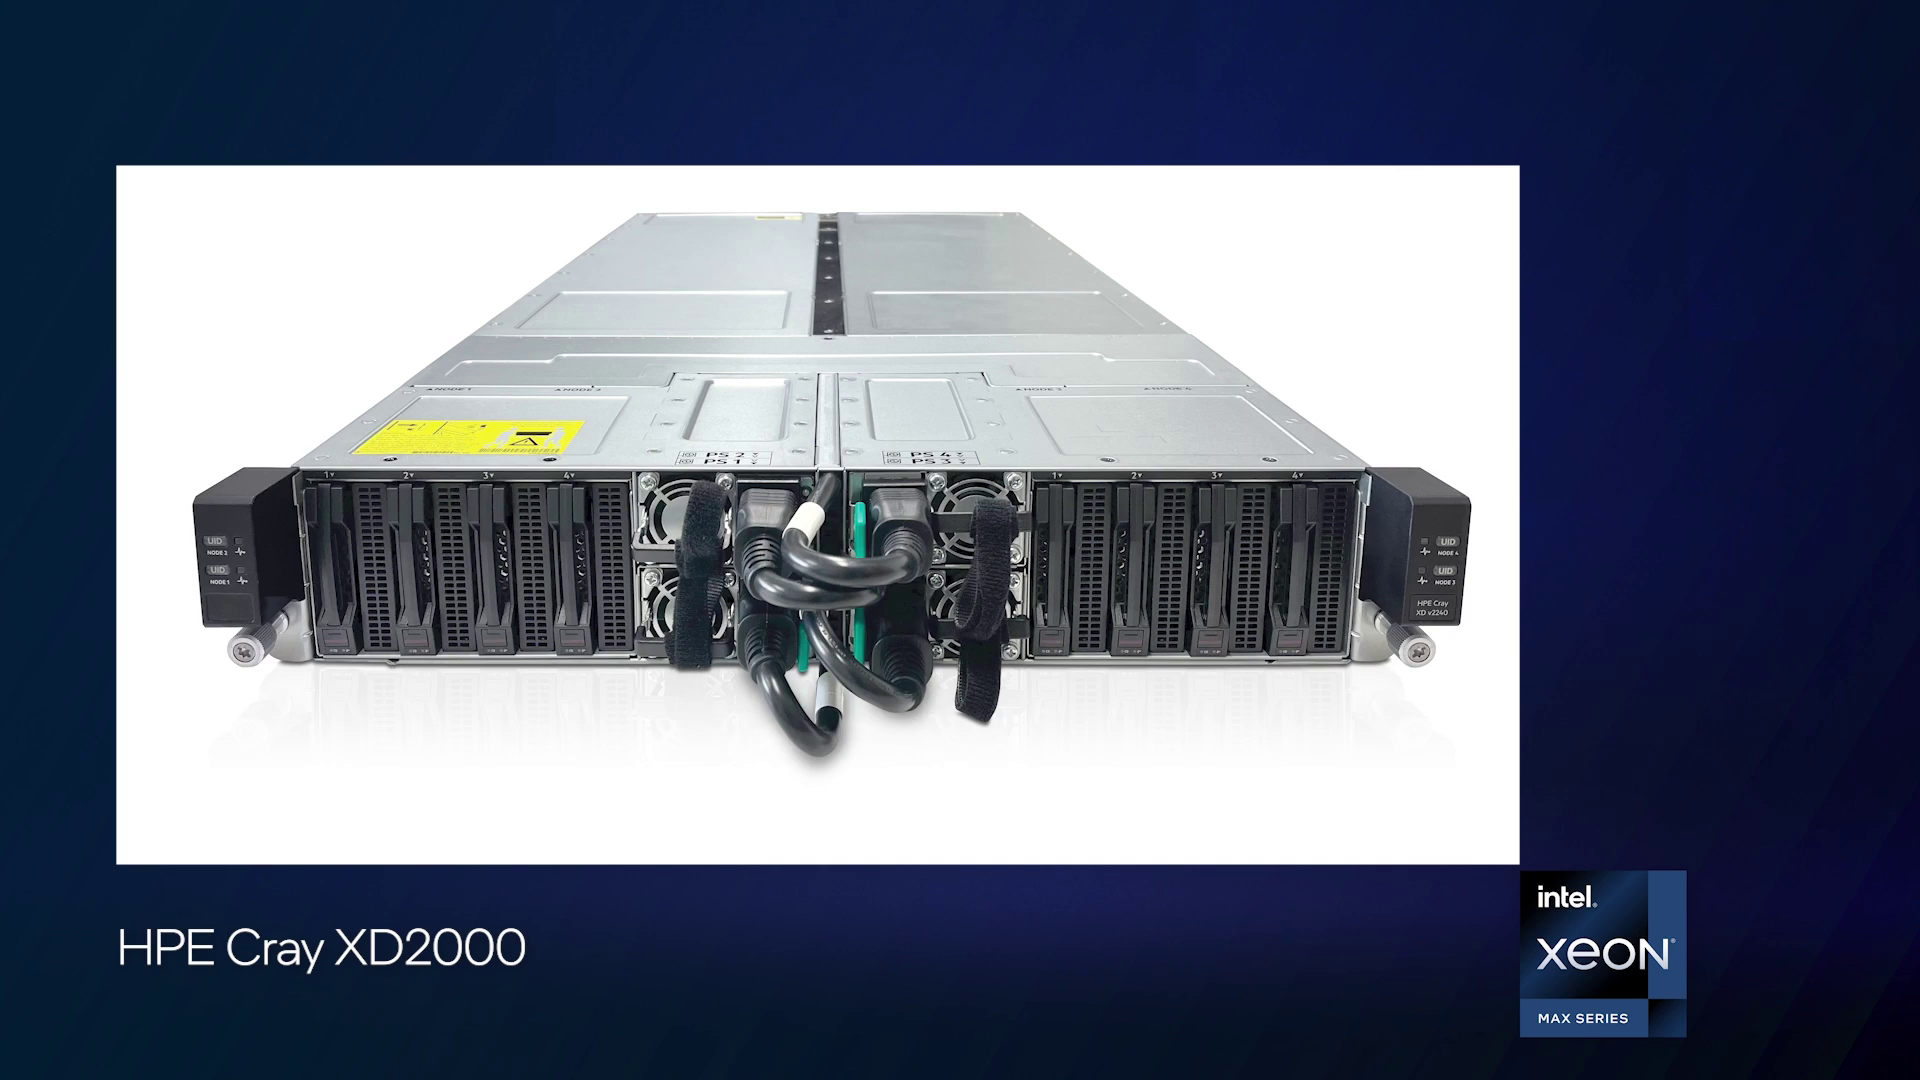
Изображение: Intel В качестве примеров выгод от использования анонсированных суперкомпьютеров в разных отраслях компания назвала:
10.11.2022 [01:55], Игорь Осколков
Intel объединила HBM-версии процессоров Xeon Sapphire Rapids и ускорители Xe HPC Ponte Vecchio под брендом MaxВ преддверии SC22 и за день до официального анонса AMD EPYC Genoa компания Intel поделилась некоторыми подробностями об HBM-версии процессоров Xeon Sapphire Rapids и ускорителях Ponte Vecchio, которые теперь входят в серию Intel Max. 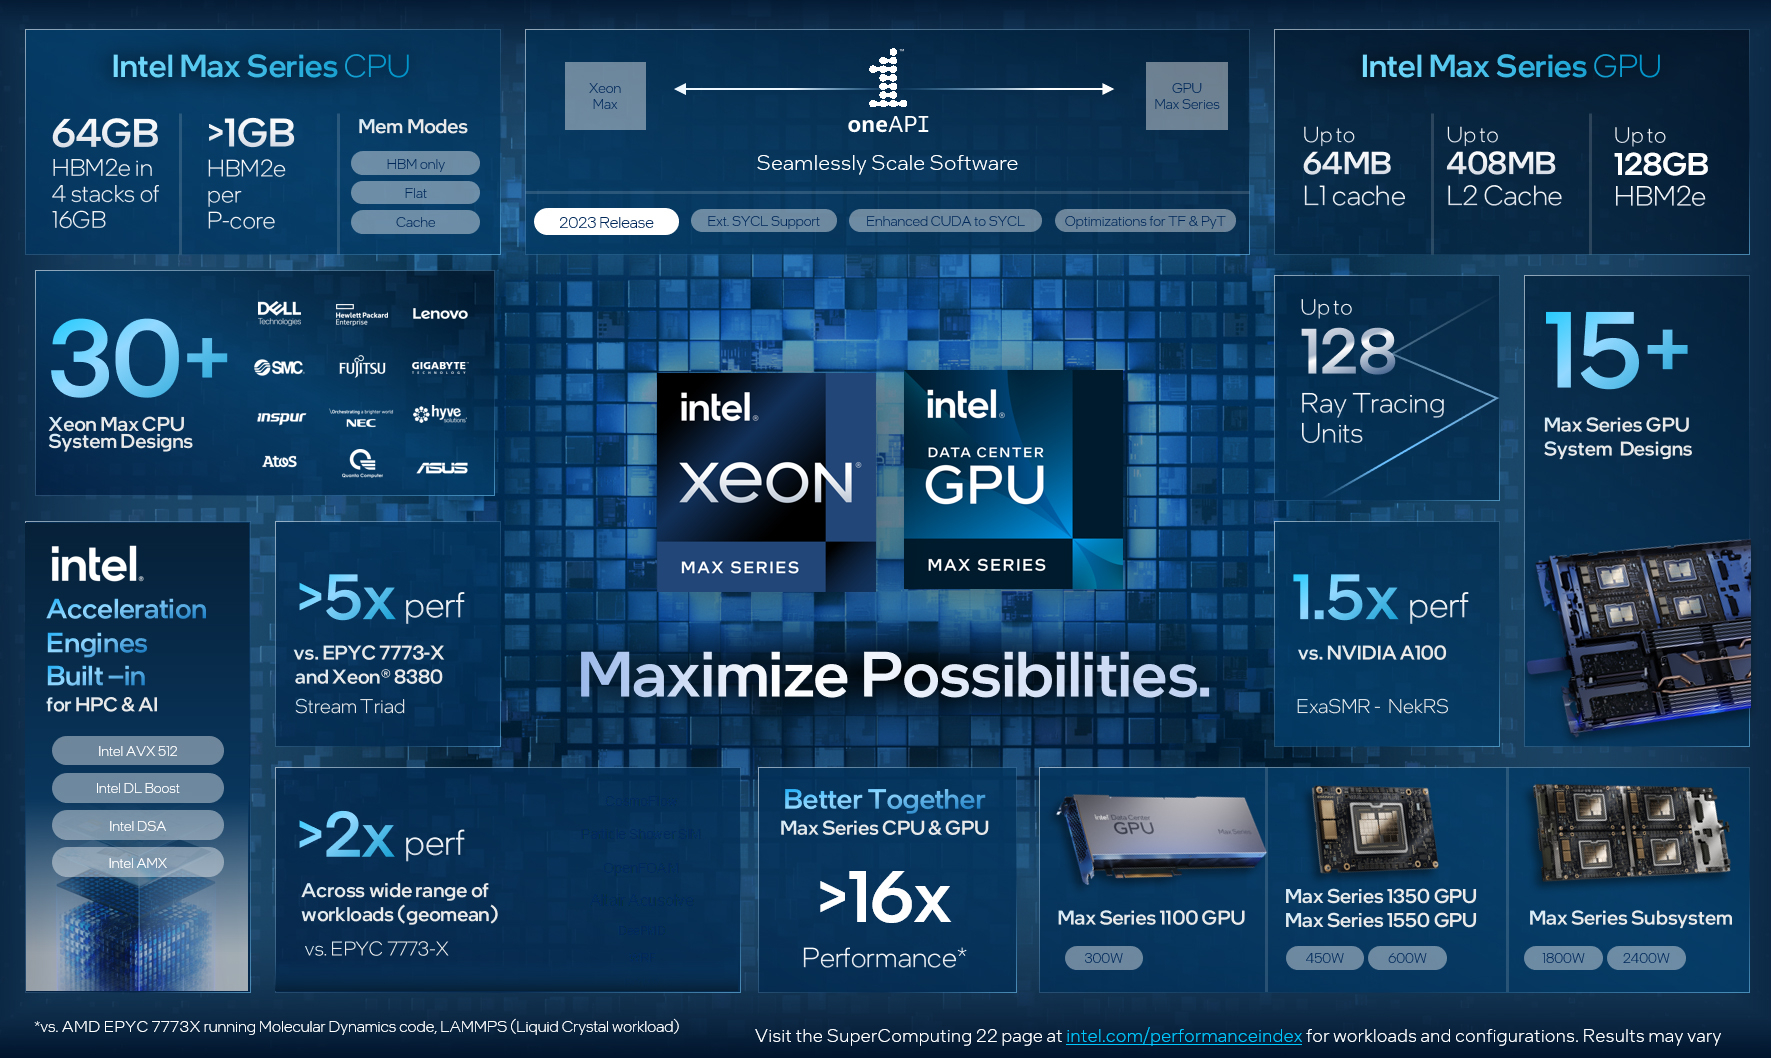
Изображения: Intel Intel Xeon Max предложат до 56 P-ядер, 112,5 Мбайт L3-кеша, 64 Гбайт HBM2e-памяти (четыре стека) с пропускной способностью порядка 1 Тбайт/с, 8 каналов памяти (DDR5-4800 в случае 1DPC, суммарно до 6 Тбайт), а также интерфейсы PCIe 5.0, CXL 1.1, UPI 2.0 и целый ряд различных технологий ускорения для задач HPC и ИИ: AVX-512, DL Boost, AMX, DSA, QAT и т.д. Заявленный уровень TDP составляет 350 Вт. 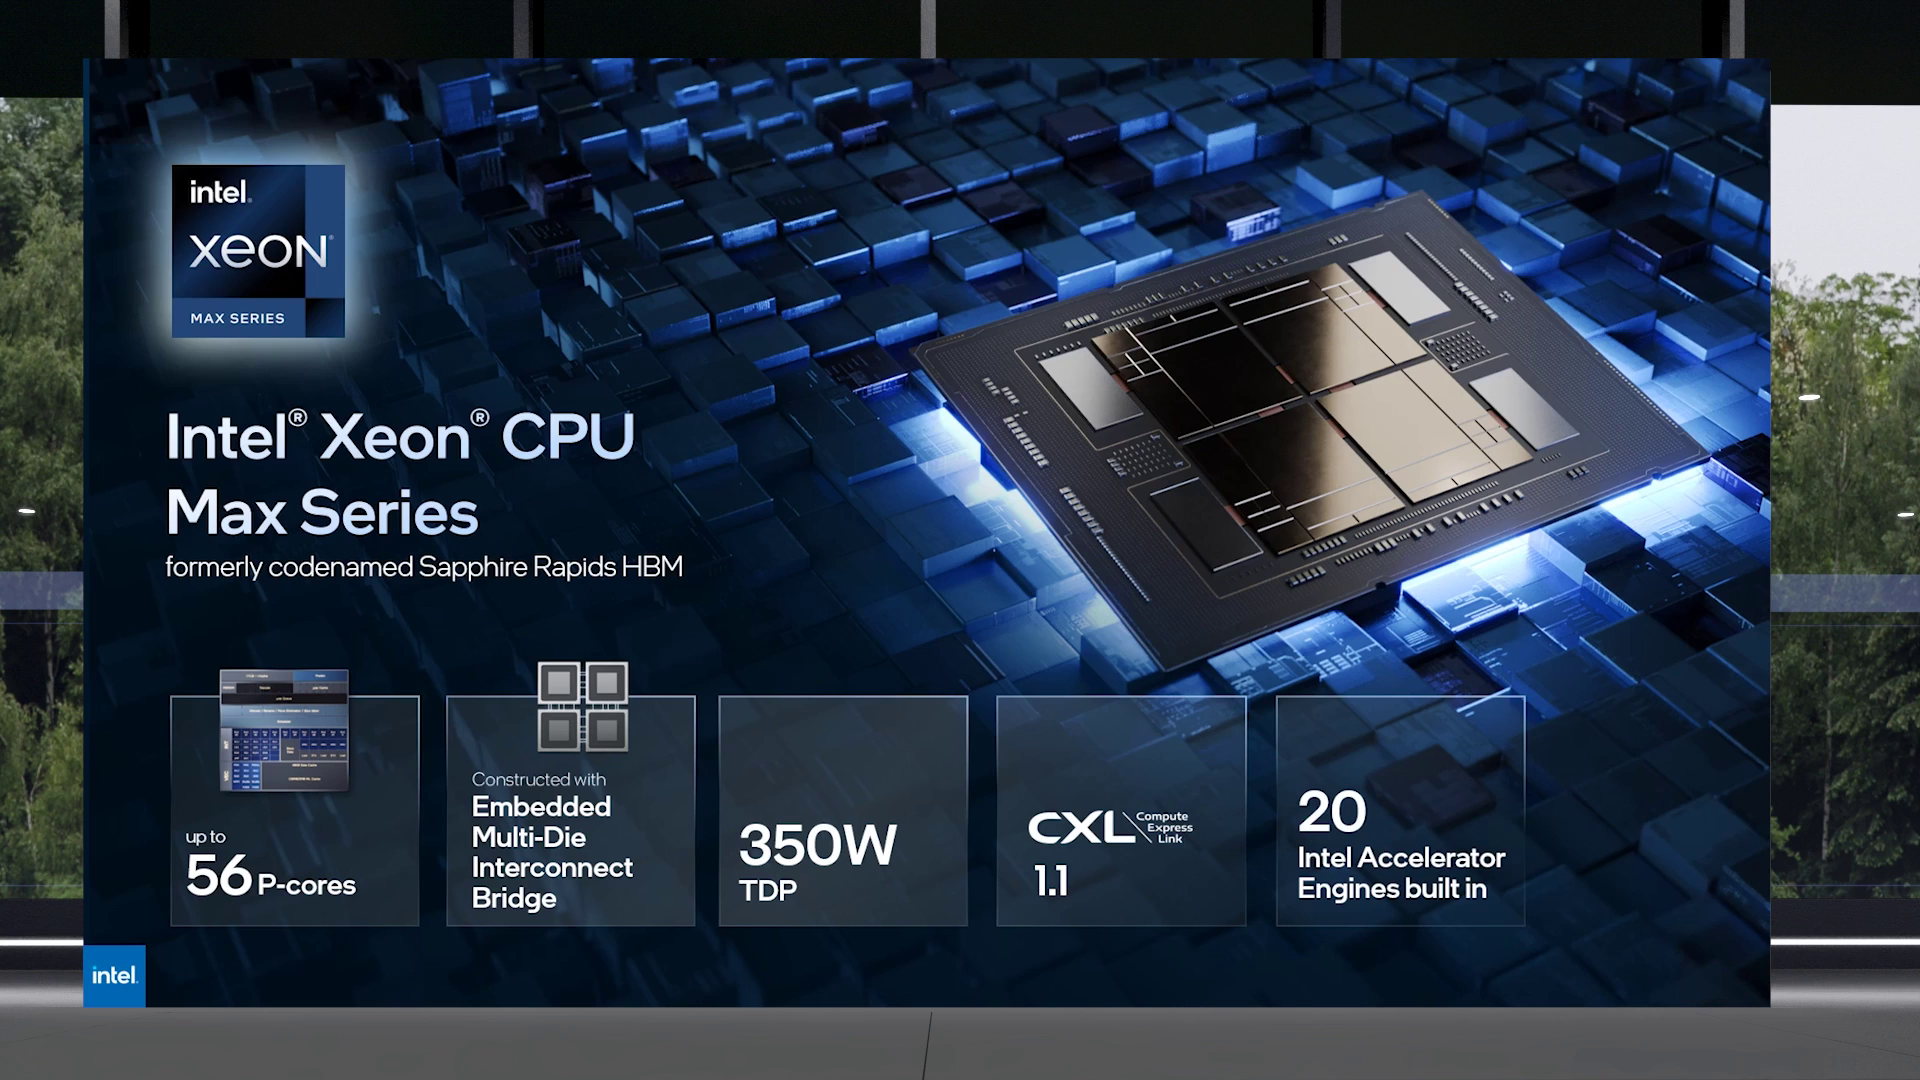 Первым процессором с набортной HBM-памятью был Arm-чип Fujitsu A64FX (48 ядер, 32 Гбайт HBM2), лёгший в основу суперкомпьютера Fugaku. Intel поднимает планку, давая более 1 Гбайт быстрой памяти на каждое ядро. А поскольку процессор состоит из четырёх отдельных чиплетов, возможно создание четырёх NUMA-доменов с выделенными HBM- и DDR-контроллерами. Но и монолитный режим тоже имеется. А поддержка CXL даёт возможность задействовать RAM-экспандеры. 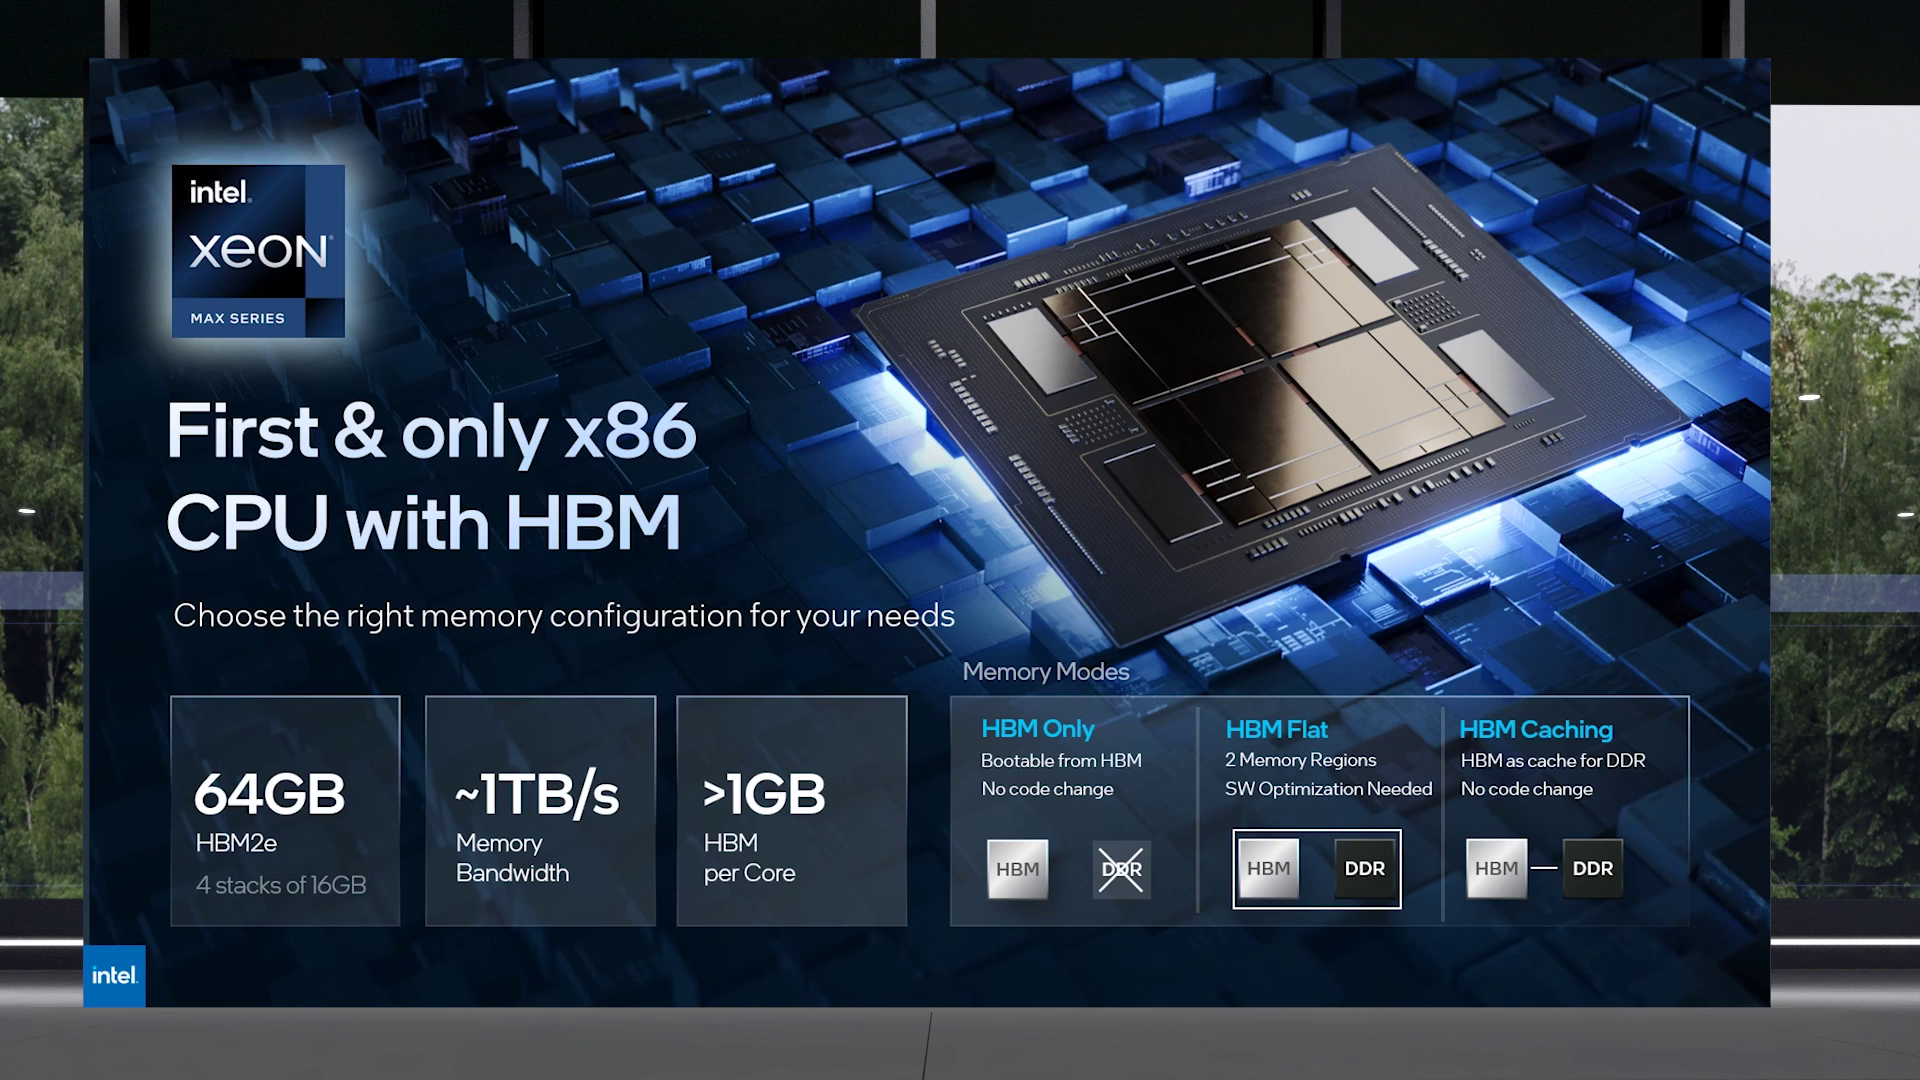 Intel Xeon Max поддерживают 2S-платформы, что суммарно даёт уже 128 Гбайт HBM-памяти, которых вполне хватит для целого ряда задач. Новые процессоры действительно могут обходиться без DIMM. Но есть и два других режима. В первом HBM-память работает в качестве кеша для обычной памяти, и для системы это происходит прозрачно, так что никаких модификаций для ПО (как в случае отсутствия DIMM вообще) не требуется. Во втором режиме HBM и DDR представлены как отдельные пространства, так что тут дорабатывать ПО придётся, зато можно добиться более эффективного использования обоих типов памяти.
В презентации Intel сравнивает новые Xeon Max с AMD EPYC Milan-X – в зависимости от задачи прирост составляет от +20 % до 4,8 раз. Но, во-первых, уже сегодня эти тесты потеряют всякий смысл в связи с презентацией EPYC Genoa (которые, к слову, должны получить AVX-512), а во-вторых, в следующем году AMD обещает представить Genoa-X с 3D V-Cache. Intel же явно не оставляет попытки создать как можно более универсальный процессор. 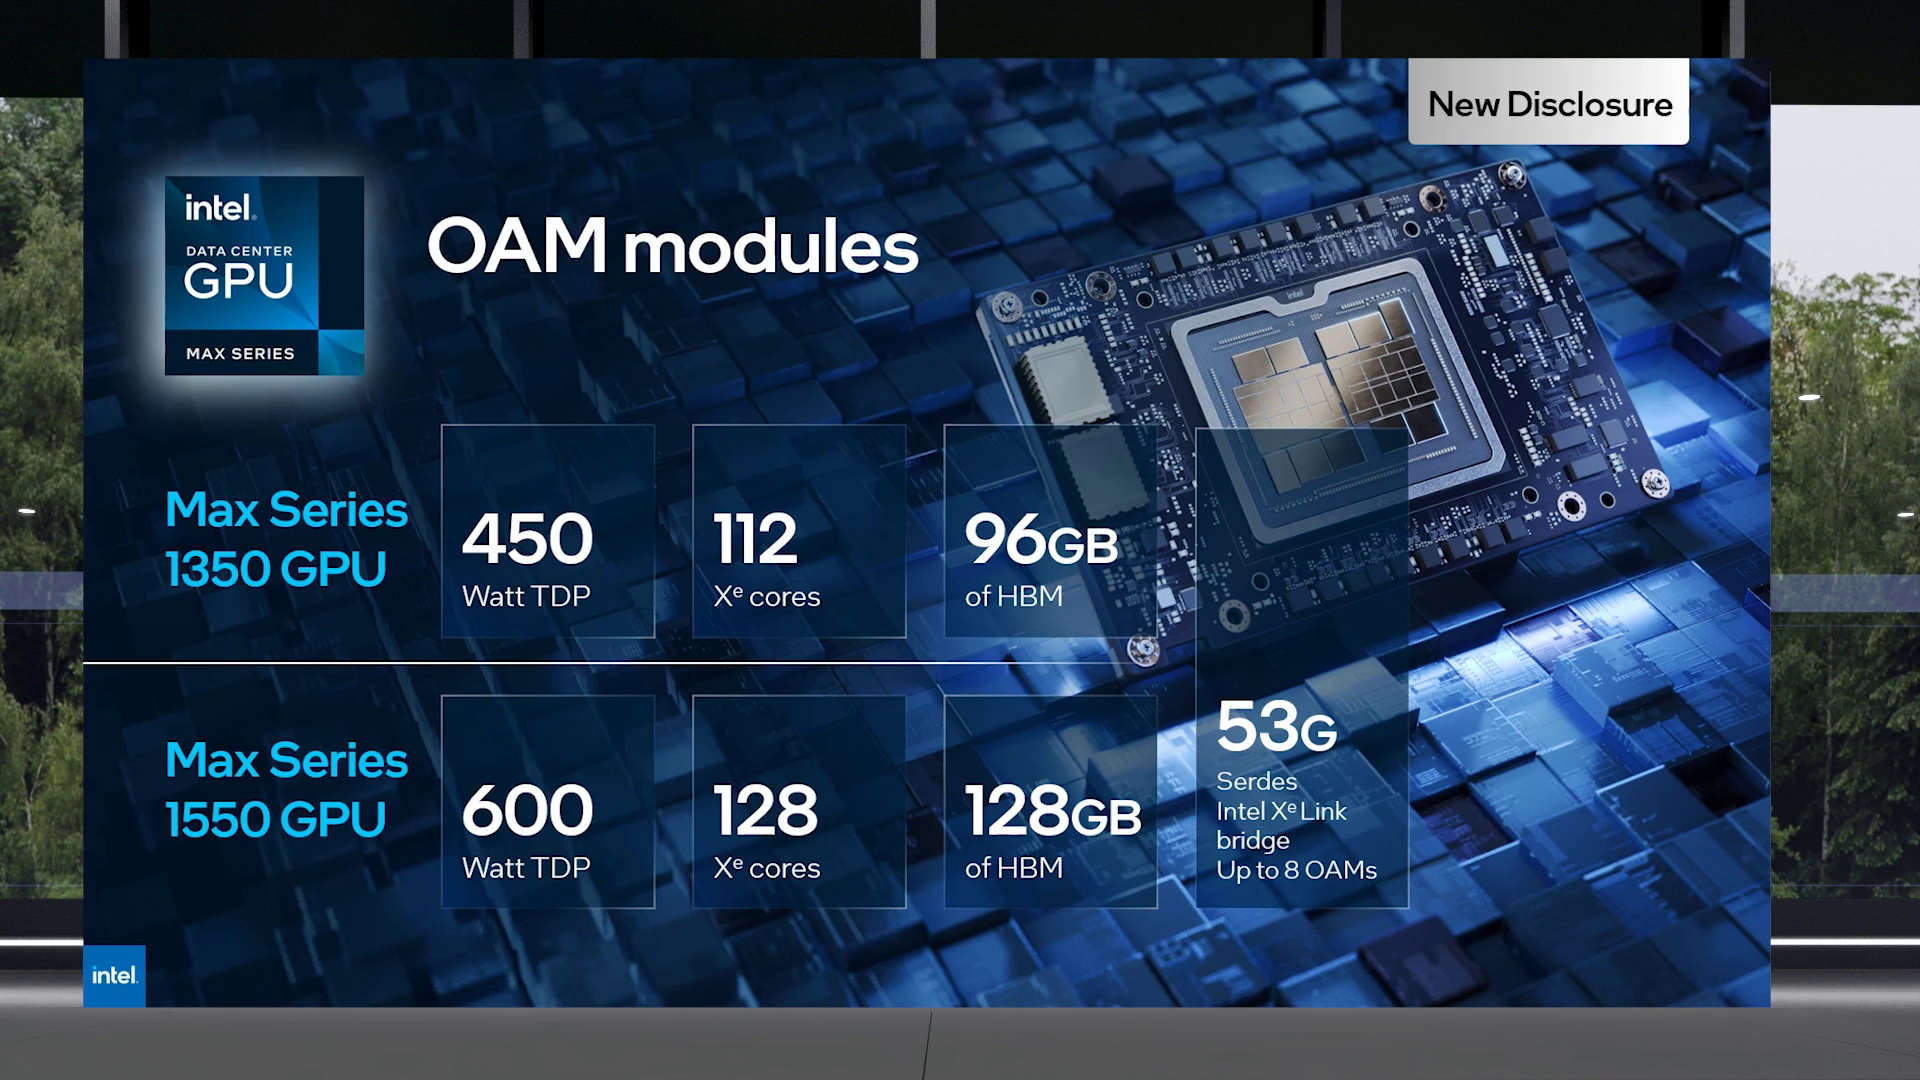 Что касается Ponte Vecchio, которые теперь называются Max GPU, то практически ничего нового относительно строения и особенностей данных ускорителей Intel не сказала: до 128 ядер Xe (только теперь стало известно об аппаратном ускорении трассировки лучей, что важно для визуализации), 64 Мбайт L1-кеша и аж 408 Мбайт L2-кеша (из них 120 Мбайт приходится на Rambo-кеш в двух стеках), 16 линий Xe Link, 8 HBM2e-контроллеров на 128 Гбайт памяти и пиковая FP64-производительность на уровне 52 Тфлопс. Все эти характеристики относятся к старшей модели Max Series 1550 в OAM-исполнении с TDP в 600 Вт. 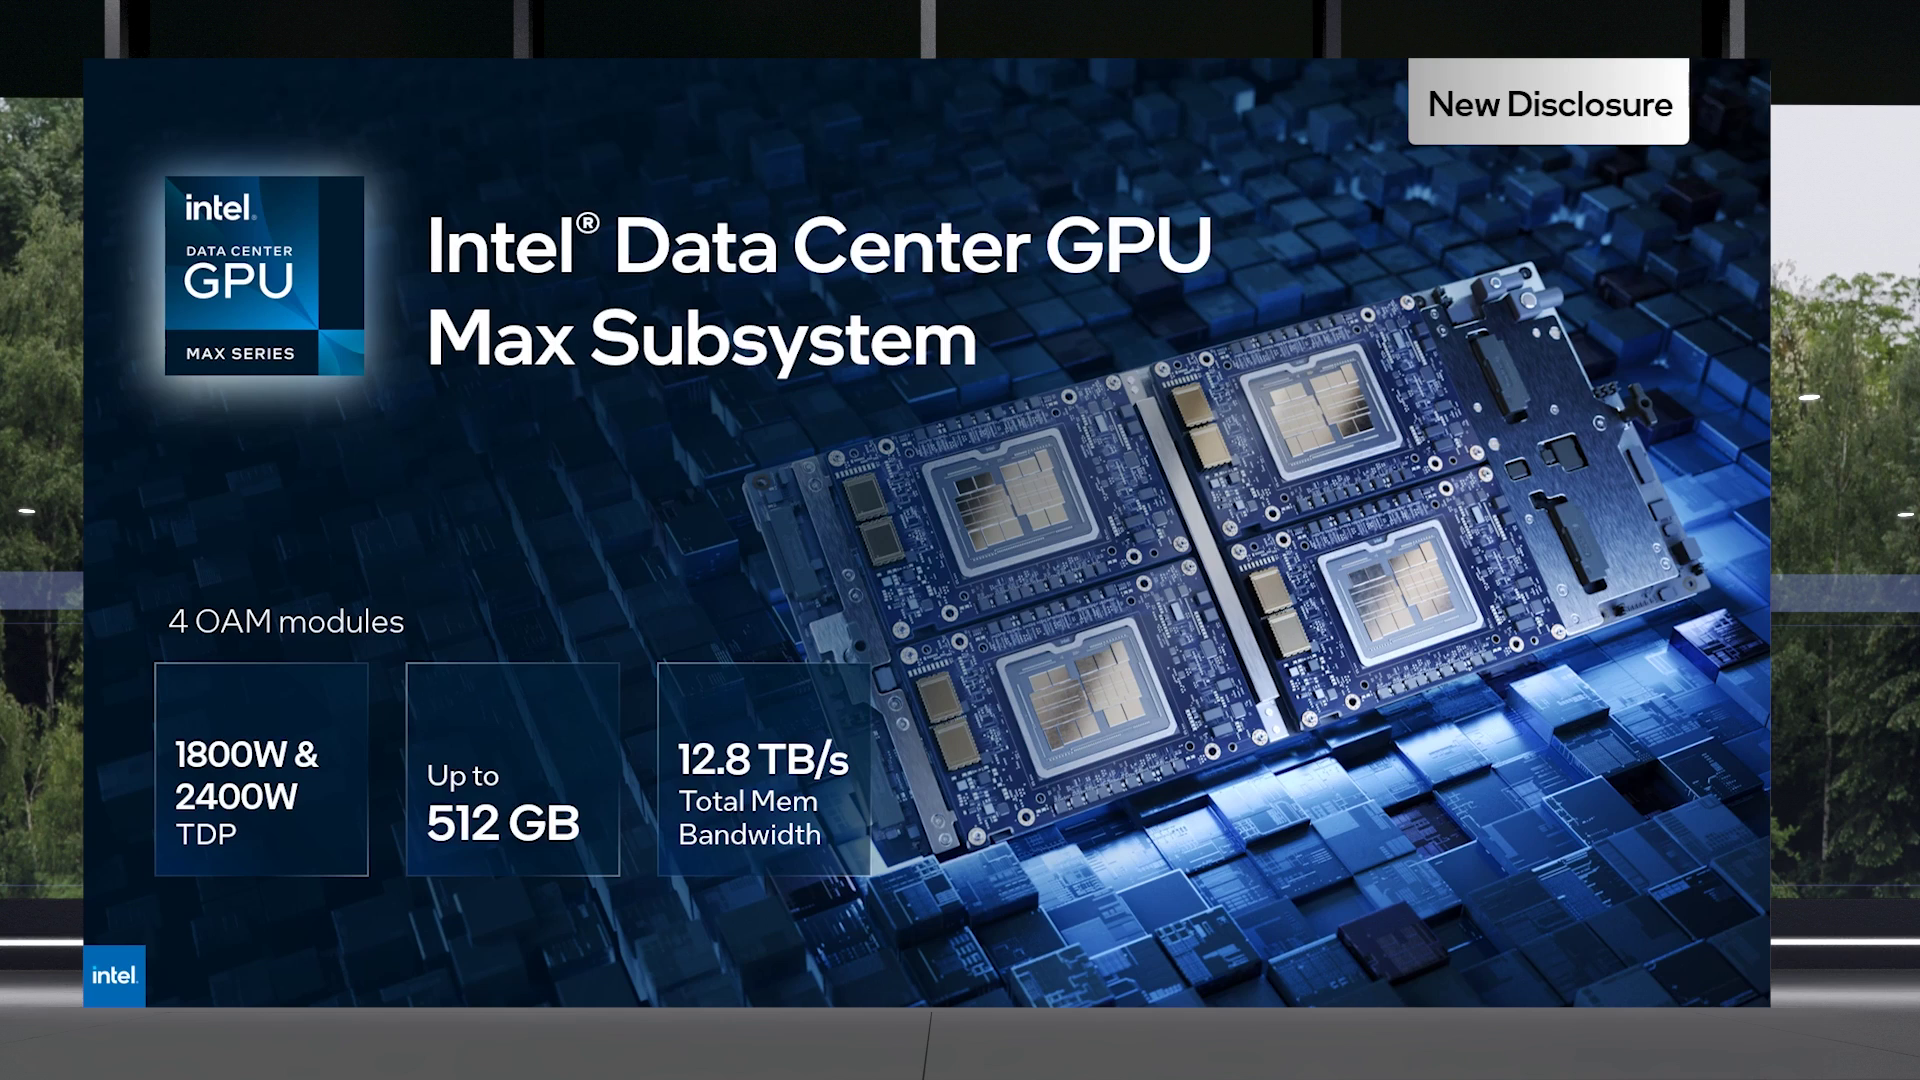 Max Series 1350 предложит 112 ядер Xe и 96 Гбайт HBM2e, но и TDP у этой модели составит всего 450 Вт. Для обеих OAM-версий также будут доступны готовые блоки из четырёх ускорителей (по примеру NVIDIA RedStone), объединённых по схеме «каждый с каждым», так что в сумме можно получить 512 Гбайт HBM2e с ПСП в 12,8 Тбайт/с. Ну а самый простой ускоритель в серии называется Max Series 1100. Это 300-Вт PCIe-плата с 56 Xe-ядрами, 48 Гбайт HBM2e и мостиками Xe Link. 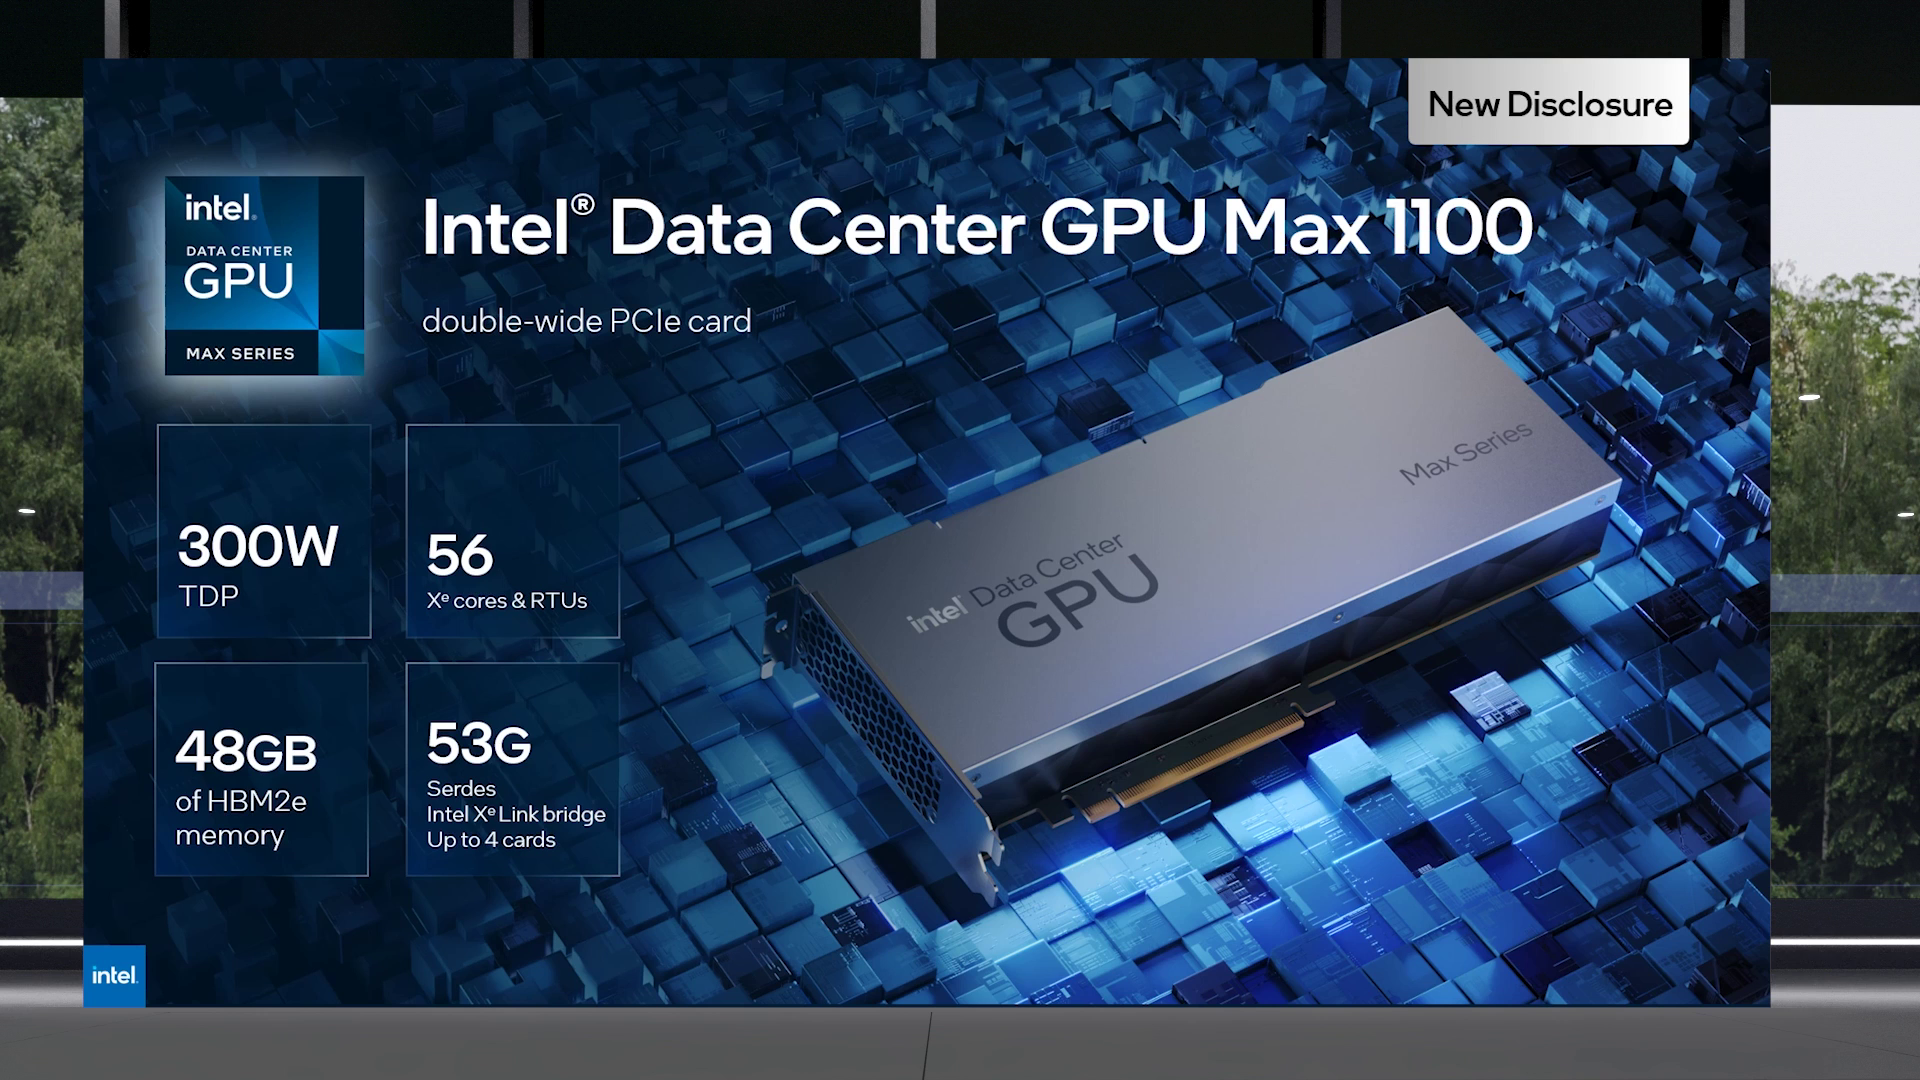 Intel утверждает, что ускорители Max до двух раз быстрее NVIDIA A100 в некоторых задачах, но и здесь история повторяется — нет сравнения с более современными H100. Хотя предварительный доступ к этим ускорителям у Intel есть, поскольку именно Sapphire Rapids являются составной частью платформы DGX H100. В целом, Intel прямо говорит, что наибольшей эффективности вычислений позволяет добиться связка CPU и GPU серии Max в сочетании с oneAPI. Всего на базе решений данной серии готовится более 40 продуктов.
Пока что приоритетным для Intel проектом является 2-Эфлопс суперкомпьютер Aurora, для которого пока что создан тестовый кластер Sunspot со 128 узлами, содержащими ускорители Max. Следующим ускорителем Intel станет Rialto Bridge, который появится в 2024 году. Также компания готовит гибридные (XPU) чипы Falcon Shores, сочетающие CPU, ускорители и быструю память. Аналогичный подход применяют AMD и NVIDIA.
09.11.2022 [14:50], Владимир Мироненко
Производители специально ухудшают характеристики чипов для китайских серверов, чтобы избежать санкций СШАВ связи с вводом Соединёнными Штатами новых экспортных ограничений на поставки в Китай, производители стали намеренно снижать производительность чипов, чтобы соответствовать требованиям экспортного контроля США и избежать проблем с получением специальных лицензий. Как отметил ресурс The Register, у систем, построенных на чипах NVIDIA, изготовленных на производственных мощностях TSMC для поставок в Китай, характеристики хуже по сравнению с теми, что были ранее. В частности, китайский производитель серверов Inspur указал на использование вместо ускорителя NVIDIA A100 чипа A800, разработанного NVIDIA специально для Китая в соответствии с экспортными ограничениями. Китайские производители H3C и Omnisky тоже представили решения на базе A800. Данный ускоритель, по словам NVIDIA, начала производиться в III квартале этого года. У A800 скорость передачи данных составляет 400 Гбайт/с, тогда как у A100 этот показатель равен 600 Гбайт/с, причём обойти эти ограничения, по словам NVIDIA, невозможно. Речь, судя по всему, идёт о характеристиках интерконнекта NVLink, которые прямо влияют на производительность кластеров из двух и более ускорителей в машинном обучении и других задачах. Изменения касаются 40- и 80-Гбайт вариантов с интерфейсами PCIe и SXM. 
Источник изображения: Inspur Между тем ускорители, находящиеся в разработке и выпускаемые TSMC по контракту с Alibaba и стартапом Biren Technology, тоже, как сообщается, имеют пониженную скорость передачи данных. Это позволит выпускать данные чипы на заводе TSMC, не опасаясь санкций США. До этого TSMC приостановила выпуск 7-нм чипов ускорителей Biren BR100 как раз из-за возможных санкций со стороны Вашингтона.
21.10.2022 [13:26], Сергей Карасёв
Meta✴ готова к массовому внедрению СЖО в своих дата-центрахКомпания Meta✴ в ходе саммита OCP (Open Compute Project) рассказала о планах по внедрению жидкостного охлаждения в своих ЦОД. Речь идёт об использовании гибридной системы AALC (Air-Assisted Liquid Cooling), предусматривающей совмещение компонентов воздушного охлаждения и жидкостного контура. Отмечается, что по мере развития машинного обучения и метавселенных всё острее встаёт проблема эффективного отвода тепла от оборудования. Дело в том, что внедряемые алгоритмы требуют больших вычислительных мощностей, что приводит к увеличению энергозатрат. Система AALC предназначена для охлаждения серверов в ЦОД, которые изначально могли быть и не спроектированы под использование СЖО. Отметим, что QCT уже представила аналогичное, полностью интегрированное решение. 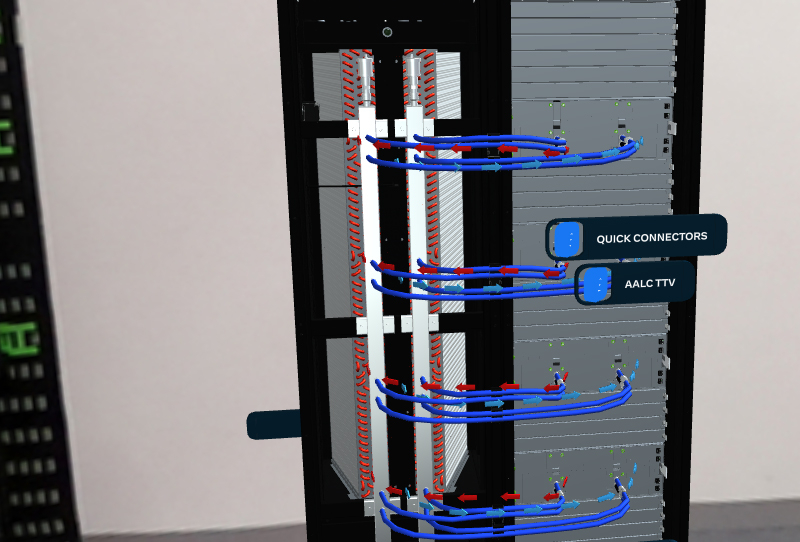
Источник изображений: Meta✴ AALC совместима со стойкой Open Rack v3 (ORV3), которая, впрочем, может интегрироваться и с другими вариантами СЖО. Система AALC в исполнении Meta✴ использует водоблоки для самых горячих компонентов, которые подключаются к отдельной стойке с помпами и прочим оборудованием. На задней панели или двери стойки располагается теплообменник, позволяющий охлаждать жидкость за счёт воздуха, циркулирующего в ЦОД. Прототипы решения справляются с охлаждением оборудования мощностью до 40 кВт на стойку. 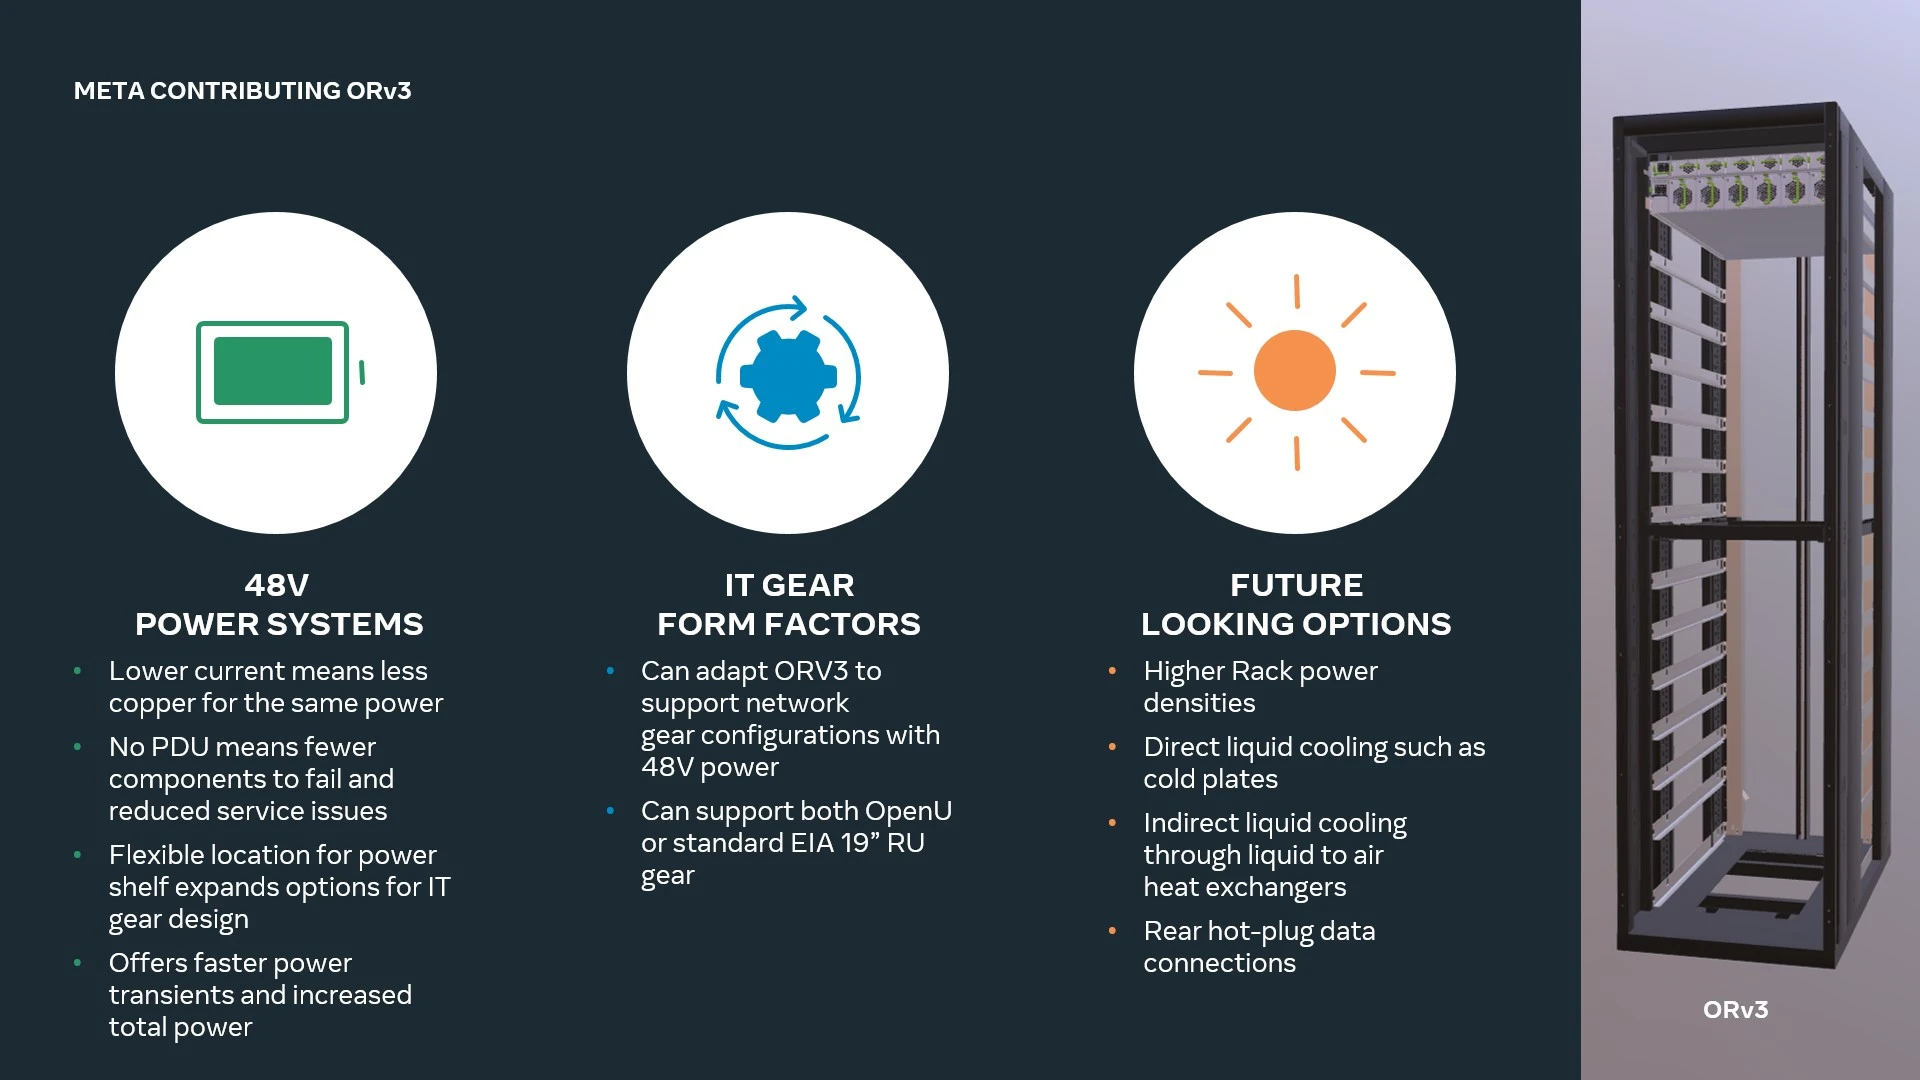 ORV3 также предлагает общую архитектуру стойки и подсистемы питания для устранения разрыва между нынешними и будущими ЦОД. Обеспечивается широкий спектр вариантов использования, включая поддержку Grand Teton. Модуль питания для общей на всю стойку шины 48 В DC не имеет жёстко определённого расположения и может устанавливается в любом месте стойки, что обеспечивает гибкость конфигурации. При этом он может быть не один, так что пиковая мощность может достигать 30 кВт на стойку. Усовершенствованный ИБП обеспечивает работу в течение 4 мин. при мощности 15 кВт (против 1,5 мин. у решения предыдущего поколения). Этот блок также может монтироваться в любом месте стойки, а дополнительно возможно применение второго резервного блока. Всё это позволит Meta✴ уже сейчас развёртывать в ЦОД высокоплотную инфраструктуру для ИИ и иных требовательных к питанию и охлаждению решений.
19.10.2022 [21:48], Сергей Карасёв
Пожар в южнокорейском дата-центре Kakao привёл к остановке 32 тыс. серверов, отказу в обслуживании 45 млн человек, падению акций и отставке топ-менеджера компанииИсполнительный содиректор южнокорейской интернет-компании Kakao Намкун Вон (Namkoong Whon) принял решение подать в отставку после массового сбоя в работе сервисов, спровоцированного пожаром в кампусе ЦОД SK C&C Data Center неподалёку от Сеула, принадлежащем SK Group. Возникшие проблемы вызвали недовольство как со стороны многочисленных пользователей, так и со стороны представителей бизнеса и власти. Пожар начался 15 октября 2022 года с возгорания в аккумуляторной в одном из зданий ЦОД. В результате была нарушена работа мессенджера KakaoTalk, аудитория которого составляет 43–47 млн пользователей в Южной Корее (при населении всей страны в почти 52 млн человек). Кроме того, возникли сбои в работе платёжной системы KakaoPay, почтовой службы, такси и других сервисов компании. Не был затронут только сервис Kakao Bank, который размещался в другом дата-центре. По состоянию на 17 октября работоспособность большинства функций KakaoTalk была восстановлена, однако доступность ряда служб всё же оставалась ограниченной. 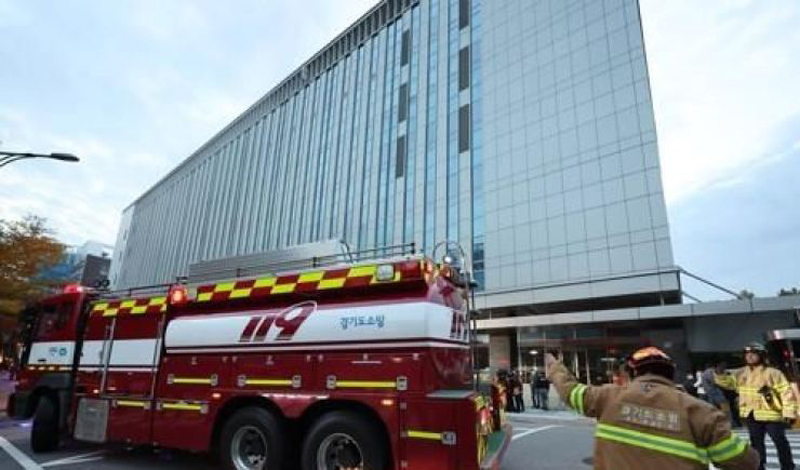
Источник изображения: Yonhap Инцидентом лично заинтересовался президент страны, а стоимость акций Kakao при этом рухнула на 9,5 % — до минимального значения с мая 2020 года. Нарушение работы KakaoTalk негативно сказалось на работе сотен предприятий малого бизнеса, использующих названный мессенджер. Kakao уже сообщила о намерении выплатить компенсации и выяснить причины медленного восстановления работы своих служб. Кроме того, Kakao намерена вложить $325 млн в открытие в 2023 году собственного ЦОД, а в 2024-м будет запущен второй дата-центр. Любопытно, что в том же кампусе находился и дата-центр Naver, ещё одного южнокорейского IT-гиганта, на работу которого инцидент оказал намного меньшее влияние. Основная претензия к Kakao заключается в том, что у компании не были разработаны планы поведения в экстренных ситуациях. В частности, компания оказалась не готова к тому, что ЦОД будет быстро обесточен после начала пожара. При этом, вероятно, это самый крупный инцидент в ЦОД в мире, поскольку речь идёт об остановке сразу 32 тыс. серверов. Нужно отметить, что в течение последнего времени пожары охватили сразу несколько крупных ЦОД. В частности, в марте прошлого года пожар уничтожил дата-центр французской компании OVHcloud в Страсбурге. В результате этого ЧП оказались недоступны в общей сложности 3,6 млн веб-сайтов, в том числе ресурсы ряда правительственных организаций, банков, интернет-магазинов и пр. А пожар, случившийся в ЦОД иранской Telecommunication Infrastructure Company (TIC), практически оставил без доступа в интернет всю страну. |
|


