
Материалы по тегу: i
|
04.10.2022 [22:57], Алексей Степин
Intel Labs представила нейроморфный ускоритель Kapoho Point — 8 млн электронных нейронов на 10-см платеКомпания Intel уже не первый год развивает направление нейроморфных процессоров — чипов, имитирующих поведение нейронов головного мозга. Уже во втором поколении, Loihi II, процессор получил 128 «ядер», эквивалентных 1 млн «цифровых нейронов», однако долгое время этот чип оставался доступен лишь избранным разработчикам Intel Neuromorphic Research Community через облако. Но ситуация меняется, пусть и спустя пять лет после анонса первого нейроморфного чипа: компания объявила о выпуске платы Kapoho Point, оснащённой сразу восемью процессорами Loihi II. Напомним, что они производятся с использованием техпроцесса Intel 4 и состоят из 2,3 млрд транзисторов, образующих асинхронную mesh-сеть из 128 нейроморфных ядер, модель работы которых задаётся на уровне микрокода. 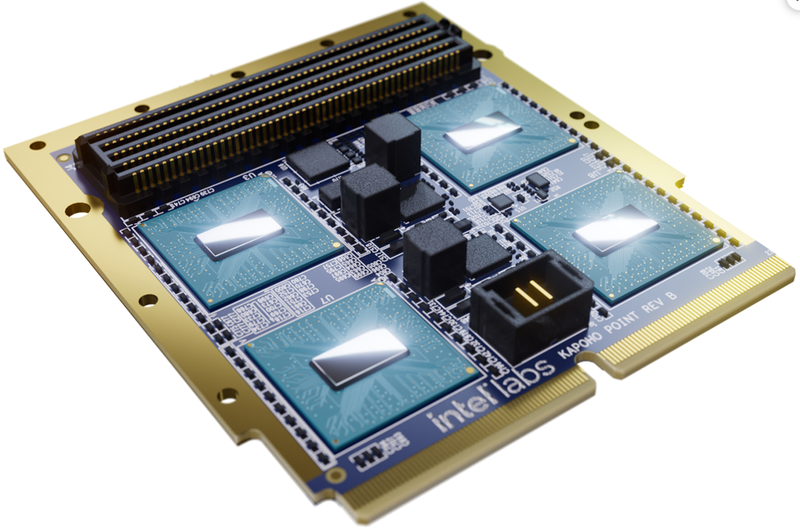
Источник изображений: Intel Labs Площадь кристалла нейроморфоного процессора Intel второго поколения составляет всего 31 мм2. Судя по всему, активного охлаждения Loihi II не требует: даже в первой реализации в виде PCIe-платы Oheo Gulch кулером оснащалась только управляющая ПЛИС, но не сам нейроморфный чип. В своём интервью ресурсу AnandTech Майк Дэвис (Mike Davies), глава проекта, отметил, что в реальных сценариях, выполняемых в человеческом масштабе времени, речь идёт о цифре порядка 100 милливатт, хотя в более быстром масштабе чип, естественно, может потреблять и больше. 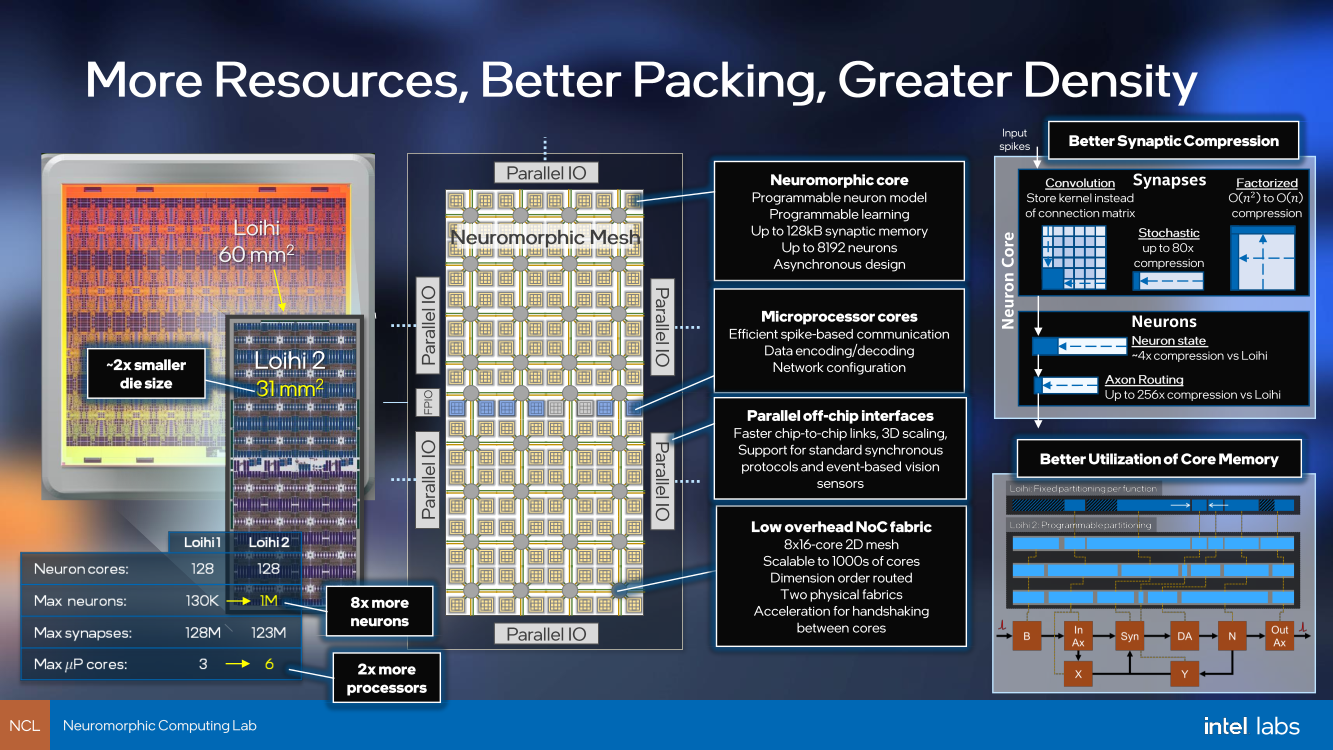
Архитектура и особенности строения Loihi II. По нажатию открывается полноразмерная версия Новый модуль, по словам компании, способен эмулировать до 1 млрд синапсов, а в задачах оптимизации с большим количеством переменных (до 8 миллионов, эквивалентно количеству «нейронов»), где нейроморфная архитектура Intel очень сильна, он может опережать традиционные процессоры в 1000 раз. Каждое ядро имеет свой небольшой пул быстрой памяти объёмом 192 Кбайт. Шесть выделенных ядер отвечают за управление нейросетью Loihi II; также в составе чипа имеются аппаратные ускорители кодирования-декодирования данных. Новинка изначально создана модульной: благодаря интерфейсному разъёму несколько плат Kapoho Point можно устанавливать одна над другой. Поддерживаются «бутерброды» толщиной до 8 плат, в деле опробован, однако, вдвое более тонкий вариант, но даже четыре Kapoho Point дают 32 миллиона нейронов в совокупности. Для коммуникации с внешним миром используется интерфейс Ethernet: в чипе реализована поддержка скоростей от 1 (1000BASE-KX) до 10 Гбит/с (10GBase-KR). Размеры каждой платы невелики, всего 4×4 дюйма (102×102 мм). 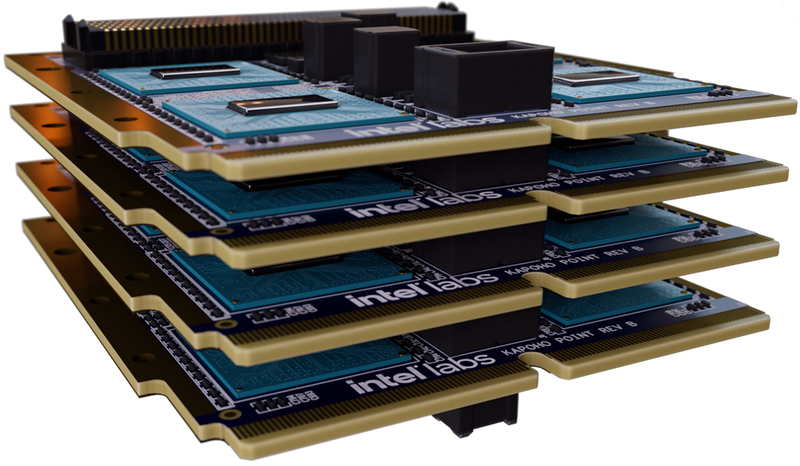
Платы Kapoho Point позволяют легко расширять нейросеть на базе Loihi II В отличие от первого поколения Loihi, доступ к которому можно было получить лишь виртуально, через облако, системы на базе Kapoho Point уже доставлены избранным клиентам Intel, и речь идёт о реальном «железе». В число первых клиентов входит Исследовательская лаборатория ВВС США (Air Force Research Laboratory, AFRL), для задач которой такие достоинства Loihi II, как компактность и экономичность являются решающими. 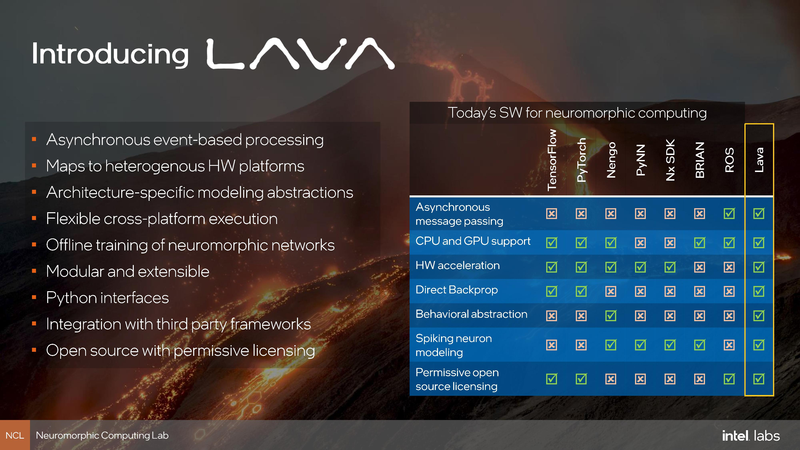
Возможности SDK Lava Одновременно с анонсом Kapoho Point компания Intel обновила и фреймворк Lava. В отлчиие от SDK первого поколения Nx новая открытая программная платформа разработки сделана аппаратно-независимой, что позволит разрабатывать нейро-приложения не только на платформе, оснащённой чипами Loihi II.
24.08.2022 [22:42], Владимир Мироненко
Untether AI представила ИИ-ускоритель speedAI240 — 1,5 тыс. ядер RISC-V и 238 Мбайт SRAM со скоростью 1 Пбайт/сКомпания Untether AI анонсировала ИИ-архитектуру следующего поколения speedAI (кодовое название «Boqueria»), ориентированную на инференс-нагрузки. При энергоэффективности 30 Тфлопс/Вт и производительности до 2 Пфлопс на чип speedAI устанавливает новый стандарт энергоэффективности и плотности вычислений, говорит компания. 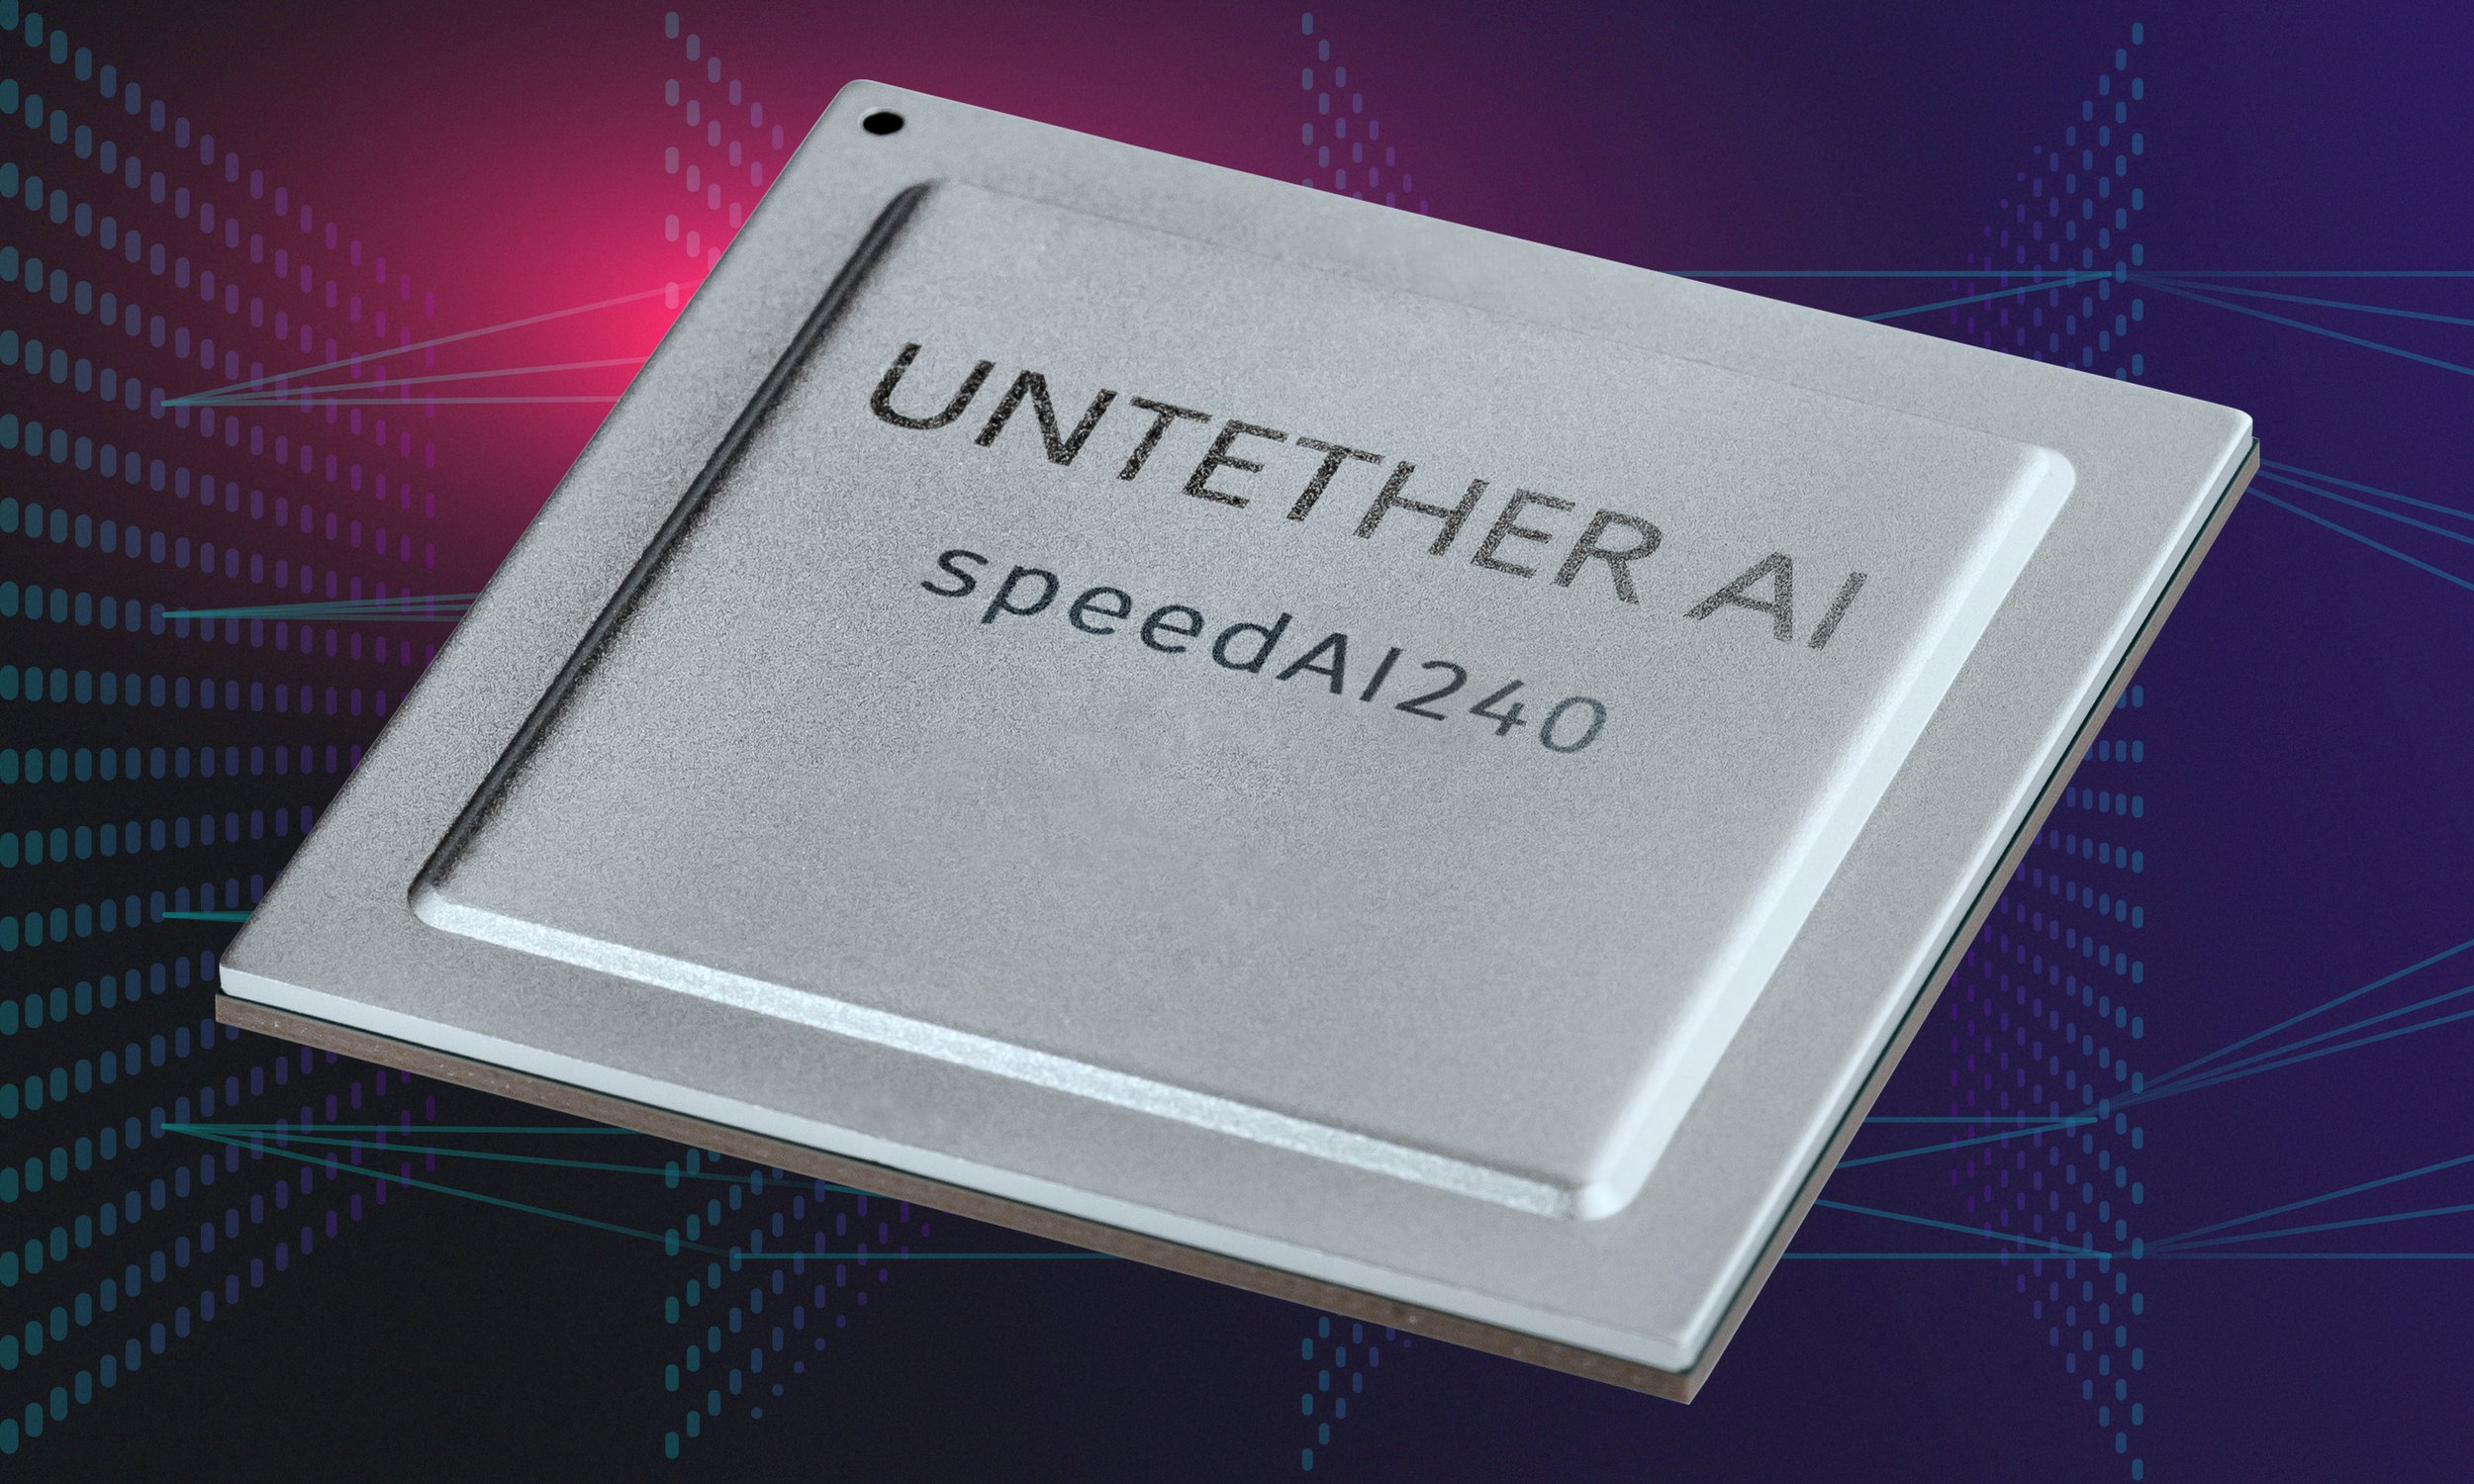 Поскольку at-memory вычисления в ряде задач значительно энергоэффективнее традиционных архитектур, они могут обеспечить более высокую производительность при одинаковых затратах энергии. Первое поколение устройств runAI в 2020 году Untether AI достигла энергоэффективности на уровне 8 Тфлопс/Вт для INT8-вычислений. Новая архитектура speedAI обеспечивает уже 30 Тфлопс/Вт. 
Изображения: Untether AI (via ServeTheHome) 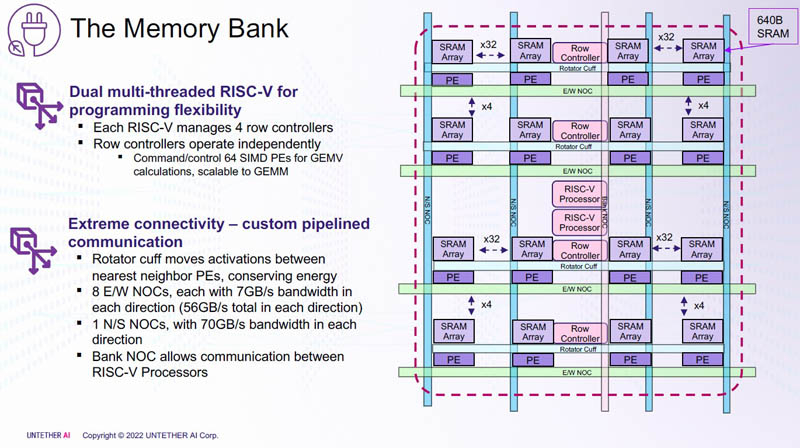 Этого удалось добиться благодаря архитектуре второго поколения, использованию более 1400 оптимизированных 7-нм ядер RISC-V (1,35 ГГц) с кастомными инструкциями, энергоэффективному управлению потоком данных и внедрению поддержки FP8. Вкупе это позволило вчетверо поднять эффективность speedAI по сравнению с runAI. Новинка может быть гибко адаптирована к различным архитектурам нейронных сетей. Концептуально speedAI напоминает ещё один тысячеядерный чип RISC-V — Esperanto ET-SoC-1. 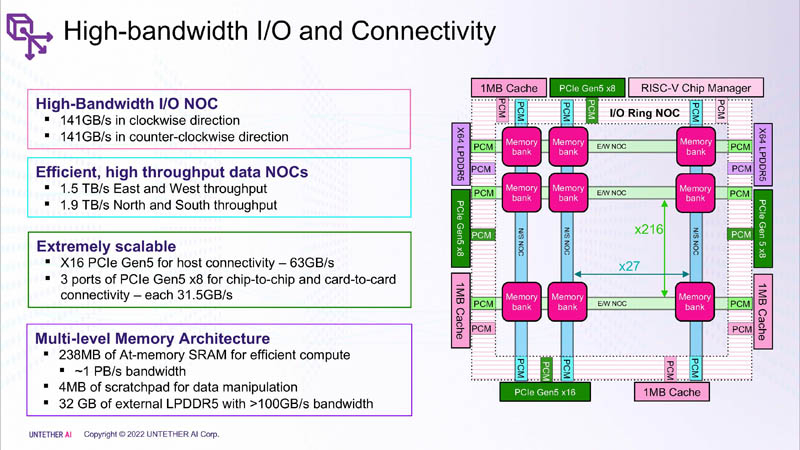 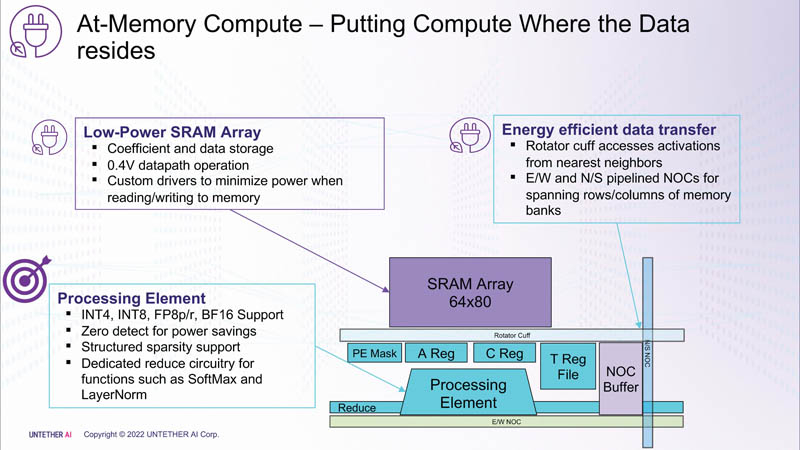 Первый член семейства speedAI — speedAI240 — обеспечивает 2 Пфлопс вычислениях в FP8-вычислениях или 1 Пфлопс для BF16-операций. Благодаря этому обеспечивается самая высокая в отрасли эффективность — например, для модели BERT заявленная производительность составляет 750 запросов в секунду на Вт (qps/w), что, по словам компании, в 15 раз выше, чем у современных GPU. Добиться повышения производительности удалось благодаря тесной интеграции вычислительных элементов и памяти. 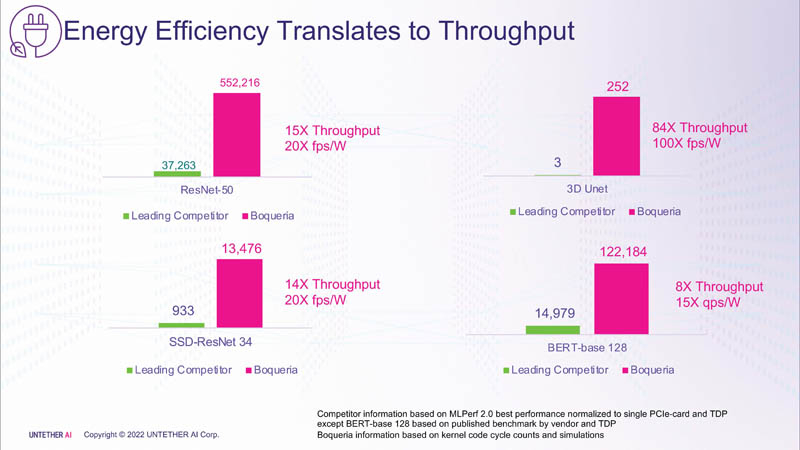 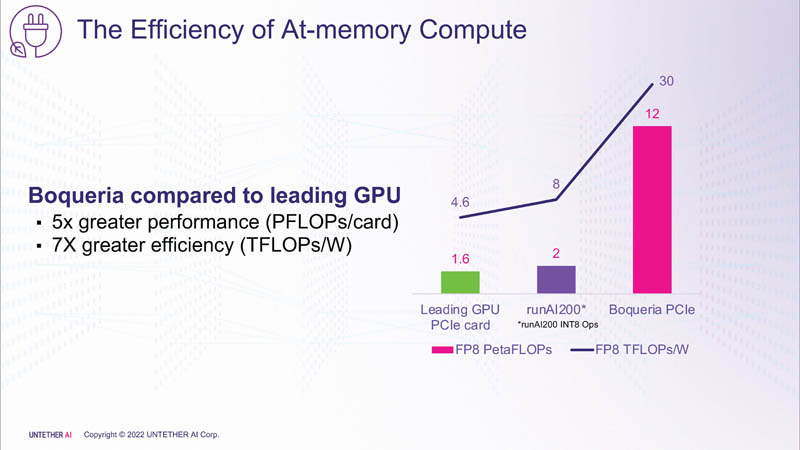 На каждый блок SRAM объёмом 328 Кбайт приходится 512 вычислительных блоков, поддерживающих работу с форматами INT4, INT8, FP8 и BF16. Каждый вычислительный блок имеет два 32-бит (RV32EMC) кастомных ядра RISC-V с поддержкой четырёх потоков и 64 SIMD. Всего есть 729 блоков, так что суммарно чип несёт 238 Мбайт SRAM и 1458 ядер. Блоки провязаны между собой mesh-сетью, к которой также подключены кольцевая IO-шина, несущая четыре 1-Мбайт блока общего кеша, два контроллера LPDRR5 (64 бит) и порты PCIe 5.0: один x16 для подключения к хосту и три x8 для объединения чипов. Суммарная пропускная способность SRAM составляет около 1 Пбайт/с, mesh-сети — от 1,5 до 1,9 Тбайт/с, IO-шины — 141 Гбайт/c в обоих направлениях, а 32 Гбайт DRAM — чуть больше 100 Гбайт/с. PCIe-интерфейсы позволяют объединить до трёх ускорителей, с шестью speedAI240 чипами у каждого. Решения speedAI будут предлагаться как в виде отдельных чипов, так и в составе готовых PCIe-карт и M.2-модулей. Ожидается, что первые поставки избранным клиентам начнутся в первой половине 2023 года.
01.08.2022 [23:00], Игорь Осколков
Великое объединение: спецификации и наработки OpenCAPI и OMI планируется передать консорциуму CXLКонсорциумы OpenCAPI Consortium (OCC) и Compute Express Link (CXL) подписали соглашение, которое подразумевает передачу в пользу CXL всех наработок и спецификаций OpenCAPI и OMI. Если будет получено одобрения всех участвующих сторон, то это будет ещё один шаг в сторону унификации ключевых системных интерфейсов и возможности реализации новых архитектурных решений. Во всяком случае, на бумаге. Консорциумы OpenCAPI (Open Coherent Accelerator Processor Interface) был сформирован в 2016 году с целью создание единого, универсального, скоростного и согласованного интерфейса для связи CPU с ускорителями, сетевыми адаптерами, памятью, контроллерами и устройствами хранения и т.д. Причём в независимости от типа и архитектуры самого CPU. На тот момент новый интерфейс был определённо лучше распространённого тогда PCIe 3.0. С течением времени дела у OpenCAPI шли ни шатко ни валко, однако фактически его использование было ограничено только POWER-платформами от IBM. 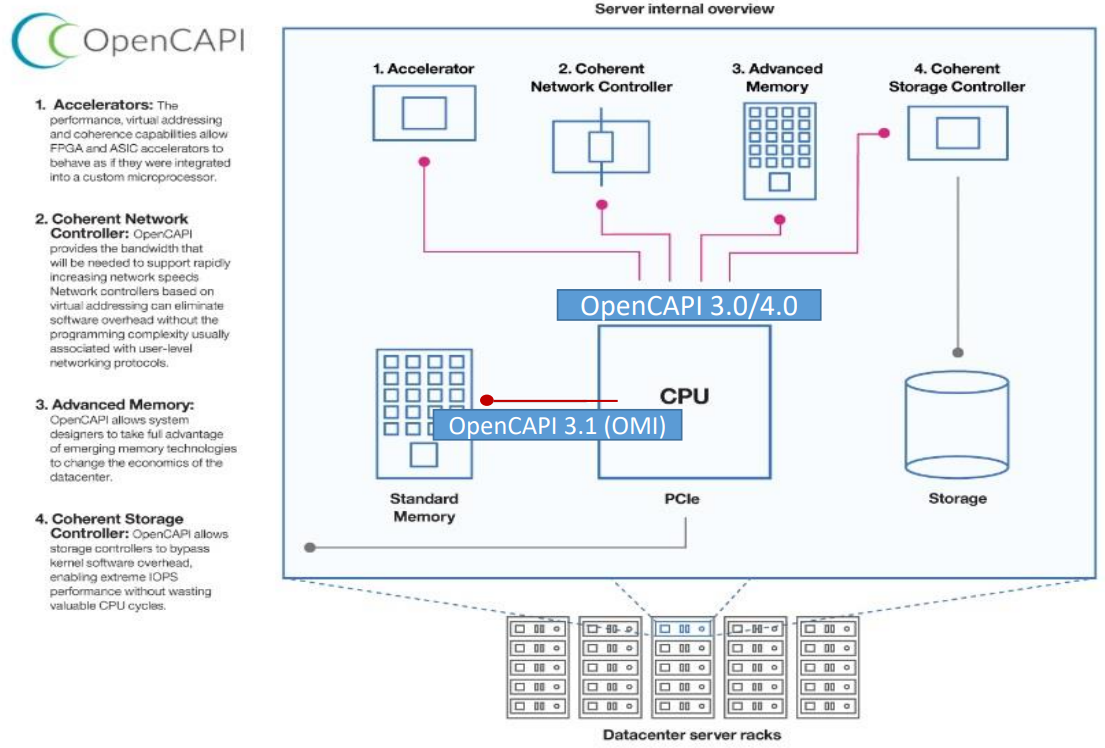
Источник: OpenCAPI Тем не менее, в недрах OpenCAPI родился ещё один очень интересный стандарт — Open Memory Interface (OMI). OMI, если коротко, предлагает некоторую дезагрегацию путём добавления буферной прослойки между CPU и RAM. С одной стороны у OMI есть унифицированный последовательный интерфейс для подключения к CPU, с другой — интерфейсы для подключения какой угодно памяти, на выбор конкретного производителя. 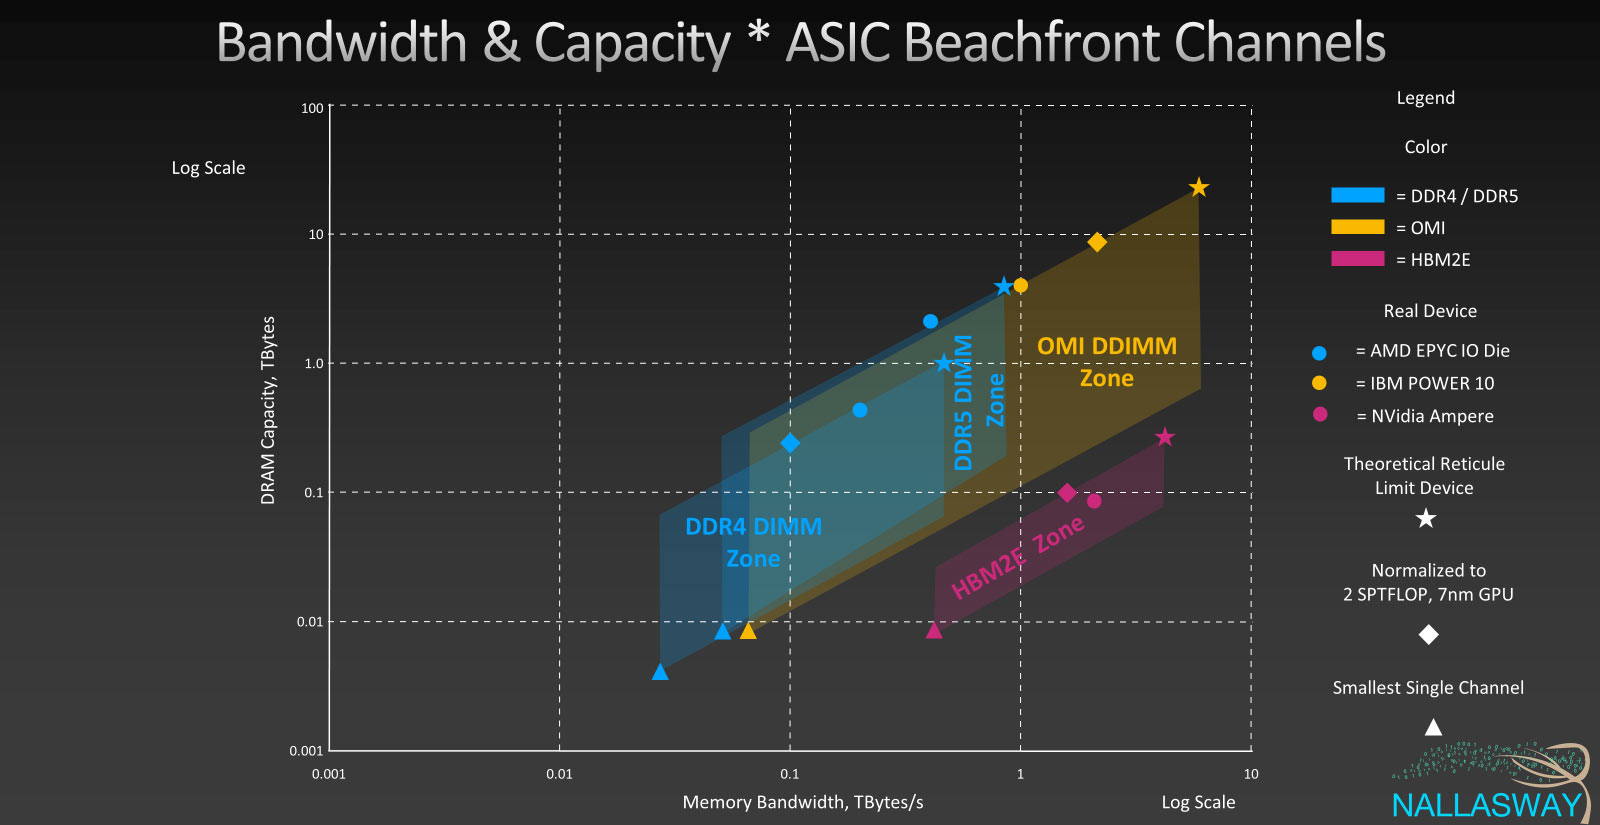
Источник: Open Memory Interface (OMI) OMI позволяет поднять пропускную способность памяти, не раздувая число контактов и физические размеры и самого CPU, и модулей. Однако и в данном случае массовая поддержка OMI по факту есть только в процессорах IBM POWER10. Концептуально CXL в части работы с памятью повторяет идею OMI, только в данном случае в качестве физического интерфейса используется распространённый PCIe. 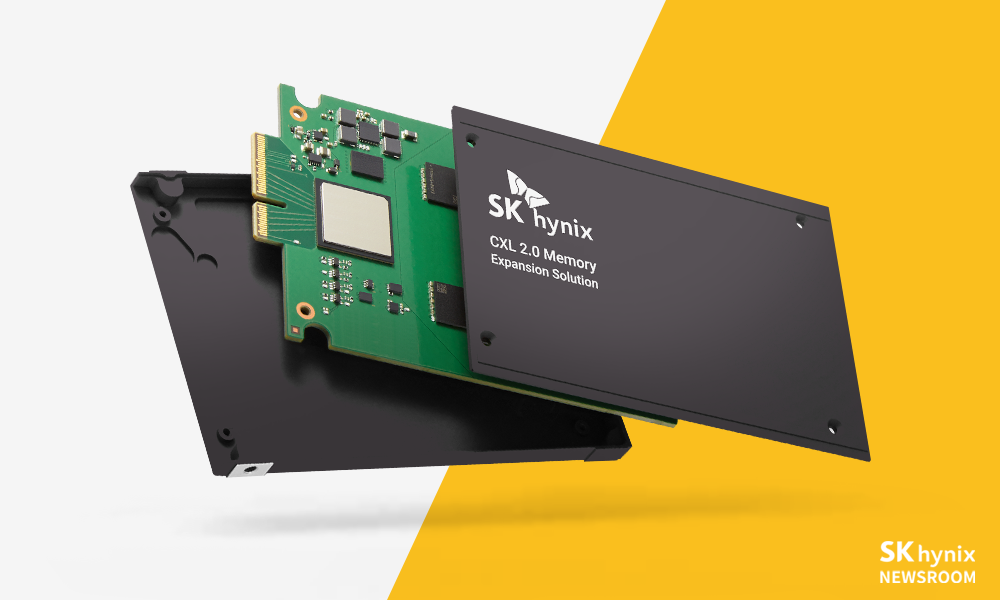
Изображение: SK Hynix Существенная разница c OMI в том, что начальная поддержка CXL будет в грядущих процессорах AMD и Intel. А Samsung и SK Hynix уже готовят соответствующие DDR5-модули. Да и в целом поддержка CXL в индустрии намного шире. Так что консорциуму CXL, по-видимому, осталось поглотить только ещё один конкурирующий стандарт в лице CCIX, как это уже произошло с Gen-Z. Комментируя соглашение, президент консорциума CXL отметил, что сейчас наиболее удачное время для объединения усилий, которое принесёт пользу всей IT-индустрии. Участники OpenCAPI имеют богатый опыт, который поможет улучшить грядущие спецификации CXL и избежать ошибок.
11.03.2022 [14:14], Владимир Мироненко
CDN-провайдер Akamai прекращает продажи в России и Беларуси, но сохраняет присутствиеAkamai Technologies, поставщик услуг для акселерации онлайн-сервисов, а также платформ доставки контента и приложений, объявил о предпринятых в последние дни мерах для соблюдения всех применяемых санкций. В частности, компания сообщила о приостановке всех продаж в России и Беларуси, а также о прекращении работы с российскими и белорусскими клиентами с государственным участием. Кроме того, компания намерена задействовать фонд Akamai Foundation для оказания гуманитарной помощи пострадавшим. 
Источник изображения: Akamai Тем не менее, было объявлено об «обдуманном решении сохранить своё присутствие в Сети в России». «Это поддержит наших глобальных клиентов, в том числе многие крупнейшие мировые службы новостей, социальные сети и демократические государственные институты, поскольку они стремятся предоставлять важную и точную информацию во все уголки земного шара, в том числе гражданам России», — пояснила компания. Ранее аналогичное решение принял другой крупный CDN-провайдер — Cloudflare.
16.02.2022 [13:04], Сергей Карасёв
Akamai купила облачного провайдера LinodeКомпания Akamai Technologies, крупный провайдер платформ доставки контента и приложений, сообщила о заключении соглашения о покупке фирмы Linode. Предполагается, что данное приобретение позволит Akamai превратиться в наиболее распределённую вычислительную платформу в мире. Завершить поглощение планируется в текущем квартале после получения необходимых разрешений со стороны регулирующих органов. Частная американская компания Linode была основана ещё в 2003 году. Она специализируется на предоставлении облачных услуг по модели IaaS (инфраструктура как сервис). Штаб-квартира Linode находится в Филадельфии (штат Пенсильвания). Облачные дата-центры компании расположены во многих странах — в США, Канаде, Великобритании, Германии, Японии, Австралии, Сингапуре и Индии. 
Источник изображения: Akamai После покупки Linode компания Akamai намерена развернуть уникальную инфраструктуру для создания, запуска и обеспечения безопасности приложения на всех уровнях — от edge-решений до облачных систем. Сумма сделки оценивается приблизительно в $900 млн. Ожидается, что слияние позволит Akamai увеличить выручку по итогам 2022 финансового года примерно на $100 млн.
19.12.2021 [18:06], Алексей Степин
Nebulon поможет HCI-решениям освоить рынок периферийных вычисленийПо мере внедрения 5G-сетей объёмы данных, добываемых и обрабатываемых на периферии, будут только расти, и здесь новое решение Nebulon для микро-ЦОД окажется весьма к месту. Компания Nebulon была основана лишь 2018 году, а в 2020 году она представила свои первые решения, концептуально очень схожие с тем, что сейчас принято называть DPU. Изначально это были ускорители под названием SPU (Storage Processing Unit), однако впоследствии первое слово заменили на Service, поскольку речь шла уже об облачных системах, и данные платы стали частью того, что сама Nebulon называет «умной инфраструктурой» (Smart Infrastructure). 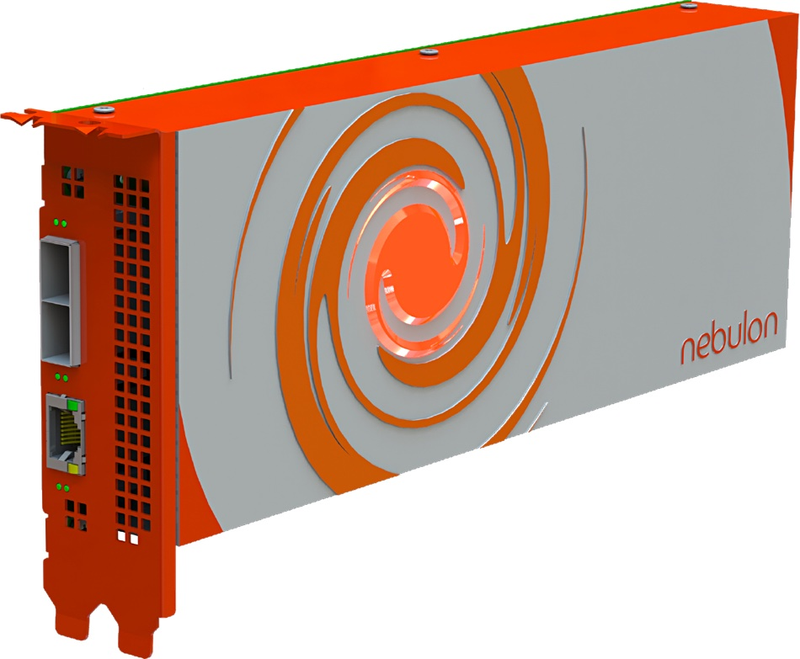
Nebulon SPU. Изображения: Nebulon Но у SPU нашлось и ещё одно применение, связанное с периферийной серверной инфраструктурой. Её особенности таковы, что требуют максимальной компактности оборудования, и это, по мнению Nebulon, затрудняет использование классических решений для гиперконвергентной инфраструктуры (HCI), поскольку, по словам Nebulon, она обычно для арбитража, который необходим для стабильности работы, требует наличия в системе минимум трёх узлов. 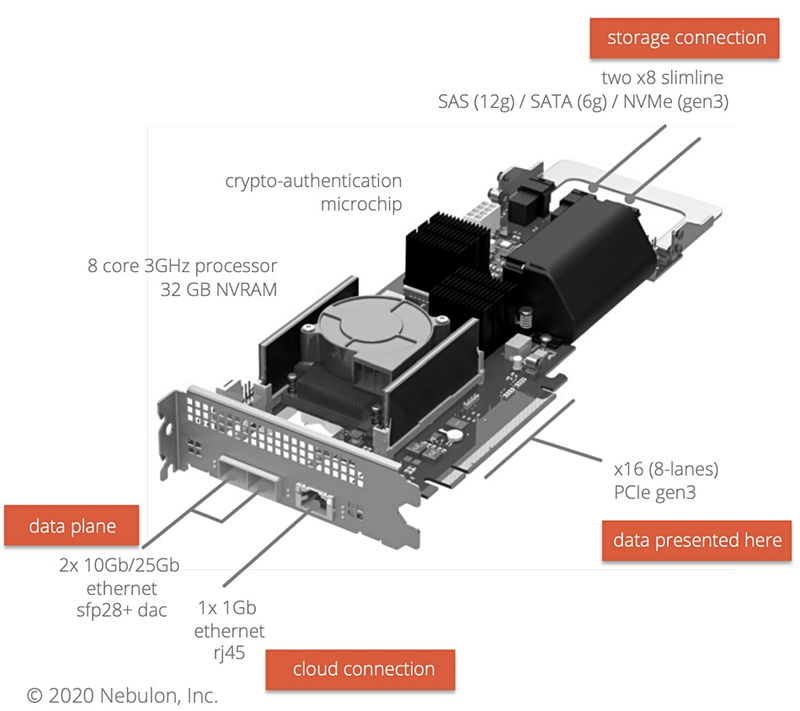 Такой «узел-арбитр» (quorum witness, QW) гарантирует бесперебойную работу системы в том случае, если какой-либо из её основных узлов испытывает проблемы с сетевым подключением. Но в условиях периферии третьему узлу бывает просто негде разместиться, а ведь нужен ещё и сетевой коммутатор. Тут-то на помощь и может прийти ускоритель Nebulon SPU, который можно назвать полноценным «сервером на плате»: он несёт на борту восьмиядерный CPU и 32 Гбайт DRAM. Основным интерфейсом SPU является PCIe 3.0 x16 (8 линий) + ещё два набора по 8 линий могут обслуживать NVMe SSD (но есть и поддержка SAS/SATA). С такой платой HCI-кластер может иметь в составе всего два узла. Коммутатор не требуется, поскольку плата располагает двумя портами 10/25GbE. Интеграцию такого HCI-кластера с облаком, автоматизацию и арбитраж посредством Nebulon ON также берёт на себя SPU. Компания-разработчик назвала данную технологию smartEdge.
13.12.2021 [11:30], Алексей Степин
СХД Huawei OceanStor Dorado V6: для тех, кто превыше всего ценит надёжность и скоростьКомплексные программно-аппаратные решения одного производителя практически всегда превосходят похожие по параметрам, но более разнородные системы. Высокая степень интеграции и продуманная многоуровневая оптимизация всех компонентов не только позволяют добиться более высоких технических показателей, но и существенно упрощают и удешевляют внедрение и поддержку такого оборудования. Компанию Huawei можно назвать лидером в области таких решений, и особенно ярко это проявилось в шестом поколении СХД OceanStor Dorado. Их Huawei позиционирует как СХД высшего класса, обладающие не только высочайшей производительностью, но и надёжностью класса минимум «шесть девяток», то есть 99,9999%. Достаточно привести лишь один факт: Dorado 18000 V6 остаётся работоспособной при выходе семи контроллеров из восьми в каждой стойке, а также легко переживает одновременный выход из строя трёх накопителей в массиве. Для сравнения, классический RAID6 может пережить потерю лишь двух накопителей в массиве.  По результатам тестирования, проведённого Storage Performance Council в октябре 2020 года, СХД Huawei OceanStor Dorado 18000 V6 признана быстрейшим в мире флеш-хранилищем. На случайных операциях данное решение способно развивать 21 млн IOPS. Не удивительно, что разработками Huawei заинтересовались крупные финансовые организации, нуждающиеся не просто в надёжных, но и быстрых системах хранения данных. Уже 8 из 20 крупнейших мировых банков пользуются системами OceanStor Dorado и этот «клуб» будет только расти. Компания разместила на своём сайте подробный вебинар, посвящённый особенностям шестого поколения СХД OceanStor Dorado. 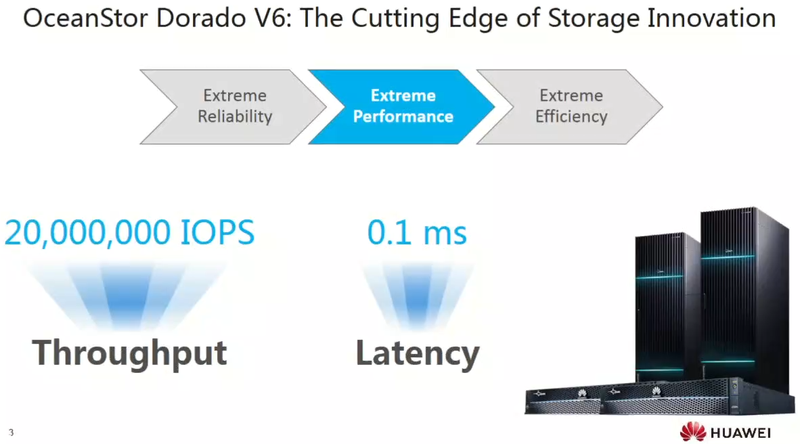 Высочайший уровень производительности OceanStor Dorado 18000 V6 обуславливается монолитностью и отлаженностью платформы, которая целиком построена на высокинтегрированных между собой собственных разработках Huawei в области процессоров, ускорителей и сетевых контроллеров. «Умные технологии» в шестом поколении Dorado начинаются уже на уровне отдельного накопителя. 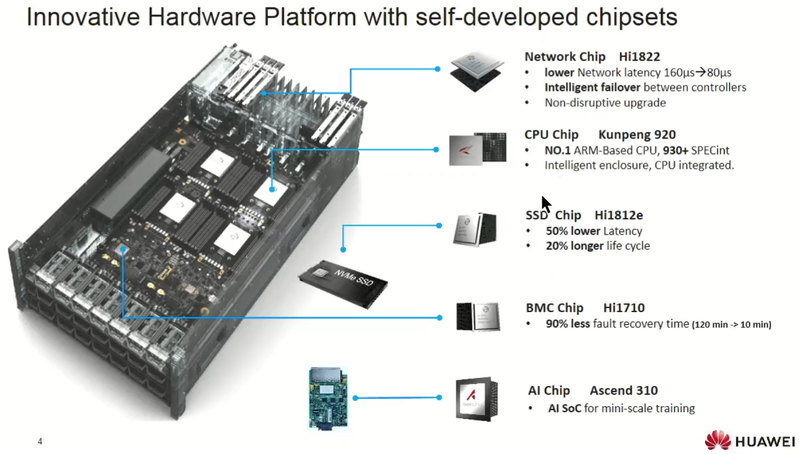
Платформа Dorado V6 целиком базируется на собственных разработках Huawei Такие SSD сами следят за износом фонда ячеек NAND, используют продвинутые методы коррекции ошибок LDPC и SmartFSP 3.0 и обеспечивают базовый уровень надёжности, поскольку контроллер Hi1812e работает с NAND как с динамическим RAID-массивом. Такие накопители на 20% долговечнее обычных и на 50% отзывчивее в плане задержек. В качестве основного процессора используется Kunpeng 920, 48-ядерный чип с архитектурой ARMv8.2, имеющий набор движков-ускорителей и собственные контроллеры SAS 3.0 и 100GbE (с RoCE, конечно). Четыре таких процессора умещаются в 1U-шасси. Им может помогать устанавливаемый дополнительно ИИ-ускоритель Ascend 310, отвечающий за обслуживание массива NVMe-накопителей и оптимизацию дисковых кешей. 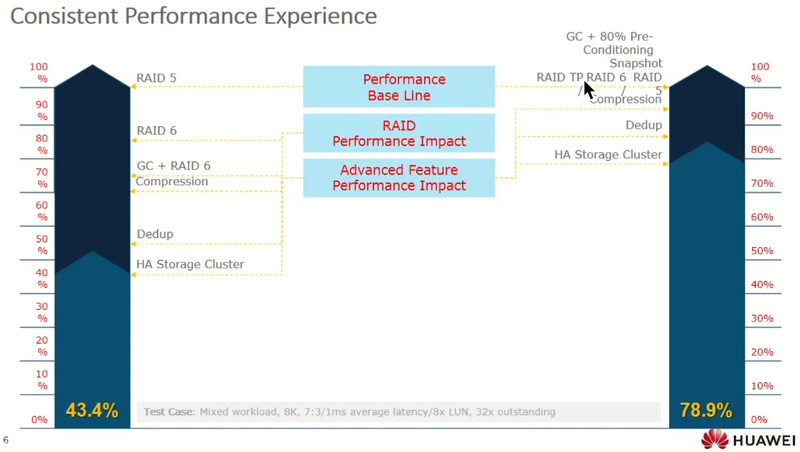
Унифицированная симметричная архитектура обеспечивает предсказуемый и постоянный уровень производительности За сеть отвечает чип ASIC Hi1822, который полностью совместим с RoCE и NVMe-oF. Адаптеры на базе этого чипа могут иметь различную конфигурацию портов — от двух 25GbE SFP28 до двух 100GbE QSFP28 — и обеспечивают латентность всего лишь 80 мкс против 160 мкс у конкурентов. В дисковых полках Dorado 18000 V6 таких адаптеров несколько, заменять их можно без остановки системы. Даже контроллер управления (BMC) у СХД Huawei свой, Hi1710. Высокая интеграция всех программмно-аппаратных компонентов системы (а кто ещё может лучше знать, как задействовать весь потенциал «железа», кроме самих разработчиков) обеспечивает не только высокую производительность и надёжность, но и быстрое восстановление системы при сбоях — десятки минут для OceanStor Dorado V6 против нескольких часов у обычных СХД. 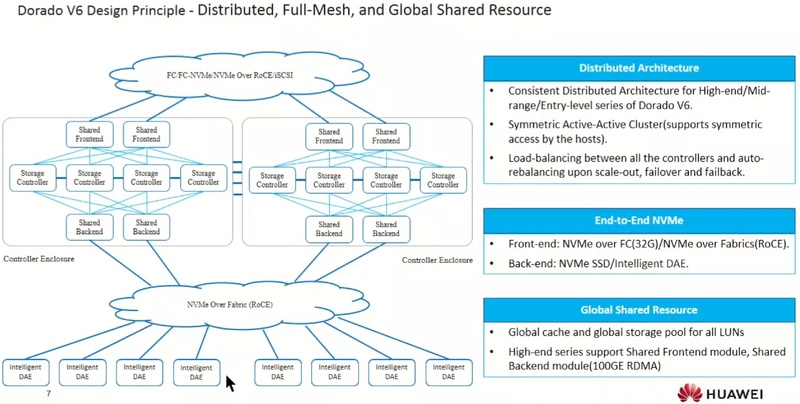
Распределённая архитектура OceanStor Dorado V6 Архитектурно OceanStor Dorado 18000 V6 представляет собой симметричную распределённую меш-сеть, в которой на уровне стоек контроллеров все компоненты соединены со всеми, что и обеспечивает беспрецедентный уровень надёжности. Компания называет эту технологию SmartMatrix. С «умными» дисковыми полками бэкенды контроллеров общаются посредством NVMe-oF, а с внешней сетью — либо через NVMe-oF/RoCE (100 Гбит/с на порт), либо через NVMe-oF/FC 32G. 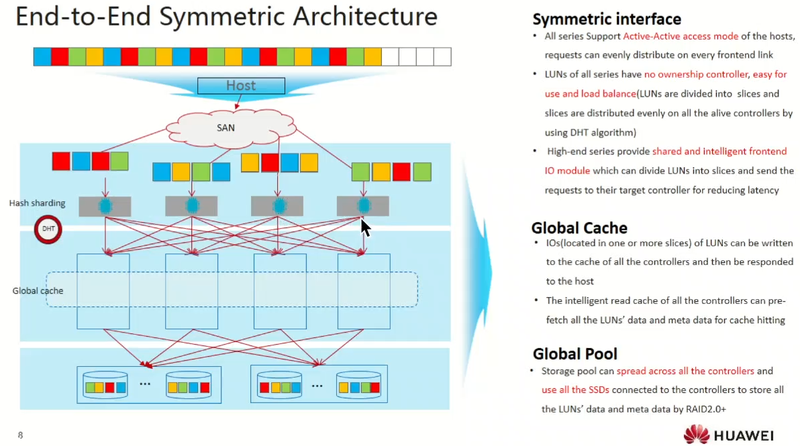
У Dorado V6 нет привилегированных контроллеров, что упрощает балансировку нагрузки Huawei вполне справедливо считает, что за сочетанием NVMe-oF и RoCE лежит будущее высокопроизводительных систем хранения данных. Данные технологии к настоящему моменту хорошо проработаны и полностью описываются стандартами, которые обеспечивают гибкость и взаимозаменяемость элементов инфраструктуры. Некоторые производители всё ещё поддерживают SAS, но время старых дисковых стандартов уходит. 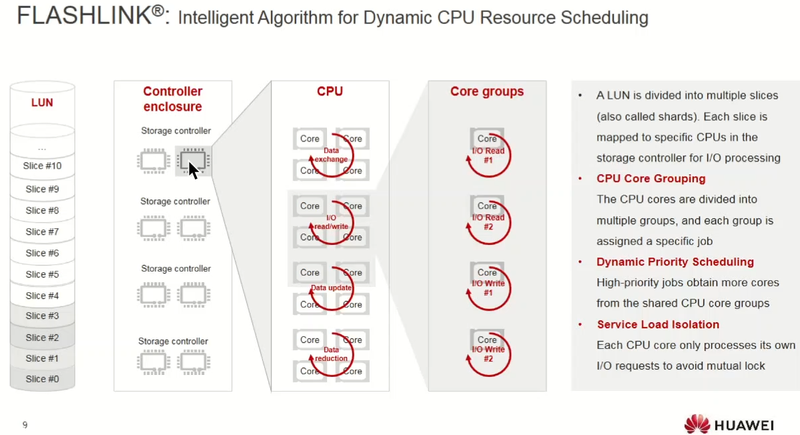
Технология Huawei FLASHLINK отвечает за распределение вычислительных ресурсов Симметрия архитектуры СХД данной серии выражена в том числе и в том, что все логические тома (LUN) не привязаны к главному контроллеру (ownership), вместо этого они «нарезаются» системой на сегменты (shards в терминологии Huawei), которые равномерно распределяются по всем активным в системе в настоящий момент контроллерам. Сами контроллеры работают с едиными пулами кеша и SSD, из которого и черпают необходимые ресурсы. За распределение обработки сегментов по процессорным ядрам отвечает фирменная технология FLASHLINK, которая работает в динамическом режиме: высокоприоритетные задачи получают больше ядер из выделенной группы. При этом каждое ядро выполняет IO-запросы только своей назначенной задачи, чтобы избежать конфликтов. 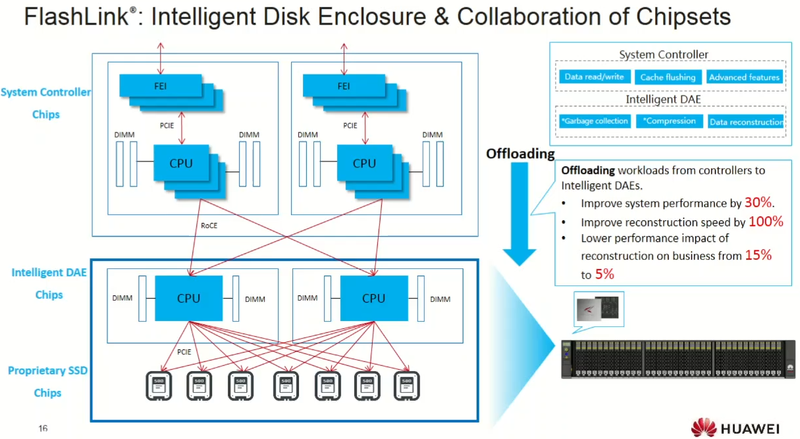
Глубокая интеграция ускорителей экономит процессорное время и ускоряет перестройку массивов Дисковые полки Dorado V6 имеют свой «интеллект» и не загружают CPU контроллеров низкоуровневыми задачами, а это позволяет, по словам разработчиков, повысить производительность СХД на 30% по сравнению с классическими архитектурами с «глупыми» полками. Этот же подход существенно ускоряет процесс восстановления данных — Huawei говорит о двукратном превосходстве в скорости, при этом влияние этого процесса на производительность СХД минимально и не превышает 5% против десятков процентов у СХД классической архитектуры. Более того, архитектура Dorado V6 такова, что производительность дисковых массивов в ней не зависит от типа используемого RAID и всегда одинаково высока как в простом режиме RAID10, так и в куда более сложных в плане нагрузки на контроллеры режимах RAID-6 или RAID-TP. 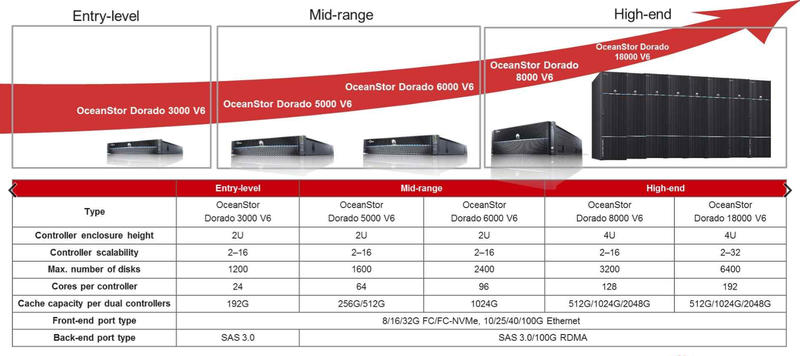
Модельный ряд и позиционирование СХД Huawei OceanStor Dorado Что касается более высокоуровневых программных компонентов, то в серии Dorado V6 все сложные процессы, от драйвера NVMe и управления пулом ресурсов до клиентских дополнений выполняются в пространстве пользователя (user space), что позволяет избежать лишних задержек, так как обращений в пространство ядра практически нет. 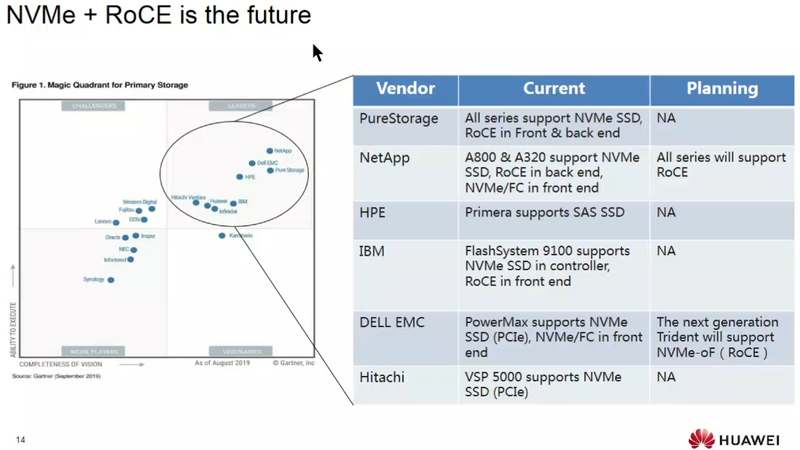
За NVMe и RDMA over Converged Ethernet — будущее В настоящее время Huawei предлагает заказчикам СХД нового поколения в двух вариациях: Dorado 8000 V6 и Dorado 18000 V6. Отличаются они только количеством модулей в максимальной комплектации (ну и габаритами, массой, количеством ядер в процессорах контроллера). 18000 V6 поддерживает до 32 контроллеров и до 32 Тбайт пула кеширования. Оба варианта могут работать с фронтендами 10/25/40/100GbE RoCE или FC-8/16/32G, поддерживая протоколы FC, iSCSI, NFS и CIFS. Каждый блок контроллеров может иметь до 28 IO-модулей и до 96 сетевых портов. Максимальное количество SSD в системе также одинаково и составляет 6400. Они могут работать в разных режимах RAID, включая фирменный RAID-TP, способный вынести одновременный отказ трёх накопителей. Максимальный объём флеш-хранилища составляет 98,3 Пбайт для модели Dorado 8000 V6, а у Dorado 18000 V6 он достигает 196,6 Пбайт.  Поскольку речь идёт о комплексных системах, способных обеспечить доступностью класса «шесть девяток» (99,9999%) и производительность на уровне свыше 20 млн IOPS при непревзойдённом уровне надёжности, стоимость конечной реализации вырабатывается в процессе проработки сертифицированными партнёрами Huawei проекта, создаваемого под нужды конкретного заказчика. Ознакомиться с OceanStor Dorado 8000/18000 V6 можно на сайте Huawei, там же можно найти подходящего партнёра для разработки законченного решения с учётом нужд заказчика.
26.08.2021 [13:00], Илья Коваль
Huawei OceanProtect X8000 и X9000 — быстрые, ёмкие и надёжные All-Flash СХД для резервного копированияПерефразируя старую поговорку: люди делятся на тех, кто ещё не делает бэкапы, на тех, кто уже делает, и на тех, кто делает их правильно. Хотя, казалось бы, с начала пандемии первая категория должна стремительно уменьшаться, это происходит не везде, несмотря на совершенно неприличные для современной IT-индустрии — как по активности злоумышленников, так и по беспомощности жертв — атаки на бизнес любого размера. Впрочем, даже в тех индустриях, где резервное копирование делать привыкли, есть области с особыми требованиями. Это в первую очередь финансовые институты, энергетика, телекоммуникации, управление производством, ретейл и т.д. Во всех этих областях минута простоя обходится более чем $1 млн, а в случае финансовых учреждений эта цифра достигает почти $6,5 млн. 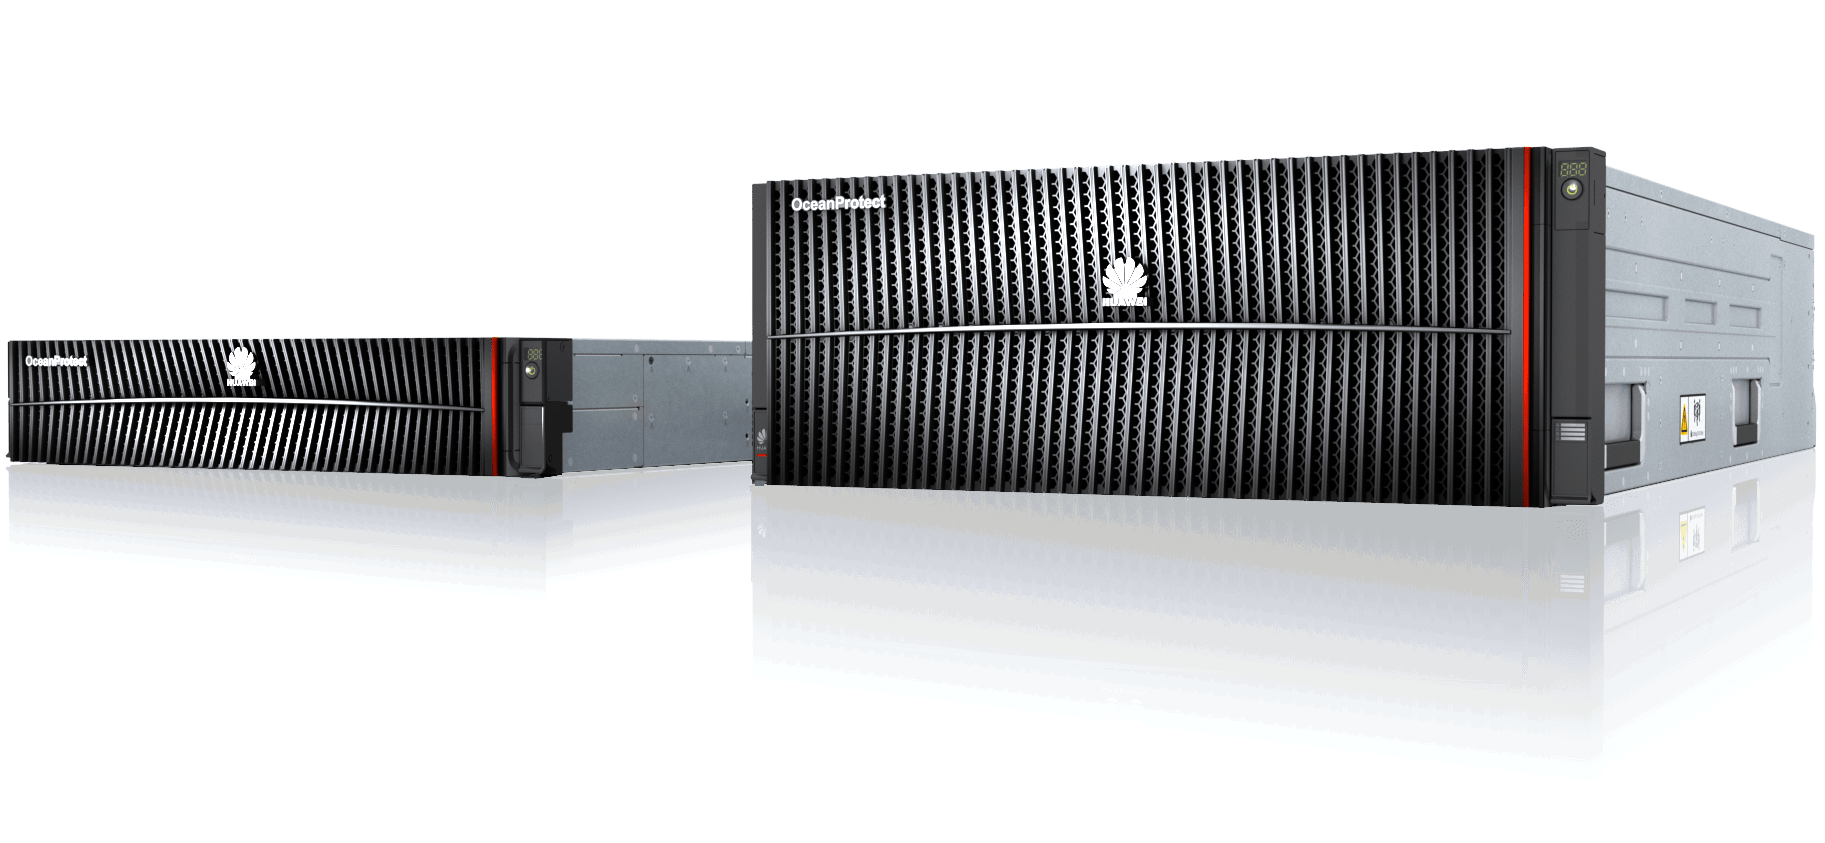
Huawei OceanProtect X8000 и X9000 По оценкам экспертов, отсутствие катастрофоустойчивости, важнейшим элементом которой является именно резервное копирование, в более чем половине случае приводит к банкротству в течение 2-3 лет после первого падения IT-систем. А причин такого падения масса — от природных бедствий и человеческого фактора до неумышленного (сбой оборудования) или умышленного (атака) вмешательства в работу систем. 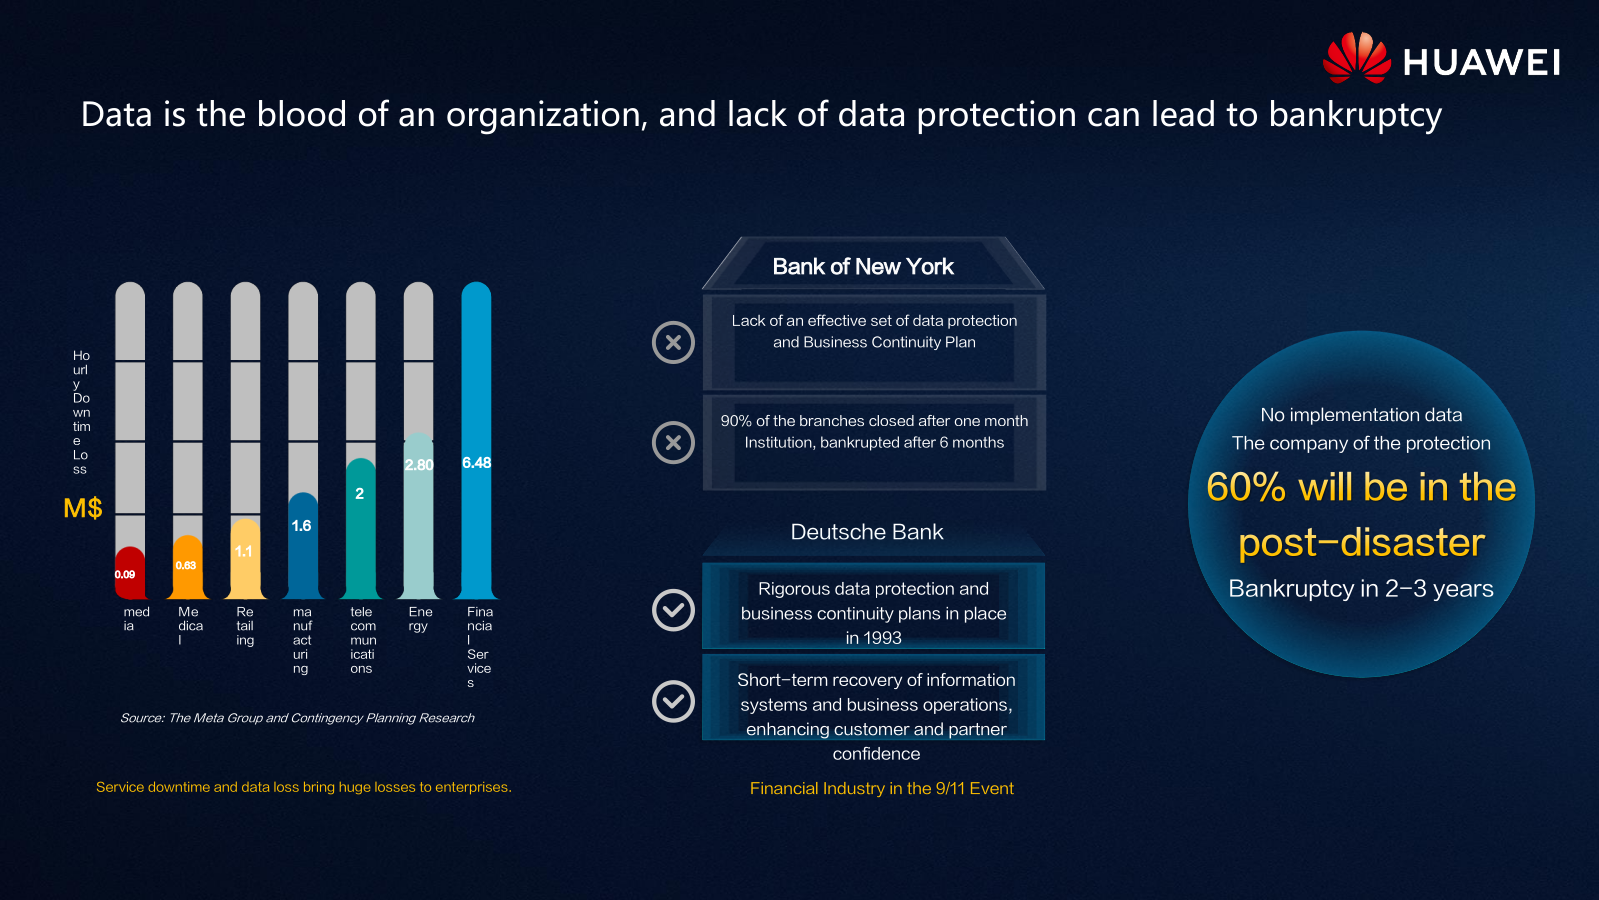 Вместе с тем в последние годы поменялись и сами данные, и требования к работе с ними. Никого уже не удивляет необходимость поддержки надёжности в семь «девяток», резкий рост объёмов «горячих» и «тёплых» данных и постепенный переход от петабайтных хранилищ к экзабайтным, а также изменение самой сути хранимой и обрабатываемой информации — структурированные данные становятся всё менее заметными на фоне растущих как снежный ком неструктурированных. 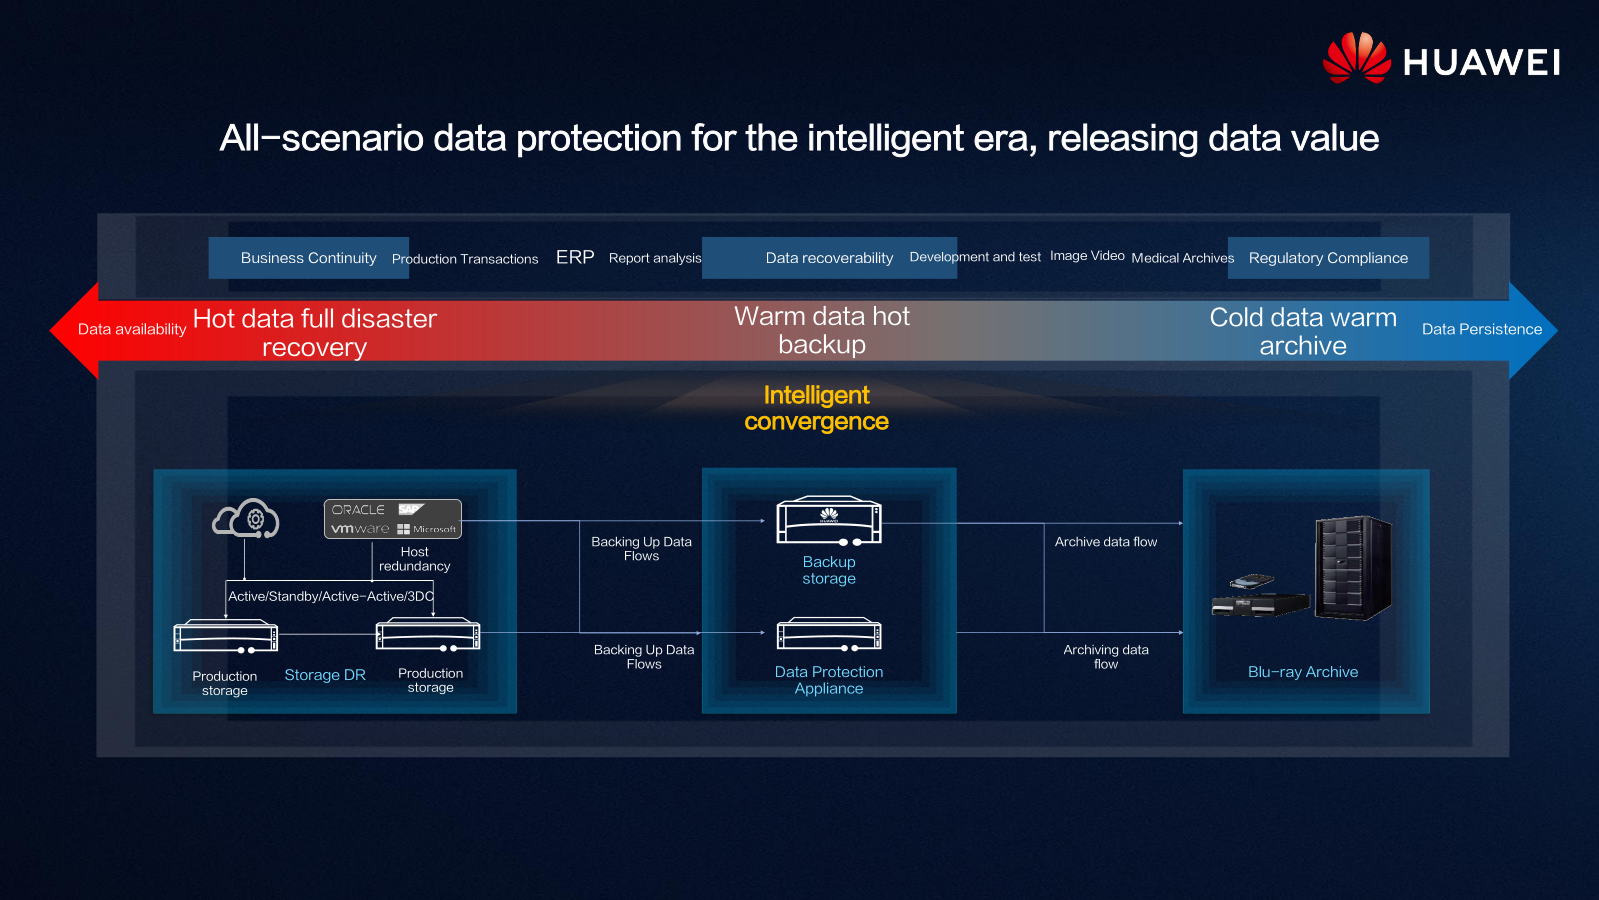 Всё это кардинальным образом меняет требования и к «боевым» СХД, и в особенности к системам резервного копирования. Без бэкапа «тёплых» данных кое-где уже не обойтись, но такие СХД должны обладать уникальным набором характеристик: достаточно высокое быстродействие, причём не только на получение, но и на отдачу данных; повышенная надёжность; универсальность, то есть работа и с SAN, и с NAS; масштабируемость по ёмкости и производительности. 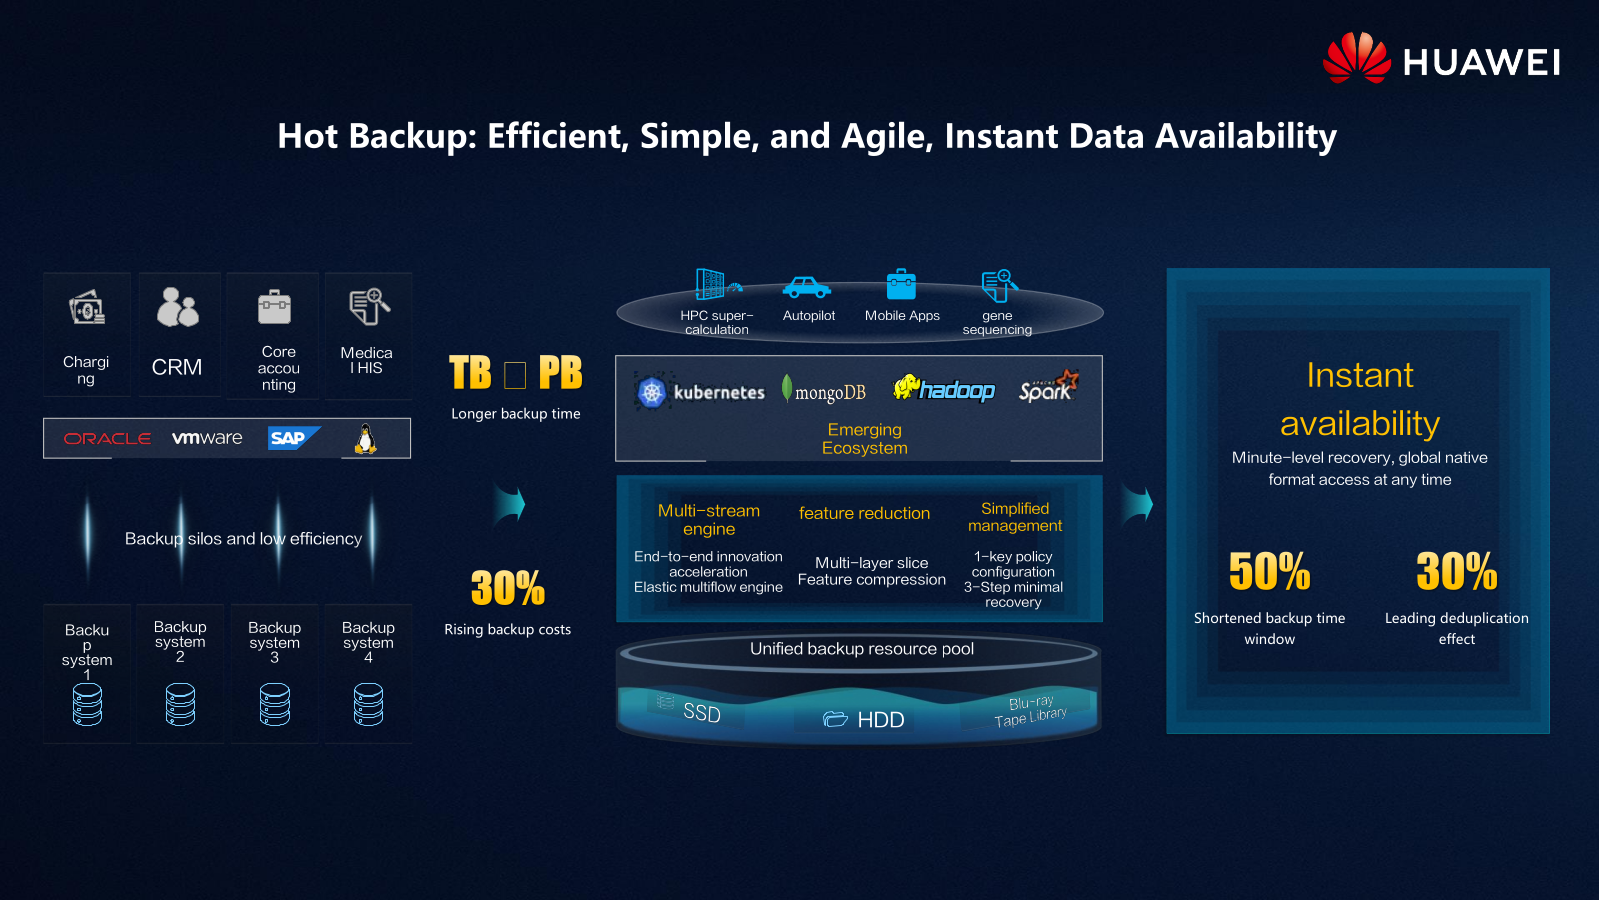 Ровно те же требования предъявляются и к основным СХД, однако для задач бэкапа нужно соблюсти ещё два очень важных условия. Во-первых, доступное пространство должно значительно превышать ёмкость резервируемых СХД, чего, не раздувая размеры системы, можно добиться лишь правильным использованием дедупликации и компрессии, которые при этом должны происходить на лету и минимально влиять на производительность. Во-вторых, такая система должны быть выгоднее, чем просто установка дубля основной СХД. 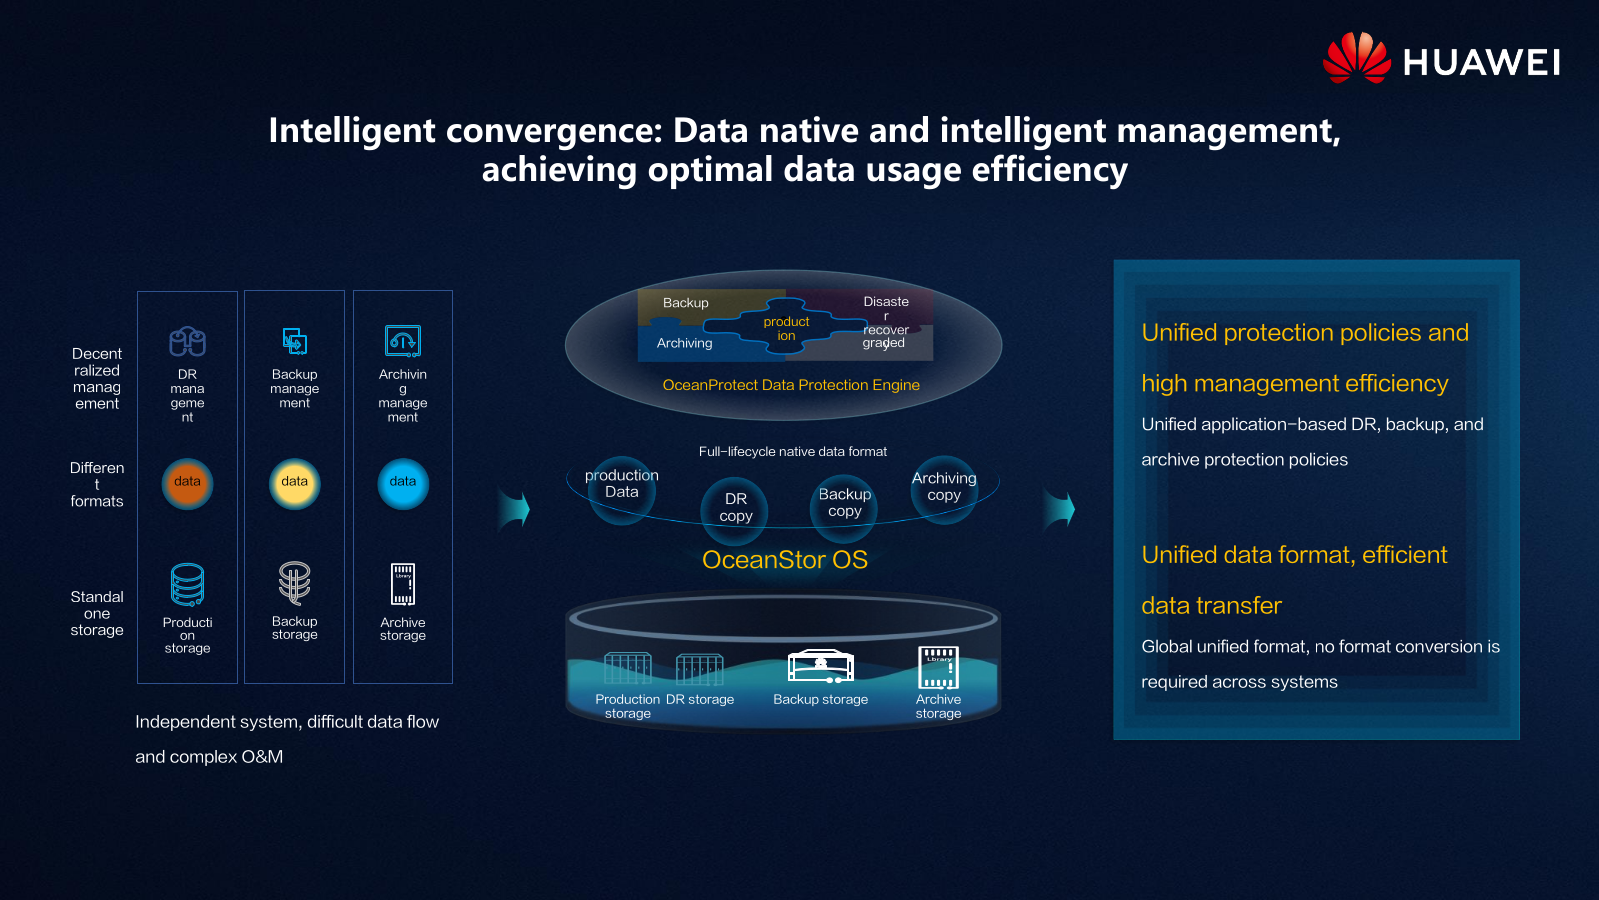 И у Huawei есть именно такое уникальное решение. Весной компания анонсировала новую серию СХД с говорящим названием OceanProtect. Наиболее интересными в ней являются модели X9000 и X8000, относящиеся к высокому и среднему сегменту соответственно. «Хитрость» в том, что основой для них является всё та же современная OceanStor Dorado, которую лишили части некритичных для задач резервного копирования функций и оснастили исключительно SAS SSD.
И, конечно, добавили ряд специфичных для работы с бэкапом оптимизаций. Например, в OceanProtect наряду с RAID-5/6 доступен и фирменный массив RAID-TP, сохраняющий работоспособность при потере до трёх накопителей сразу. Однако в данном случае данные агрегируются в длинные непрерывные блоки в кеше, сливаются воедино и записываются с использованием RoW (redirect-on-write) целыми страйпами. 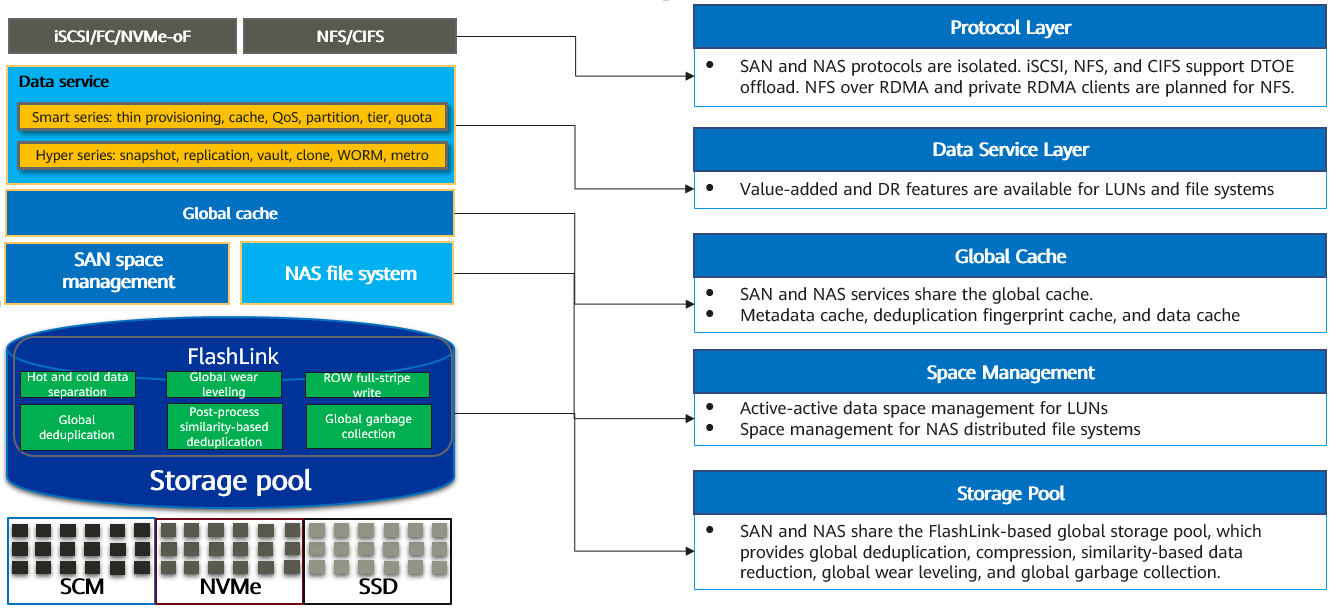 Такой подход отчасти связан с используемыми в OceanProtect алгоритмами дедупликации и компрессии, которые вместе позволяют достичь коэффициента сжатия вплоть до 55:1. Для этого используется несколько техник. В частности, мета✴-данные выявляются и отделяются от остальных, подвергаясь только компрессии. Для основных же данных используется динамически подстраиваемая системой дедупликация с сегментами переменной длины. После неё данные снова анализируются и делятся на те, которые хорошо подвергаются компрессии и для которых используются стандартные алгоритмы сжатия, и на те, которые просто так сжать не удастся. 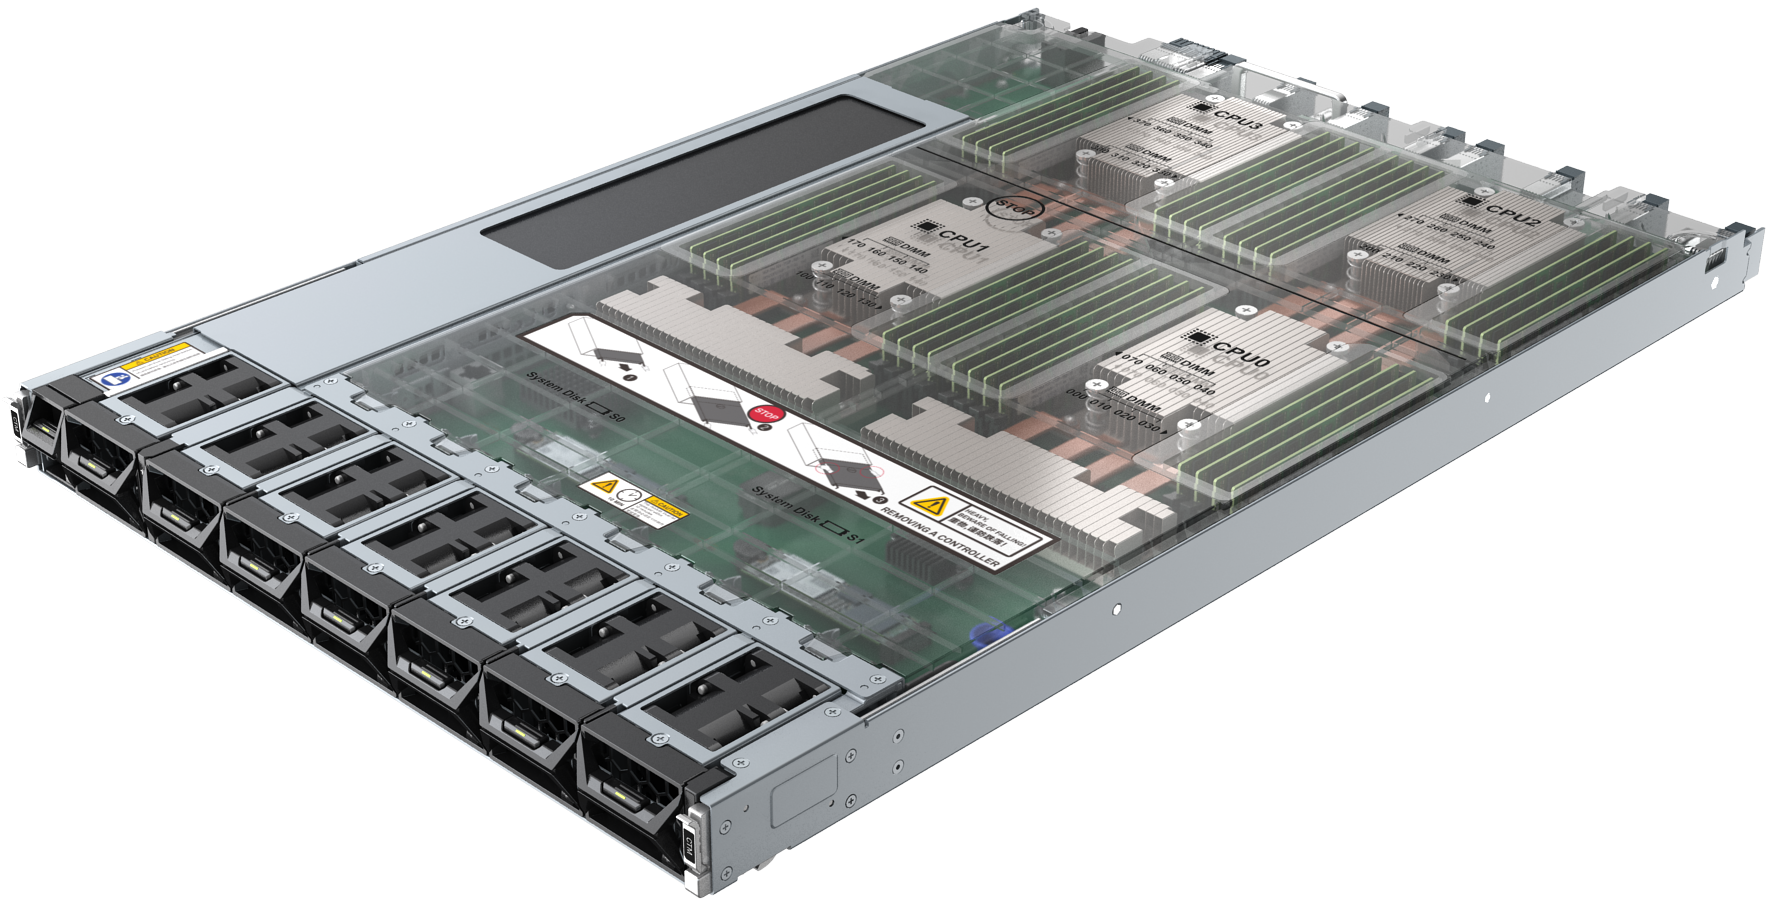
Контроллер Huawei OceanProtect X9000 Для последних применяется фирменный алгоритм сжатия, который, к слову, является детищем российского подразделения исследований и разработок компании — Huawei регулярно проводит конкурс по созданию именно таких алгоритмов среди отечественных вузов, так что некоторые наработки попадают в столь заметные продукты. Сжатые данные побайтно выравниваются для компактности и отправляются на запись. Таким образом достигается и эффективное использование дискового пространства, и снижение нагрузки на накопители. 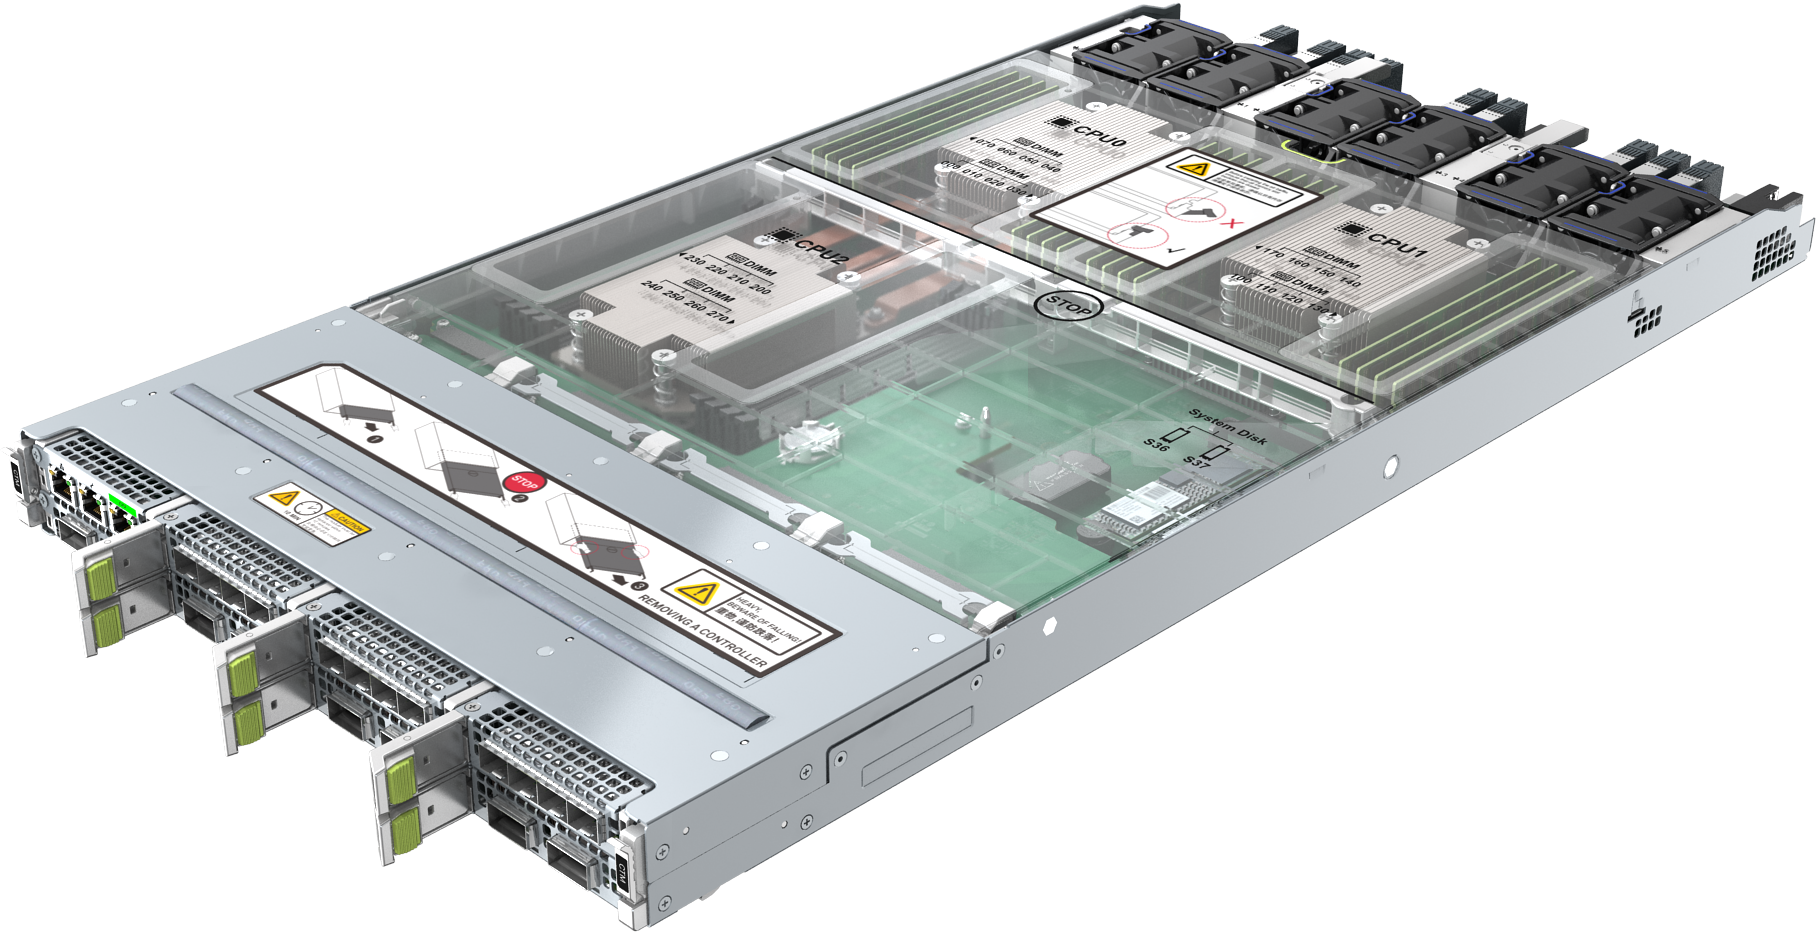
Контроллер Huawei OceanProtect X8000 Повышение надёжности СХД достигается несколькими механизмами на различных уровнях. Так, непосредственно внутри SSD из чипов памяти формируются массивы RAID 4. Сами SSD представляются системе не как «монолиты», а в виде групп RAID 2.0+ из блоков фиксированного размера. Это позволяет не только повысить надёжность без потери производительности, но и сбалансировать нагрузку, выровнять износ и значительно сократить время на пересборку массивов. 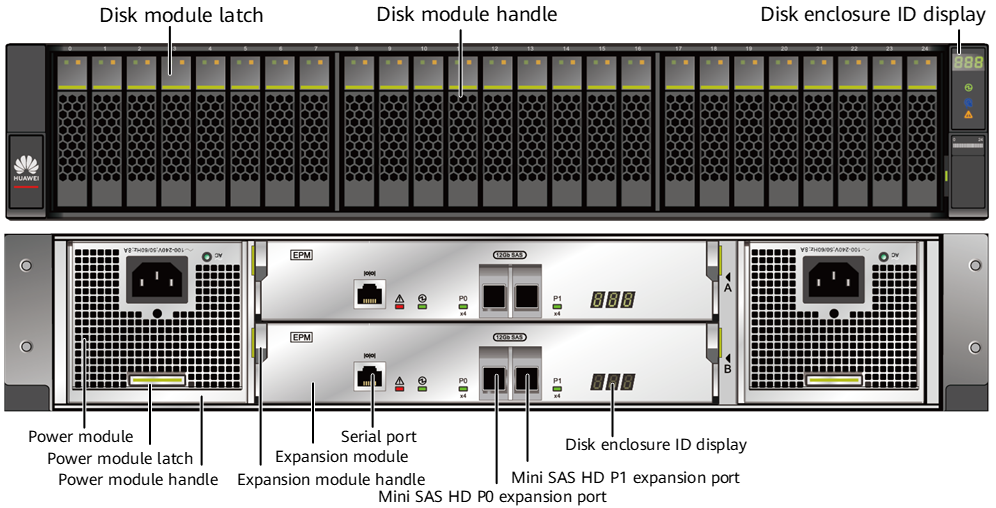
Дисковая полка Huawei OceanProtect X8000/X9000 Для подключения дисковых полок используются 4-портовые (Mini-SAS) интерфейсные модули SAS-3, для контроллеров — 25/100GbE с RDMA, а для хостов — модули FC8/16/32 и 10/25/40/100GbE с RDMA. Ethernet-контроллеры поддерживают разгрузку стека TCP/IP, избавляя CPU от лишней нагрузки. Посадочных мест для модулей достаточно для того, чтобы объединить контроллеры с резервированием подключения без использования внешнего коммутатора. Для SAN доступна поддержка Fibre Channel и iSCSI, а для NAS — NFSv3/4.1, SMB/CIFS 2.0/3.0 и NDMP. 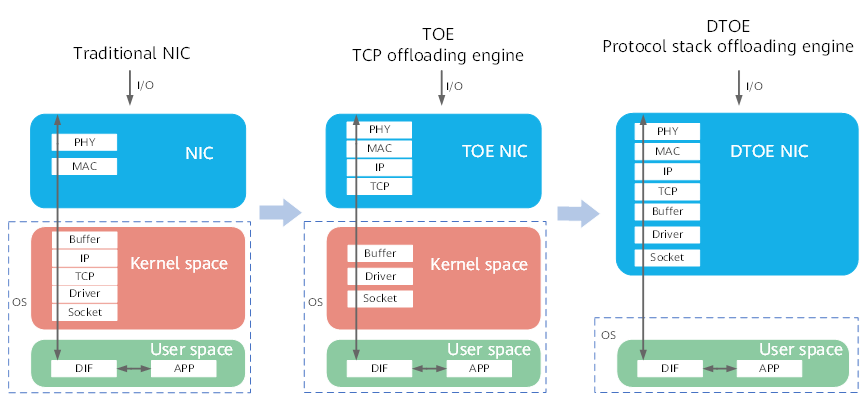 Дисковый бэкенд и IO-фронтенд подключаются к контроллерам по схеме «каждый-с-каждым» с дополнительным резервированием, да и сами контроллеры провязаны между собой по той же схеме. Таким образом формируется полноценная mesh-сеть из всех компонентов и линков. Это даёт всё те же отказоустойчивость, производительность и сбалансированность. Ну и поддержку горячей замены или обновления (что программного, что аппаратного) практически любого из компонентов системы без её остановки. 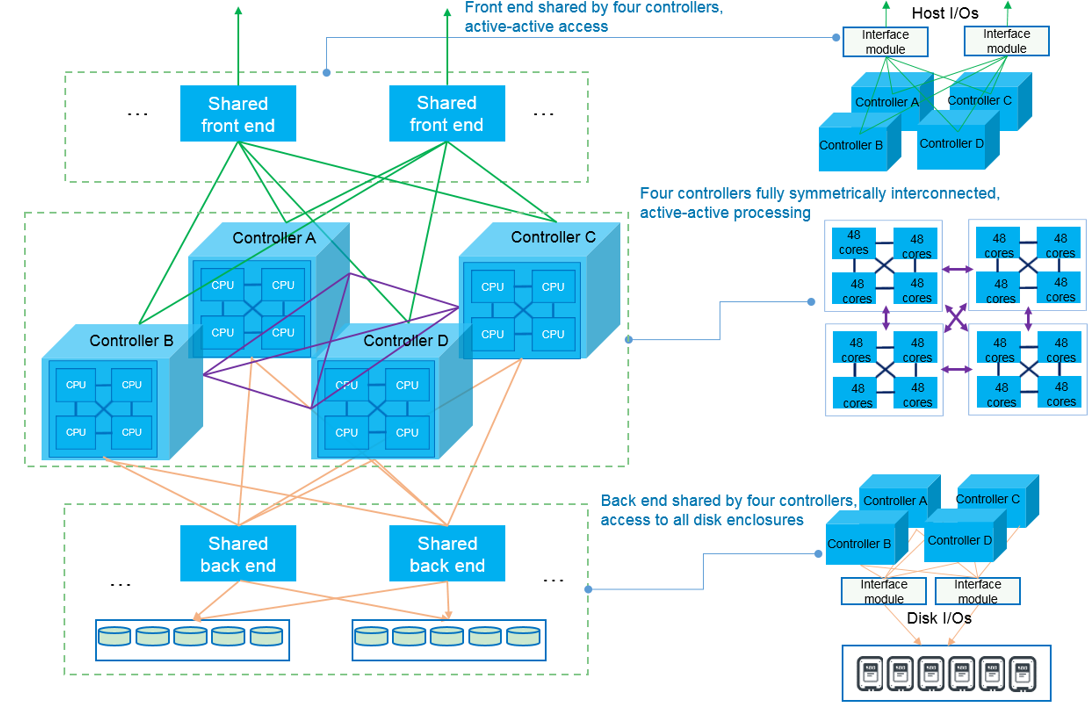 На программном уровне доступны различные варианты репликации и работы со снапшотами, «умные» квоты и классы обслуживания (по скорости, IOPS и задержке), расширенная система мониторинга, прогнозная аналитика по состоянию системы в целом и отдельных её компонентов, в том числе по производительности и ёмкости. Для задач безопасности доступно шифрование на уровне дисков, безопасное затирание данных по международным стандартам, а также аппаратный RoT, формирующий цепочку доверия для всего ПО. 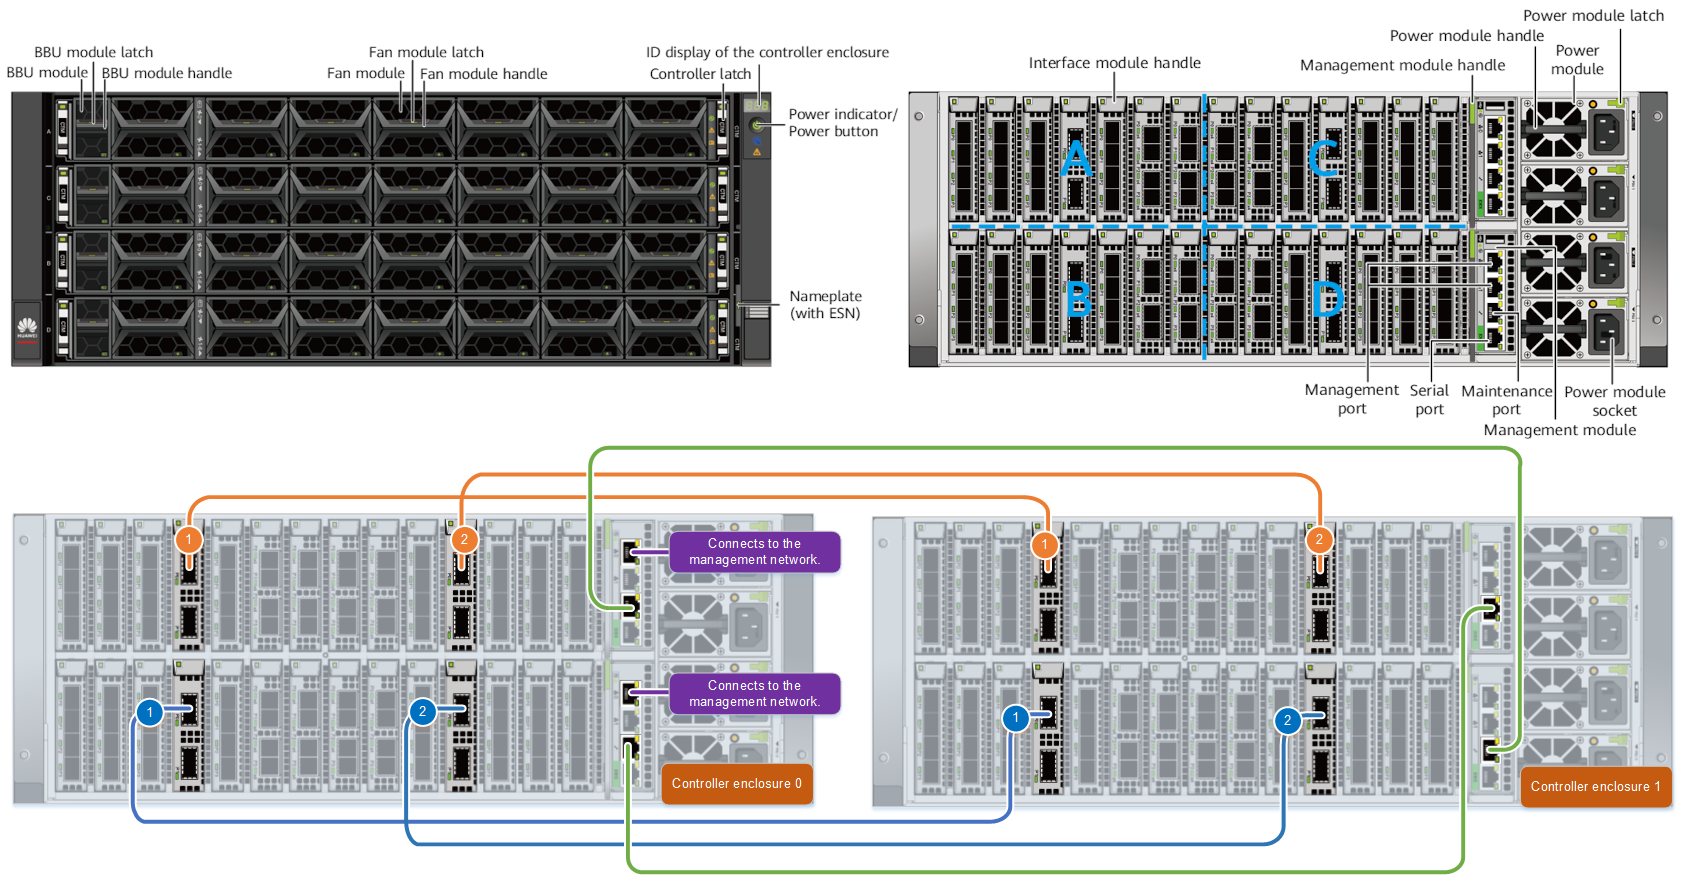
Huawei OceanProtect X9000 Всё вышесказанное относится к обеим моделям, X8000 и X900. Но различия между ними, конечно, есть. У OceanProtect X9000 в отдельном 4U-шасси находятся четыре контроллера Active-Active, каждый из которых может иметь до четырёх CPU и до 1 Тбайт памяти для кеширования. Система сохраняет работоспособность при выходе из строя трёх из четырёх контроллеров. На шасси приходится 28 интерфейсных модулей и четыре БП, которые являются общими для всех. Можно объединить два шасси, то есть получить восемь контроллеров, связанных между собой 100GbE-подключениями. 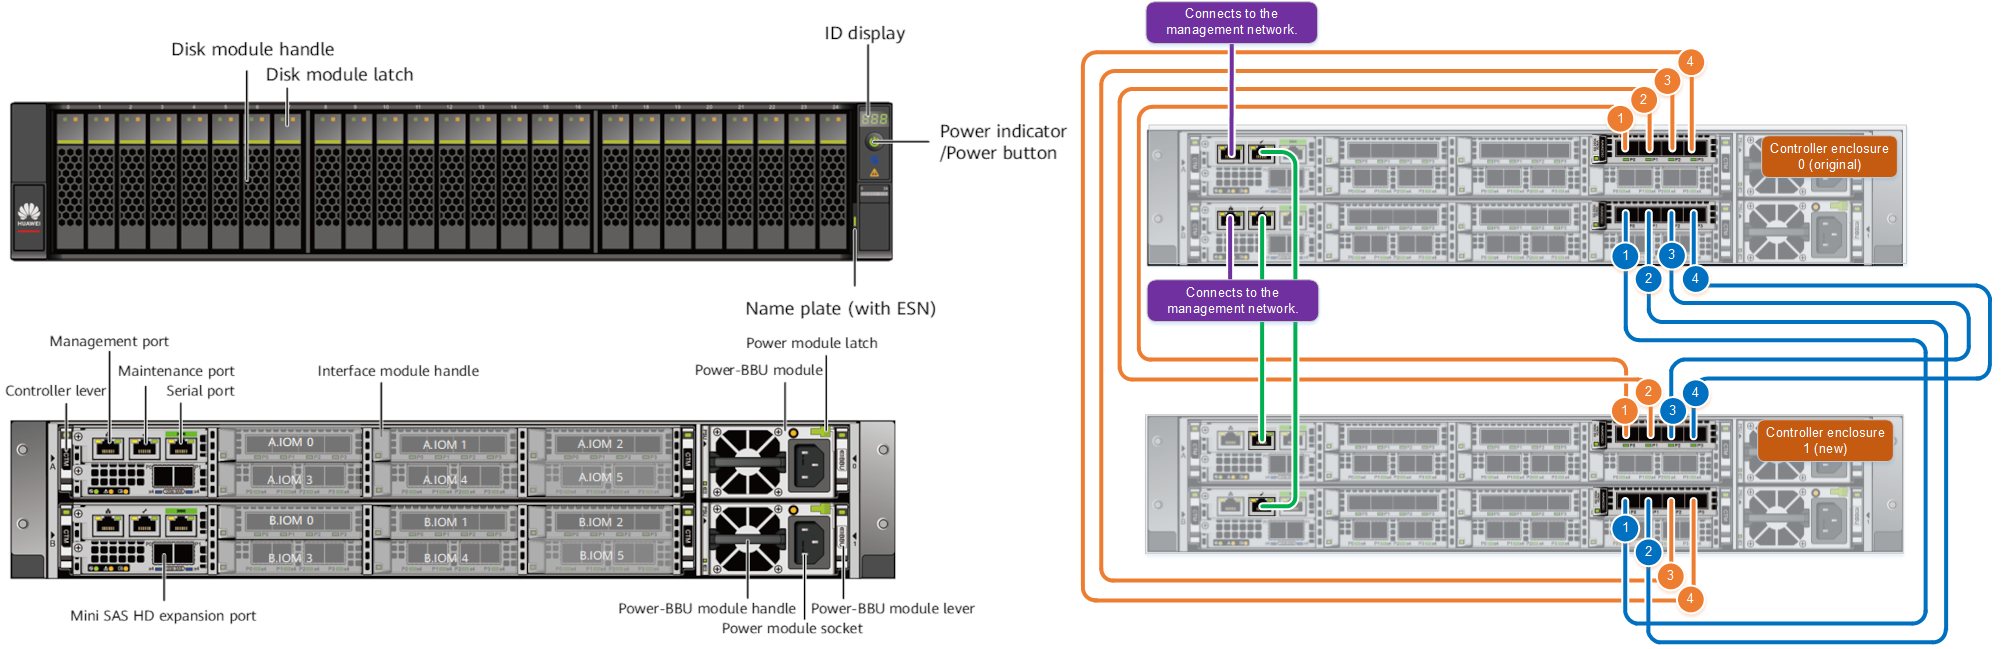
Huawei OceanProtect X8000 OceanProtect X8000 объединяет в 2U-шасси два контроллера Active-Active, 25 накопителей SAS-3 и два БП. Каждый контроллер имеет до 2 CPU, до 512 Гбайт памяти для кеширования и шесть интерфейсных модулей. Можно объединить два шасси (четыре контроллера) посредством 25GbE-подключений. Дисковые полки одинаковые для обеих моделей — 2U-шасси на 25 накопителей с четырьмя портами Mini-SAS и двумя БП. Пока что доступны только накопители объёмом 3,84 и 7,68 Тбайт, но в будущем появятся и более ёмкие модели. 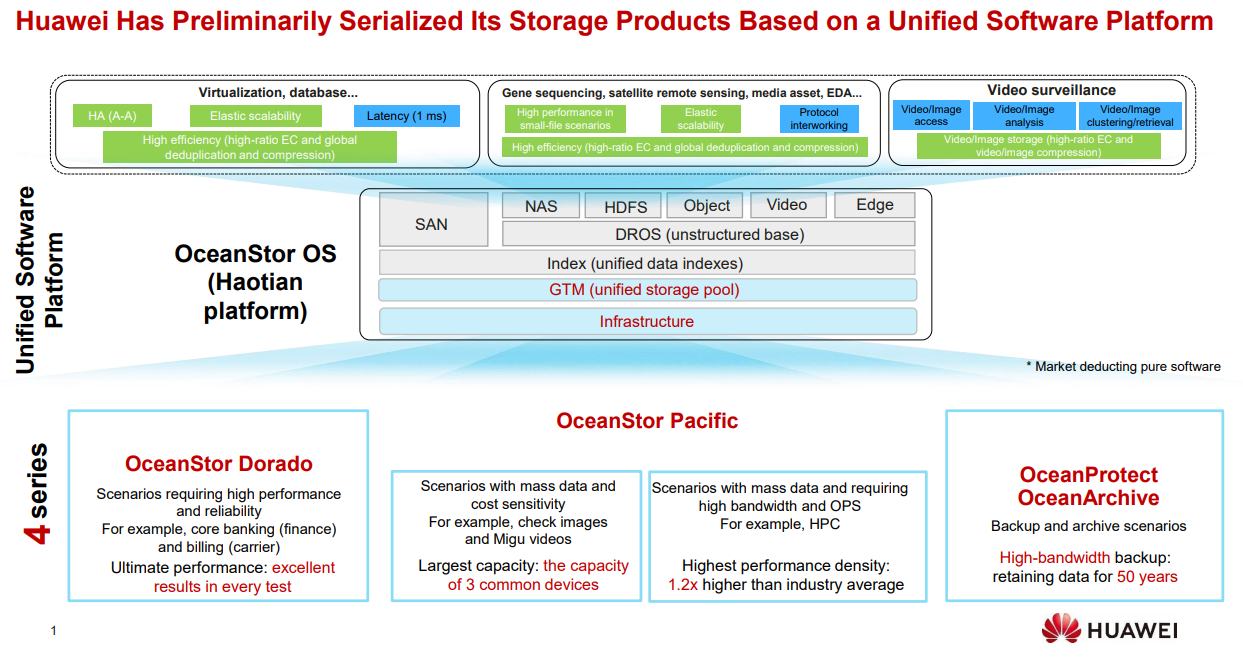 В серии OceanProtect есть и СХД попроще. Так, модель A8000 похожа на X8000, но имеет более скромные показатели производительности и предлагает только 10/25GbE-интерфейсы. А линейка Huawei DPA использует уже SATA-накопители и 1/10GbE-подключения. В будущем появится и серия оптических библиотек OceanArchive для «холодных» данных. Таким образом, продукты компании покроют все ключевые задачи в этом сегменте. Huawei ожидает, что рынок СХД для резервного копирования вырастет к 2025 году до $14,7 млрд и рассчитывает «отъесть» от него примерно половину.
05.04.2021 [23:46], Владимир Мироненко
Новая версия VMware ESXi для Arm поддерживает Ampere AltraВ прошлом году VMware выпустила первую экспериментальную версию ESXi для Arm-процессоров. Следует отметить, что перенос ESXi на Arm является огромной технической задачей не только потому, что ESXi — большая кодовая база со множеством технических тонкостей, но и потому что семантика, лежащая в основе процессоров Arm, сильно отличается от архитектуры x86. Как сообщили в VMware, это потребовало тщательного тестирования и доработки, чтобы гарантировать, что ESXi работает как на Arm, так и на x86-платформах, сохраняя при этом высокие стандарты ESXi. Тем не менее, работа на Arm-версией продолжается, и на днях компания представила очередной минорный релиз ESXi Arm Edition 1.3. 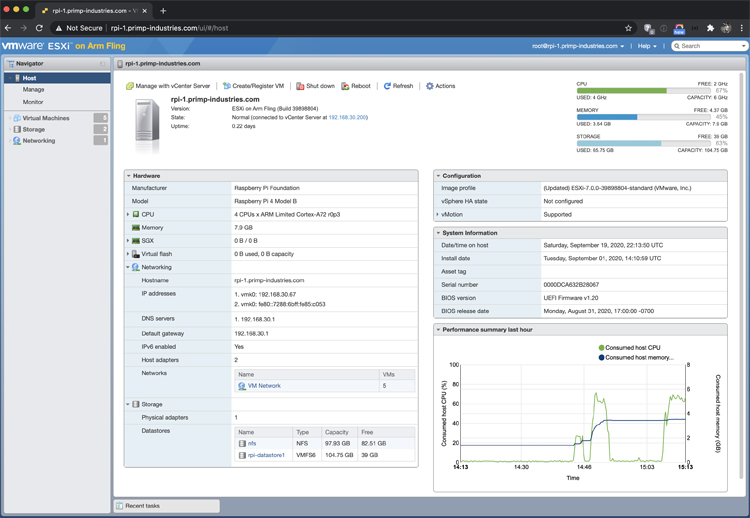
Источник изображения: vmware.com Обновление включает в себя несколько новых функций и компонентов, и требует новой установки. Как сообщила компания, обновление представляет собой оценочную программу, предназначенную для корпоративных архитекторов, которые рассматривают возможность виртуализации рабочих нагрузок на Arm, а также для команд разработчиков и тестировщиков, ищущих способ развернуть свои рабочие среды на Arm, и для профессионалов, которые просто хотят изучить возможности ESXi-Arm. Основные особенности ESXi Arm fling v1.3:
23.02.2021 [22:23], Андрей Галадей
Вышло обновление ZLUDA v2, открытой реализации CUDA для GPU IntelРанее мы уже писали об экспериментальнои проекте ZLUDA, развивающем открытую реализацию CUDA для GPU Intel, которая позволила бы нативно исполнять CUDA-приложения на ускорителях Intel без каких-либо модификаций. При этом её разработка ведётся независимо и от Intel, и от NVIDIA. Новинка построена на базе интерфейса Intel oneAPI Level Zero, и может работать на картах Intel UHD/Xe с неплохим уровнем производительности. Однако у первой версии был ряд ограничений. Вчера же вышла вторая версия, которая получила ряд улучшений. Кроме того, автор проекта объявил о переходе на модель непрерывного выпуска релизов.  Основной упор в новой версии сделан на улучшение поддержки Geekbench и работы в Windows-окружении. Собственно говоря, автор прямо говорит, что оптимизация под Geekbench пока является основной целью, а другие CUDA-приложения могут не работать. Кроме того, такое ПО, запущенное с помощью ZLUDA будет работать медленнее, чем на картах NVIDIA, в силу разности архитектур GPU и необходимости эмуляции некоторых возможностей. Подробности приведены на странице проекта. |
|
|||||||||||||||||||||||||||||||||||||

