
Материалы по тегу: i
|
21.01.2021 [16:44], Сергей Карасёв
Плата Raspberry Pi Pico с микроконтроллером RP2040 оценена всего в $4Организация Raspberry Pi Foundation объявила о выпуске своего первого микроконтроллера: плата под названием Raspberry Pi Pico выполнена на основе микрочипа собственной разработки RP2040. В состав RP2040 входят два ядра Cortex M0+ с базовой тактовой частотой 48 МГц и возможностью повышения до 133 МГц. Предусмотрены 264 Кбайт памяти SRAM. Корпус: QFN56 с размерами 7 × 7 мм. 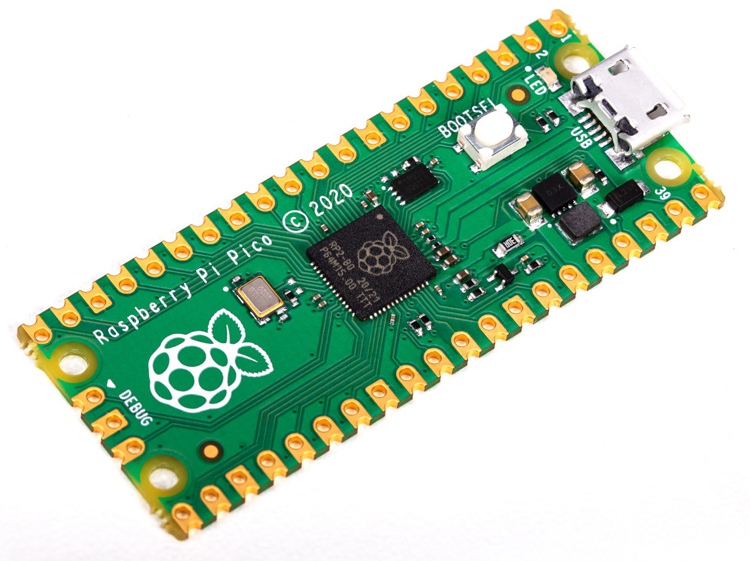 Собственно мини-плата Raspberry Pi Pico имеет габариты 51 × 21 мм. Она оснащена единственным разъёмом Micro-USB 1.1, который служит как для подачи питания, так и для загрузки прошивок в формате UF2. Имеется массив из 30 GPIO-контактов, позволяющий задействовать интерфейсы 2 × UART, 2 × I2C, 2 × SPI (всего до 16 Мбайт QSPI Flash с XIP), а также 16 PWM-каналов. Кроме того, упомянут температурный датчик и 4 ADC-канала. 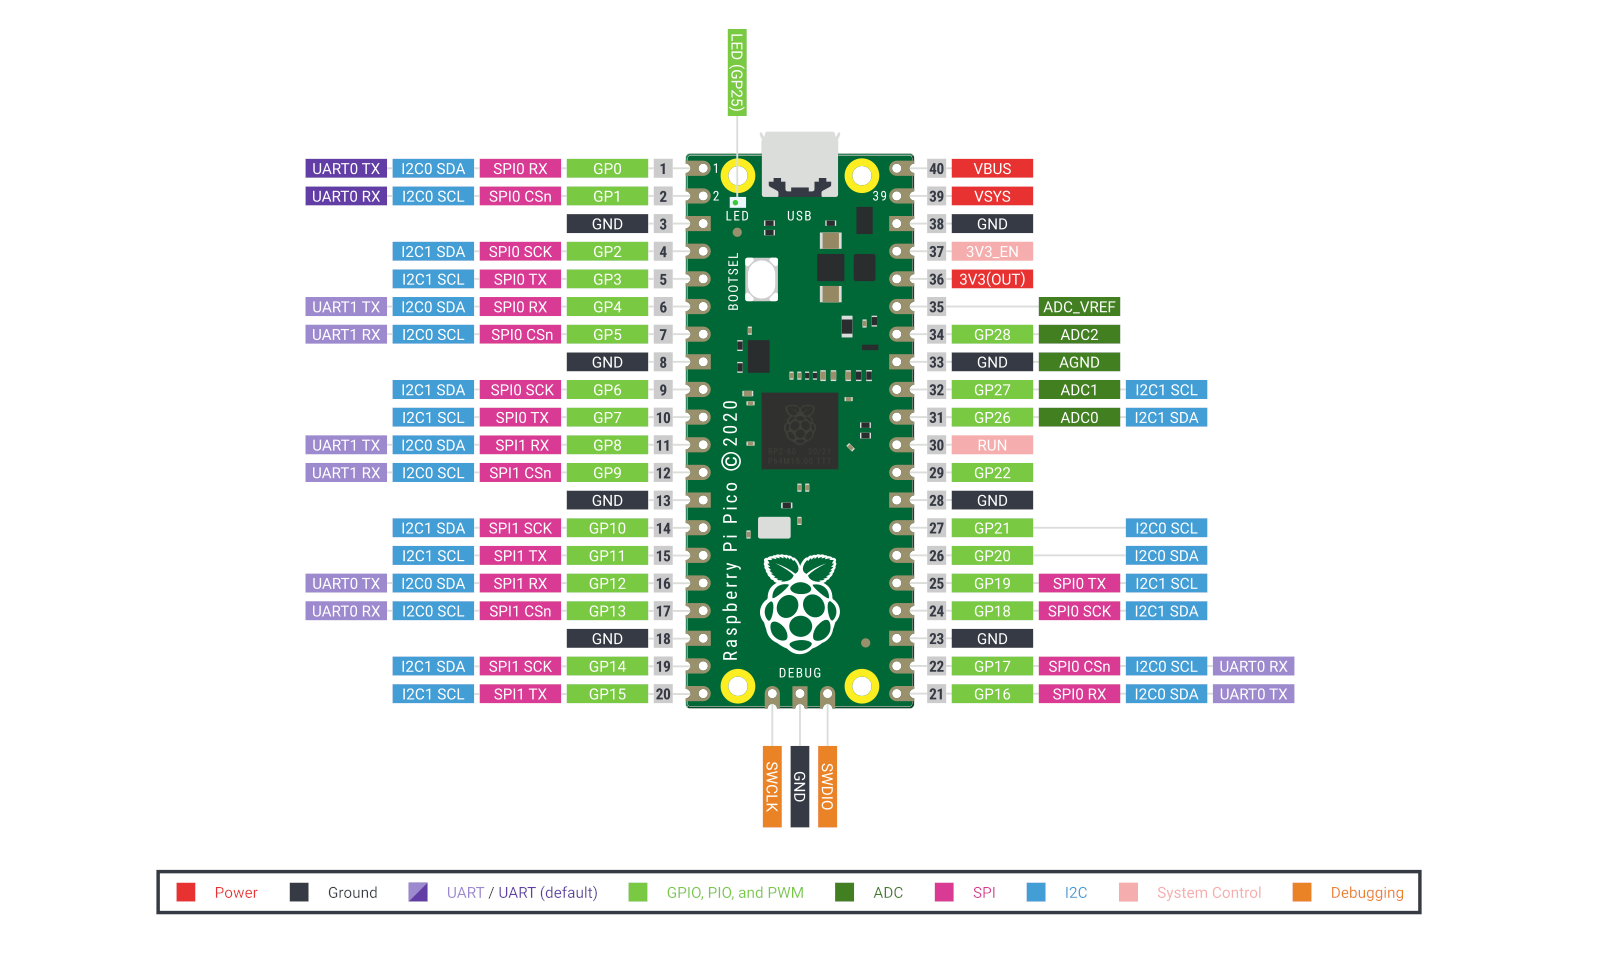 Микроконтроллер Raspberry Pi Pico может применяться в учебных целях, а также для создания тех или иных устройств для Интернета вещей, промышленной сферы и пр. Для упрощения работы имеются средства разработки на MicroPython и C/C++. Цена Raspberry Pi Pico с 2 Мбайт QSPI Flash составляет всего 4 доллара США. 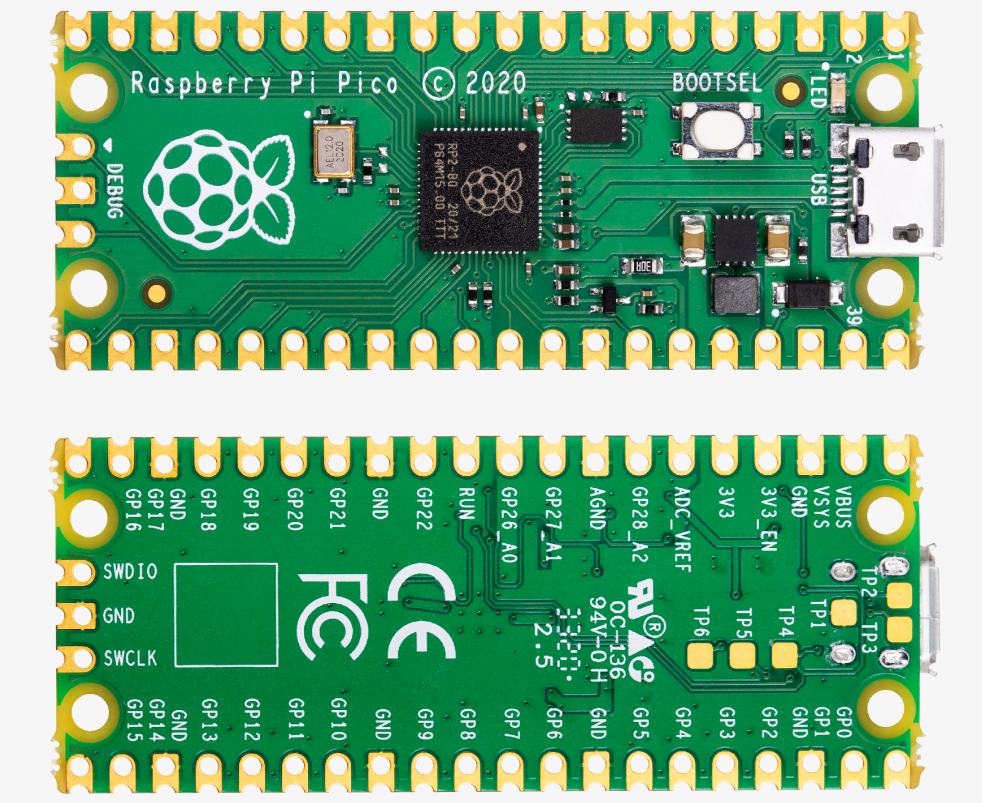 Любопытно, что чип RP2040 также использоуетсяя в изделиях сторонних производителей. Свои решения на этой платформе уже представили Arduino, Adafruit, Sparkfun и Pimoroni. Они могут применяться для сбора различных данных, задач машинного обучения и пр.
02.11.2020 [17:56], Илья Коваль
Прощание с Xeon Phi: ядро Linux лишится поддержки MIC-архитектурыФинальная партия Intel Xeon Phi была отгружена летом этого года, хотя сам закат продуктов на базе архитектуры MIC (Many Integrated Core) начался за несколько лет до этого. Теперь же можно сказать, что в их истории поставлена последняя точка — из основной ветки ядра Linux 5.10 поддержка этих процессоров убрана уже в rc2. В ядре Linux поддержка MIC появилась в 2013 году, и Intel очень активно развивала её, почти втрое увеличив объём кодовой базы. Однако в последние годы развитие прекратилось и код остался фактически заброшенным. Связано это, понятное дело, с уходом ускорителей с рынка, где они не стали массовыми, проиграв конкуренцию NVIDIA как в HPC, так и в остальных сегментах. 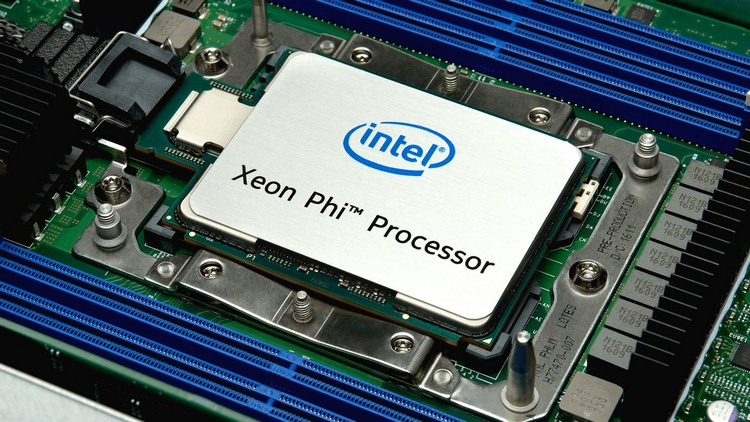 Intel последовательно отменила выпуск следующего поколения MIC и продуктов всех прошлых поколений Xeon Phi, переключившись на создание универсальной архитектуры GPU. HPC-ускорители на её базе должны появиться в скором времени. Шине Intel Omni-Path, которая была непосредственно интегрирована в некоторые поздние модели Xeon Phi, повезло больше — после отказа Intel разработки были переданы свежесозданной Cornelis Networks. Тем не менее, кое-какое наследие MIC в ядре всё же может сохраниться. Речь идёт подсистеме VOP (VirtIO over PCIe), которая решает некоторые проблемы виртуализации PCI Express и для устройств других вендоров. Однако в текущем она ориентирована только на поддержку продуктов и драйверов Intel, и сможет вернуться в ядро Linux лишь после доработки.
17.08.2020 [15:32], Алексей Степин
Подробности о процессорах IBM POWER10: SMT8, OMI DDR5, PCIe 5.0 и PowerAXON 2.0Мы внимательно следим за судьбой и развитием архитектуры POWER, которая наряду с ARM представляет определённую угрозу для x86 в сфере серверов и суперкомпьютеров — недаром одна из самых мощных в мире HPC систем, суперкомпьютер Ок-Риджской национальной лаборатории Summit, использует процессоры POWER9. Ранее ожидалось что по ряду причин выход следующей в семействе архитектуры, POWER10, откладывается до 2021 года, хотя IBM и продвигала активно новые решения вроде универсального стандарта оперативной памяти OMI. Однако официальный анонс IBM POWER10 состоялся сегодня, а немецкий портал Hardwareluxx выложил слайды презентации компании. 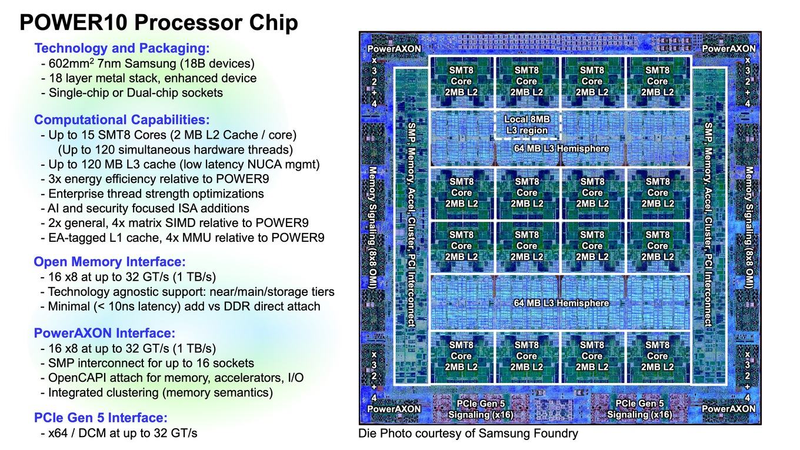 Как компания уже отмечала ранее, она делает упор на большие системы и гибридные облака. С учётом этих тенденций и были разработаны новые процессоры. Поскольку в крупных облачных ЦОД упаковка вычислительных плотностей достигает уже невиданного ранее уровня, всё острее встаёт вопрос с энергоэффективностью и отводом тепла. Но именно здесь, как считает IBM, POWER10 и должен показать себя с наилучшей стороны — новые процессоры производятся с использованием 7-нм техпроцесса и могут демонстрировать трёхкратное преимущество в энергоэффективности в сравнении с POWER9. 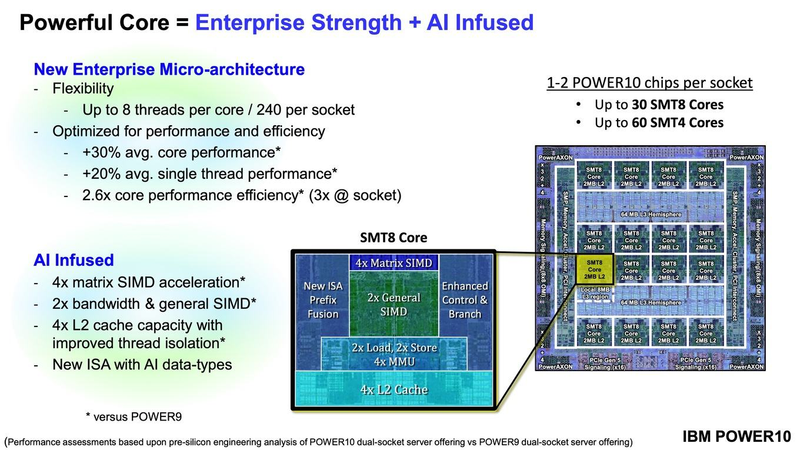 POWER10 — первый коммерческий процессор IBM, использующий нормы производства 7 нм; любопытно, что теперь Intel отстаёт не только от AMD, которая стала пионером в использовании столь тонкого техпроцесса в «крупных» серверных процессорах, но и от IBM. В отличие от AMD EPYC, производимых на мощностях TSMC, новинки IBM «куются» в полупроводниковых кузнях Samsung. Площадь кристалла, состоящего из 18 миллиардов транзисторов, у новых процессоров достигает 602 мм2, что меньше, чем у новейших графических ядер, но всё равно цифра довольно солидная. 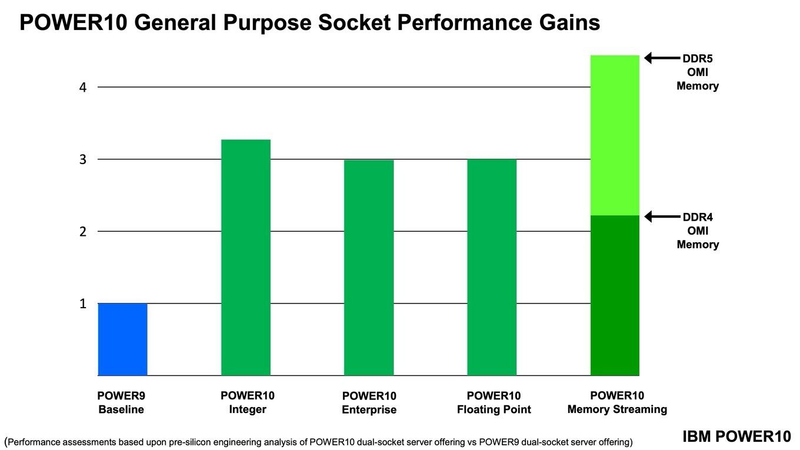 Техпроцесс POWER10 является совместной разработкой Samsung и IBM. В нём реализованы некие особенности, которые, предположительно, должны позитивно сказаться на характеристиках отдельных транзисторов. Не забыта и мода на установку нескольких кристаллов в один корпус: POWER10 доступны как в классическом варианте (SCM), так и в виде сборки из двух кристаллов (DCM), так что для каждого сценария использования можно выбрать подходящий вариант. В варианте SCM тактовая частота ядер составляет 4 ГГц, количество процессорных разъёмов в системе может достигать 16. В версии DCM частота снижена до 3,5 ГГц. 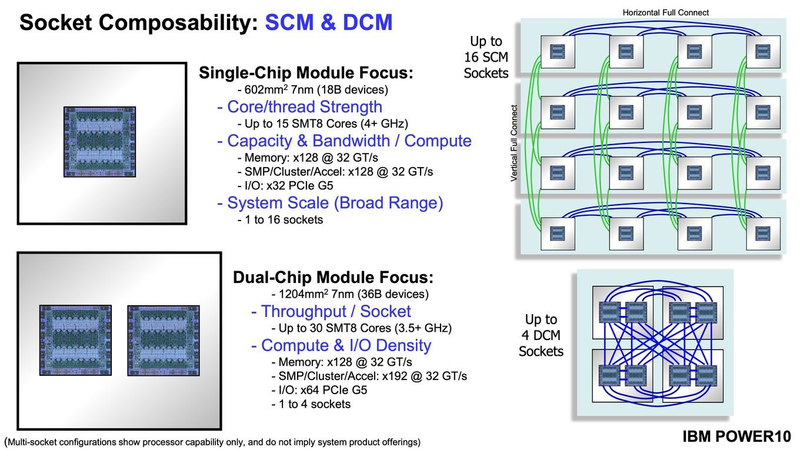 Базовый кристалл POWER10 имеет 16 вычислительных ядер, хотя используется из них только 15, каждое ядро дополнено 2 Мбайт кеша L2, а общий объём кеша L3 может достигать внушительных 120 Мбайт. Степень параллелизма была увеличена с SMT4 до SMT8, так что процессор может исполнять одновременно до 120 потоков, хотя, естественно, не в любой задаче такое распараллеливание ресурсов ядер будет эффективным. Производительность блоков SIMD была существенно увеличена, они вдвое быстрее аналогичных блоков POWER9, а на матричных операциях — быстрее в четыре раза. 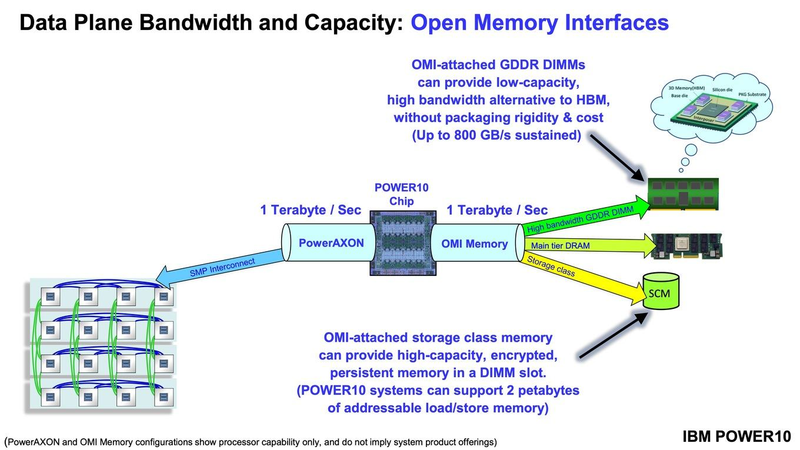 За общение процессора с «внешним миром» отвечают интерфейсы PowerAXON 2.0 и PCI Express 5.0, в первом случае поддерживается открытый стандарт OpenCAPI, во втором реализовано 64 линии со скоростью 32 ГТ/с на линию, как и предписано стандартом. Компоновка связей у DCM и SCM разная. В первом случае сокетов может быть только 4, зато используется топология «каждый с каждым», а вот в 16-сокетном варианте SCM «по диагонали» между собой процессоры напрямую не общаются. 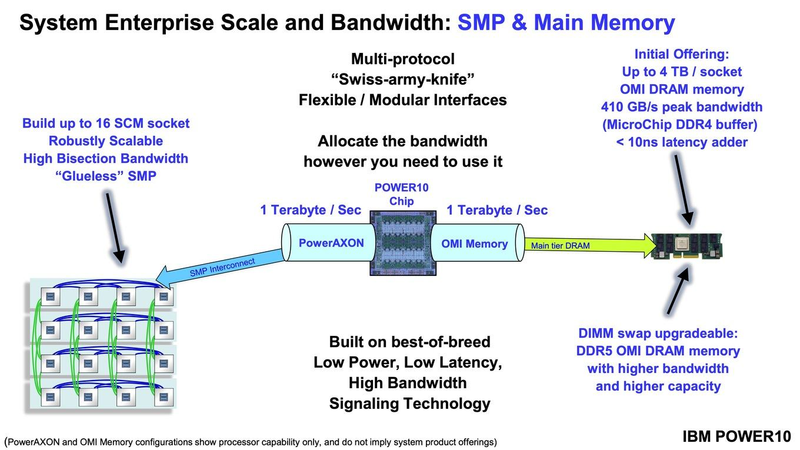 Интерфейс PowerAXON универсален, он использовался, в числе прочего, для реализации протокола NVLink для подключения ускорителей на базе графических процессоров NVIDIA. Проблем с пропускной способностью быть не должно, у каждого процессора в системе PowerAXON обеспечивает до 1 Тбайт/с. Кроме подключения ускорителей и общения процессоров между собой, у PowerAXON есть и ещё одно интересное и важное применение, о котором ниже. 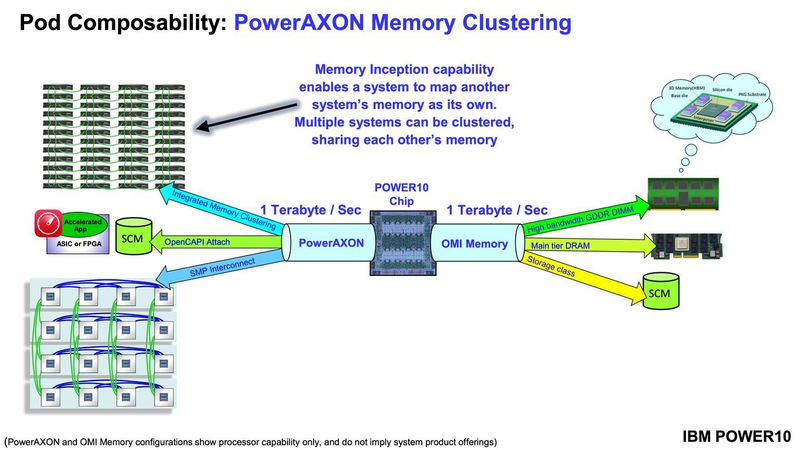 О преимуществах унифицированного интерфейса OMI, позволяющего «малой кровью» модернизировать подсистему памяти, мы уже рассказывали читателям ранее. В новом процессоре эти возможности задействованы полностью. Каждый базовый кристалл POWER10 имеет 16 линков OMI x8, общая пропускная способность достигает 1 Тбайт/с. Латентность, разумеется, возросла, поскольку контроллер DDR у OMI, по сути, внешний, но прирост небольшой и составляет менее 10 наносекунд. ✴-media" data-instgrm-captioned=" " data-instgrm-permalink="https://www.instagram.com/p/B5I5Dmpj0rw/?utm_source=ig_embed&utm_campaign=loading" data-instgrm-version="12"> Универсальность и возможность модернизации этот недостаток искупают с лихвой. В текущем варианте пиковая пропускная способность достигает 410 Гбайт/с на разъём, объём — 4 Тбайт на разъём, однако с внедрением более быстрых типов памяти (DDR5, GDDR или даже HBM) может быть достигнута цифра 800 Гбайт/с на разъём. Отдельно упоминается возможность работы с SCM, но без конкретики. На данный момент такая память массово представлена только 3D XPoint в виде Intel Optane DCPMM. 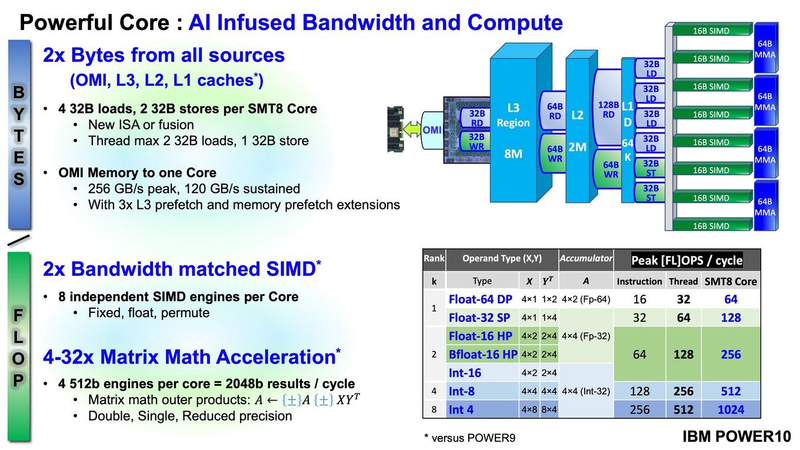 Любопытна технология Memory Clustering. С помощью PowerAXON система может обращаться к оперативной памяти в другой системе, как к собственной. Латентность при этом составляет 50 ‒ 100 нс, для систем типа NUMA совсем немного. Общий объем на одну систему POWER10 может достигать 2 Пбайт; с учётом применения систем IBM для запуска таких «пожирателей памяти», как SAP HANA такие объемы очень к месту. 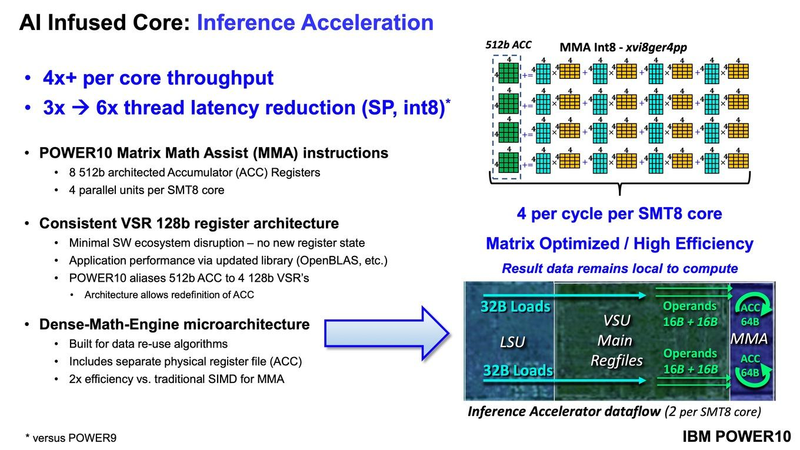 Следуя текущей моде на машинное обучение, разработчики реализовали в POWER10 развитую поддержку форматов вычислений, отличных от традиционных FP32/64. Блок плавающих вычислений в новом процессоре носит название Matrix Math Accelerator. В сравнении с POWER9 он быстрее в 10, 15 и 20 раз в режимах FP32, BFloat16 и INT8 соответственно. Иными словами, именно для инференс-систем POWER10 станет хорошим выбором. 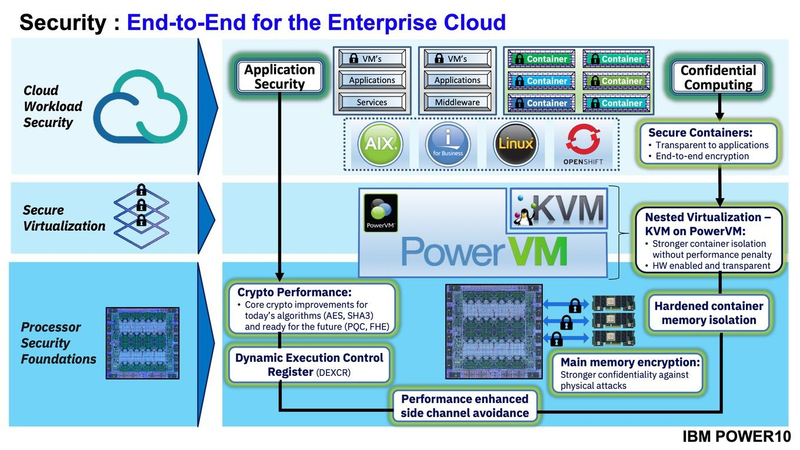 Поскольку одним из применений POWER10 компания видит облачные комплексы, серьёзное внимание уделено обеспечению безопасности. Новые процессоры поддерживают полное шифрование содержимого оперативной памяти, а для ускорения криптографических процедур в их составе есть соответствующие аппаратные блоки, причём не только для широко распространённого стандарта AES. Они достаточно гибки, чтобы поддерживать и шифрование будущего класса quantum safe. Также поддерживается защита и изоляция контейнеров на аппаратном уровне. Успешная атака на один контейнер в пределах машины не означает и успеха с другими контейнерами. 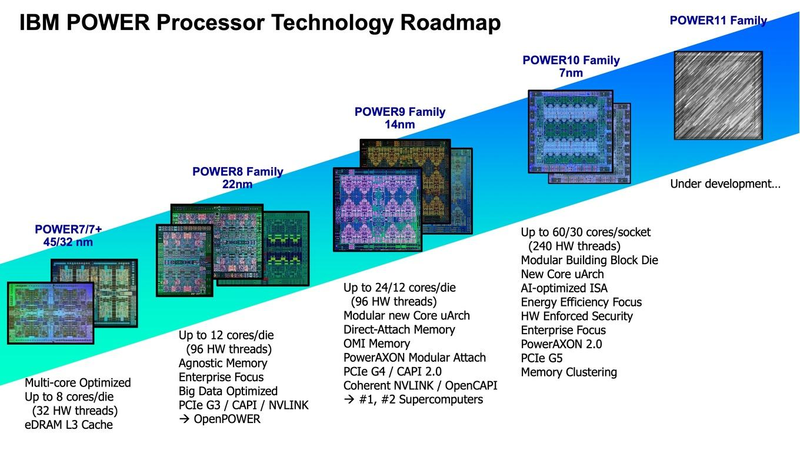 В качестве программной основы IBM предлагает Red Hat OpenShift, и архитектура POWER10 была соответствующим образом оптимизирована, чтобы показывать наилучшие результаты именно с этой средой. В целом, можно уверенно сказать: новые процессоры Голубого Гиганта получились интересными и весьма достойно выглядящими решениями даже на фоне успеха AMD EPYC.  Официальный анонс состоялся сегодня, но развёртывание массового производства должно занять определённое время, так что появления первых серверов на базе IBM POWER10 стоит ожидать не ранее начала следующего, 2021 года. А планы компании говорят о том, что POWER11 уже находится в разработке.
05.06.2020 [23:23], Алексей Степин
Предложение Huawei отказаться от TCP/IP восторгов не вызвалоСтеку TCP/IP, благодаря которому существует всемирная сеть, уже не один десяток лет. DARPA начало исследования по этой теме ещё в конце 60-х, и не все согласны с тем, что данная технология продолжает отвечать требованиям времени: Huawei предложила Международному союзу электросвязи (ITU) план по отказу от TCP/IP и переходу на более современное и безопасное, по её мнению, решение New IP. Определённый резон в этом есть: современные сети чрезвычайно сложны, они базируются на весьма разнообразном оборудовании, и что такое «кибервойна» сегодня, пожалуй, знают все, кто хоть сколько-то интересуется тематикой информационных технологий. Достаточно хотя бы сделать на нашем сайте поиск по слову «уязвимость» — и становится понятным, что понятия «интернет» и «безопасность» сегодня сочетаются не очень хорошо. 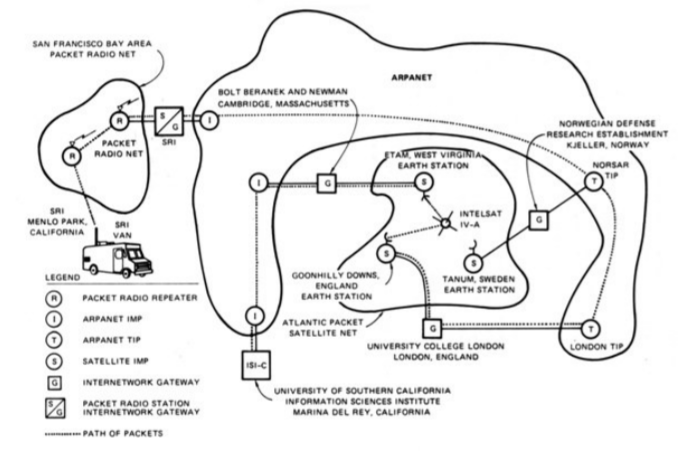
Демонстрация TCP/IP, объединяющая сети ARPANET, PRNET и SATNET. 1977 год Корпорация Huawei выступила в ITU с предложением отказаться от стека TCP/IP и перейти на использование более гибких и безопасных технологий. Понять позицию китайской компании можно: она находится в состоянии «войны» с США и желание продвинуть собственные технологии для нее совершенно естественно. Позиции, предлагаемые Huawei, выглядят довольно привлекательно:
Технических деталей, к сожалению, в публичном доступе пока нет. Реакция на предложение Huawei оказалась достаточно негативной: оно было охарактеризовано, как попытка внедрения централизации и «тоталитарных» методов. В частности, предложенный механизм отсечения частей сети можно использовать не только для защиты от DDoS-атак. Сама Huawei обвинения в «тоталитаризме» отвергла, заявив, что не связывает технологию с политикой. Еврокомиссия опубликовала свой ответ: в нём говорится, что за время своего существования модель TCP/IP доказала свою жизнеспособность, продемонстрировав нужную степень отказоустойчивости и масштабируемости. Аналогичной точки зрения придерживается Cisco, считая TCP/IP достаточно гибкой технологией, чтобы отвечать вызовам времени. 
О дивный, новый Интернет! Нужда в усовершенствовании сетевых технологий существует, но это следует делать в рамках существующих стандартов. Евросоюз планирует защищать «видение единого, открытого, нейтрального, свободного и нефрагментированного интернета». («the vision of a single, open, neutral, free and unfragmented internet»). Тем не менее, война технологий, скорее всего, в ближайшее время продолжится. Предсказать исход пока не представляется возможным, но Huawei явно не собирается сдаваться просто так и будет продвигать инициативу New IP далее.
04.11.2019 [21:00], Алексей Степин
IBM продвигает открытый стандарт оперативной DDIMM-памяти OMI для серверовПрактически у всех современных процессоров контроллер памяти давно и прочно является частью самого ЦП, будь то монолитный кристалл или чиплетная сборка. Но не всегда подобная монолитность является плюсом — к примеру, она усложняет задачу увеличения количества каналов доступа к памяти. Таких каналов уже 8 и существуют проекты процессоров с 10 каналами памяти. Но это усложняет как сами ЦП, так и системные платы, ведь только на подсистему памяти, без учёта интерфейса PCI Express, может уйти 300 и более контактов, которые ещё требуется корректно развести и подключить. 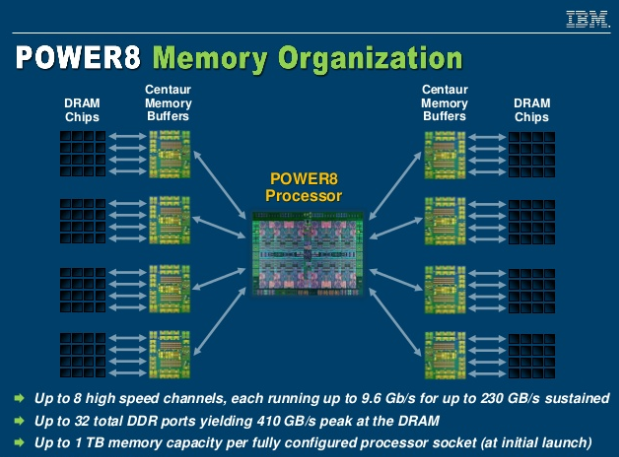
Организация подсистемы памяти у POWER8 У IBM есть ответ, и заключается он в переносе части функций контроллера памяти на сторону модулей DIMM. Сам интерфейс между ЦП и модулями памяти становится последовательным и предельно унифицированным. Похожая схема использовалась в стандарте FB-DIMM, аналогичную компоновку применила и сама IBM в процессорах POWER8 и POWER9 в варианте Scale-Up. 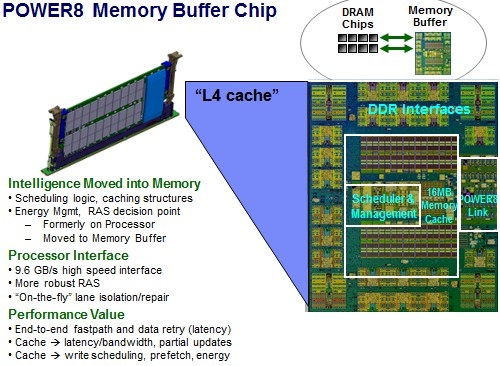
Роль и возможности буфера Centaur у POWER8 Контроллер памяти у этих процессоров упрощён, в нём отсутствует контроллер физического уровня (PHY). Его задачи возложены на чип-буфер Centaur, который посредством одноимённого последовательного интерфейса и связывается с процессором на скорости 28,8 Гбайт/с. Контроллеров интерфейса Centaur в процессорах IBM целых восемь, что дает ПСП в районе 230 Гбайт/с. За счёт выноса ряда функций в чипы-буфера удалось сократить площадь кристалла, и без того немалую (свыше 700 мм2), но за это пришлось заплатить увеличением задержек в среднем на 10 нс. Частично это сглажено за счёт наличия в составе Centaur кеша L4. 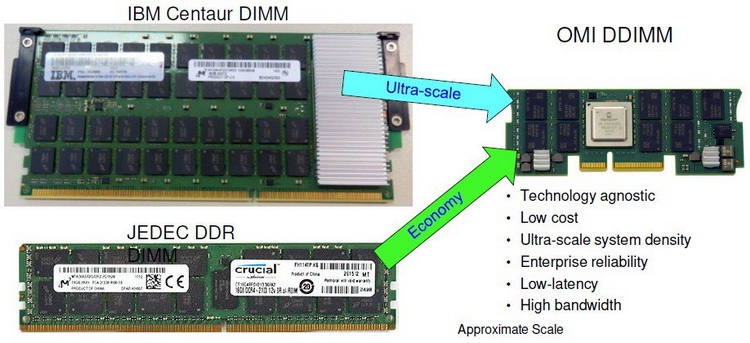
Сравнительные размеры модулей Centaur, RDIMM и OMI DDIMM Стандарт не является открытым, но IBM предлагает ему на смену полностью открытый вариант под названием Open Memory Interface (OMI). В его основу положена семантика и протоколы, описанные в стандарте OpenCAPI 3.1, а физический уровень представлен шиной BlueLink (25 Гбит/с на линию), которая уже используется для реализации NVLink и OpenCAPI. Реализация OMI проще Centaur, что позволяет сделать чип-буфер более компактным и выделяющим меньше тепла. Но все преимущества сохраняются: так, число контактов процессора, отвечающих за интерфейс памяти, можно снизить с примерно 300 до 75, поскольку посылаются только простые команды загрузки и сохранения данных. Вся реализация физического интерфейса осуществляется силами чипа-компаньона OMI, и в нём же может находиться дополнительный кеш. 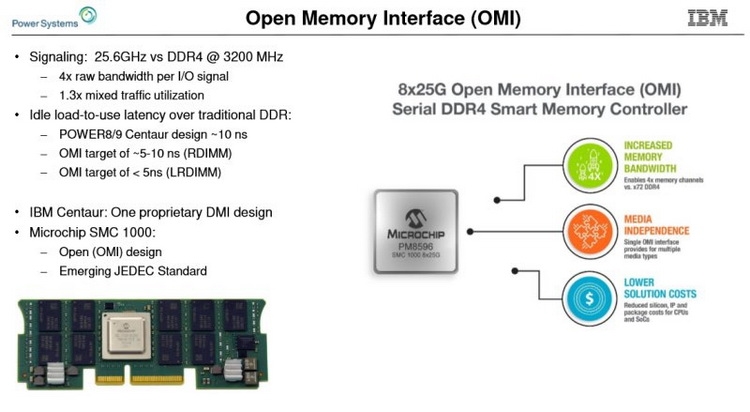
Модули OMI DDIMM станут стандартом JEDEC Помимо экономии контактов есть и ещё одна выгода: можно реализовать любой тип памяти, будь то DDR, GDDR и даже NVDIMM — вся PHY-часть придётся на различные варианты чипов OMI, но со стороны стандартного разъёма любой модуль OMI будет выглядеть одинаково. Сейчас взят прицел на реализацию модулей с памятью DDR5. При использовании существующих чипов DDR4 система с интерфейсом OMI может достичь совокупной ПСП порядка 650 Гбайт/с. Дополнительные задержки составят 5 ‒ 10 нс для RDIMM и лишь 4 нс для LRDIMM. Из всех соперников технологии на такое способны только сборки HBM, которые в силу своей природы имеют ограниченную ёмкость, дороги в реализации и не могут быть вынесены с общей с ЦП подложки. 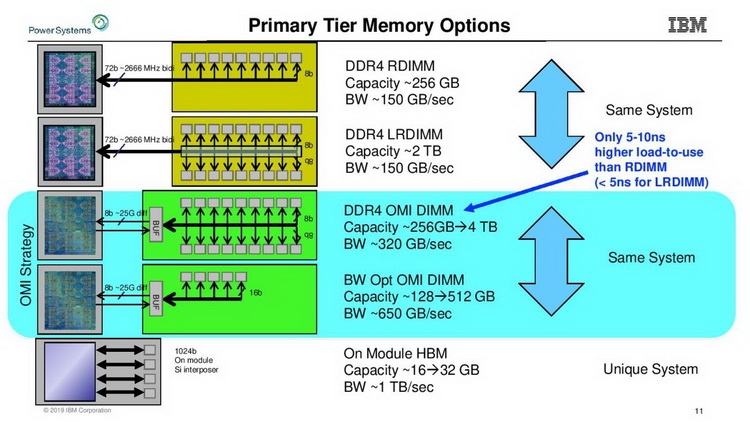
Новый стандарт упростит процессоры и позволит увеличить ёмкость подсистемы памяти Чипы-буферы OMI можно разместить как на модуле памяти, так и на системной плате. Разумеется, для стандартизации выбран первый вариант. В нём предусмотрено 84 контакта на модуль, сами же модули получили название Dual-Inline Memory Module (DDIMM). ✴-media" data-instgrm-captioned="" data-instgrm-permalink="https://www.instagram.com/p/B5I5Dmpj0rw/?utm_source=ig_embed&utm_campaign=loading" data-instgrm-version="12"> DDIMM вышли существенно компактнее своих традиционных собратьев: ширина модуля сократилась со 133 до 85 мм. Реализация буфера OMI ↔ DDR4 уже существует в кремнии: компания Microsemi продемонстрировала чип SMC 1000 (PM8596), поддерживающего 8 линий OMI со скоростью 25 Гбит/с каждая. Допустима также работа в режиме 4 × 1 с вдвое меньшей общей пропускной способностью. 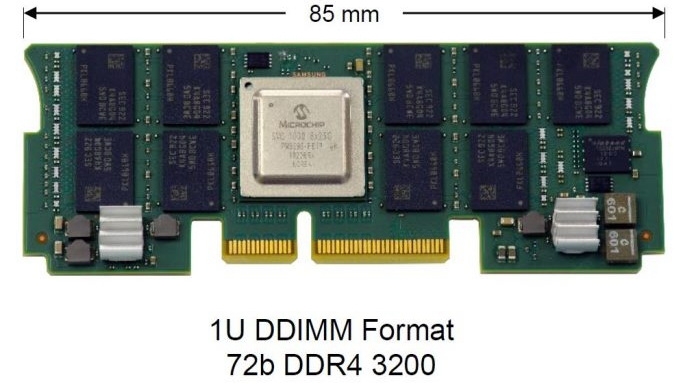
DDIMM: меньше ширина, проще разъём Со стороны чипов памяти SMC 1000 имеет стандартный 72-битный интерфейс с ECC и поддержкой различных комбинаций DRAM и NAND-устройств. Тактовая частота DRAM — до 3,2 ГГц, высота модуля зависит от количества и типов устанавливаемых чипов. В случае одиночной высоты модули могут иметь ёмкость до 128 Гбайт, двойная высота позволит создать DDIMM объёмом свыше 256 Гбайт. Сам чип SMC 1000 невелик, всего 17 × 17 мм, а невысокое тепловыделение гарантирует отсутствие проблем с перегревом, свойственных FB-DIMM. 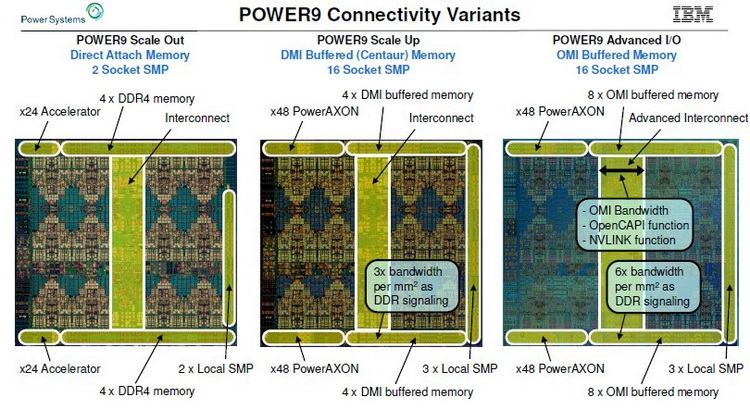
Процессоры IBM POWER9 AIO дополнили существующую серию Первыми процессорами с поддержкой OMI стали новые POWER9 версии Advanced I/O (AIO), дополнившие семейства Scale Up (SC) и Scale Out (SO). В них реализовано 16 каналов OMI по 8 линий каждый (до 650 Гбайт/с суммарно), а также новые версии интерфейсов NVLink (возможно, 3.0) и OpenCAPI 4.0. Количество линий PCI Express 4.0 по-прежнему составляет 48. Шина IBM BlueLink была переименована в PowerAXON. За счёт её использования в системах на базе процессоров POWER возможна реализация 16-сокетных систем без применения дополнительной логики. Максимальное количество ядер у POWER9 AIO равно 24, с учётом SMT4 это даёт 96 исполняемых потоков. Имеется также кеш L3 типа eDRAM объёмом 120 Мбайт. Техпроцесс остался прежним, это 14-нм FinFET. 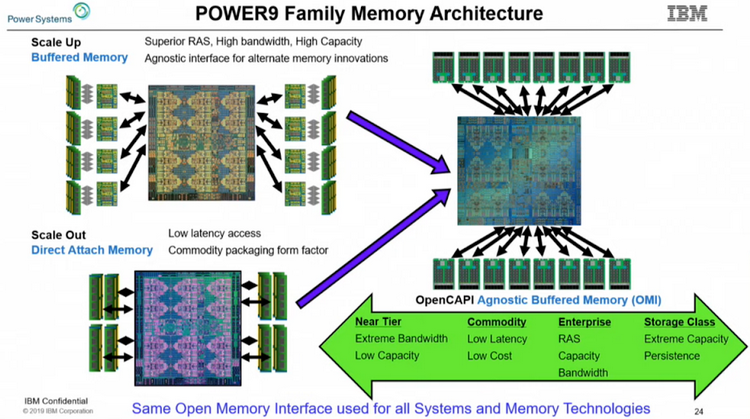
Архитектура подсистем памяти у семейства IBM POWER9 Поставки POWER9 AIO начнутся в этом году, цены неизвестны, но с учётом 8 миллиардов транзисторов и кристалла площадью 728 мм2 они не могут быть низкими. Однако без OMI эти процессоры были бы ещё более дорогими. В комплект поставки входит и чип-буфер OMI, правда, не самая быстрая версия с пропускной способностью на уровне 410 Гбайт/с. Задел для модернизации есть, и для расширения ПСП достаточно будет заменить модули DDIMM на более быстрые варианты. 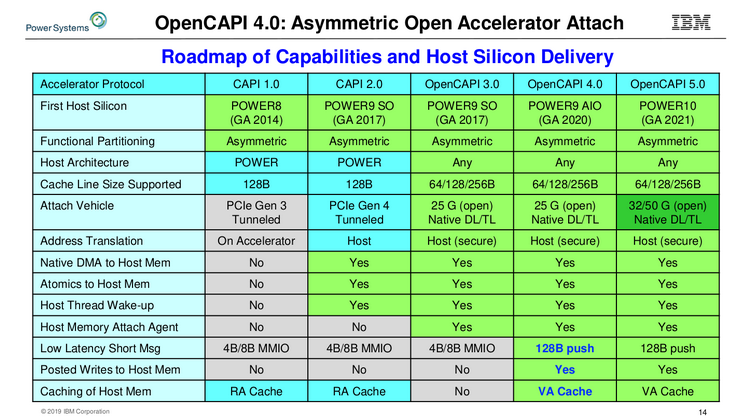
Сравнительная таблица существующих и будущих версий OpenCAPI Следующее поколение процессоров IBM, POWER10, появится только в 2021 году. К этому времени ожидается принятие стандарта OMI на рынке высокопроизводительных многопроцессорных систем. Попутно IBM готовит новые версии OpenCAPI, не привязанные к архитектуре POWER, а значит, путь к OMI будет открыт и другим вендорам.
27.08.2019 [11:00], Геннадий Детинич
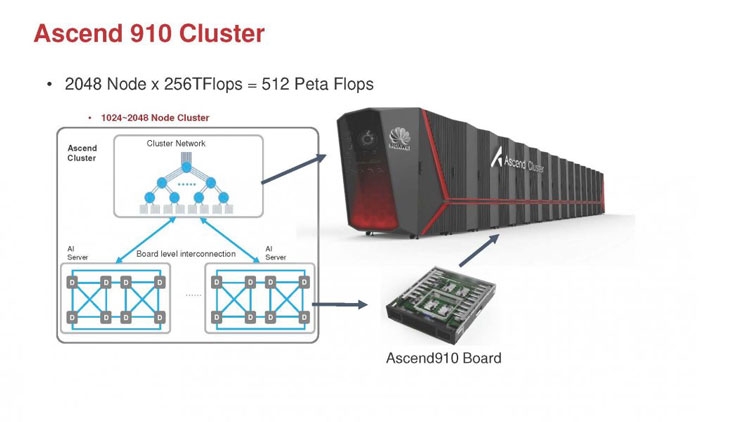
Huawei Ascend 910: китайская альтернатива ИИ-платформам NVIDIAГлубокое машинное обучение ― это сравнительно новая область приложения для вычислительных архитектур. Как всё новое, ML заставляет искать альтернативные пути решения задач. В этом поиске китайские разработчики оказались на равных и даже в привилегированных условиях, что привело к появлению в Китае мощнейших ИИ-платформ. Как всем уже известно, на конференции Hot Chips 31 компания Huawei представила самый мощный в мире ИИ-процессор Ascend 910. Процессоры для ИИ каждый разрабатывает во что горазд, но все разработчики сравнивают свои творения с ИИ-процессорами компании NVIDIA (а NVIDIA с процессорами Intel Xeon). Такова участь пионера. NVIDIA одной из первых широко начала продвигать свои модифицированные графические архитектуры в качестве ускорителей для решения задач с машинным обучением.  Гибкость GPU звездой взошла над косностью x86-совместимой архитектуры, но во время появления новых подходов и методов тренировки машинного обучения, где пока много открытых дорожек, она рискует стать одной из немногих. Компания Huawei со своими платформами вполне способна стать лучшей альтернативой решениям NVIDIA. Как минимум, это произойдёт в Китае, где Huawei готовится выпускать и надеется найти сбыт для миллионов процессоров для машинного обучения. 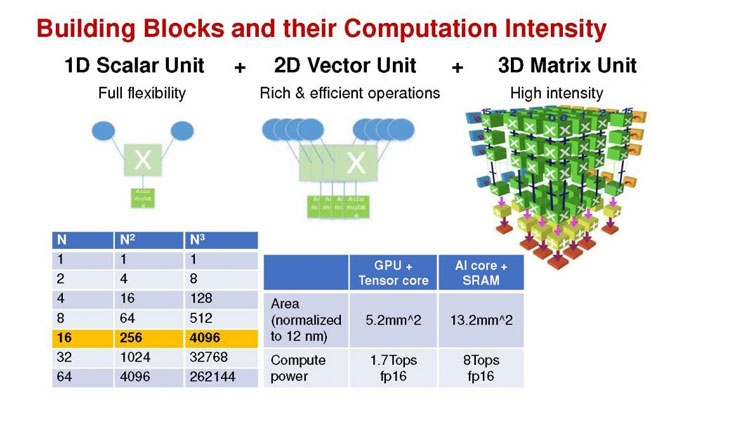 Мы уже публиковали анонс наиболее мощного ускорителя для ML чипа Huawei Ascend 910. Сейчас посмотрим на это решение чуть пристальнее. Итак, Ascend 910 выпускается компанией TSMC с использованием второго поколения 7-нм техпроцесса (7+ EUV). Это техпроцесс характеризуется использованием сканеров EUV для изготовления нескольких слоёв чипа. На конференции Huawei сравнивала Ascend 910 с ИИ-решением NVIDIA на архитектуре Volta, выпущенном TSMC с использованием 12-нм FinFET техпроцесса. Выше на картинке приводятся данные для Ascend 910 и Volta, с нормализацией к 12-нм техпроцессу. Площадь решения Huawei на кристалле в 2,5 раза больше, чем у NVIDIA, но при этом производительность Ascend 910 оказывается в 4,7 раза выше, чем у архитектуры Volta. 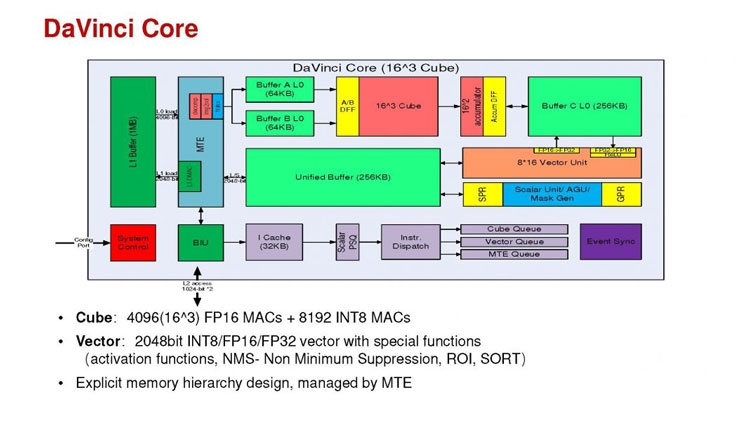 Также на схеме видно, что Huawei заявляет о крайне высокой масштабируемости архитектуры. Ядра DaVinci, лежащие в основе Ascend 910, могут выпускаться в конфигурации для оперирования скалярными величинами (16), векторными (16 × 16) и матричными (16 × 16 × 16). Это означает, что архитектура и ядра DaVinci появятся во всём спектре устройств от IoT и носимой электроники до суперкомпьютеров (от платформ с принятием решений до машинного обучения). Чип Ascend 910 несёт матричные ядра, как предназначенный для наиболее интенсивной работы. 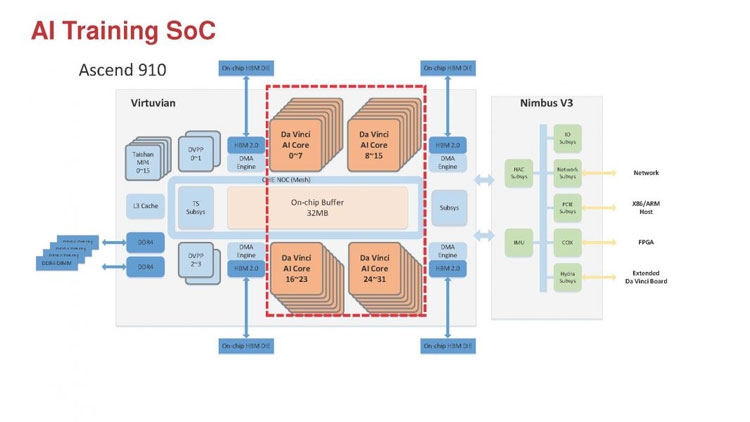 Ядро DaVinci в максимальной конфигурации (для Ascend 910) содержит 4096 блоков Cube для вычислений с половинной точностью (FP16). Также в ядро входят специализированные блоки для обработки скалярных (INT8) и векторных величин. Пиковая производительность Ascend с 32 ядрами DaVinci достигает 256 терафлопс для FP16 и 512 терафлопс для целочисленных значений. Всё это при потреблении до 350 Вт. Альтернатива от NVIDIA на тензорных ядрах способна максимум на 125 терафлопс для FP16. Для решения задач ML чип Huawei оказывается в два раза производительнее. 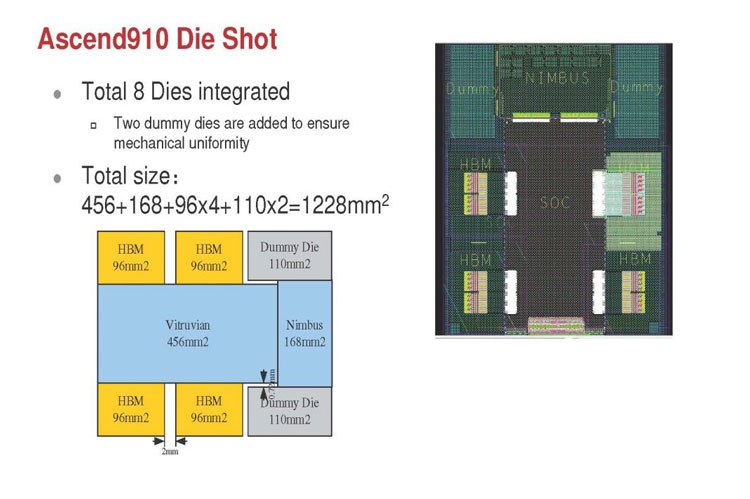 Помимо ядер DaVinci на кристалле Ascend 910 находятся несколько других блоков, включая контроллер памяти HBM2, 128-канальный движок для декодирования видеопотоков. Мощный чип для операций ввода/вывода Nimbus V3 выполнен на отдельном кристалле на той же подложке. Рядом с ним для механической прочности всей конструкции пришлось расположить два кристалла-заглушки, каждый из которых имеет площадь 110 мм2. С учётом болванок и четырёх чипов HBM2 площадь всех кристаллов достигает 1228 мм2. 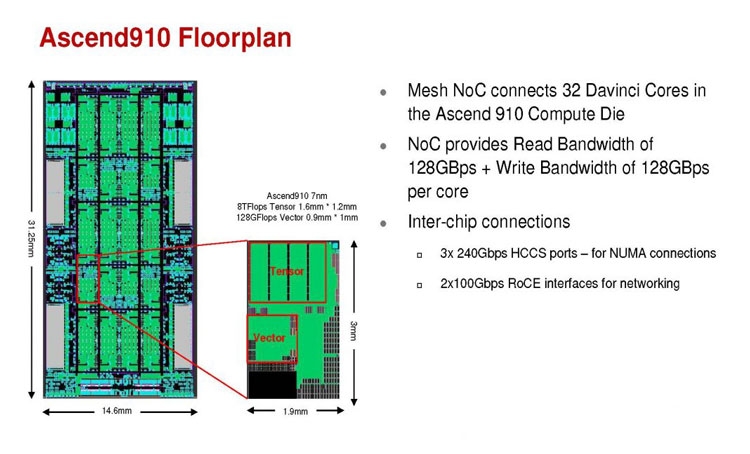 Для связи ядер и памяти на кристалле создана ячеистая сеть в конфигурации 6 строк на 4 колонки со скоростью доступа 128 Гбайт/с на каждое ядро для одновременных операций записи и чтения. Для соединения с соседними чипами предусмотрена шина со скоростью 720 Гбит/с и два линка RoCE со скоростью 100 Гбит/с. К кеш-памяти L2 ядра могут обращаться с производительностью до 4 Тбайт/с. Скорость доступа к памяти HBM2 достигает 1,2 Тбайт/с. 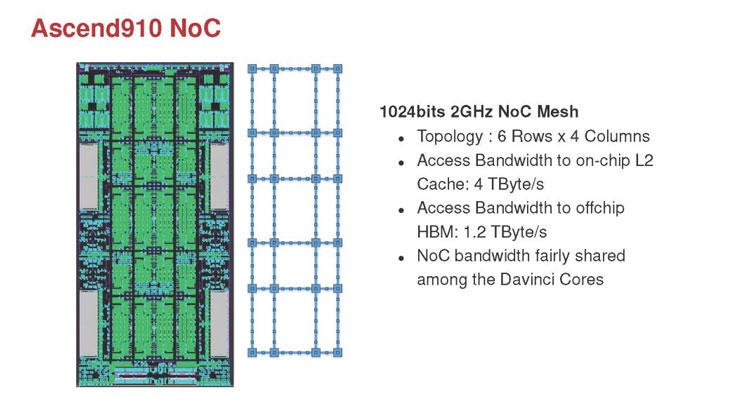 В каждый полочный корпус входят по 8 процессоров Ascend 910 и блок с двумя процессорами Intel Xeon Scalable. Спецификации полки ниже на картинке. Решения собираются в кластер из 2048 узлов суммарной производительностью 512 петафлопс для операций FP16. Кластеры NVIDIA DGX Superpod обещают производительность до 9,4 петафлопс для сборки из 96 узлов. В сравнении с предложением Huawei это выглядит бледно, но создаёт стимул рваться вперёд. 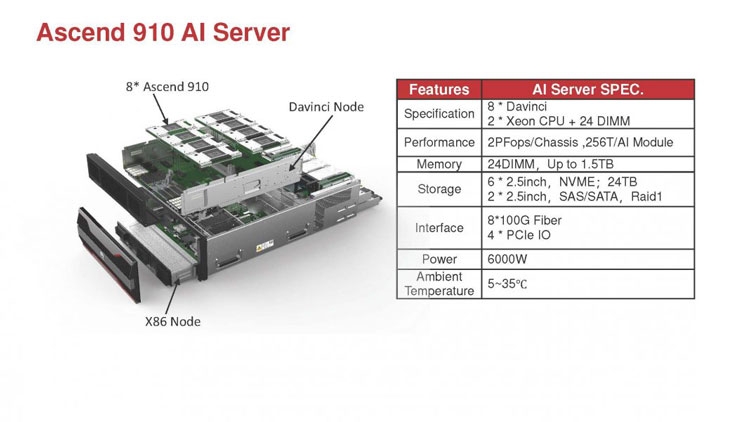
06.12.2017 [23:45], Сергей Юртайкин
IBM представила первый сервер на процессоре POWER9IBM представила свой первый собственный сервер на процессоре POWER9. Особенность решения под названием IBM Power Systems AC922 заключается в том, что новая аппаратная платформа разработана специально для работы с интенсивными вычислительными нагрузками технологий искусственного интеллекта (ИИ). 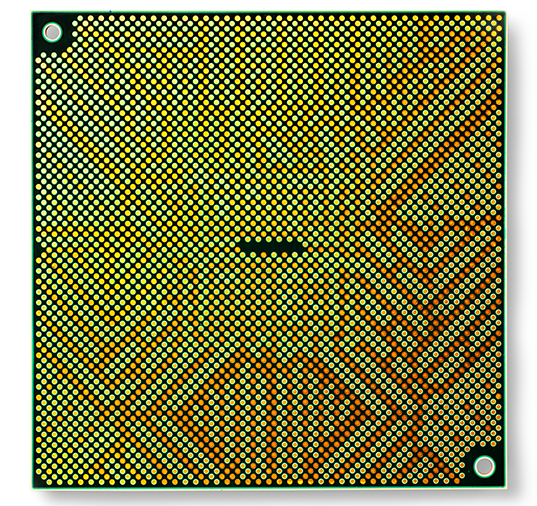
CPU IBM POWER9 В IBM отмечают, что Power 9 позволяет ускорить тренировки фреймворков глубинного обучения обучения почти в четыре раза, благодаря чему клиенты смогут быстрее создавать более точные ИИ-приложения. Утверждается, что новый сервер разработан для получения значительных улучшений производительности всех популярных фреймворков ИИ, таких как Chainer, TensorFlow и Caffe, а также современных баз данных, использующих ускорители, например, Kinetica. 
Сервер IBM Power System AC922 Сервер IBM Power Systems AC922 использует шину PCI-Express 4.0 и технологии NVIDIA NVLink 2.0 и CAPI 2.0/OpenCAPI, способные ускорить пропускную способность в 9,5 раза по сравнению с системами x86 на базе PCI-E 3.0. Это, в частности, позволяет задействовать ускорителям (GPU или FPGA) системную ОЗУ без значительных, по сравнению с прошлыми решениями, потерь производительности, что важно для обработки больших массивов данных. Кроме того, новые поколения карт расширения и ускорителей уже поддерживают эту шину. 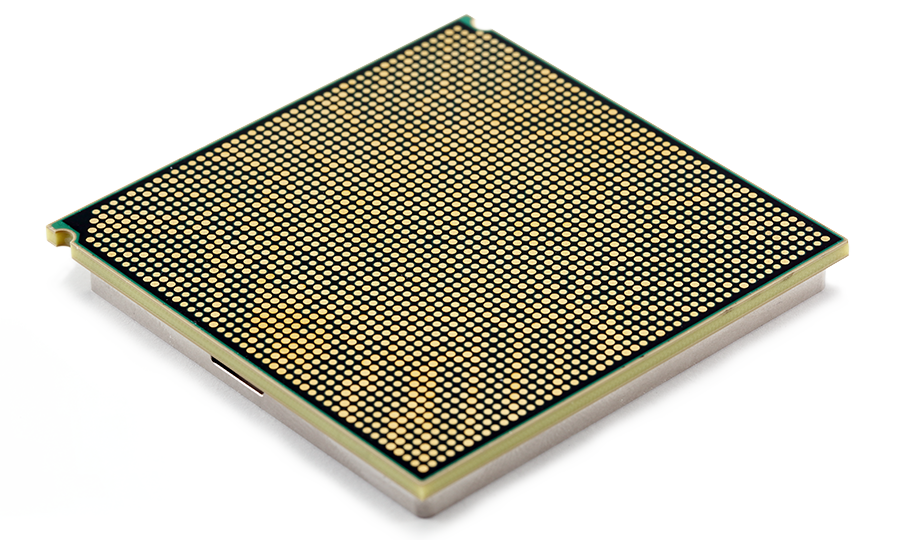 IBM Power Systems AC922 создан в нескольких конфигурациях, оснащаемых двумя процессорами POWER9. Стандартные версии включают CPU c 16 (2,6 ГГц, турбо 3,09 ГГц) и 20 (2,0/2,87 ГГц) ядрами (4 потока на ядро), а позже появятся версии с 18- и 22 -ядерными процессорами. Всего в сервере есть 16 слотов для модулей ECC DDR4-памяти, что на текущий момент позволяет оснастить его 1 Тбайт RAM. Для хранения данных предусмотрено два слота для 2,5" SSD/HDD (RAID-контроллера нет). 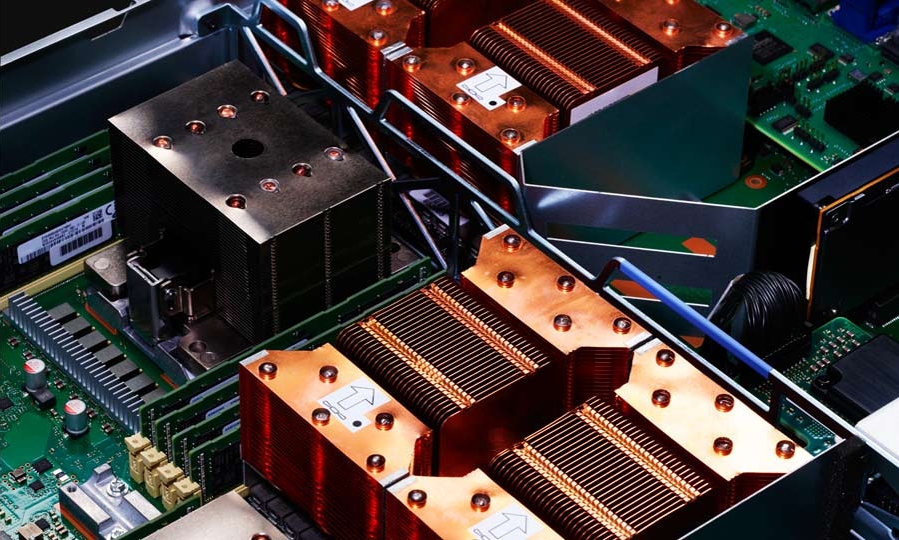 AC922 может иметь на борту от двух до четырёх ускорителей NVIDIA Tesla V100 форм-фактора SXM2 с памятью 16 Гбайт и шиной NVLink 2.0. В сумме они дают до 500 Тфлопс на расчётах половинной точности. Дополнительные ускорители можно подключить к слотам PCI-E 4.0. 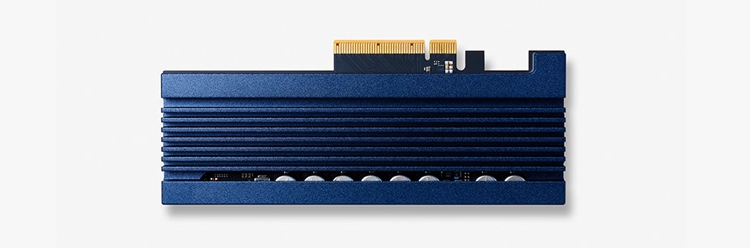 Сервер рассчитан на установку четырёх дополнительных низкопрофильных карт расширения: два слота PCI-E 4.0 x16, один PCI-E 4.0 x8 и один PCI-E 4.0 x4. Все слоты, кроме последнего, также умеют работать с CAPI. Также есть два порта USB 3.0. Поддерживается ОС Red Hat Enterprise Linux 7.4 for Power LE. 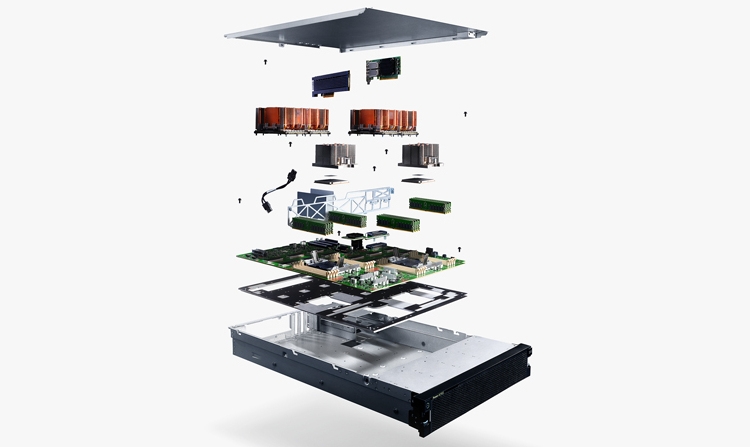 Процессоры IBM Power 9, которые нашли применение в IBM Power Systems AC922, легли в основу суперкомпьютеров Summit и Sierra Министерства энергетики США, а также используются компанией Google. Чипы и использующие их системы стали частью совместной работы участников организации OpenPower Foundation, в которую входят IBM, Google, Mellanox, NVIDIA и др. 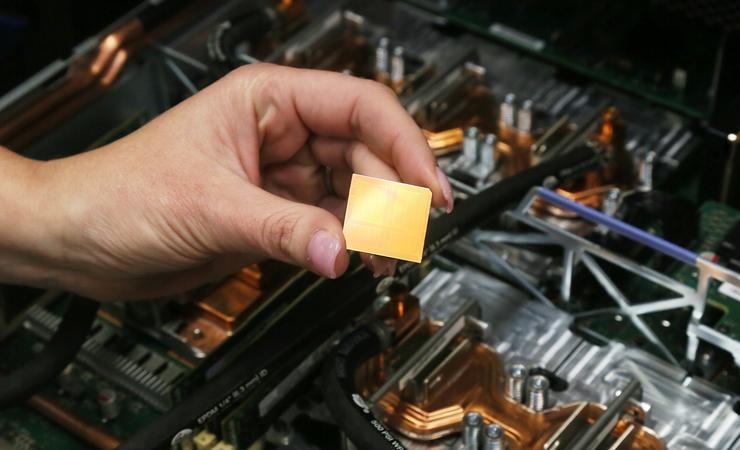
Процессор IBM Power 9 «Мы создали уникальную в своём роде систему для работы с технологиями ИИ и когнитивными вычислениями, — говорит старший вице-президент подразделения IBM Cognitive Systems Боб Пиччиано (Bob Picciano). — Серверы на Power 9 являются не только основой самых высокопроизводительных компьютеров, они позволят заказчикам масштабировать невиданные ранее инсайты, что будет способствовать научным прорывам и революционным улучшениям бизнес-показателей». 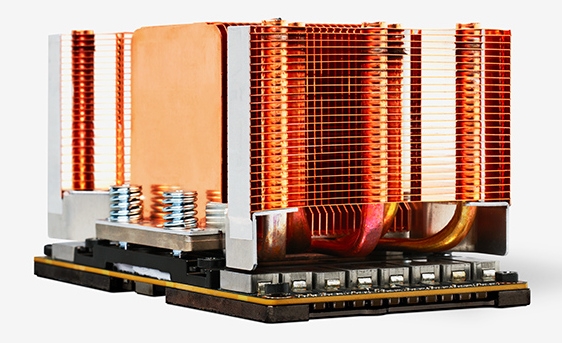 Сервер имеет стандартное 2U-шасси и оснащается двумя (1+1) блоками питания мощностью 2,2 кВт каждый. Система охлаждения может быть гибридной. Начало продаж IBM Power Systems AC922 намечено на 22 декабря 2017 года. В 2018 году будут доступны конфигурации с шестью ускорителями Tesla и СЖО. 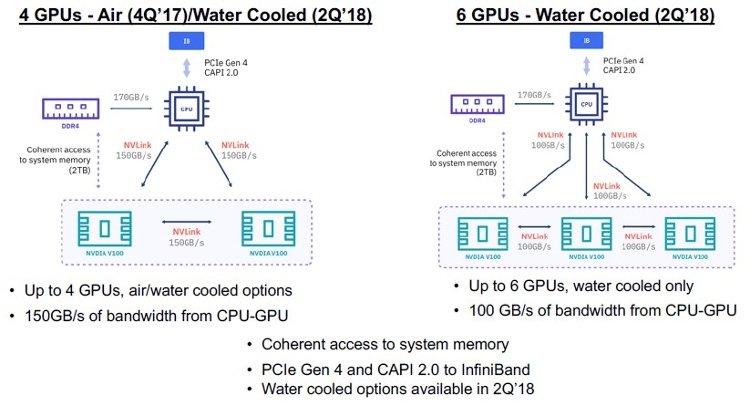
18.08.2016 [09:50], Валерий Косихин
IDF 2016: Intel анонсировала Knights Mill — новую архитектуру ускорителей Xeon Phi для задач глубинного обученияНа конференции Intel Developer Forum, которая в данный момент проходит в Сан-Франциско, была названа следующая версия архитектуры MIC (Many Integrated Cores), основанные на которой продукты пополнят семейство ускорителей параллельных вычислений Xeon Phi — Knights Mill. От Intel давно не поступало новостей касательно планов по развитию этой линейки устройств. На сегодняшний день Intel выпустила два поколения Xeon Phi — Knights Corner в 2013 году и Knights Landing в 2016-м. Согласно предыдущим заявлениям, третье поколение получит кодовое название Knights Hill, а соответствующие чипы будут производиться по технологической норме 10 нм. В кратком выступлении, которое Intel посвятила анонсу Knights Mill, не пояснили, как новинка соотносится с прошлыми планами. Возможно, что Knights Mill является промежуточной остановкой на пути к Knights Hill. По другой версии, новый продукт олицетворяет ответвление от основного пути развития, предназначенное для специфической ниши — глубинного обучения. 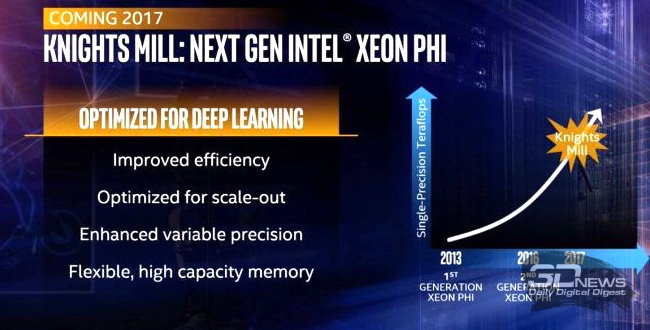 Глубинное обучение — одно из направлений задач машинного обучения, которое предполагает моделирование абстрактных понятий за счет построения многократно ветвящихся графов. На практике это применяется в программах компьютерного зрения, распознавания объектов, человеческой речи и т.п. Определяющий признак, который сделает Knights Mill подходящей платформой для глубинного обучения — то, что Intel довольно расплывчато обозначила термином «переменная точность». Скорее всего, речь идет о поддержке формата чисел с плавающей запятой FP16 (половинная точность) либо других форматов с еще меньшей разрядностью. FP16 является приоритетным форматом для задач глубинного обучения, поскольку они не требуют более высокой точности, а процессор достигает более высокой пропускной способности при условии, что FP16 поддерживается им «в железе». Поддержка половинной точности реализована в GPU последнего поколения от AMD и NVIDIA, и ускорители вычислений Tesla на базе архитектуры Pascal специально оптимизированы для высокой скорости в работе с FP16. Появление чипов Knights Mill упрочит позиции Intel в конкуренции с NVIDIA на этом рынке. При этом разработчики указывают на ряд преимуществ архитектуры MIC по сравнению с графическими процессорами. Xeon Phi, начиная с поколения Kings Landing, существуют в сокетном форм-факторе, который позволяет загружать ОС непосредственно с MIC без необходимости в отдельном CPU традиционной архитектуры. Также, наряду с массивом высокоскоростной набортной памяти MCDRAM (разновидность HBM) Knights Landing, как и его потомок Knights Mill, может напрямую адресовать внешние модули DDR4 SDRAM. NVIDIA Tesla не может похвастаться такими функциями.  Массовое производство чипов Knights Mill намечено на 2017 г. Судя по графику на слайде Intel (который, впрочем, вряд ли отражает какие-либо твердые числа), Knights Mill удвоит показатели быстродействия, характерные для предыдущего поколения Xeon Phi. Это, в свою очередь, сигнализирует о применении техпроцесса 10 нм, и в таком случае не исключено, что Knights Mill — это просто новое название для ранее анонсированной архитектуры Knights Hill.
20.06.2016 [19:30], Илья Гавриченков
Intel представила процессоры Xeon Phi Knights LandingМногоядерные ускорители вычислений Intel Xeon Phi продолжают своё развитие. Об их очередном поколении с кодовым именем Knights Landing разработчик рассказывает уже почти три года, а с конца прошлого года даже поставляет образцы систем с ними своим избранным партнёрам. Однако до официального анонса дело дошло только сейчас. В рамках проходящей в эти дни в Германии конференции ISC High Performance 2016 компания Intel официально объявила о выходе принципиально новых Xeon Phi на базе дизайна Knights Landing, ключевое свойство которых заключается в том, что теперь это — не сопроцессоры, а полноценные x86-процессоры, способные взять на себя роль центрального компонента системы. Иными словами, новые Xeon Phi могут работать полностью самостоятельно, не нуждаясь ни в каком дополнительном управляющем CPU. И это очень важное улучшение, так как проведённое коренное изменение архитектуры ликвидирует узкое место — шину PCI Express, которую используют для передачи данных предшествующие и конкурирующие ускорители вычислений, например, базирующиеся на GPU. 
Источник изображений: Intel Knights Landing воплощают собой уже третье поколение многоядерной x86-архитектуры Intel. Предыдущее поколение, известное под кодовым именем Knights Corner, базировалось на Pentium-подобных ядрах P54C. Новая же версия ускорителей переехала на модифицированную 14-нм микроархитектуру Airmont, известную по процессорам Atom. Однако в Knights Landing ядра Airmont попарно объединены в модули, которые включают также мегабайтный L2-кеш и четыре блока VPU (Vector Processing Unit), отвечающих за поддержку векторных инструкций AVX-512. Всего в новых процессорах Xeon Phi содержится до 36 таких модулей, то есть, общее число ядер в ускорителе может достигать 72. При этом каждое ядро дополнительно поддерживает технологию Hyper-Threading и способно выполнять до четырёх потоков одновременно, что наделяет Xeon Phi впечатляющим арсеналом средств для работы с параллельными вычислениями. Учитывая, что в Knights Landing производительность на поток по сравнению с Knights Corner выросла примерно втрое только за счёт смены микроархитектуры, обновление ускорителей Xeon Phi дало им возможность дотянуться до планки в 3 Тфлопс. Процессоры Knights Landing снабжены также интегрированной памятью MCDRAM с пропускной способностью до 500 Гбайт/с и объёмом 16 Гбайт, которая может взаимодействовать с системной шестиканальной DDR4-памятью по нескольким принципиально различным алгоритмам. Упоминания заслуживает и реализация в новых Xeon Phi отдельного двухпортового 100 Гбит/с-контроллера Omni-Path, который предполагается использовать для высокоскоростного объединения узлов, основанных на Knights Landing, в вычислительные кластеры. Объявленная сегодня линейка процессоров Xeon Phi поколения Knights Landing включает четыре модели с числом ядер от 64 до 72 и частотой от 1,3 до 1,5 ГГц.  Стоит отметить, что в настоящее время для заказчиков доступны лишь три младшие модели: Xeon Phi 7250, 7230 и 7210. Самая же мощная 72-ядерная версия ускорителя, Xeon Phi 7290, обещана к сентябрю. Также пока Intel не поставляет варианты с интегрированным контроллером Omni-Path, который по плану появится в перечисленных моделях в октябре этого года. Высокая производительность процессоров Xeon Phi, простая масштабируемость систем на их основе, а также полная совместимость с x86-экосистемой и знакомым всем средствами разработки, делает новинки отличным вариантом для использования в массе областей, где требуются параллельные высокопроизводительного вычисления. И особенно Intel подчёркивает применимость построенных на Xeon Phi кластеров в системах машинного обучения и искусственного интеллекта, то есть тех областях, где в последнее время высокую активность развила NVIDIA, реализующая свои ускорители семейства Tesla. В подтверждение лидирующих характеристик Knights Landing, компания Intel приводит информацию о кратном превосходстве системы на базе Xeon Phi 7250 над системой, в которой используется конкурирующий ускоритель вычислений NVIDIA Tesla K80 и пара центральных процессоров Xeon E5-2697 v4. 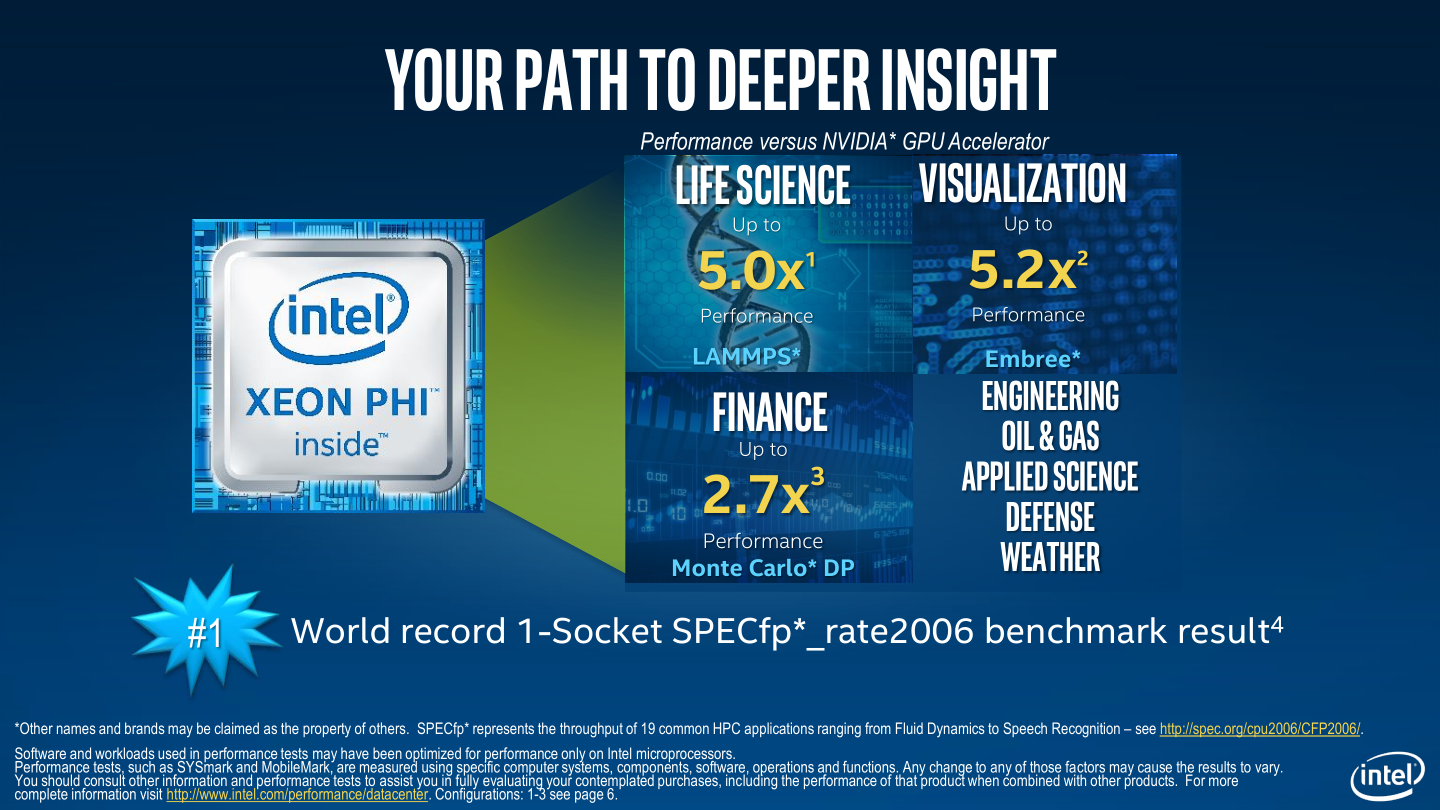 При этом, Intel говорит не только о достигающем пятикратного размера преимуществе Xeon Phi в производительности. Согласно информации компании, конфигурация с процессором Xeon Phi 7250 оказывается в восемь раз экономичнее и в девять — дешевле. Учитывая всё сказанное, Intel ожидает, что внедрение новых Xeon Phi пойдёт очень быстрыми темпами. До конца года производитель намеревается продать более ста тысяч процессоров, а готовые системы на базе Knights Landing будут поставлять более 50 компаний, включая Dell, Fujitsu, Hitachi, HP, Inspur, Lenovo, NEC, Oracle, Quanta, SGI, Supermicro, Colfax и другие. Кстати, в этом списке место нашлось и для российского интегратора — группы компаний РСК — которая собирается поставлять высокоплотные кластерные решения на базе Xeon Phi, оснащённые системами жидкостного охлаждения. |
|

