
Материалы по тегу: инференс
|
16.09.2026 [12:55], Руслан Авдеев
Anthropic заключила первое соглашение об аренде ИИ ЦОД в Австралии, одного из крупнейших в миреАмериканский ИИ-гигант Anthropic подписал первое соглашение об аренде дата-центров в Австралии. Компания стремится извлечь максимальную выгоду из благоприятной политической среды в стране и имеющихся на континенте в изобилии источников возобновляемой энергии для создания одного из крупнейших в мире вычислительных объектов, сообщает Reuters. Договор предусматривает аренду кампуса с проектной мощностью 2,16 ГВт — на уровне некоторых крупнейших дата-центров, уже действующих в мире. Предложенный кампус должен будет разместиться на сельскохозяйственных угодьях в 250 км от Брисбена (Brisbane), начало ввода в эксплуатацию предполагается в 2027 году. ОБъект будет использовать замкнутую систему охлаждения, позволяющую снизить потребности в чистой воде при отводе тепла от серверов. Благодаря сделке Anthropic станет последним «ИИ-тяжеловесом», закрепившим свои позиции в Австралии — после OpenAI, которая ещё в прошлом году заключила договор об использовании ЦОД в Сиднее. Компании конкурируют за возможность заранее закрепить за собой права на энергию и землю, поскольку там они значительно дешевле и доступнее в сравнении с более «загруженными» рынками США или Азии. 
Источник изображения: Megan Clark/unsplash.com Австралийское правительство в ответ на противодействие жителей строительству ЦОД пообещало ввести с 2027 года ограничения на использование ресурсов дата-центрами. При этом оно продолжает приветствовать инвестиционный бум, который, по прогнозам аналитиков, может принести в Австралию A$150 млрд ($107 млрд) к 2030 году. В целом же предполагается отход от полностью рыночных принципов, что даст властям рычаги давления на операторов ЦОД. В случае с Anthropic речь идёт об аренде ЦОД, строительство которого запланировано сингапурской Zerra DC, которая будет заключать сделки о покупке возобновляемой энергии (PPA) и сама намерена нести расходы по подключениям к сети, не перекладывая их тяжесть на имеющихся клиентов. По данным источников, объект планируют использовать для инференса, но не обучения. Ранее Австралия заявляла, что новые правила для ИИ-проектов ограничивают использование созданного в стране контента для «тренировки» ИИ-моделей. Anthropic уже говорила, что готова потратить миллиарды долларов на ЦОД в стране, но взамен требует переписать законы об интеллектуальной собственности. На тот момент она собиралась заняться именно обучением ИИ.
16.09.2026 [01:35], Владимир Мироненко
144-ядерные Arm-процессоры Fujitsu MONAKA станут доступны в ноябреFujitsu объявила о предстоящем старте глобальных продаж процессора нового поколения Fujitsu MONAKA, намеченном на ноябрь 2026 года. Также компания выпустит на базе новинок сервер Fujitsu MONAKA Server для суверенной ИИ-инфраструктуры, который станет доступен для заказа с ноября 2026 года операторам ЦОД, предприятиям, академическим учреждениями и HPC-центрам в Японии и Европе, и оборонному сектору. Массовые поставки начнутся в апреле следующего года. В процессоре Fujitsu MONAKA используется 3D-стековая архитектура с 2-нм техпроцессом для Arm-ядер и 5-нм техпроцессом для кеша и I/O-блоков. Чип имеет до 144 ядер, работает на частоте до 3,8 ГГц и поддерживает память DDR5-8800. Также сообщалось, что процессоры MONAKA получат продвинутую упаковку Broadcom 3.5D XDSiP. Использование собственной технологии Ultra Low Voltage обеспечивает высокую энергоэффективность процессора. MONAKA обеспечивает аппаратное ускорение матричных операций, используя специальные инструкции, которое в сочетании с поддержкой векторных вычислений SVE2 и программной оптимизацией позволяет ускорять ИИ-инференс непосредственно на уровне CPU. Как сообщает Fujitsu, чип обеспечивает вдвое большую пропускную способность для ИИ-инференса по сравнению с другими процессорами. 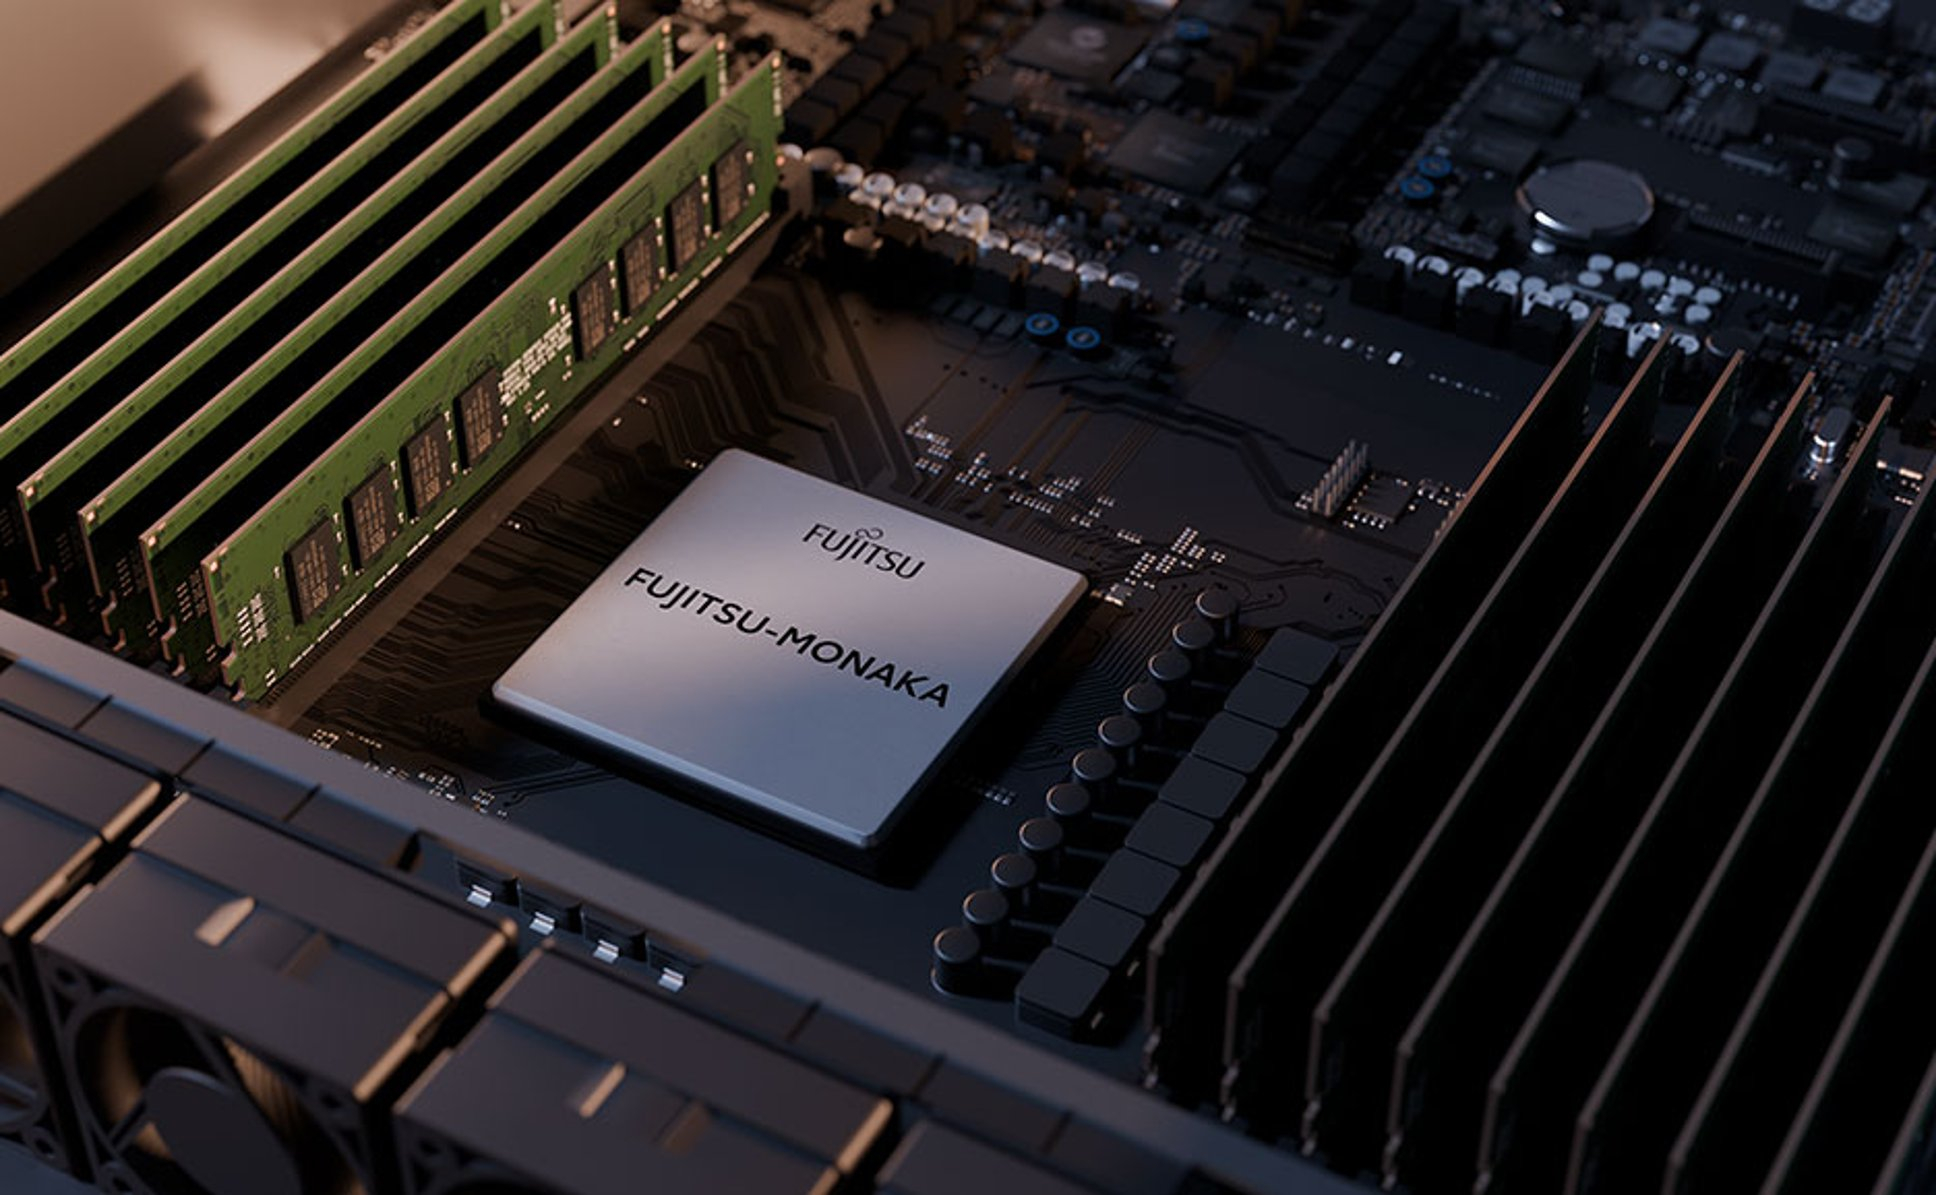
Источник изображений: Fujitsu Кроме того, MONAKA поддерживает конфиденциальные вычисления для защиты данных и приложений на аппаратном уровне с помощью технологии Arm CCA, которая обеспечивает шифрование приложений и данных непосредственно во время их выполнения в оперативной памяти, в том числе при работе в многопользовательских облачных средах с разделением ресурсов. 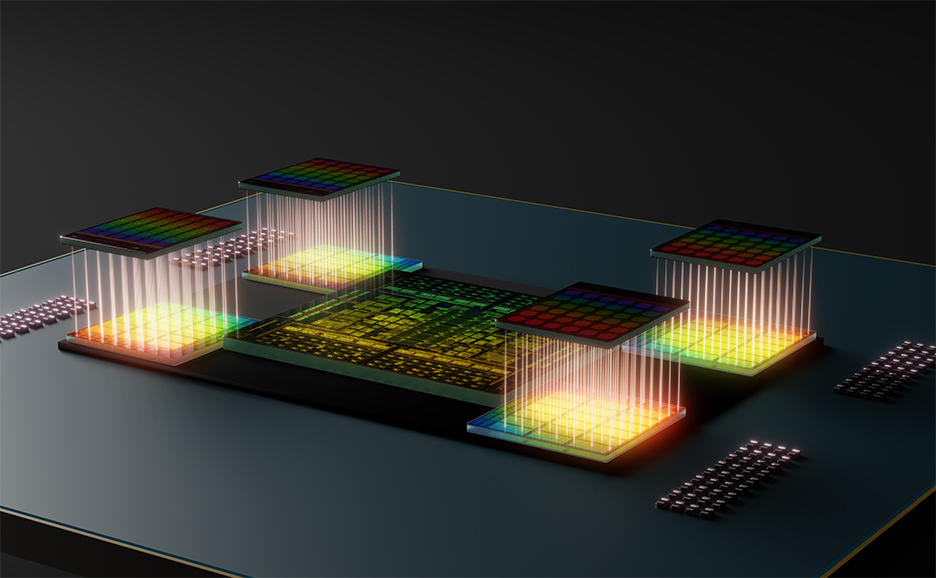 Первоначально серверы на базе MONAKA будут доступны в конфигурациях 1U (один или два сокета) и 2U (два сокета) для задач ИИ-инференса и работы ИИ-агентов. Также планируется выпуск отдельной многоузловой системы формата 2U4N (два сокета на узел) для академических целей и HPC. В частности, эта система подходит для создания суррогатных моделей и CFD-расчётов. 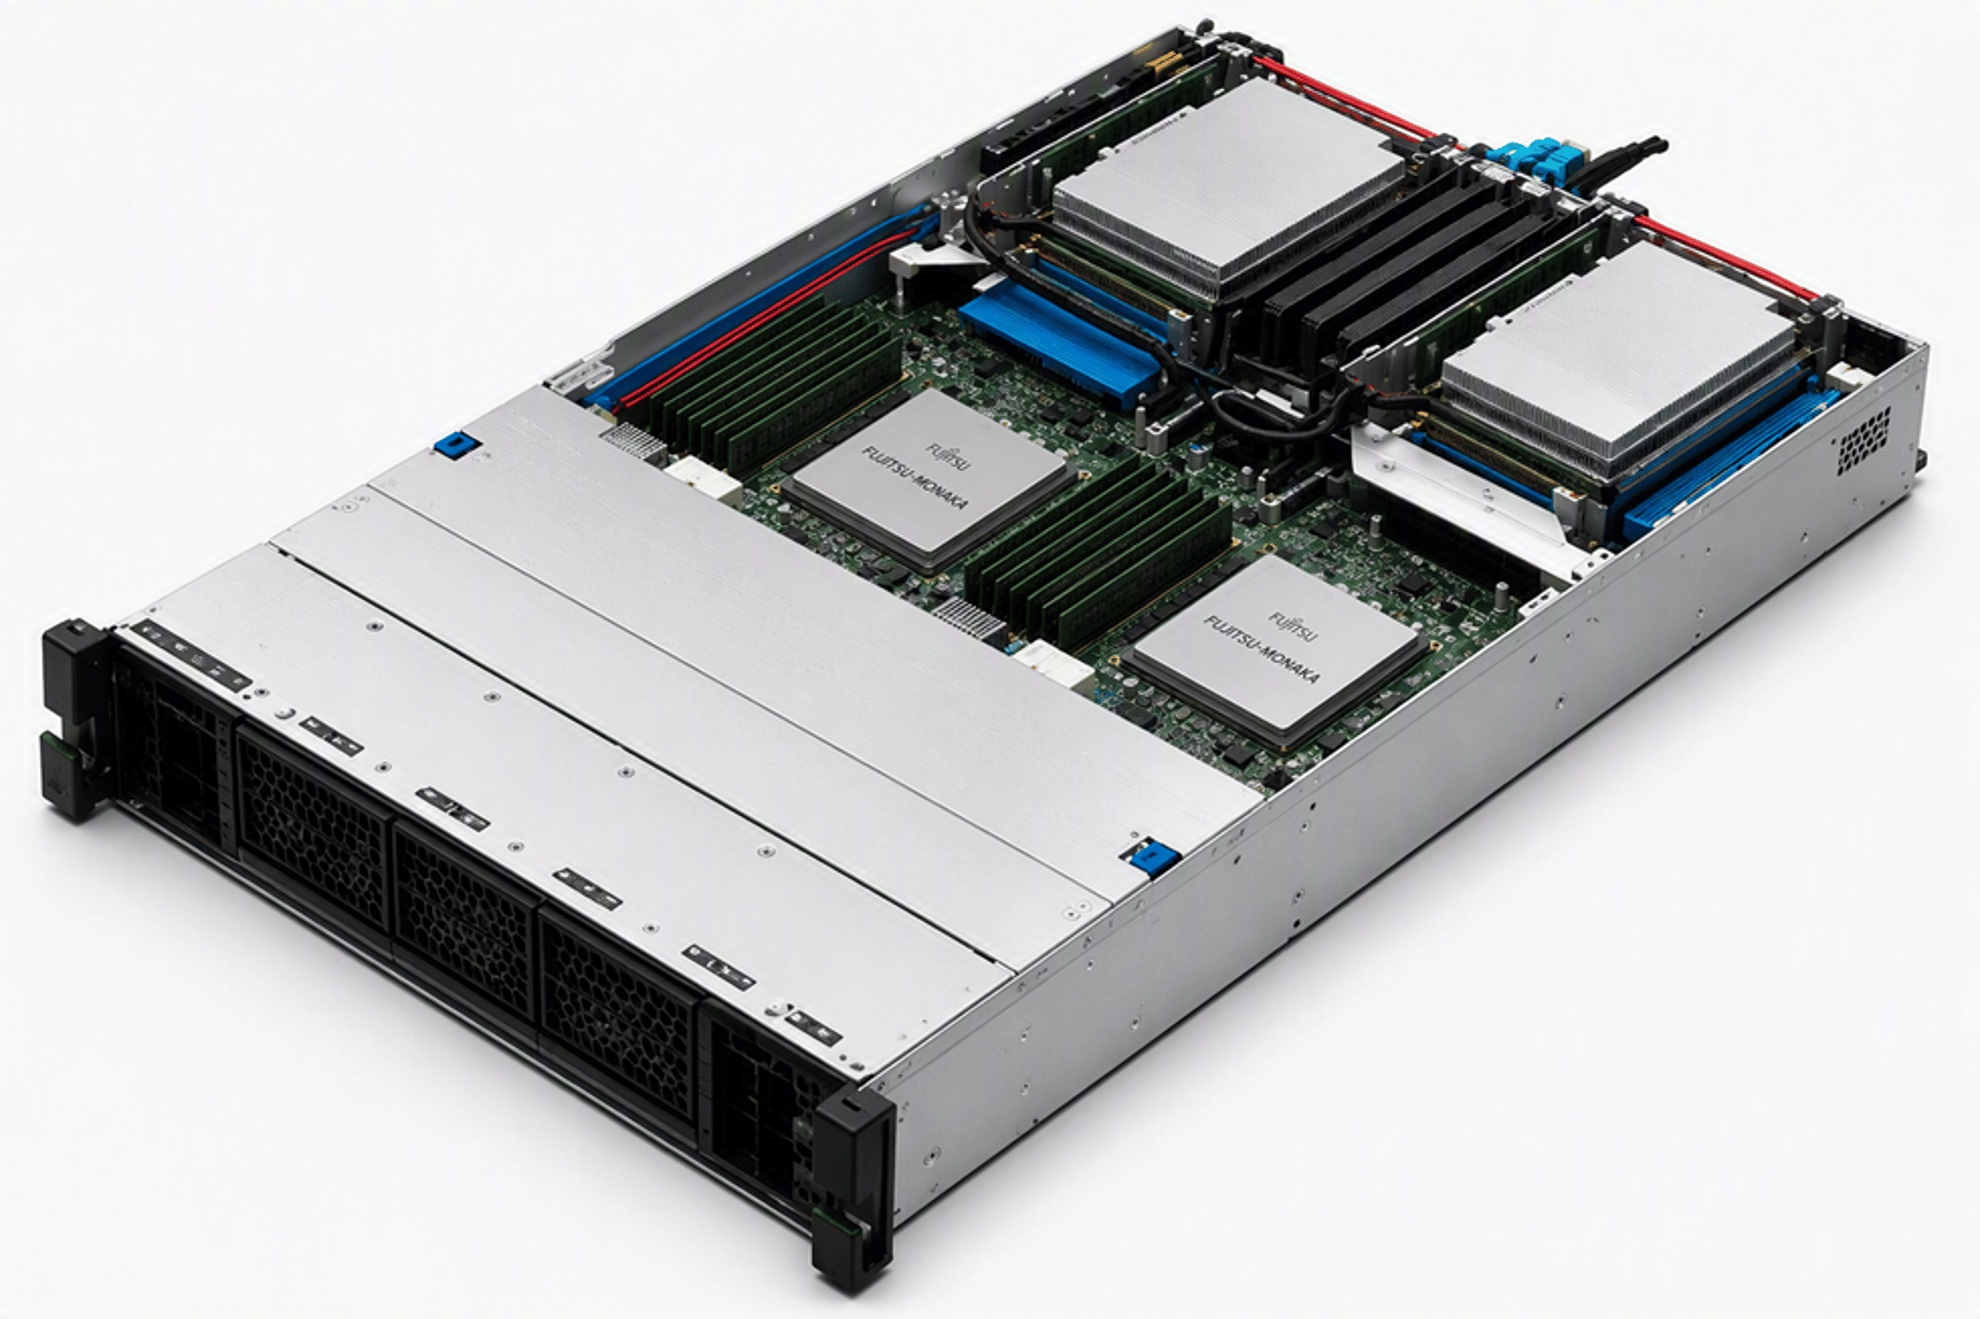 1U-версия поддерживает воздушное охлаждение с температурой окружающей среды до +40 °C (базовая частота ядер — 2,1 ГГц) и СЖО с температурой воды до +45 °C (базовая частота ядер — 2,9 ГГц) без необходимости в специализированной инфраструктуре охлаждения. Согласно Fujitsu, фирменная технология охлаждения серверов позволяет снизить энергопотребление систем охлаждения до 80 %. Каждому процессору полагается 12 слотов памяти. Подсистема хранения включает восемь слотов E3.S и два слота M.2. Основная шина — PCIe 6.0, но поддержка GPU не заявлена. 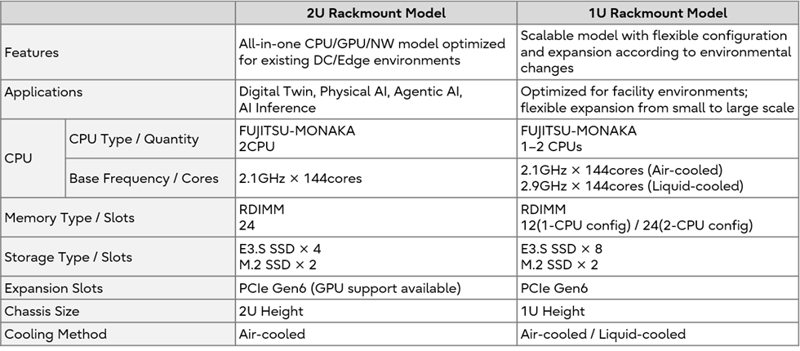 Кроме того, доступная память 1U-версии может быть расширена путём использования дезагеграции и CXL. Речь, вероятно, о внешних разделяемых пулах памяти. Такой подход решает проблему нехватки памяти — распространённую при ИИ-инференсе — и максимизирует эффективность использования ресурсов, обеспечивая гибкую адаптацию к будущим крупномасштабным ИИ-моделям и изменениям рабочих нагрузок, говорит Fujitsu. 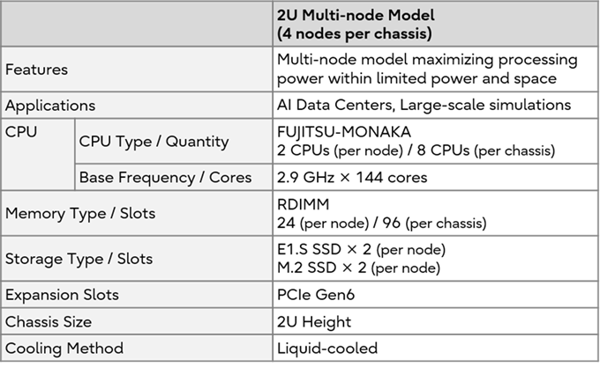 2U-сервер включает два процессора с базовой частотой 2,1 ГГц, 24 слота для памяти RDIMM, четыре слота для E.3 SSD и два — для M.2. Он поддерживает только воздушное охлаждение. Доступна установка GPU. Наконец, многоузловой 2U-сервер с СЖО включает восемь процессоров MONAKA с частотой 2,9 ГГц и 96 слотов для RDIMM. На каждый узел приходится лишь по паре E.3 и M.2 SSD, зато с PCIe 6.0. Разработкой серверов для новых CPU также занимается Supermicro.  Сервер Fujitsu MONAKA Server спроектирован, разработан и произведен в Японии для использования в системах, обеспечивающих технологический суверенитет. Производство осуществляется на заводе Fujitsu в Касашиме (Kasashima), где на всех этапах производства можно отследить происхождение компонентов и историю изготовления. На базе Fujitsu MONAKA Server строится вертикально интегрированная модель «суверенного ИИ», объединяющая ИИ-технологии Fujitsu (такие как платформа Fujitsu Kozuchi и корпоративный генеративный ИИ Takane) со специализированными отраслевыми моделями, что создает безопасную среду для предприятий и госучреждений.
14.09.2026 [22:55], Владимир Мироненко
Минюст США проверит сделку NVIDIA с Groq, но это ничего не изменитМинистерство юстиции США проводит проверку с целью выяснить, не была ли структура лицензионного соглашения NVIDIA с Groq стоимостью $20 млрд намеренно выстроена таким образом, чтобы избежать антимонопольного расследования, сообщила газета The New York Times со ссылкой на информированные источники. В рамках сделки, заключённой в прошлом году, которую компания Groq охарактеризовала как «неисключительное лицензионное соглашение с NVIDIA на технологии инференса», генеральный директор Groq Джонатан Росс (Jonathan Ross) и президент компании Санни Мадра (Sunny Madra), а также часть инженерной команды Groq перешли на работу в NVIDIA. Представитель NVIDIA Джон Риццо (John Rizzo) заявил, что «история с Groq — яркий пример того, как американская система работает именно так, как было задумано: она стимулирует инновации, вознаграждает предпринимателей и приносит пользу потребителям». Он добавил: «Законодательство призвано поддерживать экосистему стартапов в США и защищать фундаментальные права изобретателей и наемных работников на реализацию своих стремлений». Формально Groq осталась независимой компанией. Именно это сочетание обстоятельств и стало предметом расследования. Сделка не была заявлена на проверку регулятором возможного нанесения ущерба конкуренции на рынке, хотя NVIDIA получила не только технологии, но и двух ключевых руководителей Groq. По словам одного из источников, Министерство юстиции США начало расследование сделки с Groq вскоре после объявления о ней в декабре, направив в NVIDIA официальный запрос. Эндрю Фергюсон (Andrew Ferguson), возглавляющий Федеральную торговую комиссию (FTC) США, в январе сообщил агентству Bloomberg, что ведомство начало проверку с целью выяснить, не были ли подобные сделки намеренно структурированы так, чтобы избежать надзора со стороны регулирующих органов. 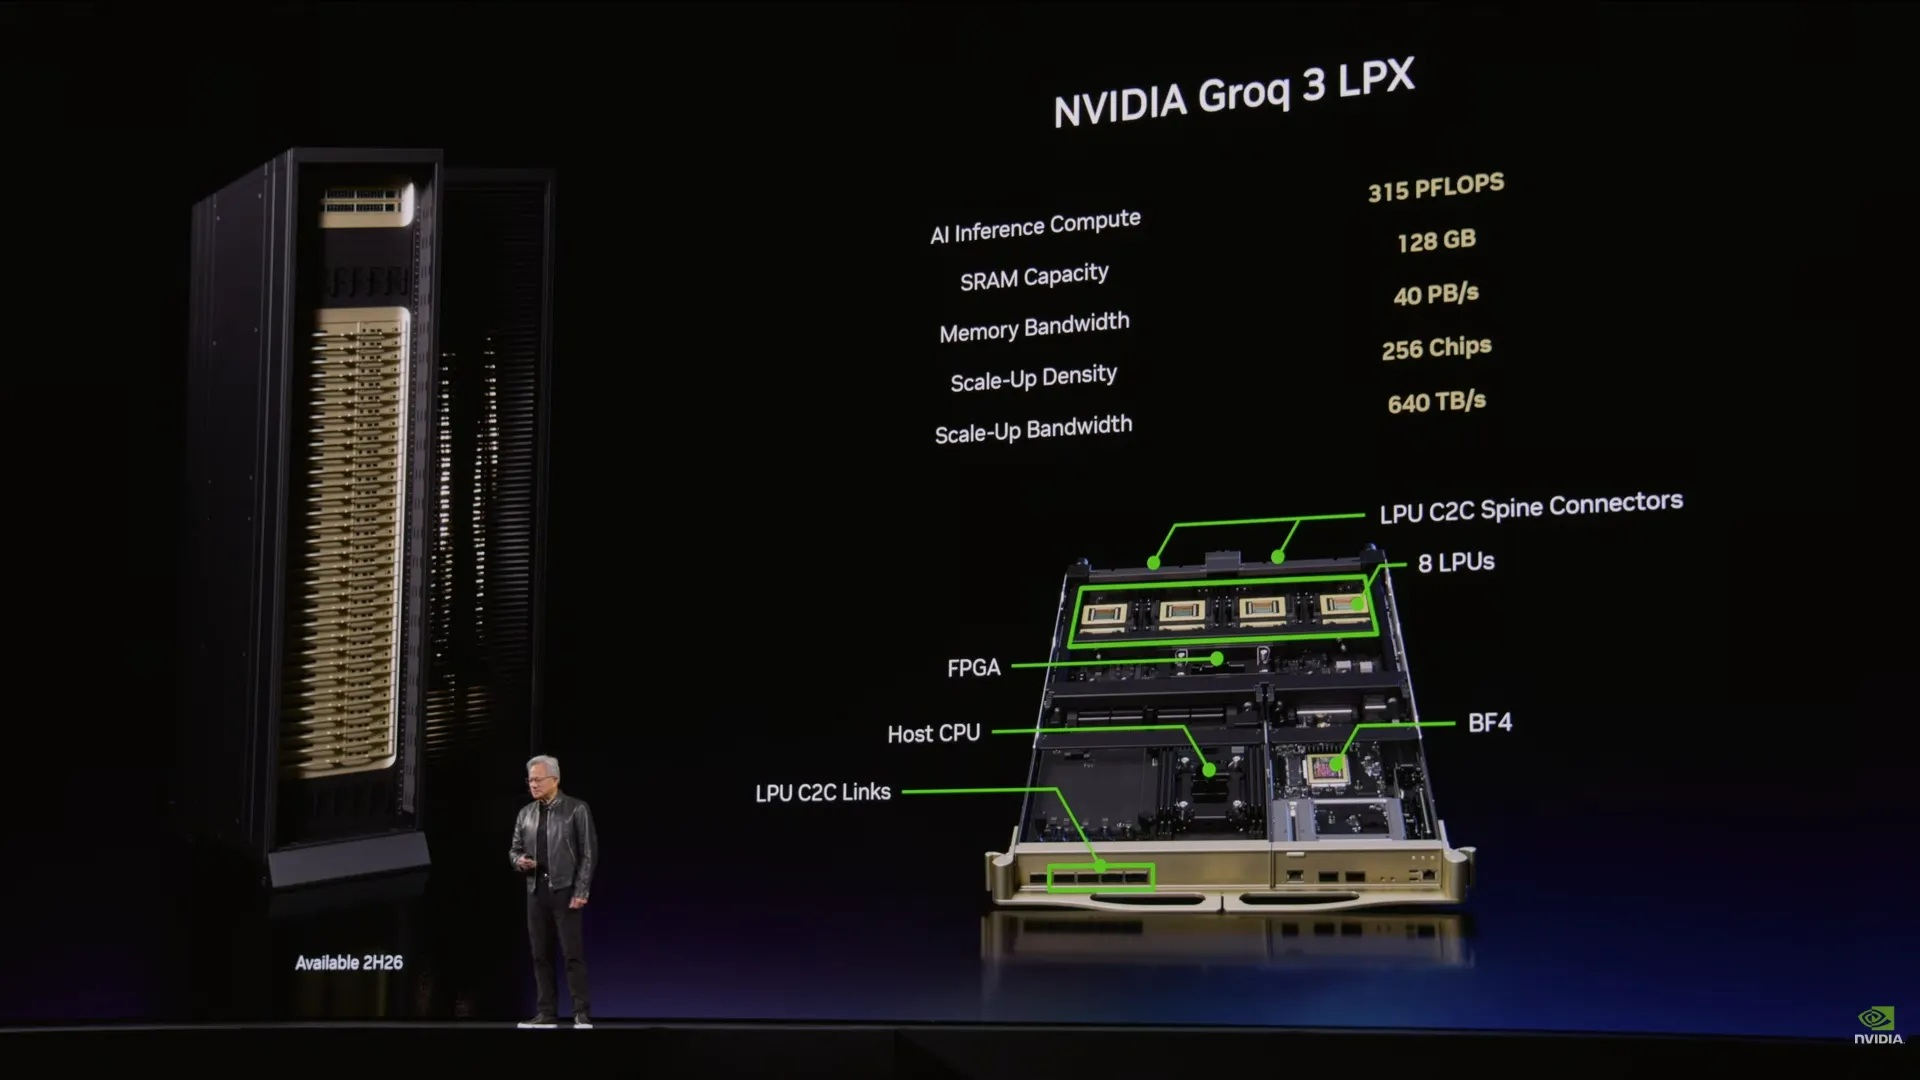
Источник изображения: NVIDIA Если Минюст США придёт к выводу, что NVIDIA должна была получить антимонопольное одобрение сделки, ведомство может потребовать взыскания гражданско-правовых штрафов. В то же время, по словам источника, окончательное решение ещё не принято, и Министерство юстиции в итоге может не обнаружить никаких нарушений. Впрочем, по данным Bloomberg, Минюст изучает возможные нарушения антимонопольного законодательства со стороны производителя чипов с 2024 года. Сообщается, что вопросы со стороны регулирующих органов относительно соглашения между NVIDIA и Groq возникли в начале текущего года в рамках этого более масштабного расследования. Сделки также привлекли внимание сенаторов, которые призвали FTC и Министерство юстиции США расследовать ряд таких сделок, включая партнёрство NVIDIA с компанией Groq. «По сути, эти сделки представляют собой фактические слияния, позволяющие компаниям объединять кадровые, информационные и финансовые ресурсы, при этом, судя по всему, пытаясь обойти процедуры контроля, обычно применяемые к сделкам по слиянию и поглощению», — указали сенаторы в письме, направленном в FTC и Министерство юстиции США. Хотя формально NVIDIA не покупала Groq, фактически её итоги равносильны поглощению. Внимание со стороны Министерства юстиции к этим вопросам возникло на фоне того, как NVIDIA — компания с рыночной капитализацией $5,4 трлн — фактически превратилась в «центральный банк» Кремниевой долины, используя свои огромные финансовые ресурсы для поддержки ИИ-стартапов и финансирования клиентов, отметила The New York Times. Главный вопрос для Министерства юстиции США заключается в том, нанесла ли эта сделка ущерб конкуренции; учитывая текущую ситуацию на рынке, доказать наличие такого ущерба может быть непросто, пишет The Register. Но даже если бы Минюст нашёл основания для судебного иска и добился отмены сделки, это вряд ли что-то кардинально изменило бы, отметил ресурс. 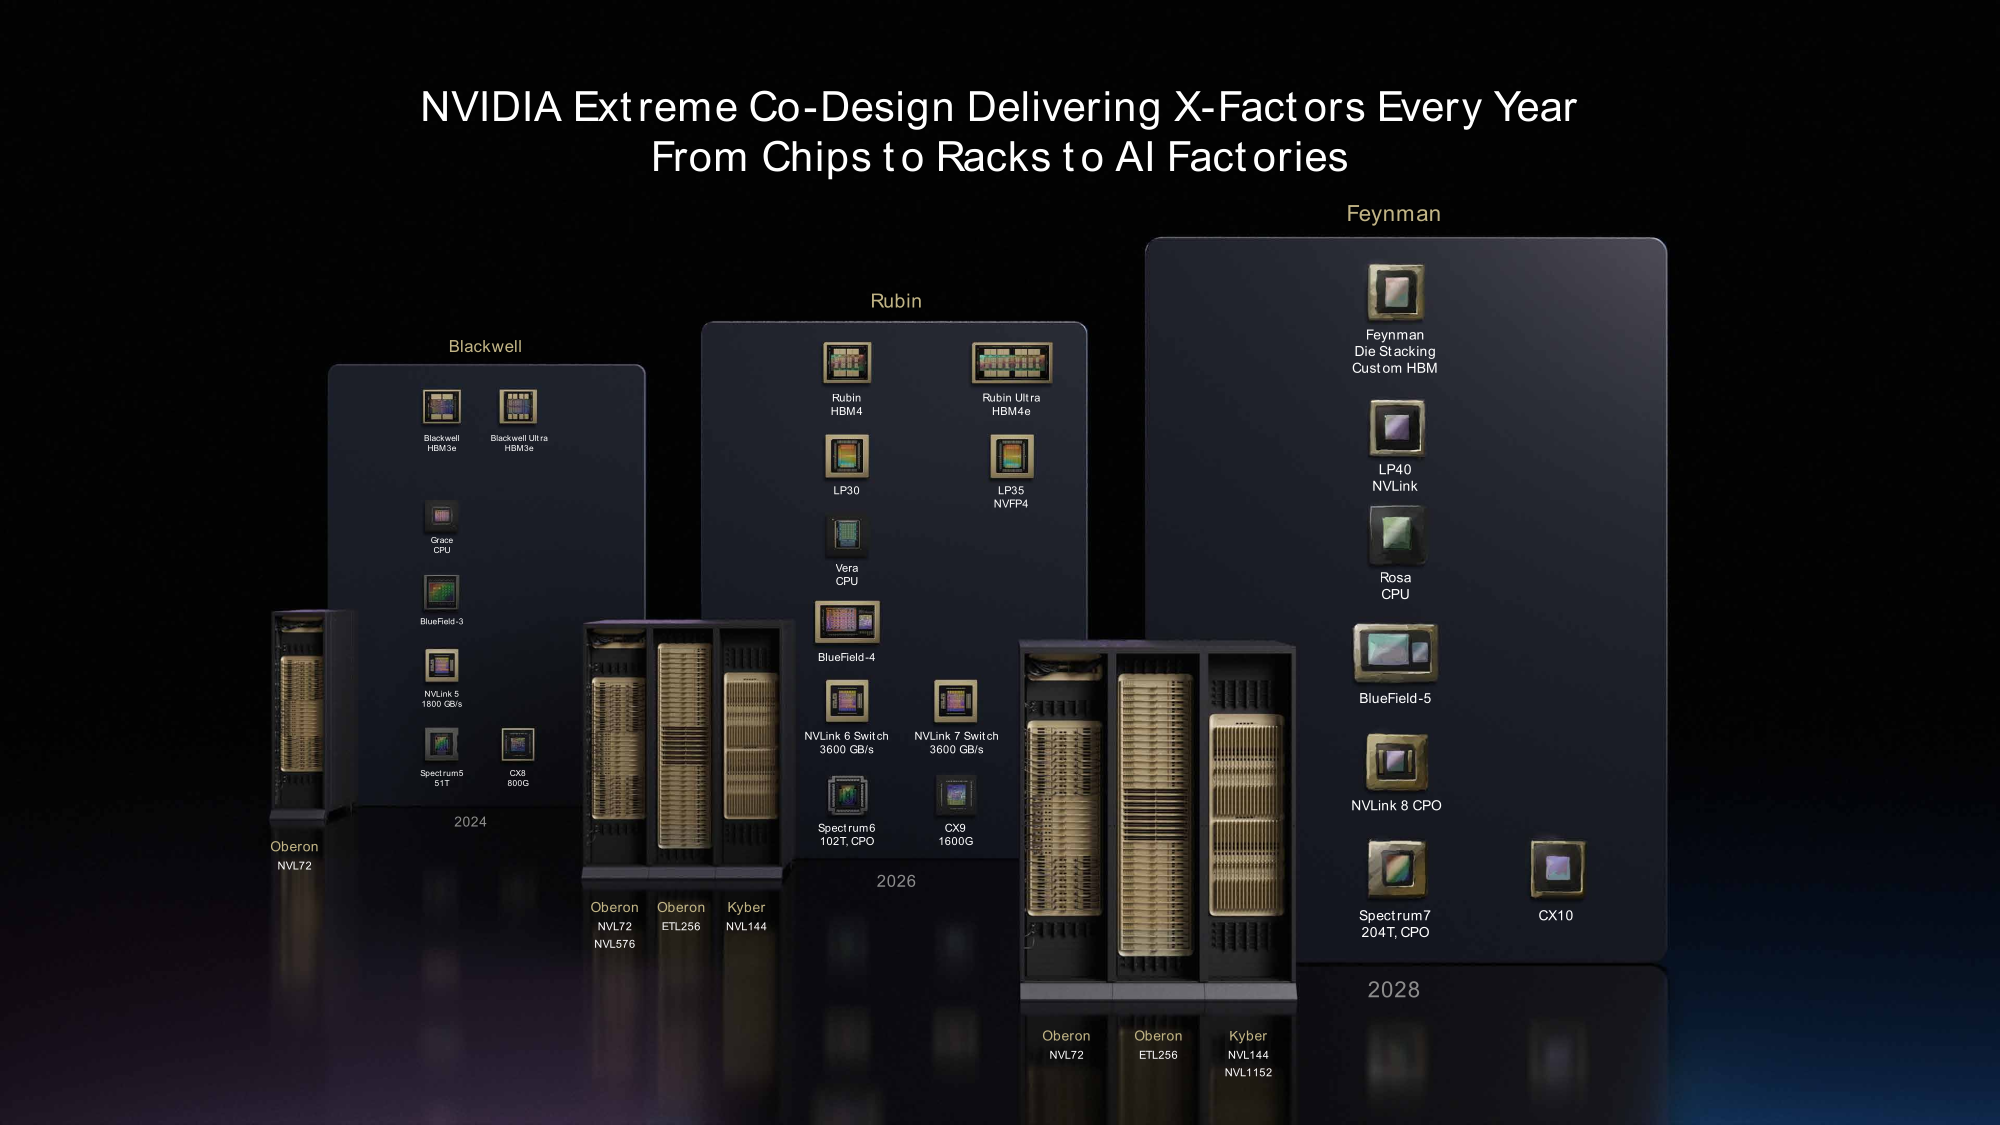 Сделка с Groq обеспечила NVIDIA два ключевых актива: готовые аппаратные решения (чипы) и специалистов, необходимых для их дальнейшей разработки. Groq стала известна благодаря созданию ускорителей с потоковой архитектурой и большим объёмом памяти SRAM, что позволило ускорить инференс больших языковых моделей (LLM) до показателей, которых системы NVIDIA на базе GPU самостоятельно достичь не могли. В марте NVIDIA представила стойки LPX, оснащённые 256 ускорителями LPU Groq 3. Глава NVIDIA пообещал, что связка Groq и Vera Rubin обеспечит оптимальную производительность для всего спектра задач инференса. The Register отметил, что дезагрегация вовсе не уникальная особенность Groq. Cerebras создаёт аналогичные системы совместно с AWS и AMD; SambaNova сотрудничает с Intel; а d-Matrix и ее партнёры объединяют свою платформу с GPU NVIDIA, преследуя те же цели, что и в случае комбинации Vera Rubin NVL72 с Groq 3 LPX. Ещё до объявления о сделке с Groq компания уже закладывала фундамент экосистемы, в центре которой находилось её подразделение сетевых технологий. Она передала свои проекты стоек MGX в Open Compute Project (OCP), позволив тем самым любому производителю чипов размещать свою продукцию в стойках, изначально спроектированных для GPU NVIDIA. Затем NVIDIA открыла доступ к своему интерконнекту в рамках программы NVLink Fusion. И теперь, если Министерство юстиции США заблокирует сделку (целью которой было поглощение компании ради получения её специалистов) и аннулирует соглашение с Groq, NVIDIA может лишиться прямого контроля над разработкой LPU и доходов от их продажи, но это не обязательно будет означать конец для стоек Groq LPX. Groq просто пополнит ряды растущего числа аппаратных партнёров NVIDIA, создающих решения для ИИ-фабрик (AI factory) этой компании. Более того, сама эта сделка гарантирует, что даже если регуляторы в итоге её сорвут, наготове окажется множество альтернатив.
11.09.2026 [09:44], Владимир Мироненко
d-Matrix присоединилась к альянсу NVLink Fusion, чтобы интегрировать свои ИИ-ускорители в экосистему NVIDIAРазработчик ИИ-ускорителей d-Matrix пополнил растущий список производителей чипов, лицензировавших технологию NVLink Fusion и эталонные стоечные решения компании NVIDIA. Стартап объявил, что новое соглашение о сотрудничестве позволит интегрировать его XPU в широко распространённую экосистему NVIDIA AI Factory. Финансовые условия сделки не раскрываются. В числе тех, кто также полагается на NVLink, уже есть Qualcomm, Arm, Marvell, Amazon, Fujitsu, Ayar, SiFive, Intel и MediaTek. В качестве партнёра по программе NVLink Fusion компания d-Matrix будет сотрудничать с NVIDIA для интеграции своих XPU нового поколения для задач инференса (начиная с Raptor) непосредственно в новейшую эталонную стоечную архитектуру NVIDIA, которая включает CPU Vera, коммутаторы NVLink, адаптеры ConnectX-9 SuperNIC/DPU BlueField-4 и решения Spectrum-X Ethernet. d-Matrix также сотрудничает с компанией Astera Labs — специализирующейся в области решений для межкомпонентных соединений в экосистеме NVIDIA NVLink Fusion, — для создания специализированных решений, обеспечивающих высокую пропускную способность и бесперебойную передачу данных. Стоечные решения d-Matrix на базе платформы MGX будут оснащены модульными бескабельными узлами, разработанными с использованием экосистемы и цепочки поставок NVIDIA, что обеспечит их быстрое беспроблемное развёртывание. 
Источник изображения: NVIDIA Как отметила d-Matrix, развёртывание автономных ИИ-агентов вызвало резкий рост спроса на инференс, и провайдеры ИИ-сервисов всё чаще выбирают системы со смешанной архитектурой, способные обеспечить экономическую эффективность, необходимую их клиентам. Система d-Matrix MGX разработана для ИИ-приложений, чувствительных к задержке: ИИ-помощников для написания кода, чат-ботов реального времени и голосовых агентов, для которых имеют большое значение интерактивность и высокая скорость работы. Система, созданная на базе NVIDIA MGX, расширяет возможности унифицированной архитектуры стоек, позволяя ИИ-фабрикам гибко подбирать вычислительные ресурсы под конкретную задачу. Используя принцип гетерогенной дезагрегации, операторы могут распределять нагрузку между XPU d-Matrix Raptor и CPU NVIDIA Vera Rubin, оптимизируя каждый этап инференса. Например, при генерации кода с помощью ИИ — GPU могут брать на себя ресурсоёмкий этап предварительного заполнения, тогда как XPU d-Matrix ускоряют критически важный для задержки этап декодирования (decode). Ожидается, что первые образцы XPU d-Matrix Raptor в составае MGX-стоек станут доступны в IV квартале 2027 года, а разработка самих Raptor должна завершиться к концу текущего года. 
Источник изображения: NVIDIA Новые системы будут объединять до 144 XPU Raptor в единую сеть NVLink с топологией «каждый с каждым» (All-to-All). Как сообщает The Register, на конференции Hot Chips в прошлом месяце компания сообщила, что каждая карта Raptor будет оснащена 32 Гбайт сверхбыстрой памяти DRAM с 3D-компоновкой (3D-stacked), обеспечивающей пропускную способность 100 Тбайт/с — это примерно в 4,5 раза больше, чем у ускорителя NVIDIA Rubin. Также есть возможность использовать стойку Raptor в качестве дополнения к стойкам NVIDIA Vera Rubin. «Прелесть этого решения в том, что мы берем узлы Raptor, подключаем их к той же архитектуре стойки NVL144 MGX, которая широко используется во многих ЦОД, и получаем мгновенный доступ к этим площадкам», — отметил Сид Шет (Sid Sheth), генеральный директор и соучредитель d-Matrix, о чём сообщил ресурс The Next Platform. Строго говоря, гибридные системы инференса на базе ASIC d-Matrix и традиционных GPU уже анонсировали Parasail и Gimlet Labs. 
Источник изображения: d-Matrix The Register сообщил, что XPU для d-Matrix NVL144 будут примерно вдвое меньше обычных карт Raptor, показанных на Hot Chips. Они получат 16 Гбайт памяти 3D-DRAM и с пропускной способностью около 50 Тбайт/с. При размещении 144 таких чипов в одной стойке общий объём памяти составит около 2,3 Тбайт, чего достаточно для моделей с более 4 трлн параметров при 4-бит точности, а пиковая агрегированная пропускная способность памяти (ПСП) достигнет примерно 7,2 Пбайт/с. ПСП является главным «узким местом» при выполнении инференса. Архитектура чипа Groq LPU, ориентированная на интенсивное использование SRAM, позволяет достичь скорости передачи данных 150 Тбайт/с на один чип, однако обратной стороной медали является низкая плотность размещения SRAM: на одном кристалле удаётся разместить лишь порядка 500 Мбайт памяти. Raptor обеспечивает схожий уровень ПСП при несоизмеримо большем объёме RAM. Это позволит использовать гораздо меньше чипов для работы одной модели. Если для модели с 1 трлн параметров при 8-бит точности может потребоваться более 2 тыс. Groq LPU, то системе d-Matrix будет достаточно всего 64 Raptor (или 32 при 4-бит точности). Как и LPU от Groq, чипы d-Matrix могут использоваться как автономно, так и в составе гетерогенных вычислительных систем. Чипы d-Matrix могут стать более доступным вариантом выхода на рынок для корпоративных клиентов, заинтересованных в сверхнизкой задержке при инференсе, поскольку для работы системы требуется меньшее количество вычислительных модулей (XPU). Как отметил The Register, NVIDIA настолько стремится привлечь клиентов в свою закрытую экосистему, что тратит для этого миллиарды долларов. MediaTek она заплатила $3,5 млрд, а привлечение Marvell обошлось ей в $2 млрд.
09.09.2026 [13:25], Сергей Карасёв
Qualcomm и Amazon займутся разработкой ИИ-чипов и оптического интерконнектаКомпании Qualcomm Technologies и Amazon объявили о заключении многолетнего соглашения о сотрудничестве. Работы будут осуществляться по нескольким направлениям, включая создание кастомизированных чипов для дата-центров, ориентированных на ИИ-задачи. Партнёры отмечают, что в настоящее время наблюдается экспоненциальный рост нагрузок, связанных с ИИ. Это приводит к стремительному увеличению спроса на вычислительные ресурсы и хранилища данных. Одновременно повышаются требования к пропускной способности каналов связи. Совместные усилия Qualcomm и Amazon как раз и будут направлены на создание аппаратных решений для высокопроизводительных ИИ-инфраструктур следующих поколений. Компании, в числе прочего, займутся разработкой передовых чипов, оптимизированных для задач инференса в крупномасштабных дата-центрах. Qualcomm и Amazon также намерены сотрудничать в области высокопроизводительных оптических систем связи: речь идёт о решениях класса 1,6 Тбит/с и выше. При этом будут использоваться технологии Qualcomm, включая DSP и SerDes. 
Источник изображения: Qualcomm В рамках сотрудничества Qualcomm намерена расширить использование облачной инфраструктуры AWS, включая платформу Amazon Bedrock, которая обеспечивает доступ к большим языковым моделям (LLM) и ИИ-инструментам через общий интерфейс. Эти сервисы Qualcomm будет применять для автоматизации проектирования электроники (EDA), что позволит значительно ускорить процессы создания передовых микросхем. Конечной целью сотрудничества Qualcomm и Amazon называют формирование высокопроизводительной, эффективной и экономичной инфраструктуры для ИИ и сопутствующих нагрузок.
07.09.2026 [09:32], Сергей Карасёв
Корейский стартап HyperAccel представил ускорители Bertha для ИИ-инференсаЮжнокорейский стартап HyperAccel продемонстрировал специализированные ускорители Bertha, предназначенные для выполнения ИИ-инференса. Ключевой особенностью изделий, по заявлениям разработчика, является высокая экономическая эффективность. Вместо дорогостоящей памяти HBM в решениях Bertha применяются чипы LPDDR. При этом задействована фирменная архитектура Streamlined Dataflow, которая минимизирует перемещение данных. Обеспечивается точное согласование пропускной способности памяти с вычислительными возможностями ускорителя, что позволяет использовать до 90 % имеющихся аппаратных ресурсов во время инференса. Благодаря этому достигается в пять раз более высокое значение токенов в секунду при сопоставимой величине TOPS по сравнению с обычными решениями. 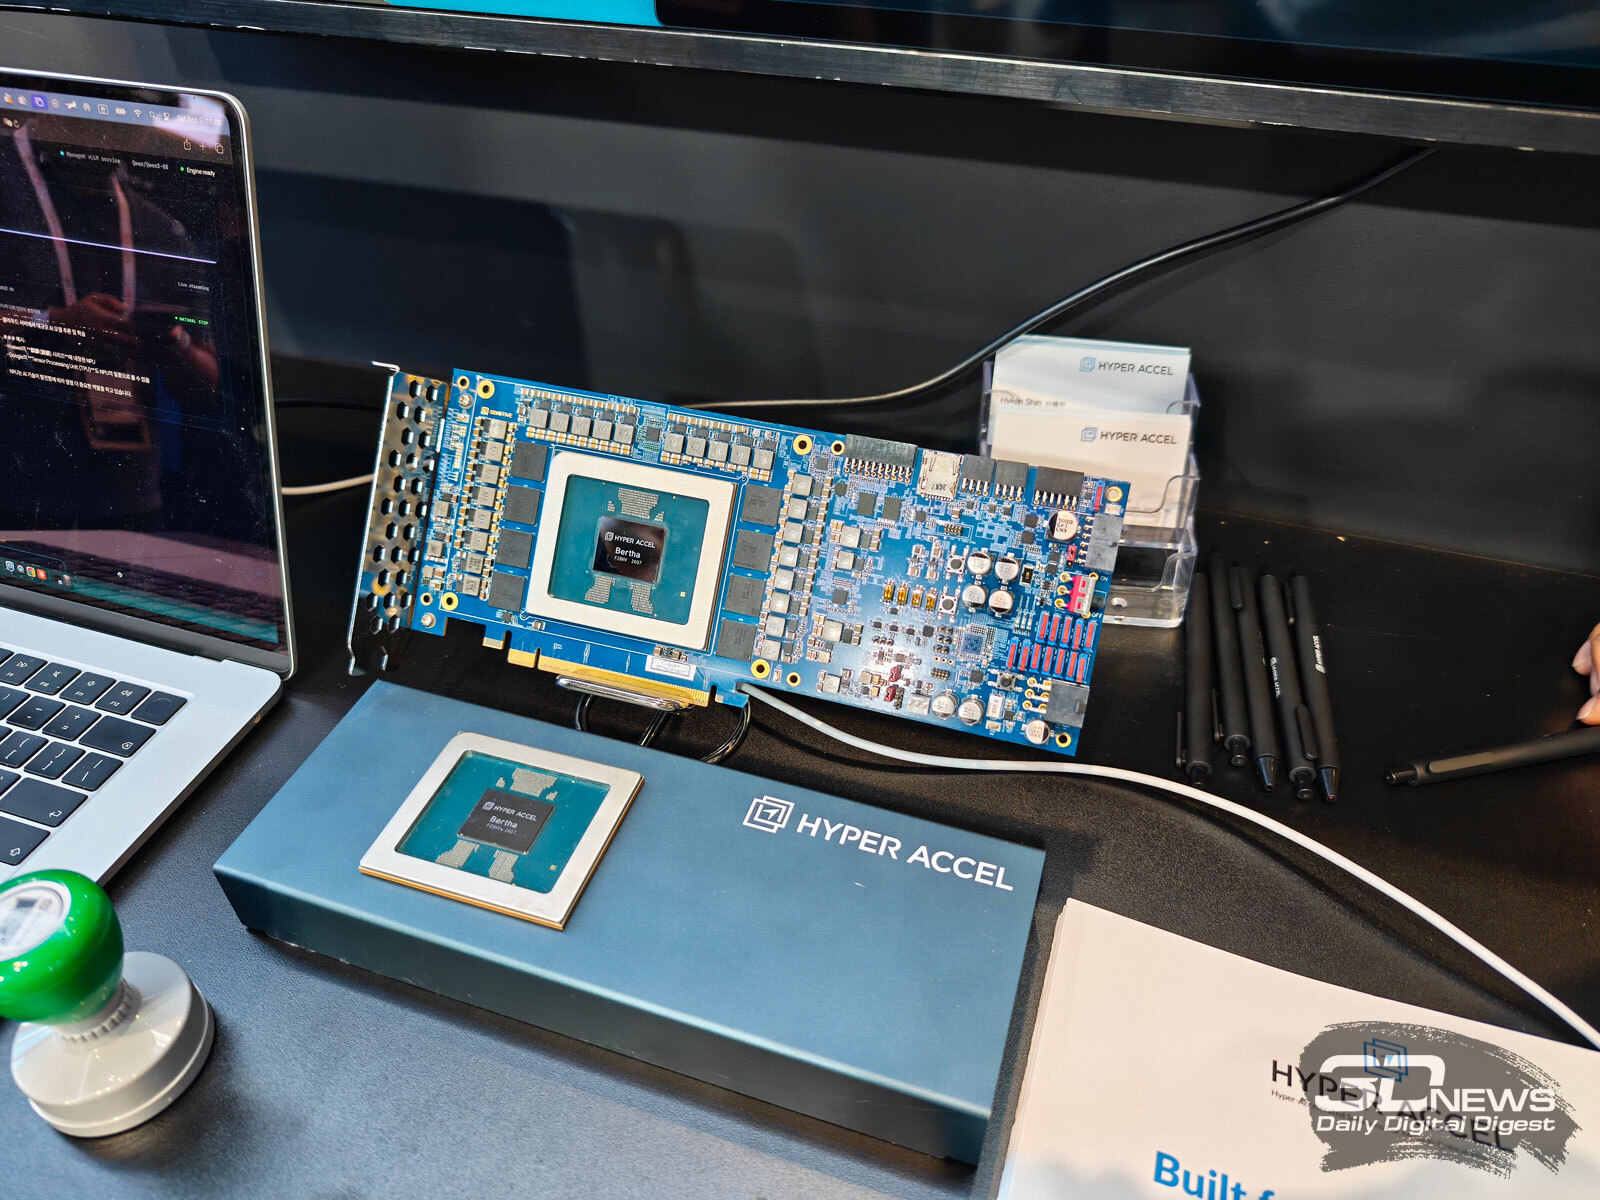 HyperAccel показала ускоритель Bertha 500, который изготавливается с применением 4-нм технологии Samsung. Это устройство, выполненное в виде двухслотовой карты расширения, содержит 32 ядра LPU, четыре ядра Arm Cortex-A53, 256 Мбайт SRAM и 128 Гбайт LPDDR5X (в перспективе — 256 Гбайт) с пропускной способностью до 546 Гбайт/с. Показатель TDP равен 250 Вт. Новинка обеспечивает производительность до 768 Тфлопс в режиме FP8/INT8 и до 384 Тфлопс на операциях FP16. Кроме того, поддерживаются форматы FP4, BF16, INT4. Серийное производство планируется организовать в начале 2027 года. 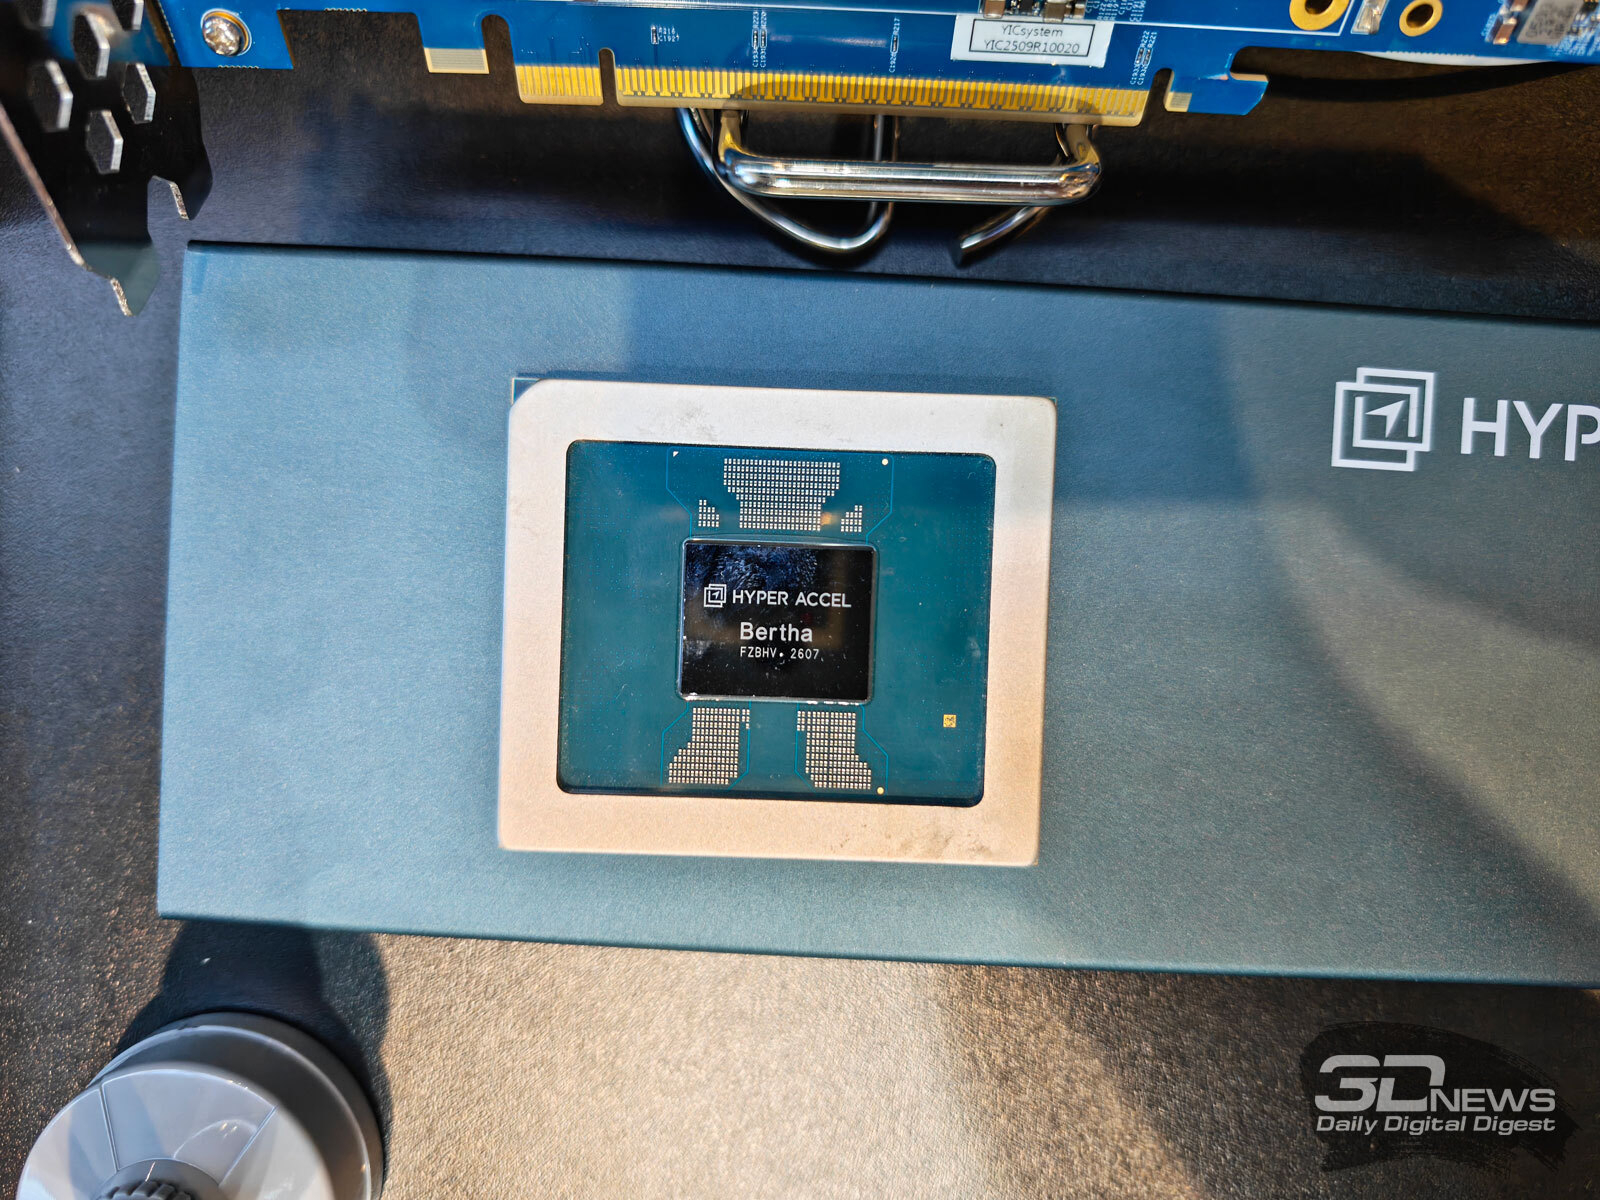 Компания HyperAccel также готовит ускоритель Bertha 100 для агентного ИИ. Это изделие получило форм-фактор M.2. Оно несёт на борту 16 Гбайт LPDDR5X с пропускной способностью 64 Гбайт/с. Быстродействие находится на отметке 32 Тфлопс на операциях FP8. Поддерживаются также режимы BF16, FP4, INT8 и INT4. Образцы изделия появятся в IV квартале нынешнего года. Ускорители совместимы с фреймворками PyTorch, ONNX, vLLM и др. Разработчикам доступен комплект SDK для дальнейшей оптимизации, развёртывания и профилирования решений в соответствии с конкретными потребностями. По заявлениям HyperAccel, Bertha в пять раз энергоэффективнее NVIDIA H100 и даёт примерно в 20 раз лучшее соотношение цены и производительности. По состоянию на февраль 2026 года компания HyperAccel привлекла $45 млн инвестиций, а её штат насчитывает около 80 человек.
04.09.2026 [18:44], Руслан Авдеев
Equinix представила решения Fabric One и Inference Exchange для распределённого ИИ-инференса в системах NVIDIA и Together AIКомпания Equinix расширяет платформу ЦОД и межсетевого взаимодействия, добавив взаимодополняющие сервисы, обеспечивающие распределённую эксплуатацию вычислительных ресурсов. Equinix Fabric One обеспечивает подключение между корпоративными площадками, облаками и ИИ-провайдерами, а Equinix Inference Exchange позволяет объединить эталонные решения NVIDIA Enterprise Reference Architectures с открытой платформой для инференса компании Together AI в пределах экосистемы Equinix. Сервисы позволят решить распространённую проблему архитектуры данных, когда корпоративная информация, приложения и пользователи распределены по разным объектам, облакам и юрисдикциям с отдельными правовыми нормами, а обслуживающие эти ресурсы вычислительные системы отделены от них и работают в других локациях. Equinix рассчитывает превратить распределение рабочих нагрузок и управление подключениями в единый управляемый сервис вместо того, чтобы реализовать сетевые подключения в рамках отдельных ИИ-проектов. Fabric One позволит клиентам описывать необходимый результат подключений на естественном языке. Equinix будет самостоятельно определять и организовывать маршрутизацию, облачные подключения, шифрование, управлять отказоустойчивостью и переключением на резервные ресурсы. 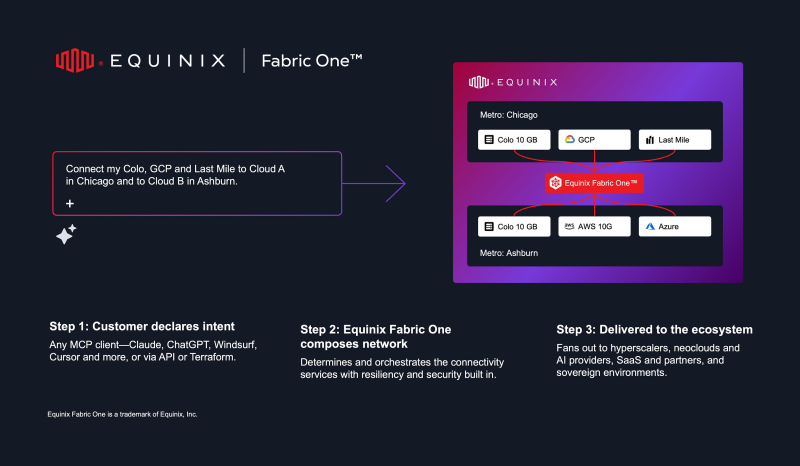
Источник изображения: Equinix Основными партнёрами по интеграции выступят AWS и Google Cloud, Fabric One будет использовать открытые спецификации OpenAPI 3.0 Interconnect, разработанные в рамках программ AWS и Google по организации мультиоблачных сетей, к которым присоединились Microsoft Azure и OCI. Приложения и инфраструктурные агенты смогут программно запрашивать необходимые соединения вместо того, чтобы полагаться на ручную координацию кросс-соединений и ручное предоставление сетевых ресурсов. Inference Exchange представляет собой распределённую платформу для ИИ-инференса. Equinix будет поставлять объекты, электроэнергию, передовые системы охлаждения, обеспечит эксплуатацию инфраструктуры после ввода в эксплуатацию и подключение через Equinix Fabric. NVIDIA обеспечит развёртывание с помощью проверенных эталонных архитектур Enterprise Reference Architectures, а Together AI обеспечит платформу для инференса с более 200 open source ИИ-моделей. Платформа будет поддерживать общие многопользовательские проекты и выделенные среды для отдельных клиентов, которым требуются гарантированные объёмы ресурсов и высокий уровень «изоляции» данных. 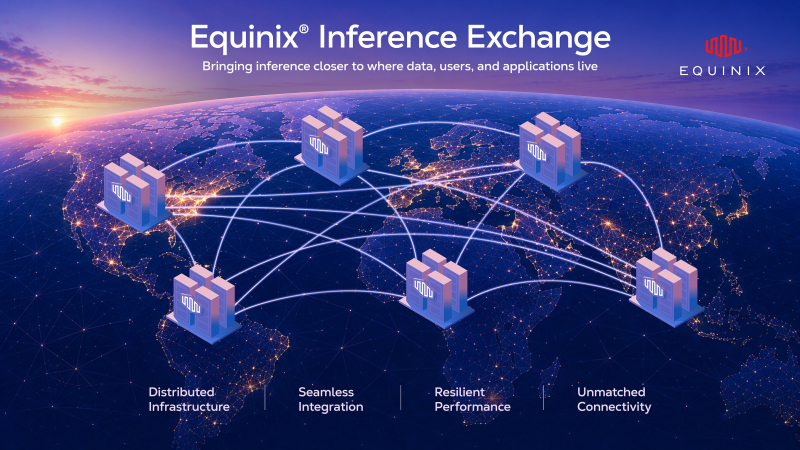
Источник изображения: Equinix По данным Storage Review, платформа Inference Exchange ориентирована на три ключевых топологии развёртывания. Во-первых, для инференса на уровне городских периферийных узлов организации способны запускать модели в рамках агломераций, с быстрым откликом API-обращений к открытым базовым моделям. Во-вторых, её можно использовать для перехода от закрытых проприетарных API на модели с открытым исходным кодом. Наконец, для обеспечения суверенного ИИ и выполнения нормативных требований локальных регуляторов — компании из регулируемых сфер могут обеспечить инференс и обработку данных в пределах заданных географических границ. Предполагается, что бета-тестирование Fabric One начнётся до конца 2026 года, а полная доступность сервиса запланирована на 2027 год, сначала в Северной Америке. Inference Exchange будет доступен в I квартале 2027 года. Стратегическим преимуществом Equinix является инфраструктура компании и плотность сосредоточенной вокруг неё экосистемы. На конец 2025 года она управляла 280 ЦОД на 77 рынках 36 стран. Платформа объединяет более 10,5 тыс. компаний, около 3 тыс. поставщиков облачных и IT-сервисов, а также более 500 тыс. физических и виртуальных интерконнектов. Объекты совредоточены в мегаполисах и городских агломерациях, где пересекаются телеком-операторы, облачные провайдеры, корпорации, платформы с контентом и и финансовые площадки. Для распределённого инференса близость всех игроков может быть важнее масштаба вычислительных ресурсов, поскольку часто корпоративные данные невозможно переместить в удалённый регион из-за требований к задержке, стоимости, управлению, безопасности, юрисдикции и т. п. Fabric One и Inference Exchange координируют два уровня физической инфраструктуры Equinix — на одном находятся объекты International Business Exchange (IBX), предназначенные для разных клиентов, на другом — дата-центры xScale для крупных заказчиков, в том числе гиперскейлеров. Fabric One координирует подключения между разными инфраструктурными доменами, а Inference Exchange позволяет размещать и эксплуатировать мощности для инференса ближе к локациям, где корпоративный спрос максимален. Впрочем, это не сделает инфраструктуру Equinix однородной, поскольку, например, некоторые IBX могут быть ограничены по своим проектным техническим характеристикам. Новые объекты IBX проектируются с расширенными возможностями в контексте электропитания и охлаждения.
27.08.2026 [09:25], Владимир Мироненко
MTIA 300: первый ИИ-чип Meta✴ со встроенными 800GbE-адаптерами и механизмами разгрузки коммуникацийMeta✴ сообщила новые подробности о 667-Вт ИИ-ускорителе MTIA 300 — своём первом чипе, оптимизированном для обучения DLRM-моделей. В отличие от LLM, требующих огромной пропускной способности вычислений с плавающей запятой, рекомендательные модели сталкиваются с проблемой необходимости быстрого и эффективного взаимодействия ускорителей в сочетании с большой ёмкостью памяти и высокой пропускной способностью интерконнекта. Их таблицы эмбеддингов могут содержать более 99 % параметров модели, что требует гибридного параллелизма, генерирующего частые коллективные операции AllReduce, AllToAll и AllGather на сотнях ускорителей. На таких чипах, как GPU, эти коммуникационные операции конкурируют с вычислениями за одни и те же ресурсы, часто приводя к неэффективному использованию дорогостоящего оборудования. Для решения этой проблемы разработчики, используя совместную разработку MTIA 300 с HCCL, библиотекой коммуникационных интерфейсов, созданной на основе разработанного с нуля оборудования, сделали коммуникацию первостепенной задачей в проектировании микросхем. На практике HCCL обеспечивает пропускную способность передачи данных до 940 Гбайт/с в пределах одной стойки. На модели со 150 млрд параметров, работающей на 40 ускорителях, общее время обмена данными при использовании MTIA 300 в 3,9 раза меньше, чем у эквивалентного кластера на базе GPU. 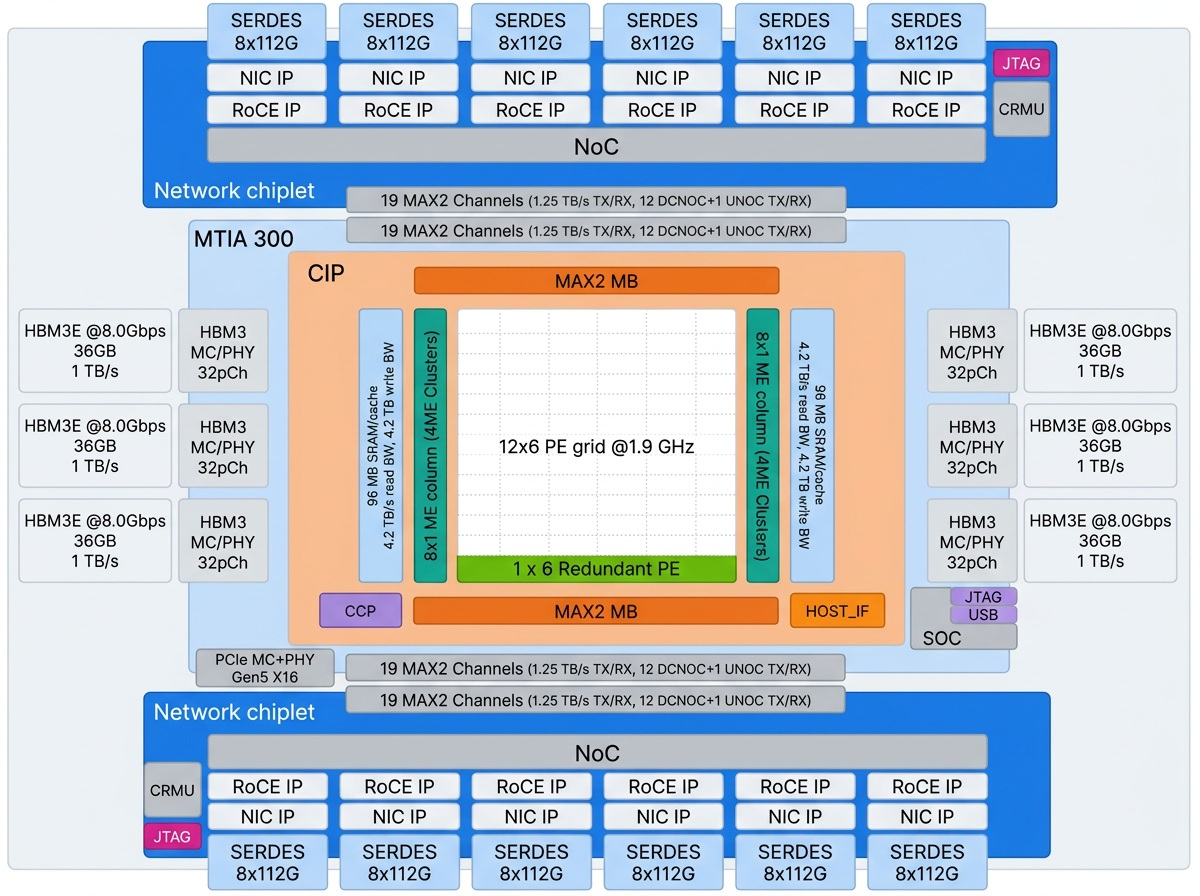
Источник изображения: Meta✴ В MTIA 300 сетевой интерфейс находится внутри самой упаковки микросхемы. Два 5-нм сетевых чиплета, каждый из которых содержит по шесть специализированных 800GbE RoCE-адаптеров, обеспечивают общую пропускную способность I/O 1,2 Тбайт/с без пересечения c шиной PCIe. Это устраняет узкое место в цепочке «хост-устройство-NIC», присутствующей в традиционных архитектурах GPU, где CPU должен выступать посредником между ускорителем и сетью, и позволяет избежать перегрузки PCIe между ускорителем и NIC. При этом NIC можно гибко использовать для масштабирования. Поскольку используются одни и те же 12 NIC на базе Ethernet для вертикального масштабирования (внутри стойки из 16 узлов, до 1 Тбайт/с) и горизонтального масштабирования (между стойками, до 200 Гбайт/с), можно гибко распределять NIC в соответствии с меняющимися потребностями. По мере изменения требований модели можно переконфигурировать сеть, а не само оборудование. Для минимизации задержки транзакций разработчики внедрили экспресс-оповещения (doorbell). Сама запись запроса на выполнение служит оповещением, исключая дополнительное чтение из памяти и экономя около 800 нс на операцию. 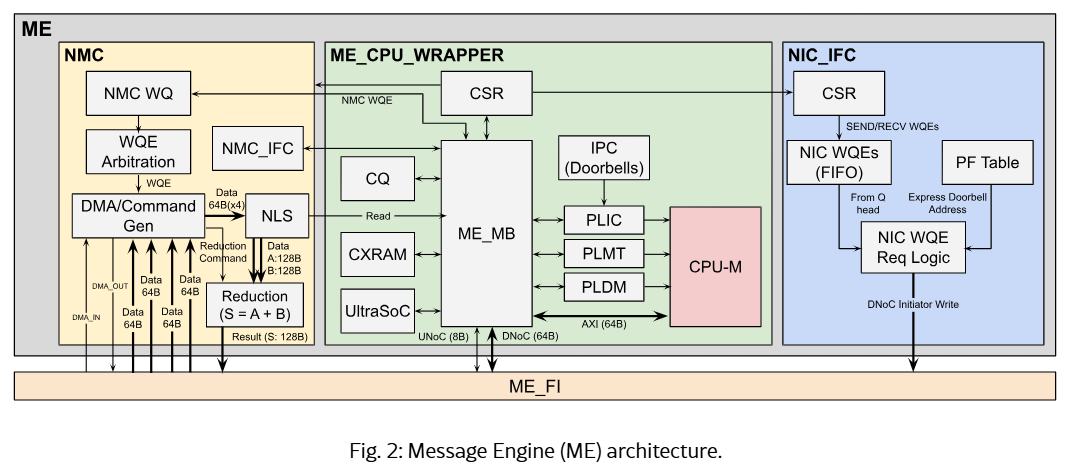
Источник изображения: Meta✴ В случае GPU библиотеки вроде NCCL реализуют операции коллективных коммуникаций в виде вычислительных ядер (kernel), которые используют те же ресурсы, что нужны для вычислений при обучении. Пересечение коллективных операций и операций обучения приводит к замедлению обоих и того, и другого. В MTIA 300 использовали другой подход. Наряду с матрицей из 72 3-нм вычислительных элементов (PE), чип включает 16 выделенных механизмов обработки сообщений (ME), которые обрабатывают всю коммуникацию независимо. ME содержит ядро RISC-V для оркестрации; сетевой интерфейс, который направляет запросы к нужному NIC; вычислительный блок Near-Memory Computing (NMC), который выполняет операции редукции со скоростью 128 байт/цикл. Расположенные по краям чипа, рядом с HBM и кешем, NMC в совокупности обеспечивают пропускную способность редукции более 2,8 Тбайт/с — более чем вдвое превышающую пропускную способность I/O. Это позволяет выполнять коллективные операции AllReduce и ReduceScatter на линейной скорости NIC без использования ресурсов PE. 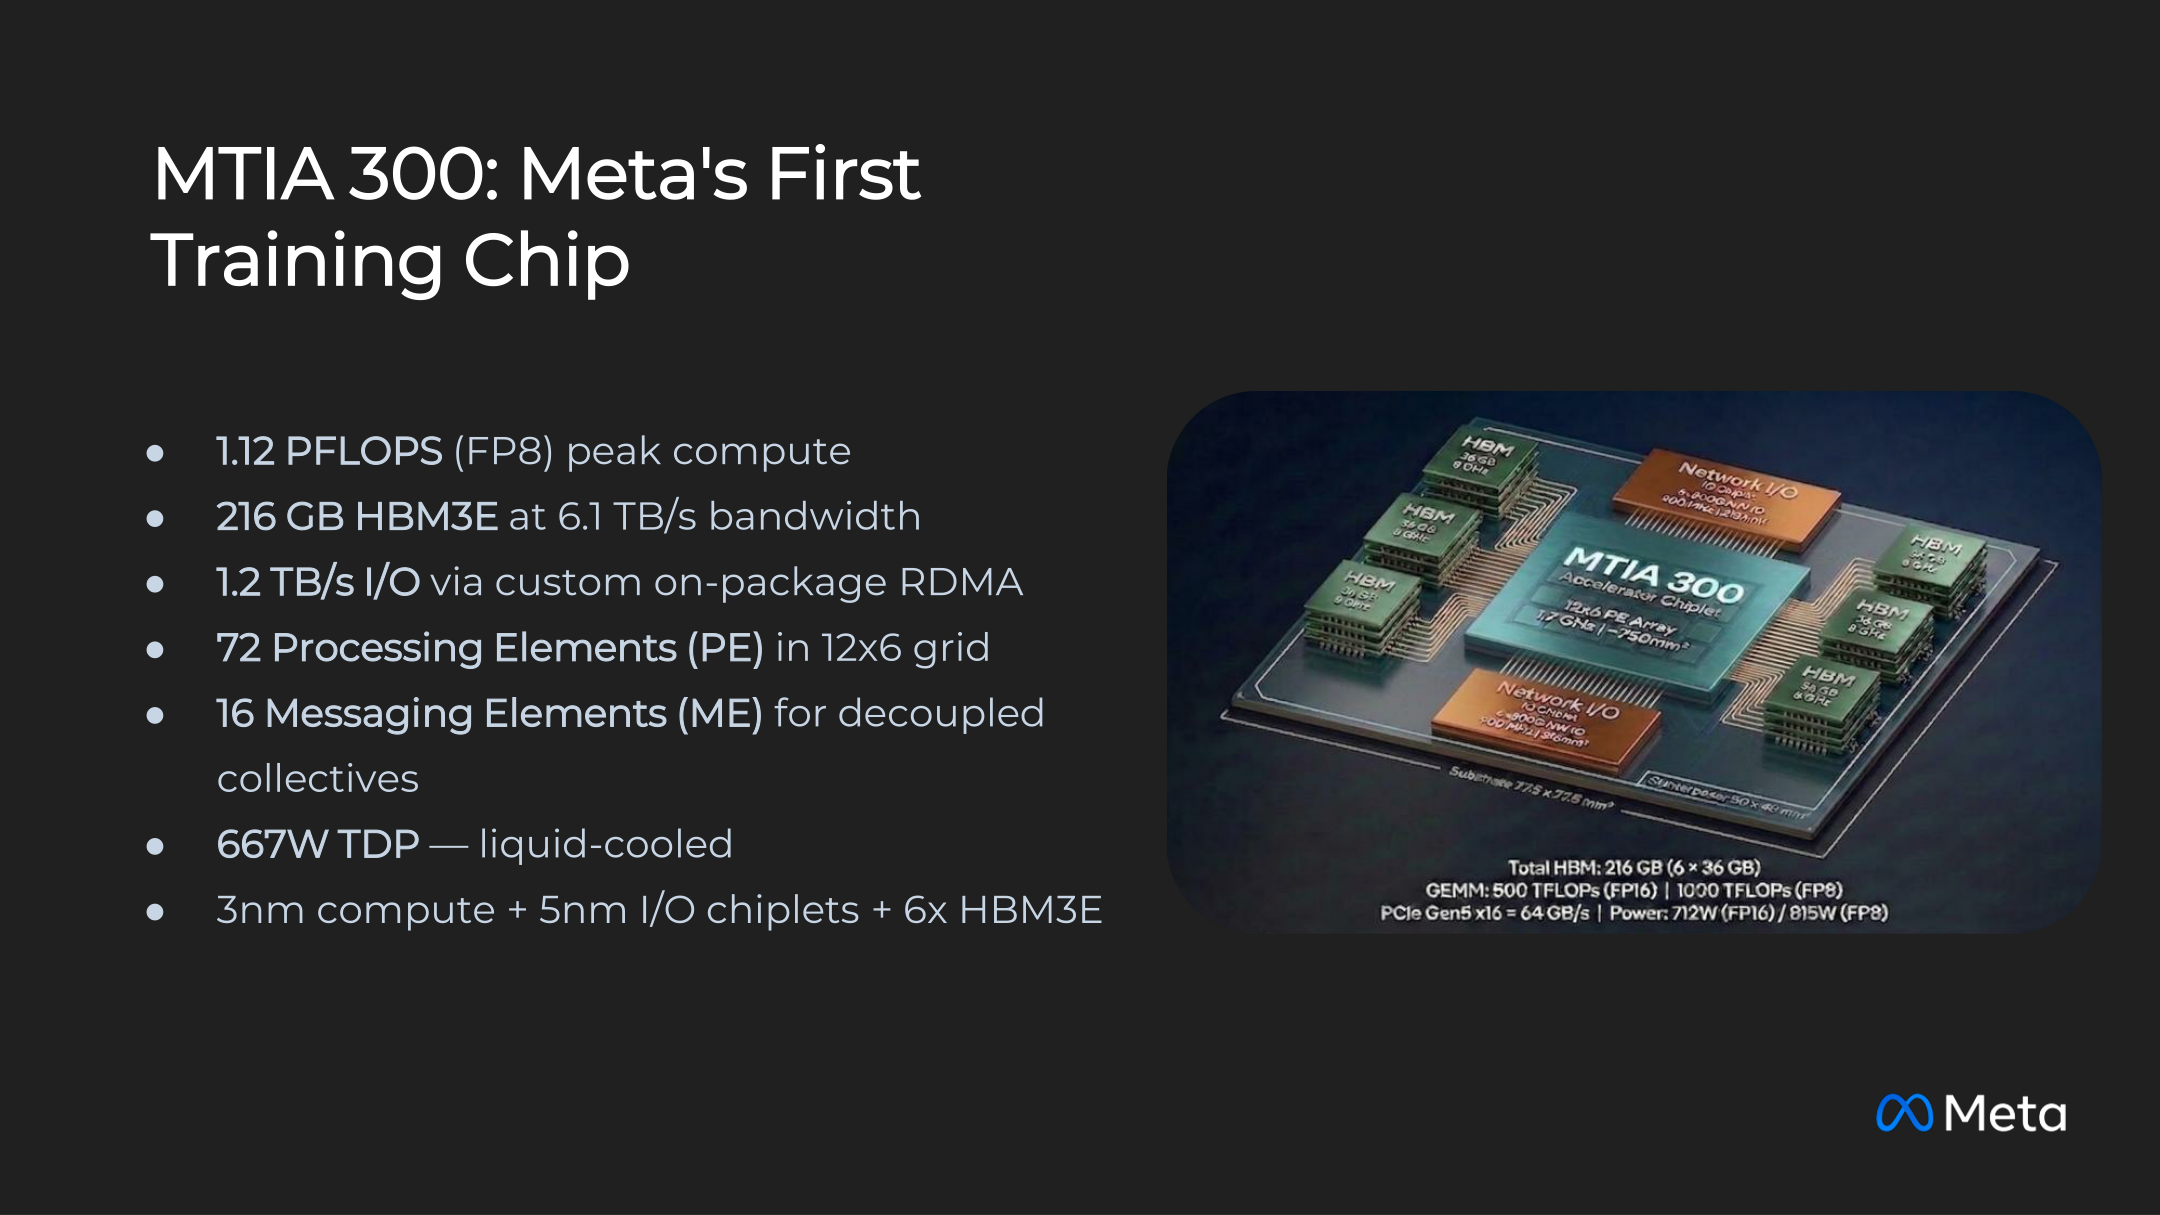
Источник изображения: Meta✴ В результате обеспечивается практически идеальная изоляция операций. Одновременное выполнение больших GEMM-операций с коллективными операциями приводит к снижению вычислительной пропускной способности менее чем на 0,5 %, в отличие от традиционных GPU, где снижение может превышать 20 % из-за использования одних и тех же ресурсов на обмен данными и вычисления. Разработанная совместно с MTIA 300 библиотека HCCL вместо управления обменом данными с хостом во время выполнения компилирует каждую коллективную операцию в полный набор подграфов (массивы очередей задач с явным указанием зависимостей), которые отправляются на ME для полностью автономного выполнения. Таким образом, хост лишь единожды отправляет ускорителю набор сетевых инструкций и более не вмешивается в работу сети. 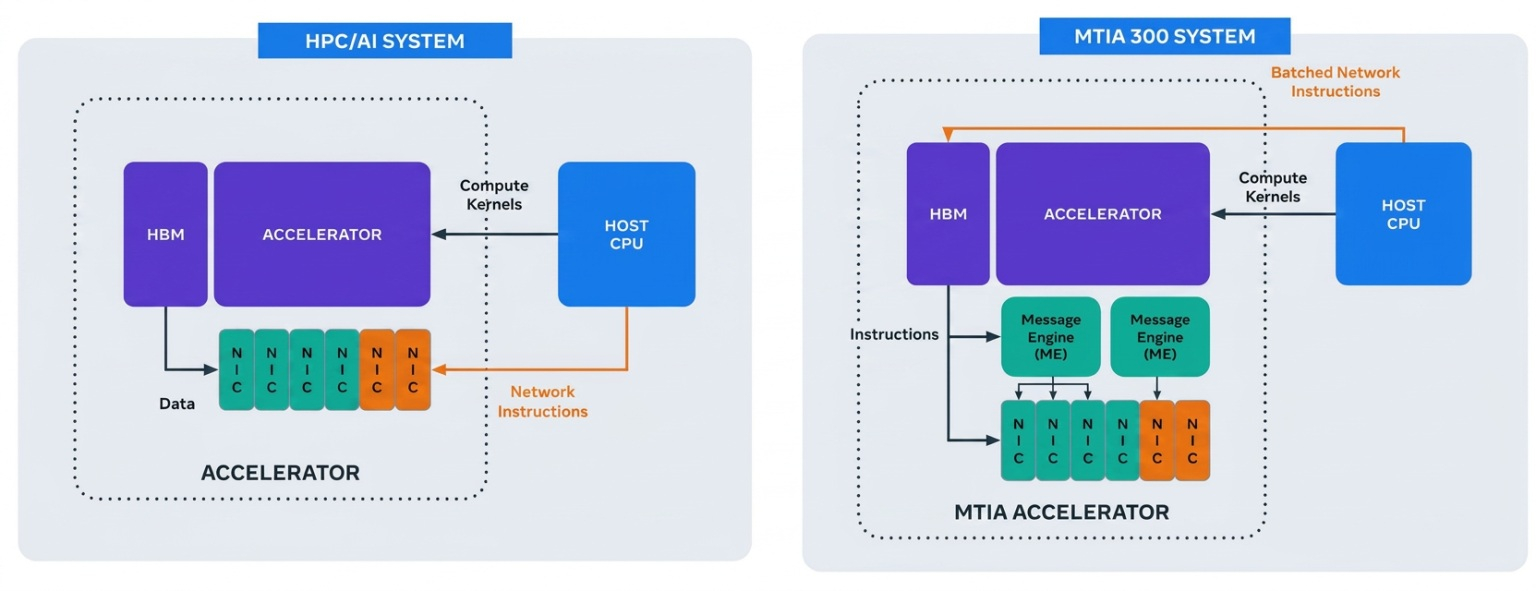
Источник изображения: Meta✴ По словам Meta✴, такая архитектура естественным образом интегрируется с PyTorch. Коллективные операции компилируются в единый граф вместе с вычислительными задачами. HCCL сама выбирает алгоритмы, учитывающие топологию сети и асимметричность полос пропускания, по возможности минимизируя межстоечный трафик. Для инференса были разработаны дополнительные пути: односторонняя коммуникация, когда PE используют экспресс-оповещения, и параллельный запуск коллективных операций по сигналу от kernel'а без прерывания работы последнего. Компания отметила, что MTIA 300 имеет и другие плюсы 216 Гбайт HBM3E (6,1 Тбайт/с) позволяют разместить больше данных на одном чипе, а не загружать их лишний раз извне; на каждый ускоритель приходится всего один CPU, что позволяет нагружать его интенсивными вычислениями на некоторых этапах; высокая пропускная способность сети позволяет при необходимости использовать форматы данных с более высокой точностью. Хотя сочетание умеренной FP-производительности с ёмкой и быстрой HBM в MTIA 300 изначально было оптимизировано для обучения DLRM, эти качества позволяет эффективно использовать чипа для более широкого спектра нагрузок, включая инференс моделей генеративного ИИ. Стоит отметить, что подход Meta✴ с внедрением NIC непосредственно в чип не нов сам по себе. Например, чипы Intel/Habana Gaudi2, представленные в 2022 году, использовали 24 100GbE-интерфейса RoCE для вертикального и горизонтального масштабирования.
27.08.2026 [08:59], Владимир Мироненко
OpenAI: Jalapeño опередил в тестах чипы NVIDIAOpenAI сообщила новые подробности об ИИ-ускорителе Jalapeño, разработанном в сотрудничестве с Broadcom, пишет The Register. Как утверждает OpenAI, Jalapeño, предназначенный для инференса, показал в тестах лучше результаты, чем текущая линейка ускорителей NVIDIA — GB200 и GB300. Тестирование в бенчмарк-пакете SemiAnalysis InferenceX показало, что системы OpenAI на базе Jalapeño обеспечивают в 1,5–1,9 раза больший объём «работы ИИ» при пиковой пропускной способности и в 1,7–3,6 раза меньшую сквозную задержку, чем у конкурентов, на GPT-OSS-120B, DeepSeek R1 670B и Kimi K2.5 1T. Во время внутренних тестов Jalapeño также хорошо показал себя при работе с некоторыми крупными, продвинутыми моделями OpenAI, которые ещё не выпущены. Это говорит о том, что конструкция чипа «становится более ценной по мере роста рабочих нагрузок и повышения их сложности», сообщила компания в блоге. На системном уровне стойка со 128 ускорителями Jalapeño обеспечивает 1,7 Эфлопс 4-бит вычислений, имеет 27,5 Тбайт HBM4 с агрегированной пропускной способностью чуть менее 2 Пбайт/с. Чип сочетает вычислительный кристалл с шестью стеками HBM4 общим объёмом 216 ГиБ (15,4 Тбайт/с), обеспечивая производительность 13,4 Пфлопс в операциях MXFP4, и масштабируется до 27 Эфлопс и 432 ТиБ памяти в системе из 2048 ASIC. 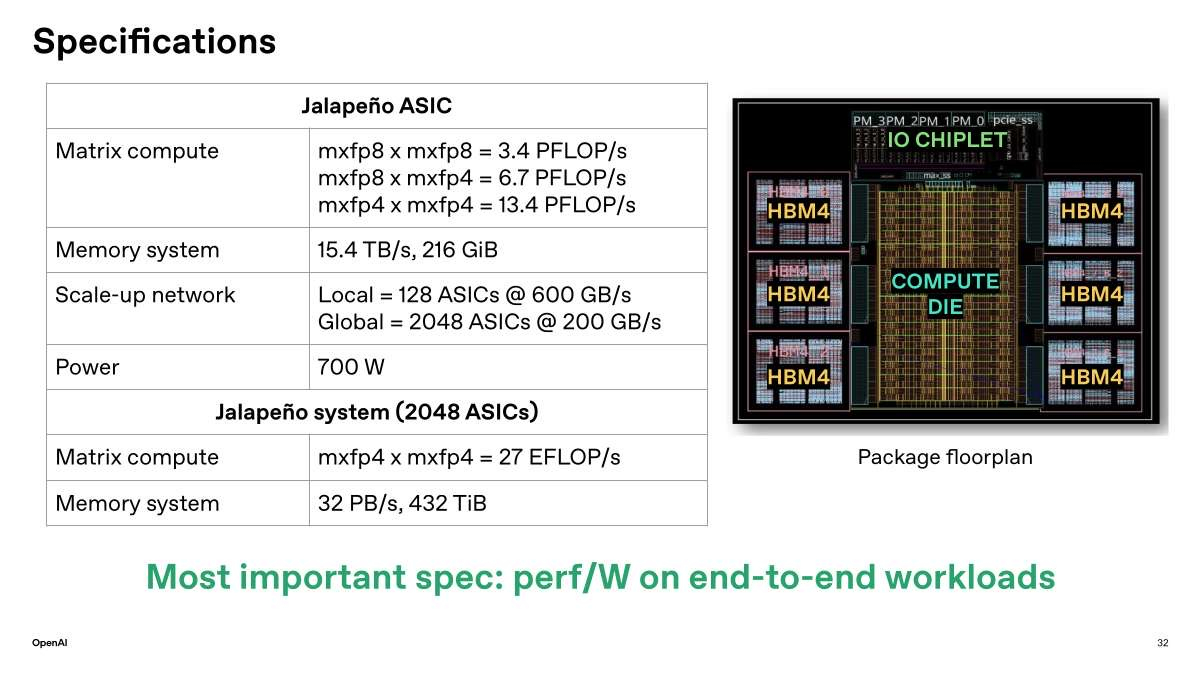
Источник изображений: OpenAI/ServeTheHome Поскольку чип демонстрирует высокие результаты при низком энергопотреблении — 700 Вт — Jalapeno позволит OpenAI экономить средства при эксплуатации своих ЦОД, где электроэнергия является ключевой статьей расходов, заявил агентству Bloomberg вице-президент по аппаратному обеспечению OpenAI Ричард Хо (Richard Ho). Новейшие стоечные системы AMD и NVIDIA работают быстрее, обеспечивая в 1,46–2 раза больше вычислительных ресурсов и до 12 % больше памяти (Helios), но имеют всего лишь 85 % пропускной способности памяти стойки OpenAI. Ричард Хо сообщил, что чип был разработан для минимизации перемещения данных и хранения промежуточных операций. «Мы разработали Jalapeño таким образом, чтобы минимизировать перемещение данных и задержки связи. Это означает, что состояние модели, включая KV-кеш, используемый при генерации ответа, может быть явно размещено и храниться локально, пока система активирует правильную комбинацию вычислительных ресурсов, памяти и сети для каждой фазы инференса», — сообщила компания в своем блоге. 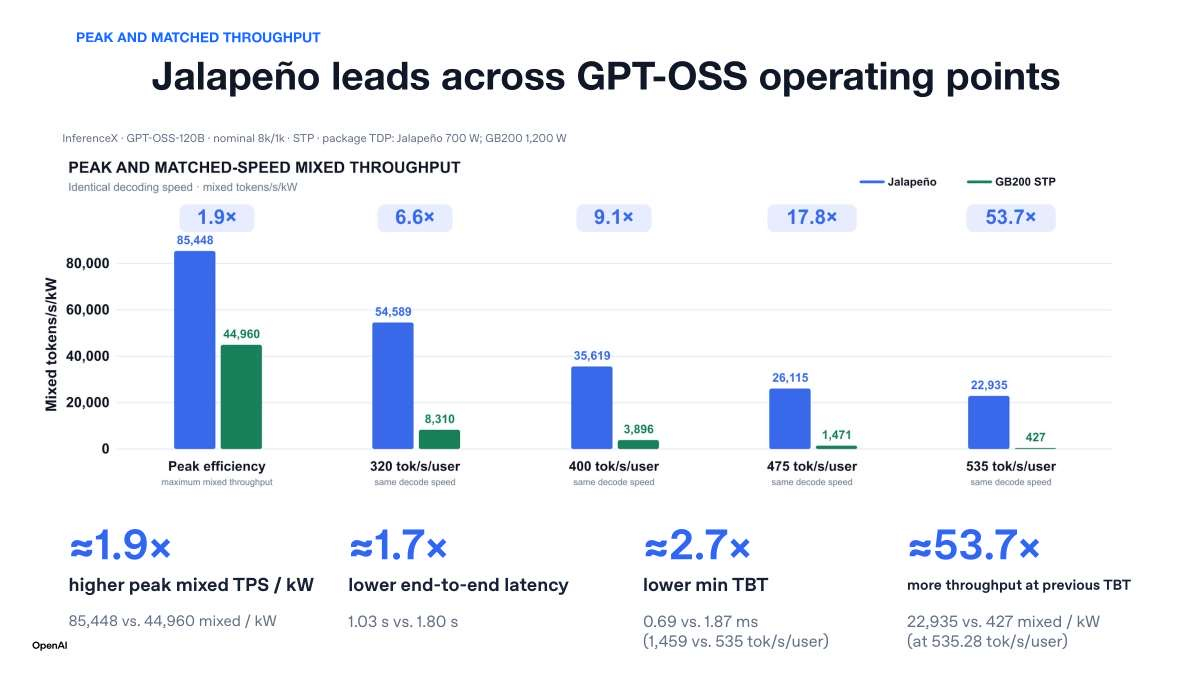 В отличие от стоек NVIDIA Groq LPX, Jalapeño не является узкоспециализированным решением. В компании сообщили ресурсу The Register, что он оптимизирован как для ресурсоёмких операций предварительного заполнения, где обрабатываются промты, так и для фазы декодирования, требующей большой пропускной способности памяти, где генерируются выходные токены. Также следует отметить, что благодаря использованию ИИ для проектирования архитектуры и оптимизации чипа для инференса, OpenAI потратила на его разработку от начала до готовности первого пробного чипа всего девять месяцев. Процесс включал использование собственных моделей для оптимизации механизмов обработки инференса и для написания пользовательских ядер по мере внедрения новых моделей. 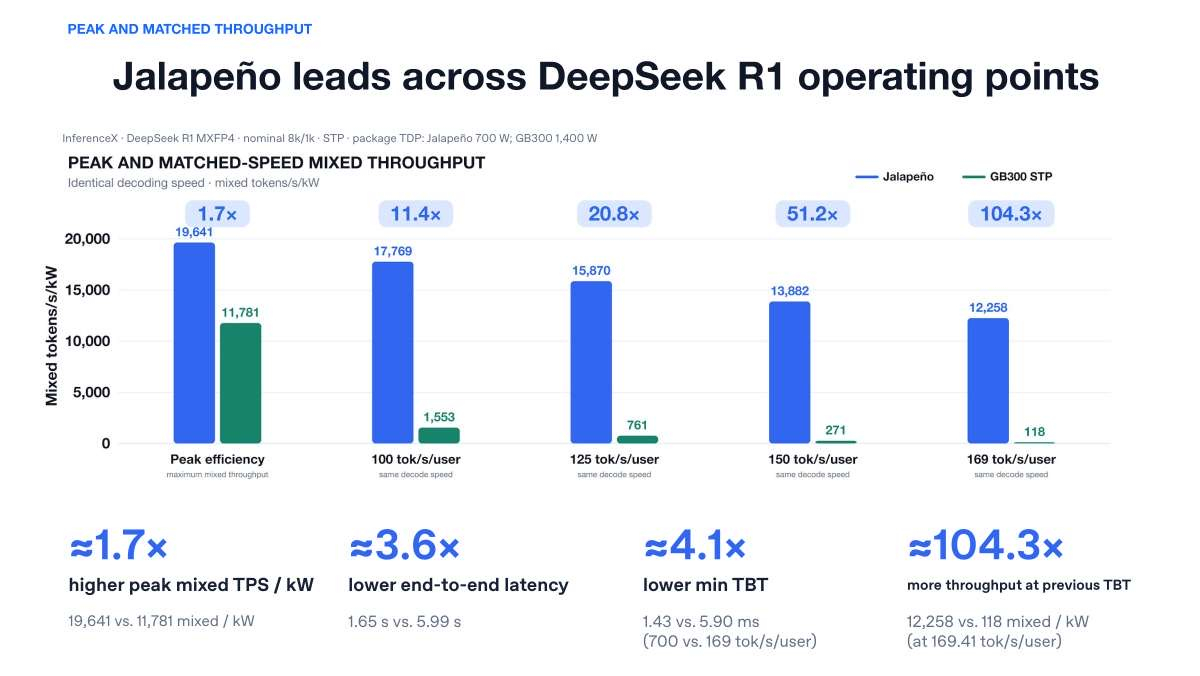 Преимущество Jalapeño в скорости настолько велико, что OpenAI может получать результаты, ранее достижимые только с помощью чипов, использующих другой тип памяти и конструкцию. Например, в настоящее время OpenAI использует чипы Cerebras для некоторых своих LLM, которые, по словам Хо, лучше всего подходят для небольших моделей. Jalapeño, напротив, может обрабатывать более крупные модели, отметил он. Тем не менее, компания не собирается отказываться от сотрудничества с другими поставщиками, включая NVIDIA. «У нас огромная потребность в вычислительных мощностях, поэтому мы привлекли так много разных поставщиков, — сказал он. — Это будет продолжаться ещё некоторое время». Ожидается, что Jalapeño будет выпущен в ограниченных объёмах в конце этого года с дальнейшим увеличение производства в следующем году. 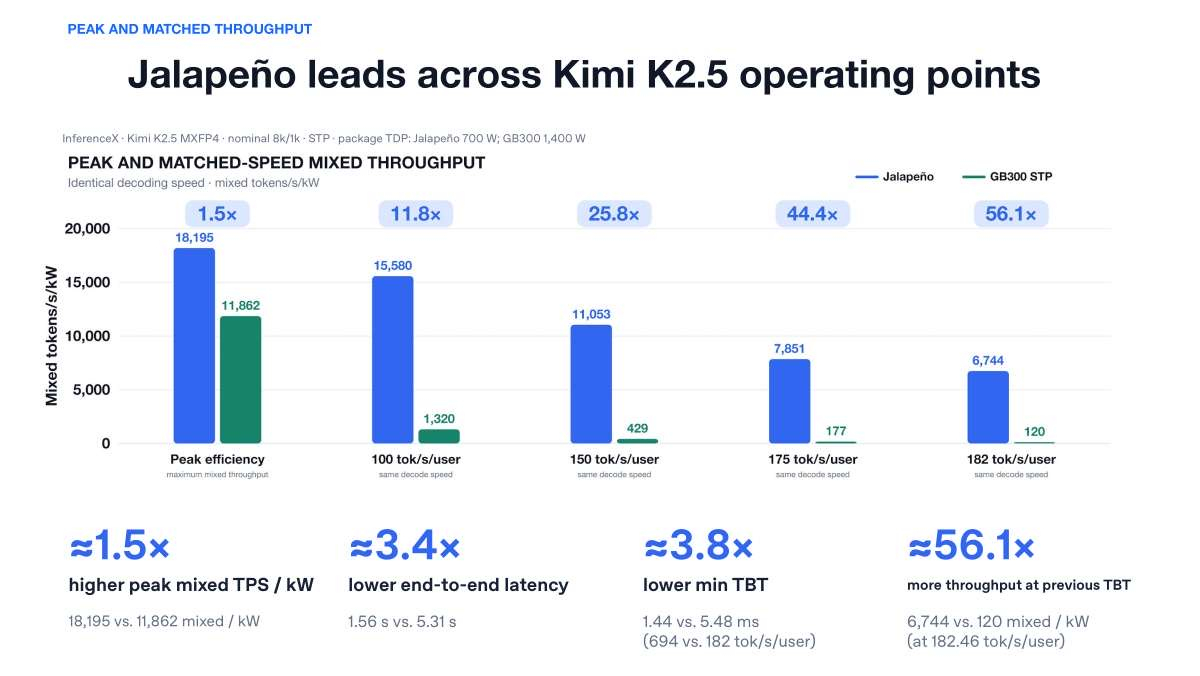 Вторая версия Jalapeño находится на продвинутой стадии разработки, готовность к производству ожидается в «ближайшие месяцы», сказал Хо. Также уже разрабатывается концепция чипа третьего поколения. The Register призвал относиться с осторожностью к заявлениям OpenAI. Новый чип тестировался в сравнении с системами NVIDIA GB200 NVL72 и GB300 NVL72, выпущенными в 2024 и 2025 годах соответственно, но не сравнивался с Vera Rubin, поставки которого только начались.
26.08.2026 [12:45], Сергей Карасёв
32 ядра Xe3P и до 480 Гбайт памяти LPDDR5X: Intel раскрыла детали об ИИ-ускорителе Crescent IslandIntel поделилась информацией об ИИ-ускорителях Crescent Island, предназначенных для использования в серверах и рабочих станциях. Ожидается, что поставки образцов изделий начнутся в текущем полугодии. Решения Crescent Island будут предлагаться в виде карт расширения с интерфейсом PCIe 5.0 x16. Конфигурация включает 32 ядра Xe3P и 256 матричных движков XMX. Кроме того, задействованы 256 векторных движков. На каждое ядро приходится 1 Мбайт регистра общего назначения (GRF) и 512 Кбайт кеша L1. Помимо этого, есть 32 Мбайт унифицированного кеша L2. В случае Crescent Island корпорация Intel решила отказаться от использования дорогостоящей памяти НВМ с высокой пропускной способностью. Вместо этого применяются чипы LPDDR5X с пониженным энергопотреблением (скоростные характеристики не раскрываются). Референсный вариант ускорителя несёт на борту 160 Гбайт LPDDR5X, тогда как ODM-производители будут предлагать модификации, имеющие до 480 Гбайт памяти. Заявленное энергопотребление карты находится на уровне 350 Вт; применяется воздушное охлаждение. 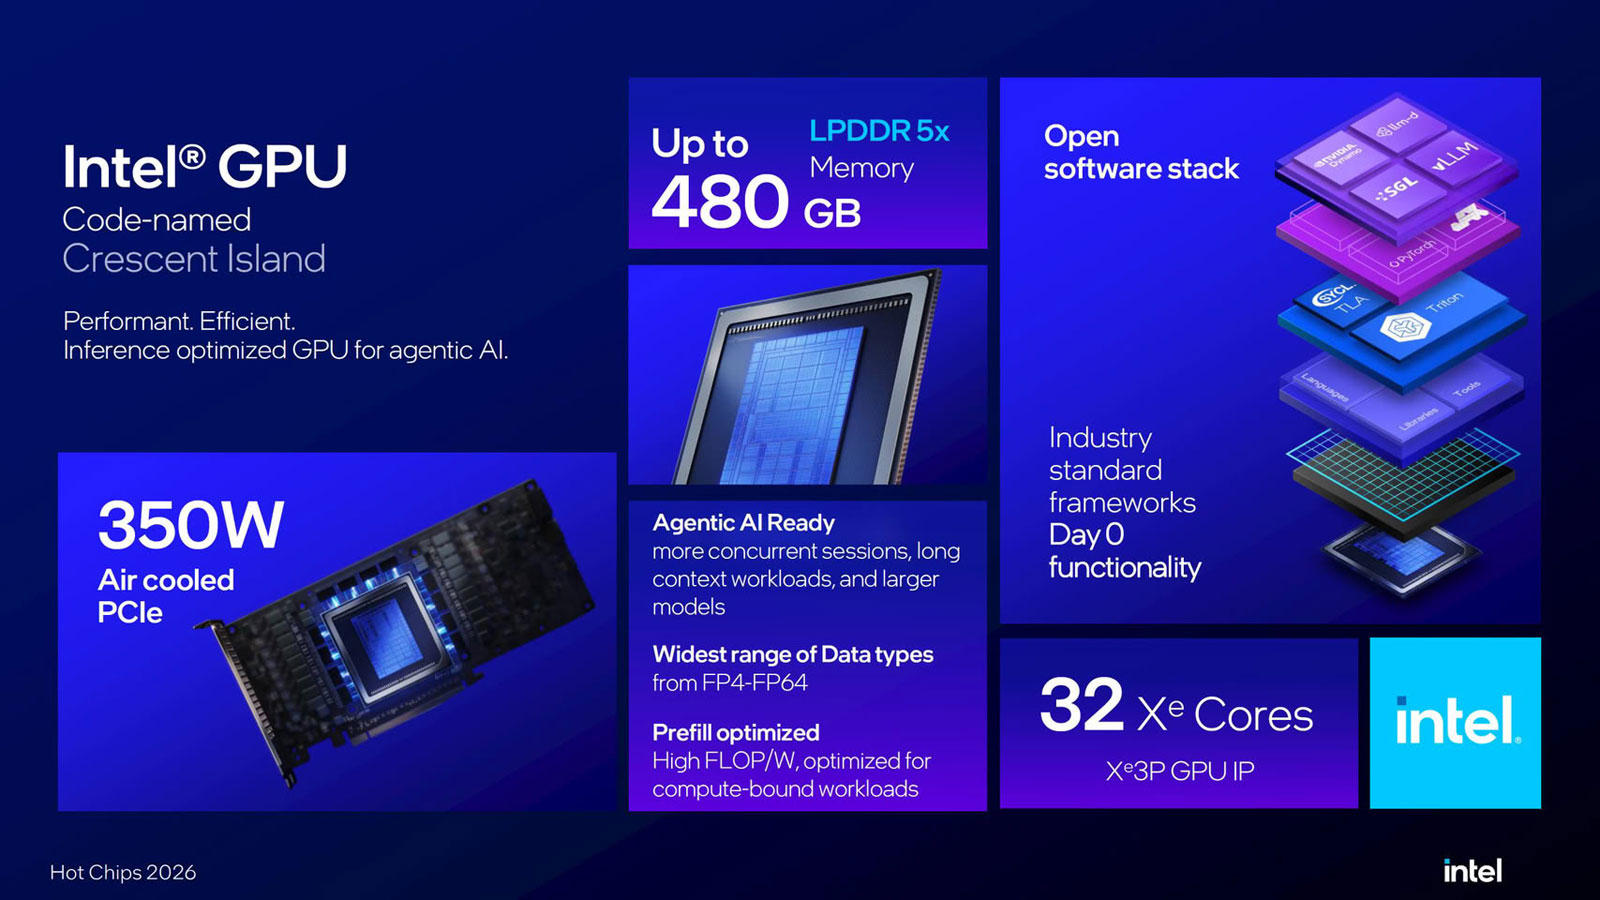
Источник изображений: Intel 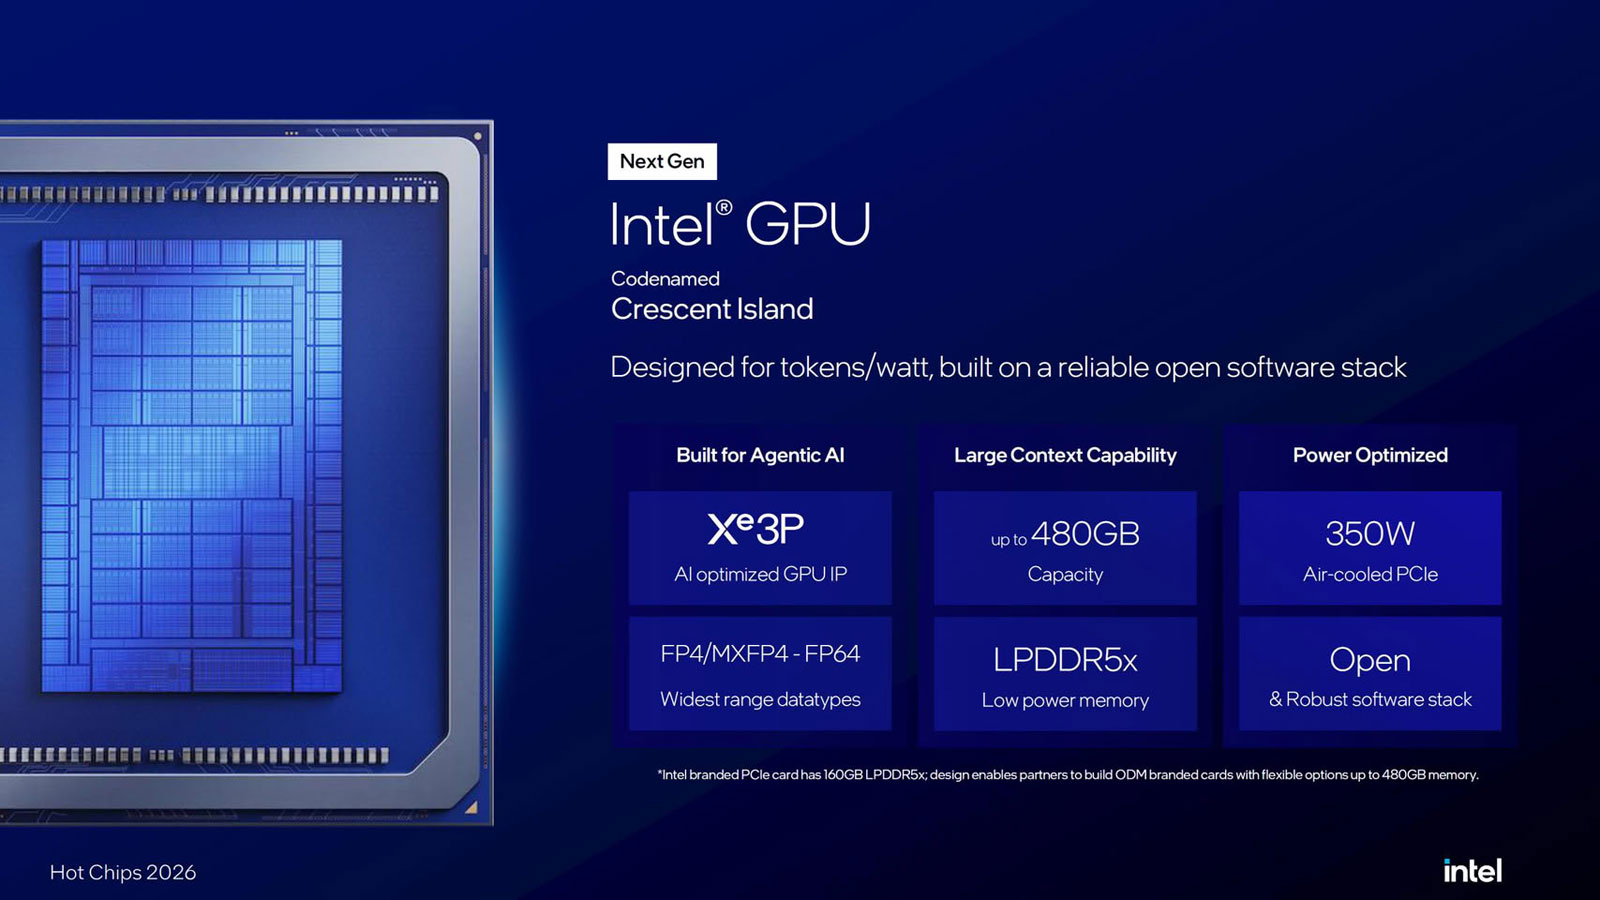
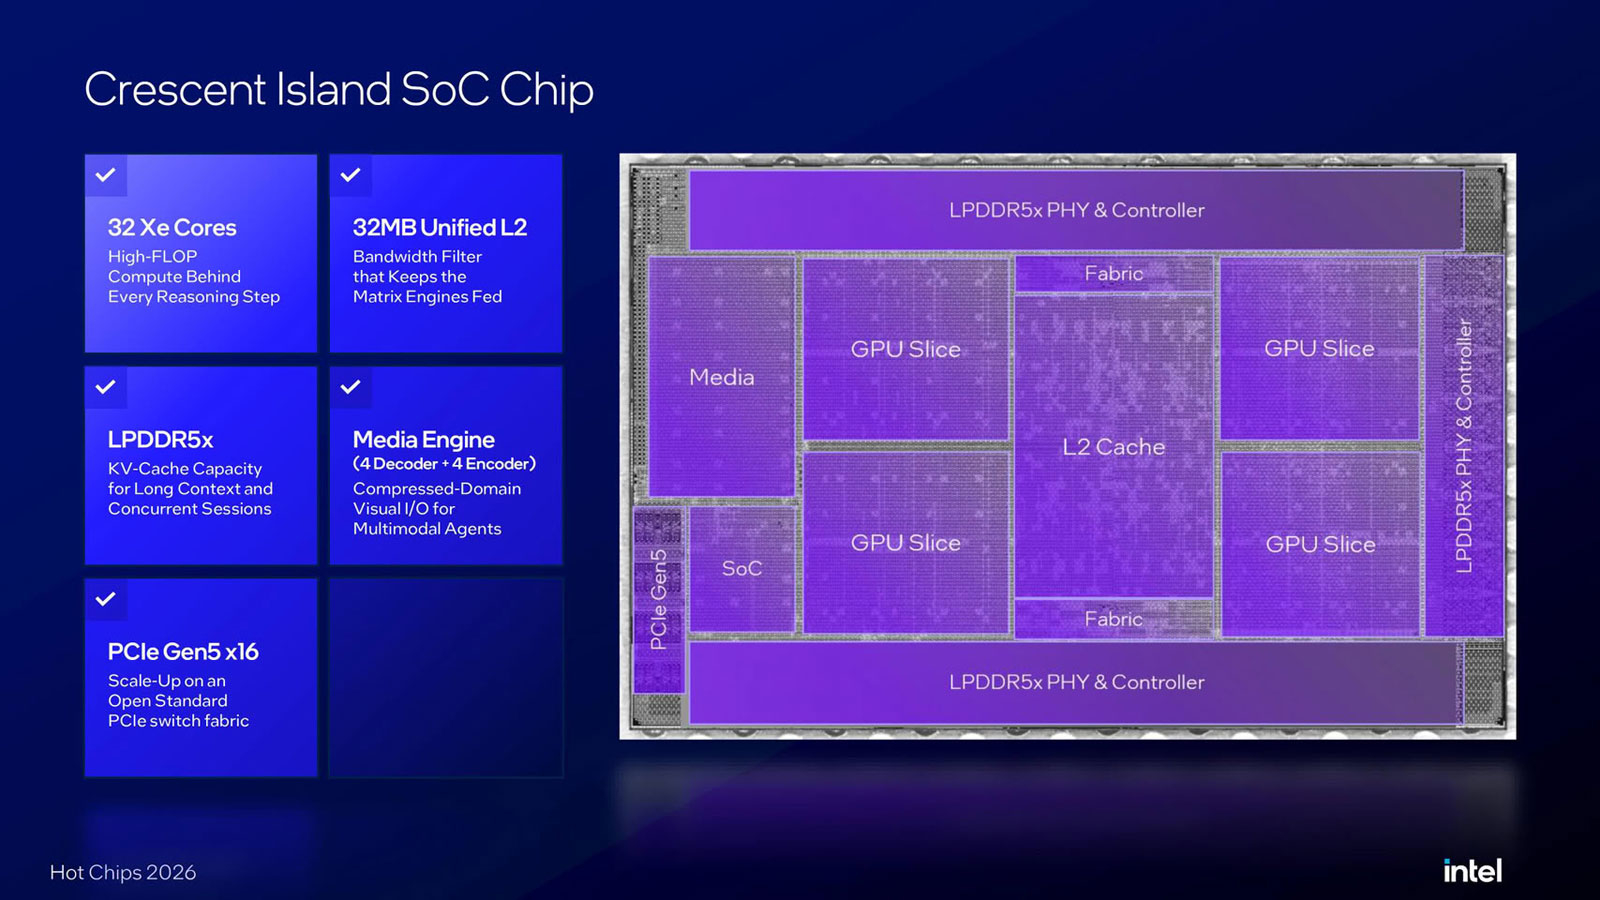 Изделие поддерживает различные форматы данных — FP64, FP16, BF16, TF32, INT8, INT4, FP8 и FP4. Ускоритель ориентирован прежде всего на задачи инференса. Он хорошо подходит для работы с агентным ИИ и длинными контекстами, где ключевой фактор эффективности — возможность размещения модели и её KV-кеша в памяти. Отмечается, что рабочая станция, оборудованная четырьмя ускорителями Crescent Island с 480 Гбайт памяти, сможет использовать в локальном режиме модели с триллионом параметров, например, Kimi K3. В области программного обеспечения Intel указывает на поддержку vLLM, SGLang, llm-d и NVIDIA Dynamo, что позволяет ИИ-агентам функционировать в гетерогенной инфраструктуре без изменений в коде. |
|

