Лента новостей
|
17.08.2022 [00:28], Алексей Степин
Broadcom представила 5-нм ASIC Tomahawk 5 с производительностью 51,2 Тбит/сРастущие объемы сетевого трафика, широкое распространение медиа-сервисов и видеоконференций, новые облачные услуги — всё это требует и нового сетевого «железа», способного справляться с повышающейся нагрузкой. И если не так давно для ASIC высшего класса нормой стал считаться показатель 25,6 Тбит/с, то сейчас вендоры осваивают следующий уровень производительности. Первенство в этой гонке принадлежит NVIDIA с её чипами Spectrum-4, но сейчас в игру вступила Broadcom. Компания представила пятое поколение «сетевого кремния» в серии StrataXGS Tomahawk, тоже способное осуществлять коммутацию на скоростях до 51,2 Тбит/с — 5-нм чип Tomahawk 5 (BCM78900). Появление ASIC такого класса существенно облегчает жизнь разработчикам HPС-систем для задач машинного обучения, поскольку позволит объединить в единый комплекс больше узлов без «наценки» на латентность в конфигурациях 64х800GbE, 128х400GbE или 256х100GbE. Поддерживается RoCEv2 и другие протоколы RDMA, виртуализация и сегментация сетей, VxLAN и прочие современные технологии. 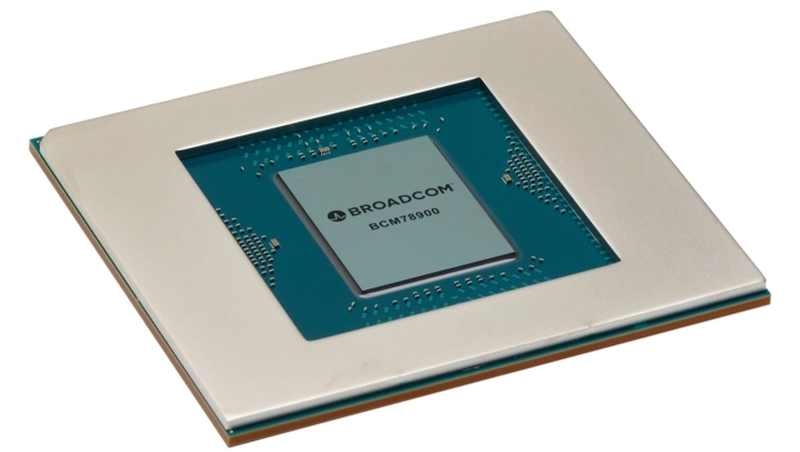
Источник: Broadcom Несколько ограничивают возможности новинки SerDes-блоки Peregrine (PAM4/106 Гбит/с). Каждые 8 таких блоков собраны в трансиверное ядро, всего ядер в новом чипе 64, что ограничивает эффективную производительность на порт именно цифрой 800 Гбит/с. Достоинством Tomahawk 5 станет его экономичность: использование 5-нм техпроцесса позволило довести удельное энергопотребление до цифры менее 1 Вт на 100 Гбит/с, то есть речь идёт о потреблении в районе 500 Вт для полной конфигурации. Цифра немалая, но всё же позволяющая сохранить воздушное охлаждение. Кроме того, новый ASIC снабжён шестью Arm-блоками для настраиваемой потоковой телеметрии. Следует отметить, что реальной потребности в таких скоростях пока очень немного: лишь 15 % (в деньгах) рынка Ethernet-устройств приходится на 400G-оборудование, но Broadcom считает, что постоянный рост аппетитов гиперскейлеров должен довести этот показатель до более чем 50 % уже к 2026 году. В случае же Tomahawk 5 пока речь идёт о первых поставках самих чипов, которые OEM-производителям ещё предстоит интегрировать в свои продукты. Они должны появиться на рынке в следующем году.
16.08.2022 [16:14], Руслан Авдеев
ЦОД Microsoft в Нидерландах потребляют в разы больше воды, чем обещали власти и компанияКак выяснили СМИ Нидерландов, в 2021 году местный кластер дата-центров Microsoft потребовал намного больше воды, чем обещали до его строительства власти и сам техногигант. Как сообщает Data Center Dynamics, ранее говорилось, что ежегодный расход составит 12–20 тыс. м3, однако оказалось, что только в 2021 году объекты компании потребляли 84 тыс. м3. Предполагается, что в текущем году объект Microsoft в Холландс-Крон (Hollands Kroon) истратит ещё больше воды из-за засухи. Хотя проект в своё время встретил противодействие со стороны местных фермеров, строительство новых ЦОД было всё же одобрено в 2021 году рядом с уже существующим объектом. Здесь же расположены и мощности Google, тоже потребляющие огромные объёмы воды. Обычно ЦОД Microsoft довольствуются для охлаждения забортным воздухом, но когда температура превышает +25 °C, вынуждены использовать воду. В 2021 году такое случалось лишь несколько раз, однако расход воды всё равно оказался в разы выше заявленного: 75 тыс. м3 ушло на охлаждение и ещё 9 тыс. м3 — на «другие нужды». Всего расположенные в окрестностях 28 ЦОД Microsoft, Google и других компаний суммарно потребили 550 тыс. м3, т.е. 0,5 % от общего объёма поставок питьевой воды. В этом году ситуация, как ожидается, будет значительно хуже. 
Источник изображения: E Mens/unsplash.com В июне совет Холландс-Крон объявил о приостановке строительства новых ЦОД в районе. Хотя девятимесячный мораторий на строительство ЦОД пока действует по всей стране, Холландс-Крон попал в число двух исключений из общего правила для гиперскейлеров, поэтому ограничения пришлось вносить самому совету. Второй «исключительный» проект планировала реализовать Meta✴ в Зееволде, но в прошлом месяце компания окончательно отказалась от его реализации, в том числе из-за активных протестов местного населения. Ранее Microsoft под давлением местных фермеров пообещала, что будет собирать дождевую воду для использования в системах охлаждения. Однако идея пока не пошла дальше проекта и пока неизвестно приблизительно, когда начнётся хотя бы тестовый период. Кроме того, в США компания собиралась построить установку для очистки сточных вод своих дата-центров. Microsoft обещала стать «водно-положительной» к 2030 году, схожее обещание сделано и Google.
15.08.2022 [15:15], Сергей Карасёв
Капитализация китайского разработчика HPC-чипов Hygon превысила $20 млрдКитайская компания Hygon Information Technology, разработчик процессоров, осуществила первичное публичное размещение акций (IPO) на Шанхайской фондовой бирже. Стоимость ценных бумаг достигла ¥70 (приблизительно $10,34), что на 94 % больше цены начального предложения в ¥36 ($5,32). Hygon Information Technology, тесно связанная с одним из крупных китайских IT-вендоров, была основана в 2014 году. Она специализируется на создании чипов с архитектурой х86, а также ускорителей (DCU). CPU и DCU компании в настоящее время используются только в персональных компьютерах и серверах китайского производства, в которых особое внимание уделяется информационной безопасности и стоимости владения. 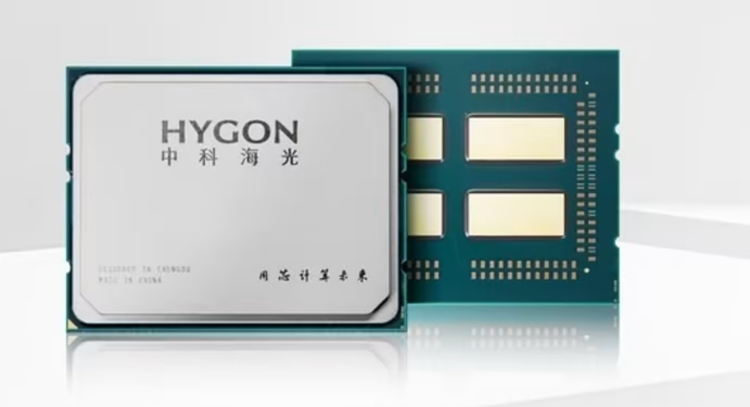
Источник изображения: Hygon В активе компании имеются серверные чипы Hygon Dhyana, клоны первого поколения EPYC. Однако без сопровождения со стороны AMD, разрыв с которой произошёл в 2019 году из-за санкций США, как-либо заметно улучшить их она вряд ли сможет. Впрочем, ранее Hygon и объявляла, что планирует перевести эти чипы на 7-нм техпроцесс Samsung или TSMC. Нужно отметить, что Sugon намеревалась использовать процессоры Hygon Dhyana и ускорители DCU для создания суперкомпьютера экзафлопсного класса, который должен был составить компанию OceanLight и Tianhe-3. Однако в сложившейся ситуации этот проект оказался под угрозой срыва: пока окончательные сроки создания системы не называются. Так или иначе, но процедура размещения акций Hygon на Шанхайской фондовой бирже прошла с большим успехом: капитализация компании оценена в ¥139,6 млрд ($20,7 млрд). При этом выручка по итогам прошлого года составила 2,3 млрд юаней, из которых почти 70 % тратится на исследования и разработки.
10.08.2022 [22:05], Владимир Мироненко
На пути к Aurora: запущен «тренировочный» суперкомпьютер PolarisАргоннская национальная лаборатория (ANL) Министерства энергетики США объявила о доступности суперкомпьютера Polaris, ранний вариант которого занял 14-е место в последней версии списка TOP500. Он будет использоваться для проведения научных исследований и в качестве испытательного стенда для 2-Эфлопс суперкомпьютера Aurora, запуск которой намечен на ближайшие месяцы. Правда, аппаратно Aurora и Polaris отличаются. Созданная HPE система Polaris состоит из 560 узлов Apollo 6500, каждый из которых оснащён процессором AMD EPYC Milan, четырьмя ускорителями NVIDIA A100 (40 Гбайт) и 512 Гбайт DDR4-памяти. Эти узлы объединены в сеть интерконнектом HPE Slingshot 10 (осенью он будет обновлен до Slingshot 11) и подключены к сдвоенному 100-Пбайт Lustre-хранилищу (Grand и Eagle). Заявленная пиковая производительность должна составить 44 Пфлопс. «Polaris примерно в четыре раза быстрее нашего суперкомпьютера Theta, что делает его самым мощным компьютером в Аргонне на сегодняшний день», — отметил Майкл Папка (Michael Papka), директор Argonne Leadership Computing Facility (ALCF). Он добавил, что возможности Polaris позволят пользователям выполнять моделирование, анализ данных и ИИ-задачи с такими масштабом и скоростью, которые были невозможны с предыдущими вычислительными системами. 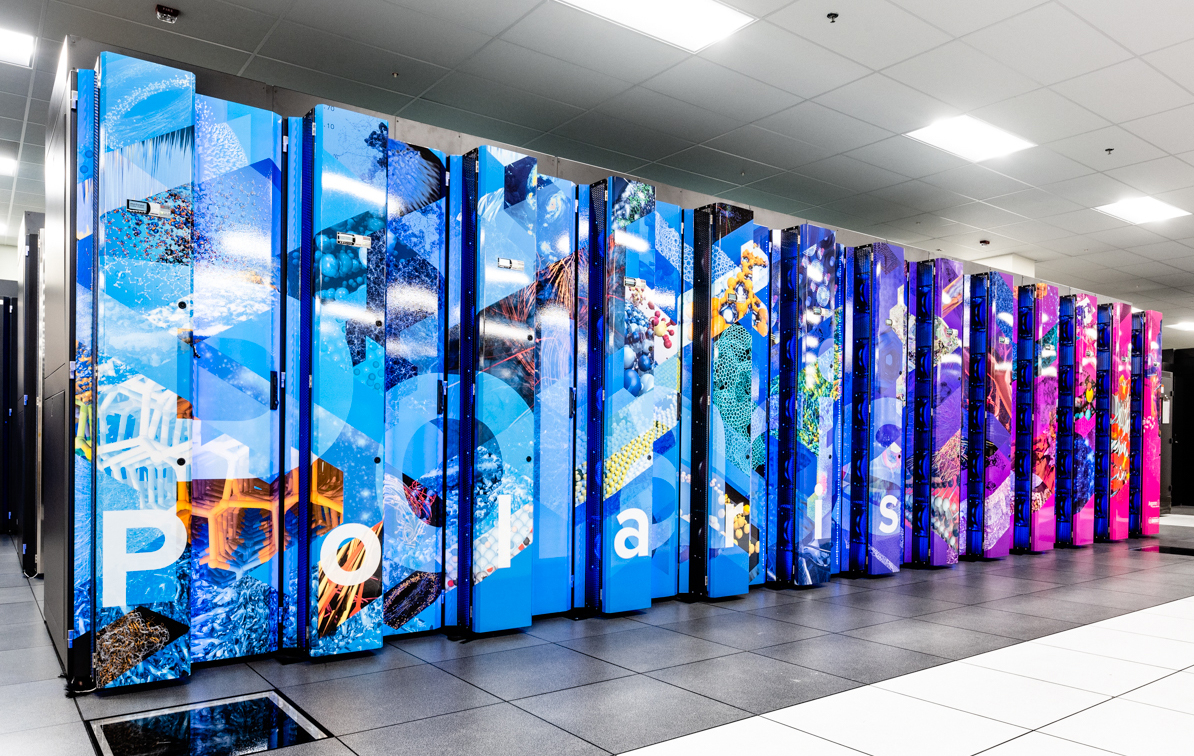
Фото: ANL Помимо работы над подготовкой к запуску Aurora, суперкомпьютер Polaris будет обслуживать внутренние потребности лаборатории, например, работу с комплексом Advanced Photon Source (APS) X-ray. «Благодаря тесной интеграции суперкомпьютеров ALCF с APS, CNM и другими экспериментальными установками мы можем помочь ускорить проведение анализа данных и предоставить информацию, которая позволит исследователям управлять своими экспериментами в режиме реального времени», — заявил Майкл Папка.
09.08.2022 [18:09], Игорь Осколков
Китайская компания Biren представила ИИ-ускоритель BR100, который обгоняет по производительности NVIDIA A100Шанхайская компания Biren Technology, основанная в 2019 году и уже получившая более $280 млн инвестиций, официально представила серию ускорителей BR100, которые способные потягаться с актуальными решениями от западных IT-гигантов. Утверждается, что это первое изделие подобного класса, созданное в Поднебесной. Компания уже подписала соглашение о сотрудничестве с ведущим производителем серверов Inspur. Новинка содержит 77 млрд транзисторов, использует чиплетную компоновку, изготавливается по 7-нм техпроцессу на TSMC и имеет 2.5D-упаковку CoWoS. Для сравнения — грядущие NVIDIA H100 имеют такую же упаковку, но включают 80 млрд транзисторов и изготавливаются по более современному техпроцессу TSMC N4. При этом BR100 примерно вдвое производительнее 7-нм NVIDIA A100 и примерно вдвое же медленнее H100. Впрочем, Biren приводит только данные о вычислениях пониженной точности, да и в целом говорит о том, что новинка предназначена в первую очередь для ИИ-нагрузок. 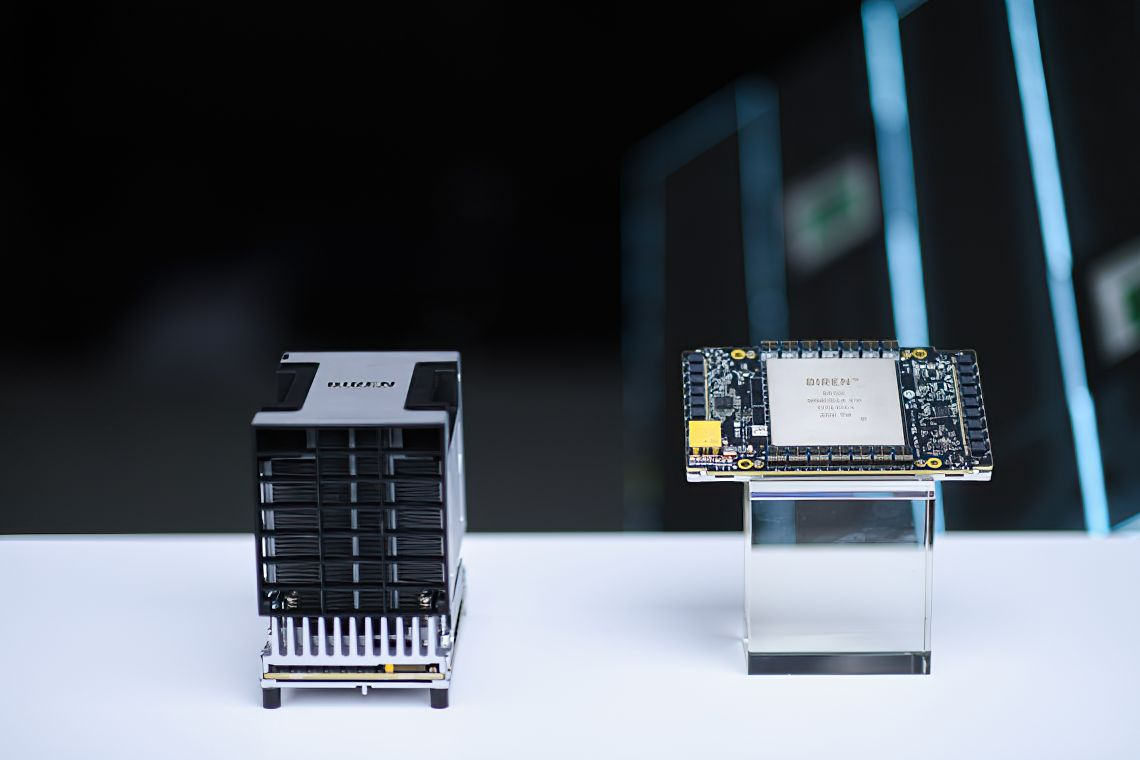
Изображения: Biren В серию входят два решения: BR100 и BR104. Оба варианта оснащаются интерфейсом PCIe 5.0 x16 с поддержкой CXL. Первый вариант имеет OAM-исполнение с TDP на уровне 550 Вт. Он позволяет объединить до восьми ускорителей на UBB-плате, связав их между собой фирменным интерконнектом BLink (512 Гбайт/с) по схеме каждый-с-каждым. BR100 полагается 300 Мбайт кеш-памяти и 64 Гбайт HBM2e (4096 бит, 1,64 Тбайт/c). 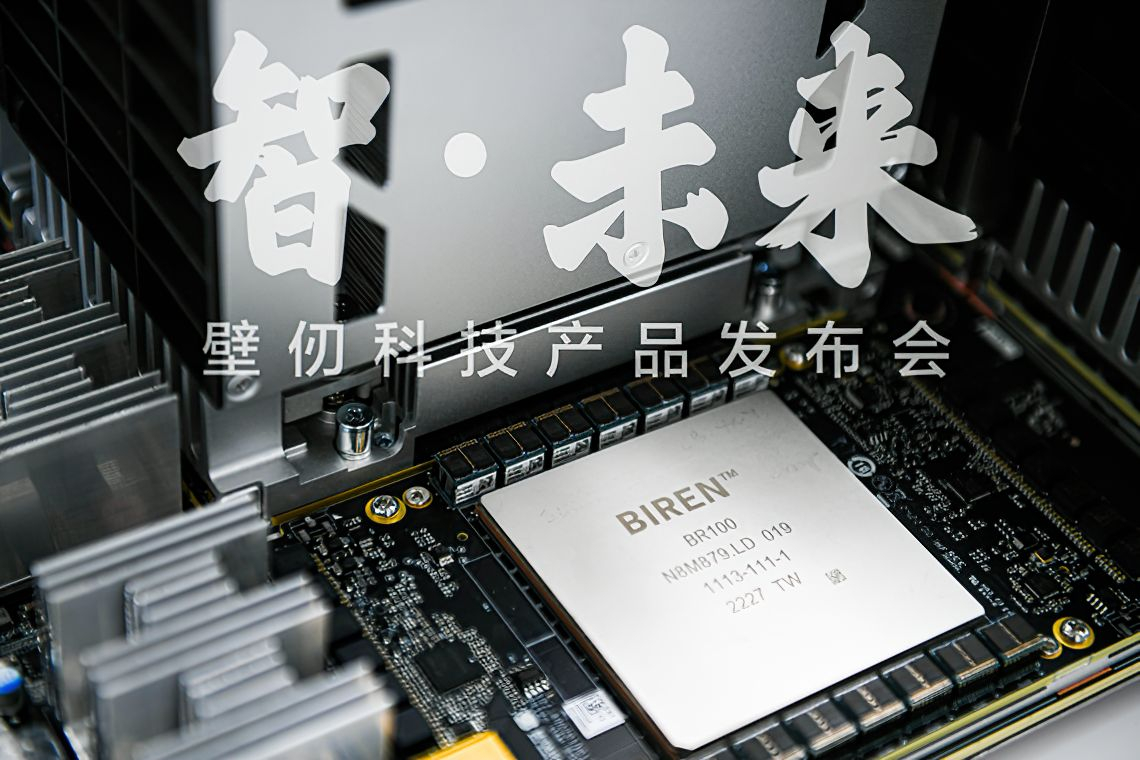
BR100 Также он способен одновременно кодировать до 64 потоков FullHD@30 HEVC/H.264, а декодировать — до 512. Кроме того, доступно создание до 8 аппаратно изолированных инстансов Secure Virtual Instance (SVI) по аналогии с NVIDIA MIG. Заявленная производительность составляет 256 Тфлопс для FP32-вычислений, 512 Тфлопс для TF32+ (по-видимому, подразумевается некая совместимость с фирменным форматом NVIDIA TF32), 1024 Тфлопс для BF16 и, наконец, 2048 Топс для INT8. 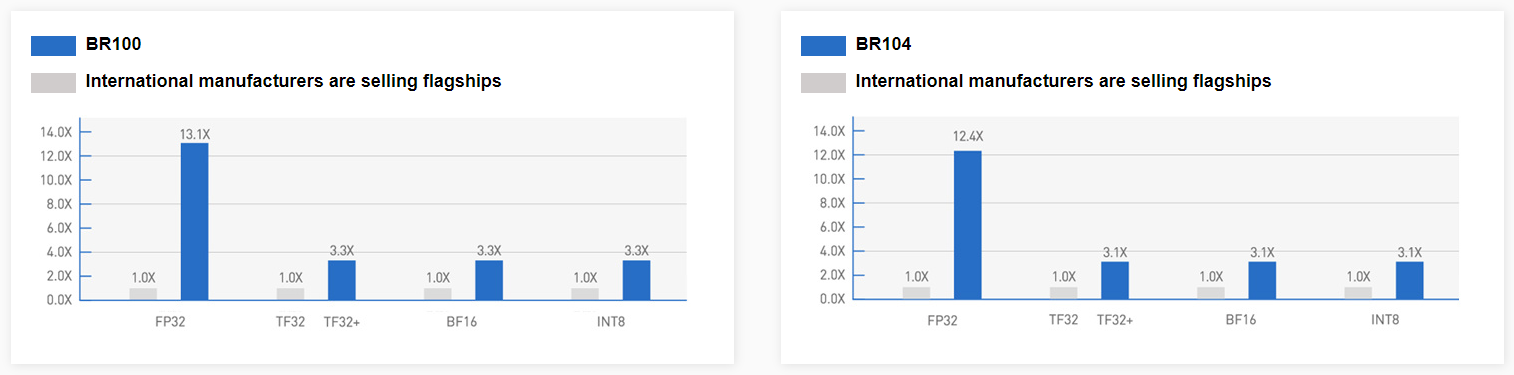 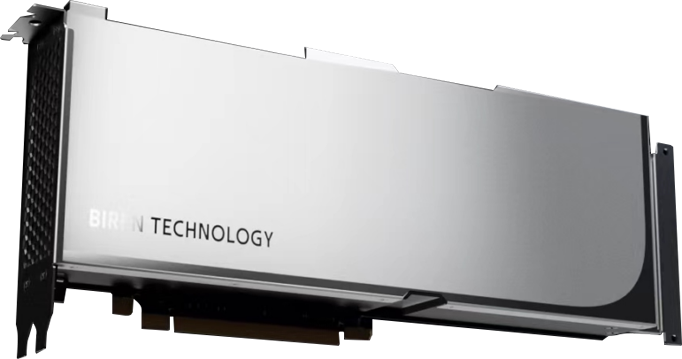
BR104 BR104 представляет более традиционную FHFL-карту с TDP на уровне 300 Вт. По производительности она ровно вдвое медленнее старшей версии BR100, способна обрабатывать вдвое меньшее количество видеопотоков и предлагает только до 4 SVI-инстансов. BR104 имеет 150 Мбайт кеш-памяти, 32 Гбайт HBM2e (2048 бит, 819 Гбайт/c) и три 192-Гбайт/с интерфейса BLink. Для работы с ускорителями компания предлагает собственную программную платформу BIRENSUPA, совместимую с популярными фреймворками PyTorch, TensorFlow и PaddlePaddle.
04.08.2022 [15:54], Владимир Мироненко
Разработчик серверных чипов Prodigy с невероятными характеристиками обвинил в своих бедах CadenceКак сообщает The Register, cтартап Tachyum подал в суд на Cadence Design Systems, обвинив компанию в саботаже при выполнении контракта на поставку IP-блоков для будущих 5-нм серверных процессоров Prodigy. По словам Tachyum, старшие 128-ядерные CPU Prodigy с частотой 5,7 ГГц будут втрое быстрее AMD EPYC 7763 и NVIDIA H100. В иске утверждается, что заключённая в 2019 году сделка на предоставление решений Cadence для процессоров Prodigy, была сорвана, поскольку Cadence не смогла предоставить необходимые технологии для вывода продукта на рынок. Заказанные Tachyum блоки не относятся к разряду новшеств, и инженеры Cadence уверяли Tachyum, что стандартные компоненты могли быть без труда интегрированы в процессор. Однако график поставок был нарушен, и дошло даже до того, что Cadence посоветовала Tachyum не использовать её компоненты или вообще приобрести аналоги у других поставщиков. 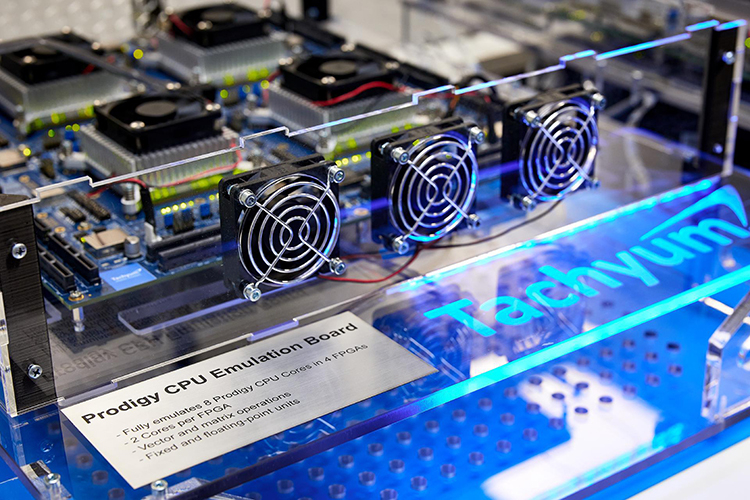
Источник изображения: Tachyum Стартап добавил в иске, что Cadence усугубила ущерб, прекратив доступ Tachyum к ПО eDAcard, тем самым вынудив понести расходы на лицензирование другого ПО и переобучение своих инженеров. Срыв сроков и прочие препятствия привели к задержке выхода Prodigy примерно на два года. Tachyum потребовал возместить упущенную выгоду в размере $206 млн и ещё $27 млн дополнительных затрат на поиск альтернативных решений в сжатые сроки. 
Источник изображения: Tachyum Tachyum также указала, что из-за срыва сроков она потеряла возможность получения заказов на поставку чипов для испанского суперкомпьютера MareNostrum 5 стоимостью €151,41 млн. В итоге Барселонский суперкомпьютерный центр (BSC), с которым был подписан меморандум о взаимопонимании, предпочёл компанию Atos. Последняя выбрала ускорители NVIDIA и процессоры Intel, поскольку ни одна европейская компания не могла бы поставить чипы, отвечающие ключевым критериям отбора. В иске Tachyum отмечает, что тогдашний генеральный директор Cadence Лип-Бу Тан (Lip-Bu Tan) входил в совет директоров двух конкурентов Tachyum — SambaNova и Nuvia (поглощена Qualcomm) — и активно участвовал в фондах Walden International и Walden Catalyst, которые инвестировали в другие «кремниевые» стартапы. Ещё один член совета директоров Cadence, Янг Сон (Young Sohn), также является директором одного из этих инвестфондов. По мнению Tachyum, налицо явный конфликт интересов.
02.08.2022 [16:00], Алексей Степин
Опубликованы спецификации Compute Express Link 3.0Мало-помалу стандарт Compute Express Link пробивает себе путь на рынок: хотя процессоров с поддержкой ещё нет, многие из элементов инфраструктуры для нового интерконнекта и базирующихся на нём концепций уже готово — в частности, регулярно демонстрируются новые контроллеры и модули памяти. Но развивается и сам стандарт. В версии 1.1, спецификации на которую были опубликованы ещё в 2019 году, были только заложены основы. Но уже в версии 2.0 CXL получил массу нововведений, позволяющих говорить не просто о новой шине, но о целой концепции и смене подхода к архитектуре серверов. А сейчас консорциум, ответственный за разработку стандарта, опубликовал свежие спецификации версии 3.0, ещё более расширяющие возможности CXL. 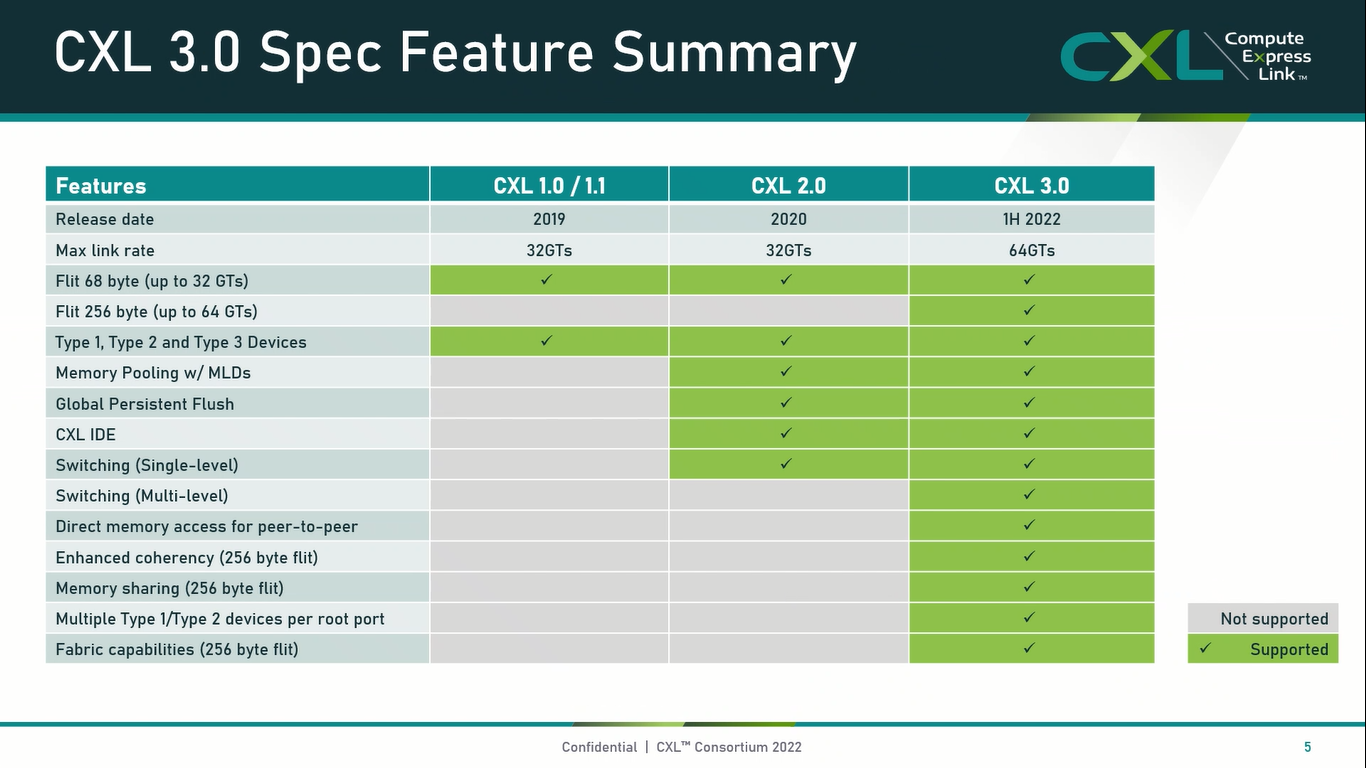
Источник: CXL Consortium И не только расширяющие: в версии 3.0 новый стандарт получил поддержку скорости 64 ГТ/с, при этом без повышения задержки. Что неудивительно, поскольку в основе лежит стандарт PCIe 6.0. Но основные усилия разработчиков были сконцентрированы на дальнейшем развитии идей дезагрегации ресурсов и создания компонуемой инфраструктуры. 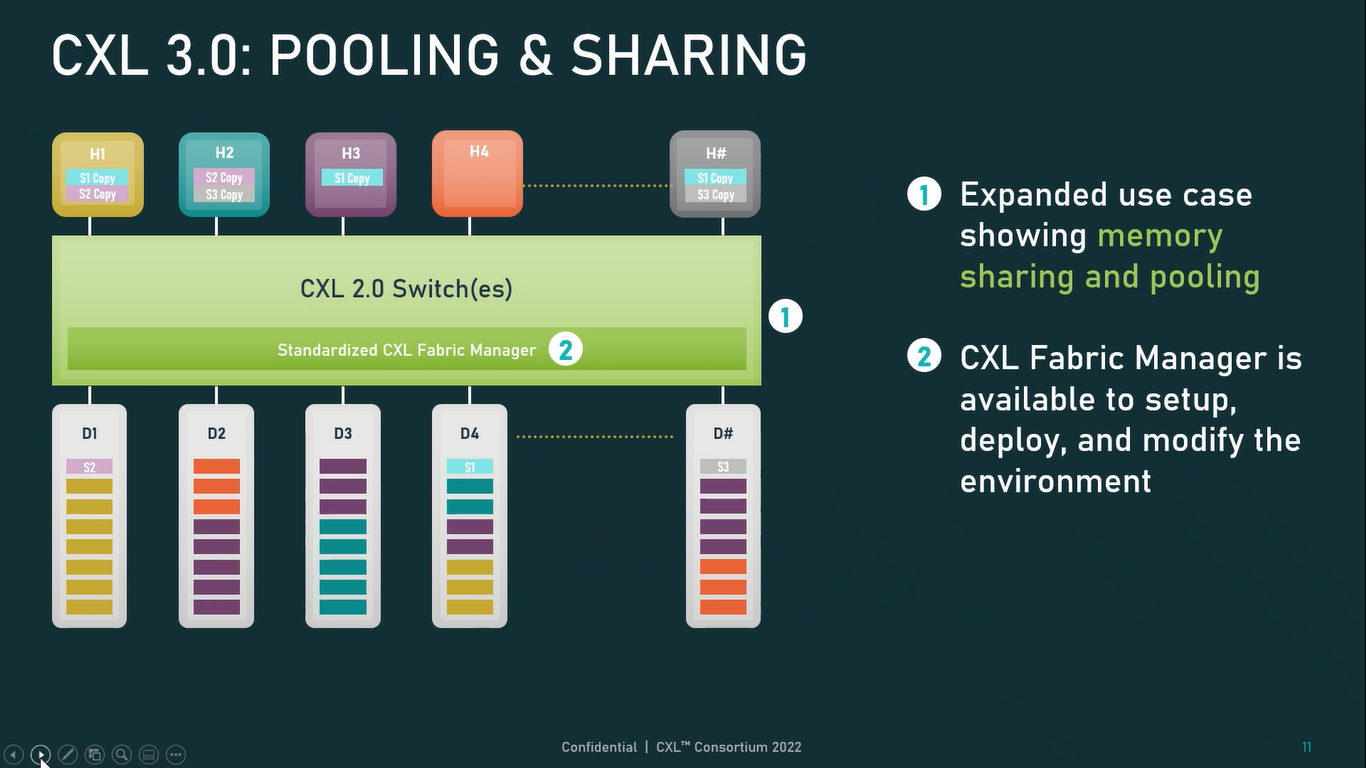 Сама фабрика CXL 3.0 теперь допускает создание и подключение «многоголовых» (multi-headed) устройств, расширены возможности по управлению фабрикой, улучшена поддержка пулов памяти, введены продвинутые режимы когерентности, а также появилась поддержка многоуровневой коммутации. При этом CXL 3.0 сохранил обратную совместимость со всеми предыдущими версиями — 2.0, 1.1 и даже 1.0. В этом случае часть имеющихся функций попросту не будет активирована. 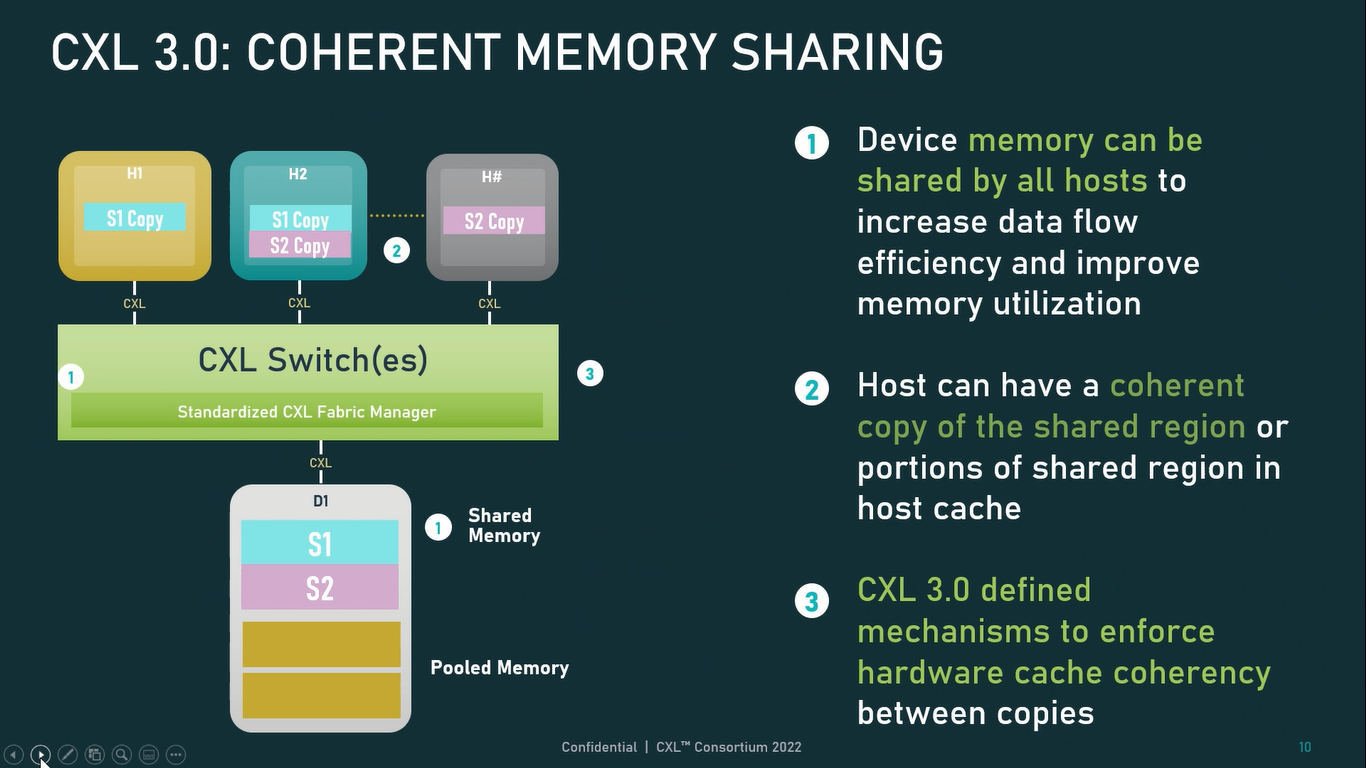 Одно из ключевых новшеств — многоуровневая коммутация. Теперь топология фабрики CXL 3.0 может быть практически любой, от линейной до каскадной с группами коммутаторов, подключенных к коммутаторам более высокого уровня. При этом каждый корневой порт процессора поддерживает одновременное подключение через коммутатор устройств различных типов в любой комбинации. 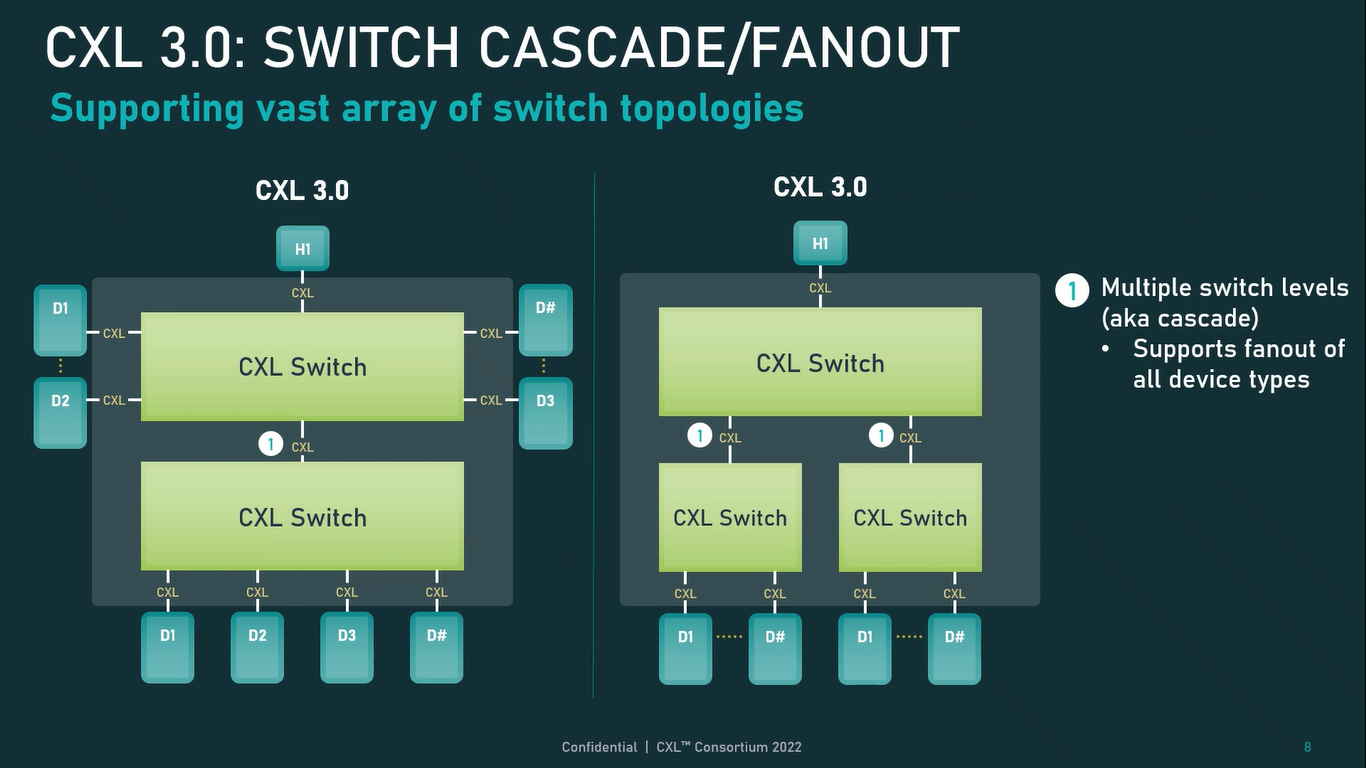 Ещё одним интересным нововведением стала поддержка прямого доступа к памяти типа peer-to-peer (P2P). Проще говоря, несколько ускорителей, расположенных, к примеру, в соседних стойках, смогут напрямую общаться друг с другом, не затрагивая хост-процессоры. Во всех случаях обеспечивается защита доступа и безопасность коммуникаций. Кроме того, есть возможность разделить память каждого устройства на 16 независимых сегментов. 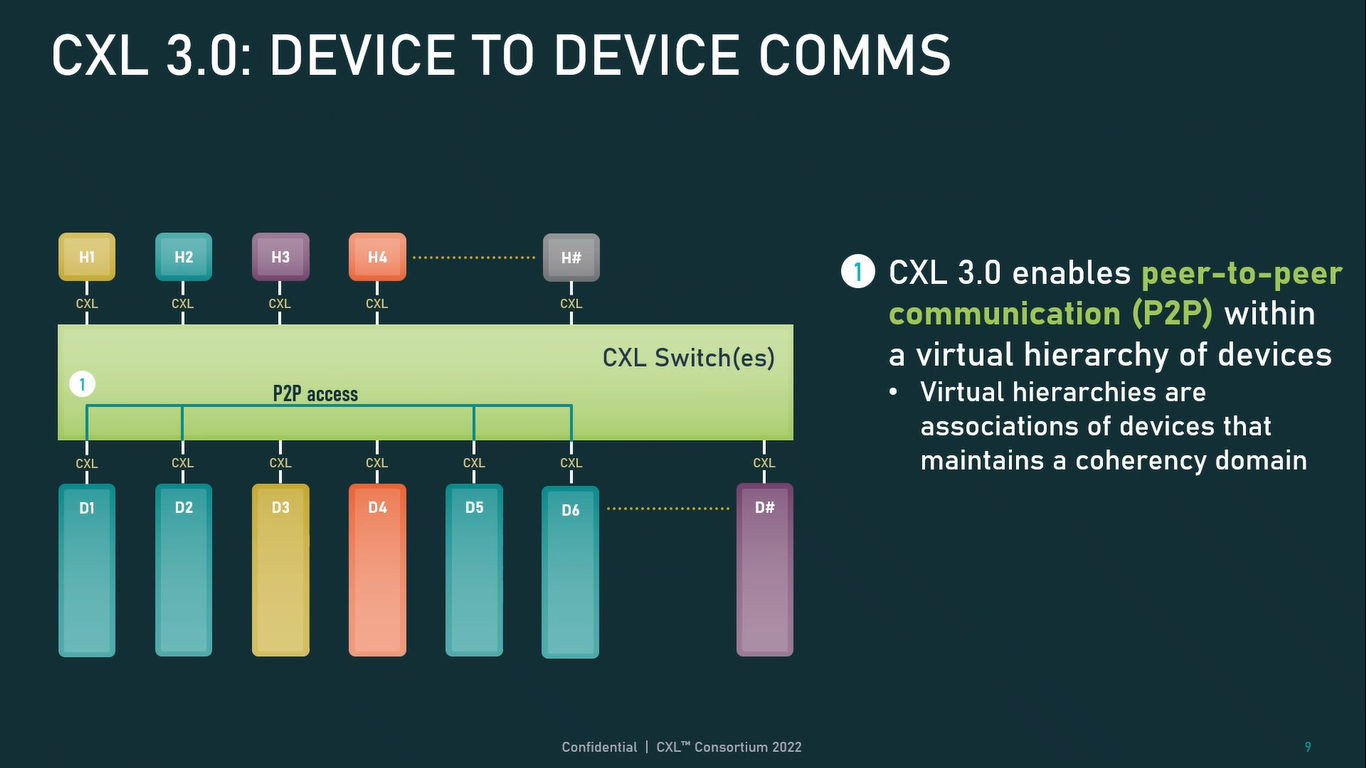 При этом поддерживается иерархическая организация групп, внутри которых обеспечивается когерентность содержимого памяти и кешей (предусмотрена инвалидация). Теперь помимо эксклюзивного доступа к памяти из пула доступен и общий доступ сразу нескольких хостов к одному блоку памяти, причём с аппаратной поддержкой когерентности. Организация пулов теперь не отдаётся на откуп стороннему ПО, а осуществляется посредством стандартизированного менеджера фабрики. 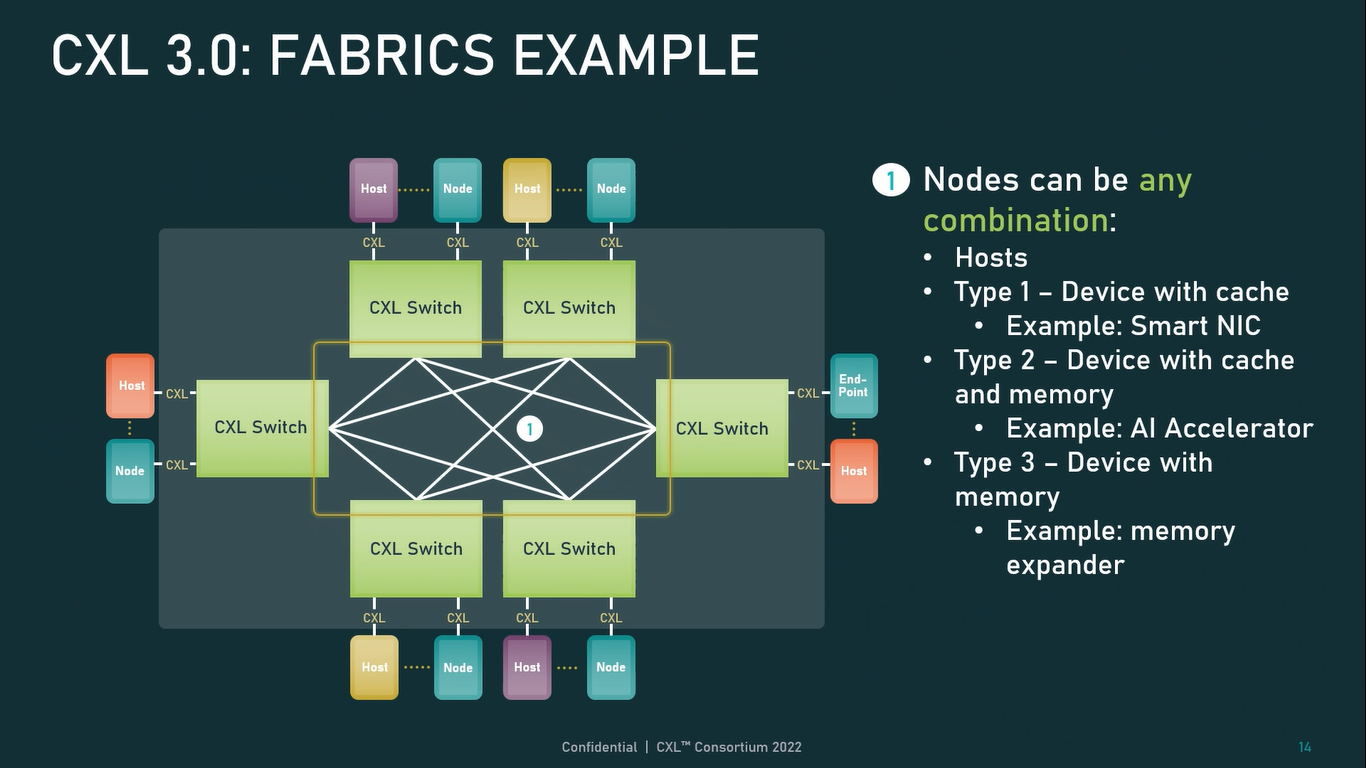 Сочетание новых возможностей выводит идею разделения памяти и вычислительных ресурсов на новый уровень: теперь возможно построение систем, где единый пул подключенной к фабрике CXL 3.0 памяти (Global Fabric Attached Memory, GFAM) действительно существует отдельно от вычислительных модулей. При этом возможность адресовать до 4096 точек подключения скорее упрётся в физические лимиты фабрики. 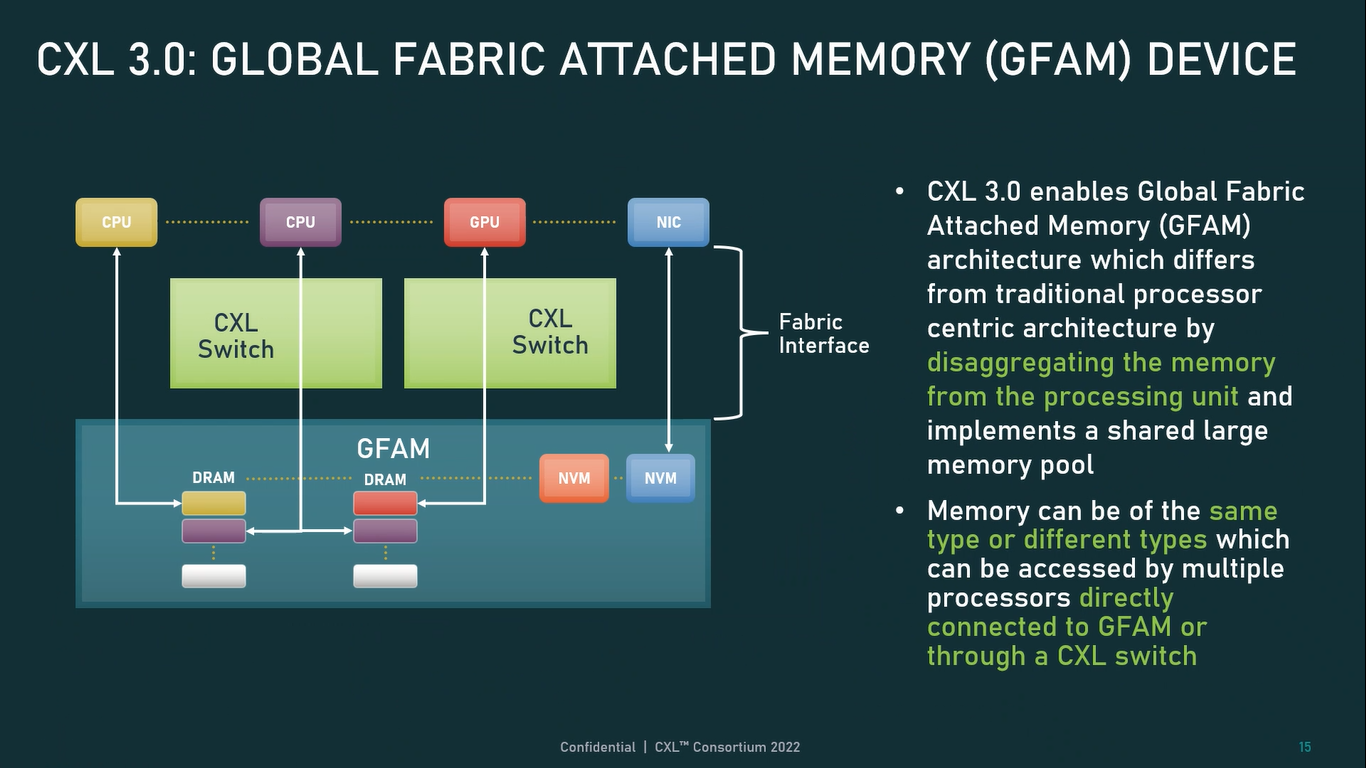 Пул может содержать разные типы памяти — DRAM, NAND, SCM — и подключаться к вычислительным мощностями как напрямую, так и через коммутаторы CXL. Предусмотрен механизм сообщения самими устройствами об их типе, возможностях и прочих характеристиках. Подобная архитектура обещает стать востребованной в мире машинного обучения, в котором наборы данных для нейросетей нового поколения достигают уже поистине гигантских размеров. 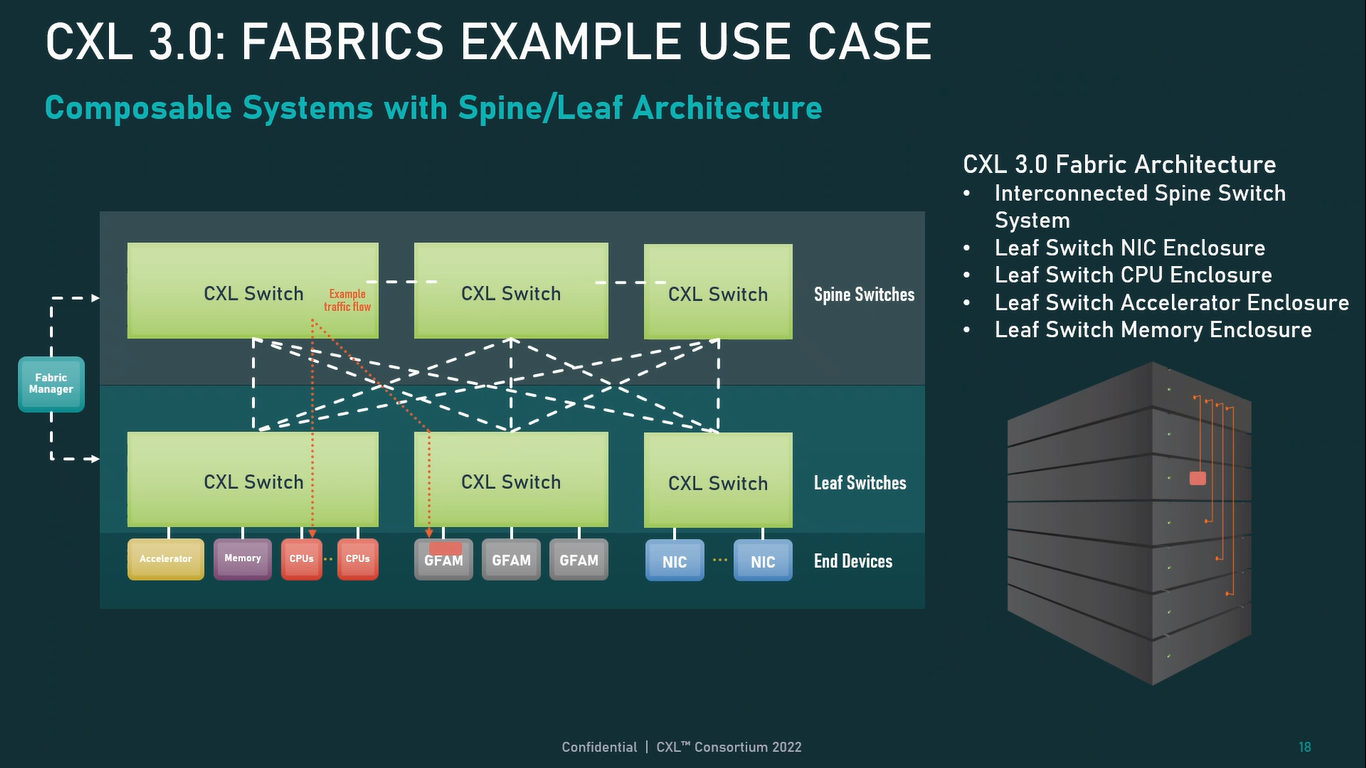 В настоящее время группа CXL уже включает 206 участников, в число которых входят компании Intel, Arm, AMD, IBM, NVIDIA, Huawei, крупные облачные провайдеры, включая Microsoft, Alibaba Group, Google и Meta✴, а также ряд крупных производителей серверного оборудования, в том числе, HPE и Dell EMC.
01.08.2022 [23:00], Игорь Осколков
Великое объединение: спецификации и наработки OpenCAPI и OMI планируется передать консорциуму CXLКонсорциумы OpenCAPI Consortium (OCC) и Compute Express Link (CXL) подписали соглашение, которое подразумевает передачу в пользу CXL всех наработок и спецификаций OpenCAPI и OMI. Если будет получено одобрения всех участвующих сторон, то это будет ещё один шаг в сторону унификации ключевых системных интерфейсов и возможности реализации новых архитектурных решений. Во всяком случае, на бумаге. Консорциумы OpenCAPI (Open Coherent Accelerator Processor Interface) был сформирован в 2016 году с целью создание единого, универсального, скоростного и согласованного интерфейса для связи CPU с ускорителями, сетевыми адаптерами, памятью, контроллерами и устройствами хранения и т.д. Причём в независимости от типа и архитектуры самого CPU. На тот момент новый интерфейс был определённо лучше распространённого тогда PCIe 3.0. С течением времени дела у OpenCAPI шли ни шатко ни валко, однако фактически его использование было ограничено только POWER-платформами от IBM. 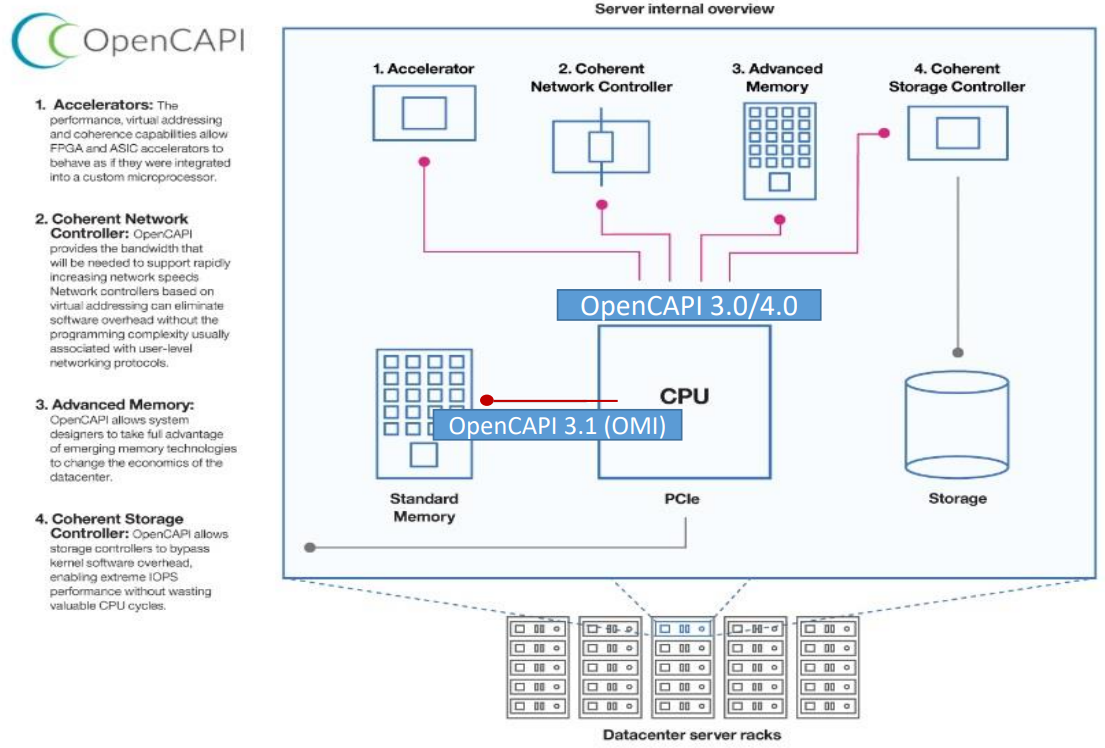
Источник: OpenCAPI Тем не менее, в недрах OpenCAPI родился ещё один очень интересный стандарт — Open Memory Interface (OMI). OMI, если коротко, предлагает некоторую дезагрегацию путём добавления буферной прослойки между CPU и RAM. С одной стороны у OMI есть унифицированный последовательный интерфейс для подключения к CPU, с другой — интерфейсы для подключения какой угодно памяти, на выбор конкретного производителя. 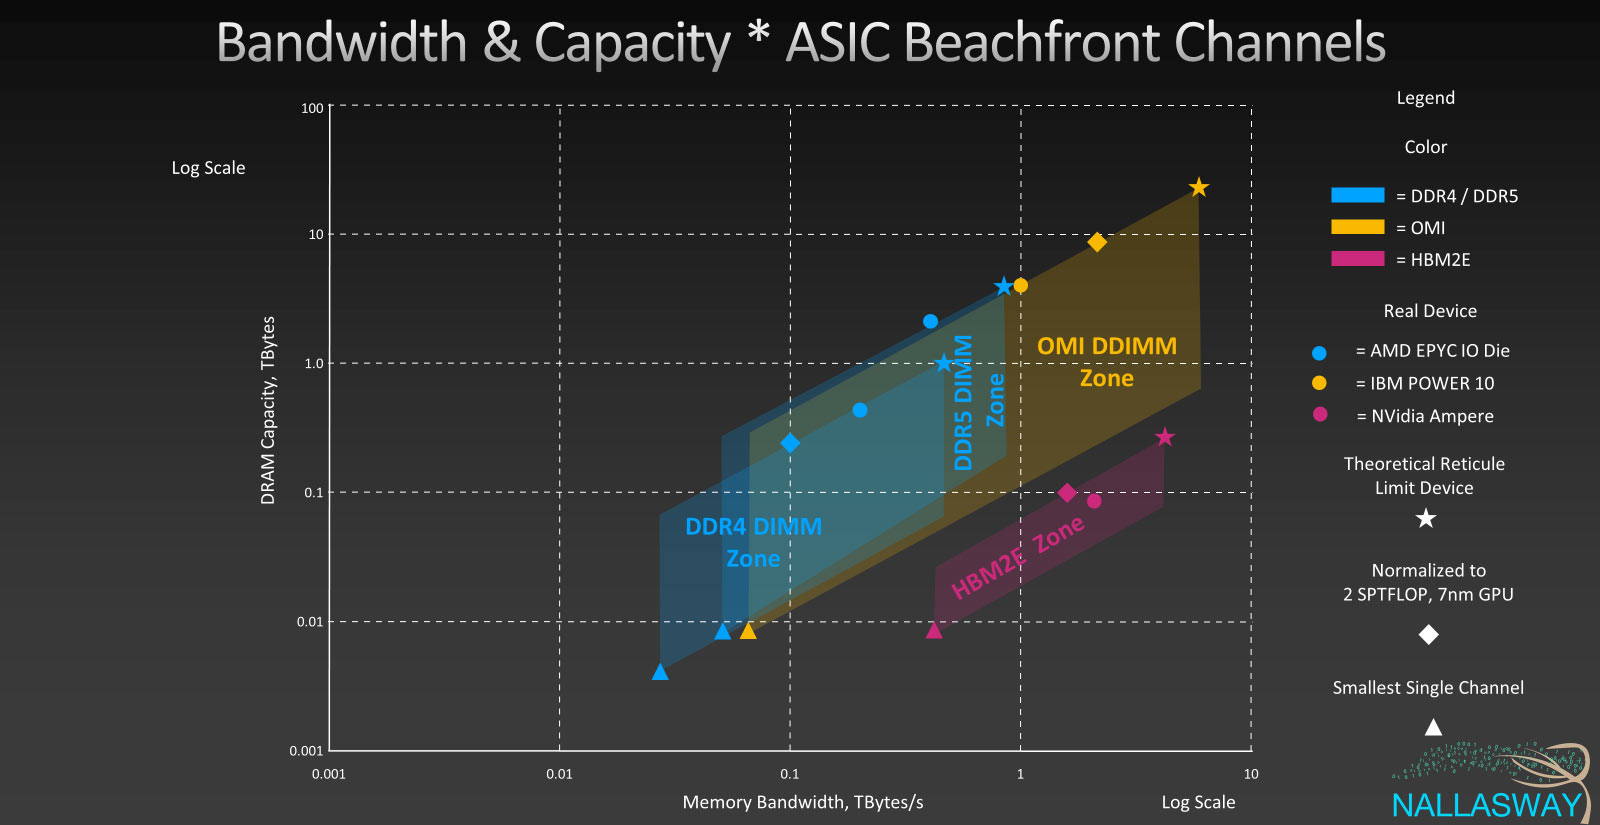
Источник: Open Memory Interface (OMI) OMI позволяет поднять пропускную способность памяти, не раздувая число контактов и физические размеры и самого CPU, и модулей. Однако и в данном случае массовая поддержка OMI по факту есть только в процессорах IBM POWER10. Концептуально CXL в части работы с памятью повторяет идею OMI, только в данном случае в качестве физического интерфейса используется распространённый PCIe. 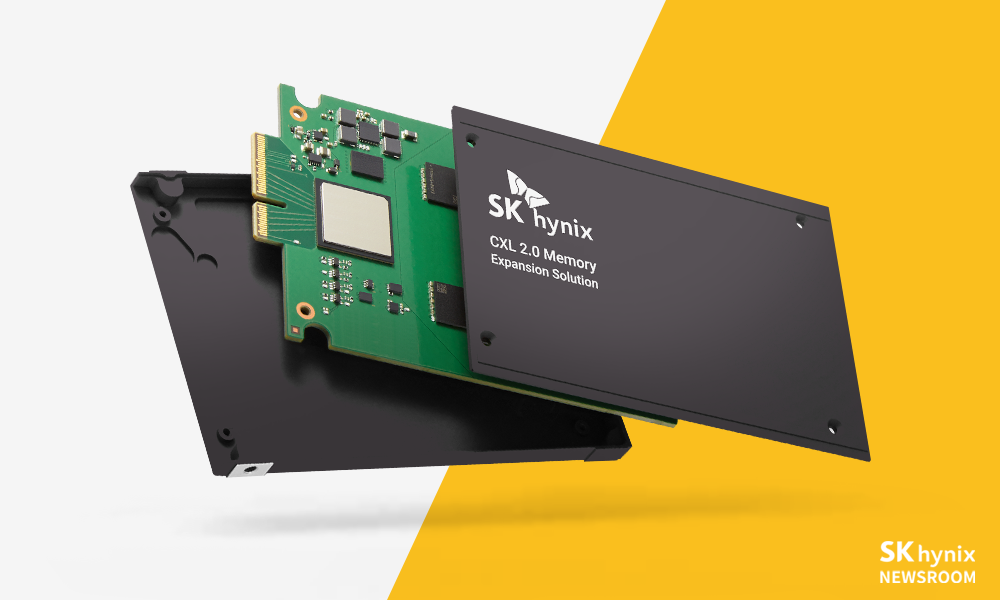
Изображение: SK Hynix Существенная разница c OMI в том, что начальная поддержка CXL будет в грядущих процессорах AMD и Intel. А Samsung и SK Hynix уже готовят соответствующие DDR5-модули. Да и в целом поддержка CXL в индустрии намного шире. Так что консорциуму CXL, по-видимому, осталось поглотить только ещё один конкурирующий стандарт в лице CCIX, как это уже произошло с Gen-Z. Комментируя соглашение, президент консорциума CXL отметил, что сейчас наиболее удачное время для объединения усилий, которое принесёт пользу всей IT-индустрии. Участники OpenCAPI имеют богатый опыт, который поможет улучшить грядущие спецификации CXL и избежать ошибок.
01.08.2022 [15:52], Руслан Авдеев
На крупнейшем в мире рынке ЦОД наметился катастрофический недостаток электроэнергии — дата-центрам не хватает ЛЭПРынок ЦОД Северной Вирджинии продолжают преследовать неприятности. Помимо того, что местные жители активно выступают против старых и новых дата-центров, в местной округе наметилась масштабная нехватка электроэнергии. Как сообщает The Register, в регионе буквально не хватает линий электропередач для снабжения всех ЦОД энергией. По данным Digital Realty, владеющей и обслуживающей более 290 ЦОД, местная энергоснабжающая компания Dominion Energy разослала оповещение ключевым местным потребителям, сообщив, что проблемы с электроснабжением в регионе закончатся не раньше 2026 года. При этом проблема заключается не в нехватке генерирующих мощностей, а именно в дефиците линий электропередач для достаточного энергообеспечения ЦОД. Текущая ёмкость дата-центров в штате составляет порядка 1,7 ГВт. 
Источник изображения: Matthew Henry/unsplash.com Округ Лаудон (Loudoun County) фактически является крупнейшим в мире хабом для дата-центров с общей полезной площадью ЦОД в миллионы квадратных метров. Округ нередко называют «ключевым игроком» в мировой цифровой экономике. Одни только налоги на недвижимость от сектора ЦОД должны составить в фискальном 2023 году почти $600 млн — этого достаточно, чтобы покрыть все расходы властей округа. Проблемы с энергоснабжением могут означать, что многие планируемые проекты переедут в соседние округа Принс-Уильям (Prince William) и Фокир (Fauquier), а то и вовсе в соседний штат Мэриленд. Dominion Energy как минимум частично обслуживает и Принс-Улильям, а вот округ Фредерик в Мэриленде подключен к другой энергосети. 
Источник изображения: Álvaro Serrano/unsplash.com Известно, что беспрецедентный рост нагрузки на сеть Dominion начался в 2018 году на фоне стремительного развития дата-центров и всё ещё не остановился, поэтому в существующие планы развития энергосетей придётся вносить корректировки. На днях Dominion Energy признала, что не сможет обслуживать потребности города Эшберна (Ashburn) в округе Лаудон, где расположена т.н. «Аллея дата-центров». Это будет означать не только остановку уже стартовавших многомиллиардных проектов строительства ЦОД, но и снижение налоговых поступлений. Как сообщает портал DataCenter Dynamics, по прогнозам Wells Fargo, компания может остановить поставки энергии новым ЦОД до 2025 или 2026 года — если проектам, до завершения строительства которых осталось не более полугода, энергии может хватить, то совсем новые объекты, возможно, электричества не получат, несмотря на ранее полученные от Dominion гарантии. А строительство ЦОД, запланированных на 2023-2024 годы, может быть значительно отложено. Впрочем, в Wells Fargo считают, что с нехваткой электричества могут в скором времени столкнуться и уже существующие в регионе кампусы ЦОД.
29.07.2022 [14:18], Алексей Степин
Бесславный конец Optane: полмиллиарда убытков и полный отказ от технологииВ своё время совместная инициатива Intel и Micron, целью которой стало создание принципиально нового типа энергонезависимой памяти 3D XPoint, наделало много шума. Первые же выпущенные на основе данной технологии SSD показали великолепные результаты. Эту память сегодня мы знаем как Optane, и, увы, с надеждами на появление новых решений на её основе придётся распрощаться. Тревожные звонки раздавались давно: в 2018 году Micron вышла из бизнеса, уступив своё производство 3D XPoint партнёру, а сама Intel отказалась от идеи выпуска потребительских накопителей на базе Optane. Но, по крайней мере, на тот момент она сосредоточила усилия на выпуске серверных решений. В их число вошёл и принципиально новый продукт: энергонезависимые модули DCPMM/PMem. 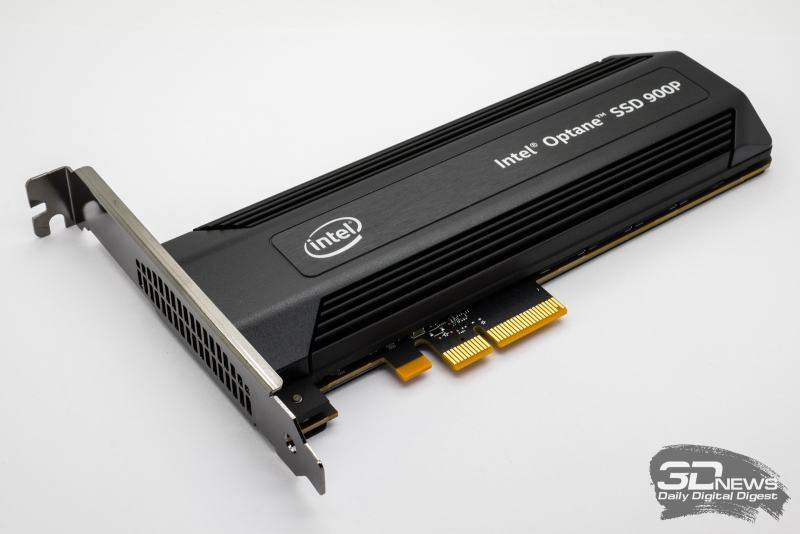 Они устанавливались в обычные слоты DIMM, не слишком сильно уступали в производительности классической оперативной памяти и позволяли кардинально нарастить объём доступной памяти за меньшую стоимость, нежели при использовании только DRAM. Казалось бы, память Optane нашла свою, пусть и довольно экзотическую нишу, что подтверждалось и многочисленными результатами тестов систем с Optane DCPMM, в том числе, в научных задачах. Но грянул гром! По результатам II квартала 2022 года Intel сообщила, что изрядно похудевшее к этому моменту подразделение Optane принесло $559 млн убытков. Решение списать текущие запасы готовых решений и чипов по графе «убытки» окончательно доказывает то, что Intel действительно намеревается покончить с этой страницей своей истории. Равно как и с SSD — соответствующее подразделение продано компании SK Hynix. 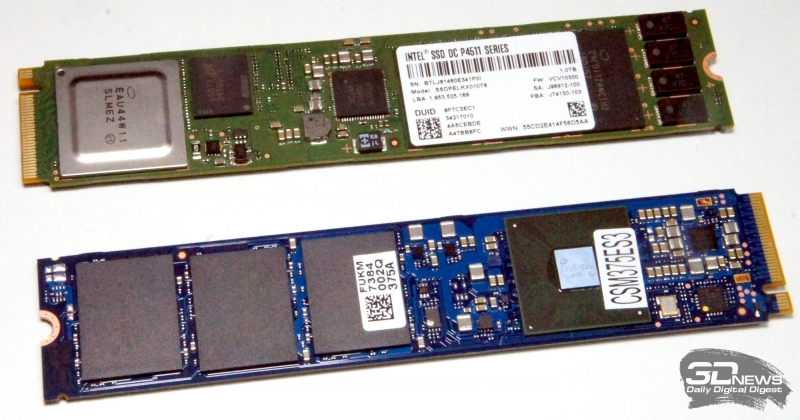 На данный момент сама Intel официально подтвердила отказ от Optane: в рамках новой стратегии оптимизации бизнеса IDM 2.0 компания закроет подразделения, не являющиеся решающими в стратегическом отношении, либо просто недостаточно прибыльные. Впрочем, поддержка клиентов, уже вложившихся в Optane будет продолжена. Сама же Intel отметила, что переход на CXL позволит хотя бы отчасти заменить Optane PMem. Из альтернатив технологии Optane, тоже не слишком популярных, можно вспомнить Samsung Z-SSD и Toshiba/Kioxia XL-Flash. Таким образом, приходится расстаться с мечтой о твердотельных накопителях не просто надёжных, но и лишённых традиционной медлительности NAND при операциях записи, особенно мелкоблочных. Стоимость производства чипов 3D XPoint даже во втором поколении, когда память удалось сделать четырёхслойной, всё же оказалась слишком высокой для того, чтобы устройства на её основе стали действительно выгодными для Intel. |
|

