
Материалы по тегу: ocp
|
19.10.2026 [09:32], Владимир Мироненко
Восемь на одного: Meta✴ представила сетевую архитектуру Flattened Planar Fabric для ИИ-инфраструктурыMeta✴ представила ИИ-архитектуру Flattened Planar Fabric (FPF), созданную для масштабирования обширной ИИ-инфраструктуры и поддержки вычислительных нагрузок нового поколения. В архитектуре FPF каждый GPU подключается посредством восьми независимых каналов по 100 Гбит/с к восьми разным коммутаторам. 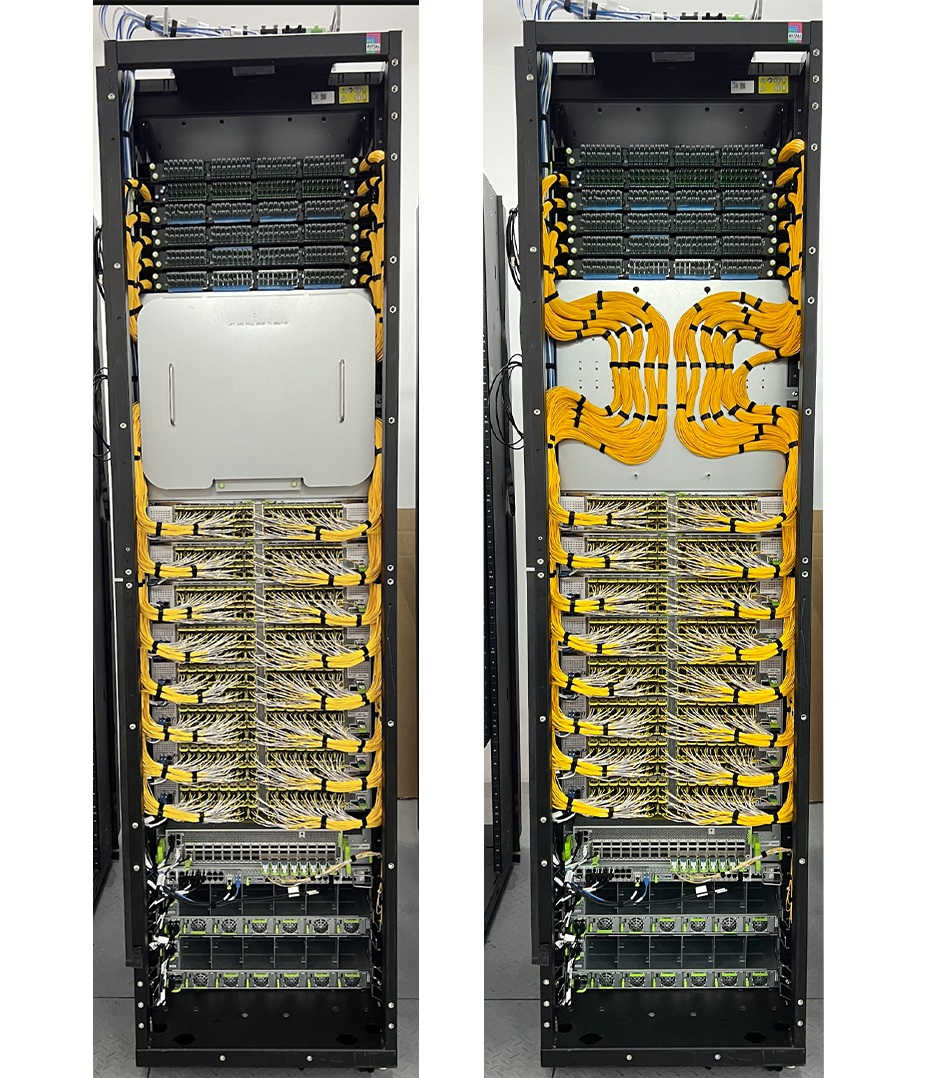
Источник изображений: Meta✴ Такой подход приходит на смену традиционной архитектуре единичных восходящих каналов (uplink), обеспечивая четыре ключевых преимущества:
Оборудование включает коммутаторы IceCube с пропускной способностью 102,4 Тбит/с в стойке IcePack (ORv3-HPRv1) с жидкостным охлаждением. Внутри каждой стойки размещаются модули коммутации IceCube — устройства с пропускной способностью 102,4 Тбит/с, обеспечивающие неблокирующую коммутацию для 128 портов по 800 Гбит/с каждый. Модули IceCube представлены в двух вариантах: на базе специализированных интегральных схем (ASIC) Broadcom Tomahawk6C или NVIDIA Spectrum-6. 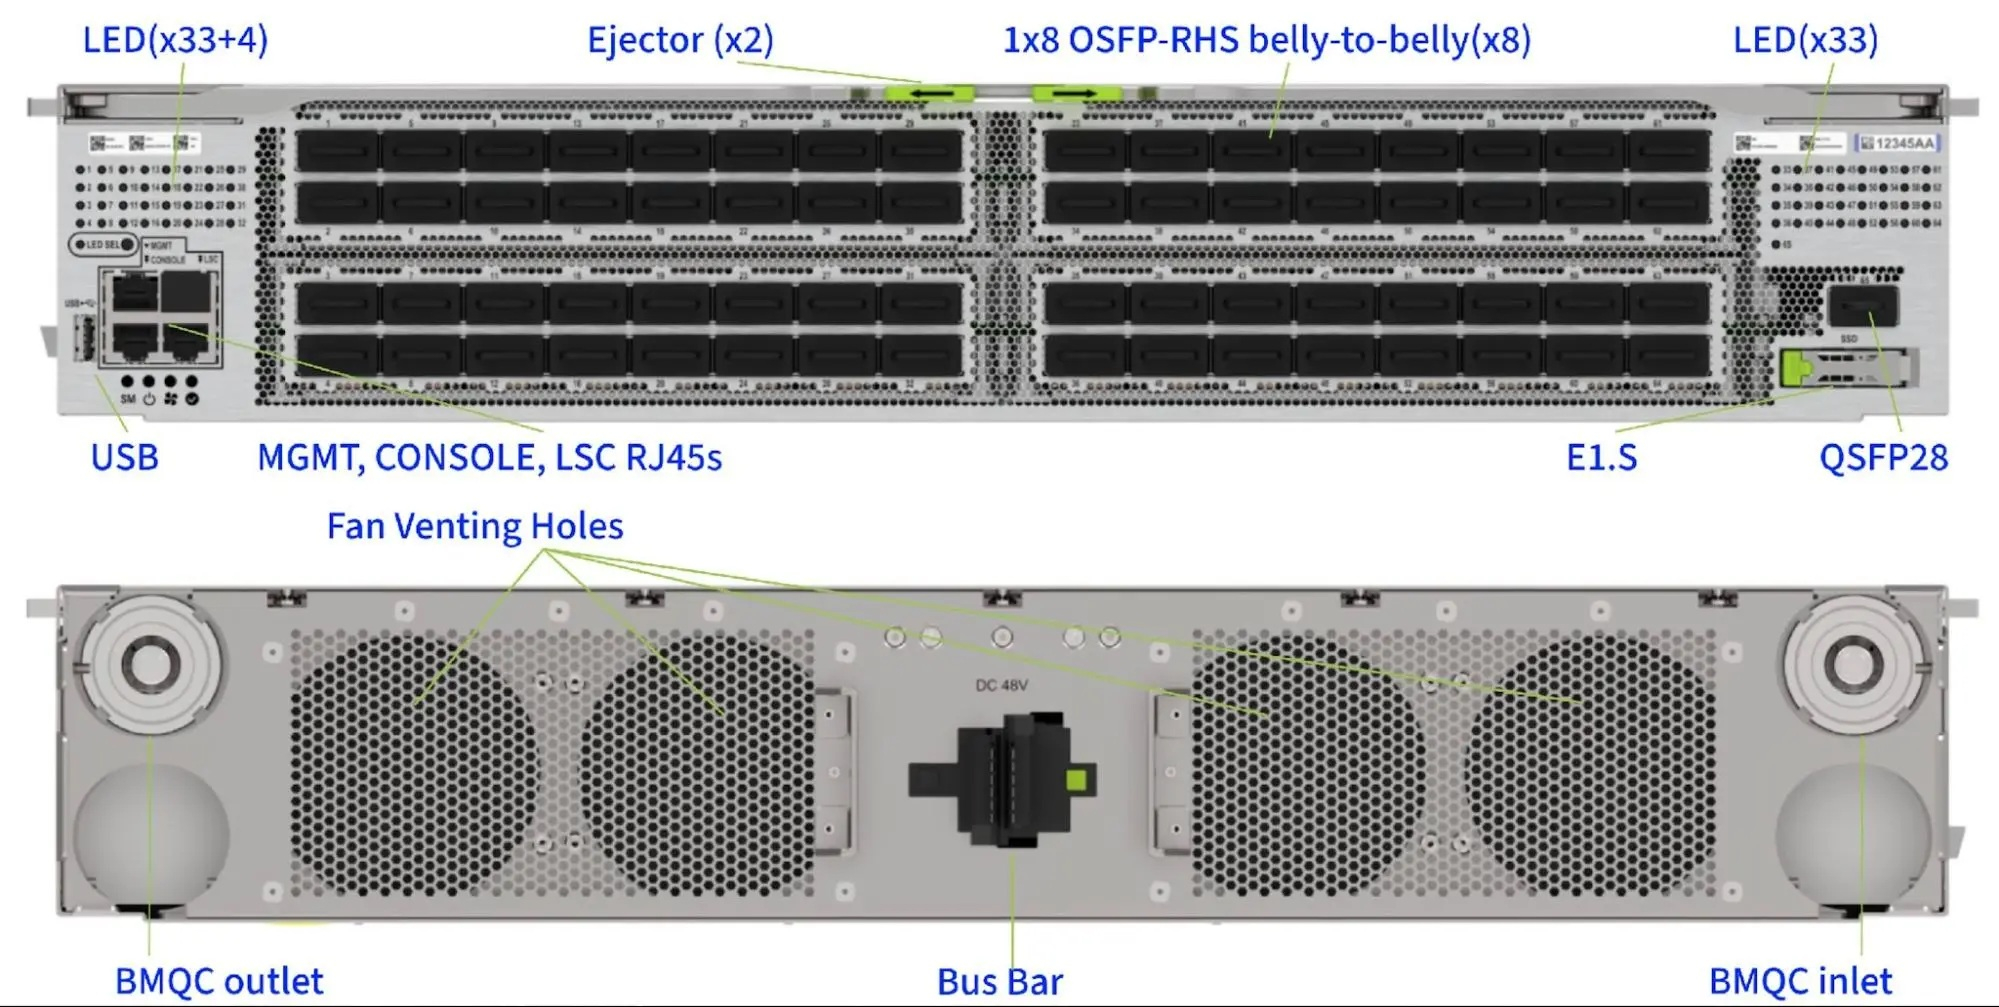
IceCube Оба решения работают под управлением открытой NOS FBOSS от Meta✴, которая использует интерфейс абстракции коммутаторов OCP SAI (Switch Abstraction Interface). Архитектура Open Switch Platform Architecture (OSPA) обращается к функциям управления, включая последовательность включения питания, обнаружение компонентов, терморегулирование, восстановление микропрограммного обеспечения и диагностика. 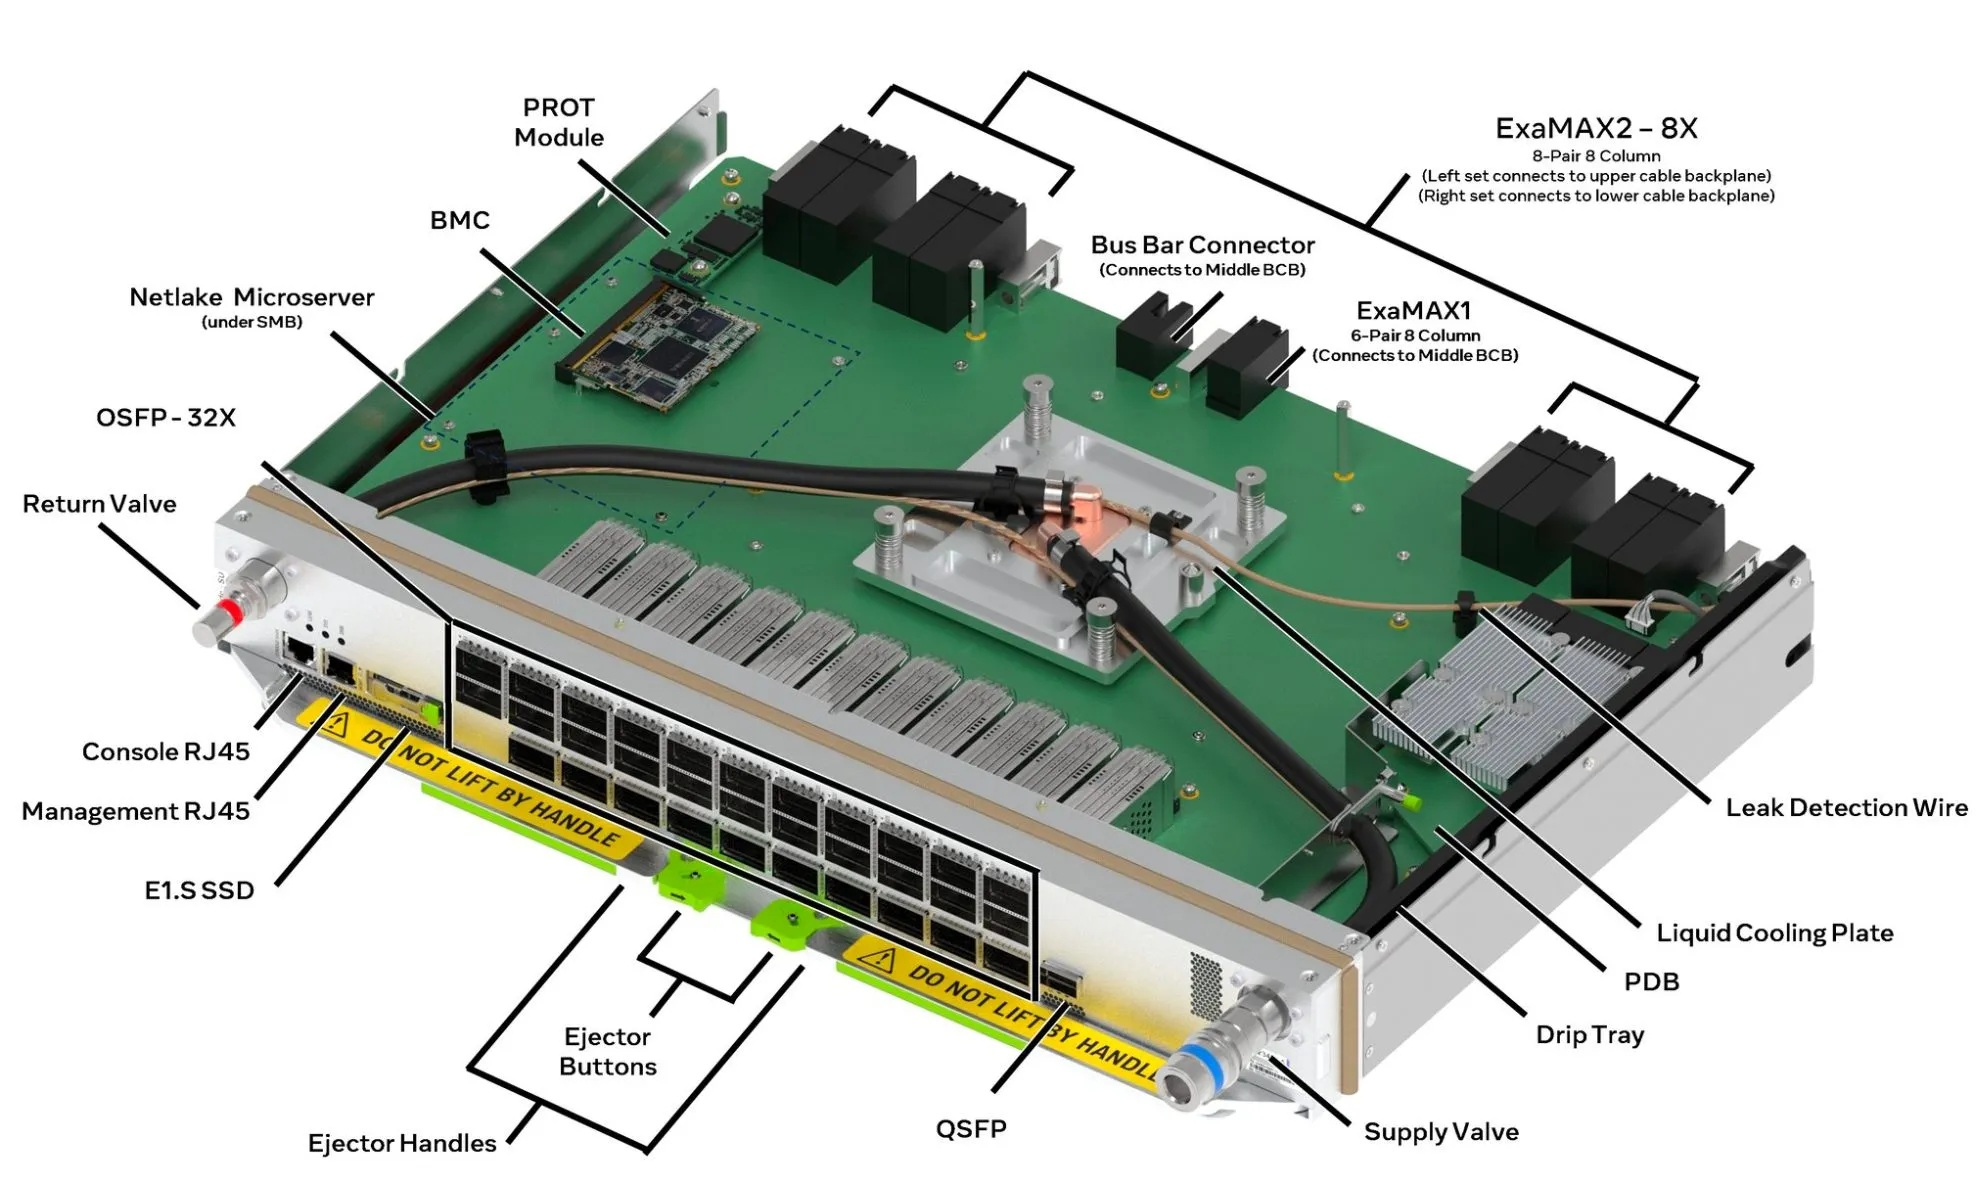
Tahan FPF переносит управление платформой преимущественно на сторону хоста, сохраняя при этом традиционный BMC для функций контроля и восстановления. FPGA-мосты I/O, подключённые через PCIe, объединяют периферийные интерфейсы, а модель учёта аппаратных средств, организованная в виде иерархической структуры, предоставляет ПО согласованный способ перечисления компонентов. Предложение также охватывает автономное управление питанием, обнаружение утечек и резервные образы прошивки. Следует отметить, что это проектные требования, находящиеся на стадии рассмотрения, а не доказательство функциональной совместимости между всеми решениями участвующих вендоров. 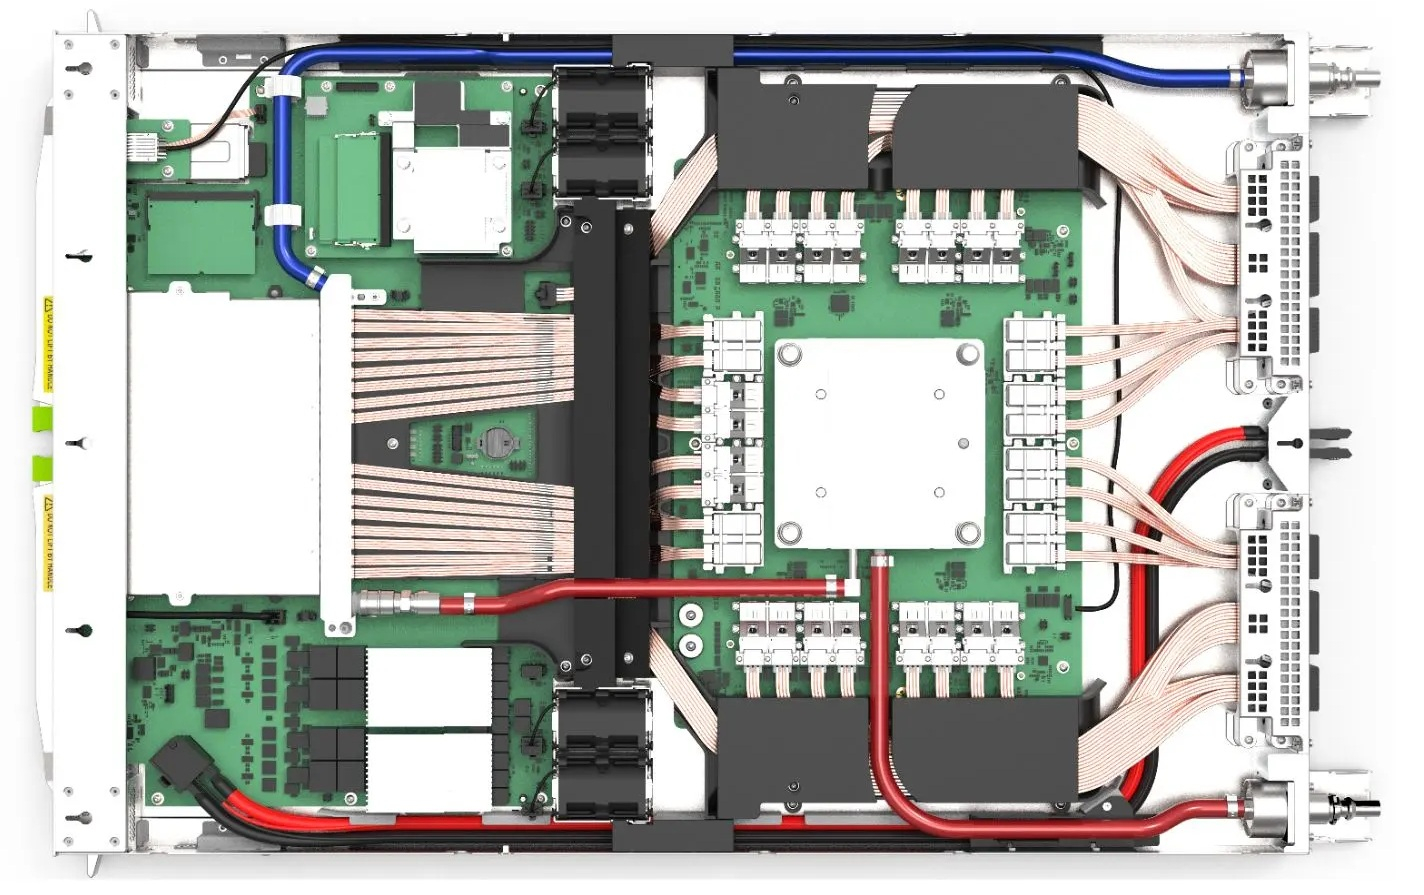
ESUN для MTIA 300 Также Meta✴ сообщила подробности о коммутаторе Tahan Ethernet Scale Up для MTIA 300, показала прототип стойки на 72 ускорителя и анонсировала открытую реализацию MetaRoCE. Эти элементы отражают разные стадии разработки: сейчас Tahan использует режим lossless RoCE, в будущих аппаратных решениях для вертикального масштабирования планируется переход на ESUN, а версия OSPA 1.0.0 пока остаётся на рассмотрении в OCP. 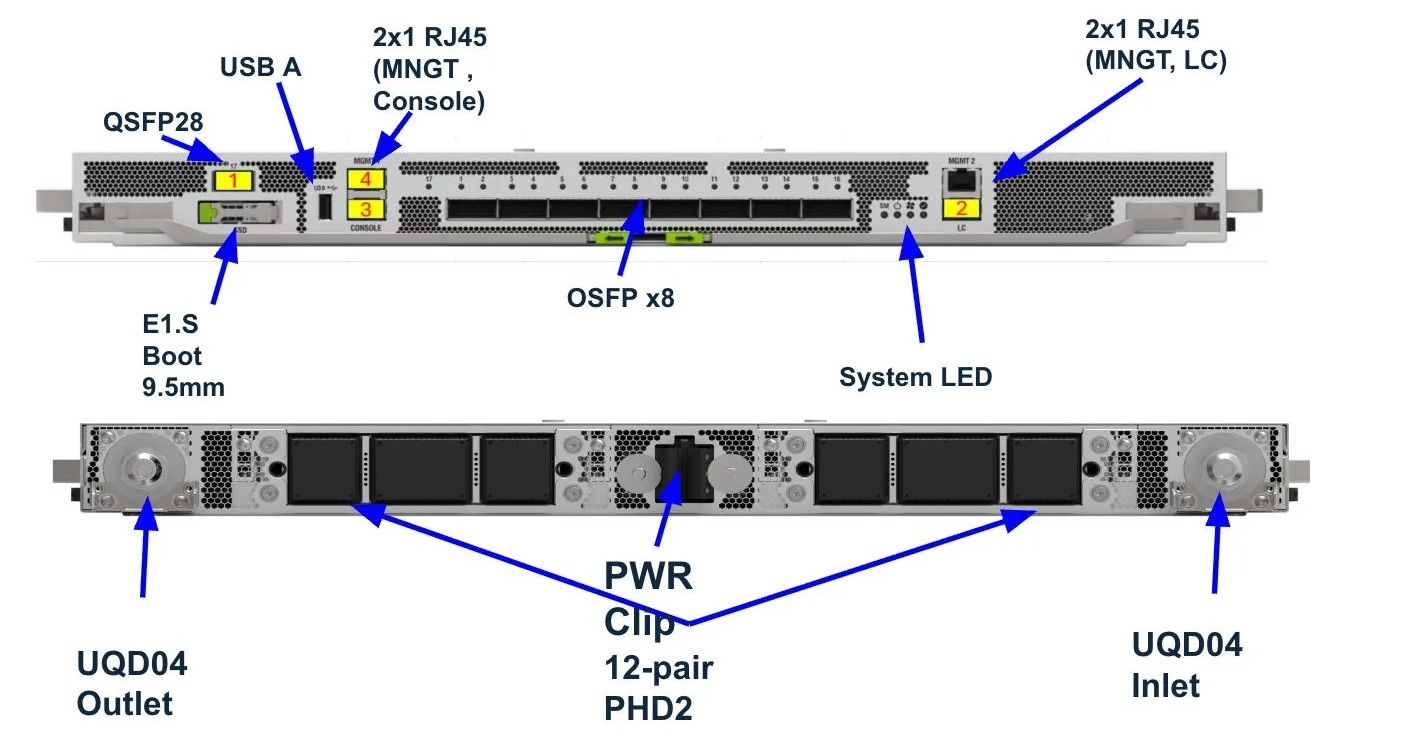
ESUN для MTIA 300 Tahan построен на базе ASIC Tomahawk 5 с пропускной способностью 51,2 Тбит/с (64 × 800G). Четыре коммутатора Tahan соединяют 16 ускорителей в неблокирующей топологии. Компания отметила, что Tahan использует тот же самый lossless RoCE (маршрутизируемый IPv6, PFC и QoS, настроенный для ИИ), объединяя scale-up и scale-out сети под управлением FBOSS. Параллельно компания работает над CXL-фабриками масштаба целого ЦОД.
15.10.2026 [13:53], Сергей Карасёв
Модули безопасности Axiado войдут в состав серверной платформы Arm AGIКомпании Axiado и Arm объявили о заключении соглашения о сотрудничестве. Речь идёт об интеграции модулей управления и безопасности Axiado DC-SCM (Data Center Secure Control Module) в серверную платформу Arm AGI. Отмечается, что для серверных ИИ-систем следующего поколения требуется качественно новый подход к управлению и защите. Критически важными становятся функции RoT (Root of Trust), находящиеся на более низком уровне, чем CPU. Это нужно для обеспечения непрерывной работы и эффективного управления IT-инфраструктурой, а также для предотвращения атак на встроенное ПО, цепочки поставок и среду выполнения. Модуль Axiado DC-SCM построен на базе специализированного чипа TCU (Trusted Control/Compute Unit). Он объединяет функции контроллера BMC, аппаратной защиты и ИИ-ускорения для выявления угроз в реальном времени. Это обеспечивает безопасность, оперативный контроль и управление платформой с самой первой инструкции после включении питания. 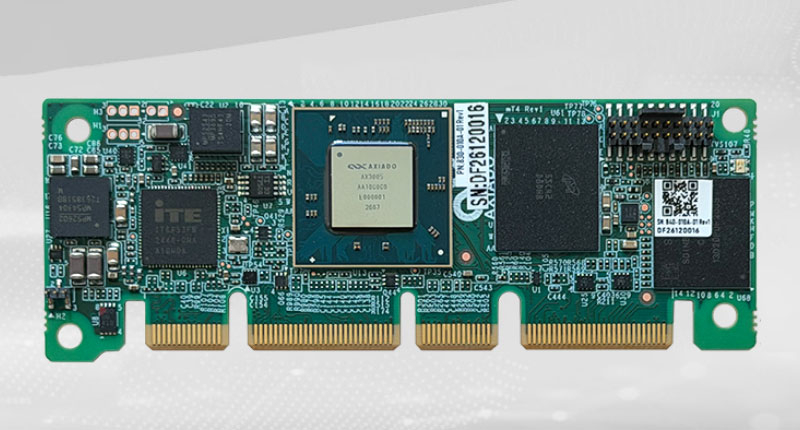
Источник изображения: Axiado Интеграция Axiado DC-SCM и Arm AGI основана на отраслевых стандартах и протоколах, таких как OpenBMC, OCP DC-SCM и DC-SCI, а также Redfish. Ожидается, что сотрудничество Axiado и Arm поможет клиентам в создании безопасных и масштабируемых инфраструктур, ориентированных на задачи ИИ.
15.10.2026 [10:14], Руслан Авдеев
IDC: расходы на OCP-инфраструктуру вырастут в 2030 году до $892 млрдСогласно результатам последнего исследования, заказанного у IDC фондом Open Compute Project Foundation (OCP), актуальный прогноз расходов на OCP-совместимую инфраструктуру резко вырос. Это происходит на фоне роста вложений в ИИ-проекты и расширение применения искусственного интеллекта. OCP Foundation объявил о повышении прогноза IDC, касающимся расходов на IT-оборудование. В исследовании 2026 IDC Market Impact Study отмечается, что годовые расходы на OCP-инфраструктуру в 2029 году составят $800 млрд, тогда как ранее прогнозировалось, что они будут на уровне $295 млрд. Разница почти трёхкратная. Для сравнения, В 2025 году расходы составили $154 млрд. Ожидаемый среднегодовой прирост в течение следующих пяти лет составит приблизительно 42 %. В 2030 году, согласно новому прогнозу, расходы на OCP-системы вырастут до $892 млрд, что составит более половины всего рынка (около 51 %). Из них на серверы, в основном с ИИ-ускорителями, придётся $814 млрд. Всего, по оценкам, на связанные с ИИ OCP-решения придётся около $628 млрд, т.е. примерно 70 % мирового рынка в целом. 
Источник изображения: OCP По оценкам IDC, распространению OCP-совместимых решений способствует расширение экосистемы поставщиков и доступность открытых разработок. IT-оборудование, соответствующее требованиям OCP, используют не только организации-участники фонда — оно применяется по всему миру. Результаты исследования косвенно подтверждают актуальность расширенной концепции Open Data Center Ecosystem Vision, посвящённой развитию открытой инфраструктуры ЦОД, продвигаемой OCP. Концепция учитывает взаимосвязанные потребности ИИ-инфраструктуры в масштабах всей экосистемы, от чипа до энергосети. За последний год в рамках OCP значительно продвинулась разработка стоек повышенной мощности, СЖО, сетевые решение для ИИ на основе Ethernet и открытые спецификации чиплетов. В числе прочего идёт работа над решениями для распределения постоянного тока, накопления энергии и координации взаимодействия ЦОД с электросетями. Инициатива Open Data Center for AI объединяет направления работы, охватывая электроснабжение, системы охлаждения и управления инфраструктурой. OCP Energy Project расширяет взаимодействие в сфере генерации и хранения энергии, а AI Computing Continuum поддерживает внедрение решений за пределами ЦОД гиперскейлеров.
13.10.2026 [16:17], Руслан Авдеев
Visionbay.ai разработала типовой проект ИИ-фабрики с питанием 800 В DC для платформы NVIDIA Vera RubinКомпания Visionbay.ai, подразделение Foxconn, представила референсный проект ИИ-фабрики нового поколения K-1 для платформы NVIDIA Vera Rubin с электропитанием 800 В DC и технологиями терморегуляции Vertiv. Использование стандартизированной LVDC-архитектуры создаёт условия для дальнейшего повышения плотности ИИ-инфраструктуры. При этом сохраняется возможность гибкой модернизации уже действующих объектов. Вместо полного одномоментного перехода на новые технологические решения предлагается поэтапное внедрение распределения питания 800 В DC там, где это целесообразнее всего. Такой подход даёт возможность операторам ЦОД подготовиться к появлению новых поколений ИИ-систем без необходимости масштабной разовой модернизации инженерной инфраструктуры зданий. Предложенная архитектура предполагает использование центров электропитания на уровне кластеров (cluster-level power centers) с централизацией преобразования переменного тока в постоянный (AC/DC) и распределяют питание 800 В DC ближе к вычислительным ресурсам. Поддерживается модульное расширение, возможно создание типовых инфраструктурных блоков для масштабирования ИИ-фабрик. 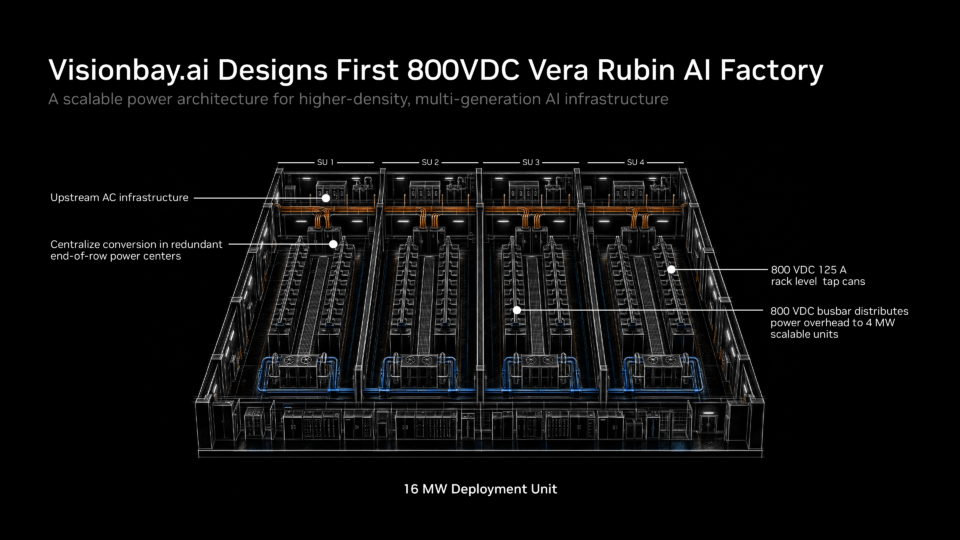
Источник изображения: NVIDIA K-1 отражает системный подход NVIDIA к проектированию ИИ-фабрик. С таким подходом электропитание, охлаждение и вычислительные ресурсы сразу разрабатываются как единая система. Поддержка инфраструктуры с СЖО, масштабируемого распределения электроэнергии и будущих систем класса Vera Rubin позволяет партнёрам экосистемы превращать референсную архитектуру ИИ-фабрик NVIDIA в готовую к развёртыванию инфраструктуру для нового этапа ускоренных вычислений. Примером реализации такой инфрастуркутуры стало предложение Supermicro.
13.10.2026 [13:50], Руслан Авдеев
MGX 1.2: NVIDIA представила открытые спецификации стоек Vera RubinNVIDIA объявила о новых партнёрствах и технологических решениях для создания единой основы для ИИ-инфраструктуры нового поколения. В частности, OCP переданы спецификации стоек NVIDIA Vera Rubin и вычислительных узлов в рамках открытой архитектуры MGХ. В рамках инициативы Open DC Initiative проекта OCP компания присоединилась к лидерам отрасли, принимающим участие в разработке референсного дизайна ИИ ЦОД третьего поколения. Наряду с открытыми технологиями жидкостного охлаждения MQD и MQDB, работа над MGX позволит превратить проверенные решения для ИИ-фабрик в отраслевые стандарты, доступные для внедрения, производства и масштабирования другими участниками рынка. Обновлённая спецификация MGX 1.2 расширяет возможности открытой архитектуры за счёт СЖО со «слепым» (blind-mate) монтажом. Также стандартизирована совместимая стоечная инфраструктура интерконнектов и DC-шина на 5000 А с жидкостным охлаждением, рассчитанная на мощные ИИ-системы. Дополнительно добавлена поддержка 19″ оборудования и стоек с повышенной плотностью размещения оборудования. Дополнительно MGX 1.2 расширяет возможности модульной конфигурации. Так, добавлены конфигурируемые IO-модули, безвентиляторные вычислительные узлы с СЖО, стандартизированные интерфейсы электропитания и охлаждения и единая инфраструктурная основа, дающая партнёрам экосистемы строить совместимые платформы для ускоренных вычислений. 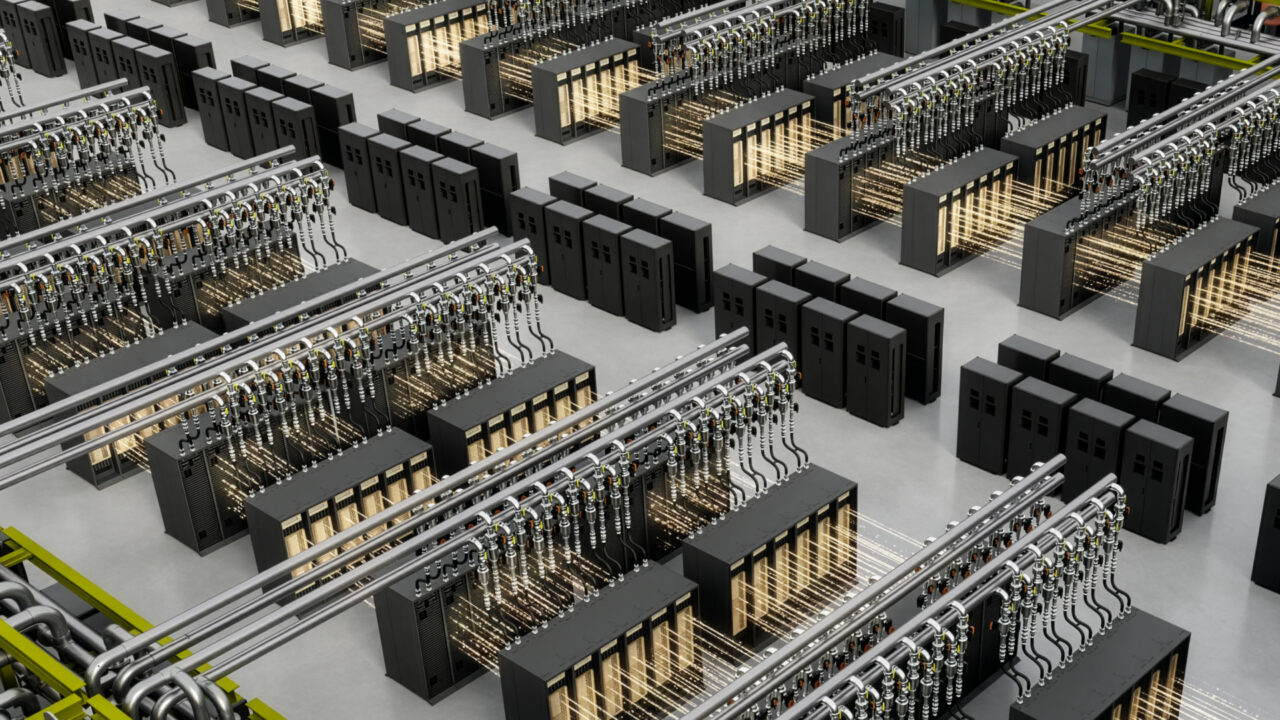
Источник изображения: NVIDIA Архитектура позволяет сокращать время сборки, тестирования и обслуживания оборудования. Это упрощает развёртывание и обслуживание на местах и должно повысить эффективность инфраструктуры. Архитектурой поддерживается конфигурация стоек до 250 кВт. В то же время упрощается техобслуживание проектов, ввод в эксплуатацию и даже повторное использование инфраструктуры. Спецификация стоек на основе CPU NVIDIA Vera дополнительно расширяет архитектуру MGX за пределы ускоренных вычислений. Фактически речь идёт о специализированной платформы эпохи агентного ИИ. Если NVIDIA Vera Rubin NVL72 служит основой для обучения и инференса ИИ-моделей, то стойки на основе CPU Vera предназначены для вызова инструментов, оркестрации и песочниц. Стойка Vera CPU на основе MGX третьего поколения использует те же принципы проектирования на уровне стоек — они позволяют объединять вычислительные ресурсы, сетевую инфраструктуру, электропитание и охлаждение в единой модульной платформе. Соответствующий подход позволяет NVIDIA и партнёрам обеспечивать развёртывание специализированной инфраструктуры, в то же время используя преимущества общей экосистемы, упрощённой интеграции и единой технологической базы для ИИ-фабрик нового поколения.
12.10.2026 [21:40], Владимир Мироненко
AMD «загнала» ИИ-агентов в стойку HelionAMD представила эталонный проект AMD Helion для агентных систем, выполненный в форм-факторе серверной стойки ORv3 высотой 44OU. По словам компании, Helion, созданный на основе спецификаций Open Compute Project (OCP), является дальнейшим развитием подхода к открытой платформе, заложенном в решении AMD Helios. 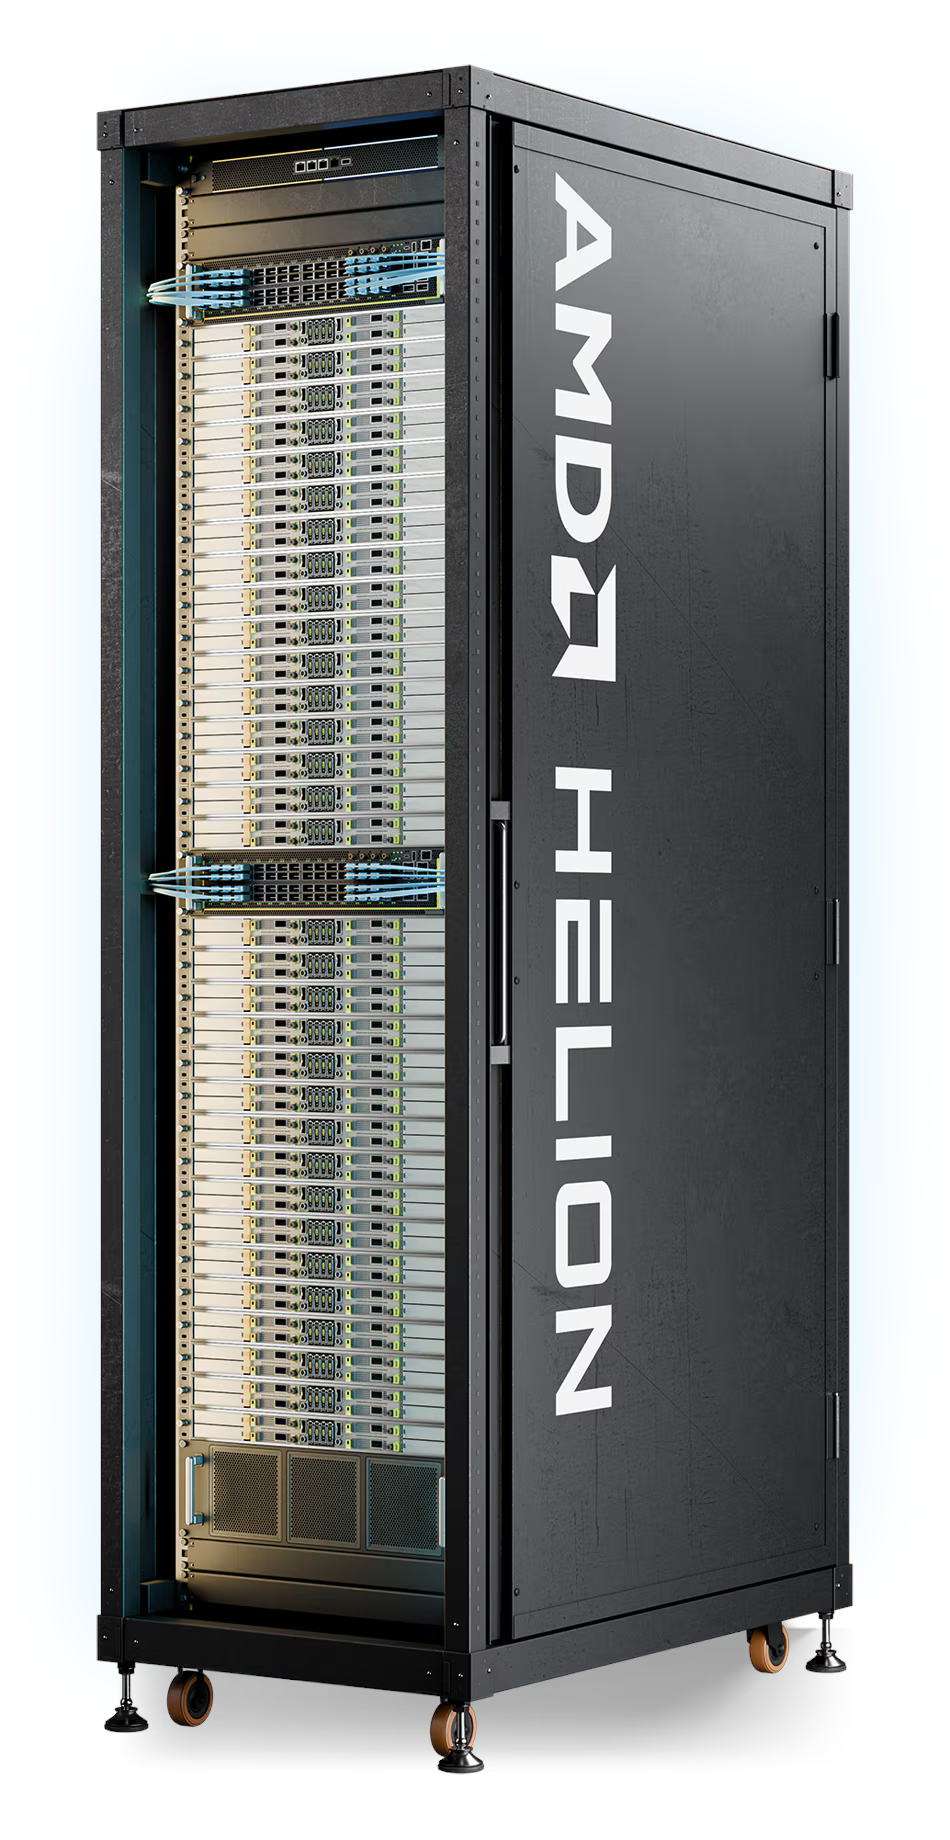
Источник изображений: AMD С помощью AMD Helion заказчики смогут оптимально сочетать производительность CPU, плотность ядер и энергопотребление с возможностями ускорения на базе GPU, исходя из специфики задач, выполняемых ИИ-агентами. Решение может поставляться как на базе исключительно CPU (для гиперскейлеров), так и с интеграцией CPU/GPU (для корпоративного сектора). 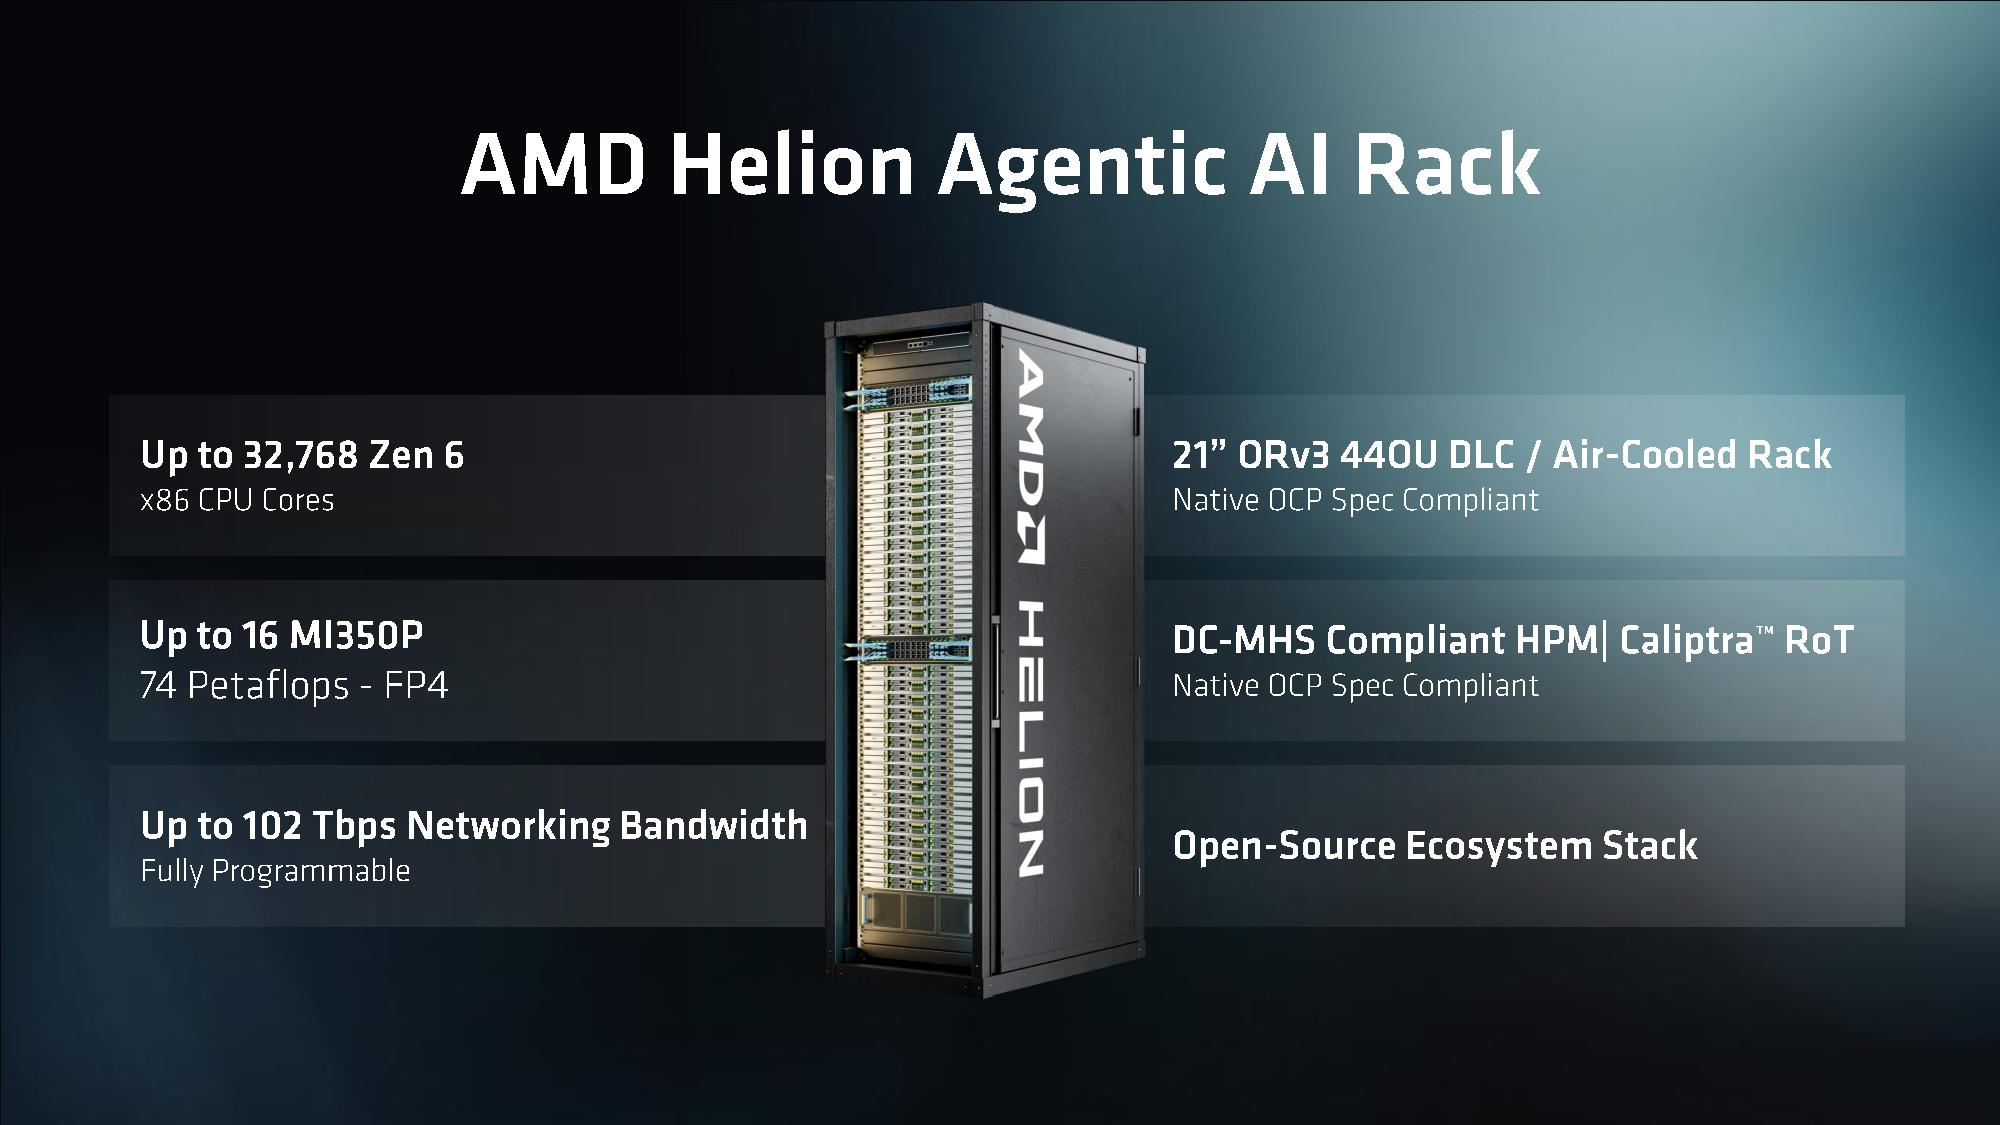 OCP-архитектура стойки AMD Helion поддерживает открытое ПО и допускает различные варианты конфигурации, включая версии с жидкостным и воздушным охлаждением. Это позволяет заказчикам создавать практически любые системы, отвечающие их конкретным требованиям. 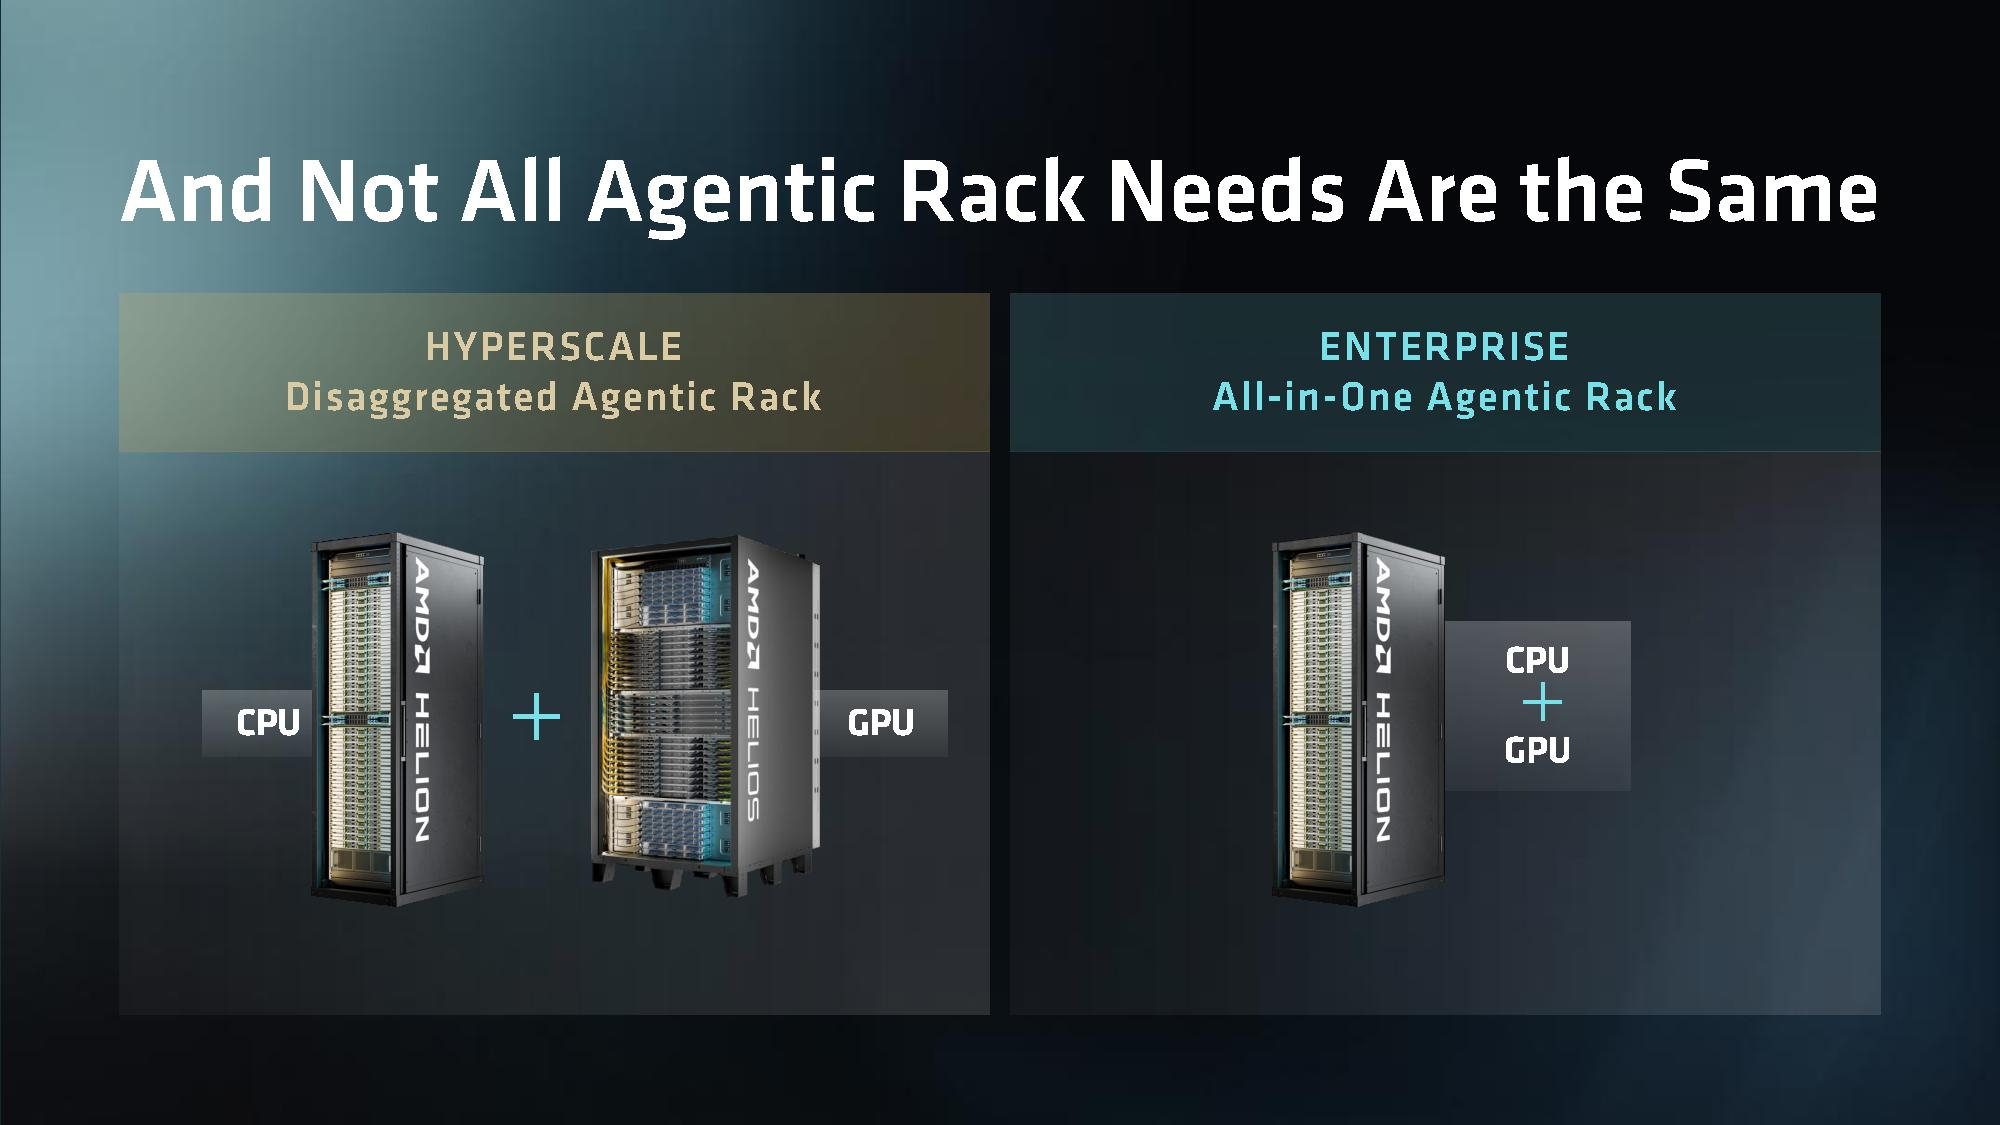 Например, стойка, использующая только CPU (на базе AMD EPYC Venice) и поддерживающая до 32 768 ядер, предназначена для систем гиперскейлеров. Она обеспечивает выделенные мощности для выполнения задач агентов, а также возможность подключения к отдельной инфраструктуре для инференса моделей. 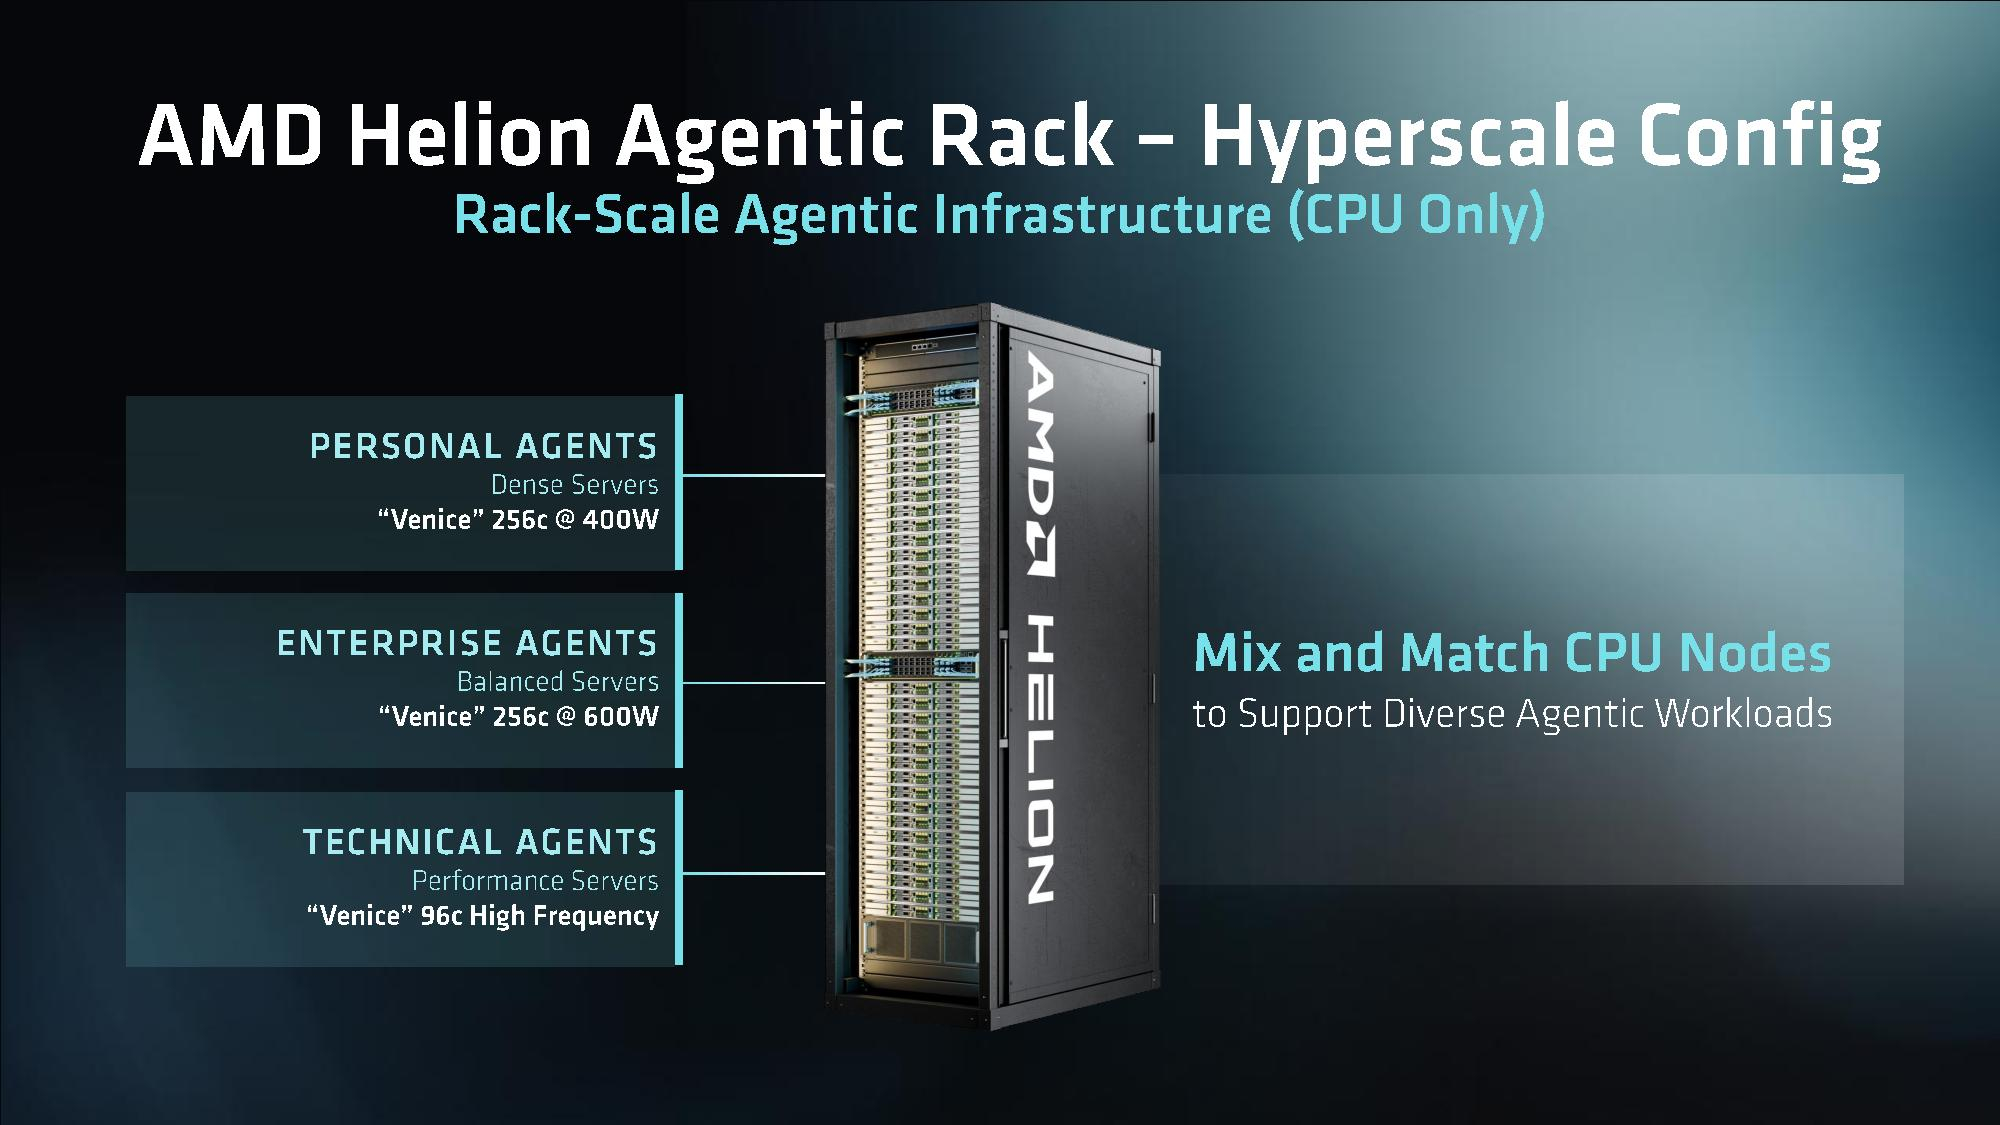 В свою очередь, комплексное стоечное решение, объединяющее на одной платформе узлы с EPYC, узлы с Instinct MI350P (до 16 единиц), интерконнект с пропускной способностью до 102,4 Тбит/с и вычислительные ресурсы общего назначения, представляет собой универсальный вариант для внедрения агентного ИИ корпоративного уровня. 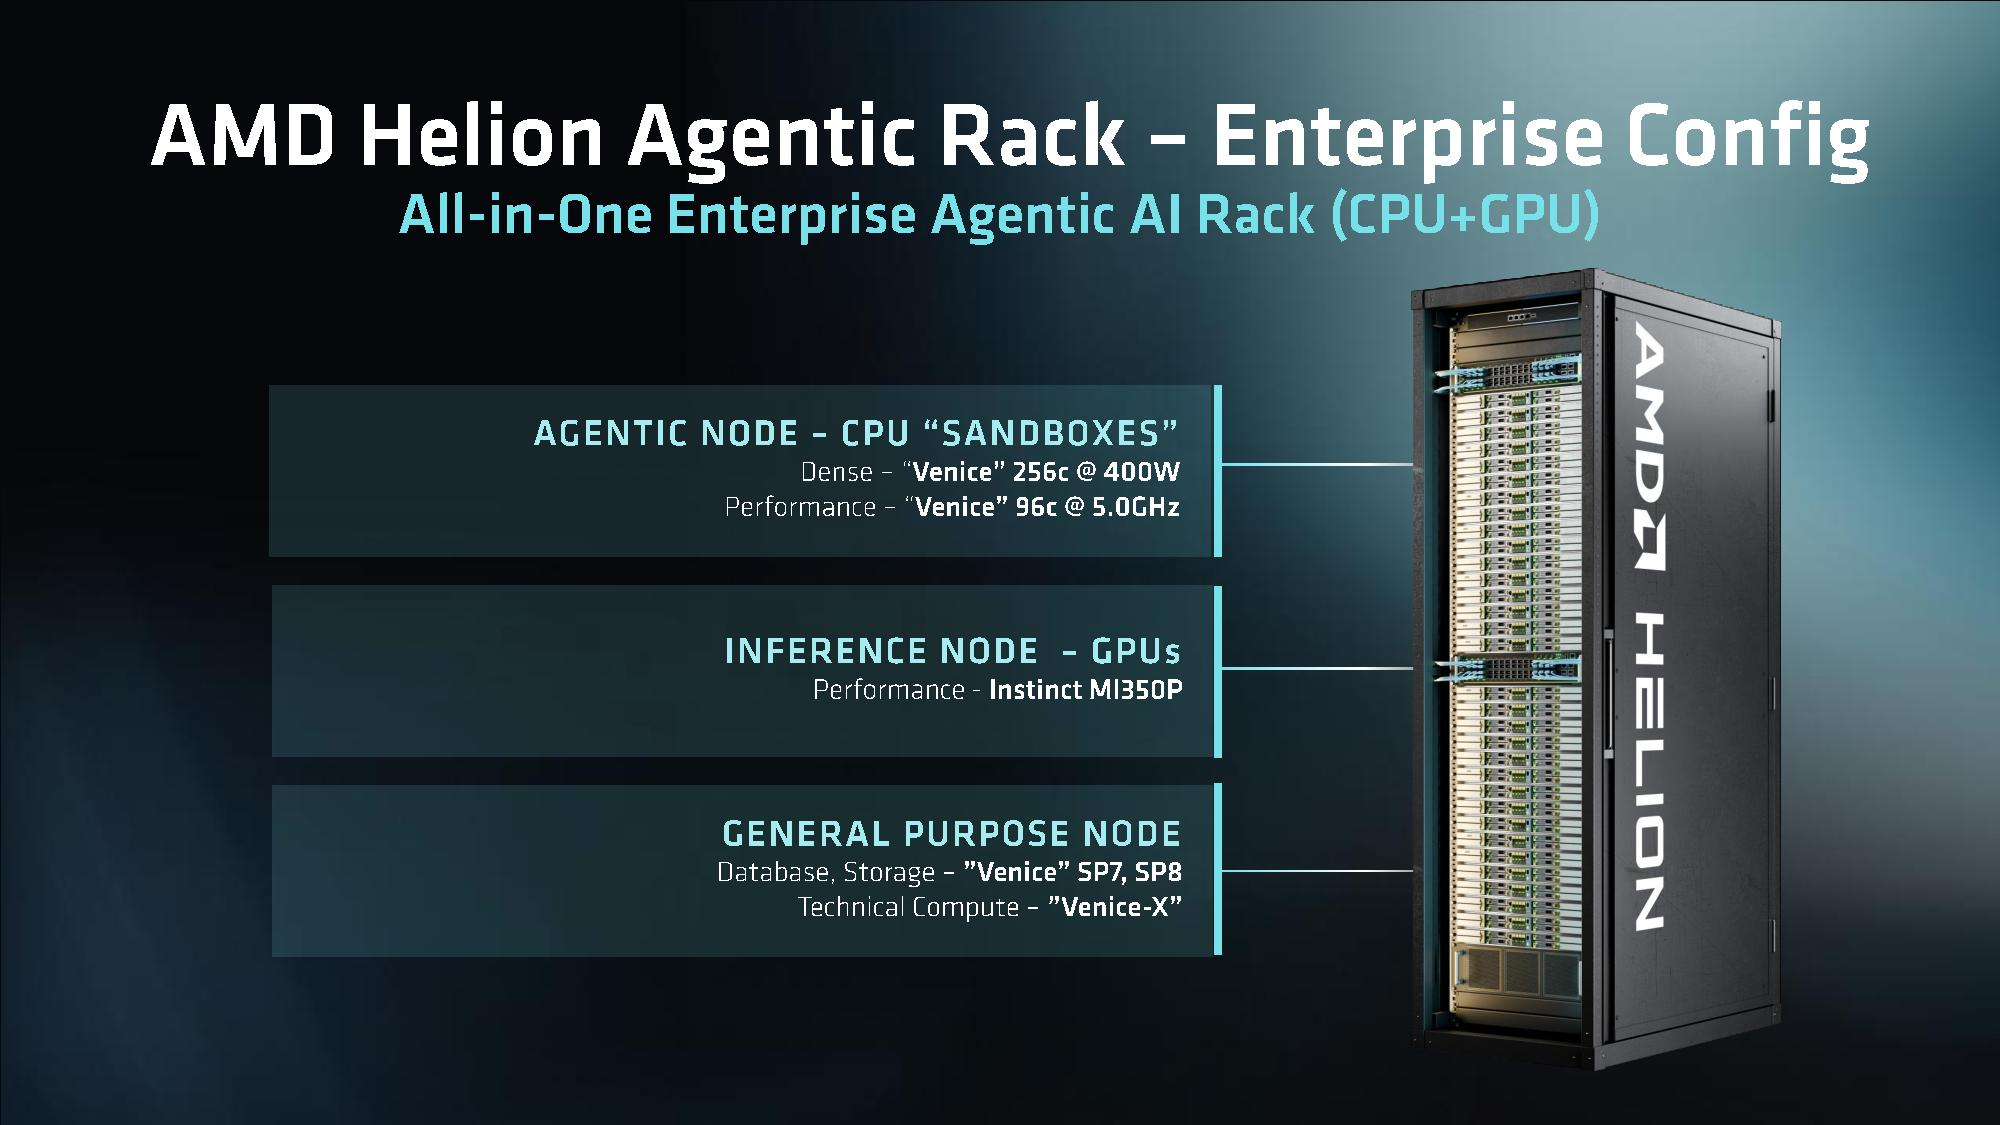 AMD Helion позволяет клиентам развёртывать системы агентного ИИ в рамках уже имеющейся ИТ-инфраструктуры, адаптируя конфигурации CPU и GPU под конкретные рабочие нагрузки и подбирая оптимальное соотношение ресурсов для выполнения задач агентов, инференса моделей и вспомогательных вычислений с учётом требований к производительности, энергопотреблению и стоимости. 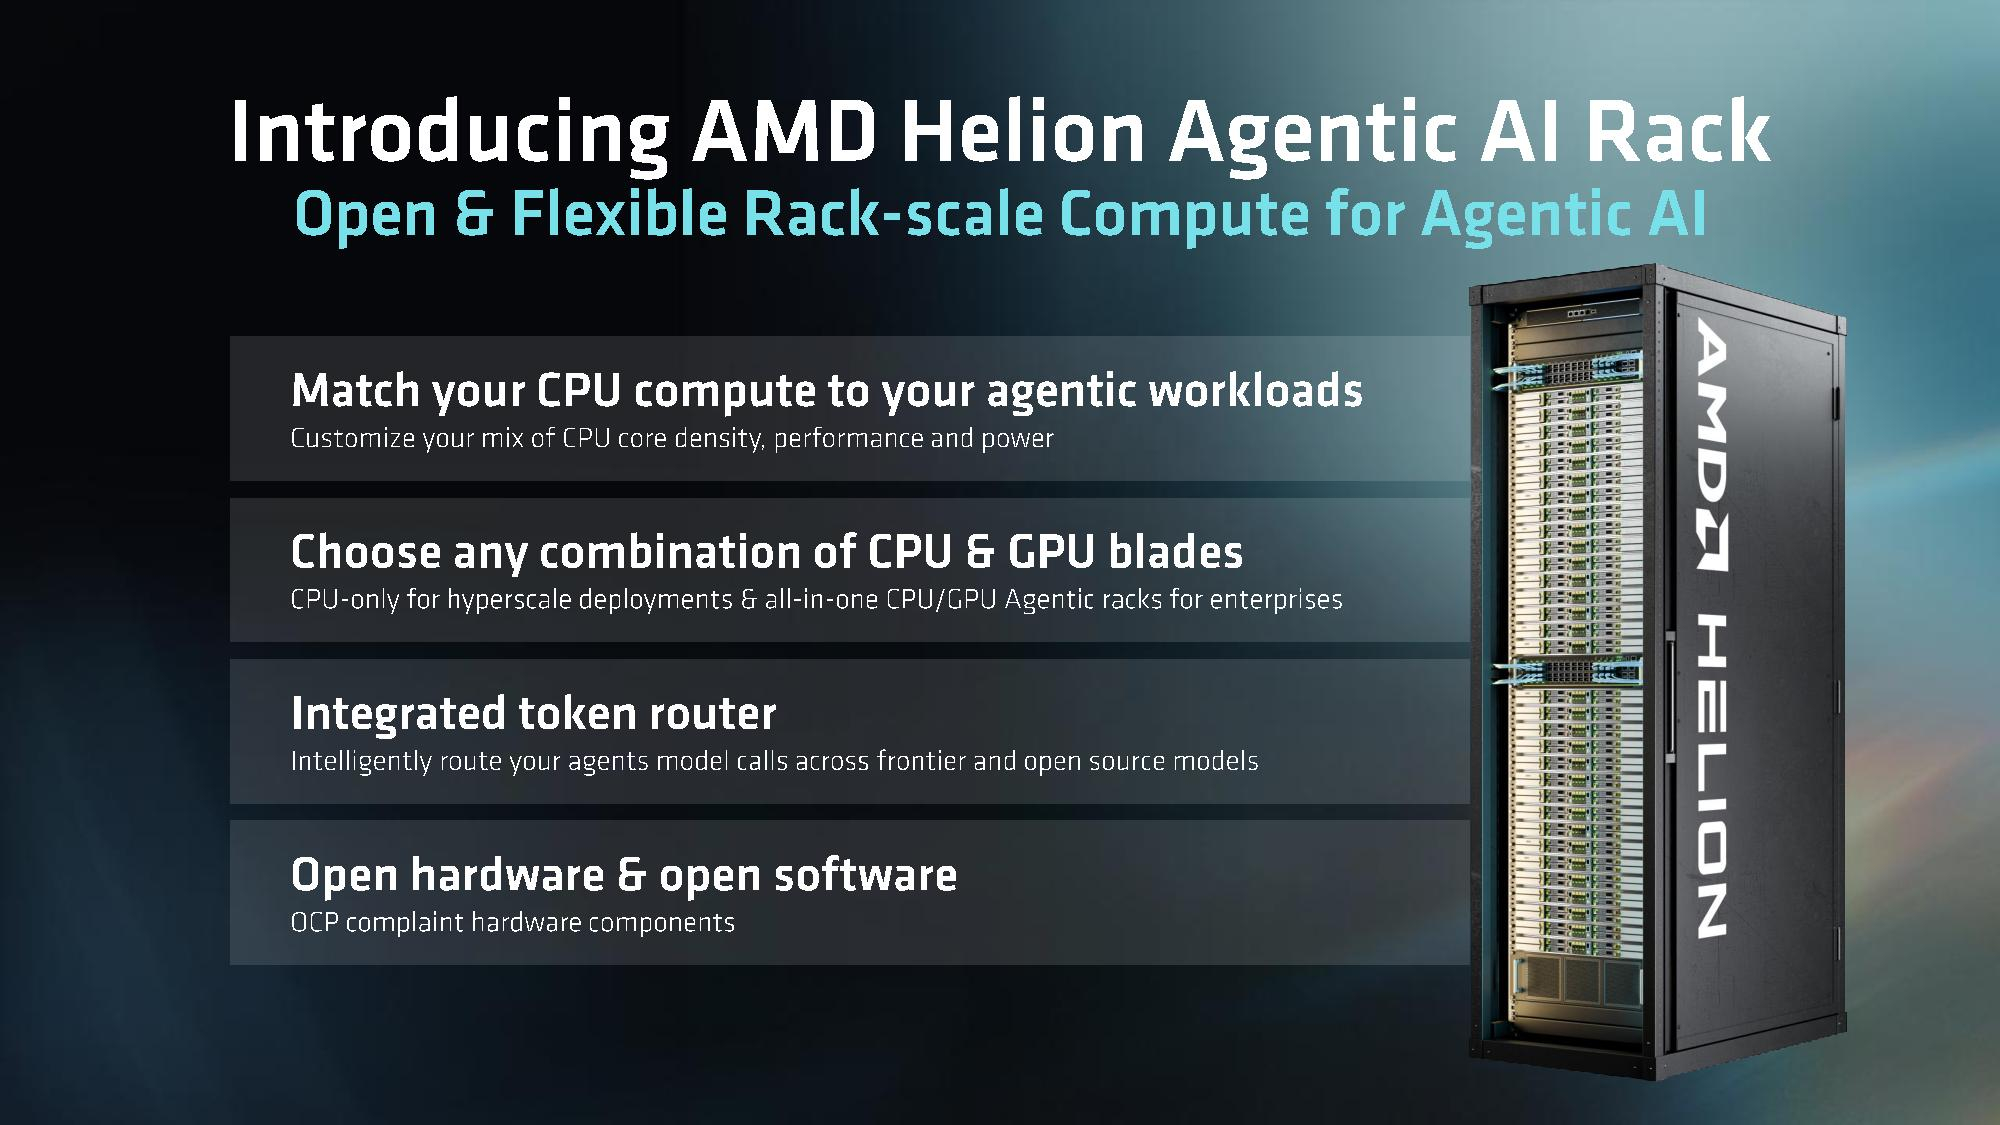 AMD сообщила, что планирует передать спецификацию AMD Helion организации OCP (Open Compute Project), сделав её доступной для сообщества с целью дальнейшей разработки и внедрения. Конфигурации стоек AMD Helion для агентного ИИ в настоящее время разрабатываются совместно с партнёрами по экосистеме; их выпуск запланирован на ноябрь 2026 года.
12.10.2026 [09:37], Владимир Мироненко
Upscale AI представил архитектуру Token Fabric для ИИ-фабрикСтартап Upscale AI представил архитектуру Token Fabric, призванную объединить вертикальное и горизонтальное масштабирование в рамках одной сетевой платформы. Решение сочетает в себе фирменный чип SkyFabriX (scale-up), NVIDIA Spectrum-X Ethernet (scale-out) и единый программный уровень для управления. Система, построенная на открытых стандартах, должна обеспечить непрерывную работу ИИ-чипов, чтобы они не простаивали в ожидании данных, тем самым помогая клиентам повысить отдачу от своих инвестиций. Token Fabric включает:
Клиенты могут внедрять Token Fabric, выбирая отдельные компоненты (чипы, системы, ПО) или весь стек целиком. Вариант с полным стеком рассчитан на неооблака и корпоративных клиентов, не располагающих сетевыми командами масштаба гиперскейлеров. Вариант с интегрированными системами предназначен для производителей XPU, которым требуется проверенное оборудование без необходимости самостоятельной разработки сетевого стека. Третий вариант предусматривает поставку чипов или специализированных систем вместе с SDK/SAI от Upscale, поверх которых работает собственная NOS заказчика. 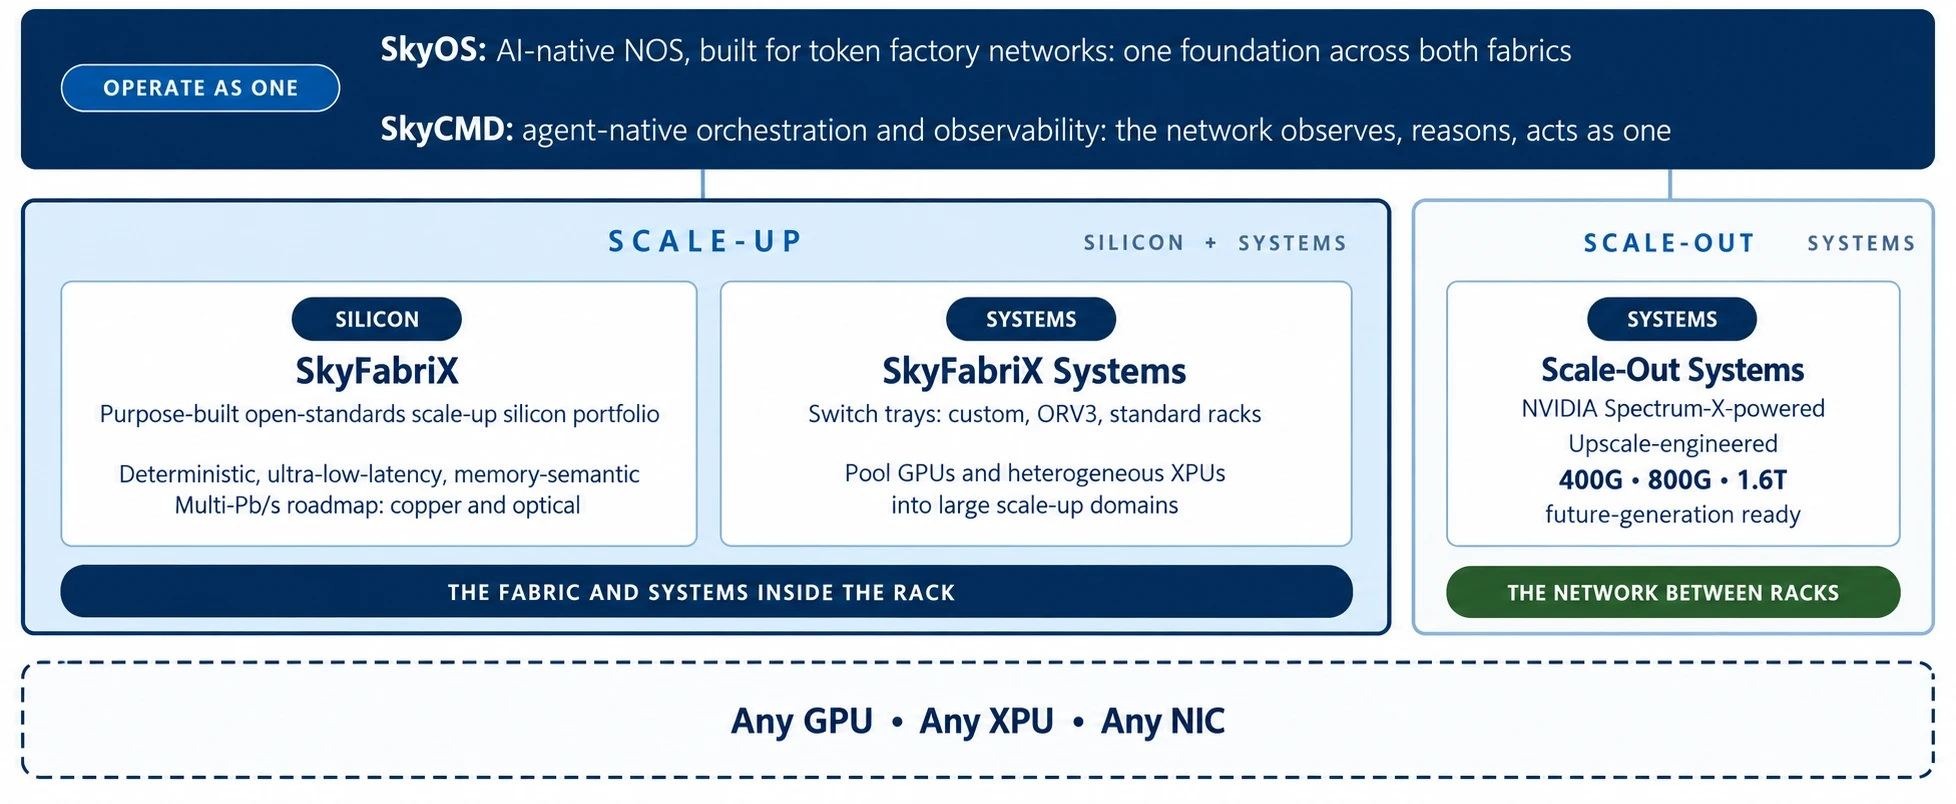
Источник изображения: Upscale AI Upscale AI расширяет существующие протоколы, а не заменяет их, говорит компания. Upscale AI также вносит вклад в открытые проекты, лежащие в основе стека. К ним относятся SONiC, расширения интерфейса абстракции коммутатора (SAI) для поддержки ESUN, а также инициативы Ultra Ethernet Consortium (UEC) и UALink. SkyOS абстрагирует нижележащее оборудование и обеспечивает единую плоскость управления для всего кластера, а SkyCMD унифицирует управление. Любая вычислительная платформа в гетерогенном кластере может использовать этот интерфейс для управления сетью. «Операционная система должна быть компактной и эффективной, чтобы обеспечивать быстродействие, гибкость и безопасность, — сообщил изданию Network World Барун Кар (Barun Kar), генеральный директор Upscale AI. — Кроме того, поверх неё необходим уровень оркестрации, позволяющий поддерживать такие возможности, как гетерогенные вычисления». Полномасштабный выпуск Token Fabric запланирован на начало 2027 года; в настоящее время действуют программы раннего доступа и совместного тестирования. Компания Upscale AI вышла из скрытого (stealth) режима в сентябре 2025 года. Она привлекла $100 млн в рамках посевного раунда финансирования, потом — $200 млн в раунде A, а затем — ещё $190 млн, при оценке капитализации в $2 млрд. В результате общий объём инвестиций составил $500 млн. Стартап поддерживают как NVIDIA, Salesforce и сингапурский государственный инвестиционный фонд Temasek. Главный инвестор — фонд Premji Invest. Штат компании превышает 300 сотрудников.
10.10.2026 [13:37], Сергей Карасёв
HPE анонсировала серверы ProLiant Gen13 на платформе AMD EPYC Venice 9006HPE представила серверы ProLiant Gen13 на аппаратной платформе AMD EPYC Venice 9006, предназначенные для решения ресурсоёмких задач, таких как ИИ-инференс, виртуализация, обработка больших массивов данных и пр. Дебютировали четыре модели: стандартные стоечные системы ProLiant DL585a Gen13 и ProLiant DL525 Gen13, а также решения высокой плотности ProLiant XD245 и ProLiant XD285. 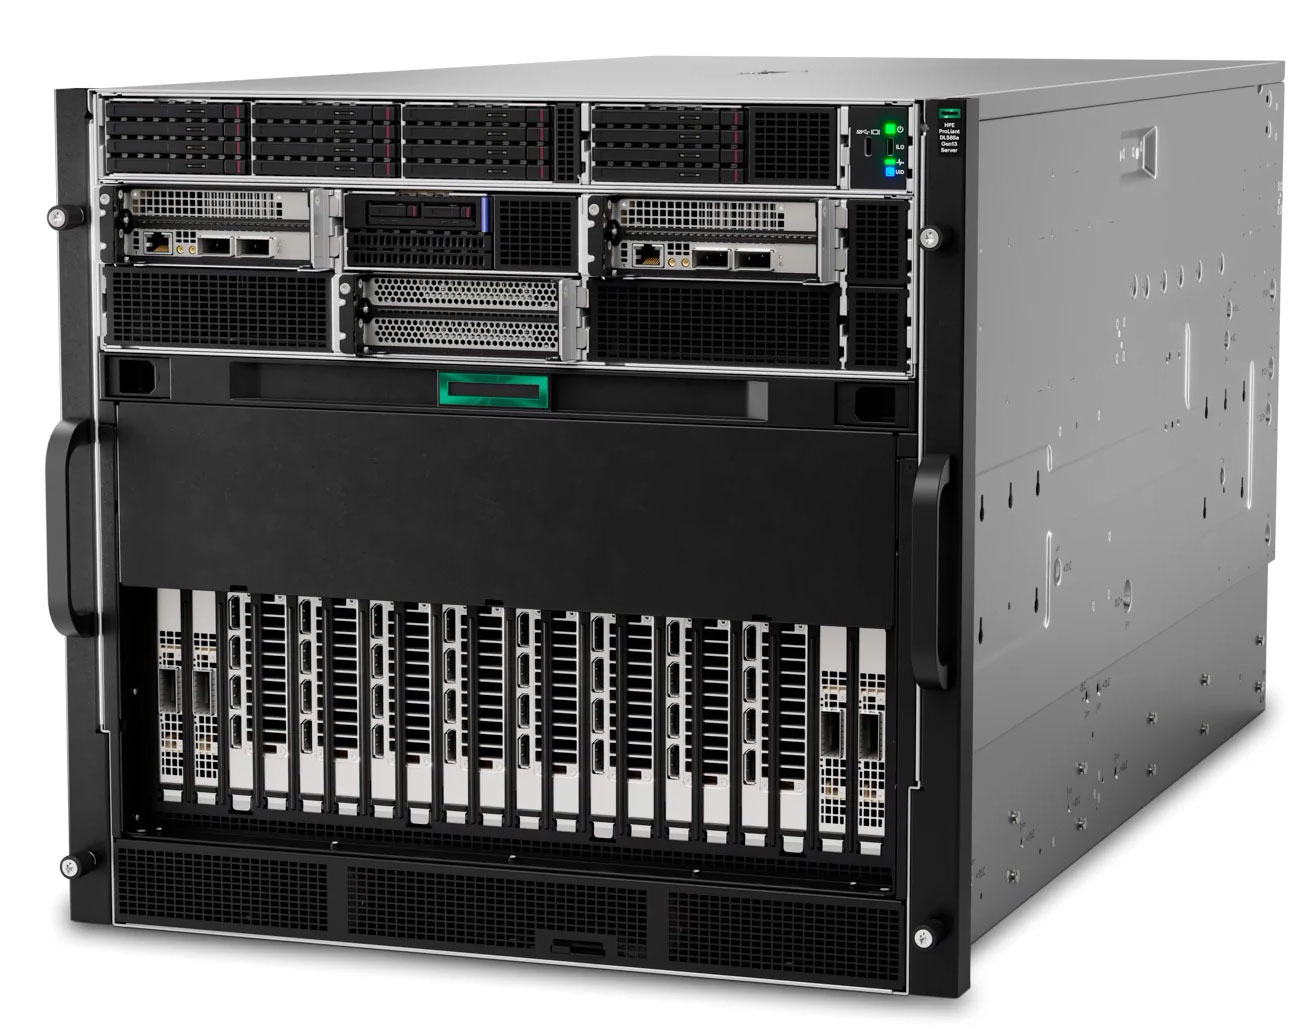
Источник изображений: HPE Старшая из представленных новинок, ProLiant DL585a Gen13, выполнена в форм-факторе 10U. Допускается установка двух процессоров EPYC Venice 9006 в исполнении SP7 (до 256 вычислительных ядер) с показателем TDP до 600 Вт. Есть 32 слота для модулей оперативной памяти DDR5-8000 RDIMM суммарным объёмом до 8 Тбайт или DDR5-12800 MRDIMM объёмом до 4 Тбайт. Сервер поддерживает до 16 накопителей E3.S EDSFF NVMe, до восьми GPU-ускорителей двойной ширины или до 16 ускорителей одинарной ширины с жидкостным охлаждением. В частности, могут применяться изделия NVIDIA RTX PRO 6000 Blackwell Server Edition с 96 Гбайт памяти или RTX PRO 6000D с 84 Гбайт памяти. Реализованы восемь слотов PCIe 6.0 x16 и один слот OCP 3.0. Подсистема питания включает до 14 блоков мощностью 3200 Вт каждый с сертификатом 80 Plus Titanium. Установлены 15 двухроторных вентиляторов диаметром 80 мм с возможностью горячей замены. 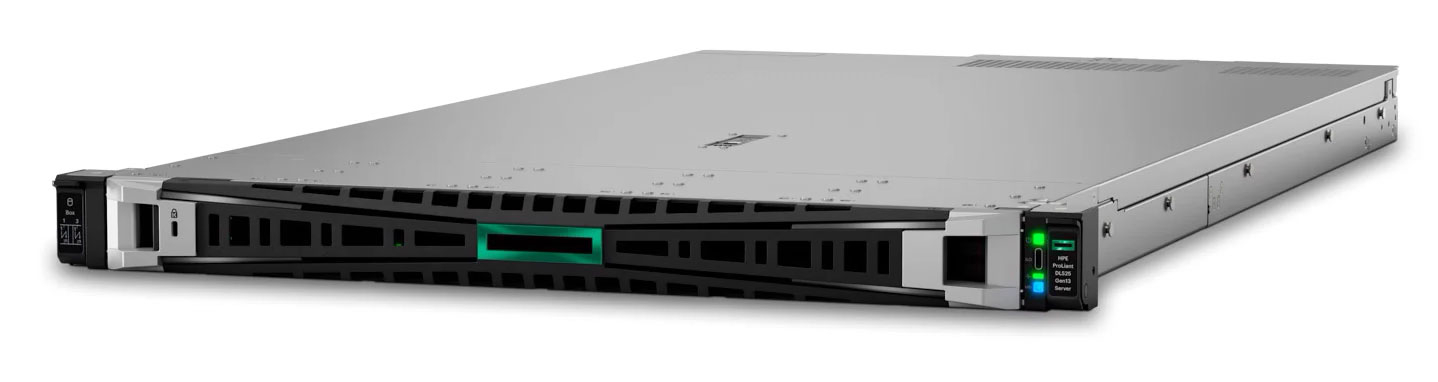 В свою очередь, ProLiant DL525 Gen13 — это сервер типоразмера 1U с поддержкой одного чипа EPYC Venice 9006 (до 600 Вт) и 16 модулей DDR5-8000/12800 (до 4/2 Тбайт). Машина может нести на борту 20 накопителей EDSFF E3.S (NVMe) и один SSD формата M.2 2280 (NVMe). Во фронтальной части расположены четыре слота PCIe 6.0 и один разъём OCP 3.0, в тыльной — три слота PCIe 6.0 и один OCP 3.0. Могут быть установлены до двух блоков питания мощностью 3200 Вт. Допускается применение воздушного и жидкостного охлаждения. 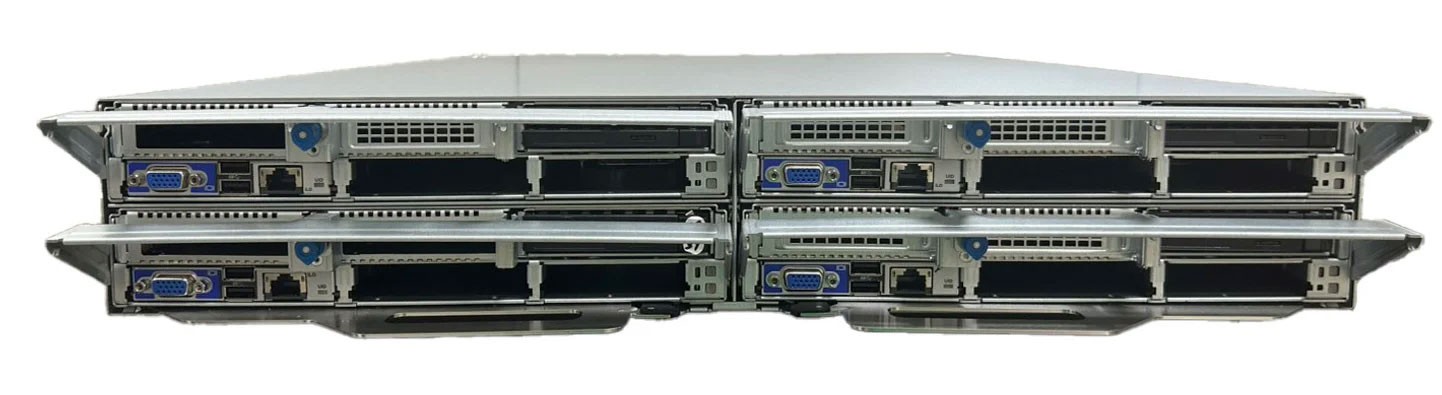 Наконец, серверы ProLiant XD245 и ProLiant XD285 получили шасси 2U. Первое из этих устройств имеет четырёхузловую конфигурацию и использует прямое жидкостное охлаждение, второе — двухузловую с воздушным охлаждением. Каждый узел поддерживает два чипа EPYC Venice 9006 (до 600 Вт) и 32 модуля DDR5-8000/12800 RDIMM/MRDIMM. Есть два слота PCIe 6.0 x16 и один разъём OCP 3.0, два отсека EDSFF и два коннектора M.2. Серверы рассчитаны на монтаж в 21″ стойку ORv3.
04.09.2026 [08:56], Владимир Мироненко
MetaRoCE — RDMA-транспорт от Meta✴ для крупных ИИ-кластеров с обычным EthernetMeta✴ представила MetaRoCE — новый транспортный RDMA-протокол на базе обычного Ethernet, созданный для крупных ИИ-кластеров. Компания разместила спецификации MetaRoCE, эталонную программную реализацию и набор тестов на соответствие требованиям (Compliance Test Suite, CTS) в рамках OCP, предоставив возможность его внедрения всем желающим. В Meta✴ настаивают на том, что Ethernet должен быть предпочтительной инфраструктурой для ИИ, продемонстрировав, что её реализация RoCE может обеспечивать распределённое обучение ИИ в масштабе, объединяя миллионы GPU. Компания отметила, что в ходе инференса низкая задержка коммуникации между распределёнными сегментами модели напрямую влияет на время отклика для сотен миллионов пользователей. Даже небольшие сетевые помехи ограничивают вычислительную мощность. Протокол RoCE (RDMA over Converged Ethernet) предполагает, что сеть будет доставлять каждый пакет в определённом порядке, используя PFC и препятствуя распылению пакетов, обеспечивая производительность в многоплоскостных и крупномасштабных сетях. При использовании MetaRoCE в строгом выполнении очерёдности передачи данных нет необходимости. Главная задача — обеспечение высокой пропускной способности, низкой задержки в конце очереди распределения и простоты эксплуатации по мере роста сети при увеличении количества ускорителей и расстояний между ними. 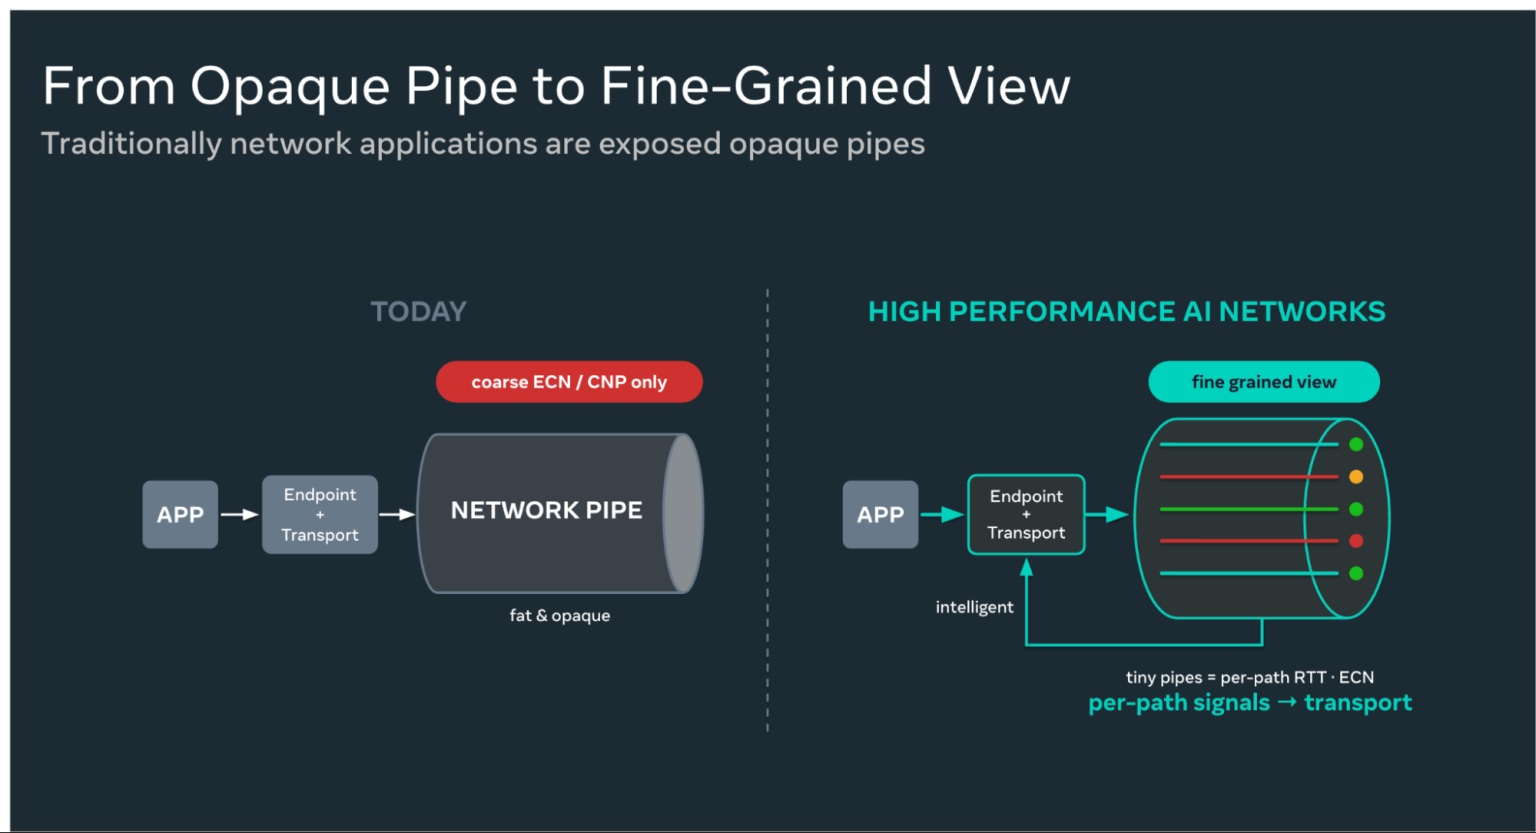
Источник изображений: engineering.fb.com Как указано в блоге Meta✴, суть MetaRoCE проста: сетевая фабрика видит пакеты, а сетевая карта (NIC) — намерения. Традиционные архитектуры ориентированы на «ум» фабрики, полагаясь на коммутаторы для обеспечения отсутствия потерь и поддержания порядка. Перенося интеллектуальные функции на конечную точку, MetaRoCE декомпозирует сеть на множество детализированных (мелкозернистых) логических путей, каждый из которых имеет свою собственную телеметрию в реальном времени — время приёма-передачи данных для каждого пути (Per-path RTT), состояние ECN и загрузку. Такая прозрачность открывает возможности, которые трудно достичь с помощью традиционного RDMA. MetaRoCE распределяет пакеты по множеству путей, поэтому они поступают не в том порядке, в каком были отправлены. Транспортный уровень рассматривает неупорядоченное поступление как обычный случай. Каждый пакет имеет свой адрес назначения, а данные записываются непосредственно в конечную область памяти по мере их поступления, без буфера переупорядочивания и блокировок. При этом MetaRoCE всегда рассматривает Ethernet-фабрику как систему с потерями и не требует от неё иного поведения. Прикладной уровень практически не затрагивается — существующие RDMA-«глаголы» и программные стеки работают без изменений, а дополнительные функции поддерживаются с помощью расширений стандартных API. 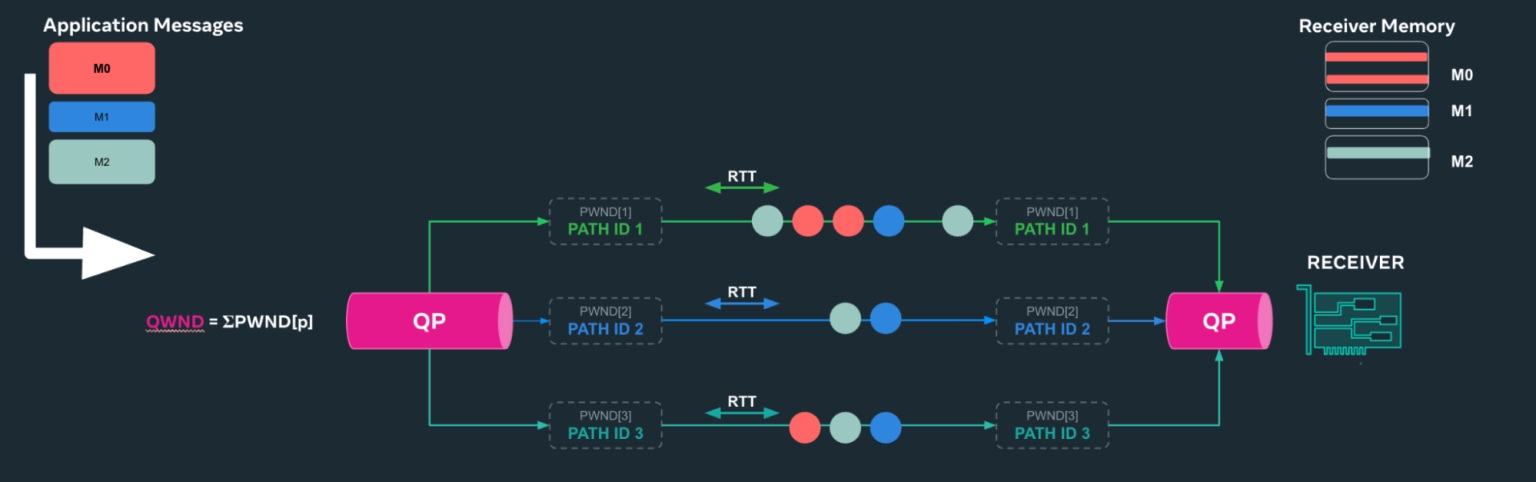 MetaRoCE предоставляет каждому соединению несколько путей и распределяет по ним пакет за пакетом. Каждый путь имеет свой уникальный исходный UDP-порт в качестве энтропии ECMP, который сетевая карта может изменить в любой момент, чтобы перенаправить трафик с неподходящего маршрута. Выбор пути пакета полностью зависит от NIC, так что и эффективность работы всей фабрики зависит от NIC. Оценка каждого пути позволяет явно отличить перегрузку и от сбоя, и сделать перебалансировку, избавившись от плохо работающего пути без обрыва соединение целиком и с возможностью переотправки ровно того пакета, который потерялся из-за сбоя или перегрузки. MetaRoCE сочетает в себе традиционный ECN-контроль перегрузки с AIMD у отправителя с обратной связью со стороны получателя, который при каждом ACK уведомляет отправителя о выделенной ему доле из общей доступной получателю полосы. MetaRoCE запрашивает у фабрики олько две функции, которые уже есть в каждом коммутаторе: ECN и ECMP. Протокол Meta✴ не требует обрезки пакетов, внутрисетевой телеметрии, управления потоком на основе кредитов или распыления пакетов на стороне коммутатора, но и наличие этих функций не мешает работе протокола. MetaRoCE совместим практически с любыми топологиями, в том числе с сегментами в облачных системах, конфигурацию которых нельзя контролировать. В протоколе нет проприетарных компонентов, поэтому фабрика может свободно оптимизироваться с точки зрения стоимости и кабельной разводки. 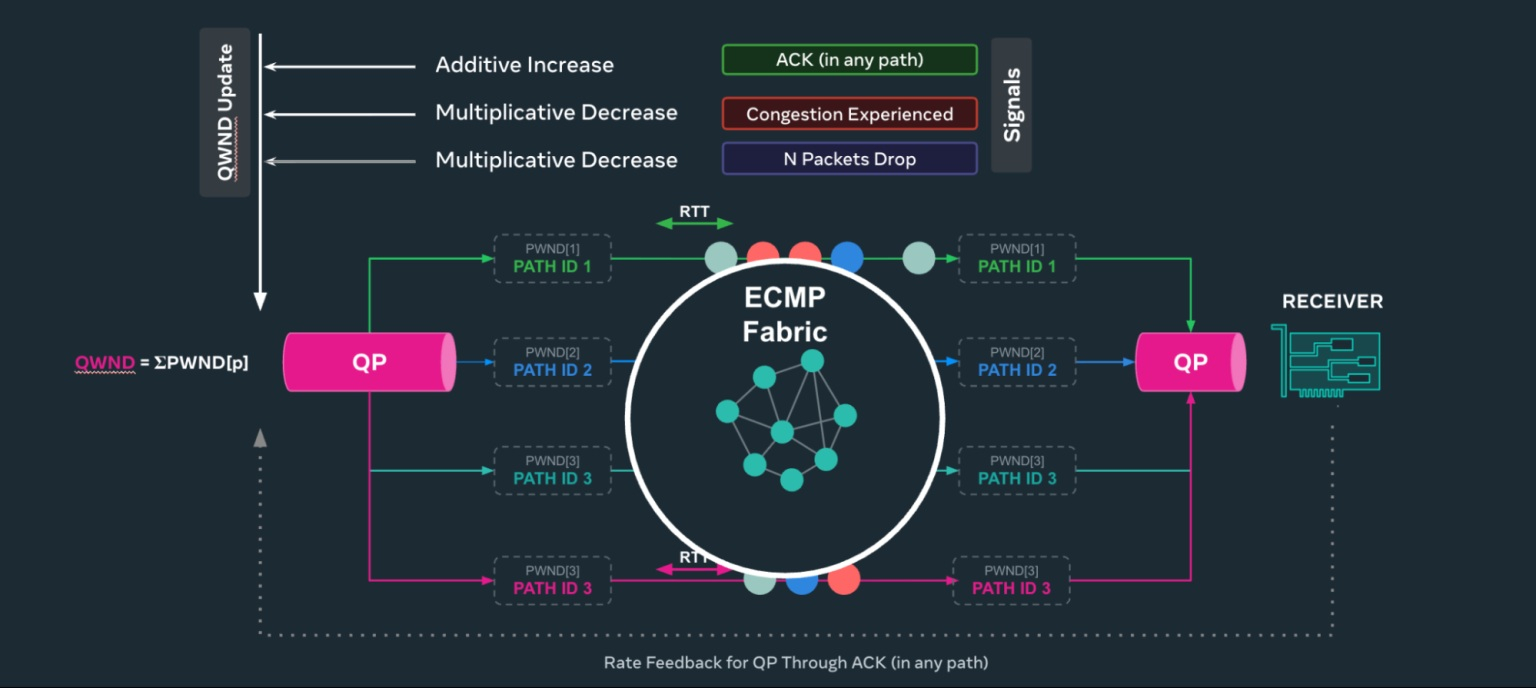 Очередь отправки и очередь приёма (Queue Pair, QP) отвечают как за упорядоченный поток сообщений, так и за пропускную способность. Традиционный RDMA получает больше того или другого путём открытия большего количества QP (по несколько десятков на каждую пару узлов), не знающих ничего ни о друг друге в плане перегрузки, ни об их состоянии в NIC. MetaRoCE использует одно соединение для множества независимых упорядоченных потоков (в т.ч. по одному на каждую коллективную операцию), использующее множественные пути под управлением одного контроллера перегрузки. Чтобы ускорить проверку аппаратного обеспечения, Meta✴ совместно с AMD реализовала MetaRoCE на DPU Pensando. На 64-узловом кластере GPU AMD, работающем под управлением RCCL, компании напрямую сравнили MetaRoCE с RoCEv2 при выполнении коллективных операций All-Reduce и All-to-All. 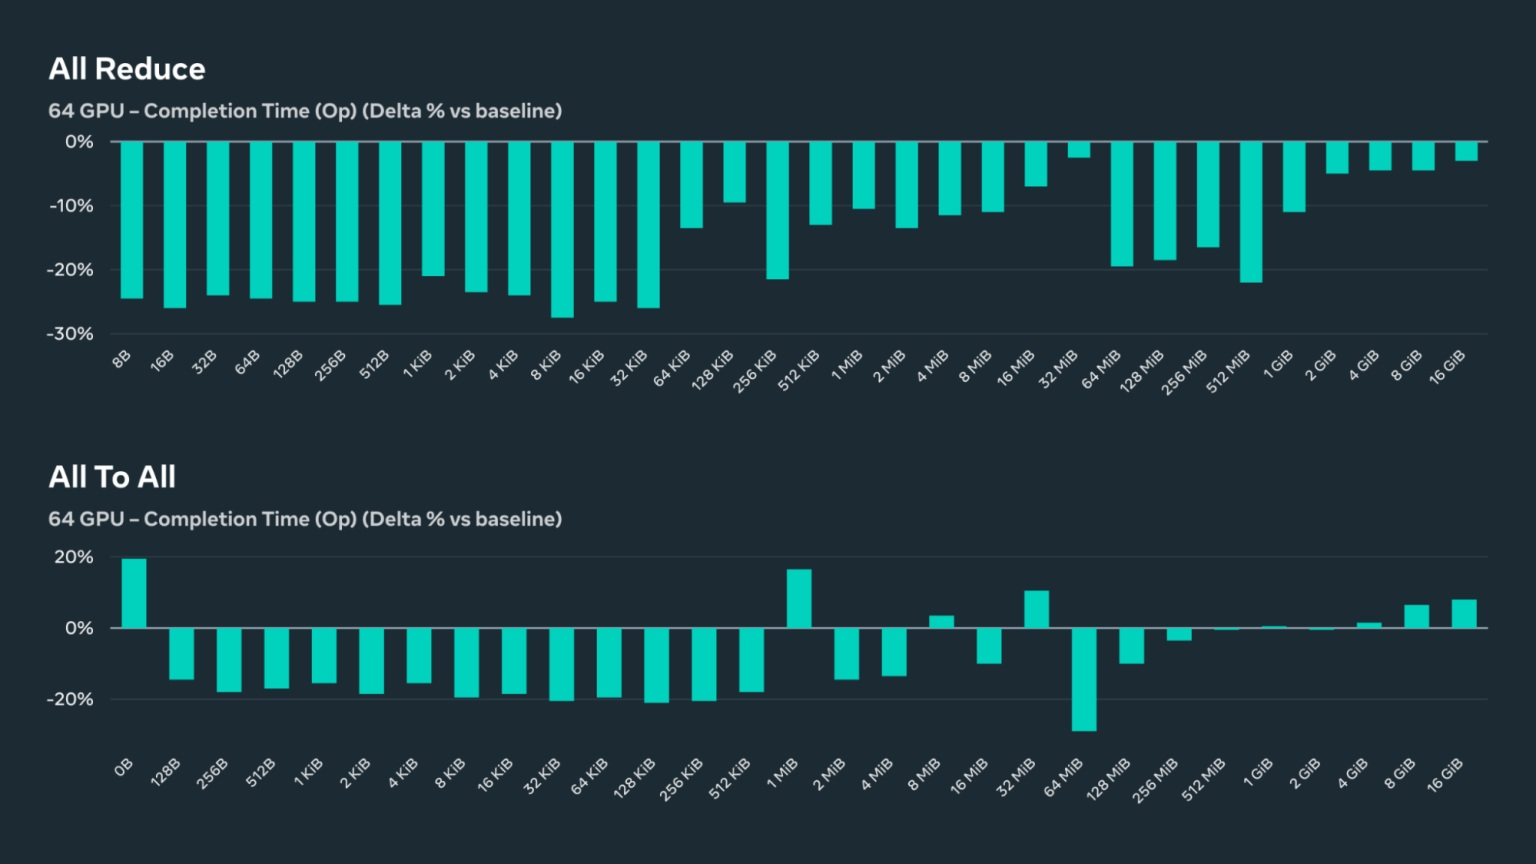 Результаты, как утверждает Meta✴, соответствуют поставленным целям:
Эти результаты подтверждают правильность выбора, сделанного при разработке MetaRoCE, отметила Meta✴. Благодаря тому, что протокол с самого начала разрабатывался с учётом возможных потерь пакетов, а интеллектуальные функции вынесены на периферию, он обеспечивает более высокую производительность в идеальных условиях и плавно снижает нагрузку при сбоях. Компания подчеркнула, что протокол MetaRoCE является открытым, его спецификации добавлены в OCP, и любой поставщик может с их помощью создать и реализовать совместимое оборудование. Впрочем, во многом похожий протокол MRC (Multipath Reliable Connection) также передан в OCP, да и Ultra Ethernet тоже решает схожие задачи.
29.08.2026 [14:38], Сергей Карасёв
Пропускная способность оптических модулей XPO вырастет вдвое — до 25,6 Тбит/сУчастники многостороннего соглашения XPO MSA (eXtra-dense Pluggable Optics Multi-Source Agreement) под предводительством Arista Networks поделились планами по дальнейшему развитию оптических модулей XPO для высокоплотных ИИ-инфраструктур следующего поколения. В оригинальном исполнении модуль XPO объединяет 64 канала с пропускной способностью 200 Гбит/с, что в сумме даёт 12,8 Тбит/с. Отмечается, что один XPO заменяет восемь модулей OSFP: это позволяет существенно сократить площадь под сетевые коммутаторы в дата-центрах, ориентированных на ресурсоёмкие задачи ИИ. Так, в шасси 1OU могут быть размещены 16 модулей XPO, что обеспечивает скорость передачи данных до 204,8 Тбит/с. При этом стойка стандарта ORv3 с такими устройствами способна поддерживать коммутационную ёмкость до 6,5 Пбит/с. Для XPO изначально предусмотрено применение жидкостного охлаждения. 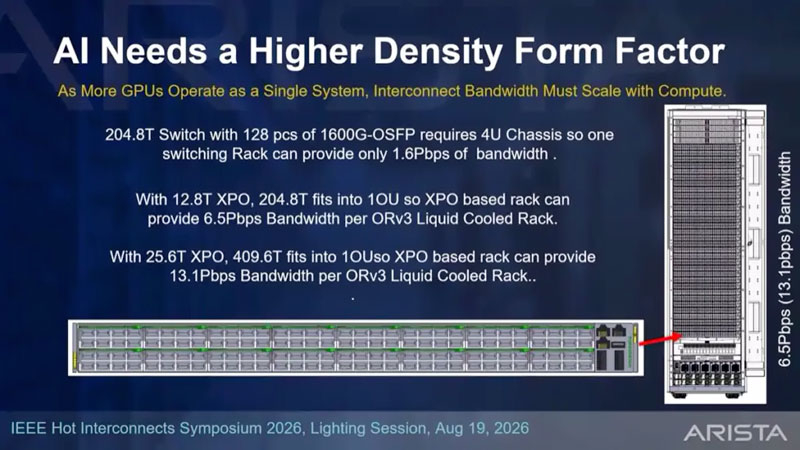
Источник изображений: Arista В перспективе участники XPO MSA намерены удвоить пропускную способность модулей. В частности, каждый из 64 каналов сможет работать в режиме 400 Гбит/с, или в совокупности 25,6 Тбит/с. Это поднимет плотность до 409,6 Тбит/с на шасси 1OU и до 13,1 Пбит/с на стойку ORv3. Говорится о поддержке медных кабелей и оптики с полным восстановлением синхронизации на базе DSP. Упомянута совместимость со стандартами DR, FR, LR, SR, ZR. 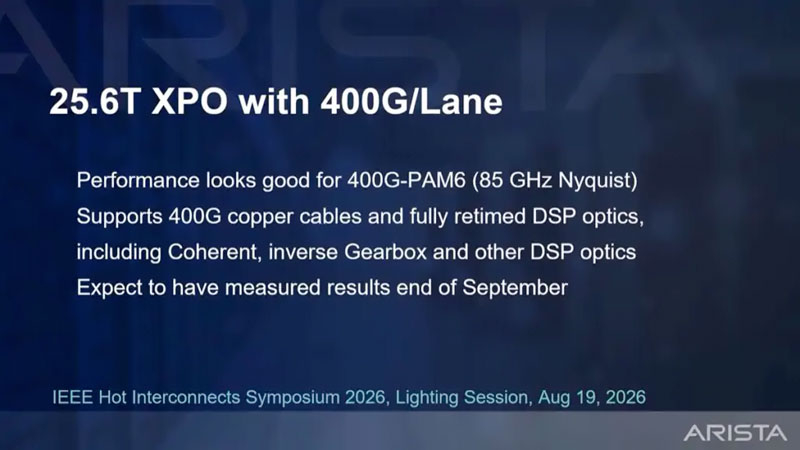 Архитектура новых модулей по-прежнему предусматривает наличие встроенного жидкостного охлаждения на основе водоблока с быстроразъёмными соединениями. Поддерживаются конфигурации с энергопотреблением до 500 Вт на модуль. Прямое подключение к источнику DC-питания 50 В избавляет от необходимости использования преобразователей напряжения на системной плате. В целом, изделия XPO занимают нишу между классическими съёмными модулями OSFP и интегрированной оптикой CPO. 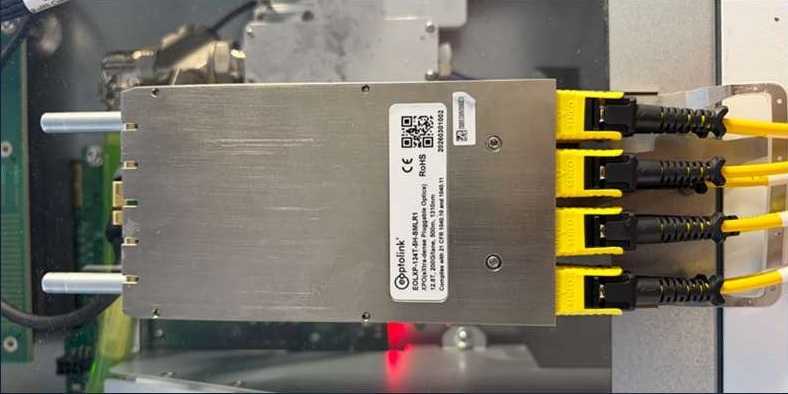 |
|

