
Материалы по тегу: hpc
|
13.06.2022 [16:34], Руслан Авдеев
Площадка для будущего 2-Эфлопс суперкомпьютера El Capitan готова: 85 МВт + мощная система охлажденияНациональное управление ядерной безопасности (NNSA) при Министерстве энергетики США официально закончило реконструкцию ЦОД при Ливерморской национальной лаборатории (LLNL) в рамках проекта Exascale Computing Facility Modernization. Обновлены энергетическая система и система охлаждения местного вычислительного центра для использования вычислительных мощностей экзафлопсного уровня. Первой новой действующей системой NNSA станет 2-Эфлопс суперкомпьютер El Capitan, предназначенный для выполнения задач Ливерморской лаборатории, Лос-Аламосской национальной лаборатории и Сандийской национальной лаборатории. По словам представителя NNSA, экзафлопсные вычисления помогут стране в важных, неотложных проектах модернизации вооружений. 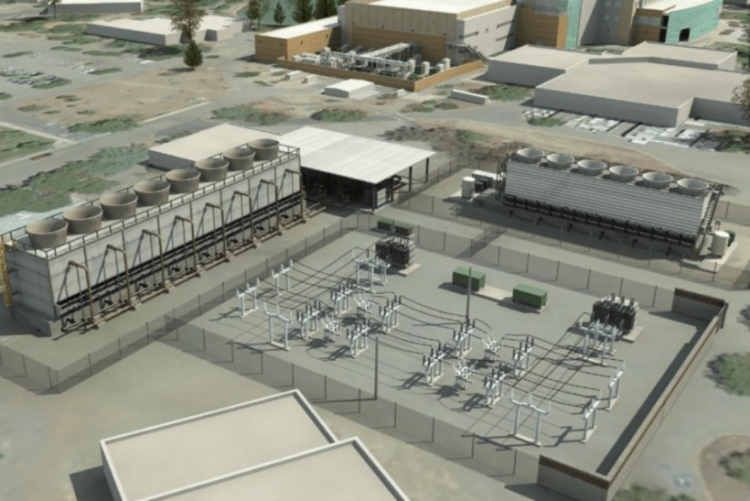
Источник изображения: Department of Energy Обновление позволит Ливерморской лаборатории выполнять ресурсоёмкие задачи, 3D-моделирование и симуляцию процессов, связанных с реализацией военных проектов — это необходимо для того, чтобы соответствовать требованиям к сертификации Программы сопровождения ядерного арсенала, реализуемой под эгидой NNSA, основной миссией которой декларируется расширение возможностей американских средств ядерного сдерживания. Сейчас стадия обновления ЦОД завершена и намечен переход к следующим этапам. В результате реализации проекта более, чем удвоилась охлаждающая мощность объекта — теперь он способен ежедневно поглощать количество тепла, достаточного для того, чтобы растопить 28 тыс. тонн льда. Энергетическая мощность ЦОД увеличена с 45 до 85 МВт, а в процессе строительства были обновили линии электропередач, подстанции и управляющее оборудование. Ожидается, что итоговая производительность El Capitan составит более 2 Эфлопс, а потреблять он будет порядка 30–35 МВт. Проработать он должен до 2029 года, однако параллельно будет строиться ещё один суперкомпьютер нового поколения. Некоторые предполагают, что подобные площадки станут последними в своём роде, в первую очередь из-за проблем с электропитанием.
01.06.2022 [01:18], Владимир Мироненко
Ведущий специалист NERSC перешёл в Microsoft, заявив, что строящиеся экзафлопсные суперкомпьютеры будут последними в своём родеГленн Локвуд (Glenn K. Lockwood), ведущий специалист Национального научного вычислительного центра энергетических исследований (NERSC) при Министерстве энергетики США перешёл на работу в Microsoft. Он является архитектором высокопроизводительных масштабируемых систем хранения данных для суперкомпьютеров. Локвуд, в частности, руководил развёртыванием первого в мире 35-Пбайт All-Flash хранилища с ФС Lustre для суперкомпьютера Perlmutter. В своём блоге Локвуд объяснил, почему он ушёл из NERSC в Microsoft. По его словам, лидирующие HPC-системы балансируют на грани выживания, в то время как HPC-системы среднего клсса практически полностью обесцениваются поставщиками облачных услуг. При текущих тенденциях стоимость строительства нового дата-центра и обширной инфраструктуры питания и охлаждения для каждого нового мощного суперкомпьютера очень скоро станет непомерно высокой, говорит Локвуд. Он высказал мнение, что ЦОД мощностью 50–60 МВт, строящиеся сейчас для экзафлопсных суперкомпьютеров, будут последними в своём роде. 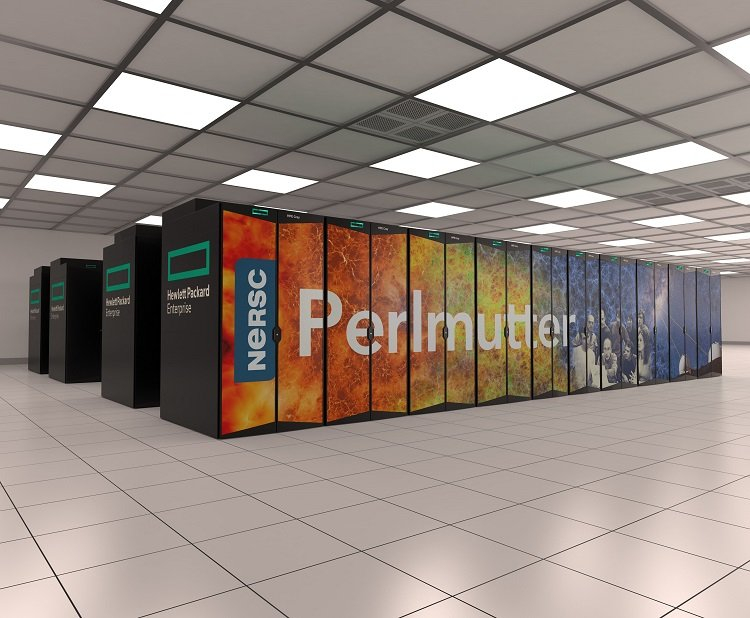
Источник изображения: AMD Что касается менее мощных систем, таких как Perlmutter, то необходимость в них постепенно сокращается по мере того, как облако набирает обороты. «Вы можете установить полную систему [HPE] Cray EX, идентичную той, что вы можете найти в NERSC или OLCF, в Azure <…> и интегрировать её с богатыми инфраструктурными возможностями облака», — говорит Локвуд. Кроме того, облака действительно гораздо быстрее внедряют новинки. Так, процессоры AMD EPYC MilanX и ускорители Instinct MI200 появились в инфраструктуре Microsoft Azure намного раньше, чем в HPC-центрах. «Я не утверждаю, что знаю будущее, и многое из того, что я изложил, является в лучшем случае гипотетическим», — заявил Гленн Локвуд, отметив, что приверженность Министерства энергетики США к независимым HPC-системам сохранится по меньшей мере ещё десятилетие. Локвуд стал очередным специалистом, покинувшем традиционный HPC-сектор и ушедшим в Microsoft. В 2020 году в Microsoft перешёл технический директор Cray Стив Скотт (Steve Scott). Год спустя к Microsoft присоединился соруководитель программы Cray PathForward доктор Дэн Эрнст (Dan Ernst).
30.05.2022 [23:43], Владимир Мироненко
HPE и SiPearl займутся совместной разработкой HPC-решений с использованием европейских Arm-процессоровSiPearl, европейский разработчик высокопроизводительных и энергоэффективных процессоров для суперкомпьютеров, и американская компания HPE объявили о стратегическом партнёрстве с целью совместной разработки решений для высокопроизводительных вычислений (HPC). Как ожидается, сотрудничество двух компаний, которое расширяет возможности гетерогенных вычислений для суперкомпьютеров и использует европейские архитектуры, позволит ускорить внедрение экзафлопсных систем в Европе. HPE и SiPearl займутся разработкой комплексной HPC-платформы, которая сочетает в себе решения HPE, разработанные с учётом требований нового поколения суперкомпьютеров к производительности и масштабируемости, и будущий Arm-процессор SiPearl Rhea, который позволит достичь экзафлопсного уровня производительности европейским суперкомпьютерам. Ранее SiPearl заключила похожие соглашения с Intel и NVIDIA. 
Источник изображения: SiPearl Ожидается, что HPE предоставит свою программно-аппаратную платформу, включая интерконнект Slingshot, фирменный компилятор и HPC-стек ПО. Причём изначально закладывается поддержка гетерогенных систем. Кроме того, в рамках партнёрства совместные решения HPE и SiPearl будут предоставлены Центру передового опыта (CoE) HPE в Гренобле (Франция), где проводятся исследования в области полупроводников, чтобы позволит ускорить тестирование и оптимизацию новых продуктов.
30.05.2022 [10:00], Игорь Осколков
Июньский TOP500: есть экзафлопс!59-я редакция TOP500, публичного рейтинга самых производительных суперкомпьютеров мира, стала наиболее знаменательной за последние 14 лет, поскольку официально был преодолён экзафлопсный барьер. Путь от петафлопса оказался долгим — первой петафлопсной системой стал суперкомпьютер IBM Roadrunner, и произошло это аж в 2008 году. Но минимальным порогом для попадания в TOP500 эта отметка стала только в 2019 году. Как и было обещано, официально и публично отметку в 1 Эфлопс в бенчмарке HPL на FP64-вычислениях первым преодолел суперкомпьютер Frontier — его устоявшаяся производительность составила 1,102 Эфлопс при теоретическом пике в 1,686 Эфлопс. Система на платформе HPE Cray EX235a использует оптимизированные 64-ядерные процессоры AMD EPYC Milan (2 ГГц), ускорители AMD Instinct MI250X и фирменный интерконнект Slingshot 11-го поколения. Система имеет суммарно 8 730 112 ядер, потребляет 21,1 МВт и выдаёт 52,23 Гфлопс/Вт, что делает её второй по энергоэффективности в мире. 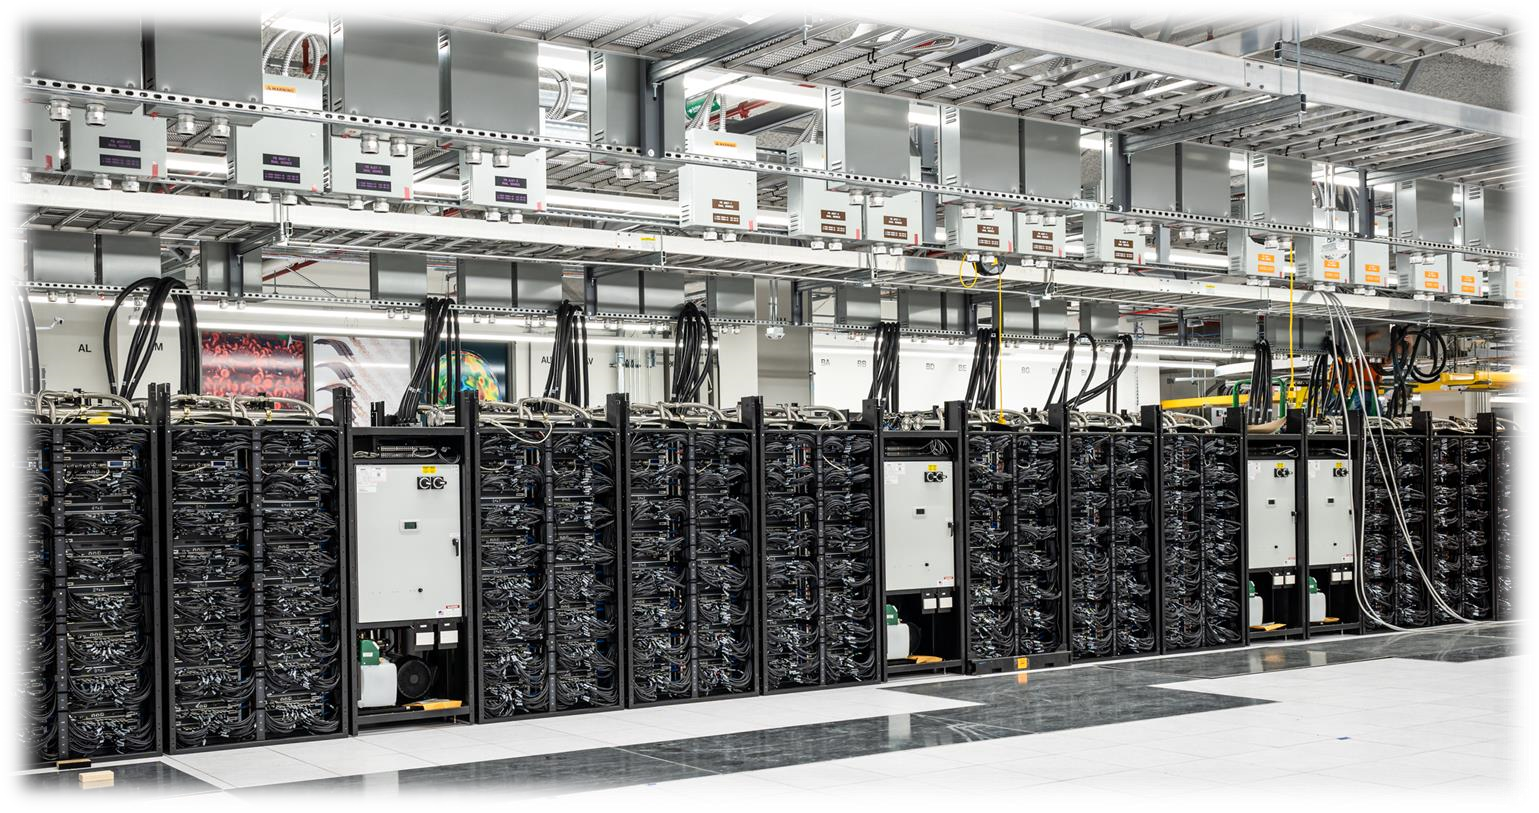
Суперкомпьютер Frontier (Фото: AMD) Впрочем, первое место в Green500 по данному показателю всё равно занимает тестовый кластер в составе всё того же Frontier: 120 832 ядра, 19,2 Пфлопс, 309 кВт, 62,68 Гфлопс/Вт. Третье и четвёртое места достались европейским машинам LUMI и Adastra, новичкам TOP500, которые по «железу» идентичны Frontier, но значительно меньше. Да и разница в Гфлопс/Вт между ними минимальна. Скопом они сместили предыдущего лидера — экзотичную японскую систему MN-3 от Preferred Networks. Японская система Fugaku, лидер по производительности в течение двух последних лет, сместилась на второе место TOP500. Третье место у финской системы LUMI с показателем производительности 151,9 Пфлопс — обратите внимание, насколько велик разрыв в первой тройке машин. Наконец, в Топ-10 последнее место занял новичок Adastra (46,1 Пфлопс), который расположен во Франции. 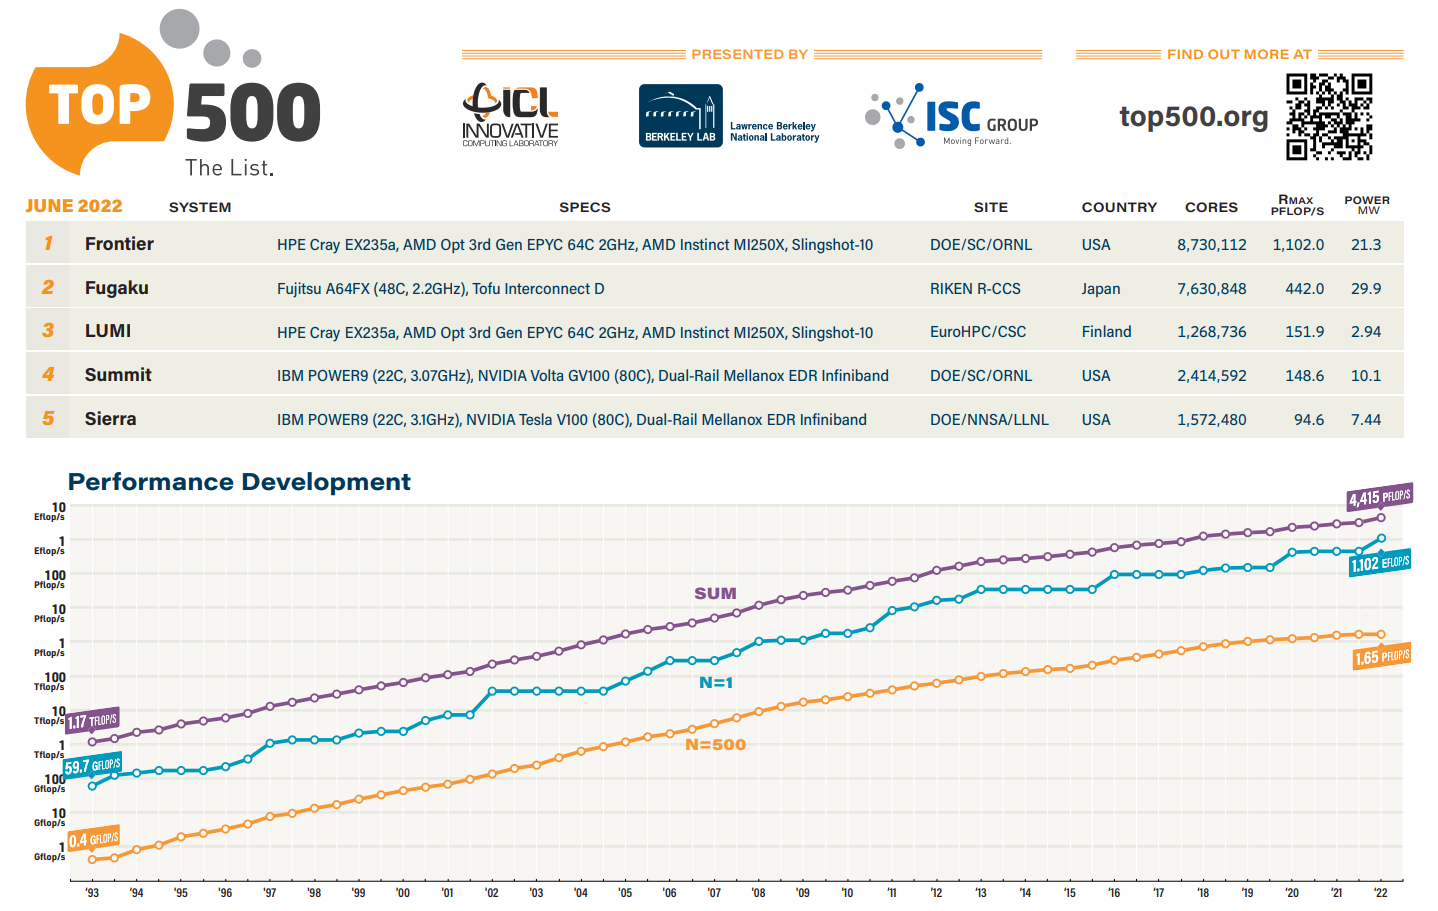
Источник: TOP500 В бенчмарке HPCG всё ещё лидирует Fugaku (16 Пфлопс), но, судя по всему, только потому, что для Frontier данных пока нет. Ну и потому, что результат суперкомпьютера LUMI, который почти на порядок медленнее Frontier, в HPCG составляет 1,94 Пфлопс. Наконец, в HPL-AI Frontier также отобрал первенство у Fugaku — 6,86 Эфлопс в вычислениях смешанной точности против 2 Эфлопс. В общем, у Frontier полная победа по всем фронтам, и эту машину можно назвать не только самой быстрой в мире, но первой по-настоящему экзафлопсной системой. Если, конечно, не учитывать неофициальные результаты OceanLight и Tianhe-3 из Поднебесной, которые в TOP500 никто не заявил. Число китайских систем в нынешнем рейтинге осталось прежним (173 шт.), тогда как США «ужались» со 150 до 127 шт. Российских систем в списке всё так же семь. Лидерами по числу поставленных систем остаются Lenovo, HPE и Inspur, а по их суммарной производительности — HPE, Fujitsu и Lenovo. С другой стороны, массовых изменений и не было — в нынешнем списке всего около сорока новых систем. 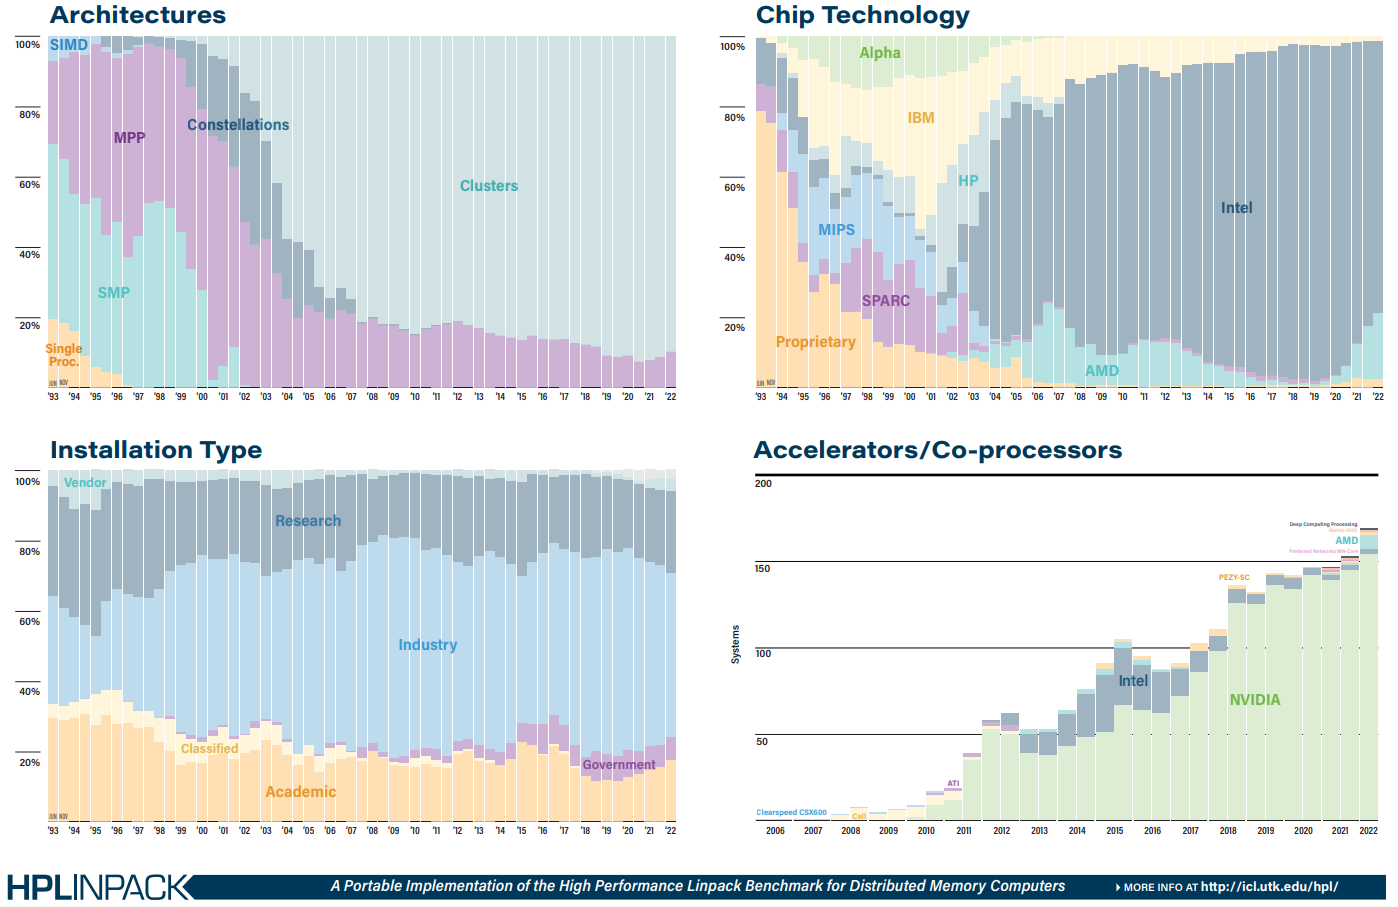
Источник: TOP500 Однако нельзя не отметить явный прогресс AMD — да, чуть больше трёх четвертей машин из списка используют процессоры Intel, но AMD удалось за полгода отъесть около 4 %. При этом AMD EPYC Milan присутствует в более чем трёх десятках систем, а доля Intel Xeon Ice Lake-SP вдвое меньше, хотя эти процессоры появились практически одновременно. Ускорители ожидаемо стали использовать больше — они применяются в 170 системах (было 150). Подавляющее большинство приходится на решения NVIDIA разных поколений, но и для новых Instinct MI250X нашлось место в восьми машинах. Ну а в области интерконнекта Infiniband потихоньку догоняет Ethernet: 226 машин против 196 + ещё 40 с Omni-Path + редкие проприетарные решения.
29.05.2022 [20:15], Игорь Осколков
Европейские Arm-процессоры SiPearl получат поддержку ускорителей и DPU NVIDIASiPearl, европейский разработчик высокопроизводительные и энергоэффективных процессоров для суперкомпьютеров, в том числе экзафлопсного класса, и NVIDIA объявили о сотрудничестве, в рамках которого предложат заказчикам совместные решения, включающие HPC-продукты и сетевые компоненты NVIDIA и CPU SiPearl (первым станет Rhea). Сотрудничество направленно на объединение портфолио аппаратных и программных решений обеих компаний, а также на совместную работу в области разработки продуктов и развития бизнеса. 
Источник: NVIDIA NVIDIA и SiPearl создадут прокси-платформу для переноса и анализа рабочих нагрузок, которая позволит наилучшим образом задействовать сильные стороны продуктов обеих компаний, например, HBM-память в процессорах SiPearl и массивно-параллельную архитектуру ускорителей NVIDIA. Кроме того, планируется совместная работа со сторонними европейскими исследовательскими институтами над открытыми инструментами для моделирования SoC и NoC. Компании намерены добиться полной совместимости на уровне «железа», а также совместно развивать программную экосистему для HPC-решений на базе платформы Arm. Ранее аналогичное соглашение о сотрудничестве было заключено между SiPearl и Intel. И в том и в другом случае SiPearl, штат которой, к слову, недавно вырос до более чем ста сотрудников, говорит о возможности предоставить европейским заказчикам наиболее оптимальное решение для их задач. Несмотря на то, что Европа стремится стать независимой от США в области высокопроизводительных вычислений (HPC), на первом этапе этого, судя по всему, исключительно своими силами обойтись будет нельзя.
24.05.2022 [07:00], Игорь Осколков
NVIDIA представила референсные платформы CGX, OVX и HGX на базе собственных Arm-процессоров GraceНа весенней конференции GTC 2022 NVIDIA поделилась подробностями о грядущих серверных Arm-процессорах Grace Superchip и гибридах Grace Hopper Superchip, а на Computex 2022 представила первые референсные платформы на базе этих чипов для OEM-производителей и объявила о расширении программы NVIDIA Certified. Последнее, впрочем, не означает отказ от x86-систем, поскольку программа будет просто расширена. Да и портирование стороннего и собственного ПО займёт некоторое время. Первые несколько десятков моделей серверов от ASUS, Foxconn, GIGABYTE, QCT, Supermicro и Wiwynn появятся в первой половине 2023 года. Представлены они будут в трёх категориях, причём все, за исключением одной, базируются на «сдвоенных» процессорах Grace Superchip, насчитывающих до 144 ядер. 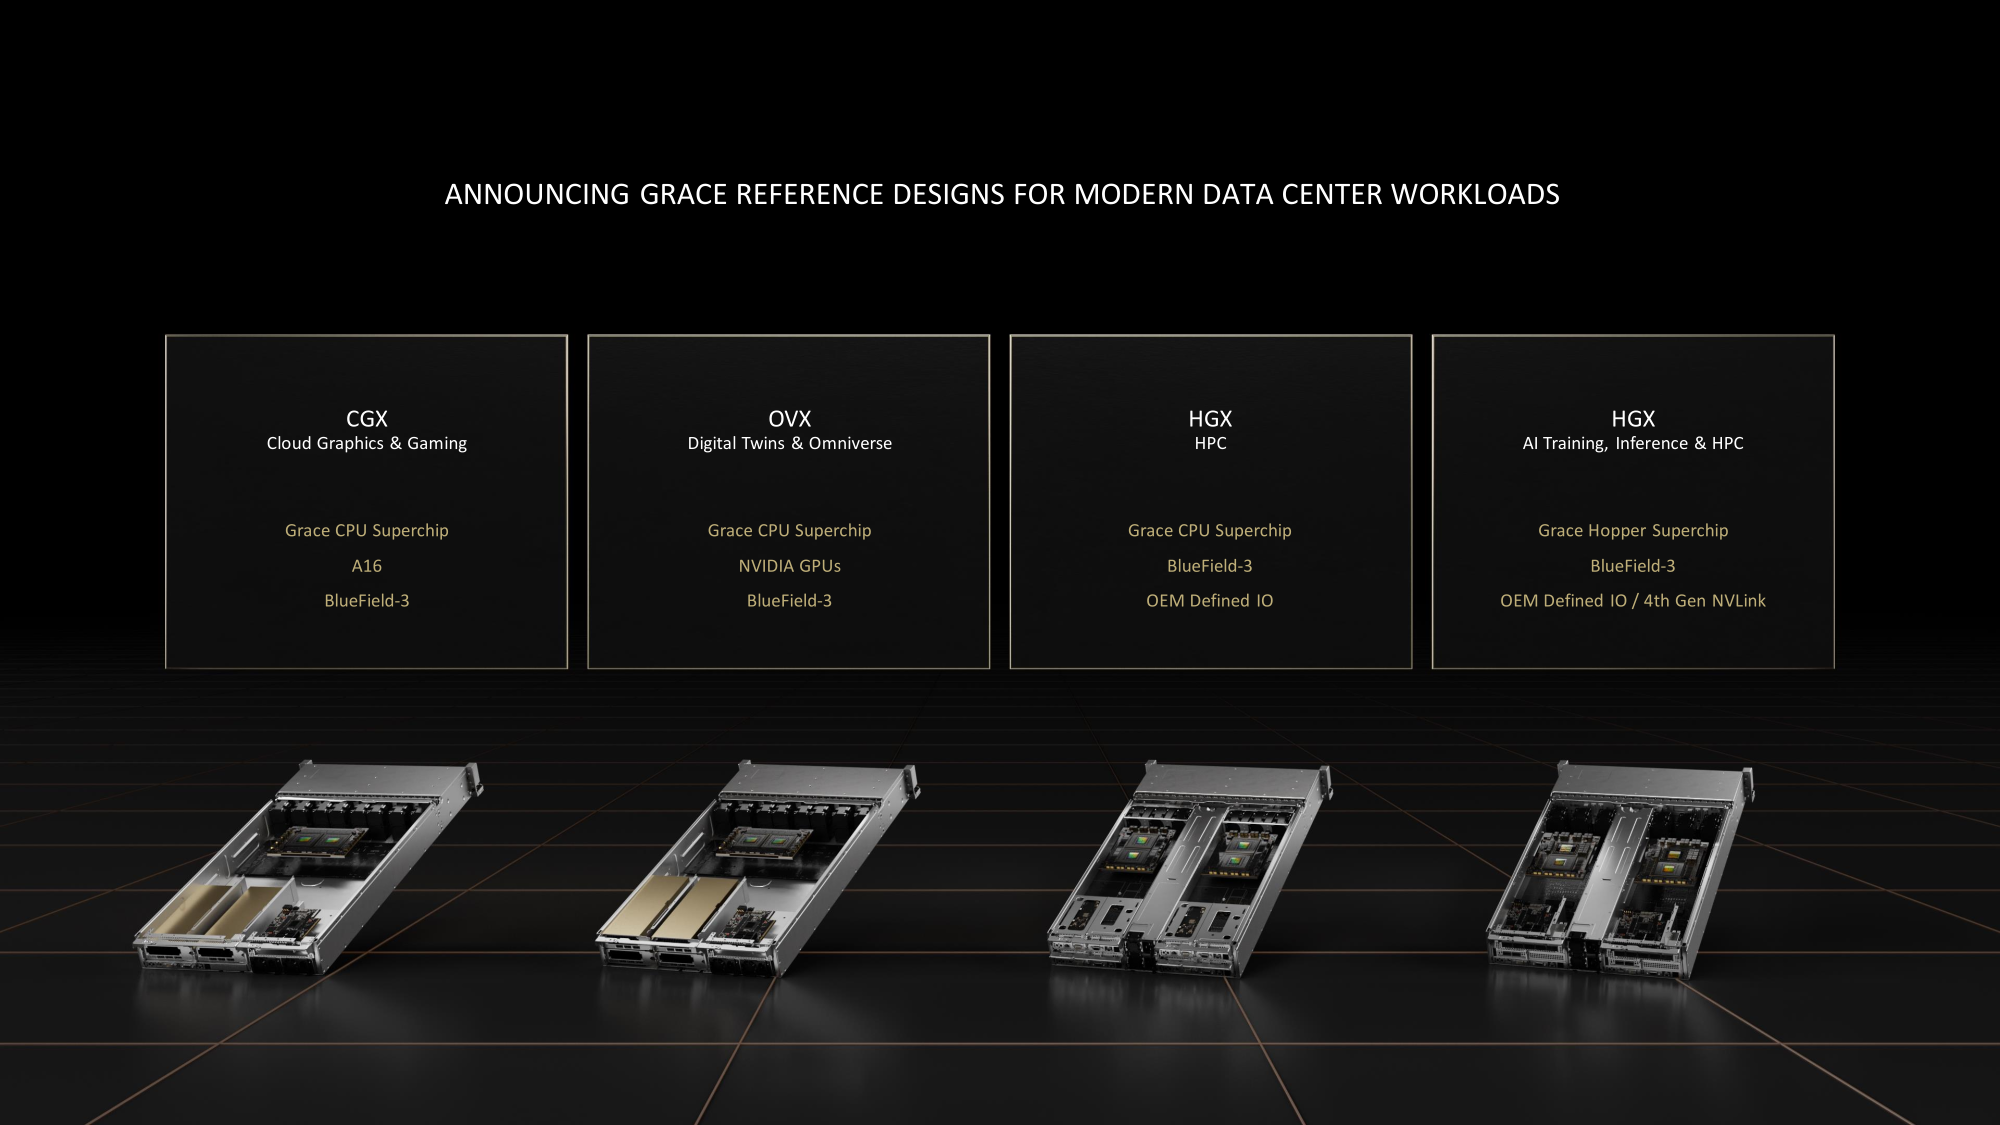
Источник: NVIDIA Системы серии OVX, представленной ранее, всё так же будут предназначены для цифровых двойников и Omniverse — NVIDIA продолжает наставить на том, что любое современное производство или промышленное предприятие должно быть интеллектуальным. Arm-версия OVA получит неназванные ускорители NVIDIA и DPU Bluefield-3. Новая платформа NVIDIA CGX очень похожа на OVX — она тоже получит DPU Bluefield-3 и до четырёх ускорителей NVIDIA A16. CGX создана специального для облачных гейминга и работы с графикой. А вот новое поколение платформы NVIDIA HGX гораздо интереснее. Оно заметно отличается от предыдущих, которые в основном представляли собой различные комбинации базовых плат NVIDIA с четырьмя или восемью ускорителями, вокруг которых OEM-партнёры строили системы в меру своих умений и фантазий. Нынешняя инкарнация NVIDIA HGX всё же несколько более комплексная, поскольку сейчас предлагается два варианта узлов, специально спроектированных для высокоплотных систем и явно ориентированных на высокопроизводительные вычисления (HPC). 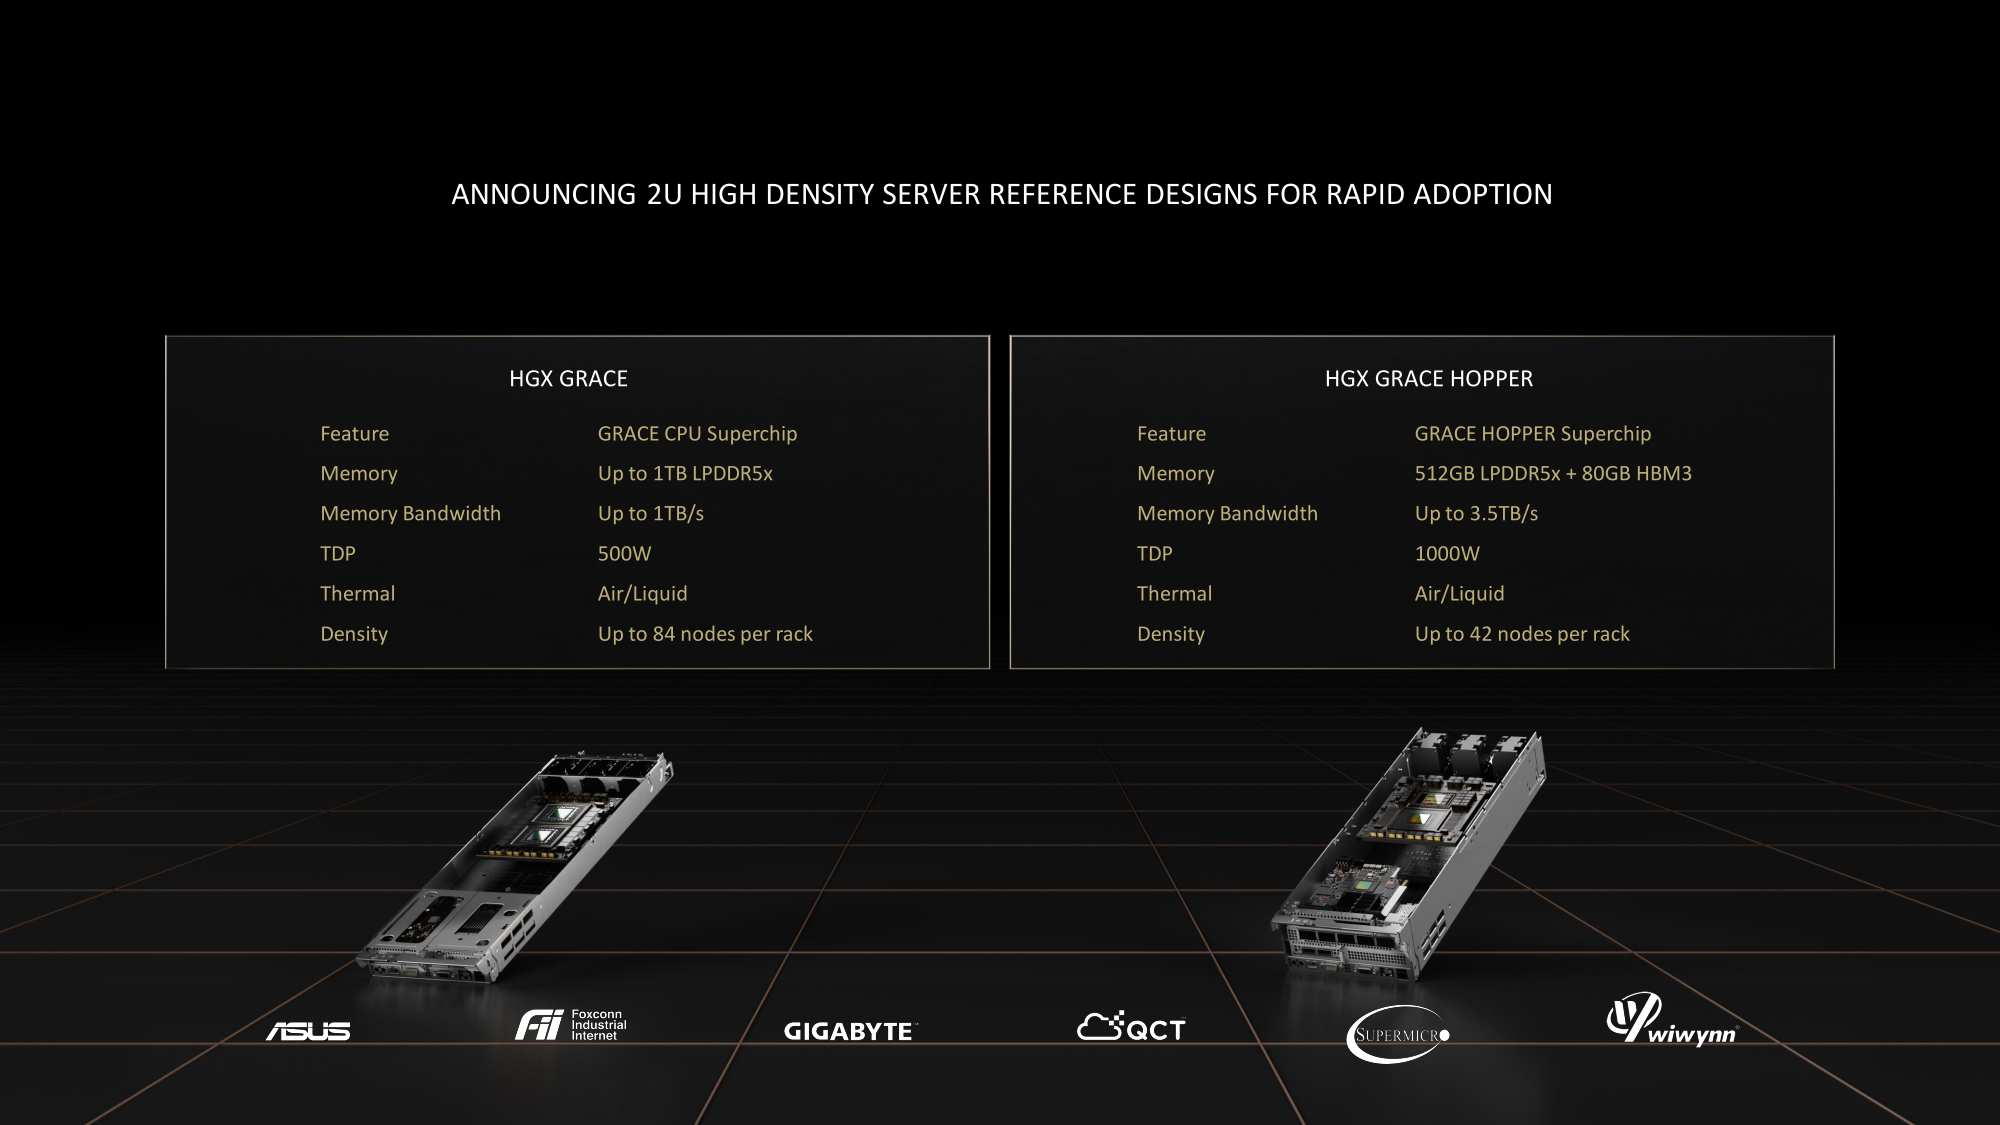
Источник: NVIDIA Первый вариант — это 1U-лезвие (до 84 шт. в стандартной стойке), которое включает один процессор Grace Superchip, до 1 Тбайт LPDDR5x-памяти с пропускной способностью (ПСП) до 1 Тбайт/с и DPU BlueField-3. Иные варианты сетевого подключения оставлены на усмотрение конечного производителя. Заявленный уровень TDP составляет 500 Вт, так что на выбор доступны системы с воздушным и жидкостным охлаждением. Второй вариант базируется на гибридных чипах Grace Hopper Superchip, объединяющих в себе посредством шины NVLink-C2C процессорную часть с 512 Гбайт LPDDR5x-памяти и ускоритель NVIDIA H100 c 80 Гбайт HBM3-памяти (ПСП до 3,5 Тбайт/с). Помимо DPU BlueField-3 опционально доступен и интерконнект NVLink 4.0, но и здесь вендору оставлена свобода выбора. Уровень TDP для данной платформы составляет 1 кВт, но вот обойтись одним только воздушным охлаждением (а такой вариант есть) при полном заполнении стойки всеми 42-мя 2U-лезвиями будет трудно.
16.04.2022 [23:54], Алексей Степин
Космический суперкомпьютер HPE Spaceborne-2 успешно завершил 24 эксперимента на МКСПериферийные вычисления подразумевают работу достаточно мощных серверов в нестандартных условиях. Казалось бы, 400 километров — не такое уж большое расстояние. Но если это высота орбиты космической станции, то более «периферийное» место найти будет сложно. А ведь если человечество планирует и далее осваивать космос, оно неизбежно столкнётся и с проблемами, свойственными космическим ЦОД. Первый космический суперкомпьютер, как его окрестили создатели из HPE, появился в 2017 году и успешно проработал на орбите 615 дней. Инженеры учли выявленные особенности работы такой системы на орбите и в прошлом году отправили на МКС Spaceborne-2 (SBC-2), который стал вдвое производительнее предшественника. 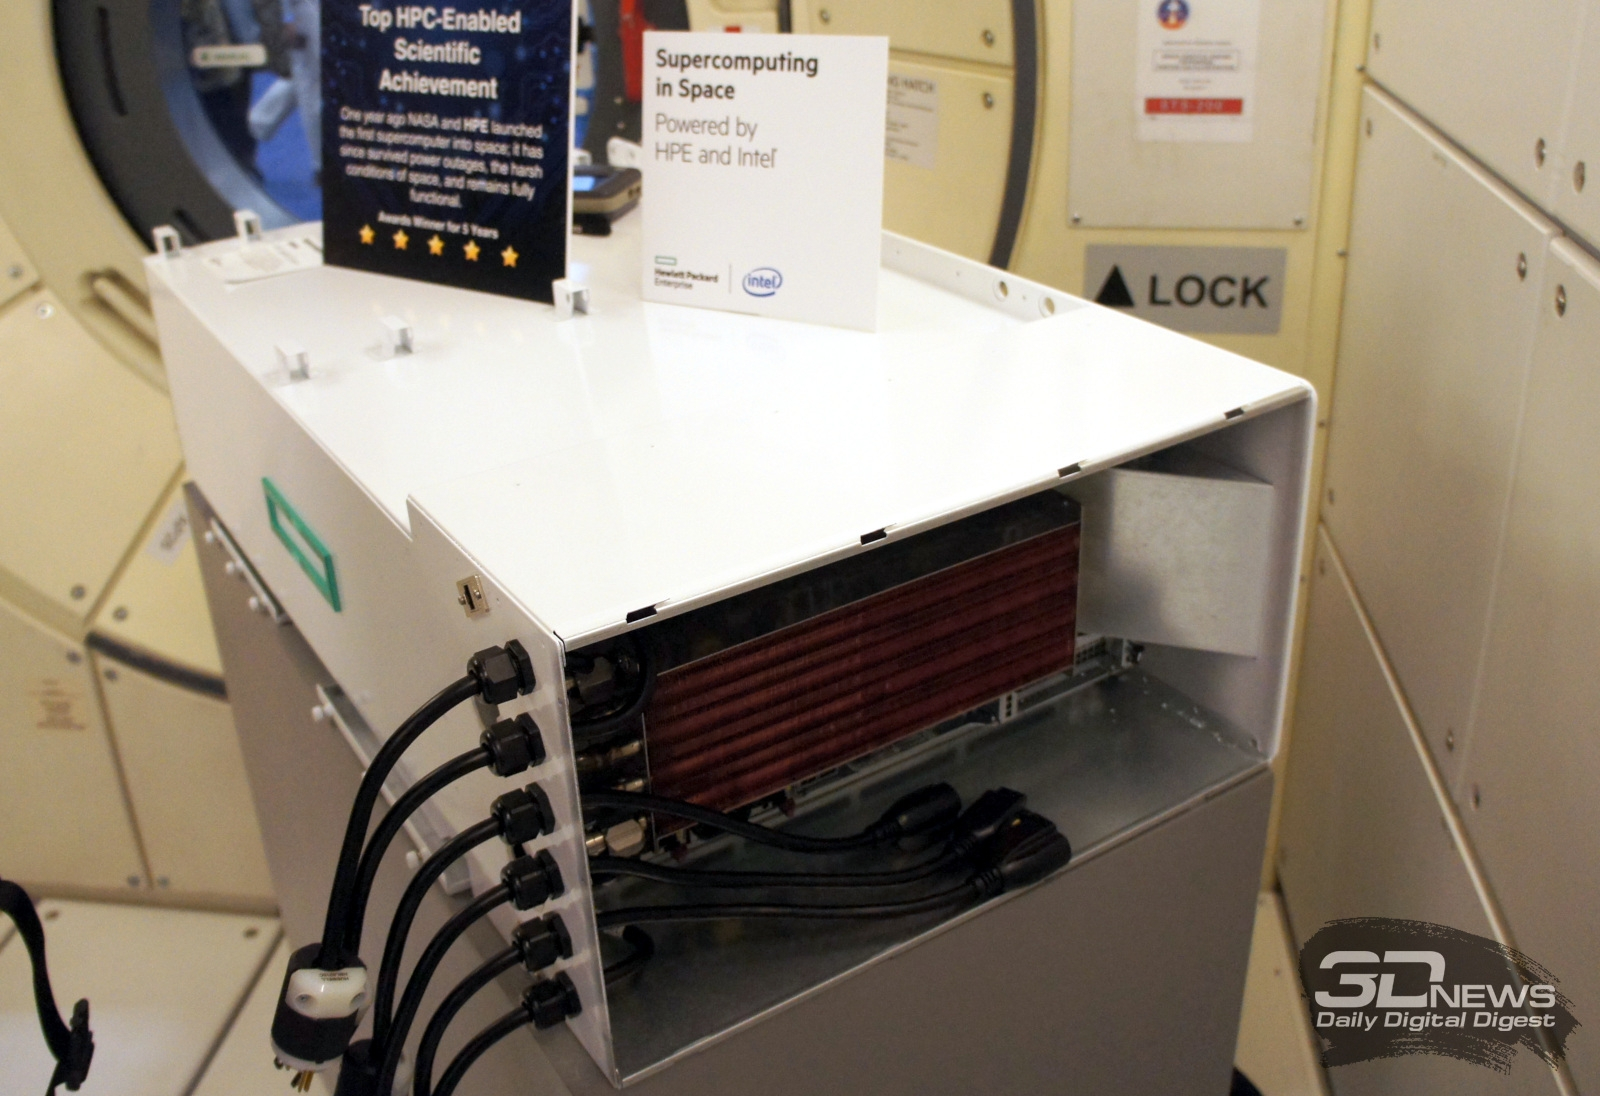
HPE Spaceborne-1 Хотя SBC-2 по земным меркам и невелик и состоит всего из двух вычислительных узлов (HPE Edgeline EL4000 и HPE ProLiant DL360 Gen10, совокупно чуть более 2 Тфлопс), это самая мощная компьютерная система, когда-либо работавшая в космосе. К тому же, это единственная космическая вычислительная система, оснащённая ИИ-ускорителем NVIDIA T4. 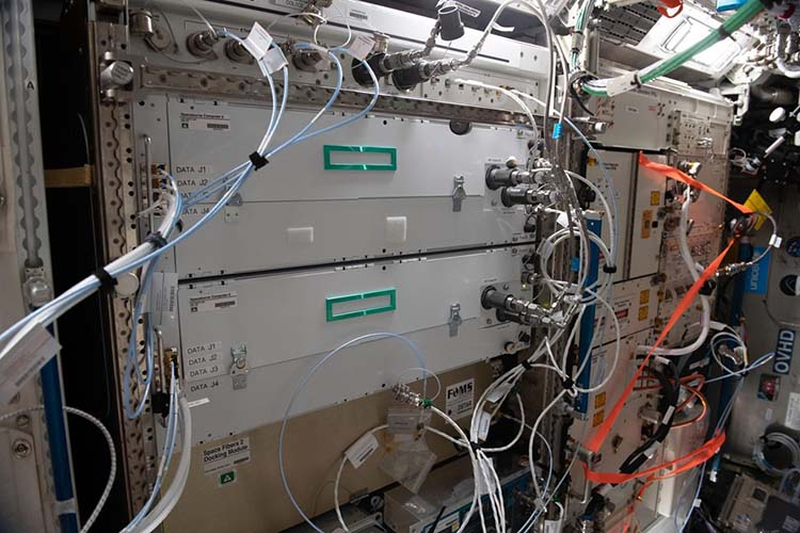
HPE Spaceborne-2 (Изображения: HPE) Теперь же HPE сообщает, что эта машина меньше чем за год помогла в проведении 24 важных научных экспериментов. Всё благодаря достаточно высокой производительности. Одним из первых стал стал анализ генов — обработка данных непосредственно на орбите позволила снизить объём передаваемой информации с 1,8 Гбайт до 92 Кбайт. Но это далеко не единственный результат. 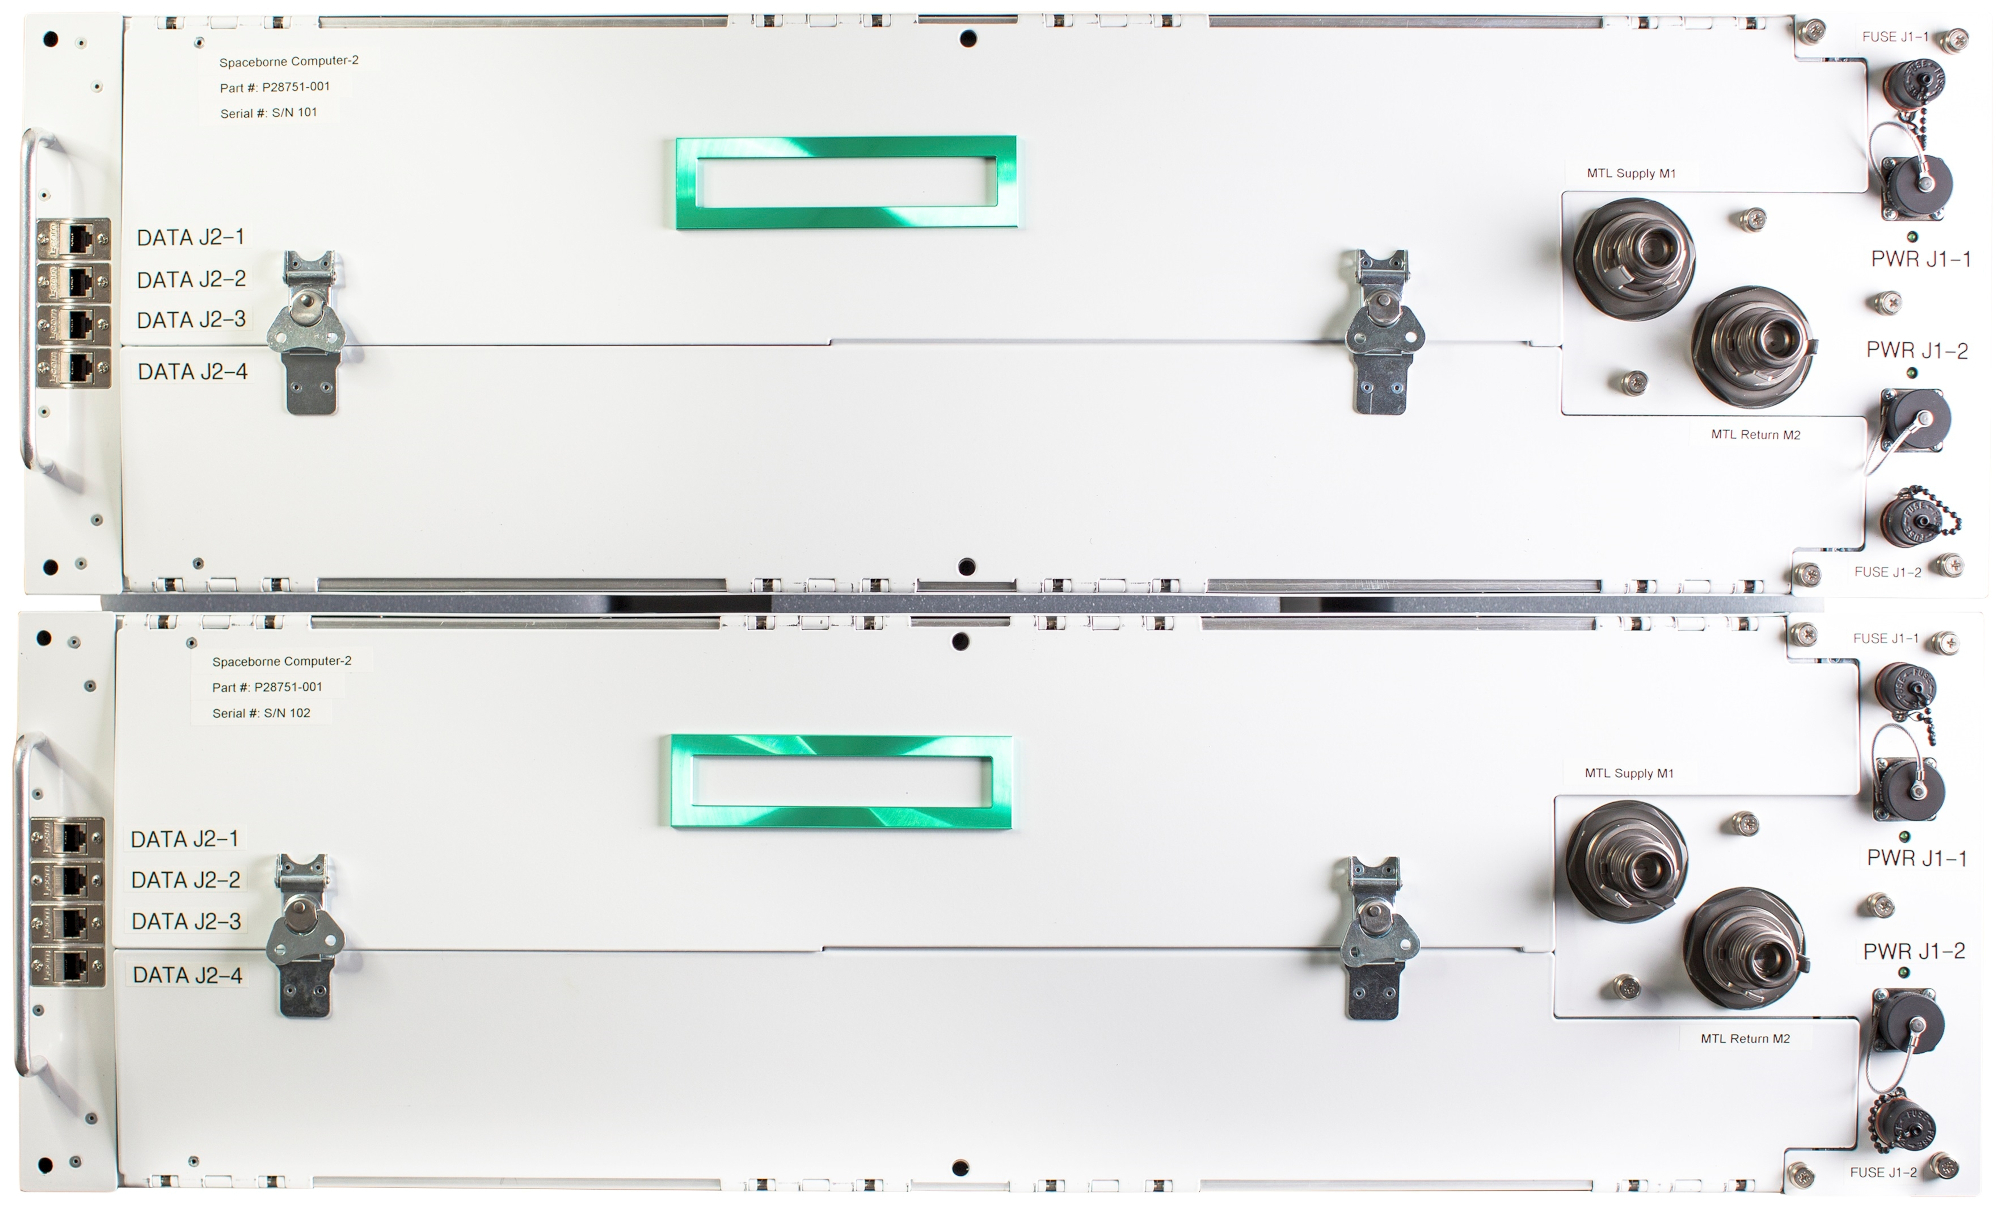 Так, ИИ-ускорители были задействованы для визуального анализа микроскопических повреждений скафандров, используемых для выхода в открытый космос. Они же помогли в обработке данных наблюдения за крупными погодными изменениями и природными катаклизмами. Также был проведён анализ поведения металлических частиц при 3D-печати в невесомости, проверена возможность работы 5G-сетей космических условиях, ускорены расчёты требуемых объёмов топлива для кораблей и т.д. 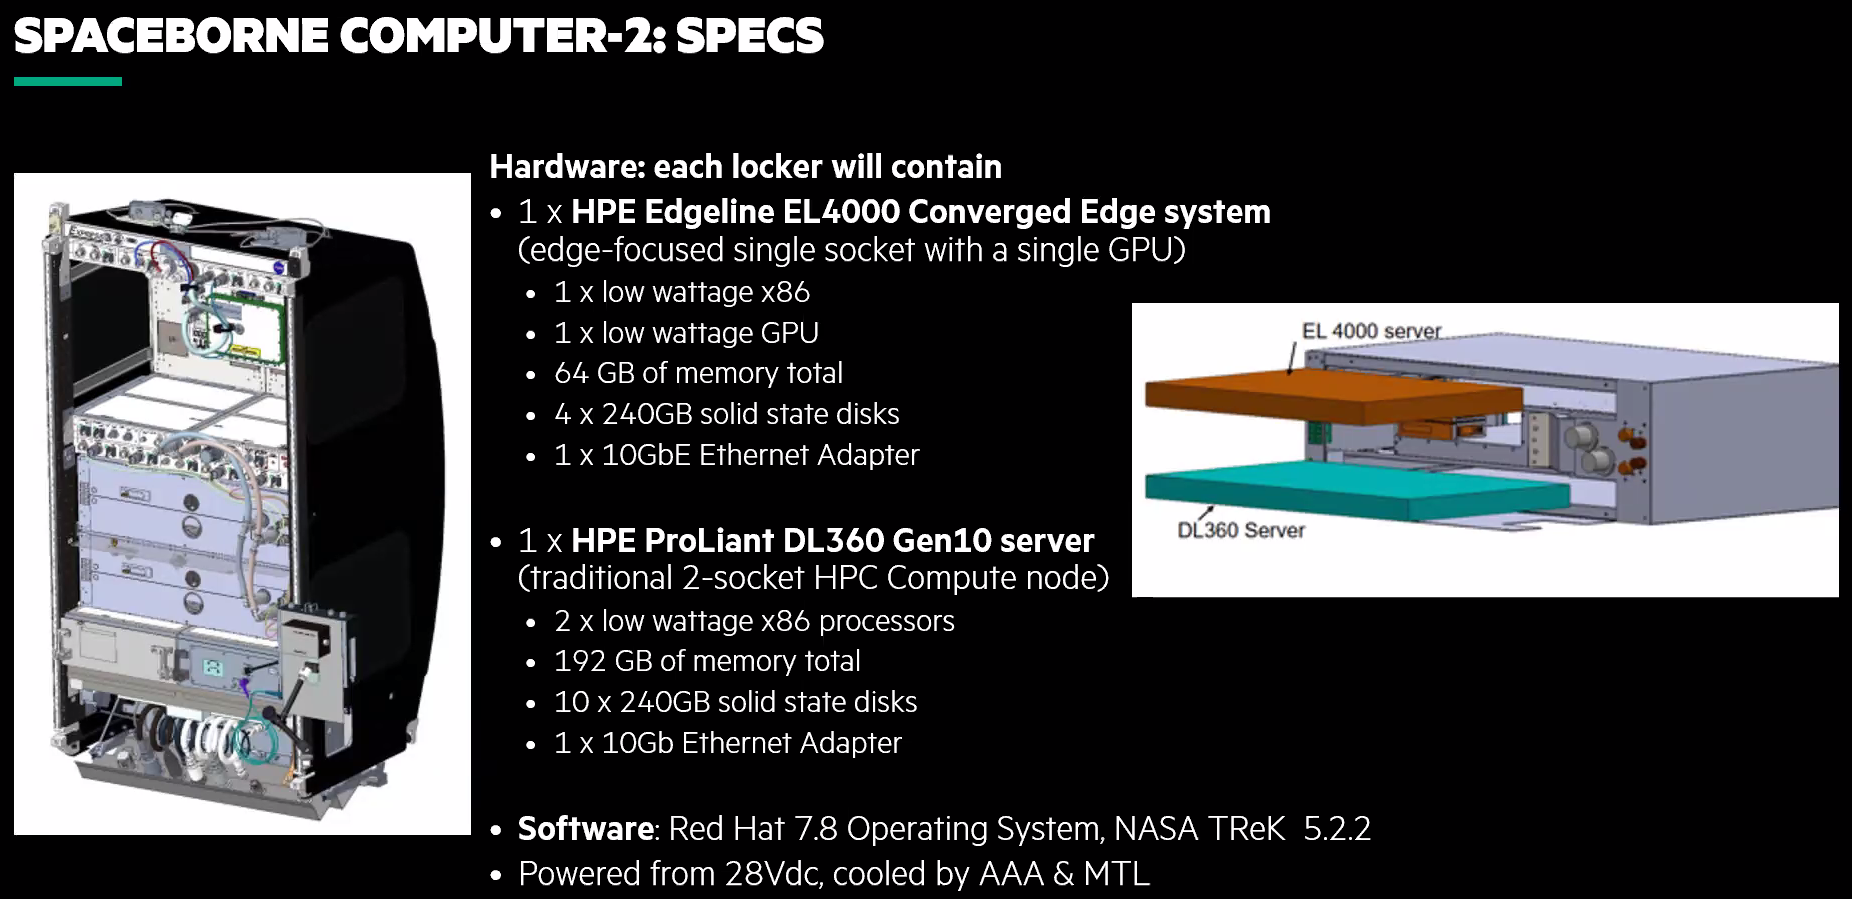 Ряд проблем ещё предстоит решить: в частности, в условиях повышенной космической радиации существенно быстрее выходят из строя SSD, что естественно для технологии, основанной на «ловушках заряда». По всей видимости, для дальнего космоса целесообразнее будет использовать накопители на базе иной энергонезависимой памяти. Впрочем, при освоении Луны или Марса полагаться на земные ЦОД тоже будет трудно, а значит, достаточно мощные вычислительные ресурсы придётся везти с собой.
30.03.2022 [22:01], Владимир Мироненко
Российская суперкомпьютерная платформа «РСК Торнадо» объединила отечественные «Эльбрусы» и зарубежные x86-процессорыГруппа компаний РСК на конференции «Параллельные вычислительные технологии (ПаВТ) 2022» сообщила о создании суперкомпьютерной платформы «РСК Торнадо», которая позволяет одновременно использовать в одной системе вычислительные узлы на базе зарубежных x86-процессоров и отечественных чипов «Эльбрус». Возможность использования различных типов микропроцессорных архитектур в одном монтажном шкафу (до 104 серверов в стойке), позволит ускорить темпы импортозамещения в области высокопроизводительных вычислительных систем (HPC), решений для центров обработки данных (ЦОД) и систем хранения данных (СХД). Унифицированная интероперабельная (т.е. обеспечивающая функциональную совместимость разных решений) платформа «РСК Торнадо» предназначена для решения широкого круга задач, в том числе для работы с нагрузками Big Data, HPC и ИИ. 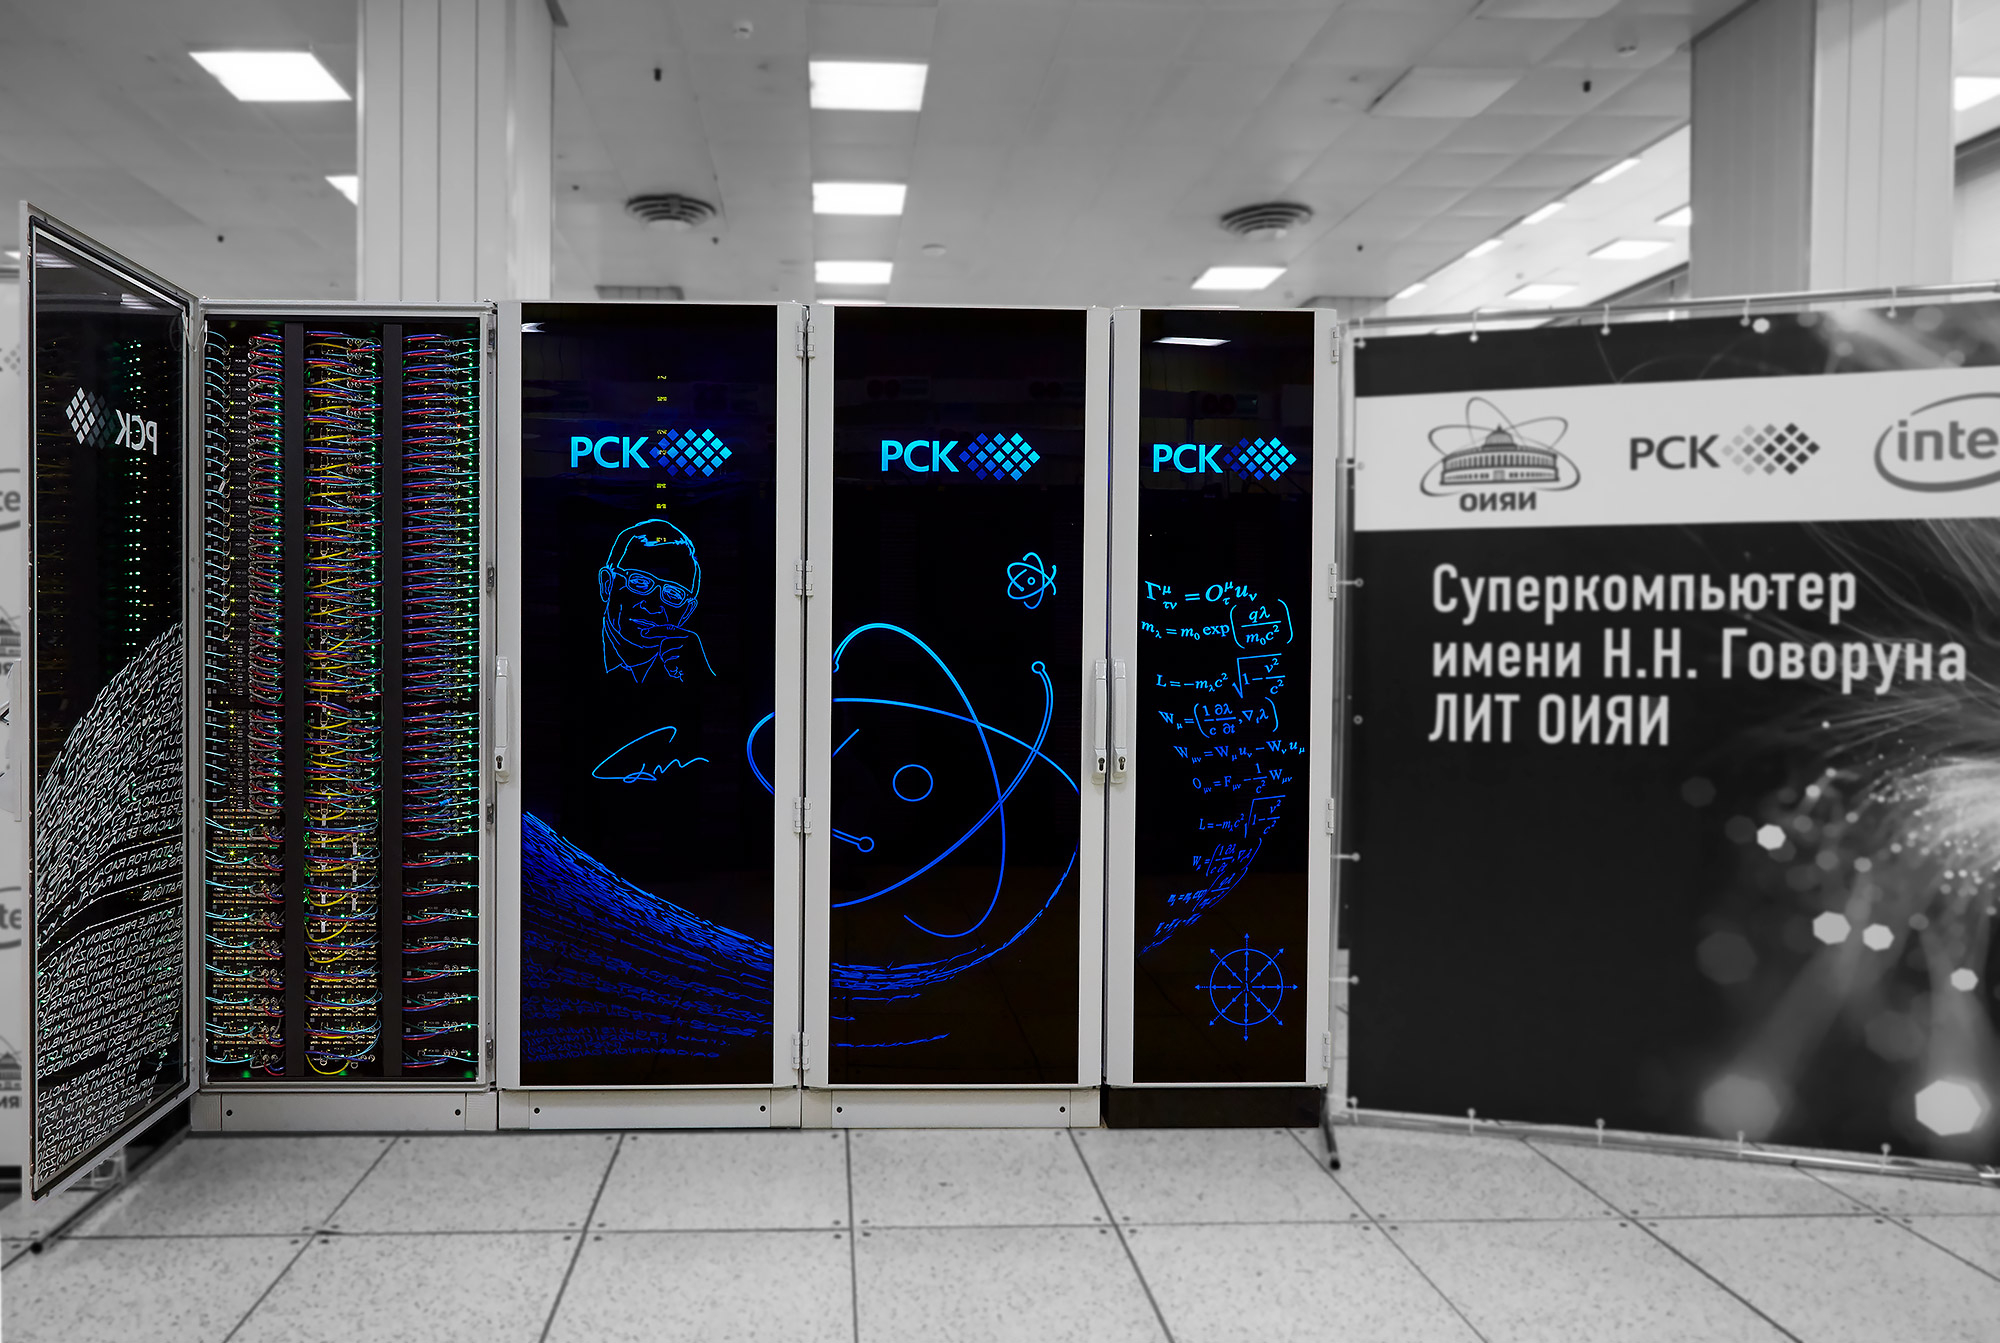
Суперкомпьютер «Говорун» в ОИЯИ (Фото: Группа компаний РСК) Разработка и создание вычислительных систем на основе «РСК Торнадо» осуществляется на территории России в рамках соглашения с Министерством промышленности и торговли Российской Федерации с целью реализации подпрограммы «Развитие производства вычислительной техники» в составе государственной программы «Развитие электронной и радиоэлектронной промышленности». Программный стек «РСК БазИС» для вышеупомянутой платформы тоже разработан в России. В настоящее время система «РСК БазИС» используется для оркестрации вычислительных мощностей Межведомственного суперкомпьютерного центра (МСЦ) РАН, Санкт-Петербургского политехнического университета (СПбПУ) и Объединенного института ядерных исследований (ОИЯИ), сведённых в единую инфраструктуру для оптимизации вычислительных ресурсов.
22.03.2022 [18:40], Игорь Осколков
NVIDIA анонсировала 4-нм ускорители Hopper H100 и самый быстрый в мире ИИ-суперкомпьютер EOS на базе DGX H100На GTC 2022 компания NVIDIA анонсировала ускорители H100 на базе новой архитектуры Hopper. Однако NVIDIA уже давно говорит о себе как создателе платформ, а не отдельных устройств, так что вместе с H100 были представлены серверные Arm-процессоры Grace, в том числе гибридные, а также сетевые решения и обновления наборов ПО. 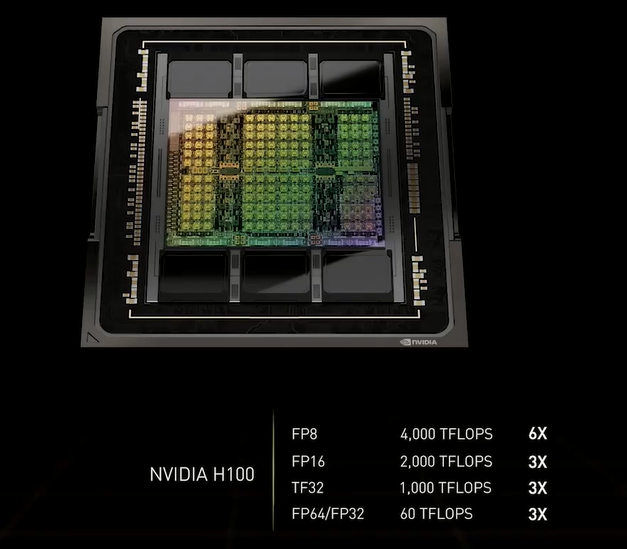
NVIDIA H100 (Изображения: NVIDIA) NVIDIA H100 использует мультичиповую 2.5D-компоновку CoWoS и содержит порядка 80 млрд транзисторов. Но нет, это не самый крупный чип компании на сегодняшний день. Кристаллы новинки изготавливаются по техпроцессу TSMC N4, а сопровождают их — впервые в мире, по словам NVIDIA — сборки памяти HBM3 суммарным объёмом 80 Гбайт. Объём памяти по сравнению с A100 не вырос, зато в полтора раза увеличилась её скорость — до рекордных 3 Тбайт/с. 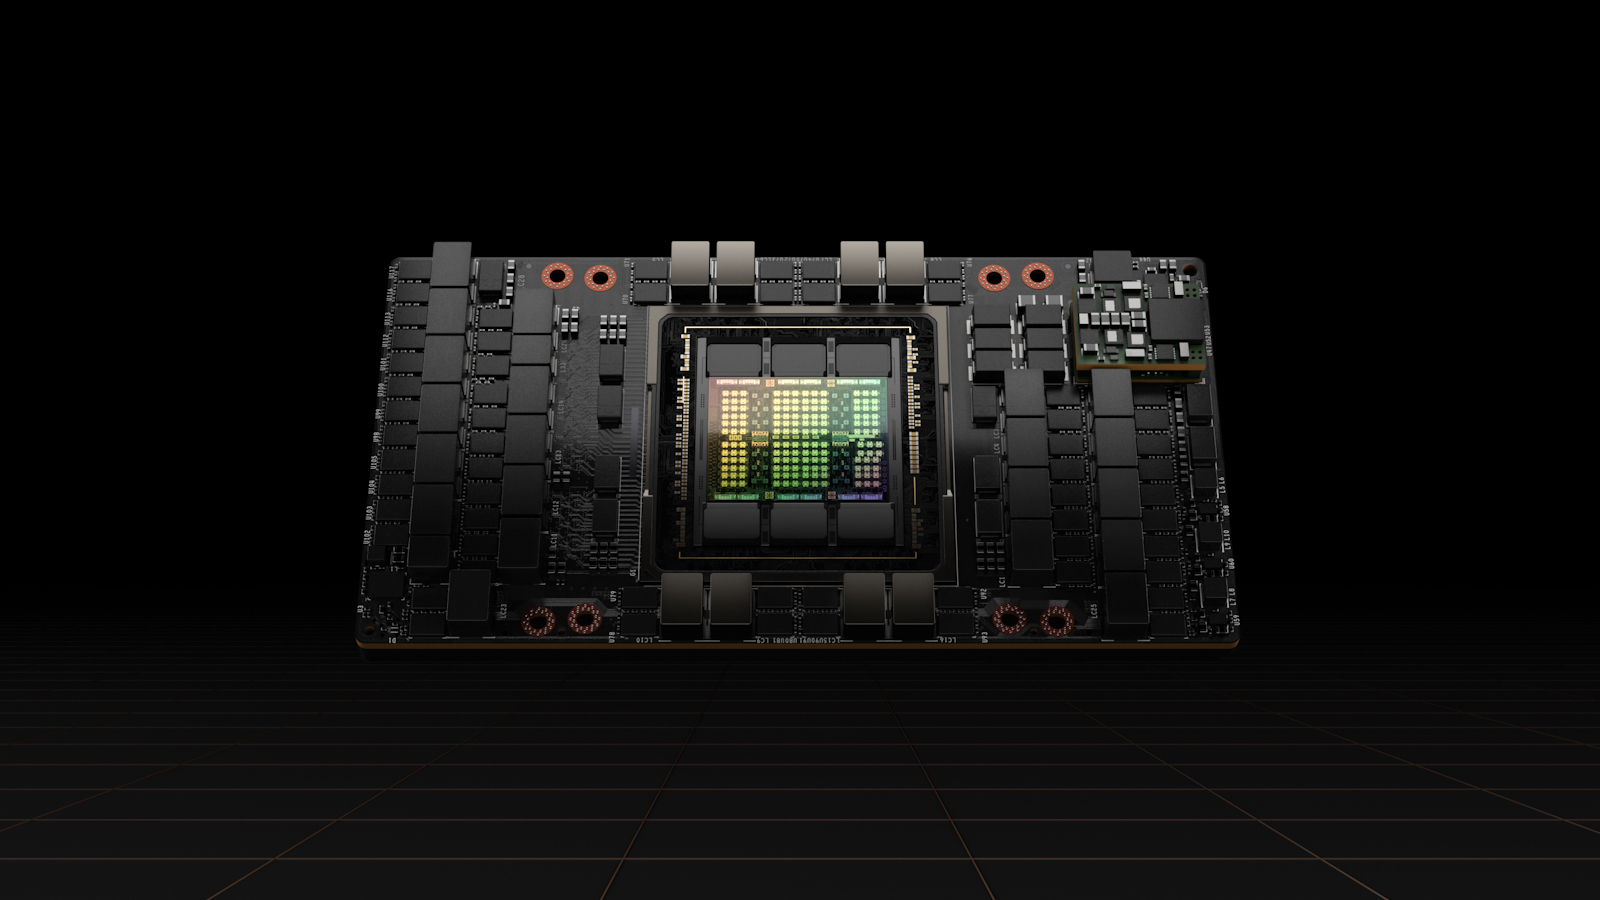
NVIDIA H100 (SXM) Подробности об архитектуре Hopper будут представлены чуть позже. Пока что NVIDIA поделилась некоторыми сведениями об особенностях новых чипов. Помимо прироста производительности от трёх (для FP64/FP16/TF32) до шести (FP8) раз в сравнении с A100 в Hopper появилась поддержка формата FP8 и движок Transformer Engine. Именно они важны для достижения высокой производительности, поскольку само по себе четвёртое поколение ядер Tensor Core стало втрое быстрее предыдущего (на всех форматах). 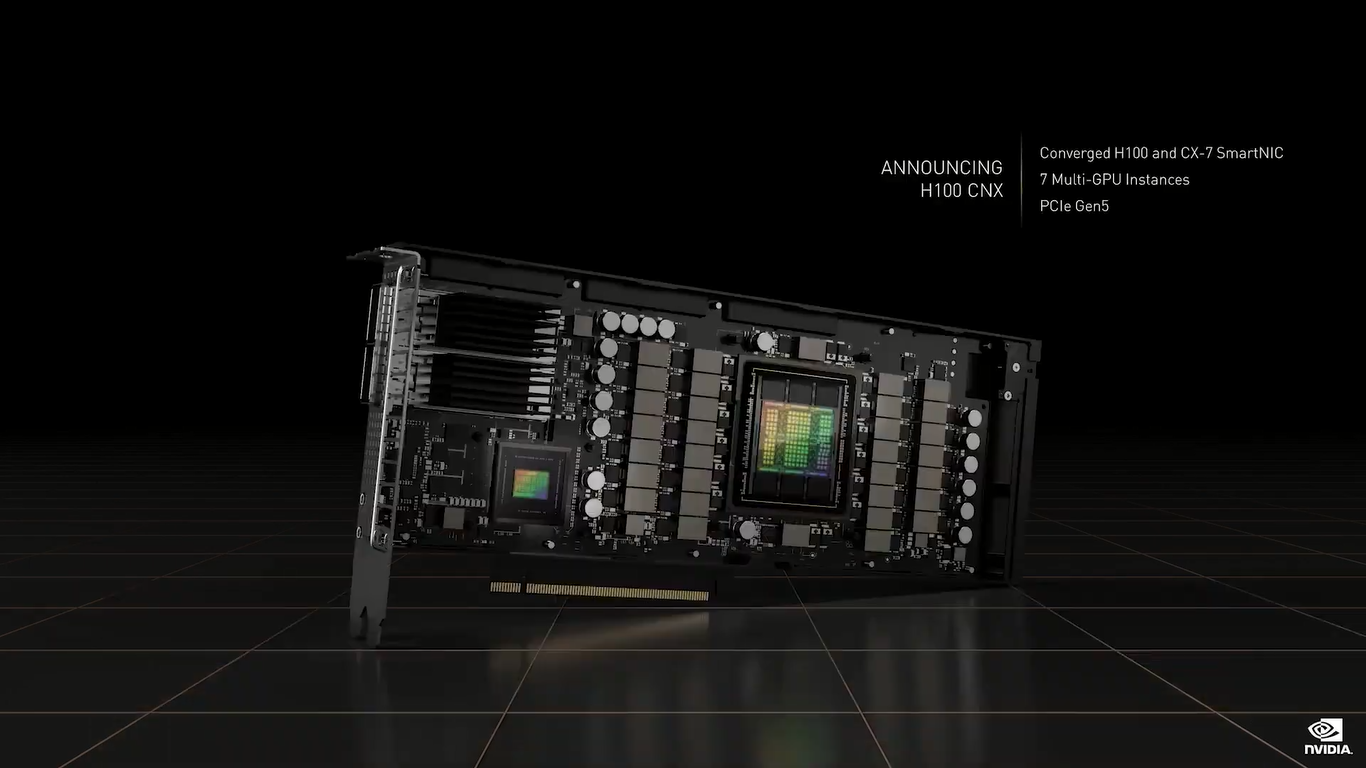
NVIDIA H100 CNX (PCIe) TF32 останется форматом по умолчанию при работе с TensorFlow и PyTorch, но для ускорения тренировки ИИ-моделей NVIDIA предлагает использовать смешанные FP8/FP16-вычисления, с которыми Tensor-ядра справляются эффективно. Хитрость в том, что Transformer Engine на основе эвристик позволяет динамически переключаться между ними при работе, например, с каждым отдельным слоем сети, позволяя таким образом добиться повышения скорости обучения без ущерба для итогового качества модели.  На больших моделях, а именно для таких H100 и создавалась, сочетание Transformer Engine с другими особенностями ускорителей (память и интерконнект) позволяет получить девятикратный прирост в скорости обучения по сравнению с A100. Но Transformer Engine может быть полезен и для инференса — готовые FP8-модели не придётся самостоятельно конвертировать в INT8, движок это сделает на лету, что позволяет повысить пропускную способность от 16 до 30 раз (в зависимости от желаемого уровня задержки). 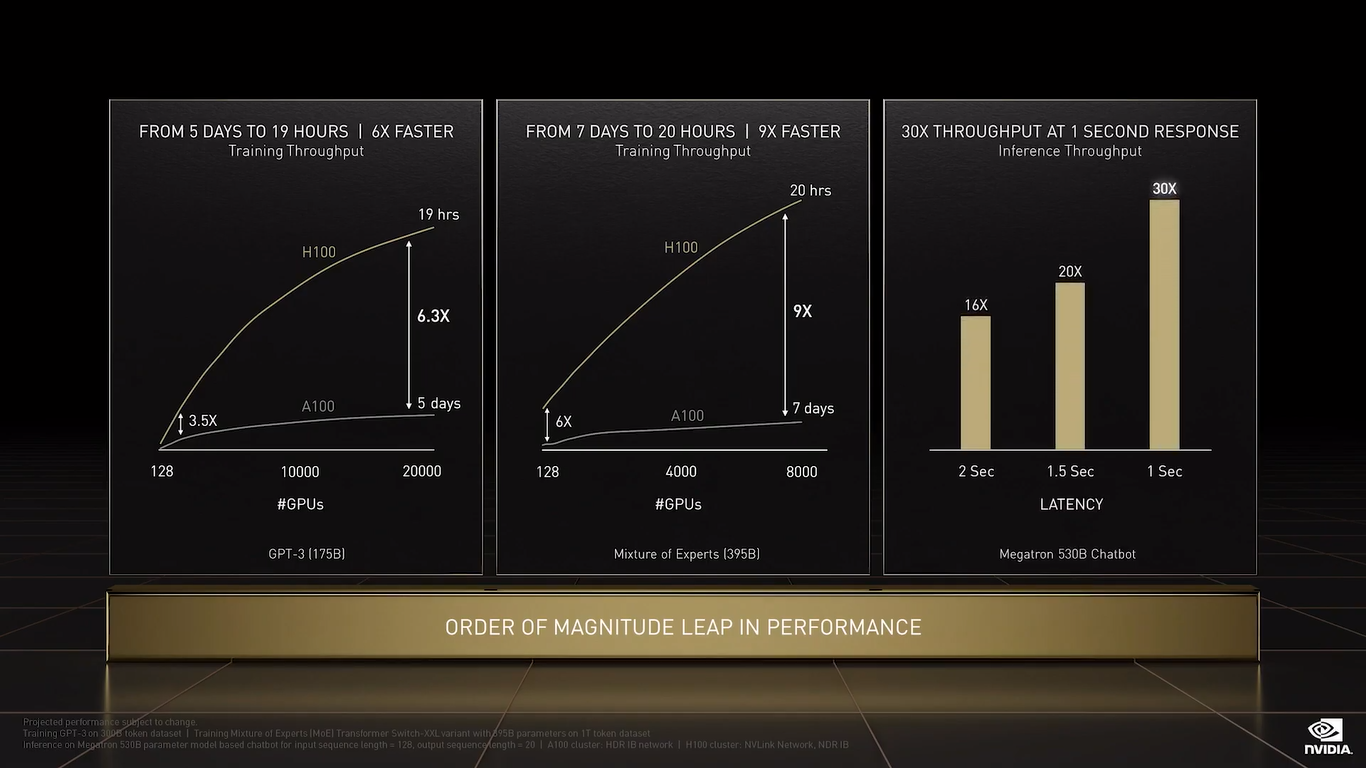 Другое любопытное нововведение — специальные DPX-инструкции для динамического программирования, которые позволят ускорить выполнение некоторых алгоритмов до 40 раз в задачах, связанных с поиском пути, геномикой, квантовыми системами и при работе с большими объёмами данных. Кроме того, H100 получили дальнейшее развитие виртуализации. В новых ускорителях всё так же поддерживается MIG на 7 инстансов, но уже второго поколения, которое привнесло больший уровень изоляции благодаря IO-виртуализации, выделенным видеоблокам и т.д. 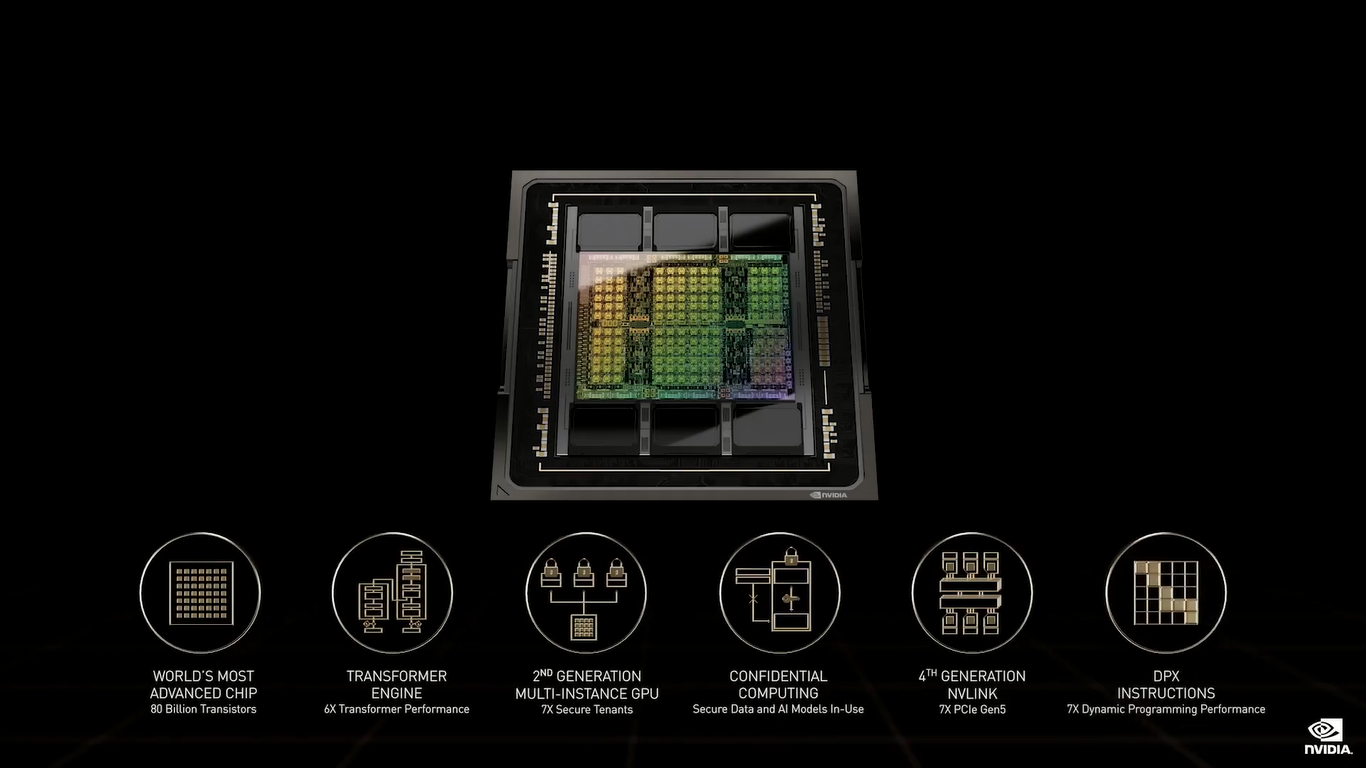 Так что MIG становится ещё более предпочтительным вариантом для облачных развёртываний. Непосредственно к MIG примыкает и технология конфиденциальных вычислений, которая по словам компании впервые стала доступна не только на CPU. Программно-аппаратное решение позволяет создавать изолированные ВМ, к которым нет доступа у ОС, гипервизора и других ВМ. Поддерживается сквозное шифрование при передаче данных от CPU к ускорителю и обратно, а также между ускорителями. 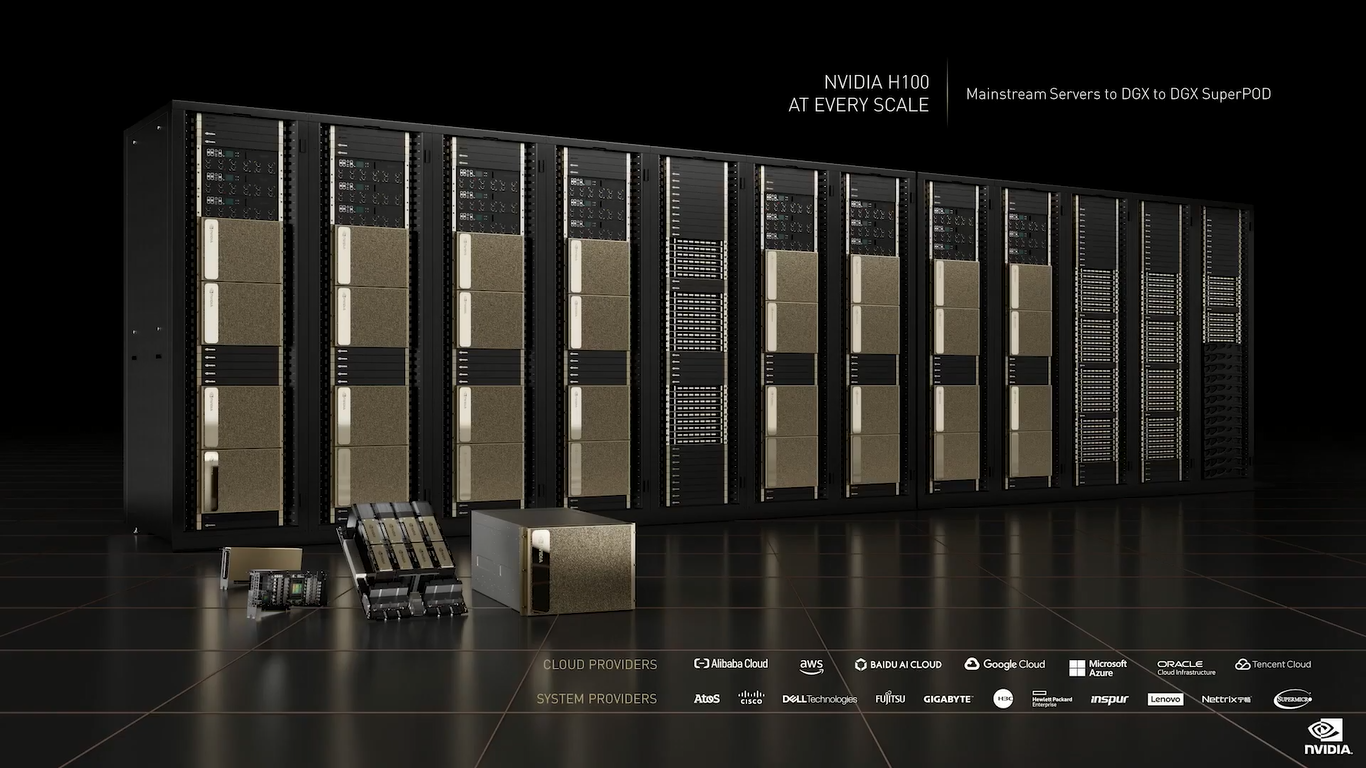 Память внутри GPU также может быть изолирована, а сам ускоритель оснащается неким аппаратным брандмауэром, который отслеживает трафик на шинах и блокирует несанкционированный доступ даже при наличии у злоумышленника физического доступа к машине. Это опять-таки позволит без опаски использовать H100 в облаке или в рамках колокейшн-размещения для обработки чувствительных данных, в том числе для задач федеративного обучения. 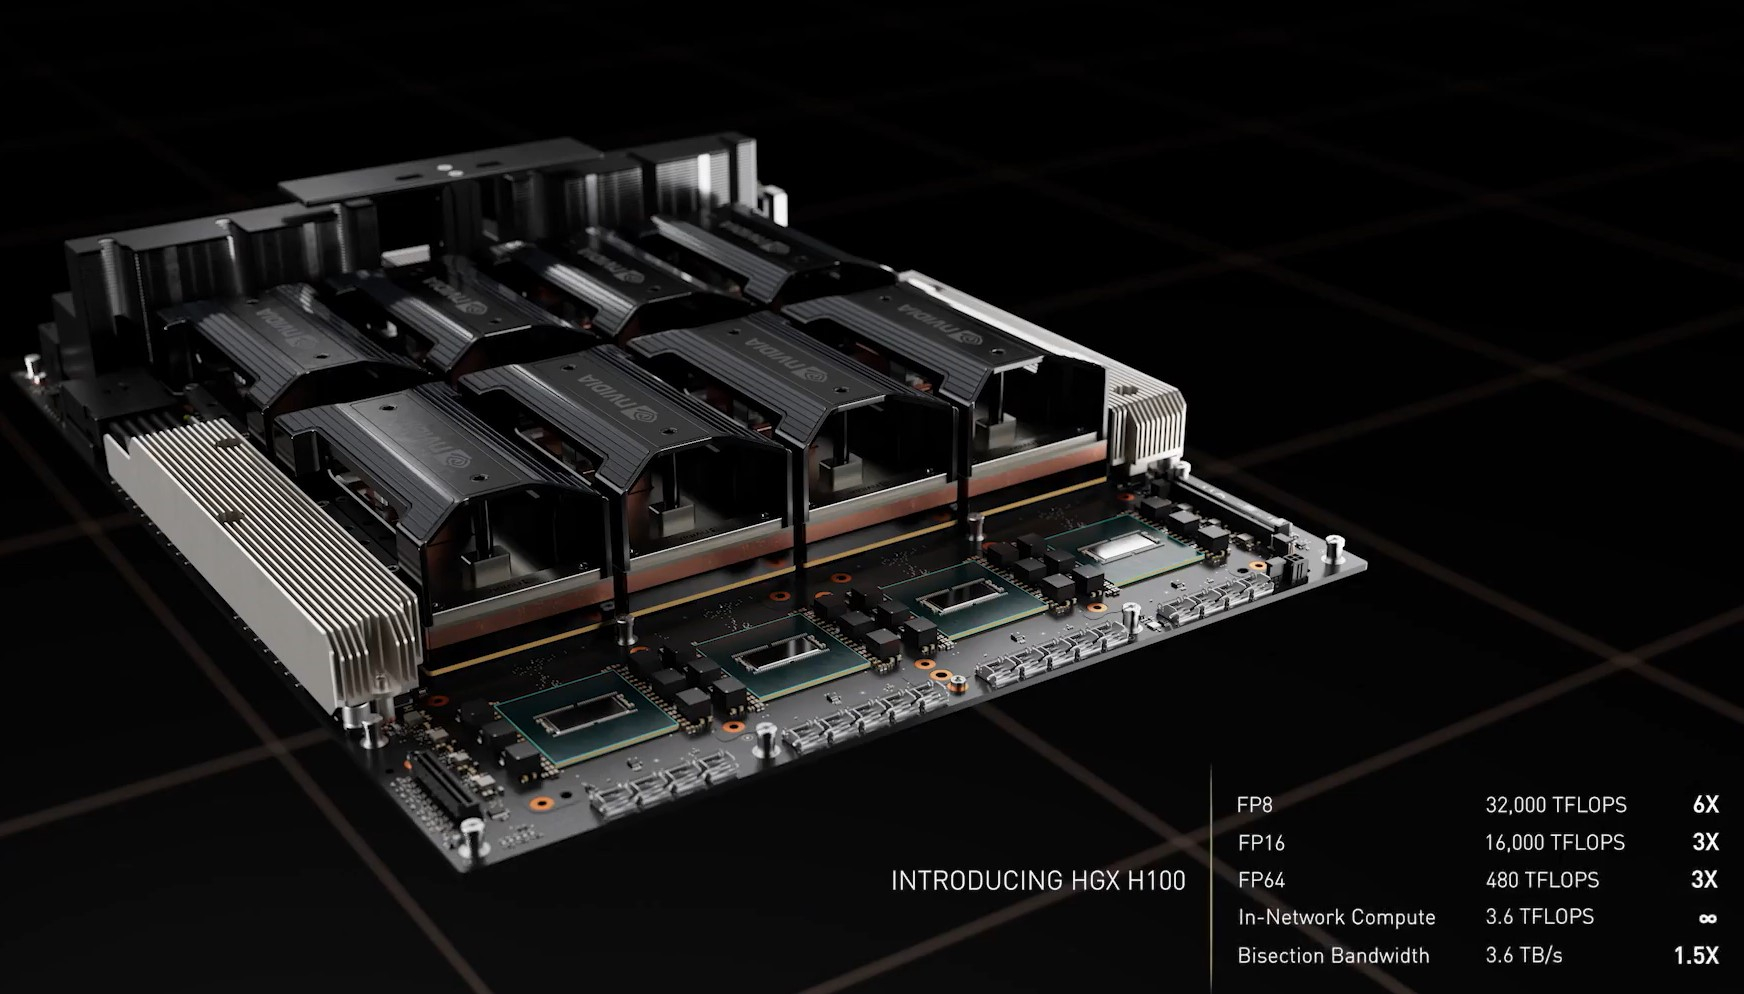 NVIDIA HGX H100 Но главная инновация — это существенное развитие интерконнекта по всем фронтам. Суммарная пропускная способность внешних интерфейсов чипа H100 составляет 4,9 Тбайт/с. Да, у H100 появилась поддержка PCIe 5.0, тоже впервые в мире, как утверждает NVIDIA. Однако ускорители получили не только новую шину NVLink 4.0, которая стала в полтора раза быстрее (900 Гбайт/с), но и совершенно новый коммутатор NVSwitch, который позволяет напрямую объединить между собой до 256 ускорителей! Пропускная способность «умной» фабрики составляет до 70,4 Тбайт/с. 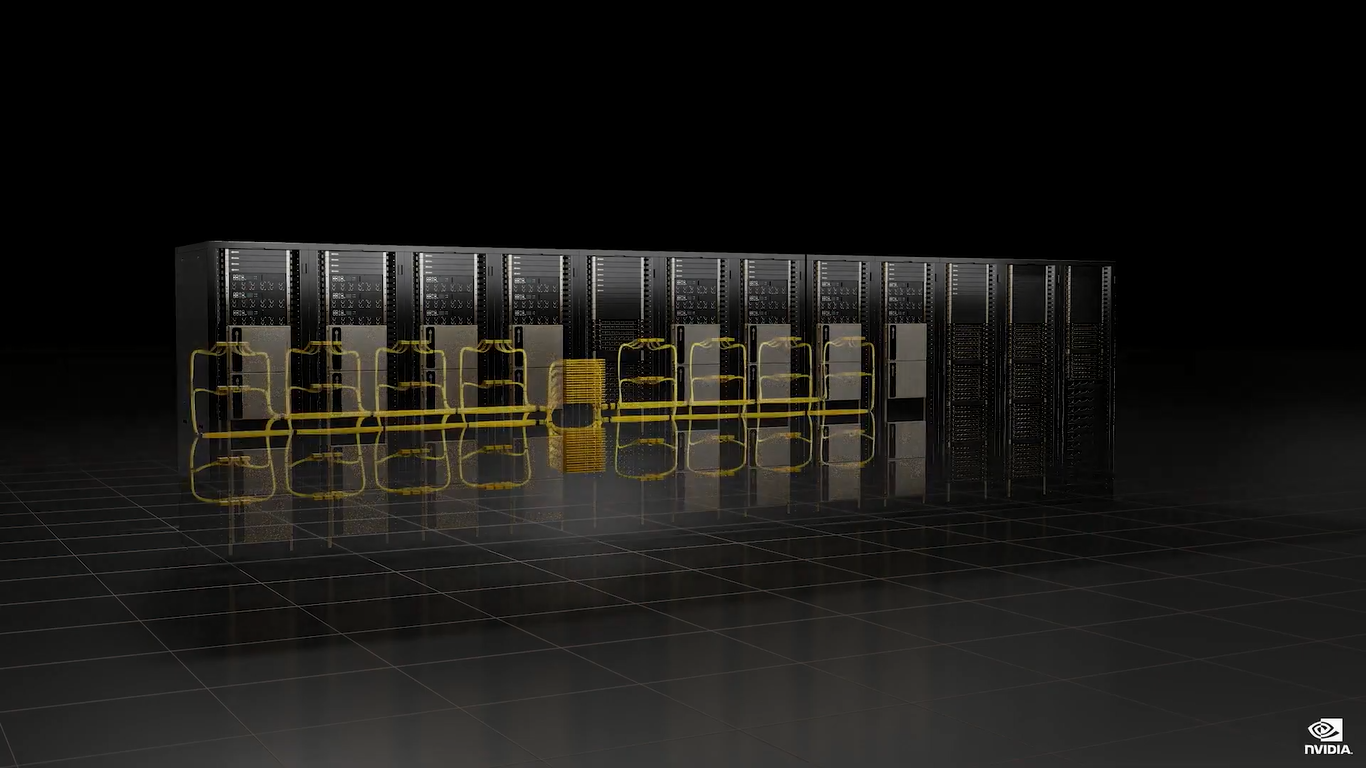 Сама NVIDIA предлагает как новые системы DGX H100 (8 × H100, 2 × BlueField-3, 8 × ConnectX-7), так и SuperPOD-сборку из 32-х DGX, как раз с использованием NVLink и NVSwitch. Партнёры предложат HGX-платформы на 4 или 8 ускорителей. Для дальнейшего масштабирования SuperPOD и связи с внешним миром используются 400G-коммутаторы Quantum-2 (InfiniBand NDR). Сейчас NVIDIA занимается созданием своего следующего суперкомпьютера EOS, который будет состоять из 576 DGX H100 и получит FP64-производительность на уровне 275 Пфлопс, а FP16 — 9 Эфлопс. 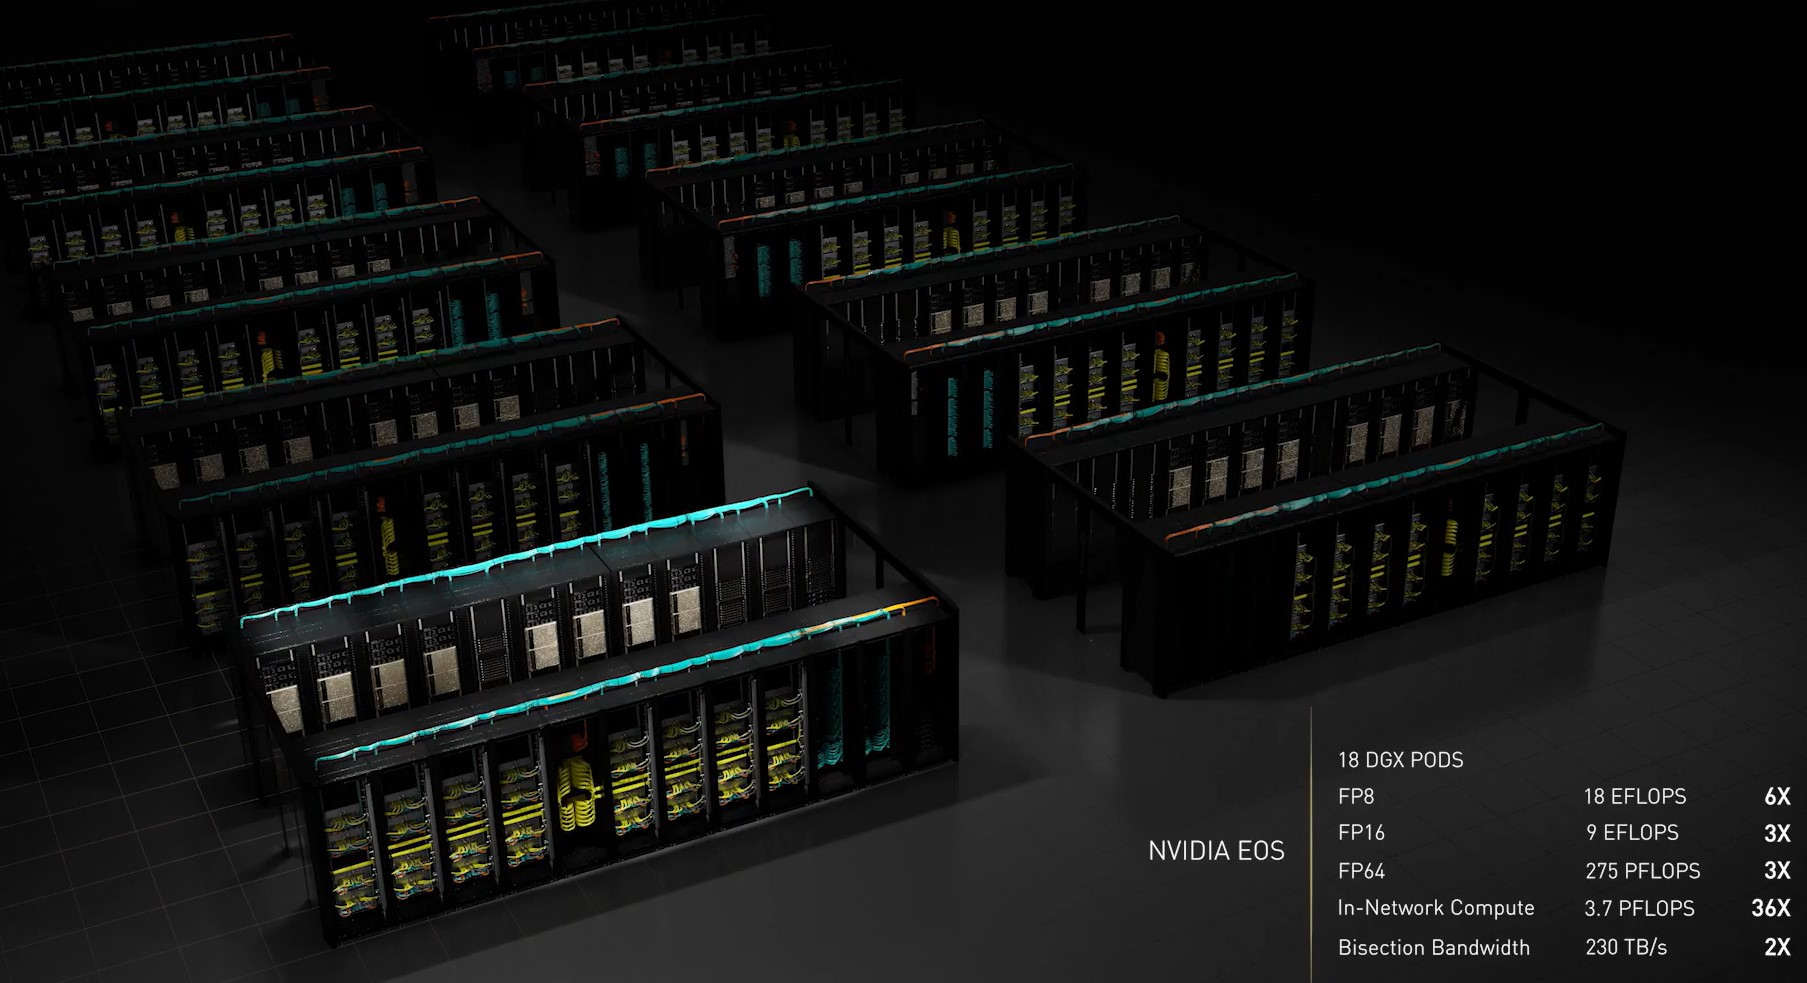 Компания надеется, что EOS станет самой быстрой ИИ-машиной в мире. Появится она чуть позже, как и сами ускорители, выход которых запланирован на III квартал 2022 года. NVIDIA представит сразу три версии. Две из них стандартные, в форм-факторах SXM4 (700 Вт) и PCIe-карты (350 Вт). А вот третья — это конвергентный ускоритель H100 CNX со встроенными DPU Connect-X7 класса 400G (подключение PCIe 5.0 к самому ускорителю) и интерфейсом PCIe 4.0 для хоста. Компанию ей составят 400G/800G-коммутаторы Spectrum-4.
16.02.2022 [21:17], Алексей Степин
Atos анонсировала экзафлопсные суперкомпьютеры BullSequana XH3000 — гибридные и «зелёные»Atos представила суперкомпьютерную платформу BullSequana XH3000, которая придёт на смену XH2000 и станет основой для машин экзафлопсного класса, ориентированных на такие требовательные к вычислениям области науки как климатология, фармакология и генетика. Суперкомпьютер имеет гибридную архитектуру и на данный момент является самым мощным и энергоэффективным решением в арсенале Atos. Что немаловажно, новая система разработана в Европе и будет производиться на заводе Atos в городе Анже ( Франция). Начало коммерческих поставок запланировано на IV квартал 2022 года.  Наиболее интересной особенностью BullSequana XH3000, пожалуй, можно назвать действительно беспрецедентный уровень гибридизации архитектур «под одной крышей». В рамках одного кластера могут быть задействованы вычислительные архитектуры AMD, Intel, NVIDIA и даже чипы, разрабатываемые консорциумом EPI, в том числе SiPearl. А в будущем возможна интеграция квантовых систем. Такая гибкость позволяет компании-разработчику говорить о шестикратном превосходстве новинки над решениями предыдущего поколения. 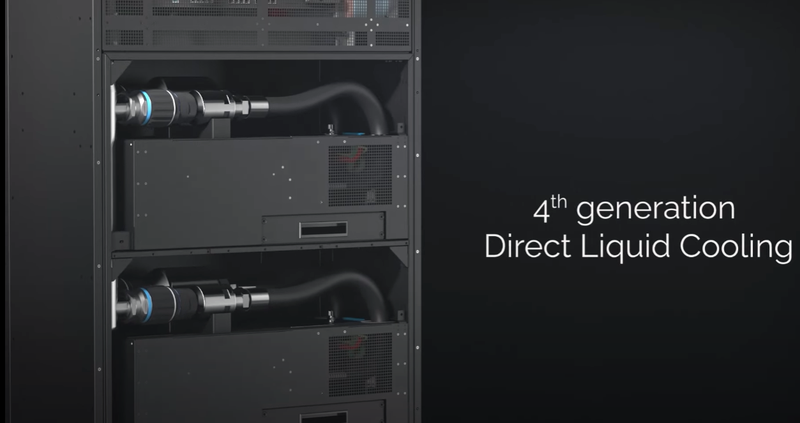 Кроме того, Atos весьма серьёзное внимание уделяет проблеме энергоэффективности и экологичности. В BullSequana XH3000 используется последнее, четвёртое поколение систем жидкостного охлаждения с «прямым контактом», которое минимум на 50% эффективнее предыдущего поколения. К тому же, вся платформа спроектирована таким образом, чтобы весь её жизненный цикл, от добычи материалов и производства до демонтажа и утилизации, был как можно более «зелёным». Новый суперкомпьютер изначально спроектирован как масштабируемое решение — будут доступны конфигурации производительностью от 1 Пфлопс до 1 Эфлопс, а к моменту появления ускорителей следующего поколения появятся и варианты с производительностью 10 Экзафлопс. Также разработчики обращают внимание на крайнюю гибкость BullSequana XH3000 по части интерконнекта — она будет совместима с фирменной фабрикой BXI, Ethernet, а также InfiniBand HDR/NDR. |
|

