
Материалы по тегу: gpu
|
03.11.2026 [14:08], Сергей Карасёв
NVIDIA скорректировала характеристики GPU Rubin, снизив пропускную способность HBM4 и NVLinkКомпания NVIDIA, по сообщению ресурса ServeTheHome, утвердила окончательные технические характеристики графических процессоров поколения Rubin, а также систем на их основе, включая Vera Rubin NVL72 и HGX Rubin NVL8. Ключевые изменения по сравнению с предварительными спецификациями связаны со скоростью работы подсистем. Первоначально NVIDIA планировала обеспечить пропускную способность памяти HBM4 на уровне 22 Тбайт/с в расчёте на один чип Rubin. В конфигурации с восемью стеками HBM4 (по 36 Гбайт, в сумме 288 Гбайт) это означало работу каждого стека со скоростью около 10,75 Гбит/с на контакт. В окончательном варианте значения снижены до 19,2 Тбайт/с и 9,375 Гбит/с соответственно, то есть примерно на 13 %. Вместе с тем пропускная способность интерконнекта NVLink уменьшена с 3,6 до 3 Тбайт/с — на 17 %. При этом пропускная способности интерконнекта для горизонтального масштабирования (Scale Out), напротив, увеличена с 0,4 до 0,45 Тбайт/с. 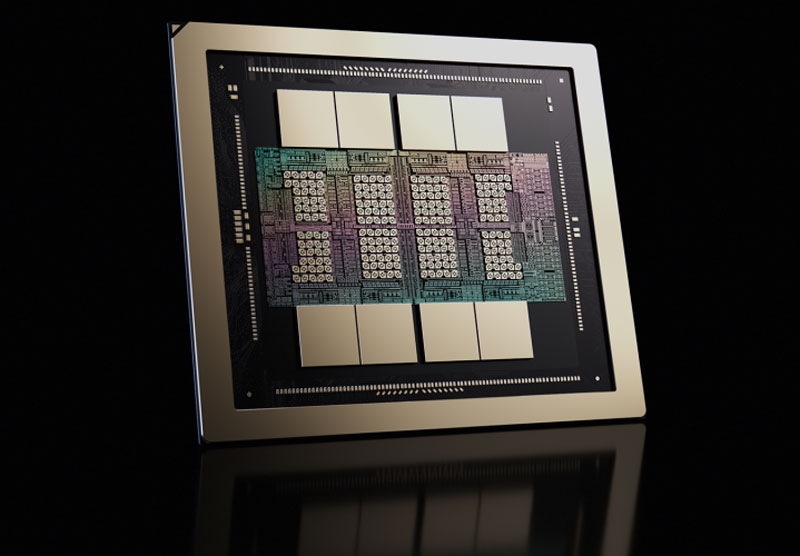
Источник изображения: NVIDIA Несмотря на корректировки, показатели ИИ-производительности сохранились на прежнем уровне. На задачах инференса и обучения моделей в режиме NVFP4 быстродействие достигает 50 и 35 Пфлопс. На операциях INT8 показатель составляет до 250 TOPS, на операциях TF32 — до 2 Пфлопс. Таким образом, помимо указанных изменений, NVIDIA не внесла никаких других модификаций в характеристики Rubin. В случае флагманской системы Vera Rubin NVL72 общая пропускная способность подсистемы памяти HBM4 сократилась с 1580 до 1400 Тбайт/с, интерконнекта NVLink — с 260 до 216 Тбайт/с. Пропускная способности интерконнекта (Scale Out) поднялась с 28,8 до 32,4 Тбайт/с. Наконец, у HGX Rubin NVL8 показатель ПСП HBM4 упал со 176 до 130 Тбайт/с, NVLink — с 28,8 до 24 Тбайт/с, тогда как для сети значение выросло с 1,6 до 1,8 Тбайт/с. Причём у этих систем NVIDIA также уменьшила объём памяти HBM4. Если первоначально HGX Rubin NVL8 планировалось наделить 2,3 Тбайт HBM4, то в соответствии с окончательными спецификациями размер памяти составит 2 Тбайт.
22.10.2026 [23:03], Павел Котов
ASUS объявила о готовности поставлять системы на базе NVIDIA HGX Rubin NVL8ASUS объявила, что в IV квартале 2026 года будет готова выпустить новые стоечные серверы на платформе NVIDIA HGX Rubin NVL8. Они будут доступны в конфигурациях как частично, так и полностью укомплектованной стойки. Линейка включает модели XR R1I12B-M1BHFS (3U, гибридное охлаждение) и XR R1I12B-M1BLFS (2U, полностью жидкостное охлаждение). Система ASUS XR R1I12B-M1BHFS в формфакторе 3U сочетает систему прямого жидкостного охлаждения микросхем (D2C) для базовой платы NVIDIA HGX Rubin с восемью GPU и воздушное охлаждение для двух процессоров Intel Xeon 6. Модульная конструкция с воздушным охлаждением CPU на 50 % сокращает время технического обслуживания; поддержка накопителей форматов U.2 и E1.S обеспечивает гибкость при развёртывании системы. ASUS XR R1I12B-M1BLFS отличают формфактор 2U и полноценное жидкостное охлаждение — система имеет высокую тепловую эффективность, высокую вычислительную плотность и способствует улучшению PUE. Сертифицированная NVIDIA конструкция и архитектура без использования кабелей для соединения плат снижают сложность развёртывания системы. 
Источник изображения: servers.asus.com Формирование инфраструктуры для ИИ требует оптимизации вычислительных мощностей, систем питания, охлаждения и сопутствующей инженерной части. ASUS сочетает свой опыт с решением NVIDIA DSX Sim Blueprint — эталонным проектом системы моделирования и проверки инфраструктуры ЦОД в среде цифровых двойников — и помогает оптимизировать инфраструктуру для задач масштабной генерации токенов. Совместно с партнёрами по экосистеме производитель объединяет вычислительные ресурсы, сетевое оборудование, СХД, системы питания и охлаждения и инженерную инфраструктуру в единую среду цифрового двойника. Это помогает заказчикам оценивать конфигурации инфраструктуры, выявлять ограничения, оптимизировать производительность и энергоэффективность системы ещё до её развёртывания.
17.10.2026 [16:40], Сергей Карасёв
Сервер ASUS XA P2N-E2 для агентного ИИ оснащён двумя чипами NVIDIA VeraКомпания ASUS анонсировала сервер XA P2N-E2 для агентного ИИ, обучения с подкреплением и ресурсоёмких задач по обработке данных. Новинка выполнена в форм-факторе 2U на модульной архитектуре NVIDIA MGX. Система рассчитана на два процессора NVIDIA Vera, каждый из которых содержит 88 ядер Olympus (Arm v9.2) с возможностью одновременной обработки до 176 потоков инструкций. Могут быть задействованы 16 модулей оперативной памяти SOCAMM2 LPDDR5X-9600 суммарным объёмом до 1,5 Тбайт: эти изделия, как утверждается, обеспечивают до двух раз более высокую энергоэффективность по сравнению с RDIMM. Во фронтальной части расположены восемь отсеков для накопителей E1.S с интерфейсом PCIe 6.0 и возможностью горячей замены. 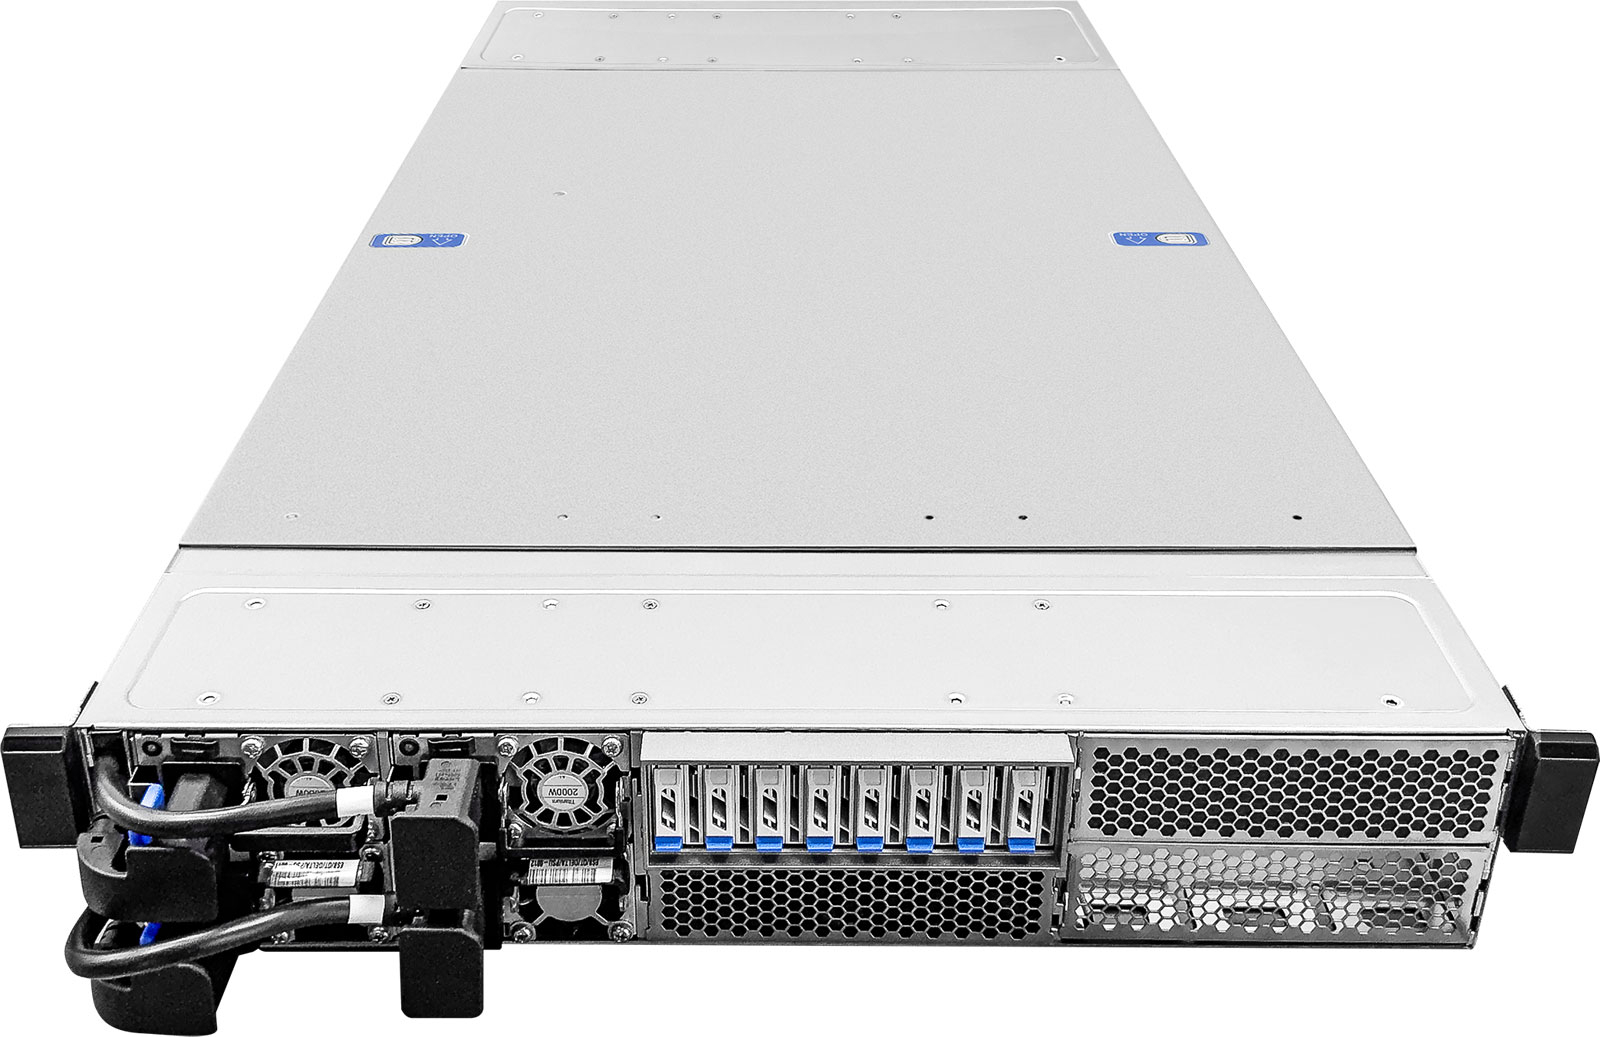
Источник изображений: ASUS Сервер располагает двумя слотами PCIe 6.0 x16 для двухслотовых GPU-ускорителей, двумя разъёмами PCIe 6.0 x16 для сетевых адаптеров типоразмера HHHL и слотом PCIe 6.0 x16 для DPU стандарта FHFL. Предусмотрены два порта USB Type-C в тыльной части корпуса и выделенный сетевой порт управления RJ45. Установлены четыре блока питания мощностью 2000 Вт с резервированием и сертификатом 80 PLUS Titanium. Задействована традиционная система воздушного охлаждения. Диапазон рабочих температур — от +10 до +35 °C. 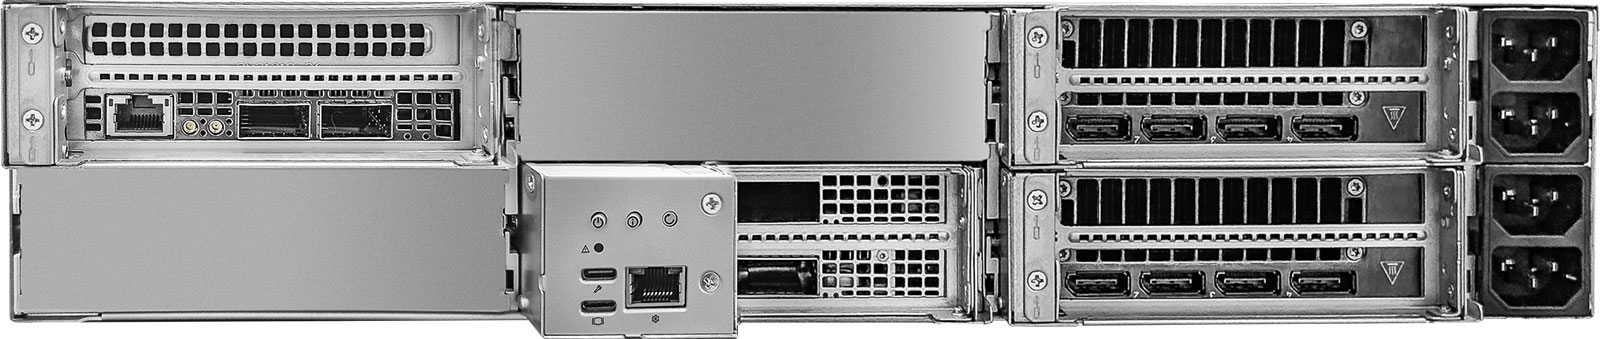 Новинка имеет размеры 900 × 438 × 88 мм и весит примерно 40 кг. Модульная конструкция позволяет осуществлять независимое обслуживание или модернизацию секций CPU и GPU. Сервер рассчитан на работу с ИИ-ускорителями семейства NVIDIA RTX PRO Blackwell, в частности, с картами RTX PRO 6000 Blackwell Server Edition.
13.10.2026 [15:45], Владимир Мироненко
Анонсирован Intel GPU D270, оптимизированный для инференса агентного ИИIntel представила Intel GPU D270 — первый продукт серии ускорителей D-series, ранее известной под кодовым именем Crescent Island. Некоторые подробности о новой серии стали известны в августе. Уже начаты поставкм инженерных образцов чипа заказчикам: серверным OEM- и ODM-производителям, провайдерам облачных услуг, включая неооблака, и независимым разработчикам программного обеспечения. Как сообщается, Intel GPU D270 — это ускоритель для ЦОД, оптимизированный для задач инференса и разработанный с учётом требований применения агентного ИИ. Он предназначен для поддержки корпоративных ИИ-решений, сервисов SaaS и GPUaaS, а также развёртывания в государственных или суверенных облачных инфраструктурах, где необходимы энергоэффективные средства ускорения ИИ с большим объёмом памяти. Intel GPU D270 может использоваться промышленных задач ИИ-инференса, таких как агентный ИИ, генерация с дополненным поиском (RAG) с использованием длинного контекста, корпоративные ИИ-ассистенты, помощники для написания кода, анализ документов, мультимодальный ИИ, диффузионные модели и обслуживание запросов в условиях высокой конкурентности. Чип разработан с учётом специфики работы агентного ИИ, решающего задачи с разбивкой на несколько этапов: вызовы модели, использование внешних инструментов, поиск информации и генерация ответа. При создании Intel GPU D270 учитывалась специфика требований таких сценариев, включая обработку этапа предварительного заполнения (prefill), работу с увеличенным контекстом, достаточный объём памяти, поддержку высокой конкурентности и энергоэффективность. 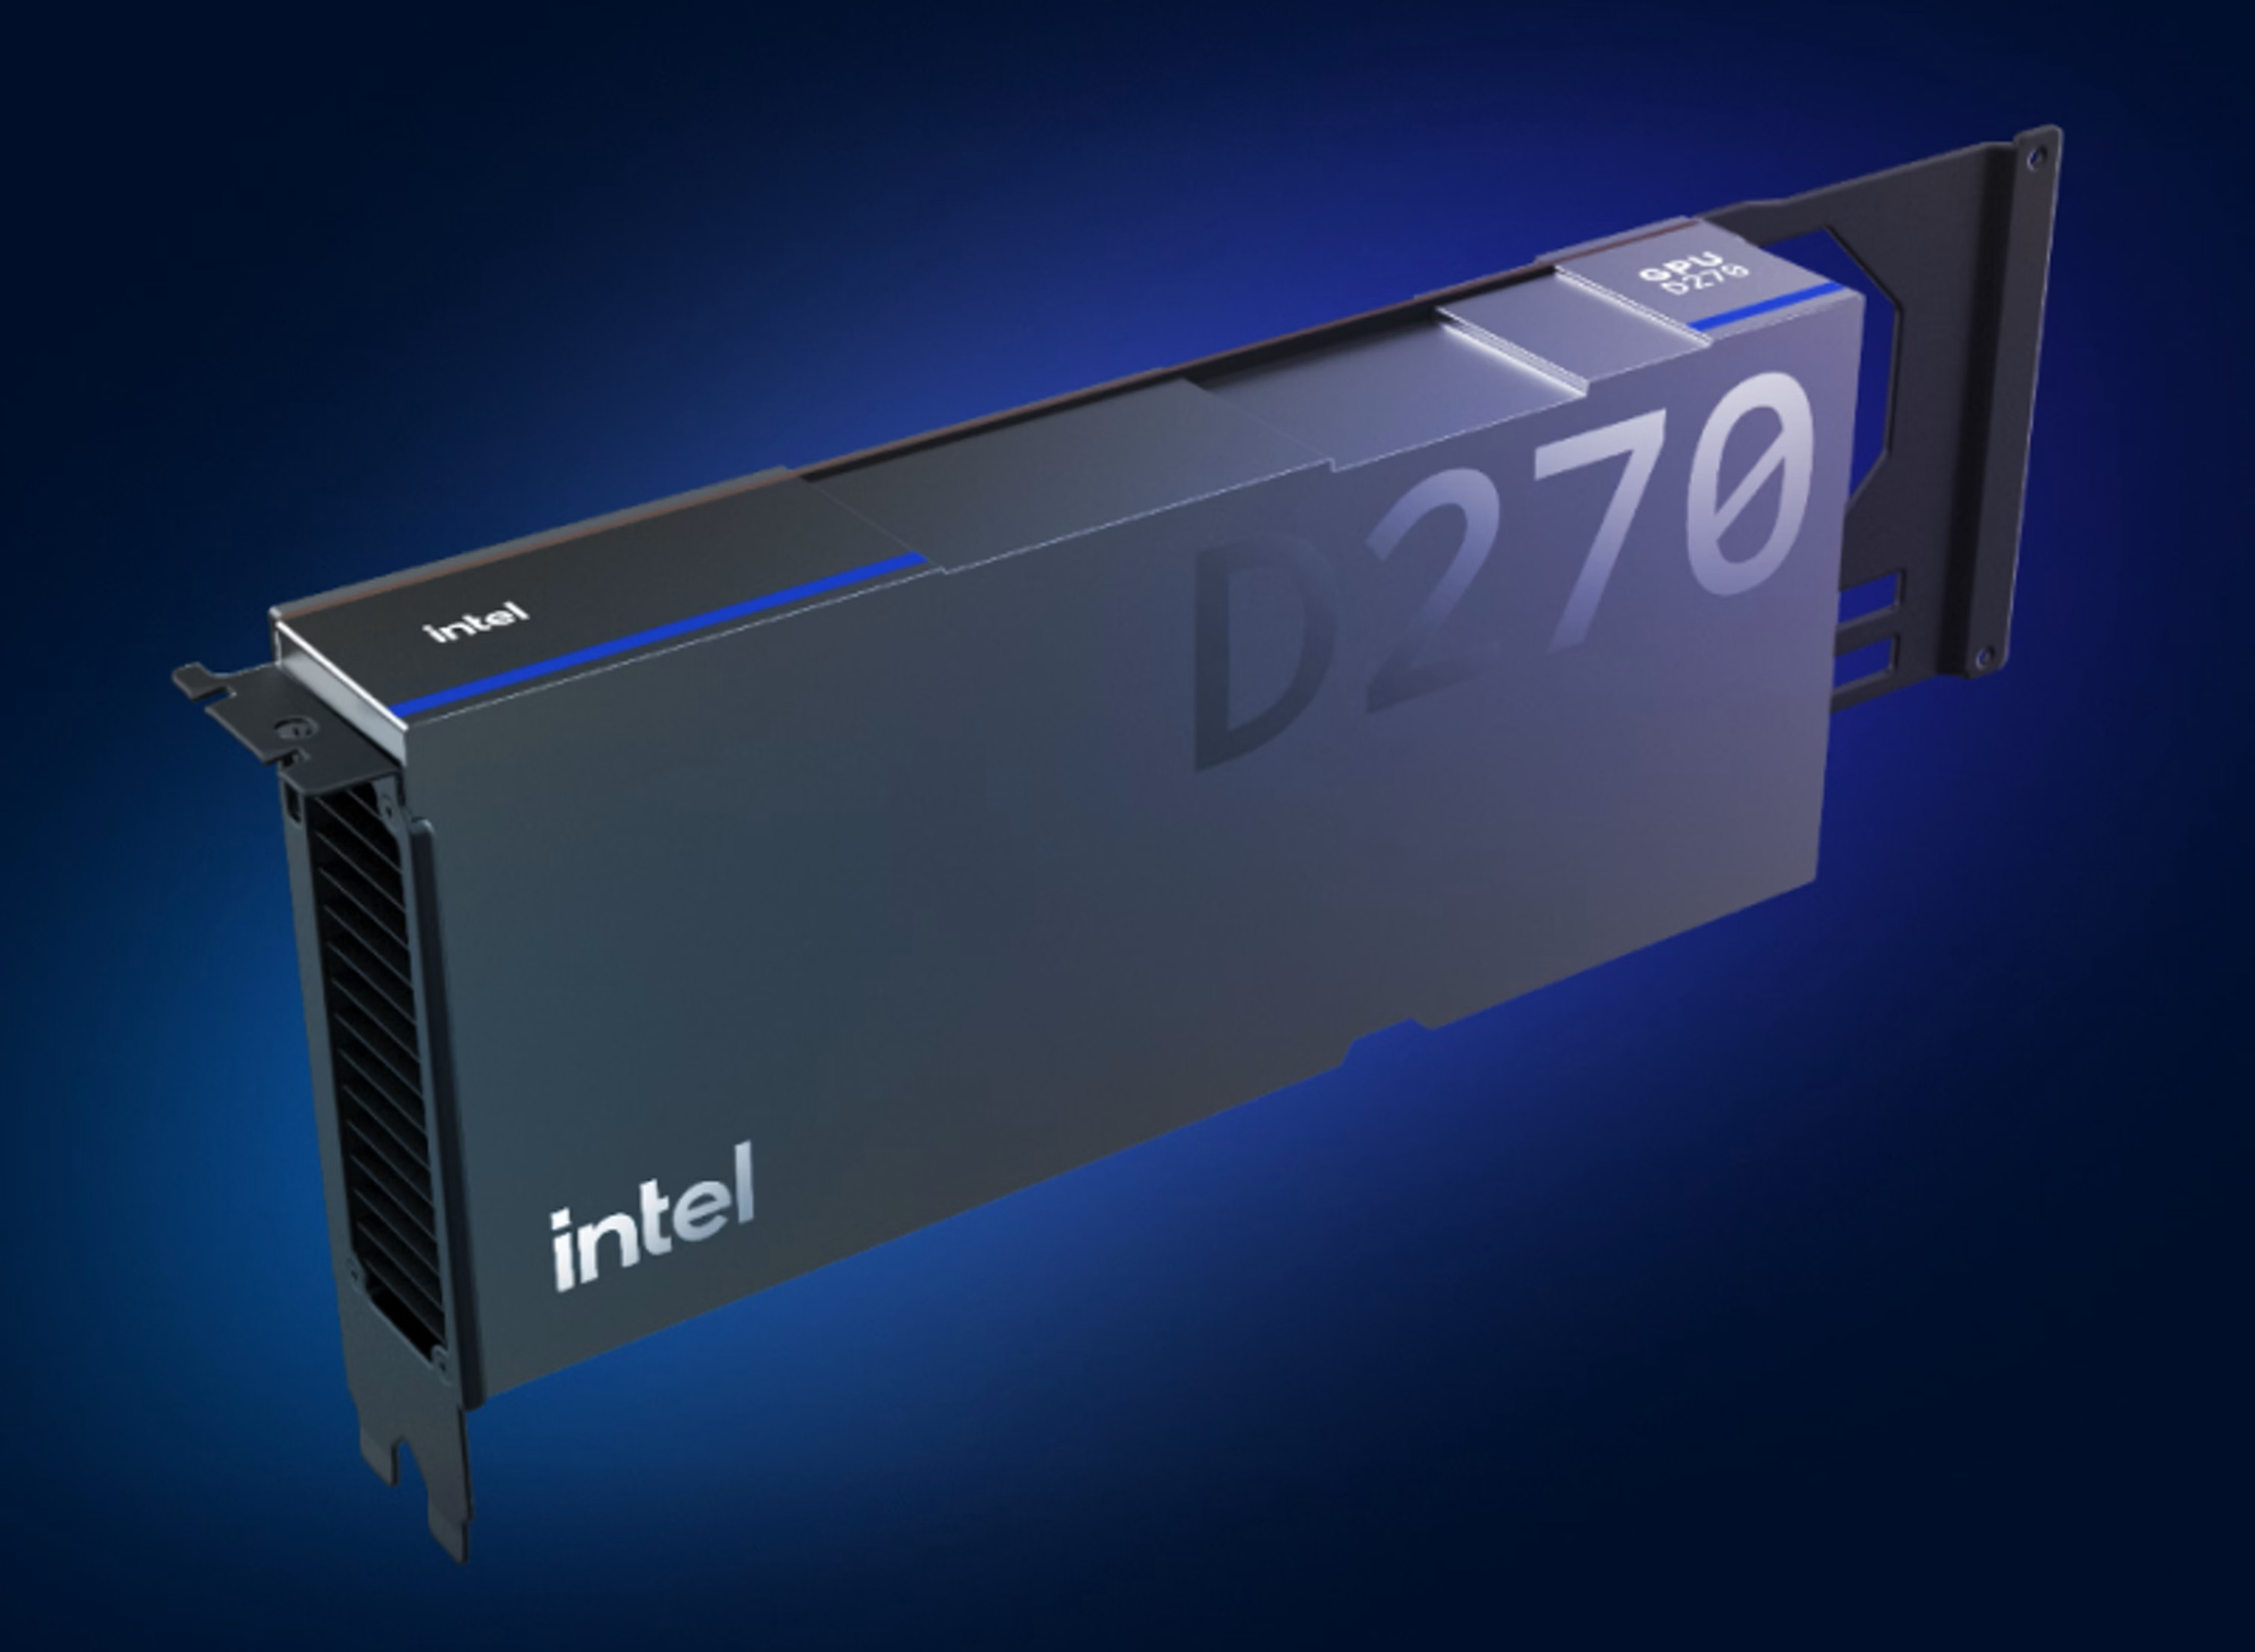
Источник изображения: Intel D270 обладает достаточно большим объёмом доступной памяти, что позволяет поддерживать более крупные модели, длинный контекст и большее количество одновременных сеансов, обеспечивая поддержку больших промптов, процессы с интенсивным поиском данных и рост KV-кеша в ходе инференса. LPDDR5X уступает HBM по пропускной способности, однако позволяет обеспечить большой объём при меньших затратах и энергопотреблении. Объём памяти составляет до 480 Гбайт в GPU сторонних производителей. Фирменный GPU от самой Intel оснащается 160 Гбайт памяти. Intel GPU D270 выполнен в форм-факторе двухслотовой карты с интерфейсом PCIe 5.0 x16. Архитектура Intel Xe3P — усовершенствованная версия графической архитектуры Xe3 — отличается увеличенным количеством матричных блоков XMX и расширенной подсистемой памяти LPDDR5X. Ускоритель включает 32 ядра Xe и 256 матричных блоков. Пропускная способность памяти (ПСП) составляет до 1,5 Тбайт/с, производительность в режиме FP8 — на уровне 1,3 Пфлопс при потреблении 350 Вт. Пиковая векторная производительность (FP64) — 10,2 Тфлопс. По данным Intel, одна карта серии D способна вместить модели с до 300 млрд параметров, а система с восемью такими ускорителями позволяет обслуживать модели с 1+ трлн параметров. При этом Intel делает ставку на такие метрики, как объём памяти на ватт и на доллар, считая их более важными для задач обслуживания моделей с интенсивным этапом декодирования, чем пиковая ПСП. «Выпуская GPU Intel D-series, мы стремимся сделать развёртывание систем инференса с большим объёмом памяти практичным, а их масштабирование — экономически выгодным», — заявила компания. Программная часть базируется на единой архитектуре Xe — код, написанный для GPU Arc Pro, можно перенести на серию D без переписывания ядер (kernels). Программный стек Intel объединяет стандартные среды выполнения (runtimes) и фреймворки для обслуживания моделей. Предусмотрена поддержка «нулевого дня» (Day 0) для модели Muse Glimmer от Meta✴. Инструментарий Intel AI for Enterprise Agent Toolkit, который уже работает на базе Xeon, будет адаптирован для работы с серией D, благодаря чему уровень оркестрации будет готов ещё до начала массовых поставок ускорителей. С Intel GPU D270 будут совместимы PyTorch, vLLM, SGLang и OpenAI Triton.
10.10.2026 [13:37], Сергей Карасёв
HPE анонсировала серверы ProLiant Gen13 на платформе AMD EPYC Venice 9006HPE представила серверы ProLiant Gen13 на аппаратной платформе AMD EPYC Venice 9006, предназначенные для решения ресурсоёмких задач, таких как ИИ-инференс, виртуализация, обработка больших массивов данных и пр. Дебютировали четыре модели: стандартные стоечные системы ProLiant DL585a Gen13 и ProLiant DL525 Gen13, а также решения высокой плотности ProLiant XD245 и ProLiant XD285. 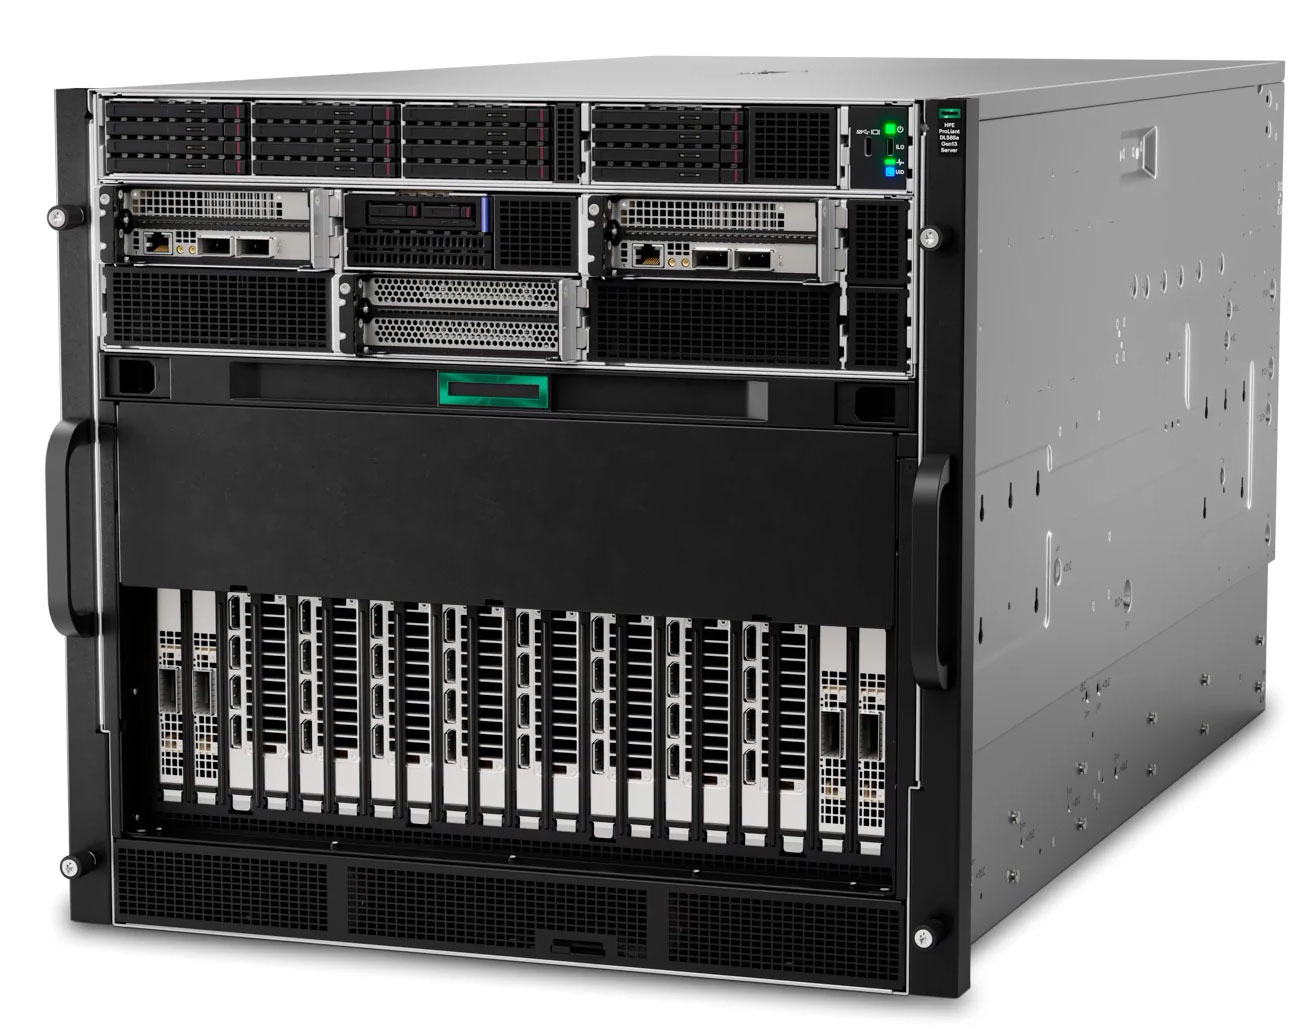
Источник изображений: HPE Старшая из представленных новинок, ProLiant DL585a Gen13, выполнена в форм-факторе 10U. Допускается установка двух процессоров EPYC Venice 9006 в исполнении SP7 (до 256 вычислительных ядер) с показателем TDP до 600 Вт. Есть 32 слота для модулей оперативной памяти DDR5-8000 RDIMM суммарным объёмом до 8 Тбайт или DDR5-12800 MRDIMM объёмом до 4 Тбайт. Сервер поддерживает до 16 накопителей E3.S EDSFF NVMe, до восьми GPU-ускорителей двойной ширины или до 16 ускорителей одинарной ширины с жидкостным охлаждением. В частности, могут применяться изделия NVIDIA RTX PRO 6000 Blackwell Server Edition с 96 Гбайт памяти или RTX PRO 6000D с 84 Гбайт памяти. Реализованы восемь слотов PCIe 6.0 x16 и один слот OCP 3.0. Подсистема питания включает до 14 блоков мощностью 3200 Вт каждый с сертификатом 80 Plus Titanium. Установлены 15 двухроторных вентиляторов диаметром 80 мм с возможностью горячей замены. 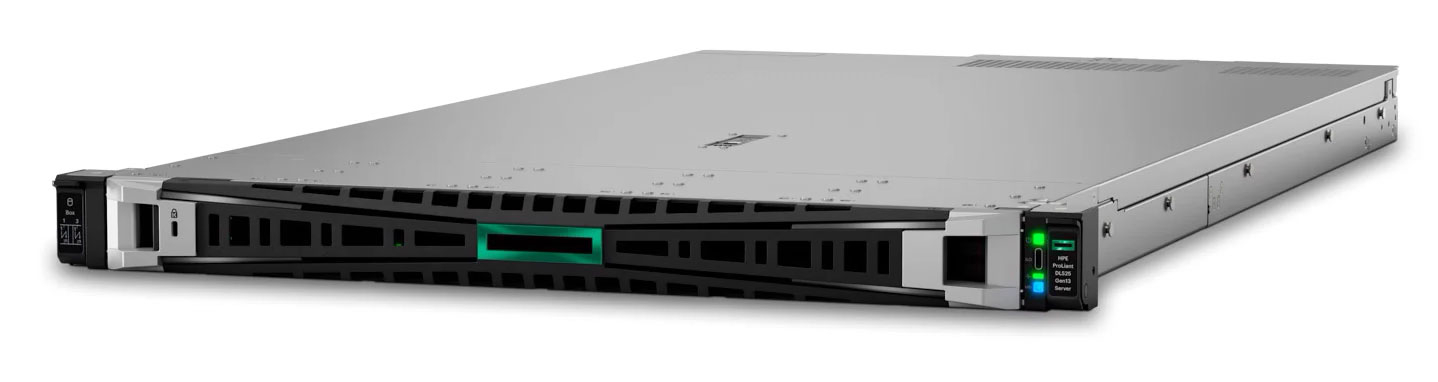 В свою очередь, ProLiant DL525 Gen13 — это сервер типоразмера 1U с поддержкой одного чипа EPYC Venice 9006 (до 600 Вт) и 16 модулей DDR5-8000/12800 (до 4/2 Тбайт). Машина может нести на борту 20 накопителей EDSFF E3.S (NVMe) и один SSD формата M.2 2280 (NVMe). Во фронтальной части расположены четыре слота PCIe 6.0 и один разъём OCP 3.0, в тыльной — три слота PCIe 6.0 и один OCP 3.0. Могут быть установлены до двух блоков питания мощностью 3200 Вт. Допускается применение воздушного и жидкостного охлаждения. 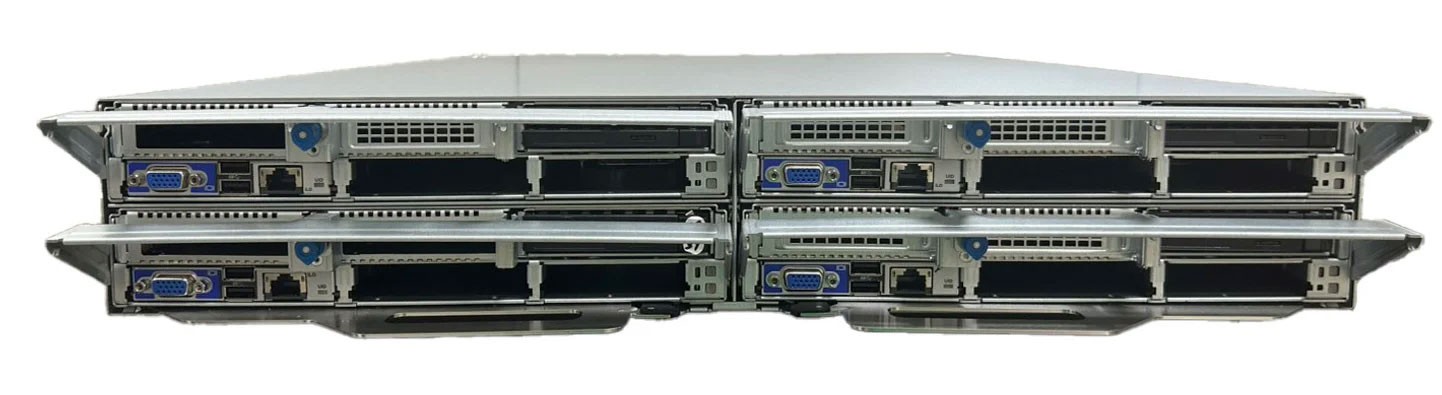 Наконец, серверы ProLiant XD245 и ProLiant XD285 получили шасси 2U. Первое из этих устройств имеет четырёхузловую конфигурацию и использует прямое жидкостное охлаждение, второе — двухузловую с воздушным охлаждением. Каждый узел поддерживает два чипа EPYC Venice 9006 (до 600 Вт) и 32 модуля DDR5-8000/12800 RDIMM/MRDIMM. Есть два слота PCIe 6.0 x16 и один разъём OCP 3.0, два отсека EDSFF и два коннектора M.2. Серверы рассчитаны на монтаж в 21″ стойку ORv3.
08.10.2026 [13:40], Сергей Карасёв
YADRO представила GPU-сервер G4208P G3 на базе Intel Xeon Emerald Rapids с СЖОКомпания YADRO, входящая в «ИКС Холдинг», анонсировала сервер G4208P G3 для ресурсоёмких задач, таких как обучение нейросетей, разработка ИИ-приложений, высокоскоростной рендеринг, видеоаналитика, предиктивное обслуживание оборудования, автоматизация технологических процессов, обработка больших массивов информации и пр. Новинка, выполненная в форм-факторе 4U, использует аппаратную платформу Intel: возможна установка двух процессоров Xeon Sapphire Rapids или Xeon Emerald Rapids с TDP до 350 Вт. Поддерживается до 8 Тбайт DDR5-5600 RDIMM/LRDIMM ECC в виде 32 модулей по 256 Гбайт. Во фронтальной части расположены 12 отсеков для накопителей LFF/SFF в конфигурации 8 × SAS/SATA и 4 × SAS/SATA/NVMe. Возможно формирование массивов RAID 0/1/10/5/50/6/60, а опционально может быть добавлен суперконденсатор для защиты содержимого кеш-памяти при отключении питания. Сервер способен нести на борту до восьми двухслотовых GPU с интерфейсом PCIe 5.0 х16 и энергопотреблением до 600 Вт каждый. Среди совместимых изделий названы NVIDIA H200 NVL, RTX PRO 6000 Blackwell, L40S, A30, A16, RTX 6000 Ada, RTX 4000 Ada, L4, а также MetaX C500. Реализована система жидкостного охлаждения, которая охватывает CPU и GPU. Отмечается, что в ходе испытаний при 100 % загрузке температура GPU не превышала 60 °C при температуре окружающей среды 22–23 °C и 77 °C — при 39 °C. При существенном росте температуры на площадке тепловой режим ускорителей сохранялся предсказуемым. Дополнительно задействованы 12 двухроторных вентиляторов с размерами 60 × 56 мм, резервированием N+2 и поддержкой горячей замены. 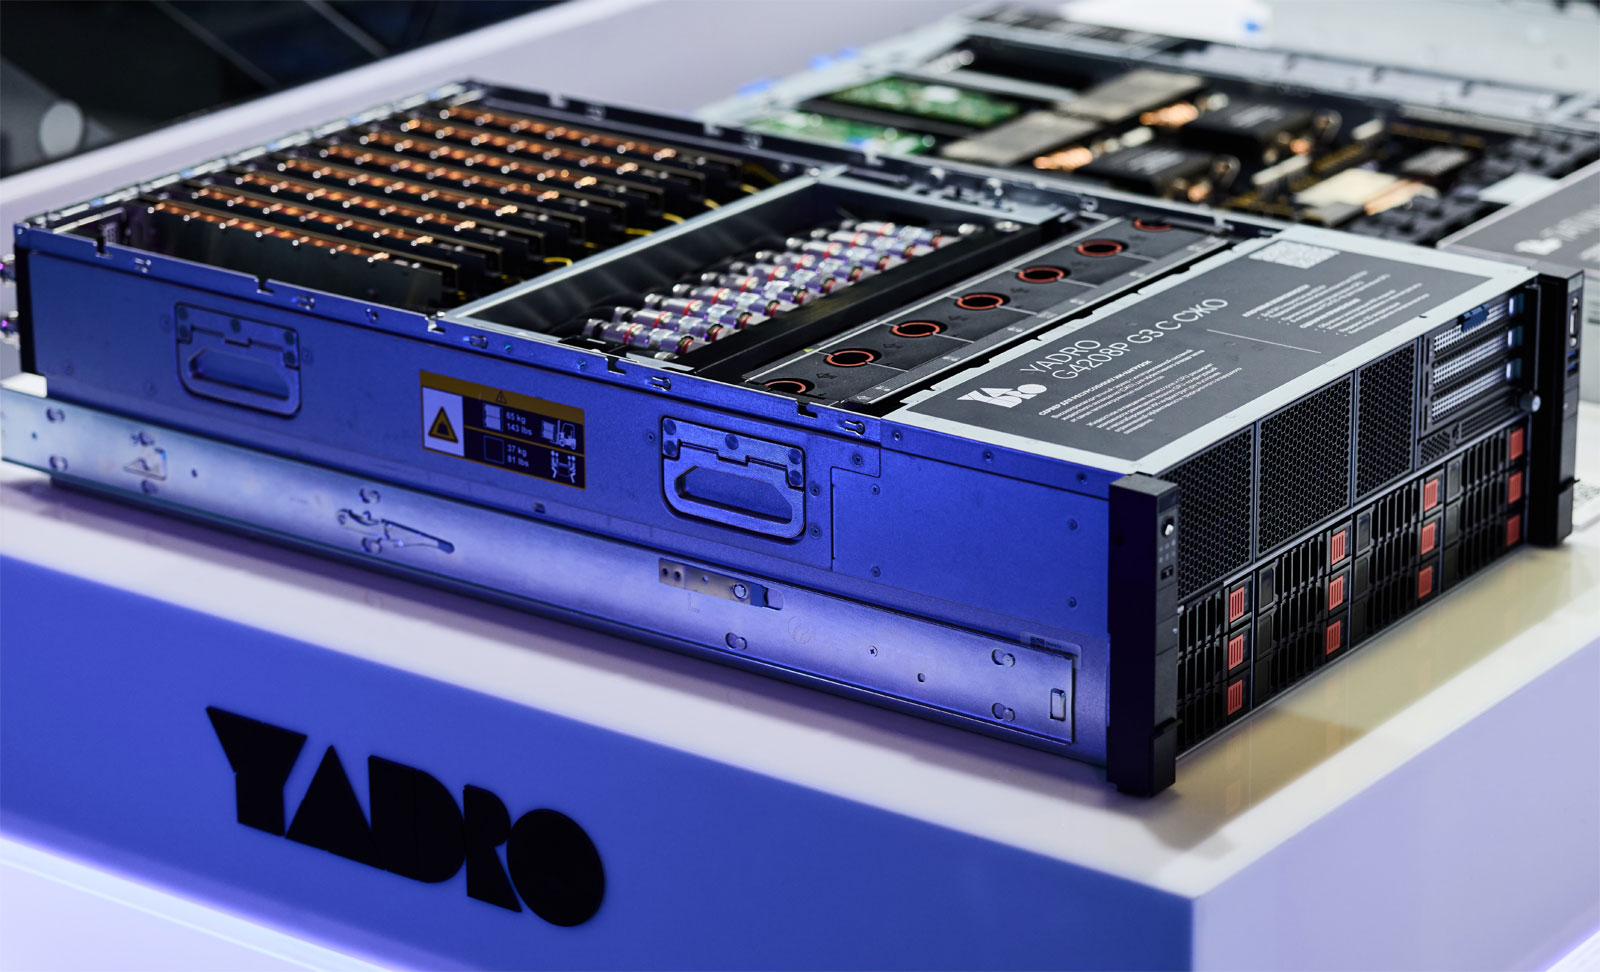
Источник изображения: YADRO В передней части машины находится один слот PCIe 5.0 x16 FHFL, в задней — восемь слотов PCIe 5.0 x16 FHFL, два разъёма PCIe 5.0 x16 FHFL и один слот OCP 3.0 (PCIe 5.0 x8). Питание обеспечивают четыре блока мощностью 3200 Вт с сертификатом 80 Plus Platinum и резервированием по схеме 2+2 или 3+1. Есть выделенный сетевой порт управления 1GbE RJ45, три порта USB 3.0 Type-A (один спереди), коннектор USB 2.0, а также два разъёма D-Sub (по одному спереди и сзади). Диапазон рабочих температур простирается от +5 до +40 °C. Габариты составляют 447 × 844,3 × 174,8 мм, масса — до 65 кг. Говорится о совместимости с Windows Server, Ubuntu, «Альт СП Сервер», «Альт Сервер», «РЕД ОС», Astra Linux Special Edition, «РЕД Виртуализация», zVirt, moncloud, «Соболь», SberLinux, РОСА ХРОМ.
01.10.2026 [14:35], Сергей Карасёв
OpenYard выпустила GPU-серверы RG2D4 на базе Intel Xeon Granite Rapids и AMD EPYC TurinРоссийский разработчик и производитель оборудования OpenYard анонсировал GPU-серверы семейства RG2D4 для задач машинного обучения и ИИ, обработки больших данных, видеоаналитики, визуальных вычислений и других ресурсоёмких приложений. Дебютировали модели RG2D4I и RG2D4A, построенные на аппаратной платформе Intel и AMD соответственно. Все новинки выполнены в форм-факторе 2U. Возможна установка до восьми ускорителей NVIDIA H100 NVL или NVIDIA L40s либо до четырёх изделий NVIDIA H200 NVL или NVIDIA RTX PRO 6000 Blackwell Server Edition. Доступны также два дополнительных слота PCIe 5.0 x16 для низкопрофильных карт расширения, например, сетевых адаптеров. Модель RG2D4I рассчитана на два процессора Intel Xeon 6500/6700 поколения Granite Rapids-SP. Реализованы 24 слота для модулей оперативной памяти DDR5-8000 MRDIMM суммарным объёмом до 3 Тбайт. В свою очередь, модификация RG2D4A позволяет задействовать два чипа AMD EPYC 9004 Genoa или EPYC 9005 Turin. Могут быть установлены до 24 модулей DDR5 RDIMM (до 3 Тбайт). Оба сервера оборудованы восемью фронтальными отсеками для SFF-накопителей NVMe/SATA/SAS с возможностью горячей замены. Имеются аппаратный RAID-контроллер с поддержкой RAID 0/1/5/6/10/50/60 и контроллер ASPEED AST2600. В оснащение включены два сетевых порта 10GbE RJ45 (Broadcom BCM57416), выделенный сетевой порт управления 1GbE RJ45, аналоговый разъём D-Sub, два порта USB 3.0 Type-A. В качестве опции доступны адаптеры 10/25/40/100/200/400GbE и FC16/32. 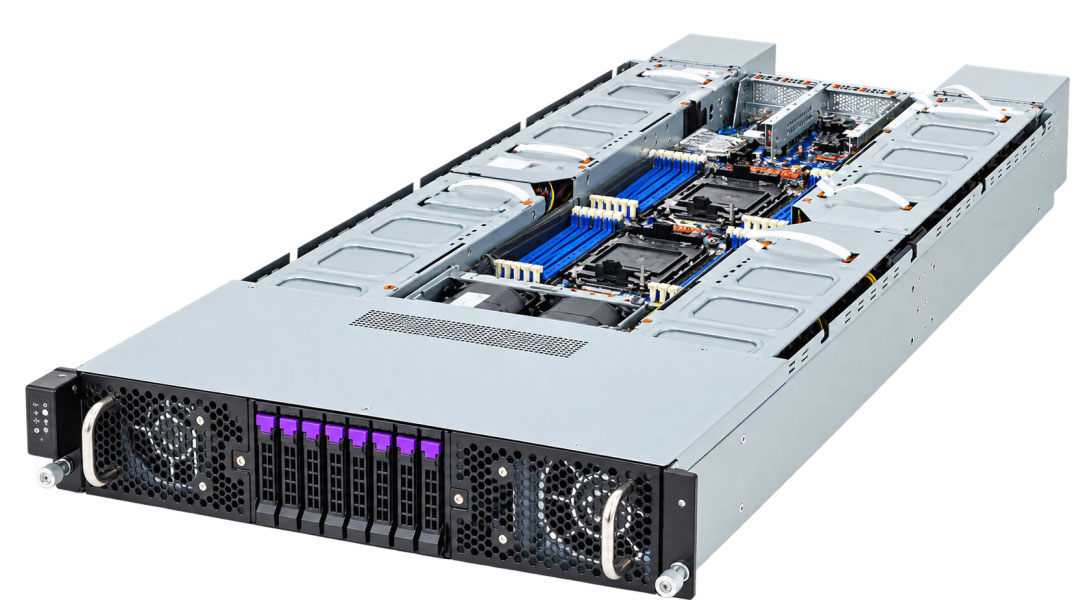
Источник изображения: OpenYard Питание обеспечивают два блока с резервирование мощностью 3000 Вт (80 PLUS Platinum). Габариты устройств составляют 448 × 87,5 × 962 мм. Применена система воздушного охлаждения; диапазон рабочих температур — от +10 до +35 °C.
15.09.2026 [11:10], Сергей Карасёв
NVIDIA представила ускоритель RTX Pro 5500 Blackwell Workstation Edition с 84 Гбайт памяти GDDR7Компания NVIDIA анонсировала ускоритель RTX Pro 5500 Blackwell Workstation Edition для профессиональных рабочих станций. Изделие подходит для решения задач в области агентного ИИ, физического моделирования, обработки высококачественной графики, анализа данных, видеопроизводства и пр. Новинка построена на архитектуре Blackwell с чипом GB202. Конфигурация включает 21 760 ядер CUDA и 84 Гбайт памяти GDDR7 с 416-битной шиной, обеспечивающей пропускную способность до 1398 Гбайт/с. Задействованы тензорные ядра пятого поколения и ядра RT четвёртого поколения. Карта использует интерфейс PCIe 5.0 x16. Максимальное энергопотребление заявлено на уровне 600 Вт. Ускоритель ориентирован на рабочие станции в стоечном исполнении. При этом может применяться воздушная или жидкостная система охлаждения. Могут использоваться до четырёх разъёмов DisplayPort 2.1b: они позволяют выводить изображение на мониторы с разрешением до 8K при 240 Гц и 16K при 60 Гц. Движки NVIDIA NVENC девятого поколения значительно ускоряют кодирование видео и улучшают качество в профессиональных видеоприложениях. Кроме того, применяются блоки декодирования NVIDIA NVDEC шестого поколения. Говорится о поддержке форматов 4:2:2 H.264 и HEVC. 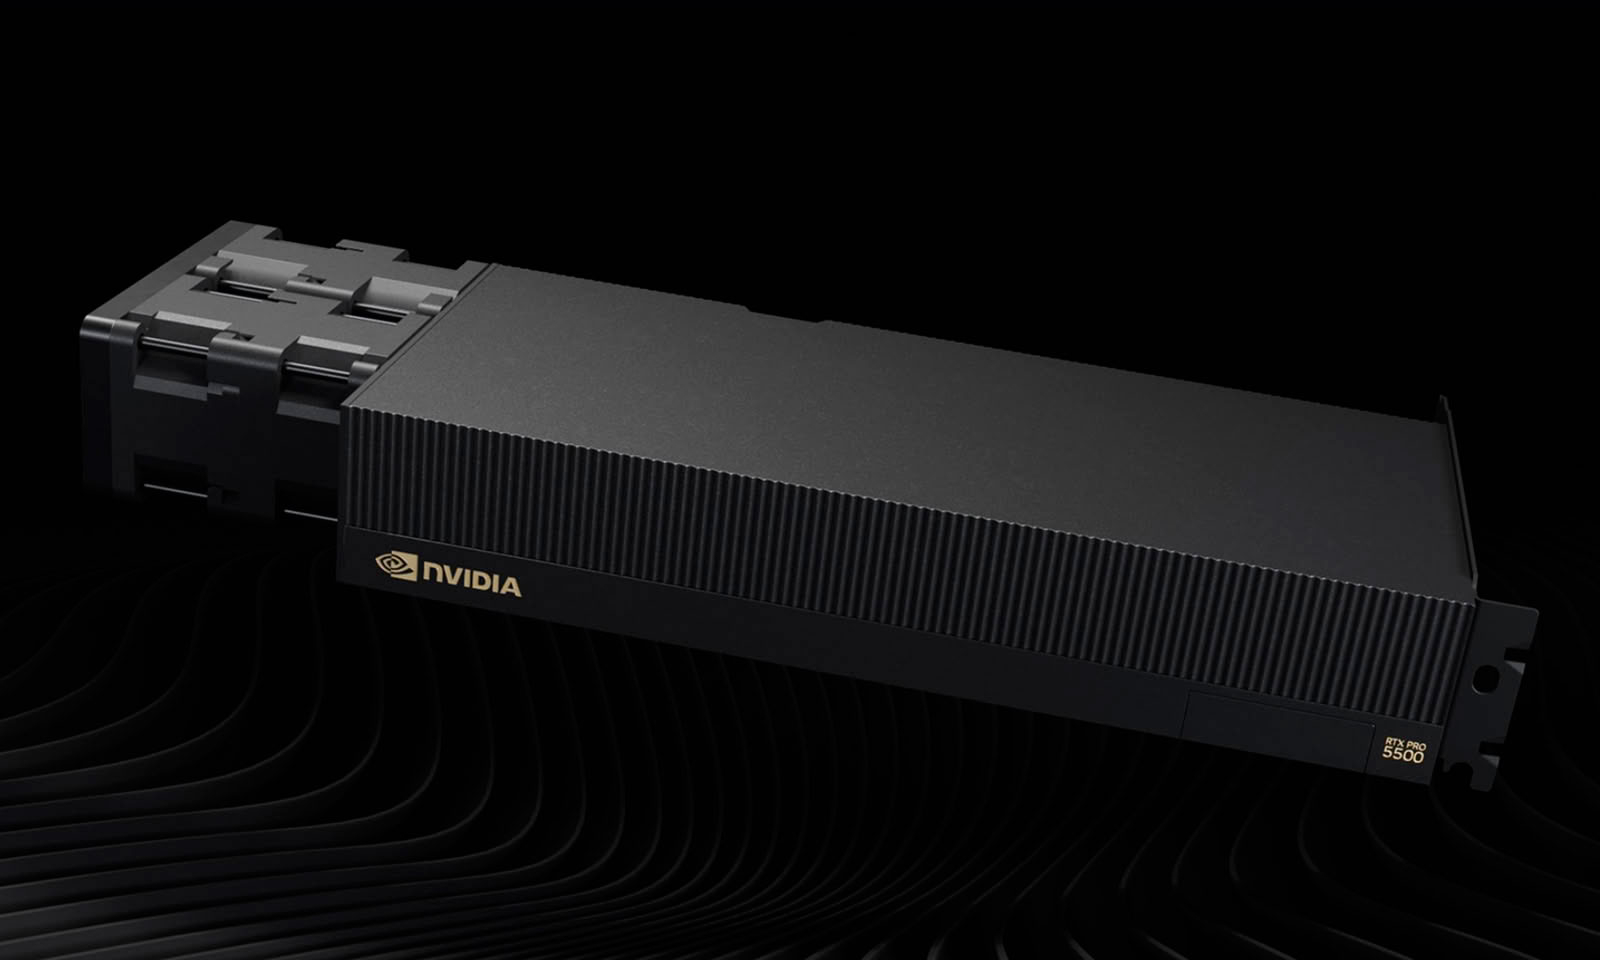
Источник изображения: NVIDIA В новинке реализована технология MIG (Multi-Instance GPU): она позволяет разделить один физический графический процессор на несколько независимых аппаратных разделов. Каждый из них функционирует как полноценный самостоятельный GPU со своей выделенной памятью, кешем и вычислительными ядрами. В случае RTX Pro 5500 Blackwell Workstation Edition могут быть сформированы два раздела с 42 Гбайт памяти GDDR7.
08.09.2026 [11:33], Сергей Карасёв
ASUS представила сервер ESC8000-E12P на архитектуре NVIDIA MGX с чипами Intel Granite RapidsКомпания ASUS анонсировала сервер ESC8000-E12P в форм-факторе 4U, предназначенный для выполнения различных задач в области ИИ, включая инференс и визуальные вычисления. Новинка построена на модульной архитектуре NVIDIA MGX с использованием процессоров Intel Xeon 6 поколения Granite Rapids-SP. Машина имеет двухсокетную конфигурацию: могут устанавливаться чипы Xeon 6500/6700 в исполнении LGA 4710 с показателем TDP до 350 Вт. Доступны 32 слота для модулей оперативной памяти DDR5-6400/5200 RDIMM/3DS RDIMM суммарным объёмом до 8 Тбайт. Во фронтальной части находятся восемь отсеков для SFF-накопителей NVMe с возможностью горячей замены. Кроме того, есть два внутренних коннектора для SSD типоразмера M.2 22110 с интерфейсом PCIe 5.0 x4. Сервер располагает восемью слотами PCIe 5.0 x16 для двухслотовых ИИ-ускорителей FHFL, таких как NVIDIA H200, NVIDIA RTX Pro 6000 Blackwell Server Edition, NVIDIA RTX Pro 4500 Blackwell Server Edition и Intel Gaud3. Кроме того, реализованы пять слотов PCIe 5.0 x16 для карт NIC/BlueField-3 (FHFL) и один разъём PCIe 5.0 x16 (FHHL). В оснащение входят два сетевых порта 10GbE RJ45 на основе контроллера Intel X710-AT2 и выделенный сетевой порт управления 1GbE RJ45. 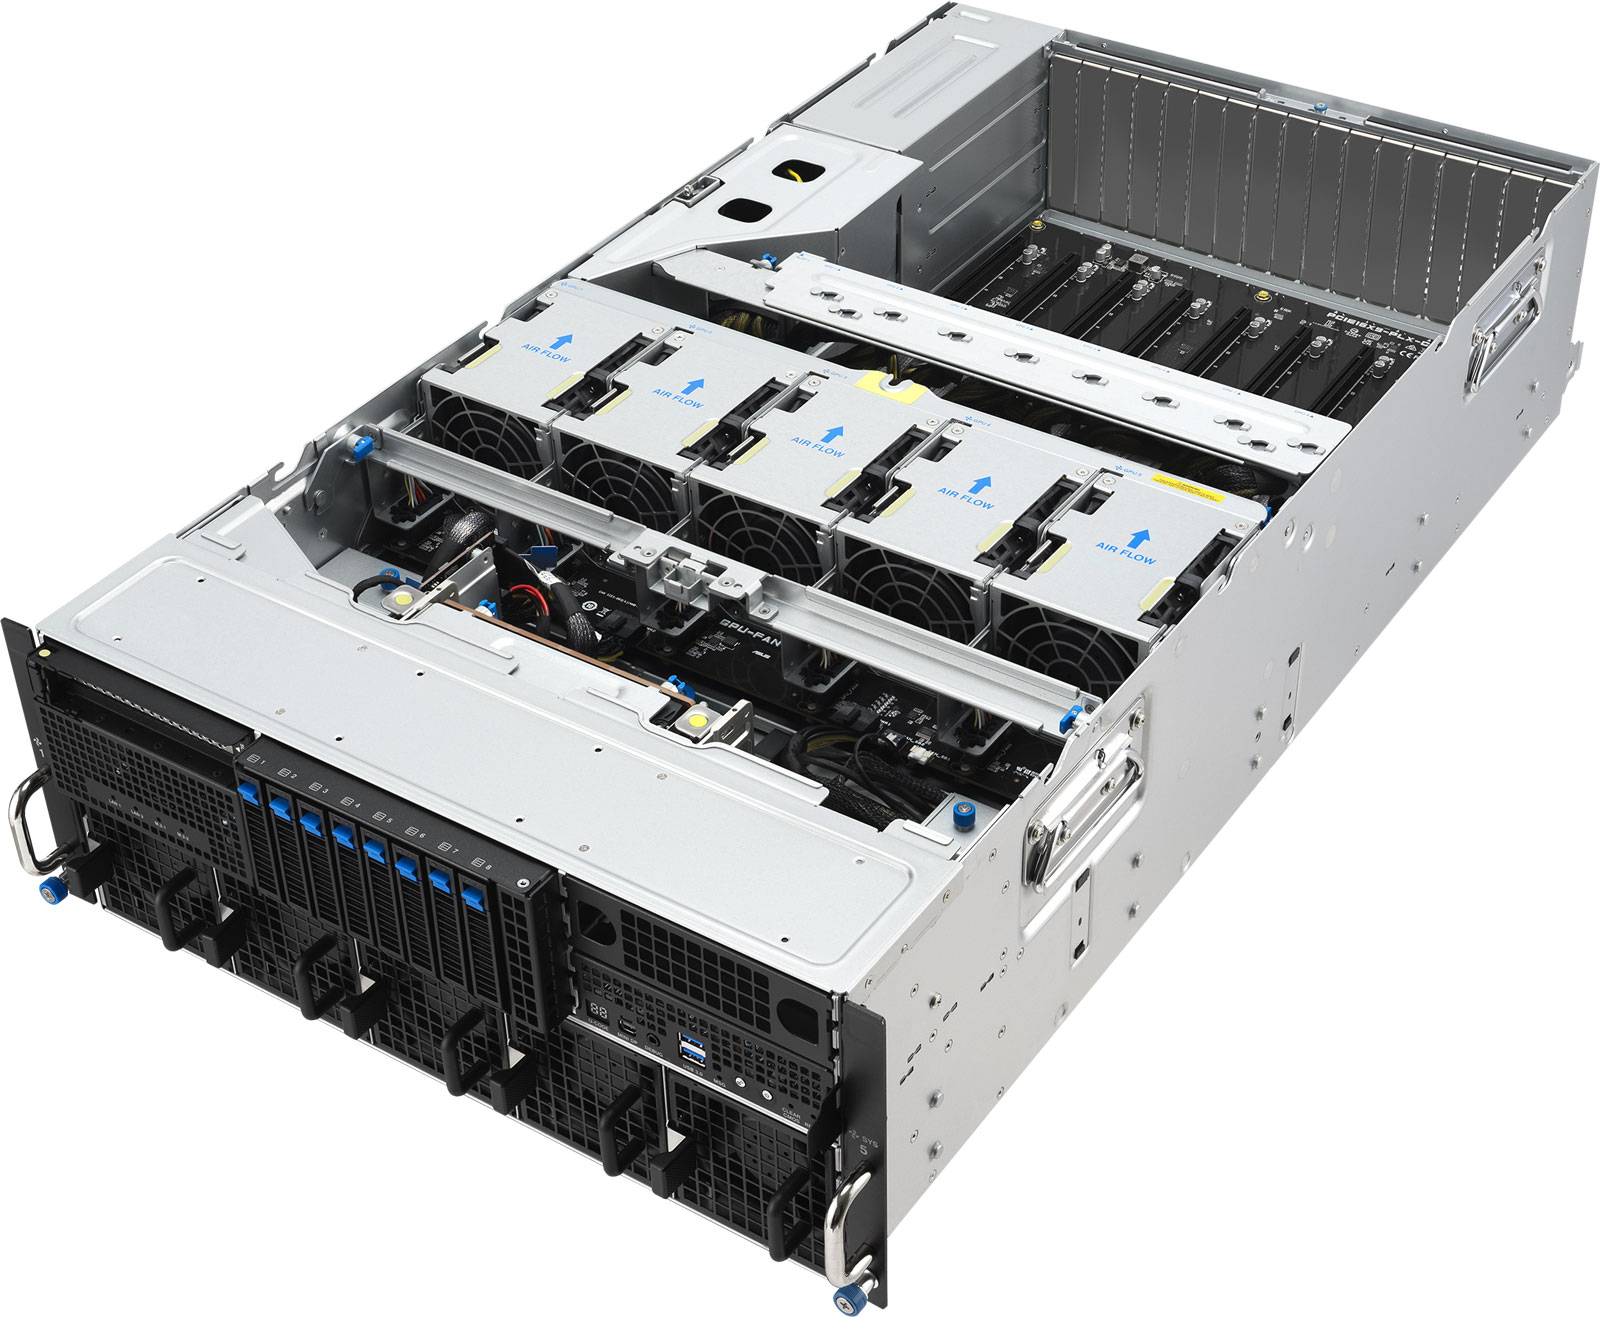
Источник изображения: ASUS Новинка оборудована воздушным охлаждением. За питание отвечают четыре блока мощностью 3200 Вт с резервированием и сертификатом 80 PLUS Titanium. Предусмотрены порты USB 3.0 и Mini DisplayPort. Габариты составляют 800 × 439,5 × 175 мм, масса — 45 кг. Диапазон рабочих температур простирается от +10 до +35 °C.
26.08.2026 [12:45], Сергей Карасёв
32 ядра Xe3P и до 480 Гбайт памяти LPDDR5X: Intel раскрыла детали об ИИ-ускорителе Crescent IslandIntel поделилась информацией об ИИ-ускорителях Crescent Island, предназначенных для использования в серверах и рабочих станциях. Ожидается, что поставки образцов изделий начнутся в текущем полугодии. Решения Crescent Island будут предлагаться в виде карт расширения с интерфейсом PCIe 5.0 x16. Конфигурация включает 32 ядра Xe3P и 256 матричных движков XMX. Кроме того, задействованы 256 векторных движков. На каждое ядро приходится 1 Мбайт регистра общего назначения (GRF) и 512 Кбайт кеша L1. Помимо этого, есть 32 Мбайт унифицированного кеша L2. В случае Crescent Island корпорация Intel решила отказаться от использования дорогостоящей памяти НВМ с высокой пропускной способностью. Вместо этого применяются чипы LPDDR5X с пониженным энергопотреблением (скоростные характеристики не раскрываются). Референсный вариант ускорителя несёт на борту 160 Гбайт LPDDR5X, тогда как ODM-производители будут предлагать модификации, имеющие до 480 Гбайт памяти. Заявленное энергопотребление карты находится на уровне 350 Вт; применяется воздушное охлаждение. 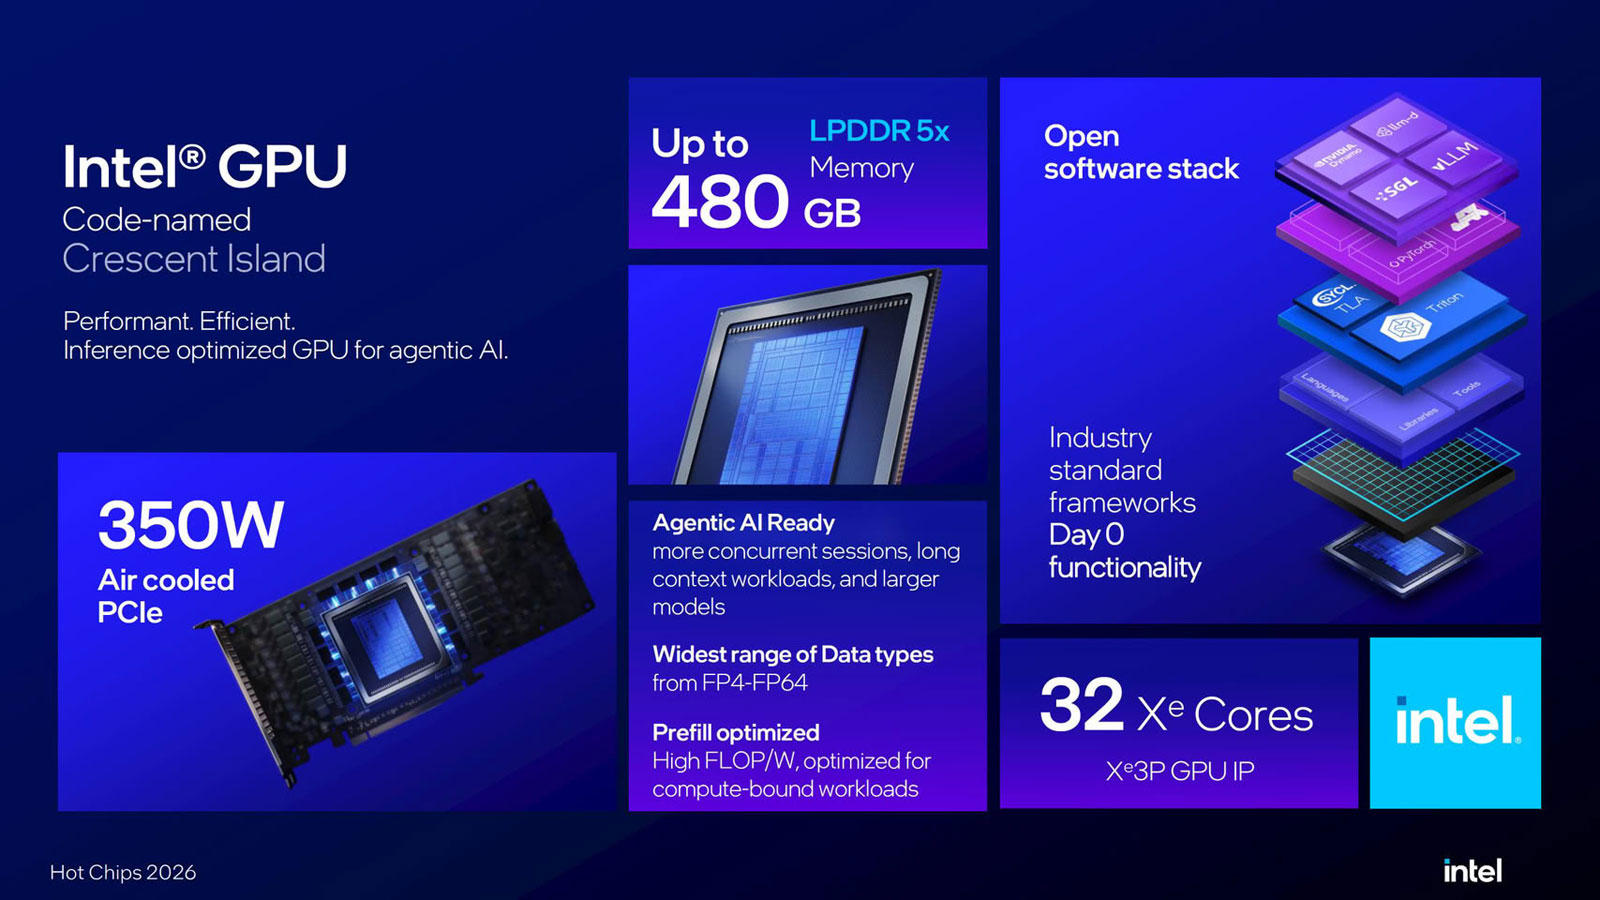
Источник изображений: Intel 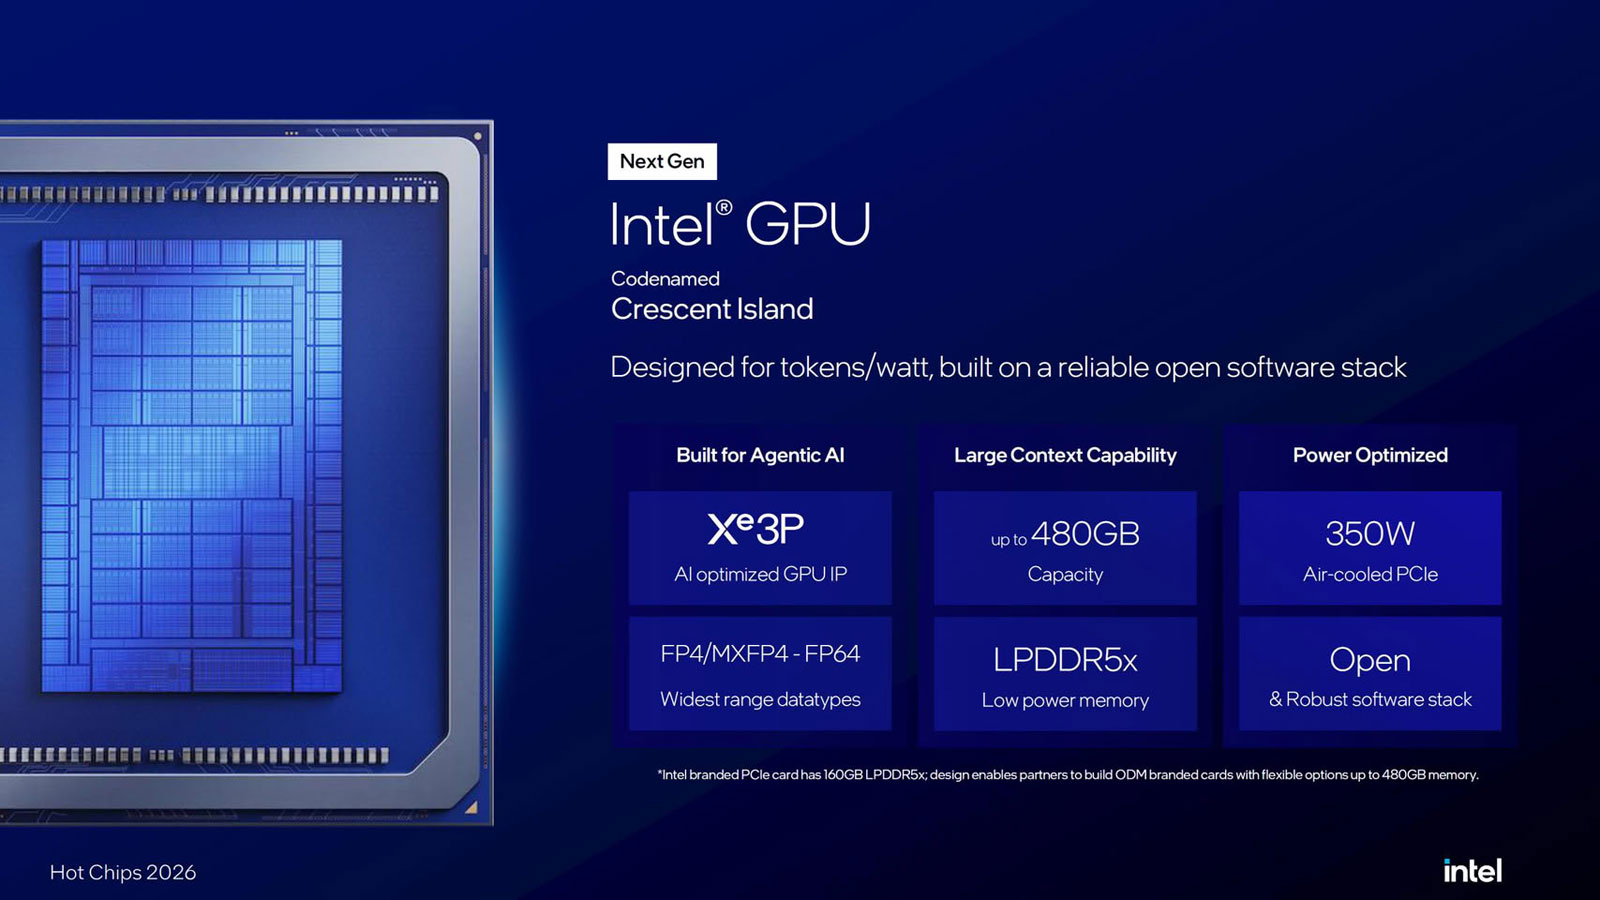
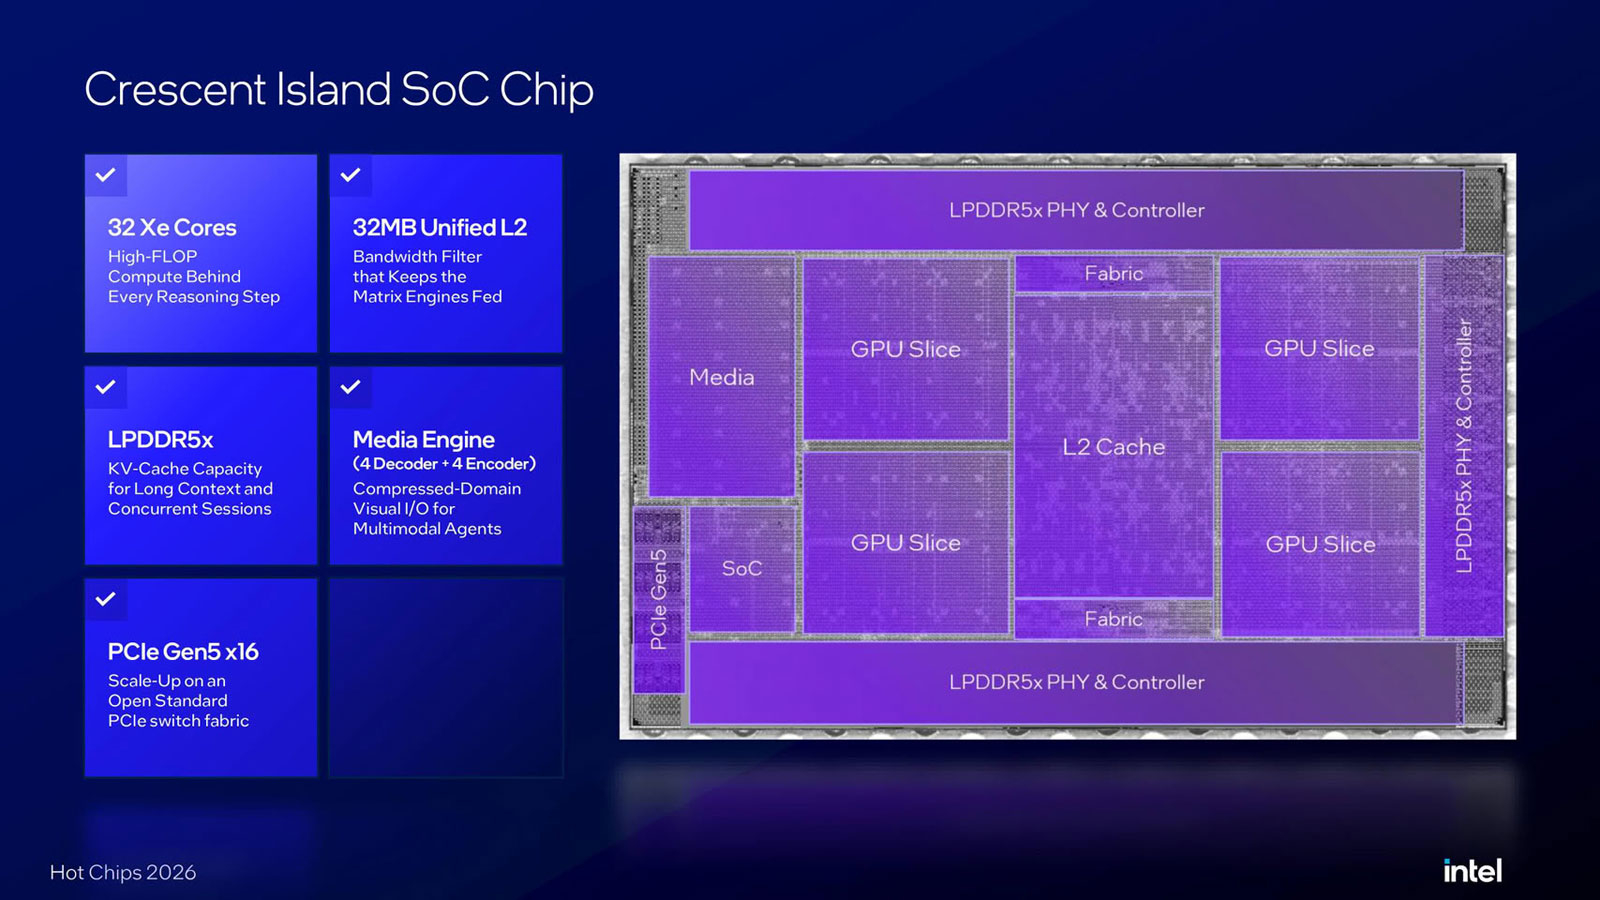 Изделие поддерживает различные форматы данных — FP64, FP16, BF16, TF32, INT8, INT4, FP8 и FP4. Ускоритель ориентирован прежде всего на задачи инференса. Он хорошо подходит для работы с агентным ИИ и длинными контекстами, где ключевой фактор эффективности — возможность размещения модели и её KV-кеша в памяти. Отмечается, что рабочая станция, оборудованная четырьмя ускорителями Crescent Island с 480 Гбайт памяти, сможет использовать в локальном режиме модели с триллионом параметров, например, Kimi K3. В области программного обеспечения Intel указывает на поддержку vLLM, SGLang, llm-d и NVIDIA Dynamo, что позволяет ИИ-агентам функционировать в гетерогенной инфраструктуре без изменений в коде. |
|

