
Материалы по тегу: 800gbe
|
29.03.2025 [10:11], Алексей Степин
Bolt Graphics анонсировала универсальную видеокарту со слотами SO-DIMM, которая может потягаться с RTX 5080Все современные графические ускорители предлагаются с жёстко заданным при производстве объёмом видеопамяти, а в наиболее производительных моделях память типа HBM вообще интегрирована на одной с основным кристаллом подложке. Однако требования к объёму памяти в последнее время растут быстрее, а за дополнительный объём вендор просят всё больше. Кардинально иной подход предлагает компания Bolt Graphics, недавно анонсировавшая серию ускорителей Zeus. Несмотря на «ИИ-пандемию», Bolt Graphics в своём анонсе не делает упор на искусственный интеллект, а называет Zeus первым GPU, специально созданным для целей HPC, рендеринга, трассировки лучей и даже компьютерных игр. Что интересно, в основе Zeus лежит не некая закрытая архитектура: скалярная часть нового GPU построена на базе спецификации RISC-V RVA23, векторная представлена FP64 ALU на базе несколько модифицированной RVV 1.0. Прочие функции реализованы путём кастомных расширений и отдельных блоков-ускорителей. Все они пользуются общим кешем объёмом 128 Мбайт. Дополняет картину блок телеметрии и внутренний интерконнект для общения с другими вычислительным блоками. 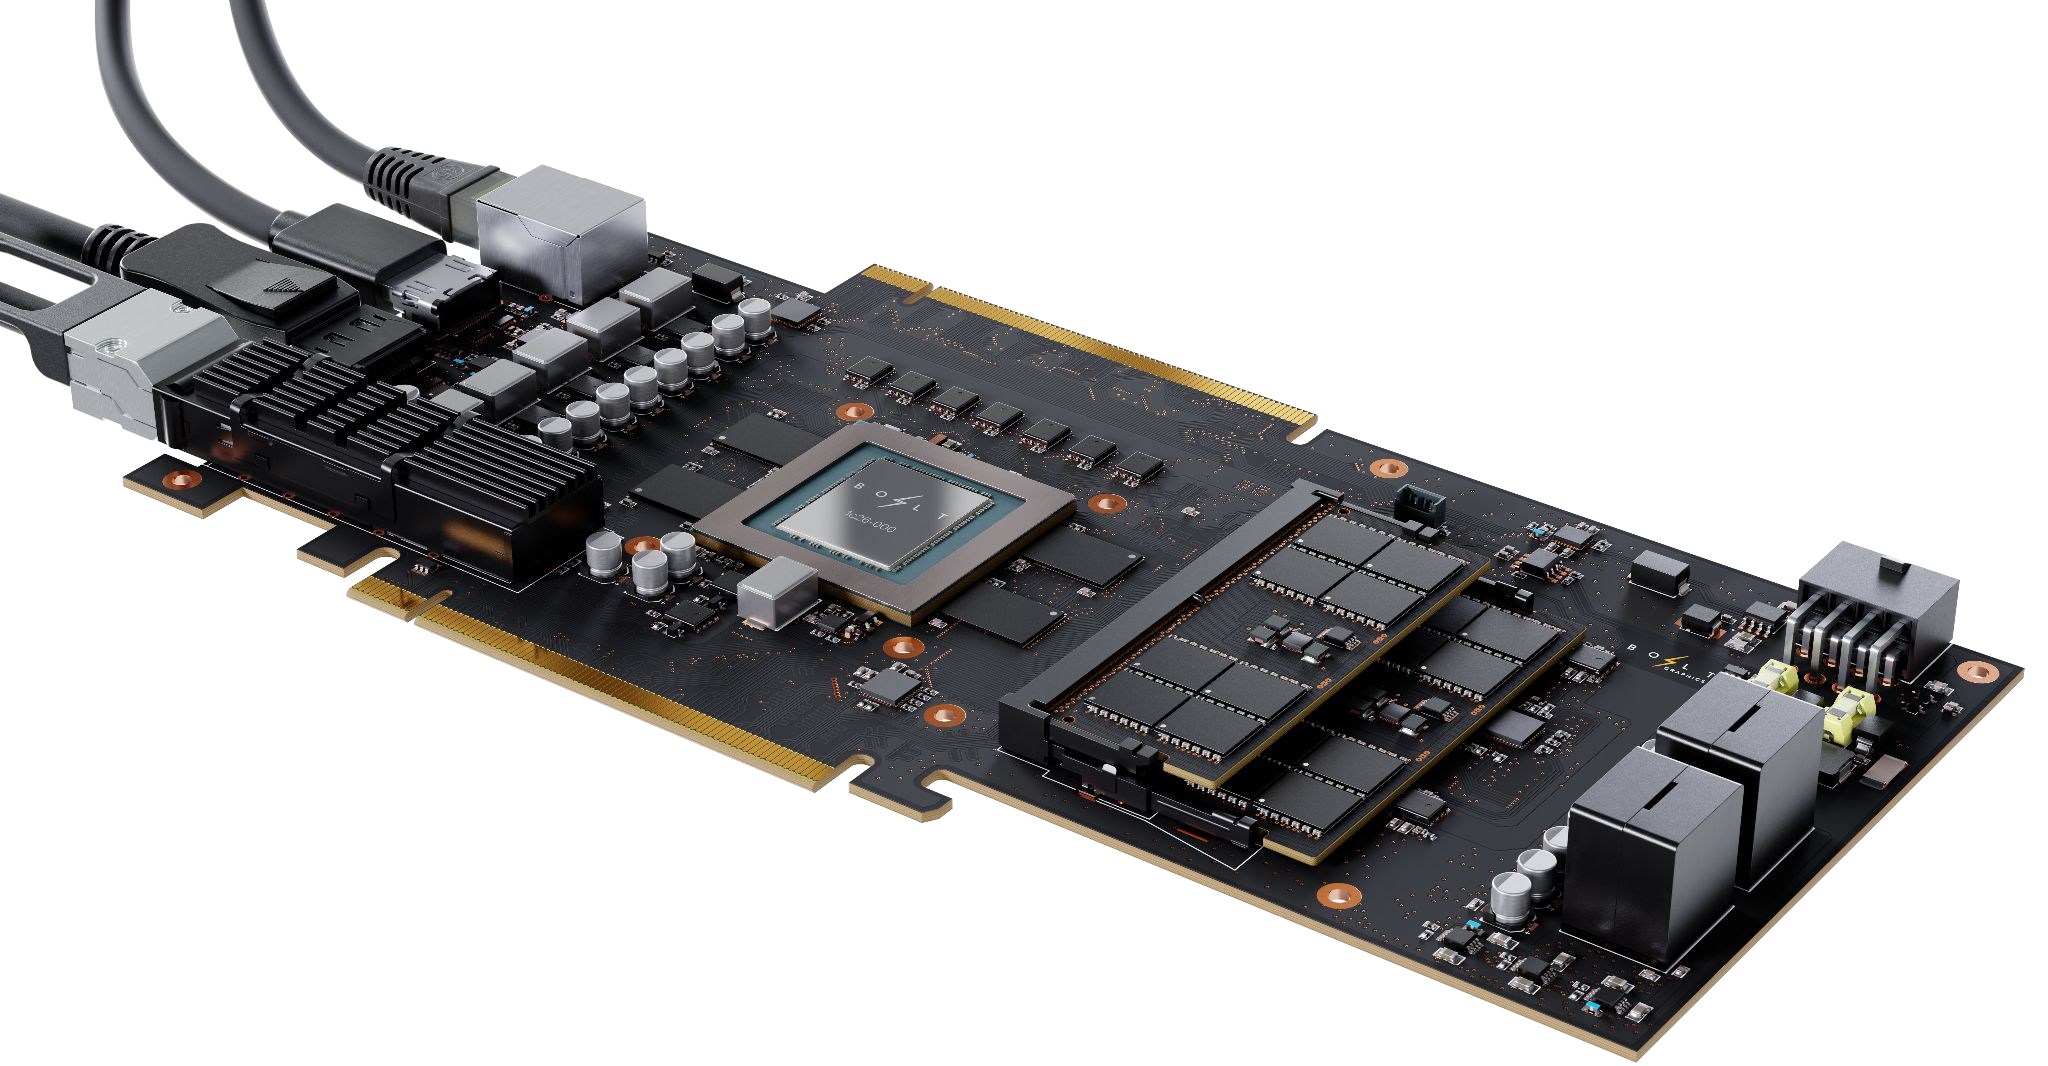
Zeus 1c26-032 (Источник изображений: Bolt Graphics) Используется чиплетный подход. Базовый «строительный блок» Zeus 1c26-032 включает GPU-чиплет, который соединён с 32 Гбайт набортной памяти LPDDR5x (273 Гбайт/с) и контроллером внешней памяти DDR5 (90 Гбайт/с), т.е. при желании можно установить ещё 128 Гбайт RAM (два модуля SO-DIMM). В GPU-чиплет встроены контроллеры DisplayPort 2.1a и HDMI 2.1b, а с внешним миром он общается посредством IO-чиплета, с которым он соединён 256-Гбайт/с каналом. IO-чиплет предлагает необычный набор портов. Помимо сразу двух интерфейсов PCIe 5.0 x16 (64 Гбайт/с каждый) имеется выделенный порт RJ-45 для BMC и 400GbE-порт QSFP-DD. Наконец, есть аппаратный блок видеокодирования, способный справиться с двумя потоками 8K@60 AV1/H.264/H.265. 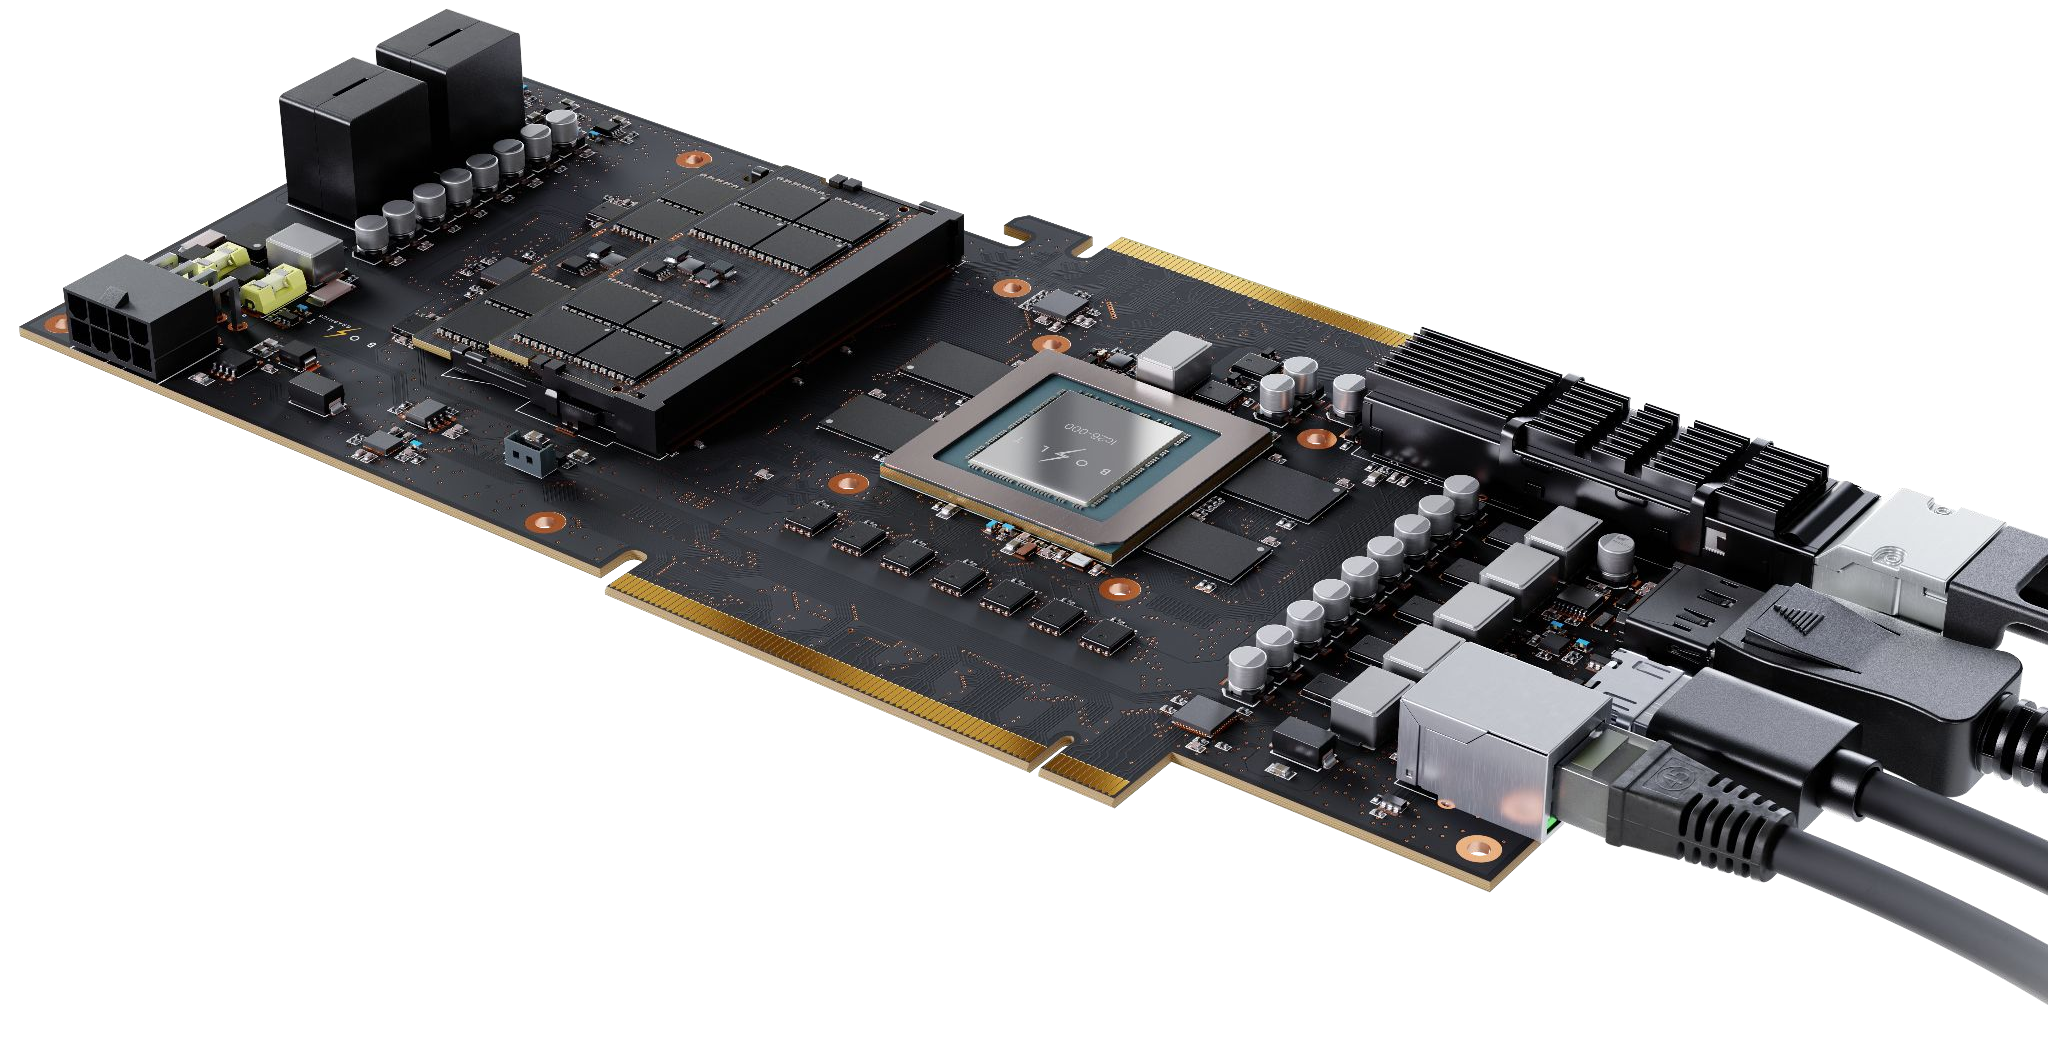 Заявленный уровень производительности в векторных FP64/FP32/FP16-вычислениях составляет 5/10/20 Тфлопс, а в матричных INT16/INT8 — 307,2/614,4 Топс. Аппаратный блок ускорения лучей (path tracing) выдаёт до 77 гигалучей. Для сравнения: NVIDIA RTX 5090 способна выдавать 32 гигалуча, а FP64-производительность составляет 1,6 Тфлопс. В то же время в расчётах пониженной точности актуальные решения NVIDIA всё равно быстрее Zeus 1c26-032. Однако у новинки есть важное преимущество — её уровень TDP составляет всего 120 Вт. Второй интерфейс PCIe 5.0 x16 можно использовать для прямого объединения двух карт. 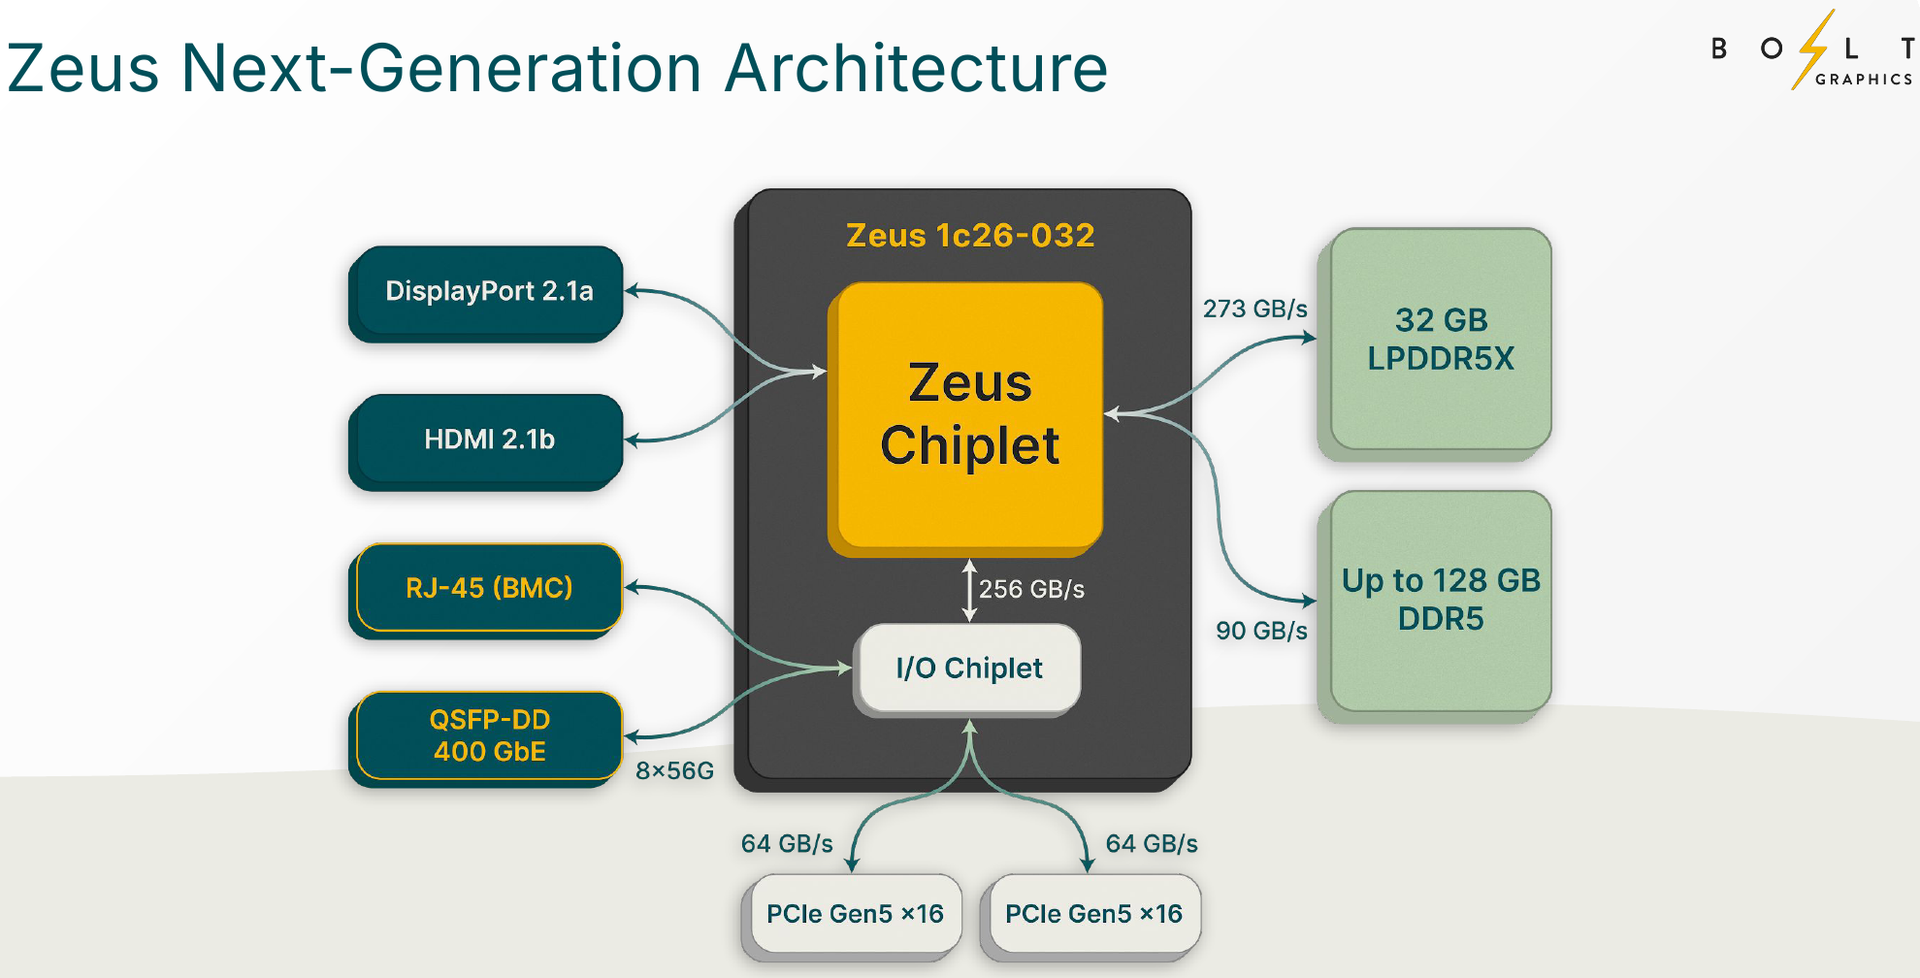 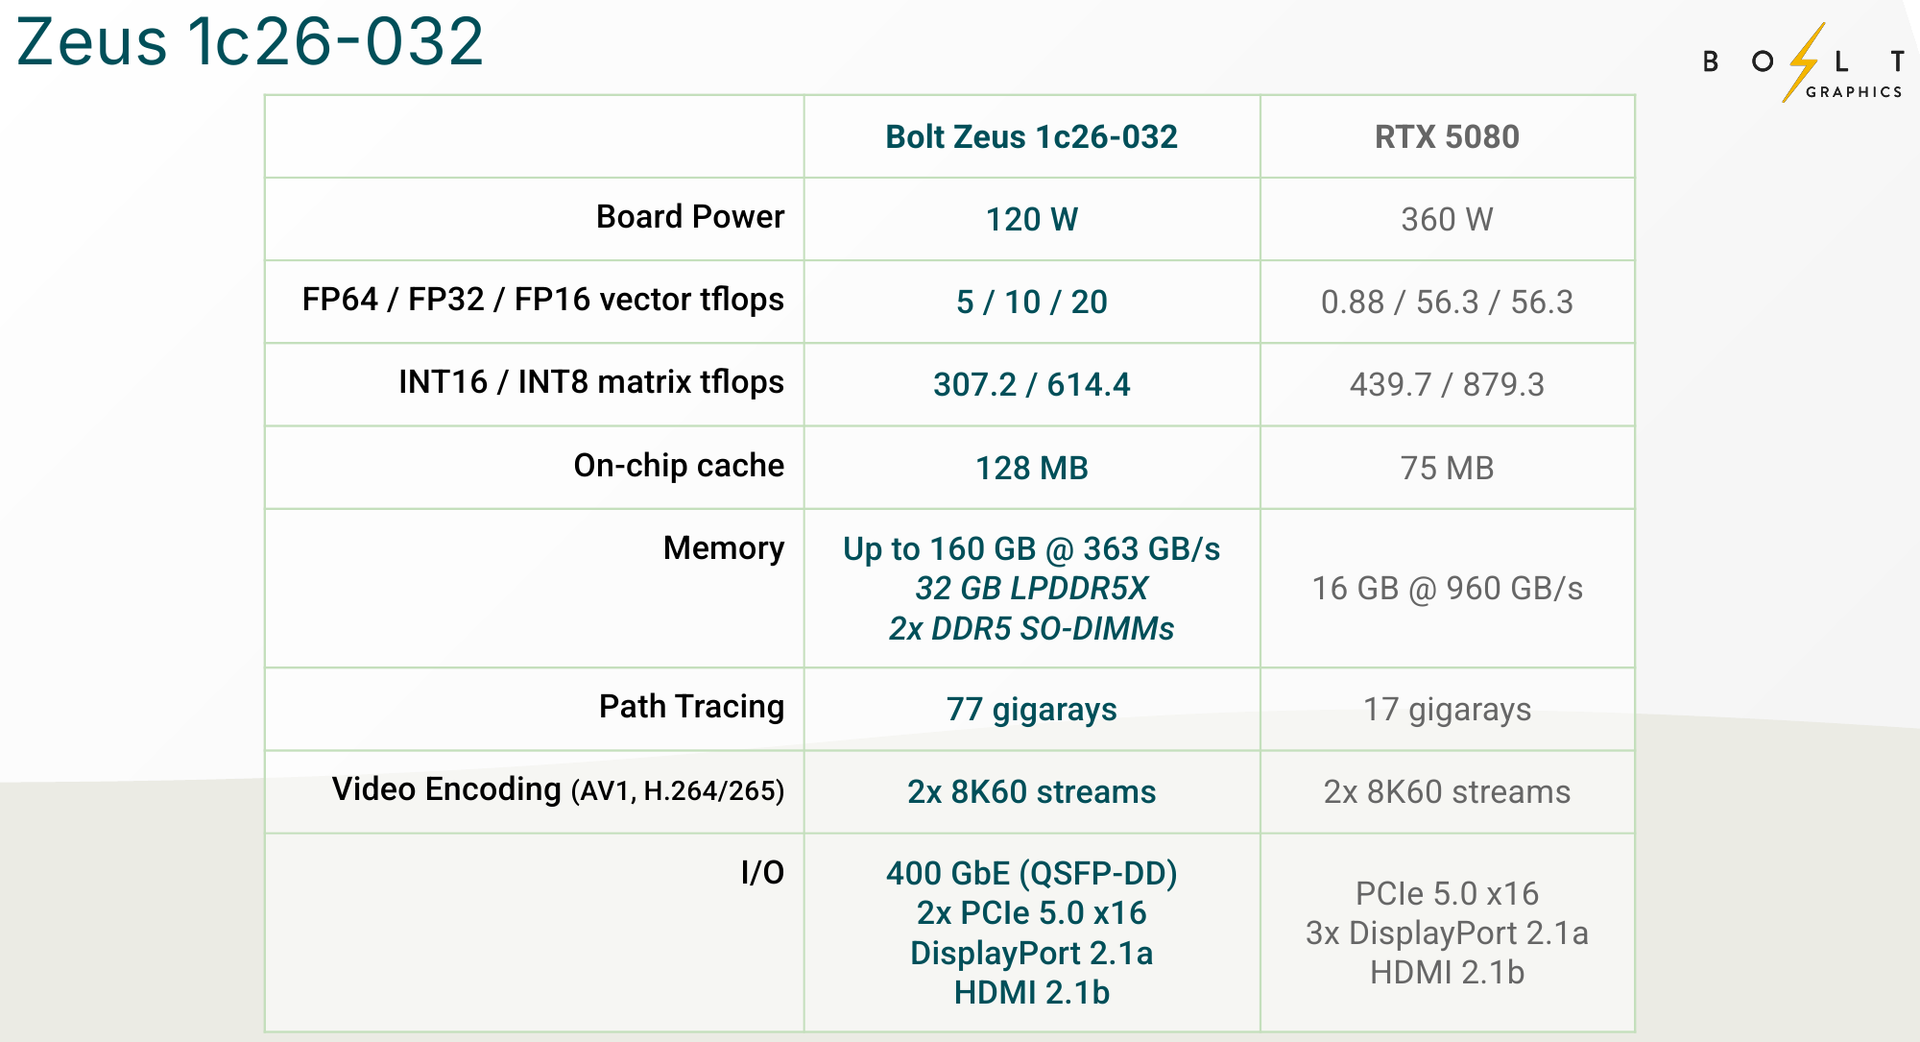 Вариант ускорителя с двумя чиплетами носит название Zeus 2c26-064/128, а с четырьмя — 4c26-256. Последние числа обозначают объём распаянной памяти LPDDR5X. Что касается расширяемой памяти, то количество доступных разъёмов SO-DIMM также зависит от модели и составляет до восьми, так что во флагманской конфигурации базовые 256 Гбайт LPDDR5x можно дополнить аж 2 Тбайт DDR5. Производительность с увеличением количеств GPU-чиплетов растёт практически пропорционально, но есть некоторые другие нюансы. Так, в Zeus 2c26-064 и Zeus 2c26-128 (оба варианта имеют TDP 250 Вт) есть только один IO-чиплет, а GPU-чиплеты объединены шиной со скоростью 768-Гбайт. 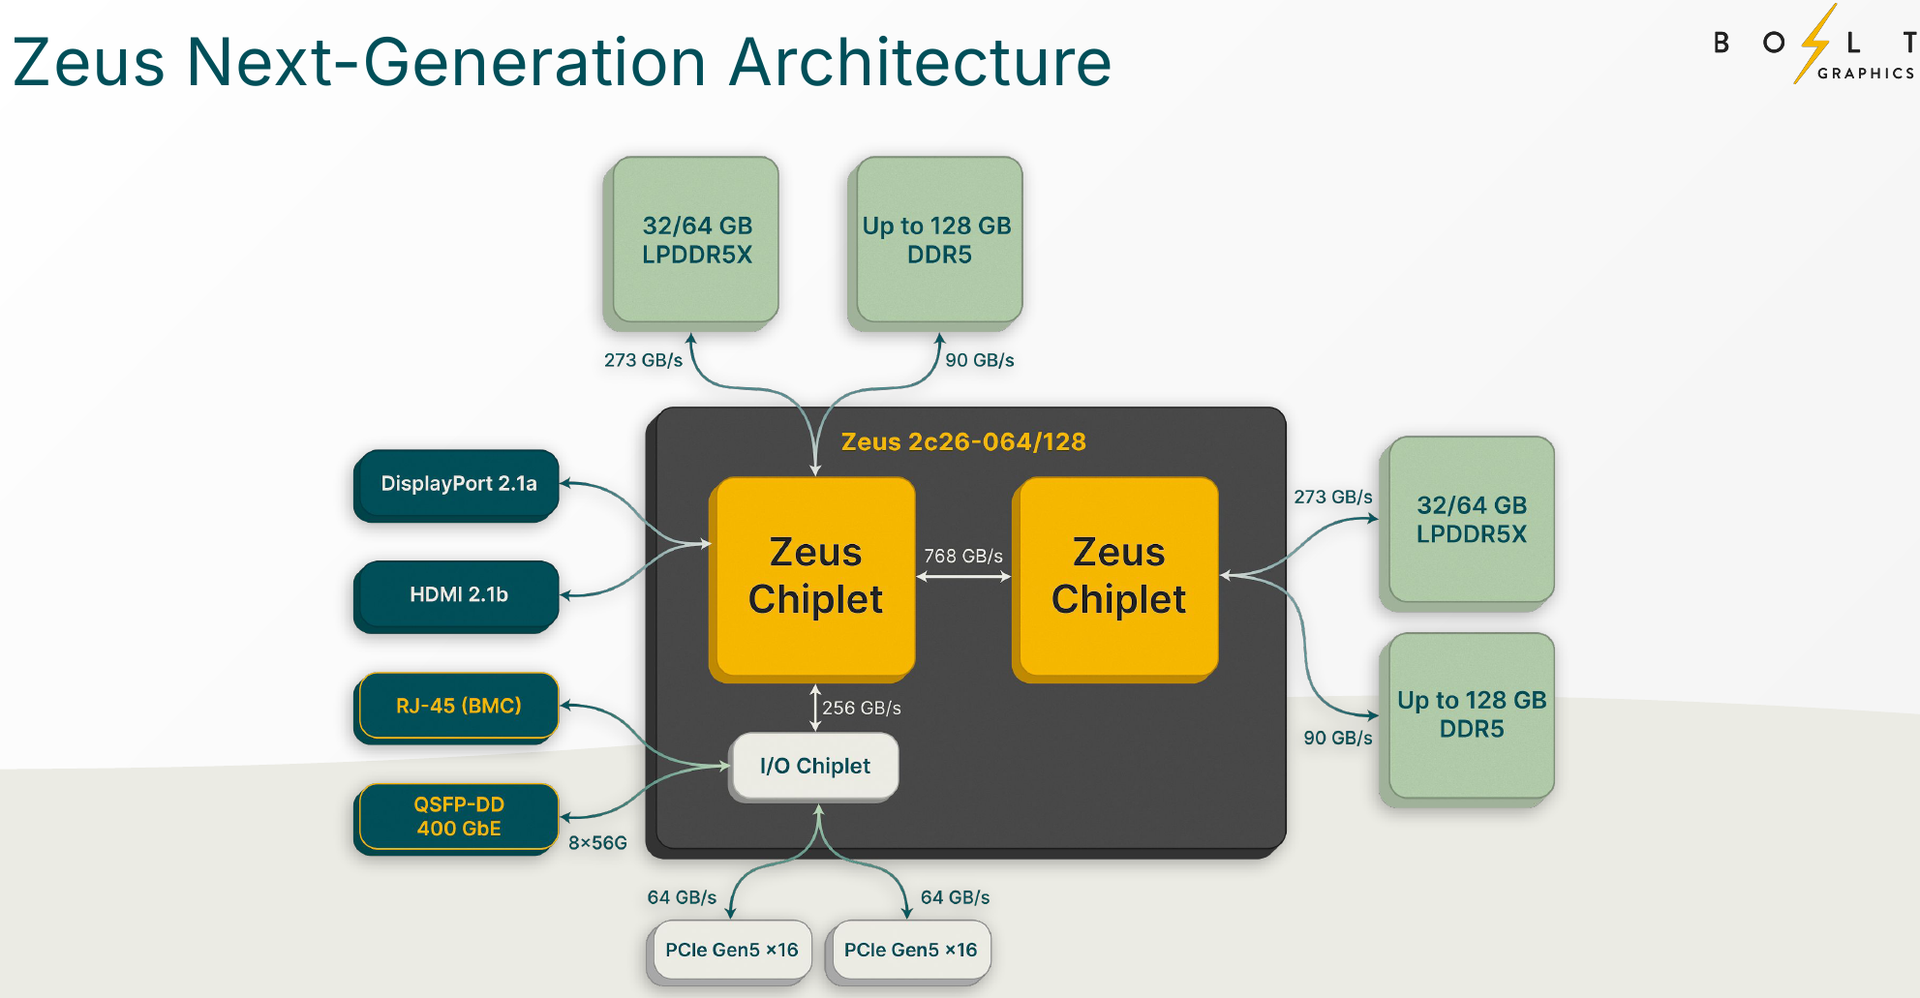 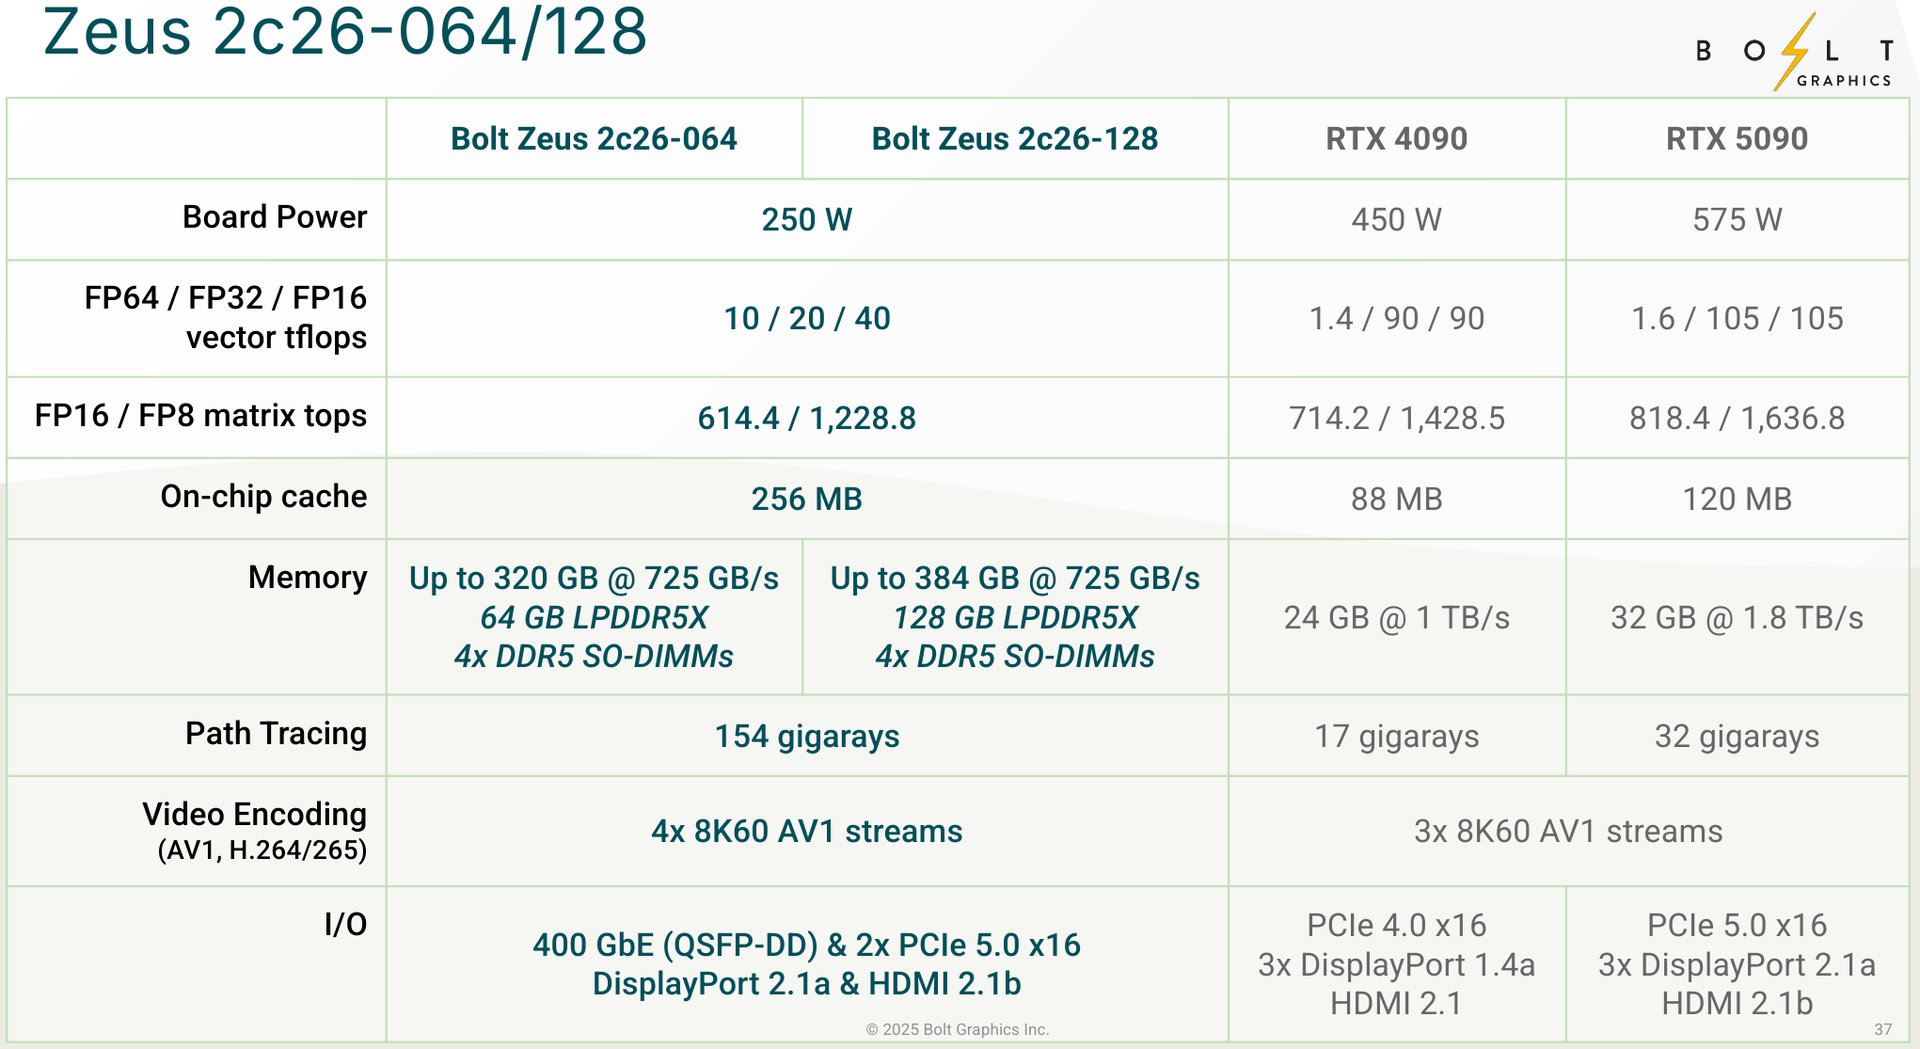 Zeus 4c26-256 имеет сразу четыре I/O чиплета в составе, которые дают восемь контроллеров PCIe 5.0 x4 (один чиплет, совокупно 32 линии) и шесть 800GbE-портов OSFP (три чиплета). Между собой GPU-чиплеты объединены шиной со скоростью 512-Гбайт/с. Каждый из них соединён с собственным IO-чиплетом на скорости 256 Гбайт/с. Теплопакет флагмана составляет 500 Ватт, ускоритель, если верить Bolt Graphnics, развивает 20 Тфлопс в режиме FP64, почти 2500 Топс на вычислениях FP8 и способен обрабатывать до 307 гигалучей. 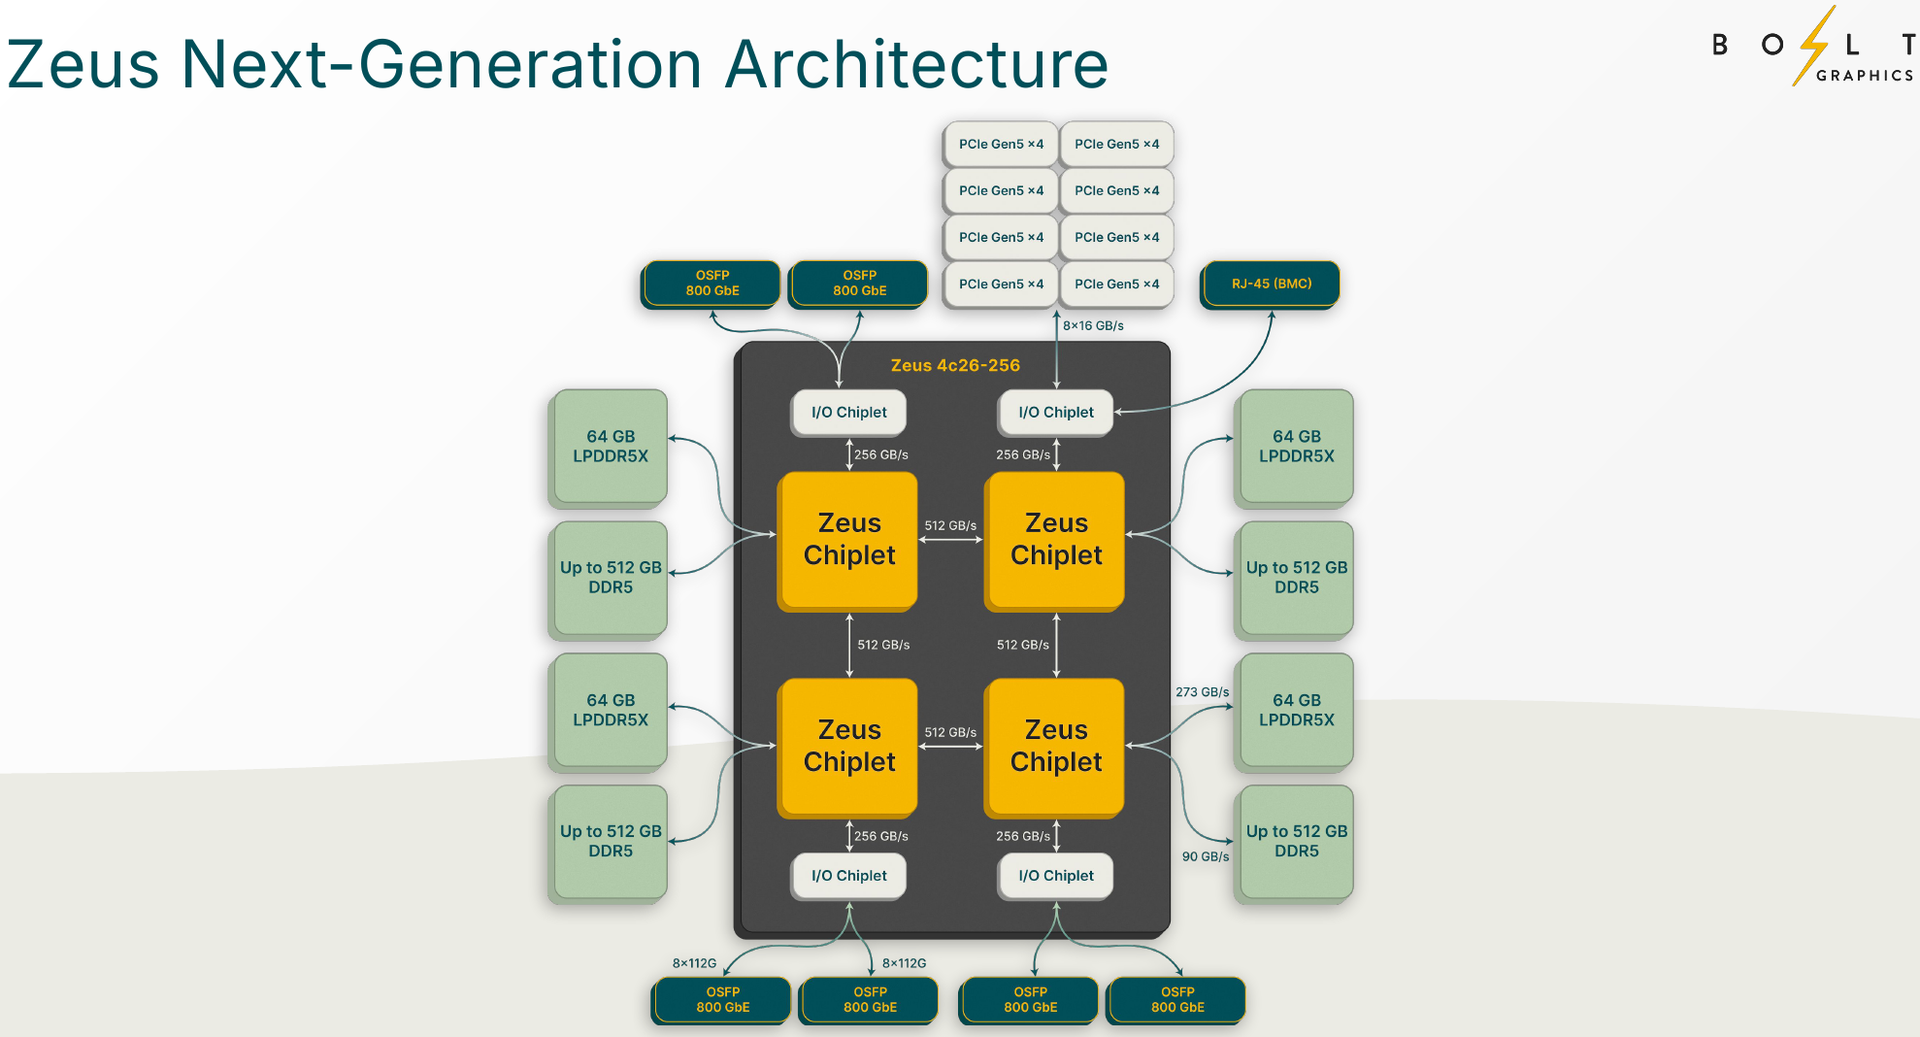 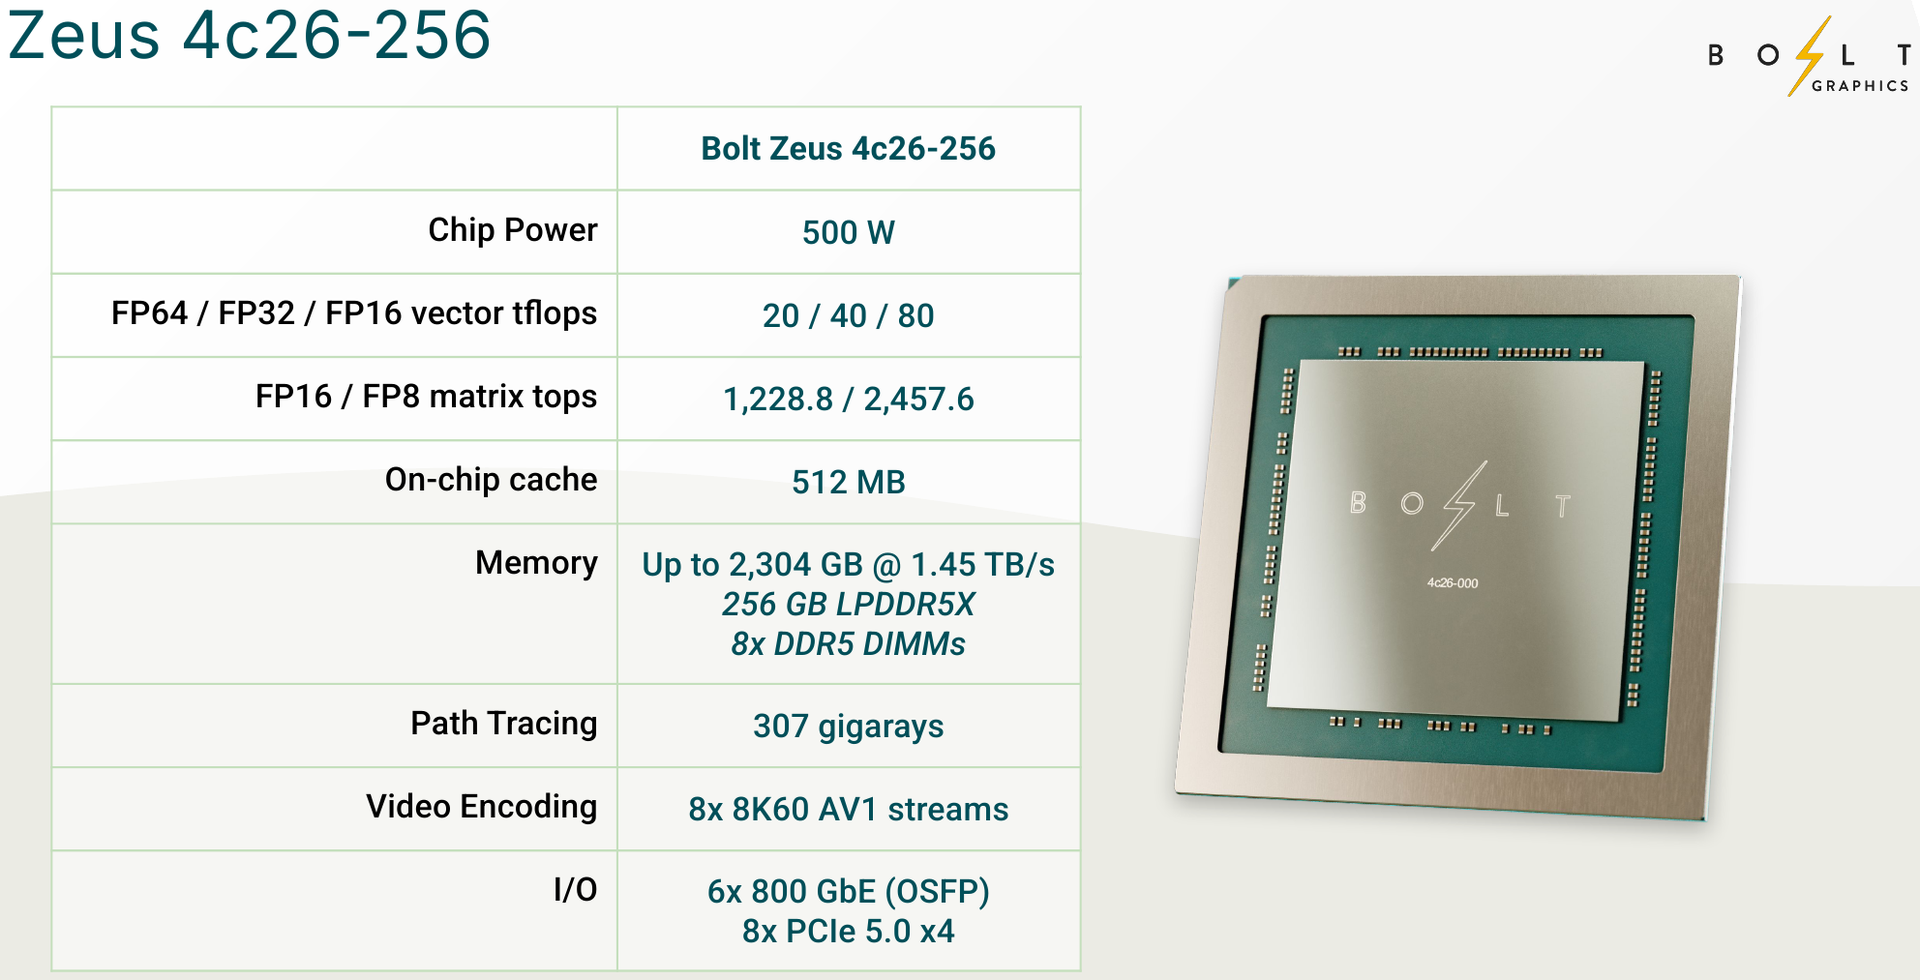 Разработчики явно заложили в своё детище широкие возможности кластеризации, о чём свидетельствует наличие мощной сетевой подсистемы. Поддерживаются как скромные конфигурации из двух GPU, соединённых непосредственно по Ethernet 400GbE, так и масштабные системы уровня стойки, содержащей 80 плат Zeus 4c26-256, соединённых как с коммутатором, так и напрямую друг с другом. Такой кластер потребляет 44 кВт, но зато способен обеспечивать запуск крупных физических симуляций или обучение ИИ моделей за счёт огромного массива общей памяти, составляющего 160 Тбайт. Вычислительная производительность такого кластера достигает 1,6 Пфлопс в режиме FP64 и 196 Попс в режиме FP8. 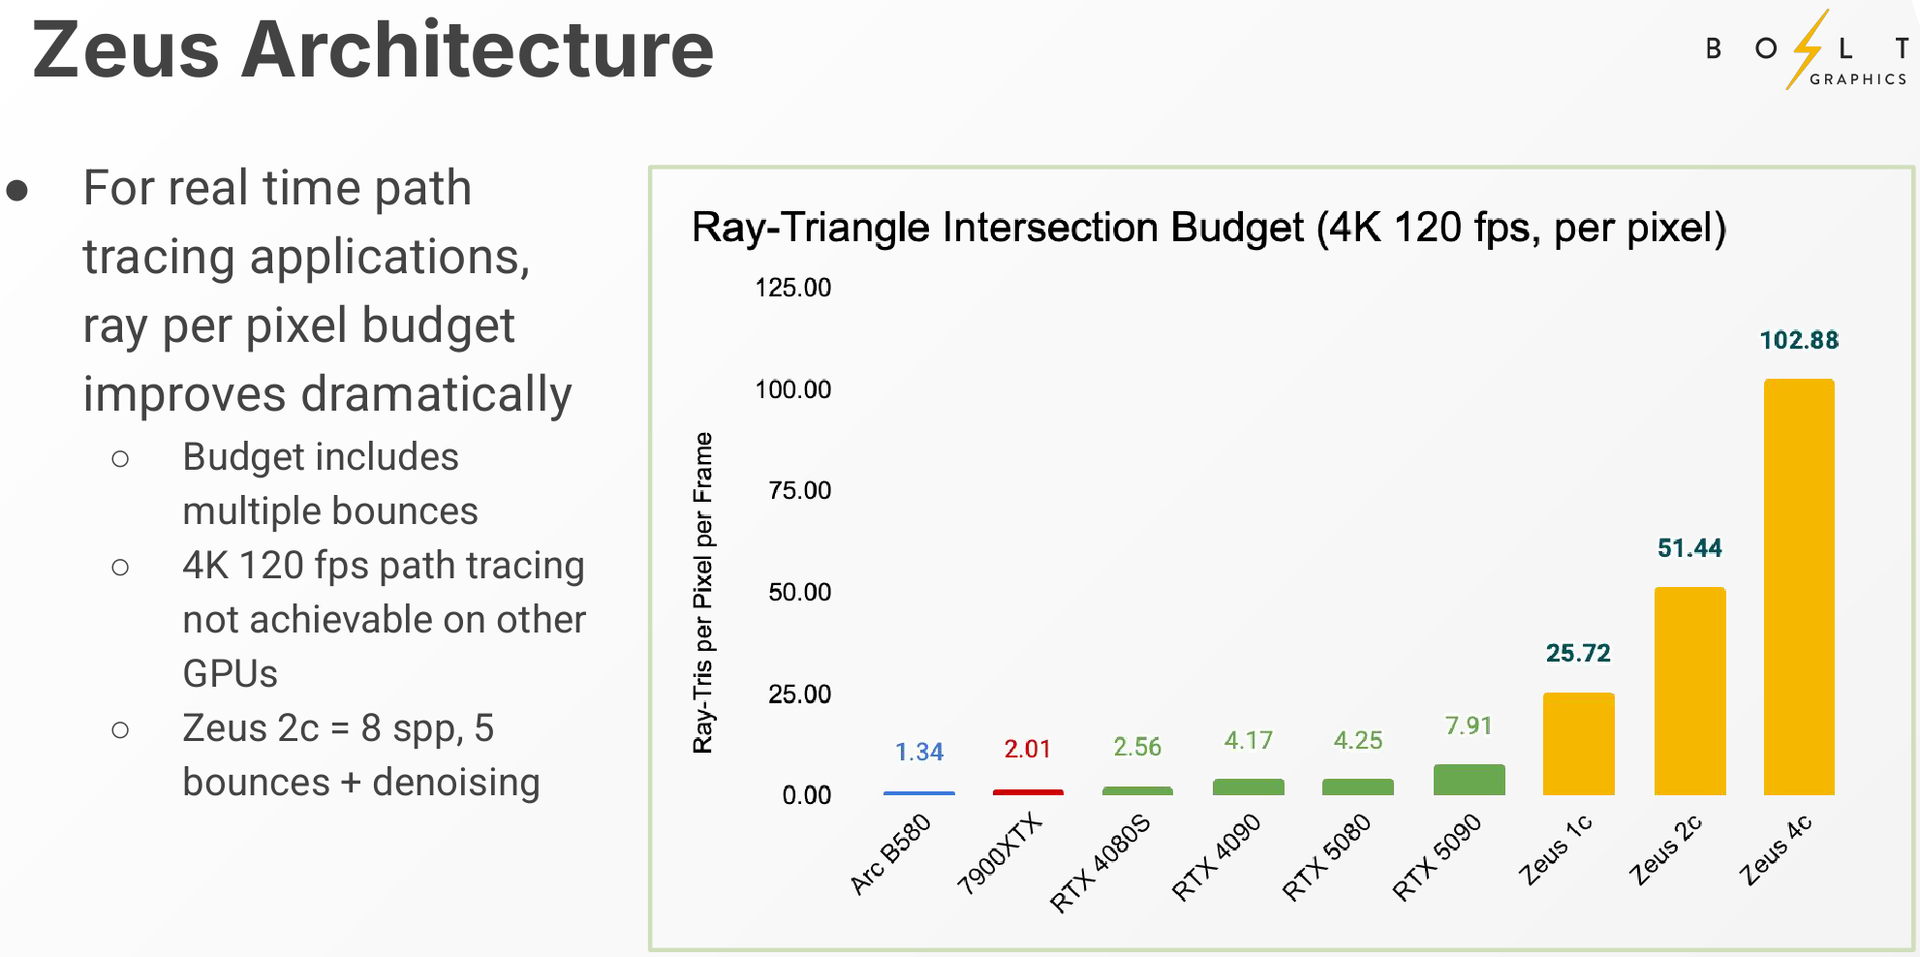 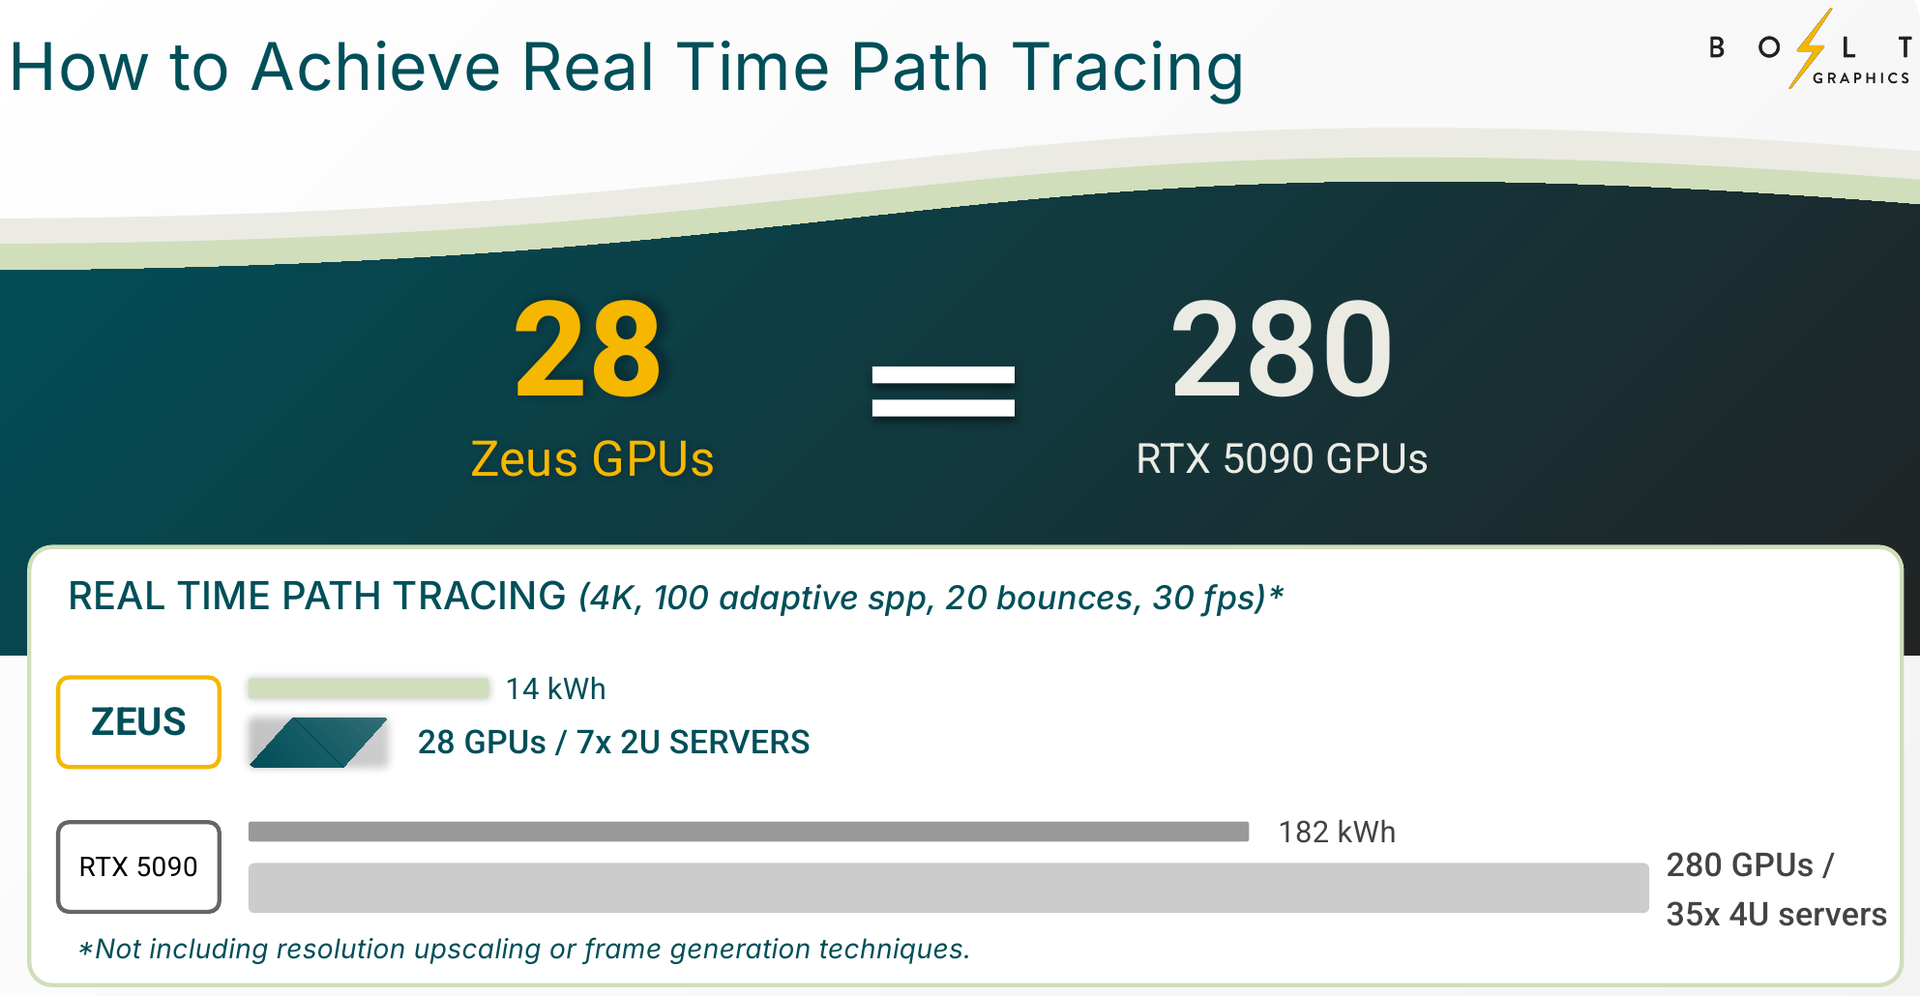 Одной из особенностей новинок является трассировщик лучей Glowstick, способный работать в режиме реального времени практически во всех современных пакетах 3D-моделирования или видеоредактирования, таких как Maya, 3ds Max, Blender, SketchUp, Houdini и Nuke. Он будет дополнен фирменной библиотекой Bolt MaterialX, содержащей более 5000 текстур высокого качества. А благодаря поддержке стандарта OpenUSD он сможет легко интегрироваться в любую цепочку рендеринга и пост-обработки. Также запланирован электромагнитный симулятор Bolt Apollo. Обещаны фирменные драйверы Vulkan/DirectX и SDK с использованием LLVM. 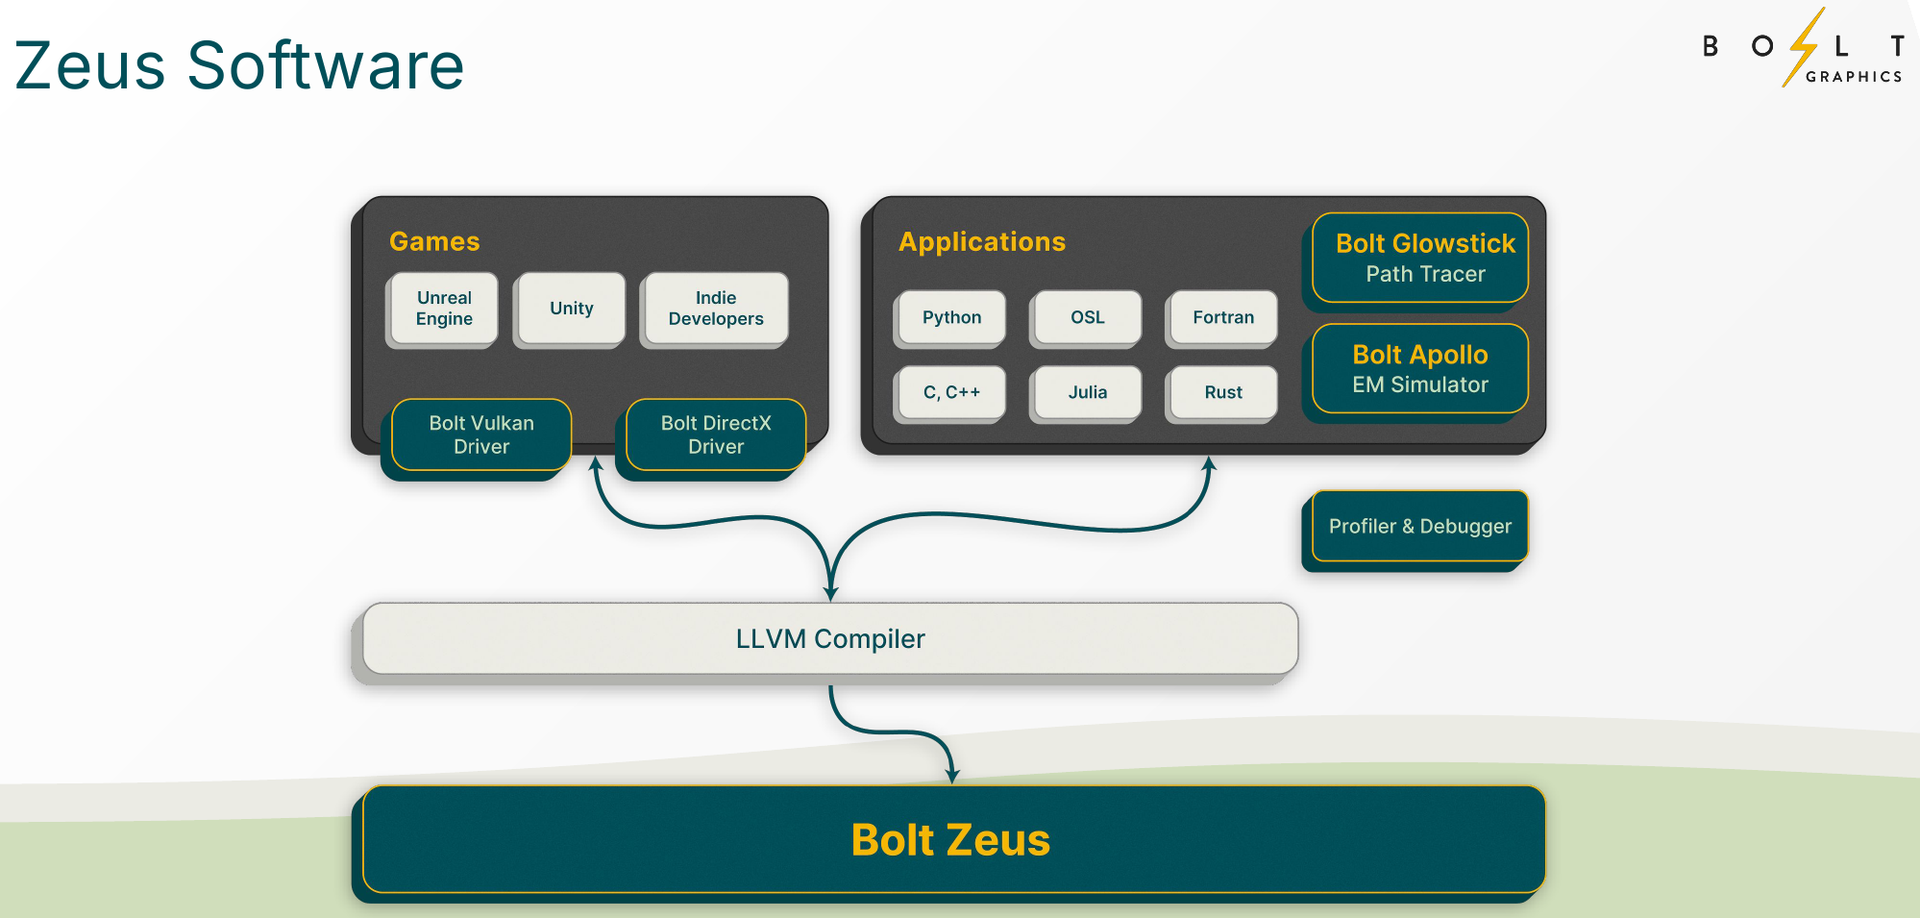 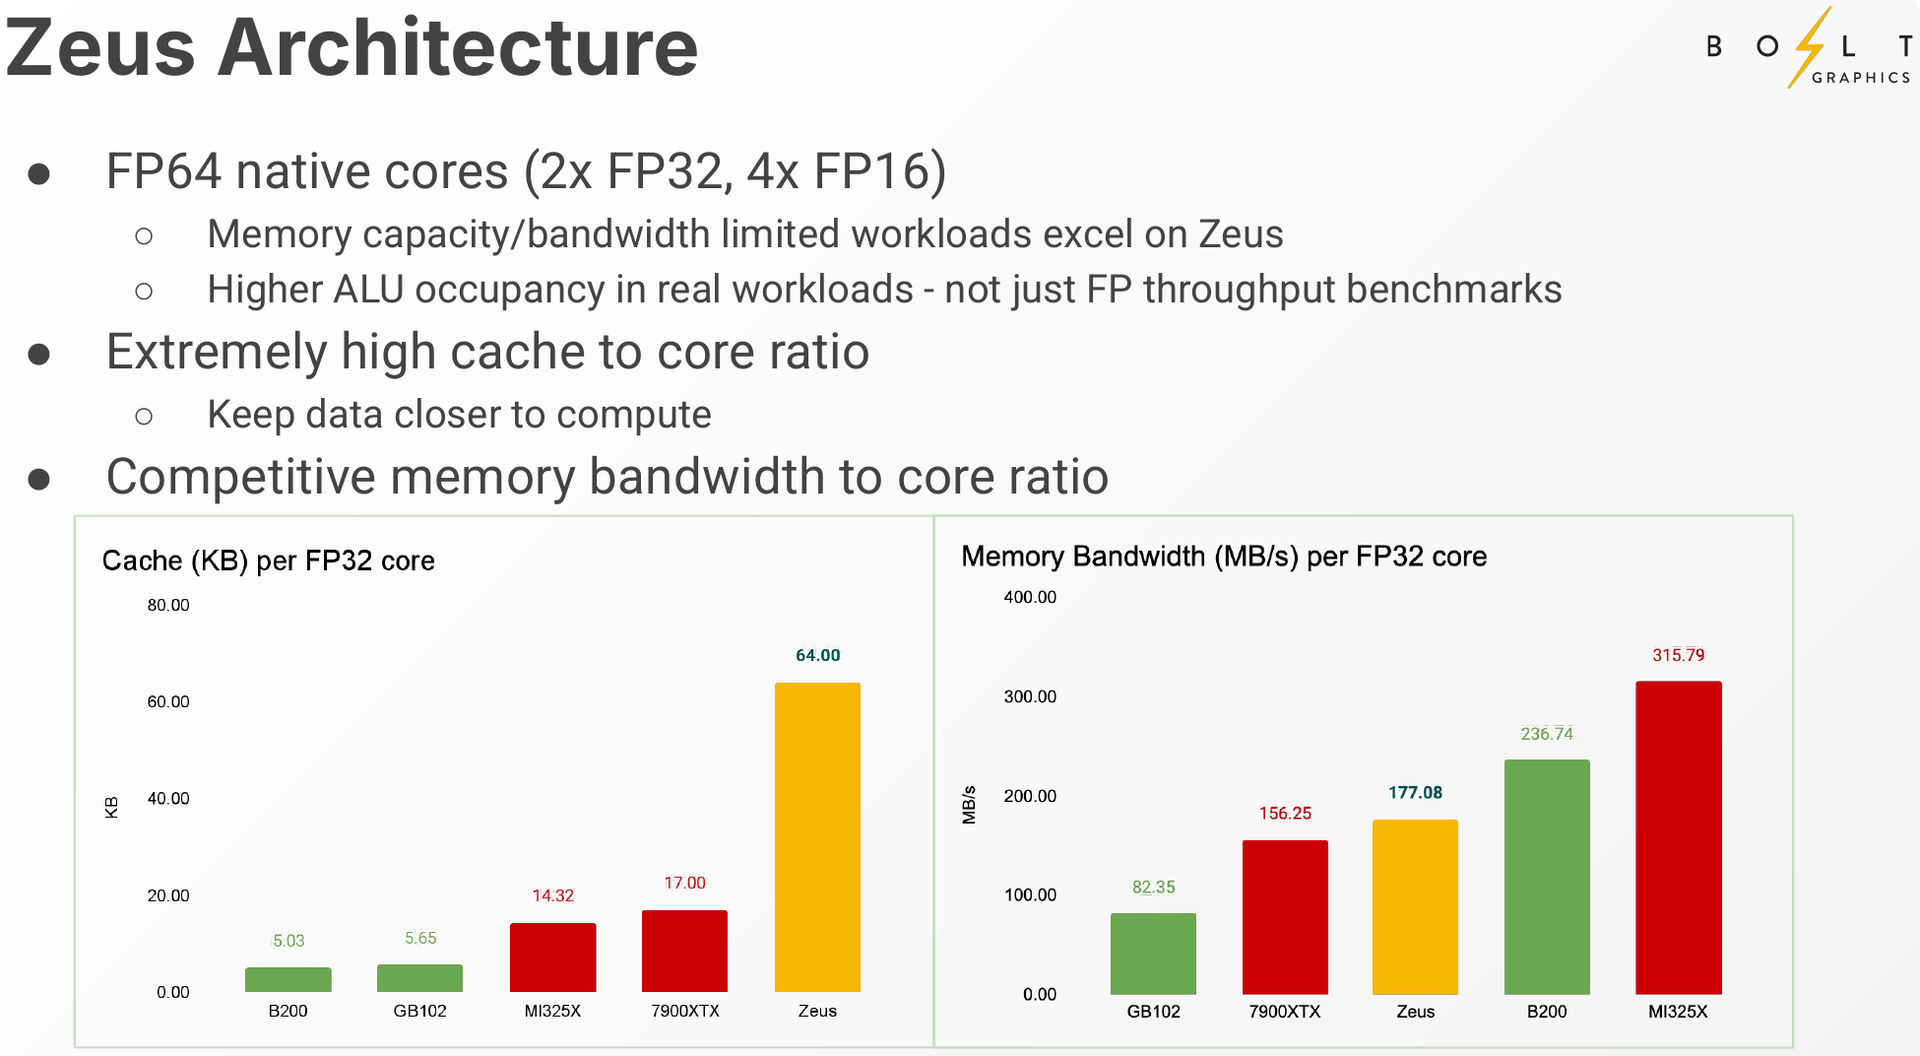 Ранний доступ к комплектам разработчика Bolt Graphics наметила на IV квартал текущего года. В III квартале 2026 года должны появиться 2U-серверы на базе Zeus, а массовые поставки серверов и PCIe-карт начнутся не ранее IV квартала того же года. Пока сложно сказать, насколько хорошо новая архитектура себя проявит, но если верить предварительным тестам Zeus, выигрыш в сравнении с существующими ускорителями существенен, особенно в энергопотреблении.
18.03.2025 [23:12], Алексей Степин
Интегрированная фотоника и СЖО: NVIDIA анонсировала 800G-коммутаторы Spectrum-X и Quantum-XГонка в области ИИ накладывает отпечаток на облик ЦОД: сетевая инфраструктура становится всё сложнее и сложнее в погоне за высокой пропускной способностью и минимальными задержками. За это приходится платить повышенным расходом энергии на обеспечение работы оптических трансиверов. Поэтому NVIDIA представила новое поколение коммутаторов с интегрированной кремниевой фотоникой, которое должно решать эту проблему, а заодно обеспечить повышенную надёжность и скорость развёртывания сетевой инфраструктуры. По оценкам NVIDIA, традиционный облачный дата-центр на каждые 100 тысяч серверов расходует 2,3 МВт энергии на обеспечение работы оптических трансиверов, но в ИИ-кластерах, где каждому ускорителю нужно своё быстрое сетевое подключение, эта величина может достигать уже 40 МВт, т.е. до 10 % от общего уровня энергопотребления всего комплекса. Гораздо разумнее было тратить эту энергию на вычислительную, а не сетевую инфраструктуру. 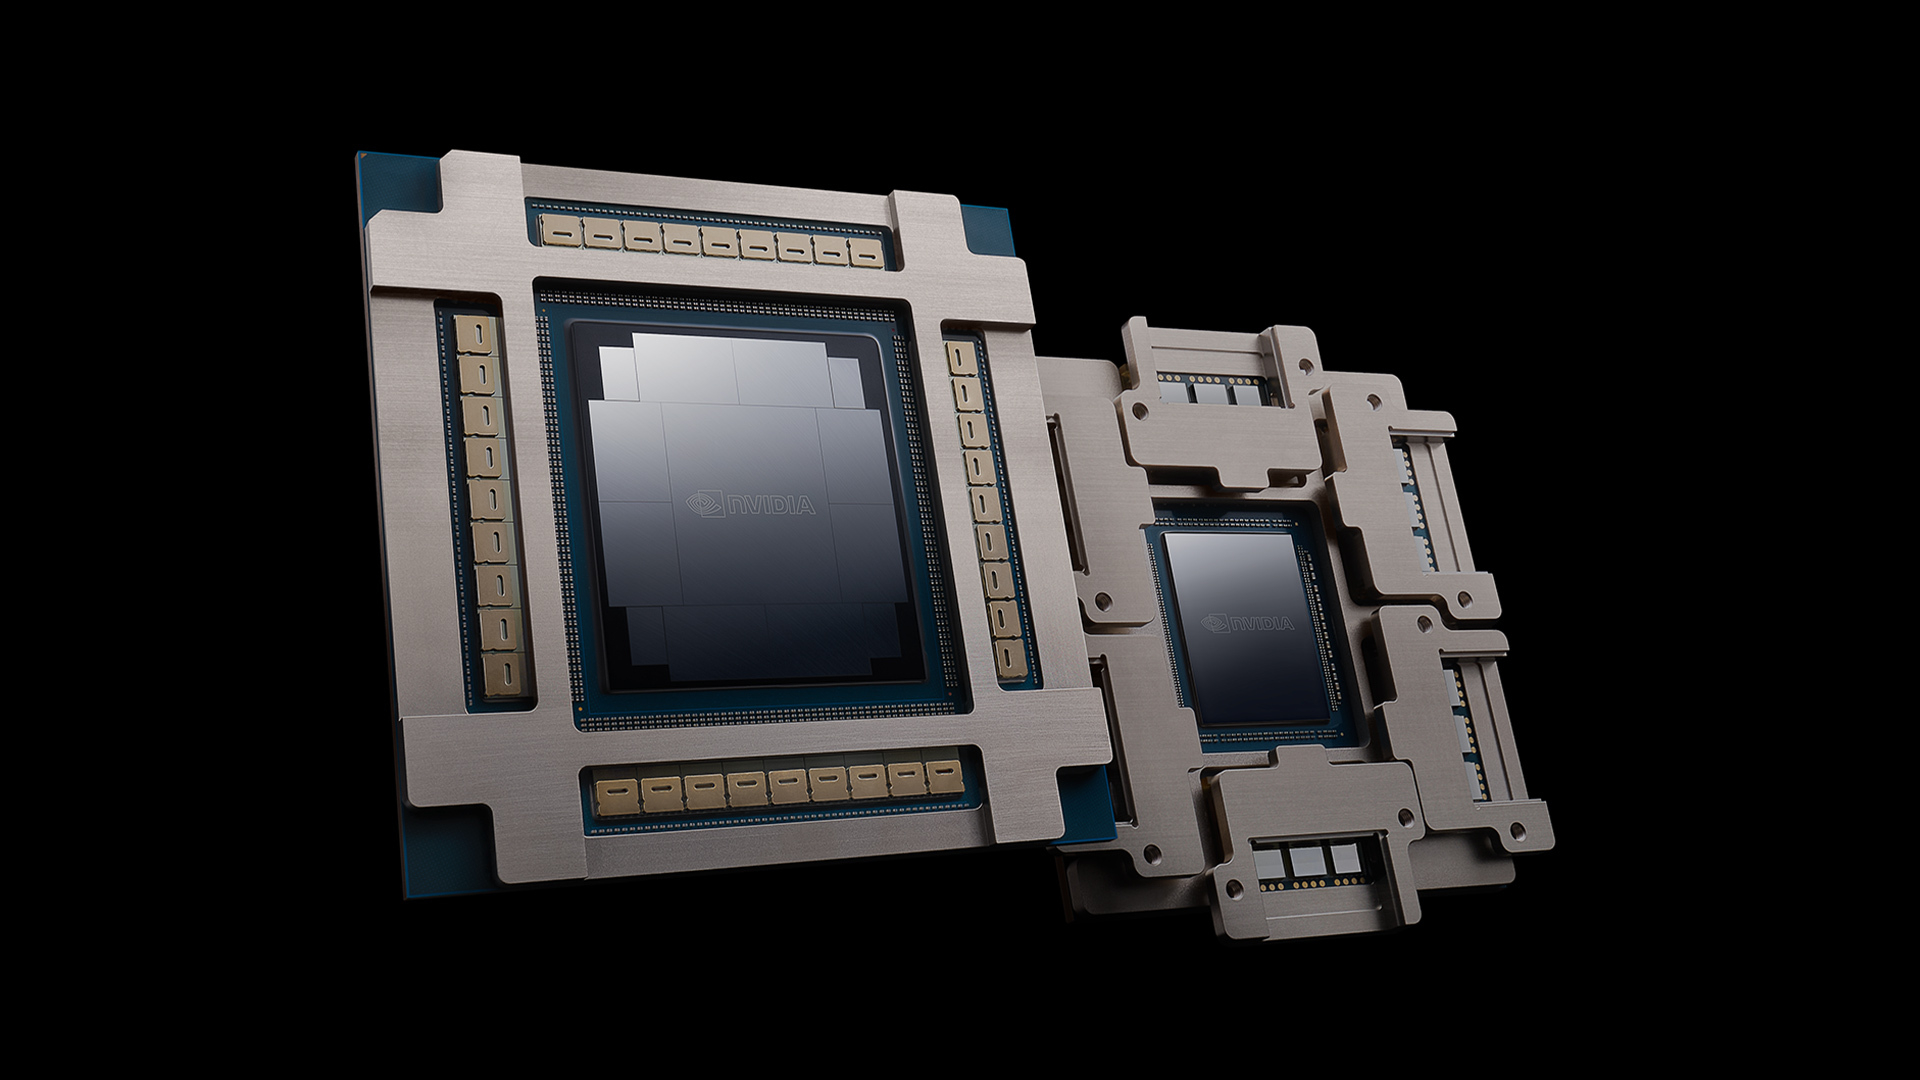
Источник здесь и далее: NVIDIA Новые коммутаторы Spectrum-X и Quantum-X должны решить эту проблему кардинально. В них применены новые ASIC, объединяющие на одной подложке чип-коммутатор и фотонные модули. Такой подход позволяет отказаться сразу от нескольких звеньев традиционной цепочки, входящих в классический оптический трансивер. Современный высокоскоростной трансивер включает восемь лазеров, которые потребляют порядка 10 Вт, и DSP-блок, который требует 20 Вт. 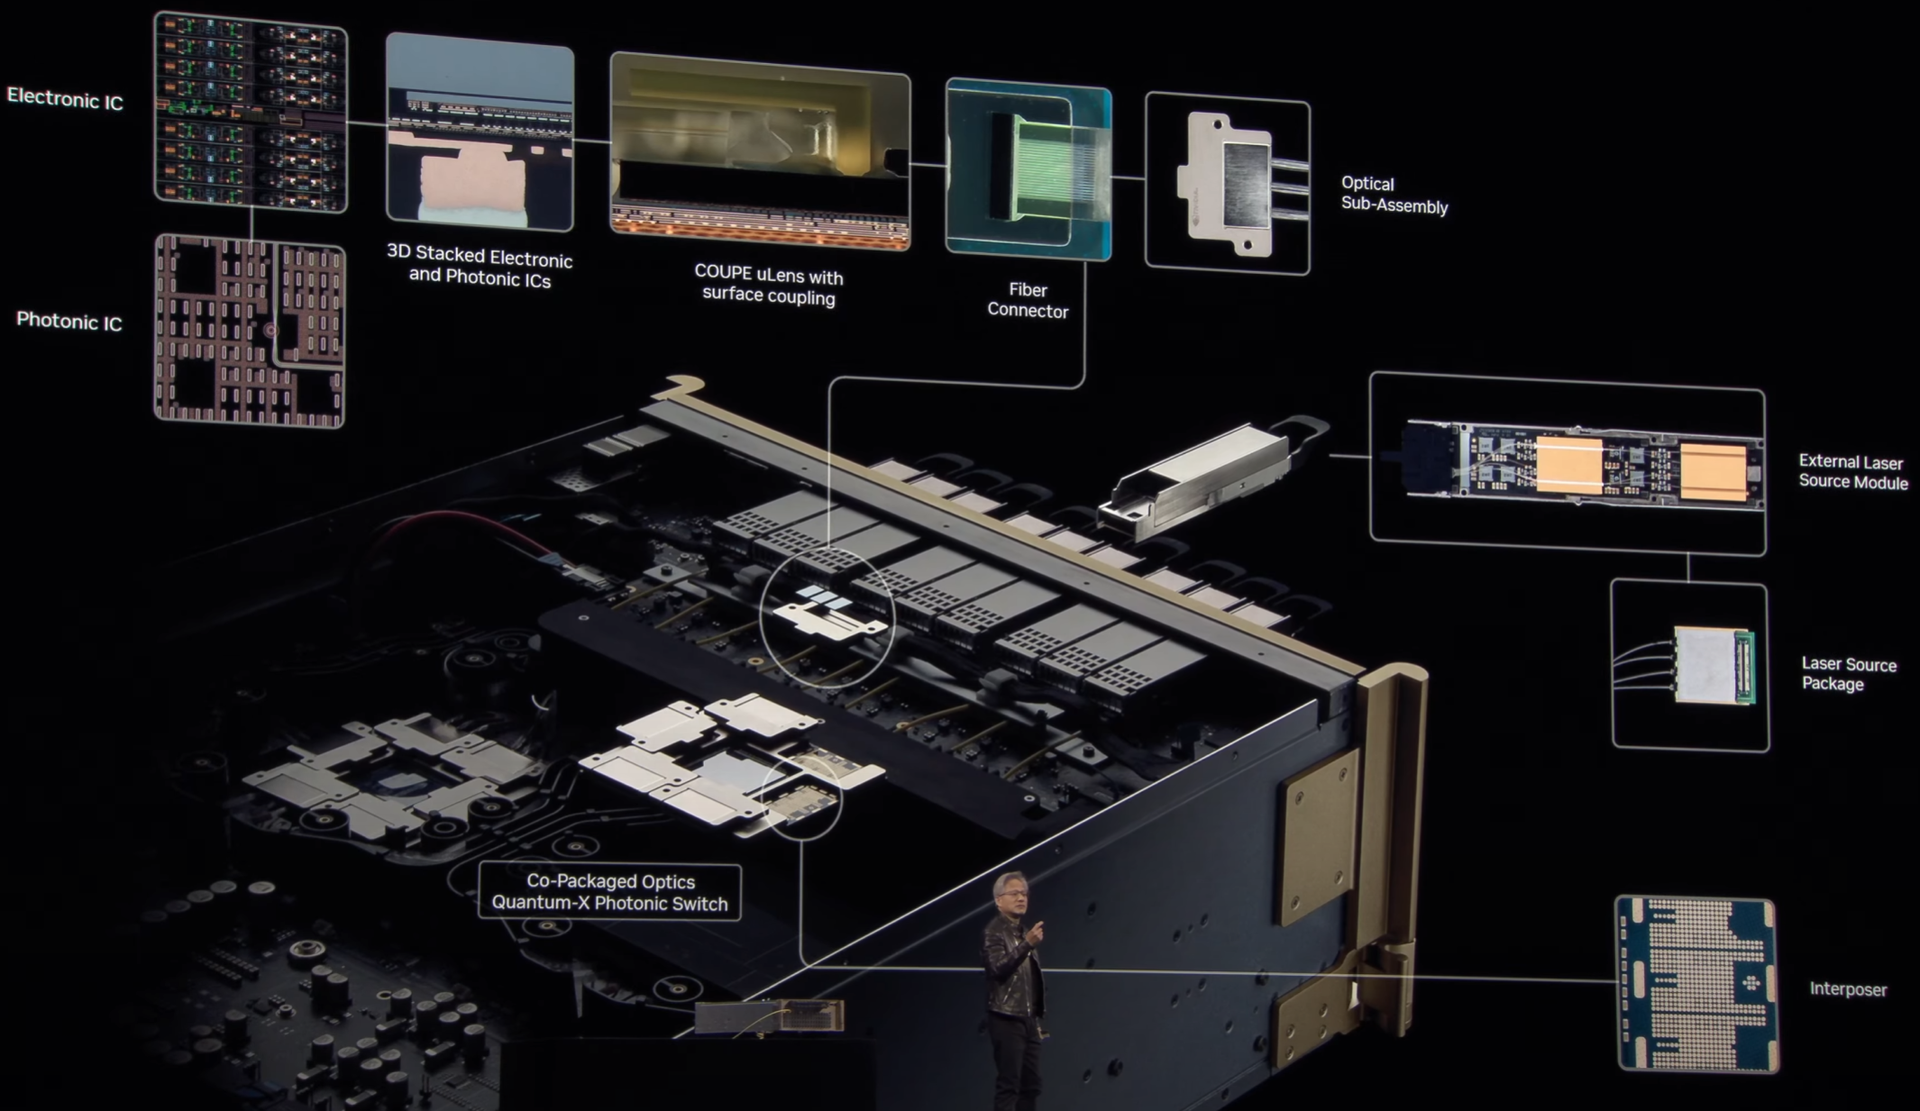 Интегрированная фотоника (CPO) позволяет обойтись всего двумя внешними лазерами для обеспечения работы одного порта 1,6 Тбит/с. Лазеры соединяется в этой схеме непосредственно с фотонным модулем на борту новых ASIC. Собственно оптический движок в составе ASIC потребляет всего 7 Вт, ещё 2 Вт требует лазер. Разница в энергопотреблении минимум трёхкратная. 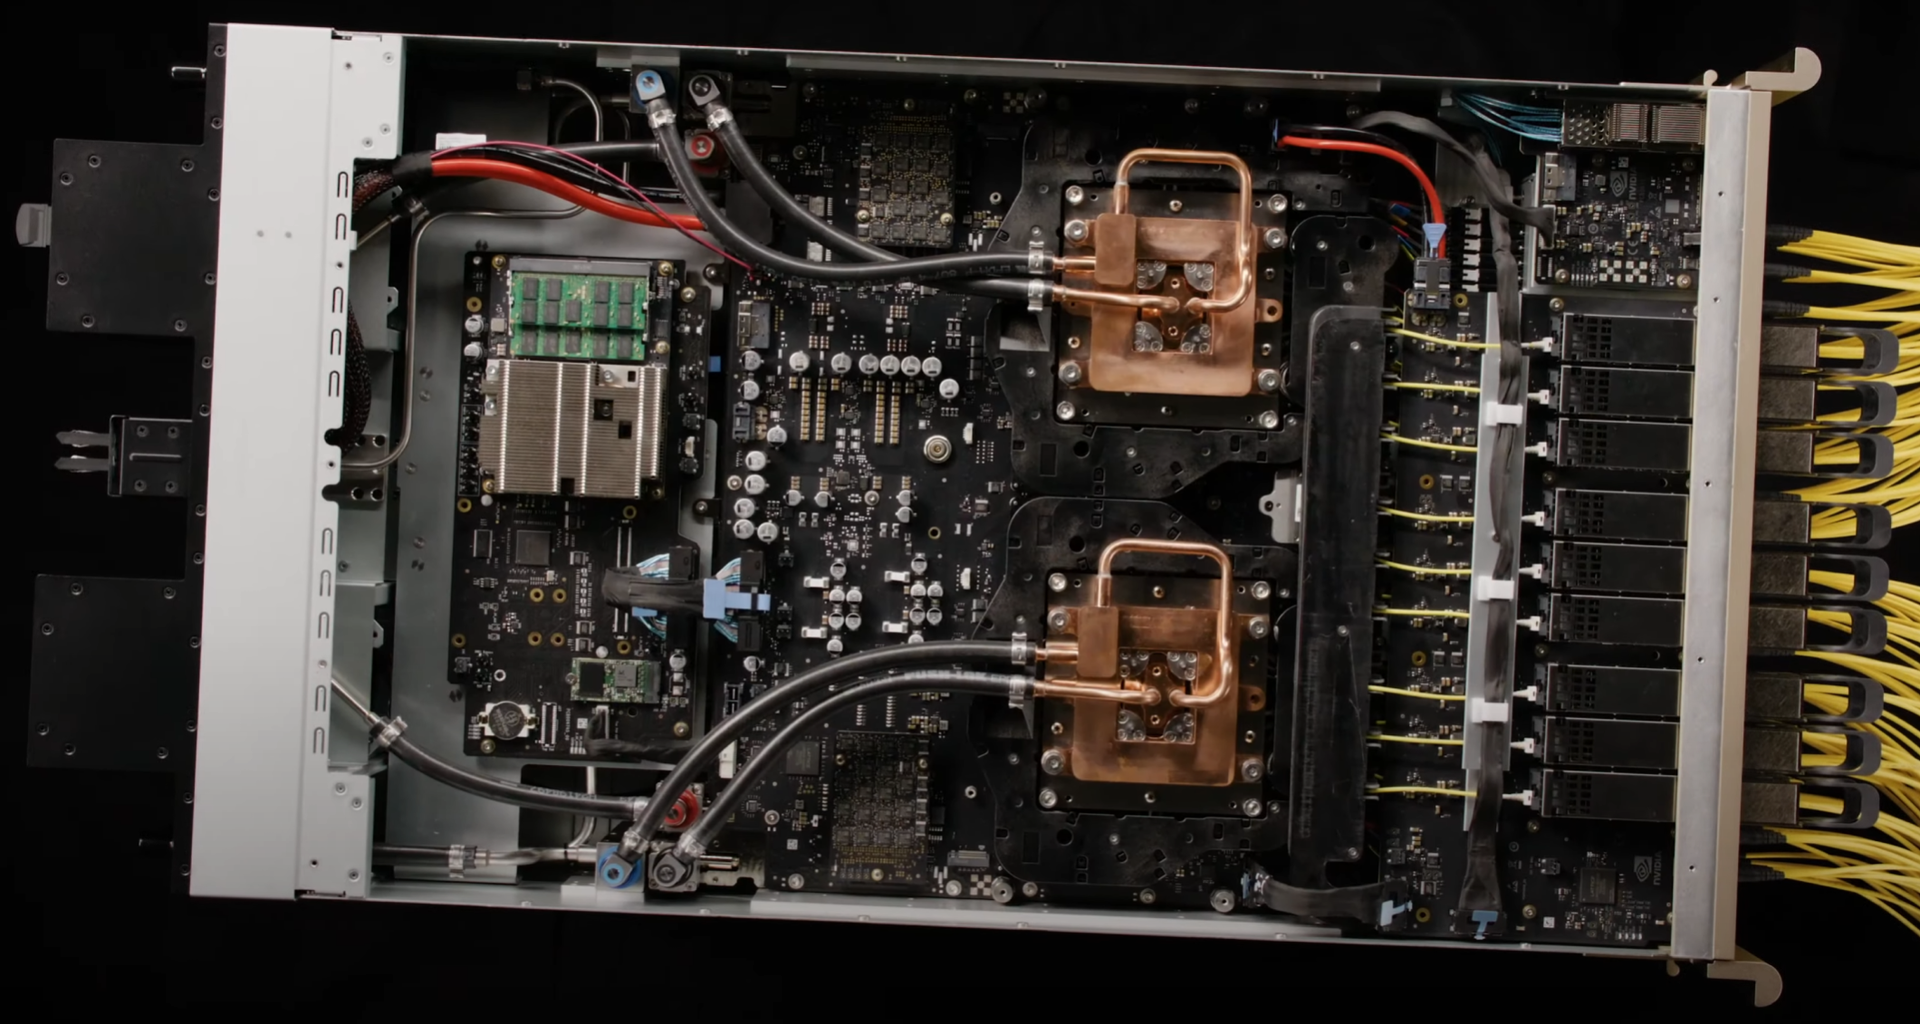 Кроме того, упрощение схемы соединений способствует повышению надёжности: NVIDIA говорит о 63-кратном улучшении целостности сигнала, которому не приходится добираться через несколько электрических соединений от ASIC до трансивера и внутри последнего, и о десятикратном повышении общей надёжности сети. Если в традиционной схеме потери сигнала на его электрическом пути могут составлять 22 дБ, то для схемы с фотонным модулем этот показатель составляет всего 4 дБ. 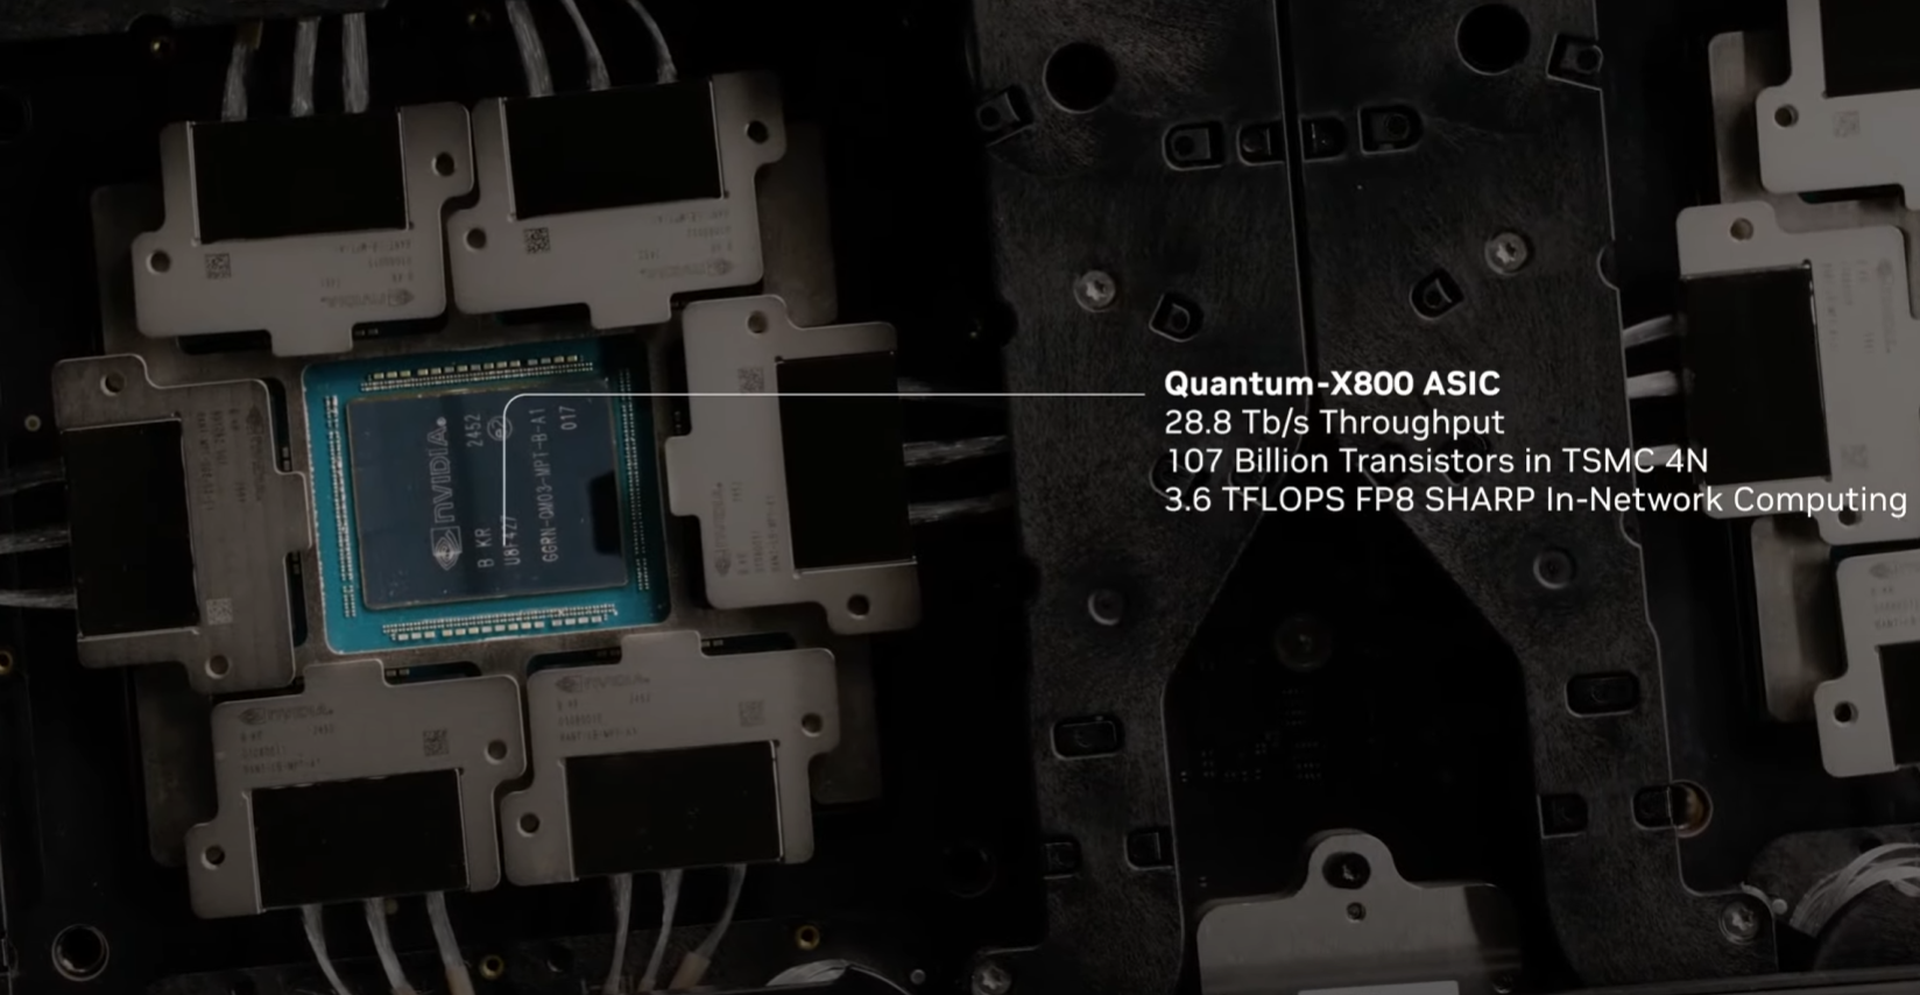 Новая схема упаковки ASIC достаточно сложна: в ней реализованы разъёмные оптические соединители, позволяющие реализовывать сценарии с различной конфигурацией портов коммутаторов, со скоростями от 200 до 800 Гбит/с. Флагманский коммутатор Spectrum SN6800 включает 512 портов 800GbE с совокупной скоростью коммутации 409,6 Тбит/с. Модель SN6810 компактнее, она предлагает 128 портов 800GbE и коммутацию до 102,4 Тбит/с. 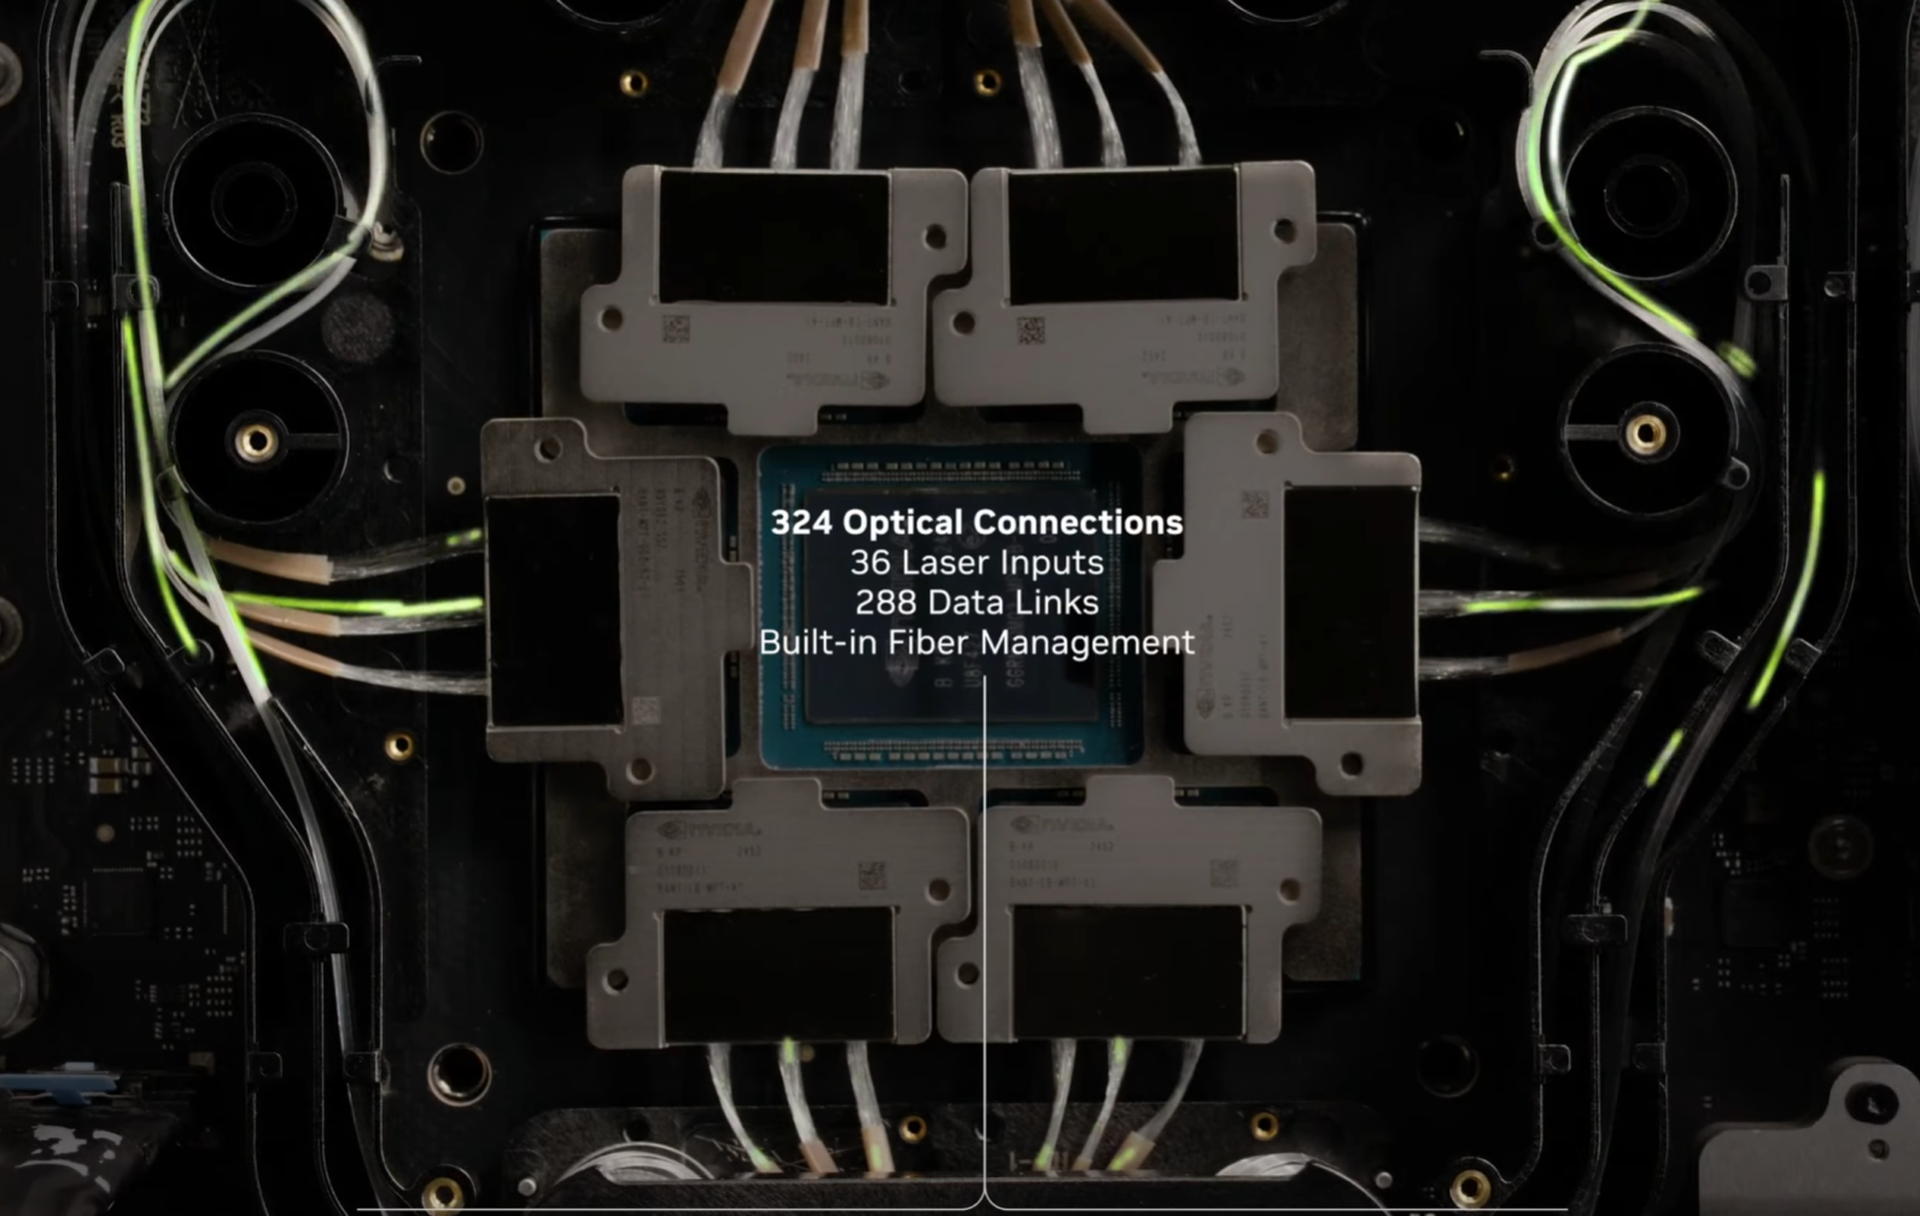 Серия Quantum-X пока представлена моделью Quantum 3450-LD: 144 порта 800G InfiniBand с совокупной производительностью 115 Тбит/с. Сочетание высокой плотности с такими скоростями потребовала разработки и интеграции кастомной системы жидкостного охлаждения. Новые коммутаторы Quantum-X станут доступны во II половине этого года, а Spectrum-X — во II половине 2026 года. 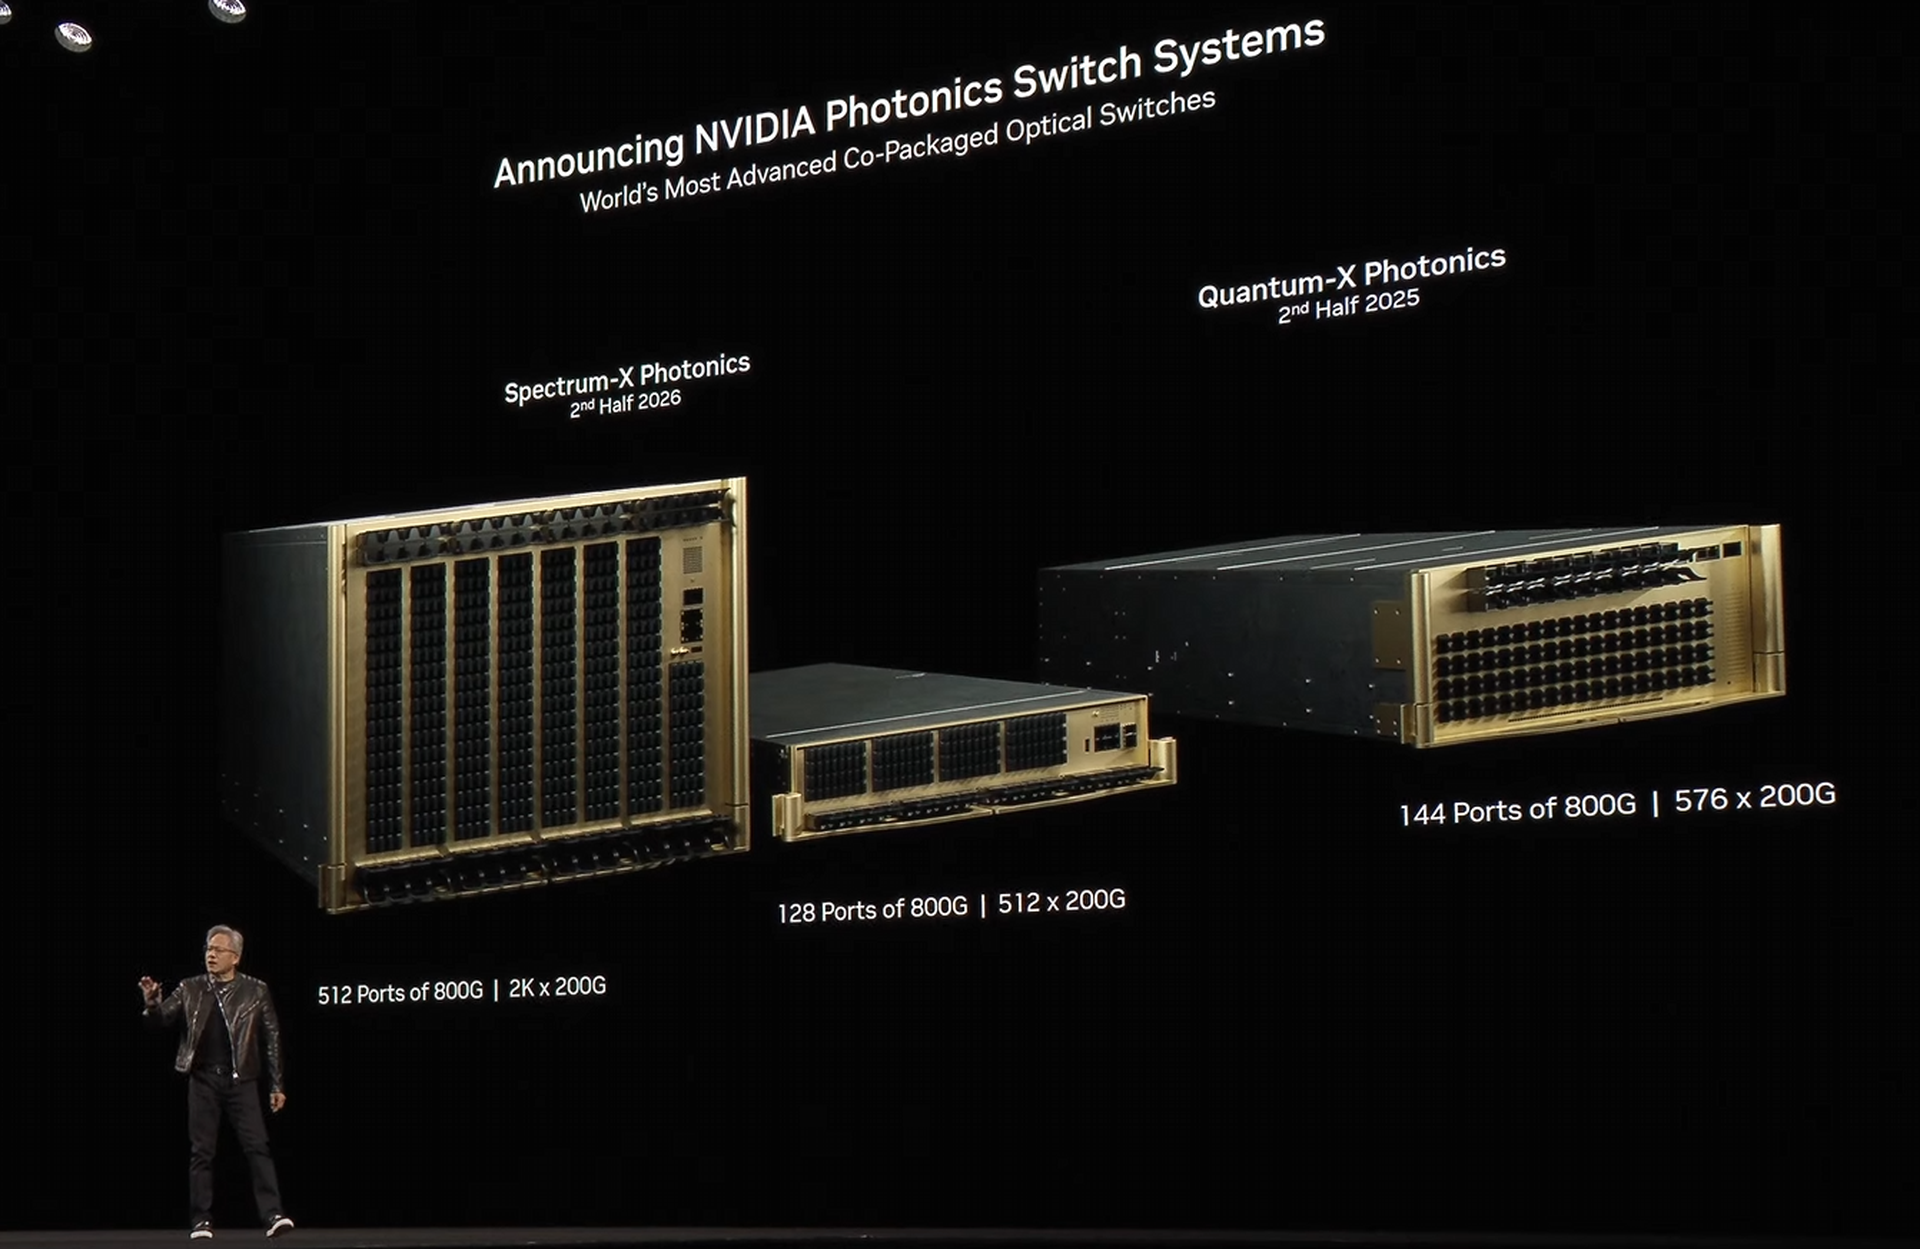 В оптических движках собственной разработки NVIDIA использованы микрокольцевые модуляторы (MRM), реализация которых стала доступной благодаря сотрудничеству NVIDIA с TSMC в области упаковки «многоэтажных» чипов COUPE. Помимо TSMC в создании новых коммутаторов приняли участие компании Browave, Coherent, Corning Incorporated, Fabrinet, Foxconn, Lumentum, SENKO, SPIL, Sumitomo Electric Industries и TFC Communication. 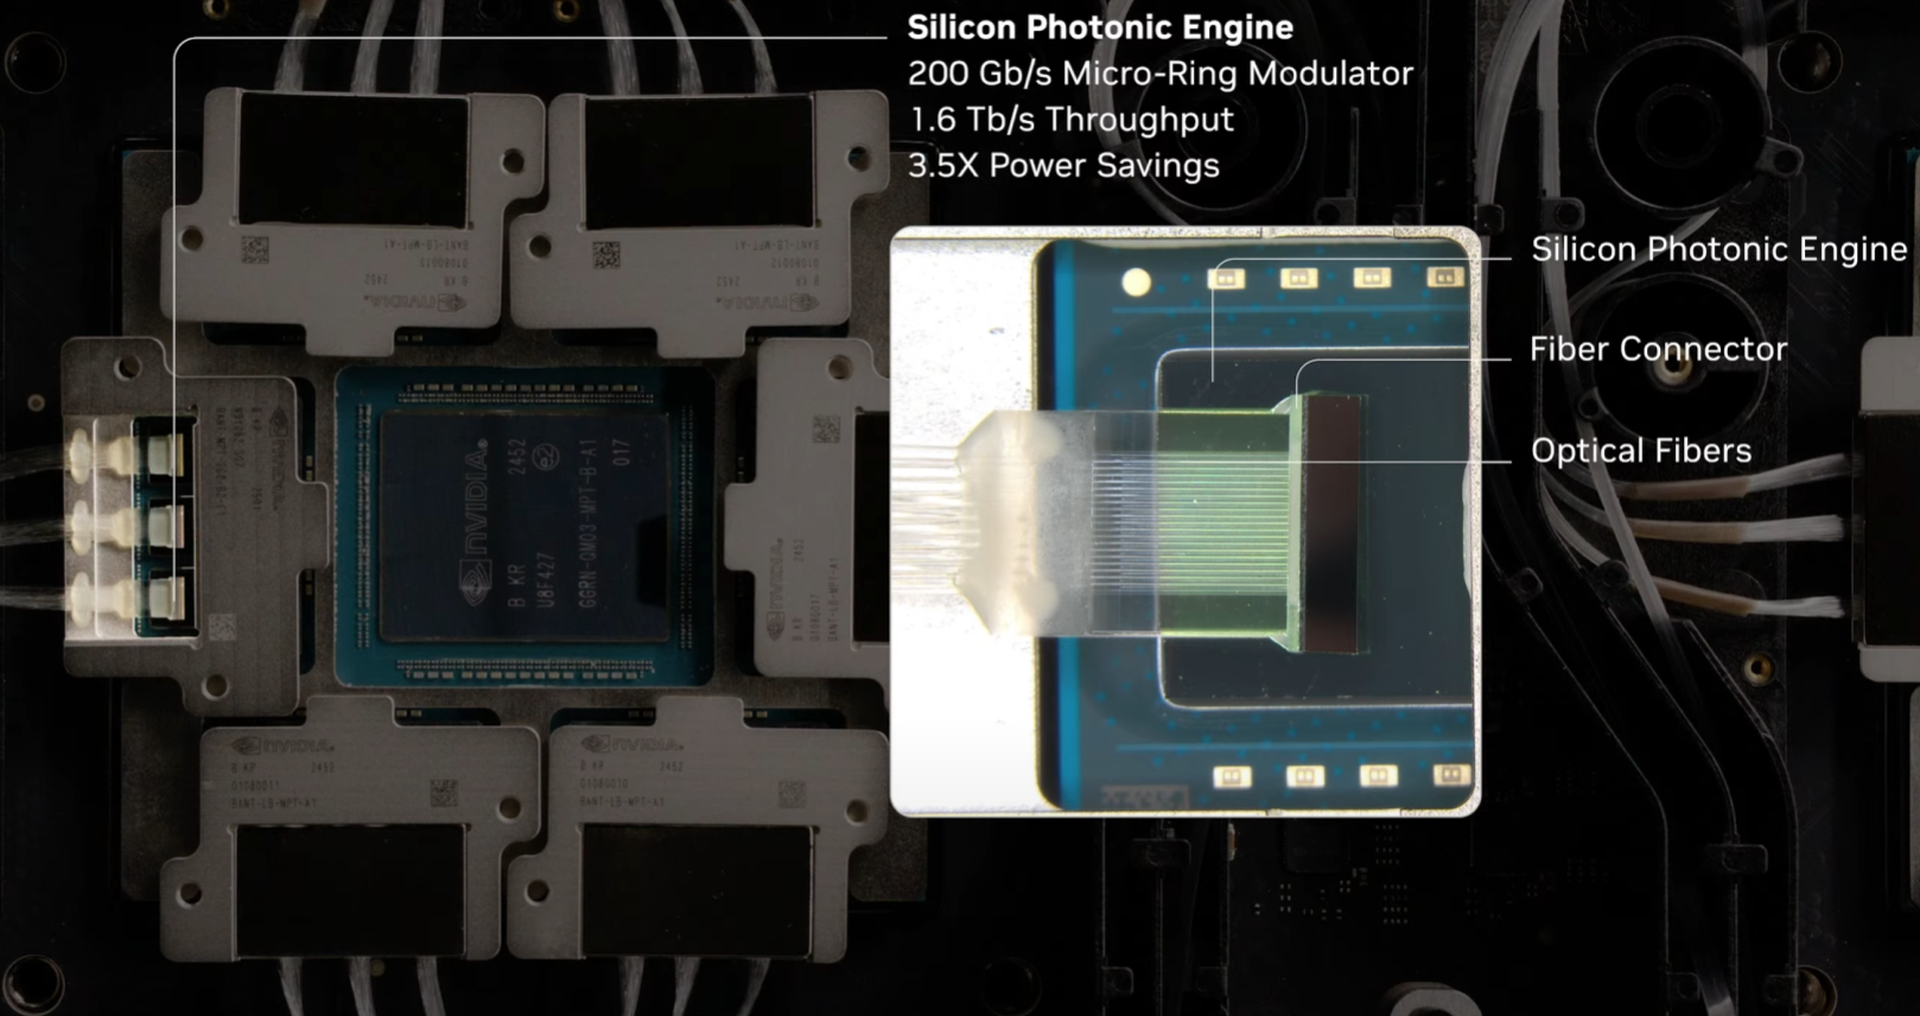 Особенно серьёзно преимущества новой схемы проявляют себя в больших масштабах, на уровне сотен тысяч ускорителей. Время развёртывания снижается в 1,3 раза, а общая надёжность сети становится на порядок выше. Правда, пока что речь идёт только о коммутаторах — оптические кабели будут напрямую подключаться к их портам. Однако другой конец кабеля всё равно будет уходить в трансивер, обслуживающий отдельный ускоритель или узел. Также пока нет никаких планов по переводу NVLink на «оптику», поскольку внутри узла и NVL-стойки работать с «медью» по-прежнему проще и выгоднее.
22.02.2025 [22:38], Сергей Карасёв
STMicroelectronics представила фотонный чип для 1,6-Тбит/с сетейКомпания STMicroelectronics объявила о разработке фотонного чипа PIC100, предназначенного для организации высокоскоростного оптического интерконнекта в дата-центрах, ориентированных на задачи ИИ. Изделие создано в сотрудничестве с Amazon Web Services (AWS). Чипы PIC100 планируется изготавливать с использованием технологического процесса BiCMOS на основе 300-мм кремниевых пластин. Метод BiCMOS предполагает объединение биполярных и КМОП-транзисторов на одном кристалле. Такой подход позволяет совместить преимущества компонентов обоих типов: технология обеспечивает улучшенную производительность по сравнению с КМОП-решениями при меньшей рассеиваемой мощности по сравнению с продуктами на основе только биполярных транзисторов. По заявлениям STMicroelectronics, на начальном этапе чипы PIC100 смогут поддерживать пропускную способность до 200 Гбит/с на линию. Это даёт возможность формировать соединения, обеспечивающие скорость передачи данных до 800 Гбит/с и 1,6 Тбит/с. Более того, STMicroelectronics работает над решениями с пропускной способностью до 400 Гбит/с на линию, что в конечном итоге, как ожидается, позволит создавать оптические интерконнекты со скоростью до 3,2 Тбит/с. 
Источник изображения: STMicroelectronics Одной из проблем на пути практического применения подобных изделий являет рост выделяемого тепла, что может приводить к снижению производительности или увеличению частоты сбоев оборудования. Для минимизации таких негативных эффектов специалисты STMicroelectronics разработали специальные волноводы и оптоволоконные адаптеры. Производить чипы PIC100 планируется на предприятии STMicroelectronics в Кроле (Crolles) во Франции. Выпуск будет организован к концу текущего года.
16.12.2024 [11:19], Сергей Карасёв
Раскрыты характеристики сетевых устройств Eviden с технологией BXI v3В ноябре текущего года компания Eviden (дочерняя структура Atos) представила интерконнект третьего поколения BullSequana eXascale Interconnect (BXI v3) для рабочих нагрузок ИИ и HPC. Теперь, как сообщает ресурс Next Platform, раскрыты некоторые характеристики устройств с поддержкой данной технологии. BXI v3 в качестве базового протокола связи использует Ethernet. Технология BXI v3 ляжет в основу интеллектуального сетевого адаптера (Smart NIC) и соответствующего коммутатора. Говорится, что для изготовления чипов ASIC с поддержкой BXI v3 компания Eviden рассматривает возможность применения 3-нм или 4-нм методики TSMC. Коммутатор BXI v3 располагает 64 портами, работающими на скорости 800 Гбит/с. Их можно переконфигурировать в 128 портов с пропускной способностью 400 Гбит/с. В свою очередь, адаптер Smart NIC функционирует на скорости 400 Гбит/с. Он будет предлагаться в виде двухслотовой карты расширения PCIe или OCP-3 (с интерфейсом PCIe 5.0). Возможны варианты адаптеров с двумя портами 400 Гбит/с. Карта BXI v3 способна управлять пакетами объёмом до 9 Мбайт, что полезно в нагруженных инфраструктурах ИИ. 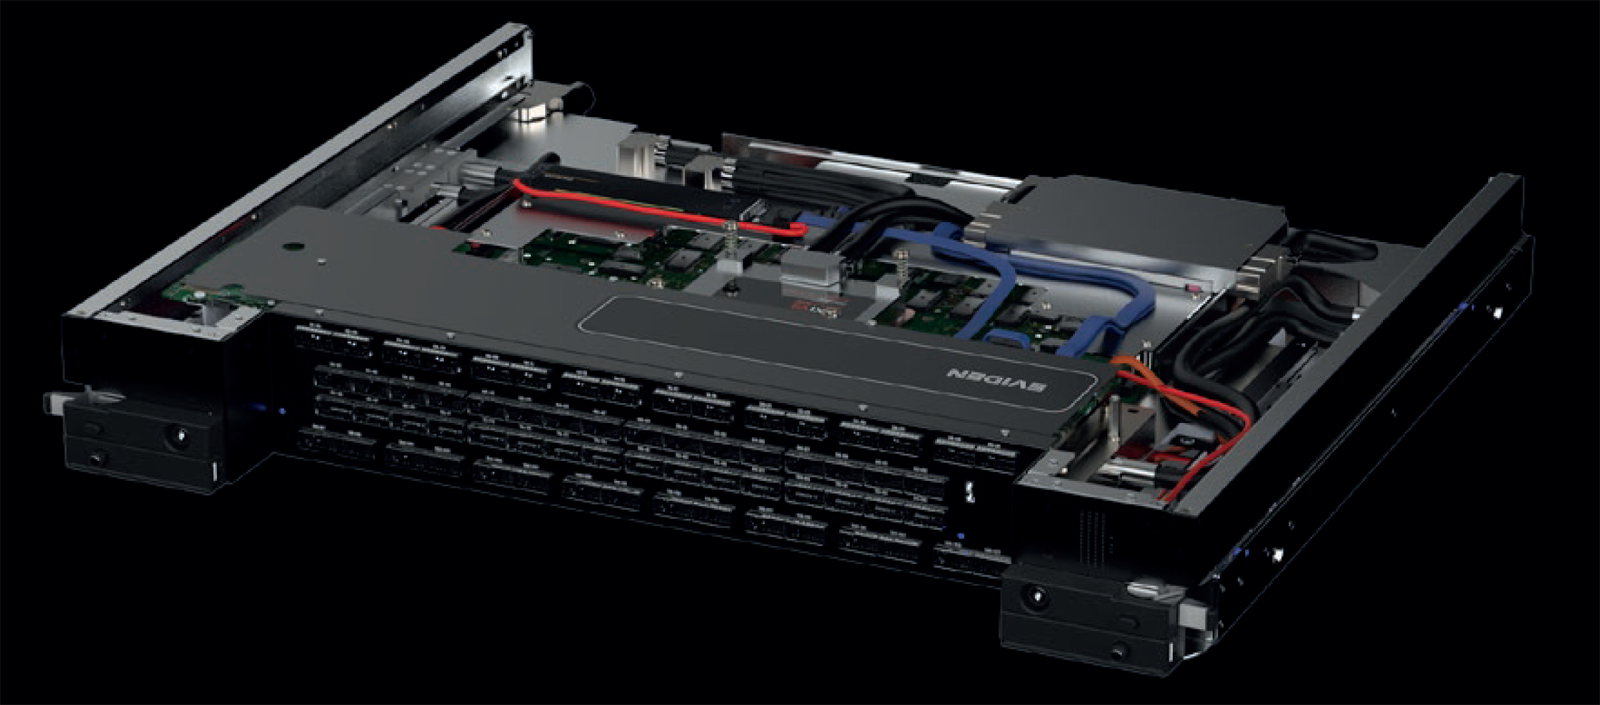
Источник изображения: Eviden Платформа BXI v3 поддерживает топологии fat tree и dragonfly+, а также fat tree с оптимизацией маршрутов (используется при обучении больших языковых моделей). Для BXI v3 заявлена поддержка до 64 тыс. конечных точек, а задержка составляет менее 200 нс от порта к порту. Изделия с поддержкой BXI v3 поступит в продажу в 2025 году. Осенью 2027 года ожидается появление интерконнекта BXI v4, который предусматривает повышение пропускной способности портов на сетевых картах и коммутаторах до 1,6 Тбит/с. При этом сетевые адаптеры получат поддержку интерфейса PCIe 6.0. В 2029-м планируется переход на интерконнект BXI v5: он обеспечит скорость портов на коммутаторах до 3,2 Тбит/с, тогда как сетевые адаптеры продолжат работать на скоростях до 1,6 Тбит/с, но получат поддержку PCIe 7.0.
23.11.2024 [12:38], Сергей Карасёв
Стартап Enfabrica выпустил чип ACF SuperNIC для ИИ-кластеров на базе GPUКомпания Enfabrica, занимающаяся разработкой инфраструктурных решений в сфере ИИ, объявила о доступности чипа Accelerated Compute Fabric (ACF) SuperNIC, предназначенного для построения высокоскоростных сетей в рамках кластеров ИИ на основе GPU. Кроме того, стартап провёл очередной раунд финансирования. Напомним, Enfabrica предлагает CXL-платформу ACF на базе ASIC собственной разработки, которая позволяет напрямую подключать друг к другу любую комбинацию GPU, CPU, DDR5 CXL и SSD, а также предоставляет 800GbE-интерконнект. Утверждается, что ACF SuperNIC может обеспечить улучшенную масштабируемость и производительность с более низкой совокупной стоимостью владения для распределённых рабочих нагрузок ИИ по сравнению с другими решениями, доступными на рынке. Изделие ACF SuperNIC (ACF-S) позволяет использовать от четырёх до восьми самых современных ускорителей в расчёте на серверную систему. Чип обеспечивает поддержку 800GbE, 400GbE и 100GbE, 32 сетевых портов и 160 линий PCIe. Благодаря этому становится возможным формирование ИИ-кластеров, насчитывающих более 500 тыс. GPU. 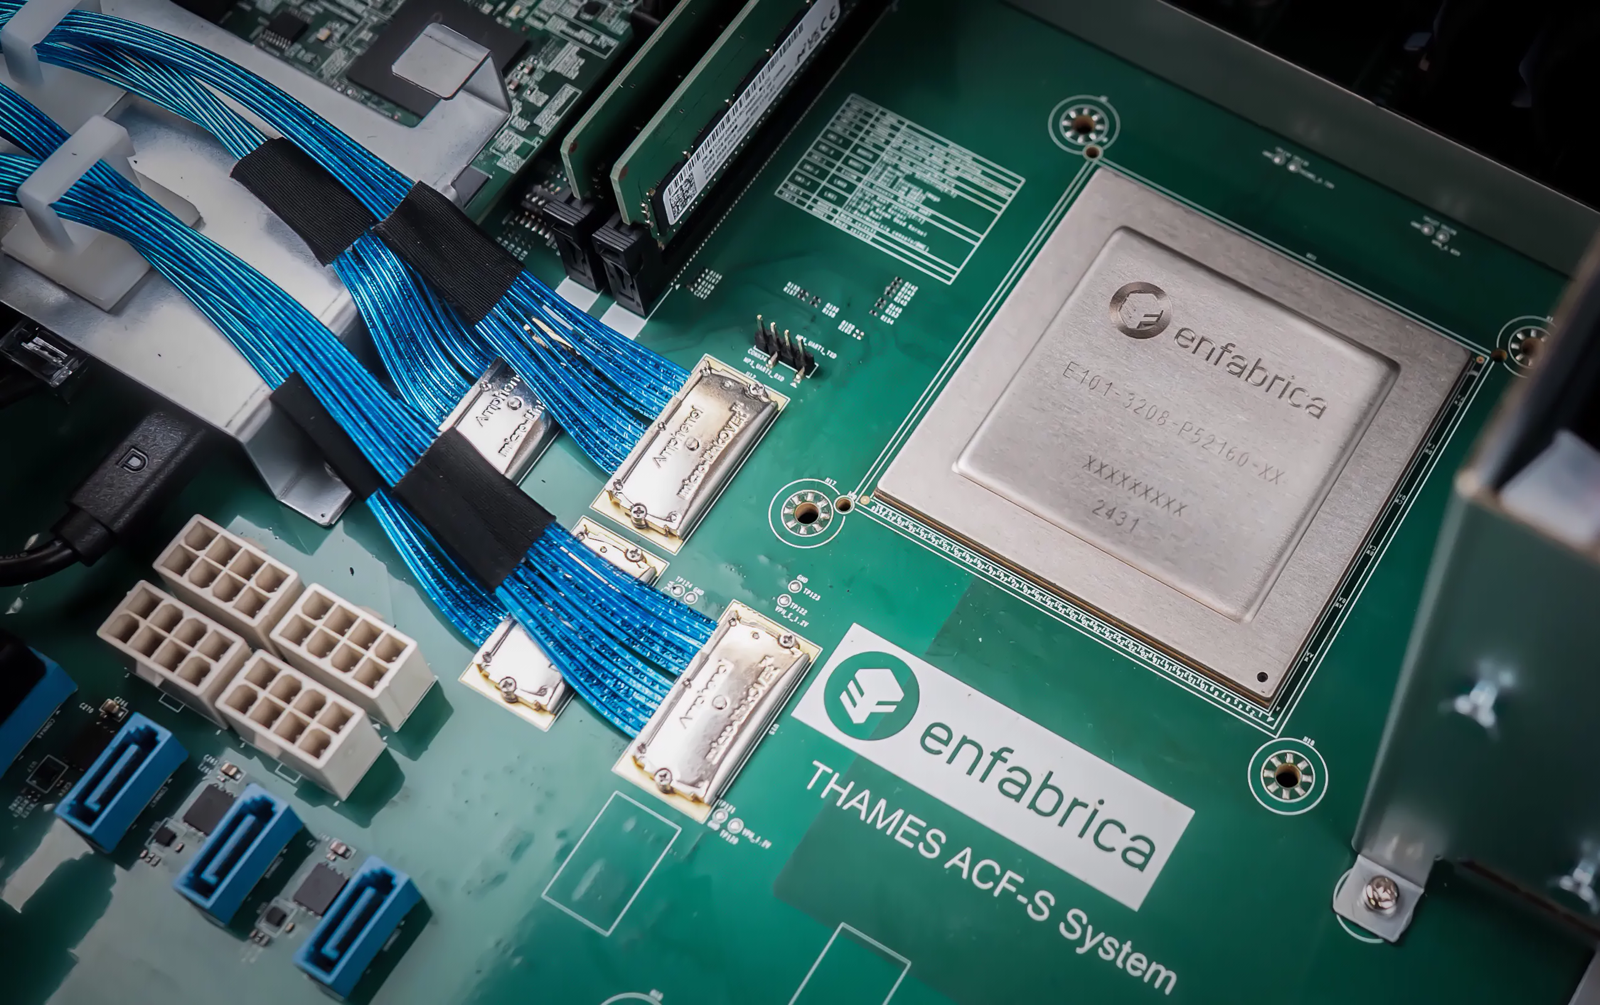
Источник изображения: Enfabrica Программный стек ACF-S поддерживает стандартные коммуникационные и сетевые операции RDMA через набор библиотек, совместимых с существующими интерфейсами. Фирменная технология Resilient Message Multipathing (RMM) повышает отказоустойчивость кластера ИИ и удобство обслуживания. RMM устраняет простои из-за сбоев и отказов сетевых соединений, повышая эффективность. Функция Collective Memory Zoning обеспечивает снижение задержек. Поставки чипов ACF SuperNIC начнутся в I квартале 2025 года. Что касается нового раунда финансирования, то по программе Series C привлечено $115 млн. Раунд возглавила фирма Spark Capital с участием новых инвесторов — Maverick Silicon и VentureTech Alliance. Кроме того, средства предоставили существующие инвесторы в лице Atreides Management, Sutter Hill Ventures, Alumni Ventures, IAG Capital и Liberty Global Ventures.
22.03.2024 [09:09], Алексей Степин
NVIDIA представила 800G-платформы Quantum-X800 и Spectrum-X800 для InfiniBand- и Ethernet-фабрик нового поколенияДополнением к только что представленным ИИ-ускорителям NVIDIA Blackwell станут новые сетевые 800G-платформы Quantum-X800 и Spectrum-X800, а также сетевые адаптеры ConnectX-8. Именно они позволят вывести масштабирование ИИ-кластеров на новый уровень и позволят «прокормить» гигантские массивы ускорителей в дата-центрах гиперскейлеров. Платформа NVIDIA Quantum-X800 ориентирована на наиболее производительные ИИ- и HPC-кластеры. Она использует новое поколение технологии InfiniBand, всё ещё обладающей рядом преимуществ в сравнении с Ethernet, и включает в себя обновлённые SHARP-движки. Технология SHARPv4 реализует «вычисления в сети» (In-Network Computing), что позволяет не только существенно разгрузить вычислительные узлы и серверы, но и обеспечить более высокую пропускную способность интерконнекта вкупе с более серьёзными возможностями его масштабирования. 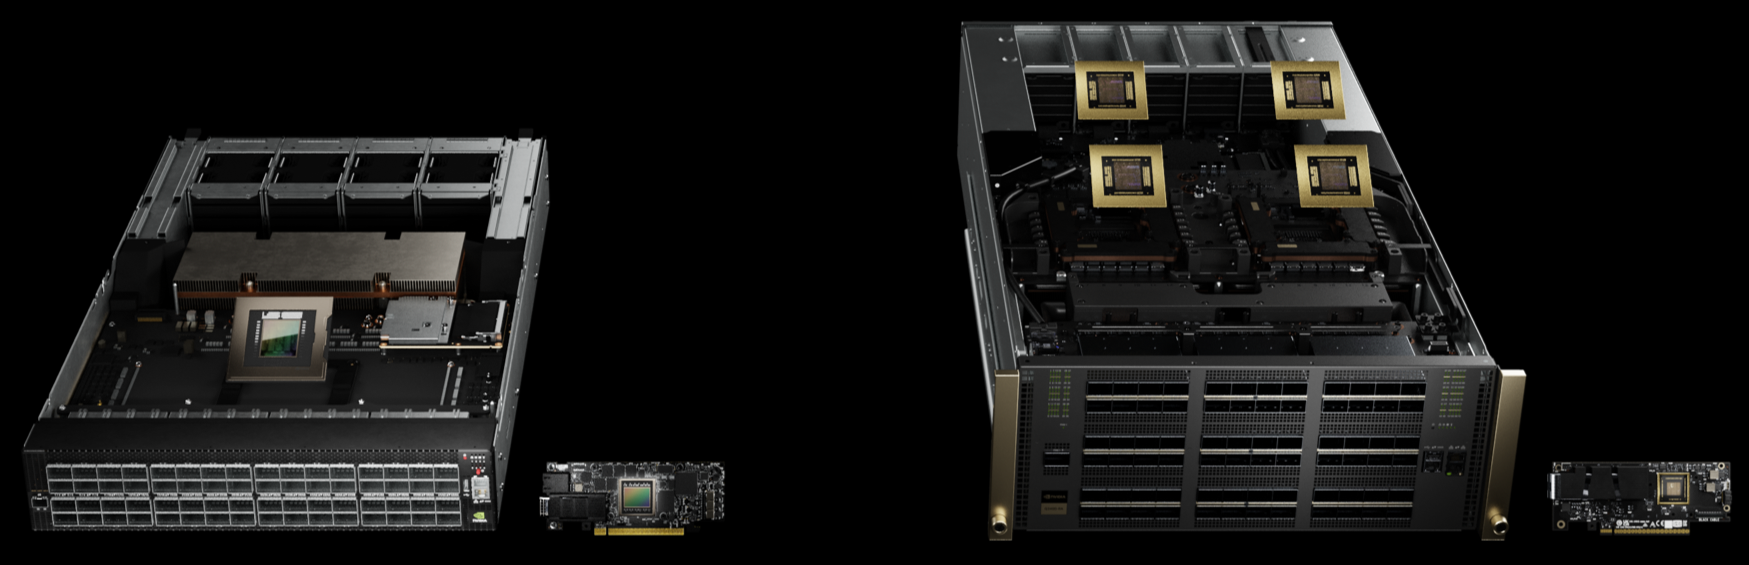
NVIDIA Q3400-RA 4U (справа) и SN5600. Источник изображений здесь и далее: NVIDIA Основой платформы Quantum-X800 стал 4U-коммутатор Q3400-RA, впервые в индустрии, как говорит компания, использующий 200G-блоки SerDes для каждой линии InfiniBand. Коммутатор располагает 144 портами 800G в 72 OSFP-модулях и выделенным портом для Unified Fabric Manager. Новинка имеет стандартное 19″ исполнение с воздушным охлаждением, но есть и вариант Q3400-LD с жидкостным охлаждением, предназначенный для 21″ OCP-стоек. В двухуровневом варианте fat tree коммутаторы позволят объединить 10 368 NIC. 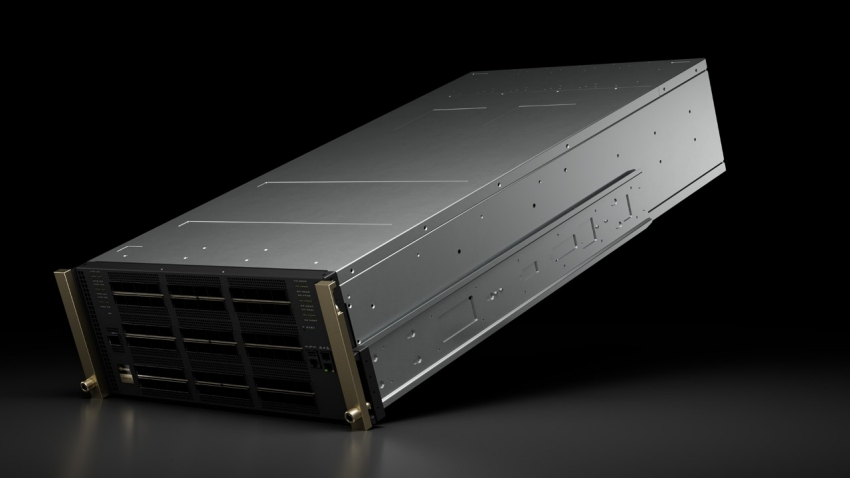 Основным адаптером для новой платформы InfiniBand является ConnectX-8 SuperNIC с интерфейсом PCIe 6.0. Он является частью SHARPv4 и предлагается в однопортовом (OSFP224) и двухпортовом (QSFP112) вариантах и в нескольких форм-факторах, включая OCP 3.0. На платах также имеется разъём SocketDirect на 16 линий PCIe. Также компания представила компоненты NVIDIA LinkX: оптические трансиверы 2xDR4/2xFR4 и активные медные кабели (LACC). 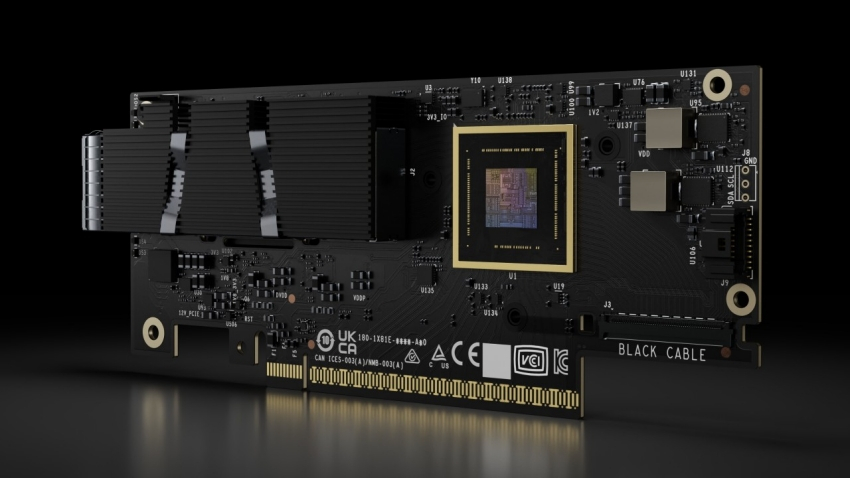 Не забыла NVIDIA и про Ethernet: здесь вывести производительность сети на новый уровень должна платформа Spectrum-X800. Её основой служит новейший коммутатор SN5600 — это, по словам NVIDIA, первый в мире Ethernet-коммутатор класса 800GbE, специально разработанный для применения гиперскейлерами в крупных облачных ИИ-комплексах. Применяемая архитектура позволяет гарантировать каждому клиенту оптимальный и постоянный уровень производительности, а потоковая телеметрия позволит находить и ликвидировать возможные «бутылочные горлышки» в сети буквально на лету. 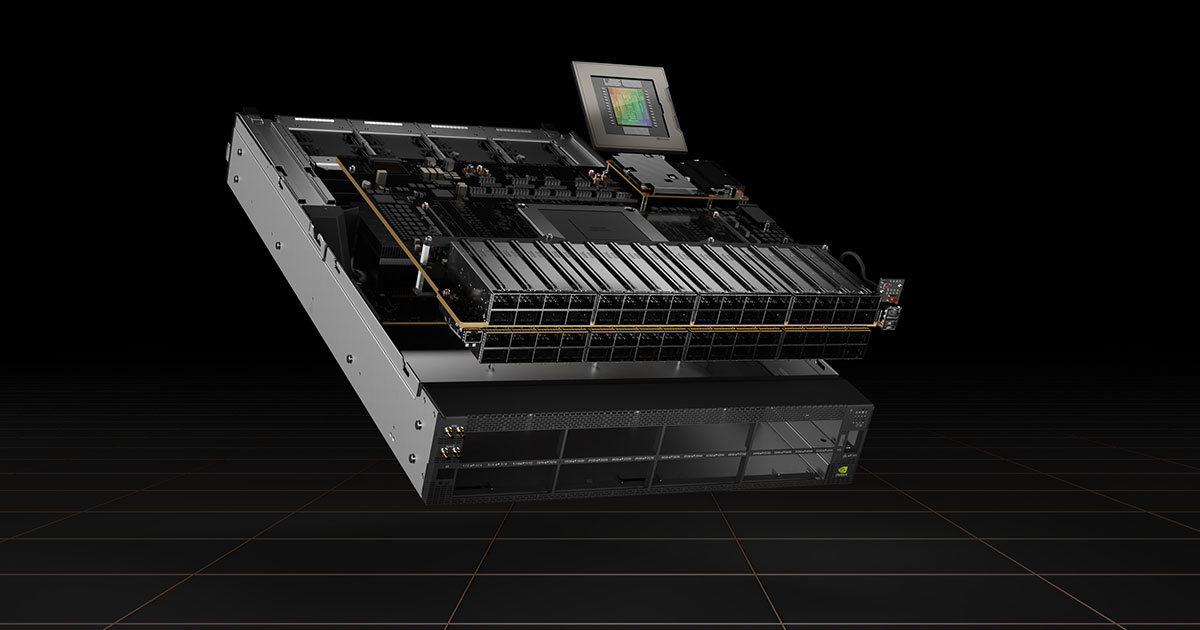 Общая пропускная способность SN5600 составляет 51,2 Тбит/с. Коммутатор располагает 64 портами 800GbE в формате OSFP. В нём используется ASIC пятого поколения на базе архитектуры Spectrum-4. В качестве основного адаптера предлагается SuperNIC на базе DPU BlueField-3 с двумя 400GbE-портами. 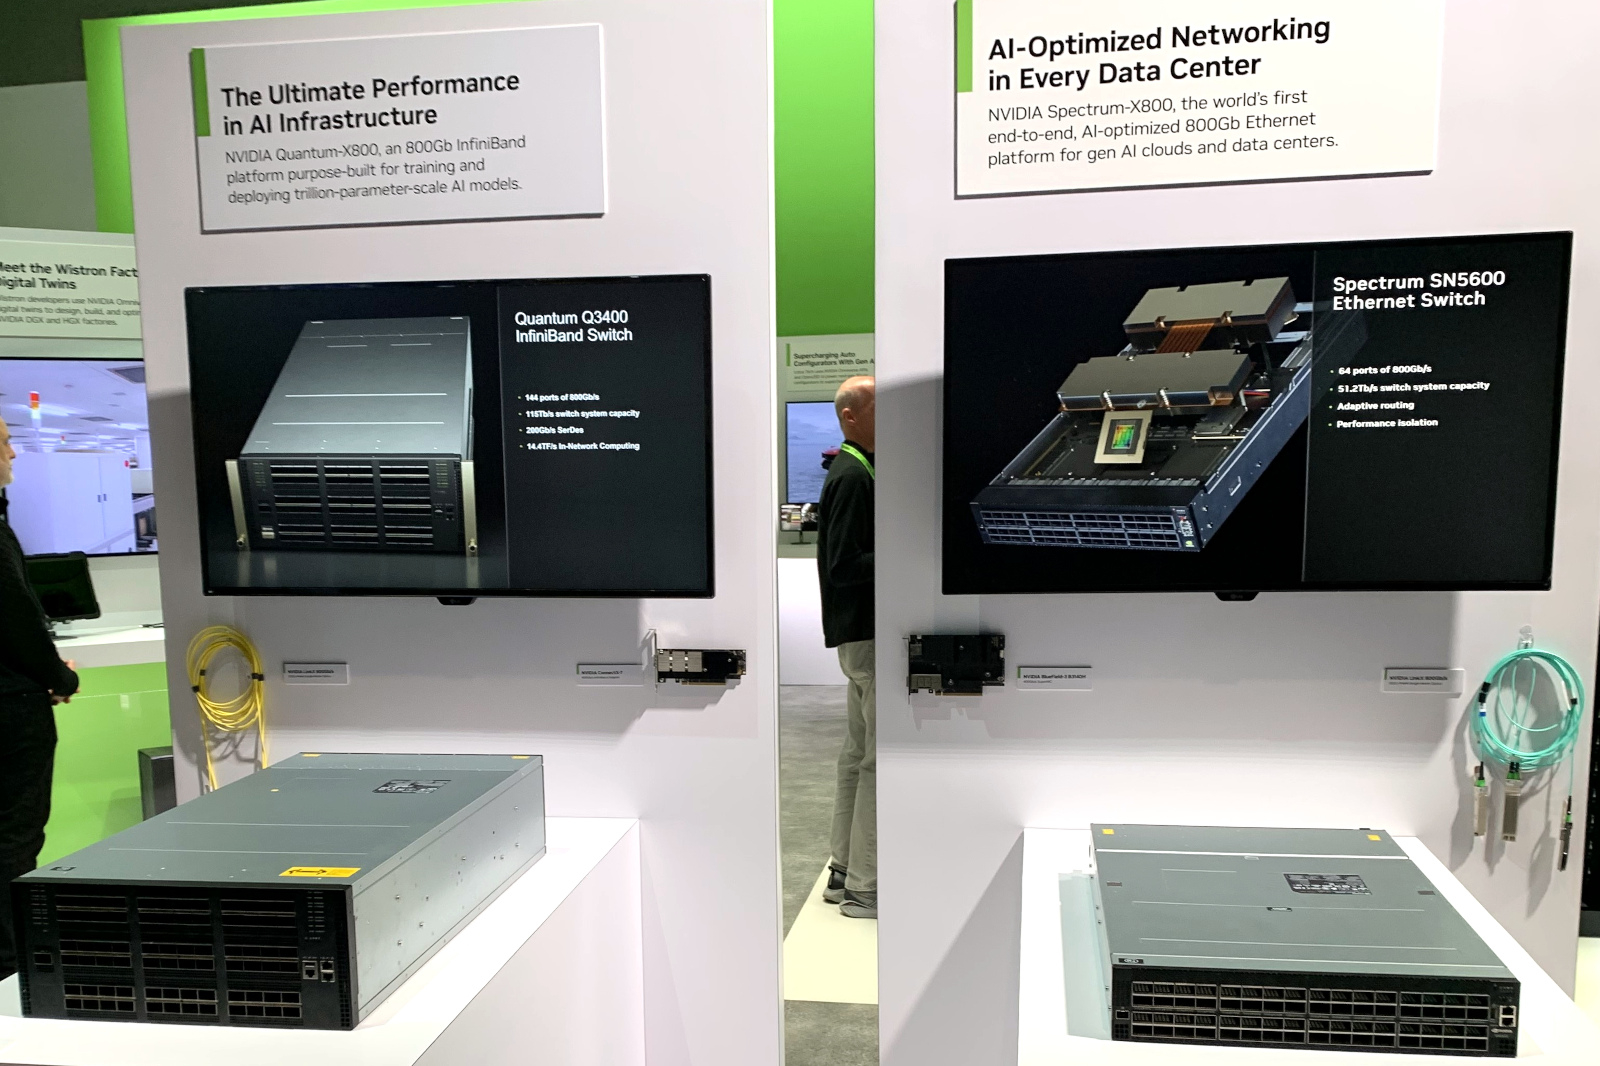
Фото: Twitter/NVIDIANetworkng Spectrum-X800 сопровождает полноценный спектр инфраструктурных компонентов, включая кабели DAC и LACC. С оптическими трансиверами длина соединения 800GbE может достигать двух километров. Начиная со следующего года, решения на базе новых сетевых платформ NVIDIA будут доступны от широкого круга поставщиков оборудования, включая Aivres, DDN, Dell Technologies, Eviden, Hitachi Vantara, HPE, Lenovo, Supermicro и VAST Data.
20.07.2023 [23:30], Игорь Осколков
AMD, Broadcom, Cisco, Intel и другие вендоры создадут интерконнект Ultra Ethernet для HPC и ИИAMD, Arista, Broadcom, Cisco, Eviden (Atos), HPE, Intel, Meta✴ и Microsoft в рамках Linux Foundation сформировали новый консорциум Ultra Ethernet Consortium, который намерен создать на базе Ethernet новый масштабируемый и эффективный с точки зрения стоимости коммуникационный стек, ориентированный на высокопроизводительные вычисления (HPC) и ИИ. Иными словами, речь идёт о создании спецификаций интерконнекта нового поколения на базе Ethernet для современных кластеров, облаков и иных платформ. UEC сформировал четыре рабочих группы, ответственных за физический, канальный и транспортный уровни, а также за уровень ПО. Целью же является создание современного сетевого стека, который учитывает потребности HPC- и ИИ-нагрузок, включая новые методы борьбы с заторами в сети, высокий уровень утилизации канала (в том числе 800G/1.6T), многопутевую и гарантированную доставку, сквозную телеметрию, консистентность и низкий уровень задержек, автоматизацию, безопасность и защищённость, масштабируемость, стабильность, надёжность, снижение TCO и так далее. 
Источник: Ultra Ethernet Consortium Фактически отдельные вендоры уже наделили рядом перечисленных свойств свои продукты, однако унификация и объединение усилий, как считается, должны пойти на пользу всем. Всем, кроме, по-видимому, NVIDIA, которой в списке основателей UEC нет (как и Marvell, к слову). NVIDIA после поглощения Mellanox фактически стала монополистом на рынке InfiniBand, который она активно продвигает, не забывая, впрочем, и о своём проприетарном интерконнекте NVLink, который в последней своей версии выбрался за пределы узла. Справедливости ради — про Ethernet компании тоже не забывает. В обзоре UEC аккуратно критикуется и InfiniBand, и его адаптация в виде RoCE. Авторы указывают на правильность и успешность идеи RDMA, но жалуются на не слишком высокую практичность и удобство современных реализаций. И именно поэтому они первым делом предлагают внедрить новый транспортный протокол Ultra Ethernet Transport (UET), который и позволит реализовать интерконнект будущего, а заодно ещё раз доказать эффективность и гибкость технологии Ethernet, которой в этом году исполнилось 50 лет. Впрочем, это только один из кирпичиков UEC. Примечательно, что первые продукты на базе новых спецификаций обещали показать уже в 2024 году.
25.06.2023 [16:53], Алексей Степин
Cisco представила ASIC Silicon One G200: 51,2 Тбит/с для ИИКомпания Cisco успешно выпустила новые ASIC для сетевых коммутаторов с производительностью 51,2 Тбит/с. Как заявляют разработчики, коммутаторы на базе чипа серии G200 способны объединить в единый комплекс 32 тыс. ускорителей. Новое решение входит в портфолио Cisco Silicon One и изначально нацелено на рынок гиперскейлеров и создателей ИИ-кластеров. В новом чипе в два раза увеличено количество блоков SerDes с производительностью 112 Гбит/с (с 256 до 512), что и позволило довести общую коммутационную производительность до 51,2 Тбит/с. Доступны конфигурации 64×800GbE, 128×400GbE или 256×200GbE, всё зависит от желаемой плотности размещения и скорости портов. Это, в частности, позволяет избавиться от избыточных уровней в топологии сети. 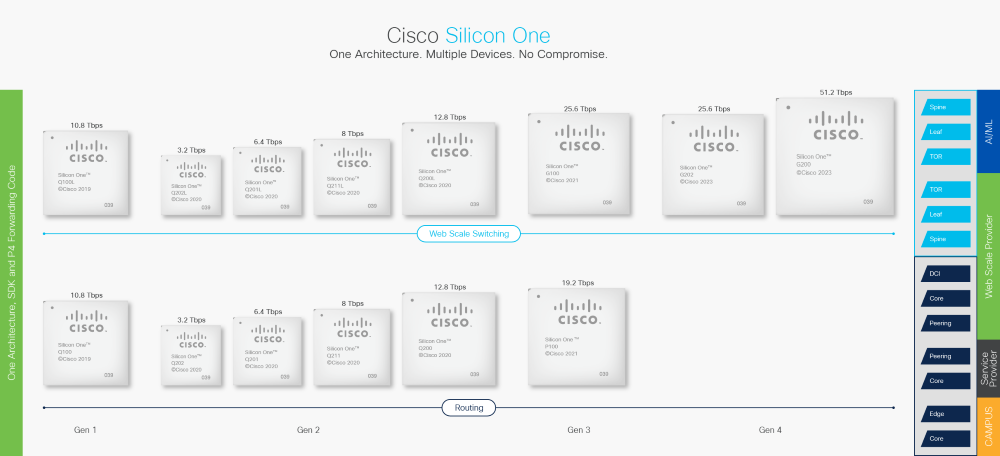
Источник изображений: Cisco Cisco отмечает, что новинка вдвое энергоэффективнее и имеет вдвое меньшую задержку в сравнении с G100. Кроме того, чипы предлагают расширенную телеметрию, поддержку языка P4 для обработки трафика на лету, а также возможность использования современных интерфейсов, в том числе интегрированную оптику или медные кабели длиной до 4 м, чего более чем достаточно для организации связи на уровне стойки. 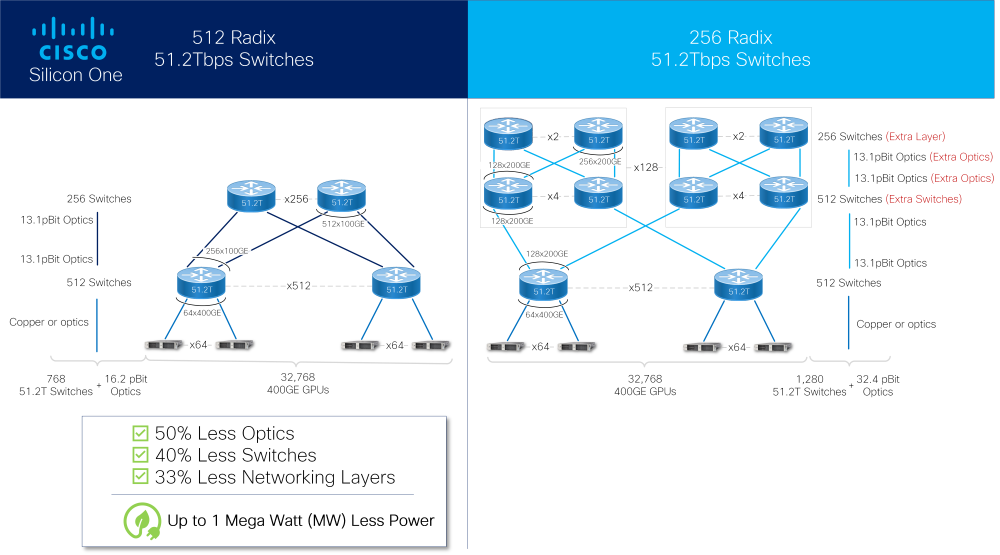 Как и Broadcom Tomahawk-5 или Jericho3-AI, Marvell Teralynx 10 и NVIDIA Spectrum-X, новый чип Cisco содержит возможности, востребованные в среде ИИ-систем, такие как продвинутые средства преодоления заторов в сети (congestion), технологии packet spraying и резервирование линков с возможностью мгновенного восстановления разорванного соединения. Новые чипы серии G200 уже поставляются, но компания пока не назвала даты появления на рынке коммутаторов Cisco на базе нового «кремния».
19.04.2023 [22:00], Алексей Степин
Broadcom представила чип-коммутатор Jericho3-AI для ИИ-платформ, попутно раскритиковав NVIDIAКомпания Broadcom, один из ведущих поставщиков «кремния» для сетевых решений, анонсировала новый сетевой процессор Jerico3-AI, который ориентирован на ИИ-системы. Более того, Broadcom считает подход NVIDIA к «интеллектуальным сетевым решениям» с использованием InfiniBand неверным и даже вредным для кластерных ИИ-систем. Ethernet-коммутаторы компании можно разделить три ветви: наиболее высокопроизводительные чипы Tomahawk, ориентированная на дополнительные возможности ветвь Trident и, наконец, серия Jericho, отличающаяся наибольшей гибкостью в программировании и располагающая более ёмкими буферами. Чип Jericho3-AI BCM88890 — новинка в последней категории, относящаяся к классу 28,8 Тбит/с. Новый коммутатор имеет 144 линка SerDes (106Gbps, PAM4) и может работать в конфигурации 18×800GbE, 36×400GbE или 72×200GbE. 
Источник здесь и далее: Broadcom (via ServeTheHome) В своей презентации Broadcom раскритиковала традиционный подход NVIDIA и других крупных игроков на сетевом рынке, заявив о том, что прямое наращивание пропускной способности и снижение латентности кластерной сети якобы является тупиковой ветвью развития. Вместо этого фабрика на базе Jericho3-AI, по словам компании, позволяет сделать так, чтобы процесс обучения нейросети как можно меньше времени тратил не сетевые операции. 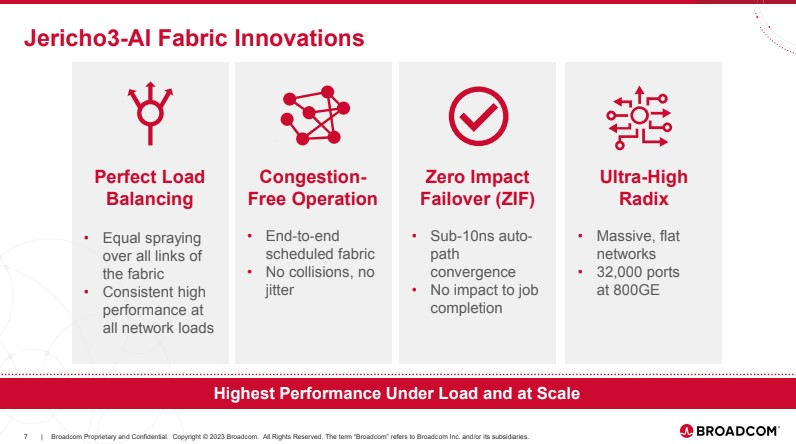 Новый коммутатор обеспечивает идеальную балансировку загрузки, гарантирующую отсутствие заторов, и автоматическое переключение отказавшего соединения на резервное менее, чем за 10-нс, а также позволяет создавать большие «плоские» сети (до 32 тыс. портов 800GbE), характерные для ИИ-кластеров. Каждый ускоритель может получить 800G-подключение, а суммарная производительность фабрики на базе новых коммутаторов может достигать 26 Пбит/с. 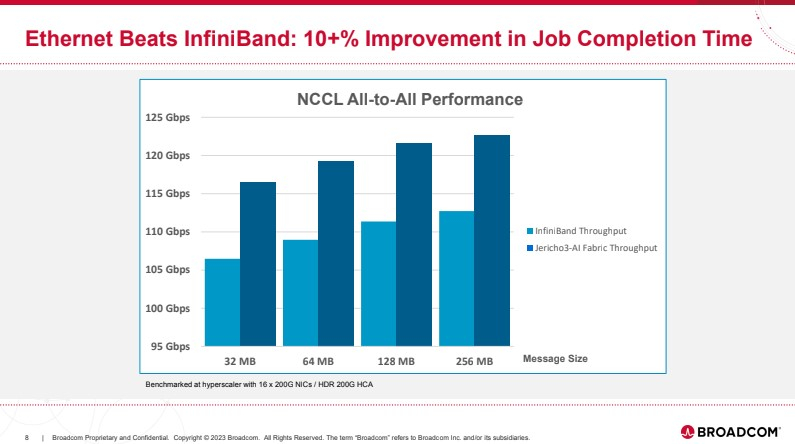 Broadcom утверждает, что сеть Ethernet на базе Jericho3-AI превосходит аналогичную по классу сеть NVIDIA InfiniBand в тестах с использованием NCCL. При этом новый коммутатор не содержит никаких вычислительных мощностей общего назначения — он проще, а за счёт использования стандарта Ethernet сети на его основе универсальны, что также снижает стоимость владения инфраструктурой. 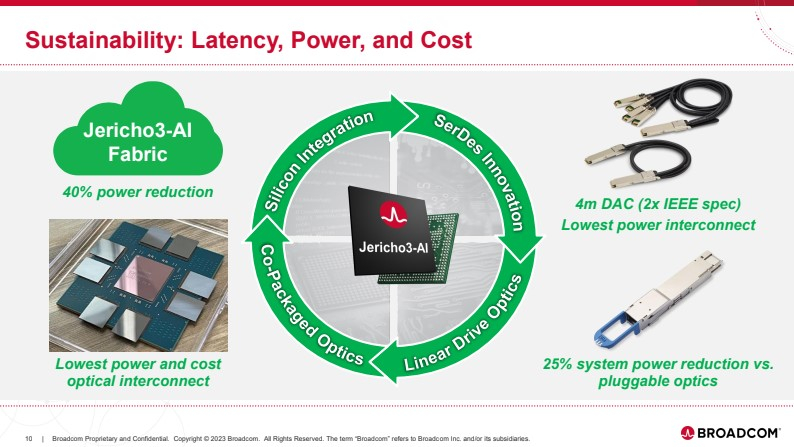 Высокая степень интегрированности обеспечит и большую экономичность, а значит, решения на базе нового коммутатора Broadcom окажутся и более дружелюбны к экологии. Новые чипы уже доступны избранным клиентам Broadcom.
17.08.2022 [00:28], Алексей Степин
Broadcom представила 5-нм ASIC Tomahawk 5 с производительностью 51,2 Тбит/сРастущие объемы сетевого трафика, широкое распространение медиа-сервисов и видеоконференций, новые облачные услуги — всё это требует и нового сетевого «железа», способного справляться с повышающейся нагрузкой. И если не так давно для ASIC высшего класса нормой стал считаться показатель 25,6 Тбит/с, то сейчас вендоры осваивают следующий уровень производительности. Первенство в этой гонке принадлежит NVIDIA с её чипами Spectrum-4, но сейчас в игру вступила Broadcom. Компания представила пятое поколение «сетевого кремния» в серии StrataXGS Tomahawk, тоже способное осуществлять коммутацию на скоростях до 51,2 Тбит/с — 5-нм чип Tomahawk 5 (BCM78900). Появление ASIC такого класса существенно облегчает жизнь разработчикам HPС-систем для задач машинного обучения, поскольку позволит объединить в единый комплекс больше узлов без «наценки» на латентность в конфигурациях 64х800GbE, 128х400GbE или 256х100GbE. Поддерживается RoCEv2 и другие протоколы RDMA, виртуализация и сегментация сетей, VxLAN и прочие современные технологии. 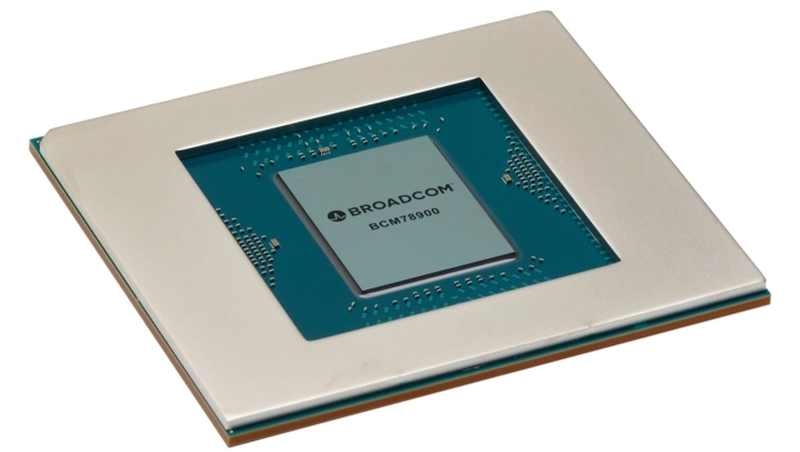
Источник: Broadcom Несколько ограничивают возможности новинки SerDes-блоки Peregrine (PAM4/106 Гбит/с). Каждые 8 таких блоков собраны в трансиверное ядро, всего ядер в новом чипе 64, что ограничивает эффективную производительность на порт именно цифрой 800 Гбит/с. Достоинством Tomahawk 5 станет его экономичность: использование 5-нм техпроцесса позволило довести удельное энергопотребление до цифры менее 1 Вт на 100 Гбит/с, то есть речь идёт о потреблении в районе 500 Вт для полной конфигурации. Цифра немалая, но всё же позволяющая сохранить воздушное охлаждение. Кроме того, новый ASIC снабжён шестью Arm-блоками для настраиваемой потоковой телеметрии. Следует отметить, что реальной потребности в таких скоростях пока очень немного: лишь 15 % (в деньгах) рынка Ethernet-устройств приходится на 400G-оборудование, но Broadcom считает, что постоянный рост аппетитов гиперскейлеров должен довести этот показатель до более чем 50 % уже к 2026 году. В случае же Tomahawk 5 пока речь идёт о первых поставках самих чипов, которые OEM-производителям ещё предстоит интегрировать в свои продукты. Они должны появиться на рынке в следующем году. |
|

