
Материалы по тегу: r200
|
17.11.2026 [14:25], Владимир Мироненко
Платформа NVIDIA Vera Rubin обошла конкурентов во всех тестах MLPerf Training v6.1Дебют платформы NVIDIA Vera Rubin в бенчмарках MLPerf был отмечен её лидерством по производительности в таких областях, как обучение моделей, постобучение и выполнение задач интеллектуальными агентами (agentic inference), сообщила NVIDIA. NVIDIA опередила конкурентов во всех тестах MLPerf Training v6.1. При этом, в категории MLPerf Endpoints компания показала более чем десятикратный прирост (по сравнению с предыдущим поколением) пропускной способности на ватт для систем на базе ИИ-агентов. NVIDIA стала единственной, показавшей результаты во всех тестах текущего цикла — от больших языковых моделей и генерации изображений до рекомендательных систем и постобучения моделей с подкреплением. При этом система Vera Rubin NVL72 продемонстрировала до двух раз более высокую производительность в расчете на один GPU по сравнению с NVIDIA GB300 NVL72. NVIDIA также провела тестирование на 10 240 GPU в составе систем GB300 — это самый масштабный показатель в данном раунде. А платформа Microsoft Azure провела тесты, задействовав 10 240 GPU NVIDIA в системах GB200. 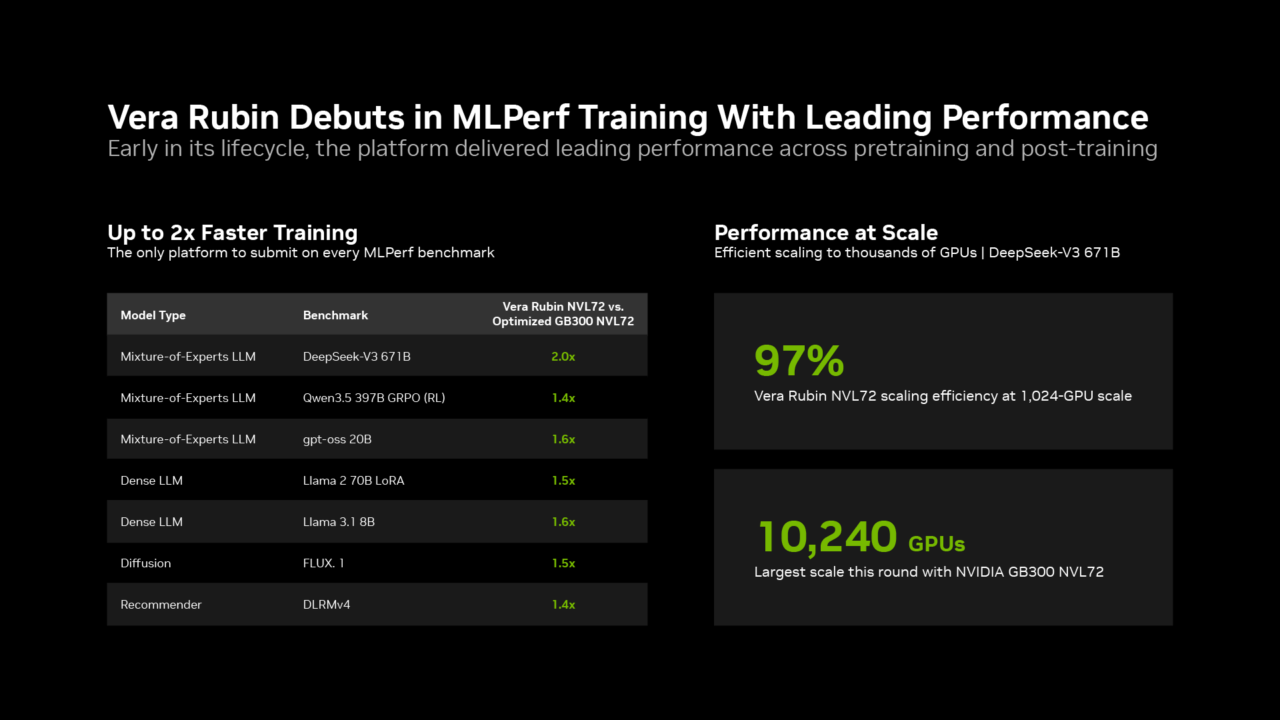
Источник изображений: NVIDIA NVIDIA Vera Rubin стала лидером в области агентных вычислений (agentic inference) по результатам тестов MLPerf Endpoints, показав лучшие показатели во всех бенчмарках, ориентированных на работу AI-агентов. Тестирование MLPerf Endpoints оценивает производительность систем в реальных сценариях работы AI-агентов, одновременно проверяя, насколько успешно и корректно они справляются с поставленными целями. Согласно предварительным результатам для Kimi K3 — крупной открытой модели, разработанной специально для агентных рабочих процессов, — системы VR200 NVL72 обеспечили более чем десятикратное преимущество по пропускной способности на ватт затраченной энергии по сравнению с GB300 NVL72 при идентичной скорости отклика. Предварительные результаты для системы Vera Rubin ожидают подтверждения со стороны ассоциации MLCommons. 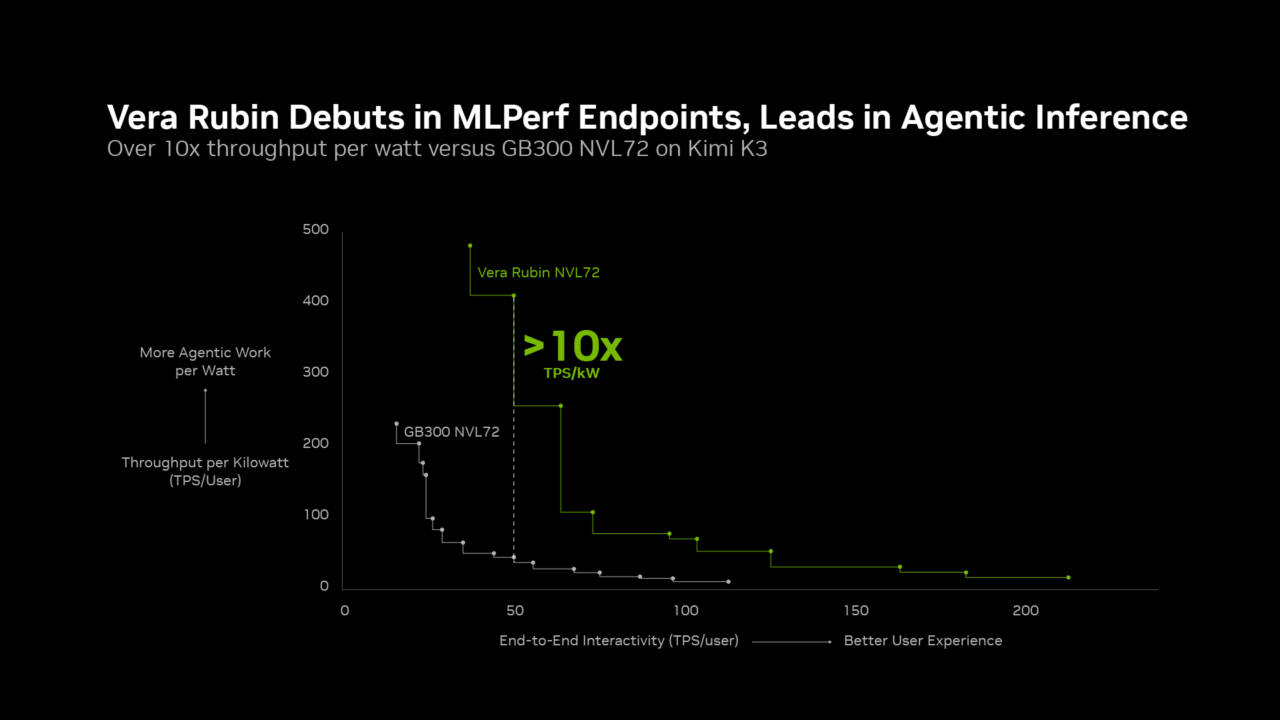 NVIDIA отметила, что Vera Rubin также демонстрирует передовые показатели в независимых бенчмарках, таких как SemiAnalysis AgentX и Artificial Analysis AgentPerf, что подтверждает широкие возможности инфраструктура NVIDIA, способной эффективно поддерживать самые разные задачи: от предварительного и последующего обучения моделей до выполнения агентных вычислений (agentic inference), а также решать задачи, не связанные напрямую с ИИ — например, обеспечивать HPC.
12.11.2026 [11:25], Павел Котов
SpaceX разрабатывает стоечную систему Kessel на базе NVIDIA VR200 NVL72SpaceX ведёт разработку собственной стоечной системы на платформе NVIDIA Vera Rubin NVL72 — её отличительной особенностью является отказ от традиционных кабельных соединений в пользу массивной 84-слойной печатной платы, сообщает Tom’s Hardware. Одна из возможных целей такого решения — использование системы в орбитальных ЦОД. Система с кодовым именем Kessel включает 36 CPU Vera, 72 GPU Rubin, девять лотков с коммутаторами NVLink и принципиально иную архитектура интерконнекта. Компания Илона Маска (Elon Musk) закупает оборудование напрямую у NVIDIA, но прочие компоненты она приобретает самостоятельно, обеспечивая себе более полный контроль над цепочкой поставок аппаратного обеспечения. Система Kessel сохранила базовую конфигурацию NVIDIA Vera Rubin NVL72 с 72 GPU, распределёнными по 18 вычислительным модулям с девятью коммутаторами NVLink. В отличие от стандартного решения NVIDIA, где используются внутренние кабельные блоки NVLink, SpaceX намерена размещать вычислительные и коммутационные модули «спина к спине» вокруг пассивной центральной печатной платы. Такая архитектура напоминает уменьшенную версию системы NVIDIA Kyber с 576 ИИ-ускорителями в 144 узлах, где для соединения вместо кабелей также используется печатная плата. Есть версия, что данная конструкция предназначается как для наземного, так и для орбитального применения. 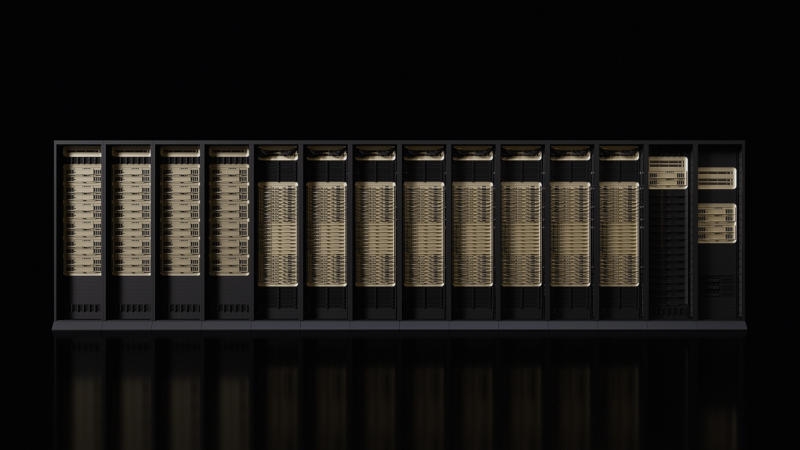
Источник изображения: nvidia.com 84-слойная печатная плата является самой характерной особенностью Kessel — она изготавливается с использованием медных ламинатов марки M10 со сверхнизким уровнем потери сигнала. Для сравнения, архитектура NVIDIA Kyber предусматривает объединительную 156-слойную плату на основе ламинатов M9. Сокращение количества слоёв почти вдвое способно существенно упростить процесс производства и повысить выход годных изделий, но применение более совершенных медных ламинатов грозит ростом затрат на материалы. В любом случае, изготовить 84-слойную печатную плату чрезвычайно сложно. Переход на использование платы в качестве интерконнекта может упростить сборку системы благодаря исключению множества высокоскоростных кабельных соединений, но едва ли поможет снизить производственные затраты. Для сравнения, современные серверные материнские платы высокого класса обычно содержат от 15 до 20 слоёв; в отладочных серверных платах их число превышает 20, чтобы практически полностью исключить проблемы с передачей электрических сигналов, обусловленные конструкцией самой платы. Серьёзным препятствием при производстве 84-слойных плат может стать низкий выход годных изделий: достаточно дефекта лишь на одном из слоёв, чтобы непригодной стала вся плата. Таким образом, экономическая целесообразность проекта Kessel будет зависеть от того, смогут ли сэкономленные за счёт самостоятельной закупки компонентов и отказа от кабелей средства компенсировать расходы на создание такой сложной объединительной платы. Kessel также знаменует собой отход от традиционной для NVIDIA модели поставок на системном уровне — в рамках поколения Vera Rubin она предлагает готовые вычислительные модули и серверные стойки. SpaceX, по имеющимся данным, намерена закупать ИИ-ускорители, CPU, коммутаторы и сетевое оборудование напрямую у NVIDIA, а остальные компоненты — у сторонних поставщиков. С таким подходом она сама сможет выбирать производителей печатных плат, поставщиком компонентов и производственных партнёров, оптимизировать оборудование нужды собственной инфраструктуры, что особенно важно с учётом перспективы орбитальных ЦОД — возможно, это будет способствовать снижению расходов за счёт отказа от посредников. При этом компания берёт на себя больше ответственности за проектирование системы, её проверку, качество производства и управление цепочками поставок — это всё более характерная для гиперскейлеров стратегия. Для NVIDIA не всё так однозначно. С одной стороны, прямые продажи CPU и GPU грозят снижением выручки от реализации готовых печатных плат; с другой, и прочие крупные клиенты могут принять решение создавать собственные системы на базе технологий NVIDIA. В итоге технологии NVIDIA будут применяться чаще — и это важно, потому что гиперскейлеры сейчас всё активнее внедряют собственные чипы. Но сначала проект Kessel должен обернуться успехом и предложить явные преимущества по сравнению с системами NVIDIA. Ранее Илон Маск заявил, что NVIDIA стала эксклюзивным партнёром SpaceX — единственным поставщиком ускорителей для ЦОД компании. Две компании уже не первый месяц ведут разработку оптимизированной для орбитальных условиях версии системы NVIDIA Vera Rubin NVL72.
03.11.2026 [14:08], Сергей Карасёв
NVIDIA скорректировала характеристики GPU Rubin, снизив пропускную способность HBM4 и NVLinkКомпания NVIDIA, по сообщению ресурса ServeTheHome, утвердила окончательные технические характеристики графических процессоров поколения Rubin, а также систем на их основе, включая Vera Rubin NVL72 и HGX Rubin NVL8. Ключевые изменения по сравнению с предварительными спецификациями связаны со скоростью работы подсистем. Первоначально NVIDIA планировала обеспечить пропускную способность памяти HBM4 на уровне 22 Тбайт/с в расчёте на один чип Rubin. В конфигурации с восемью стеками HBM4 (по 36 Гбайт, в сумме 288 Гбайт) это означало работу каждого стека со скоростью около 10,75 Гбит/с на контакт. В окончательном варианте значения снижены до 19,2 Тбайт/с и 9,375 Гбит/с соответственно, то есть примерно на 13 %. Вместе с тем пропускная способность интерконнекта NVLink уменьшена с 3,6 до 3 Тбайт/с — на 17 %. При этом пропускная способности интерконнекта для горизонтального масштабирования (Scale Out), напротив, увеличена с 0,4 до 0,45 Тбайт/с. 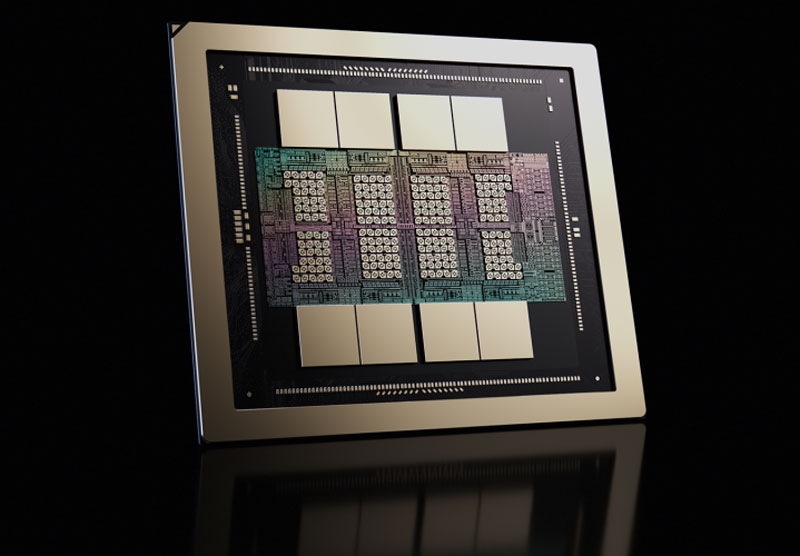
Источник изображения: NVIDIA Несмотря на корректировки, показатели ИИ-производительности сохранились на прежнем уровне. На задачах инференса и обучения моделей в режиме NVFP4 быстродействие достигает 50 и 35 Пфлопс. На операциях INT8 показатель составляет до 250 TOPS, на операциях TF32 — до 2 Пфлопс. Таким образом, помимо указанных изменений, NVIDIA не внесла никаких других модификаций в характеристики Rubin. В случае флагманской системы Vera Rubin NVL72 общая пропускная способность подсистемы памяти HBM4 сократилась с 1580 до 1400 Тбайт/с, интерконнекта NVLink — с 260 до 216 Тбайт/с. Пропускная способности интерконнекта (Scale Out) поднялась с 28,8 до 32,4 Тбайт/с. Наконец, у HGX Rubin NVL8 показатель ПСП HBM4 упал со 176 до 130 Тбайт/с, NVLink — с 28,8 до 24 Тбайт/с, тогда как для сети значение выросло с 1,6 до 1,8 Тбайт/с. Причём у этих систем NVIDIA также уменьшила объём памяти HBM4. Если первоначально HGX Rubin NVL8 планировалось наделить 2,3 Тбайт HBM4, то в соответствии с окончательными спецификациями размер памяти составит 2 Тбайт.
28.10.2026 [16:16], Павел Котов
NVIDIA и Oracle расширят инфраструктуру OCI на базе Vera Rubin NVL72 до мультигигаваттного масштабаNVIDIA и Oracle объявили о планах по расширению суперкластеров в Oracle Cloud Infrastructure (OCI) с использованием систем Vera Rubin NVL72 и Vera CPU, сообщает HPCwire. Масштаб таких решений достигнет гигаваттных значений — системы помогут удовлетворить спрос клиентов на обучение, инференс, а также на работу ИИ-агентов. Суперкластеры OCI объединяют стоечные системы NVIDIA NVL72, сетевые решения Oracle Acceleron, в том числе NVIDIA Spectrum-X Ethernet с коммутаторами Spectrum-6 и DPU BlueField-4, а также системы электропитания и охлаждения. В стойке ускорители объединены с помощью NVLink, а отказоустойчивая многоплоскостная сеть OCI позволяет масштабировать систему до сотен тысяч GPU. Планируется также внедрение системы NVIDIA HGX Rubin NVL8 с двумя 64-ядерными процессорами Intel Xeon 6, 4 Тбайт DDR5 и RDMA-интерфейсом 6,4 Тбит/с. Это решение обеспечивает гибкие возможности для обучения, дообучения и инференса ИИ-моделей при сохранении совместимости с приложениями на базе архитектуры x86. Такая гибкость позволяет адаптировать инфраструктуру ИИ к различным моделям и рабочим нагрузкам по мере изменения потребностей. 
Источник изображения: BoliviaInteligente / unsplash.com Ранее Oracle призналась, что направление ИИ ЦОД является для неё рискованным. Компания обеспечила высокоскоростное подключение своей инфраструктуры к AWS, а также сдала китайской Tencent 100 тысяч передовых ускорителей в аренду для развития ИИ-систем.
23.10.2026 [16:25], Руслан Авдеев
NVIDIA научилась разворачивать ИИ ЦОД за две недели вместо полугодаNVIDIA представила эталонную архитектуру DSX Pod — модульного контейнерного ИИ ЦОД, оснащаемого семью стойками Vera Rubin NVL72, а также необходимым для работы сетевым, охлаждающим и электротехническим оборудованием. Компания утверждает, что такая архитектура позволяет сократить время развёртывания ЦОД на заранее подготовленной площадке примерно с шести месяцев до двух недель, сообщает Datacenter Knowledge. Анонсированное в ходе мероприятия GTC Berlin модульное решение рассчитано на организации, которым требуется быстро ввести в эксплуатацию большие вычислительные мощности без длительного планирования, строительства и значительных трудозатрат, характерных для реализации обычных ИИ-проектов. NVIDIA заявила, что сотрудничает с 17 партнёрами, включая Bull, Dell Technologies, HPE, Lenovo, Eaton, Schneider Electric и Vertiv. Они начнут поставлять варианты решений на основе DSX Pod в начале 2027 года. По словам представителя NVIDIA, речь идёт о полностью собранном и протестированном контейнерном решении со стандартизированным вводом питания на 800 В постоянного тока (DC) и заранее смонтированными трубопроводами. Это строительный блок для будущих ИИ-фабрик. NVIDIA сообщает, что сама компания разрабатывает и проверяет эталонную архитектуру, а партнёры производят контейнеры, интегрируют оборудование, адаптируют системы электроснабжения и жидкостного охлаждения, а также устанавливают и обслуживают готовые комплексы. Речь идёт не об универсальном готовом продукте NVIDIA, а о проектной основе для решений разных вендоров. 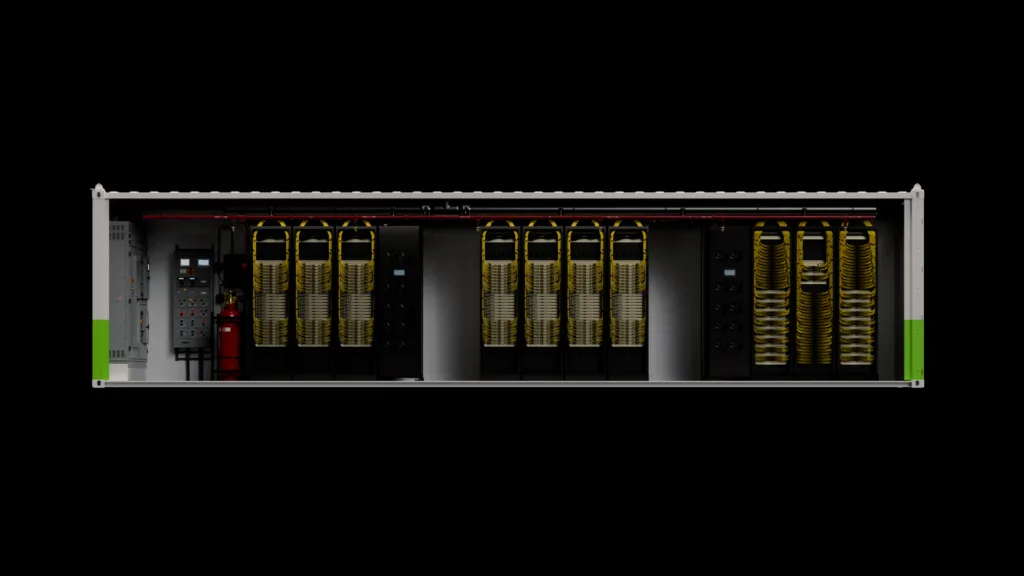 По мнению экспертов IDC, DSX Pod подходит для трёх сценариев развёртывания. Его можно использовать в суверенных проектах, требующих физической изоляции оборудования, в небольших ИИ-проектах для выполнения специализированных задач, а также для периферийных ИИ-вычислений — там, где необходимы комплексные решения для ускоренных вычислений «под ключ». Компания также представила программное обеспечение и механизмы безопасности для масштабных ИИ-проектов. В частности, была представлена эталонная архитектура OpenShell Reference Architecture, призванная помочь организациям управлять ИИ-агентами. Она позволяет определять, к каким ресурсам могут обращаться агенты, отслеживать их активность и принудительно обеспечивать соблюдение заданных политик при выявлении небезопасного поведения. В компании рассказали, что архитектура объединяет инфраструктуру NVIDIA Vera Rubin NVL72 для обучения и инференса с системами на базе процессоров NVIDIA Vera, которые обеспечивают работу и управление средой выполнения ИИ-агентов. Между этими системами располагаются DPU BlueField, выполняющие функции изолированного средства контроля безопасности. Последние анализируют сетевой трафик и позволяют обновлять политики безопасности, в том числе отключая агента при выявлении его небезопасного поведения. По данным NVIDIA, среди компаний, использующих OpenShell Reference Architecture для повышения безопасности при работе с ИИ-агентами, — Anthropic, AWS, Google Cloud, Meta✴, Microsoft, OpenAI и Perplexity.
22.10.2026 [23:03], Павел Котов
ASUS объявила о готовности поставлять системы на базе NVIDIA HGX Rubin NVL8ASUS объявила, что в IV квартале 2026 года будет готова выпустить новые стоечные серверы на платформе NVIDIA HGX Rubin NVL8. Они будут доступны в конфигурациях как частично, так и полностью укомплектованной стойки. Линейка включает модели XR R1I12B-M1BHFS (3U, гибридное охлаждение) и XR R1I12B-M1BLFS (2U, полностью жидкостное охлаждение). Система ASUS XR R1I12B-M1BHFS в формфакторе 3U сочетает систему прямого жидкостного охлаждения микросхем (D2C) для базовой платы NVIDIA HGX Rubin с восемью GPU и воздушное охлаждение для двух процессоров Intel Xeon 6. Модульная конструкция с воздушным охлаждением CPU на 50 % сокращает время технического обслуживания; поддержка накопителей форматов U.2 и E1.S обеспечивает гибкость при развёртывании системы. ASUS XR R1I12B-M1BLFS отличают формфактор 2U и полноценное жидкостное охлаждение — система имеет высокую тепловую эффективность, высокую вычислительную плотность и способствует улучшению PUE. Сертифицированная NVIDIA конструкция и архитектура без использования кабелей для соединения плат снижают сложность развёртывания системы. 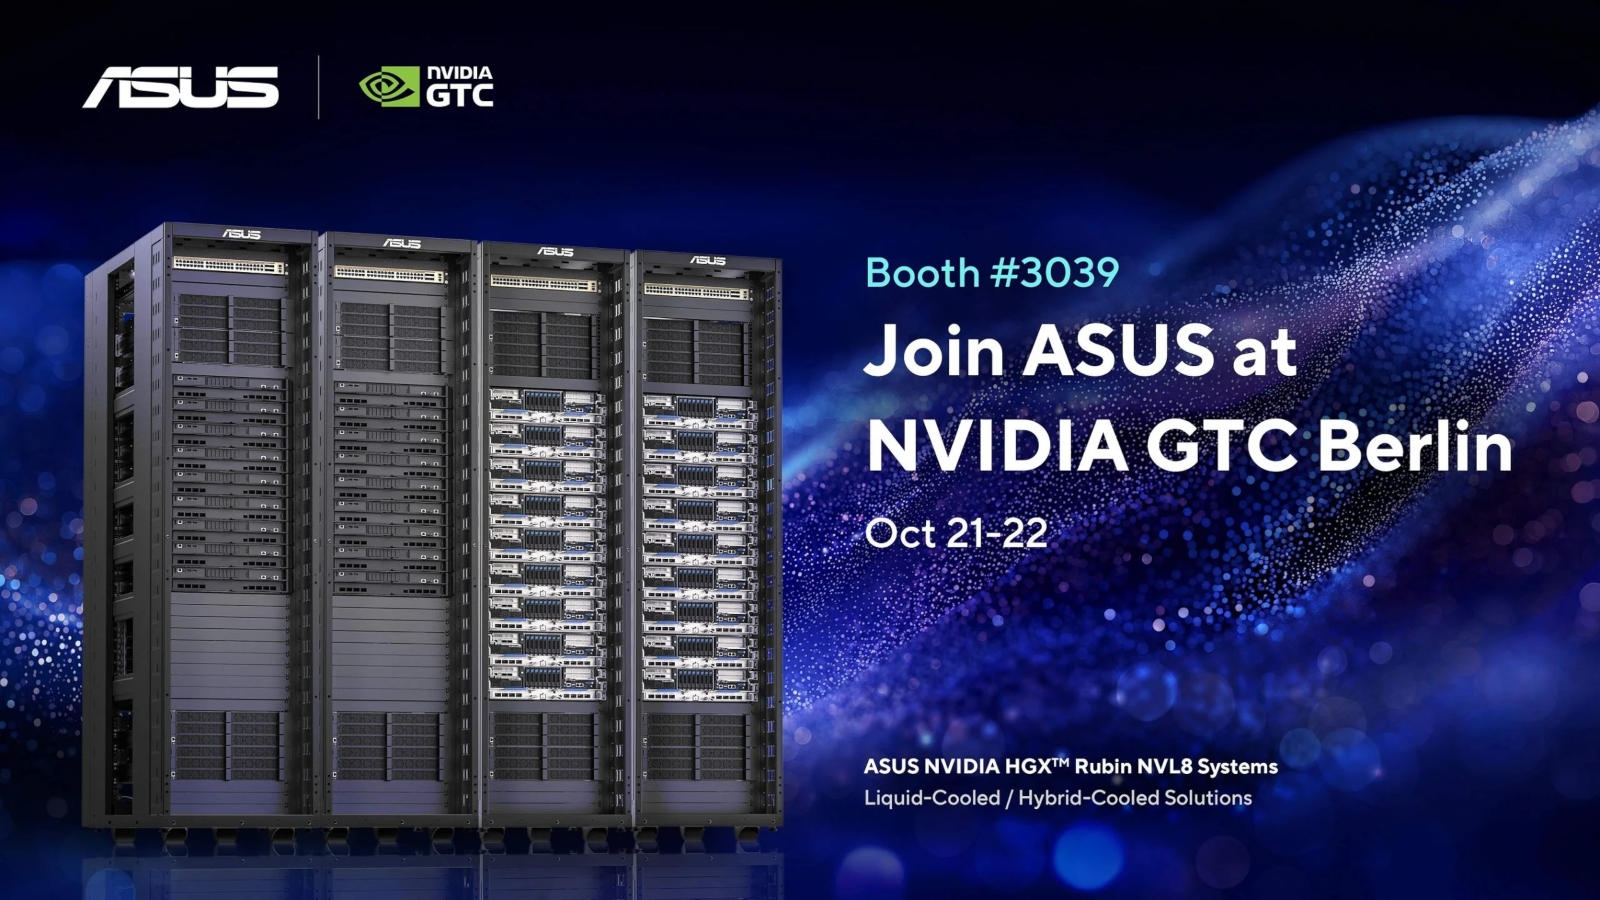
Источник изображения: servers.asus.com Формирование инфраструктуры для ИИ требует оптимизации вычислительных мощностей, систем питания, охлаждения и сопутствующей инженерной части. ASUS сочетает свой опыт с решением NVIDIA DSX Sim Blueprint — эталонным проектом системы моделирования и проверки инфраструктуры ЦОД в среде цифровых двойников — и помогает оптимизировать инфраструктуру для задач масштабной генерации токенов. Совместно с партнёрами по экосистеме производитель объединяет вычислительные ресурсы, сетевое оборудование, СХД, системы питания и охлаждения и инженерную инфраструктуру в единую среду цифрового двойника. Это помогает заказчикам оценивать конфигурации инфраструктуры, выявлять ограничения, оптимизировать производительность и энергоэффективность системы ещё до её развёртывания.
22.10.2026 [00:36], Владимир Мироненко
Google Cloud и NVIDIA запустят в ноябре инстансы на базе Vera Rubin NVL72Google Cloud и NVIDIA объявили, что в следующем месяце в Европе станут общедоступны инстансы Google Cloud A5X на базе систем NVIDIA Vera Rubin NVL72. Они предоставят клиентам комплексную платформу для обучения моделей, инференса и масштабного обучения с подкреплением. A5X интегрирует архитектуру Vera Rubin в систему Google Cloud AI Hypercomputer, объединяя вычислительные мощности, сетевые ресурсы и системы хранения данных для поддержки обучения на основе опыта. A5X используют системы NVIDIA Vera Rubin NVL72, сетевые адаптеры NVIDIA ConnectX-9 SuperNIC, сеть Virgo Network и передовую технологию жидкостного охлаждения четвертого поколения от Google Cloud. Сообщается, что Google Cloud планирует расширить инфраструктуру на базе архитектуры Vera Rubin, доведя количество ускорителей Rubin до 960 тыс. единиц, размещённых на различных площадках. По мере развёртывания агентских систем компаниям необходимо обеспечивать защиту проприетарных моделей и конфиденциальных данных, лежащих в основе этих систем, даже при использовании инфраструктуры сторонней организации. Google Cloud станет одним из первых облачных провайдеров, предлагающих NVIDIA Confidential Computing в масштабе стойки на bare-metal-инстансах, таких как A4X Max на базе NVIDIA GB300 NVL72. 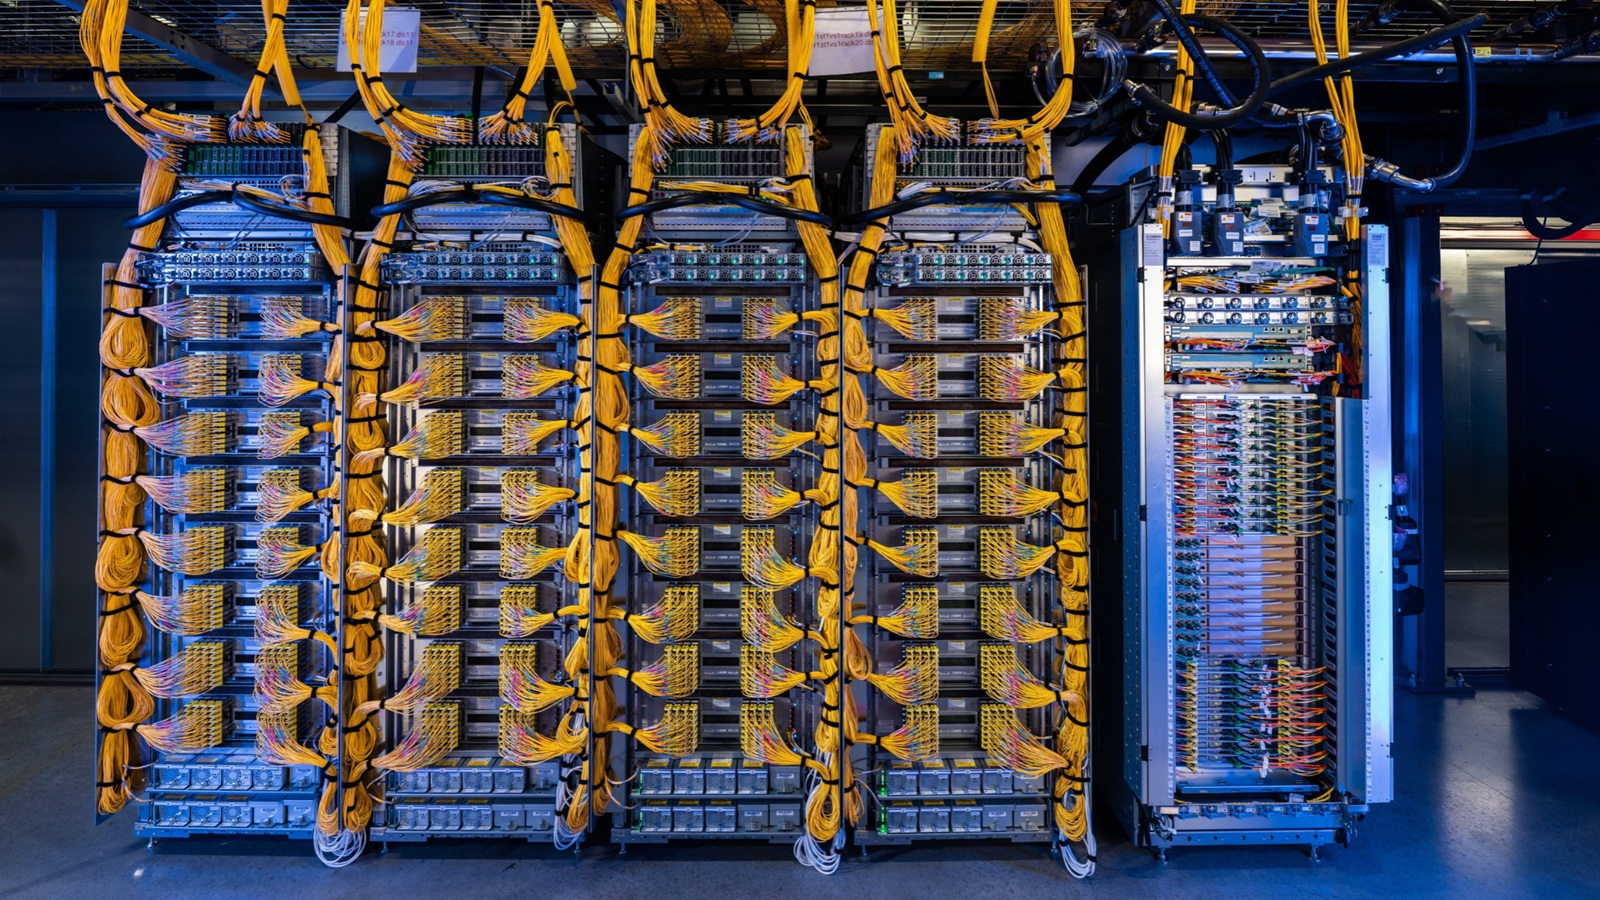
Источник изображения: NVIDIA Кроме того, Google Cloud делает конфиденциальные вычисления (Confidential Computing) общедоступными на виртуальных машинах G4 на базе ускорителей NVIDIA RTX PRO 6000 Blackwell Server Edition, предлагая гибкую платформу для конфиденциального инференса и тонкой настройки. Клиенты, включая Vertebrae, Polaris Cloud и Confidential Core AI, используют ВМ Confidential G4 для обеспечения конфиденциальности разговоров, проверяемой работы агентов и корпоративного ИИ, управляемого в рамках заданных политик. Google Cloud и NVIDIA также изучают возможности комплекса технологий NVIDIA DSX MaxLPS для инфраструктуры на базе Vera Rubin, чтобы оптимизировать производительность на Вт и расширить возможности в рамках доступного бюджета электропитания ЦОД.
13.10.2026 [13:50], Руслан Авдеев
MGX 1.2: NVIDIA представила открытые спецификации стоек Vera RubinNVIDIA объявила о новых партнёрствах и технологических решениях для создания единой основы для ИИ-инфраструктуры нового поколения. В частности, OCP переданы спецификации стоек NVIDIA Vera Rubin и вычислительных узлов в рамках открытой архитектуры MGХ. В рамках инициативы Open DC Initiative проекта OCP компания присоединилась к лидерам отрасли, принимающим участие в разработке референсного дизайна ИИ ЦОД третьего поколения. Наряду с открытыми технологиями жидкостного охлаждения MQD и MQDB, работа над MGX позволит превратить проверенные решения для ИИ-фабрик в отраслевые стандарты, доступные для внедрения, производства и масштабирования другими участниками рынка. Обновлённая спецификация MGX 1.2 расширяет возможности открытой архитектуры за счёт СЖО со «слепым» (blind-mate) монтажом. Также стандартизирована совместимая стоечная инфраструктура интерконнектов и DC-шина на 5000 А с жидкостным охлаждением, рассчитанная на мощные ИИ-системы. Дополнительно добавлена поддержка 19″ оборудования и стоек с повышенной плотностью размещения оборудования. Дополнительно MGX 1.2 расширяет возможности модульной конфигурации. Так, добавлены конфигурируемые IO-модули, безвентиляторные вычислительные узлы с СЖО, стандартизированные интерфейсы электропитания и охлаждения и единая инфраструктурная основа, дающая партнёрам экосистемы строить совместимые платформы для ускоренных вычислений. 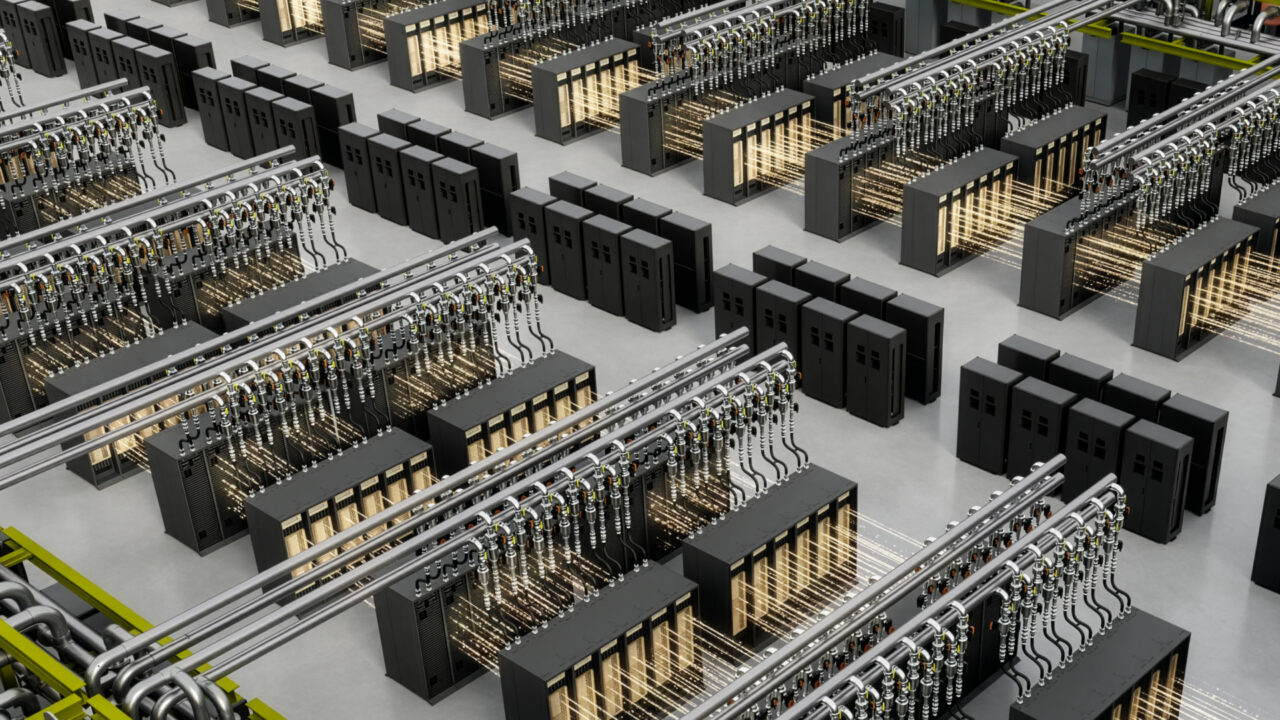
Источник изображения: NVIDIA Архитектура позволяет сокращать время сборки, тестирования и обслуживания оборудования. Это упрощает развёртывание и обслуживание на местах и должно повысить эффективность инфраструктуры. Архитектурой поддерживается конфигурация стоек до 250 кВт. В то же время упрощается техобслуживание проектов, ввод в эксплуатацию и даже повторное использование инфраструктуры. Спецификация стоек на основе CPU NVIDIA Vera дополнительно расширяет архитектуру MGX за пределы ускоренных вычислений. Фактически речь идёт о специализированной платформы эпохи агентного ИИ. Если NVIDIA Vera Rubin NVL72 служит основой для обучения и инференса ИИ-моделей, то стойки на основе CPU Vera предназначены для вызова инструментов, оркестрации и песочниц. Стойка Vera CPU на основе MGX третьего поколения использует те же принципы проектирования на уровне стоек — они позволяют объединять вычислительные ресурсы, сетевую инфраструктуру, электропитание и охлаждение в единой модульной платформе. Соответствующий подход позволяет NVIDIA и партнёрам обеспечивать развёртывание специализированной инфраструктуры, в то же время используя преимущества общей экосистемы, упрощённой интеграции и единой технологической базы для ИИ-фабрик нового поколения.
13.10.2026 [09:35], Руслан Авдеев
CoreWeave получит 240 МВт в индийском кампусе AdaniConneX Taloja, где развернёт NVIDIA Vera RubinCoreWeave выходит на индийский рынок. Компания намерена развернуть ИИ-облако мощностью 240 МВт в кампусе Taloja местной компании AdaniConneX в Нави-Мумбаи (Navi Mumbai) и открыть локальный офис для работы с местными заказчиками, сообщает Converge! Digest. Возможно дальнейшее масштабирование проекта. Это первый инфраструктурный проект компании в Индии — компания последовательно осваивает всё новые рынки Азиатско-Тихоокеанского региона. Проект предусматривает использование трёх зданий ЦОД по 80 МВт с возможностью расширения в будущем до 480 МВт, CoreWeave выступит единственным арендатором. Компания развернёт новейшую платформу NVIDIA Vera Rubin. Первая очередь должна заработать в середине 2028 года. Объекты в кампусе Taloja специально разработаны для использования высокоплотной ИИ-инфраструктуры с применением СЖО (DLC) без испарительных систем. Равные доли в AdaniConneX принадлежат Adani Enterprises и EdgeConneX. Компания строит инфраструктуру крупных ЦОД в Индии, комбинируя возможности Adani в сфере инфраструктуры и энергетики с опытом EdgeConneX в сфере строительства дата-центров. Для индийского рынка ЦОД проект означает масштабное объединение местной инфраструктурной платформы и оператора облачных ИИ-вычислений глобального уровня. 
Источник изображения: C Rayban/unsplash.com Ранее CoreWeave уже объявила о намерении развернуть в Индонезии три ЦОД общей мощностью 360 МВт, а также в иных локациях за пределами Северной Америки и Европы. То есть общая мощность проектов в Азиатско-Тихоокеанском регионе составит около 600 МВт, причём оба региональных проекта должны заработать в 2028 году. CoreWeave стала одним из первых получателей систем на VR200 NVL72.
29.09.2026 [12:35], Сергей Карасёв
Supermicro начала поставки NVIDIA Vera Rubin NVL72 с CDU на 1,8 МВтКомпания Supermicro объявила о начале отгрузок стоек NVIDIA Vera Rubin NVL72. Эта аппаратная платформа, приходящая на смену GB200 NVL72, рассчитана на ресурсоёмкие ИИ-нагрузки, включая задачи обучения с подкреплением и приложения агентного ИИ. Стойки Vera Rubin NVL72 содержат 18 вычислительных узлов форм-фактора 1U, в каждом из которых размещены по четыре ускорителя Rubin и два чипа Vera (88 Arm-ядер Olympus). Таким образом, в общей сложности задействованы 72 ускорителя Rubin и 36 изделий Vera (в сумме 3168 ядер). Система оперирует 20,7 Тбайт памяти HBM4 и 54 Тбайт памяти LPDDR5X. Платформа Supermicro предусматривает применение технологии прямого жидкостного охлаждения DLC-2. Используются блоки распределения охлаждающей жидкости (CDU) с резервированием N+1. Их охлаждающая ёмкость достигает 1,8 МВт. Опционально доступны теплообменники на задней дверце. В целом, передовая система DLC-2 рассчитана на мощность оборудования до 360 кВт на стойку. 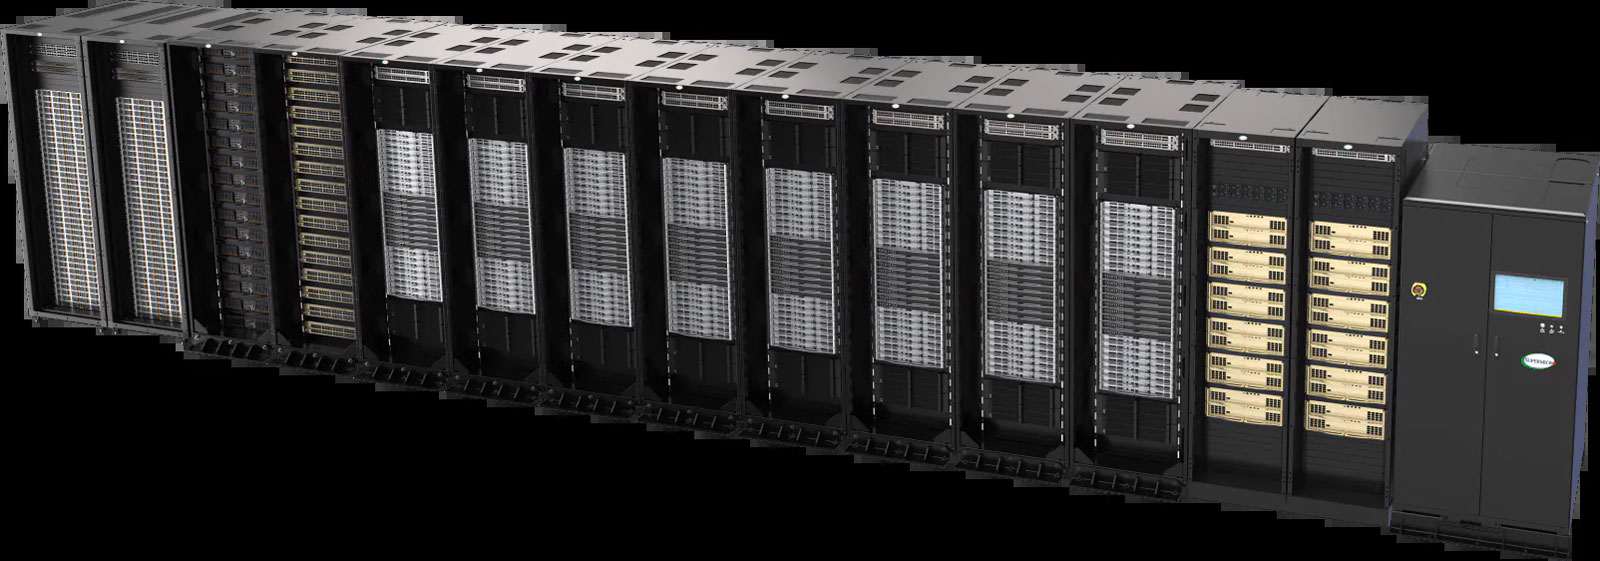
Источник изображения: Supermicro Supermicro отмечает, что команда её специалистов оказывает заказчикам комплексную поддержку при развёртывании NVIDIA Vera Rubin NVL72 — от анализа характеристик площадки и проектирования до установки и интеграции. Клиентам доступно программное обеспечение SuperCloud, которое предоставляет полный контроль над инфраструктурой, автоматизирует внедрение, содержит инструменты для разработчиков и обеспечивает эффективное управление мультитенантным GPU-облаком. Стойки NVIDIA Vera Rubin NVL72 входят в продуктовое семейство Supermicro Data Center Building Block Solutions (DCBBS). |
|

