
Материалы по тегу: nvidia
|
24.10.2026 [13:48], Павел Котов
Infineon и NVIDIA разработают технологию питания на основе GaN для стоек на 800 ВInfineon заключила партнёрское соглашение с NVIDIA, в рамках которого будет разработана технология преобразования энергии с компонентами на основе нитрида галлия (GaN), предназначенная для архитектуры питания ИИ ЦОД с напряжением 800 В постоянного тока, сообщает Data Centre Dynamics. Новое соглашение стало продолжением договорённостей, достигнутых в мае 2025 года. В рамках нового соглашения основное внимание будет уделяться разработке преобразователей промежуточной шины питания (IBC) — эти устройства понижают напряжение основной шины, питающей карты ускорителей, до более низких уровней, позволяя последующим каскадам питания формировать необходимые значения для работы компонентов в системах ИИ. Многокаскадная архитектура помогает снизить потери при распределении энергии и соблюсти жёсткие требования к занимаемой площади на плате, тепловым характеристикам и времени безотказной работы. Стандарт HVDC внедряется наряду с существующими системами AC и LVDC в качестве дополнительного решения для систем с повышенной плотностью мощности. 
Источник изображения: infineon.com GaN-компоненты переключаются быстрее кремниевых аналогов и характеризуются меньшими потерями, что позволяет достичь частот переключения до 1 МГц на этапе промежуточного преобразования. Благодаря этому можно уменьшить размеры магнитных и других пассивных компонентов, повысить плотность мощности и снизить высоту конструкции печатных плат — всё это важно с учётом того, что мощность серверных стоек приближается к мегаваттному уровню. В ассортименте решений Infineon на базе GaN значатся преобразователи для различных диапазонов: с 800 В до 50, 12 и 6 В; компания также располагает микроконтроллерами питания PSoC Control C3, чипами EiceDRIVER для управления силовыми транзисторами — и предлагает комплексные системные решения IBC. Есть также аналоги на компонентах из кремния и карбида кремния. Ранее тайваньская Winbond договорилась о приобретении у Infineon бизнеса по производству памяти NOR и FRAM; Infineon, в свою очередь, поглотила индийского производителя систем электропитания для ЦОД C2i Semiconductors.
23.10.2026 [17:26], Павел Котов
Dell представила системы на NVIDIA Vera и первую стойку для инференса на чипах Groq 3 LPUDell расширила ассортимент решений серии Dell AI Factory with NVIDIA — производитель представил серверы и стойки на процессорах NVIDIA Vera, а также стоечную систему для инференса с ускорителями Groq 3 LPU. Система Dell PowerEdge M9882 включает 256 процессоров NVIDIA Vera в одной стойке формата 48U — решение призвано более эффективно использовать ресурсы питания и охлаждения в ЦОД за счёт отделения вычислительных мощностей CPU от кластеров GPU. Стойка, отметили в Dell, разрабатывалась специально для поддержки агентного ИИ; система может работать параллельно с инфраструктурой на базе GPU, ориентированной на инференс моделей. Сервер Dell PowerEdge R8822 представляет собой двухпроцессорное решение на базе NVIDIA Vera с воздушным охлаждением, совместимое со стандартными 19″ стойками. Как и стоечный вариант, модель R8822 оптимизирована для агентного ИИ: на ней можно запускать задачи обучения с подкреплением, обработки данных и аналитики; поддерживается установка до четырёх двухслотовых GPU. 
Источник изображения: dell.com Dell также представила PowerEdge XE9810 — свой первый продукт с ускорителями Groq 3 LPU. Система состоит из 16 вычислительных модулей с прямым жидкостным охлаждением. Точное число LPU в каждом модуле не уточняется, но в Dell отмечают, что решение служит «идеальным дезагрегированным дополнением к существующим GPU-кластерам». Система разрабатывалась для обеспечения высокой пропускной способности, необходимой для массового выполнения задач агентного ИИ в реальных условиях. Сервер Dell PowerEdge R8822 станет доступным уже в октябре; модели M9882 и XE9810 появятся в I квартале 2027 года. Ранее компания рассказала о расширении возможностей Dell AI Data Platform. Производитель анонсировал первую в мире СХД PowerEdge R7725 с поддержкой SSD на 245 Гбайт; в ассортименте Dell также значится сервер PowerEdge XE8812 на архитектуре NVIDIA Vera Rubin NVL4.
23.10.2026 [16:25], Руслан Авдеев
NVIDIA научилась разворачивать ИИ ЦОД за две недели вместо полугодаNVIDIA представила эталонную архитектуру DSX Pod — модульного контейнерного ИИ ЦОД, оснащаемого семью стойками Vera Rubin NVL72, а также необходимым для работы сетевым, охлаждающим и электротехническим оборудованием. Компания утверждает, что такая архитектура позволяет сократить время развёртывания ЦОД на заранее подготовленной площадке примерно с шести месяцев до двух недель, сообщает Datacenter Knowledge. Анонсированное в ходе мероприятия GTC Berlin модульное решение рассчитано на организации, которым требуется быстро ввести в эксплуатацию большие вычислительные мощности без длительного планирования, строительства и значительных трудозатрат, характерных для реализации обычных ИИ-проектов. NVIDIA заявила, что сотрудничает с 17 партнёрами, включая Bull, Dell Technologies, HPE, Lenovo, Eaton, Schneider Electric и Vertiv. Они начнут поставлять варианты решений на основе DSX Pod в начале 2027 года. По словам представителя NVIDIA, речь идёт о полностью собранном и протестированном контейнерном решении со стандартизированным вводом питания на 800 В постоянного тока (DC) и заранее смонтированными трубопроводами. Это строительный блок для будущих ИИ-фабрик. NVIDIA сообщает, что сама компания разрабатывает и проверяет эталонную архитектуру, а партнёры производят контейнеры, интегрируют оборудование, адаптируют системы электроснабжения и жидкостного охлаждения, а также устанавливают и обслуживают готовые комплексы. Речь идёт не об универсальном готовом продукте NVIDIA, а о проектной основе для решений разных вендоров. 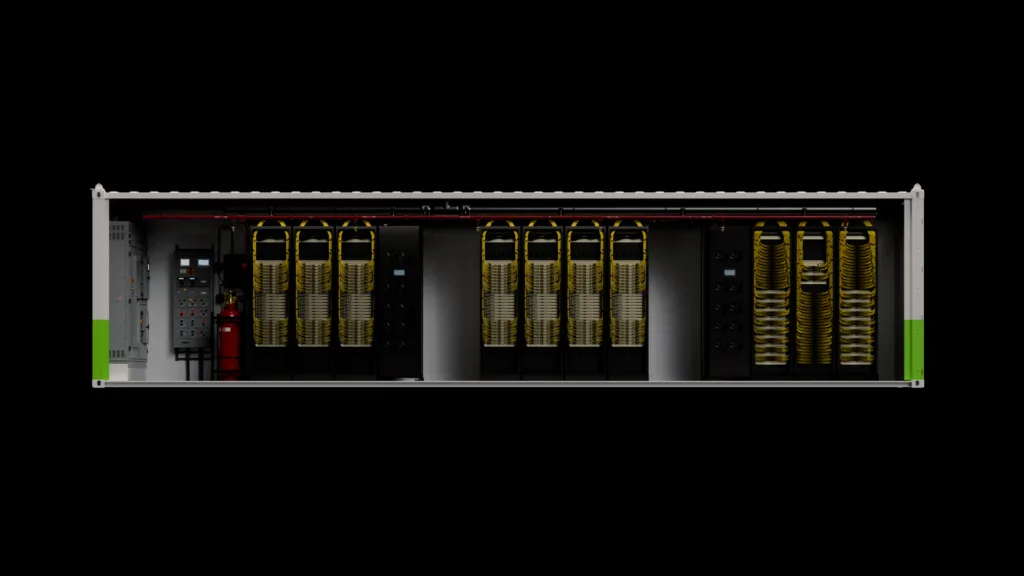 По мнению экспертов IDC, DSX Pod подходит для трёх сценариев развёртывания. Его можно использовать в суверенных проектах, требующих физической изоляции оборудования, в небольших ИИ-проектах для выполнения специализированных задач, а также для периферийных ИИ-вычислений — там, где необходимы комплексные решения для ускоренных вычислений «под ключ». Компания также представила программное обеспечение и механизмы безопасности для масштабных ИИ-проектов. В частности, была представлена эталонная архитектура OpenShell Reference Architecture, призванная помочь организациям управлять ИИ-агентами. Она позволяет определять, к каким ресурсам могут обращаться агенты, отслеживать их активность и принудительно обеспечивать соблюдение заданных политик при выявлении небезопасного поведения. В компании рассказали, что архитектура объединяет инфраструктуру NVIDIA Vera Rubin NVL72 для обучения и инференса с системами на базе процессоров NVIDIA Vera, которые обеспечивают работу и управление средой выполнения ИИ-агентов. Между этими системами располагаются DPU BlueField, выполняющие функции изолированного средства контроля безопасности. Последние анализируют сетевой трафик и позволяют обновлять политики безопасности, в том числе отключая агента при выявлении его небезопасного поведения. По данным NVIDIA, среди компаний, использующих OpenShell Reference Architecture для повышения безопасности при работе с ИИ-агентами, — Anthropic, AWS, Google Cloud, Meta✴, Microsoft, OpenAI и Perplexity.
23.10.2026 [13:01], Павел Котов
Казахстан расширит мощности ИИ ЦОД на чипах NVIDIAКазахстан продолжает наращивать свою вычислительную базу, планируя развёртывание инфраструктуры на архитектуре NVIDIA Vera Rubin. Движущей силой на данном этапе роста выступают компании, изначально ориентированные на отрасль искусственного интеллекта. Казахстанская экосистема ИИ переходит от этапа планирования инфраструктуры к её практическому развёртыванию. Процесс охватывает весь арсенал технологий ИИ от проектирования инфраструктуры и моделей до конечных приложений. Firebird, построившая свою ИИ-фабрику в Армении, расширяет своё присутствие в Казахстане. Компания получила от властей США экспортную лицензию на поставку 45 тыс. Grace Blackwell — первый этап проекта реализуется совместно с «Казахтелекомом» в «Долине ЦОД»; коммерческий запуск намечен на III квартал 2027 года. На втором этапе планируется довести совокупную мощность инфраструктуры Firebird в Казахстане примерно до 500 МВт. Компания намерена создать подразделение Firebird Labs Kazakhstan для поддержки местных ИИ-стартапов, проведения исследований и развития кадрового потенциала. Для реализации проекта задействуют механизмы финансирования, обеспечения доступа к вычислительным ресурсам и научно-исследовательское партнёрство. 
Источник изображения: nvidia.com «Казахтелеком», крупнейший телекоммуникационный оператор в стране, уже развернул 400 ускорителей H200 и 480 B300 в Астане и Алматы. В следующем году компания планирует разместить более 1000 чипов в «Долине ЦОД» и ещё более 1000 чипов в составе платформы NVIDIA Vera Rubin в районе Экибастуза. Эта инфраструктура позволит выполнять широкий спектр задач и будет доступна для предприятий и разработчиков. Ранее Akashi Data Center рассказала о планах построить в Казахстане Tier IV ЦОД мощностью 100 МВт. В минувшем году стало известно о намерении запустить в стране самый мощный суперкомпьютер в Центральной Азии. С Россией обсуждается план прокладки интернет-кабеля по дну Каспийского моря.
22.10.2026 [23:03], Павел Котов
ASUS объявила о готовности поставлять системы на базе NVIDIA HGX Rubin NVL8ASUS объявила, что в IV квартале 2026 года будет готова выпустить новые стоечные серверы на платформе NVIDIA HGX Rubin NVL8. Они будут доступны в конфигурациях как частично, так и полностью укомплектованной стойки. Линейка включает модели XR R1I12B-M1BHFS (3U, гибридное охлаждение) и XR R1I12B-M1BLFS (2U, полностью жидкостное охлаждение). Система ASUS XR R1I12B-M1BHFS в формфакторе 3U сочетает систему прямого жидкостного охлаждения микросхем (D2C) для базовой платы NVIDIA HGX Rubin с восемью GPU и воздушное охлаждение для двух процессоров Intel Xeon 6. Модульная конструкция с воздушным охлаждением CPU на 50 % сокращает время технического обслуживания; поддержка накопителей форматов U.2 и E1.S обеспечивает гибкость при развёртывании системы. ASUS XR R1I12B-M1BLFS отличают формфактор 2U и полноценное жидкостное охлаждение — система имеет высокую тепловую эффективность, высокую вычислительную плотность и способствует улучшению PUE. Сертифицированная NVIDIA конструкция и архитектура без использования кабелей для соединения плат снижают сложность развёртывания системы. 
Источник изображения: servers.asus.com Формирование инфраструктуры для ИИ требует оптимизации вычислительных мощностей, систем питания, охлаждения и сопутствующей инженерной части. ASUS сочетает свой опыт с решением NVIDIA DSX Sim Blueprint — эталонным проектом системы моделирования и проверки инфраструктуры ЦОД в среде цифровых двойников — и помогает оптимизировать инфраструктуру для задач масштабной генерации токенов. Совместно с партнёрами по экосистеме производитель объединяет вычислительные ресурсы, сетевое оборудование, СХД, системы питания и охлаждения и инженерную инфраструктуру в единую среду цифрового двойника. Это помогает заказчикам оценивать конфигурации инфраструктуры, выявлять ограничения, оптимизировать производительность и энергоэффективность системы ещё до её развёртывания.
22.10.2026 [15:07], Павел Котов
Red Hat и NVIDIA расширили партнёрство для обеспечения безопасности ИИ-агентовRed Hat объявила о расширении сотрудничества с NVIDIA. Цель партнёрства — обеспечить клиентам безопасность ИИ-агентов, контроль доступа к ИИ-моделям и развёртывание рабочих нагрузок на инфраструктуре Vera Rubin, пишет SiliconANGLE. В центре внимания — решение Red Hat AI Factory with NVIDIA, которое объединяет средства управления средой выполнения агентов, ПО для инференса моделей и аппаратную поддержку в гибридных облачных средах. Red Hat работает над интеграцией эталонной архитектуры NVIDIA OpenShell в свои ИИ-платформы как встроенной функциональности. Предложенный подход направлен на устранение двух основных рисков: выхода ИИ-агентов за пределы установленных для них границ, а также их компрометации злоумышленниками — например, посредством внедрения вредоносных запросов или атак на цепочку поставок. Компании стремятся вынести механизмы контроля безопасности за пределы доступности ИИ-агентов, а в ряде случаев и за пределы ОС на хосте. OpenShell выступает в качестве песочницы — изолированной среды выполнения для ИИ-агентов. На более низком уровне работает система безопасности NVIDIA Sentry на базе DPU BlueField; для мониторинга рабочих нагрузок используется ПО DOCA Argus на отдельном устройстве. Argus анализирует определённые структуры памяти хоста, определяя, какие процессы запущены, с какими файлами производится работа, и какие используются сетевые соединения. При обнаружении угрозы система безопасности может инициировать применение политик BlueField, которые изолируют скомпрометированную рабочую нагрузку. Эта архитектура опирается на реализованную в Red Hat OpenShift 4.22 поддержку платформы BlueField-3. Она позволяет отделить рабочие нагрузки ИИ на CPU серверов от сетевых функций и сервисов безопасности, работающих на Arm-процессорах модулей BlueField. Таким образом, если злоумышленник скомпрометирует хост, элементы управления инфраструктурой останутся защищёнными. Sentry может изолировать скомпрометированный ИИ-агент за считанные миллисекунды. Перенос функций мониторинга и управления сетью на DPU снижает нагрузку на основные процессоры сервера, высвобождая ресурсы для выполнения ИИ-задач. 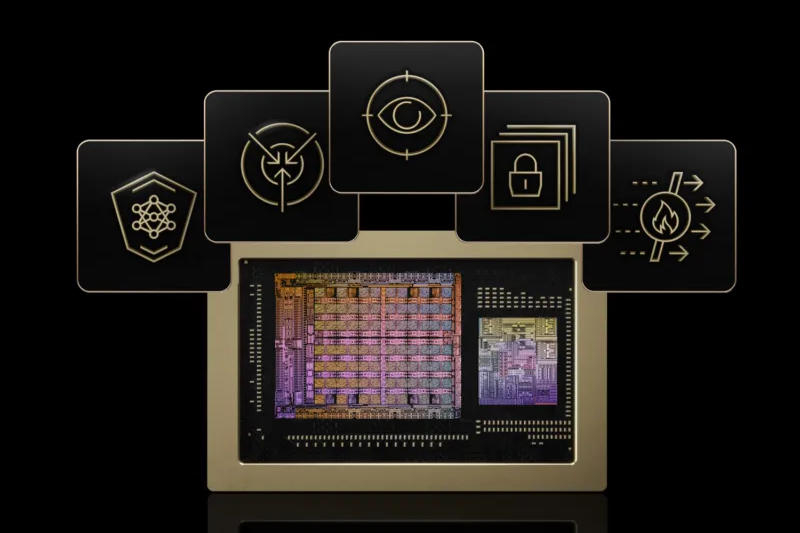
Источник изображения: NVIDIA Партнёрство также связано с вопросами инфраструктуры моделей, необходимых агентам для принятия решения и выполнения действий. Эталонный проект включает средства контроля доступа в рамках схемы «модель как услуга» (Model-as-a-Service) и ИИ-шлюз с технологиями инференса, такими как vLLM, llm-d, NVIDIA Dynamo и микросервисы NVIDIA NIM. Основанное на NVIDIA Inference Hub решение поддерживает самостоятельный выбор моделей пользователями, возможности задавать политики доступа, ограничивать частоту запросов и разграничивать возможности по подписке. Функции управления доступом и выполнения моделей разделены — это даёт клиентам возможность контролировать квоты, распределять затраты и поддерживать производительность в гибридных средах. Компании объявили о совместной поддержке моделей NVIDIA Nemotron, в том числе Nemotron 3.5 Super VL, в среде vLLM. В Red Hat отметили механизмы квантования и спекулятивного декодирования, позволяющие снижать задержку при запуске моделей без потери точности. Версия Red Hat Enterprise Linux for NVIDIA теперь поддерживает процессоры Vera и готова к работе с платформой Vera Rubin. Партнёры стремятся обеспечить совместимость ОС и платформы к моменту выхода нового оборудования. В RHEL for NVIDIA 26.03 для поддержки новой платформы внесены изменения в набор базовых пакетов; при этом сохранены стандартное пользовательское окружение и средства безопасности, включая SELinux. Когда поддержка оборудования будет включена в основное ядро Linux, клиенты смогут перейти на стандартную версию RHEL без переустановки системы. Сценарии использования, эталонные решения и функции работы с агентами доступны у партнёров, в том числе Cisco, Dell и Lenovo; продолжается работа по нативной интеграции OpenShell.
22.10.2026 [00:36], Владимир Мироненко
Google Cloud и NVIDIA запустят в ноябре инстансы на базе Vera Rubin NVL72Google Cloud и NVIDIA объявили, что в следующем месяце в Европе станут общедоступны инстансы Google Cloud A5X на базе систем NVIDIA Vera Rubin NVL72. Они предоставят клиентам комплексную платформу для обучения моделей, инференса и масштабного обучения с подкреплением. A5X интегрирует архитектуру Vera Rubin в систему Google Cloud AI Hypercomputer, объединяя вычислительные мощности, сетевые ресурсы и системы хранения данных для поддержки обучения на основе опыта. A5X используют системы NVIDIA Vera Rubin NVL72, сетевые адаптеры NVIDIA ConnectX-9 SuperNIC, сеть Virgo Network и передовую технологию жидкостного охлаждения четвертого поколения от Google Cloud. Сообщается, что Google Cloud планирует расширить инфраструктуру на базе архитектуры Vera Rubin, доведя количество ускорителей Rubin до 960 тыс. единиц, размещённых на различных площадках. По мере развёртывания агентских систем компаниям необходимо обеспечивать защиту проприетарных моделей и конфиденциальных данных, лежащих в основе этих систем, даже при использовании инфраструктуры сторонней организации. Google Cloud станет одним из первых облачных провайдеров, предлагающих NVIDIA Confidential Computing в масштабе стойки на bare-metal-инстансах, таких как A4X Max на базе NVIDIA GB300 NVL72. 
Источник изображения: NVIDIA Кроме того, Google Cloud делает конфиденциальные вычисления (Confidential Computing) общедоступными на виртуальных машинах G4 на базе ускорителей NVIDIA RTX PRO 6000 Blackwell Server Edition, предлагая гибкую платформу для конфиденциального инференса и тонкой настройки. Клиенты, включая Vertebrae, Polaris Cloud и Confidential Core AI, используют ВМ Confidential G4 для обеспечения конфиденциальности разговоров, проверяемой работы агентов и корпоративного ИИ, управляемого в рамках заданных политик. Google Cloud и NVIDIA также изучают возможности комплекса технологий NVIDIA DSX MaxLPS для инфраструктуры на базе Vera Rubin, чтобы оптимизировать производительность на Вт и расширить возможности в рамках доступного бюджета электропитания ЦОД.
21.10.2026 [21:22], Руслан Авдеев
Десятки тысяч ускорителей NVIDIA простаивают в суперкластере Meta✴, ожидая отказа рабочих чиповБолее 11 % ИИ-ускорителей в суперкластере Meta✴ Prometheus в Нью-Олбани (New Albany, штат Огайо) либо уже вышли из строя, либо простаивают. Последние ожидают, когда перестанет функционировать ещё один из уже активных чипов, сообщает The Register со ссылкой на информацию самой компании. Такой резерв ускорителей — лишь одна из мер, принимаемых гиперскейлером для обеспечения бесперебойного обучения ИИ-моделей. Prometheus представляет собой один из крупнейших вычислительных проектов Meta✴, оснащённый стоечными системами Grace Blackwell и в будущем Vera Rubin. Meta✴ рассчитывает масштабировать комплекс до 1 ГВт с использованием порядка миллиона ускорителей. При этом увеличение количества ускорителей обычно ведёт к росту числа проблем. В узле с восемью ускорителями вероятность отказа невелика, но в кластере из 100 тыс. ускорителей отказы неизбежны. Масштаб проекта Meta✴ значительно больше, причём распределённые вычисления осуществляются сразу в нескольких ЦОД. Поэтому поддержание бесперебойной работы инфраструктуры до следующей контрольной точки обучения — непростая задача. В корпоративном блоге Meta✴ рассказала о мерах, принимаемых для защиты процесса обучения моделей от аппаратных сбоев. На первом этапе развёртывания Prometheus в Нью-Олбани происходило порядка 1 тыс. прерываний вычислений в сутки на каждые 8 тыс. ускорителей. Прерывания не обязательно означают отказ ускорителя. Речь идёт практически о любом сбое, в результате которого процесс приходится останавливать и «откатываться» к последней успешно сохранённой контрольной точке. 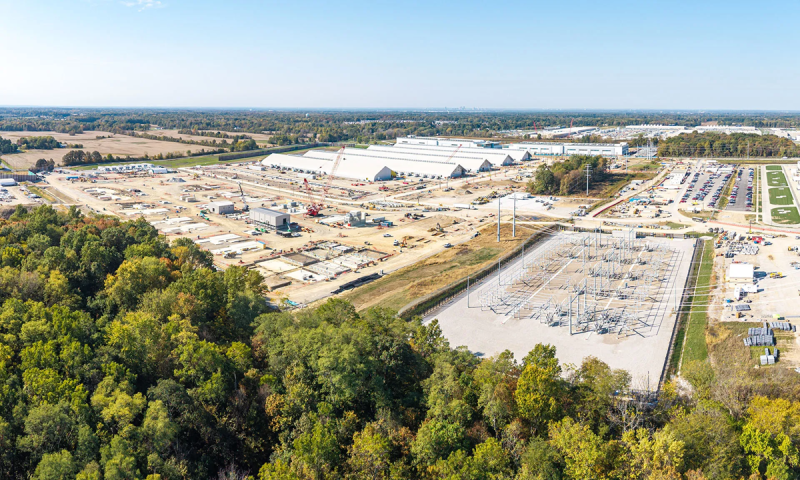
Источник изображения: Meta✴ По данным Meta✴, за последовавший год компания сократила количество таких прерываний на 99 %, до порядка 11 на каждые 8 тыс. ускорителей. Один из способов — постоянно держать часть из них в резерве. Кластер работает на основе комбинации систем GB200 и GB300, каждая из которых включает 72 ускорителя в одном домене NVLink. В каждый отдельный момент работают только 64 из них, а оставшиеся восемь находятся в «горячем резерве». Такую схему внедрили, поскольку даже отказ одного ускорителя мог прервать процесс обучения во всей стойке. Теперь в случае отказа сразу задействуется резервный экземпляр, что позволяет сэкономить время. Прерывание вычислений по-прежнему происходит, но затраты времени на восстановление значительно сокращаются. Чтобы уменьшить последствия подобных сбоев, Meta✴ использует принцип параллелизма данных, при котором в одном кластере одновременно работают несколько копий модели. В случае сбоя неисправность локализуется в одной из копий, а остальные продолжают обучение, повторно выполняя соответствующий этап. В результате совокупная производительность лишь ненадолго снижается, а обучение не приходится начинать с нуля. Распределённая архитектура сохранения контрольных точек тем временем обеспечивает запись состояния модели в многоуровневую систему хранения. 
Источник изображения: Meta✴ По данным Meta✴, одной из сложнейших задач стало обеспечение с помощью NVLink работы 72 ускорителей как единого целого. В системах H100 и H200 использовалось всего по восемь чипов на домен, поэтому соединения были значительно короче, а их количество — меньше. Для Blackwell размер одного домена увеличился в девять раз — при наличии более 600 тыс. соединений даже небольшое падение качества сигнала приводит к частым циклам восстановления соединений NVLink. Для решения проблемы пришлось внедрить систему непрерывного телеметрического мониторинга, а также проводить стресс-тесты уровня L11, позволяющие выявлять ненадёжные соединения до начала эксплуатации систем. Ещё одна проблема связана с обеспечением электропитания. Одновременное включение и выключение десятков тысяч ускорителей при запуске и завершении задач может вызывать скачки энергопотребления, перегружающие оборудование, отвечающее за электропитание. Meta✴ даже пришлось добавить в PyTorch опцию PYTORCH_NO_POWERPLANT_BLOWUP, которая загружает ускорители бессмысленной работой в моменты простоя. По данным Meta✴, меры по повышению стабильности и надёжности кластера позволили добиться доли полезной вычислительной работы (так называемого goodput) на уровне более 85 % при предварительном обучении и более 90 % при обучении с подкреплением последней модели Muse Wonder. На этом амбиции Meta✴ не заканчиваются: компания по-прежнему стремится создать инфраструктуру на миллион ускорителей. Частоту прерываний предполагается снизить до двух в сутки на каждые 8 тыс. ускорителей. Также компания рассчитывает обеспечить среднее время между прерываниями на уровне 100 тыс. GPU-часов.
19.10.2026 [10:32], Сергей Карасёв
Navitas и NVIDIA создали плату питания мощностью 24 кВт для ИИ ЦОДКомпания Navitas Semiconductor в партнёрстве с NVIDIA разработала новую плату питания мощностью 24 кВт для поддержки экосистемы NVIDIA MGX и развития архитектуры питания 800 В DC в современных дата-центрах, ориентированных на нагрузки ИИ и НРС. Решение обеспечивает преобразование напряжения с 800 В постоянного тока напрямую в 12 В постоянного тока за один этап, исключая необходимость в промежуточном силовом каскаде на 50 В. Это повышает общую эффективность системы и сокращает занимаемое пространство, что важно в условиях высокой плотности компоновки оборудования в ИИ ЦОД. В плате питания применяются силовые компоненты Navitas GaNFast на основе нитрида галлия (GaN). В частности, задействованы 16 транзисторов GaNFast NV6034 (650 В, 18 мОм) на первичной стороне, которые сконфигурированы в многослойной полумостовой топологии. Применен корпус DFN 8 × 8 мм с двухсторонним охлаждением, благодаря чему снижается тепловое сопротивление. Пиковая эффективность достигает 97 % при полной нагрузке, тогда как удельная мощность превышает 2000 Вт/дюйм3. 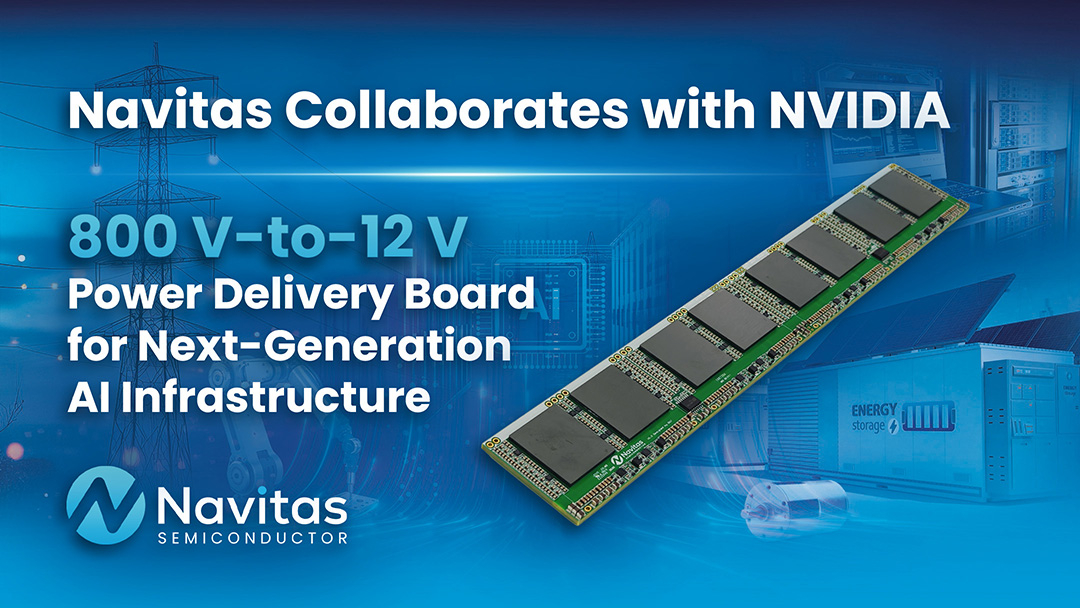
Источник изображения: Navitas Изделие выполнено в новейшем форм-факторе NVIDIA 400 × 60 мм. Плата питания может быть интегрирована на вычислительную материнскую плату максимально близко к ИИ-ускорителям (xPU): это даёт возможность минимизировать потери и удовлетворить высокие требования по энергопотреблению. В этом случае 12 В постоянного тока подаётся непосредственно на модуль регулятора напряжения (VRM), питающий xPU. В целом, предложенная архитектура питания повышает эффективность и надёжность систем, одновременно снижая потери мощности и общую сложность при экономии места. Изделие создано в рамках программы трансформации Navitas 2.0, цель которой заключается в том, чтобы ускорить замену устаревших кремниевых компонентов на высокомощные технологии GaN и SiC (карбид кремния) следующего поколения во всей инфраструктуре ИИ.
19.10.2026 [09:32], Владимир Мироненко
Восемь на одного: Meta✴ представила сетевую архитектуру Flattened Planar Fabric для ИИ-инфраструктурыMeta✴ представила ИИ-архитектуру Flattened Planar Fabric (FPF), созданную для масштабирования обширной ИИ-инфраструктуры и поддержки вычислительных нагрузок нового поколения. В архитектуре FPF каждый GPU подключается посредством восьми независимых каналов по 100 Гбит/с к восьми разным коммутаторам. 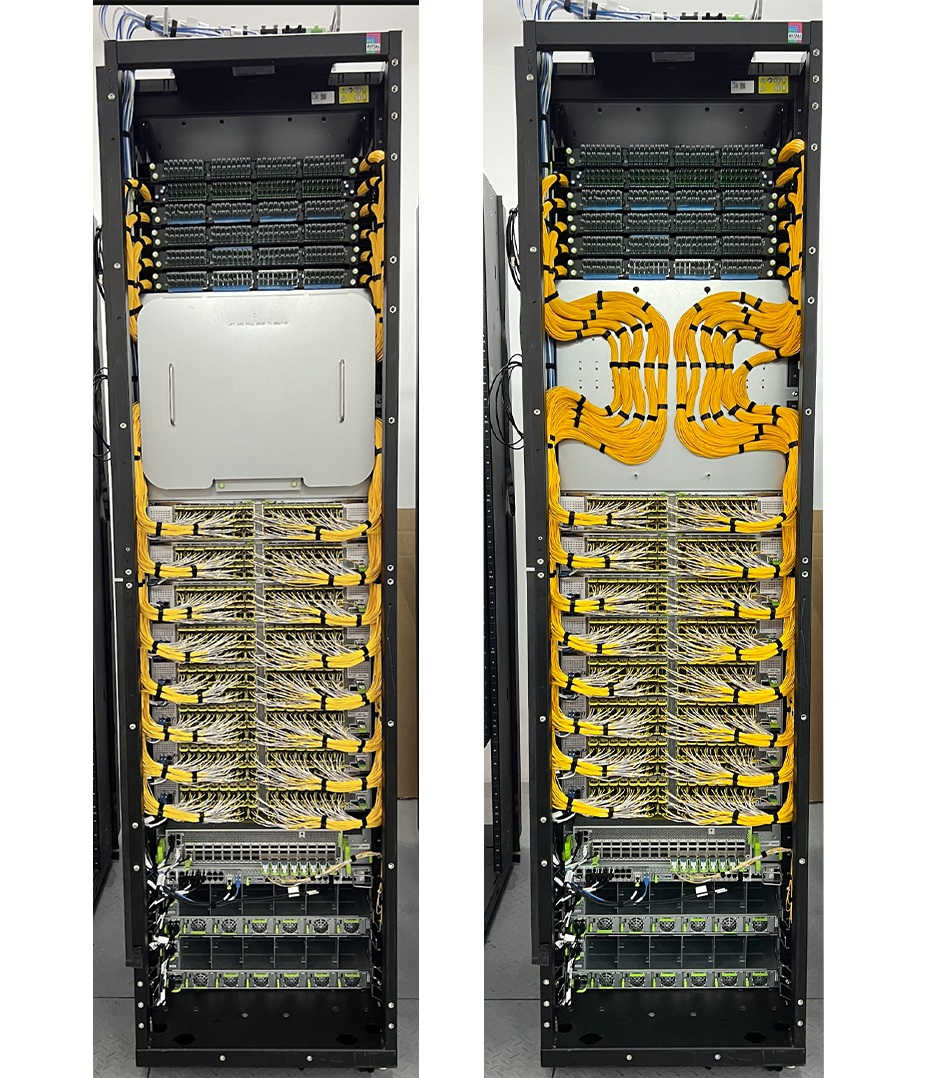
Источник изображений: Meta✴ Такой подход приходит на смену традиционной архитектуре единичных восходящих каналов (uplink), обеспечивая четыре ключевых преимущества:
Оборудование включает коммутаторы IceCube с пропускной способностью 102,4 Тбит/с в стойке IcePack (ORv3-HPRv1) с жидкостным охлаждением. Внутри каждой стойки размещаются модули коммутации IceCube — устройства с пропускной способностью 102,4 Тбит/с, обеспечивающие неблокирующую коммутацию для 128 портов по 800 Гбит/с каждый. Модули IceCube представлены в двух вариантах: на базе специализированных интегральных схем (ASIC) Broadcom Tomahawk6C или NVIDIA Spectrum-6. 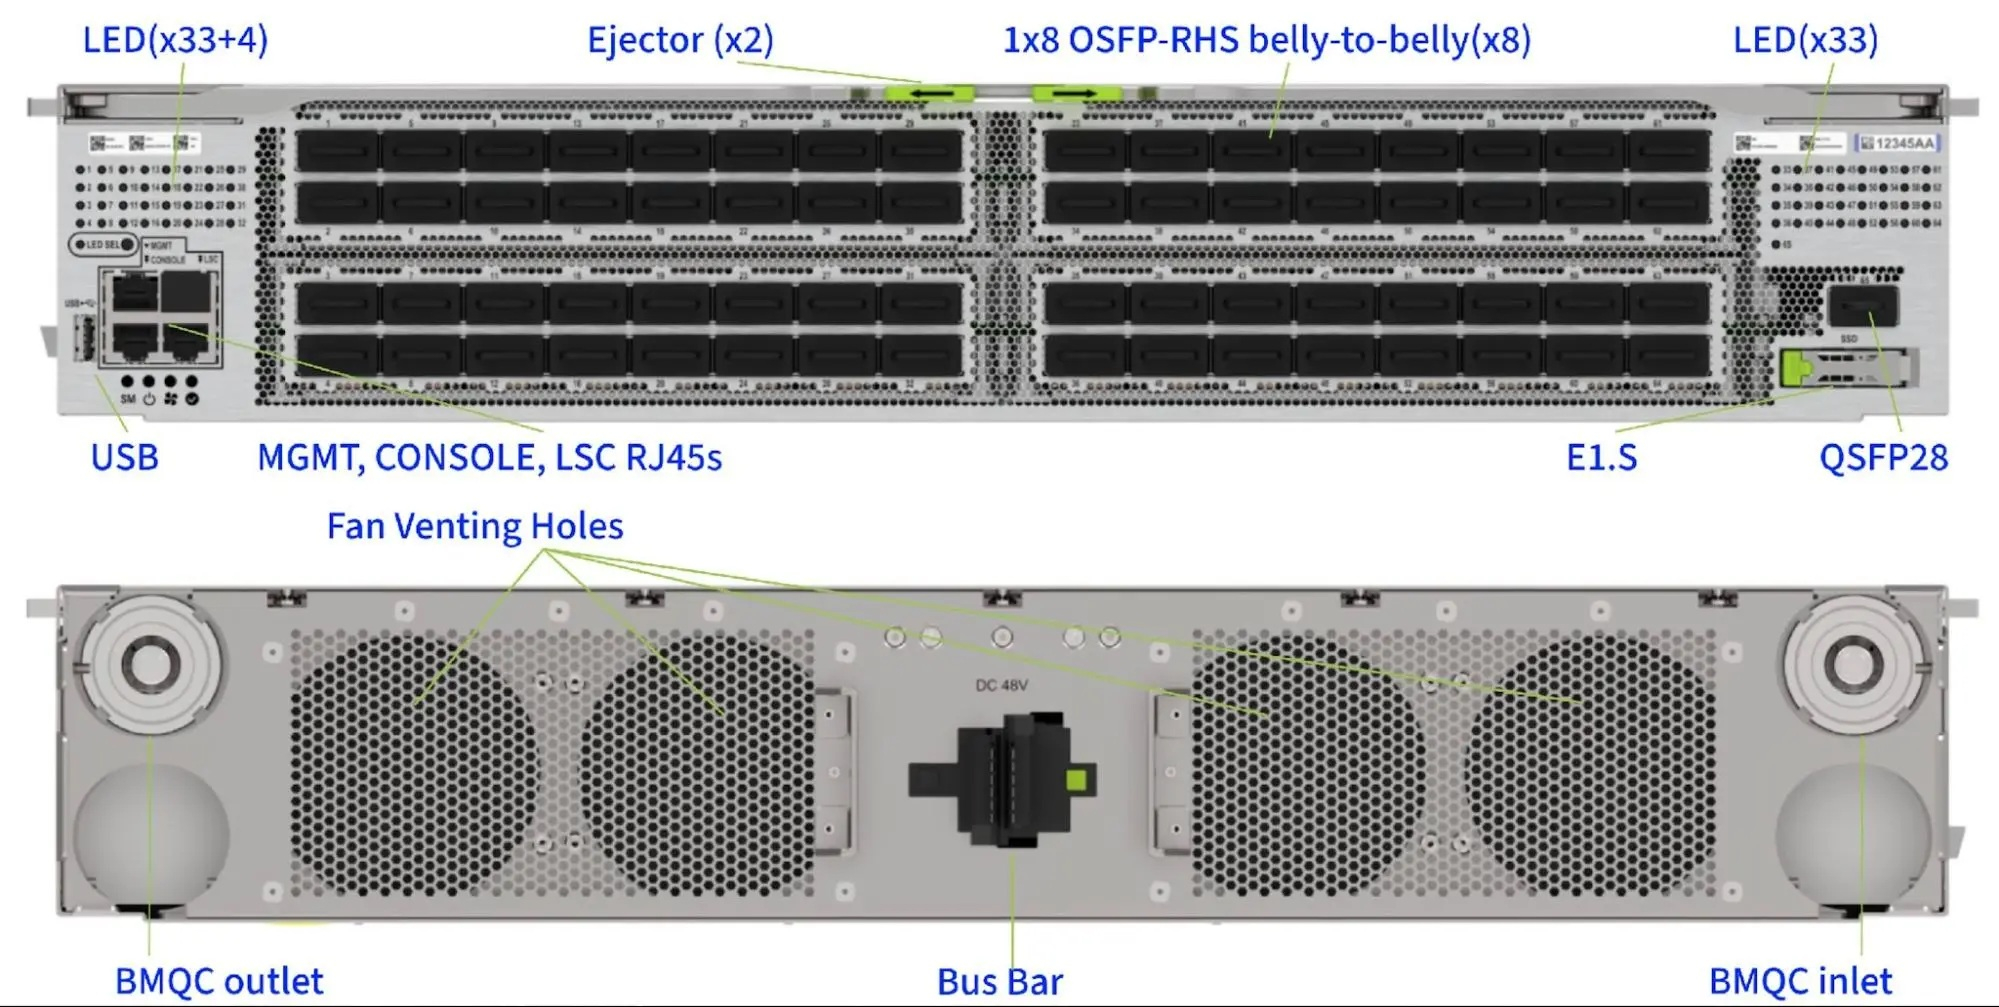
IceCube Оба решения работают под управлением открытой NOS FBOSS от Meta✴, которая использует интерфейс абстракции коммутаторов OCP SAI (Switch Abstraction Interface). Архитектура Open Switch Platform Architecture (OSPA) обращается к функциям управления, включая последовательность включения питания, обнаружение компонентов, терморегулирование, восстановление микропрограммного обеспечения и диагностика. 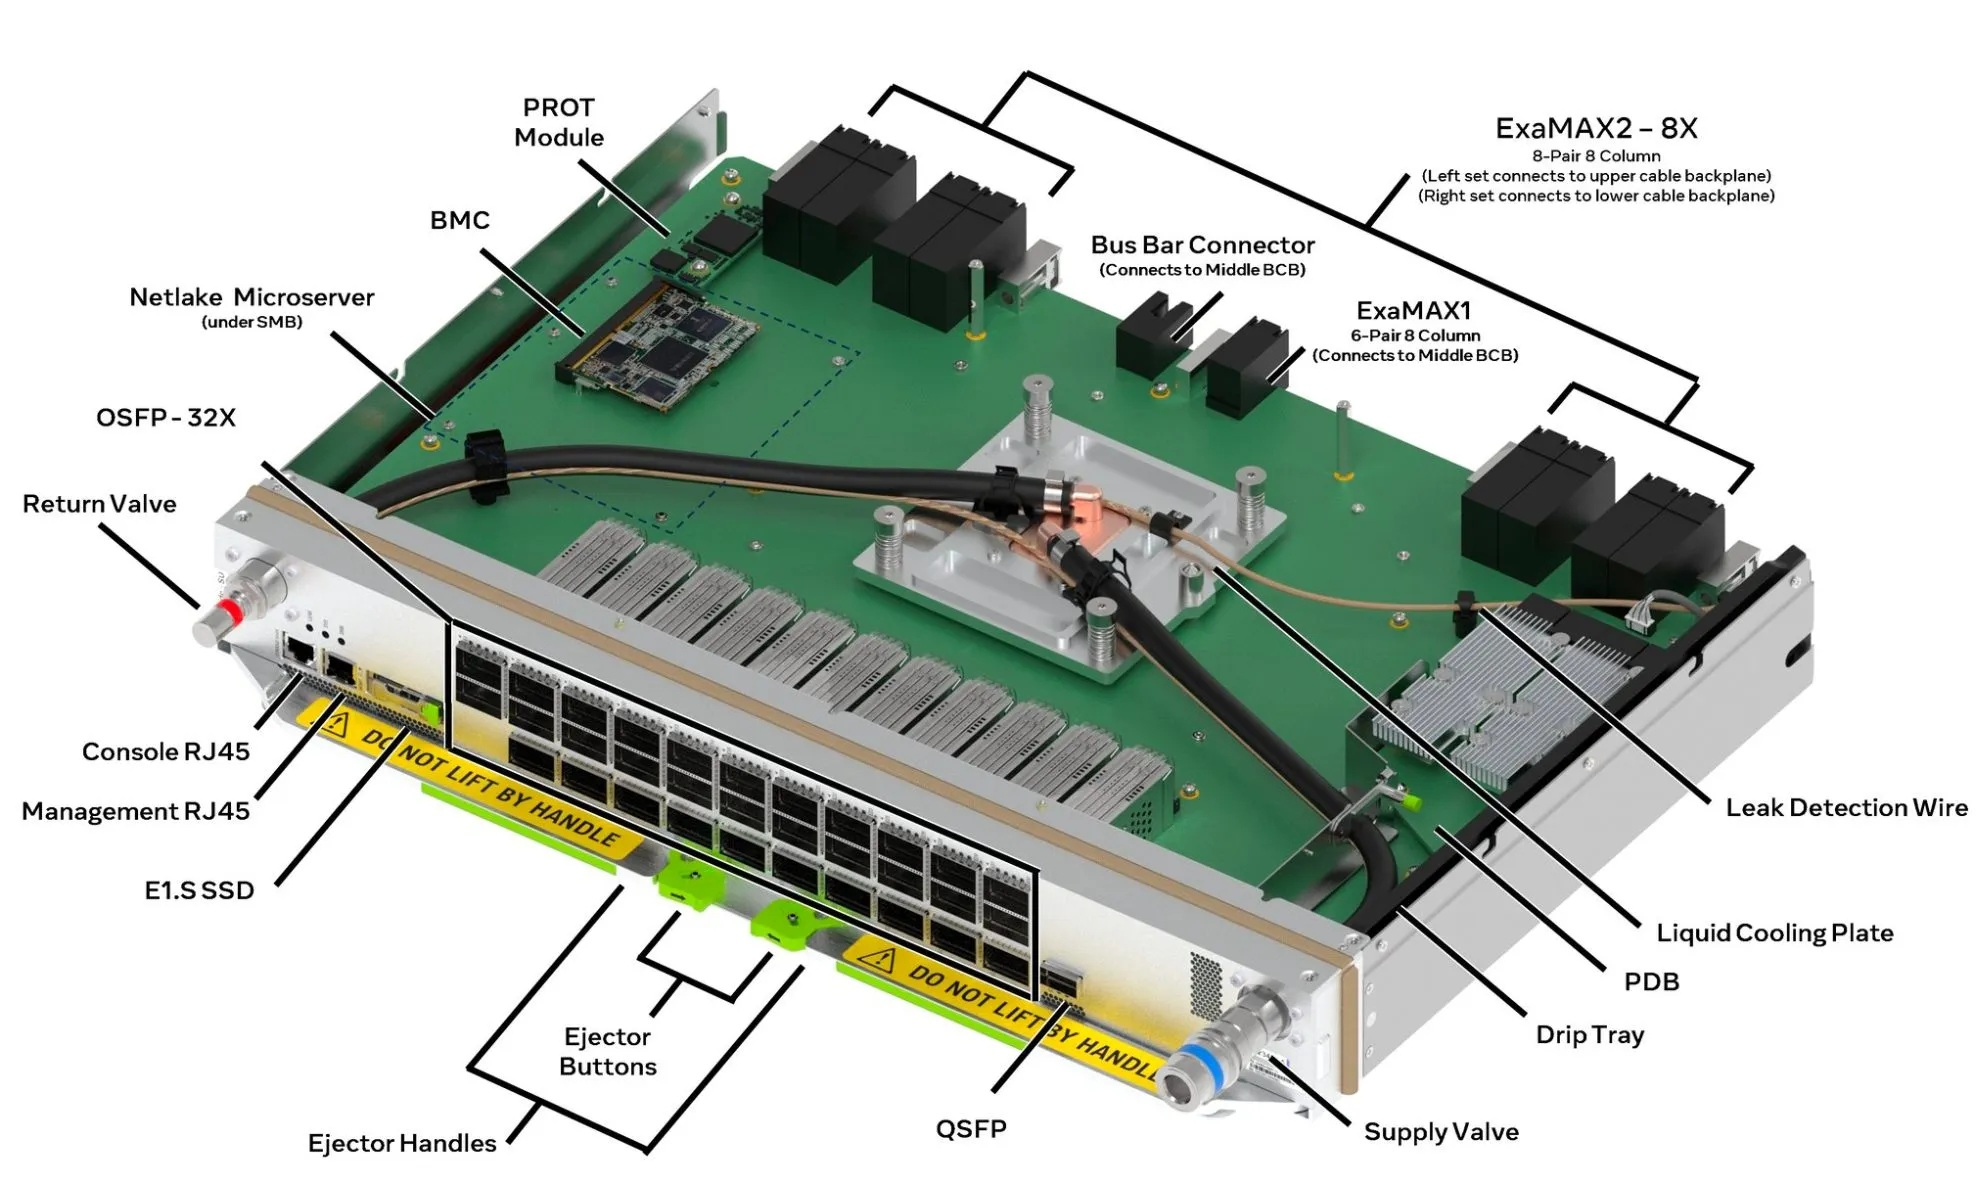
Tahan FPF переносит управление платформой преимущественно на сторону хоста, сохраняя при этом традиционный BMC для функций контроля и восстановления. FPGA-мосты I/O, подключённые через PCIe, объединяют периферийные интерфейсы, а модель учёта аппаратных средств, организованная в виде иерархической структуры, предоставляет ПО согласованный способ перечисления компонентов. Предложение также охватывает автономное управление питанием, обнаружение утечек и резервные образы прошивки. Следует отметить, что это проектные требования, находящиеся на стадии рассмотрения, а не доказательство функциональной совместимости между всеми решениями участвующих вендоров. 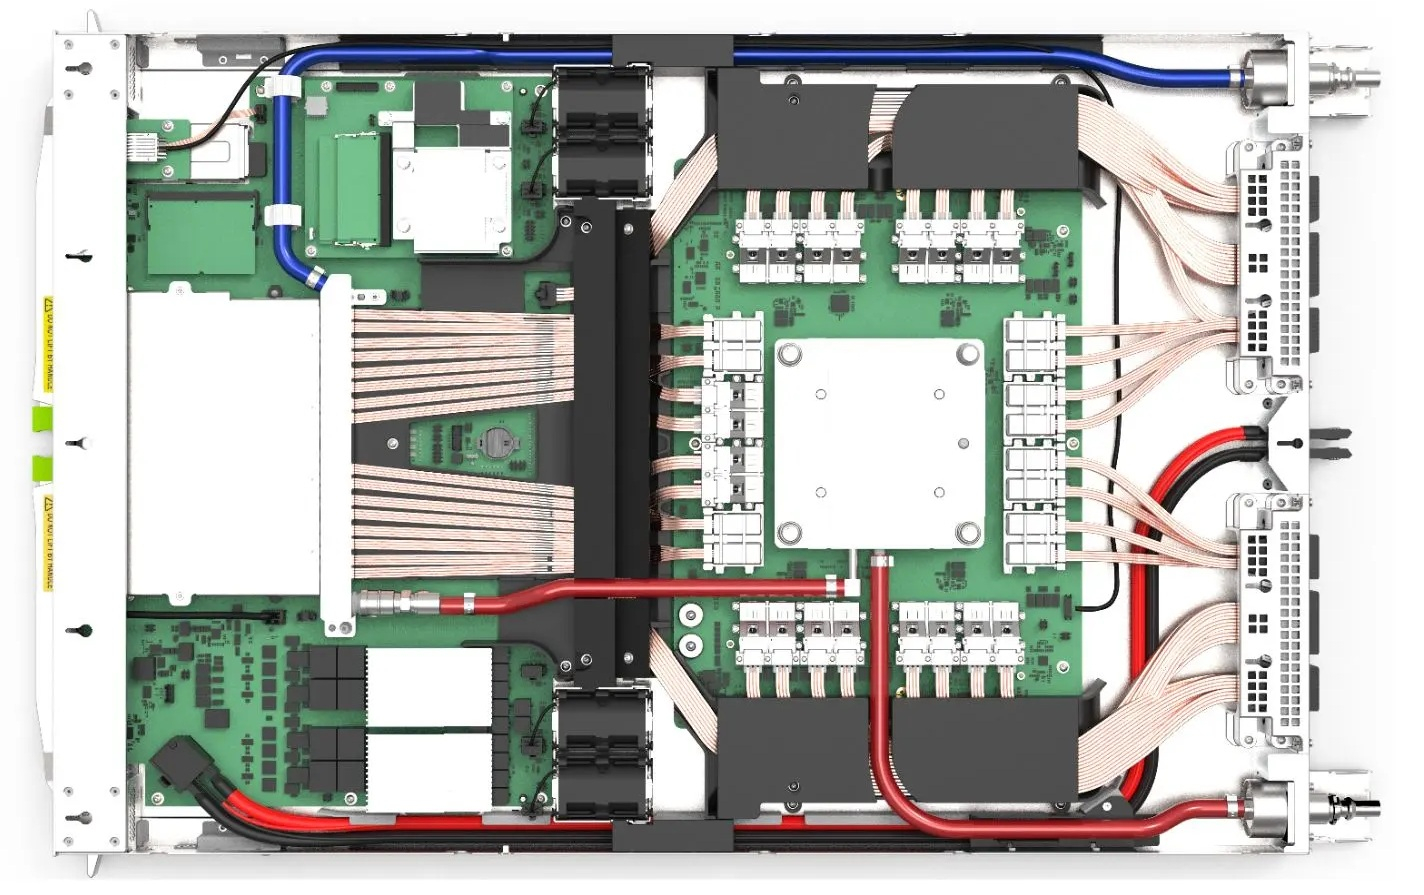
ESUN для MTIA 300 Также Meta✴ сообщила подробности о коммутаторе Tahan Ethernet Scale Up для MTIA 300, показала прототип стойки на 72 ускорителя и анонсировала открытую реализацию MetaRoCE. Эти элементы отражают разные стадии разработки: сейчас Tahan использует режим lossless RoCE, в будущих аппаратных решениях для вертикального масштабирования планируется переход на ESUN, а версия OSPA 1.0.0 пока остаётся на рассмотрении в OCP. 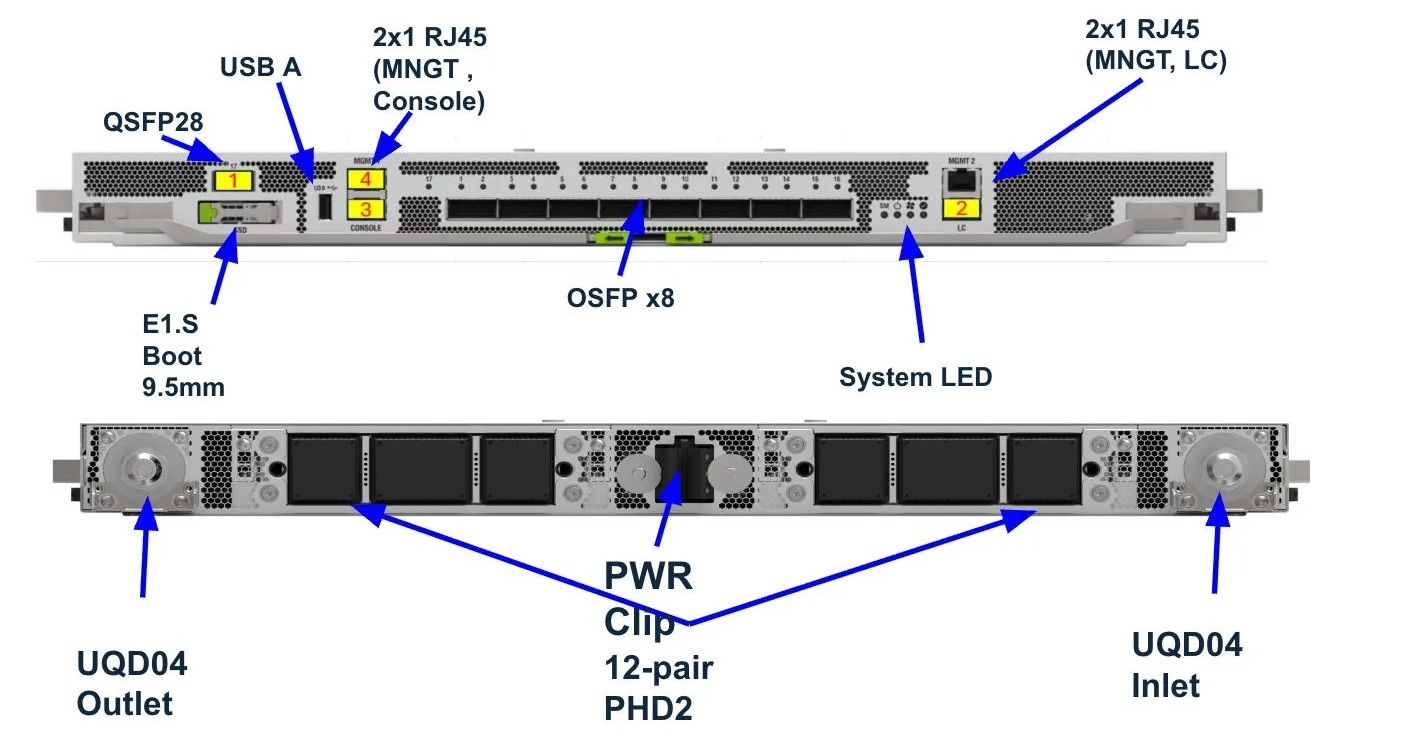
ESUN для MTIA 300 Tahan построен на базе ASIC Tomahawk 5 с пропускной способностью 51,2 Тбит/с (64 × 800G). Четыре коммутатора Tahan соединяют 16 ускорителей в неблокирующей топологии. Компания отметила, что Tahan использует тот же самый lossless RoCE (маршрутизируемый IPv6, PFC и QoS, настроенный для ИИ), объединяя scale-up и scale-out сети под управлением FBOSS. Параллельно компания работает над CXL-фабриками масштаба целого ЦОД. |
|

