
Материалы по тегу: ix
|
21.10.2026 [16:27], Владимир Мироненко
Власти России собираются упростить импорт IT-оборудования для ЦОДВ правительстве сейчас ведётся работа по корректировке приказа Минпромторга, которым с мая были исключены из перечня оборудования, разрешённого для параллельного импорта, изделия около двух десятков мировых компьютерных брендов. Особенно сильно ограничения отразились на поставках для ЦОД, из-за чего выросли затраты их операторов, сообщил Forbes. По данным источников Forbes, в августе — сентябре в рабочей группе «Инфраструктура и центры обработки данных (ЦОДы) для ИИ» правительственной подкомиссии по ИИ обсуждался вопрос упрощения импорта вычислительной техники. С целью решения проблемы дефицита GPU и высокой стоимости оборудования для ИИ группа готовит изменения в приказ Минпромторга, чтобы свести к минимуму ограничения на ввоз IT-оборудования. По словам источников, планируют «откатить этот приказ», поскольку у заказчиков в России возникли сложности с закупками памяти, в частности, южнокорейских брендов Samsung и SK Hynix, которые были исключены из параллельного импорта с мая. 
Источник изображения: Domaintechnik/unsplash.com В приказе Минпромторга были указаны вычислительные машины, поставляемые в виде систем (код ТН ВЭД 8471 49 000 0), а также запоминающие устройства (код ТН ВЭД 8471 70) товарных знаков Acer, Adata, AIC, Apacer, ASUS, AToS, Cisco, Compal, Fujitsu, HP, Hitachi, HPE, IBM, Inspur, Intel, Kingston, Samsung, Sandisk, Toshiba, Transcend, xFusion. Согласно разъяснению Минпромторга, речь идёт о серверном оборудовании и СХД этих брендов. В компании «Рустам Курмаев и партнёры» напомнили, что товары брендов, исключённых из параллельного импорта, по-прежнему можно ввозить с согласия правообладателя: «Без такого согласия ввоз становится нарушением прав на товарный знак, что грозит изъятием партии на таможне, конфискацией, компенсацией правообладателю и административной ответственностью». Однако вряд ли можно получить согласие у Samsung, которая в 2022 году приостановила поставки своей продукции в Россию, или у SK Hynix, закрывшей в 2024 году свой филиал в России по изучению конъюнктуры рынка и общественного мнения. Старший партнёр адвокатского бюро «Залесов, Тимофеев, Гусев и партнёры» Владимир Чикин отметил, что отечественные компании выпускают готовые серверы и СХД, но сопоставимого отечественного производства SSD, а также микросхем памяти DRAM, NAND и HBM сейчас нет. «Поэтому оборудование может быть произведено или собрано в России, но при этом использовать импортные накопители и микросхемы памяти», — говорит он. Решения российских производителей твердотельных накопителей также имеют ограничения по определённым форм-факторам и интерфейсам, добавил руководитель группы аппаратных проектов ГК Softline («Софтлайн Решения») Иван Афанасьев. «Судя по всему, прогнозируются массовые закупки комплектующих, а учитывая поднявшиеся цены — это попытка снизить нагрузку на близких государству игроков: “Яндекс”, VK и т.п., — полагает сооснователь «Моего офиса» Дмитрий Комиссаров. — Игроков, способных производить память, в России нет. SSD [производить] кто-то пытается, но масштабы точно не для “Яндекса”». Приказ Минпромторга вышел на фоне мирового кризиса на рынке памяти, а отечественные производители при этом зависят от импортных процессоров, памяти и контроллеров. В ситуации дефицита памяти по всему миру любое сужение каналов поставки усугубляет проблему, указывает инвестиционный аналитик Kama Flow Анна Лабунец, назвавшая предложение вывести Samsung и SK Hynix из-под действия приказа Минпромторга вполне логичным. По её словам, после атак БПЛА на дата-центры необходимость устранить ограничения на поставки становится ещё очевиднее: «Отрасль перешла от планового наращивания мощностей к аварийному восстановлению и резервированию. В таких условиях скорость поставки и наличие на складе — приоритет, а приказ затрудняет и то и другое».
18.10.2026 [23:00], Владимир Мироненко
SK hynix придумала энергоэффективные и компактные ядра H-TPU для сверхбыстрых SSD будущегоКомпания SK hynix представила архитектуру H-TPU (Hynix Transaction Processing Unit, не путать с Google TPU), разработанную для снижения нагрузки на универсальные процессорные ядра в будущих SSD-контроллерах. Ядра H-TPU предназначены исключительно для выполнения низкоуровневых и повторяющихся задач, включая обработку команд чтения и записи, управление метаданными и контроль буфера. Это разгрузит основной процессор, который продолжит отвечать за более сложные задачи, такие как управление политиками хранения данных, восстановление после ошибок и обработка исключительных ситуаций. H-TPU потребляют около 2,5 % энергии и занимают примерно 4 % площади кристалла по сравнению с универсальными CPU. SK hynix отметила, что процессоры в контроллерах SSD достигли своих пределов с точки зрения энергопотребления и занимаемой площади. В представленной компанией на Международной конференции по проектированию SoC (ISOCC 2026) презентации отмечено, что пропускная способность интерфейса PCIe удваивается с каждым новым поколением, тогда как тактовая частота и управляющие возможности CPU в составе контроллеров растут гораздо медленнее. 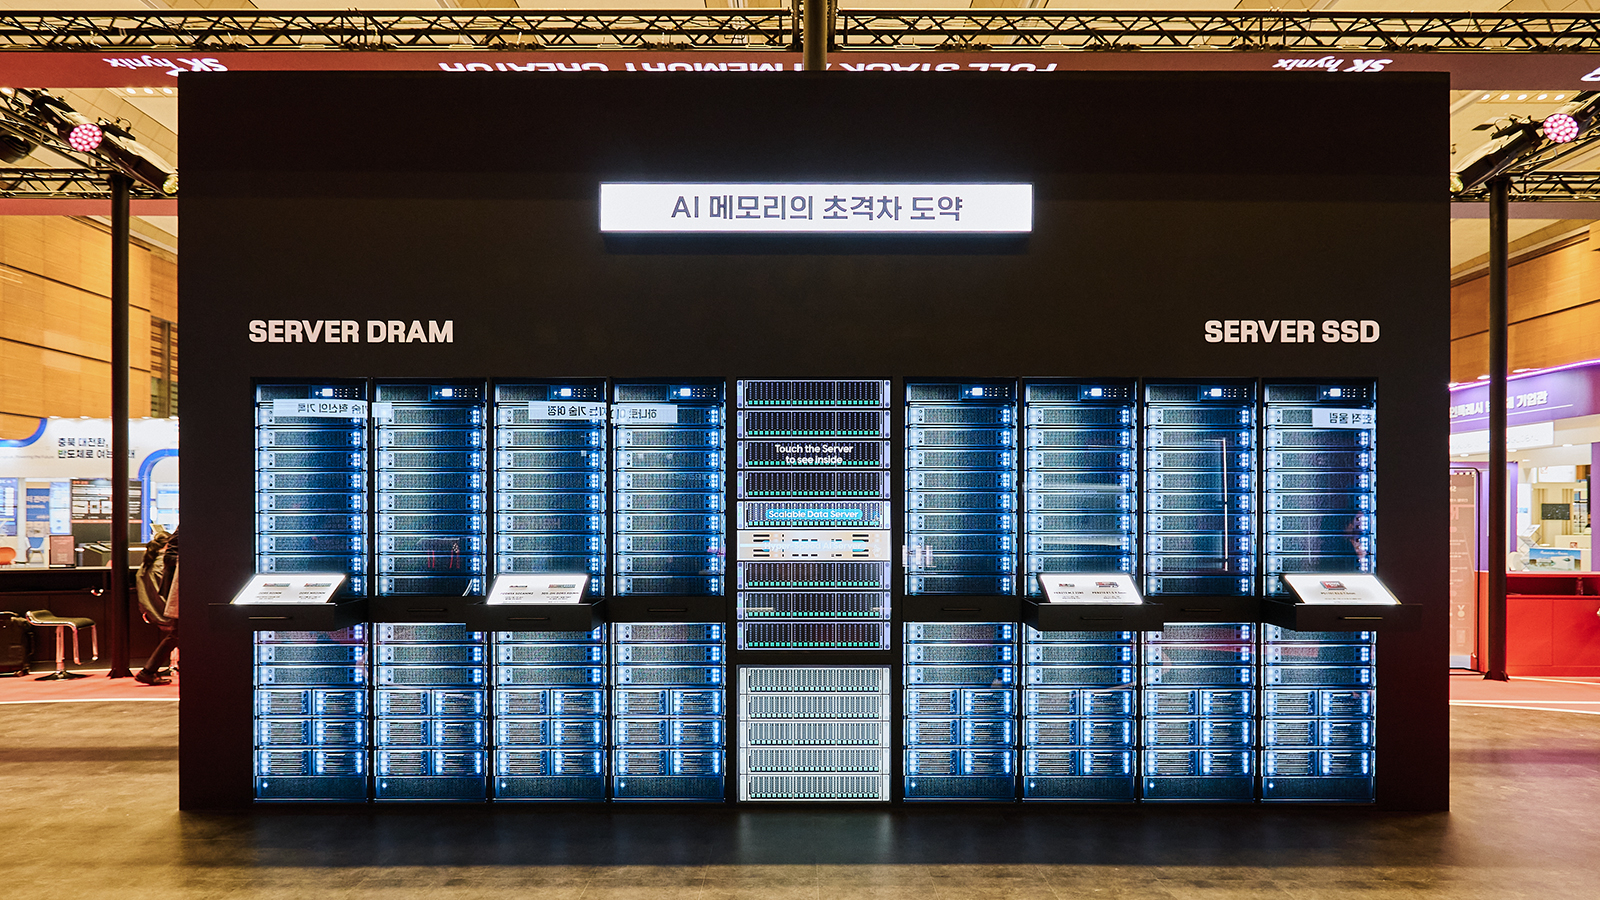
Источник изображений: SK hynix Эта проблема особенно остро стоит в сегменте SSD корпоративного класса. В условиях растущей конкуренции по показателю IOPS увеличение числа процессорных ядер в контроллерах стало общепринятой практикой, однако это привело к росту энергопотребления и увеличению площади кристалла. Например, контроллер Marvell Bravera SC6 с поддержкой PCIe 6.0, содержит 16 ядер: 12 ядер Cortex-R82, три ядра Cortex-M7 и одно ядро Cortex-M3. Предшественник Bravera SC5 (PCIe 5.0) имеет лишь 11 ядер. Архитектура H-TPU базируется на четырёхступенчатом конвейере с последовательным выполнением команд (in-order execution) и не поддерживает суперскалярность или внеочередное выполнение. H-TPU — программируемый процессор, специализирующийся на управлении потоками данных в SSD и обработке транзакций. H-TPU распределяет специфические для работы с данными операции между более чем 100 компактными вычислительными элементами. Каждый такой блок отвечает за выполнение одной конкретной задачи. Ядра, не задействованные в текущей операции I/O, переходят в режим минимального энергопотребления. 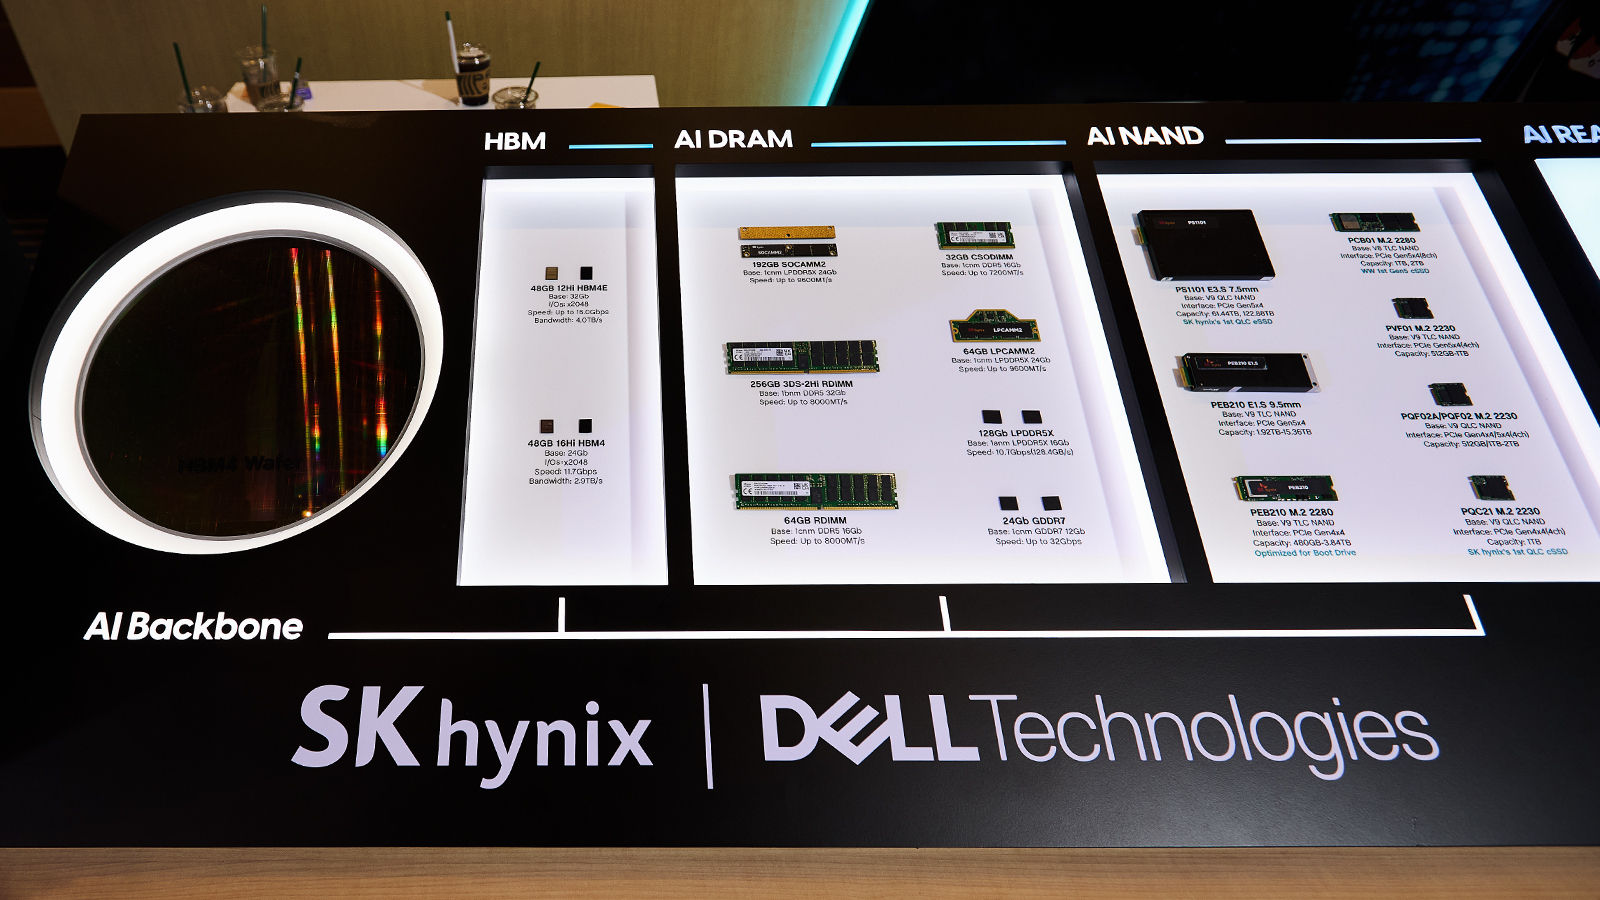 Преимущество такого подхода заключается не только в снижении энергопотребления контроллера. Перенос обработки команд на специализированные блоки высвобождает основные Arm-ядра для выполнения задач прошивки, которые с трудом поддаются распараллеливанию. Кроме того, это позволяет масштабировать контроллер для поддержки большего числа каналов NAND-памяти без увеличения размера или энергопотребления основной вычислительной подсистемы, пишет Blocks & Files. Подход сам по себе не является принципиально новым. Например, Phison в рамках концепции CoXProcessor объединил в контроллере X1 два ядра Arm Cortex-R5 и 32 «микроядра», каждое из которых предназначено для выполнения одной-двух конкретных задач. H-TPU от SK hynix развивает и масштабирует эту идею. В патенте, поданном компанией ещё в ноябре 2020 года, описывается архитектура, в которой CPU отвечает за управление (control plane), а множество небольших сопроцессоров формируют уровень I/O (I/O plane), отвечая за приём данных от хоста, работу с кешем, энергонезависимой памятью и адресами, образуя I/O-конвейер. 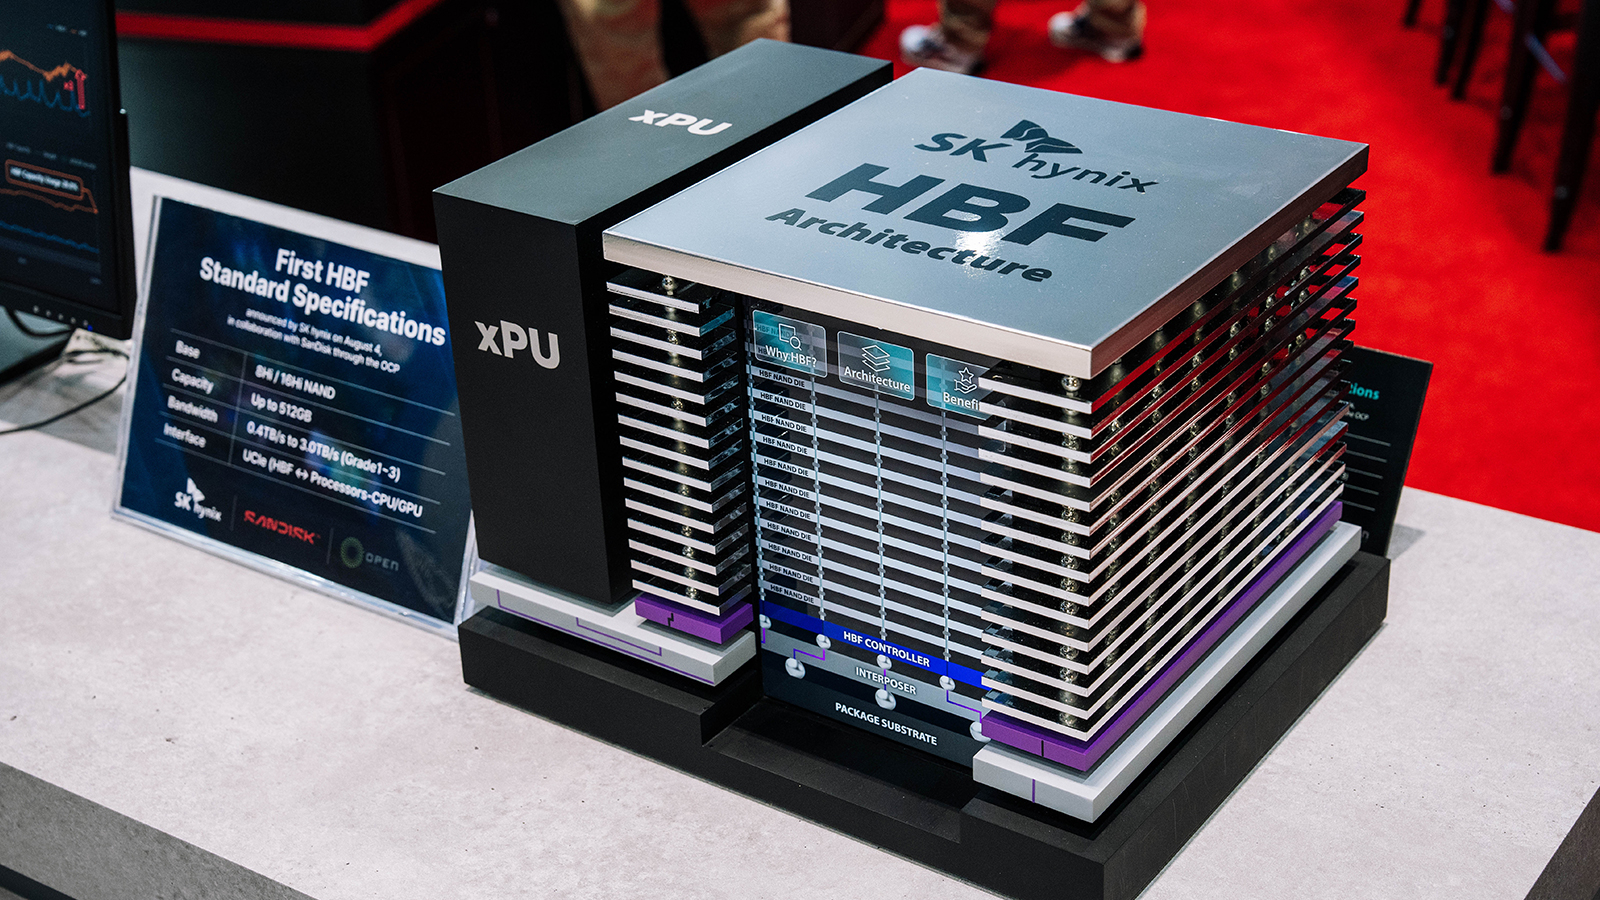 В дальнейшем компания планирует развивать аппаратную автоматизацию (HWA). В рамках концепции HWA простые, но трудоёмкие задачи по управлению хранилищем данных — обработка повторяющихся команд, поиск адресов, копирование информации во временные буферы и т.п. — полностью передаются специализированным аппаратным схемам, которые выполняют их автоматически для повышения предсказуемости времени завершения операций. В корпоративных SSD, где требуется высокий показатель IOPS, стабильность времени завершения операций I/O особенно критична. В свою очередь, CPU и H-TPU используются только для задач высокого уровня: например, для обработки исключительных ошибок или принятия критически важных управляющих решений. Также планируется использование H-TPU в рамках совместного с NVIDIA проекта Storage Next с целью уменьшения гранулярности доступа к NAND-памяти примерно до 512 байт (что меньше действующих стандартов), оптимизируя работу системы для ИИ-задач. H-TPU найдёт применение в контроллерах для устройств серии AIN. Кроме того, H-TPU предполагается интегрировать в память типа High Bandwidth Flash (HBF), выпуск которой намечен на следующий год.
14.10.2026 [18:07], Владимир Мироненко
Эскадрон ИИ-агентов шальных: d-Matrix анонсировала мегаваттные кластеры Squadron для инференсаd-Matrix анонсировала d-Matrix Squadron — вычислительный комплекс из многостоечных систем, обеспечивающий мощность порядка мегаватт для выполнения задач ИИ-инференса. По словам компании, благодаря вычислительной архитектуре d-Matrix, ориентированной на работу с памятью (memory-centric), кластеры Squadron идеально подходят для исследовательских лабораторий в сфере ИИ, корпораций и государственных организаций. Они оптимальны для приложений, критически чувствительных к задержкам, включая инструменты для написания кода, персональных ИИ-агентов, системы кибербезопасности и платформы для высокочастотного трейдинга (HFT). Система Squadron, разработанная в партнёрстве с компаниями Arista, Broadcom и Supermicro, уже задействована в дата-центре d-Matrix в Аризоне для внутренних исследований и разработок. Компания начала её поставки приоритетным клиентам для внедрения в их ЦОД. Кроме того, в свободную продажу поступили отдельные компоненты системы: серверы и стойки d-Matrix Corsair SquadRack. 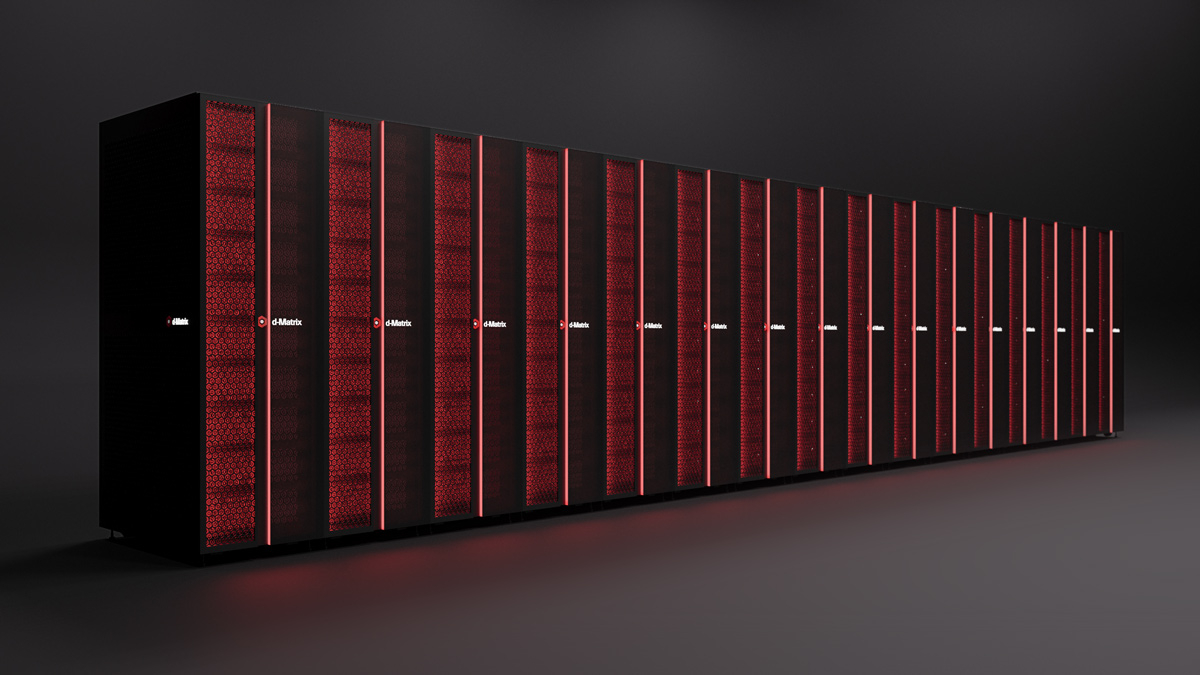
Источник изображения: d-Matrix Система Squadron предлагается в различных конфигурациях: от отдельных стоек d-SquadRack (в каждой — восемь серверов) до полномасштабных интегрированных вычислительных кластеров, включающих до 1024 ускорителей Corsair. Кластеры объединяются в единую сеть с помощью 400G-адаптеров JetStream, а ПО d-Matrix Aviator упрощает их развёртывание. Поскольку кластеры Squadron используют воздушное охлаждение и созданы на базе отраслевых стандартов, заказчики могут интегрировать их в уже существующие ЦОД без необходимости внедрения СЖО или реконструкции инфраструктуры. Кластеры Squadron, оптимизированные для быстрого и эффективного развёртывания ИИ-систем, способны обеспечиваать работу моделей исключительно на чипах Corsair. Они рассчитаны на работу в гетерогенных средах с использованием дезагрегированных вычислений. Генеральный директор и соучредитель d-Matrix сообщил, что компания успешно реализовала технологию дезагрегации Attention-FFN (AFD), используя собственную систему Squadron в связке с серверами на базе GPU. При переносе вычислений компонентов Experts/FFN на стойки Corsair гетерогенная система обеспечила генерацию 845 т/с на одного пользователя. При одновременной работе 64 пользователей такая гетерогенная конфигурация с поддержкой AFD продемонстрировала общую пропускную способность 20 415 т/с. d-Matrix уверяет, что первой в отрасли продемонстрировала реализацию концепции AFD на реальном «железе», доступном уже сегодня.
01.10.2026 [09:02], Руслан Авдеев
Schneider Electric испытывает в ЦОД Equinix распределительные устройства среднего напряжения с программным управлениемSchneider Electric проводит пилотные испытания электрораспределительных устройств среднего напряжения с программным управлением на площадке Equinix. Использование ПО должно обеспечить ускоренное строительство ЦОД и внедрение электрических систем там, где необходимо добавить новые возможности, без необходимости менять само оборудование, сообщает The Register. Распределительные модули управляют подачей электричества на объекты, изолируя неисправное оборудование, если это необходимо. Системы среднего напряжения (1–36 кВ) обычно связывают высоковольтные подключения и низковольтные модули, питающие серверные стойки. Обычное оборудование такого рода разрабатывается под потребности конкретной площадки. Schneider Electric предлагает использование стандартизированных модулей, в которых конфигурация «железа», защита, автоматизация, измерения, мониторинг и контроль осуществляются программными методами. Можно наладить массовое производство таких модулей, а их конфигурация будет осуществляться уже после монтажа в ЦОД. Обновления «по воздуху» позволят добавлять новые функции и улучшать производительность без физической модификации и даже без отключения оборудования. Такая архитектура уже работает на колокейшн-объекте Equinix в рамках пилотного проекта. 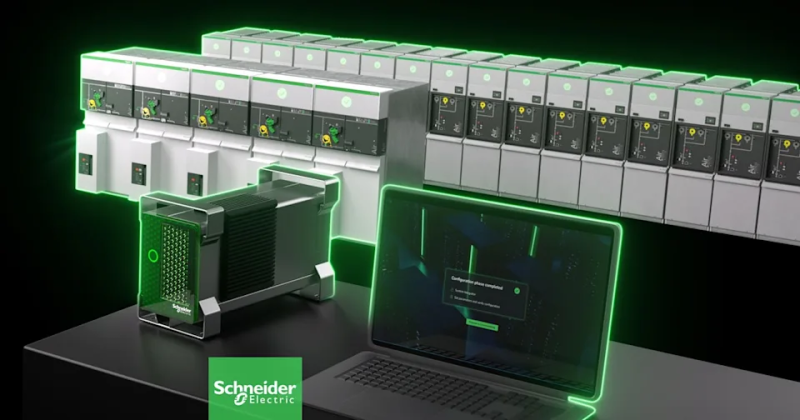
Источник изображения: Schneider Electric В документации компании, посвящённой технологии, отмечается, что мощность некоторых из запланированных дата-центров приближается к гигаватту. Им требуется инфраструктура распределения с линиями 13,8 кВ, 34,5 кВ или тех и других, в зависимости от характеристик площадки. Также кампус может иметь локальные генерирующие мощности или энергохранилища, которые увеличивают масштаб и сложность инфраструктуры среднего напряжения. Исторически системы распределения разрабатывались в соответствии с особенностями конкретной площадки и проходили тщательное тестирование до ввода в эксплуатацию — это могло бы привести к значительным задержкам начала работы оборудования. В Schneider утверждают, что новый подход может сократить время на заказ и производство до трёх раз, а также вдвое сократить время, необходимое на пусконаладочные работы и приёмку в сравнении с обычными системами, сделанными на заказ. По словам Equinix, технология позволяет стандартизировать разработку, внедрение и управление распределительными системами, в то же время обеспечивая безопасность, качество и надежность. Schneider намерена распространить архитектуру среди своих решений для среднего напряжения, включая линейки PremSet и AirSeT. Пилотные программы продолжатся до 2027 года, а доступными для рядовых клиентов решения должны стать в 2028 году. Тем временем, делегирование функций по защите и управлению программному обеспечению также поднимает вопросы о кибербезопасности, тестировании обновлений и восстановлении после сбоев. Некачественные или откровенно вредоносные обновления для критически важного оборудования могут привести к непредсказуемым последствиям, поэтому Schneider придётся убедительно продемонстрировать, как обновления идентифицируются, тестируются и «откатываются» и каким образом система защищена от перебоев с электричеством.
11.09.2026 [09:44], Владимир Мироненко
d-Matrix присоединилась к альянсу NVLink Fusion, чтобы интегрировать свои ИИ-ускорители в экосистему NVIDIAРазработчик ИИ-ускорителей d-Matrix пополнил растущий список производителей чипов, лицензировавших технологию NVLink Fusion и эталонные стоечные решения компании NVIDIA. Стартап объявил, что новое соглашение о сотрудничестве позволит интегрировать его XPU в широко распространённую экосистему NVIDIA AI Factory. Финансовые условия сделки не раскрываются. В числе тех, кто также полагается на NVLink, уже есть Qualcomm, Arm, Marvell, Amazon, Fujitsu, Ayar, SiFive, Intel и MediaTek. В качестве партнёра по программе NVLink Fusion компания d-Matrix будет сотрудничать с NVIDIA для интеграции своих XPU нового поколения для задач инференса (начиная с Raptor) непосредственно в новейшую эталонную стоечную архитектуру NVIDIA, которая включает CPU Vera, коммутаторы NVLink, адаптеры ConnectX-9 SuperNIC/DPU BlueField-4 и решения Spectrum-X Ethernet. d-Matrix также сотрудничает с компанией Astera Labs — специализирующейся в области решений для межкомпонентных соединений в экосистеме NVIDIA NVLink Fusion, — для создания специализированных решений, обеспечивающих высокую пропускную способность и бесперебойную передачу данных. Стоечные решения d-Matrix на базе платформы MGX будут оснащены модульными бескабельными узлами, разработанными с использованием экосистемы и цепочки поставок NVIDIA, что обеспечит их быстрое беспроблемное развёртывание. 
Источник изображения: NVIDIA Как отметила d-Matrix, развёртывание автономных ИИ-агентов вызвало резкий рост спроса на инференс, и провайдеры ИИ-сервисов всё чаще выбирают системы со смешанной архитектурой, способные обеспечить экономическую эффективность, необходимую их клиентам. Система d-Matrix MGX разработана для ИИ-приложений, чувствительных к задержке: ИИ-помощников для написания кода, чат-ботов реального времени и голосовых агентов, для которых имеют большое значение интерактивность и высокая скорость работы. Система, созданная на базе NVIDIA MGX, расширяет возможности унифицированной архитектуры стоек, позволяя ИИ-фабрикам гибко подбирать вычислительные ресурсы под конкретную задачу. Используя принцип гетерогенной дезагрегации, операторы могут распределять нагрузку между XPU d-Matrix Raptor и CPU NVIDIA Vera Rubin, оптимизируя каждый этап инференса. Например, при генерации кода с помощью ИИ — GPU могут брать на себя ресурсоёмкий этап предварительного заполнения, тогда как XPU d-Matrix ускоряют критически важный для задержки этап декодирования (decode). Ожидается, что первые образцы XPU d-Matrix Raptor в составае MGX-стоек станут доступны в IV квартале 2027 года, а разработка самих Raptor должна завершиться к концу текущего года. 
Источник изображения: NVIDIA Новые системы будут объединять до 144 XPU Raptor в единую сеть NVLink с топологией «каждый с каждым» (All-to-All). Как сообщает The Register, на конференции Hot Chips в прошлом месяце компания сообщила, что каждая карта Raptor будет оснащена 32 Гбайт сверхбыстрой памяти DRAM с 3D-компоновкой (3D-stacked), обеспечивающей пропускную способность 100 Тбайт/с — это примерно в 4,5 раза больше, чем у ускорителя NVIDIA Rubin. Также есть возможность использовать стойку Raptor в качестве дополнения к стойкам NVIDIA Vera Rubin. «Прелесть этого решения в том, что мы берем узлы Raptor, подключаем их к той же архитектуре стойки NVL144 MGX, которая широко используется во многих ЦОД, и получаем мгновенный доступ к этим площадкам», — отметил Сид Шет (Sid Sheth), генеральный директор и соучредитель d-Matrix, о чём сообщил ресурс The Next Platform. Строго говоря, гибридные системы инференса на базе ASIC d-Matrix и традиционных GPU уже анонсировали Parasail и Gimlet Labs. 
Источник изображения: d-Matrix The Register сообщил, что XPU для d-Matrix NVL144 будут примерно вдвое меньше обычных карт Raptor, показанных на Hot Chips. Они получат 16 Гбайт памяти 3D-DRAM и с пропускной способностью около 50 Тбайт/с. При размещении 144 таких чипов в одной стойке общий объём памяти составит около 2,3 Тбайт, чего достаточно для моделей с более 4 трлн параметров при 4-бит точности, а пиковая агрегированная пропускная способность памяти (ПСП) достигнет примерно 7,2 Пбайт/с. ПСП является главным «узким местом» при выполнении инференса. Архитектура чипа Groq LPU, ориентированная на интенсивное использование SRAM, позволяет достичь скорости передачи данных 150 Тбайт/с на один чип, однако обратной стороной медали является низкая плотность размещения SRAM: на одном кристалле удаётся разместить лишь порядка 500 Мбайт памяти. Raptor обеспечивает схожий уровень ПСП при несоизмеримо большем объёме RAM. Это позволит использовать гораздо меньше чипов для работы одной модели. Если для модели с 1 трлн параметров при 8-бит точности может потребоваться более 2 тыс. Groq LPU, то системе d-Matrix будет достаточно всего 64 Raptor (или 32 при 4-бит точности). Как и LPU от Groq, чипы d-Matrix могут использоваться как автономно, так и в составе гетерогенных вычислительных систем. Чипы d-Matrix могут стать более доступным вариантом выхода на рынок для корпоративных клиентов, заинтересованных в сверхнизкой задержке при инференсе, поскольку для работы системы требуется меньшее количество вычислительных модулей (XPU). Как отметил The Register, NVIDIA настолько стремится привлечь клиентов в свою закрытую экосистему, что тратит для этого миллиарды долларов. MediaTek она заплатила $3,5 млрд, а привлечение Marvell обошлось ей в $2 млрд.
04.09.2026 [18:44], Руслан Авдеев
Equinix представила решения Fabric One и Inference Exchange для распределённого ИИ-инференса в системах NVIDIA и Together AIКомпания Equinix расширяет платформу ЦОД и межсетевого взаимодействия, добавив взаимодополняющие сервисы, обеспечивающие распределённую эксплуатацию вычислительных ресурсов. Equinix Fabric One обеспечивает подключение между корпоративными площадками, облаками и ИИ-провайдерами, а Equinix Inference Exchange позволяет объединить эталонные решения NVIDIA Enterprise Reference Architectures с открытой платформой для инференса компании Together AI в пределах экосистемы Equinix. Сервисы позволят решить распространённую проблему архитектуры данных, когда корпоративная информация, приложения и пользователи распределены по разным объектам, облакам и юрисдикциям с отдельными правовыми нормами, а обслуживающие эти ресурсы вычислительные системы отделены от них и работают в других локациях. Equinix рассчитывает превратить распределение рабочих нагрузок и управление подключениями в единый управляемый сервис вместо того, чтобы реализовать сетевые подключения в рамках отдельных ИИ-проектов. Fabric One позволит клиентам описывать необходимый результат подключений на естественном языке. Equinix будет самостоятельно определять и организовывать маршрутизацию, облачные подключения, шифрование, управлять отказоустойчивостью и переключением на резервные ресурсы. 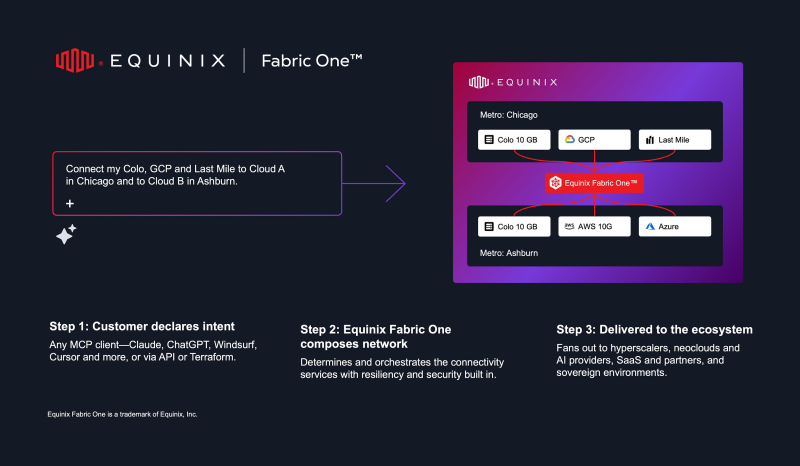
Источник изображения: Equinix Основными партнёрами по интеграции выступят AWS и Google Cloud, Fabric One будет использовать открытые спецификации OpenAPI 3.0 Interconnect, разработанные в рамках программ AWS и Google по организации мультиоблачных сетей, к которым присоединились Microsoft Azure и OCI. Приложения и инфраструктурные агенты смогут программно запрашивать необходимые соединения вместо того, чтобы полагаться на ручную координацию кросс-соединений и ручное предоставление сетевых ресурсов. Inference Exchange представляет собой распределённую платформу для ИИ-инференса. Equinix будет поставлять объекты, электроэнергию, передовые системы охлаждения, обеспечит эксплуатацию инфраструктуры после ввода в эксплуатацию и подключение через Equinix Fabric. NVIDIA обеспечит развёртывание с помощью проверенных эталонных архитектур Enterprise Reference Architectures, а Together AI обеспечит платформу для инференса с более 200 open source ИИ-моделей. Платформа будет поддерживать общие многопользовательские проекты и выделенные среды для отдельных клиентов, которым требуются гарантированные объёмы ресурсов и высокий уровень «изоляции» данных. 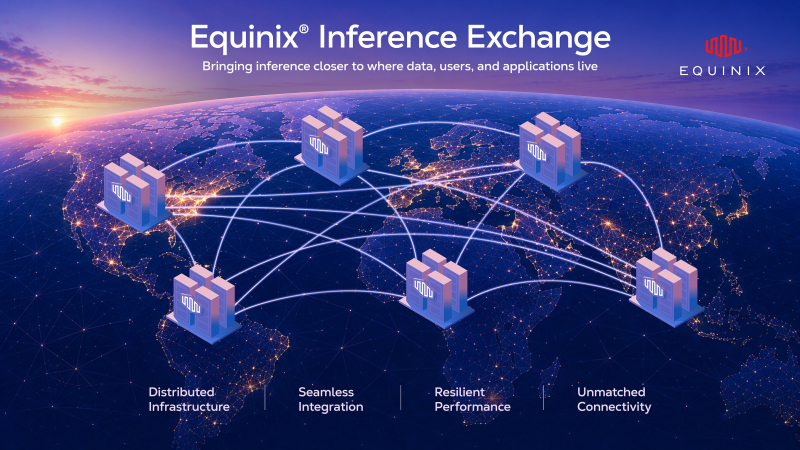
Источник изображения: Equinix По данным Storage Review, платформа Inference Exchange ориентирована на три ключевых топологии развёртывания. Во-первых, для инференса на уровне городских периферийных узлов организации способны запускать модели в рамках агломераций, с быстрым откликом API-обращений к открытым базовым моделям. Во-вторых, её можно использовать для перехода от закрытых проприетарных API на модели с открытым исходным кодом. Наконец, для обеспечения суверенного ИИ и выполнения нормативных требований локальных регуляторов — компании из регулируемых сфер могут обеспечить инференс и обработку данных в пределах заданных географических границ. Предполагается, что бета-тестирование Fabric One начнётся до конца 2026 года, а полная доступность сервиса запланирована на 2027 год, сначала в Северной Америке. Inference Exchange будет доступен в I квартале 2027 года. Стратегическим преимуществом Equinix является инфраструктура компании и плотность сосредоточенной вокруг неё экосистемы. На конец 2025 года она управляла 280 ЦОД на 77 рынках 36 стран. Платформа объединяет более 10,5 тыс. компаний, около 3 тыс. поставщиков облачных и IT-сервисов, а также более 500 тыс. физических и виртуальных интерконнектов. Объекты совредоточены в мегаполисах и городских агломерациях, где пересекаются телеком-операторы, облачные провайдеры, корпорации, платформы с контентом и и финансовые площадки. Для распределённого инференса близость всех игроков может быть важнее масштаба вычислительных ресурсов, поскольку часто корпоративные данные невозможно переместить в удалённый регион из-за требований к задержке, стоимости, управлению, безопасности, юрисдикции и т. п. Fabric One и Inference Exchange координируют два уровня физической инфраструктуры Equinix — на одном находятся объекты International Business Exchange (IBX), предназначенные для разных клиентов, на другом — дата-центры xScale для крупных заказчиков, в том числе гиперскейлеров. Fabric One координирует подключения между разными инфраструктурными доменами, а Inference Exchange позволяет размещать и эксплуатировать мощности для инференса ближе к локациям, где корпоративный спрос максимален. Впрочем, это не сделает инфраструктуру Equinix однородной, поскольку, например, некоторые IBX могут быть ограничены по своим проектным техническим характеристикам. Новые объекты IBX проектируются с расширенными возможностями в контексте электропитания и охлаждения.
25.08.2026 [17:52], Руслан Авдеев
«Зомби-иск» о коде Linux вот-вот окончательно закопаютМноголетняя судебная тяжба, касающаяся прав собственности на Linux, которому сегодня исполнилось 35 лет, ближе к завершению чем когда-либо. Три судьи апелляционного суда в США вынесли решение о том, что иск в отношении IBM и Red Hat не имеет оснований, а срок для дальнейших юридических манёвров истёк, сообщает The Register. История началась ещё в 1998 году, когда в IBM пришли к выводу, что миру достаточно одной версии ОС UNIX, способной работать на разных архитектурах процессоров. Для этого компания совместно с Santa Cruz Operation (SCO), выпускавшей версию UNIX на архитектуре x86, Intel и Sequent заключили соглашение о реализации т.н. Project Monterey, который конкурировать с Linux не смог. Поэтому IBM решила перенести в Linux часть кода, созданного в процессе реализации Project Monterey, после чего SCO и её юридические преемники заявили, что код Linux в некоторой степени принадлежит им, как и, отчасти, права на операционную систему. В 2021 году TSG Group, представлявшая интересы части некогда причастных к SCO структур и лиц, заключила с IBM мировое соглашение на $14,25 млн. Такая сумма свидетельствует, скорее, об отсутствии сильных доказательств SCO, чем об успехе инициаторов тяжб. Ещё одна преемница — Xinuos подала новый иск, требуя привлечь IBM к ответственности, поскольку та якобы использовала не принадлежащий ей код для Linux, и знала об этом — у IBM была лишь неэксклюзивная лицензия на его использование. Xinuos утверждала, что передав код Project Monterey в Linux, IBM нарушила условия лицензирования. 
Источник изображения: ZBRA Marketing/unsplash.com Xinuos представила соответствующие аргументы в окружном суде США по Южному округу Нью-Йорка, но так и не сумела убедить судей в том, что IBM и Red Hat вообще должны нести перед ней ответственность. Первоначально иск отклонили ещё в 2025 году, поскольку Xinuos ещё тогда не смогла доказать, что имеет право быть истцом в этом деле. После подачи апелляции Апелляционный суд США второго округа решил, что решение окружного суда не подлежит пересмотру. Суд посчитал, что представленные документы не позволяют вновь рассматривать вопрос по исходному решению, касающемуся Project Monterey — слишком поздно. Кроме того, истец пытался представить дело, как спор о лицензировании, тогда как фактически речь шла об установлении права собственности, которого у Xinuos, вероятно, нет вообще. Xinuos не намерена сдаваться — компания намерена ходатайствовать о рассмотрении дела полным составом Апелляционного суда. Вероятно, этого никогда не случится, поскольку такое происходит крайне редко и если суд обнаружит существенные ошибки или важные юридические упущения, которые оправдывали бы повторное рассмотрение дел. Данный окружной апелляционный суд соглашался на пересмотры дел в 0,03 % случаев. Другими словами, возвращение «зомби-иска» к жизни крайне маловероятно.
24.08.2026 [09:52], Владимир Мироненко
От чипов до стоек: SK hynix делает ставку на CPO в деле масштабирования ИИ-инфраструктурSK hynix опубликовала в журнале Nature Electronics статью, подготовленную совместно с исследователями из США, Сингапура и Южной Кореи, под названием «CPO для HPC и ИИ». В ней изложены планы по развитию интегрированной оптики (CPO) — технологии оптического интерконнекта следующего поколения, которая решает проблемы узких мест в передаче данных с точки зрения целостной системы, выходящей за рамки одной только памяти и охватывающей стойки целиком, пишет StorageReview.com. По мере того как кластеры ИИ-систем масштабируются до тысяч GPU и стеков HBM, традиционные медные каналы связи достигают своих пределов, а более высокие скорости и большие расстояния приводят к увеличению энергопотребления, задержек и сложности передачи сигналов, отметила SK hynix. Согласно исследованию SK hynix, производительность вычислительных систем растёт примерно в три раза каждые два года, в то время как пропускная способность интерконнекта за тот же период увеличивается примерно в 1,4 раза, что приводит к барьеру, который всё больше ограничивает перемещение данных между ИИ-системами. Даже если GPU будут становиться всё более быстрее, производительность ИИ-кластера не будет расти с той же скоростью, если данные не смогут достаточно быстро перемещаться между процессорами, памятью и ускорителями. 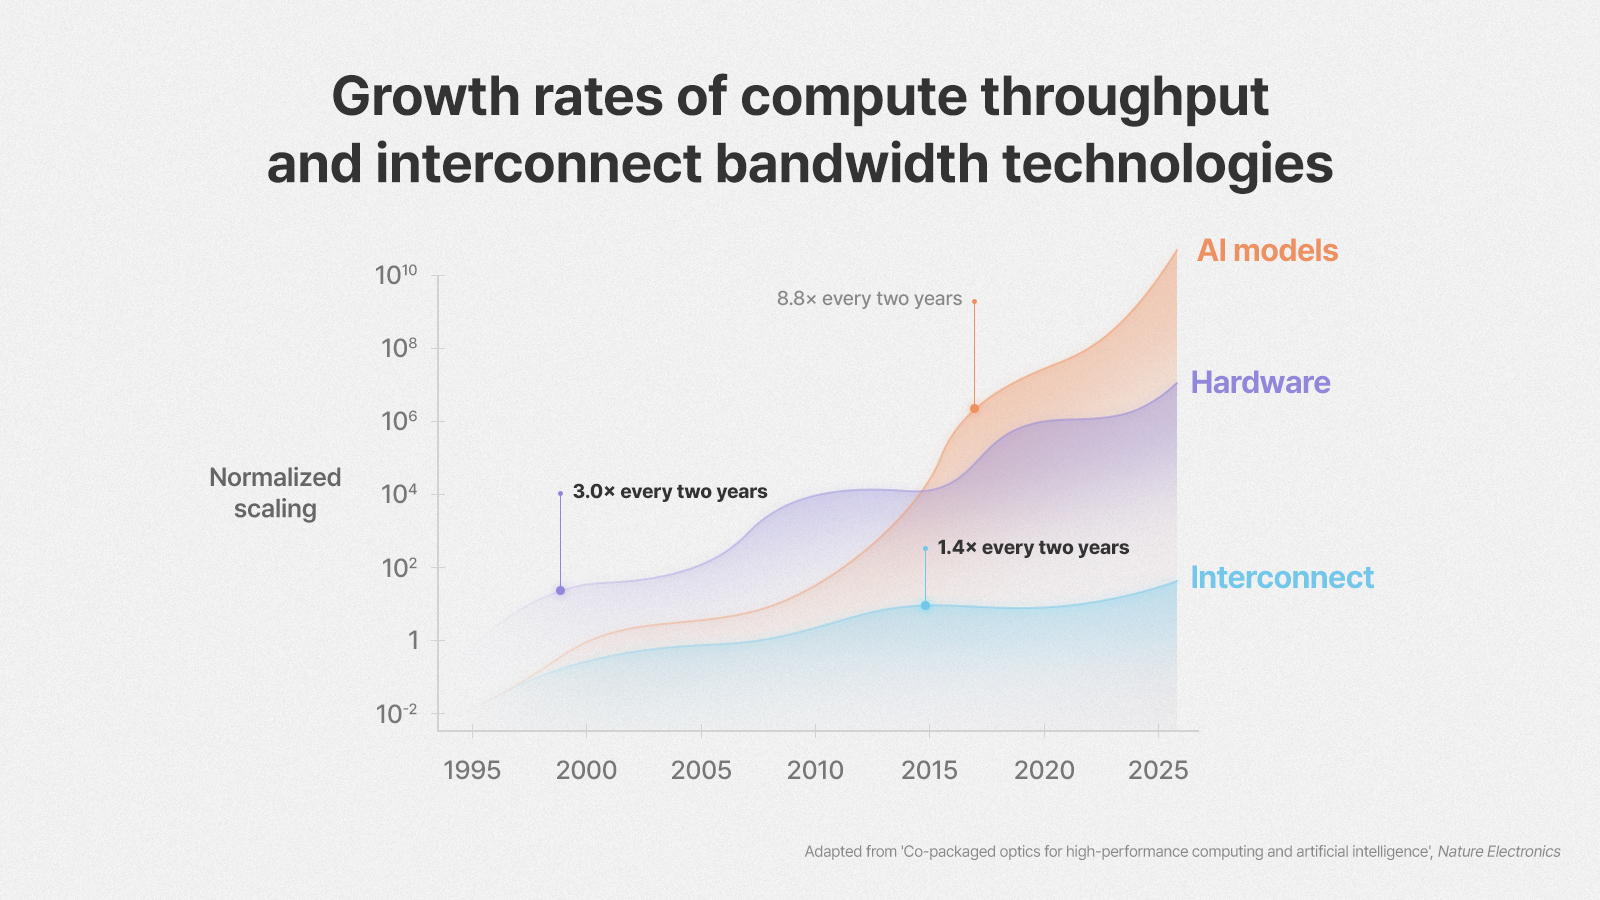
Источник изображений: SK hynix CPO позволяет решить эту проблему, размещая оптические трансиверы вблизи процессора или ускорителя на той же подложке. Преобразование высокоскоростных электрических сигналов в фотонные каналы, непосредственно прилегающие к вычислительному кремнию, минимизирует длину электрических дорожек, уменьшая паразитную ёмкость и затухание или искажение сигнала. Эта архитектура обеспечивает оптическую передачу с низкими потерями и высокой пропускной способностью по платам, стойкам и модулям, сохраняя при этом более высокую плотность полосы пропускания и улучшенную устойчивость к электромагнитным помехам. Физическая упаковка накладывает ограничения на количество процессоров и модулей памяти, которые можно разместить на одной подложке. Оптическая связь предлагает возможность их физического разделения, позволяя им при этом работать как часть гораздо более крупной вычислительной системы. 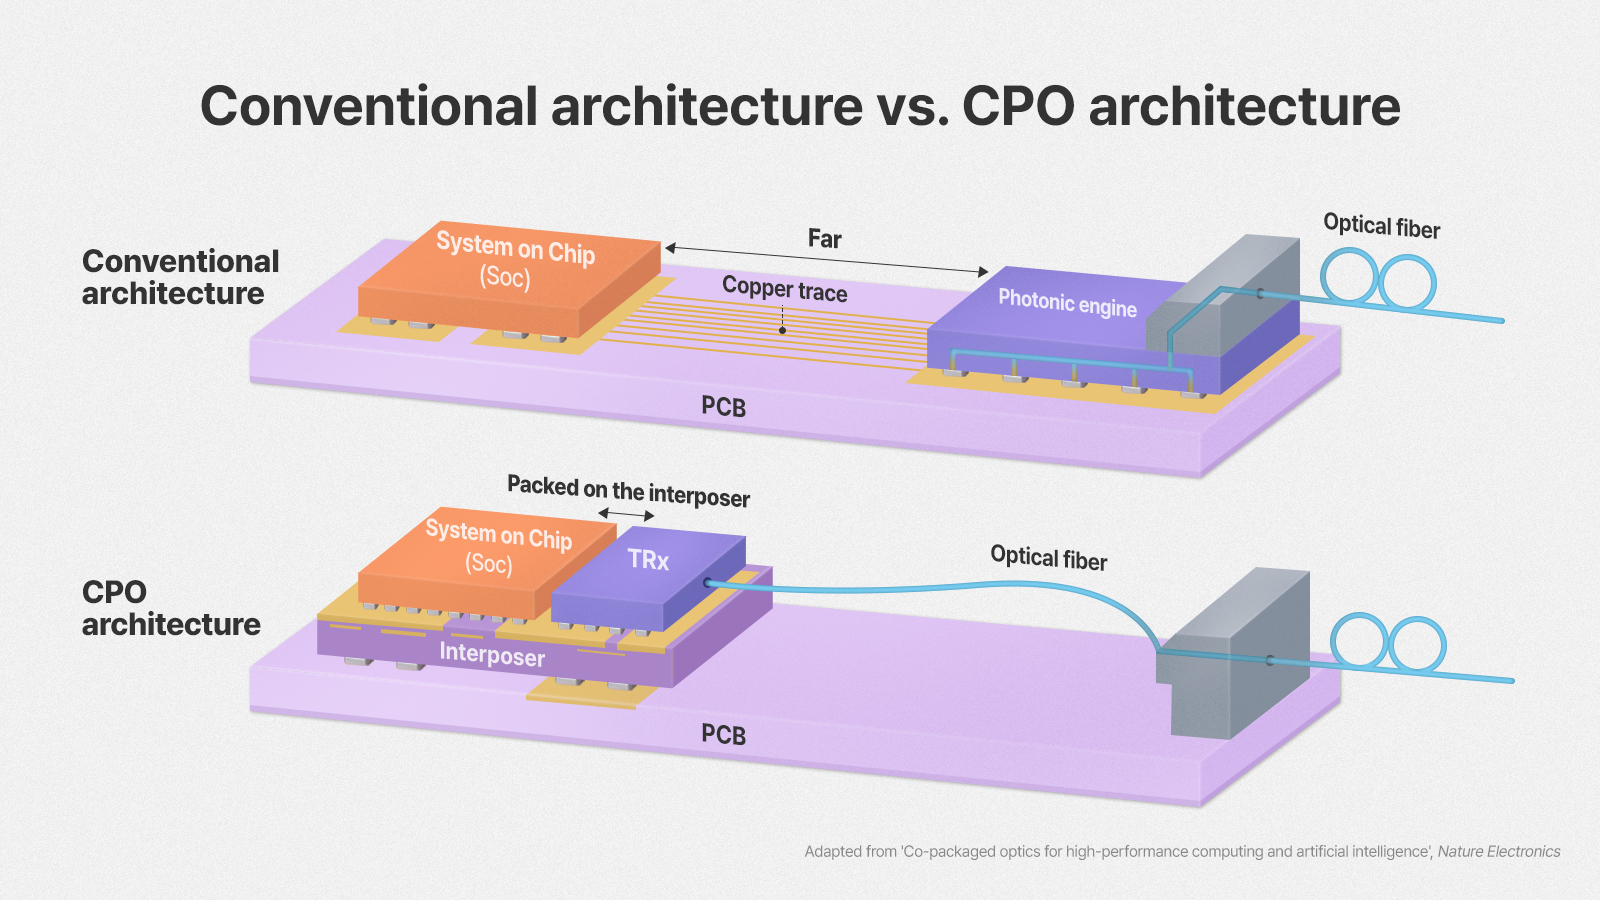 Концептуальная схема оптико-ориентированной архитектуры напрямую соединяет пулы вычислительных ресурсов (XPU) и пулы памяти посредством оптических сигналов с использованием интерпозера. Такой подход позволяет создавать дезагрегированные пулы общей памяти с низкой задержкой, где несколько вычислительных модулей могут получать доступ к общей ёмкости через оптическую объединительную плату без типичных для традиционных сетевых фабрик затрат на (де-)сериализацию, обеспечивая более гибкое перемещение данных на системном уровне и более быструю реакцию на растущий масштаб ИИ-моделей. Как отметил ресурс The Korea Times, значение статьи в Nature Electronics заключается не только в определении CPO как потенциального решения, но и в определении целей для будущей ИИ-инфраструктуры. Исследователи предполагают, что в будущем системы будут обеспечивать пропускную способность более 100 Тбит/с на узел, потребляя менее 1 пДж/бит и поддерживая межчиповую задержку менее 10 нс. SK hynix также прогнозирует архитектурную эволюция от стандартных 2D-многочиповых модулей и интеграции 2.5D-кремниевых интерпозеров к 3D-гетерогенной стековой компоновке. 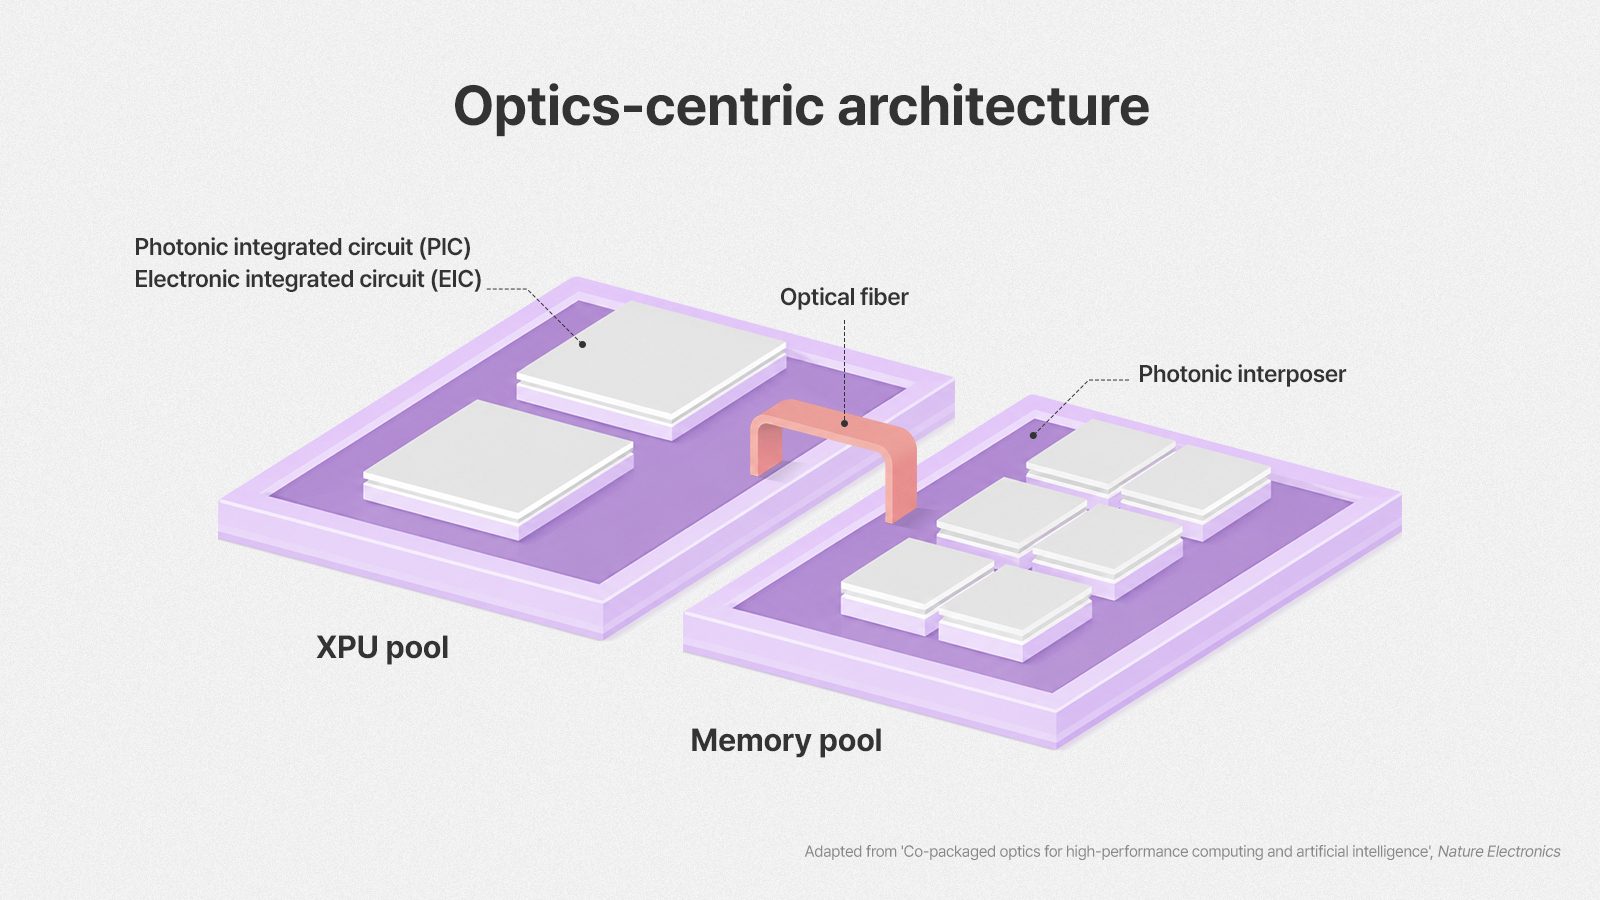 Кроме того, были указаны ключевые проблемы коммерциализации. Переход от демонстрации передовых вариантов упаковки к серийному производству оборудования сопряжён с рядом нерешенных инженерных проблем. Интеграция маломощных кремниевых фотонных устройств вместе с мощной логикой хоста требует сложной теплоизоляции и передовых микроканальных или иных систем прямого охлаждения упаковки. Также отрасли необходимо разработать стандартизированные протоколы когерентности с низкой задержкой, способные координировать операции с оптически связанной памятью без дополнительных затрат на проприетарные решения. Надёжная коммерциализация потребует комплексного проектирования оборудования, охватывающего топологии кристаллов DRAM, специализированные контроллеры памяти, фотонные модули и гетерогенную упаковку подложек. Статья также даёт представление о том, как SK hynix позиционирует себя на следующем этапе развития ИИ-инфраструктуры. Компания стала одним из главных бенефициаров бума генеративного ИИ благодаря HBM. Следующий этап требует, чтобы устройства памяти, контроллеры, оптические компоненты, процессоры и передовые технологии упаковки проектировались совместно, а не оптимизировались по отдельности. Именно поэтому исследователи делают акцент на «совместном проектировании». Нечто похожее уже разрабатывает Marvell, Lightmatter, Ayar Labs и другие вендоры. OCP также взялась за стандартизацию CPO, а группа гиперскейлеров сформировала альянс OCI MSA.
19.08.2026 [23:41], Владимир Мироненко
Sandisk спроектировала первый кристалл HBF и готовит выпуск образцов в 2027 годуСпустя всего несколько дней после презентации совместно с SK hynix первых спецификаций стандарта High Bandwidth Flash (HBF), компания SanDisk объявила о завершении финального этапа проектирования (стадии tape-out) первого кристалла HBF, продемонстрировав его образец на слайде. Заодно компания сообщила подробности о своей стратегии роста и долговременной экономической модели. В HBF используется многослойная архитектура NAND вместо DRAM с размещением её рядом с ускорителем, подобно HBM. HBF использует запатентованную технологию, которая помогает уменьшить напряжение и деформацию кристалла и улучшить теплопроводность, позволяя использовать многослойную структуру из 16 кристаллов для достижения целевой ёмкости и пропускной способности. 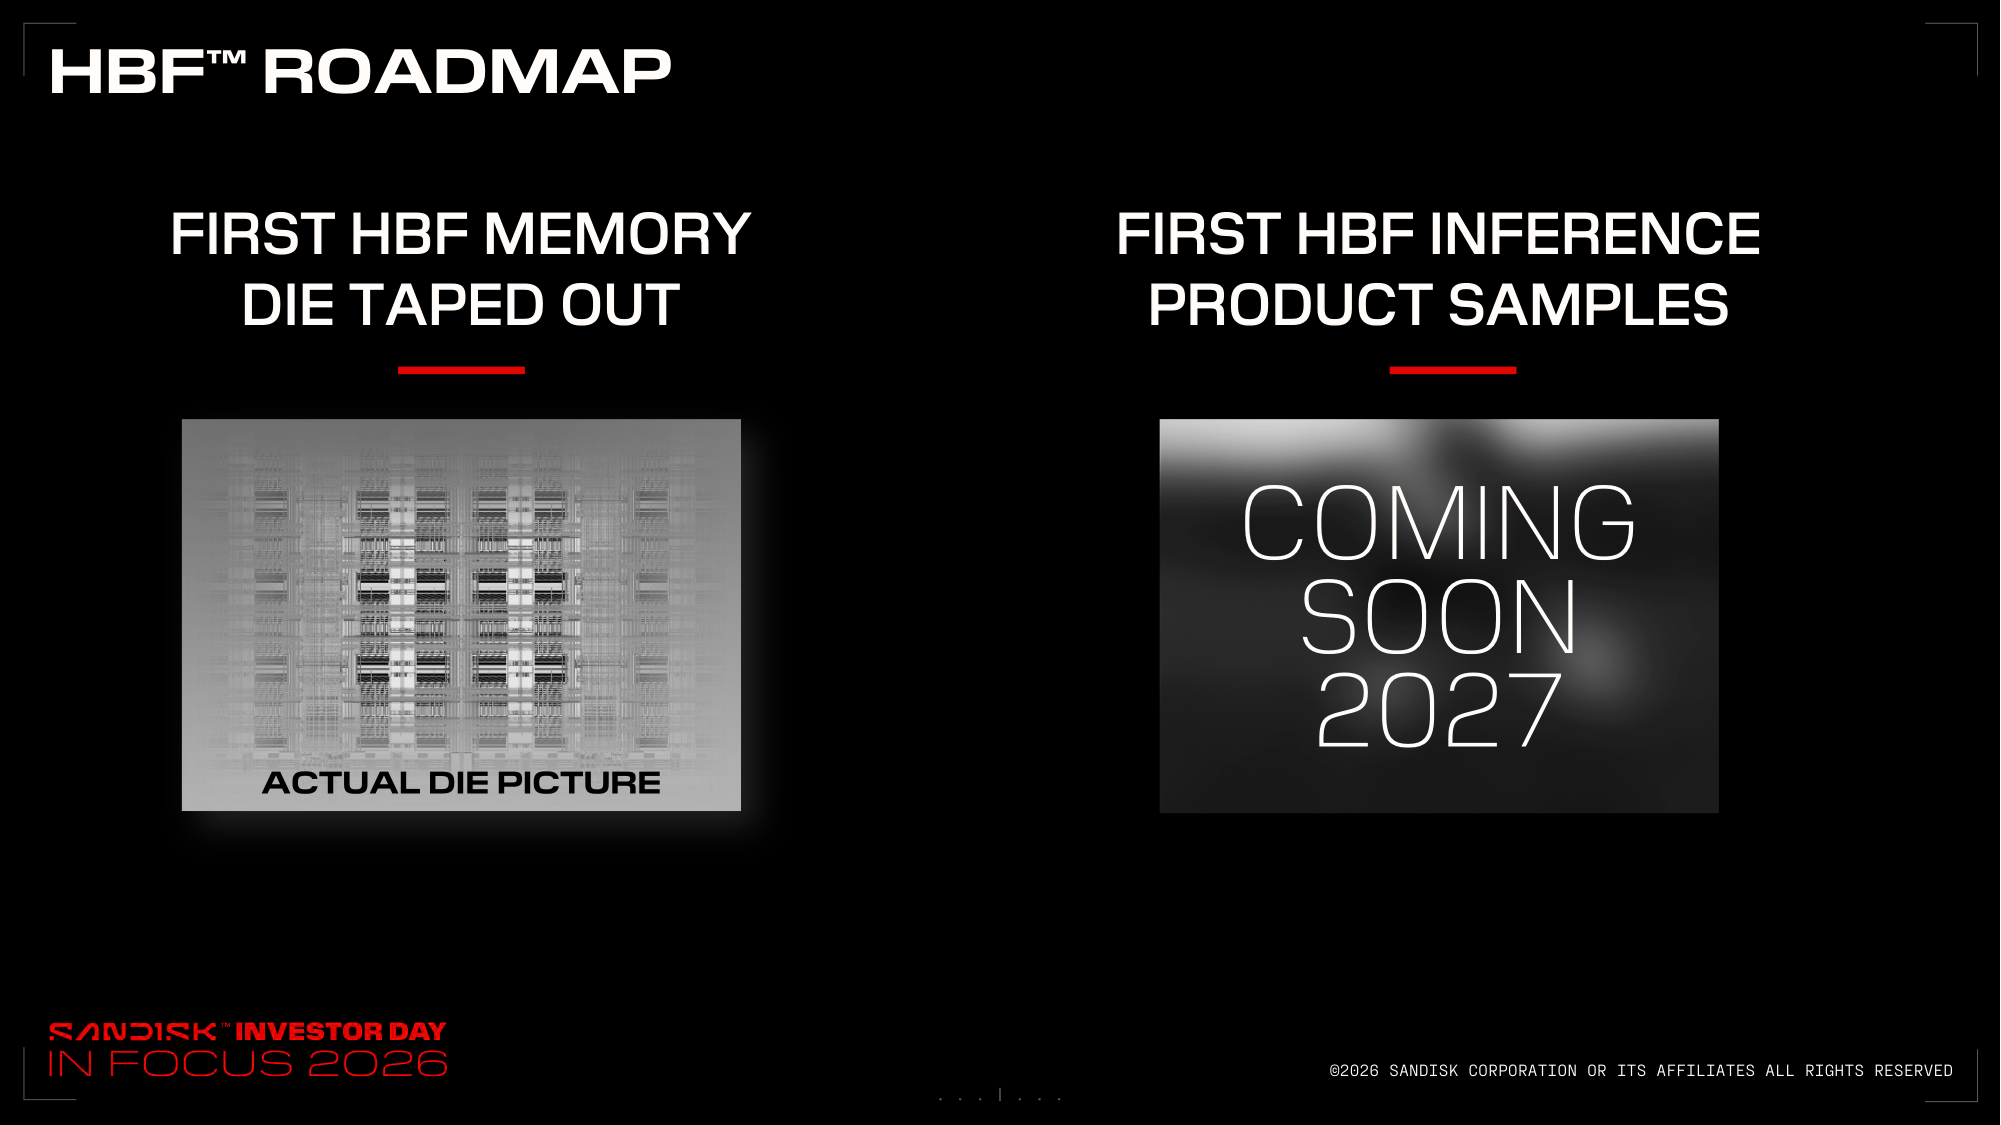
Источник изображений: SanDisk Как сообщила SanDisk, первое поколение HBF нацелено на 512 Гбайт на один стек — 16 кристаллов по 256 Гбайт с общей пропускной способностью 1,6 Тбайт/с при чтении. SanDisk утверждает, что HBF обеспечивает в 8–16 раз большую ёмкость, чем HBM, при аналогичной стоимости и в упаковке, по размерам, высоте стека и энергопотреблению практически не уступающем HBM4. А поскольку это NAND-память, она энергонезависима. 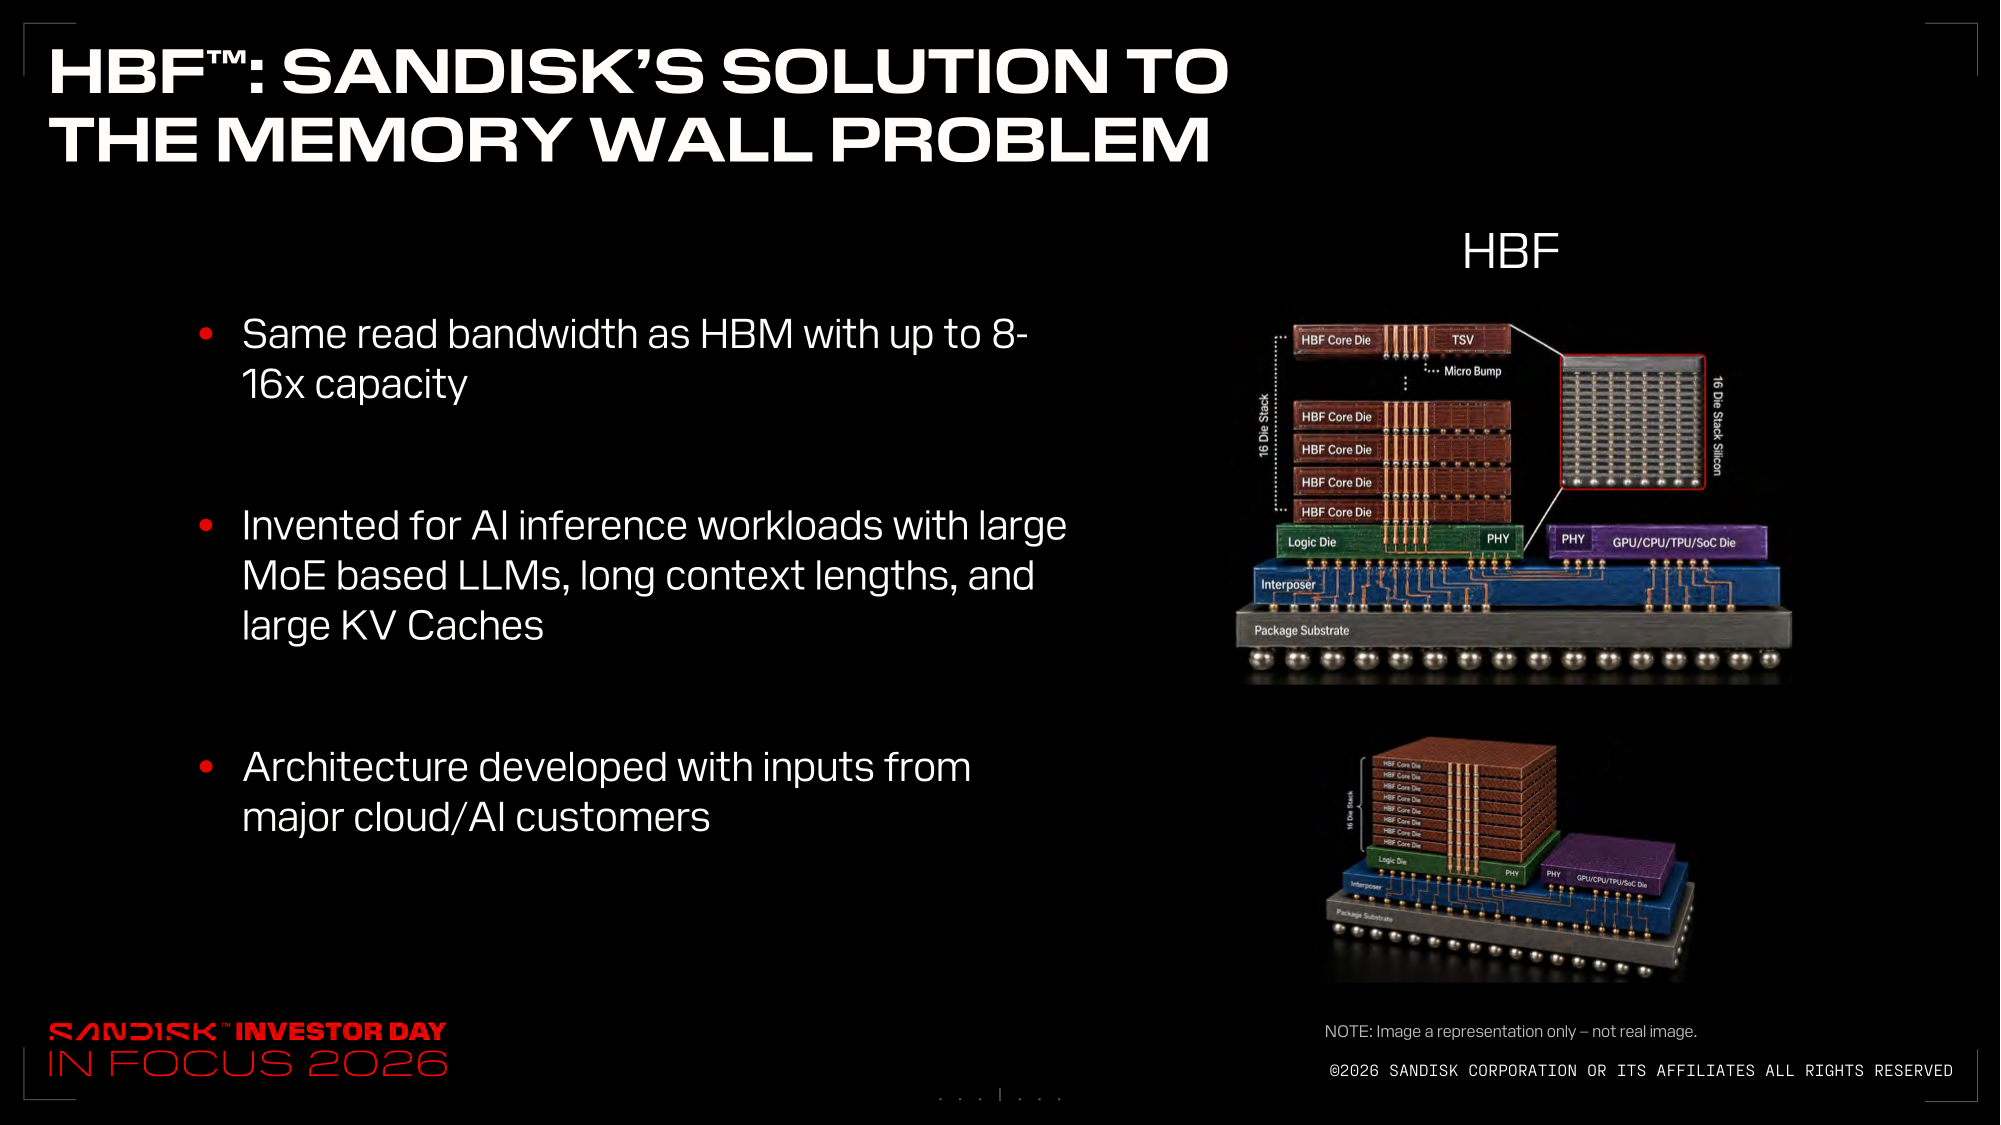 Ожидается, что второе и третье поколение HBF обеспечат скорость чтения, превышающую 2 и 3,2 Тбайт/с соответственно, а ёмкость многослойной структуры достигнет 1 и 1,5 Тбайт на стек. При этом они будут потреблять соответственно в 0,8 и 0,64 раза меньше энергии, чем память первого поколения. Как сообщает StorageReview.com, в презентации SanDisk были чётко обозначены целевые рабочие нагрузки HBF: LLM с MoE-архитектурой, длинные контекстные окна и большие KV-кеши — всё с учётом предложений крупных клиентов в области облачных вычислений и ИИ. 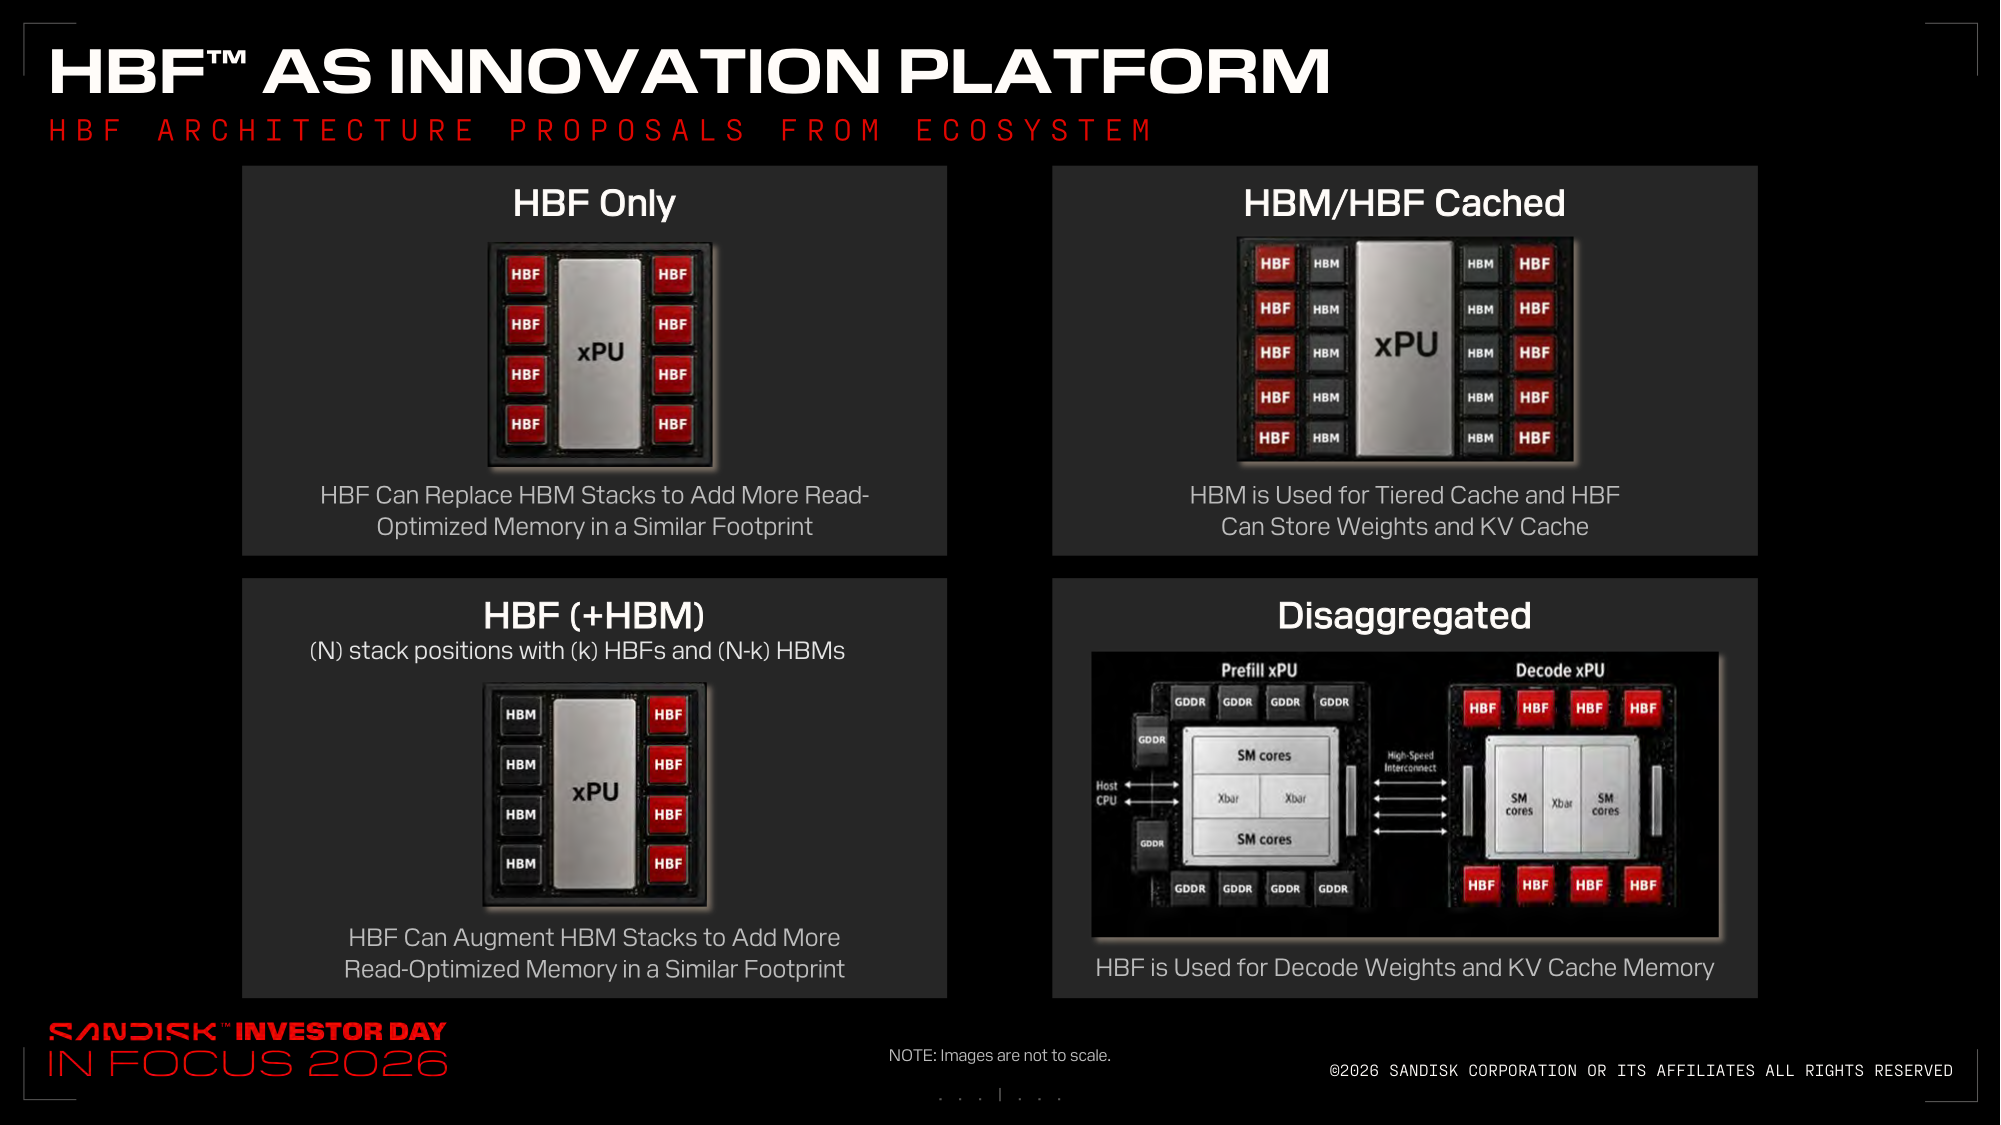 В представленной презентации также указаны три варианта развёртывания памяти HBF в рамках одного XPU. Она может дополнять HBM, заполняя некоторые позиции в стеке вокруг xPU, или полностью заменять её, занимая аналогичную площадь. Либо же она будет хранить веса декодирования и KV-кеши, тогда как HBM (меньшего объёма) будет работать как кеш. Эта гибкость важнее, чем кажется на первый взгляд, поскольку позволяет использовать HBF, не требуя от производителя ускорителя отказа от HBM. SanDisk показала результаты внутренних тестов генерации токенов для одного GPU c HBF, четырёх GPU с HBF и восемью GPU с HBM. На основе тестов компания сделала два заявления. Первое — о восьмикратном увеличении эффективности капитальных затрат исходя из минимальной конфигурации, необходимой для запуска модели: один GPU с HBF против восьми GPU с HBM. Второе — о двукратном увеличении эффективности GPU: четыре GPU с HBF выдают тот же объём токенов, что и восемь GPU с HBM. 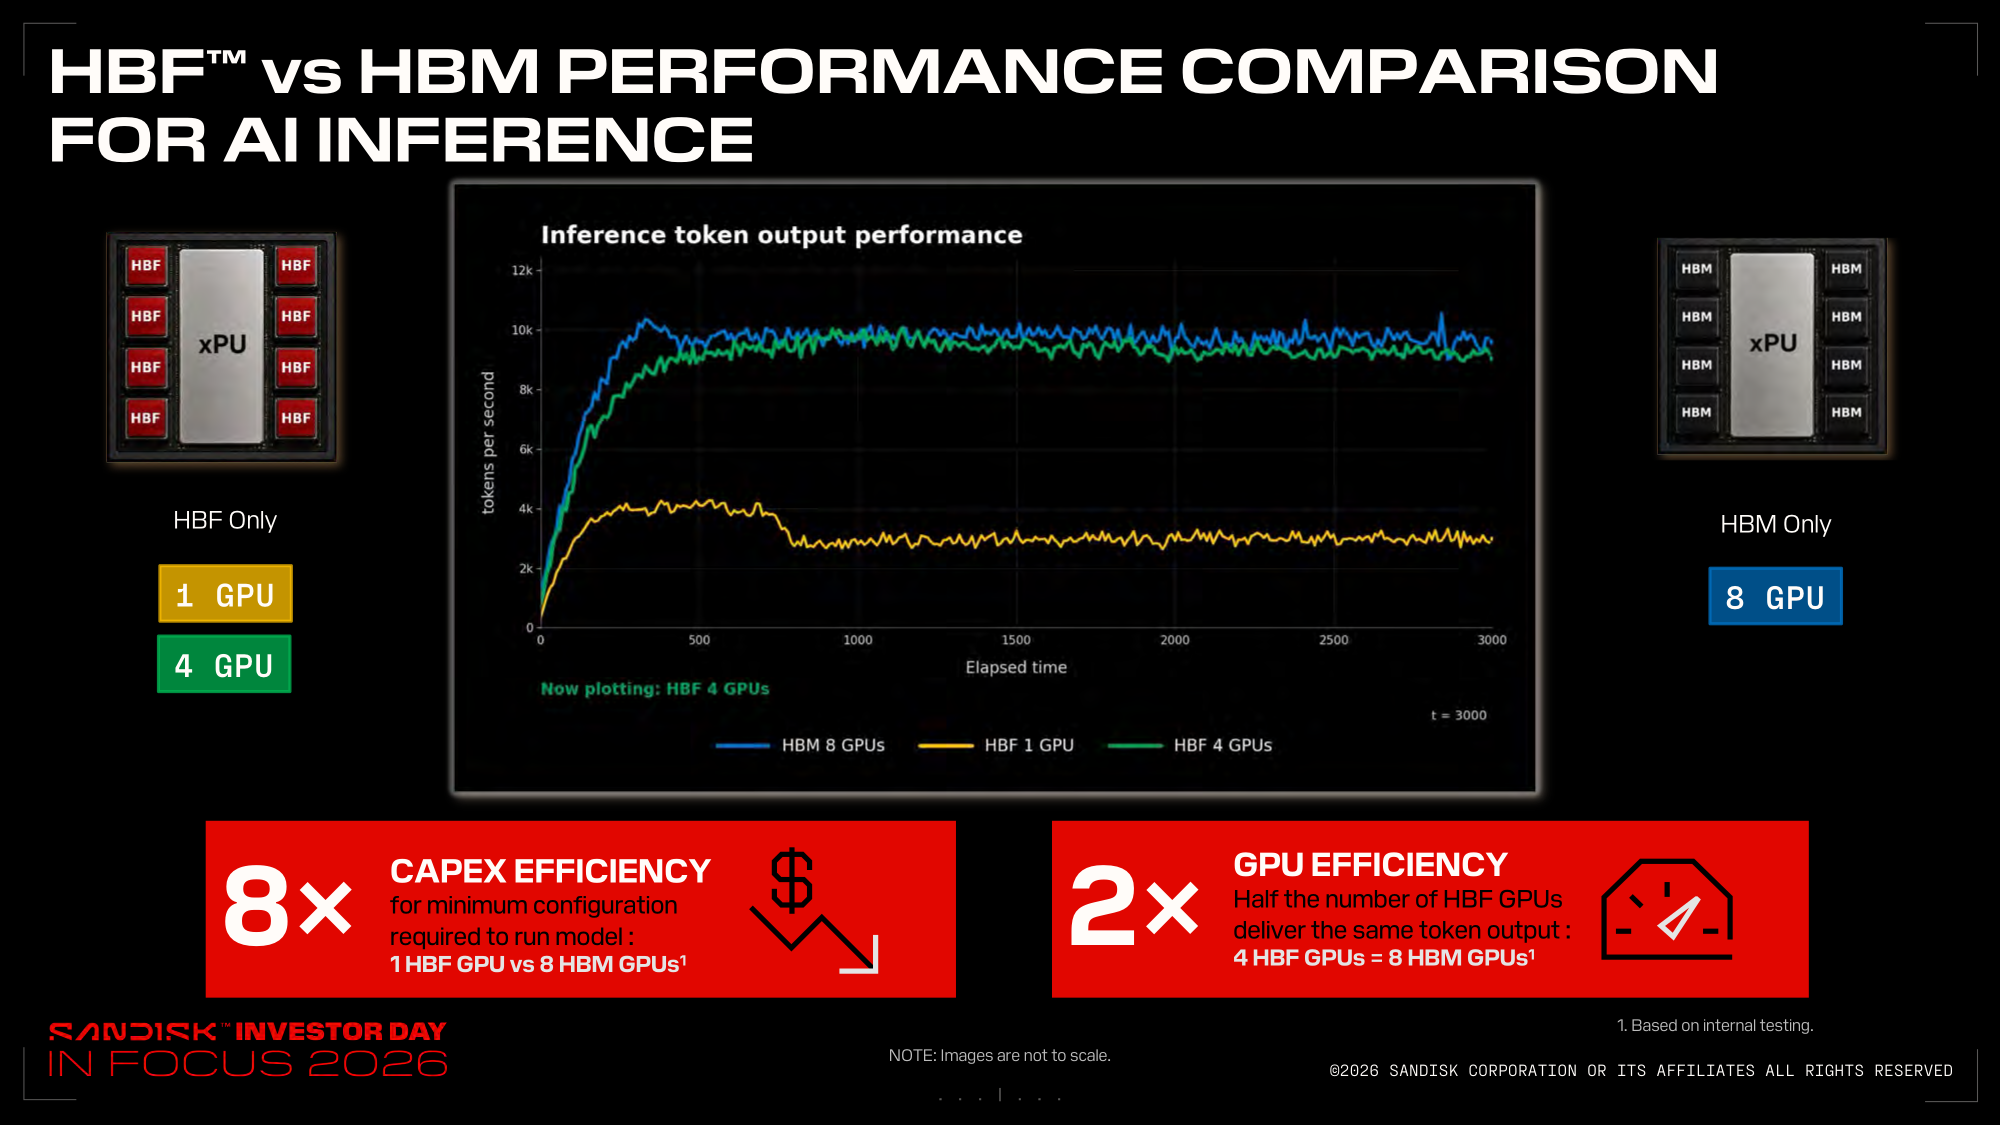 HBF показывает результат, отличающийся от HBM с высокой пропускной способностью всего на 2,2 % при чтении весов для Llama 3.1 405B. Следует учесть, что речь идёт о предварительных данных самой SanDisk, где, например, не даны точные значения по скорости генерации токенов. Но в целом компания говорит о том, что увеличение объёма набортной памяти ускорителя в 8–16 раз при той же пропускной способности и примерно той же мощности, что у HBM, потребует меньшего количества ускорителей для хранения одной и той же модели, а сами ускорители будут тратить меньше времени на ожидание данных. 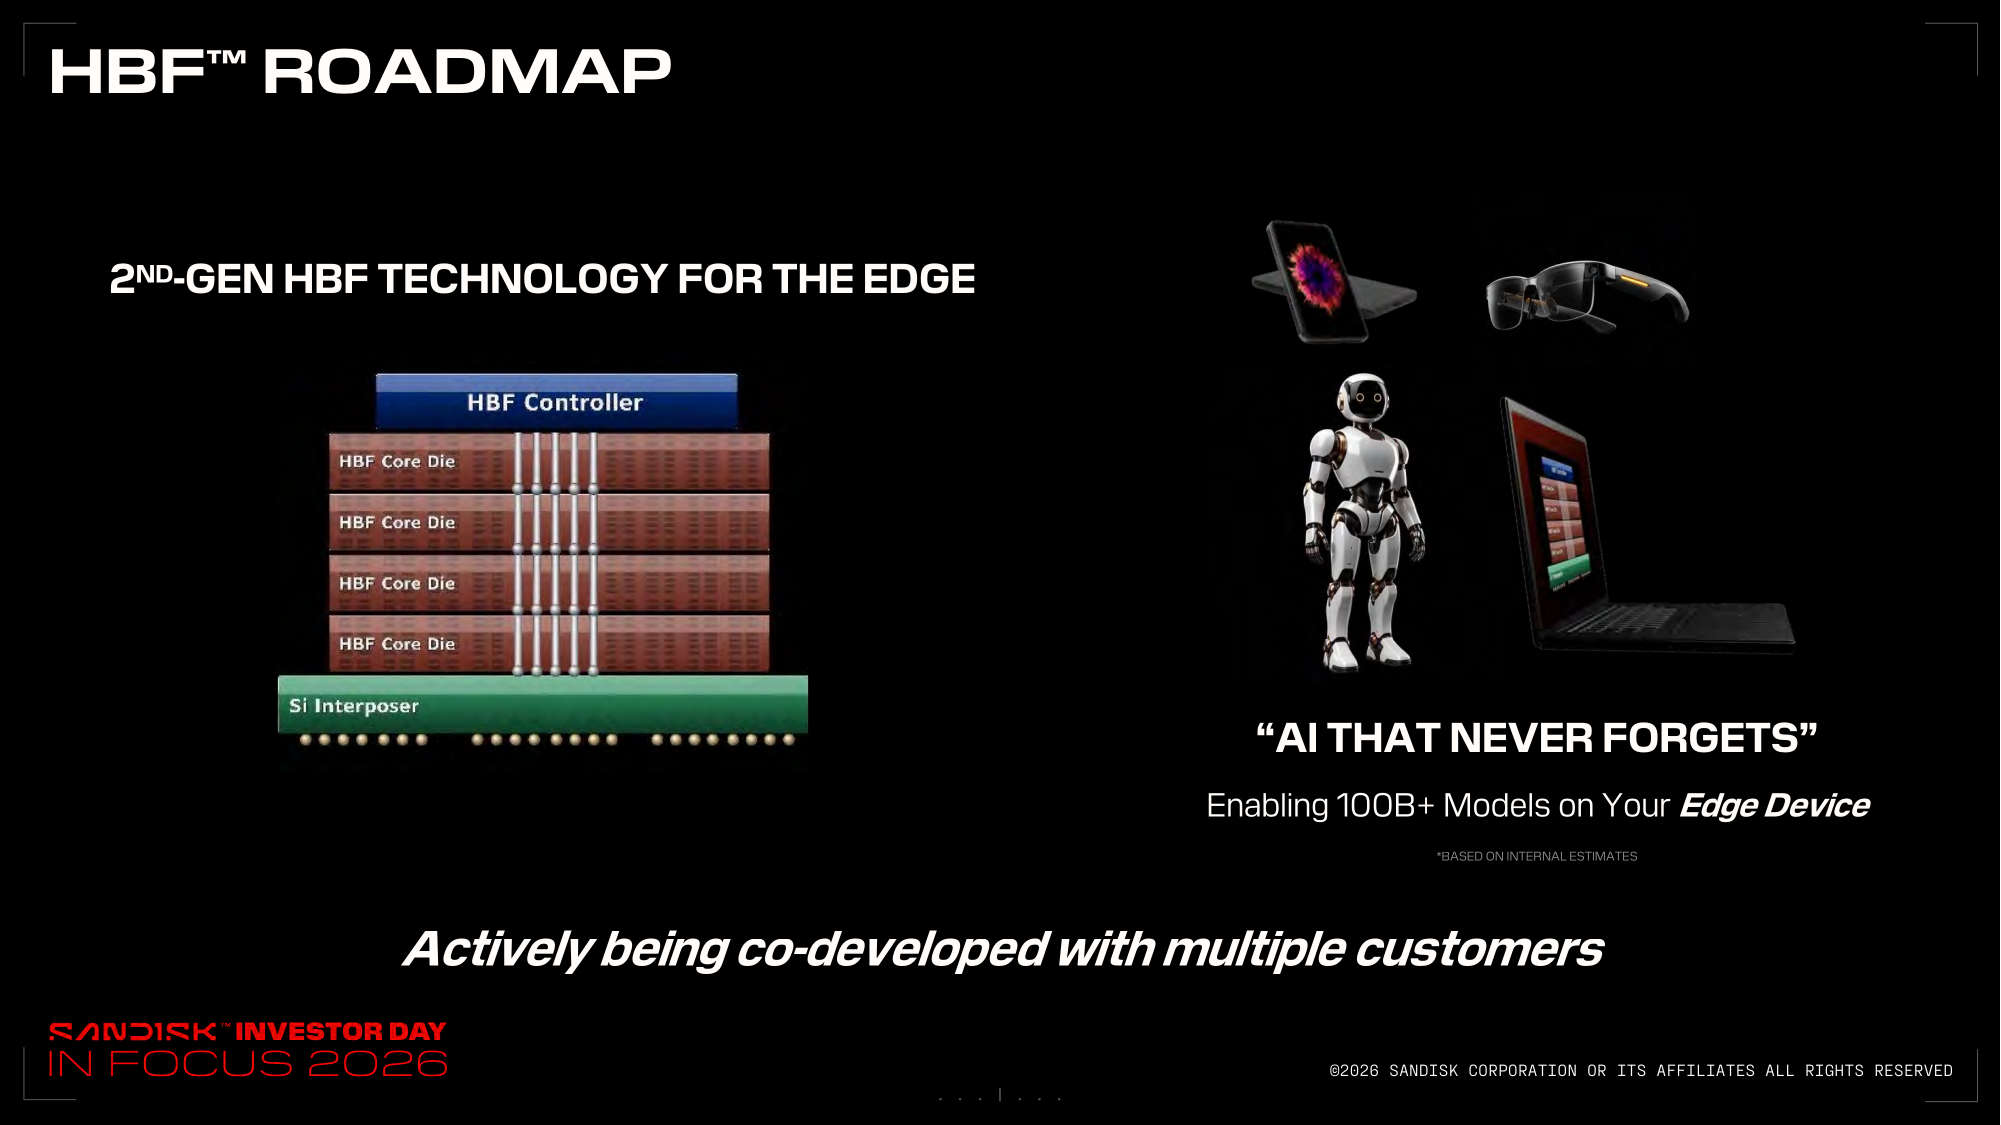 Как сообщает TrendForce со ссылкой на Mizuho Securities и Goldman Sachs, компания планирует выпустить первые образцы HBF в 2027 году, а массовое производство, как ожидается, начнётся в 2028 году. В Mizuho Securities полагают, что HBF вряд ли полностью заменит HBM, но позволит создавать дезагрегированные архитектуры для ИИ-инференса — консорциум HBF, куда входят Google, Meta✴, SK hynix и Tenstorrent, работает над развитием этого подхода. TrendForce полагает, что в долгосрочной перспективе выиграет гибридная архитектура, где HBM будет использоваться для высокоскоростных вычислений, а HBF — для повышения плотности хранения. Такая иерархия памяти может стать ключевым фактором крупномасштабной коммерциализации ИИ.
17.08.2026 [09:12], Сергей Карасёв
Macronix создала двухуровневые SSD со слоями SLC и TLCТайваньская компания Macronix в сотрудничестве с исследовательским центром IBM разработала так называемые двухуровневые SSD (Dual-Tier SSD), передаёт Blocks & Files. Идея заключается в том, что в одном устройстве объединяются высокопроизводительный слой на основе флеш-чипов SLC NAND и слой большой ёмкости на базе TLC NAND. Система рассматривает каждый из уровней в составе Dual-Tier SSD в качестве отдельного NVMe-накопителя. За перераспределение данных между слоями отвечает специальное ПО. Так, наиболее часто используемая информация помещается в SLC-раздел, который обеспечивает высокие скорости записи и чтения, но имеет сравнительно небольшую вместимость. В свою очередь, «холодные» и «теплые» данные могут храниться в менее производительном, но более ёмком TLC-разделе. 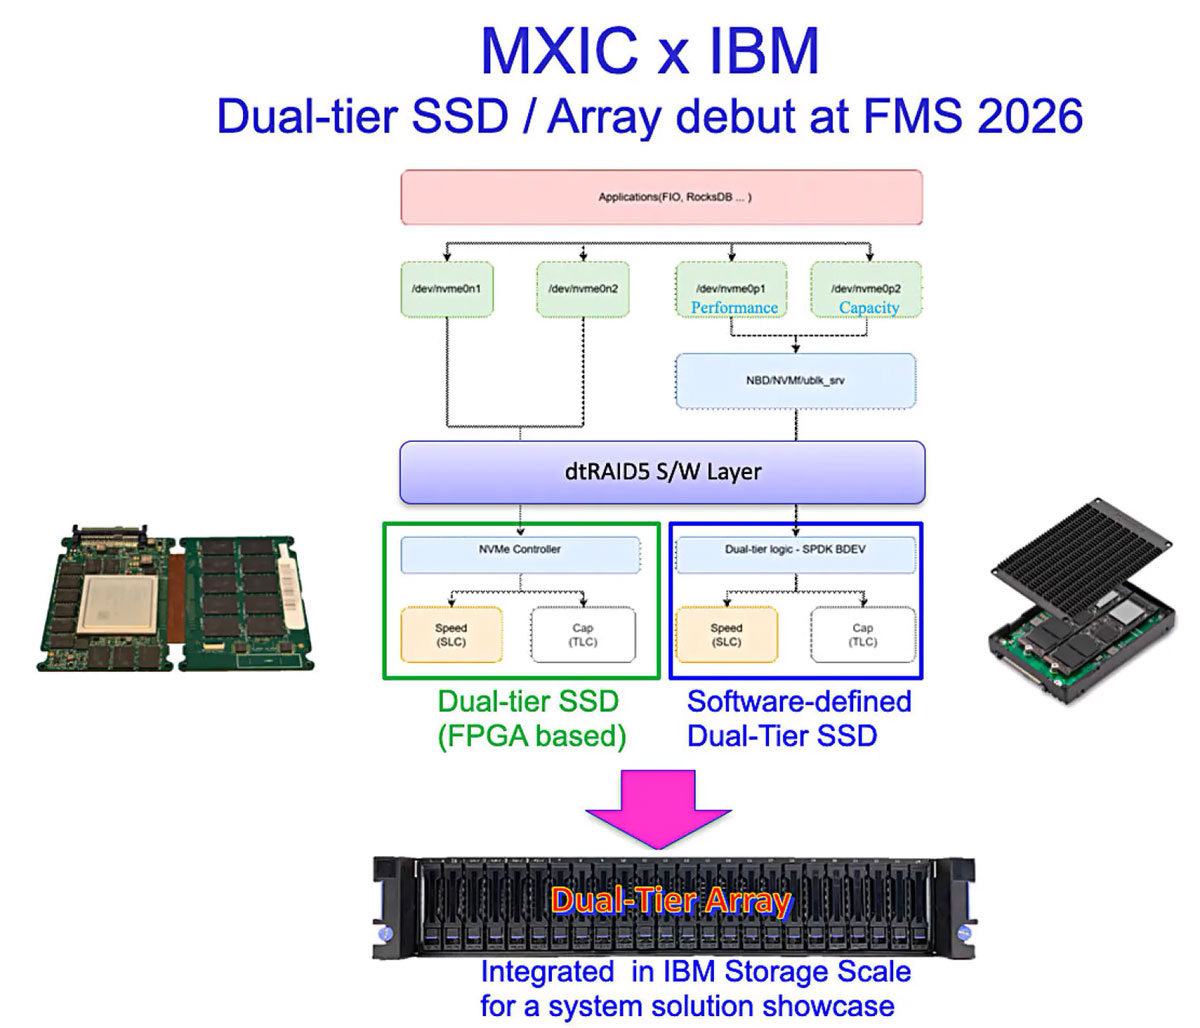
Источник изображения: Blocks & Files Благодаря гибкому управлению на основе собираемой статистики и анализа текущих нагрузок в Dual-Tier SSD достигается оптимальный баланс между производительностью, надёжностью и сроком службы чипов NAND. Кроме того, может осуществляться параллельное взаимодействие с разными слоями накопителя. Рассматривается также возможность динамического перераспределения ёмкости между разными уровнями хранения в Dual-Tier SSD. В этом случае в зависимости от текущей нагрузки часть ёмкости TLC NAND может быть использована в режиме pseudo-SLC (pSLC) — такой подход уже применяется во множестве накопителей. Это даст дополнительную гибкость при работе с высоконагруженными приложениями — например, в области ИИ и НРС. Предполагается, что Dual-Tier SSD смогут заменить связку из традиционных HDD и SSD в платформах хранения IBM Storage Scale System. |
|

