Материалы по тегу: h100
|
29.10.2024 [20:28], Сергей Карасёв
Раскрыты подробности архитектуры ИИ-кластера xAI Colossus со 100 тыс. ускорителей NVIDIA H100Портал ServeTheHome рассказал подробности об архитектуре вычислительного кластера xAI Colossus, предназначенного для обучения крупных ИИ-моделей. Эта система использует 100 тыс. NVIDIA H100, а в дальнейшем количество ускорителей планируется увеличить вдвое. Это самый крупный из известных ИИ-кластеров на текущий момент. Оборудование для него поставили компании Dell и Supermicro. Стартап xAI, курируемый Илоном Маском (Elon Musk), объявил о запуске суперкомпьютера Colossus в начале сентября нынешнего года. Утверждается, что на создание системы потребовалось всего 122 дня. Причём с момента установки первой стойки с серверами до начала обучения ИИ-моделей прошло только 19 суток. Впрочем, как отмечают эксперты, поскольку машина является «однозадачной», т.е. в отличие от традиционных суперкомпьютеров предназначенной только для работы с ИИ, ускорить строительство было не так уж сложно, хотя результат всё равно впечатляющий. Как сообщается, в составе Colossus применены серверы на платформе NVIDIA HGX H100, оборудованные системой жидкостного охлаждения. Каждый узел Supermicro серии TNHR2-LCC типоразмера 4U содержит восемь ускорителей NVIDIA H100 и два CPU. Узел разделён на две половинки, одна с CPU и PCIe-коммутаторами и одна с HGX-платой, которые могут извлекаться независимо для простоты обслуживания. CPU, коммутаторы и ускорители охлаждаются посредством СЖО. 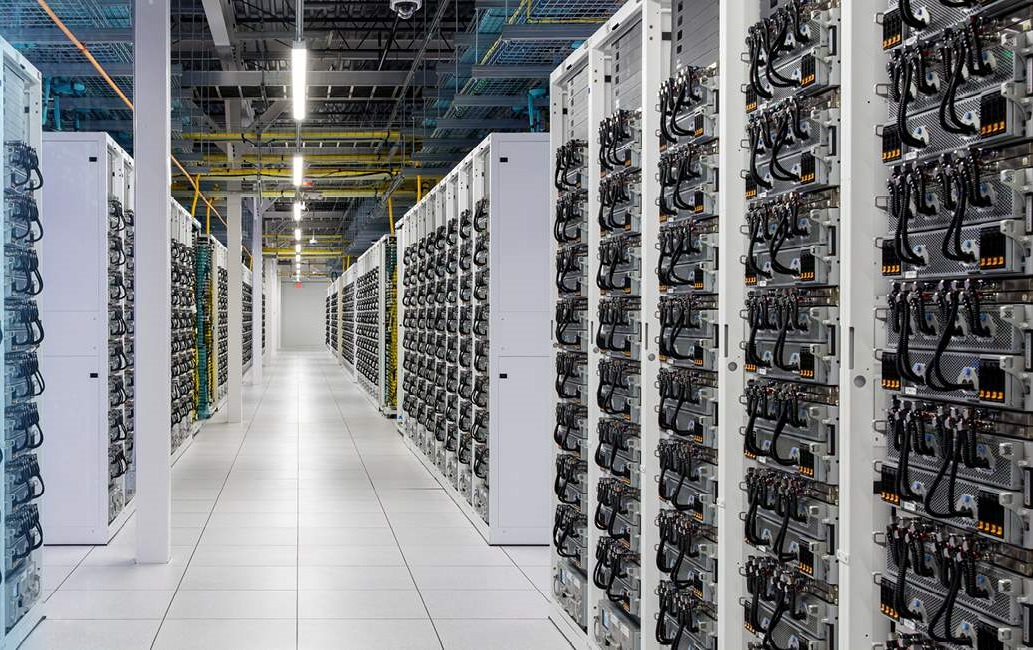
Источник изображения: Supermicro Вентиляторы в шасси тоже есть. Воздух от них попадает на теплообменники на задней двери, которые уносят остаточное тепло. Холодных и горячих коридоров в ЦОД нет, воздух имеет одинаковую температуру во всём зале. В нижней части стоек располагается ещё один 4U-блок Supermicro для CDU с резервированием и поддержкой горячей заменой насосов. Каждый сервер имеет четыре блока питания с резервированием и возможностью горячей замены, которые подключены к трёхфазным PDU. Одна стойка объединяет восемь узлов NVIDIA HGX H100, между которыми располагаются коллекторы СЖО в формате 1U. Таким образом, каждая стойка насчитывает 64 экземпляра H100. Стойки организованы в группы по восемь штук, которые образуют малые кластеры из 512 ускорителей H100. Они в свою очередь объединены в т.н. «острова» по 25 тыс. ускорителей, каждому из которых полагается собственный машинный зал. Общее количество стоек в составе Colossus превышает 1500. 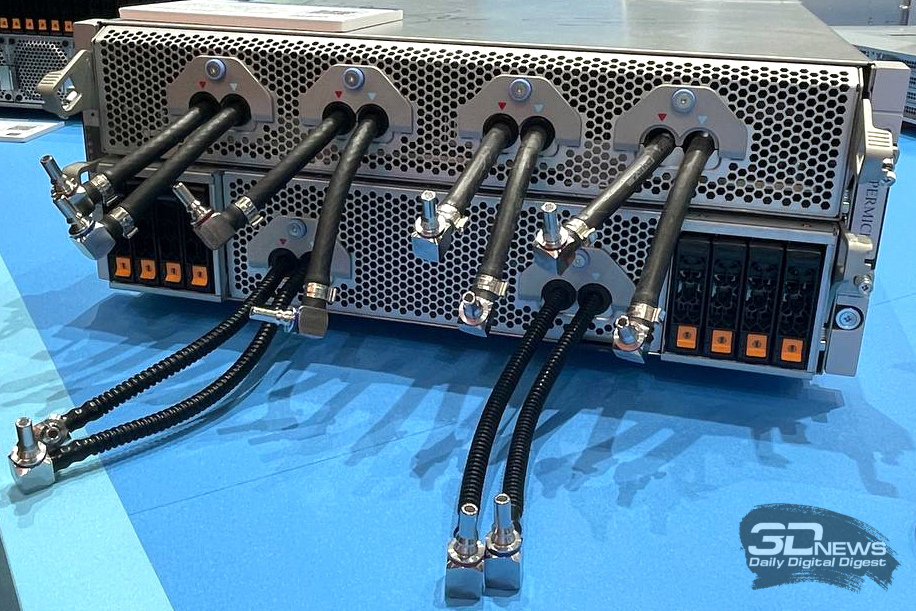 Помимо узлов с ускорителями также есть CPU-узлы и узлы хранения All-Flash (1U). Как отмечает NVIDIA, в кластере Colossus задействована сетевая платформа Spectrum-X Ethernet. Применены коммутаторы Spectrum-X SN5600 и сетевые карты на базе чипа BlueField-3. Компания говорит об использовании трёхуровневой Ethernet-сети с 400GbE-подключением, но точная топология не указана. Судя по всему, выделенной сети для работы с хранилищем не предусмотрено. Каждом ускорителю полагается один 400GbE-адаптер SuperNIC, который и объединяет их в RDMA-сеть. Кроме того, у каждого GPU-узла есть ещё один 400GbE DPU, а также подключение к сервисной сети. Сетевые карты находятся в собственных лотках, благодаря чему их можно заменять без демонтажа шасси. По словам NVIDIA, уровень утилизации сети достигает 95 %. В качестве энергетического буфера между электросетью и суперкомпьютером используются аккумуляторные банки Tesla Megapack ёмкостью 3,9 МВт·ч каждый. Они необходимы для того, чтобы компенсировать всплески потребляемой мощности, когда нагрузка на ускорители резко возрастает в силу выполняемых ИИ-задач. Впрочем, вероятно, есть и ещё одна причина для такого решения — на первом этапе Colossus был лишён подключения к основной энергосети и в вопросе питания во многом полагался на генераторы.
26.10.2024 [14:00], Сергей Карасёв
Дженсен Хуанг и король Фредерик X запустили самый производительный в Дании ИИ-суперкомьютер GefionОснователь и генеральный директор NVIDIA Дженсен Хуанг (Jensen Huang) и король Дании Фредерик X объявили о запуске крупнейшего в стране суверенного суперкомпьютера для задач ИИ. Система получила название Gefion («Гевьон») — в честь скандинавской богини плодородия. НРС-комплекс эксплуатируется Датским центром инноваций в области искусственного интеллекта (DCAI), который был создан при поддержке фонда Novo Nordisk Foundation и Датского фонда экспорта и инвестиций. В церемонии ввода Gefion в эксплуатацию, проходившей в Копенгагене, приняла участие Надя Карлстен (Nadia Carlsten), генеральный директор DCAI. Суперкомпьютер объединяет 191 систему DGX H100, что в общей сложности даёт 1528 ускорителей NVIDIA H100. Задействованы 382 процессора Intel Xeon Platinum и интерконнект NVIDIA Quantum-2 InfiniBand. Прочие технические характеристики, а также показатели быстродействия системы пока не раскрываются. Пиковая теоретическая FP64-производительность должна составить около 52 Пфлопс, а в FP8-расчётах с разреженностью — порядка 6 Эфлопс. 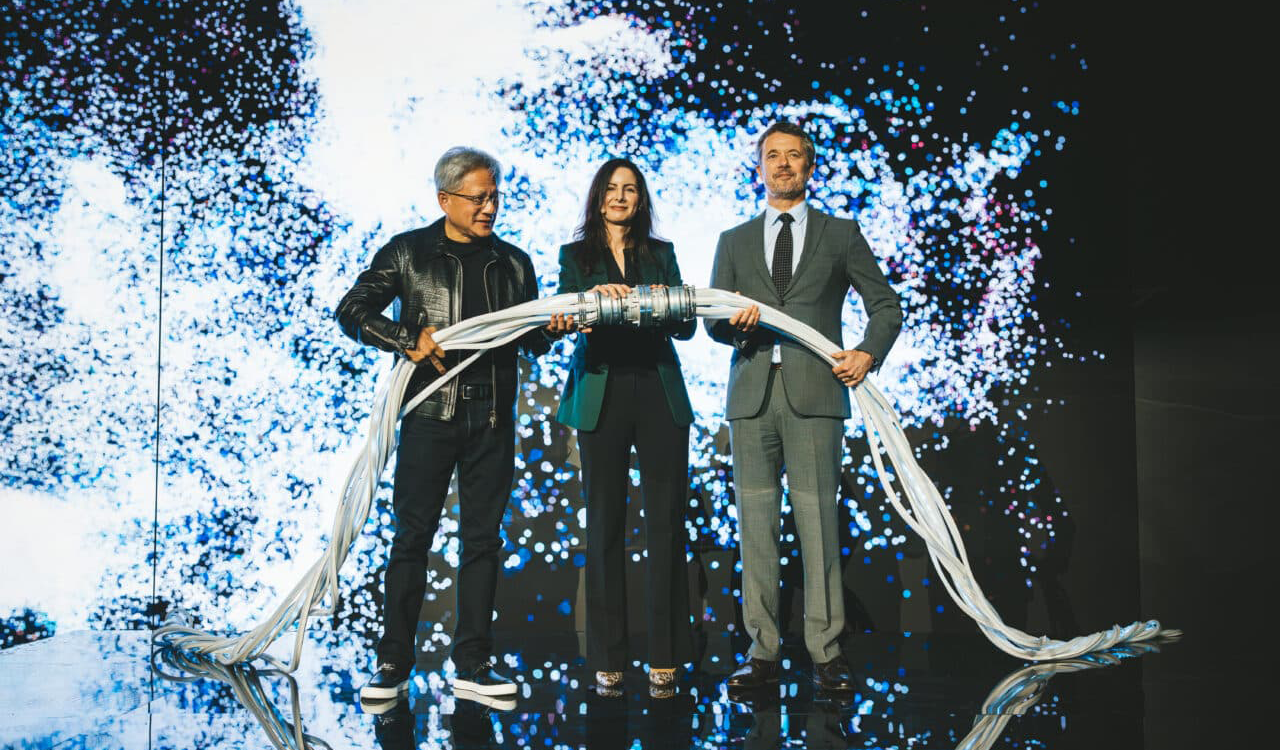
Источник изображения: NVIDIA Сообщается, что Gefion будет применяться для решения сложных задач в области квантовых вычислений, «зелёной» энергетики, биотехнологий и пр. В частности, исследователи из Копенгагенского университета (UCPH) намерены задействовать машину для проведения крупномасштабного распределённого моделирования квантовых компьютерных схем. Кроме того, UCPH, Технический университет Дании (DTU), Novo Nordisk и Novonesis совместно разработают многомодальную геномную ИИ-модель для анализа мутаций заболеваний и разработки вакцин. Доступ к Gefion также получат стартапы, реализующие перспективные проекты в области обработки текста, изображений и видео. 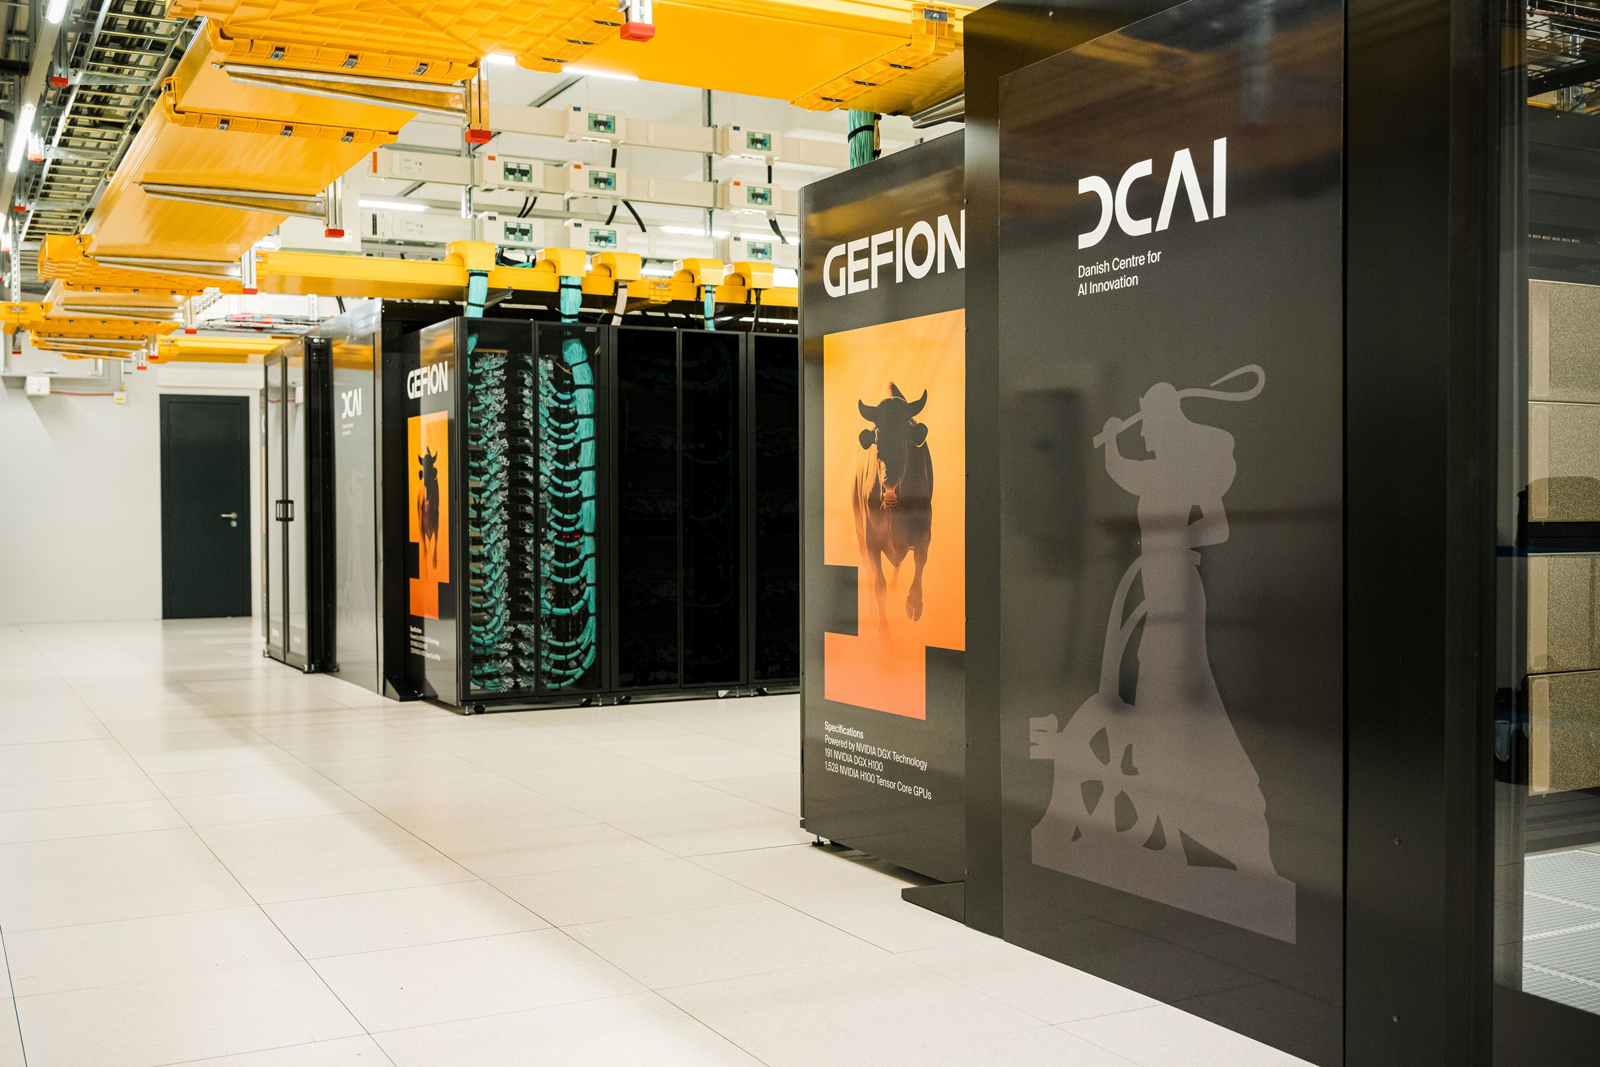
Источник изображения: DCAI Суперкомпьютер размещён в одном из дата-центров Digital Realty на территории Дании. Этот объект на 100 % получает питание от возобновляемых источников энергии. Сборкой и установкой вычислительного комплекса занимались специалисты Eviden.
26.10.2024 [00:53], Владимир Мироненко
Tesla до конца месяца запустит ИИ-кластер из 50 тыс. NVIDIA H100Tesla планирует ввести в эксплуатацию ЦОД с 50 тыс. ускорителей NVIDIA H100 в конце этого месяца, пишет Data Center Dynamics (DCD) со ссылкой на заявление компании. «Мы начали использовать кластер на базе нашего завода раньше срока и находимся на пути к развертыванию 50 тыс. GPU в Техасе к концу этого месяца», — сообщил финансовый директор Вайбхав Танеджа (Vaibhav Taneja) в ходе отчёта о финансовых результатах за III квартал. Предполагается, что именно этот кластер, размещённый в Остине (Техас) отставал от графика, из-за чего гендиректор Илон Маск (Elon Musk) уволил в апреле руководителя строительства. В июне по распоряжению Маска 12 тыс. ускорителей H100, предназначавшихся Tesla, были переданы xAI. Сама xAI в сентябре запустила ИИ-кластер со 100 тыс. ускорителей NVIDIA H100. Капитальные затраты Tesla достигли $3,5 млрд в отчётном квартале, «последовательно увеличившись в основном из-за инвестиций в ИИ-вычисления», а капитальные затраты за год, как ожидается, превысят $11 млрд, что на $1 млрд больше год к году. При этом Танеджа сообщил, что компания «очень разумно подходит к расходам на ИИ», пытаясь наилучшим способом использовать существующую инфраструктуру, прежде чем делать дальнейшие инвестиции. 
Источник изображения: Taylor Vick / Unsplash Маск заявил, что Tesla продолжает расширять возможности обучения ИИ, чтобы удовлетворить как потребности в обучении автопилота Full Self Driving (FSD), так и роботов Optimus, отметив, что в настоящее время компания не испытывает дефицита вычислительных ресурсов. В квартальном отчёте не упоминается Dojo, ИИ-инфраструктура Tesla на базе ускорителей собственной разработки.
17.10.2024 [14:36], Руслан Авдеев
Nebius, бывшая Yandex, представила облачную ИИ-платформу с ускорителями NVIDIA H100 и H200ИИ-компания Nebius, сформированная из бывшей Yandex N.V., представила облачную платформу с современными ускорителями NVIDIA. Как уточняет Datacenter Dynamics, речь идёт о моделях NVIDIA H100 и H200, а также L40S. В скором будущем компания рассчитывает добавить и новейшие суперускорители GB200 NVL72. 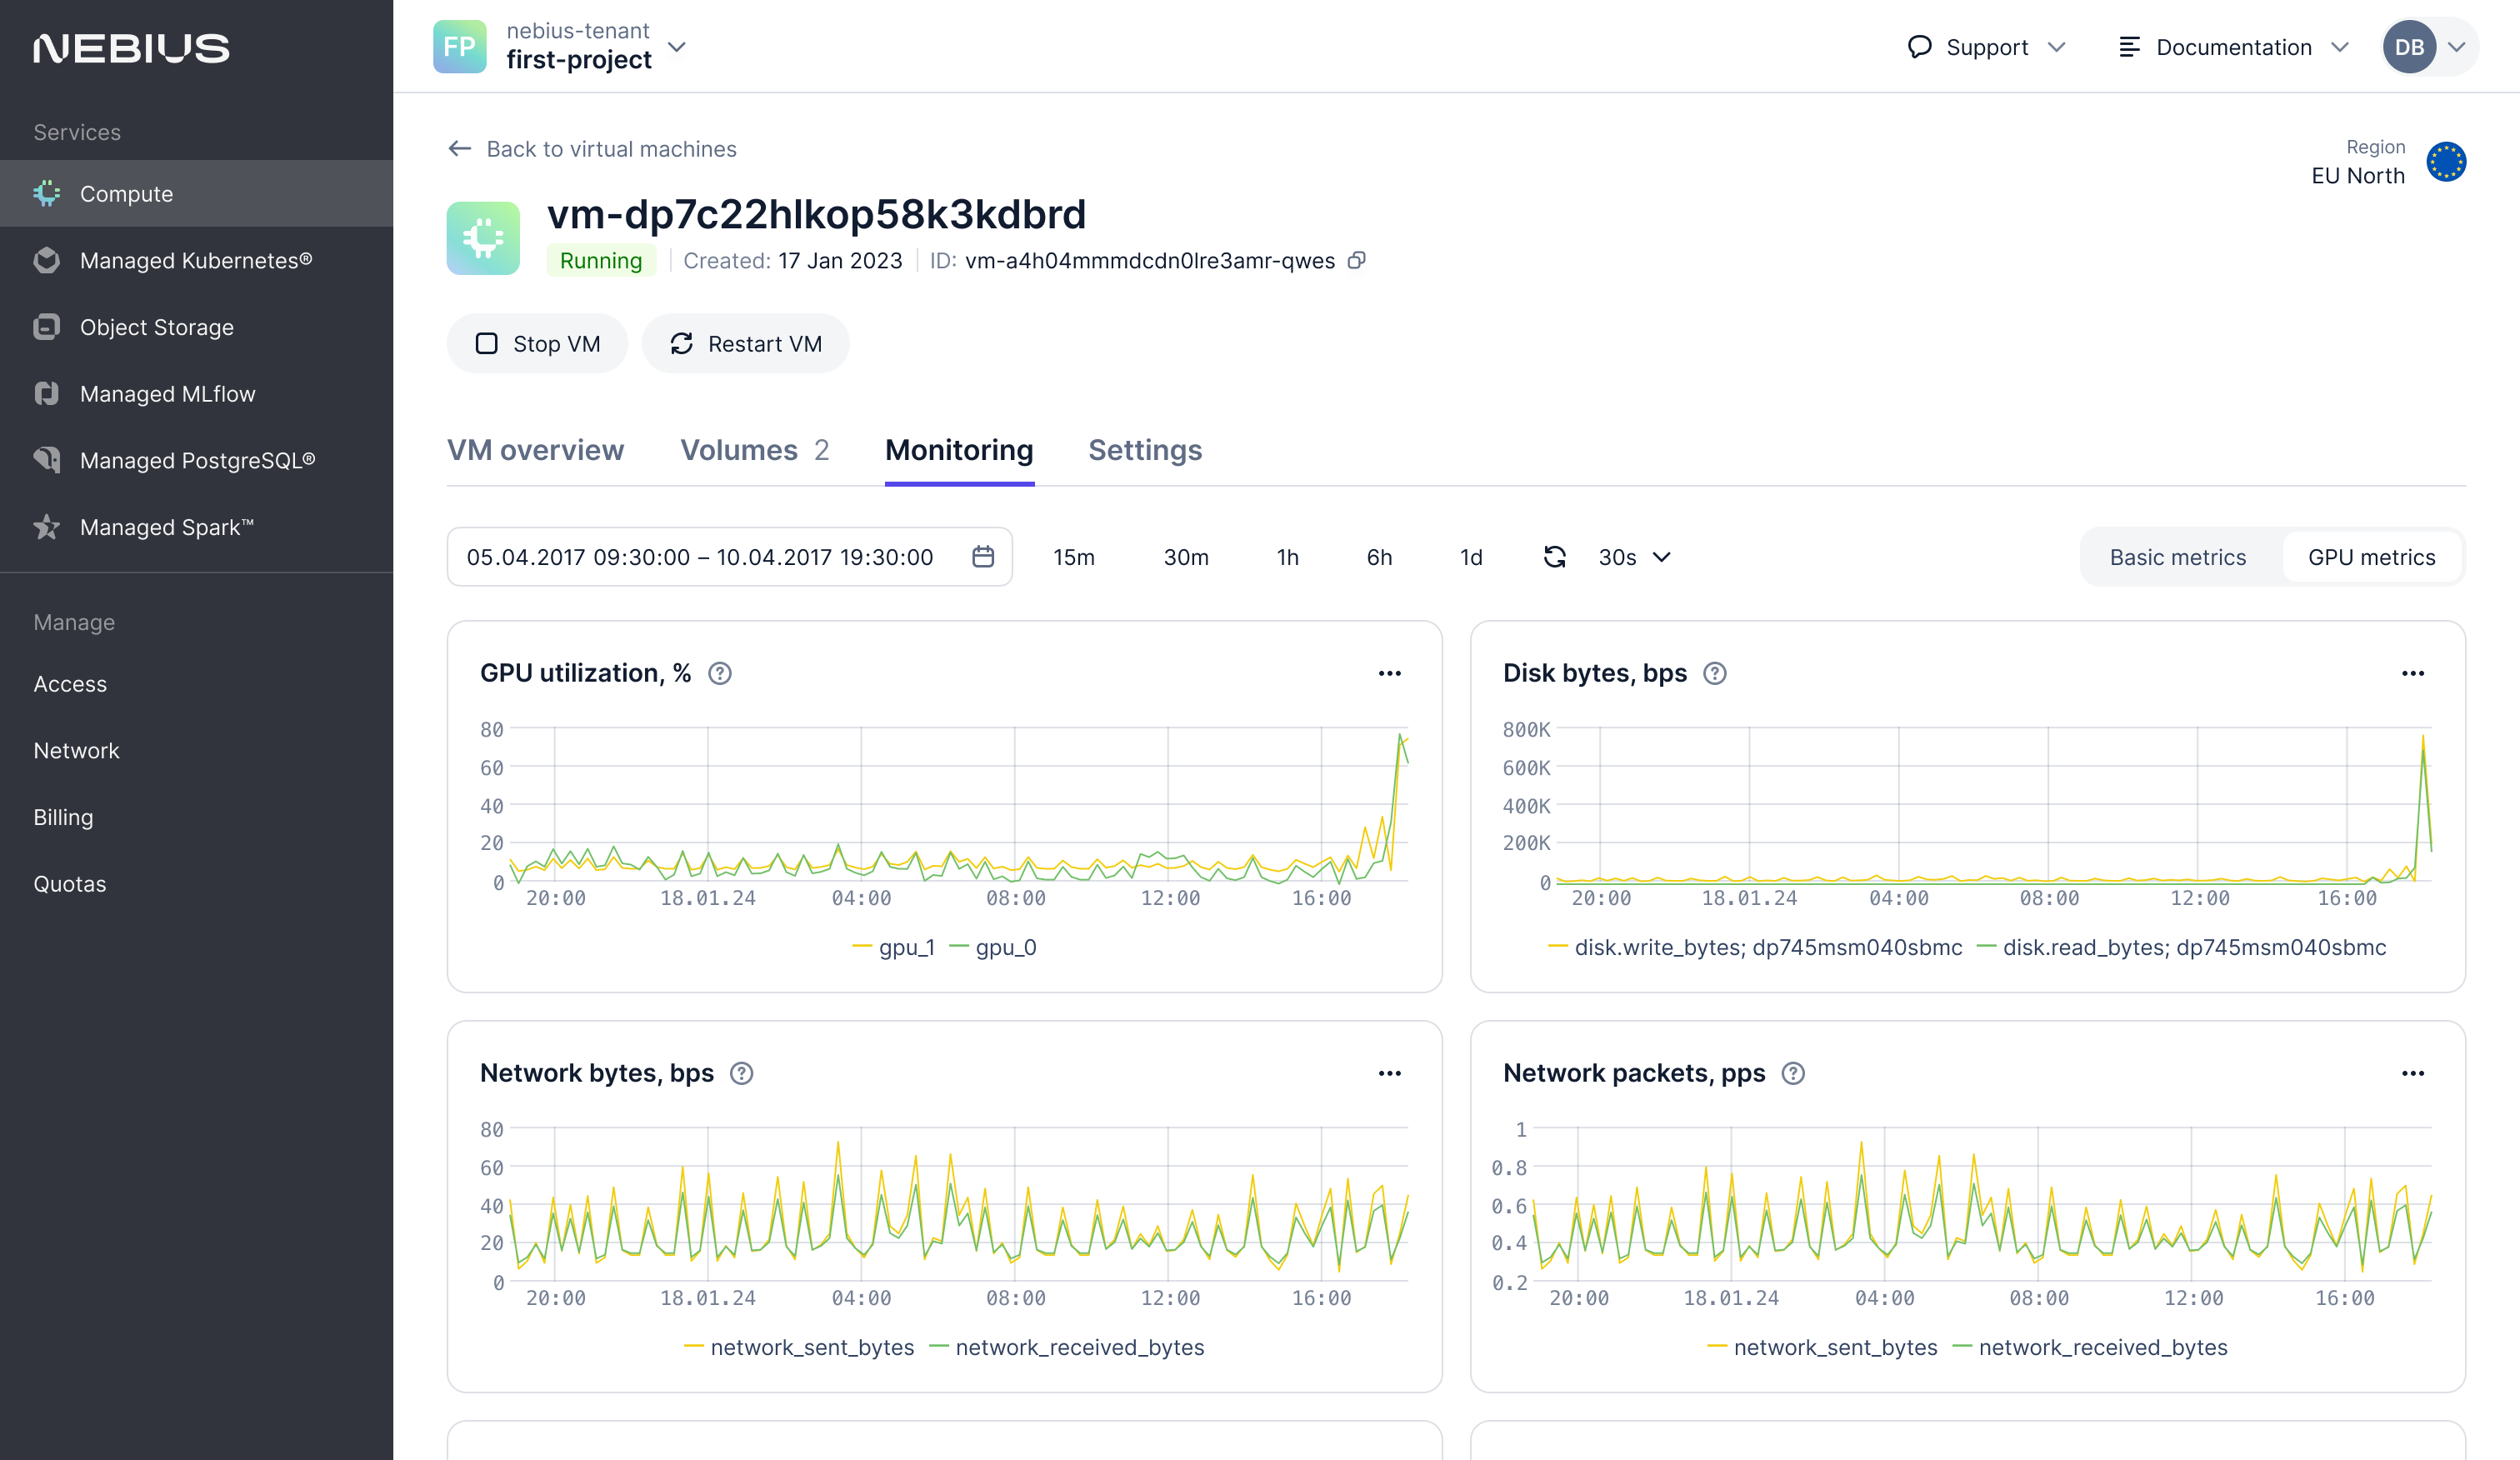
Источник изображения: Nebius Облачное хранилище обеспечивает агрегированную скорость чтения до 100 Гбайт/с и 1 млн IOPS. Платформа также предлагает управляемые Apache Spark и MLFlow, а ВМ по умолчанию включают ИИ-библиотеки и драйверы. По словам компании, она прислушалась к запросам клиентов, нуждавшихся в самостоятельном доступе и инфраструктуре, отлично от просто «базовой». Речь идёт о крупномасштабных кластерах с InfiniBand-подключением на базе эталонной архитектуры NVIDIA, но с кастомизированным оборудованием и проприетарной программной облачной платформой. После введения антироссийских санкций Nebius дистанцировалась от «Яндекса», основная часть активов которого была продана группе российских инвесторов. У Nebius остался дата-центр в Финляндии, ёмкость которого она намерена утроить в обозримом будущем. Там разместятся более 60 тыс. ускорителей. В августе сообщалось, что компания увеличила облачную выручку на 60 % год к году во II квартале.
27.07.2024 [23:44], Алексей Степин
Не так просто и не так быстро: учёные исследовали особенности работы памяти и NVLink C2C в NVIDIA Grace HopperГибридный ускоритель NVIDIA Grace Hopper объединяет CPU- и GPU-модули, которые связаны интерконнектом NVLink C2C. Но, как передаёт HPCWire, в строении и работе суперчипа есть некоторые нюансы, о которых рассказали шведские исследователи. Им удалось замерить производительность подсистем памяти Grace Hopper и интерконнекта NVLink в реальных сценариях, дабы сравнить полученные результаты с характеристиками, заявленными NVIDIA. Напомним, для интерконнекта изначально заявлена скорость 900 Гбайт/с, что в семь раз превышает возможности PCIe 5.0. Память HBM3 в составе GPU-части имеет ПСП до 4 Тбайт/с, а вариант с HBM3e предлагает уже до 4,9 Тбайт/с. Процессорная часть (Grace) использует LPDDR5x с ПСП до 512 Гбайт/с. В руках исследователей оказалась базовая версия Grace Hopper с 480 Гбайт LPDDR5X и 96 Гбайт HBM3. Система работала под управлением Red Hat Enterprise Linux 9.3 и использовала CUDA 12.4. В бенчмарке STREAM исследователям удалось получить следующие показатели ПСП: 486 Гбайт/с для CPU и 3,4 Тбайт/с для GPU, что близко к заявленным характеристиками. Однако результат скорость NVLink-C2C составила всего 375 Гбайт/с в направлении host-to-device и лишь 297 Гбайт/с в обратном направлении. Совокупно выходит 672 Гбайт/с, что далеко от заявленных 900 Гбайт/с (75 % от теоретического максимума). 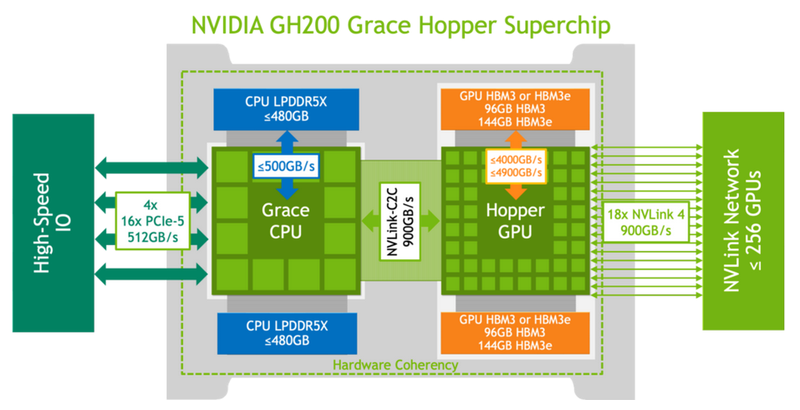
Источник: NVIDIA Grace Hopper в силу своей конструкции предлагает два вида таблицы для страниц памяти: общесистемную (по умолчанию страницы размером 4 Кбайт или 64 Кбайт), которая охватывает CPU и GPU, и эксклюзивную для GPU-части (2 Мбайт). При этом скорость инициализации зависит от того, откуда приходит запрос. Если инициализация памяти происходит на стороне CPU, то данные по умолчанию помещаются в LPDDR5x, к которой у GPU-части есть прямой доступ посредством NVLink C2C (без миграции), а таблица памяти видна и GPU, и CPU. 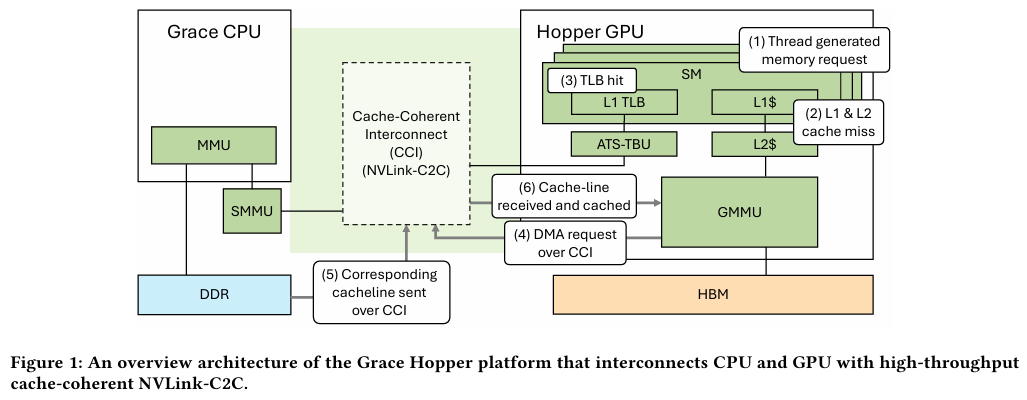
Источник: arxiv.org Если же памятью управляет не ОС, а CUDA, то инициализацию можно сразу организовать на стороне GPU, что обычно гораздо быстрее, а данные поместить в HBM. При этом предоставляется единое виртуальное адресное пространство, но таблиц памяти две, для CPU и GPU, а сам механизм обмена данными между ними подразумевает миграцию страниц. Впрочем, несмотря на наличие NVLink C2C, идеальной остаётся ситуация, когда GPU-нагрузке хватает HBM, а CPU-нагрузкам достаточно LPDDR5x. 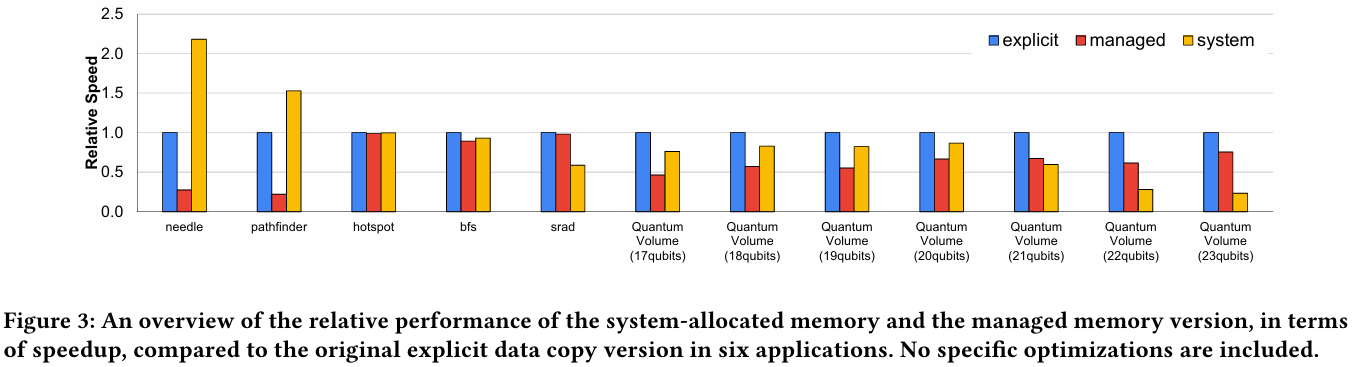
Источник: arxiv.org Также исследователи затронули вопрос производительности при использовании страниц памяти разного размера. 4-Кбайт страницы обычно используются процессорной частью с LPDDR5X, а также в тех случаях, когда GPU нужно получить данные от CPU через NVLink-C2C. Но как правило в HPC-нагрузках оптимальнее использовать 64-Кбайт страницы, на управление которыми расходуется меньше ресурсов. Когда же доступ в память хаотичен и непостоянен, страницы размером 4 Кбайт позволяют более тонко управлять ресурсами. В некоторых случаях возможно двукратное преимущество в производительности за счёт отсутствия перемещения неиспользуемых данных в страницах объёмом 64 Кбайт. В опубликованной работе отмечается, что для более глубокого понимания механизмов работы унифицированной памяти у гетерогенных решений, подобных Grace Hopper, потребуются дальнейшие исследования.
29.03.2024 [21:54], Сергей Карасёв
Eviden увеличит производительность французского суперкомпьютера Jean Zay более чем втроеФранцузское национальное агентство по высокопроизводительным вычислениям (GENCI) и Национальный центр научных исследований (CNRS) заключили соглашение с компанией Eviden (дочерняя структура Atos) о модернизации НРС-комплекса Jean Zay. Ожидается, что производительность этого суперкомпьютера увеличится приблизительно в 3,5 раза. В рамках проекта Eviden оборудует комплекс 1456 ускорителями NVIDIA H100 в дополнение к 416 ускорителям NVIDIA A100 и 1832 ускорителям NVIDIA V100, которые задействованы в настоящее время. Модернизация предполагает использование 14 стоек суперкомпьютерной платформы Eviden BullSequana XH3000. В общей сложности будут задействованы 364 двухпроцессорных узла на базе Intel Xeon Sapphire Rapids с 48 ядрами. Каждый сервер получит 512 Гбайт оперативной памяти и четыре ускорителя NVIDIA H100 SXM5. Говорится об использовании адаптеров NVIDIA ConnectX-7. 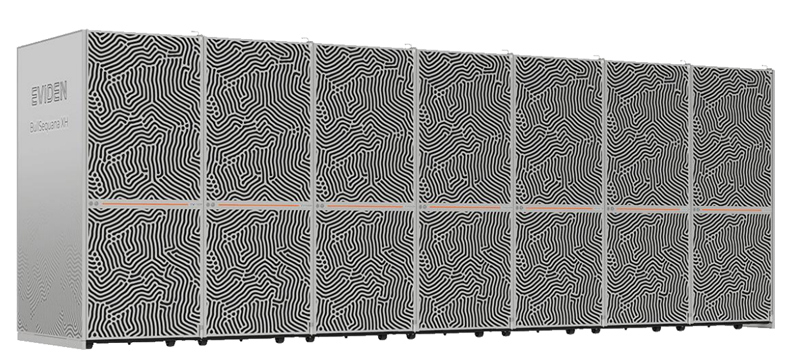
Источник изображения: Eviden Проект также предусматривает комплексное обновление подсистемы хранения данных. Она будет состоять из флеш-массива вместимостью 4,3 Пбайт со скоростями чтения/записи свыше 1 Тбайт/с и дискового массива ёмкостью 39 Пбайт со скоростями чтения/записи более 300 Гбайт/с. Компоненты СХД поставит компания DataDirect Networks (DDN). Для обоих уровней хранения предусмотрено использование файловой системы Lustre. 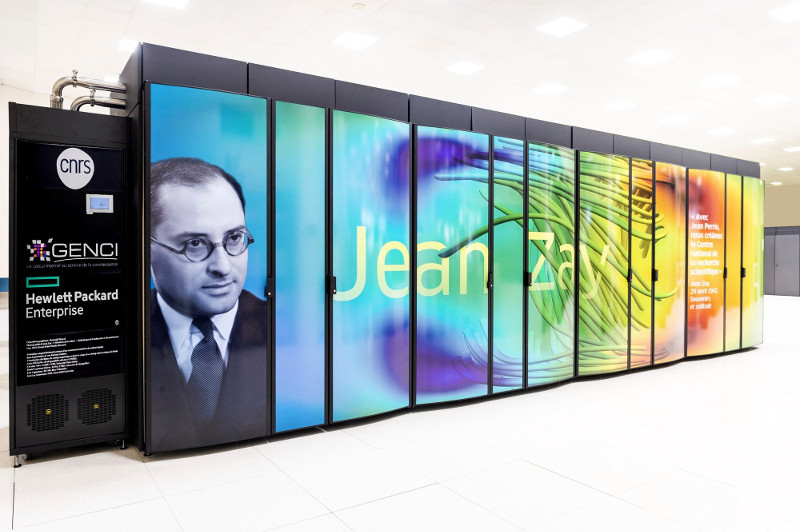
Фото: Photothèque CNRS/Cyril Frésillon Ожидается, что модернизация позволит увеличить пиковую производительность Jean Zay с 36,85 до 125,9 Пфлопс. Проект получил финансирование в рамках национальной инвестиционной программы «Франция 2030». Усовершенствованный суперкомпьютер будет использоваться для решения ресурсоёмких задач, в том числе в области ИИ. Отмечается, что Jean Zay — это один из наиболее экологичных суперкомпьютеров в Европе. Отчасти это достигается благодаря использованию генерируемого машиной тепла для обогрева более 1000 зданий в кампусе Париж-Сакле.
22.03.2023 [20:32], Алексей Степин
Экспортный китайский вариант NVIDIA H100 получил модельный номер H800В связи с санкционными ограничениями некоторые разновидности сложных микроэлектронных чипов запрещено экспортировать в Китайскую Народную Республику. Однако производители находят выход. В частности, компания NVIDIA анонсировала экспортный вариант ускорителя H100, не нарушающий никаких санкций. Модельный номер у такого варианта изменён на H800. Введённые правительством США в 2022 году санкции сделали «невыездными» два наиболее продвинутых продукта NVIDIA: A100 и H100. Такие процессоры сегодня являются основой наиболее динамично развивающейся вычислительной отрасли — нейросетевой. Именно на кластерах из таких ускорителей «натаскивают» мощные нейросети вроде ChatGPT и подобных. 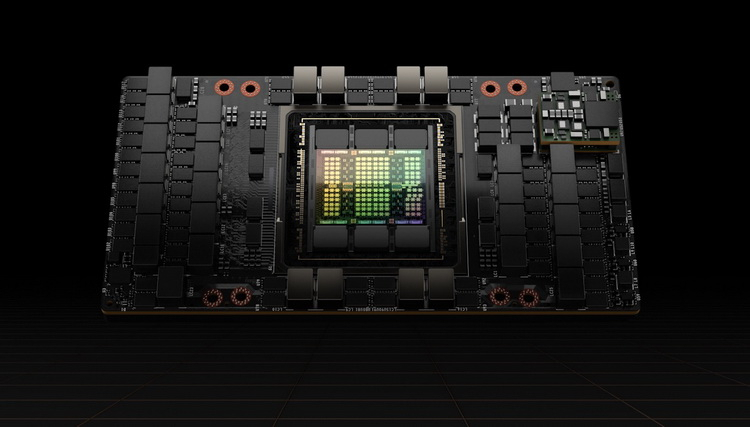
Ускоритель Hopper H100 в SXM-исполнении. Источник изображений здесь и далее: NVIDIA Ещё осенью прошлого года NVIDIA анонсировала A800 — экспортный вариант A100, не попадающий под ограничения за счёт некоторого снижения пропускной способности NVLink, с 600 до 400 Гбайт/с. Сейчас пришло время архитектуры Hopper, которая запущена в массовое производство. По аналогии с флагманом Ampere модернизированный чип получил модельный номер H800. Ограничения в нём реализованы схожим образом: как известно, NVLink в H100 имеет производительность 900 Гбайт/с в базовом SXM-варианте. 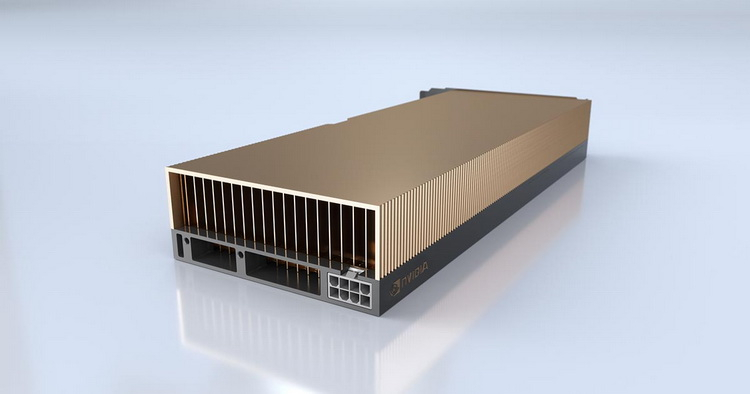
H100 также существует в PCIe-варианте Версия H800 использует примерно половину этого потенциала, что, впрочем, не делает её в Китае менее популярной: новинка уже используется китайскими облачными гигантами, такими, как Alibaba, Baidu и Tencent. Есть ли у H800 другие отличия от H100, не говорится — NVIDIA пока отказывается предоставлять такую информацию. Достоверно известно лишь то, что они полностью соответствуют всем санкционным ограничениям. Интересно, появится ли в будущем вариант H800 NVL на базе NVIDIA H100 NVL.
21.03.2023 [20:45], Владимир Мироненко
NVIDIA запустила облачный сервис DGX Cloud — доступ к ИИ-супервычислениям прямо в браузереNVIDIA запустила сервис ИИ-супервычислений DGX Cloud, предоставляющий предприятиям доступ к инфраструктуре и программному обеспечению, необходимым для обучения передовых моделей для генеративного ИИ и других приложений. DGX Cloud предлагает выделенные ИИ-кластеры NVIDIA DGX в сочетании с фирменным набором ПО NVIDIA. С его помощью предприятие сможет получить доступ к облачному ИИ-суперкомпьютеру, используя веб-браузер и без надобности в приобретении, развёртывании и управлении собственной HPC-инфраструктурой. Правда, удовольствие это всё равно не из дешёвых — стоимость инстансов DGX Cloud начинается от $36 999/мес., причём деньги получает в первую очередь сама NVIDIA. Для сравнения — полностью укомплектованная система DGX A100 в Microsoft Azure обойдётся примерно в $20 тыс. Облачные кластеры DGX предлагаются предприятиям на условиях ежемесячной аренды, что гарантирует им возможность быстро масштабировать разработку больших рабочих нагрузок. «DGX Cloud предоставляет клиентам мгновенный доступ к супервычислениям NVIDIA AI в облаках глобального масштаба», — сообщил Дженсен Хуанг (Jensen Huang), основатель и генеральный директор NVIDIA. 
Источник изображения: NVIDIA Развёртыванием инфраструктуры DGX Cloud компания NVIDIA будет заниматься в сотрудничестве с ведущими поставщиками облачных услуг. Первым среди них стала платформа Oracle Cloud Infrastructure (OCI), предлагающая суперкластер (SuperCluster) с объединёнными RDMA-сетью (в том числе на базе BlueField-3 и Connect-X7) системами DGX (bare metal), которые дополняет высокопроизводительное локальное и блочное хранилище. Cуперкластер может включать до 32 768 ускорителей, но этот рекорд был поставлен с использованием DGX A100, а вот предложение DGX H100 пока что ограничено. В следующем квартале похожее решение появится в Microsoft Azure, а потом в Google Cloud и у других провайдеров. 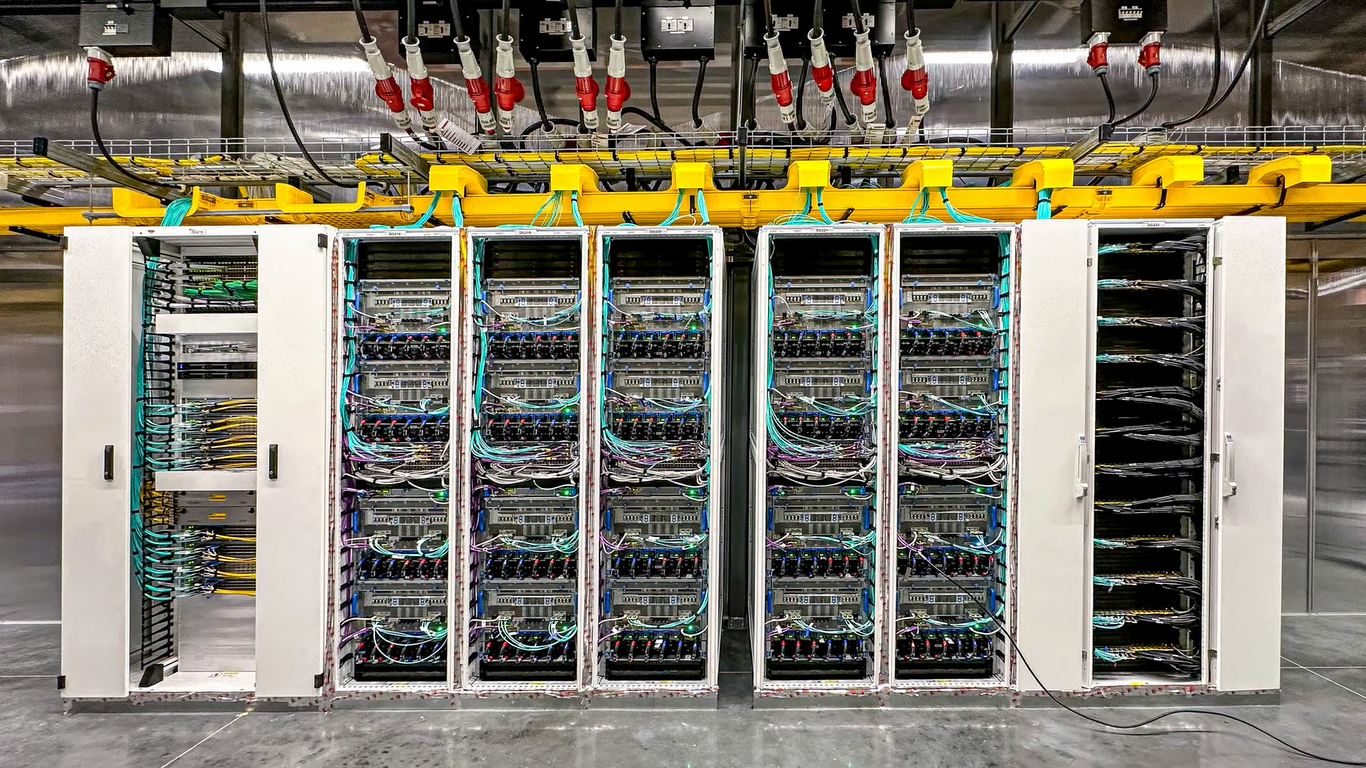
Источник изображения: NVIDIA Первыми пользователями DGX Cloud стали Amgen, одна из ведущих мировых биотехнологических компаний, лидер рынка страховых технологий CCC Intelligent Solutions (CCC) и провайдер цифровых бизнес-платформ ServiceNow. «Мощные вычислительные и многоузловые возможности DGX Cloud позволили нам в 3 раза ускорить обучение белковых LLM с помощью BioNeMo и до 100 раз ускорить анализ после обучения с помощью NVIDIA RAPIDS по сравнению с альтернативными платформами», — сообщил представитель Amgen. Для управления нагрузками в DGX Cloud предлагается NVIDIA Base Command. Также DGX Cloud включает в себя набор инструментов NVIDIA AI Enterprise для создания и запуска моделей, который предоставляет комплексные фреймворки и предварительно обученные модели для ускорения обработки данных и оптимизации разработки и развёртывания ИИ. DGX Cloud предоставляет поддержку экспертов NVIDIA на всех этапах разработки ИИ. Клиенты смогут напрямую работать со специалистами NVIDIA, чтобы оптимизировать свои модели и быстро решать задачи разработки с учётом сценариев отраслевого использования.
21.03.2023 [19:45], Игорь Осколков
Толстый и тонкий: NVIDIA представила самый маленький и самый большой ИИ-ускорители L4 и H100 NVLНа весенней конференции GTC 2023 компания NVIDIA представила два новых ИИ-ускорителя, ориентированных на инференес: неприличной большой H100 NVL, фактически являющийся парой обновлённых ускорителей H100 в формате PCIe-карты, и крошечный L4, идущий на смену T4. 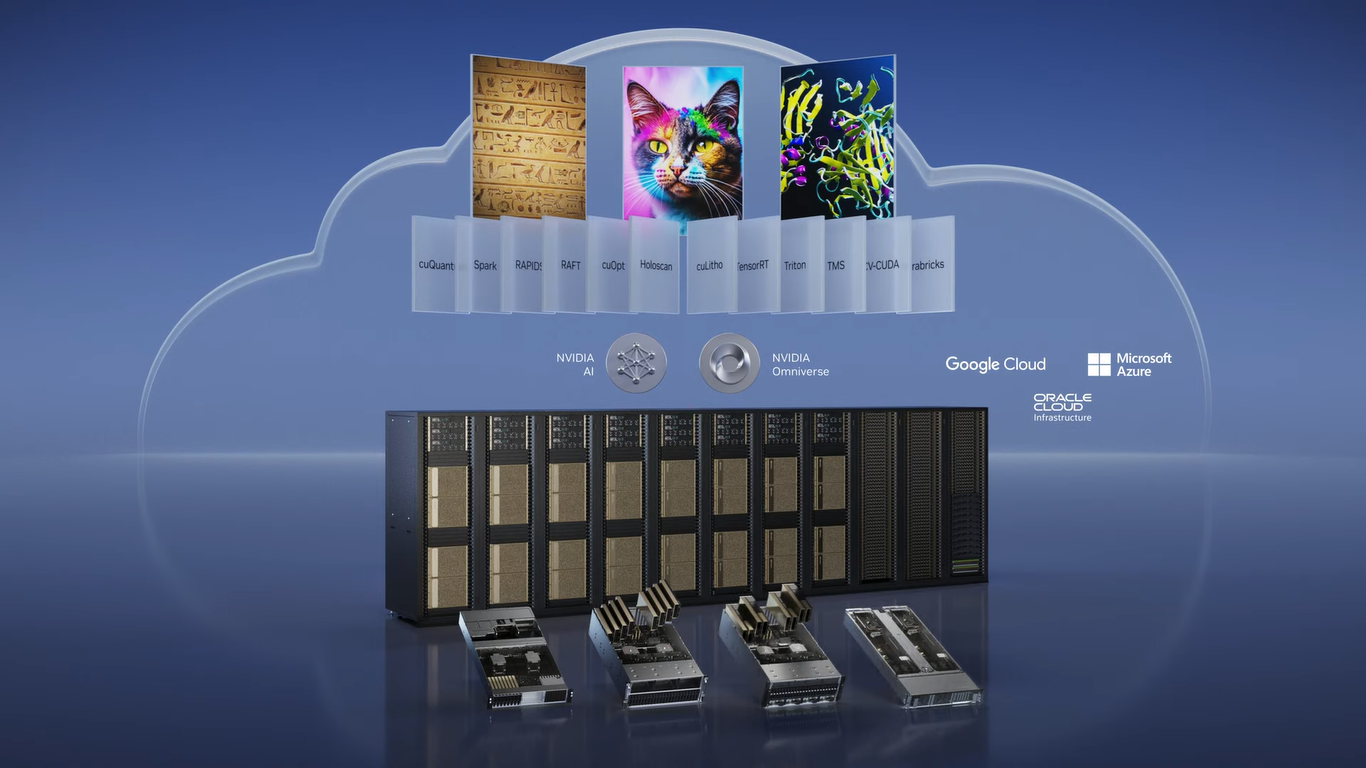
Изображения: NVIDIA NVIDIA H100 NVL действительно выглядит как пара H100, соединённых мостиками NVLink. Более того, с точки зрения ОС они выглядят как пара независимых ускорителей, однако ПО воспринимает их как единое целое, а обмен данными между двумя картам идёт в первую очередь по мостикам NVLink (600 Гбайт/с). Новинка создана в первую очередь для исполнения больших языковых ИИ-моделей, в том числе семейства GPT, а не для их обучения. 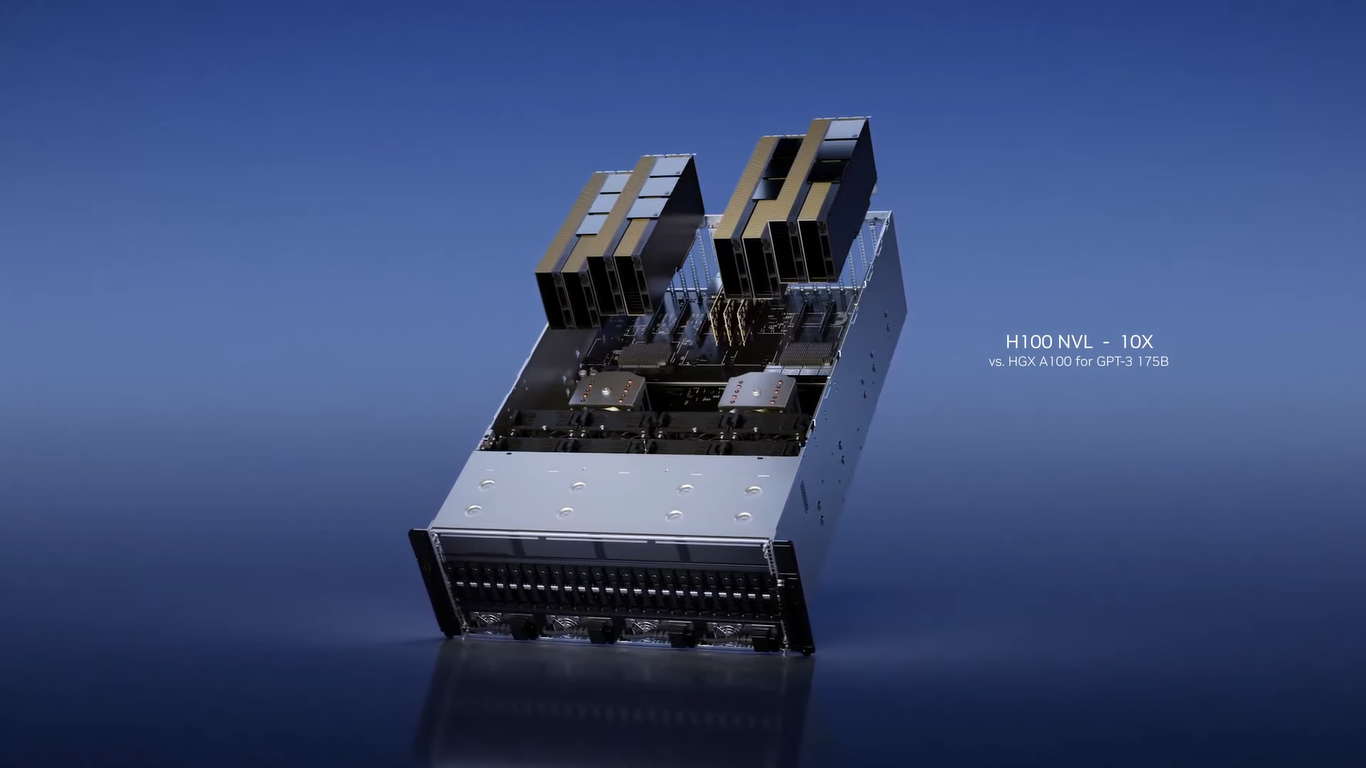
NVIDIA H100 NVL Однако аппаратно это всё же не просто пара обычных H100 PCIe. По уровню заявленной производительности NVL-вариант вдвое быстрее одиночного ускорителя H100 SXM, а не PCIe — 3958 и 7916 Тфлопс в разреженных (в обычных показатели вдвое меньше) FP16- и FP8-вычислениях на тензорных ядрах соответственно, что в 2,6 раз больше, чем у H100 PCIe. Кроме того, NVL-вариант получил сразу 188 Гбайт HBM3-памяти с суммарной пропускной способностью 7,8 Тбайт/с. 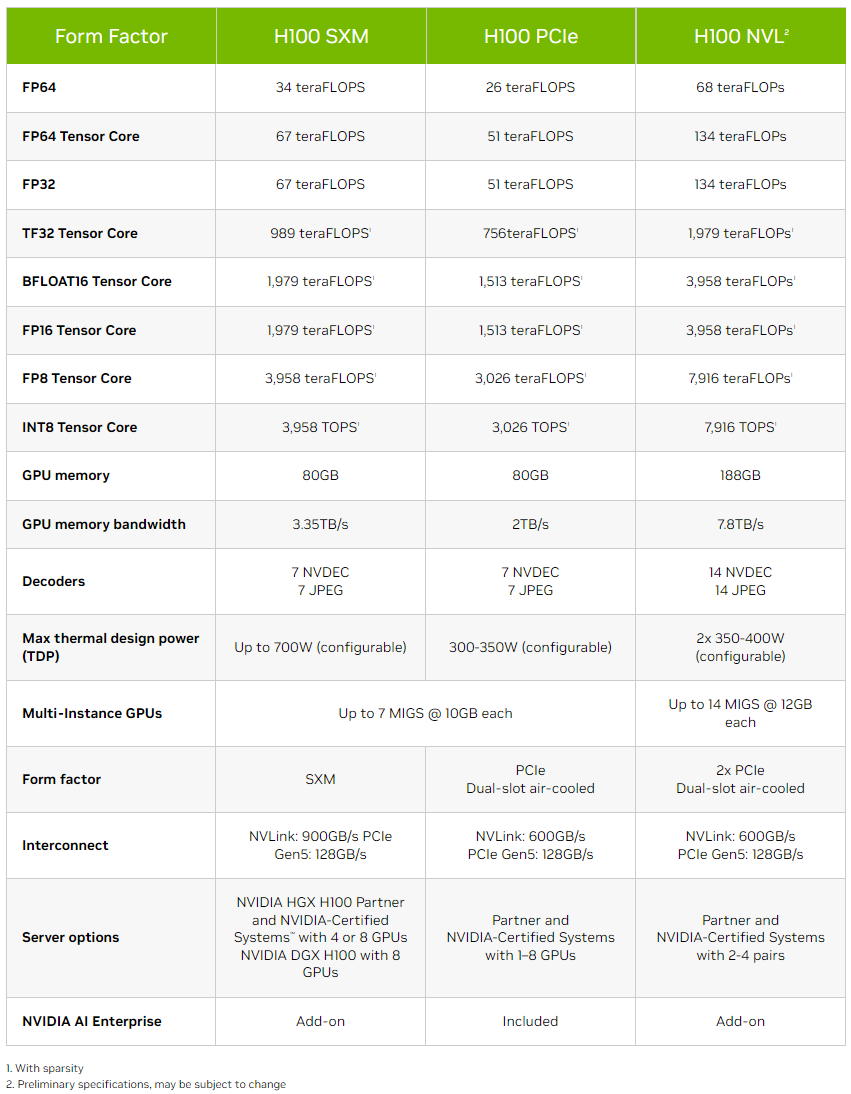 NVIDIA утверждает, что форм-фактор H100 NVL позволит задействовать новинку большему числу пользователей, хотя четыре слота и TDP до 800 Вт подойдут далеко не каждой платформе. NVIDIA H100 NVL станет доступна во второй половине текущего года. А вот ещё одну новинку, NVIDIA L4 на базе Ada, в ближайшее время можно будет опробовать в облаке Google Cloud Platform, которое первым получило этот ускоритель. Кроме того, он же будет доступен в рамках платформы NVIDIA Launchpad, да и ключевые OEM-производители тоже взяли его на вооружение. 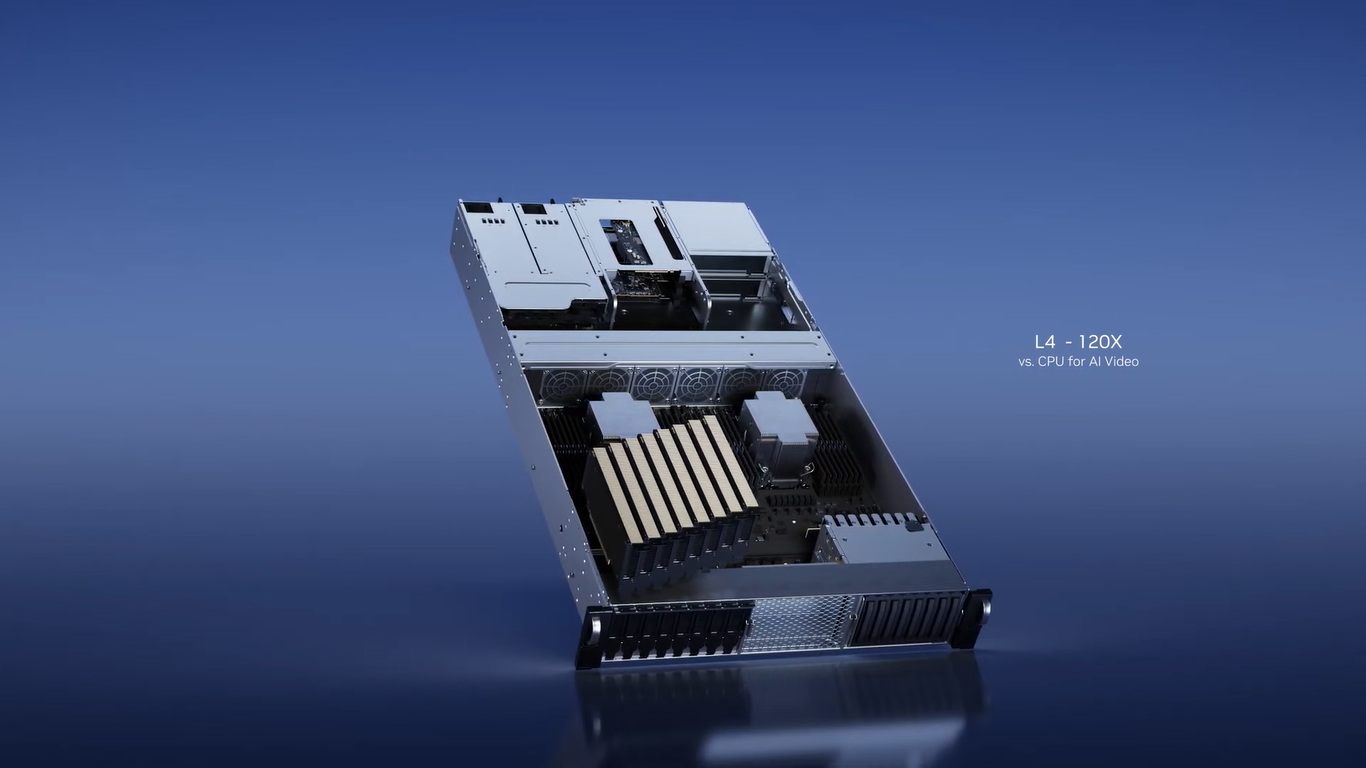
NVIDIA L4 Сама NVIDIA называет L4 поистине универсальным серверным ускорителем начального уровня. Он вчетверо производительнее NVIDIA T4 с точки зрения графики и в 2,7 раз — с точки зрения инференса. Маркетинговые упражнения компании при сравнении L4 с CPU оставим в стороне, но отметим, что новинка получила новые аппаратные ускорители (де-)кодирования видео и возможность обработки 130 AV1-потоков 720p30 для мобильных устройств. С L4 возможны различные сценарии обработки видео, включая замену фона, AR/VR, транскрипцию аудио и т.д. При этом ускорителю не требуется дополнительное питание, а сам он выполнен в виде HHHL-карты. 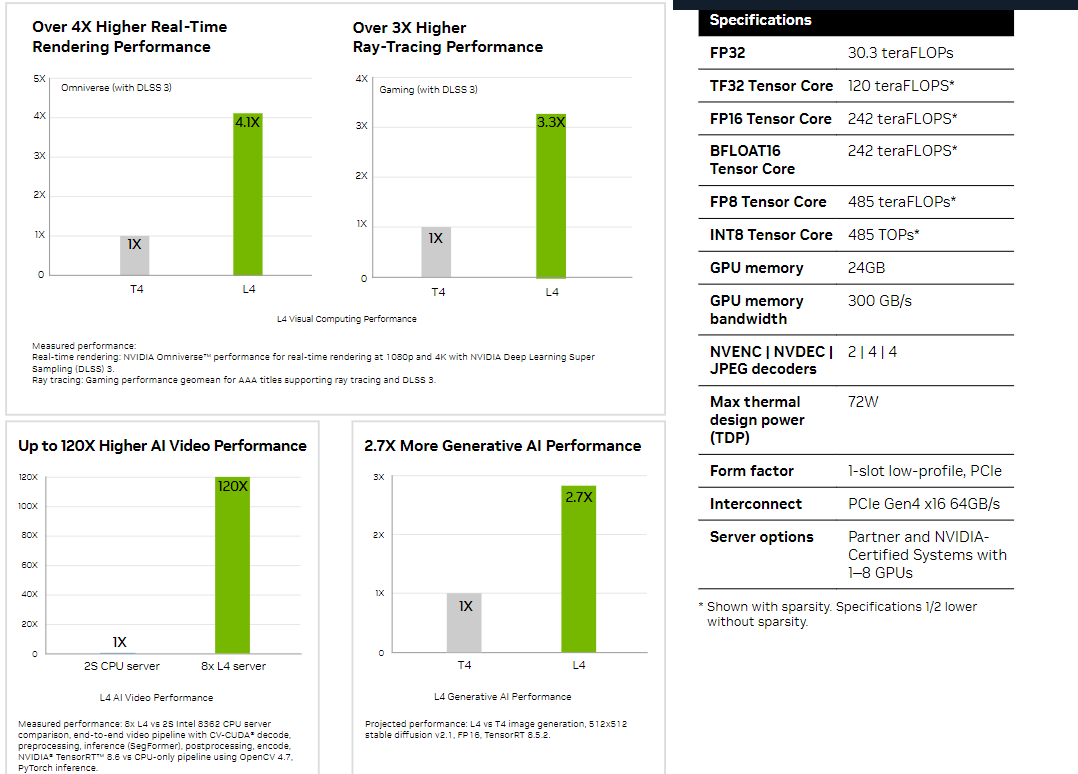
21.03.2023 [19:15], Сергей Карасёв
NVIDIA представила систему DGX Quantum для гибридных квантово-классических вычисленийКомпания NVIDIA в партнёрстве с Quantum Machines анонсировала DGX Quantum — первую систему, объединяющую GPU и квантовые вычисления. Решение использует новую открытую программную платформу CUDA Quantum. Утверждается, что система предоставляет революционно архитектуру для исследователей, работающими с гибридными вычислениями с низкой задержкой. NVIDIA DGX Quantum объединяет средства ускоренных вычислений на базе Grace Hopper (Arm-процессор + ускоритель H100), модели программирования с открытым исходным кодом CUDA Quantum и передовую квантовую управляющую платформу Quantum Machines OPX+. Такая комбинация позволяет создавать ресурсоёмкие приложения, сочетающие квантовые вычисления с современными классическими вычислениями. При этом в числе прочего обеспечивается работа гибридных алгоритмов и коррекция ошибок. 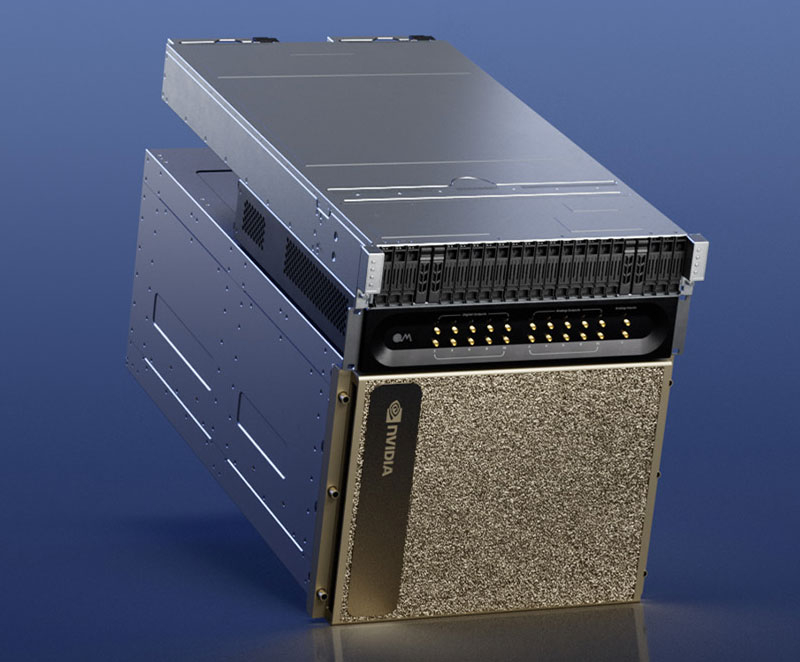
Источник изображения: NVIDIA Представленное решение предполагает соединение Grace Hopper и Quantum Machines OPX+ посредством интерфейса PCIe. Это обеспечивает задержку менее микросекунды между ускорителем и блоками квантовой обработки (QPU). Отмечается, что OPX+ — это универсальная система квантового управления. Таким образом, можно максимизировать производительность QPU и предоставить разработчикам новые возможности при использовании квантовых алгоритмов. Системы Grace Hopper и OPX+ можно масштабировать в соответствии с потребностями — от QPU с несколькими кубитами до суперкомпьютера с квантовым ускорением. 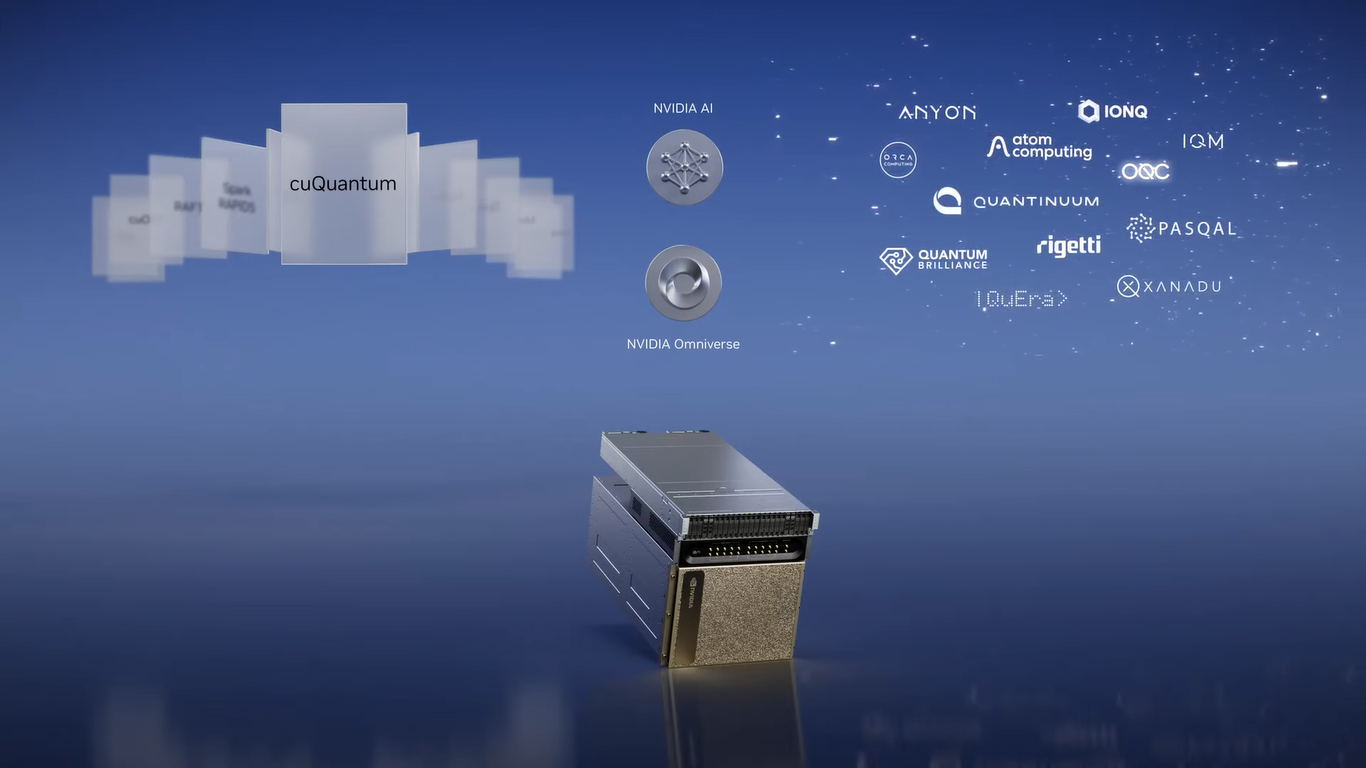
Источник изображения: NVIDIA О намерении интегрировать CUDA Quantum в свои платформы уже заявили компании по производству квантового оборудования Anyon Systems, Atom Computing, IonQ, ORCA Computing, Oxford Quantum Circuits и QuEra, разработчики ПО Agnostiq и QMware, а также некоторые суперкомпьютерные центры. |
|

