Лента новостей
|
10.04.2024 [01:30], Алексей Степин
Google анонсировала Axion, свой первый серверный Arm-процессорКомпания Google объявила о выпуске собственного процессора для своих ЦОД. В основу новинки, получившей имя Axion, легла архитектура Arm, что ставит её в один ряд с Amazon Graviton, Alibaba Yitian и Microsoft Cobalt. Это не первый процессор, разработанный Google: c 2015 года компания успела создать пять поколений ИИ-ускорителей Tensor Processing Units (TPU), а в 2018 она представила процессор Video Coding Unit (VCU) Argos для транскодирования видео. Но Axion стал первым чипом Google, который подпадает под определение «процессор общего назначения». При его создании компания сделала упор не только на энергоэффективность, но и на высокий уровень производительности, достаточный для использования в современных серверах. 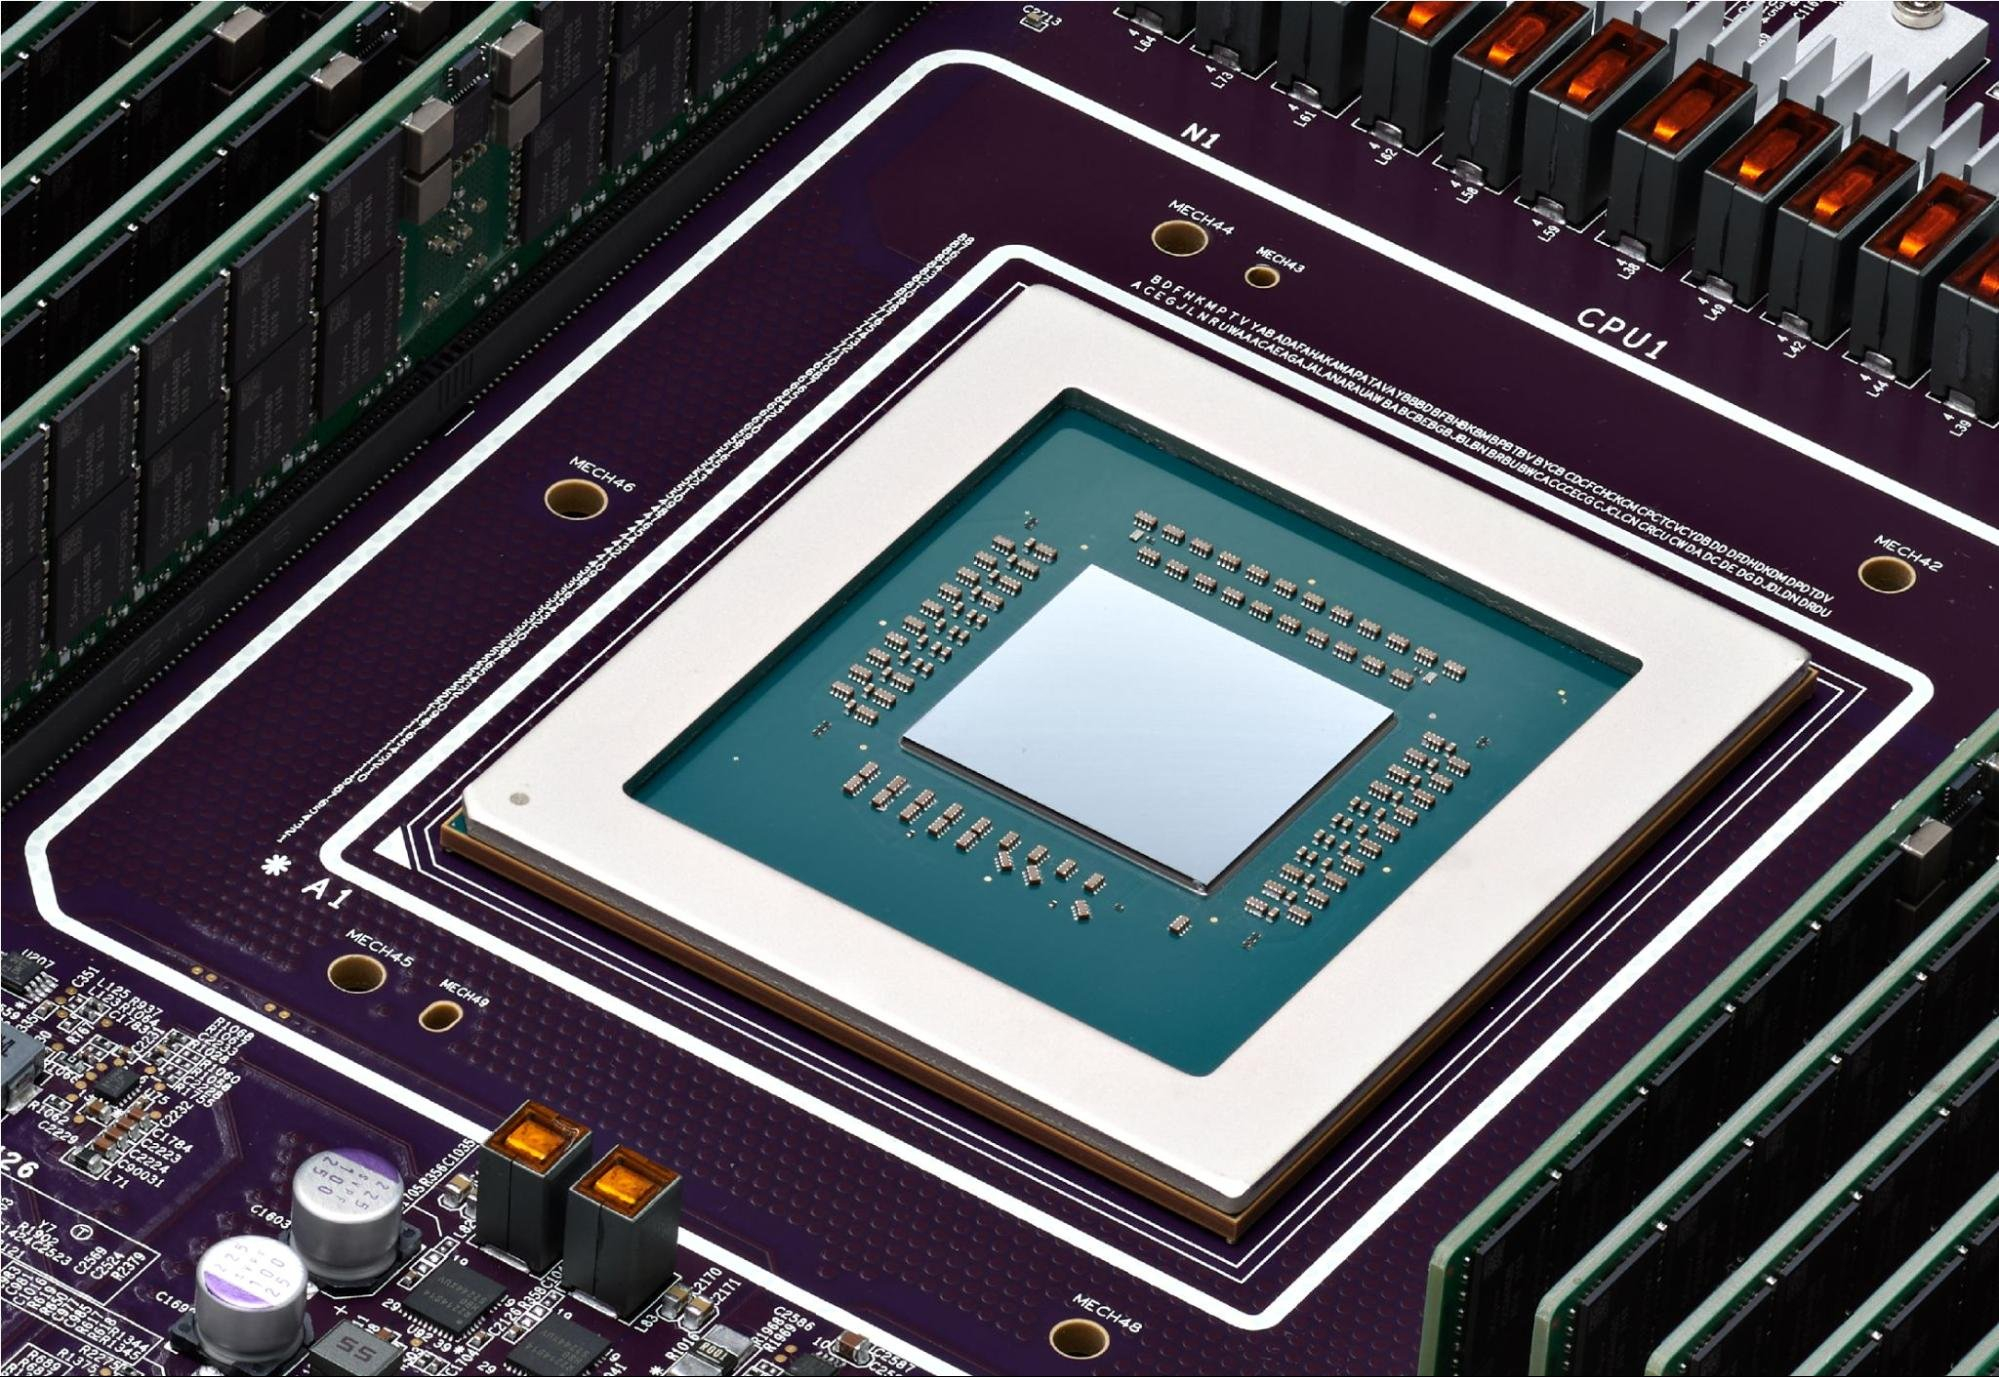
Источник изображений: Google В основу Axion легли Armv9-ядра Neoverse V2 (Demeter). Этот же дизайн используется в AWS Graviton4 и NVIDIA Grace. К сожалению, архитектурных подробностей Google пока не раскрывает, известно лишь, что ядра Neoverse V2 работают совместно с фирменными контроллерами Titanium. Последние отвечают за работу с сетью, защиту и разгрузку IO-операций при работе с блочным хранилищем Hyperdisk, то есть чем-то напоминают AWS Nitro. При этом Google вложилась в SystemReady Virtual Environment (VE), чтобы упростить перенос нагрузок на новые чипы как для себя, так и для пользователей облака. 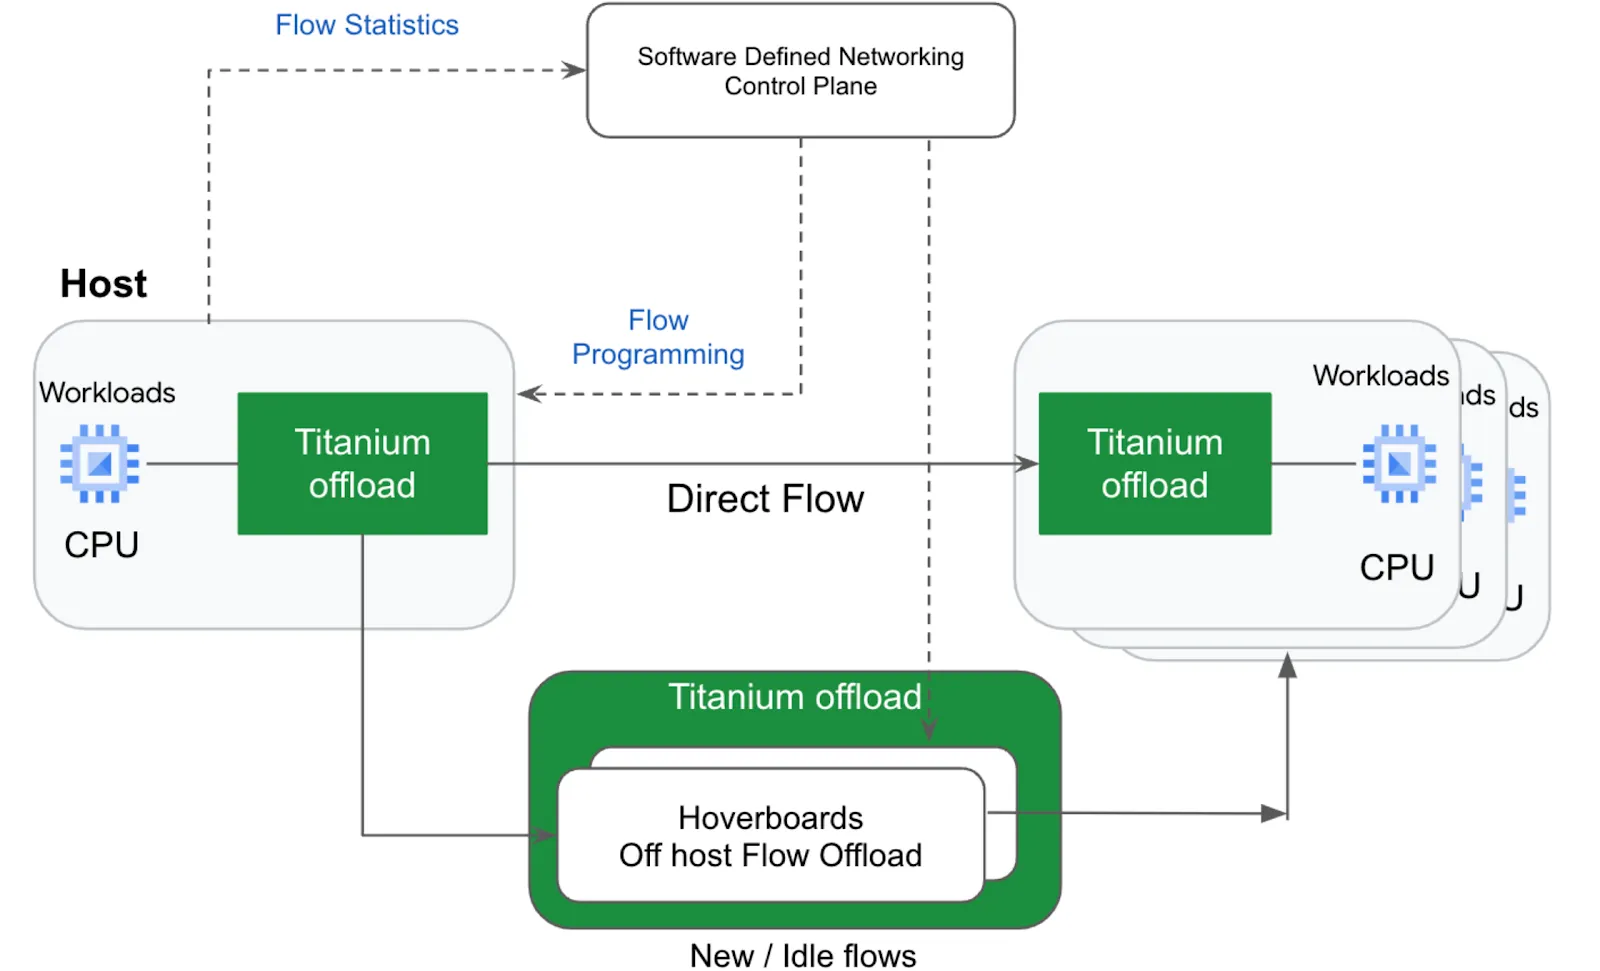 Если верить разработчикам, на момент анонса Google инстансы на базе Axion минимум на 30 % производительнее инстансов на базе самых быстрых Arm-процессоров других вендоров, а по сравнению с сопоставимыми по классу x86-процессорами преимущество может достигать и 50 % при 60 % выигрыше в энергоэффективности. Судя по всему, Axion ранее был известен под кодовым именем Cypress. А ещё один Arm-процессор Google Maple, который, по слухам, являлся наследником почивших Marvell ThunderX, в серию, видимо, не пошёл. Сама компания уже начала переводить на Axion сервисы BigTable, Spanner, BigQuery, Blobstore, Pub/Sub, Google Earth Engine и YouTube Ads. Ряд клиентов и партнёров Google уже оценили Axion по достоинству. Виртуальные машины с новыми процессорами будут доступны в ближайшие месяцы. Они же будут доступны и в Kubernetes Engine, Dataproc, Dataflow, Cloud Batch и т.д.
09.04.2024 [23:45], Сергей Карасёв
Intel представила чипы Meteor Lake PS, Raptor Lake PS и Atom x7000RE для edge-устройствКорпорация Intel анонсировала сразу три семейства процессоров для встраиваемых устройств и edge-оборудования: это чипы Core Ultra Meteor Lake PS, Core Raptor Lake PS и Atom x7000RE. Изделия серии Core Ultra PS (Meteor Lake) изготавливаются по технологии Intel 4. Они рассчитаны на установку в разъём нового поколения LGA 1851. Конструкция включает ядра P-cores и E-cores, графический блок Intel Arc GPU, а также нейропроцессорный движок (NPU), предназначенный для ускорения ИИ-операций. 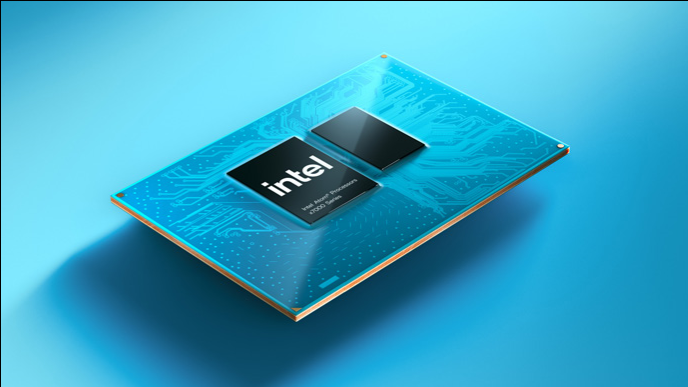
Источник изображения: Intel Семейство Core Ultra PS представлено моделями HL со стандартным значением TDP в 45 Вт и UL с базовым TDP в 15 Вт. Реализована поддержка оперативной памяти DDR5-5600 и до 20 линий PCIe 4.0. В общей сложности в серию Core Ultra PS вошли девять моделей. Количество ядер достигает 16, число одновременно обрабатываемых потоков инструкций — 22. Объём кеша L3 составляет до 24 Мбайт, тактовая частота — до 5,0 ГГц. 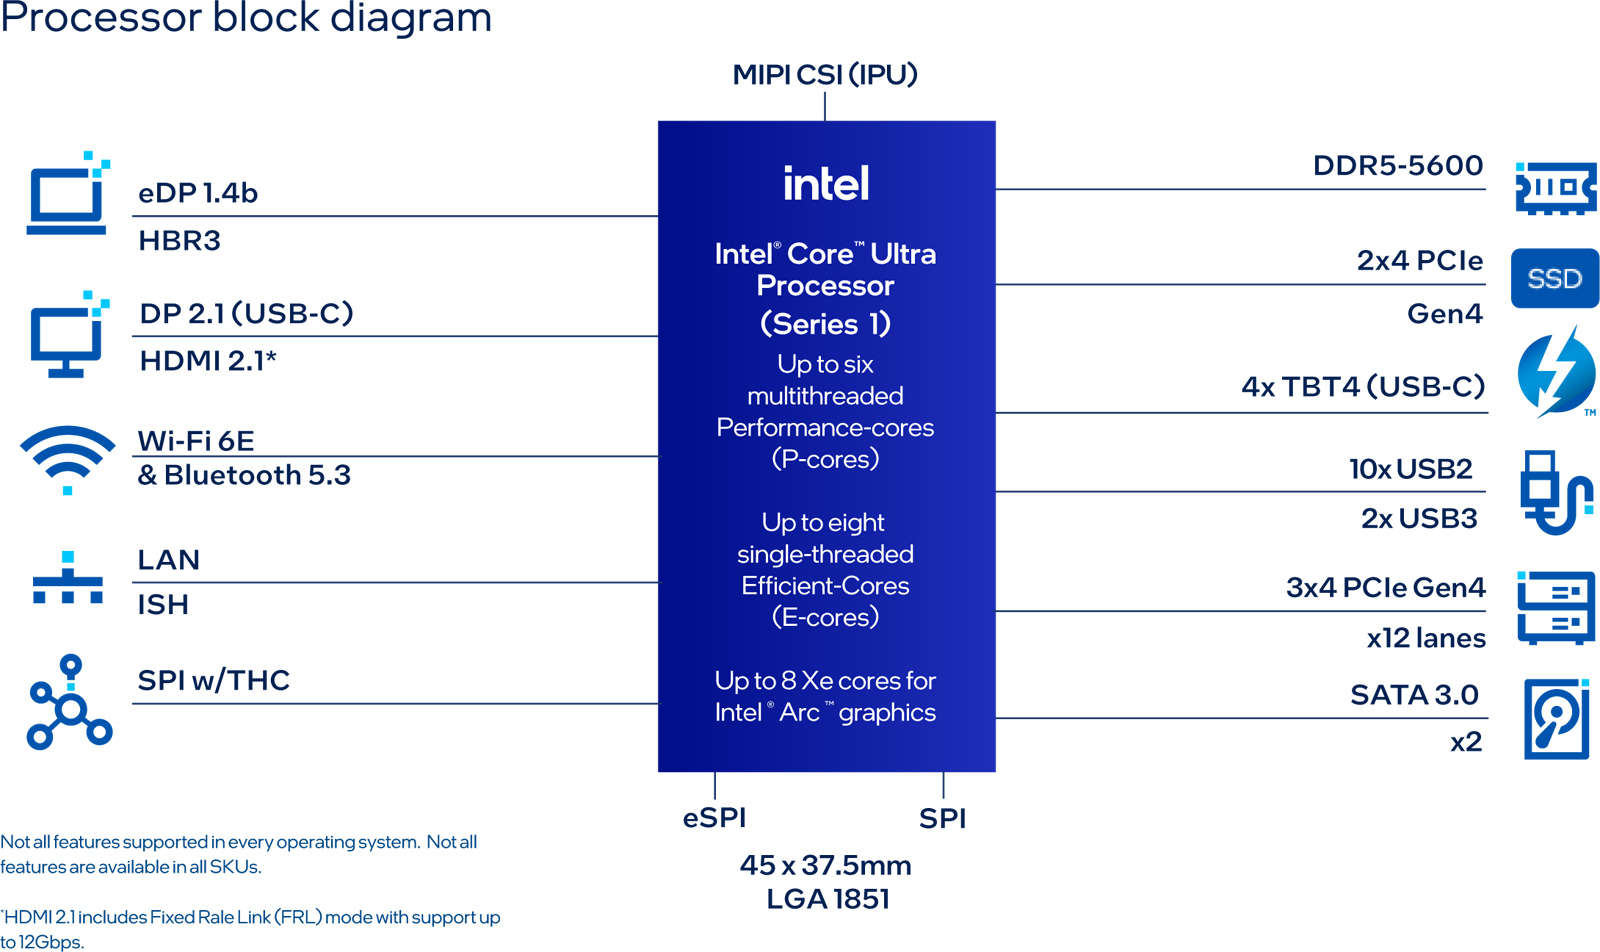
Источник изображения: Intel В свою очередь, процессоры семейства Core PS (Raptor Lake) используют сокет LGA 1700. Эти чипы также подразделяются на подсерии HL и UL с базовым TDP соответственно 45 и 15 Вт. Они содержат до 14 ядер с поддержкой до 20 потоков инструкций. Поддерживается работа с оперативной памятью DDR5–5200 и DDR4-3200. Возможно использование 8 линий PCIe 4.0 в дополнение к 12 линиям PCIe 3.0 в составе интегрированного PCH. Используется графика Intel Graphics. Объём кеша L3 достигает 24 Мбайт, тактовая частота — до 5,2 ГГц. В семейство Core PS на сегодняшний день входят 14 моделей.
Наконец, изделия Atom x7000RE (Amston Lake) выполнены по технологии Intel 7. Они насчитывают до восьми ядер E-cores, а показатель TDP варьируется от 6 до 12 Вт. Поддерживаются память LPDDR5-4800, DDR5-4800 и DDR4-3200, до девяти линий PCIe 3.0, графика Intel UHD Graphics. Максимальная тактовая частота — 3,6 ГГц.
08.04.2024 [01:50], Владимир Мироненко
Groq больше не продаёт свои ИИ-ускорители, предлагая вместо этого совместно создавать ЦОД и облачные сервисыСтартап Groq, создавший ускоритель LPU на базе собственного массивно-параллельного тензорного процессора TSP, больше не продаёт оборудование, предлагая вместо этого воспользоваться его облачными ИИ-сервисами или стать партнёром в создании ЦОД. Об этом генеральный директор Groq Джонатан Росс (Jonathan Ross) сообщил ресурсу EE Times. Он пояснил, что для стартапа заниматься продажами чипов слишком сложно, потому что «минимальная сумма покупки, чтобы это имело смысл, высока, затраты высоки, и никто не хочет рисковать, покупая большое количество оборудования — неважно, насколько оно потрясающее». По его словам, в облаке GroqCloud для инференса больших языковых моделей (LLM) в реальном времени уже зарегистрировано 70 тыс. разработчиков и запущено более 19 тыс. новых приложений. 
Источник изображений: Groq В случае поступления заказов на поставку больших объёмов чипов для очень крупных систем Groq вместо продажи предлагает партнёрство по развёртыванию ЦОД. Groq подписала соглашение с саудовской государственной нефтяной компанией Aramco, которое предполагает масштабное развёртывание LPU. Похожее соглашение в ОАЭ подписала Cerebras, ещё один молодой разработчик ИИ-ускорителей. «Правительство США и его союзники — единственные, кому мы готовы продавать оборудование, — говорит Росс. — Для всех остальных мы лишь (совместно) создаём коммерческие облака». По его словам, в этом году Groq планирует разместить 42 тыс. LPU в GroqCloud, при этом Aramco и другие партнёры «завершают» свои сделки по получению такого же количества чипов. Компания способна выпустить 220 тыс. LPU только в этом году, а общий объём производства на ближайшее время составляет 1,5 млн ускорителей. Около 1 млн из них всё ещё не зарезверированы, но это количество быстро сокращается. Росс пообещал, что к концу 2025 году компания развернёт столько LPU, что их вычислительная мощность будет эквивалентна ИИ-мощностям всех гиперскейлерам вместе взятых.  Росс с оптимизмом смотрит на перспективы Groq, поскольку чипы TSP не используют память HBM, на которую полагаются решения конкурентов, включая NVIDIA, и поставки которой расписаны до конца 2024 года. Что касается LPU следующего поколения, то компания планирует сразу перейти с 14-нм техпроцесса (Global Foundries) на 4-нм. По словам Росса, новый чип будет оптимизирован для генеративного ИИ, но у него в силу универсальности архитектуры не будет каких-то специальных функций для обработки LLM. Будет ли новый ускоритель всё так же изготавливаться на территории США, не уточняется. Groq, похоже, достаточно уверена в своих чипах, которые в бенчмарках действительно обгоняют конкурентов. После анонса архитектуры NVIDIA Blackwell, обеспечивающей кратное увеличение производительности в задачах генеративного ИИ, компания выпустил в ответ пресс-релиз из одного предложения: «Groq всё ещё быстрее». А чуть позже даже раскритиковала NVIDIA.
07.04.2024 [23:52], Руслан Авдеев
Утром — деньги, вечером — SMR: Equinix заплатила $25 млн за право получить до 500 МВт от малых модульных реакторов OkloEquinix заключила предварительное соглашение с создателем малых модульных реакторов (SMR) Oklo, поддерживаемым главой OpenAI Сэмом Альтманом (Sam Altman). По данным Datacenter Dynamics, это первый договор, подписанный оператором, предусматривающий использование SMR. В заявлении по форме S4, поданном AltC Acquisition Corp в Комиссию по ценным бумагам и биржам США (SEC), раскрываются некоторые детали сделки. В частности, Equinix внесла в качестве предоплаты $25 млн. Считается, что в данном случае речь идёт о финансировании акционерного капитала — Equinix получает возможность купить долю в 1,5-1,9 % в бизнесе Oklo. Сейчас разработчик реакторов находится в стадии обратного слияния со SPAC-компанией AltC Acquisition, намеренной вывести специалистов по атомной энергетике на IPO в июле 2024 года. Вместо акций Equinix также может получить дисконт на приобретение энергии. 
Источник изображения: Oklo Модульные реакторы Oklo на быстрых нейтронах способны генерировать до 15 МВт каждый и работать до 10 лет без перезарядки. Equinix будет получать энергию от SMR Oklo в США в течение 20 лет. Конкретные объёмы будут оговариваться в будущих соглашениях о покупке энергии (PPA), а в будущем Equinix сможет обновить и расширить PPA ещё на 20 лет. Оператор ЦОД также получил право преимущественной покупки энергии, вырабатываемой определёнными реакторами, сроком на 36 месяцев — выкупаемая мощность составит 100–500 МВт. SMR, разрабатываемые также NuScale, Rolls-Royce и другими компаниями, предлагаются в качестве источника «низкоуглеродного» экобезопасного питания для ЦОД — это позволит дата-центрам работать без подключения к магистральным электросетям. В прошлом году Standard Power анонсировала планы приобрести 24 SMR у NuScale, хотя позже его назвали фейковым.
02.04.2024 [21:13], Алексей Степин
Три в одном: AMD представила процессоры Ryzen Embedded 8000 с интегрированными NPU и GPUКомпания AMD продолжает активно развивать направление процессоров для встраиваемых систем: если в начале года она представила гибридную платформу Embedded+, сочетающую в себе архитектуру Zen и ПЛИС Versal, то сегодня анонсировала процессоры Ryzen Embedded 8000 с интегрированным ИИ-сопроцессором. Это первое решение AMD для промышленного применения, сочетающее в себе целых три архитектуры: классическую процессорную Zen 4, графическую RDNA 3 и предназначенную для ИИ-вычислений XDNA. Новые процессоры должны найти применение в системах машинного зрения, робототехнике, промышленной автоматике и многих других сценариях. 
Источник: AMD AMD говорит о производительности в ИИ-сценариях, достигающей 39 Топс, что в рамках теплопакета, не превышающего у старшей модели 54 Вт, выглядит неплохо. Но в данном случае речь идёт о совокупной производительности всех архитектур, на долю же NPU приходится только 16 Топс. В качестве памяти используется двухканальная DDR5-5600 с поддержкой ECC. Благодаря графическому ядру RDNA 3 новые Ryzen Embedded 8000 смогут выводить информацию на четыре экрана с разрешением 4K, а также обеспечивать кодирование и декодирование всех популярных видеоформатов, включая H.264, H.265 и AV1. Для связи со специфическими ускорителями или контроллерами оборудования чипы получили 20 линий PCI Express 4.0. 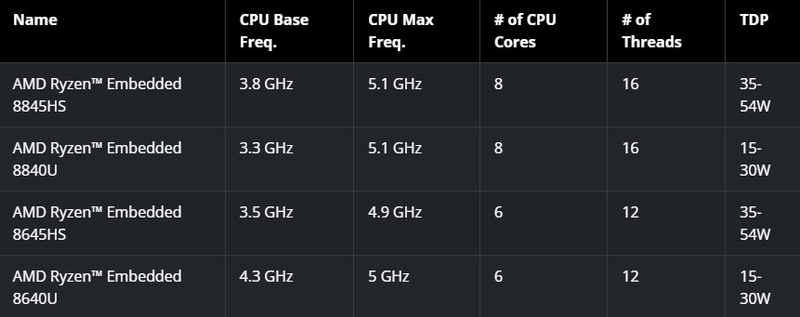 На момент анонса в серию Ryzen Embedded 8000 вошли четыре процессора — два шестиядерных (8645HS и 8640U) и два восьмиядерных (8845HS и 8840U), оба варианта поддерживают SMT и имеют тактовые частоты в диапазоне от 3,3 до 5,1 ГГц. Теплопакет у новинок конфигурируемый, в зависимости от условий охлаждения он может варьироваться либо в пределах 15–30 Вт или 35–54 Вт, что позволит обойтись пассивным теплоотводом там, где это необходимо. Новые решения AMD будут сопровождаться средствами SDK, поддерживающими Windows, а также популярные ИИ-фреймворки PyTorch и TensorFlow. В том числе анонсированы уже обученные модели, которые доступны на HuggingFace. В деле построения экосистемы для Ryzen Embedded 8000 компания тесно сотрудничает с известными производителями оборудования, в том числе с Advantech, ASRock и iBASE. Также для новых процессоров заявлен удлинённый жизненный цикл.
29.03.2024 [21:54], Сергей Карасёв
Eviden увеличит производительность французского суперкомпьютера Jean Zay более чем втроеФранцузское национальное агентство по высокопроизводительным вычислениям (GENCI) и Национальный центр научных исследований (CNRS) заключили соглашение с компанией Eviden (дочерняя структура Atos) о модернизации НРС-комплекса Jean Zay. Ожидается, что производительность этого суперкомпьютера увеличится приблизительно в 3,5 раза. В рамках проекта Eviden оборудует комплекс 1456 ускорителями NVIDIA H100 в дополнение к 416 ускорителям NVIDIA A100 и 1832 ускорителям NVIDIA V100, которые задействованы в настоящее время. Модернизация предполагает использование 14 стоек суперкомпьютерной платформы Eviden BullSequana XH3000. В общей сложности будут задействованы 364 двухпроцессорных узла на базе Intel Xeon Sapphire Rapids с 48 ядрами. Каждый сервер получит 512 Гбайт оперативной памяти и четыре ускорителя NVIDIA H100 SXM5. Говорится об использовании адаптеров NVIDIA ConnectX-7. 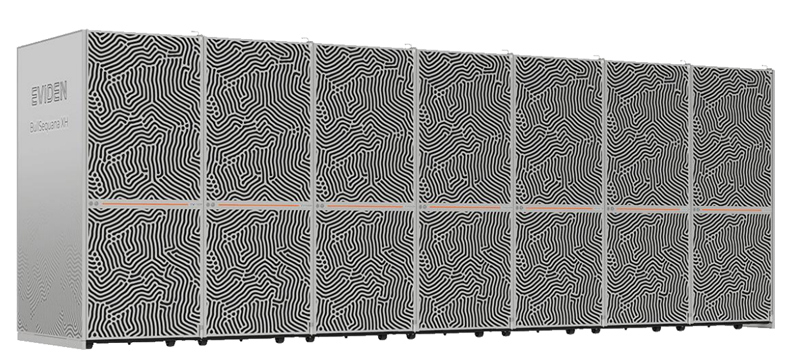
Источник изображения: Eviden Проект также предусматривает комплексное обновление подсистемы хранения данных. Она будет состоять из флеш-массива вместимостью 4,3 Пбайт со скоростями чтения/записи свыше 1 Тбайт/с и дискового массива ёмкостью 39 Пбайт со скоростями чтения/записи более 300 Гбайт/с. Компоненты СХД поставит компания DataDirect Networks (DDN). Для обоих уровней хранения предусмотрено использование файловой системы Lustre. 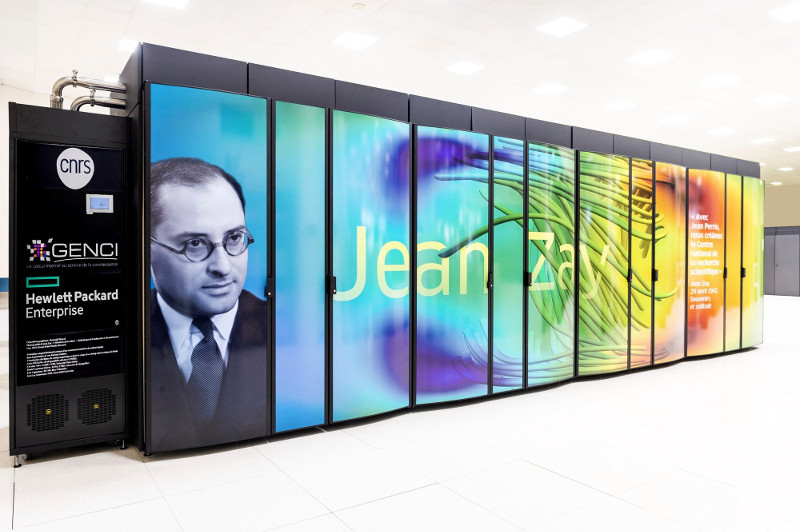
Фото: Photothèque CNRS/Cyril Frésillon Ожидается, что модернизация позволит увеличить пиковую производительность Jean Zay с 36,85 до 125,9 Пфлопс. Проект получил финансирование в рамках национальной инвестиционной программы «Франция 2030». Усовершенствованный суперкомпьютер будет использоваться для решения ресурсоёмких задач, в том числе в области ИИ. Отмечается, что Jean Zay — это один из наиболее экологичных суперкомпьютеров в Европе. Отчасти это достигается благодаря использованию генерируемого машиной тепла для обогрева более 1000 зданий в кампусе Париж-Сакле.
28.03.2024 [21:03], Руслан Авдеев
Nautilus запустила линейку инфраструктурных решений EcoCore для модульных ЦОДNautilus Data Technologies запустила новую серию решений для модульных дата-центров на основе разработанных ранее технологий охлаждения. По данным Datacenter Dynamics, новый проект предлагает варианты для ЦОД ёмкостью до 2,5 МВт. По словам Nautilus, EcoCore расширяет эффективность сборных конструкций и упрощает процесс строительства, позволяя интегрировать рабочее пространство с техническими помещениями и размещать MEP-компоненты (электрику, водоснабжение и вентиляцию) на крыше. Конструкция использует четыре CDU-установки для кондиционирования, каждая из которых способна отводить до 833 кВт тепла. Система поддерживает как традиционные варианты охлаждения, так и современные жидкостные. Основной модуль электропитания (PEU) обеспечивает мощность 1250 кВт (415 В, три фазы), но есть и точно такой же резервный (N+1). Новинка будет развёрнута в Start Campus в Синише (Португалия) — впервые за пределами собственных мощностей Nautilus. EcoCore, по словам компании, соответствует запросам Start по организации бесперебойной работы серверов высокой плотности с СЖО. Компании договорились о сотрудничестве в прошлом году и заключили «многомегаваттное» соглашение. Первый модуль EcoCore будет развёрнут в ходе первой фазы строительства кампуса Start. В Nautilus и Start заявляют, что экобезопасные технологии первой задают новый стандарт в индустрии, обеспечивая непревзойдённые эффективность и адаптивность. 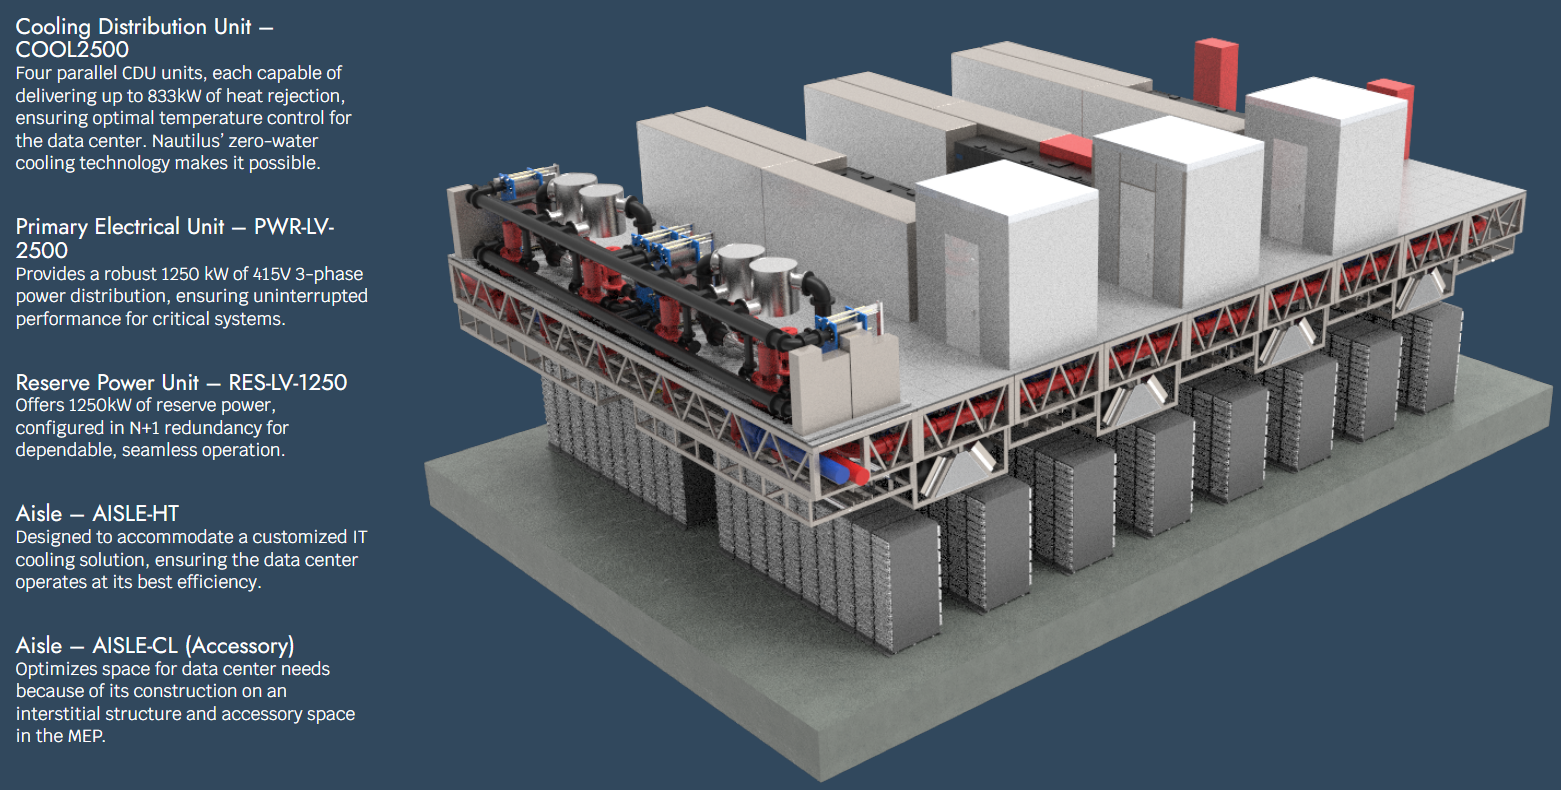
Источник изображения: Nautilus Nautilus известна прежде всего проектами плавучих ЦОД и системой охлаждения дата-центров речной или морской водой. Пока компания выступает лишь оператором ЦОД-баржи в Стоктоне (Калифорния), но планирует построить и наземный объект в Мэне. Также в работе находятся и другие проекты в США, Франции и Ирландии. Меморандумы о взаимопонимании заключены в Таиланде и на Филиппинах. Впрочем, появление EcoCore, похоже, указывает на желание стать поставщиком решений для других операторов. Принадлежащая инвестиционному фонду Davidson Kempner и британской British Pioneer Point Partners компания Start намерена построить 495-МВт кампус площадью 60 га в Португалии. Компании заявили, что Nautilus поставит охладительные системы и для второй фазы проекта, предусматривающего расширение на 120 МВт. Ранее Start оказалась вовлечена в коррупционный скандал.
27.03.2024 [23:40], Сергей Карасёв
Coherent представила оптические коммутаторы для дата-центров, ориентированных на задачи ИИCoherent анонсировала специализированные оптические коммутаторы для ИИ-кластеров высокой плотности. В основу устройств Optical Circuit Switch (OCS) положена фирменная платформа кросс-коммутации Lightwave Cross-Connect (DLX). В изделиях, в отличие от традиционных коммутаторов, не применяются приемопередатчики для преобразования фотонов в электроны и обратно. Вместо этого все операции осуществляются в оптическом тракте: импульсы поступают в один порт и выходят из другого (конечно, с небольшим ослаблением). Coherent выделяет несколько ключевых преимуществ своей технологии. Прежде всего значительно возрастает производительность, что важно при решении ресурсоёмких задач, связанных с приложениями ИИ. Кроме того, благодаря отказу от преобразования среды сокращаются энерозатраты. Наконец, отпадает необходимость в обновлении собственно коммутаторов при установке в ЦОД оборудования следующего поколения. Это значительно повышает окупаемость капитальных затрат. 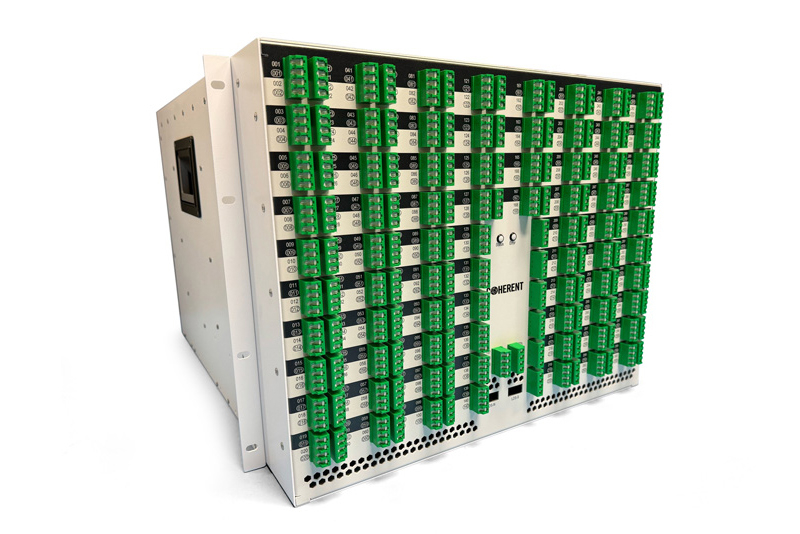
Источник изображения: Coherent Представленное решение насчитывает 300 входных и 300 выходных оптических портов. Коммутаторы OCS помогают решить проблемы масштабируемости и надёжности дата-центров, ориентированных на приложения ИИ. Аналитики Dell'Oro Group отмечают, что для ИИ-задач требуется более высокий уровень отказоустойчивости, нежели для традиционных приложений. Крайне важно, чтобы коммутаторы, используемые в составе ИИ-платформ, не провоцировали никаких перебоев во время обучения или эксплуатации больших языковых моделей. Устройства Coherent, как сообщается, обеспечивают необходимый уровень надёжности. Массовые поставки новых коммутаторов планируется организовать в 2025 году. При этом Google уже использует в своих дата-центрах оптические коммутаторы (OCS) собственной разработки на базе MEMS-переключателей для формирования ИИ-кластеров, а Meta✴ совместно с MIT разработала систему TopoOpt, представляющую собой оптическую патч-панель с манипулятором, который позволяет менять топологию сети.
22.03.2024 [21:10], Сергей Карасёв
Консорциум Ultra Ethernet пополнился 45 участниками, но NVIDIA среди них так и нетКонсорциум Ultra Ethernet объявил о том, что в его состав вошли 45 новых участников. Таким образом, на сегодняшний день общее количество членов этой организации достигает 55. К участию в Ultra Ethernet приглашаются и другие заинтересованные компании и институты. Напомним, консорциум был создан в июле 2023 года. Его задача заключается в разработке основанной на Ethernet открытой высокопроизводительной архитектуры с полным коммуникационным стеком, отвечающей задачам современных рабочих нагрузок ИИ и НРС. Изначально в состав Ultra Ethernet входили AMD, Arista, Broadcom, Cisco, Eviden (Atos), HPE, Intel, Meta✴ и Microsoft. Позднее к консорциуму присоединилась компания Cornelis Networks, поставщик HPC-интерконнекта на базе Omni-Path. 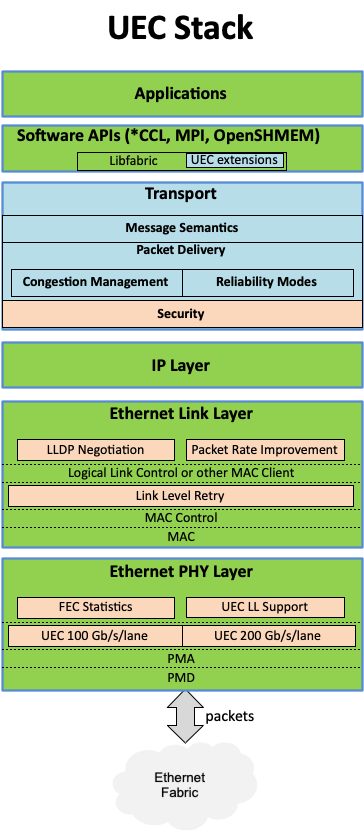
Источник изображения: Ultra Ethernet С ноября 2023-го организация начала принимать новых участников в массовом порядке. С тех пор инициативу поддержали Nokia, Lenovo, Baidu, Dell, Huawei, IBM, Supermicro, Tencent и многие другие компании. Примечательно, что в списке участников так и нет AWS, Google и NVIDIA. Последняя по-прежнему считает InfinBand лучшим интерконнектом для HPC/ИИ-кластеров и является фактически единственным поставщиком данной технологии. Более того, даже Ethernet-решения NVIDIA подвергаются критике со стороны конкурентов. 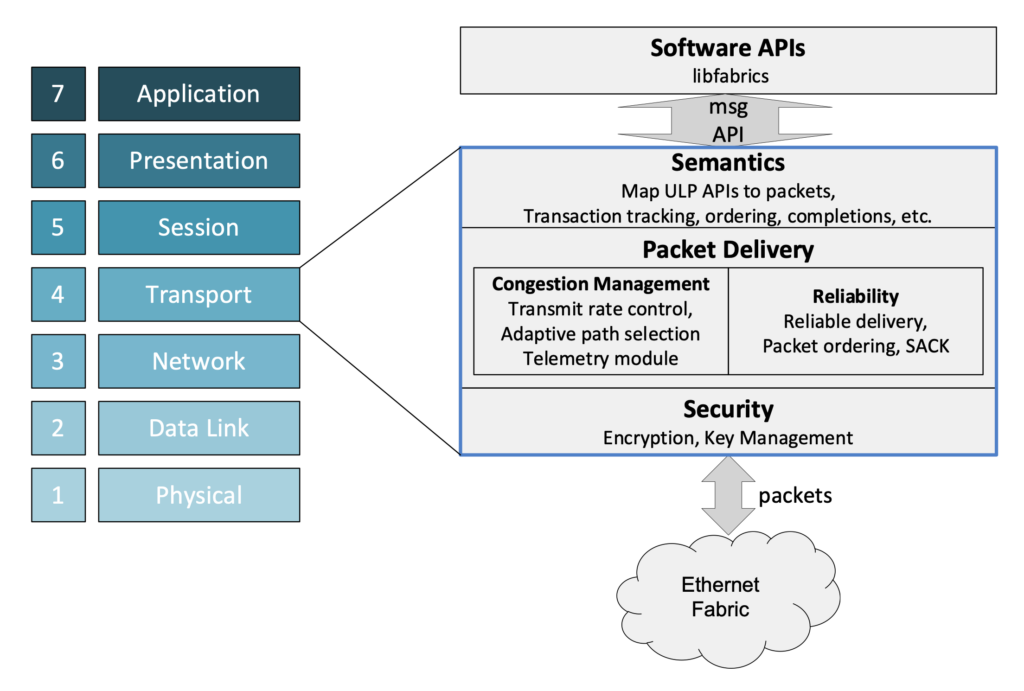
Источник изображения: Ultra Ethernet Для тех, кто заинтересован в работах в рамках проекта, Ultra Ethernet предлагает различные варианты участия через восемь технических групп. В их число, в частности, входят физический, транспортный и программный уровни, хранение, управление, отладка и пр. В настоящее время ведётся активная работа над спецификацией Ultra Ethernet версии 1.0: представить её планируется в III квартале текущего года. Ожидается, что совместная работа десятков IT-компаний в перспективе позволит создать революционные коммуникационные платформы.
22.03.2024 [09:09], Алексей Степин
NVIDIA представила 800G-платформы Quantum-X800 и Spectrum-X800 для InfiniBand- и Ethernet-фабрик нового поколенияДополнением к только что представленным ИИ-ускорителям NVIDIA Blackwell станут новые сетевые 800G-платформы Quantum-X800 и Spectrum-X800, а также сетевые адаптеры ConnectX-8. Именно они позволят вывести масштабирование ИИ-кластеров на новый уровень и позволят «прокормить» гигантские массивы ускорителей в дата-центрах гиперскейлеров. Платформа NVIDIA Quantum-X800 ориентирована на наиболее производительные ИИ- и HPC-кластеры. Она использует новое поколение технологии InfiniBand, всё ещё обладающей рядом преимуществ в сравнении с Ethernet, и включает в себя обновлённые SHARP-движки. Технология SHARPv4 реализует «вычисления в сети» (In-Network Computing), что позволяет не только существенно разгрузить вычислительные узлы и серверы, но и обеспечить более высокую пропускную способность интерконнекта вкупе с более серьёзными возможностями его масштабирования. 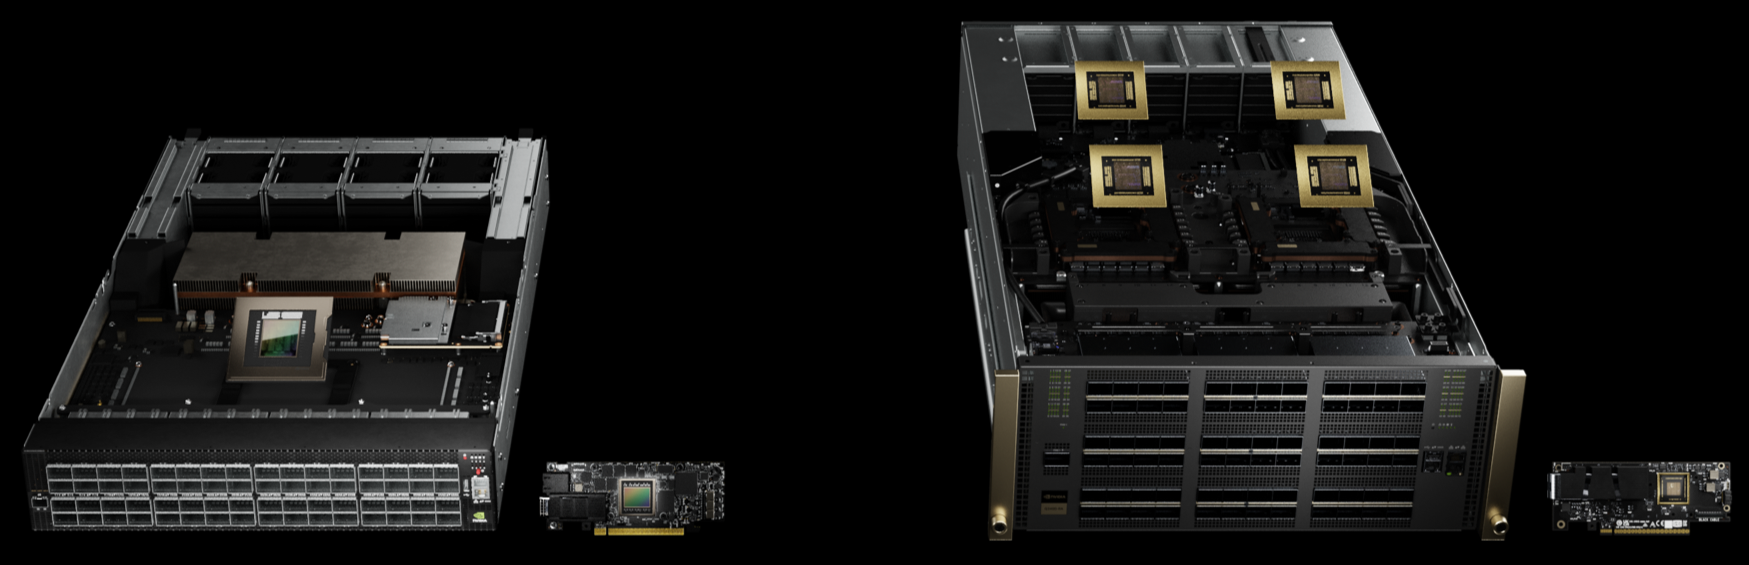
NVIDIA Q3400-RA 4U (справа) и SN5600. Источник изображений здесь и далее: NVIDIA Основой платформы Quantum-X800 стал 4U-коммутатор Q3400-RA, впервые в индустрии, как говорит компания, использующий 200G-блоки SerDes для каждой линии InfiniBand. Коммутатор располагает 144 портами 800G в 72 OSFP-модулях и выделенным портом для Unified Fabric Manager. Новинка имеет стандартное 19″ исполнение с воздушным охлаждением, но есть и вариант Q3400-LD с жидкостным охлаждением, предназначенный для 21″ OCP-стоек. В двухуровневом варианте fat tree коммутаторы позволят объединить 10 368 NIC. 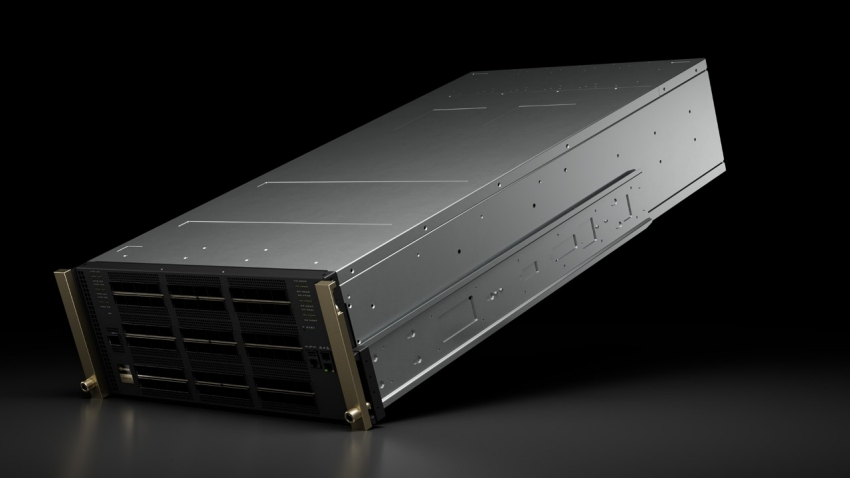 Основным адаптером для новой платформы InfiniBand является ConnectX-8 SuperNIC с интерфейсом PCIe 6.0. Он является частью SHARPv4 и предлагается в однопортовом (OSFP224) и двухпортовом (QSFP112) вариантах и в нескольких форм-факторах, включая OCP 3.0. На платах также имеется разъём SocketDirect на 16 линий PCIe. Также компания представила компоненты NVIDIA LinkX: оптические трансиверы 2xDR4/2xFR4 и активные медные кабели (LACC). 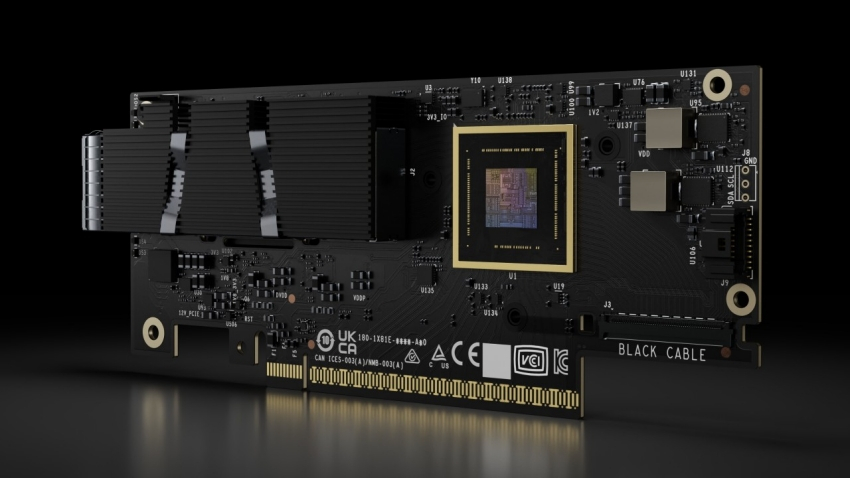 Не забыла NVIDIA и про Ethernet: здесь вывести производительность сети на новый уровень должна платформа Spectrum-X800. Её основой служит новейший коммутатор SN5600 — это, по словам NVIDIA, первый в мире Ethernet-коммутатор класса 800GbE, специально разработанный для применения гиперскейлерами в крупных облачных ИИ-комплексах. Применяемая архитектура позволяет гарантировать каждому клиенту оптимальный и постоянный уровень производительности, а потоковая телеметрия позволит находить и ликвидировать возможные «бутылочные горлышки» в сети буквально на лету. 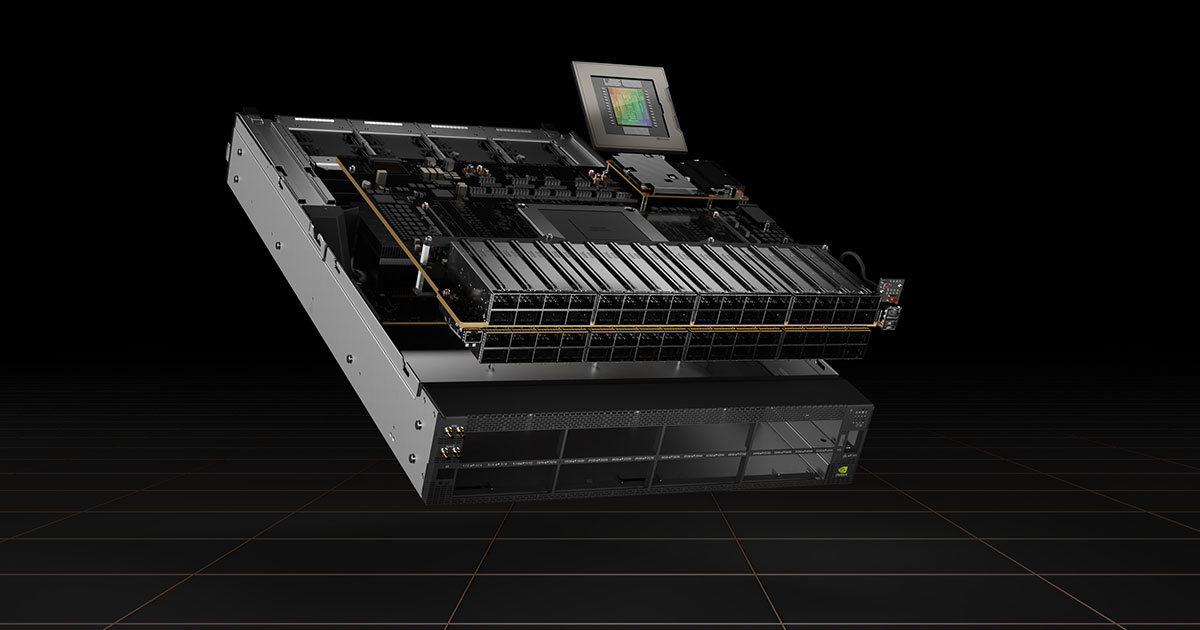 Общая пропускная способность SN5600 составляет 51,2 Тбит/с. Коммутатор располагает 64 портами 800GbE в формате OSFP. В нём используется ASIC пятого поколения на базе архитектуры Spectrum-4. В качестве основного адаптера предлагается SuperNIC на базе DPU BlueField-3 с двумя 400GbE-портами. 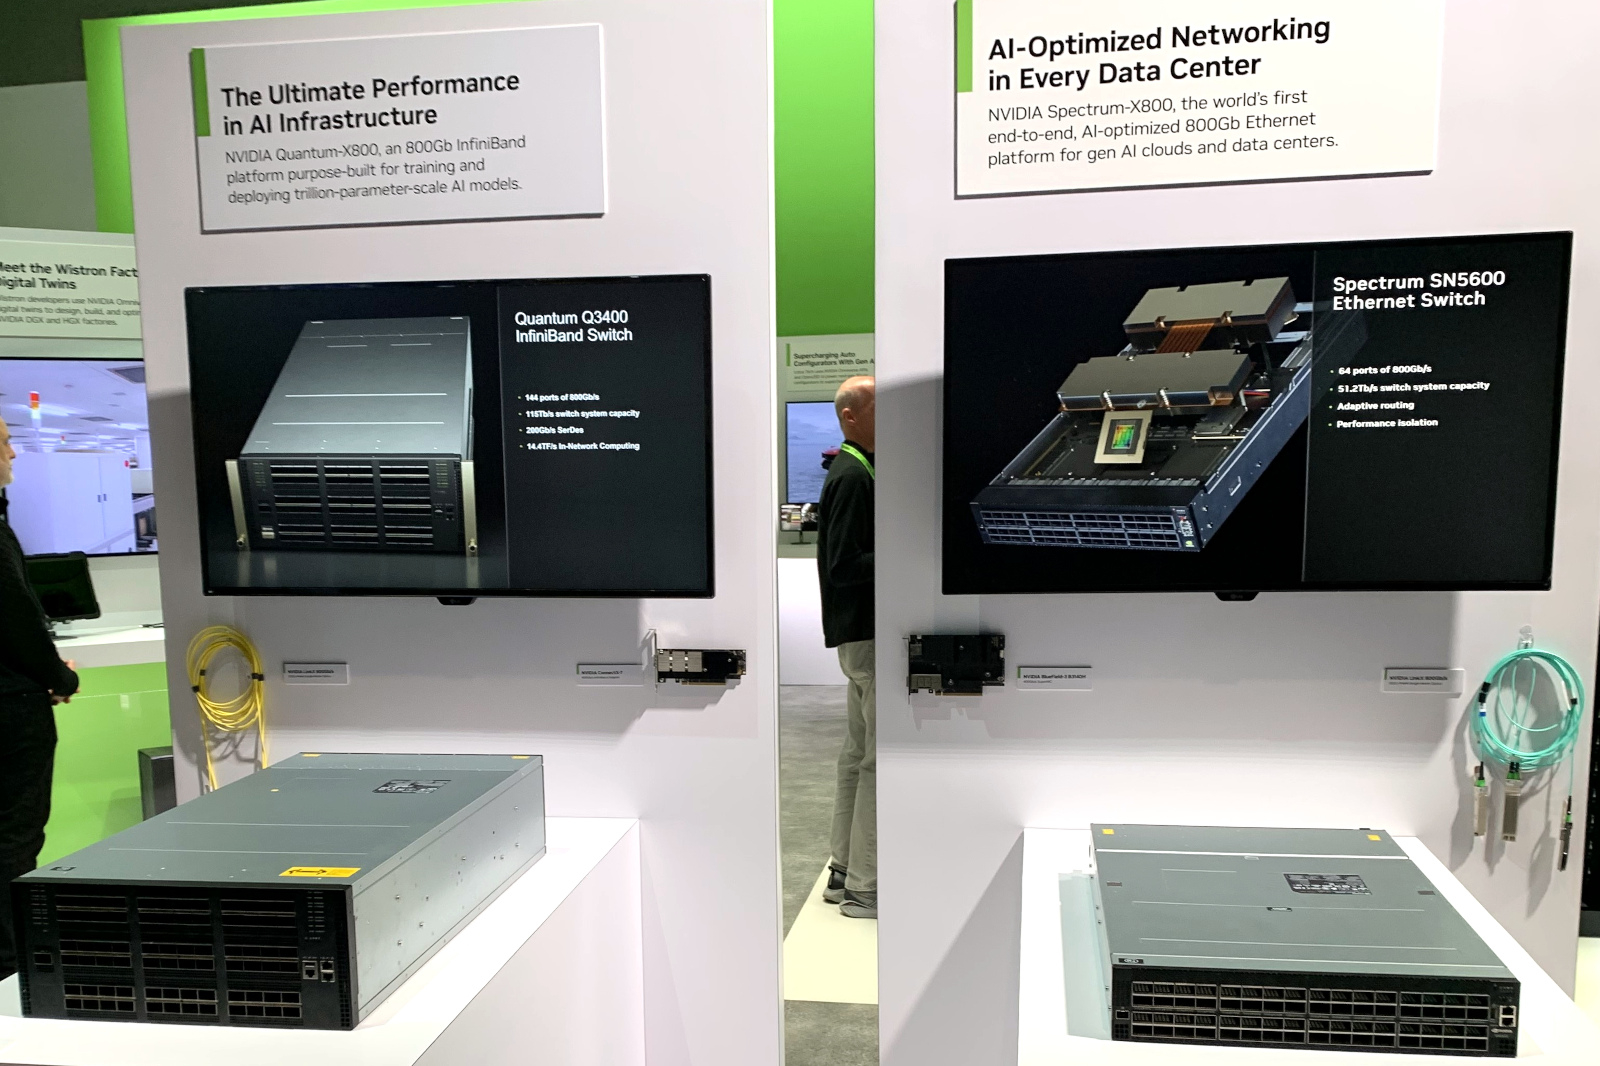
Фото: Twitter/NVIDIANetworkng Spectrum-X800 сопровождает полноценный спектр инфраструктурных компонентов, включая кабели DAC и LACC. С оптическими трансиверами длина соединения 800GbE может достигать двух километров. Начиная со следующего года, решения на базе новых сетевых платформ NVIDIA будут доступны от широкого круга поставщиков оборудования, включая Aivres, DDN, Dell Technologies, Eviden, Hitachi Vantara, HPE, Lenovo, Supermicro и VAST Data. |
|


