
Материалы по тегу: суперкомпьютер
|
14.11.2024 [08:17], Владимир Мироненко
SoftBank построит в Японии первый в мире ИИ-суперкомпьютер на базе NVIDIA DGX B200NVIDIA объявила о серии совместных проектов с SoftBank, направленных на ускорение суверенных инициатив Японии в области ИИ, которые также обеспечат возможность получения дохода от ИИ для поставщиков телекоммуникационных услуг по всему миру. В выступлении на саммите NVIDIA AI Summit Japan генеральный директор NVIDIA Дженсен Хуанг (Jensen Huang) объявил, что SoftBank создаёт самый мощный в Японии ИИ-суперкомпьютер с использованием платформы NVIDIA DGX SuperPOD B200 и интерконнекта Quantum-2 InfiniBand. Эта система станет первой в мире, которая получит системы DGX B200. Она будет использоваться компанией для разработки генеративного ИИ и развития других бизнес-решений, а также для предоставления вычислительных услуг университетам, научно-исследовательским институтам и предприятиям в стране. Суперкомпьютер идеально подойдёт для разработки больших языковых моделей (LLM), говорится в пресс-релизе. Пока что на звание самого мощного ИИ-суперкомьютера Японии претендует система ABCI 3.0 на базе NVIDIA H200. Впрочем, Softbank не сидит сложа руки и планирует построить ещё один суперкомпьютер, на этот раз на базе суперускорителей GB200 NVL72. Они же будут использоваться в проекте Sharp, KDDI и Supermicro по созданию «крупнейшего в Азии» ИИ ЦОД. 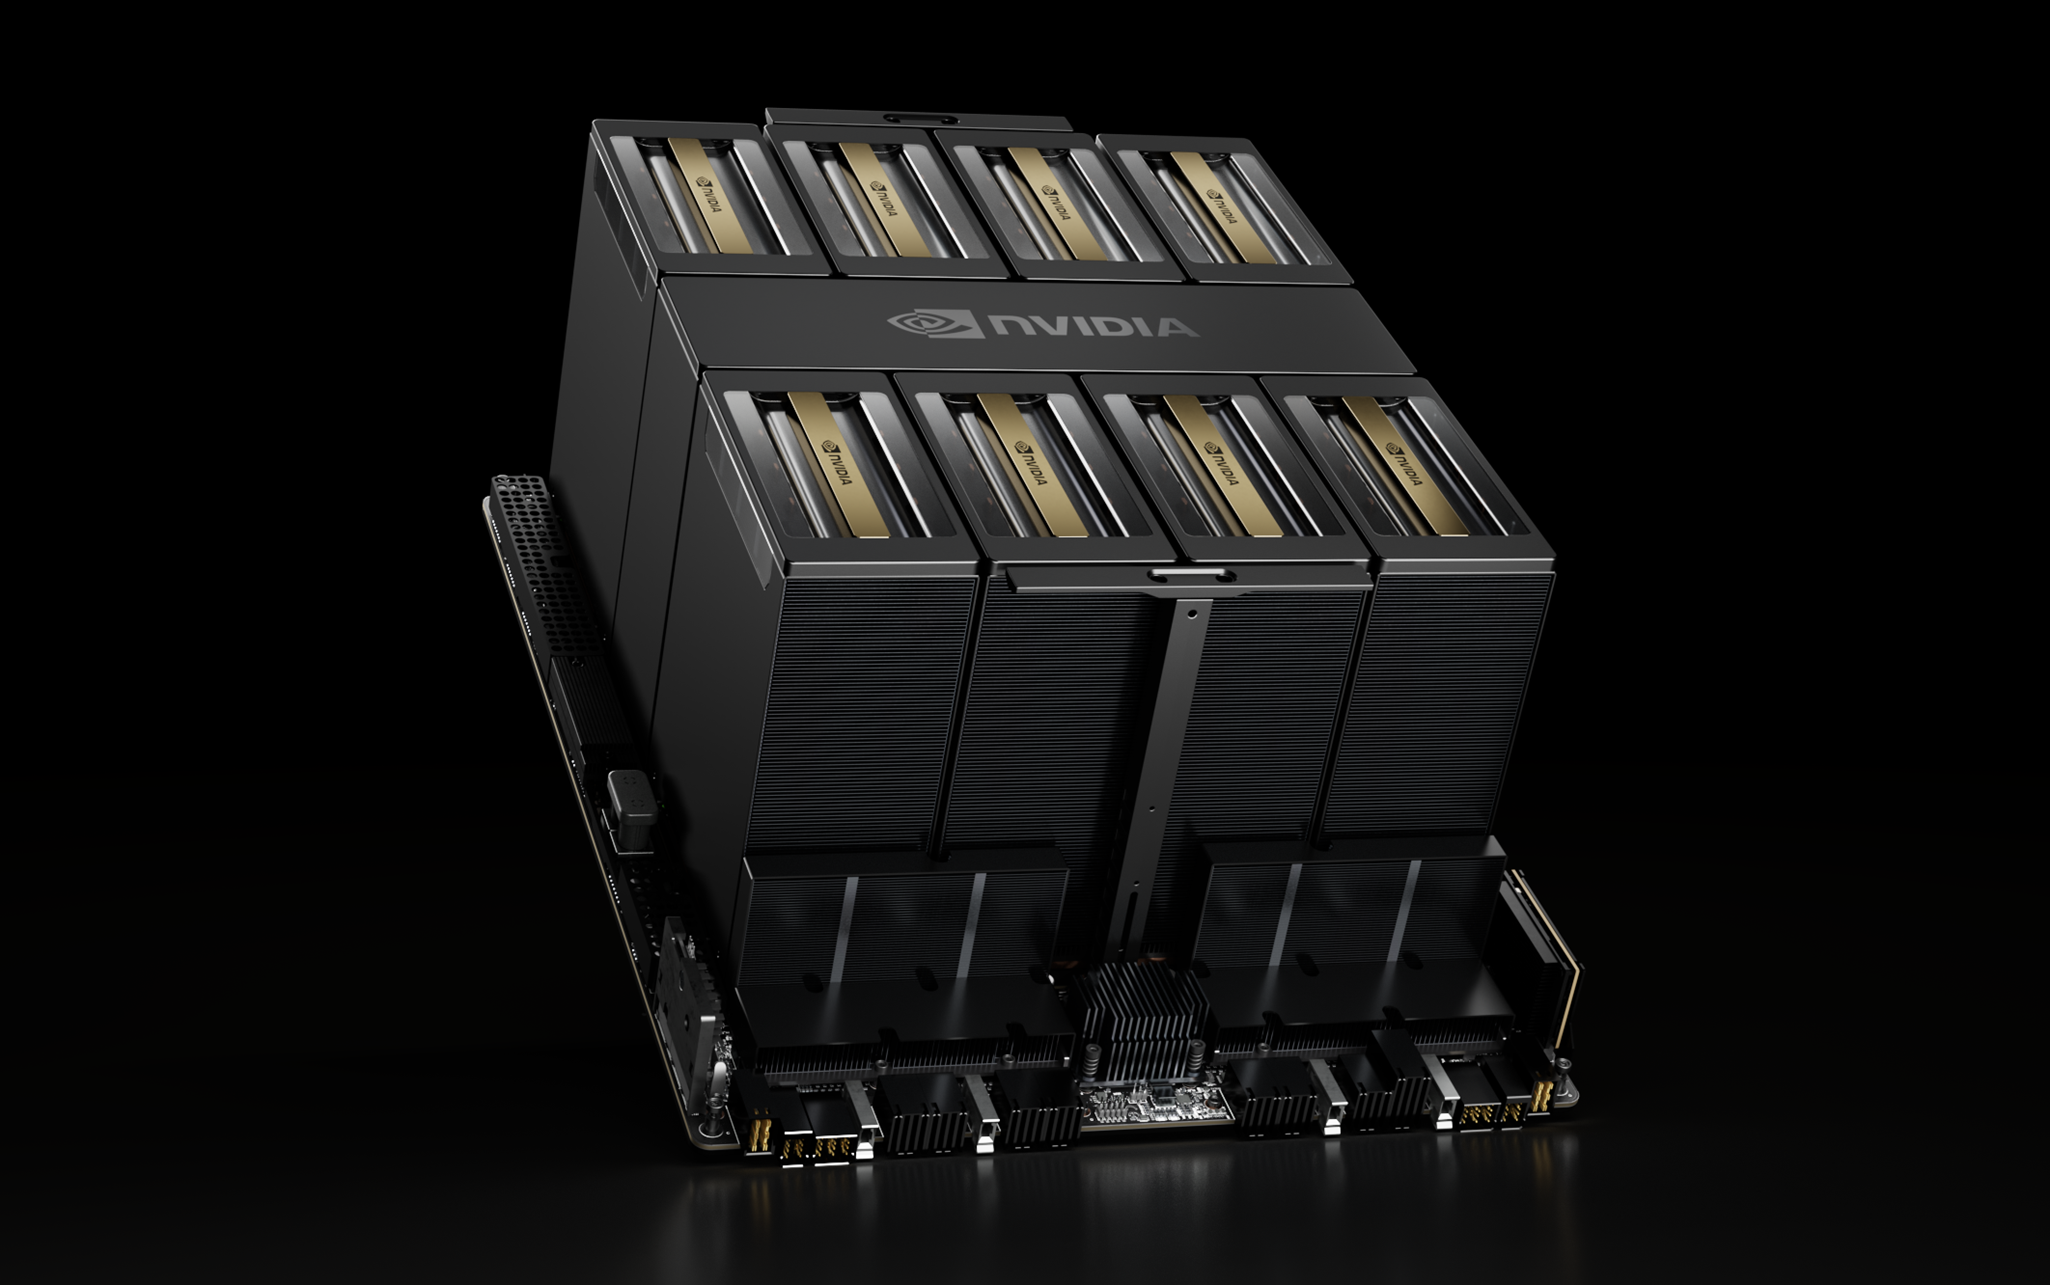
Источник изображения: NVIDIA Также в ходе саммита было объявлено, что SoftBank, используя платформу ускоренных вычислений NVIDIA AI Aerial, успешно запустил первую в мире телекоммуникационную сеть, объединяющую возможности ИИ и 5G. В ходе испытаний, проведенных в префектуре Канагава, SoftBank продемонстрировала, что решение AI-RAN достигло производительности 5G операторского класса, используя ресурсы ускорителя для одновременной обработки сетевого трафика и инференса. Отмечается, что мобильные сети традиционно рассчитаны на обработку пиковых нагрузок и в среднем задействуют только треть аппаратных ресурсов, что позволяет монетизировать оставшиеся две трети путём предоставления ИИ-сервисов. NVIDIA и SoftBank также сообщили, что с помощью ПО NVIDIA AI Enterprise японская компания будет создавать локализованные безопасные ИИ-сервисы.
12.11.2024 [14:31], Руслан Авдеев
Supermicro лишилась огромного заказа на NVIDIA GB200 NVL72, который был передан WiwynnSupermicro, по данным UDN, лишилась заказа от индонезийской YTL Group (YTLP) на поставку новейших суперускорителей NVIDIA GB200 NVL72 для одного из крупнейших в Юго-Восточной Азии ИИ-суперкомпьютеров. Изначально заказ YTL был поделен между Supermicro и Wiwynn (Wistron), но теперь поставками будет заниматься только Wiwynn. В начале ноября появилась информация о том, что NVIDIA начала менять цепочку поставок, перенаправляя чипы, предназначавшиеся Supermicro, другим вендорам. В последнее время Supermicro была третьим по величине партнёром NVIDIA по объёму закупок чипов. Supermicro, по слухам, остановила расширение двух заводов в Малайзии, которые должны были удвоить её производственные мощности до 10 тыс. полностью укомплектованных стоек с СЖО в месяц. Остановка строительства заводов негативно сказалась на планах YTL Group, крупного покупателя ИИ-серверов NVIDIA и одного из крупнейших клиентов Supermicro. YTL намерена за $4,3 млрд построить кампус ЦОД площадью более 660 га в Джохоре (Малайзия) и разместить там самый производительный в стране или даже регионе ИИ-суперкомпьютер (300 Эфлопс). По данным UDN, YTL вынужденно передала заказ тайваньской Wywinn. Последняя также владеет современным производством в Малайзии, которое недавно было расширено.  Крупные неприятности у Supermicro начались в августе, когда Hindenburg Research обвинила компанию в различных злоупотреблениях, включая манипуляции с бухгалтерской отчётностью. Впоследствии собственное расследование открыло Министерства юстиции США. Ernst & Young отказалась от аудита Supermicro, а сама компания уже несколько раз откладывала публикацию финансовой отчётности. Всё это привело к резкому падению стоимости акций компании. А сейчас ей и вовсе грозит делистинг с Nasdaq.
11.11.2024 [07:52], Сергей Карасёв
Lenovo поставит Италии НРС-кластер на базе Intel Xeon Emerald Rapids для исследований в области чистой энергииНациональное агентство по новым технологиям, энергетике и устойчивому экономическому развитию Италии (ENEA) выбрало компанию Lenovo для создания нового суперкомпьютера. Использовать НРС-комплекс планируется для ускорения исследований в области чистой энергии, в частности, по направлению ядерного синтеза. Проект нацелен на повышение вычислительной мощности платформы CRESCO (Computational Center for Research on Complex Systems — Вычислительный центр в области исследований сложных систем). Эта суперкомпьютерная система располагается в исследовательском центре Портичи (регион Кампания, административный центр Неаполь). Lenovo развернёт кластер из 758 узлов, в оснащение каждого из которых войдут два процессора Intel Xeon Platinum 8592+ поколения Emerald Rapids (64С/128T; 1,9–3,9 ГГц; 350 Вт). Говорится о применении технологии прямого жидкостного охлаждения Lenovo Neptune Direct Water-Cooling, которая позволяет отводить до 98 % тепла, генерируемого НРС-комплексом. Подчёркивается, что, помимо повышения производительности, оборудование Lenovo обеспечит высокую энергетическую эффективность. Серверы изготавливаются на предприятии Lenovo в Венгрии, а близость к месту установки позволяет сократить расходы по транспортировке и снизить выбросы вредных газов в атмосферу. 
Источник изображения: Lenovo После введения в эксплуатацию новой системы общее быстродействие CRESCO поднимется примерно в шесть раз: с нынешних 1,01 до более чем 6,5 Пфлопс. Это выведет платформу в лидеры по вычислительной мощности в Италии. ENEA управляет развитой вычислительной инфраструктурой, которая предоставляет пользователям ресурсы для расчётов, моделирования и трёхмерной визуализации данных. В настоящее время сеть объединяет шесть объектов в разных областях: это Фраскати, Портичи, Болонья, Казачча, Трисайя и Бриндизи.
25.07.2024 [09:57], Сергей Карасёв
Илон Маск показал ИИ-суперкомпьютер Dojo на основе чипов Tesla D1Глава Tesla Илон Маск (Elon Musk), по сообщению ресурса Tom's Hardware, обнародовал фотографии вычислительного комплекса Dojo, который будет использоваться для разработки инновационных автомобильных технологий, а также для обучения автопилота. Tesla, напомним, начала создание ИИ-суперкомпьютера Dojo в июле 2023 года. Основой системы послужат специализированные чипы собственной разработки Tesla D1. Дата-центр Dojo, расположенный в штаб-квартире Tesla в Остине (Техас, США), по своей конструкции напоминает бункер. В апреле нынешнего года сообщалось, что при строительстве ЦОД компания Маска столкнулась с трудностями, связанными в том числе с доставкой необходимых материалов. Как теперь сообщается, Tesla намерена ввести Dojo в эксплуатацию до конца 2024 года. По производительности этот суперкомпьютер будет сопоставим с кластером из 8 тыс. ускорителей NVIDIA H100. По словам Маска, это «не слишком много, но и не тривиально». Для сравнения: мощнейший ИИ-суперкомпьютер компании xAI, также курируемой Илоном Маском, объединит 100 тыс. карт H100. 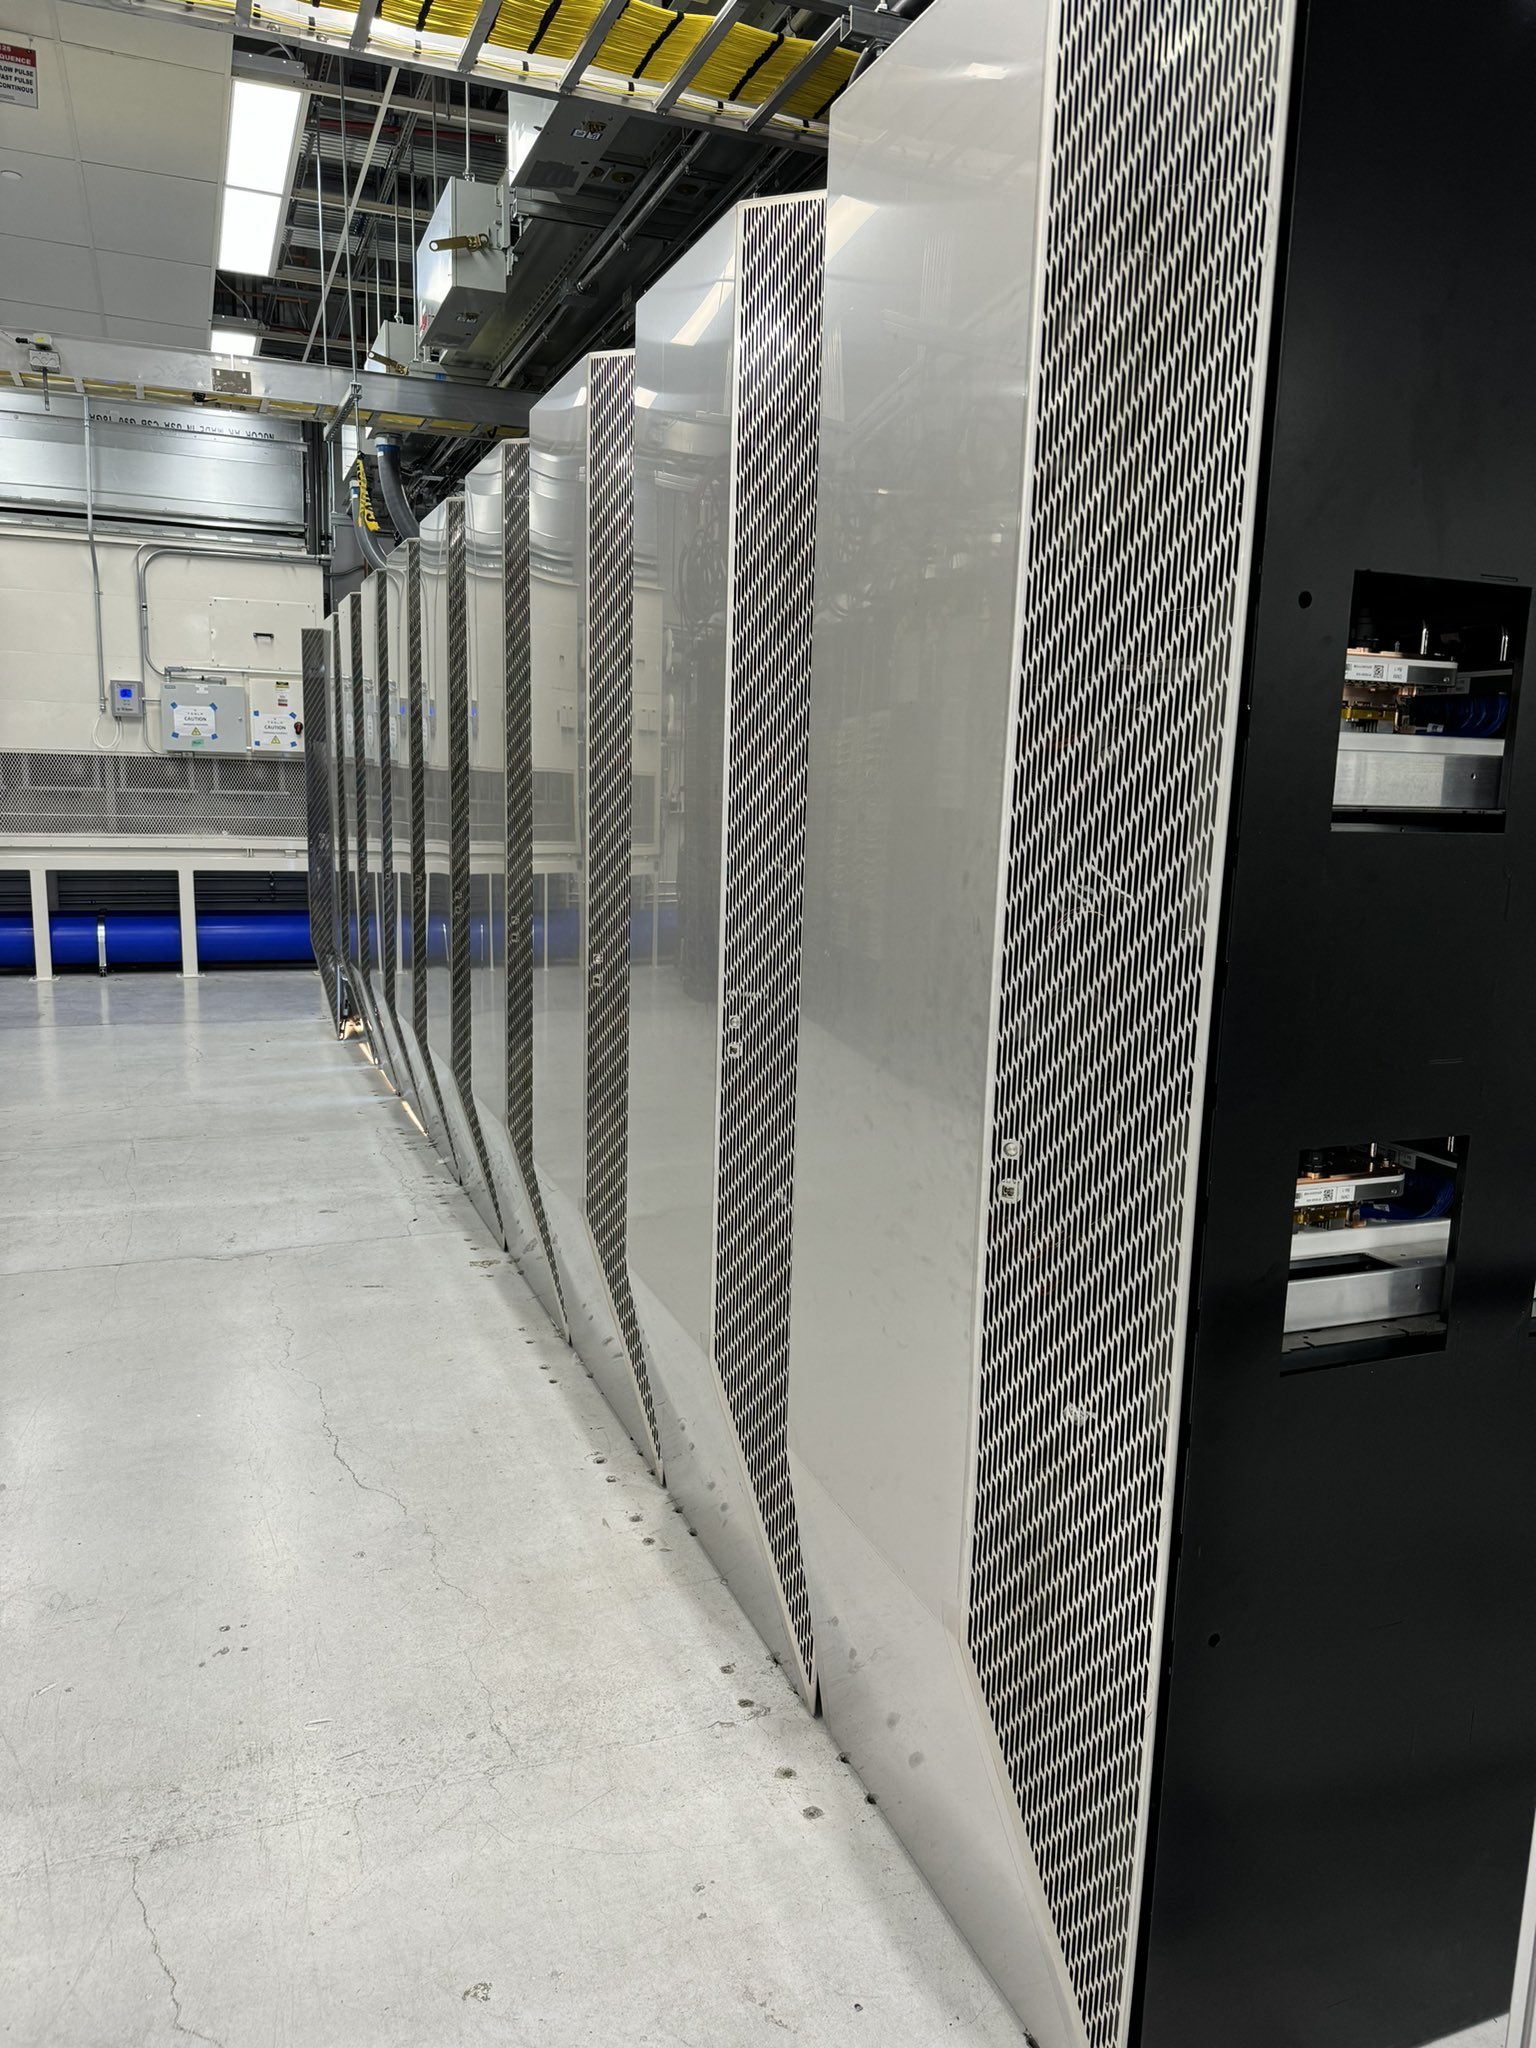
Источник изображений: Илон Маск Отмечается, что чипы Tesla D1 специально ориентированы на машинное обучение и анализ видеоданных. Поэтому систему Dojo планируется использовать прежде всего для совершенствования технологии автономного вождения Tesla путём обработки видеоданных, полученных от автомобилей компании. В свою очередь, «ИИ-гигафабрика» xAI поможет в развитии чат-ботов Grok следующего поколения. 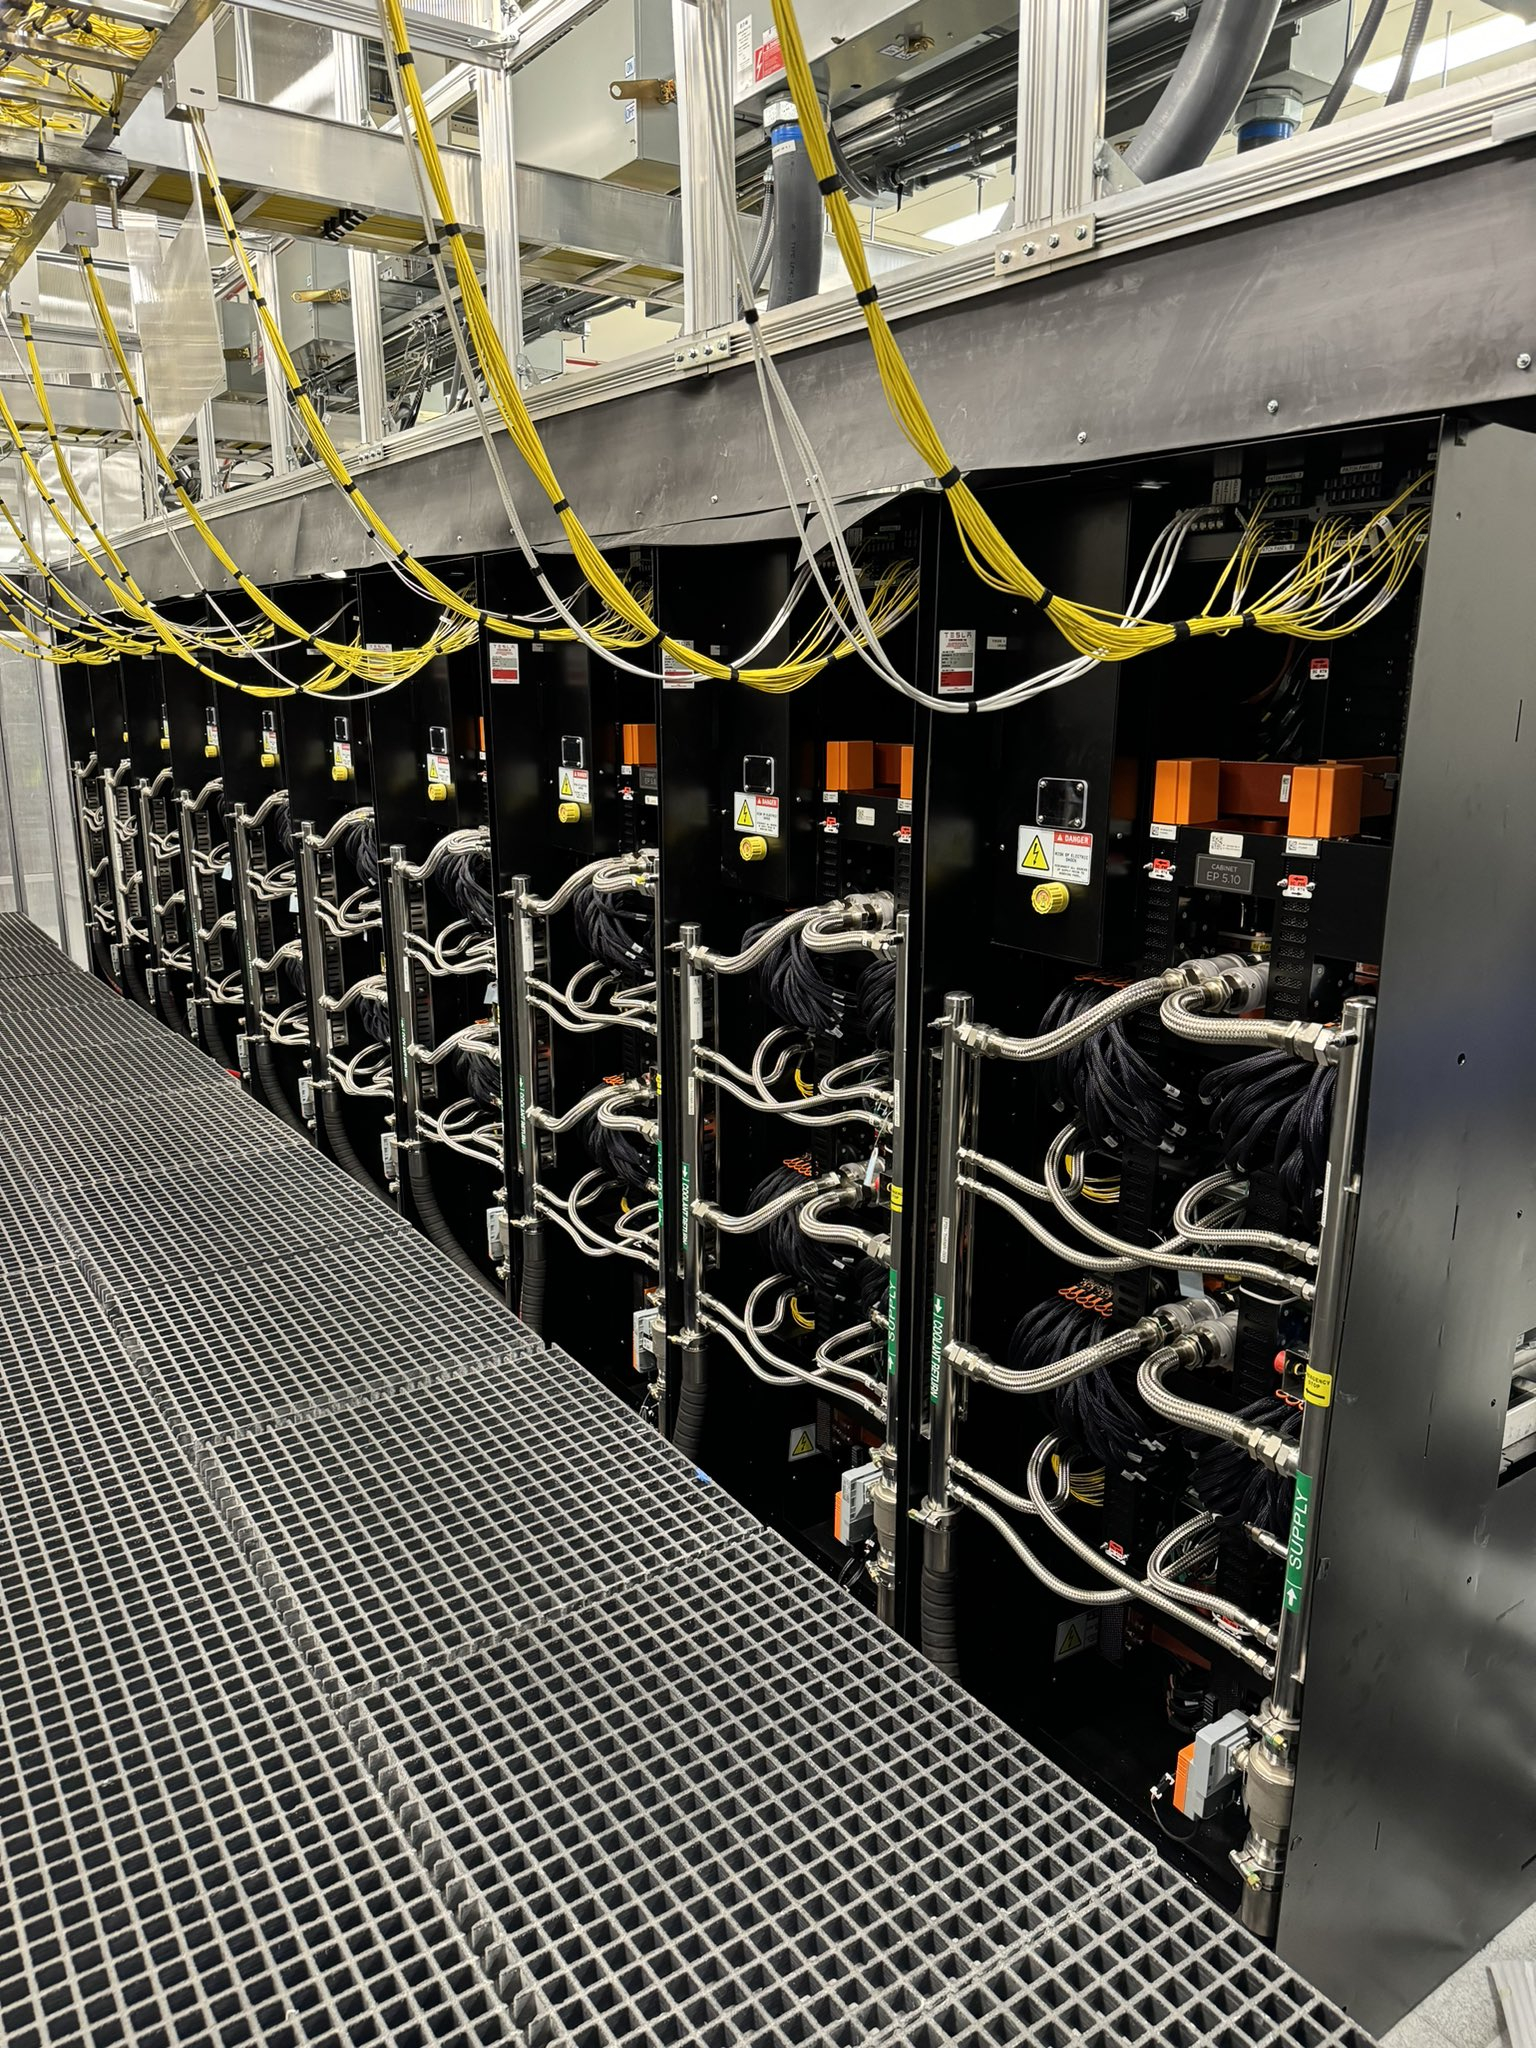 Маск также сообщил, что компания Tesla намерена «удвоить усилия» по разработке и развертыванию Dojo из-за высоких цен на оборудование NVIDIA. Вместе с тем финансовый директор Tesla Вайбхав Танеджа (Vaibhav Taneja) заявил, что, несмотря на снижение капвложений во II квартале 2024 года, компания по-прежнему ожидает, что соответствующие затраты превысят $10 млрд.
26.05.2024 [13:24], Руслан Авдеев
Эрик Шмидт: будущие суперкомпьютеры США и Китая будут окружены пулемётами и колючей проволокой и питаться от АЭС
hardware
hpc
аэс
безопасность
ии
информационная безопасность
китай
суперкомпьютер
сша
цод
энергетика
Бывший генеральный директор Google Эрик Шмидт (Eric Schmidt) прогнозирует, что в обозримом будущем в США и Китае большие суперкомпьютеры будут заниматься ИИ-вычислениями под защитой военных баз. В интервью Noema он подробно рассказал о том, каким видит новые ИИ-проекты, и это будущее вышло довольно мрачным. Шмидт поведал о том, как правительства будут регулировать ИИ и искать возможности контроля ЦОД, работающих над ИИ. Покинув Google, бизнесмен начал очень тесно сотрудничать с военно-промышленным комплексом США. По его словам, рано или поздно в США и Китае появится небольшое число чрезвычайно производительных суперкомпьютеров с возможностью «автономных изобретений» — их производительность будет гораздо выше, чем государства готовы свободно предоставить как своим гражданам, так и соперникам. Каждый такой суперкомпьютер будет соседствовать с военной базой, питаться от атомного источника энергии, а вокруг будет колючая проволока и пулемёты. Разумеется, таких машин будет немного — гораздо больше суперкомпьютеров будут менее производительны и доступ к ним останется более широким. Строго говоря, самые производительные суперкомпьютеры США принадлежат Национальным лабораториям Министерства энергетики США, которые усиленно охраняются и сейчас. Как заявил Шмидт, необходимы и договорённости об уровнях безопасности вычислительных систем по примеру биологических лабораторий. В биологии широко распространена оценка по уровням биологической угрозы для сдерживания её распространения и оценки уровня риска заражения. С суперкомпьютерами имеет смысл применить похожую классификацию. 
Источник изображения: Joel Rivera-Camacho/unsplash.com Шмидт был председателем Комиссии национальной безопасности США по ИИ и работал в Совете по оборонным инновациям. Также он активно инвестировал в оборонные стартапы. В то же время Шмидт сохранил влияние и в Alphabet и до сих пор владеет акциями компании стоимостью в миллиарды долларов. Военные и разведывательные службы США пока с осторожностью относятся к большим языковым моделям (LLM) и генеративному ИИ вообще из-за распространённости «галлюцинаций» в таких системах, ведущих к весьма правдоподобным на первый взгляд неверным выводам. Кроме того, остро стоит вопрос сохранения секретной информации в таких системах. Ранее в этом году Microsoft подтвердила внедрение изолированной от интернета генеративной ИИ-модели для спецслужб США после модернизации одного из своих ИИ-ЦОД в Айове. При этом представитель Microsoft два года назад предрекал, что нынешнее поколение экзафлопсных суперкомпьютеров будет последним и со временем все переберутся в облака.
15.05.2024 [14:18], Руслан Авдеев
PUE у вас неправильный: NVIDIA призывает пересмотреть методы оценки энергоэффективности ЦОД и суперкомпьютеровОператорам дата-центров и суперкомпьютеров не хватает инструментов для корректного измерения энергоэффективности их оборудования и оценки прогресса на пути к экоустойчивым вычислениям. Как утверждает NVIDIA, нужна новая система оценки показателей при использовании оборудования в реальных задачах. Для оценки эффективности ЦОД существует как минимум около трёх десятков стандартов, некоторые уделяют внимание весьма специфическим критериям вроде расхода воды или уровню безопасности. Сегодня чаще всего используется показатель PUE (power usage effectiveness), т.е. отношение энергопотребления всего объекта к потреблению собственно IT-инфраструктуры. В последние годы многие операторы достигли практически идеальных значений PUE, поскольку, например, на преобразование энергии и охлаждение нужно совсем мало энергии. В эпоху роста облачных сервисов оценка PUE показала довольно высокую эффективность, но в эру ИИ-вычислений этот индекс уже не вполне соответствует запросам отрасли ЦОД — оборудование заметно изменилось. NVIDIA справедливо отмечает, что PUE не учитывает эффективность инфраструктуры в реальных нагрузках. С таким же успехом можно измерять расход автомобилем бензина без учёта того, как далеко он может проехать без дозаправки. При этом среднемировой показатель PUE дата-центров остаётся неизменным уже несколько лет, а улучшать его всё дороже. 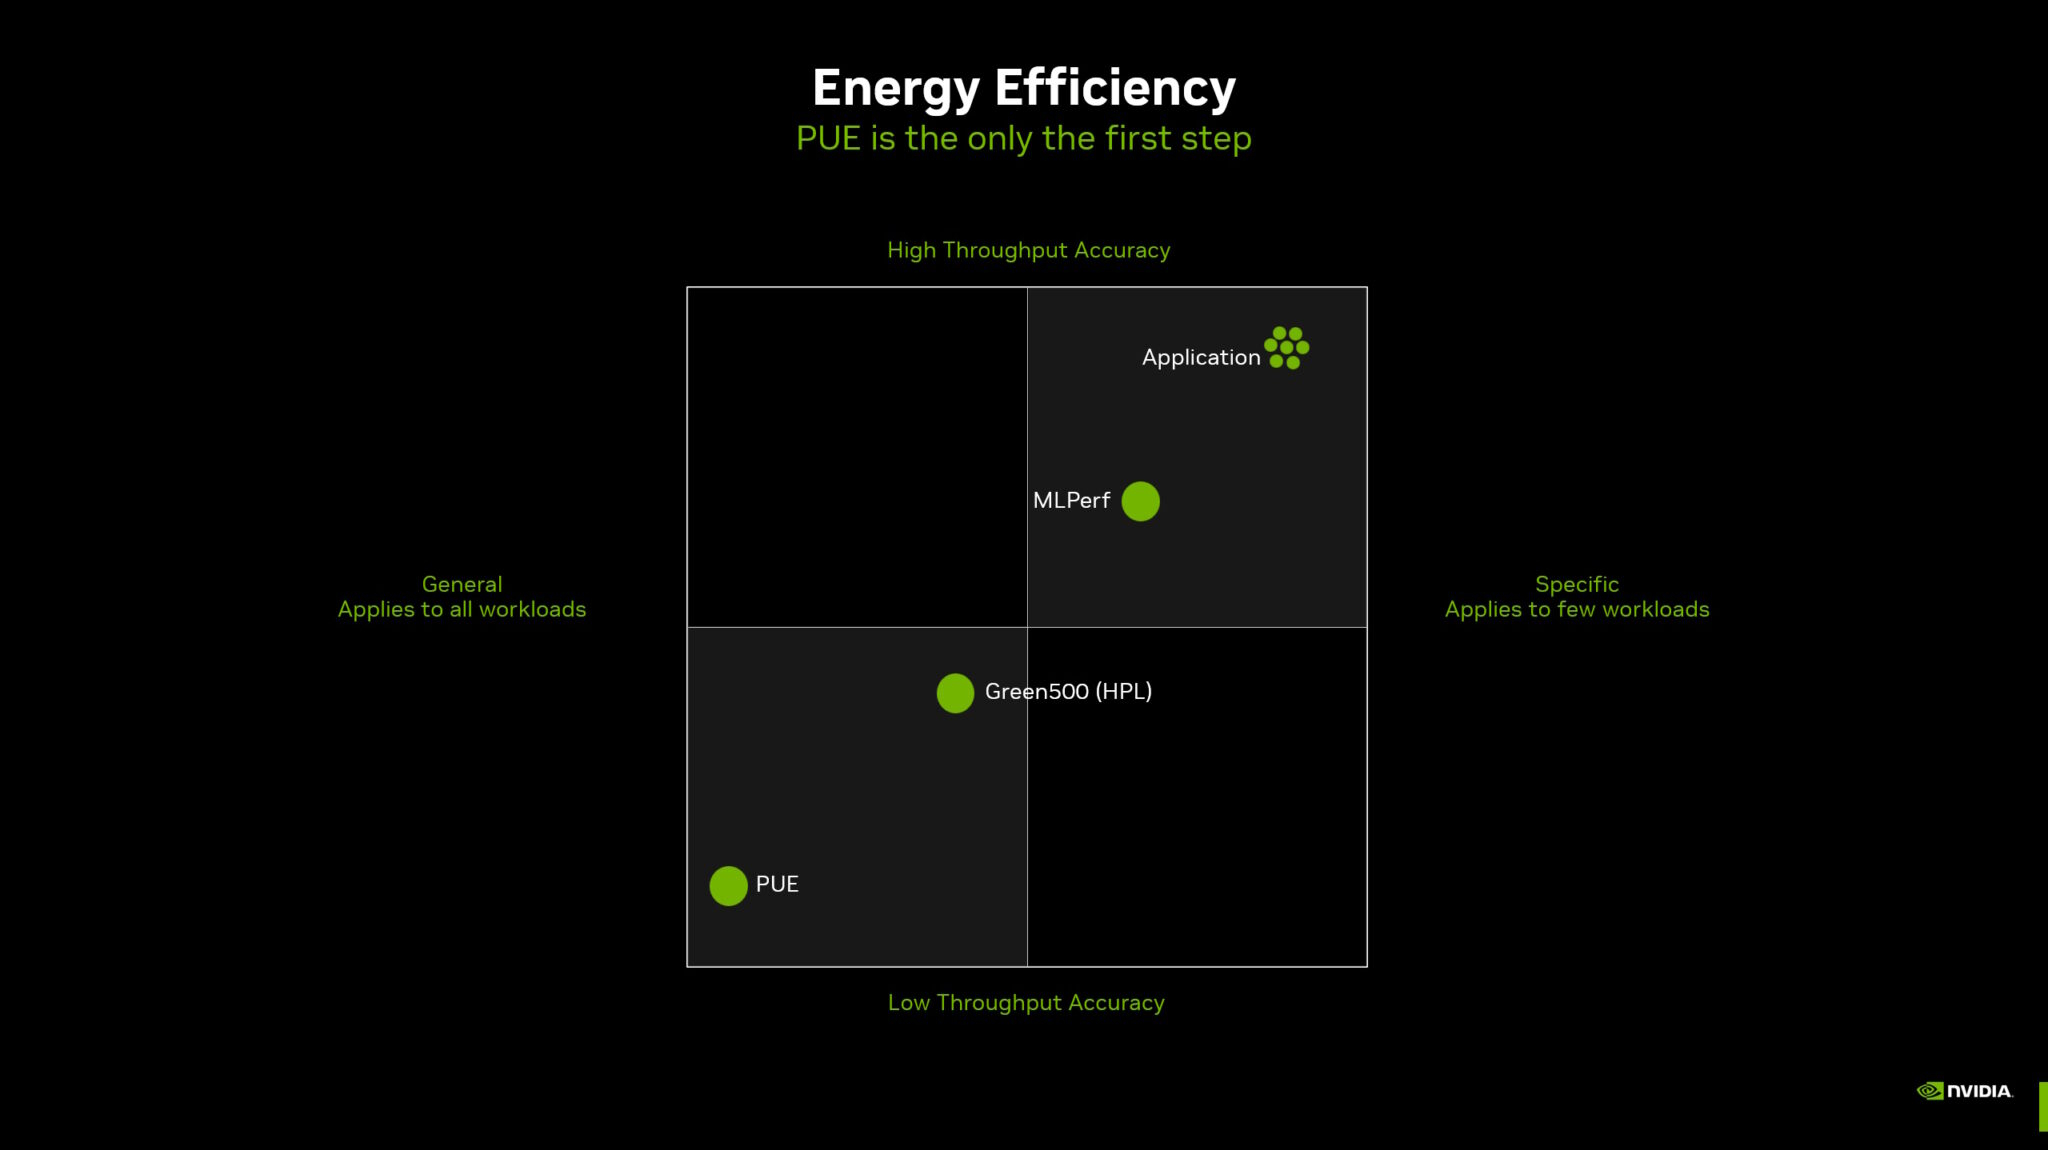
Источник изображений: NVIDIA Что касается энергопотребления, разное оборудование при одинаковых затратах может давать самые разные результаты. Другими словами, если современные ускорители потребляют больше энергии, это не значит, что они менее эффективны, поскольку они дают несопоставимо лучший результат в сравнении со старыми решениями. NVIDIA неоднократно приводила подобные сравнения и между своими GPU с обычными CPU, а теперь предлагает распространить этот подход на ЦОД целиком, что справедливо, учитывая стремление NVIDIA сделать минимальной единицей развёртывания целую стойку. 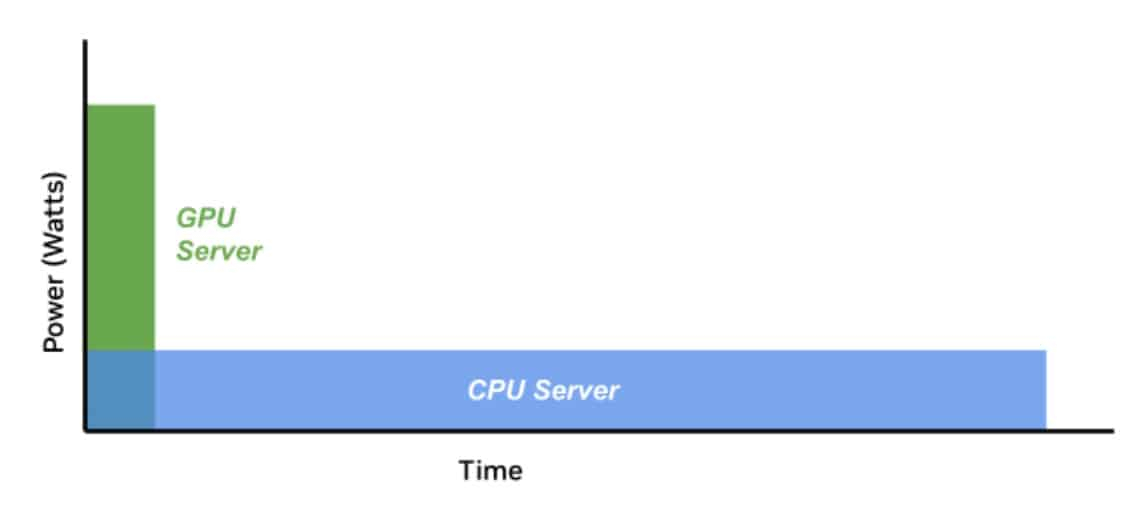 Как считают в NVIDIA, оценивать качество ЦОД можно только с учётом того, сколько энергии тратится для получения результата. Так, ЦОД для ИИ могут полагаться на MLPerf-бенчмарки, суперкомпьютеры для научных исследований могут требовать измерения других показателей, а коммерческие дата-центры для стриминговых сервисов — третьих. В идеале бенчмарки должны измерять прогресс в ускоренных вычислениях с использованием специализированных сопроцессоров, ПО и методик. Например, в параллельных вычислениях GPU намного энергоэффективнее обычных процессоров Отмечается, что с 2003 года производительность ускорителей выросла приблизительно в 7 тыс. раз, а соотношение цены и производительности стало в 5,6 тыс. раз лучше. А с учётом того, что современные ЦОД достигли PUE на уровне приблизительно 1,2, подобная метрика практически исчерпала себя, теперь стоит ориентироваться на другие показатели, релевантные актуальным проблемам. Хотя напрямую сравнить некоторые аспекты невозможно, сегментировав деятельность ЦОД на типы рабочих нагрузок, возможно, удалось бы получить некоторые результаты. В частности, операторам ЦОД нужен пакет бенчмарков, измеряющих показатели при самых распространённых рабочих ИИ-нагрузках. Например, неплохой метрикой может стать Дж/токен. Впрочем, NVIDIA грех жаловаться на недостойные оценки — в последнем рейтинге Green500 именно её системы заняли лидерские позиции.
05.05.2024 [13:56], Сергей Карасёв
Власти США продали на аукционе 5,34-ПФлопс суперкомпьютер Cheyenne из-за растущего числа сбоев и протечек СЖОАдминистрация общих служб США (GSA) реализовала на аукционе НРС-систему под названием Cheyenne, которая была введена в строй в Центре суперкомпьютерных вычислений NCAR-Wyoming (NWSC) штата Вайоминг в 2016 году. Стоимость лота составила $480 085, тогда как затраты на строительство машины оцениваются как минимум в $25 млн. Cheyenne стал одним из последних суперкомпьютеров компании Silicon Graphics International (SGI). Корпорация HPE приобрела эту фирму после того, как Cheyenne был смонтирован, но до фактического запуска системы в эксплуатацию. На момент начала работы производительность комплекса составляла 5,34 Пфлопс, что соответствовало 20 месту в актуальном тогда списке ТОР500. Cheyenne представляет собой кластер SGI ICE XA с 4032 узлами, каждый из которых содержит два процессора Intel Xeon E5-2697v4 Broadwell (18C/36; 2,3 ГГц). Таким образом, суммарное количество ядер достигает 145 152. Применяется оперативная память DDR4-2400 ECC общей ёмкостью 313 Тбайт (4890 модулей на 64 Гбайт). В состав машины изначально входило хранилище данных вместимостью 40 Пбайт. Энергопотребление — приблизительно 1,7 МВт. Задействована система жидкостного охлаждения. 
Источник изображения: GSA Две стойки управления с воздушным охлаждением состоят из 26 серверов типоразмера 1U (20 со 128 Гбайт ОЗУ и ещё 6 с 256 Гбайт ОЗУ), 10 коммутаторов и двух блоков питания. Суперкомпьютер эксплуатировался с 12 января 2017 года по 31 декабря 2023-го, решая задачи в области изменений климата и в других сферах, связанных с науками о Земле. Cheyenne превзошёл свой запланированный срок службы: в заявлении NWSC говорилось, что он будет эксплуатироваться до 2021 года. Однако к концу 2023-го количество сбоев и проблем стало слишком большим. В описании лота говорится, что «примерно 1 % узлов столкнулись с отказами за последние шесть месяцев», в основном из-за модулей памяти. Кроме того, система испытывает ограничения по техническому обслуживанию из-за неисправных быстроразъёмных соединений, вызывающих протечки воды. Таким образом, «учитывая затраты и время простоя, связанные с устранением проблем», дальнейшее использование комплекса признано нецелесообразным, в связи с чем он пущен с молотка. Вместе с тем, как отмечает Tom's Hardware, новый владелец суперкомпьютера может реализовать его основные компоненты на вторичном рынке. Например, стоимость чипов Xeon E5-2697 v4 на eBay составляет около $50, а модулей DDR4-2400 ECC ёмкостью 64 Гбайт — примерно $65. То есть, по самым скромным подсчётам, только эти компоненты могут принести новому владельцу суперкомпьютера приблизительно $700 тыс. без учёта затрат на демонтаж и вывоз машины массой 43 т, а также на тестирование компонентов. Впрочем, массовый выброс на рынок CPU и RAM в таких объёмах приведёт к снижению цен.
29.03.2024 [21:54], Сергей Карасёв
Eviden увеличит производительность французского суперкомпьютера Jean Zay более чем втроеФранцузское национальное агентство по высокопроизводительным вычислениям (GENCI) и Национальный центр научных исследований (CNRS) заключили соглашение с компанией Eviden (дочерняя структура Atos) о модернизации НРС-комплекса Jean Zay. Ожидается, что производительность этого суперкомпьютера увеличится приблизительно в 3,5 раза. В рамках проекта Eviden оборудует комплекс 1456 ускорителями NVIDIA H100 в дополнение к 416 ускорителям NVIDIA A100 и 1832 ускорителям NVIDIA V100, которые задействованы в настоящее время. Модернизация предполагает использование 14 стоек суперкомпьютерной платформы Eviden BullSequana XH3000. В общей сложности будут задействованы 364 двухпроцессорных узла на базе Intel Xeon Sapphire Rapids с 48 ядрами. Каждый сервер получит 512 Гбайт оперативной памяти и четыре ускорителя NVIDIA H100 SXM5. Говорится об использовании адаптеров NVIDIA ConnectX-7. 
Источник изображения: Eviden Проект также предусматривает комплексное обновление подсистемы хранения данных. Она будет состоять из флеш-массива вместимостью 4,3 Пбайт со скоростями чтения/записи свыше 1 Тбайт/с и дискового массива ёмкостью 39 Пбайт со скоростями чтения/записи более 300 Гбайт/с. Компоненты СХД поставит компания DataDirect Networks (DDN). Для обоих уровней хранения предусмотрено использование файловой системы Lustre. 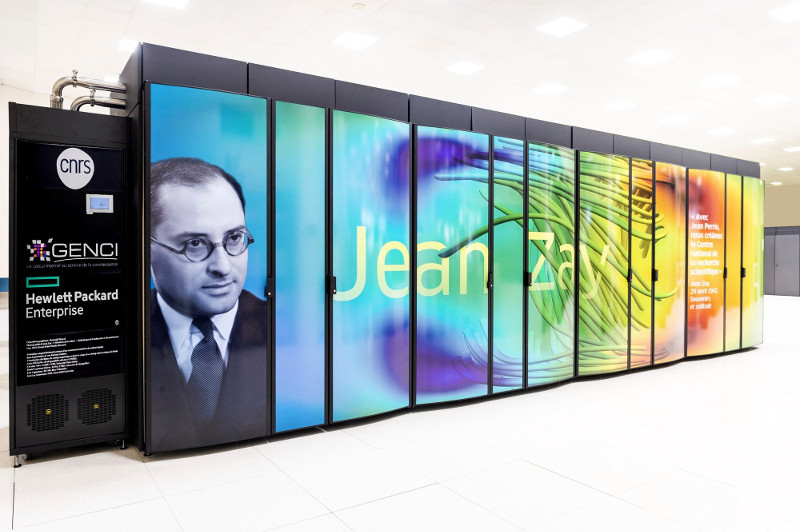
Фото: Photothèque CNRS/Cyril Frésillon Ожидается, что модернизация позволит увеличить пиковую производительность Jean Zay с 36,85 до 125,9 Пфлопс. Проект получил финансирование в рамках национальной инвестиционной программы «Франция 2030». Усовершенствованный суперкомпьютер будет использоваться для решения ресурсоёмких задач, в том числе в области ИИ. Отмечается, что Jean Zay — это один из наиболее экологичных суперкомпьютеров в Европе. Отчасти это достигается благодаря использованию генерируемого машиной тепла для обогрева более 1000 зданий в кампусе Париж-Сакле.
13.03.2024 [22:40], Алексей Степин
Больше флопс за те же ватты: Cerebras представила царь-ускоритель WSE-3 и подружилась с QualcommКомпания Cerebras Systems, известная своими разработками в области сверхбольших ИИ-процессоров, рассказала о третьем поколении чипов Wafer Scale Engine. В своё время компания произвела фурор, представив процессор, занимающий всю площадь кремниевой пластины (46225 мм2). В первом поколении WSE речь шла о 1,2 трлн транзисторов при 400 тыс. ядер и 18 Гбайт сверхбыстрой памяти. WSE-2 состоял из 2,6 трлн транзисторов, имел 850 тыс. ядер и 40 Гбайт интегрированной памяти. В WSE-3 разработчики перешли на использование 5-нм техпроцесса TSMC, что позволило разместить на пластине такого же размера уже 4 трлн транзисторов, составляющих 900 тыс. ядер и 44 Гбайт SRAM. Суммарная пропускная способность набортной памяти достигает 21 Пбайт/с, а внутреннего интерконнекта — 214 Пбит/с. 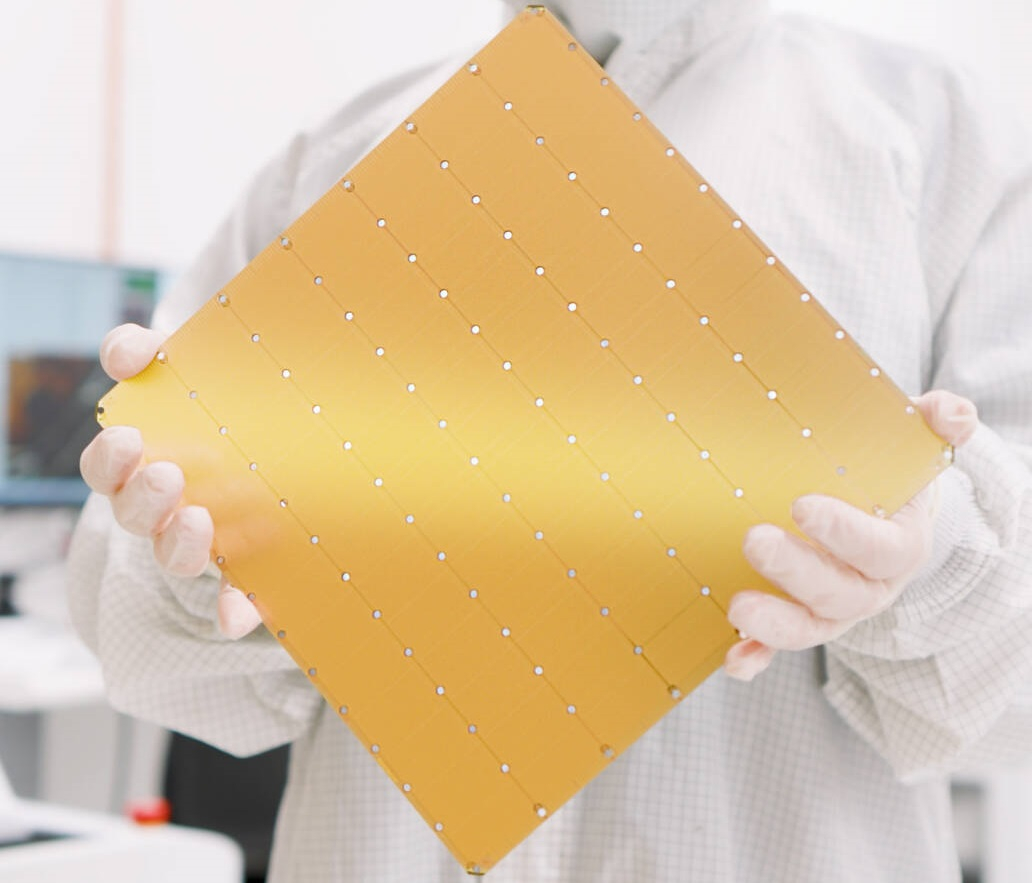
Источник изображений: Cerebras Казалось бы, выигрыш в количестве ядер по сравнению с WSE-2 не так уж велик, однако на этот раз Cerebras сделала упор на архитектуру. Если верить заявлениям разработчиков, WSE-3 практически вдвое быстрее WSE-2 при сопоставимом уровне энергопотребления (15 кВт) и той же цене: 125 Пфлопс против 75 Пфлопс в разреженных FP16-вычислениях. WSE-3 в 62 раза быстрее NVIDIA H100, хотя и сам чип WSE-3 в 57 раз больше. 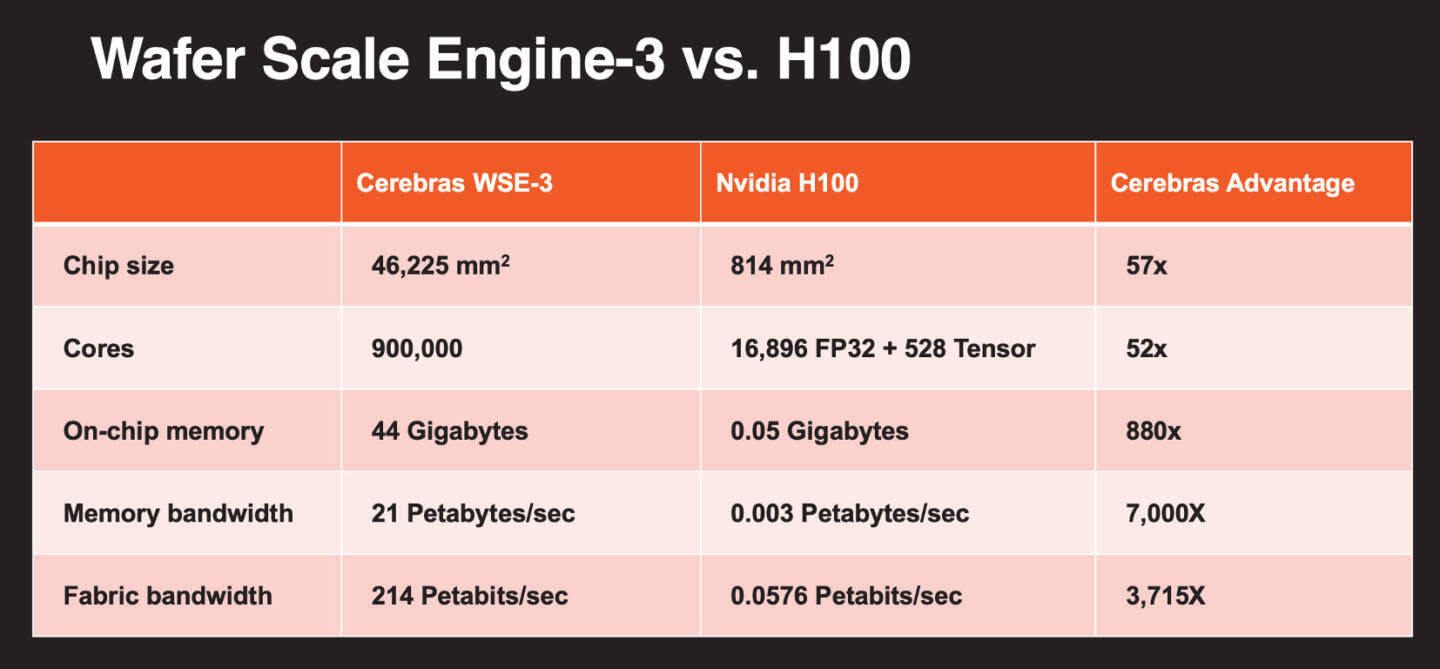 WSE-3 по-прежнему требует специфического окружения. Он станет сердцем новой системы CS-3 (23 кВт), содержащей всю необходимую сопутствующую инфраструктуру, включая СЖО, подсистемы питания, а также сетевого интерконнекта Ethernet. Последний не изменился и состоит из 12 каналов со скоростью 100 Гбит/с. Для подготовки «сырых» данных по-прежнему будет использоваться внешний суперсервер. А для их хранения будут использоваться узлы MemoryX ёмкостью до 1200 Тбайт (1,2 Пбайт). 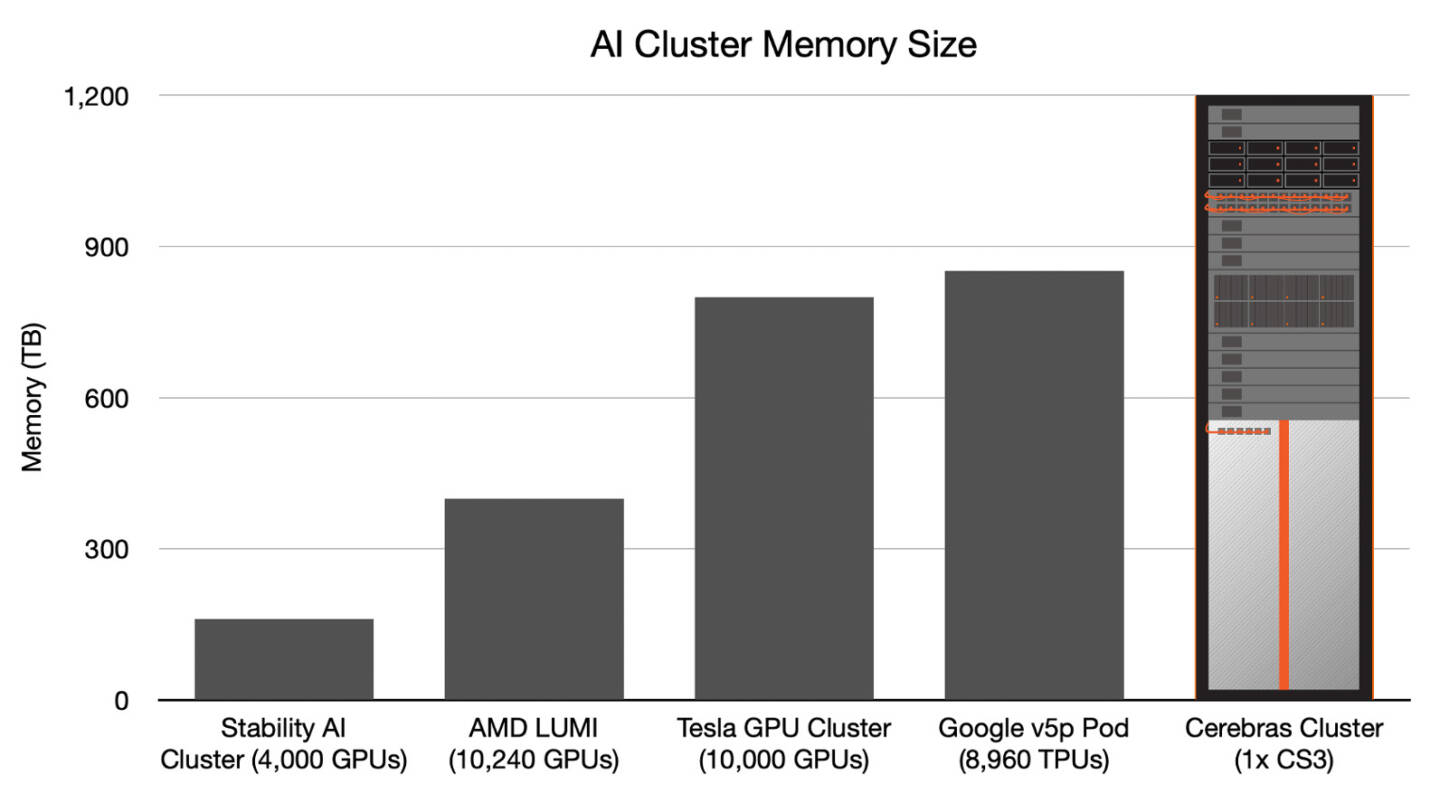 Главной задачей CS-3 станет «натаскивание» сверхбольших языковых моделей, в 10 раз превышающих по количеству параметров GPT-4 и Google Gemini. Cerebras говорит о 24 трлн параметров, причём без необходимости различных ухищрений для эффективного распараллеливания процесса обучения, что требуется в случае с GPU-кластерами. По словам компании, для обучения Megatron 175B на таких кластерах требуется 20 тыс. строка кода Python/C++/CUDA, а в случае WSE-3 потребуется лишь 565 строк на Python.  CS-3 поддерживает масштабирование вплоть до 2048 систем. Такая конфигурация вкупе с MemoryX сможет обучить модель типа Llama 70B всего за день. Первый суперкомпьютер на базе CS-3 — 8-Эфлопс Condor Galaxy 3 — будет скромнее и получит всего 64 стойки CS-3, которые разместятся в Далласе (США). В совокупности с уже имеющимися кластерами на базе CS-1 и CS-2 вычислительная мощность систем Cerebras должна достигнуть 16 Эфлопс. В сотрудничестве c группой G42 запланировано создание ещё шести систем CS-3, что в сумме позволит довести производительность до 64 Эфлопс.  Condor Galaxy 3 будет отличаться от предшественников ещё одним нововведением: в рамках сотрудничества с Qualcomm Cerebras установит в новом кластере существенное число инференс-ускорителей Qualcomm Cloud AI100 Ultra. Каждый такой ускоритель имеет 64 ядра, 128 Гбайт памяти LPDDR4x, потребляет 140 Вт и развивает 870 Топс на INT8-операциях. Причём програмнный стек полностью интегрирован, что позволит в один клик запустить обученные WSE-3 модели на ускорителях Qualcomm. 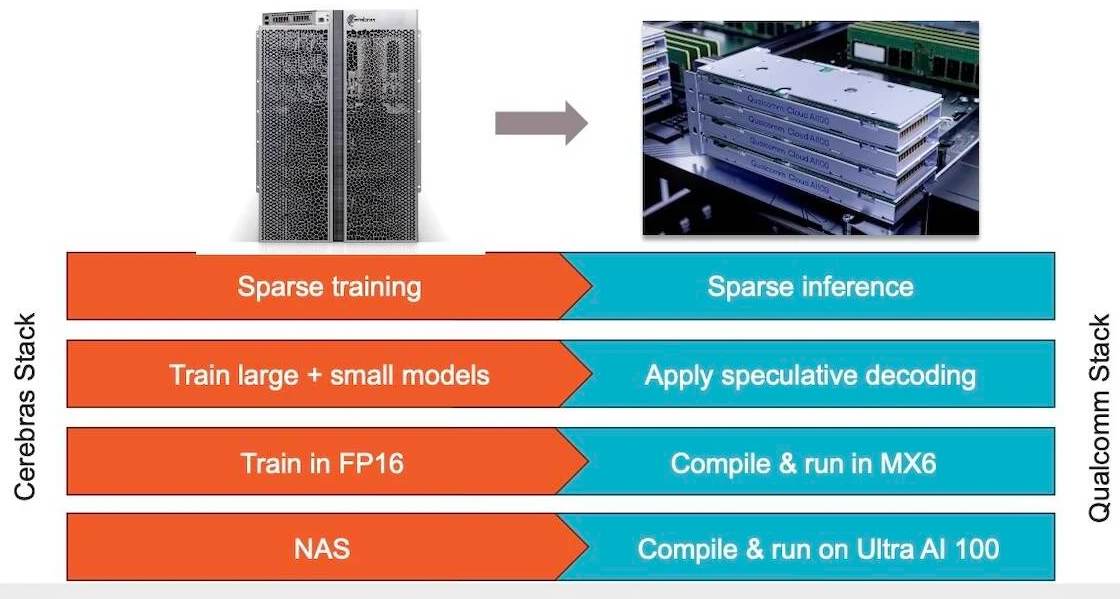 Сотрудничество Cerebras и Qualcomm носит официальный характер, его целью является оптимизация ИИ-моделей для запуска на AI100 Ultra с учетом различных продвинутых техник, таких как разреженные вычисления, спекулятивное исполнение (сочетание малых LLM для получения быстрого результата с проверкой большой LLM), использование «сжатого» формата MxFP6 для весов и других. Благодаря мощностям, предоставляемым WSE-3, цикл разработки, оптимизации и тестирования таких моделей удастся существенно ускорить, что в итоге должно обеспечить десятикратное улучшение удельной производительности новых решений.
23.12.2023 [02:11], Владимир Мироненко
В Испании официально запустили 314-Пфлопс суперкомпьютер MareNostrum 5, который вскоре объединится с двумя квантовыми компьютерами21 декабря в Суперкомпьютерном центре Барселоны — Centro Nacional de Supercomputación (BSC-CNS) — в торжественной обстановке официально запустили европейский суперкомпьютер MareNostrum 5 производительностью 314 Пфлопс. В церемонии, посвящённой машине, созданной в рамках проекта European High Performance Computing Joint Undertaking (EuroHPC JU), принял участие председатель правительства Испании. MareNostrum 5 представляет собой крупнейшую инвестицию, когда-либо сделанную Европой в научную инфраструктуру Испании — суммарно €202 млн, из которых €151,4 млн ушло на приобретение суперкомпьютера. Финансирование было проведено EuroHPC JU через Фонд ЕС «Соединение Европы» и программу исследований и инноваций «Горизонт 2020», а также государствами-участниками: Испанией (через Министерство науки, инноваций и университетов и правительство Каталонии), Турцией и Португалией. С запуском MareNostrum 5 заметно укрепились позиции BSC в качестве одного из ведущих суперкомпьютерных центров мира с более чем 900 сотрудниками, занимающимися исследования в области информатики, наук о жизни и о Земле, а также вычислительных систем для науки и техники. Обладая максимальной общей производительностью 314 Пфлопс, MareNostrum 5 присоединяется к двум другим системам EuroHPC: Lumi (Финляндия) и Leonardo (Италия), тоже являющихся суперкомпьютерами предэкзафлопсного класса, единственными системами такого уровня в Европе. 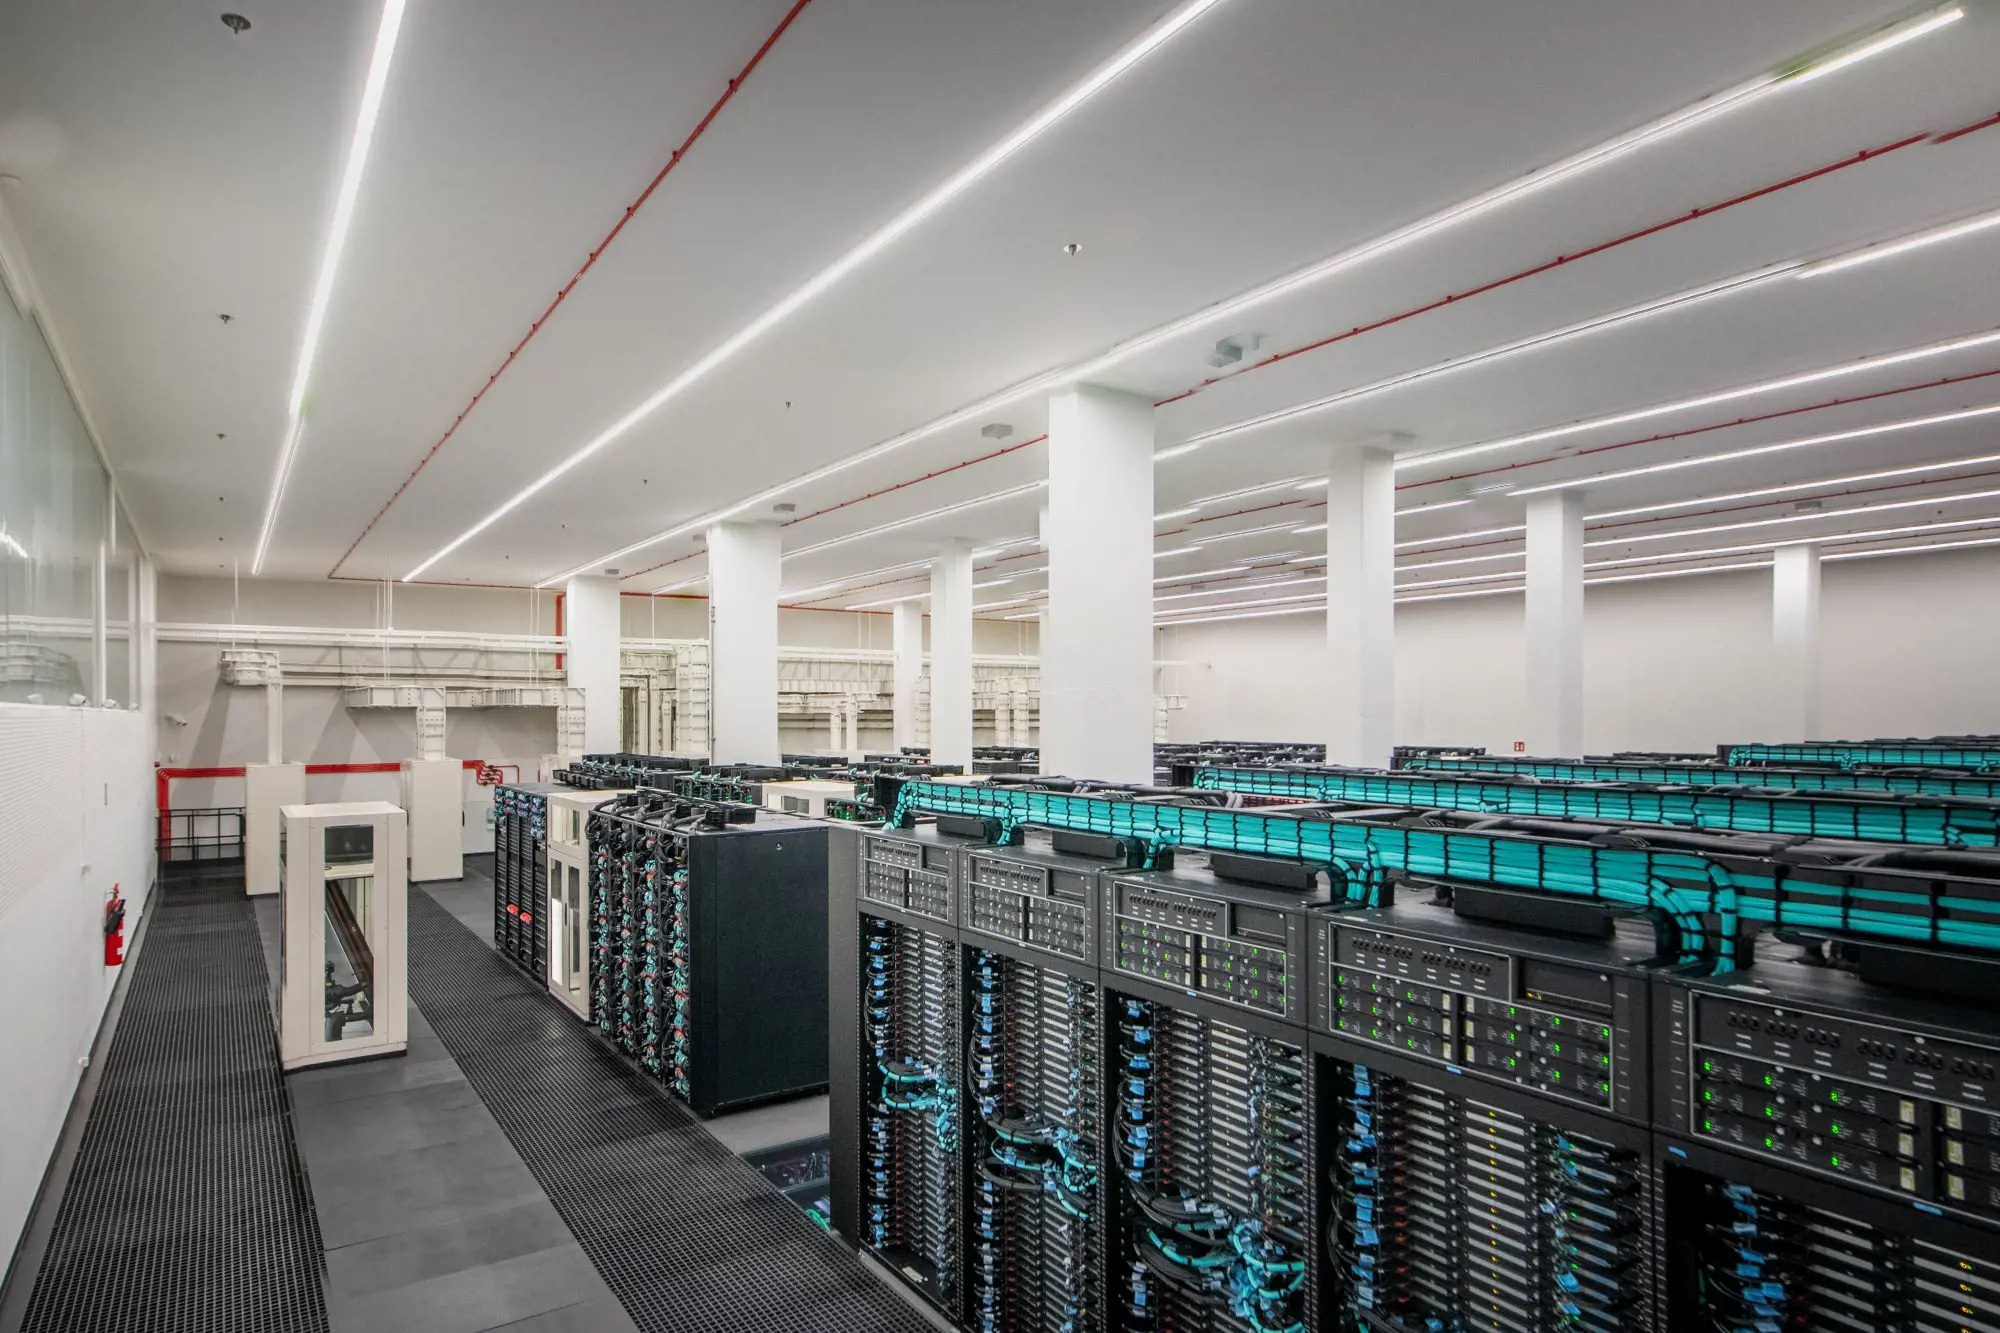
Источник изображений: BSC Eviden (Atos) была выбрана в качестве основного поставщика, но в создании машины приняли участие Lenovo, IBM, Intel и NVIDIA, а также Partec. Как отмечено в пресс-релизе, уникальная архитектура MareNostrum 5 была создана для того, чтобы предоставить исследователям лучшие из доступных технологий. Это гетерогенная машина, сочетающая в себе две отдельные системы: раздел общего назначения (GPP), предназначенный для классических вычислений, и GPU-раздел (ACC), ориентированный на ИИ. Обе системы по отдельности входят в первую двадцатку TOP500, занимая 19-е и 8-е места соответственно. Раздел общего назначения (GPP) является крупнейшим в мире x86-кластером на базе Intel Xeon Sapphire Rapids. Эта часть суперкомпьютера имеет пиковую производительность 45,9 Пфлопс. Система, произведённая Lenovo, специально разработана для решения сложных научных задач с разделением ресурсов, что обеспечивает большую гибкость и повышает эффективность системы, поскольку разные пользователи или проекты могут использовать её одновременно. GPP имеет 6408 стандарных узлов следующей конфигурации:
Дополнительно система имеет 72 узла с двумя 56-ядерными Xeon Max (1,7 ГГц) и набортной памятью HBM2e объёмом 128 Гбайт. 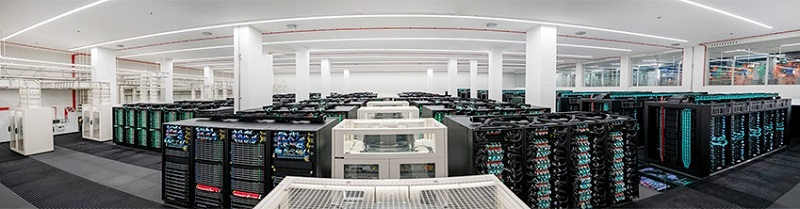 GPU-раздел (ACC) производства Eviden является третьим по мощности в Европе и восьмым в мире по версии TOP500, с пиковой производительностью 260 Пфлопс. Он основан на 4480 ускорителях NVIDIA H100. Раздел имеет 1120 узлов, каждый из которых включает:
Общая ёмкость хранилища MareNostrum 5 составляет 650 Пбайт, из которых, 402 Пбайт приходятся на LTO, 248 Пбайт — на HDD, а остальное — на NVMe SSD. Задействована ФС IBM Spectrum Scale. Машина использует интерконнект InfiniBand NDR200, объединяющий более 8000 узлов. Можно заметить, что NVIDIA предоставила BSC не совсем стандартные решения. В будущем ожидается появление ещё одного GPP-раздела на базе NVIDIA Grace, а вот расширение ACC узлами с Xeon Emerald Rapids и Rialto Bridge не состоится. 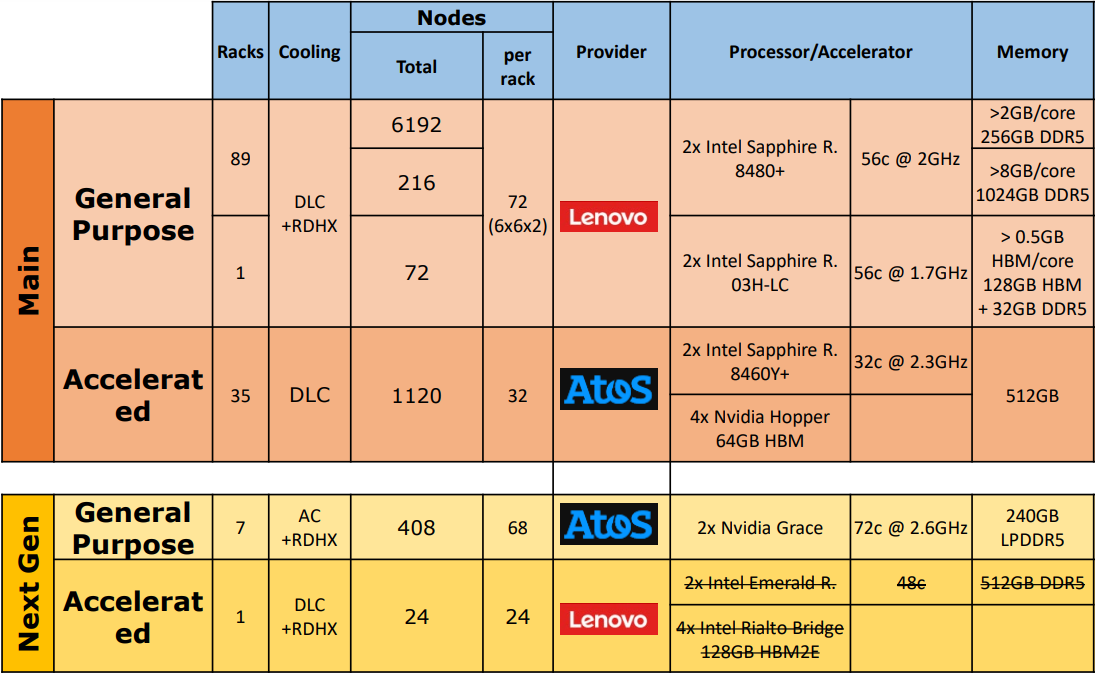 Благодаря увеличенной вычислительной мощности MareNostrum 5 позволяет решать всё более сложные задачи. Например, климатические модели получат более высокое разрешение, что сделает прогнозы гораздо более точными и надёжными. Также появится возможность решать гораздо более сложные проблемы в области ИИ и Big Data. Отдельное внимание уделено поддержке европейских медицинских исследований в области создания новых лекарств, разработки вакцин и моделирования распространения вирусов. Суперкомпьютер также станет важнейшим инструментом для материаловедения и инженерии, включая проектирование и оптимизацию самолётов, развитие более безопасной, экологически чистой и эффективной авиации. Аналогичным образом, машина будет использоваться для моделирования процессов энергогенерации, включая ядерный синтез. В ближайшие месяцы MareNostrum 5 объединится с двумя квантовыми компьютерами: первой системой испанской суперкомпьютерной сети (RES), которая является частью инициативы Quantum Spain, и одним из первых европейских квантовых компьютеров EuroHPC JU. Оба квантовых компьютера будут одними из первых, которых запустили в Южной Европе. |
|

