
Материалы по тегу: nvidia
|
23.02.2022 [16:35], Руслан Авдеев
«Сингулярность» планетарного масштаба: ИИ-инфраструктура Microsoft включает более 100 тыс. GPU, FPGA и ASICMicrosoft неожиданно раскрыла подробности использования своей распределённой службы планирования «планетарного масштаба» Singularity, предназначенной для управления ИИ-нагрузками. В докладе компании целью Singularity названа помощь софтверному гиганту в контроле затрат путём обеспечения высокого коэффициента использования оборудования при выполнении задач, связанных с глубоким обучением. Singularity удаётся добиться этого с помощью нового планировщика, способного обеспечить высокую загрузку ускорителей (в том числе FPGA и ASIC) без роста числа ошибок или снижения производительности. Singularity предлагает прозрачное выделение и эластичное масштабирование выделяемых каждой задаче вычислительных ресурсов. Фактически она играет роль своего рода «умной» прослойки между собственно аппаратным обеспечением и программной платформой для ИИ-нагрузок. 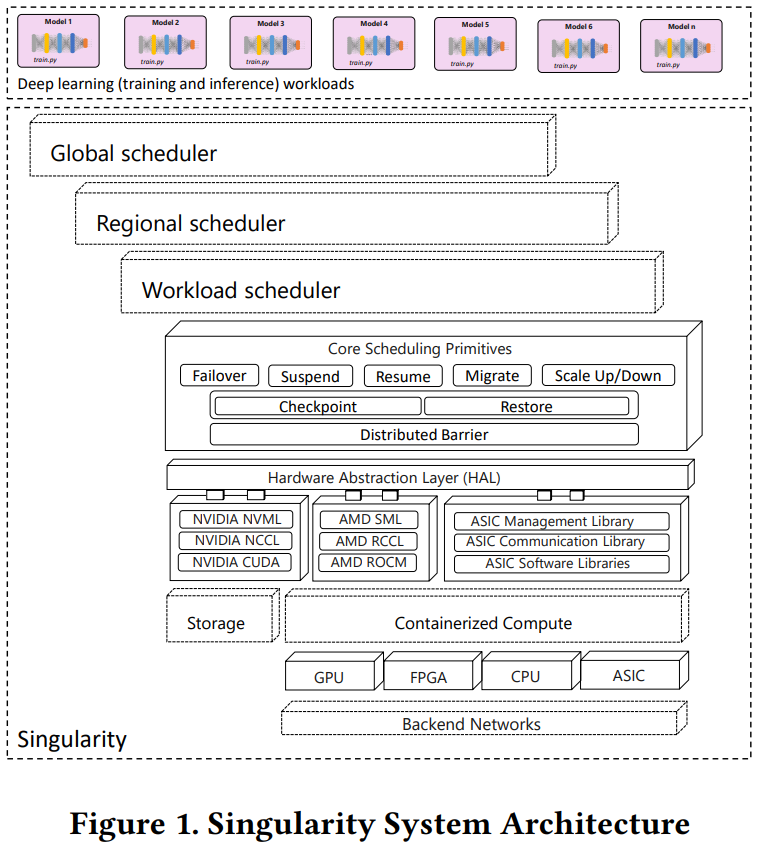
Изображение: Microsoft Singularity позволяет разделять задачи, поручаемые ресурсам ускорителей. Если необходимо масштабирование, система не просто меняет число задействованных устройств, но и управляет распределением и выделением памяти, что крайне важно для ИИ-нагрузок. Правильное планирование позволяет не простаивать без нужды весьма дорогому «железу», благодаря чему и достигается положительный экономический эффект. 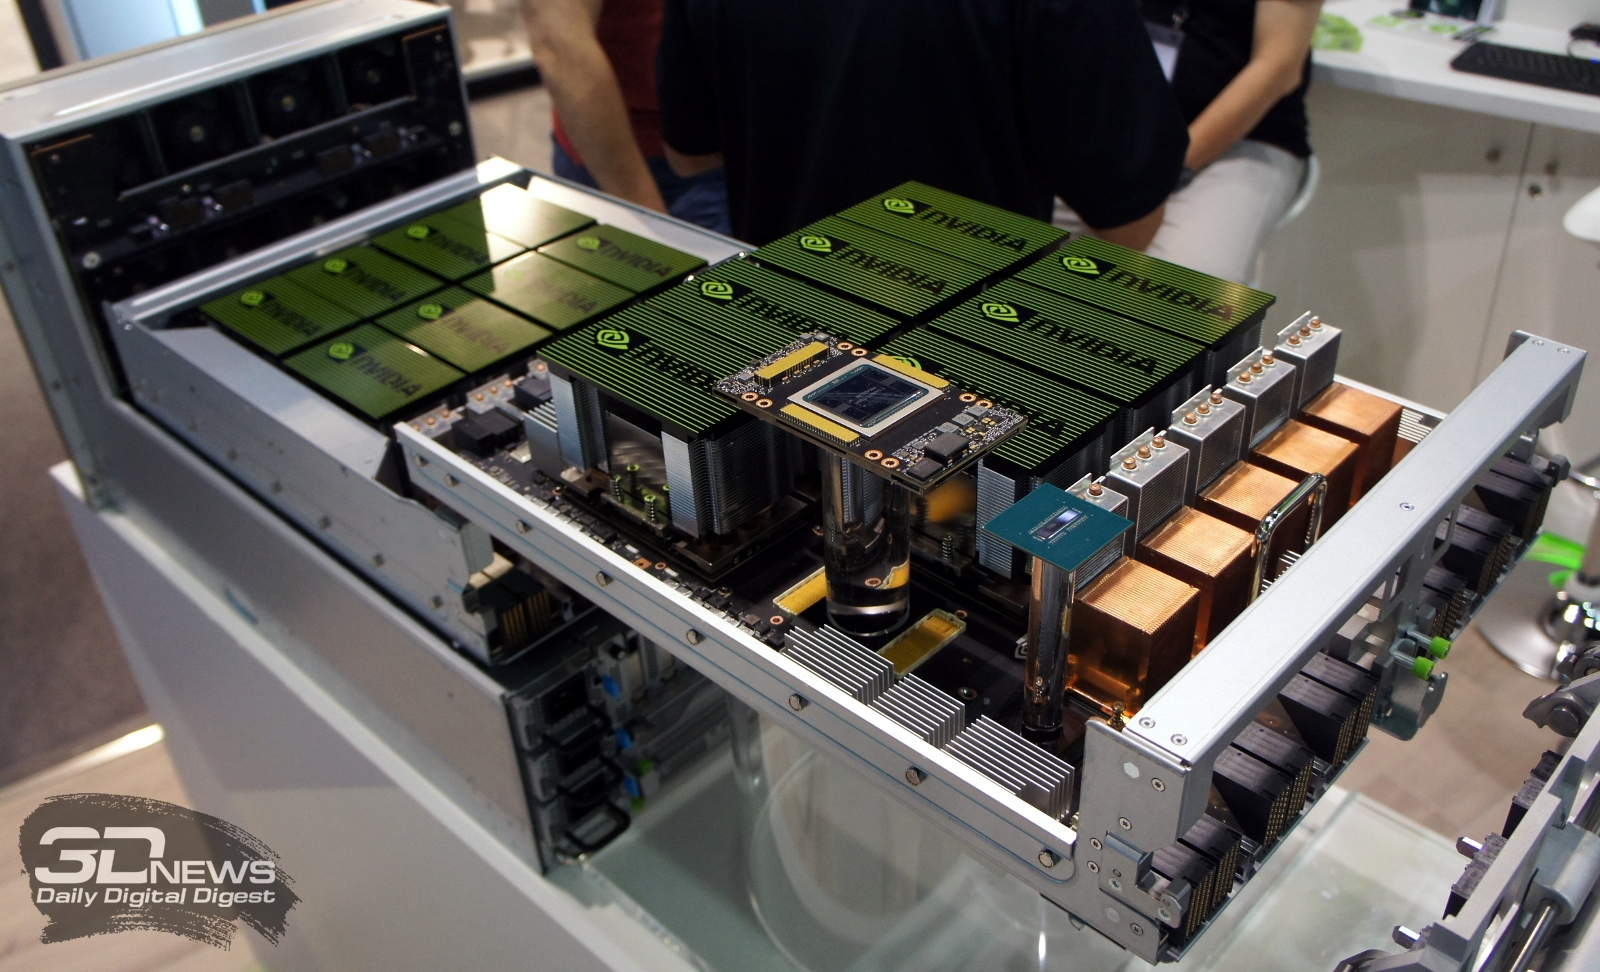
NVIDIA DGX-2 В докладе также прямо говорится, что у Microsoft есть сотни тысяч GPU и других ИИ-ускорителей. В частности, упоминается, что Singularity используется на платформах NVIDIA DGX-2: два Xeon Platinum 8168 (по 20 ядер каждый), восемь ускорителей V100 с NVSwitch, 692 Гбайт RAM и интерконнект InfiniBand. Таким образом, ИИ-парк компании должен включать десятки тысяч узлов, поэтому эффективное управление им очень важно.
25.01.2022 [03:33], Владимир Мироненко
Meta✴ и NVIDIA построят самый мощный в мире ИИ-суперкомпьютер RSC: 16 тыс. ускорителей A100 и хранилище на 1 ЭбайтMeta✴ (ранее Facebook✴) анонсировала новый крупномасштабный исследовательский кластер — ИИ-суперкомпьютер Meta✴ AI Research SuperCluster (RSC), предназначенный для ускорения решения задач в таких областях, как обработка естественного языка (NLP) с обучением всё более крупных моделей и разработка систем компьютерного зрения. На текущий момент Meta✴ RSC состоит из 760 систем NVIDIA DGX A100 — всего 6080 ускорителей. К июлю этого года, как ожидается, система будет включать уже 16 тыс. ускорителей. Meta✴ ожидает, что RSC станет самым мощным ИИ-суперкомпьютером в мире с производительностью порядка 5 Эфлопс в вычислениях смешанной точности. Близкой по производительность системой станет суперкомпьютер Leonardo, который получит 14 тыс. NVIDIA A100. 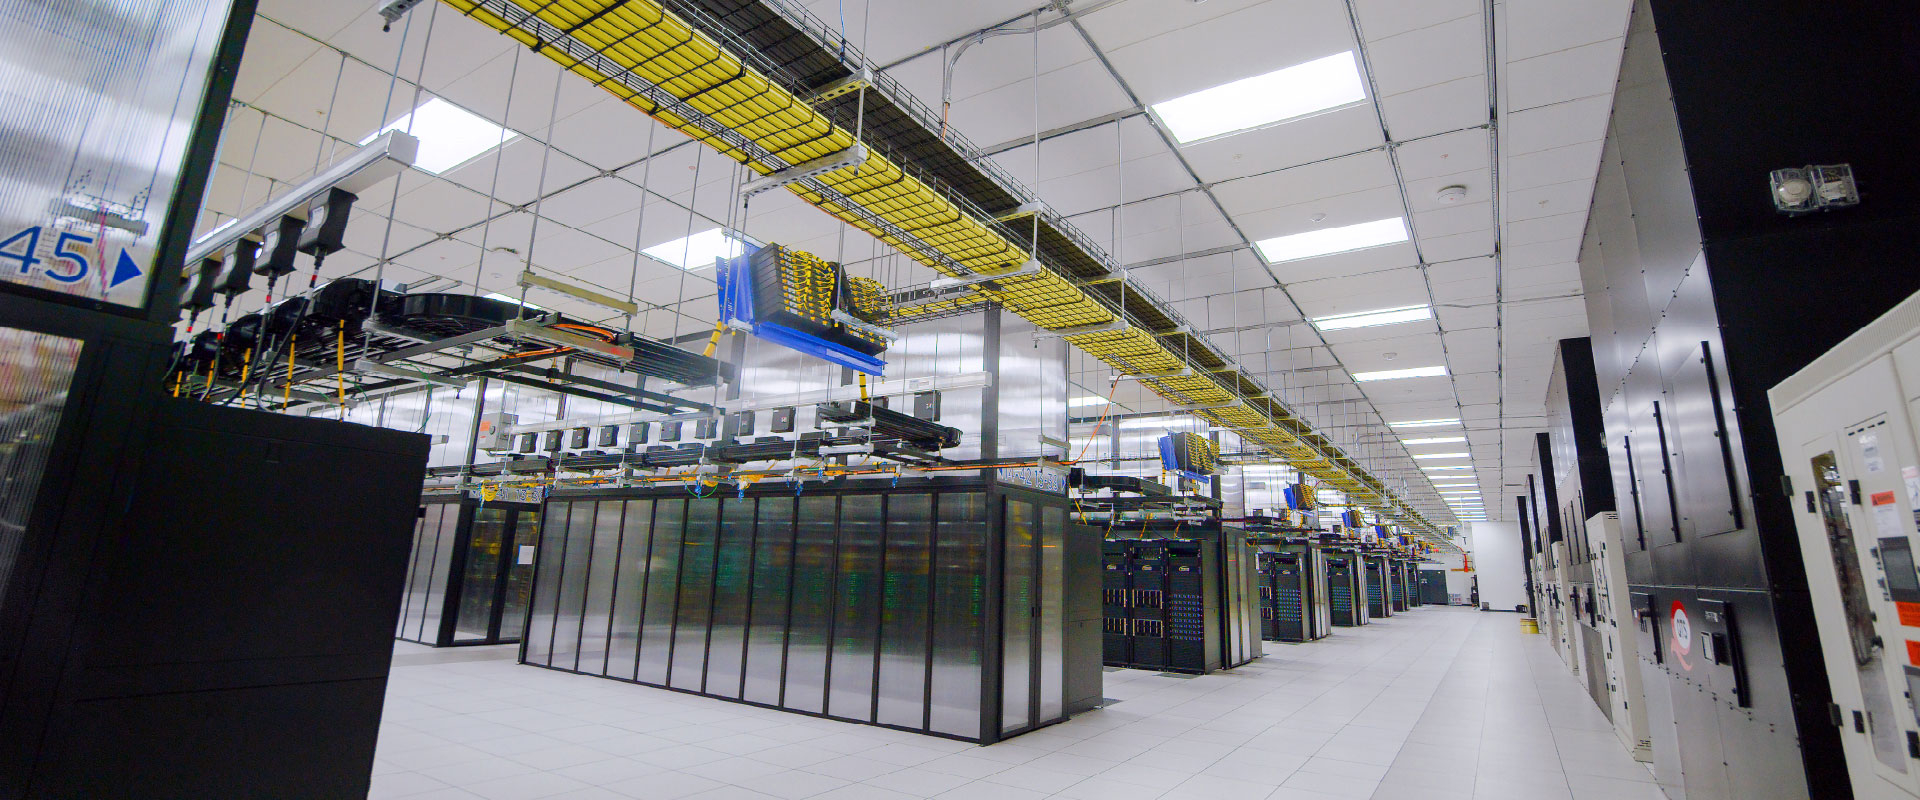
Изображения: Meta✴ Meta✴ RSC будет в 20 раз быстрее в задачах компьютерного зрения и в 3 раза быстрее в обучении больших NLP-моделей (счёт идёт уже на десятки миллиардов параметров), чем кластер Meta✴ предыдущего поколения, который включает 22 тыс. NVIDIA V100. Любопытно, что даже при грубой оценке производительности этого кластера он наверняка бы попал в тройку самых быстрых машин нынешнего списка TOP500. 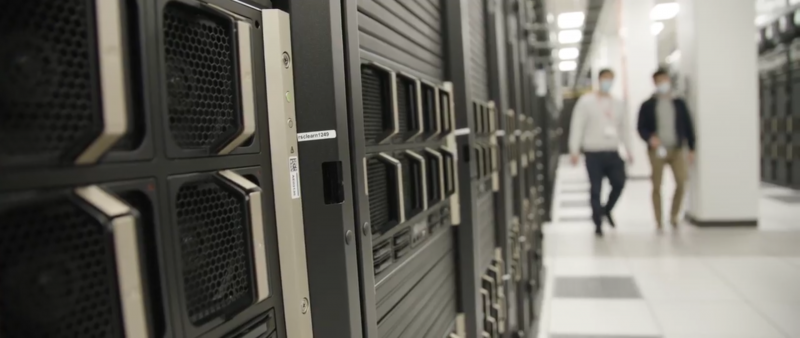 Новый же кластер создаётся с прицелом на возможность обучения моделей с триллионом параметров на наборах данных объёмом порядка 1 Эбайт. Именно такого объёма хранилище планируется создать для Meta✴ RSC. Сейчас же система включает массив Pure Storage FlashArray объемом 175 Пбайт, 46 Пбайт кеш-памяти на базе систем Penguin Computing Altus и массив Pure Storage FlashBlade ёмкостью 10 Пбайт. Вероятно, именно этой СХД и хвасталась Pure Storage несколько месяцев назад, не уточнив, правда, что речь шла об HPC-сегменте. 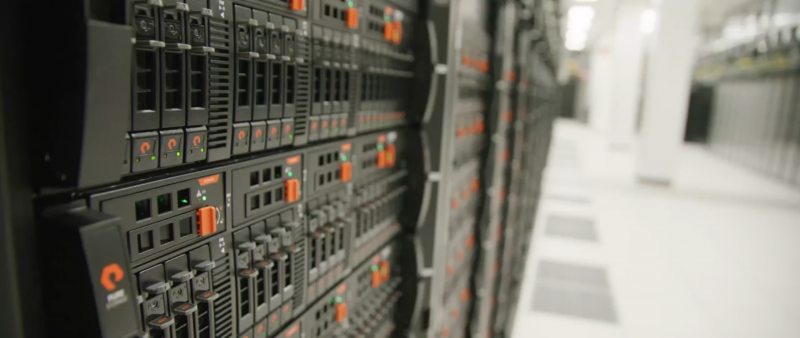 Итоговая пропускная способность хранилища должна составить 16 Тбайт/с. Meta✴ RSC сможет обучать модели машинного обучения на реальных данных, полученных из социальных сетей компании. В качестве основного интерконнекта используются коммутаторы NVIDIA Quantum и адаптеры HDR InfiniBand (200 Гбит/с), причём, судя по видео, с жидкостным охлаждением. Каждому ускорителю полагается выделенное подключение. Фабрика представлена двухуровневой сетью Клоза. 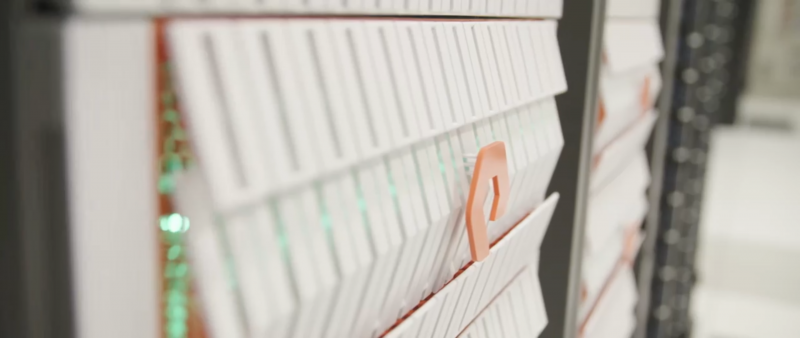 Meta✴ также разработала службу хранения AI Research Store (AIRStore) для удовлетворения растущих требований RSC к пропускной способности и ёмкости. AIRStore выполняет предварительную обработку данных для обучения ИИ-моделей и предназначена для оптимизации скорости передачи. Компания отдельно подчёркивает, что все данные проходят проверку на корректность анонимизации. Более того, имеется сквозное шифрование — данные расшифровываются только в памяти узлов, а ключи регулярно меняются. 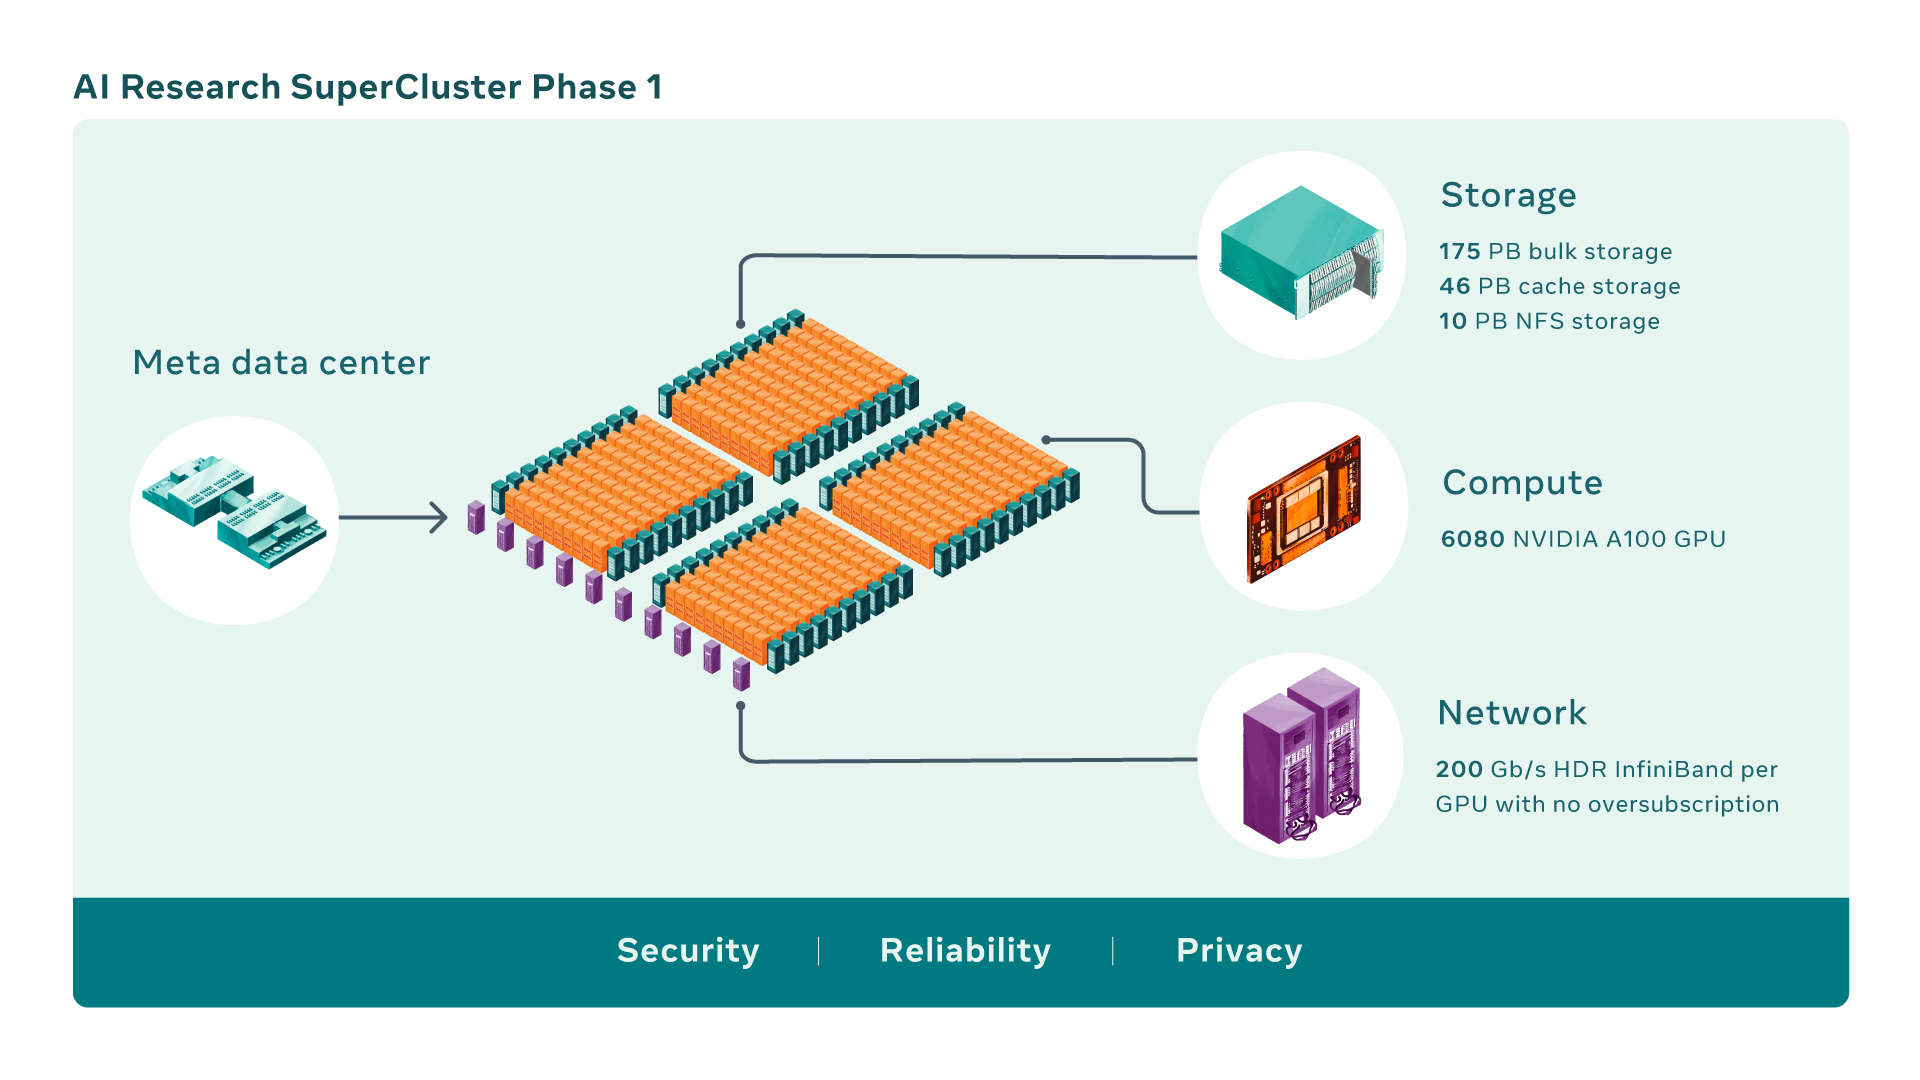 Однако ни о стоимости проекта, ни о потребляемой мощности, ни о физическом местоположении Meta✴ RSC, ни даже о том, почему были выбраны узлы DGX, а не HGX (или вообще другие ускорители), Meta✴ не рассказала. Для NVIDIA же эта машина определённо стала очень крупным и важным заказом.
11.01.2022 [16:02], Сергей Карасёв
NVIDIA купила Bright Computing, разработчика решений для управления НРС-кластерамиКомпания NVIDIA сообщила о заключении соглашения по приобретению фирмы Bright Computing, разработчика специализированных программных продуктов для управления кластерами. О сумме сделки ничего не сообщается. Bright Computing была выделена из состава нидерландской ClusterVision в 2009 году; последняя после банкротства в 2019 году была поглощена Taurus Group. Штаб-квартира Bright Computing базируется в Амстердаме. Основным направлением деятельности компании является разработка инструментов, позволяющих автоматизировать процесс построения и управления Linux-кластерами. 
Источник изображения: Bright Computing В число клиентов Bright Computing входят более 700 корпораций и организаций по всему миру. Среди них упоминаются Boeing, Siemens, NASA, Университет Джонса Хопкинса и др. Отмечается, что NVIDIA и Bright сотрудничают уже более десяти лет. Речь идёт об интеграции ПО с аппаратными платформами и другими продуктами NVIDIA. Поглощение Bright Computing, как ожидается, позволит NVIDIA предложить новые решения в области НРС, которые будут отличаться относительной простотой развёртывания и управления. Эти решения могут применяться в дата-центрах, в составе различных облачных платформ и edge-систем. В рамках сделки вся команда Bright Computing присоединится к NVIDIA.
09.11.2021 [12:33], Алексей Степин
NVIDIA представила платформу Jetson AGX Orin для периферийных ИИ-вычислений, робототехники и автономного транспортаОдним из лидеров в создании высокопроизводительных встраиваемых решений давно является NVIDIA с серией Jetson. На смену уже немолодой платформе Jetson AGX Xavier пришла Jetson AGX Orin, обладающая ускорителем с архитектурой Ampere. Компания не без оснований называет Jetson AGX Orin самой мощной, компактной и энергоэффективной платформой для робототехники, автономного транспорта и встраиваемых решений для работы на периферии — её производительность оценивается в 200 Топс, что более чем в шесть раз выше показателей Xavier. По словам NVIDIA новинка сравнима по скорости работы с GPU-сервером, но при этом умещается на человеческой ладони. 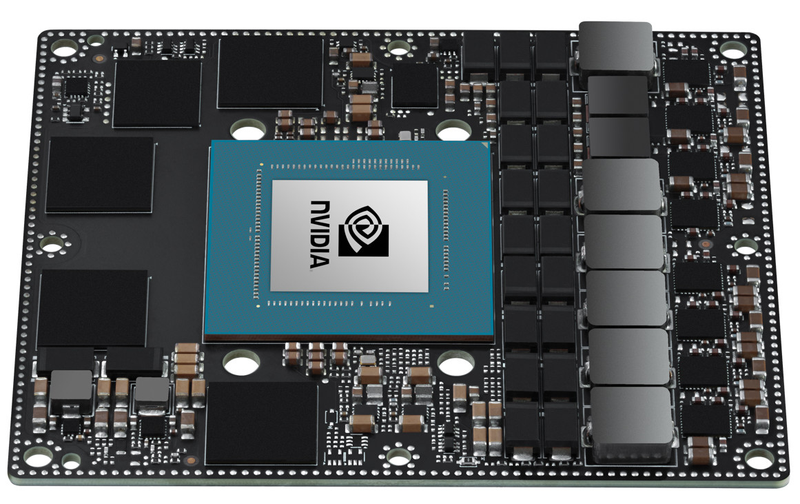 Новая 7-нм SoC состоит из 17 млрд транзисторов. Она включает 12 ядер Cortex-A78AE, одних из самых мощных в арсенале Arm, предназначенных для задач класса mission critical и имеющих продвинутые механизмы защиты от системных сбоев Это немаловажно, к примеру, при применении в беспилотных транспортных средствах и промышленной автоматике. Всё это дополнено 2048 ядрами NVIDIA Ampere. ускорители. Ускорена подсистема памяти (200 Гбайт/с). Серьёзно возросли сетевые возможности — новый чип имеет сразу четыре интерфейса 10 Гбит/с. 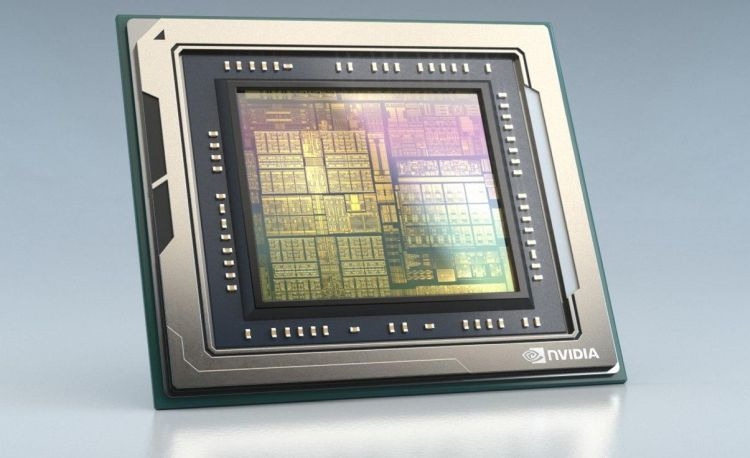 Разработчики решений на базе Jetson AGX Orin могут использовать NVIDIA CUDA-X, JetPack SDK и наиболее новые версии утилит NVIDIA. Также на момент анонса уже доступны предварительно натренированные и оптимизированные под новую платформу ИИ-модели из каталога NVIDIA TAO, которые помогут сократить время создания новых решений на базе Orin. Доступность новых плат Jetson AGX запланирована на первый квартал следующего года. Дабы не пропустить этот момент, NVIDIA предлагает зарегистрироваться в соответствующем разделе своего сайта.
09.11.2021 [12:17], Алексей Степин
NVIDIA представила Quantum-2, первый 400G-коммутатор InfiniBand NDRNVIDIA, нынешний владелец Mellanox, представила обновления своих решений InfiniBand NDR: коммутаторы Quantum-2, сетевые адаптеры ConnectX-7 и ускорители DPU BlueField-3. Это весьма своевременный апдейт, поскольку 400GbE-решения набирают популярность, а с приходом PCIe 5.0 в серверный сегмент станут ещё более актуальными. 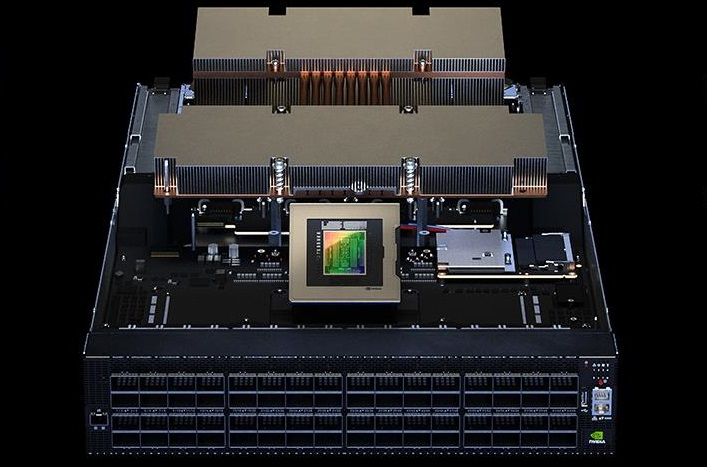
NVIDIA Quantum-2 (Здесь и ниже изображения NVIDIA) Первый и самый важный анонс — это платформа Quantum-2. Новый коммутатор не только обеспечивает вдвое более высокую пропускную способность на порт (400 Гбит/с против 200 Гбит/c), но также предоставляет в три раза больше портов, нежели предыдущее поколение. Это сочетание позволяет снизить потребность в коммутаторах в 6 раз при той же суммарной ёмкости сети. При этом новая более мощная инфраструктура также окажется более экономичной и компактной. 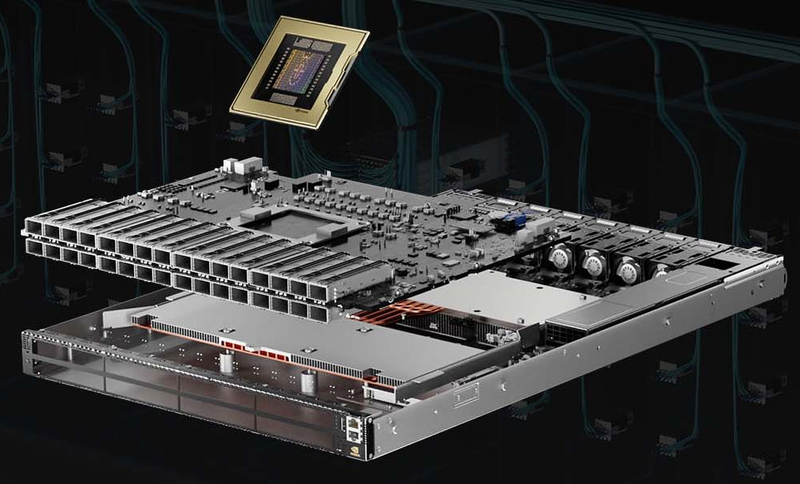 Более того, Quantum-2 относится к серии «умных» устройств и содержит в 32 раза больше акселераторов, нежели Quantum HDR первого поколения. В нём также реализована предиктивная аналитика, позволяющая избежать проблем с сетевой инфраструктурой ещё до их возникновения; за это отвечает технология UFM Cyber-AI. Также коммутатор предлагает синхронизацию времени с наносекундной точностью, что важно для распределённых нагрузок. 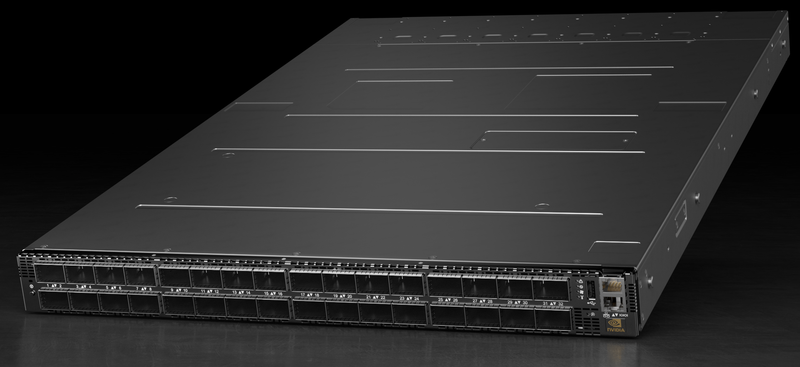 7-нм чип Quantum-2 содержит 57 млрд транзисторов, то есть он даже сложнее A100 с 54 млрд транзисторов. В стандартной конфигурации чип предоставляет 64 порта InfiniBand 400 Гбит/с, однако может работать и в режиме 128 × 200 Гбит/с. Коммутаторы на базе нового сетевого процессора уже доступны у всех крупных поставщиков серверного оборудования, включая Inspur, Lenovo, HPE и Dell Technologies. Возможно масштабирование вплоть 2048 × 400 Гбит/с или 4096 × 200 Гбит/с. 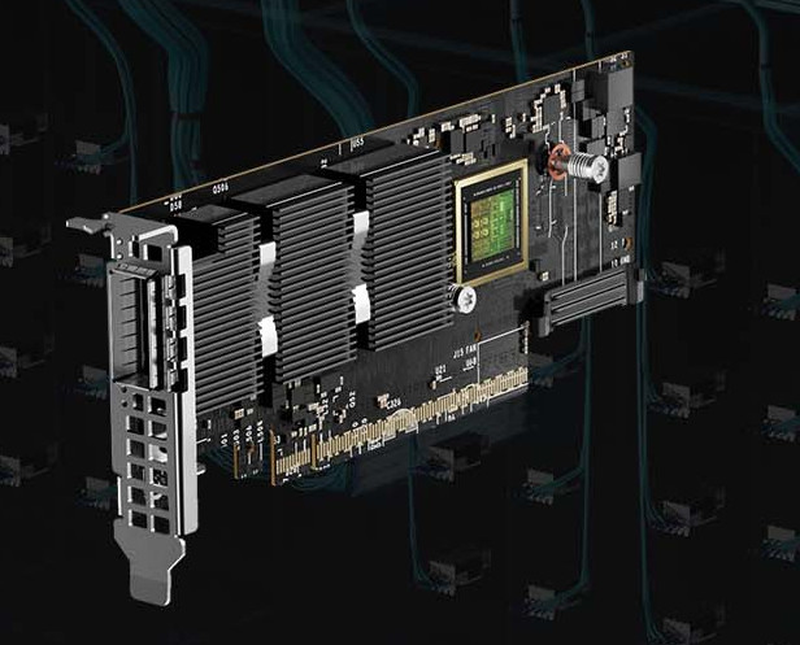
NVIDIA ConnectX-7 Конечные устройства для новой инфраструктуры InfiniBand доступны в двух вариантах: это относительно простой сетевой адаптер ConnectX-7 и куда более сложный BlueField-3. В первом случае изменения, в основном, количественные: новый чип, состоящий из 8 млрд транзисторов, позволил вдвое увеличить пропускную способность, равно как и вдвое же ускорить RDMA и GPUDirect. 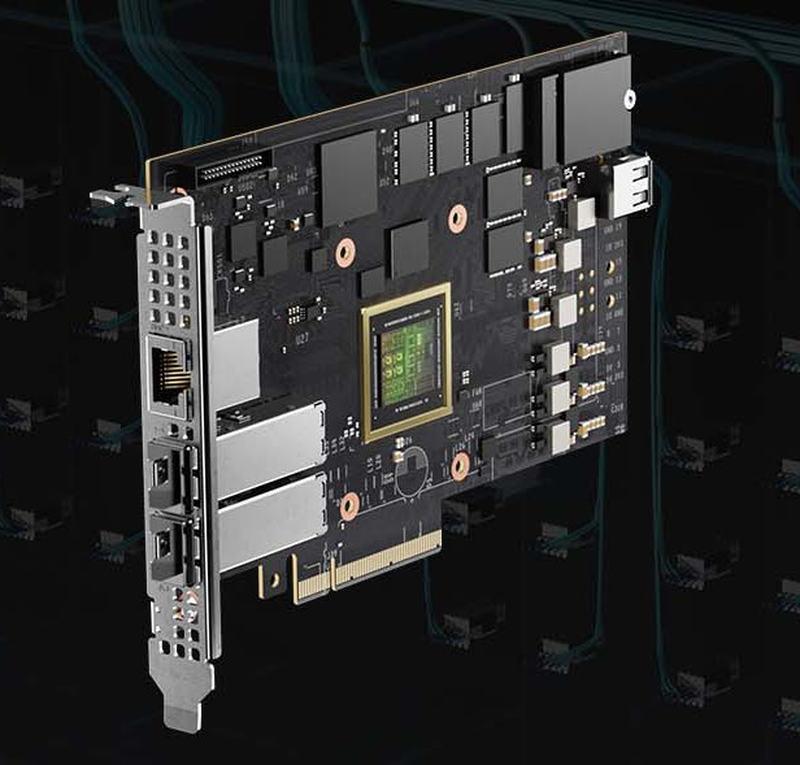
NVIDIA BlueField-3 DPU BlueField-3, анонсированный ещё весной этого года, куда сложнее с его 22 млрд транзисторов. Он предоставляет гораздо больше возможностей, чем обычный сетевой адаптер или SmartNIC, и крайне важен для будущего развития инфраструктурных решений NVIDIA. Начало поставок ConnectX-7 намечено на январь, а вот BlueField-3 появится только в мае 2022 года. Оба адаптера совместимы с PCIe 5.0.
29.06.2021 [13:25], Владимир Мироненко
МТС запустила суперкомпьютер MTS GROM: третья российская система в TOP500Российская компания МТС объявила о запуске суперкомпьютера MTS GROM, который будет использоваться для развития цифровой экосистемы. С производительностью 2,26 Пфлопс в мировом рейтинге высокопроизводительных машин TOP500 он находится на 241 месте, а среди российских суперкомпьютеров рейтинга он занимает третье место (из трёх). Суперкомпьютер MTS GROM построен на базе программно-аппаратной платформы NVIDIA DGX A100 и включает 155 узлов: 2 × AMD EPYC 7742 (64C/128T, 2,25/2,4 ГГц, 256 Мбайт L3-кеш, TDP 225 Вт) + 8 × NVIDIA A100 (40 Гбайт) c NVSwitch. Суммарный объём RAM составляет 20,48 Тбайт, а число ядер CPU достигает 19840. Работает система под управлением Ubuntu 20.04.1 LTS. Узлы объединены посредством InfiniBand, а для хранения данных используется NVMe-oF СХД NetApp, благодаря чему достигается сверхбыстрое взаимодействие вычислительных узлов с СХД для сокращения времени обучения ИИ-моделей. Система построена является воплощением NVIDIA DGX SuperPOD for Enterprise и была развёрнута всего за месяц. 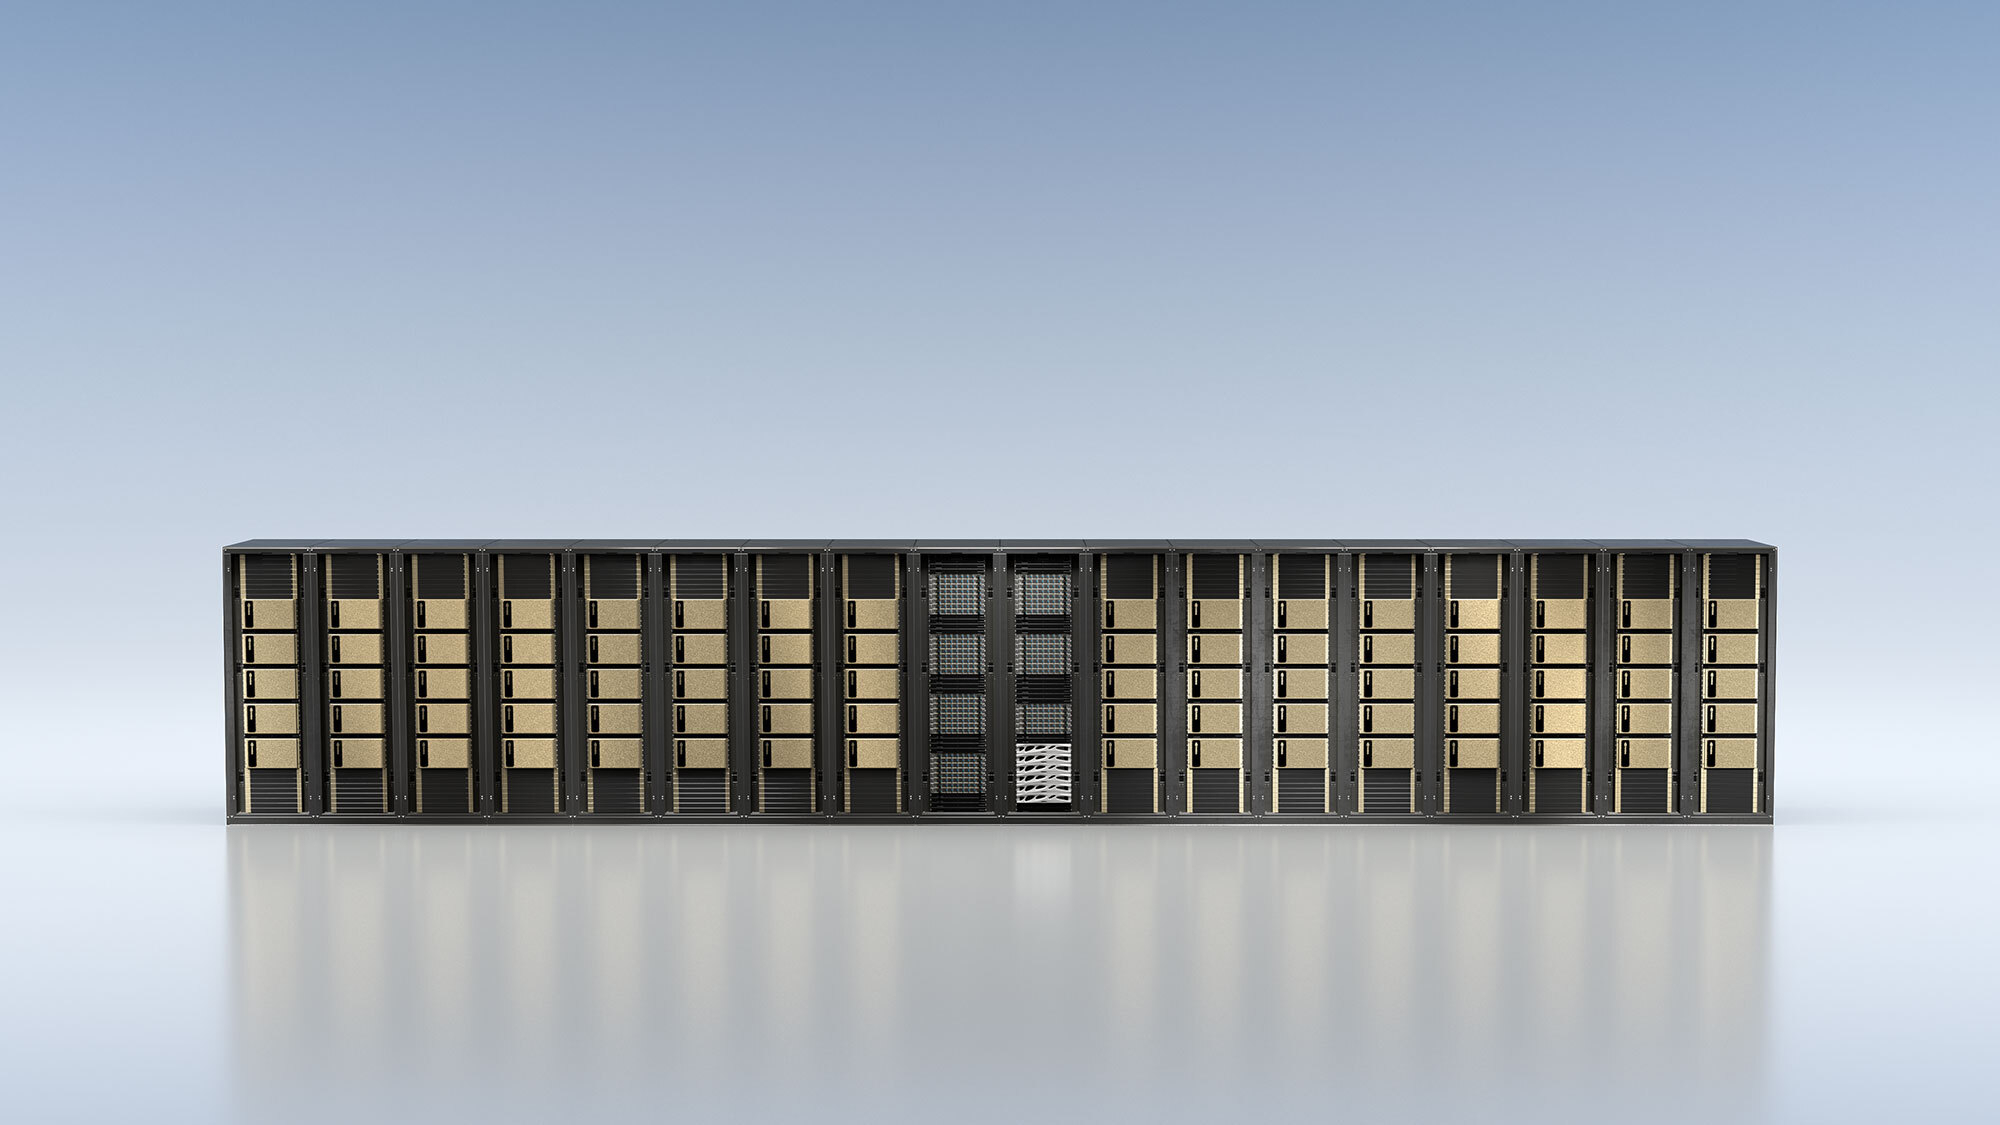 С помощью нового суперкомпьютера Центр искусственного интеллекта МТС планирует реализовывать внутренние и внешние проекты в области клиентского сервиса и повышения операционной эффективности бизнеса. В частности, MTS GROM будет полезен образовательным учреждениям, крупным научным и медицинским центрам в исследованиях, связанных с моделированием сложных процессов. Как сообщает компания, «в дальнейшем высокопроизводительные мощности MTS GROM станут доступны российским компаниям в портфеле провайдера #CloudMTS. Это позволит крупному бизнесу кратно сократить время на разработку и внедрение проектов на основе искусственного интеллекта и больших данных. Стартапам — в сотни раз снизить затраты на высокопроизводительные вычисления для анализа речи, обработки видео и распознавания лиц». Воспользоваться мощностями MTS GROM можно будет, оставив заявку на сайте #CloudMTS. «МТС формирует цифровую экосистему для российских компаний. На базе MTS GROM мы будем развивать самые перспективные технологии, связанные с искусственным интеллектом, анализом больших данных и облачными решениями. Суперкомпьютер MTS GROM призван повысить технологичность компании, а также лечь в основу будущих сервисов, которые бизнес и научные организации смогут получить в облаке #CloudMTS, значительно экономя», — отметил директор облачного бизнеса МТС Олег Мотовилов.
28.06.2021 [13:22], Алексей Степин
Обновление NVIDIA HGX: PCIe-вариант A100 с 80 Гбайт HBM2e, InfiniBand NDR и Magnum IO с GPUDirect StorageНа суперкомпьютерной выставке-конференции ISC 2021 компания NVIDIA представила обновление платформы HGX A100 для OEM-поставщиков, которая теперь включает PCIe-ускорители NVIDIA c 80 Гбайт памяти, InfiniBand NDR и поддержку Magnum IO с GPUDirect Storage. В основе новинки лежат наиболее продвинутые на сегодняшний день технологии, имеющиеся в распоряжении NVIDIA. В первую очередь, это, конечно, ускорители на базе архитектуры Ampere, оснащённые процессорами A100 с производительностью почти 10 Тфлопс в режиме FP64 и 624 Топс в режиме тензорных вычислений INT8. 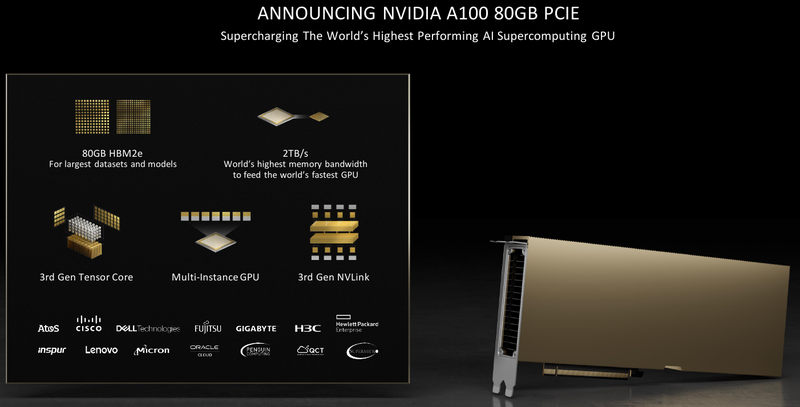 HGX A100 предлагает 300-Вт версию ускорителей с PCIe 4.0 x16 и удвоенным объёмом памяти HBM2e (80 Гбайт). Увеличена и пропускная способность (ПСП), в новой версии ускорителя она достигла 2 Тбайт/с. И если по объёму и ПСП новинки догнали SXM-версию A100, то в отношении интерконнекта они всё равно отстают, так как позволяют напрямую объединить посредством NVLink только два ускорителя. 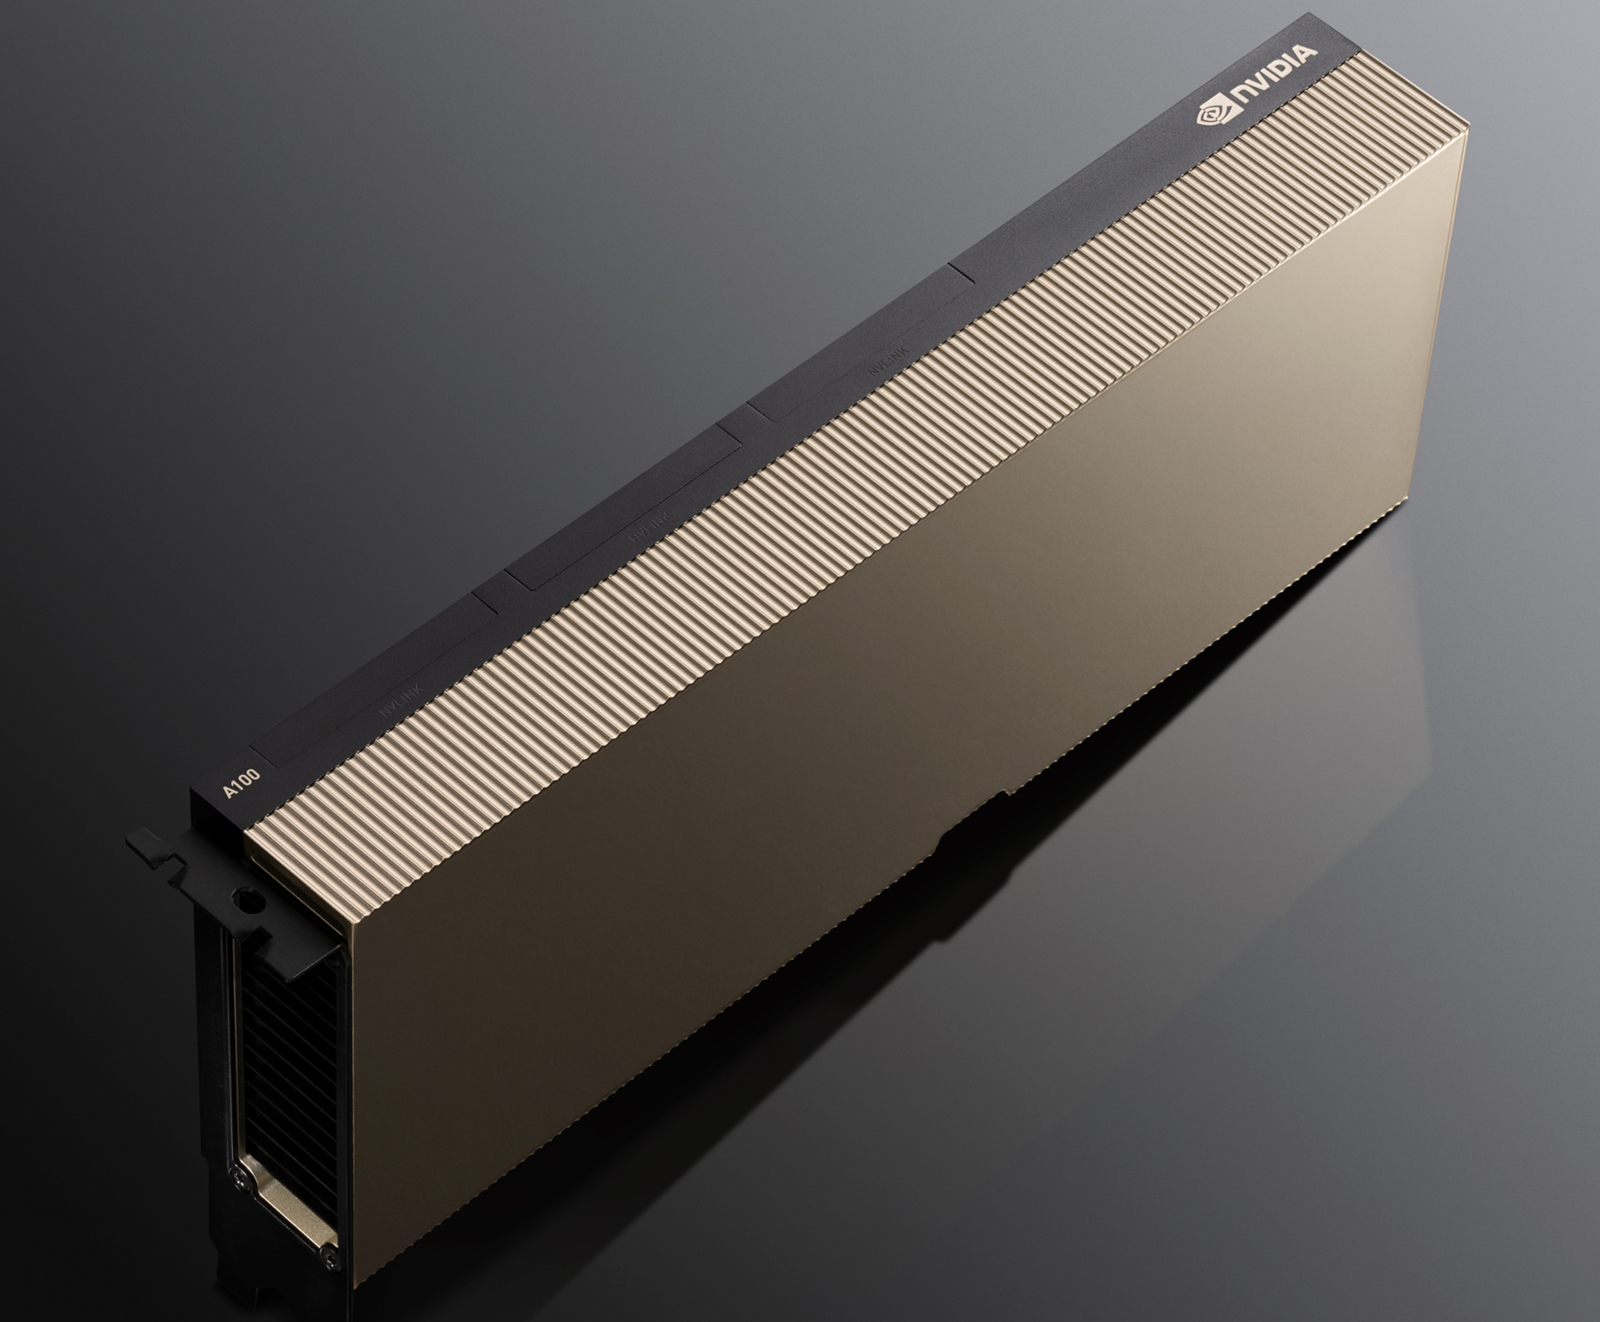 В качестве сетевой среды в новой платформе NVIDIA применена технология InfiniBand NDR со скоростью 400 Гбит/с. Можно сказать, что InfiniBand догнала Ethernet, хотя не столь давно её потолком были 200 Гбит/с, а в плане латентности IB по-прежнему нет равных. Сетевые коммутаторы NVIDIA Quantum 2 поддерживают до 64 портов InfiniBand NDR и вдвое больше для скорости 200 Гбит/с, а также имеют модульную архитектуру, позволяющую при необходимости нарастить количество портов NDR до 2048. Пропускная способность при этом может достигать 1,64 Пбит/с. 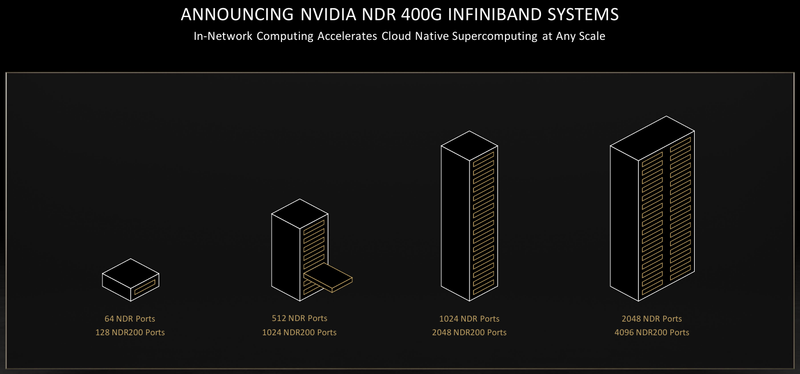 Технология NVIDIA SHARP In-Network Computing позволяет компании заявлять о 32-крантом превосходстве над системами предыдущего поколения именно в области сложных задач машинного интеллекта для индустрии и науки. Естественно, все преимущества машинной аналитики используются и внутри самого продукта — технология UFM Cyber-AI позволяет новой платформе исправлять большинство проблем с сетью на лету, что минимизирует время простоя. 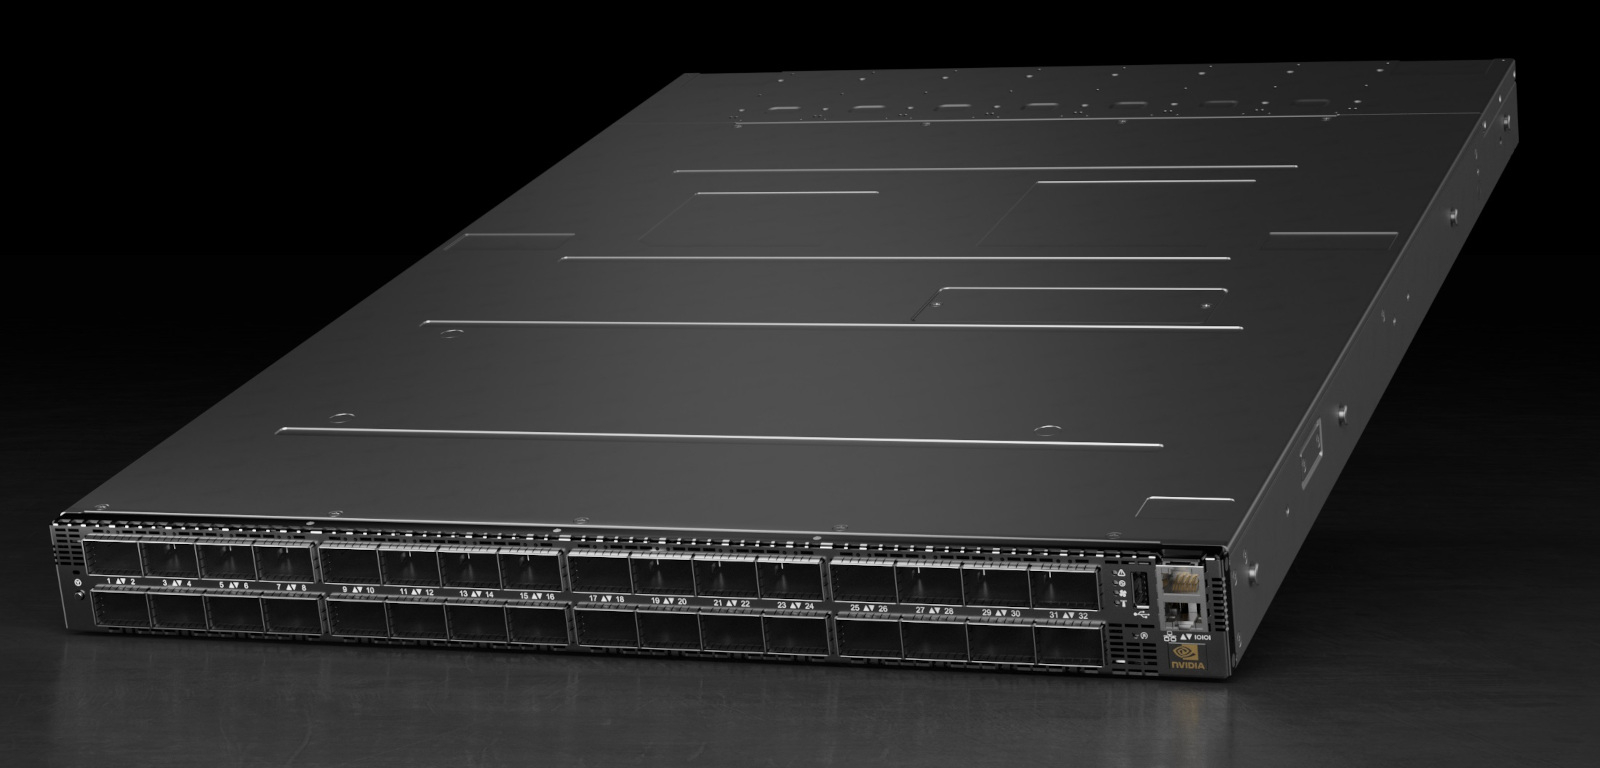 Отличным дополнением к новым сетевым возможностями является технология GPUDirect Storage, которая позволяет NVMe-накопителям общаться напрямую с GPU, минуя остальные компоненты системы. В качестве программной прослойки для обслуживания СХД новая платформа получила систему Magnum IO с поддержкой вышеупомянутой технологии, обладающую низкой задержкой ввода-вывода и по максимуму способной использовать InfiniBand NDR. 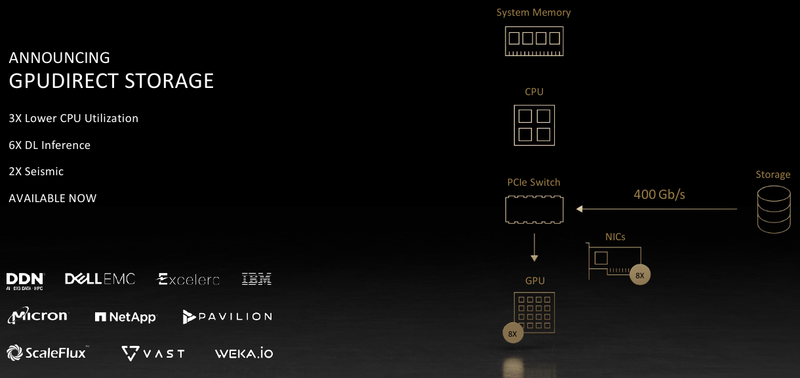 Три новых ключевых технологии NVIDIA помогут супервычислениям стать ещё более «супер», а суперкомпьютерам следующего поколения — ещё более «умными» и производительными. Достигнуты договорённости с такими крупными компаниями, как Atos, Dell Technologies, HPE, Lenovo, Microsoft Azure и NetApp. Решения NVIDIA используются как в индустрии — в качестве примера можно привести промышленный суперкомпьютер Tesla Automotive, так и в ряде других областей. 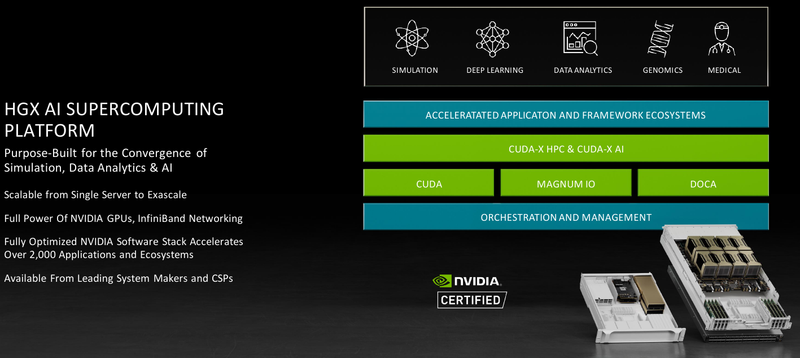 В частности, фармакологическая компания Recursion использует наработки NVIDIA в области машинного обучения для поиска новых лекарств, а национальный научно-исследовательский центр энергетики (NERSC) применяет ускорители A100 в суперкомпьютере Perlmutter при разработке новых источников энергии. И в дальнейшем NVIDIA продолжит своё наступление на рынок HPC, благо, она может предложить заказчикам как законченные аппаратные решения, так и облачные сервисы, также использующие новейшие технологии компании.
28.05.2021 [00:33], Владимир Мироненко
Perlmutter стал самым мощным ИИ-суперкомпьютером в мире: 6 тыс. NVIDIA A100 и 3,8 ЭфлопсВ Национальном вычислительном центре энергетических исследований США (NERSC) Национальной лаборатории им. Лоуренса в Беркли состоялась торжественная церемония, посвящённая официальному запуску суперкомпьютера Perlmutter, также известного как NERSC-9, созданного HPE в партнёрстве с NVIDIA и AMD. Это самый мощный в мире ИИ-суперкомпьютер, базирующийся на 6159 ускорителях NVIDIA A100 и примерно 1500 процессорах AMD EPYC Milan. Его пиковая производительность в вычислениях смешанной точности составляет 3,8 Эфлопс или почти 60 Пфлопс в FP64-вычислениях. Perlmutter основан на платформе HPE Cray EX с прямым жидкостным охлаждением и интерконнектом Slingshot. В состав системы входят как GPU-узлы, так и узлы с процессорами. Для хранения данных используется файловая система Lustre объёмом 35 Пбайт скорость обмена данными более 5 Тбайт/с, которая развёрнута на All-Flash СХД HPE ClusterStor E1000 (тоже, к слову, на базе AMD EPYC). 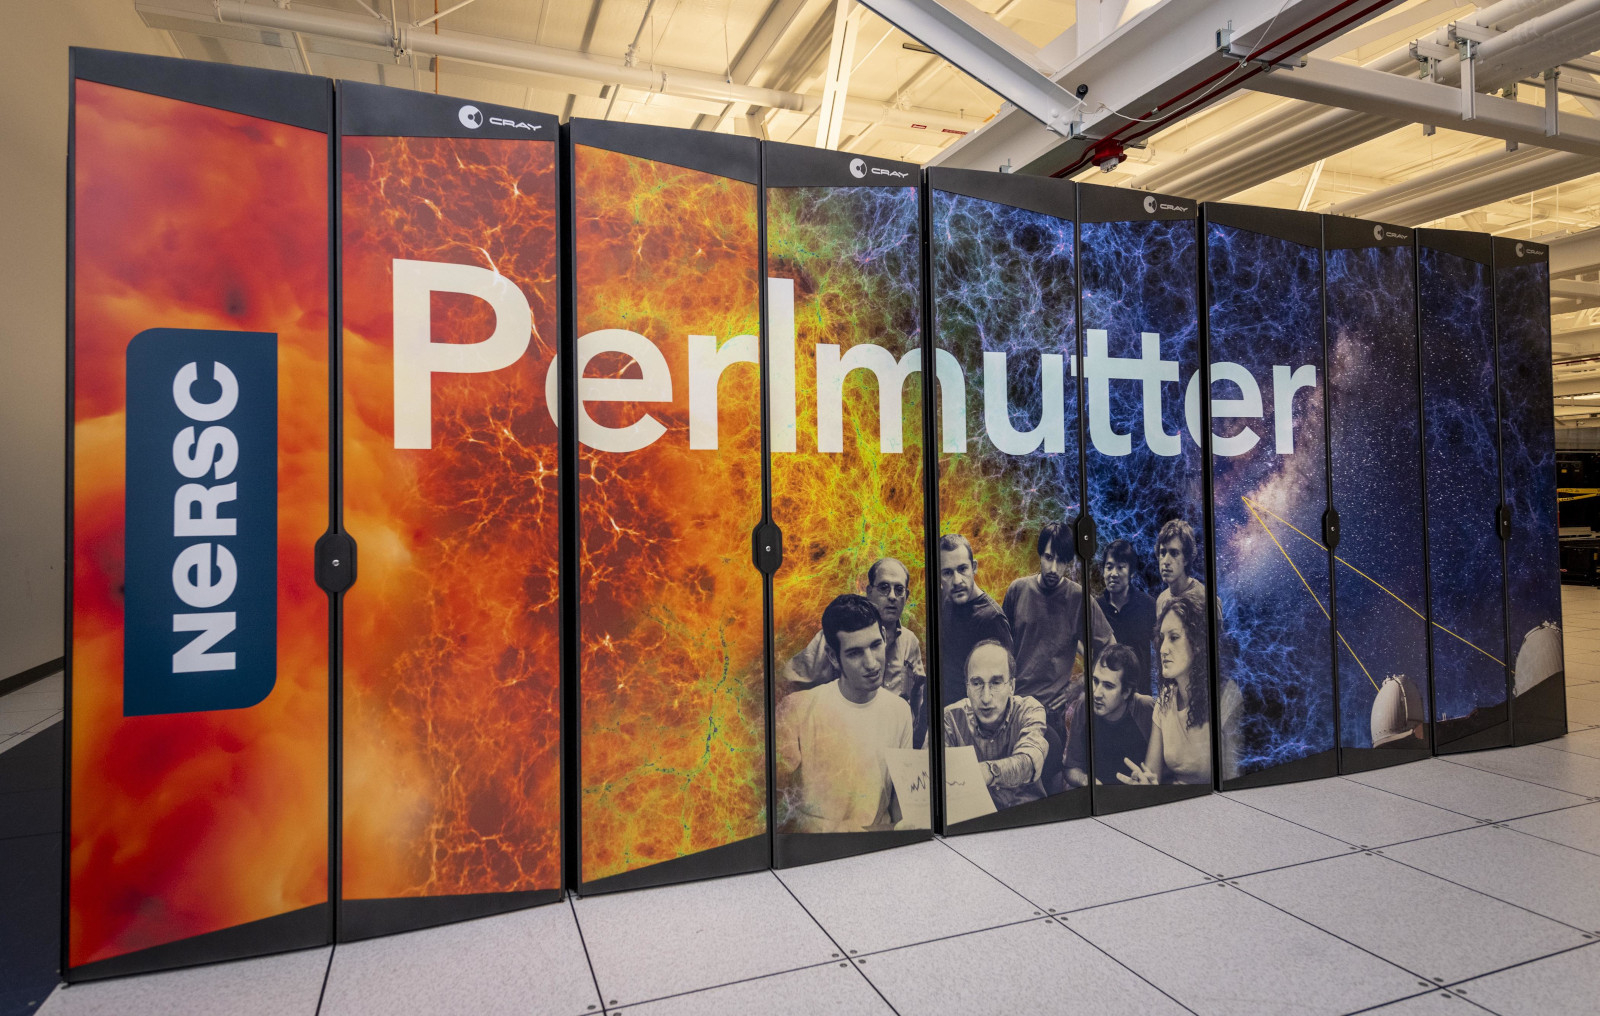
Perlmutter (Phase 1). Фото: NERSC Установка Perlmutter разбита на два этапа. На сегодняшней презентации было объявлено о завершении первого (Phase 1) этапа, который начался в ноябре прошлого года. В его рамках было установлено 1,5 тыс. вычислительных узлов, каждый из которых имеет четыре ускорителя NVIDIA A100, один процессор AMD EPYC Milan и 256 Гбайт памяти. На втором этапе (Phase 2) в конце 2021 года будут добавлены 3 тыс. CPU-узлов c двумя AMD EPYC Milan и 512 Гбайт памяти., а также ещё ещё 20 узлов доступа и четыре узла с большим объёмом памяти. 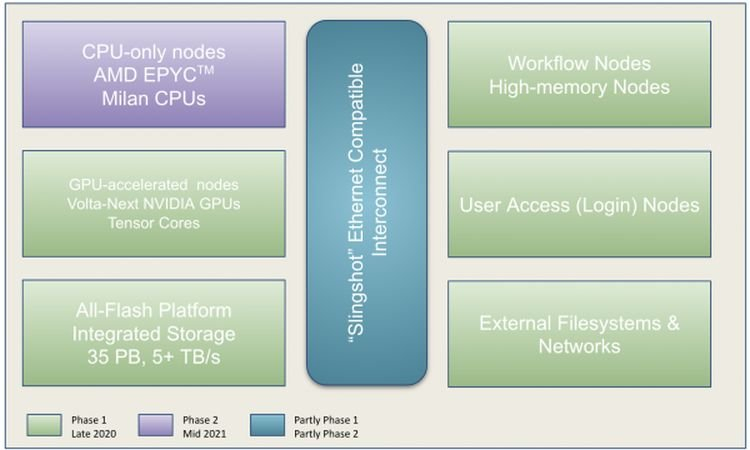
NERSC Также на первом этапе были развёрнуты служебные узлы, включая 20 узлов доступа пользователей, на которых можно подготавливать контейнеры с приложениями для последующего запуска на суперкомпьютере и использовать Kubernetes для оркестровки. Среда разработки будет включать NVDIA HPC SDK в дополнение к наборам компиляторов CCE (Cray Compiling Environment), GCC и LLVM для поддержки различных средств параллельного программирования, таких как MPI, OpenMP, CUDA и OpenACC для C, C ++ и Fortran. 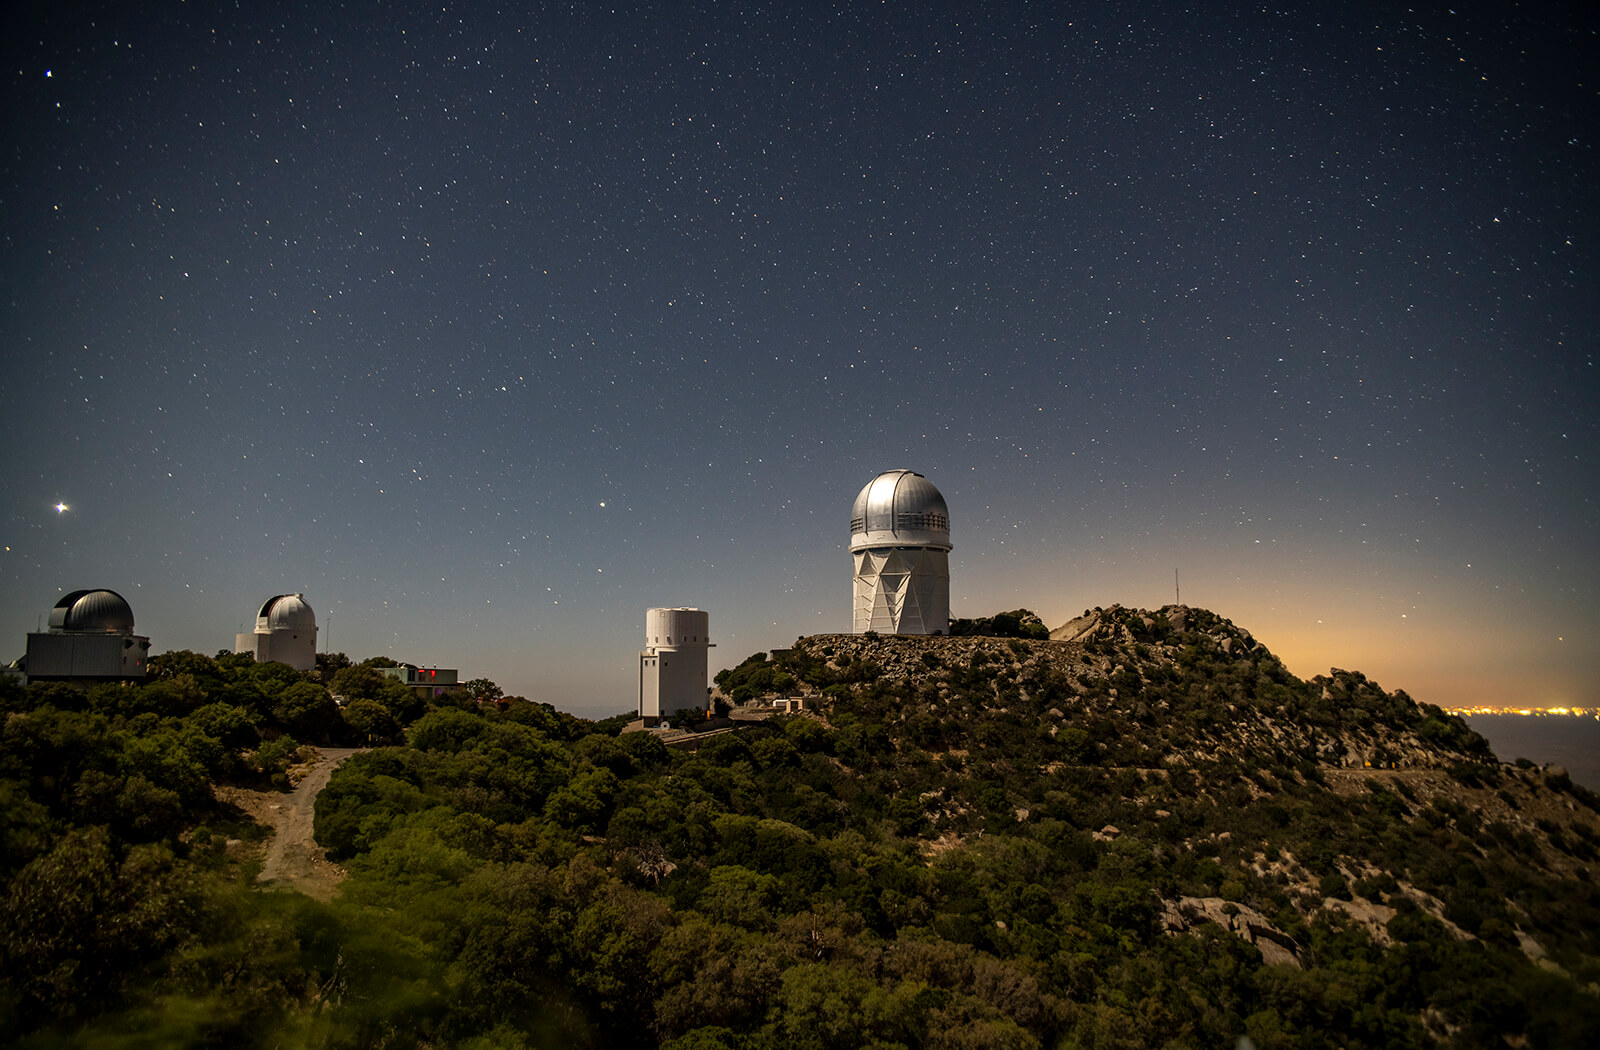
Фото: DESI Сообщается, что для Perlmutter готовится более двух десятков заявок на вычисления в области астрофизики, прогнозирования изменений климата и в других сферах. Одной из задач для новой системы станет создание трёхмерной карты видимой Вселенной на основе данных от DESI (Dark Energy Spectroscopic Instrument). Ещё одно направление, для которого задействуют суперкомпьютер, посвящено материаловедению, изучению атомных взаимодействий, которые могут указать путь к созданию более эффективных батарей и биотоплива.
15.04.2021 [21:24], Игорь Осколков
DPU BlueField — третий столп будущего NVIDIAВо время открытия GTC’21 наибольшее внимание привлёк, конечно, анонс собственного серверного Arm-процессора NVIDIA — Grace. Говорят, из-за этого даже акции Intel просели, хотя в последних решениях самой NVIDIA процессоры x86-64 были нужны уже лишь для поддержки «обвязки» вокруг непосредственно ускорителей. Да, теперь у NVIDIA есть три точки опоры, три столпа для будущего развития: GPU, DPU и CPU. Причём расположение их именно в таком порядке неслучайно. 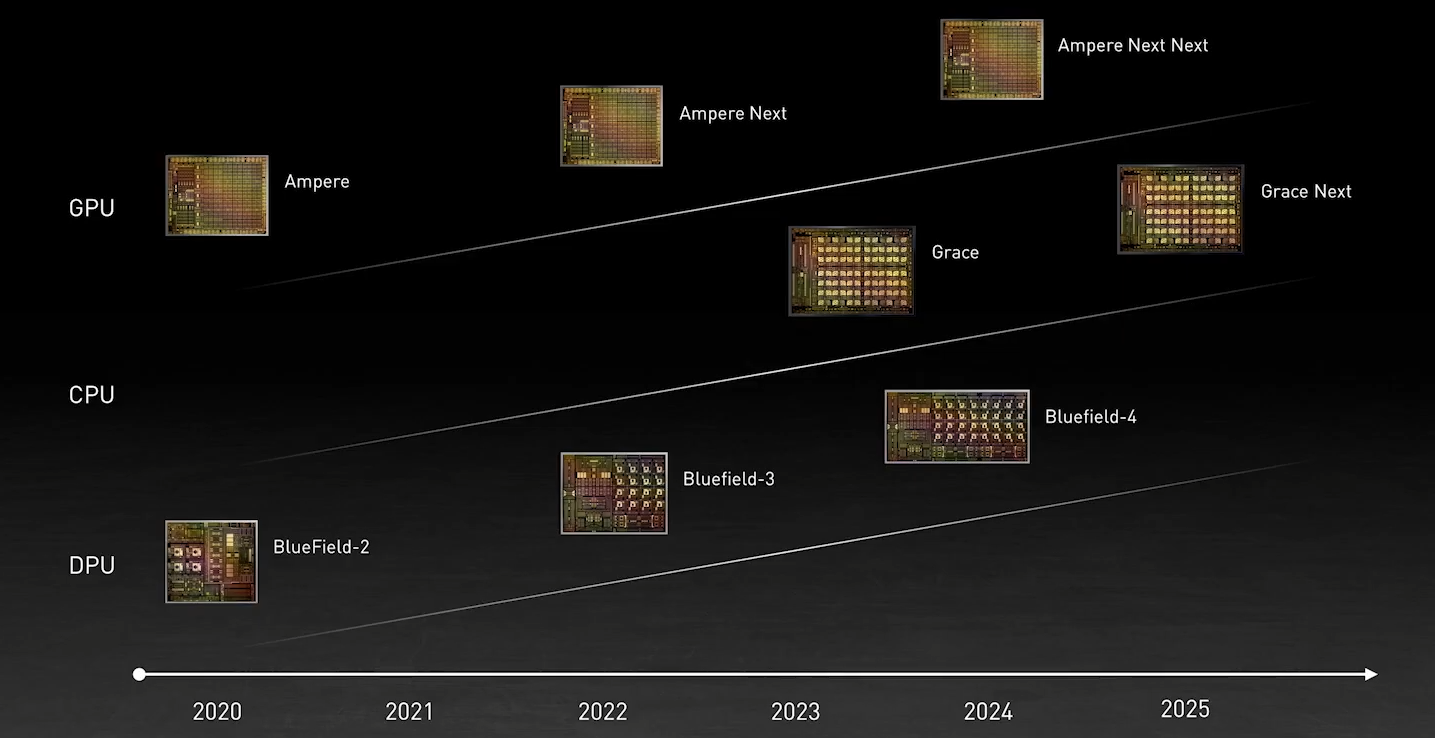 У процессора Grace, который выйдет только в 2023 году, даже по современным меркам «голая» производительность не так уж высока — в SPECrate2017_int его рейтинг будет 300. Но это и неважно потому, что он, как и сейчас, нужен лишь для поддержки ускорителей (которые для краткости будем называть GPU, хотя они всё менее соответствуют этому определению), что возьмут на себя основную вычислительную нагрузку. 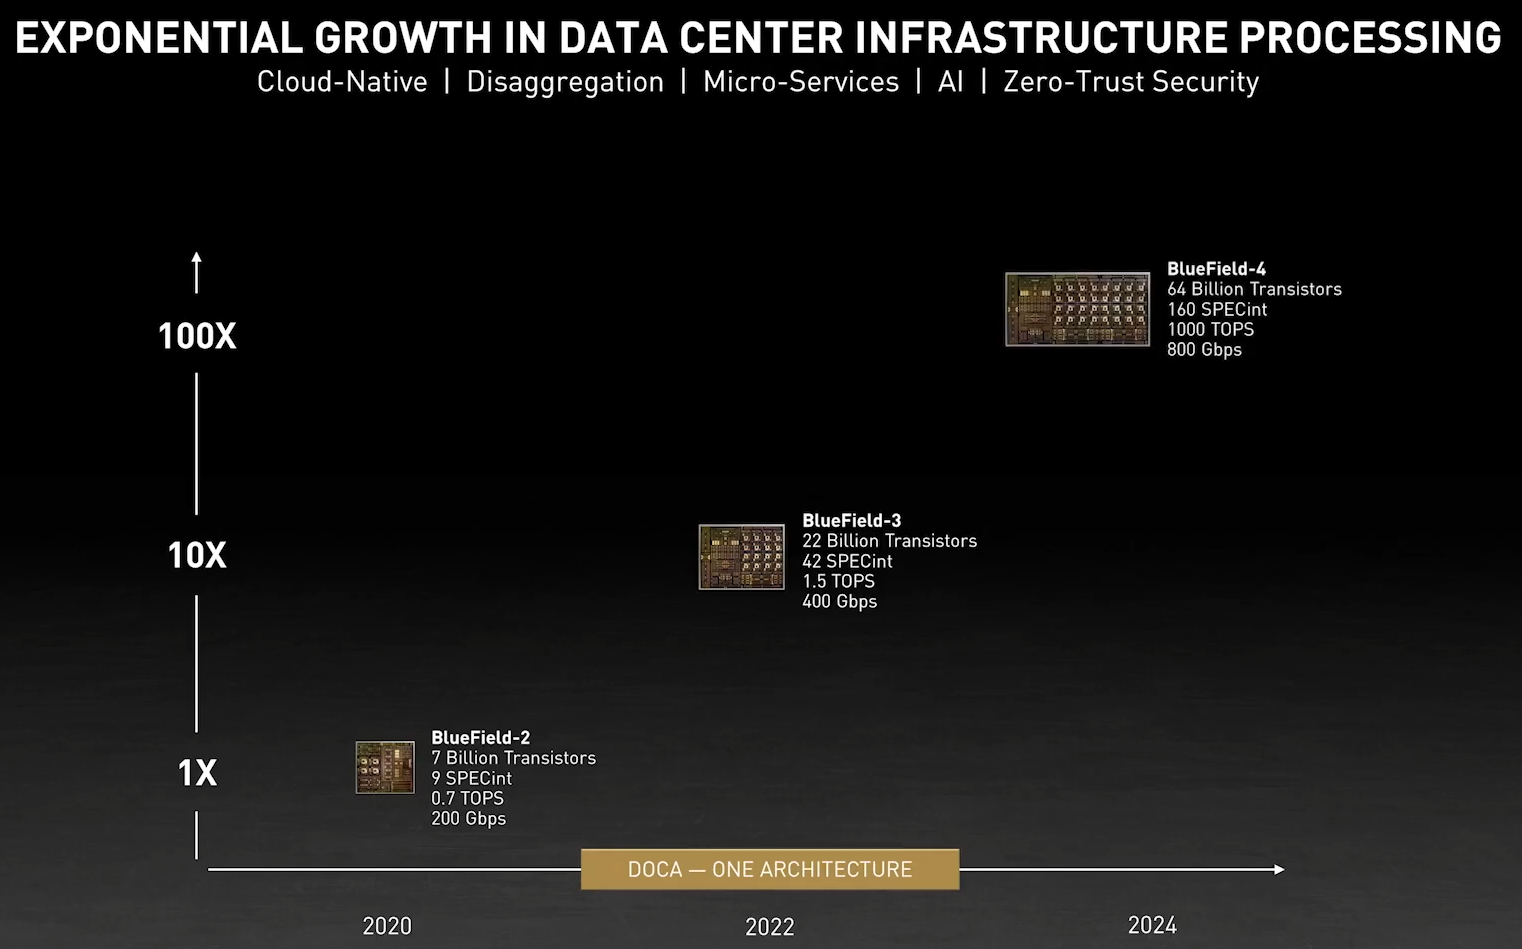 Гораздо интереснее то, что уже в 2024 году появятся BlueField-4, для которых заявленный уровень производительности в том же SPECrate2017_int составит 160. То есть DPU (Data Processing Unit, сопроцессор для данных) формально будет всего лишь в два раза медленнее CPU Grace, но при этом включать 64 млрд транзисторов. У нынешних ускорителей A100 их «всего» 54 млрд, и это один из самых крупных массово производимых чипов на сегодня. 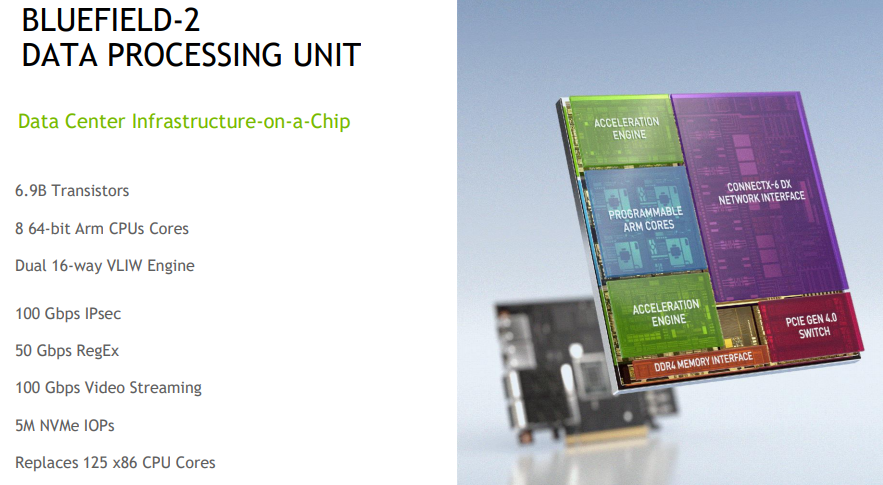 Значительный объём транзисторного бюджета, очевидно, пойдёт не на собственной сетевую часть, а на Arm-ядра и различные ускорители. Анонсированные в прошлом году и ставшие доступными сейчас DPU BlueField-2 намного скромнее. Но именно с их помощью NVIDIA готовит экосистему для будущих комплексных решений, где DPU действительно станут «третьим сокетом», как когда-то провозгласил стартап Fubgible, успевший анонсировать до GTC’21 и собственную СХД, и более общее решение для дата-центров. Однако подход двух компаний отличается. 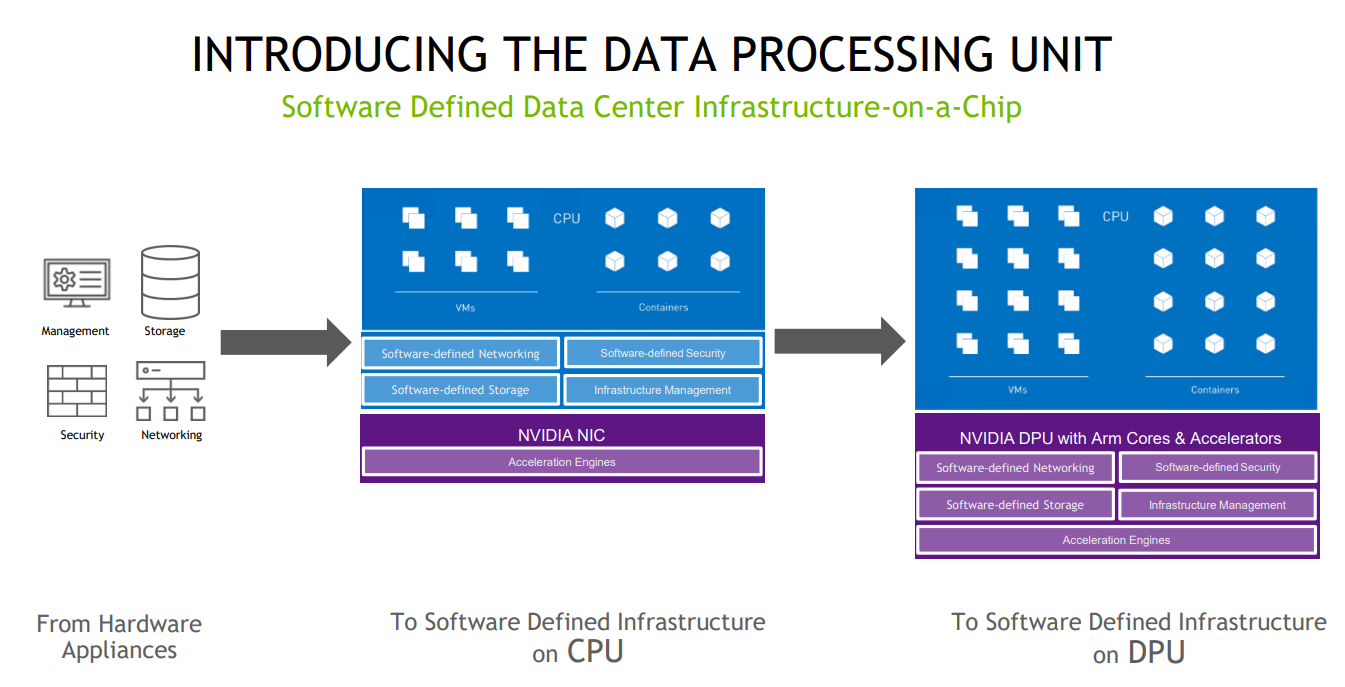 Напомним основные характеристики BlueField-2. Сетевая часть, представленная Mellanox ConnectX-6 Dx, предлагает до двух портов 100 Гбит/с, причём доступны варианты и с Ethernet, и с InfiniBand. Есть отдельные движки для ускорения криптографии, регулярных выражений, (де-)компрессии и т.д. Всё это дополняют 8 ядер Cortex-A78 (до 2,5 ГГц), от 8 до 32 Гбайт DDR4-3200 ECC, собственный PCIe-свитч и возможность подключения M.2/U.2-накопителя. Кроме того, будет вариант BlueField-2X c GPU на борту. Характеристики конкретных адаптеров на базе BlueField-2 отличаются, но, в целом, перед нами полноценный компьютер. А сама NVIDIA называет его DOCA (DataCenter on a Chip Architecture), дата-центром на чипе. 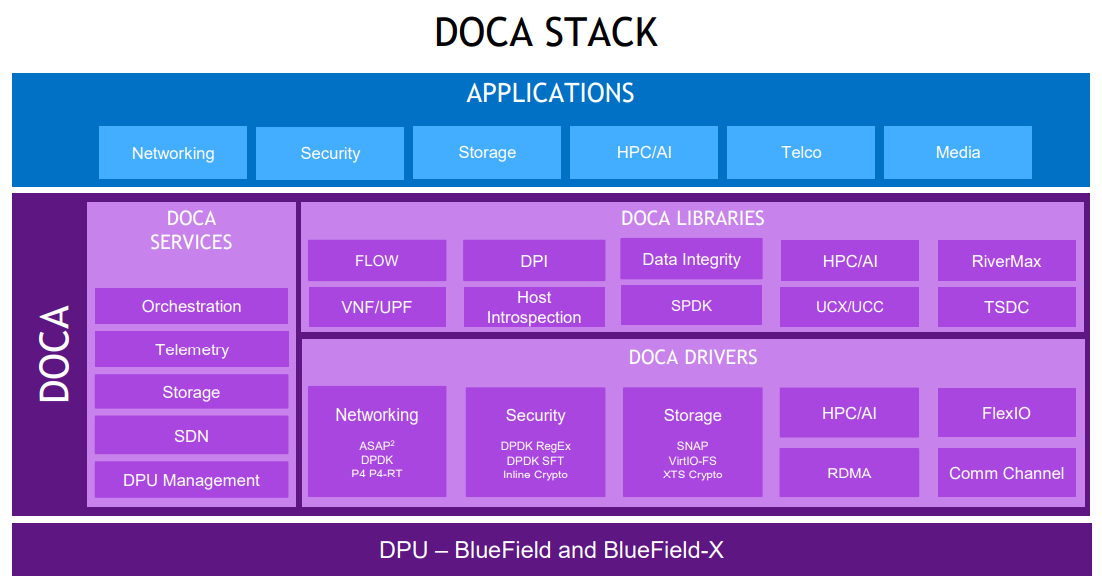 Для работы с ним предлагается обширный набор разработчика DOCA SDK, который включает драйверы, фреймворки, библиотеки, API, службы и собственно среду исполнения. Все вместе они покрывают практически все возможные типовые серверные нагрузки и задачи, а также сервисы, которые с помощью SDK относительно легко перевести в разряд программно определяемых, к чему, собственно говоря, все давно стремятся. NVIDIA обещает, что DOCA станет для DPU тем же, чем стала CUDA для GPU, сохранив совместимость с последующими версиями ПО и «железа». 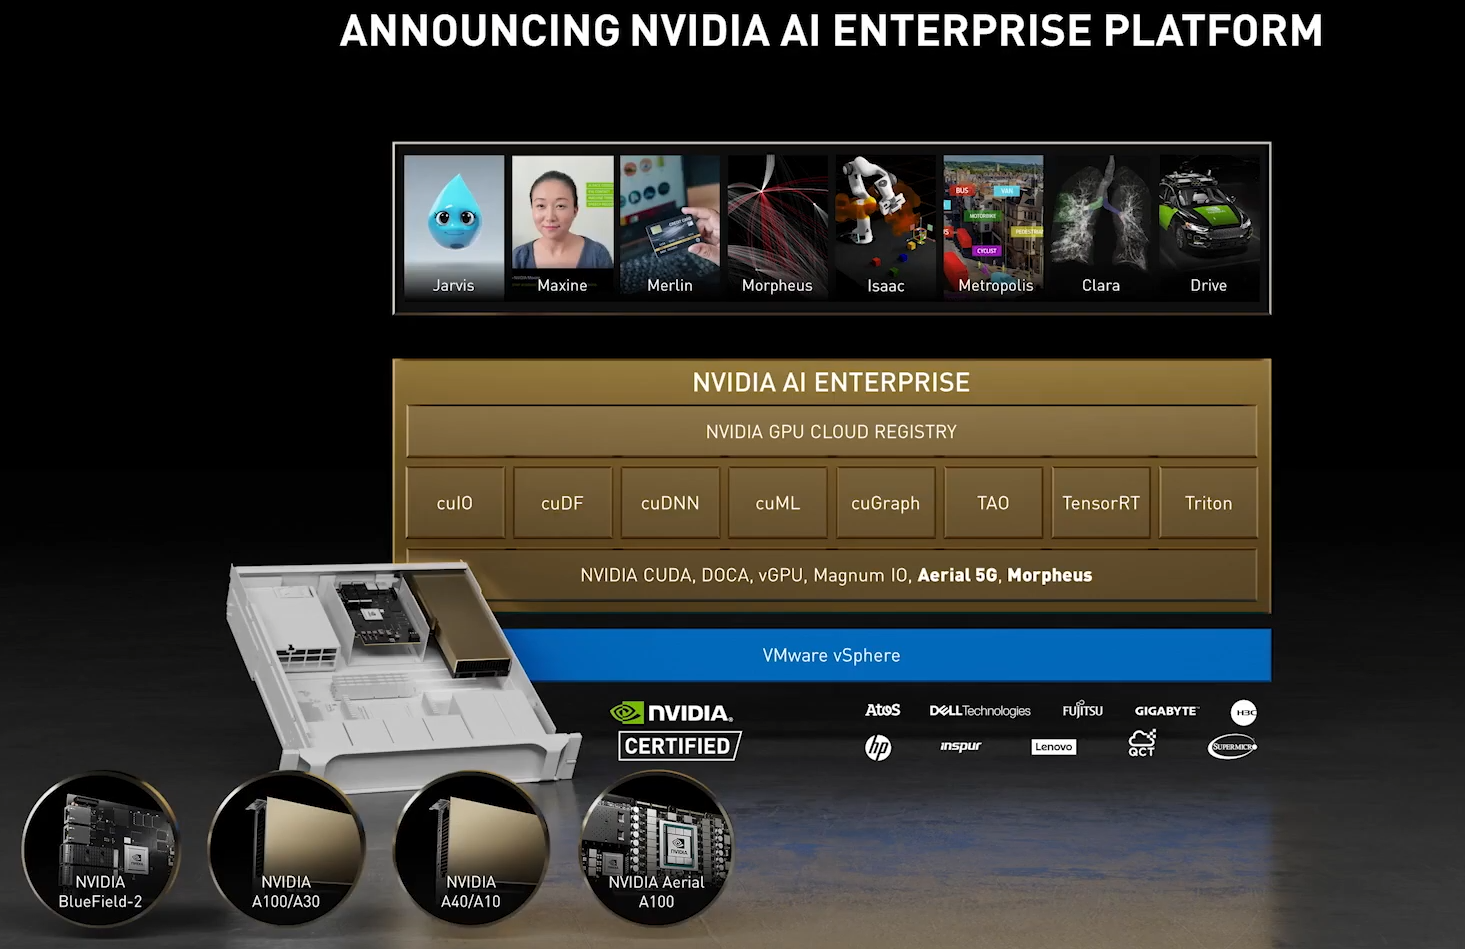 На базе этого программно-аппаратного стека компания уже сейчас предлагает несколько решений. Первое — платформа NVIDIA AI Enterprise для простого, быстрого и удобного внедрения ИИ-решений. В качестве основы используется VMware vSphere, где развёртываются виртуальные машины и контейнеры, что упрощает работу с инфраструктурой, при этом производительность обещана практически такая же, как и в случае bare-metal. 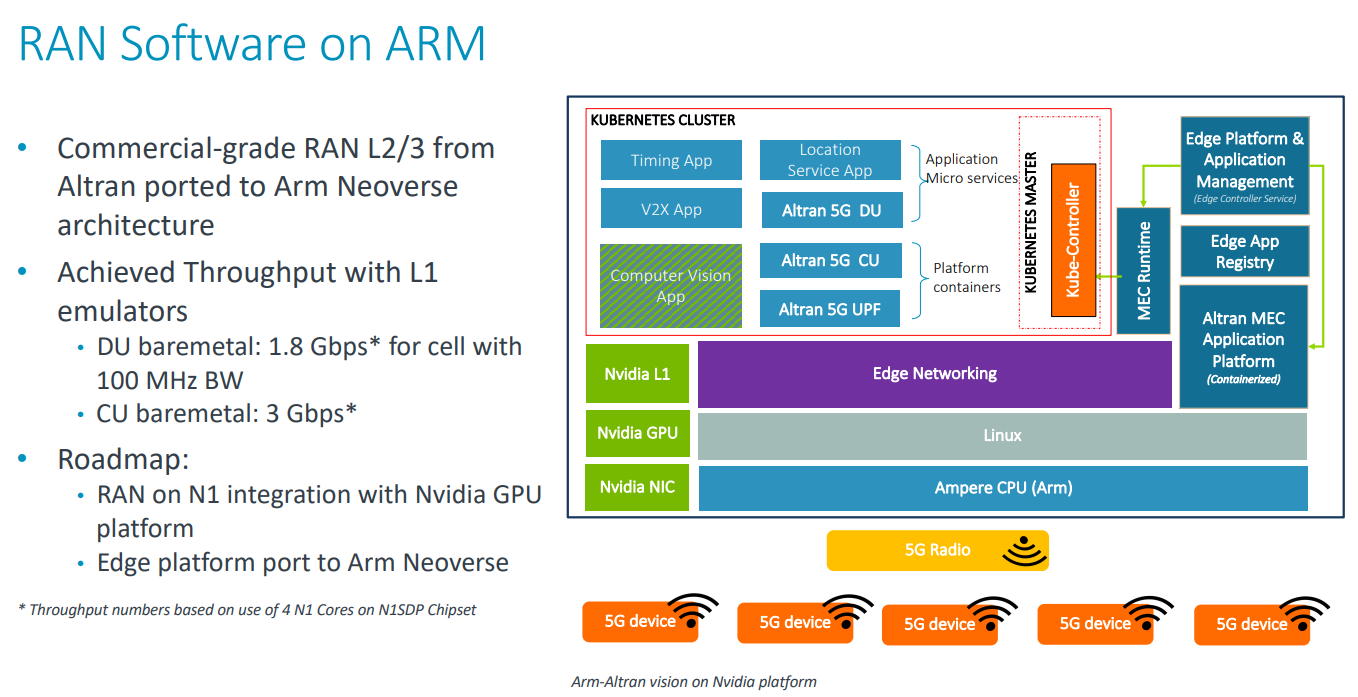 DPU и в текущем виде поддерживают возможность разгрузки для некоторых задач, но VMware вместе с NVIDIA переносят часть типовых задач гипервизора с CPU непосредственно на DPU. Кроме того, VMware продолжает работу над переносом своих решений с x86-64 на Arm, что вполне укладывается в планы развития Arm-экосистемы со стороны NVIDIA. Одним из направлений является 5G, причём работа ведётся по нескольким направлениям. Во-первых, сама Arm разрабатывает периферийную платформу на базе Ampere Altra, дополненных GPU и DPU. 
NVIDIA Aerial A100 Во-вторых, у NVIDIA конвергентное решение — ускоритель Aerial A100, который объединяет в одной карте собственно A100 и DPU. При этом он может использоваться как для ускорения работы собственно радиочасти, так и для обработки самого трафика и реализации различных пограничных сервисов. Там же, где не требуется высокая плотность (как в базовой станции), NVIDIA предлагает использовать более привычную EGX-платформу с раздельными GPU (от A100 и A40 до A30/A10) и DPU. 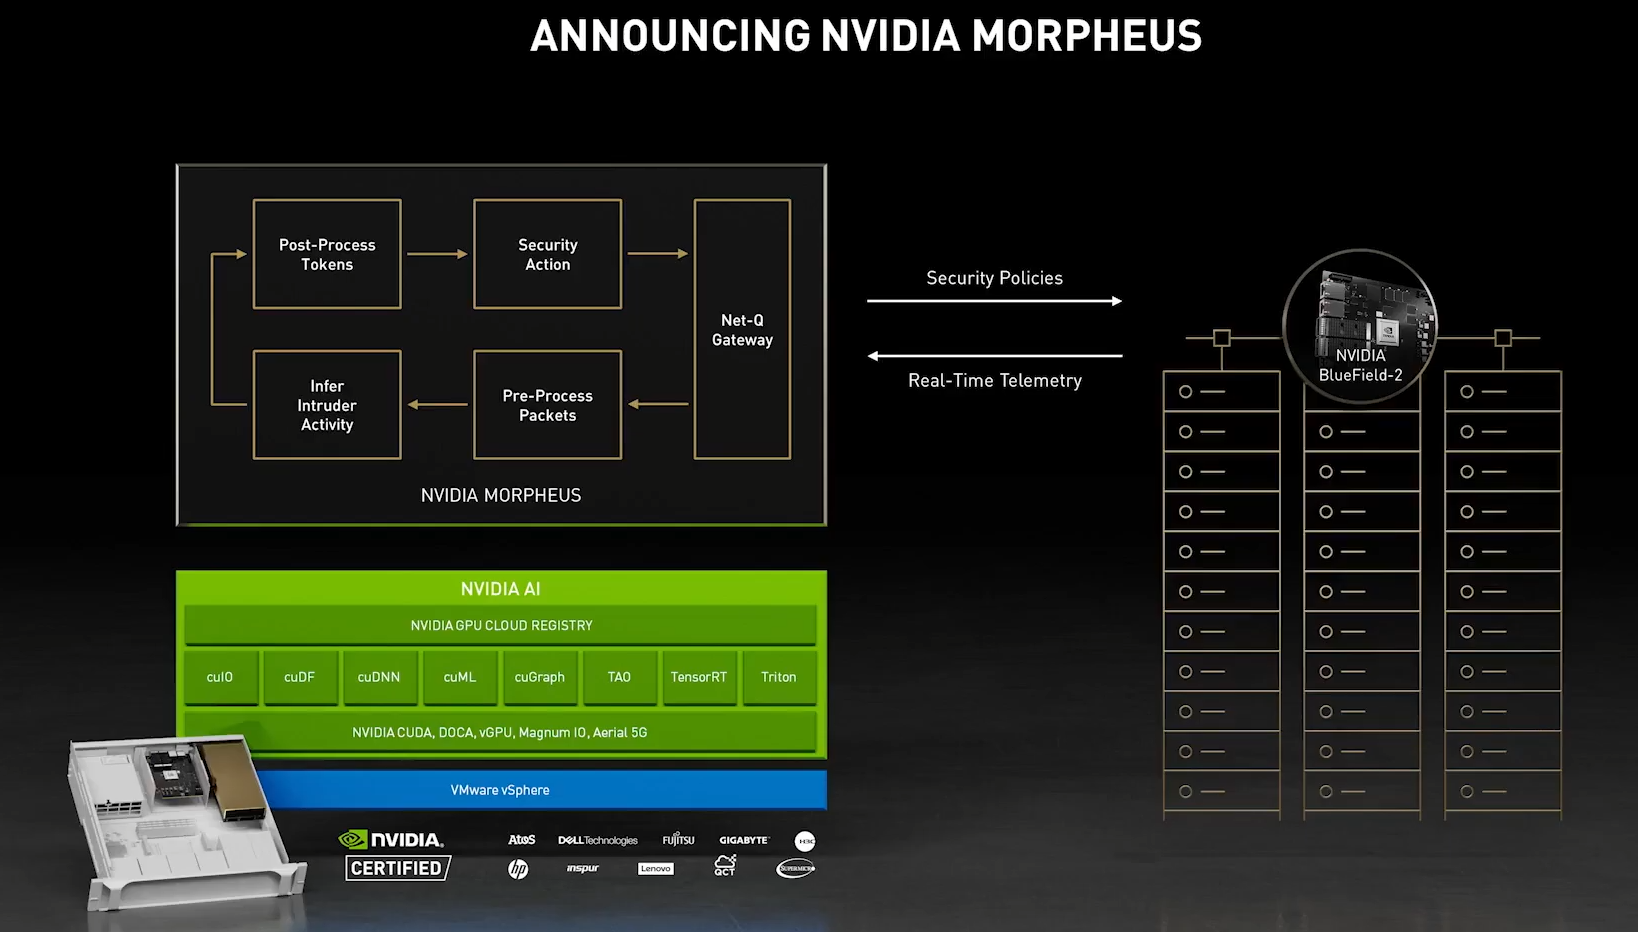 Одним из вариантов комплексного применения таких платформ является проект Morpheus. В его рамках предполагается установка DPU в каждый сервер в дата-центре. Мощностей DPU, в частности, вполне хватает для инспекции трафика, что позволяет отслеживать взаимодействие серверов, приложений, ВМ и контейнеров внутри ЦОД, а также, очевидно, применять различные политики в отношении трафика. DPU в данном случае выступают как сенсоры, данных от которых стекаются в EGX, и, вместе с тем локальными шлюзами безопасности. 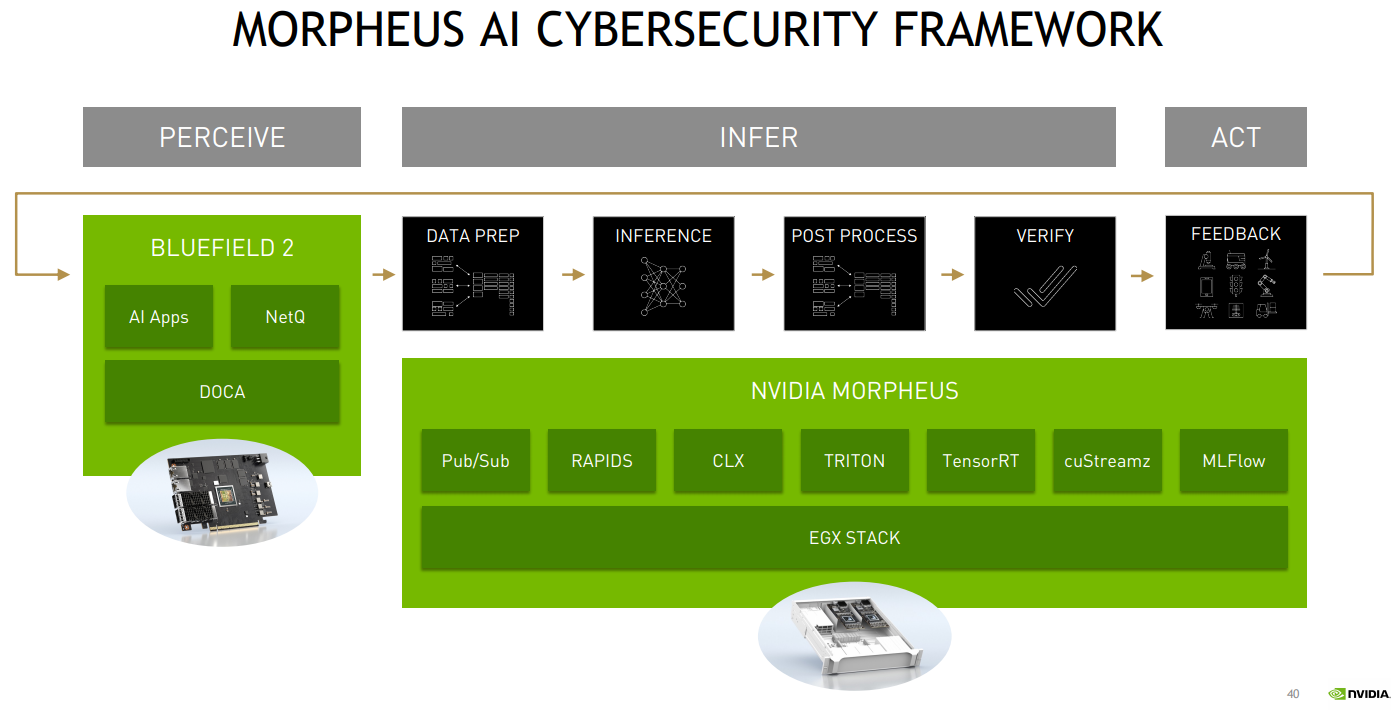 Ручная настройка политик и отслеживание поведения всего парка ЦОД возможны, но не слишком эффективны. Поэтому NVIDIA предлагает как возможность обучения, так и готовые модели (с дообучением по желанию), которые исполняются на GPU внутри EGX и позволяют быстро выявить аномальное поведение, уведомить о нём и отсечь подозрительные приложения или узлы от остальной сети. В эпоху микросервисов, говорит компания, более чем актуально следить за состоянием инфраструктуры внутри ЦОД, а не только на его границе, как было раньше, когда всё внутри дата-центра по умолчанию считалось доверенной средой. 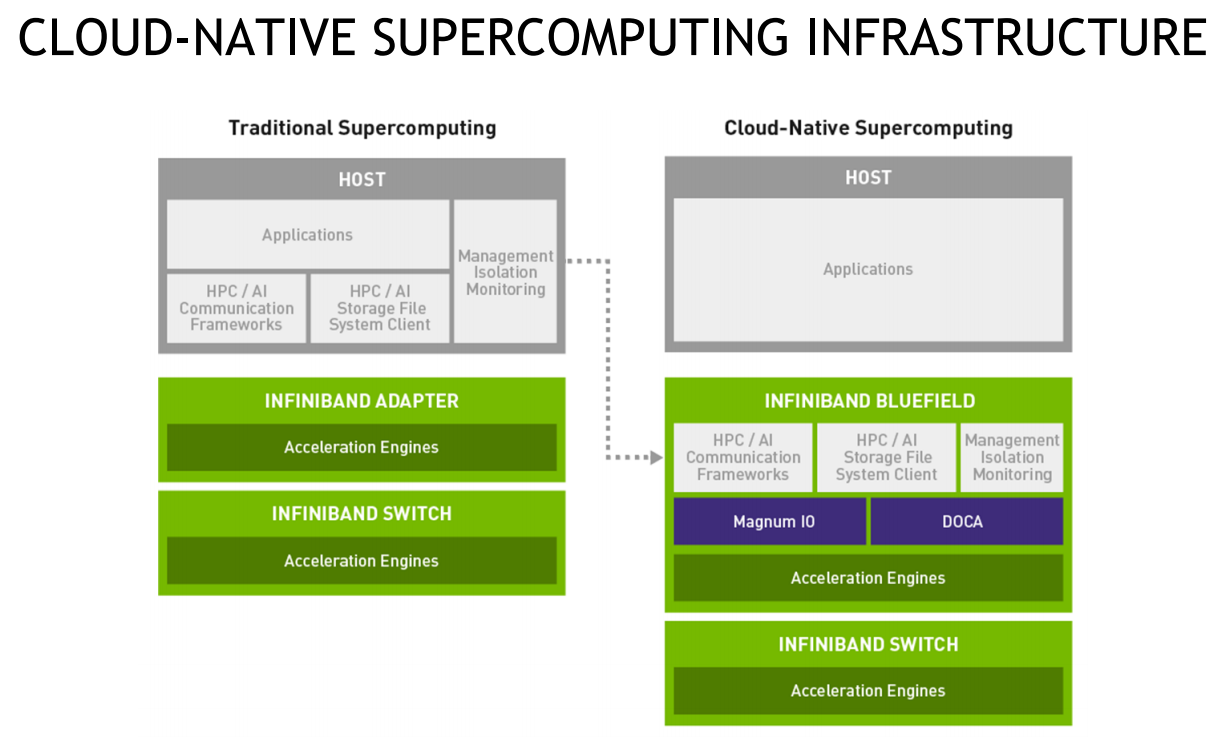 Кроме того, с помощью DPU и DOCA можно перевести инфраструктуру ЦОД на облачную модель и упростить оркестрацию. Но не только ЦОД — обновлённая суперкомпьютерная платформа DGX SuperPOD for Enterprise теперь тоже обзавелась DPU (с InfiniBand) и ПО Base Command, которые позволяют «нарезать» машину на изолированные инстансы с необходимой конфигурацией, упрощая таким образом совместное использование и мониторинг. А это, в свою очередь, повышает эффективность загрузки суперкомпьютера. Base Command выросла из внутренней системы управления Selene, собственным суперкомпьютером NVIDIA, на котором, например, компания обучает модели. 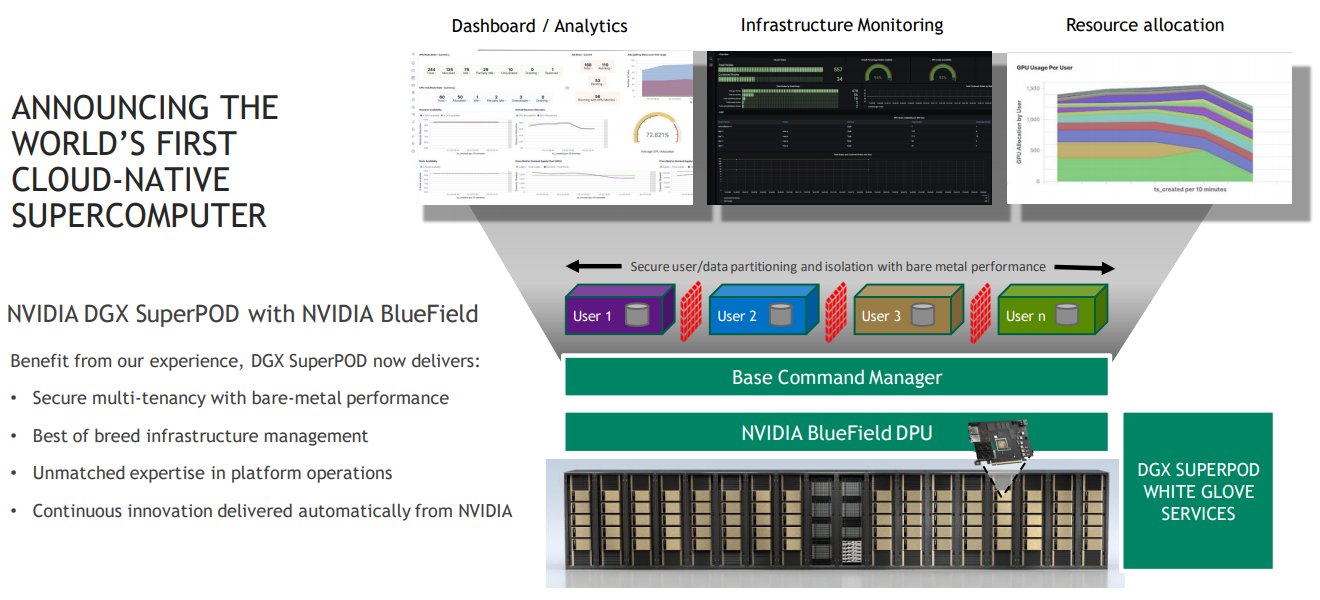 DPU доступны как отдельные устройства, так и в составе сертифицированных платформ NVIDIA и решений партнёров компании, причём спектр таковых велик. Таким образом компания пытается выстроить комплексный подход, предлагая программно-аппаратные решения вкупе с данными (моделями). Аналогичный по своей сути подход исповедует Intel, а AMD с поглощением Xilinx, надо полагать, тоже будет смотреть в эту сторону. И «угрозу» для них представляют не только GPU, но теперь и DPU. А вот новые CPU у NVIDIA, вероятно, на какое-то время останутся только в составе собственных продуктов, в независимости от того, разрешат ли компании поглотить Arm.
12.04.2021 [20:00], Сергей Карасёв
NVIDIA представила младшие серверные ускорители A10 и A30Компания NVIDIA в рамках конференции GPU Technology Conference 2021 анонсировала ускорители A10 и A30, предназначенные для обработки приложений искусственного интеллекта и других задач корпоративного класса. Модель NVIDIA A10 использует 72 ядра RT и может оперировать 24 Гбайт памяти GDDR6 с пропускной способностью до 600 Гбайт/с. Максимальное значение TDP составляет 150 Вт. Новинка выполнена в виде полноразмерной карты расширения с интерфейсом PCIe 4.0: в корпусе сервера устройство займёт один слот расширения. Производительность в вычислениях одинарной точности (FP32) заявлена на уровне 31,2 терафлопса. Новинку можно рассматривать как замену NVIDIA T4. 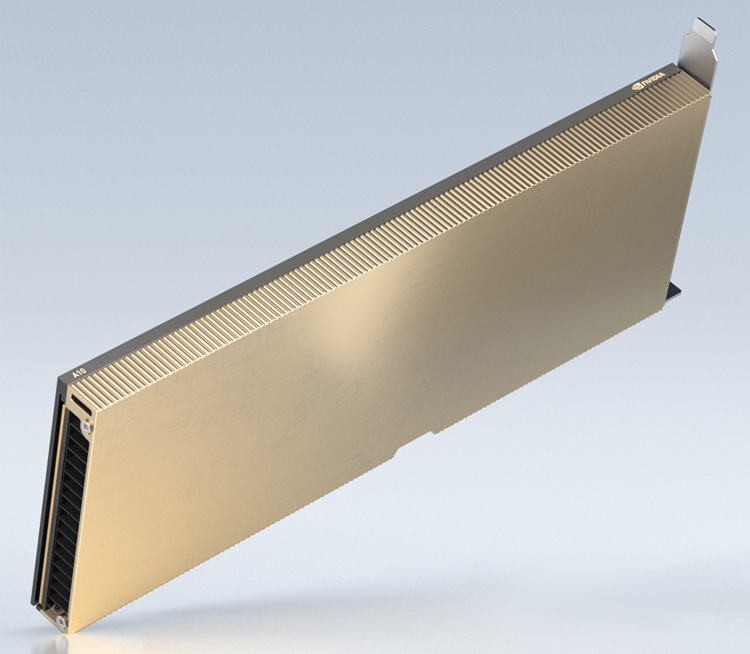 Модель NVIDIA A30, в свою очередь, получила исполнение в виде двухслотовой карты расширения с интерфейсом PCIe 4.0. Задействованы 24 Гбайт памяти HBM2 с пропускной способностью до 933 Гбайт/с. Показатель TDP равен 165 Вт. Обе новинки используют архитектуру Ampere с тензорными ядрами третьего поколения. 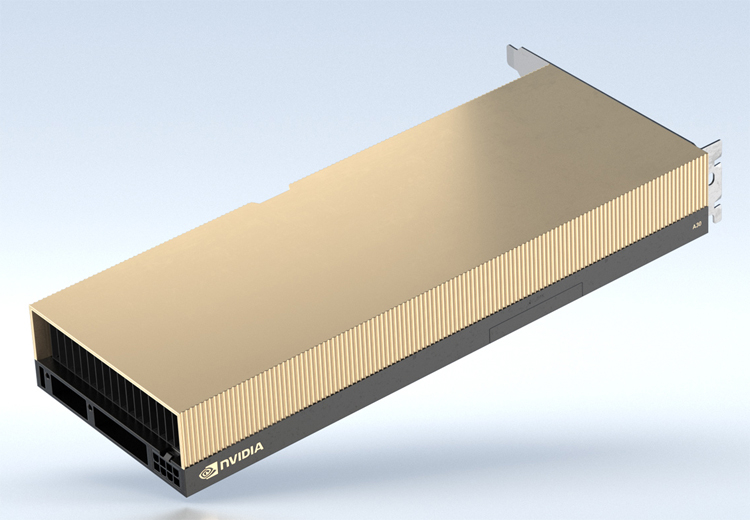 Решения подходят для применения в серверах массового сегмента, рабочих станциях, а также в составе платформы NVIDIA EGX и для периферийных вычислений. 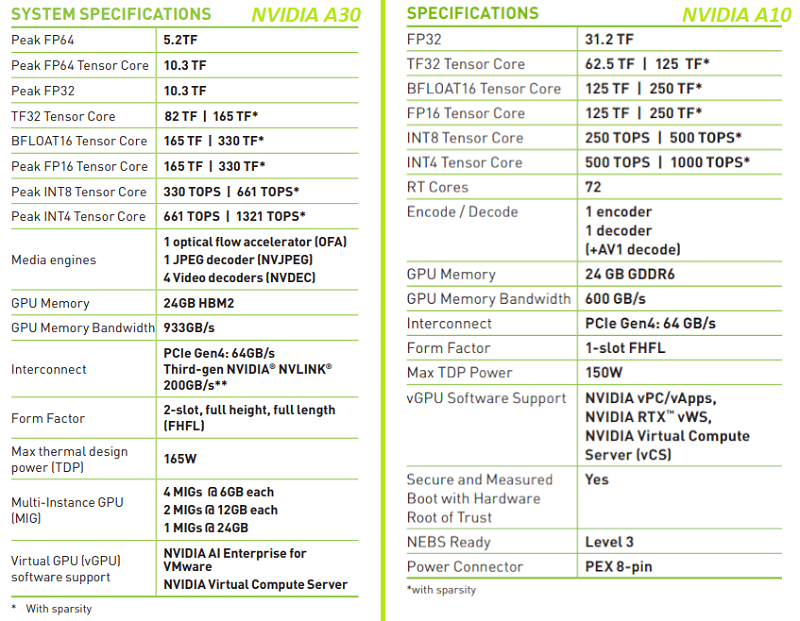 |
|

