
Материалы по тегу: instinct
|
20.02.2025 [13:12], Сергей Карасёв
Облако Vultr первым получило ускорители AMD Instinct MI325XVultr, крупнейший в мире частный облачный провайдер, объявил о том, что в его инфраструктуре появились ускорители AMD Instinct MI325X, предназначенные для ресурсоёмких ИИ-нагрузок. Говорится об использовании открытого программного стека ROCm и о поддержке ключевых фреймворков. Vultr стал первым поставщиком облачных услуг, взявшим на вооружение изделия AMD Instinct MI325X. Ускорители развёрнуты в дата-центре компании в Чикаго (Иллинойс, США). Внедрение этих решений является частью усилий по расширению сотрудничества с AMD: в сентябре прошлого года в облаке Vultr появились ускорители Instinct MI300X. Изделия Instinct MI325X несут на борту 256 Гбайт памяти HBM3E с пропускной способностью до 6 Тбайт/с. Пиковая производительность достигает 1,3 Пфлопс в режиме FP16 и 2,6 Пфлопс в режиме FP8. Решения подходят в том числе для задач инференса. 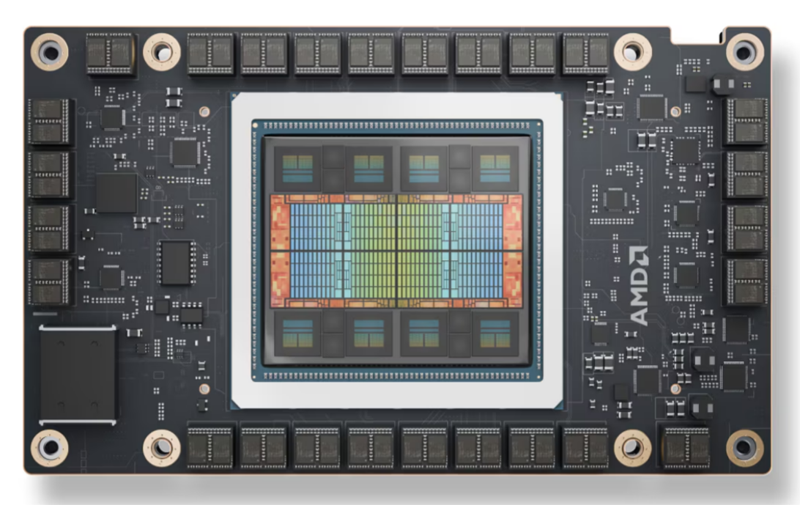
Источник изображения: AMD Отмечается, что Vultr использует ускорители Instinct MI325X в составе серверов Supermicro AS-8126GS-TNMR типоразмера 8U. Эти машины комплектуются двумя процессорами AMD EPYC 9005/9004 с показателем TDP до 500 Вт. Доступны 24 слота для модулей DDR5-6000 суммарным объёмом до 9 Тбайт. Во фронтальной части расположены десять отсеков для SFF-накопителей в конфигурации 8 × NVMe и 2 × SATA. Кроме того, есть два коннектора М.2 (NVMe). Предусмотрены восемь слотов PCIe 5.0 x16 LP и два слота PCIe 5.0 x16 FHHL. За питание отвечают шесть блоков мощностью 5250 Вт с сертификатом Titanium. Применяется воздушное охлаждение. «Ускорители AMD Instinct MI325X устанавливают новые стандарты в области ИИ, обеспечивая невероятную производительность и эффективность для задач инференса», — говорит глава Vultr. Цены на новые инстансы пока не названы.
11.02.2025 [16:24], Владимир Мироненко
ИИ ЦОД за 20 недель: G42 и DataOne построят крупнейший во Франции суперкомьютер на чипах AMD InstinctХолдинг G42 из Абу-Даби (ОАЭ) объявил о стратегических инвестициях во Франции в партнёрстве с недавно образованной DataOne, которая сама себя называет первым в Европе оператором гига-ЦОД для ИИ. Вместе компании в кратчайшие сроки построят в Гренобле ИИ ЦОД, оснащённый ускорителями AMD Instinct. Ожидается, что объект будет полностью введён в эксплуатацию к середине 2025 года. Вычислительные возможности нового ЦОД позволят французским компаниям и учёным разрабатывать передовые модели ИИ, агентов и приложения, а также проводить различные исследования. Реализацией проекта будет заниматься компания Core42, дочернее предприятие G42, совместно с DataOne. По словам главы DataOne Шарля-Антуана Бейни (Charles-Antoine Beyney), на развёртывание крупнейшего ИИ-суперкомпьютера в Европе потребуется всего 20 недель. Для сравнения: кластер xAI Colossus был построен за 122 дня. Как заявила Лиза Су (Lisa Su), председатель и генеральный директор AMD, стратегическое сотрудничество с G42 поможет активизировать французскую экосистему ИИ, предоставив вычислительную мощность, необходимую для поддержки местных стартапов и новаторов, занимающихся передовыми разработками, которые укрепляют французскую экономику. «Работа с G42 является ещё одним примером нашей приверженности объединению открытых экосистем с ведущими в отрасли технологиями ИИ AMD, что обеспечивает возможность государственным учреждениям и частным предприятиям использовать весь потенциал ИИ», — подчеркнула Лиза Су. 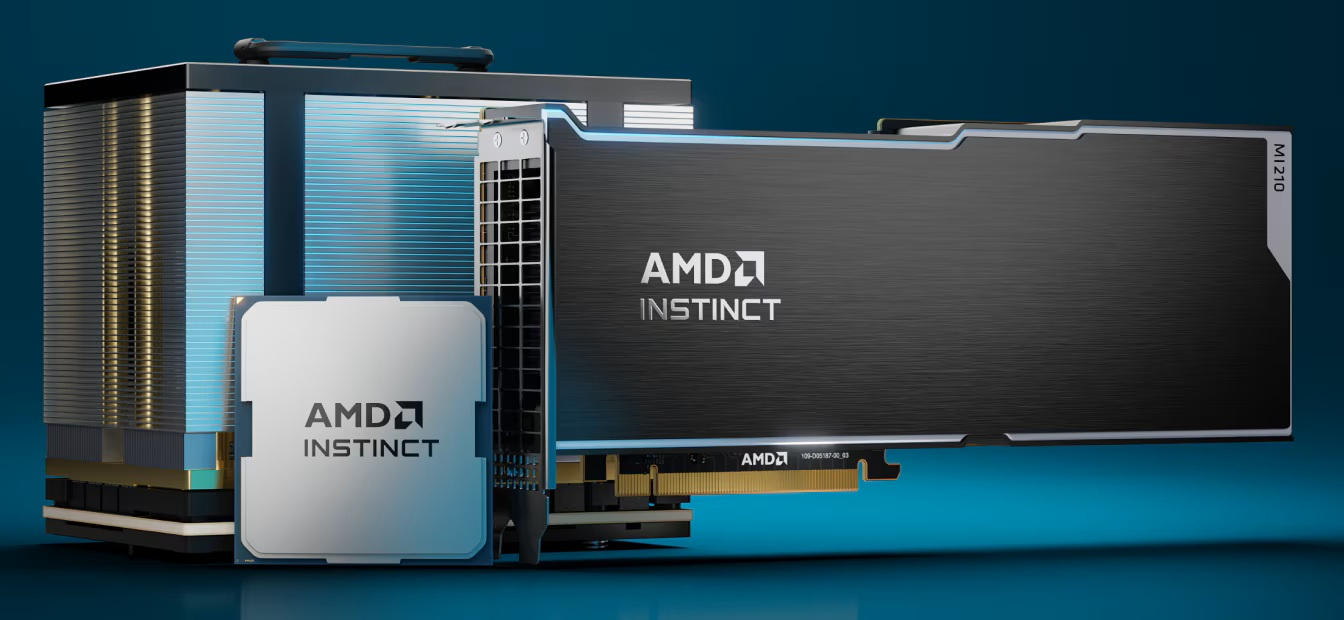
Источник изображения: AMD Инвестиции G42 входят в пакет частных инвестиций в ИИ-инфраструктуру страны на €109 млрд, анонсированный президентом Франции Эммануэле Макроном (Emmanuel Macron) в качестве ответа на представленный в США проект Stargate. Ранее было объявлено о планах ОАЭ вложить при участии фонда MGX €30–50 млрд в проект по созданию кампуса ИИ ЦОД во Франции. В G42 называют инвестиции в ИИ одним из главных направлений своей деятельности. Деятельность холдинга получила поддержку Microsoft, инвестировавшей в него $1,5 млрд. В прошлом году G42 договорился с Cerebras о строительстве в Техасе ИИ-суперкомпьютера со 173 млн ядер.
19.01.2025 [22:43], Сергей Карасёв
Германия запустила «переходный» 48-Пфлопс суперкомпьютер Hunter на базе AMD Instinct MI300AЦентр высокопроизводительных вычислений HLRS при Штутгартском университете в Германии объявил о вводе в эксплуатацию НРС-системы Hunter. Этот суперкомпьютер планируется использовать для решения широко спектра задач в области инженерии, моделирования погоды и климата, биомедицинских исследований, материаловедения и пр. Кроме того, комплекс будет применяться для крупномасштабного моделирования, ИИ-приложений и анализа данных. О создании Hunter сообщалось в конце 2023 года: соглашение на строительство системы стоимостью примерно €15 млн было заключено с HPE. Проект финансируется Федеральным министерством образования и исследований Германии и Министерством науки, исследований и искусств Баден-Вюртемберга. Hunter базируется на той же архитектуре, что El Capitan — самый мощный в мире суперкомпьютер. Задействована платформа Cray EX4000, а каждый из узлов оснащён четырьмя адаптерами HPE Slingshot. Суперкомпьютер использует комбинацию из APU Instinct MI300A и процессоров EPYC Genoa. Как отмечает The Register, в общей сложности система объединяет 188 узлов с жидкостным охлаждением и насчитывает суммарно 752 APU и 512 чипов Epyc с 32 ядрами. Применена СХД HPE Cray Supercomputing Storage Systems E2000, специально разработанная для суперкомпьютеров HPE Cray. 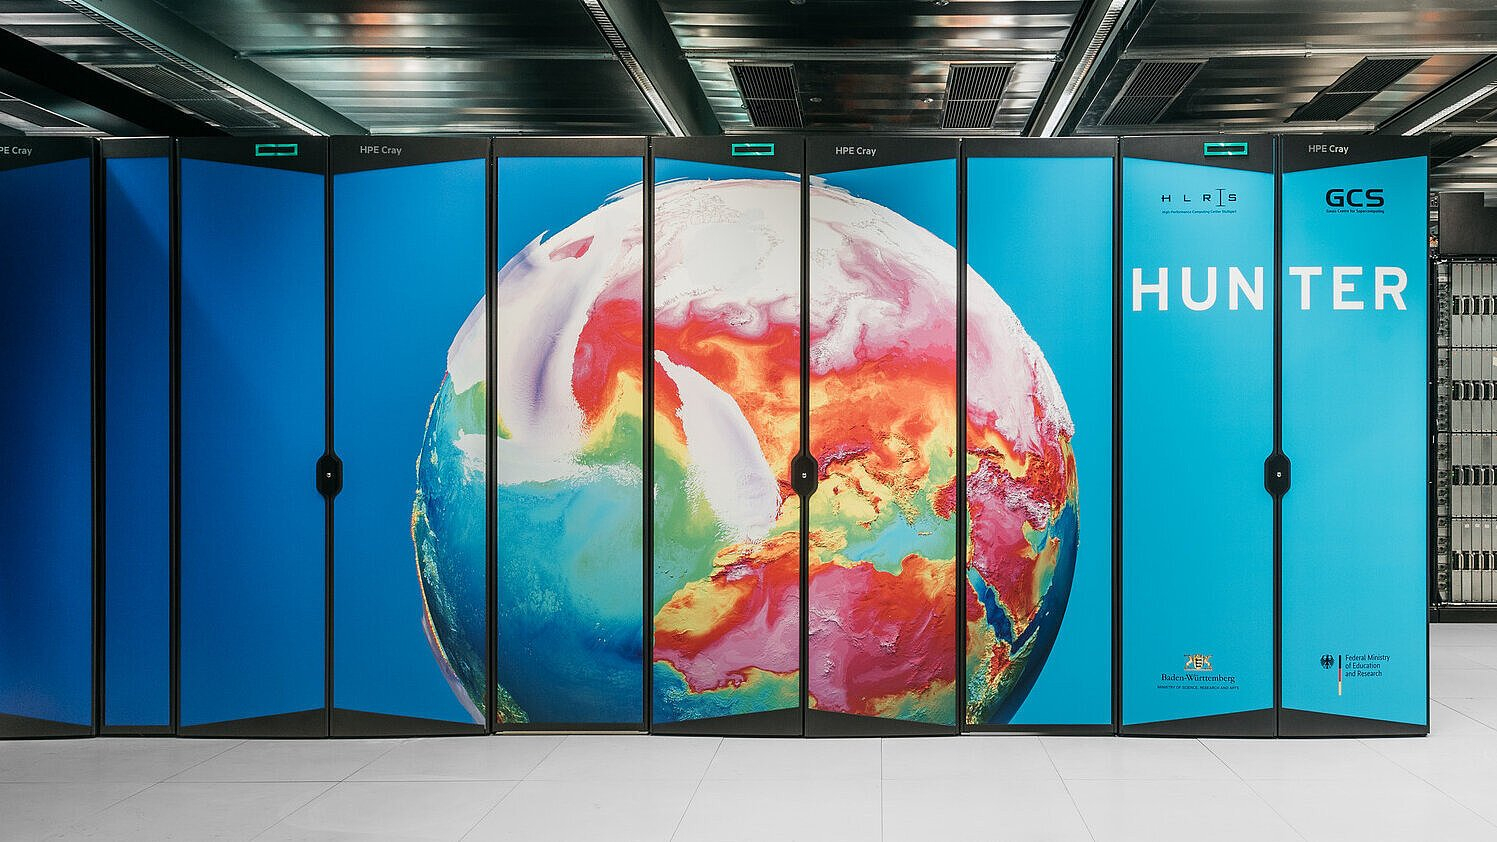
Источник изображения: HLRS HLRS оценивает пиковую теоретическую FP64-производительность Hunter в 48,1 Пфлопс на операциях двойной точности, что практически вдвое выше, чем у предшественника Hawk. В режимах BF16 и FP8 быстродействие, как ожидается, будет варьироваться от 736 Пфлопс до 1,47 Эфлопс. При этом Hunter потребляет на 80% меньше энергии, нежели Hawk. 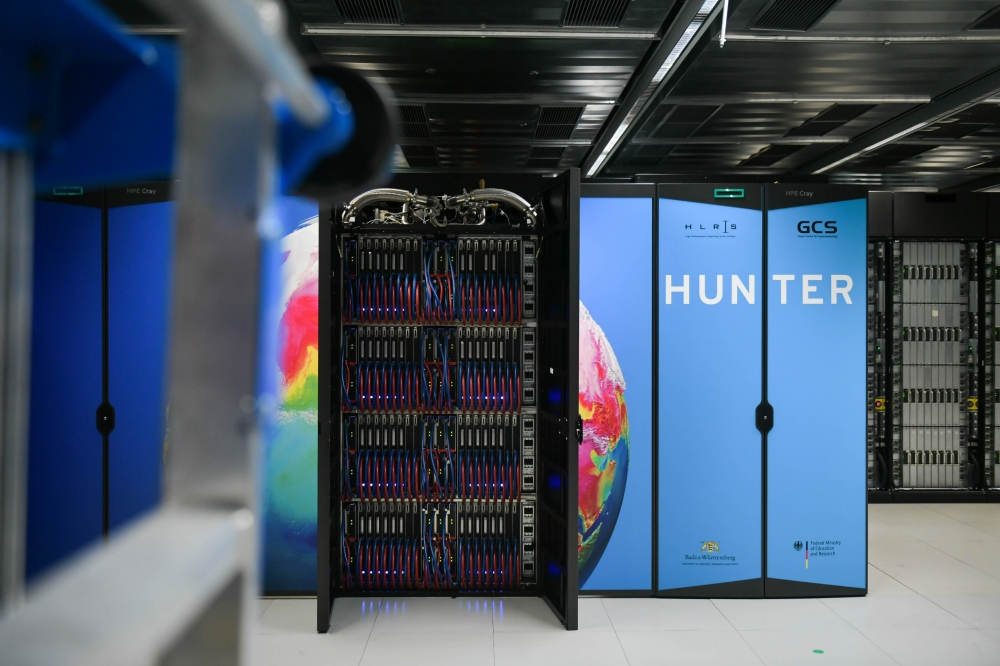
Источник изображения: Штутгартский университет Отмечается, что Hunter задуман как переходная система, которая подготовит почву для суперкомпьютера HLRS следующего поколения под названием Herder. Ввести этот комплекс в эксплуатацию планируется в 2027 году. Предполагается, что он обеспечит производительность «в несколько сотен петафлопс».
17.01.2025 [15:02], Владимир Мироненко
Аналитики снизили рейтинг акций AMD из-за более низких ожиданий по продажам ускорителейАкции Advanced Micro Devices (AMD) могут потерять своё конкурентное преимущество, сообщил аналитик Wolfe Research Крис Касо (Chris Caso), понизив рейтинг акций производителя чипов с Buy (покупать) до Peer Perform (нейтральный), сообщает ресурс Barron's. Аналитик отметил, что после вчерашнего отчёта TSMC о прибыли выросли акции всех компаний по производству оборудования для изготовления пластин — Lam Research, KLA Corporation и Applied Materials. А у AMD, для которой TSMC производит чипы, такого же роста не наблюдалось. Наоборот, её акции упали в четверг на 1,3 % до $118,44. Понизив рейтинг акций AMD, Крис Касо также снял свою целевую цену в $210 за акцию, пояснив свой шаг более низкими, чем прогнозировалось, ожиданиями относительно доходов компании от производства ускорителей для ЦОД. Ускорители являются одним из ключевых продуктов AMD, и Касо утверждает, что бизнес компании по этому направлению «работает ниже ожиданий». Аналитик выразил мнение, что ситуация улучшится после выхода во II половине 2025 года ускорителей AMD Instinct MI350. 
Источник изображения: AMD Ранее в этом месяце рейтинг AMD снизили Goldman Sachs и HSBC. Аналитики Goldman понизили свой рейтинг с «Покупать» (Buy) до «Нейтральный» (Peer Perform), сославшись на скромный рост продаж ускорителей для ЦОД на фоне жесткой конкуренции, в то время как команда HSBC понизила рейтинг AMD с «Покупать» (Buy) до «Сокращать позицию» (Reduce) из-за опасений, что акции могут упасть ещё ниже после трёхмесячного спада. Wolfe Research снизила прогнозы выручки и прибыли AMD за I квартал до $6,6 млрд и $0,80 на акцию соответственно, по сравнению с более ранними прогнозами выручки в $7,04 млрд и прибыли в $0,93 на акцию. Скорректированные цифры оказались ниже ожиданий Уолл-стрит в $7,04 млрд по выручке и $0,95 по прибыли на акцию. Компания тоже снизила свой годовой прогноз по выручке и прибыли до $29,9 млрд и $4,19 на акцию соответственно с предыдущих $33,6 млрд и $5,33 на акцию при консенсус-прогнозе аналитиков выручки в размере $32,3 млрд и прибыли в $5,02 на акцию.
28.12.2024 [12:42], Сергей Карасёв
Итальянская нефтегазовая компания Eni запустила суперкомпьютер HPC6 с производительностью 478 ПфлопсИтальянский нефтегазовый гигант Eni запустил вычислительный комплекс HPC6. На сегодняшний день это самый мощный суперкомпьютер в Европе и один из самых производительных в мире: в свежем рейтинге TOP500 он занимает пятую позицию. О подготовке HPC6 сообщалось в начале 2024 года. В основу системы положены процессоры AMD EPYC Milan и ускорители AMD Instinct MI250X. Комплекс выполнен на платформе HPE Cray EX4000 с хранилищем HPE Cray ClusterStor E1000 и интерконнектом HPE Slingshot 11. В общей сложности в состав HPC6 входят 3472 узла, каждый из которых несёт на борту 64-ядерный CPU и четыре ускорителя. Таким образом, суммарное количество ускорителей Instinct MI250X составляет 13 888. Суперкомпьютер обладает FP64-быстродействием 477,9 Пфлопс в тесте Linpack (HPL), тогда как пиковый теоретический показатель достигает 606,97 Пфлопс. Максимальная потребляемая мощность системы составляет 10,17 МВА. Комплекс HPC6 смонтирован на площадке Eni Green Data Center в Феррера-Эрбоньоне: это, как утверждается, один из самых энергоэффективных и экологически чистых дата-центров в Европе. Новый суперкомпьютер оснащён системой прямого жидкостного охлаждения, которая способна рассеивать 96 % вырабатываемого тепла. ЦОД, где располагается HPC6, оборудован массивом солнечных батарей мощностью 1 МВт. 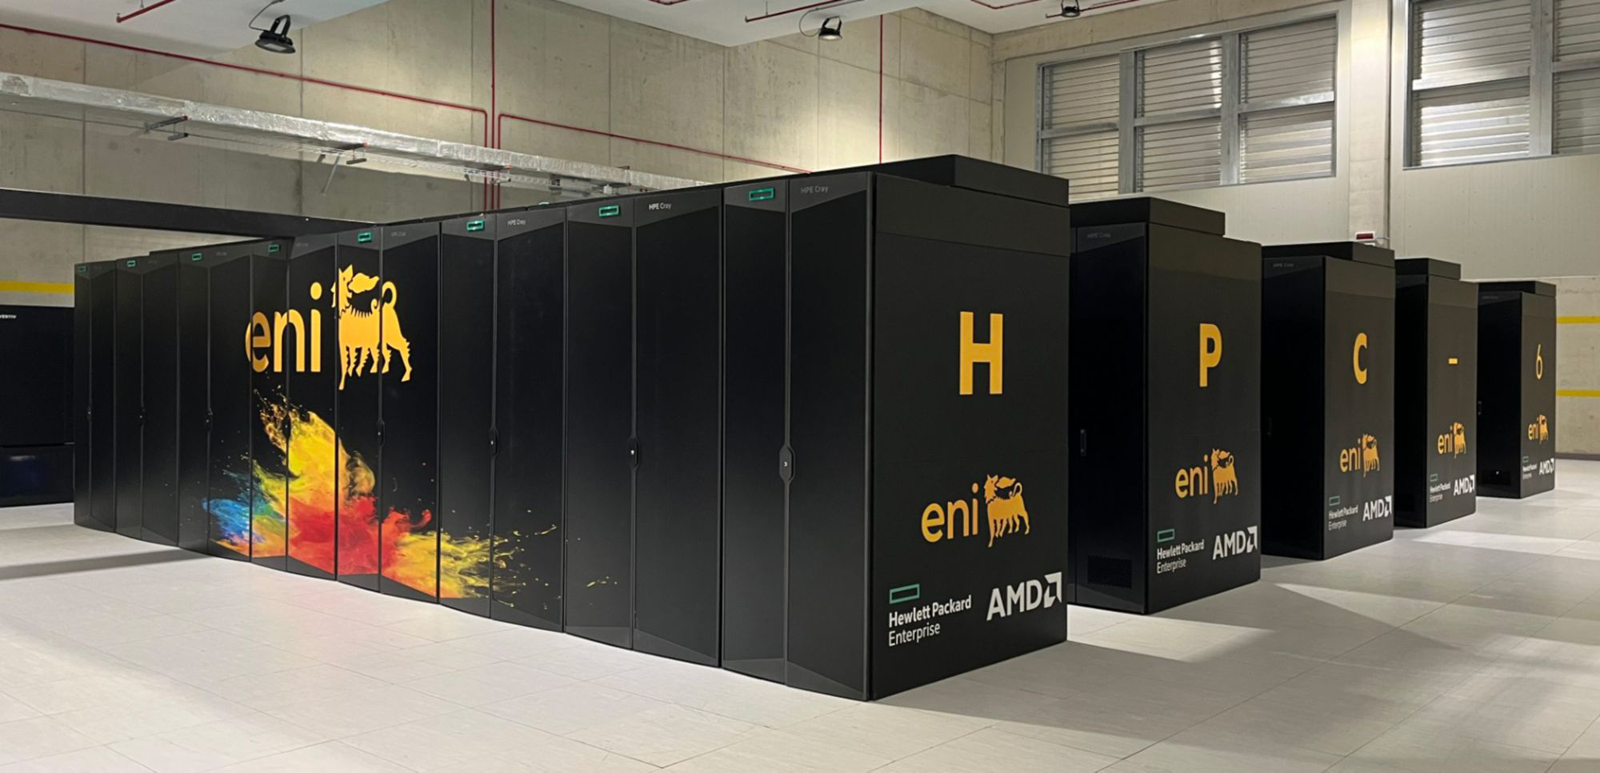
Источник изображения: Eni Как отмечает ресурс Siliconangle, на создание суперкомпьютера потрачено более €100 млн. Применять комплекс планируется, в частности, для оптимизации работы промышленных предприятий, повышения точности геологических и гидродинамических исследований, разработки источников питания нового поколения, оптимизации цепочки поставок биотоплива, создания инновационных материалов и моделирования поведения плазмы при термоядерном синтезе с магнитным удержанием.
25.12.2024 [01:00], Владимир Мироненко
Гладко было на бумаге: забагованное ПО AMD не позволяет раскрыть потенциал ускорителей Instinct MI300XАналитическая компания SemiAnalysis опубликовала результаты исследования, длившегося пять месяцев и выявившего большие проблемы в ПО AMD для работы с ИИ, из-за чего на данном этапе невозможно в полной мере раскрыть имеющийся у ускорителей AMD Instinct MI300X потенциал. Проще говоря, из-за забагованности ПО AMD не может на равных соперничать с лидером рынка ИИ-чипов NVIDIA. При этом примерно три четверти сотрудников последней заняты именно разработкой софта. Как сообщает SemiAnalysis, из-за обилия ошибок в ПО обучение ИИ-моделей с помощью ускорителей AMD практически невозможно без значительной отладки и существенных трудозатрат. Более того, масштабирование процесса обучения как в рамках одного узла, так и на несколько узлов показало ещё более существенное отставание решения AMD. И пока AMD занимается обеспечением базового качества и простоты использования ускорителей, NVIDIA всё дальше уходит в отрыв, добавляя новые функции, библиотеки и повышая производительность своих решений, отметили исследователи. 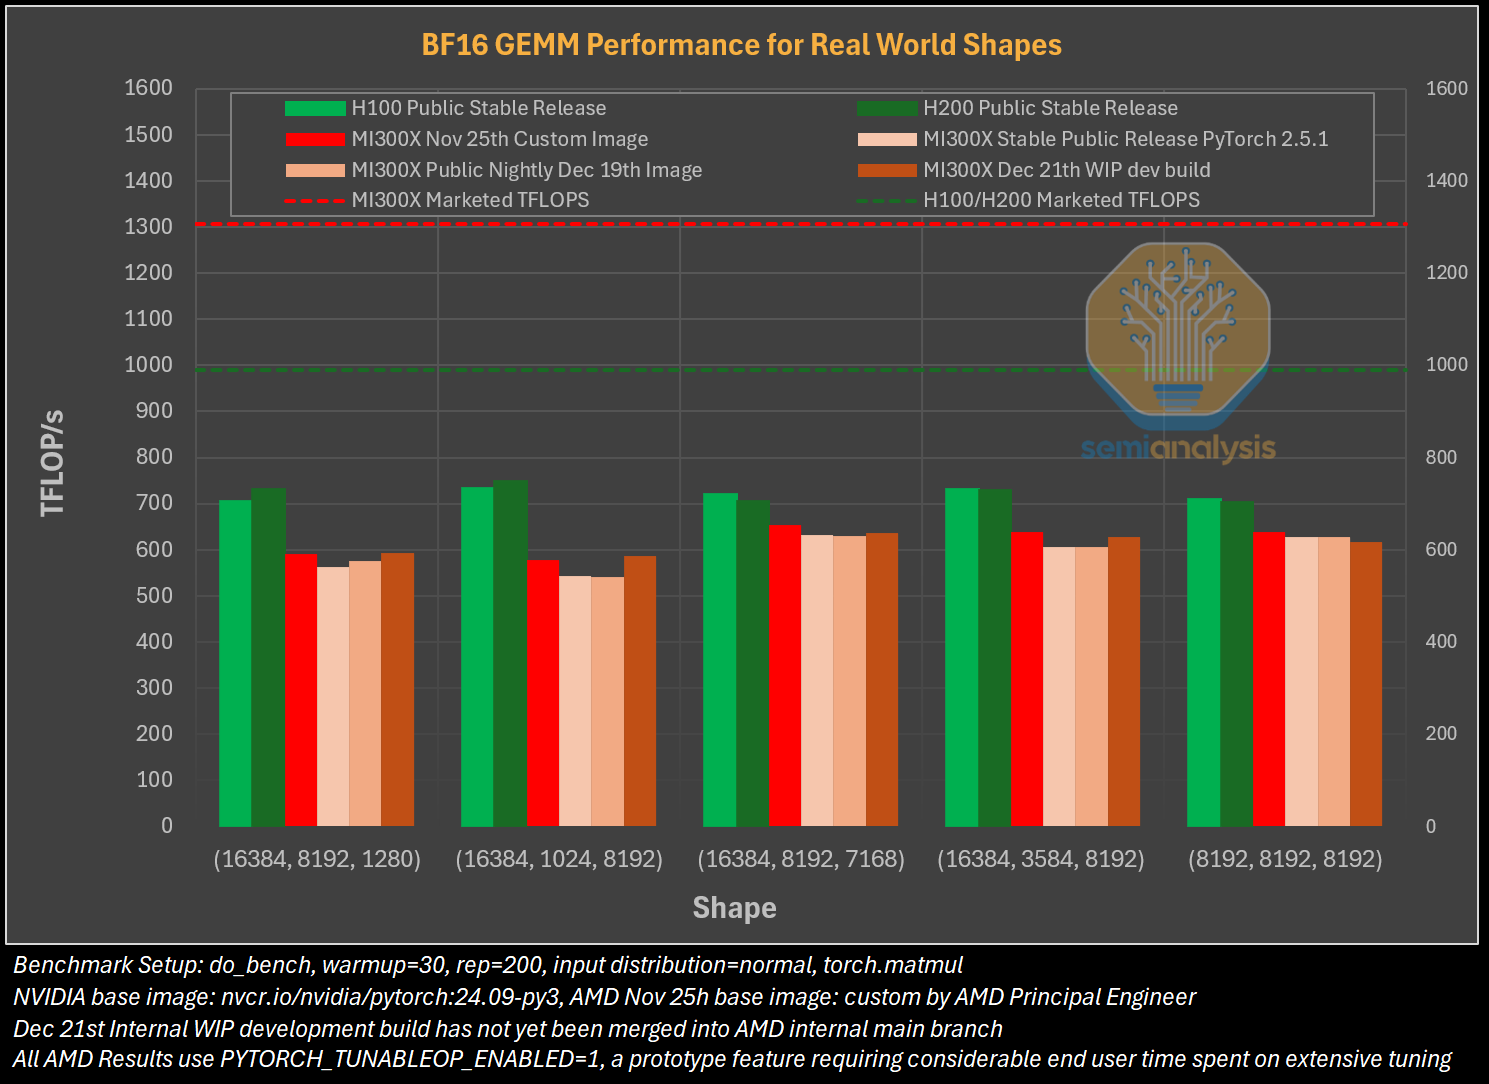
Источник изображений: SemiAnalysis На бумаге чип AMD Instinct MI300X выглядит впечатляюще с FP16-производительностью 1307 Тфлопс и 192 Гбайт памяти HBM3 в сравнении с 989 Тфлопс и 80 Гбайт памяти у NVIDIA H100. К тому же чипы AMD предлагают более низкую общую стоимость владения (TCO) благодаря более низким ценам и использованию более дешёвого интерконнекта на базе Ethernet. Но проблемы с софтом сводят это преимущество на нет и не находят реализации на практике. При этом исследователи отметили, что в NVIDIA H200 объём памяти составляет 141 Гбайт, что означает сокращение разрыва с чипами AMD по этому параметру. Кроме того, внутренняя шина xGMI лишь формально обеспечивает пропускную способность 448 Гбайт/с для связки из восьми ускорителей MI300X. Фактически же P2P-общение между парой ускорителей ограничено 64 Гбайт/с, тогда как для объединения H100 используется NVSwitch, что позволяет любому ускорителю общаться с другим ускорителем на скорости 450 Гбайт/с. А включённый по умолчанию механизм NVLink SHARP делает часть коллективных операций непосредственно внутри коммутатора, снижая объём передаваемых данных. 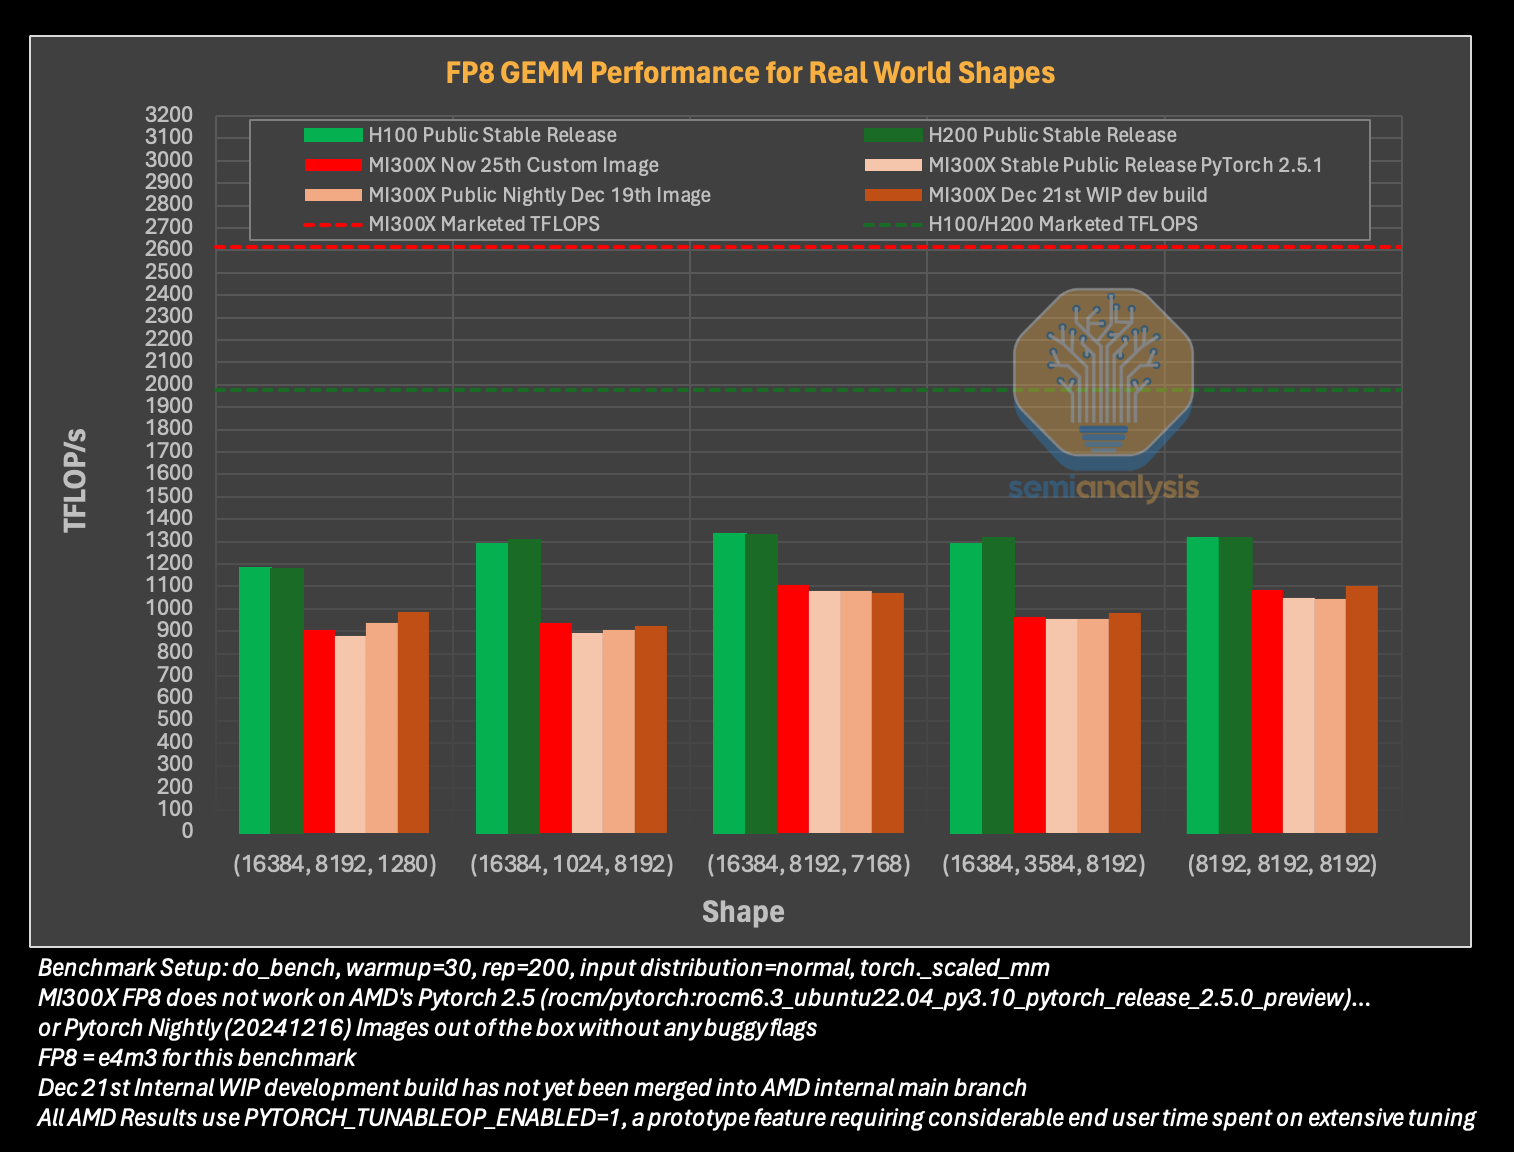 Как отметили в SemiAnalysis, сравнение спецификаций чипов двух компаний похоже на «сравнение камер, когда просто сверяют количество мегапикселей», и AMD просто «играет с числами», не обеспечивая достаточной производительности в реальных задачах. Чтобы получить пригодные для аналитики результаты тестов, специалистам SemiAnalysis пришлось работать напрямую с инженерами AMD над исправлением многочисленных ошибок, в то время как системы на базе NVIDIA работали сразу «из коробки», без необходимости в дополнительной многочасовой отладке и самостоятельной сборке ПО. В качестве показательного примера SemiAnalysis рассказала о случае, когда Tensorwave, крупнейшему провайдеру облачных вычислений на базе ускорителей AMD, пришлось предоставить целой команде специалистов AMD из разных отделов доступ к оборудованию с её же ускорителями, чтобы те устранили проблемы с софтом. Обучение с использованием FP8 в принципе не было возможно без вмешательства инженеров AMD. Со стороны NVIDIA был выделен только один инженер, за помощью к которому фактически не пришлось обращаться. 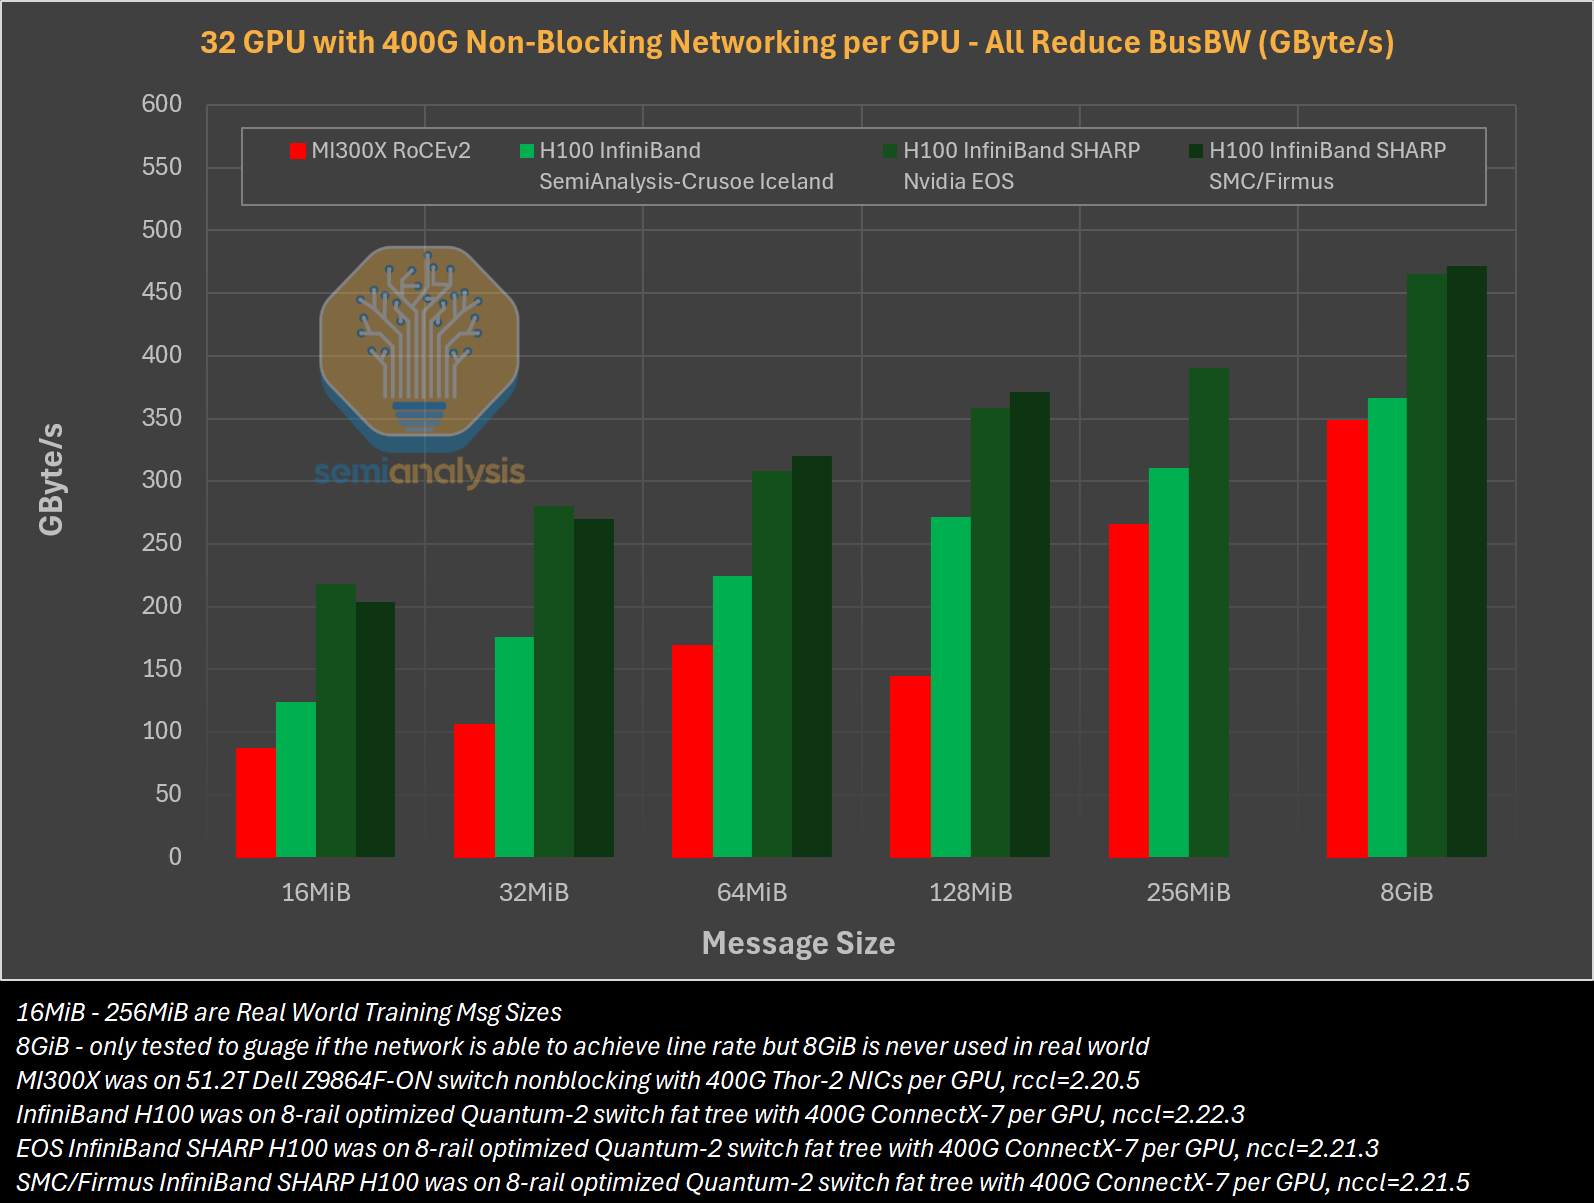 У AMD есть лишь один выход — вложить значительные средства в разработку и тестирование ПО, считают в SemiAnalysis. Аналитики также предложили выделить тысячи чипов MI300X для автоматизированного тестирования, как это делает NVIDIA, и упростить подготовку окружения, одновременно внедряя лучшие настройки по умолчанию. Проблемы с ПО — основная причина, почему AMD не хотела показывать результаты бенчмарка MLPerf и не давала такой возможности другим. В SemiAnalysis отметили, что AMD предстоит немало сделать, чтобы устранить выявленные проблемы. Без серьёзных улучшений своего ПО AMD рискует еще больше отстать от NVIDIA, готовящей к выпуску чипы Blackwell следующего поколения. Для финальных тестов Instinct использовался специально подготовленный инженерами AMD набор ПО, который станет доступен обычным пользователям лишь через один-два квартала. Речь не идёт о Microsoft или Meta✴, которые самостоятельно пишут ПО для Instinct. Один из автором исследования уже провёл встречу с главой AMD Лизой Су (Lisa Su), которая пообещала приложить все усилия для исправления ситуации.
19.11.2024 [17:30], Сергей Карасёв
1,742 Эфлопс: El Capitan стал самым мощным в мире суперкомпьютером рейтинга TOP500Ливерморская национальная лаборатория им. Э. Лоуренса (LLNL) Министерства энергетики США (DOE), Администрация по национальной ядерной безопасности США (NNSA), компании AMD и HPE официально представили El Capitan — самый производительный в мире суперкомпьютер. Эта машина возглавила ноябрьский рейтинг мощнейших вычислительных систем TOP500. Комплекс El Capitan создан специалистами HPE Cray. Суперкомпьютер обладает FP64-быстродействием 1,742 Эфлопс в тесте Linpack (HPL), тогда как пиковый теоретический показатель достигает 2,746 Эфлопс. Прежний лидер TOP500 — система Frontier — с производительностью 1,353 Эфлопс теперь находится на втором месте рейтинга. Машина Aurora, так и не прибавившая в производительности, хотя и заявленная когда-то как 2-Эфлопс система, занимает теперь третье место. В основу El Capitan легла платформа HPE Cray Shasta. Используется гибридная архитектура AMD с APU Instinct MI300A: изделие содержит 24 ядра Zen 4 общего назначения, блоки CDNA 3 и 128 Гбайт памяти HBM3. В общей сложности в составе суперкомпьютера объединены 11 136 узлов, каждый из которых несёт на борту четыре экземпляра Instinct MI300A. Применён интерконнект HPE Slingshot-11 с пропускной способностью 200 Гбит/с. Система включает узлы Rabbit, которые формируют дезагрегированное NVMe-хранилище с прямым PCIe-подключением к вычислительным узлам. 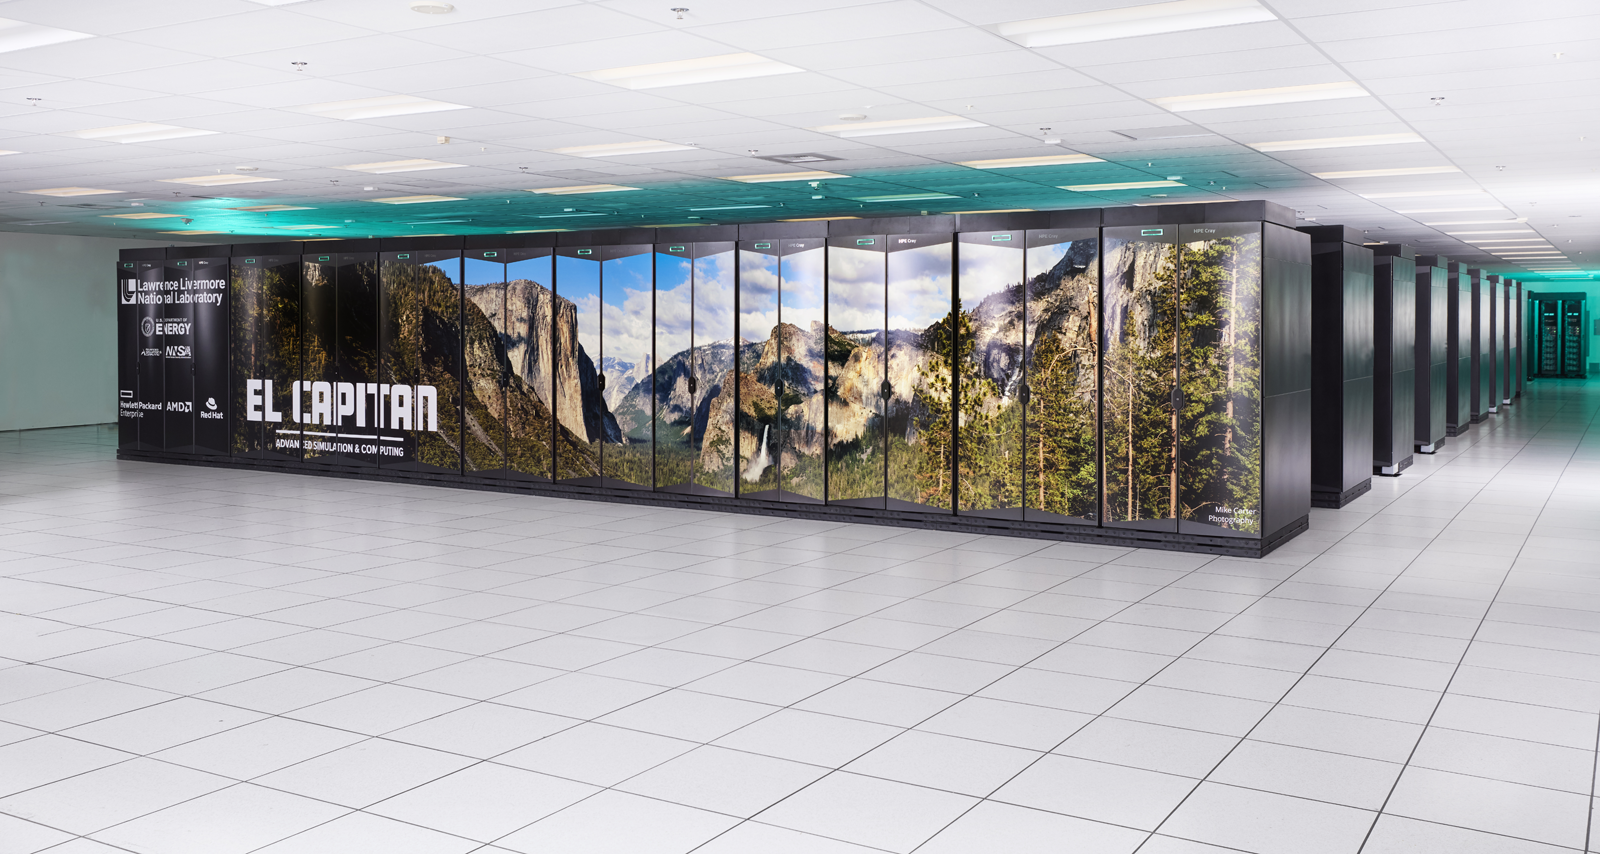
Источник изображений: LLNL Суммарное количество ядер CPU и GPU в составе El Capitan достигает 11 039 616, объём памяти — 5,4375 Пбайт. За отвод тепла отвечает система прямого жидкостного охлаждения HPE. Заявленная энергетическая эффективность составляет 58,89 Гфлопс/Вт: с таким показателем машина оказалась на 18-м месте в списке «зелёных» суперкомпьютеров GREEN500, но с учётом масштаба и общего энергопотребления 29,58 МВт — это хороший показатель. Система охлаждения HPC-объекта использует 28 тыс. т воды. Отмечается, что El Capitan станет главным вычислительным ресурсом для Tri-lab — группы, в которую вместе с LLNL входят Сандийские национальные лаборатории (SNL) и Лос-Аламосская национальная лаборатория (LANL). Использовать мощности нового суперкомпьютера планируется для обеспечения национальной безопасности и решения сложных задач, связанных с ядерным оружием. В частности, El Capitan обеспечит беспрецедентные возможности моделирования и имитации, необходимые для Программы управления ядерными запасами NNSA. Кроме того, НРС-комплекс поможет в модернизации и создании нового оружия, такого как боеголовки W87-1 и W93, которые в настоящее время находятся на стадии разработки. 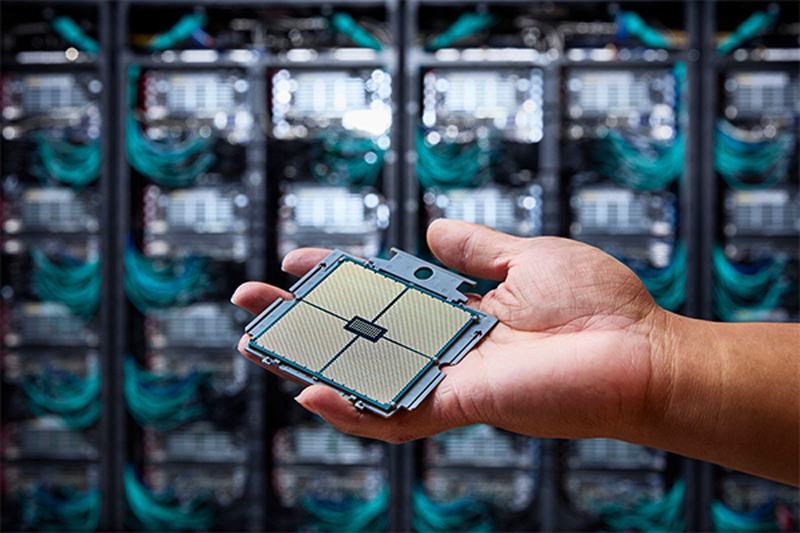 Отмечается также, что на 10-й позиции в рейтинге TOP500 оказался суперкомпьютер Tuolumne, также построенный в рамках проекта LLNL и NNSA. Фактически Tuolumne — это младший брат El Capitan: машина использует ту же архитектуру на базе Instinct MI300A, но обладает примерно на порядок меньшей FP64-производительностью 208,10 Пфлопс с пиковым значением 288,88 Пфлопс. Применять мощности Tuolumne планируется для «несекретных» задач, таких как исследования в области энергетической безопасности, изменений климата, вычислительной биологии, разработки лекарственных препаратов следующего поколения и пр. Стоит отметить, что Frontier — не единственная система, которая уступила пальму первенства более новым НРС-комплексам в ноябрьском рейтинге TOP500. Та же участь постигла самый мощный суперкомпьютер Европы LUMI, который опустился с пятого на восьмое место. На пятой позиции оказалась совершенно новая система HPC6, расположенная в центре нефтегазовой компании Eni в Феррера-Эрбоньоне (Италия). Её производительность достигает 477,9 Пфлопс при пиковом показателе 606,97 Пфлопс.
17.11.2024 [11:32], Сергей Карасёв
NEC создаст в Японии суперкомпьютер на базе Intel Xeon 6900P и AMD Instinct MI300A для исследований термоядерного синтезаКорпорация NEC займётся созданием нового НРС-комплекса, который планируется ввести в эксплуатацию в Японии в июле 2025 года. Система, базирующаяся на компонентах AMD и Intel, будет использоваться для различных исследований и разработок в области термоядерного синтеза. Заказ на создание суперкомпьютера поступил от Национальных институтов квантовой науки и технологий Японии (QST) при Национальном агентстве исследований и разработок (ANID), а также от Национального института термоядерных наук (NIFS) в составе Национальных институтов естественных наук (NINS). Система будет установлена в Институте термоядерной энергии Rokkasho (входит в QST) в Аомори (Япония). Основой проектируемого суперкомпьютера послужат 360 узлов NEC LX 204Bin-3, в состав каждого из которых войдут два процессора Intel Xeon 6900P поколения Granite Rapids (всего 720 чипов) и память DDR5 MRDIMM. Кроме того, будут задействованы 70 узлов NEC LX 401Bax-3GA, несущих на борту по четыре ускорителя AMD Instinct MI300A (в общей сложности 280 изделий). Говорится о применении интерконнекта InfiniBand с 400G-коммутаторами NVIDIA QM9700, а также хранилища DDN EXAScaler ES400NVX2 вместимостью 42,2 Пбайт с файловой системой Lustre. Для управления рабочими нагрузками будет использоваться софт Altair PBS Professional. 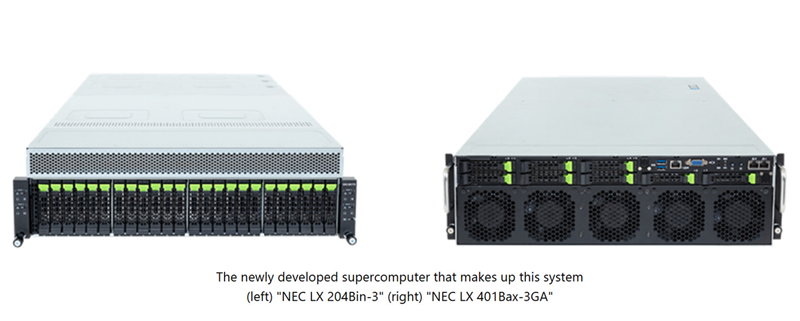
Источник изображения: NEC Ожидается, что производительность суперкомпьютера достигнет 40,4 Пфлопс. Это в 2,7 раза больше суммарных показателей двух нынешних НРС-систем, установленных в рамках независимых проектов QST и NIFS. Учёные намерены применять новый НРС-комплекс для точного прогнозирования экспериментов и создания сценариев работы для Международного экспериментального термоядерного реактора (ITER). Кроме того, мощности суперкомпьютера будут востребованы исследовательскими группами токамака Satellite Tokamak JT-60SA и электростанции DEMO (DEMOnstration Power Plant), использующей термоядерный синтез.
18.10.2024 [00:10], Алексей Степин
Meta✴ представила свой вариант суперускорителя NVIDIA GB200 NVL72Meta✴ поделилась своими новинками в области аппаратной инфраструктуры и рассказала, каким именно видит будущее открытых ИИ-платформ. В своей презентации Meta✴ рассказала о новой ИИ-платформе, новых дизайнах стоек, включая варианты с повышенной мощностью питания, а также о новинках в области сетевой инфраструктуры. 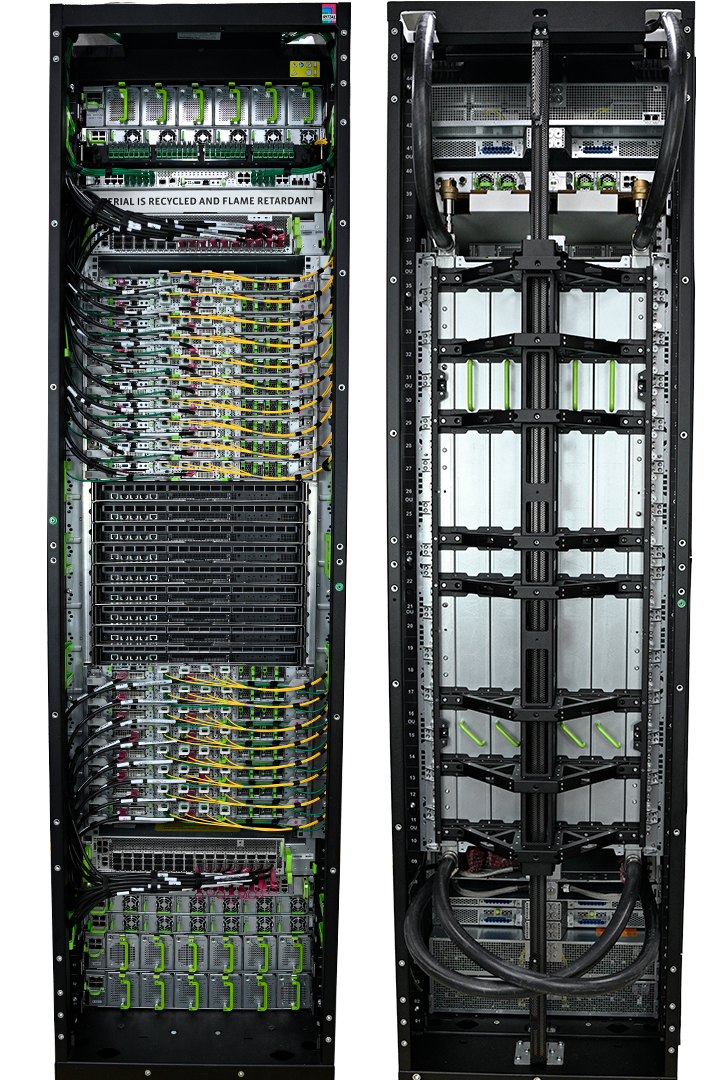
Источник изображений: Meta✴ В настоящее время компания использует нейросеть Llama 3.1 405B. Контекстное окно у этой LLM достигает 128 тыс. токенов, всего же токенов свыше 15 трлн. Чтобы обучать такие модели, требуются очень серьёзные ресурсы и глубокая оптимизация всего программно-аппаратного стека. В обучении базовой модели Llama 3.1 405B участвовал кластер 16 тыс. ускорителей NVIDIA H100, один из первых такого масштаба. Но уже сейчас для обучения ИИ-моделей Meta✴ использует два кластера, каждый с 24 тыс. ускорителей. Проекты такого масштаба зависят не только от ускорителей. На передний план выходят проблемы питания, охлаждения и, главное, интерконнекта. В течение нескольких следующих лет Meta✴ ожидает скоростей в районе 1 Тбайт/с на каждый ускоритель. Всё это потребует новой, ещё более плотной архитектуры, которая, как считает Meta✴, должна базироваться на открытых аппаратных стандартах. 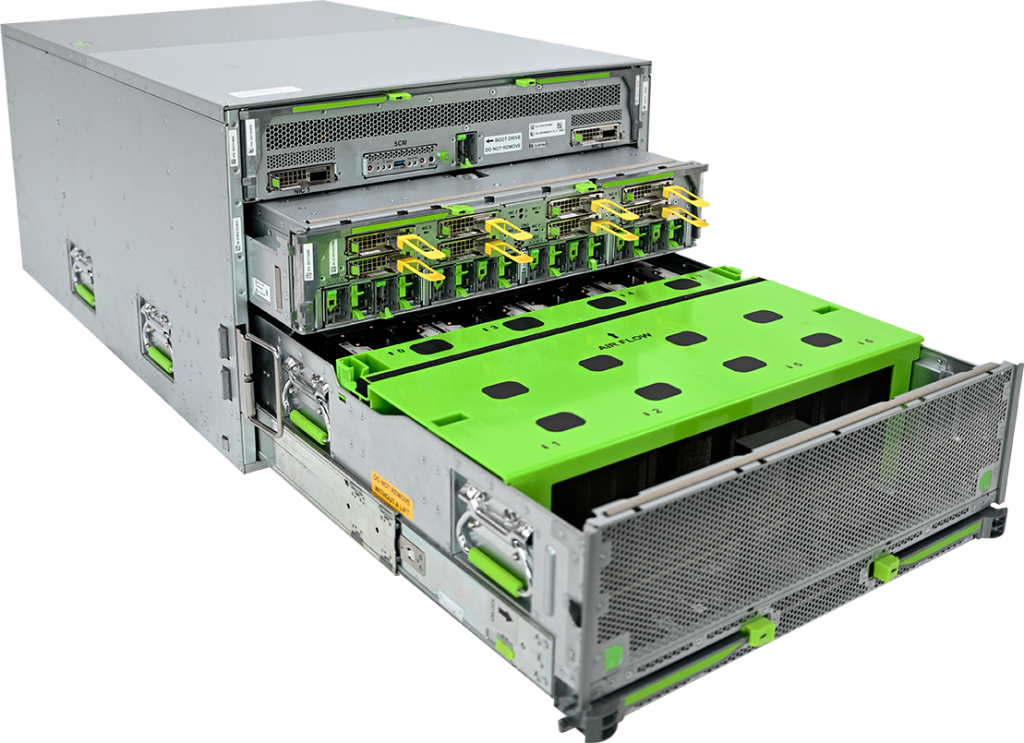 Одной из новинок стала платформа Catalina. Это Orv3-стойка, сердцем которой являются гибридные процессоры NVIDIA GB200. Стойка относится к классу HPR (High Power Rack) и рассчитана на 140 КВт. Сейчас Microsoft и Meta✴ ведут работы над модульной и масштабируемой системой питания Mount Diablo. Свой вариант GB200 NVL72 у Microsoft тоже есть. Также Meta✴ обновила ИИ-серверы Grand Teton, впервые представленные в 2022 году. Это по-прежнему монолитные системы, но теперь они поддерживают не только ускорители NVIDIA, но и AMD Instinct MI300X и будущие MI325X. 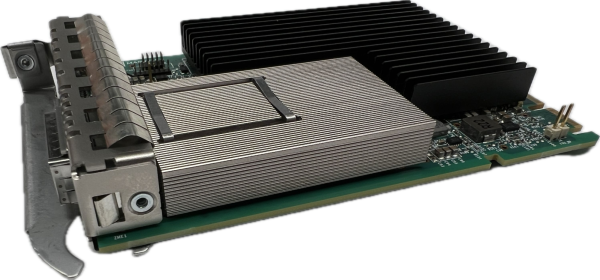 Интерконнектом будущих платформ станет сеть DSF (Disaggregated Scheduled Fabric). Благодаря переходу на открытые стандарты компания планирует избежать ограничений, связанных с масштабированием, зависимостью от вендоров аппаратных компонентов и плотностью подсистем питания. В основе DSF лежит стандарт OCP-SAI и ОС Meta✴ FBOSS для коммутаторов. Аппаратная часть базируется на стандартном интерфейсе Ethernet/RoCE. Meta✴ уже разработала и воплотила в металл новые коммутаторы класса 51Т на базе кремния Broadcom и Cisco, а также сетевые адаптеры FBNIC, созданные при поддержке Marvell. FBNIC может иметь до четырёх 100GbE-портов. Используется интерфейс PCIe 5.0, причём могущий работать как четыре отдельных слайса. Новинка соответствует открытому стандарту OCP NIC 3.0 v1.2.0.
11.10.2024 [19:55], Алексей Степин
256 Гбайт HBM3e — это хорошо, а 288 Гбайт — ещё лучше: AMD анонсировала ускорители Instinct MI325X и MI355XВчера компания AMD анонсировала серверные процессоры EPYC 9005 (Turin) и ускорители Instinct MI325X. Если верить AMD, новинки устанавливают новые эталоны производительности в своих сферах применения. О процессорах речь пойдёт в отдельном материале, а сейчас попробуем разобраться с Instinct MI325X — чем же именно он отличается от представленного ранее MI300X, архитектура которого в своё время была разобрана достаточно подробно. Сама AMD позиционирует MI325X в качестве наследника MI300X, способного конкурировать с NVIDIA H200 и, возможно, даже с B200. В сравнении с тем, что было опубликовано ранее, характеристики новинки несколько изменились. В частности, новый ускоритель получил 256 Гбайт памяти HBM3e, а не 288 Гбайт, как было обещано ранее. 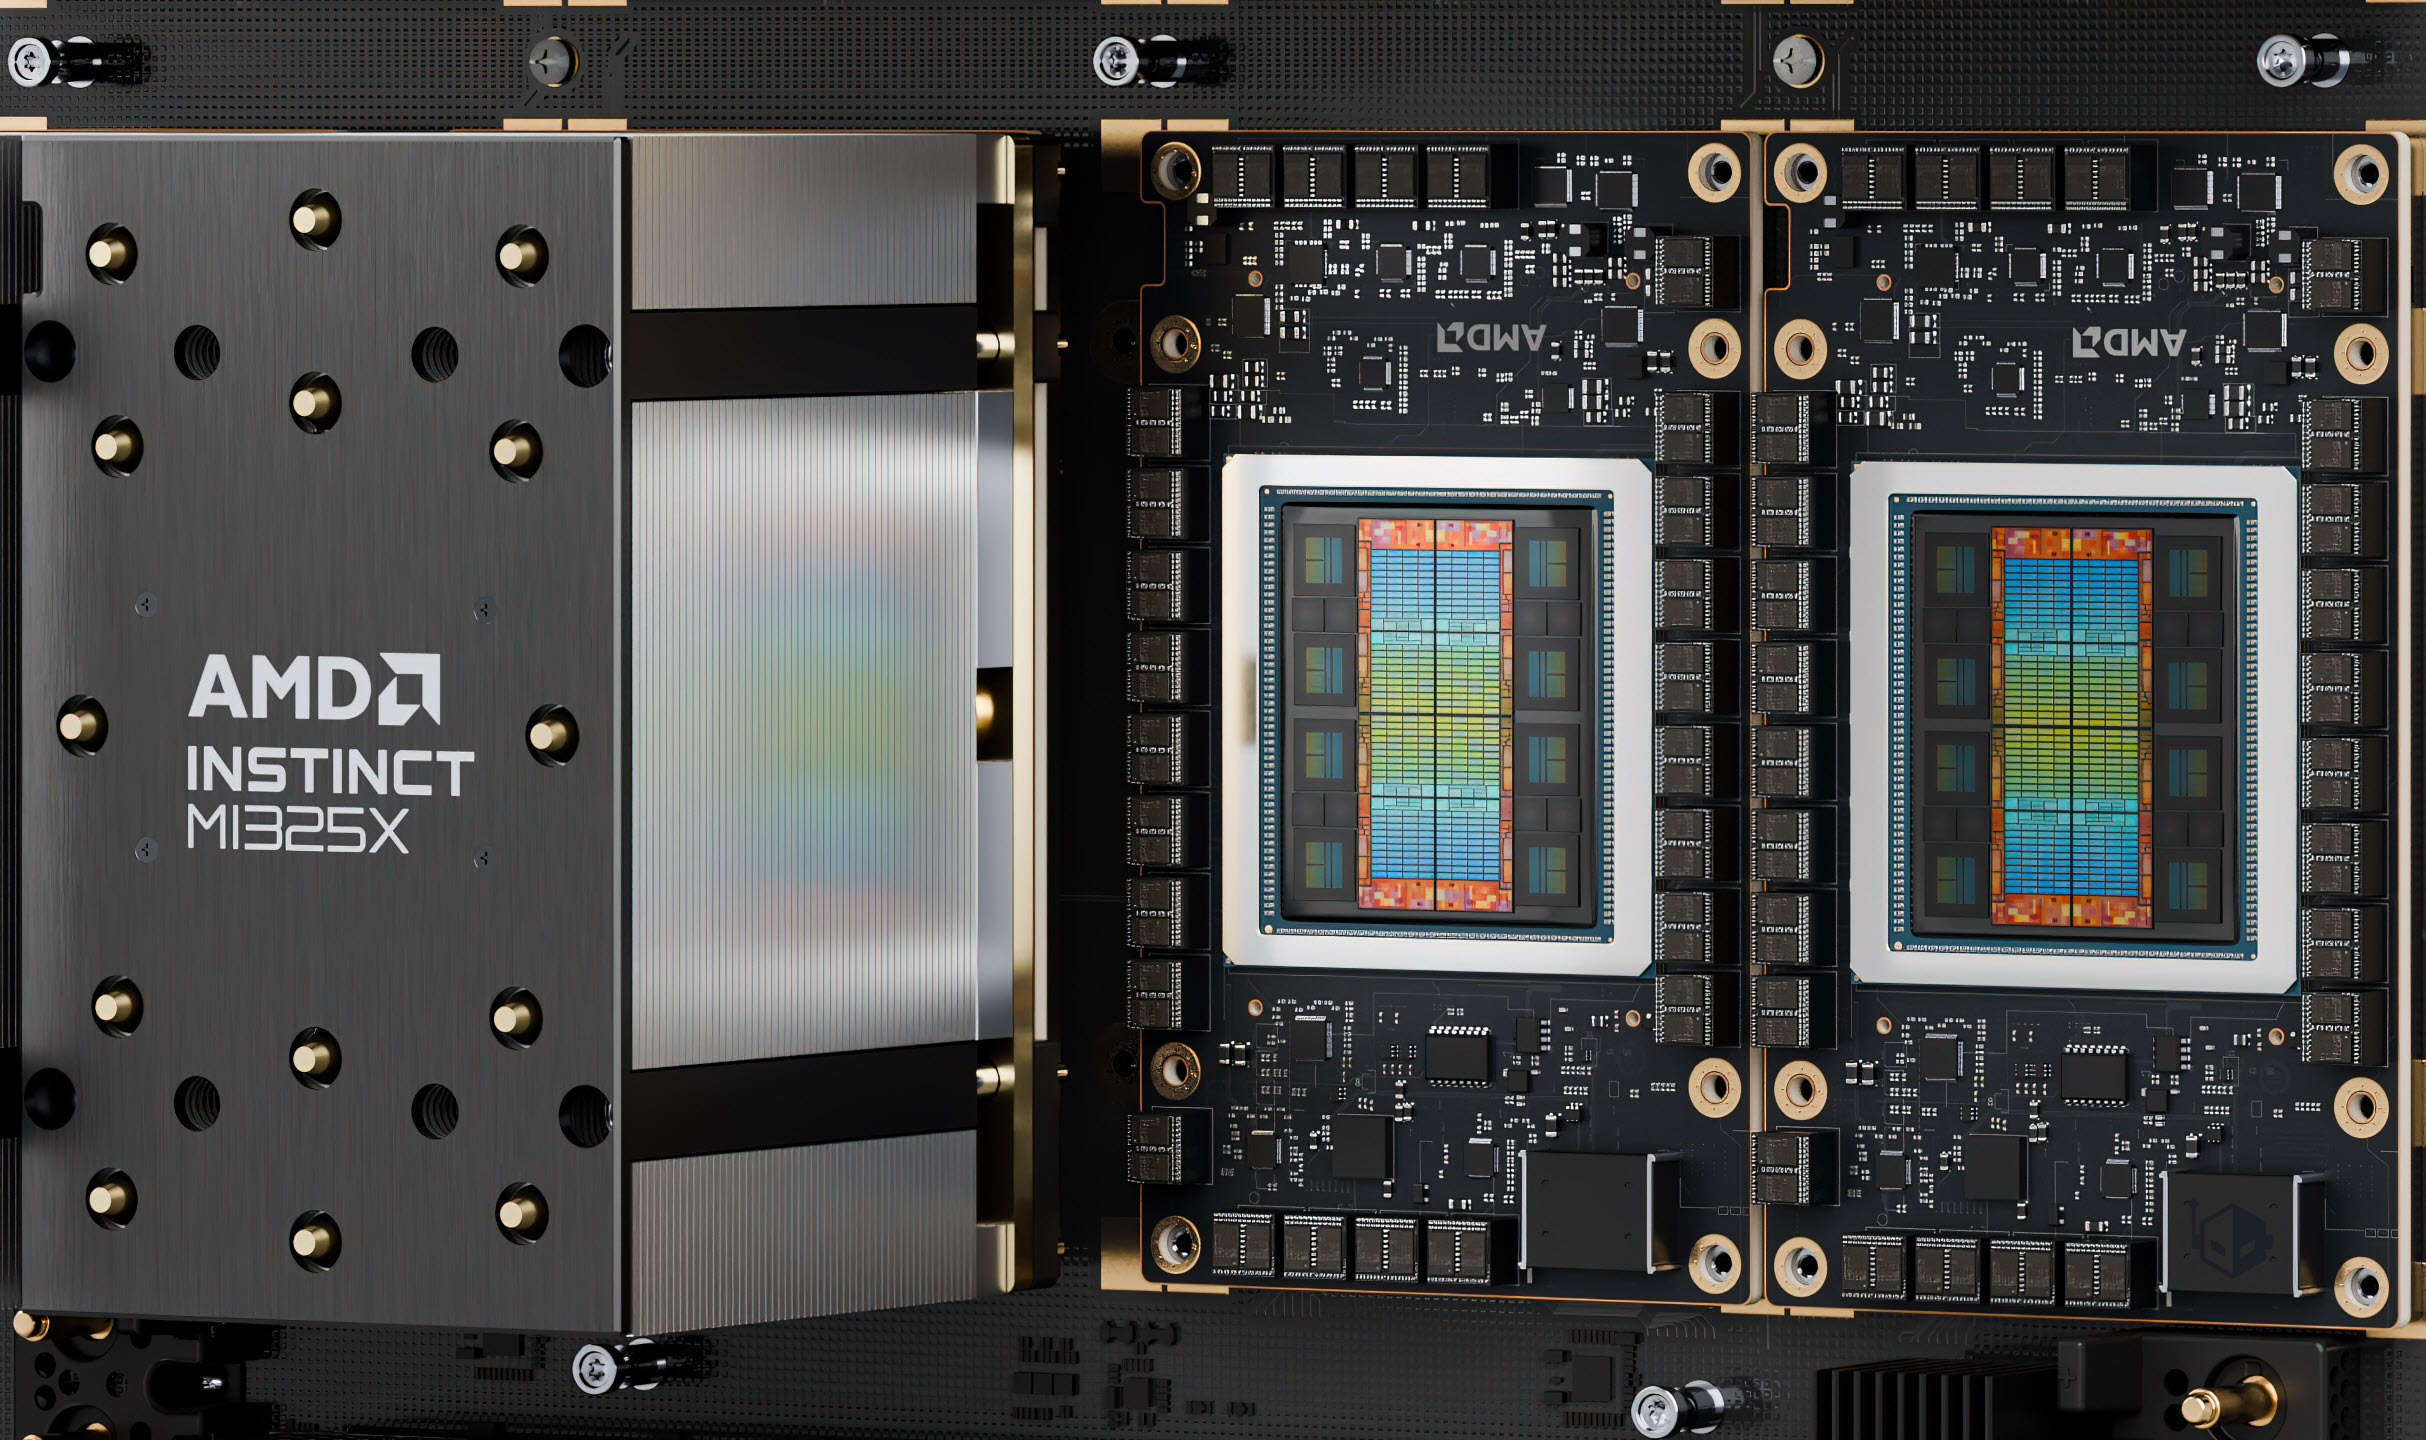
Источник здесь и далее: AMD via WCCFTech На приведённых слайдах с изображением кристалла MI325X отчетливо видно, что количество сборок HBM по-прежнему равно восьми, однако вместо ожидаемых сборок ёмкостью 36 Гбайт использованы менее ёмкие «стопки» на 32 Гбайт. Это не позволяет говорить о 50 % приросте по объёму, только о 33 %. Но и это немало! Пропускная способность подросла с 5,3 до 6 Тбайт/с. 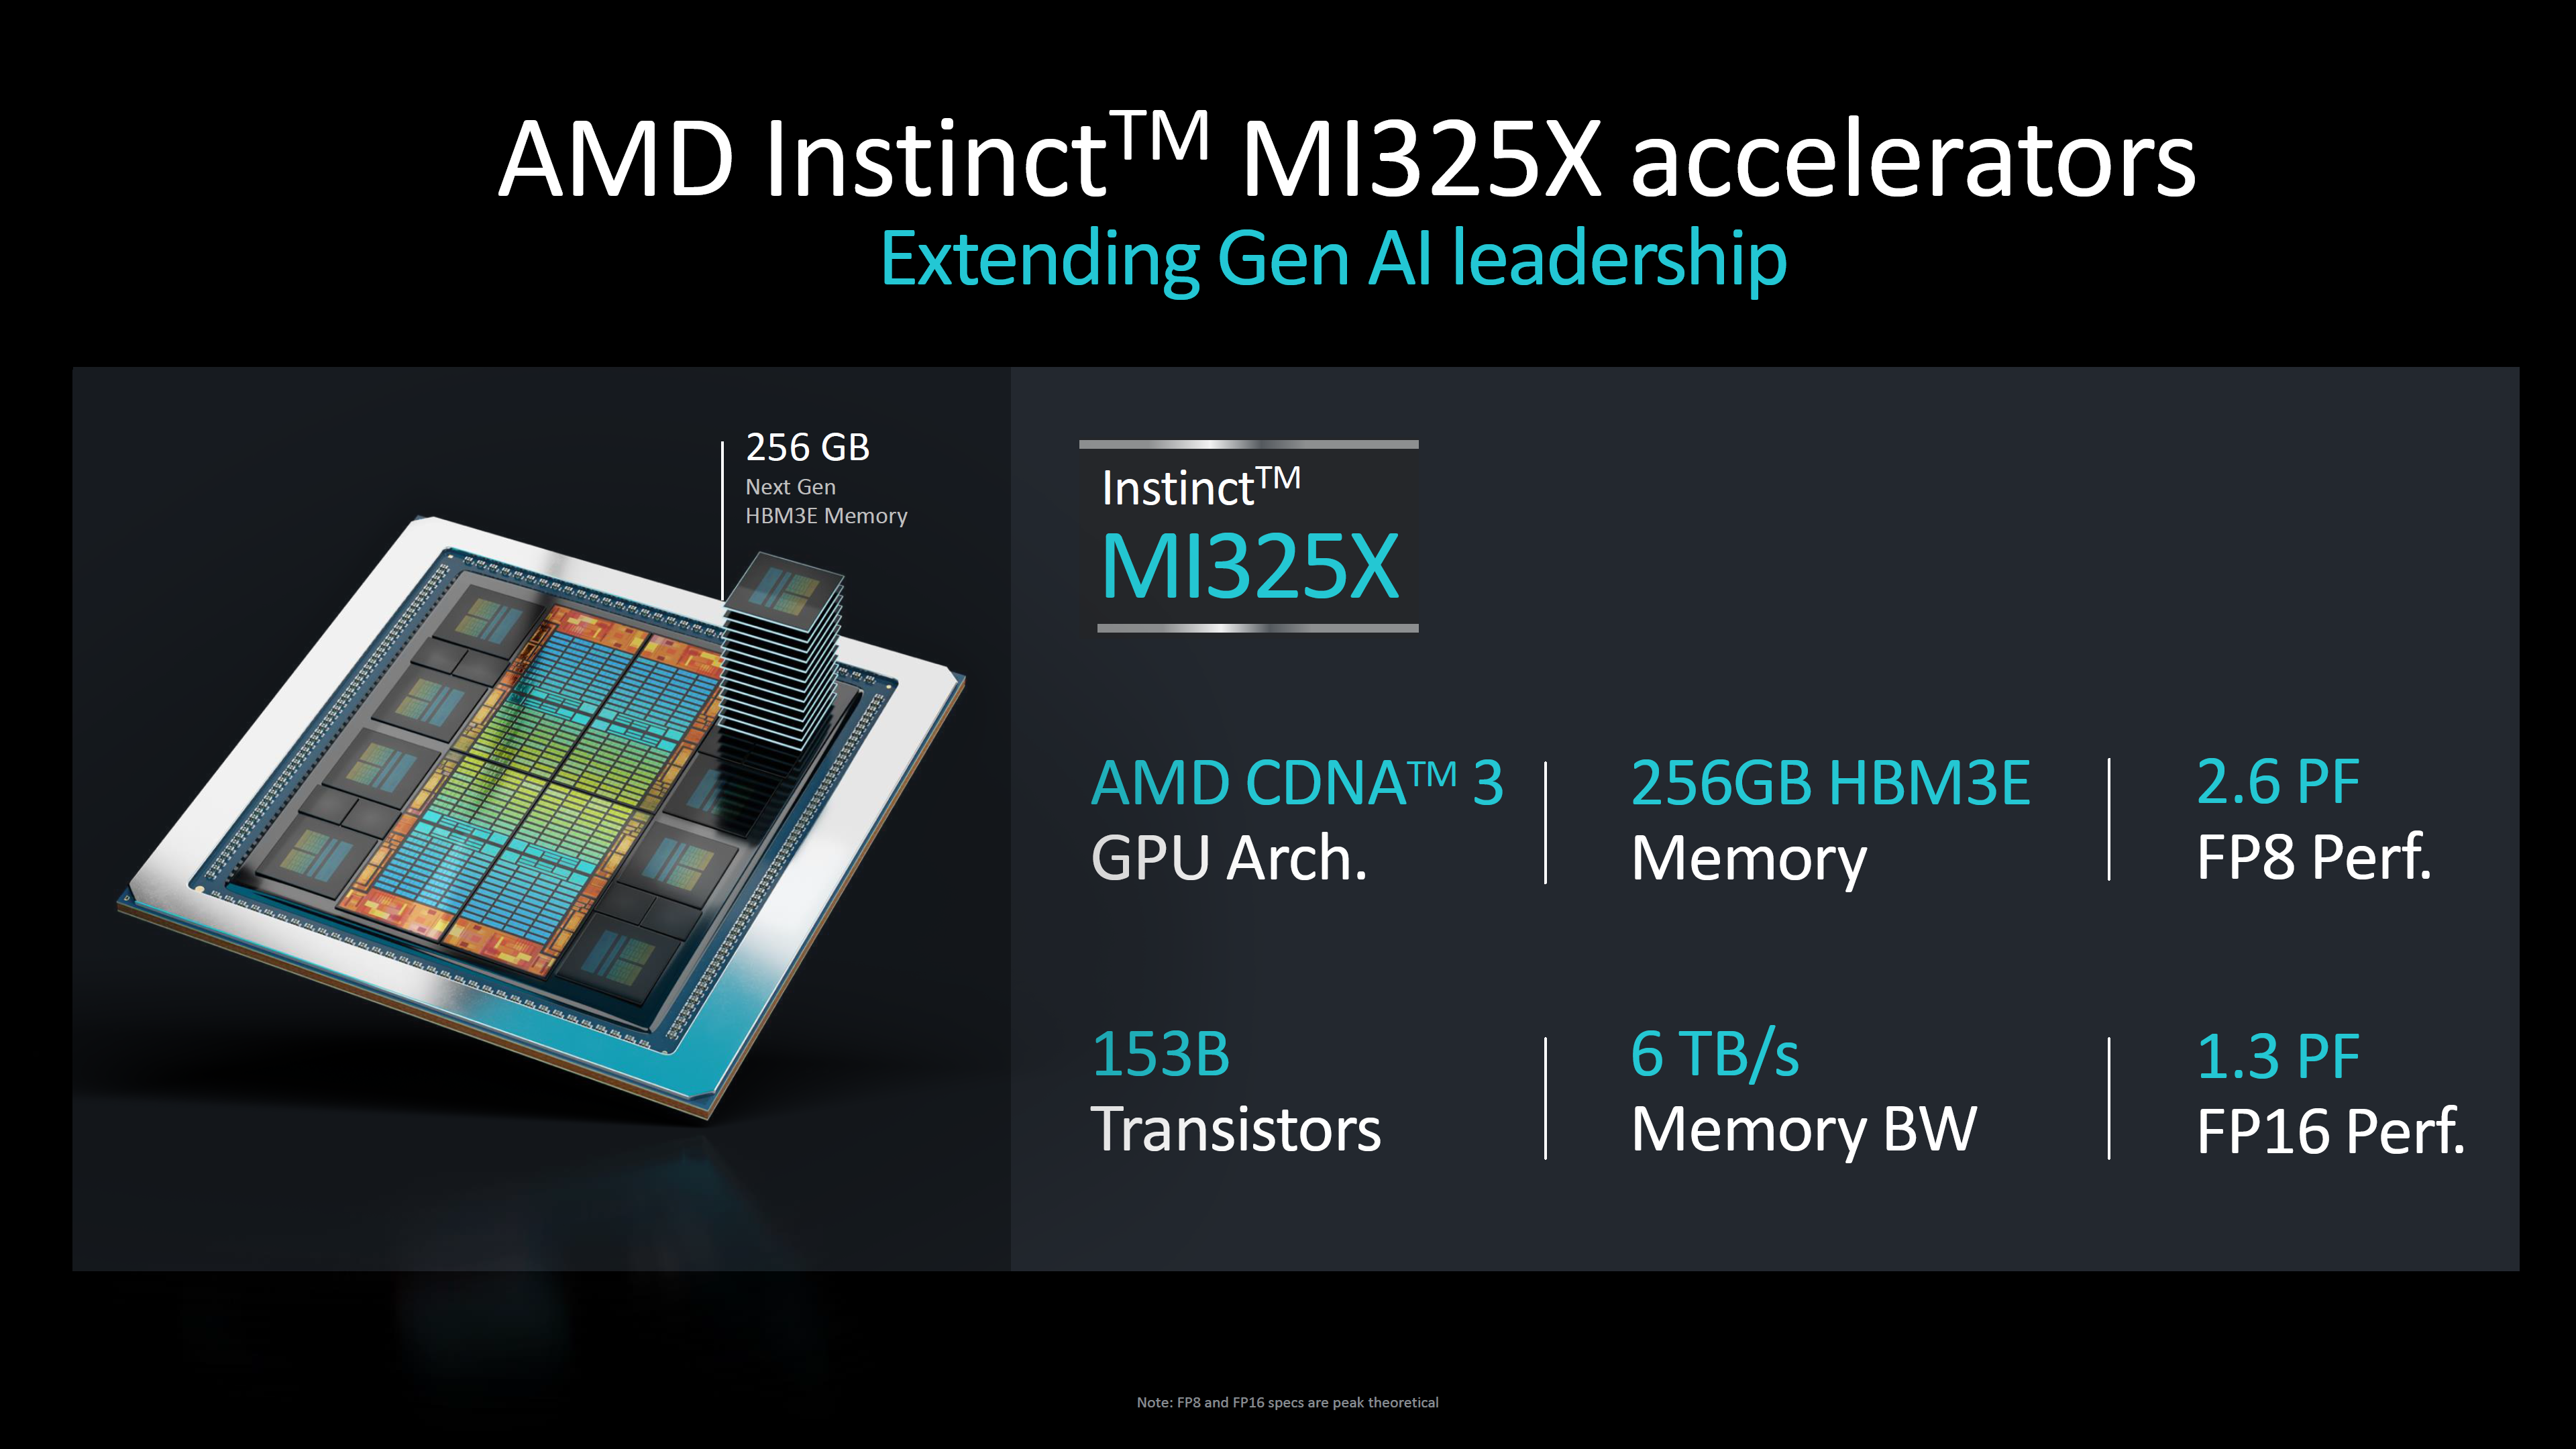 Последнее может быть объяснено повышением тактовой частоты, но из-за тесной интеграции HBM3e с остальными частями ускорителя должна была вырасти и производительность. Тем не менее, AMD приводит же цифры, что и для MI300X —1,3 Пфлопс в режиме FP16 и 2,6 Пфлопс в режиме FP8. По сути, улучшены только характеристики подсистемы памяти. 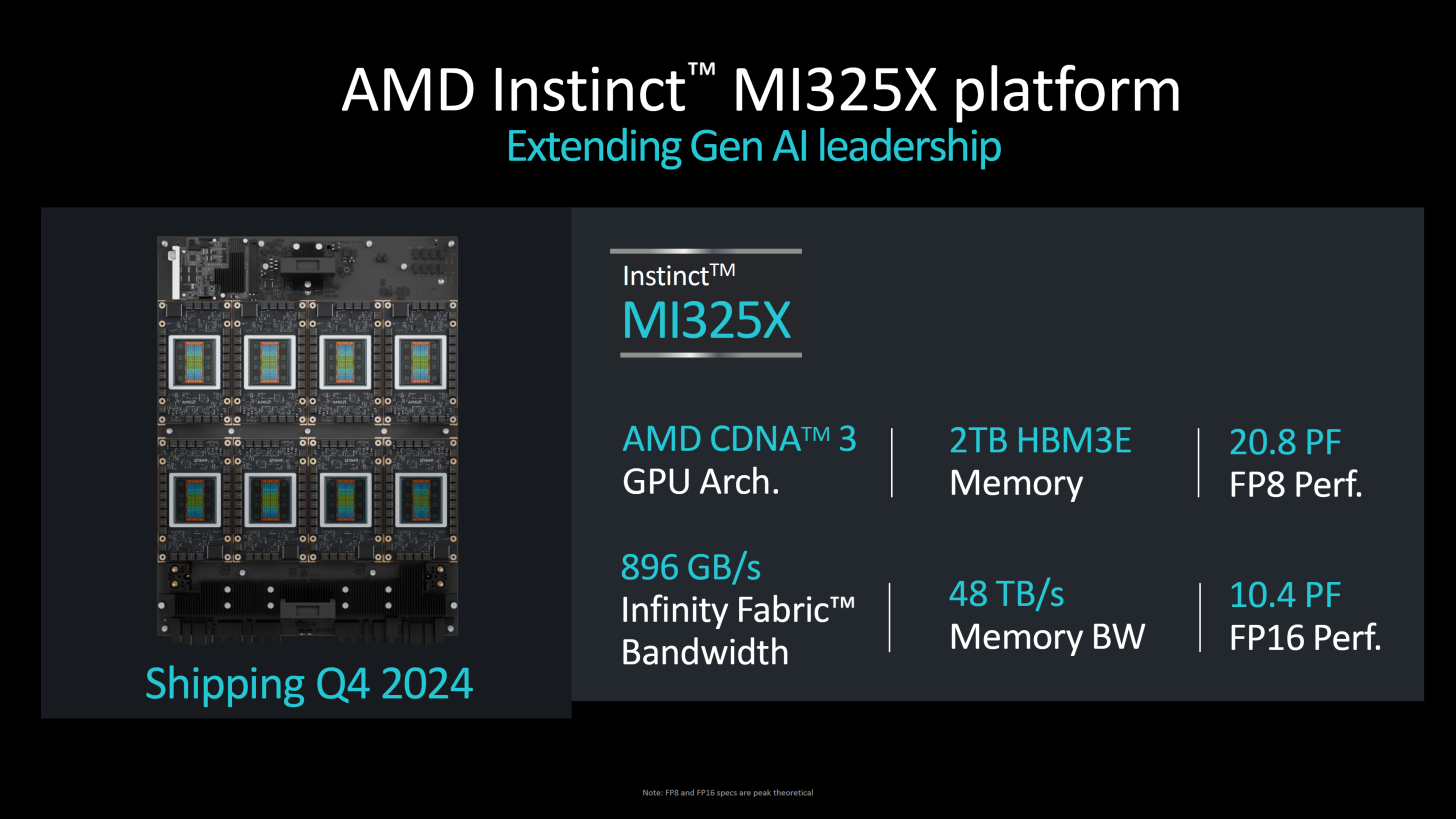 Архитектурно MI325X полностью подобен предшественнику, за исключением блока HBM. Он по-прежнему базируется на CDNA 3, имеет такое же количество транзисторов (153 млрд) и производится с использованием тех же техпроцессов, 5 нм для блоков XCD и 6 нм для IOD. Но теплопакет превышает 750 Вт, в то время как у MI300X данный параметр не достигал столь высокого значения. 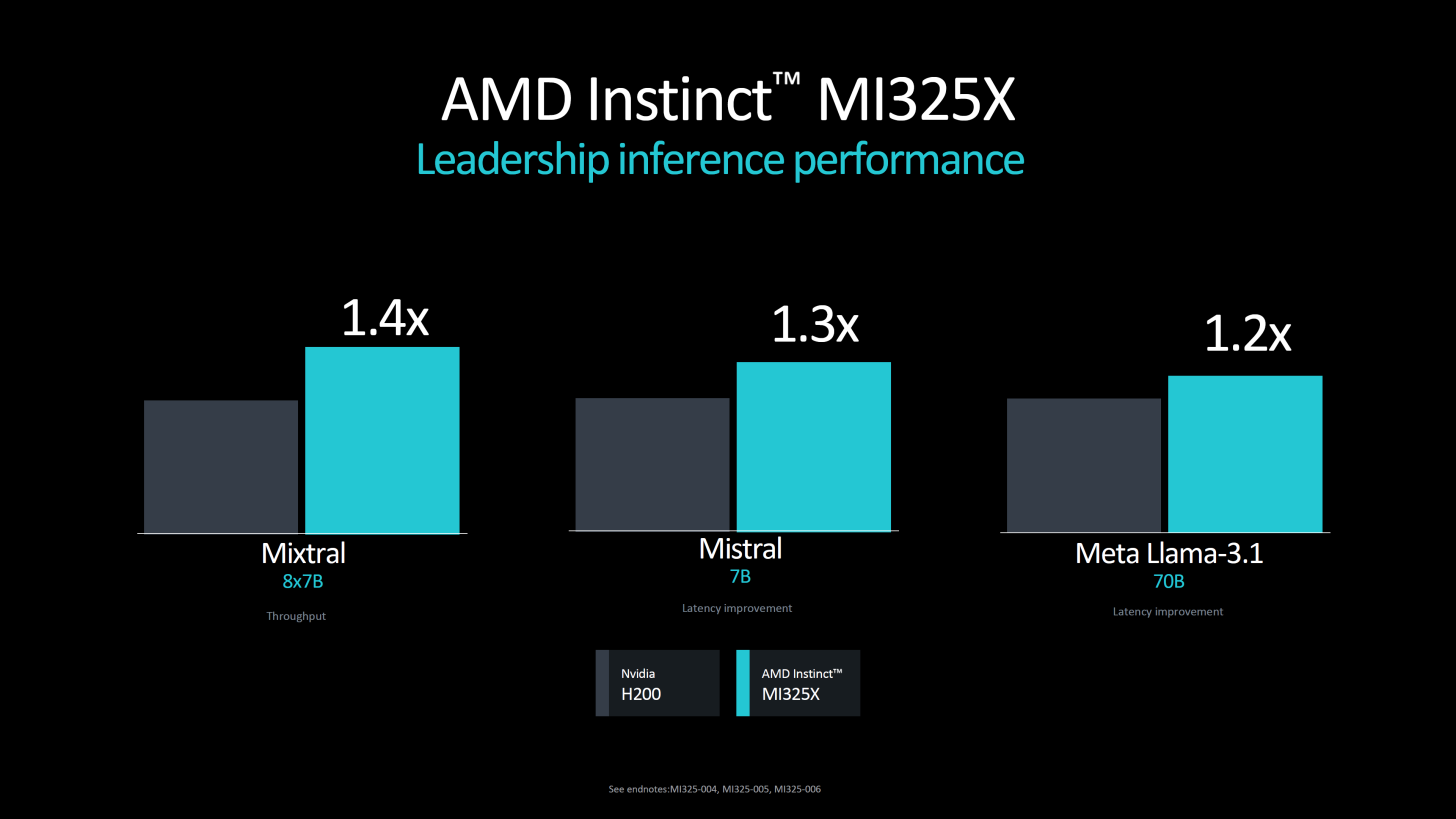 Ускорители подобного класса невозможно представить вне программной экосистемы. В настоящий момент AMD приводит данные о превосходстве MI325X над NVIDIA H200, варьирующемся в районе 20-40 % (в зависимости от нагрузки). Конечно, отчасти это заслуга памяти, но основной прирост заключается в оптимизации программной среды ROCm. По словам AMD, в задачах обучения и инференса производительность в версии 6.2 была увеличена более чем вдвое. 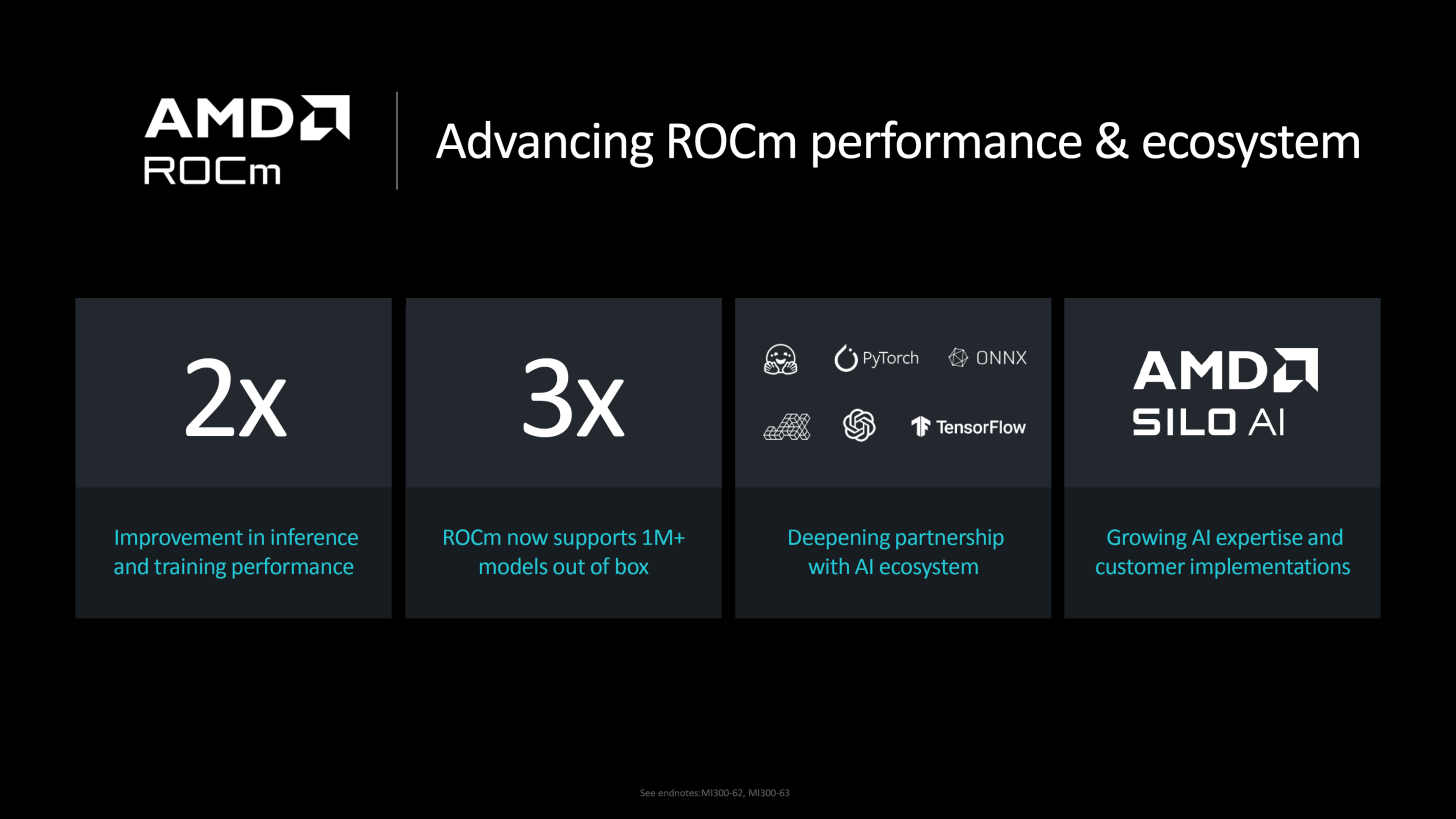 Для сравнения, в первых тестах MI300X в MLPerf Inference 4.1 отстал от NVIDIA H200 примерно на 50 %. Однако для полноты картины следует дождаться результатов тестов, проведённых сторонними источниками. Кроме того, H200 уже не самый совершенный ускоритель NVIDIA — в следующем году MI325X предстоит столкнуться с B200 на базе архитектуры Blackwell. 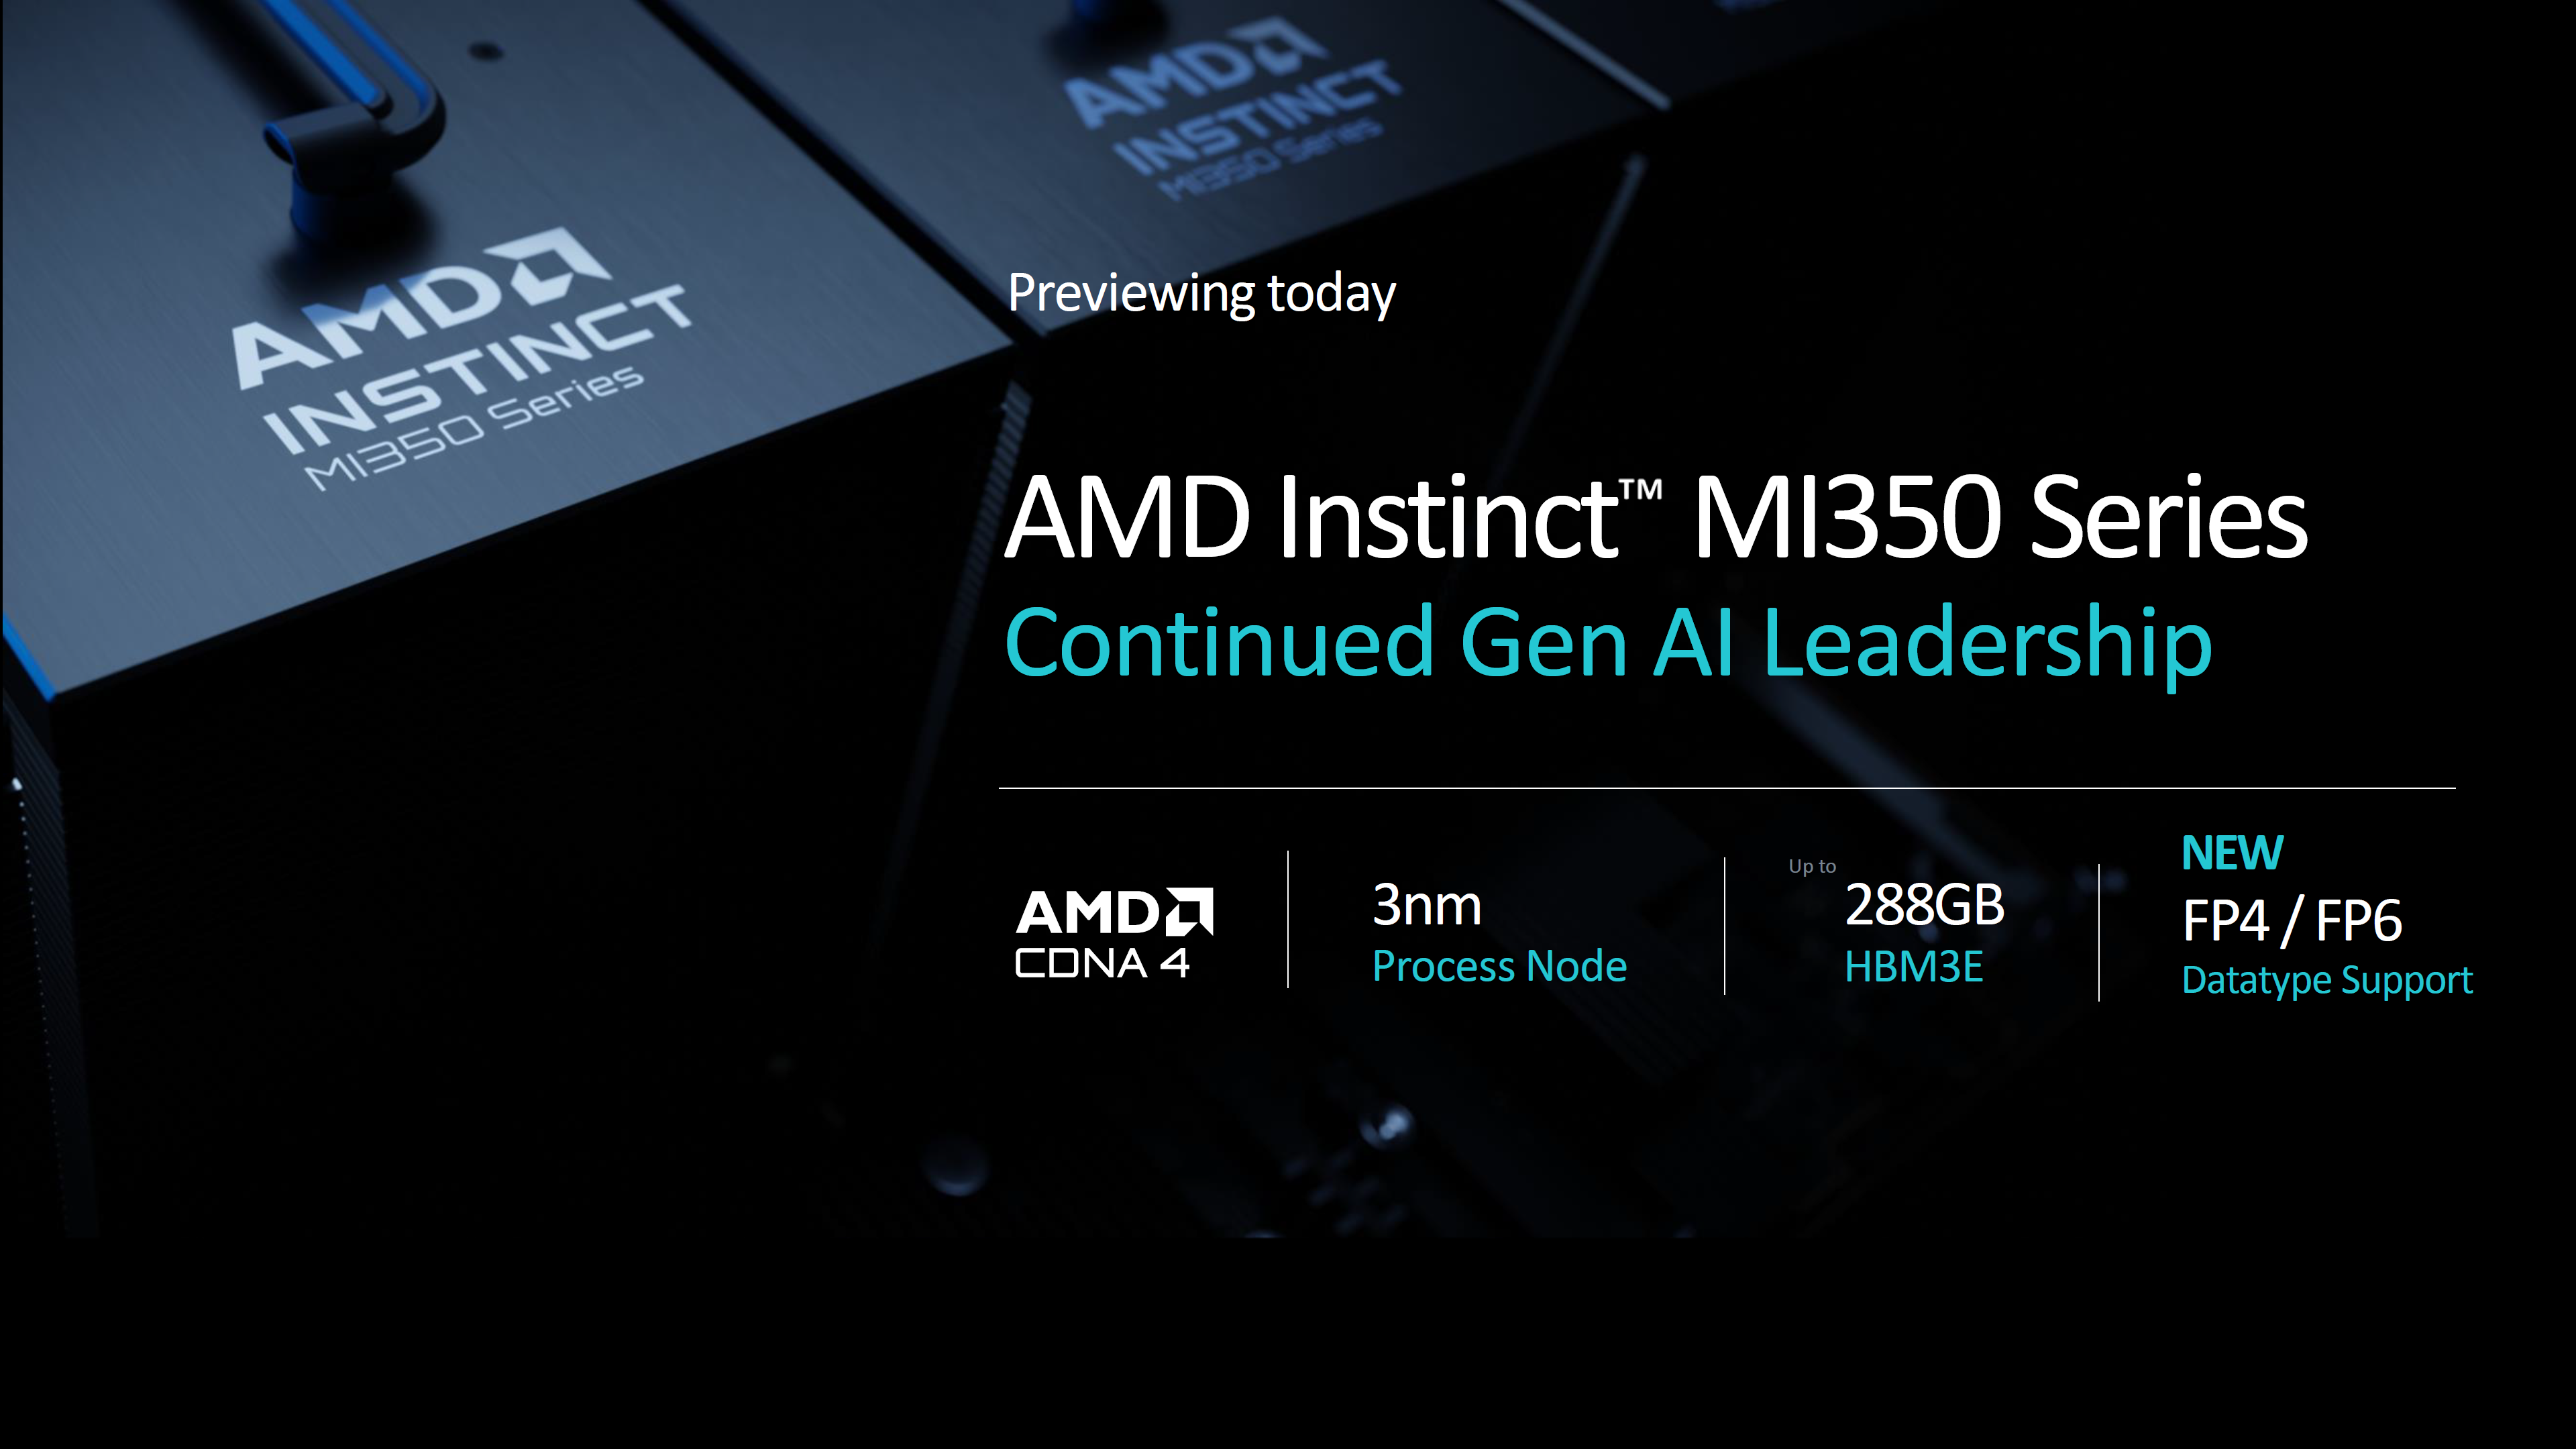 Ускорители Instinct MI325X будут доступны в I квартале 2025 года, но уже сейчас ясно, что усложнить жизнь своему главному конкуренту AMD в состоянии: так, вся обработка Llama 405B, используемой Meta✴, легла на плечи именно на MI300X. Активно используются решения AMD и в ЦОД Microsoft Azure. 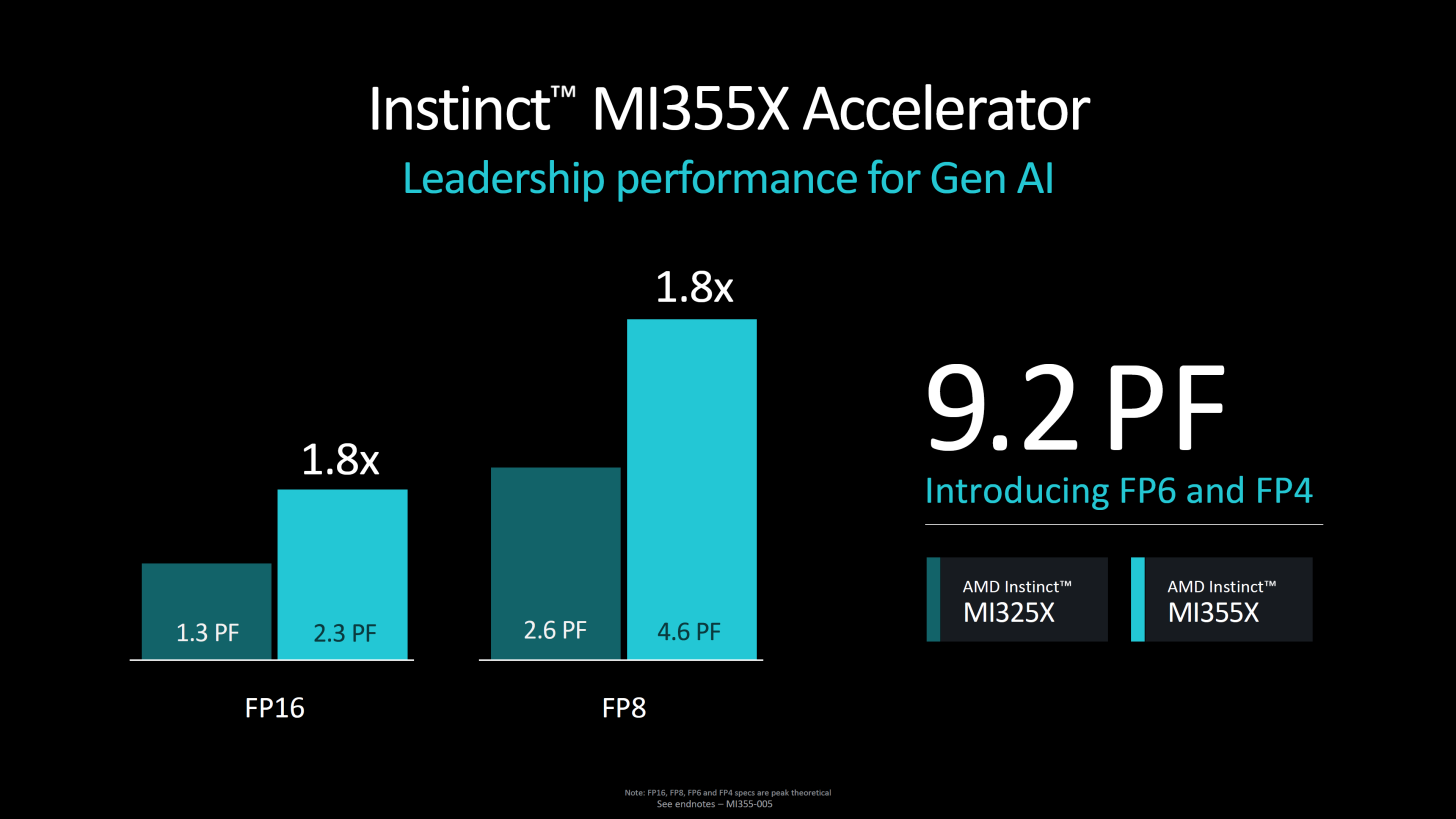 Что касается следующего поколения ускорителей AMD Instinct MI355X, то оно намечено на II половину 2025 года. Оно получит обновлённую архитектуру CDNA 4, о которой пока нет никаких сведений, кроме упоминания о поддержке режимов FP6 и FP4. Вычислительные тайлы будут переведены на 3-нм техпроцесс, а их количество, как ожидается, возрастёт с 8 до 10. Тем не менее, роста тепловыделения избежать не удастся: заявлен теплопакет до 1000 Вт. 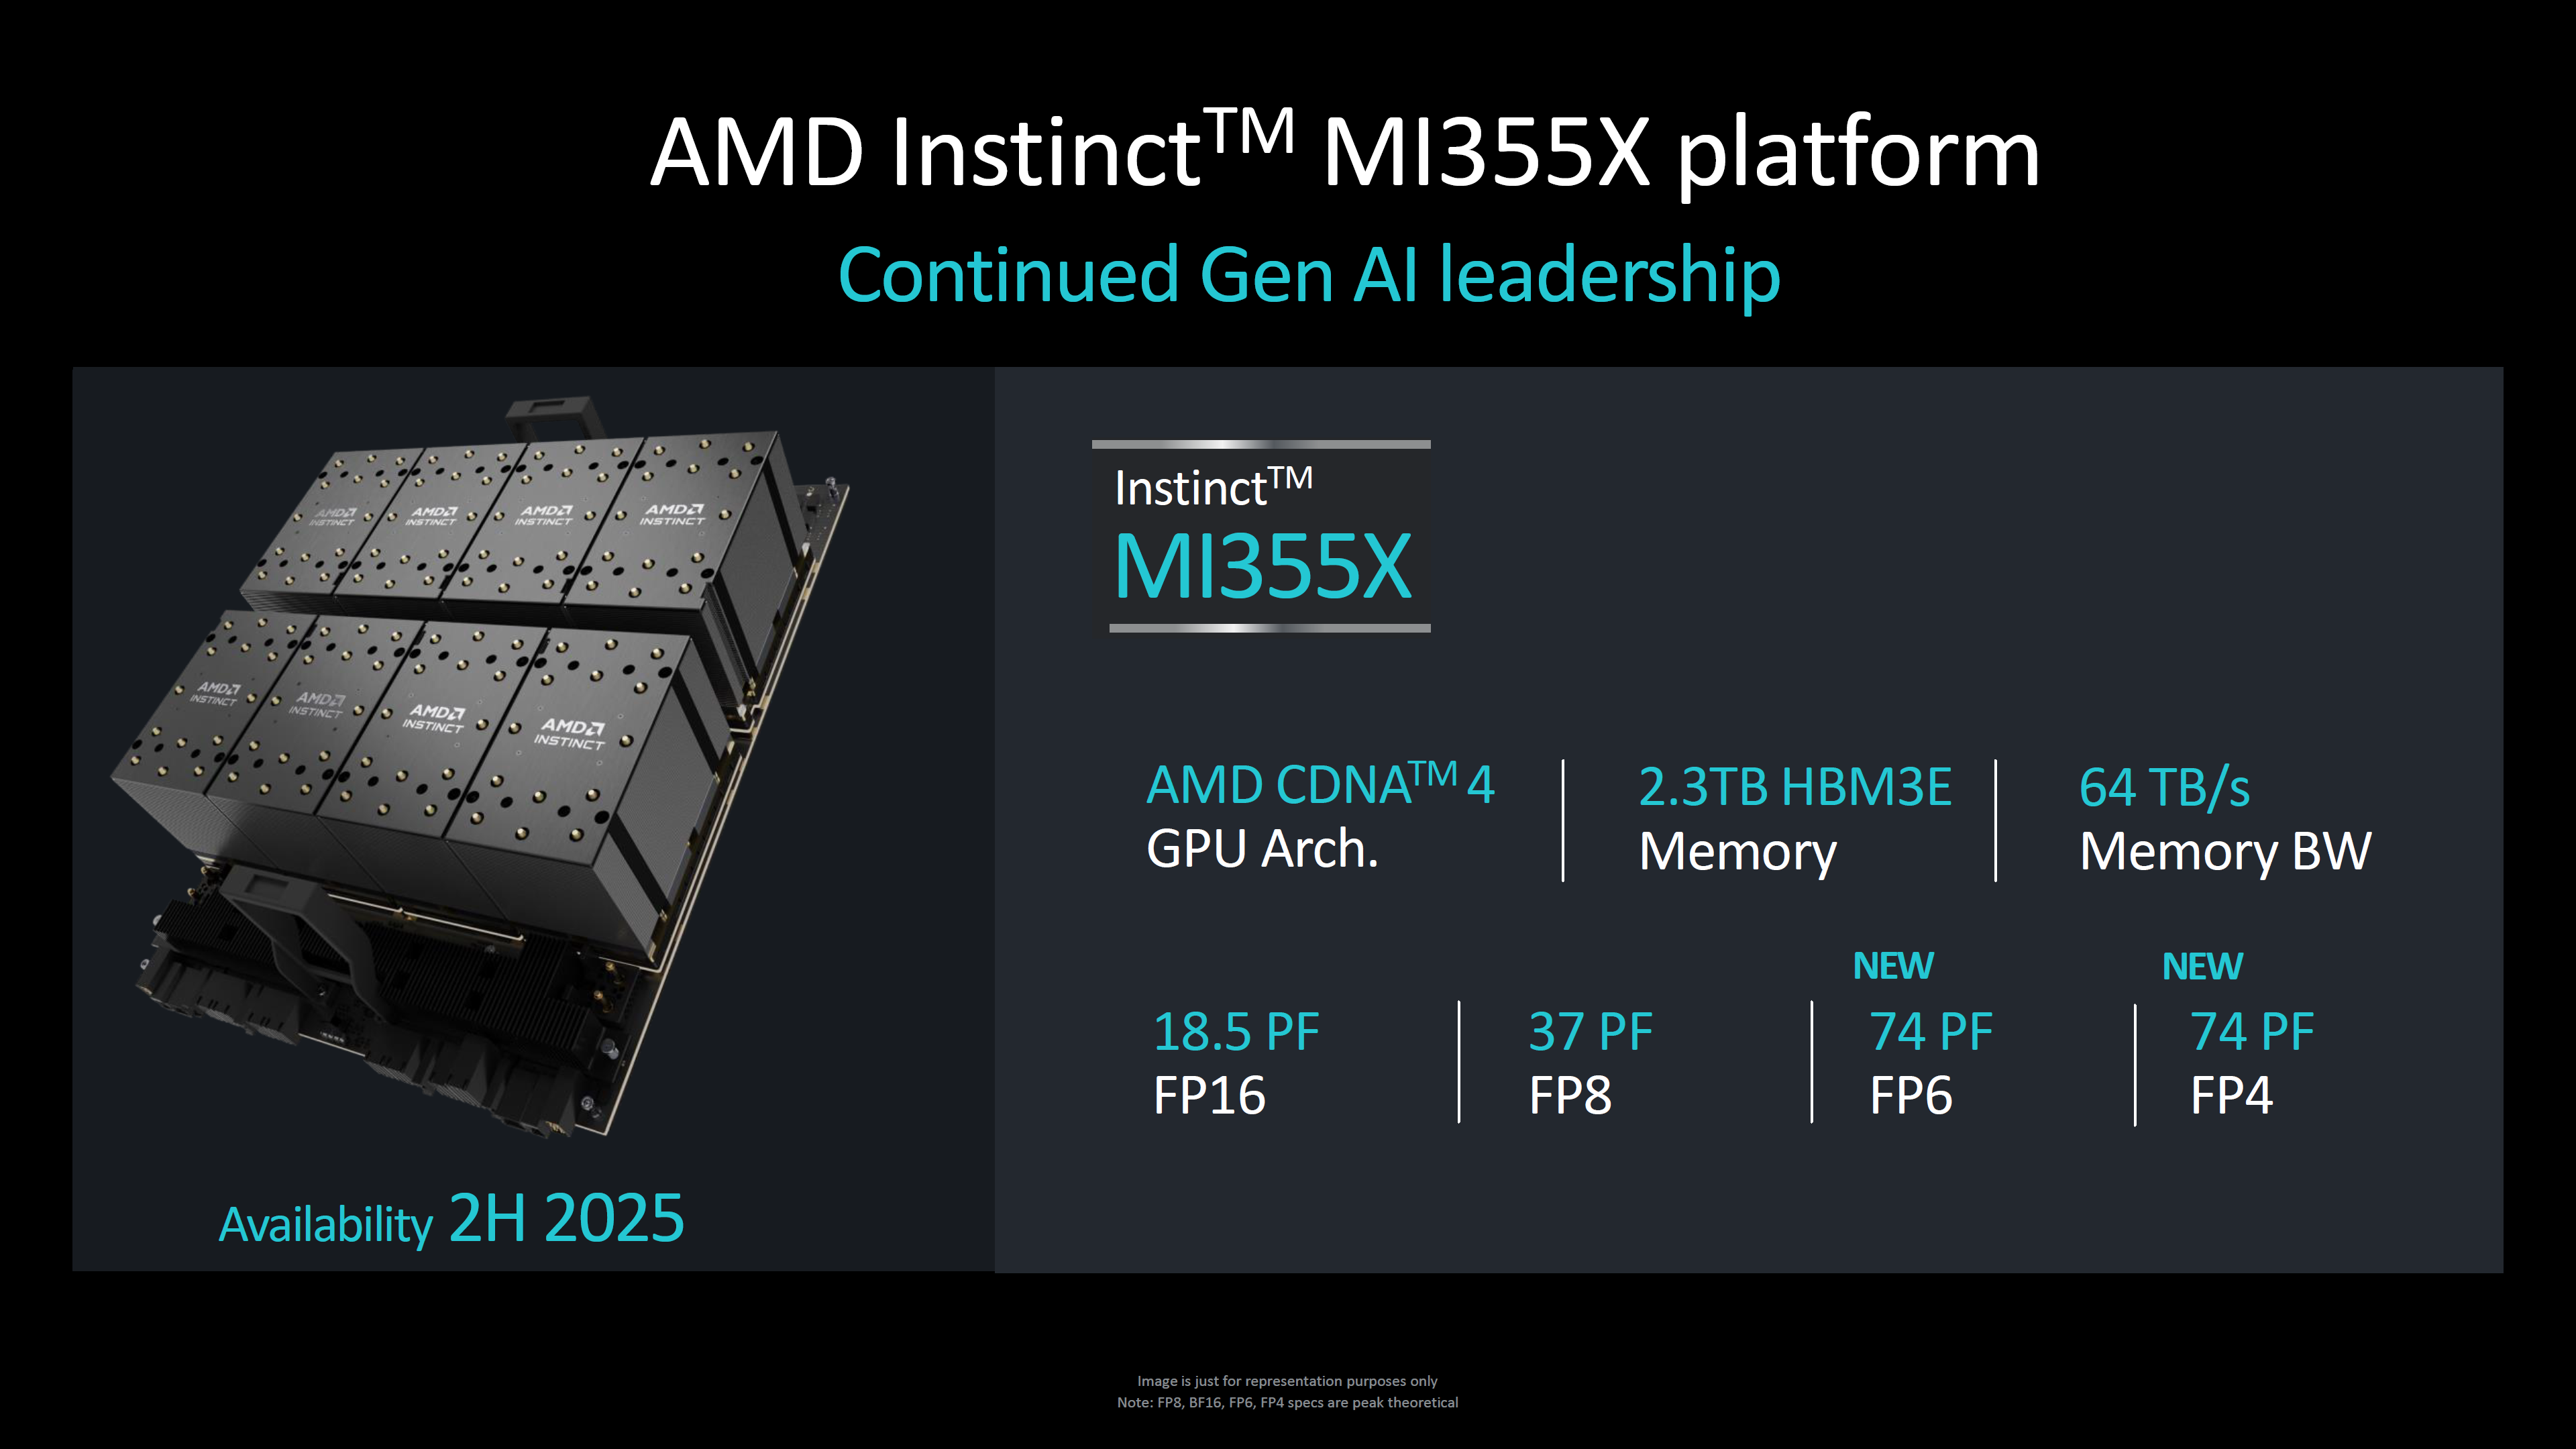 В Instinict MI355X получит дальнейшее развитие и подсистема памяти. Объём набортной HBM3e всё-таки достигнет 288 Гбайт, а пропускная способность вырастет с 6 до 8 Тбайт/с. Для связки из восьми MI355X AMD заявляет производительность в 18,5 Пфлопс в режиме FP16, что позволяет говорить о 2,31 Пфлопс для единственного ускорителя — то есть о примерно 80 % прироста в сравнении с MI325X. 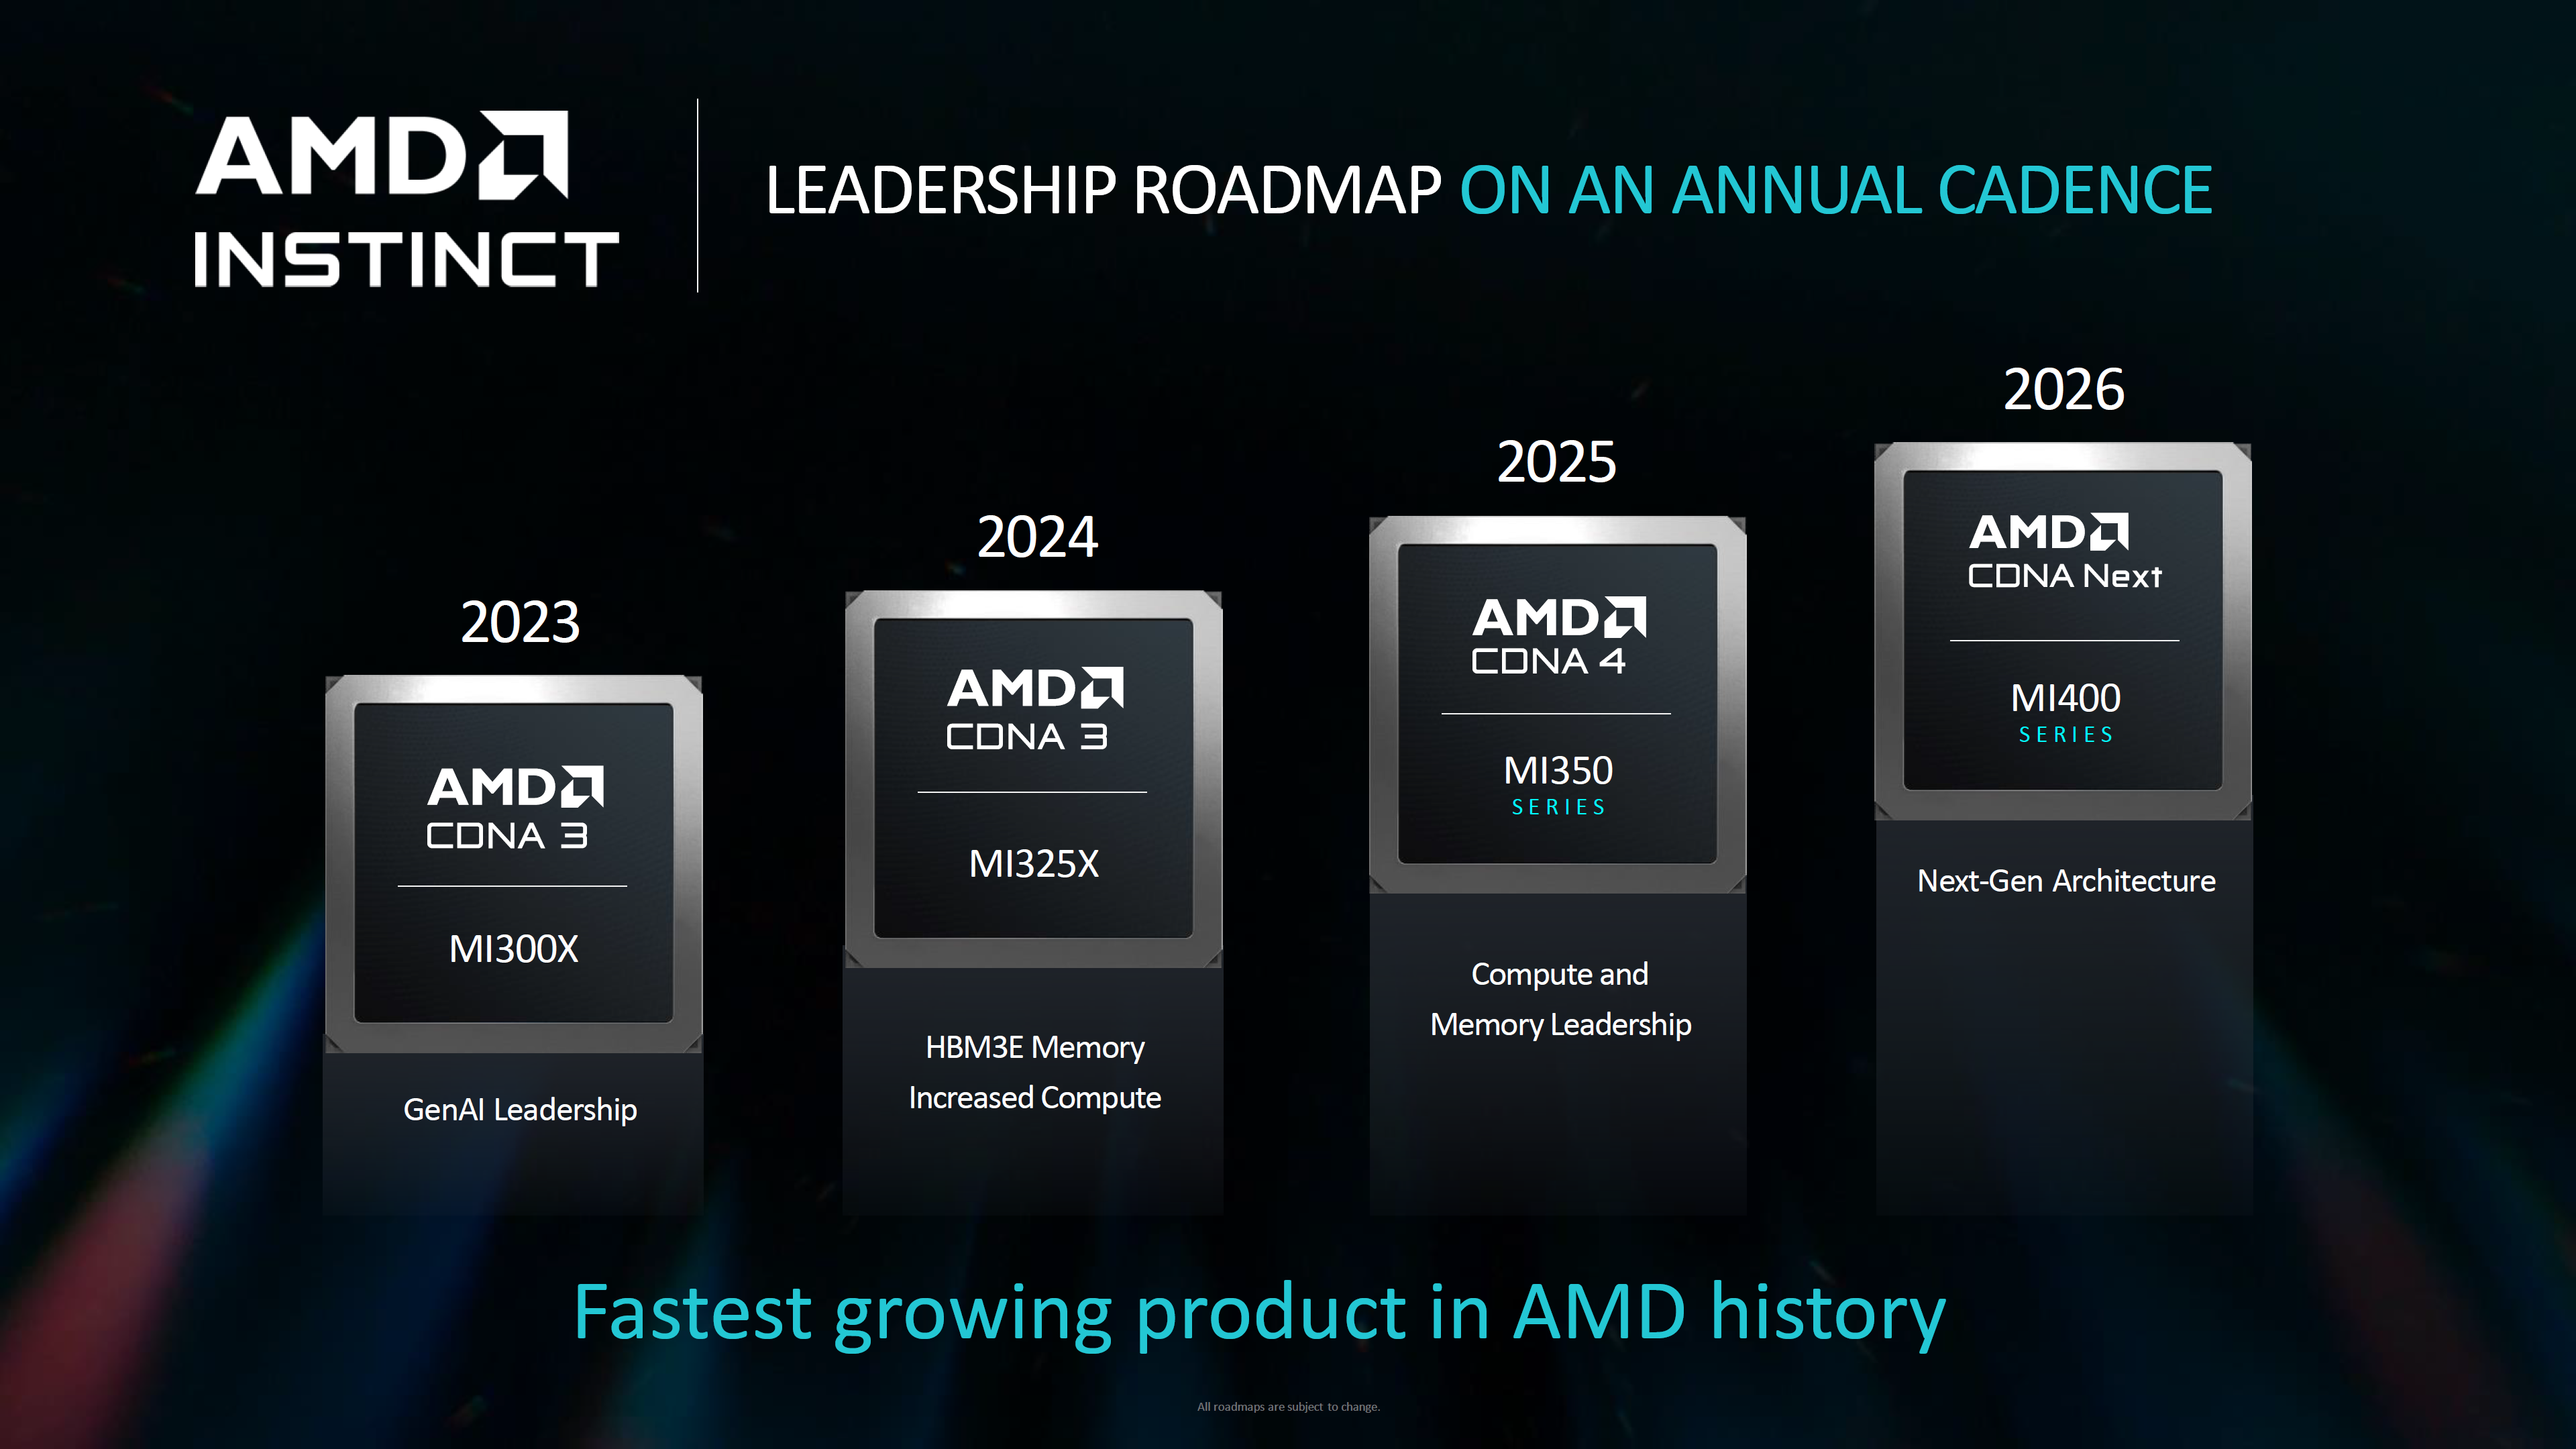 Делать какие-либо далеко идущие выводы о решениях на базе CDNA 4 рано: вероятнее всего, даже лаборатории AMD ещё не располагают финальной версией MI355X, а кроме того, как уже понятно, огромную роль играет постоянно изменяющаяся и совершенствуемая программная среда, которая ко II половине 2025 года может претерпеть существенные изменения. 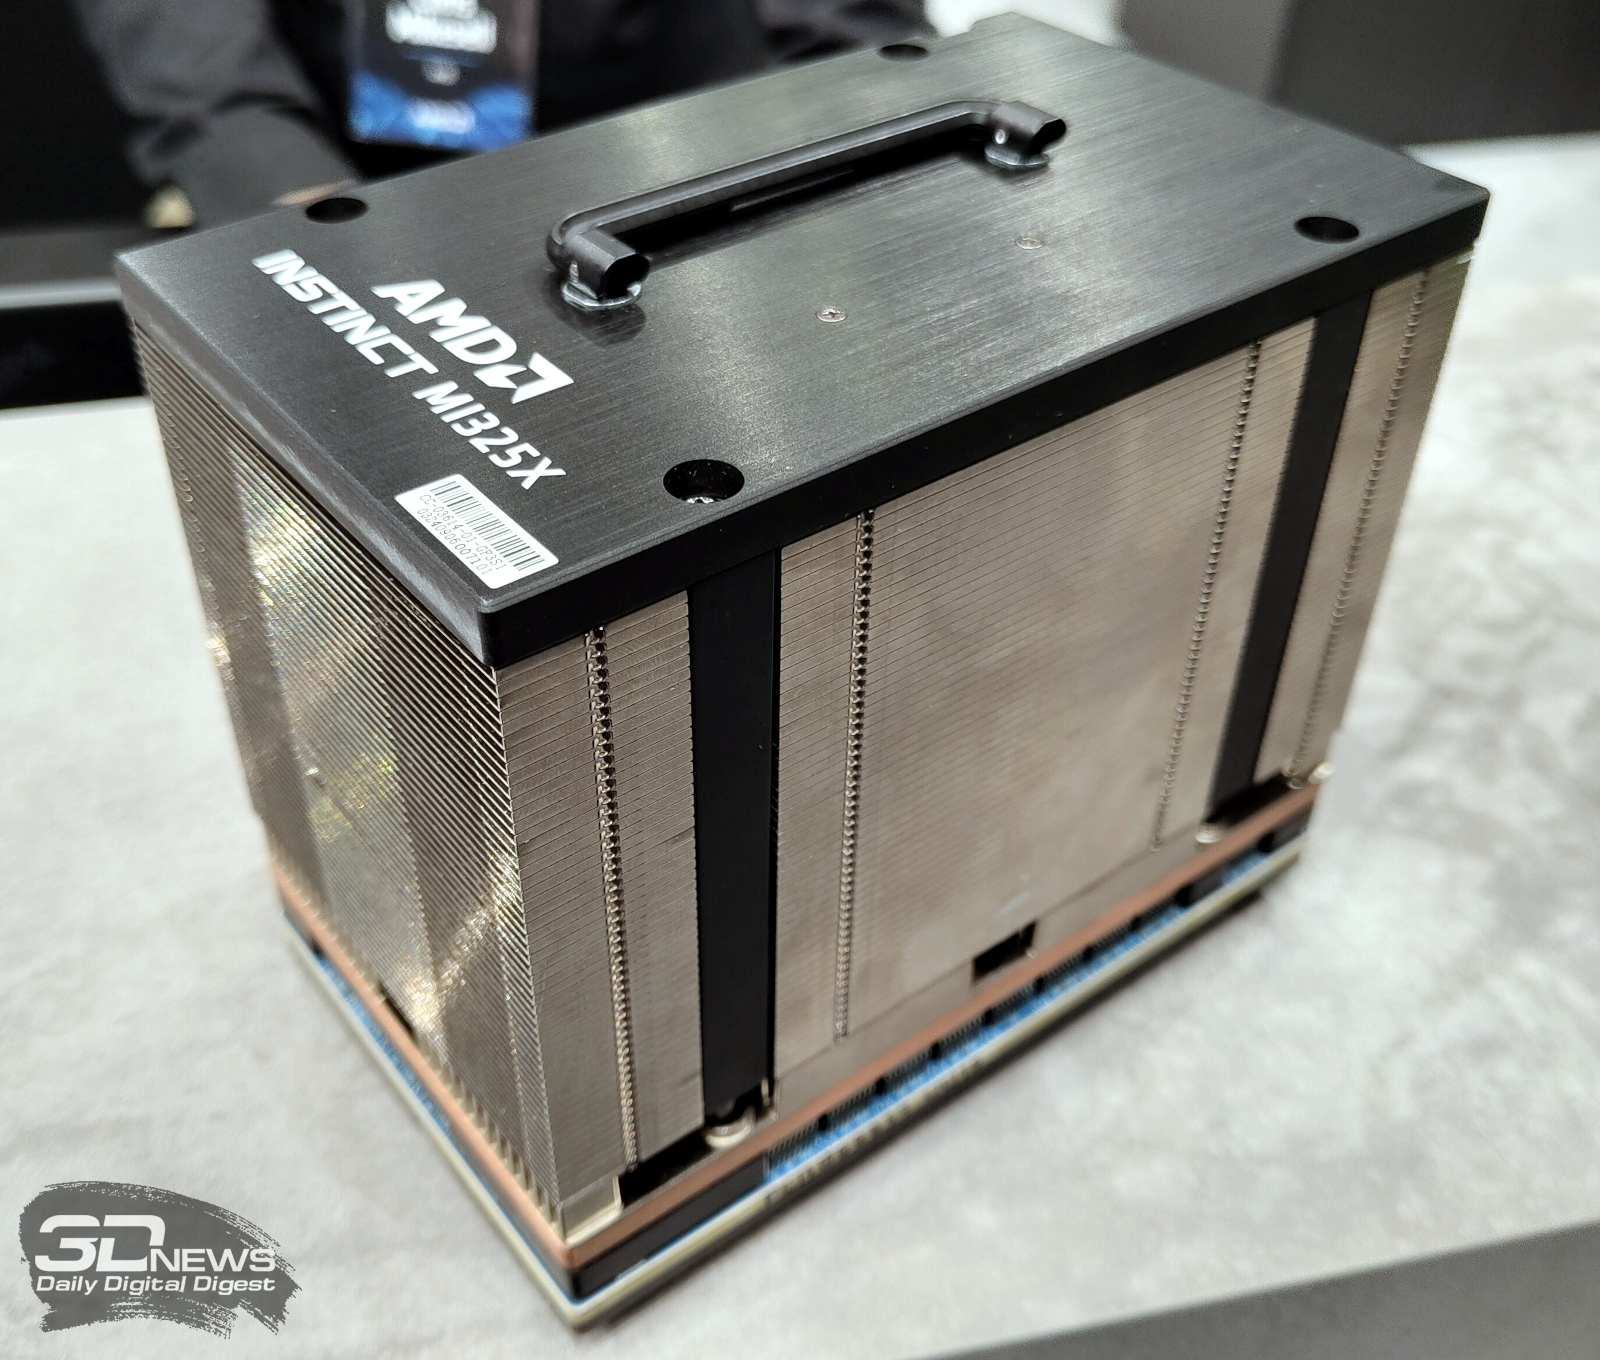 А вот гибридным решениям AMD планирует положить конец: преемника для Instinct MI300A, сочетающего в себе архитектуры CDNA 3 и Zen 4 не запланировано. Похоже, рынок для таких решений оказался слишком мал. |
|

