Лента новостей
|
07.07.2018 [13:35], Андрей Созинов
Китайский серверный процессор Hygon Dhyana построен на архитектуре AMD ZenКитайская компания Hygon начала производство x86-совместимых серверных процессоров Dhyana, построенных на микроархитектуре AMD Zen. Эти процессоры стали плодом совместной работы китайского производителя с компанией AMD, а именно лицензирования технологий последней, связанных с архитектурой x86. Компания AMD утверждает, что она не продаёт свои окончательные проекты чипов китайским партнёрам, а лишь позволяет создавать им свои собственные процессоры на основе её разработок, которые будут адаптированы именно к китайскому рынку. Но это лишь слова, и в реальности процессоры Hygon Dhyana настолько похожи на процессоры AMD EPYC, что разработчики Linux в обновление ядра для обеспечения их поддержки добавили лишь идентификаторы поставщика и номера семейств. А коды поддержки для новых китайских процессоров были полностью заимствованы у EPYC. То есть между процессорами практически нет разницы. 
Источник изображений: AMD Новые китайские серверные процессоры появились как раз во время обостряющейся торговой войны между Китаем и США, так что собственное производство процессоров является стратегически важным для КНР. Также начать производство собственных процессоров Китай подстегнуло то, что в 2015 году администрация Обамы запретила Intel продавать Поднебесной процессоры Xeon из-за того, что они помогают в развитии её ядерной программы.  То, что AMD смогла создать франшизу, которая позволяет китайским производителям процессоров создавать и продавать x86-совместимые процессоры, на этом фоне выглядит ещё более удивительно. Как это удалось американской компании? Если вкратце, то AMD создала в Китае совместное предприятие с местными частными и государственными компаниями. В итоге получилось достаточно сложная структура, но она позволяет лицензировать AMD технологии, связанные с архитектурой x86, не нарушая какие-либо законы или соглашения, с той же Intel.
29.06.2018 [13:00], Геннадий Детинич
Опубликованы финальные спецификации CCIX 1.0: разделяемый кеш и PCIe 4.0Чуть больше двух лет назад в мае 2016 года семёрка ведущих компаний компьютерного сектора объявила о создании консорциума Cache Coherent Interconnect for Accelerators (CCIX, произносится как «see six»). В число организаторов консорциума вошли AMD, ARM, Huawei, IBM, Mellanox, Qualcomm и Xilinx, хотя платформа CCIX объявлена и развивается в рамках открытых решений Open Compute Project и вход свободен для всех. В основе платформы CCIX лежит дальнейшее развитие идеи согласованных (когерентных) вычислений вне зависимости от аппаратной реализации процессоров и ускорителей, будь то архитектура x86, ARM, IBM Power или нечто уникальное. Скрестить ежа и ужа — вот едва ли не буквальный смысл CCIX. 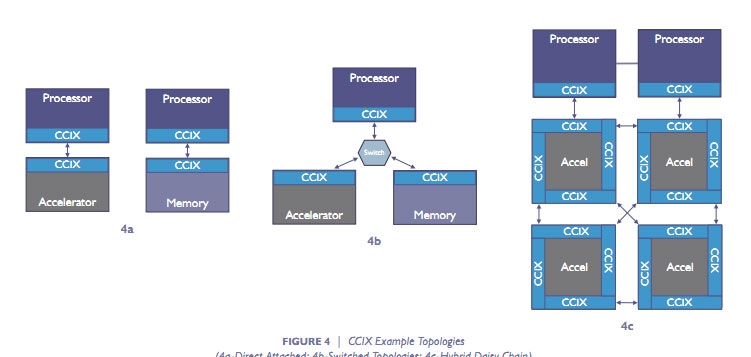
Варианты топологии CCIX На днях консорциум сообщил, что подготовлены и представлены финальные спецификации CCIX первой версии. Это означает, что вскоре с поддержкой данной платформы на рынок может выйти первая совместимая продукция. По словам разработчиков, CCIX позволит организовать новый класс подсистем обмена данными с согласованием кеша с низкими задержками для следующих поколений облачных систем, искусственного интеллекта, больших данных, баз данных и других применений в инфраструктуре ЦОД. Следующая ступенька в производительности невозможна без эффективных гетерогенных (разнородных) вычислений, которые смешают в одном котле исполнение кода общего назначения и спецкода для ускорителей на базе GPU, FPGA, «умных» сетевых карт и энергонезависимой памяти. 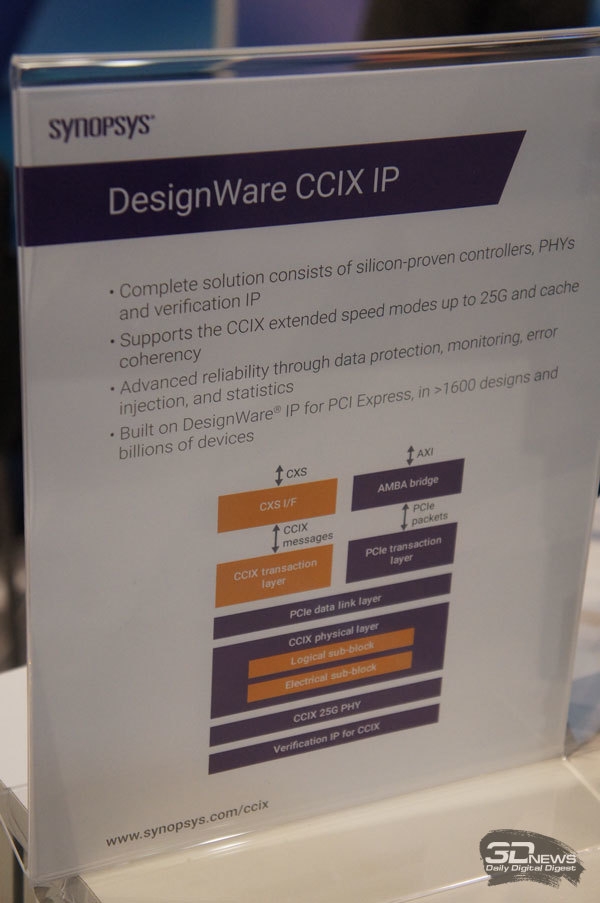
Решение CCIX IP компании Synopsys Базовые спецификации CCIX Base Specification 1.0 описывают межчиповый и «бесшовный» обмен данными между вычислительными ресурсами (процессорными ядрами), ускорителями и памятью во всём её многообразии. Все эти подсистемы объединены разделяемой виртуальной памятью с согласованием кеша. В основе спецификаций CCIX 1.0, добавим, лежит архитектура PCI Express 4.0 и собственные наработки в области быстрой коррекции ошибок, что позволит по каждой линии обмениваться данными со скоростью до 25 Гбайт/с. 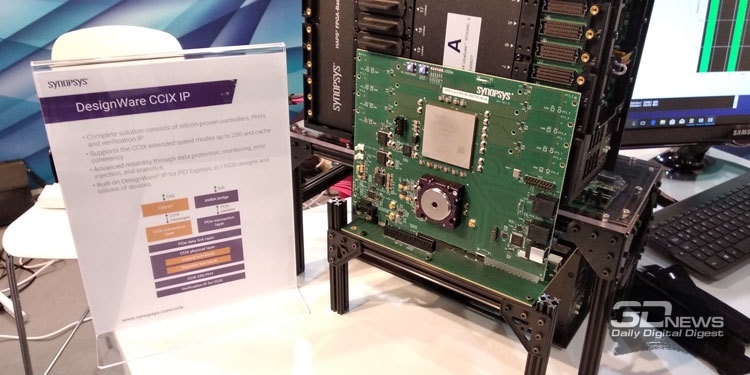
Тестовая платформа с поддержкой CCIX Synopsys на FPGA матрице Но главное, конечно, не скорость обмена, хотя это важная составляющая CCIX. Главное — в создании программируемых и полностью автономных процессов по обмену данными в кешах процессоров и ускорителей, что реализуется с помощью новой парадигмы разделяемой виртуальной памяти для когерентного кеша. Это радикально упростит создание программ для платформ CCIX и обеспечит значительный прирост в ускорении работы гетерогенных платформ. Вместо механизма прямого доступа к памяти (DMA), со всеми его тонкостями для обмена данными, на платформе CCIX достаточно будет одного указателя. Причём обмен данными в кешах будет происходить без использования драйвера на уровне базового протокола CCIX. Ждём в готовой продукции. Кто первый, AMD, ARM или IBM? 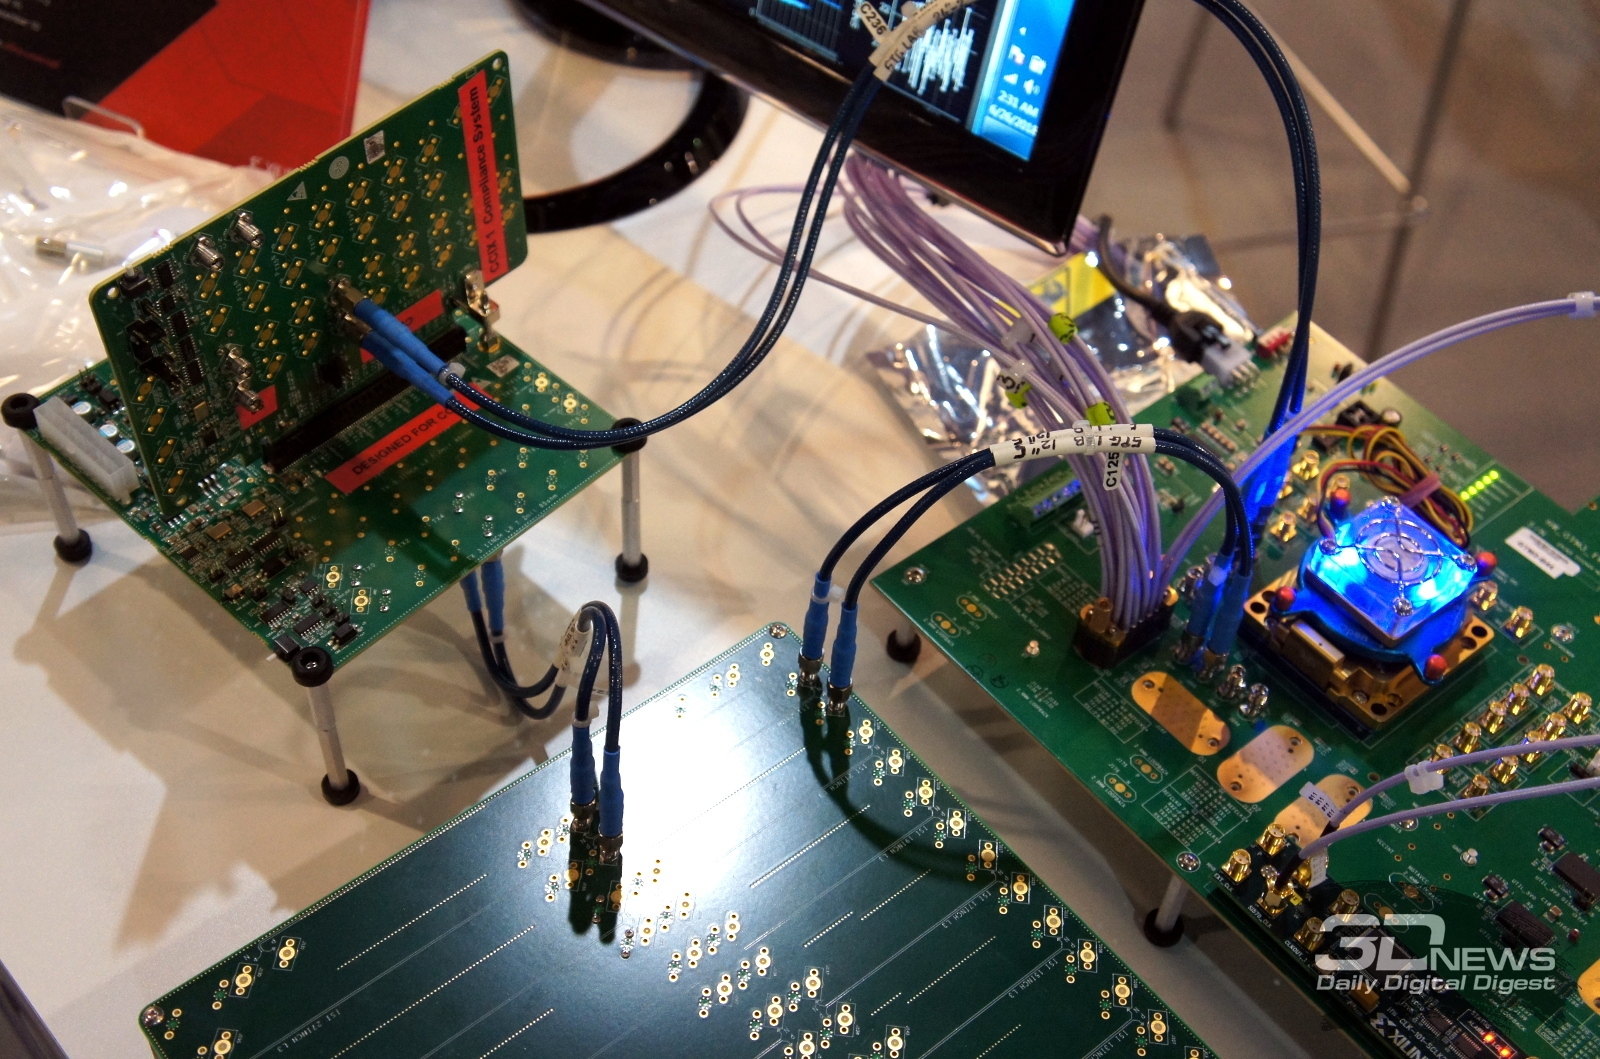
Тестовый набор CCIX 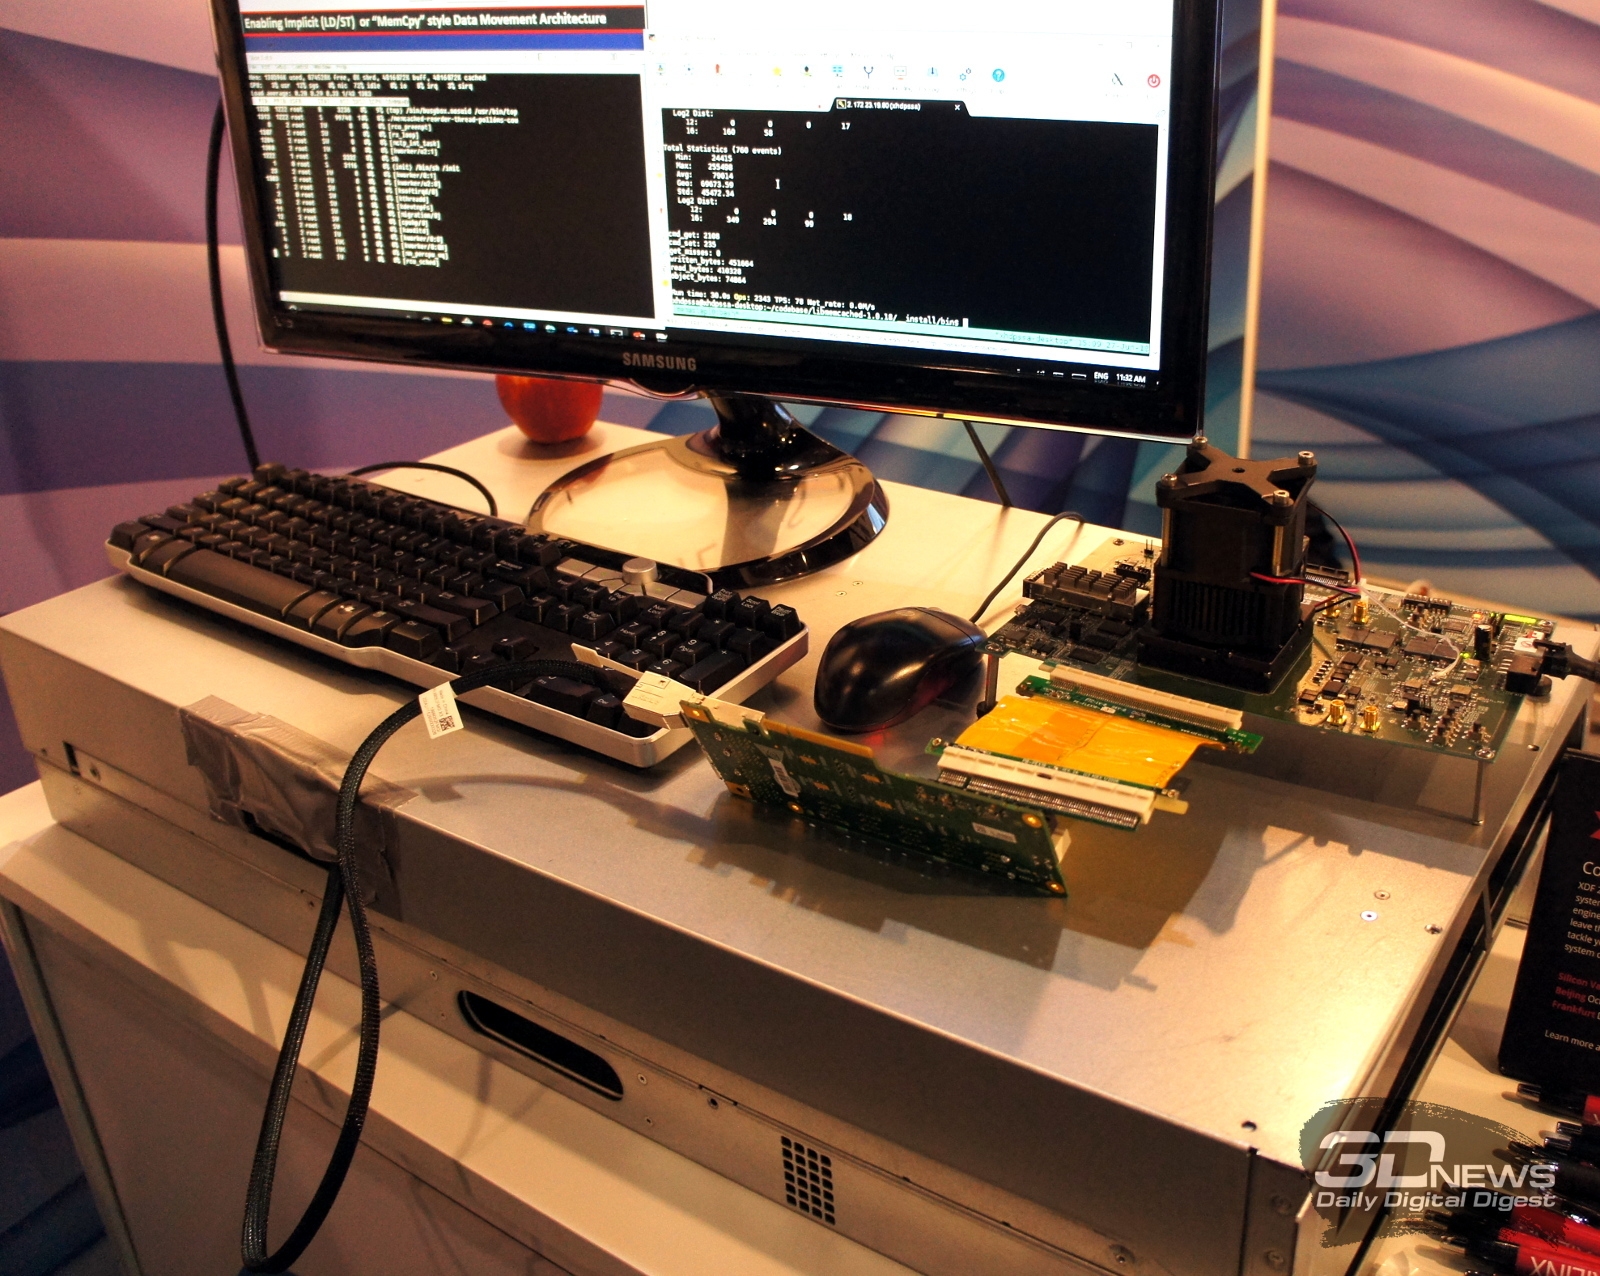
Рабочая демо-система с неназванным CPU и FPGA, соединённых шиной CCIX
11.05.2018 [12:30], Алексей Степин
Процессоры Cavium ThunderX2 стали доступны массовоМедленно, но верно процессоры с архитектурой, отличной от x86, становятся доступными всем, а не только избранным заказчикам. Так, чипы ThunderX2 разработки Cavium проделали долгий путь: ещё в прошлом году на ISC 2017 компания объявила о создании второго поколения процессоров с кодовым названием ThunderX. Эти решения должны были показать миру, что ARM не является «слабой архитектурой», пригодной лишь для мобильных применений. И действительно, в максимальной конфигурации чип ThunderX2 мог похвастаться наличием 54 ядер с частотой до 3 ГГц, поддержкой двухсокетных конфигураций и интегрированным сетевым контроллером Ethernet класса 100G. Доступные решения, однако, появились существенно позже: лишь в марте этого года компания GIGABYTE продемонстрировала рабочую станцию на базе ThunderX2. Но теперь процессоры Cavium ThunderX2 доступны официально и, что называется, «в металле», поскольку первый анонс 31 мая 2016 года всё-таки был бумажным. Не все выдерживают трудности на пути внедрения новой архитектуры. К примеру, Qualcomm, как оказалось, и вовсе планирует отказаться от выпуска серверных процессоров, а ведь её 48-ядерные чипы Centriq 2400 были основным соперником семейства ThunderX2.  Любопытно, что архитектурно ThunderX2 не является прямым наследником ThunderX, а продолжает собой разработку Broadcom под названием Vulcan. На текущий момент компании удалось заручиться партнёрством у таких известных производителей, как Cray, HPE, Atos и Penguin Computing. Модельный ряд выглядит вполне «взросло» и включает в себя 40 различных версий ThunderX2. Самый мощный вариант с 54 ядрами пока не выпущен, но доступны версии с количеством ядер от 16 до 32 и частотой до 2,5 ГГц (3,0 ГГц в турборежиме). Имеется развитая поддержка многопоточности, причём, разная для разных моделей процессора — количество потоков на ядро может варьироваться от 1 до 4, что ставит ThunderX2 в один ряд с такими чипами, как POWER9, которые также поддерживают SMT4. Компания-разработчик позиционирует свои решения в качестве соперников новейшим Intel Xeon и всерьёз намерена конкурировать с Intel во всех отраслях, от HPC и суперкомпьютеров до облачных решений. 
Рабочая станция на базе Cavium ThunderX2 О производительности Cavium ThunderX2 известно мало; производитель пока не разглашает соответствующих данных, ограничиваясь довольно туманными заявлениями о «сопоставимости с наиболее мощными моделями Xeon». В теории это далеко не так, поскольку самый быстрый Xeon с архитектурой Skylake развивает в пике до 2000 гигафлопс, а ThunderX2 — лишь 560 гигафлопс, но теория в мире HPC, как мы уже знаем, довольно часто расходится с практикой. Цифра 560 Гфлопс взята не с потолка, она выведена из характеристик 64-узлового кластера Apollo 70 мощностью 72 Тфлопс. Три таких кластера будут установлены в различных университетах Великобритании, все они будут использовать старшую на данный момент 32-ядерную версию ThunderX2. Компания Cray мыслит более широкими масштабами и в её планах значится создание системы Isambard (Cray XC50) c более чем 10 тысячами процессоров ThunderX2 на борту. От этого монстра ожидаются показатели пиковой производительности в районе 175 Тфлопс. 
Процессоры ThunderX2 используют свой разъём и имеют 8 каналов DDR4 Надо отметить, что Cavium хорошо понимает современные проблемы HPC, и при создании ThunderX2 усилия были сосредоточены не на достижении «чистой» вычислительной мощности, а на обеспечении высокой пропускной способности подсистемы памяти. Восьмиканальный контроллер DDR4 в Cavium X2 поддерживает до 16 модулей на разъём с максимальным объёмом памяти для системы 2S, составляющим 4 Тбайт. Это даёт Cavium право заявлять о 33 % превосходстве над Intel, ведь Xeon Scalable могут похвастаться лишь шестиканальным контроллером памяти. Цены на новые процессоры установлены более чем конкурентоспособные: при массовых заказах чипы ThunderX2 в зависимости от версии стоят от $800 до $1795 — существенно дешевле, нежели Xeon Scalable. В пересчёте на доллар это даёт вдвое более высокие показатели, нежели у Intel, но, опять-таки, это утверждение Cavium подлежит проверке практикой. Долго ждать её не придётся: помимо упомянутых систем, серверы на базе ThuhderX2 также будут установлены в одной из Сандийских национальных лабораторий, задействованы в проекте Mont-Blanc и даже в облачной платформе Microsoft Azure.
06.12.2017 [23:45], Сергей Юртайкин
IBM представила первый сервер на процессоре POWER9IBM представила свой первый собственный сервер на процессоре POWER9. Особенность решения под названием IBM Power Systems AC922 заключается в том, что новая аппаратная платформа разработана специально для работы с интенсивными вычислительными нагрузками технологий искусственного интеллекта (ИИ). 
CPU IBM POWER9 В IBM отмечают, что Power 9 позволяет ускорить тренировки фреймворков глубинного обучения обучения почти в четыре раза, благодаря чему клиенты смогут быстрее создавать более точные ИИ-приложения. Утверждается, что новый сервер разработан для получения значительных улучшений производительности всех популярных фреймворков ИИ, таких как Chainer, TensorFlow и Caffe, а также современных баз данных, использующих ускорители, например, Kinetica. 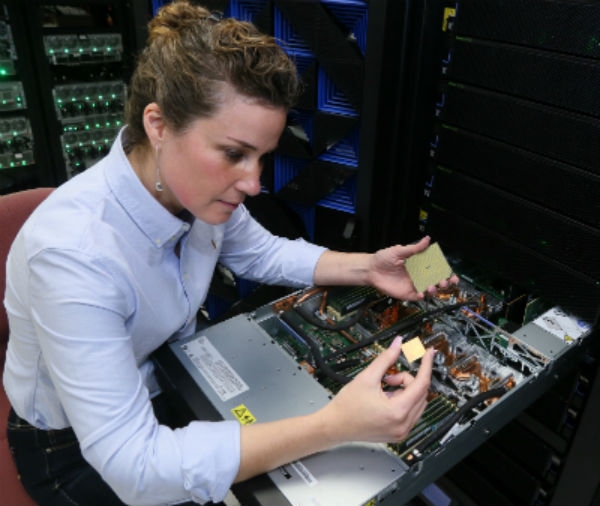
Сервер IBM Power System AC922 Сервер IBM Power Systems AC922 использует шину PCI-Express 4.0 и технологии NVIDIA NVLink 2.0 и CAPI 2.0/OpenCAPI, способные ускорить пропускную способность в 9,5 раза по сравнению с системами x86 на базе PCI-E 3.0. Это, в частности, позволяет задействовать ускорителям (GPU или FPGA) системную ОЗУ без значительных, по сравнению с прошлыми решениями, потерь производительности, что важно для обработки больших массивов данных. Кроме того, новые поколения карт расширения и ускорителей уже поддерживают эту шину. 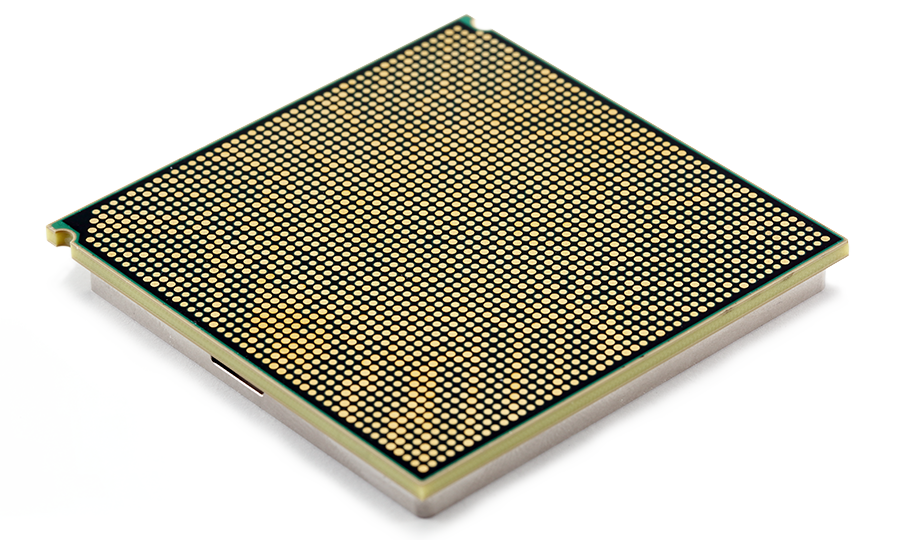 IBM Power Systems AC922 создан в нескольких конфигурациях, оснащаемых двумя процессорами POWER9. Стандартные версии включают CPU c 16 (2,6 ГГц, турбо 3,09 ГГц) и 20 (2,0/2,87 ГГц) ядрами (4 потока на ядро), а позже появятся версии с 18- и 22 -ядерными процессорами. Всего в сервере есть 16 слотов для модулей ECC DDR4-памяти, что на текущий момент позволяет оснастить его 1 Тбайт RAM. Для хранения данных предусмотрено два слота для 2,5" SSD/HDD (RAID-контроллера нет). 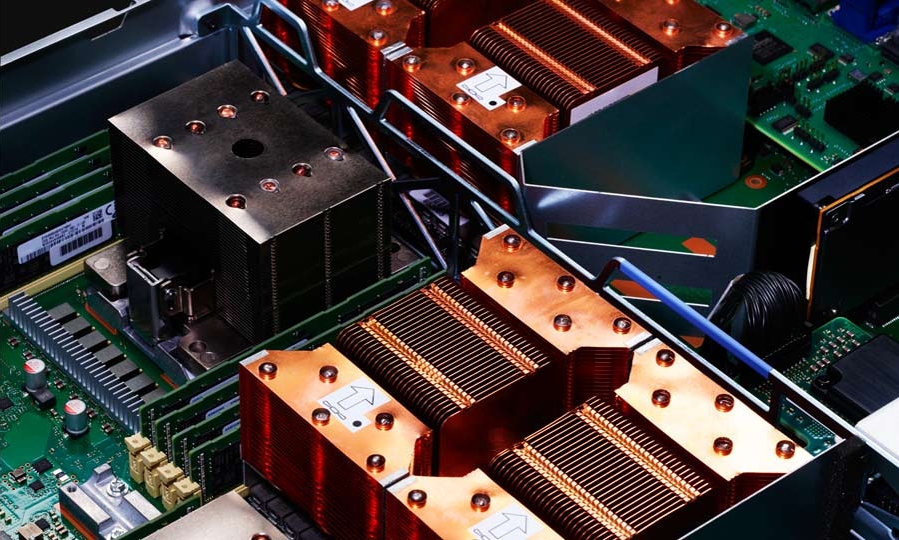 AC922 может иметь на борту от двух до четырёх ускорителей NVIDIA Tesla V100 форм-фактора SXM2 с памятью 16 Гбайт и шиной NVLink 2.0. В сумме они дают до 500 Тфлопс на расчётах половинной точности. Дополнительные ускорители можно подключить к слотам PCI-E 4.0.  Сервер рассчитан на установку четырёх дополнительных низкопрофильных карт расширения: два слота PCI-E 4.0 x16, один PCI-E 4.0 x8 и один PCI-E 4.0 x4. Все слоты, кроме последнего, также умеют работать с CAPI. Также есть два порта USB 3.0. Поддерживается ОС Red Hat Enterprise Linux 7.4 for Power LE. 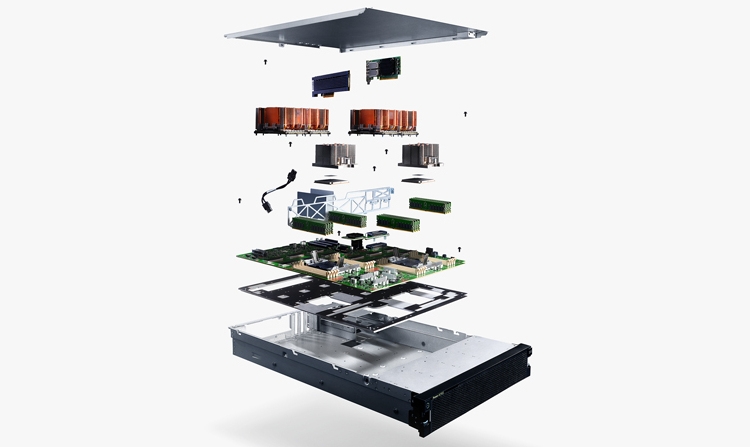 Процессоры IBM Power 9, которые нашли применение в IBM Power Systems AC922, легли в основу суперкомпьютеров Summit и Sierra Министерства энергетики США, а также используются компанией Google. Чипы и использующие их системы стали частью совместной работы участников организации OpenPower Foundation, в которую входят IBM, Google, Mellanox, NVIDIA и др. 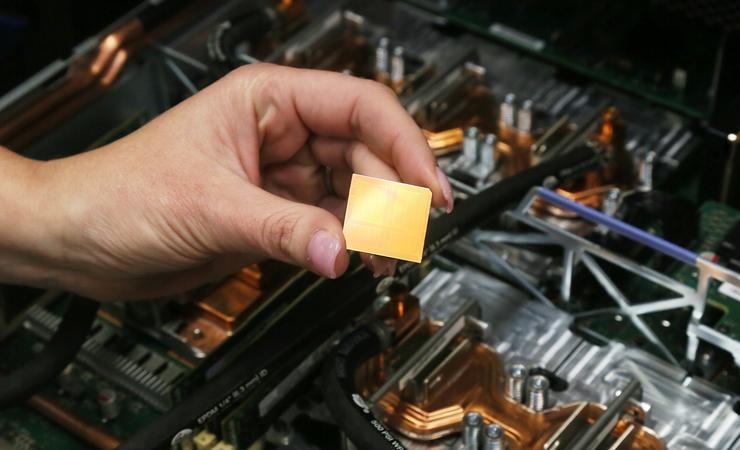
Процессор IBM Power 9 «Мы создали уникальную в своём роде систему для работы с технологиями ИИ и когнитивными вычислениями, — говорит старший вице-президент подразделения IBM Cognitive Systems Боб Пиччиано (Bob Picciano). — Серверы на Power 9 являются не только основой самых высокопроизводительных компьютеров, они позволят заказчикам масштабировать невиданные ранее инсайты, что будет способствовать научным прорывам и революционным улучшениям бизнес-показателей». 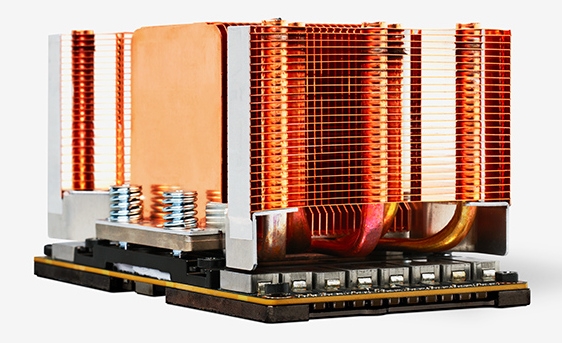 Сервер имеет стандартное 2U-шасси и оснащается двумя (1+1) блоками питания мощностью 2,2 кВт каждый. Система охлаждения может быть гибридной. Начало продаж IBM Power Systems AC922 намечено на 22 декабря 2017 года. В 2018 году будут доступны конфигурации с шестью ускорителями Tesla и СЖО. 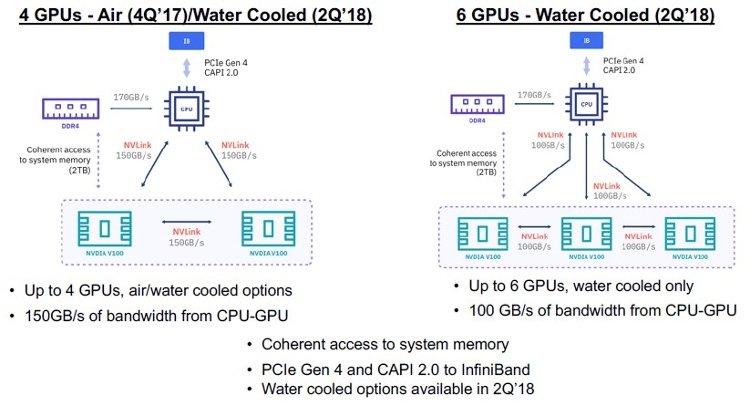
09.11.2017 [13:07], Сергей Карасёв
Начались коммерческие поставки 10-нм серверных чипов Qualcomm Centriq 2400Компания Qualcomm Datacenter Technologies, подразделение Qualcomm Incorporated, объявила о старте коммерческих поставок первых в мире 10-нанометровых серверных процессоров — решений семейства Centriq 2400. О разработке чипов Centriq 2400 стало известно ещё в декабре прошлого года. Позднее Qualcomm раскрыла детали об этих изделиях. И вот теперь настало время массовых поставок процессоров. 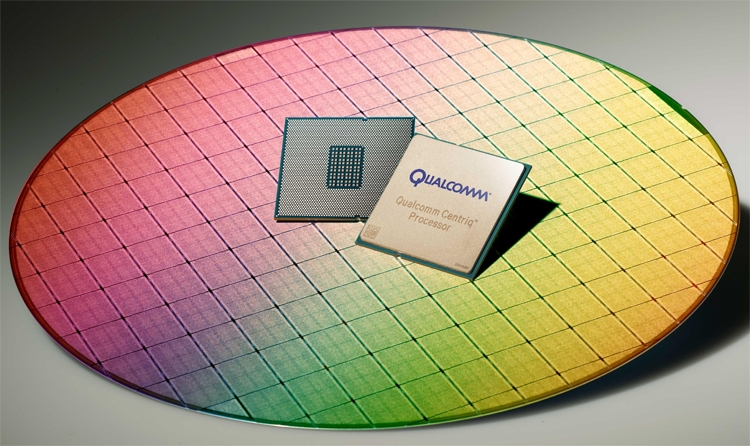
Источник изображений: Qualcomm В основу Centriq 2400 положены 64-битные вычислительные ядра с кодовым именем Falkor, обладающие поддержкой команд ARMv8. Количество таких ядер в составе чипов может достигать 48. Максимальная тактовая частота — 2,6 ГГц. 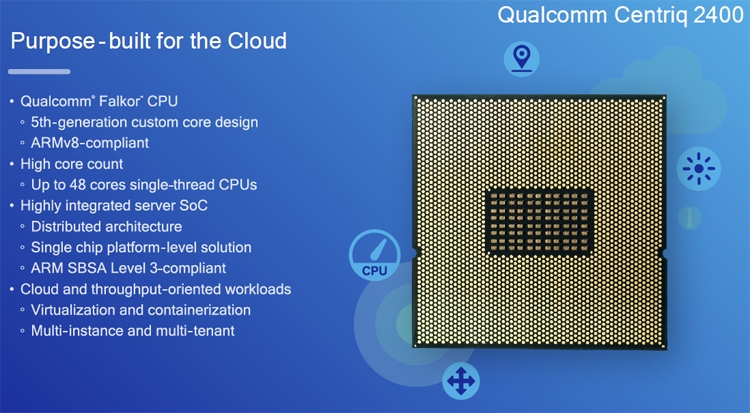 При изготовлении изделий применяется 10-нанометровая технология Samsung FinFET. Процессоры насчитывают до 18 млрд транзисторов. Каждая пара ядер снабжена 512 Кбайт общей кеш-памяти L2, а объём кеша L3 у чипов достигает 60 Мбайт. 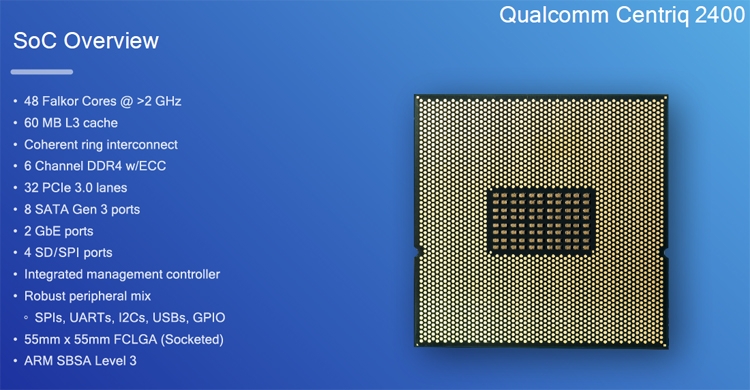 В состав Centriq 2400 вошли 6-канальный контроллер памяти с поддержкой DDR4-2667 МГц ECC (до двух модулей на канал), 32 линии PCI Express 3.0, интерфейсы SATA, USB и пр. 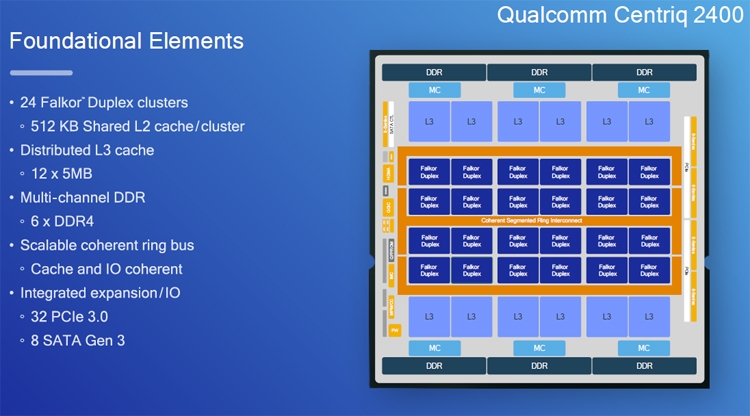 Процессоры ориентированы на современные облачные платформы и центры обработки данных. Более подробную информацию о технических характеристиках можно найти здесь. Что касается стоимости, то изделие Qualcomm Centriq 2460, насчитывающее 48 вычислительных ядер, обойдётся заказчикам в 1995 долларов США.
02.11.2017 [12:12], Алексей Степин
Qualcomm готовит почву для серверного процессора CentriqКомпанию Qualcomm представлять не надо — множество смартфонов оснащены именно процессорами этого разработчика, и многие пользователи не без оснований считают их лучшими, ставя данную серию выше моделей Samsung Exynos или MediaTek. С другой стороны, архитектура ARM пусть и очень медленно, но всё же проникает на корпоративный рынок, а именно — в сектор серверных решений. Известны проекты таких компаний, как Cavium, Applied Micro и даже AMD. Не стоит удивляться тому, что Qualcomm, имея огромный опыт в разработке процессоров с архитектурой ARM, тоже решила откусить кусочек от готовящегося пирога. Уже в течение двух лет существуют слухи о серверном процессоре Qualcomm, но теперь эти слухи переходят в разряд фактов. Последние несколько месяцев представители компании довольно охотно рассказывали о новом процессоре класса SoC под названием Centriq 2400. 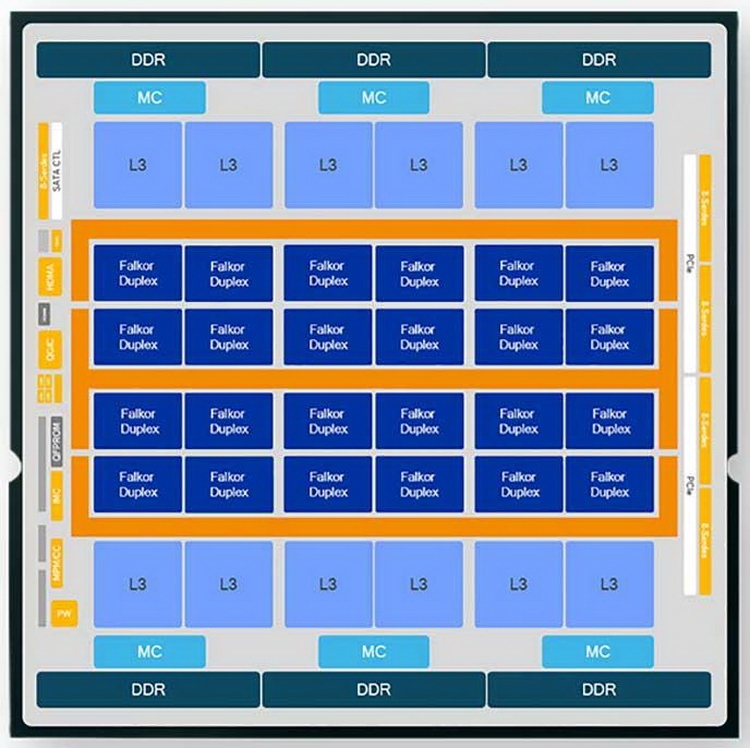
Шестиканальный контроллер памяти обещает отсутствие нехватки ПСП Так, теперь известно, что этот чип будет производиться с использованием 10-нанометрового техпроцесса, и главной целевой аудиторией этого продукта станут поставщики облачных услуг и владельцы крупных ЦОД, для которых очень важную роль играют такие параметры, как энергопотребление и энергоэффективность процессоров. Замах Qualcomm взяла серьезный: если верить заявлениям, система на базе одного процессора Centriq сможет предложить уровень производительности, эквивалентный решениям на базе пары процессоров Xeon с архитектурой Skylake. В отличие от Intel, Qualcomm не обязана тянуть за собой тяжкое наследие совместимости с процессорами настольного класса и использует в своей разработке всё лучшее, что было воплощено в чипах для смартфонов и планшетов. Centriq 2400 должен получить 24 процессорных ядра с кодовым названием Falkor. Это архитектура собственной разработки Qualcomm, но отвечающая всем требованиям стандарта ARMv8. 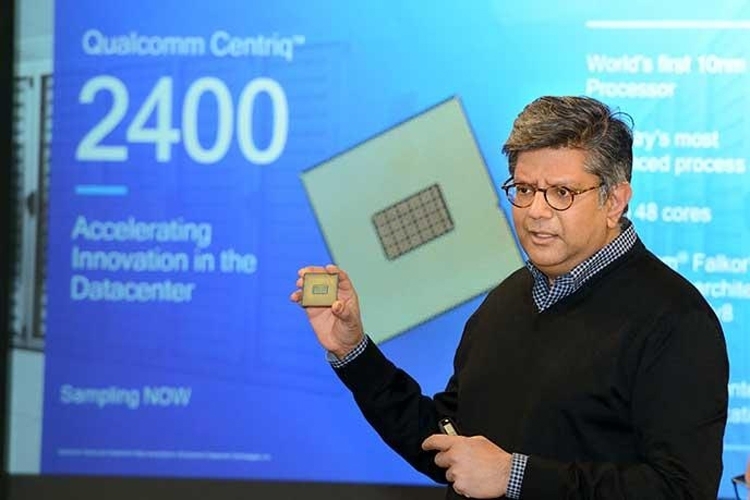
Выглядит Cenriq практически так же, как и обычные Xeon, Opteron или EPYC На диаграмме слово Duplex присутствует не зря, поскольку в целом можно говорить о 48 однопоточных ядрах, но в будущем компания планирует наращивать и количество ядер, и количество потоков на ядро. Интересен также тот факт, что Intel отказалась от кольцевой внутренней шины в новых Xeon, а Qualcomm, наоборот, пришла к этой идее. Контроллер памяти DDR4 у Centriq шестиканальный и дополненный, к тому же, средствами аппаратного сжатия данных. Имеется встроенная поддержка сетевых стандартов 10 и 100 GbE, 32 линии PCIe (скорее всего, 3.0) и функций южного моста, а также развитая подсистема управлением питанием. В рамках Open Compute Project компания уже разработала две референсные платформы формата 1OU — с одним либо с двумя процессорными разъёмами под Centriq. Пока это практически всё, что известно о Сentriq 2400. Кое-что было опубликовано нами ранее, но пока мы не знаем тактовых частот и сроков начала массовых поставок. Однако судя по имеющимся сведениям, Qualcomm решила заняться развитием серверной ветки ARM всерьёз и надолго.
30.09.2017 [00:15], Алексей Степин
Терафлопс в космосе: на МКС тестируется компьютер HPE SpaceborneБытует мнение, что в космической отрасли используется всё самое лучшее, включая компьютерные компоненты. Это не совсем так: вы не встретите в космических аппаратах 18-ядерных Xeon и ускорителей Tesla. Во-первых, энергетические резервы за пределами Земли строго ограничены, и даже на МКС никто не будет тратить несколько киловатт на питание «космического суперкомпьютера». Во-вторых, практически вся электроника, работающая за пределами атмосферы, выпускается в специальном радиационно-стойком исполнении. Чаще всего за счёт техпроцессов «кремний на диэлектрике» (SOI) и «сапфировая подложка» (SOS), используется также биполярная логика вместо менее стойкой к внешним излучениям CMOS. 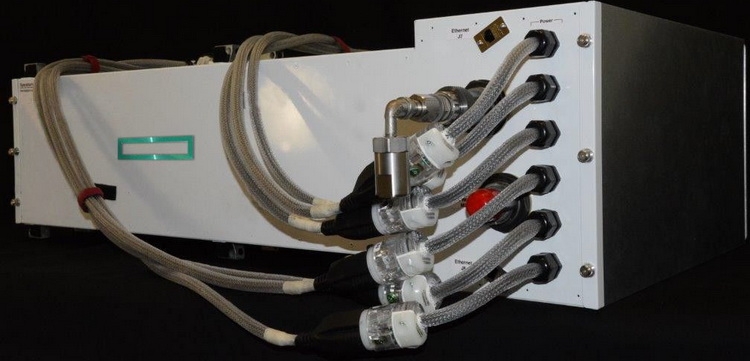
Мини-кластер в космическом исполнении. Охлаждение жидкостное Мощными в космосе считаются такие решения, как BAE Systems серии RAD, особенно новая RAD5500 (от 1 до 4 ядер, 45-нм SOI, PowerPC, 64 бита). Четырёхъядерный вариант RAD5545 развивает производительность более 3,7 гигафлопс при потреблении около 20 ватт. Иными словами, вычислительные мощности в космосе тоже растут, но совсем иными темпами, нежели на Земле. Тому подтверждением служит недавно вступивший в строй на борту Международной космической станции компьютер HPE Spaceborne. Если на Земле мощность суперкомпьютеров измеряется десятками и сотнями петафлопс, то Spaceborne куда скромнее — судя по проведённым тестам, его вычислительная мощность достигает 1 терафлопса. Достигнута она путём сочетания современных процессоров Intel с ускорителями NVIDIA Tesla P100 (NVLink-версия). 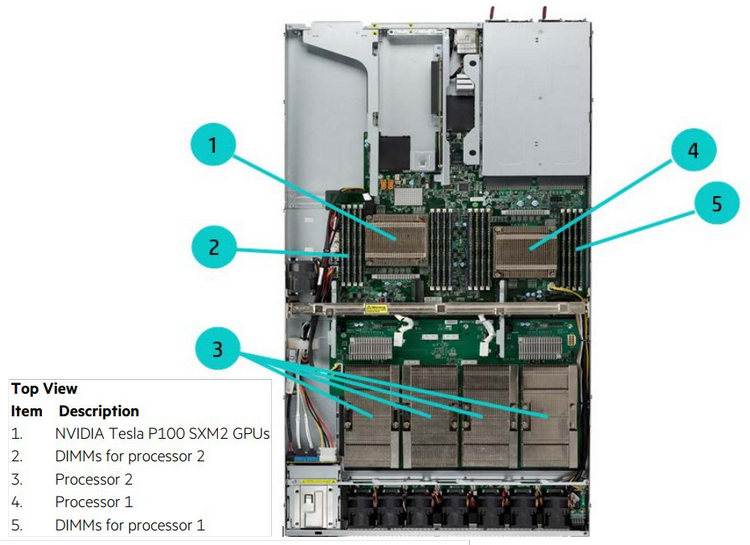
Конфигурация каждого из узлов Spaceborne Для космических систем это большое достижение, и не стоит иронизировать над этим показателем производительности. Интересно, что сама по себе система Spaceborne, доставленная на борт станции миссией SpaceX CRS-12, является своего рода экспериментом на тему «как чувствуют себя в космосе обычные компьютерные комплектующие». Это связка из двух серверов HPE Apollo 40 на базе Intel Xeon, объединённая сетью со скоростью 56 Гбит/с. 14 сентября на систему было подано питание (48 и 110 вольт), а недавно проведены первые тесты High Performance LINPACK. 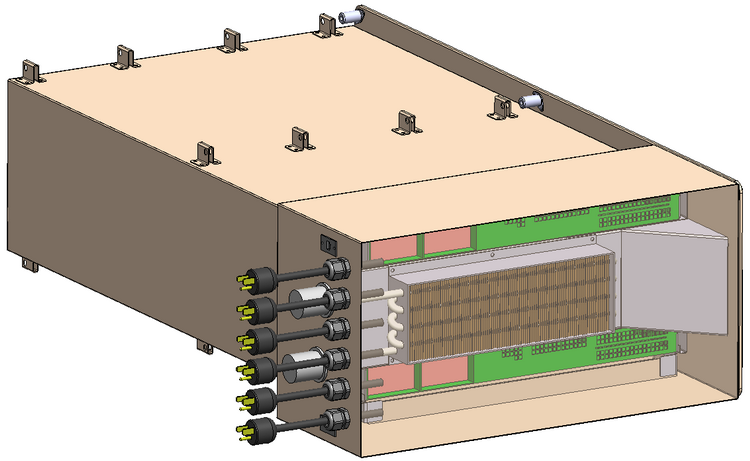
Системы охлаждения и электропитания Spaceborne Пока Spaceborne не будет использоваться для анализа научных данных или управления какими-либо системами станции. Его миссия — продемонстрировать то, насколько живучи обычные серверы в космосе. Результаты постоянных тестов будут сравниваться с аналогичной системой, оставшейся на Земле. Тем не менее, достижение первого терафлопса в космосе является своеобразным мировым рекордом. Это маленький шаг для супервычислений, но большой для всей космической индустрии, поскольку за Spaceborne явно последуют его более совершенные и мощные потомки.
05.09.2017 [17:44], Андрей Крупин
«Ростелеком» запустил личный кабинет для операторов связи«Ростелеком» объявил о развёртывании в федеральном масштабе системы «Личный кабинет оператора», позволяющей российским телекоммуникационным компаниям дистанционно заказывать и подключать лицензируемые услуги связи, обмениваться с поставщиком бухгалтерскими документами, узнавать о новых сервисах в режиме онлайн и решать прочие задачи. Новый сервис обеспечивает структурированный учёт информации о взаимодействии, автоматизирует обмен расчётными данными, позволяет сократить сроки обработки заявок и ускорить процесс предоставления новых услуг операторам-партнёрам «Ростелекома». Ожидается, что использование нового инструмента уменьшит число телефонных переговоров и объем рутинного и ручного труда персонала как со стороны операторов связи, так и со стороны «Ростелекома», что позволит существенно сократить сроки заключения договоров и соглашений, а в дальнейшем — и сроки реагирования на различные запросы клиентов.  «Запуск личного кабинета для операторов связи — важный элемент построения технологического партнёрства на телекоммуникационном рынке. «Ростелеком» выполняет функцию не только инфраструктурного оператора, но создателя основы для эффективного межоператорского сотрудничества. Новый сервис позволит повысить прозрачность и оперативность взаимодействия операторов, а также предоставит нашим партнёрам лёгкий дистанционный доступ к телеком-инфраструктуре национального оператора связи и даст возможность пользоваться технологическими достижениями компании», — говорится в сообщении «Ростелекома». В «Ростелекоме» видят огромные перспективы нового сервиса на рынке и поэтому планируют развивать и совершенствовать его функциональные возможности.
23.08.2017 [12:40], Геннадий Детинич
Qualcomm поделилась деталями о 48-ядерных процессорах Centriq 2400Пять лет назад компания Qualcomm приступила к разработкам процессора для серверного рынка. Успешный разработчик уникальных вычислительных архитектур, совместимых с наборами команд ARM, вполне обоснованно решил перенести опыт создания SoC для смартфонов и планшетов в область высокопроизводительных серверных решений. К тому времени требования к серверным процессорам изменились в сторону снижения потребления и лучшей масштабируемости. Социальные сети и облачные сервисы создают настолько неравномерную нагрузку на вычислительные ресурсы ЦОД, что обычные x86-совместимые или RISC/UNIX-платформы перестают считаться эффективным инструментом для решения насущных задач. 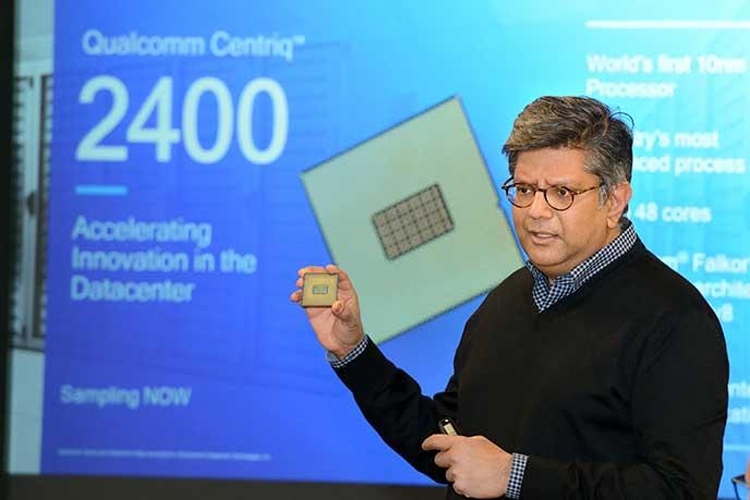 В декабре 2016 года Qualcomm сообщила о завершении разработки и начале пробных поставок процессора Centriq 2400 с числом ядер до 48 штук. На днях компания подтвердила график вывода новинки на рынок, который предусматривает массовые коммерческие поставки SoC Centriq 2400 позднее в текущем году. Также Qualcomm поделилась деталями о строении и архитектуре Centriq 2400. Ниже мы расскажем о ключевых особенностях разработки. 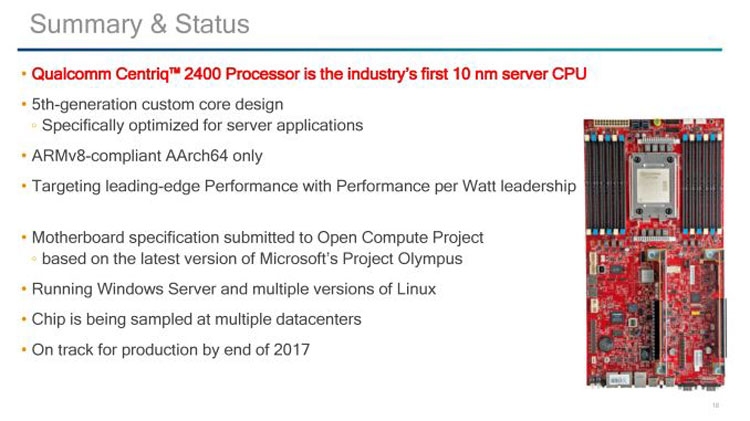 Начнём с того, что внутренний согласованный интерфейс однокристальной сборки Centriq 2400 представляет собой сегментированную кольцевую шину. Компания Intel, как нам известно, в новых серверных и высокопроизводительных настольных процессорах перестанет использовать кольцевую шину в пользу ячеистой шины, что должно улучшить масштабируемость архитектуры для многоядерного окружения. Компания AMD использует другой принцип обмена данными между кластерами в процессорах на ядрах Zen. Все они соединены между собой двунаправленной шиной, топология которой ближе к кольцевой. Сегментированная кольцевая шина в составе Centriq 2400 использует преимущества кольцевой шины (простота, сравнительно низкое потребление) и элементы ячеистой сети внутри сегмента, что даёт возможность балансировать между скоростью, задержками и потреблением. 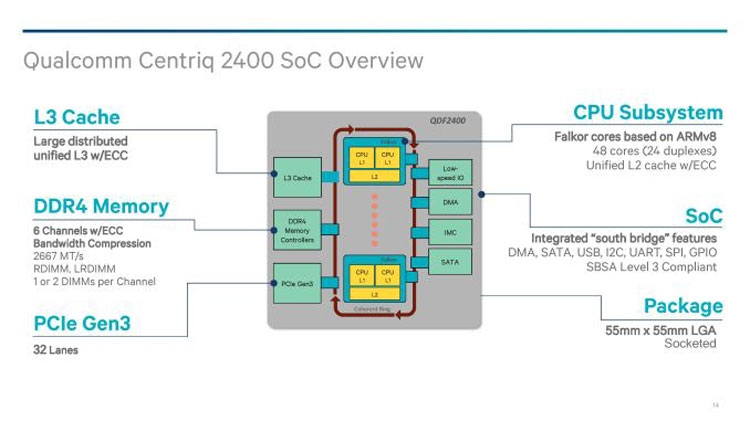 Вычислительные ядра в составе Centriq 2400 самостоятельно разработаны инженерами компании и носят кодовое имя Falkor. Это 64-битные решения с поддержкой команд ARMv8, которые разбиты на модули из двух связанных ядер (дуплексное строение, по определению Qualcomm). Подобное строение позволяет выпускать SoC Centriq 2400 с заданным числом ядер и облегчает масштабирование вычислительной структуры в процессе выполнения задачи. Каждая пара ядер имеет разделяемую кеш-память L2 и разделяемый доступ к кольцевой шине Qualcomm System Bus (QSB). 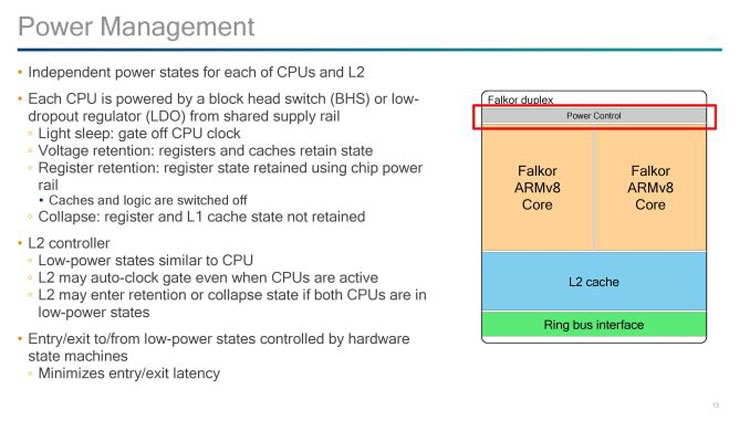 Для снижения потребления каждое ядро и кеш-память L2 имеют ряд состояний потребления энергии, которые контролируются на аппаратном уровне и могут переключаться с минимальными задержками. Вычислительные конвейеры Falkor имеют переменную длину с внеочередным исполнением команд. Это снижает вероятность простоя конвейеров в процессе работы с командами и инструкциями, не оптимизированными для немедленного исполнения. 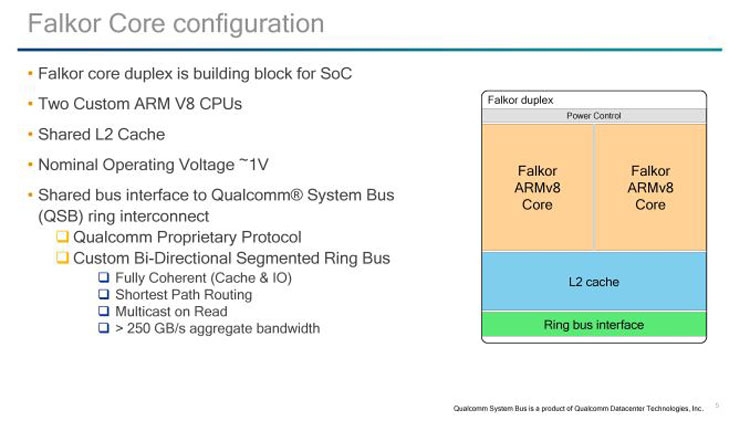 Иерархия кеш-памяти Falkor оптимизирована для обработки значительных массивов данных. Так, кеш-память первого уровня для приёма данных объёмом 32 Кбайт дополнена «несимметричной» кеш-памятью L1 для инструкций: 24 Кбайт L0 и 64 Кбайт L1 (всего 88 Кбайт). Всё это снабжено многоуровневым движком предварительной выборки, который динамически адаптируется под текущую нагрузку. В состав SoC Centriq 2400 вошли 6-канальный контроллер памяти с поддержкой DDR4-2667 МГц ECC (до двух модулей на канал), 32 линии PCI Express 3.0, интерфейсы SATA, USB и более специализированные сигнальные структуры. Также Centriq 2400 несёт интегрированный криптографический блок TrustZone и поддерживает аппаратную виртуализацию. В компании Qualcomm уверены, что данную разработку ждёт успешное будущее.
12.08.2017 [21:20], Алексей Степин
Cavium представила стандарт FC-NVMe 1.0Протокол NVMe стремительно отвоёвывает позиции у более привычных SAS и SATA, что неудивительно — последние несут в себе тяжелый груз наследия механических накопителей и далеко не самым оптимальным образом работают с современными твердотельными устройствами хранения данных. В локальном масштабе проблем у NVMe нет, но крупные вычислительные системы часто нуждаются в пробросе протоколов в сетевой среде, объединяющей вычислительные узлы или соединяющей их с системами хранения данных. 
FC-NVMe может параллельно работать с FC-SCSI Довольно активно в качестве такой среды используется технология Fibre Channel. Первая волна решений шестого поколения обеспечивает передачу данных со скоростью 3200 Мбайт/с, а вторая уже рассчитана на внушительные 12800 Мбайт/с. Проблему проброса NVMe в среде Fibre Channel решила компания Cavium, известный разработчик интеллектуальных сетевых процессоров и решений. Она в числе первых обнародовала поддержку стандарта NVMe over Fibre Channel (FC-NVMe) версии 1.0. Процессоры Cavium QLogic серий 2700 и 2690 (шестое и пятое поколение FC, соответственно), используемые в адаптерах HBA, получили полную поддержку FC-NVMe 1.0 путём обновления прошивок и драйверов. 
Адаптеры QLogic 2700 (поколение 6.1, 3200 Мбайт/с) Теперь соответствующие адаптеры отлично подходят для подключения серверных систем к хранилищам данных на базе флеш-памяти, использующим протокол NVMe. Новый стандарт позволяет использовать пропускную способность Fibre Channel эффективно, без дополнительных задержек и падения производительности. В открытом доступе обновлений пока нет, но их можно запросить у продажного отдела Cavium. Рассчитаны новые драйверы на работу в среде Linux и поддерживают режимы Initiator, Target и Target SPDK. Поддерживается параллельная обработка потоков FC-NVMe и FCP-SCSI, что делает Fibre Channel ещё более универсальной технологией. В настоящее время именно Cavium является компанией, внесшей наибольший вклад в развитие технологии FC-NVMe. |
|

