
Материалы по тегу: hbm
|
12.12.2024 [22:54], Владимир Мироненко
Всё дальше от народа: Marvell предложила гиперскейлерам кастомизацию HBM для ИИ-ускорителейMarvell Technology анонсировала новый подход к интеграции HBM (CHBM) в специализированные XPU, который предоставляет адаптированные интерфейсы для оптимизации производительности, мощности, размера кристалла и стоимости для конкретных конструкций ИИ-ускорителей. Как указано в пресс-релизе, этот подход учитывает вычислительный «кремний», стеки HBM и упаковку. Marvell сотрудничает с облачными клиентами и ведущими производителями HBM, такими, как Micron, Samsung и SK hynix. CHBM повышает возможности XPU, ускоряя ввода-вывод между внутренними кристаллами самого ускорителя и базовыми кристаллами HBM. Это приводит к повышению производительности и снижению энергопотребления интерфейса памяти до 70 % по сравнению со стандартными интерфейсами HBM. Оптимизированные интерфейсы также уменьшают требуемую площадь кремния в каждом кристалле, позволяя интегрировать логику для поддержки HBM в базовый кристалл и сэкономить до 25 % площади. 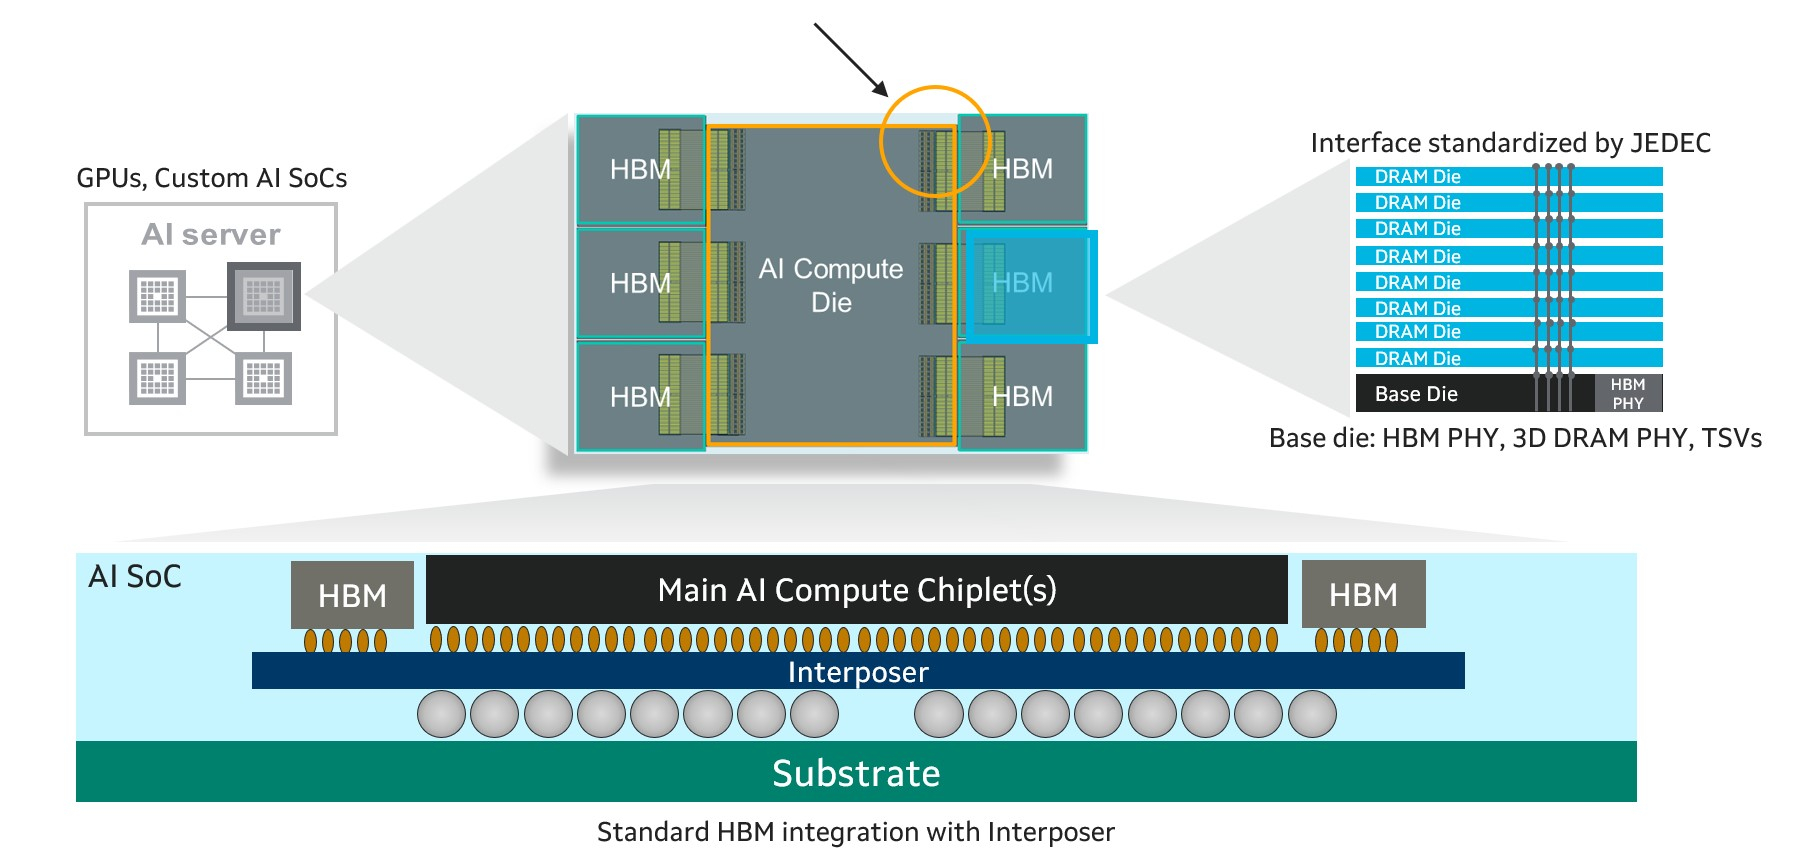
Источник изображений: Marvell Высвободившееся пространство может быть использовано для размещения дополнительных вычислительных или функциональных блоков и поддержки до 33 % большего количества стеков HBM. Всё это повышает производительность и энергоэффективность XPU, одновременно снижая совокупную стоимость владения для операторов облачных инфраструктур. Правда, это же означает и несоответствие стандартами JEDEC. Как отметил ресурс ServeTheHome, HBM4 требует более 2000 контактов, т.е. вдвое больше, чем HBM3. Для кастомного решения нет необходимости в таком количестве контактов, что также высвобождает место для размещения других компонентов. 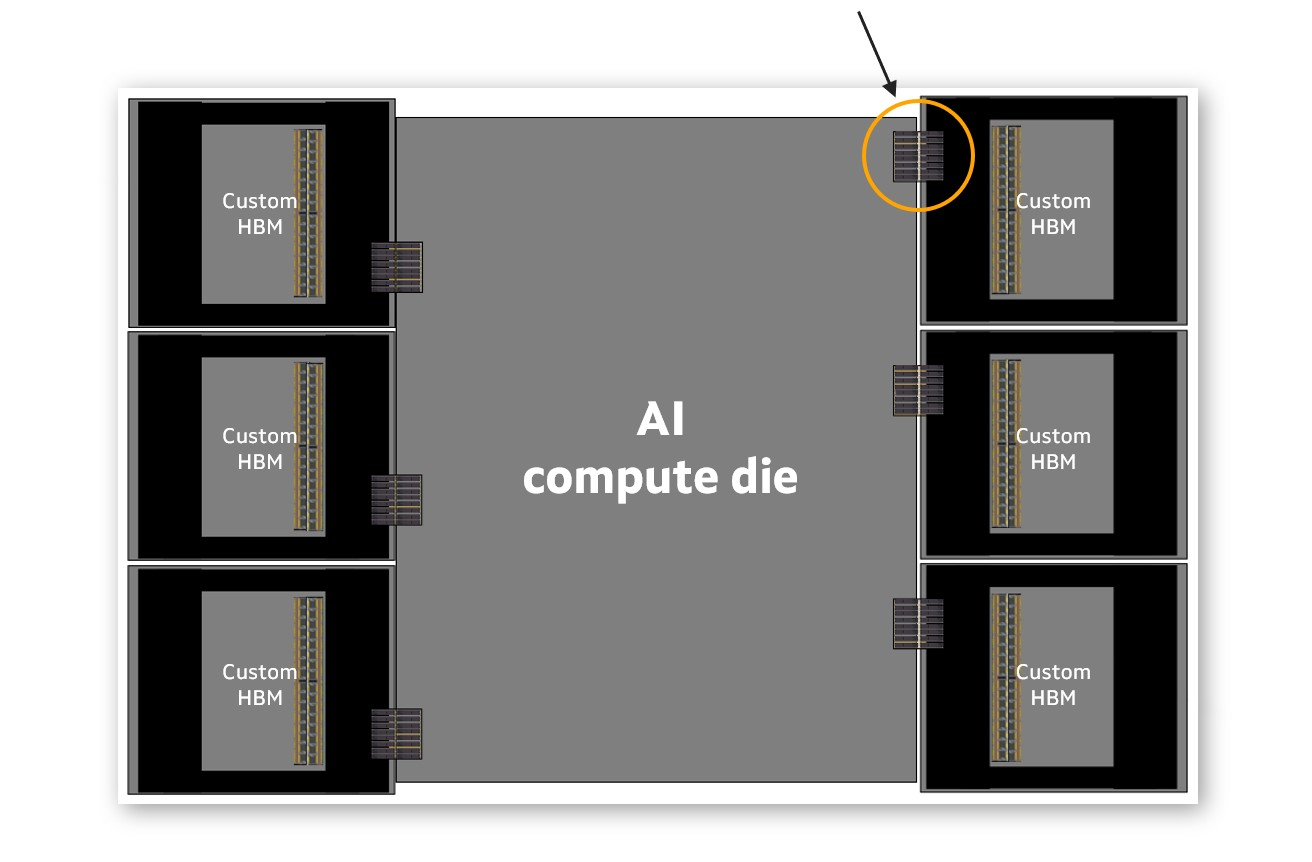 «Ведущие операторы ЦОД масштабируются с помощью индивидуальной инфраструктуры. Улучшение XPU путем адаптации HBM к конкретной производительности, мощности и общей стоимости владения — это последний шаг в новой парадигме разработки и поставки ускорителей ИИ», — сказал Уилл Чу (Will Chu), старший вице-президент Marvell и генеральный менеджер группы Custom, Compute and Storage. В свою очередь, Гарри Юн (Harry Yoon), корпоративный исполнительный вице-президент Samsung Electronics, отметил, что оптимизация HBM для конкретных XPU и программных сред значительно повысит производительность облачной инфраструктуры операторов и её энергоэффективность. Согласно данным ServeTheHome, в этом году гиперскейлеры увеличили капзатраты примерно на $100 млрд. Следующее поколение ИИ-кластеров будет в десять и более раз превосходить по мощности систему xAI Colossus на базе 100 тыс. NVIDIA H100. Отказ от стандартов JEDEC и появление возможности настройки памяти с учётом потребностей гиперскейлеров является монументальным шагом для отрасли. Также этого говорит о нацеленности архитектуры Marvell XPU на гиперскейлеров, поскольку в таком «тюнинге» памяти небольшие заказчики не нуждаются.
03.12.2024 [18:42], Руслан Авдеев
Довести до беспамятства: США запретили китайским структурам покупать HBM для ИИ-ускорителейУходящая администрация действующего президента США Джо Байдена (Joe Biden) объявила об ограничениях экспорта в Китай высокопроизводительной HBM-памяти, критически важной для производства ИИ-ускорителей. Запрет коснётся более сотни китайских организаций, сообщает The Register. Ограничения, обновлённые и анонсированные Бюро промышленности и безопасности (BIS) в минувший понедельник, препятствуют экспорту HBM в ряд стран, в частности — в КНР. Модули такой памяти производятся всего несколькими поставщиками в мире, включая южнокорейские Samsung и SK Hynix, а также американскую Micron. В модулях HBM применяются передовые технологии упаковки, недоступные КНР. В Китае активно ведутся работы по импортозамещению технологий. В частности, над собственными HBM-модулями трудится ChangXin Memory Technologies (CXMT). 
Источник изображения: Debbie Molle/unsplash.com HBM чрезвычайно важна для обучения ИИ и инференса и гораздо эффективнее (G)DDR, хотя она дороже и потребляет больше энергии. В последних поколениях оборудования память порой даже важнее FP-производительности. Например, в версиях NVIDIA H200 и AMD MI325X HBM3 заменена на более быструю HBM3e. Особенно результаты заметны при эксплуатации больших языковых моделей (LLM). Однако для моделей поменьше достаточно более простых и доступных ускорителей NVIDIA и AMD с памятью GDDR. По новым правилам производители памяти должны будут получать специальные экспортные лицензии для продажи HBM китайскому бизнесу. Как показал опыт Cerebras и Groq, при выполнении некоторых технических условий можно обойтись и SRAM. Оба разработчика добились отличных показателей при инференсе, даже в сравнении с решениями с HBM. Пока неизвестно, сможет ли SMIC предложить собственное решение аналогичного класса. В любом случае, запрет на экспорт в Китай HBM не означает завершение масштабных китайских ИИ-проектов. При Байдене США уже ввели множество ограничений на экспорт, чтобы лишить Китай доступа к технологиям, связанным с передовыми полупроводниками и ИИ-ускорителями, в том числе на поставки высокопроизводительных чипов и литографических EUV-машин для их выпуска. Тем не менее, успехи КНР в сфере ИИ ставят под сомнение эффективность санкций.
27.11.2024 [10:39], Владимир Мироненко
TrendForce: высокий спрос на память DDR5 и HBM для ЦОД подстегнул рост доходов отрасли в III кварталеСогласно оценкам аналитической компании TrendForce, в III квартале 2024 года глобальный доход производителей памяти DRAM достиг $26,02 млрд (последовательный рост на 13,6 %) на фоне растущего спроса на память DDR5 и HBM для ЦОД, несмотря на снижение поставок памяти LPDDR4 и DDR4 из-за сокращения запасов китайскими брендами смартфонов и расширения мощностей китайскими поставщиками DRAM. Как и в предыдущем квартале средняя цена продажи (ASP) продолжала расти, чему способствовало, в том числе, вытеснение памятью HBM производства обычной DRAM. При этом контрактные цены выросли на 8–13 %. В IV квартале TrendForce ожидает квартальный рост общих поставок DRAM в битах, полагая при этом, что ограничения мощностей, вызванные производством HBM, окажут более слабое, чем ожидалось, влияние на цены. Кроме того, расширение мощностей китайскими поставщиками может побудить производителей ПК и бренды смартфонов активно расходовать имеющиеся запасы, чтобы пополнять их более дешёвой DRAM. Это может привести к снижению контрактных цен на обычную DRAM. 
Источник изображения: SK hynix Благодаря росту контрактных цен на DRAM для серверов и ПК в III квартале увеличились доходы трёх крупнейших производителей памяти. Samsung сохранила лидерство с доходом в $10,7 млрд, что на 9 % больше показателя предыдущего квартала. В связи со стратегическим снижением запасов LPDDR4 и DDR4 поставки компанией памяти в битах остались на уровне предыдущего квартала. На втором месте по-прежнему находится SK hynix с доходом в $8,95 млрд (последовательный рост на 13,1 %). Несмотря на рост поставок HBM3e, более слабые продажи LPDDR4 и DDR4 привели к снижению показателя поставок в битах на 1–3% в квартальном исчислении. Доход Micron вырос на 28,3 % в квартальном исчислении до $5,78 млрд благодаря значительному росту поставок серверной памяти DRAM и HBM3e, что привело к увеличению поставок в битах на 13 % по сравнению с предыдущим кварталом. 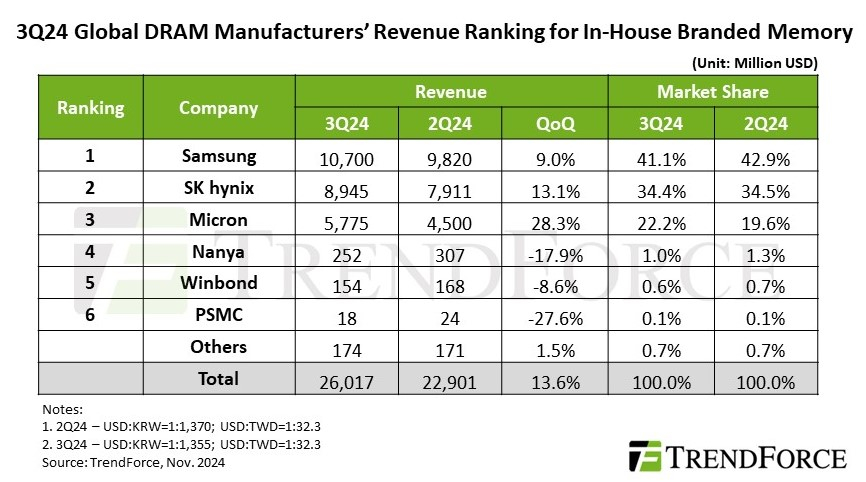
Источник изображения: TrendForce Тайваньские поставщики DRAM, столкнувшиеся в III квартале с падением выручки, значительно отстали от тройки лидеров. У Nanya Technology было отмечено падение поставок в битах более чем на 20 % в квартальном исчислении из-за более слабого спроса на потребительскую DRAM и усиления конкуренции на рынке DDR4 со стороны китайских поставщиков. Операционная прибыль ещё больше снизилась (с -23,4 % до -30,8 %) из-за инцидента с отключением электроэнергии. Выручка Winbond снизилась в квартальном исчислении на 8,6 % до $154 млн на фоне падения спроса на потребительскую DRAM снизился, что также негативно отразилось на объёме поставок в битах. Наконец, PSMC сообщила о падении выручки от собственного производства потребительской DRAM на 27,6 %. Однако, с учётом полупроводникового производства, её общая выручка от поставок DRAM выросла на 18 % в квартальном исчислении, что обусловлено продолжающимся пополнением запасов клиентами в сфере производства полупроводников.
20.11.2024 [10:56], Сергей Карасёв
Microsoft представила инстансы Azure HBv5 на основе уникальных чипов AMD EPYC 9V64H с памятью HBM3Компания Microsoft на ежегодной конференции Ignite для разработчиков, IT-специалистов и партнёров анонсировала облачные инстансы Azure HBv5 для HPC-задач, которые предъявляют наиболее высокие требования к пропускной способности памяти. Новые виртуальные машины оптимизированы для таких приложений, как вычислительная гидродинамика, автомобильное и аэрокосмическое моделирование, прогнозирование погоды, исследования в области энергетики, автоматизированное проектирование и пр. Особенность Azure HBv5 заключается в использовании уникальных процессоров AMD EPYC 9V64H (поколения Genoa). Эти чипы насчитывают 88 вычислительных ядер Zen4, тактовая частота которых достигает 4 ГГц. Ближайшим родственником является изделие EPYC 9634, которое содержит 84 ядра (168 потоков) и функционирует на частоте до 3,7 ГГц. По данным ресурса ComputerBase.de, чип EPYC 9V64H также фигурирует под именем Instinct MI300C: по сути, это процессор EPYC, дополненный памятью HBM3. При этом клиентам предоставляется возможность кастомизации характеристик. Отметим, что ранее x86-процессоры с набортной памятью HBM2e были доступны в серии Intel Max (Xeon поколения Sapphire Rapids). Каждый инстанс Azure HBv5 объединяет четыре процессора EPYC 9V64H, что в сумме даёт 352 ядра. Система предоставляет доступ к 450 Гбайт памяти HBM3, пропускная способность которой достигает 6,9 Тбайт/с. Задействован интерконнект NVIDIA Quantum-2 InfiniBand со скоростью передачи данных до 200 Гбит/с в расчёте на CPU. 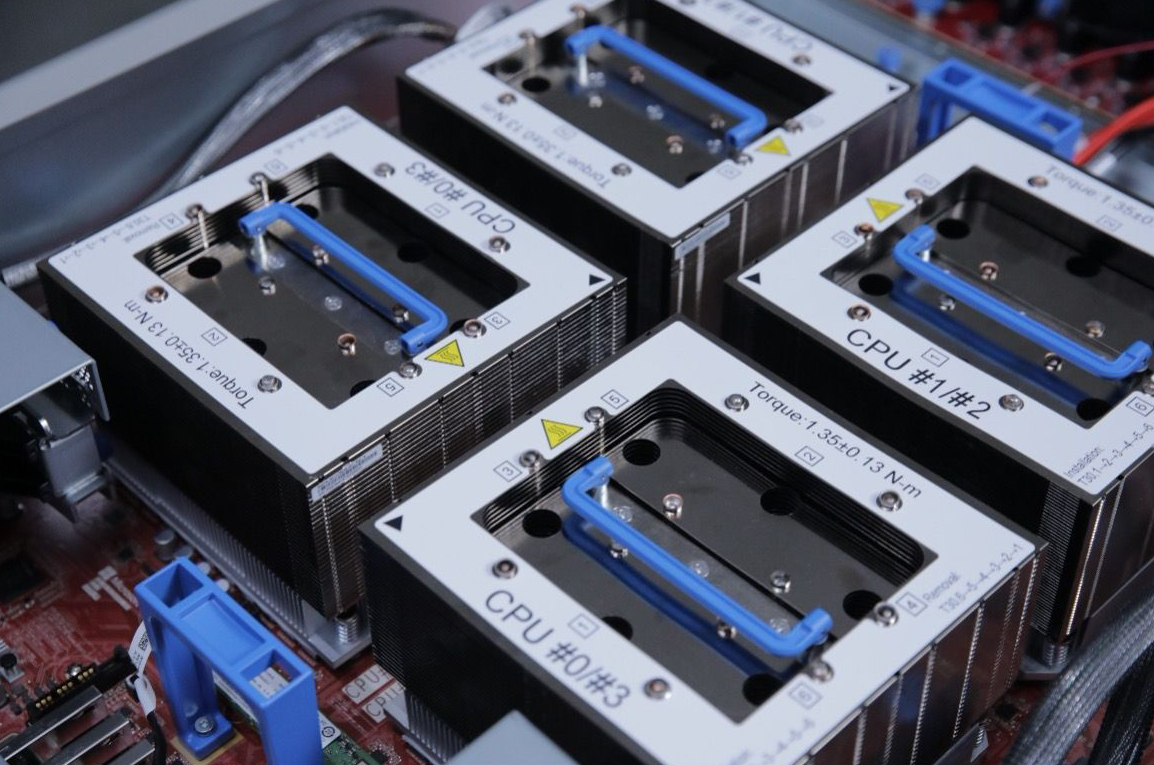
Источник изображений: Microsoft Применены сетевые адаптеры Azure Boost NIC второго поколения, благодаря которым пропускная способность сети Azure Accelerated Networking находится на уровне 160 Гбит/с. Для локального хранилища на основе NVMe SSD заявлена скорость чтения информации до 50 Гбайт/с и скорость записи до 30 Гбайт/с. 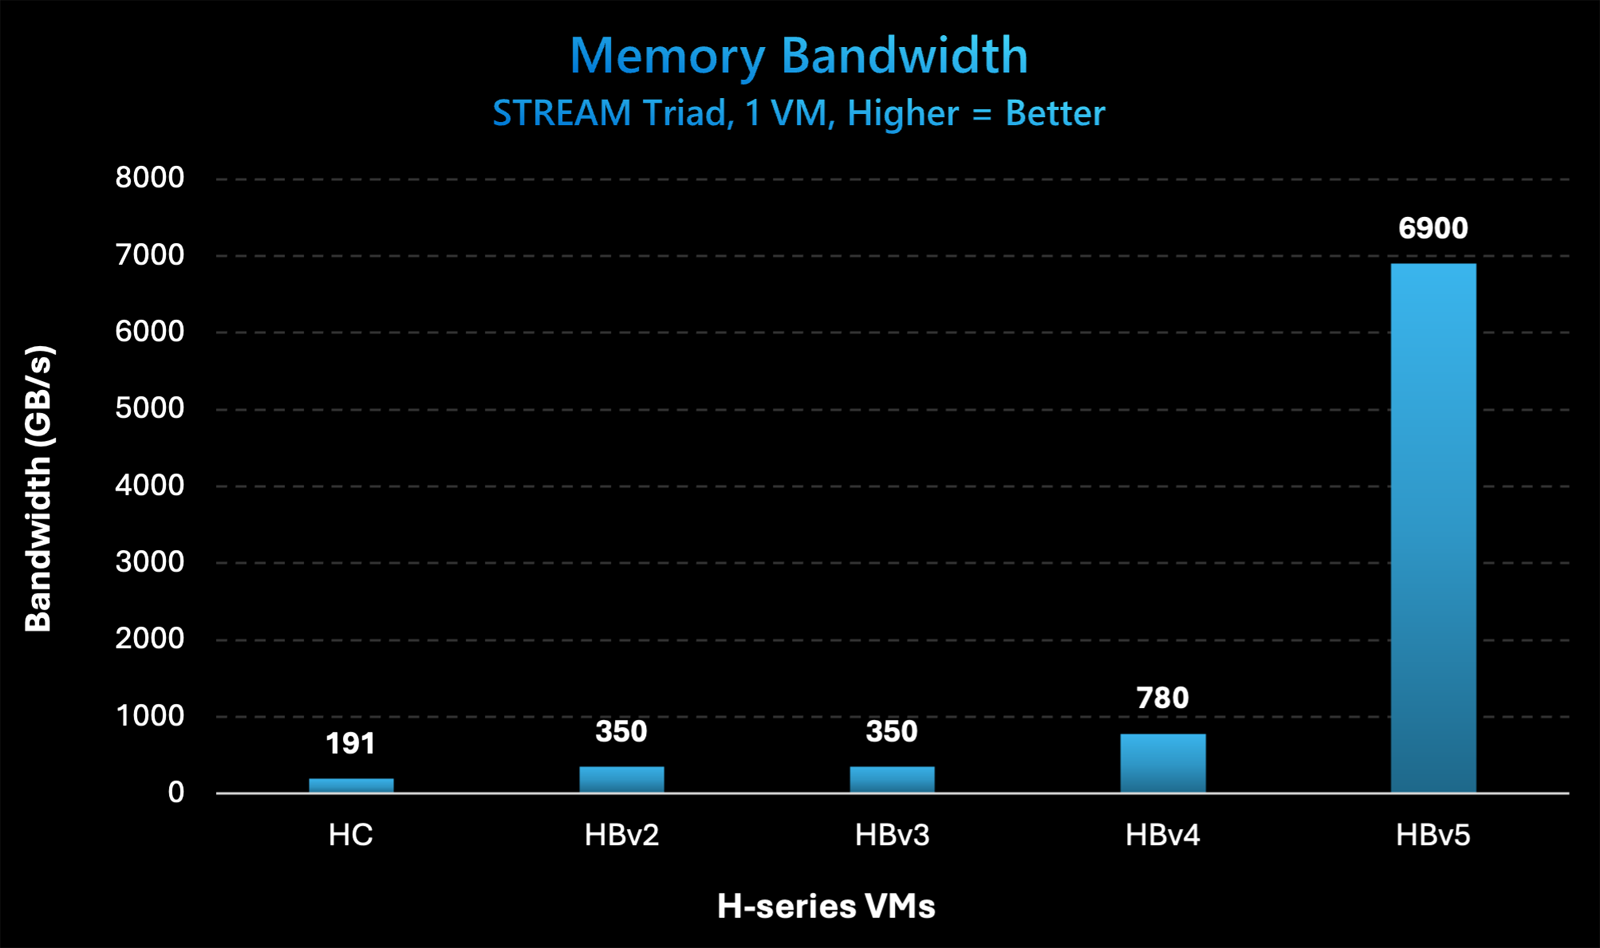 Отмечается, что по показателю пропускной способности памяти виртуальные машины Azure HBv5 примерно в 8 раз превосходят новейшие альтернативы bare-metal и cloud, в 20 раз опережают инстансы Azure HBv3 и Azure HBv2 (на базе EPYC Milan-X и EPYC Rome) и в 35 раз обходят HPC-серверы возрастом 4–5 лет, жизненный цикл которых приближается к завершению. Машины Azure HBv5 станут доступны в I половине 2025 года.
20.11.2024 [01:40], Владимир Мироненко
Microsoft представила кастомные чипы Azure Boost DPU и Integrated HSM, уникальный AMD EPYC 9V64H с HBM и собственный вариант NVIDIA GB200 NVL72
amd
azure arc
azure stack
dpu
epyc
gb200
hardware
hbm
hpc
microsoft
microsoft azure
nvidia
гибридное облако
ии
информационная безопасность
облако
стойка
ускоритель
Microsoft представила на конференции Microsoft Ignite новые специализированные чипы Azure Boost DPU и Azure integrated Hardware Security Module (HSM), предназначенные для использования в ЦОД с целью поддержки рабочих нагрузок в облаке Azure и повышения безопасности. 
Источник изображений: Microsoft Чтобы снизить зависимость от поставок чипов сторонних компаний, Microsoft занимается разработкой собственных решений для ЦОД. Например, на прошлогодней конференции Microsoft Ignite компания представила Arm-процессор Azure Cobalt 100 и ИИ-ускоритель Azure Maia 100 собственной разработки. Azure Boost DPU включает специализированные ускорители для работы с сетью и хранилищем, а также предлагает функции безопасности. Так, скорость работы с хранилищем у будущих инстансов Azure будет вчетверо выше, чем у нынешних, а энергоэффективность при этом вырастет втрое. 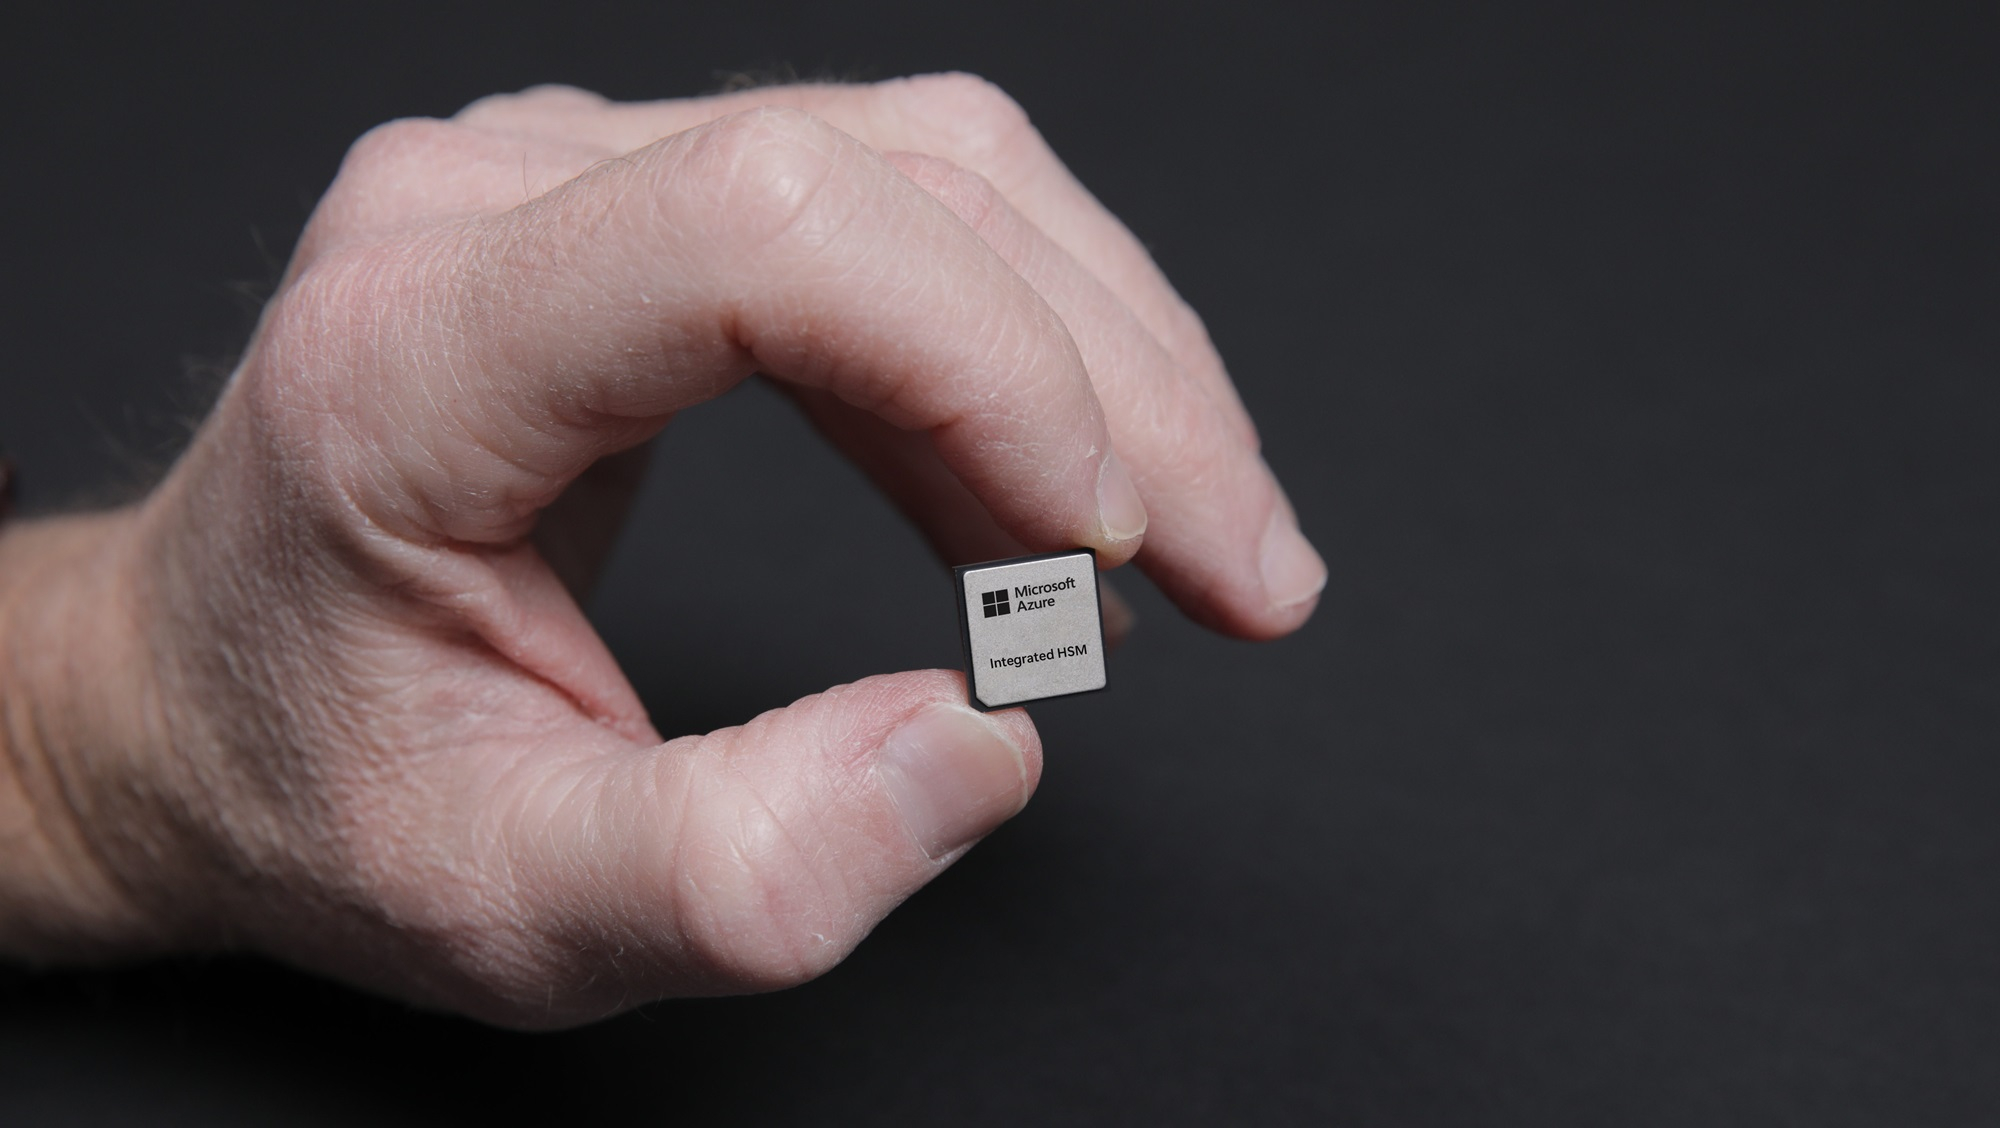 Не вызывает сомнений, что в разработке Azure Boost DPU участвовали инженеры Fungible, производителя DPU, который Microsoft приобрела в декабре прошлого года. Как отмечает TechCrunch, в последние годы популярность DPU резко увеличилась. AWS разработала уже несколько поколений Nitro, Google совместно с Intel создала IPU, AMD предлагает DPU Pensando, а NVIDIA — BlueField. Есть и другие нишевые игроки. Согласно оценкам Allied Analytics, рынок чипов DPU может составить к 2031 году $5,5 млрд. 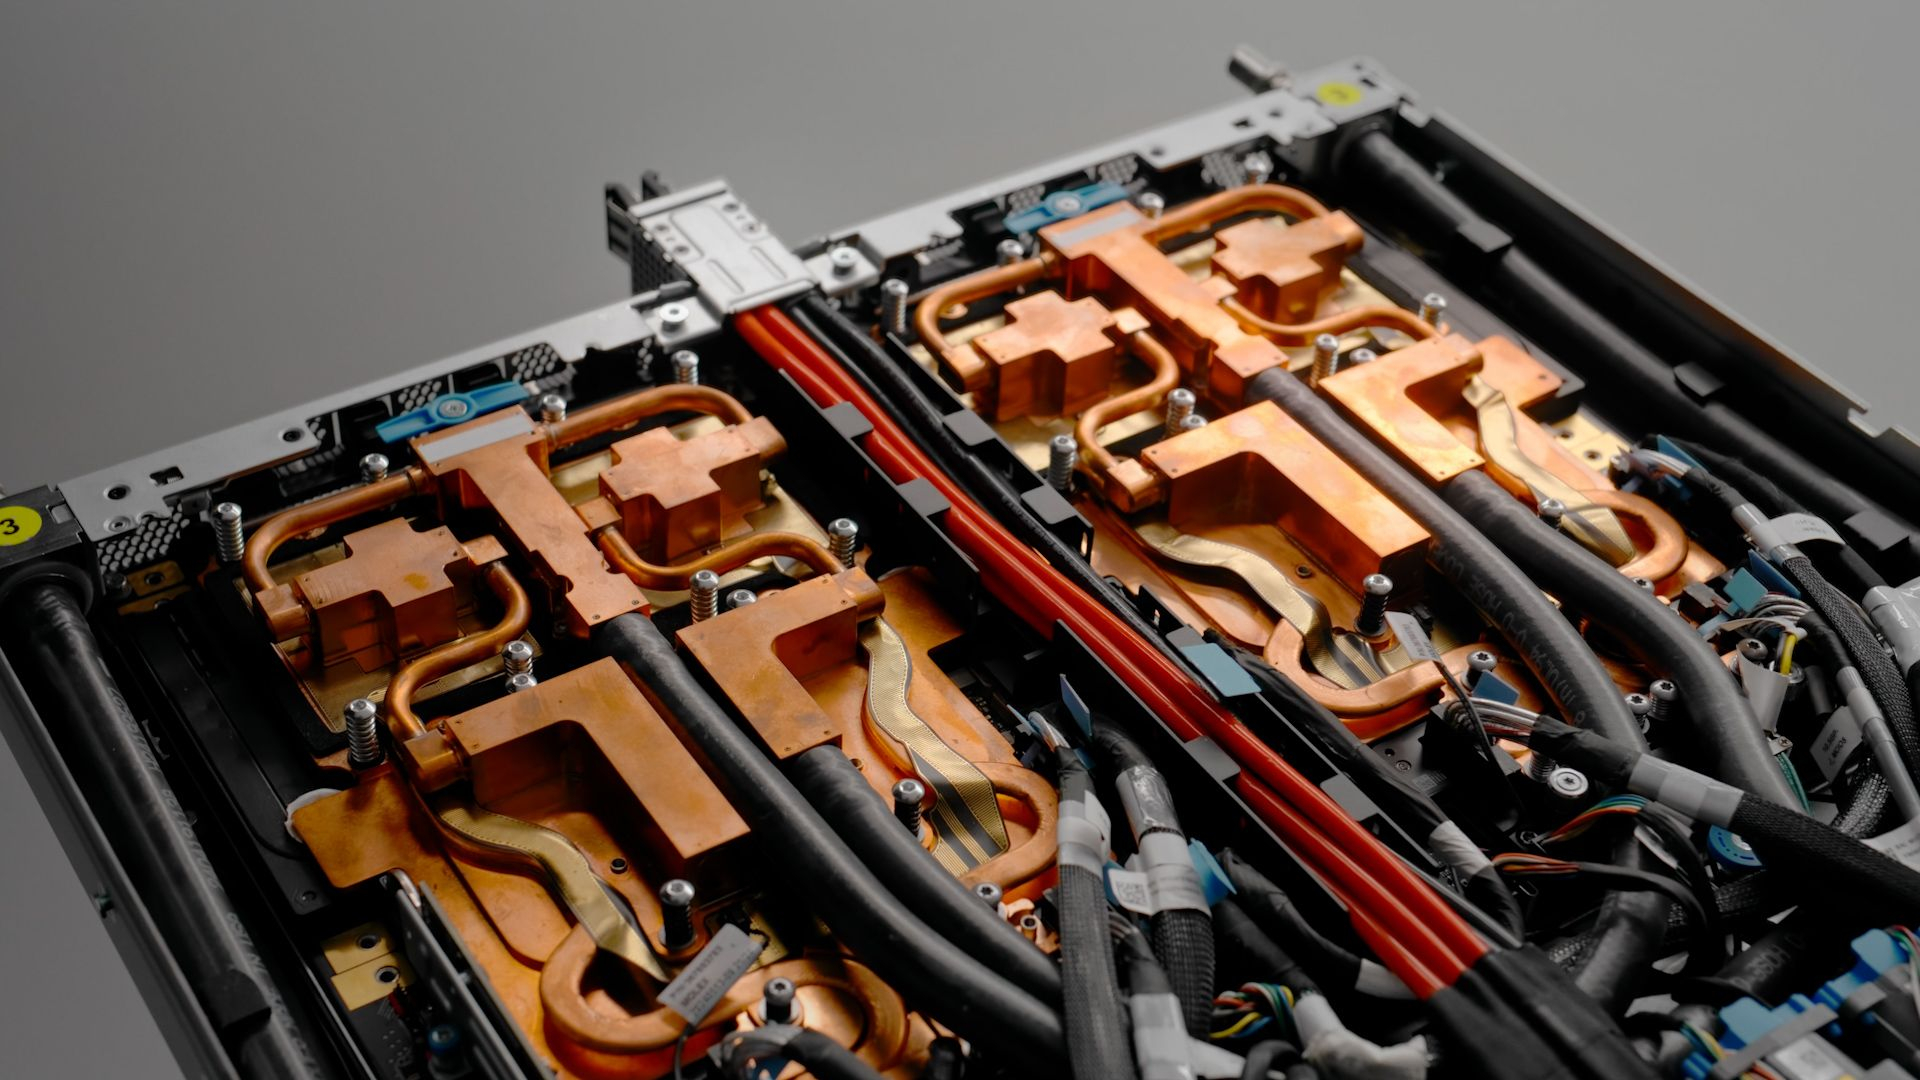 Ещё один кастомный чип — Azure integrated Hardware Security Module (HSM) — отвечает за хранение цифровых криптографических подписей и ключей шифрования в защищённом модуле «без ущерба для производительности или увеличения задержки». «Azure Integrated HSM будет устанавливаться на каждом новом сервере в ЦОД Microsoft, начиная со следующего года, чтобы повысить защиту всего парка оборудования Azure как для конфиденциальных, так и для общих рабочих нагрузок», — заявила Microsoft. Azure Integrated HSM работает со всем стеком Azure, обеспечивая сквозную безопасность и защиту.  Microsoft также объявила, что задействует ускорители NVIDIA Blackwell и кастомные серверные процессоры AMD EPYC. Так, инстансы Azure ND GB200 v6 будут использовать суперускорители NVIDIA GB200 NVL 72 в собственном исполнении Microsoft, а интерконнект Quantum InfiniBand позволит объединить десятки тысяч ускорителей Blackwell. Компания стремительно наращивает закупки этих систем. А инстансы Azure HBv5 получат уникальные 88-ядерные AMD EPYC 9V64H с памятью HBM, которые будут доступны только в облаке Azure. Каждый инстанс включает четыре таких CPU и до 450 Гбайт памяти с агрегированной пропускной способностью 6,9 Тбайт/с.  Кроме того, Microsoft анонсировала новое решение Azure Local, которое заменит семейство Azure Stack. Azure Local — это облачная гибридная инфраструктурная платформа, поддерживаемая Azure Arc, которая объединяет локальные среды с «большим» облаком Azure. По словам компании, клиенты получат обновление до Azure Local в автоматическом режиме. Наконец, Microsoft анонсировала новые возможности в Azure AI Foundry, новой «унифицированной» платформе приложений ИИ, где организации смогут проектировать, настраивать и управлять своими приложениями и агентами ИИ. В числе новых опций — Azure AI Foundry SDK (пока в виде превью).
01.08.2024 [00:53], Игорь Осколков
Ampere анонсировала 512-ядерные Arm-процессоры AmpereOne Aurora с HBM-памятью и встроенным ИИ-ускорителемAmpere Computing анонсировала процессоры AmpereOne Aurora, которые получат до 512 однопоточных Arm-ядер собственной разработки, набортную HBM-память и фирменные IP-блоки для обучения и инференса ИИ-моделей. Речь, судя по всему, идёт о чиплетной компоновке, поскольку компания говорит не только о фирменном меш-интерконнекте для вычислительных блоков, но и об объединении разных кристаллов в рамках SoC. Предполагается, что Aurora появятся где-то на рубеже 2025–2026 гг. 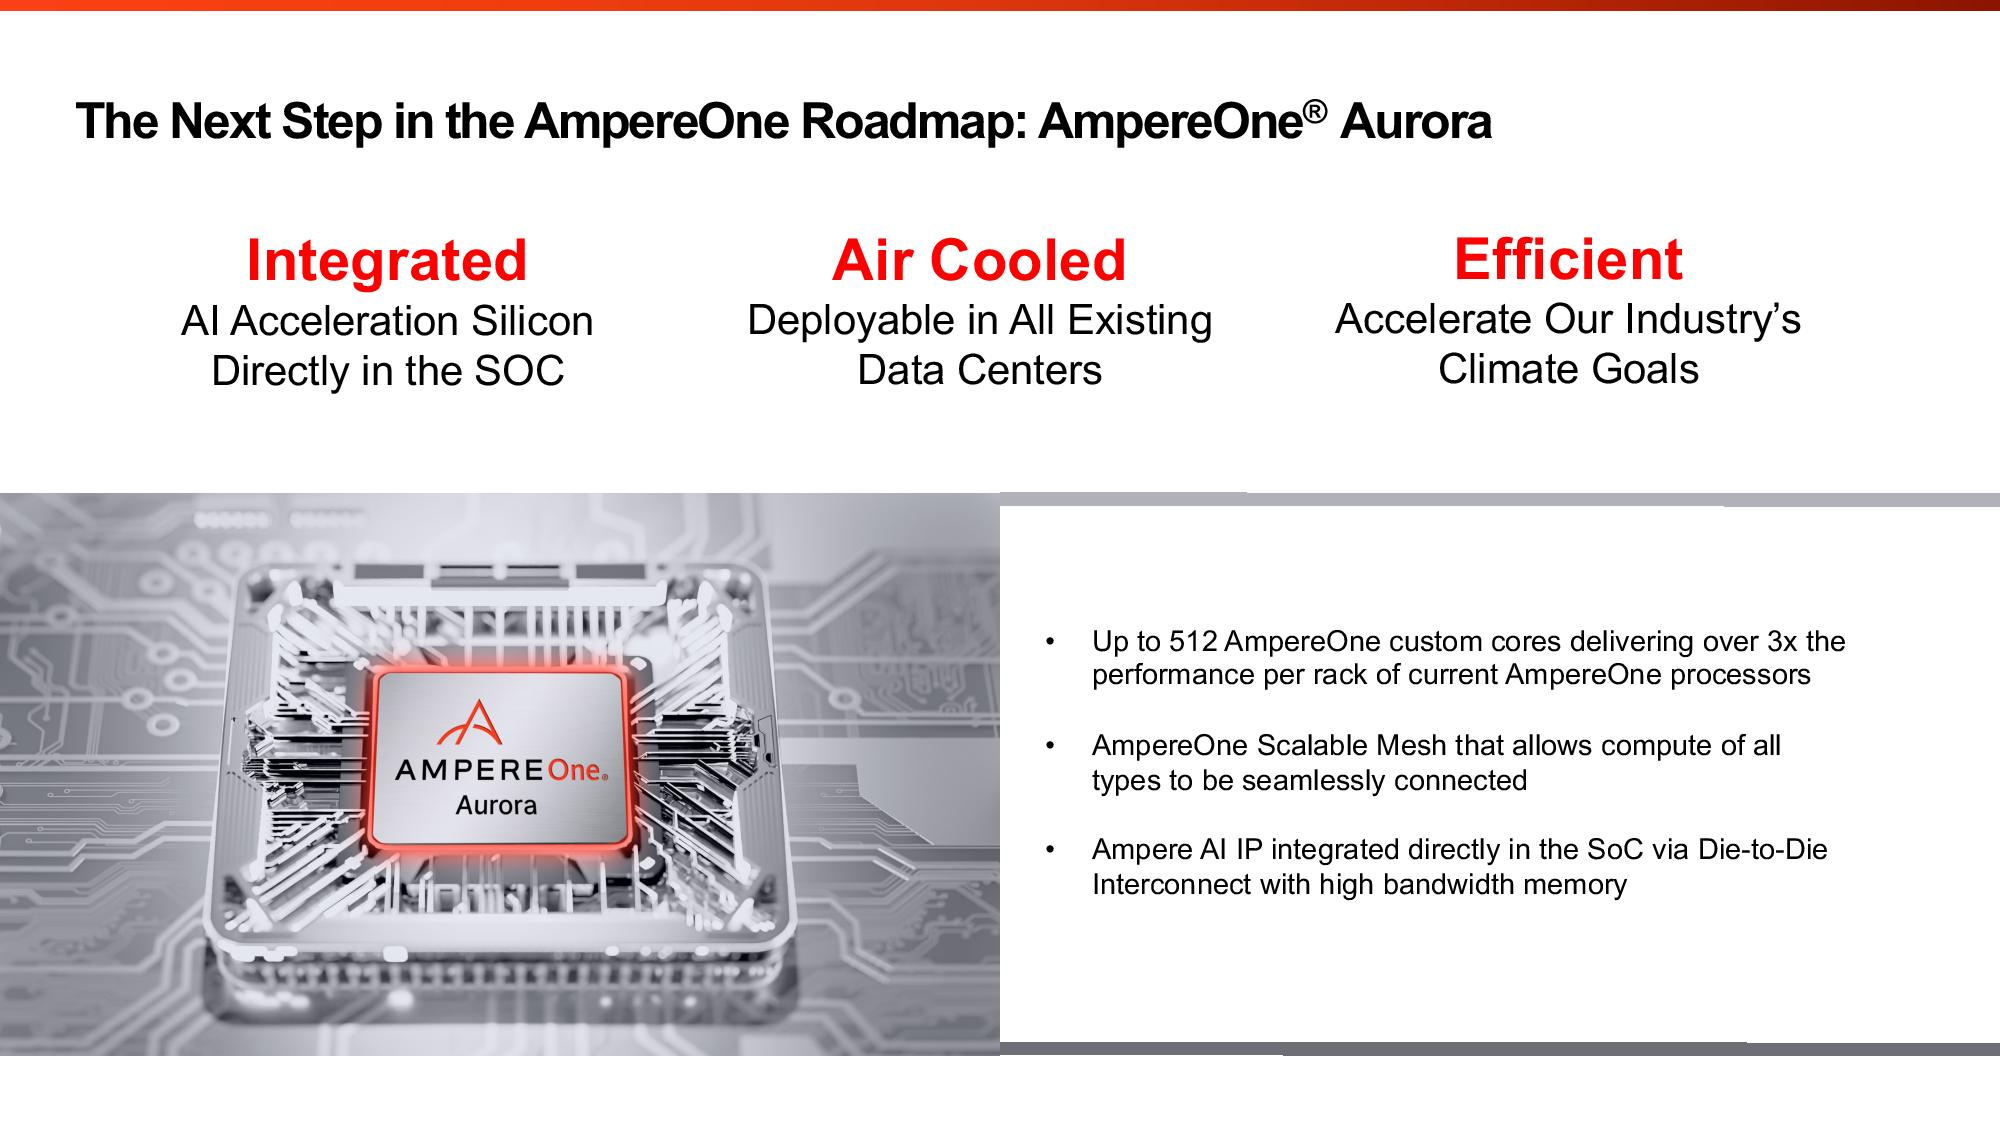
Источник изображений: Ampere Computing Что интересно, для Aurora обещана возможность использования воздушного охлаждения. Для гиперскейлеров, на которых Ampere по-прежнему ориентируется, это важный пункт. Впрочем, больше никаких подробностей о новинках компания не сообщила, отметив лишь, что встроенный ускоритель сгодится для RAG и векторных баз данных. Ну и сообщив, что по количеству ядер и производительности её ещё не выпущенный чип обгоняет все остальные чипы: 144-ядерные Intel Xeon 6 (Sierra Forest), которые вскоре станут 288-ядерными (при этом все варианты без Hyper-Threading), и 128-ядерные AMD EPYC Bergamo (256 потоков), которым на смену придут 192-ядерные EPYC Turin Dense (384 потока). 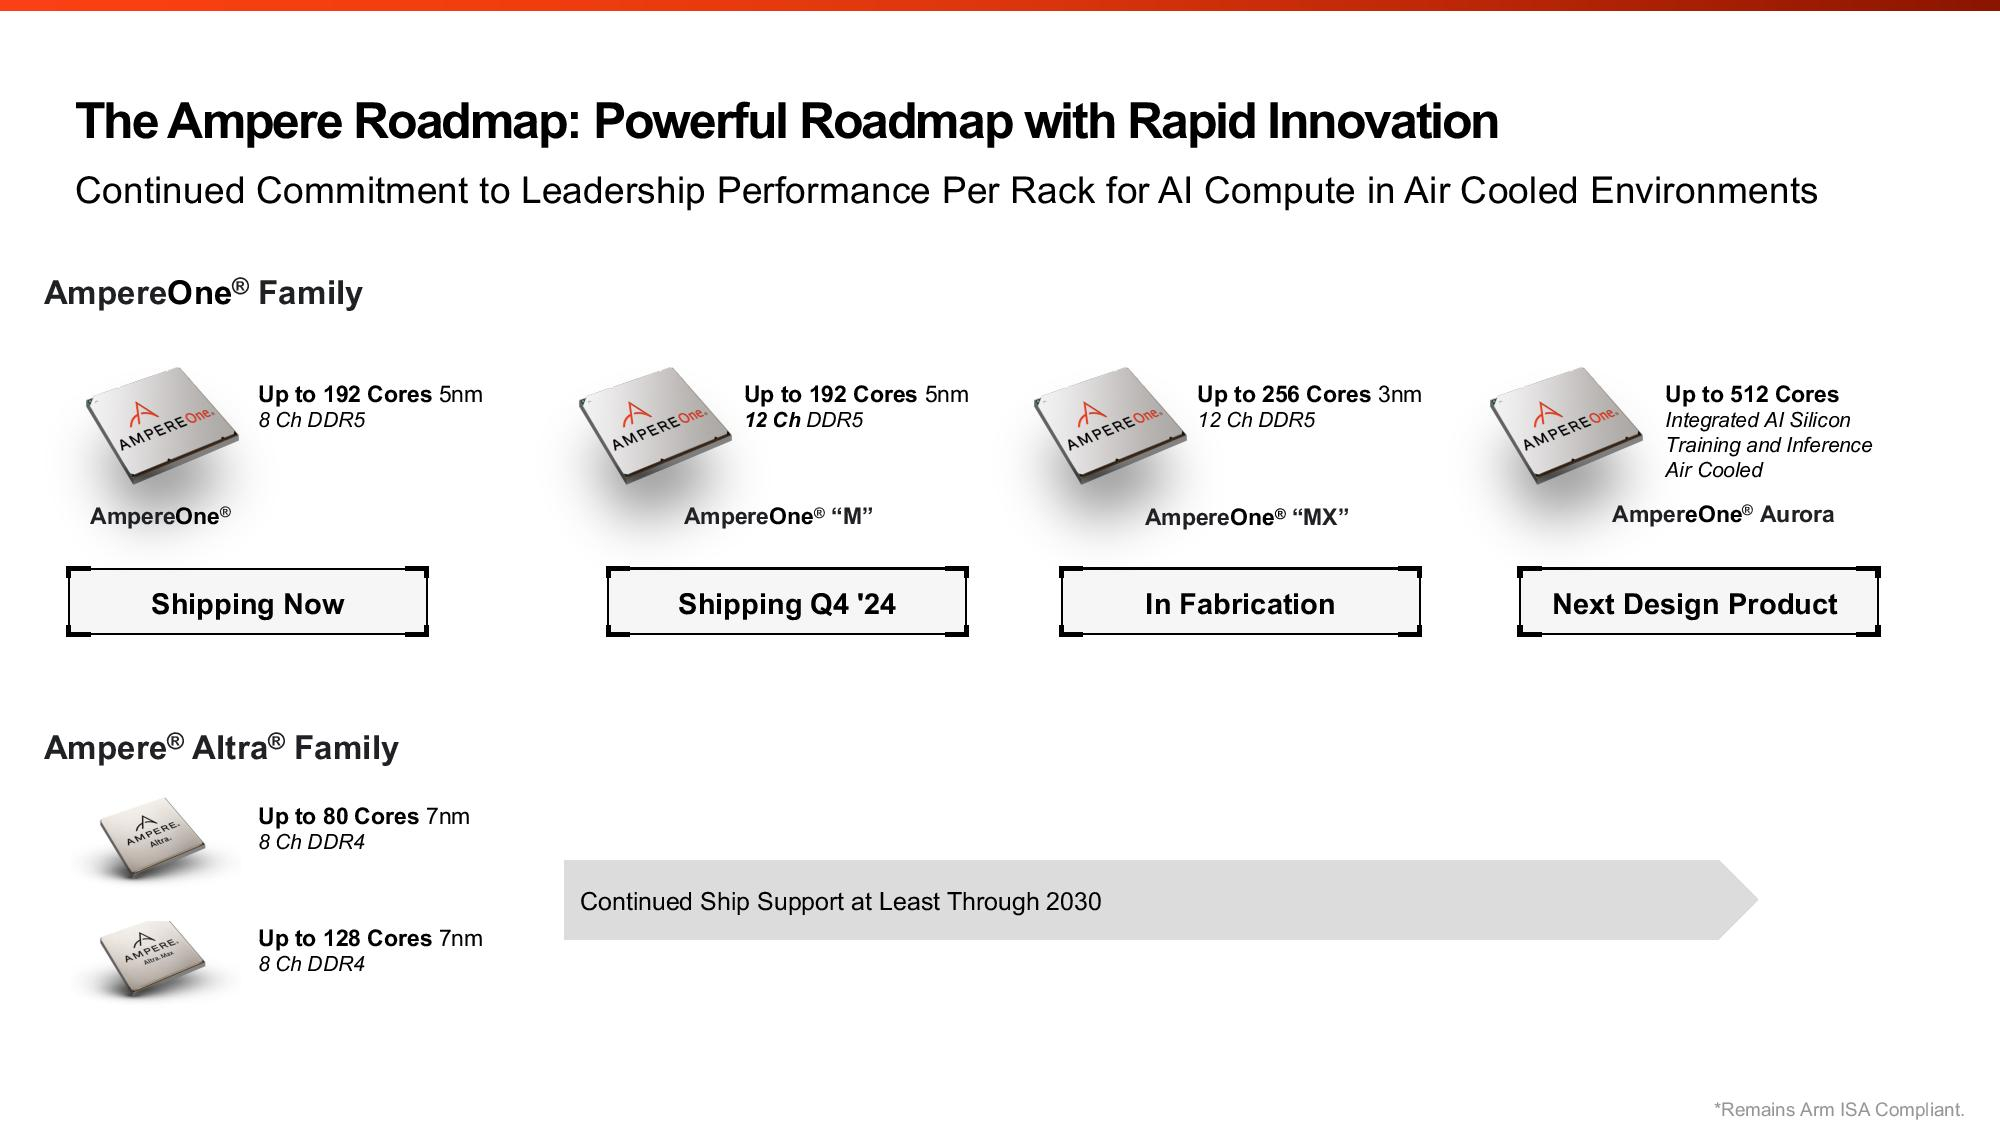 До Aurora компания выпустит ещё две серии процессоров AmpereOne: M в конце 2024 года и MX в 2025 году. 5-нм AmpereOne M получат до 192 ядер и 12-канальный контроллер памяти DDR5. 3-нм AmpereOne MX получат такой же контроллер и до 256 ядер. Заодно компания опубликовала прайс-лист актуальных CPU. В нём нет изначально заявлявшихся 136- и 172-ядерных моделей. Кроме того, остальные процессоры несколько подорожали в сравнении с прошлым поколением Altra Max, но по цене всё ещё привлекательнее решений AMD и Intel — $5555 за 192 ядра. Следует учесть, что в таблице приведён не привычный показатель TDP, а усреднённое энергопотребление чипа, из-за чего сравнивать процессоры Ampere с другими чипами затруднительно. 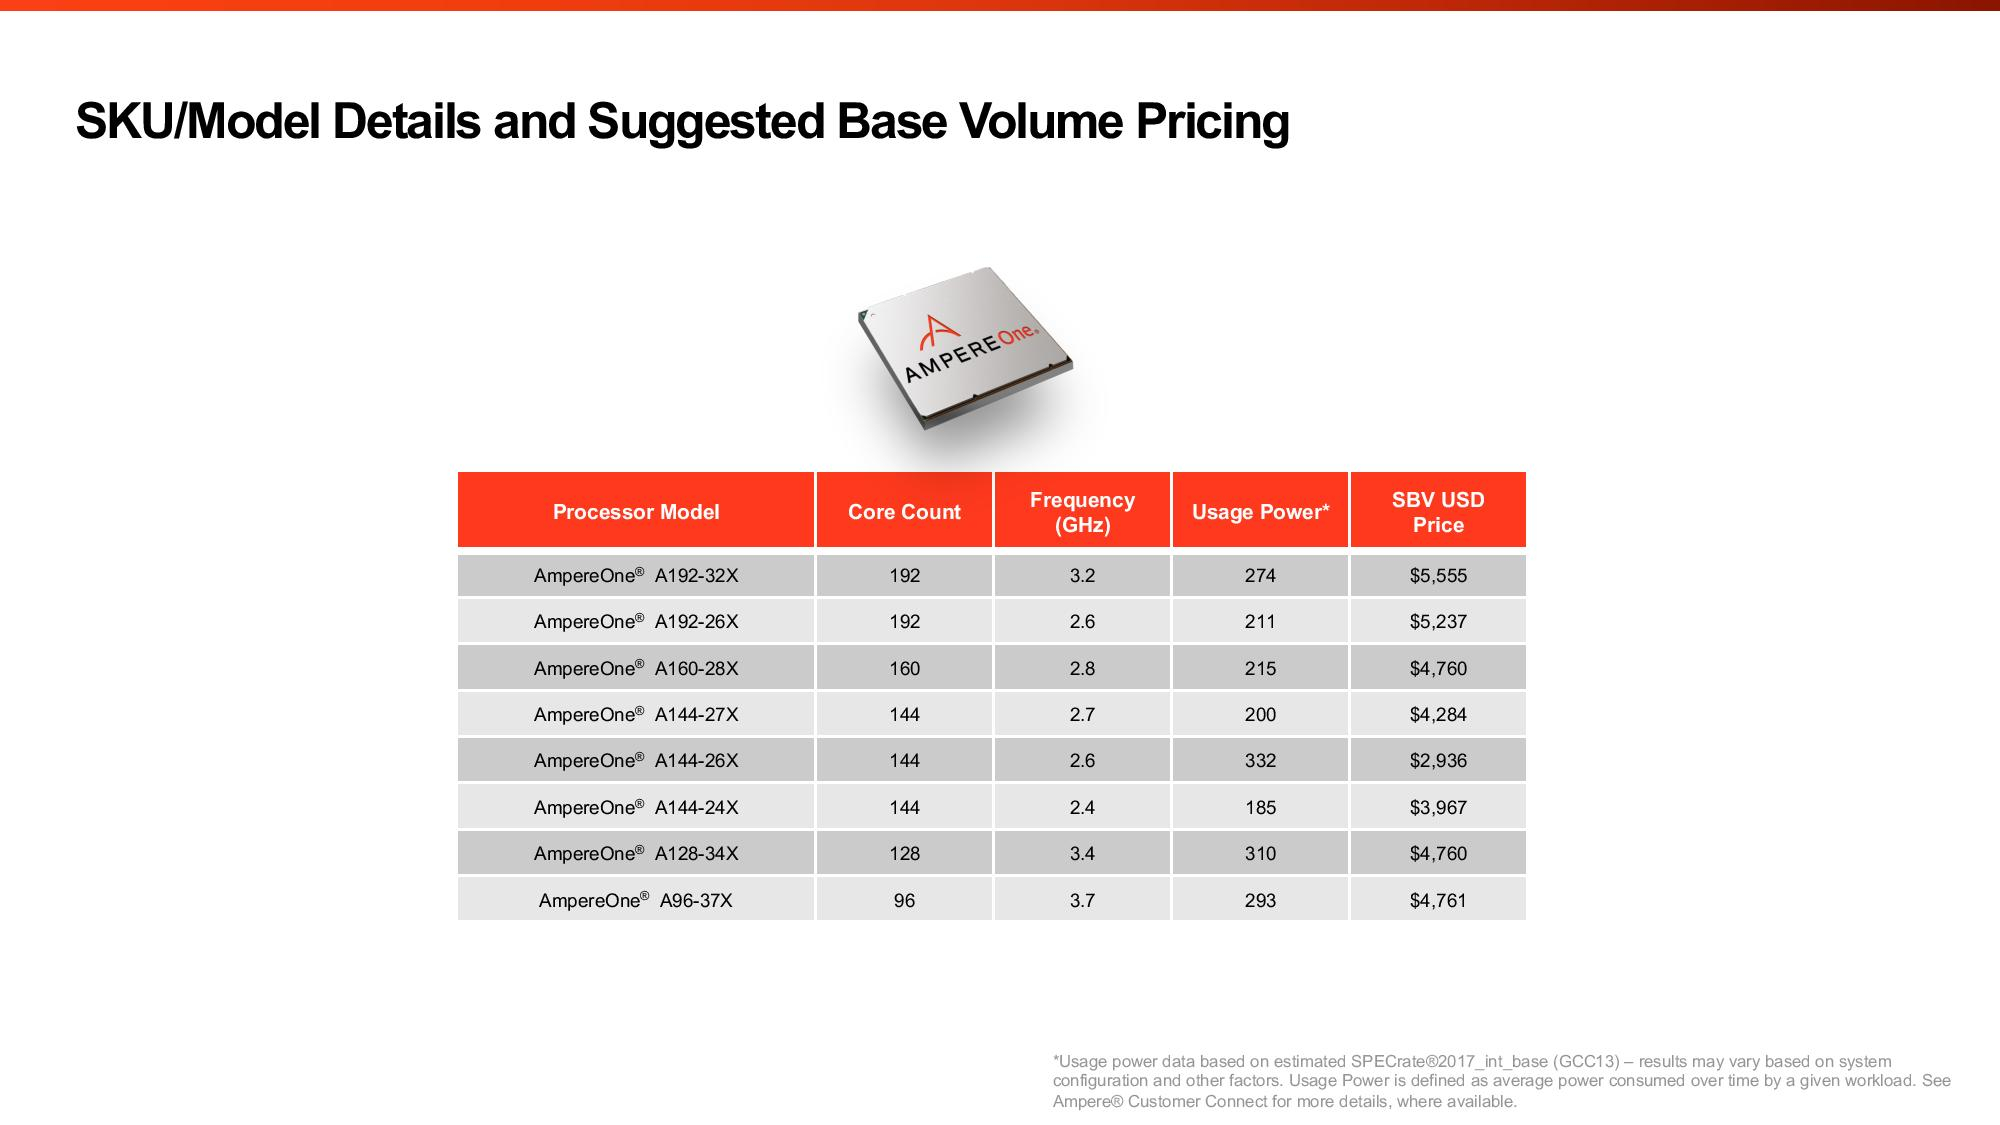 Насколько Aurora станет популярным у гиперскейлеров и других заказчиков, покажет время. У Ampere есть якорный заказчик в лице Oracle, но другие IT-гиганты уже сами разрабатывают собственные Arm-процессоры. AWS в Graviton4 довела количество ядер до 96, Microsoft анонсировала 128-ядерный Cobalt 100, Alibaba массово внедряет 128-ядерные Yitian 710, а Google готовит Axion. Fujitsu к 2027 году подготовит 144-ядерные MONAKA, которые тоже получат поддержку ИИ-нагрузок, но упор в них сделан не на HBM, а на SRAM. Собственно говоря, HBM есть только у HPC-процессоров: Fujitsu A64FX, SiPearl Rhea1 и C-DAC AUM. Даже NVIDIA Grace, которые в основном ассистируют ускорителям, обходятся LPDDR5x.
16.05.2024 [01:05], Игорь Осколков
И для ИИ, и для HPC: первые европейские серверные Arm-процессоры SiPearl Rhea1 получат HBM-памятьКомпания SiPearl уточнила спецификации разрабатываемых ею серверных Arm-процессоров Rhea1, которые будут использоваться, в частности, в составе первого европейского экзафлопсного суперкомпьютера JUPITER, хотя основными чипами в этой системе будут всё же гибридные ускорители NVIDIA GH200. Заодно SiPearl снова сдвинула сроки выхода Rhea1 — изначально первые образцы планировалось представить ещё в 2022 году, а теперь компания говорит уже о 2025-м. При этом существенно дизайн процессоров не поменялся. Они получат 80 ядер Arm Neoverse V1 (Zeus), представленных ещё весной 2020 года. Каждому ядру полагается два SIMD-блока SVE-256, которые поддерживают, в частности, работу с BF16. Объём LLC составляет 160 Мбайт. В качестве внутренней шины используется Neoverse CMN-700. Для связи с внешним миром имеются 104 линии PCIe 5.0: шесть x16 + две x4. О поддержке многочиповых конфигураций прямо ничего не говорится. 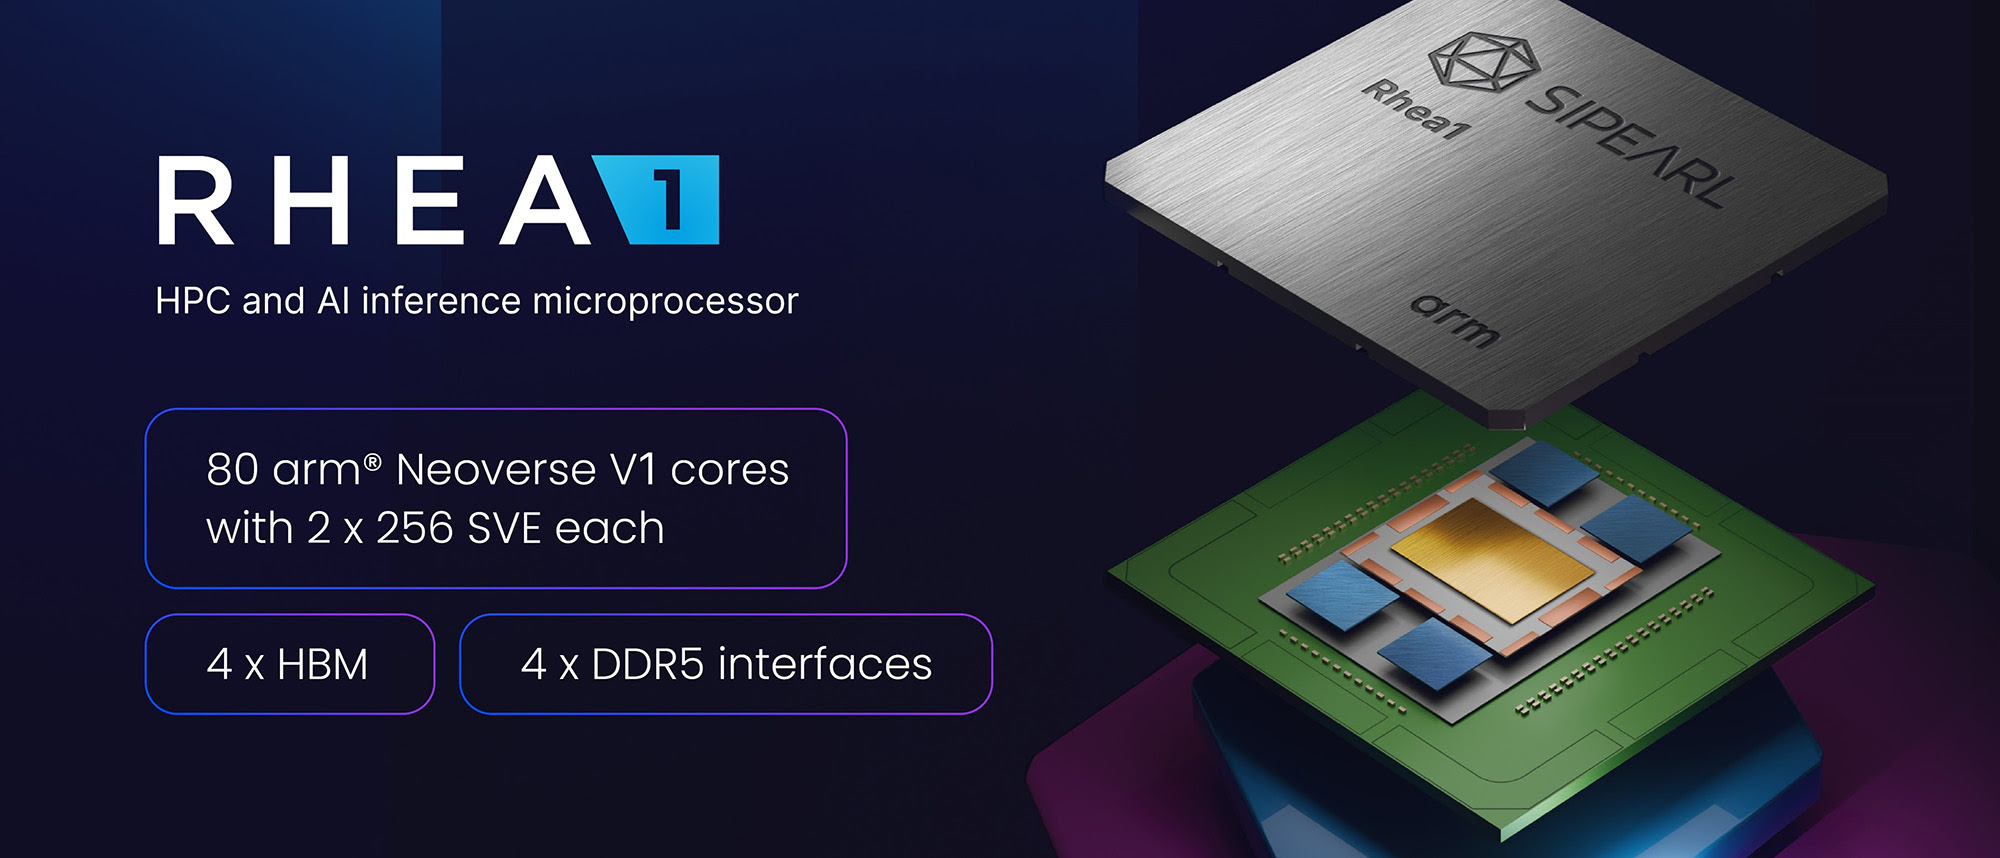
Источник изображения: SiPearl Очень похоже на то, что SiPearl от референсов Arm особо и не отдалялась, поскольку Rhea1 хоть и получит четыре стека памяти HBM, но это будет HBM2e от Samsung. При этом для DDR5 отведено всего четыре канала с поддержкой 2DPC, а сам процессор ожидаемо может быть поделён на четыре NUMA-домена. И в такой конфигурации к общей эффективности работы с памятью могут быть вопросы. Именно наличие HBM позволяет говорить SiPearl о возможности обслуживать и HPC-, и ИИ-нагрузки (инференс). 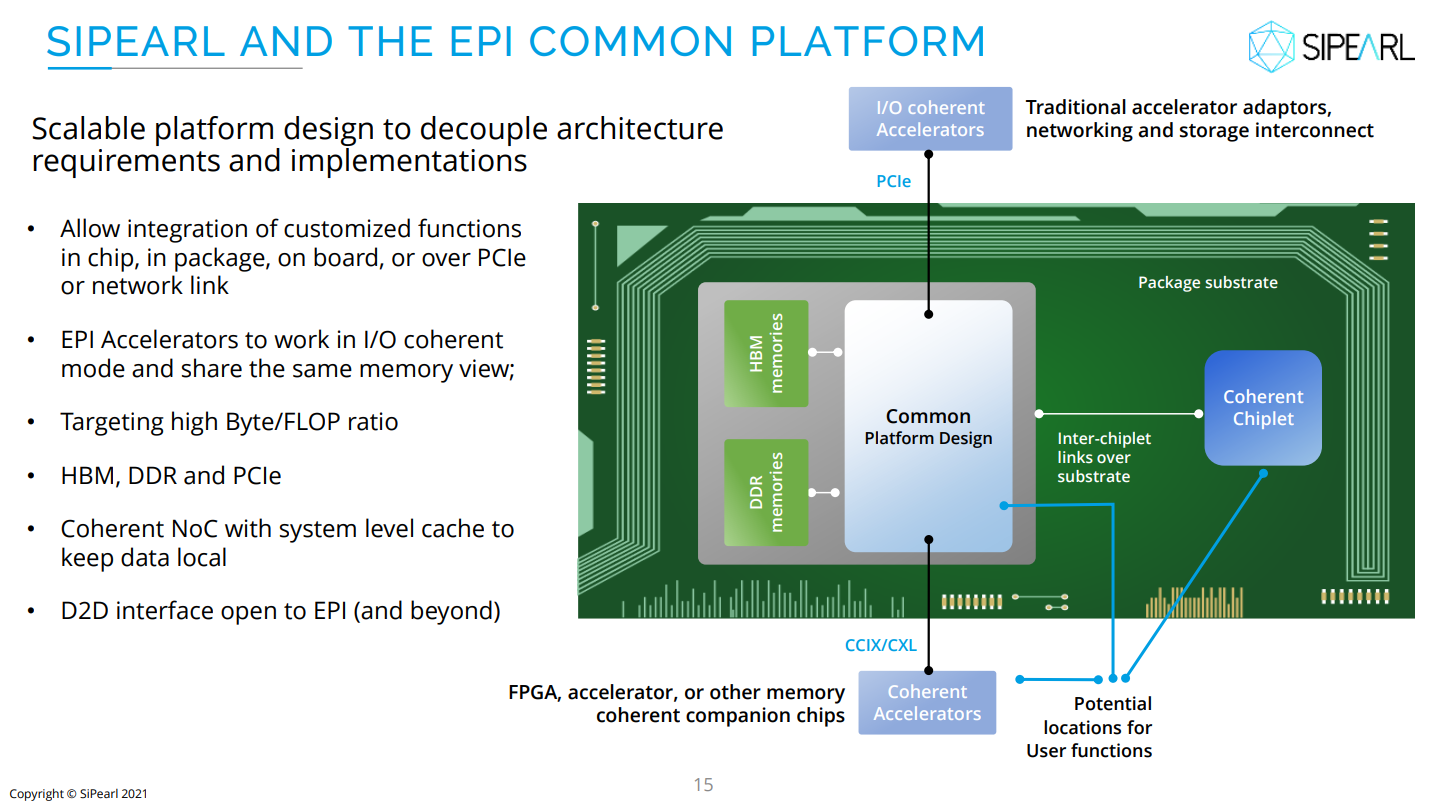
Источник изображения: SiPearl На примере Intel Xeon Max (Sapphire Rapids c 64 Гбайт HBM2e) видно, что наличие сверхбыстрой памяти на борту даёт прирост производительности в означенных задачах, хотя и не всегда. Однако это другая архитектура, другой набор инструкций (AMX), другая же подсистема памяти и вообще пока что единичный случай. С Fujitsu A64FX сравнения тоже не выйдет — это кастомный, дорогой и сложный процессор, который, впрочем, доказал эффективность и в HPC-, и даже в ИИ-нагрузках (с оговорками). В MONAKA, следующем поколении процессоров, Fujitsu вернётся к более традиционному дизайну. 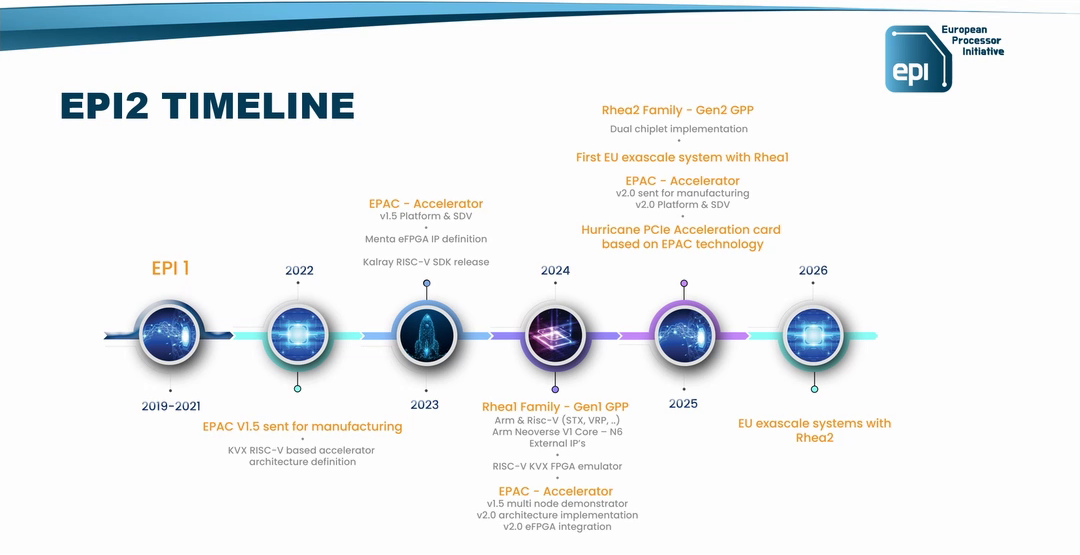
Источник изображения: EPI Пожалуй, единственный похожий на Rhea1 чип — это индийский 5-нм C-DAC AUM, который тоже базируется на Neoverse V1, но предлагает уже 96 ядер (48+48, два чиплета), восемь каналов DDR5 и до 96 Гбайт HBM3 в четырёх стеках, а также поддержку двухсокетных конфигураций. AWS Graviton3E, который тоже ориентирован на HPC/ИИ-нагрузки, вообще обходится 64 ядрами Zeus и восемью каналами DDR5. Наконец, NVIDIA Grace и Grace Hopper в процессорной части тоже как-то обходятся интегрированной LPDRR5x, да и ядра у них уже Neoverse V2 (Demeter), и своя шина для масштабирования имеется. 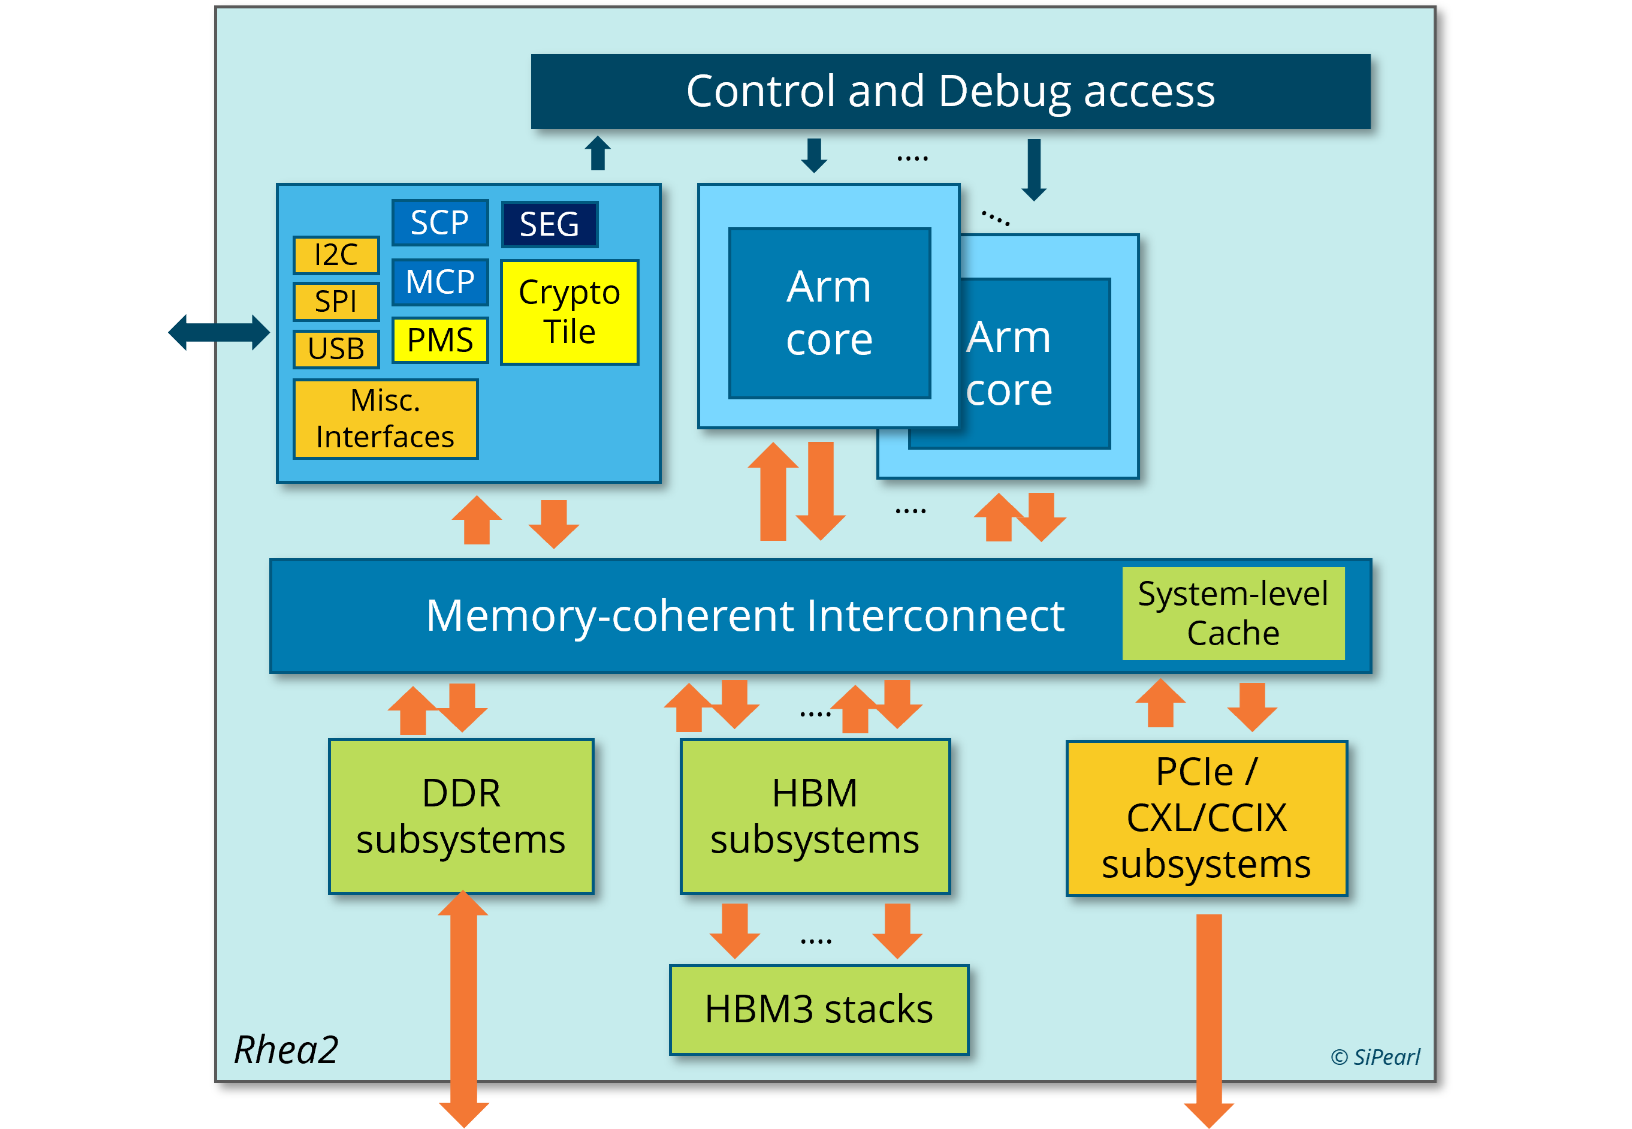
Источник изображения: EPI В любом случае в 2025 году Rhea1 будет выглядеть несколько устаревшим чипом. Но в этом же году SiPearl собирается представить более современные чипы Rhea2 и обещает, что их разработка будет не столь долгой как Rhea1. Компанию им должны составить европейские ускорители EPAC, тоже подзадержавшиеся. А пока Европа будет обходиться преимущественно американскими HPC-технологиями, от которых стремится рано или поздно избавиться. |
|

