Материалы по тегу: ии
|
29.11.2023 [01:21], Руслан Авдеев
Cerebras, критиковавшая NVIDIA за сотрудничество с Китаем, сама оказалась связана с компанией, ведущей дела с ПекиномХотя стартап Cerebras, занимающийся разработкой чипов, раскритиковал NVIDIA за попытки обойти санкционные ограничения в отношении Китая и призвал соблюдать не букву, но дух американского закона, у компании, похоже, нашлись свои скелеты в шкафу. Как сообщает The Register, сейчас в США расследуют деятельность клиента Cerebras — группы G42, возможно, помогавшей Поднебесной обходить санкционные ограничения. Американские спецслужбы подозревают, что базирующаяся в ОАЭ многопрофильная компания G42 поставляет в Китай передовые технологии. Для своих ИИ-исследований компания обратилась к Cerebras с целью постройки суперкомпьютерного кластера Condor Galaxy за $100 млн, а всего стартап намерен построить девять подобных объектов на $900 млн. При этом узлы кластера используют разработанные Cerebras чипы WSE-2, подходящие для обучения ИИ-систем. 
Источник изображения: Arthur Wang/unsplash.com Как показывают предварительные результаты расследования американских журналистов, властей и спецслужб, G42 пытается сотрудничать с Пекином и работает с китайскими компаниями вроде Huawei, давно находящимися под санкциями. В самой G42 утверждают, что принимают все меры для того, чтобы соблюдать американские ограничения. При этом, по данным журналистов, G42 считают прокси-компанией для работы в интересах КНР, помогающей Пекину получать вычислительные ресурсы и подсанкционные технологии. По словам главы Cerebras Эндрю Фельдмана (Andrew Feldman), его компания точно не будет вести бизнес с Китаем. Бизнесмен попал в неловкую ситуацию после того, как появилась информация о тесных связях G42 с Пекином. На запрос журналистов в Cerebras заявили, что кластеры Condor Galaxy находятся в США, а G42 получает к ним облачный доступ, так что любая активность контролируется и соответствует американским законам — государства-противники не имеют прямого доступа к ИИ-системам. Фельдман якобы не знал о сомнительном статусе G42, а в стартапе подчеркнули, что не комментируют слухи. Бюро промышленности и безопасности США уже обратилось к поставщикам облачных инфраструктур для консультаций о целесообразности дополнительных ограничений доступа к их услугам из некоторых стран. В частности, бюро интересует, как операторы намерены выявлять разработчиков ИИ-моделей, вызывающих обеспокоеность властей и что можно предпринять для устранения угроз. Кроме того, президент США предложил новые правила, согласно которым облакам потребуется докладывать о деятельности иностранцев, связанной с обучением больших языковых моделей (LLM).
28.11.2023 [22:20], Игорь Осколков
NVIDIA анонсировала суперускоритель GH200 NVL32 и очередной самый мощный в мире ИИ-суперкомпьютер Project CeibaAWS и NVIDIA анонсировали сразу несколько новых совместно разработанных решений для генеративного ИИ. Основным анонсом формально является появление ИИ-облака DGX Cloud в инфраструктуре AWS, вот только облако это отличается от немногочисленных представленных ранее платформ DGX Cloud тем, что оно первом получило гибридные суперчипах GH200 (Grace Hoppper), причём в необычной конфигурации. 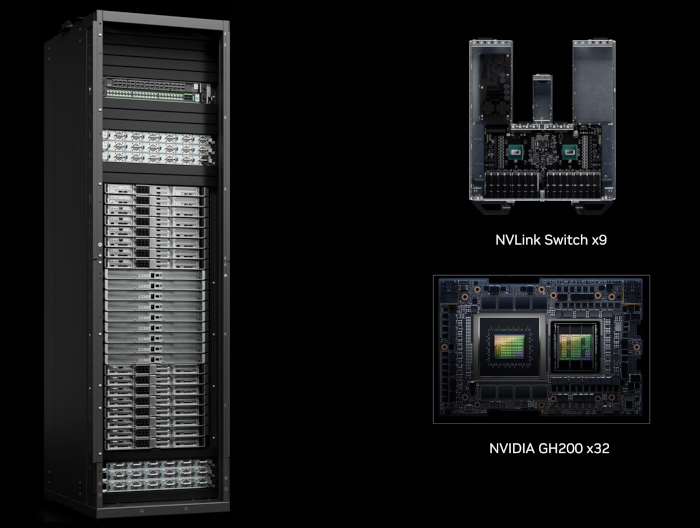
Изображения: NVIDIA В основе AWS DGX Cloud лежит платформа GH200 NVL32, но это уже не какой-нибудь сдвоенный акселератор вроде H100 NVL, а целая, готовая к развёртыванию стойка, включающая сразу 32 ускорителя GH200, провязанных 900-Гбайт/с интерконнектом NVLink. В состав такого суперускорителя входят 9 коммутаторов NVSwitch и 16 двухчиповых узлов с жидкостным охлаждением. По словам NVIDIA, GH200 NVL32 идеально подходит как для обучения, так и для инференса действительно больших LLM с 1 трлн параметров. 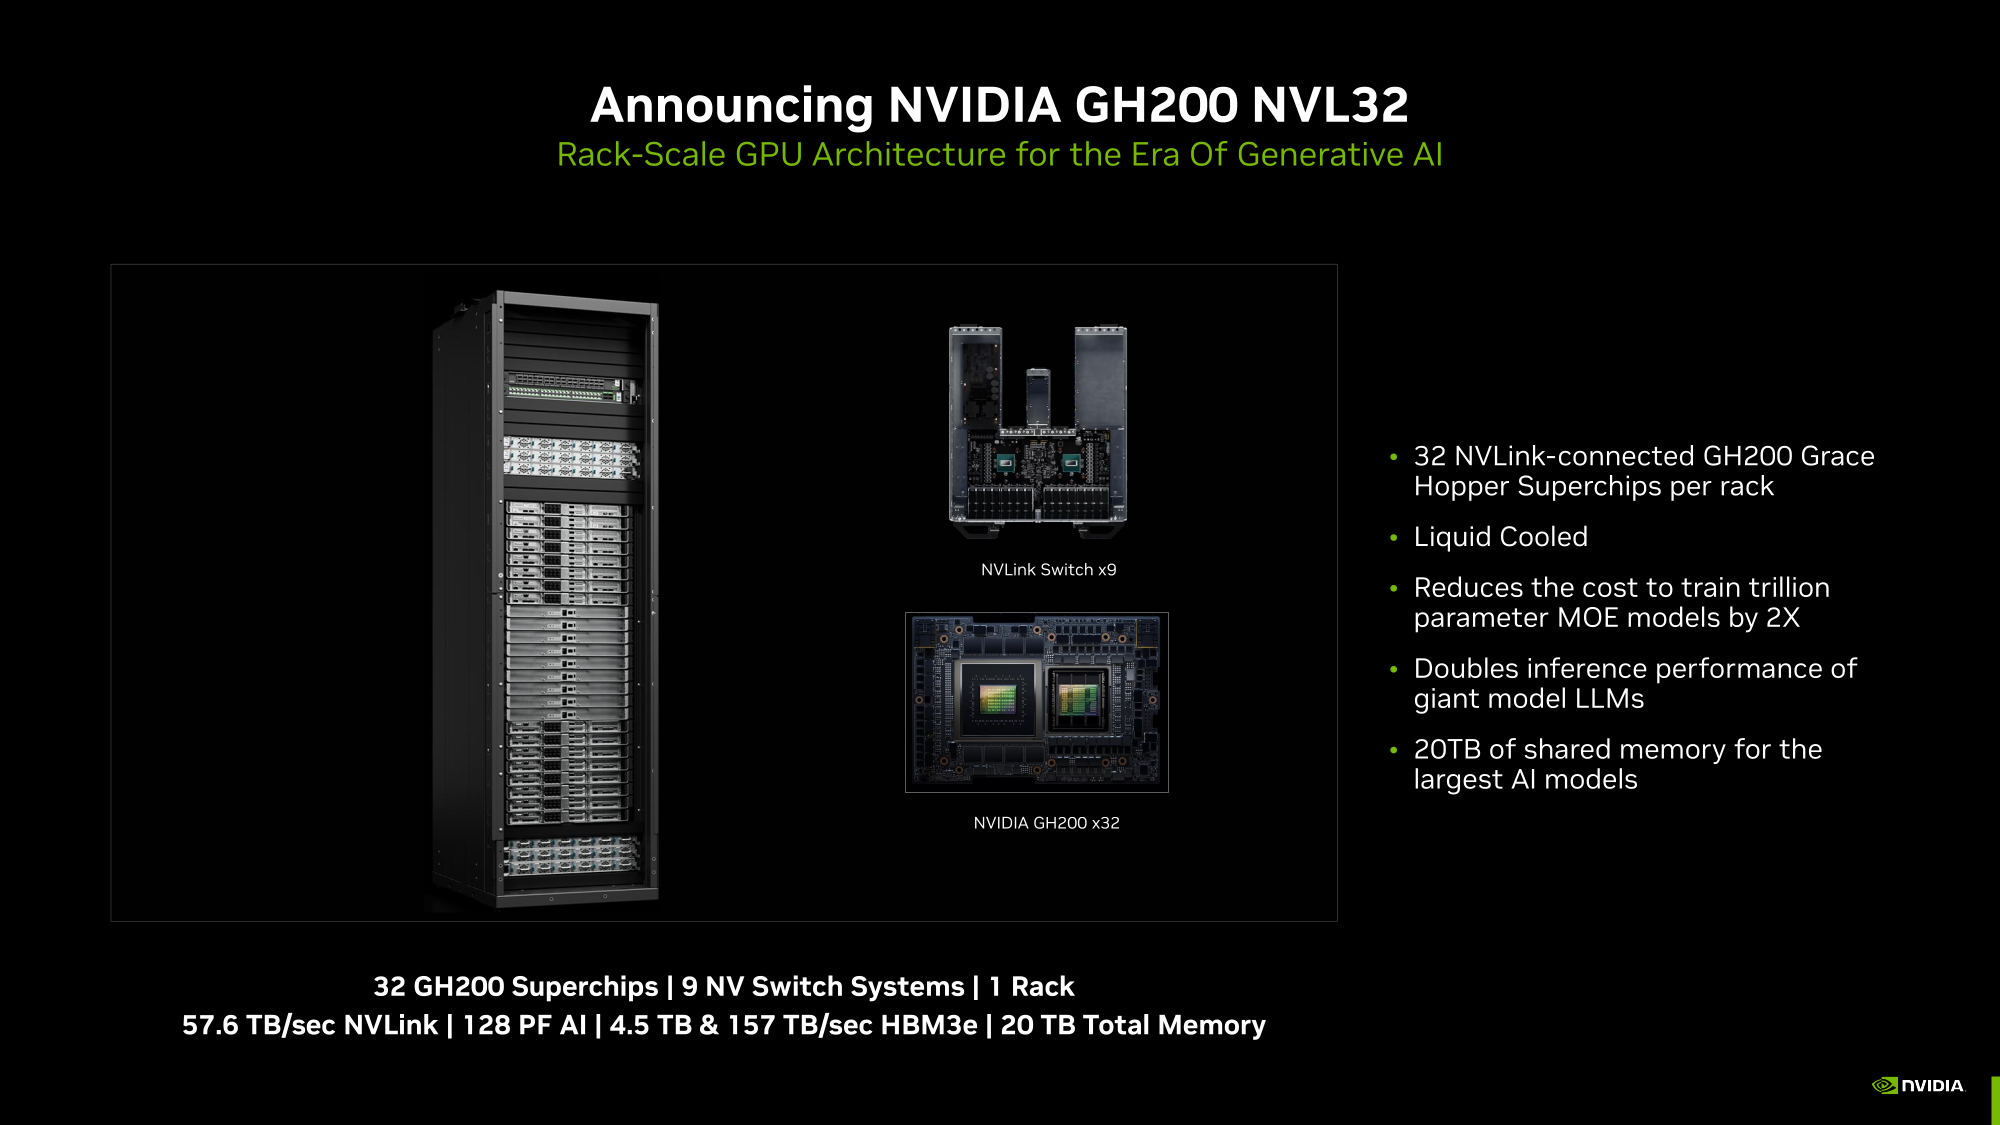 Простым перемножением количества GH200 на характеристики каждого ускорителя получаются впечатляющие показатели: 128 Пфлопс (FP8), 20 Тбайт оперативной памяти, из которых 4,5 Тбайт приходится на HBM3e с суммарной ПСП 157 Тбайтс, и агрегированная скорость NVLink 57,6 Тбайт/с. И всё это с составе одного EC2-инстанса! Да, новая платформа использует фирменные DPU AWS Nitro и EFA-подключение (400 Гбит/с на каждый GH200). Новые инстансы, пока что безымянные, можно объединять в кластеры EC2 UltraClasters. 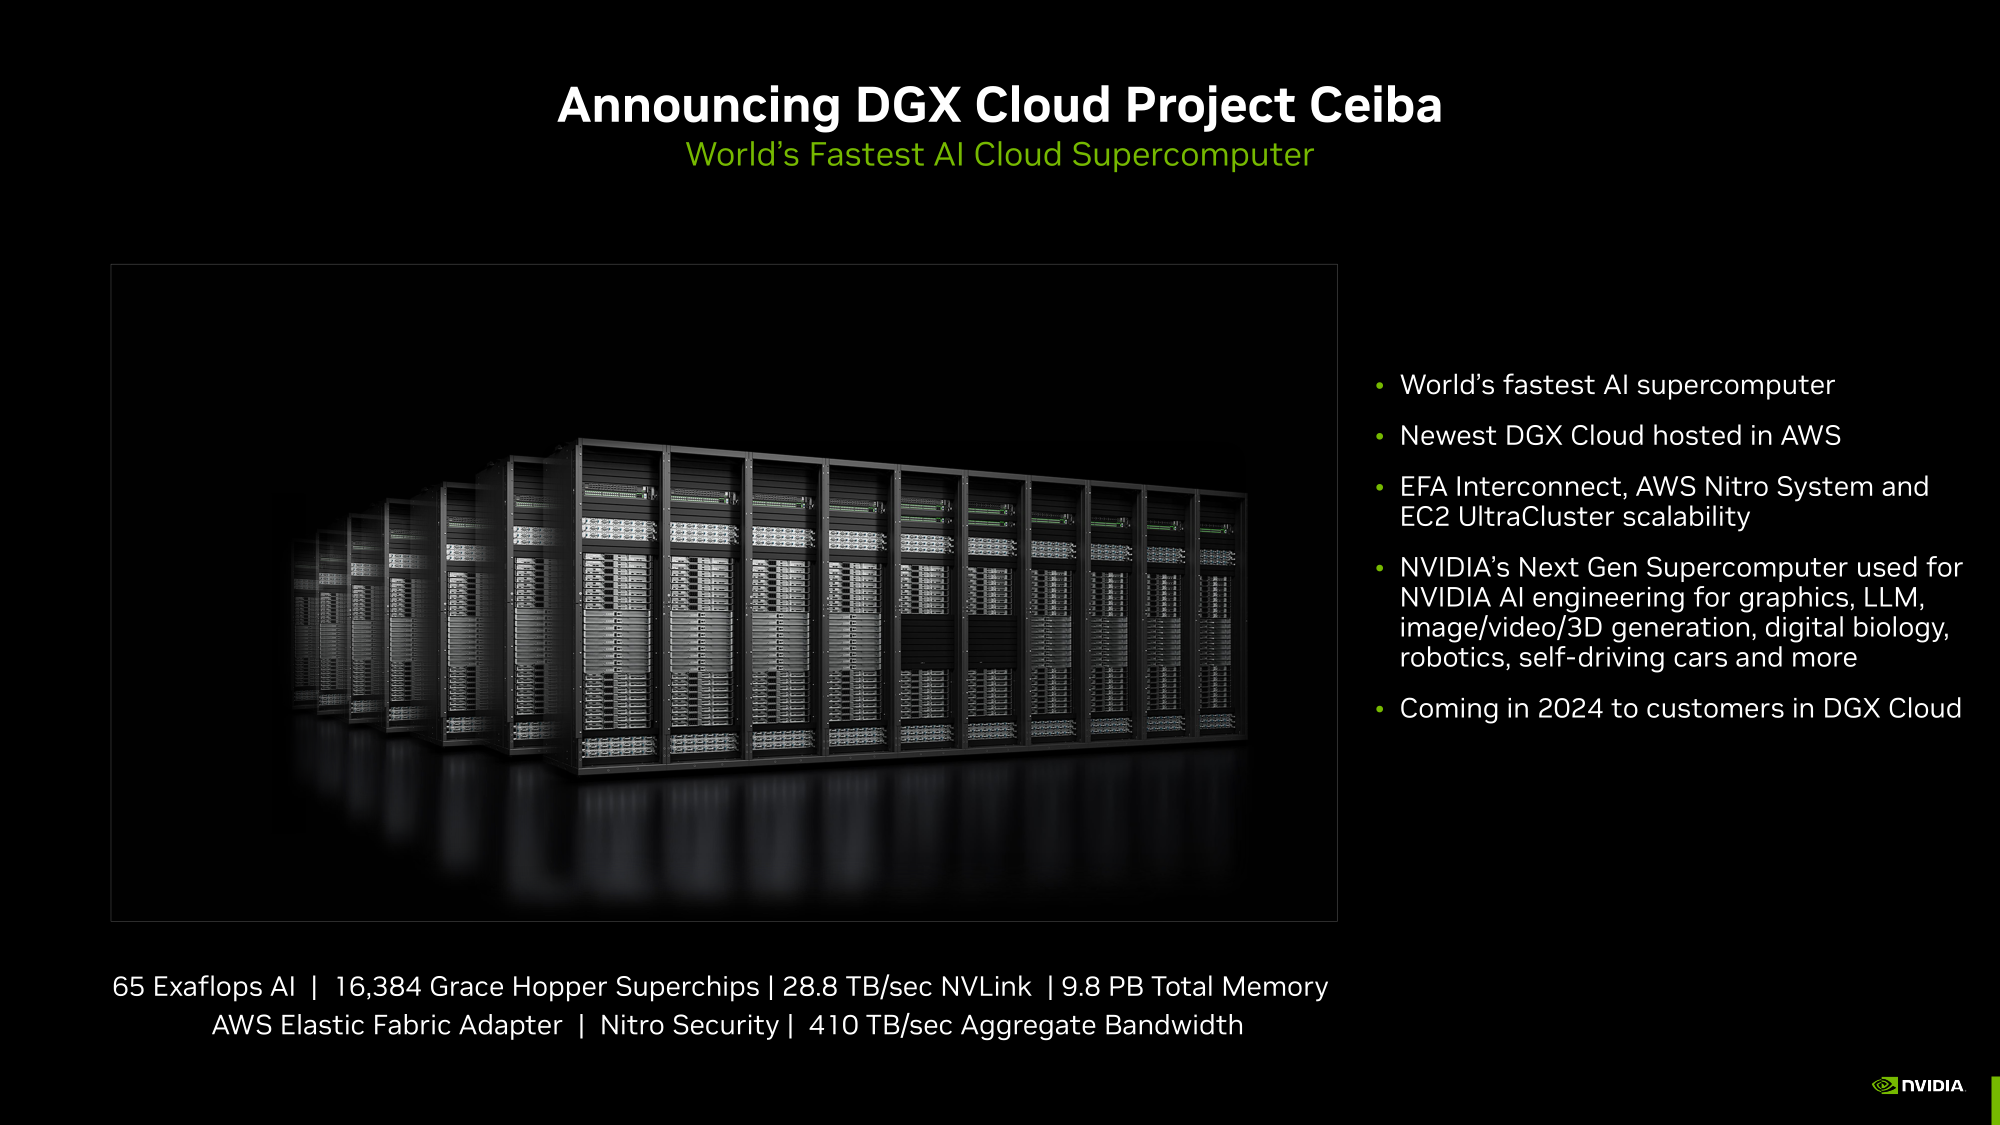 Одним из таких кластеров станет Project Ceiba, очередной самый мощный в мире ИИ-суперкомпьютер с FP8-производительность 65 Эфлопс, объединяющий сразу 16 384 ускорителя GH200 и имеющий 9,1 Пбайт памяти, а также агрегированную пропускную способность интерконнекта на уровне 410 Тбайт/с (28,8 Тбайт/с NVLink). Он и станет частью облака AWS DGX Cloud, которое будет доступно в начале 2024 года. В скором времени появятся и EC2-инстансы попроще: P5e с NVIDIA H200, G6e с L40S и G6 с L4. 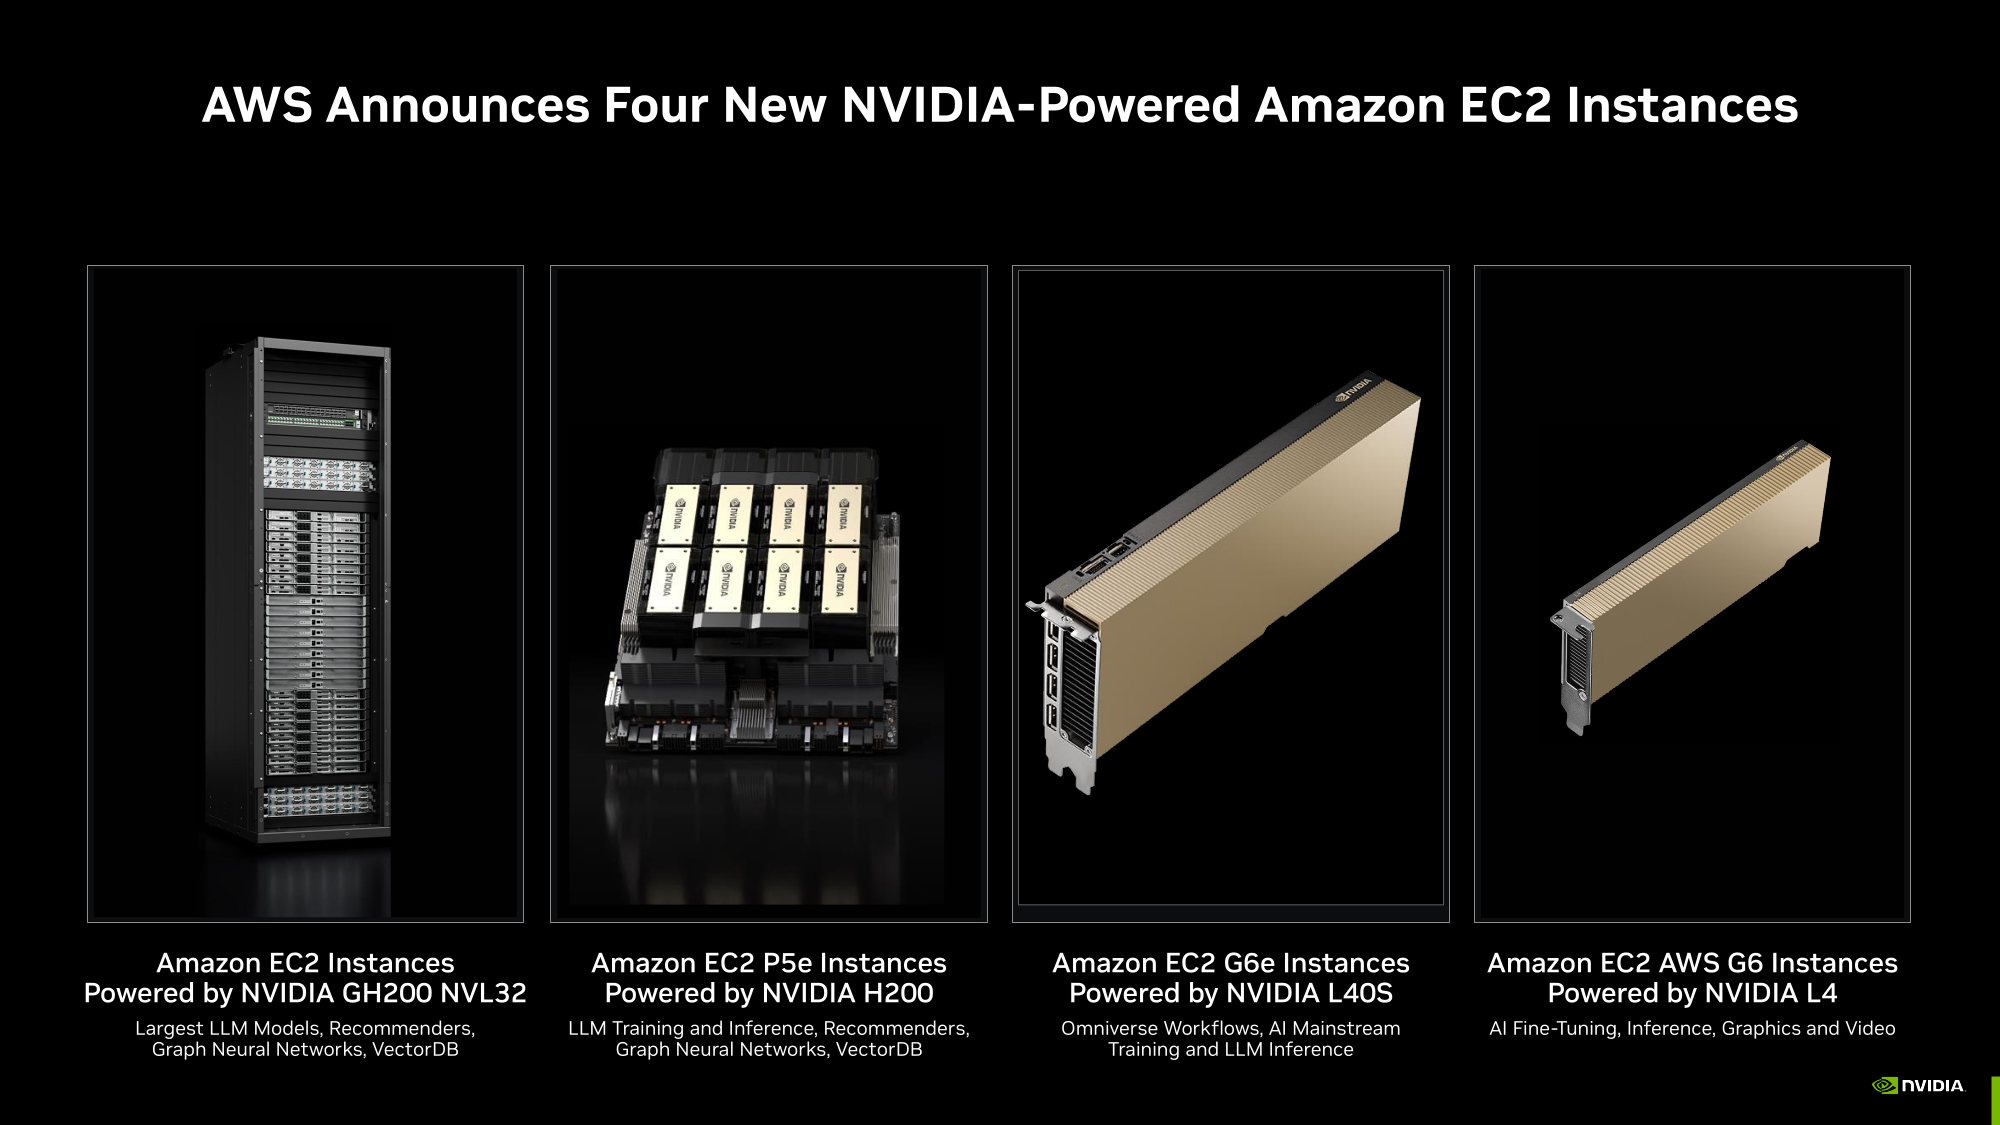
19.11.2023 [03:00], Сергей Карасёв
Южнокорейский стартап Sapeon представил 7-нм ИИ-чип X330ИИ-стартап Sapeon, поддерживаемый южнокорейским телекоммуникационным гигантом SK Group, анонсировал чип X330, предназначенный для инференса и обслуживания больших языковых моделей (LLM). Изделие ляжет в основу специализированных ускорителей для дата-центров. Sapeon заявляет, что новый нейропроцессор (NPU) обеспечивает примерно вдвое более высокую производительность и в 1,3 раза лучшую энергоэффективность, чем продукты конкурентов, выпущенные в этом году. По сравнению с предыдущим решением самой компании — Sapeon X220 — достигается увеличение быстродействия в четыре раза и повышение энергоэффективности в два раза. 
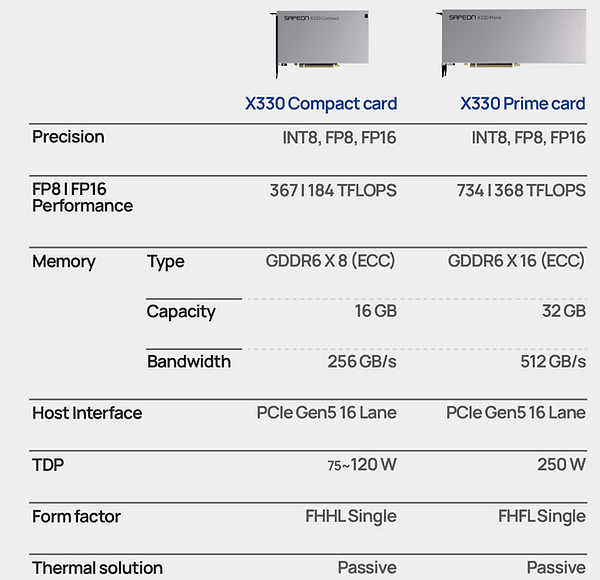
Изображения: Sapeon Новинка будет изготавливаться на TSMC по 7-нм технологии. Массовое производство запланировано на I полугодие 2024 года. На базе чипа будут предлагаться два ускорителя — X330 Compact Card и X330 Prime Card. Оба имеют однослотовое исполнение и оснащаются системой пассивного охлаждения. Для подключения применяется интерфейс PCIe 5.0 х16. Карты могут осуществлять вычисления INT8, FP8 и FP16. 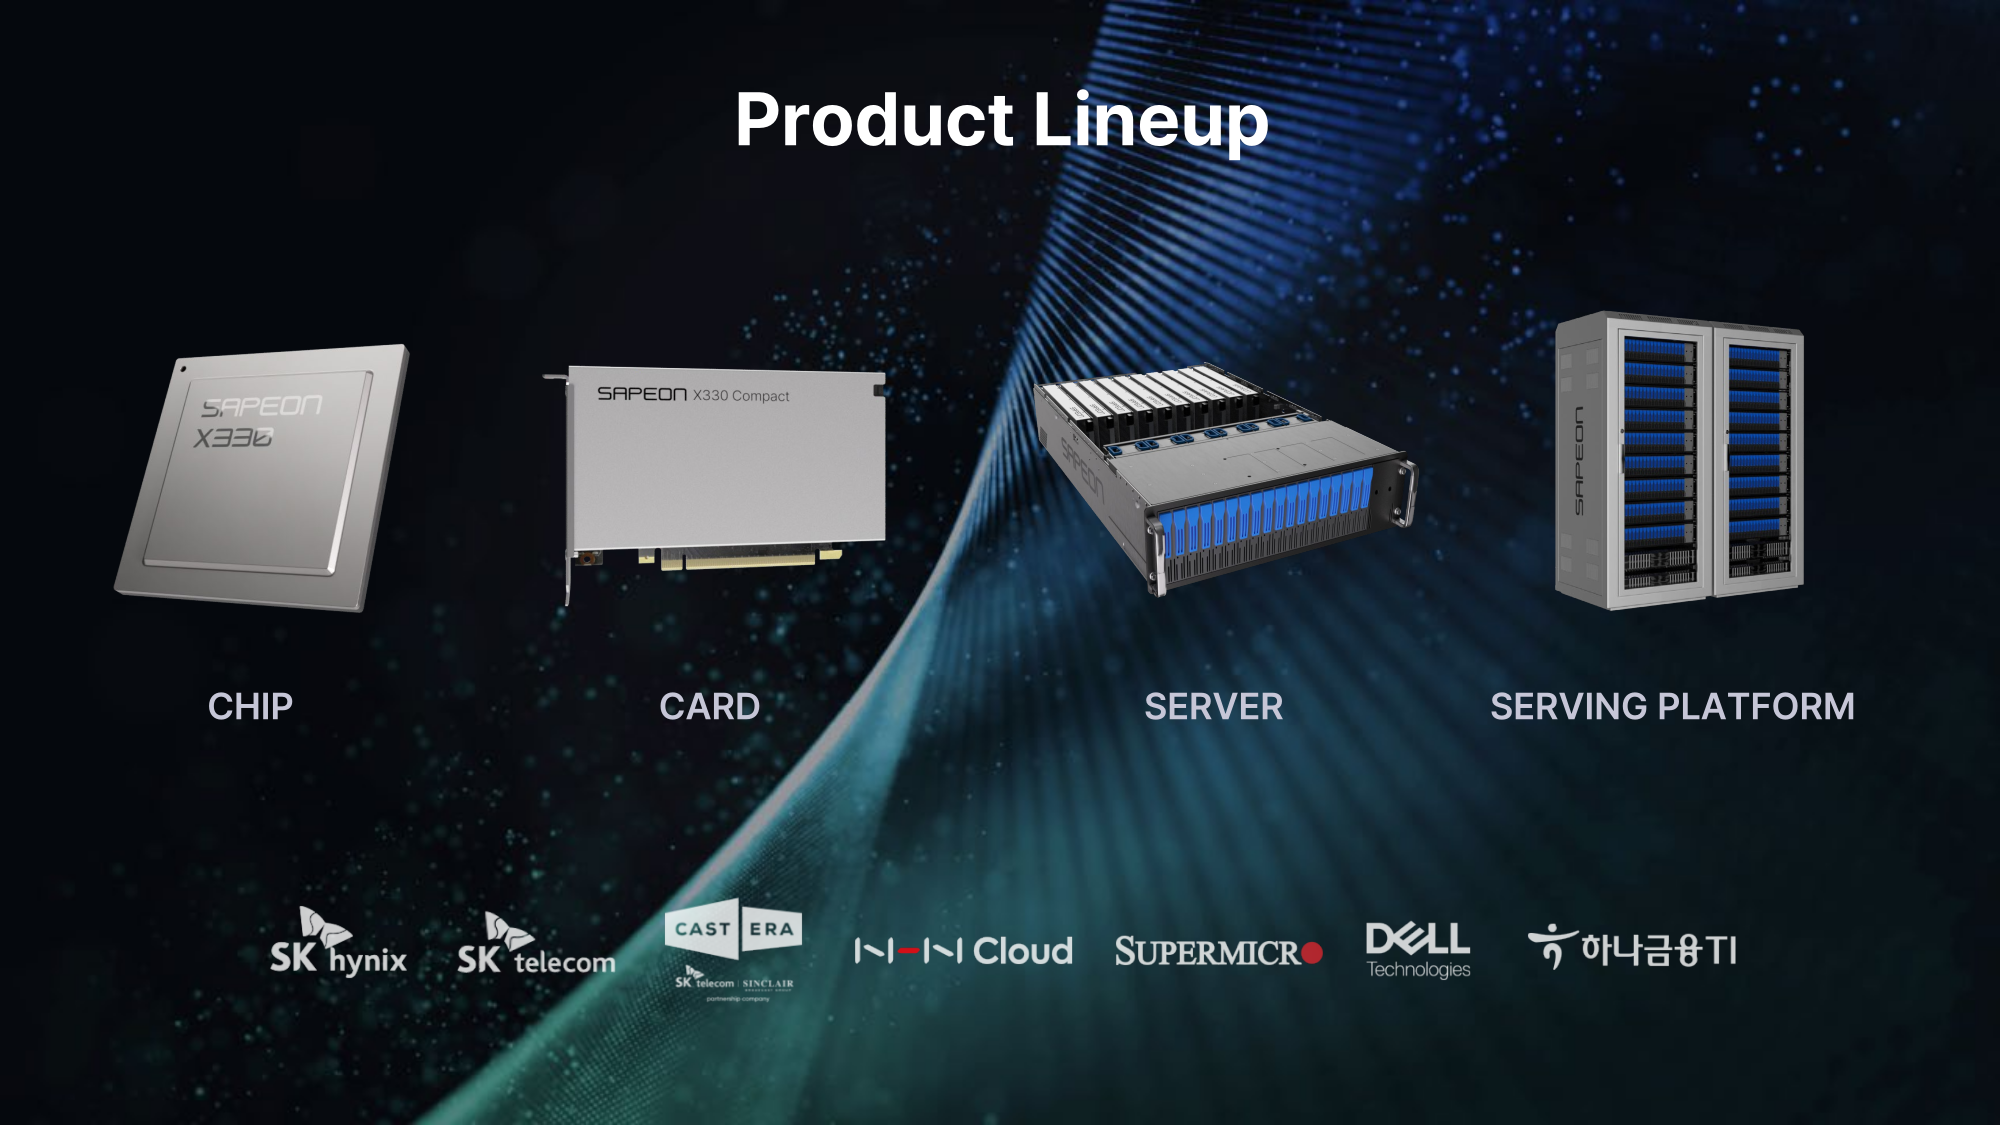 Модель X330 Compact Card уменьшенной длины несёт на борту 16 Гбайт памяти GDDR6 с пропускной способностью до 256 Гбайт/с. Заявленная производительность на операциях FP8 и FP16 достигает соответственно 367 и 184 Тфлопс. Энергопотребление варьируется в диапазоне от 75 до 120 Вт. Полноразмерная модификация X330 Prime Card получила 32 Гбайт памяти GDDR6 с пропускной способностью до 512 Гбайт/с. Заявленное быстродействие FP8 и FP16 составляет до 734 и 368 Тфлопс. Энергопотребление — 250 Вт. 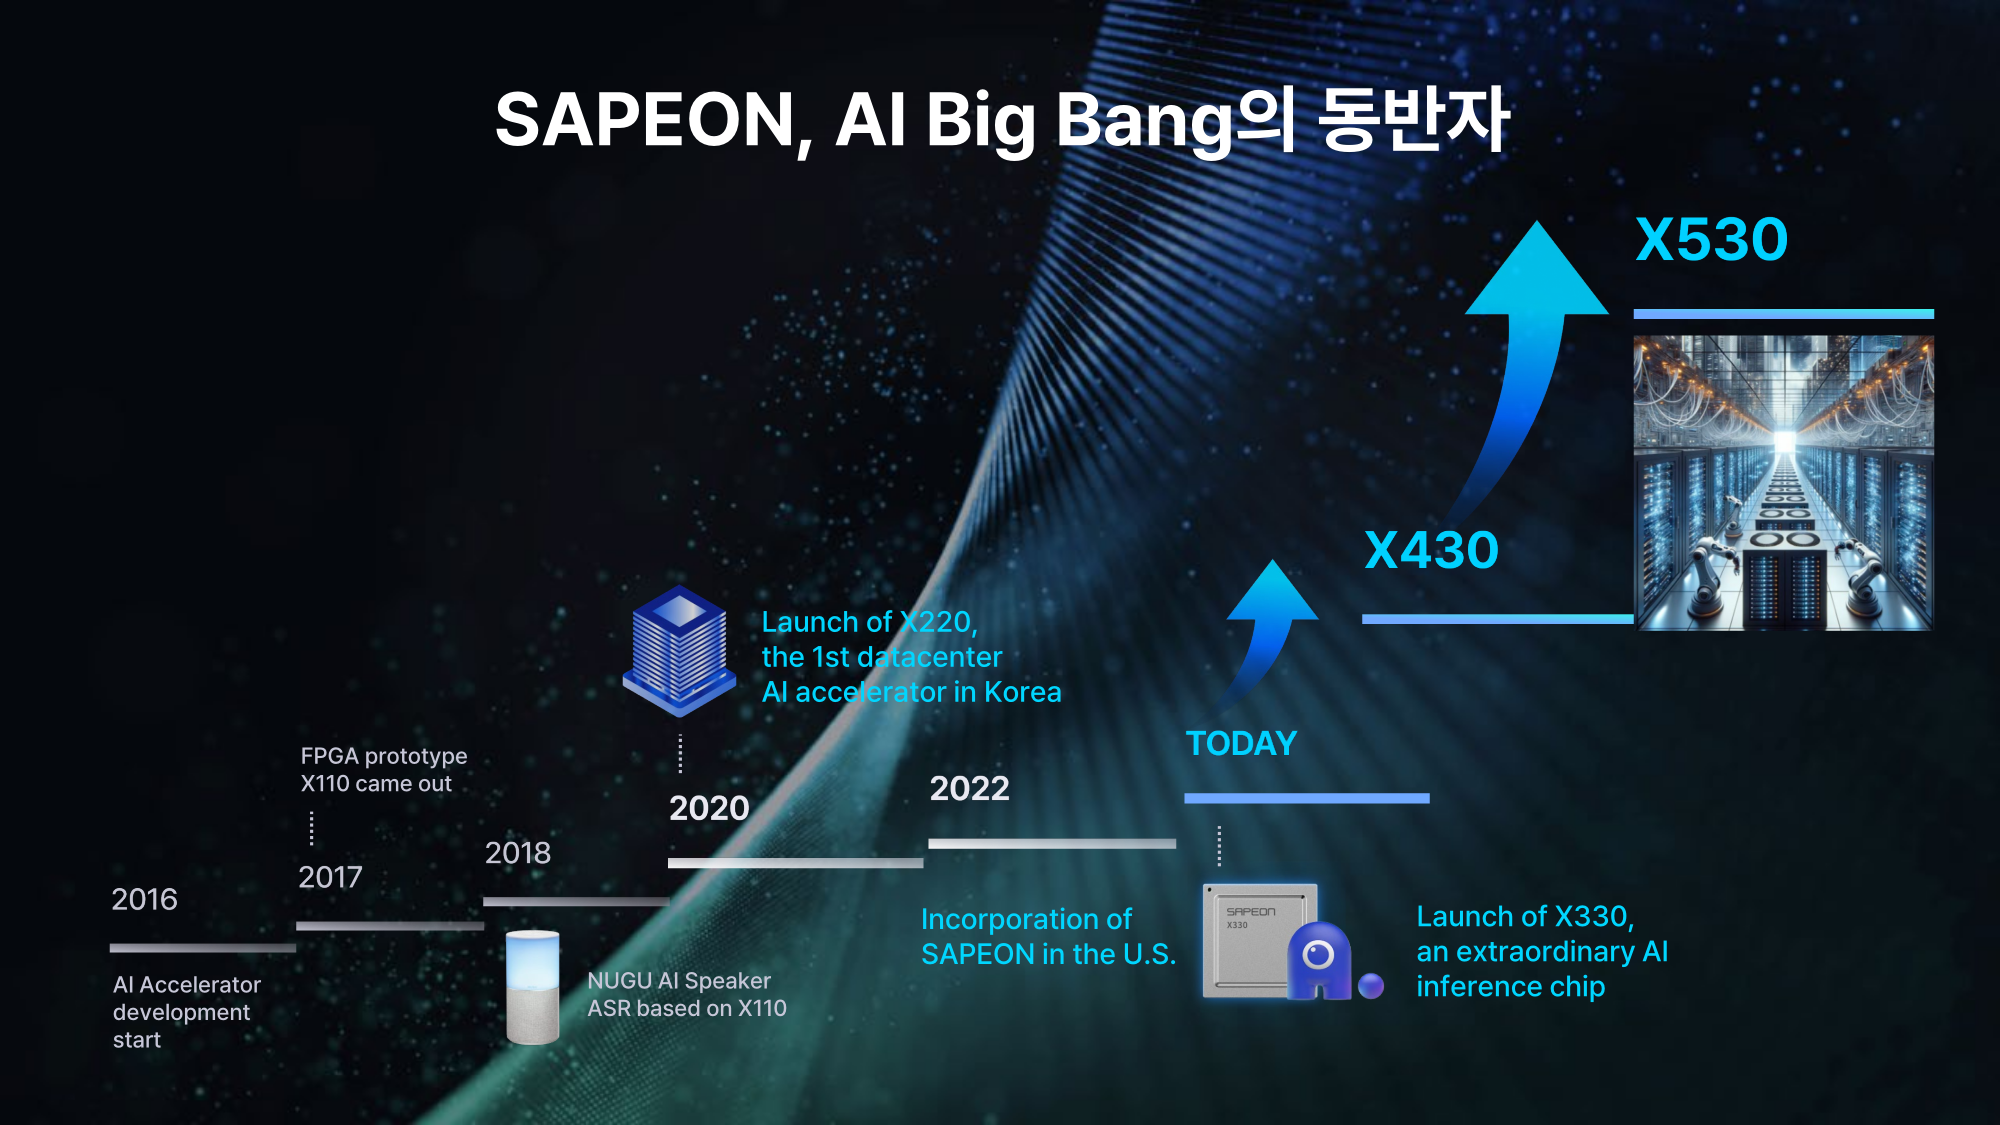 Группа SK в последнее время активно вкладывается в развитие ИИ, инвестируя напрямую или через дочерние структуры как в софт, так и в железо. С ней, в частности, связан ещё один южнокорейский разработчик ИИ-чипов Rebellions, также поддерживаемый правительством страны, которое намерено к 2030 году довести долю отечественных ИИ-чипов в местных дата-центрах до 80 %. Делается это для того, чтобы снизить зависимость от иностранных решений и избежать дефицита. Сама же Sapeon готовит ещё минимум два поколения своих чипов.
16.11.2023 [02:43], Алексей Степин
Microsoft представила 128-ядерый Arm-процессор Cobalt 100 и ИИ-ускоритель Maia 100 собственной разработкиГиперскейлеры ради снижения совокупной стоимости владения (TCO) и зависимости от сторонних вендоров готовы вкладываться в разработку уникальных чипов, изначально оптимизированных под их нужды и инфраструктуру. К небольшому кругу компаний, решившихся на такой шаг, присоединилась Microsoft, анонсировавшая Arm-процессор Azure Cobalt 100 и ИИ-ускоритель Azure Maia 100. 
Изображения: Microsoft Первопроходцем в этой области стала AWS, которая разве что память своими силами не разрабатывает. У AWS уже есть три с половиной поколения Arm-процессоров Graviton и сразу два вида ИИ-ускорителей: Trainium для обучения и Inferentia2 для инференса. Крупный китайский провайдер Alibaba Cloud также разработал и внедрил Arm-процессоры Yitian и ускорители Hanguang. Что интересно, в обоих случаях процессоры оказывались во многих аспектах наиболее передовыми. Наконец, у Google есть уже пятое поколение ИИ-ускорителей TPU. 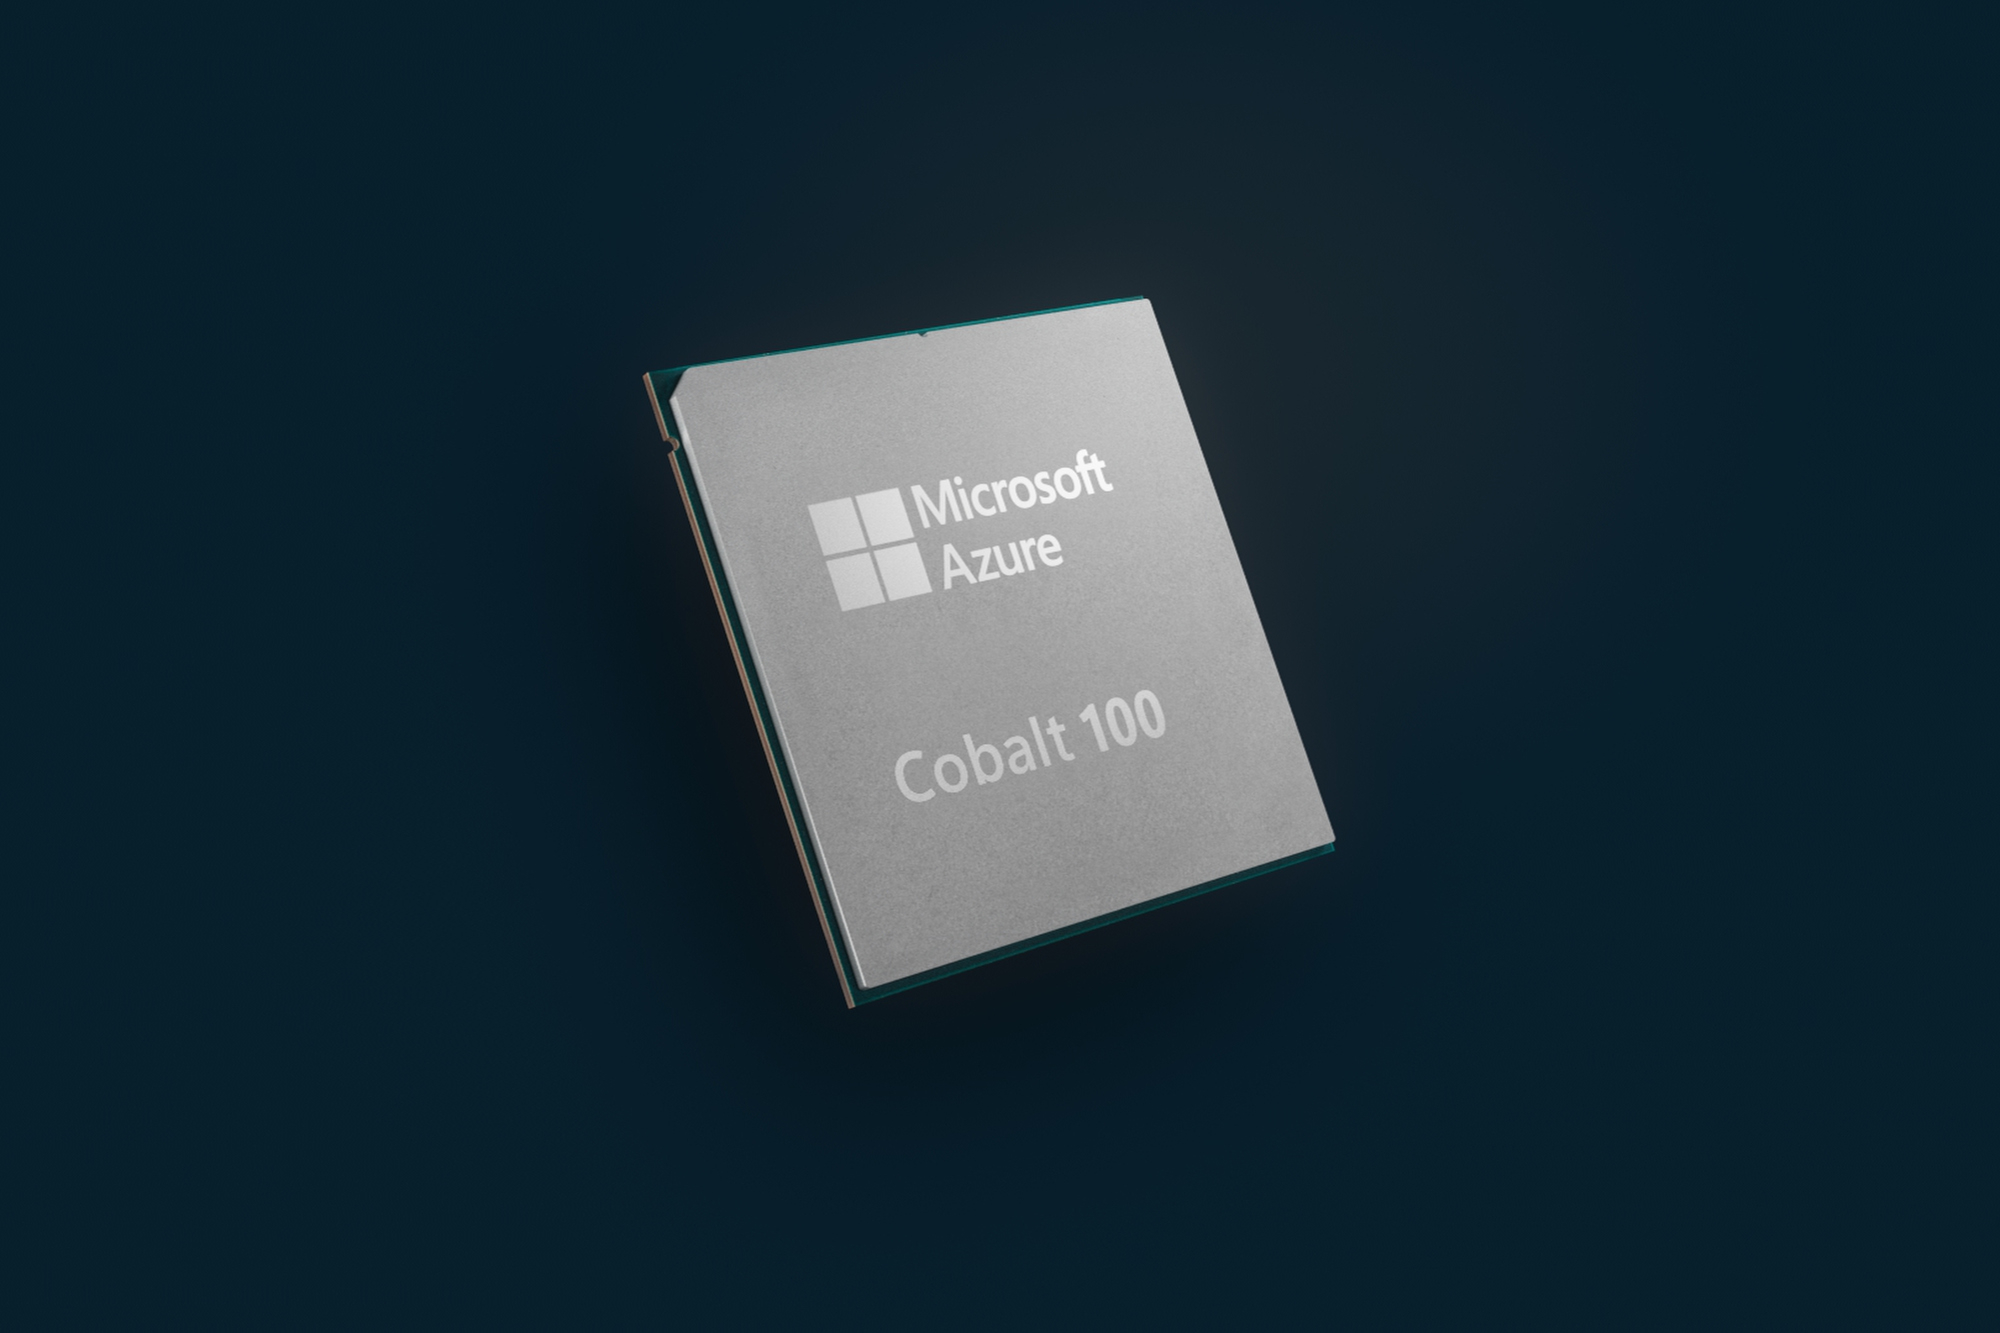 Microsoft заявила, что оба новых чипа уже производятся на мощностях TSMC с использованием «последнего техпроцесса» и займут свои места в ЦОД Microsoft в начале следующего года. Как минимум, в случае с Maia 100 речь идёт о 5-нм техпроцессе, вероятно, 4N. В настоящее время Microsoft Azure находится в начальной стадии развёртывания инфраструктуры на базе новых чипов, которая будет использоваться для Microsoft Copilot, Azure OpenAI и других сервисов. Например, Bing до сих пор во много полагается на FPGA, а вся ИИ-инфраструктура Microsoft крайне сложна. 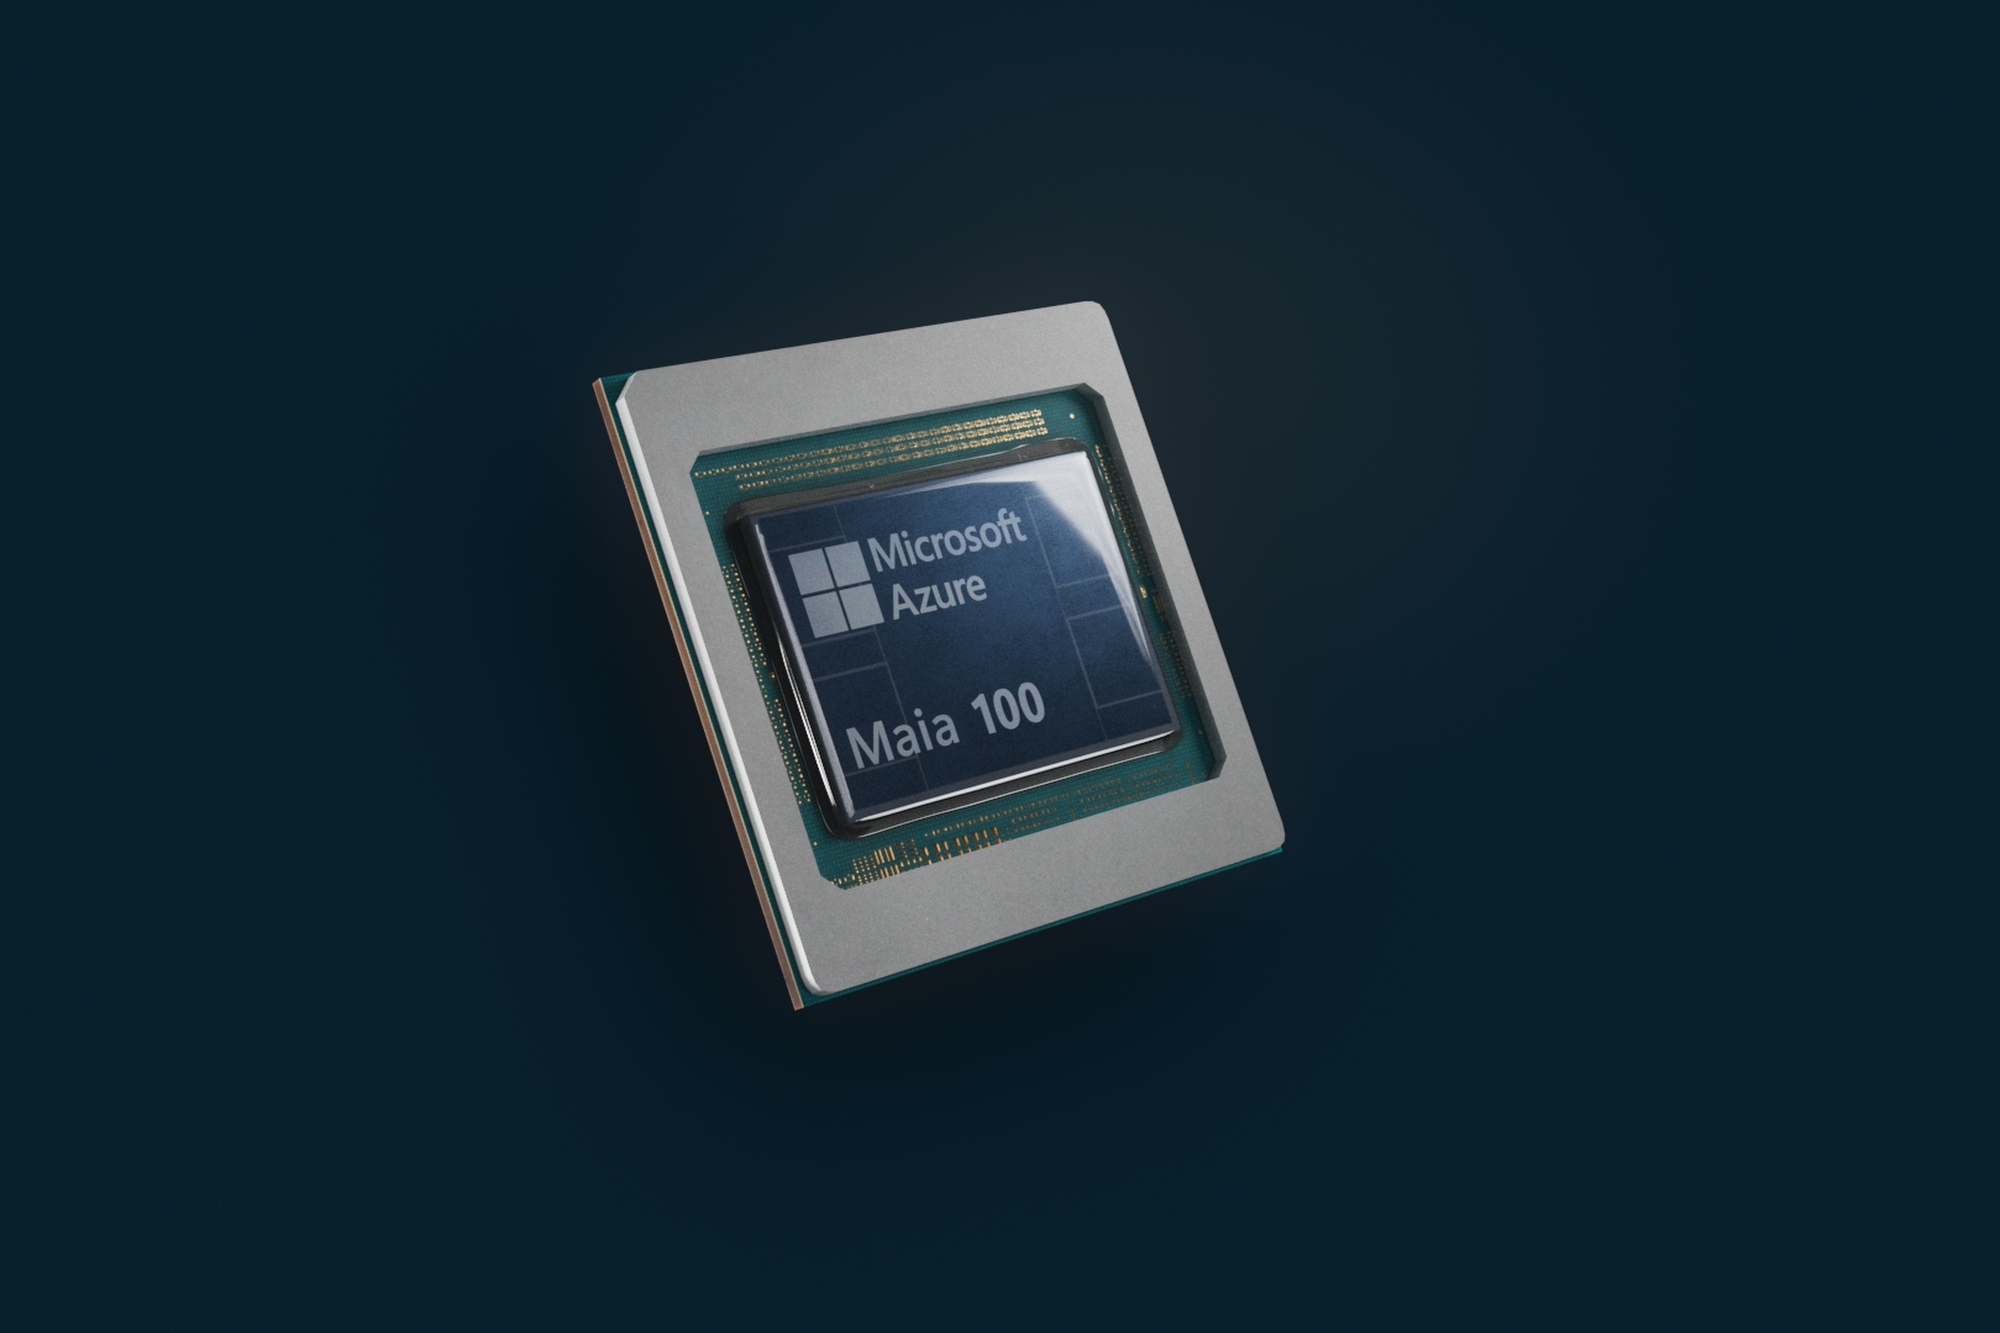 Microsoft приводит очень мало технических данных о своих новинках, но известно, что Azure Cobalt 100 имеет 128 ядер Armv9 Neoverse N2 (Perseus) и основан на платформе Arm Neoverse Compute Subsystem (CSS). По словам компании, процессоры Cobalt 100 до +40 % производительнее имеющихся в инфраструктуре Azure Arm-чипов, они используются для обеспечения работы служб Microsoft Teams и Azure SQL. Oracle, вложившаяся в своё время в Ampere Comptuing, уже перевела все свои облачные сервисы на Arm. 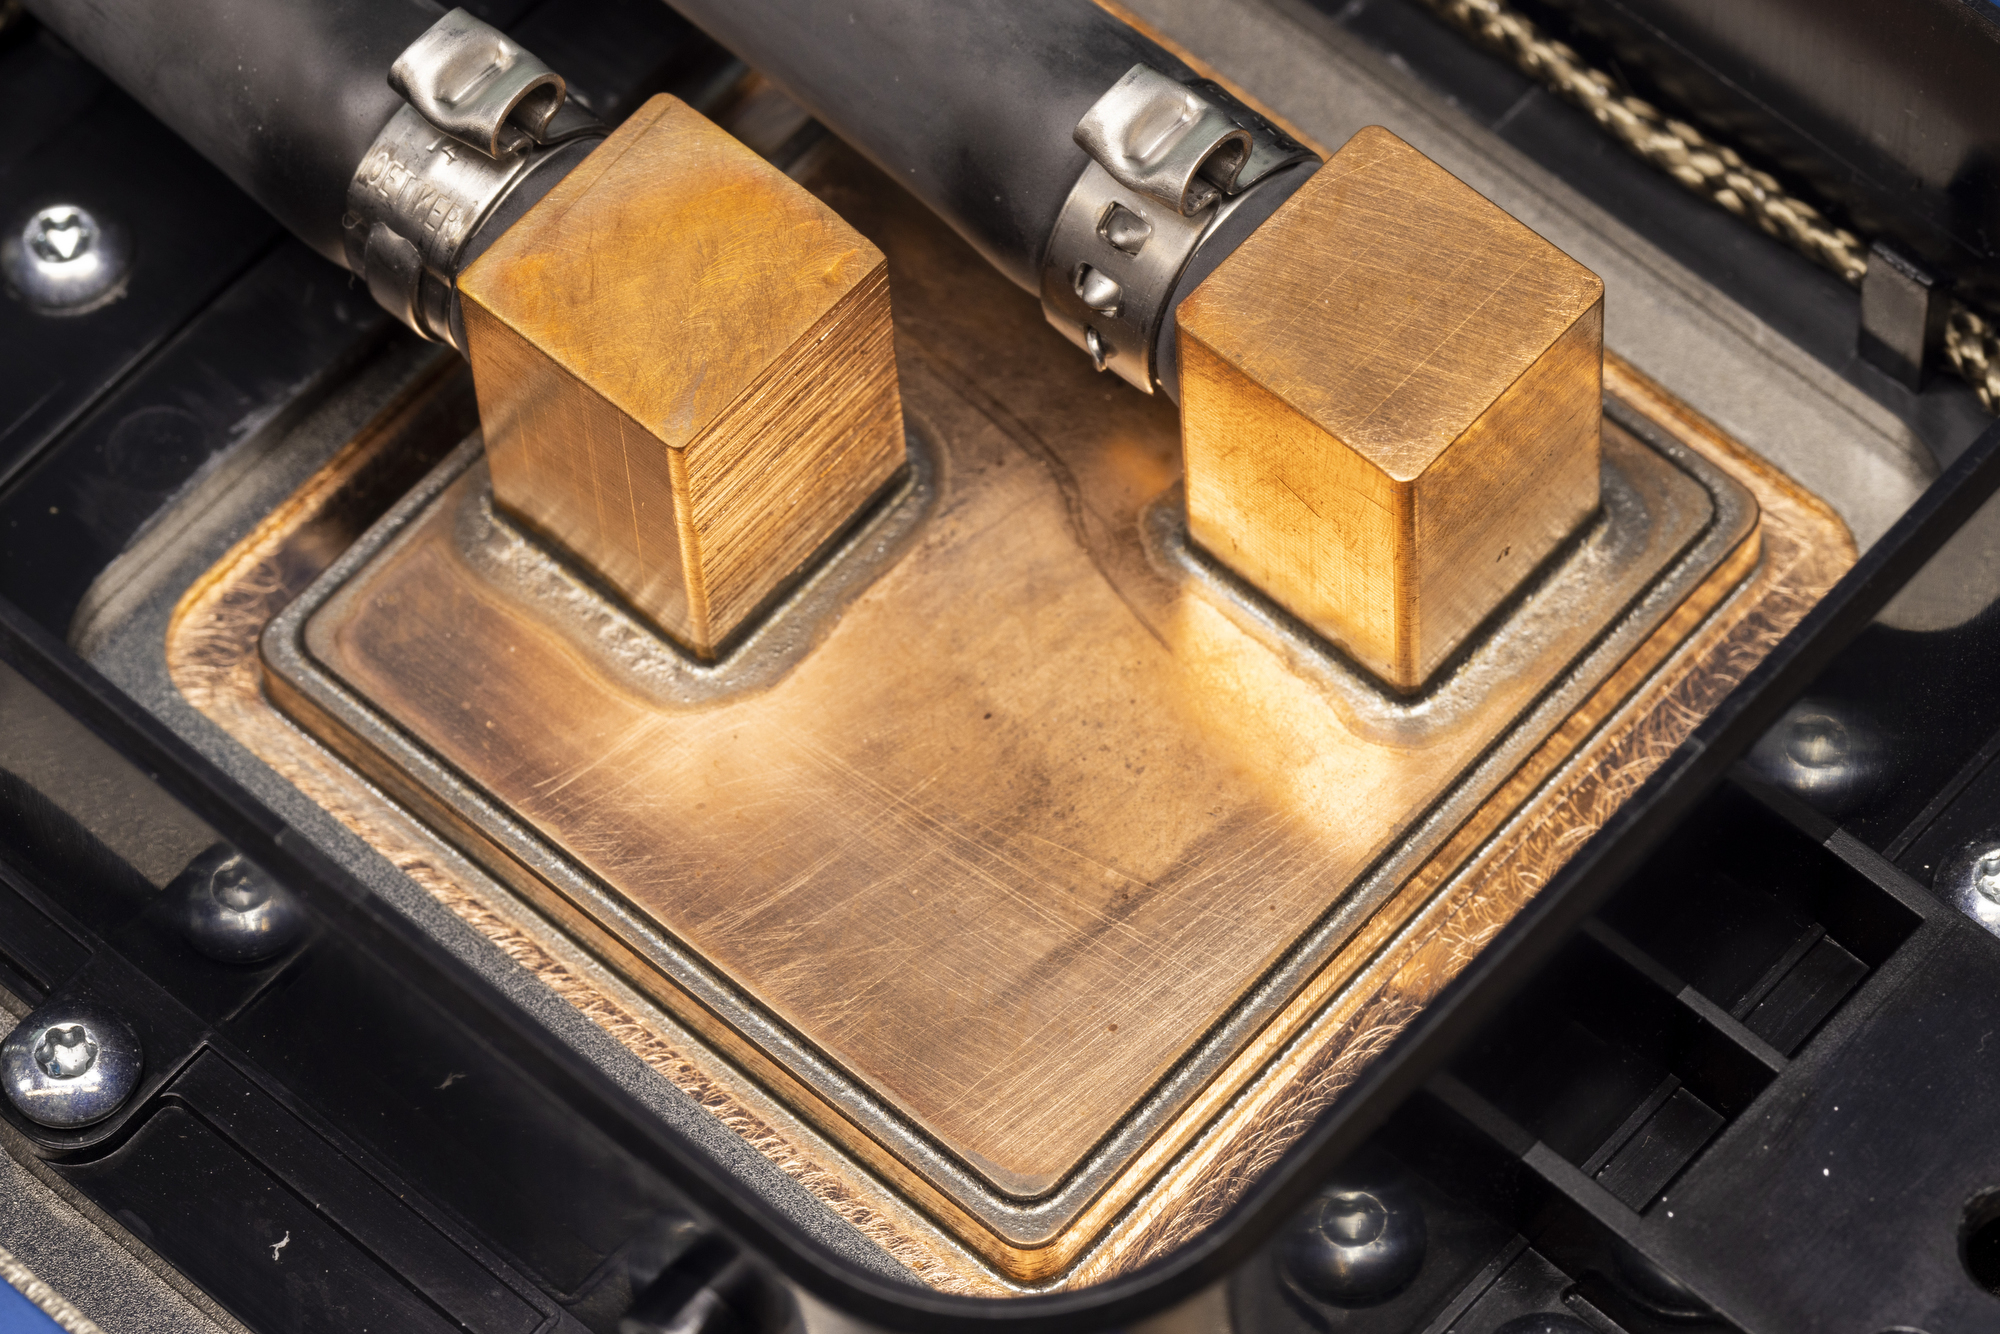 Чип Maia 100 (Athena) изначально спроектирован под задачи облачного обучения ИИ и инференса в сценариях с использованием моделей OpenAI, Bing, GitHub Copilot и ChatGPT в инфраструктуре Azure. Чип содержит 105 млрд транзисторов, что больше, нежели у NVIDIA H100 (80 млрд) и ставит Maia 100 на один уровень с Ponte Vecchio (~100 млрд). Для Maia организован кастомный интерконнект на базе Ethernet — каждый ускоритель располагает 4,8-Тбит/с каналом для связи с другими ускорителями, что должно обеспечить максимально эффективное масштабирование. 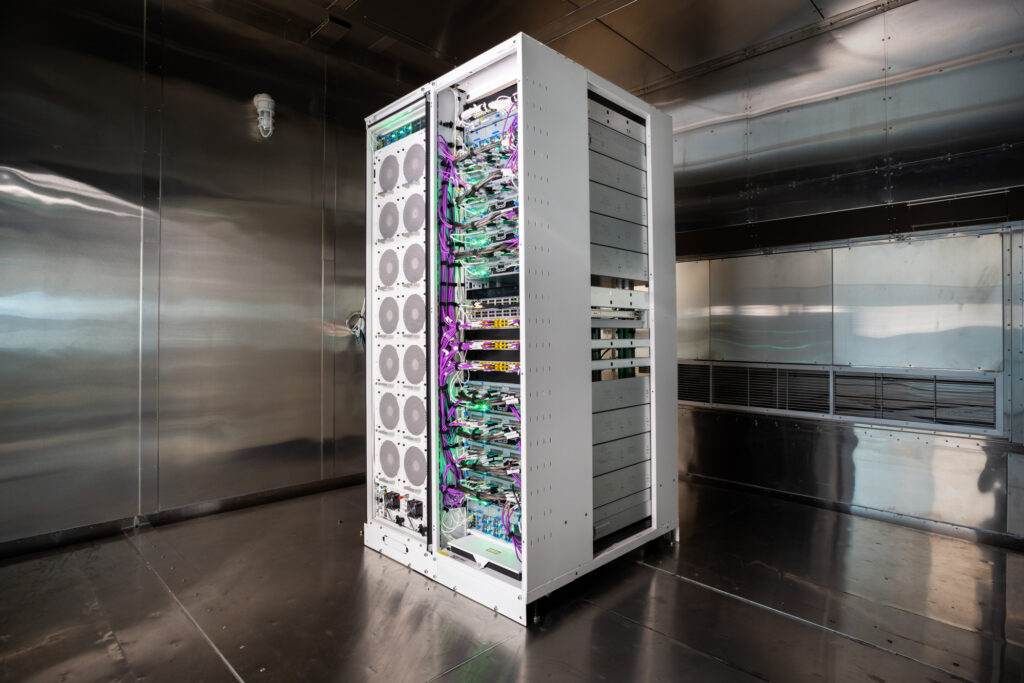 Сами Maia 100 используют СЖО с теплообменниками прямого контакта. Поскольку нынешние ЦОД Microsoft проектировались без учёта использования мощных СЖО, стойку пришлось сделать более широкой, дабы разместить рядом с сотней плат с чипами Maia 100 серверами и большой радиатор. Этот дизайн компания создавала вместе с Meta✴, которая испытывает аналогичные проблемы с текущими ЦОД. Такие стойки в настоящее время проходят термические испытания в лаборатории Microsoft в Редмонде, штат Вашингтон. 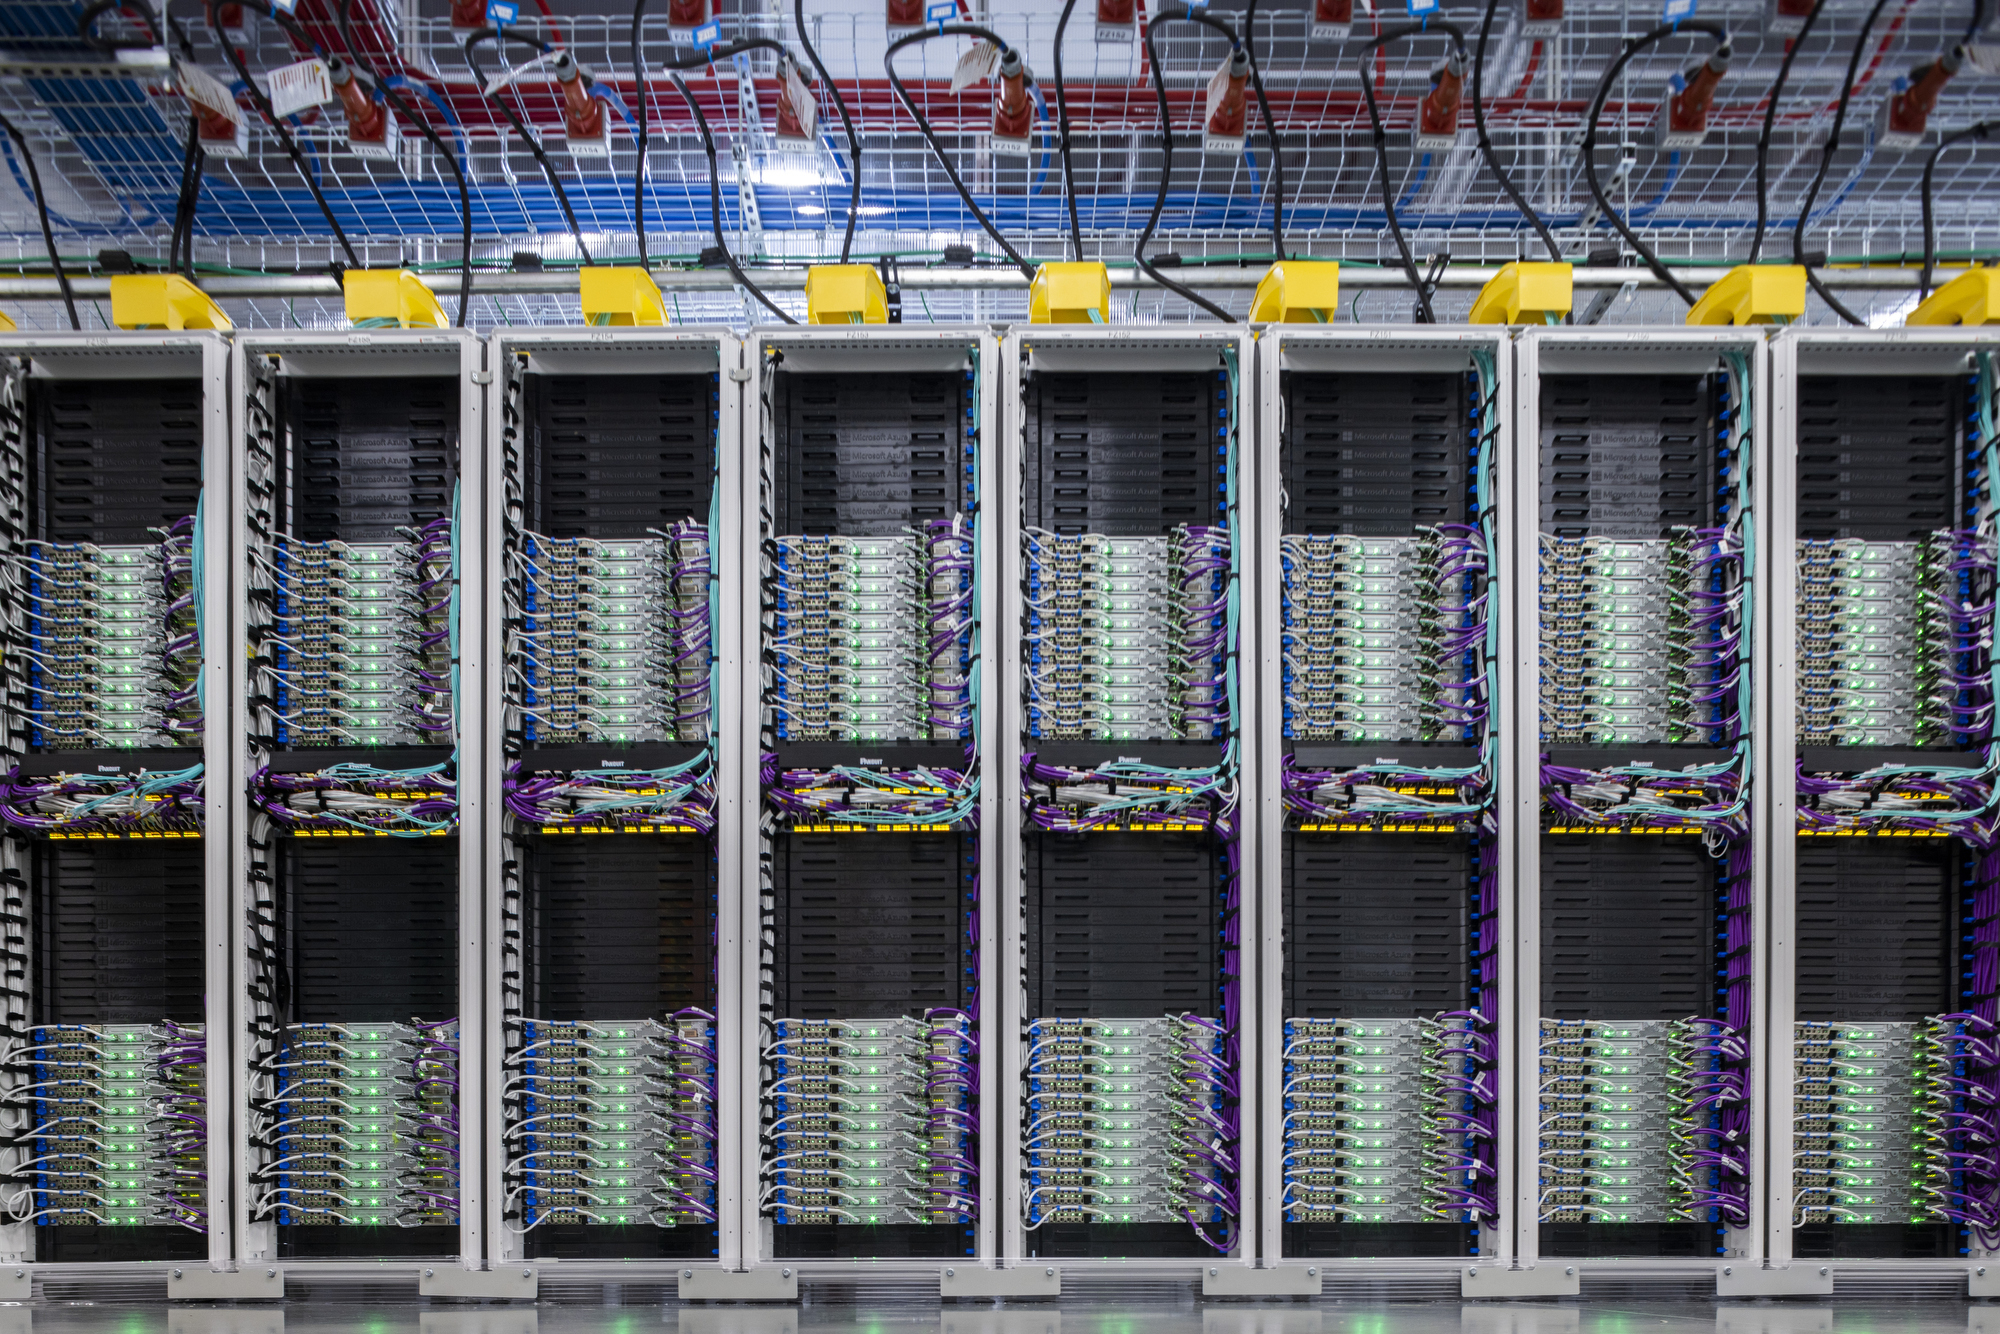 В дополнение к Cobalt и Maia анонсирована широкая доступность услуги Azure Boost на базе DPU MANA, берущего на себя управление всеми функциями виртуализации на манер AWS Nitro, хотя и не целиком — часть ядер хоста всё равно используется для обслуживания гипервизора. DPU предлагает 200GbE-подключение и доступ к удалённому хранилищу на скорости до 12,5 Гбайт/с и до 650 тыс. IOPS. 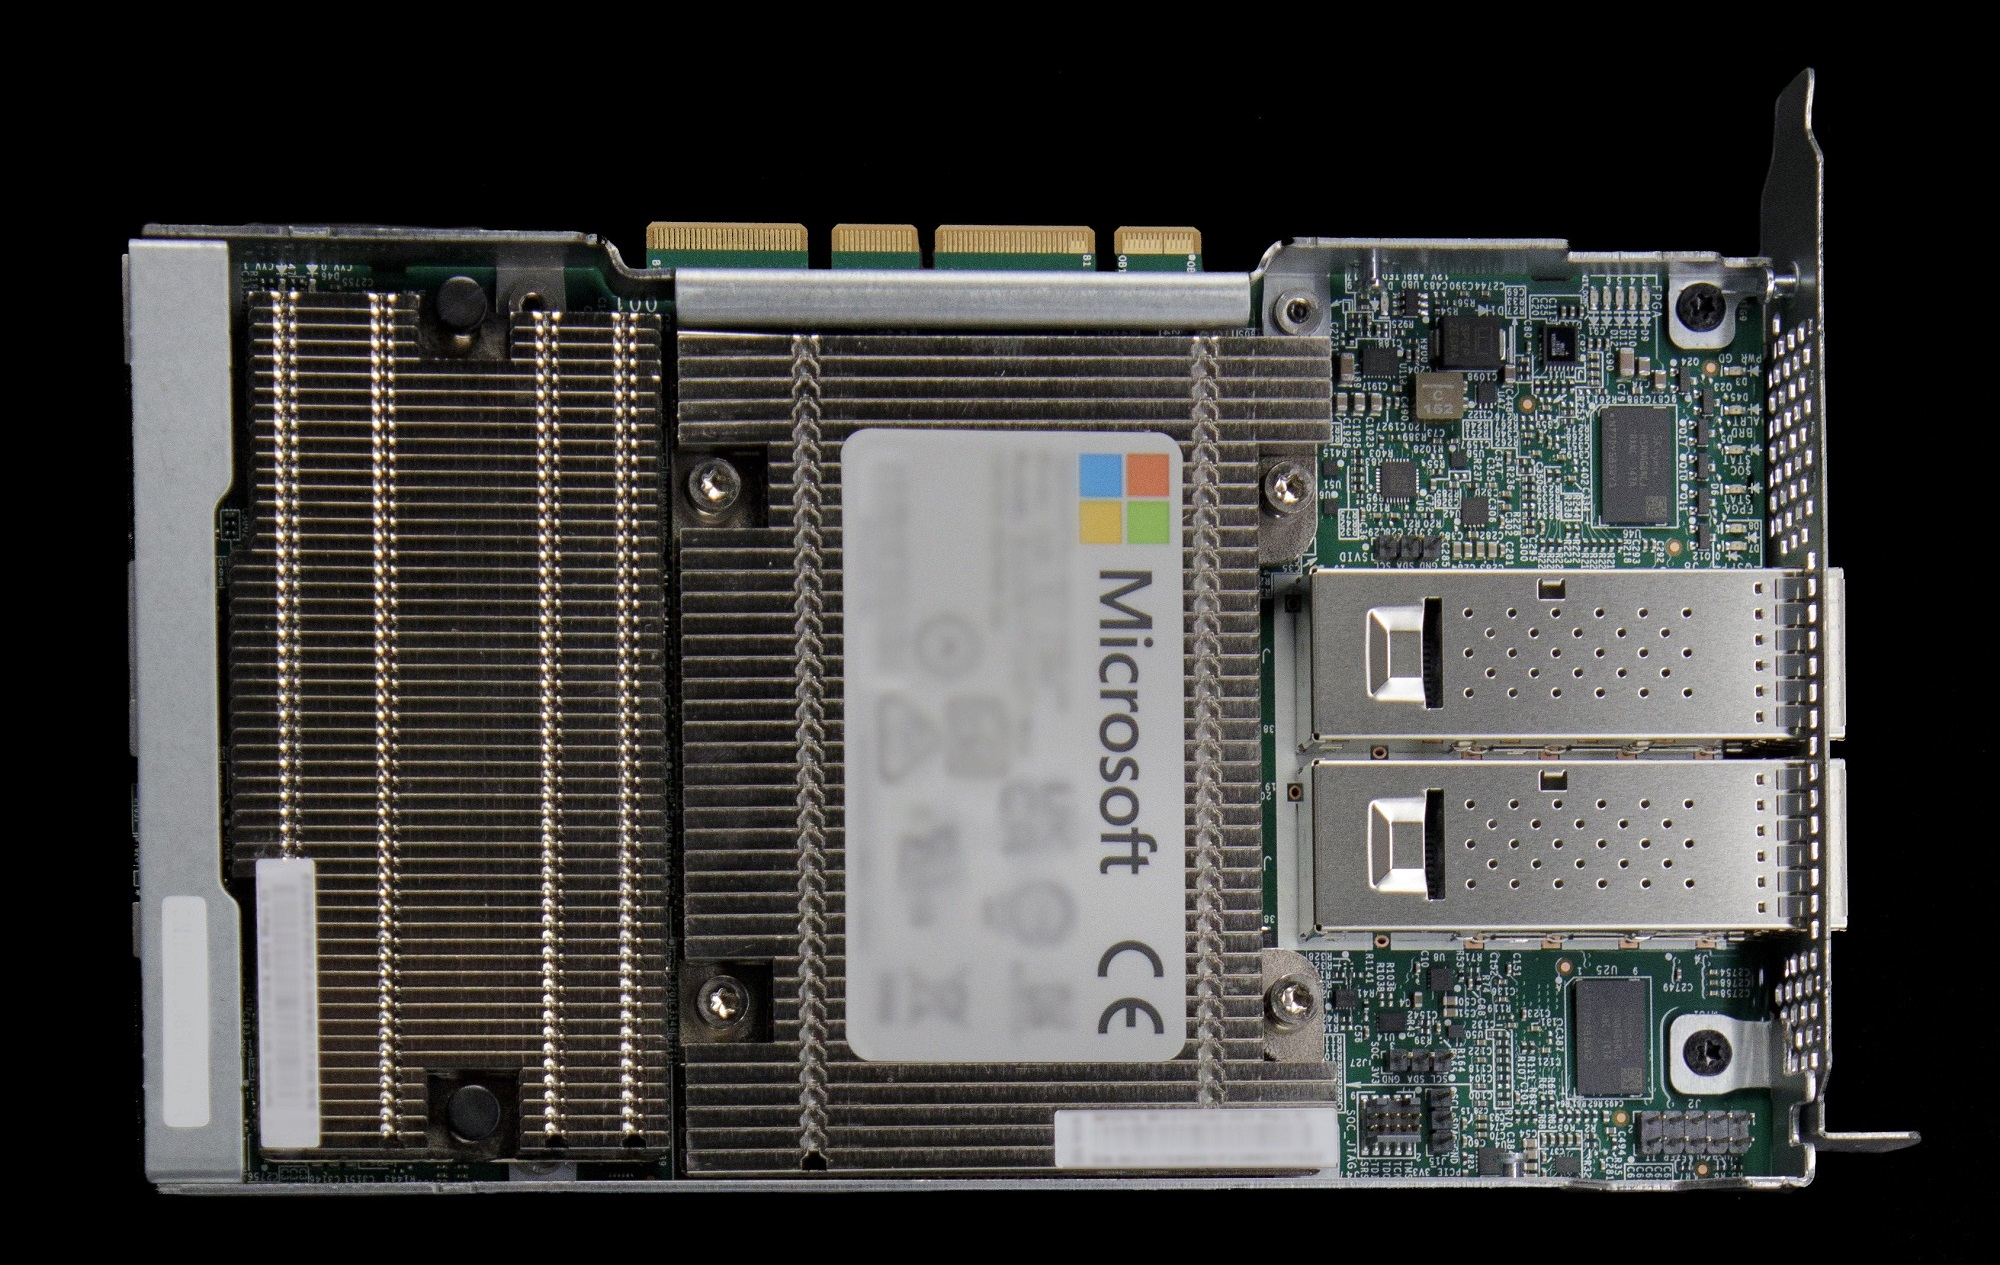 Microsoft не собирается останавливаться на достигнутом: вводя в строй инфраструктуру на базе новых чипов Cobalt и Maia первого поколения, компания уже ведёт активную разработку чипов второго поколения. Впрочем, совсем отказываться от партнёрства с другими вендорами Microsoft не намерена. Компания анонсировала первые инстансы с ускорителями AMD Instinct MI300X, а в следующем году появятся инстансы с NVIDIA H200. 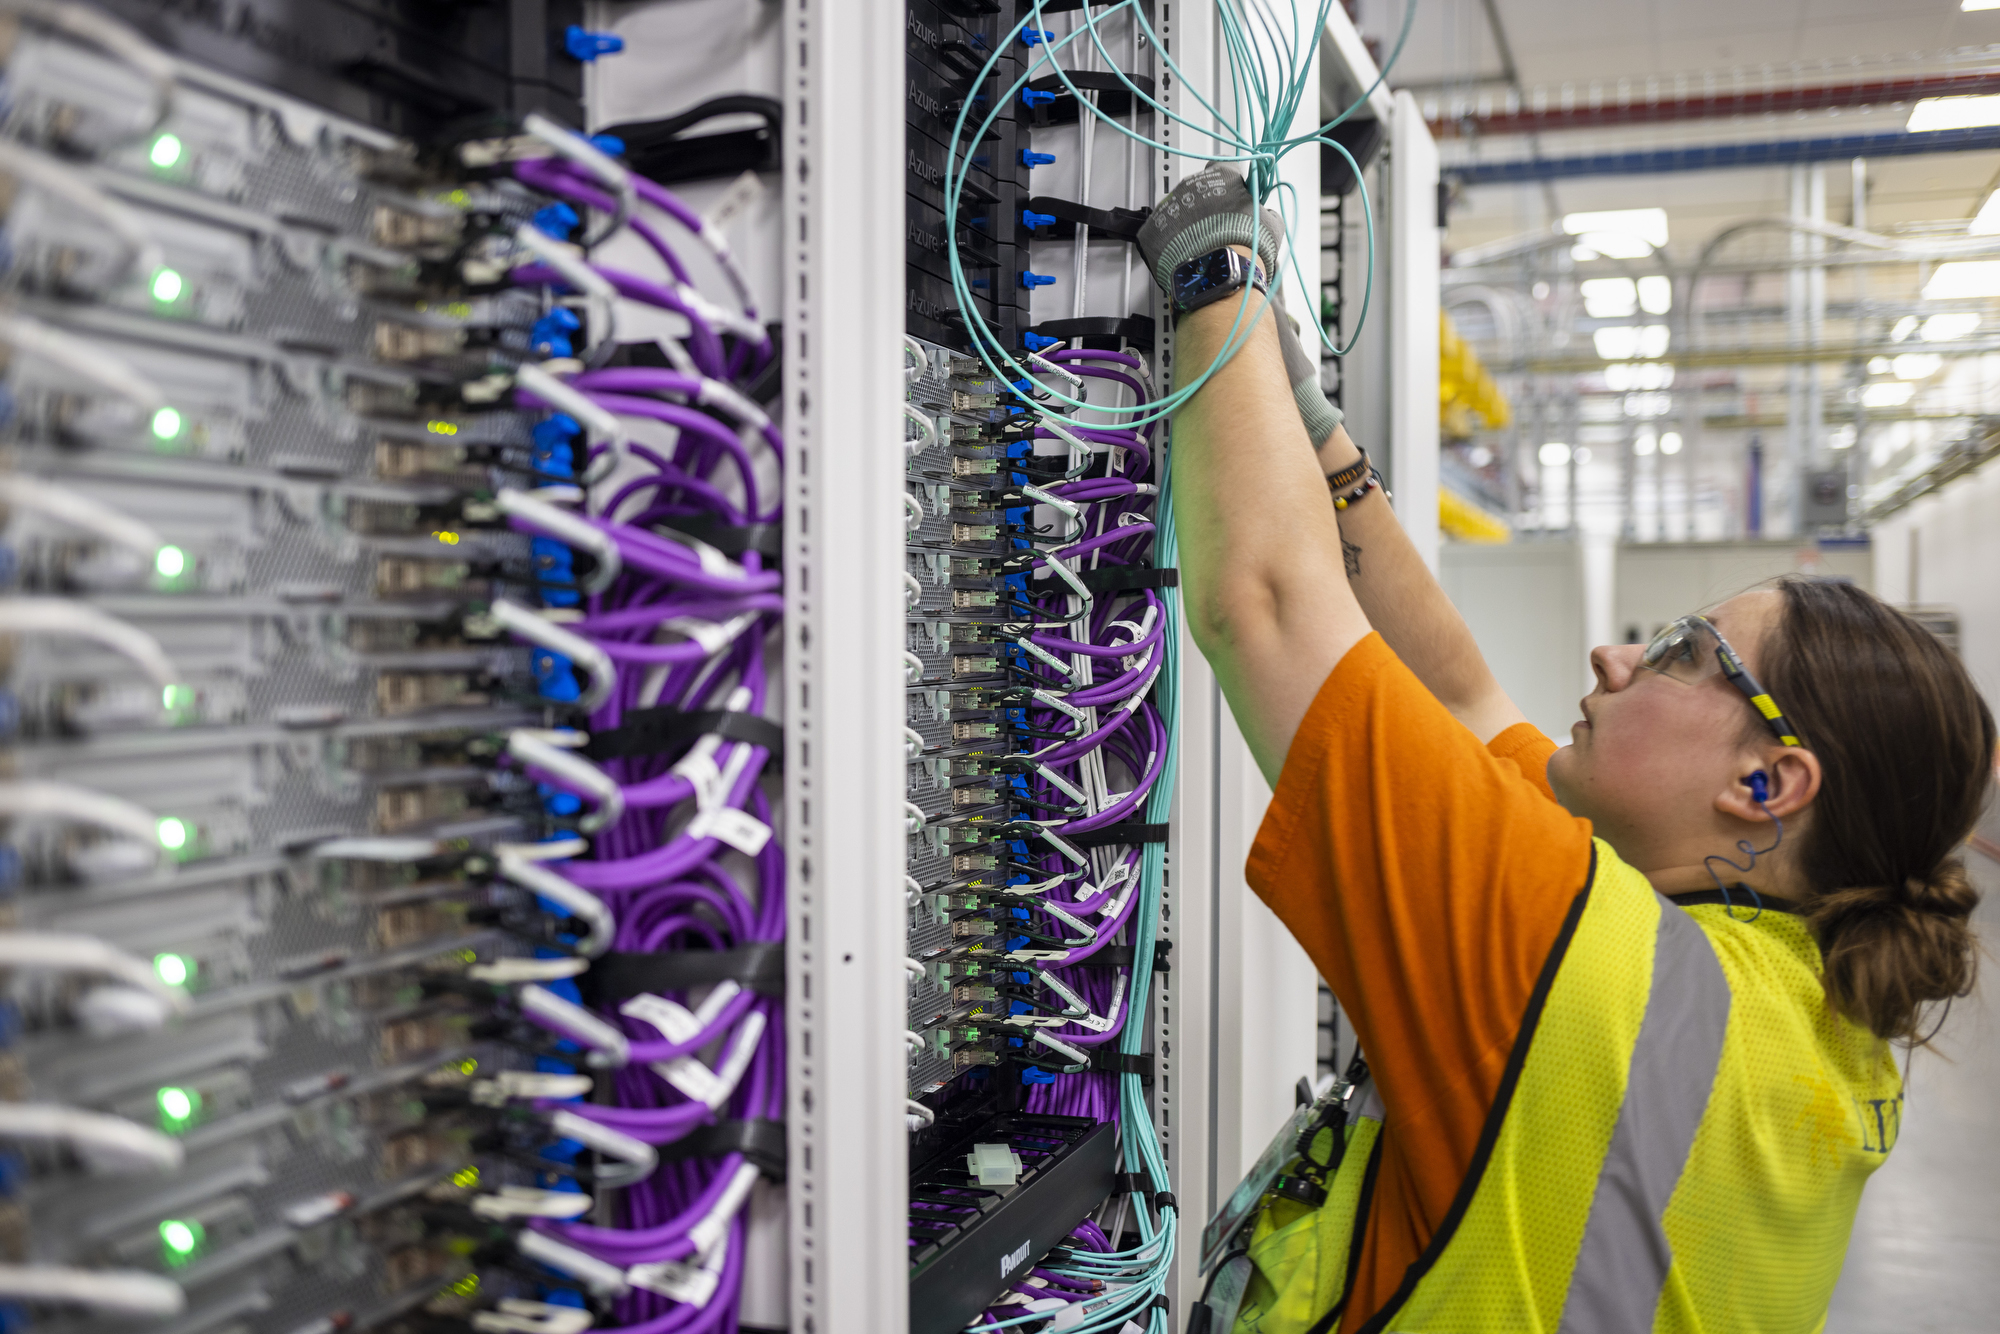
13.11.2023 [17:00], Игорь Осколков
NVIDIA анонсировала ускорители H200 и «фантастическую четвёрку» Quad GH200NVIDIA анонсировала ускорители H200 на базе всё той же архитектуры Hopper, что и их предшественники H100, представленные более полутора лет назад. Новый H200, по словам компании, первый в мире ускоритель, использующий память HBM3e. Вытеснит ли он H100 или останется промежуточным звеном эволюции решений NVIDIA, покажет время — H200 станет доступен во II квартале следующего года, но также в 2024-м должно появиться новое поколение ускорителей B100, которые будут производительнее H100 и H200. 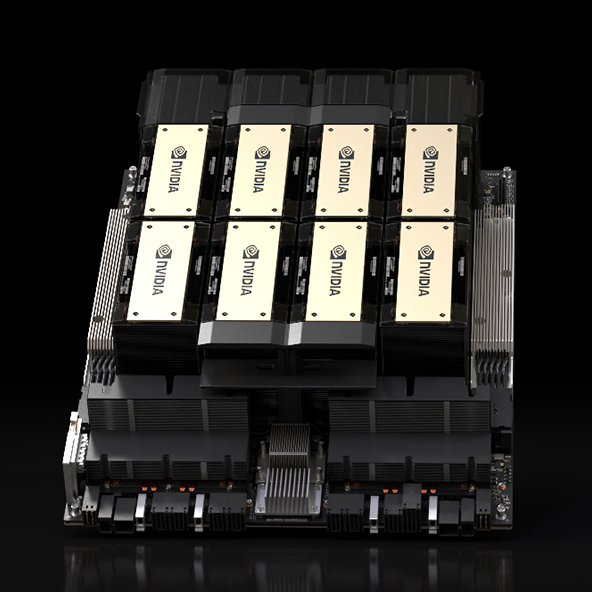
HGX H200 (Источник здесь и далее: NVIDIA) H200 получил 141 Гбайт памяти HBM3e с суммарной пропускной способностью 4,8 Тбайт/с. У H100 было 80 Гбайт HBM3, а ПСП составляла 3,35 Тбайт/с. Гибридные ускорители GH200, в состав которых входит H200, получат до 480 Гбайт LPDDR5x (512 Гбайт/с) и 144 Гбайт HBM3e (4,9 Тбайт/с). Впрочем, с GH200 есть некоторая неразбериха, поскольку в одном месте NVIDIA говорит о 141 Гбайт, а в другом — о 144 Гбайт HBM3e. Обновлённая версия GH200 станет массово доступна после выхода H200, а пока что NVIDIA будет поставлять оригинальный 96-Гбайт вариант с HBM3. Напомним, что грядущие конкурирующие AMD Instinct MI300X получат 192 Гбайт памяти HBM3 с ПСП 5,2 Тбайт/с. 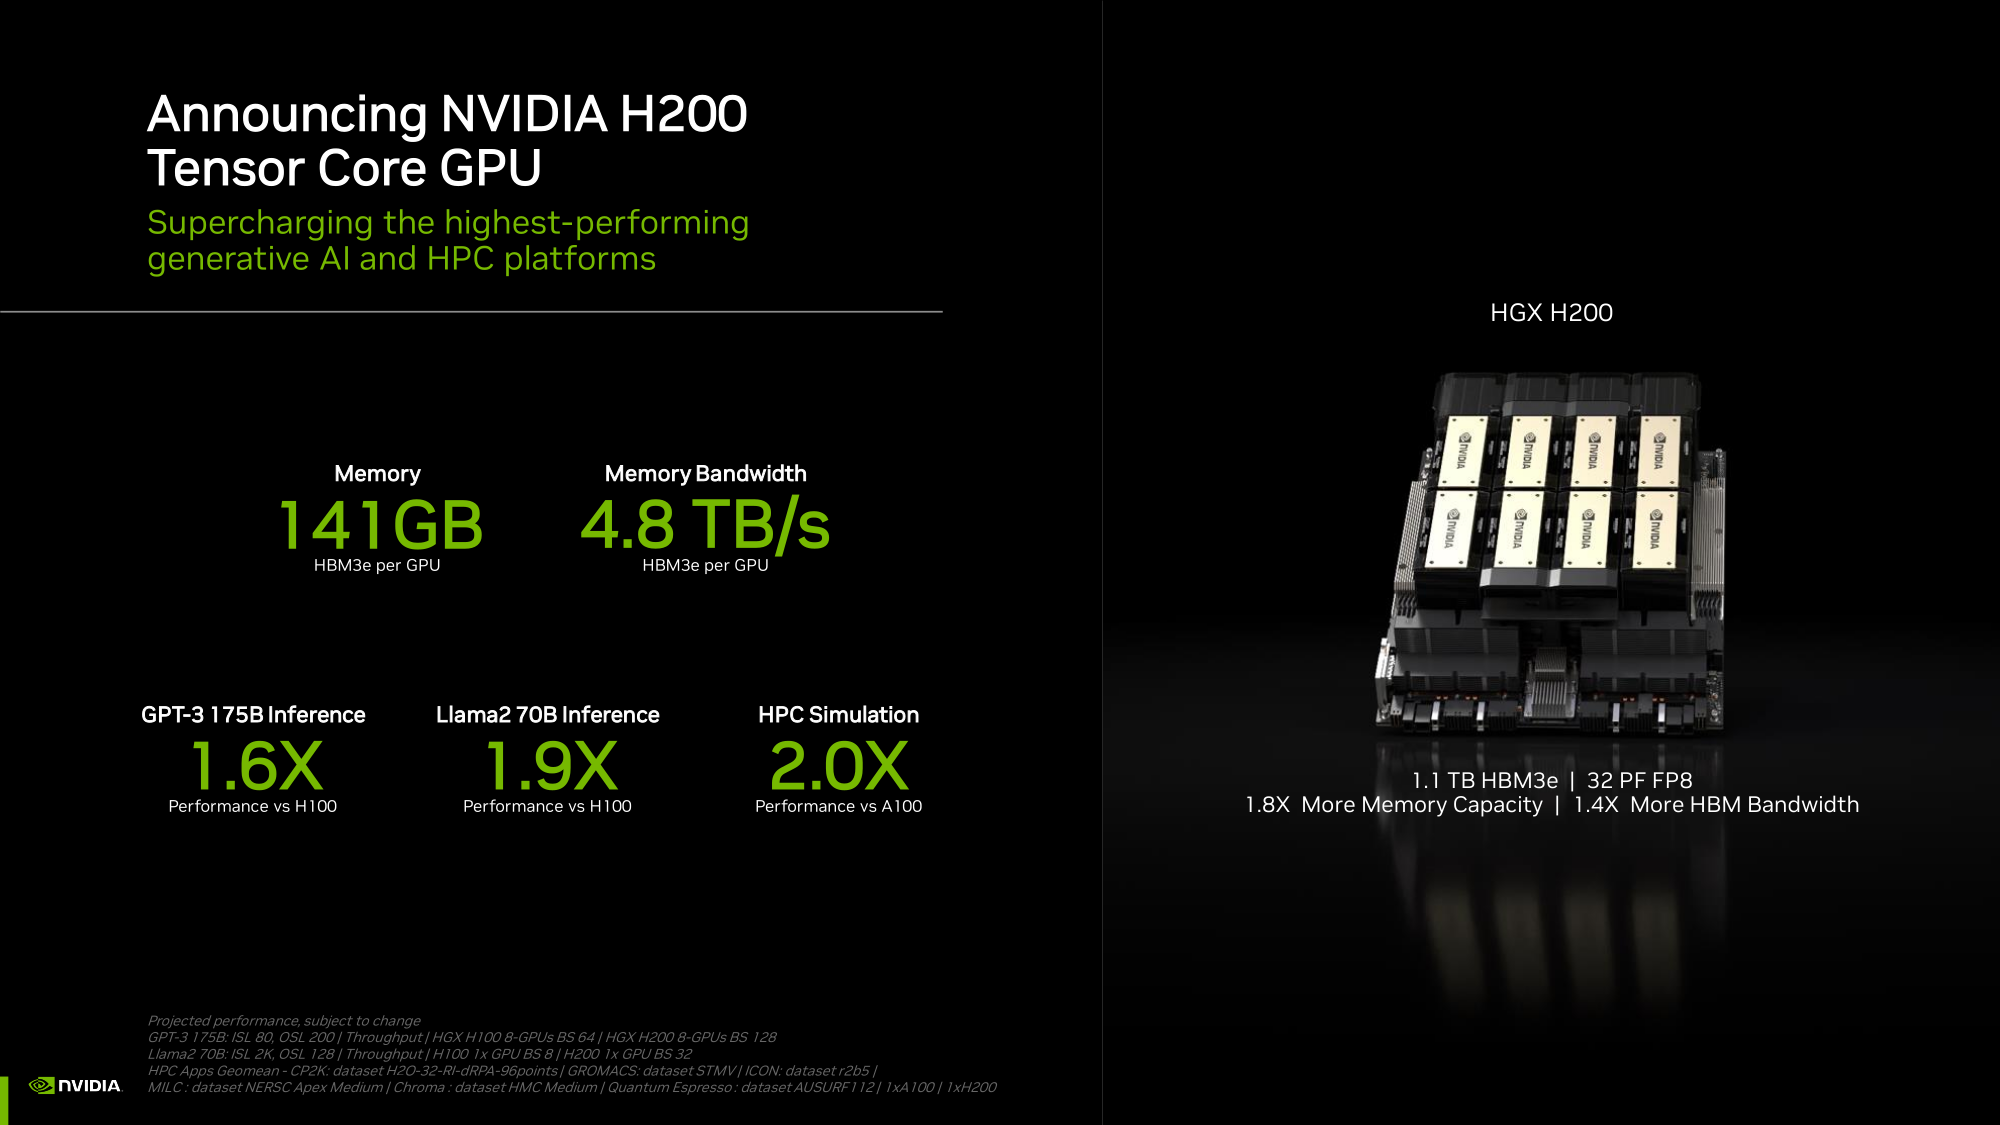 На момент написания материала NVIDIA не раскрыла полные характеристики H200, но судя по всему, вычислительная часть H200 осталась такой же или почти такой же, как у H100. NVIDIA приводит FP8-производительность HGX-платформы с восемью ускорителями (есть и вариант с четырьмя), которая составляет 32 Пфлопс. То есть на каждый H200 приходится 4 Пфлопс, ровно столько же выдавал и H100. Тем не менее, польза от более быстрой и ёмкой памяти есть — в задачах инференса можно получить прирост в 1,6–1,9 раза. 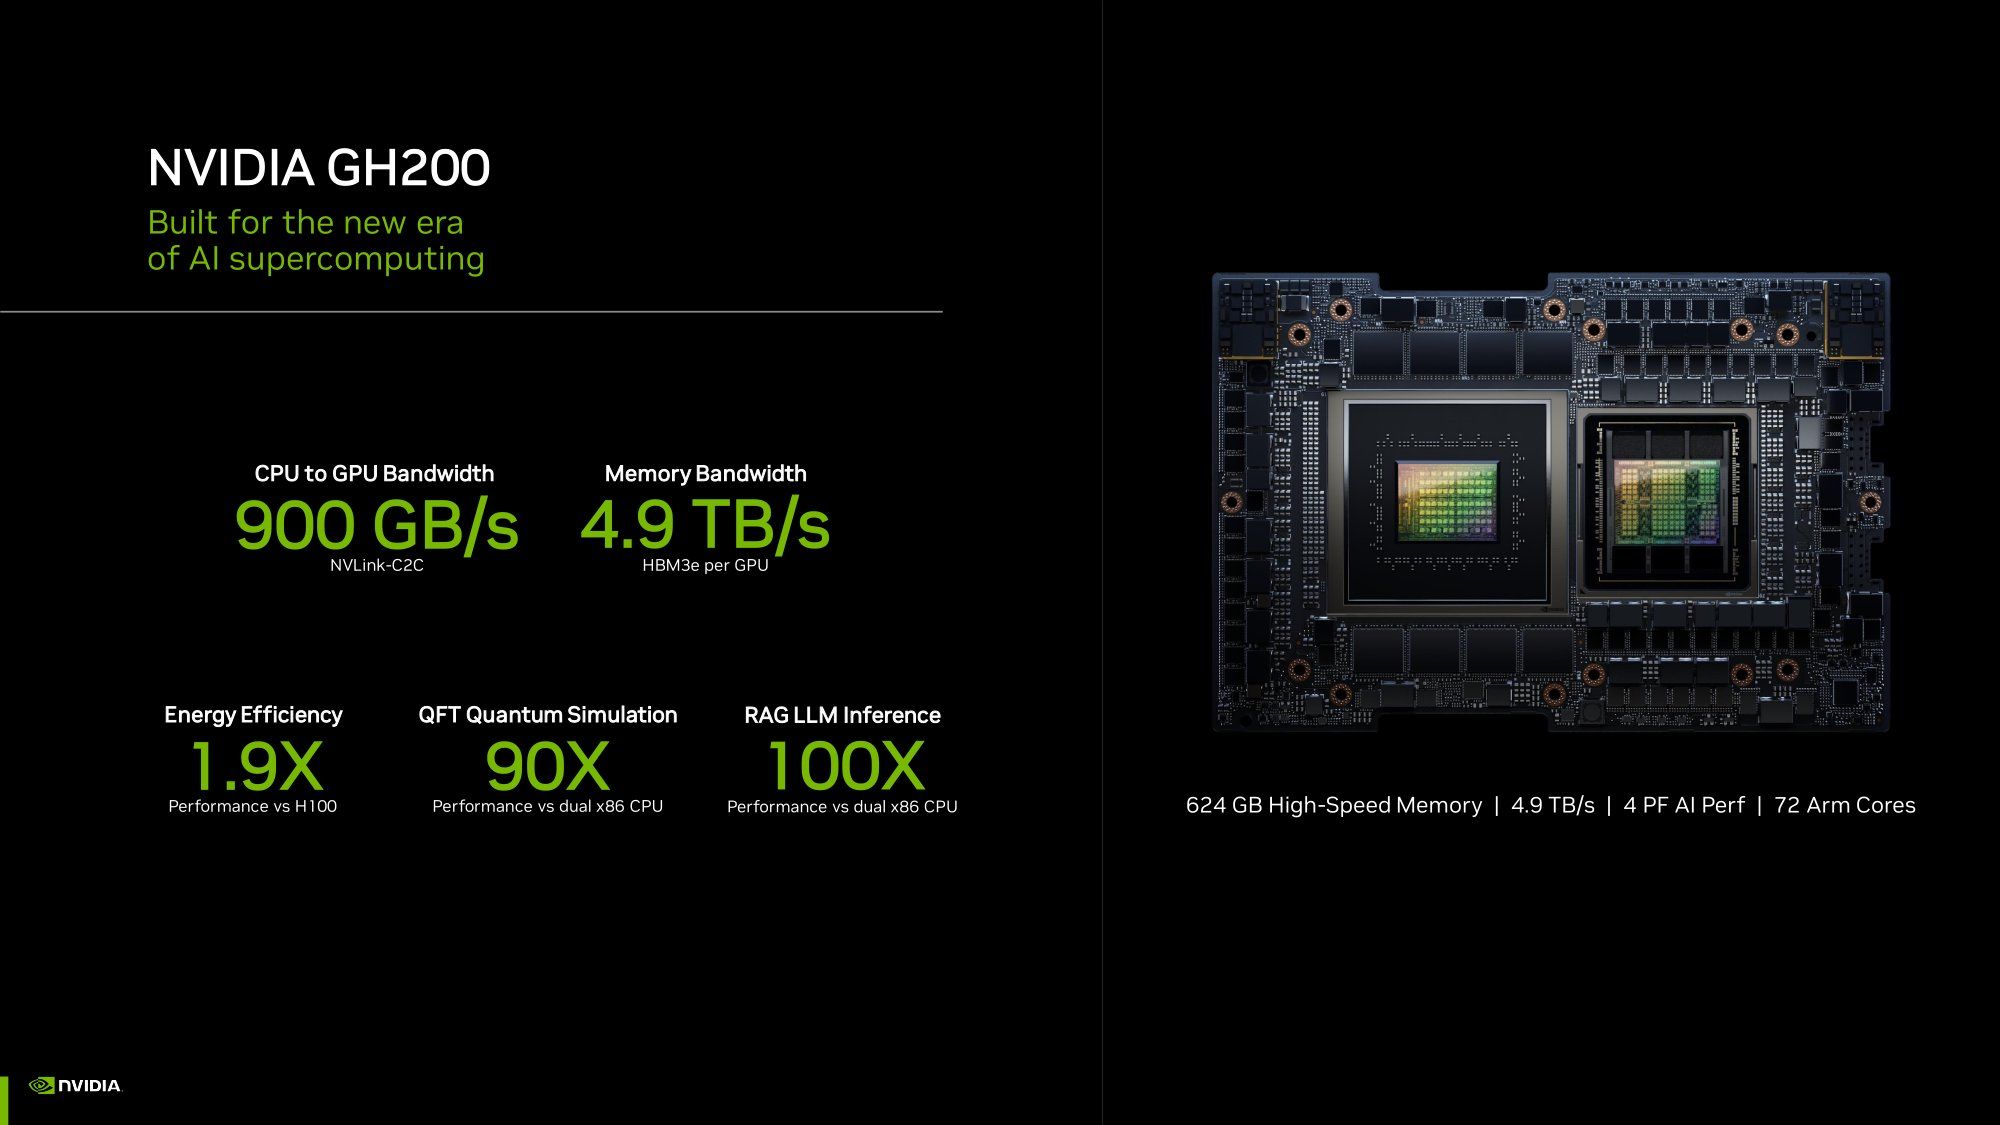 При этом платы HGX H200 полностью совместимы с уже имеющимися на рынке платформами HGX H100 как механически, так и с точки зрения питания и теплоотвода. Это позволит очень быстро обновить предложения партнёрам компании: ASRock Rack, ASUS, Dell, Eviden, GIGABYTE, HPE, Lenovo, QCT, Supermicro, Wistron и Wiwynn. H200 также станут доступны в облаках. Первыми их получат AWS, Google Cloud Platform, Oracle Cloud, CoreWeave, Lambda и Vultr. Примечательно, что в списке нет Microsoft Azure, которая, похоже, уже страдает от недостатка H100. 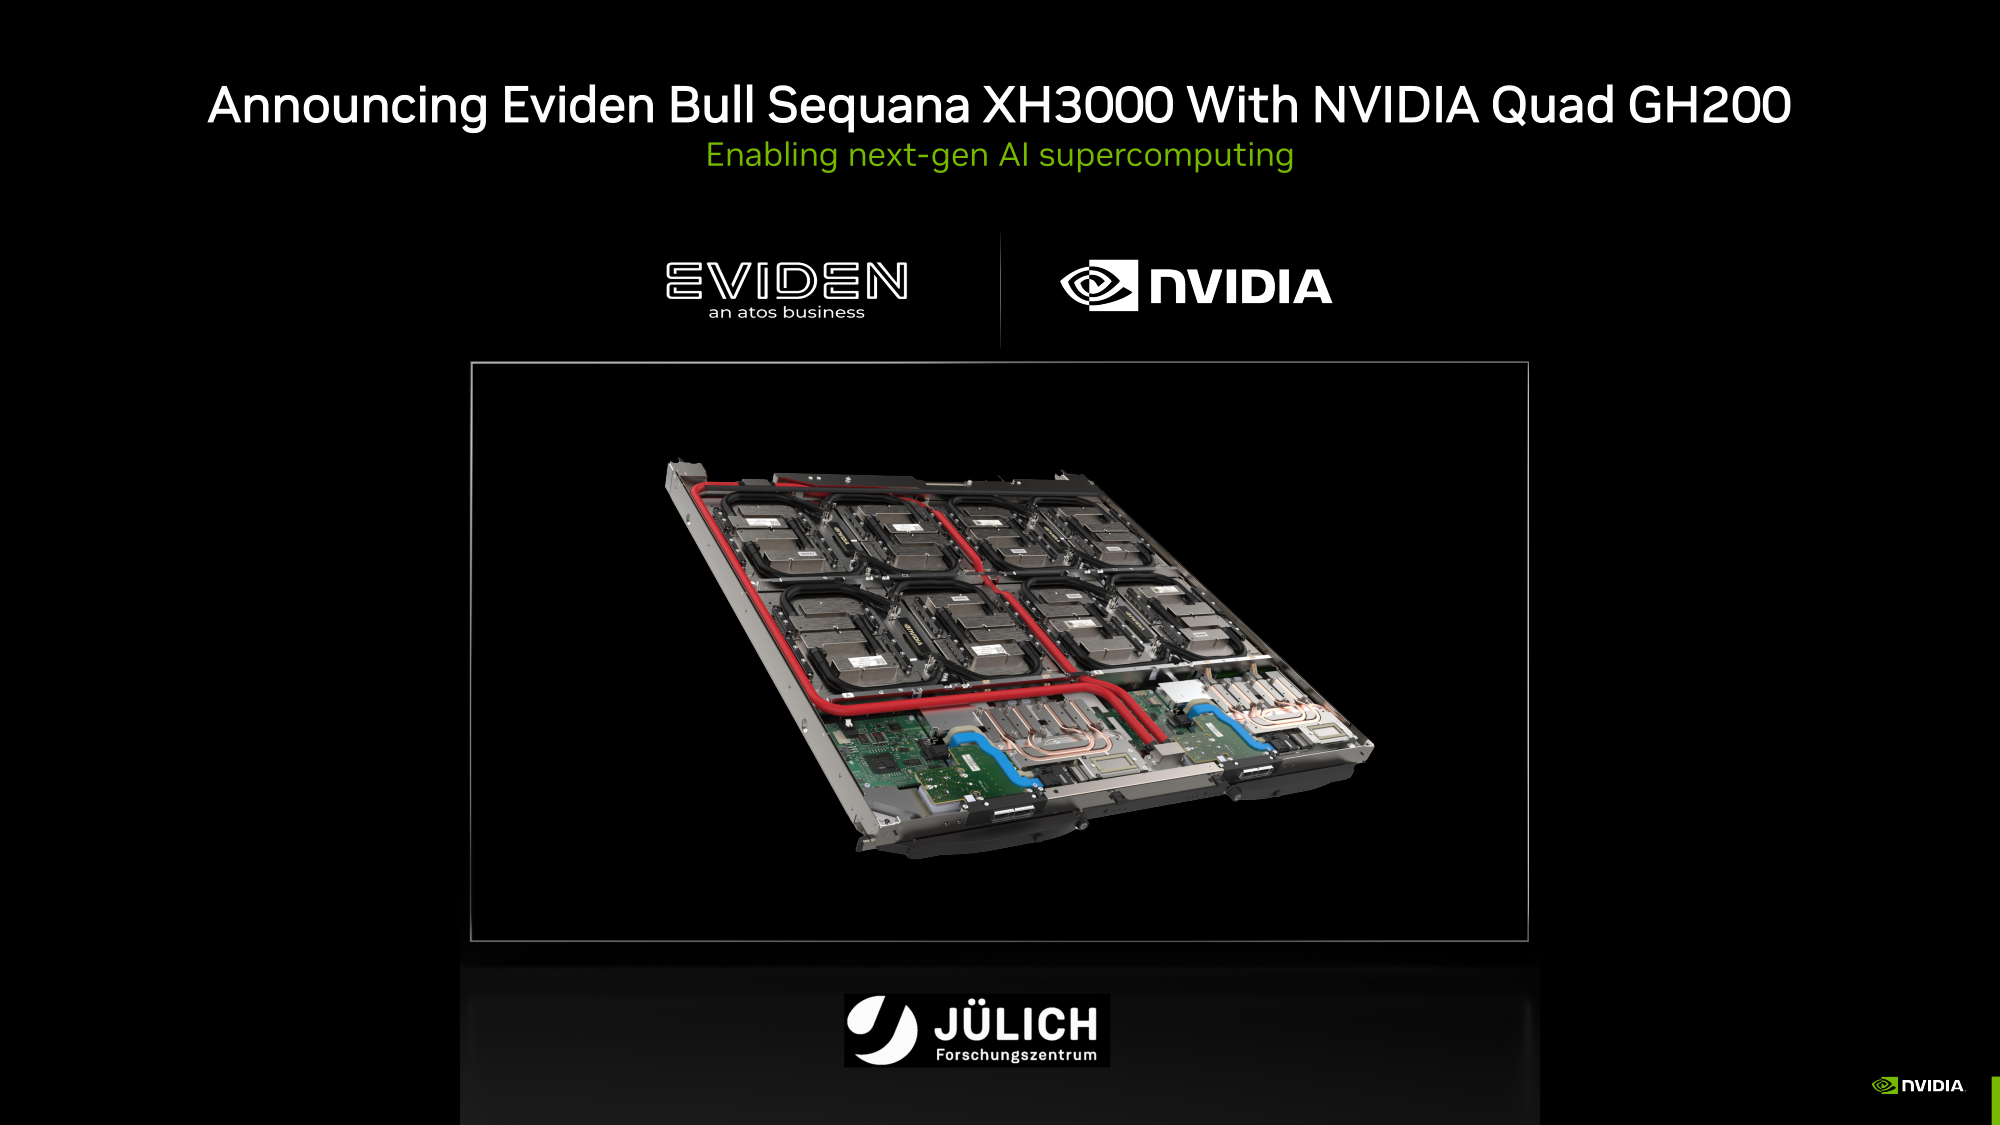 GH200 уже доступны избранным в облаках Lamba Labs и Vultr, а в начале 2024 года они появятся у CoreWeave. До конца этого года поставки серверов с GH200 начнут ASRock Rack, ASUS, GIGABYTE и Ingrasys. В скором времени эти чипы также появятся в сервисе NVIDIA Launchpad, а вот про доступность там H200 компания пока ничего не говорит. 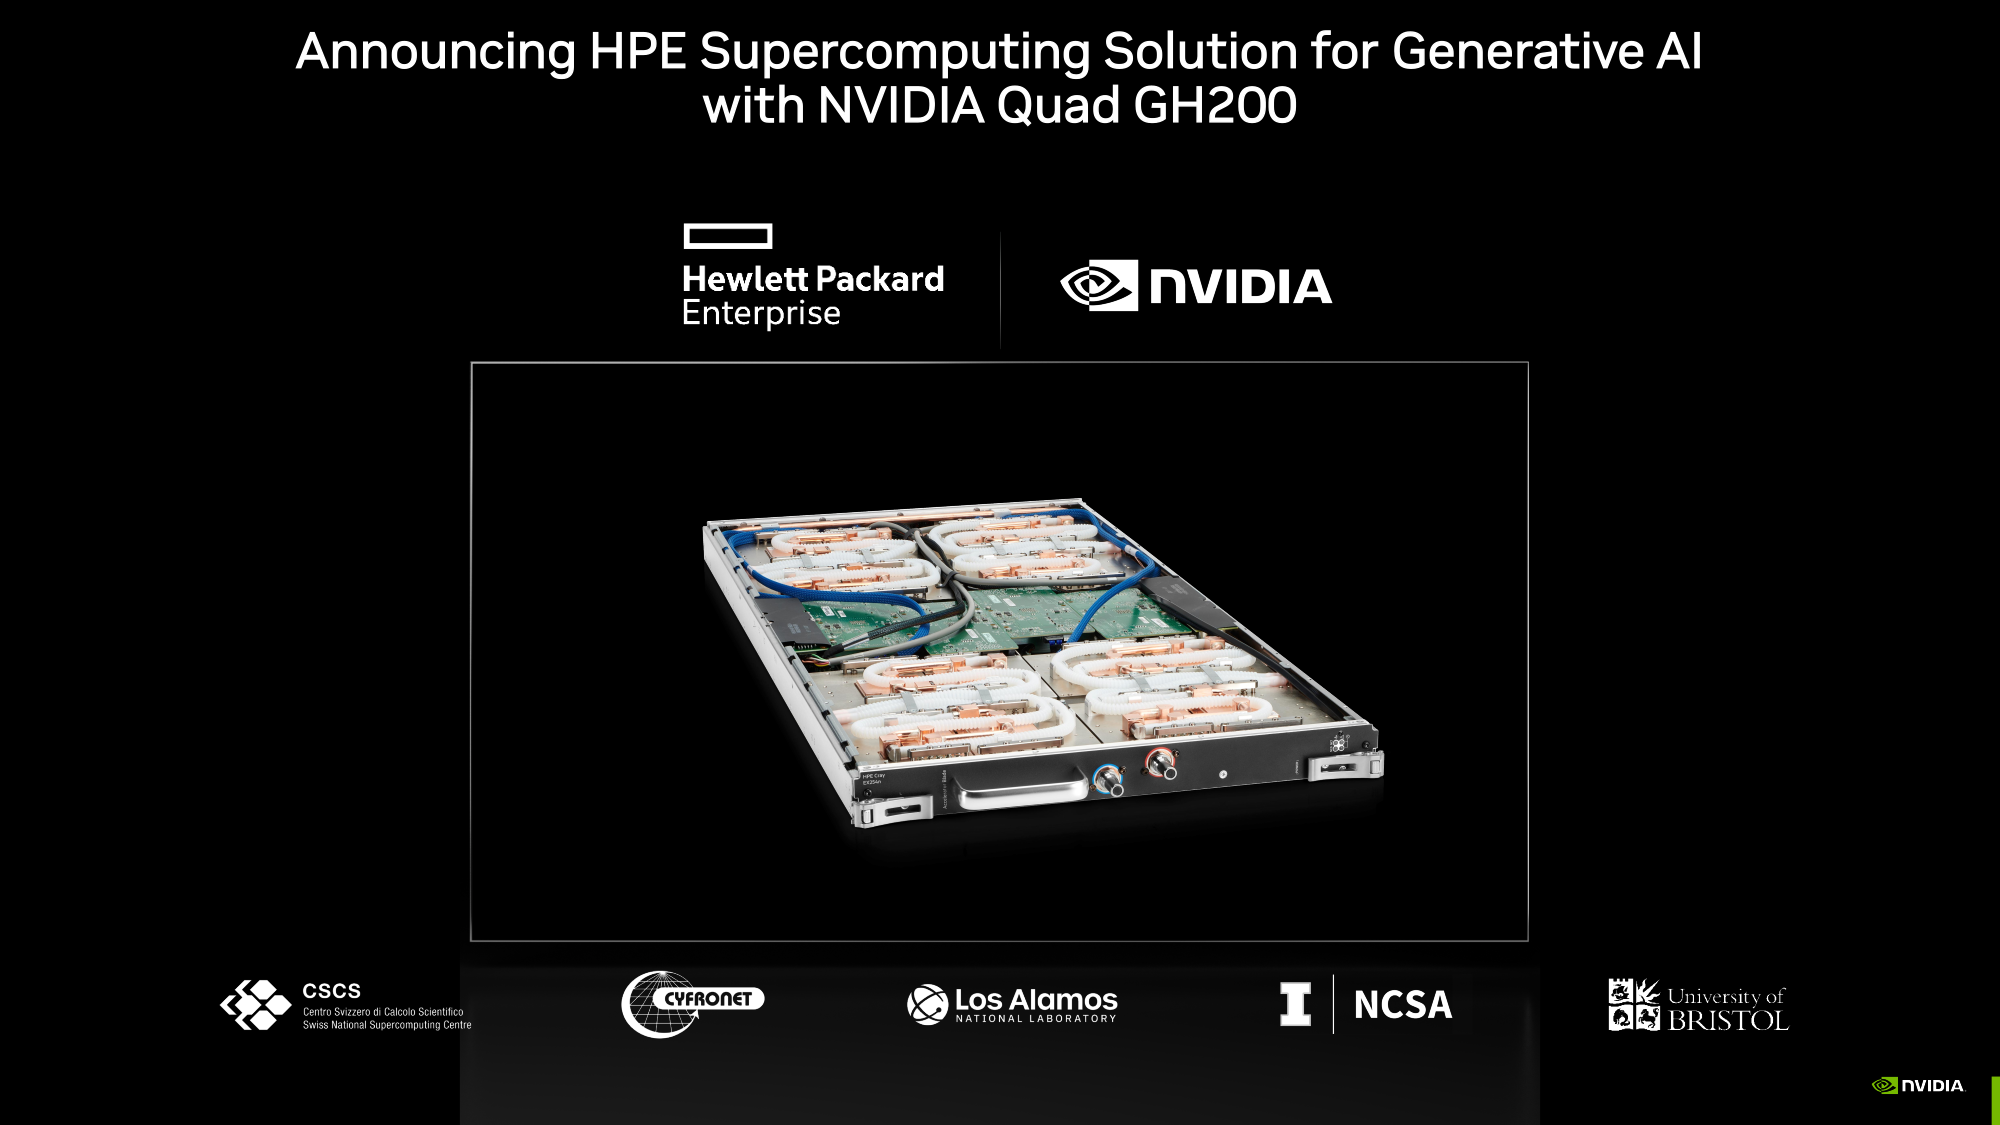 Одновременно NVIDIA представила и базовый «строительный блок» для суперкомпьютеров ближайшего будущего — плату Quad GH200 с четырьмя чипами GH200, где все ускорители связаны друг с другом посредством NVLink по схеме каждый-с-каждым. Суммарно плата несёт более 2 Тбайт памяти, 288 Arm-ядер и имеет FP8-производительность 16 Пфлопс. На базе Quad GH200 созданы узлы HPE Cray EX254n и Eviden Bull Sequana XH3000. До конца 2024 года суммарная ИИ-производительность систем с GH200, по оценкам NVIDIA, достигнет 200 Эфлопс.
09.11.2023 [16:15], Сергей Карасёв
NVIDIA готовит для Китая три новых ускорителя взамен подпавших под санкции: H20, L20 и L2Компания NVIDIA, по сообщению Reuters, планирует выпустить три новых ИИ-ускорителя, модифицированных специально для Китая с учётом дополнительных санкций со стороны США. Изделия фигурируют под обозначениями HGX H20 (SXM), L20 (PCIe) и L2 (PCIe), а их официальная презентация состоится не раньше 16 ноября. Напомним, в середине октября 2023 года США ввели новые ограничения на поставку передовых чипов NVIDIA в Китай: они затронули решения A800 и H800 — модифицированные версии A100 и H100, созданные специально для рынка КНР с учетом ранее действовавших американских ограничений. После этого NVIDIA пришлось искать новые регионы сбыта для «урезанных» ускорителей, предназначавшихся для Поднебесной. Как теперь сообщается, NVIDIA снова нашла возможность поставлять ускорители на китайский рынок, который потенциально может обеспечить значительную выручку. Решения H20, L20 и L2 не подпадают ни под одно из действующих экспортных ограничений. Обратной стороной медали является то, что производительность у них серьёзно снижена (см. характеристики в таблице выше), передаёт SemiAnalysis. 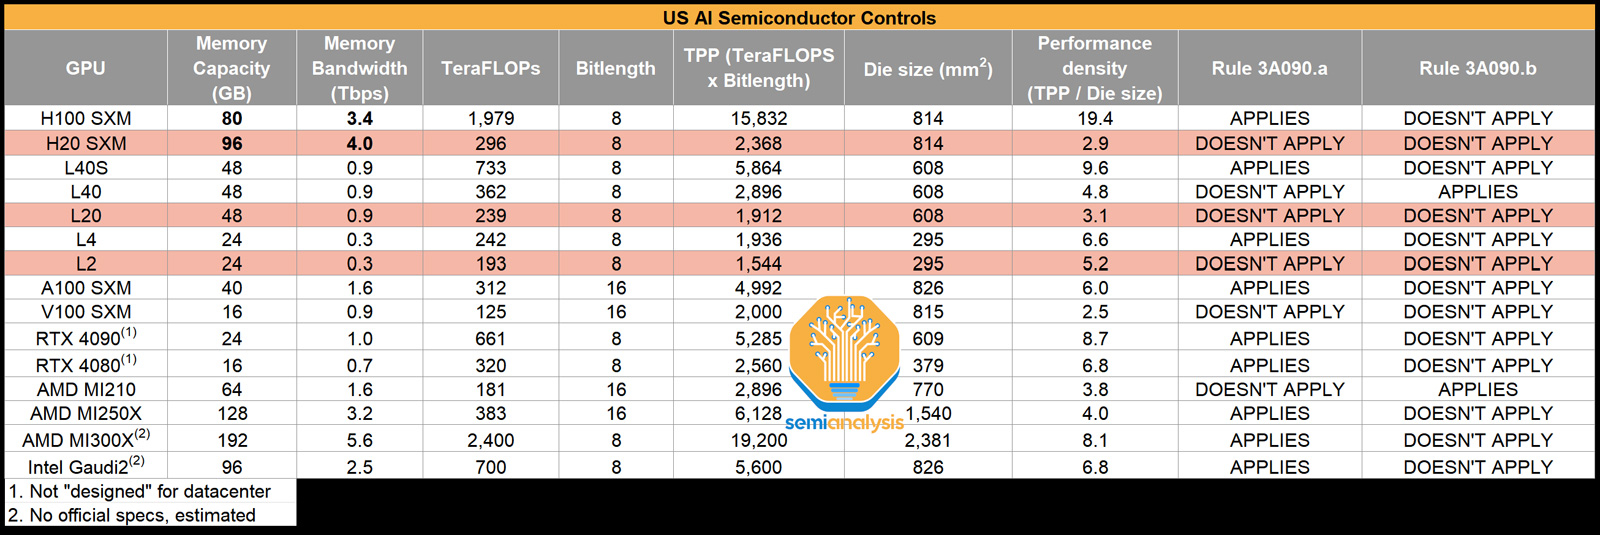
Источник: SemiAnalysis Отмечается, что у NVIDIA уже готовы образцы новых ускорителей для китайского рынка, а их массовое производство будет организовано в течение следующего месяца. Сама компания какие-либо комментарии по поводу обнародованной в интернете информации не даёт.
23.10.2023 [20:57], Алексей Степин
Новый нейроморфный ИИ-процессор IBM NorthPole на порядок превосходит современные GPUПо большей части современные нейросетевые технологии используют ускорители на базе GPU или родственных архитектур как для обучения, так и для инференса. Впрочем, разработчики альтернативных решений не дремлют. В число последних входит компания IBM, недавно сообщившая об успешном завершении испытаний нового нейроморфного процессора NorthPole. Разработкой чипов, в том или ином виде пытающихся имитировать работу живого мозга, компания занимается давно — чипы IBM TrueNorth второго поколения увидели свет более пяти лет назад. Уже тогда разработчики отошли от традиционных архитектур, отказавшись от понятия памяти как внешнего устройства. 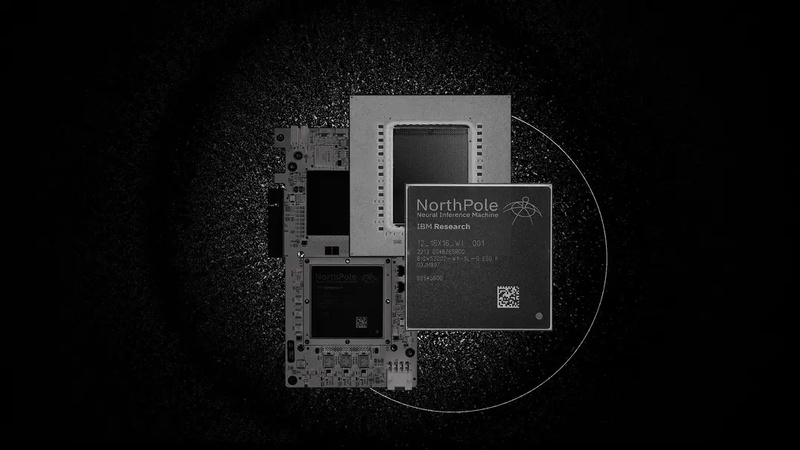
Источник изображений здесь и далее: IBM Research В итоге TrueNorth получил 400 Мбит (~50 Мбайт) сверхбыстрой интегрированной памяти SRAM (~100 Кбайт на ядро, всего 4096 ядер) и мог эмулировать 1 млн нейронов с 256 млн межнейронных связей. Чип моделировал бинарные нейроны, а вес каждого синапса был закодирован двумя битами. 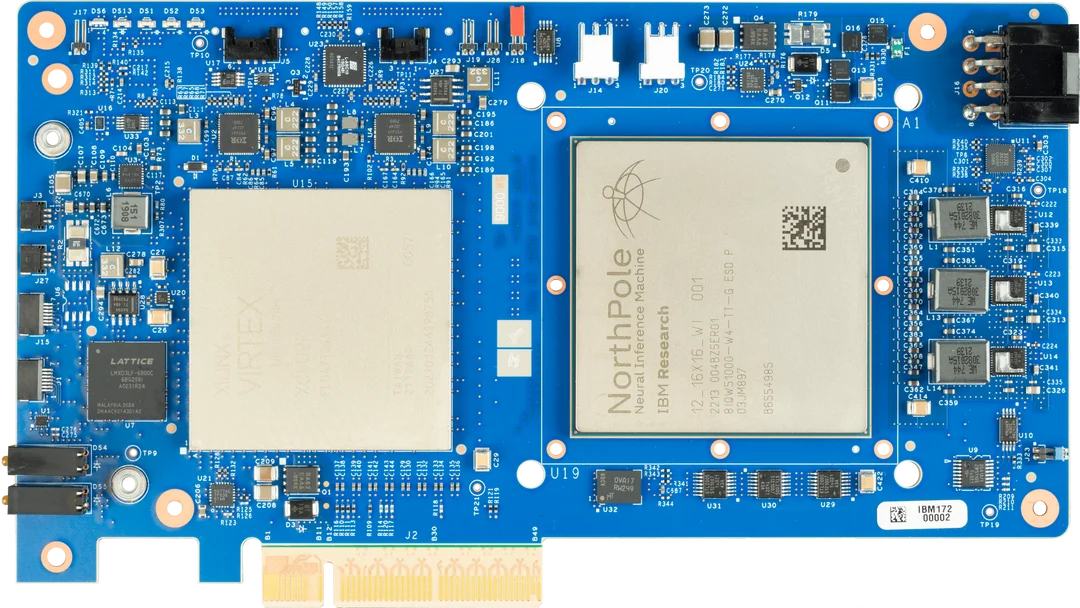
FPGA (слева) используется только в качестве PCIe-моста Новый 12-нм нейрочип NorthPole устроен несколько иначе: он состоит из 256 ядер, которые, впрочем, всё так же используют внутреннюю память общим объёмом 192 Мбайт. Дополнительно имеется буфер объёмом 32 Мбайт для IO-тензоров. Каждое из ядер NorthPole за такт способно выполнять 2048 операций с 8-бит точностью вычислений. В режимах 4- и 2-бит точности производительность растёт соответствующим образом. По словам IBM, новый NPU превосходит предшественника в 4000 раз и на частоте 400 МГц мог бы развивать производительность в районе 840 Топс. Из-за довольно ограниченного объёма памяти NorthPole не подходит для запуска сложных нейросетей вроде GPT-4, но его главное назначение не в этом — чип позиционируется в качестве основы систем машинного зрения, в том числе в системах автопилотов, хирургических роботов и т.п. И в этом качестве новинка, состоящая из 22 млрд транзисторов и имеющая площадь кристалла 800 мм2, проявляет себя очень хорошо. 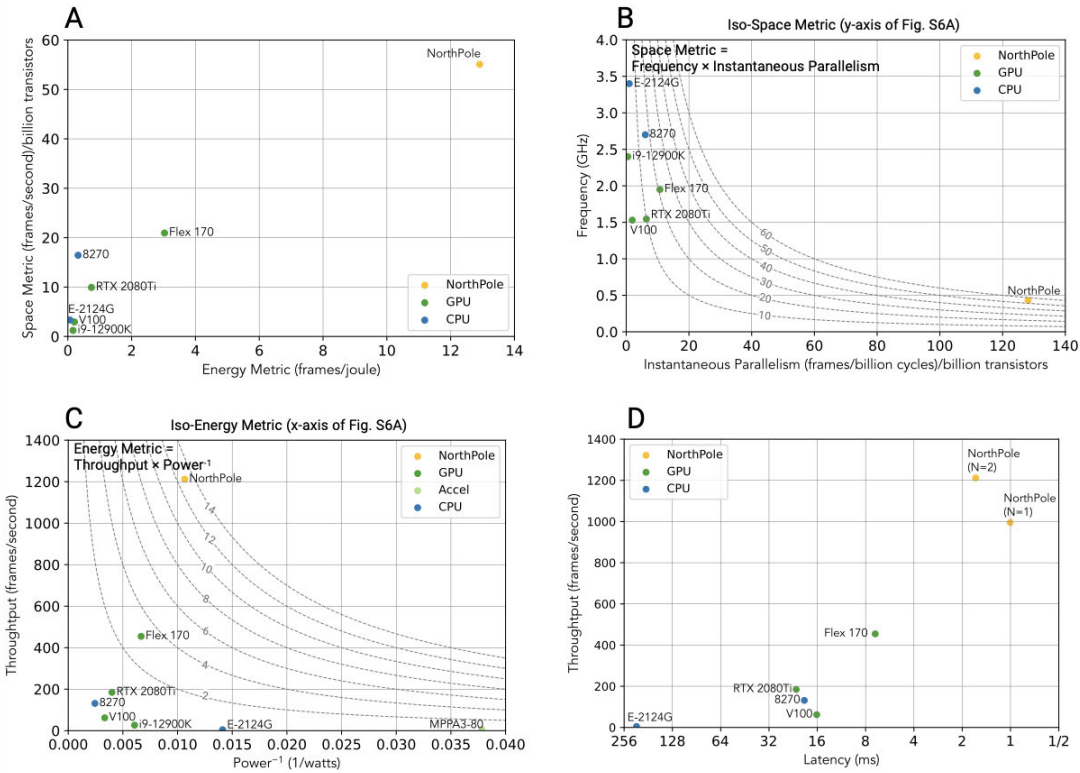
Результаты тестов на эффективность архитектуры NorthPole Так, в тестах ResNet-50 NorthPole в 25 раз превзошёл по энергоэффективности сопоставимые по техпроцессу GPU, а показатели латентности при этом оказались в 22 раза лучше. В пересчёте на транзисторную сложность IBM говорит о превосходстве даже над новейшими 4-нм решениями NVIDIA. Полные результаты тестирования доступны на science.org. К сожалению, речь всё ещё идёт об экспериментальном прототипе с довольно грубым по современным меркам 12-нм техпроцессом. По словам исследователей, производительность NorthPole благодаря более совершенным техпроцессам удалось поднять бы ещё в 25 раз. Параллельно IBM ведёт разработки в области ИИ-чипов с элементами аналоговой логики. Достигнутые в рамках 14-нм техпроцесса результаты позволяют говорить об удельной производительности в районе 10,5 Топс/Вт или 1,59 Топс/мм2.
21.10.2023 [16:09], Сергей Карасёв
В Аргоннской национальной лаборатории запущена ИИ-система GroqАргоннская национальная лаборатория Министерства энергетики США сообщила о запуске вычислительного кластера, использующего специализированные ИИ-решения Groq. Ресурсы системы предоставляются исследователям на базе тестовой площадки ALCF (Argonne Leadership Computing Facility). Groq является разработчиком чипов GroqChip, спроектированных с прицелом на решение задач ИИ и машинного обучения. Эти изделия, наделённые 230 Мбайт памяти SRAM, обеспечивают производительность до 750 TOPS INT8 и до 188 Тфлопс FP16. 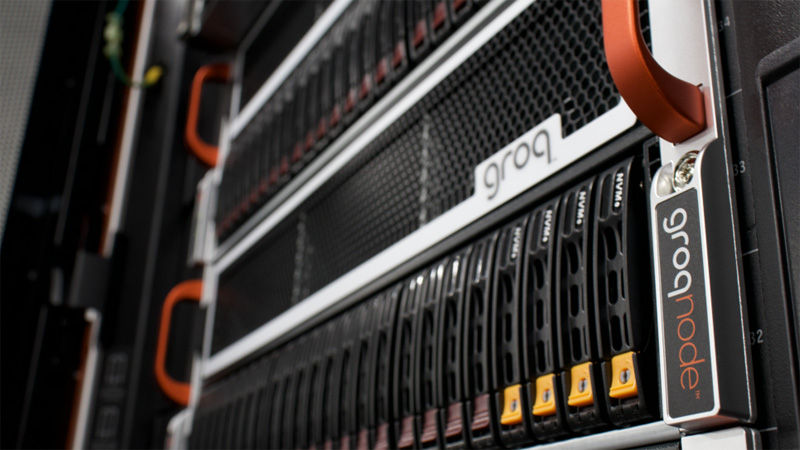
Источник изображения: Аргоннская национальная лаборатория Процессоры GroqChip являются основой ускорителей GroqCard с интерфейсом PCIe 4.0 x16. Восемь таких карт входят в состав сервера GroqNode формата 4U. Наконец, до восьми серверов GroqNode используются в кластерах GroqRack. И именно такие узлы являются основой новой ИИ-платформы ALCF. Заявленная производительность каждого узла достигает 48 POPS (INT8) или 12 Пфлопс (FP16). Экосистема программного и аппаратного обеспечения Groq предназначена для ускорения решения сложных ИИ-задач, в частности, инференса. Исследователи будут применять НРС-платформу при реализации ресурсоёмких научных проектов в таких областях, как визуализация, термоядерная энергия, материаловедение, создание лекарственных препаратов нового поколения и пр. Отмечается, что уникальная архитектура Groq и универсальный компилятор обеспечат повышенную производительность для широкого спектра ИИ-моделей. В рамках сотрудничества Аргоннская национальная лаборатория и Groq работают над лекарствами от коронавируса, спровоцировавшего пандемию COVID-19: говорится, что время получения результатов сократилось с дней до минут. Создавая модели вируса и помогая исследователям быстро сравнивать их с базой данных, содержащей миллиарды молекул препаратов, модели ИИ позволяют идентифицировать перспективные соединения, которые будут использоваться в клинических терапевтических испытаниях.
12.10.2023 [15:16], Владимир Мироненко
«ИЭК холдинг» приобрёл активы покинувшей российский рынок LegrandОдин из ведущих производителей электротехники в России ООО «ИЭК ХОЛДИНГ» (коммерческое обозначение — IEK GROUP) объявил о покупке российских активов французской компании Legrand Group, объявившей об уходе с российского рынка 25 января этого года. Как указано в пресс-релизе, предметом сделки стали три производственные площадки, более 20 представительств компании в российских городах. Также сообщается, что при одобрении сделки правительственная комиссия установила для бывших предприятий Legrand ключёвые показатели на три года. В частности, суммарная выручка трех производственных площадок в 2025 году должна составить около 8,5 млрд руб., а инвестиции IEK Group в развитие производства на них достичь 1 млрд руб. Legrand производит электромонтажное и индустриальное оборудование, распределители электроэнергии, системы автоматизации зданий, а также умную бытовую электронику под брендом Netatmo, начиная от умных выключателей и заканчивая системами безопасности. 
Источник изображения: IEK GROUP «IEK GROUP и бывшие российские подразделения Legrand дополняют друг друга в технологиях и продуктовых решениях, поэтому сделка обеспечит эффект синергии», — заявил гендиректор IEK GROUP. Он отметил, что приобретение российских активов Legrand даст импульс масштабной программе локализации продукции и дополнительным инвестициям IEK GROUP в производство. А коммерческий директор IEK GROUP заявил, что после привлечения производственных мощностей и технологий Legrand компания сможет предложить российским потребителям электротехнику ещё более высокого качества.
27.09.2023 [19:44], Руслан Авдеев
SAP представила ИИ-помощника Joule, который будет интегрирован во все продукты компанииРазработчик корпоративного ПО, компания SAP, создала виртуального помощника Joule на основе генеративного ИИ. Joule будет интегрирован практически во все программные продукты компании и обеспечит проактивную работу с набором облачных сервисов компании и сторонними системами. Как сообщают в SAP, он может быстро разбираться в разрозненных корпоративных данных, выдавая качественные ответы на запросы, что должно повысить производительность сотрудников. Например, сотрудники смогут задавать боту вопросы в свободной форме, а тот будет давать осмысленные ответы на основе баз данных, доступных в средах SAP, специфических для каждой отдельной компании. Для этого он изучит корпоративные тексты, базы данных, изображения и другой контент во всех проектах на базе SAP и сторонних разработках. При этом гарантируется сохранение конфиденциальности приватных данных. 
Источник изображения: SAP Некоторые задачи он сможет выполнять самостоятельно — готовить описания вакансий для HR, разрабатывать релевантные вопросы для интервьюирования соискателей, и др. Это освободит ресурсы сотрудников для более эффективной работы. Ожидается, что Joule окажет большое влияние на всю экосистему SAP, поскольку услугами компании пользуются более 300 млн сотрудников по всему миру ежедневно. Как заявляют в компании, чат-бот «знает, что сотрудники имеют в виду, а не то, что они говорят». На момент релиза в ноябре Joule будет доступен в SAP SuccessFactors, SAP S/4HANA Public Cloud Edition и SAP Start, а несколькими неделями позже он дебютирует в SAP CX, SAP Ariba и SAP Business Technology Platform, после чего появится и в других приложениях. В SAP уверены, что хотя инструменты компании для различных сфер иногда непросто использовать, Joule, обученный на большой базе знаний SAP, значительно упростит жизнь пользователям. 
Источник изображения: SAP Появление Joule стало естественным продолжением развития инструментов Business AI, представленных SAP в мае и помогающих автоматизировать множество бизнес-процессов. Сообщается, что SAP Business AI уже используют во множестве сценариев более 26 тыс. корпоративных клиентов. Также в мае SAP представила инструменты в рамках пакета SAP Signavio Process Manager для оптимизации деятельности и принятия обоснованных бизнес-решений. В SAP заявляют, что Joule — лишь малая часть планов построения современной ИИ-экосистемы. Компания уже инвестировала немалые средства в ИИ-стартапы Cohere Inc., Aleph Alpha GmbH и Anthropic в этом году и сотрудничает с облачными провайдерами вроде IBM и Google для обеспечения пользователям доступа к данным, способным обеспечить работоспособность ещё более передовых ИИ-технологий. |
|