
Материалы по тегу: ии
|
11.10.2024 [19:55], Алексей Степин
256 Гбайт HBM3e — это хорошо, а 288 Гбайт — ещё лучше: AMD анонсировала ускорители Instinct MI325X и MI355XВчера компания AMD анонсировала серверные процессоры EPYC 9005 (Turin) и ускорители Instinct MI325X. Если верить AMD, новинки устанавливают новые эталоны производительности в своих сферах применения. О процессорах речь пойдёт в отдельном материале, а сейчас попробуем разобраться с Instinct MI325X — чем же именно он отличается от представленного ранее MI300X, архитектура которого в своё время была разобрана достаточно подробно. Сама AMD позиционирует MI325X в качестве наследника MI300X, способного конкурировать с NVIDIA H200 и, возможно, даже с B200. В сравнении с тем, что было опубликовано ранее, характеристики новинки несколько изменились. В частности, новый ускоритель получил 256 Гбайт памяти HBM3e, а не 288 Гбайт, как было обещано ранее. 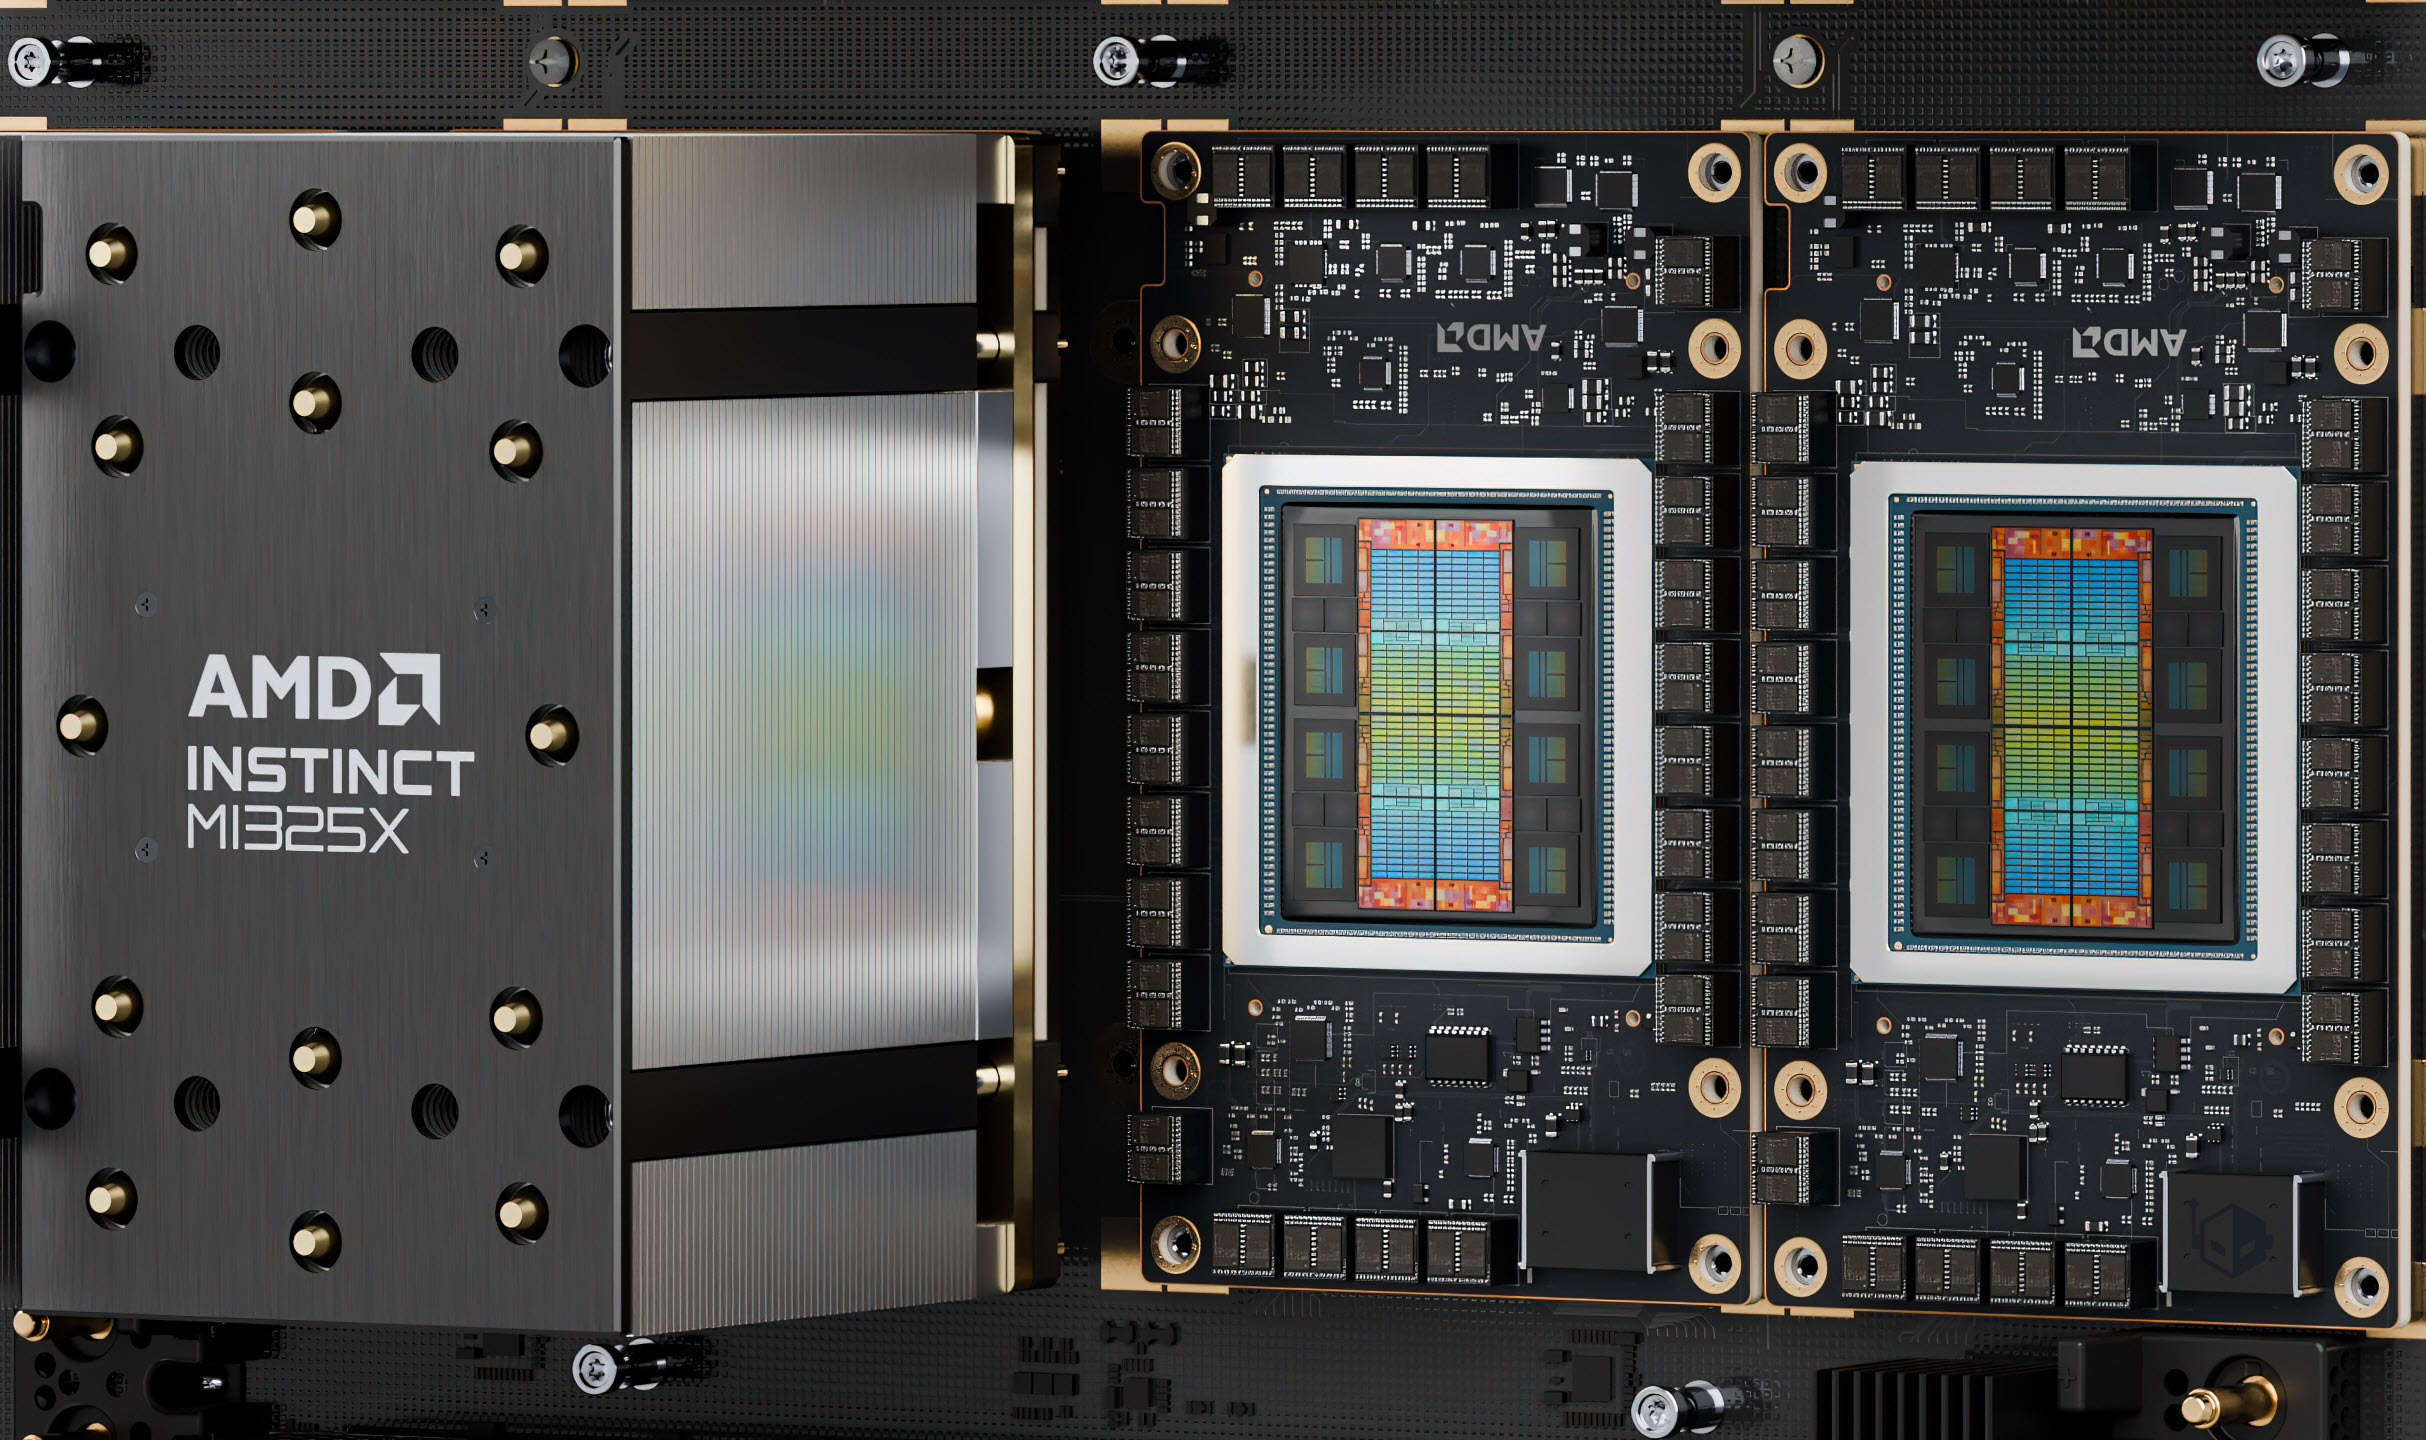
Источник здесь и далее: AMD via WCCFTech На приведённых слайдах с изображением кристалла MI325X отчетливо видно, что количество сборок HBM по-прежнему равно восьми, однако вместо ожидаемых сборок ёмкостью 36 Гбайт использованы менее ёмкие «стопки» на 32 Гбайт. Это не позволяет говорить о 50 % приросте по объёму, только о 33 %. Но и это немало! Пропускная способность подросла с 5,3 до 6 Тбайт/с. 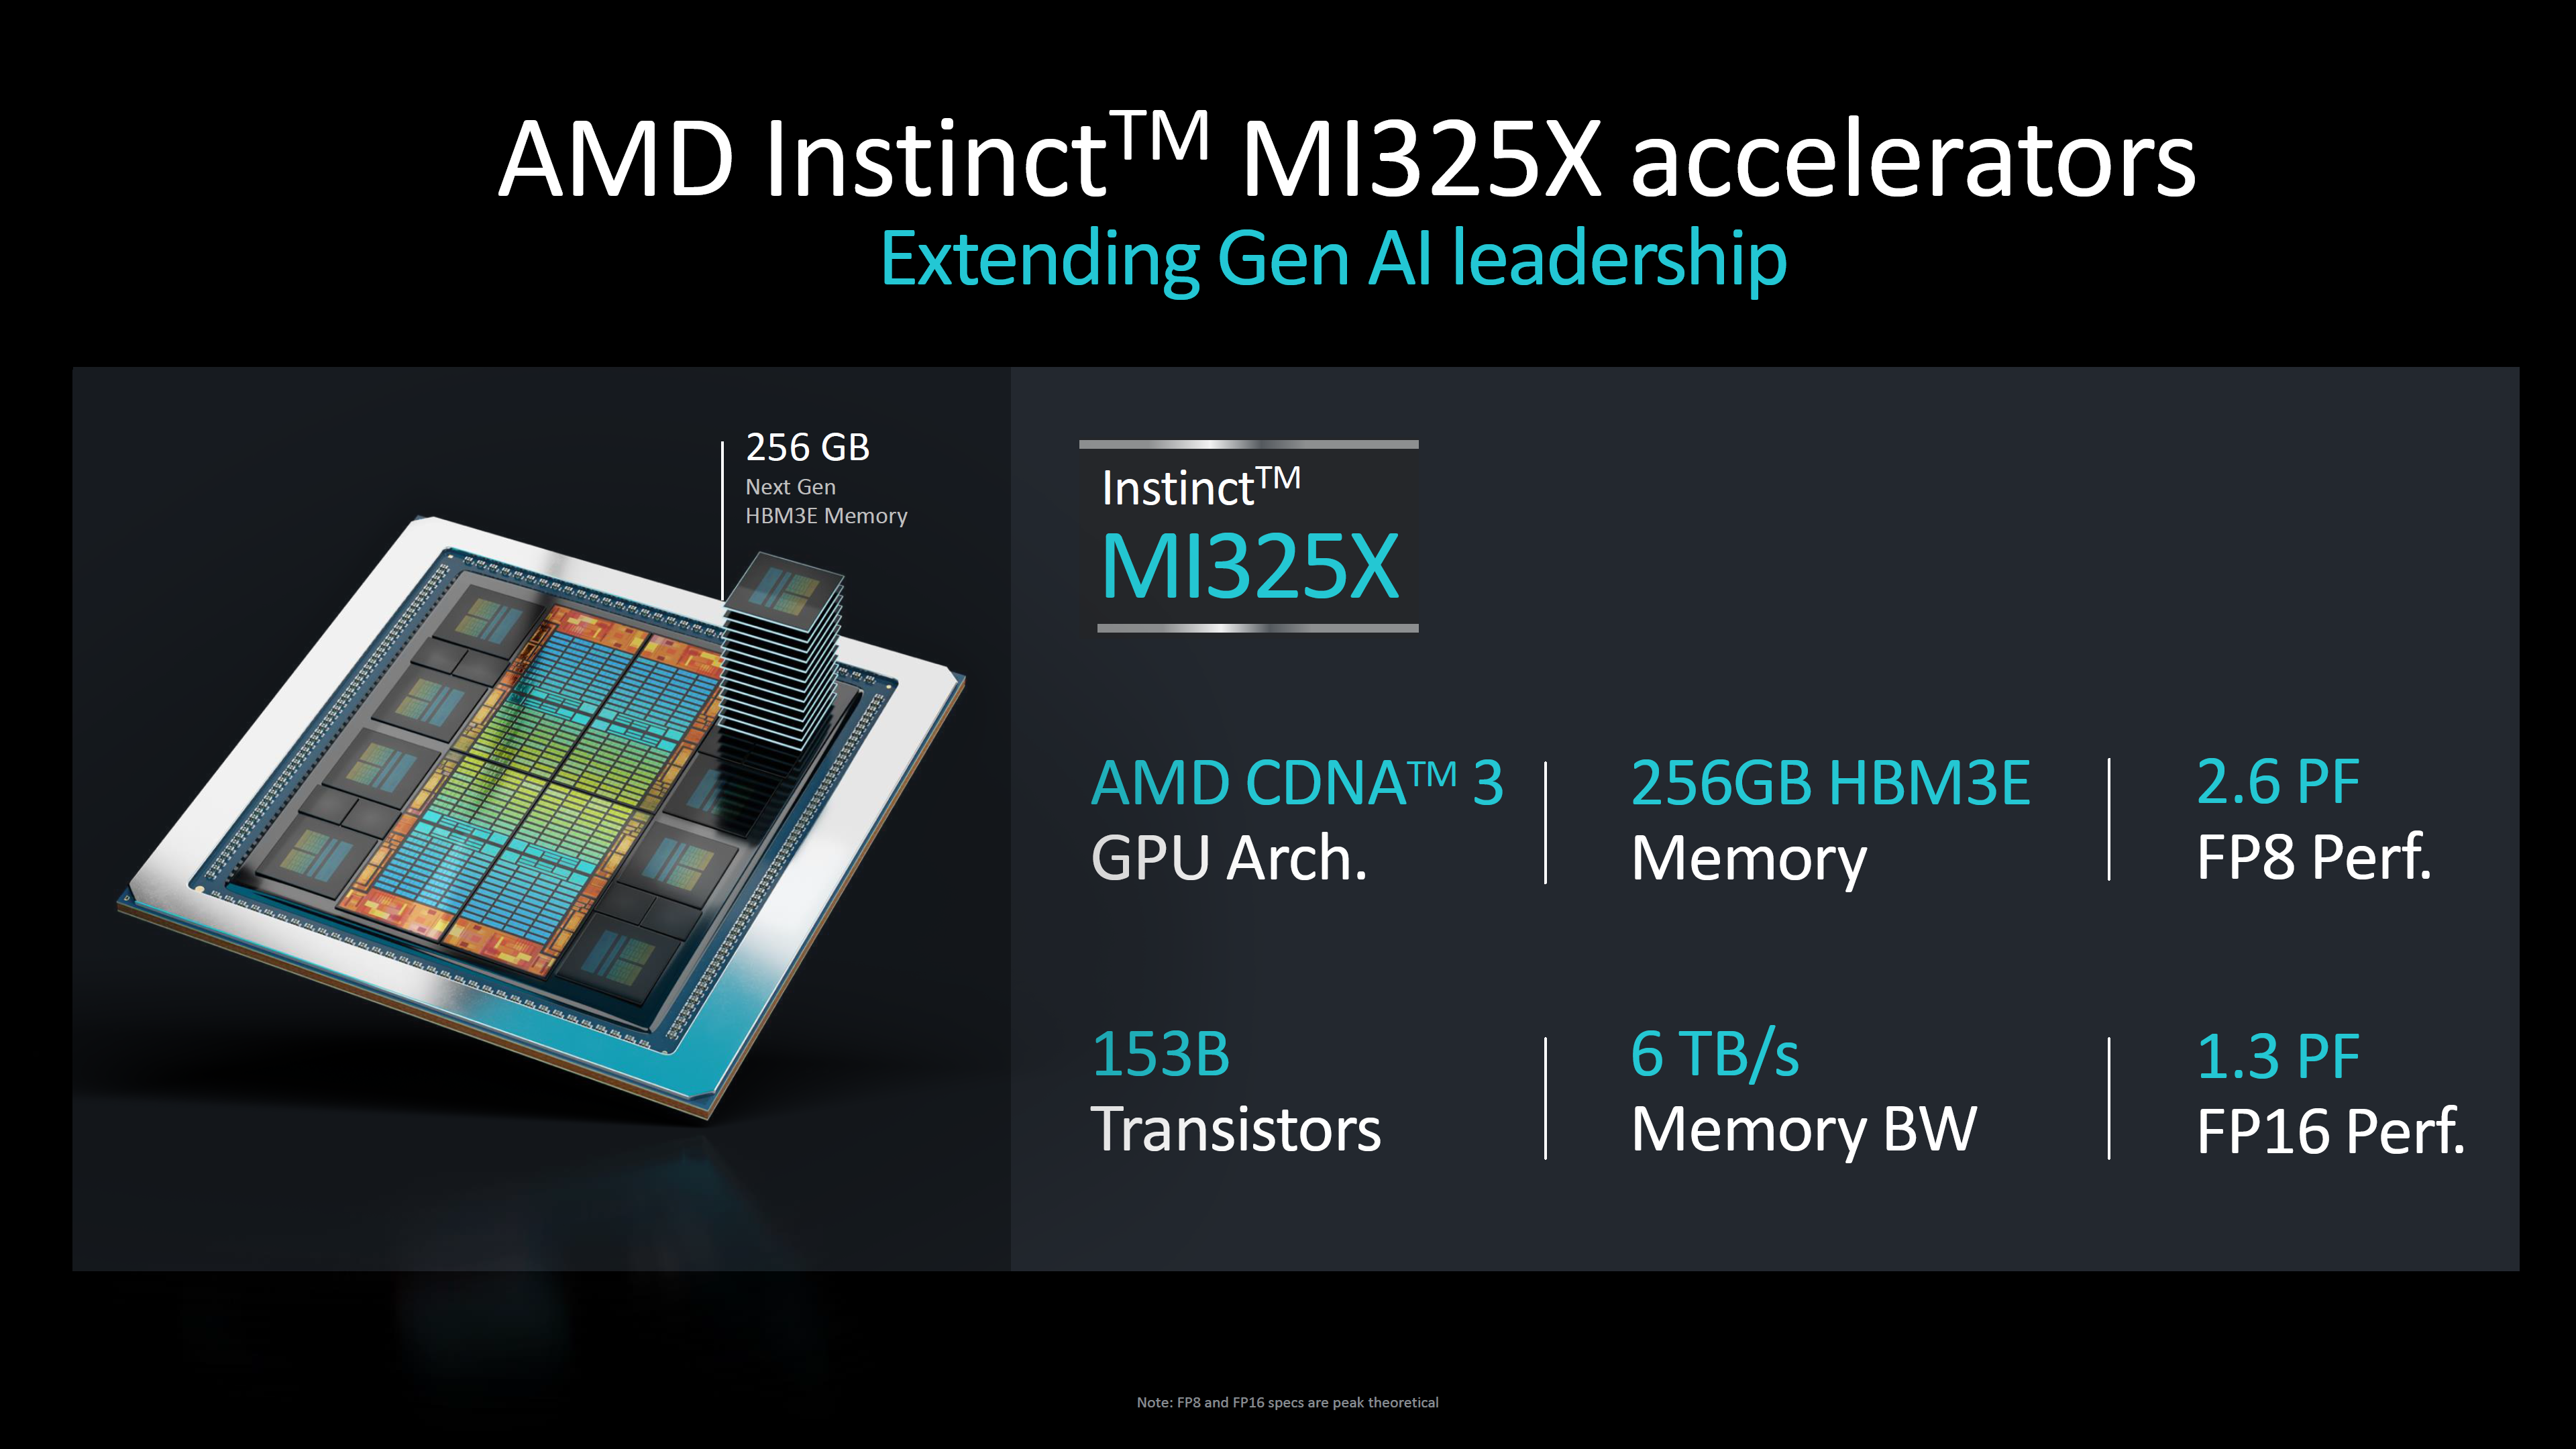 Последнее может быть объяснено повышением тактовой частоты, но из-за тесной интеграции HBM3e с остальными частями ускорителя должна была вырасти и производительность. Тем не менее, AMD приводит же цифры, что и для MI300X —1,3 Пфлопс в режиме FP16 и 2,6 Пфлопс в режиме FP8. По сути, улучшены только характеристики подсистемы памяти. 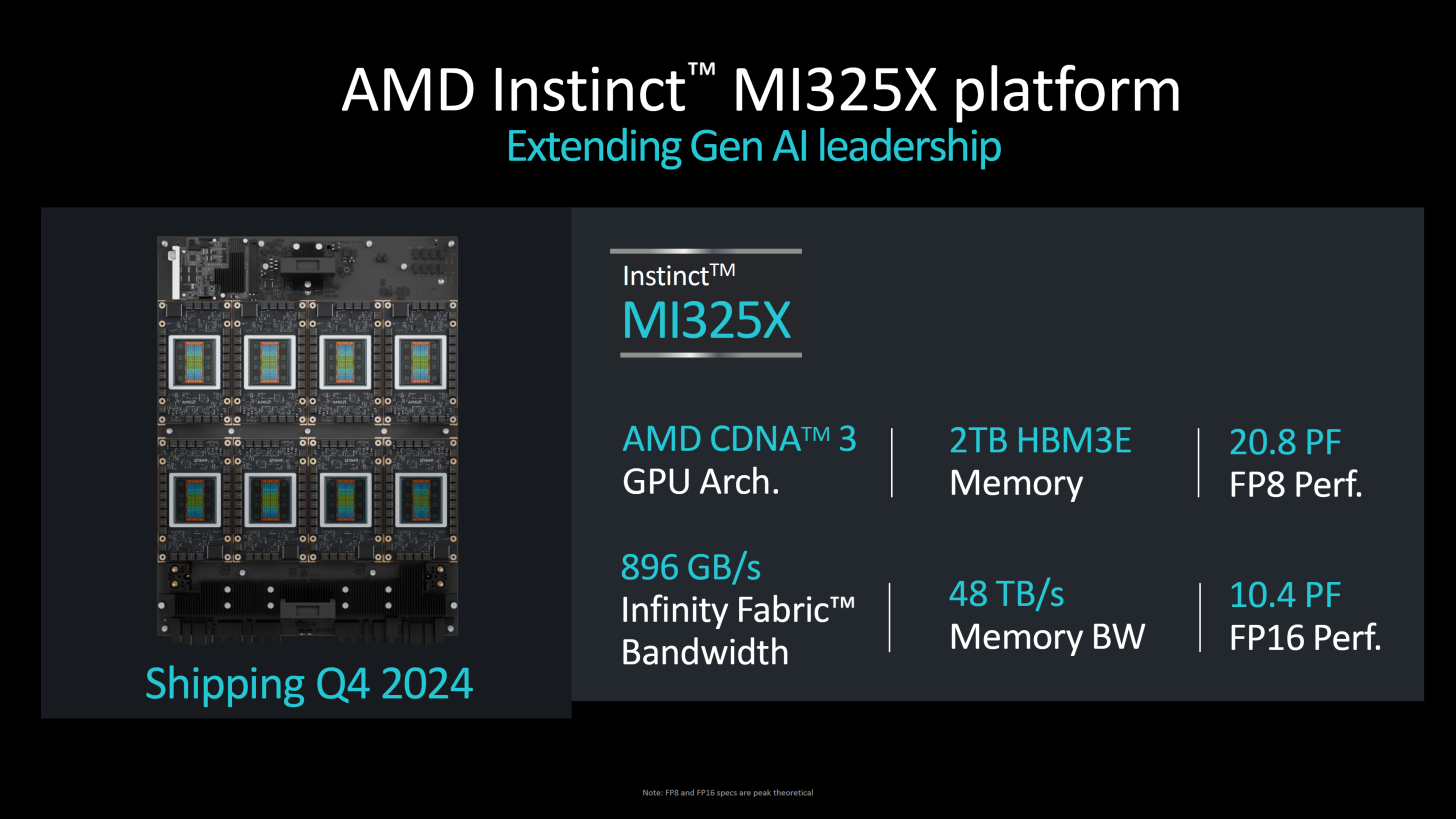 Архитектурно MI325X полностью подобен предшественнику, за исключением блока HBM. Он по-прежнему базируется на CDNA 3, имеет такое же количество транзисторов (153 млрд) и производится с использованием тех же техпроцессов, 5 нм для блоков XCD и 6 нм для IOD. Но теплопакет превышает 750 Вт, в то время как у MI300X данный параметр не достигал столь высокого значения. 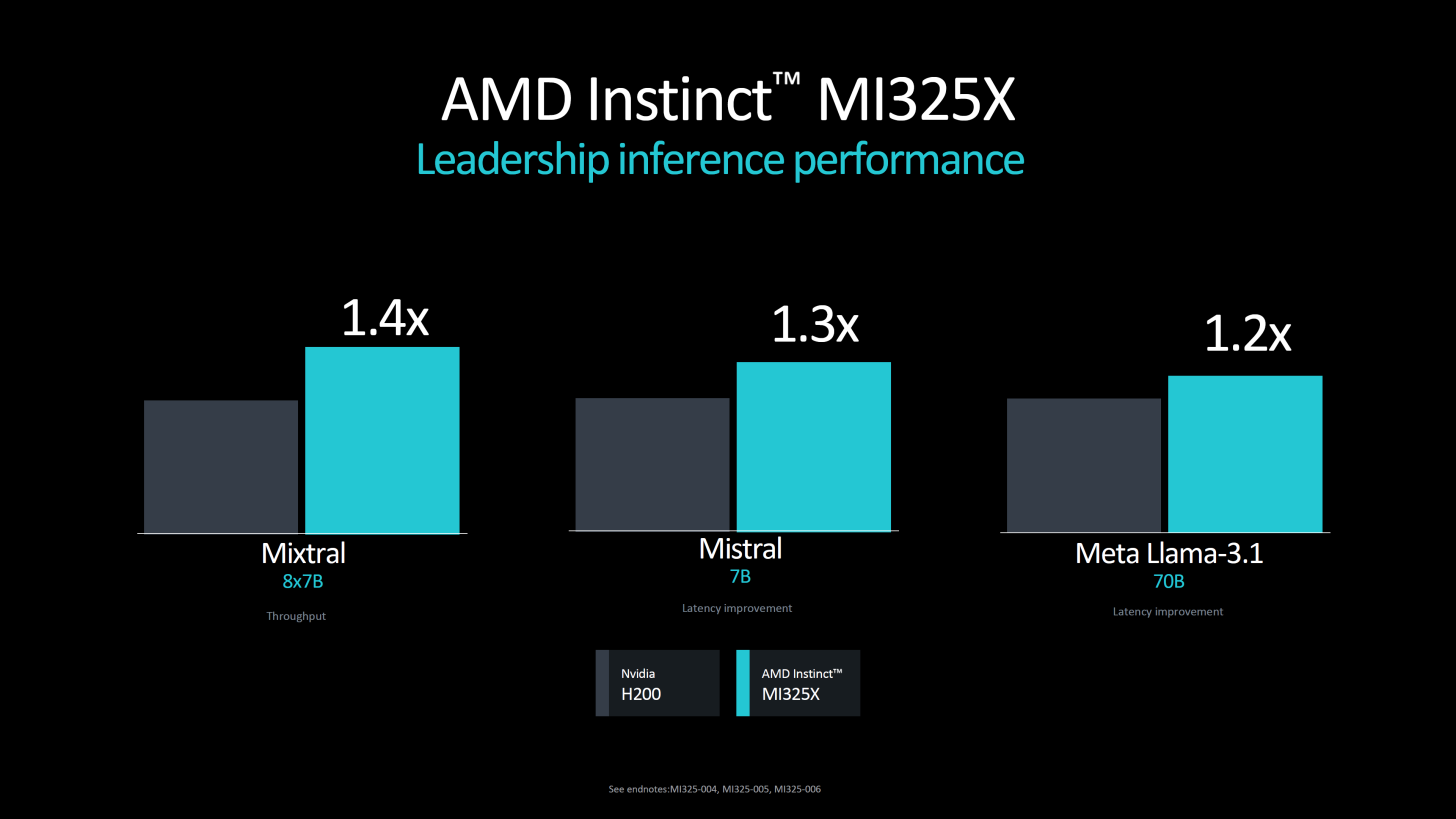 Ускорители подобного класса невозможно представить вне программной экосистемы. В настоящий момент AMD приводит данные о превосходстве MI325X над NVIDIA H200, варьирующемся в районе 20-40 % (в зависимости от нагрузки). Конечно, отчасти это заслуга памяти, но основной прирост заключается в оптимизации программной среды ROCm. По словам AMD, в задачах обучения и инференса производительность в версии 6.2 была увеличена более чем вдвое. 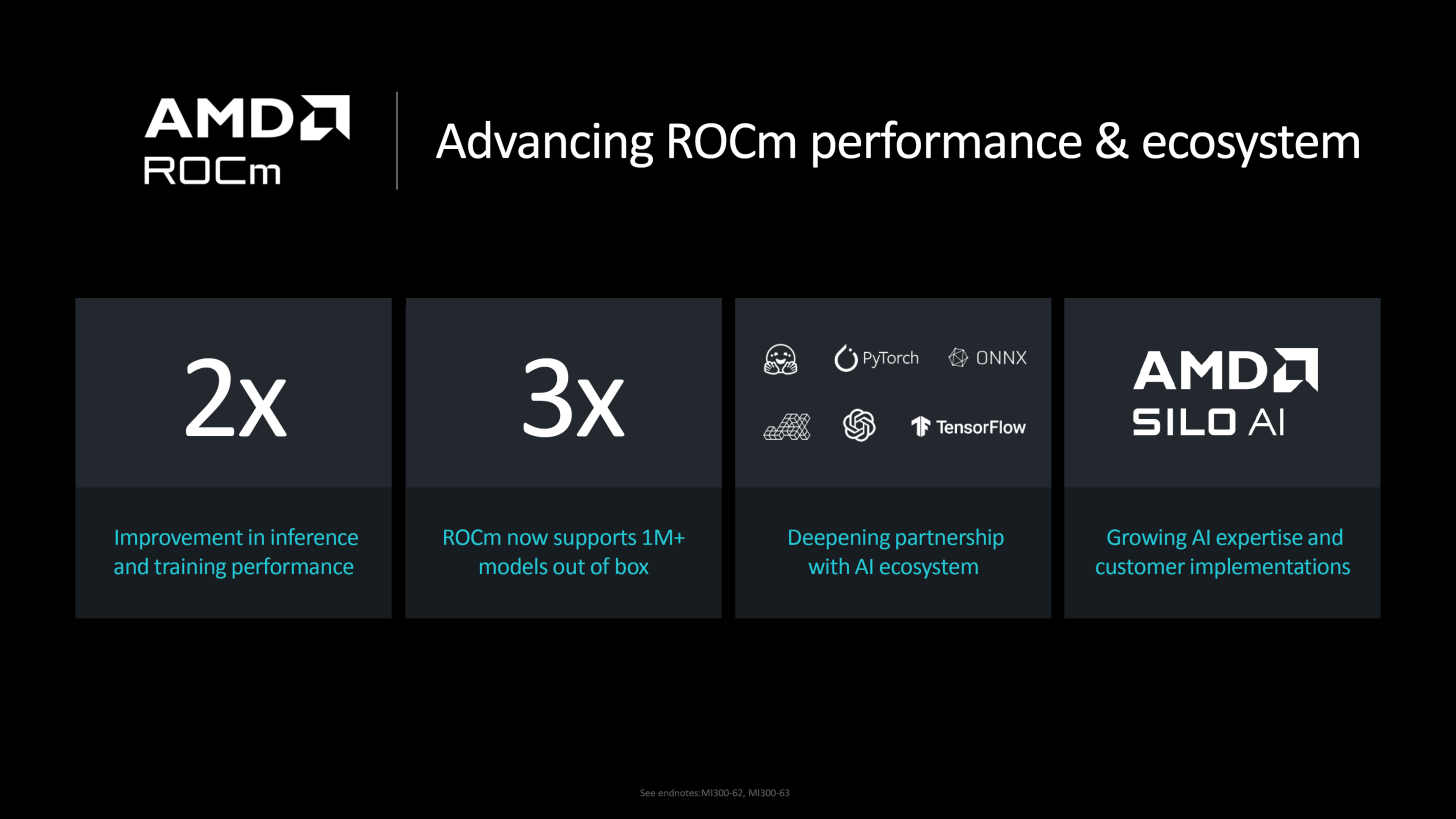 Для сравнения, в первых тестах MI300X в MLPerf Inference 4.1 отстал от NVIDIA H200 примерно на 50 %. Однако для полноты картины следует дождаться результатов тестов, проведённых сторонними источниками. Кроме того, H200 уже не самый совершенный ускоритель NVIDIA — в следующем году MI325X предстоит столкнуться с B200 на базе архитектуры Blackwell. 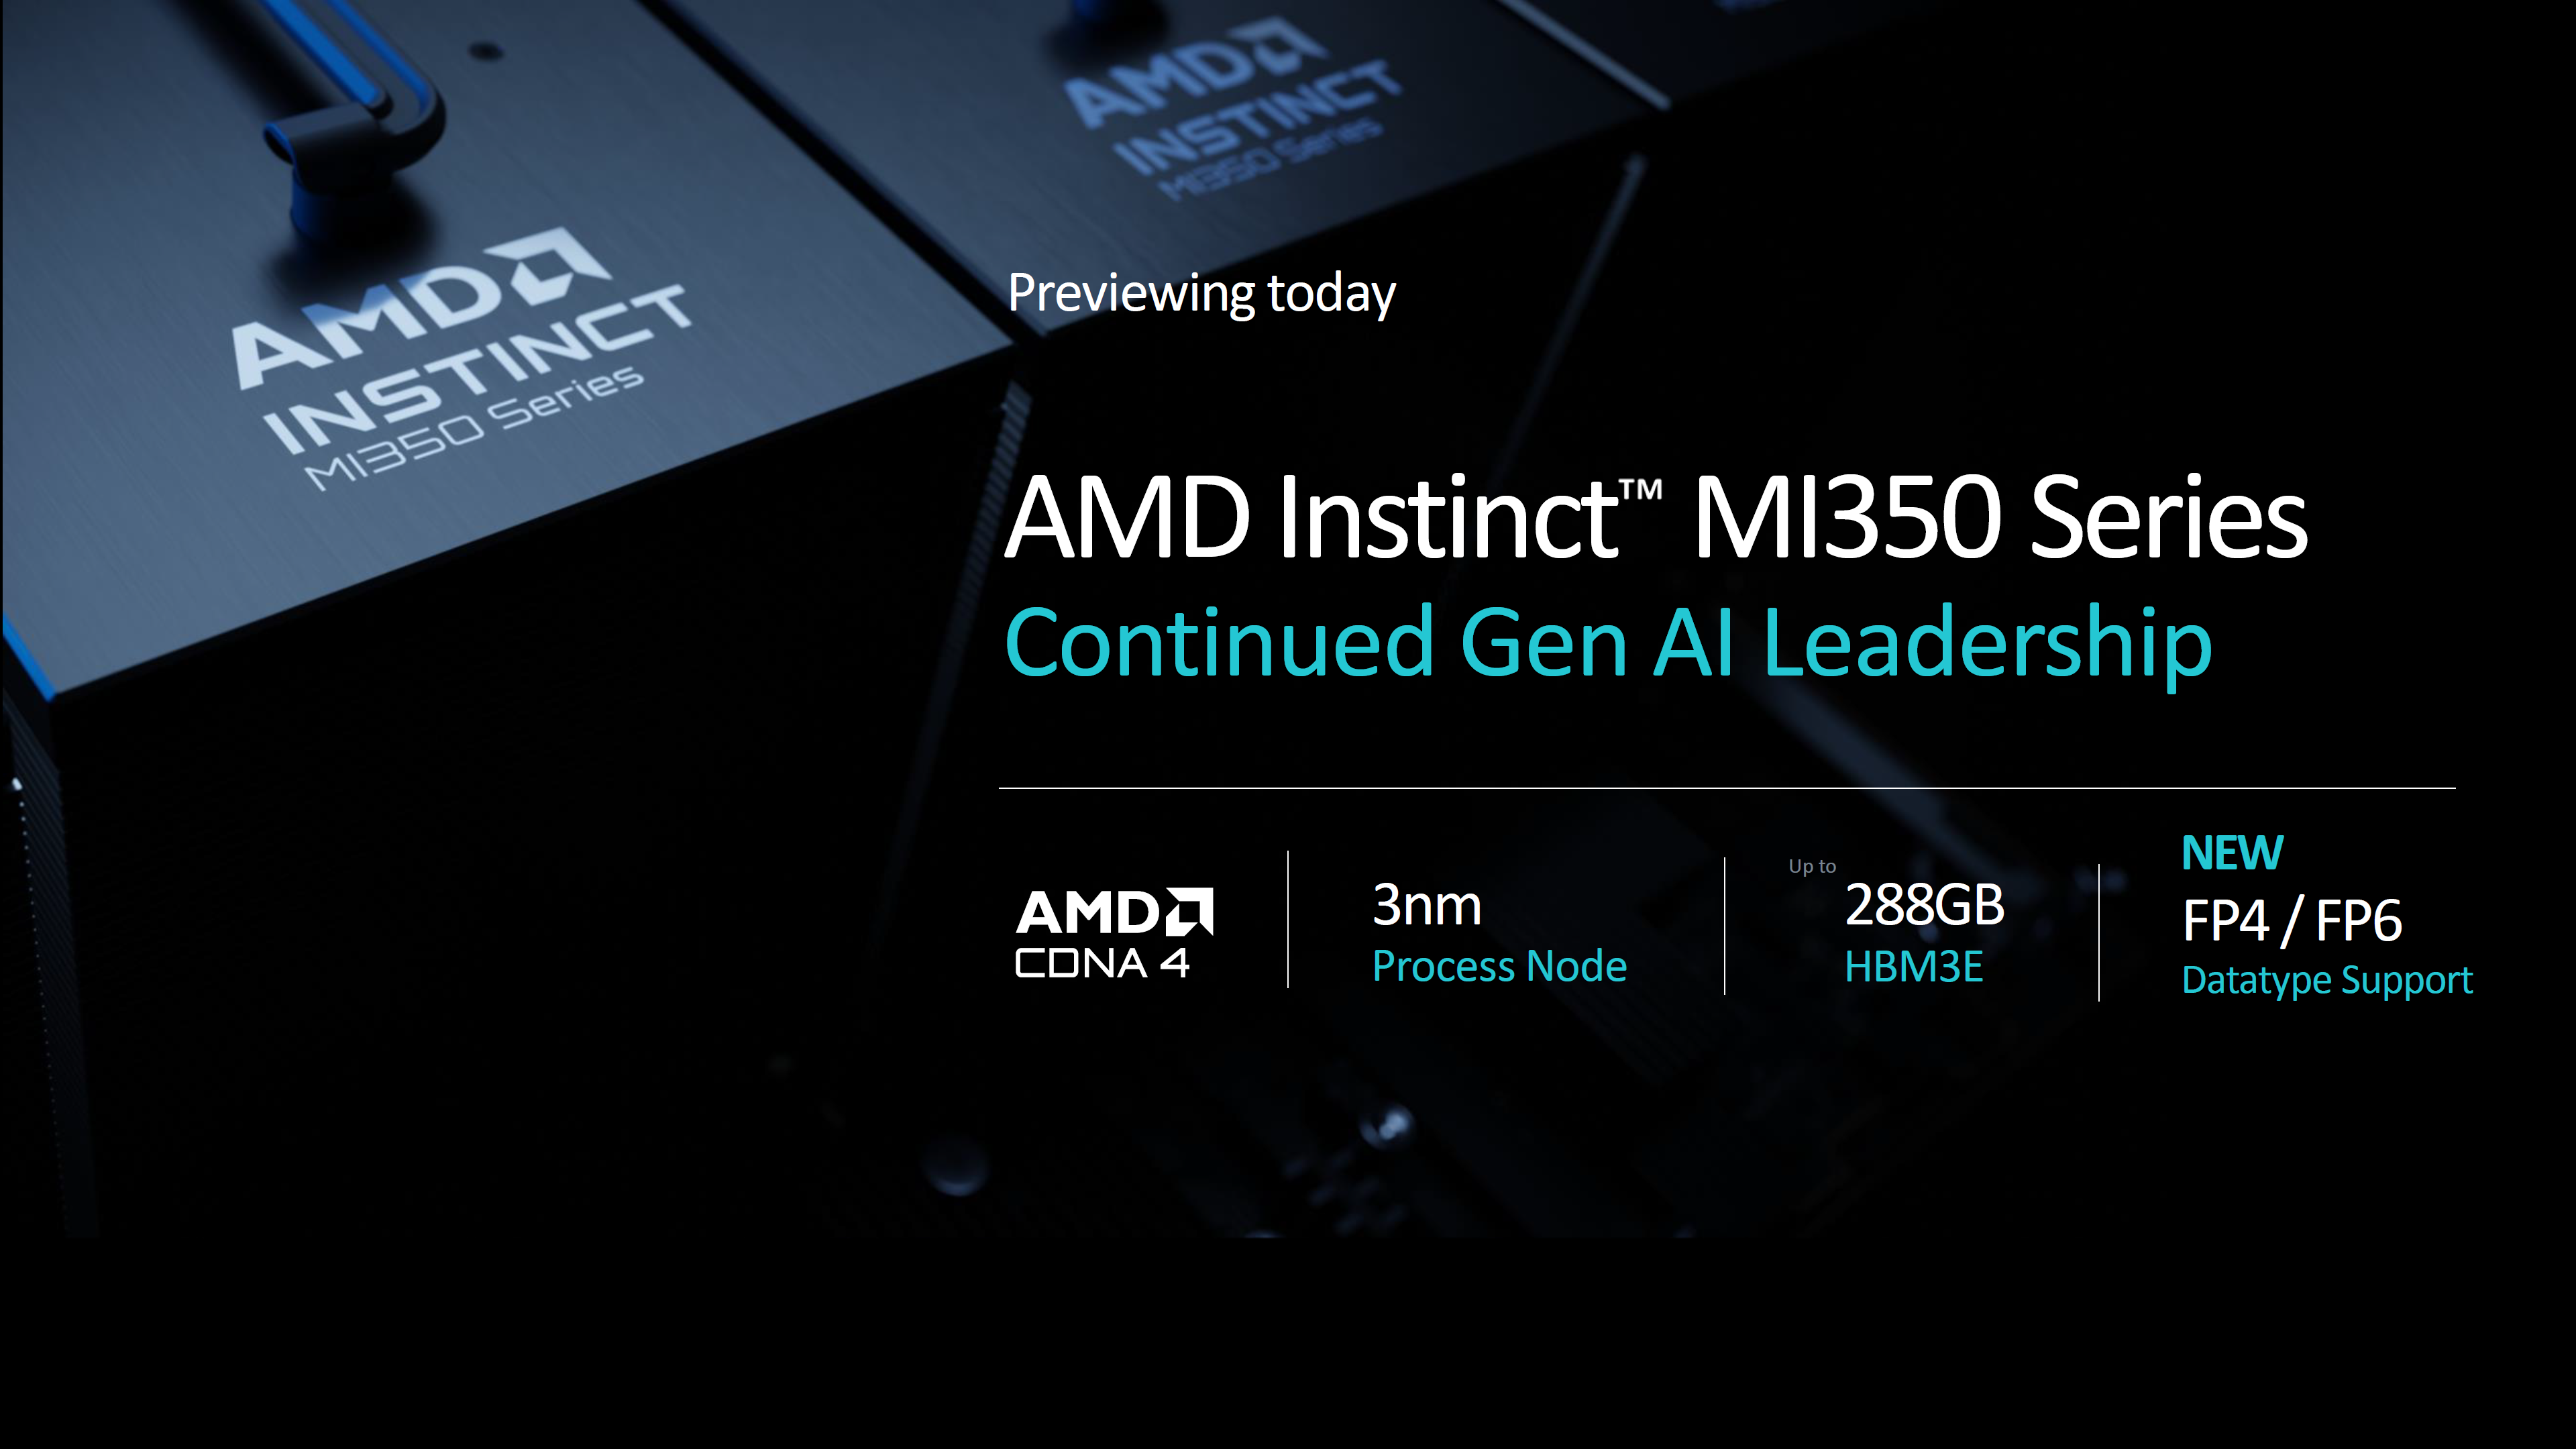 Ускорители Instinct MI325X будут доступны в I квартале 2025 года, но уже сейчас ясно, что усложнить жизнь своему главному конкуренту AMD в состоянии: так, вся обработка Llama 405B, используемой Meta✴, легла на плечи именно на MI300X. Активно используются решения AMD и в ЦОД Microsoft Azure. 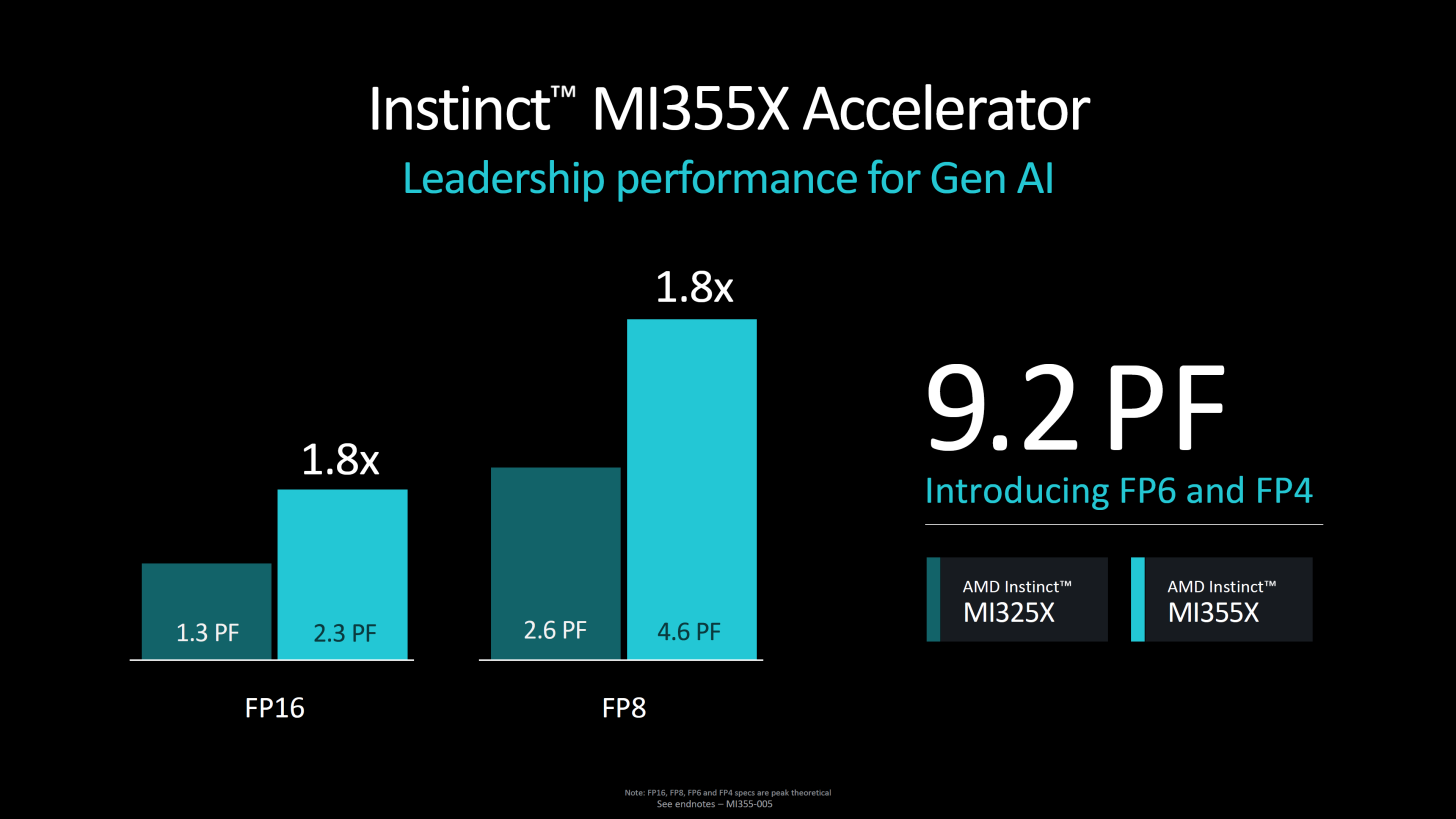 Что касается следующего поколения ускорителей AMD Instinct MI355X, то оно намечено на II половину 2025 года. Оно получит обновлённую архитектуру CDNA 4, о которой пока нет никаких сведений, кроме упоминания о поддержке режимов FP6 и FP4. Вычислительные тайлы будут переведены на 3-нм техпроцесс, а их количество, как ожидается, возрастёт с 8 до 10. Тем не менее, роста тепловыделения избежать не удастся: заявлен теплопакет до 1000 Вт. 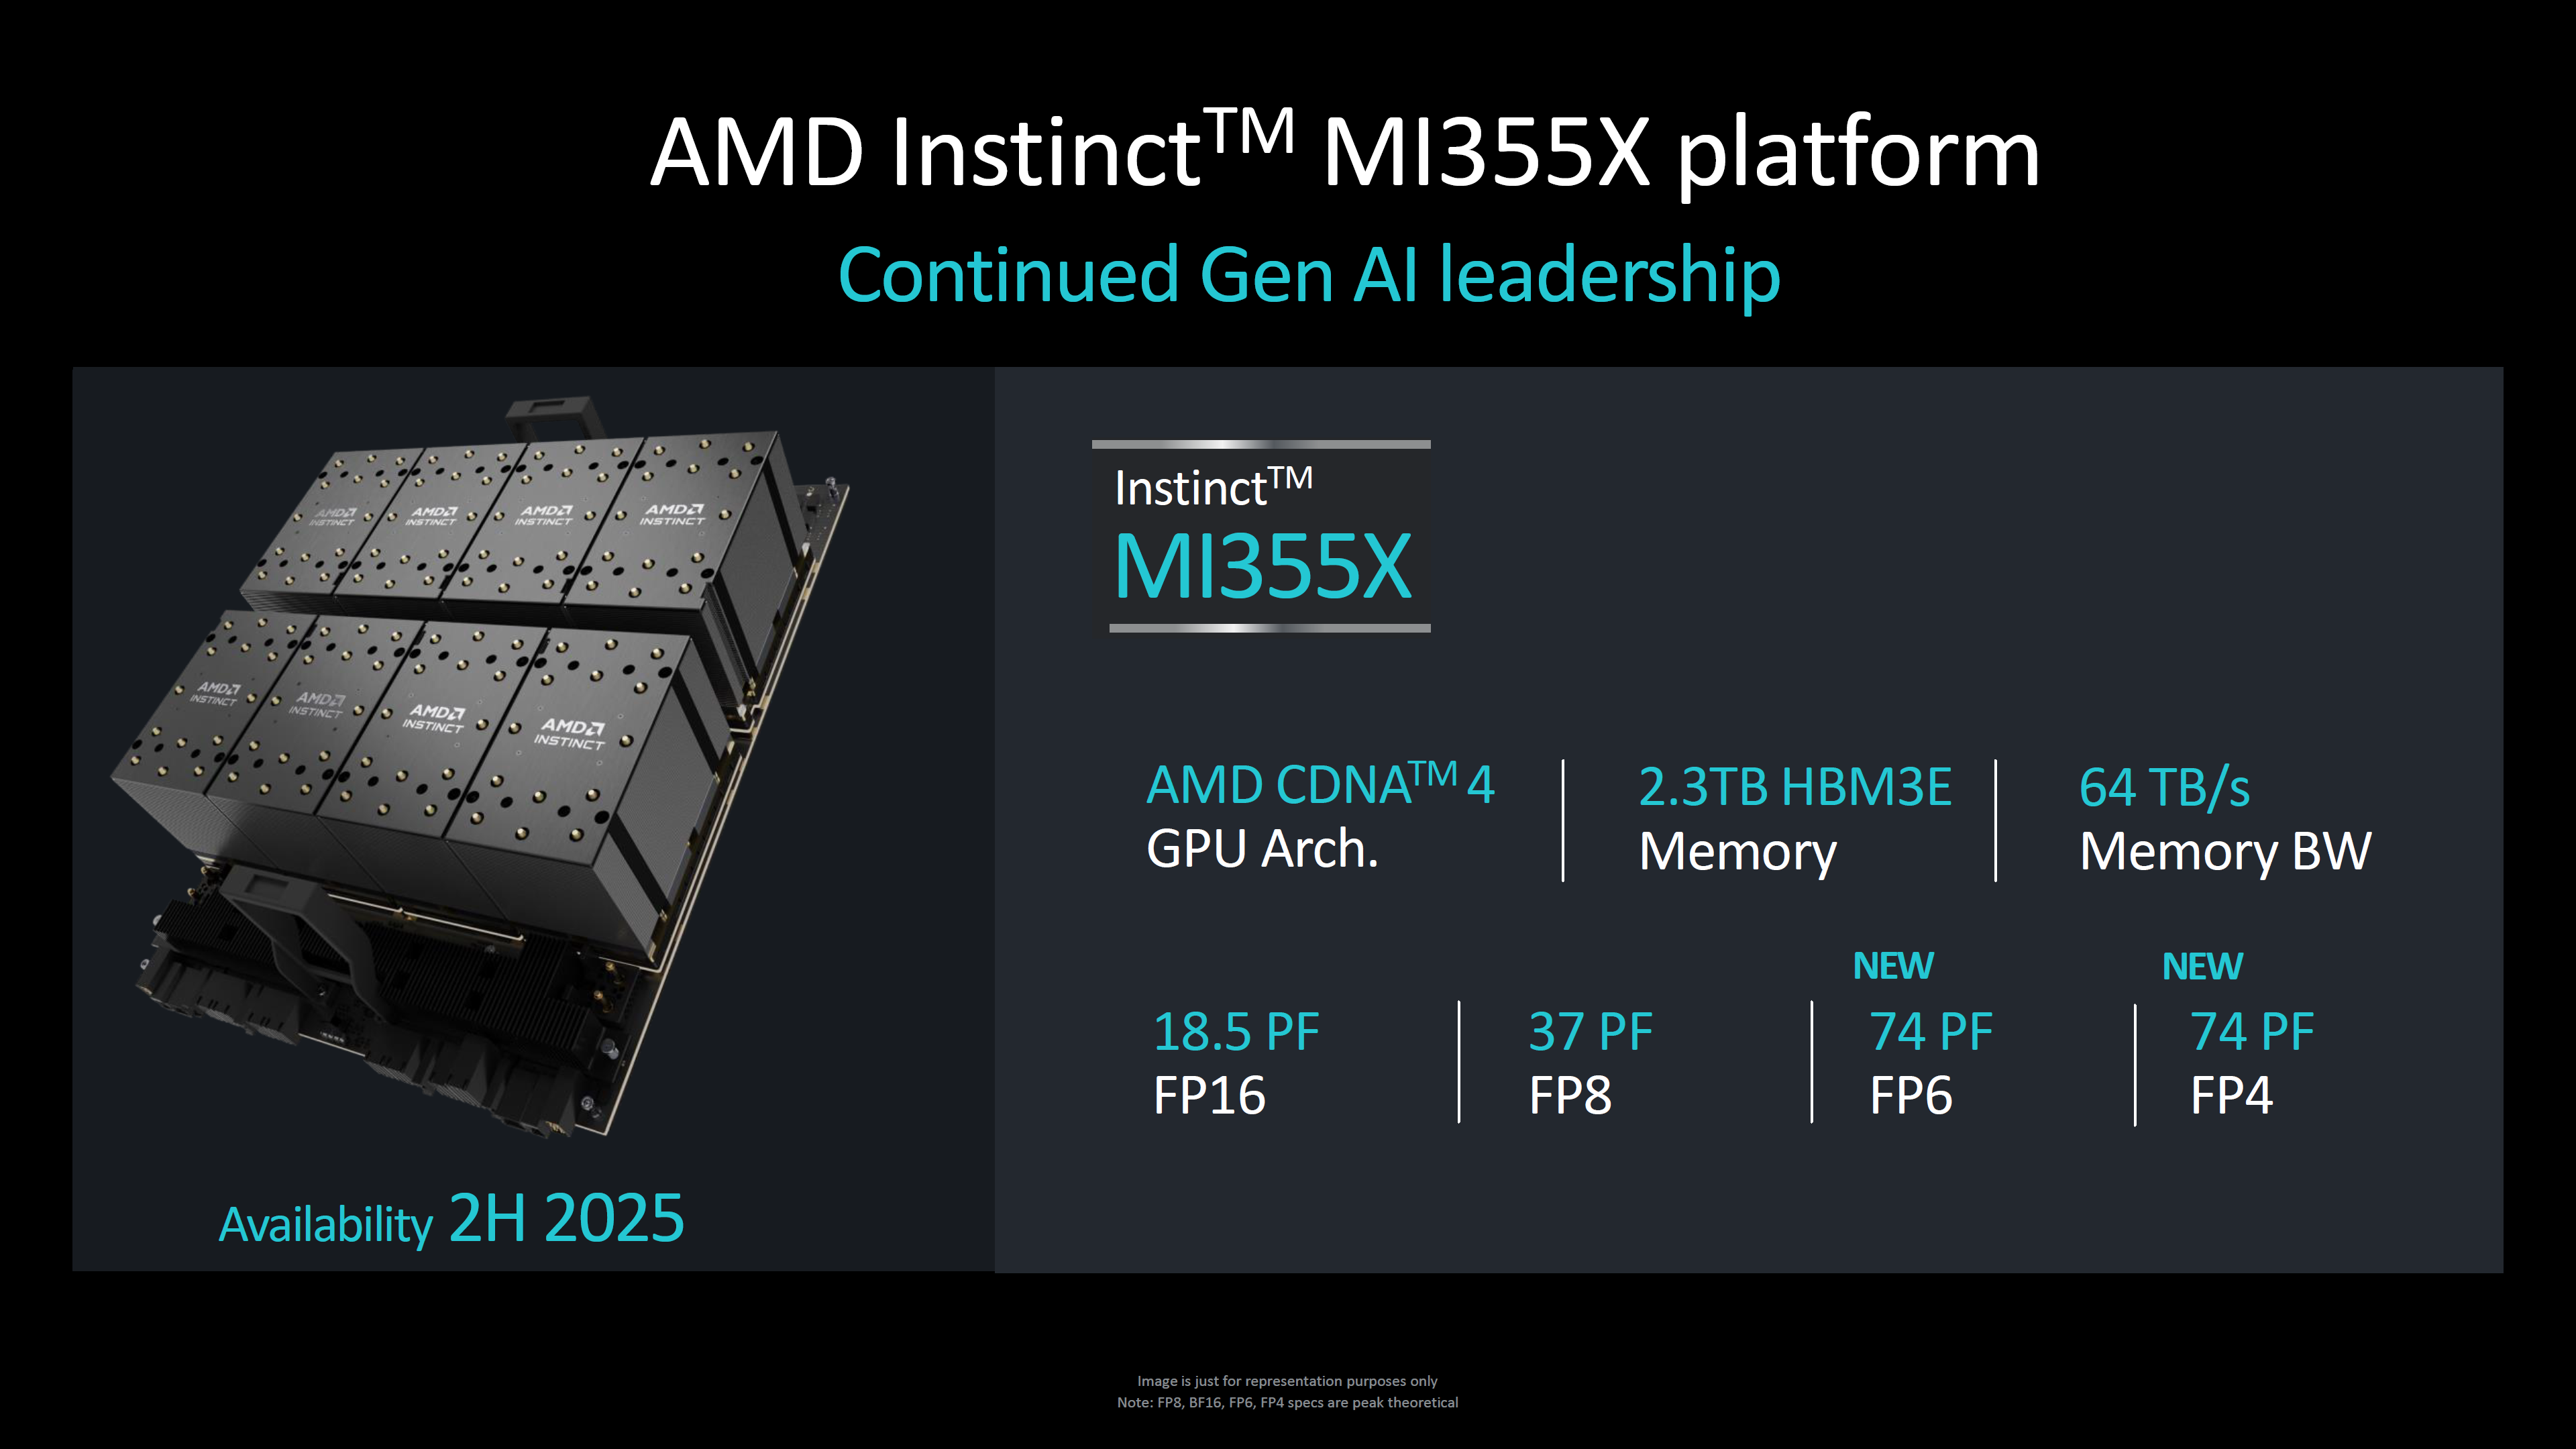 В Instinict MI355X получит дальнейшее развитие и подсистема памяти. Объём набортной HBM3e всё-таки достигнет 288 Гбайт, а пропускная способность вырастет с 6 до 8 Тбайт/с. Для связки из восьми MI355X AMD заявляет производительность в 18,5 Пфлопс в режиме FP16, что позволяет говорить о 2,31 Пфлопс для единственного ускорителя — то есть о примерно 80 % прироста в сравнении с MI325X. 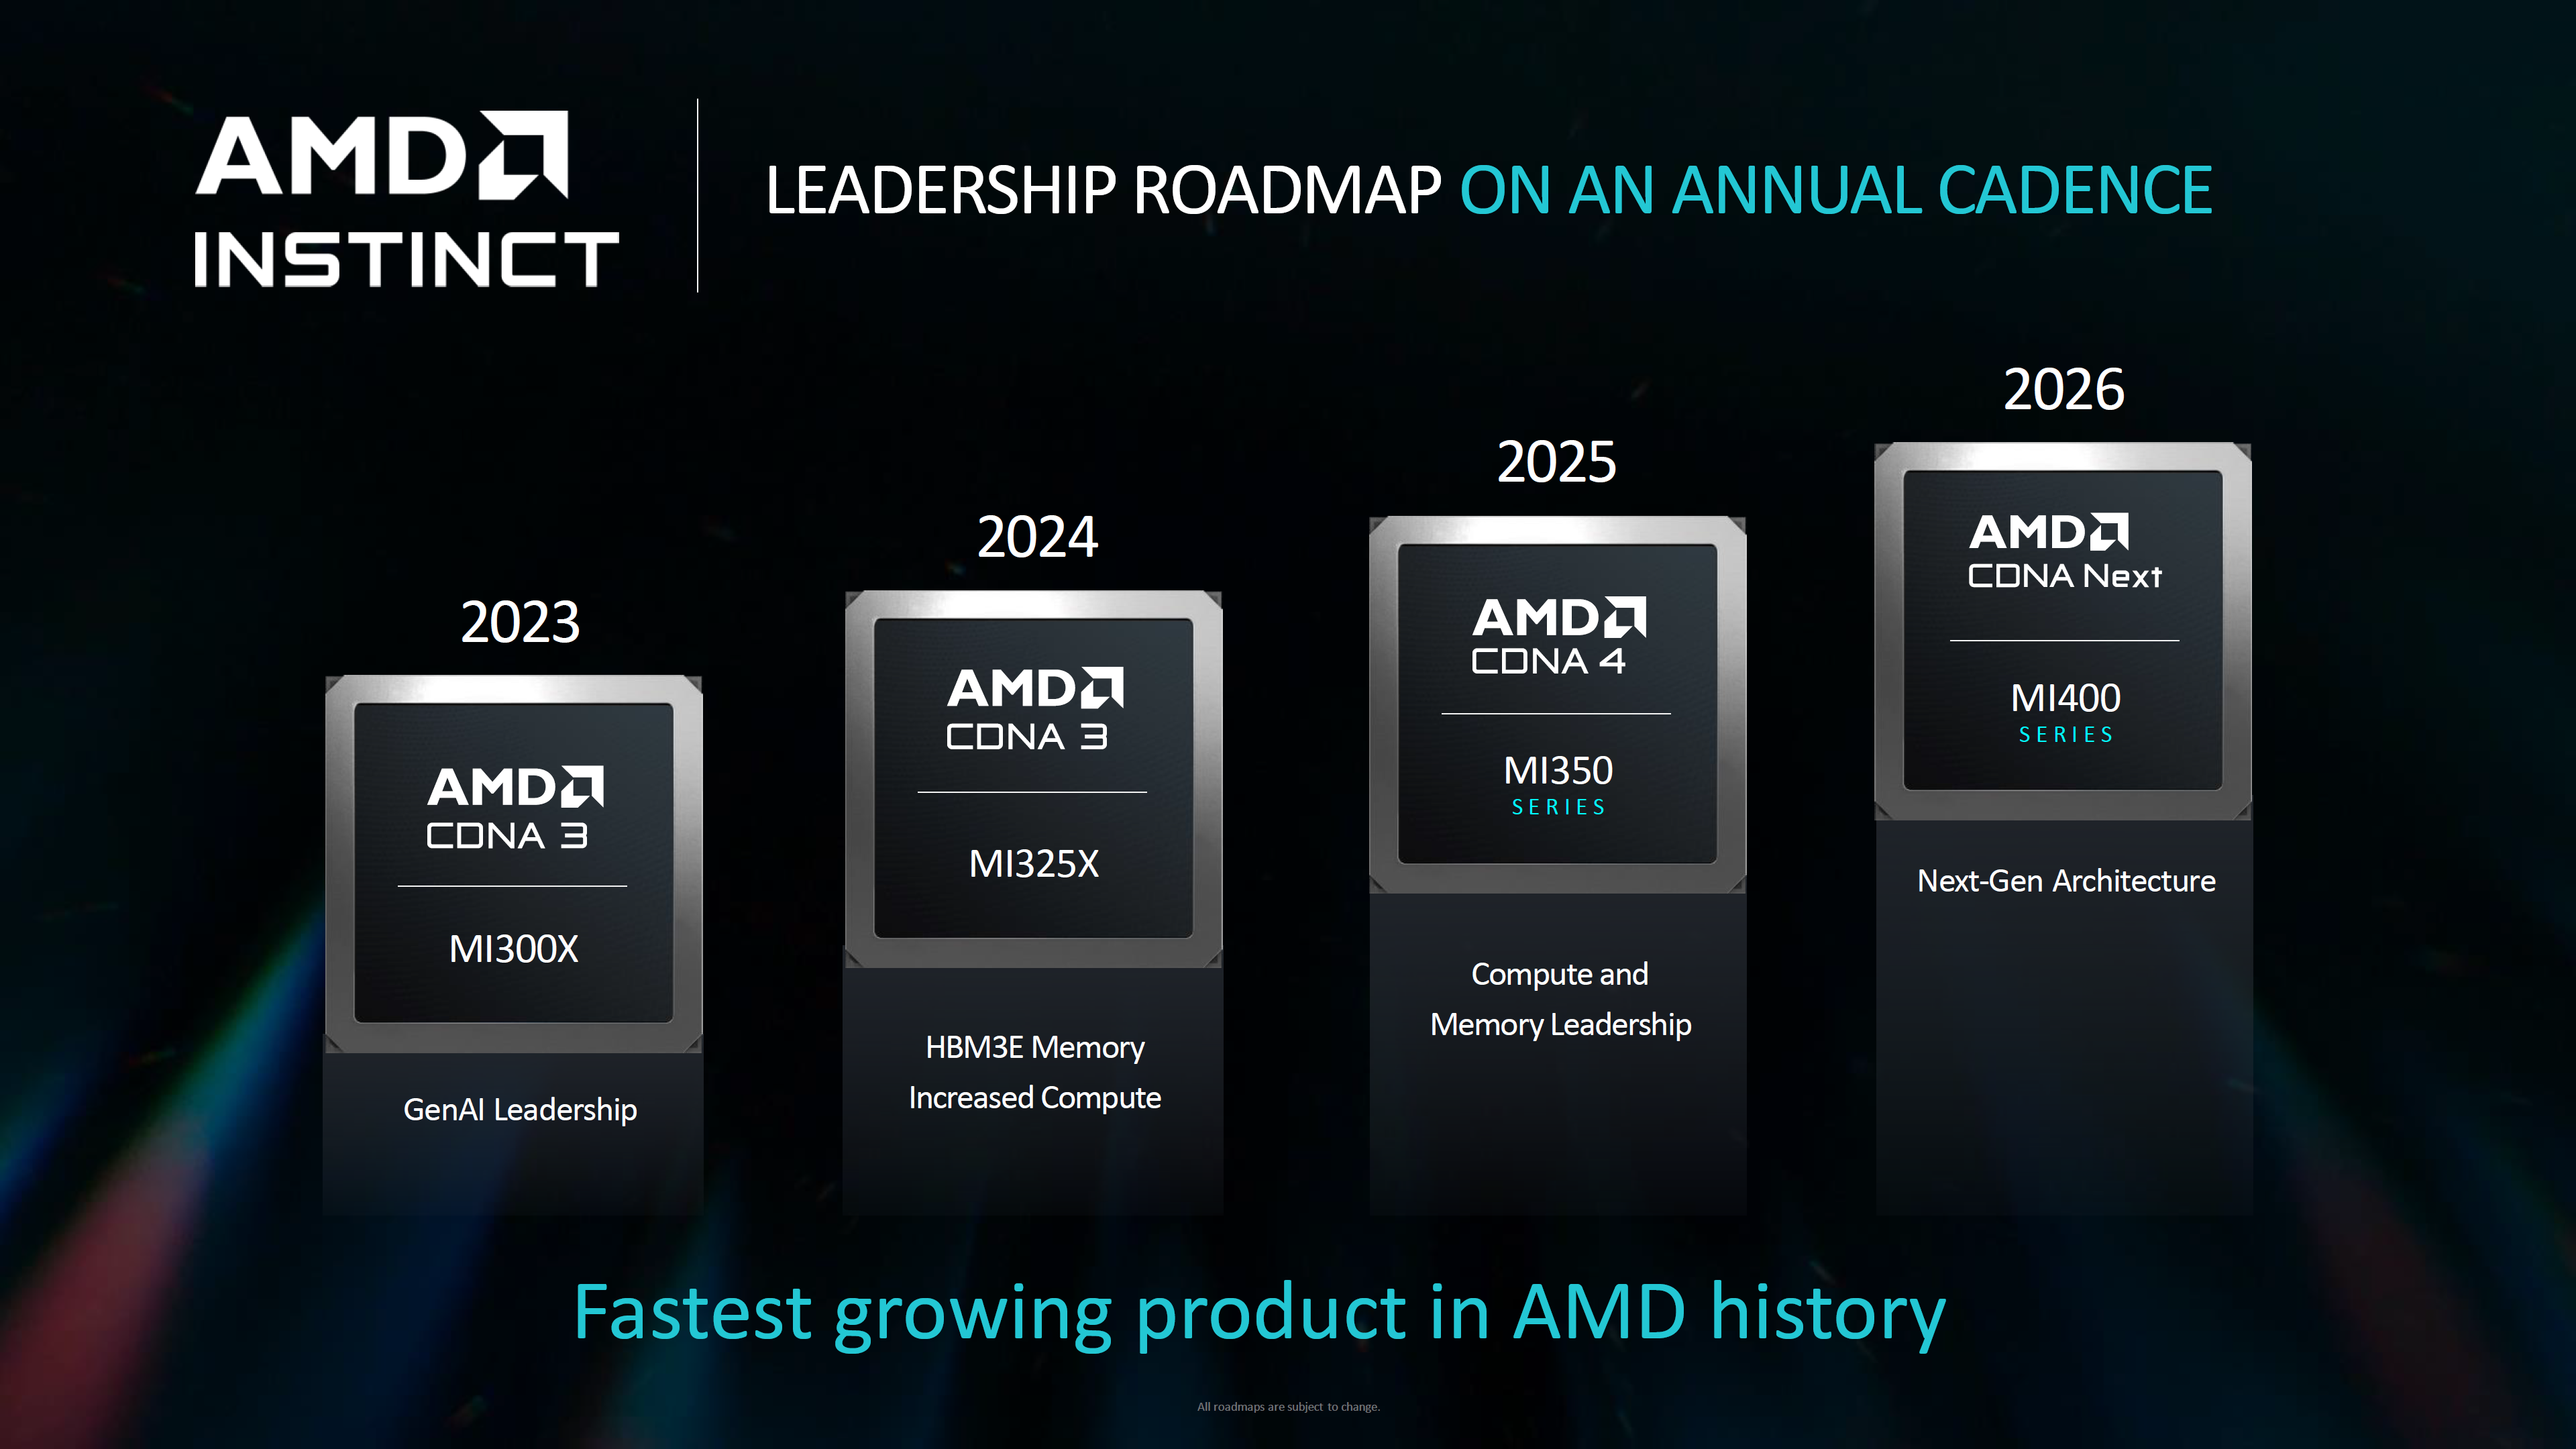 Делать какие-либо далеко идущие выводы о решениях на базе CDNA 4 рано: вероятнее всего, даже лаборатории AMD ещё не располагают финальной версией MI355X, а кроме того, как уже понятно, огромную роль играет постоянно изменяющаяся и совершенствуемая программная среда, которая ко II половине 2025 года может претерпеть существенные изменения. 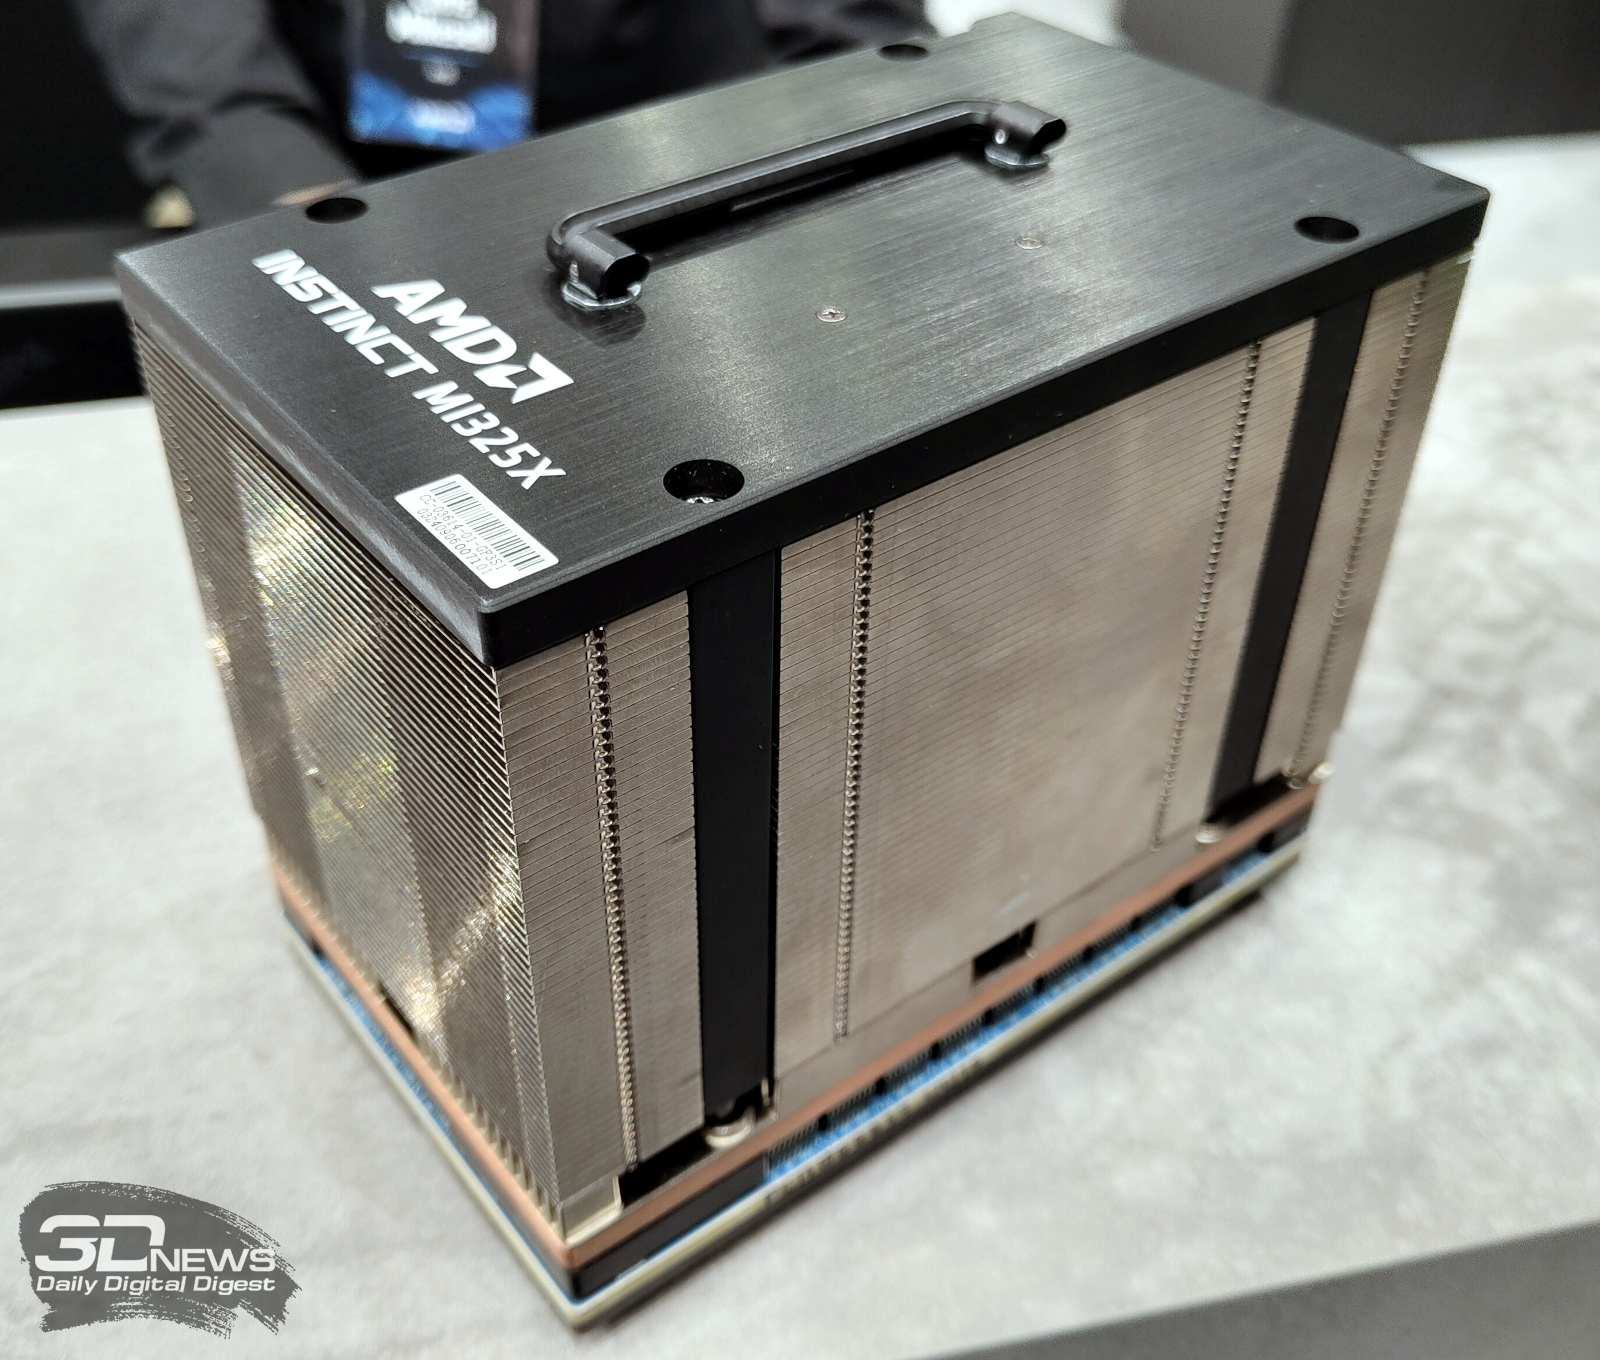 А вот гибридным решениям AMD планирует положить конец: преемника для Instinct MI300A, сочетающего в себе архитектуры CDNA 3 и Zen 4 не запланировано. Похоже, рынок для таких решений оказался слишком мал.
25.09.2024 [17:37], Руслан Авдеев
Многочисленные наспех построенные ИИ ЦОД в Китае оказались невостребованнымиСтремительное развитие ИИ-технологий в Китае проходит не без эксцессов. По данным Datacenter Knowledge, в стране создано большое количество дата-центров для ИИ-систем, однако их ёмкость оказалась избыточной, а сами они оказались не лучшим образом приспособлены под такие нагрузки. По информации китайских СМИ, проводящих собственные расследования, местные операторы создали слишком большие ёмкости, переоценив спрос. Негативно сказывается на отрасли и отсутствие достаточных компетенций в создании и управлении сложными ИИ-инфраструктурами. Для ИИ-приложений требуется иная архитектура ЦОД, более плотно интегрирующая на уровне «железа» и ПО вычисления, хранение и сети. Кроме того, такие объекты потребляют примерно вчетверо больше энергии в сравнении с традиционными ЦОД на базе CPU. 
Источник изображения: Nadiia Ganzhyi/unsplash.com При этом эксплуатация среднестатистического ИИ ЦОД на 1250 серверов в Китае обходится довольно дорого, до ¥1 млрд ($141 млн) в год. В основном расходы приходятся на электроэнергию и амортизацию. В прошлом году эксперты AI Technology Review пришли к выводу, что прогнозы в необходимости большого числа ЦОД были не вполне верными и спрос оказался переоценен. В результате это привело к простою серверов, а в некоторых случаях даже к закрытию ИИ-центров. К 2025 году Китай планирует ввести в эксплуатацию 50 вычислительных центров для систем искусственного интеллекта, за четыре года вычислительные способности страны должны вырасти на треть. По некоторым оценкам, 70 новых центров строятся уже сейчас. Представители государственных структур КНР раскрыли, что за последний год власти потратили $6,1 млрд на строительство крупных кампусов ЦОД, а ещё $28 млрд вложили в отрасль частные компании. Однако программа по переносу крупных ЦОД в западные регионы страны, например, во Внутреннюю Монголию, где есть избыток энергии, а рабочая сила и земля дешевле, чем на востоке, не вполне оправдала себя. Заказчики из густонаселённых восточных районов предпочитают использовать новые кампусы на западе исключительно для хранения, но не обработки данных. Этому мешают высокая задержка доступа, а также дороговизна подключения — порядка ¥160 тыс. ($22,5 тыс.) в месяц за выделенный канал шириной 1 Гбит/с.
21.09.2024 [01:14], Владимир Мироненко
Microsoft перезапустит АЭС Three Mile Island, чтобы запитать свои ИИ ЦОДКомпания Constellation Energy, крупнейший оператор АЭС в США, объявила о заключении 20-летнего контракта с Microsoft на поставку электроэнергии (PPA), которая будет производиться на АЭС Three Mile Island в Пенсильвании, печально известной по аварии на втором энергоблоке в 1979 году — самом серьёзном инциденте за всю историю атомной энергетики США. В результате аварии второй энергоблок АЭС был частично разрушен, но первый энергоблок не пострадал и проработал до 2019 года. Из-за убыточности АЭС и отказа властей штата продолжать субсидировать её работу она была окончательно остановлена 20 сентября 2019 года, после чего её передали Constellation Energy, имеющей опыт ликвидации АЭС. В рамках соглашения Constellation Energy планирует вновь ввести первый энергоблок в эксплуатацию к 2028 году, если будет получено одобрение Комиссии по ядерному регулированию США после всеобъемлющей проверки безопасности и защиты окружающей среды, а также разрешения от иных государственных и местных органов. Constellation Energy будет добиваться продления лицензии, что позволит эксплуатировать АЭС как минимум до 2054 года. 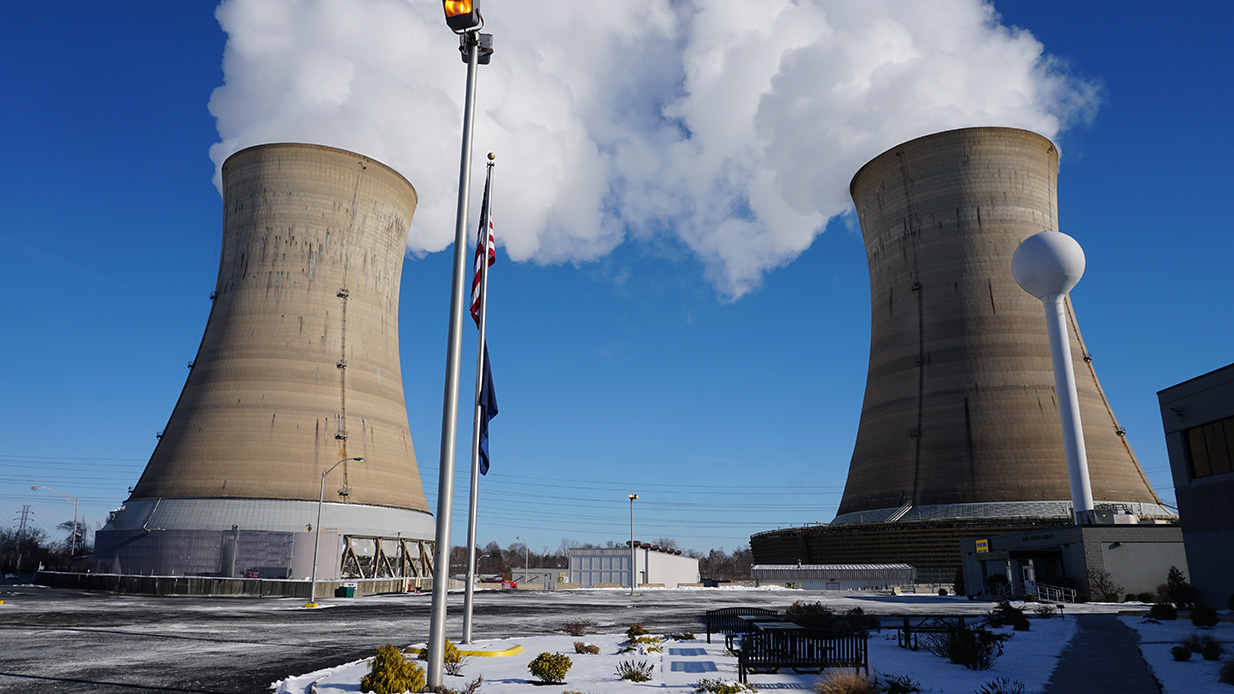
Источник изображений: Constellation Energy Планируемый к восстановлению объект был переименован в Центр чистой энергии Крейна (Crane Clean Energy Center, CCEC) в честь Криса Крейна (Chris Crane), который был гендиректором бывшей материнской компании Constellation и умер в апреле 2024 года. Хотя полные условия сделки не раскрываются, Constellation Energy объявила, что для возобновления работы необходимо около $1,6 млрд на восстановление оборудования, включая турбину, генератор, главный силовой трансформатор, а также системы охлаждения и управления. Мощность восстановленной АЭС составит 837 МВт. Вся производимая ею электроэнергия будет поступать Microsoft. Этого достаточно, чтобы обеспечить работу всех ЦОД компании в Пенсильвании, Чикаго, Вирджинии и Огайо. Согласно исследованию, которое профинансировал Совет по строительным профессиям Пенсильвании, повторное открытие АЭС создаст 3400 рабочих мест на объекте и в обслуживающих его предприятиях, а также принесёт в казну $3 млрд в виде государственных и федеральных налогов.  Сделка позволит Microsoft решить углубляющуюся энергетическую проблему, поскольку разрастающиеся ЦОД, необходимые ей для обслуживания ИИ-нагрузок, перегружают существующие в стране источники энергии. Как отмечают американские СМИ, никогда прежде атомная электростанция в США не возвращалась в строй после вывода из эксплуатации, и никогда прежде вся продукция одной коммерческой АЭС не поставлялась единственному заказчику. Срок действия соглашения с Constellation Energy значительно больше традиционных соглашений Microsoft о закупках солнечной и ветровой энергии. По всей видимости, сделка готовилась длительное время. За последние 12 месяцев Microsoft сформировала команду по работе над атомной энергетикой и наняла целый ряд опытных специалистов. Ранее Microsoft приобрела кредиты на возобновляемую энергию (CEC) у канадской энергетической компании Ontario Power Generation (OPG) и подписала соглашение с Constellation о поставке электроэнергии с АЭС для своего ЦОД в Бойдтоне. Атомная энергетика, гарантирующая в отличие от энергии ветра и солнца стабильную поставку электроэнергии вне зависимости от капризов погоды, становится всё популярнее среди гиперскейлеров. Ранее AWS приобрела за $650 млн кампус Talen Energy рядом с АЭС Susquehanna Steam Electric Station в Пенсильвании, которая обеспечит ЦОД до 960 МВт. Также в этом месяце Oracle объявила, что построит в США 1-ГВт кампус ЦОД с питанием от трёх малых модульных реакторов (SMR). А Oklo даже подписала соглашения с несколькими ЦОД.
28.08.2024 [09:14], Владимир Мироненко
Google поделилась подробностями истории создания ИИ-ускорителей TPUВ огромной лаборатории в штаб-квартире Google в Маунтин-Вью (Калифорния, США) установлены сотни серверных стоек с ИИ-ускорителями TPU (Tensor Processing Unit) собственной разработки, с помощью которых производится обучение больших языковых моделей, пишет ресурс CNBC, корреспонденту которого компания устроила небольшую экскурсию. Первое поколение Google TPU, созданное ещё в 2015 году, и представляет собой ASIC для обработки ИИ-нагрузок. Сейчас компания использует такие, хотя и более современные ускорители для обучения и работы собственного чат-бота Gemini. С 2018 года TPU Google доступны облачным клиентам компании. В июле этого года Apple объявила, что использует их для обучения моделей ИИ, лежащих в основе платформы Apple Intelligence. 
TPU v1 (Источник изображений здесь и далее: Google) «В мире есть фундаментальное убеждение, что весь ИИ, большие языковые модели, обучаются на (чипах) NVIDIA, и, конечно, на решения NVIDIA приходится львиная доля объёма обучения. Но Google пошла по собственному пути», — отметил гендиректор Futurum Group Дэниел Ньюман (Daniel Newman). Благодаря расширению использованию ИИ подразделение Google Cloud увеличило доход, и в последнем квартальном отчёте холдинг Alphabet сообщил, что выручка от облачных вычислений выросла на 29 %, впервые превысив $10 млрд за квартал. Google была первым провайдером облачных вычислений, создавшим кастомные ИИ-чипы. Лишь спустя три года Amazon Web Services анонсировала свой первый ИИ-ускоритель Inferentia, Microsoft представила ИИ-ускоритель Azure Maia 100 в ноябре 2023 года, а в мае того же года Meta✴ рассказала об семействе MTIA. Однако лидирует на рынке генеративного ИИ компания OpenAI, обученная на ускорителях NVIDIA, тогда как нейросеть Gemini была представлена Google спустя год после презентации ChatGPT.  В Google рассказали, что впервые задумались о создании собственного чипа в 2014 году, когда в руководстве решили обсудить, насколько большими вычислительными возможностями нужно обладать, чтобы дать возможность всем пользователям поговорить с поиском Google в течение хотя бы 30 с каждый день. По оценкам, для этого потребовалось бы удвоить количество серверов в дата-центрах. «Мы поняли, что можем создать специальное аппаратное обеспечение, <…> в данном случае тензорные процессоры, для обслуживания [этой задачи] гораздо, гораздо более эффективно. Фактически в 100 раз эффективнее, чем было бы в противном случае», — отметил представитель Google. С выходом второго поколения TPU в 2018 году Google расширила круг выполняемых чипом задач, добавив к инференсу обучение ИИ-моделей. Процесс создания ИИ-ускорителя не только отличается высокой сложностью, но и требует больших затрат. Так что реализация таких проектов в одиночку не по силам даже крупным гиперскейлерам. Поэтому с момента создания первого TPU Google сотрудничает с разработчиком чипов Broadcom, который также помогает её конкуренту Meta✴ в создании собственных ASIC. Broadcom утверждает, что потратила более $3 млрд в рамках реализации совместных проектов.  В рамках сотрудничества Google отвечает за собственно вычислительные блоки, а Broadcom занимается разработкой I/O-блоков, SerDes и иных вспомогательных компонентов, а также упаковкой. Самы чипы выпускаются на TSMC. С 2018 года в Google трудятся ещё одни кастомные чипы — Video Coding Unit (VCU) Argos, предназначенной для обработки видео. Что касается TPU, то в этом году клиентам Google будет доступно шестое поколение TPU Trillium. Более того, им станут доступны и первые Arm-процессоры Axion собственной разработки. Google выходит на этот рынок с большим отставанием от конкурентов. Amazon выпустила первый собственный процессор Graviton в 2018 году, Alibaba Yitian 710 появились в 2021 году, а Microsoft анонсировала Azure Cobalt 100 в ноябре. Все эти чипы основаны на архитектуре Arm — более гибкой и энергоэффективной альтернативе x86. Энергоэффективность имеет решающее значение. Согласно последнему экологический отчёту Google, с 2019 по 2023 год выбросы компании выросли почти на 50 %, отчасти из-за увеличения количества ЦОД для ИИ-нагрузок. Для охлаждения ИИ-серверов требуется огромное количество воды. Именно поэтому начиная с третьего поколения TPU компания использует прямое жидкостное охлаждение, которое только теперь становится практически обязательным для современных ИИ-ускорителей вроде NVIDIA Blackwell.
27.08.2024 [12:08], Сергей Карасёв
Стартап FuriosaAI представил эффективный ИИ-ускоритель RNGD для LLM и мультимодальных моделейЮжнокорейский стартап FuriosaAI на мероприятии анонсировал специализированный чип RNGD (произносится как «Renegade»), который позиционируется в качестве альтернативы ускорителям NVIDIA. Новинка предназначена для работы с большими языковыми моделями (LLM) и мультимодальным ИИ. FuriosaAI основана в 2017 году тремя инженерами, ранее работавшими в AMD, Qualcomm и Samsung. Своё первое решение компания выпустила в 2021 году: чип Warboy представляет собой высокопроизводительный ЦОД-ускоритель, специально разработанный для рабочих нагрузок компьютерного зрения. Новое изделие RNGD, как утверждает FuriosaAI, является результатом многолетних инноваций. Чип изготавливается по 5-нм техпроцессу TSMC. ИИ-ускоритель на базе RNGD выполнен в виде карты расширения PCIe 5.0 x16. Он наделён 48 Гбайт памяти HBM3 с пропускной способностью до 1,5 Тбайт/с и 256 Мбайт памяти SRAM (384 Тбайт/с). Показатель TDP находится на уровне 150 Вт, что позволяет использовать устройство в системах с воздушным охлаждением. Для сравнения: у некоторых ускорителей на базе GPU величина TDP достигает 1000 Вт и более. 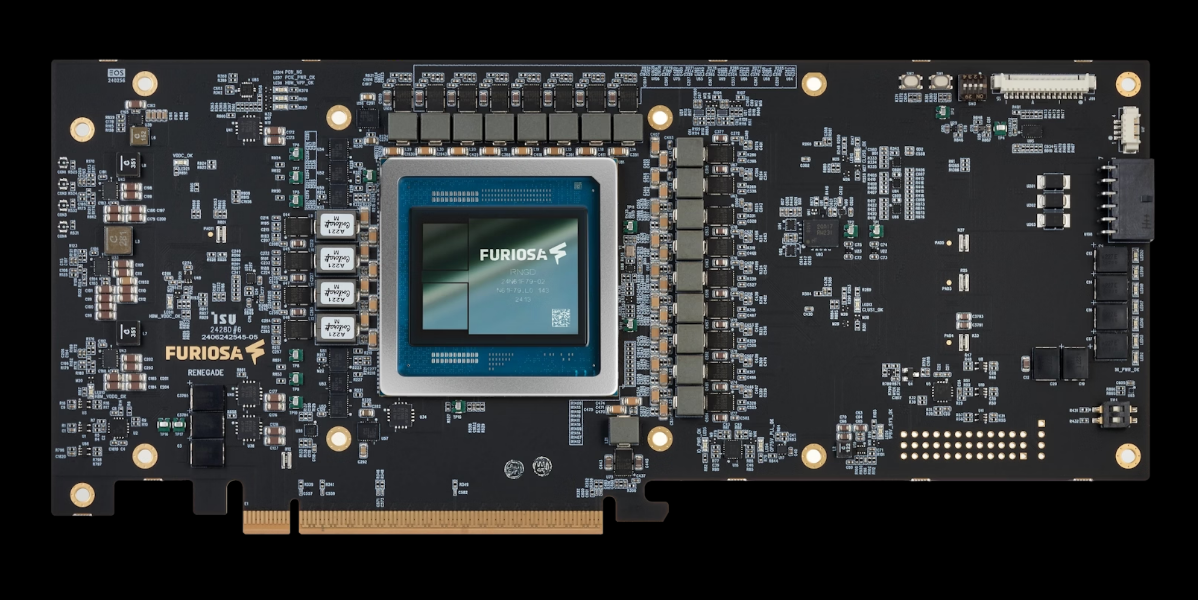
Источник изображения: FuriosaAI Утверждается, что RNGD обеспечивает производительность до 512 Тфлопс в режиме FP8 и до 256 Тфлопс в режиме BF16. Быстродействие INT8/INT4 достигает 512/1024 TOPS. Карта позволяет эффективно запускать открытые LLM, такие как Llama 3.1 8B. Говорится, что один PCIe-ускоритель RNGD обеспечивает пропускную способность от 2000 до 3000 токенов в секунду (в зависимости от длины контекста) для моделей с примерно 10 млрд параметров. В системе можно объединить до восьми карт для работы с моделями, насчитывающими около 100 млрд параметров. RNGD основан на архитектуре свёртки тензора (Tensor Contraction Processor, TCP), которая, как отмечается, обеспечивает оптимальный баланс между эффективностью, программируемостью и производительностью. Программный стек состоит из компрессора моделей, сервисного фреймворка, среды выполнения, компилятора, профилировщика, отладчика и набора API для простоты программирования и развёртывания. Говорится, что чипы RNGD можно настроить для выполнения практически любой рабочей нагрузки LLM или мультимодального ИИ.
23.08.2024 [16:00], Владимир Мироненко
Китайские компании нашли лазейку в законах США для доступа к передовым ИИ-ускорителям и моделям в облаках AWS и AzureГосударственные китайские организации используют облачные сервисы Amazon, Microsoft и их конкурентов для доступа к передовым американским чипам и технологиям ИИ, пишет Reuters со ссылкой на тендерную документацию, размещённую в общедоступных китайских базах данных. О попытках китайских компаний получить доступ к ИИ-ускорителям на территории США в условиях запрета на их поставки в Китай сообщалось и ранее. Правительство США ограничивает экспорт высокопроизводительных чипов ИИ в КНР в течение последних двух лет в связи с потенциальной возможностью их использования для укрепления военного потенциала Поднебесной. Однако предоставление доступа к таким чипам или передовым ИИ-моделям в облаках не является нарушением законодательства США, которым регулируется в данном случае только экспорт или передача товара, ПО или технологии, отметило Reuters. Согласно 50 тендерным документам, с которыми ознакомилось агентство, по крайней мере 11 китайских организаций пытались получить доступ к подпадающим под ограничение технологиям США или облачным сервисам. В четырёх случаях Amazon Web Services (AWS) явно названа поставщиком облачных услуг, хотя компании получили доступ к облачным услугам через посредников, а не напрямую у AWS. Таким образом, не только китайские компании обходят ограничения, но и американские компании извлекают выгоду из растущего в Китае спроса на вычислительные мощности. 
Источник изображения: Mark Daynes / Unsplash «AWS соблюдает все применимые законы США, включая торговые законы, в отношении предоставления услуг AWS внутри и за пределами Китая», — заявил представитель облачного бизнеса Amazon. По данным Synergy Research Group, AWS контролирует почти треть мирового рынка облачной инфраструктуры. А согласно данным исследовательской компании IDC, AWS является в Китае шестым по величине поставщиком облачных услуг. «Эта лазейка беспокоит меня уже годы, и нам давно пора её устранить», — заявил агентству Reuters председатель Комитета по иностранным делам Палаты представителей США Майкл Маккол (Michael McCaul), имея в виду удалённый облачный доступ иностранных субъектов к передовым вычислительным решениям США. В апреле в Конгресс США был внесён законопроект, дающий Министерству торговли полномочия регулировать удалённый доступ к технологиям США, но пока неясно, будет ли он принят и когда. В январе Министерство торговли США также предложило изменения в законодательства с требованием к сервисам облачных вычислений проверять пользователей крупных моделей ИИ и сообщать регулирующим органам об обучения крупных моделей ИИ, способных на «злонамеренную киберактивность». Поправки также дают ведомству право налагать запрет на доступ тех или иных клиентов. Но этот документ всё ещё находится в стадии доработки. 
Источник изображения: Eric Prouzet / Unsplash Китайские организации также стремятся получить доступ к облачным сервисам Microsoft. Например, в апреле Сычуаньский университет указал в тендерной документации, что он создаёт платформу генеративного ИИ и закупает 40 млн токенов Microsoft Azure OpenAI. В мае токены поставила компания Sichuan Province Xuedong Technology Co Ltd. В связи с этим OpenAI сообщила Reuters, что её собственные сервисы не поддерживаются в Китае, а сервисы Azure OpenAI работает в соответствии с политикой Microsoft. Наконец, Институт перспективных исследований Сучжоуского университета науки и технологий Китая (USTC) сообщил в тендерной документации в марте этого года, что хотел бы арендовать 500 облачных серверов с восемью ускорителями NVIDIA A100 в каждом. Согласно апрельским документам, тендер был выполнен компанией Hefei Advanced Computing Center Operation Management Co Ltd, но в них не был указан поставщик облачных услуг, и Reuters не удалось его идентифицировать. USTC был добавлен Минторгом США в чёрный список Entity List в мае этого года из-за получения доступа к американской технологии квантовых вычислений, которая могла бы использоваться военно-промышленным комплексом Китая и помочь в развитии ядерной программы. Согласно тендерным документам, Amazon предоставляет китайским организациям доступ не только к передовым ИИ-чипам, но и к передовым моделям ИИ, таким как Claude от Anthropic, к которым они не могут получить доступ иным образом, пишет Reuters. Да и сама AWS в сообщениях на китайском языке подчёркивает возможность опробовать «модели ИИ мирового класса» и упоминает китайскую игровую фирму Source Technology как одного из своих клиентов, использующих Claude. После того как Reuters обратилось к Amazon за разъяснением, компания добавила в десятки постов на своих китаеязычных каналах примечание о том, что некоторые из услуг недоступны в китайских облачных регионах. Она также удалила несколько рекламных постов, включая пост об Source Technology.
01.08.2024 [00:53], Игорь Осколков
Ampere анонсировала 512-ядерные Arm-процессоры AmpereOne Aurora с HBM-памятью и встроенным ИИ-ускорителемAmpere Computing анонсировала процессоры AmpereOne Aurora, которые получат до 512 однопоточных Arm-ядер собственной разработки, набортную HBM-память и фирменные IP-блоки для обучения и инференса ИИ-моделей. Речь, судя по всему, идёт о чиплетной компоновке, поскольку компания говорит не только о фирменном меш-интерконнекте для вычислительных блоков, но и об объединении разных кристаллов в рамках SoC. Предполагается, что Aurora появятся где-то на рубеже 2025–2026 гг. 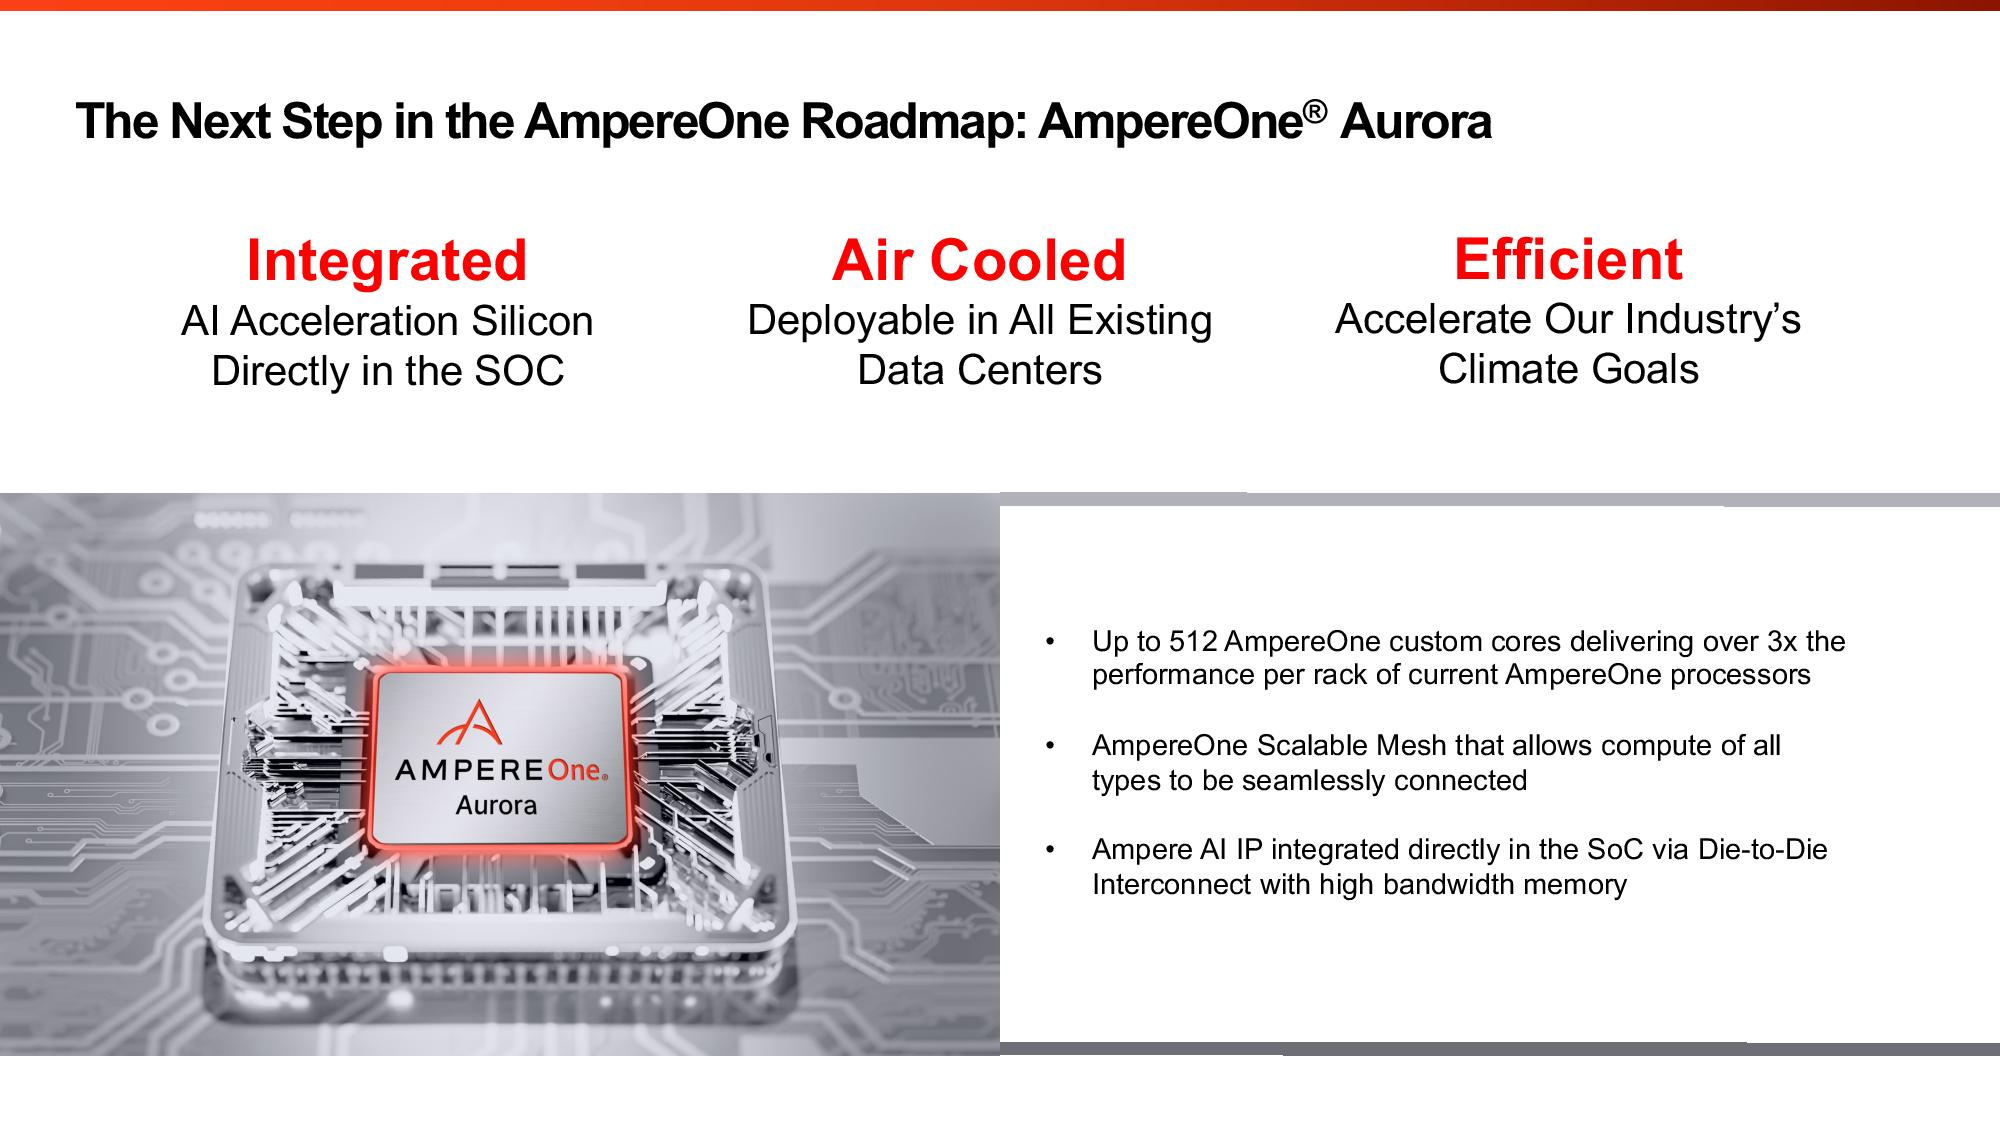
Источник изображений: Ampere Computing Что интересно, для Aurora обещана возможность использования воздушного охлаждения. Для гиперскейлеров, на которых Ampere по-прежнему ориентируется, это важный пункт. Впрочем, больше никаких подробностей о новинках компания не сообщила, отметив лишь, что встроенный ускоритель сгодится для RAG и векторных баз данных. Ну и сообщив, что по количеству ядер и производительности её ещё не выпущенный чип обгоняет все остальные чипы: 144-ядерные Intel Xeon 6 (Sierra Forest), которые вскоре станут 288-ядерными (при этом все варианты без Hyper-Threading), и 128-ядерные AMD EPYC Bergamo (256 потоков), которым на смену придут 192-ядерные EPYC Turin Dense (384 потока). 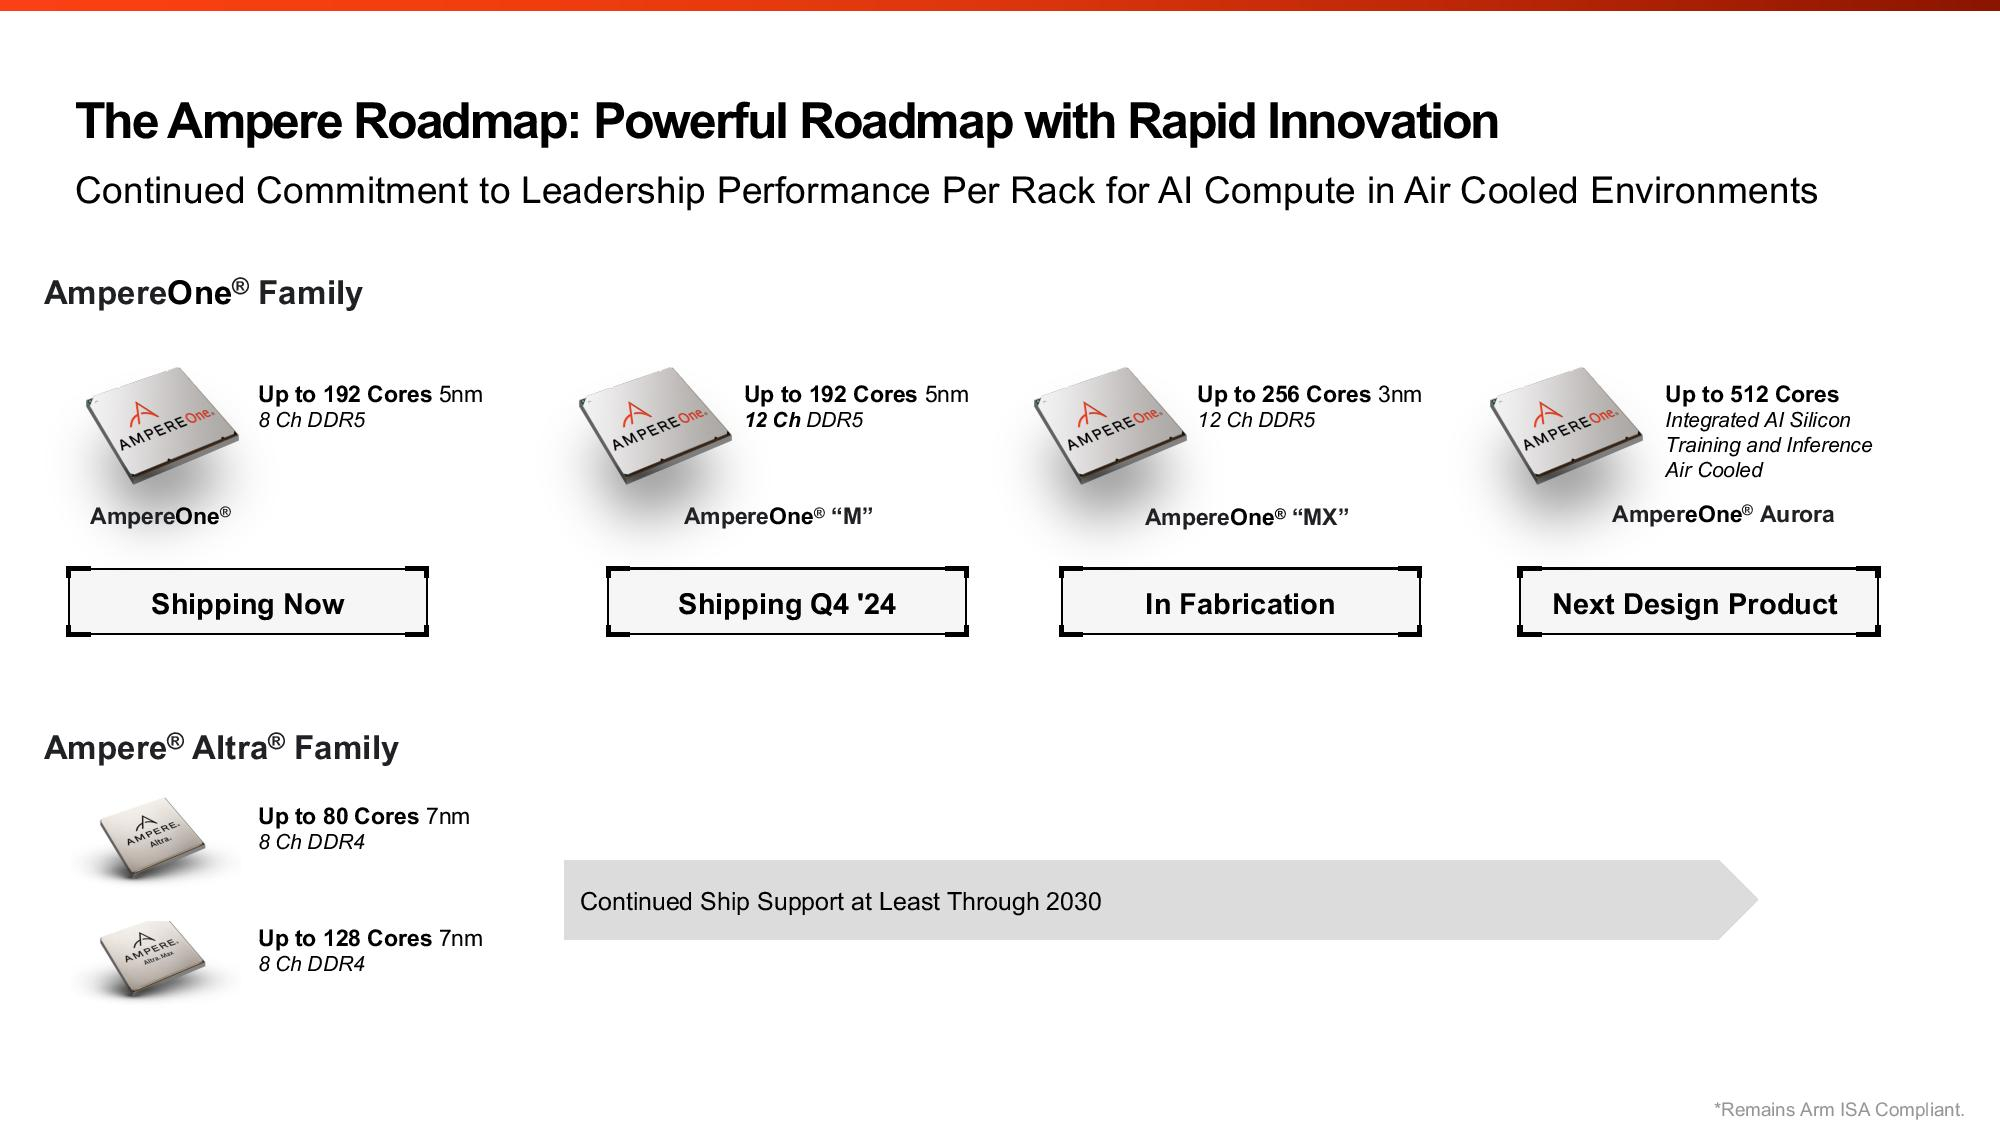 До Aurora компания выпустит ещё две серии процессоров AmpereOne: M в конце 2024 года и MX в 2025 году. 5-нм AmpereOne M получат до 192 ядер и 12-канальный контроллер памяти DDR5. 3-нм AmpereOne MX получат такой же контроллер и до 256 ядер. Заодно компания опубликовала прайс-лист актуальных CPU. В нём нет изначально заявлявшихся 136- и 172-ядерных моделей. Кроме того, остальные процессоры несколько подорожали в сравнении с прошлым поколением Altra Max, но по цене всё ещё привлекательнее решений AMD и Intel — $5555 за 192 ядра. Следует учесть, что в таблице приведён не привычный показатель TDP, а усреднённое энергопотребление чипа, из-за чего сравнивать процессоры Ampere с другими чипами затруднительно. 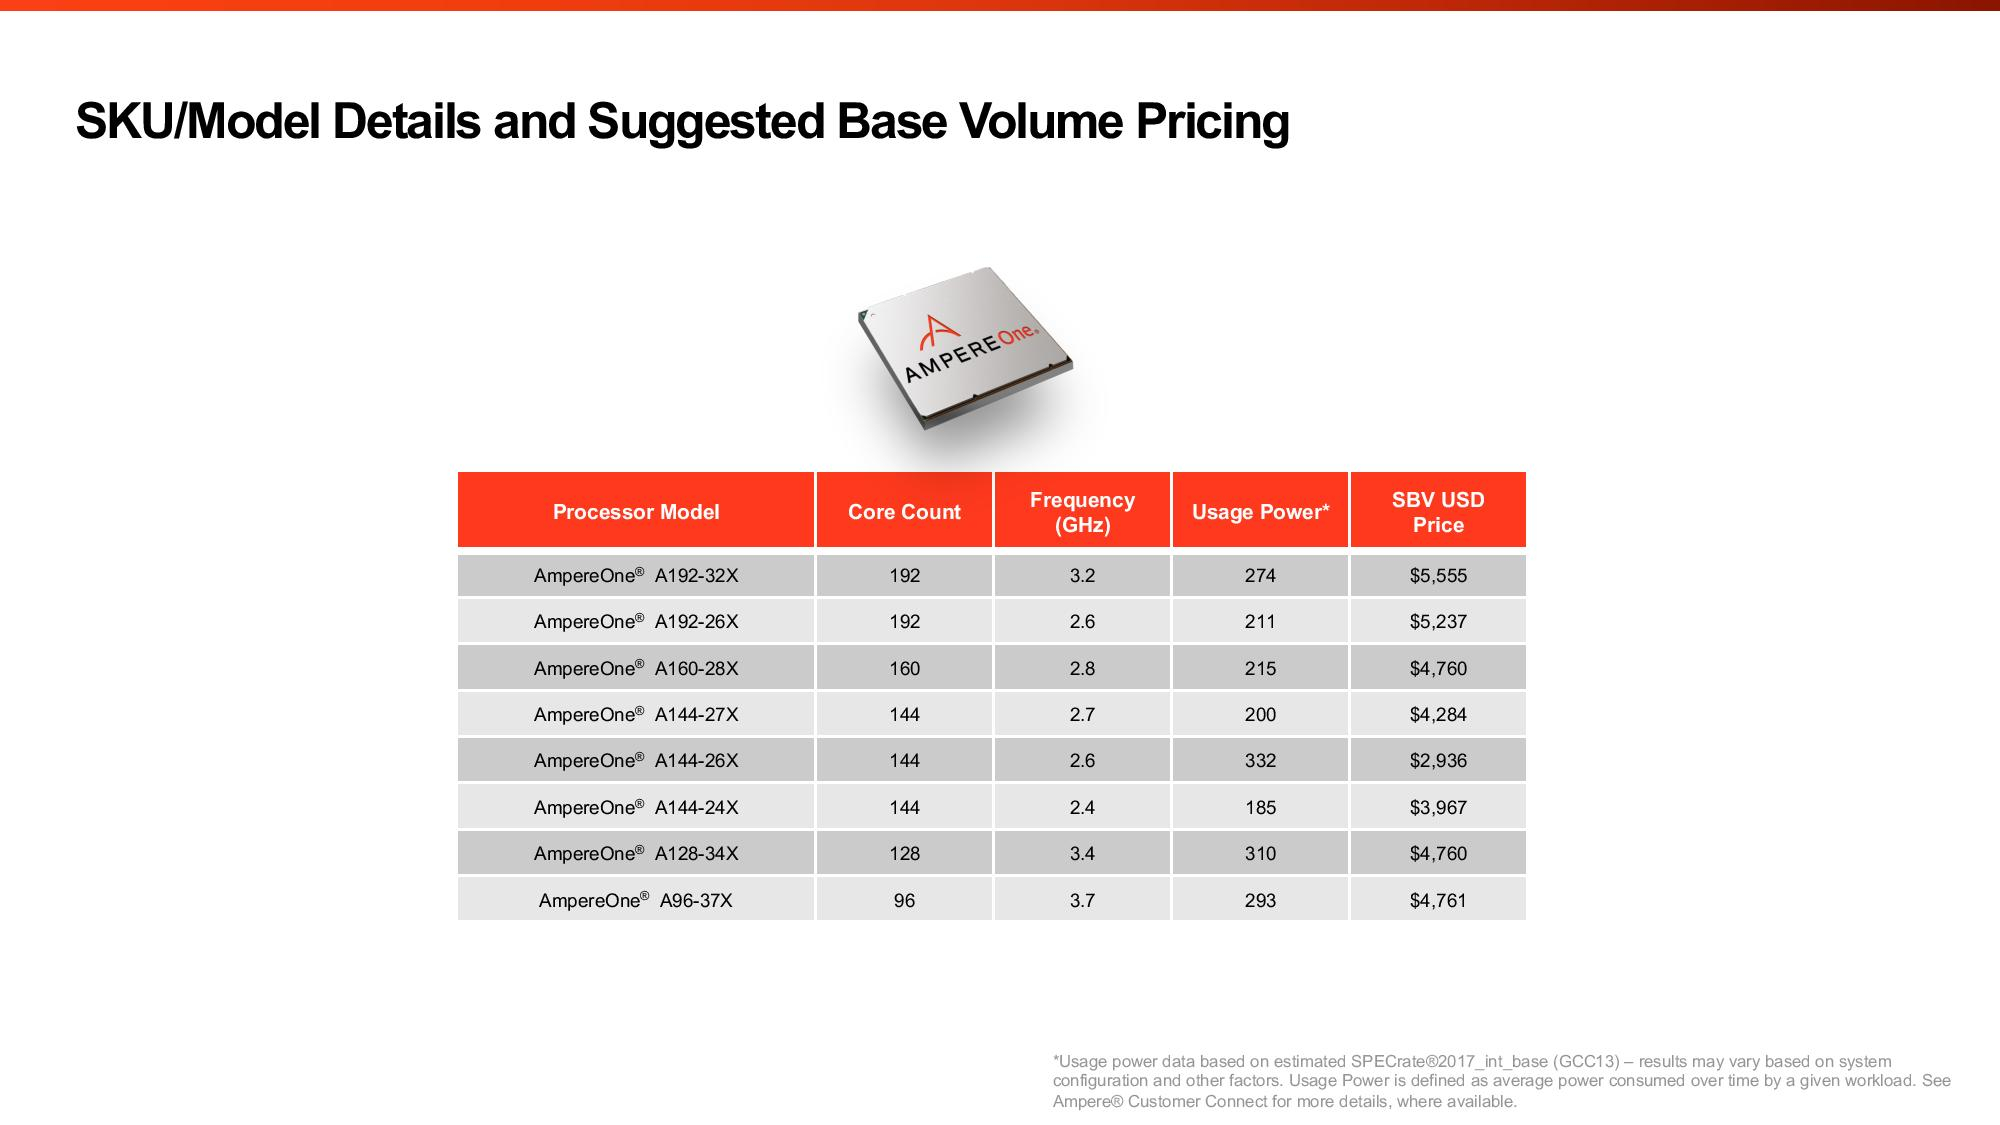 Насколько Aurora станет популярным у гиперскейлеров и других заказчиков, покажет время. У Ampere есть якорный заказчик в лице Oracle, но другие IT-гиганты уже сами разрабатывают собственные Arm-процессоры. AWS в Graviton4 довела количество ядер до 96, Microsoft анонсировала 128-ядерный Cobalt 100, Alibaba массово внедряет 128-ядерные Yitian 710, а Google готовит Axion. Fujitsu к 2027 году подготовит 144-ядерные MONAKA, которые тоже получат поддержку ИИ-нагрузок, но упор в них сделан не на HBM, а на SRAM. Собственно говоря, HBM есть только у HPC-процессоров: Fujitsu A64FX, SiPearl Rhea1 и C-DAC AUM. Даже NVIDIA Grace, которые в основном ассистируют ускорителям, обходятся LPDDR5x.
25.07.2024 [09:57], Сергей Карасёв
Илон Маск показал ИИ-суперкомпьютер Dojo на основе чипов Tesla D1Глава Tesla Илон Маск (Elon Musk), по сообщению ресурса Tom's Hardware, обнародовал фотографии вычислительного комплекса Dojo, который будет использоваться для разработки инновационных автомобильных технологий, а также для обучения автопилота. Tesla, напомним, начала создание ИИ-суперкомпьютера Dojo в июле 2023 года. Основой системы послужат специализированные чипы собственной разработки Tesla D1. Дата-центр Dojo, расположенный в штаб-квартире Tesla в Остине (Техас, США), по своей конструкции напоминает бункер. В апреле нынешнего года сообщалось, что при строительстве ЦОД компания Маска столкнулась с трудностями, связанными в том числе с доставкой необходимых материалов. Как теперь сообщается, Tesla намерена ввести Dojo в эксплуатацию до конца 2024 года. По производительности этот суперкомпьютер будет сопоставим с кластером из 8 тыс. ускорителей NVIDIA H100. По словам Маска, это «не слишком много, но и не тривиально». Для сравнения: мощнейший ИИ-суперкомпьютер компании xAI, также курируемой Илоном Маском, объединит 100 тыс. карт H100. 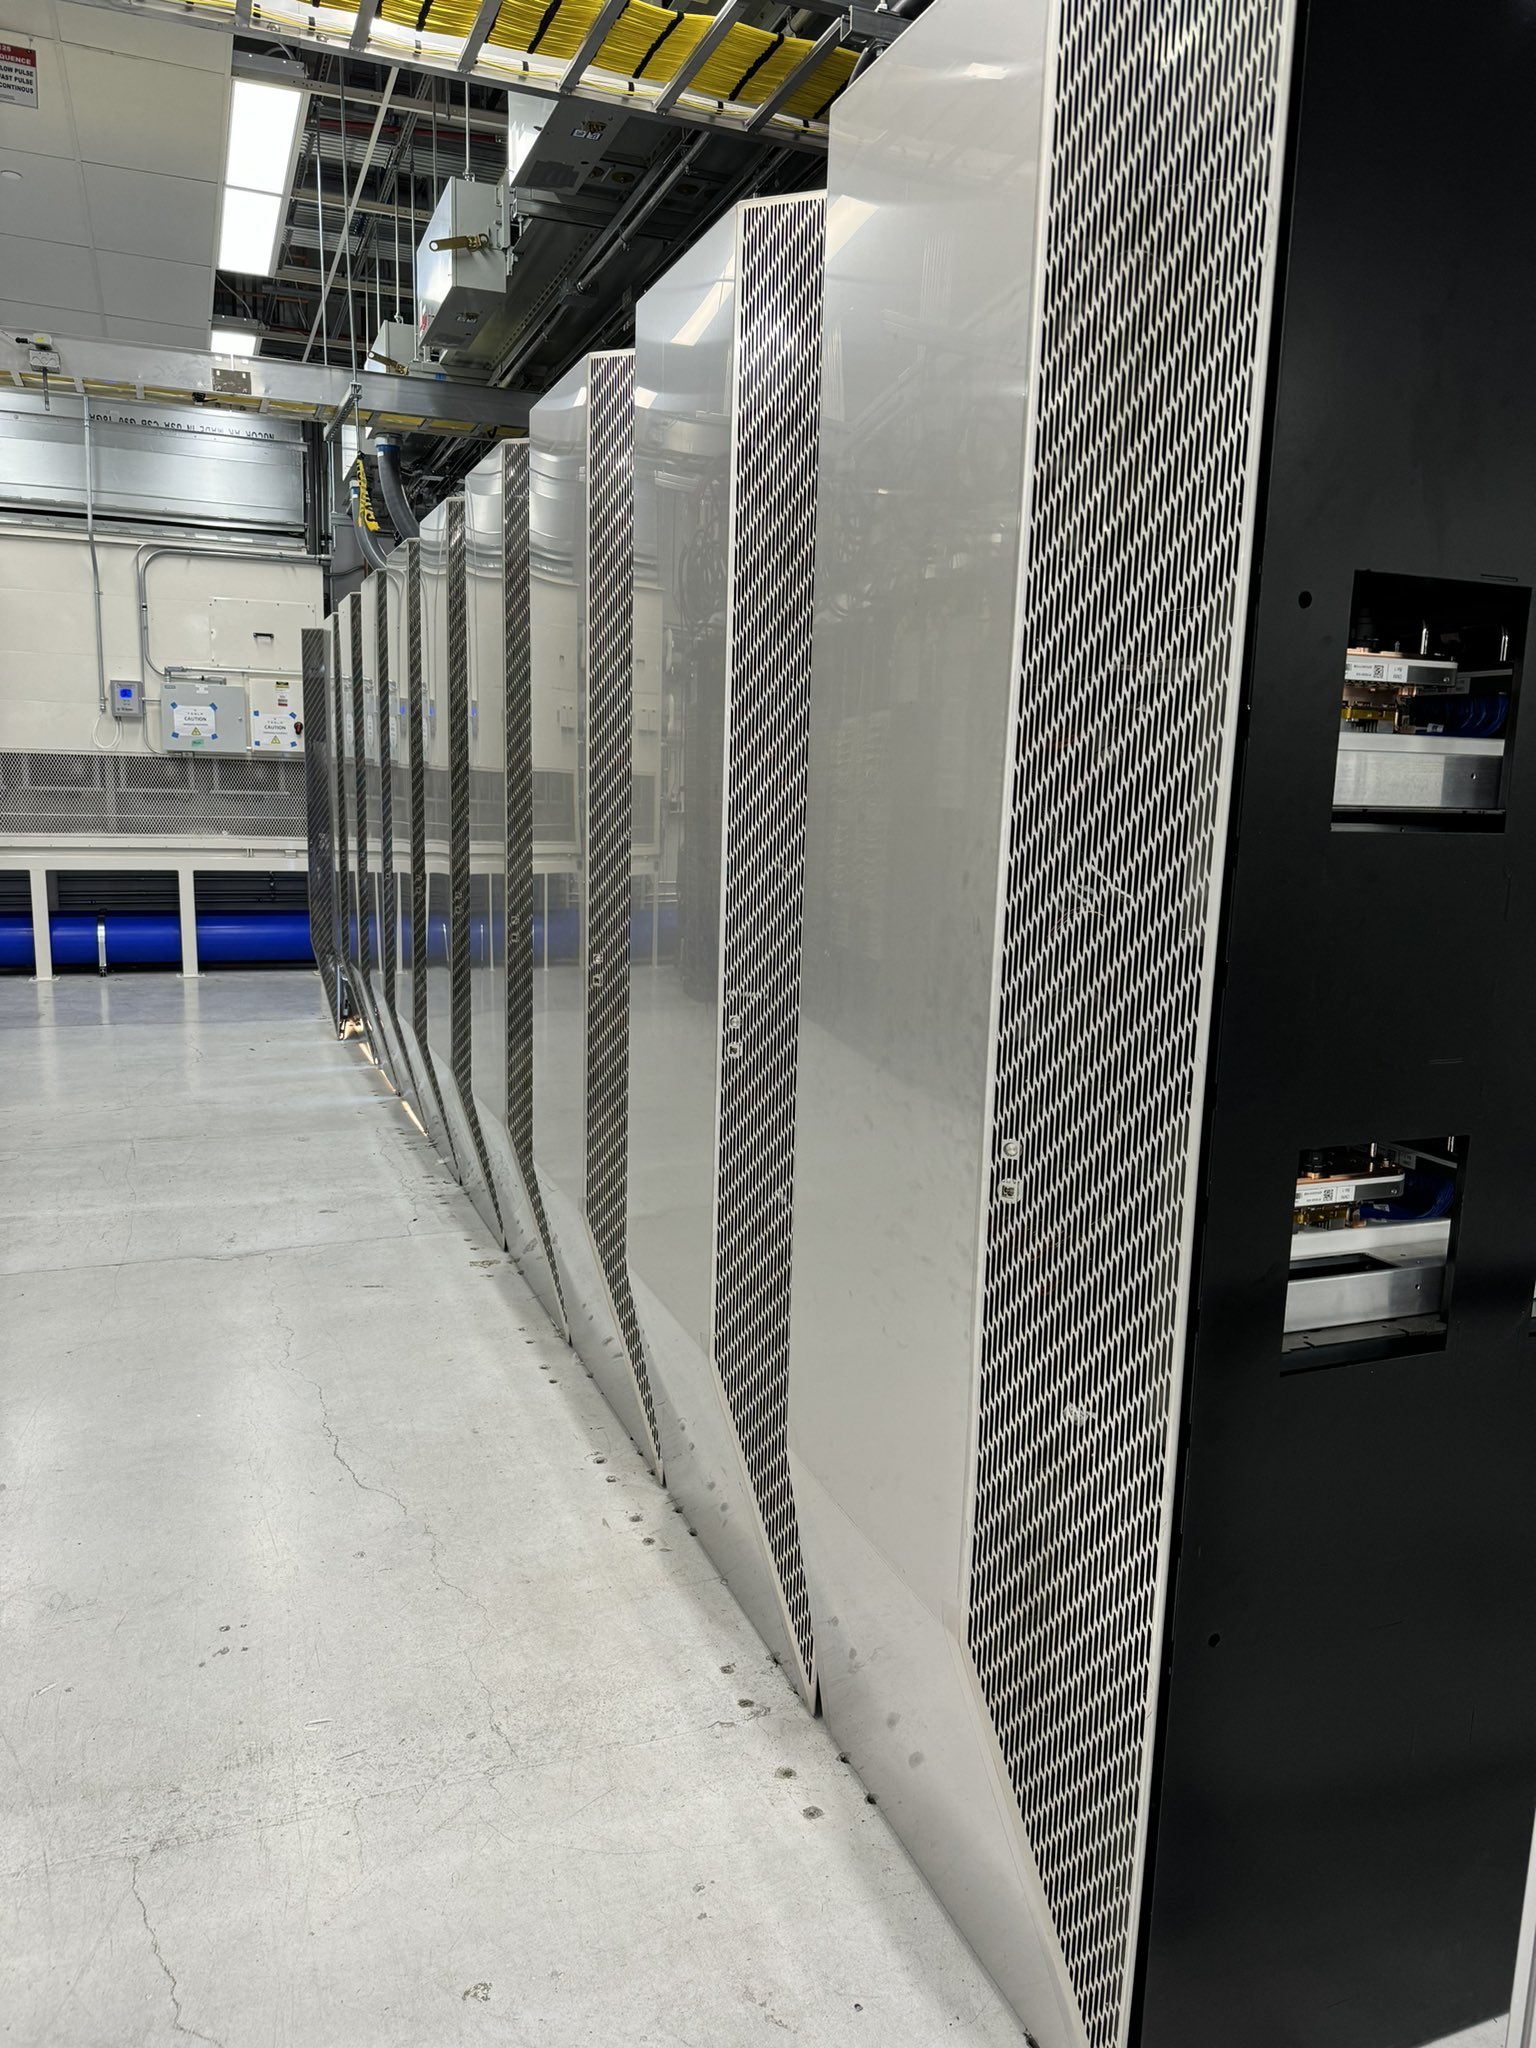
Источник изображений: Илон Маск Отмечается, что чипы Tesla D1 специально ориентированы на машинное обучение и анализ видеоданных. Поэтому систему Dojo планируется использовать прежде всего для совершенствования технологии автономного вождения Tesla путём обработки видеоданных, полученных от автомобилей компании. В свою очередь, «ИИ-гигафабрика» xAI поможет в развитии чат-ботов Grok следующего поколения. 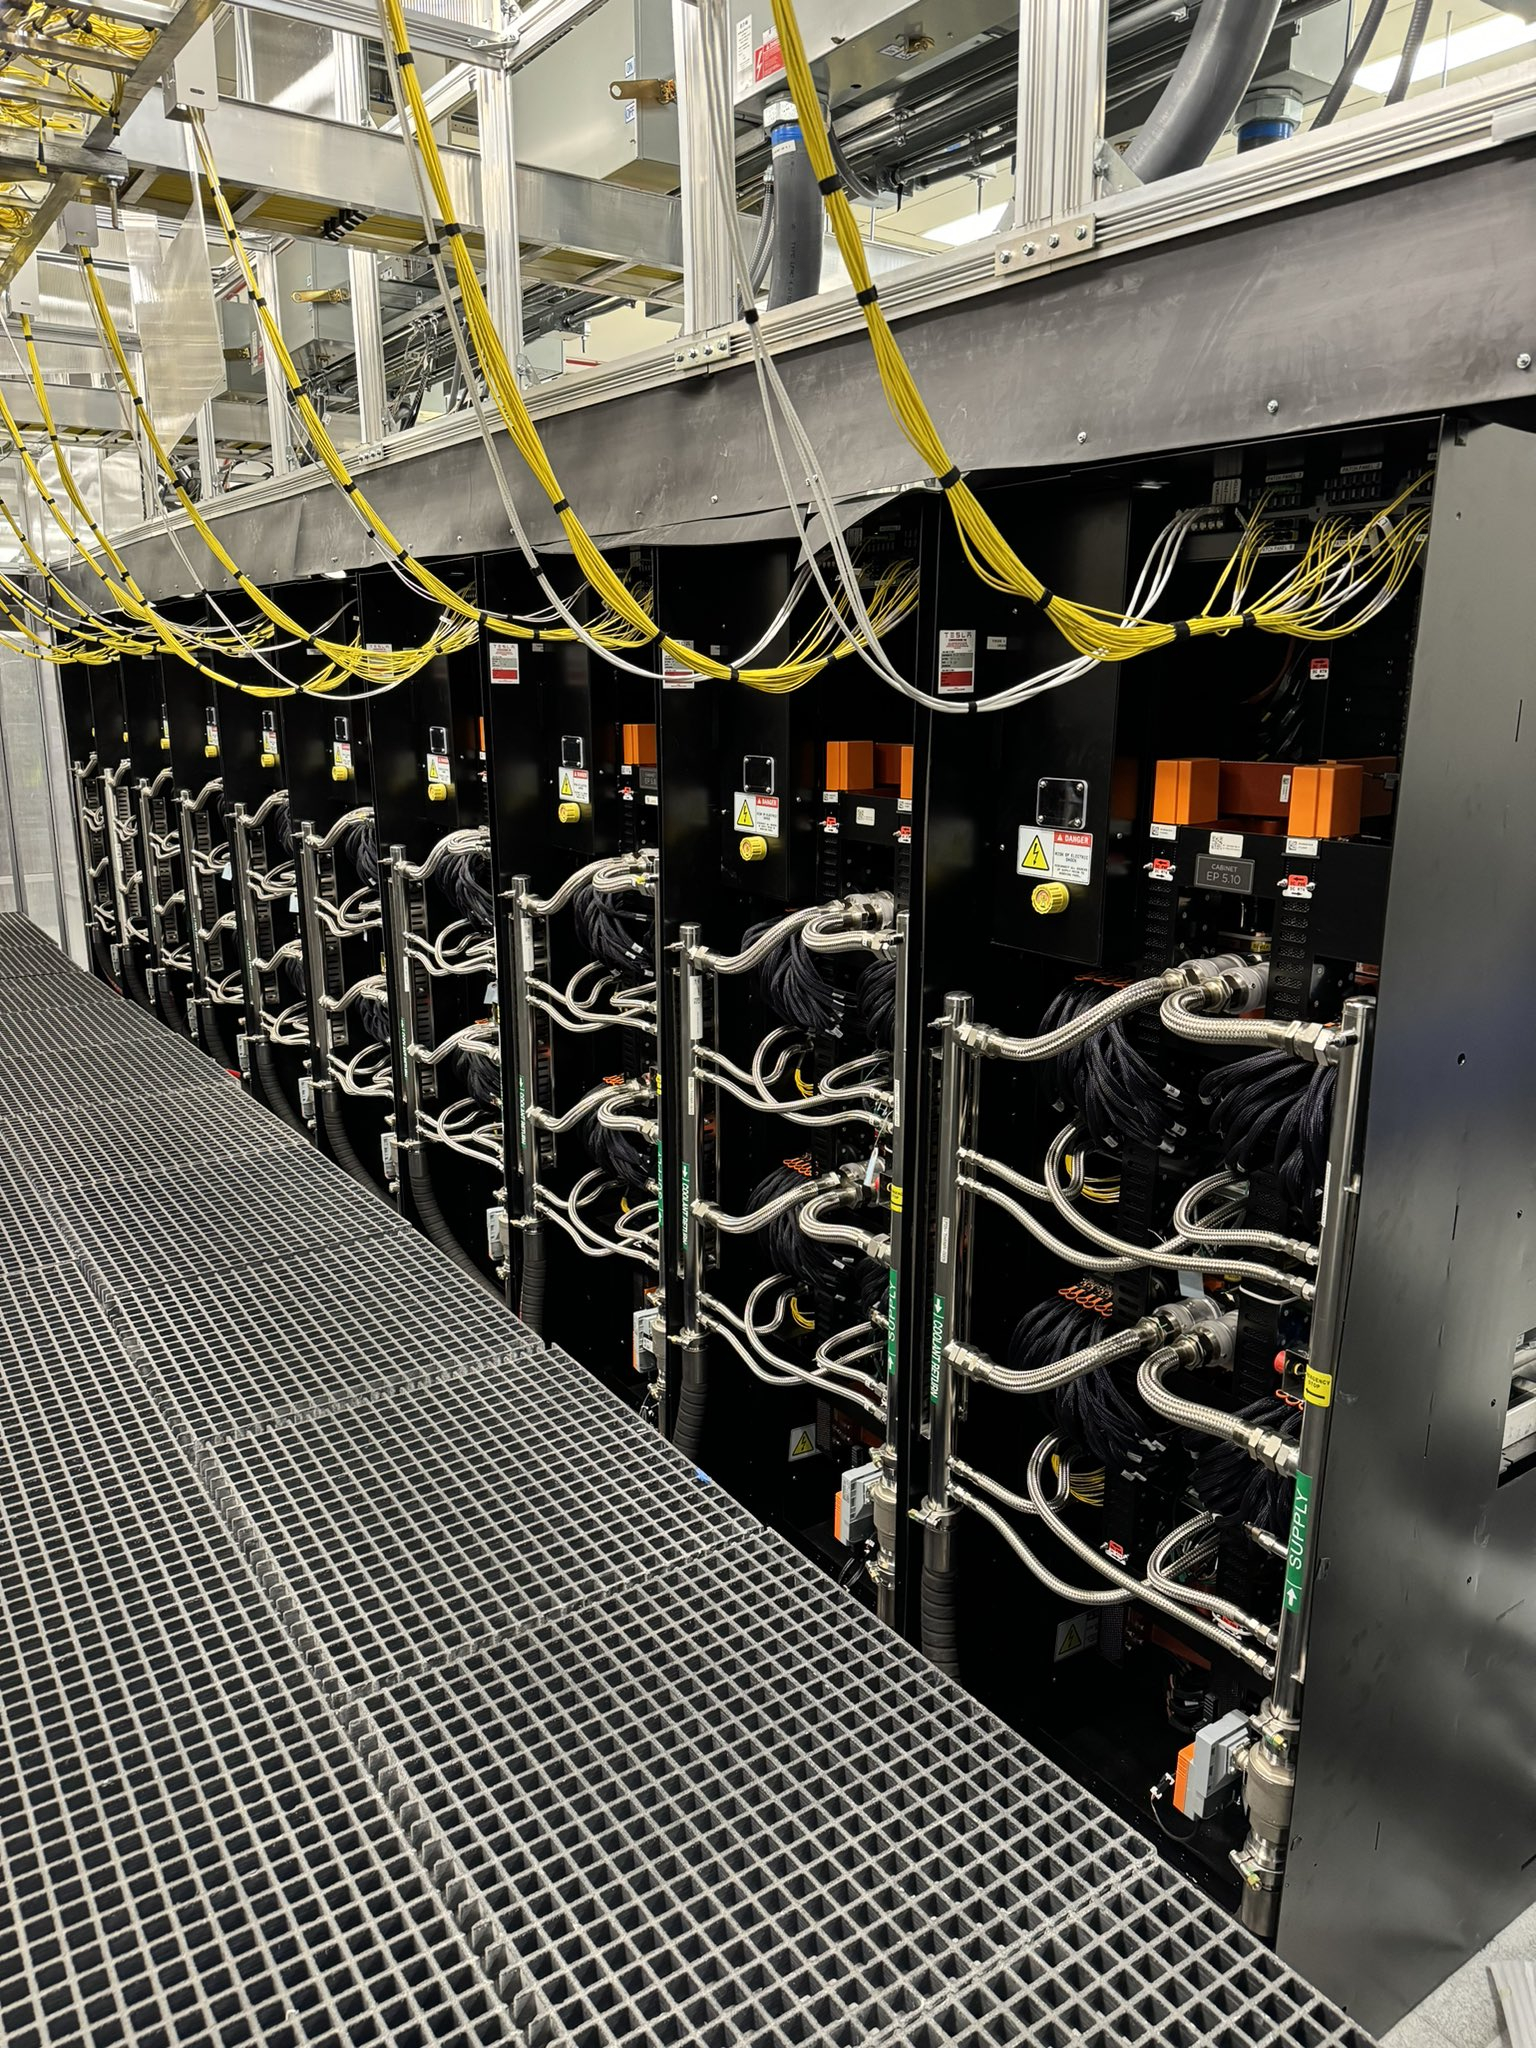 Маск также сообщил, что компания Tesla намерена «удвоить усилия» по разработке и развертыванию Dojo из-за высоких цен на оборудование NVIDIA. Вместе с тем финансовый директор Tesla Вайбхав Танеджа (Vaibhav Taneja) заявил, что, несмотря на снижение капвложений во II квартале 2024 года, компания по-прежнему ожидает, что соответствующие затраты превысят $10 млрд.
20.07.2024 [21:45], Владимир Мироненко
Tenstorrent начала продажи ИИ-ускорителей Wormhole и рабочие станции на их основеКанадский стартап Tenstorrent приступил к выпуску ИИ-чипов Wormhole. В настоящее время стартап предлагает построенные на них ИИ-ускорители Wormhole n150 и n300, а также рабочие станции TT-LoudBox и TT-QuietBox на их базе. ИИ-ускорители Wormhole n150 и n300 представляют собой двухслотовые FHFL-карты (PCIe 4.0 x16): n150 с одним чипом Wormhole, n300 — с двумя. Wormhole n150 и n300 имеют пассивное охлаждение и теплопакет 160 Вт и 300 Вт соответственно. Процессоры Wormhole были разработаны в 2021 году, но их внедрение происходит только сейчас. Это второе поколение ИИ-ускорителей Tenstorrent, которые придут на смену Grayskull. 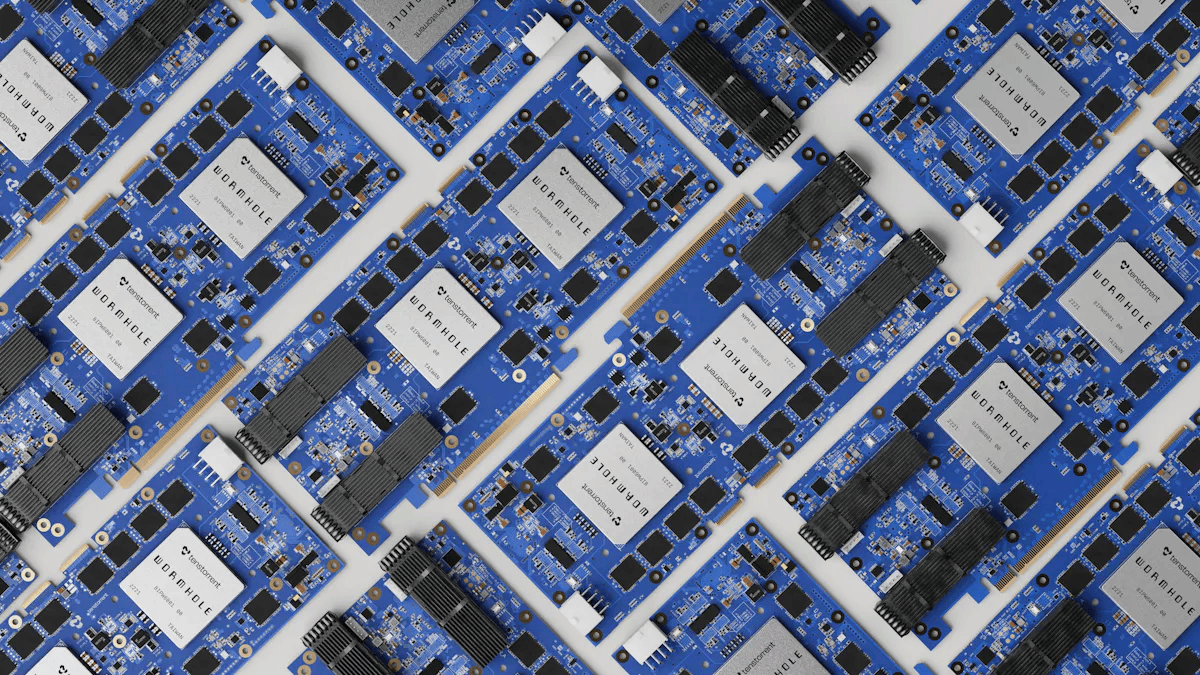
Источник изображений: Tenstorrent Wormhole n150 оснащён 72 ядрами Tensix, каждое из которых включает пять ядер RISC-V, поддерживающих различные форматы данных, и 108 Мбайт SRAM — вместе они предоставляют до 262 Тфлопс (FP8). Ускоритель также оснащён 12 Гбайт памяти GDDR6 с ПСП 288 Гбайт/с. У Wormhole n300 таких ядер 128, а частота также равна 1 ГГц. Объём SRAM составляет 192 Мбайт, а внешняя подсистема памяти включает 24 Гбайт GDDR6 с ПСП 576 Гбайт/с. Ускоритель обеспечивает производительность до 466 Тфлопс (FP8). 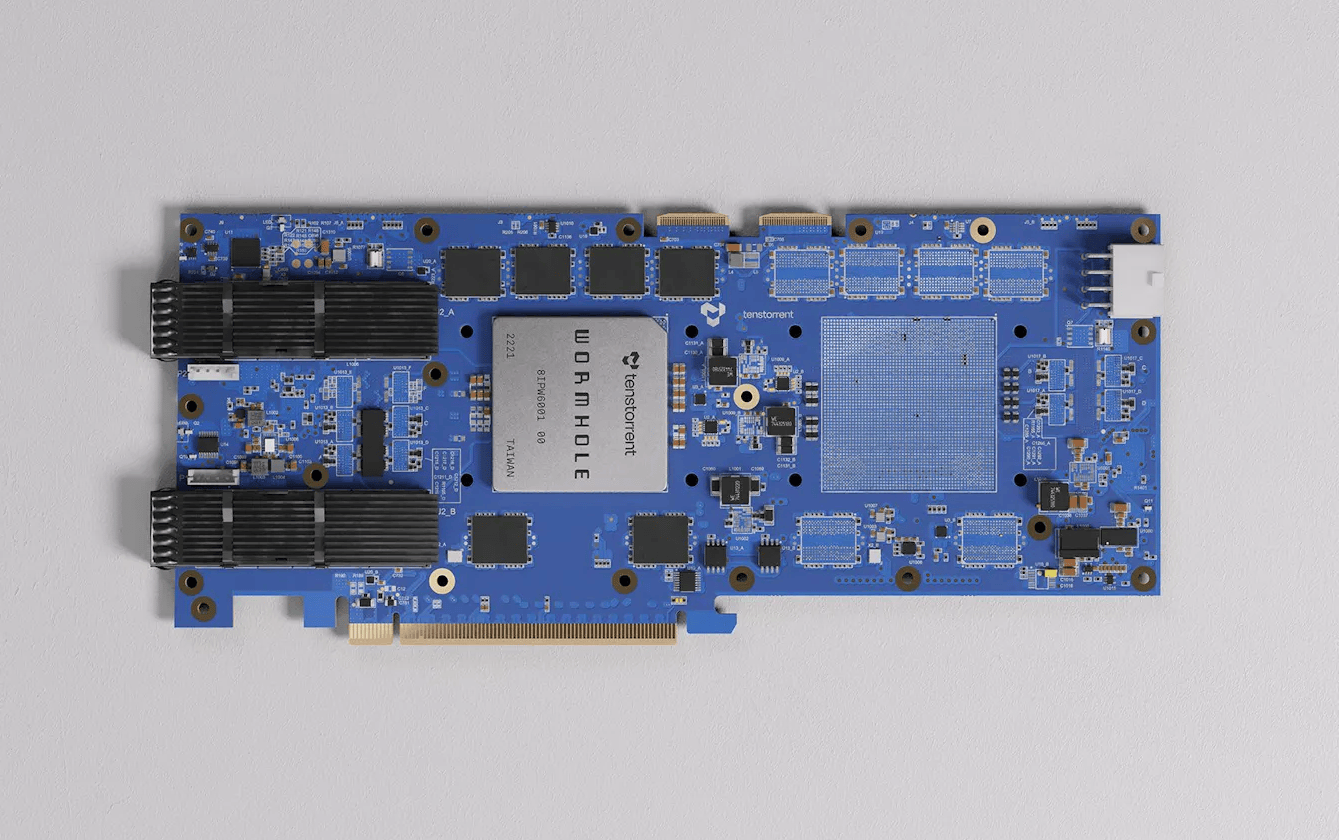 RISC-V ядра Tensix обладают аппаратной и программной поддержкой вертикального и горизонтального масштабирования — объединения множества ядер в единое целое как внутри одного узла, так и за его пределами с другими ядрами Tensix на нескольких чипах Wormhole. Именно эта функциональность, как надеется Tenstorrent, позволит ей отобрать долю рынка у NVIDIA. Впрочем, стоимость новинок тоже невелика: Wormhole n150 предлагается по цене $999, а n300 — за $1399. 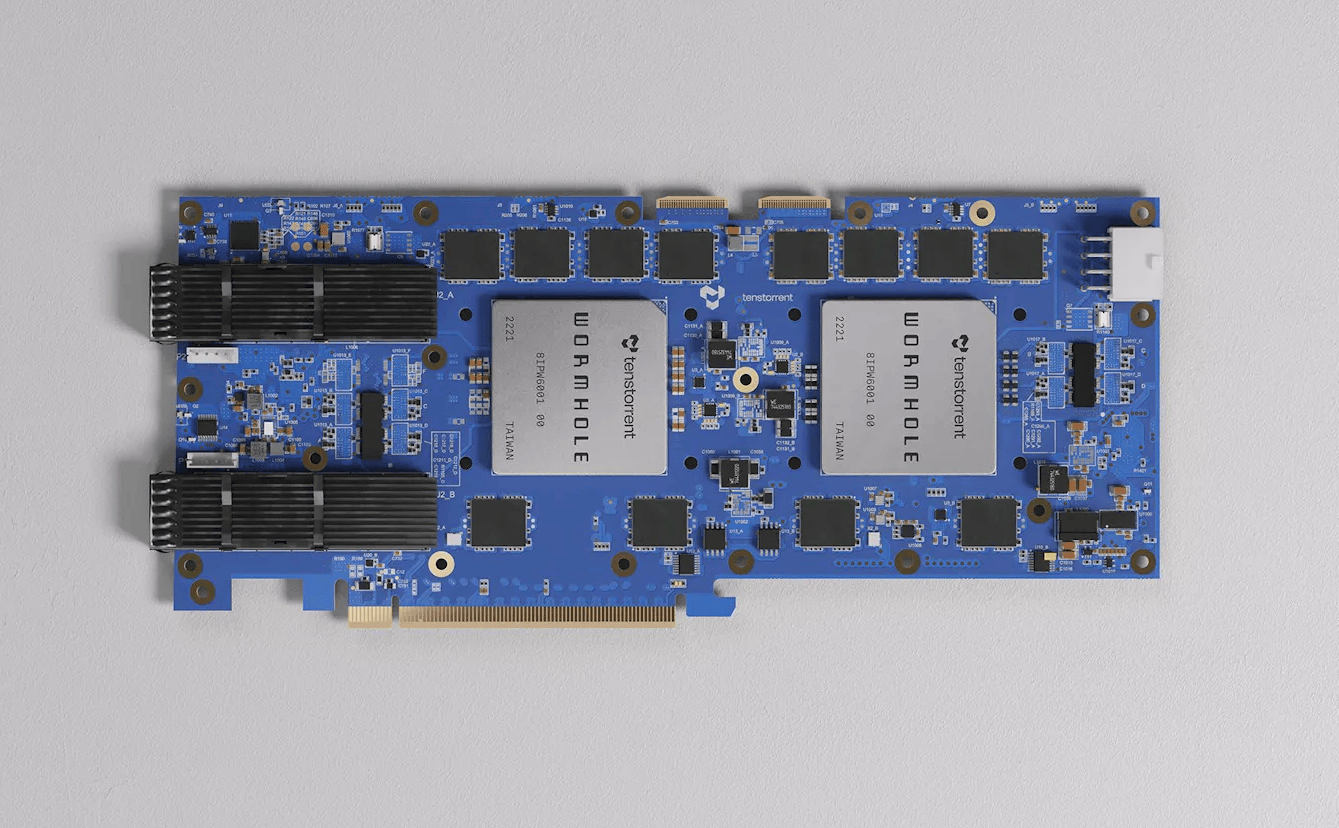 В рабочих станциях Tenstorrent четыре Wormhole n300 могут работать как один ускоритель, который с точки зрерния ПО выглядит как единый массив ядер Tensix. Впрочем, можно отдать по одному ускорителю каждому пользователю или же одновременно обрабатывать восемь разных ИИ-моделей, причём всё это без использования виртуализации. 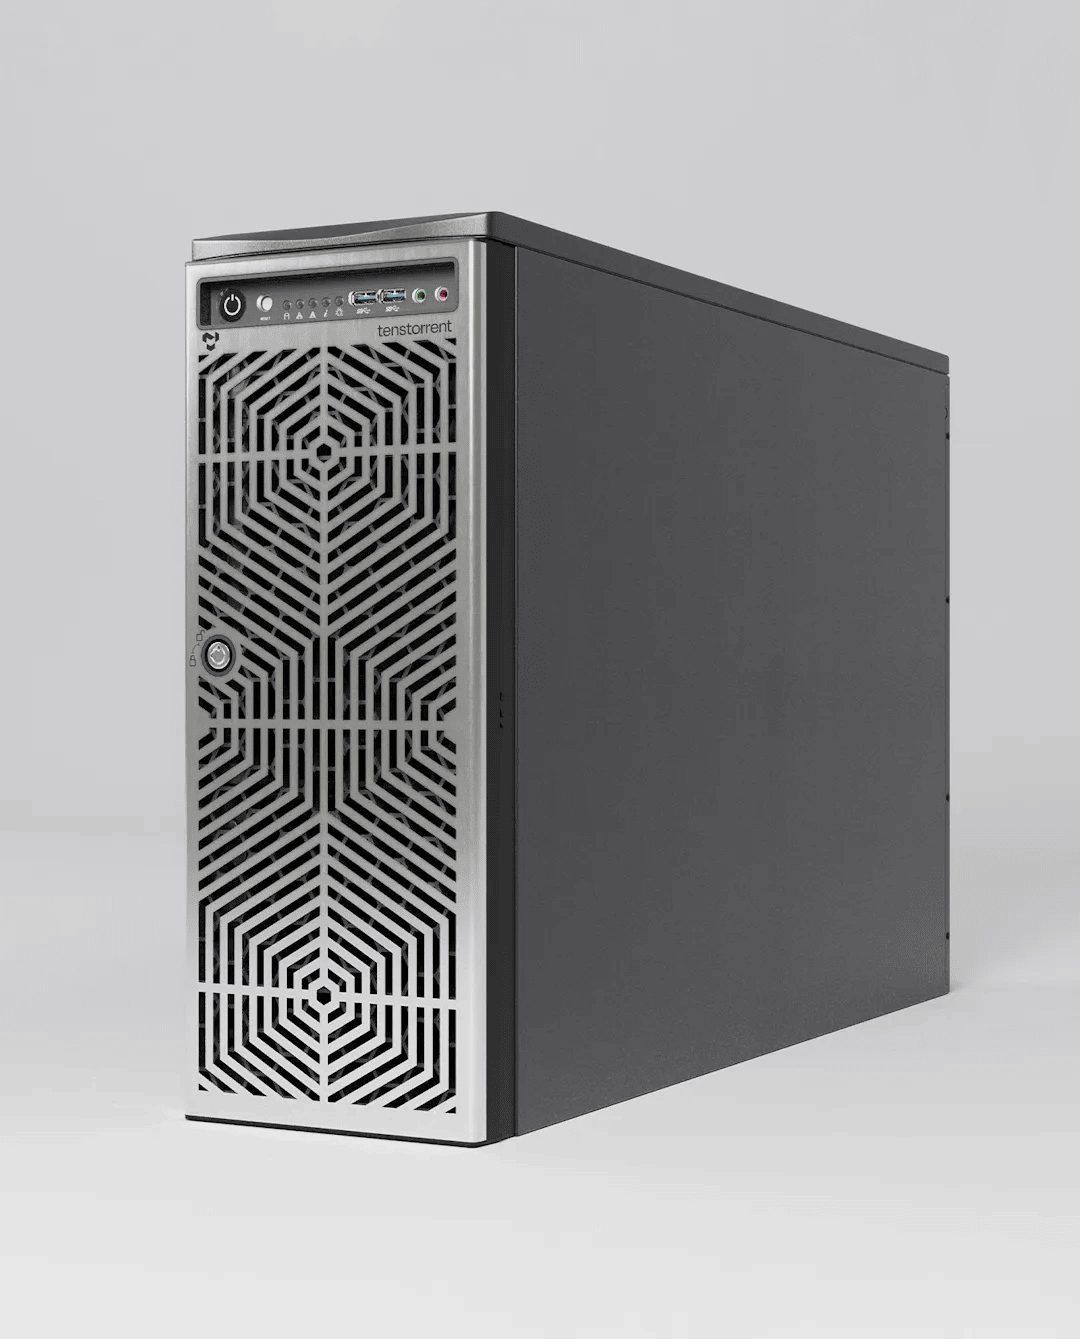 В состав рабочей станции TT-LoudBox помимо четырёх ускорителей n300 (суммарно восемь чипов Wormhole) входят два восьмиядерных процессора Intel Xeon 4309Y (Ice Lake-SP), 512 Гбайт RAM, NVMe-хранилище ёмкостью 4 Тбайт и пара портов 10 GbE. TT-LoudBox уже поступила в продажу по цене $12 тыс. 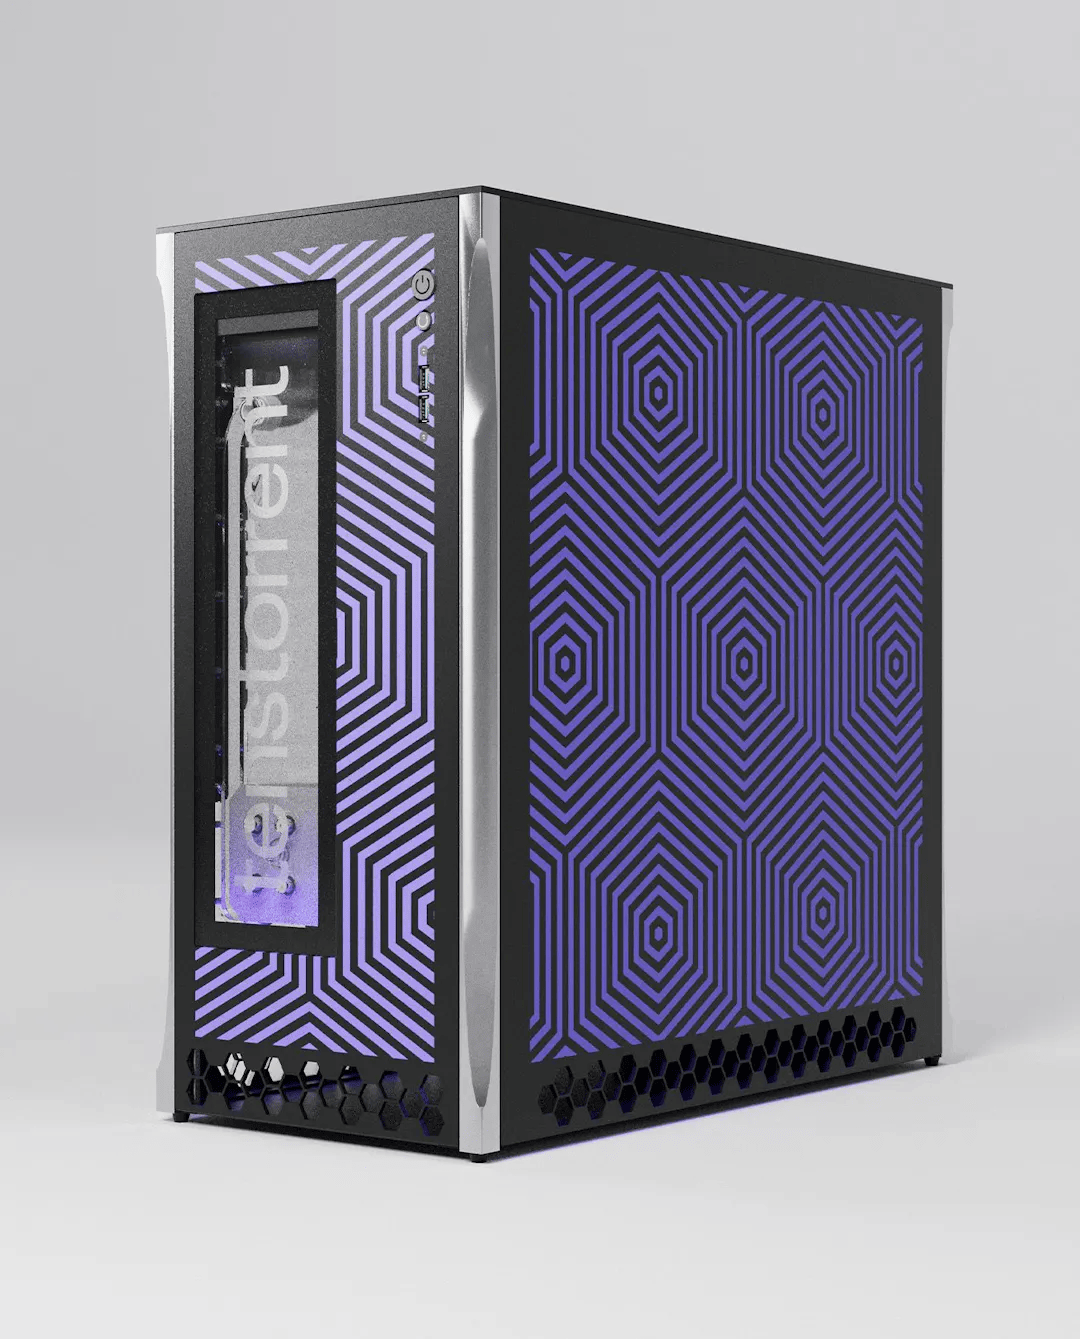 Рабочая станция TT-QuietBox оснащена четырьмя Wormhole n300 и 16-ядерным AMD EPYC 8124P (Siena). Для отвода тепла от компонентов используется жидкостное охлаждение, а остальные характеристики идентичны TT-LoudBox. Устройство доступно для предзаказа по цене $15 тыс. с поставкой в течение 8–10 недель.
17.07.2024 [23:33], Игорь Осколков
Суперускоритель по суперцене — NVIDIA GB200 NVL72, вероятно, будет стоить $3 млнКомпания NVIDIA значительно увеличила заказ на ускорители Blackwell у TSMC, сообщает TrendForce со ссылкой на United Daily News (UDN). По данным источника, NVIDIA намерена получить уже не 40 тыс., а 60 тыс. суперускорителей нового поколения, причём 50 тыс. из них придётся на стоечные системы GB200 NVL36. При этом Blackwell всё равно будут в дефиците, как и обещал ещё зимой глава NVIDIA Дженсен Хуанг (Jensen Huang). B200 включает два тайла, объединённых 2,5D-упаковкой CoWoS-L и соединённых интерконнектом NV-HBI. Чип имеет 208 млрд транзисторов, изготовленных по кастомному техпроцессу TSMC 4NP. GB200 объединяет два ускорителя B200 и один 72-ядерный Arm-процессор Grace. А суперускоритель GB200 NVL72, в свою очередь, объединяет в рамках одной стойки Oberon сразу 18 1U-узлов с парой GB200 в каждом (плата Bianca, 72 × B200 и 36 × Grace), провязанных шиной NVLink 5. Вся эта система потребляет порядка 120 кВт, оснащена СЖО и единой DC-шиной питания. Однако у GB200 NVL72 довольно специфические требования к окружению, поэтому NVIDIA предлагает суперускоритель попроще — GB200 NVL36, который как раз и должен стать наиболее массовым в данной серии. Эта платформа точно так же занимает целую стойку, но использует 2U-узлы с теми же платами Bianca (суммарно 36 × B200 и 18 × Grace), потребляя всего 66 кВт. При этом всё равно подразумевается использование двух стоек GB200 NVL36, объединённых интерконнектом, так что GB200 NVL72 всё равно получается более энергоэффективным решением. 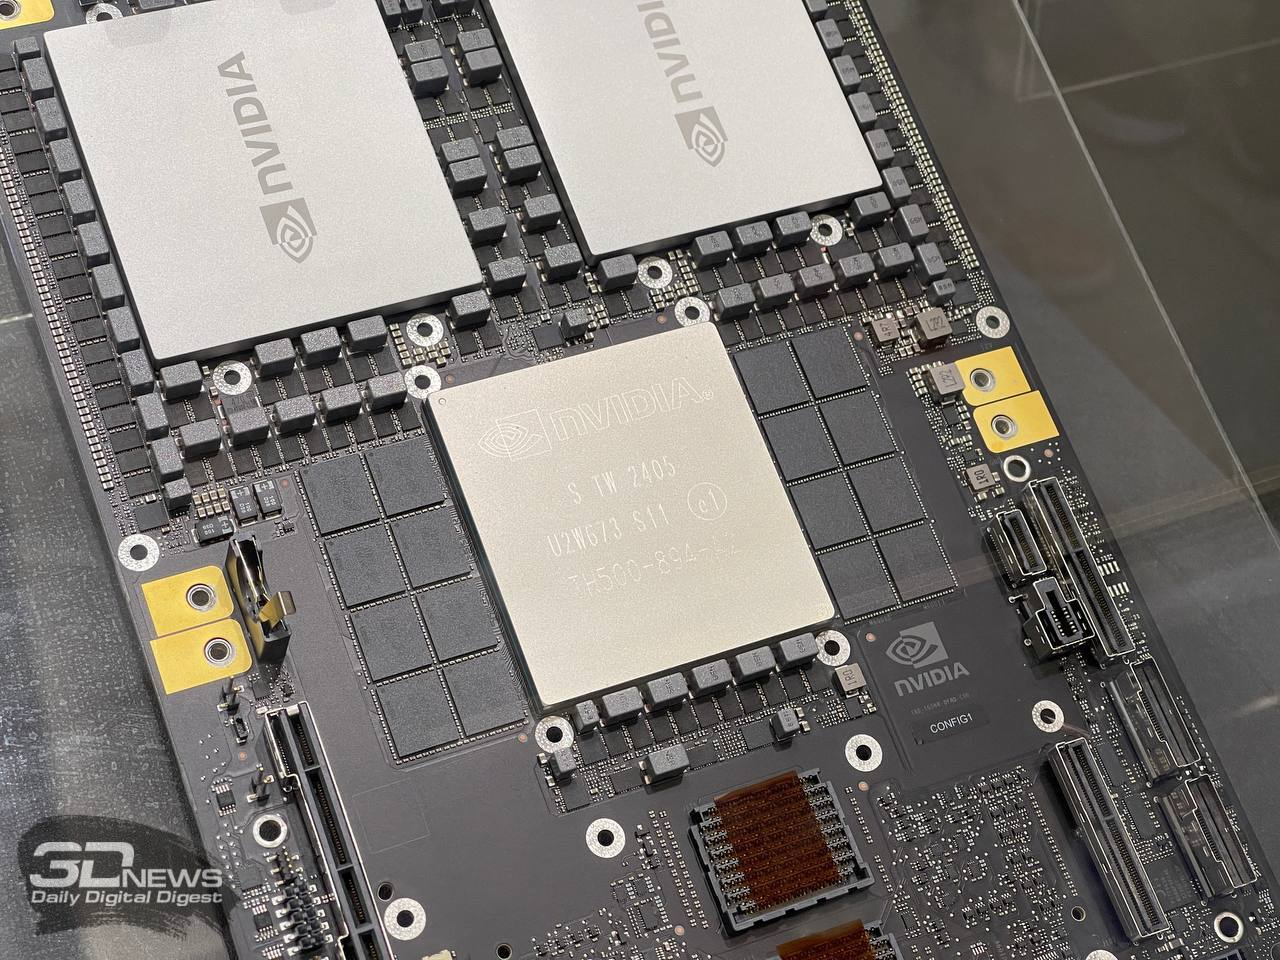
NVIDIA GB200 Как отмечает SemiAnalysis, GB200 NVL36 также будет доступен в варианте с платами Ariel, имеющими по одному чипу B200 и Grace. Наконец, во II квартале 2025 года появятся системы B200 NVL72 и B200 NVL36 с x86-процессорами (Miranda). Кроме того, NVIDIA представила и отдельные MGX-узлы GB200 NVL2 с парой GB200. В общем, ускорителей B200 компании понадобится много, чтобы наверняка удержать лидерство на рынке. 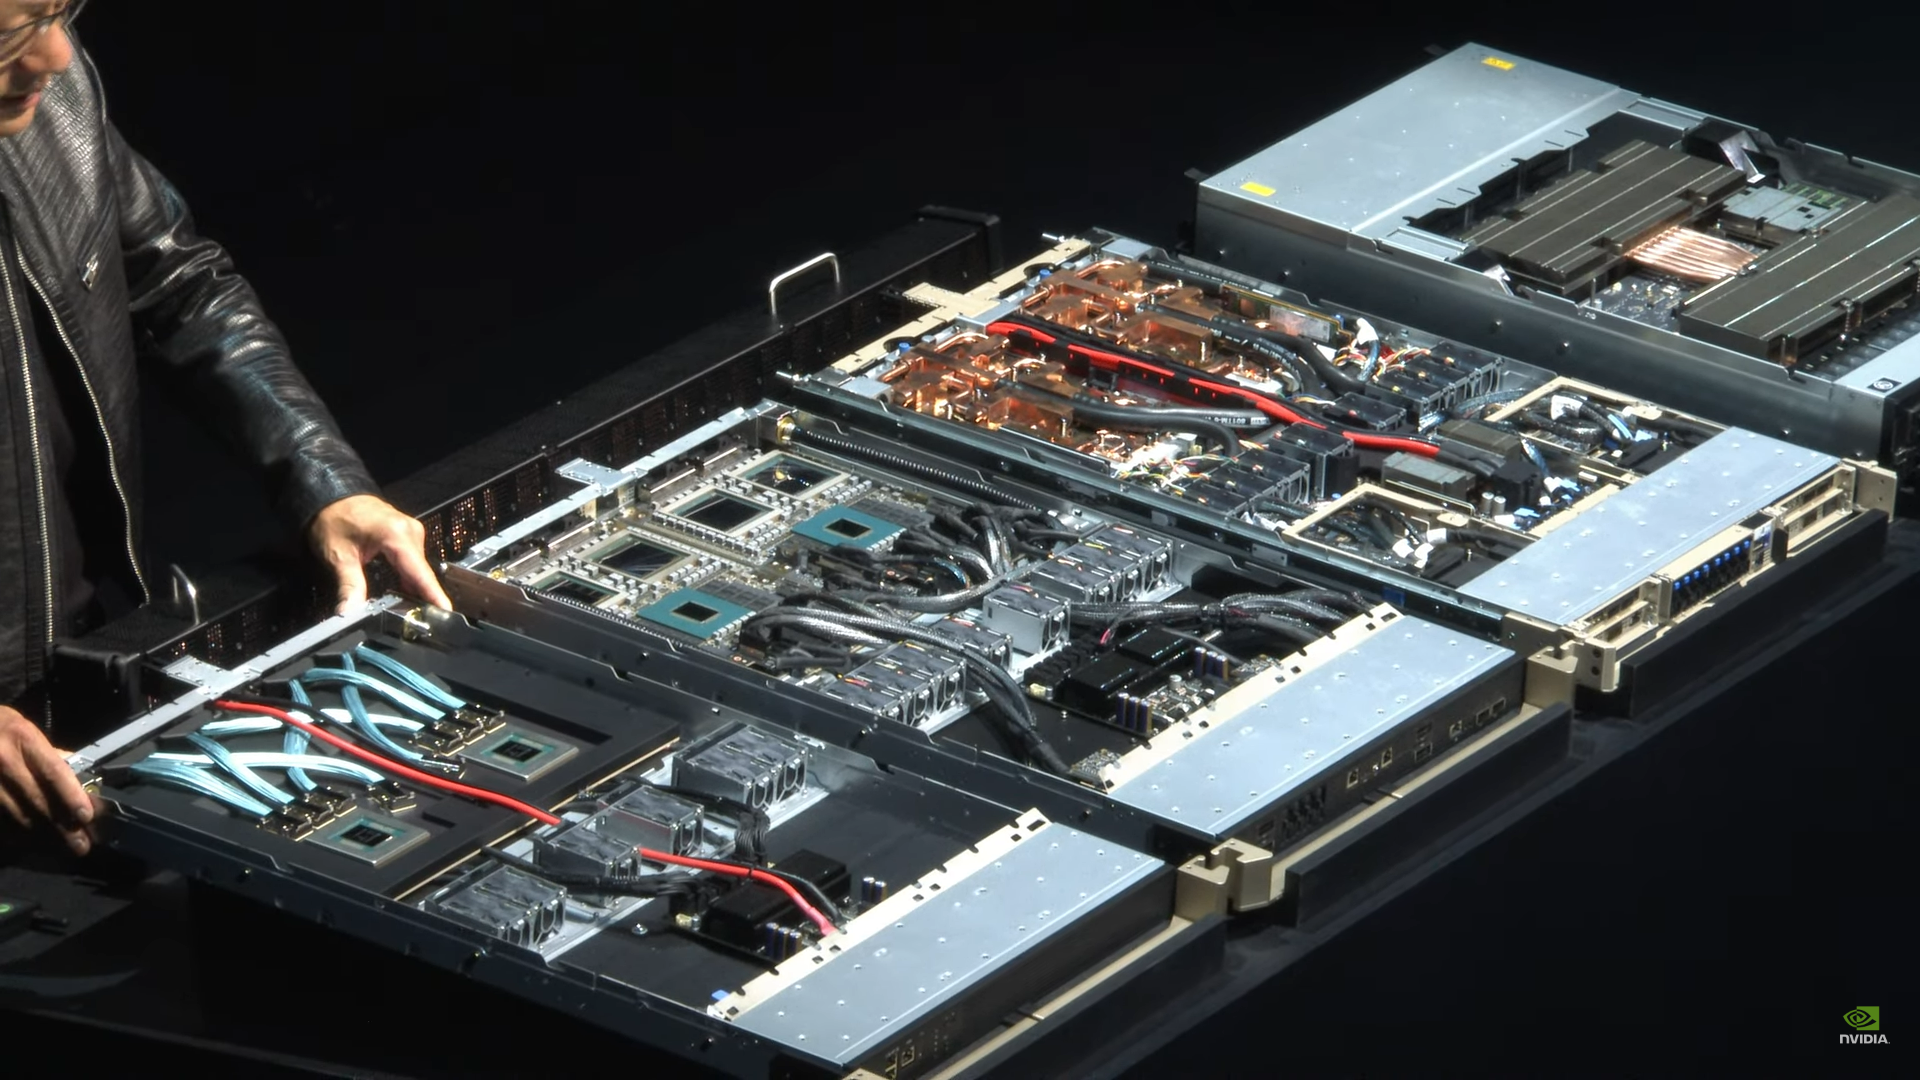
Источник изображения: NVIDIA По словам UDN, GB200 NVL36 будет стоить порядка $1,8 млн, а GB200 NVL72 обойдётся уже в $3 млн. Одиночный GB200 будет стоить $60–$70 тыс., а самый простой ускоритель B100 оценён в $30–$35 тыс. Нужно подчеркнуть, что это оценки сторонних аналитиков. Сама компания официально не раскрывает стоимость своих продуктов. Это устоявшаяся практика на данном рынке, против которой пошла только Intel, публично назвавшая стоимость ИИ-ускорителей Gaudi. Впрочем, ранее глава NVIDIA намекнул, что B200 будет стоить приблизительно $30–$40 тыс. |
|

