Лента новостей
|
20.08.2024 [14:16], Руслан Авдеев
Разработчик универсальных криптоускорителей Fabric Cryptography привлёк $33 млнПредлагающий чипы для аппаратного ускорения криптографических операций стартап Fabric Cryptography Inc. в ходе раунда финансирования A сумел привлечь $33 млн для поддержки дальнейшей разработки своих продуктов. По данным Silicon Angle, общий объём внешнего финансирования достиг $39 млн. Ведущими инвесторами стали Blockchain Capital и 1kx, свой вклад сделали и криптовалютные компании Offchain Labs, Polygon и Matter Labs. Основным продуктом компании является SoC Verifiable Processing Unit (VPU), специально созданный для обработки криптографических алгоритмов. На обработку таких алгоритмов требуется немало вычислительных ресурсов при (де-)шифровании больших массивов данных. Вендор заявляет, что VPU могут более эффективно использовать криптографическое ПО, чем традиционные процессоры, снижая эксплуатационные расходы. На рынке уже имеются многочисленные чипы для криптографических задач. Однако многие из них оптимизированы лишь для определённого набора криптографических алгоритмов. Fabric Cryptography наделила VPU набором команд (ISA), оптимизированных именно для операций, применяемых при шифровании и хешировании. Это позволяет перепрограммировать VPU для новых алгоритмов. 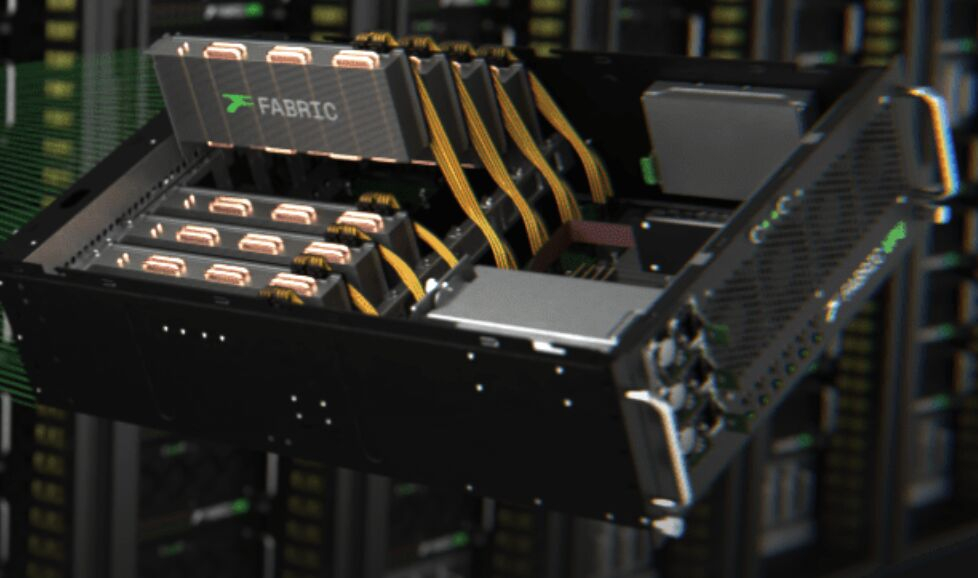
Источник изображений: Fabric Cryptography VPU включает RISC-V ядра, векторные блоки, быстрый неблокирующий интерконнект и унифицированную память неназванного типа. Чип FC 1000 включает один VPU. PCIe-карта VPU 8060 включает три чипа FC 1000 и 30 Гбайт памяти с пропускной способностью около 1 Тбайт/с. Сервер Byte Smasher включает до восьми VPU 8060 и обеспечивает производительность более 1 Тбайт/с на задачах хеширования. Первым целевым примером использования VPU является ускорение алгоритмов ZKP (Zero-knowledge proof, доказательство с нулевым разглашением), которые применяются некоторыми блокчейн-платформами. В Fabric Cryptography рассказали, что получили предварительные заказы на VPU на десятки миллионов долларов именно от клиентов, рассчитывающих на выполнение ZKP-задач. 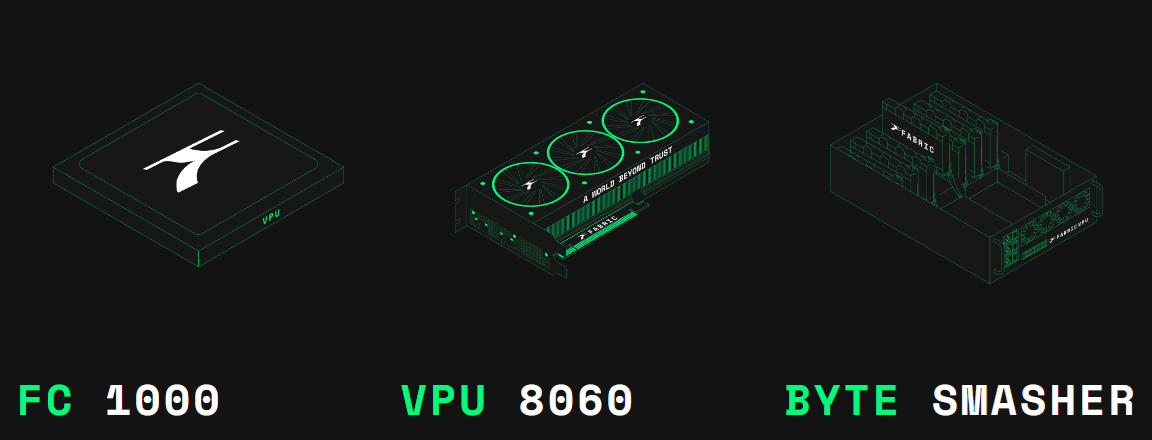 Fabric Cryptography намерена использовать полученные инвестиции на разработку новой, более производительной версии ускорителя и найм разработчиков ПО. Сейчас в компании работают более 60 инженеров, перешедших из AMD, Apple, Galois, Intel, NVIDIA и т.д. В комплекте с чипами компания предлагает компилятор и несколько связанных инструментов, которые упрощают внедрение приложений, использующих VPU.
15.08.2024 [09:36], Алексей Степин
256 × RISC-V: SiFive представила высокопроизводительные ядра P870-D для серверов и СХДОткрытая архитектура RISC-V, которая, как многие надеются, станет конкурентом Arm не только в компактных и экономичных устройствах, но и в серверных системах, продолжает развиваться. Один из ведущих разработчиков в этой сфере, компания SiFive, анонсировала новое ядро P870-D. Как следует из системы обозначений, принятой SiFive, это высокопроизводительное (Performance) ядро, а суффикс D означает Datacenter. Новинка предназначена для серверных процессоров с количеством ядер до 256. Дизайн P870-D нельзя назвать полностью новым, поскольку он основан на ядре P870, анонсированном в конце 2023 года. Данное решение предназначалось для создания процессоров с числом ядер до 32 и включало в себя два 128-бит векторных блока, при этом каждые четыре ядра группировались в кластер, использовавший разделяемый кеш L2. 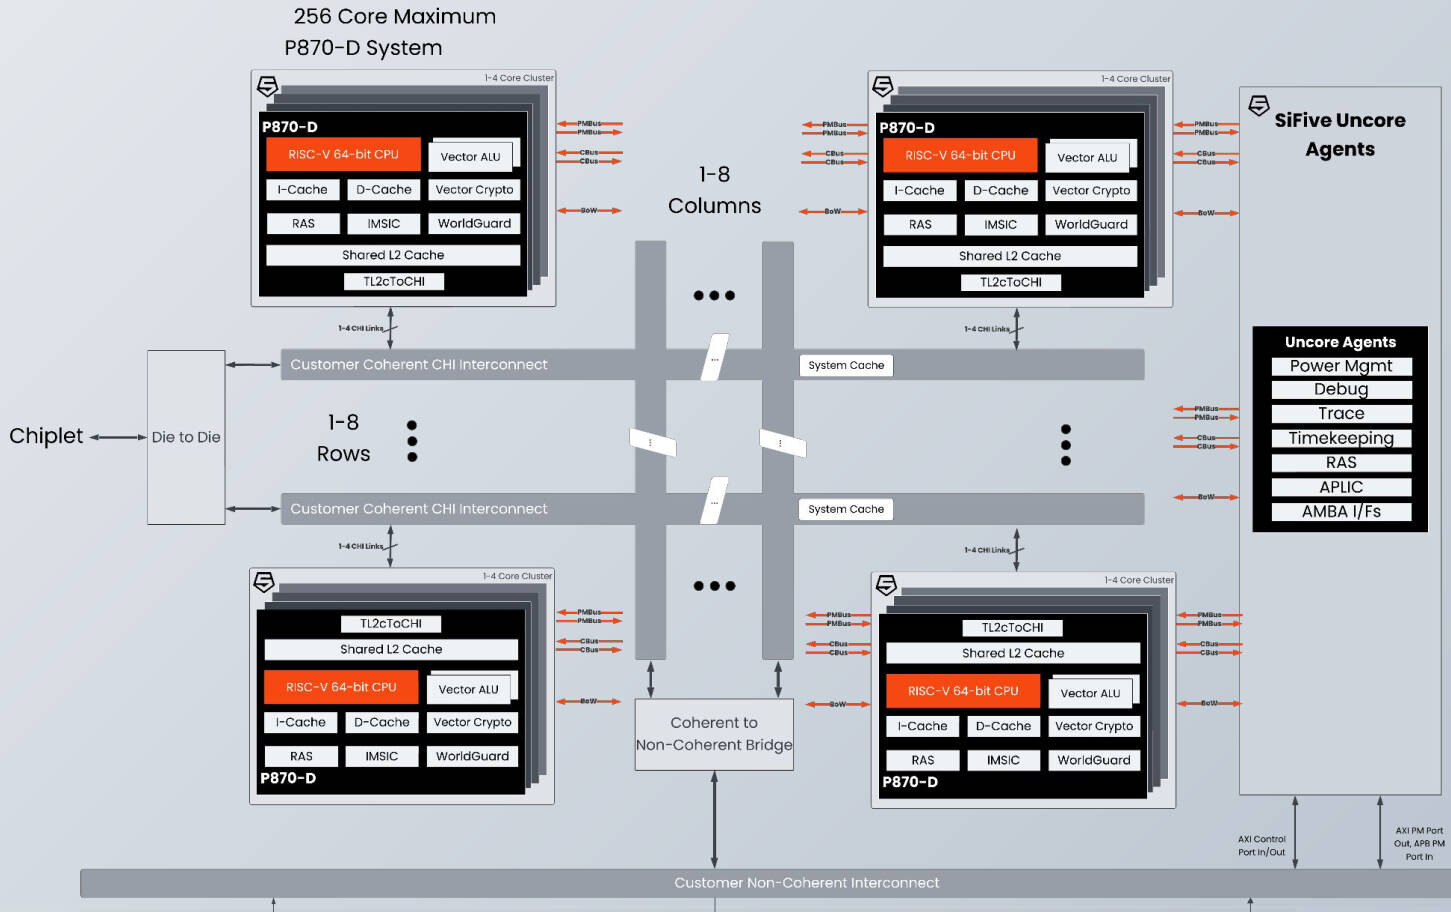
Источник здесь и далее: SiFive P870-D сохранило черты предшественника. Это 64-бит ядро с поддержкой внеочередного исполнения инструкций и шириной декодера 6. В нём реализована поддержка набора инструкций RVA 23, Vector 1.0 и Vector Crypto. Появилась поддержка функций обеспечения повышенной надёжности RAS (Reliability, availability and serviceability). Контроль чётности присутствует уже на уровне регистровых файлов, а на всех уровнях подсистемы кешей имеется коррекция ошибок SECDED ECC. Но это не всё, в P870D есть поддержка AMBA CHI (4 порта). Это нововведение позволило SiFive существенно улучшить масштабирование — P870-D может служить основой для процессоров с числом ядер до 256, включая гетерогенные, в том числе возможны многочиповые дизайны и варианты с поддержкой CXL. Сами ядра по-прежнему группируются в кластеры по четыре, а CHI-подключение может обеспечиваться как встроенным мостом, так и внешним чиплетом. 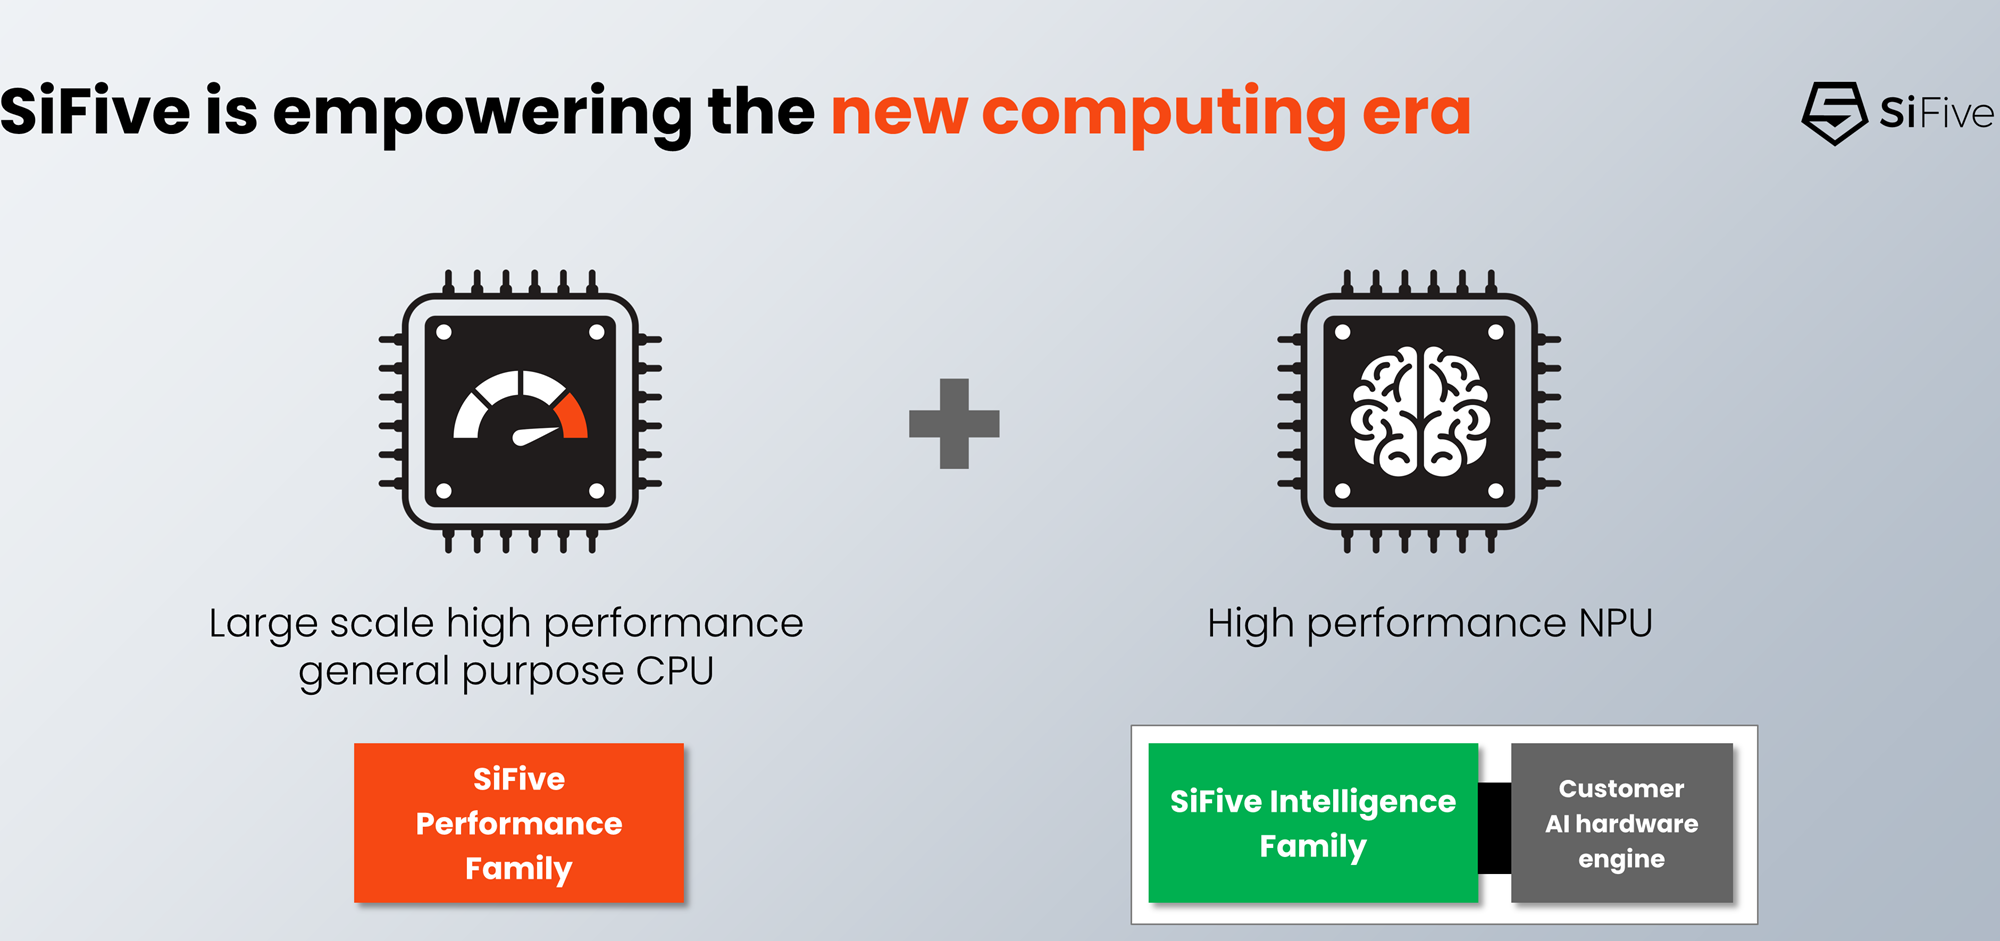 Также в состав P870-D входит распределённый масштабируемый блок IOMMU, платформа безопасности WorldGuard и uncore-агент, ответственный за питание, отладку, трассировку и т.д. Есть и контроллер прерываний Advanced Interrupt Architecture (AIA) с поддержкой Message Signal Interrupts (MSI) и виртуализации. В настоящее время это самое мощное ядро в арсенале SiFive, основными его конкурентами названы Arm Cortex-X2 и AMD Zen 4c. Однако перекоса в сторону исключительно производительности у P870-D нет. Поскольку данный дизайн ориентирован на современные высокоплотные ЦОД и платформы периферийных вычислений, разработчики уделили серьёзное внимание вопросам энергопотребления и тепловыделения. Впрочем, точных данных по этим параметрам пока приведено не было. 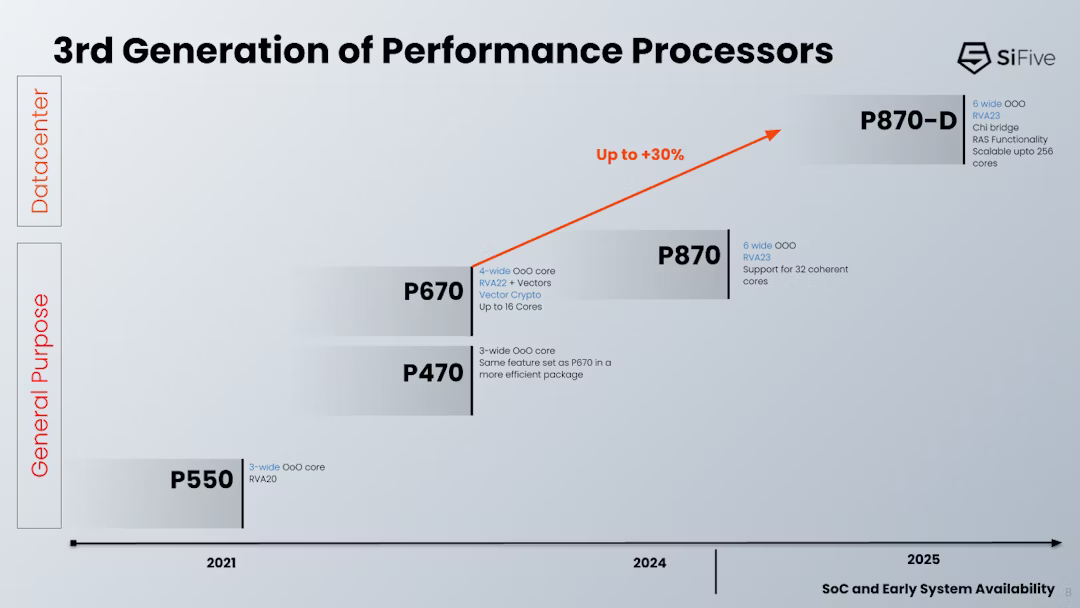 Компания активно сотрудничает с партнерами по экосистеме RISC-V. Так, уже заключено соглашение с Arteris, которая выпустит референсные платформы валидации на базе P870-D и X280 с интегрированной поддержкой Arteris Network-on-Chip (NoC), что должно упростить дальнейшую разработку сложных гетерогенных чипов с функциями ИИ (за счёт блоков SiFive Intelligence) и ускорить вывод на рынок решений на базе таких чипов. Образцы чипов на базе SiFive P870-D уже поставляются ведущим партнёрам компании, а начало массового производства намечено на конец текущего 2024 года. Зарубежные аналитики полагают, что за энергоэффективными платформами на базе открытых стандартов большое будущее. К 2030 году решения, подобные SiFive P870-D, как ожидается, займут более 40 % всего рынка серверных процессоров.
01.08.2024 [00:53], Игорь Осколков
Ampere анонсировала 512-ядерные Arm-процессоры AmpereOne Aurora с HBM-памятью и встроенным ИИ-ускорителемAmpere Computing анонсировала процессоры AmpereOne Aurora, которые получат до 512 однопоточных Arm-ядер собственной разработки, набортную HBM-память и фирменные IP-блоки для обучения и инференса ИИ-моделей. Речь, судя по всему, идёт о чиплетной компоновке, поскольку компания говорит не только о фирменном меш-интерконнекте для вычислительных блоков, но и об объединении разных кристаллов в рамках SoC. Предполагается, что Aurora появятся где-то на рубеже 2025–2026 гг. 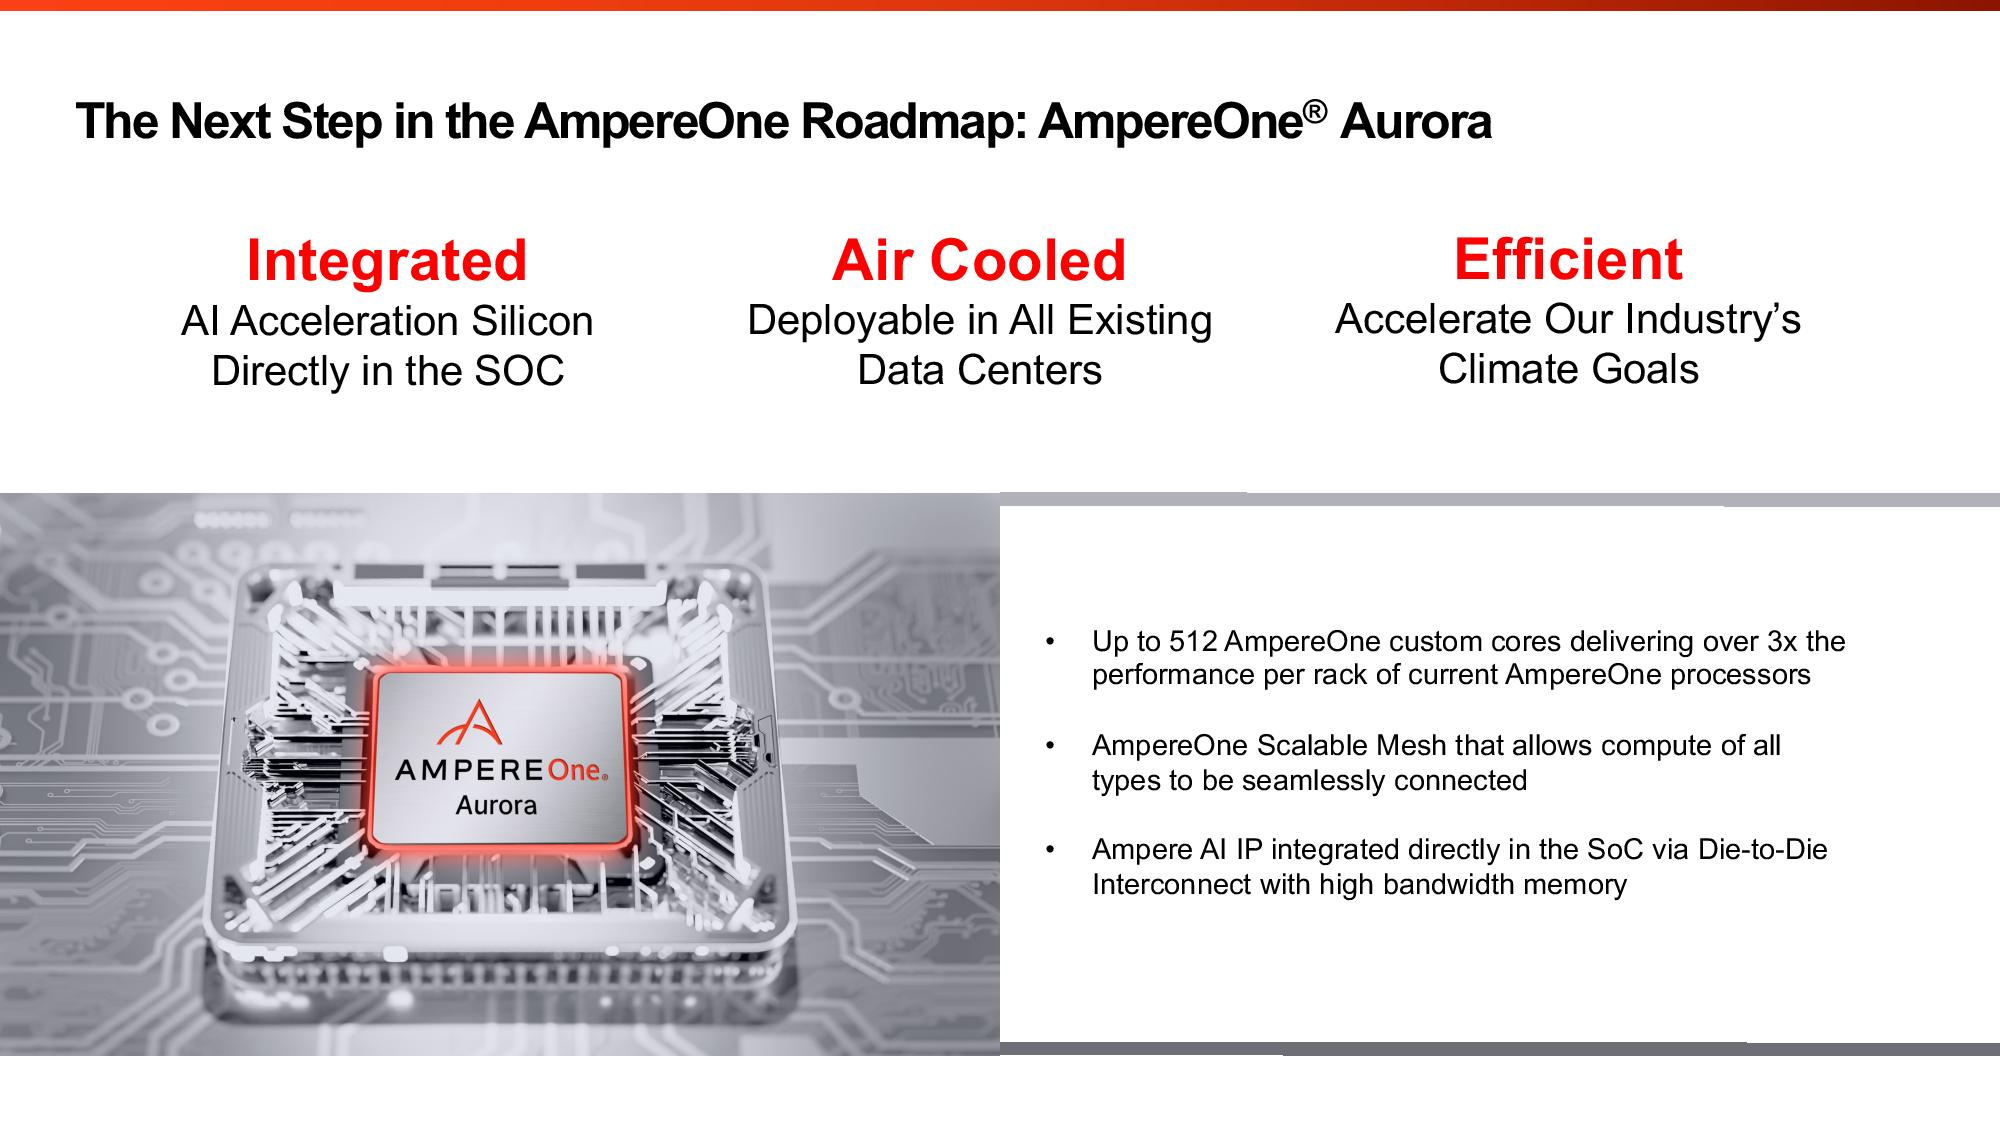
Источник изображений: Ampere Computing Что интересно, для Aurora обещана возможность использования воздушного охлаждения. Для гиперскейлеров, на которых Ampere по-прежнему ориентируется, это важный пункт. Впрочем, больше никаких подробностей о новинках компания не сообщила, отметив лишь, что встроенный ускоритель сгодится для RAG и векторных баз данных. Ну и сообщив, что по количеству ядер и производительности её ещё не выпущенный чип обгоняет все остальные чипы: 144-ядерные Intel Xeon 6 (Sierra Forest), которые вскоре станут 288-ядерными (при этом все варианты без Hyper-Threading), и 128-ядерные AMD EPYC Bergamo (256 потоков), которым на смену придут 192-ядерные EPYC Turin Dense (384 потока). 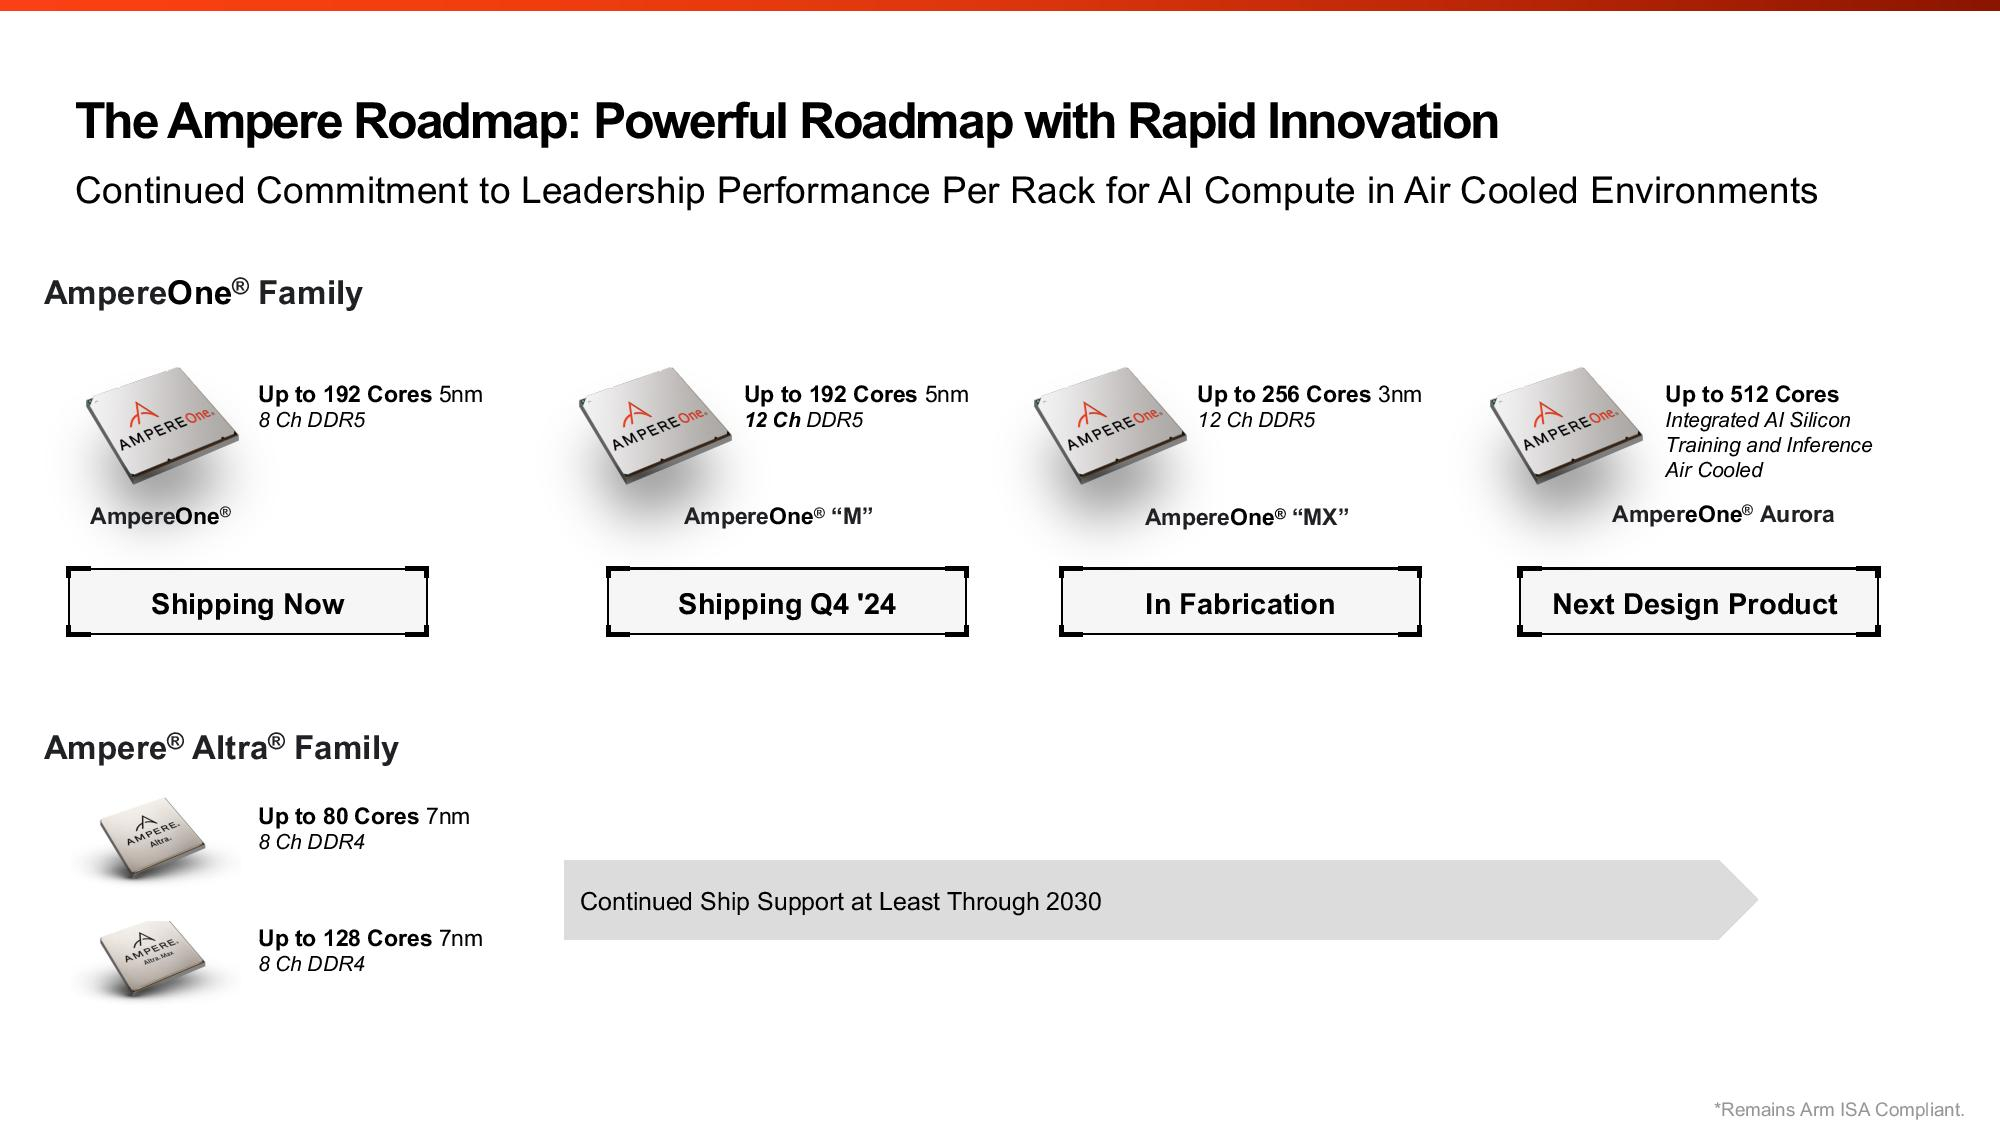 До Aurora компания выпустит ещё две серии процессоров AmpereOne: M в конце 2024 года и MX в 2025 году. 5-нм AmpereOne M получат до 192 ядер и 12-канальный контроллер памяти DDR5. 3-нм AmpereOne MX получат такой же контроллер и до 256 ядер. Заодно компания опубликовала прайс-лист актуальных CPU. В нём нет изначально заявлявшихся 136- и 172-ядерных моделей. Кроме того, остальные процессоры несколько подорожали в сравнении с прошлым поколением Altra Max, но по цене всё ещё привлекательнее решений AMD и Intel — $5555 за 192 ядра. Следует учесть, что в таблице приведён не привычный показатель TDP, а усреднённое энергопотребление чипа, из-за чего сравнивать процессоры Ampere с другими чипами затруднительно. 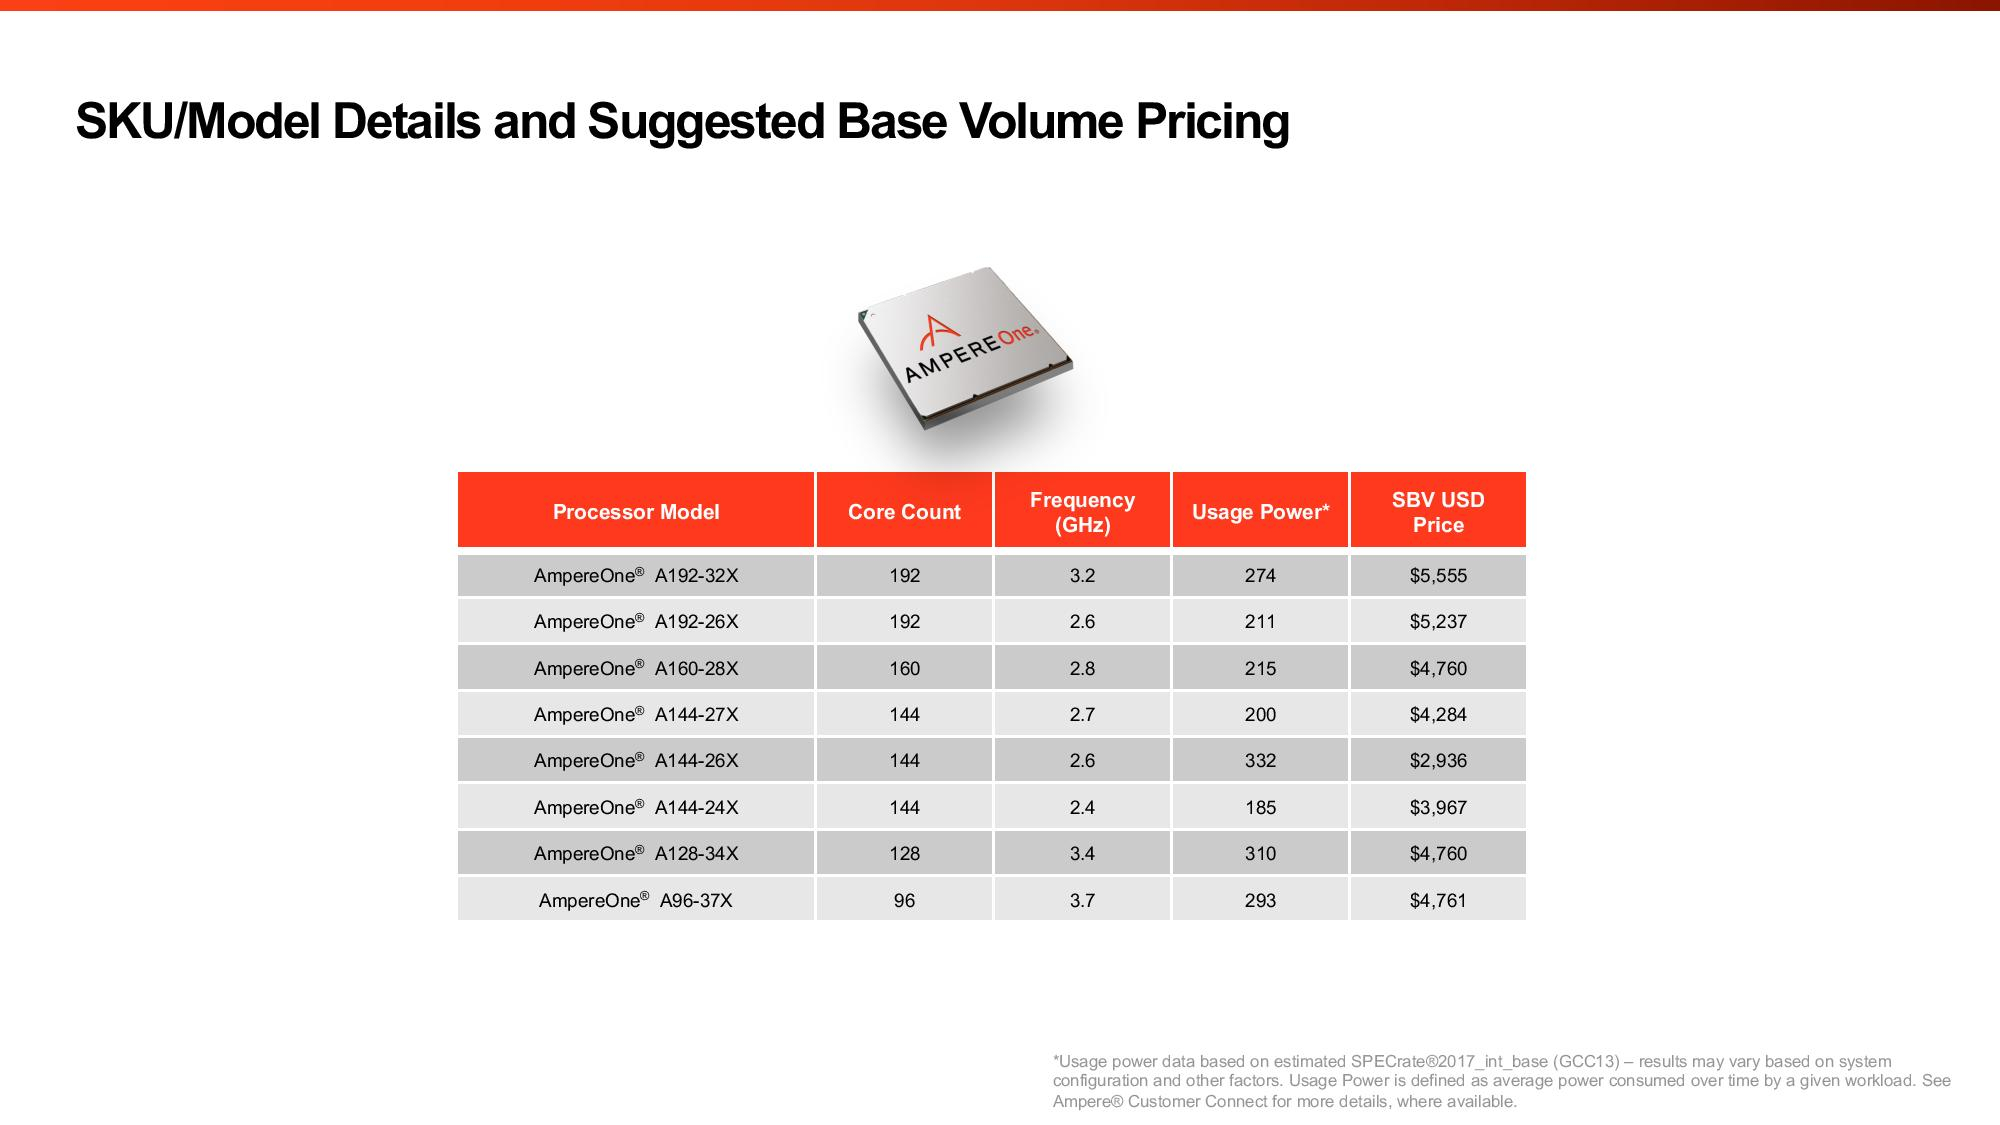 Насколько Aurora станет популярным у гиперскейлеров и других заказчиков, покажет время. У Ampere есть якорный заказчик в лице Oracle, но другие IT-гиганты уже сами разрабатывают собственные Arm-процессоры. AWS в Graviton4 довела количество ядер до 96, Microsoft анонсировала 128-ядерный Cobalt 100, Alibaba массово внедряет 128-ядерные Yitian 710, а Google готовит Axion. Fujitsu к 2027 году подготовит 144-ядерные MONAKA, которые тоже получат поддержку ИИ-нагрузок, но упор в них сделан не на HBM, а на SRAM. Собственно говоря, HBM есть только у HPC-процессоров: Fujitsu A64FX, SiPearl Rhea1 и C-DAC AUM. Даже NVIDIA Grace, которые в основном ассистируют ускорителям, обходятся LPDDR5x.
27.07.2024 [23:44], Алексей Степин
Не так просто и не так быстро: учёные исследовали особенности работы памяти и NVLink C2C в NVIDIA Grace HopperГибридный ускоритель NVIDIA Grace Hopper объединяет CPU- и GPU-модули, которые связаны интерконнектом NVLink C2C. Но, как передаёт HPCWire, в строении и работе суперчипа есть некоторые нюансы, о которых рассказали шведские исследователи. Им удалось замерить производительность подсистем памяти Grace Hopper и интерконнекта NVLink в реальных сценариях, дабы сравнить полученные результаты с характеристиками, заявленными NVIDIA. Напомним, для интерконнекта изначально заявлена скорость 900 Гбайт/с, что в семь раз превышает возможности PCIe 5.0. Память HBM3 в составе GPU-части имеет ПСП до 4 Тбайт/с, а вариант с HBM3e предлагает уже до 4,9 Тбайт/с. Процессорная часть (Grace) использует LPDDR5x с ПСП до 512 Гбайт/с. В руках исследователей оказалась базовая версия Grace Hopper с 480 Гбайт LPDDR5X и 96 Гбайт HBM3. Система работала под управлением Red Hat Enterprise Linux 9.3 и использовала CUDA 12.4. В бенчмарке STREAM исследователям удалось получить следующие показатели ПСП: 486 Гбайт/с для CPU и 3,4 Тбайт/с для GPU, что близко к заявленным характеристиками. Однако результат скорость NVLink-C2C составила всего 375 Гбайт/с в направлении host-to-device и лишь 297 Гбайт/с в обратном направлении. Совокупно выходит 672 Гбайт/с, что далеко от заявленных 900 Гбайт/с (75 % от теоретического максимума). 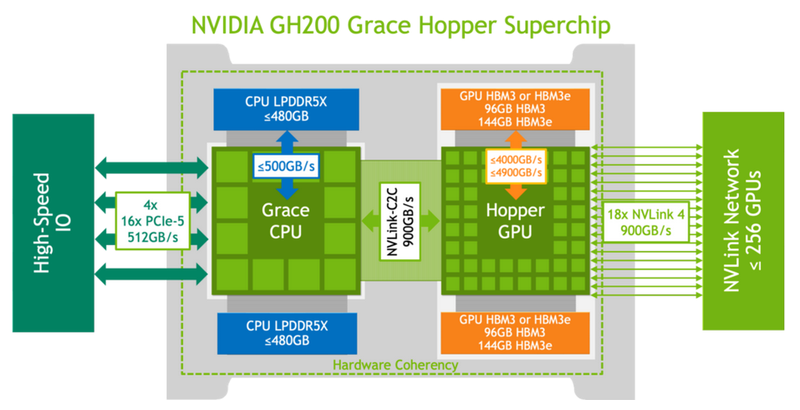
Источник: NVIDIA Grace Hopper в силу своей конструкции предлагает два вида таблицы для страниц памяти: общесистемную (по умолчанию страницы размером 4 Кбайт или 64 Кбайт), которая охватывает CPU и GPU, и эксклюзивную для GPU-части (2 Мбайт). При этом скорость инициализации зависит от того, откуда приходит запрос. Если инициализация памяти происходит на стороне CPU, то данные по умолчанию помещаются в LPDDR5x, к которой у GPU-части есть прямой доступ посредством NVLink C2C (без миграции), а таблица памяти видна и GPU, и CPU. 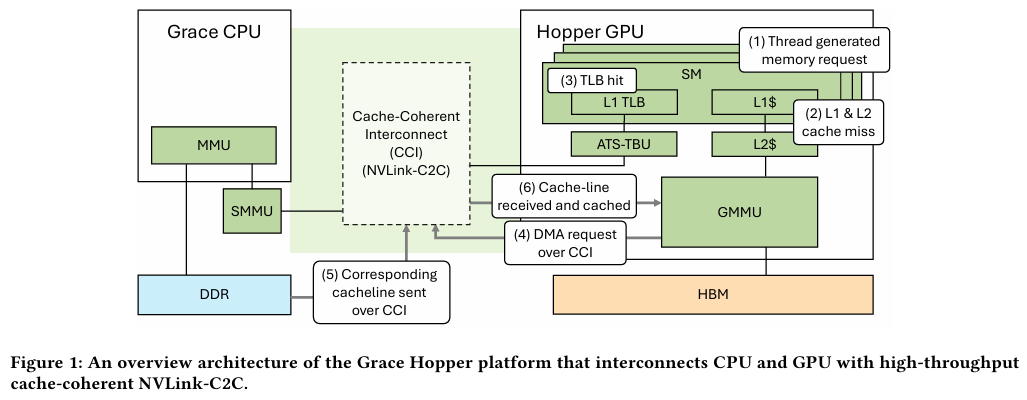
Источник: arxiv.org Если же памятью управляет не ОС, а CUDA, то инициализацию можно сразу организовать на стороне GPU, что обычно гораздо быстрее, а данные поместить в HBM. При этом предоставляется единое виртуальное адресное пространство, но таблиц памяти две, для CPU и GPU, а сам механизм обмена данными между ними подразумевает миграцию страниц. Впрочем, несмотря на наличие NVLink C2C, идеальной остаётся ситуация, когда GPU-нагрузке хватает HBM, а CPU-нагрузкам достаточно LPDDR5x. 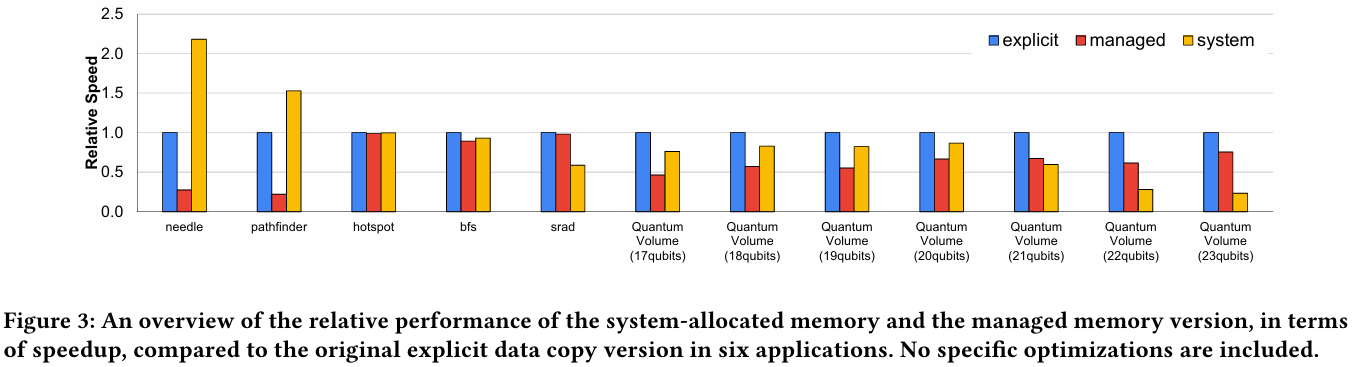
Источник: arxiv.org Также исследователи затронули вопрос производительности при использовании страниц памяти разного размера. 4-Кбайт страницы обычно используются процессорной частью с LPDDR5X, а также в тех случаях, когда GPU нужно получить данные от CPU через NVLink-C2C. Но как правило в HPC-нагрузках оптимальнее использовать 64-Кбайт страницы, на управление которыми расходуется меньше ресурсов. Когда же доступ в память хаотичен и непостоянен, страницы размером 4 Кбайт позволяют более тонко управлять ресурсами. В некоторых случаях возможно двукратное преимущество в производительности за счёт отсутствия перемещения неиспользуемых данных в страницах объёмом 64 Кбайт. В опубликованной работе отмечается, что для более глубокого понимания механизмов работы унифицированной памяти у гетерогенных решений, подобных Grace Hopper, потребуются дальнейшие исследования.
25.07.2024 [09:57], Сергей Карасёв
Илон Маск показал ИИ-суперкомпьютер Dojo на основе чипов Tesla D1Глава Tesla Илон Маск (Elon Musk), по сообщению ресурса Tom's Hardware, обнародовал фотографии вычислительного комплекса Dojo, который будет использоваться для разработки инновационных автомобильных технологий, а также для обучения автопилота. Tesla, напомним, начала создание ИИ-суперкомпьютера Dojo в июле 2023 года. Основой системы послужат специализированные чипы собственной разработки Tesla D1. Дата-центр Dojo, расположенный в штаб-квартире Tesla в Остине (Техас, США), по своей конструкции напоминает бункер. В апреле нынешнего года сообщалось, что при строительстве ЦОД компания Маска столкнулась с трудностями, связанными в том числе с доставкой необходимых материалов. Как теперь сообщается, Tesla намерена ввести Dojo в эксплуатацию до конца 2024 года. По производительности этот суперкомпьютер будет сопоставим с кластером из 8 тыс. ускорителей NVIDIA H100. По словам Маска, это «не слишком много, но и не тривиально». Для сравнения: мощнейший ИИ-суперкомпьютер компании xAI, также курируемой Илоном Маском, объединит 100 тыс. карт H100. 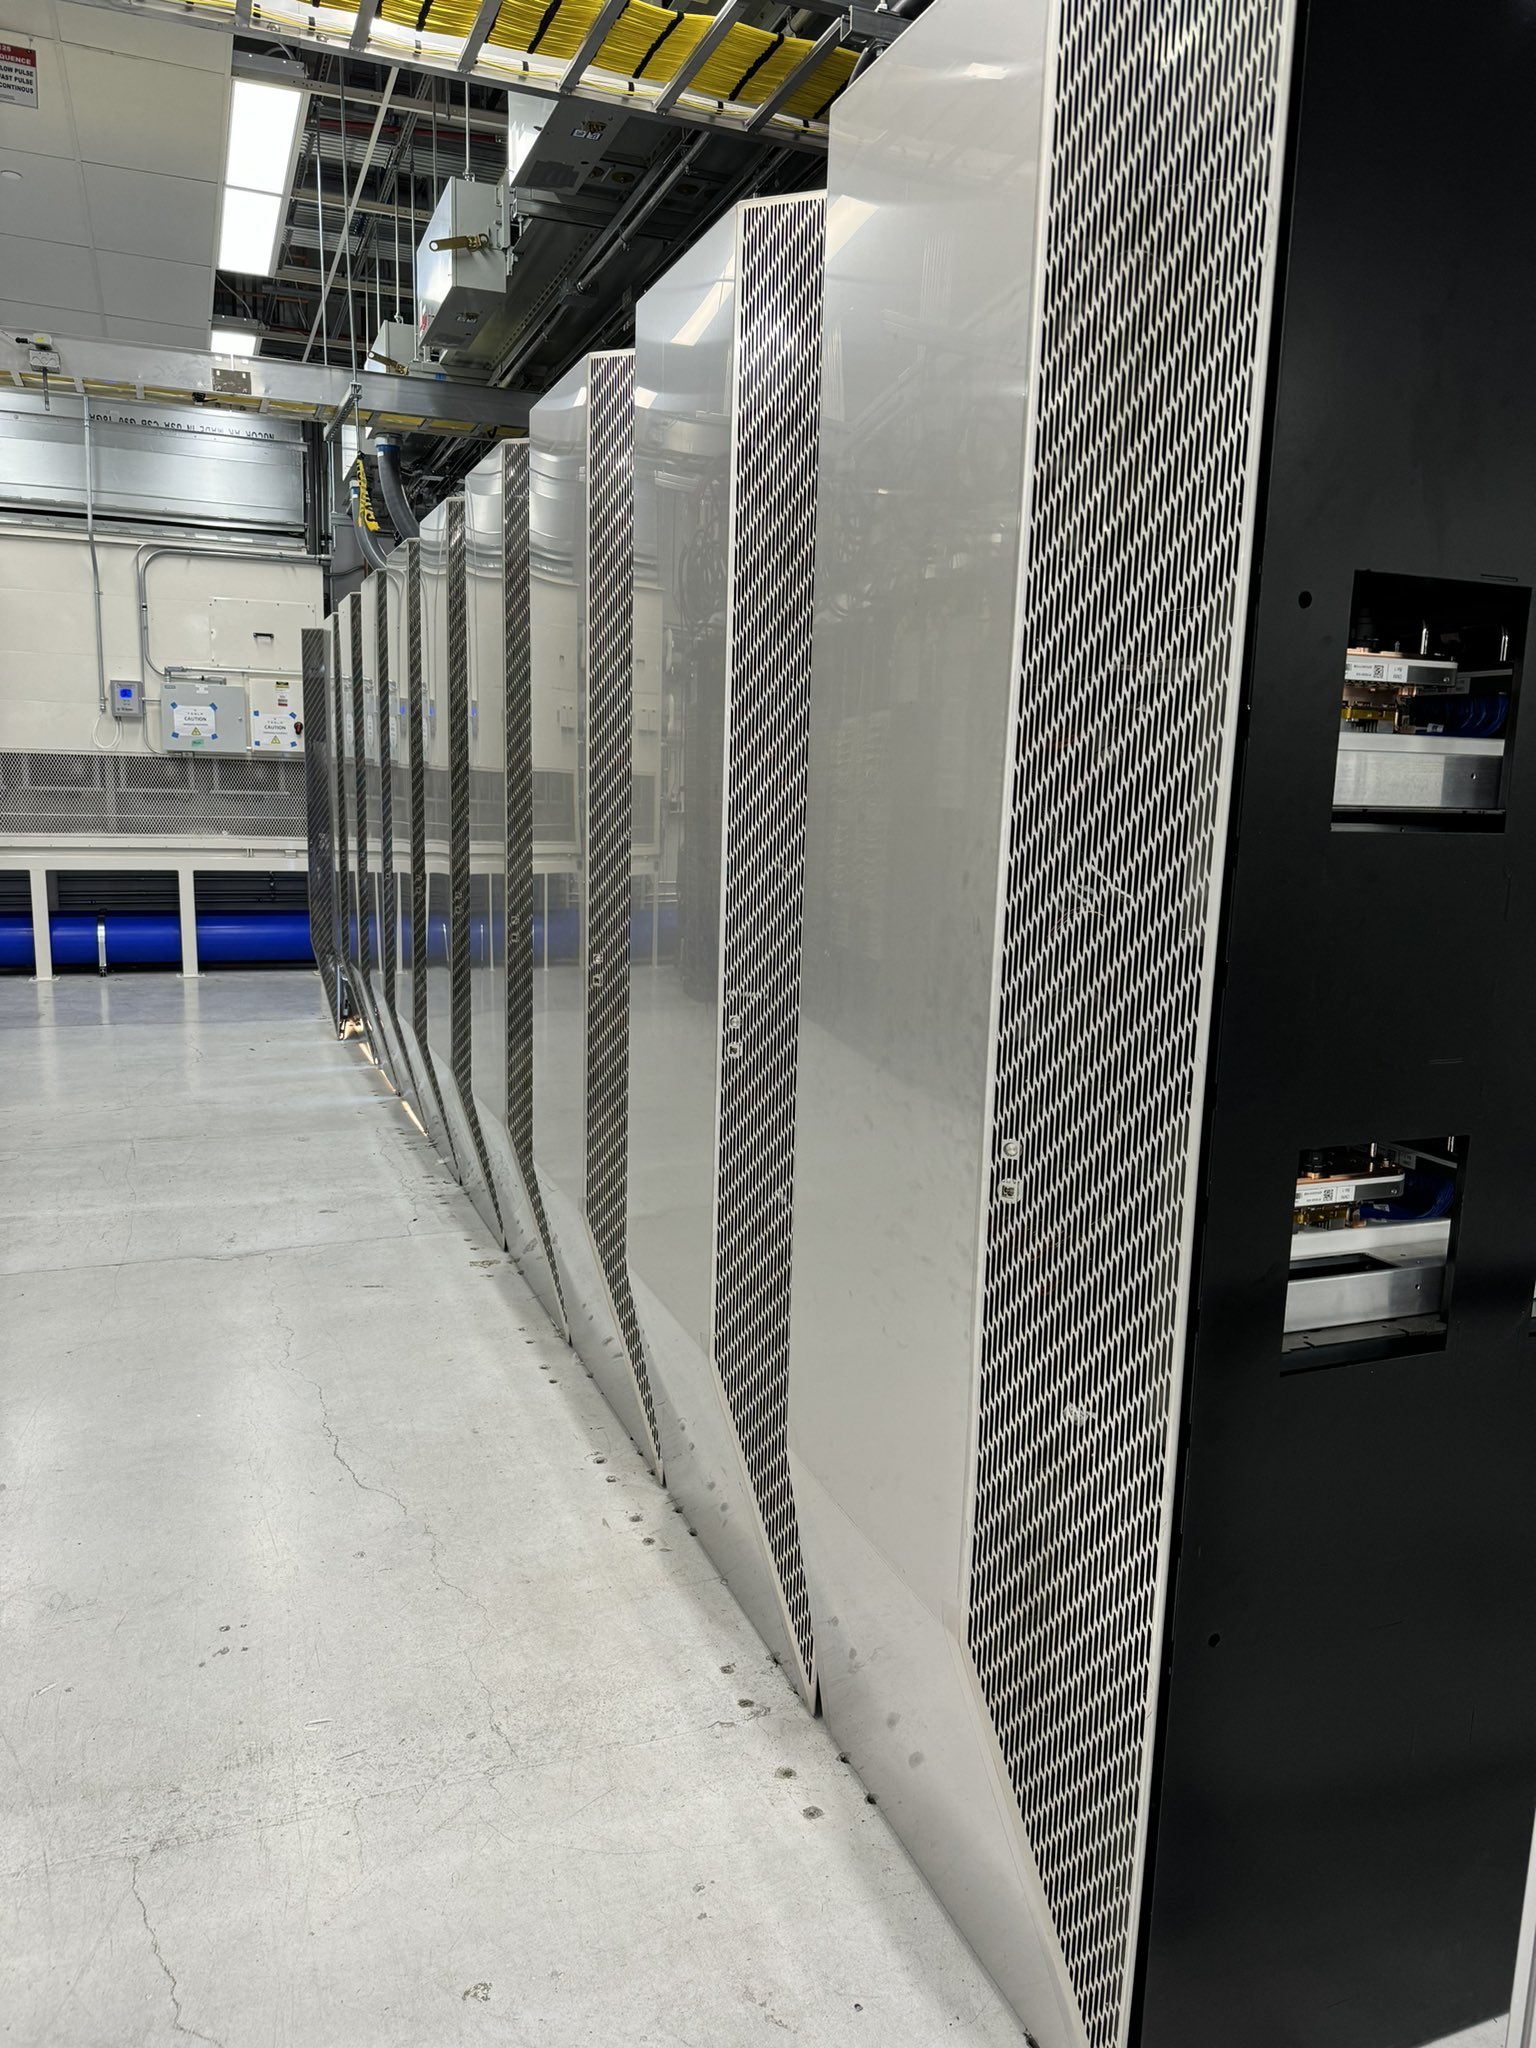
Источник изображений: Илон Маск Отмечается, что чипы Tesla D1 специально ориентированы на машинное обучение и анализ видеоданных. Поэтому систему Dojo планируется использовать прежде всего для совершенствования технологии автономного вождения Tesla путём обработки видеоданных, полученных от автомобилей компании. В свою очередь, «ИИ-гигафабрика» xAI поможет в развитии чат-ботов Grok следующего поколения. 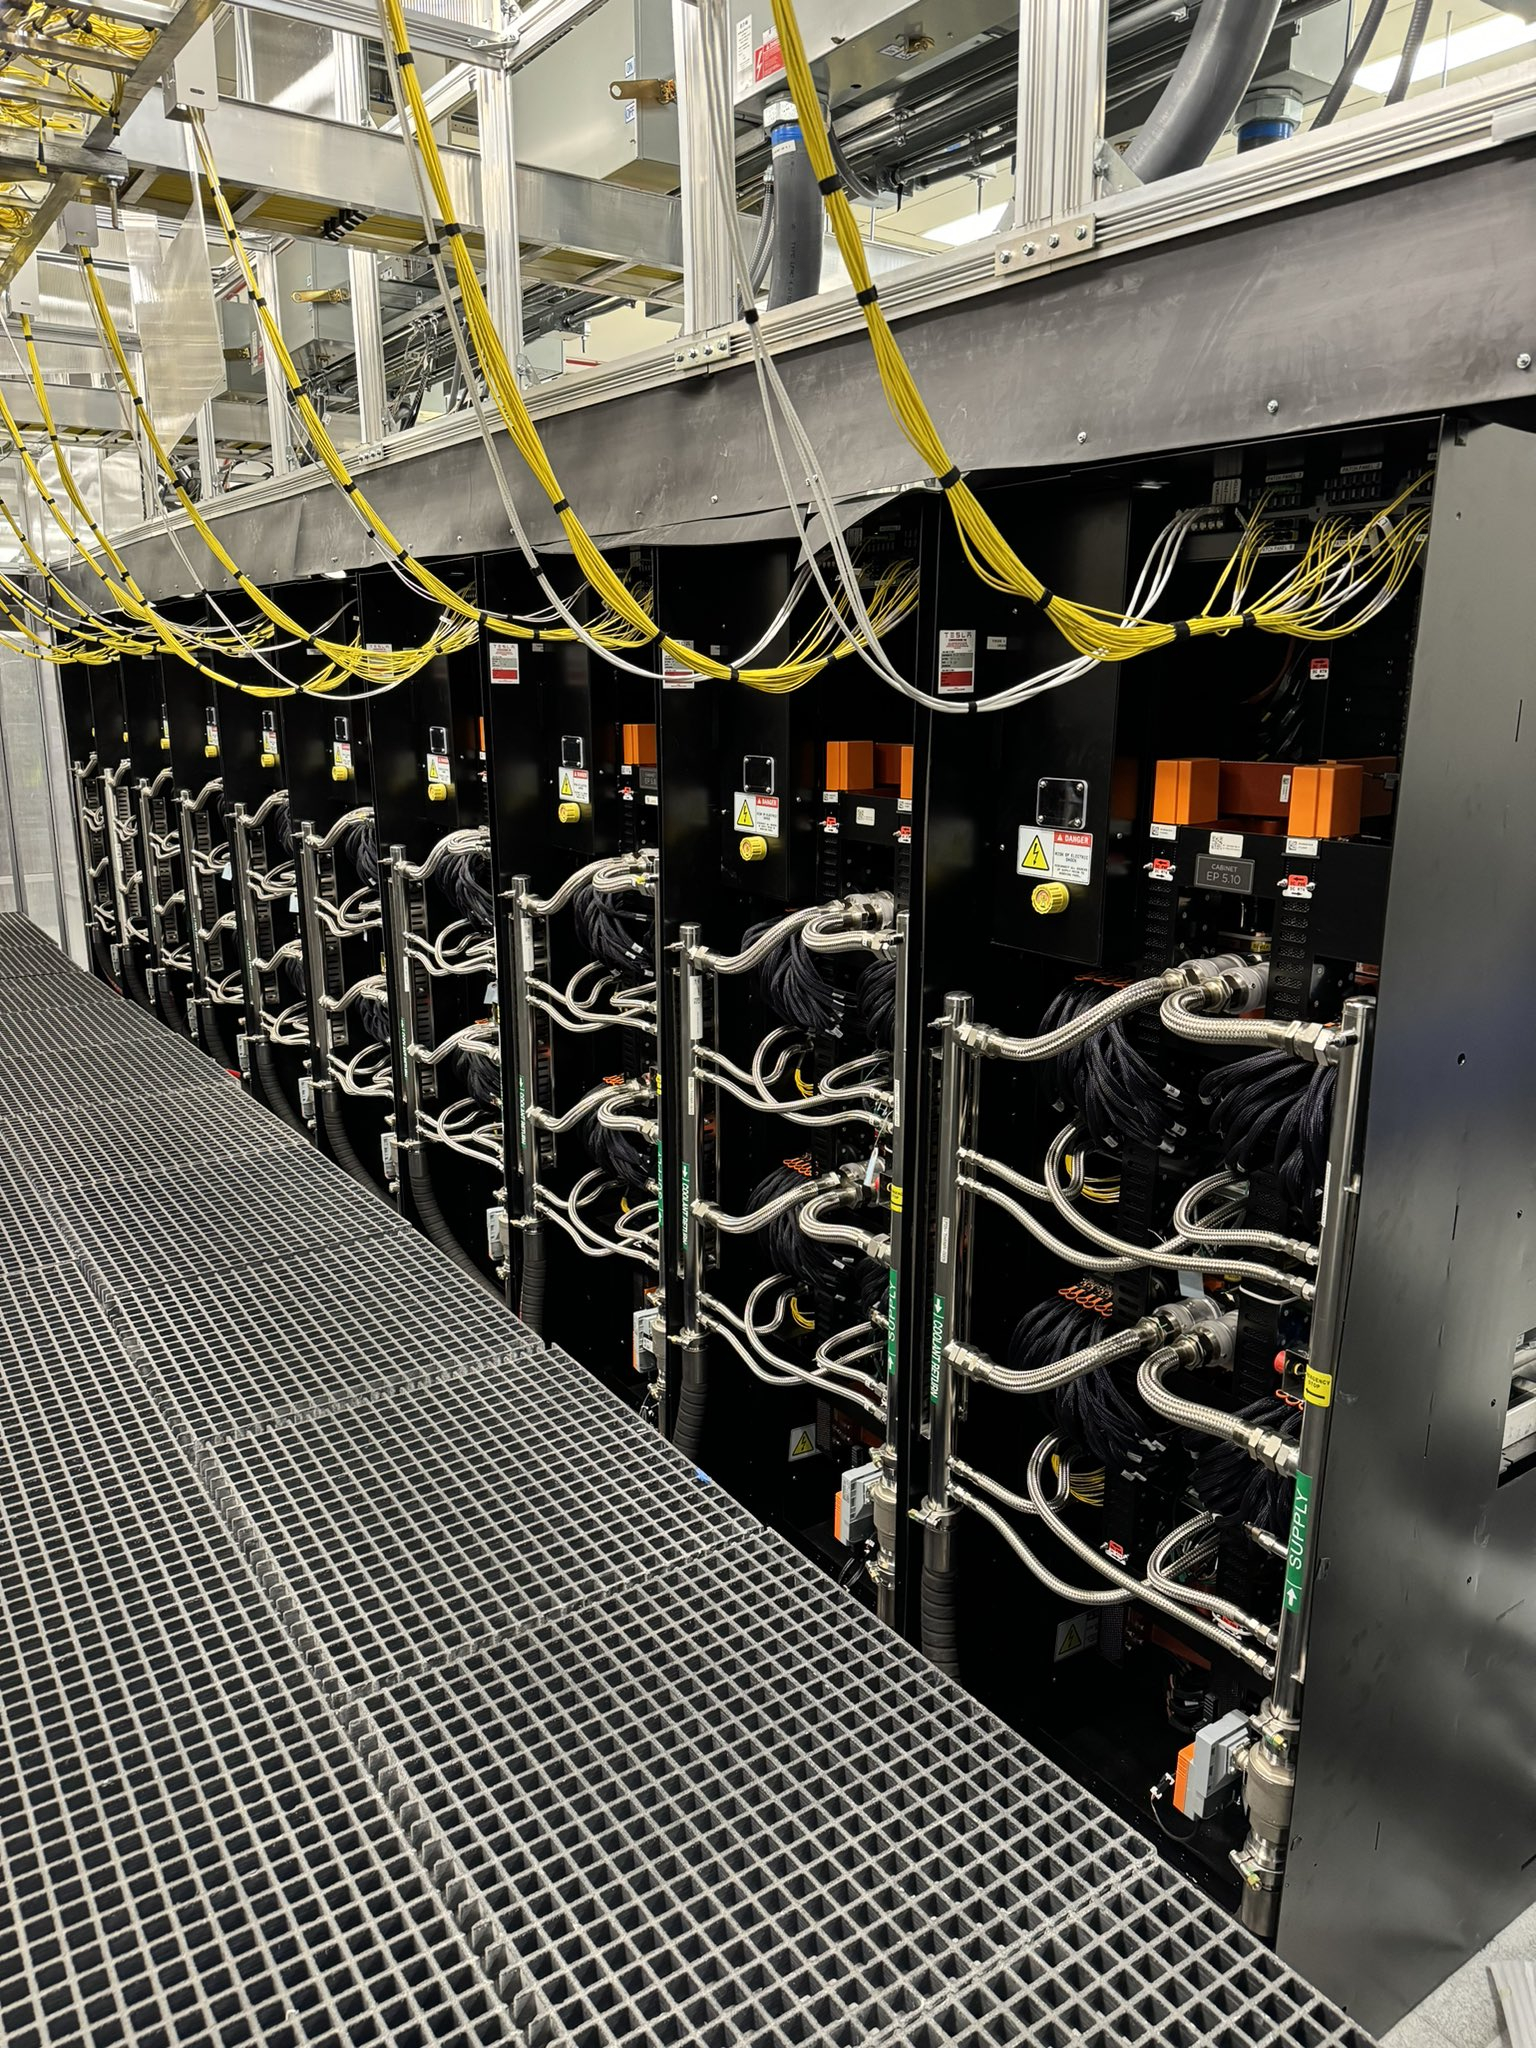 Маск также сообщил, что компания Tesla намерена «удвоить усилия» по разработке и развертыванию Dojo из-за высоких цен на оборудование NVIDIA. Вместе с тем финансовый директор Tesla Вайбхав Танеджа (Vaibhav Taneja) заявил, что, несмотря на снижение капвложений во II квартале 2024 года, компания по-прежнему ожидает, что соответствующие затраты превысят $10 млрд.
22.07.2024 [09:12], Сергей Карасёв
Intel представила чипы Raptor Lake Refresh с отключёнными E-ядрами для встраиваемых устройствКомпания Intel, по сообщению ресурса Wccftech, анонсировала процессоры Raptor Lake Refresh (Core 14-го поколения) для встраиваемых устройств. У этих чипов деактивирован кластер энергоэффективных Е-ядер (Gracemont) — они оперируют только производительными Р-ядрами (Raptor Cove). В общей сложности перечислены 11 моделей: Core i9-14901KE, Core i9-14901E, Core i9-14901TE, Core i7-14701E, Core i7-14701TE, Core i5-14501E, Core i5-14501TE, Core i5-14401E, Core i5-14401TE, Core i5-14401EF и Core i5-14401TEF. Они имеют исполнение LGA1700, а показатель TDP варьируется от 45 до 125 Вт. 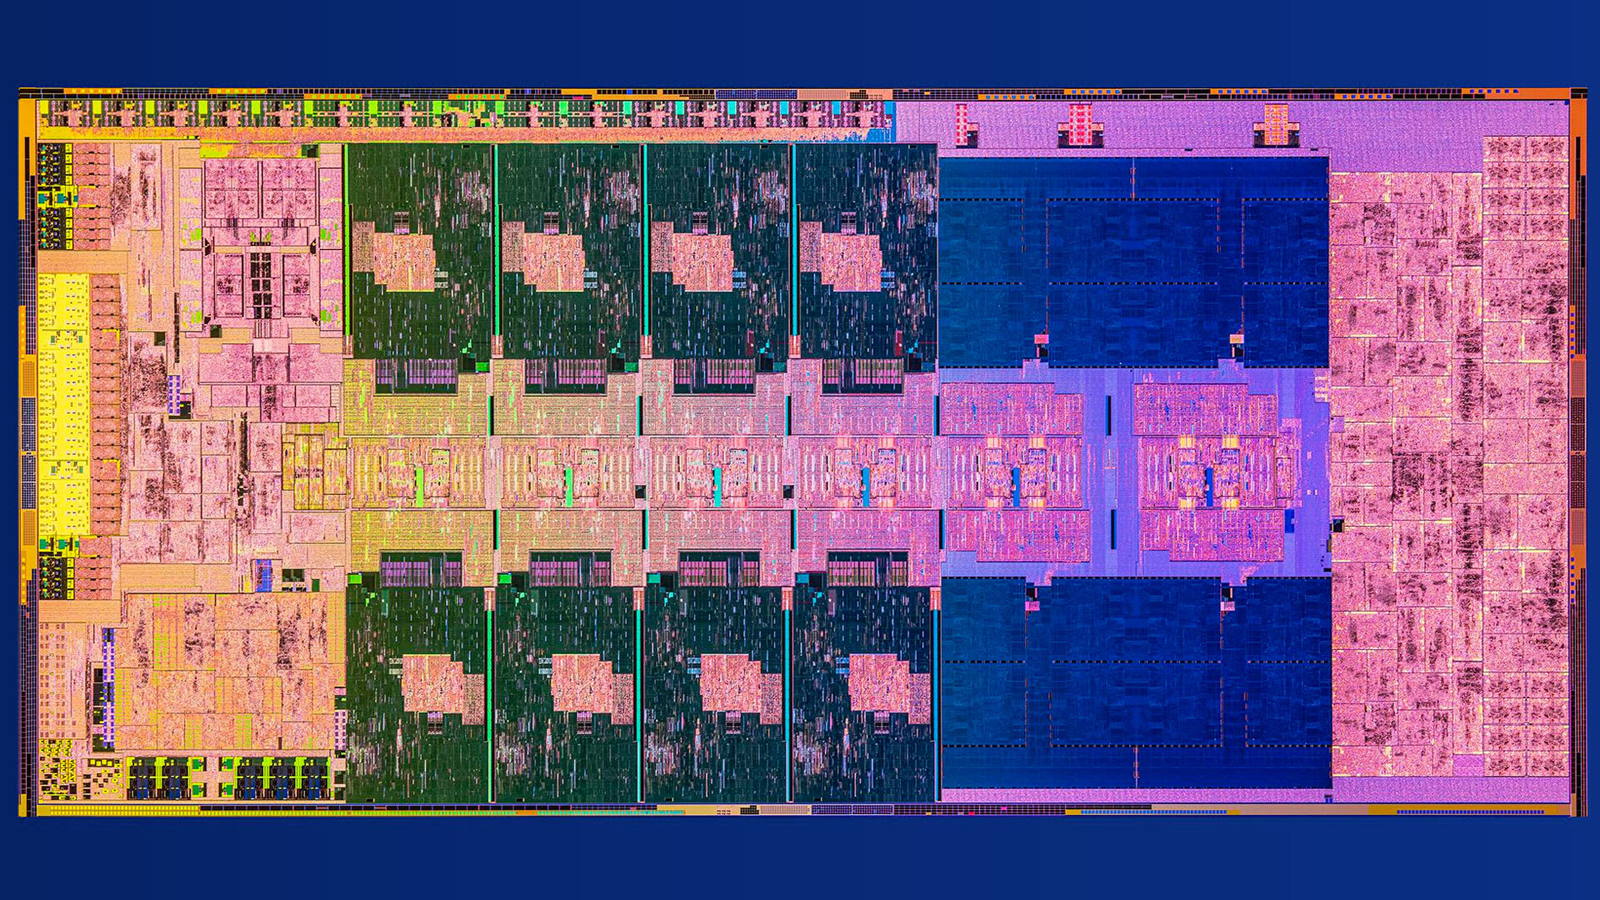
Источник изображения: Intel На вершине семейства располагается изделие Core i9-14901KE с восемью ядрами (16 потоков), базовая частота которого составляет 3,8 ГГц с возможностью динамического повышения до 5,8 ГГц. Объём кеша третьего уровня равен 36 Мбайт. Индекс «К» в обозначении указывает на возможность разгона. Возможно, данная особенность заинтересует DIY-энтузиастов. 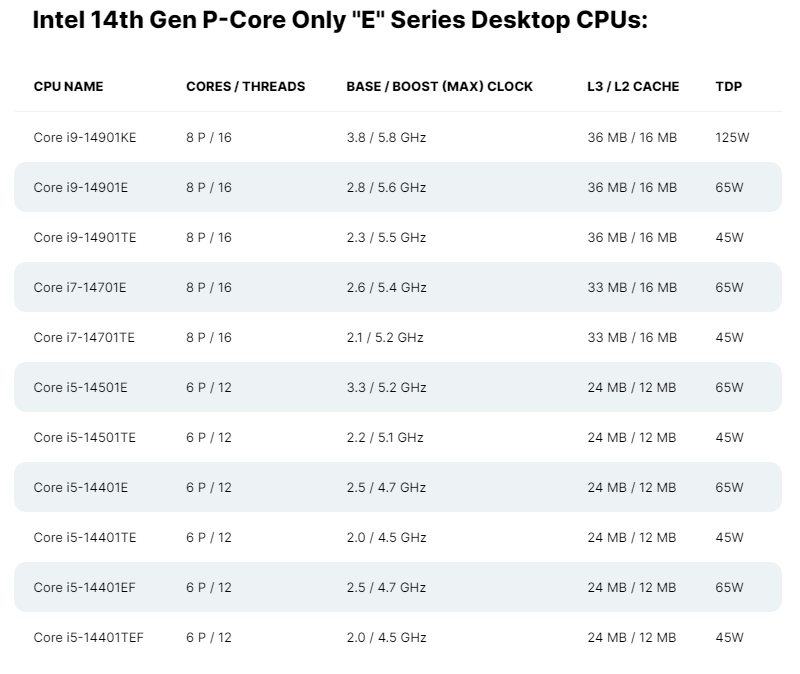
Источник изображения: Wccftech В зависимости от модификации новые процессоры насчитывают шесть или восемь Р-ядер, при этом все чипы поддерживают технологию многопоточности. Возможна работа с двухканальной оперативной памятью DDR4/DDR5. Изделия с индексом «F» не имеют встроенного графического контроллера, тогда как модели «Т» обладают повышенной энергоэффективностью. Среди прочего упомянута поддержка PCIe 5.0 x16, PCIe 4.0 x4 (NVMe) и DMI 4.0 x8.
20.07.2024 [21:45], Владимир Мироненко
Tenstorrent начала продажи ИИ-ускорителей Wormhole и рабочие станции на их основеКанадский стартап Tenstorrent приступил к выпуску ИИ-чипов Wormhole. В настоящее время стартап предлагает построенные на них ИИ-ускорители Wormhole n150 и n300, а также рабочие станции TT-LoudBox и TT-QuietBox на их базе. ИИ-ускорители Wormhole n150 и n300 представляют собой двухслотовые FHFL-карты (PCIe 4.0 x16): n150 с одним чипом Wormhole, n300 — с двумя. Wormhole n150 и n300 имеют пассивное охлаждение и теплопакет 160 Вт и 300 Вт соответственно. Процессоры Wormhole были разработаны в 2021 году, но их внедрение происходит только сейчас. Это второе поколение ИИ-ускорителей Tenstorrent, которые придут на смену Grayskull. 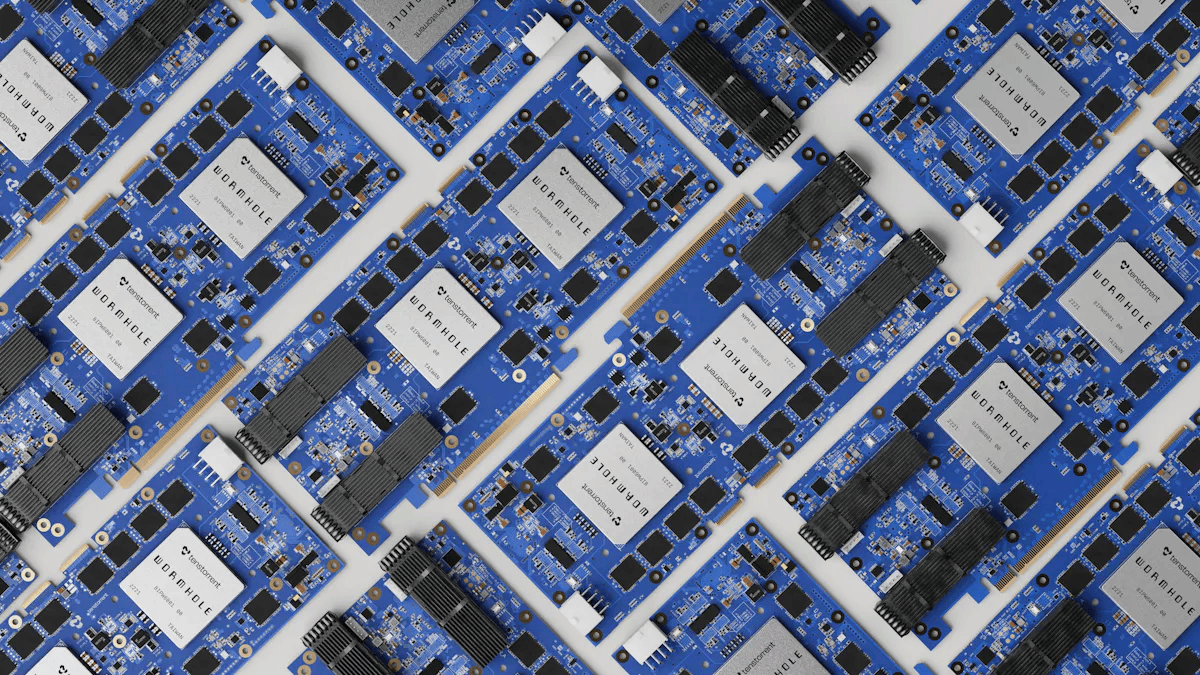
Источник изображений: Tenstorrent Wormhole n150 оснащён 72 ядрами Tensix, каждое из которых включает пять ядер RISC-V, поддерживающих различные форматы данных, и 108 Мбайт SRAM — вместе они предоставляют до 262 Тфлопс (FP8). Ускоритель также оснащён 12 Гбайт памяти GDDR6 с ПСП 288 Гбайт/с. У Wormhole n300 таких ядер 128, а частота также равна 1 ГГц. Объём SRAM составляет 192 Мбайт, а внешняя подсистема памяти включает 24 Гбайт GDDR6 с ПСП 576 Гбайт/с. Ускоритель обеспечивает производительность до 466 Тфлопс (FP8). 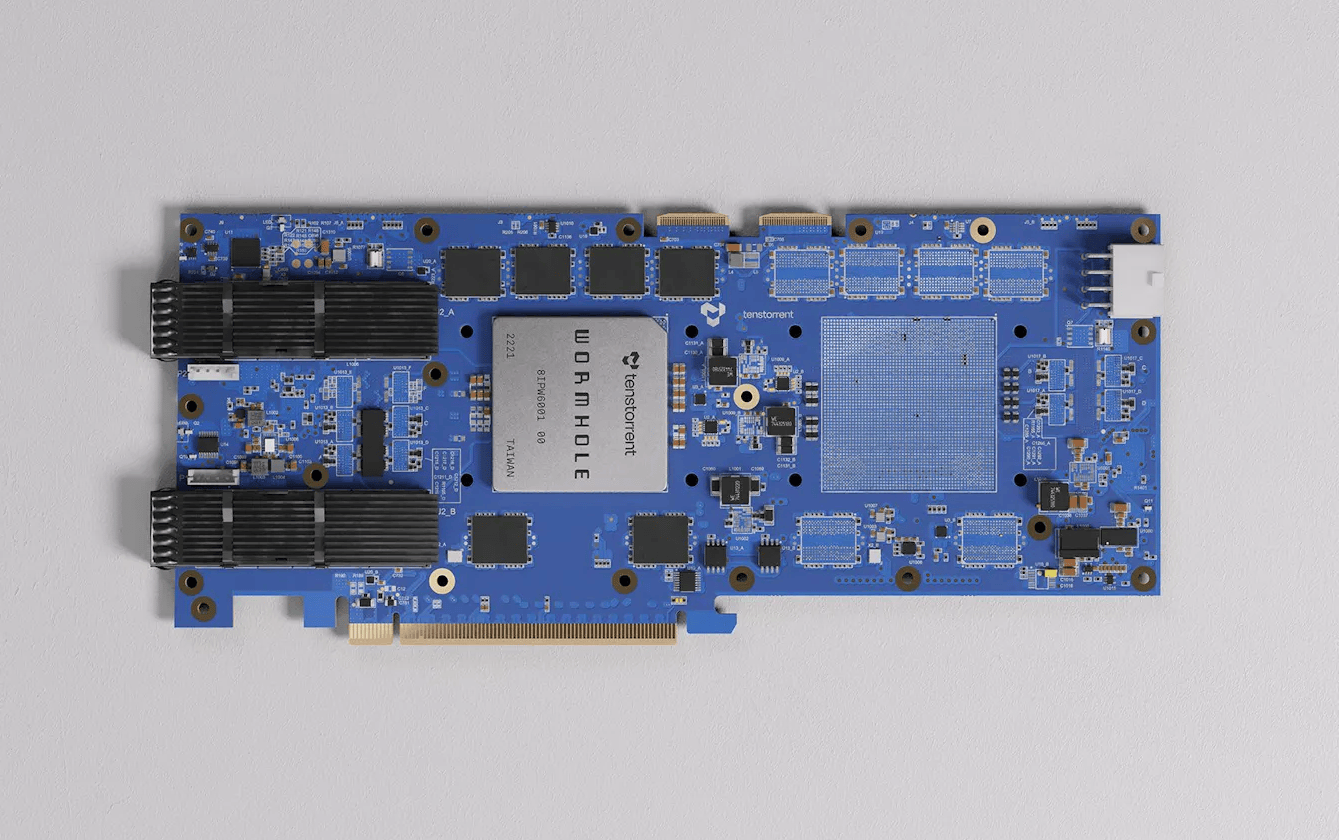 RISC-V ядра Tensix обладают аппаратной и программной поддержкой вертикального и горизонтального масштабирования — объединения множества ядер в единое целое как внутри одного узла, так и за его пределами с другими ядрами Tensix на нескольких чипах Wormhole. Именно эта функциональность, как надеется Tenstorrent, позволит ей отобрать долю рынка у NVIDIA. Впрочем, стоимость новинок тоже невелика: Wormhole n150 предлагается по цене $999, а n300 — за $1399. 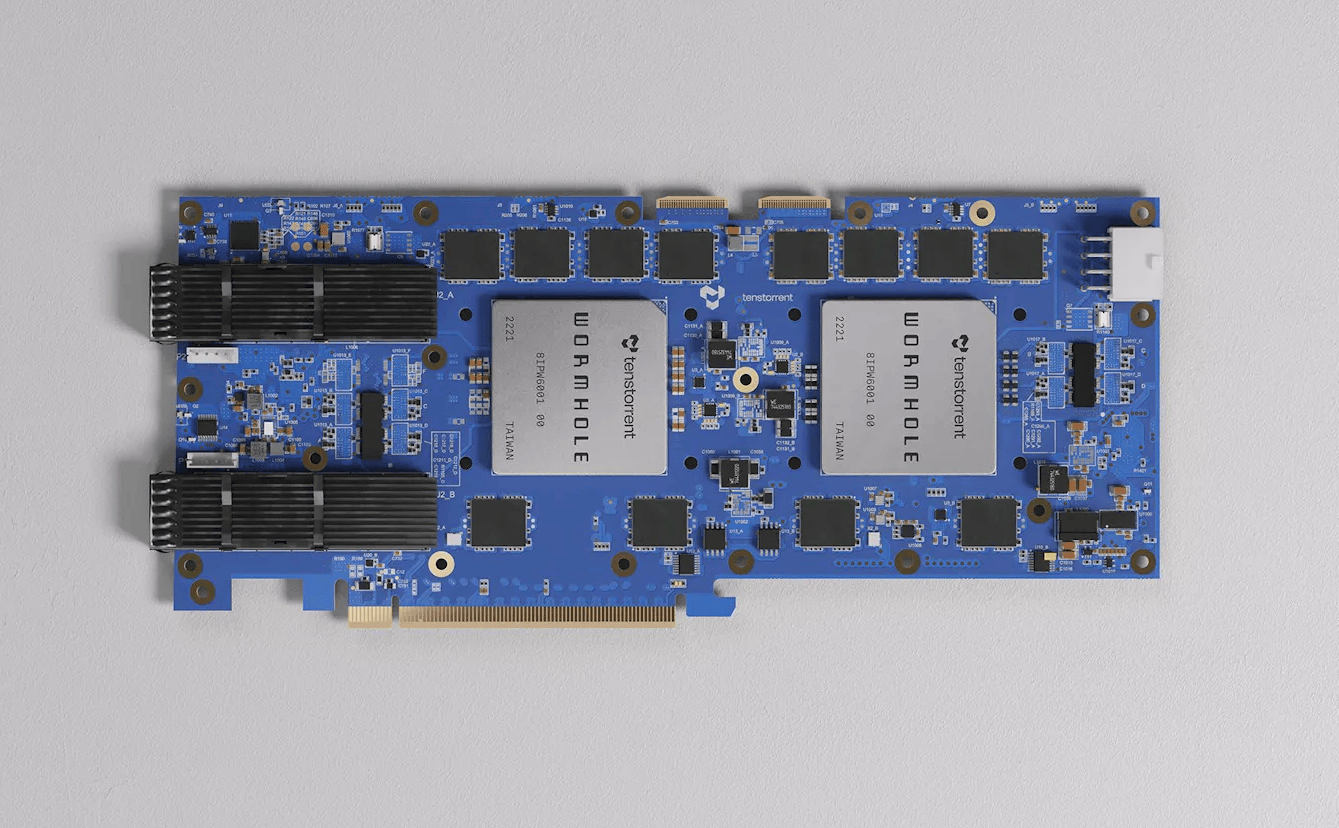 В рабочих станциях Tenstorrent четыре Wormhole n300 могут работать как один ускоритель, который с точки зрерния ПО выглядит как единый массив ядер Tensix. Впрочем, можно отдать по одному ускорителю каждому пользователю или же одновременно обрабатывать восемь разных ИИ-моделей, причём всё это без использования виртуализации. 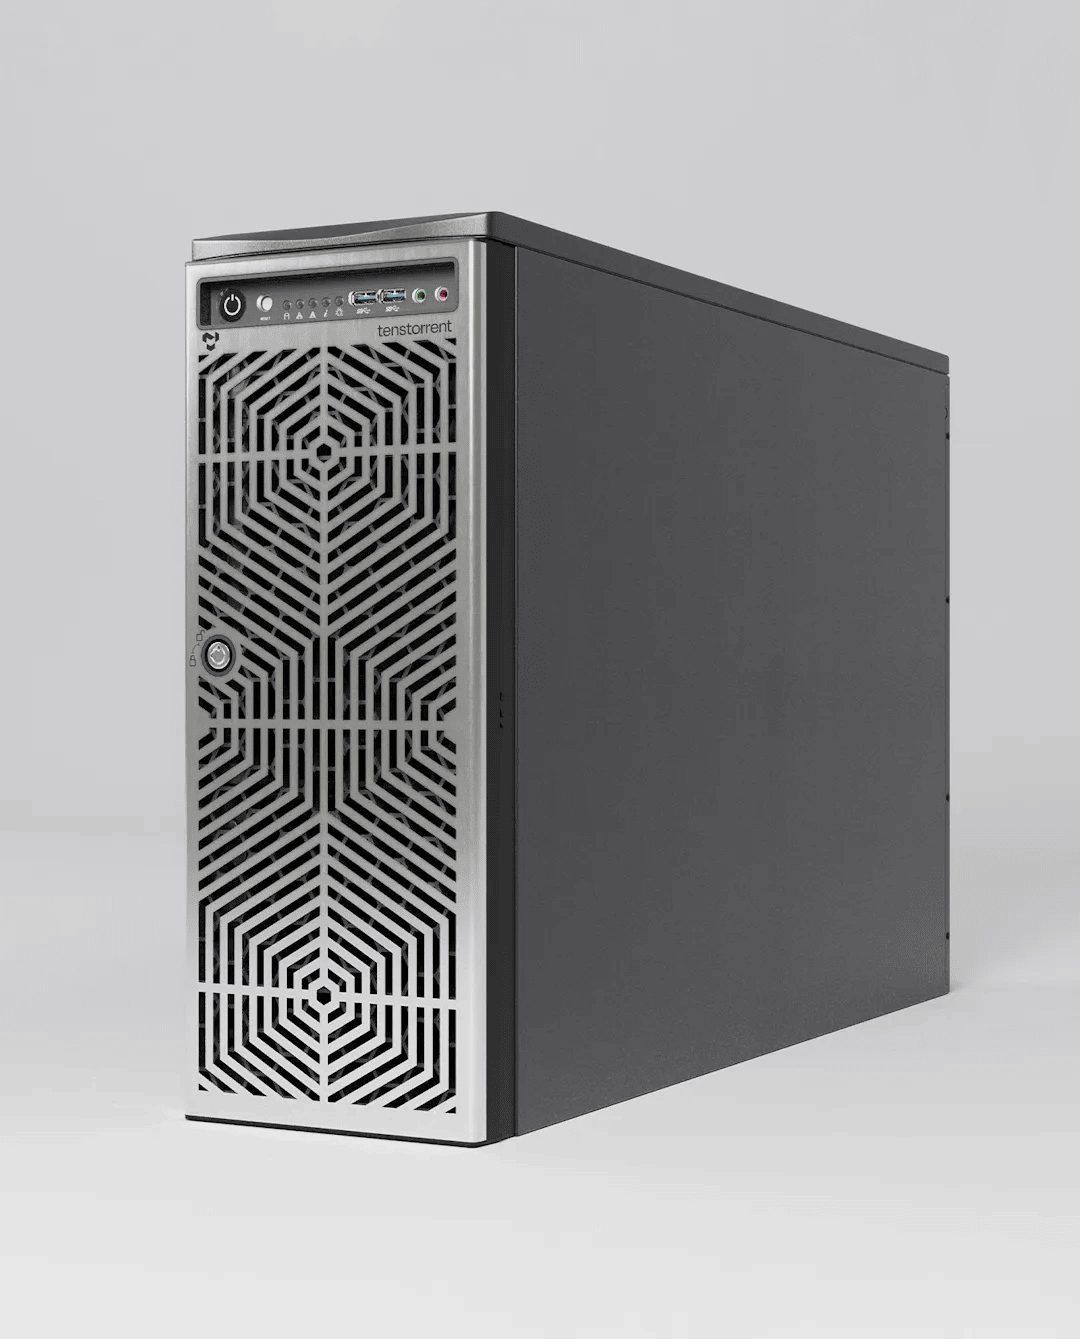 В состав рабочей станции TT-LoudBox помимо четырёх ускорителей n300 (суммарно восемь чипов Wormhole) входят два восьмиядерных процессора Intel Xeon 4309Y (Ice Lake-SP), 512 Гбайт RAM, NVMe-хранилище ёмкостью 4 Тбайт и пара портов 10 GbE. TT-LoudBox уже поступила в продажу по цене $12 тыс. 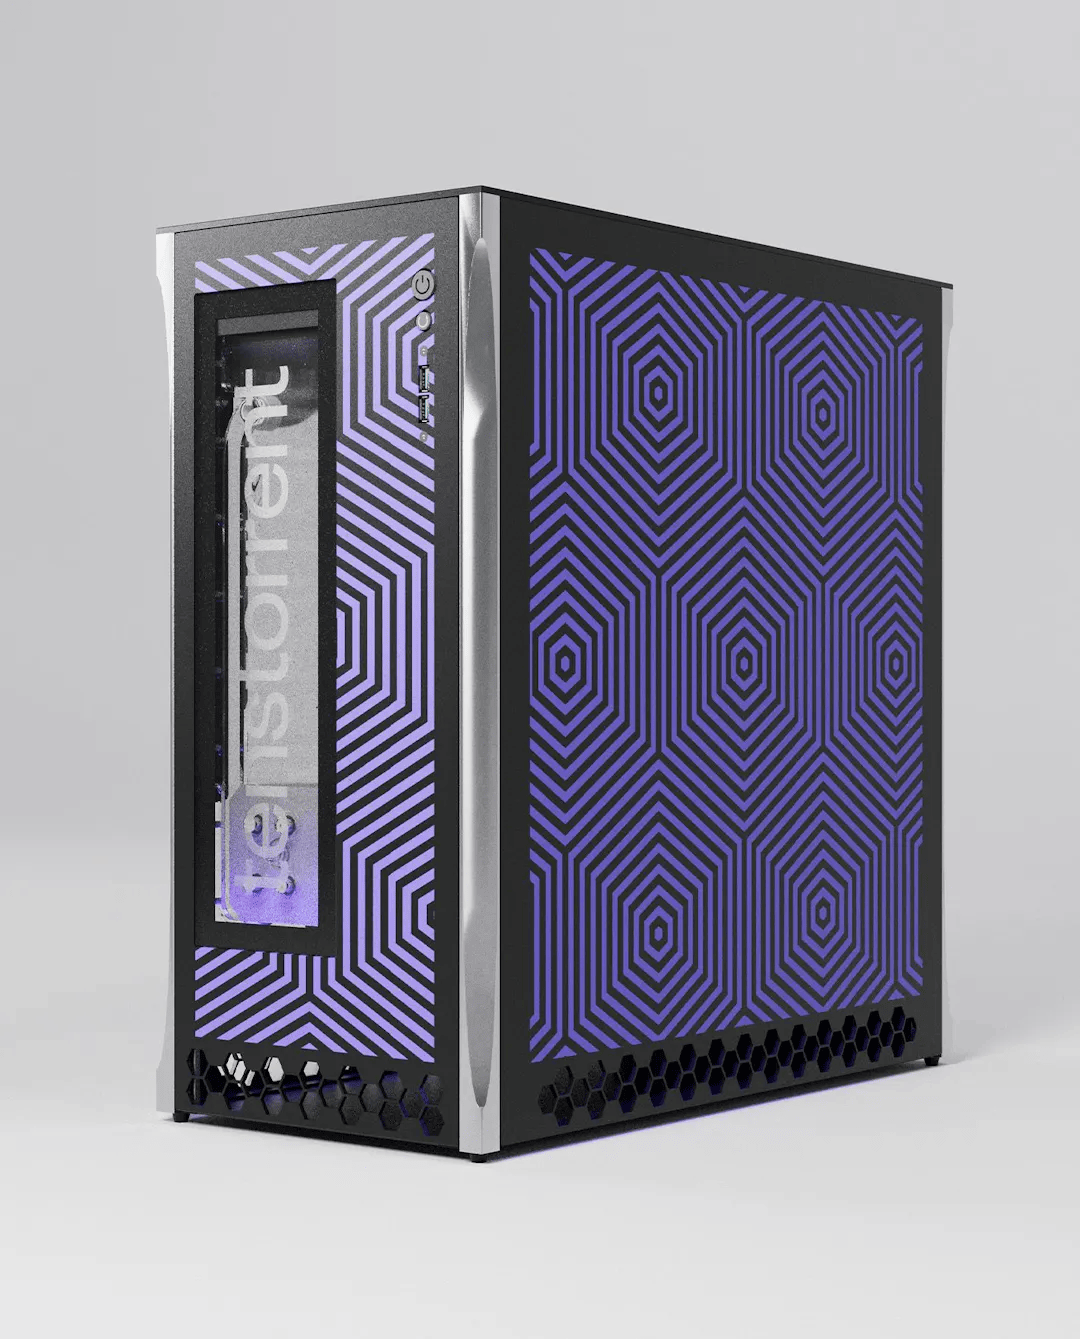 Рабочая станция TT-QuietBox оснащена четырьмя Wormhole n300 и 16-ядерным AMD EPYC 8124P (Siena). Для отвода тепла от компонентов используется жидкостное охлаждение, а остальные характеристики идентичны TT-LoudBox. Устройство доступно для предзаказа по цене $15 тыс. с поставкой в течение 8–10 недель.
17.07.2024 [23:33], Игорь Осколков
Суперускоритель по суперцене — NVIDIA GB200 NVL72, вероятно, будет стоить $3 млнКомпания NVIDIA значительно увеличила заказ на ускорители Blackwell у TSMC, сообщает TrendForce со ссылкой на United Daily News (UDN). По данным источника, NVIDIA намерена получить уже не 40 тыс., а 60 тыс. суперускорителей нового поколения, причём 50 тыс. из них придётся на стоечные системы GB200 NVL36. При этом Blackwell всё равно будут в дефиците, как и обещал ещё зимой глава NVIDIA Дженсен Хуанг (Jensen Huang). B200 включает два тайла, объединённых 2,5D-упаковкой CoWoS-L и соединённых интерконнектом NV-HBI. Чип имеет 208 млрд транзисторов, изготовленных по кастомному техпроцессу TSMC 4NP. GB200 объединяет два ускорителя B200 и один 72-ядерный Arm-процессор Grace. А суперускоритель GB200 NVL72, в свою очередь, объединяет в рамках одной стойки Oberon сразу 18 1U-узлов с парой GB200 в каждом (плата Bianca, 72 × B200 и 36 × Grace), провязанных шиной NVLink 5. Вся эта система потребляет порядка 120 кВт, оснащена СЖО и единой DC-шиной питания. Однако у GB200 NVL72 довольно специфические требования к окружению, поэтому NVIDIA предлагает суперускоритель попроще — GB200 NVL36, который как раз и должен стать наиболее массовым в данной серии. Эта платформа точно так же занимает целую стойку, но использует 2U-узлы с теми же платами Bianca (суммарно 36 × B200 и 18 × Grace), потребляя всего 66 кВт. При этом всё равно подразумевается использование двух стоек GB200 NVL36, объединённых интерконнектом, так что GB200 NVL72 всё равно получается более энергоэффективным решением. 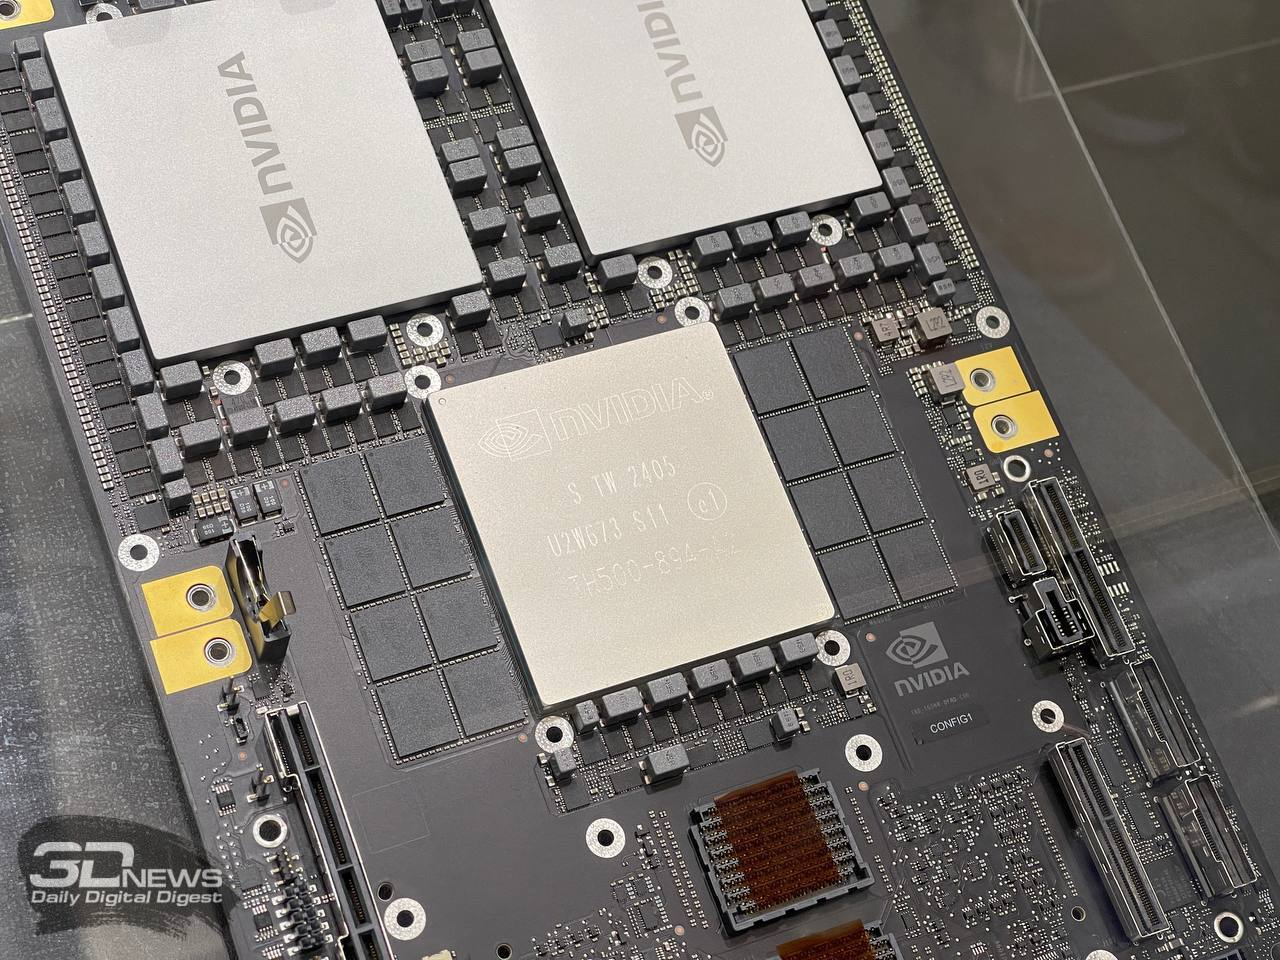
NVIDIA GB200 Как отмечает SemiAnalysis, GB200 NVL36 также будет доступен в варианте с платами Ariel, имеющими по одному чипу B200 и Grace. Наконец, во II квартале 2025 года появятся системы B200 NVL72 и B200 NVL36 с x86-процессорами (Miranda). Кроме того, NVIDIA представила и отдельные MGX-узлы GB200 NVL2 с парой GB200. В общем, ускорителей B200 компании понадобится много, чтобы наверняка удержать лидерство на рынке. 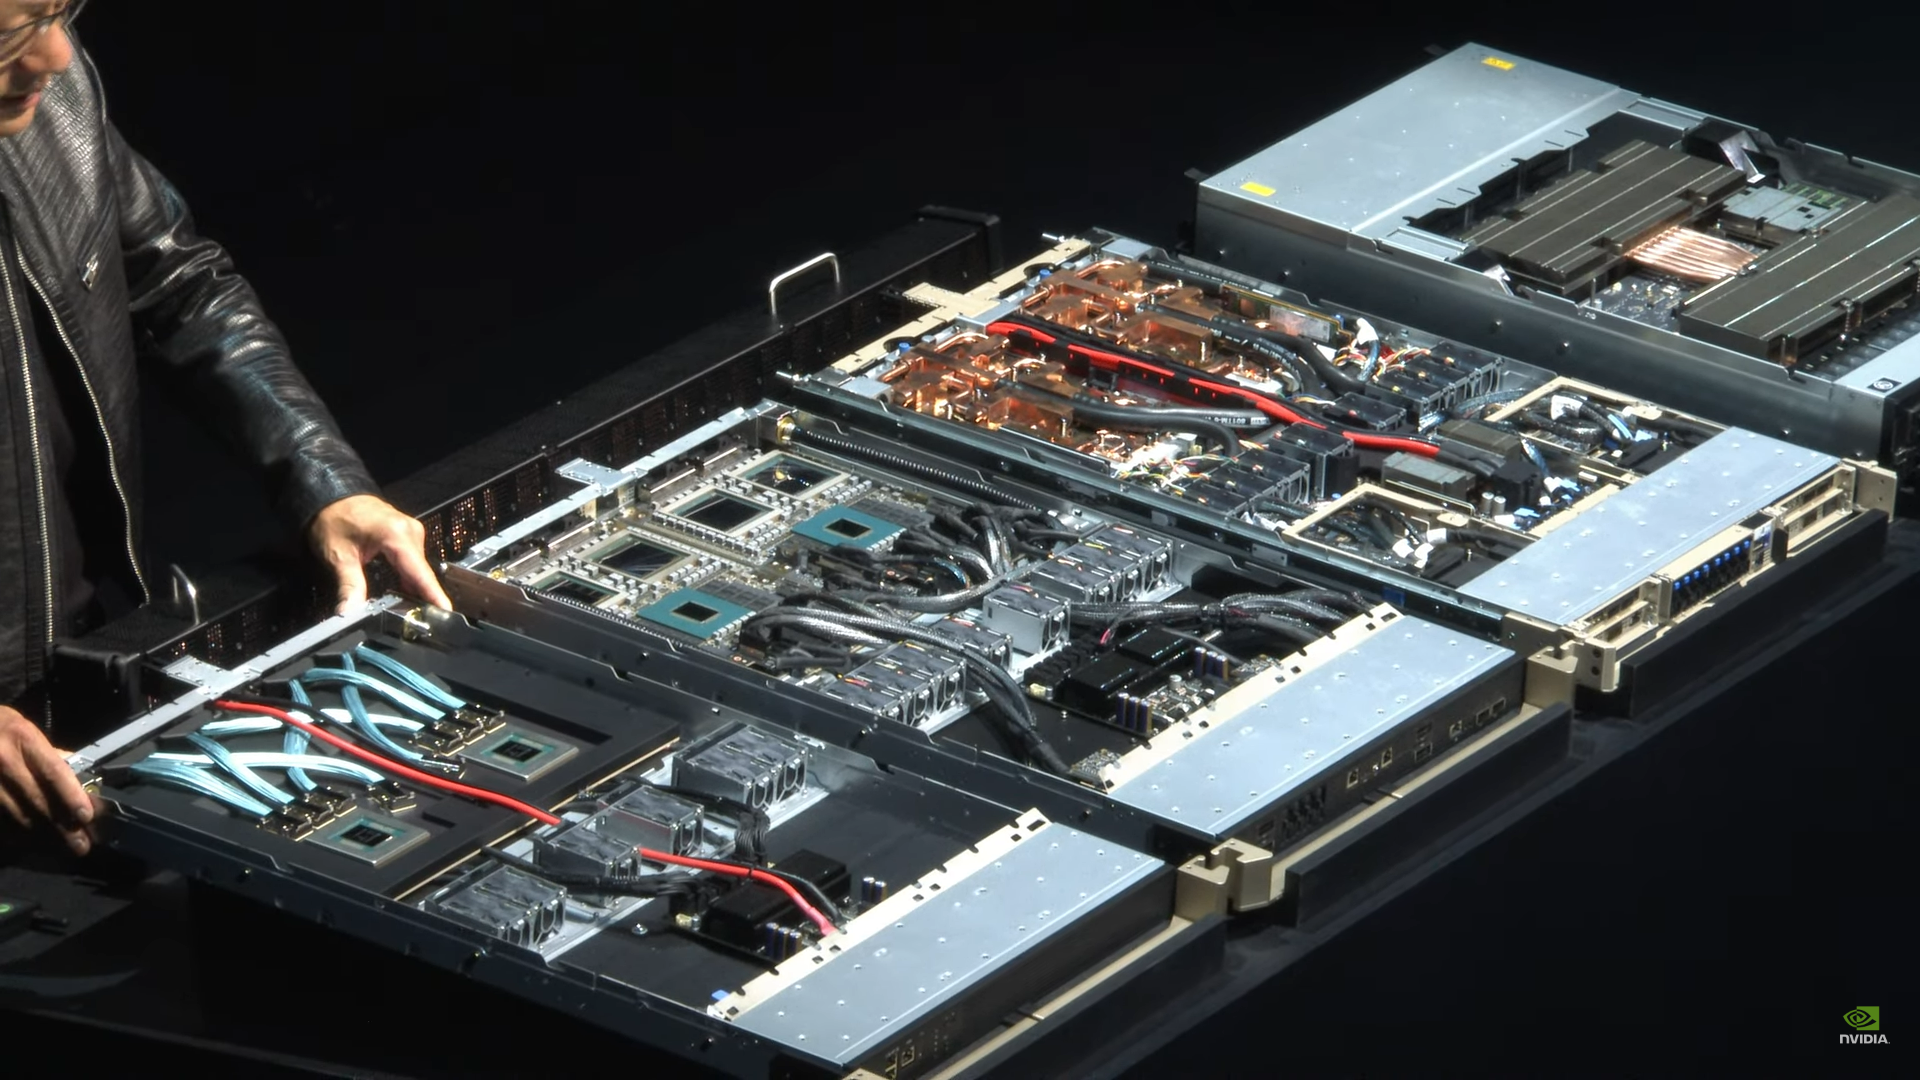
Источник изображения: NVIDIA По словам UDN, GB200 NVL36 будет стоить порядка $1,8 млн, а GB200 NVL72 обойдётся уже в $3 млн. Одиночный GB200 будет стоить $60–$70 тыс., а самый простой ускоритель B100 оценён в $30–$35 тыс. Нужно подчеркнуть, что это оценки сторонних аналитиков. Сама компания официально не раскрывает стоимость своих продуктов. Это устоявшаяся практика на данном рынке, против которой пошла только Intel, публично назвавшая стоимость ИИ-ускорителей Gaudi. Впрочем, ранее глава NVIDIA намекнул, что B200 будет стоить приблизительно $30–$40 тыс.
12.07.2024 [09:09], Алексей Степин
144 ядра, чиплеты, SRAM и 3D-упаковка: Fujitsu поделилась подробностями о грядущих Arm-процессорах MONAKAОпыт японской компании Fujitsu в разработке процессоров и суперкомпьютеров велик и многогранен. Долгое время основной архитектурой для решений Fujitsu была SPARC64, но времена меняются: в 2018 году компания анонсировала разработку собственного процессора на базе архитектуры Arm. Сегодня этот чип мы знаем под именем A64FX. В 2020 году японский кластер Fugaku на основе 48-ядерных A64FX с интегрированными HBM-памятью и интерконнектом занял первое место в рейтинге TOP500 с результатом 537,2 Пфлопс. Однако эти процессоры, которые всё ещё достойно трудятся не только в Fugaku, но и в других суперкомпьютерах, трудно назвать действительно универсальным и доступным. 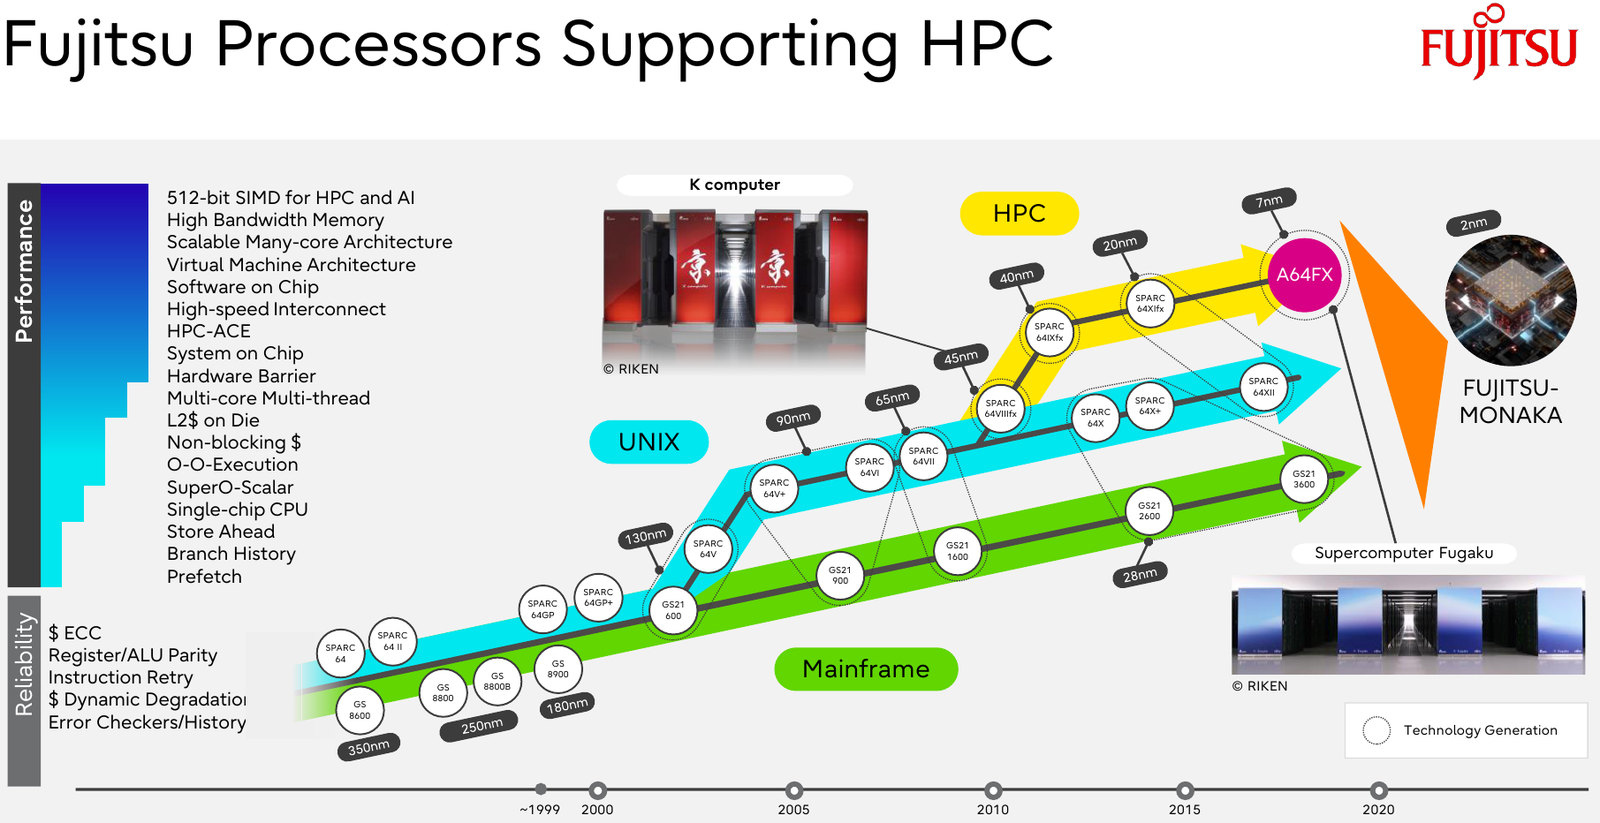
Источник изображений: Fujitsu Важность архитектурных нововведений и смену IT-ландшафта в Fujitsu прекрасно осознают. Поэтому компания объявила о разработке нового серверного процессора под кодовым именем MONAKA, для которого она намеревается вдвое увеличить показатели производительности и энергоэффективности, а также учесть растущую популярность задач класса ИИ. А совсем недавно Fujitsu впервые более детально рассказала о технических особенностях будущих CPU. 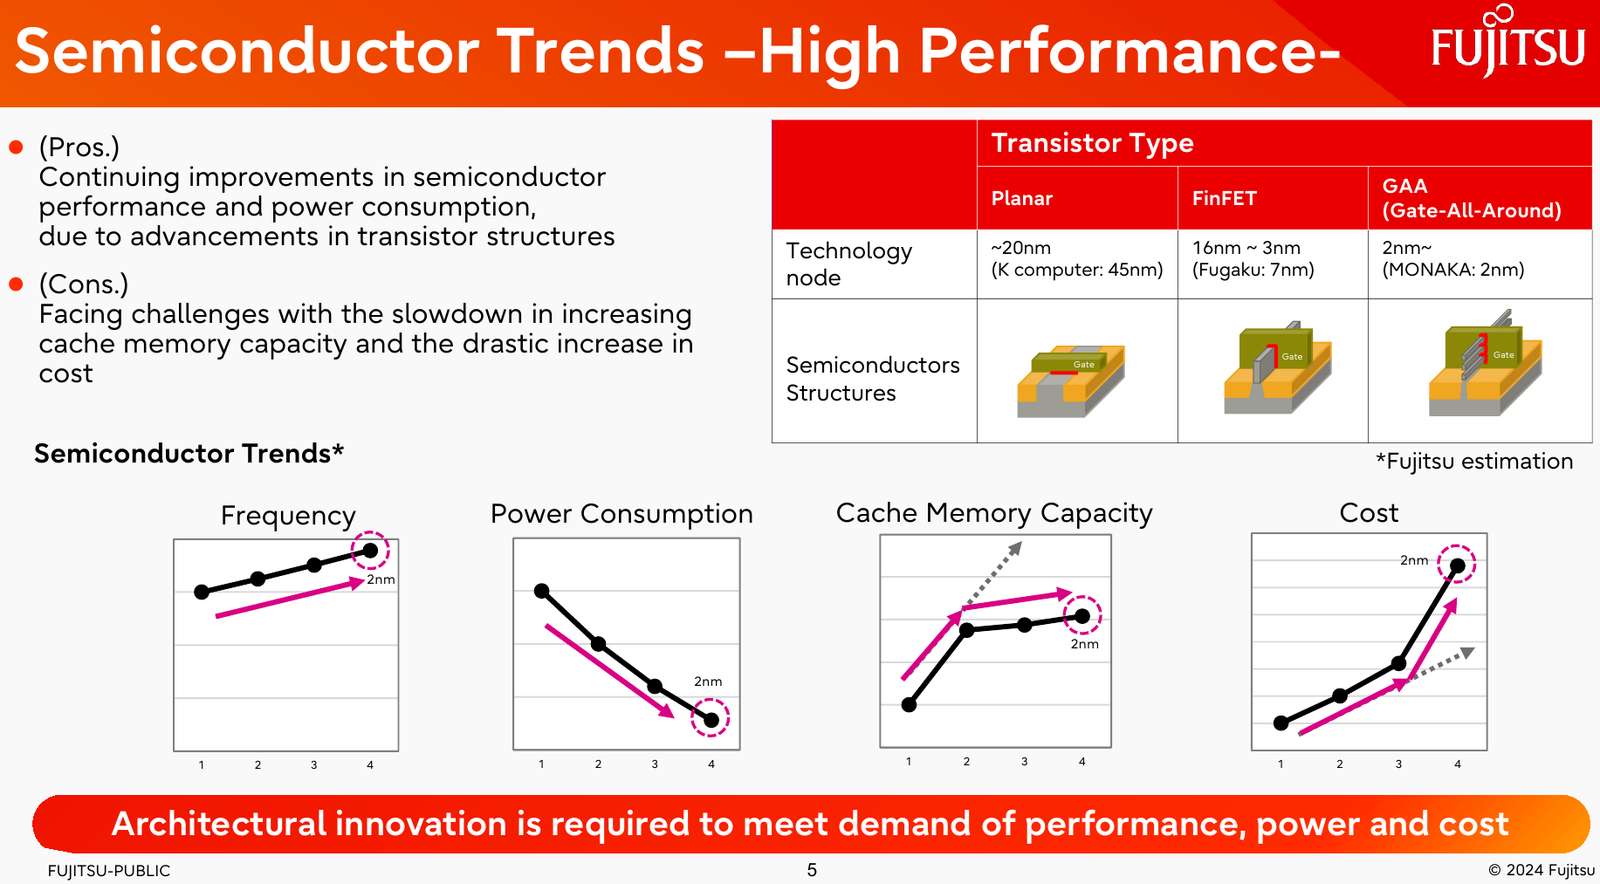 Во-первых, разработчики нового процессора хорошо осознают ограничения, накладываемые текущей транзисторной технологии. Похоже, из FinFET и её аналогов выжаты все или почти все соки и для прорывных решений нового поколения данная технология не подходит. В процессорах MONAKA будут использоваться транзисторы с затвором нового типа, так называемые GAA (Gate-all-Around). Похоже, речь идёт о технологии, которую разрабатывает и собирается внедрить в производство уже в следующем году Samsung в рамках 2-нм техпроцесса SF2. 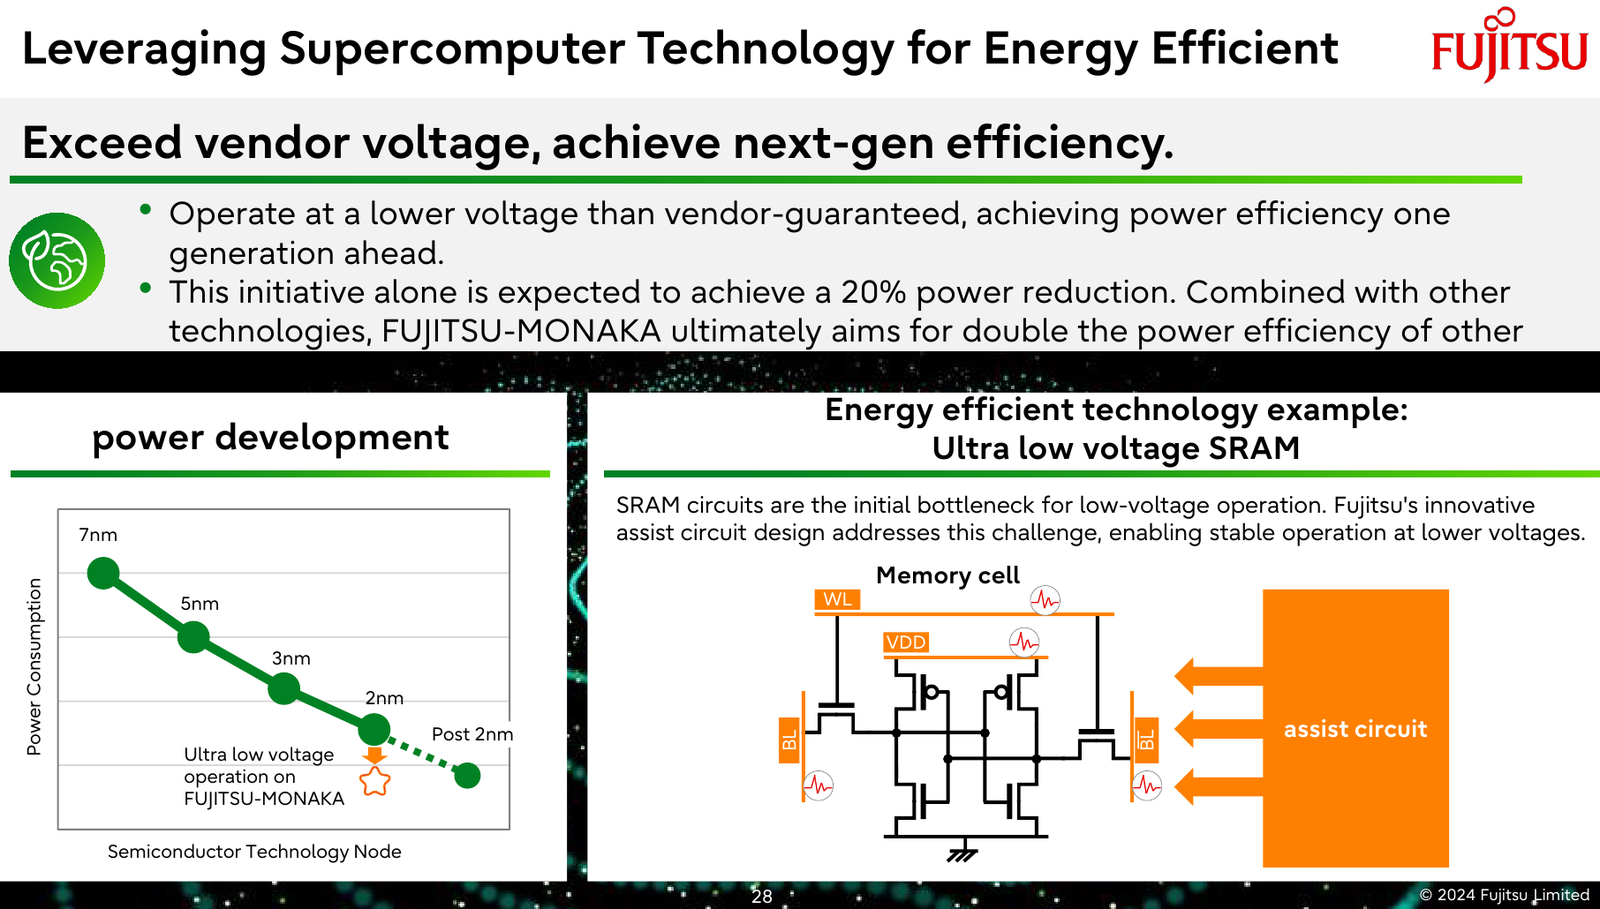 Внедрение 2-нм GAA-транзисторов позволит снизить паразитную ёмкость, а значит, добиться больших тактовых частот при меньшем напряжении питания. При этом новая технология будет применена не только в процессорных ядрах, но и в сборках кеш-памяти, также спроектированных с использованием собственного инструментария Fujitsu. 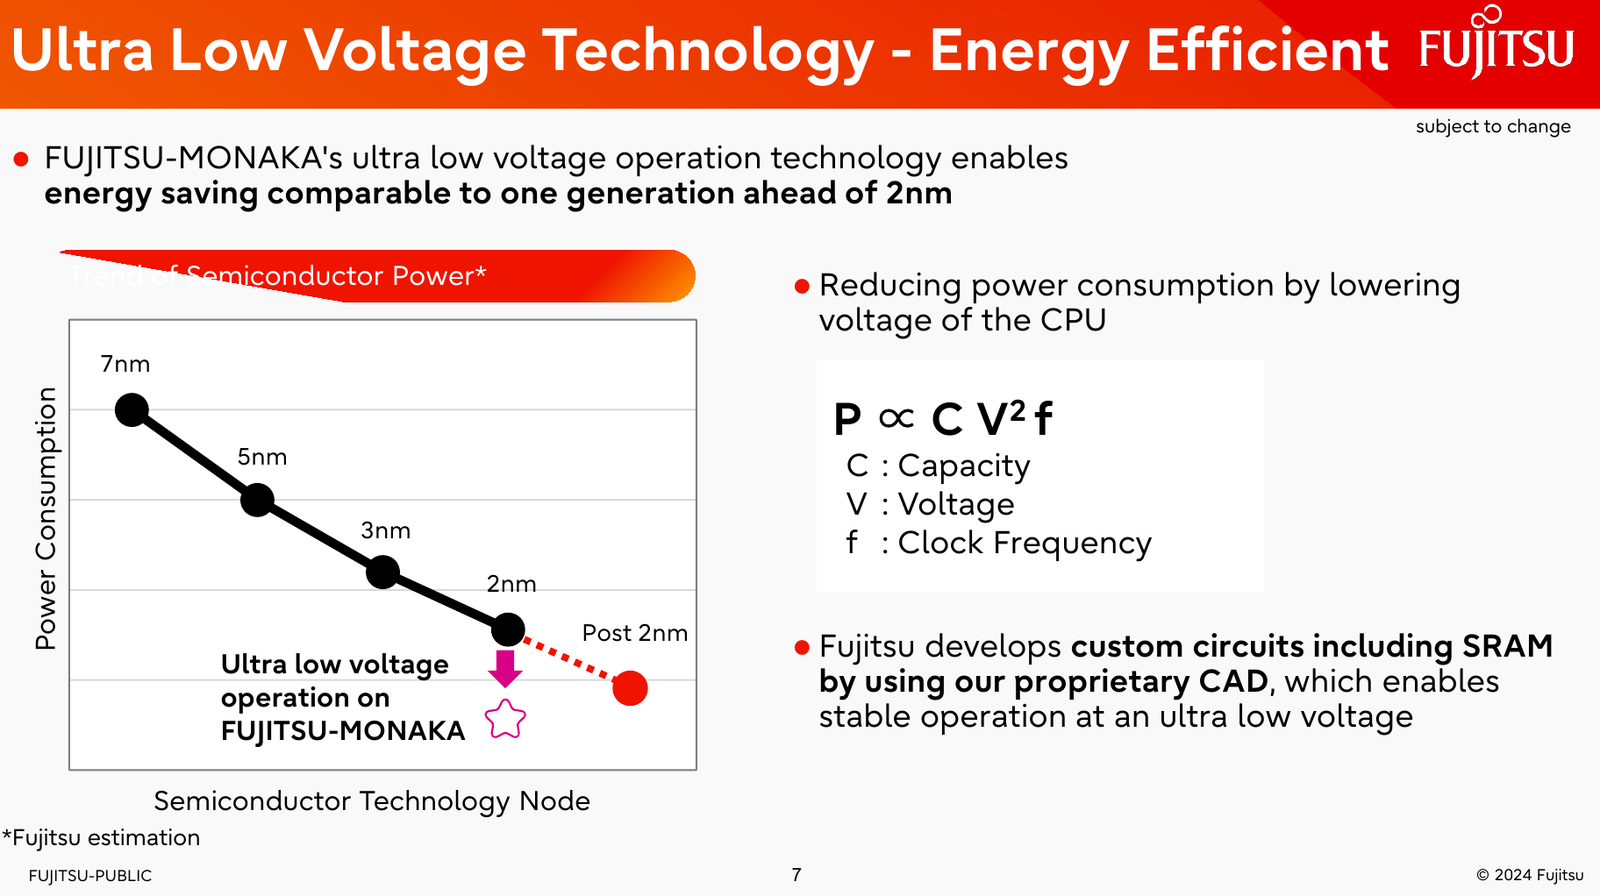 Во-вторых, MONAKA изначально проектируется как модульный процессор. В центре разместится IO-кристалл, содержащий контроллеры DDR5 (12 каналов) и PCI Express 6.0/CXL 3.0. Окружать его будут сборки из 5-нм кристаллов кеш-памяти SRAM и расположенных поверх 2-нм кристаллах с процессорными ядрами. По вертикали соединение обеспечит технология TSV, а по горизонтали — кремниевая подложка-интерпозер. Фактически речь идёт о 3D-компоновке. 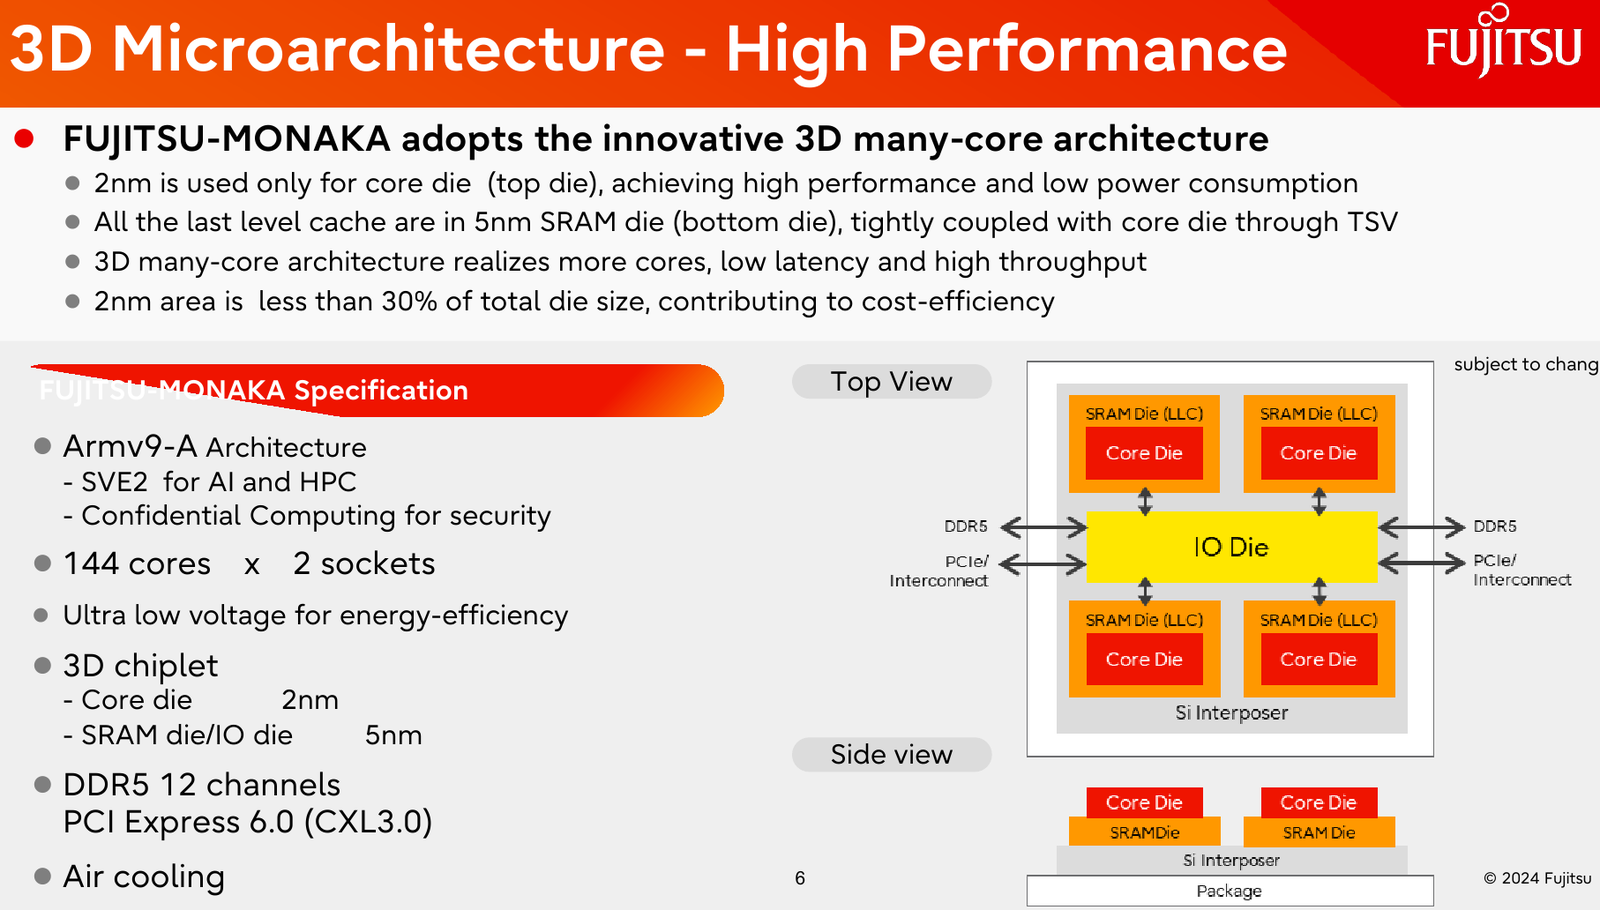 12-канальная подсистема памяти обеспечит отсутствие узких мест: у A64FX проблем с пропускной способностью благодаря использованию HBM2 не было, но объем самой памяти был ограничен 32 Гбайт. Зато у MONAKA проблем с расширением не будет — как с помощью классических модулей DIMM, так и посредством банков памяти CXL, благо, за основу сразу взята версия PCIe 6.0 с пропускной способностью 256 Гбайт/с в режиме x16. Сколько будет самих линий, пока не уточняется. 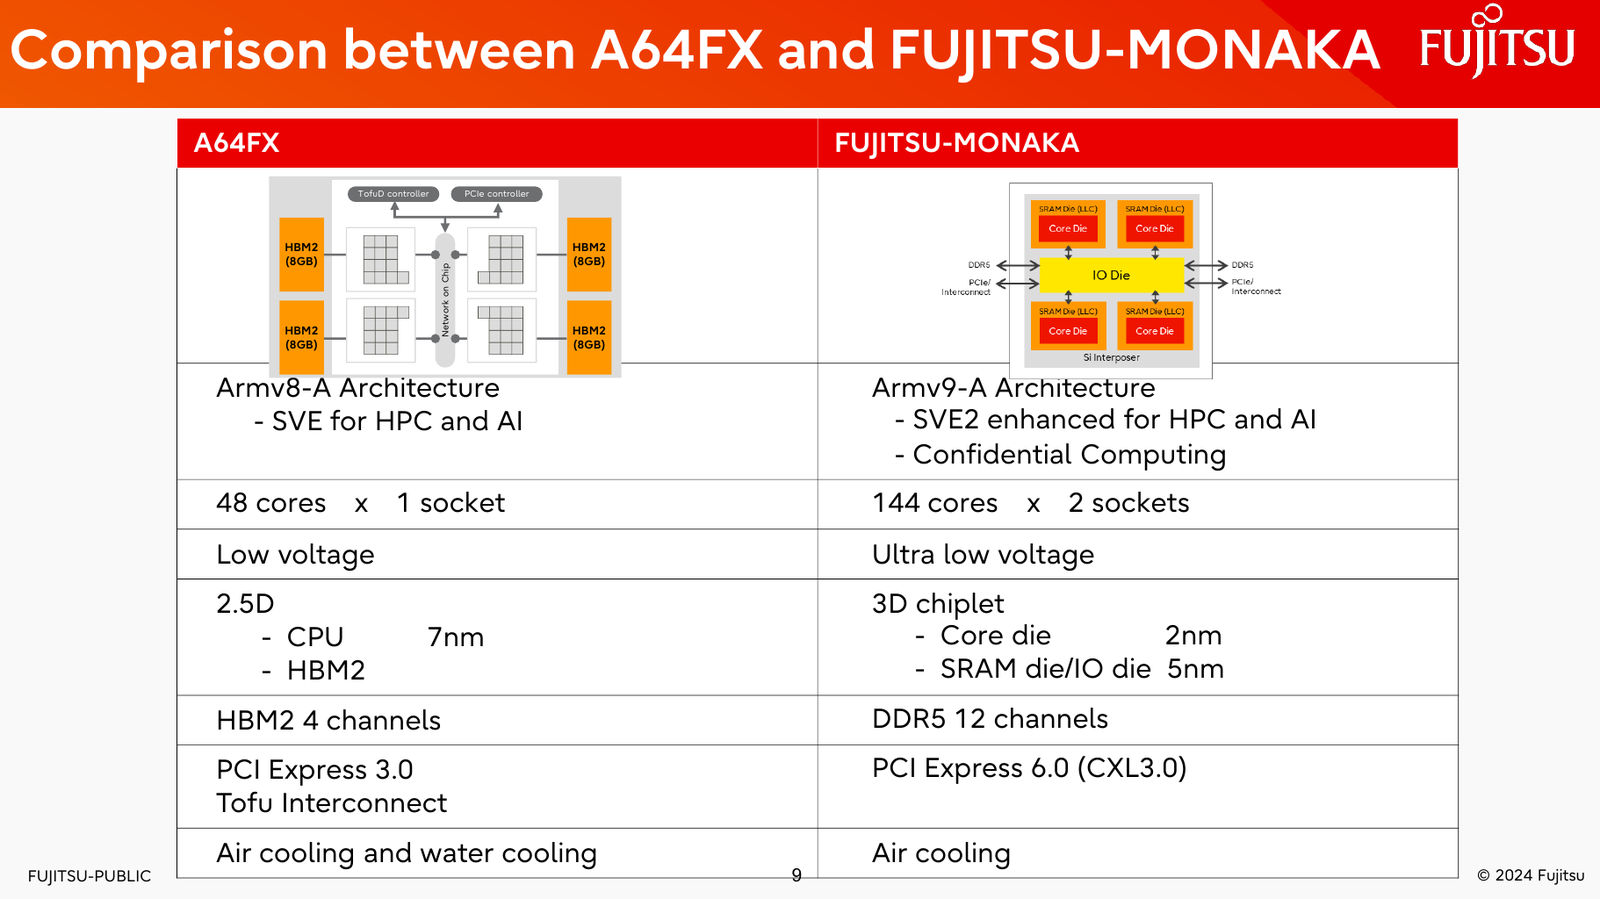 Новая платформа изначально проектируется двухсокетной, при этом в количестве ядер Fujitsu также не скромничает: процессоры MONAKA получат 144 ядра, а благодаря новому 2-нм техпроцессу они будут не такими уж горячими. Им хватит воздушного охлаждения, говорят создатели. Процессоры получат набор инструкций Armv9-A с векторными расширениями SVE2 и технологией доверенных вычислений Confidential Computing. Скорее всего, без кастомных инструкций не обойдётся и в этот раз. 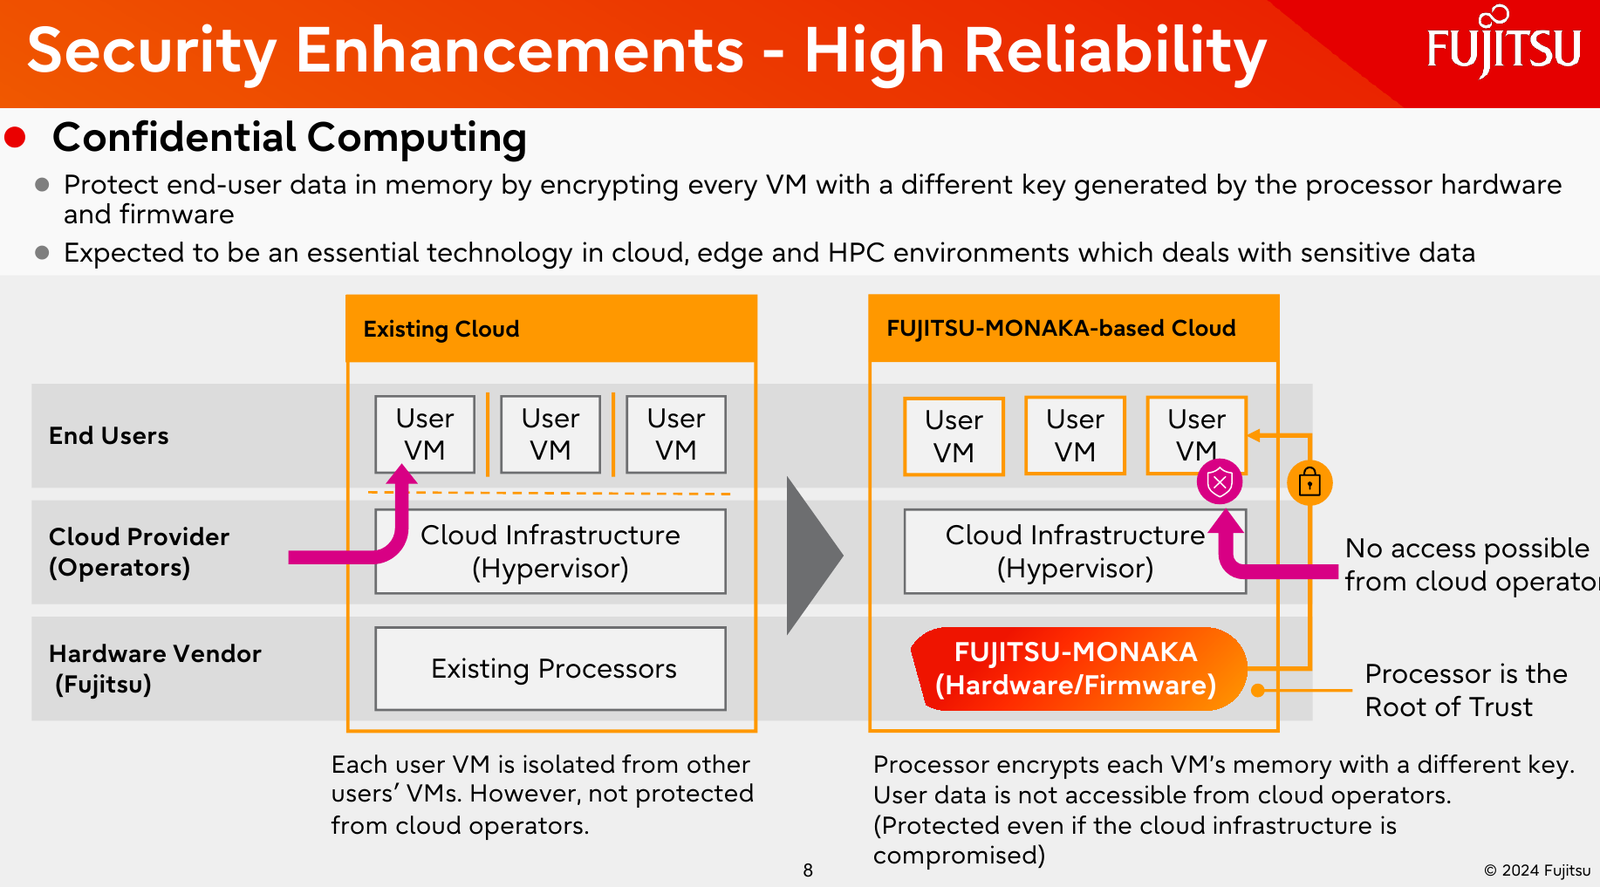 Последнее особенно важно ввиду того, что MONAKA предназначены не только для рынка HPC, но и для использования в облачных средах. Подсистема конфиденциальных вычислений позволяет шифровать содержимое каждой виртуальной машины собственным ключом, так что доступа к внутренностям ВМ не будет даже у владельцев ЦОД. Впрочем, современные HPC-комплексы всё чаще используют именно облачный подход для доступа к ресурсам. 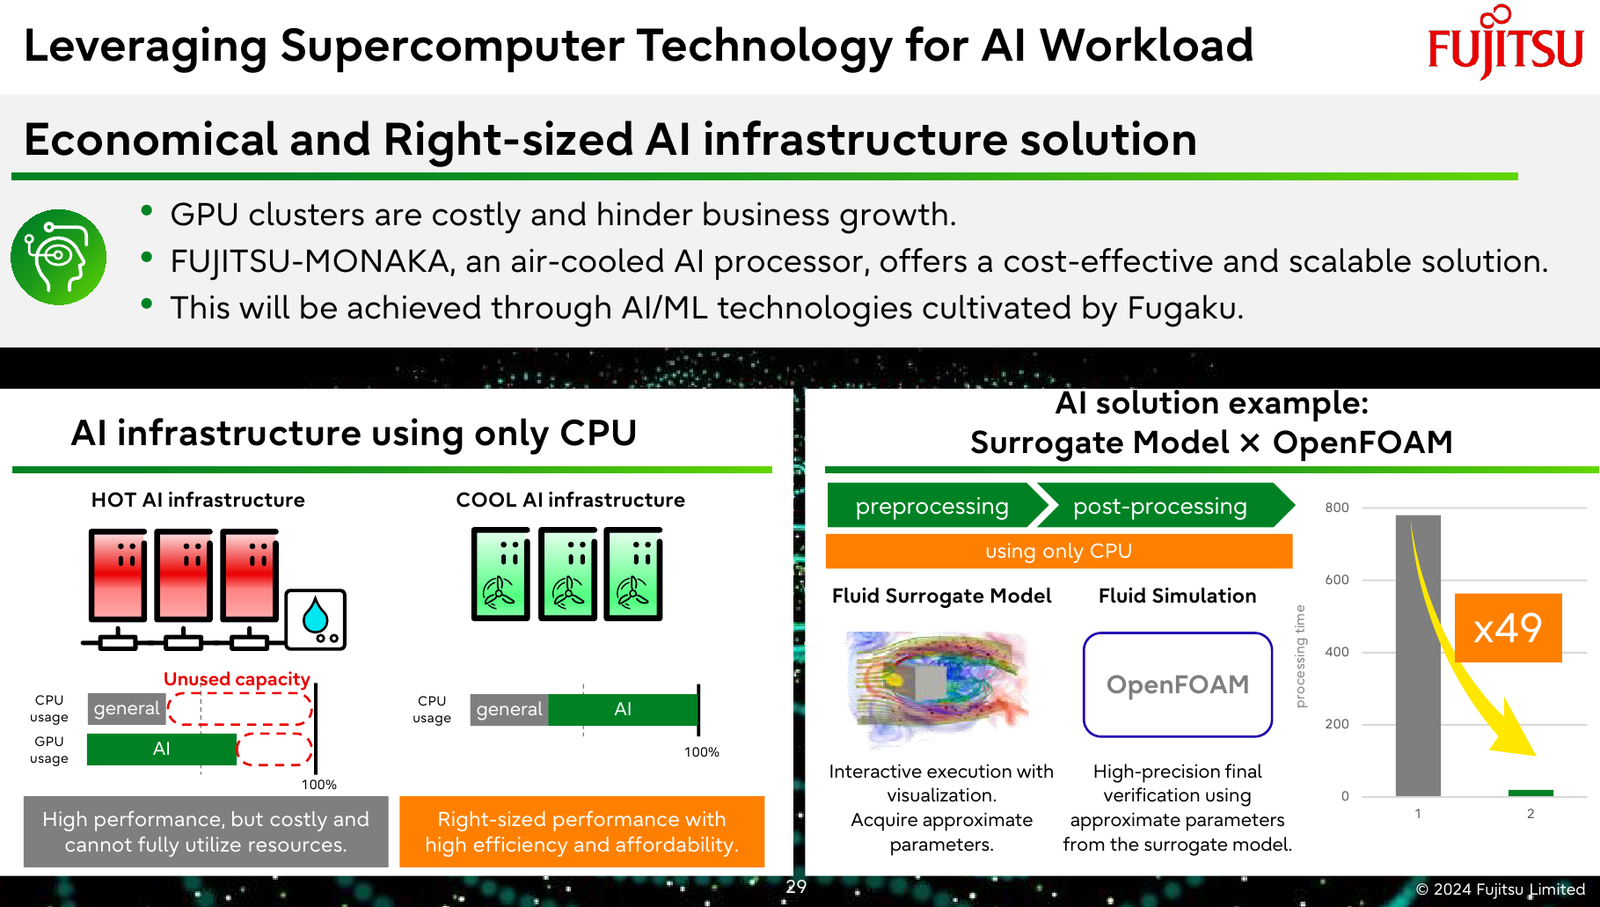 Несмотря на популярность GPU и других специализированных ускорителей, Fujitsu считает, что гетерогенная архитектура имеет существенные недостатки — она заметно дороже, особенно с учётом ценовой политики производителей, склонна к неполной утилизации ресурсов, а также не слишком экономична и зачастую требует специфических систем охлаждения. Компания полагает, что гомогенная архитектура MONAKA этих недостатков лишена и в сочетании с ПО Fujitsu может успешно обрабатывать ИИ-нагрузки.  В программной части Fujitsu активно полагается на решения с открытым кодом. Процессоры MONAKA будут отвечать стандартам Arm System Ready и получат полноценную поддержку Linux и сопутствующего инструментария, в частности, GCC, glibc, live-patch, papi и т.д. Разработка ведётся в тесном содружестве с Linaro, организацией, занимающейся консолидацией открытого ПО для Arm, а также с альянсом UXL. Для MONAKA компания подготовит, например, оптимизированную библиотеку OpenBLAS. 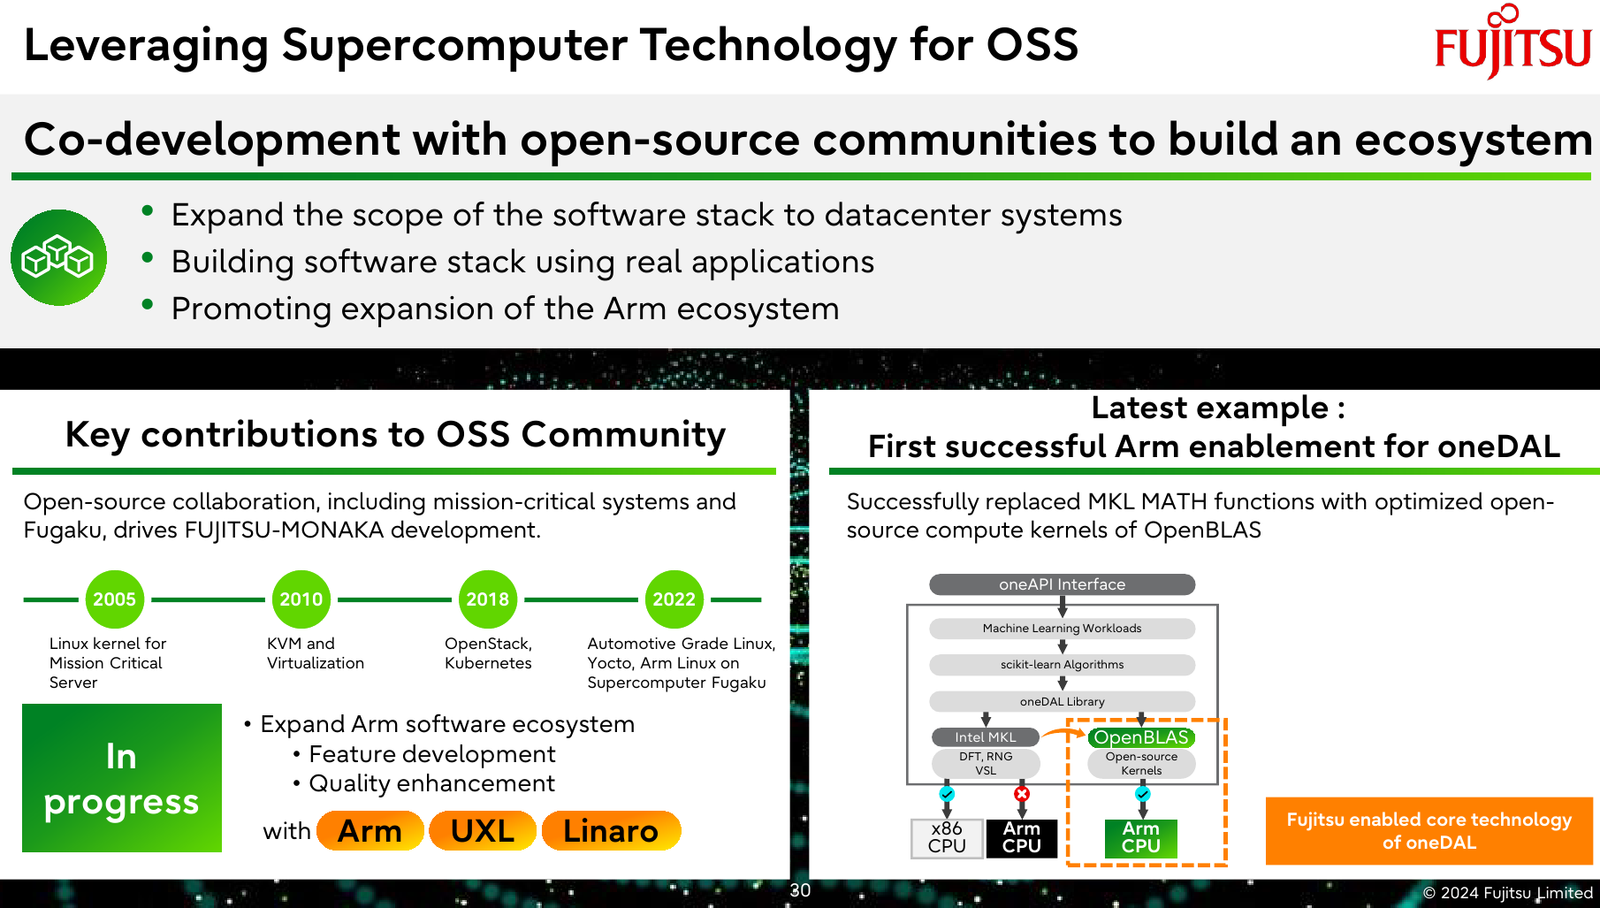 Также Fujitsu уделяет внимание экологии: напомним, одной из главных черт нового процессора будет его экономичность, что отвечает целям японской национальной программы NEDO, ставящей своей целью достижение 40 % снижения энергопотребления ЦОД к 2030 году. 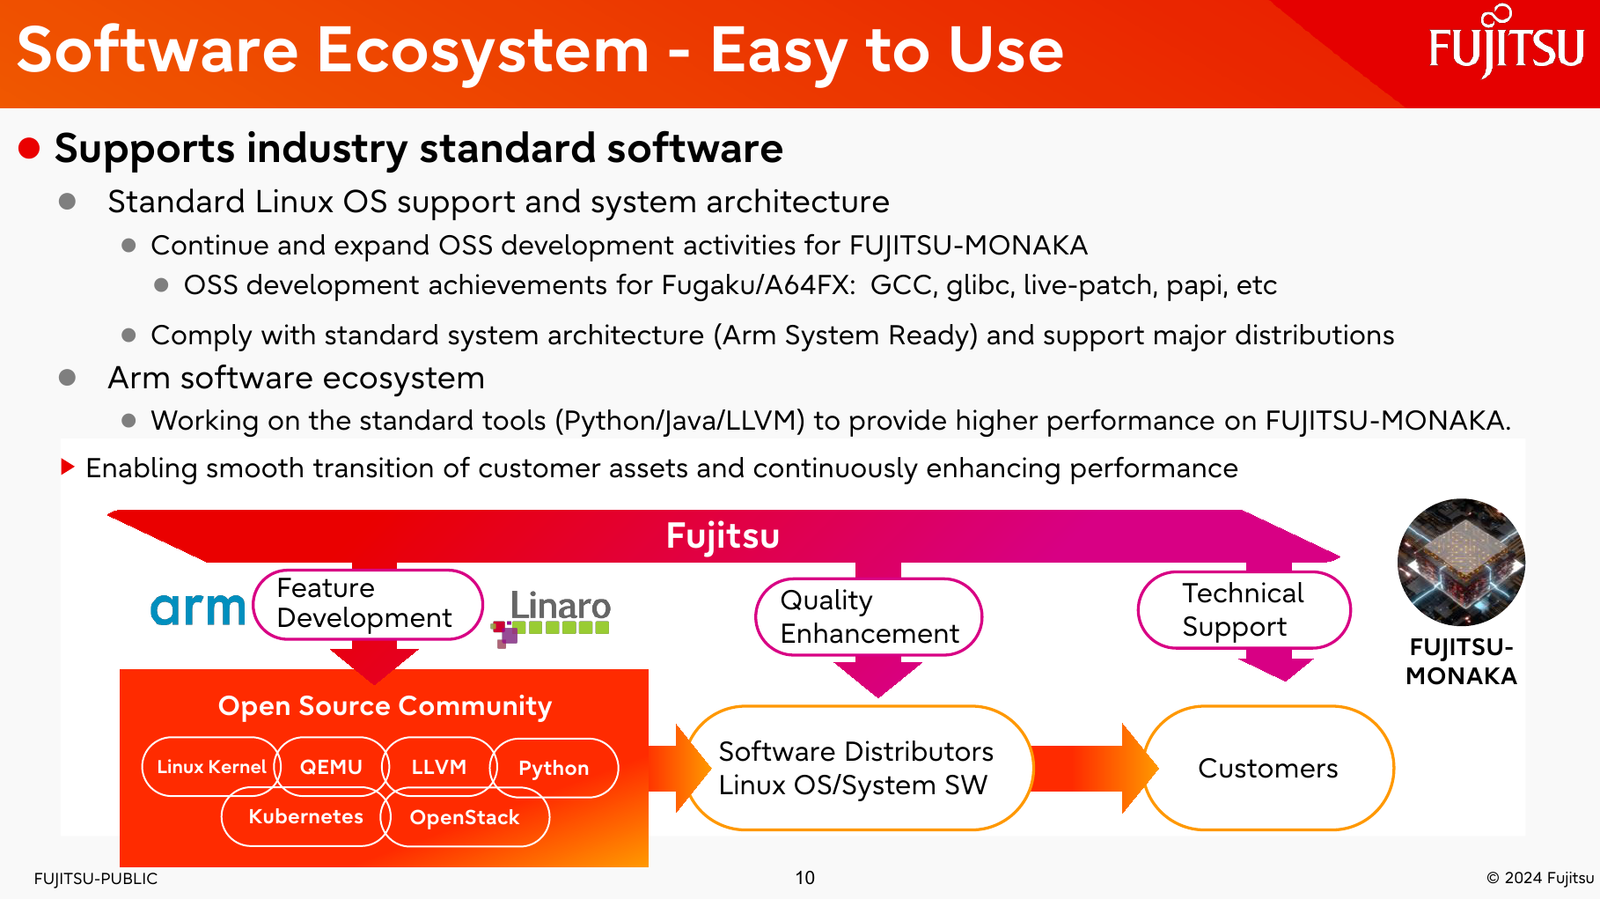 Что касается начала поставок MONAKA, здесь всё идёт по плану: первые партии новых процессоров найдут своё место в серверах и вычислительных узлах уже в 2027 году. Это вполне согласуется с циклом разработки PCI Express, согласно которому появления решений PCIe 6.0 на рынке следует ожидать не ранее 2025 года.
03.07.2024 [23:49], Сергей Карасёв
Panmnesia расширит память GPU с помощью DRAM или даже SSDЮжнокорейский стартап Panmnesia сообщил о разработке специализированного CXL-решения, которое позволяет расширять встроенную память ускорителей на базе GPU путём подключения внешних блоков DRAM или даже SSD. Отмечается, что современным приложениям ИИ и НРС требуется значительный объём быстрой памяти, но возможности ускорителей в этом плане ограничены. Сложность расширения памяти актуальных ускорителей заключается в том, что в таких изделиях отсутствуют логическая структура CXL и компоненты, поддерживающие DRAM и/или SSD. Кроме того, подсистемы кеша и памяти GPU не распознают никаких расширений. В лучшем случае предлагается механизм унифицированной виртуальной памяти (UVM) для совместного доступа к содержимому памяти и CPU, и GPU. Однако этот механизм довольно медленный. 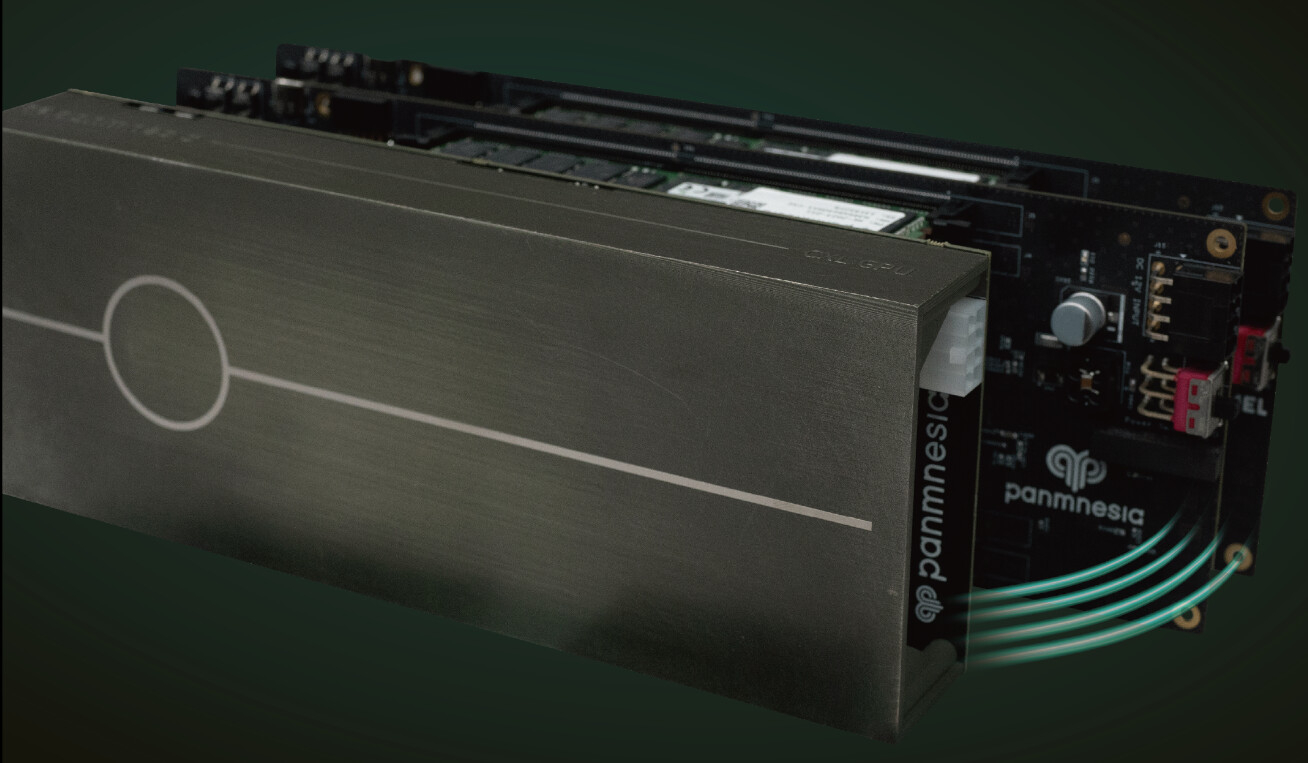
Источник изображений: Panmnesia Panmnesia обошла существующие ограничения путём создания собственного root-комплекса, совместимого со стандартом CXL 3.1 и предоставляющего несколько root-портов. Он и обеспечивает поддержку внешней памяти через PCIe. При этом задействован особый декодер HDM (Host-managed Device Memory), отвечающий за работу с адресными пространствами. Это сложное решение в каком-то смысле «обманывает» подсистему памяти ускорителя, заставляя ее рассматривать внешнюю PCIe-память как доступную напрямую. 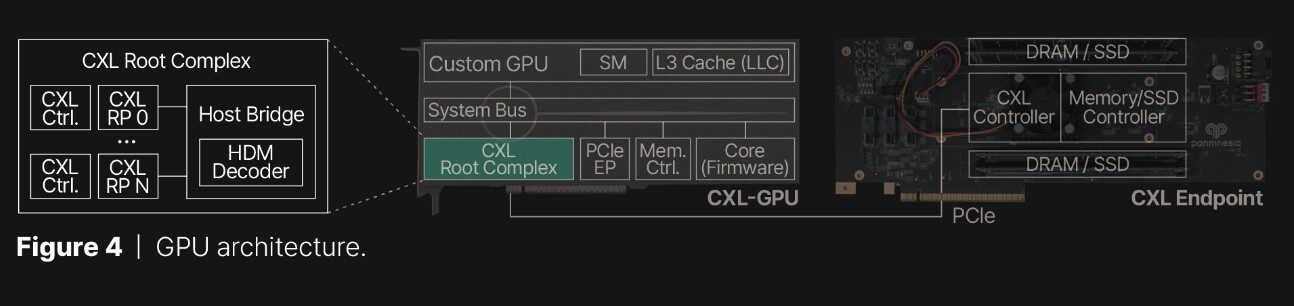 Прототип, основанный на кастомизированном GPU, в ходе тестов продемонстрировало задержки менее 100 нс при передаче данных в обоих направлениях. При этом решение Panmnesia предоставляет более гранулярный доступ к памяти в сравнении с UVM. Быстродействие CXL-системы Panmnesia оказалось в 3,22 раза выше в пересчёте на IPC по сравнению с UVM. |
|

