Материалы по тегу: ethernet
|
23.11.2024 [12:38], Сергей Карасёв
Стартап Enfabrica выпустил чип ACF SuperNIC для ИИ-кластеров на базе GPUКомпания Enfabrica, занимающаяся разработкой инфраструктурных решений в сфере ИИ, объявила о доступности чипа Accelerated Compute Fabric (ACF) SuperNIC, предназначенного для построения высокоскоростных сетей в рамках кластеров ИИ на основе GPU. Кроме того, стартап провёл очередной раунд финансирования. Напомним, Enfabrica предлагает CXL-платформу ACF на базе ASIC собственной разработки, которая позволяет напрямую подключать друг к другу любую комбинацию GPU, CPU, DDR5 CXL и SSD, а также предоставляет 800GbE-интерконнект. Утверждается, что ACF SuperNIC может обеспечить улучшенную масштабируемость и производительность с более низкой совокупной стоимостью владения для распределённых рабочих нагрузок ИИ по сравнению с другими решениями, доступными на рынке. Изделие ACF SuperNIC (ACF-S) позволяет использовать от четырёх до восьми самых современных ускорителей в расчёте на серверную систему. Чип обеспечивает поддержку 800GbE, 400GbE и 100GbE, 32 сетевых портов и 160 линий PCIe. Благодаря этому становится возможным формирование ИИ-кластеров, насчитывающих более 500 тыс. GPU. 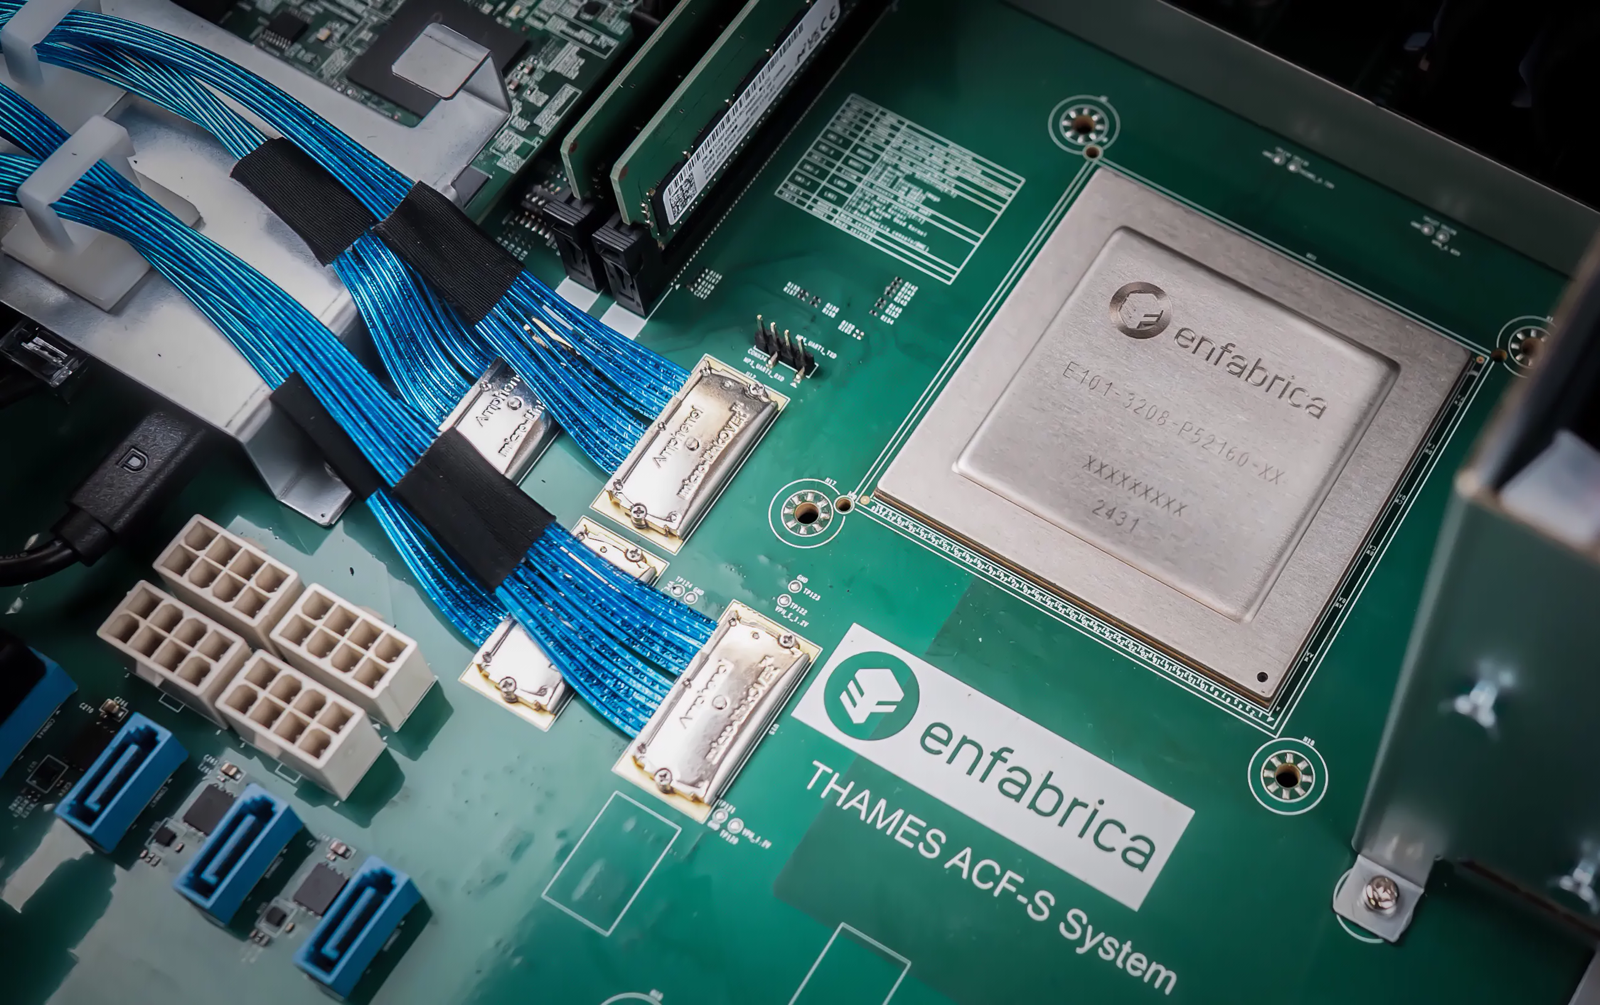
Источник изображения: Enfabrica Программный стек ACF-S поддерживает стандартные коммуникационные и сетевые операции RDMA через набор библиотек, совместимых с существующими интерфейсами. Фирменная технология Resilient Message Multipathing (RMM) повышает отказоустойчивость кластера ИИ и удобство обслуживания. RMM устраняет простои из-за сбоев и отказов сетевых соединений, повышая эффективность. Функция Collective Memory Zoning обеспечивает снижение задержек. Поставки чипов ACF SuperNIC начнутся в I квартале 2025 года. Что касается нового раунда финансирования, то по программе Series C привлечено $115 млн. Раунд возглавила фирма Spark Capital с участием новых инвесторов — Maverick Silicon и VentureTech Alliance. Кроме того, средства предоставили существующие инвесторы в лице Atreides Management, Sutter Hill Ventures, Alumni Ventures, IAG Capital и Liberty Global Ventures.
15.11.2024 [10:31], Сергей Карасёв
Eviden представила интерконнект BullSequana eXascale третьего поколения для ИИ-системКомпания Eviden (дочерняя структура Atos) анонсировала BullSequana eXascale Interconnect (BXI v3) — интерконнект третьего поколения, специально разработанный для рабочих нагрузок ИИ и HPC. Технология станет доступа на рынке во II половине 2025 года. Отмечается, что существующие высокоскоростные сетевые решения недостаточно эффективны, поскольку не устраняют критическое узкое место, известное как «сетевая стена». По заявлениям Eviden, зачастую при крупномасштабном обучении ИИ компании наращивают количество ускорителей, однако на самом деле ограничивающим фактором является интерконнект. Хотя поставщики сетевых решений продолжают удваивать пропускную способность каждые несколько лет, этого недостаточно для решения проблемы. В результате, до 70 % времени GPU простаивают, ожидая получения данных из-за задержек, утверждает Eviden. Технология BXI v3 призвана устранить этот недостаток. 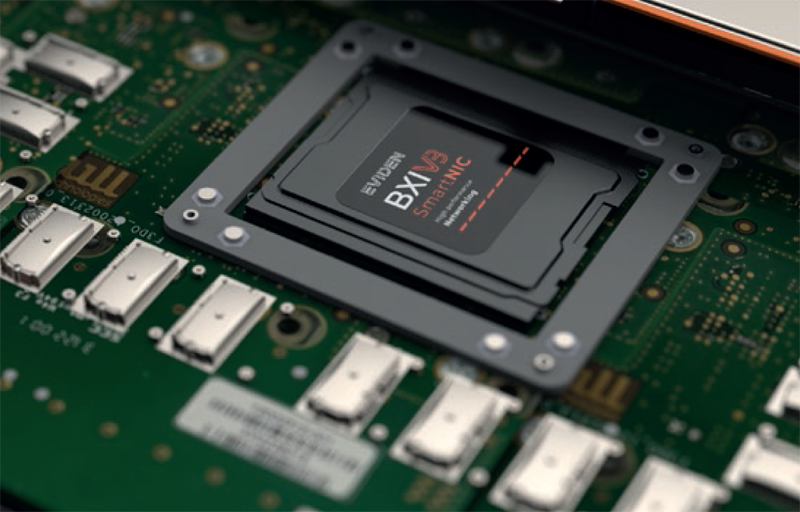
Источник изображений: Eviden Новый интерконнект использует стандарт Ethernet в качестве базового протокола связи. При этом реализованы функции, которые обычно характерны для масштабируемых сетей высокого класса, таких как Infiniband. Отмечается, что BXI v3 обеспечивает низкие задержки (менее 200 нс от порта к порту), высокую пропускную способность, упорядоченную (in order) доставку пакетов, расширенное управление перегрузками и масштабируемость. Технология BXI v3 ляжет в основу интеллектуального сетевого адаптера (Smart NIC) нового поколения, который поможет снизить влияние задержек сети на GPU и CPU. При использовании такого решения ускоритель ИИ выгружает данные на сетевой адаптер и сразу же переходит к другим задачам, что устраняет неэффективность, связанную с простоями. Подчёркивается, что протокол BXI v3 интегрируется непосредственно в Smart NIC, благодаря чему оборудование работает сразу после установки, а в приложения не требуется вносить какие-либо изменения. 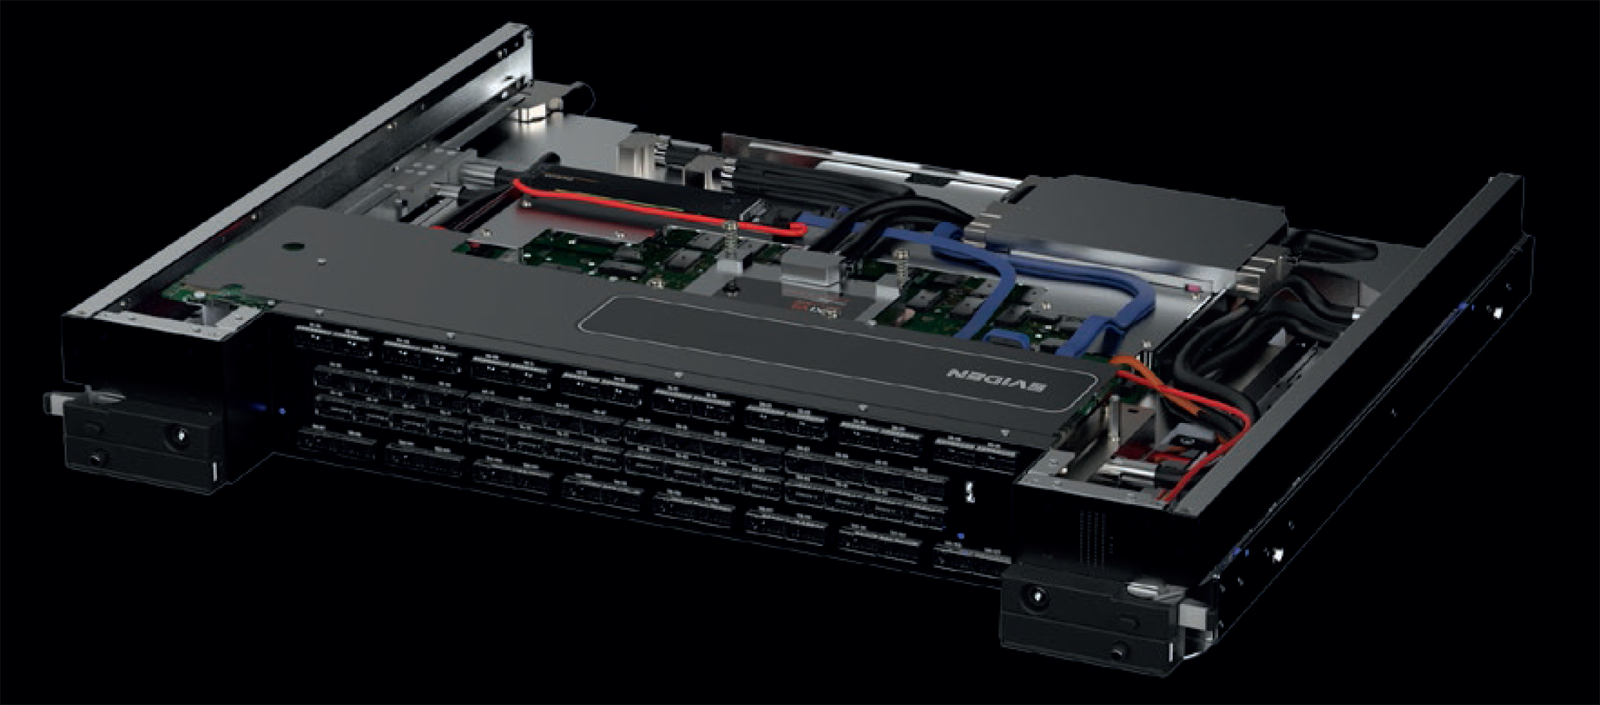 Кроме того, новая технология предоставляет ряд дополнительных функций, ориентированных на повышение производительности путём оптимизации системных операций и обработки данных. В частности, BXI v3 обеспечивает прозрачную трансляцию виртуальных адресов в физические, что позволяет приложениям напрямую отправлять запросы в SmartNIC с использованием виртуальных адресов без необходимости системных вызовов. Такой подход повышает эффективность, обеспечивая бесперебойное управление памятью при сохранении высокой производительности. Технология BXI v3 также позволяет регистрировать до 32 млн приёмных буферов, которые SmartNIC выбирает с помощью ключей сопоставления на основе атрибутов сообщения. Благодаря этому уменьшается нагрузка на CPU, что повышает общую эффективность системы. Кроме того, сетевой адаптер способен выполнять математические атомарные операции, что дополнительно высвобождает ресурсы CPU. Впрочем, деталей пока мало, зато говорится об участии в консорциуме Ultra Ethernet (UEC) и партнёрстве с AMD.
21.10.2024 [13:21], Сергей Карасёв
Xsight Labs представила 400GbE DPU серии E1Компания Xsight Labs анонсировала, как утверждается, самую производительную на рынке программно-определяемую «систему на чипе» (SoC), предназначенную для создания DPU с поддержкой RoCEv2 и UET (Ultra Ethernet Transport). Изделие под названием E1 станет доступно заказчикам для тестирования во II квартале 2025 года. Чип будет предлагаться в модификациях E1-32 и E1-64. Первая содержит 32 ядра Arm Neoverse N2 v9.0-A, имеет 16 Мбайт кеша и использует конфигурацию памяти 2 × DDR5-5200. Показатель TDP равен 65 Вт. У второго варианта количество ядер составляет 64, размер конфигурируемого кеша/буфера — 32 Мбайт. Конфигурация памяти — 4 × DDR5-5200, величина TDP — 90 Вт. В обоих случаях используется полное шифрование памяти на лету (AES-XTS). Новинка использует до восьми блоков SerDes, обеспечивая сетевую пропускную способность до 800 Гбит/с. Возможны следующие конфигурации портов: 2 × 400GbE, 4 × 200GbE и 8 × 100/50/25/10GbE. Заявлена производительность на уровне 200 Mpps и 20 млн подключений в секунду. Также есть пара 1GbE-портов для внешнего управления. Доступны программируемые DMA-движки (до 3 Тбит/с) и разгрузка типовых операций, включая шифрование AES-GCM (для IPSec) и AES-XTS (для СХД) на лету. 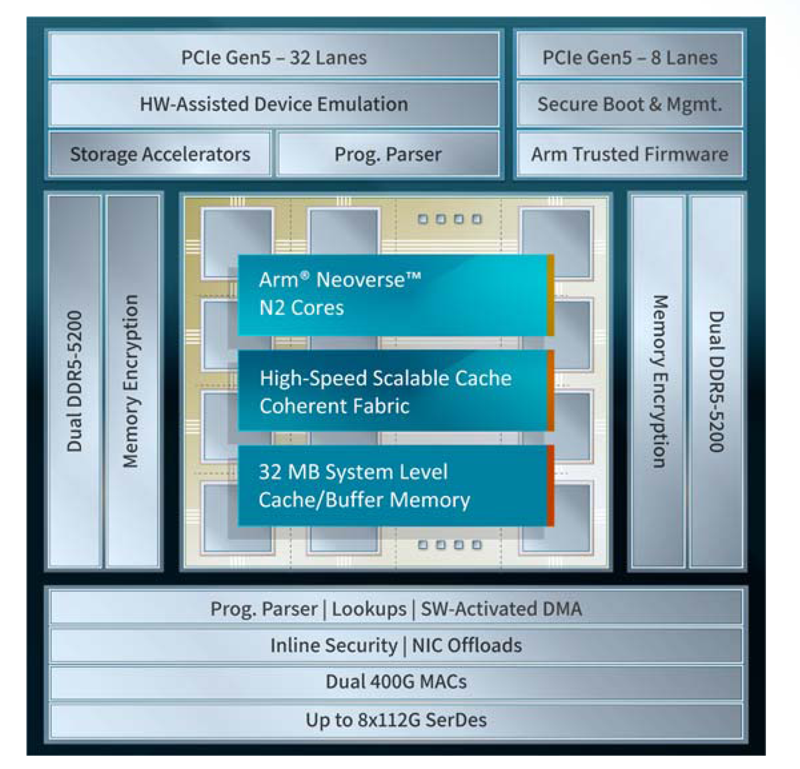
Источник изображения: Xsight Labs Есть восемь двухрежимных контроллеров и 40 (32+8) линий PCIe 5.0, а также поддержка P2P-коммутации PCIe. Упомянуты поддержка до четырёх хостов/устройств, SR-IOV (64K PF/VF), а также программная эмуляция и пространства MMIO. Реализована поддержка интерфейсов I2C/I3C/SMBus, SPI/QSPI, SMI, UART, GPIO, 1588 RTC, JTAG. Говорится о высоком уровне обеспечения безопасности: возможно создание изолированных и защищённых сред, которые аутентифицируют каждого клиента. Поддерживается функция безопасной загрузки UEFI Secure Boot with Arm Trusted Firmware (TF-A). Заявлена возможность работы «из коробки» в Debian, Ubuntu, SONiC и Lightbits Labs LightOS, а также совместимость с Netdev, VirtIO, XNA/XDP и DPDK/SPDK. В частности, возможна эмуляция NVMe-, RDMA- и сетевых устройств. Изделие E1 производится по 5-нм технологии TSMC. Оно, как утверждает Xsight Labs, обеспечивает беспрецедентную энергоэффективность и вычислительные возможности, устанавливая новый стандарт производительности для DPU SoC. Новинка ориентирована на облачные платформы и периферийные дата-центры, поддерживающие интенсивные ИИ-нагрузки. DPU позволяет создавать SDN/SDS-решения, брандмауэры, NVMe-oF СХД, вычислительные хранилища, CDN-платформы, балансировщики и т.п.
11.10.2024 [11:55], Сергей Карасёв
DPU + UEC: AMD представила 400G-адаптеры Pensando Salina и PollaraКомпания AMD анонсировала сетевой сопроцессор (DPU) третьего поколения Pensando Salina 400, а также сетевую карту Pensando Pollara 400, ориентированную на применение в составе ИИ-систем. Образцы изделий станут доступны заказчикам в текущем квартале, тогда как массовые продажи начнутся в I половине 2025 года. Решение Pensando Salina 400, рассчитанное на сетевые кластеры гиперскейлеров, обеспечивает пропускную способность до 400 Гбит/с. Утверждается, что по сравнению с DPU предыдущего поколения производительность увеличилась в два раза. Устройство Pensando Salina 400 выполнено в виде карты PCIe 5.0 с двумя портами 400GbE. Задействованы 16 ядер Arm Neoverse-N1 и 232 ядра P4 MPU. Объём памяти DDR5 достигает 128 Гбайт, её пропускная способность — 102 Гбайт/с. Новинка будет применяться в том числе в интеллектуальных коммутаторах, предназначенных для решения различных задач во внешней зоне: это может быть распределение данных, балансировка нагрузки, обеспечение безопасности, шифрование и пр. 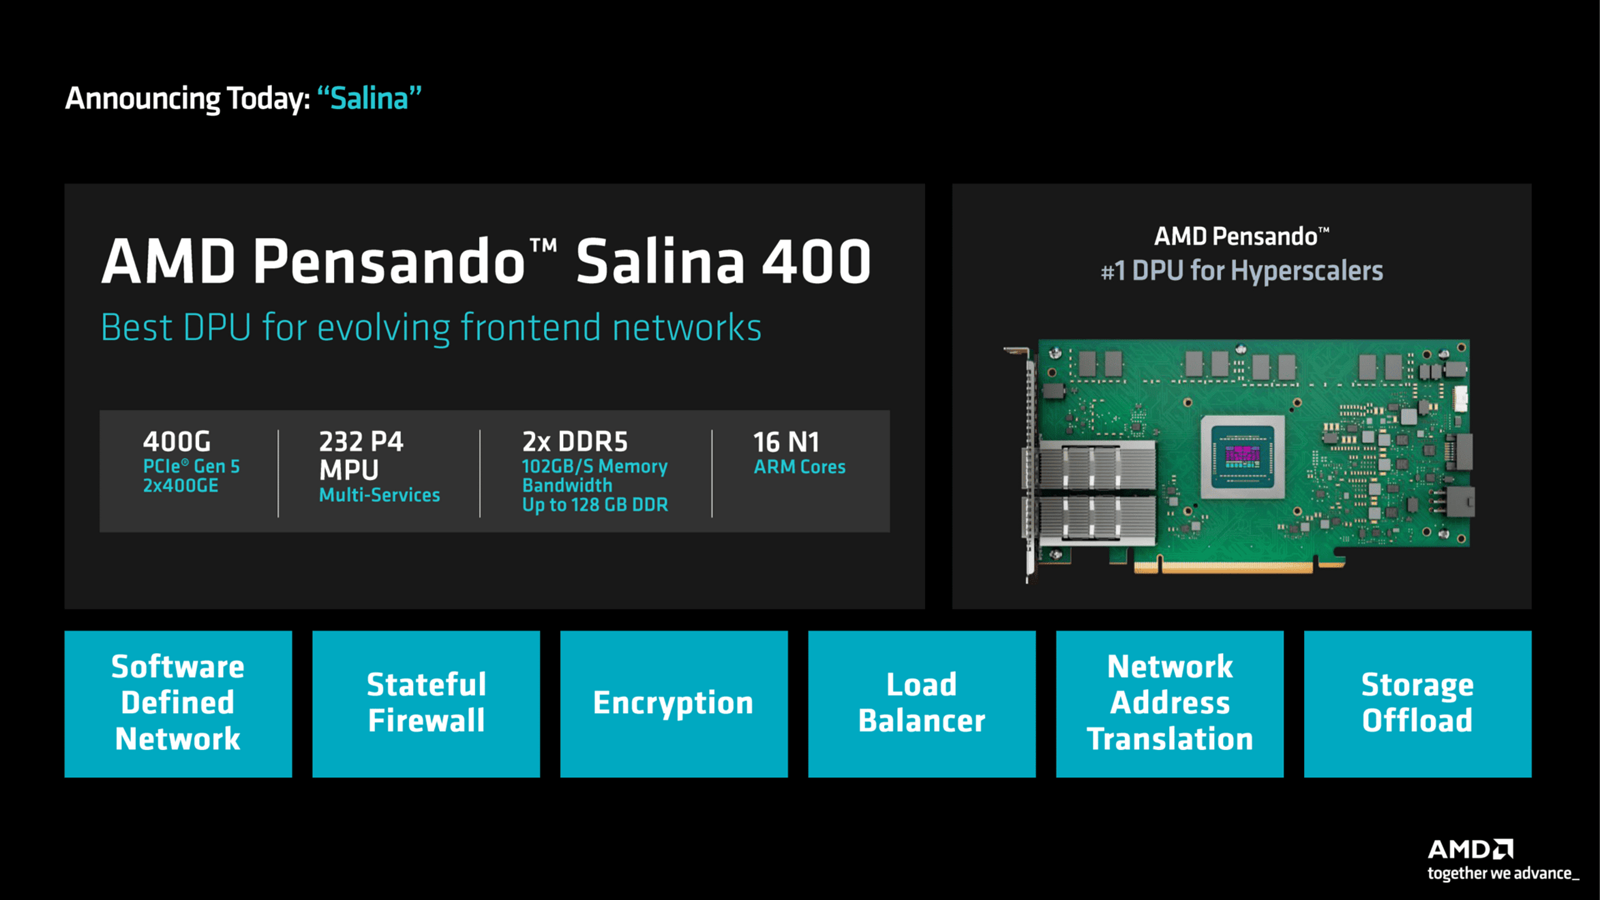
Источник изображений: AMD В свою очередь, Pensando Pollara 400 представляет собой интеллектуальный сетевой адаптер с одним портом 400 Гбит/с. Изделие выполнено на том же чипе, что и Pensando Salina 400. Компания AMD называет Pensando Pollara 400 первой в мире сетевой картой для приложений ИИ, соответствующей стандартам, которые определяет консорциум Ultra Ethernet (UEC). Примечательно, что первые спецификации консорциум намерен представить не раньше конца текущего года. 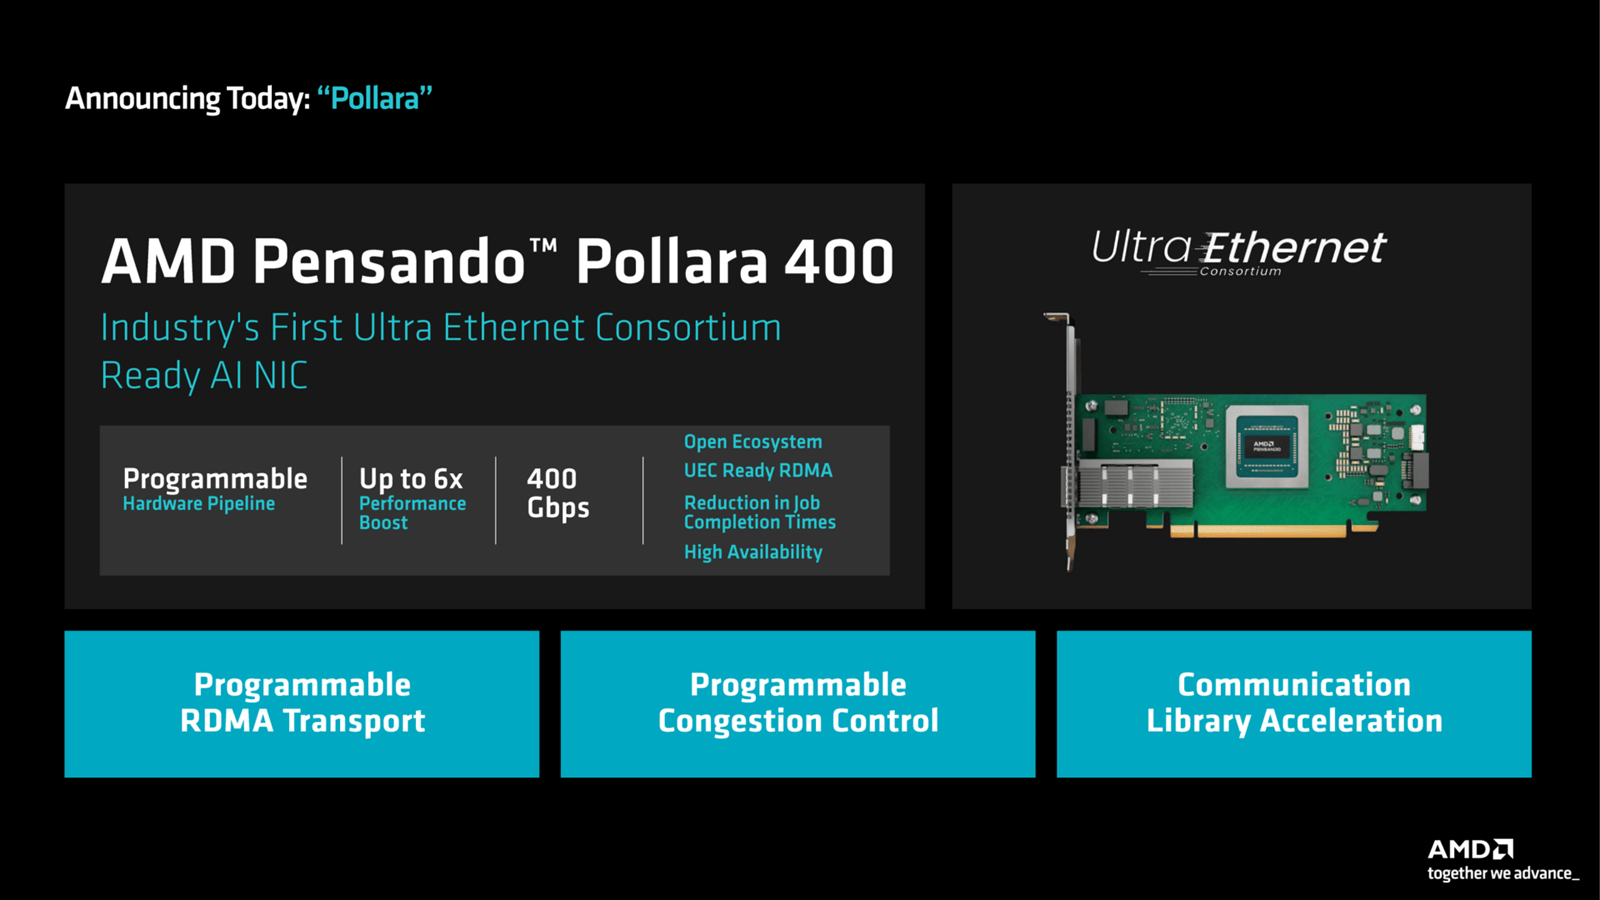 Цель UEC — разработка основанной на Ethernet открытой высокопроизводительной архитектуры с полным коммуникационным стеком, отвечающей задачам современных рабочих нагрузок ИИ и НРС. Благодаря программируемой архитектуре P4 адаптер можно настраивать с учётом конкретных требований. В целом, как утверждается, новинка является мощным решением для повышения производительности рабочих нагрузок ИИ и улучшения надёжности сети.
22.03.2024 [21:10], Сергей Карасёв
Консорциум Ultra Ethernet пополнился 45 участниками, но NVIDIA среди них так и нетКонсорциум Ultra Ethernet объявил о том, что в его состав вошли 45 новых участников. Таким образом, на сегодняшний день общее количество членов этой организации достигает 55. К участию в Ultra Ethernet приглашаются и другие заинтересованные компании и институты. Напомним, консорциум был создан в июле 2023 года. Его задача заключается в разработке основанной на Ethernet открытой высокопроизводительной архитектуры с полным коммуникационным стеком, отвечающей задачам современных рабочих нагрузок ИИ и НРС. Изначально в состав Ultra Ethernet входили AMD, Arista, Broadcom, Cisco, Eviden (Atos), HPE, Intel, Meta✴ и Microsoft. Позднее к консорциуму присоединилась компания Cornelis Networks, поставщик HPC-интерконнекта на базе Omni-Path. 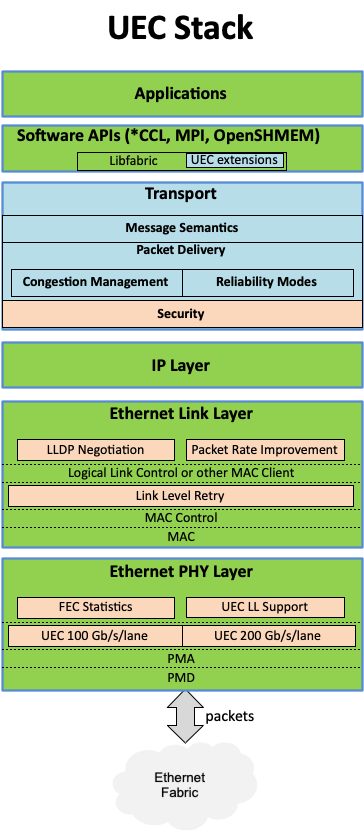
Источник изображения: Ultra Ethernet С ноября 2023-го организация начала принимать новых участников в массовом порядке. С тех пор инициативу поддержали Nokia, Lenovo, Baidu, Dell, Huawei, IBM, Supermicro, Tencent и многие другие компании. Примечательно, что в списке участников так и нет AWS, Google и NVIDIA. Последняя по-прежнему считает InfinBand лучшим интерконнектом для HPC/ИИ-кластеров и является фактически единственным поставщиком данной технологии. Более того, даже Ethernet-решения NVIDIA подвергаются критике со стороны конкурентов. 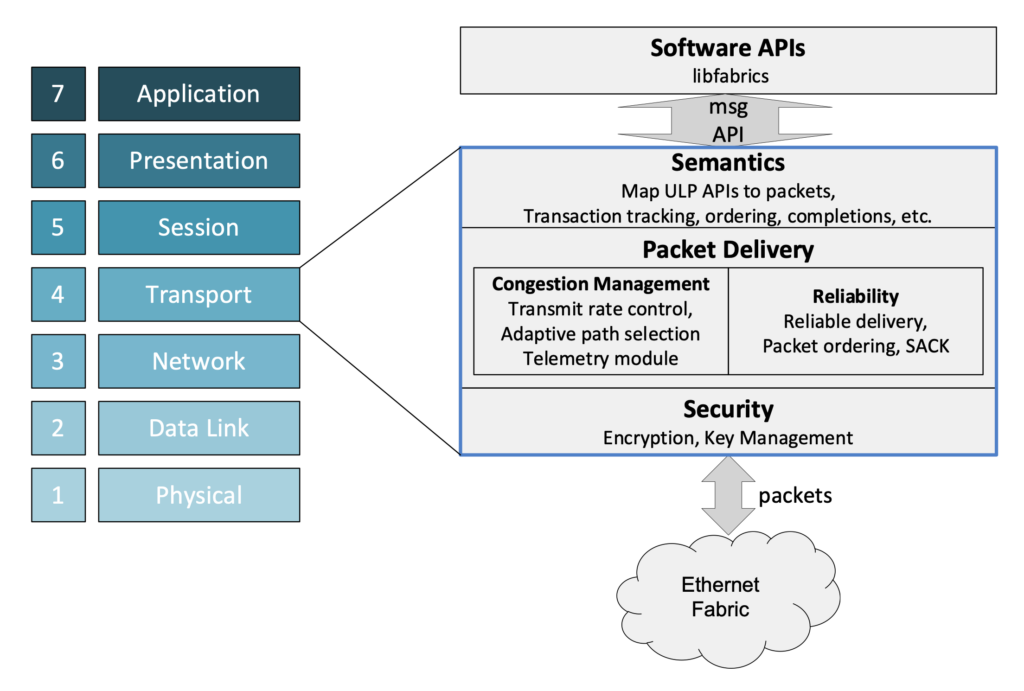
Источник изображения: Ultra Ethernet Для тех, кто заинтересован в работах в рамках проекта, Ultra Ethernet предлагает различные варианты участия через восемь технических групп. В их число, в частности, входят физический, транспортный и программный уровни, хранение, управление, отладка и пр. В настоящее время ведётся активная работа над спецификацией Ultra Ethernet версии 1.0: представить её планируется в III квартале текущего года. Ожидается, что совместная работа десятков IT-компаний в перспективе позволит создать революционные коммуникационные платформы.
22.03.2024 [09:09], Алексей Степин
NVIDIA представила 800G-платформы Quantum-X800 и Spectrum-X800 для InfiniBand- и Ethernet-фабрик нового поколенияДополнением к только что представленным ИИ-ускорителям NVIDIA Blackwell станут новые сетевые 800G-платформы Quantum-X800 и Spectrum-X800, а также сетевые адаптеры ConnectX-8. Именно они позволят вывести масштабирование ИИ-кластеров на новый уровень и позволят «прокормить» гигантские массивы ускорителей в дата-центрах гиперскейлеров. Платформа NVIDIA Quantum-X800 ориентирована на наиболее производительные ИИ- и HPC-кластеры. Она использует новое поколение технологии InfiniBand, всё ещё обладающей рядом преимуществ в сравнении с Ethernet, и включает в себя обновлённые SHARP-движки. Технология SHARPv4 реализует «вычисления в сети» (In-Network Computing), что позволяет не только существенно разгрузить вычислительные узлы и серверы, но и обеспечить более высокую пропускную способность интерконнекта вкупе с более серьёзными возможностями его масштабирования. 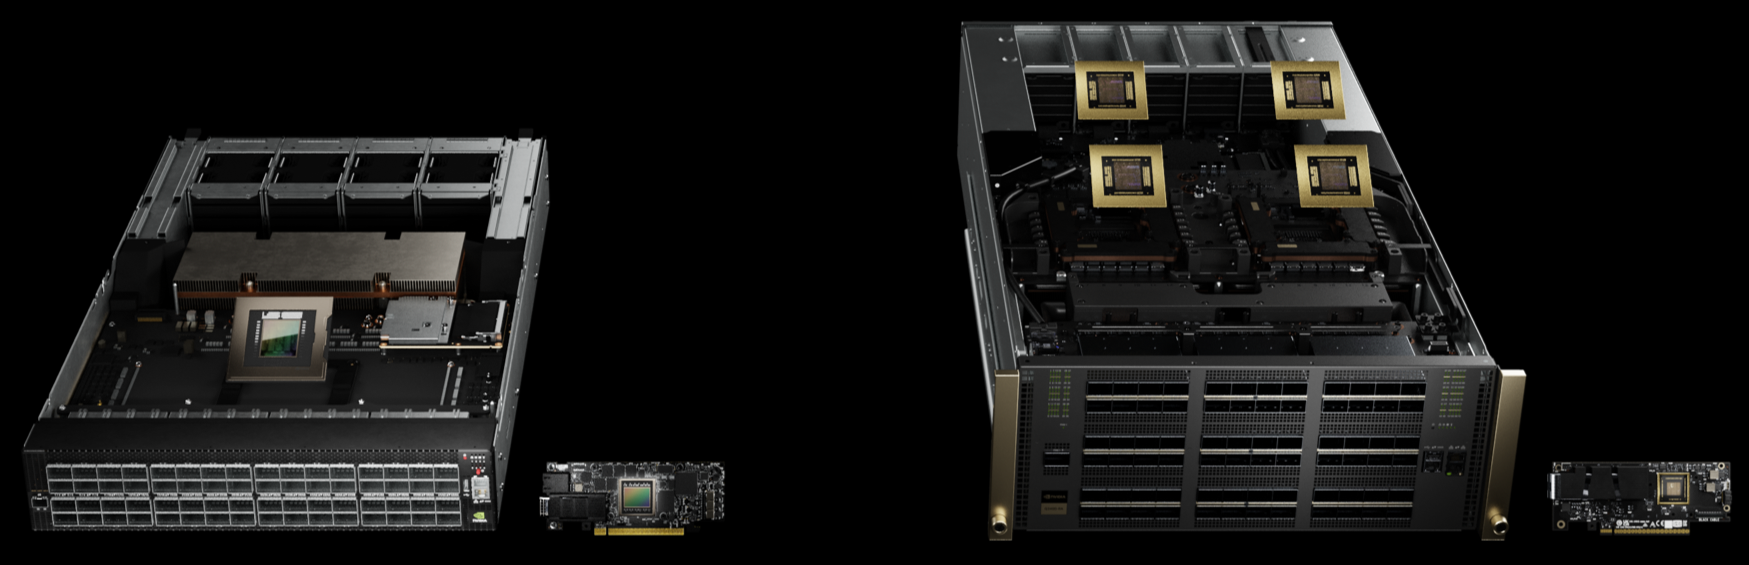
NVIDIA Q3400-RA 4U (справа) и SN5600. Источник изображений здесь и далее: NVIDIA Основой платформы Quantum-X800 стал 4U-коммутатор Q3400-RA, впервые в индустрии, как говорит компания, использующий 200G-блоки SerDes для каждой линии InfiniBand. Коммутатор располагает 144 портами 800G в 72 OSFP-модулях и выделенным портом для Unified Fabric Manager. Новинка имеет стандартное 19″ исполнение с воздушным охлаждением, но есть и вариант Q3400-LD с жидкостным охлаждением, предназначенный для 21″ OCP-стоек. В двухуровневом варианте fat tree коммутаторы позволят объединить 10 368 NIC. 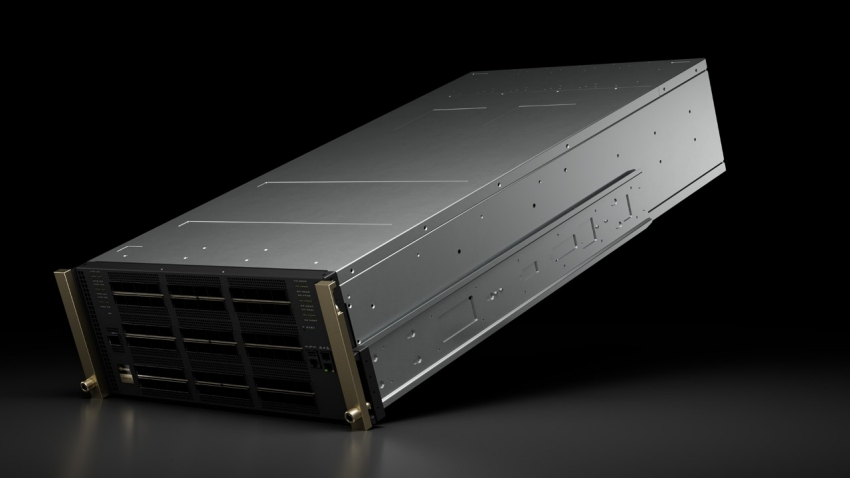 Основным адаптером для новой платформы InfiniBand является ConnectX-8 SuperNIC с интерфейсом PCIe 6.0. Он является частью SHARPv4 и предлагается в однопортовом (OSFP224) и двухпортовом (QSFP112) вариантах и в нескольких форм-факторах, включая OCP 3.0. На платах также имеется разъём SocketDirect на 16 линий PCIe. Также компания представила компоненты NVIDIA LinkX: оптические трансиверы 2xDR4/2xFR4 и активные медные кабели (LACC). 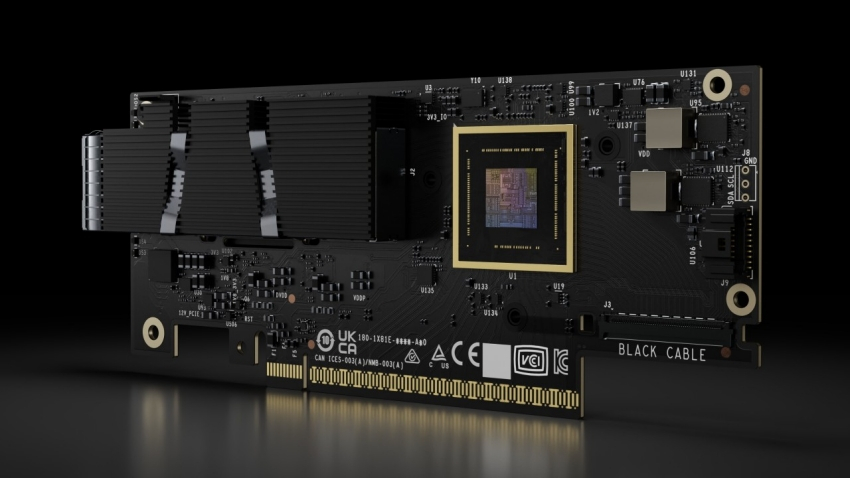 Не забыла NVIDIA и про Ethernet: здесь вывести производительность сети на новый уровень должна платформа Spectrum-X800. Её основой служит новейший коммутатор SN5600 — это, по словам NVIDIA, первый в мире Ethernet-коммутатор класса 800GbE, специально разработанный для применения гиперскейлерами в крупных облачных ИИ-комплексах. Применяемая архитектура позволяет гарантировать каждому клиенту оптимальный и постоянный уровень производительности, а потоковая телеметрия позволит находить и ликвидировать возможные «бутылочные горлышки» в сети буквально на лету. 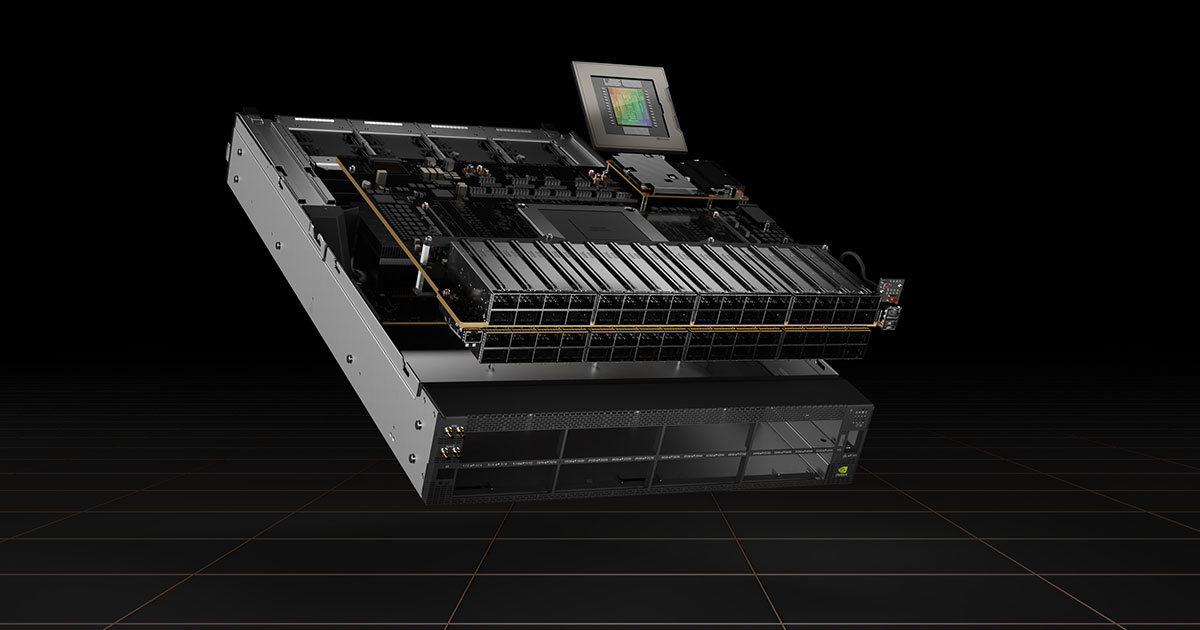 Общая пропускная способность SN5600 составляет 51,2 Тбит/с. Коммутатор располагает 64 портами 800GbE в формате OSFP. В нём используется ASIC пятого поколения на базе архитектуры Spectrum-4. В качестве основного адаптера предлагается SuperNIC на базе DPU BlueField-3 с двумя 400GbE-портами. 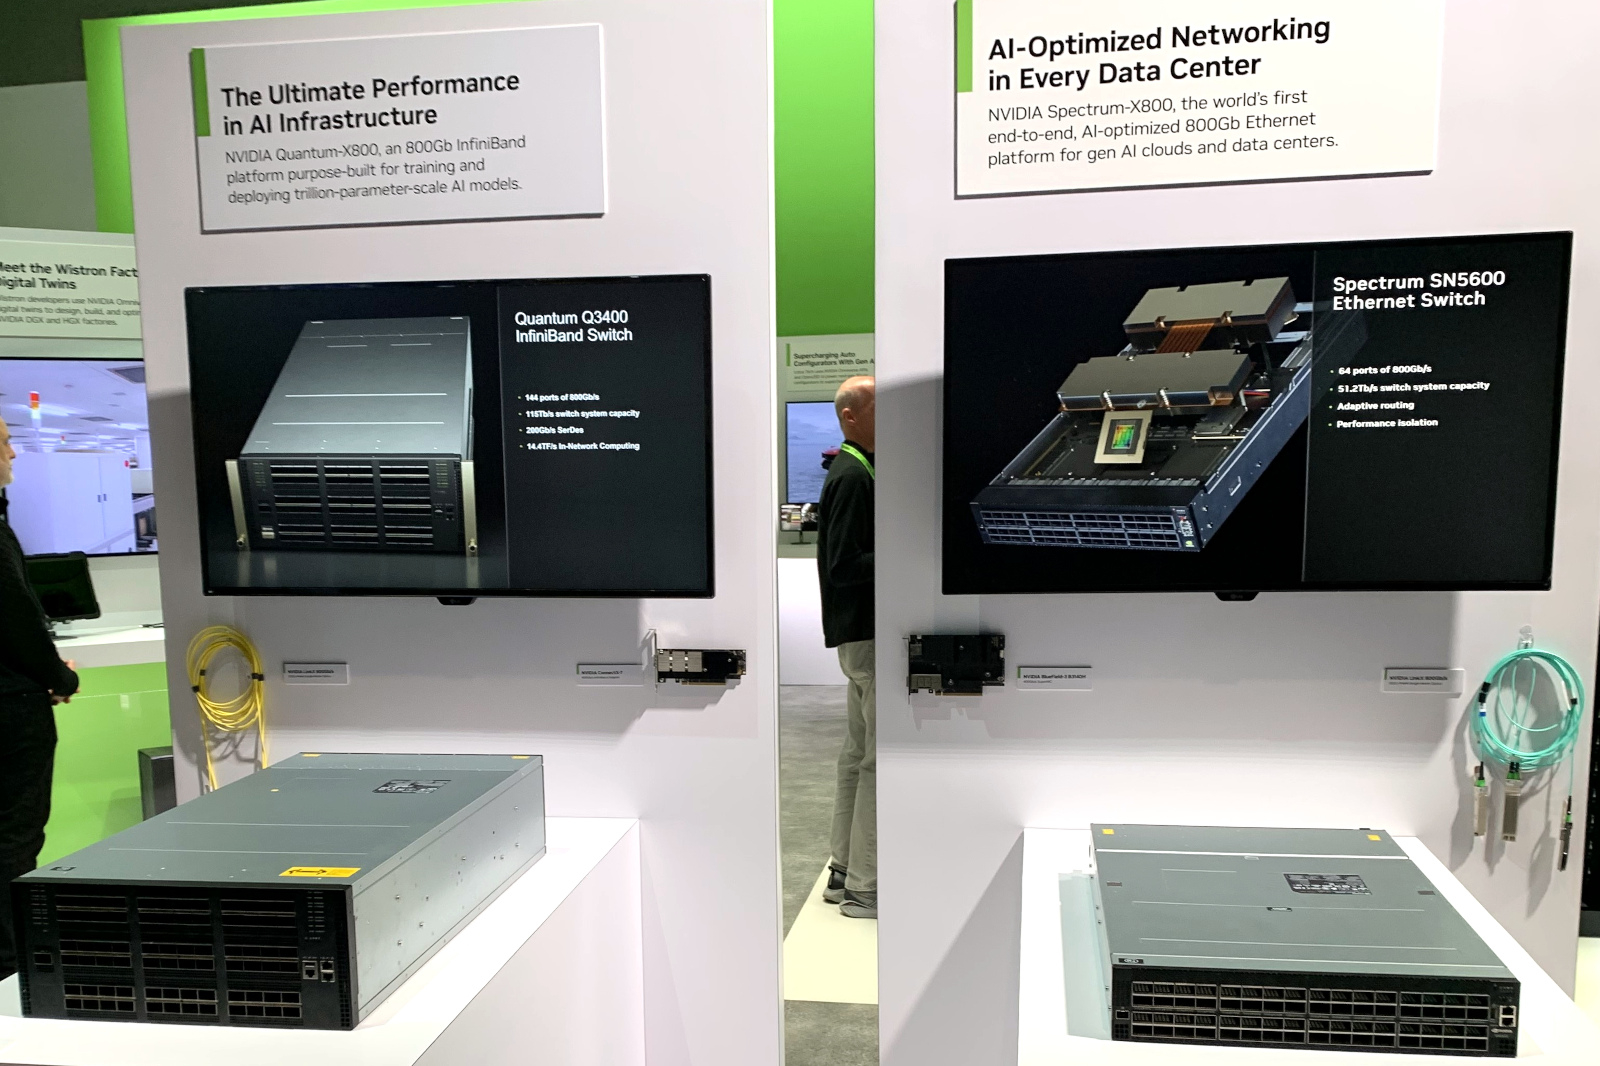
Фото: Twitter/NVIDIANetworkng Spectrum-X800 сопровождает полноценный спектр инфраструктурных компонентов, включая кабели DAC и LACC. С оптическими трансиверами длина соединения 800GbE может достигать двух километров. Начиная со следующего года, решения на базе новых сетевых платформ NVIDIA будут доступны от широкого круга поставщиков оборудования, включая Aivres, DDN, Dell Technologies, Eviden, Hitachi Vantara, HPE, Lenovo, Supermicro и VAST Data.
22.11.2023 [11:18], Сергей Карасёв
NVIDIA представила сетевой ускоритель SuperNIC для ИИ-нагрузокКомпания NVIDIA анонсировала аппаратное решение SuperNIC — это сетевой ускоритель нового типа, предназначенный для масштабных рабочих нагрузок ИИ в системах на базе Ethernet. Устройство обеспечивает скорость передачи данных до 400 Гбит/с с использованием RDMA (RoCE). Новинка выполнена на основе DPU BlueField-3: это часть сетевой 400G/800G-платформы Spectrum-X, которая предусматривает использование коммутаторов на базе ASIC NVIDIA Spectrum-4 (51,2 Тбит/с). Отмечается, что сообща BlueField-3 SuperNIC и Spectrum-4 составляют основу вычислительной системы, специально разработанной для ускорения ИИ-нагрузок. При этом платформа Spectrum-X обеспечивает высокую эффективность сети, превосходя по производительности традиционные среды Ethernet. По заявления NVIDIA, DPU предоставляет множество расширенных функций, таких как высокая пропускная способность, подключение с небольшой задержкой и пр. 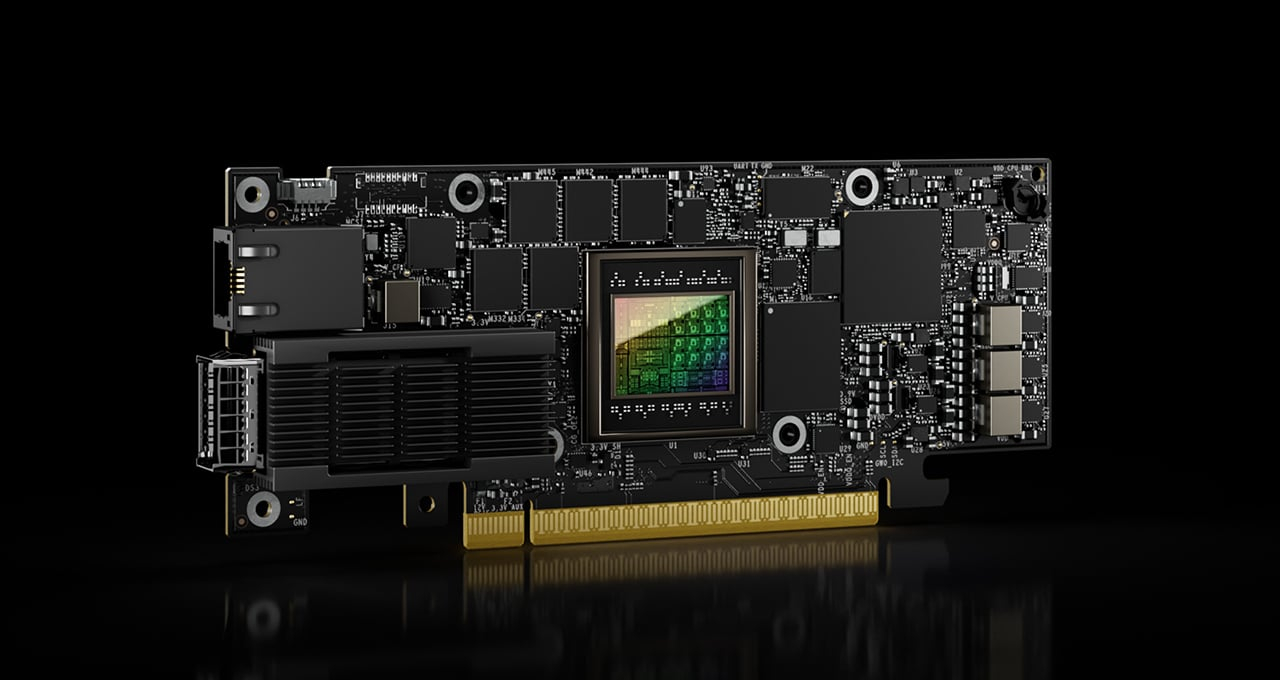
Источник изображения: NVIDIA Среди ключевых особенностей SuperNIC называются: высокоскоростное переупорядочение пакетов; расширенный контроль перегрузок с использованием данных в реальном времени и специализированных сетевых алгоритмов; возможность программирования ввода-вывода (I/O); энергоэффективный низкопрофильный дизайн; полная оптимизация для ИИ (включая вычисления, сети, хранилище, системное ПО, коммуникационные библиотеки). В одной системе могут быть задействованы до восьми SuperNIC, что позволяет добиться соотношения 1:1 с GPU. А это даёт возможность максимизировать производительность при выполнении сложных задач ИИ.
17.08.2023 [20:16], Алексей Степин
Brocade представила новые FC64-продукты — 512-портовый директор X7 и Ethernet-мост 7850 Extension SwitchПодразделение Brocade Storage Networking компании Broadcom представило новые коммутаторы класса Director, предлагающие до 512 портов FC64. Предельная пропускная способность заявлена на уровне 39,6 Тбайт/с. При этом сохранена совместимость с предыдущими поколениями Fibre Channel. Кроме того, был представлен и новый мост Ethernet ↔ Fibre Channel, который позволяет создавать распределённые SAN. Новые устройства серии Brocade X7 Directors являются наиболее высокоплотными в индустрии — они представлены в вариантах с 256 и 512 портами Fibre Channel седьмого поколения (64 Гбит/с на порт) в исполнениях 8U и 14U соответственно. Первое поколение X7 увидело свет ещё в 2020 году, но тогда оно было ограничено использованием 48-портовых лезвий FC64, что давало максимум 384 порта. Новый вариант использует новые 64-портовые модули с трансиверами SFP-DD, позволившими на треть поднять плотность портов. Устройства работают под управлением Fabric OS 9.0.x. 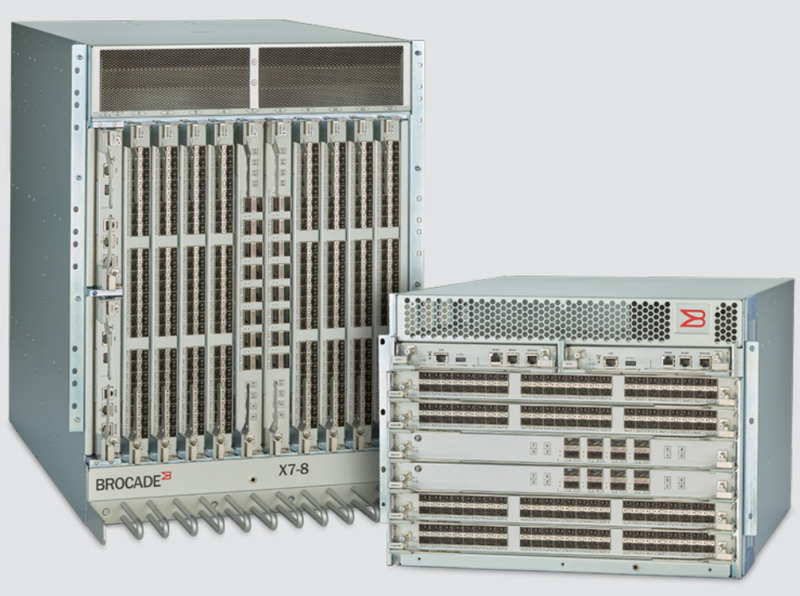
Источник изображений здесь и далее: Broadcom Другой интересной новинкой Brocade является коммутатор Brocade 7850 Extension Switch, делающий более простым построение географически распределённой SAN. По сути, это мост с 24 портами FC64/FICON, обеспечивающий проброс FC-трафика, для чего имеется 16 портов 25/10GbE, а также два WAN-порта 100GbE. WAN-трафик шифруется на лету на полной скорости по алгоритму AES с 256-битным ключом. Имеются механизмы защиты от кибер-атак, а также автоматическая проверка целостности ПО и аппаратного обеспечения. 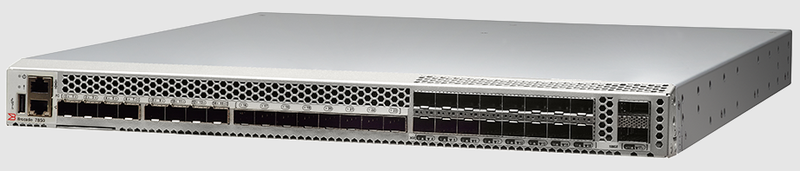
20.07.2023 [23:30], Игорь Осколков
AMD, Broadcom, Cisco, Intel и другие вендоры создадут интерконнект Ultra Ethernet для HPC и ИИAMD, Arista, Broadcom, Cisco, Eviden (Atos), HPE, Intel, Meta✴ и Microsoft в рамках Linux Foundation сформировали новый консорциум Ultra Ethernet Consortium, который намерен создать на базе Ethernet новый масштабируемый и эффективный с точки зрения стоимости коммуникационный стек, ориентированный на высокопроизводительные вычисления (HPC) и ИИ. Иными словами, речь идёт о создании спецификаций интерконнекта нового поколения на базе Ethernet для современных кластеров, облаков и иных платформ. UEC сформировал четыре рабочих группы, ответственных за физический, канальный и транспортный уровни, а также за уровень ПО. Целью же является создание современного сетевого стека, который учитывает потребности HPC- и ИИ-нагрузок, включая новые методы борьбы с заторами в сети, высокий уровень утилизации канала (в том числе 800G/1.6T), многопутевую и гарантированную доставку, сквозную телеметрию, консистентность и низкий уровень задержек, автоматизацию, безопасность и защищённость, масштабируемость, стабильность, надёжность, снижение TCO и так далее. 
Источник: Ultra Ethernet Consortium Фактически отдельные вендоры уже наделили рядом перечисленных свойств свои продукты, однако унификация и объединение усилий, как считается, должны пойти на пользу всем. Всем, кроме, по-видимому, NVIDIA, которой в списке основателей UEC нет (как и Marvell, к слову). NVIDIA после поглощения Mellanox фактически стала монополистом на рынке InfiniBand, который она активно продвигает, не забывая, впрочем, и о своём проприетарном интерконнекте NVLink, который в последней своей версии выбрался за пределы узла. Справедливости ради — про Ethernet компании тоже не забывает. В обзоре UEC аккуратно критикуется и InfiniBand, и его адаптация в виде RoCE. Авторы указывают на правильность и успешность идеи RDMA, но жалуются на не слишком высокую практичность и удобство современных реализаций. И именно поэтому они первым делом предлагают внедрить новый транспортный протокол Ultra Ethernet Transport (UET), который и позволит реализовать интерконнект будущего, а заодно ещё раз доказать эффективность и гибкость технологии Ethernet, которой в этом году исполнилось 50 лет. Впрочем, это только один из кирпичиков UEC. Примечательно, что первые продукты на базе новых спецификаций обещали показать уже в 2024 году.
25.06.2023 [16:53], Алексей Степин
Cisco представила ASIC Silicon One G200: 51,2 Тбит/с для ИИКомпания Cisco успешно выпустила новые ASIC для сетевых коммутаторов с производительностью 51,2 Тбит/с. Как заявляют разработчики, коммутаторы на базе чипа серии G200 способны объединить в единый комплекс 32 тыс. ускорителей. Новое решение входит в портфолио Cisco Silicon One и изначально нацелено на рынок гиперскейлеров и создателей ИИ-кластеров. В новом чипе в два раза увеличено количество блоков SerDes с производительностью 112 Гбит/с (с 256 до 512), что и позволило довести общую коммутационную производительность до 51,2 Тбит/с. Доступны конфигурации 64×800GbE, 128×400GbE или 256×200GbE, всё зависит от желаемой плотности размещения и скорости портов. Это, в частности, позволяет избавиться от избыточных уровней в топологии сети. 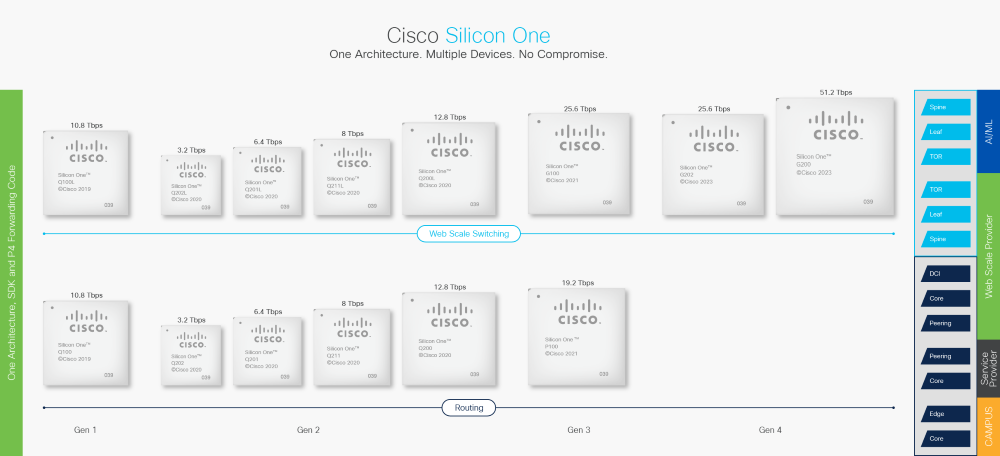
Источник изображений: Cisco Cisco отмечает, что новинка вдвое энергоэффективнее и имеет вдвое меньшую задержку в сравнении с G100. Кроме того, чипы предлагают расширенную телеметрию, поддержку языка P4 для обработки трафика на лету, а также возможность использования современных интерфейсов, в том числе интегрированную оптику или медные кабели длиной до 4 м, чего более чем достаточно для организации связи на уровне стойки. 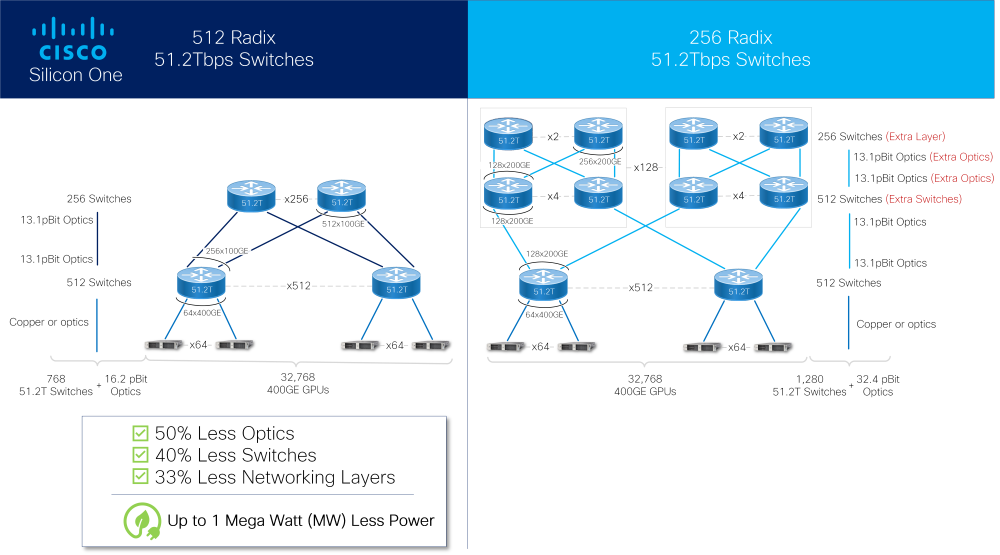 Как и Broadcom Tomahawk-5 или Jericho3-AI, Marvell Teralynx 10 и NVIDIA Spectrum-X, новый чип Cisco содержит возможности, востребованные в среде ИИ-систем, такие как продвинутые средства преодоления заторов в сети (congestion), технологии packet spraying и резервирование линков с возможностью мгновенного восстановления разорванного соединения. Новые чипы серии G200 уже поставляются, но компания пока не назвала даты появления на рынке коммутаторов Cisco на базе нового «кремния». |
|


