Материалы по тегу: интерконнект
|
01.05.2024 [17:00], Сергей Карасёв
Внутри и снаружи: PCI-SIG обнародовала спецификации кабелей CopprLink для PCIe 5.0/6.0Организация PCI Special Interest Group (PCI-SIG) обнародовала спецификации электрических кабелей и разъёмов CopprLink для внешних и внутренних подключений PCIe 5.0/6.0. Новые соединения на основе меди позволят заменить существующие кабели OCuLink в тех случаях, когда требуется более высокая пропускная способность. Стандарт CopprLink был анонсирован в конце 2023 года. Кабели данного типа обеспечат высокоскоростные подключения в пределах отдельных систем, а также между различными узлами в составе стойки. Кроме того, как отмечалось ранее, разрабатываются варианты для межстоечного соединения. Спецификация CopprLink для внутренних подключений:
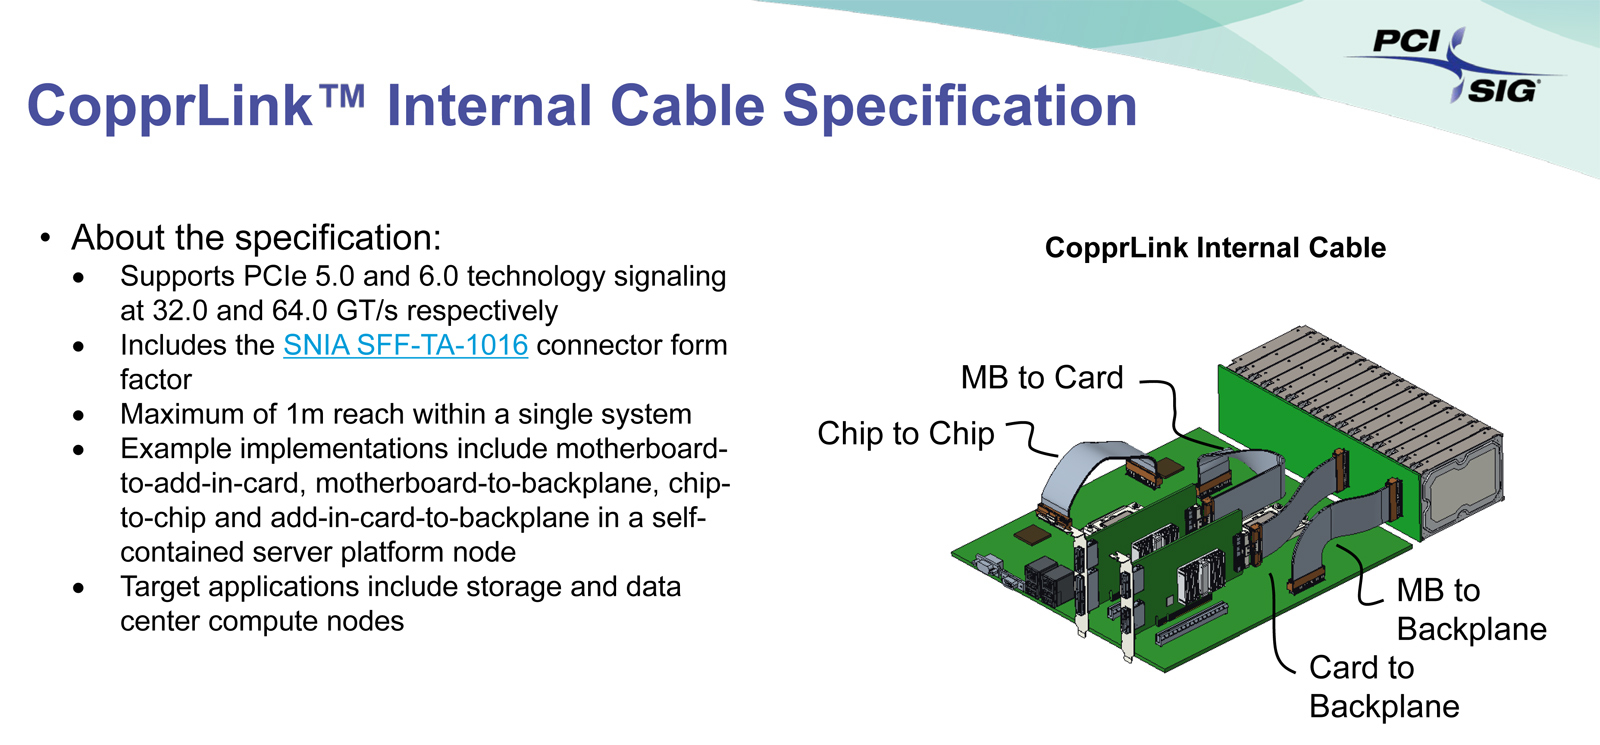
Источник изображений: PCI-SIG Спецификация CopprLink для внешних подключений:
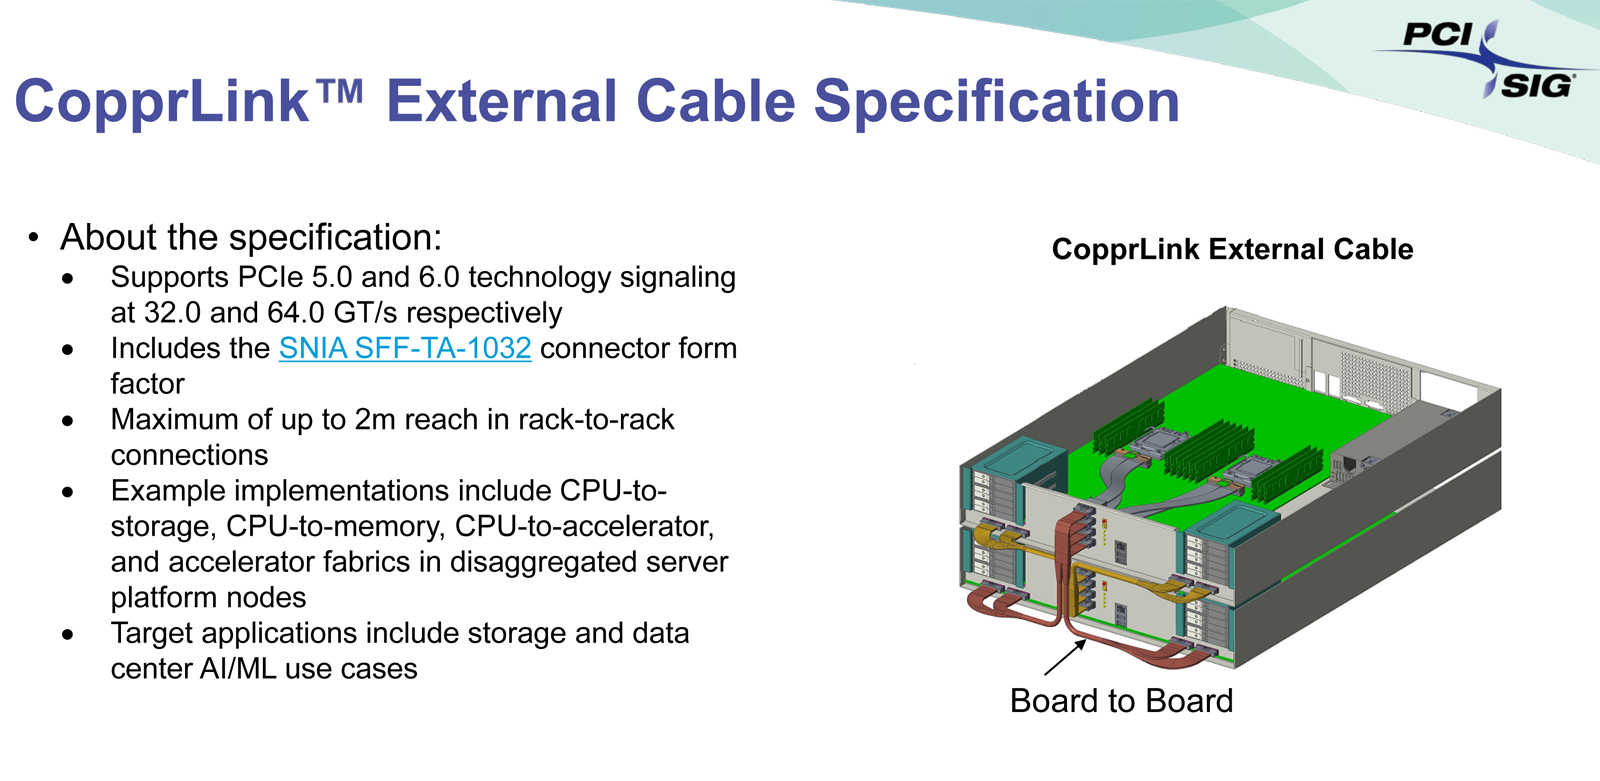 Отмечается, что в дальнейшем кабели CopprLink будут развиваться с учётом возможностей интерфейса PCIe следующих поколений. Технология CopprLink, как ожидается, будет востребована в сферах, где необходимы небольшие задержки, включая дата-центры, производительные СХД, сети и пр. В будущем ожидается появление оптических кабелей PCIe. 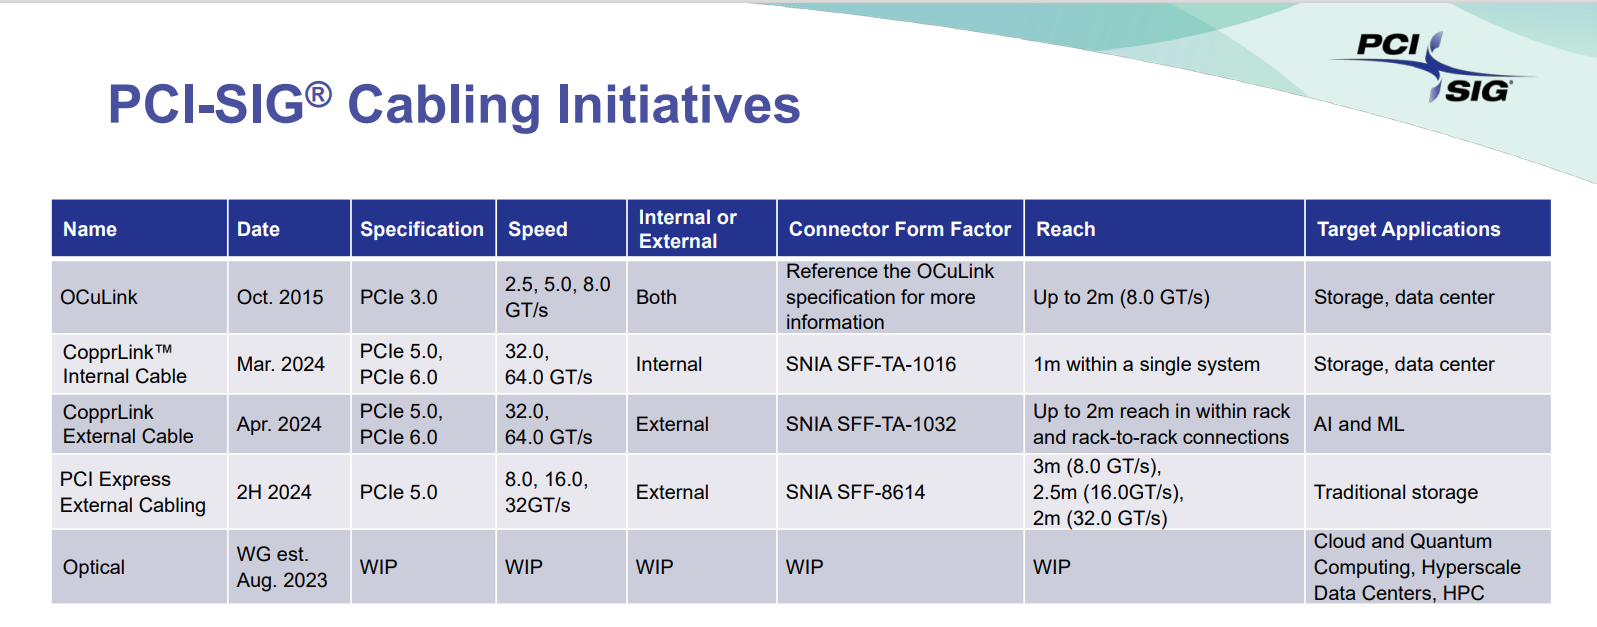
27.03.2024 [23:40], Сергей Карасёв
Coherent представила оптические коммутаторы для дата-центров, ориентированных на задачи ИИCoherent анонсировала специализированные оптические коммутаторы для ИИ-кластеров высокой плотности. В основу устройств Optical Circuit Switch (OCS) положена фирменная платформа кросс-коммутации Lightwave Cross-Connect (DLX). В изделиях, в отличие от традиционных коммутаторов, не применяются приемопередатчики для преобразования фотонов в электроны и обратно. Вместо этого все операции осуществляются в оптическом тракте: импульсы поступают в один порт и выходят из другого (конечно, с небольшим ослаблением). Coherent выделяет несколько ключевых преимуществ своей технологии. Прежде всего значительно возрастает производительность, что важно при решении ресурсоёмких задач, связанных с приложениями ИИ. Кроме того, благодаря отказу от преобразования среды сокращаются энерозатраты. Наконец, отпадает необходимость в обновлении собственно коммутаторов при установке в ЦОД оборудования следующего поколения. Это значительно повышает окупаемость капитальных затрат. 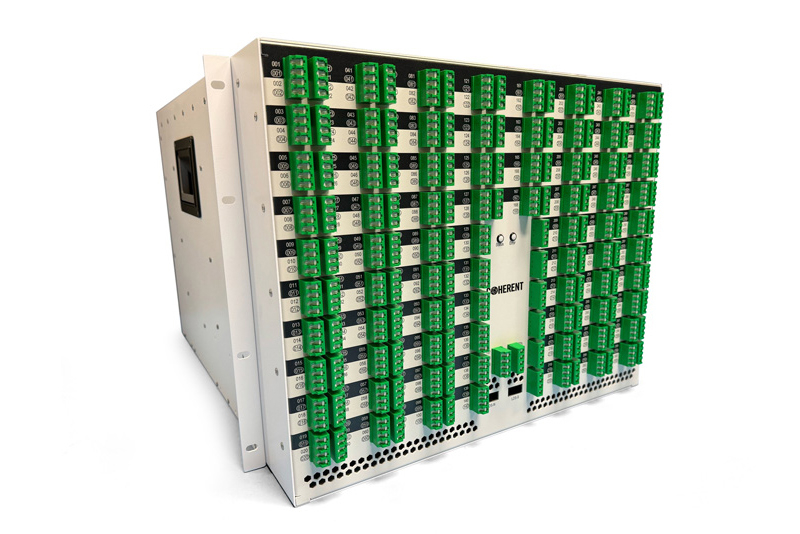
Источник изображения: Coherent Представленное решение насчитывает 300 входных и 300 выходных оптических портов. Коммутаторы OCS помогают решить проблемы масштабируемости и надёжности дата-центров, ориентированных на приложения ИИ. Аналитики Dell'Oro Group отмечают, что для ИИ-задач требуется более высокий уровень отказоустойчивости, нежели для традиционных приложений. Крайне важно, чтобы коммутаторы, используемые в составе ИИ-платформ, не провоцировали никаких перебоев во время обучения или эксплуатации больших языковых моделей. Устройства Coherent, как сообщается, обеспечивают необходимый уровень надёжности. Массовые поставки новых коммутаторов планируется организовать в 2025 году. При этом Google уже использует в своих дата-центрах оптические коммутаторы (OCS) собственной разработки на базе MEMS-переключателей для формирования ИИ-кластеров, а Meta✴ совместно с MIT разработала систему TopoOpt, представляющую собой оптическую патч-панель с манипулятором, который позволяет менять топологию сети.
22.03.2024 [21:10], Сергей Карасёв
Консорциум Ultra Ethernet пополнился 45 участниками, но NVIDIA среди них так и нетКонсорциум Ultra Ethernet объявил о том, что в его состав вошли 45 новых участников. Таким образом, на сегодняшний день общее количество членов этой организации достигает 55. К участию в Ultra Ethernet приглашаются и другие заинтересованные компании и институты. Напомним, консорциум был создан в июле 2023 года. Его задача заключается в разработке основанной на Ethernet открытой высокопроизводительной архитектуры с полным коммуникационным стеком, отвечающей задачам современных рабочих нагрузок ИИ и НРС. Изначально в состав Ultra Ethernet входили AMD, Arista, Broadcom, Cisco, Eviden (Atos), HPE, Intel, Meta✴ и Microsoft. Позднее к консорциуму присоединилась компания Cornelis Networks, поставщик HPC-интерконнекта на базе Omni-Path. 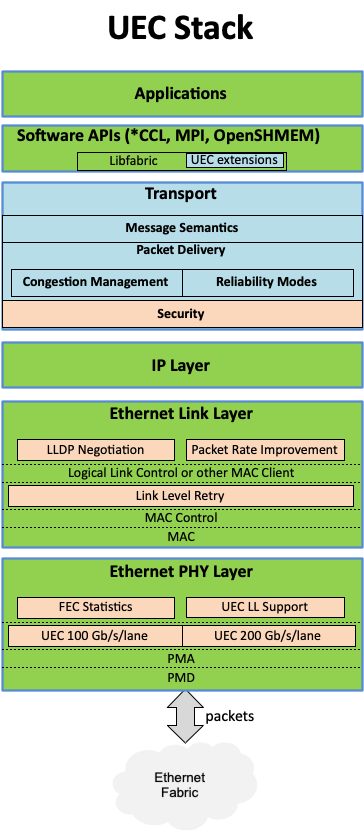
Источник изображения: Ultra Ethernet С ноября 2023-го организация начала принимать новых участников в массовом порядке. С тех пор инициативу поддержали Nokia, Lenovo, Baidu, Dell, Huawei, IBM, Supermicro, Tencent и многие другие компании. Примечательно, что в списке участников так и нет AWS, Google и NVIDIA. Последняя по-прежнему считает InfinBand лучшим интерконнектом для HPC/ИИ-кластеров и является фактически единственным поставщиком данной технологии. Более того, даже Ethernet-решения NVIDIA подвергаются критике со стороны конкурентов. 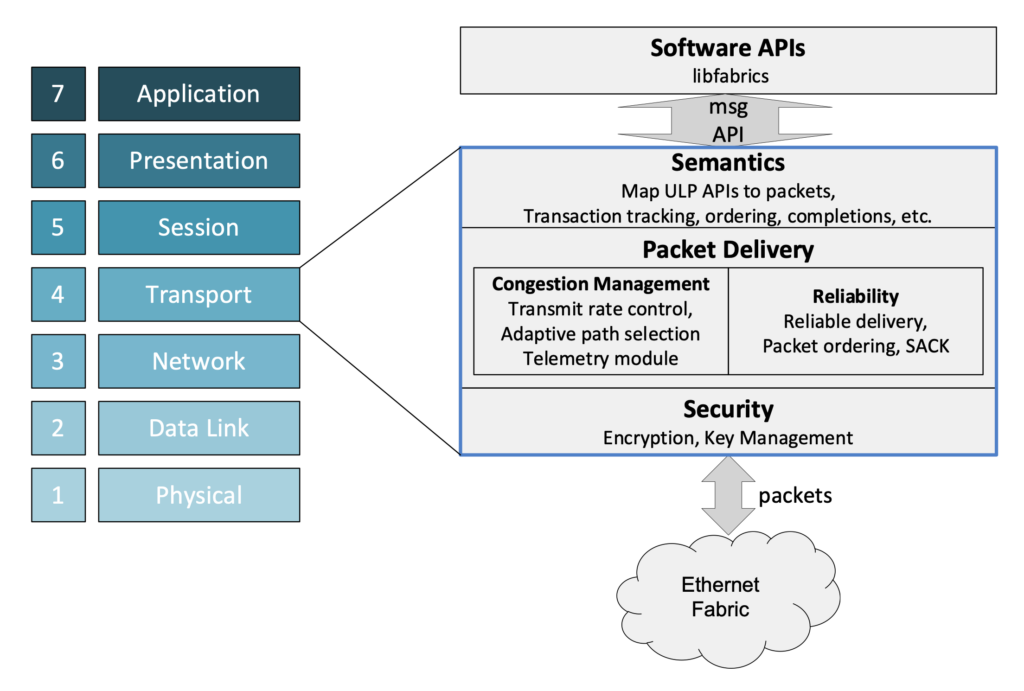
Источник изображения: Ultra Ethernet Для тех, кто заинтересован в работах в рамках проекта, Ultra Ethernet предлагает различные варианты участия через восемь технических групп. В их число, в частности, входят физический, транспортный и программный уровни, хранение, управление, отладка и пр. В настоящее время ведётся активная работа над спецификацией Ultra Ethernet версии 1.0: представить её планируется в III квартале текущего года. Ожидается, что совместная работа десятков IT-компаний в перспективе позволит создать революционные коммуникационные платформы.
22.03.2024 [09:09], Алексей Степин
NVIDIA представила 800G-платформы Quantum-X800 и Spectrum-X800 для InfiniBand- и Ethernet-фабрик нового поколенияДополнением к только что представленным ИИ-ускорителям NVIDIA Blackwell станут новые сетевые 800G-платформы Quantum-X800 и Spectrum-X800, а также сетевые адаптеры ConnectX-8. Именно они позволят вывести масштабирование ИИ-кластеров на новый уровень и позволят «прокормить» гигантские массивы ускорителей в дата-центрах гиперскейлеров. Платформа NVIDIA Quantum-X800 ориентирована на наиболее производительные ИИ- и HPC-кластеры. Она использует новое поколение технологии InfiniBand, всё ещё обладающей рядом преимуществ в сравнении с Ethernet, и включает в себя обновлённые SHARP-движки. Технология SHARPv4 реализует «вычисления в сети» (In-Network Computing), что позволяет не только существенно разгрузить вычислительные узлы и серверы, но и обеспечить более высокую пропускную способность интерконнекта вкупе с более серьёзными возможностями его масштабирования. 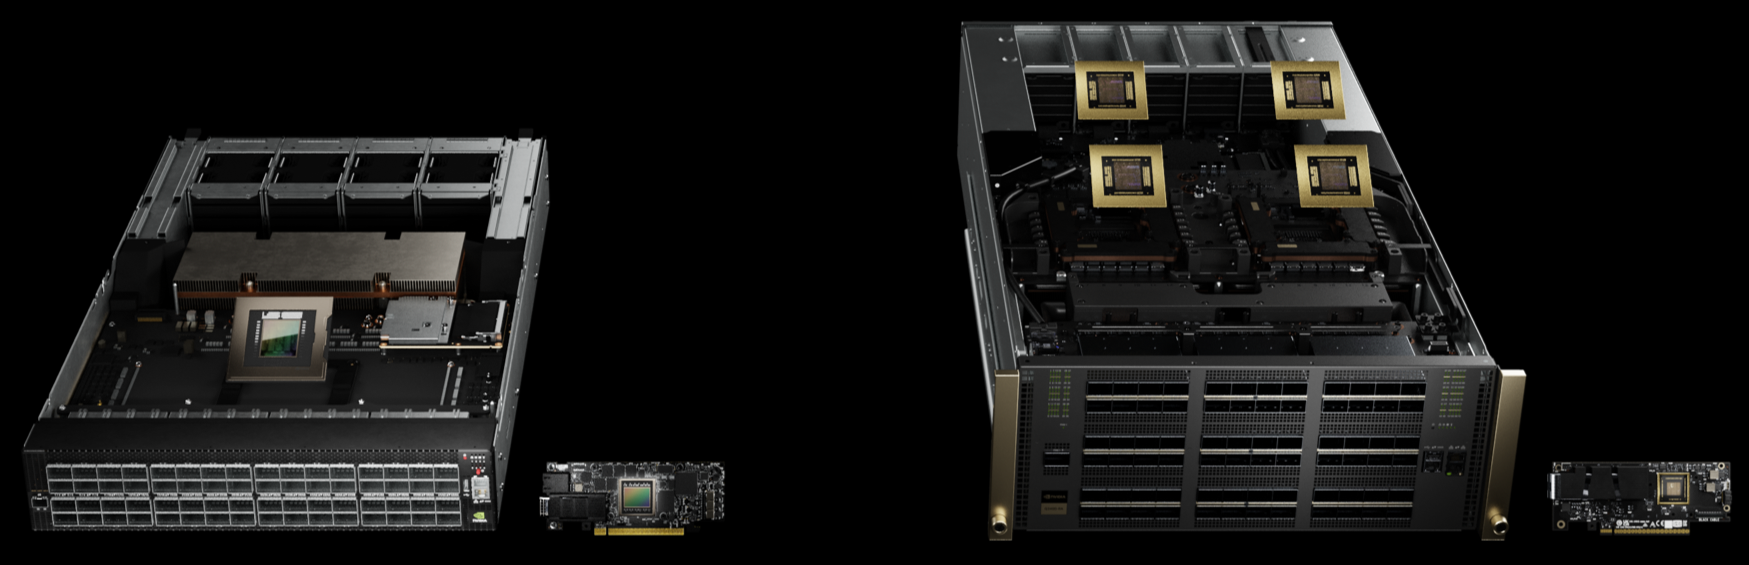
NVIDIA Q3400-RA 4U (справа) и SN5600. Источник изображений здесь и далее: NVIDIA Основой платформы Quantum-X800 стал 4U-коммутатор Q3400-RA, впервые в индустрии, как говорит компания, использующий 200G-блоки SerDes для каждой линии InfiniBand. Коммутатор располагает 144 портами 800G в 72 OSFP-модулях и выделенным портом для Unified Fabric Manager. Новинка имеет стандартное 19″ исполнение с воздушным охлаждением, но есть и вариант Q3400-LD с жидкостным охлаждением, предназначенный для 21″ OCP-стоек. В двухуровневом варианте fat tree коммутаторы позволят объединить 10 368 NIC. 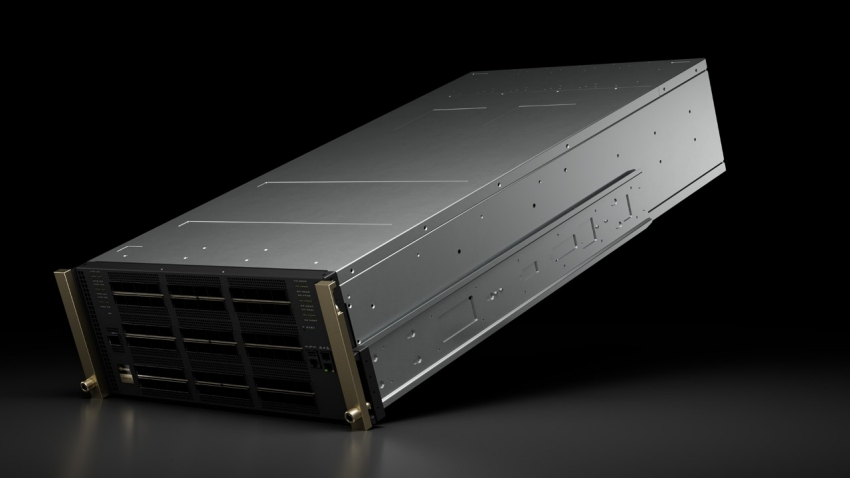 Основным адаптером для новой платформы InfiniBand является ConnectX-8 SuperNIC с интерфейсом PCIe 6.0. Он является частью SHARPv4 и предлагается в однопортовом (OSFP224) и двухпортовом (QSFP112) вариантах и в нескольких форм-факторах, включая OCP 3.0. На платах также имеется разъём SocketDirect на 16 линий PCIe. Также компания представила компоненты NVIDIA LinkX: оптические трансиверы 2xDR4/2xFR4 и активные медные кабели (LACC). 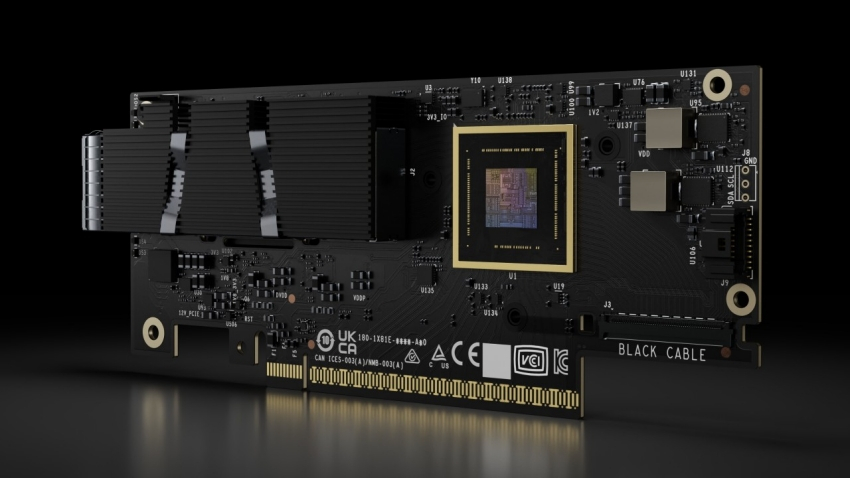 Не забыла NVIDIA и про Ethernet: здесь вывести производительность сети на новый уровень должна платформа Spectrum-X800. Её основой служит новейший коммутатор SN5600 — это, по словам NVIDIA, первый в мире Ethernet-коммутатор класса 800GbE, специально разработанный для применения гиперскейлерами в крупных облачных ИИ-комплексах. Применяемая архитектура позволяет гарантировать каждому клиенту оптимальный и постоянный уровень производительности, а потоковая телеметрия позволит находить и ликвидировать возможные «бутылочные горлышки» в сети буквально на лету. 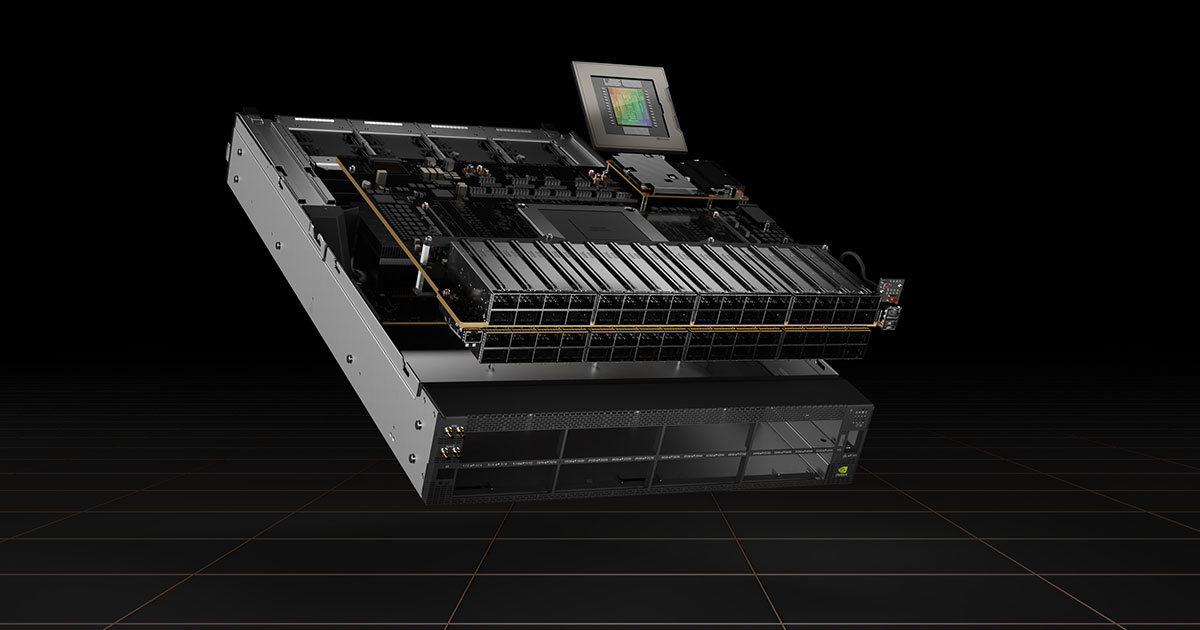 Общая пропускная способность SN5600 составляет 51,2 Тбит/с. Коммутатор располагает 64 портами 800GbE в формате OSFP. В нём используется ASIC пятого поколения на базе архитектуры Spectrum-4. В качестве основного адаптера предлагается SuperNIC на базе DPU BlueField-3 с двумя 400GbE-портами. 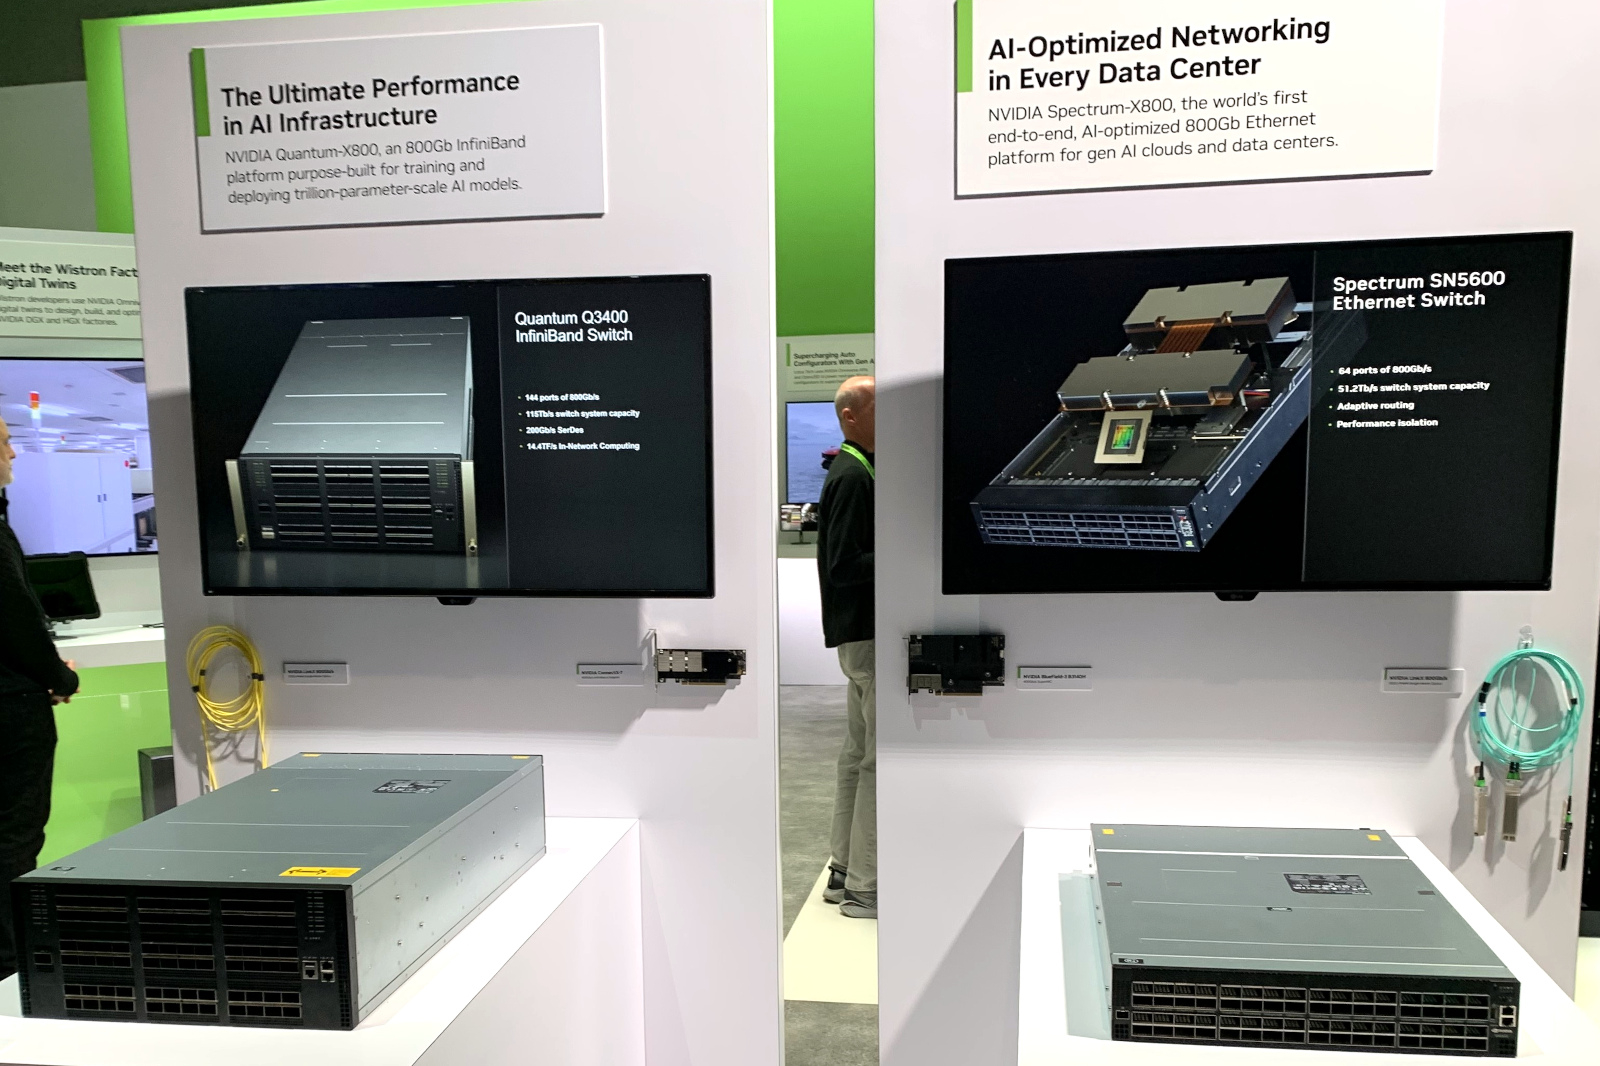
Фото: Twitter/NVIDIANetworkng Spectrum-X800 сопровождает полноценный спектр инфраструктурных компонентов, включая кабели DAC и LACC. С оптическими трансиверами длина соединения 800GbE может достигать двух километров. Начиная со следующего года, решения на базе новых сетевых платформ NVIDIA будут доступны от широкого круга поставщиков оборудования, включая Aivres, DDN, Dell Technologies, Eviden, Hitachi Vantara, HPE, Lenovo, Supermicro и VAST Data.
08.03.2024 [00:03], Алексей Степин
Broadcom готовит чипы для PCIe 6.0/7.0 с поддержкой AMD Infinity FabricОдним из столпов, на которых зиждется господство NVIDIA в мире ускорителей, является NVLink — высокоскоростной интерконнект, позволяющий чипам общаться напрямую не только в составе одного узла, но и за его пределами. AMD пытается ответить на это продвижением XGMI/Infinity Fabric, и в предварительном обзоре Instinct MI300 были затронуты вопросы топологии серверов в исполнении «красных». Ещё тогда, в момент анонса MI300, компания Broadcom объявила о поддержке данного интерконнекта в будущих поколениях своих PCIe-коммутаторов, а сейчас ресурс ServeTheHome поделился новыми подробностями. XGMI действительно станет коммутируемым, что упростит масштабирование систем на базе ускорителей AMD Instinct. Интерконнект получил официально название AFL (Accelerated Fabric Link). В основе AFL по-прежнему будет лежать PCI Express, в данном случае речь идёт уже о PCI Express 7.0. Поддержка данной технологии дебютирует в PCIe-коммутаторах Broadcom Atlas 4. В дополнение к ним будут выпущены и новые ретаймеры Vantage 7, которые также получат поддержку CXL 4.0. 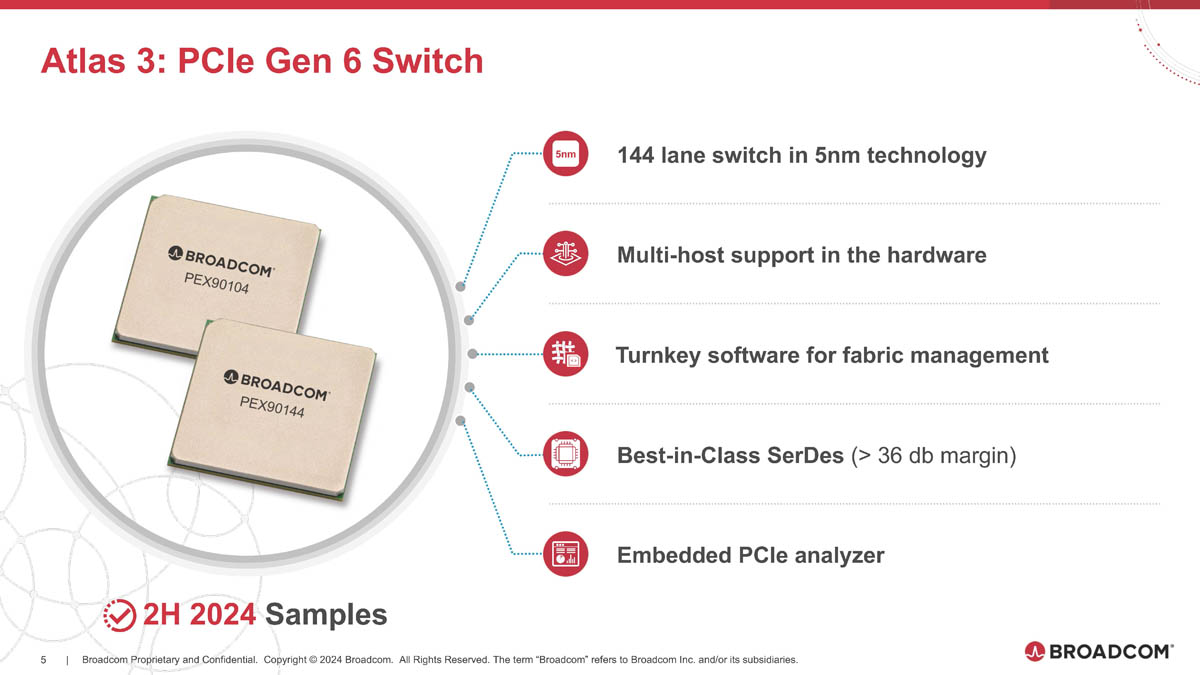
Источник здесь и далее: Broadcom via ServeTheHome Но перед этим Broadcom начнёт поставки образцов чипов-коммутаторов Atlas 3 со 144 линиями PCIe 6.0 во II половине 2024 года, а серверы с такими коммутаторами появятся в 2025 году. Поддержка CXL здесь будет расширена до версии 3.1. 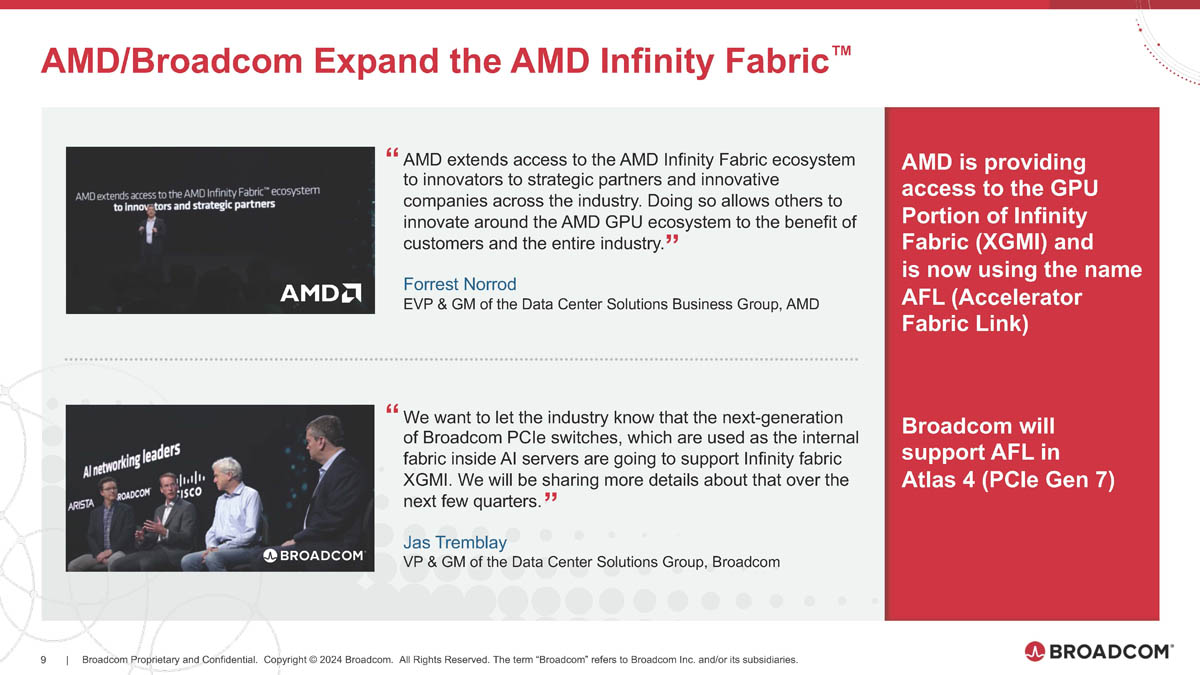 Что касается ретаймеров, то здесь Broadcom уже нанесла ответный удар Astera Labs, анонсировав чипы серий Vantage 5 и Vantage 6 для экосистем PCI Express 5.0 и PCI Express 6.0 соответственно. Они будут выпускаться в вариантах с 8 и 16 линиями с опцией бифуркации и поддержкой CXL 2.0 и 3.1. Broadcom заявляет о более низком энергопотреблении, достигнутом за счёт применения 5-нм техпроцесса, лучших в индустрии блоках SerDes и расширенных средствах диагностики, интегрированных в новые ретаймеры. 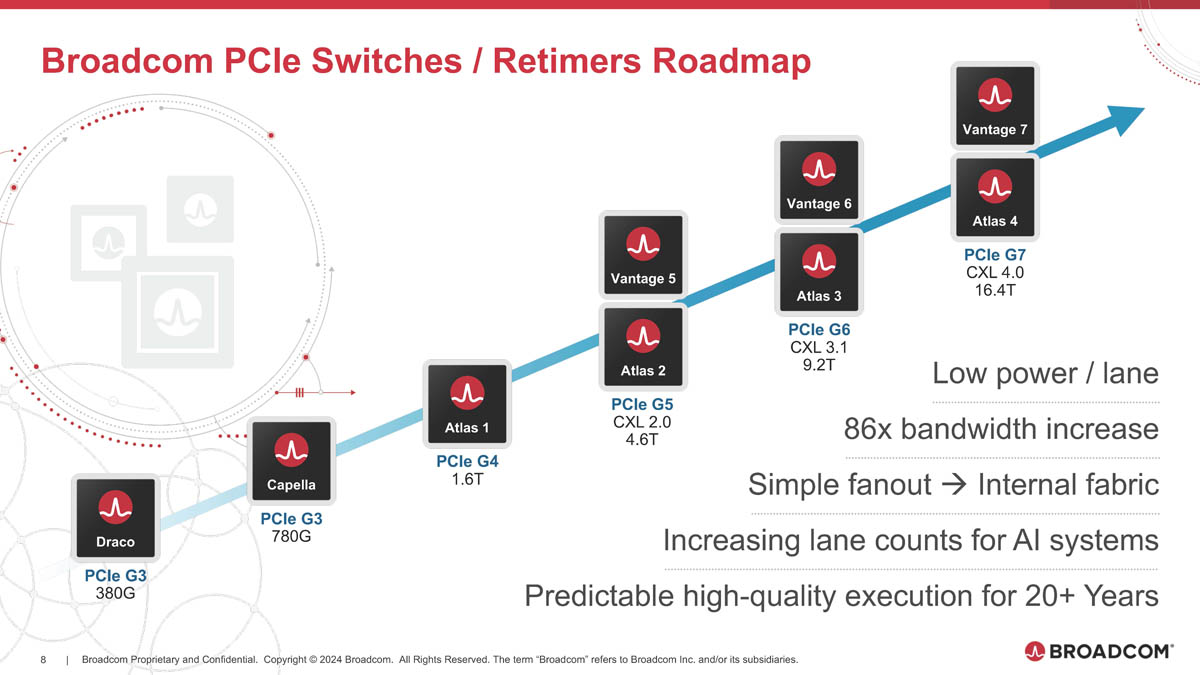 Экономичность здесь играет важную роль: хотя даже 7-нм ретаймер потребляет немного, таких микросхем в составе каждого GPU-сервера несколько, что при дальнейшем масштабировании выливается весьма серьёзные цифры. К тому же меньшая нагрузка ляжет и на систему охлаждения, ведь если CPU и ускорители могут обслуживаться СЖО, то остальные компоненты в таких серверах по-прежнему охлаждаются обычными вентиляторами. 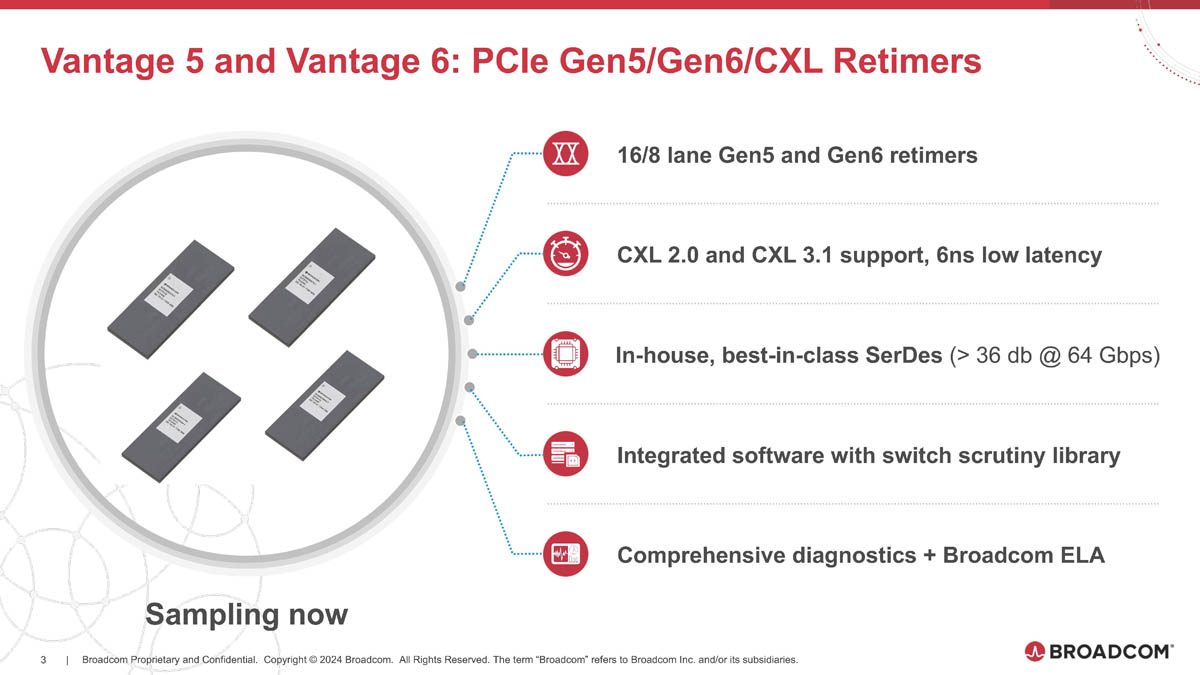 Что касается SerDes-блоков, то они позволят на 40 % удлинить соединения при сохранении стабильной работы. Ну а наличие продвинутого диагностического программного обеспечения с расширенными возможностями упростит разработку, отладку и ремонт систем нового поколения. 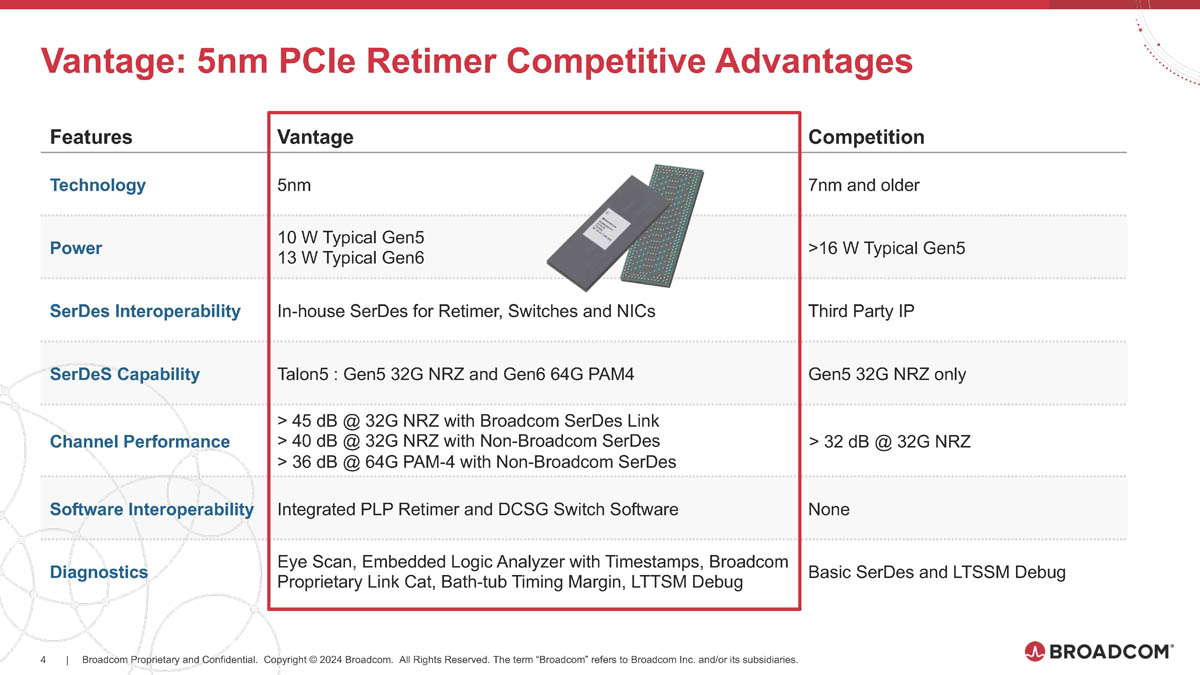 Ретаймеры Vantage 5 будут использоваться в комплекте с коммутаторами Atlas 2 в решениях Broadcom уже сегодня, они обеспечат поддержку CXL 2.0, ну а системы с Vantage 6 и поддержкой CXL 3.1, как уже упоминалось, должны увидеть свет в следующем году. 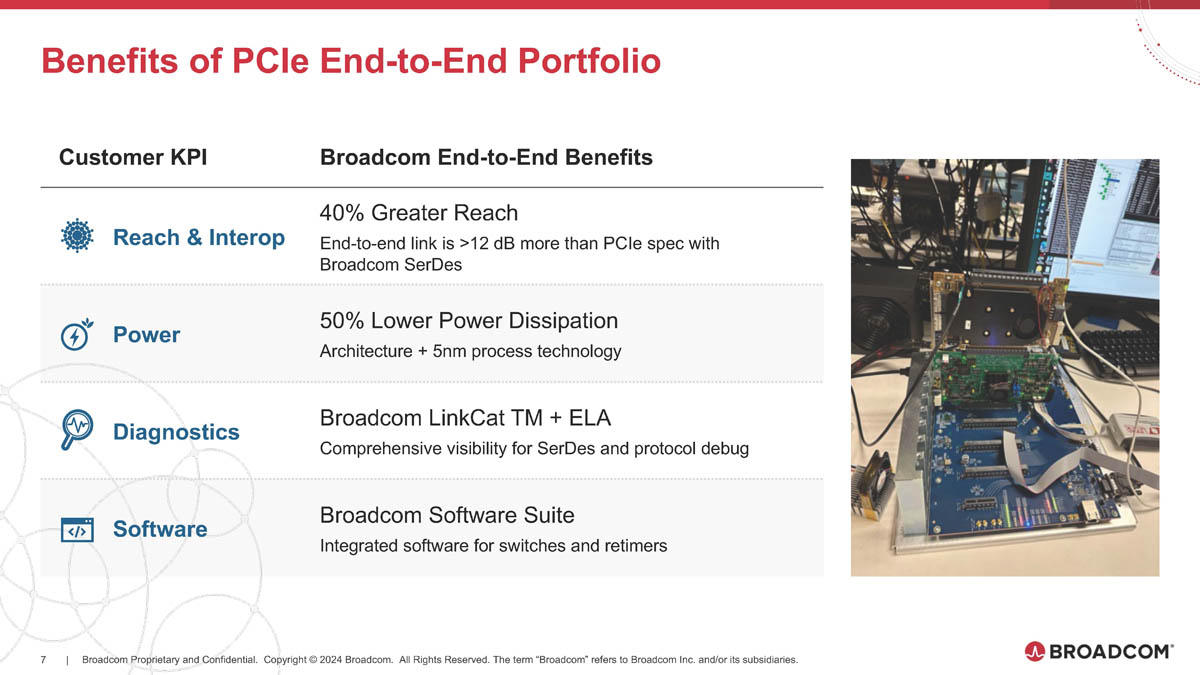 Astera Labs есть о чём беспокоиться: если на данный момент её ретаймерам почти нет альтернативы, то уже в ближайшем будущем ситуация может коренным образом измениться, поскольку Broadcom явно осознала всю важность этого компонента в экосистеме PCI Express и оценила солидный объём потенциальной клиентской базы.
09.08.2023 [18:28], Алексей Степин
Lightelligence представила оптический CXL-интерконнект PhotowaveКомпания Lightelligence, специализирующаяся в области фотоники и оптических вычислений, анонсировала любопытную новинку — систему оптического интерконнекта для ЦОД нового поколения. Решение под названием Photowave реализовано на базе стандарта CXL и призвано упростить и сделать более надёжными системы с композитной инфраструктурой, заменив традиционные медные кабели оптоволокном. Решение Photowave — дальнейшее развитие парадигмы Lightelligence, уже представившей ранее первый оптический ускоритель Hummingbird для ИИ-систем. Сердцем Photowave является оптический трансивер oNET на базе фирменных технологий компании. Согласно заявлениям Lightelligence, уровень задержки составляет менее 20 нс на уровне адаптера, кабель добавляет к этой цифре менее 1 нс. 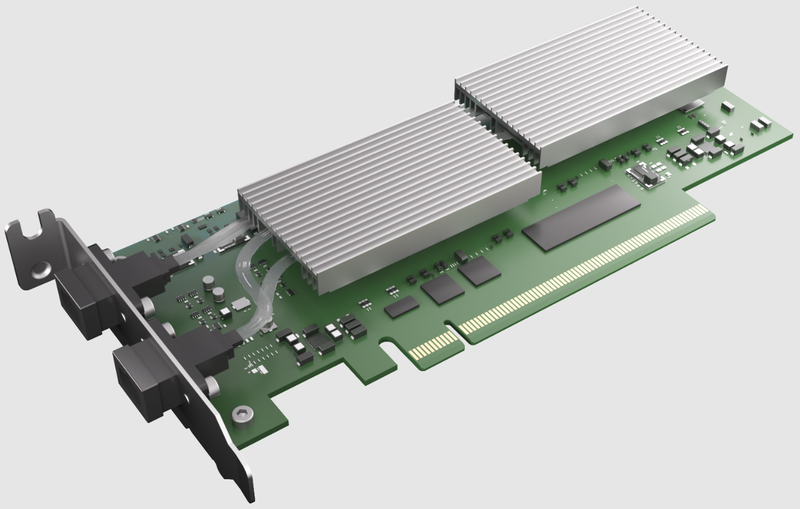
Источник изображений здесь и далее: Lightelligence Серия Photowave включает в себя трансиверы в разных форм-факторах — как в виде традиционной платы расширения PCI Express, так и в виде карты OCP 3.0 SFF. Платы трансиверов поддерживают CXL 2.0/PCIe 5.0 с числом линий от 2 до 16. Пропускная способность каждой линии составляет 32 Гбит/с. 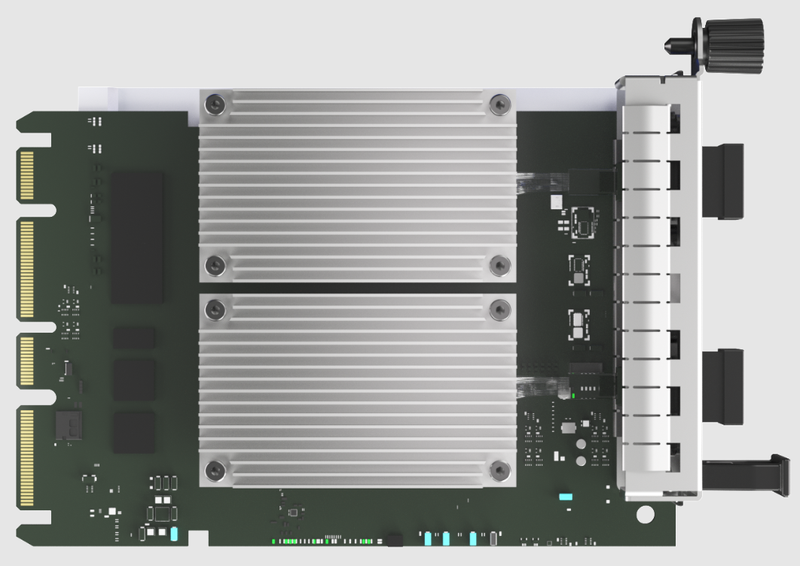 Как уже упоминалось, главная задача Photowave — создание эффективных и надёжных композитных инфраструктур в ЦОД нового поколения, где благодаря всесторонней поддержки CXL будет достигнута высокая степень дезагрегации вычислительных ресурсов, а также памяти и хранилищ.
02.08.2023 [18:00], Сергей Карасёв
Светлое будущее: у PCIe появится версия с оптическими соединениями — создана рабочая группа для разработки технологииКонсорциум PCI-SIG объявил о формировании рабочей группы PCI-SIG Optical Workgroup, которая займётся реализацией интерфейса PCI Express (PCIe) по оптическим соединениям. Это, как ожидается, станет важным этапом развития соответствующей экосистемы. Внедрение оптических соединений для PCIe по сравнению с существующими решениями обеспечит более высокую пропускную способность, пониженное энергопотребление, увеличенную дальность действия и меньшие задержки. 
Источник изображения: pixabay.com Новая технология, как ожидается, будет востребована в облачных дата-центрах, системах НРС и на площадках гиперскейлеров. Речь идёт о создании системы, поддерживающей широкий спектр оптических технологий. Консорциум PCI-SIG призывает всех своих участников присоединиться к Optical Workgroup, поделиться опытом и помочь определить конкретные цели рабочей группы и требования к аппаратным компонентам. Новая рабочая группа сосредоточит усилия над тем, чтобы сделать архитектуру PCIe более подходящей для оптических сетей. Между тем, как отмечается, продолжаются работы над спецификацией PCIe 7.0, которая предусматривает увеличение производительности до 128 ГТ/с по одной линии.
20.07.2023 [23:30], Игорь Осколков
AMD, Broadcom, Cisco, Intel и другие вендоры создадут интерконнект Ultra Ethernet для HPC и ИИAMD, Arista, Broadcom, Cisco, Eviden (Atos), HPE, Intel, Meta✴ и Microsoft в рамках Linux Foundation сформировали новый консорциум Ultra Ethernet Consortium, который намерен создать на базе Ethernet новый масштабируемый и эффективный с точки зрения стоимости коммуникационный стек, ориентированный на высокопроизводительные вычисления (HPC) и ИИ. Иными словами, речь идёт о создании спецификаций интерконнекта нового поколения на базе Ethernet для современных кластеров, облаков и иных платформ. UEC сформировал четыре рабочих группы, ответственных за физический, канальный и транспортный уровни, а также за уровень ПО. Целью же является создание современного сетевого стека, который учитывает потребности HPC- и ИИ-нагрузок, включая новые методы борьбы с заторами в сети, высокий уровень утилизации канала (в том числе 800G/1.6T), многопутевую и гарантированную доставку, сквозную телеметрию, консистентность и низкий уровень задержек, автоматизацию, безопасность и защищённость, масштабируемость, стабильность, надёжность, снижение TCO и так далее. 
Источник: Ultra Ethernet Consortium Фактически отдельные вендоры уже наделили рядом перечисленных свойств свои продукты, однако унификация и объединение усилий, как считается, должны пойти на пользу всем. Всем, кроме, по-видимому, NVIDIA, которой в списке основателей UEC нет (как и Marvell, к слову). NVIDIA после поглощения Mellanox фактически стала монополистом на рынке InfiniBand, который она активно продвигает, не забывая, впрочем, и о своём проприетарном интерконнекте NVLink, который в последней своей версии выбрался за пределы узла. Справедливости ради — про Ethernet компании тоже не забывает. В обзоре UEC аккуратно критикуется и InfiniBand, и его адаптация в виде RoCE. Авторы указывают на правильность и успешность идеи RDMA, но жалуются на не слишком высокую практичность и удобство современных реализаций. И именно поэтому они первым делом предлагают внедрить новый транспортный протокол Ultra Ethernet Transport (UET), который и позволит реализовать интерконнект будущего, а заодно ещё раз доказать эффективность и гибкость технологии Ethernet, которой в этом году исполнилось 50 лет. Впрочем, это только один из кирпичиков UEC. Примечательно, что первые продукты на базе новых спецификаций обещали показать уже в 2024 году.
22.04.2023 [00:15], Алексей Степин
Ловкость роборук: TopoOpt от Meta✴ и MIT поможет ускорить и удешевить обучение ИИТехнологии искусственного интеллекта (ИИ) сегодня бурно развиваются и требуют всё более серьёзных вычислительных мощностей. Но наряду с наращиванием этих мощностей растут требования и к сетевой подсистеме, поэтому крупные компании и исследовательские организации ищут всё новые способы оптимизации инфраструктуры. Компания Meta✴ в сотрудничестве с Массачусетским технологическим институтом (MIT) и рядом прочих исследовательских организаций опубликовала данные любопытного эксперимента, в котором ИИ-кластер мог менять топологию своего интерконнекта с помощью механической «роборуки». Система получила название TopoOpt, поскольку вычислительные узлы в ней использовали полностью оптическую сеть с оптической же патч-панелью. Эта сеть объединяла 12 вычислительных узлов ASUS ESC4000A-E10, каждый из которых был оснащён ускорителем NVIDIA A100, сетевыми адаптерами HPE и Mellanox ConnectX-5 (100 Гбит/с) с оптическими трансиверами. 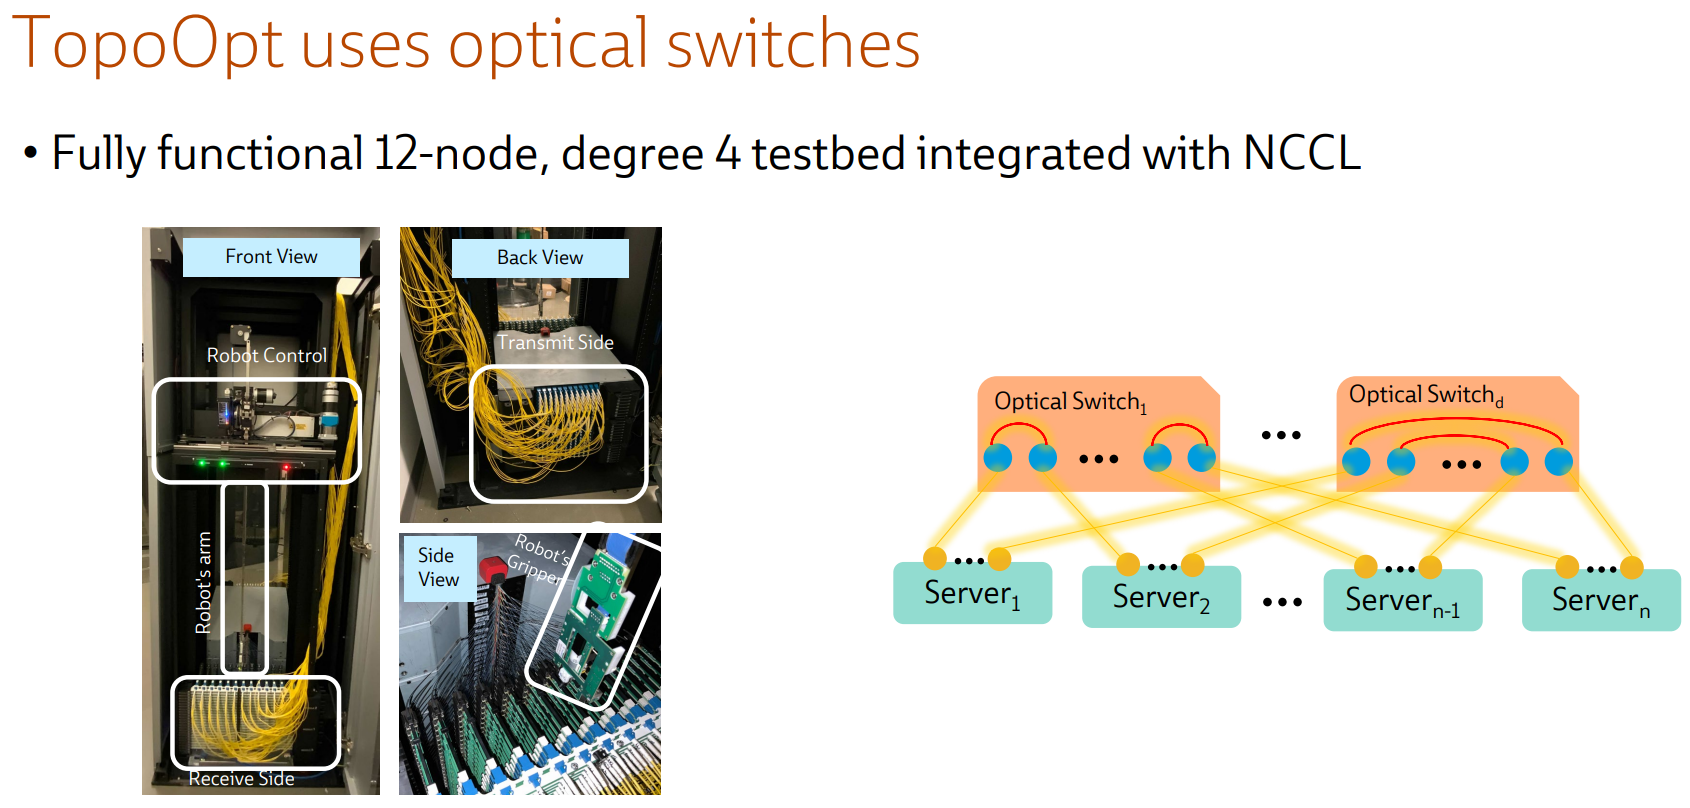
Источник здесь и далее: USENIX Наиболее интересное устройство в эксперименте — оптическая патч-панель Telescent, оснащённая механическим манипулятором, способным производить перекоммутацию на лету. Эта «роборука» работала под управлением специализированного ПО, целью которого ставилось нахождение оптимальной сетевой топологии и сегментации сети применительно к различным задачам машинного обучения. 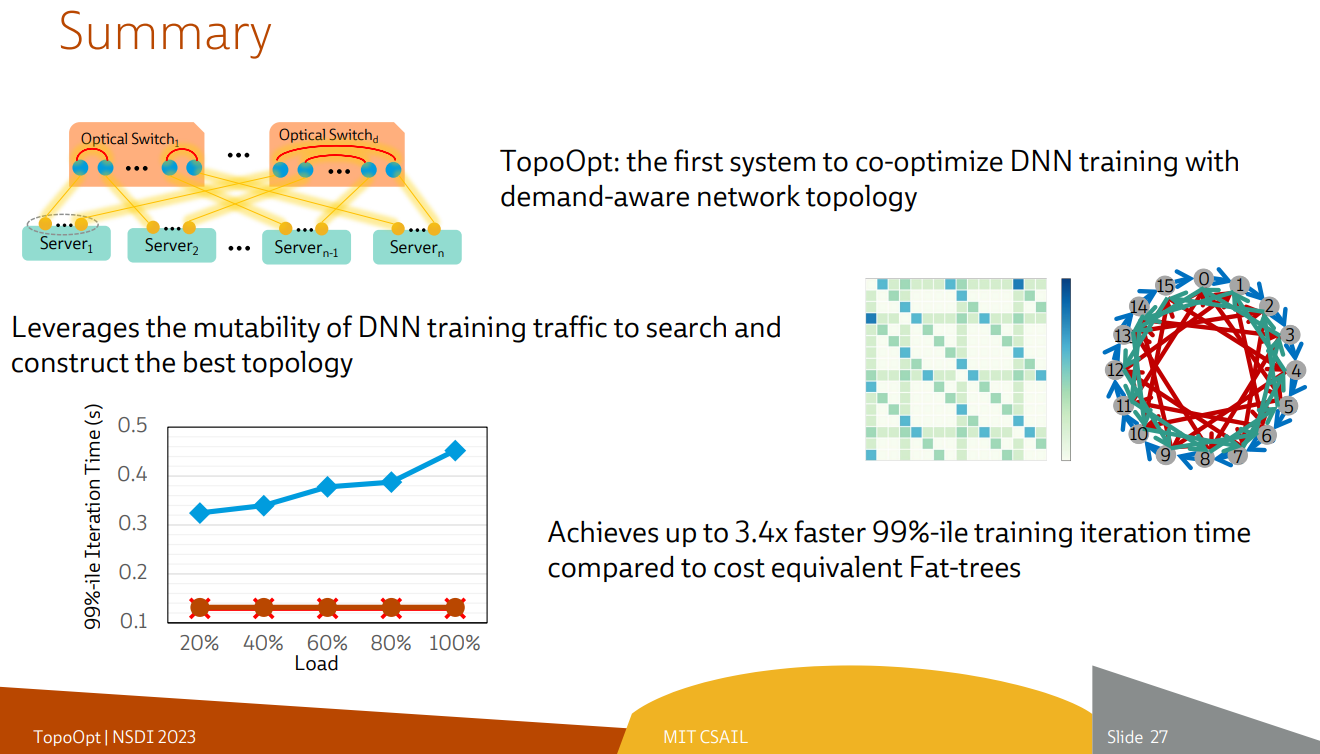
Система с перекоммутируемой оптической сетью не требует энергоёмких высокоскоростных коммутаторов и обеспечивает ряд других преимуществ Такая роботизированная патч-панель не столь расторопна, как оптические коммутаторы Google с микрозеркальной механикой, но стоит впятеро дешевле и имеет больше портов. Опубликованные экспериментальные данные уверенно свидетельствуют о том, что топология «толстого дерева» (fat tree), использующая несколько слоёв коммутаторов, не оптимальна и даже избыточна для ряда нейросетевых задач. К тому же перекоммутируемая оптическая сеть без традиционных высокоскоростных коммутаторов требует меньше оборудования, а значит, может быть не только быстрее сети fat tree в ряде ИИ-задач, но и существенно дешевле в развёртывании и поддержании в рабочем состоянии — как минимум за счёт отсутствия затрат на питание множества коммутаторов.
07.04.2023 [20:36], Сергей Карасёв
Google заявила, что её ИИ-кластеры на базе TPU v4 и оптических коммутаторов эффективнее кластеров на базе NVIDIA A100 и InfiniBandКомпания Google обнародовала новую информацию о своей облачной суперкомпьютерной платформе Cloud TPU v4, предназначенной для решения задач ИИ и машинного обучения с высокой эффективностью. Система может использоваться в том числе для работы с крупномасштабными языковыми моделями (LLM). Один кластер Cloud TPU Pod содержит 4096 чипов TPUv4, соединённых между собой через оптические коммутаторы (OCS). По словам Google, решение OCS быстрее, дешевле и потребляют меньше энергии по сравнению с InfiniBand. Google также утверждает, что в составе её платформы на OCS приходится менее 5 % от общей стоимости. Причём данная технология даёт возможность динамически менять топологию для улучшения масштабируемости, доступности, безопасности и производительности. Отмечается, что платформа Cloud TPU v4 в 1,2–1,7 раза производительнее и расходует в 1,3–1,9 раза меньше энергии, чем платформы на базе NVIDIA A100 в системах аналогичного размера. Правда, пока компания не сравнивала TPU v4 с более новыми ускорителями NVIDIA H100 из-за их ограниченной доступности и 4-нм архитектуры (по сравнению с 7-нм у TPU v4). 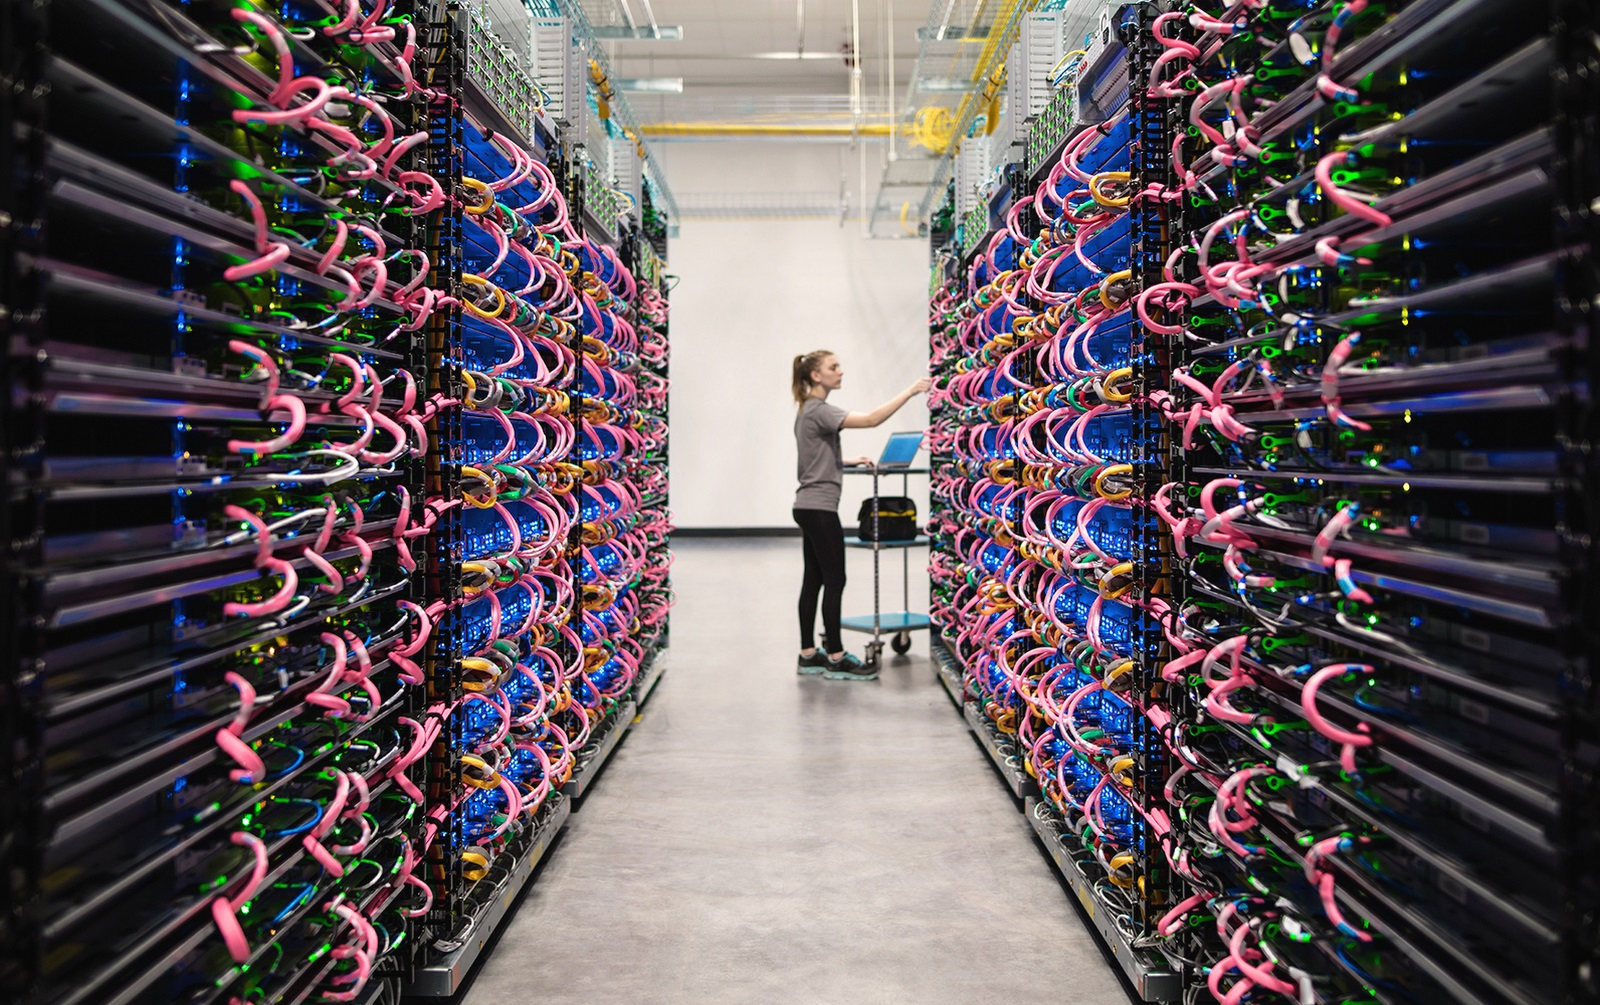
Изображение: Google Благодаря ключевым инновациям в области интерконнекта и специализированных ускорителей (DSA, Domain Specific Accelerator) платформа Google Cloud TPU v4 обеспечивает почти 10-кратный прирост в масштабировании производительности по сравнению с TPU v3. Это также позволяет повысить энергоэффективность примерно в 2–3 раза по сравнению с современными DSA ML и сократить углеродный след примерно в 20 раз по сравнению с обычными дата-центрами. |
|

