
Материалы по тегу: mi300
|
20.11.2024 [10:56], Сергей Карасёв
Microsoft представила инстансы Azure HBv5 на основе уникальных чипов AMD EPYC 9V64H с памятью HBM3Компания Microsoft на ежегодной конференции Ignite для разработчиков, IT-специалистов и партнёров анонсировала облачные инстансы Azure HBv5 для HPC-задач, которые предъявляют наиболее высокие требования к пропускной способности памяти. Новые виртуальные машины оптимизированы для таких приложений, как вычислительная гидродинамика, автомобильное и аэрокосмическое моделирование, прогнозирование погоды, исследования в области энергетики, автоматизированное проектирование и пр. Особенность Azure HBv5 заключается в использовании уникальных процессоров AMD EPYC 9V64H (поколения Genoa). Эти чипы насчитывают 88 вычислительных ядер Zen4, тактовая частота которых достигает 4 ГГц. Ближайшим родственником является изделие EPYC 9634, которое содержит 84 ядра (168 потоков) и функционирует на частоте до 3,7 ГГц. По данным ресурса ComputerBase.de, чип EPYC 9V64H также фигурирует под именем Instinct MI300C: по сути, это процессор EPYC, дополненный памятью HBM3. При этом клиентам предоставляется возможность кастомизации характеристик. Отметим, что ранее x86-процессоры с набортной памятью HBM2e были доступны в серии Intel Max (Xeon поколения Sapphire Rapids). Каждый инстанс Azure HBv5 объединяет четыре процессора EPYC 9V64H, что в сумме даёт 352 ядра. Система предоставляет доступ к 450 Гбайт памяти HBM3, пропускная способность которой достигает 6,9 Тбайт/с. Задействован интерконнект NVIDIA Quantum-2 InfiniBand со скоростью передачи данных до 200 Гбит/с в расчёте на CPU. 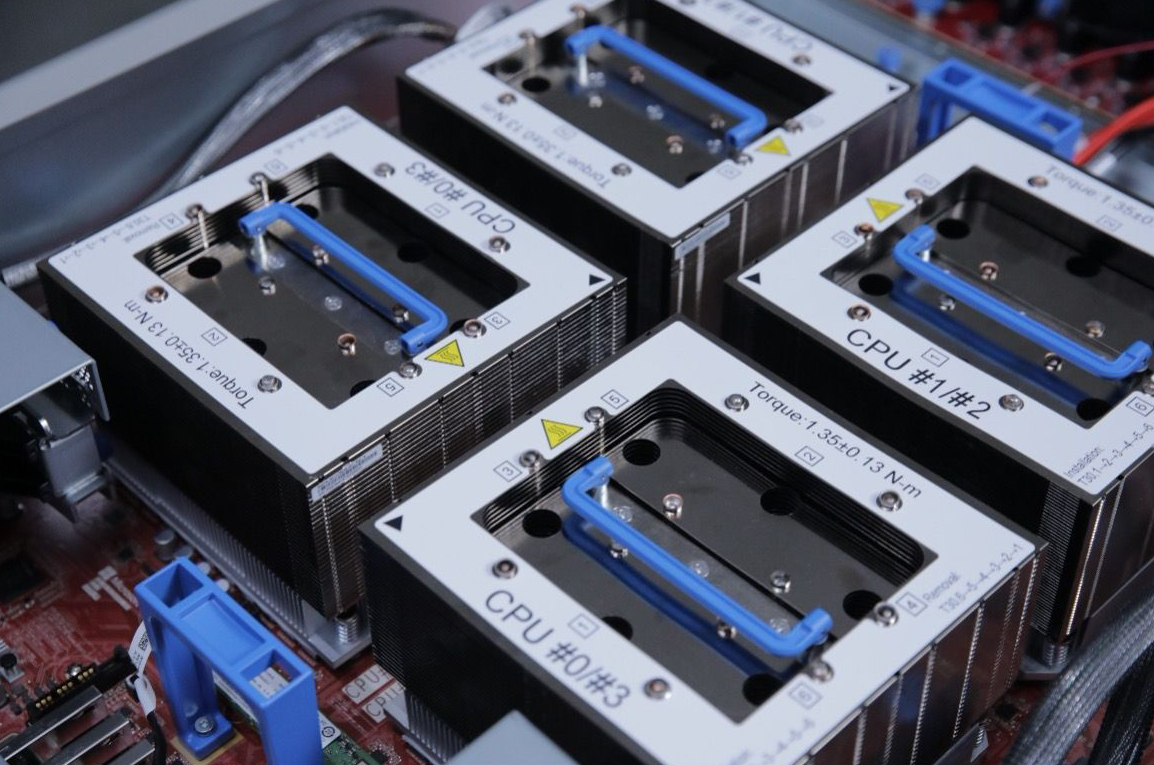
Источник изображений: Microsoft Применены сетевые адаптеры Azure Boost NIC второго поколения, благодаря которым пропускная способность сети Azure Accelerated Networking находится на уровне 160 Гбит/с. Для локального хранилища на основе NVMe SSD заявлена скорость чтения информации до 50 Гбайт/с и скорость записи до 30 Гбайт/с. 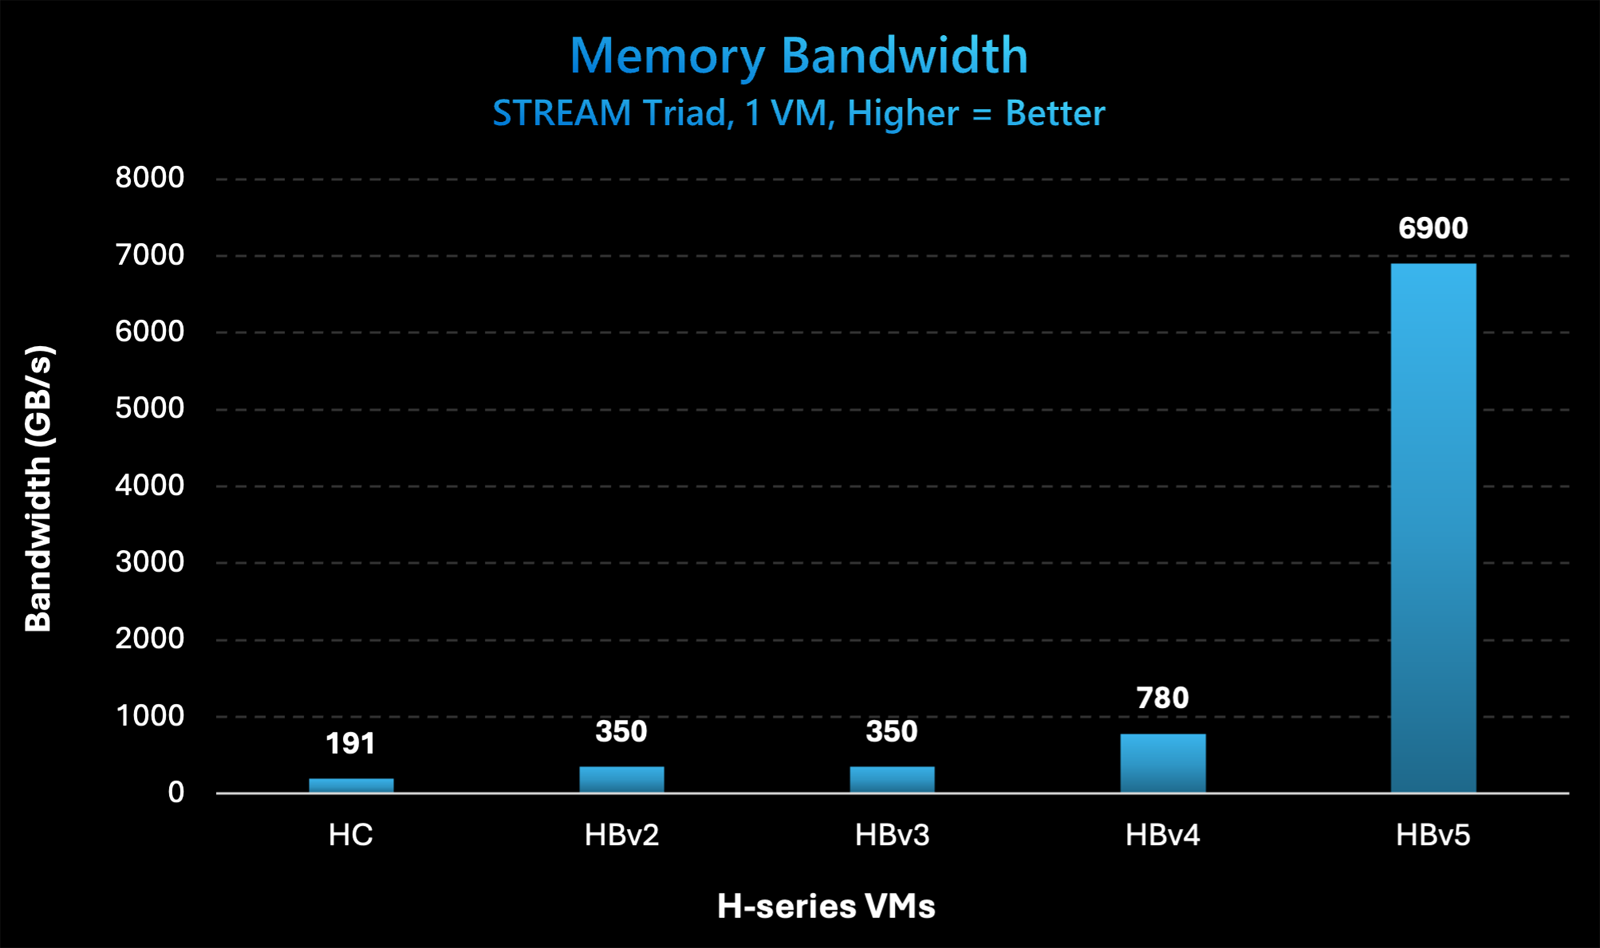 Отмечается, что по показателю пропускной способности памяти виртуальные машины Azure HBv5 примерно в 8 раз превосходят новейшие альтернативы bare-metal и cloud, в 20 раз опережают инстансы Azure HBv3 и Azure HBv2 (на базе EPYC Milan-X и EPYC Rome) и в 35 раз обходят HPC-серверы возрастом 4–5 лет, жизненный цикл которых приближается к завершению. Машины Azure HBv5 станут доступны в I половине 2025 года.
19.11.2024 [23:28], Алексей Степин
HPE обновила HPC-портфолио: узлы Cray EX, СХД E2000, ИИ-серверы ProLiant XD и 400G-интерконнект Slingshot
400gbe
amd
epyc
gb200
h200
habana
hardware
hpc
hpe
intel
mi300
nvidia
sc24
turin
ии
интерконнект
суперкомпьютер
схд
Компания HPE анонсировала обновление модельного ряда HPC-систем HPE Cray Supercomputing EX, а также представила новые модели серверов из серии Proliant. По словам компании, новые HPC-решения предназначены в первую очередь для научно-исследовательских институтов, работающих над решением ресурсоёмких задач. 
Источник изображений: HPE Обновление касается всех компонентов HPE Cray Supercomputing EX. Открывают список новые процессорные модули HPE Cray Supercomputing EX4252 Gen 2 Compute Blade. В их основе лежит пятое поколение серверных процессоров AMD EPYС Turin, которое на сегодняшний день является самым высокоплотным x86-решениями. Новые модули позволят разместить до 98304 ядер в одном шкафу. Отчасти это также заслуга фирменной системы прямого жидкостного охлаждения. Она охватывает все части суперкомпьютера, включая СХД и сетевые коммутаторы. Начало поставок узлов намечено на весну 2025 года. 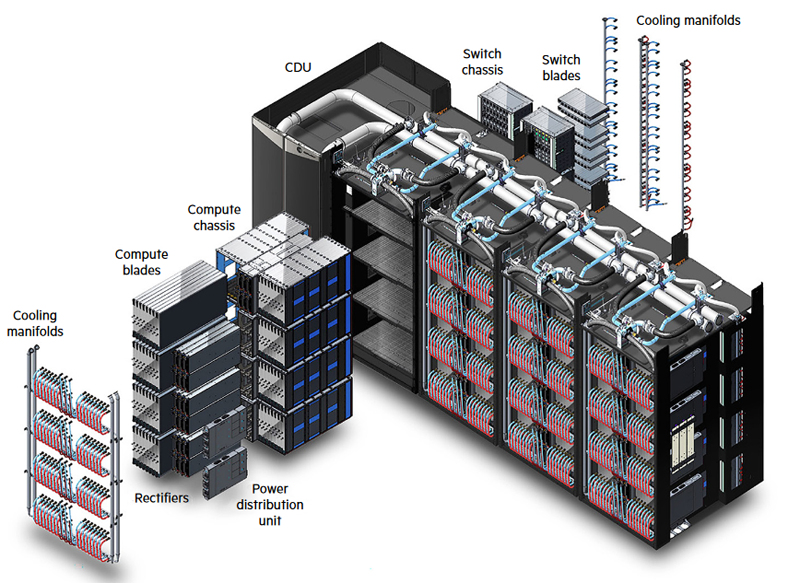 Процессорные «лезвия» дополнены новыми GPU-модулями HPE Cray Supercomputing EX154n Accelerator Blade, позволяющими разместить в одном шкафу до 224 ускорителей NVIDIA Blackwell. Речь идёт о новейших сборках NVIDIA GB200 NVL4 Superchip. Этот компонент появится на рынке позднее — HPE говорит о конце 2025 года. Обновление коснулось и управляющего ПО HPE Cray Supercomputing User Services Software, получившего новые возможности для пользовательской оптимизации вычислений, в том числе путём управления энергопотреблением. Апдейт получит и фирменный интерконнект HPE Slingshot, который «дорастёт» до 400 Гбит/с, т.е. станет вдвое быстрее нынешнего поколения Slingshot. Пропускная способность коммутаторов составит 51,2 Тбит/c. В новом поколении будут реализованы функции автоматического устранения сетевых заторов и адаптивноой маршрутизации с минимальной латентностью. Дебютирует HPE Slingshot interconnect 400 осенью 2024 года. 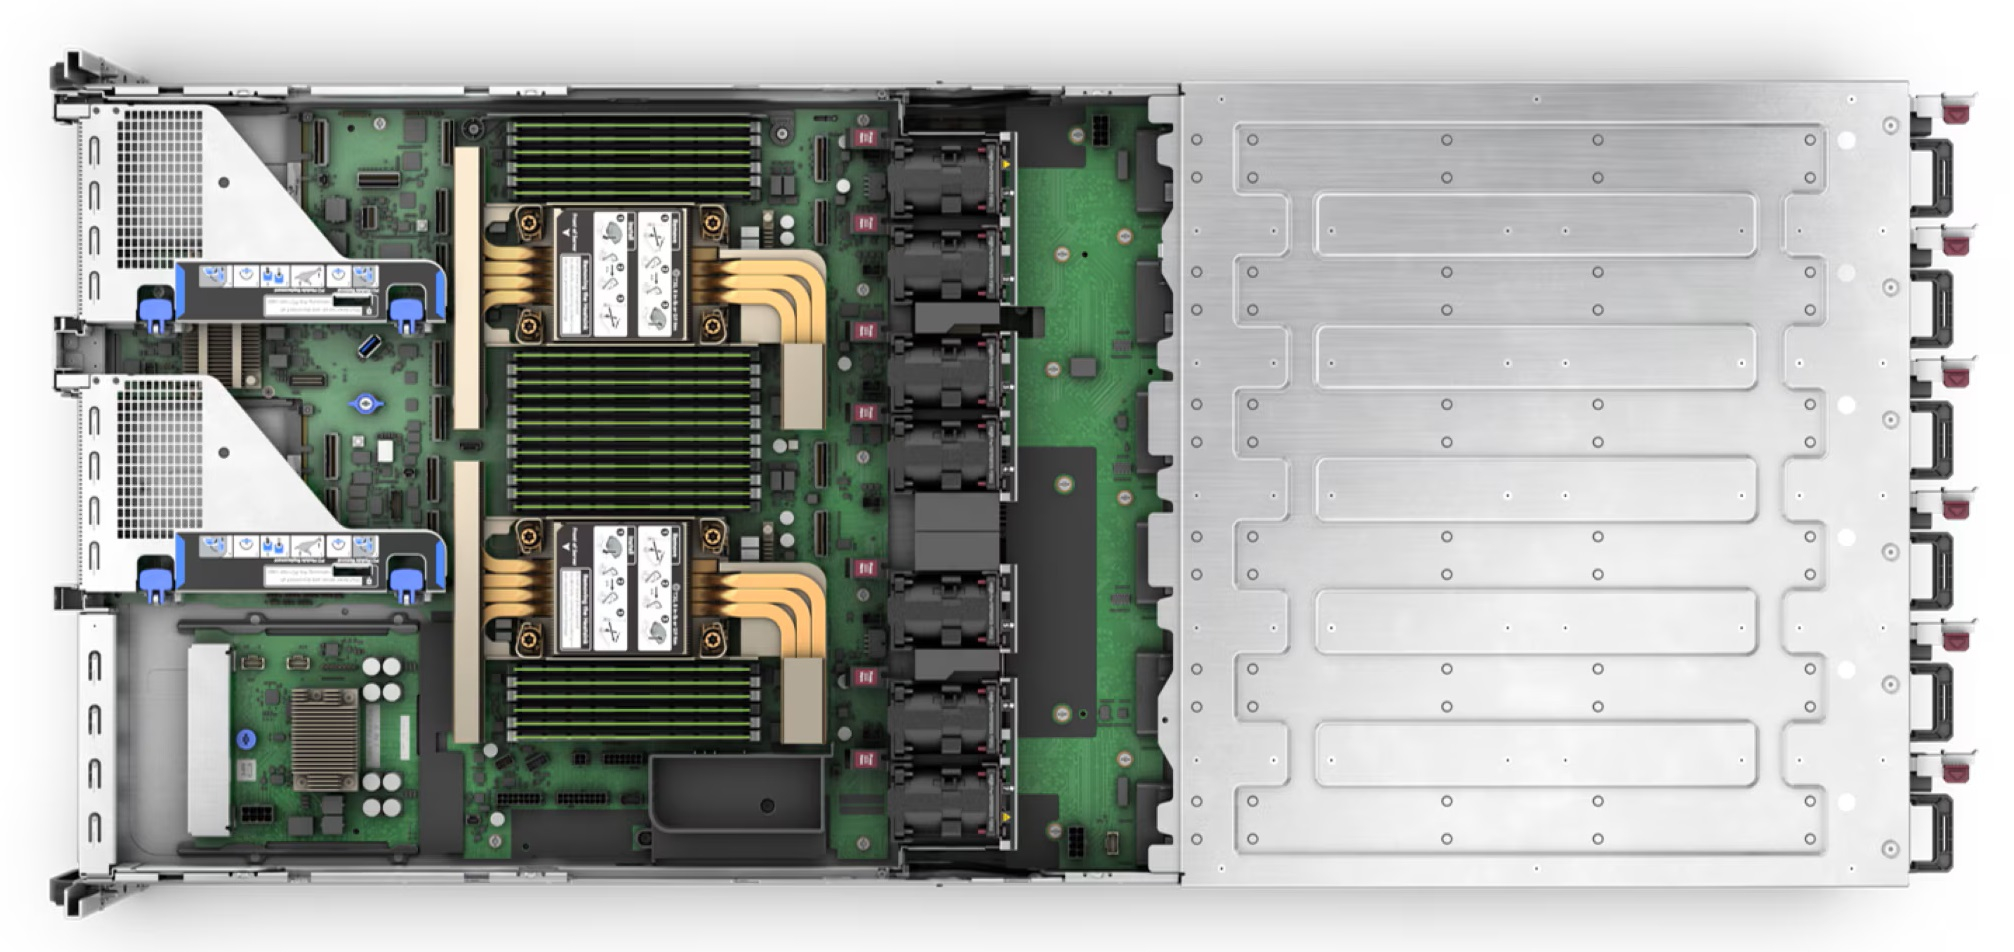 Ещё одна новинка — СХД HPE Cray Supercomputing Storage Systems E2000, специально разработанная для применения в суперкомпьютерах HPE Cray. В сравнении с предыдущим поколением, новая система должна обеспечить более чем двукратный прирост производительности: с 85 и 65 Гбайт/с до 190 и 140 Гбайт/с при чтении и записи соответственно. В основе новой СХД будет использована ФС Lustre. Появится Supercomputing Storage Systems E2000 уже в начале 2025 года. 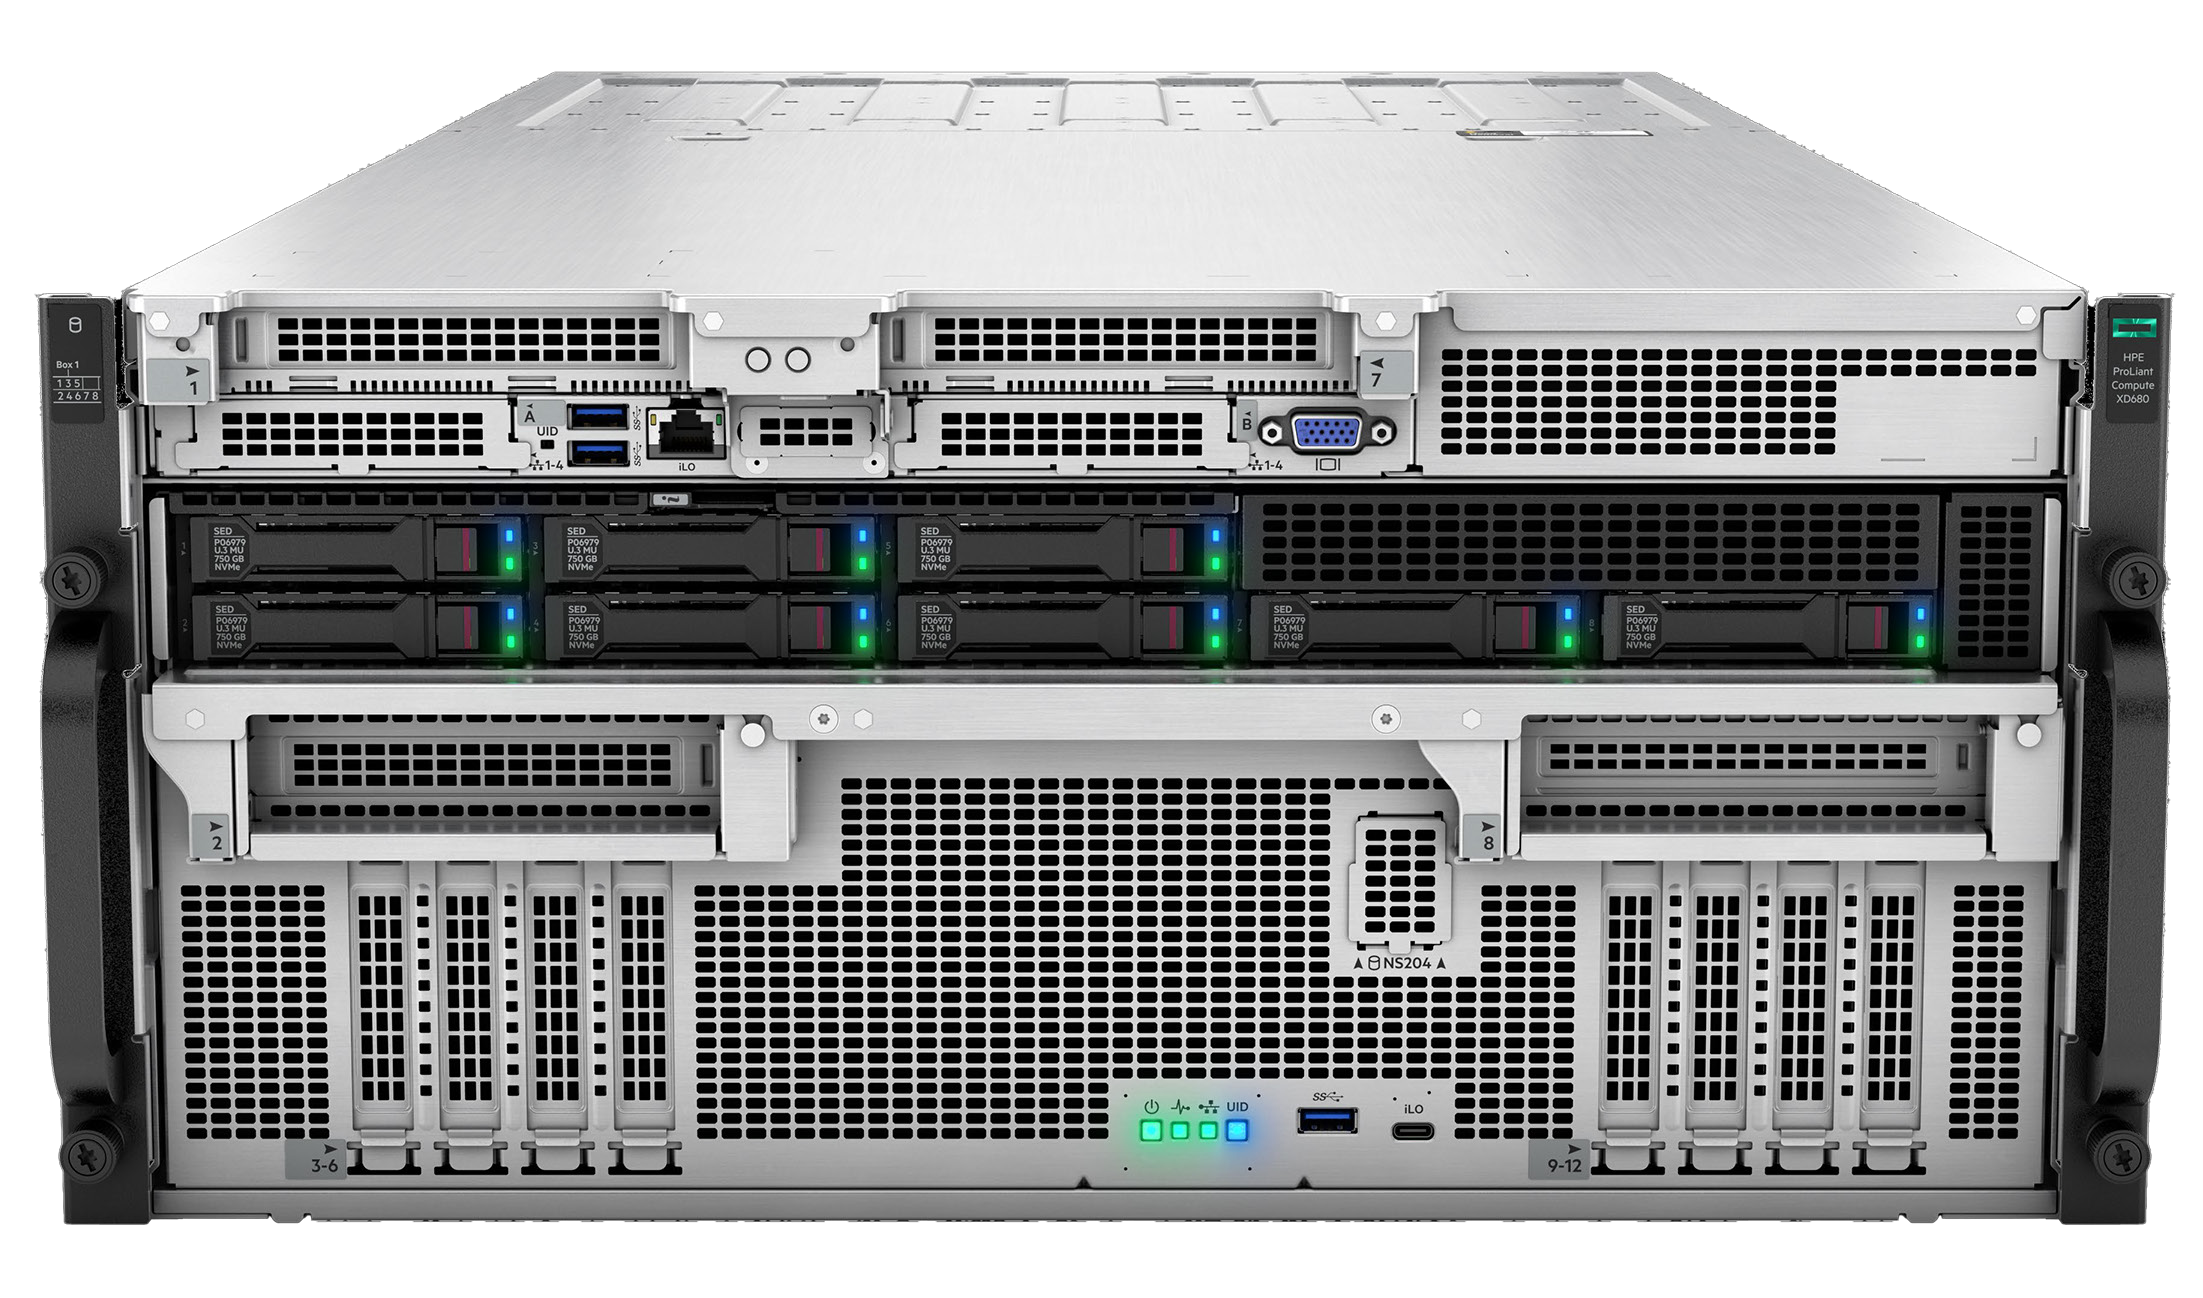 Что касается новинок из серии Proliant, то они, в отличие от вышеупомянутых решений HPE Cray, нацелены на рынок обычных ИИ-систем. 5U-сервер HPE ProLiant Compute XD680 с воздушным охлаждением представляет собой решение с оптимальным соотношением производительности к цене, рассчитанное как на обучение ИИ-моделей и их тюнинг, так и на инференс. Он оснащён восемью ускорителями Intel Gaudi3 и двумя процессорами Intel Xeon Emerald Rapids. Новинка поступит на рынок в декабре текущего года. 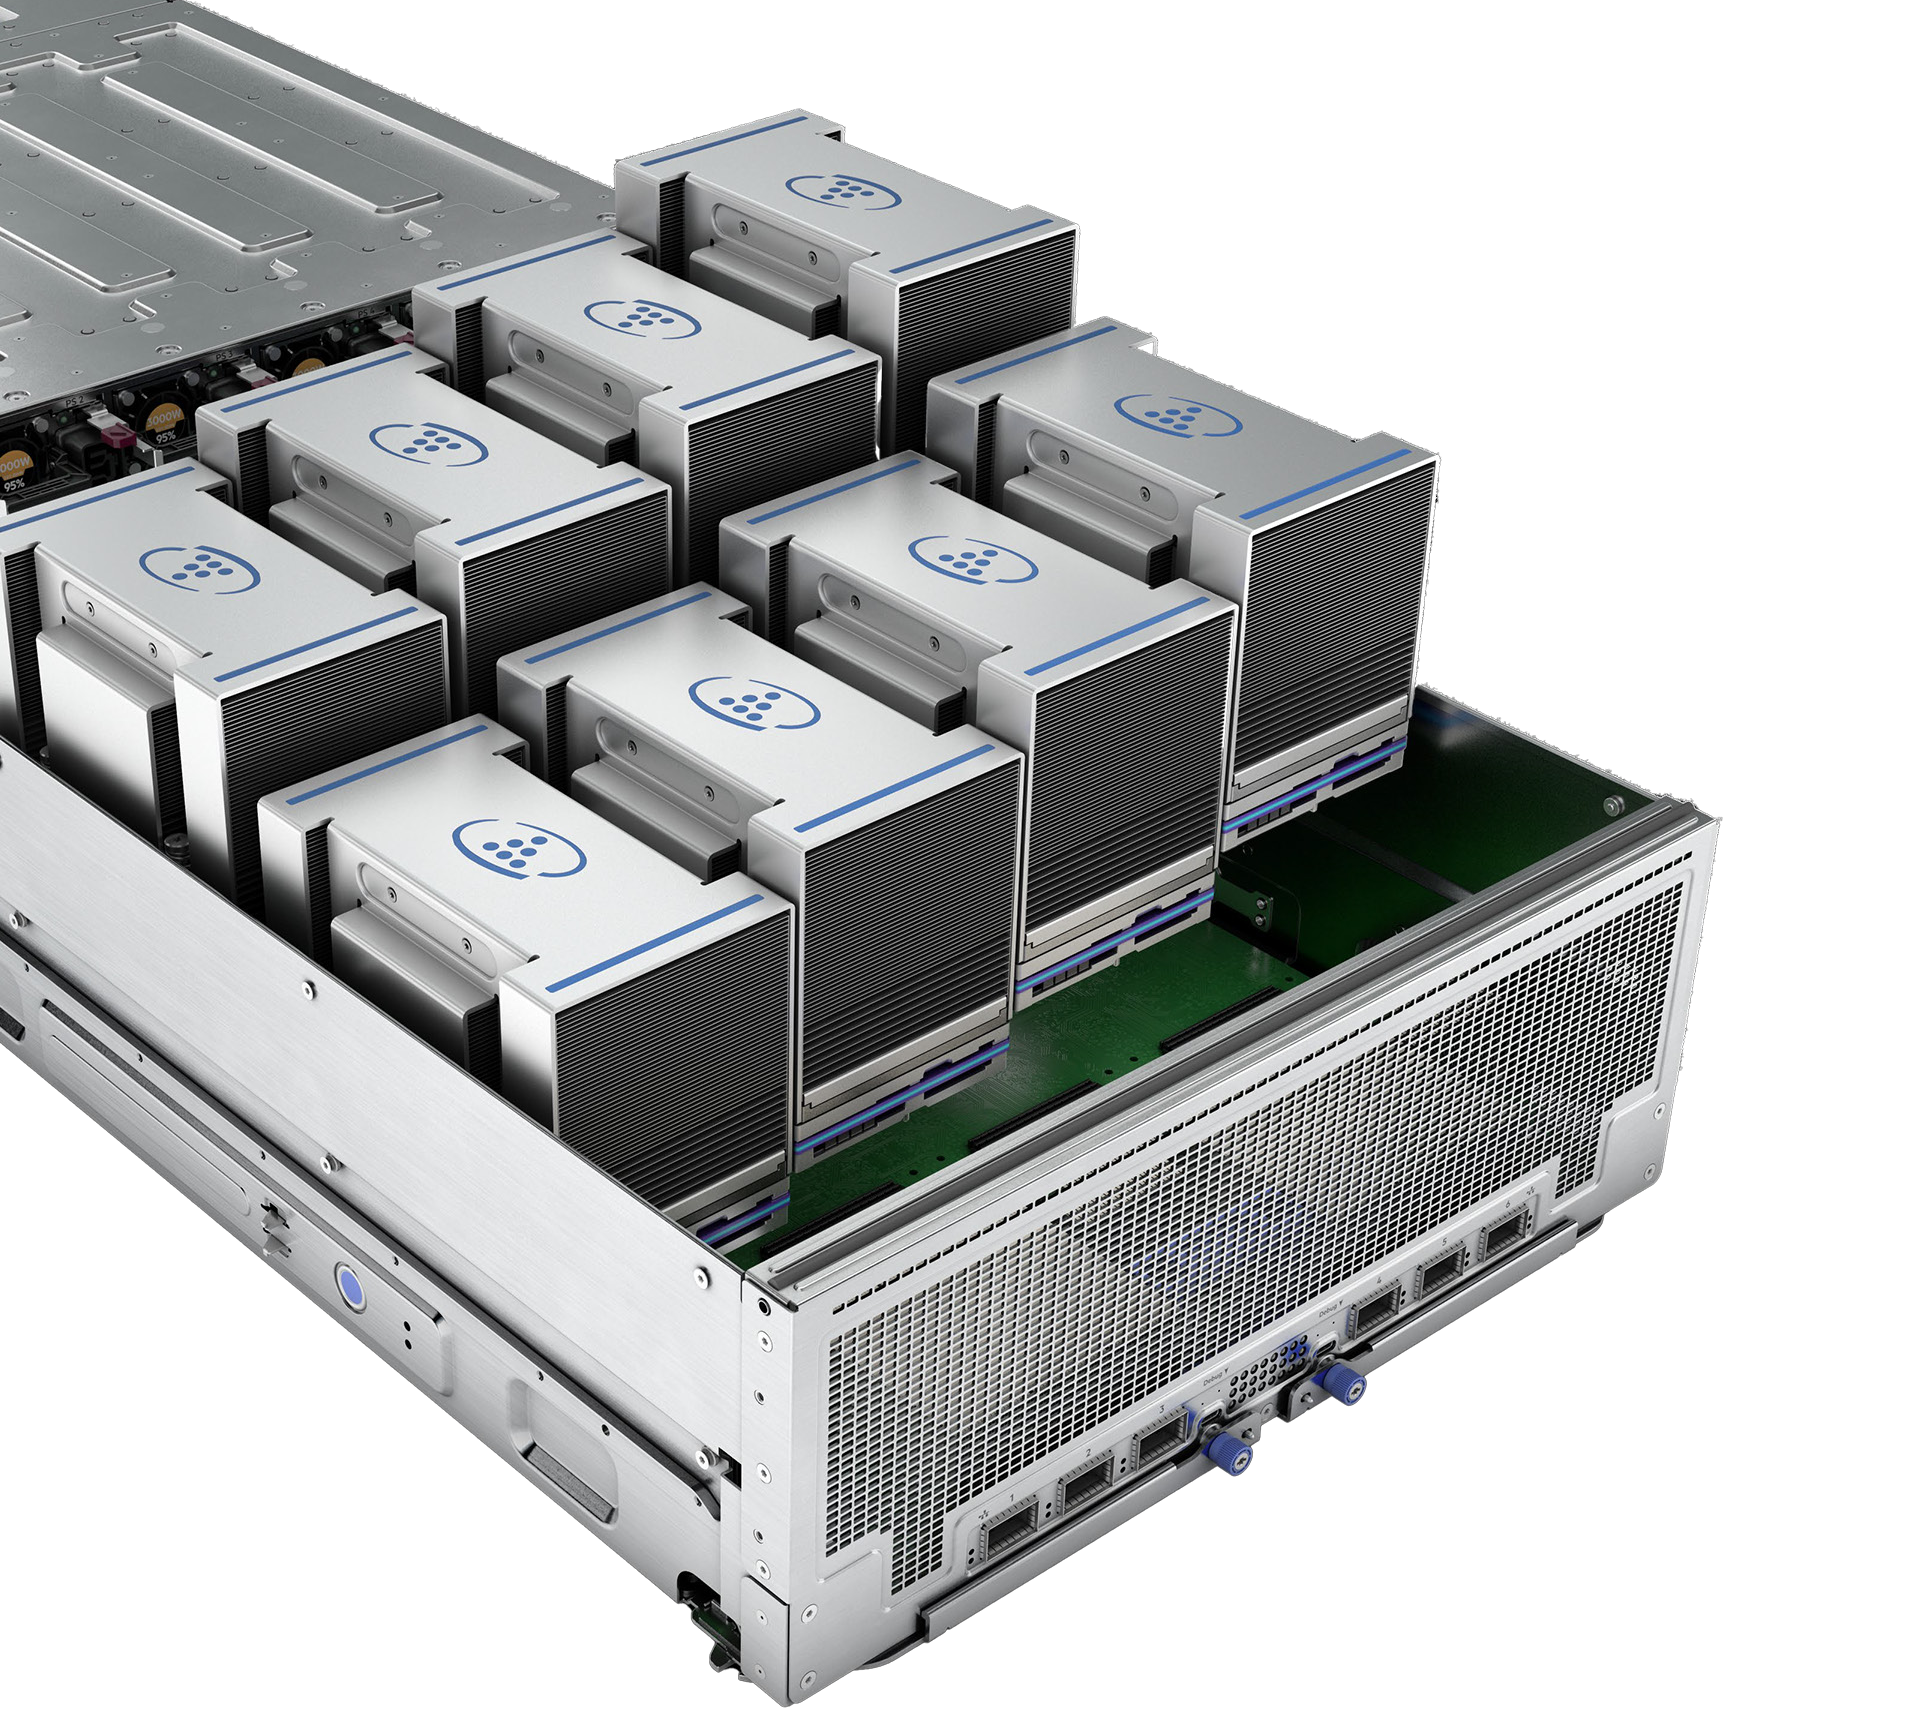 Более производительный HPE ProLiant Compute XD685 всё так же выполнен в корпусе высотой 5U, но рассчитан на жидкостное охлаждение. Он будет оснащаться восемью ускорителями NVIDIA H200 в формате SXM, либо более новыми решениями Blackwell, но последняя конфигурация будет доступна не ранее 2025 года, когда ускорители поступят на рынок. Уже доступен ранее анонсированный вариант с восемью ускорителями AMD Instinict MI325X и процессорами AMD EPYC Turin.
19.11.2024 [17:30], Сергей Карасёв
1,742 Эфлопс: El Capitan стал самым мощным в мире суперкомпьютером рейтинга TOP500Ливерморская национальная лаборатория им. Э. Лоуренса (LLNL) Министерства энергетики США (DOE), Администрация по национальной ядерной безопасности США (NNSA), компании AMD и HPE официально представили El Capitan — самый производительный в мире суперкомпьютер. Эта машина возглавила ноябрьский рейтинг мощнейших вычислительных систем TOP500. Комплекс El Capitan создан специалистами HPE Cray. Суперкомпьютер обладает FP64-быстродействием 1,742 Эфлопс в тесте Linpack (HPL), тогда как пиковый теоретический показатель достигает 2,746 Эфлопс. Прежний лидер TOP500 — система Frontier — с производительностью 1,353 Эфлопс теперь находится на втором месте рейтинга. Машина Aurora, так и не прибавившая в производительности, хотя и заявленная когда-то как 2-Эфлопс система, занимает теперь третье место. В основу El Capitan легла платформа HPE Cray Shasta. Используется гибридная архитектура AMD с APU Instinct MI300A: изделие содержит 24 ядра Zen 4 общего назначения, блоки CDNA 3 и 128 Гбайт памяти HBM3. В общей сложности в составе суперкомпьютера объединены 11 136 узлов, каждый из которых несёт на борту четыре экземпляра Instinct MI300A. Применён интерконнект HPE Slingshot-11 с пропускной способностью 200 Гбит/с. Система включает узлы Rabbit, которые формируют дезагрегированное NVMe-хранилище с прямым PCIe-подключением к вычислительным узлам. 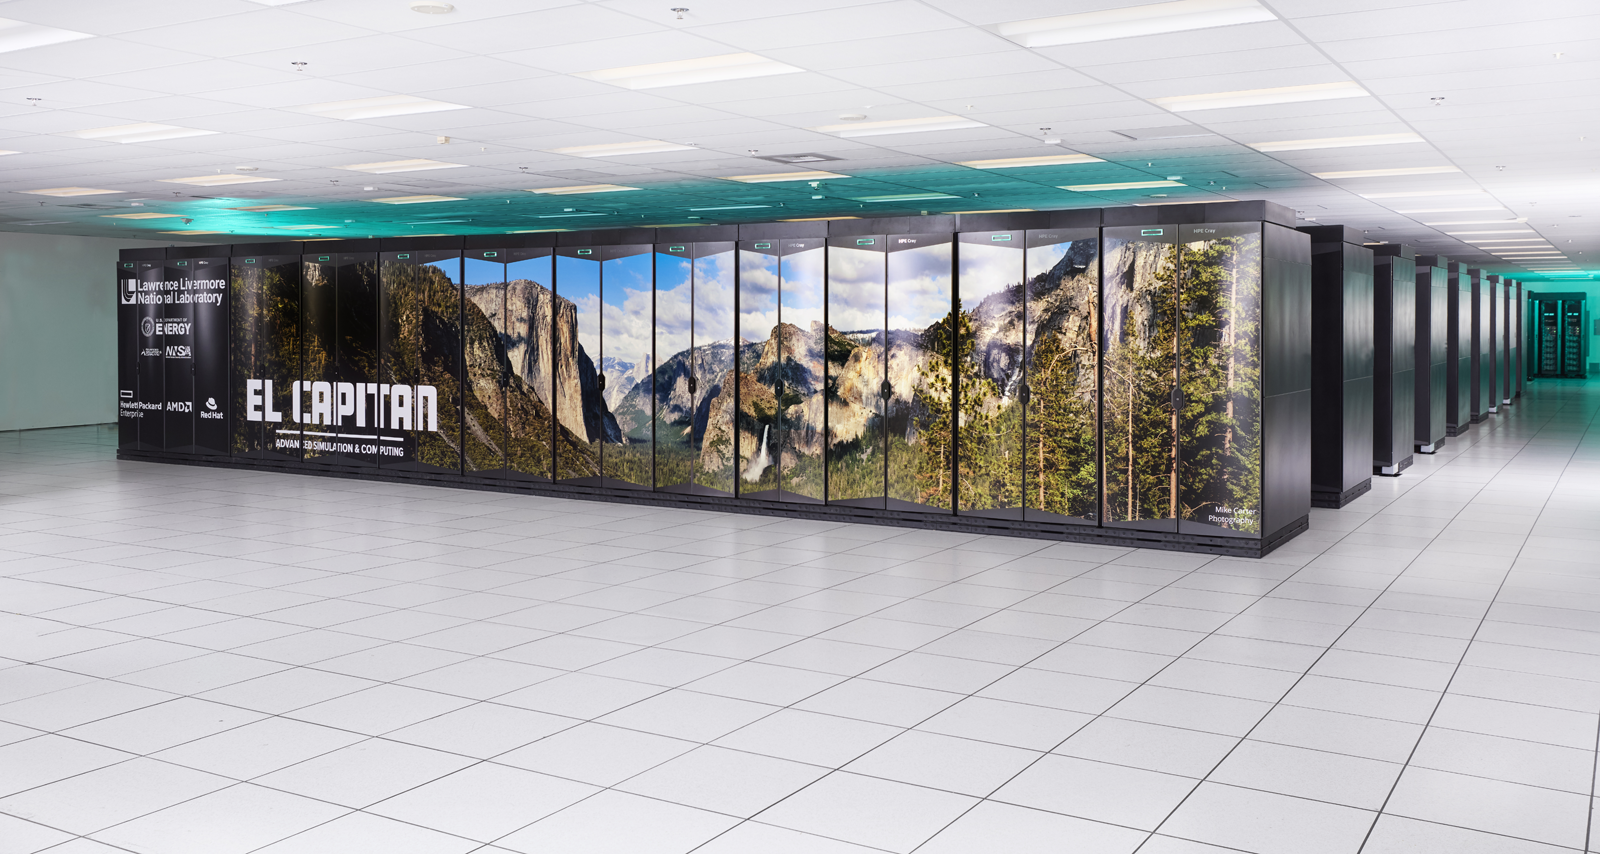
Источник изображений: LLNL Суммарное количество ядер CPU и GPU в составе El Capitan достигает 11 039 616, объём памяти — 5,4375 Пбайт. За отвод тепла отвечает система прямого жидкостного охлаждения HPE. Заявленная энергетическая эффективность составляет 58,89 Гфлопс/Вт: с таким показателем машина оказалась на 18-м месте в списке «зелёных» суперкомпьютеров GREEN500, но с учётом масштаба и общего энергопотребления 29,58 МВт — это хороший показатель. Система охлаждения HPC-объекта использует 28 тыс. т воды. Отмечается, что El Capitan станет главным вычислительным ресурсом для Tri-lab — группы, в которую вместе с LLNL входят Сандийские национальные лаборатории (SNL) и Лос-Аламосская национальная лаборатория (LANL). Использовать мощности нового суперкомпьютера планируется для обеспечения национальной безопасности и решения сложных задач, связанных с ядерным оружием. В частности, El Capitan обеспечит беспрецедентные возможности моделирования и имитации, необходимые для Программы управления ядерными запасами NNSA. Кроме того, НРС-комплекс поможет в модернизации и создании нового оружия, такого как боеголовки W87-1 и W93, которые в настоящее время находятся на стадии разработки. 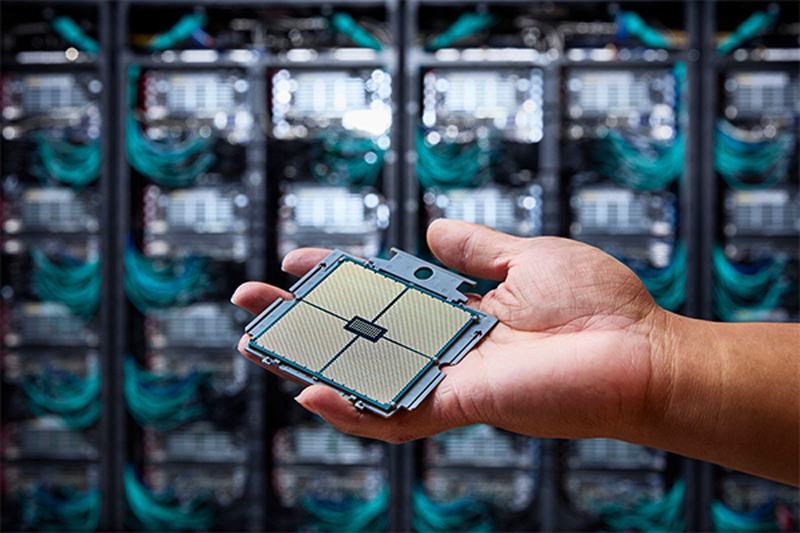 Отмечается также, что на 10-й позиции в рейтинге TOP500 оказался суперкомпьютер Tuolumne, также построенный в рамках проекта LLNL и NNSA. Фактически Tuolumne — это младший брат El Capitan: машина использует ту же архитектуру на базе Instinct MI300A, но обладает примерно на порядок меньшей FP64-производительностью 208,10 Пфлопс с пиковым значением 288,88 Пфлопс. Применять мощности Tuolumne планируется для «несекретных» задач, таких как исследования в области энергетической безопасности, изменений климата, вычислительной биологии, разработки лекарственных препаратов следующего поколения и пр. Стоит отметить, что Frontier — не единственная система, которая уступила пальму первенства более новым НРС-комплексам в ноябрьском рейтинге TOP500. Та же участь постигла самый мощный суперкомпьютер Европы LUMI, который опустился с пятого на восьмое место. На пятой позиции оказалась совершенно новая система HPC6, расположенная в центре нефтегазовой компании Eni в Феррера-Эрбоньоне (Италия). Её производительность достигает 477,9 Пфлопс при пиковом показателе 606,97 Пфлопс.
18.10.2024 [00:10], Алексей Степин
Meta✴ представила свой вариант суперускорителя NVIDIA GB200 NVL72Meta✴ поделилась своими новинками в области аппаратной инфраструктуры и рассказала, каким именно видит будущее открытых ИИ-платформ. В своей презентации Meta✴ рассказала о новой ИИ-платформе, новых дизайнах стоек, включая варианты с повышенной мощностью питания, а также о новинках в области сетевой инфраструктуры. 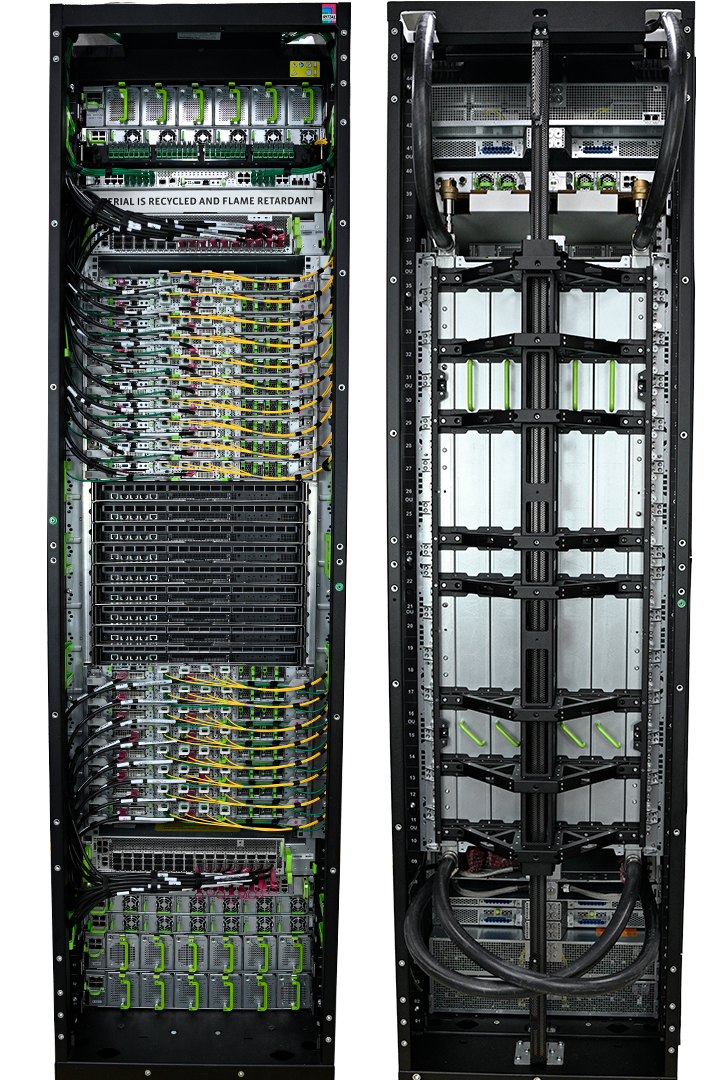
Источник изображений: Meta✴ В настоящее время компания использует нейросеть Llama 3.1 405B. Контекстное окно у этой LLM достигает 128 тыс. токенов, всего же токенов свыше 15 трлн. Чтобы обучать такие модели, требуются очень серьёзные ресурсы и глубокая оптимизация всего программно-аппаратного стека. В обучении базовой модели Llama 3.1 405B участвовал кластер 16 тыс. ускорителей NVIDIA H100, один из первых такого масштаба. Но уже сейчас для обучения ИИ-моделей Meta✴ использует два кластера, каждый с 24 тыс. ускорителей. Проекты такого масштаба зависят не только от ускорителей. На передний план выходят проблемы питания, охлаждения и, главное, интерконнекта. В течение нескольких следующих лет Meta✴ ожидает скоростей в районе 1 Тбайт/с на каждый ускоритель. Всё это потребует новой, ещё более плотной архитектуры, которая, как считает Meta✴, должна базироваться на открытых аппаратных стандартах. 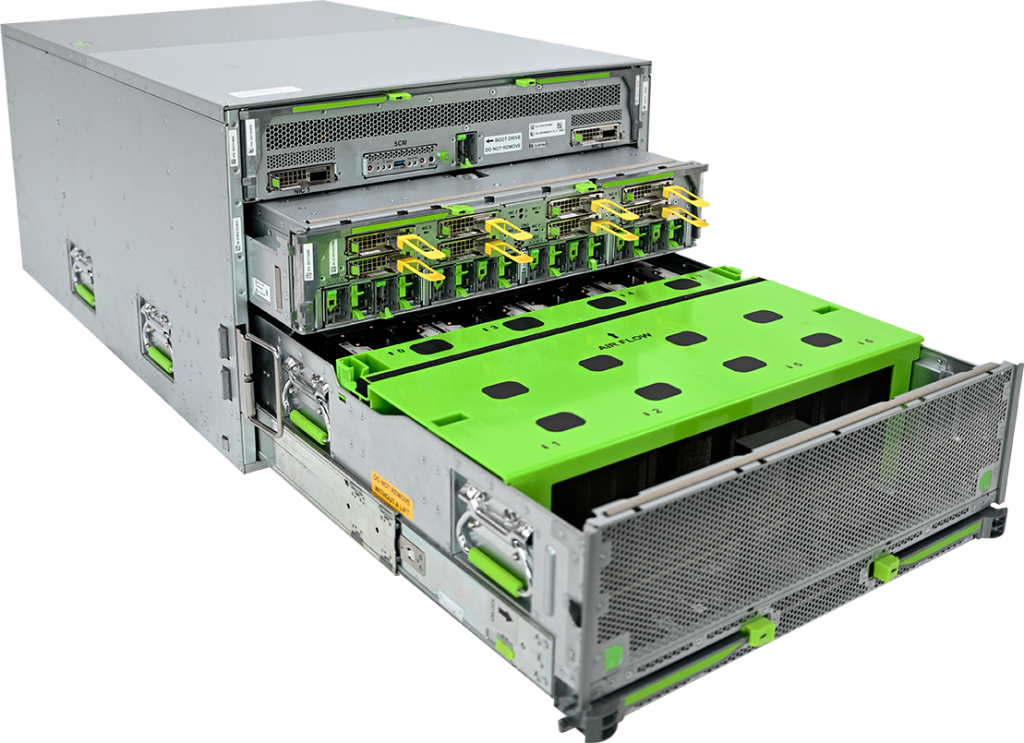 Одной из новинок стала платформа Catalina. Это Orv3-стойка, сердцем которой являются гибридные процессоры NVIDIA GB200. Стойка относится к классу HPR (High Power Rack) и рассчитана на 140 КВт. Сейчас Microsoft и Meta✴ ведут работы над модульной и масштабируемой системой питания Mount Diablo. Свой вариант GB200 NVL72 у Microsoft тоже есть. Также Meta✴ обновила ИИ-серверы Grand Teton, впервые представленные в 2022 году. Это по-прежнему монолитные системы, но теперь они поддерживают не только ускорители NVIDIA, но и AMD Instinct MI300X и будущие MI325X. 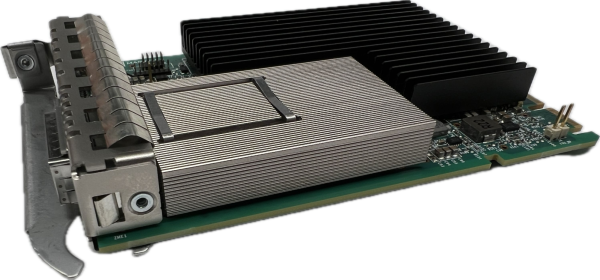 Интерконнектом будущих платформ станет сеть DSF (Disaggregated Scheduled Fabric). Благодаря переходу на открытые стандарты компания планирует избежать ограничений, связанных с масштабированием, зависимостью от вендоров аппаратных компонентов и плотностью подсистем питания. В основе DSF лежит стандарт OCP-SAI и ОС Meta✴ FBOSS для коммутаторов. Аппаратная часть базируется на стандартном интерфейсе Ethernet/RoCE. Meta✴ уже разработала и воплотила в металл новые коммутаторы класса 51Т на базе кремния Broadcom и Cisco, а также сетевые адаптеры FBNIC, созданные при поддержке Marvell. FBNIC может иметь до четырёх 100GbE-портов. Используется интерфейс PCIe 5.0, причём могущий работать как четыре отдельных слайса. Новинка соответствует открытому стандарту OCP NIC 3.0 v1.2.0.
11.10.2024 [19:55], Алексей Степин
256 Гбайт HBM3e — это хорошо, а 288 Гбайт — ещё лучше: AMD анонсировала ускорители Instinct MI325X и MI355XВчера компания AMD анонсировала серверные процессоры EPYC 9005 (Turin) и ускорители Instinct MI325X. Если верить AMD, новинки устанавливают новые эталоны производительности в своих сферах применения. О процессорах речь пойдёт в отдельном материале, а сейчас попробуем разобраться с Instinct MI325X — чем же именно он отличается от представленного ранее MI300X, архитектура которого в своё время была разобрана достаточно подробно. Сама AMD позиционирует MI325X в качестве наследника MI300X, способного конкурировать с NVIDIA H200 и, возможно, даже с B200. В сравнении с тем, что было опубликовано ранее, характеристики новинки несколько изменились. В частности, новый ускоритель получил 256 Гбайт памяти HBM3e, а не 288 Гбайт, как было обещано ранее. 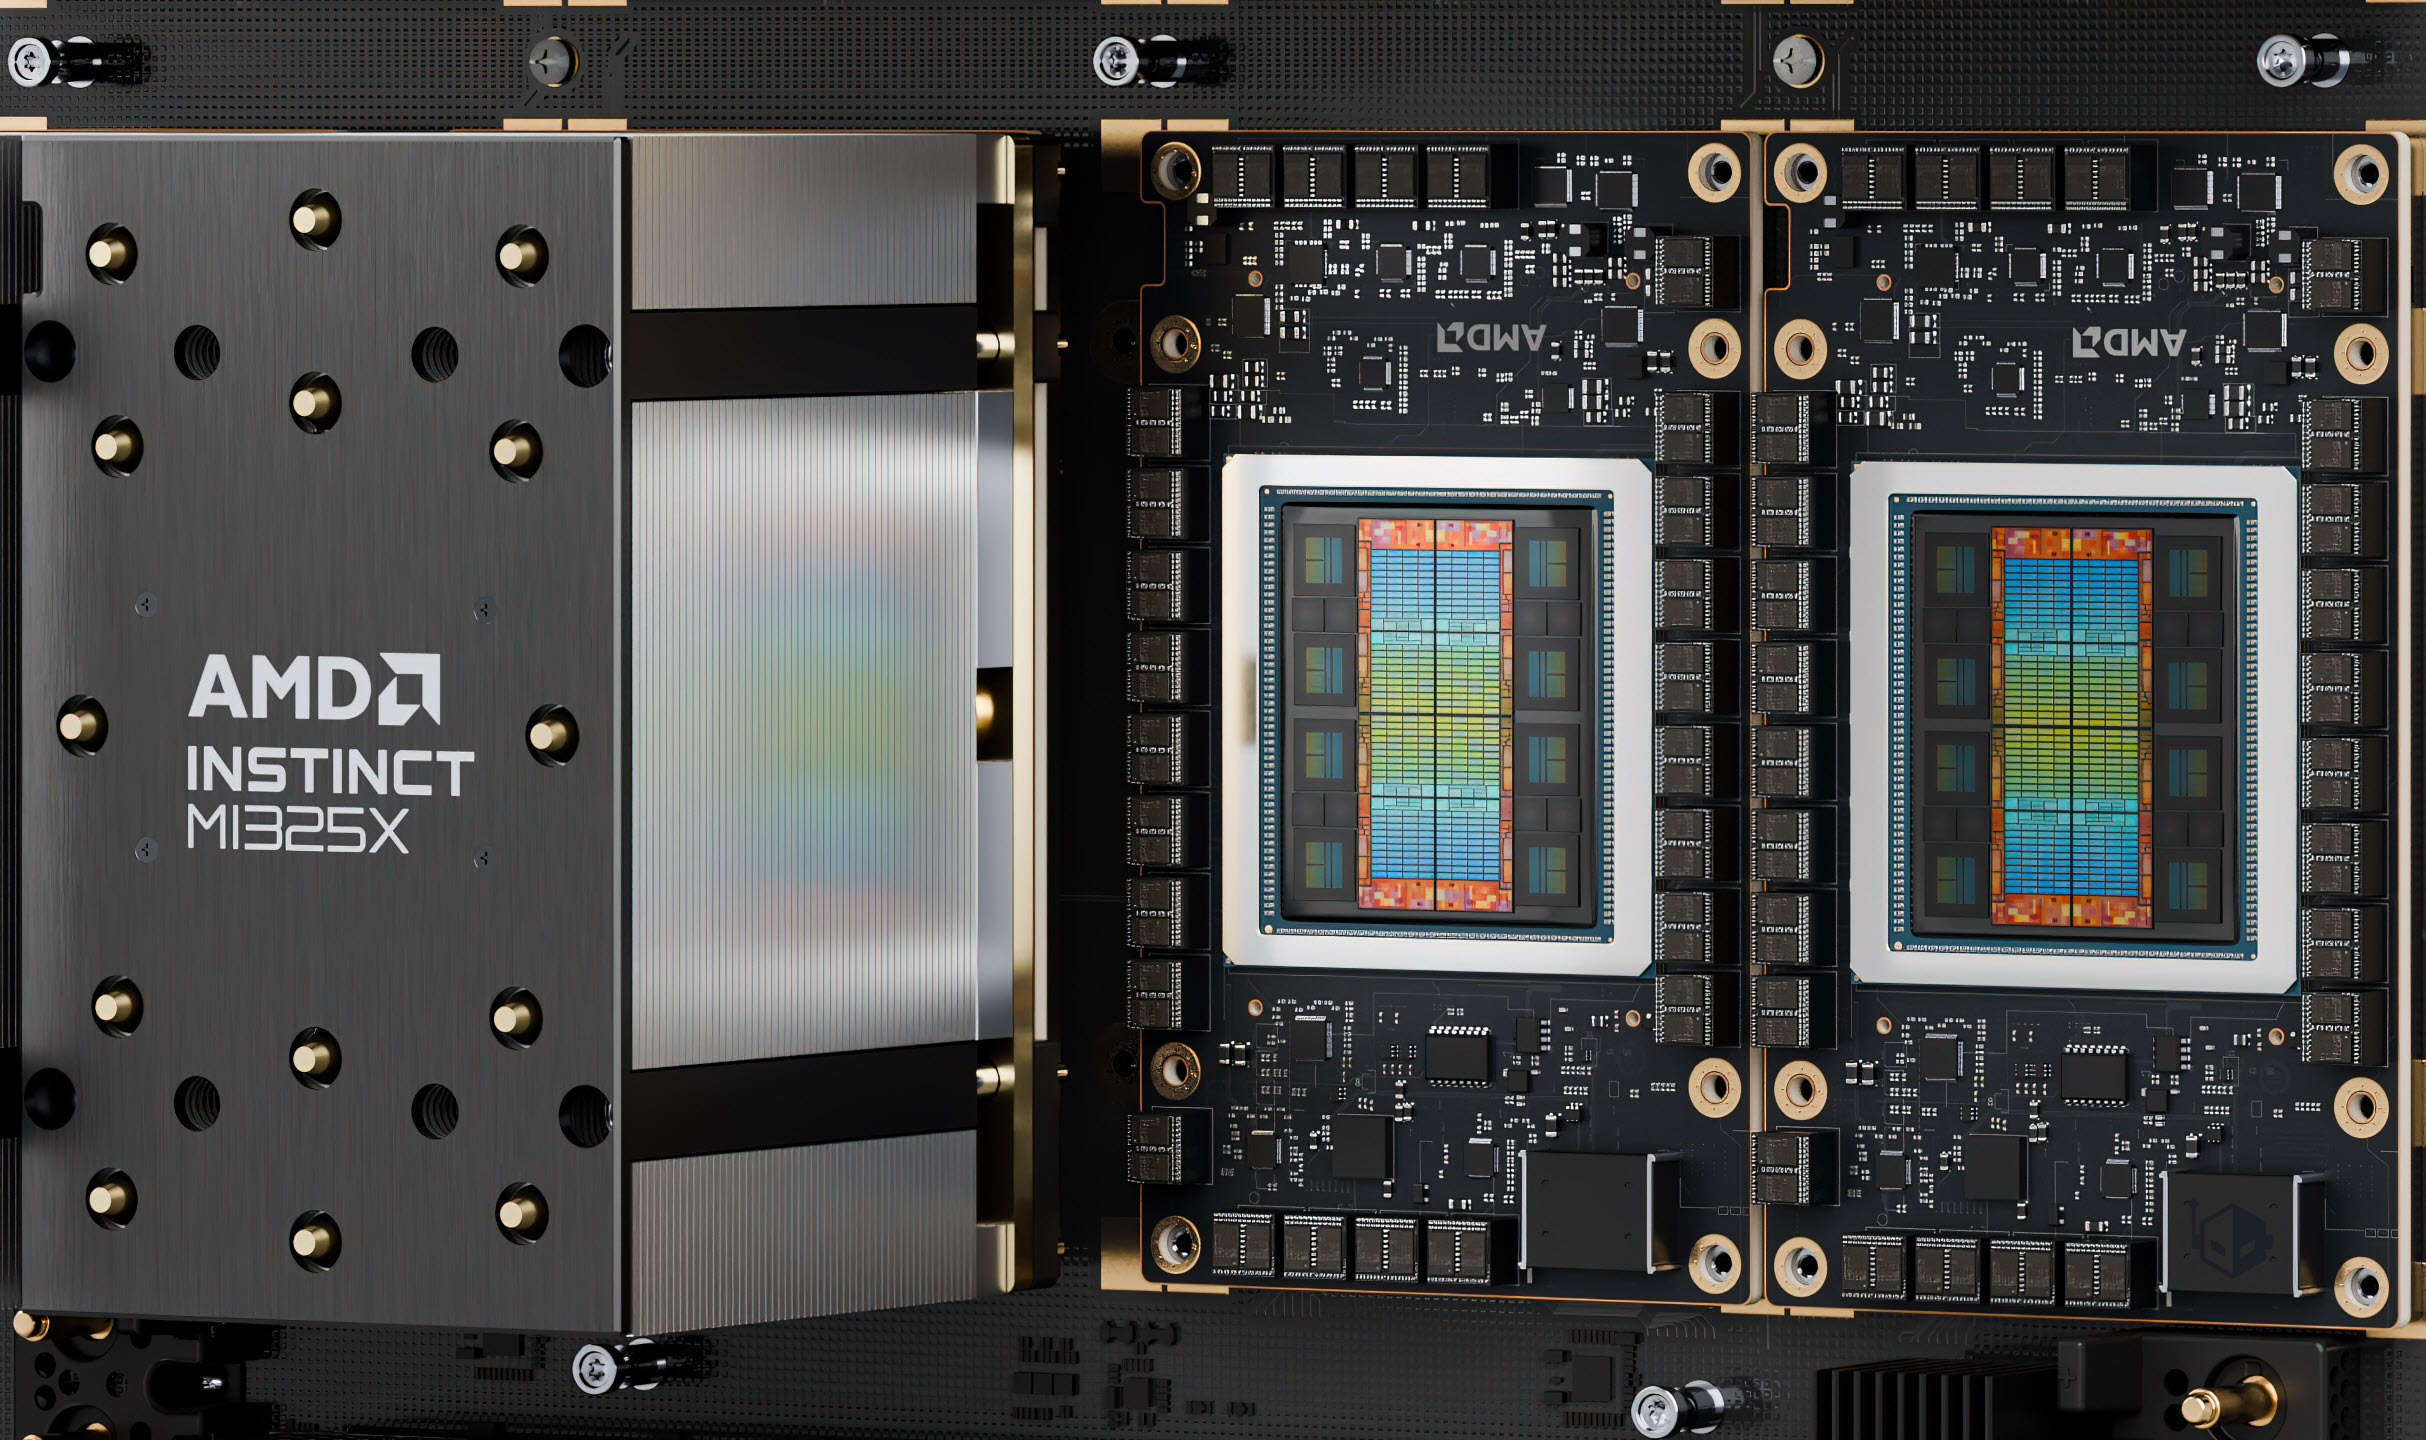
Источник здесь и далее: AMD via WCCFTech На приведённых слайдах с изображением кристалла MI325X отчетливо видно, что количество сборок HBM по-прежнему равно восьми, однако вместо ожидаемых сборок ёмкостью 36 Гбайт использованы менее ёмкие «стопки» на 32 Гбайт. Это не позволяет говорить о 50 % приросте по объёму, только о 33 %. Но и это немало! Пропускная способность подросла с 5,3 до 6 Тбайт/с. 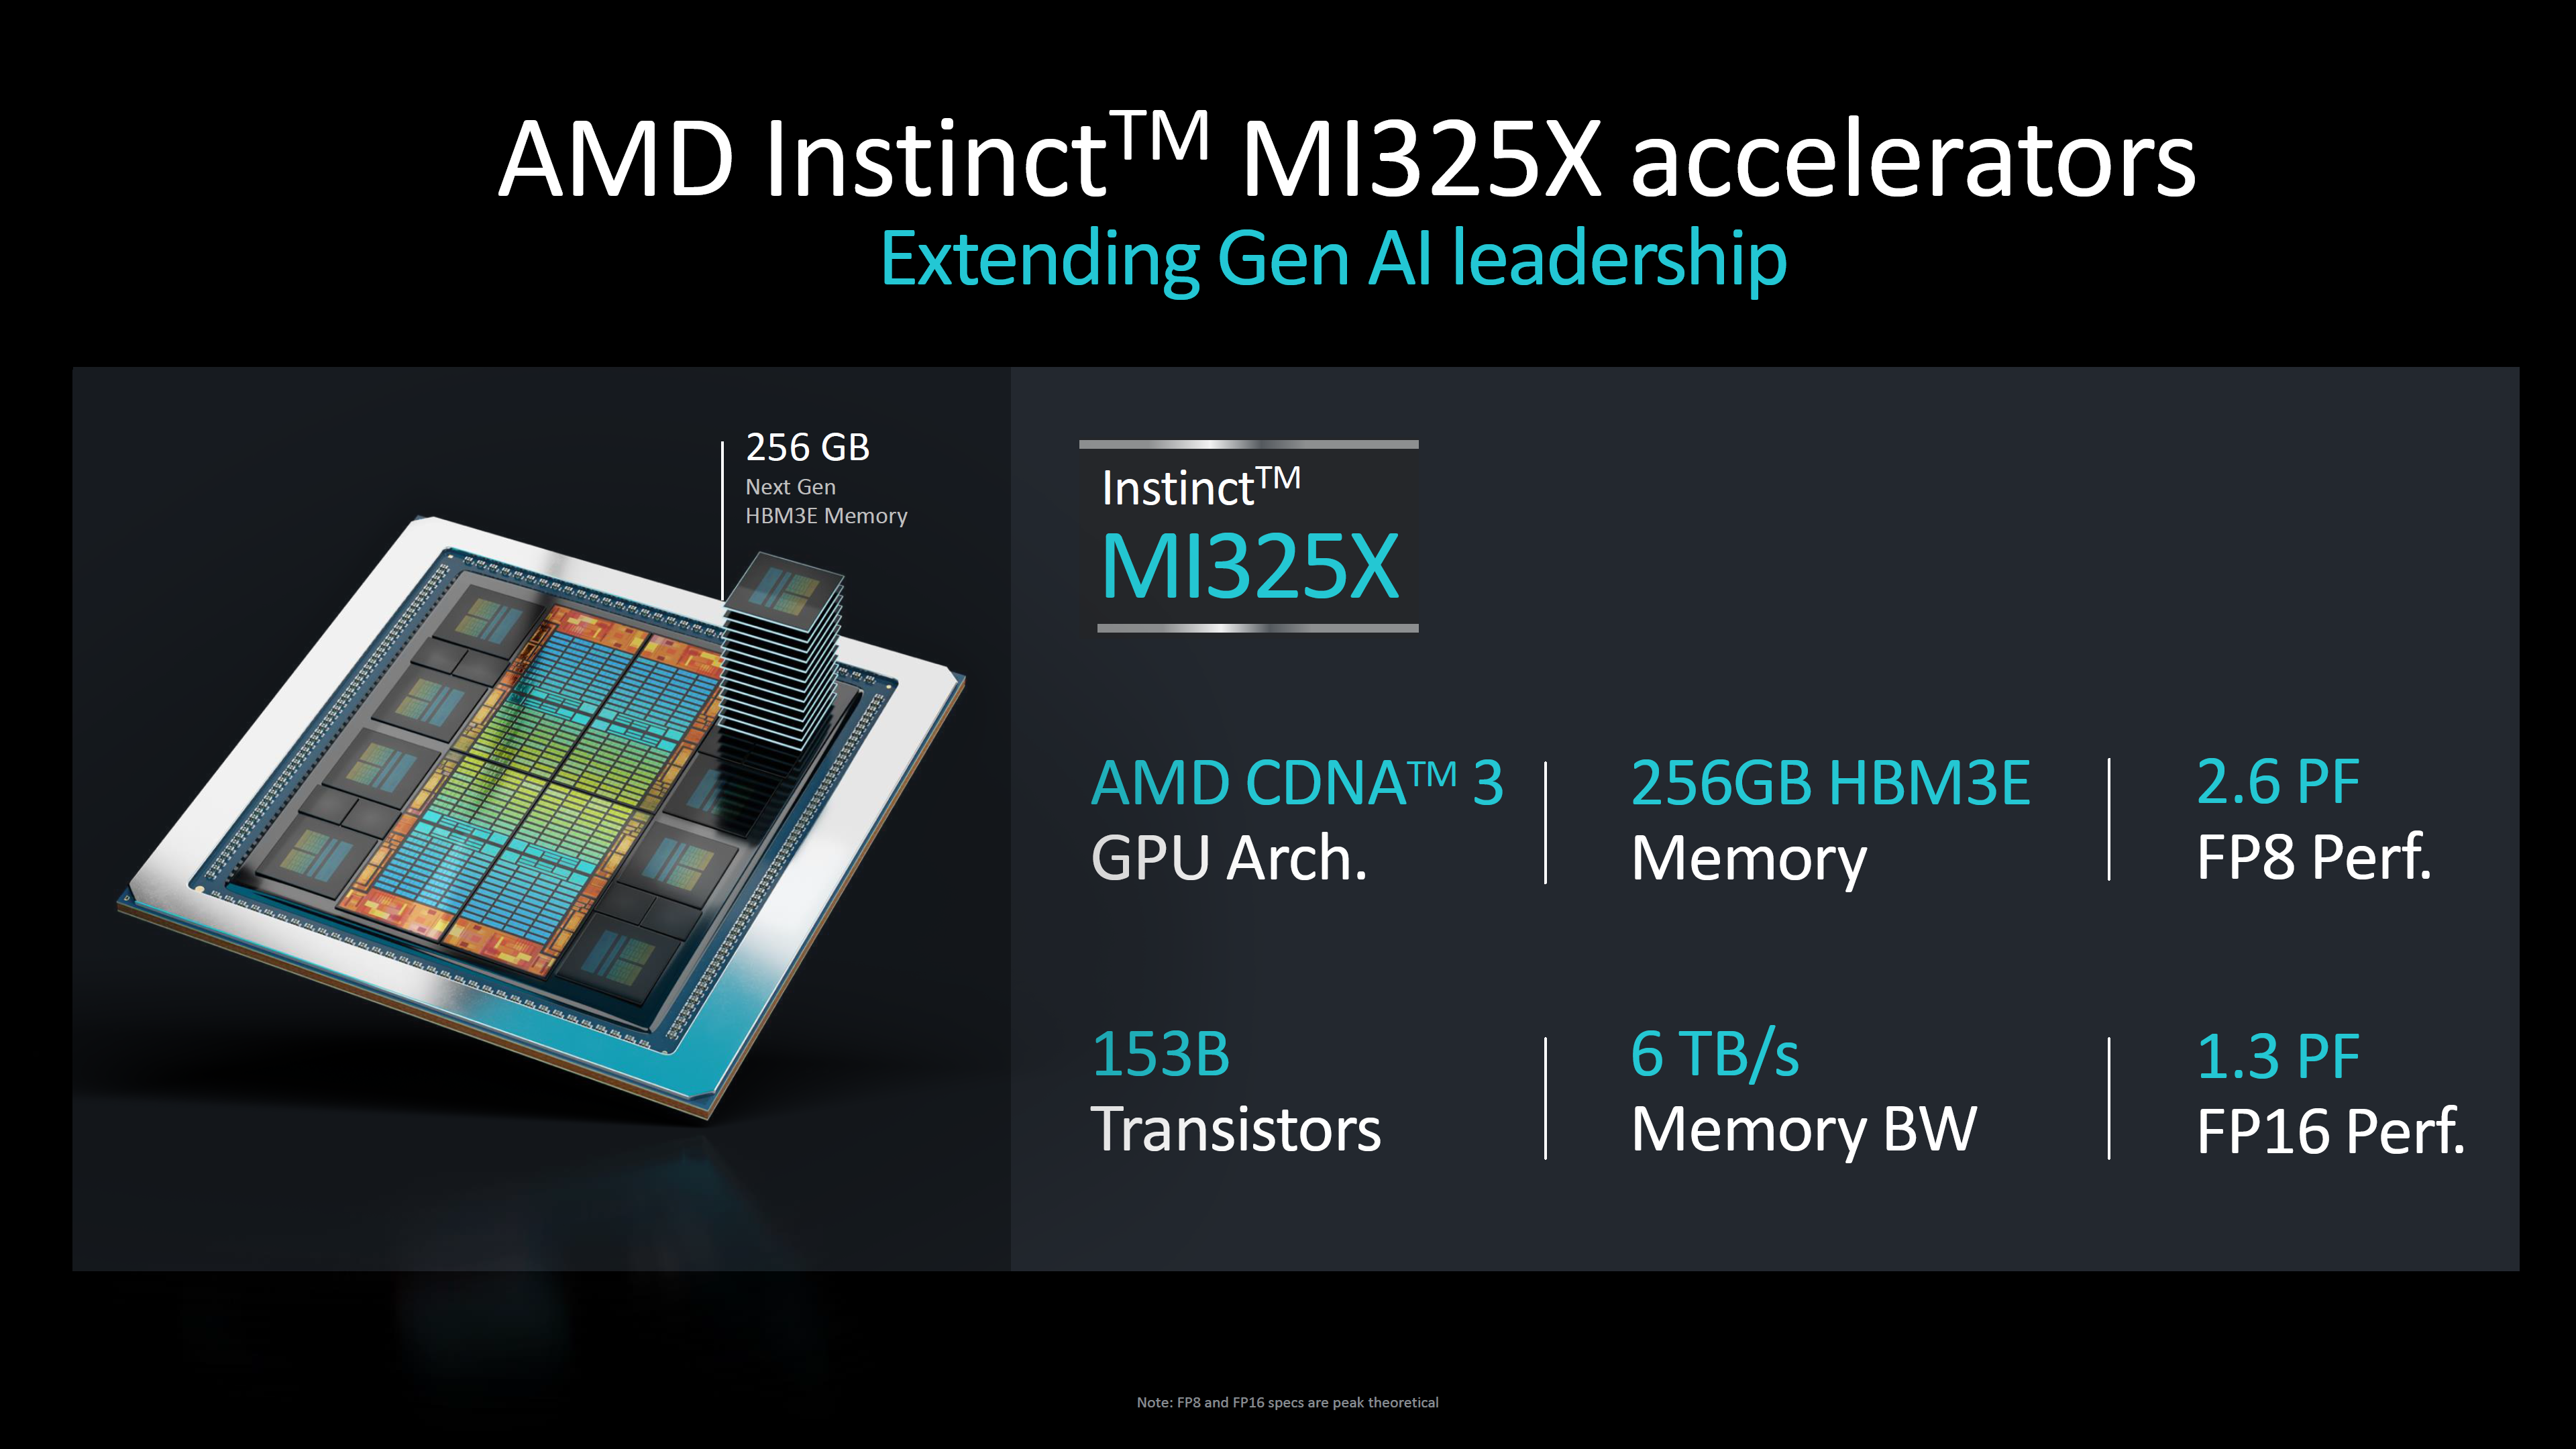 Последнее может быть объяснено повышением тактовой частоты, но из-за тесной интеграции HBM3e с остальными частями ускорителя должна была вырасти и производительность. Тем не менее, AMD приводит же цифры, что и для MI300X —1,3 Пфлопс в режиме FP16 и 2,6 Пфлопс в режиме FP8. По сути, улучшены только характеристики подсистемы памяти. 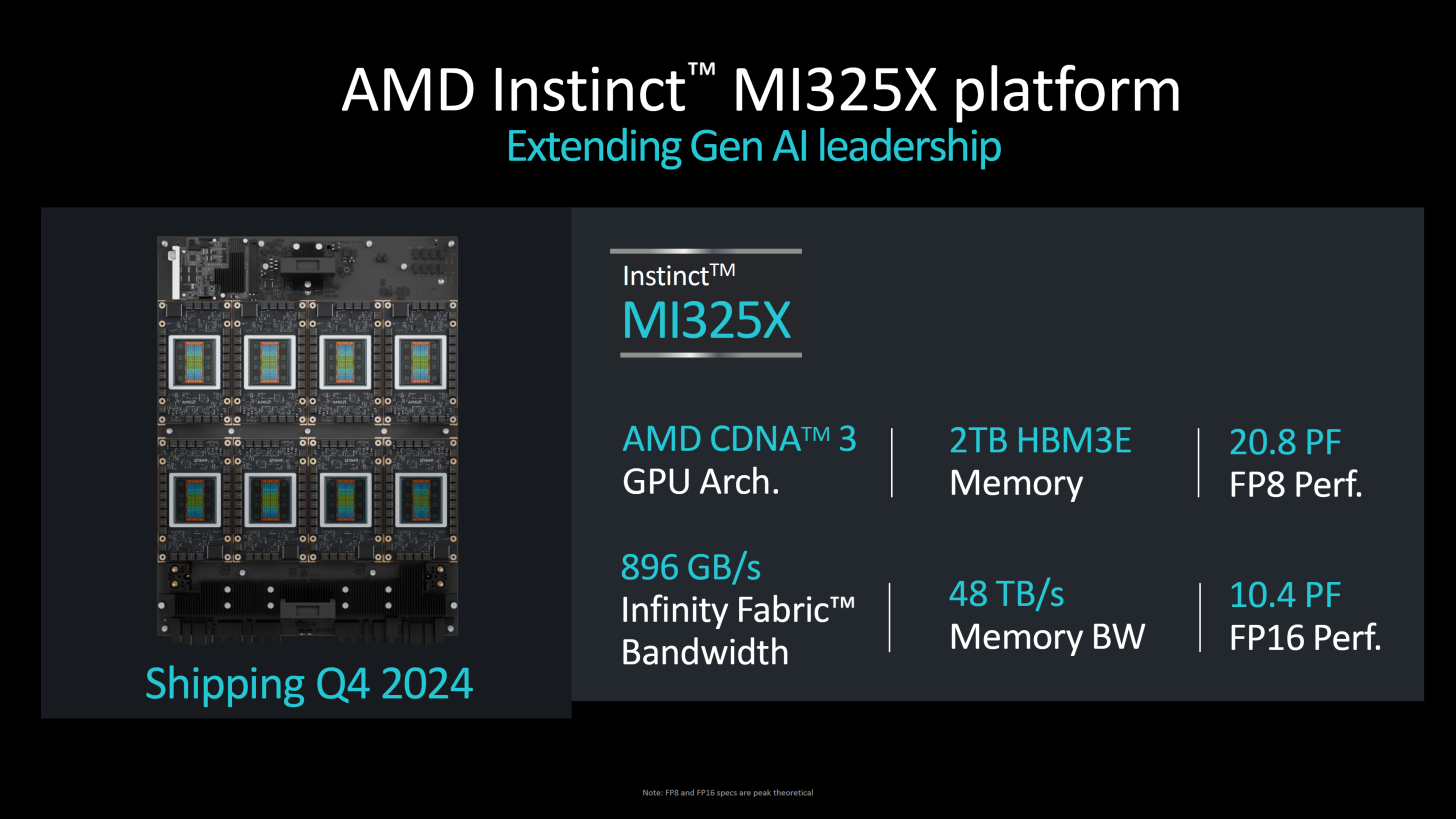 Архитектурно MI325X полностью подобен предшественнику, за исключением блока HBM. Он по-прежнему базируется на CDNA 3, имеет такое же количество транзисторов (153 млрд) и производится с использованием тех же техпроцессов, 5 нм для блоков XCD и 6 нм для IOD. Но теплопакет превышает 750 Вт, в то время как у MI300X данный параметр не достигал столь высокого значения. 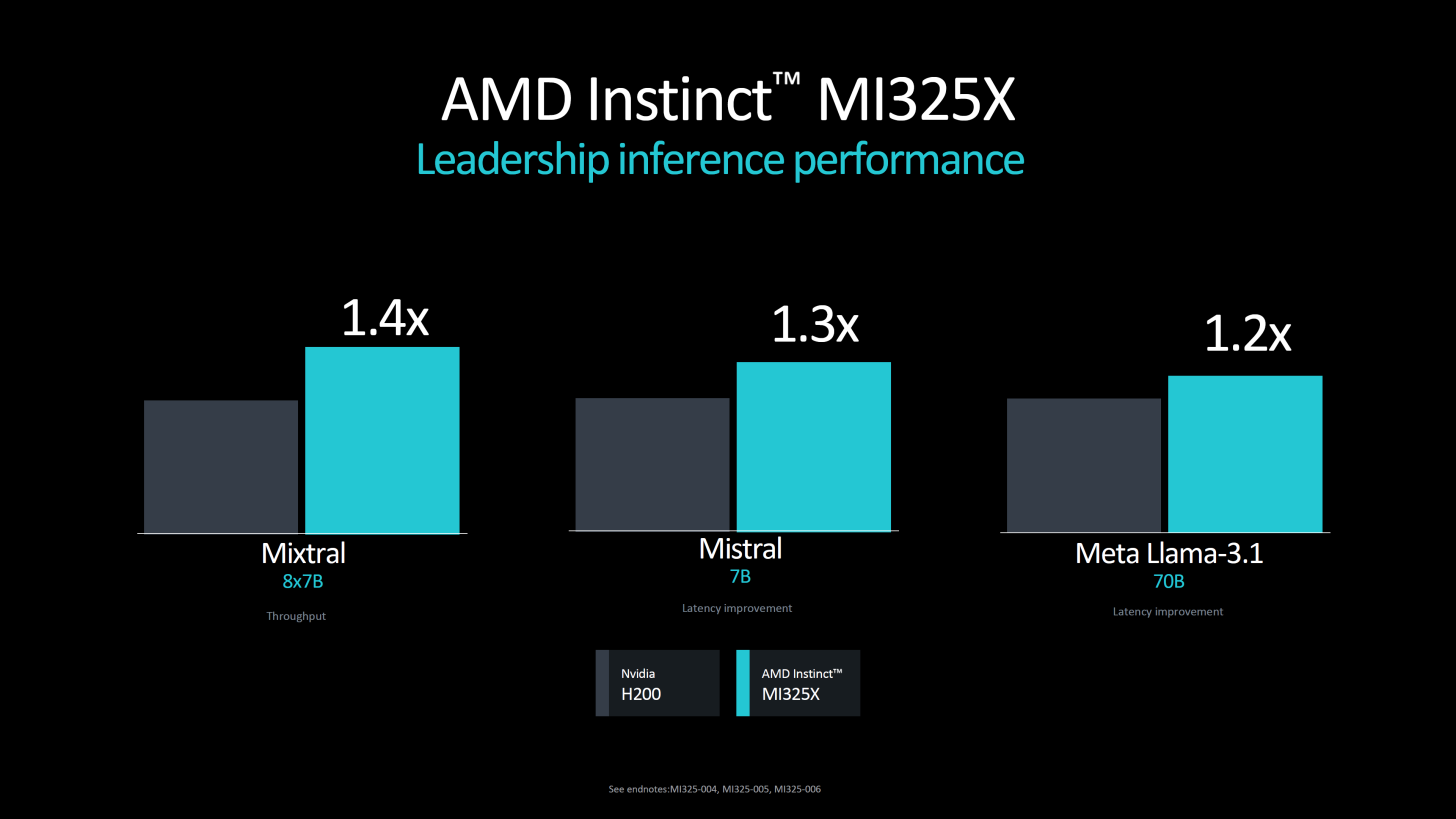 Ускорители подобного класса невозможно представить вне программной экосистемы. В настоящий момент AMD приводит данные о превосходстве MI325X над NVIDIA H200, варьирующемся в районе 20-40 % (в зависимости от нагрузки). Конечно, отчасти это заслуга памяти, но основной прирост заключается в оптимизации программной среды ROCm. По словам AMD, в задачах обучения и инференса производительность в версии 6.2 была увеличена более чем вдвое. 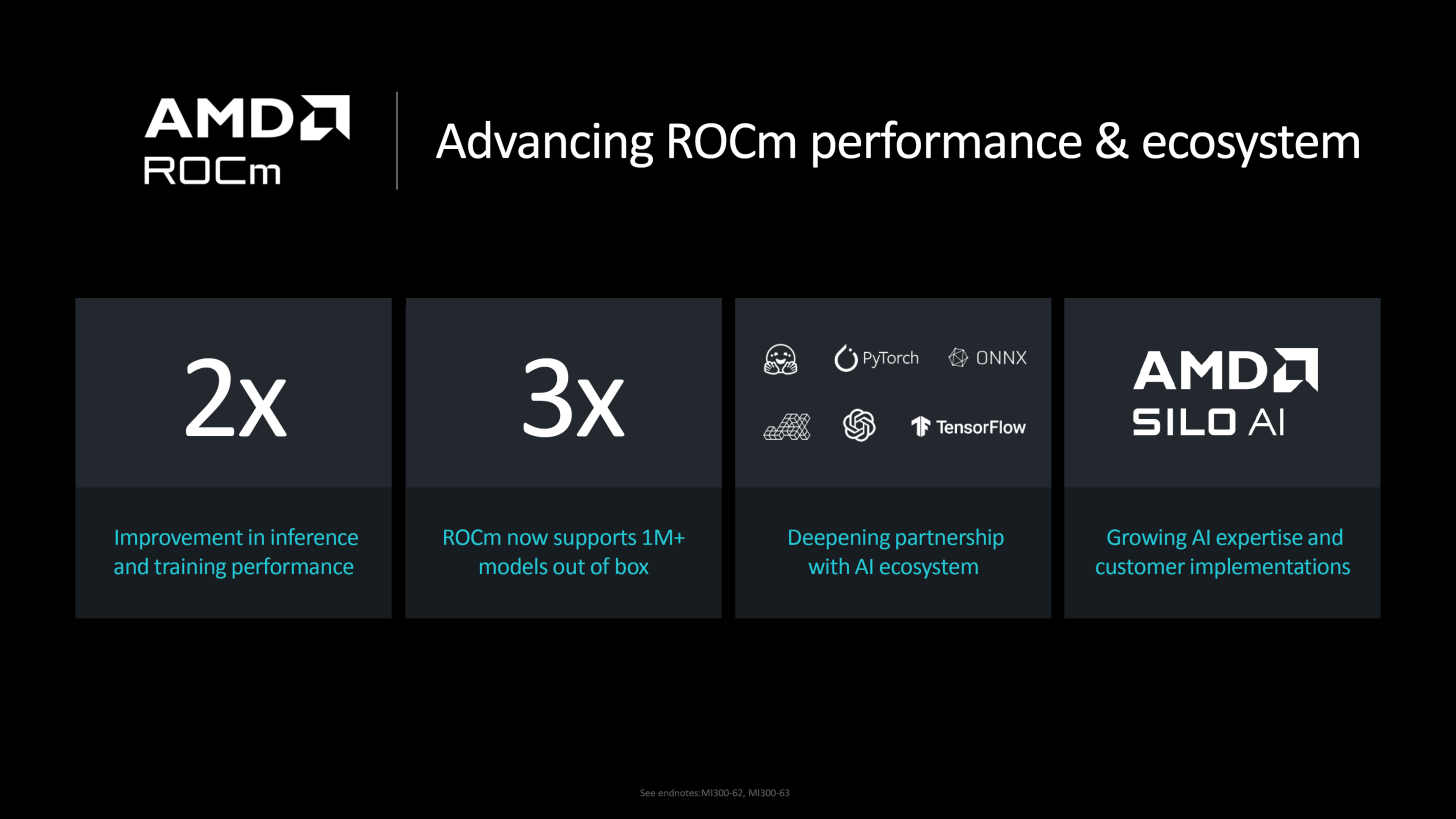 Для сравнения, в первых тестах MI300X в MLPerf Inference 4.1 отстал от NVIDIA H200 примерно на 50 %. Однако для полноты картины следует дождаться результатов тестов, проведённых сторонними источниками. Кроме того, H200 уже не самый совершенный ускоритель NVIDIA — в следующем году MI325X предстоит столкнуться с B200 на базе архитектуры Blackwell. 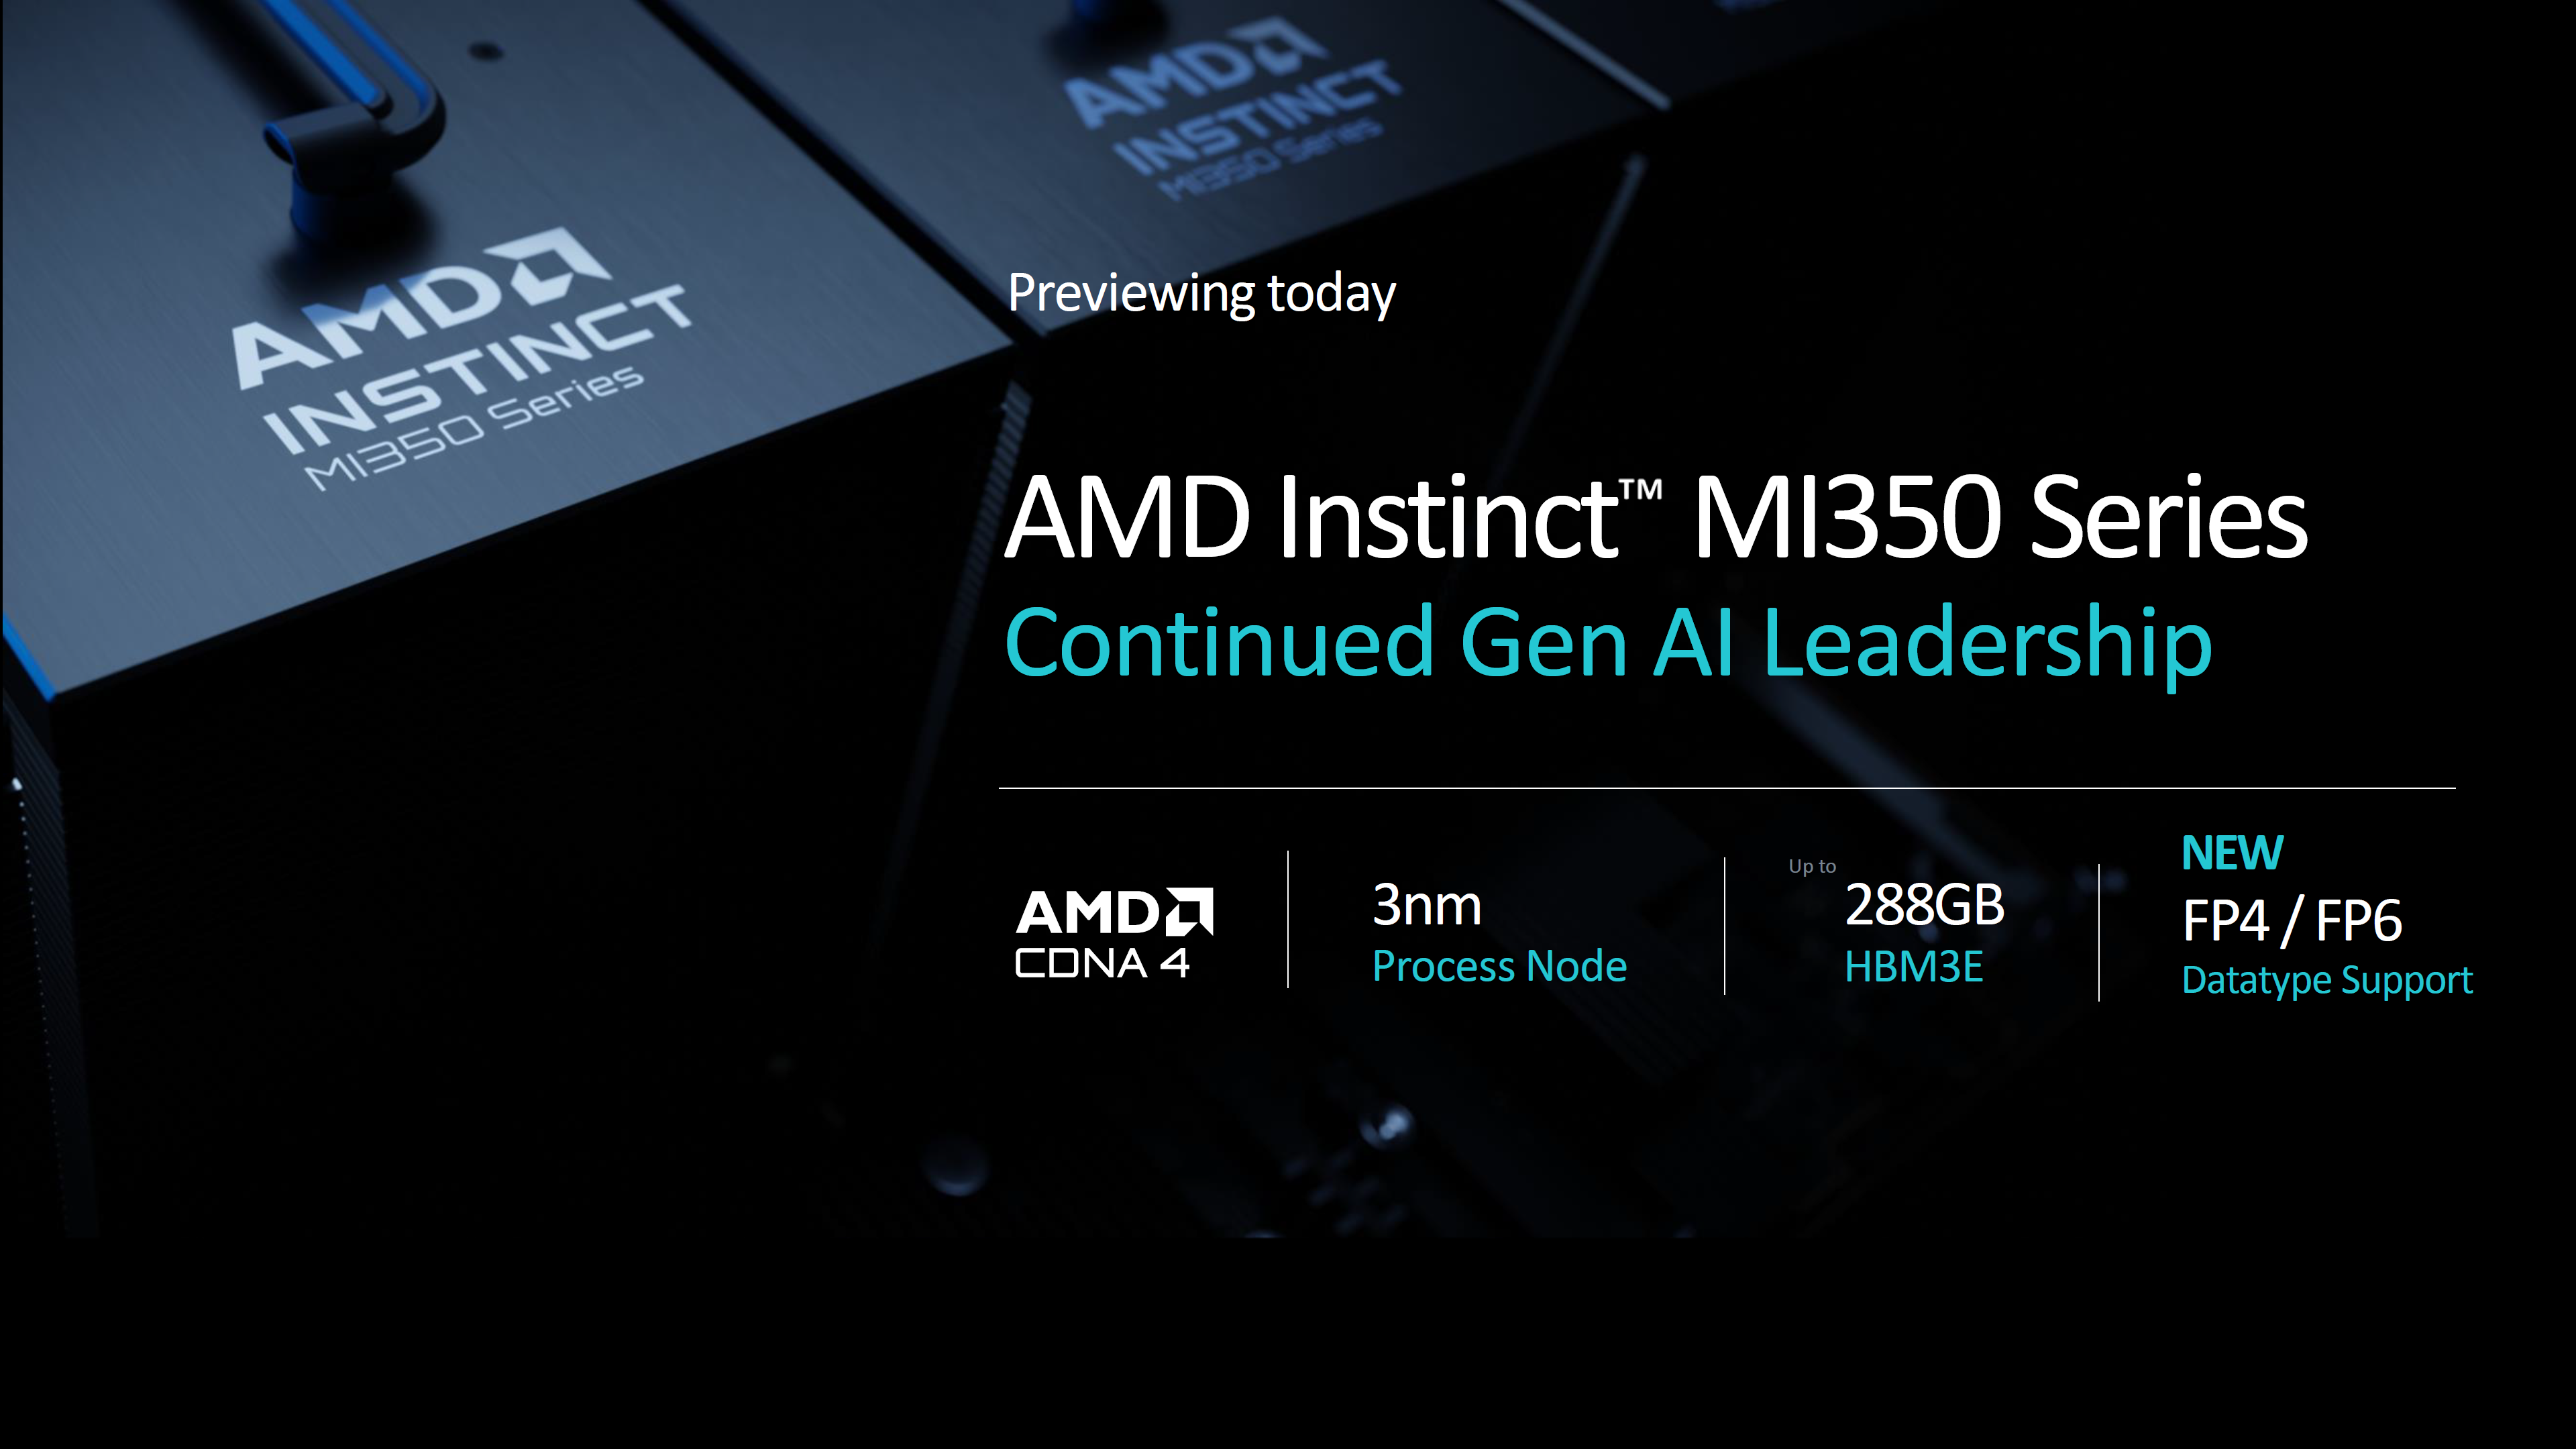 Ускорители Instinct MI325X будут доступны в I квартале 2025 года, но уже сейчас ясно, что усложнить жизнь своему главному конкуренту AMD в состоянии: так, вся обработка Llama 405B, используемой Meta✴, легла на плечи именно на MI300X. Активно используются решения AMD и в ЦОД Microsoft Azure. 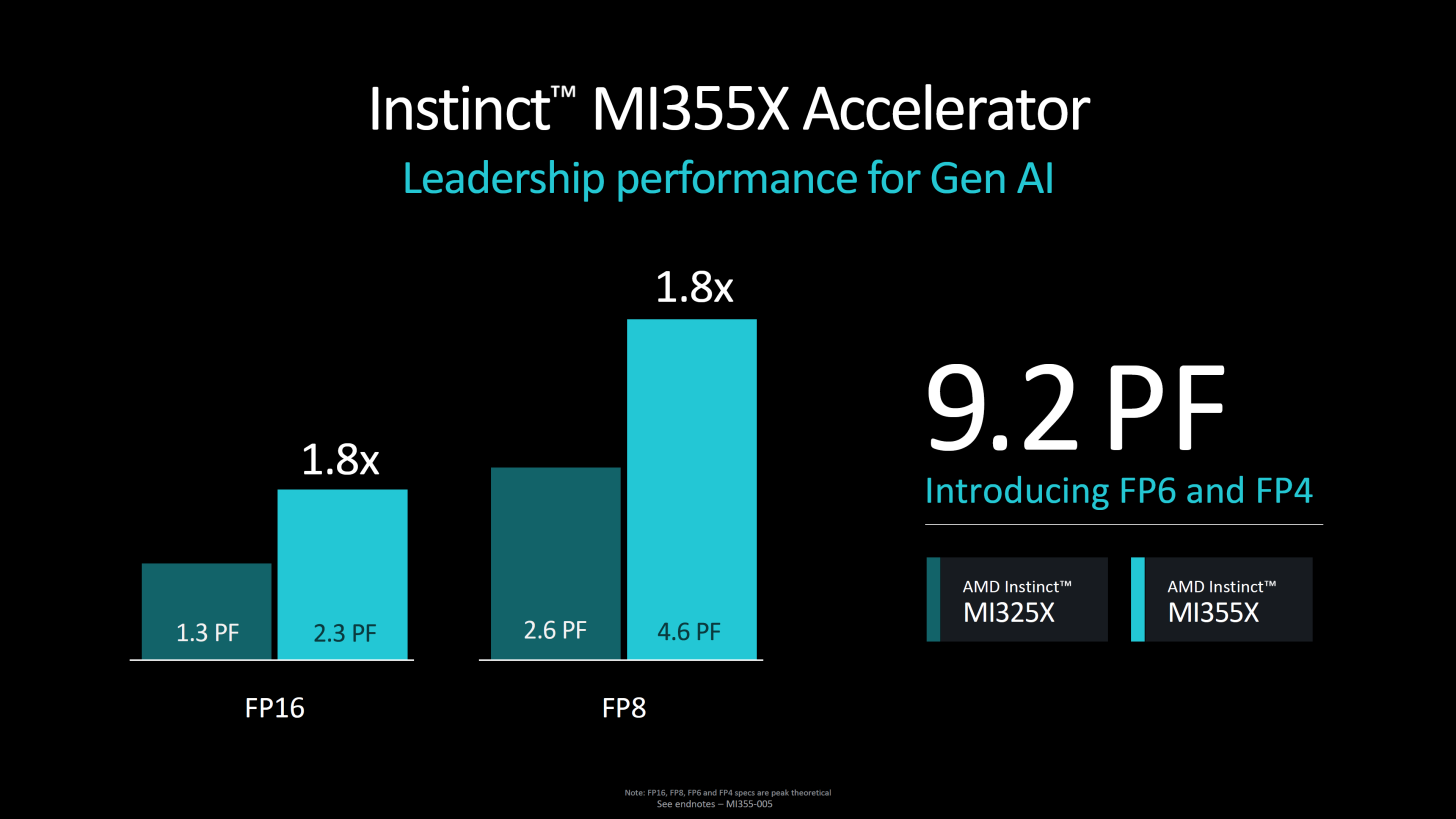 Что касается следующего поколения ускорителей AMD Instinct MI355X, то оно намечено на II половину 2025 года. Оно получит обновлённую архитектуру CDNA 4, о которой пока нет никаких сведений, кроме упоминания о поддержке режимов FP6 и FP4. Вычислительные тайлы будут переведены на 3-нм техпроцесс, а их количество, как ожидается, возрастёт с 8 до 10. Тем не менее, роста тепловыделения избежать не удастся: заявлен теплопакет до 1000 Вт. 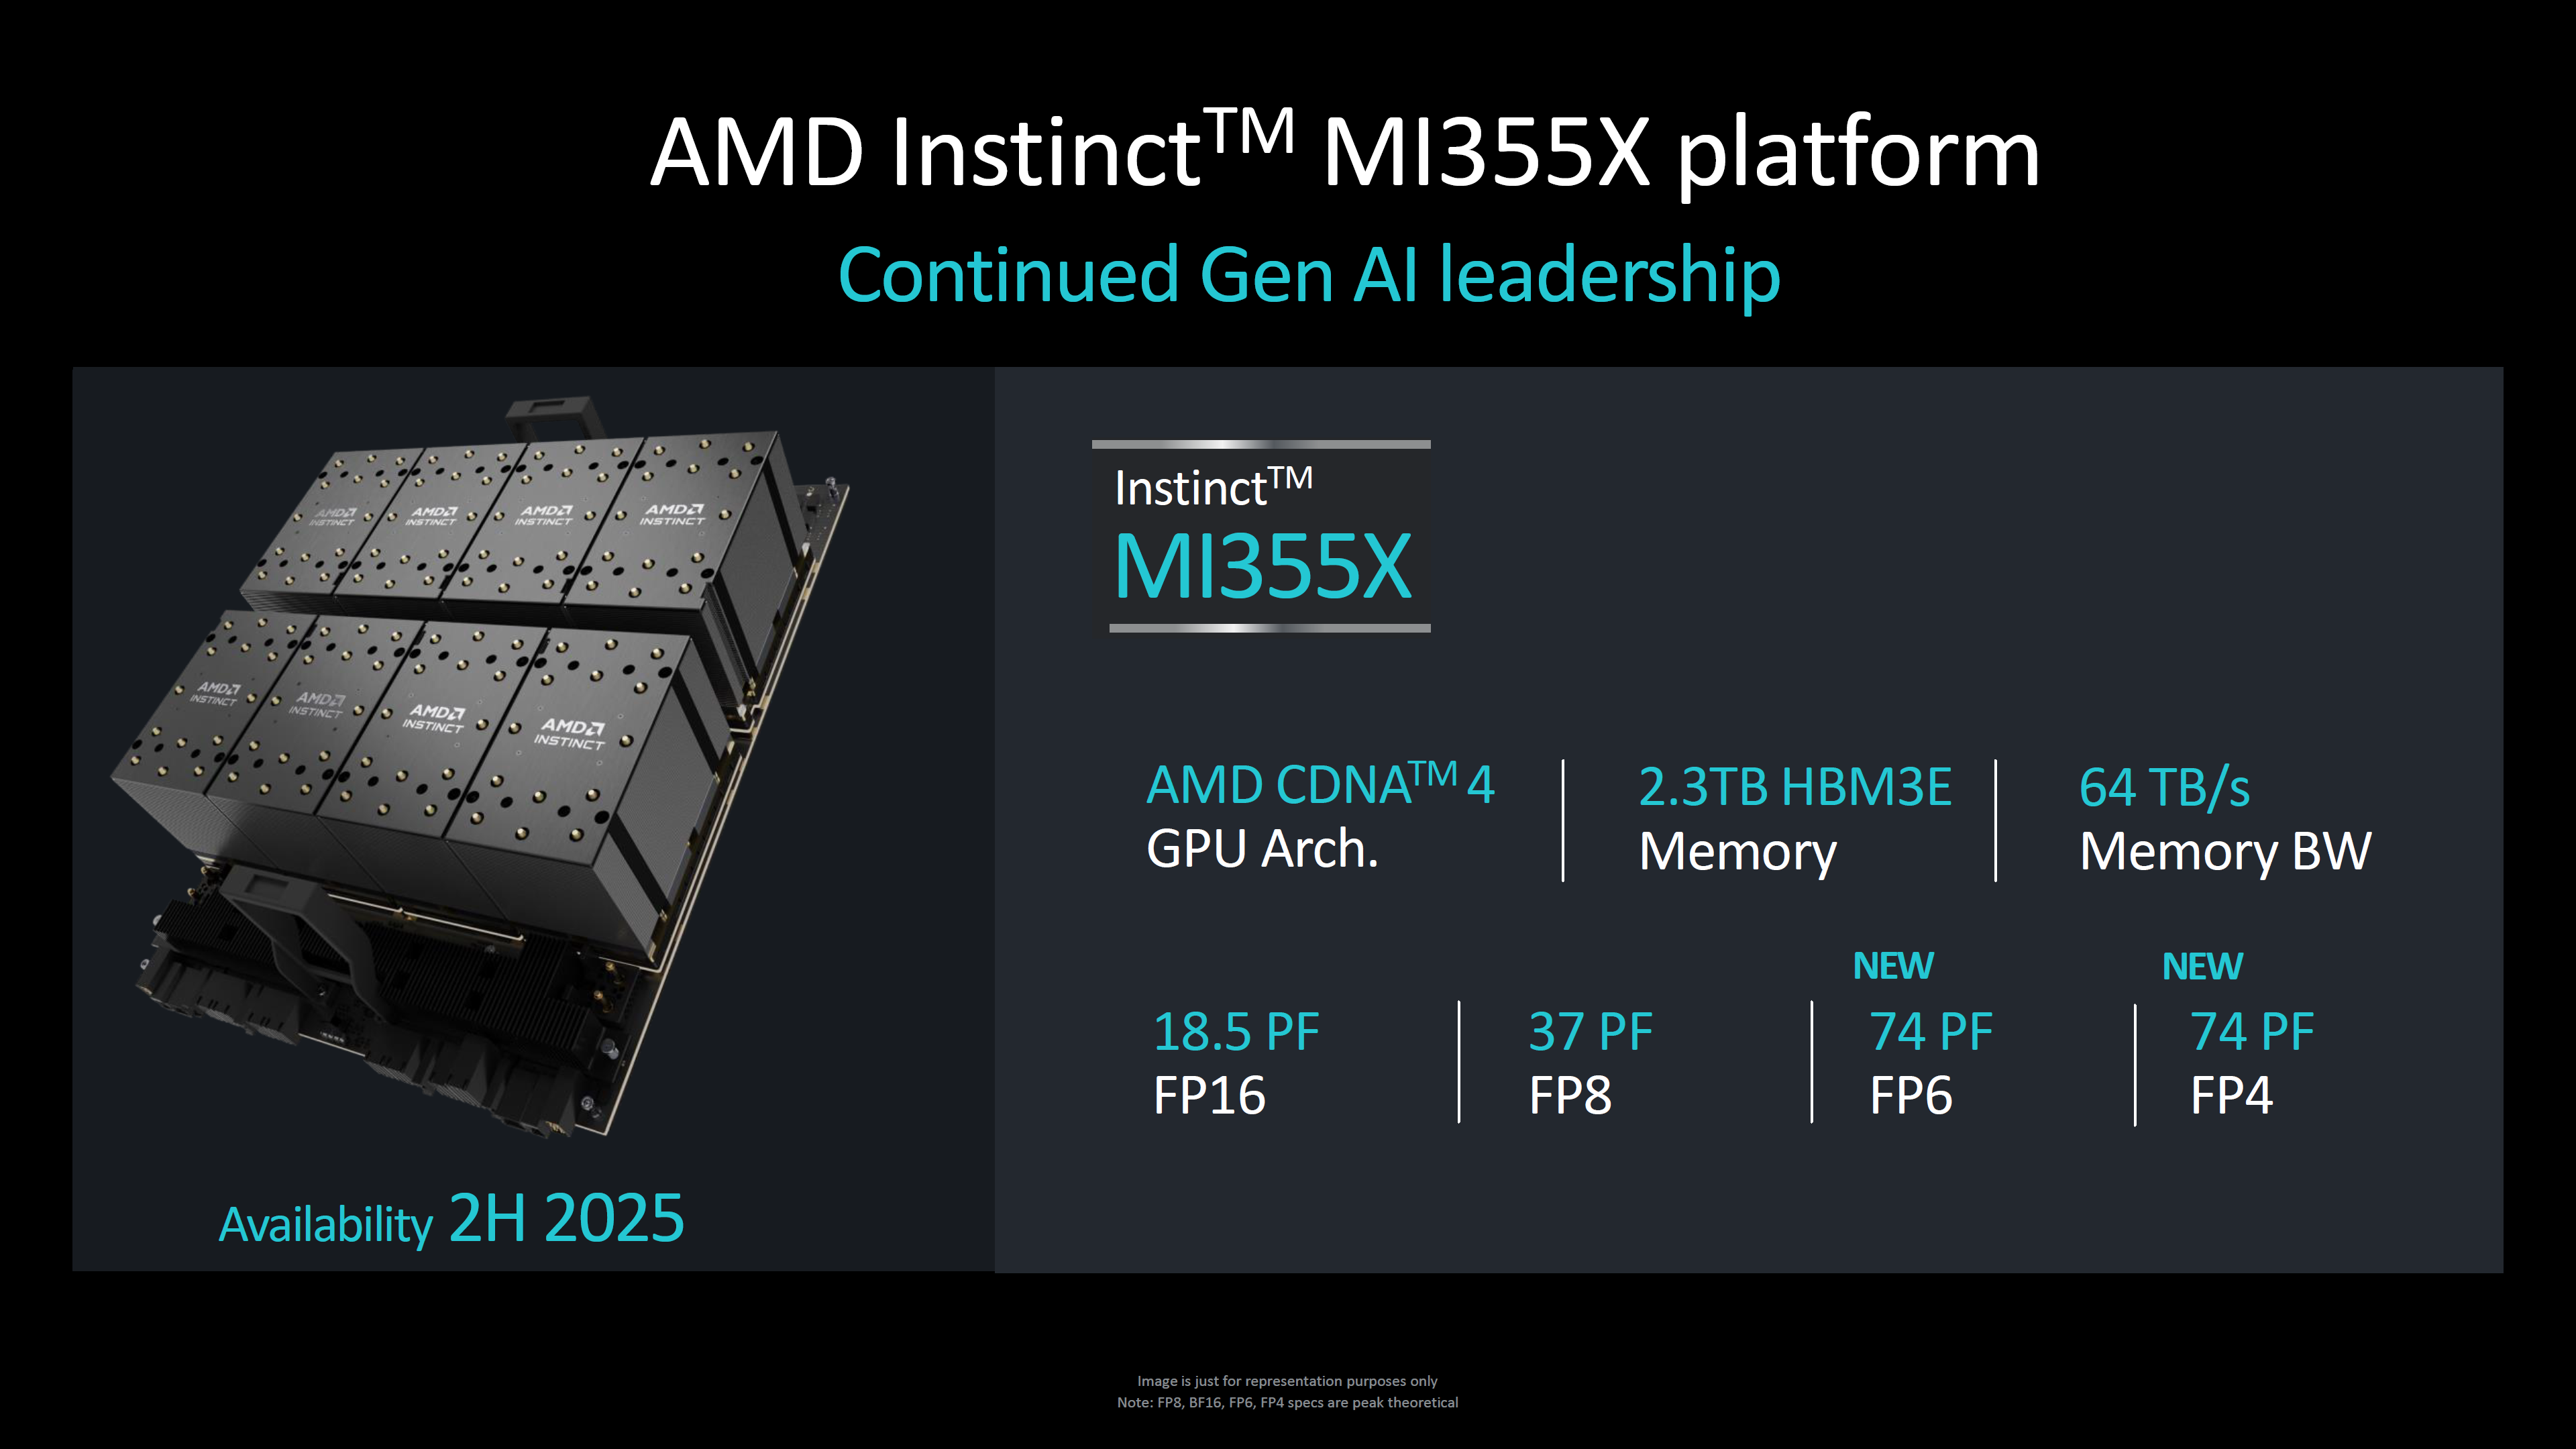 В Instinict MI355X получит дальнейшее развитие и подсистема памяти. Объём набортной HBM3e всё-таки достигнет 288 Гбайт, а пропускная способность вырастет с 6 до 8 Тбайт/с. Для связки из восьми MI355X AMD заявляет производительность в 18,5 Пфлопс в режиме FP16, что позволяет говорить о 2,31 Пфлопс для единственного ускорителя — то есть о примерно 80 % прироста в сравнении с MI325X. 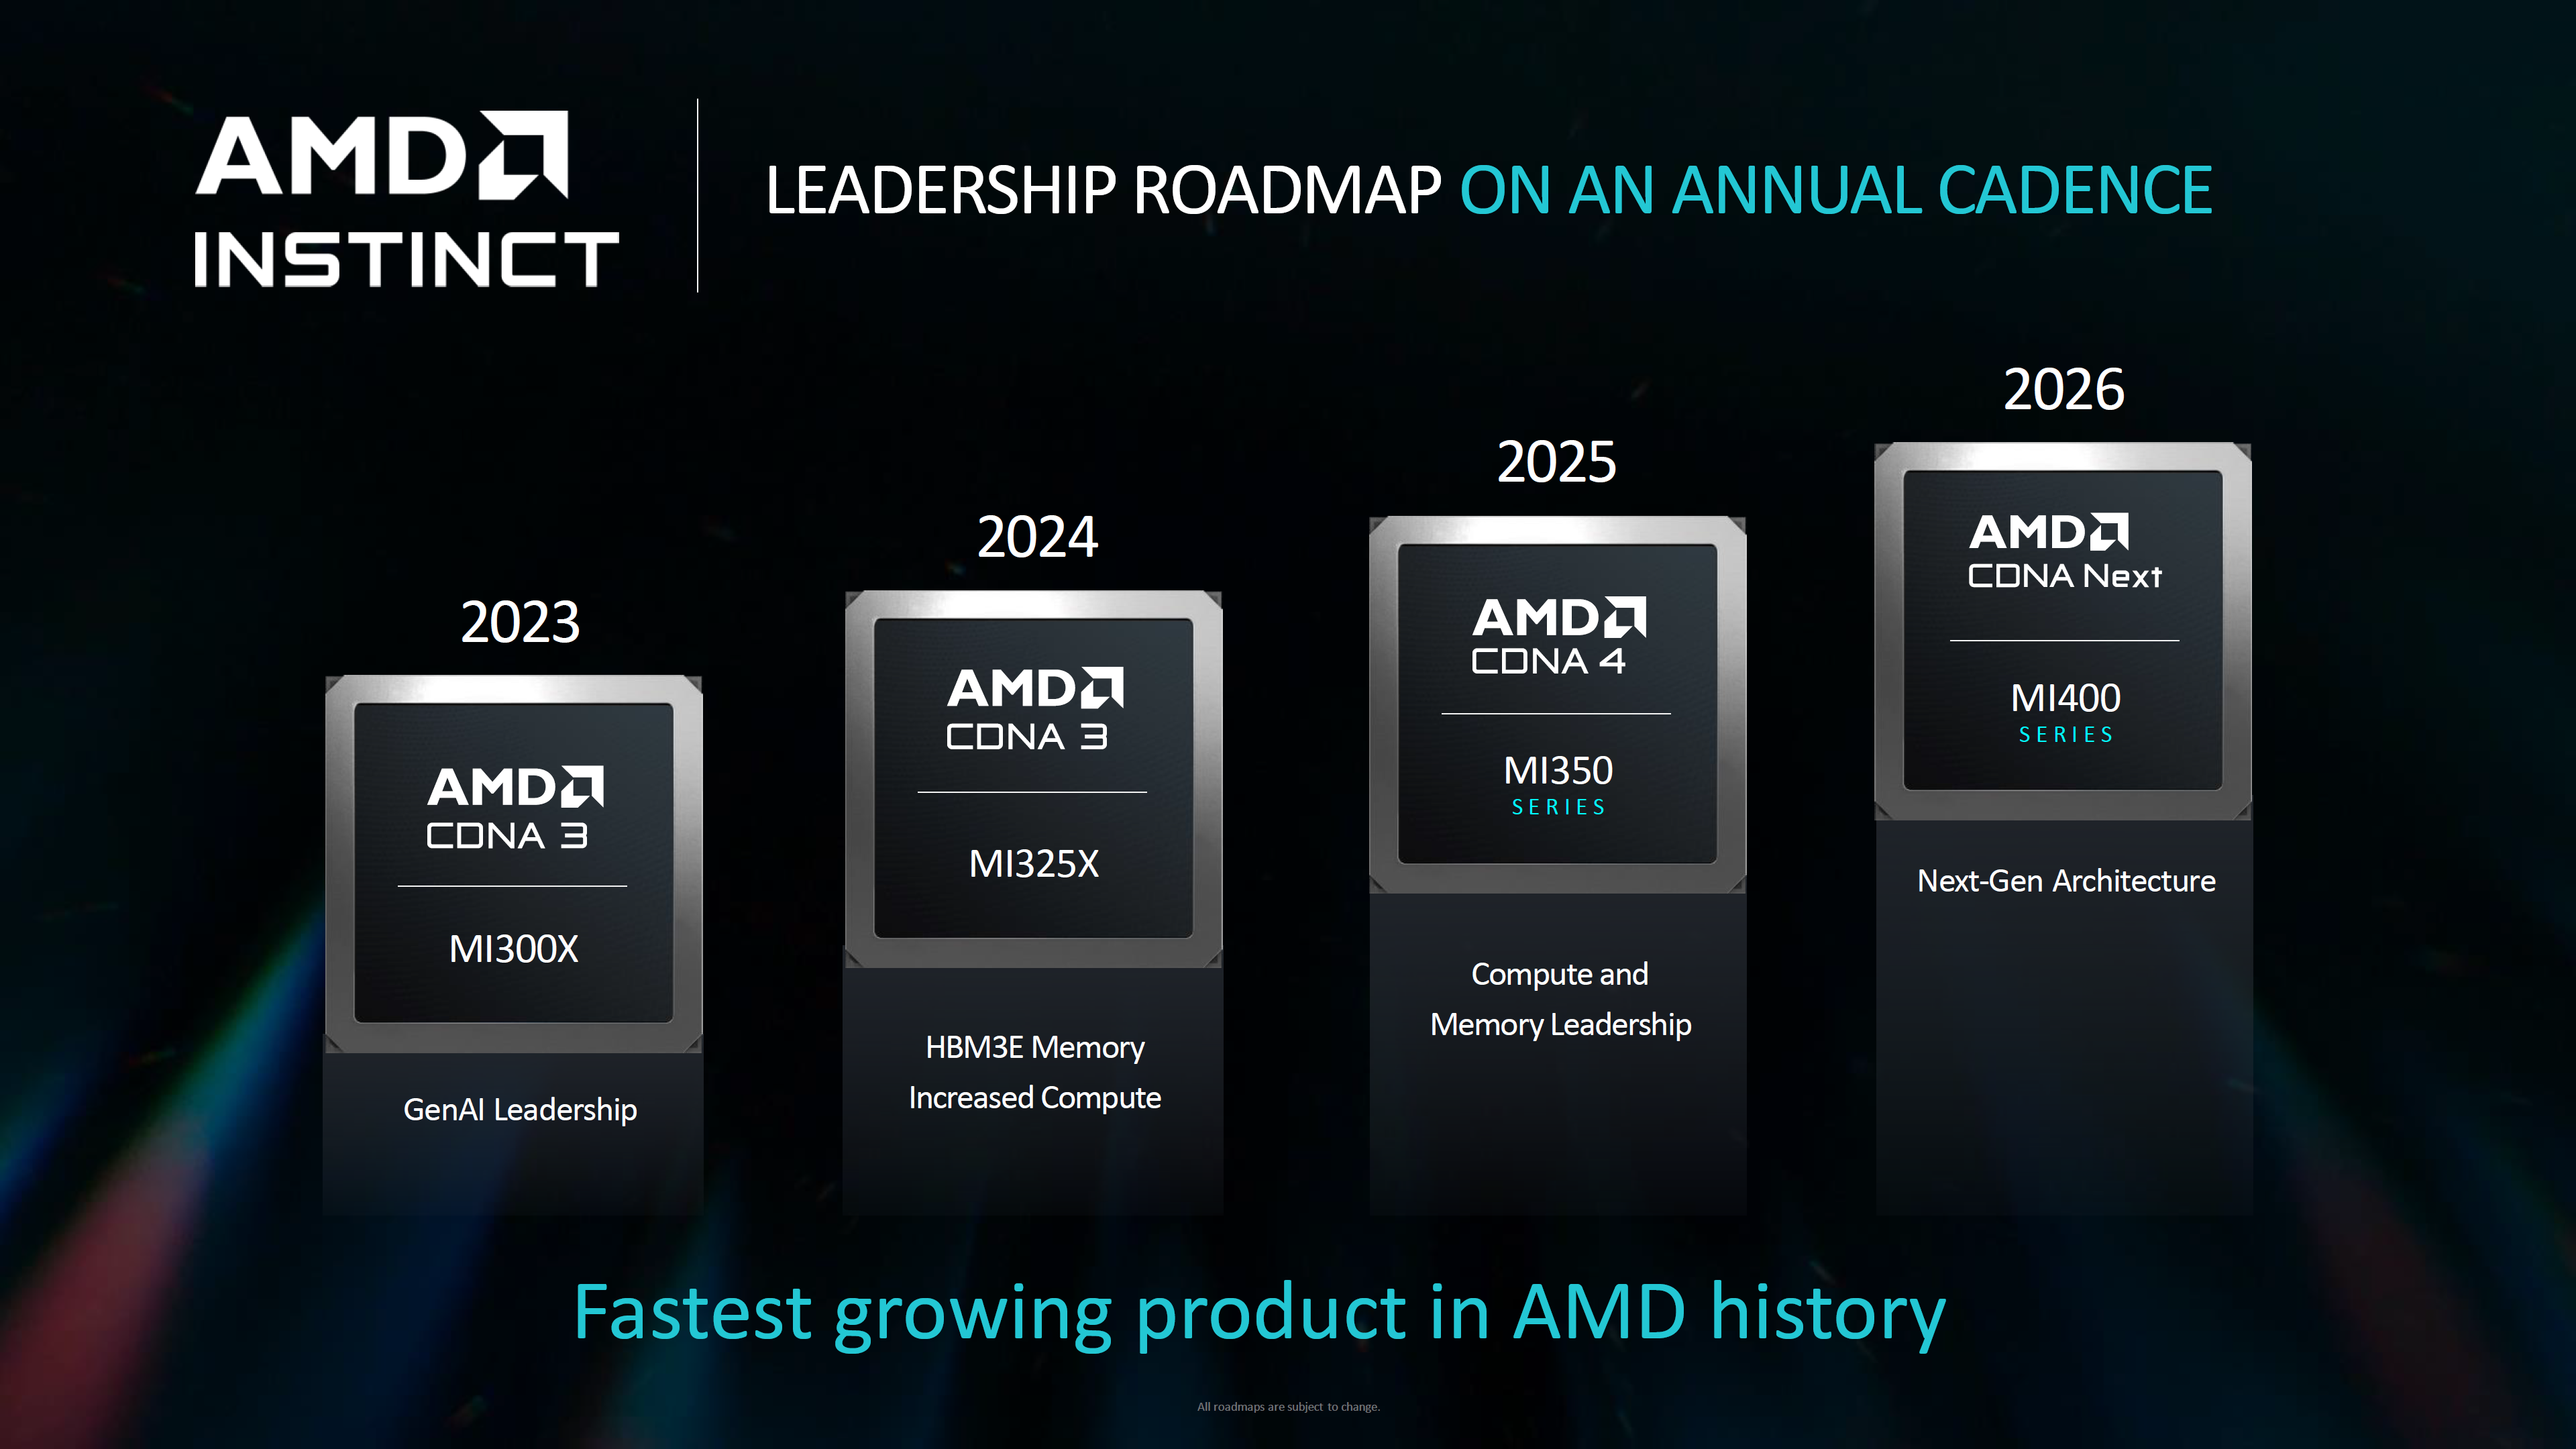 Делать какие-либо далеко идущие выводы о решениях на базе CDNA 4 рано: вероятнее всего, даже лаборатории AMD ещё не располагают финальной версией MI355X, а кроме того, как уже понятно, огромную роль играет постоянно изменяющаяся и совершенствуемая программная среда, которая ко II половине 2025 года может претерпеть существенные изменения. 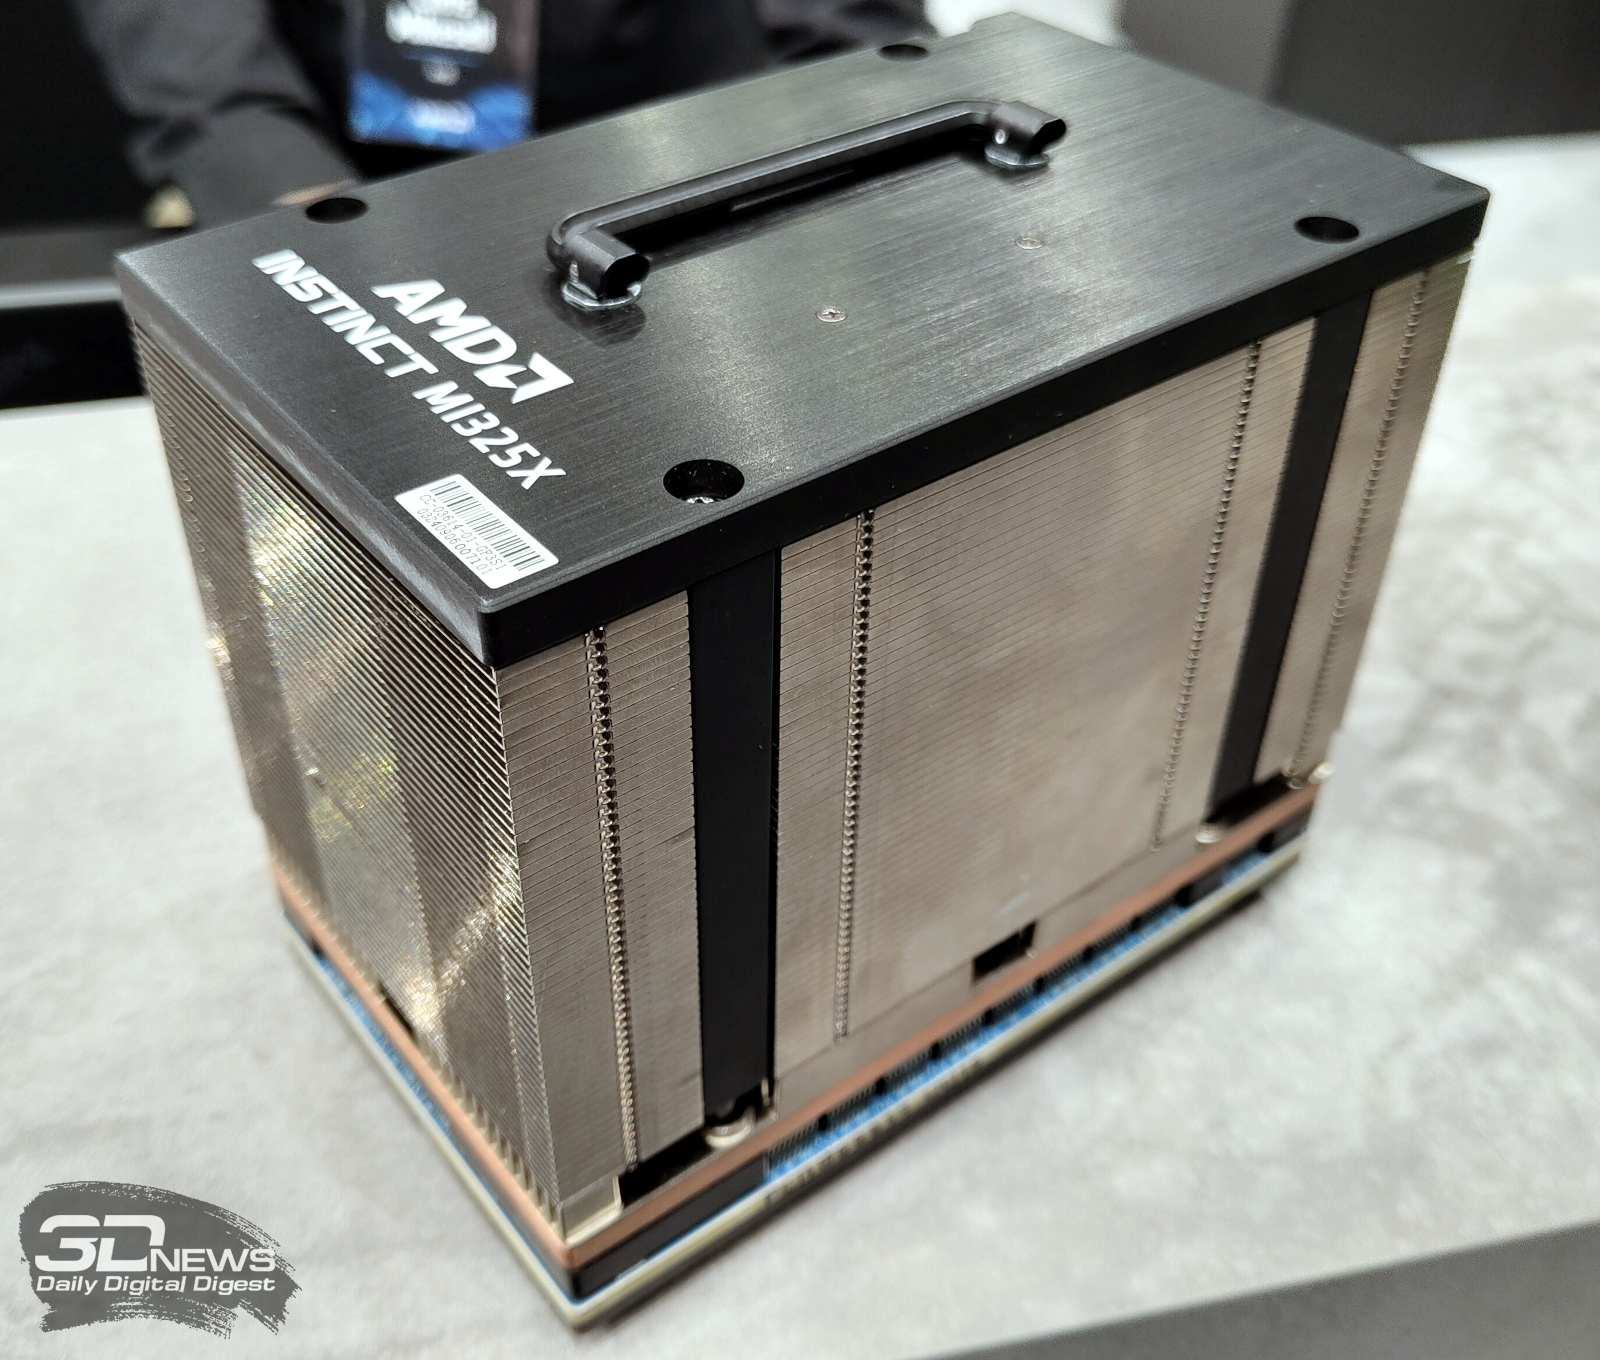 А вот гибридным решениям AMD планирует положить конец: преемника для Instinct MI300A, сочетающего в себе архитектуры CDNA 3 и Zen 4 не запланировано. Похоже, рынок для таких решений оказался слишком мал. |
|

