Материалы по тегу: intel xe
|
13.10.2026 [15:45], Владимир Мироненко
Анонсирован Intel GPU D270, оптимизированный для инференса агентного ИИIntel представила Intel GPU D270 — первый продукт серии ускорителей D-series, ранее известной под кодовым именем Crescent Island. Некоторые подробности о новой серии стали известны в августе. Уже начаты поставкм инженерных образцов чипа заказчикам: серверным OEM- и ODM-производителям, провайдерам облачных услуг, включая неооблака, и независимым разработчикам программного обеспечения. Как сообщается, Intel GPU D270 — это ускоритель для ЦОД, оптимизированный для задач инференса и разработанный с учётом требований применения агентного ИИ. Он предназначен для поддержки корпоративных ИИ-решений, сервисов SaaS и GPUaaS, а также развёртывания в государственных или суверенных облачных инфраструктурах, где необходимы энергоэффективные средства ускорения ИИ с большим объёмом памяти. Intel GPU D270 может использоваться промышленных задач ИИ-инференса, таких как агентный ИИ, генерация с дополненным поиском (RAG) с использованием длинного контекста, корпоративные ИИ-ассистенты, помощники для написания кода, анализ документов, мультимодальный ИИ, диффузионные модели и обслуживание запросов в условиях высокой конкурентности. Чип разработан с учётом специфики работы агентного ИИ, решающего задачи с разбивкой на несколько этапов: вызовы модели, использование внешних инструментов, поиск информации и генерация ответа. При создании Intel GPU D270 учитывалась специфика требований таких сценариев, включая обработку этапа предварительного заполнения (prefill), работу с увеличенным контекстом, достаточный объём памяти, поддержку высокой конкурентности и энергоэффективность. 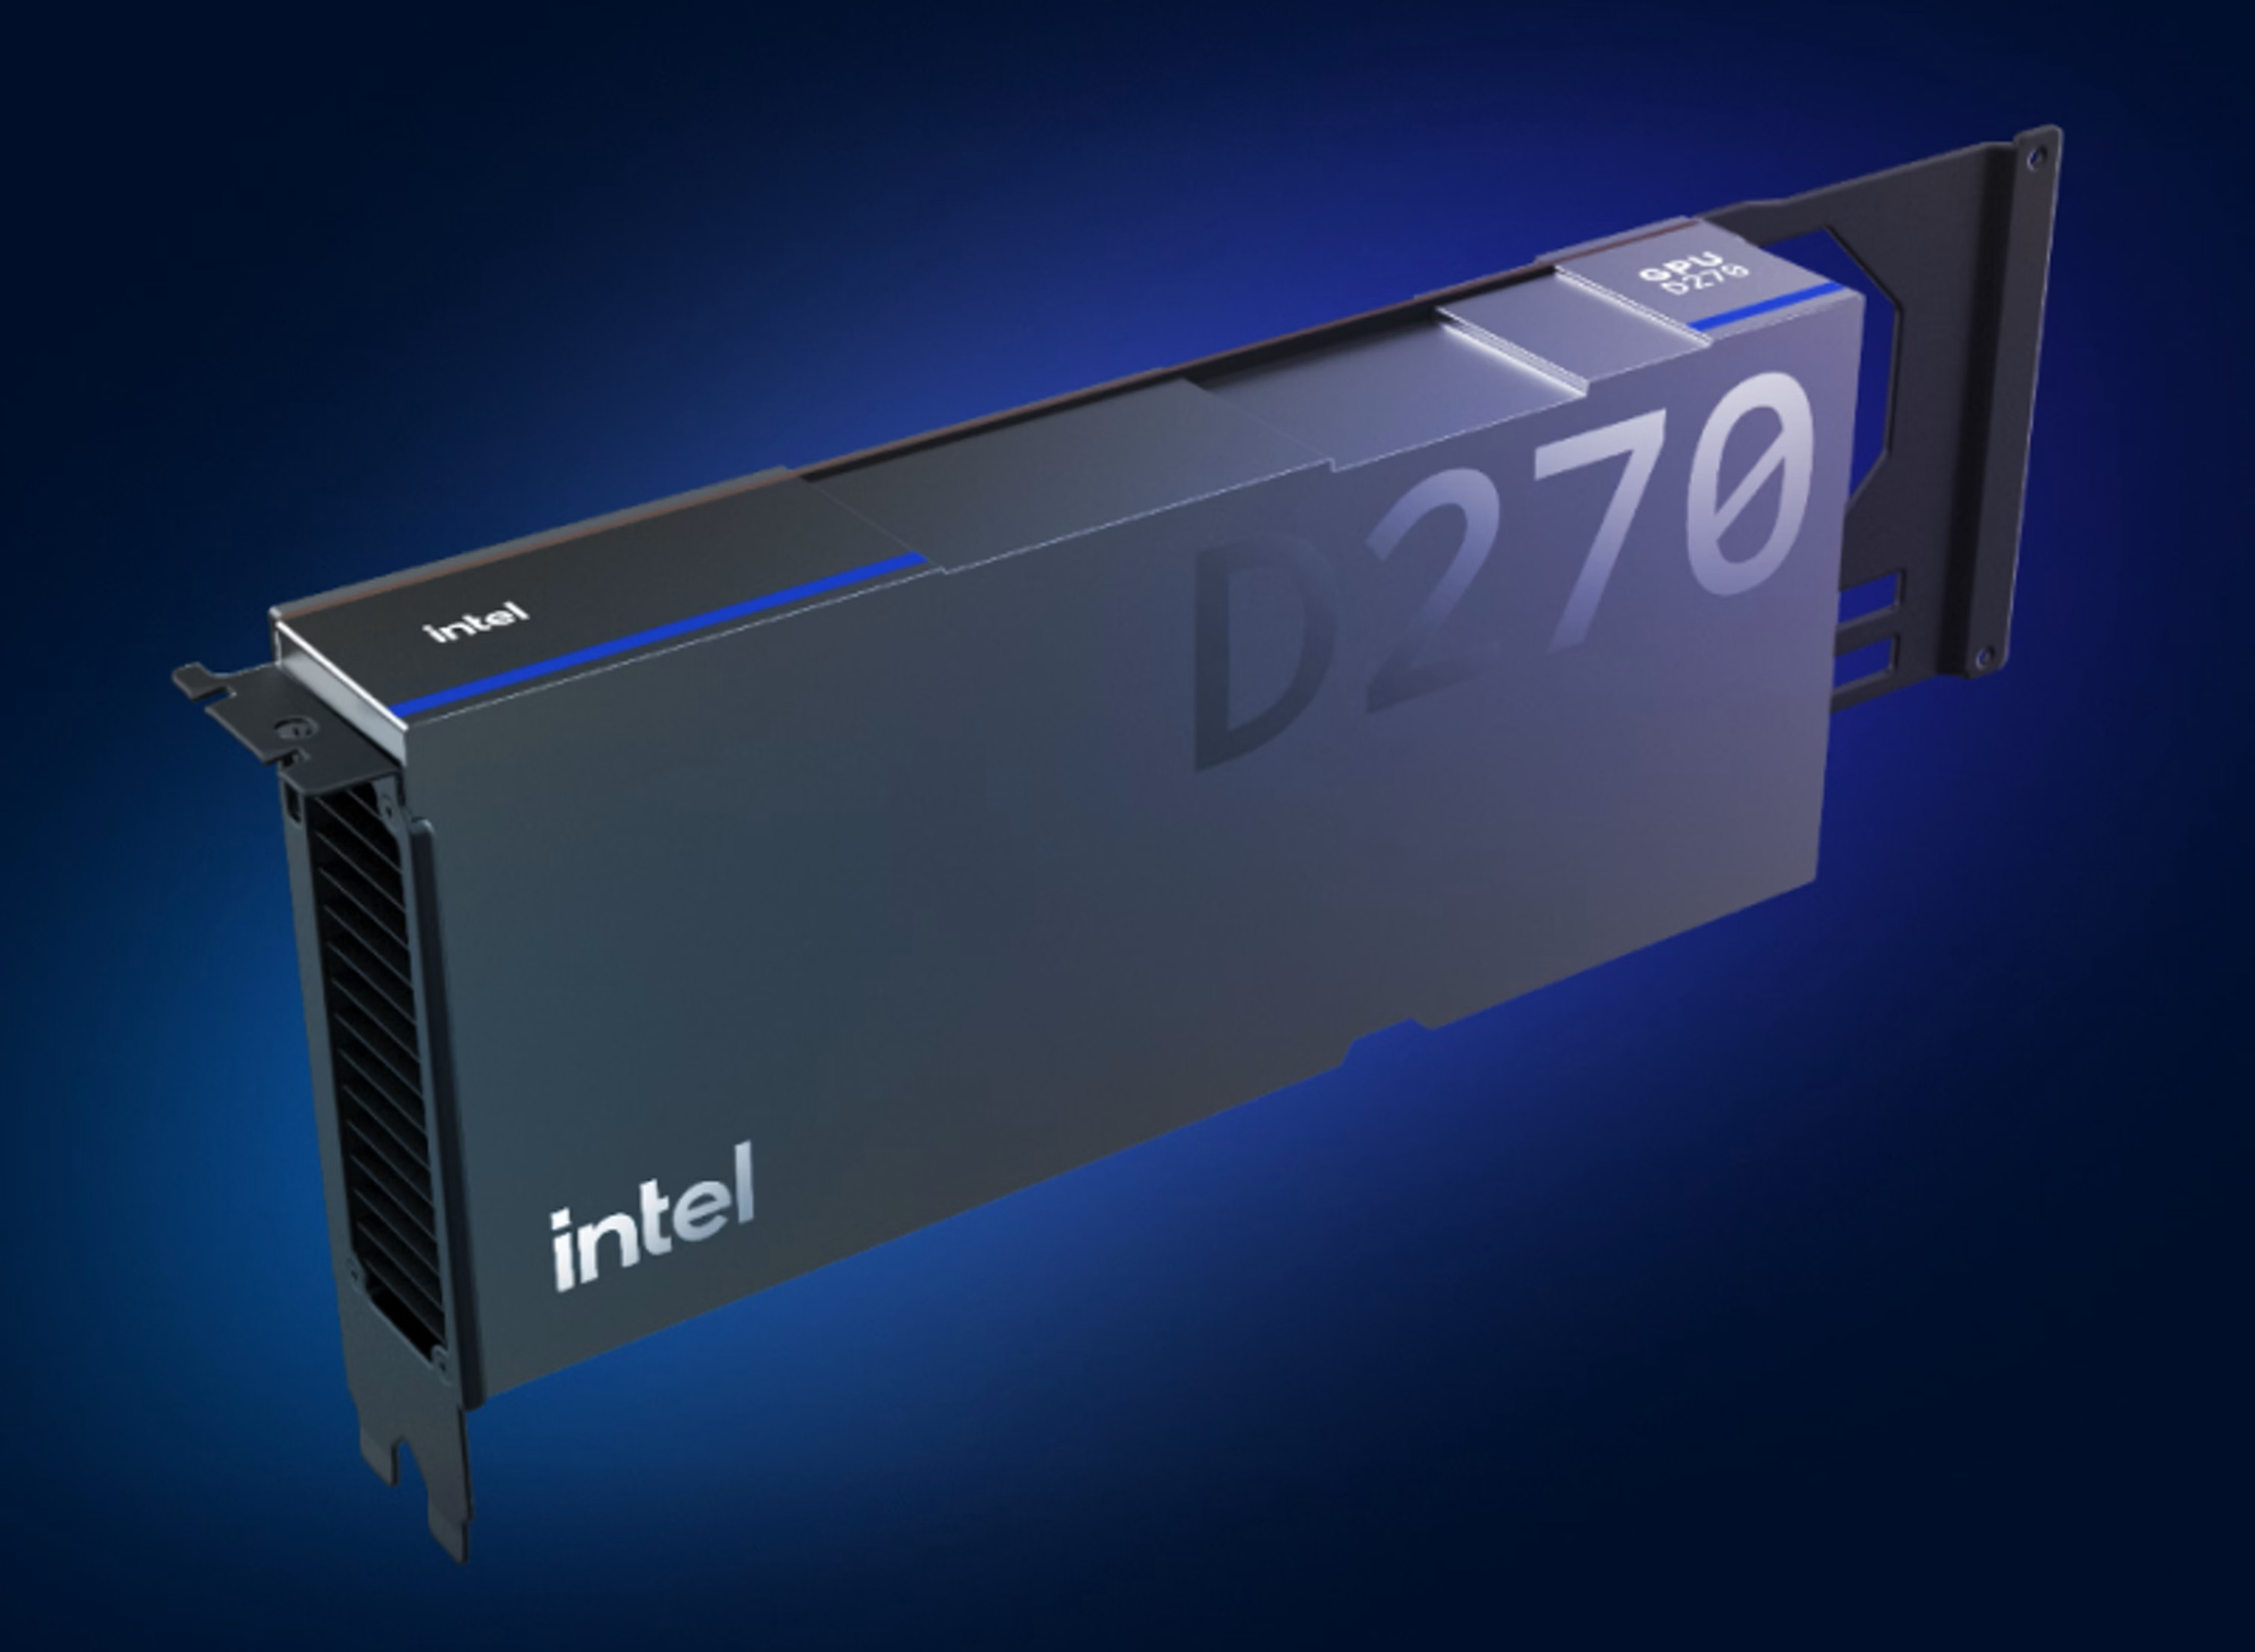
Источник изображения: Intel D270 обладает достаточно большим объёмом доступной памяти, что позволяет поддерживать более крупные модели, длинный контекст и большее количество одновременных сеансов, обеспечивая поддержку больших промптов, процессы с интенсивным поиском данных и рост KV-кеша в ходе инференса. LPDDR5X уступает HBM по пропускной способности, однако позволяет обеспечить большой объём при меньших затратах и энергопотреблении. Объём памяти составляет до 480 Гбайт в GPU сторонних производителей. Фирменный GPU от самой Intel оснащается 160 Гбайт памяти. Intel GPU D270 выполнен в форм-факторе двухслотовой карты с интерфейсом PCIe 5.0 x16. Архитектура Intel Xe3P — усовершенствованная версия графической архитектуры Xe3 — отличается увеличенным количеством матричных блоков XMX и расширенной подсистемой памяти LPDDR5X. Ускоритель включает 32 ядра Xe и 256 матричных блоков. Пропускная способность памяти (ПСП) составляет до 1,5 Тбайт/с, производительность в режиме FP8 — на уровне 1,3 Пфлопс при потреблении 350 Вт. Пиковая векторная производительность (FP64) — 10,2 Тфлопс. По данным Intel, одна карта серии D способна вместить модели с до 300 млрд параметров, а система с восемью такими ускорителями позволяет обслуживать модели с 1+ трлн параметров. При этом Intel делает ставку на такие метрики, как объём памяти на ватт и на доллар, считая их более важными для задач обслуживания моделей с интенсивным этапом декодирования, чем пиковая ПСП. «Выпуская GPU Intel D-series, мы стремимся сделать развёртывание систем инференса с большим объёмом памяти практичным, а их масштабирование — экономически выгодным», — заявила компания. Программная часть базируется на единой архитектуре Xe — код, написанный для GPU Arc Pro, можно перенести на серию D без переписывания ядер (kernels). Программный стек Intel объединяет стандартные среды выполнения (runtimes) и фреймворки для обслуживания моделей. Предусмотрена поддержка «нулевого дня» (Day 0) для модели Muse Glimmer от Meta✴. Инструментарий Intel AI for Enterprise Agent Toolkit, который уже работает на базе Xeon, будет адаптирован для работы с серией D, благодаря чему уровень оркестрации будет готов ещё до начала массовых поставок ускорителей. С Intel GPU D270 будут совместимы PyTorch, vLLM, SGLang и OpenAI Triton.
26.08.2026 [12:45], Сергей Карасёв
32 ядра Xe3P и до 480 Гбайт памяти LPDDR5X: Intel раскрыла детали об ИИ-ускорителе Crescent IslandIntel поделилась информацией об ИИ-ускорителях Crescent Island, предназначенных для использования в серверах и рабочих станциях. Ожидается, что поставки образцов изделий начнутся в текущем полугодии. Решения Crescent Island будут предлагаться в виде карт расширения с интерфейсом PCIe 5.0 x16. Конфигурация включает 32 ядра Xe3P и 256 матричных движков XMX. Кроме того, задействованы 256 векторных движков. На каждое ядро приходится 1 Мбайт регистра общего назначения (GRF) и 512 Кбайт кеша L1. Помимо этого, есть 32 Мбайт унифицированного кеша L2. В случае Crescent Island корпорация Intel решила отказаться от использования дорогостоящей памяти НВМ с высокой пропускной способностью. Вместо этого применяются чипы LPDDR5X с пониженным энергопотреблением (скоростные характеристики не раскрываются). Референсный вариант ускорителя несёт на борту 160 Гбайт LPDDR5X, тогда как ODM-производители будут предлагать модификации, имеющие до 480 Гбайт памяти. Заявленное энергопотребление карты находится на уровне 350 Вт; применяется воздушное охлаждение. 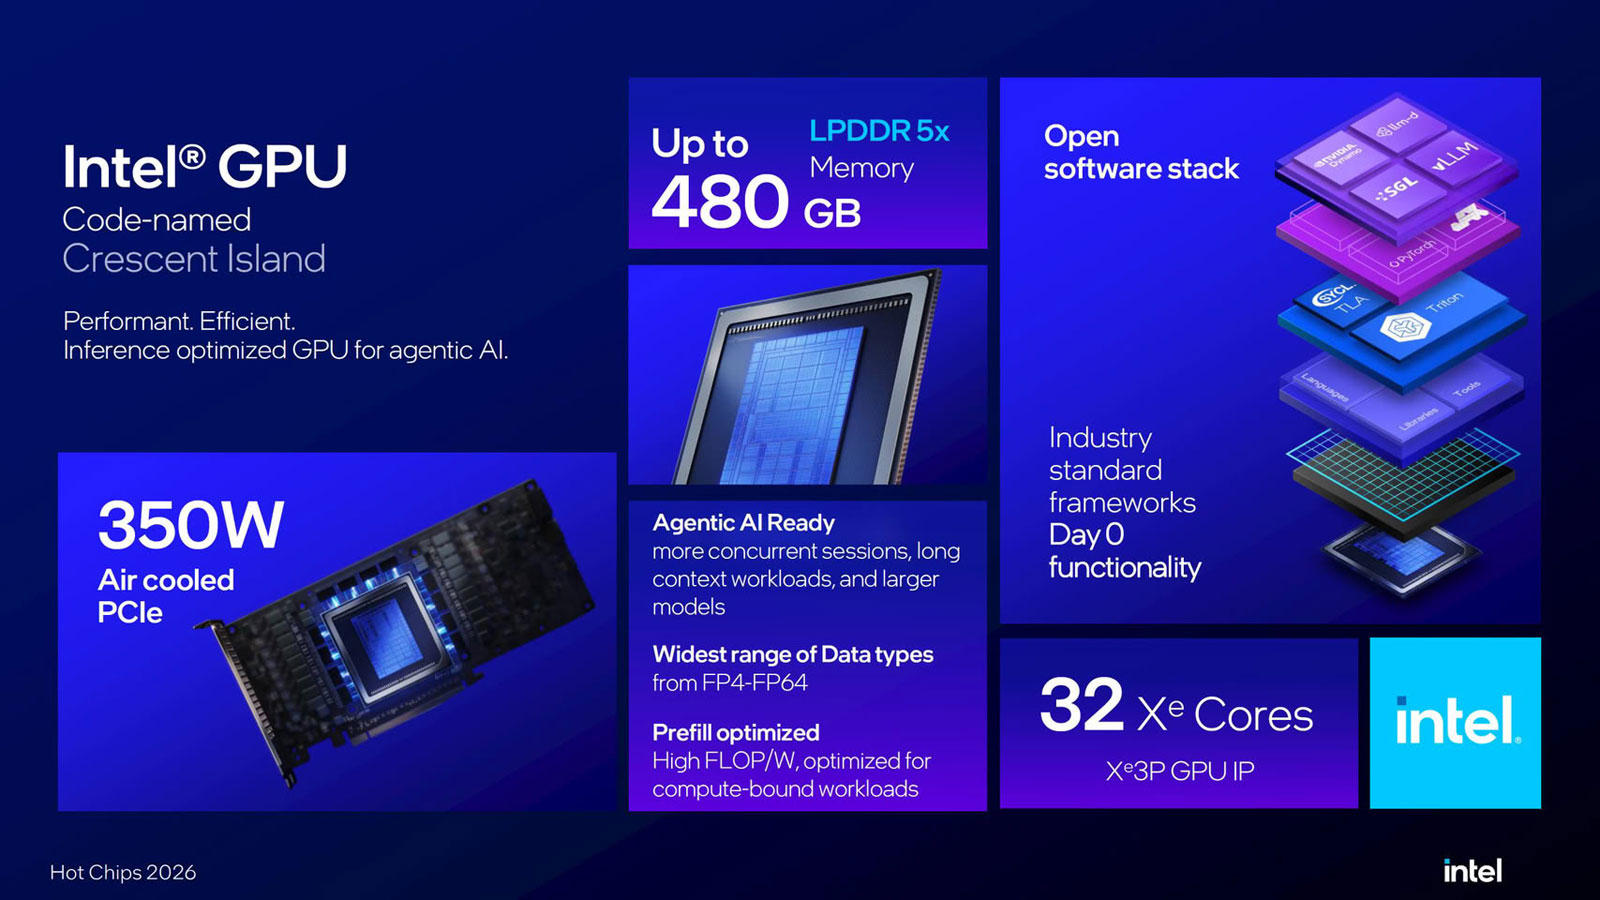
Источник изображений: Intel 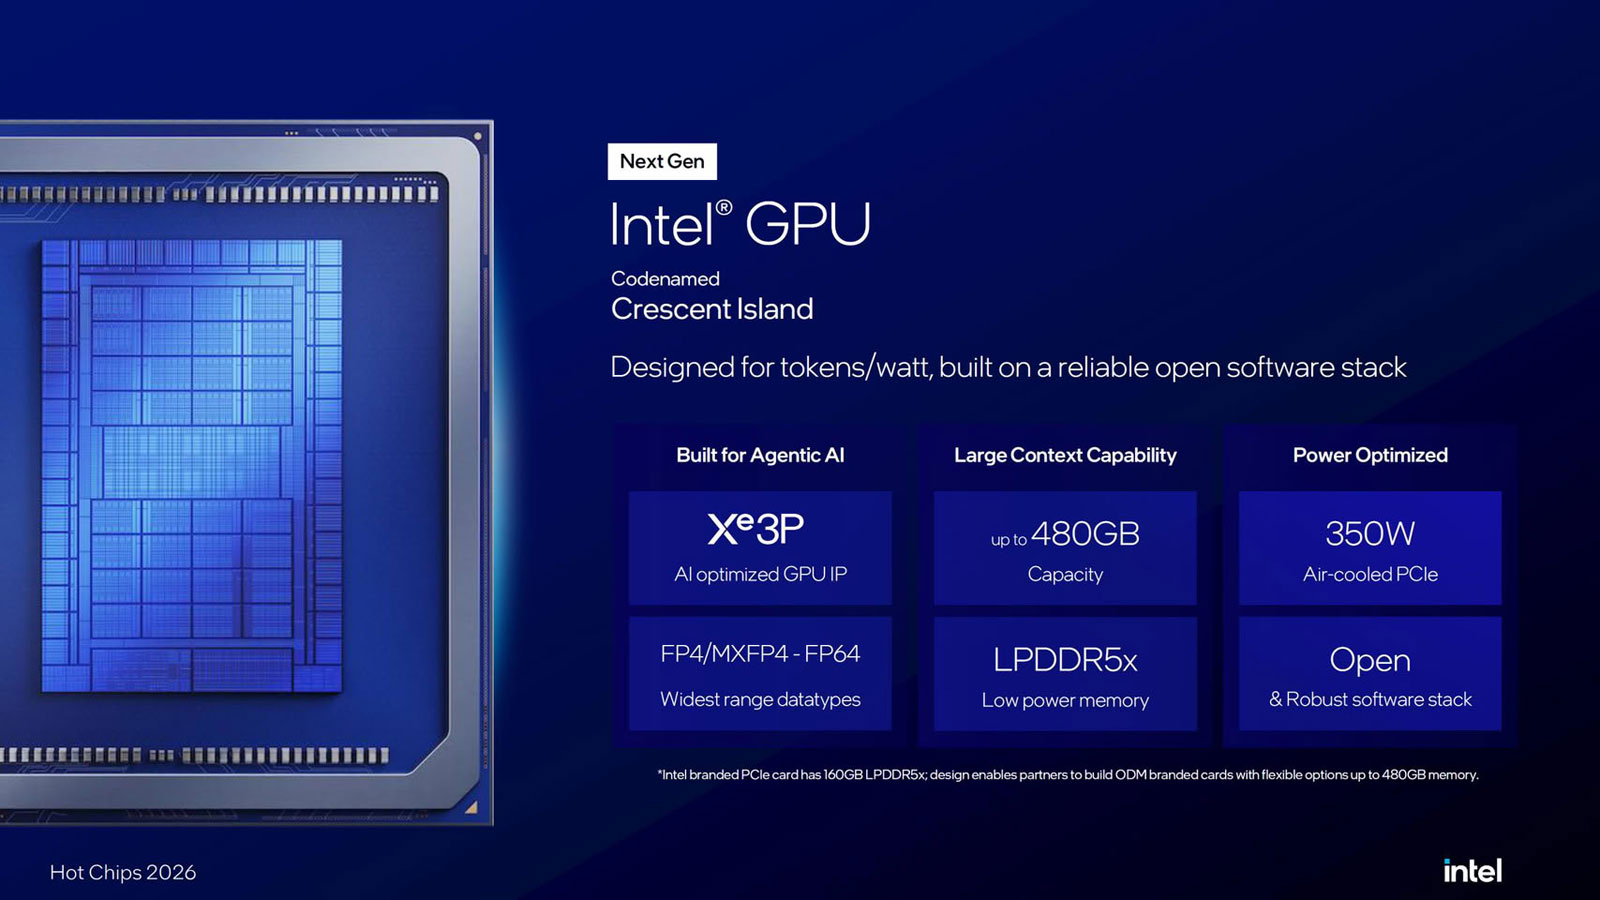
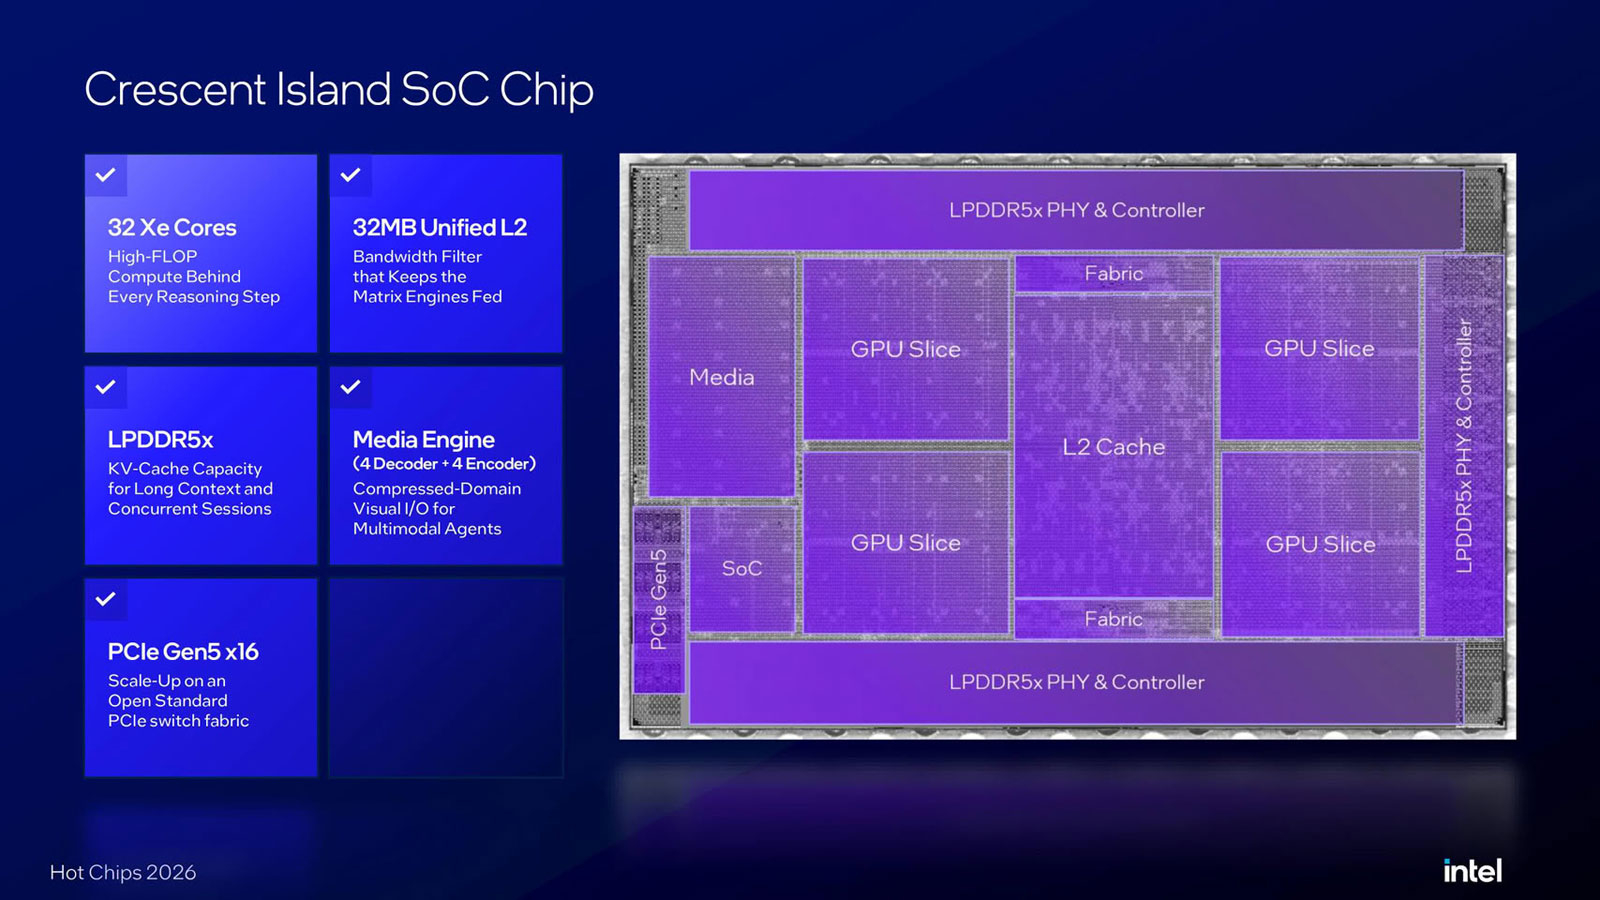 Изделие поддерживает различные форматы данных — FP64, FP16, BF16, TF32, INT8, INT4, FP8 и FP4. Ускоритель ориентирован прежде всего на задачи инференса. Он хорошо подходит для работы с агентным ИИ и длинными контекстами, где ключевой фактор эффективности — возможность размещения модели и её KV-кеша в памяти. Отмечается, что рабочая станция, оборудованная четырьмя ускорителями Crescent Island с 480 Гбайт памяти, сможет использовать в локальном режиме модели с триллионом параметров, например, Kimi K3. В области программного обеспечения Intel указывает на поддержку vLLM, SGLang, llm-d и NVIDIA Dynamo, что позволяет ИИ-агентам функционировать в гетерогенной инфраструктуре без изменений в коде.
02.06.2026 [01:04], Владимир Мироненко
ИИ-ускоритель Intel Crescent Island получит до 480 Гбайт LPDDR5XIntel сообщила новые подробности о своём будущем ИИ-ускорителе для ЦОД с кодовым именем Crescent Island, который был анонсирован в прошлом году. Новый GPU основан на архитектуре Xe3P, представляющей усовершенствованную версию Xe3, которая используется в процессорах Core Ultra 300 семейства Panther Lake. Ожидается, что Xe3P также будет использоваться в GPU Intel серии Arc-C для клиентских устройств. Компания отметила, что чип разработан специально для рабочих нагрузок агентного ИИ. В то время как традиционные ИИ-ускорители от NVIDIA и AMD полагаются на дорогую память HBM, в новом чипе Intel используется LPDDR5X, и он предназначен для работы в серверах с воздушным охлаждением, а не с жидкостным. Crescent Island будет поддерживать до 480 Гбайт памяти LPDDR5X, хотя базовая эталонная конфигурация рассчитана на 160 Гбайт. Intel заявила, что Crescent Island оптимизирован по производительности на Вт — до TDP 350 Вт в версии с воздушным охлаждением и интерфейсом PCIe. 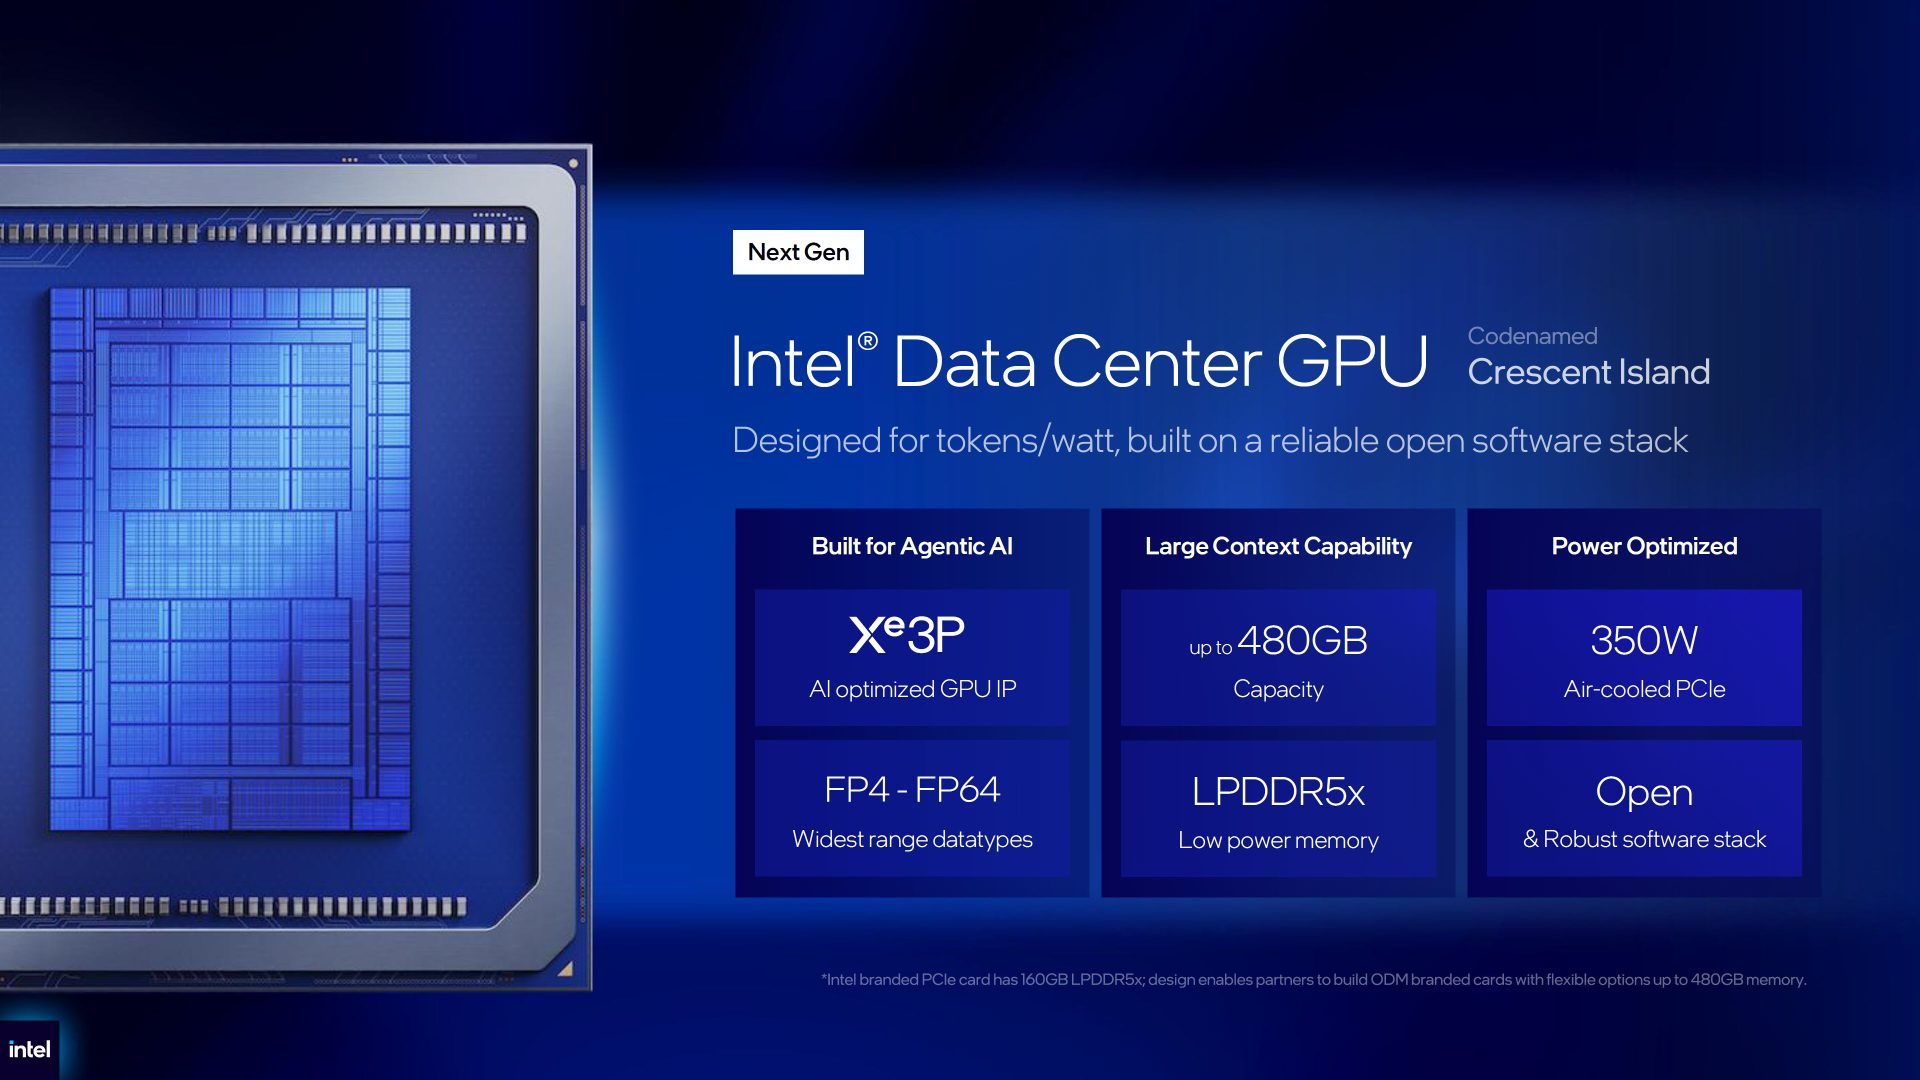
Источник изображений: Intel Сообщается, что GPU будет поддерживать широкий спектр форматов данных от FP4 до FP64, а также полностью открытый программный стек oneAPI, что идеально подходит для поставщиков услуг «токены как услуга» и сценариев использования для инференса. Концептуально новинка напоминает Rubin CPX, от которого NVIDIA отказалась. 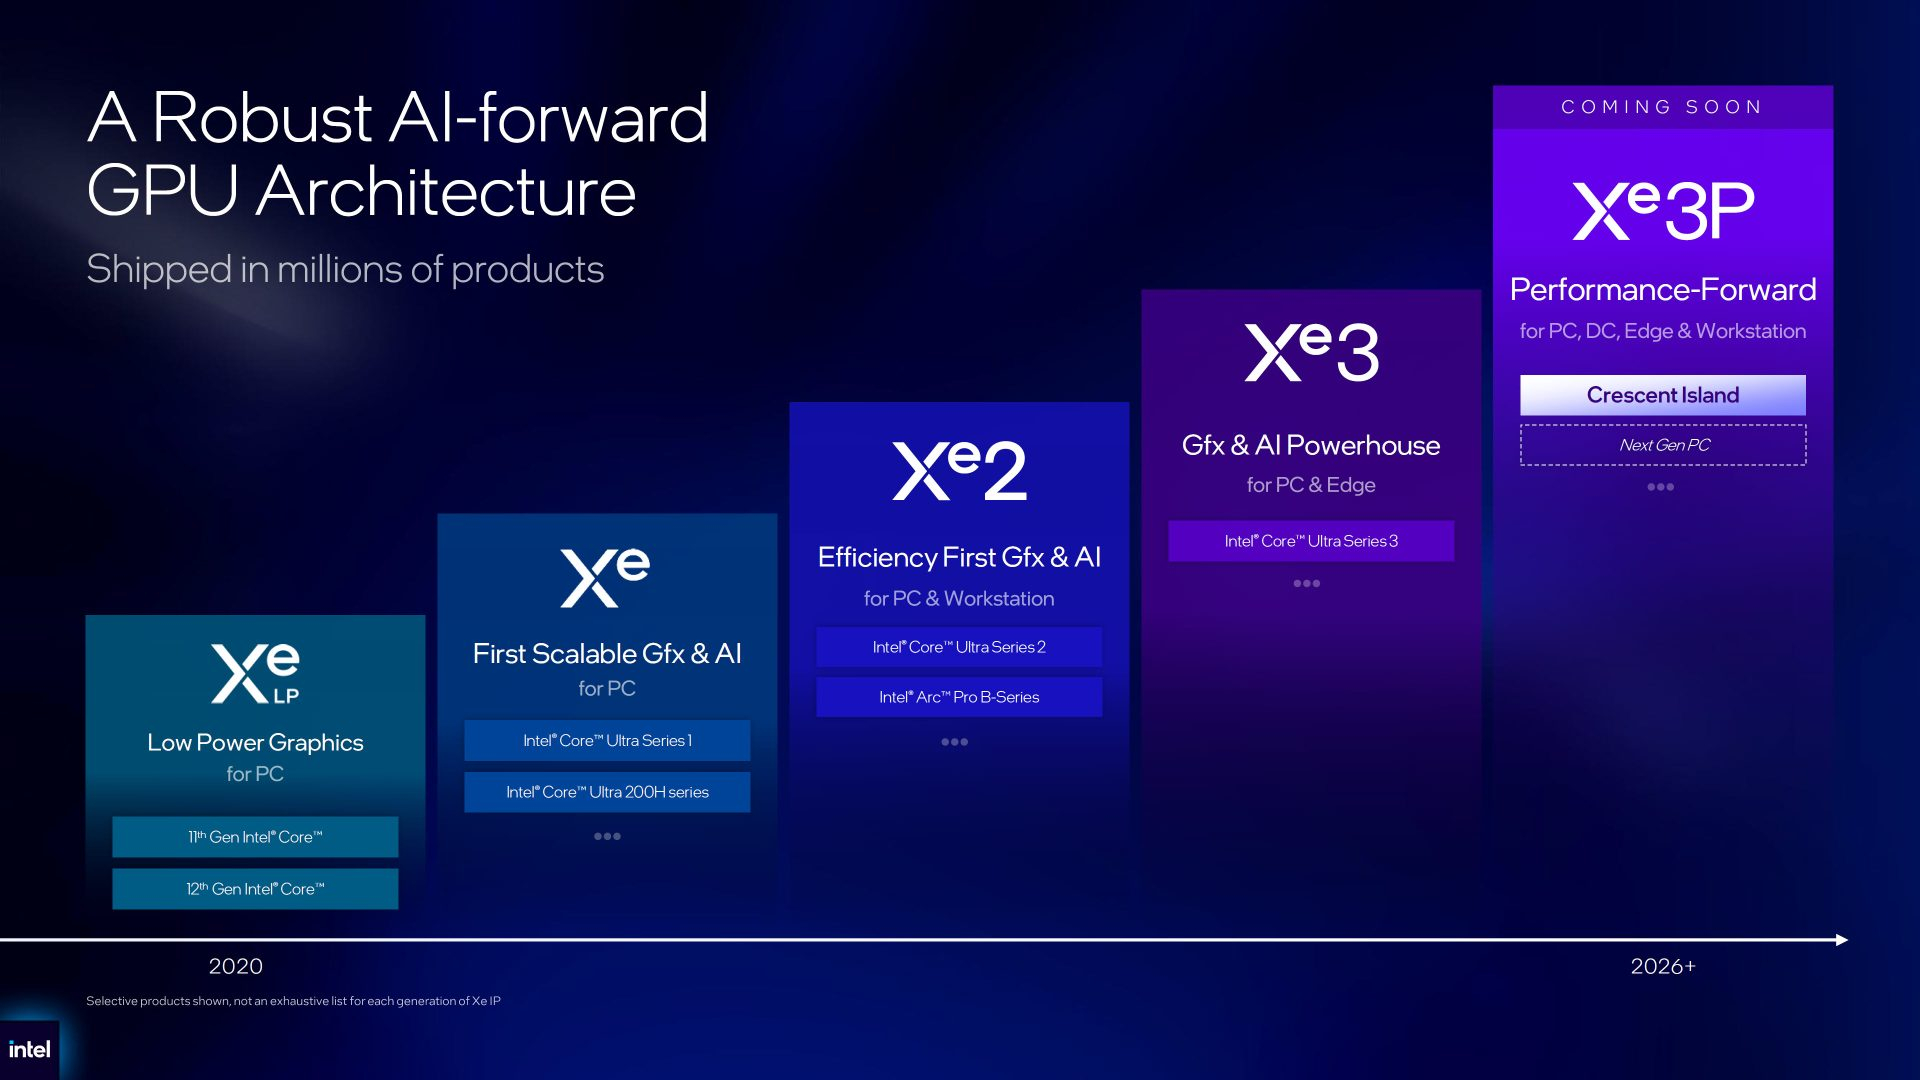 Intel уже оценивает свой открытый унифицированный программный стек для гетерогенных систем ИИ с помощью существующей линейки Arc Pro B-серии, поэтому будущие версии чипов получат доступ к этим оптимизациям на ранних этапах. Intel планирует начать тестирование GPU Crescent Island для клиентов во II половине 2026 года с общей доступностью в 2027 году.
15.10.2025 [09:13], Сергей Карасёв
Intel представила GPU-ускоритель Crescent Island для ИИ-инференсаКорпорация Intel, как и ожидалось, представила на мероприятии OCP Global Summit в Сан-Хосе (Калифорния, США) графический процессор нового поколения для дата-центров. Изделие с кодовым названием Crescent Island специально оптимизировано для задач ИИ-инференса. В основу GPU положена архитектура Xe3P. Она представляет собой усовершенствованную версию Xe3, которая используется в процессорах Core Ultra 300 семейства Panther Lake для ноутбуков и компактных настольных ПК. Говорится об улучшенном показателе производительности в расчёте на 1 Вт затрачиваемой энергии. Ускоритель на базе Crescent Island получит 160 Гбайт памяти LPDDR5X. Как отмечает ресурс Tom's Hardware, максимальный объём чипов LPDDR5X составляет 8 Гбайт. При этом используются два 16-бит канала памяти, что в сумме даёт 32 бита. Таким образом, для обеспечения 160 Гбайт памяти требуются 20 чипов LPDDR5X. Это означает, что ускоритель получит либо один массивный GPU с 640-бит интерфейсом памяти для подключения всех 20 чипов LPDDR5X, либо два менее крупных процессора с 320-бит интерфейсом, каждый из которых будет обслуживать 10 чипов LPDDR5X. 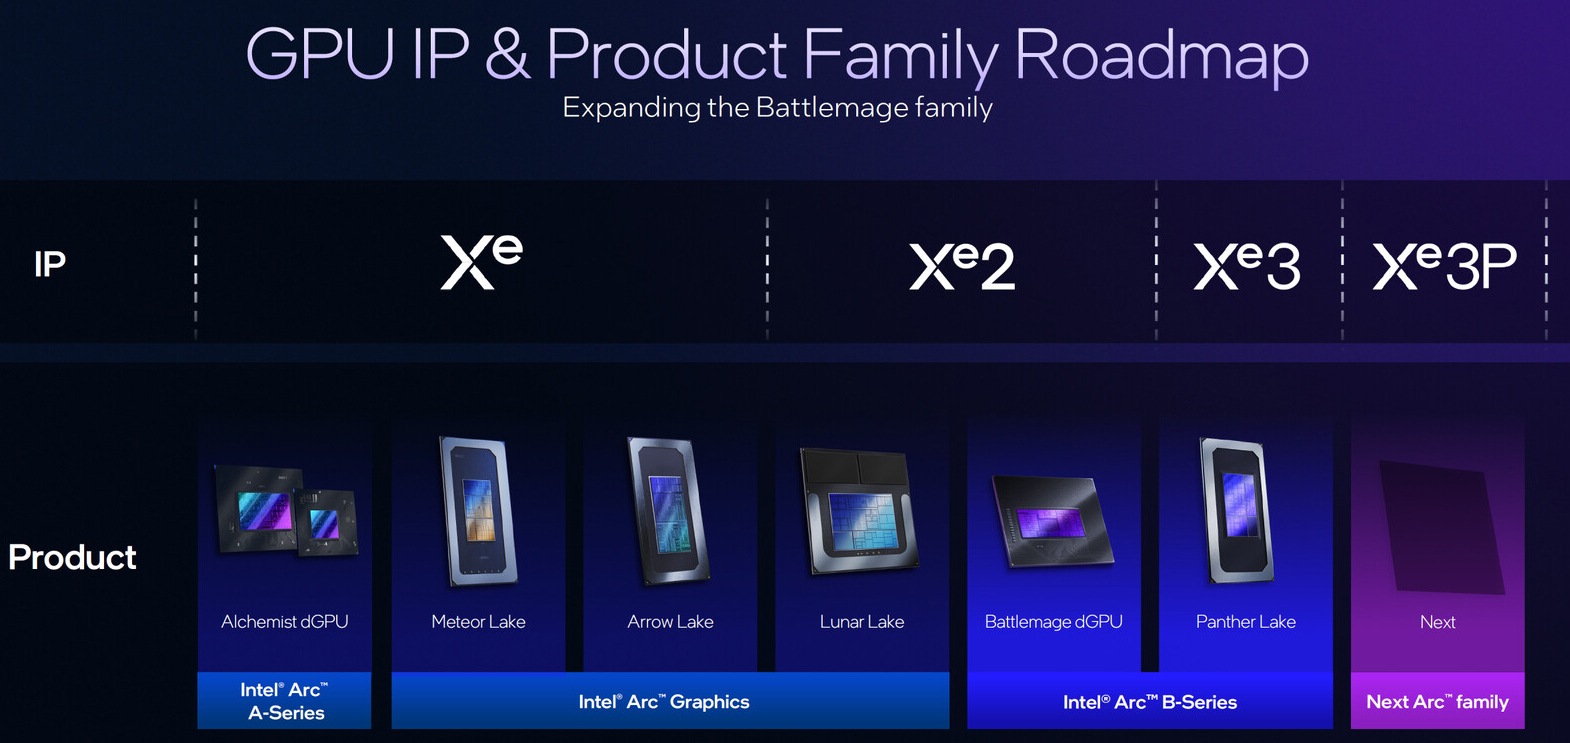
Источник изображения: Intel Прочие технические детали не раскрываются. При этом Intel отмечает, что изделие Crescent Island предназначено для использования в серверах с воздушным охлаждением. GPU поддерживает работу с широким спектром типов данных, благодаря чему может применяться в составе облачных платформ «токен как услуга» (tokens-as-a-service). 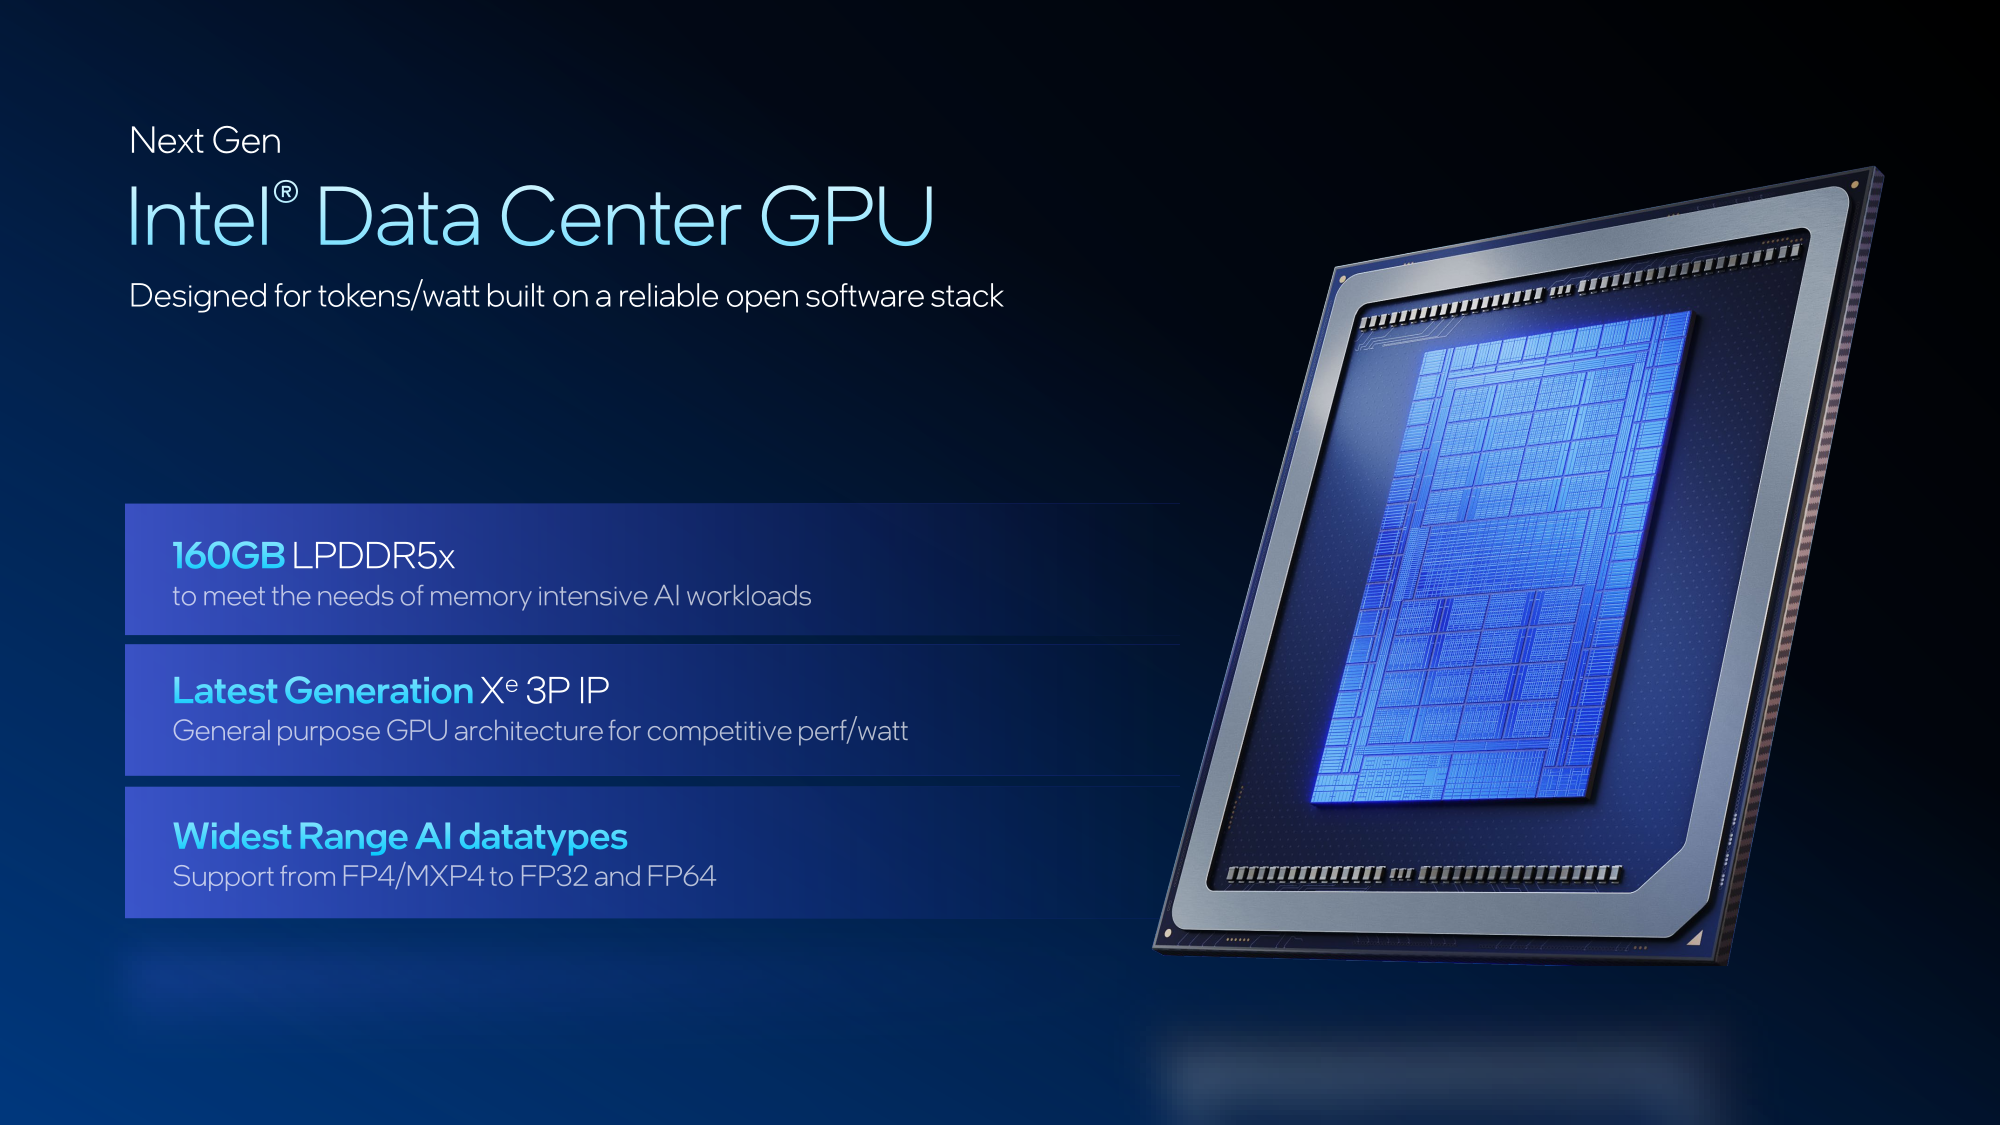
Источник изображения: Intel Пробные поставки новинки планируется начать во II половине 2026 года, тогда как широкая доступность ожидается не ранее 2027-го. Решениям на основе Crescent Island предстоит конкурировать с ИИ-ускорителями AMD и NVIDIA следующего поколения, такими как Rubin CPX.
22.09.2025 [13:02], Сергей Карасёв
ASRock представила видеокарты Intel Arc Pro B60 для рабочих станций с ИИКомпания ASRock анонсировала видеокарты Intel Arc Pro B60 Passive 24GB и Intel Arc Pro B60 Creator 24GB для профессиональных рабочих станций, ориентированных на задачи ИИ, большие языковые модели (LLM), дизайн, 3D-моделирование и пр. Новинки выполнены на архитектуре Intel Xe2-HPG и оснащены 24 Гбайт памяти GDDR6 со 192-битной шиной (19 Гбит/с). Модель Intel Arc Pro B60 Passive 24GB, наделённая пассивным охлаждением, имеет однослотовое исполнение. Карта будет доступна исключительно бизнес-заказчикам. В свою очередь, Intel Arc Pro B60 Creator 24GB получила активный кулер (с бесшумным режимом 0dB Silent Cooling) и двухслотовое исполнение. Обе новинки могут использоваться в конфигурациях с несколькими GPU в Linux-средах, что делает их подходящими для серверных развёртываний в рамках масштабных ИИ-платформ. 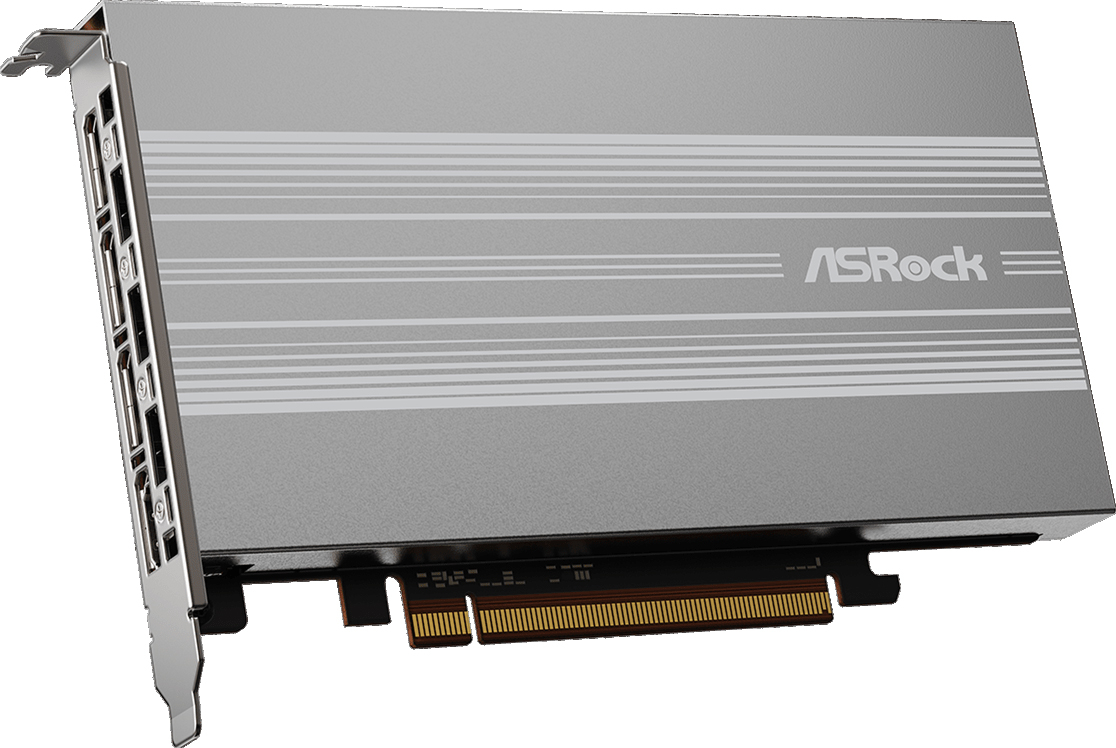
Источник изображений: ASRock Видеокарты располагают 20 ядрами Xe2-HPG и 160 матричными движками (XMX). Частота ядра составляет 2400 МГц. Задействован интерфейс PCIe 5.0. Дополнительное питание подаётся через 8-контактный коннектор. Говорится о поддержке Microsoft DirectX 12 Ultimate. Доступны четыре интерфейса DisplayPort 2.1 — основной с поддержкой UHBR13.5 и три дополнительных с поддержкой UHBR10. Видеокарта Intel Arc Pro B60 Passive 24GB имеет размеры 190 × 112 × 19 мм и весит 566 г. Габариты Intel Arc Pro B60 Creator 24GB составляют 271 × 112 × 39 мм, масса — 1118 г. 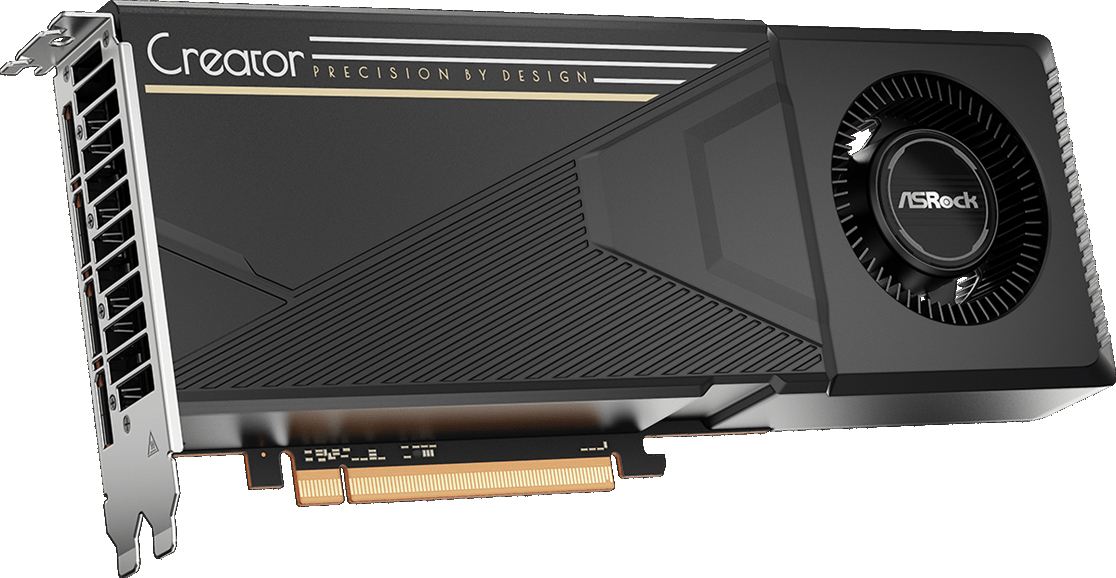 Некоторые ретейлеры уже начали приём предварительных заказов на эти решения. Так, на сайте американского магазина Central Computers версия Intel Arc Pro B60 Creator 24GB предлагается по ориентировочной цене $600.
21.11.2024 [00:26], Владимир Мироненко
Intel случайно раскрыла, что готовит ИИ-ускоритель Jaguar Shores вслед за Falcon ShoresIntel сообщила о новом ИИ-ускорителе Jaguar Shores, готовящемся в качестве преемника Falcon Shores, упомянув его в презентации во время технического семинара на конференции SC24. Презентация была посвящена чипам Gaudi, сообщает ресурс HPCwire. По мнению источника, упоминание чипа следующего поколения в презентации могло быть случайным. Ожидается, что Falcon Shores поступит в серийное производство в 2025 году. Также в следующем году в массовую продажу поступит ИИ-ускоритель Gaudi 3, представленный ещё в феврале 2023 года. В остальном Intel предпочитает не раскрывать подробностей о своих планах по выпуску ИИ-чипов. Для сравнения, NVIDIA и AMD уже анонсировали планы по выпуску чипов вплоть до 2026–2027 гг. В августе прошлого года Intel сообщила ресурсу HPCwire о работе над чипом Falcon Shores 2, который планируется к выпуску в 2026 году. «У нас упрощённая дорожная карта, поскольку мы объединяем наши GPU и ускорители в единое предложение», — пояснил тогда генеральный директор Патрик Гелсингер (Pat Gelsinger). С тех пор финансовое положение Intel значительно ухудшилось, однако компания продолжает разработку новых ИИ-ускорителей. Пока неясно, будет ли Jaguar Shores GPU или ASIC, но логика именования чипов Intel позволяет предположить, что речь идёт именно о GPU следующего поколения. 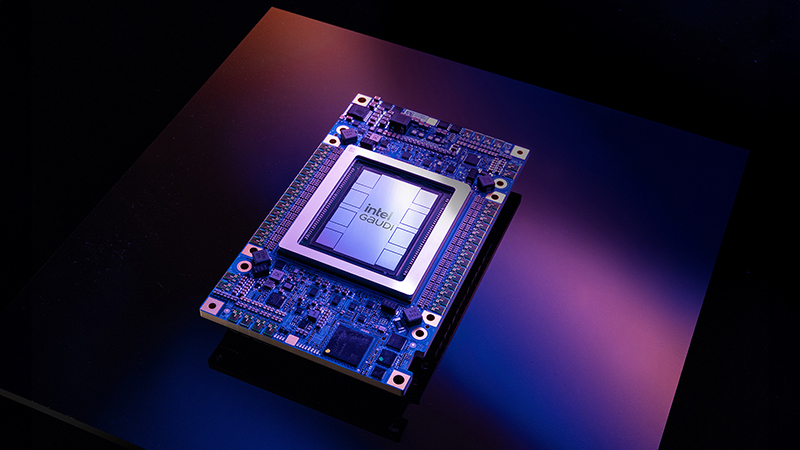
Источник изображения: Intel На данный момент Intel уступила рынок ИИ-обучения компаниям NVIDIA и AMD, сосредоточив свои усилия на инференсе с использованием ИИ-ускорителей Gaudi. Вероятно, Jaguar Shores также будет ориентирован на задачи инференса, который Гелсингер определил как более крупный и перспективный рынок. Однако чтобы догнать ушедших вперёд конкурентов NVIDIA и AMD, Jaguar Shores должен стать действительно прорывным продуктом, полагает HPCwire. «Наши инвестиции в ИИ будут дополнять и использовать наши решения на базе x86, с акцентом на корпоративный, экономически эффективный вывод данных. Наша дорожная карта для Falcon Shores остаётся неизменной», — заявил представитель Intel ресурсу HPCwire несколько месяцев назад.
23.05.2023 [15:26], Сергей Карасёв
Intel рассказала о суперкомпьютере Aurora производительностью более 2 ЭфлопсКорпорация Intel в ходе конференции ISC 2023, как сообщает AnandTech, поделилась информацией о проекте Aurora по созданию суперкомпьютера с производительностью экзафлопсного уровня. Эта система создаётся для Аргоннской национальной лаборатории Министерства энергетики США. Изначально анонс HPC-комплекса Aurora состоялся ещё в 2015 году с предполагаемым запуском в 2018-м: ожидалось, что машина обеспечит быстродействие на уровне 180 Пфлопс. Однако реализация проекта значительно затянулась, а технические параметры платформы неоднократно менялись. Пока что развёрнуты тестовый кластер Sunspot. Как теперь сообщается, в конечной конфигурации Aurora объединит 10 624 узла, каждый из которых будет включать два процессора Xeon Max и шесть ускорителей Ponte Vecchio. Таким образом, общее количество CPU будет достигать 21 248, число GPU — 63 744. Быстродействие FP64, как и было заявлено ранее, превысит 2 Эфлопс. 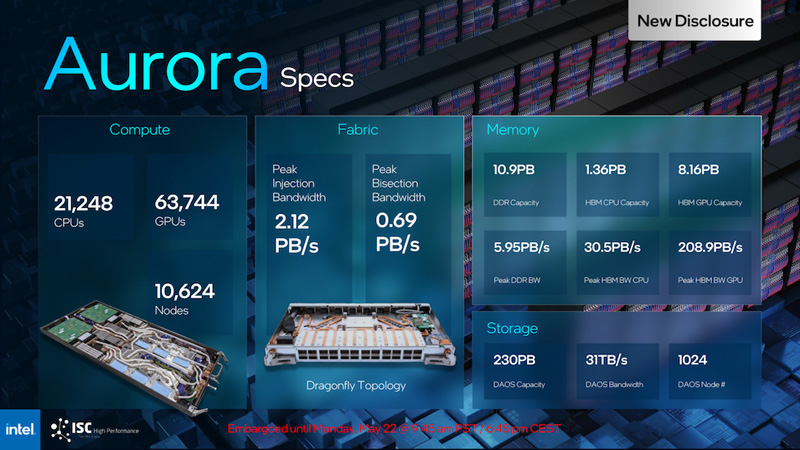
Источник изображений: Intel (via AnandTech) Каждый процессор оперирует 64 Гбайт памяти HBM, ускоритель — 128 Гбайт. В сумме это даёт соответственно 1,36 Пбайт и 8,16 Пбайт памяти HBM с пиковой пропускной способностью 30,5 Пбайт/с и 208,9 Пбайт/с. В дополнение система сможет использовать 10,9 Пбайт памяти DDR5 с пропускной способностью до 5,95 Пбайт/с. Вместимость подсистемы хранения данных составит 230 Пбайт со скоростью работы до 31 Тбайт/с. 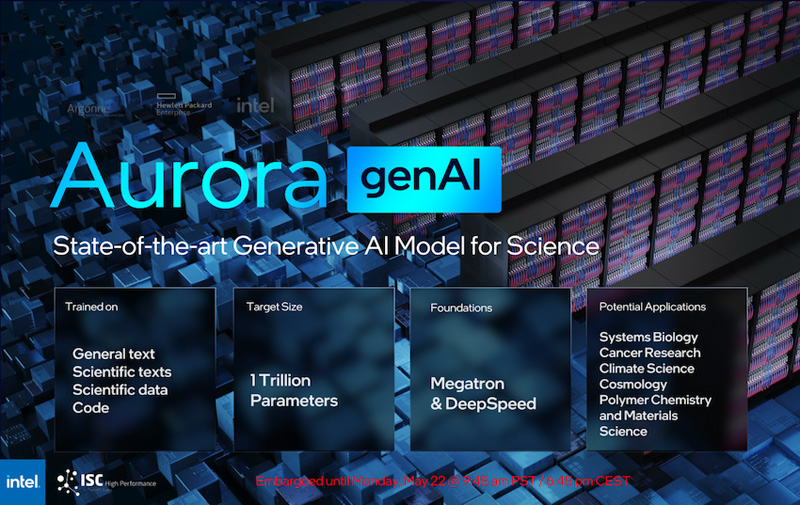 На сегодняшний день Intel поставила более 10 тыс. «лезвий» для Aurora, а это означает, что практически все узлы готовы к окончательному монтажу. Ввод суперкомпьютера в эксплуатацию намечен на текущий год. Для НРС-платформы готовится специализированная научная модель генеративного ИИ — Generative AI for Science, насчитывающая около 1 трлн параметров. Применять Aurora планируется для решения наиболее ресурсоёмких задач в различных областях.
10.11.2022 [01:55], Игорь Осколков
Intel объединила HBM-версии процессоров Xeon Sapphire Rapids и ускорители Xe HPC Ponte Vecchio под брендом MaxВ преддверии SC22 и за день до официального анонса AMD EPYC Genoa компания Intel поделилась некоторыми подробностями об HBM-версии процессоров Xeon Sapphire Rapids и ускорителях Ponte Vecchio, которые теперь входят в серию Intel Max. 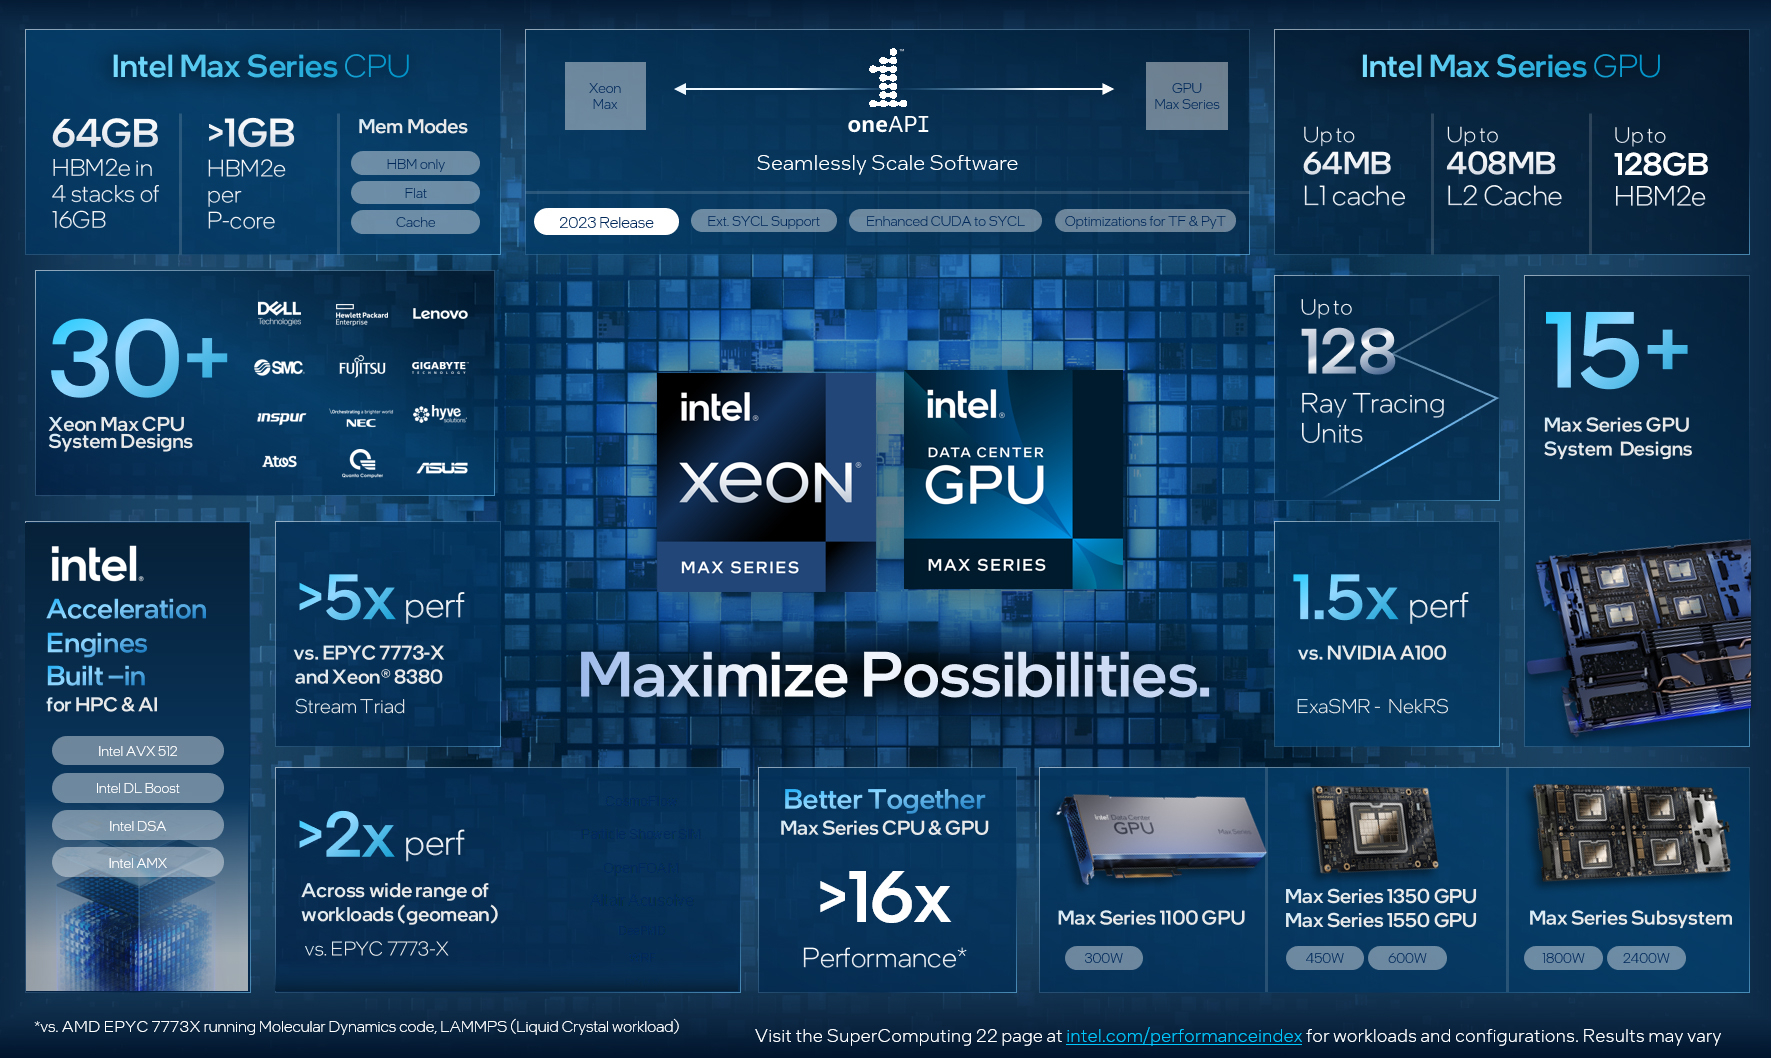
Изображения: Intel Intel Xeon Max предложат до 56 P-ядер, 112,5 Мбайт L3-кеша, 64 Гбайт HBM2e-памяти (четыре стека) с пропускной способностью порядка 1 Тбайт/с, 8 каналов памяти (DDR5-4800 в случае 1DPC, суммарно до 6 Тбайт), а также интерфейсы PCIe 5.0, CXL 1.1, UPI 2.0 и целый ряд различных технологий ускорения для задач HPC и ИИ: AVX-512, DL Boost, AMX, DSA, QAT и т.д. Заявленный уровень TDP составляет 350 Вт. 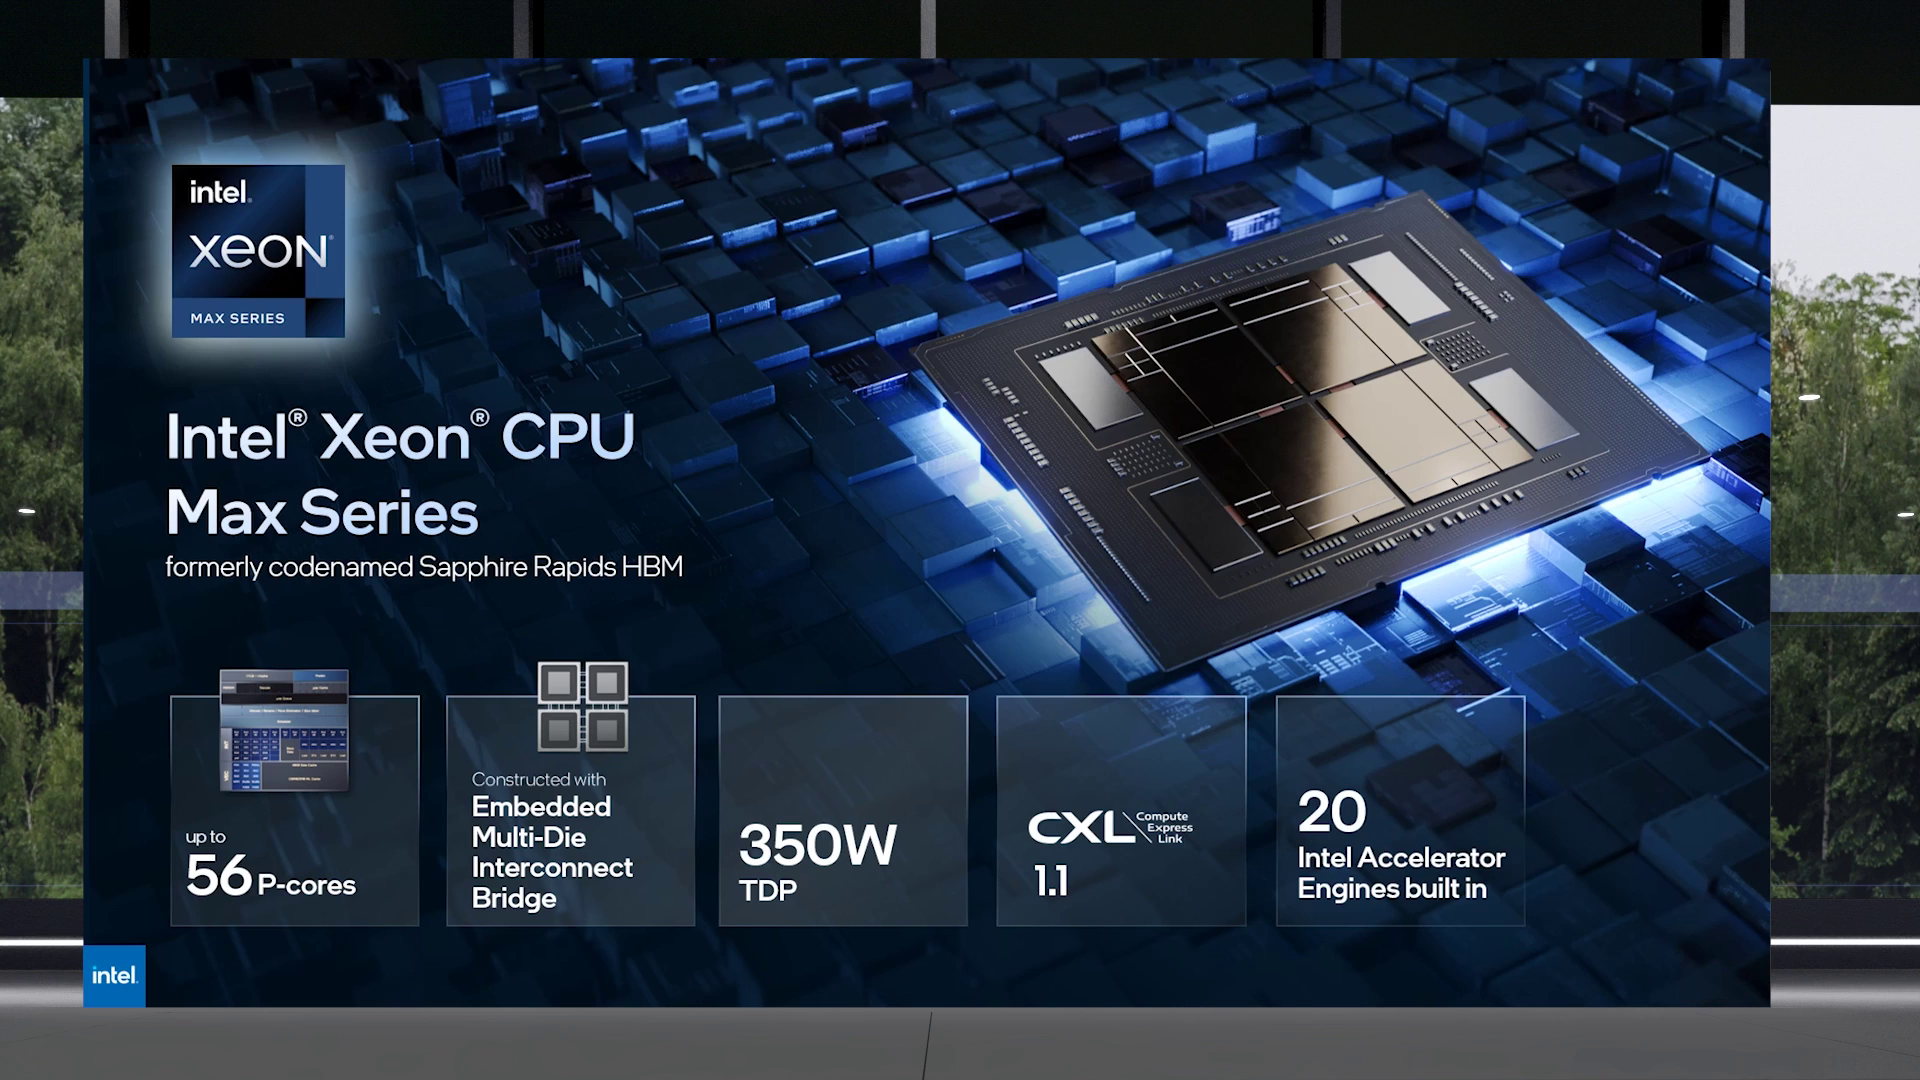 Первым процессором с набортной HBM-памятью был Arm-чип Fujitsu A64FX (48 ядер, 32 Гбайт HBM2), лёгший в основу суперкомпьютера Fugaku. Intel поднимает планку, давая более 1 Гбайт быстрой памяти на каждое ядро. А поскольку процессор состоит из четырёх отдельных чиплетов, возможно создание четырёх NUMA-доменов с выделенными HBM- и DDR-контроллерами. Но и монолитный режим тоже имеется. А поддержка CXL даёт возможность задействовать RAM-экспандеры. 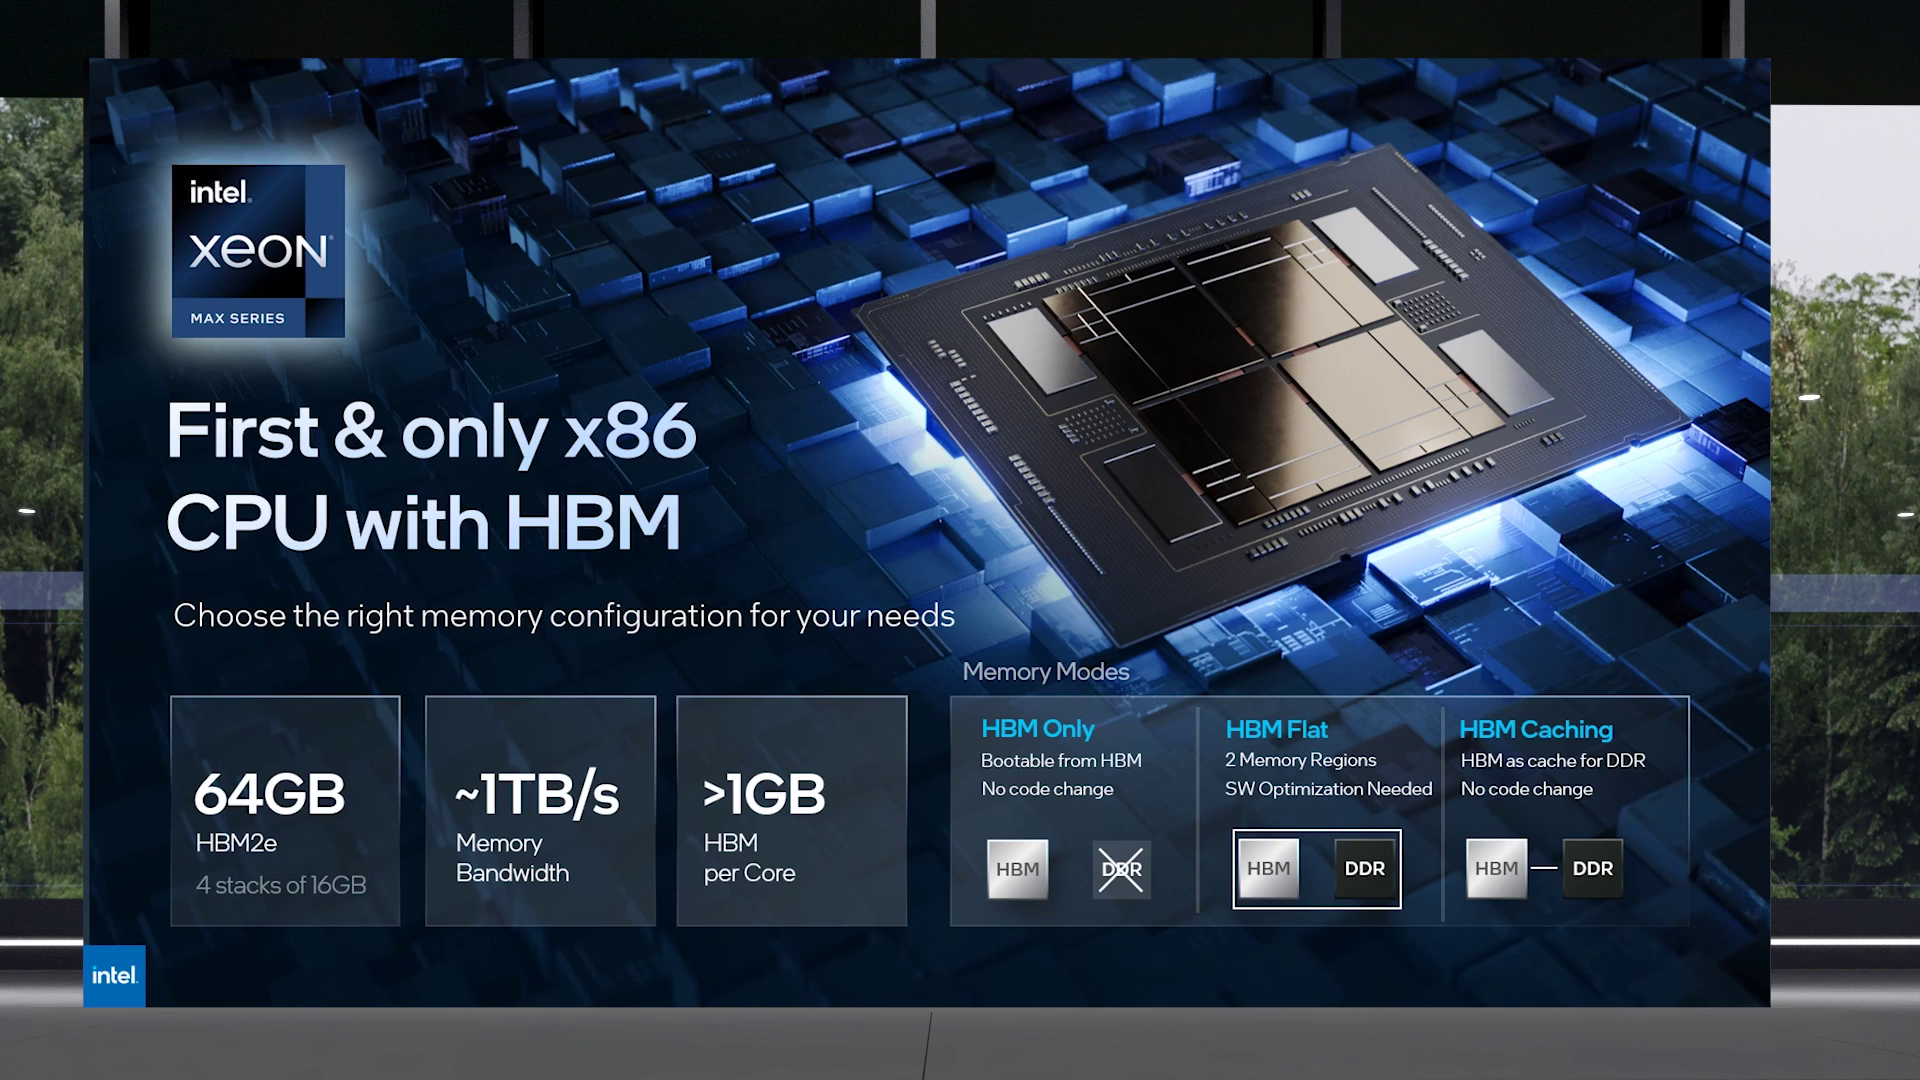 Intel Xeon Max поддерживают 2S-платформы, что суммарно даёт уже 128 Гбайт HBM-памяти, которых вполне хватит для целого ряда задач. Новые процессоры действительно могут обходиться без DIMM. Но есть и два других режима. В первом HBM-память работает в качестве кеша для обычной памяти, и для системы это происходит прозрачно, так что никаких модификаций для ПО (как в случае отсутствия DIMM вообще) не требуется. Во втором режиме HBM и DDR представлены как отдельные пространства, так что тут дорабатывать ПО придётся, зато можно добиться более эффективного использования обоих типов памяти.
В презентации Intel сравнивает новые Xeon Max с AMD EPYC Milan-X – в зависимости от задачи прирост составляет от +20 % до 4,8 раз. Но, во-первых, уже сегодня эти тесты потеряют всякий смысл в связи с презентацией EPYC Genoa (которые, к слову, должны получить AVX-512), а во-вторых, в следующем году AMD обещает представить Genoa-X с 3D V-Cache. Intel же явно не оставляет попытки создать как можно более универсальный процессор. 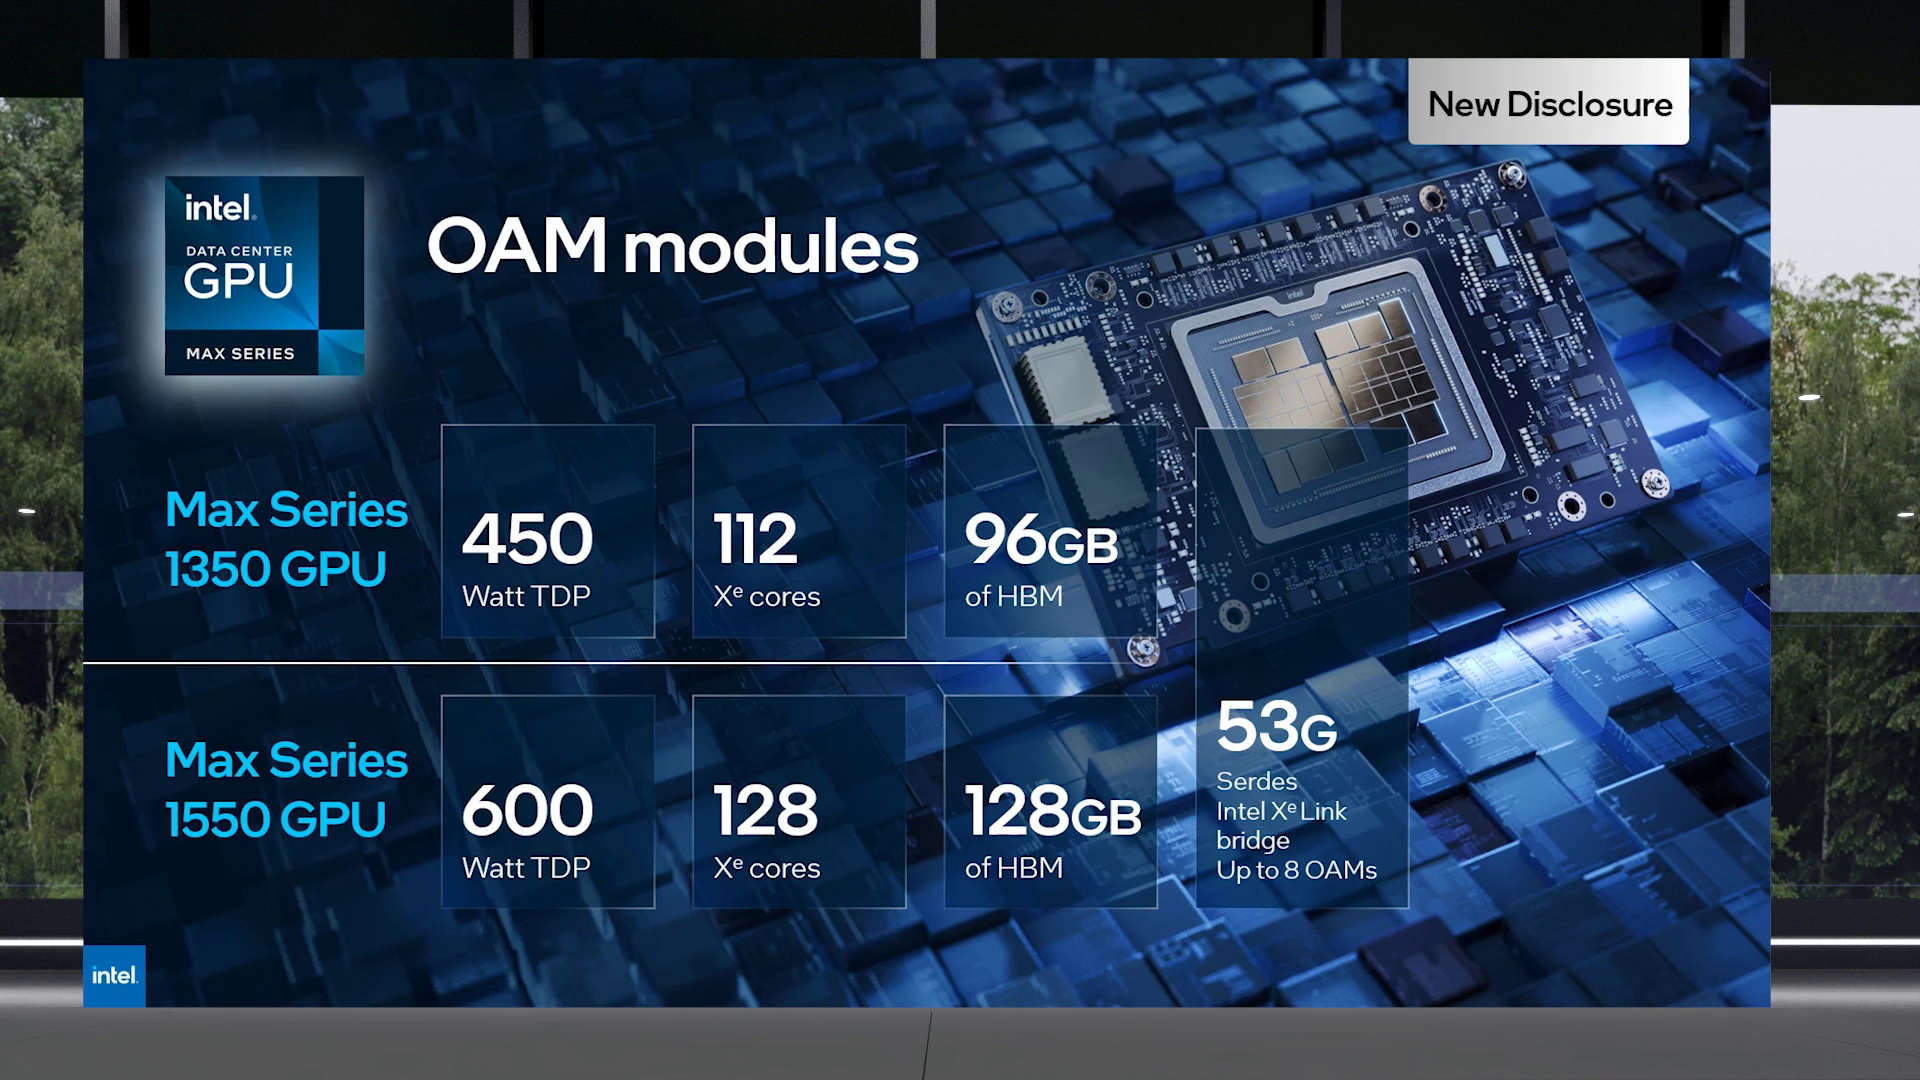 Что касается Ponte Vecchio, которые теперь называются Max GPU, то практически ничего нового относительно строения и особенностей данных ускорителей Intel не сказала: до 128 ядер Xe (только теперь стало известно об аппаратном ускорении трассировки лучей, что важно для визуализации), 64 Мбайт L1-кеша и аж 408 Мбайт L2-кеша (из них 120 Мбайт приходится на Rambo-кеш в двух стеках), 16 линий Xe Link, 8 HBM2e-контроллеров на 128 Гбайт памяти и пиковая FP64-производительность на уровне 52 Тфлопс. Все эти характеристики относятся к старшей модели Max Series 1550 в OAM-исполнении с TDP в 600 Вт. 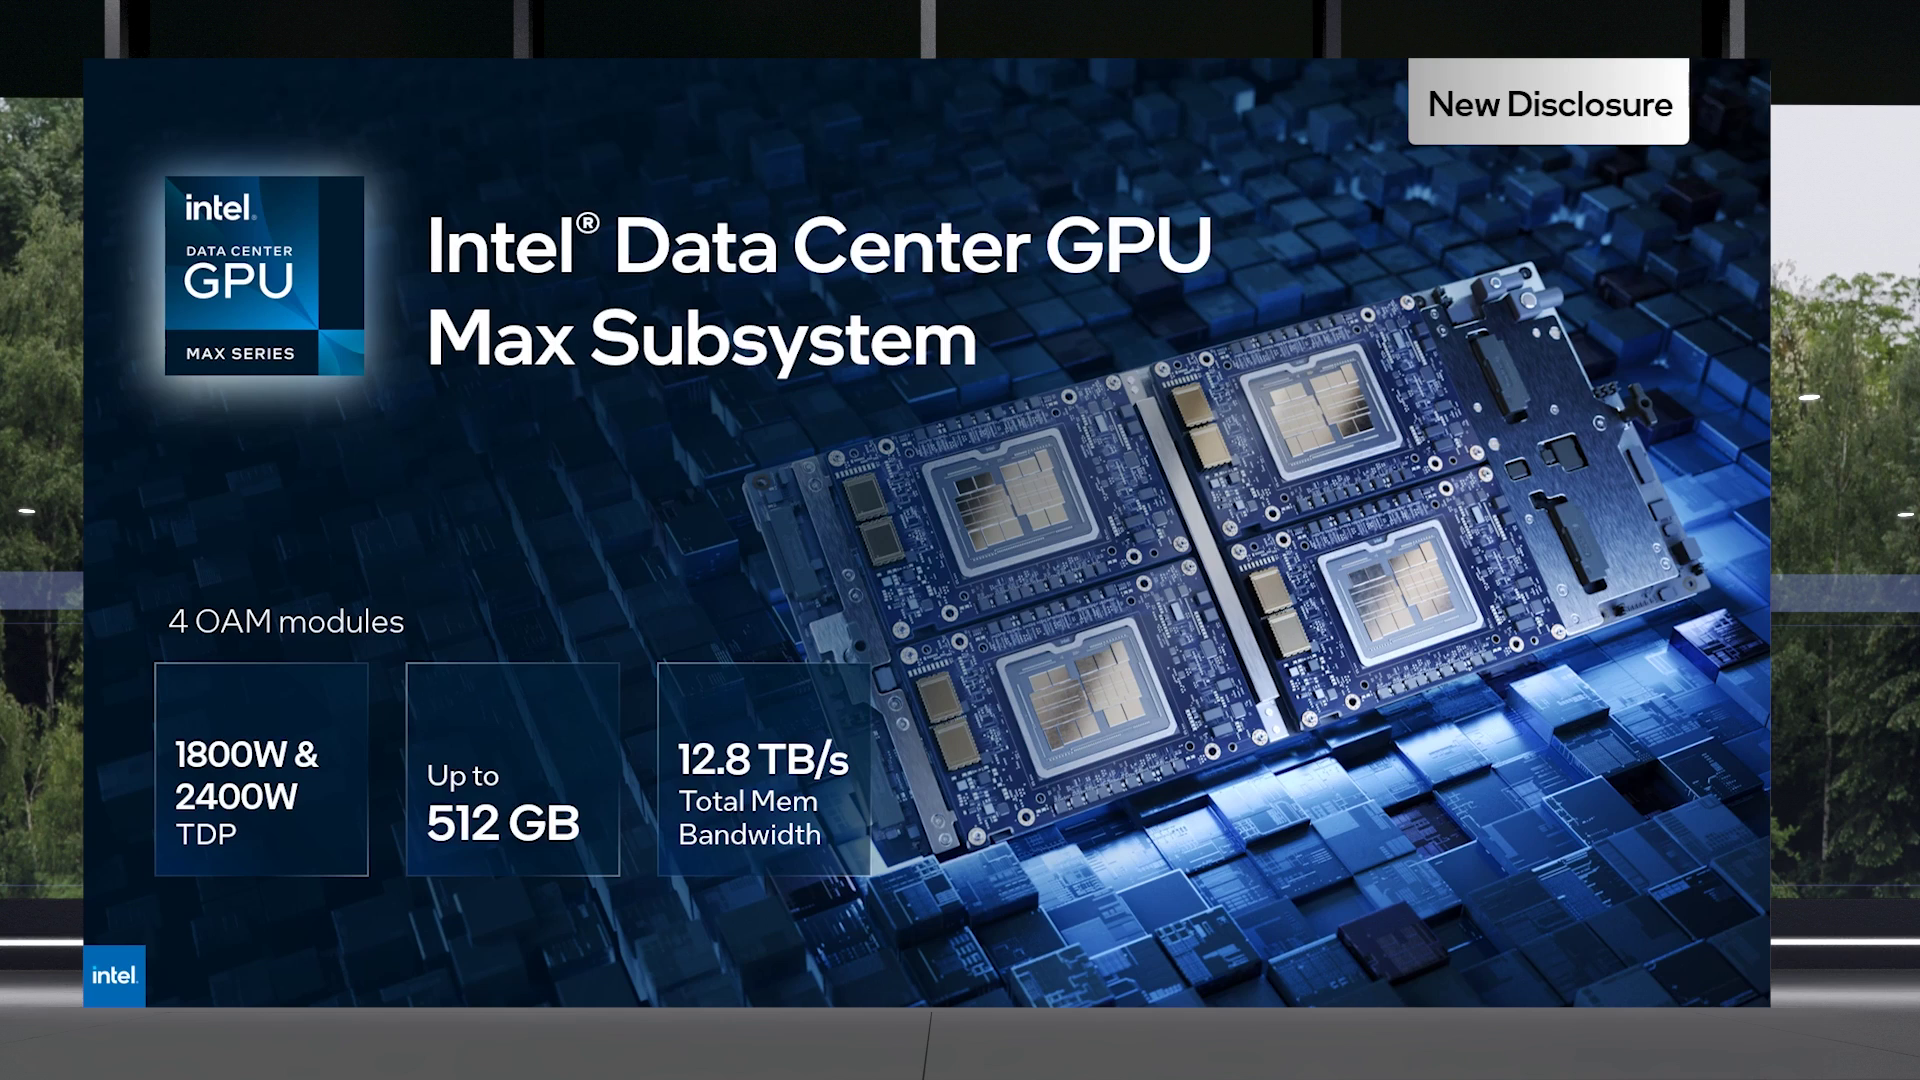 Max Series 1350 предложит 112 ядер Xe и 96 Гбайт HBM2e, но и TDP у этой модели составит всего 450 Вт. Для обеих OAM-версий также будут доступны готовые блоки из четырёх ускорителей (по примеру NVIDIA RedStone), объединённых по схеме «каждый с каждым», так что в сумме можно получить 512 Гбайт HBM2e с ПСП в 12,8 Тбайт/с. Ну а самый простой ускоритель в серии называется Max Series 1100. Это 300-Вт PCIe-плата с 56 Xe-ядрами, 48 Гбайт HBM2e и мостиками Xe Link. 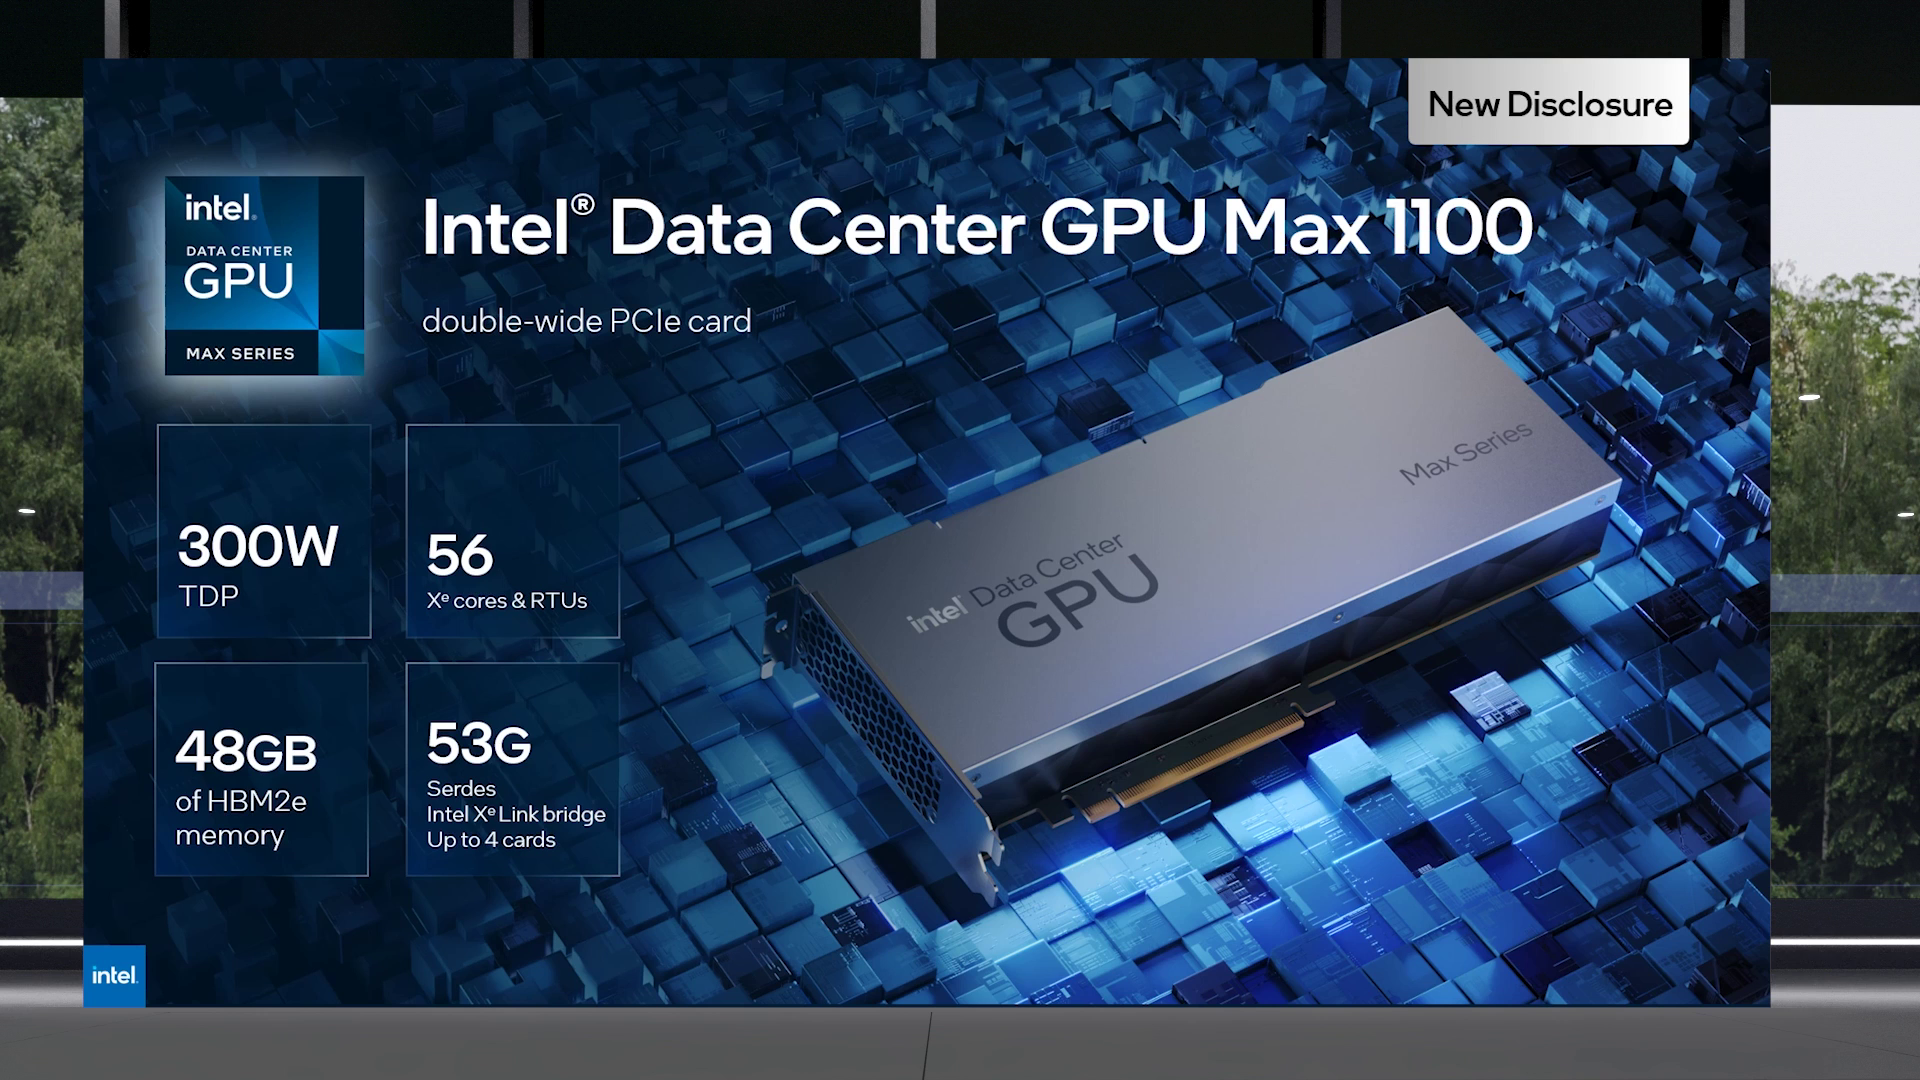 Intel утверждает, что ускорители Max до двух раз быстрее NVIDIA A100 в некоторых задачах, но и здесь история повторяется — нет сравнения с более современными H100. Хотя предварительный доступ к этим ускорителям у Intel есть, поскольку именно Sapphire Rapids являются составной частью платформы DGX H100. В целом, Intel прямо говорит, что наибольшей эффективности вычислений позволяет добиться связка CPU и GPU серии Max в сочетании с oneAPI. Всего на базе решений данной серии готовится более 40 продуктов.
Пока что приоритетным для Intel проектом является 2-Эфлопс суперкомпьютер Aurora, для которого пока что создан тестовый кластер Sunspot со 128 узлами, содержащими ускорители Max. Следующим ускорителем Intel станет Rialto Bridge, который появится в 2024 году. Также компания готовит гибридные (XPU) чипы Falcon Shores, сочетающие CPU, ускорители и быструю память. Аналогичный подход применяют AMD и NVIDIA.
24.08.2022 [21:16], Алексей Степин
Intel переименовала свои первые серверные ускорители Intel Arctic Sound-M во FlexРанее мы уже рассказывали об ускорителях Intel Arctic Sound-M, о которых впервые стало известно ещё зимой. Это универсальное решение, базирующееся на графической архитектуре Xe-HPG и предназначенное для решения широкого круга задач, от организации виртуальных рабочих мест до применения в системах машинной аналитики. Сегодня Intel официально заявила, что ускорители Arctic Sound-M теперь будут доступны под брендом Flex. В основе по-прежнему лежит микроархитектура DG2 Alchemist, и компания позиционирует Flex как решение, способное ощутимо снизить стоимость владения для серверной инфраструктуры, особенно занятой в задачах транскодирования видеопотоков. 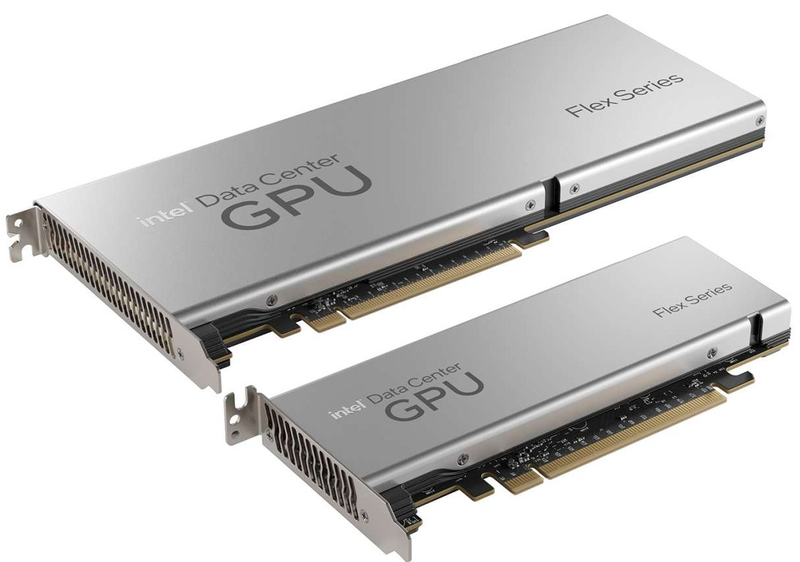
Источник: Intel Intel заявляет, что Flex 140 в пять раз превосходит NVIDIA A10 в задачах транскодирования видео, вдвое — в сценариях декодирования, и всё это с вдвое меньшим уровнем энергопотребления, а значит, и тепловыделения. Речь идёт о младшем решении в серии с интерфейсом PCIe 4.0 x8, которое имеет два восьмиядерных чипа Xe (1600/1950 МГц) и 12 Гбайт GDDR6-памяти (192 бит, 336 Гбайт/с). Flex 170 оснащён одним чипом, но в 32-ядерном варианте (1950/2050 МГц), и имеет вдвое более высокий теплопакет (150 против 75 Вт), а также 16 Гбайт GDDR6 (256 бит, 576 Гбайт/с) и интерфейс PCIe 4.0 x16. 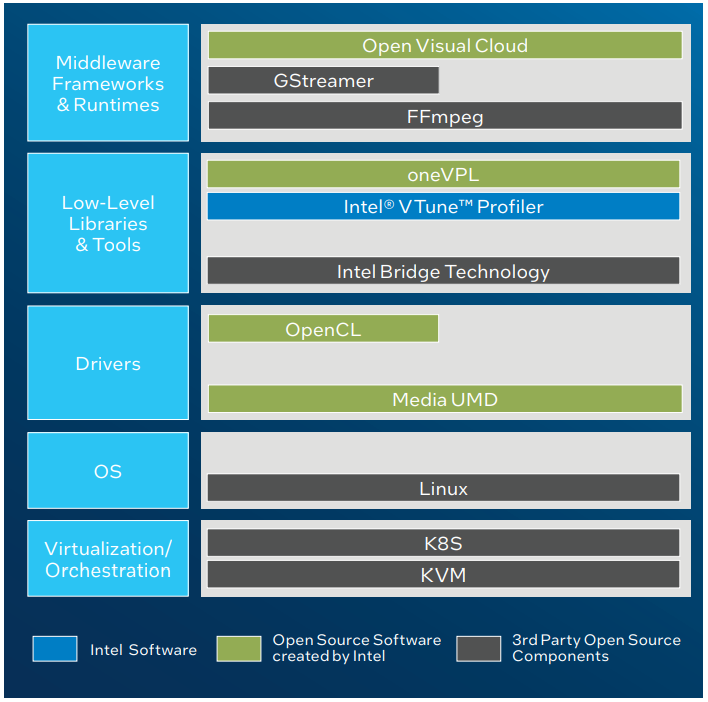
Источник: Intel До 10 ускорителей Flex 140 можно разместить в стандартном 4U-шасси, что позволит одновременно обрабатывать до 360 потоков 1080р60 HEVC. Производительность Flex 140 достаточно высока, чтобы гарантировать задержку не более 1 сек при начале транскодирования видеопотока с параметрами 8K@60 (AV1 или HEVC HDR). Intel активно делает упор на аппаратной поддержке видеостандарта AV1, но ускорители работают и с HEVC, AVC и VP9. 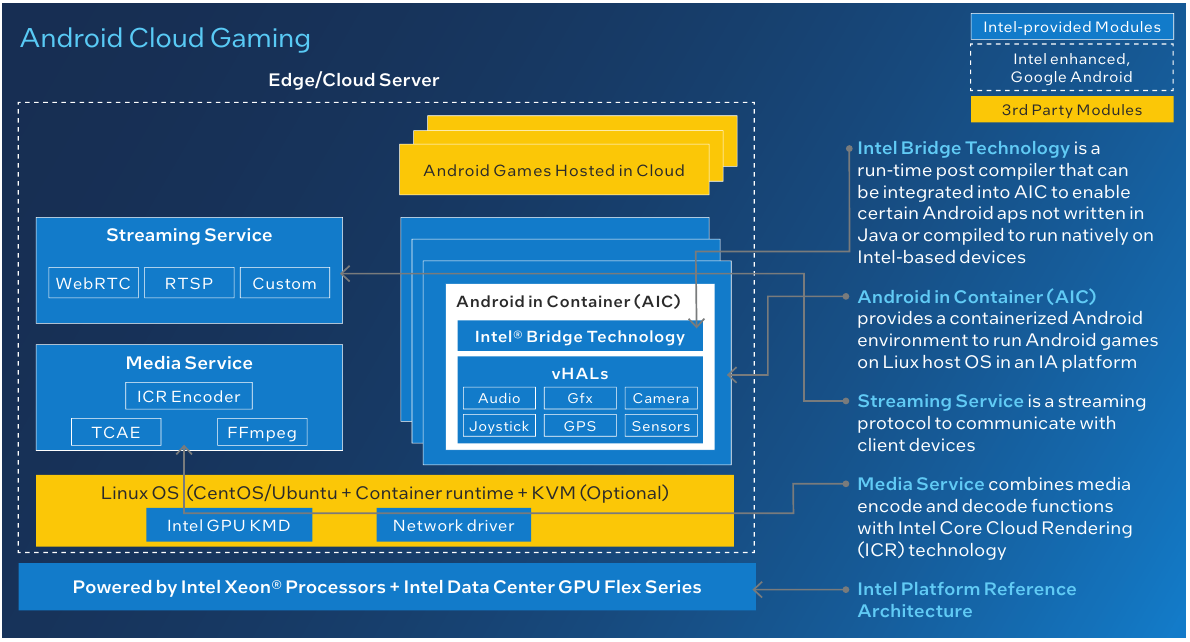
Архитектура облачного Android-гейминга Intel. Источник: Intel Также найдут своё применения ускорители Intel Flex Series и в облачных игровых платформах для Android, где единственная плата Flex 170 сможет обслуживать до 68 сессий в режиме 720p30, а шесть ускорителей Flex 140 будут в состоянии обеспечить до 216 игровых сессий с такими же параметрами. Помимо всего прочего поддерживается и аппаратное ускорение трассировки лучей. Работают новые ускорители под управлением унифицированной платформы oneAPI. 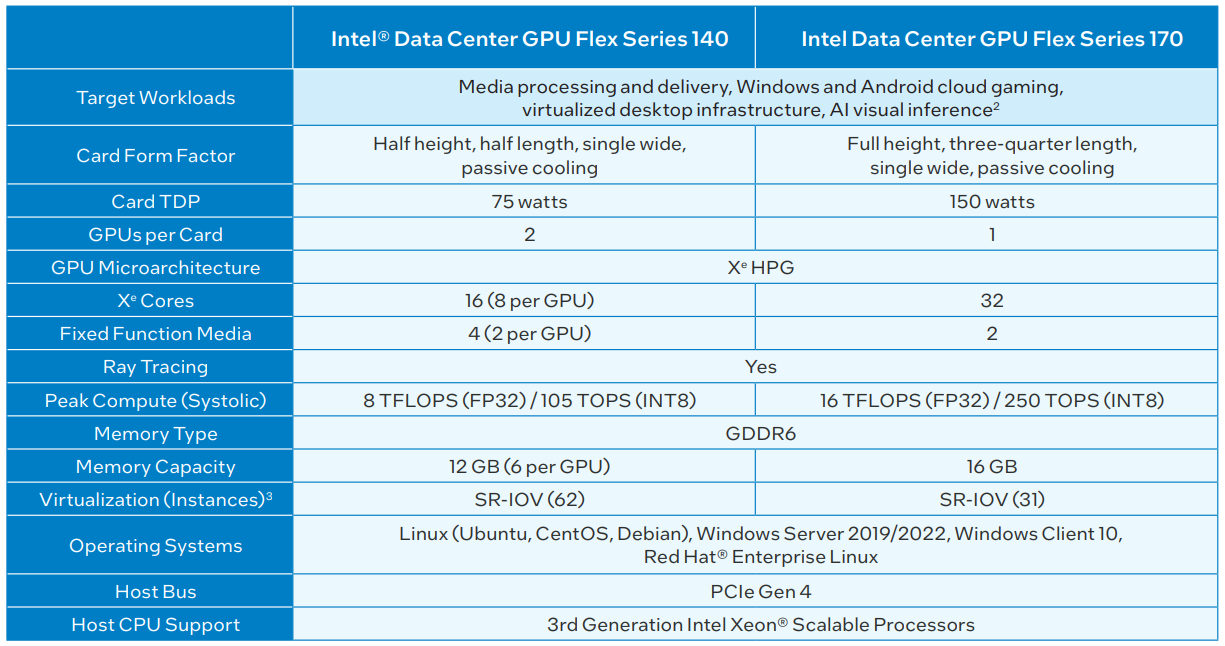 Стоимости новых ускорителей Intel пока не разглашает, но с учётом того, что компания сильно упирает на снижение стоимости владения, цена, судя по всему, будет сравнительно доступной и наверняка более привлекательной, чем у NVIDIA A10. Кроме того, Intel говорит об отсутствии необходимости докупать лицензии, чтобы воспользоваться всеми возможностями ускорителей. Но умалчивает, что производительность старшей модели Flex 170 в INT8-вычислениях совпадает с таковой у A10 (250 Топс), а в FP32-расчётах решение Intel и вовсе проигрывает. К тому же у A10 в полтора раза больше RAM.
28.10.2021 [00:43], Игорь Осколков
Европейские Arm-процессоры SiPearl Rhea получат поддержку ускорителей Intel Ponte VechhioSiPearl, ответственная за разработку CPU для европейских суперкомпьютеров, и Intel объявили о сотрудничестве, которое позволит ускорить создание экзафлопсных систем в Евросоюзе путём объединения в рамках одной системы процессоров Rhea и ускорителей Ponte Vecchio. А для работы с такими гетерогенными HPC-узлами будет использоваться открытый унифицированный программный стек oneAPI, переносим и оптимизацией которого планирует заняться SiPearl.  Фактически это предварительный анонс первых систем c Ponte Vecchio не только без CPU Intel (как у злопополучной Aurora, которой компания прочит уже 2 Эфлопс), но и без x86-64 вообще — SiPearl Rhea является HPC-процессором на базе Arm. Согласно последним данным, этот 6-нм чип получит 64 ядра Neoverse V1 (Zeus), блоки RISC-V и HBM-память в единой 2.5D-упаковке. Он также получит контроллер PCIe 5.0 — ускоритель Intel Xe будет подключаться к процессору посредством CXL, о чём прямо говорится в сообщении компаний. Впрочем, до создания реальных систем пока далеко. Выпуск Rhea намечен только на конец 2022 года, а производиться он будет на мощностях TSMC. 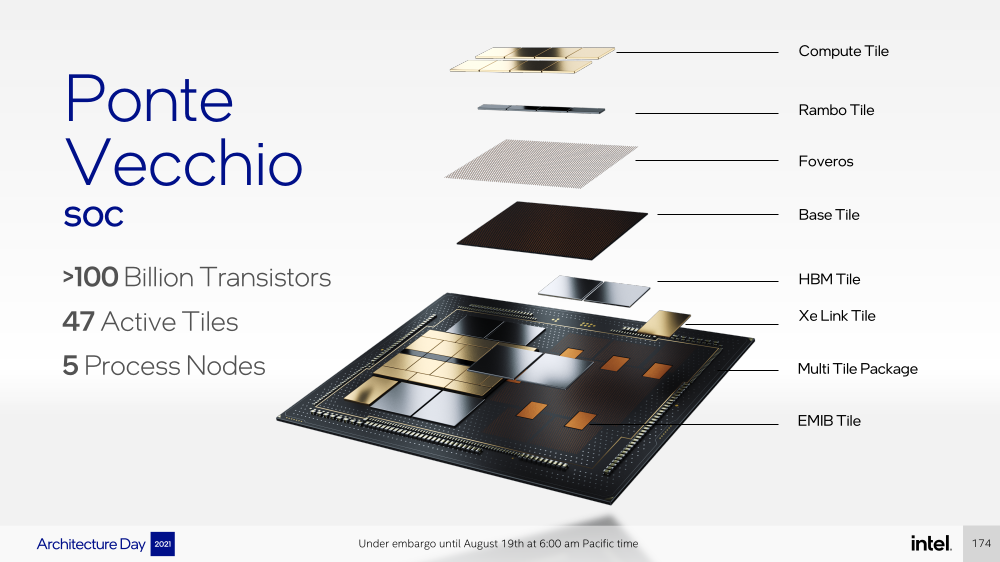 Но гораздо интереснее, будет ли связка Rhea + Ponte Vecchio считаться достаточно «европейской» для целей импортозамещения. Впрочем, для программы EuroHPC она сгодится. SiPearl уже является участником ряда проектов Евросоюза по повышению независимости от зарубежных технологий, включая и инициативу European Processor Initiative (EPI). В сентябре этот проект получил первые тестовые образцы EPAC1.0, ещё одного европейского чипа для HPC-систем, но уже на базе RISC-V и 22-нм техпроцесса GlobalFoundries. |
|


