
Материалы по тегу: dpu
|
12.04.2021 [19:21], Алексей Степин
NVIDIA анонсировала DPU BlueField-3: 400 Гбит/с, 16 ядер Cortex-A78 и PCIe 5.0Идея «сопроцессора данных», озвученная всерьёз в 2020 году компанией Fungible, продолжает активно развиваться и прокладывать себе дорогу в жизнь. На конференции GTC 2021 корпорация NVIDIA анонсировала новое поколение «умных» сетевых карт BlueField-3, способное работать на скорости 400 Гбит/с. Изначально серия ускорителей BlueField разрабатывалась компанией Mellanox, и одной из целей создания столь продвинутых сетевых адаптеров стала реализация концепции «нулевого доверия» (zero trust) для сетевой инфраструктуры ЦОД нового поколения. Адаптеры BlueField-2 были анонсированы в начале прошлого года. Они поддерживали два 100GbE-порта, микросегментацию, и могли осуществлять глубокую инспекцию пакетов полностью автономно, без нагрузки на серверные ЦП. Шифрование TLS/IPSEC такие карты могли выполнять на полной скорости, не создавая узких мест в сети. 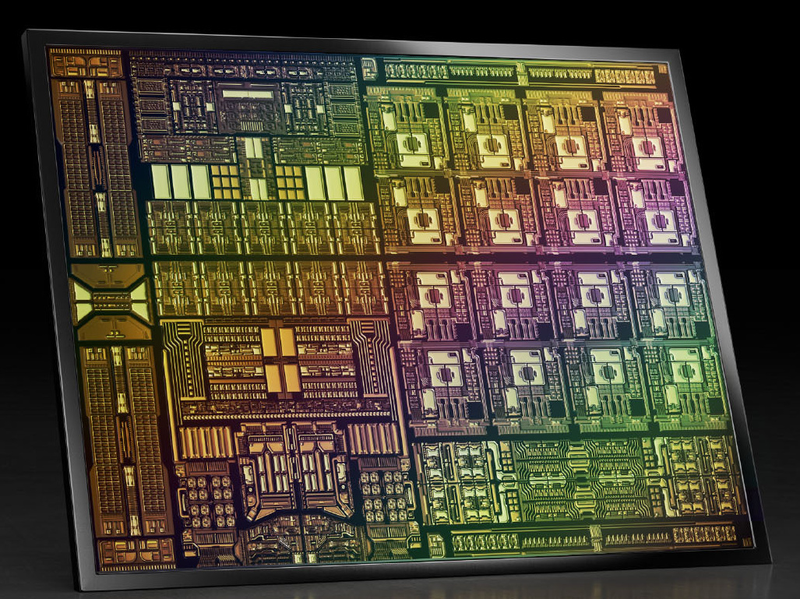
Кристалл BlueField-3 не уступает в сложности современным многоядерным ЦП — 22 млрд транзисторов Но на сегодня 100 и даже 200 Гбит/с уже не является пределом мечтаний — провайдеры и разработчики ЦОД активно осваивают скорости 400 и 800 Гбит/с. Столь скоростные сети требуют нового уровня производительности от DPU, и NVIDIA вскоре сможет предложить такой уровень: на конференции GTC 2021 анонсировано новое, третье поколение карт BlueField. 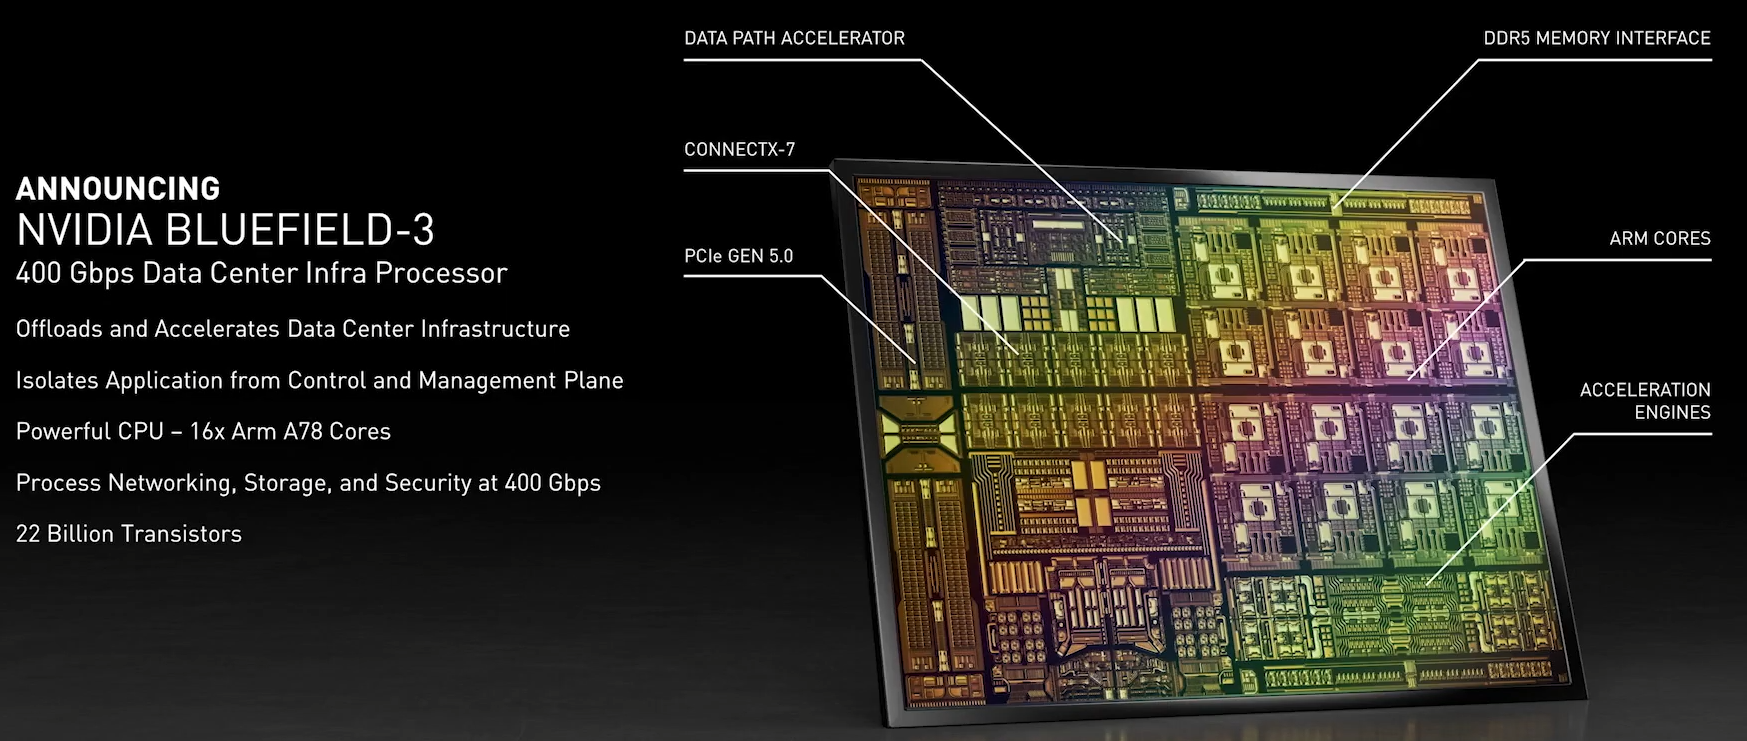 Если BlueField-2 могла похвастаться массивом из восьми ядер ARM Cortex-A72, объединённых когерентной сетью, то BlueField-3 располагает уже шестнадцатью ядрами Cortex-A78 и в четыре раза более мощными блоками криптографии и DPI. Совокупно речь идёт о росте производительности на порядок, что позволяет новинке работать без задержек на скорости 400 Гбит/с — и это первый в индустрии адаптер класса 400GbE со столь продвинутыми возможностями, поддерживающий, к тому же, стандарт PCI Express 5.0. Известно, что столь быстрым сетевым решениям PCIe 5.0 действительно необходим. 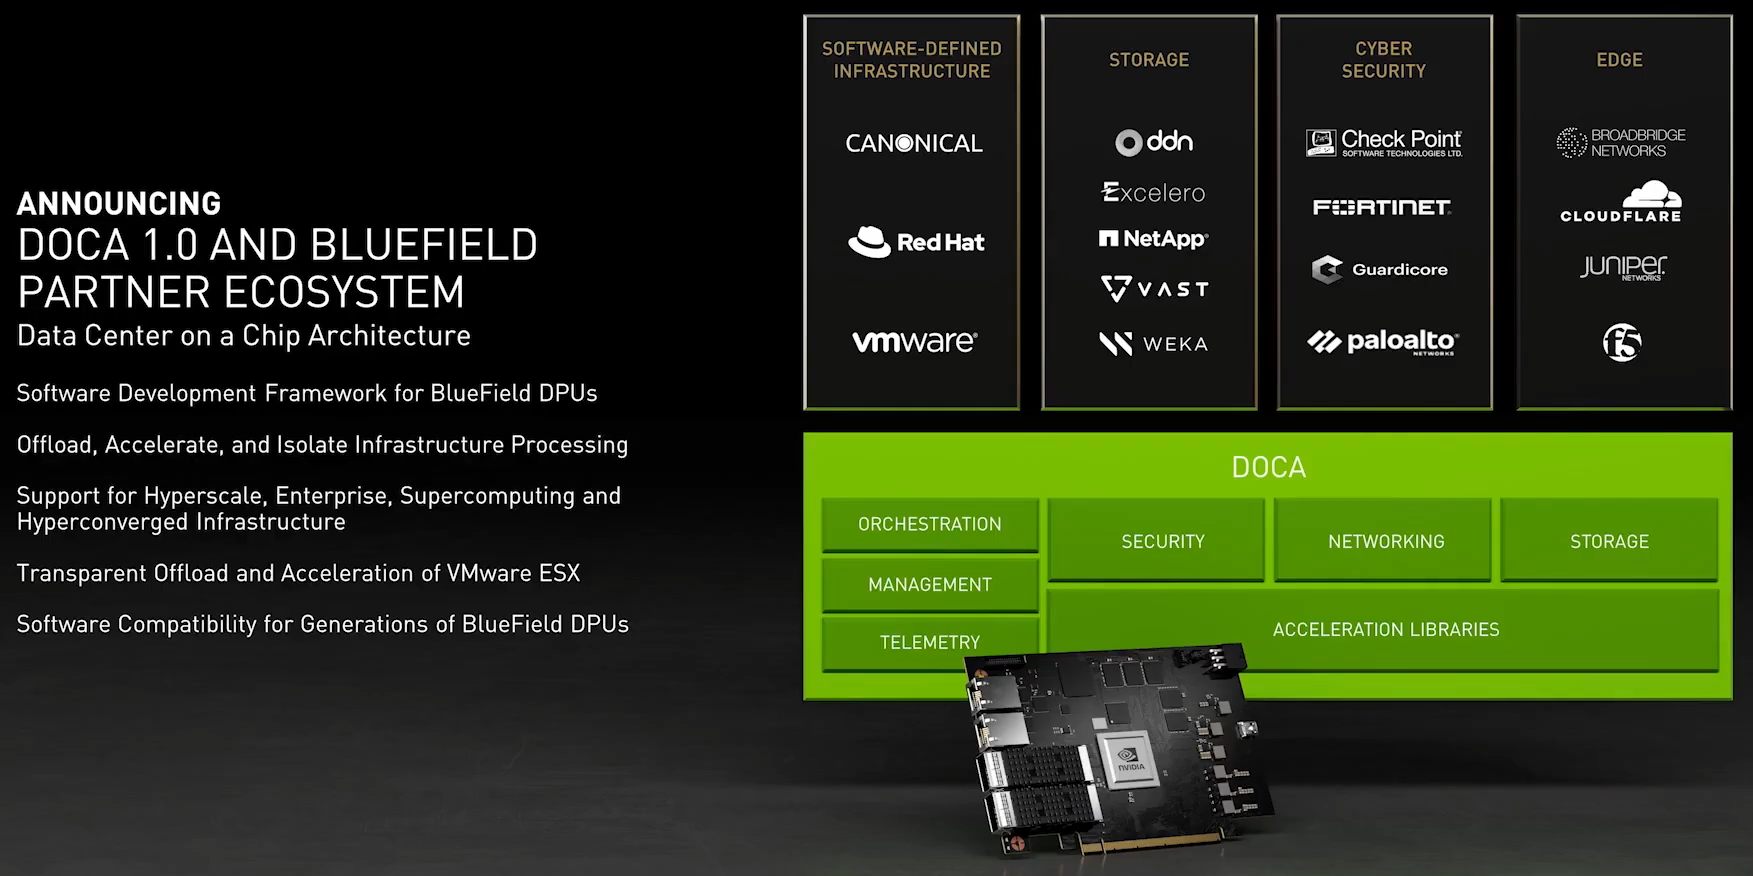 С точки зрения поддерживаемых возможностей BlueField-3 обратно совместим с BlueField-2, что позволит использовать уже имеющиеся наработки в области программного обеспечения для DPU. Одновременно с анонсом нового DPU компания представила и открытую программную платформу DOCA, упрощающую разработку ПО для таких сопроцессоров, поскольку они теперь занимаются не просто обработкой сетевого трафика, а оркестрацией работы серверов, приложений и микросервисов в рамках всего дата-центра. 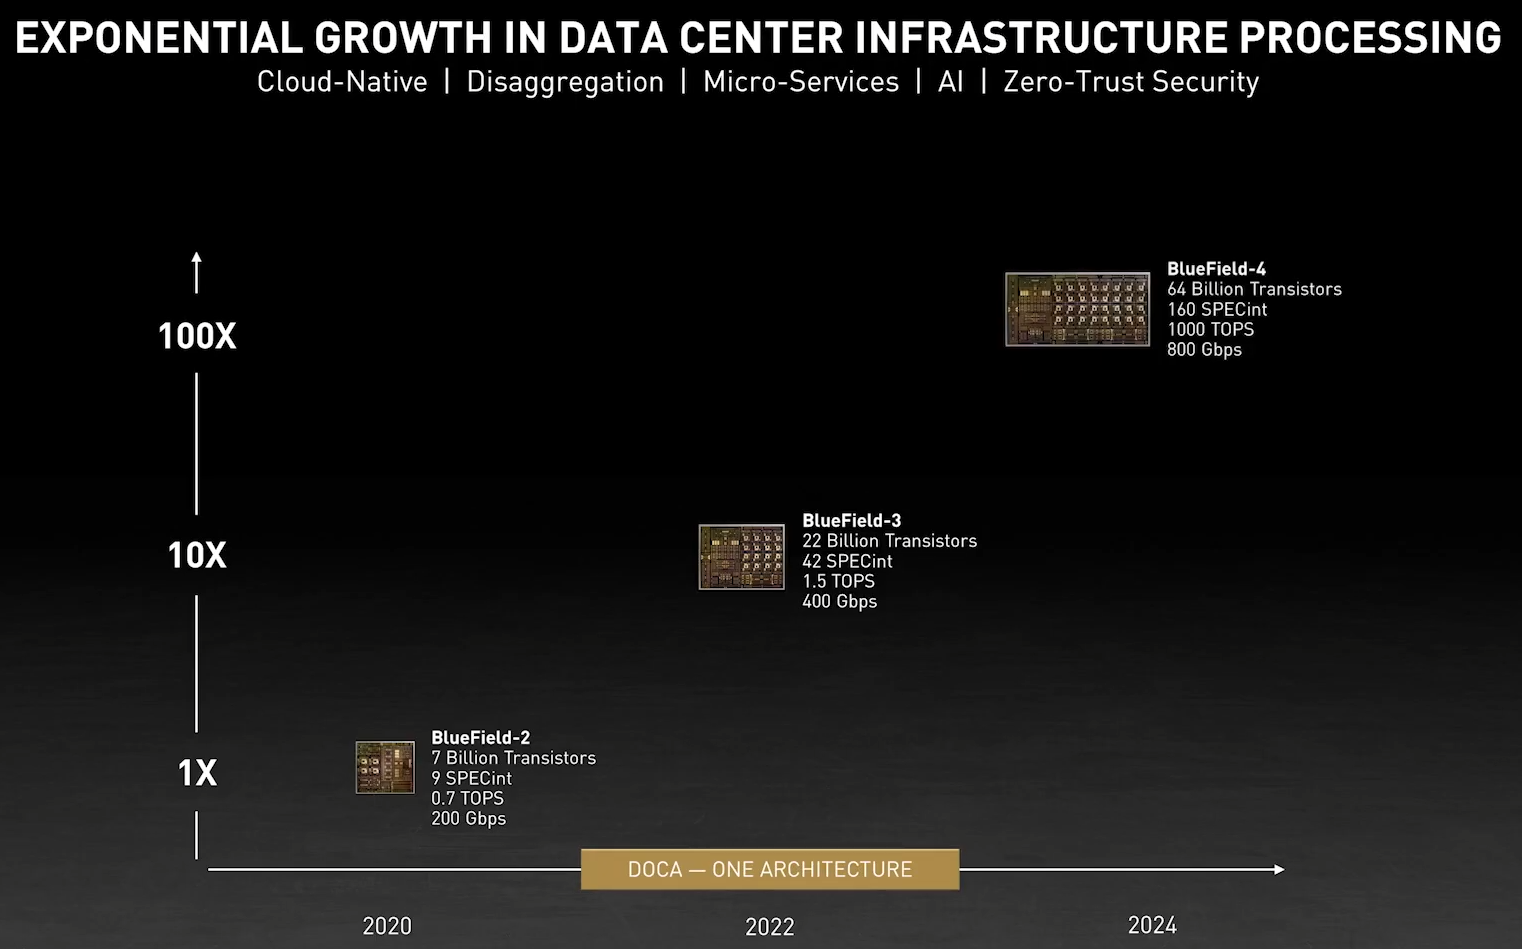 В настоящее время NVIDIA сотрудничает с такими крупными поставщиками серверных решений, как Dell EMC, Inspur, Lenovo и Supermicro, со стороны разработчиков ПО интерес к BlueField проявляют Canonical, VMWare, Red Hat, Fortinet, NetApp и ряд других компаний. О массовом производстве BlueField-3 речи пока не идёт, поставка малыми партиями ожидается в первом квартале 2022 года, но карты BlueField-2 доступны уже сейчас. А в 2024 году появятся BlueField-4 с портами 800 Гбит/с.
21.01.2021 [22:52], Алексей Степин
Wistron и Kalray представили СХД FURIO1200 с DPU K200Идея выделенного сопроцессора (Data Processing Unit, DPU), занятого исключительно задачами обслуживания подсистемы хранения данных, проста и логична: специализированный кремний работает эффективнее процессоров общего назначения и демонстрирует более высокую энергоэффективность. Одним из пионеров DPU является Fungible, о решениях которой мы неоднократно рассказывали ранее, но и других интересных разработок в этой области немало. Wistron, крупный тайваньский производитель электронного оборудования, заключила альянс с Kalray, компанией, специализирующейся на разработке сетевых процессоров и сопроцессоров обработки данных. Плодом этого сотрудничества и стала новая система FURIO1200.  В основе FURIO1200 лежит стандартное шасси Wistron LYMMA 2U с посадочными местами для 24 накопителей NVMe, но таких решений на рынке много. Самое интересное в данном случае сосредоточено в PCIe-адаптере K200, построенном на базе сопроцессора Kalray MPPA Coolidge. Он предназначен для установки в стандартные вычислительные узлы на базе x86 и обеспечивает обслуживание флеш-массива, поддержку NVMe-oF, шифрования, а также разгрузку хост-узлов от задач, связанных с обработкой специфических данных, например, данных, полученных от систем машинного зрения. 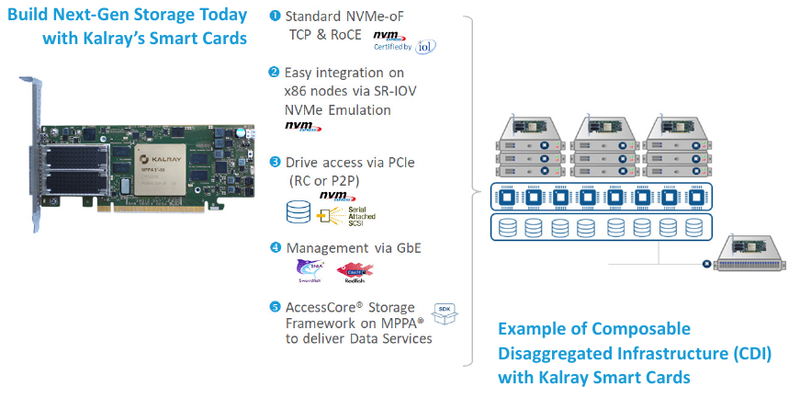 В основе MPPA Coolidge лежит фирменная архитектура Massively Parallel Processor Array. Как следует из названия, она представляет собой массив вычислительных ядер. Сами ядра построены на базе архитектуры VLIW, требующей для достижения оптимального параллелизма тщательной оптимизации на уровне компилятора. Таких ядер в составе процессора может быть до 800, частота их работы — от 600 МГц до 1,2 ГГц. Ядра сгруппированы в кластеры, каждый кластер включает в себя 16 ядер общего назначения и 1 управляющее ядро, ответственное также за функции безопасности. На кластер приходится 4 Мбайт выделенного кеша L2 с пропускной способностью 600 Гбайт/с. 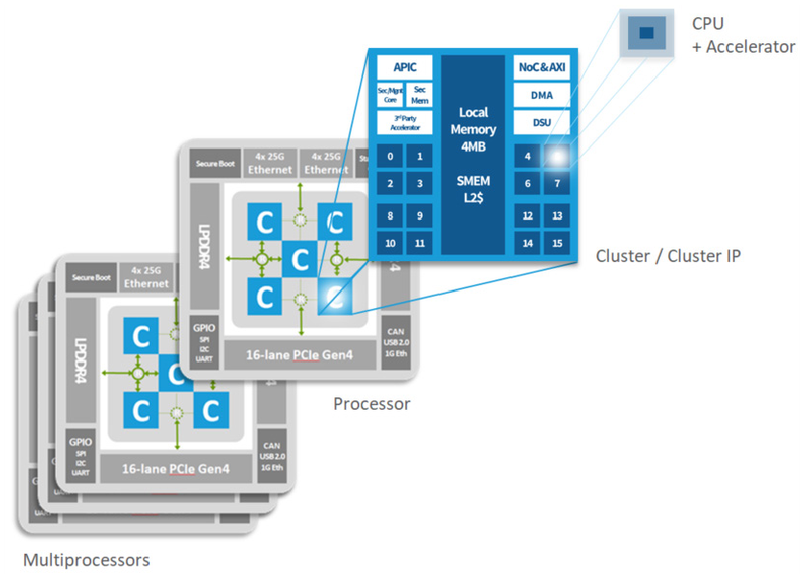 5 кластеров в составе Coolidge обеспечивают внушительную производительность: 1,15 Тфлопс на операциях FP32 и 25 Топс для INT8, что делает процессор хорошо подходящим для широкого круга задач, включая ИИ и системы машинного зрения. Имеется двухканальный контроллер DDR4-3200, а для общения с внешним миром предусмотрено 16 линий PCI Express 4.0 и два интерфейса 100GbE/RoCE v2. Интересно, что процессор может работать как в классическом многоядерном режиме SMP, так и в асимметричном режиме, в котором каждый кластер, по сути, работает как один из 16 отдельных одноядерных ЦП. В FURIO1200 процессор на борту адаптера K200 работает на благо NVMe-oF, но также позволяет запускать пользовательские приложения, для чего в комплекте поставляется открытый SDK. 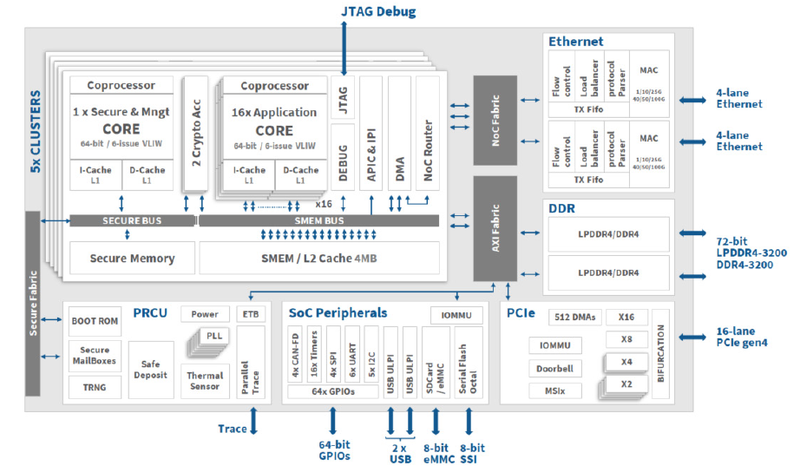
Архитектура процессора Kalray MPPA Coolidge Наличие столь мощного сопроцессора не только обеспечивает FURIO1200 гибкость в обработке данных, но также позволяет добиться внушительных скоростных характеристик. Производительность на случайных операциях у новинки может превышать 12 млн IOPS при латентности в районе 20-50 мс, а на последовательных операциях — достигать 72 Гбайт/с. Пока FURIO1200 является, скорее, концептом: первые небольшие партии будут доступны заказчикам в первом квартале, а массовое производство запланировано на середину года. Первые клиентские тесты начнутся в течение ближайших недель.
16.10.2020 [23:17], Юрий Поздеев
DPU в стиле Intel: сетевые адаптеры с Xeon D, FPGA, HBM и SSDМир сетевых карт становится умнее. Это следующий шаг в дезагрегации ресурсов центров обработки данных. Наличие расширенных возможностей сетевых карт позволяет разгрузить центральный процессор, при этом специализированные сетевые адаптеры обеспечивают более совершенные функции и безопасность. В этой новости мы познакомим вас сразу с двумя адаптерами: Silicom SmartNIC N5010 и Inventec SmartNIC C5020X. Silicom FPGA SmartNIC N5010 предназначена для систем крупных коммуникационных провайдеров. Операторы все чаще стремятся заменить проприетарные форм-факторы от поставщиков телекоммуникационного оборудования на более стандартные варианты. В рамках этого мы видим, что производители ПЛИС не прочи освоить и эту нишу. 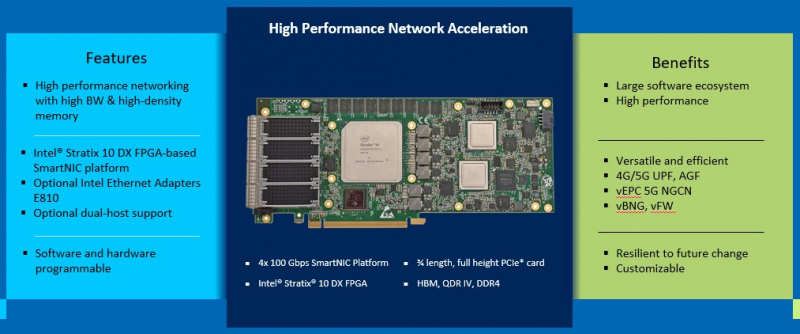 В Silicom FPGA SmartNIC N5010 используется Intel Stratix 10 DX с 8 Гбайт памяти HBM. Поскольку пропускная способность памяти становится все большим аспектом производительности системы, HBM будет продолжать распространяться за пределы графических процессоров и FPGA. В SmartNIC и DPU память HBM может использоваться для размещения индексных таблиц поиска и других функций для интенсивных сетевых нагрузок. Помимо HBM SmartNIC N5010 имеет еще 32 Гбайт памяти DDR4 ECC. SmartNIC N5010 потребляет до 225 Вт, что предполагает несколько вариантов исполнения карты, в том числе и с активным охлаждением. 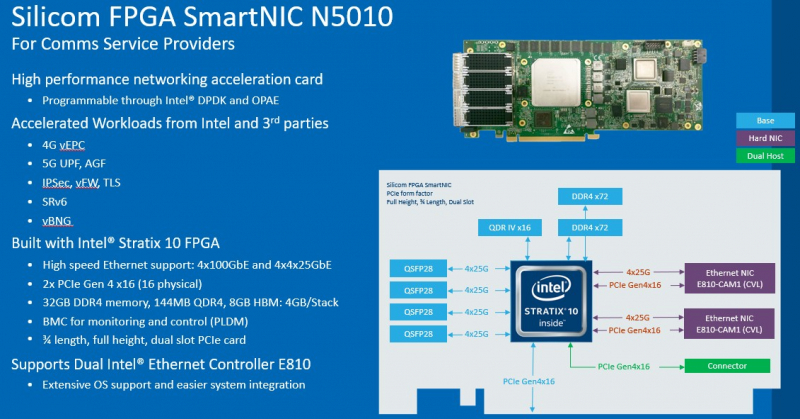 Самая интересная особенность новой карты — 4 сетевых порта по 100 Гбит/с. На плате SmartNIC N5010 установлены две базовые сетевые карты Intel E810 (Columbiaville). На приведенной схеме можно заметить, что используется интерфейс PCIe Gen4 x16, причем их тут сразу два. Для работы четырех 100GbE-портов уже недостаточно одного интерфейса PCIe 4.0 x16. Второй порт PCIe 4.0 x16 может быть подключен через дополнительный кабель к линиям второго процессора, чтобы избежать межпроцессорного взаимодействия для передачи данных. 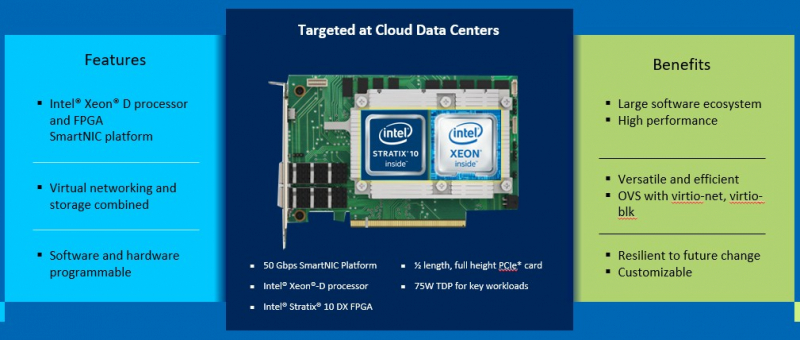 Вторая новинка, Inventec FPGA SmartNIC C5020X, совмещает на одной плате процессор Intel Xeon D и FPGA Intel Stratix 10. Этот адаптер предназначен для разгрузки центрального процессора в серверах крупных облачных провайдеров. На плате установлен процессор Intel Xeon D-1612 с 32-Гбайт SSD и 16 Гбайт DDR4, подключение к ПЛИС Intel Stratix 10 DX 1100 осуществляется через PCIe 3.0 x8. Нужно отметить, что FPGA Stratix имеет свои собственные 16 Гбайт памяти DDR4, а также обеспечивает сетевые подключения 25/50 Гбит/с и оснащен интерфейсом PCIe 4.0 x8, через который адаптер подключается к хосту. 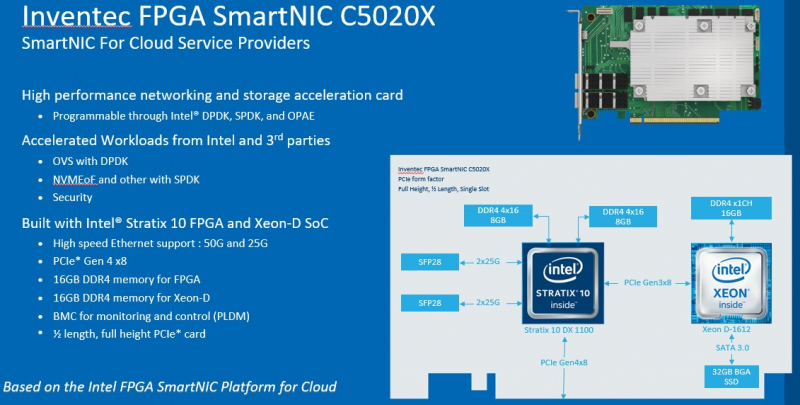 У Inventec уже есть решение на базе Arm (Inventec X250), которое использует ПЛИС Arria 10 GX660 вместе с сетевым адаптером Broadcom Stingray BCM8804, которое имеет аналогичный форм-фактор и TPD не более 75 Вт. Однако для некоторых организаций наличие единой x86 платформы, включая SmartNIC, упрощает развертывание, поэтому вариант C5020X для таких компаний более предпочтителен. Решение получилось очень интересным, однако вряд ли его можно назвать адаптером для массового рынка, как Intel Columbiaville. На примере этого адаптера Intel показала, что может объединить элементы своего портфеля для создания комплексных решений. Inventec FPGA SmartNIC C5020X является хорошей альтернативой предложению на базе Broadcom, что позволит крупным облачным провайдерам диверсифицировать свои платформы. 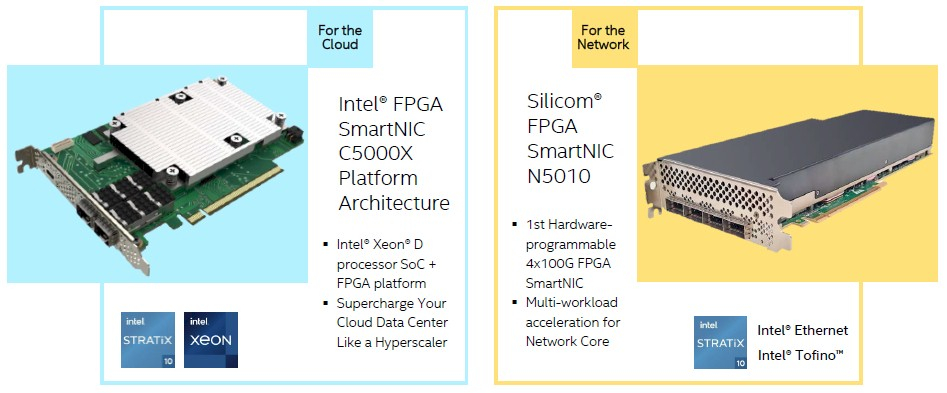 Несмотря на то, что обе новинки классифицируются как «умные» сетевые адаптеры SmartNIC, вторая, пожалуй, уже ближе к DPU, если сравнивать её с адаптерами NVIDIA DPU, в которых сетевая часть дополнена Arm-процессором и GPU-ускорителем. В данном случае есть и x86-ядра общего назначения, и ускоритель, хотя и на базе ПЛИС. Впрочем, устоявшегося определения DPU и списка критериев соответствия этому классу процессоров пока нет.
29.09.2020 [19:57], Алексей Степин
VMware возложит часть нагрузки vSphere на DPU и SmartNICКогда-то архитектура x86 была очень простой, хотя её CISC-основа и была сложнее пути, по которому пошли процессоры RISC. Но за всё время своей эволюции она постоянно усложнялась и на процессоры возлагались всё новые и новые задачи, требующие дополнительных расширений, а то и перекладывались задачи с плеч специализированных чипов. Эта тенденция сохраняется и поныне, однако один из лидеров в мире виртуализации, компания VMware, имеет иное видение. Перекладывание на x86 несвойственных этой архитектуре задач началось с внедрения расширений MMX. Сегодня современные серверные процессоры умеют практически всё и продолжают усложняться — достаточно вспомнить Intel VNNI, подмножество AVX-512, ускоряющее работу с всё более популярными задачами машинного обучения. Однако VMware считает, что x86 не успевает за усложнением программного обеспечения и полагает, что будущее ЦОД лежит в дезагрегации вычислительных ресурсов. 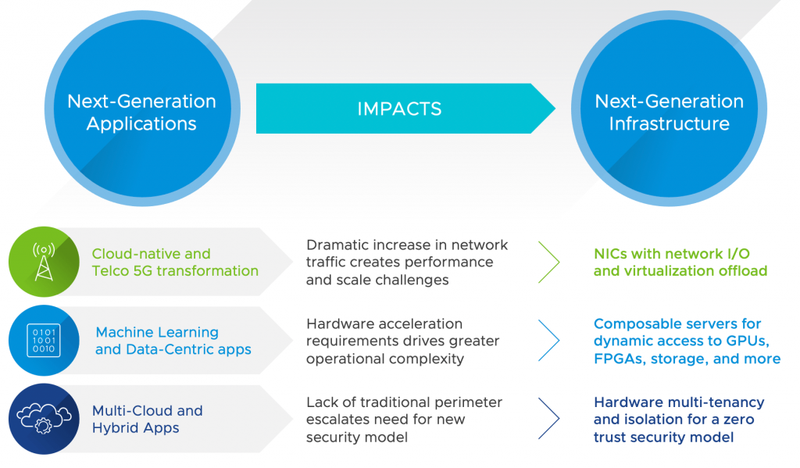
Сложность приложений и сценариев растёт, x86 может не успевать за возрастающей нагрузкой С учётом того, что задачи перед серверами и ЦОД встают всё более и более сложные, неудивительно, что наблюдается расцвет всевозможных ускорителей и сопроцессоров, от умных сетевых адаптеров и уже ставших привычными ГП-ускорителей до относительно экзотических идей, вроде «процессора обработки данных» (DPU). Последнюю концепцию на конференции VMworld 2020 поддержал такой гигант в сфере виртуализации, как VMware. Переработкой своей основной платформы виртуализации vSphere компания занимается уже давно, и в проекте прошлого года под кодовым названием Pacific переработано было многое. В частности, в основу системы управления была окончательно положена контейнерная модель на базе коммерческой системы для Kubernetes под названием Tanzu. Проект этого года, получивший имя Monterey, ознаменовал дальнейшее движение в этом направлении. 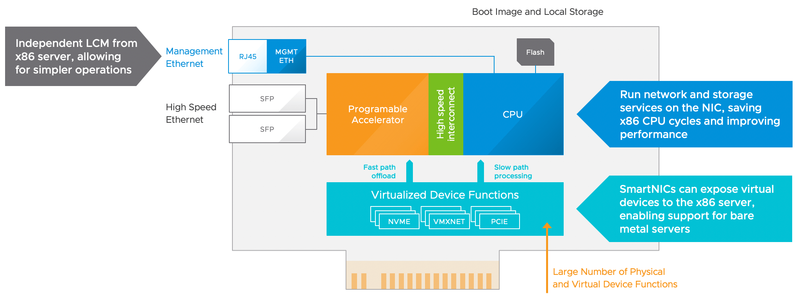
Но ряд задач можно переложить на плечи ускорителей типа SmartNIC или DPU Теперь Kubernetes стал не дополнением, пусть и включенным изначально, но единственным движком для управления как виртуальными машинами первого поколения, так и более современными контейнерами. Но из этого следует дальнейшее повышение вычислительной нагрузки на серверы. В частности, как отмечает VMware, обработка данных ввода-вывода становится всё сложнее. Как мы уже знаем, это привело к зарождению таких устройств, как «умные сетевые адаптеры» (SmartNIC) и даже специализированных чипов DPU. Как первые, так и вторые, как правило, содержат ядра на базе архитектуры ARM, и именно их-то и предлагает использовать для разгрузки основных процессоров VMware. Информация о том, что компания работает над переносом гипервизора ESXi на архитектуру ARM официально подтвердилась. 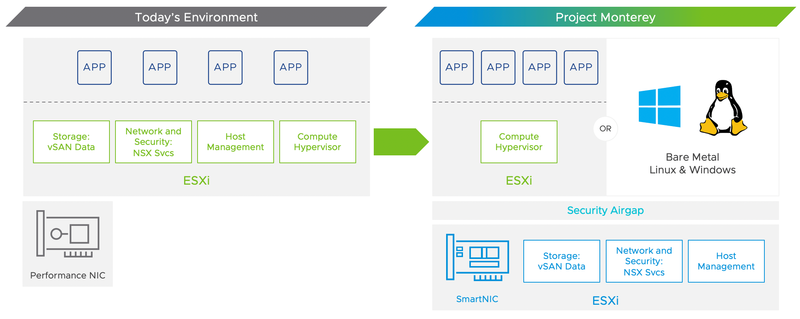
Новая версия платформы vSphere проще, но она эффективнее использует имеющиеся вычислительные ресурсы Важной частью ESXi, как известно, является виртуализация сетевой части — «коммутаторов» и «микро-файрволлов», и в Project Monterey появилась возможность запускать сетевую часть ESXi полностью на ресурсах DPU или SmartNIC, благо современные ускорители этих классов имеют весьма солидную производительность, а иногда и превосходят в этом плане классические центральные процессоры. Сама идея ускорения сетевой части, в частности, задач обеспечения сетевой безопасности в серверах за счёт SmartNIC не нова. Новизна подхода VMware заключается в другом: теперь реализация ESXi-on-ARM позволит не просто снять нагрузку в этих сценариях с плеч основных процессоров, но и представить за счёт виртуализации все сетевые ресурсы безопасно, в виде единого унифицированного пула и вне зависимости от типа процессоров, занятых в этих задачах. Среди уже существующих на рынке устройств, совместимых с новой концепцией VMware числятся, к примеру, и NVIDIA BlueField-2 — «умный сетевой адаптер», разработанный Mellanox — и решения Intel. 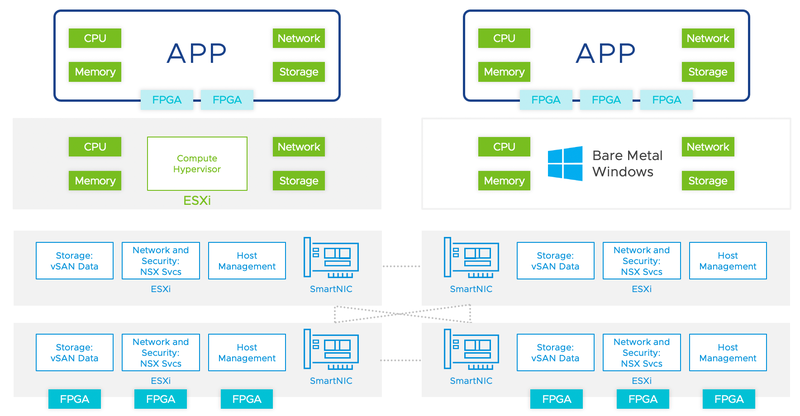
Новое видение кластера по версии VMware: каждый процессор и сопроцессор занят своим делом Как считает VMware, такой подход кардинально изменит архитектуру и экономику ЦОД нового поколения. На это есть основания, ведь если объединить пару 64-ядерных процессоров AMD EPYC второго поколения с сетевым ускорителем или DPU, работающим под управлением ESXi в составе единой платформы vSphere, то эту систему можно будет с полным правом назвать «ЦОД в коробке». Такое сочетание позволит запускать множество виртуальных машин с достаточным уровнем производительности, ведь основным x86-процессорам не придётся вывозить на себе виртуализацию сети, функционирование файрволлов и задачи класса data storage. Пока Project Monterey имеет статус «технологического демо», но сама идея дизагрегации серверов, над которой продолжает работу VMware, выглядит логичной и законченной. Каждый процессор будет выполнять ту задачу, к которой он лучше всего приспособлен, но за счёт единой системы виртуализации платформа не будет выглядеть сегментировано, и разработка ПО не усложнится. Кроме того, VMware уже подтвердила возможность запуска на SmartNIC и DPU приложений сторонних разработчиков, так что лёд явно тронулся.
19.08.2020 [19:04], Игорь Осколков
Третий сокет: Fungible представляет новый класс процессоров — DPUИдея дезагрегации ресурсов, которые в последнее время становятся всё более разнообразными, далеко не нова. Выделенные аппаратные блоки, которые помогают перемещать данные между ресурсами, тоже в том или ином виде развиваются не первый год. Fungible же решила довести эту концепцию до логического конца, создав DPU (Data Processing Unit). 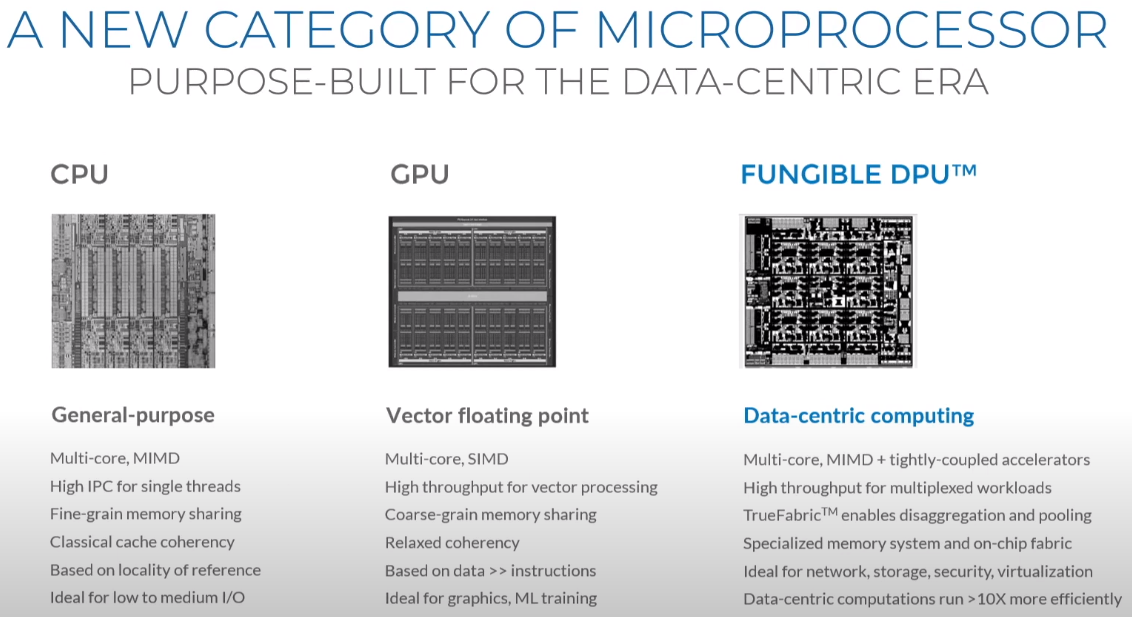 На конференции HotChips 32 компания рассказала о двух процессорах: Fungible F1 и S1. Первому из них и был посвящён основной доклад. F1 ориентирован на работу с хранилищами и безопасную обработку больших потоков данных, которые требуются современным системам ИИ и аналитики. 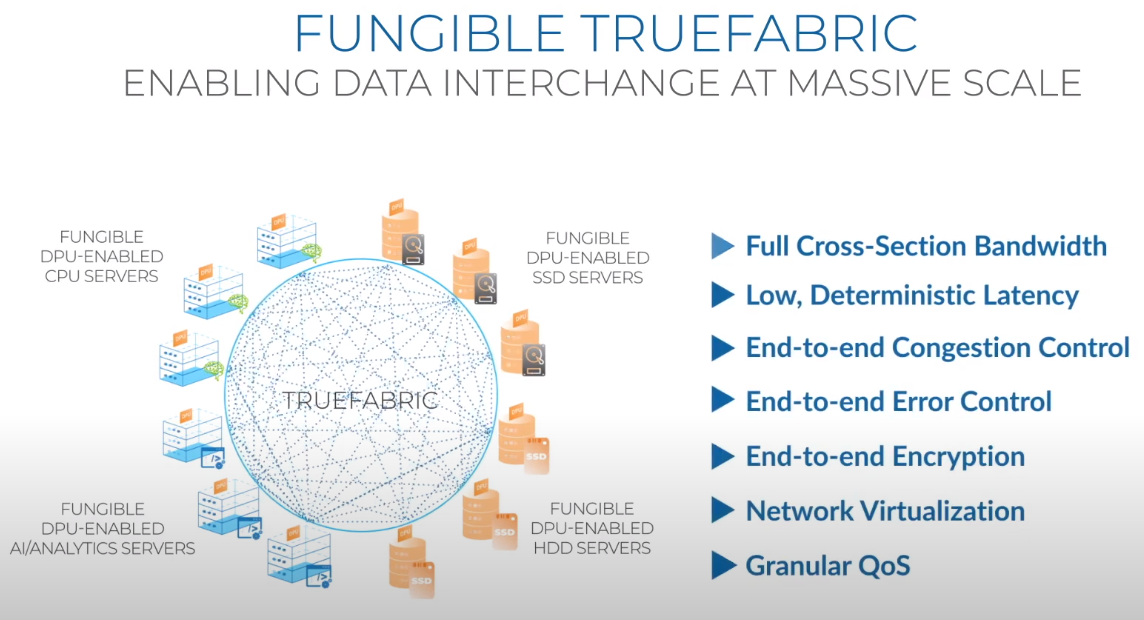 При взгляде «свысока» F1 представляет собой чип c двумя основными интерфейсами: 8 каналов 100GbE и 4 контроллера PCIe 3.0/4.0 x16. Тем не менее, это не просто очередная реализация RDMA или, допустим, NVMe-oF. Со стороны сети предполагается организация общей фабрики между всем узлами, которую разработчики называют TruFabric. 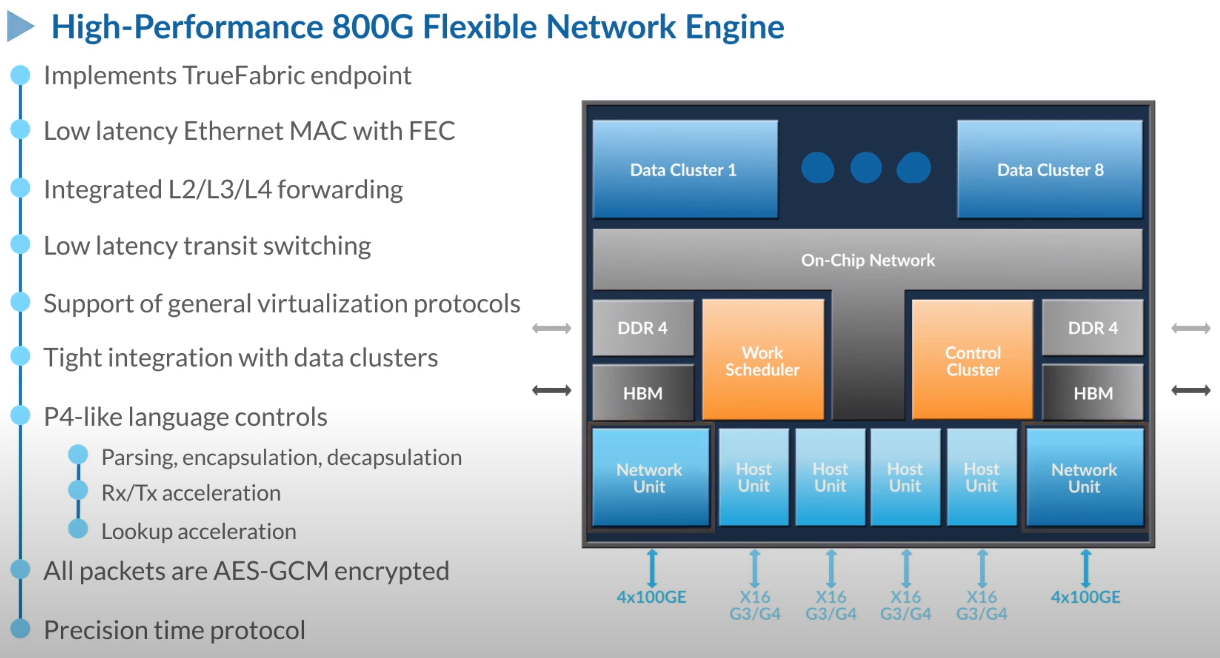 В отличие от многих других решений для фабрики здесь используется стандартный и относительно дешёвый Ethernet, а не PCIe, InfiniBand, Fibre Channel или какой-то проприетарный интерконнект. Весь трафик шифруется, а для реализации собственных функций разгрузки предлагается P4-подобный язык программирования. 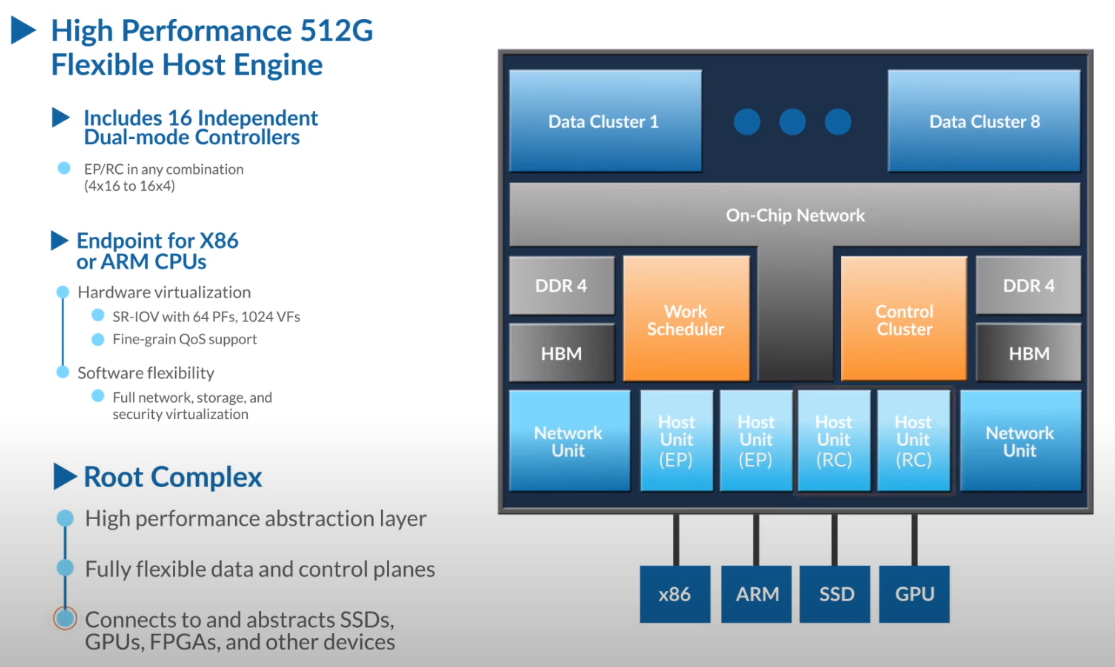 Со стороны PCIe F1 может «представляться» серверу как ещё один адаптер (с SR-IOV), а может предоставлять и собственный root-комплекс для прямого подключения и абстракции других устройств: CPU, GPU, FPGA, NVMe SSD, HDD и так далее. 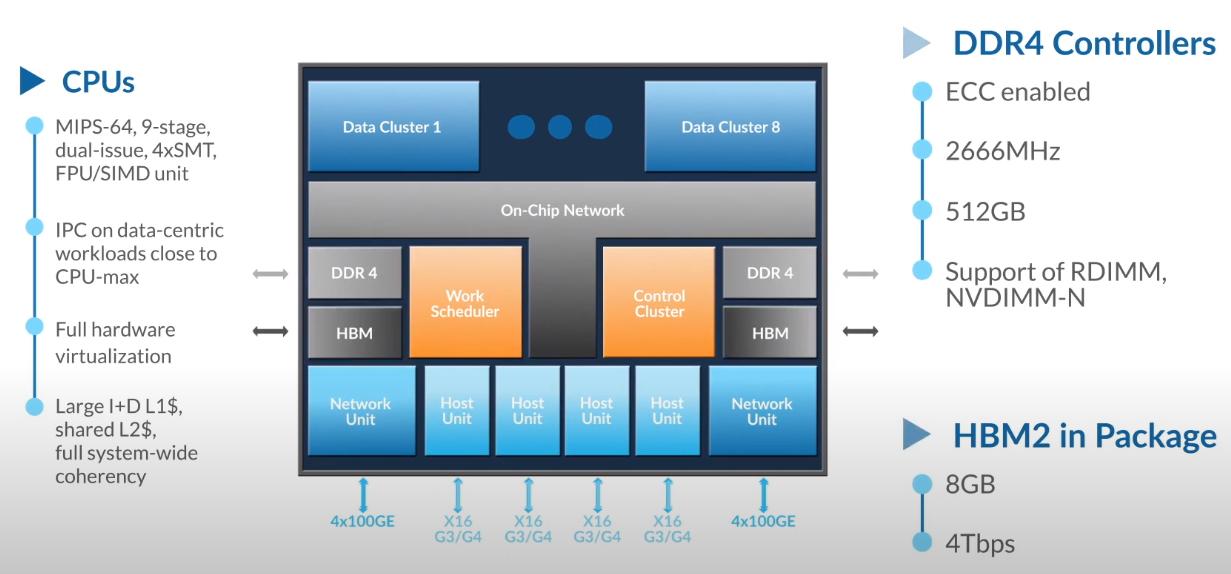 Fungible F1 помимо Ethernet и PCIe включает общий контроллер памяти, планировщик, управляющий блок и собственно блоки обработки данных. Все они объединены внутренней сверхбыстрой шиной. Контроллеры памяти обслуживают 8 Гбайт набортной HBM (4 Тбит/с) + внешние модули DDR4-2666 ECC с поддержкой NVDIMM-N, суммарный объём которых может достигать 512 Гбайт. 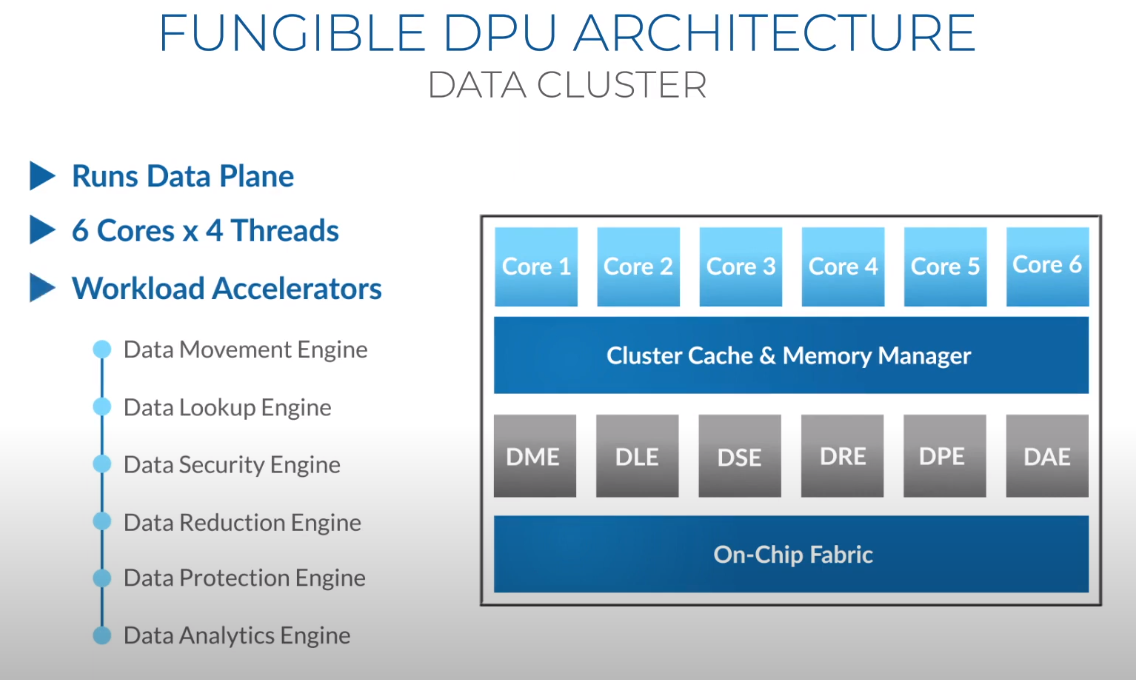 Блоков обработки данных (Data Cluster) в сумме восемь. Каждый из них имеет 6 ядер MIPS-64 общего назначения c SMT4. Их дополняют отдельные аппаратные акселераторы для поиска, передачи и сжатия объёма передаваемых данных, безопасности и защиты информации, а также для аналитики данных. Все ядра и акселераторы имеют общий кеш и менеджер памяти. Суммарно на чип приходится 48 ядер и 192 потока для обработки данных. 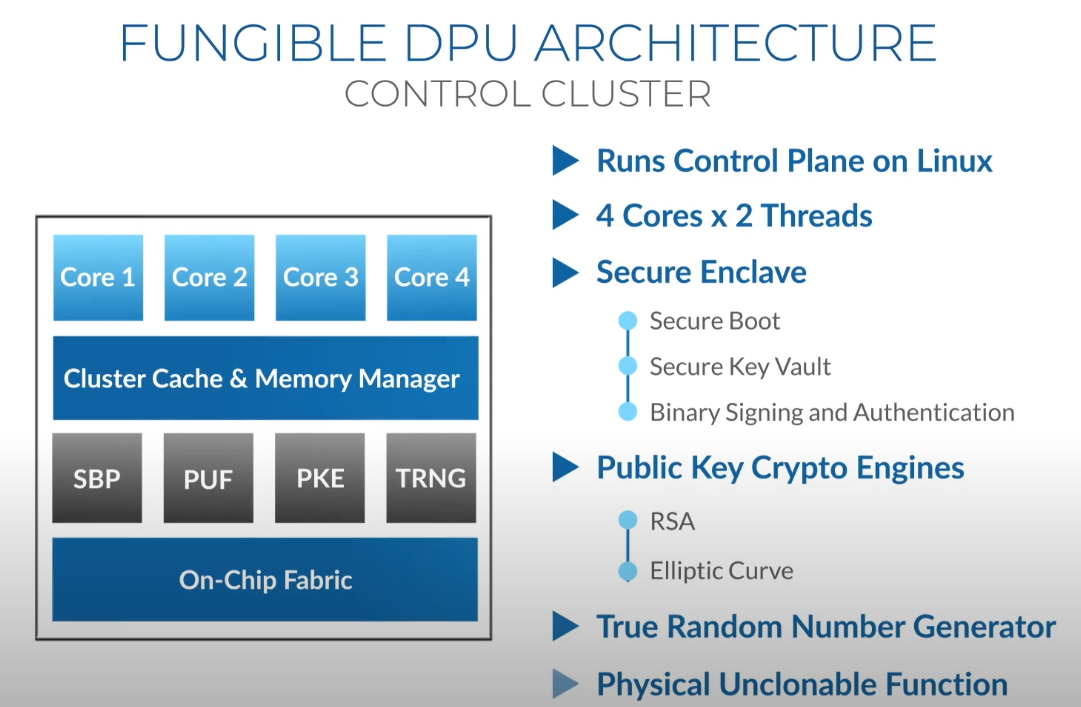 Управляет ими отдельный блок (Control Cluster), включающий 4 ядра MIPS-64 с SMT2, а также модули безопасности: изолированный анклав, генератор случайных чисел, аппаратный акселератор для работы с ключами шифрования. MIPS-ядра также имеют блоки FPU/SIMD и поддержку аппаратной виртуализации. 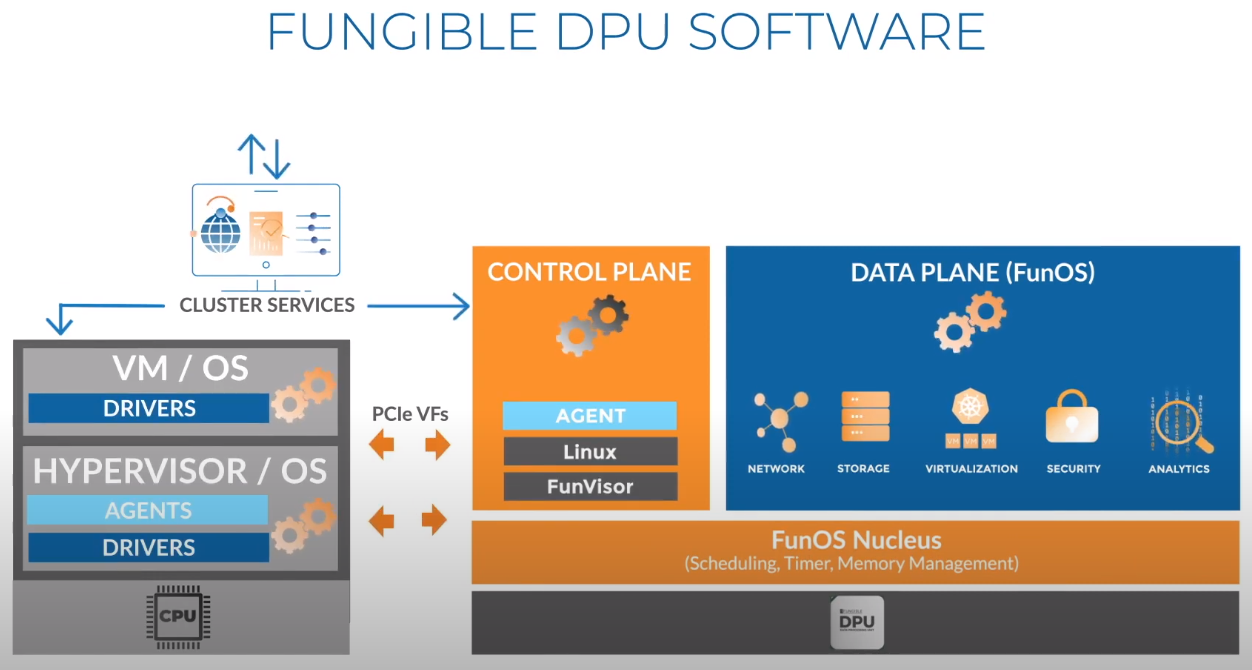 Программная часть представлена мини-ОС FunOS Nucleus, которая обеспечивает самые базовые функции. В блоках Data Cluster «живёт» FunOS, которая обслуживает пять программных стеков: сеть, хранилище, виртуализация, безопасность и аналитика. В Control Cluster работает сверхтонкий гипервизор FunVisor, поверх которого запущен Linux. Для ОС, гипервизора и ВМ, работающим на хост-процессоре x86 или ARM предлагаются драйверы и агенты. 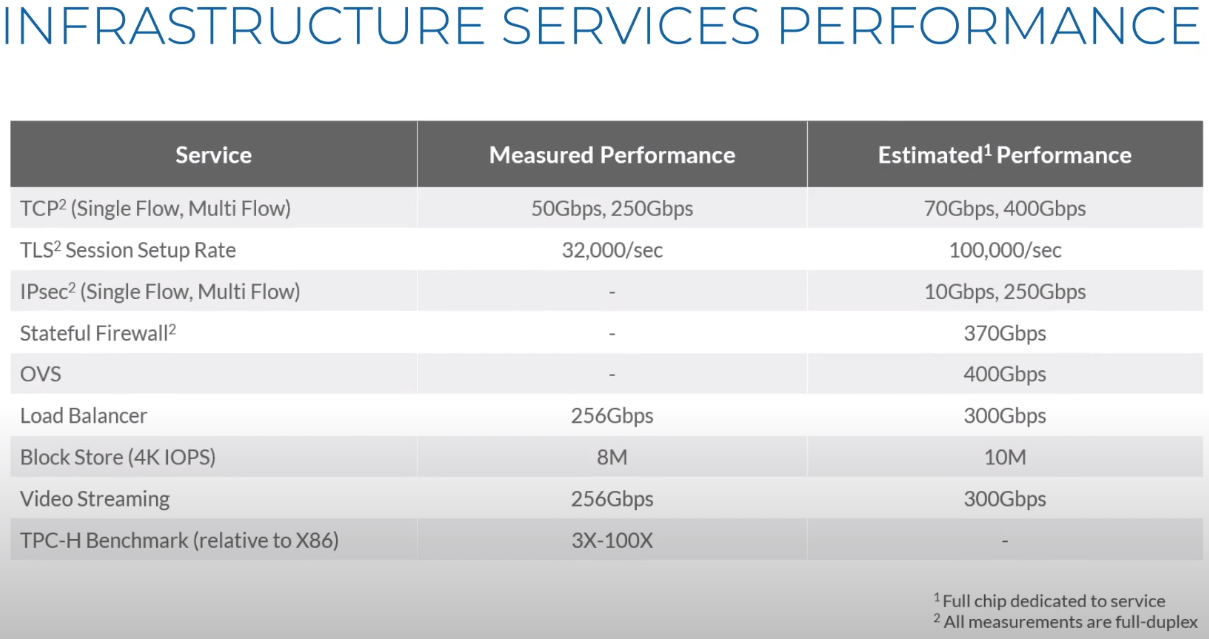 Предварительные тесты действительно показывают значительное ускорение в некоторых нагрузках, а также достаточно высокий уровень производительности самих DPU и TrueFabric. При этом в отличие от SmartNIC и других подобных решений DPU от Fungible обещают быть намного универсальнее и вместе с тем проще в работе. 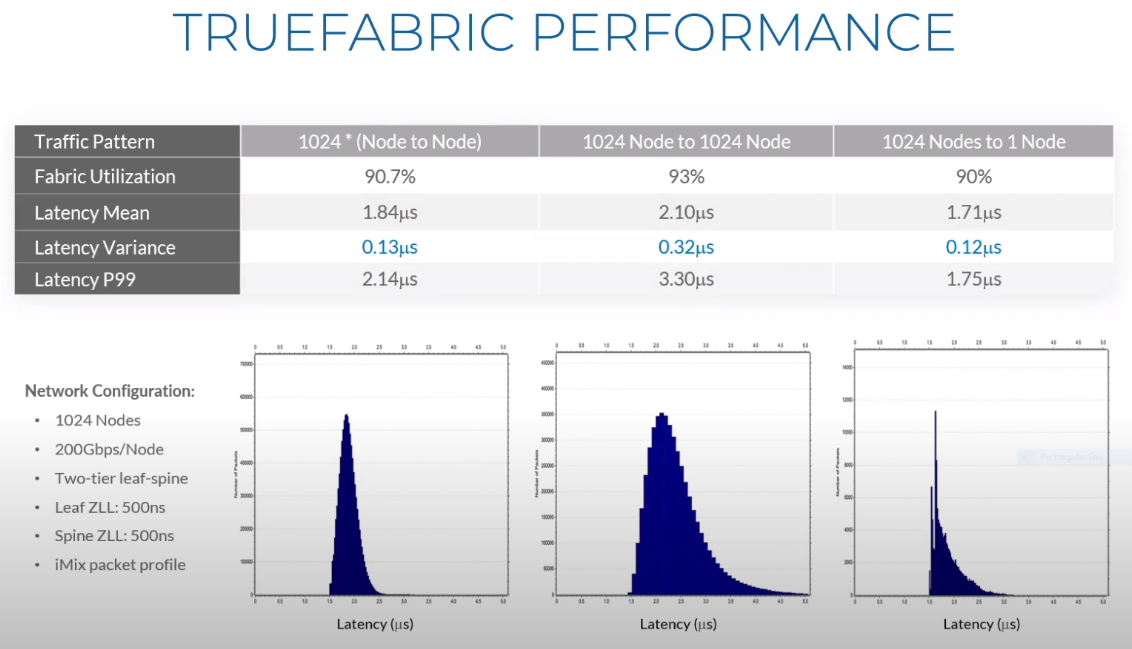 Fungible даже считает, что DPU должны стать одним из ключевых компонентов современных серверов в дата-центре, заняв третий по счёту сокет в системе после CPU и GPU. Таким образом, можно будет на лету «собирать» оптимизированные под конкретные задачи конфигурации из разрозненных ресурсов, объединённых DPU-хабами в единую фабрику. |
|

