
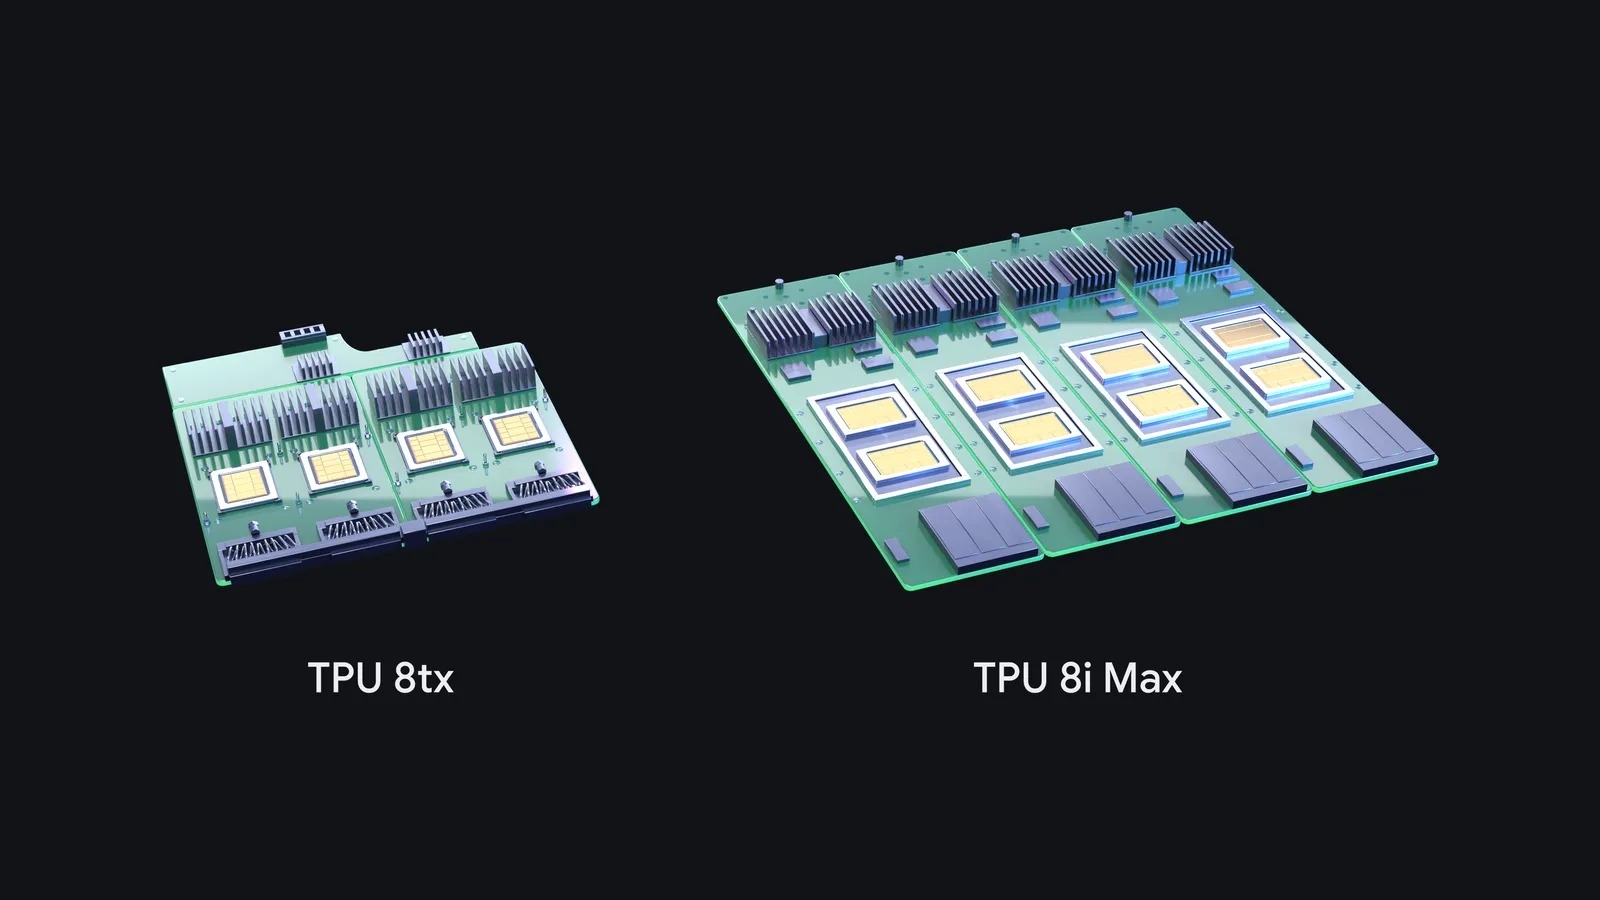
Google представила ИИ-ускорители TPU 8tx и TPU 8i Max. С учётом анонсированных ранее в этом году ускорителей TPU 8t и TPU 8i семейство TPU Google восьмого поколения теперь включает четыре модели.
Как отметил в блоге Амин Вахдат (Amin Vahdat), старший вице-президент и главный технолог Google по ИИ и инфраструктуре, TPU восьмого поколения предназначены «для решения конкретных задач на разных этапах жизненного цикла ИИ: TPU 8t — для масштабного обучения моделей; TPU 8i — для выполнения инференса с низкой задержкой; TPU 8tx — для конфиденциальных вычислений; а TPU 8i Max — для обработки огромных контекстных окон и обеспечения максимальной плотности вычислений в серверной стойке».
TPU 8t и TPU 8i стали фундаментом для этого поколения: TPU 8t — инструмент для обучения масштабных базовых моделей, обеспечивающий максимальный показатель «полезной производительности» (goodput) — то есть объём эффективных вычислений на каждый ватт затраченной энергии. А TPU 8i — вычислительный модуль для инференса и «размышлений», разработанный для преодоления «барьера памяти» (memory wall) и сокращения задержек при обмене данными между чипами — вплоть до 50 %.
Источник изображений: Google
В свою очередь, TPU 8tx оптимизирован для безопасного и конфиденциального инференса, а также обучения моделей в небольших масштабах. Он создан для организаций, работающих в регулируемых отраслях, и государственных структур, которые используют передовые или проприетарные модели и автономных агентов для работы с наиболее конфиденциальными данными.
Система TPU 8tx, построенная на той же аппаратной базе, что и TPU 8t, и работающая в связке с процессорами AMD EPYC Turin, обеспечивает безопасность на уровне «железа», сохраняя конфиденциальные данные и веса моделей защищенными и изолированными даже при их использовании. В сочетании с сетевой топологией Boardfly с низкой задержкой TPU 8tx ускоряет работу многошаговых агентов, обеспечивая снижение задержки до двух раз по сравнению с TPU 8t практически без потери производительности.
TPU 8tx также позволяет дообучать (fine-tune) модели на собственных закрытых данных, выполнять дистилляцию (сжатие) крупных моделей и обучать с подкреплением агентов без необходимости перемещать конфиденциальные данные между отдельными кластерами.
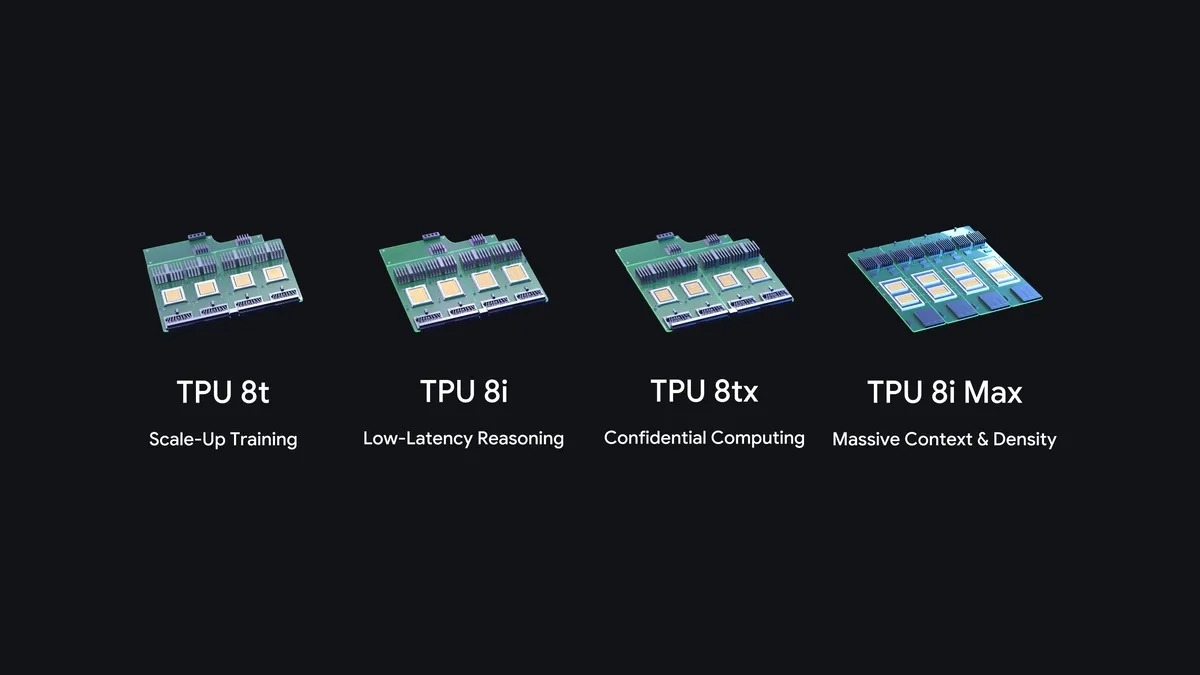
Модель TPU 8i Max, объединившая два TPU 8i, была разработана для решения проблемы «барьера памяти» (memory wall) — разрыва между скоростью вычислений и пропускной способностью памяти. Двухчиповая система предлагает вдвое больше вычислительных ресурсов, вдвое больше SRAM и вдвое более высокую пропускную способность HBM по сравнению с TPU 8i. Вычислительные мощности и объём памяти в ней масштабируются синхронно. Поскольку TPU 8i Max вмещает вдвое больше кремниевых компонентов в рамках той же серверной стойки, дата-центры могут значительно увеличить вычислительную мощность на единицу площади и на ватт потребляемой энергии, сообщил Вахдат.
Вахдат также заявил, что компания выпустила набор инструментов TPU Agent (сейчас доступен в режиме превью) для упрощения оптимизации оборудования. Он интегрируется в среды разработки — например, Claude Code, Cursor и Google Antigravity — и позволяет за считанные минуты подготовить систему к работе с TPU, выявить «узкие места» и автоматически настроить ядра (kernels) с помощью простых текстовых команд. Для промышленного использования был разработан открытый движок XLA Serving Engine, который позволяет обучать модели на Python, а затем запускать их в высокопроизводительной среде на C++ с минимальной задержкой — на базе TPU, GPU или CPU.
Источник:

