Материалы по тегу: tesla
|
11.02.2025 [13:47], Руслан Авдеев
Tesla запустила суперкомпьютер Cortex с 50 тыс. ускорителей NVIDIA H100, а общие затраты компании на ИИ уже превысили $5 млрдКомпания Tesla завершила ввод в эксплуатацию ИИ-кластера из 50 тыс. ИИ-ускорителей NVIDIA H100 в IV квартале прошлого года. В презентации для акционеров отмечалось, что кластер Cortex заработал на принадлежащем Tesla объекте Gigafactory в Остине (Техас), сообщает Datacenter Dynamics. Информация впервые появилась в отчёте компании за IV квартал и 2024 финансовый год. Новый кластер не имеет отношения к суперкомпьютеру Dojo, предназначенному для технологий автономного вождения FSD, имеющего собственную архитектуру и оснащенного кастомными чипами D1. При этом в презентации, посвящённой отчёту, Dojo не упоминается вообще. Хотя компания не уточняет, когда именно в IV квартале началось развёртывание системы, на конференции по финансовым вопросам в октябре 2024 года представитель Tesla заявил, что компания находится «на пути к развёртыванию 50 тыс. ускорителей в Техасе к концу текущего месяца». По имеющимся данным, проект реализован с опозданием, поскольку Илон Маск уволил руководителя строительством ещё в апреле, а также приказал передать xAI 12 тыс. ускорителей H100, изначально предназначавшихся Tesla. 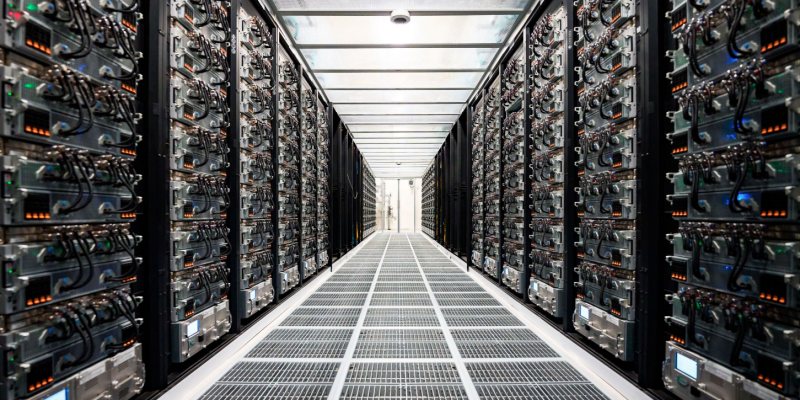
Источник изображения: Tesla В презентации сообщается, что именно Cortex уже помог в создании «автопилота» FSD V13 (Supervised). Новая версия повысила безопасность и комфорт вождения благодаря увеличению объёма данных в 4,2 раза, повышению разрешения видеопотока, а также другим усовершенствованиям. Заодно компания сообщила о продолжении работ над программной и аппаратной частями робота Optimus, в т.ч. рук нового поколения и механизмов передвижения. Также осуществлялось обучение выполнению дополнительных задач перед началом пилотного производства в 2025 году. Что касается доходов компании в IV квартале, в конце января Илон Маск (Elon Musk) сообщил, что бизнес продолжает инвестировать в обучающую инфраструктуру за пределами штаб-квартиры в Техасе. В конце января сообщалось, что Tesla наращивает вычислительные мощности для обучения Optimus. По словам миллиардера, на обучение Optimus необходимо потратить, как минимум, в 10 раз больше ресурсов в сравнении с полноценным обучением систем автомобиля. Капитальные затраты Tesla в 2024 году составили $10 млрд, столько же компания намерена потратить в ближайшие два года, хотя большая часть затрат придётся на инфраструктуру для электромобилей. В отчёте о доходах за IV квартал упоминалось, что общие капитальные затраты компании, связанные с ИИ, включая инфраструктуру, превысили $5 млрд.
31.01.2025 [07:02], Сергей Карасёв
Tesla наращивает вычислительные мощности для обучения человекоподобного робота OptimusГлава Tesla Илон Маск (Elon Musk) сообщил о том, что компания расширяет вычислительную инфраструктуру, необходимую для обучения человекоподобного робота Optimus. По словам Маска, в долгосрочной перспективе этот проект может принести более $10 трлн. Предполагается, что антропоморфные машины Optimus смогут выполнять самые разные задачи в быту и на производствах, взаимодействия с людьми. Но для разработки ИИ-систем робота требуются огромные вычислительные ресурсы. Маск подчёркивает, что обучение такой машины — гораздо более сложная задача, нежели обучение интеллектуальных автомобилей с автопилотом. Глава Tesla говорит, что у человекоподобного робота, вероятно, в 1000 раз больше функций, чем у транспортного средства. Это не означает, что обучение масштабируется в 1000 раз, но прирост вычислительных мощностей на порядок всё же необходим. «Потребности в обучении для гуманоидного робота Optimus, по всей видимости, как минимум в 10 раз превышают то, что требуется для создания полнофункционального умного автомобиля», — заявил Маск. 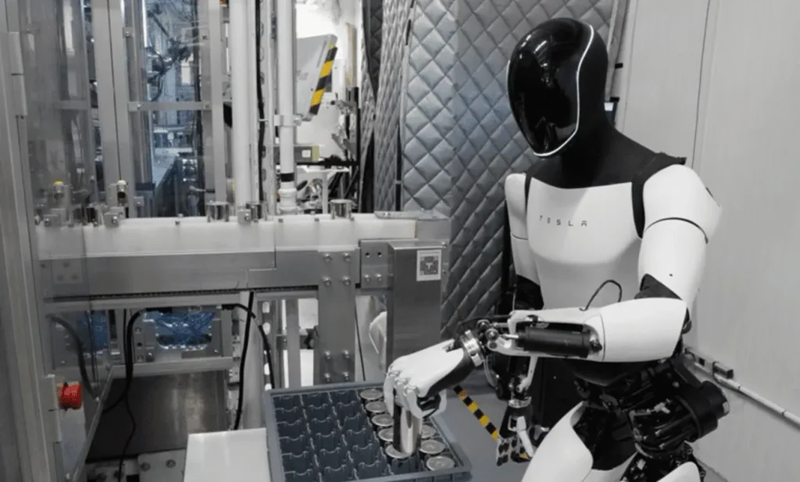
Источник изображения: channeliam.com Он не стал вдаваться в подробности о том, какая инфраструктура нужна компании для обучения Optimus. Ранее сообщалось, что Tesla планирует ввести в эксплуатацию дата-центр с 50 тыс. ускорителей NVIDIA H100. Кроме того, у компании есть кластер Dojo на базе собственных ускорителей D1. Маск говорит, что с учётом потенциала проекта Optimus даже инвестиции в размере $500 млрд в вычислительные ресурсы могут быть оправданными, хотя такую сумму Tesla на текущем этапе вкладывать не планирует. Вероятно, указанная сумма — это отсылка к проекту Stargate. Tesla потратила более $10 млрд на капитальные затраты в 2024 году. Примерно столько же средств компания намерена выделить в 2025 и 2026 годах. Ранее Маск говорил, что небольшое количество роботов Optimus будет задействовано на предприятиях Tesla до конца 2024-го. На коммерческом рынке эти человекоподобные машины, как ожидается, появятся в 2026 году.
18.11.2024 [10:59], Сергей Карасёв
OpenAI раздумывала, не купить ли разработчика ИИ-ускорителей Cerebras при участии TeslaКомпания OpenAI, по информации ресурса TechCrunch, изучала возможность приобретения американского стартапа Cerebras Systems, специализирующегося на разработке ИИ-ускорителей. Такие сведения вскрылись в рамках судебного процесса по иску Илона Маска (Elon Musk) против OpenAI. Маск является одним из основателей OpenAI — он покинул эту компанию в 2018 году. В начале августа нынешнего года Маск подал в суд на OpenAI и её генерального директора Сэма Альтмана (Sam Altman), обвинив их в нарушении прав и интересов, а также во введении в заблуждение. 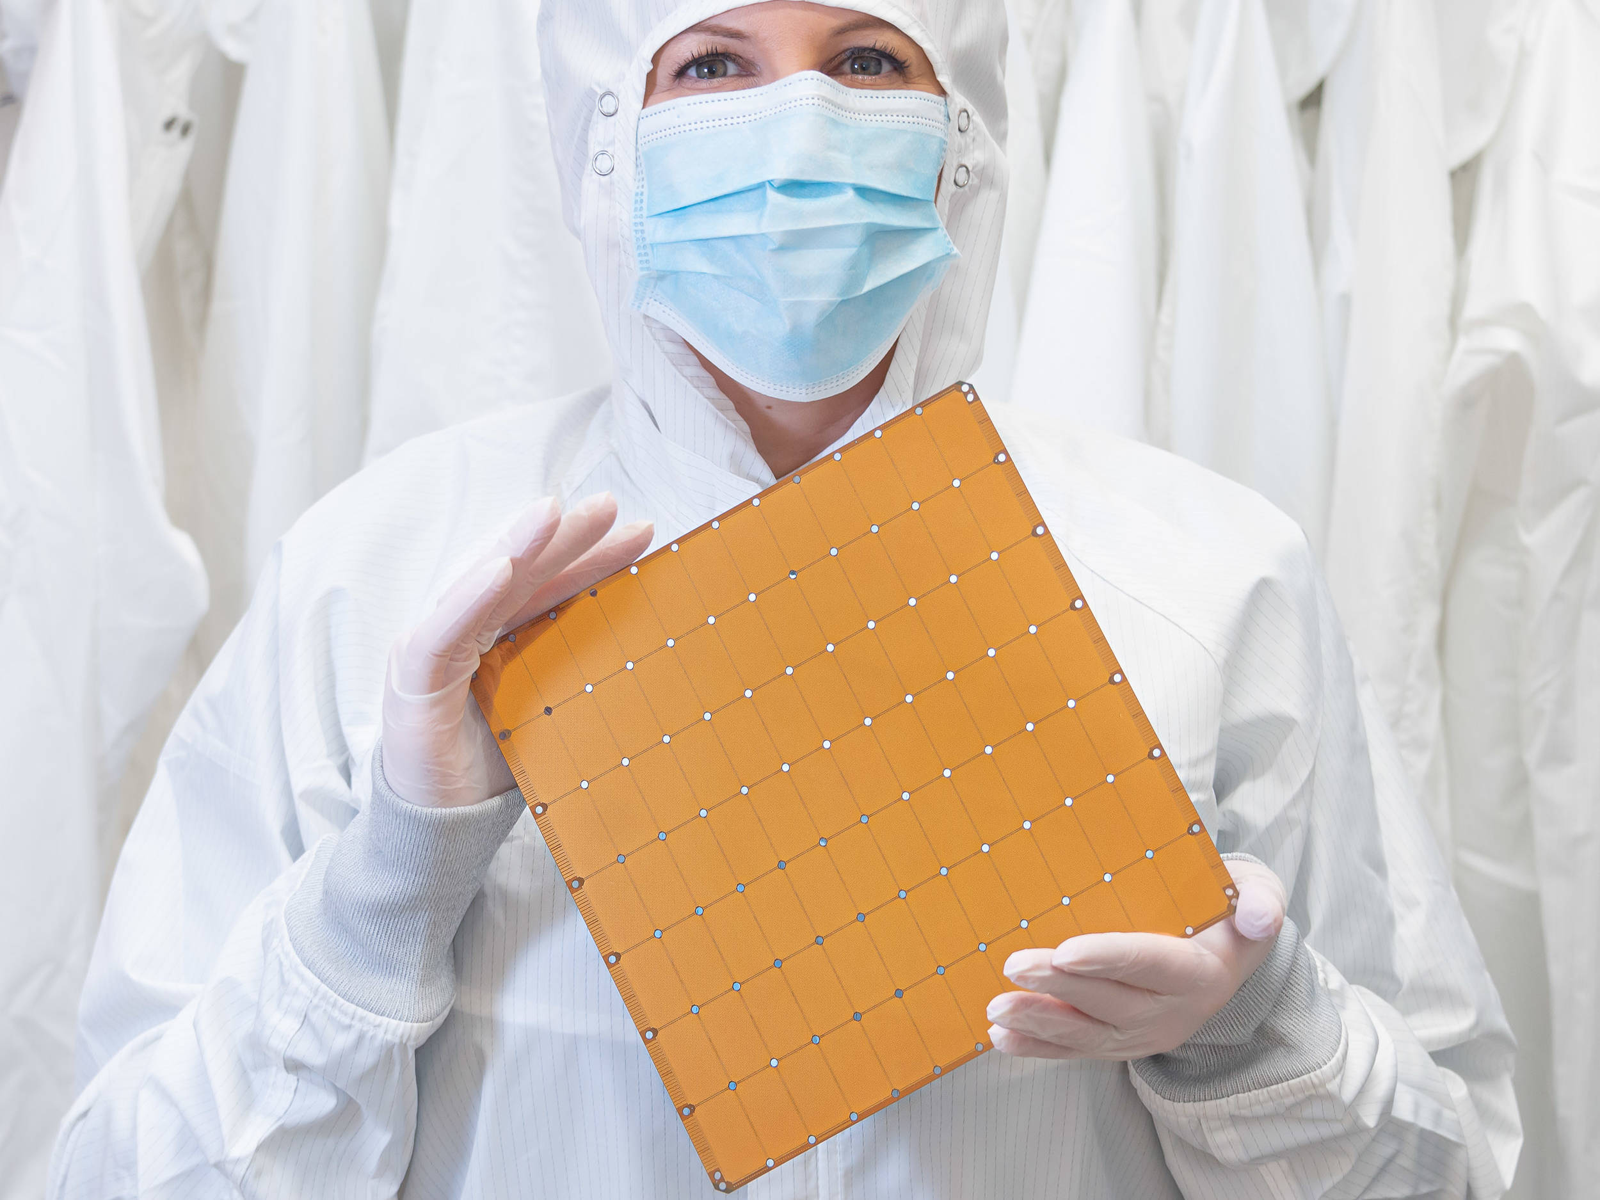
Источник изображения: Cerebras Как теперь сообщается, в электронном письме, адресованном Альтману и Маску, Илья Суцкевер (Ilya Sutskever), один из соучредителей OpenAI и бывший главный научный сотрудник компании, обсуждал идею покупки Cerebras через Tesla. В другом письме от июля 2017 года Суцкевер затрагивает ряд вопросов, связанных с Cerebras, таких как переговоры об условиях слияния и проверка благонадёжности финансового состояния Cerebras. «Если мы решим купить Cerebras, я твердо уверен, что это будет сделано через Tesla. Но зачем делать это таким образом, если мы могли бы провести сделку изнутри OpenAI? В частности, вызывает беспокойство то, что Tesla имеет обязательство перед акционерами максимизировать их доход, что не соответствует миссии OpenAI», — написал Суцкевер. Cerebras создаёт ИИ-суперускорители размером с целую кремниевую пластину. Флагманским продуктом стартапа является решение Wafer Scale Engine третьего поколения (WSE-3). Это гигантское изделие содержит 4 трлн транзисторов, 900 тыс. ядер и 44 Гбайт памяти SRAM. Предполагалось, что слияние с OpenAI будет выгодно обеим сторонам. В частности, Cerebras избежала бы сложного пути, связанного с IPO, тогда как OpenAI смогла бы получить в своё распоряжение мощные аппаратные ускорители для ресурсоёмких ИИ-задач. Однако сделка в итоге провалилась, хотя причины сворачивания переговоров не раскрываются.
01.11.2024 [19:11], Руслан Авдеев
Tesla надумала закупить у SK hynix серверные SSD на $725 млнПроизводитель электромобилей и разработчик других умных машин Tesla обсуждает с южнокорейской SK Hynix возможный заказ SSD корпоративного класса на сумму ₩1 трлн (около $725 млн), передаёт The Korea Economic Daily. Solidigm, дочерняя компания SK hynix, отмечает, что без ёмких и быстрых SSD работа с ИИ невозможна. Предполагается, что Tesla столь большая закупка SSD нужен как раз для развития ИИ-инфраструктуры. Компания вот-вот запустит ИИ-кластер из 50 тыс. NVIDIA H100. Также у неё есть собственный ИИ-суперкомпьютер Dojo, а в целом в этом году капитальные затраты за год, как ожидается, превысят $11 млрд. Значительная часть из них уйдёт как раз на ИИ ЦОД. Как уточняет ресурс Blocks & Files, поставщиками All-Flash СХД для обеих систем являются несколько вендоров. В данном случае, судя по всему, идёт закупке QLC-накопителей D5-P5336 ёмкостью 61,44 Тбайт. За указанную сумму можно приобрести порядка 100–200 тыс. накопителей суммарной ёмкостью от 10 Эбайт — конкретные значения будут зависеть от размера скидки, а при такой крупной закупке она обязательно будет. 
Источник изображения: Tesla На прошлой неделе SK hynix заявила, что в III квартале она практически удвоила прибыль. SK Hynix намерена наращивать инвестиции в чипы, связанные с ИИ-технологиями — SSD и HBM. Ожидается, что спрос на них и в следующем году будет весьма высок. В компании игнорируют опасения отраслевых экспертов, предрекающих «зиму» спроса на чипы памяти. Наоборот, компания рассчитывает на дефицит поставок памяти для ИИ-ускорителей из-за огромного спроса на соответствующую продукцию.
26.10.2024 [00:53], Владимир Мироненко
Tesla до конца месяца запустит ИИ-кластер из 50 тыс. NVIDIA H100Tesla планирует ввести в эксплуатацию ЦОД с 50 тыс. ускорителей NVIDIA H100 в конце этого месяца, пишет Data Center Dynamics (DCD) со ссылкой на заявление компании. «Мы начали использовать кластер на базе нашего завода раньше срока и находимся на пути к развертыванию 50 тыс. GPU в Техасе к концу этого месяца», — сообщил финансовый директор Вайбхав Танеджа (Vaibhav Taneja) в ходе отчёта о финансовых результатах за III квартал. Предполагается, что именно этот кластер, размещённый в Остине (Техас) отставал от графика, из-за чего гендиректор Илон Маск (Elon Musk) уволил в апреле руководителя строительства. В июне по распоряжению Маска 12 тыс. ускорителей H100, предназначавшихся Tesla, были переданы xAI. Сама xAI в сентябре запустила ИИ-кластер со 100 тыс. ускорителей NVIDIA H100. Капитальные затраты Tesla достигли $3,5 млрд в отчётном квартале, «последовательно увеличившись в основном из-за инвестиций в ИИ-вычисления», а капитальные затраты за год, как ожидается, превысят $11 млрд, что на $1 млрд больше год к году. При этом Танеджа сообщил, что компания «очень разумно подходит к расходам на ИИ», пытаясь наилучшим способом использовать существующую инфраструктуру, прежде чем делать дальнейшие инвестиции. 
Источник изображения: Taylor Vick / Unsplash Маск заявил, что Tesla продолжает расширять возможности обучения ИИ, чтобы удовлетворить как потребности в обучении автопилота Full Self Driving (FSD), так и роботов Optimus, отметив, что в настоящее время компания не испытывает дефицита вычислительных ресурсов. В квартальном отчёте не упоминается Dojo, ИИ-инфраструктура Tesla на базе ускорителей собственной разработки.
25.07.2024 [09:57], Сергей Карасёв
Илон Маск показал ИИ-суперкомпьютер Dojo на основе чипов Tesla D1Глава Tesla Илон Маск (Elon Musk), по сообщению ресурса Tom's Hardware, обнародовал фотографии вычислительного комплекса Dojo, который будет использоваться для разработки инновационных автомобильных технологий, а также для обучения автопилота. Tesla, напомним, начала создание ИИ-суперкомпьютера Dojo в июле 2023 года. Основой системы послужат специализированные чипы собственной разработки Tesla D1. Дата-центр Dojo, расположенный в штаб-квартире Tesla в Остине (Техас, США), по своей конструкции напоминает бункер. В апреле нынешнего года сообщалось, что при строительстве ЦОД компания Маска столкнулась с трудностями, связанными в том числе с доставкой необходимых материалов. Как теперь сообщается, Tesla намерена ввести Dojo в эксплуатацию до конца 2024 года. По производительности этот суперкомпьютер будет сопоставим с кластером из 8 тыс. ускорителей NVIDIA H100. По словам Маска, это «не слишком много, но и не тривиально». Для сравнения: мощнейший ИИ-суперкомпьютер компании xAI, также курируемой Илоном Маском, объединит 100 тыс. карт H100. 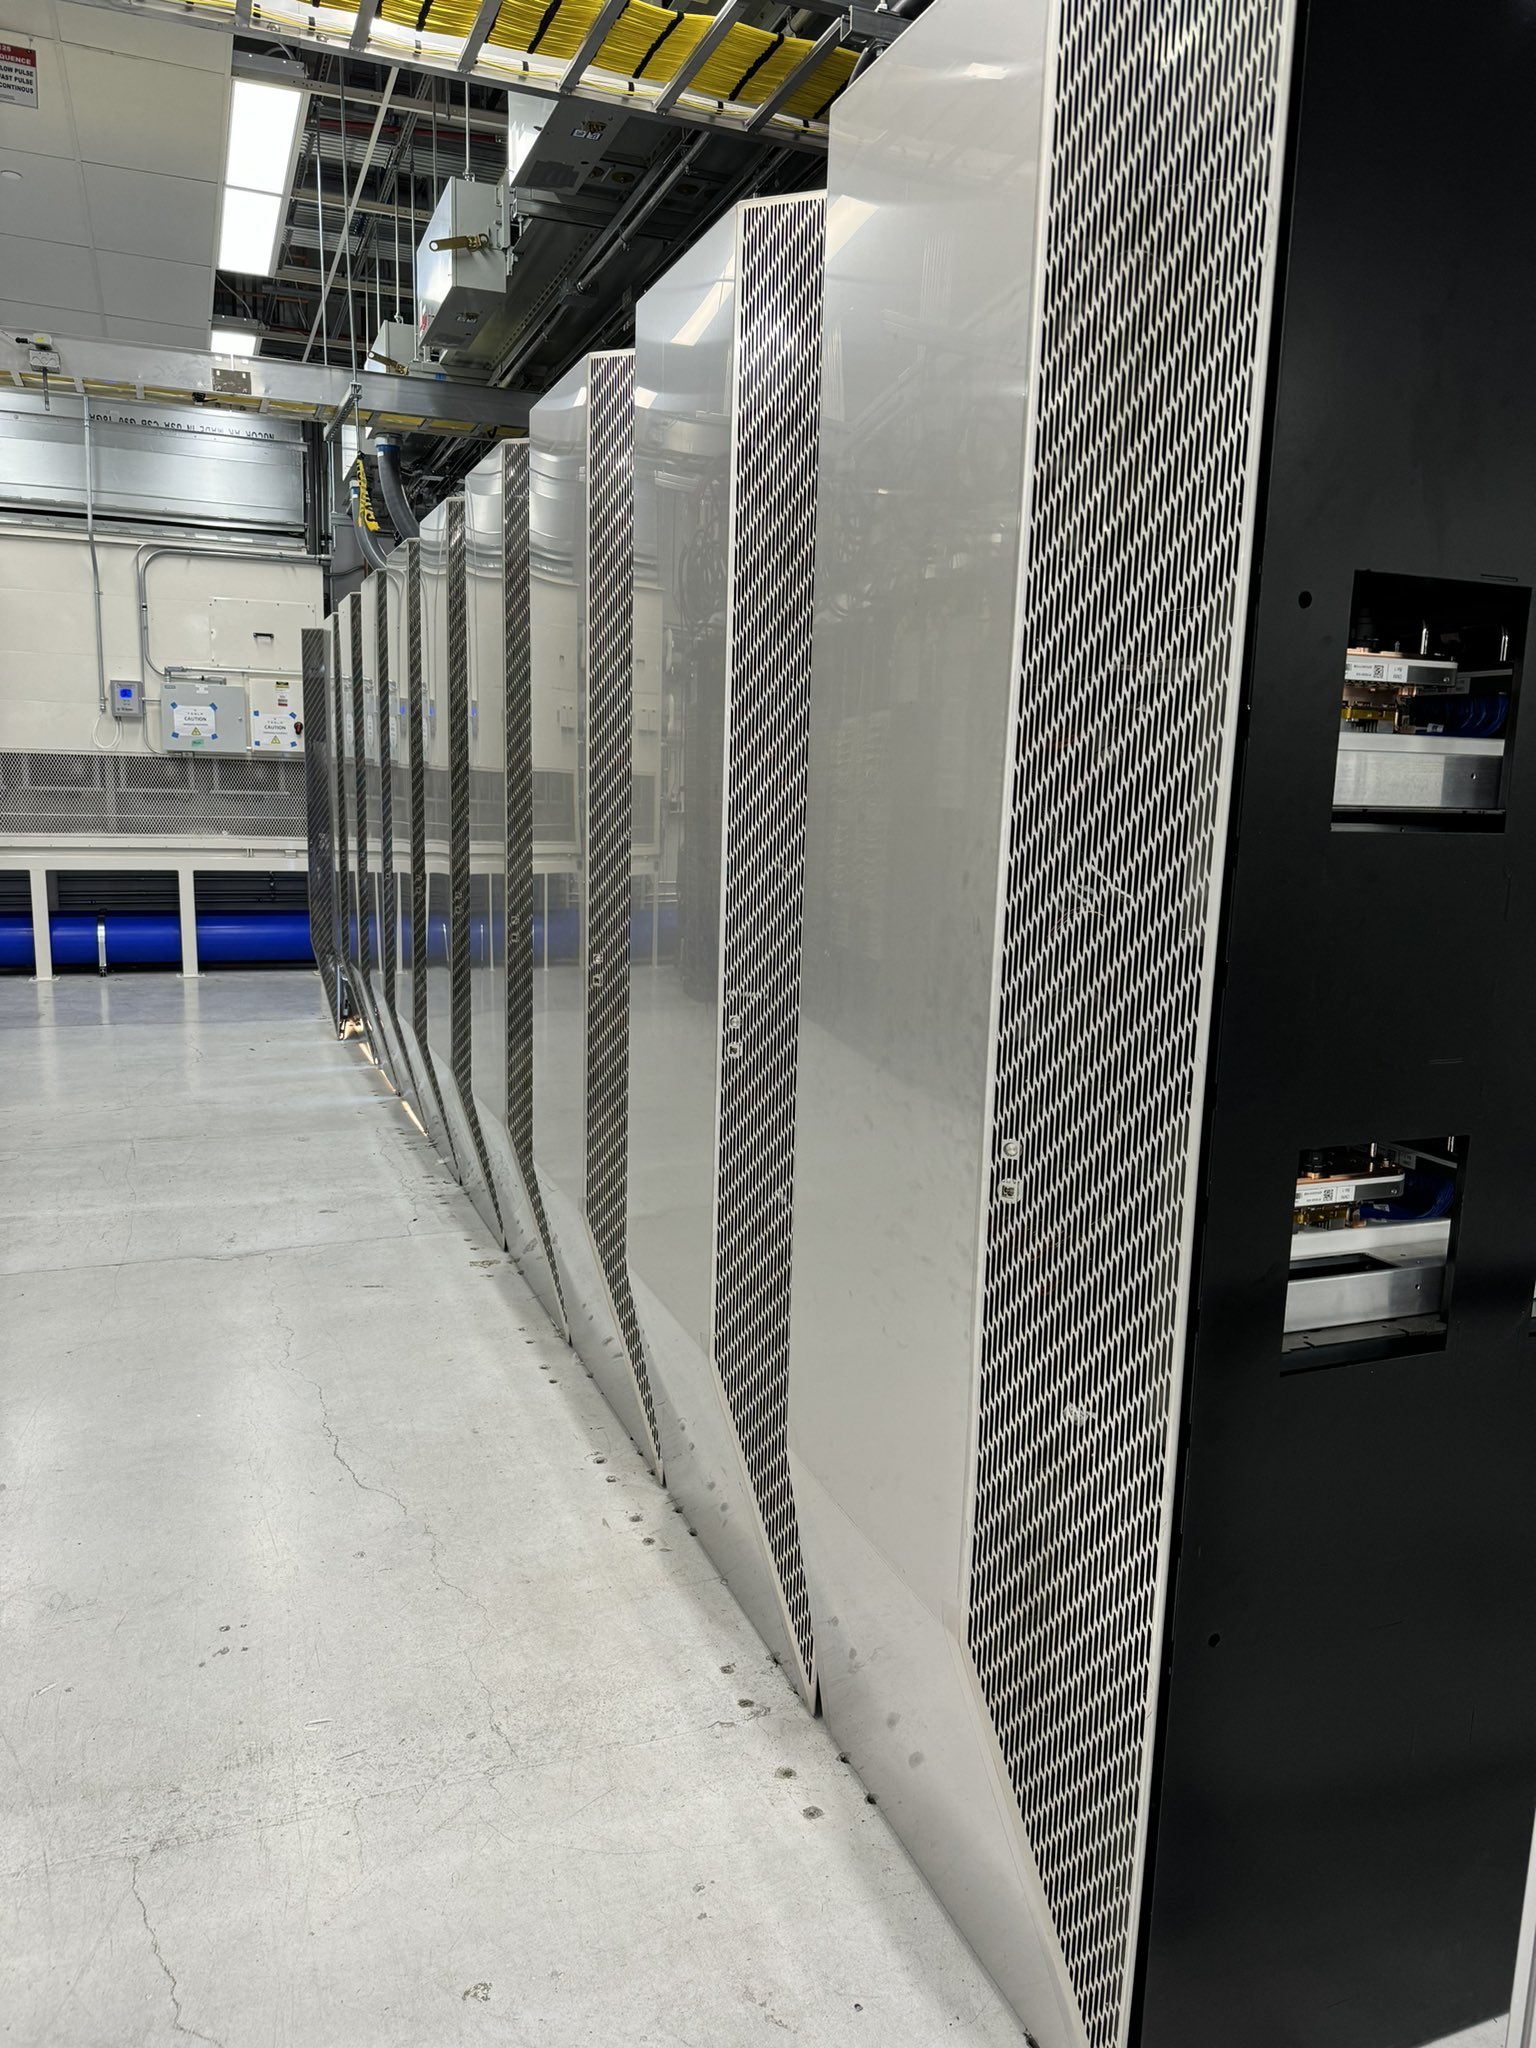
Источник изображений: Илон Маск Отмечается, что чипы Tesla D1 специально ориентированы на машинное обучение и анализ видеоданных. Поэтому систему Dojo планируется использовать прежде всего для совершенствования технологии автономного вождения Tesla путём обработки видеоданных, полученных от автомобилей компании. В свою очередь, «ИИ-гигафабрика» xAI поможет в развитии чат-ботов Grok следующего поколения. 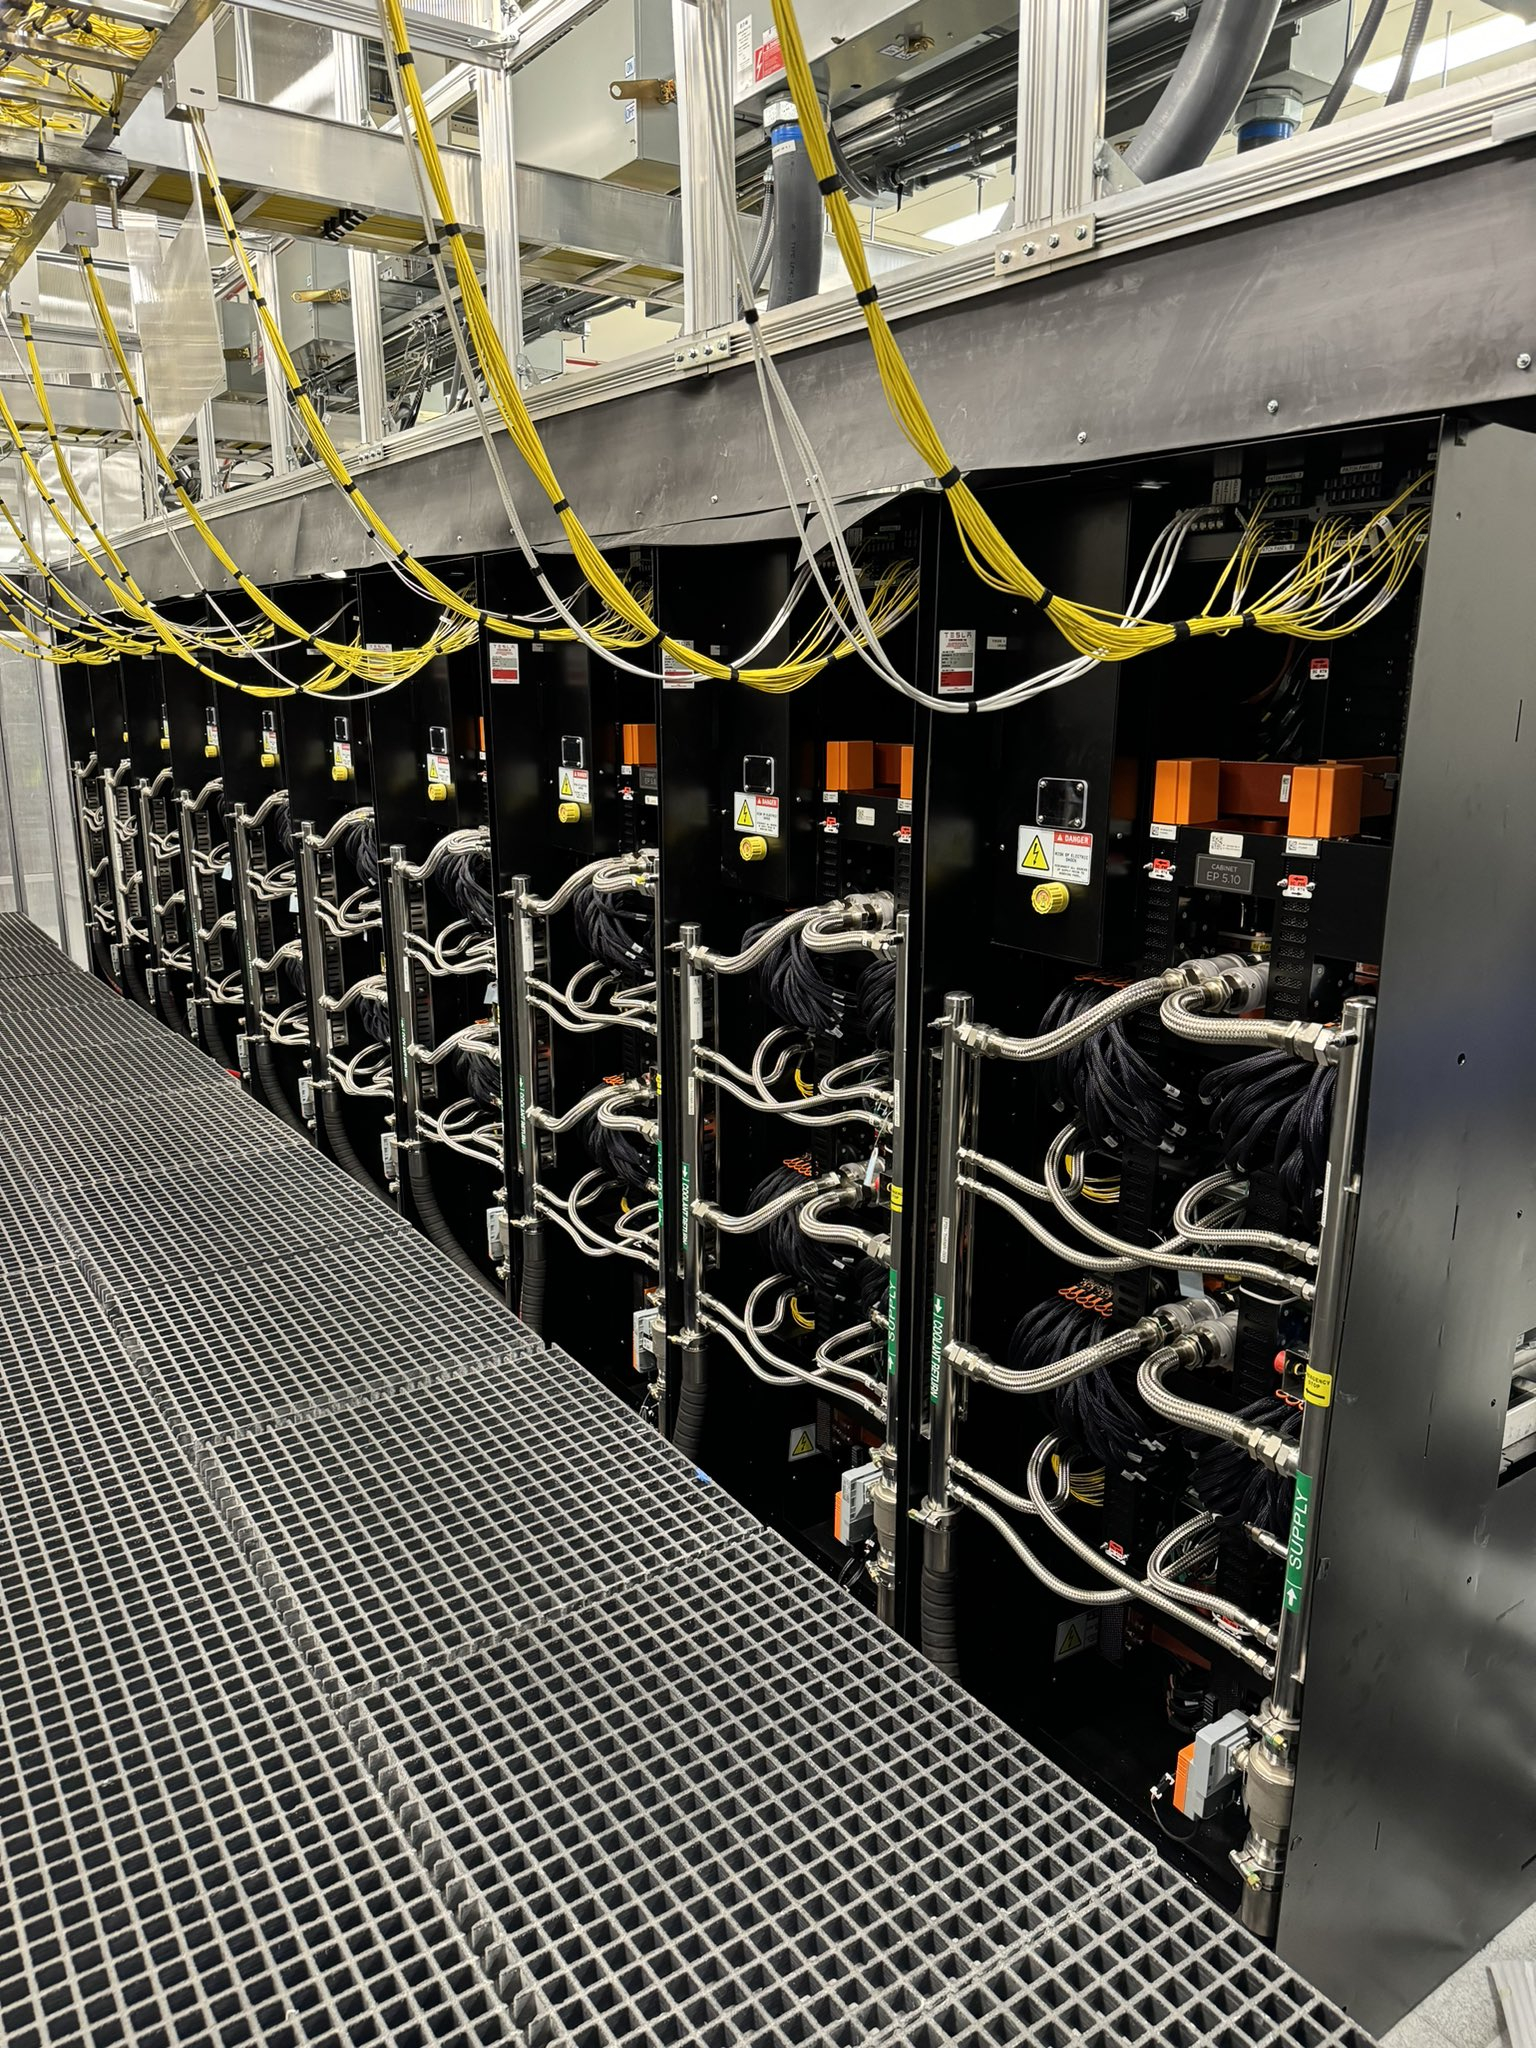 Маск также сообщил, что компания Tesla намерена «удвоить усилия» по разработке и развертыванию Dojo из-за высоких цен на оборудование NVIDIA. Вместе с тем финансовый директор Tesla Вайбхав Танеджа (Vaibhav Taneja) заявил, что, несмотря на снижение капвложений во II квартале 2024 года, компания по-прежнему ожидает, что соответствующие затраты превысят $10 млрд.
05.09.2022 [23:00], Алексей Степин
Tesla рассказала подробности о чипах D1 собственной разработки, которые станут основой 20-Эфлопс ИИ-суперкомпьютера DojoКомпания Tesla уже анонсировала собственный, созданный в лабораториях компании процессор D1, который станет основой ИИ-суперкомпьютера Dojo. Нужна такая система, чтобы создать для ИИ-водителя виртуальный полигон, в деталях воссоздающий реальные ситуации на дорогах. Естественно, такой симулятор требует огромных вычислительных мощностей: в нашем мире дорожная обстановка очень сложна, изменчива и включает множество факторов и переменных. До недавнего времени о Dojo и D1 было известно не так много, но на конференции Hot Chips 34 было раскрыто много интересного об архитектуре, устройстве и возможностях данного решения Tesla. Презентацию провел Эмиль Талпес (Emil Talpes), ранее 17 лет проработавший в AMD над проектированием серверных процессоров. Он, как и ряд других видных разработчиков, работает сейчас в Tesla над созданием и совершенствованием аппаратного обеспечения компании. 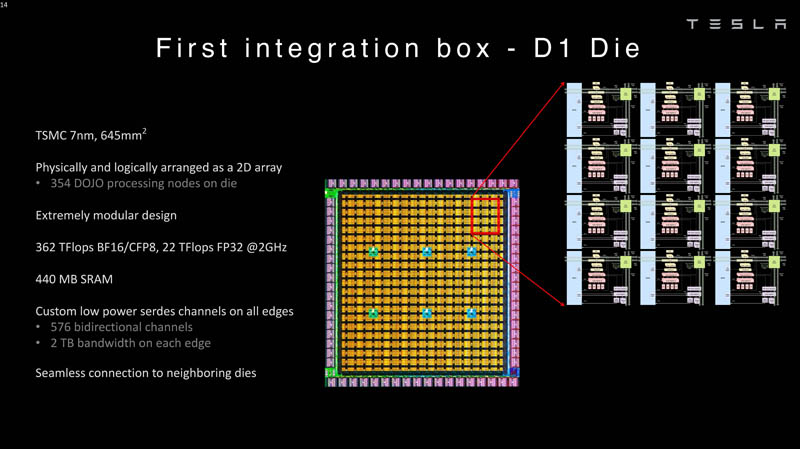
Изображения: Tesla (via ServeTheHome) Главной идеей D1 стала масштабируемость, поэтому в начале разработки нового чипа создатели активно пересмотрели роль таких традиционных концепций, как когерентность, виртуальная память и т.д. — далеко не все механизмы масштабируются лучшим образом, когда речь идёт о построении действительно большой вычислительной системы. Вместо этого предпочтение было отдано распределённой сети хранения на базе SRAM, для которой был создан интерконнект, на порядок опережающий существующие реализации в системах распределённых вычислений. 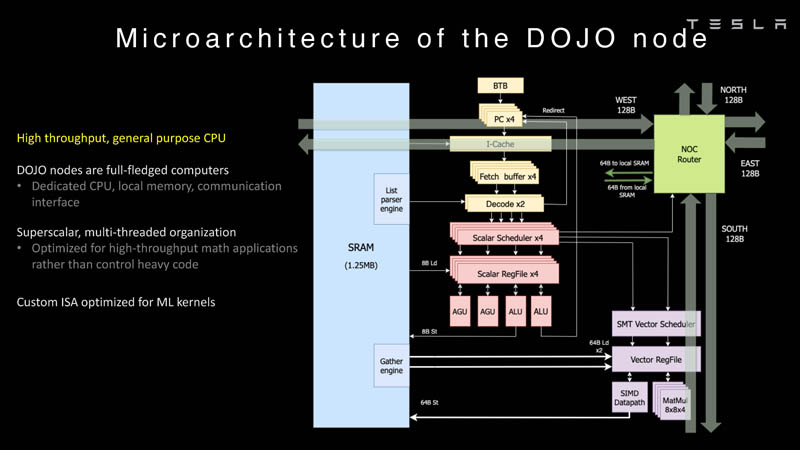 Основой процессора Tesla стало ядро целочисленных вычислений, базирующееся на некоторых инструкциях из набора RISC-V, но дополненное большим количеством фирменных инструкций, оптимизированных с учётом требований, предъявляемых ядрами машинного обучения, используемыми компанией. Блок векторной математики был создан практически с нуля, по словам разработчиков. 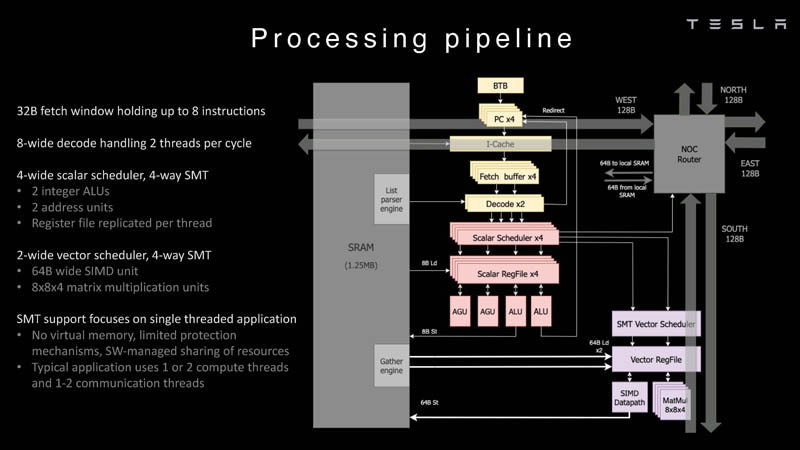 Набор инструкций Dojo включает в себя скалярные, матричные и SIMD-инструкции, а также специфические примитивы для перемещения данных из локальной памяти в удалённую, равно как и семафоры с барьерами — последние требуются для согласования работы c памятью во всей системе. Что касается специфических инструкций для машинного обучения, то они реализованы в Dojo аппаратно. 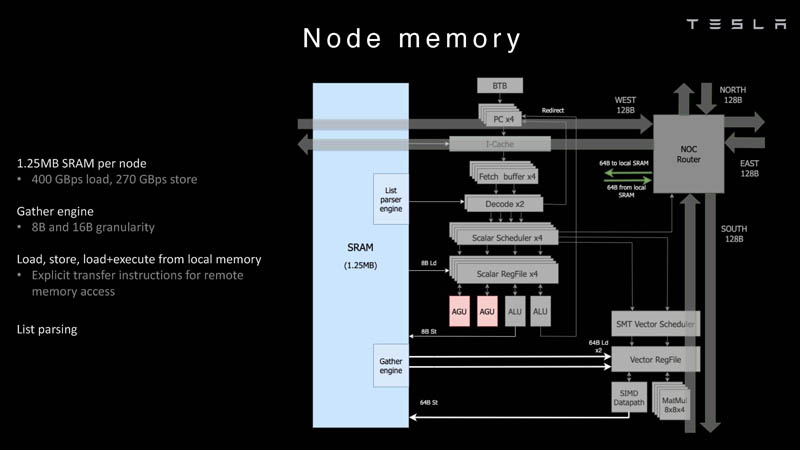 Первенец в серии, чип D1, не является ускорителем как таковым — компания считает его высокопроизводительным процессором общего назначения, не нуждающимся в специфических ускорителях. Каждый вычислительный блок Dojo представлен одним ядром D1 с локальной памятью и интерфейсами ввода/вывода. Это 64-бит ядро суперскалярно. 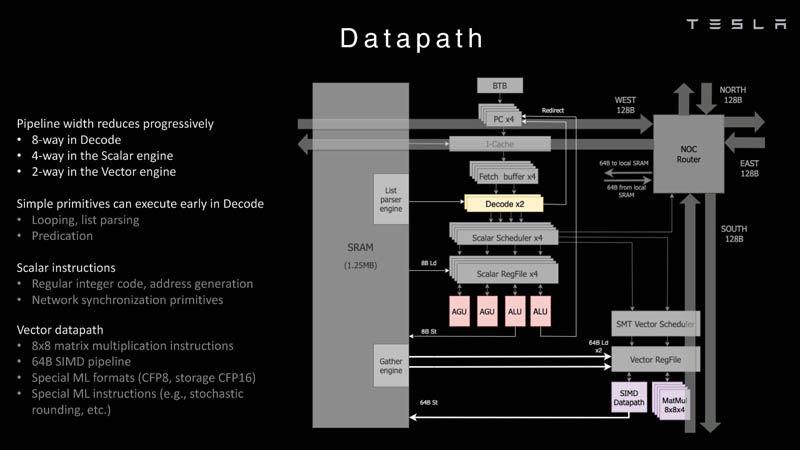 Более того, в ядре реализована поддержка многопоточности (SMT4), которая призвана увеличить производительность на такт (а не изолировать разные задачи друг от друга), поэтому виртуальную память данная реализация SMT не поддерживает, а механизмы защиты довольно ограничены в функциональности. За управление ресурсами Dojo отвечает специализированный программный стек и фирменное ПО. 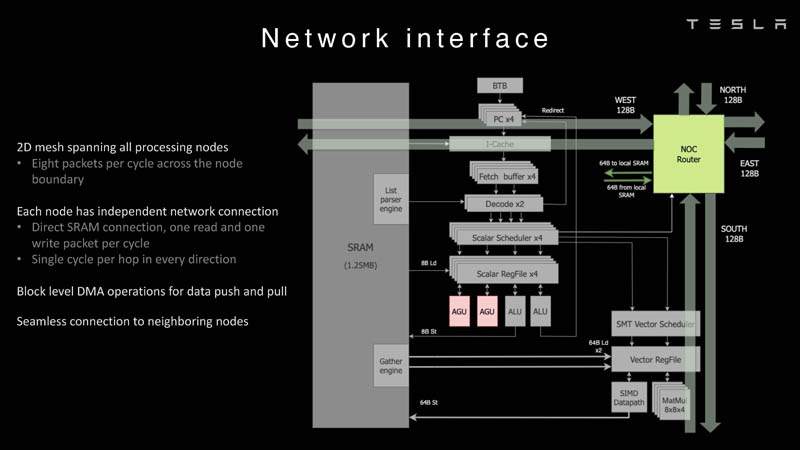 64-бит ядро имеет 32-байт окно выборки (fetch window), которое может содержать до 8 инструкций, что соответствует ширине декодера. Он, в свою очередь, может обрабатывать два потока за такт. Результат поступает в планировщики, которые отправляют его в блок целочисленных вычислений (два ALU) или в векторный блок (SIMD шириной 64 байт + перемножение матриц 8×8×4). 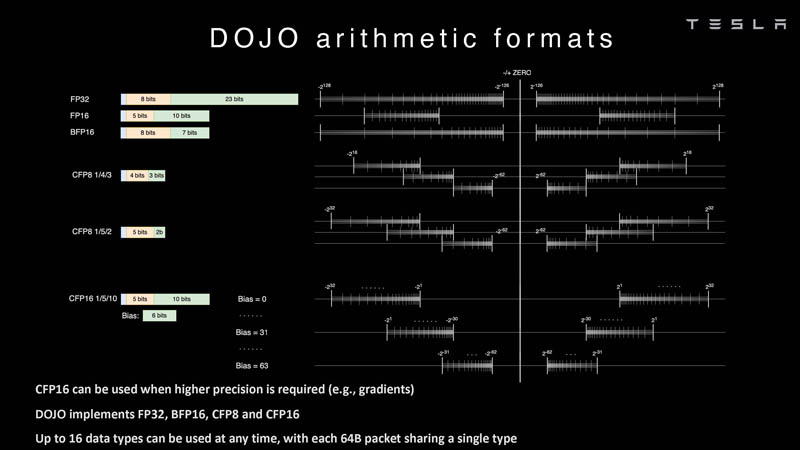 У каждого ядра D1 есть SRAM объёмом 1,25 Мбайт. Эта память — не кеш, но способна загружать данные на скорости 400 Гбайт/с и сохранять на скорости 270 Гбайт/с, причём, как уже было сказано, в чипе реализованы специальные инструкции, позволяющие работать с данными в других ядрах Dojo. Для этого в блоке SRAM есть свои механизмы, так что работа с удалённой памятью не требуют дополнительных операций. 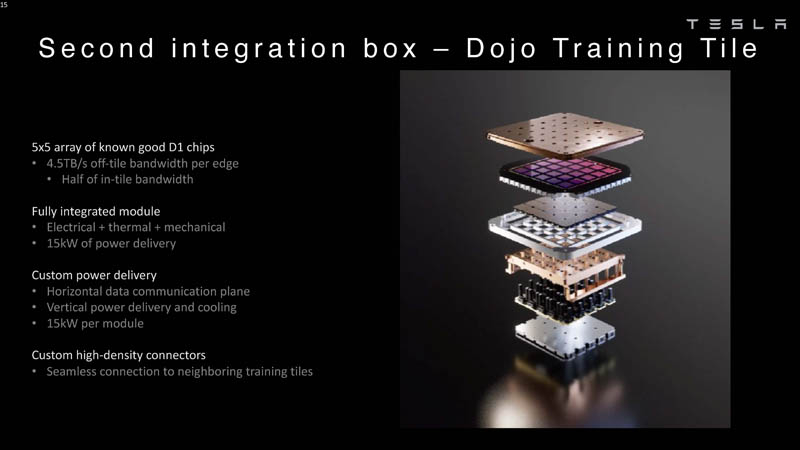 Что касается поддерживаемых форматов данных, то скалярный блок поддерживает целочисленные форматы разрядностью от 8 до 64 бит, а векторный и матричный блоки — широкий набор форматов с плавающей запятой, в том числе для вычислений смешанной точности: FP32, BF16, CFP16 и CFP8. Разработчики D1 пришли к использованию целого набора конфигурируемых 8- и 16-бит представлений данных — компилятор Dojo может динамически изменять значения мантиссы и экспоненты, так что система может использовать до 16 различных векторных форматов, лишь бы в рамках одного 64-байт блока данных он не менялся. 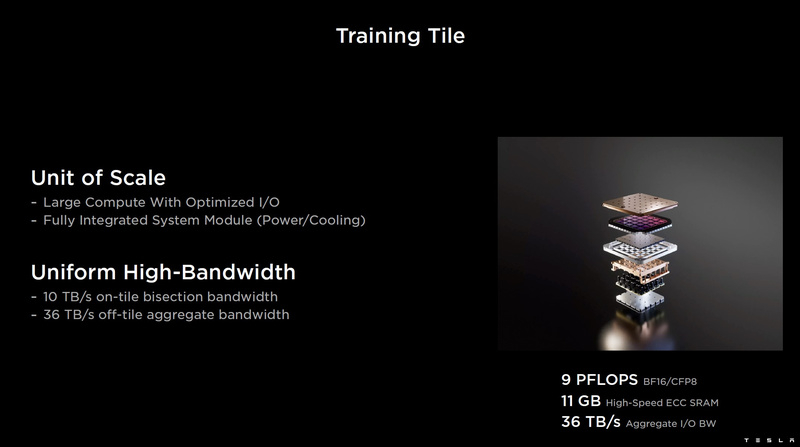 Как уже упоминалось, топология D1 использует меш-структуру, в которой каждые 12 ядер объединены в логический блок. Чип D1 целиком представляет собой массив размером 18×20 ядер, однако доступны лишь 354 ядра из 360 присутствующих на кристалле. Сам кристалл площадью 645 мм2 производится на мощностях TSMC с использованием 7-нм техпроцесса. Тактовая частота составляет 2 ГГц, общий объём памяти SRAM — 440 Мбайт. 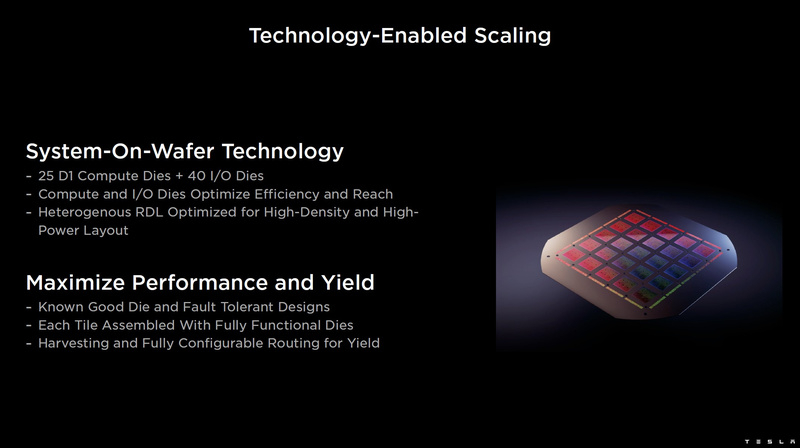 Процессор D1 развивает 362 Тфлопс в режиме BF16/CFP8, в режиме FP32 этот показатель снижается до 22 Тфлопс. Режим FP64 векторными блоками D1 не поддерживается, поэтому для многих традиционных HPC-нагрузок данный процессор не подойдёт. Но Tesla создавала D1 для внутреннего использования, поэтому совместимость её не очень волнует. Впрочем, в новых поколениях, D2 или D3, такая поддержка может появиться, если это будет отвечать целям компании. 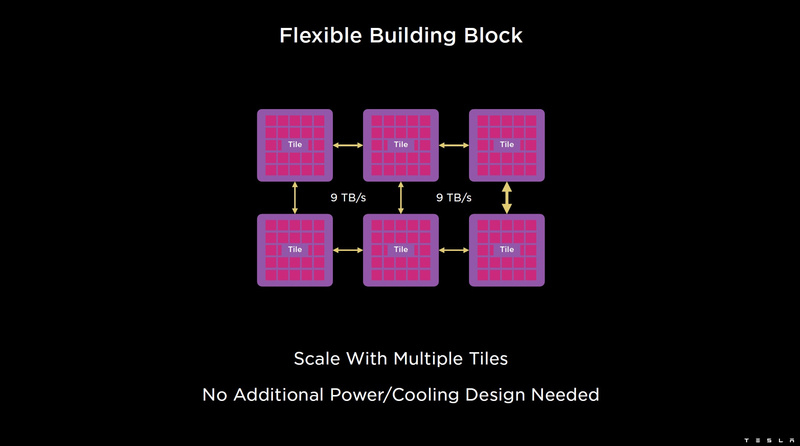 Каждый кристалл D1 имеет 576-битный внешний интерфейс SerDes с совокупной производительностью по всем четырём сторонам, составляющей 18 Тбайт/с, так что узким местом при соединении D1 он явно не станет. Этот интерфейс объединяет кристаллы в единую матрицу 5х5, такая матрица из 25 кристаллов D1 носит название Dojo training tile. 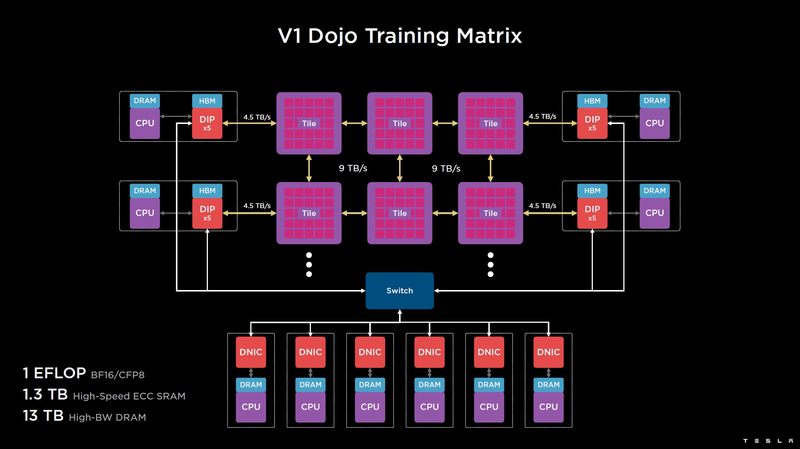 Этот тайл выполнен как законченный термоэлектромеханический модуль, имеющий внешний интерфейс с пропускной способностью 4,5 Тбайт/с на каждую сторону, совокупно располагающий 11 Гбайт памяти SRAM, а также собственную систему питания мощностью 15 кВт. Вычислительная мощность одного тайла Dojo составляет 9 Пфлопс в формате BF16/CFP8. При таком уровне энергопотребления охлаждение у Dojo может быть только жидкостное. 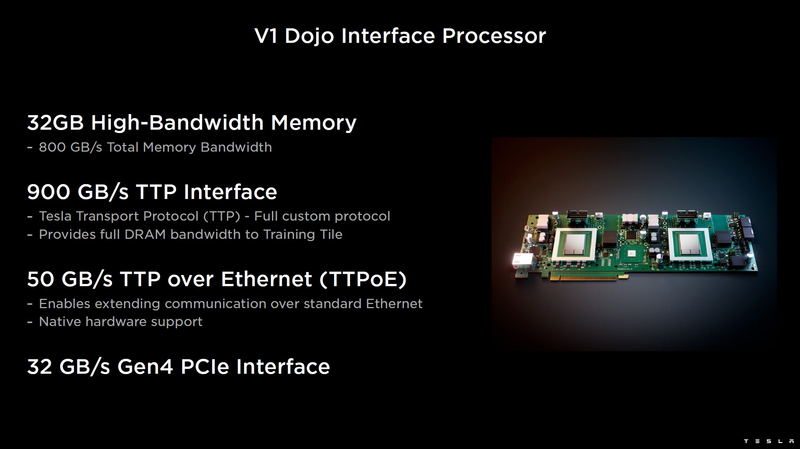 Тайлы могут объединяться в ещё более производительные матрицы, но как именно физически организован суперкомпьютер Tesla, не вполне ясно. Для связи с внешним миром используются блоки DIP — Dojo Interface Processors. Это интерфейсные процессоры, посредством которых тайлы общаются с хост-системами и на долю которых отведены управляющие функции, хранение массивов данных и т.п. Каждый DIP не просто выполняет IO-функции, но и содержит 32 Гбайт памяти HBM (не уточняется, HBM2e или HBM3). 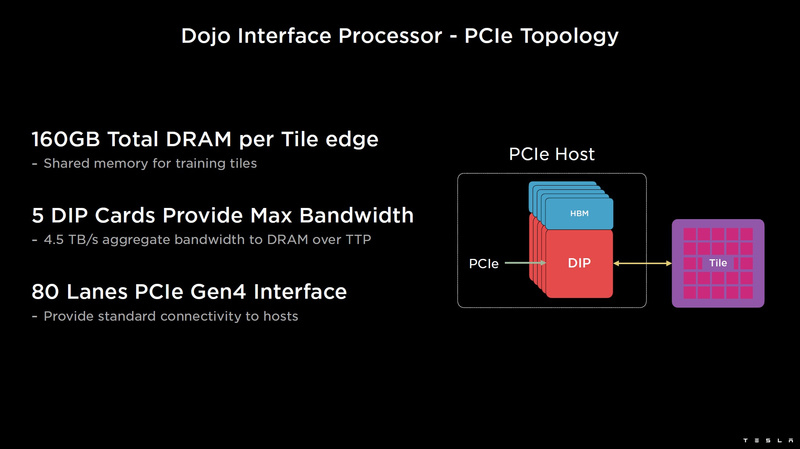 DIP использует полностью свой транспортный протокол (Tesla Transport Protocol, TTP), разработанный в Tesla и обеспечивающий пропускную способность 900 Гбайт/с, а поверх Ethernet — 50 Гбайт/с. Внешний интерфейс у карточек — PCI Express 4.0, и каждая интерфейсная карта несёт пару DIP. С каждой стороны каждого ряда тайлов установлено по 5 DIP, что даёт скорость до 4,5 Тбайт/с от HBM-стеков к тайлу. 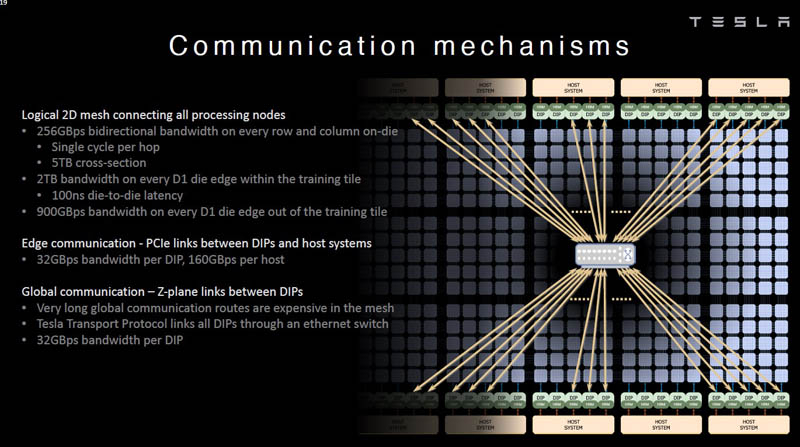 В случаях, когда во всей системе обращение от тайла к тайлу требует слишком много переходов (до 30 в случае обращения от края до края), система может воспользоваться DIP, объединённых снаружи 400GbE-сетью по топологии fat tree, сократив таким образом, количество переходов до максимум четырёх. Пропускная способность в этом случае страдает, но выигрывает латентность, что в некоторых сценариях важнее. 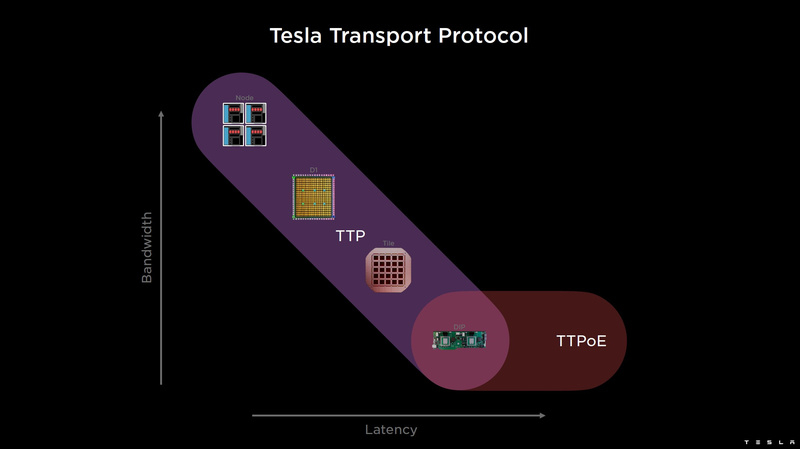 В базовой версии суперкомпьютер Dojo V1 выдаёт 1 Эфлопс в режиме BF16/CFP8 и может загружать непосредственно в SRAM модели объёмом до 1,3 Тбайт, ещё 13 Тбайт данных можно хранить в HBM-сборках DIP. Следует отметить, что пространство SRAM во всей системе Dojo использует единую плоскую адресацию. Полномасштабная версия Dojo будет иметь производительность до 20 Эфлопс. Сколько сил потребуется компании, чтобы запустить такого монстра, а главное, снабдить его рабочим и приносящим пользу ПО, неизвестно — но явно немало. Известно, что система совместима с PyTorch. В настоящее время Tesla уже получает готовые чипы D1 от TSMC. А пока что компания обходится самым большим в мире по числу установленных ускорителей NVIDIA ИИ-суперкомпьютером. |
|

