Материалы по тегу: intel
|
18.08.2020 [15:26], Алексей Степин
Intel Xeon Ice Lake-SP: второе третье поколение Xeon ScalableКорпорация Intel не так уж часто оказывается в роли догоняющего, но ей пришлось примерить на себя эту роль после анонса второго поколения AMD EPYC, а сейчас и IBM анонсировала более продвинутые в плане поддержки новейших интерфейсов и стандартов процессоры POWER10. Разумеется, команда «синих» сдаваться не собирается и на мероприятии Hot Chips 32 компания раскрыла множество подробностей о процессорах Xeon с микроархитектурой Ice Lake. Их действительно можно назвать «вторым третьим поколением», поскольку звание третьего поколения они делят с анонсированными весной Xeon Cooper Lake. 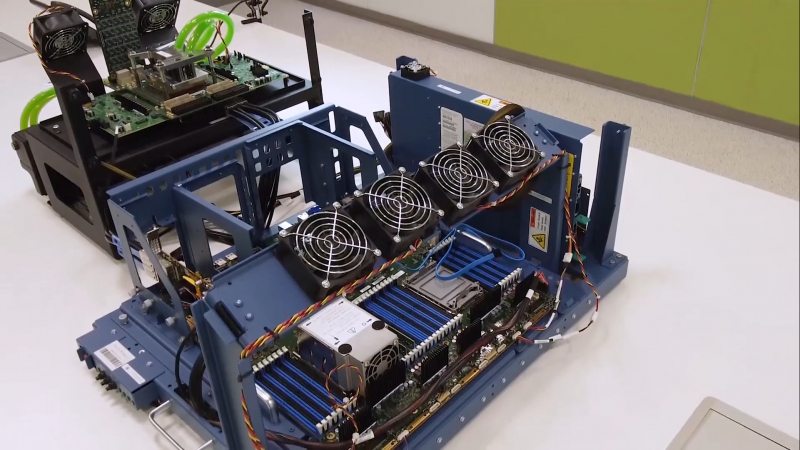
Демонстрационный стенд Intel на базе Ice Lake-SP Несмотря на это, данные серии процессоров отличаются кардинально. Cooper Lake рассчитаны на 4- и 8-сокетные системы, а Ice Lake-SP — на массовые 1- и 2-сокетные. При этом обе серии в определённой степени являются проходными, поскольку большая часть новейших технологий, таких как DDR5, PCIe 5.0, CXL 1.1 и других, будет реализована Intel лишь в поколении Sapphire Rapids в 2021 году. 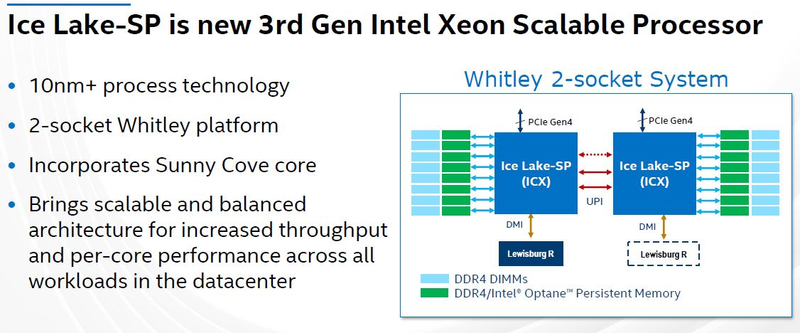 Платформа Whitley, позволяющая устанавливать до двух Ice Lake-SP, не слишком отличается от классических двухпроцессорных систем на базе Xeon Scalable. Для связи CPU всё так же используется 2, либо 3 линии UPI, системная логика — по-прежнему Lewisburg. Однако в одном такая платформа сможет поспорить с AMD EPYC: Ice Lake-SP будут поддерживать PCI Express 4.0. Системные платы и разъёмы в любом случае потребуются новые, поскольку выросло число каналов памяти. Прототип такой платы уже был показан на Intel Architecture Day 2020. 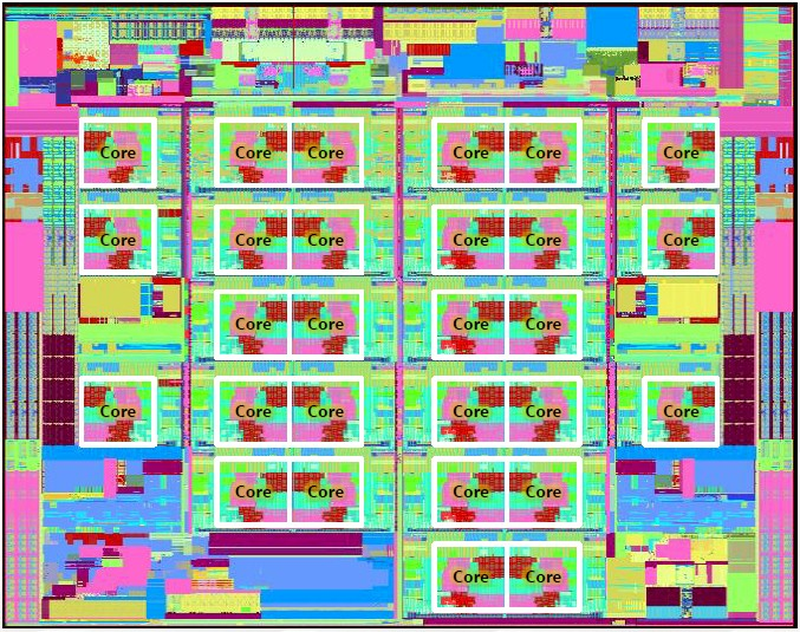 Архитектурно Cooper Lake являются продолжением серии Cascade Lake Refresh и, в свою очередь, Skylake-SP. А вот ядра Ice Lake-SP базируются на ядрах Sunny Cove, которые были представлены два года назад; впрочем, речь идёт о внедрении продвинутой версии 10-нм техпроцесса Intel (SuperFin). Максимальное число ядер одного CPU осталось равным 28, здесь прорывов Intel не предлагает, однако mesh-компоновка всех блоков изменилась: вместо матрицы 6×6 теперь реализована 6×7. 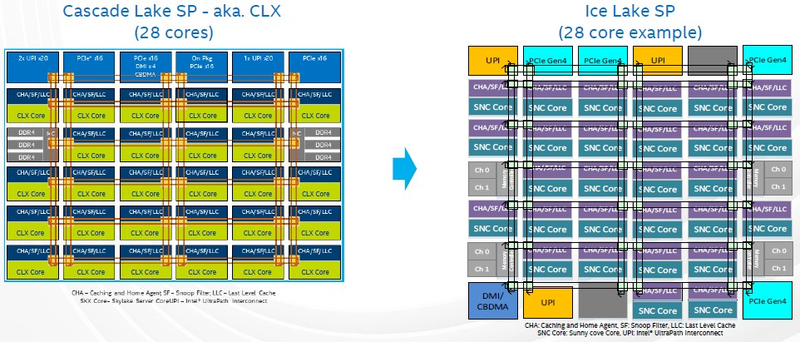 Одной из причин этому стала смена контроллера памяти. Новый контроллер разработан с нуля и в сумме обеспечивает работу восьми каналов DDR4-3200, что даёт существенный прирост пропускной способности в сравнении с прошлыми поколениями «больших» Xeon, использующими шестиканальный контроллер. Количество точек подключения контроллера памяти к внутренней mesh-структуре возросло с двух до четырёх, это должно снизить латентность в некоторых сценариях. 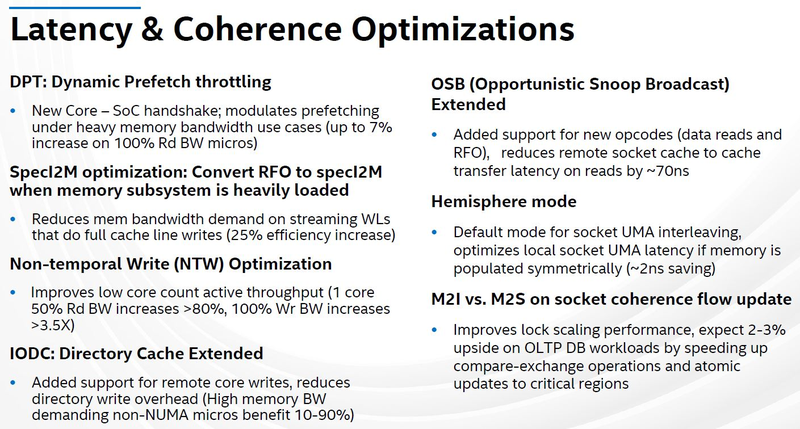 Контроллер памяти также имеет ряд дополнительных мини-оптимизаций. Часть из них позволяет повысить производительность в специфических сценариях, например, в нагрузках OLTP, но и в целом параметры улучшились. Так, латентность при доступе к кешу соседнего процессора снижена до 70 наносекунд. Оптимизированы сценарии работы с малым количеством ядер и многое другое. Поддерживаются модули Optane DCPMM 200. 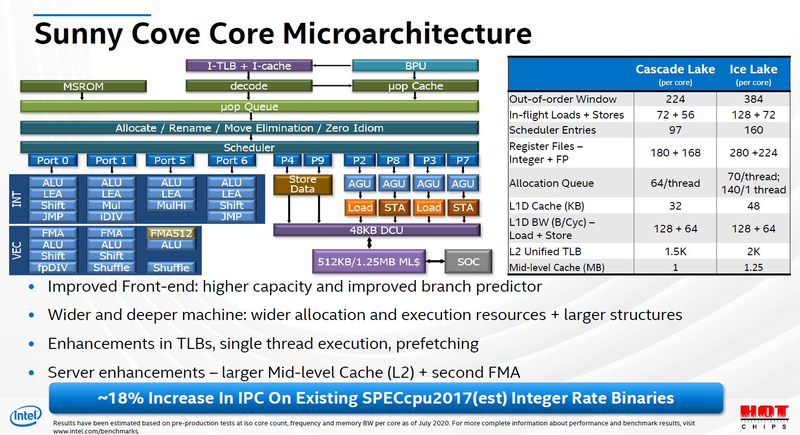 Детально об микроархитектуре Sunny Cove мы рассказывали ранее, её можно назвать эволюционным развитием Skylake. Увеличено буквально всё: ядро Sunny Cove может исполнять пять инструкций за такт вместо четырёх, исполнительных портов стало 10 вместо 8, увеличена пропускная способность кеша первого уровня, кеш второго уровня вырос с 1 до 1,25 Мбайт, появился второй блок FMA. И такой подход касается всего ядра, от размера окна внеочередного исполнения до объёма буфера ассоциативной трансляции (TLB). 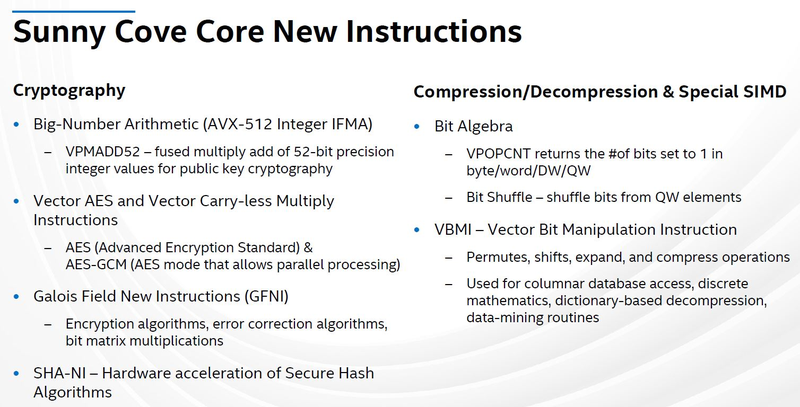 Однако имеются не только количественные нововведения. В новых процессорах Intel реализовала поддержку новых векторных инструкций AES и VBMI, добавила поддержку GFNI, расширила в очередной раз набор AVX-512. Часть нововведений служит криптографическим задачам, но также внимание уделено и сценариям компрессии/декомпрессии данных. В различных сценариях превосходство над Cascade Lake может варьироваться от полуторакратного до более чем восьмикратного, что впечатляет. 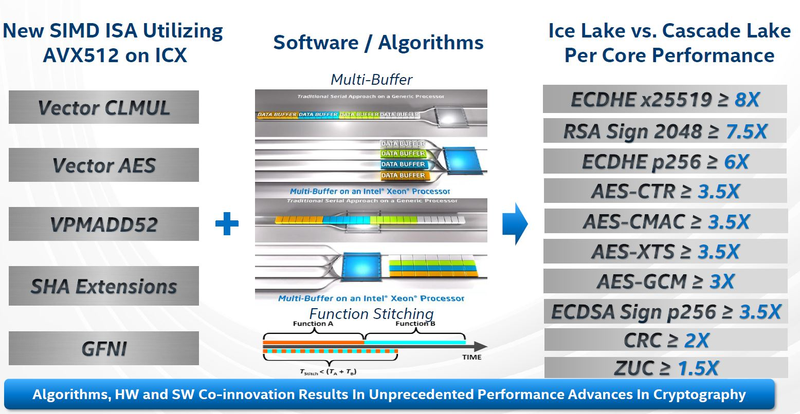 В области технологий обеспечения безопасности Intel следует основной современной тенденции и Ice Lake-SP получили поддержку TME (Total Memory Encryption), то есть полного шифрования оперативной памяти по стандарту AES-XTS 128 бит. Естественно, обещано, что аппаратно сгенерированные ключ будет невозможно извлечь из системы, а накладные расходы на шифрование снизят производительность не более чем на 5% (в предварительных тестах это 2-3%). 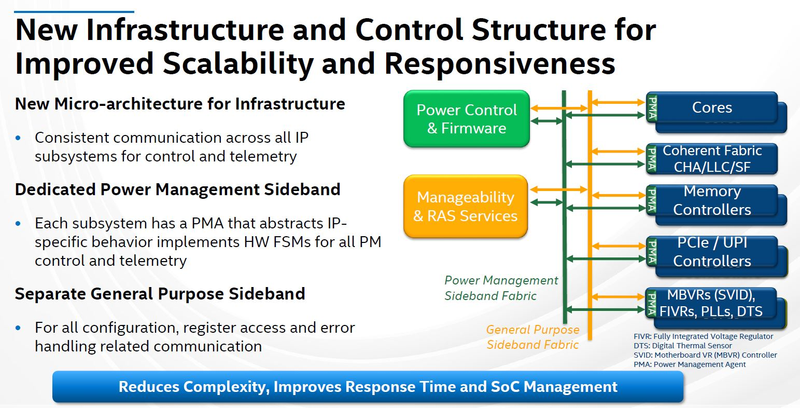 В паре с SGX-анклавами получается, судя по всему, неплохая альтернатива AMD SVE и тому, что IBM реализовала в POWER10. Кроме того, значительно внимание уделено механизму когерентности и снижению задержек. В том числе, речь идёт об уменьшении задержек при переключении процессора между разными частотами и уровнями энергопотребления. 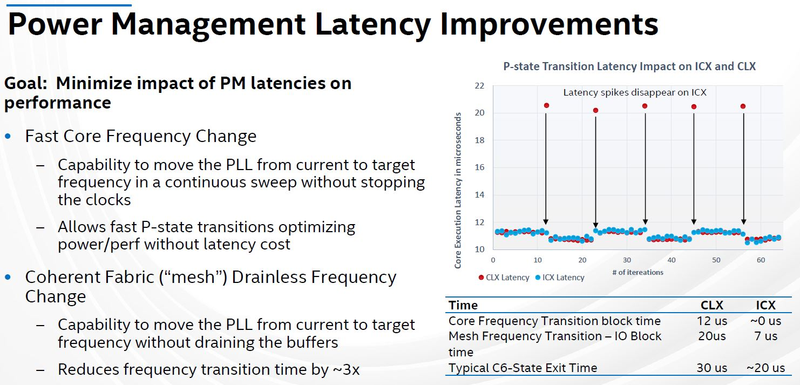 Intel придерживается целостного подхода и предпочитает говорить об оптимизации SoC как единой структуры в целом, а не только об отдельных компонентах. Тем не менее, интересно отметить, что система управления питанием процессора получило новую выделенную шину, функции которой отделены от шины общего управления и мониторинга. Подход довольно логичный: по количеству ядер «синие» пока не могут догнать AMD, поэтому уделяют первоочередное внимание повышению эффективности как отдельных ядер, так и процессора в целом. 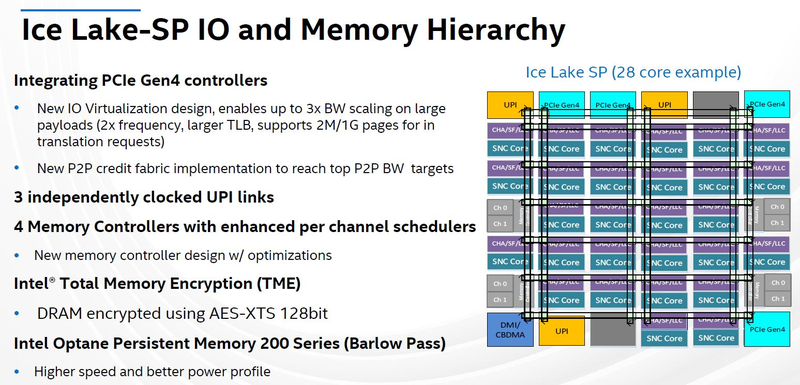 И достигнутые результаты впечатляют: Ice Lake способен менять частоту ядер примерно за 12 микросекунд, причём процесс происходит без просадок, характерных для Cascade Lake, который может иногда «задумываться», что негативно сказывается на общей производительности. Так же легко новые процессоры меняют режим энергопотребления (P-state). Минимизирована известная проблема (или особенность, если хотите) процессоров Intel, а именно снижение частоты при использовании инструкций AVX, особенно AVX-512. Ряд не слишком «прожорливых» инструкций AVX теперь исполняется на более высоких частотах. 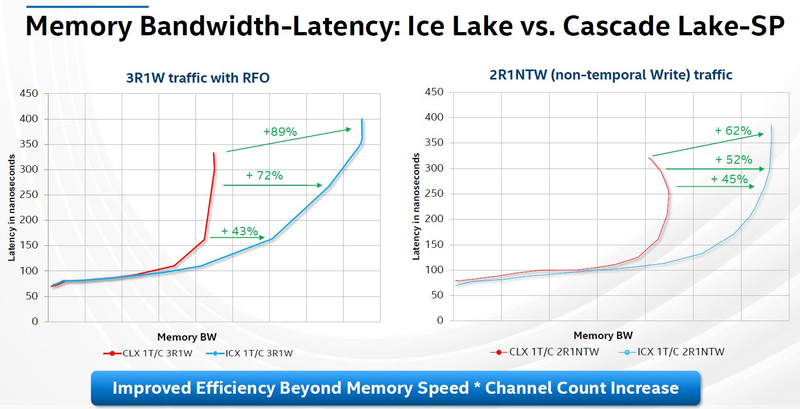 Важной частью Ice Lake-SP стали новые контроллеры PCI Express. В этом поколении о поддержке PCIe 5.0 говорить не приходится, тем более что соответствующей периферии на рынке всё равно ещё нет, но PCIe 4.0 поддерживается полностью. Сами контроллеры PCI Express усовершенствованы, они получили новый блок виртуализации (IOV) и лучше масштабируются на больших нагрузках. 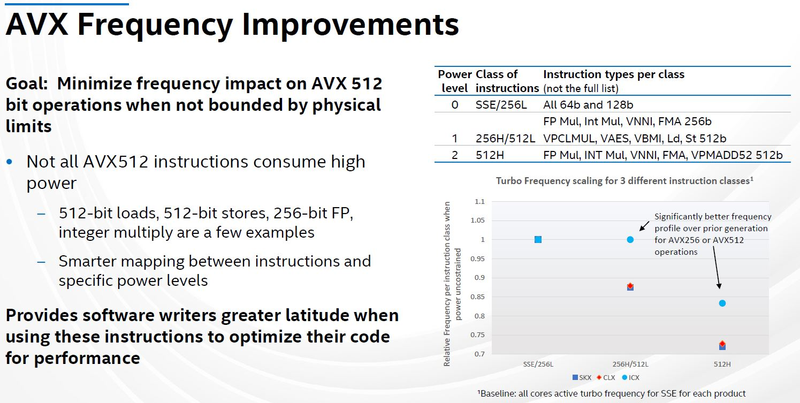 В целом процессоры Intel Xeon Ice Lake-SP являют собой достаточно современный продукт. Конечно, достигнуть многоядерности AMD EPYC 7002 «синим» на этот раз не удалось, но многочисленные оптимизации и улучшения вкупе с поддержкой PCI Express 4.0 должны помочь Intel продержаться до появления действительно инновационных процессоров Sapphire Rapids. Также появление Ice Lake-SP благотворно скажется на скорости внедрения периферии с поддержкой PCI Express 4.0. Но на горизонте уже маячит PCI Express 5.0 и новые стандарты памяти.
18.06.2020 [16:00], Алексей Степин
Intel: новая память Optane DCPMM на четверть быстрее старойВ понятие «платформа» как таковое входят три компонента: процессор, память и устройства хранения данных, хотя с появлением Optane DCPMM грань между последними двумя понятиями и стала размываться. Вместе с анонсом Xeon Scalable Cooper Lake Intel представила второе поколение памяти Optane DCPMM, которе и предназначено для новых CPU. 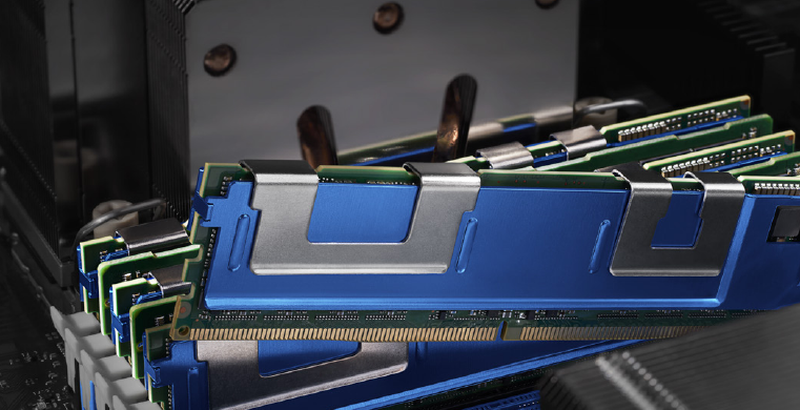 Рост популярности систем машинного интеллекта и периферийной обработки данных приводит и к тому, что от подсистем памяти требуются большие, нежели ранее, объёмы. DRAM, однако, всё ещё очень дорогое удовольствие, когда речь заходит о терабайтах и десятках терабайт, а обычная флеш-память NAND не может похвастаться высокой производительностью на мелкоблочных и случайных операциях в силу своей структуры. Intel не первый год продвигает концепцию Optane DCPMM: сам тип микросхем Optane (3D XPoint) хорошо подходит в качестве «продолжения» системной памяти, порой не критически уступая DRAM в производительности. При этом модули DCPMM энергонезависимы и могут быть весьма солидных объёмов, заведомо превышающих объёмы, достигаемые «чистой» DRAM. 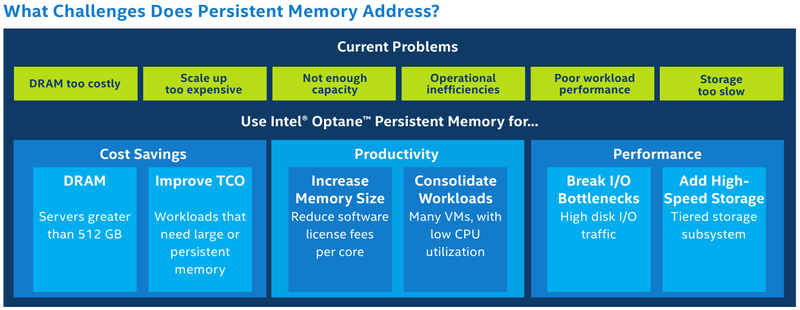
DCPMM позволяет снизить стоимость владения при увеличении объёмов памяти и лучшей производительности В прошлом году мы опубликовали заметку, рассказывающую о том, насколько хорошо смешанные системы на базе Optane DCPMM + DRAM показывают себя в научно-технических расчётах. И они доказали свою полезность, хотя речь шла о первом поколении модулей DCPMM. А сейчас компания Intel представила модули на базе Optane второго поколения, обладающие улучшенными техническими характеристиками. Они носят название Optane 200 и, по замыслу разработчика, эти модули должны составить компанию платформе Cooper Lake-SP, третьему поколению Xeon Scalable. Максимальная ёмкость модуля по-прежнему составляет 512 Гбайт. 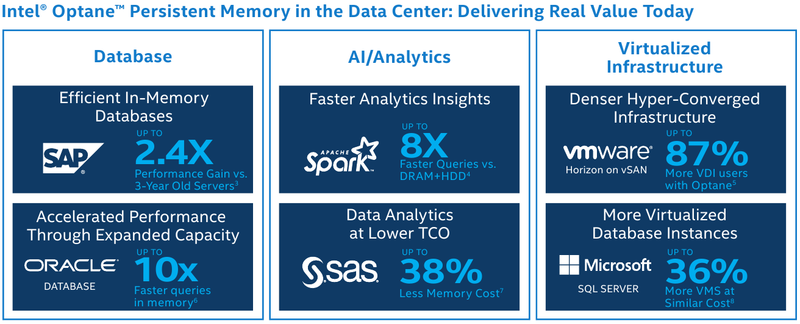
Эффективность новой DCPMM в сравнении с серверами трёхлетней давности Общий объём смешанной памяти у систем на базе Cooper Lake может достигать внушительной цифры 4,5 Тбайт на процессорный разъём, хотя для этого и требуется процессор Xeon с суффиксом HL в названии. Отличный выбор для нагрузок вроде баз данных in-memory, аналитики в реальном времени, да и системы виртуализации от такого только выиграют — один сервер сможет вместить больше инстансов. 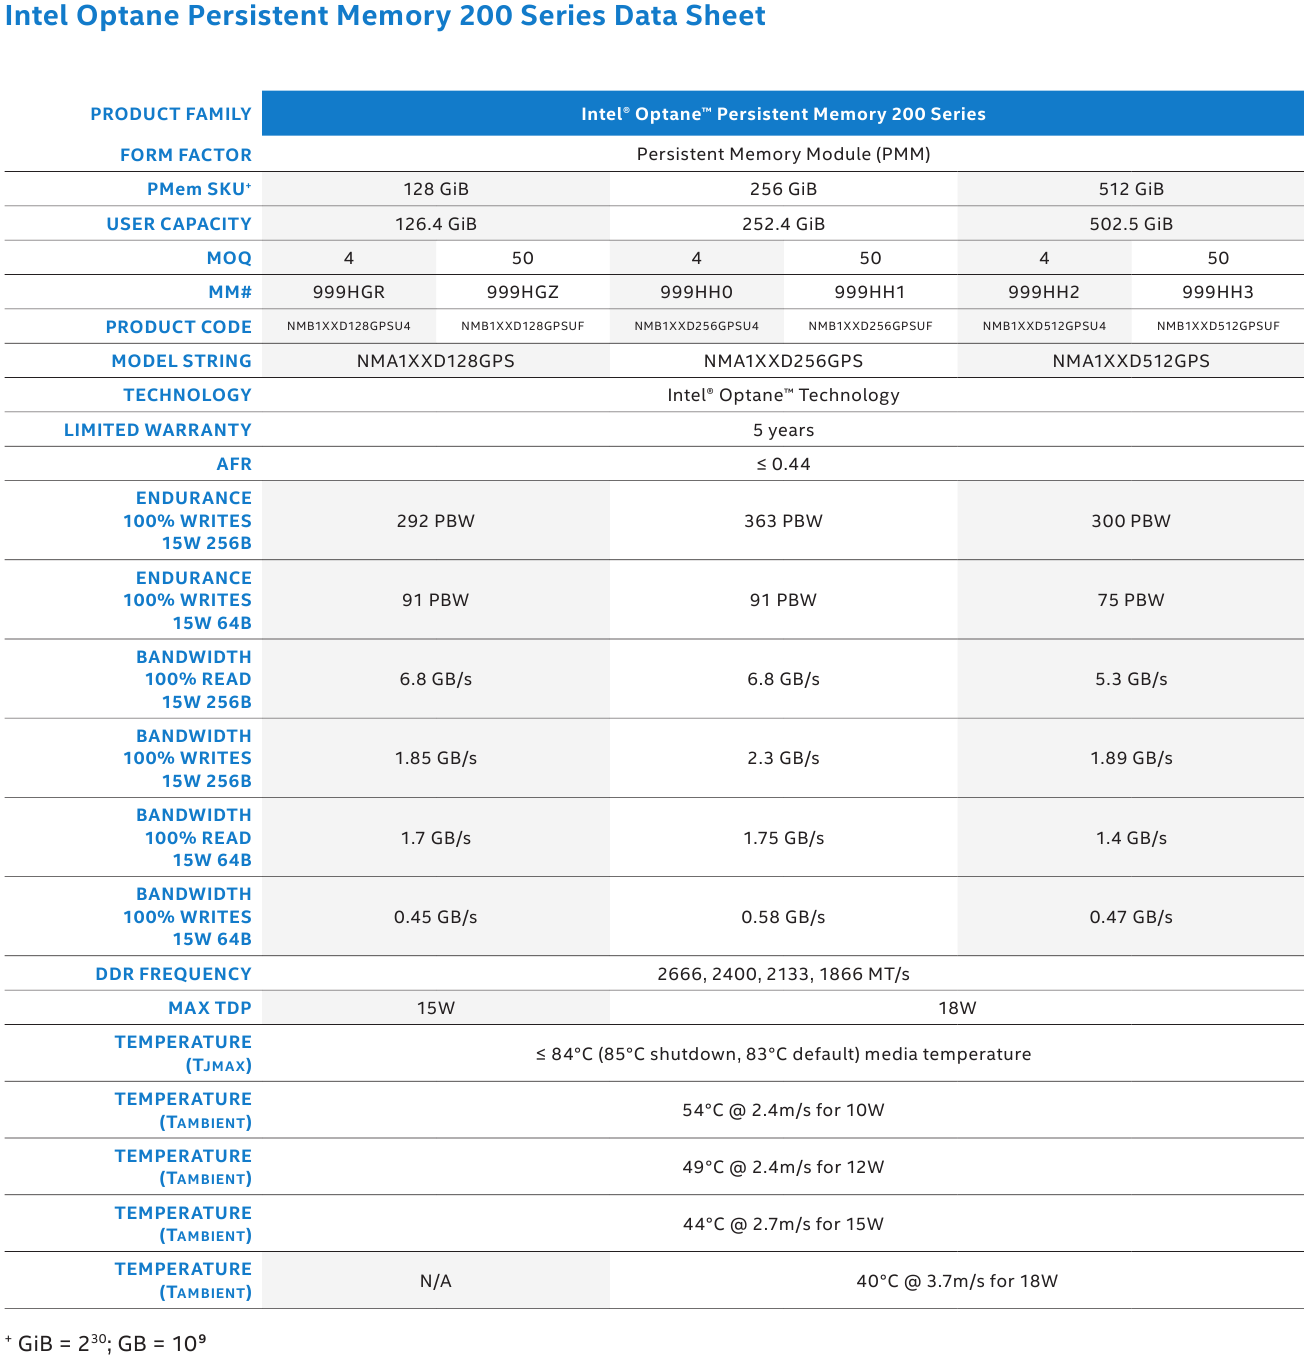 Новые модули имеют невысокий теплопакет, остающийся в рамках 12 ‒ 15 Ватт, но при этом они могут быть на четверть производительнее Optane DCPMM предыдущего поколения. По разным оценкам надёжность новинок варьируется в пределах 75 — 363 Пбайт, записанных в течение пятилетнего гарантийного срока. Поддерживаются частоты DDR4 1866, 2133, 2400 и 2666 МГц, тогда как сами процессоры Cooper Lake-SP получили поддержку и более быстрой DDR4-3200. Вместе с новой памятью и процессорами компания также анонсировала накопители Intel D7-P5500 и D7-5600 с интерфейсом PCIe 4.0 и новую FPGA Intel Stratix 10 NX.
18.06.2020 [16:00], Алексей Степин
Intel представила Xeon Cooper Lake, третье поколение Scalable-процессоровКрупнейший в мире производитель процессоров с архитектурой x86, компания Intel, представила новую платформу, нацеленную на быстро растущий рынок машинного обучения, аналитики и периферийных вычислений. Хотя платформа состоит из нескольких компонентов, главным из них являются новые процессоры Intel Xeon Scalable — это уже третье поколение серии Scalable. 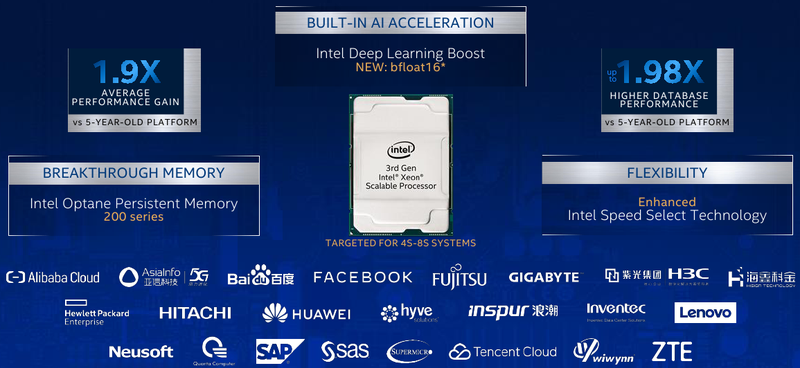 Первое поколение Xeon Scalable (Skylake) отличалось наличием поддержки векторных расширений с длиной 512 бит, хотя эта поддержка была наиболее полной в других процессорах с разъёмом LGA 3647, ныне почивших Xeon Phi 72xx. Во втором поколении Xeon Scalable, известном под кодовым именем Cascade Lake, появились расширения AVX-512 VNNI (Vector Neural Network Instructions, они же DL Boost), и это был первый реверанс в сторону машинного обучения со стороны Intel — расширения позволялил работать с INT8 и подходили для инференса. 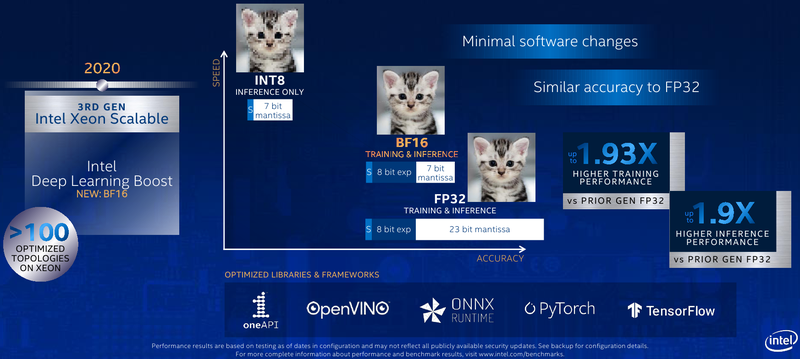 Третье поколение, получившее имя Cooper Lake, ещё больше продвинулось в сторону поддержки нетипичных для традиционной архитектуры x86 форматов вычислений. Главным нововведением здесь является поддержка формата bfloat16, который часто используется в комплексах машинного обучения и системах принятия решений (инференс). Он требует меньше вычислительных мощностей, нежели традиционные форматы FP32/64, но при этом в большинстве случаев обеспечивает достаточную точность вычислений, а итоговый выигрыш в производительности может быть почти двухкратным. 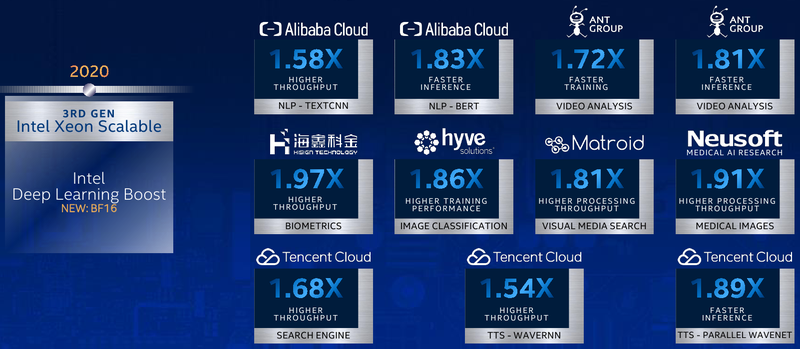 Популярные фреймворки, такие как TensorFlow и Pytorch, уже давно поддерживают bfloat16, а Intel-оптимизированные версии доступны в комплекте Intel AI Analytics Toolkit. Компания также оптимизировала среды OpenVINO и ONNX с учётом возможностей новых процессоров Xeon Scalable. Собственно говоря, самое главное в Cooper Lake то, что их теперь можно использовать и для обучения нейронных сетей, а не только для инференса. Intel отдельно подчёркивает универсальность новых CPU. 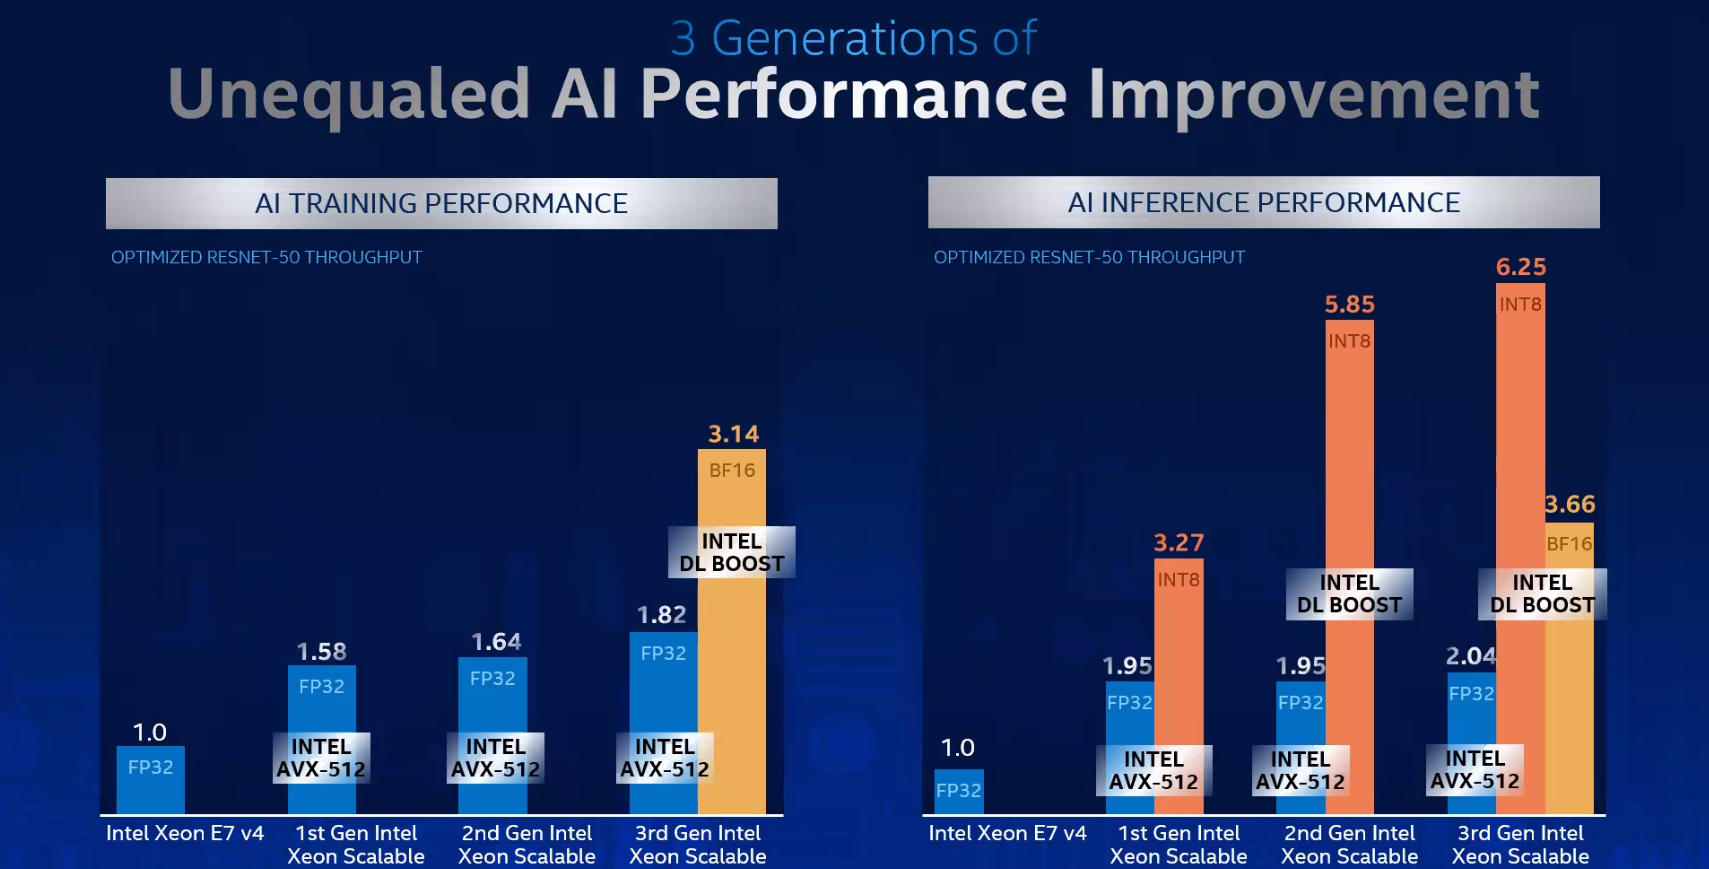 Что касается самих процессоров, то максимальное количество ядер сохранилось, их в серии Xeon Gold 53xx/63xx и Xeon Platinum 83xx по-прежнему 28 при поддержке SMT2. Однако улучшения есть, и достаточно серьёзные. Серия Xeon Platinum поддерживает память до DDR4-3200 (1DPC) и DDR4-2933 (2DPC), хотя младшие пяти- и шеститысячники так же ограничены 2666 и 2933 MT/с. Зато все они поддерживают память Intel Optane DCPMM 2-го поколения. Число каналов память осталось прежним, их шесть. Существенное отличие от Cascade Lake в том, что теперь у всех CPU есть 6 линий UPI — они могут может «бесшовно» устанавливаться в системы с четырьмя или восемью процессорными разъёмами. Другое важное отличие — серия 53xx теперь имеет два FMA-порта для AVX-512, а не один как раньше. Часть новинок поддерживает Intel Speed Select. 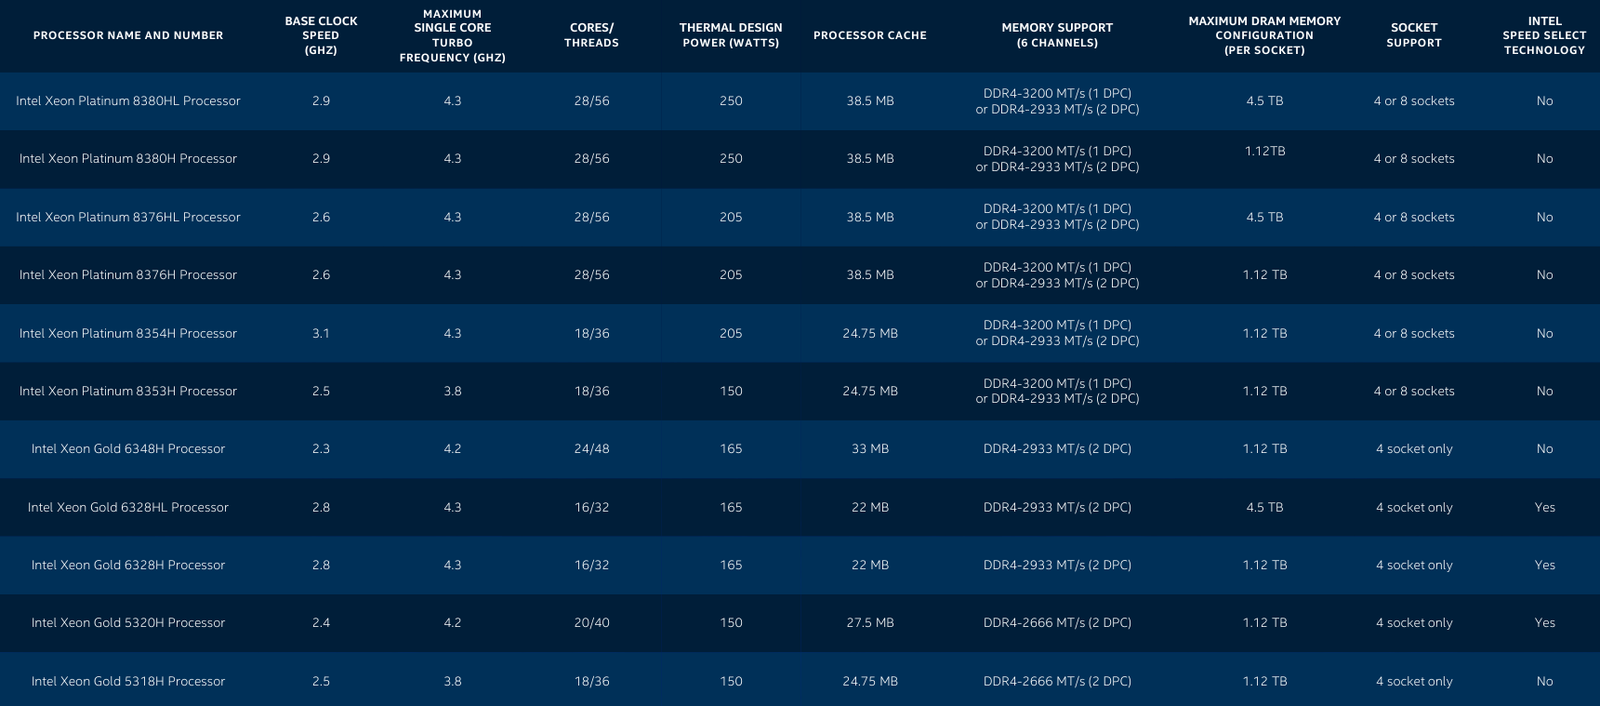 У «ёмких» моделей с суффиксом HL максимальный объём оперативной памяти достиг 4,5 Тбайт, а у базовых H — до 1,12 Тбайт. Несколько подросли тактовые частоты, в серии есть модели с частотной формулой 2,9 ‒ 4,3 ГГц, причём большая часть новинок имеет частоту в турборежиме более 4 ГГц. Исключение — модели с пониженным энергопотреблением. Всё это делает новые процессоры привлекательными для крупных предприятий, облачных провайдеров и гиперскейлеров вообще. Если даже на секунду забыть все новововведения для ИИ, Cooper Lake всё равно останется многосокетной платформой, а это значит, что он подходит для работы с большими СУБД, анализа больших объёмов данных в реальном времени, OLTP и виртуализации. В области 4S/8S-платформ у Intel давно крепкие позиции, так что новинки наверняка приглянутся определённому кругу заказчиков. Но массовыми Cooper Lake в текущем виде не станут. 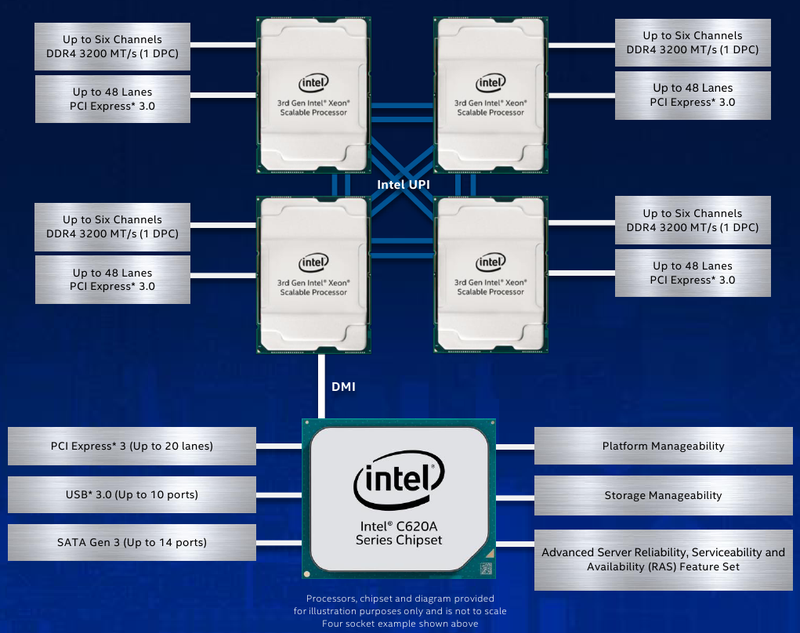 Основной системный чипсет — Intel C620A, то есть обновлённый Lewisburg. В серию пока входит всего три модели, две из которых поддерживают технологию Intel QAT, ускоряющую работы по компресии и шифрованию. Так это обновление уже имеющихся чипсетов, поддержки PCI Express 4.0 нет. Сами процессоры Xeon Scalable третьего поколения по-прежнему могут предоставить в распоряжение системы до 48 линий PCIe 3.0. С учётом того, что ориентированы они на 4-сокетные системы, этого может быть вполне достаточно. 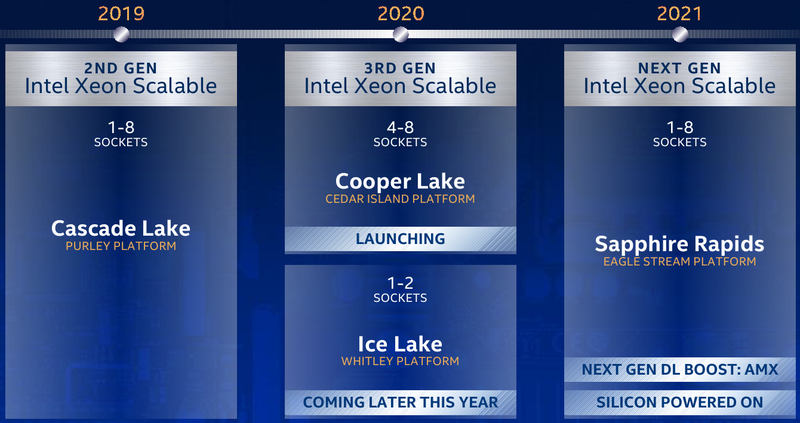 Однако другие процессоры Xeon Scalable «Ice Lake», для одно-двухсокетных платформ Whitley, которые Intel планирует представить позднее в этом году, уже получат поддержку PCI Express 4.0. Также известно, что четвёртое поколение Xeon Scalable под именем Sapphire Rapids получит набор новых матричных расширений (Advanced Matrix Extensions, AMX), которые, вероятно, буду напоминать тензорные ядра. Она увидит свет уже в 2021 году. Для массовых одно- и двухсокетных платформ пока предлагается использовать Cascade Lake Refresh. Вместе с Intel Xeon Cooper Lake компания также анонсировала второе поколение памяти Intel Optane DCPMM 200, накопители Intel D7-P5500 и D7-5600 с интерфейсом PCIe 4.0 и новую FPGA Intel Stratix 10 NX.
26.05.2020 [21:06], Алексей Степин
Facebook✴ Yosemite и Delta Lake: OCP-платформы с Intel Xeon Cooper LakeНа прошлой неделе мы писали о решении ITRenew Sesame, которое позволит небольшим компаниями получить недорогое, но производительное б/у «железо» от Facebook✴ и других гигантов. Особенность такого оборудования в том, что оно имеет OCP-исполнение. И самый простой способ познакомиться с миром OCP — посмотреть на новые решения самой Facebook✴. Среди них есть одноюнитовое шасси Sonora Pass, но это не единственная новинка, использующая самые свежие CPU Intel Xeon Cooper Lake. Есть и специфичные для OCP платформы Yosemite v3 и Delta Lake. 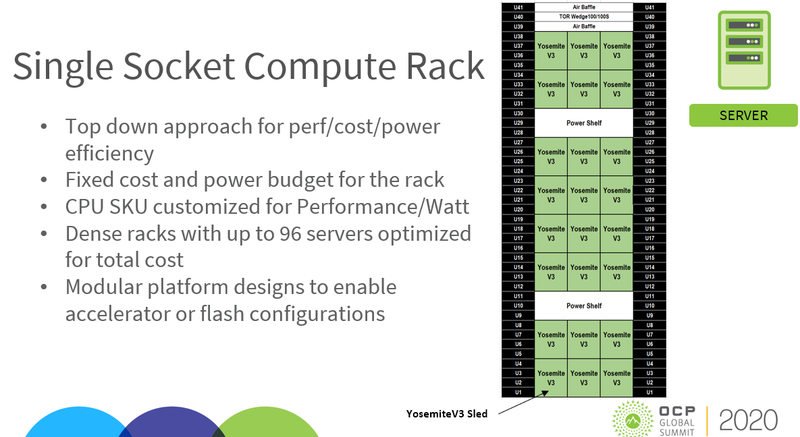 Привычные нам стоечные форм-факторы серверов создавались в те времена, когда вопрос упаковки вычислительных мощностей не стоял столь остро, как сейчас. В лучшем случае, стандартный 19-дюймовый корпус может содержать системную плату с четырьмя процессорами, но чаще ограничен двухсокетными конфигурациями. Facebook✴ использует стандарт стоек Open Rack, главное в которых — возможность более плотного размещения серверов (21"), увеличение воздушного потока и единая шина питания (12 В DC). Yosemite v3 являет собой уже третье поколение серверных систем в этом стандарте. 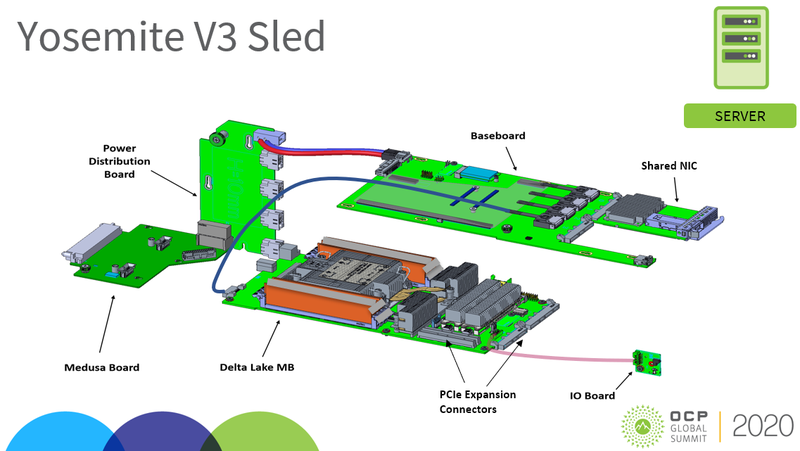 В третьей версии 4 юнита вертикального пространства стойки вмещает в себя три модуля Yosemite v3. Каждый из этих модулей может включать в себя до четырёх сверхкомпактных серверов Delta Lake на базе новых процессоров Intel Cooper Lake-SP. Предусматриваются разные варианты модулей: классический «вычислительный» с четырьмя системными платами, вариант с собственным флеш-хранилищем, версия с акселераторами и модель с интегрированным сетевым коммутатором. В зависимости от решаемой задачи, стойка может включать различные сочетания Yosemite v3. 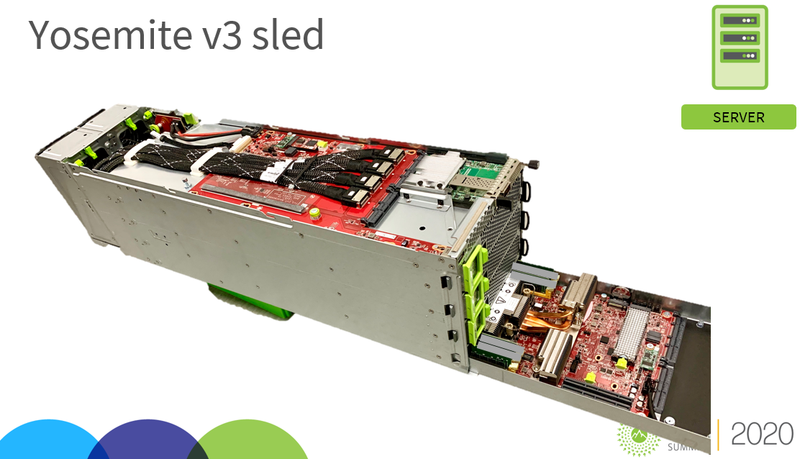 Два последних варианта предусматривают два процессорных гнезда вместо четырёх, но в них предусмотрено пространство для размещения ГП-ускорителей или собственной сетевой подсистемы, включающей в себя выделенные сетевые адаптеры и коммутатор. Все четыре варианта базируются на шасси высотой 4U и шириной в треть стойки, в верхней части которого размещается базовая плата с общим сетевым адаптером, а в задней — платы питания Medusa Board. 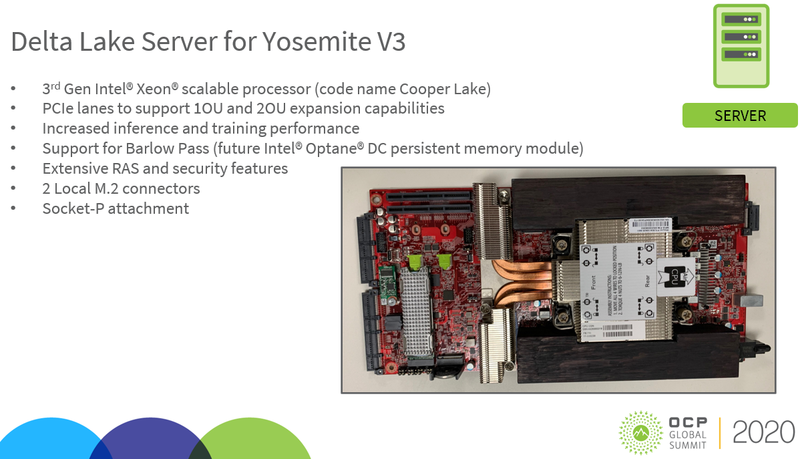 «Лезвия» с системными платами быстросъёмные. Основная модель «лезвия» носит название Delta Lake. Она представляет собой компактную системную плату с процессором Intel Xeon Scalable третьего поколения (Cooper Lake). Эти платы изначально создавались с прицелом на повышенный уровень производительности в системах машинного интеллекта и принятия решений. 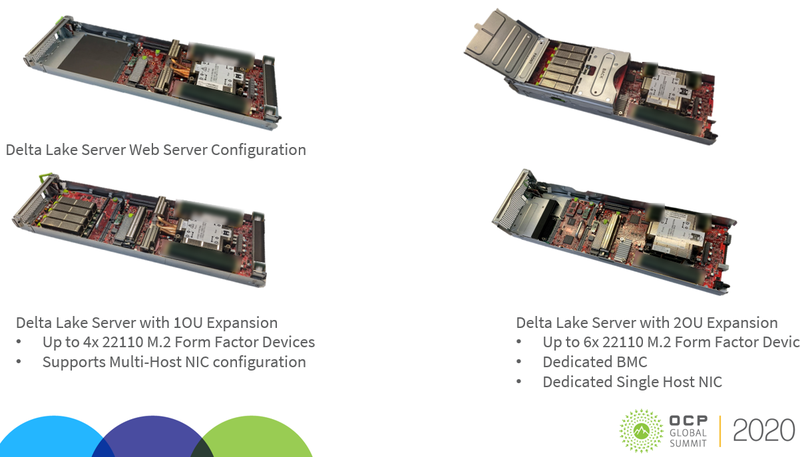 За отвод тепла отвечает компактная, но мощная система охлаждения с четырьмя тепловыми трубками и дополнительными секциями радиаторов. Поддерживаются расширенные возможности удалённого управления и администрирования, имеется пара набортных разъёмов для накопителей типа M.2. Также платы Delta Lake поддерживают новый стандарт модулей Intel Optane DCPMM под кодовым названием Barlow Pass. 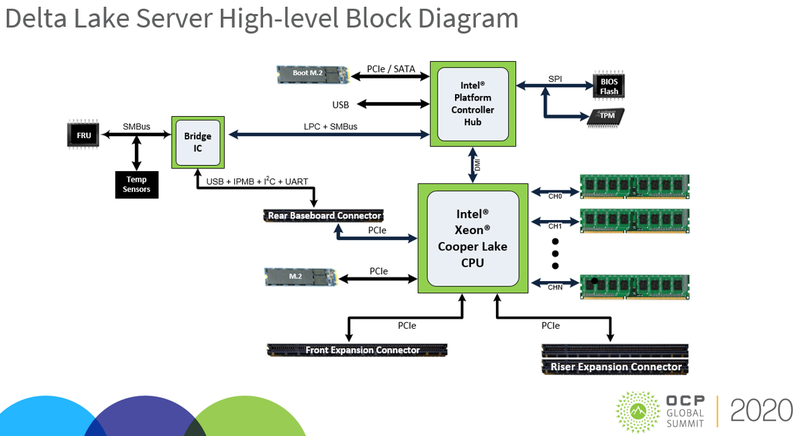 Помимо Yosemite v3, Facebook✴ представила также новую платформу для запуска нейронных сетей (инеференс). Каждый модуль этой платформы состоит из системного модуля Yosemite v2.50 и модуля расширения Glacier Point v2, общающегося с ЦП посредством 16 линий PCI Express 3.0; особенный интерес представляет именно последний. 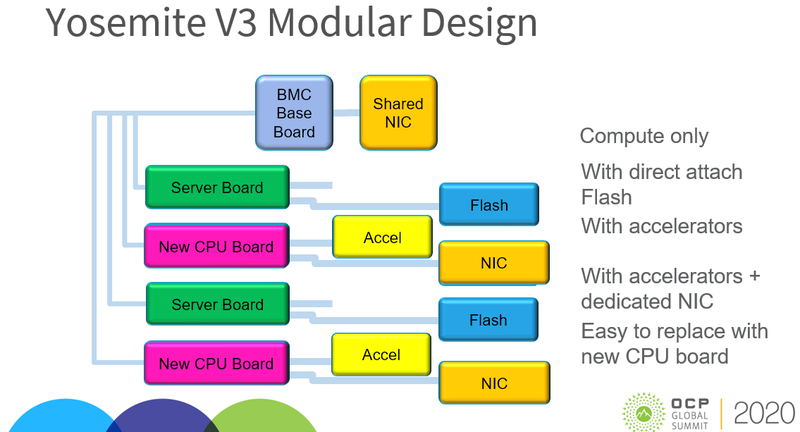 В этом модуле реализована возможность установки как стандартных одинарных модулей M.2 (теплопакет до 14 Ватт), так и двойных, с теплопакетом 25 Ватт. Всего модуль расширения может содержать до шести двойных или двенадцати одинарных плат с интерфейсом M.2. Два таких блока с модулями GPv2 устанавливаются в шасси Yosemite v2.50. В сравнении с Yosemite v2 с 600 до 720 Ватт увеличена мощность подсистем питания, реализована поддержка 100GbE, сетевой контроллер подключён к процессору, а не к мосту PCH, как ранее. 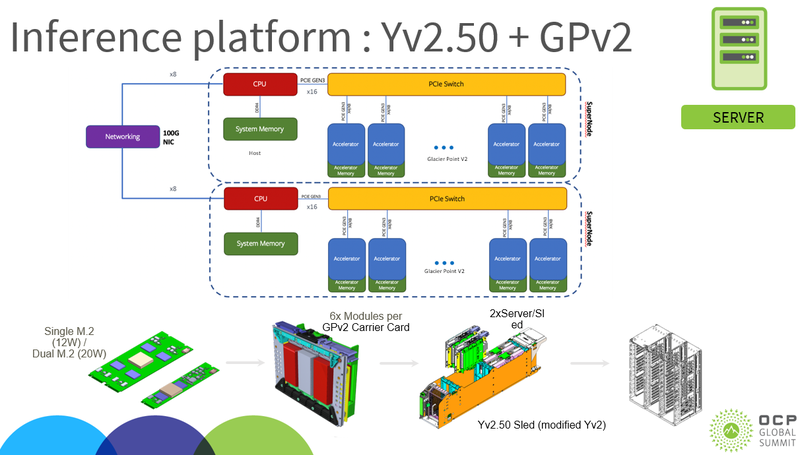
Новая платформа для инференс-систем В данном решении особый интерес вызывает поддержка M.2 двойной ширины. Сам по себе стандарт M.2 достаточно компактен, но ширина одинарной платы означает и ограничение по габаритам чипа ускорителя. Двойная ширина позволяет это ограничение преодолеть и оснащать ускорители более мощными и крупными ASIC, но не терять при этом электрической и механической совместимости. 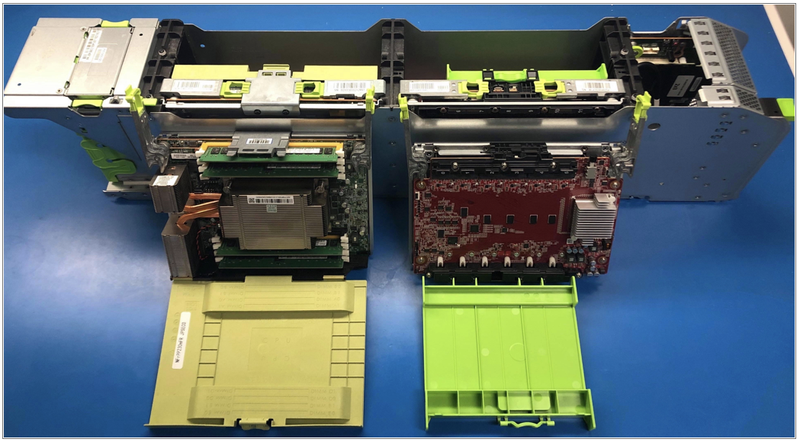 Такой модульный дизайн обеспечивает сочетанию Yv2.50 и GPv2 непревзойдённую гибкость, ведь в единой системе могут уживаться различные ускорители на базе разных чипов. А благодаря единой системе BMC и поддержке стандартных протоколов SMBUS, UART, JTag и I2C, обеспечивается полный спектр средств удаленного управления и мониторинга. Ограничение по ширине интерфейса к основному ЦП нивелируется тем, что GPv2 имеет собственный коммутатор PCIe, так что ускорители, в нём установленные, могут общаться и в режиме «точка-точка». 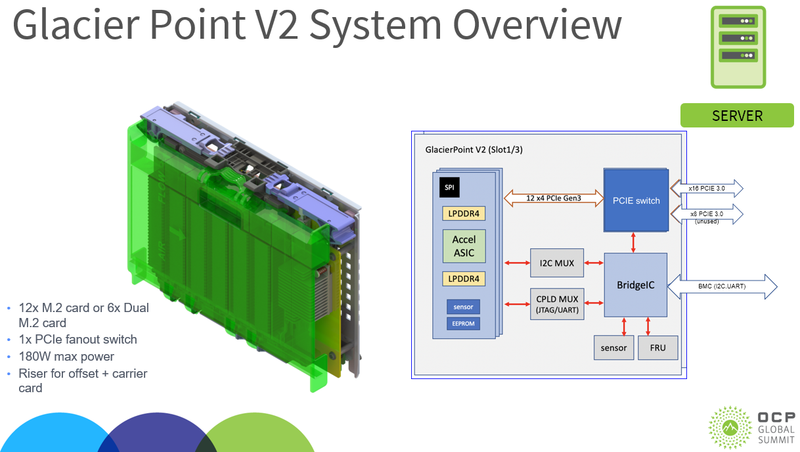 Платформа Yv2.50 + GPv2 имеет свои недостатки, но компания-разработчик их осознаёт. В частности, в будущих версиях, возможно, каждый сервер будет иметь собственный контроллер BMC и сетевой процессор, а модуль расширения получит поддержку PCI Express 4.0, что снимет возможные проблемы с нехваткой пропускной способности. 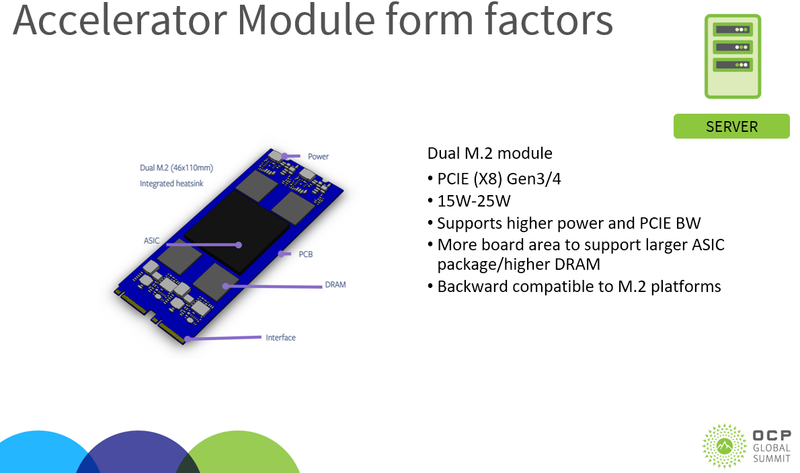 При этом необходимо отметить, что Facebook✴ является участником проекта OCP и платформа Yv2.50 + GPv2 имеет открытые спецификации. Подробнее о них можно узнать на wiki-странице проекта. Отдельно опубликованы спецификации на ускорительные модули M.2 обычной и двойной ширины.
24.02.2020 [17:00], Константин Ходаковский
Intel представила семейство процессоров Intel Xeon Cascade Lake RefreshВместе с серией продуктов для инфраструктуры сетей 5G, включающей систему на кристалле Atom P5900 для базовых станций, структурированную платформу ASIC Diamond Mesa для ускорения сетей 5G, серию сетевых контроллеров Ethernet 700 и программное решение OpenNESS для лёгкого развёртывания облачных периферийных микросервисов, корпорация Intel расширила и серию серверных процессоров Intel Xeon Scalable 2-го поколения. 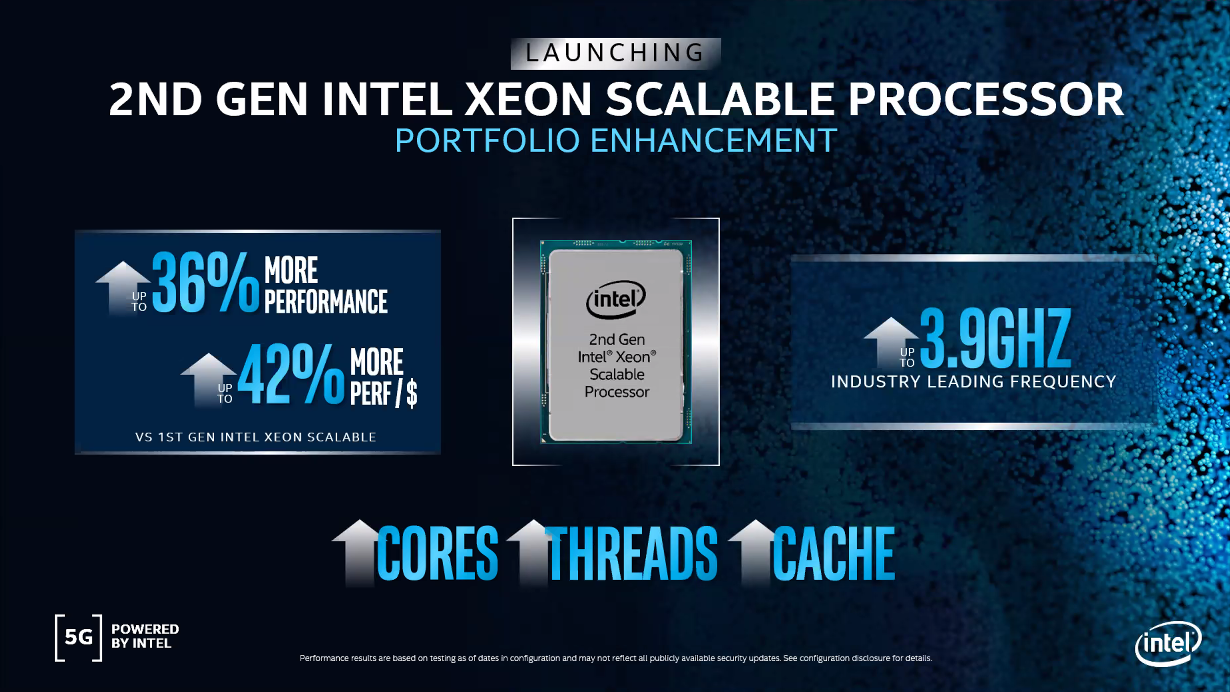 Intel Xeon Scalable 2-го поколения являются основой платформенной инфраструктуры в центрах обработки данных. На сегодняшний день чипов Xeon Scalable продано в общей сложности более 30 миллионов. Появление этих процессоров позволило трансформировать ядро сети: сегодня на их долю приходится 50 % всех виртуализированных окружений по всему миру, а к 2023 году это число дополнительно увеличится. 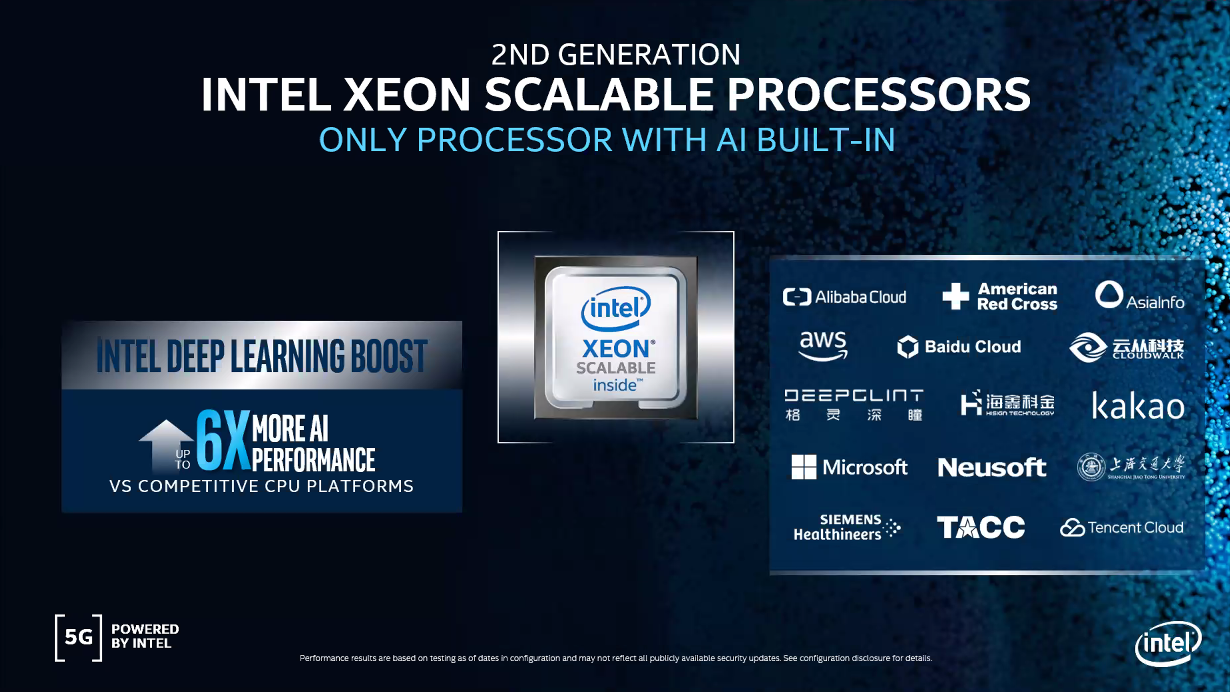 Как мы уже сообщали, новая серия серверных процессоров Intel включает 18 моделей с более высокими частотами (до 4 ГГц в режиме Turbo Boost), увеличенным количеством ядер и объёмом кеша в различной комбинации этих параметров. Но главное изменение — это существенно сниженная стоимость. Например, Xeon Gold 6238R предложит 28 ядер и базовую частоту 2,2/4 ГГц, тогда как его предшественник в лице Xeon Gold 6238 использует 22 ядра с частотой 2,1/3,7 ГГц при одинаковой стоимости.  Флагманом семейства станет Xeon Gold 6258R с 28 ядрами, поддержкой Hyper-Threading, базовой частотой 2,7 ГГц и уровнем TDP не более 205 Вт. В обозначении моделей новых процессоров, как правило, присутствует литера «R», то есть Refresh. Серия оптимизированных ЦП для высочайшей производительности отдельных ядер теперь представляет собой такой перечень. Все процессоры поддерживают Intel Optane DC Persistent Memory (жирным помечены новые модели):
Серия ЦП, оптимизированных для производительности на Ватт, представляет собой такой перечень. Все процессоры Platinum и Gold поддерживают Intel Optane DC Persistent Memory, а остальные — нет (жирным помечены новые модели):
Также компания представила новый чип в семействе энергоэффективных, рассчитанных на долгий цикл процессоров, — Silver 4210T (10 ядер, 2,3/3,2 ГГц, 13,75 Мбайт, 95 Вт, $554). Как и старая 8-ядерная модель Silver 4209T, новая тоже не поддерживает Intel Optane DC Persistent Memory. И наконец для односокетных серверов, где принципиальную роль играет стоимость, представлена 16-ядерная модель Gold 6208U (2,9/3,9 ГГц, 22 Мбайт, 150 Вт, $989, поддержка Intel Optane DC Persistent Memory). Запуск новых моделей призван сделать предложения Intel более конкурентоспособными по сравнению с 7-нм чипами AMD EPYC Rome — неслучайно затронуты были наиболее ходовые процессоры. Самое производительное (и дорогое) семейство Xeon Platinum 9000 с количеством ядер от 32 до 56 обновлено не было. Повышение показателя цены/производительности — главный повод к запуску Cascade Lake R (снижение наблюдается кратное). В новой серии процессоры разделены между семействами Bronze, Silver и Gold. Неслучайно процессоров Platinum в ней нет: старшие модели, в том числе и 28-ядерный флагман, вошли в семейство Gold. Поэтому Intel законно поставила на «новинки» более низкие ценники. Ранее компания уже серьёзно пересмотрела свои серверные предложения. Она, по сути, отказалась от процессоров серии M, которые, в отличие от стандартных решений, ограниченных объёмом ОЗУ в 1,5 Тбайт, позволяют работать в системах с 2 Тбайт памяти. Клиентам, нуждающимся в таком объёме ОЗУ, теперь предлагается использовать процессоры класса выше — L, поддерживающие уже 4,5 Тбайт. Для этого компания уравняла цены моделей L с M. Впрочем, не все OEM-производители спешат обесценить свои запасы и задерживают снижение цен.  Помимо процессоров Intel также представила 17 обновлённых решений Select Solutions, в которых реализована поддержка этих новых продуктов для ускорения наиболее важных рабочих нагрузок у заказчиков. Ведущие отраслевые производители уже начинают поставки новых платформ на базе Intel Xeon 2-го поколения Refresh.
02.08.2019 [14:32], Геннадий Детинич
Intel хоронит шину Omni-PathДовольно неожиданно компания Intel отказалась от развития интерконнекта Omni-Path, которую она продвигала в серверных и HPC-платформах сначала для соединения узлов, в том числе для гиперконвергентных систем. Первое поколение шины Omni-Path с пропускной способностью до 100 Гбит/с на порт появилось несколько лет назад. Но ожидаемого второго поколения решений с пропускной способностью до 200 Гбит/с уже не будет. 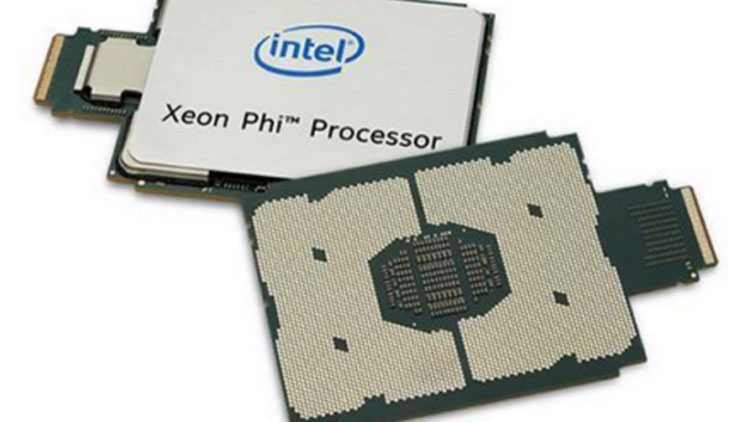
Ускорители Intel Xeon Phi с интегрированными контроллером и шиной Omni-Path Информацию о прекращении разработки и выпуска продукции Intel OmniPath Architecture 200 (OPA200) компания подтвердила, например, нашим коллегам с сайта HPCwire. Компания продолжит поддержку и поставку решений с шиной OPA100, но поставок продуктов с архитектурой OPA200 на рынок больше не будет. В принципе, сравнительно слабая поддержка шины Intel OmniPath со стороны клиентов рынка высокопроизводительных систем намекала на нечто подобное. Большей популярностью у строителей суперсистем и не только продолжает пользоваться InfiniBand и её новое HDR-воплощение с той же пропускной способностью до 200 Гбит/с. В свете ликвидации OPA200 становится понятно, почему Intel схватилась с NVIDIA за право поглощения компании Mellanox. Но не вышло: приз ушёл к NVIDIA. «Вообще, половина инсталляций в TOP500 использует Ethernet, но в основном 10/25/40 Гбит/с, и лишь совсем чуть-чуть может похвастаться 100 Гбит/с. InfiniBand установлен почти в 130 машинах, а Omni-Path есть чуть больше чем в 40. Остальное — проприетарные разработки». Что остаётся Intel? У лидера рынка микропроцессоров есть I/O-активы. Компания около 8 лет активно выстраивает направление для развития коммуникаций в ЦОД. За это время она поглотила разработчика коммутационных ASIC компанию Fulcrum Microsystems, подразделение по разработке адаптеров и коммутаторов InfiniBand компании QLogic и коммуникационное подразделение компании Cray. Относительно свежей покупкой Intel стала компания Barefoot Networks, разработчик решений для Ethernet-коммутаторов. Похоже, Intel решила вернуться к классике: InfiniBand (что менее вероятно) и Ethernet (что более вероятно), а о проприетарных шинах в виде той же Omni-Path решила забыть. В конце концов, Ethernet-подразделение компании славится своими продуктами. Новое поколения Intel Ethernet 800 Series способно заменить OPA100.
02.04.2019 [20:00], Геннадий Детинич
Intel представила процессоры Xeon D-1600: почта, телеграф, мостыВ 2015 году компания Intel представила процессоры Xeon семейства D. Первой появилась серия Xeon D-1500. Процессоры Xeon D получили архитектуру уровня Intel Core (Broadwell), став на ступеньку выше Xeon на архитектуре Atom. Целевое назначение Xeon D при этом не изменилось ― они всё так же были ориентированы на создание микросерверов, встраиваемых решений, систем для хранения данных малого и среднего уровней и сетевого оборудования. В 2018 году компания выпустила серию Xeon D-2100 на архитектуре Skylake. Тем самым в семейство Xeon D добавились решения повышенной производительности. Сегодня Intel представила третью серию Xeon D ― процессоры D-1600, которые возвращают нас к истокам семейства, главной целью которого был захват рынка производительной периферии с акцентом на плотность и сниженное потребление. 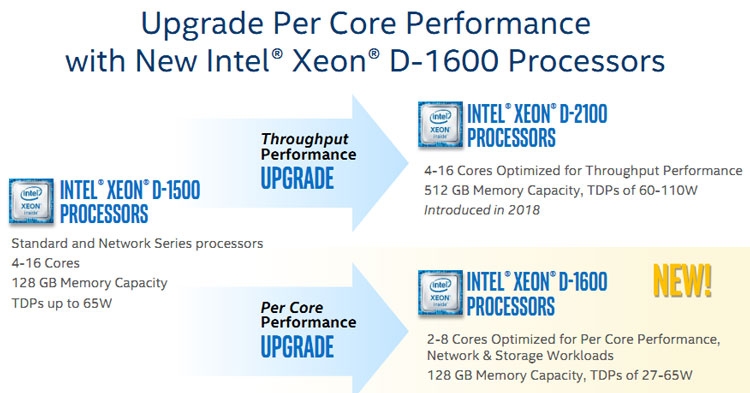 Процессоры Intel Xeon D-1600 получили меньшее число ядер, чем у их предшественников в лице Xeon D-1500. Диапазон числа физических ядер у моделей Xeon D-1600 сократился с 4–16 до 2–8. Максимальный тепловой пакет при этом остался тем же ― 65 Вт, тогда как минимальное значение TDP снизилось с 35 Вт до 27 Вт. Снижение числа ядер и сохранение максимального уровня TDP говорит о росте производительности в пересчёте на одно ядро. Во многом это достигается за счёт прироста как базовой частоты (в 1,2–1,5 раза), так и за счёт увеличения частоты при автоматическом разгоне до 3,2 ГГц, тогда как модели Xeon D-1500 в режиме турбо ограничивались частотой до 2,7 ГГц. Определённым образом Intel откатилась назад по шкале эволюции, понизив градус многоядерности в пользу наращивания однопоточной производительности. Собственно, этого требует позиционирование новой серии и активное развитие виртуализации сетевых функций (NFV). Для этого стала важнее скорость реакции сетевой платформы, что хорошо отрабатывается повышением тактовых частот. 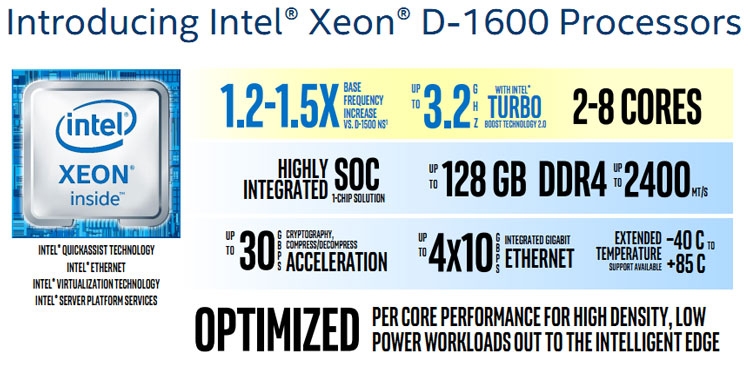 Архитектурных изменений в моделях Xeon D-1600 не очень много, если они вообще есть (пока предполагаем, что архитектура осталась прежней ― Broadwell). Интегрированный контроллер памяти остался двухканальным с поддержкой модулей DDR4 с частотой до 2400 МГц суммарным объёмом до 128 Гбайт. Также поддерживается память DDR3L-1600. Уточним, процессоры Xeon D ― это однокристальная платформа, фактически SoC, что чрезвычайно удобно для тех областей, на которые нацелены эти решения. 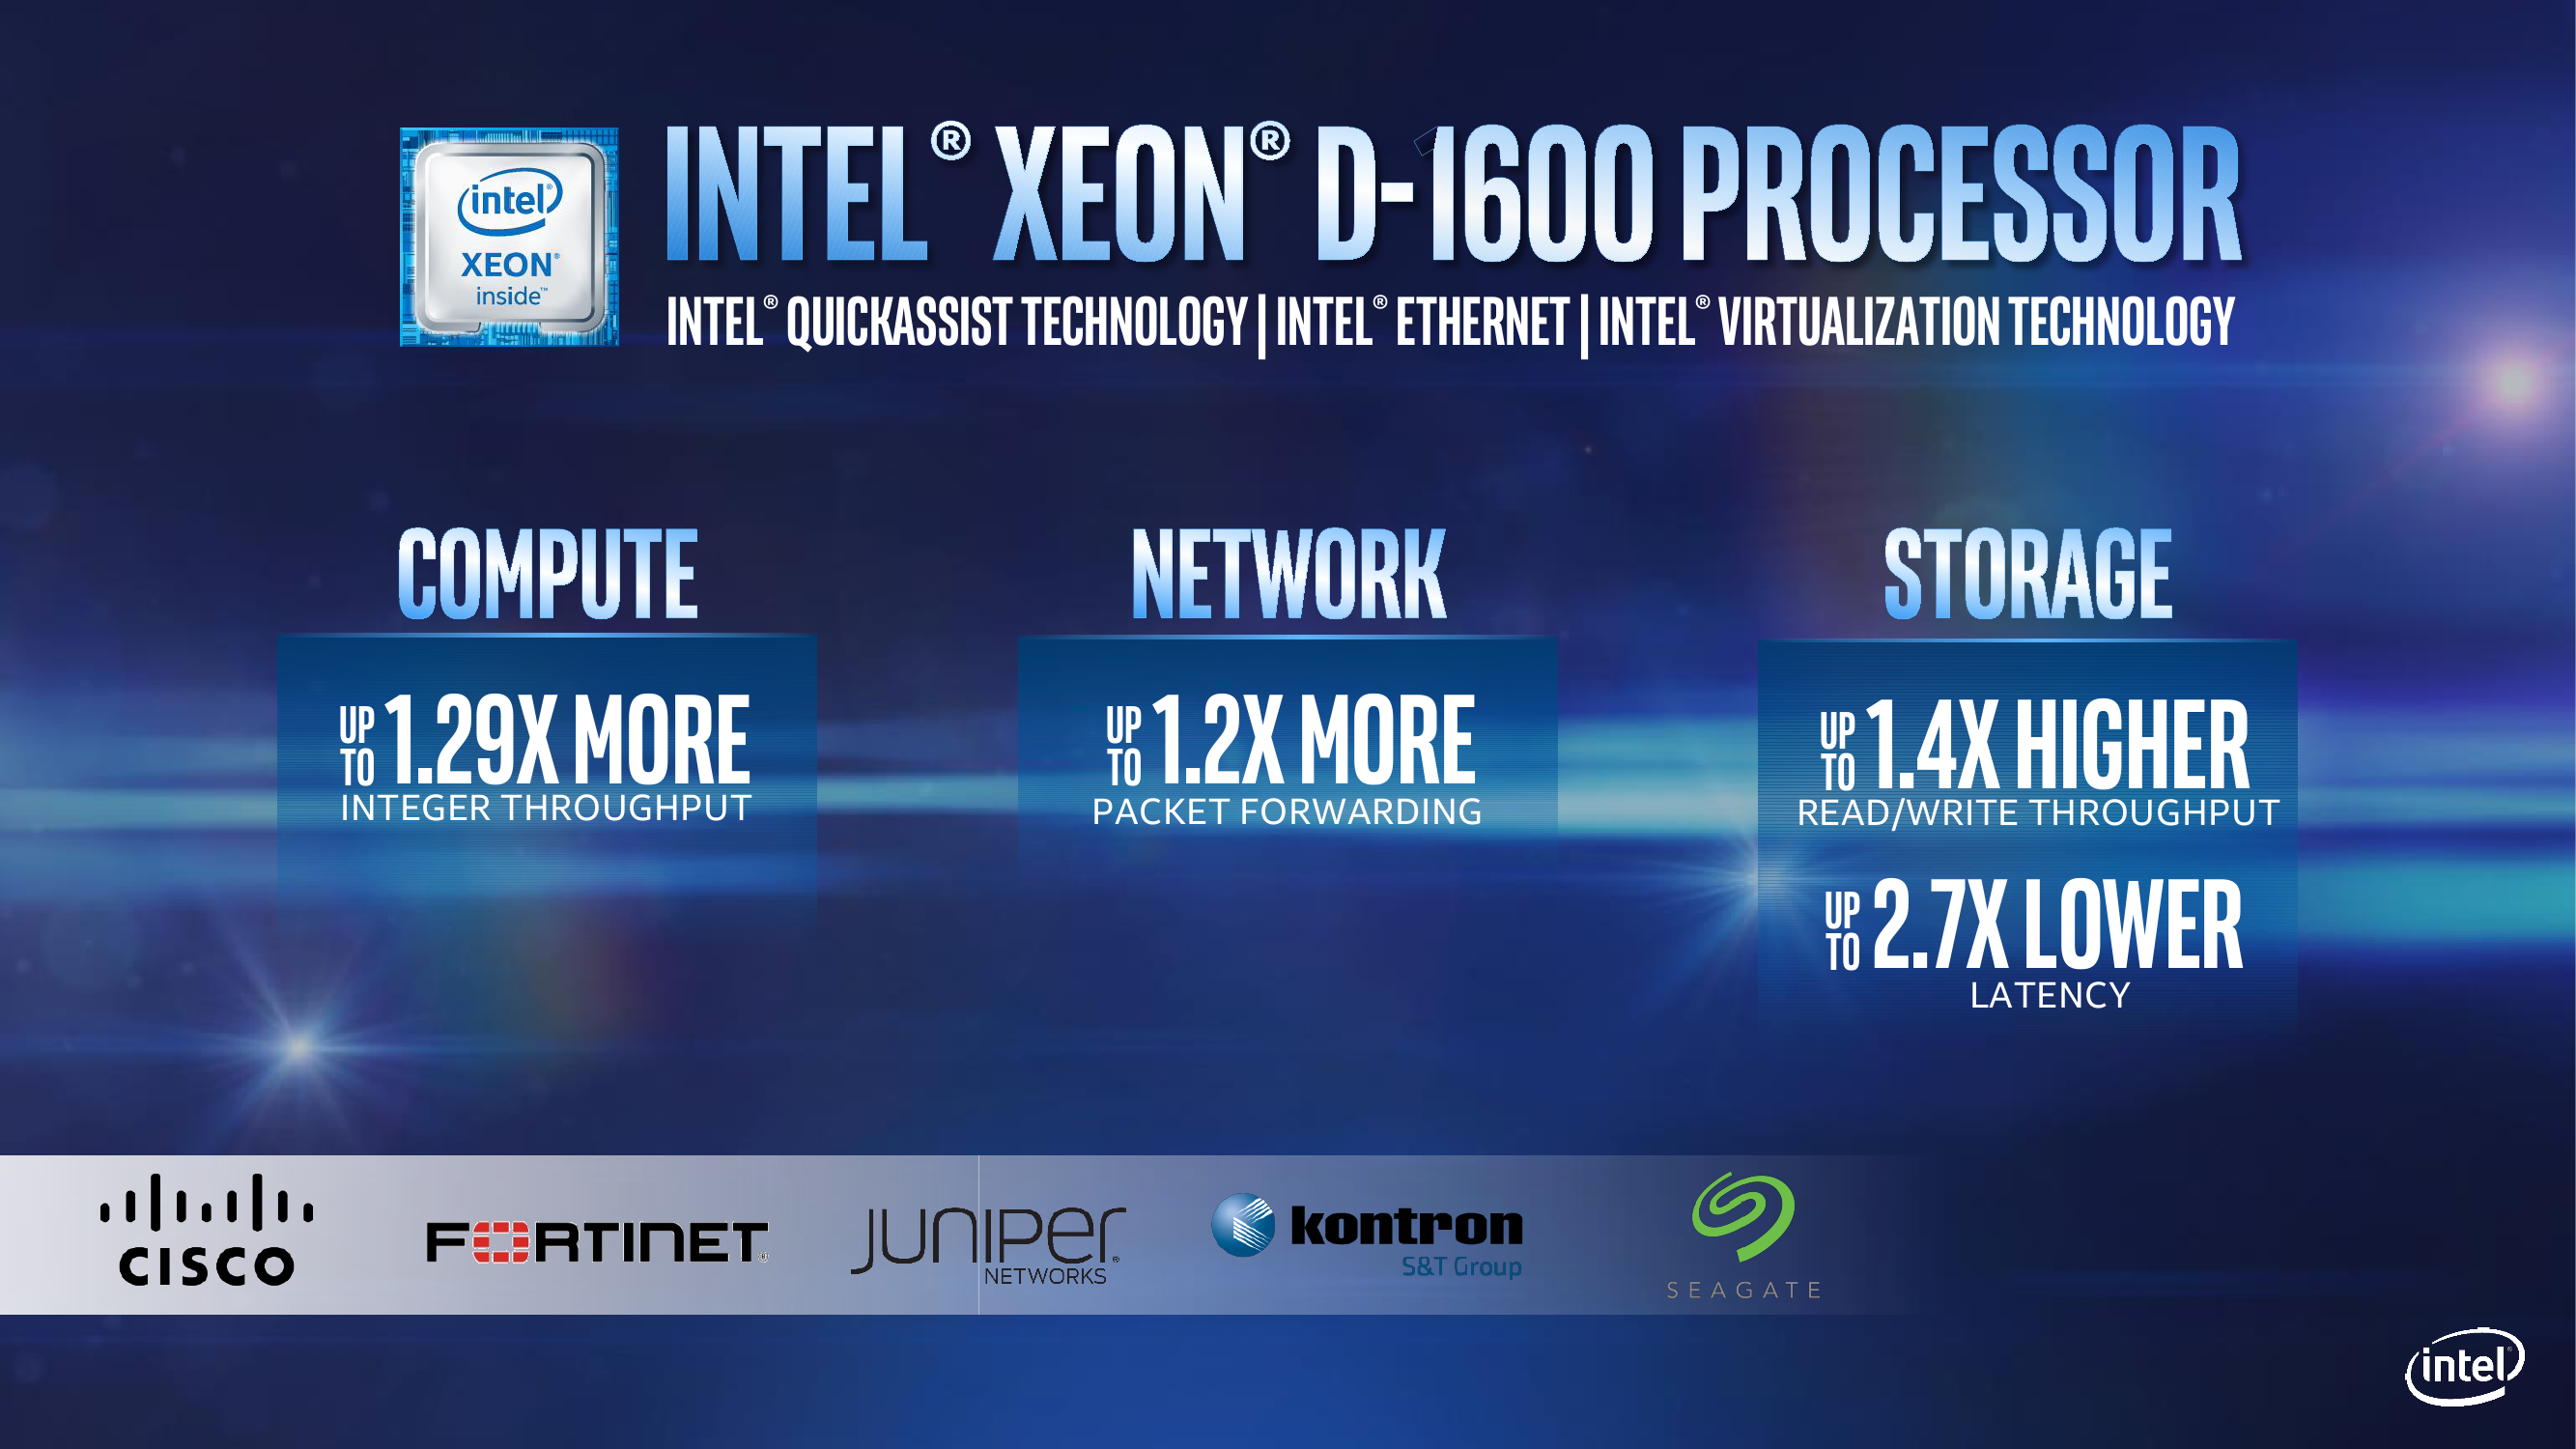 Встроенные в процессоры интерфейсы представлены 24 линиями PCIe 3.0, 8 линиями PCIe 2.0, 6 портами SATA 6 Гбит/с, 4 портами USB 3.0, 4 портами USB 2.0 и 4 портами Ethernet 10 Гбит/с. Кстати, об Ethernet. На кристалл Xeon D-1600 интегрирован контроллер Intel серии Ethernet 700. На это намекают не только четыре интерфейса Ethernet 10GbE, но также поддержка технологии Intel QuickAssist. 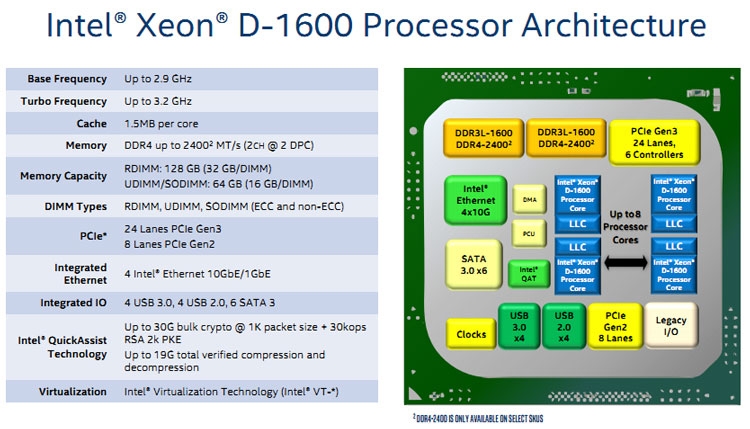 У старшей серии Xeon D-2100 модели Xeon D-1600 взяли то, чего не было у моделей Xeon D-1500 ― это поддержка технологии Intel QuickAssist (QAT). Технология QAT поддержана в моделях Xeon D-1600 с индексом «N». Наличие QAT означает, что процессор несёт встроенный аппаратный ускоритель для работы с криптографией, компрессией и обработки сетевого трафика. Поддерживается целый ряд популярных алгоритмов, что существенно разгружает вычислительные ядра и даёт ощутимый прирост производительности. Например, обработка трафика TLS/IPSec плюс компрессия происходит со скоростью 30 Гбит/с плюс 30 000 операций в секунду, как и расшифровка ключами RSA с такой же производительностью. 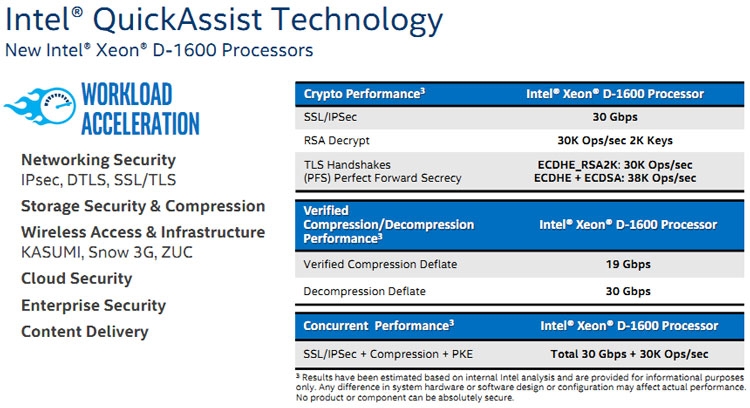 Поставки процессоров Xeon D-1600 компания Intel начнёт во втором квартале текущего года. Решения на основе новинок попадут на рынок к середине года или во второй его половине. По представлениям Intel, вычислительное и коммуникационное оборудование на базе Xeon D-1600 станет оптимальным выбором для развёртывания инфраструктуры для реализации и поддержки сотовой связи поколения 5G, а также для организации периферийных (пограничных) вычислений, когда обработка сырых данных (видео, сбор информации с датчиков, включая автомобильную электронику) происходит на месте и минимизирует пересылку в центры по обработке информации. Кроме того, они могут быть использованы в системах хранения данных. 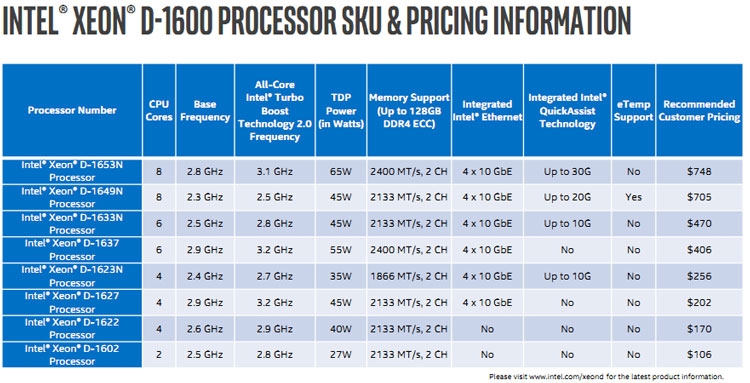 Процессоры Intel Xeon D 1600 представлены в рамках большого обновления решений для ЦОД, которое включает «взрослые» Intel Xeon Cascade Lake AP и SP с поддержкой памяти Optane в формате DDR4-модулей и новых инструкций для ИИ, модульные FPGA Agilex и сетевые контроллеры 100GbE Intel Ethernet 800. Подробности по ссылкам ниже.
31.01.2019 [20:33], Сергей Карасёв
Intel ставит крест на процессорах ItaniumКорпорация Intel опубликовала документ, по сути, знаменующий закат эпохи процессоров Itanium, на которые некогда возлагались большие надежды.  В обнародованном уведомлении речь идёт о грядущем прекращении производства чипов Itanium 9700, известных под кодовым именем Kittson. Массовые поставки этих изделий были начаты в 2017 году. Семейство включает четыре модели — Itanium 9720, Itanium 9740, Itanium 9750 и Itanium 9760 с четырьмя и восемью вычислительными ядрами. В документе Intel говорится, что приём заказов на все перечисленные процессоры прекратится через год — 30 января 2020-го. Поставки будут полностью свёрнуты 29 июля 2021 года. 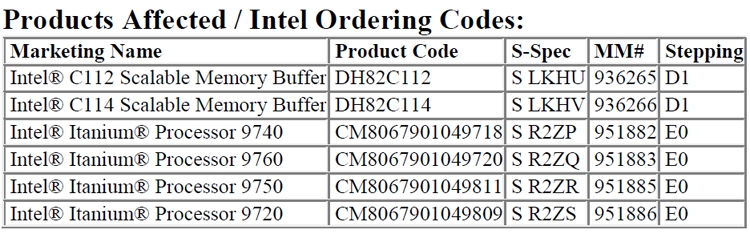 Таким образом, Intel ставит крест на решениях Itanium. Ещё в момент выхода Kittson говорилось, что эти изделия станут последними в семействе Itanium. Добавим, что впервые чипы Itanium дебютировали в мае 2001 года. Но продажи чипов оказались менее успешными, чем предполагалось. Основными причинами этому были проблемы с производительностью и малое количество оптимизированного программного обеспечения.
18.08.2016 [09:50], Валерий Косихин
IDF 2016: Intel анонсировала Knights Mill — новую архитектуру ускорителей Xeon Phi для задач глубинного обученияНа конференции Intel Developer Forum, которая в данный момент проходит в Сан-Франциско, была названа следующая версия архитектуры MIC (Many Integrated Cores), основанные на которой продукты пополнят семейство ускорителей параллельных вычислений Xeon Phi — Knights Mill. От Intel давно не поступало новостей касательно планов по развитию этой линейки устройств. На сегодняшний день Intel выпустила два поколения Xeon Phi — Knights Corner в 2013 году и Knights Landing в 2016-м. Согласно предыдущим заявлениям, третье поколение получит кодовое название Knights Hill, а соответствующие чипы будут производиться по технологической норме 10 нм. В кратком выступлении, которое Intel посвятила анонсу Knights Mill, не пояснили, как новинка соотносится с прошлыми планами. Возможно, что Knights Mill является промежуточной остановкой на пути к Knights Hill. По другой версии, новый продукт олицетворяет ответвление от основного пути развития, предназначенное для специфической ниши — глубинного обучения. 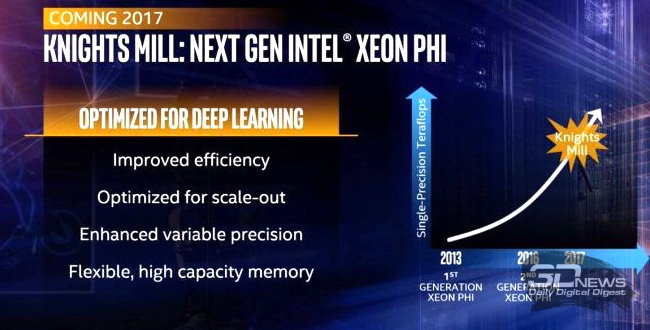 Глубинное обучение — одно из направлений задач машинного обучения, которое предполагает моделирование абстрактных понятий за счет построения многократно ветвящихся графов. На практике это применяется в программах компьютерного зрения, распознавания объектов, человеческой речи и т.п. Определяющий признак, который сделает Knights Mill подходящей платформой для глубинного обучения — то, что Intel довольно расплывчато обозначила термином «переменная точность». Скорее всего, речь идет о поддержке формата чисел с плавающей запятой FP16 (половинная точность) либо других форматов с еще меньшей разрядностью. FP16 является приоритетным форматом для задач глубинного обучения, поскольку они не требуют более высокой точности, а процессор достигает более высокой пропускной способности при условии, что FP16 поддерживается им «в железе». Поддержка половинной точности реализована в GPU последнего поколения от AMD и NVIDIA, и ускорители вычислений Tesla на базе архитектуры Pascal специально оптимизированы для высокой скорости в работе с FP16. Появление чипов Knights Mill упрочит позиции Intel в конкуренции с NVIDIA на этом рынке. При этом разработчики указывают на ряд преимуществ архитектуры MIC по сравнению с графическими процессорами. Xeon Phi, начиная с поколения Kings Landing, существуют в сокетном форм-факторе, который позволяет загружать ОС непосредственно с MIC без необходимости в отдельном CPU традиционной архитектуры. Также, наряду с массивом высокоскоростной набортной памяти MCDRAM (разновидность HBM) Knights Landing, как и его потомок Knights Mill, может напрямую адресовать внешние модули DDR4 SDRAM. NVIDIA Tesla не может похвастаться такими функциями.  Массовое производство чипов Knights Mill намечено на 2017 г. Судя по графику на слайде Intel (который, впрочем, вряд ли отражает какие-либо твердые числа), Knights Mill удвоит показатели быстродействия, характерные для предыдущего поколения Xeon Phi. Это, в свою очередь, сигнализирует о применении техпроцесса 10 нм, и в таком случае не исключено, что Knights Mill — это просто новое название для ранее анонсированной архитектуры Knights Hill.
20.06.2016 [19:30], Илья Гавриченков
Intel представила процессоры Xeon Phi Knights LandingМногоядерные ускорители вычислений Intel Xeon Phi продолжают своё развитие. Об их очередном поколении с кодовым именем Knights Landing разработчик рассказывает уже почти три года, а с конца прошлого года даже поставляет образцы систем с ними своим избранным партнёрам. Однако до официального анонса дело дошло только сейчас. В рамках проходящей в эти дни в Германии конференции ISC High Performance 2016 компания Intel официально объявила о выходе принципиально новых Xeon Phi на базе дизайна Knights Landing, ключевое свойство которых заключается в том, что теперь это — не сопроцессоры, а полноценные x86-процессоры, способные взять на себя роль центрального компонента системы. Иными словами, новые Xeon Phi могут работать полностью самостоятельно, не нуждаясь ни в каком дополнительном управляющем CPU. И это очень важное улучшение, так как проведённое коренное изменение архитектуры ликвидирует узкое место — шину PCI Express, которую используют для передачи данных предшествующие и конкурирующие ускорители вычислений, например, базирующиеся на GPU. 
Источник изображений: Intel Knights Landing воплощают собой уже третье поколение многоядерной x86-архитектуры Intel. Предыдущее поколение, известное под кодовым именем Knights Corner, базировалось на Pentium-подобных ядрах P54C. Новая же версия ускорителей переехала на модифицированную 14-нм микроархитектуру Airmont, известную по процессорам Atom. Однако в Knights Landing ядра Airmont попарно объединены в модули, которые включают также мегабайтный L2-кеш и четыре блока VPU (Vector Processing Unit), отвечающих за поддержку векторных инструкций AVX-512. Всего в новых процессорах Xeon Phi содержится до 36 таких модулей, то есть, общее число ядер в ускорителе может достигать 72. При этом каждое ядро дополнительно поддерживает технологию Hyper-Threading и способно выполнять до четырёх потоков одновременно, что наделяет Xeon Phi впечатляющим арсеналом средств для работы с параллельными вычислениями. Учитывая, что в Knights Landing производительность на поток по сравнению с Knights Corner выросла примерно втрое только за счёт смены микроархитектуры, обновление ускорителей Xeon Phi дало им возможность дотянуться до планки в 3 Тфлопс. Процессоры Knights Landing снабжены также интегрированной памятью MCDRAM с пропускной способностью до 500 Гбайт/с и объёмом 16 Гбайт, которая может взаимодействовать с системной шестиканальной DDR4-памятью по нескольким принципиально различным алгоритмам. Упоминания заслуживает и реализация в новых Xeon Phi отдельного двухпортового 100 Гбит/с-контроллера Omni-Path, который предполагается использовать для высокоскоростного объединения узлов, основанных на Knights Landing, в вычислительные кластеры. Объявленная сегодня линейка процессоров Xeon Phi поколения Knights Landing включает четыре модели с числом ядер от 64 до 72 и частотой от 1,3 до 1,5 ГГц.  Стоит отметить, что в настоящее время для заказчиков доступны лишь три младшие модели: Xeon Phi 7250, 7230 и 7210. Самая же мощная 72-ядерная версия ускорителя, Xeon Phi 7290, обещана к сентябрю. Также пока Intel не поставляет варианты с интегрированным контроллером Omni-Path, который по плану появится в перечисленных моделях в октябре этого года. Высокая производительность процессоров Xeon Phi, простая масштабируемость систем на их основе, а также полная совместимость с x86-экосистемой и знакомым всем средствами разработки, делает новинки отличным вариантом для использования в массе областей, где требуются параллельные высокопроизводительного вычисления. И особенно Intel подчёркивает применимость построенных на Xeon Phi кластеров в системах машинного обучения и искусственного интеллекта, то есть тех областях, где в последнее время высокую активность развила NVIDIA, реализующая свои ускорители семейства Tesla. В подтверждение лидирующих характеристик Knights Landing, компания Intel приводит информацию о кратном превосходстве системы на базе Xeon Phi 7250 над системой, в которой используется конкурирующий ускоритель вычислений NVIDIA Tesla K80 и пара центральных процессоров Xeon E5-2697 v4. 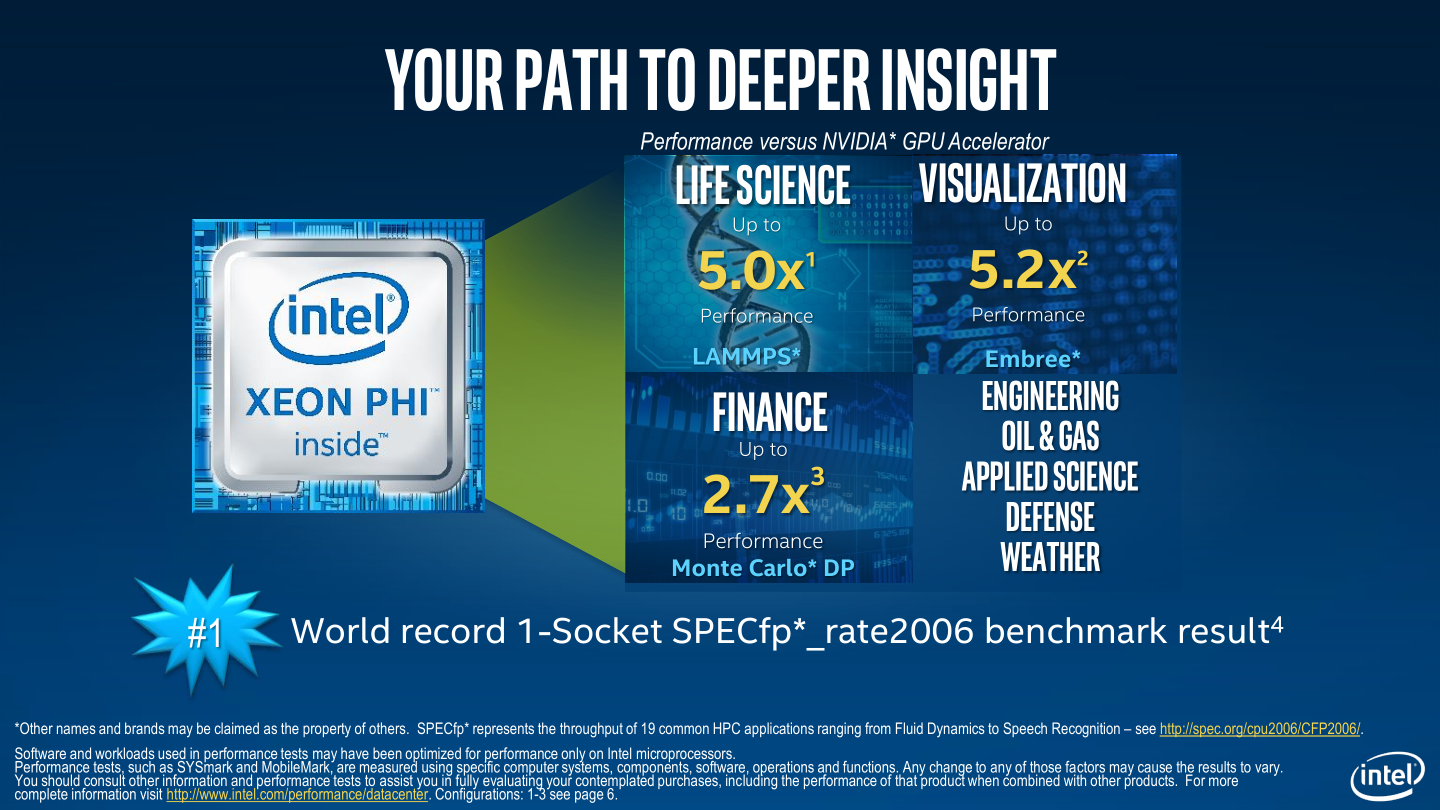 При этом, Intel говорит не только о достигающем пятикратного размера преимуществе Xeon Phi в производительности. Согласно информации компании, конфигурация с процессором Xeon Phi 7250 оказывается в восемь раз экономичнее и в девять — дешевле. Учитывая всё сказанное, Intel ожидает, что внедрение новых Xeon Phi пойдёт очень быстрыми темпами. До конца года производитель намеревается продать более ста тысяч процессоров, а готовые системы на базе Knights Landing будут поставлять более 50 компаний, включая Dell, Fujitsu, Hitachi, HP, Inspur, Lenovo, NEC, Oracle, Quanta, SGI, Supermicro, Colfax и другие. Кстати, в этом списке место нашлось и для российского интегратора — группы компаний РСК — которая собирается поставлять высокоплотные кластерные решения на базе Xeon Phi, оснащённые системами жидкостного охлаждения. |
|
|||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||