
Материалы по тегу: ram
|
15.10.2024 [19:43], Николай Хижняк
Rambus представила полный набор компонентов для выпуска DDR5-памяти MRDIMM-12800 и RDIMM-8000Компания Rambus объявила о выпуске наборов электронных SMD-компонентов, необходимых для производства модулей ОЗУ RDIMM и MRDIMM нового поколения для серверов. Наборы включают тактовые генераторы, драйверы для управления питанием и некоторые другие компоненты. В представленный Rambus набор вошли следующие базовый компоненты:
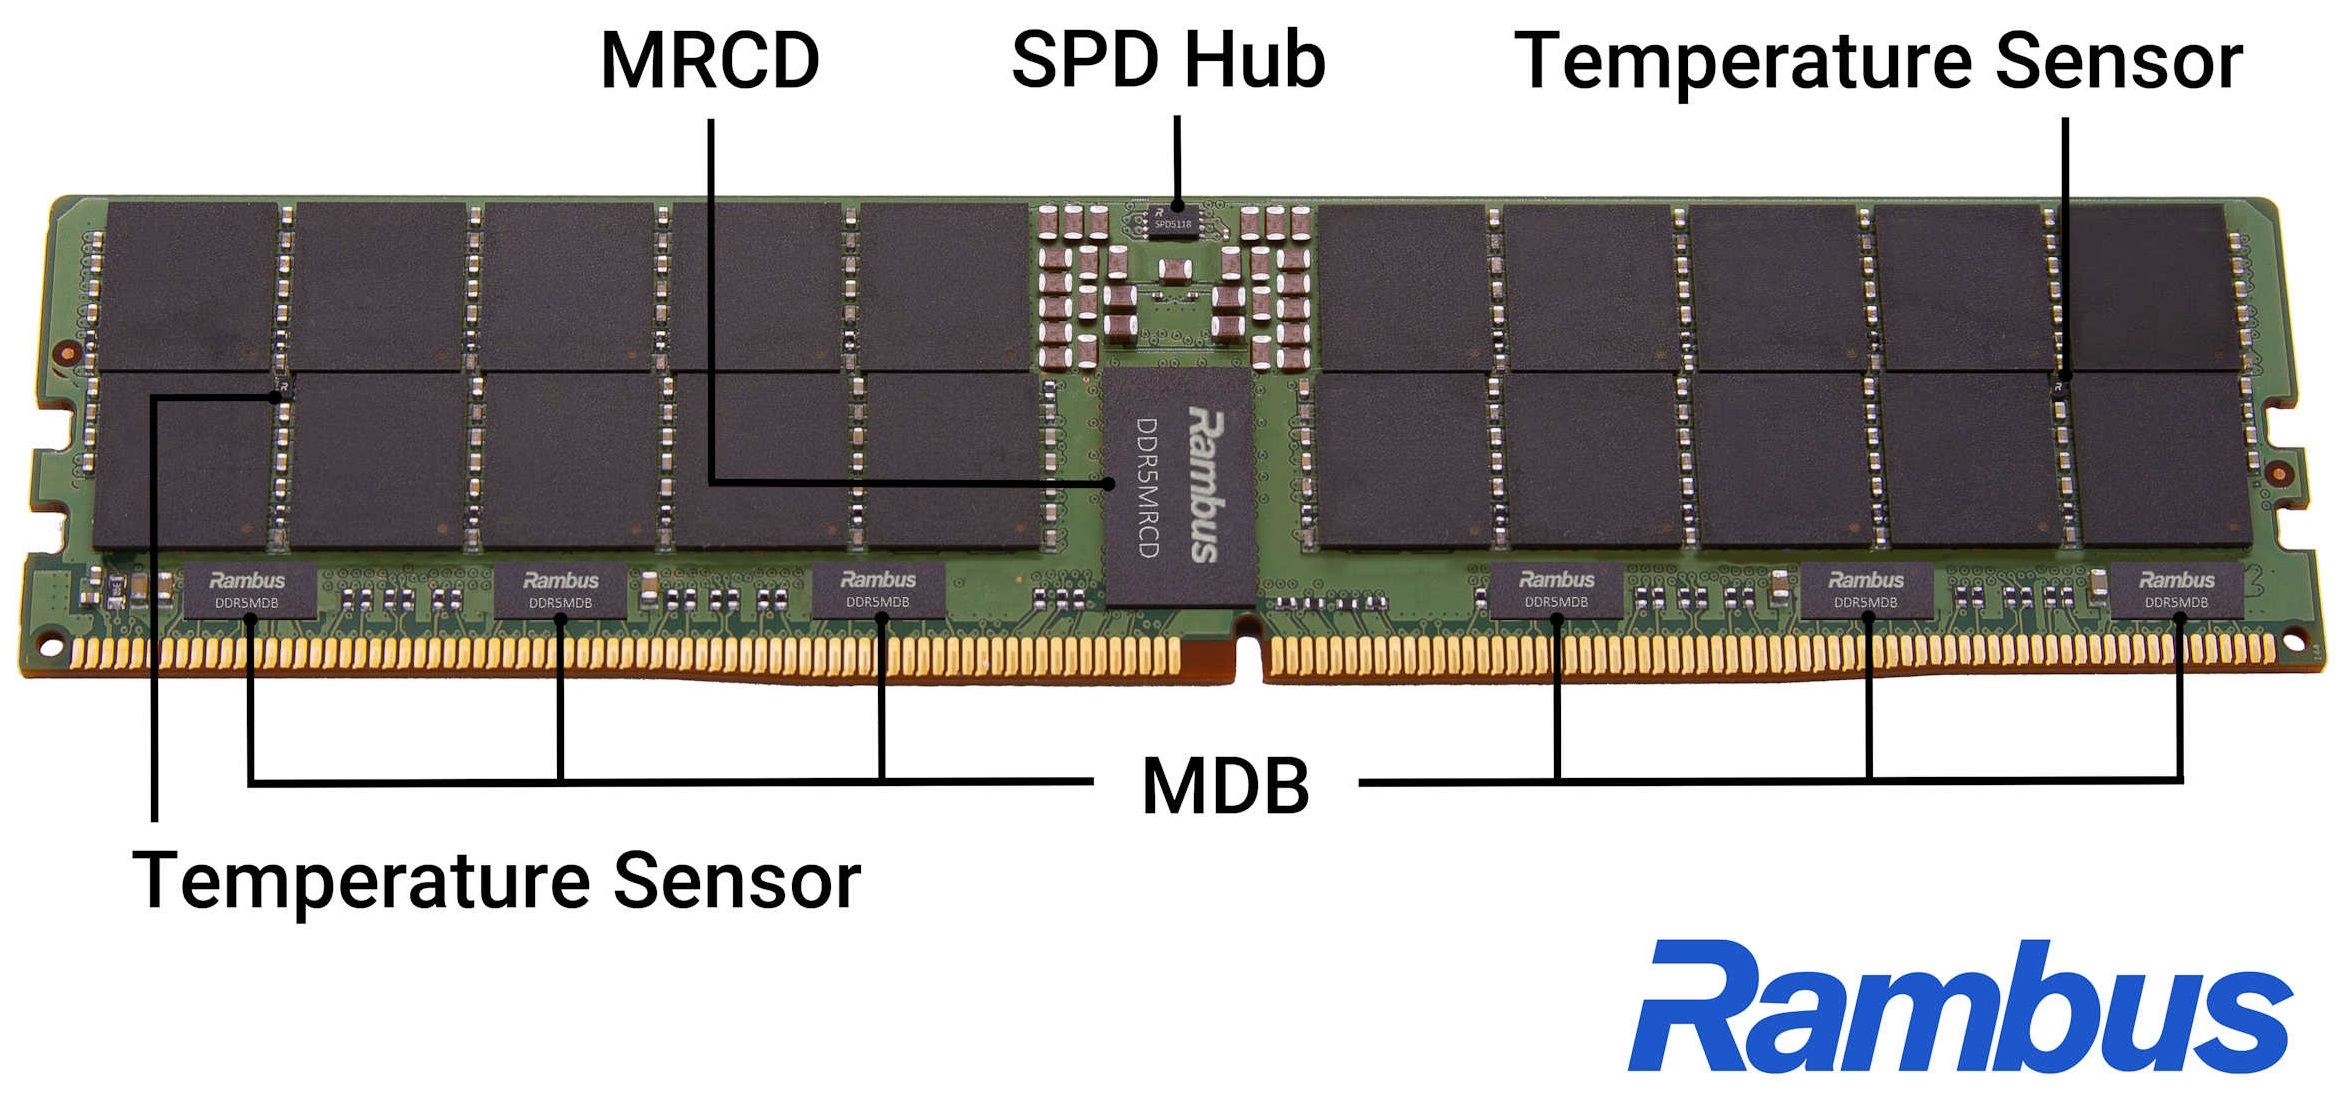
Источник изображения: Rambus Компания поясняет, что DDR5 MRDIMM-12800 использует новую конструкцию модуля, которая повышает скорость передачи данных и производительность системы за счёт мультиплексирования двух рангов, эффективно чередуя два потока данных. Это позволяет шине памяти хоста удвоить скорость передачи данных в сравнении с традиционными модулями при использовании тех же физических соединений DDR5 RDIMM. Для этого требуется чип MRCD, который может адресовать два ранга DRAM в чередующихся тактовых циклах, а также чипы MDB для управления потоками данных к микросхемам DRAM и от них. Для каждого модуля DDR5 MRDIMM-12800 требуется один MRCD и десять чипов MDB. MRCD и MDB также будут поддерживать формфактор Tall MRDIMM с четырьмя рангами.
27.07.2024 [23:44], Алексей Степин
Не так просто и не так быстро: учёные исследовали особенности работы памяти и NVLink C2C в NVIDIA Grace HopperГибридный ускоритель NVIDIA Grace Hopper объединяет CPU- и GPU-модули, которые связаны интерконнектом NVLink C2C. Но, как передаёт HPCWire, в строении и работе суперчипа есть некоторые нюансы, о которых рассказали шведские исследователи. Им удалось замерить производительность подсистем памяти Grace Hopper и интерконнекта NVLink в реальных сценариях, дабы сравнить полученные результаты с характеристиками, заявленными NVIDIA. Напомним, для интерконнекта изначально заявлена скорость 900 Гбайт/с, что в семь раз превышает возможности PCIe 5.0. Память HBM3 в составе GPU-части имеет ПСП до 4 Тбайт/с, а вариант с HBM3e предлагает уже до 4,9 Тбайт/с. Процессорная часть (Grace) использует LPDDR5x с ПСП до 512 Гбайт/с. В руках исследователей оказалась базовая версия Grace Hopper с 480 Гбайт LPDDR5X и 96 Гбайт HBM3. Система работала под управлением Red Hat Enterprise Linux 9.3 и использовала CUDA 12.4. В бенчмарке STREAM исследователям удалось получить следующие показатели ПСП: 486 Гбайт/с для CPU и 3,4 Тбайт/с для GPU, что близко к заявленным характеристиками. Однако результат скорость NVLink-C2C составила всего 375 Гбайт/с в направлении host-to-device и лишь 297 Гбайт/с в обратном направлении. Совокупно выходит 672 Гбайт/с, что далеко от заявленных 900 Гбайт/с (75 % от теоретического максимума). 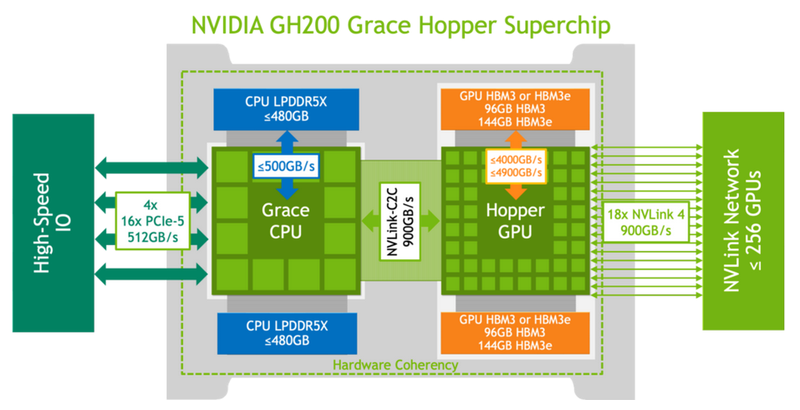
Источник: NVIDIA Grace Hopper в силу своей конструкции предлагает два вида таблицы для страниц памяти: общесистемную (по умолчанию страницы размером 4 Кбайт или 64 Кбайт), которая охватывает CPU и GPU, и эксклюзивную для GPU-части (2 Мбайт). При этом скорость инициализации зависит от того, откуда приходит запрос. Если инициализация памяти происходит на стороне CPU, то данные по умолчанию помещаются в LPDDR5x, к которой у GPU-части есть прямой доступ посредством NVLink C2C (без миграции), а таблица памяти видна и GPU, и CPU. 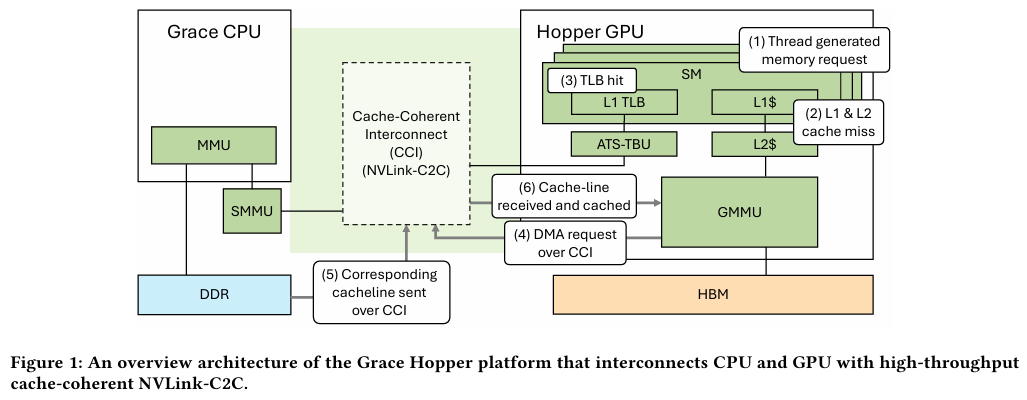
Источник: arxiv.org Если же памятью управляет не ОС, а CUDA, то инициализацию можно сразу организовать на стороне GPU, что обычно гораздо быстрее, а данные поместить в HBM. При этом предоставляется единое виртуальное адресное пространство, но таблиц памяти две, для CPU и GPU, а сам механизм обмена данными между ними подразумевает миграцию страниц. Впрочем, несмотря на наличие NVLink C2C, идеальной остаётся ситуация, когда GPU-нагрузке хватает HBM, а CPU-нагрузкам достаточно LPDDR5x. 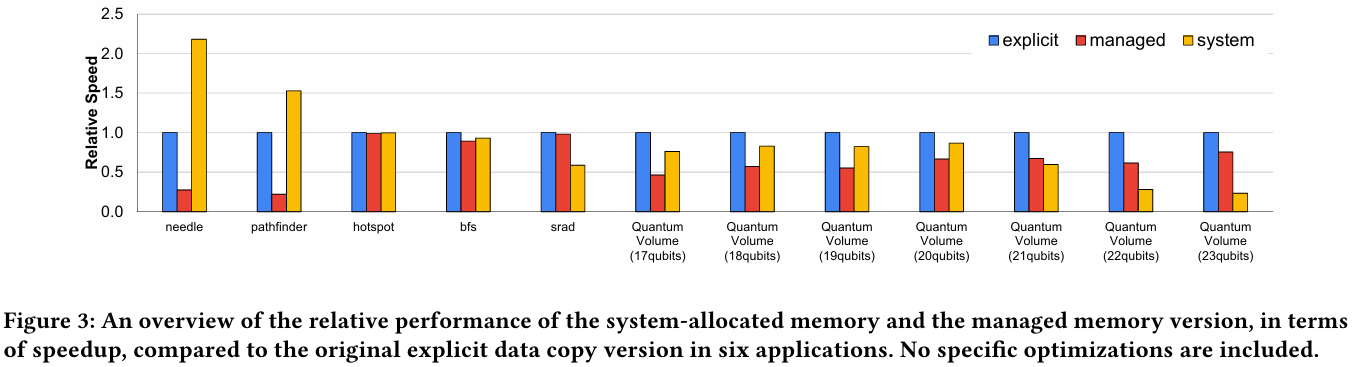
Источник: arxiv.org Также исследователи затронули вопрос производительности при использовании страниц памяти разного размера. 4-Кбайт страницы обычно используются процессорной частью с LPDDR5X, а также в тех случаях, когда GPU нужно получить данные от CPU через NVLink-C2C. Но как правило в HPC-нагрузках оптимальнее использовать 64-Кбайт страницы, на управление которыми расходуется меньше ресурсов. Когда же доступ в память хаотичен и непостоянен, страницы размером 4 Кбайт позволяют более тонко управлять ресурсами. В некоторых случаях возможно двукратное преимущество в производительности за счёт отсутствия перемещения неиспользуемых данных в страницах объёмом 64 Кбайт. В опубликованной работе отмечается, что для более глубокого понимания механизмов работы унифицированной памяти у гетерогенных решений, подобных Grace Hopper, потребуются дальнейшие исследования.
03.07.2024 [23:49], Сергей Карасёв
Panmnesia расширит память GPU с помощью DRAM или даже SSDЮжнокорейский стартап Panmnesia сообщил о разработке специализированного CXL-решения, которое позволяет расширять встроенную память ускорителей на базе GPU путём подключения внешних блоков DRAM или даже SSD. Отмечается, что современным приложениям ИИ и НРС требуется значительный объём быстрой памяти, но возможности ускорителей в этом плане ограничены. Сложность расширения памяти актуальных ускорителей заключается в том, что в таких изделиях отсутствуют логическая структура CXL и компоненты, поддерживающие DRAM и/или SSD. Кроме того, подсистемы кеша и памяти GPU не распознают никаких расширений. В лучшем случае предлагается механизм унифицированной виртуальной памяти (UVM) для совместного доступа к содержимому памяти и CPU, и GPU. Однако этот механизм довольно медленный. 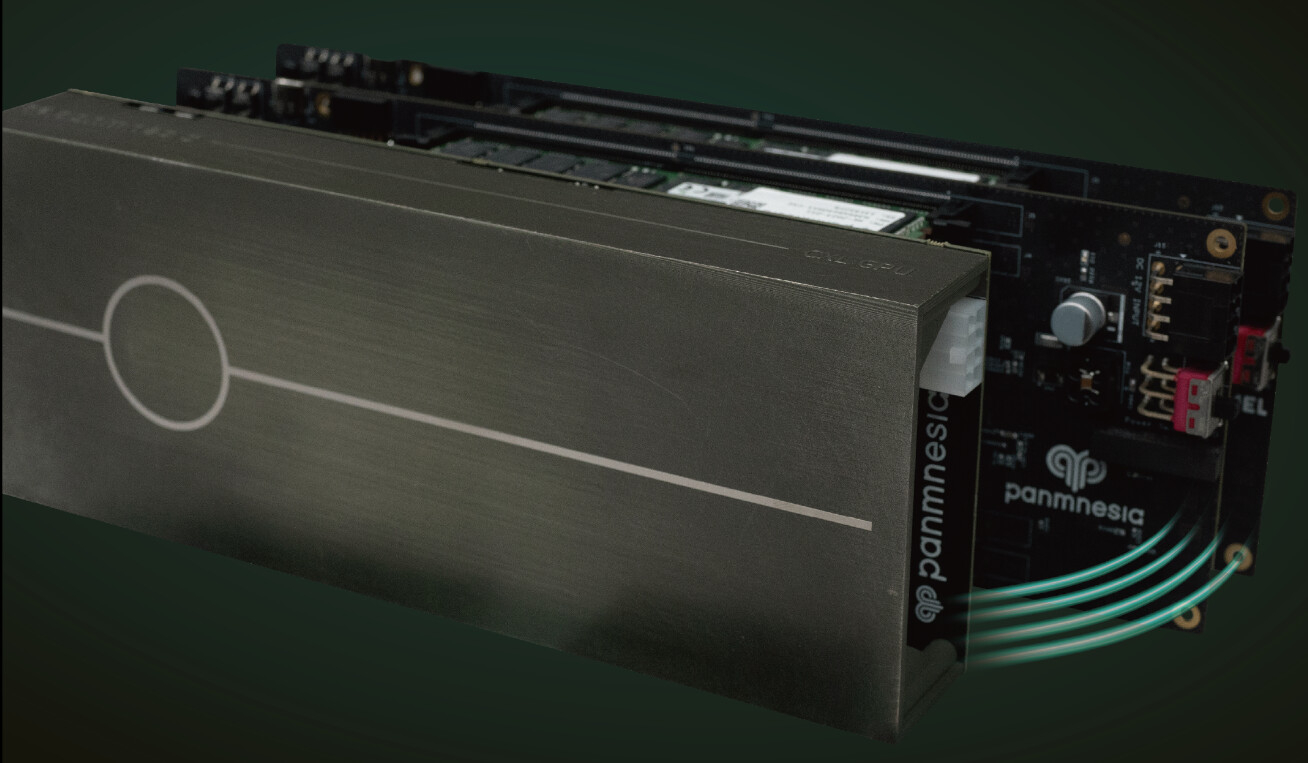
Источник изображений: Panmnesia Panmnesia обошла существующие ограничения путём создания собственного root-комплекса, совместимого со стандартом CXL 3.1 и предоставляющего несколько root-портов. Он и обеспечивает поддержку внешней памяти через PCIe. При этом задействован особый декодер HDM (Host-managed Device Memory), отвечающий за работу с адресными пространствами. Это сложное решение в каком-то смысле «обманывает» подсистему памяти ускорителя, заставляя ее рассматривать внешнюю PCIe-память как доступную напрямую. 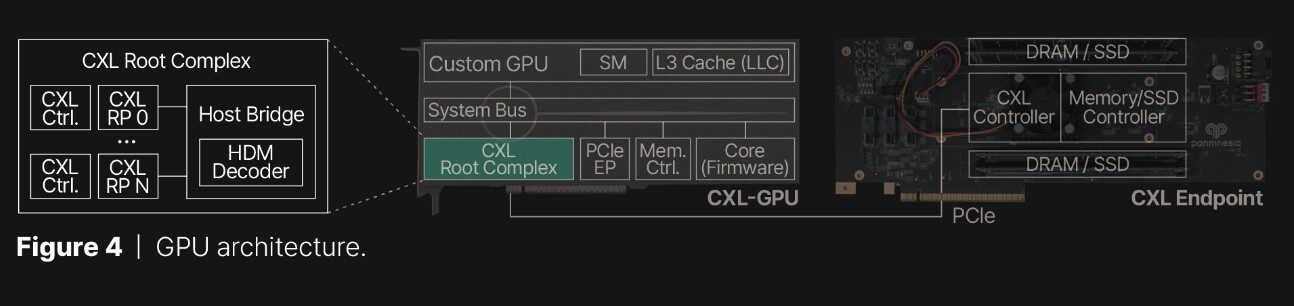 Прототип, основанный на кастомизированном GPU, в ходе тестов продемонстрировало задержки менее 100 нс при передаче данных в обоих направлениях. При этом решение Panmnesia предоставляет более гранулярный доступ к памяти в сравнении с UVM. Быстродействие CXL-системы Panmnesia оказалось в 3,22 раза выше в пересчёте на IPC по сравнению с UVM.
24.05.2024 [15:09], Сергей Карасёв
Разработчик «компрессора» для оперативной памяти ZeroPoint получил первые инвестицииСтартап ZeroPoint Technologies AB, разрабатывающий специализированные аппаратные решения для сжатия данных в высокопроизводительных системах, объявил о проведении раунда финансирования Series A, в ходе которого на развития привлечено €5 млн. 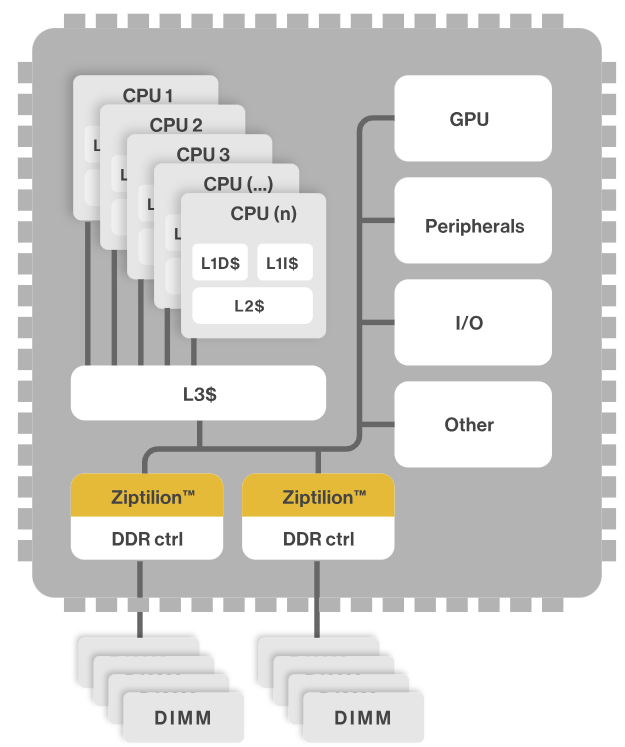
Источник изображений: ZeroPoint ZeroPoint — это дочерняя компания Технического университета Чалмерса (Chalmers University of Technology) в Гётеборге (Швеция). Стартап запущен с целью коммерциализации исследований в области методов сжатия данных, которые его соучредители Пер Стенстрём (Per Stenström) и Ангелос Арелакис (Angelos Arelakis) проводили в вузе. Скорость, с которой серверный процессор может извлекать данные из DRAM, напрямую влияет на его производительность, а значит, и на быстродействие всей системы в целом. При этом, как заявляет ZeroPoint, обычно до 70 % хранимых данных являются избыточными. Одним из способов ускорить процесс получения информации является сжатие. Однако исторически применение этого метода было непрактичным, поскольку даже самые продвинутые алгоритмы компрессии относительно медленны, что сводит на нет любую потенциальную выгоду.  ZeroPoint решает проблему с помощью, как утверждается, первого в своём роде подхода с аппаратным ускорением. Технология сочетает в себе сверхбыстрое сжатие данных без потерь и на лету, уплотнение в реальном времени и «прозрачное» управление памятью. Для выполнения этих задач применяется небольшой IP-блок Ziptilion-BW, который может быть интегрирован практически с любым стандартным контроллером памяти и совместим с (LP)DDR4/5 и HBM.  ZeroPoint заявляет, что предложенный подход позволят увеличить эффективную ёмкость памяти в 2–4 раза, а также обеспечивает повышение производительности на Ватт до 50 %. Таким образом, общая стоимость владения серверами в дата-центрах может быть снижена на 25 %. Утверждается, что технология ZeroPoint в 1000 раз быстрее, чем другие существующие методы сжатия. ZeroPoint использует проприетарные методы, которые динамически определяют, какие именно данные можно сжать и каким именно образом. Для дополнительного ускорения извлечения данных в устройство интегрирован собственный кеш. Раунд финансирования Series A возглавила мюнхенская компания Matterwave Ventures. Средства также предоставили Industrifonden, Climentum Capital и Chalmers Ventures. Деньги будут использованы для дальнейших разработок и коммерциализации технологии. Компания также предлагает «компрессоры» для L2/L3-кеша и CXL/NVMe-устройств, ускоритель для zram/zswap и блок (де-)шифрования.
16.03.2024 [23:19], Сергей Карасёв
Pure Storage: рост ёмкости SSD будет ограничен возможностями DRAMКомпания Pure Storage, специализирующаяся на All-Flash СХД, считает, что дальнейшее увеличение вместимости SSD будет сопряжено с рядом трудностей, продиктованных необходимостью применения DRAM. Об этом, как сообщает ресурс Blocks & Files, рассказал Шон Роузмарин (Shawn Rosemarin), вице-президент Pure по исследованиям и разработкам. По его словам, коммерческим SSD требуется примерно 1 Гбайт DRAM на каждый 1 Тбайт флеш-памяти. Наличие DRAM необходимо для подсистемы Flash Translation Layer (FTL). По словам Роузмарина, для накопителя ёмкостью 30 Тбайт требуется 30 Гбайт DRAM, для 75 Тбайт — 75 Гбайт и т. д. Таким образом, для SSD вместимостью, например, 128 Тбайт нужно 128 Гбайт DRAM, а это уже сопоставимо с объёмом ОЗУ в сервере. 
Источник изображения: Pure Storage Роузмарин отмечает, что увеличение вместимости корпоративных SSD свыше 30 Тбайт будет проблематично. Во-первых, DRAM заметно дороже NAND, что приведёт к значительному росту стоимости SSD. Во-вторых, из-за увеличения объёма DRAM возрастает энергопотребление, что не только поднимет стоимость владения, но и ухудшит надёжность накопителя. В результате по мере роста вместимости SSD заказчики могут столкнуться с серьёзным увеличением затрат. Роузмарин заявляет, что единственный способ обойти указанные проблемы — найти более экономичную и менее энергозатратную альтернативу DRAM. Необходимые функции, по его словам, могут быть перенесены непосредственно на ПО СХД. Именно такой подход Pure реализует со своими проприетарными накопителями DFM (Direct Flash Module), последняя модификация которых имеет ёмкость 75 Тбайт. В этих устройствах отсутствует зависимость от DRAM на уровне накопителей. Компания намерена выпустить DFM ёмкостью 150 Тбайт в 2025 году, а на 300 Тбайт — ориентировочно в 2026-м. В дальнейшие планы входит создание изделий вместимостью 600 Тбайт и 1,2 Пбайт. Аналогичного подхода придерживается и IBM в своих накопителях FlashCore Modules (FCM).
14.08.2023 [17:37], Алексей Степин
CXL-пул Panmnesia втрое быстрее RDMA-систем и может предложить 6 Тбайт RAMНа конференции Flash Memory Summit южнокорейская компания Panmnesia продемонстрировала свою версию CXL-пула DRAM объёмом 6 Тбайт на базе программно-аппаратного стека собственной разработки. Новинка продемонстрировала более чем троекратное превосходство над системой, построенной на базе технологии RDMA, в нагрузках, связанной с работой рекомендательной ИИ-системы Meta✴. Panmnesia разработана в сотрудничестве с Корейским инститом передовых технологий (KAIST). О более раннем варианте разработок KAIST в этой области мы рассказывали в 2022 году. Коммерческий вариант комплекса поддерживает CXL 3.0 и состоит из CXL-процессора, коммутатора и модулей расширения памяти. Все модули выполнены в форм-факторе, чрезвычайно напоминающем FHFL-карты. Модули устанавливаются в универсальное шасси, при этом их можно произвольно комбинировать. 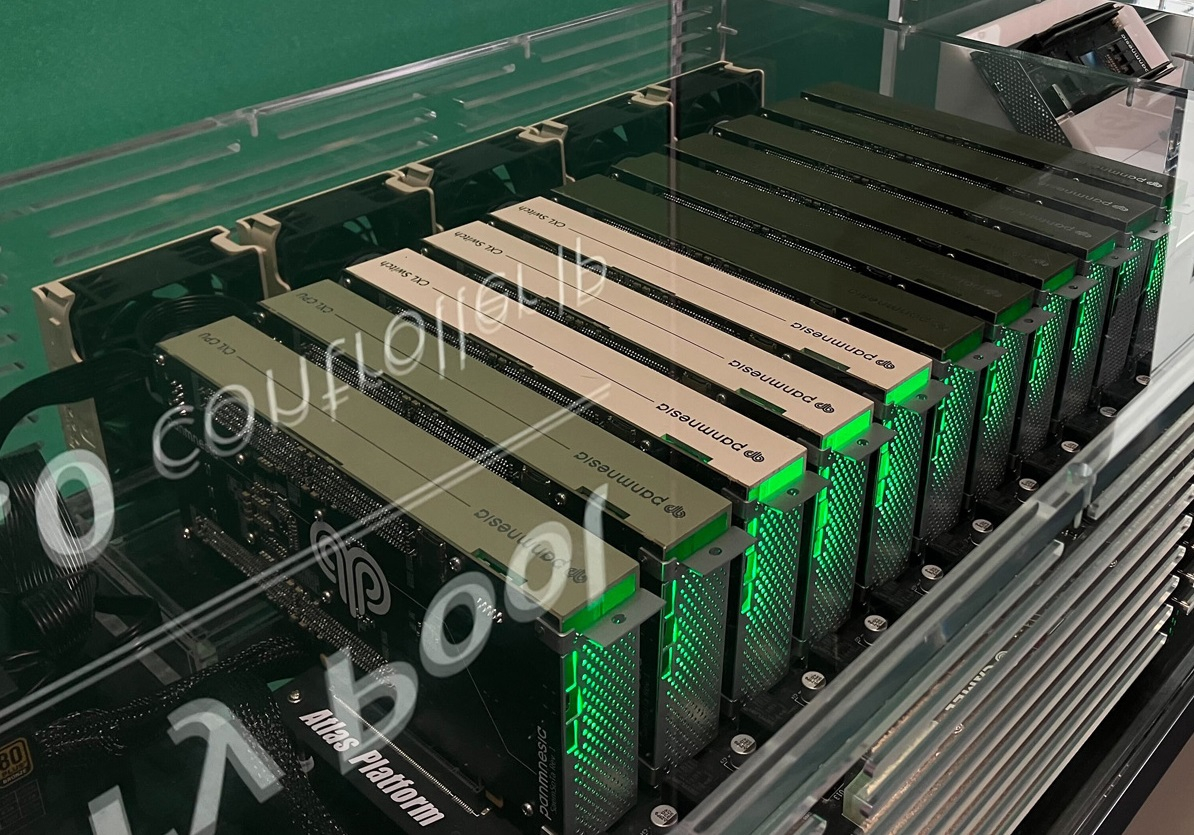
Источник изображений здесь и далее: Panmnesia Демо-платформа содержала два процессорных модуля, три модуля коммутации и шесть 1-Тбайт модулей памяти. Модули памяти построены на базе обыкновенных DIMM-планок и поддерживают их замену и расширение. Реализован не только режима CXL.mem, но и CXL.cache и CXL.io. При этом компания предлагает не только готовые IP-решения, но и их кастомизацию под конкретного заказчика, что поможет оптимизировать цикл создания продукта и снизить общую стоимость разработки и валидации. 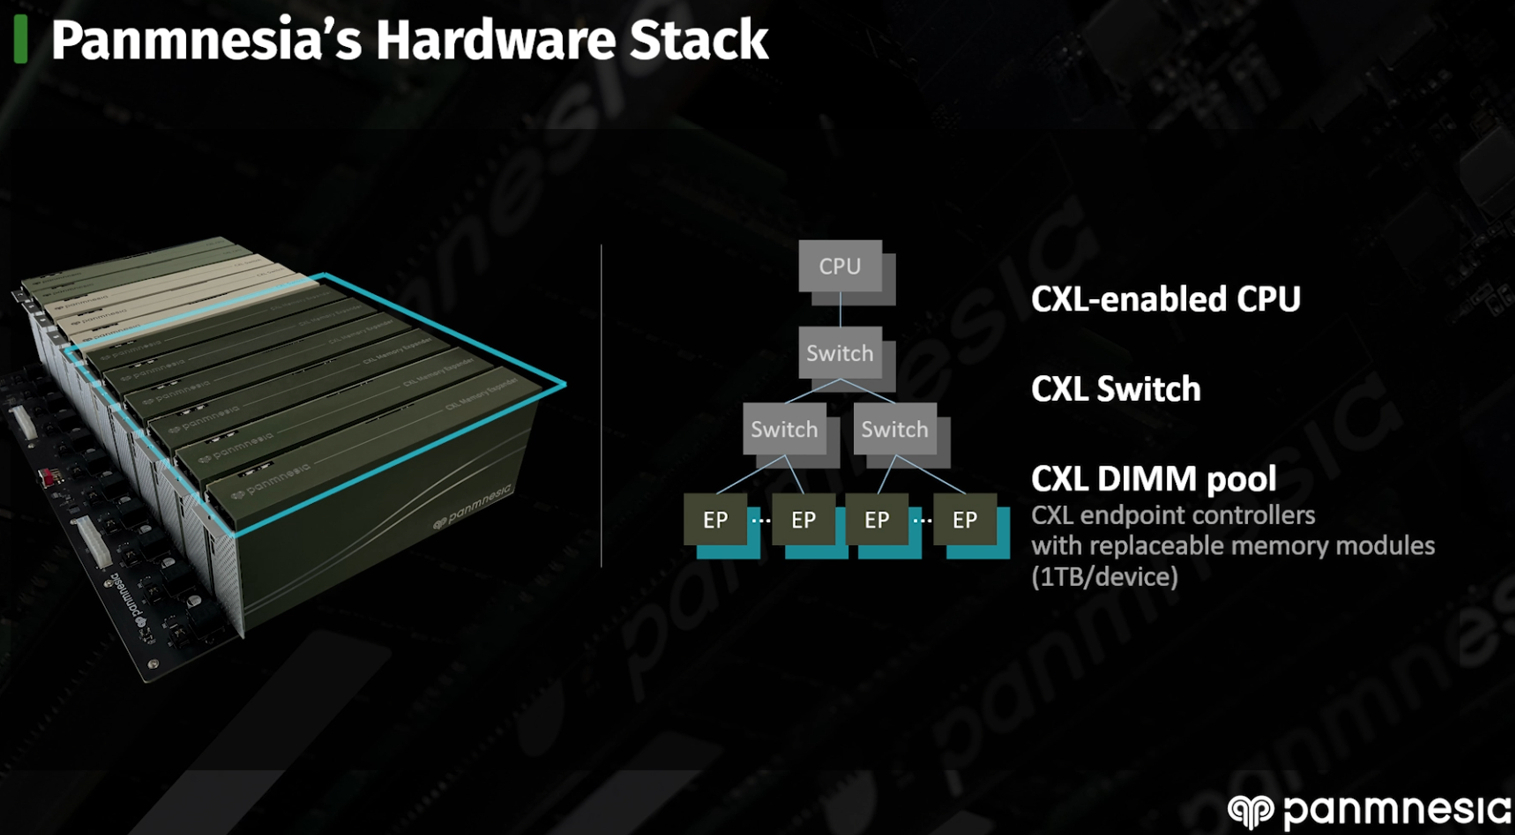 Фирменное ПО базируется на Linux и содержит необходимые драйверы, а также специализированную виртуальную машину, с помощью которой пространство памяти представляется в виде безпроцессорного NUMA-узла. Поверх этих компонентов функционирует пользовательская часть, отвечающая за эффективное размещение и предвыборку (prefetching) данных. По ряду параметров Panmnesia можно назвать лидером в области CXL-решений. В частности, по объёму DRAM она уже обгоняет совместное решение Samsung, MemVerge, H3 и XConn, а использование DIMM-модулей только придаёт ей гибкости. Развитая программная часть, как утверждается, упрощает и удешевляет интеграцию в существующую инфраструктуру ЦОД. Спектр применения, как и у всех систем CXL-пулинга, крайне широкий и включает в себя не только ИИ-сценарии, но и любые задачи, требующие большого объёма оперативной памяти.
04.11.2019 [21:00], Алексей Степин
IBM продвигает открытый стандарт оперативной DDIMM-памяти OMI для серверовПрактически у всех современных процессоров контроллер памяти давно и прочно является частью самого ЦП, будь то монолитный кристалл или чиплетная сборка. Но не всегда подобная монолитность является плюсом — к примеру, она усложняет задачу увеличения количества каналов доступа к памяти. Таких каналов уже 8 и существуют проекты процессоров с 10 каналами памяти. Но это усложняет как сами ЦП, так и системные платы, ведь только на подсистему памяти, без учёта интерфейса PCI Express, может уйти 300 и более контактов, которые ещё требуется корректно развести и подключить. 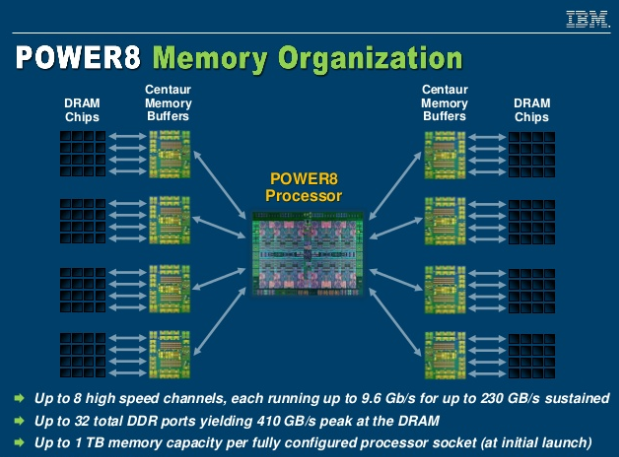
Организация подсистемы памяти у POWER8 У IBM есть ответ, и заключается он в переносе части функций контроллера памяти на сторону модулей DIMM. Сам интерфейс между ЦП и модулями памяти становится последовательным и предельно унифицированным. Похожая схема использовалась в стандарте FB-DIMM, аналогичную компоновку применила и сама IBM в процессорах POWER8 и POWER9 в варианте Scale-Up. 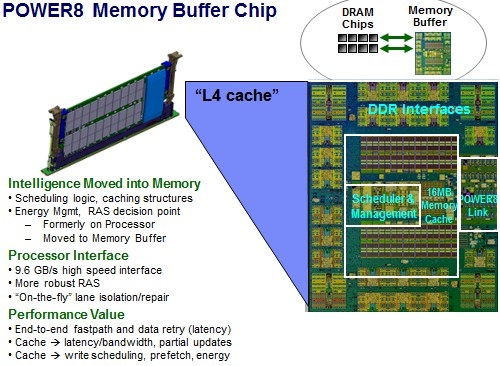
Роль и возможности буфера Centaur у POWER8 Контроллер памяти у этих процессоров упрощён, в нём отсутствует контроллер физического уровня (PHY). Его задачи возложены на чип-буфер Centaur, который посредством одноимённого последовательного интерфейса и связывается с процессором на скорости 28,8 Гбайт/с. Контроллеров интерфейса Centaur в процессорах IBM целых восемь, что дает ПСП в районе 230 Гбайт/с. За счёт выноса ряда функций в чипы-буфера удалось сократить площадь кристалла, и без того немалую (свыше 700 мм2), но за это пришлось заплатить увеличением задержек в среднем на 10 нс. Частично это сглажено за счёт наличия в составе Centaur кеша L4. 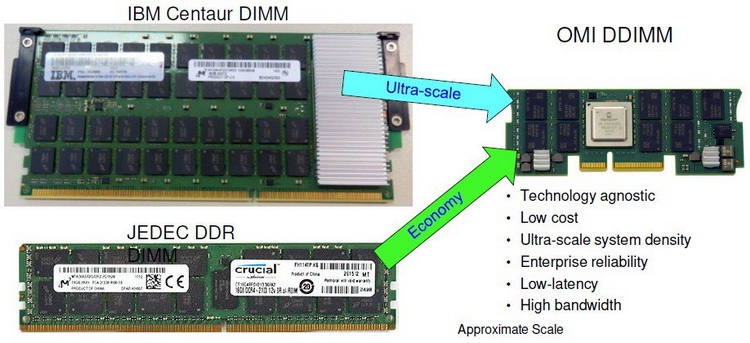
Сравнительные размеры модулей Centaur, RDIMM и OMI DDIMM Стандарт не является открытым, но IBM предлагает ему на смену полностью открытый вариант под названием Open Memory Interface (OMI). В его основу положена семантика и протоколы, описанные в стандарте OpenCAPI 3.1, а физический уровень представлен шиной BlueLink (25 Гбит/с на линию), которая уже используется для реализации NVLink и OpenCAPI. Реализация OMI проще Centaur, что позволяет сделать чип-буфер более компактным и выделяющим меньше тепла. Но все преимущества сохраняются: так, число контактов процессора, отвечающих за интерфейс памяти, можно снизить с примерно 300 до 75, поскольку посылаются только простые команды загрузки и сохранения данных. Вся реализация физического интерфейса осуществляется силами чипа-компаньона OMI, и в нём же может находиться дополнительный кеш. 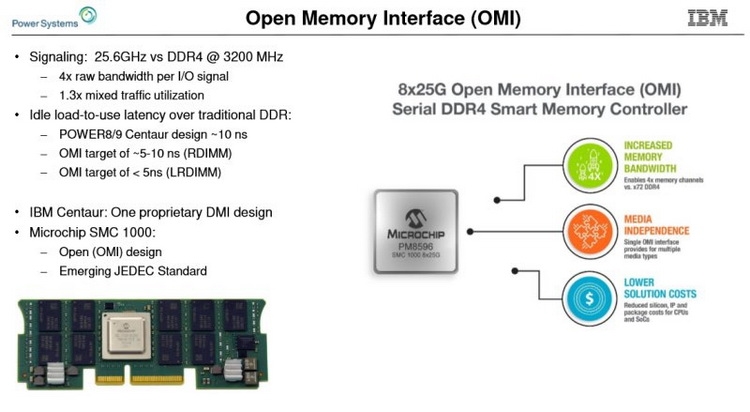
Модули OMI DDIMM станут стандартом JEDEC Помимо экономии контактов есть и ещё одна выгода: можно реализовать любой тип памяти, будь то DDR, GDDR и даже NVDIMM — вся PHY-часть придётся на различные варианты чипов OMI, но со стороны стандартного разъёма любой модуль OMI будет выглядеть одинаково. Сейчас взят прицел на реализацию модулей с памятью DDR5. При использовании существующих чипов DDR4 система с интерфейсом OMI может достичь совокупной ПСП порядка 650 Гбайт/с. Дополнительные задержки составят 5 ‒ 10 нс для RDIMM и лишь 4 нс для LRDIMM. Из всех соперников технологии на такое способны только сборки HBM, которые в силу своей природы имеют ограниченную ёмкость, дороги в реализации и не могут быть вынесены с общей с ЦП подложки. 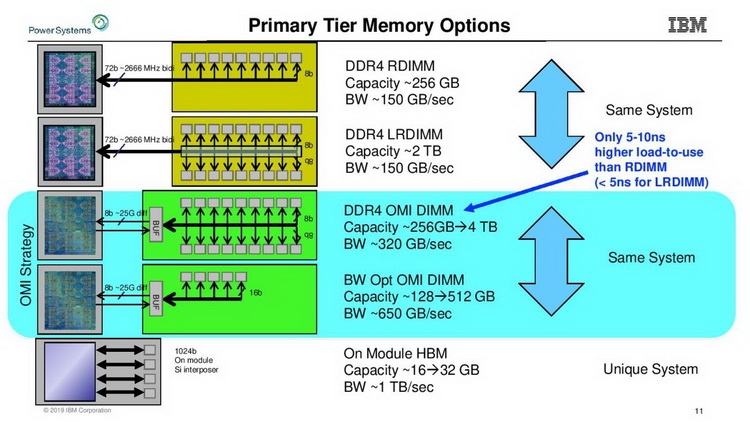
Новый стандарт упростит процессоры и позволит увеличить ёмкость подсистемы памяти Чипы-буферы OMI можно разместить как на модуле памяти, так и на системной плате. Разумеется, для стандартизации выбран первый вариант. В нём предусмотрено 84 контакта на модуль, сами же модули получили название Dual-Inline Memory Module (DDIMM). ✴-media" data-instgrm-captioned="" data-instgrm-permalink="https://www.instagram.com/p/B5I5Dmpj0rw/?utm_source=ig_embed&utm_campaign=loading" data-instgrm-version="12"> DDIMM вышли существенно компактнее своих традиционных собратьев: ширина модуля сократилась со 133 до 85 мм. Реализация буфера OMI ↔ DDR4 уже существует в кремнии: компания Microsemi продемонстрировала чип SMC 1000 (PM8596), поддерживающего 8 линий OMI со скоростью 25 Гбит/с каждая. Допустима также работа в режиме 4 × 1 с вдвое меньшей общей пропускной способностью. 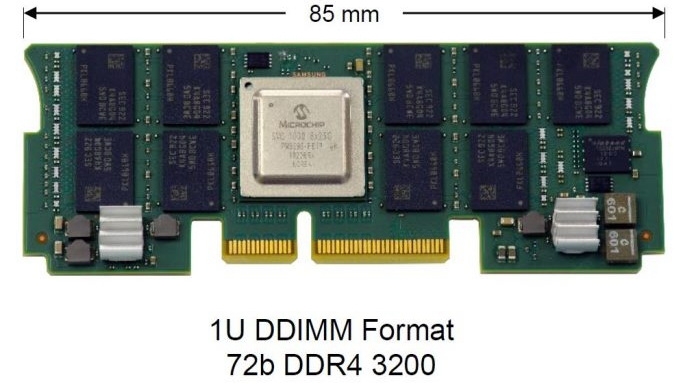
DDIMM: меньше ширина, проще разъём Со стороны чипов памяти SMC 1000 имеет стандартный 72-битный интерфейс с ECC и поддержкой различных комбинаций DRAM и NAND-устройств. Тактовая частота DRAM — до 3,2 ГГц, высота модуля зависит от количества и типов устанавливаемых чипов. В случае одиночной высоты модули могут иметь ёмкость до 128 Гбайт, двойная высота позволит создать DDIMM объёмом свыше 256 Гбайт. Сам чип SMC 1000 невелик, всего 17 × 17 мм, а невысокое тепловыделение гарантирует отсутствие проблем с перегревом, свойственных FB-DIMM. 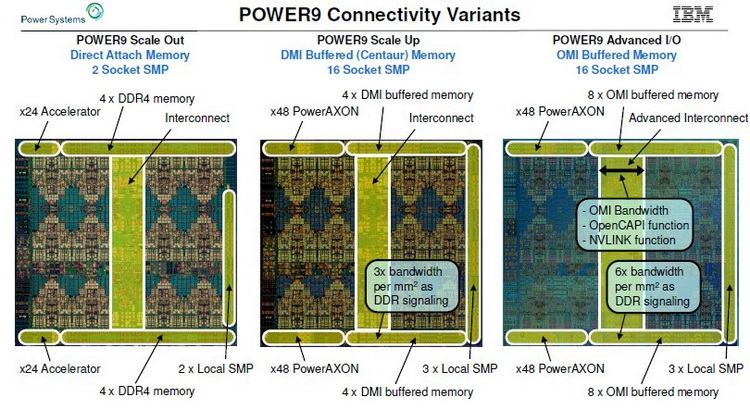
Процессоры IBM POWER9 AIO дополнили существующую серию Первыми процессорами с поддержкой OMI стали новые POWER9 версии Advanced I/O (AIO), дополнившие семейства Scale Up (SC) и Scale Out (SO). В них реализовано 16 каналов OMI по 8 линий каждый (до 650 Гбайт/с суммарно), а также новые версии интерфейсов NVLink (возможно, 3.0) и OpenCAPI 4.0. Количество линий PCI Express 4.0 по-прежнему составляет 48. Шина IBM BlueLink была переименована в PowerAXON. За счёт её использования в системах на базе процессоров POWER возможна реализация 16-сокетных систем без применения дополнительной логики. Максимальное количество ядер у POWER9 AIO равно 24, с учётом SMT4 это даёт 96 исполняемых потоков. Имеется также кеш L3 типа eDRAM объёмом 120 Мбайт. Техпроцесс остался прежним, это 14-нм FinFET. 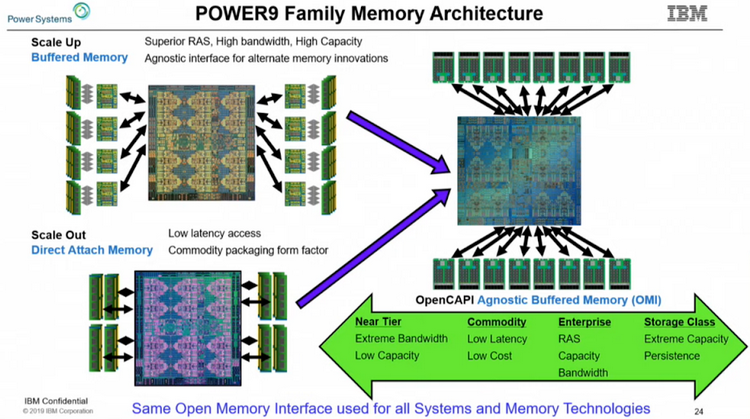
Архитектура подсистем памяти у семейства IBM POWER9 Поставки POWER9 AIO начнутся в этом году, цены неизвестны, но с учётом 8 миллиардов транзисторов и кристалла площадью 728 мм2 они не могут быть низкими. Однако без OMI эти процессоры были бы ещё более дорогими. В комплект поставки входит и чип-буфер OMI, правда, не самая быстрая версия с пропускной способностью на уровне 410 Гбайт/с. Задел для модернизации есть, и для расширения ПСП достаточно будет заменить модули DDIMM на более быстрые варианты. 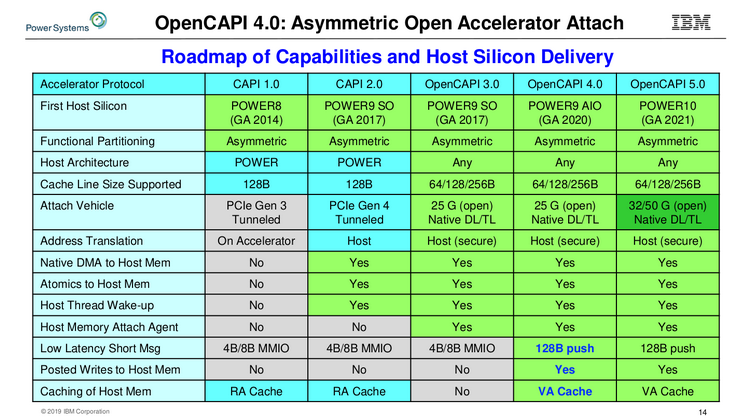
Сравнительная таблица существующих и будущих версий OpenCAPI Следующее поколение процессоров IBM, POWER10, появится только в 2021 году. К этому времени ожидается принятие стандарта OMI на рынке высокопроизводительных многопроцессорных систем. Попутно IBM готовит новые версии OpenCAPI, не привязанные к архитектуре POWER, а значит, путь к OMI будет открыт и другим вендорам. |
|

