
Материалы по тегу: xeon
|
17.01.2023 [15:33], Сергей Карасёв
Intel Xeon на китайский лад: Montage представила защищённые процессоры Jintide четвёртого поколения на базе Sapphire RapidsКитайская компания Montage Technology анонсировала процессор Jintide четвёртого поколения, рассчитанный на облачные платформы, корпоративные нагрузки, ИИ-приложения и системы НРС. В основу решения положен новейший чип Intel Xeon Sapphire Rapids, о котором можно подробно узнать в нашем материале. Ключевые отличия Jintide от стандартных Xeon заключаются в расширенных функциях безопасности. В новинках используются технологии PrC и DSC, которые обеспечивают различные уровни аппаратной защиты. Кроме того, такие чипы лучше адаптированы под потребности китайских поставщиков серверного оборудования. Решения Jintide совместимы с экосистемой x86, обладают хорошей масштабируемостью, гибкостью и удобством использования. Jintide — это комплексная платформа Montage, работающая в тандеме с фирменными гибридными модулями оперативной памяти HSDIMM, которые также обеспечивают защиту на аппаратном уровне. 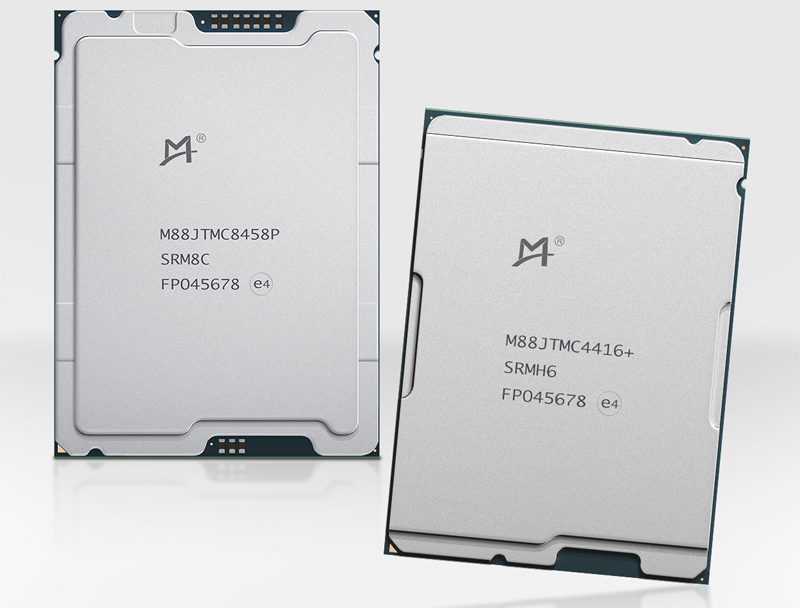
Источник изображения: Montage Technology Конфигурация Jintide четвёртого поколения включает до 48 вычислительных ядер и до 105 Мбайт кеша. Максимальная частота в турбо-режиме составляет 4,2 ГГц. Заявлена поддержка инструкций AMX (Advanced Matrix Extensions), памяти DDR5-4800 и 80 линий PCIe 5.0/CXL 1.1. Ранее Montage также представила CXL-экспандеры DDR4/DDR5. По запросу могут быть активированы дополнительные функции: Dynamic Load Balancer (DLB), Intel Data Streaming Accelerator (DSA), Intel In-Memory Analytics Accelerator (IAA), Intel In-Memory Analytics Accelerator и Intel QuickAssist (QAT).
12.01.2023 [15:47], Алексей Степин
Atos представила серверы BullSequana SH и edge-платформы EXR и EXD на базе Sapphire RapidsНовые процессоры Intel Xeon с архитектурой Sapphire Rapids навёрстывают упущенное и находят своё место в новых моделях серверов. На этот раз о новинках объявила компания Atos, представившая вычилительную систему BullSequana SH класса HPC и новые серверы в серии EX. Система BullSequana SH является модульной и расширяемой, базовым строительным блоком служит модуль SH20 с двумя процессорам Sapphire Rapids и 32 слотами DDR5 с поддержкой Optane PMem 300. Опциально такой модуль может нести на борту и пару DPU или GPU. До четырёх таких блоков можно объединить в единую систему с 8 процессорами, 32 Тбайт оперативной памяти и 8 ускорителями. Для этого нужны лишь UPI-коннекторы. Однако это не предел: с помощью специального модуля UBox высотой 3U, систему можно расширять и далее, не прибегая к помощи InfiniBand или иных сетей. Модуль UBox содержит внутри два контроллера Intel Ultra Path Interconnect (UPI), что позволяет с помощью одного модуля объединить в единую NUMA-систему до 16 процессоров. С помощью ещё одного UBox это число можно довести до 32 — именно такую конфигурацию имеет старшая модель BullSequana SH320. 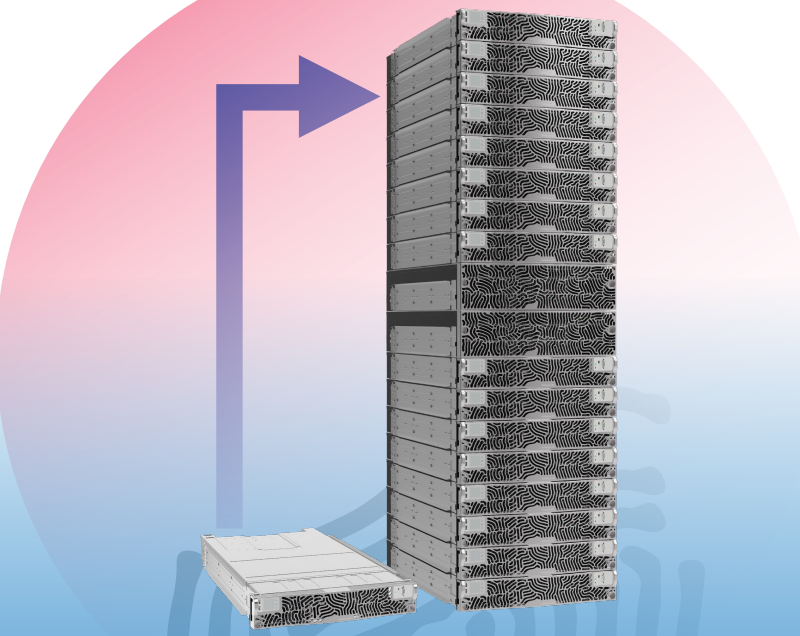
Источник изображений здесь и далее: Atos Все решения в серии SH поддерживают новые модели Xeon с числом ядер от 8 до 60 и частотами до 4,2 ГГц. Каждый модуль располагает двумя (1+1) блоками питания мощностью от 2200 до 3000 Вт, а также 12 вентиляторами с возможностью горячей замены. Для загрузки ОС в каждом модуле имеется 2 слота M.2, но опционально доступны дополнительные модули для установки NVMe-накопителей, а также корзины для GPU и PCIe-устройств с поддержкой горячей замены. 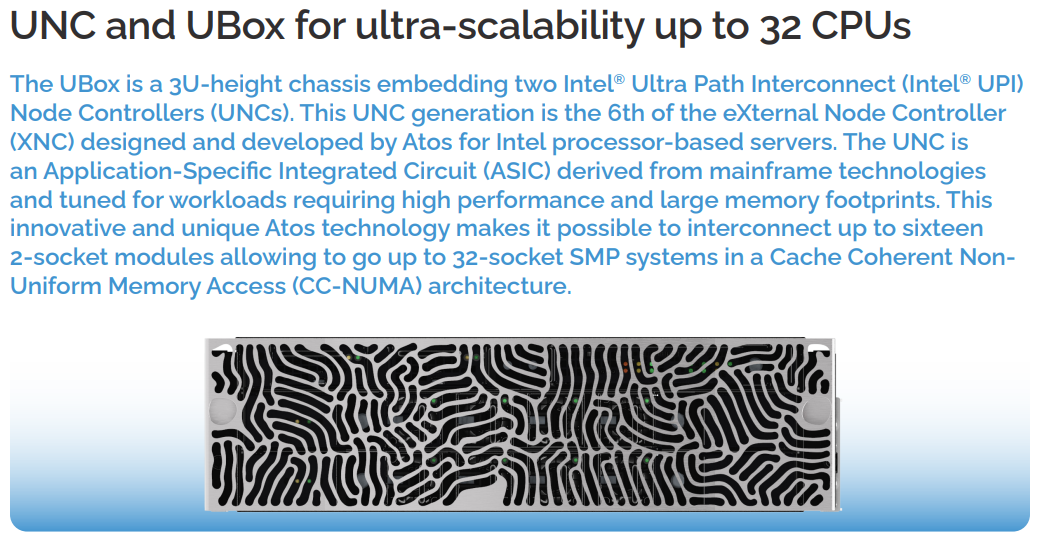 Компания также уделила внимание периферийным вычислениям: для этой сферы предназначены новые серверы BullSequana Edge EXR и EXD в корпусах 1U и 2U соответственно. Системы рассчитаны на использование процессоров Sapphire Rapids с числом ядер не более 24 и теплопакетом, не превышающим 185 Вт. Серверы могут функционировать при температурах от 0 до +45 °C в диапазоне влажности от 5% до 95%. Предусмотрена возможность крепления на стену. 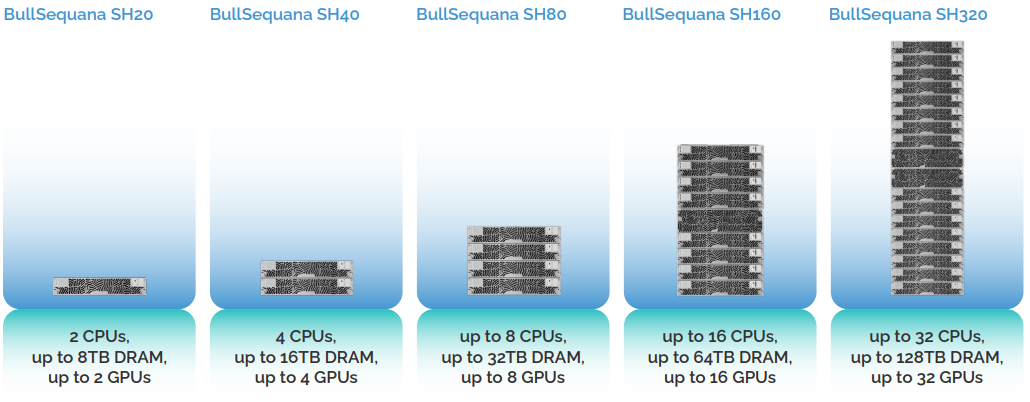
Модельный ряд BullSequana SH При этом предусмотрена возможность установки широкого ассортимента различных ускорителей — в спецификациях упоминаются NVIDIA T4, L40, H100, A2 и A16. Опционально в состав систем может входить поддержка беспроводных сетей LTE/5G, LoRA и Wi-Fi 6, поэтому серверы отлично подойдут и для развёртывания на периферии беспроводной инфраструктуры нового поколения. 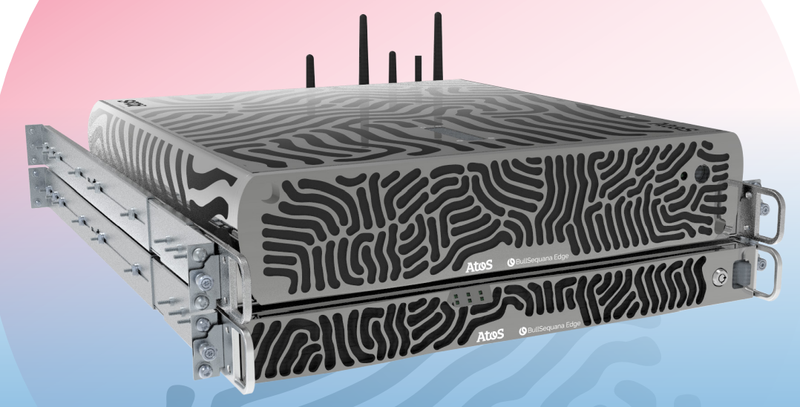
BullSequana Edge EXD (сверху) и EXR Модель EXR располагает 2 слотами M.2, но может комплектоваться дополнительной корзиной на 6 дисков SATA или 8 NVMe-накопителей, а EXD в некоторых конфигурациях может вмещать до 8 накопителей M.2 NVMe. Обе модели комплектуются двухпортовым 10GbE-контроллером (опционально 25GbE). Все новые системы Atos на базе новых процессоров Intel Xeon обеспечивают высокую степень безопасности благодаря поддержке Atos Root of Trust и Atos Chain-of-Trust.
11.01.2023 [03:00], Игорь Осколков
Асимметричный ответ: Intel официально представила процессоры Xeon Sapphire RapidsIntel официально представила серверные процессоры Xeon семейства Sapphire Rapids (SPR), выход которых изрядно задержался, а также ускорители ранее известные как Ponte Vecchio и теперь объединённые вместе с HBM-версиями SPR в отдельную HPC-серию Max. В этом поколении Intel не смогла догнать AMD EPYC Genoa по числу ядер, числу каналов памяти и линий PCIe, но заготовила ассиметричный, хотя и очень странно реализованный ответ. Всего представлено 52 модели с числом P-ядер от 8 до 60 и с TDP от 125 до 350 Вт. По числу ядер это существенный апгрейд по сравнению с Ice Lake-SP (до 40 ядер), да и IPC вырос у Golden Cove на 15 % в сравнении с Sunny Cove. Но это существенный проигрыш в сравнении с Genoa (до 96 ядер), особенно если учитывать их максимальный TDP в 360 Вт (cTDP до 400 Вт). Правда, у Sapphire Rapids есть ещё и экономичный режим работы, в котором энергопотребление снижается на 20 %, а производительность для некоторых нагрузок — всего на 5 %. 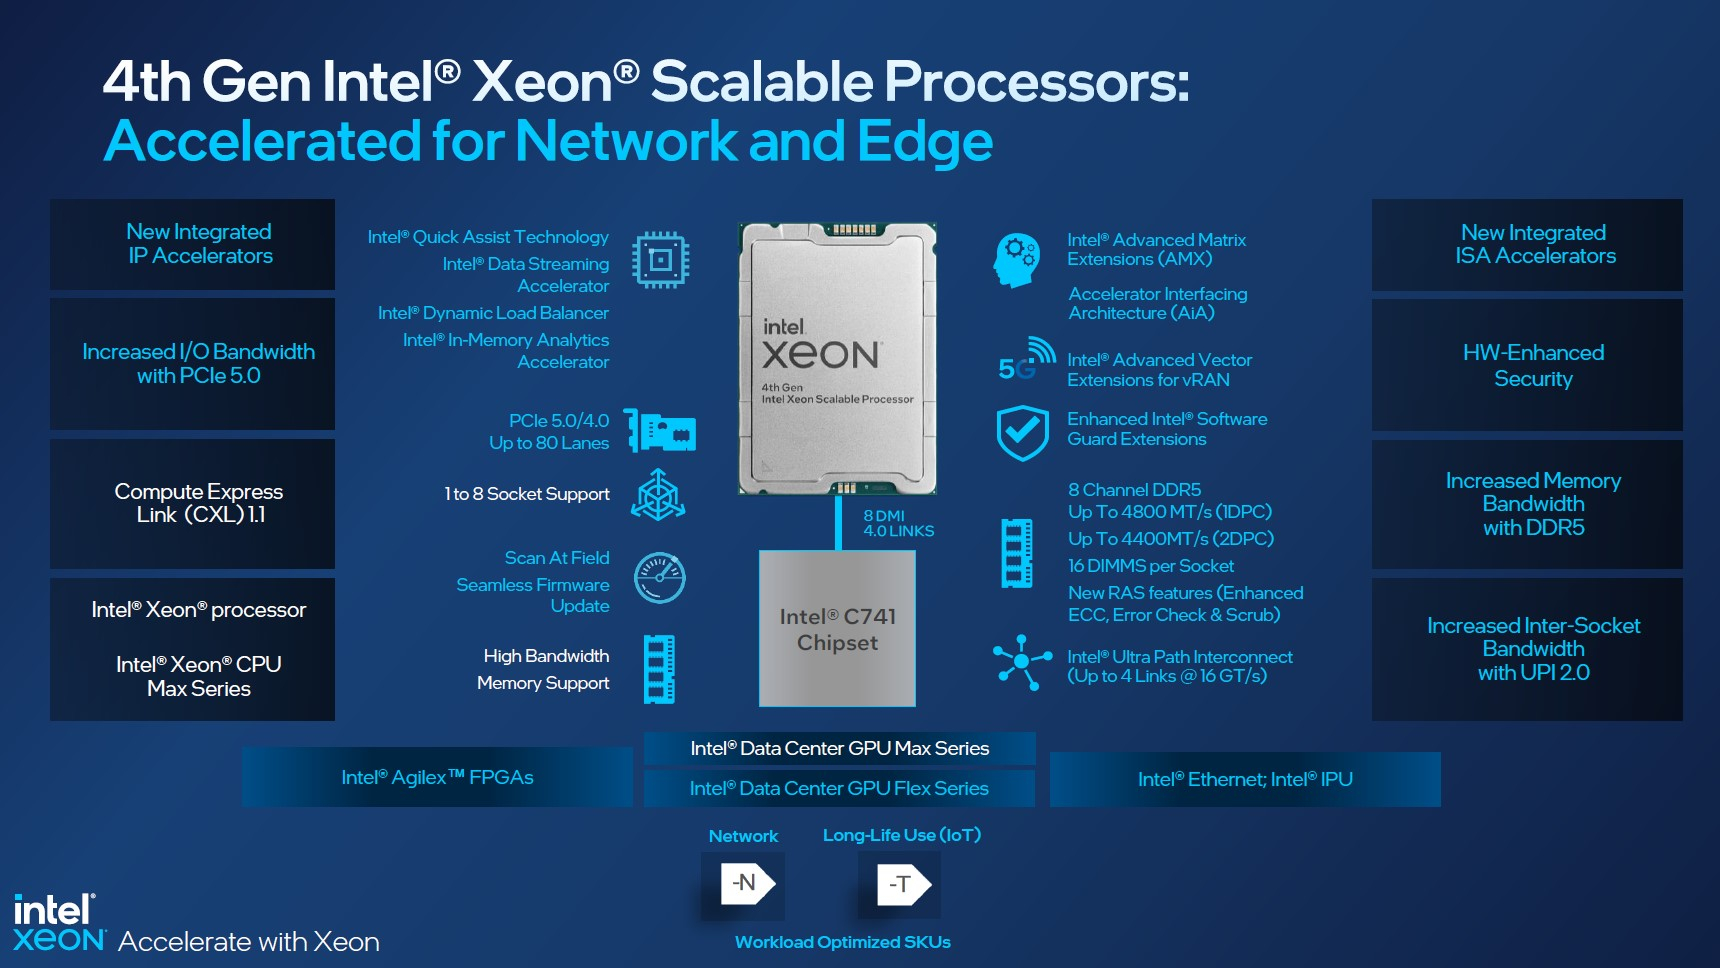
Изображения: Intel Sapphire Rapids предлагают 8 каналов памяти DDR5-4800 (1DPC) и DDR5-4400 (2DPC). 2DPC у Genoa пока что нет. Кроме того, контроллеры поддерживают и модули Optane PMem 300 (Crow Pass), но с учётом того, что производство 3D XPoint прекращено, достаться они могут не всем (впрочем, не всем они и нужны). Ну а маленькая серия Max также включает 64 Гбайт набортной HBM2e-памяти (1,2 Тбайт/с). Остались и отличия в максимальном объёме SGX-анклавов в зависимости от модели CPU. 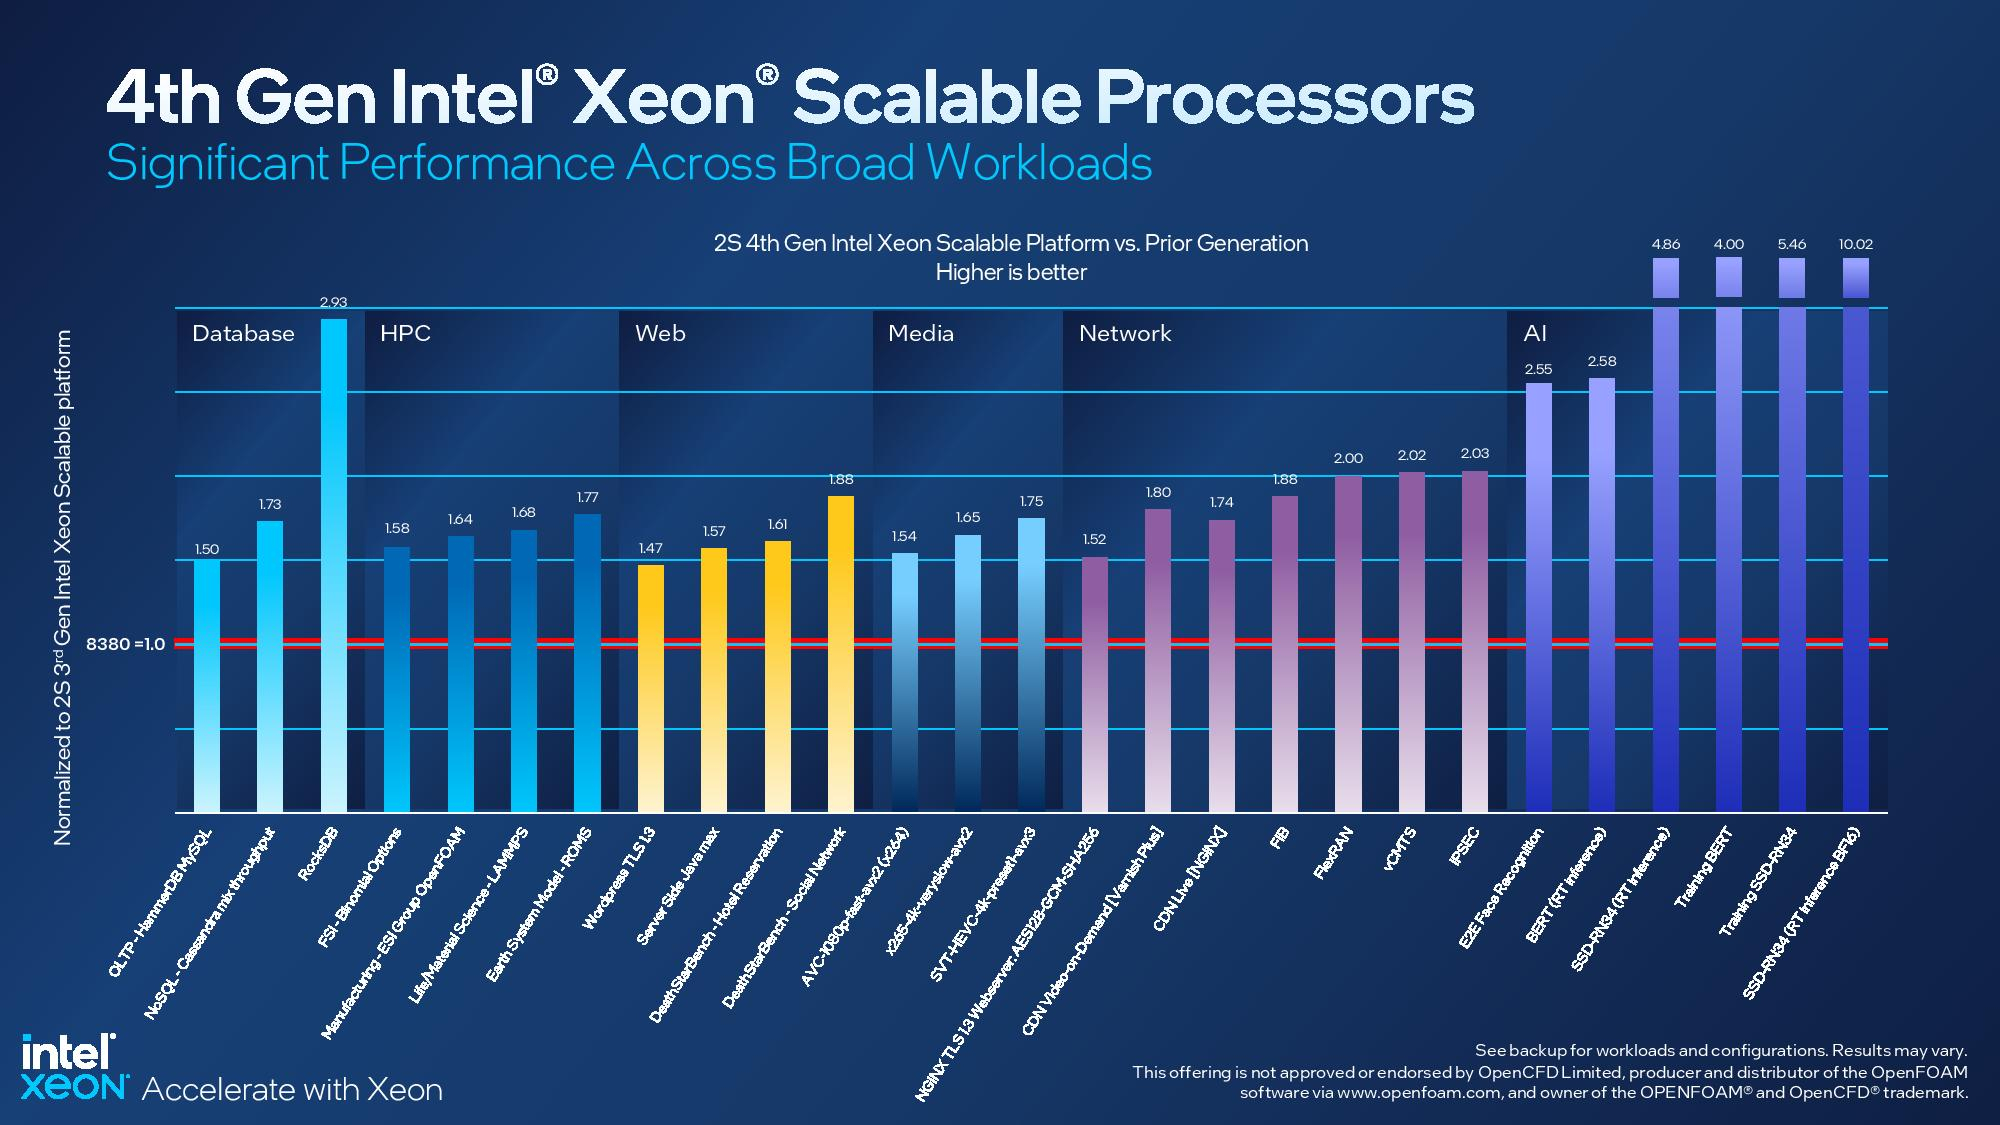 Однако по числу ядер на узел всё равно лидирует Intel. Если AMD поддерживает только 2S-конфигурации, то Intel снова предлагает и 4S, и 8S (а с момента выхода Cooper Lake-SP прошло немало времени) — на процессор доступно до 4 линий UPI 2.0 (16 ГТ/с в сравнении с 11,2 ГТ/с у Ice Lake-SP). В 2S-платформах Sapphire Rapids также формально обгоняет Genoa по числу линий PCIe 5.0, которых тут по 80 шт. на сокет. Формально потому, что в случае Genoa при желании всё же можно получить 160 линий, пожертвовав скоростью шины между CPU, но в односокетном варианте EPYC в любом случае интереснее Xeon. 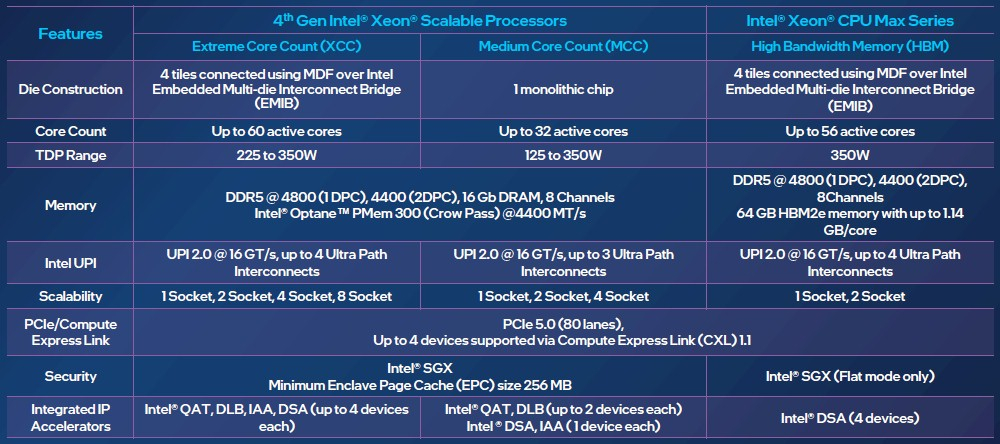 Без нюансов тут не обошлось. Так, при бифуркации до 8 x2 скорость падает до PCIe 4.0. Зато каждый root-комплекс поддерживает CXL 1.1, тогда как у Genoa CXL есть только у половины! Впрочем, поддержка всё равно ограничена 4x CXL-устройствами на CPU. Что ещё более странно, официально заявлена поддержка только устройств Type 1 и Type 2, но не Type 3, хотя последние весьма пригодились бы в ряде конфигураций, где требуется больше относительно недорогой, пусть и несколько более медленной, RAM. 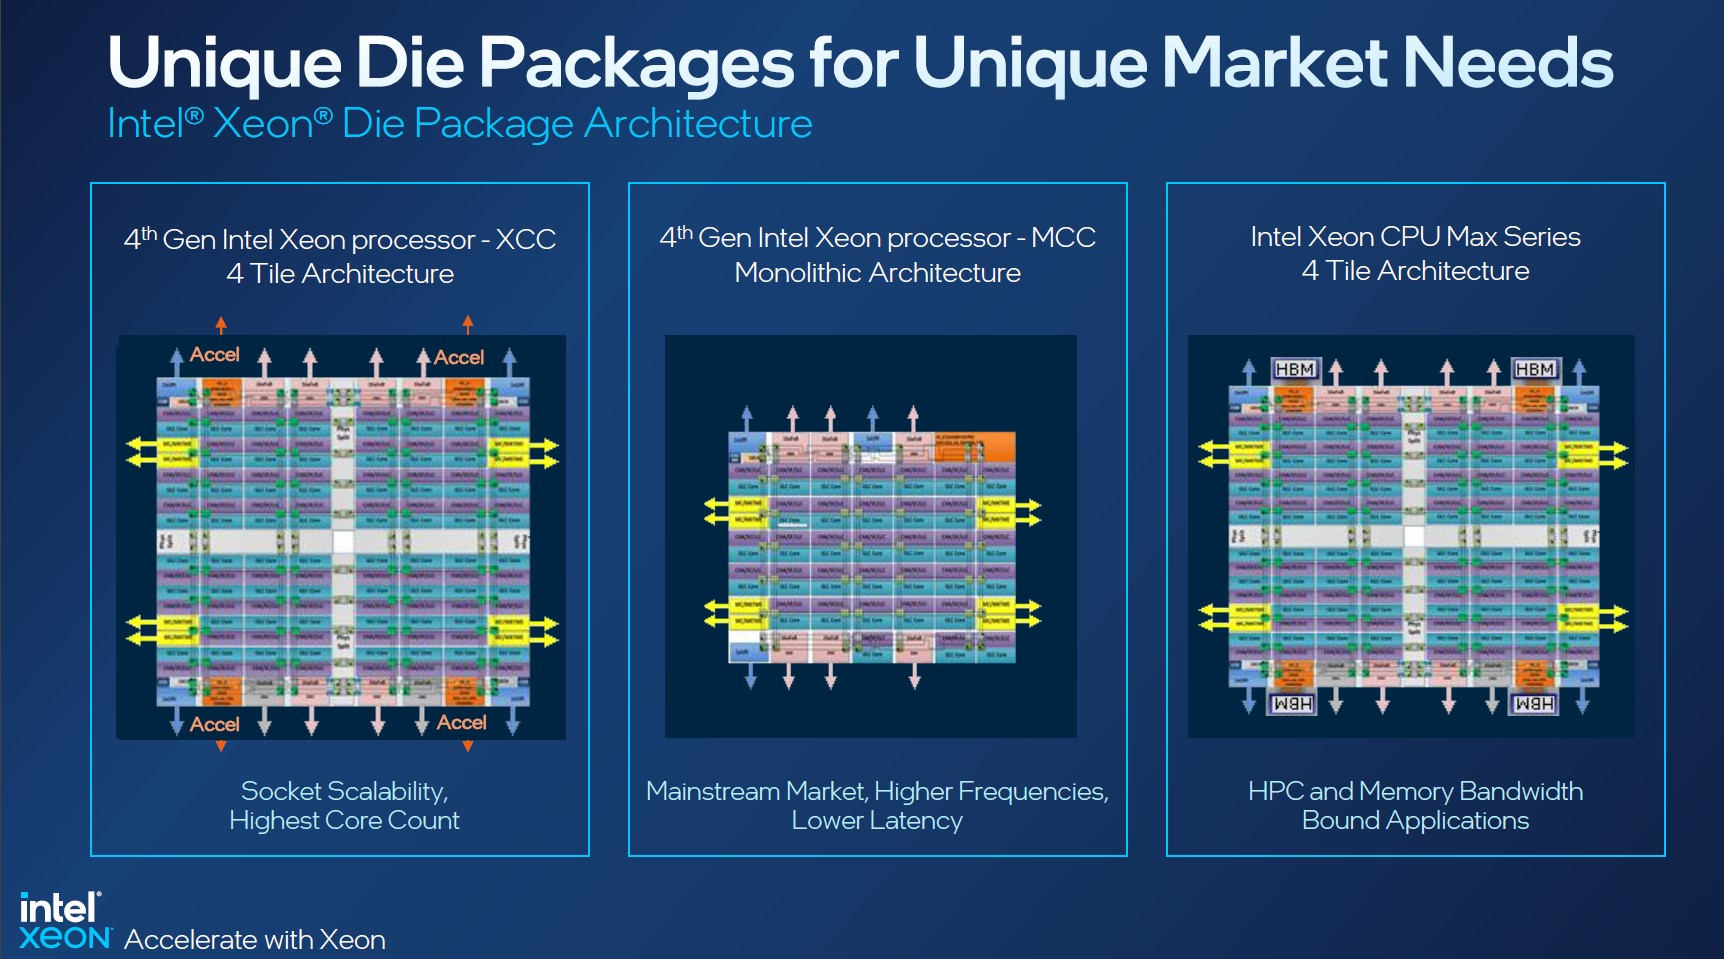 Сохранилось традиционное разделение на серии Platinum (8000), Gold (6000/5000), Silver (4000) и Bronze (3000), к которым теперь добавилась серия Max (9400). Список суффиксов, означающих оптимизацию под те или иные задачи и наличие каких-то особенностей, стал чуть шире: Y (SST-PP 2.0), Q (рассчитаны на работу с СЖО), U (односокетные общего назначения), T (увеличенный жизненный цикл), H (in-memory СУБД, аналитика, виртуализация), N (сетевые решения, в том числе для 5G), облачные P/V/M (IaaS/Paa/медиа), S (СХД и HCI). 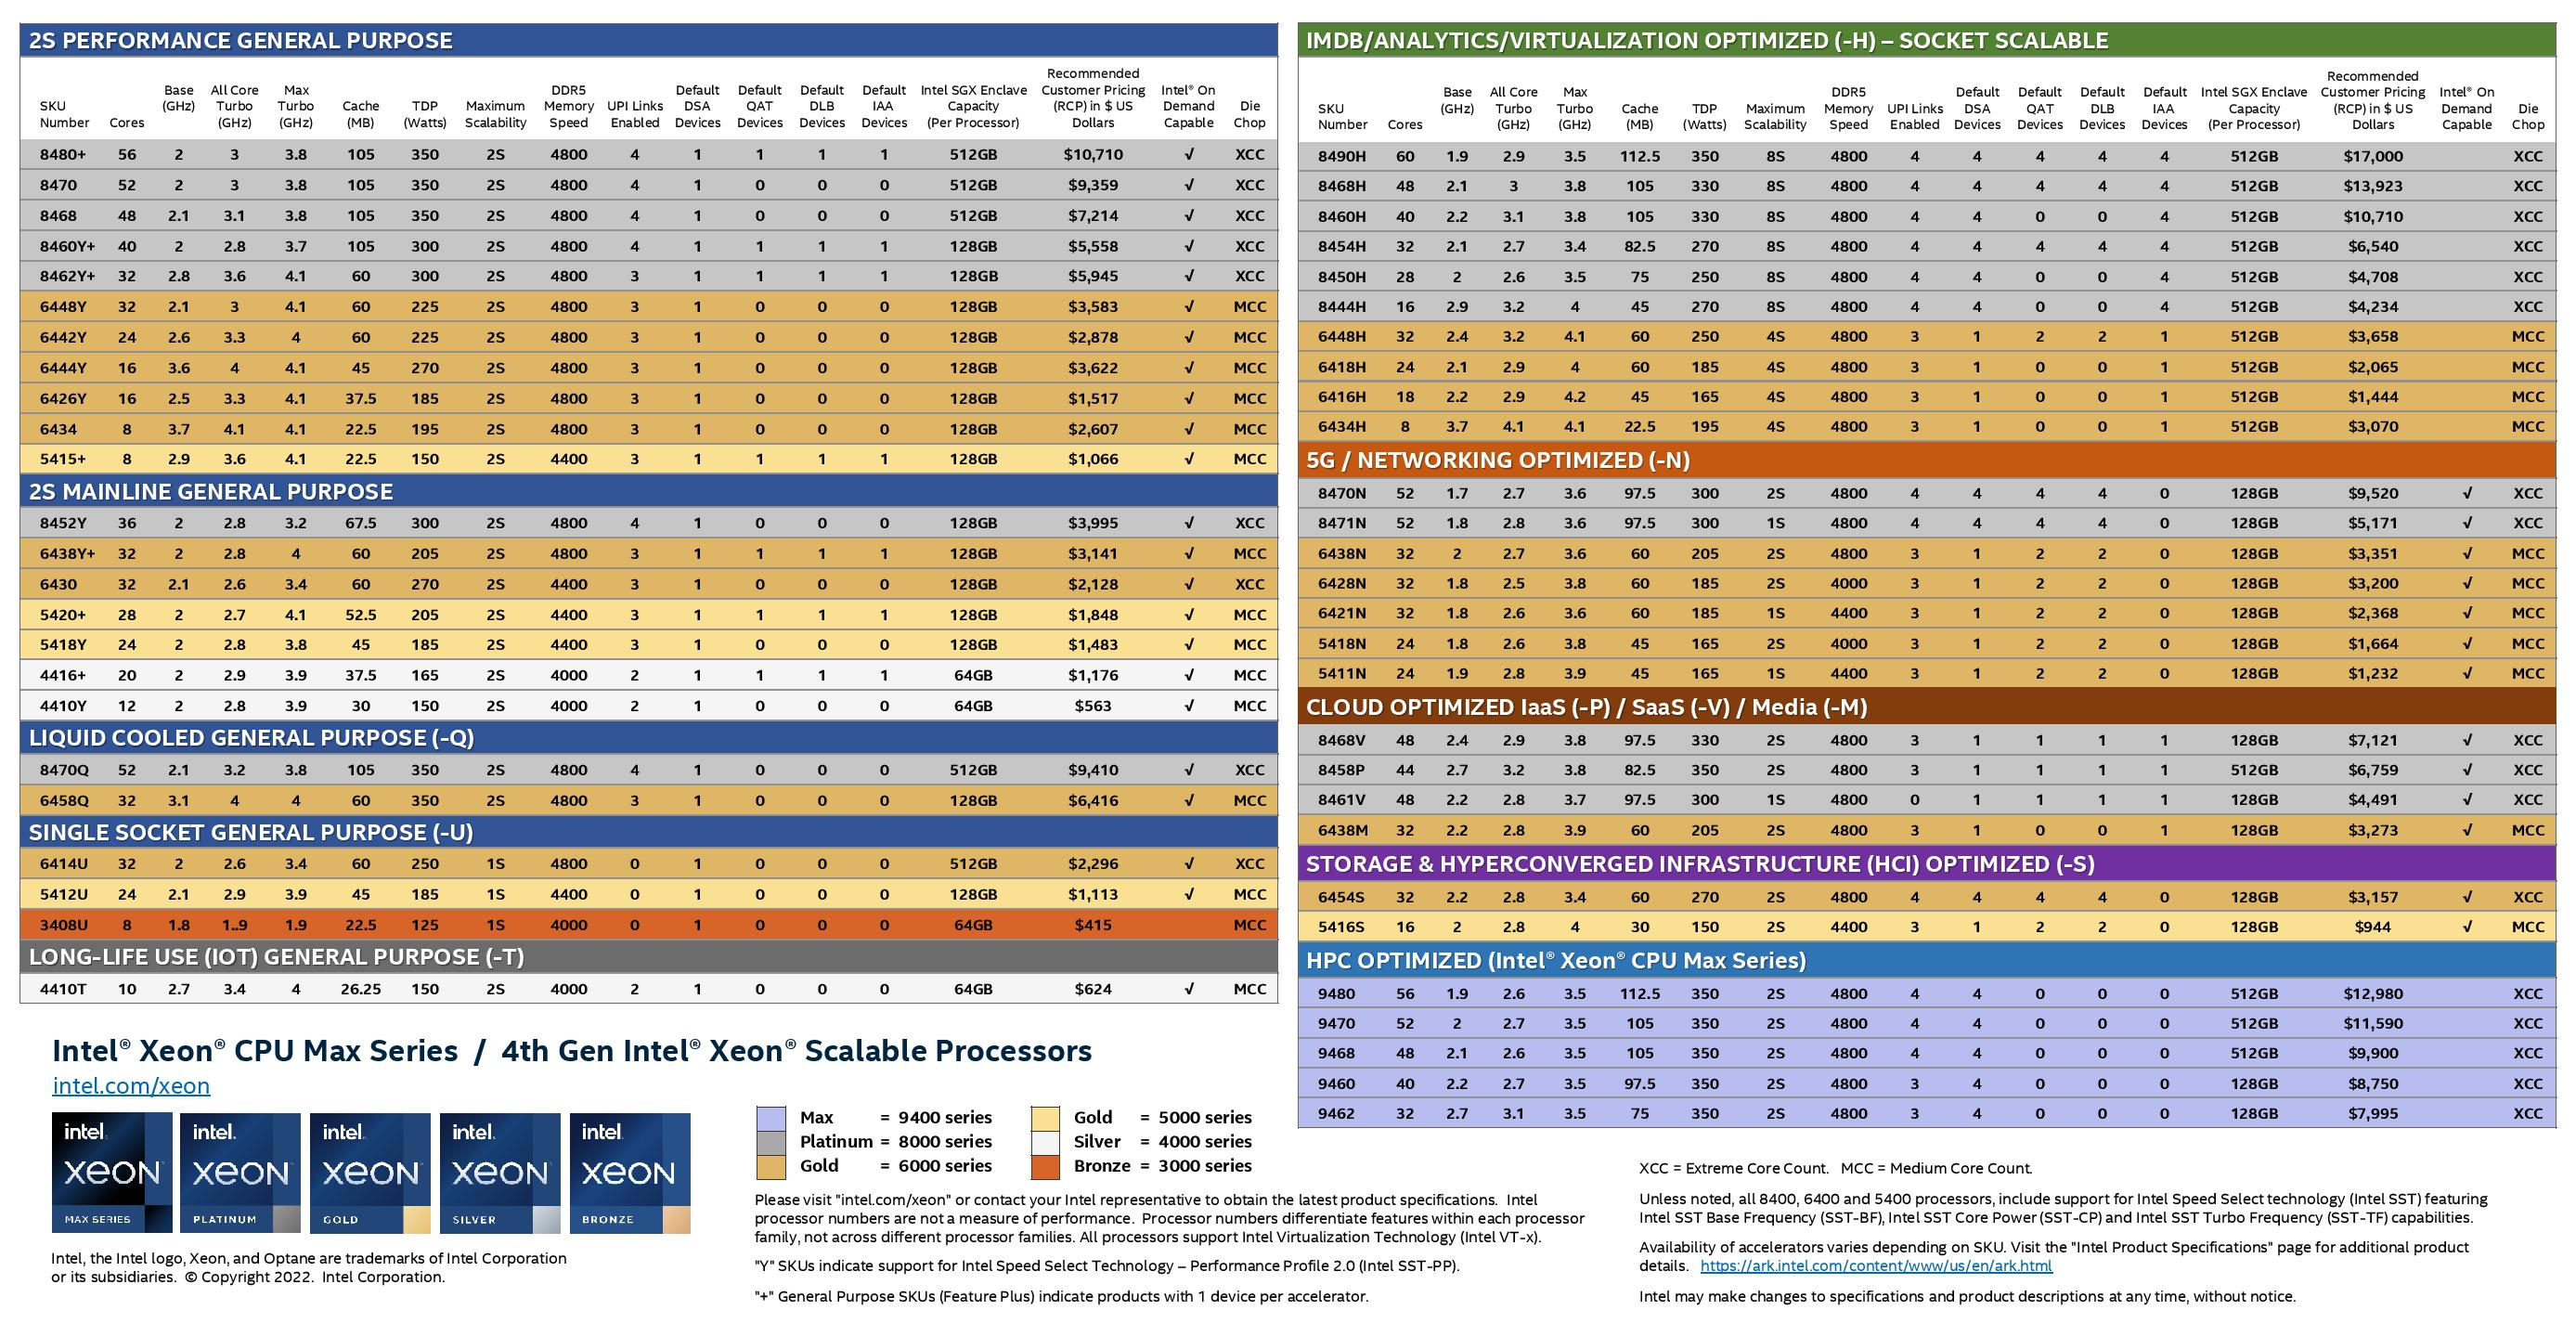 Но некоторые модели также имеют в названии «+». И вот тут начинается самое интересное! Все процессоры получили «традиционную» (в сравнении с Genoa) реализацию AVX-512, включая DL Boost, а также целый новый набор ИИ-инструкций AMX (до 10 раз быстрее обучение и инференс в сравнении с Ice Lake-SP). Есть и всяческие Speed Select, DDIO, TDX, CET и т.д. Но Sapphire Rapids также получили четыре отдельных ускорителя:
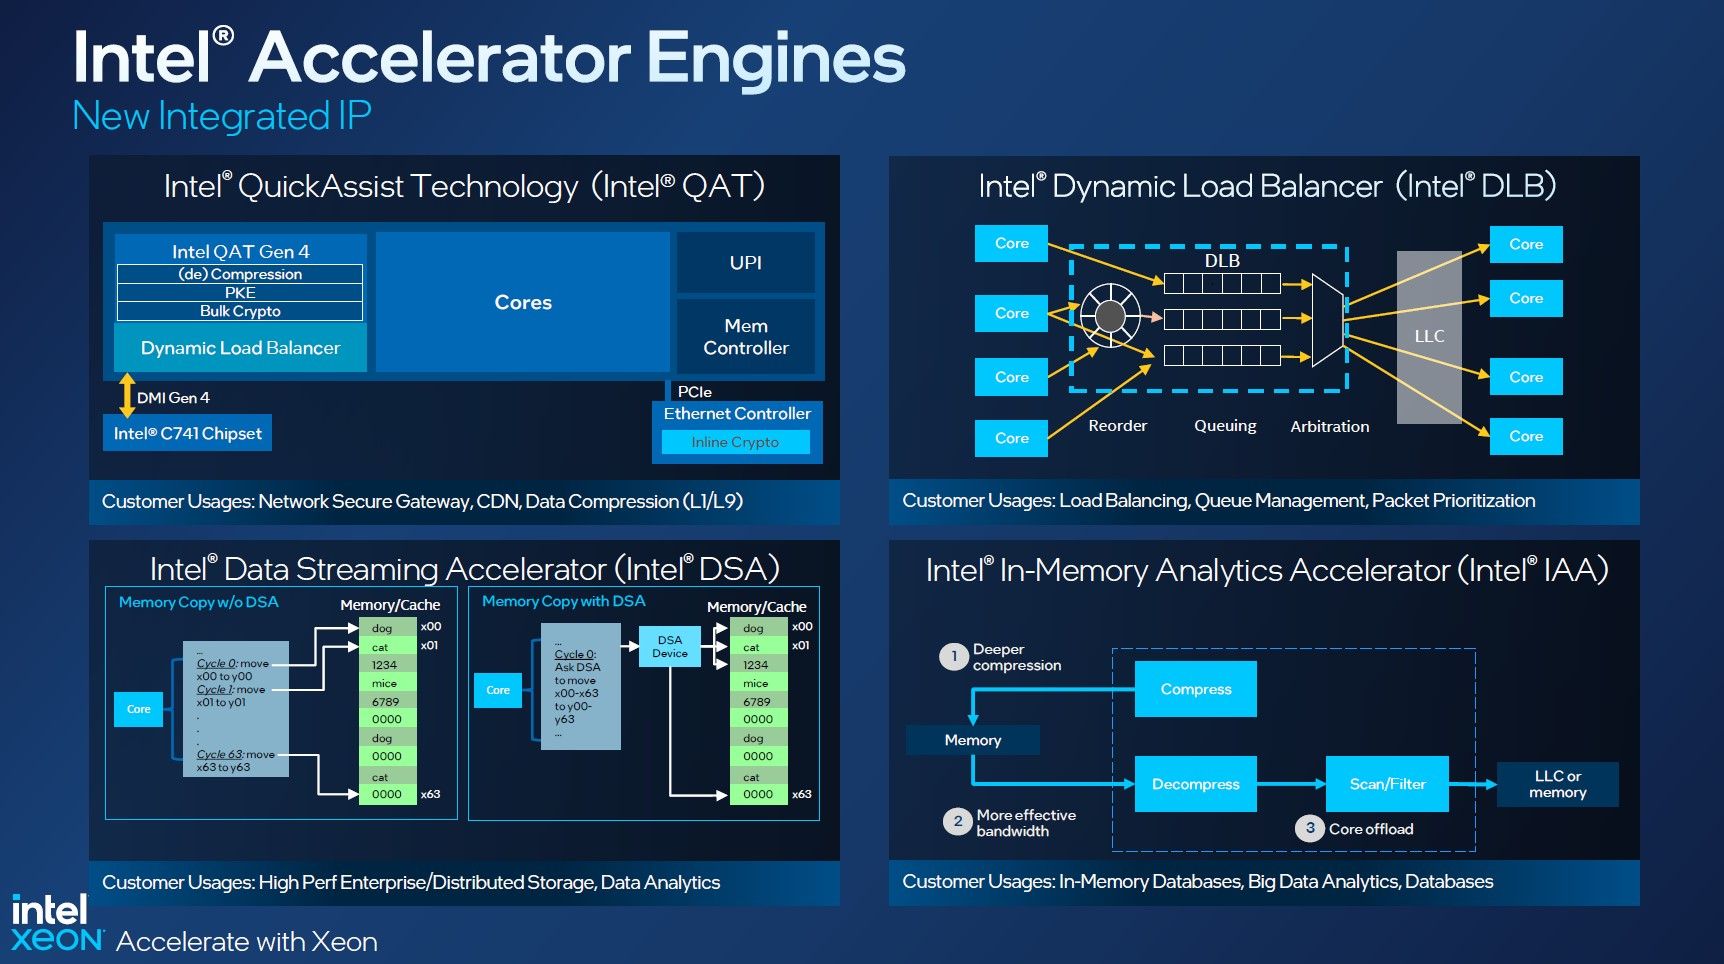 Intel заявляет, что средний прирост производительности Sapphire Rapids в сравнении с Ice Lake-SP составил 1,53 раза. А вот для ряда нагрузок, которые могут задействовать новые ускорители прирост производительности на Вт составляет уже до 2,9 раз! То есть Intel продолжает придерживаться стратегии создания максимально универсальных CPU для различных нагрузок. И действительно, спорить с гибкостью Sapphire Rapids трудно. Но какой ценой это достигается? Т.е. буквально: во сколько это обойдётся заказчику? Ответа пока нет. 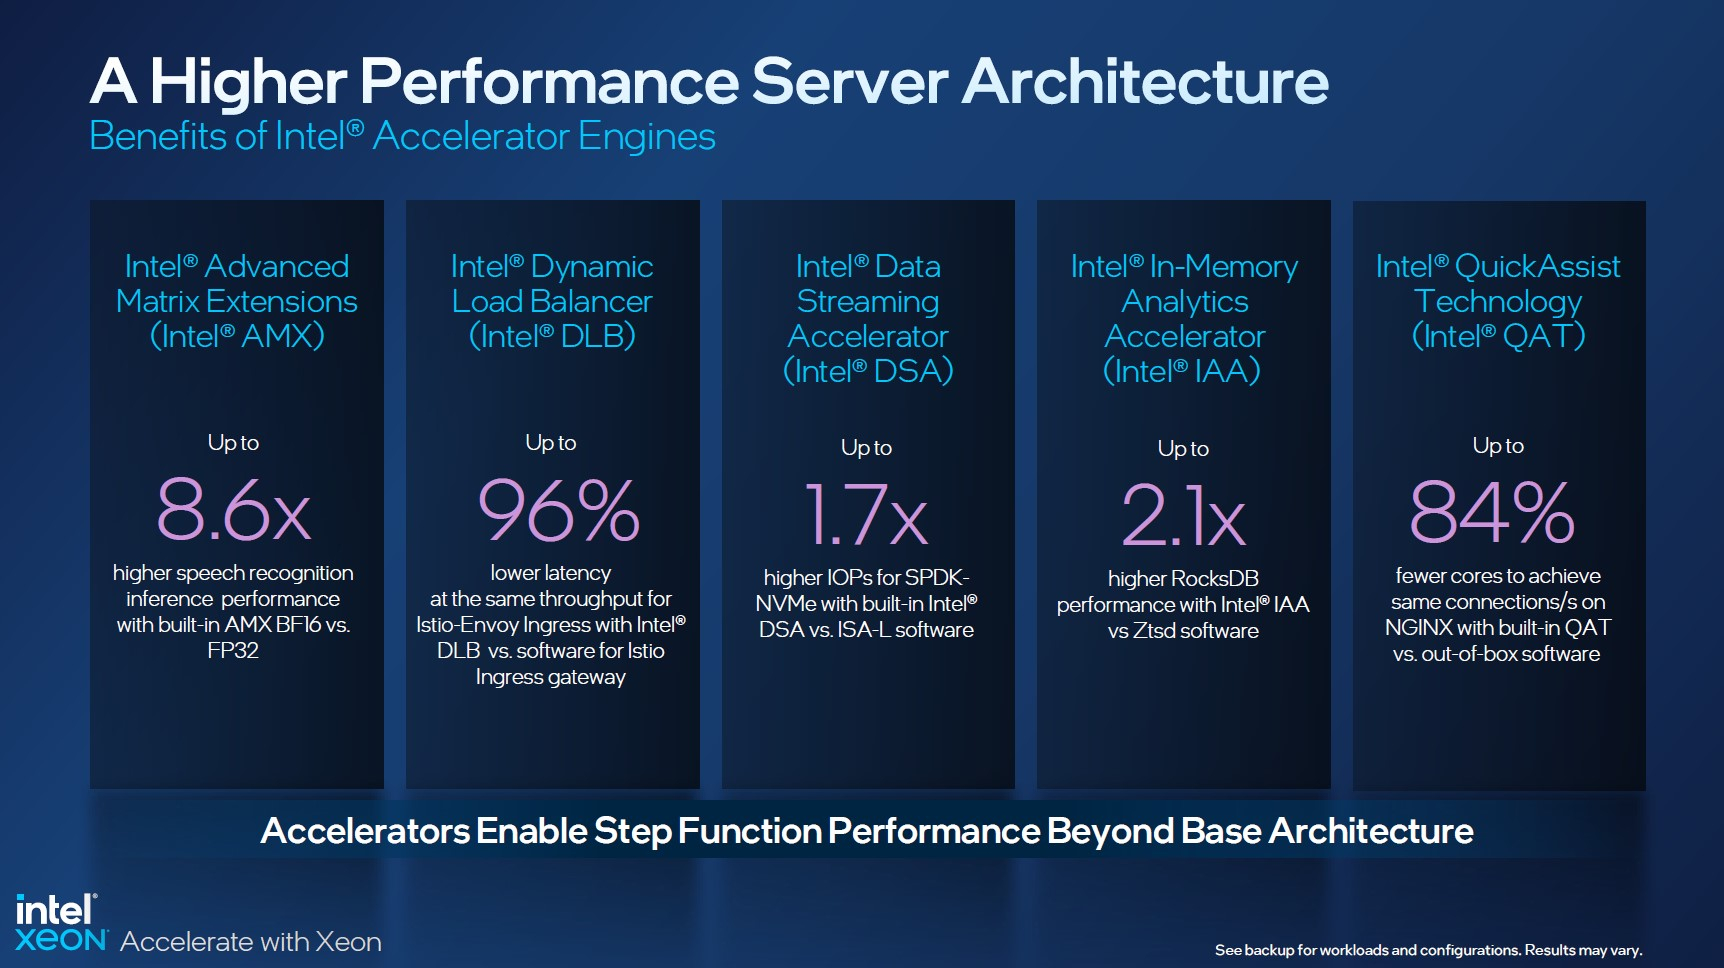 Дело в том, что в зависимости от модели отличается число доступных и число активированных ускорителей. Фактически в новом поколении используется два вида кристаллов: XCC, «сшитые» из четырёх отдельных тайлов, и монолитные MCC (до 32 ядер, причём 32-ядерных моделей в серии большинство). У каждого тайла в XCC есть по одному блоку QAT, DSA, DLB и IAA, т.е. суммарно на CPU приходится до четырёх ускорителей каждого типа. В случае MCC может быть по два QAT и DLB и по одному DSA и IAA на процессор. Например, у тех моделей, что помечены «+», активно по одному блоку каждого типа, а минимум один DSA активен есть вообще у всех CPU. 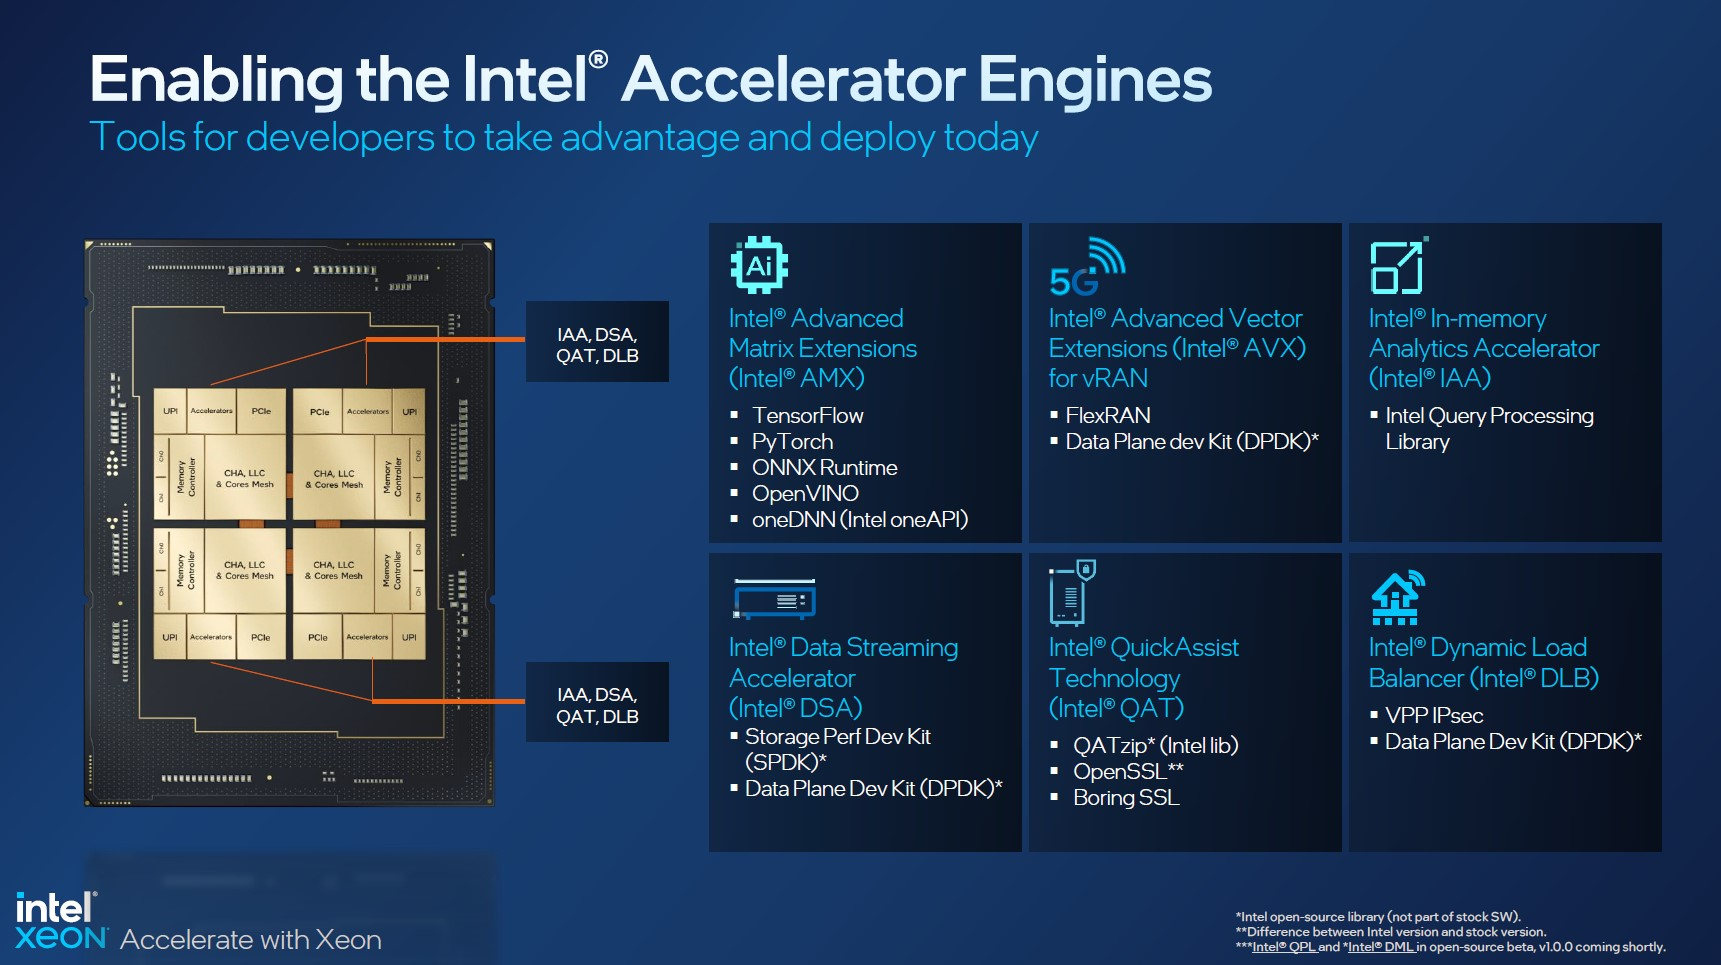 За не активированные по умолчанию ускорители придётся заплатить в рамках программы Intel On Demand (SDSi), причём есть опции как с единовременным платежом за постоянную активацию, так и с оплатой по факту использования (это удобно в случае облаков и платформ по типу HPE Greenlake). Исключением являются H-модели, куда входит и самый дорогой ($17000) 60-ядерный процессор 8490H с полностью разблокированными ускорителями и поддержкой 8S-конфигураций, а также процессоры Max, которым доступно только четыре DSA-блока и 2S-платформы, например, 56-ядерный 9480 ($12980). 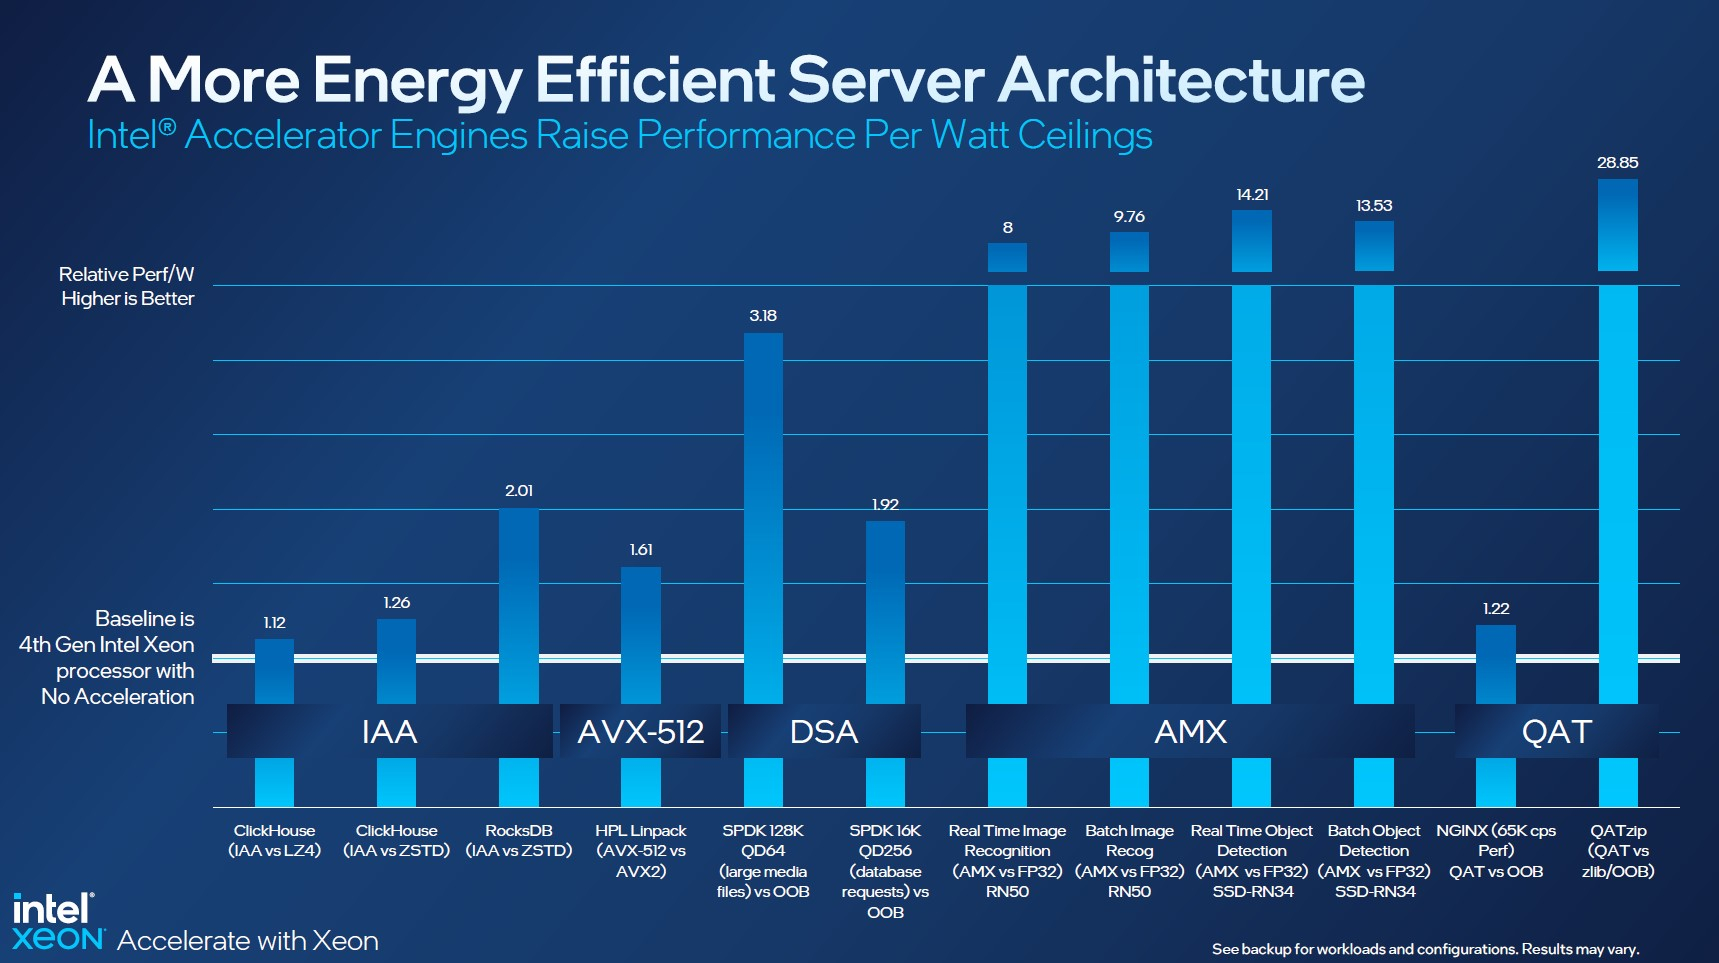 С одной стороны, желание Intel предоставить больше гибкости заказчикам, а заодно чуть увеличить выход годных к продаже процессоров, понятно. С другой — не очень-то и похоже, что CPU без «лишних» ускорителей отдаются с какой-то существенной скидкой. При этом транзисторный бюджет на них всё равно расходуется. Кроме того, есть ещё момент востребованности этих ускорителей и готовности ПО. У Intel есть и опыт ресурсы для помощи разработчикам, но процесс адаптации в любом случае не мгновенен. 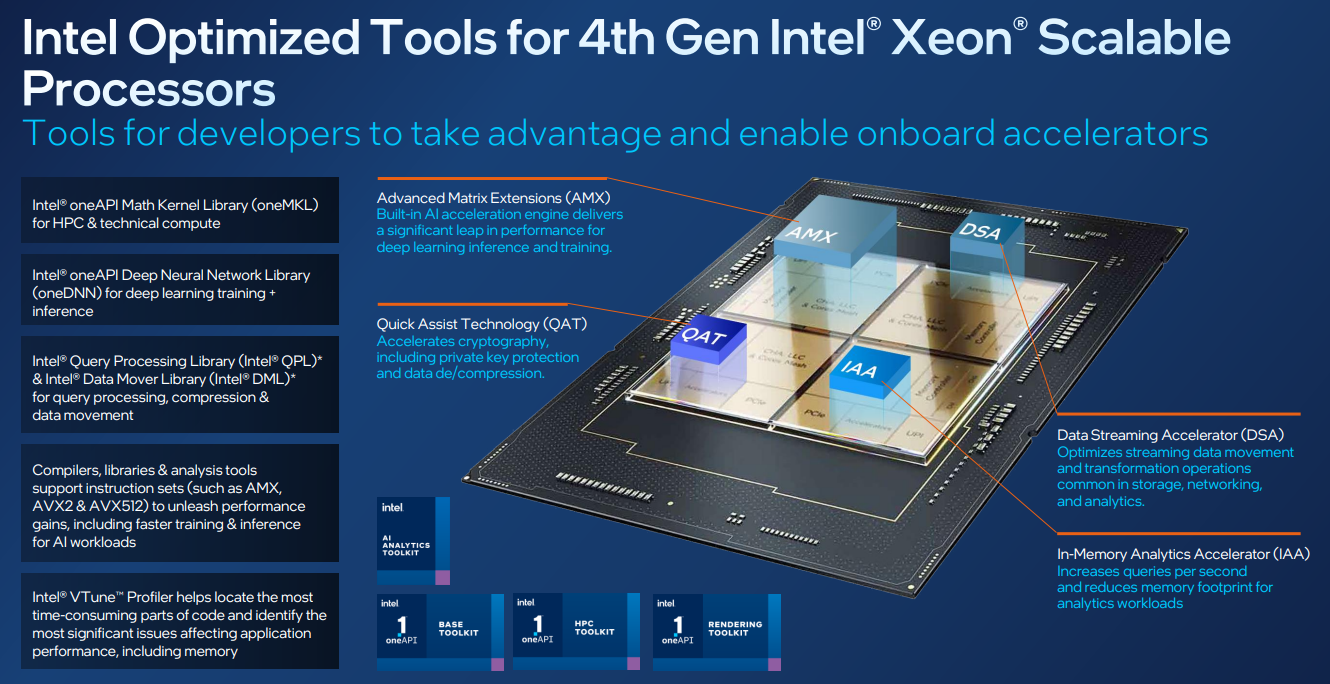 Впрочем, у Intel по сравнению с AMD есть и ещё одно важное преимущество — в среднем более высокая доступность процессоров для большинства заказчиков. Так что с Sapphire Rapids может повториться та же история, что с Ice Lake-SP, когда вендоры здесь и сейчас готовы были предложить Intel-платформы. 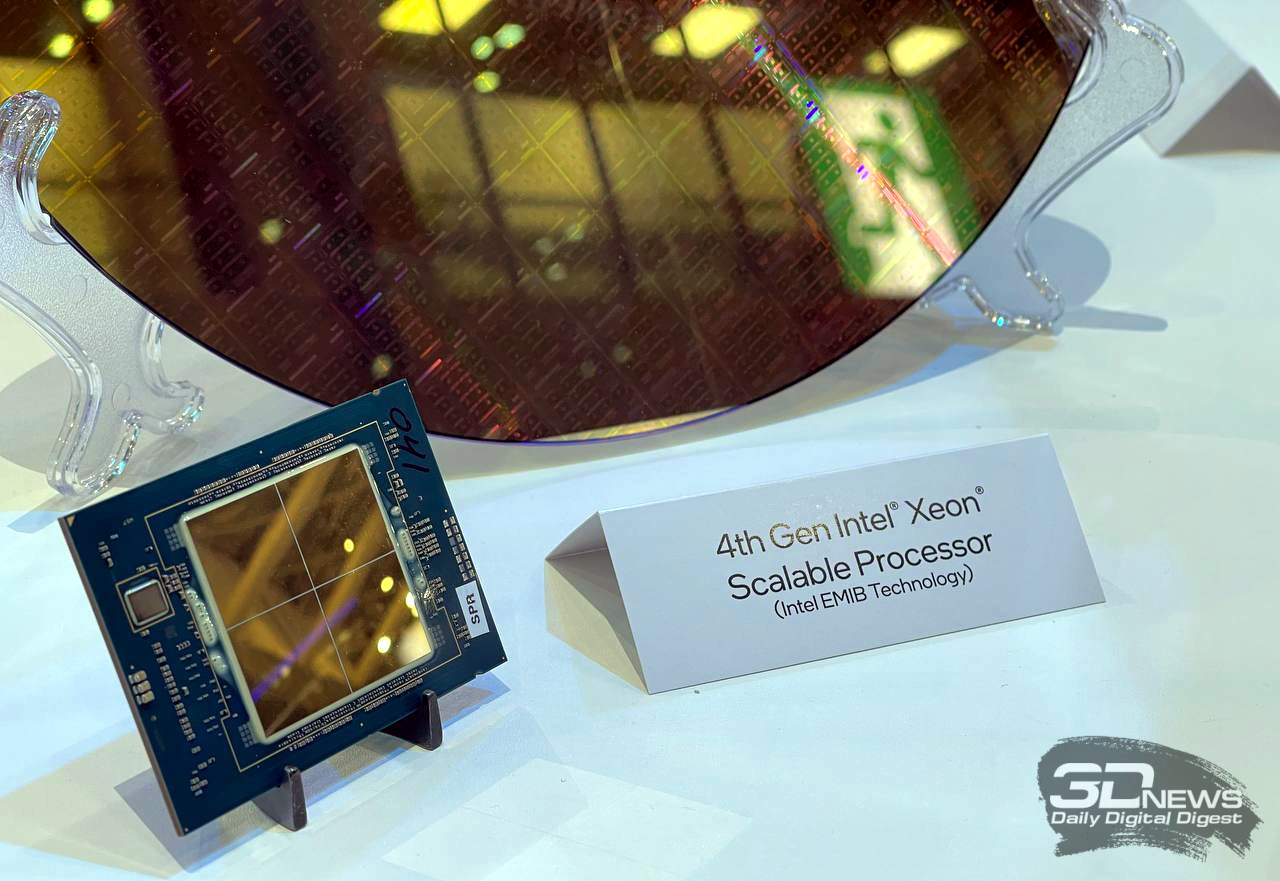 В целом же, в новом семействе наиболее любопытны Xeon Max, которые, по словам Intel, по сравнению с прошлым поколением в 3,7 раз производительнее в задачах, завязанных на пропускную способность памяти (а это целый пласт HPC-нагрузок), и которые не так уж дороги. Правда, и здесь без приключений не обошлось — несчастный суперкомпьютер Aurora ожидает утомительный апгрейд его 10 тыс. узлов c простых Xeon Sapphire Rapids на Xeon Max — по полчаса на каждый узел.
10.11.2022 [01:55], Игорь Осколков
Intel объединила HBM-версии процессоров Xeon Sapphire Rapids и ускорители Xe HPC Ponte Vecchio под брендом MaxВ преддверии SC22 и за день до официального анонса AMD EPYC Genoa компания Intel поделилась некоторыми подробностями об HBM-версии процессоров Xeon Sapphire Rapids и ускорителях Ponte Vecchio, которые теперь входят в серию Intel Max. 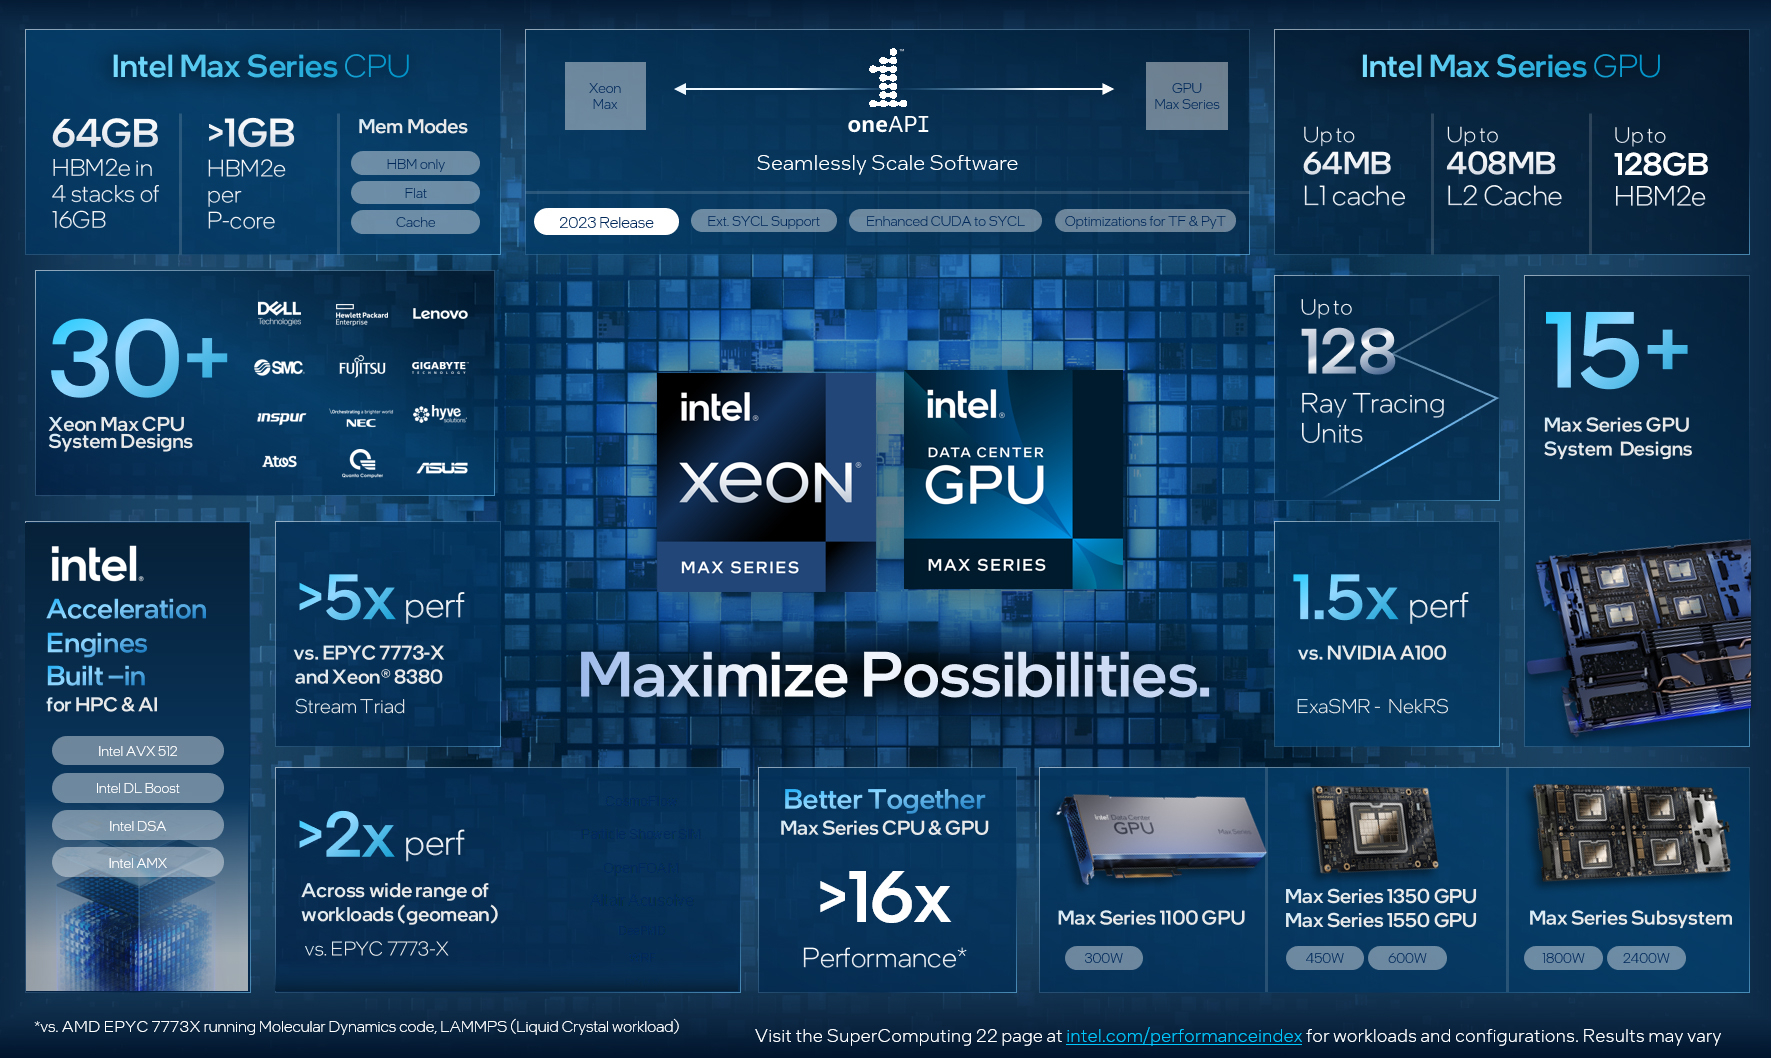
Изображения: Intel Intel Xeon Max предложат до 56 P-ядер, 112,5 Мбайт L3-кеша, 64 Гбайт HBM2e-памяти (четыре стека) с пропускной способностью порядка 1 Тбайт/с, 8 каналов памяти (DDR5-4800 в случае 1DPC, суммарно до 6 Тбайт), а также интерфейсы PCIe 5.0, CXL 1.1, UPI 2.0 и целый ряд различных технологий ускорения для задач HPC и ИИ: AVX-512, DL Boost, AMX, DSA, QAT и т.д. Заявленный уровень TDP составляет 350 Вт. 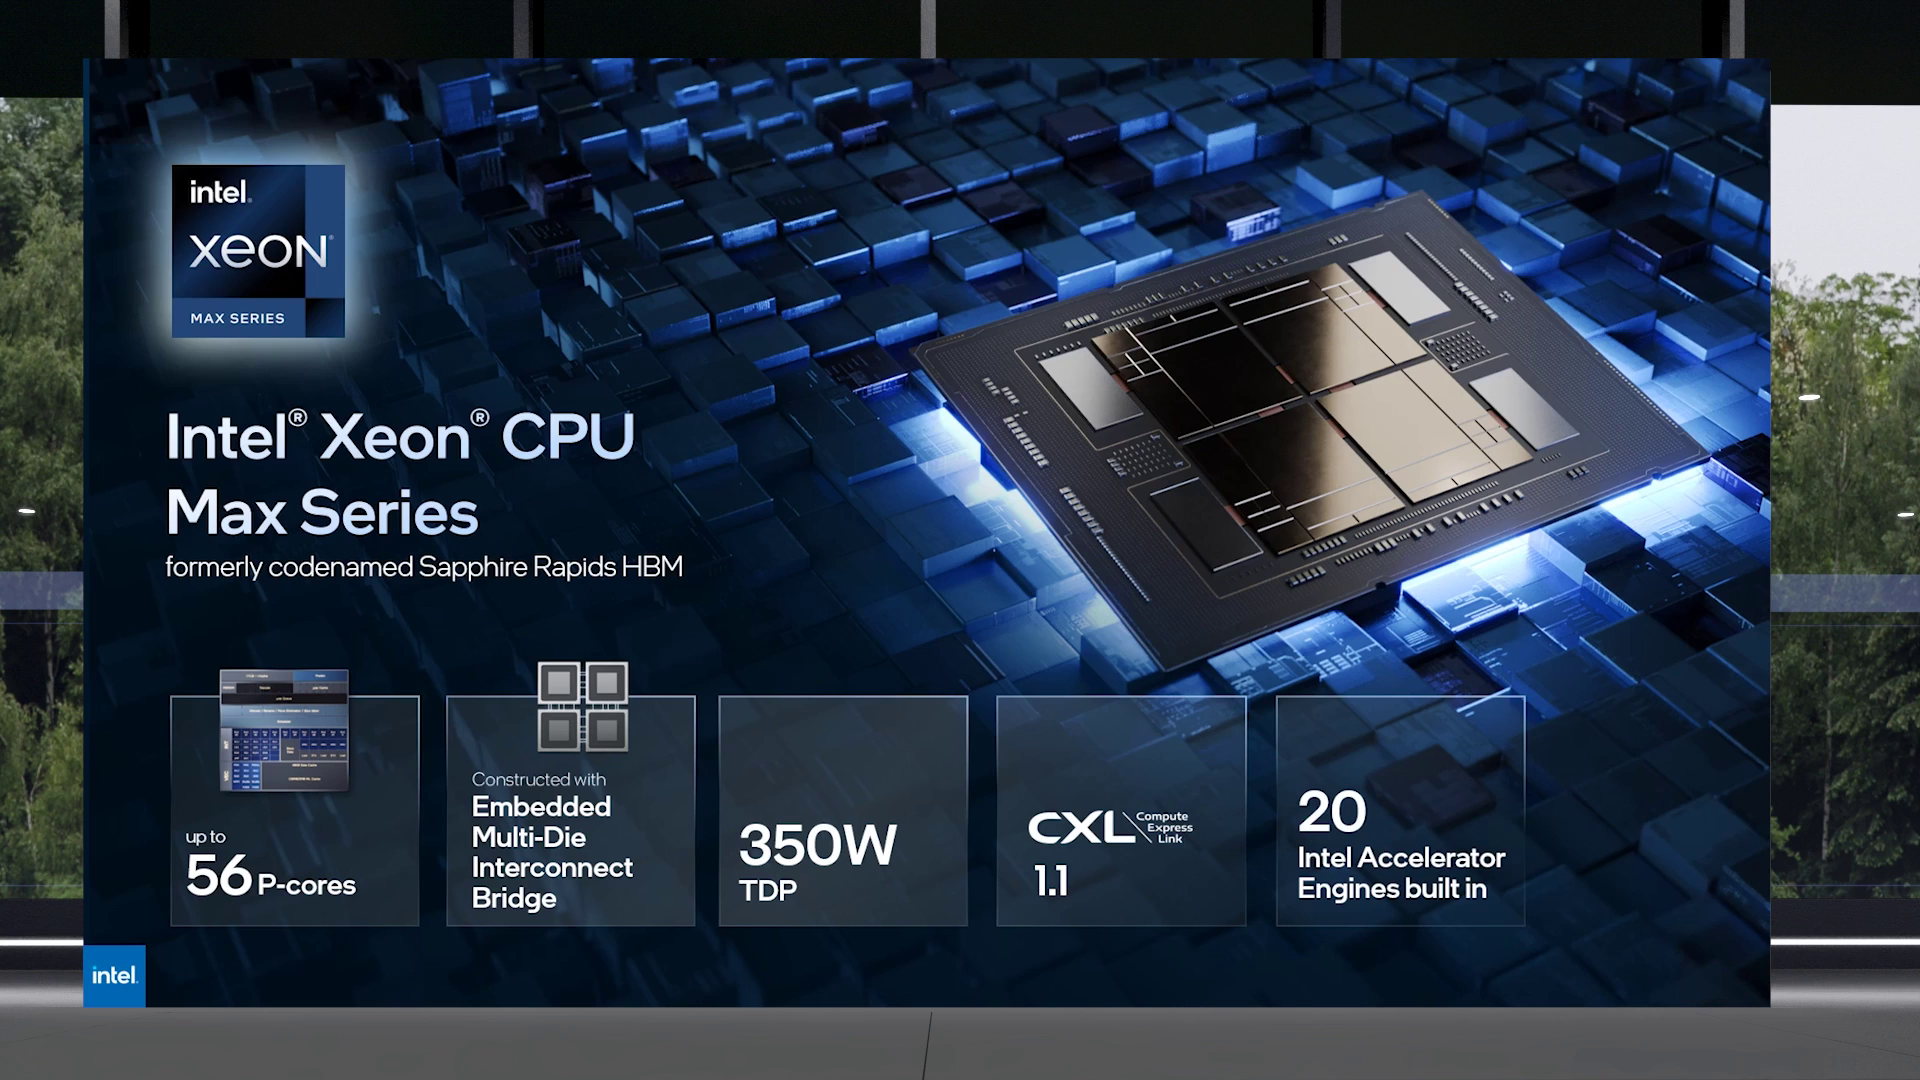 Первым процессором с набортной HBM-памятью был Arm-чип Fujitsu A64FX (48 ядер, 32 Гбайт HBM2), лёгший в основу суперкомпьютера Fugaku. Intel поднимает планку, давая более 1 Гбайт быстрой памяти на каждое ядро. А поскольку процессор состоит из четырёх отдельных чиплетов, возможно создание четырёх NUMA-доменов с выделенными HBM- и DDR-контроллерами. Но и монолитный режим тоже имеется. А поддержка CXL даёт возможность задействовать RAM-экспандеры. 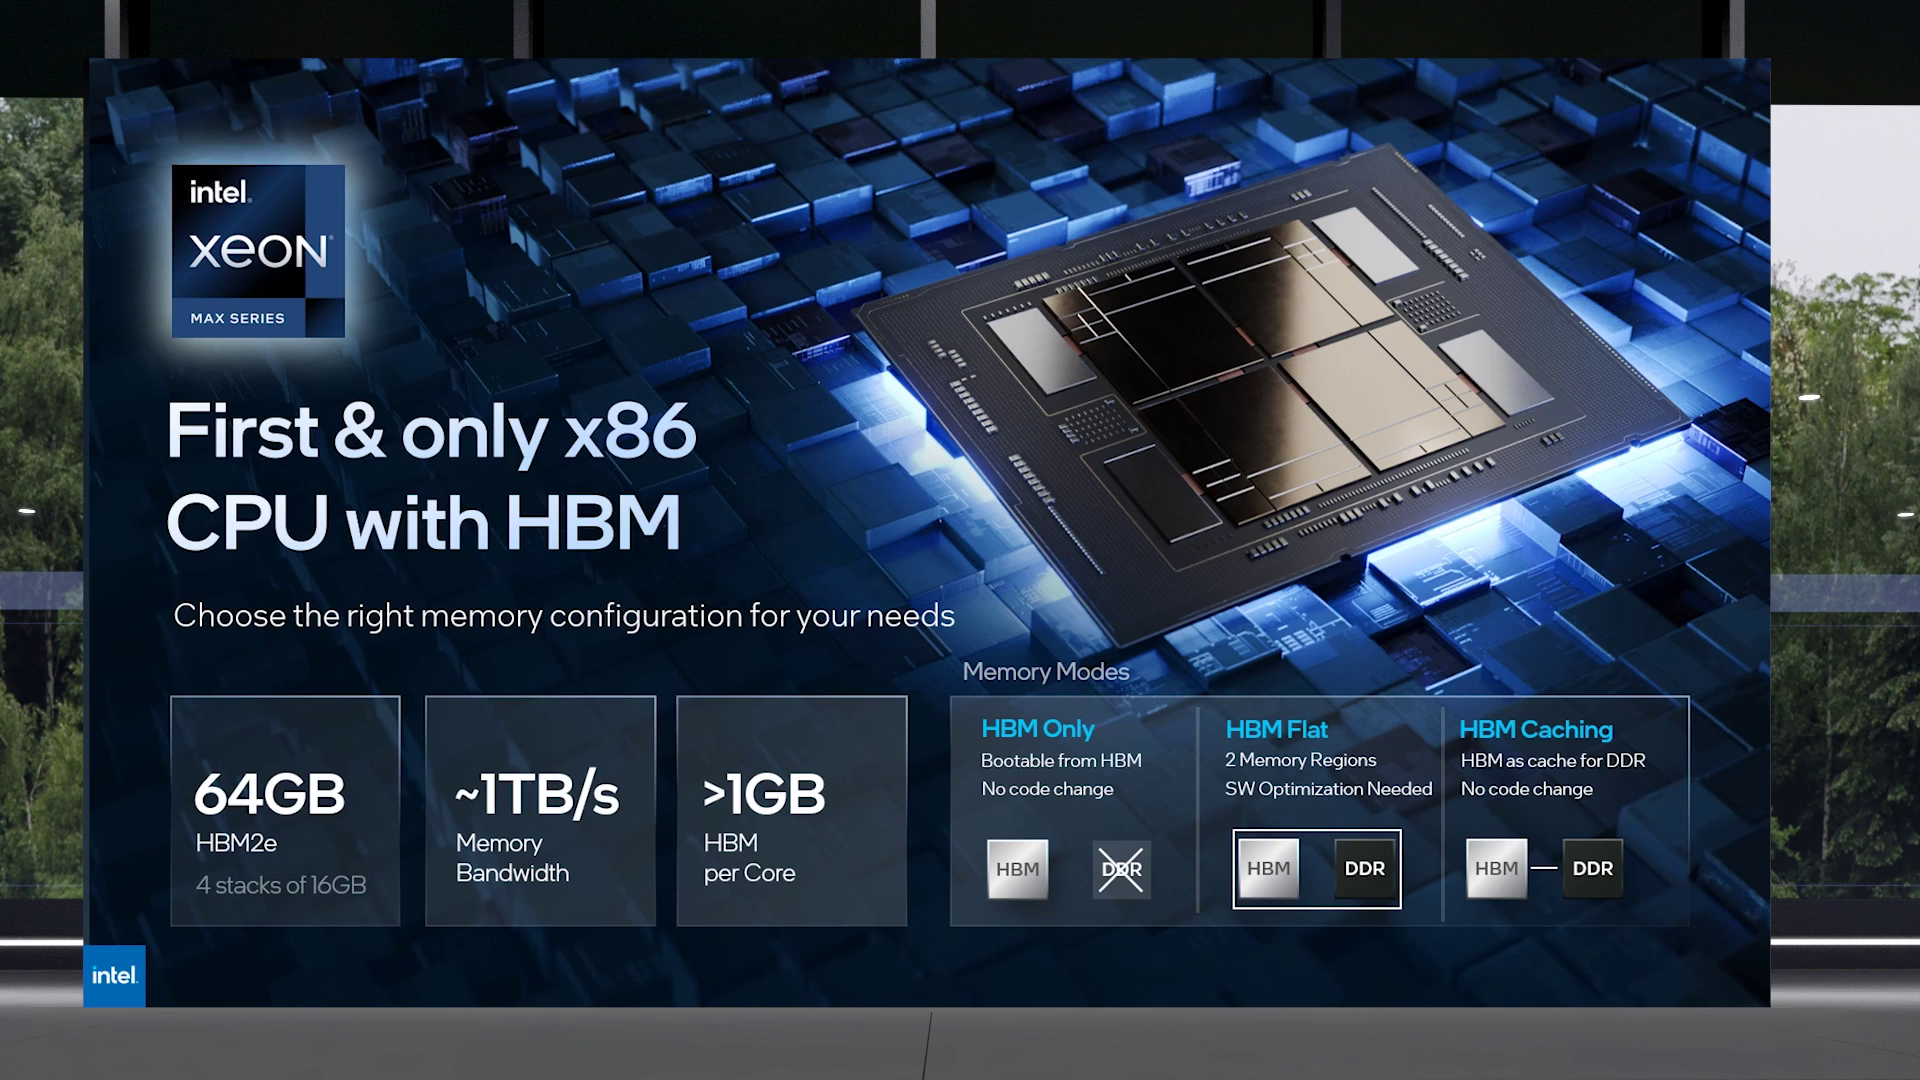 Intel Xeon Max поддерживают 2S-платформы, что суммарно даёт уже 128 Гбайт HBM-памяти, которых вполне хватит для целого ряда задач. Новые процессоры действительно могут обходиться без DIMM. Но есть и два других режима. В первом HBM-память работает в качестве кеша для обычной памяти, и для системы это происходит прозрачно, так что никаких модификаций для ПО (как в случае отсутствия DIMM вообще) не требуется. Во втором режиме HBM и DDR представлены как отдельные пространства, так что тут дорабатывать ПО придётся, зато можно добиться более эффективного использования обоих типов памяти.
В презентации Intel сравнивает новые Xeon Max с AMD EPYC Milan-X – в зависимости от задачи прирост составляет от +20 % до 4,8 раз. Но, во-первых, уже сегодня эти тесты потеряют всякий смысл в связи с презентацией EPYC Genoa (которые, к слову, должны получить AVX-512), а во-вторых, в следующем году AMD обещает представить Genoa-X с 3D V-Cache. Intel же явно не оставляет попытки создать как можно более универсальный процессор. 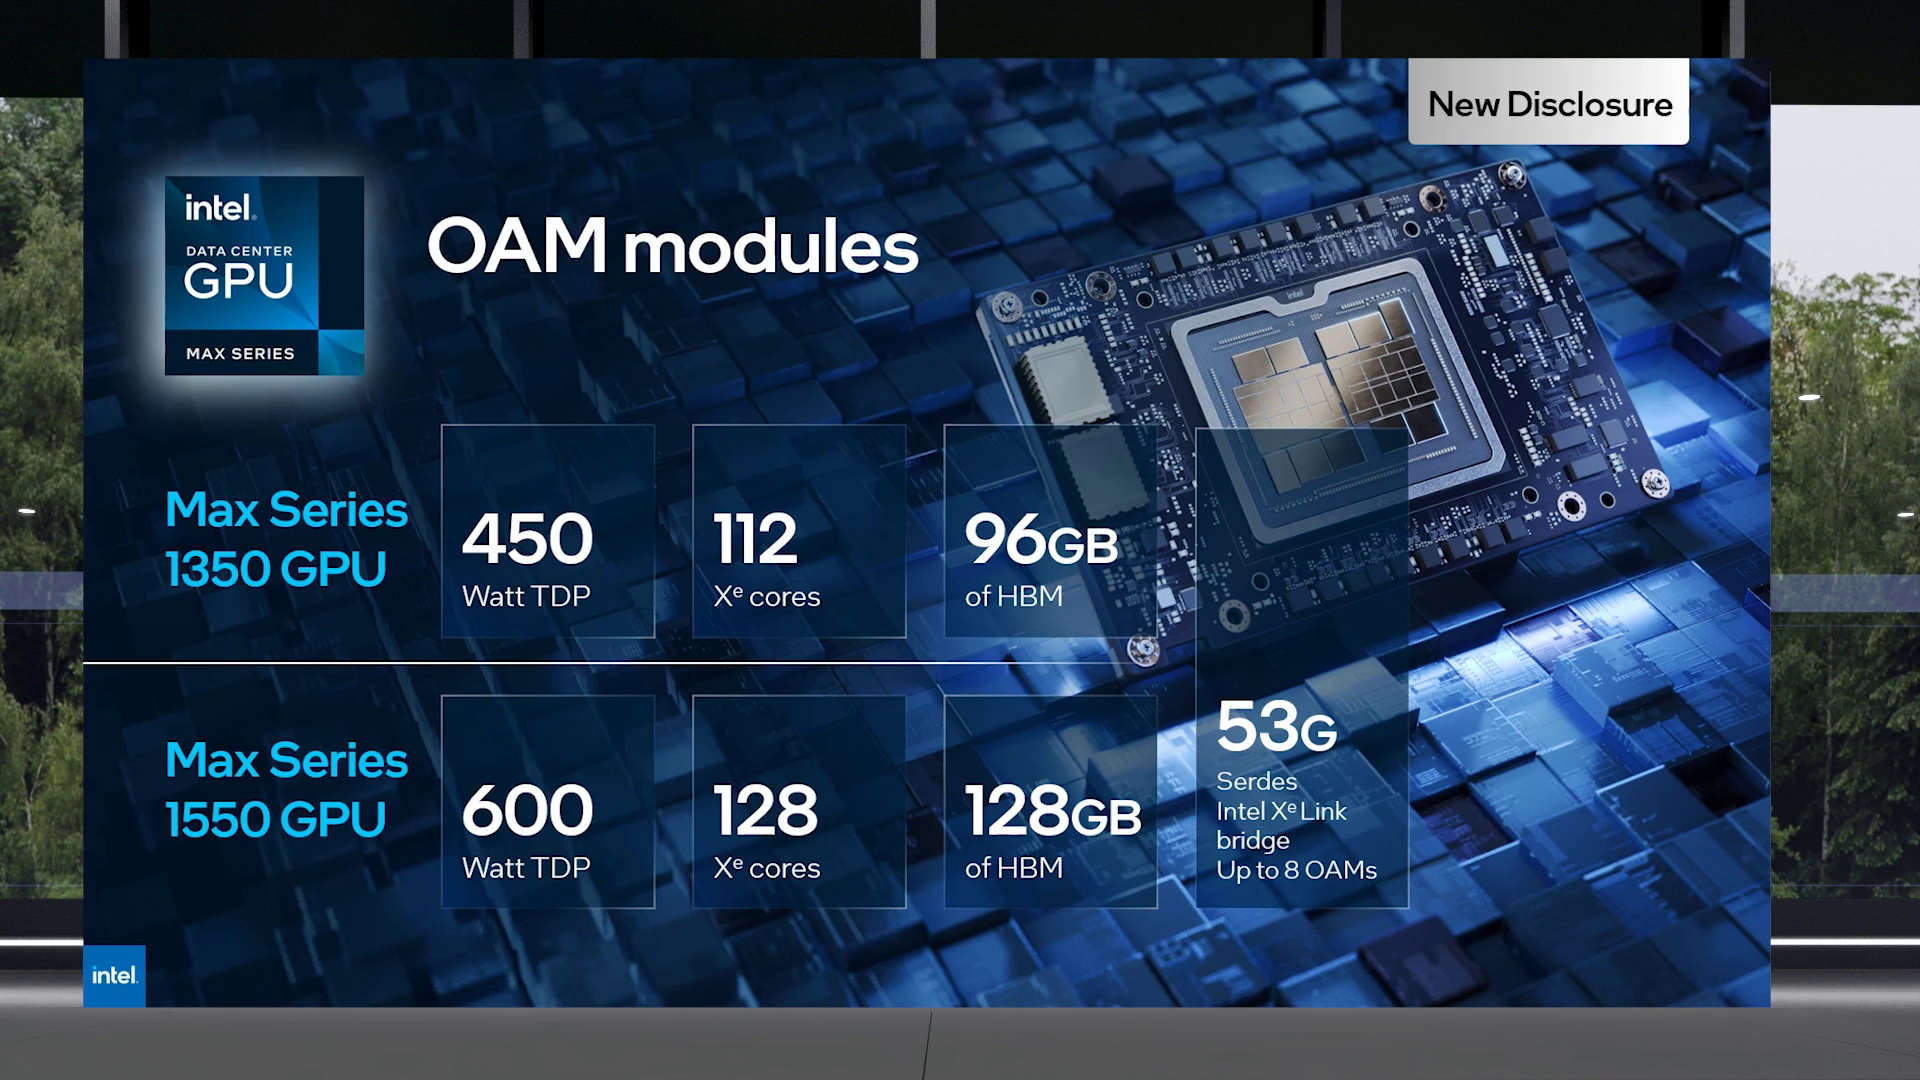 Что касается Ponte Vecchio, которые теперь называются Max GPU, то практически ничего нового относительно строения и особенностей данных ускорителей Intel не сказала: до 128 ядер Xe (только теперь стало известно об аппаратном ускорении трассировки лучей, что важно для визуализации), 64 Мбайт L1-кеша и аж 408 Мбайт L2-кеша (из них 120 Мбайт приходится на Rambo-кеш в двух стеках), 16 линий Xe Link, 8 HBM2e-контроллеров на 128 Гбайт памяти и пиковая FP64-производительность на уровне 52 Тфлопс. Все эти характеристики относятся к старшей модели Max Series 1550 в OAM-исполнении с TDP в 600 Вт. 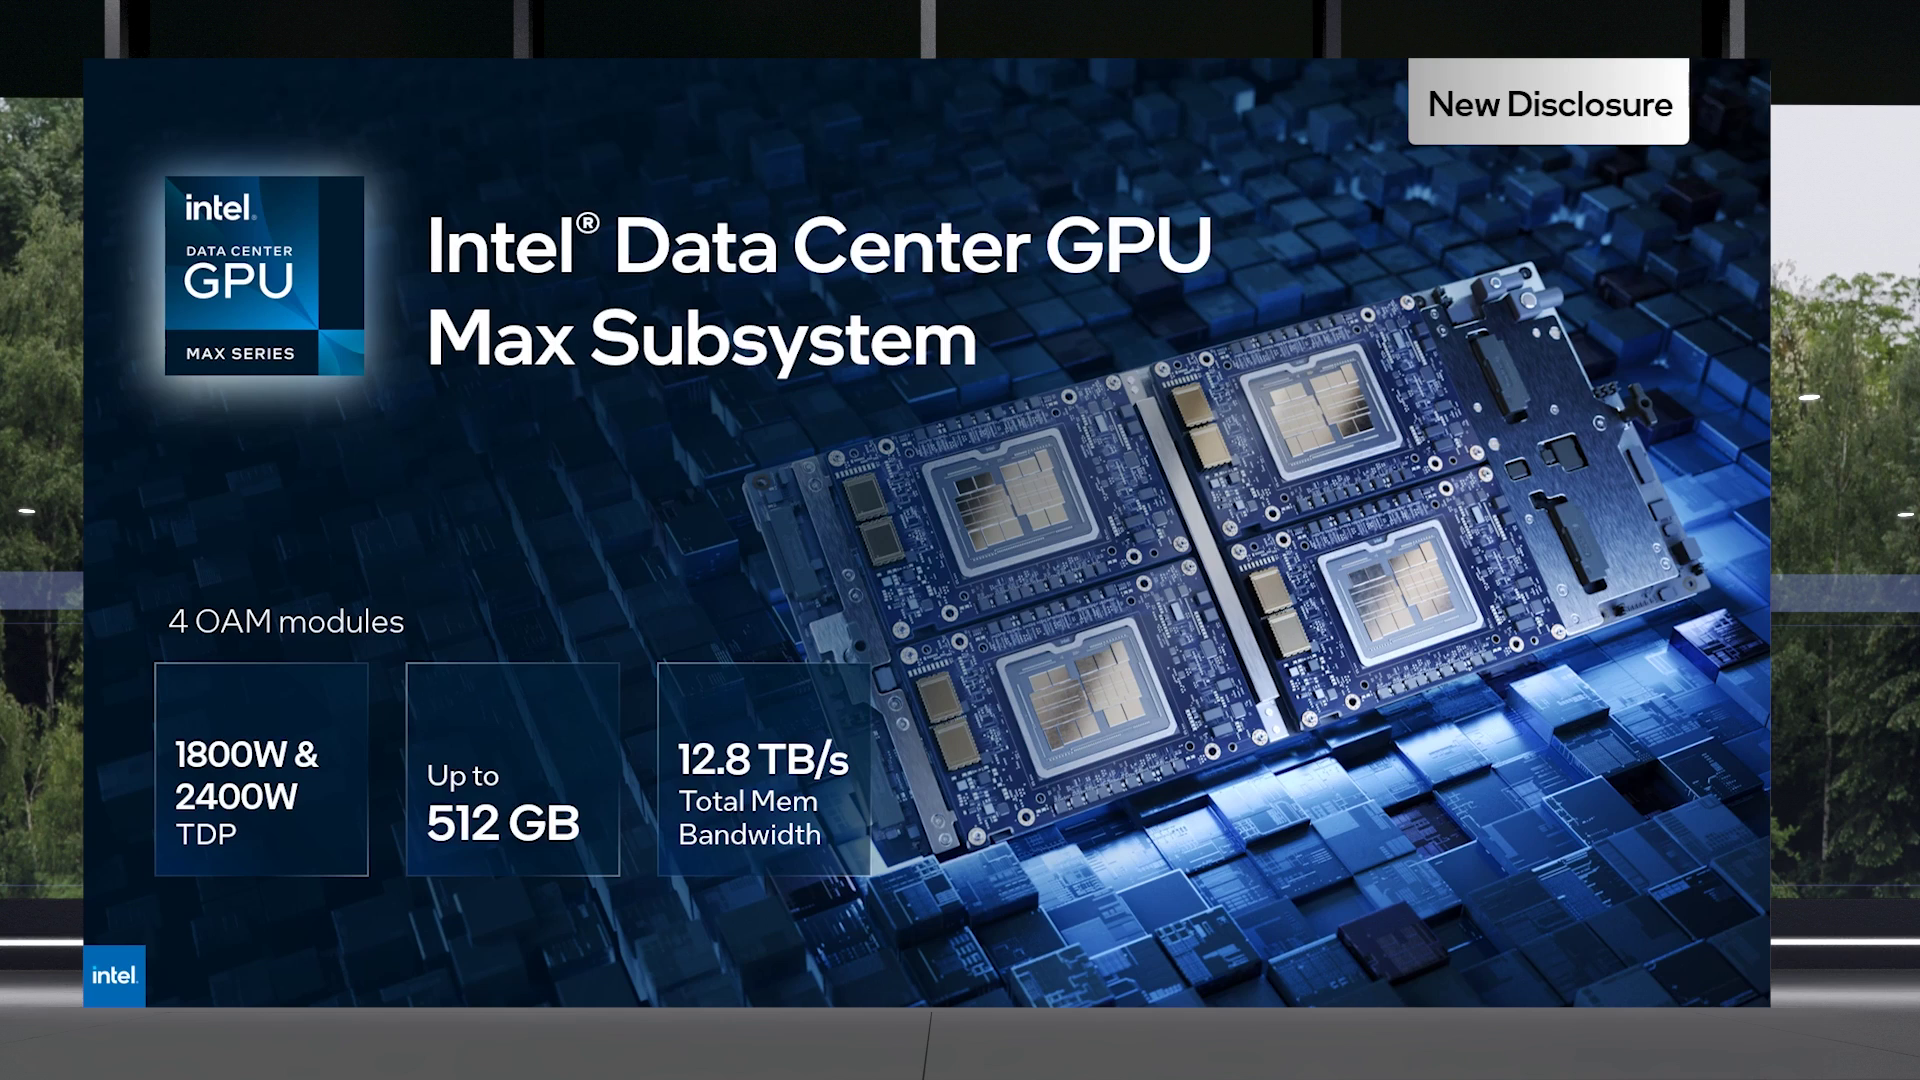 Max Series 1350 предложит 112 ядер Xe и 96 Гбайт HBM2e, но и TDP у этой модели составит всего 450 Вт. Для обеих OAM-версий также будут доступны готовые блоки из четырёх ускорителей (по примеру NVIDIA RedStone), объединённых по схеме «каждый с каждым», так что в сумме можно получить 512 Гбайт HBM2e с ПСП в 12,8 Тбайт/с. Ну а самый простой ускоритель в серии называется Max Series 1100. Это 300-Вт PCIe-плата с 56 Xe-ядрами, 48 Гбайт HBM2e и мостиками Xe Link. 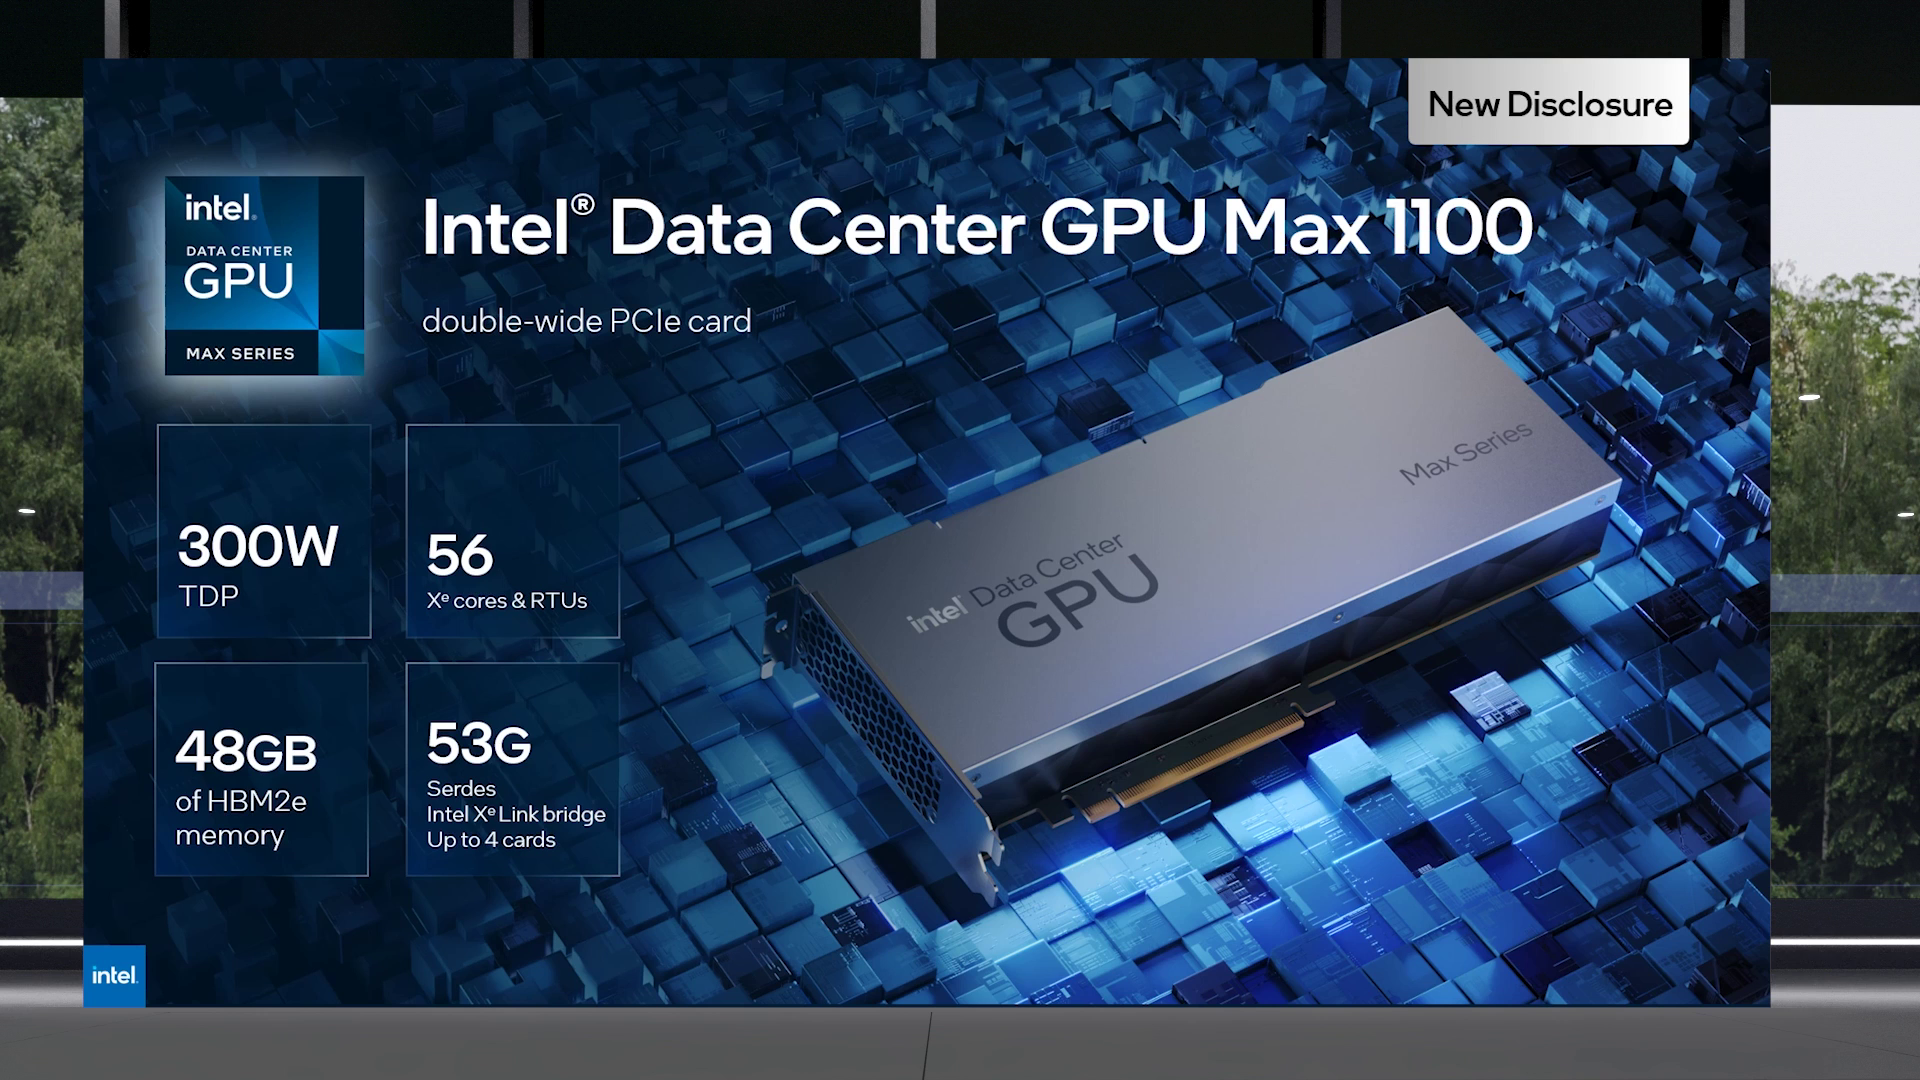 Intel утверждает, что ускорители Max до двух раз быстрее NVIDIA A100 в некоторых задачах, но и здесь история повторяется — нет сравнения с более современными H100. Хотя предварительный доступ к этим ускорителям у Intel есть, поскольку именно Sapphire Rapids являются составной частью платформы DGX H100. В целом, Intel прямо говорит, что наибольшей эффективности вычислений позволяет добиться связка CPU и GPU серии Max в сочетании с oneAPI. Всего на базе решений данной серии готовится более 40 продуктов.
Пока что приоритетным для Intel проектом является 2-Эфлопс суперкомпьютер Aurora, для которого пока что создан тестовый кластер Sunspot со 128 узлами, содержащими ускорители Max. Следующим ускорителем Intel станет Rialto Bridge, который появится в 2024 году. Также компания готовит гибридные (XPU) чипы Falcon Shores, сочетающие CPU, ускорители и быструю память. Аналогичный подход применяют AMD и NVIDIA.
02.05.2022 [01:08], Владимир Мироненко
AWS представила инстансы I4i с Intel Xeon Ice Lake-SP и NVMe-накопителями Nitro SSD собственной разработкиAWS представила инстансы I4i со сверхбыстрым хранилищем. Новинки используют Intel Xeon Ice Lake-SP и NVMe-накопители Nitro SSD, разработанные самой Amazon. I4i обеспечивают снижение задержки операций ввода-вывода до 60 % (разброс тоже ниже на 75 %) по сравнению с инстансами I3, а также до 30 % лучшее соотношение цены и производительности. Благодаря использованию сразу нескольких компонентов Nitro, все физические ресурсы узлов доступны инстансам практически полностью. I4i «предназначены для минимизации задержки и максимизации количества транзакций в секунду (TPS) для рабочих нагрузок, которым требуется очень быстрый доступ к наборам данных среднего размера в локальном хранилище. Сюда входят транзакционные базы данных, такие как MySQL, Oracle DB и Microsoft SQL Server, а также базы данных NoSQL: MongoDB, Couchbase, Aerospike, Redis и т.д.». Они также подходят для рабочих нагрузок, требующих высокую производительность вычислений в пересчёте на Тбайт хранилища, таких как аналитика данных и поисковые системы. 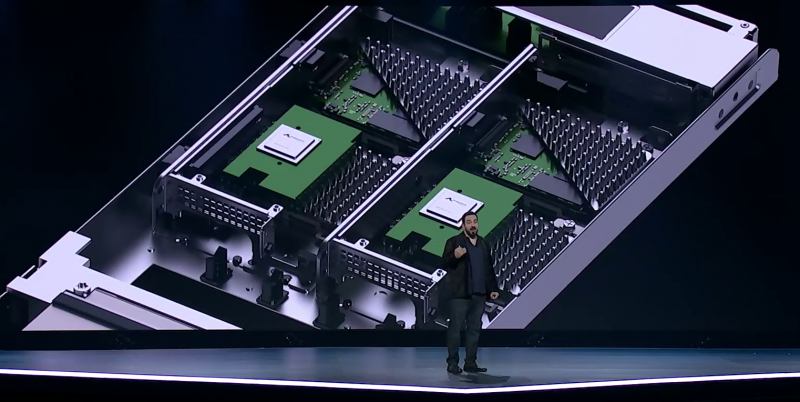
Узлы с Nitro SSD (Изображение: AWS) У всех новинок частота всех ядер в турборежиме составляет 3,5 ГГц; есть поддержка AVX-512 и Intel Total Memory Encryption. Для особо ресурсоёмких задач предлагается инстанс I4i.32xlarge: 128 vCPU, 1 Тбайт RAM (с NUMA), сетевое подключение 75 Гбит/с, 40-Гбит/с доступ к EBS-томам и восемь локальных Nitro SSD суммарной ёмкостью 30 Тбайт. Nitro SSD имеют продвинутую прошивку, отвечающую за реализацию многих функций, включая телеметрию и диагностику на лету, а также управление хранилищем на уровне инстанса для повышения надёжности и обеспечения стабильного уровня производительности. Инстансы I4i уже доступны в регионах AWS US East (Северная Виргиния), US East (Огайо), US West (Орегон) и Европа (Ирландия) по запросу и в качестве спотовых и зарезервированных. Доступны планы Savings, а также выделенные инстансы и выделенные хосты. Клиентам рекомендуется использовать последние AMI, включающие текущие драйверы ENA и поддержку NVMe 1.4.
08.09.2021 [19:00], Алексей Степин
Intel представила процессоры Xeon E-2300: Rocket Lake-E для серверов и рабочих станций начального уровняВ современном мире нагрузки на процессор год от года становятся всё сложнее и объёмнее, и не только крупные ЦОД нуждаются в архитектурных новшествах и новых наборах инструкций — малому бизнесу также требуются чипы нового поколения. Корпорация Intel ответила на это выпуском новых процессоров Xeon серии E-2300 и соответствующей платформы для них. Новинки стали быстрее и получили долгожданную поддержку PCI Express 4.0. Платформа Xeon E-2x00 не обновлялась достаточно давно: процессоры серии E-2200 были представлены ещё в 2019 году. На тот момент это был действительно прорыв в сегменте чипов Intel начального уровня — они впервые получили до 8 ядер Coffee Lake-S, а поддерживаемый объём памяти вырос с 64 до 128 Гбайт. Однако на сегодня таких возможностей уже может оказаться недостаточно: у E-2200 нет AVX-512 с VNNI, шина PCIe ограничена версией 3.0, а графическое ядро HD Graphics P630 и по меркам 2019 года быстрым назвать было нельзя. 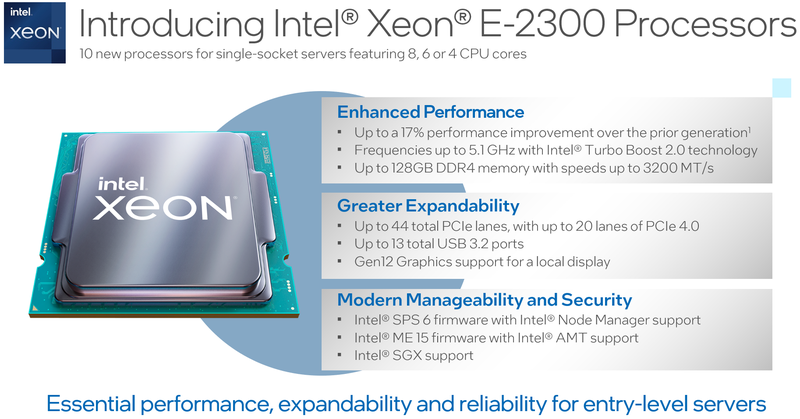
Источник изображений: Intel 10 новых процессоров Xeon E-2300, анонсированных Intel сегодня, должны заполнить пустующую нишу младших бизнес-решений. Нововведений в новой платформе не так уж мало, как может показаться на первый взгляд, ведь максимальное количество процессорных ядер у Xeon E-2300 по-прежнему восемь. Однако их максимальная частота выросла до 5,1 ГГц. Изменился процессорный разъём, теперь это LGA1200. 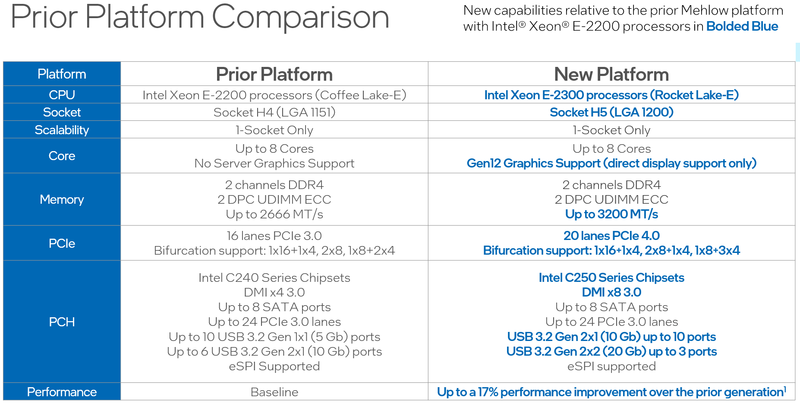 Ядра 11-го поколения Rocket Lake-E (Cypress Cove) по-прежнему используют 14-нм техпроцесс, но оптимизированная микроархитектура позволила Xeon E-2300 быть быстрее соответствующих моделей предыдущего поколения на 17%, и это без учёта качественных нововведений — теперь у них есть AVX-512 с поддержкой инструкций VNNI, ускоряющих работу нейросетей. Нововведения касаются и вопросов информационной безопасности, в которой малый бизнес нуждается не меньше крупного. Как и «большие» Xeon на базе Ice Lake-SP, процессоры Xeon E-2300 получили «взрослую» поддержку защищённых анклавов SGX объёмом до 512 Мбайт, что существенно выше максимально доступных для прошлого поколения Xeon E 64 Мбайт. Максимальный объём памяти остался прежним, но скорость подросла — до 128 Гбайт DDR4-3200 ECC UDIMM в двух каналах (2DPC). 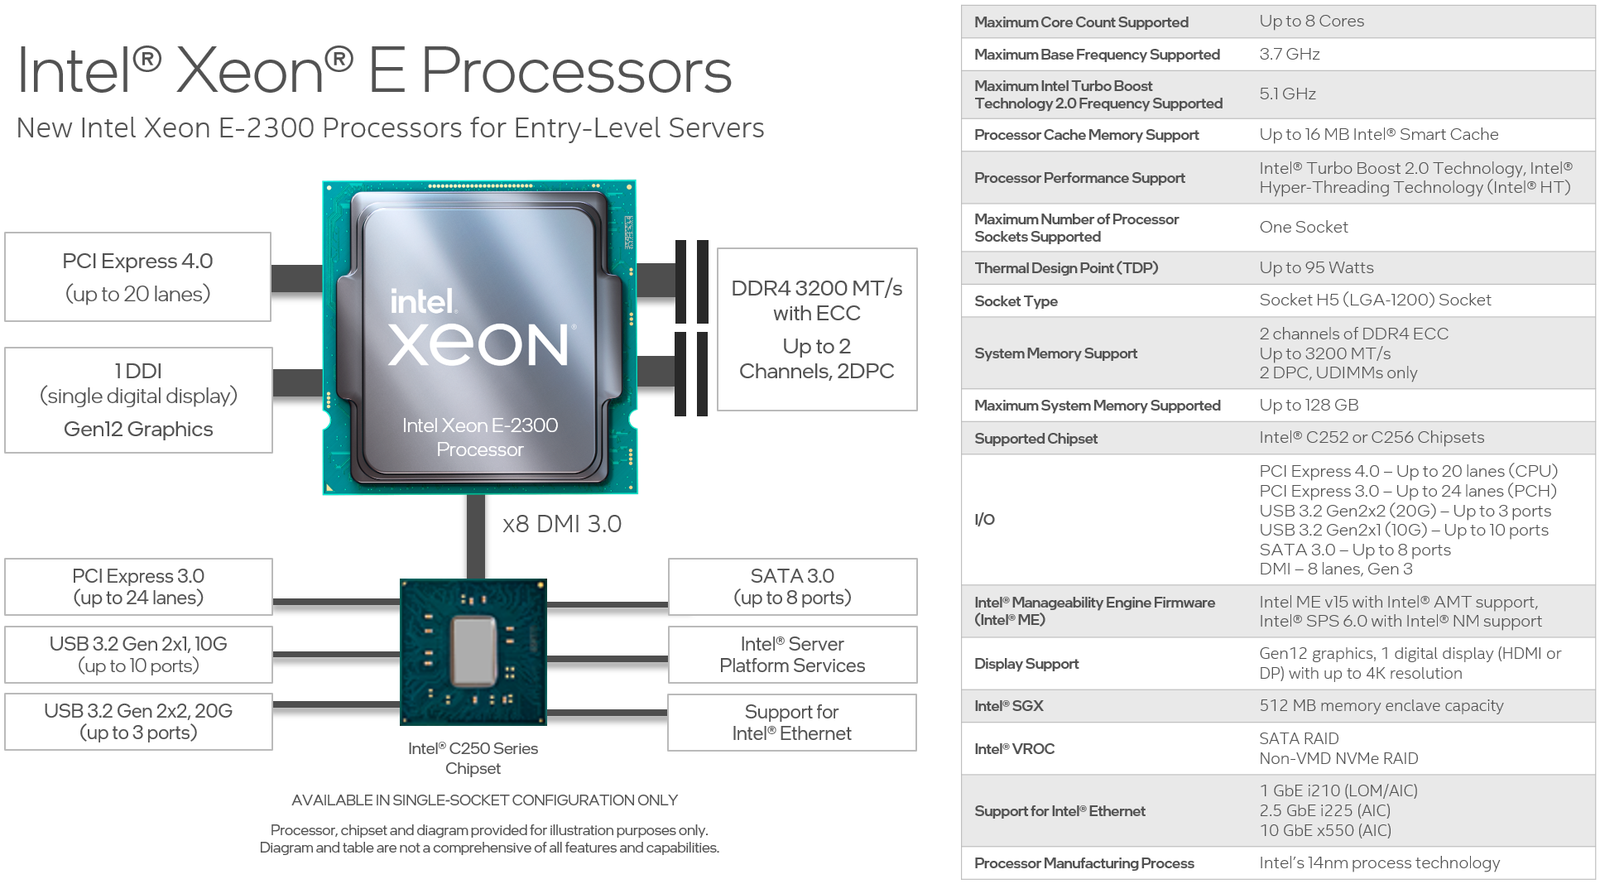 Весьма важно также появление нового графического ядра с архитектурой Xe-LP. Конечно, высокой 3D-производительности от него ждать не стоит, но даже в этом оно на шаг впереди устаревшей архитектуры. К этому стоит добавить поддержку HDMI 2.0b и DP 1.4a, аппаратное декодирование 12-бит HEVC и VP9 и 10-бит AV1, а также кодирование в 8-бит AVC и 10-бит HEVC и VP9. 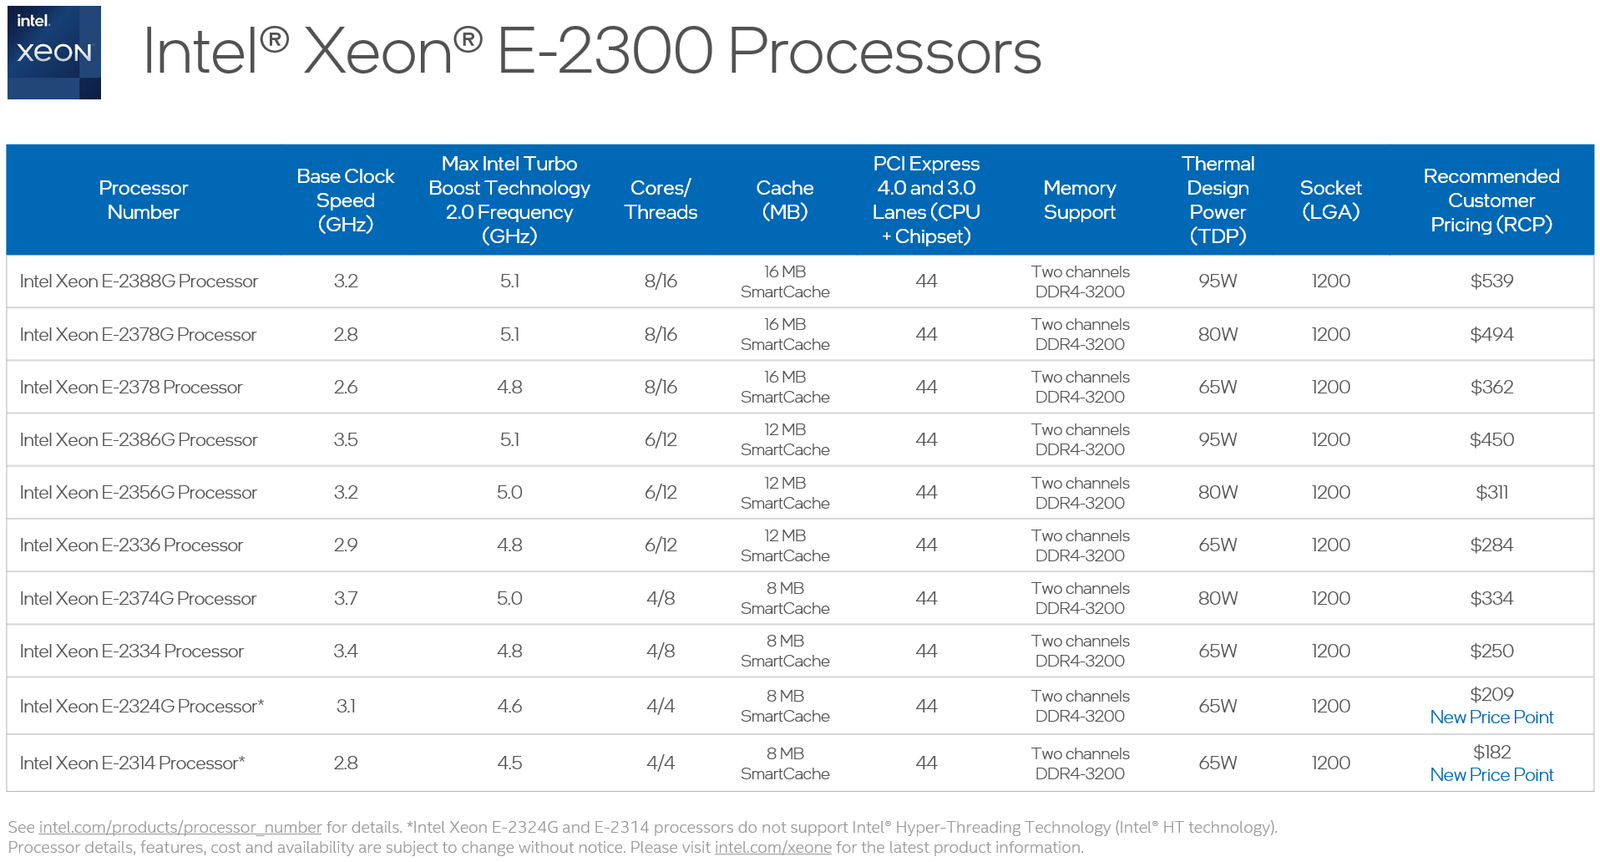 Поддержка PCIe 4.0 пришла и на платформу Xeon E — новые процессоры могут предложить 20 линий PCIe 4.0, причём с поддержкой бифуркации. Ещё 24 линии PCIe 3.0 включает чипсет серии C250. В нём же имеется поддержка 8 портов SATA-3 и USB 3.2 Gen 2x2 — до трёх портов со скоростью 20 Гбит/с. Сетевая часть может быть реализована как на базе недорогих чипов i210, так и более производительных i225 (2,5 Гбит/с) или x550 (10 Гбит/с).  В новой серии, как уже было сказано, представлено 10 процессоров, стоимостью от $182 до $539 и теплопакетами от 65 до 95 Вт. Лишь две младшие модели в списке не имеют поддержки Hyper-Threading. Все Xeon E-2300 располагают встроенным движком Manageability Engine 15 и поддержкой Intel Server Platform Services 6, облегчающей развёртывание и удалённое управление. Свои решения на базе новой платформы представят все ведущие производители серверного оборудования.
19.08.2021 [16:00], Игорь Осколков
Intel представила Xeon Sapphire Rapids: четырёхкристалльная SoC, HBM-память, новые инструкции и ускорителиВ рамках Architecture Day компания Intel рассказала о грядущих серверных процессорах Sapphire Rapids, подтвердив большую часть опубликованной ранее информации и дополнив её некоторыми деталями. Intel позиционирует новинки как решение для более широкого круга задач и рабочих нагрузок, чем прежде, включая и популярные ныне микросервисы, контейнеризацию и виртуализацию. Компания обещает, что CPU будут сбалансированы с точки зрения вычислений, работой с памятью и I/O. Новые процессоры, наконец, получили чиплетную, или тайловую в терминологии Intel, компоновку — в состав SoC входят четыре «ядерных» тайла на техпроцессе Intel 7 (10 нм Enhanced SuperFIN). Каждый тайл объединён с соседом посредством EMIB. Их системные агенты, включающие общий на всех L3-кеш объём до 100+ Мбайт, образуют быструю mesh-сеть с задержкой порядка 4-8 нс в одну сторону. Со стороны процессор будет «казаться» монолитным.  Каждые ядро или поток будут иметь свободный доступ ко всем ресурсам соседних тайлов, включая кеш, память, ускорители и IO-блоки. Потенциально такой подход более выгоден с точки зрения внутреннего обмена данными, чем в случае AMD с общим IO-блоком для всех чиплетов, которых в будущих EPYC будет уже 12. Но как оно будет на самом деле, мы узнаем только в следующем году — выход Sapphire Rapids запланирован на первый квартал 2022-го, а массовое производство будет уже во втором квартале. 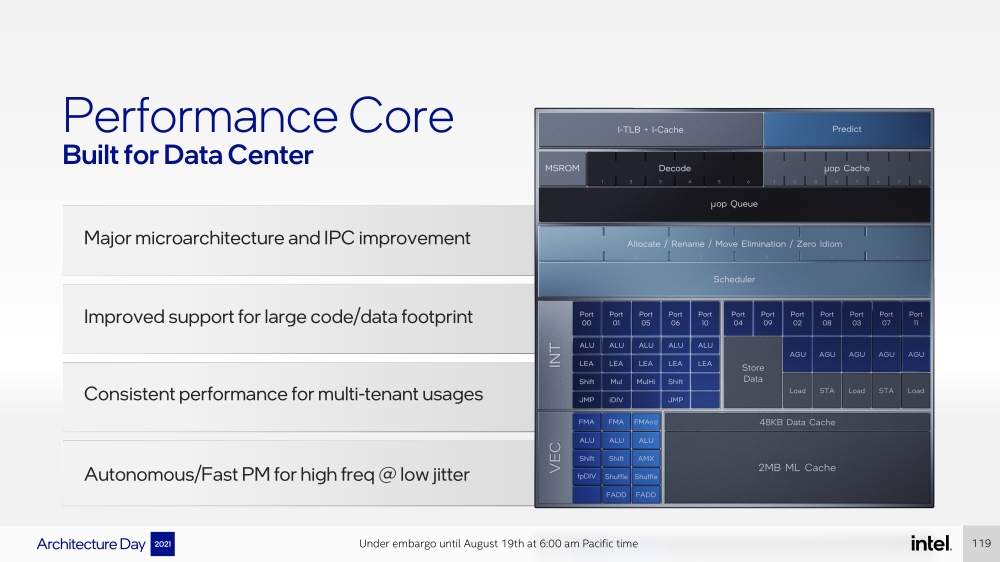 Ядра Sapphire Rapids базируются на микроархитектуре Golden Cove, которая стала шире, глубже и «умнее». Она же будет использована в высокопроизводительных ядрах Alder Lake, но в случае серверных процессоров есть некоторые отличия. Например, увеличенный до 2 Мбайт на ядро объём L2-кеша или новый набор инструкций AMX (Advanced Matrix Extension). Последний расширяет ИИ-функциональность CPU и позволяет проводить MAC-операции над матрицами, что характерно для такого рода нагрузок. 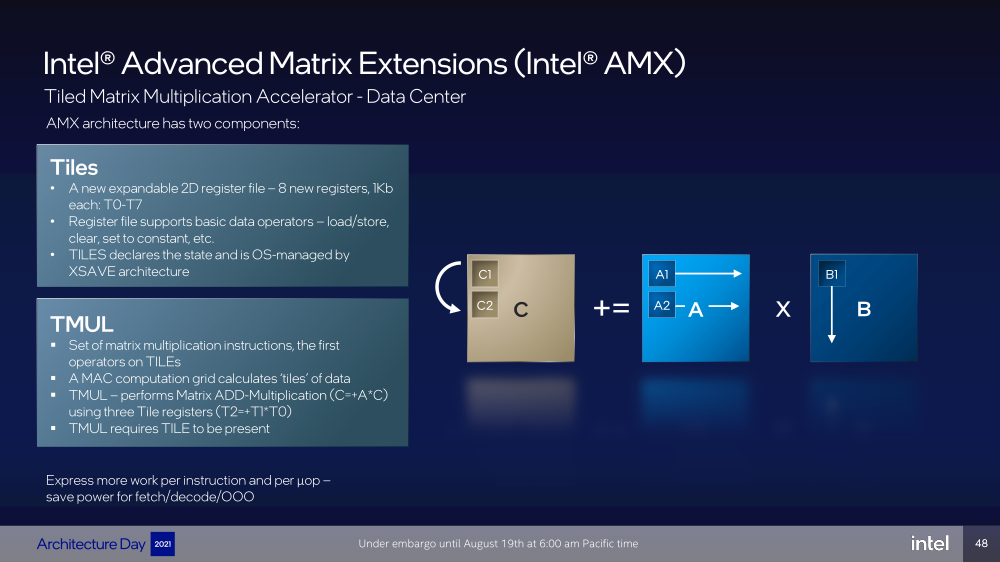 Для AMX заведено восемь выделенных 2D-регистров объёмом по 1 Кбайт каждый (шестнадцать 64-байт строк). Отдельный аппаратный блок выполняет MAC-операции над тремя регистрами, причём делаться это может параллельно с исполнением других инструкций в остальной части ядра. Настройкой параметров и содержимого регистров, а также перемещением данных занимается ОС. Пока что в процессорах представлен только MAC-блок, но в будущем могут появиться блоки и для других, более сложных операций. 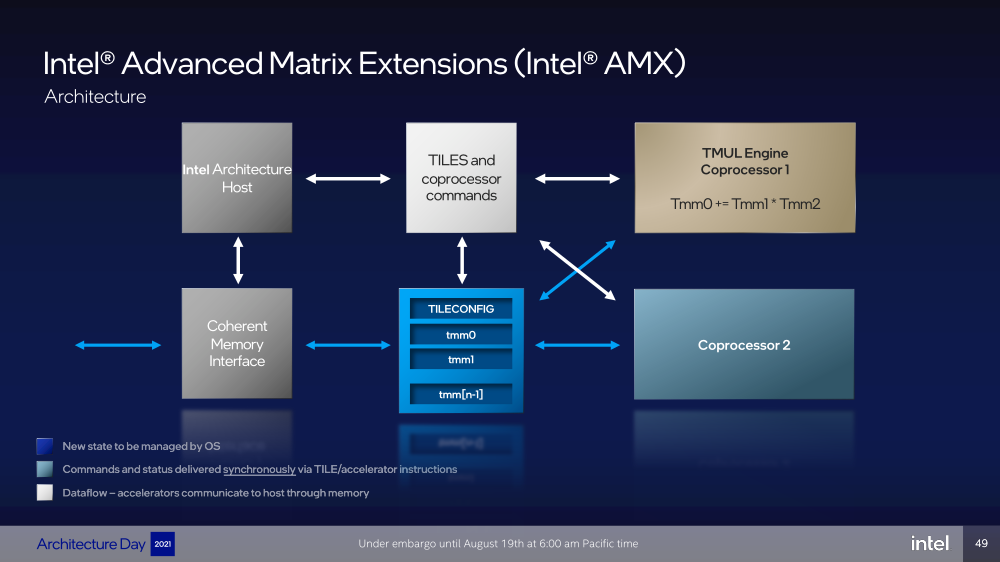 В пике производительность AMX на INT8 составляет 2048 операций на цикл на ядро, что в восемь раз больше, чем при использовании традиционных инструкций AVX-512 (на двух FMA-портах). На BF16 производительность AMX вдвое ниже, но это всё равно существенный прирост по сравнению с прошлым поколением Xeon — Intel всё так же пытается создать универсальные ядра, которые справлялись бы не только с инференсом, но и с обучением ИИ-моделей. Тем не менее, компания говорит, что возможности AMX в CPU будут дополнять GPU, а не напрямую конкурировать с ними. 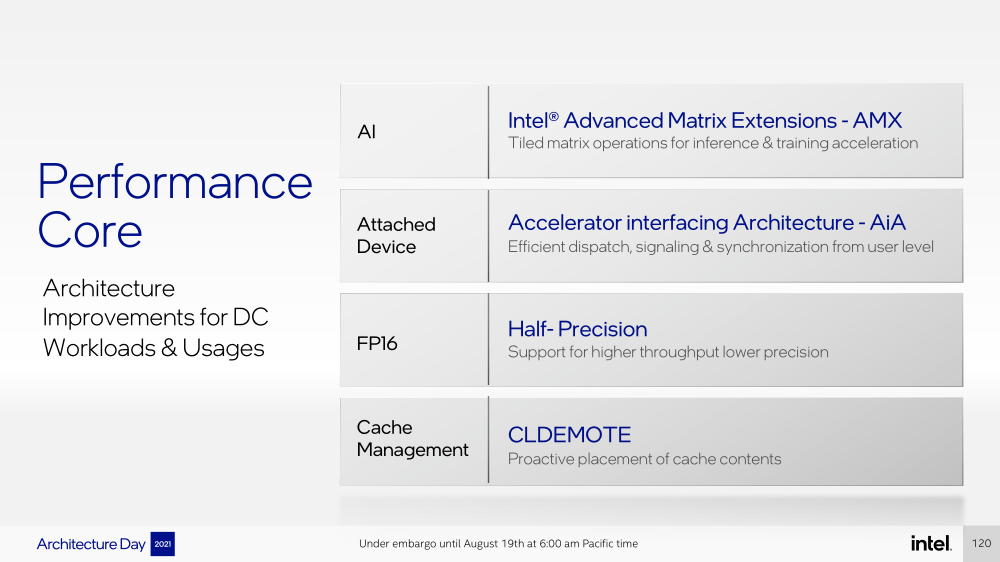 К слову, именно Sapphire Rapids должен, наконец, сделать BF16 более массовым, поскольку Cooper Lake, где поддержка этого формата данных впервые появилась в CPU Intel, имеет довольно узкую нишу применения. Из прочих архитектурных обновлений можно отметить поддержку FP16 для AVX-512, инструкции для быстрого сложения (FADD) и более эффективного управления данными в иерархии кешей (CLDEMOTE), целый ряд новых инструкций и прерываний для работы с памятью и TLB для виртуальных машин (ВМ), расширенную телеметрию с микросекундными отсчётами и так далее. 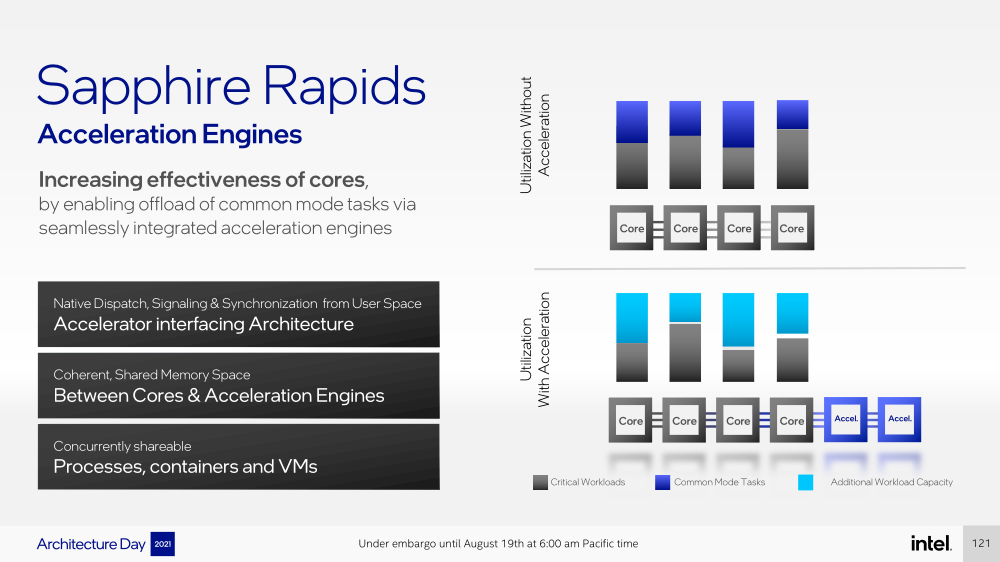 Последние пункты, в целом, нужны для более эффективного и интеллектуального управления ресурсами и QoS для процессов, контейнеров и ВМ — все они так или иначе снижают накладные расходы. Ещё больше ускоряют работу выделенные акселераторы. Пока упомянуты только два. Первый, DSA (Data Streaming Accelerator), ускоряет перемещение и передачу данных как в рамках одного хоста, так и между несколькими хостами. Это полезно при работе с памятью, хранилищем, сетевым трафиком и виртуализацией. 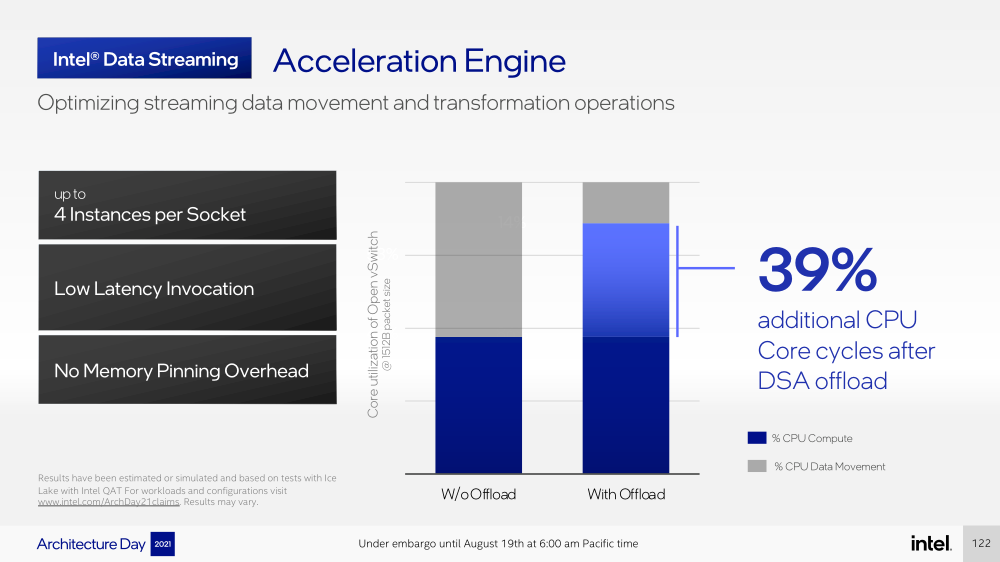 Второй упомянутый ускоритель — это движок QAT (Quick Assist Engine), на который можно возложить операции или сразу цепочки операций (де-)компрессии (до 160 Гбит/с в обе стороны одновременно), хеширования и шифрования (до 400 Гбитс/с) в популярных алгоритмах: AES GCM/XTS, ChaChaPoly, DH, ECC и т.д. Теперь блок QAT стал частью самого процессора, тогда как прежде он был доступен в составе некоторых чипсетов или в виде отдельной карты расширения. Это позволило снизить задержки и увеличить производительность блока. 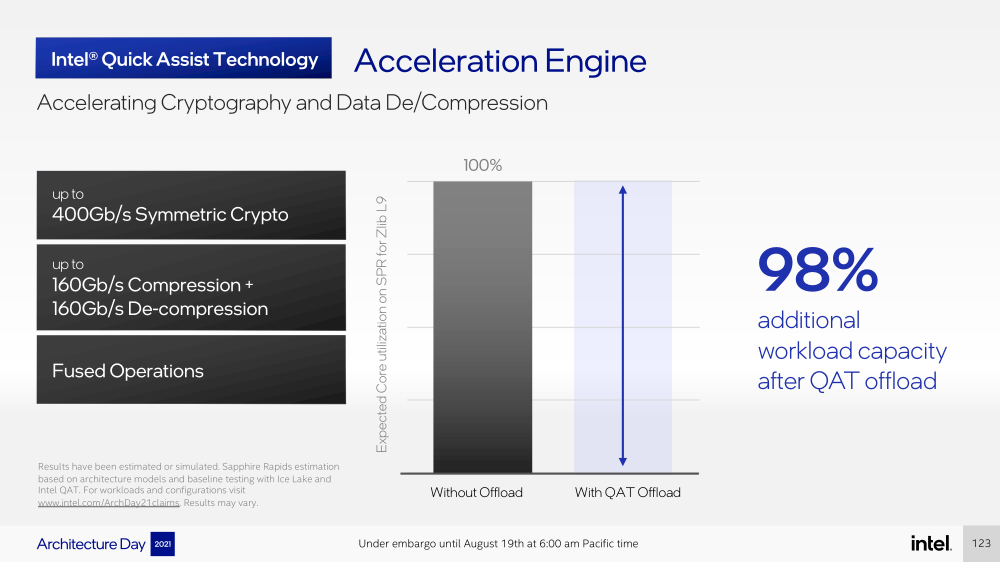 Кроме того, QAT можно будет задействовать, например, для виртуализации или Intel Accelerator Interfacing Architecture (AiA). AiA — это ещё один новый набор инструкций, предназначенный для более эффективной работы с интегрированными и дискретными ускорителями. AiA помогает с управлением, синхронизацией и сигнализацией, что опять таки позволит снизить часть накладных расходов при взаимодействии с ускорителями из пространства пользователя. 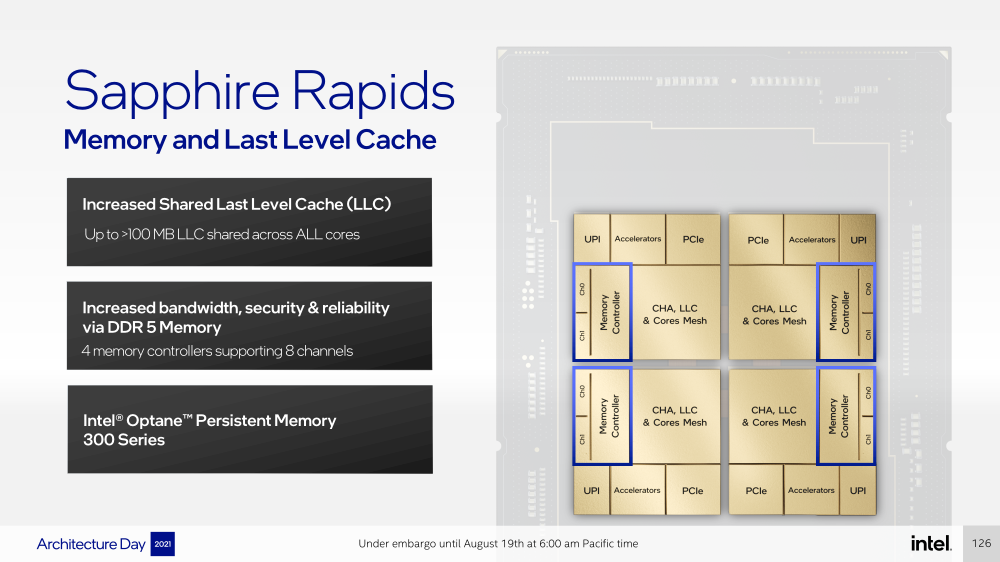 Подсистема памяти включает четыре двухканальных контроллера DDR5, по одному на каждый тайл. Надо полагать, что будут доступные четыре же NUMA-домена. Больше деталей, если не считать упомянутой поддержки следующего поколения Intel Optane PMem 300 (Crow Pass), предоставлено не было. Зато было официально подтверждено наличие моделей с набортной HBM, тоже по одному модулю на тайл. HBM может использоваться как в качестве кеша для DRAM, так и независимо. В некоторых случаях можно будет обойтись вообще без DRAM. 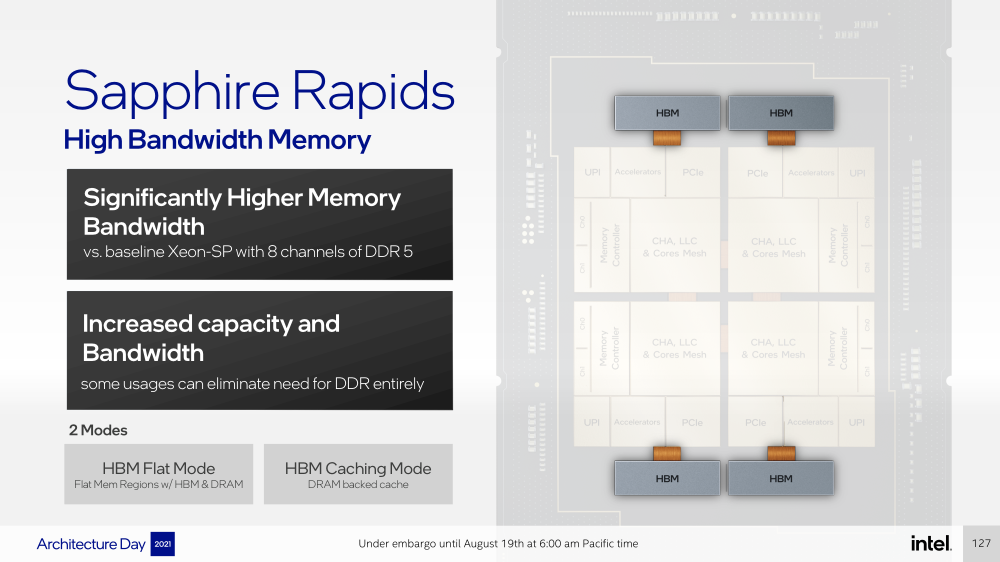 Про PCIe 5.0 и CXL 1.1 (CXL.io, CXL.cache, CXL.memory) добавить нечего, хотя в рамках другого доклада Intel ясно дала понять, что делает ставку на CXL в качестве интерконнекта не только внутри одного узла, но и в перспективе на уровне стойки. Для объединения CPU (бесшовно вплоть до 8S) всё так же будет использоваться шина UPI, но уже второго поколения (16 ГТ/с на линию) — по 24 линии на каждый тайл. 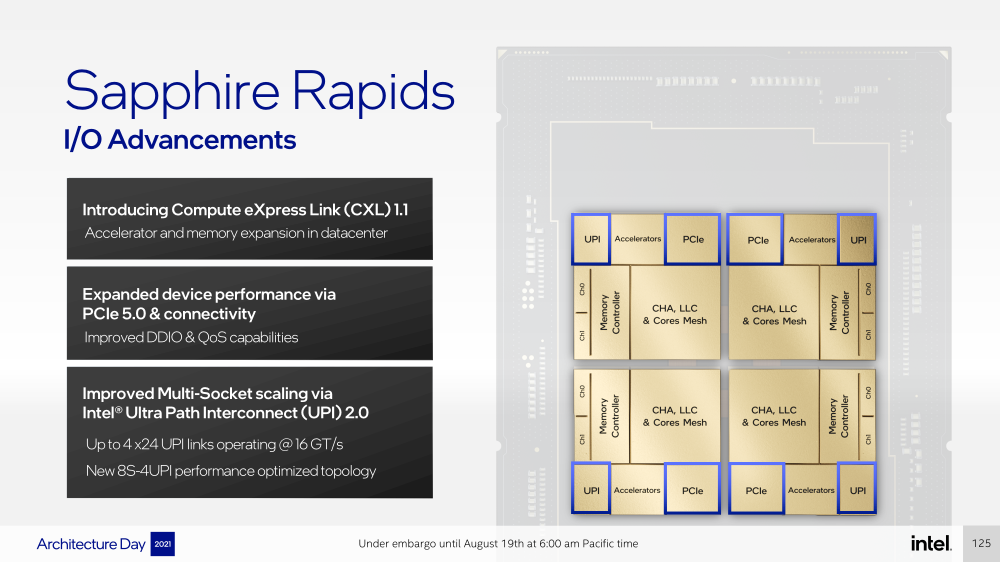 Конкретно для Sapphire Rapids Intel пока не приводит точные данные о росте IPC в сравнении с Ice Lake-SP, ограничиваясь лишь отдельными цифрами в некоторых задачах и областях. Также не был указан и ряд других важных параметров. Однако AMD EPYC Genoa, если верить последним утечкам, даже по чисто количественным характеристикам заметно опережает Sapphire Rapids.
18.08.2020 [15:26], Алексей Степин
Intel Xeon Ice Lake-SP: второе третье поколение Xeon ScalableКорпорация Intel не так уж часто оказывается в роли догоняющего, но ей пришлось примерить на себя эту роль после анонса второго поколения AMD EPYC, а сейчас и IBM анонсировала более продвинутые в плане поддержки новейших интерфейсов и стандартов процессоры POWER10. Разумеется, команда «синих» сдаваться не собирается и на мероприятии Hot Chips 32 компания раскрыла множество подробностей о процессорах Xeon с микроархитектурой Ice Lake. Их действительно можно назвать «вторым третьим поколением», поскольку звание третьего поколения они делят с анонсированными весной Xeon Cooper Lake. 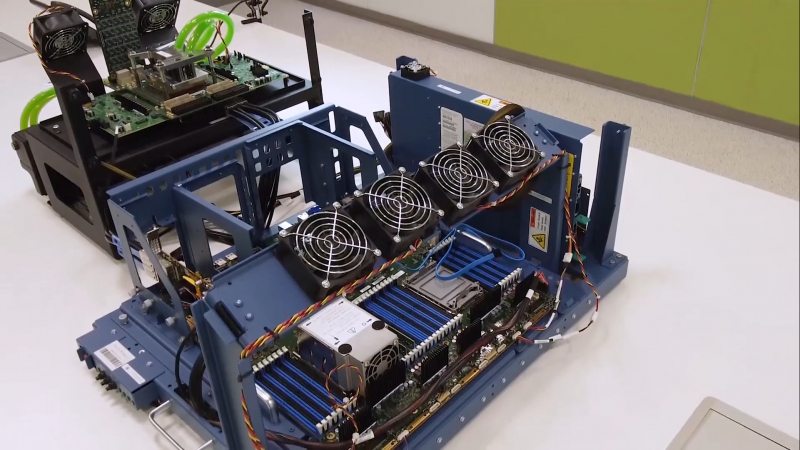
Демонстрационный стенд Intel на базе Ice Lake-SP Несмотря на это, данные серии процессоров отличаются кардинально. Cooper Lake рассчитаны на 4- и 8-сокетные системы, а Ice Lake-SP — на массовые 1- и 2-сокетные. При этом обе серии в определённой степени являются проходными, поскольку большая часть новейших технологий, таких как DDR5, PCIe 5.0, CXL 1.1 и других, будет реализована Intel лишь в поколении Sapphire Rapids в 2021 году. 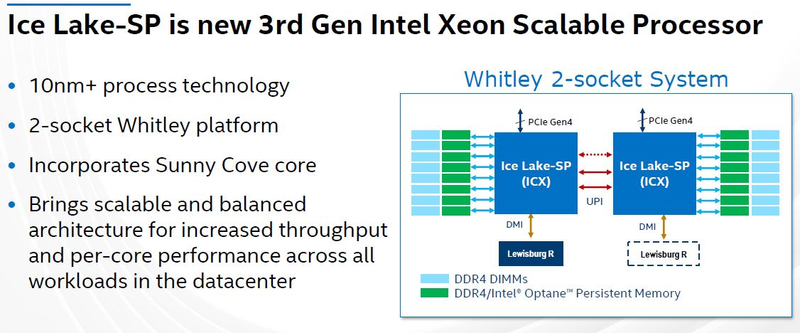 Платформа Whitley, позволяющая устанавливать до двух Ice Lake-SP, не слишком отличается от классических двухпроцессорных систем на базе Xeon Scalable. Для связи CPU всё так же используется 2, либо 3 линии UPI, системная логика — по-прежнему Lewisburg. Однако в одном такая платформа сможет поспорить с AMD EPYC: Ice Lake-SP будут поддерживать PCI Express 4.0. Системные платы и разъёмы в любом случае потребуются новые, поскольку выросло число каналов памяти. Прототип такой платы уже был показан на Intel Architecture Day 2020. 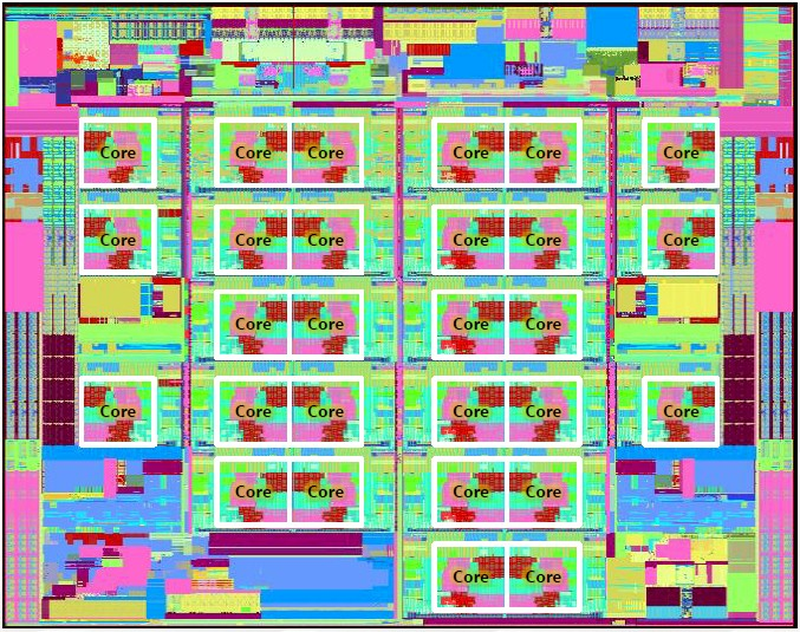 Архитектурно Cooper Lake являются продолжением серии Cascade Lake Refresh и, в свою очередь, Skylake-SP. А вот ядра Ice Lake-SP базируются на ядрах Sunny Cove, которые были представлены два года назад; впрочем, речь идёт о внедрении продвинутой версии 10-нм техпроцесса Intel (SuperFin). Максимальное число ядер одного CPU осталось равным 28, здесь прорывов Intel не предлагает, однако mesh-компоновка всех блоков изменилась: вместо матрицы 6×6 теперь реализована 6×7. 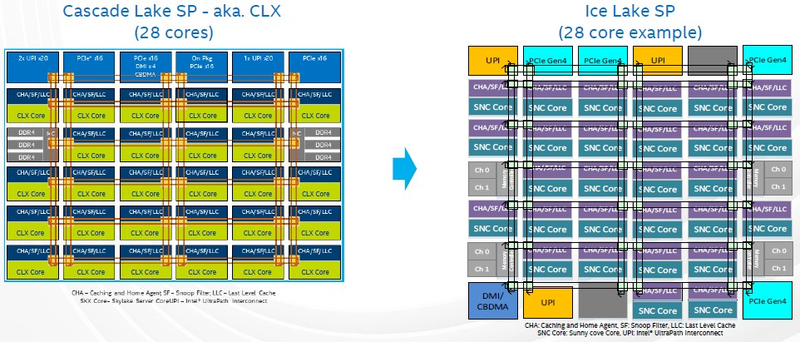 Одной из причин этому стала смена контроллера памяти. Новый контроллер разработан с нуля и в сумме обеспечивает работу восьми каналов DDR4-3200, что даёт существенный прирост пропускной способности в сравнении с прошлыми поколениями «больших» Xeon, использующими шестиканальный контроллер. Количество точек подключения контроллера памяти к внутренней mesh-структуре возросло с двух до четырёх, это должно снизить латентность в некоторых сценариях. 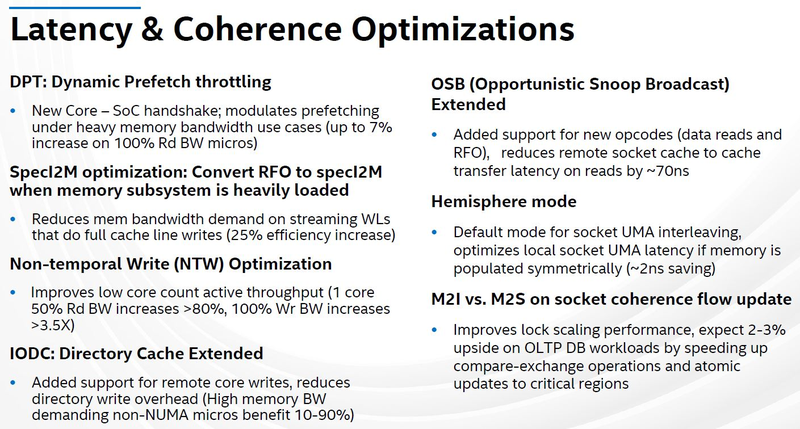 Контроллер памяти также имеет ряд дополнительных мини-оптимизаций. Часть из них позволяет повысить производительность в специфических сценариях, например, в нагрузках OLTP, но и в целом параметры улучшились. Так, латентность при доступе к кешу соседнего процессора снижена до 70 наносекунд. Оптимизированы сценарии работы с малым количеством ядер и многое другое. Поддерживаются модули Optane DCPMM 200. 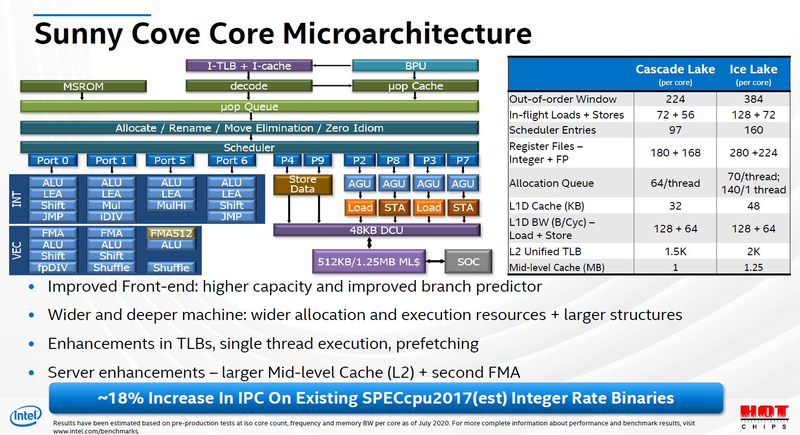 Детально об микроархитектуре Sunny Cove мы рассказывали ранее, её можно назвать эволюционным развитием Skylake. Увеличено буквально всё: ядро Sunny Cove может исполнять пять инструкций за такт вместо четырёх, исполнительных портов стало 10 вместо 8, увеличена пропускная способность кеша первого уровня, кеш второго уровня вырос с 1 до 1,25 Мбайт, появился второй блок FMA. И такой подход касается всего ядра, от размера окна внеочередного исполнения до объёма буфера ассоциативной трансляции (TLB). 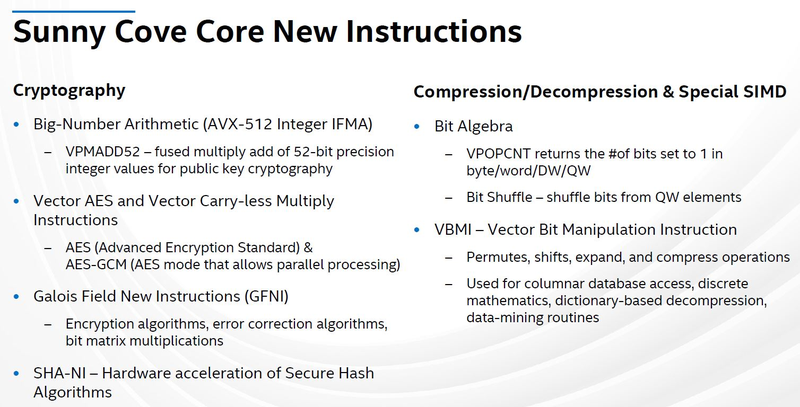 Однако имеются не только количественные нововведения. В новых процессорах Intel реализовала поддержку новых векторных инструкций AES и VBMI, добавила поддержку GFNI, расширила в очередной раз набор AVX-512. Часть нововведений служит криптографическим задачам, но также внимание уделено и сценариям компрессии/декомпрессии данных. В различных сценариях превосходство над Cascade Lake может варьироваться от полуторакратного до более чем восьмикратного, что впечатляет. 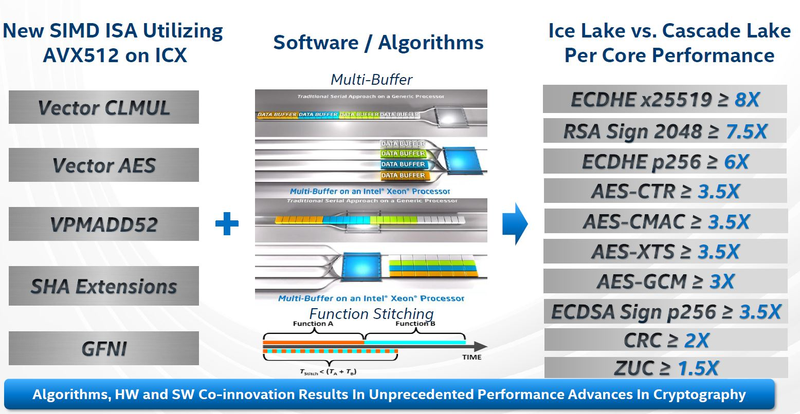 В области технологий обеспечения безопасности Intel следует основной современной тенденции и Ice Lake-SP получили поддержку TME (Total Memory Encryption), то есть полного шифрования оперативной памяти по стандарту AES-XTS 128 бит. Естественно, обещано, что аппаратно сгенерированные ключ будет невозможно извлечь из системы, а накладные расходы на шифрование снизят производительность не более чем на 5% (в предварительных тестах это 2-3%). 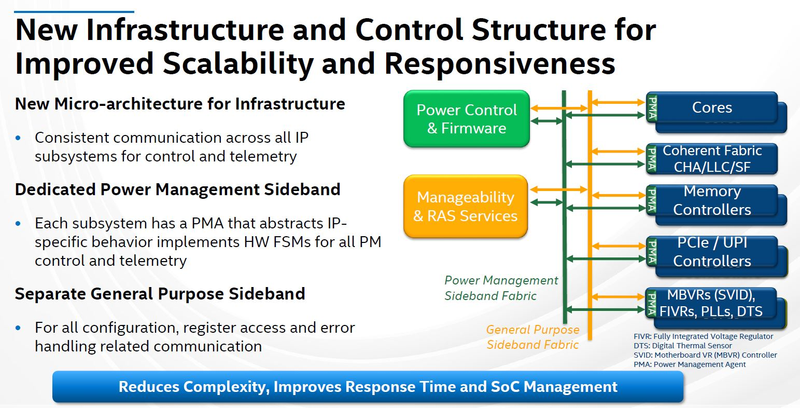 В паре с SGX-анклавами получается, судя по всему, неплохая альтернатива AMD SVE и тому, что IBM реализовала в POWER10. Кроме того, значительно внимание уделено механизму когерентности и снижению задержек. В том числе, речь идёт об уменьшении задержек при переключении процессора между разными частотами и уровнями энергопотребления. 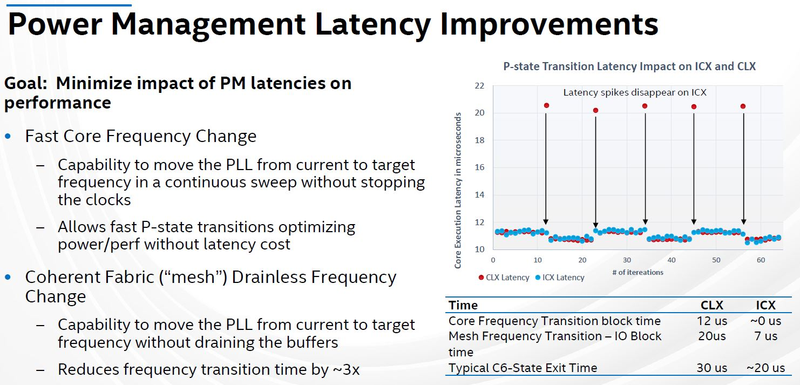 Intel придерживается целостного подхода и предпочитает говорить об оптимизации SoC как единой структуры в целом, а не только об отдельных компонентах. Тем не менее, интересно отметить, что система управления питанием процессора получило новую выделенную шину, функции которой отделены от шины общего управления и мониторинга. Подход довольно логичный: по количеству ядер «синие» пока не могут догнать AMD, поэтому уделяют первоочередное внимание повышению эффективности как отдельных ядер, так и процессора в целом. 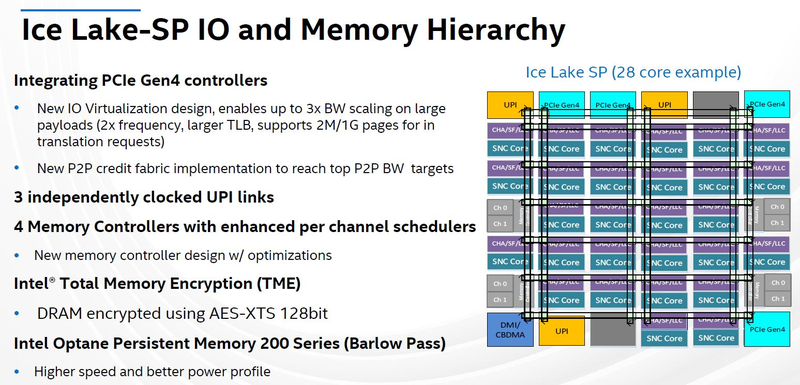 И достигнутые результаты впечатляют: Ice Lake способен менять частоту ядер примерно за 12 микросекунд, причём процесс происходит без просадок, характерных для Cascade Lake, который может иногда «задумываться», что негативно сказывается на общей производительности. Так же легко новые процессоры меняют режим энергопотребления (P-state). Минимизирована известная проблема (или особенность, если хотите) процессоров Intel, а именно снижение частоты при использовании инструкций AVX, особенно AVX-512. Ряд не слишком «прожорливых» инструкций AVX теперь исполняется на более высоких частотах. 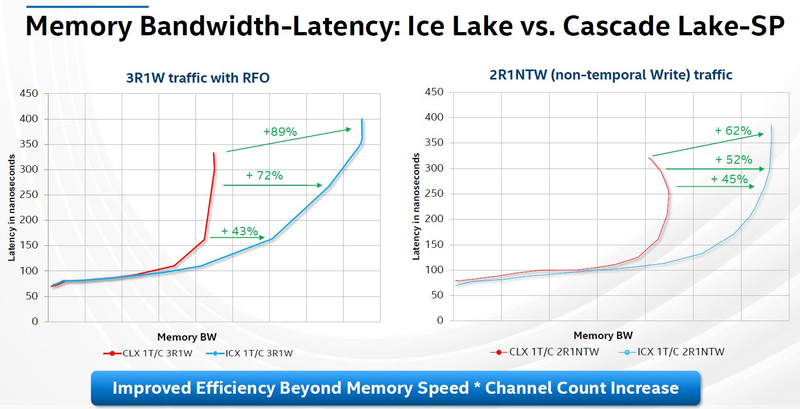 Важной частью Ice Lake-SP стали новые контроллеры PCI Express. В этом поколении о поддержке PCIe 5.0 говорить не приходится, тем более что соответствующей периферии на рынке всё равно ещё нет, но PCIe 4.0 поддерживается полностью. Сами контроллеры PCI Express усовершенствованы, они получили новый блок виртуализации (IOV) и лучше масштабируются на больших нагрузках. 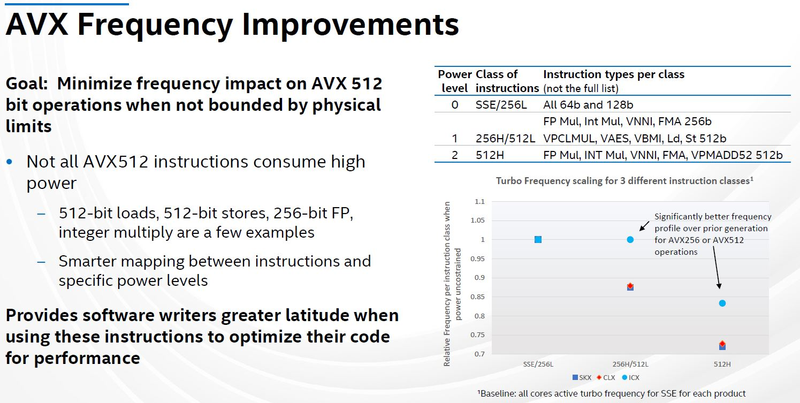 В целом процессоры Intel Xeon Ice Lake-SP являют собой достаточно современный продукт. Конечно, достигнуть многоядерности AMD EPYC 7002 «синим» на этот раз не удалось, но многочисленные оптимизации и улучшения вкупе с поддержкой PCI Express 4.0 должны помочь Intel продержаться до появления действительно инновационных процессоров Sapphire Rapids. Также появление Ice Lake-SP благотворно скажется на скорости внедрения периферии с поддержкой PCI Express 4.0. Но на горизонте уже маячит PCI Express 5.0 и новые стандарты памяти.
18.06.2020 [16:00], Алексей Степин
Intel представила Xeon Cooper Lake, третье поколение Scalable-процессоровКрупнейший в мире производитель процессоров с архитектурой x86, компания Intel, представила новую платформу, нацеленную на быстро растущий рынок машинного обучения, аналитики и периферийных вычислений. Хотя платформа состоит из нескольких компонентов, главным из них являются новые процессоры Intel Xeon Scalable — это уже третье поколение серии Scalable. 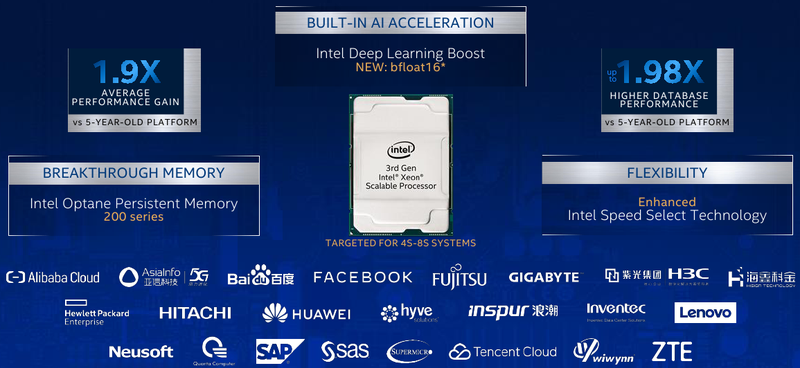 Первое поколение Xeon Scalable (Skylake) отличалось наличием поддержки векторных расширений с длиной 512 бит, хотя эта поддержка была наиболее полной в других процессорах с разъёмом LGA 3647, ныне почивших Xeon Phi 72xx. Во втором поколении Xeon Scalable, известном под кодовым именем Cascade Lake, появились расширения AVX-512 VNNI (Vector Neural Network Instructions, они же DL Boost), и это был первый реверанс в сторону машинного обучения со стороны Intel — расширения позволялил работать с INT8 и подходили для инференса. 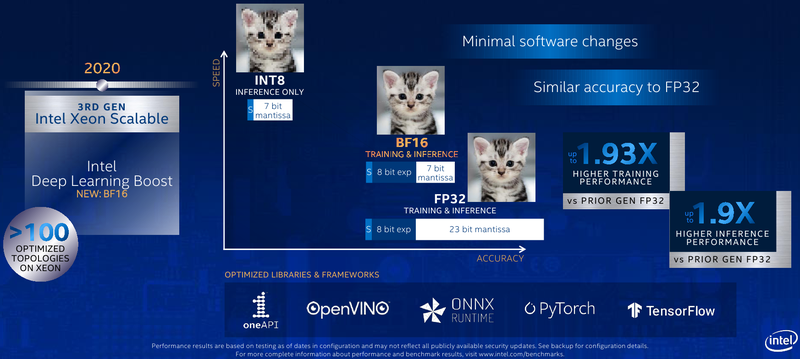 Третье поколение, получившее имя Cooper Lake, ещё больше продвинулось в сторону поддержки нетипичных для традиционной архитектуры x86 форматов вычислений. Главным нововведением здесь является поддержка формата bfloat16, который часто используется в комплексах машинного обучения и системах принятия решений (инференс). Он требует меньше вычислительных мощностей, нежели традиционные форматы FP32/64, но при этом в большинстве случаев обеспечивает достаточную точность вычислений, а итоговый выигрыш в производительности может быть почти двухкратным. 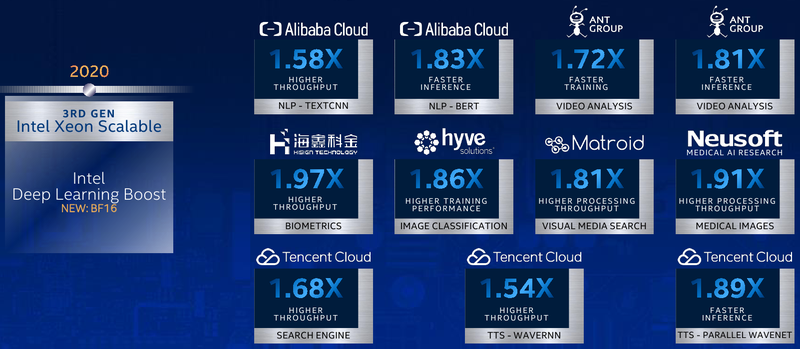 Популярные фреймворки, такие как TensorFlow и Pytorch, уже давно поддерживают bfloat16, а Intel-оптимизированные версии доступны в комплекте Intel AI Analytics Toolkit. Компания также оптимизировала среды OpenVINO и ONNX с учётом возможностей новых процессоров Xeon Scalable. Собственно говоря, самое главное в Cooper Lake то, что их теперь можно использовать и для обучения нейронных сетей, а не только для инференса. Intel отдельно подчёркивает универсальность новых CPU. 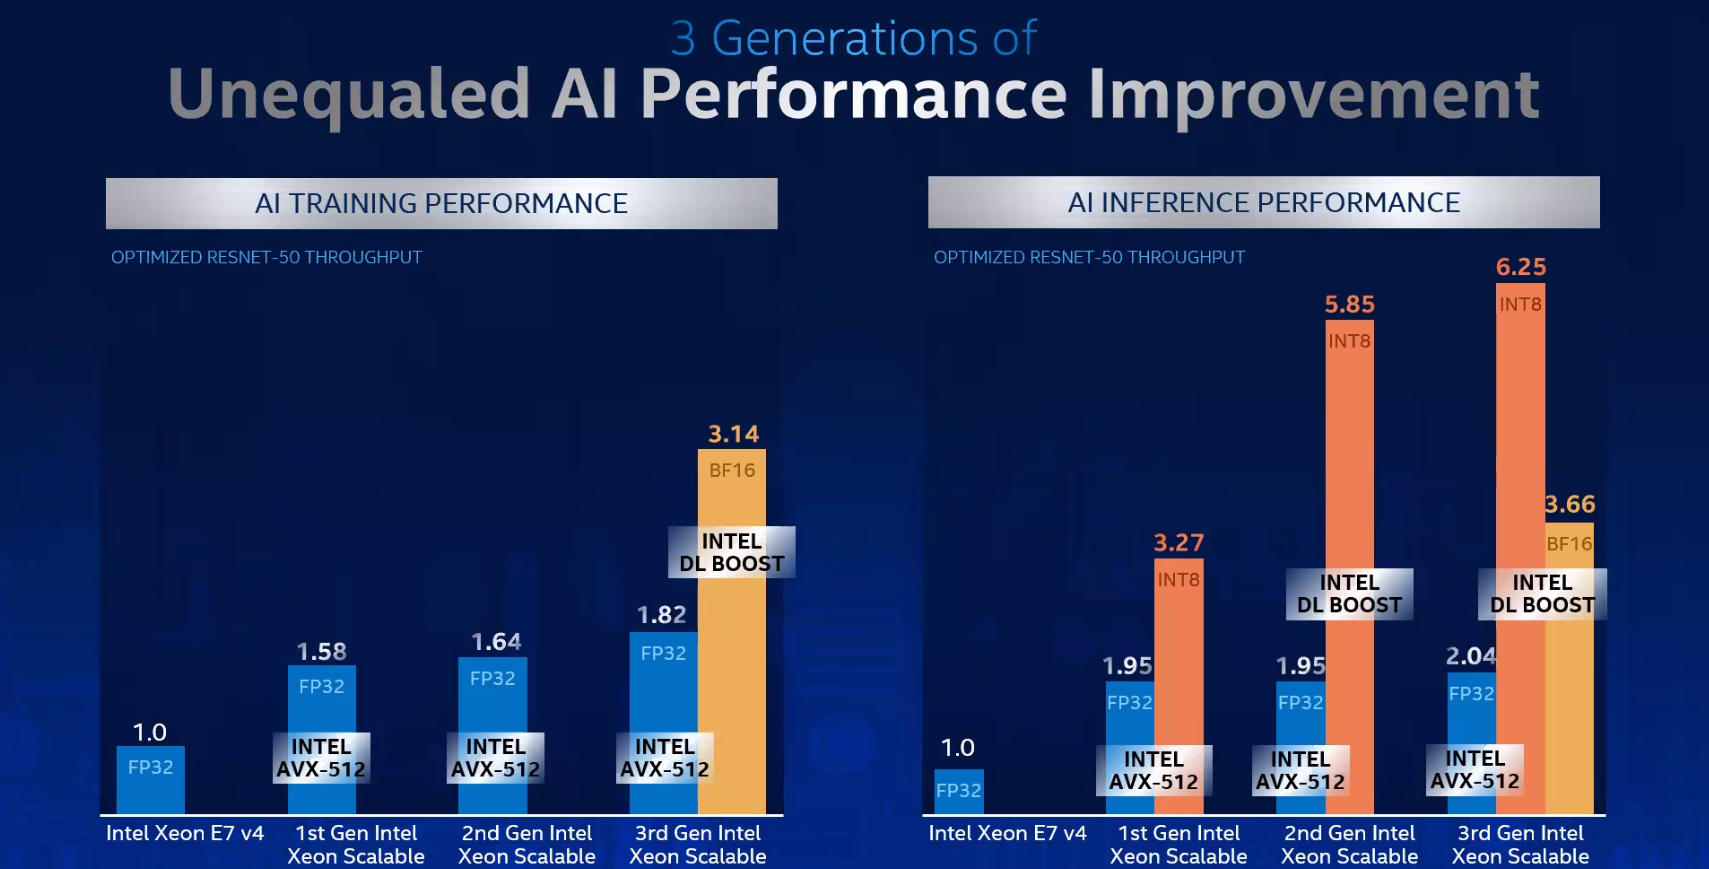 Что касается самих процессоров, то максимальное количество ядер сохранилось, их в серии Xeon Gold 53xx/63xx и Xeon Platinum 83xx по-прежнему 28 при поддержке SMT2. Однако улучшения есть, и достаточно серьёзные. Серия Xeon Platinum поддерживает память до DDR4-3200 (1DPC) и DDR4-2933 (2DPC), хотя младшие пяти- и шеститысячники так же ограничены 2666 и 2933 MT/с. Зато все они поддерживают память Intel Optane DCPMM 2-го поколения. Число каналов память осталось прежним, их шесть. Существенное отличие от Cascade Lake в том, что теперь у всех CPU есть 6 линий UPI — они могут может «бесшовно» устанавливаться в системы с четырьмя или восемью процессорными разъёмами. Другое важное отличие — серия 53xx теперь имеет два FMA-порта для AVX-512, а не один как раньше. Часть новинок поддерживает Intel Speed Select. 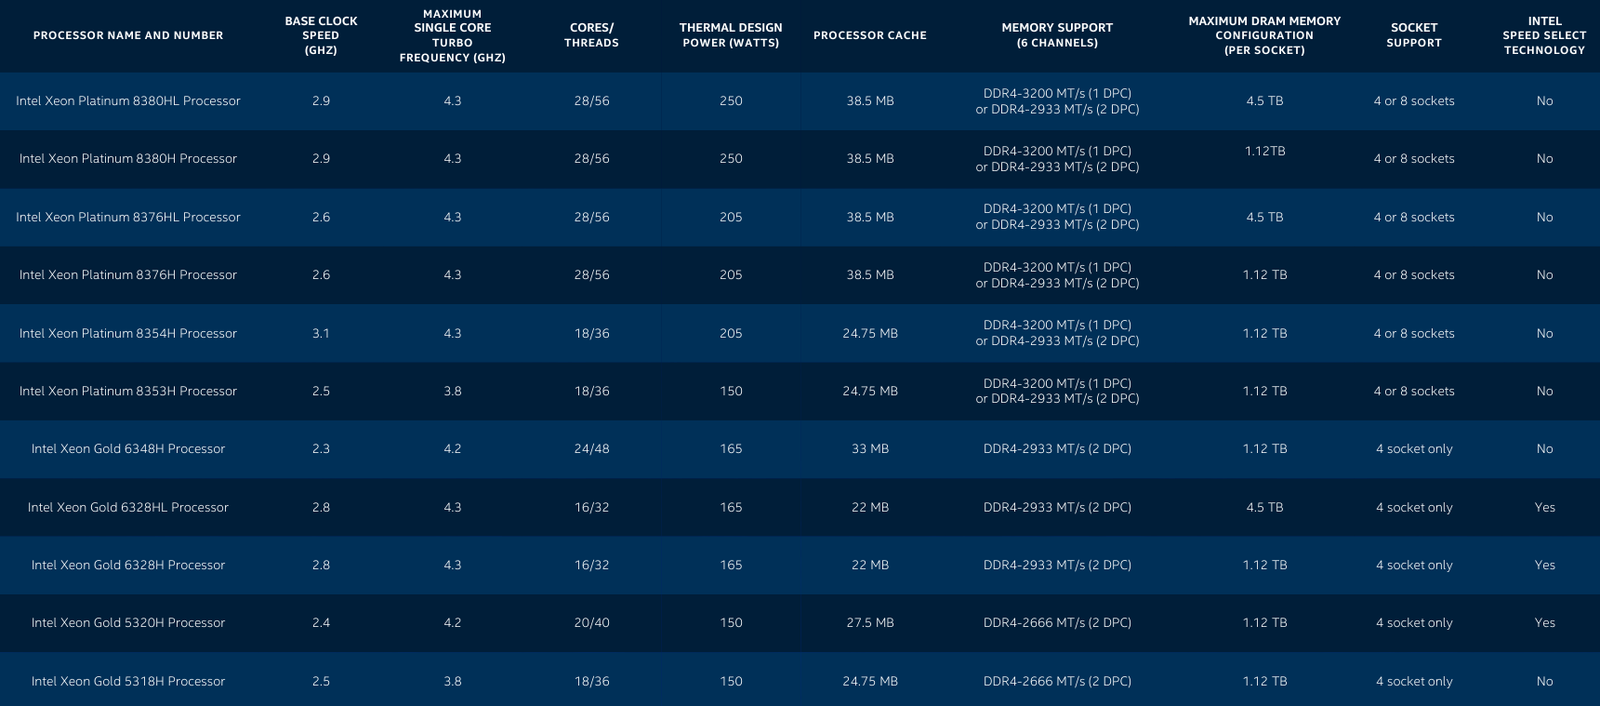 У «ёмких» моделей с суффиксом HL максимальный объём оперативной памяти достиг 4,5 Тбайт, а у базовых H — до 1,12 Тбайт. Несколько подросли тактовые частоты, в серии есть модели с частотной формулой 2,9 ‒ 4,3 ГГц, причём большая часть новинок имеет частоту в турборежиме более 4 ГГц. Исключение — модели с пониженным энергопотреблением. Всё это делает новые процессоры привлекательными для крупных предприятий, облачных провайдеров и гиперскейлеров вообще. Если даже на секунду забыть все новововведения для ИИ, Cooper Lake всё равно останется многосокетной платформой, а это значит, что он подходит для работы с большими СУБД, анализа больших объёмов данных в реальном времени, OLTP и виртуализации. В области 4S/8S-платформ у Intel давно крепкие позиции, так что новинки наверняка приглянутся определённому кругу заказчиков. Но массовыми Cooper Lake в текущем виде не станут. 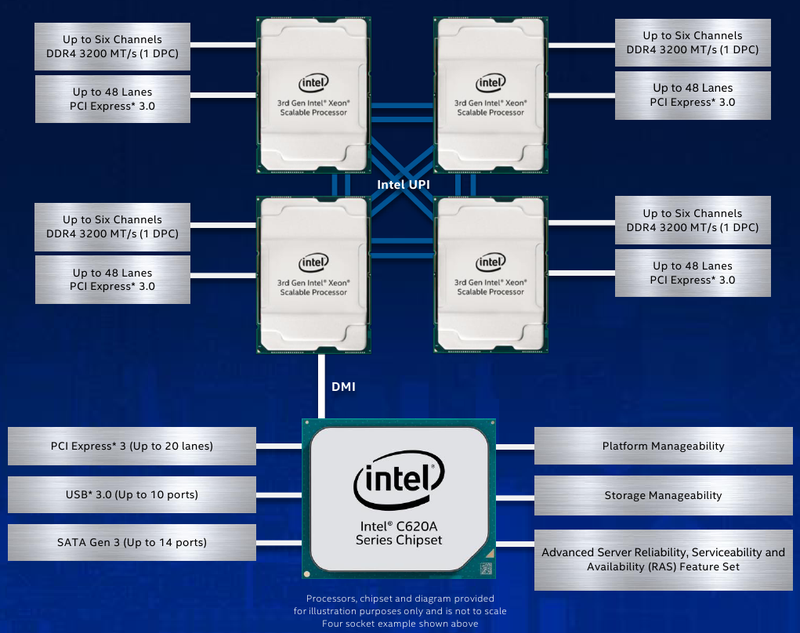 Основной системный чипсет — Intel C620A, то есть обновлённый Lewisburg. В серию пока входит всего три модели, две из которых поддерживают технологию Intel QAT, ускоряющую работы по компресии и шифрованию. Так это обновление уже имеющихся чипсетов, поддержки PCI Express 4.0 нет. Сами процессоры Xeon Scalable третьего поколения по-прежнему могут предоставить в распоряжение системы до 48 линий PCIe 3.0. С учётом того, что ориентированы они на 4-сокетные системы, этого может быть вполне достаточно. 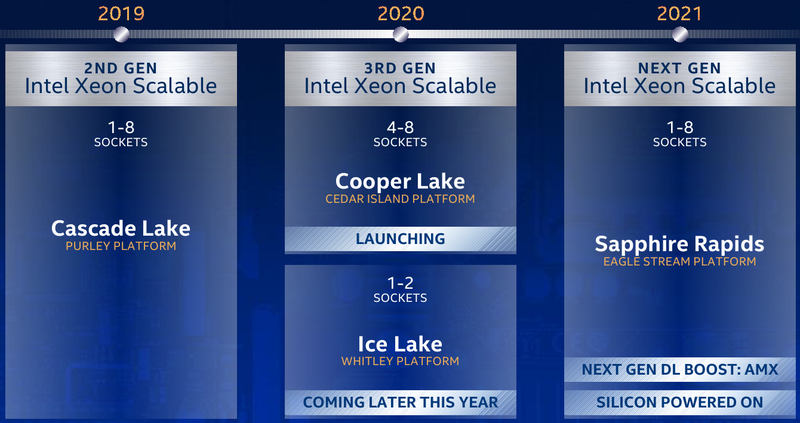 Однако другие процессоры Xeon Scalable «Ice Lake», для одно-двухсокетных платформ Whitley, которые Intel планирует представить позднее в этом году, уже получат поддержку PCI Express 4.0. Также известно, что четвёртое поколение Xeon Scalable под именем Sapphire Rapids получит набор новых матричных расширений (Advanced Matrix Extensions, AMX), которые, вероятно, буду напоминать тензорные ядра. Она увидит свет уже в 2021 году. Для массовых одно- и двухсокетных платформ пока предлагается использовать Cascade Lake Refresh. Вместе с Intel Xeon Cooper Lake компания также анонсировала второе поколение памяти Intel Optane DCPMM 200, накопители Intel D7-P5500 и D7-5600 с интерфейсом PCIe 4.0 и новую FPGA Intel Stratix 10 NX.
26.05.2020 [21:06], Алексей Степин
Facebook✴ Yosemite и Delta Lake: OCP-платформы с Intel Xeon Cooper LakeНа прошлой неделе мы писали о решении ITRenew Sesame, которое позволит небольшим компаниями получить недорогое, но производительное б/у «железо» от Facebook✴ и других гигантов. Особенность такого оборудования в том, что оно имеет OCP-исполнение. И самый простой способ познакомиться с миром OCP — посмотреть на новые решения самой Facebook✴. Среди них есть одноюнитовое шасси Sonora Pass, но это не единственная новинка, использующая самые свежие CPU Intel Xeon Cooper Lake. Есть и специфичные для OCP платформы Yosemite v3 и Delta Lake. 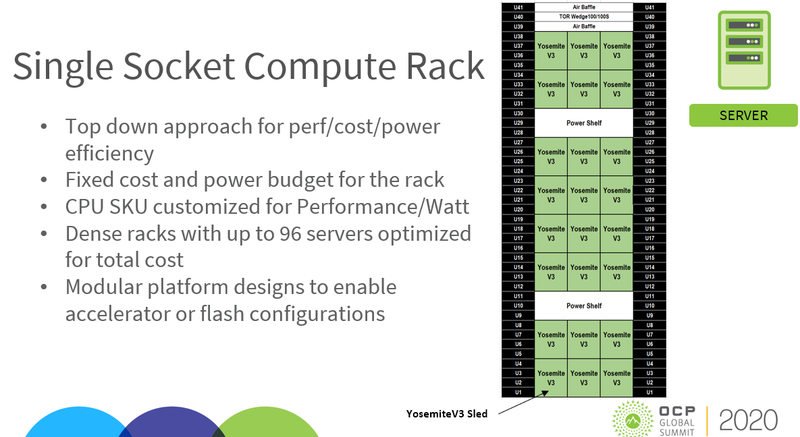 Привычные нам стоечные форм-факторы серверов создавались в те времена, когда вопрос упаковки вычислительных мощностей не стоял столь остро, как сейчас. В лучшем случае, стандартный 19-дюймовый корпус может содержать системную плату с четырьмя процессорами, но чаще ограничен двухсокетными конфигурациями. Facebook✴ использует стандарт стоек Open Rack, главное в которых — возможность более плотного размещения серверов (21"), увеличение воздушного потока и единая шина питания (12 В DC). Yosemite v3 являет собой уже третье поколение серверных систем в этом стандарте. 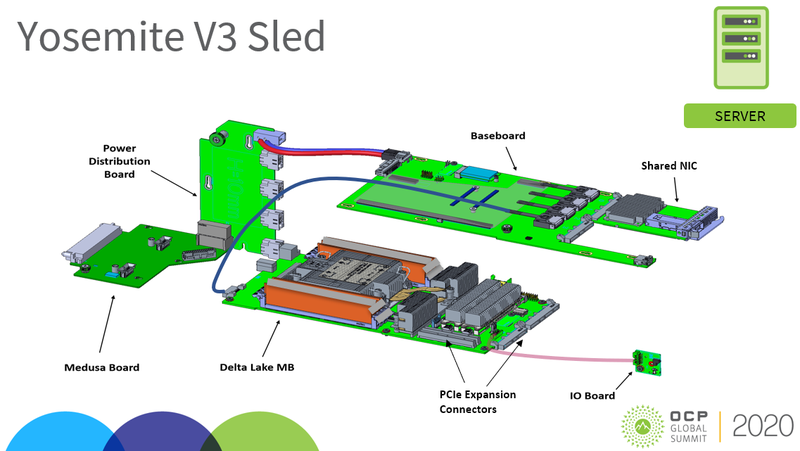 В третьей версии 4 юнита вертикального пространства стойки вмещает в себя три модуля Yosemite v3. Каждый из этих модулей может включать в себя до четырёх сверхкомпактных серверов Delta Lake на базе новых процессоров Intel Cooper Lake-SP. Предусматриваются разные варианты модулей: классический «вычислительный» с четырьмя системными платами, вариант с собственным флеш-хранилищем, версия с акселераторами и модель с интегрированным сетевым коммутатором. В зависимости от решаемой задачи, стойка может включать различные сочетания Yosemite v3. 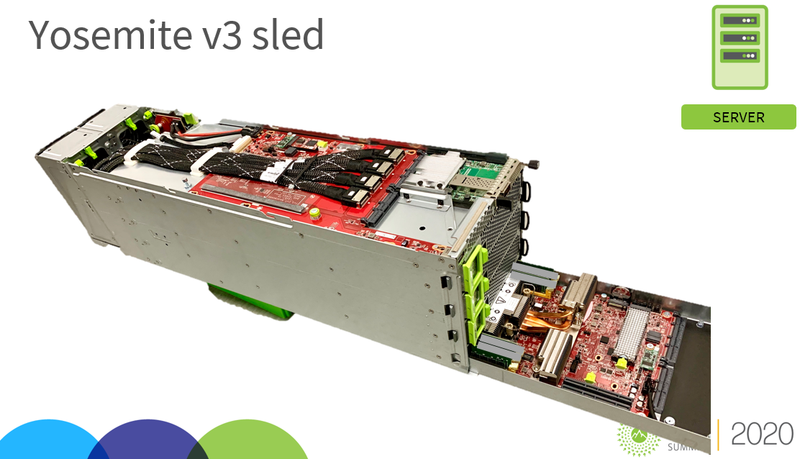 Два последних варианта предусматривают два процессорных гнезда вместо четырёх, но в них предусмотрено пространство для размещения ГП-ускорителей или собственной сетевой подсистемы, включающей в себя выделенные сетевые адаптеры и коммутатор. Все четыре варианта базируются на шасси высотой 4U и шириной в треть стойки, в верхней части которого размещается базовая плата с общим сетевым адаптером, а в задней — платы питания Medusa Board. 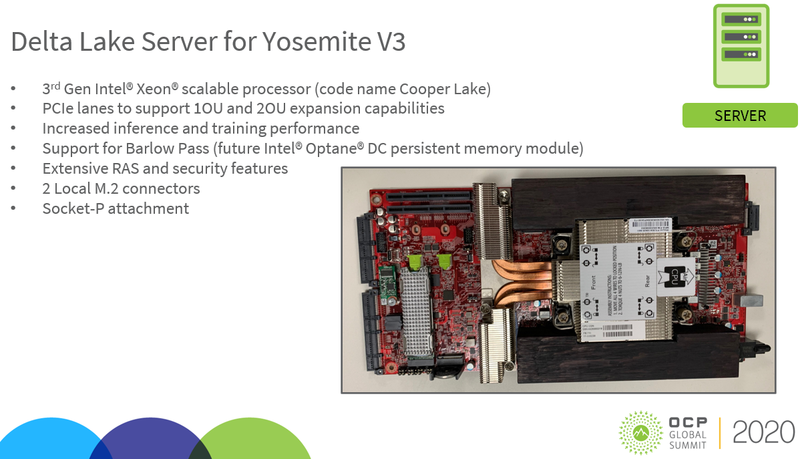 «Лезвия» с системными платами быстросъёмные. Основная модель «лезвия» носит название Delta Lake. Она представляет собой компактную системную плату с процессором Intel Xeon Scalable третьего поколения (Cooper Lake). Эти платы изначально создавались с прицелом на повышенный уровень производительности в системах машинного интеллекта и принятия решений. 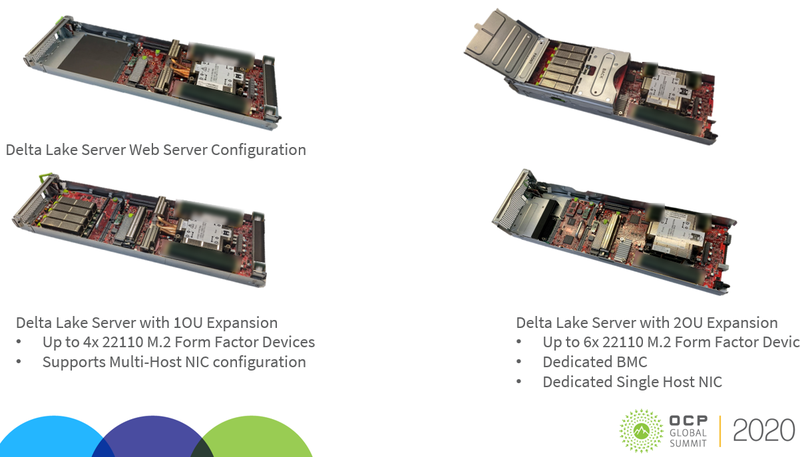 За отвод тепла отвечает компактная, но мощная система охлаждения с четырьмя тепловыми трубками и дополнительными секциями радиаторов. Поддерживаются расширенные возможности удалённого управления и администрирования, имеется пара набортных разъёмов для накопителей типа M.2. Также платы Delta Lake поддерживают новый стандарт модулей Intel Optane DCPMM под кодовым названием Barlow Pass. 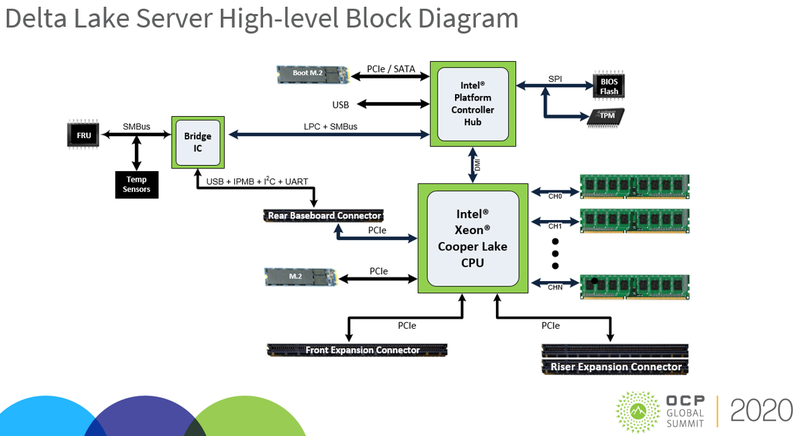 Помимо Yosemite v3, Facebook✴ представила также новую платформу для запуска нейронных сетей (инеференс). Каждый модуль этой платформы состоит из системного модуля Yosemite v2.50 и модуля расширения Glacier Point v2, общающегося с ЦП посредством 16 линий PCI Express 3.0; особенный интерес представляет именно последний. 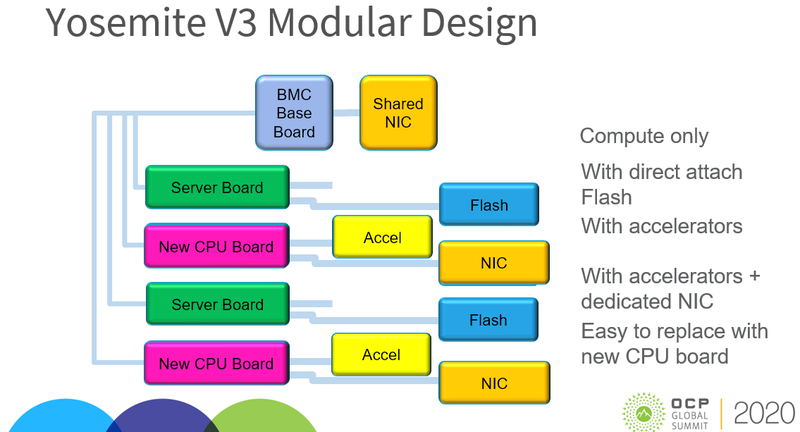 В этом модуле реализована возможность установки как стандартных одинарных модулей M.2 (теплопакет до 14 Ватт), так и двойных, с теплопакетом 25 Ватт. Всего модуль расширения может содержать до шести двойных или двенадцати одинарных плат с интерфейсом M.2. Два таких блока с модулями GPv2 устанавливаются в шасси Yosemite v2.50. В сравнении с Yosemite v2 с 600 до 720 Ватт увеличена мощность подсистем питания, реализована поддержка 100GbE, сетевой контроллер подключён к процессору, а не к мосту PCH, как ранее. 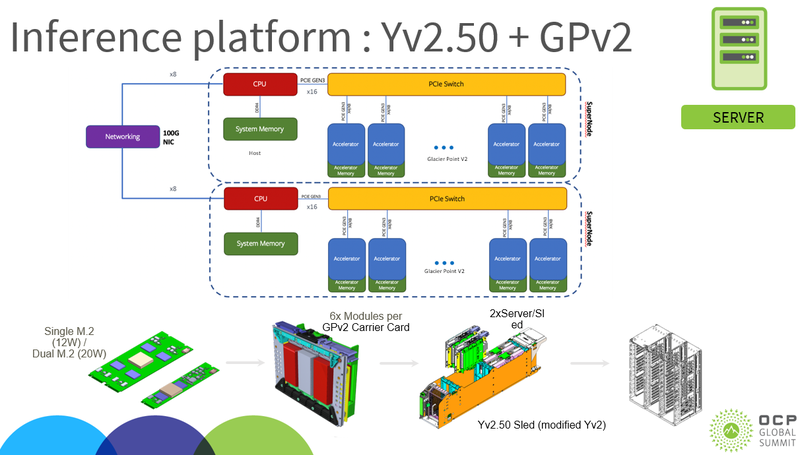
Новая платформа для инференс-систем В данном решении особый интерес вызывает поддержка M.2 двойной ширины. Сам по себе стандарт M.2 достаточно компактен, но ширина одинарной платы означает и ограничение по габаритам чипа ускорителя. Двойная ширина позволяет это ограничение преодолеть и оснащать ускорители более мощными и крупными ASIC, но не терять при этом электрической и механической совместимости. 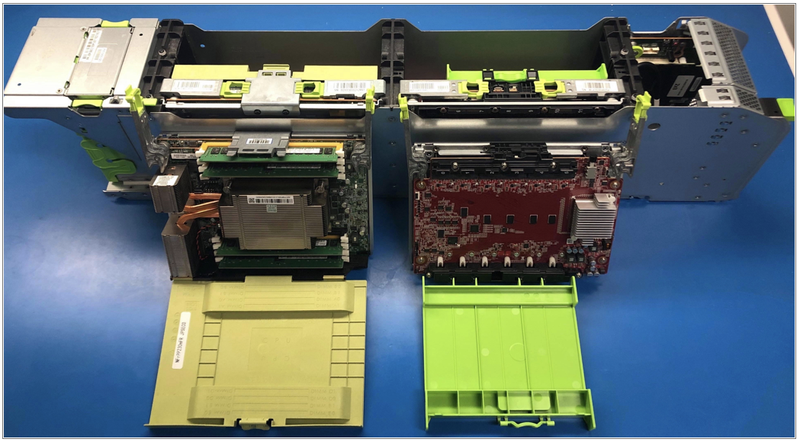 Такой модульный дизайн обеспечивает сочетанию Yv2.50 и GPv2 непревзойдённую гибкость, ведь в единой системе могут уживаться различные ускорители на базе разных чипов. А благодаря единой системе BMC и поддержке стандартных протоколов SMBUS, UART, JTag и I2C, обеспечивается полный спектр средств удаленного управления и мониторинга. Ограничение по ширине интерфейса к основному ЦП нивелируется тем, что GPv2 имеет собственный коммутатор PCIe, так что ускорители, в нём установленные, могут общаться и в режиме «точка-точка». 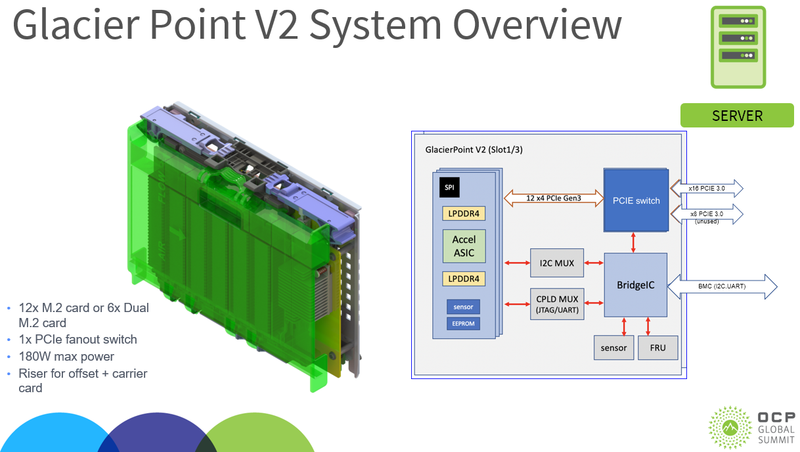 Платформа Yv2.50 + GPv2 имеет свои недостатки, но компания-разработчик их осознаёт. В частности, в будущих версиях, возможно, каждый сервер будет иметь собственный контроллер BMC и сетевой процессор, а модуль расширения получит поддержку PCI Express 4.0, что снимет возможные проблемы с нехваткой пропускной способности. 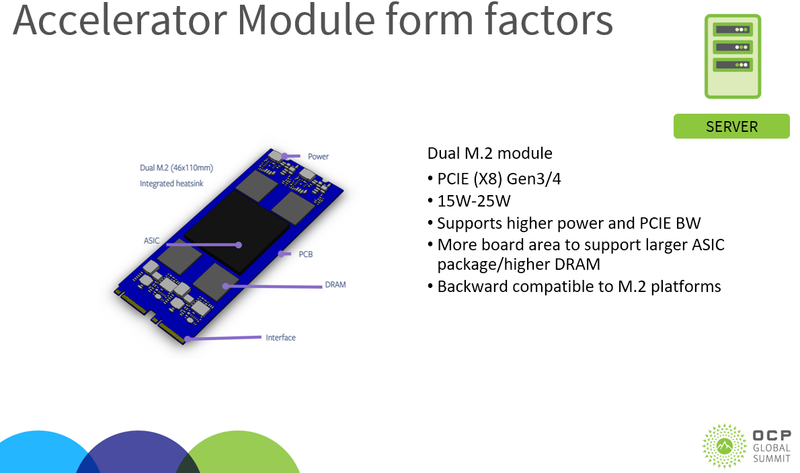 При этом необходимо отметить, что Facebook✴ является участником проекта OCP и платформа Yv2.50 + GPv2 имеет открытые спецификации. Подробнее о них можно узнать на wiki-странице проекта. Отдельно опубликованы спецификации на ускорительные модули M.2 обычной и двойной ширины. |
|


