Материалы по тегу: ascend
|
26.02.2025 [17:18], Руслан Авдеев
ИИ-ускорители Ascend впервые стали приносить Huawei прибыльHuawei поступательно улучшает качество своих чипов. По последним данным, уже 40 % экземпляров новейших ускорителей Ascend пригодны к эксплуатации, а их производство впервые стало для компании прибыльным, говорят отраслевые эксперты. Компания намерена повысить показатель годности до 60 % в соответствии со стандартами индустрии, сообщает The Financial Times. Год назад речь шла якобы лишь о 20 %. Это чрезвычайно важно для компании, поскольку Ascend 910C значительно производительнее 910B. Это очередной шаг на пути Китая к строительству независимой вычислительной инфраструктуры, не подверженной санкциям. Местную полупроводниковую отрасль активно поддерживает государство. Пекин постоянно призывает китайские компании покупать местные альтернативы продуктов NVIDIA, которая до сих пор остаётся лидером рынка ускорителей в КНР. По данным отраслевых источников, в этом году Huawei намерена выпустить 100 тыс. чипов 910C и 300 тыс. 910B. В 2024 году последних выпустили 200 тыс. экземпляров, а массовый впуск 910С ещё не был налажен. Впрочем, компании придётся постараться, чтобы убедить потенциальных покупателей отказаться от продукции NVIDIA. Отмечается, что программная экосистема NVIDIA CUDA намного удобнее и производительнее ПО Huawei. Кроме того, бизнес и сама Huawei признают, Ascend 910B недостаточно хороши для обучения больших моделей. Эту проблему компания попыталась решить в модели 910C. 
Источник изображения: Huawei В 2020 году США буквально заставили тайваньскую TSMC прекратить производство для Huawei ускорителей Ascend и чипсетов для смартфонов компании. Выпуском ускорителей Huawei занимается китайская SMIC, которая тоже находится под американскими санкциями. Компания использует техпроцесс N+2, позволяющий выпускать высокопроизводительные чипы без EUV-литографии. В Китай запрещено продавать соответствующее оборудование нидерландской ASML. Так или иначе, Huawei является единственным конкурентом, способным состязаться с NVIDIA при производстве чипов для инференса. Правда, как отмечают многие китайские заказчики, компания не может обеспечить действительно масштабных поставок для всех желающих, отдавая приоритет крупным облачным провайдерам, за которыми стоит государство, например, China Mobile. По мнению экспертов, на Huawei сегодня приходится более ¾ общего производства ИИ-чипов в Китае, мелким соперникам трудно конкурировать с техногигантом из-за того, что тот имеет доступ к самым передовым технологическим процессам SMIC. Предполагается, что NVIDIA всё равно будет продавать больше ускорителей в Китае, чем Huawei, несмотря на то что американской компании разрешено поставлять только урезанные модели H20. По оценкам SemiAnalysis, выручка NVIDIA за продажу только в 2024 году в Китай 1 млн ускорителей составила $12 млрд. Триумф ИИ-моделей DeepSeek только подстегнул спрос на чипы NVIDIA H20 в Китае.
22.01.2025 [08:08], Руслан Авдеев
Ускорители Ascend не готовы состязаться с чипами NVIDIA в деле обучения ИИ, но за эффективность инференса Huawei будет бороться всеми силамиХотя на китайском рынке ИИ-ускорителей по-прежнему доминирует NVIDIA, Huawei намерена отнять у неё значительную его долю. Для этого китайский разработчик намерен помочь китайским ИИ-компаниям внедрять чипы собственного производства для инференса, сообщает The Financial Times. Для обучения ИИ-моделей китайские производители в массе своей применяют чипы NVIDIA. Huawei пока не готова заменить продукты NVIDIA в этом деле из-за ряда технических проблем, в том числе из-за проблем с интерконнектом ускорителей при работе с крупными моделями. Предполагается, что в будущем именно инференс станет пользоваться большим спросом, если темпы обучения ИИ-моделей замедлятся, а приложения вроде чат-ботов будут распространены повсеместно. Если инференс нужен постоянно, то к обучению ИИ-моделей прибегают лишь время от времени. По словам сотрудников и клиентов Ascend, компания сосредоточена на менее сложном, но, возможно, более прибыльном пути. Но поскольку ускорители NVIDIA и Huawei используют разные программные экосистемы, последняя предлагает бизнесам ПО для обеспечения совместимости. Продукция Huawei продвигается при поддержке китайского правительства, внутри страны именно эта компания считается наиболее серьёзным конкурентом NVIDIA. И хотя китайские компании всё более ограничены в доступе к аппаратным решениям NVIDIA из-за санкций, они охотно покупают даже урезанные чипы H20, которые всё равно считают более предпочтительным вариантом, чем китайские альтернативы. 
Источник изображения: Huawei Задача Huawei — убедить разработчиков отказаться от платформы CUDA, во многом благодаря которой NVIDIA и смогла добиться успеха на рынке. От проблем с ПО страдает и AMD — по словам экспертов, именно оно не позволяет раскрыть потенциал ускорителей Instinct MI300X. Впрочем, готовящаяся к релизу версия Huawei Ascend 910C должна решить эти проблемы, поскольку новое поколение ускорителей получит ПО, упрощающее работу разработчиков. Тем временем китайские Baidu и Cambricon добились определённых успехов в разработке собственных ИИ-ускорителей, а ByteDance обратилась за помощью к Broadcom. По оценкам SemiAnalysis, в прошлом году NVIDIA заработала $12 млрд на продажах своей продукции в Китае, поставив 1 млн ускорителей H20, т.е. вдвое больше, чем Ascend 910B. Впрочем, отрыв, по словам экспертов, быстро сокращается, поскольку Huawei наращивает производство. Отмечается, что рост доли Huawei на рынке ИИ-ускорителей отчасти сдерживается лишь недостаточным предложением её продукции. По мнению экспертов, наращивать производство будет трудно, поскольку Китайское вынужден использовать устаревшее оборудование из-за санкций США. Специализация на инференсе может свидетельствовать и об особом векторе развития китайских ИИ-систем, отличающемся от американского. Китайские компании не участвуют в гонке Meta✴, xAI и OpenAI по созданию мегакластеров на базе решений NVIDIA. Зато большей эффективности в задачах инференса можно добиться даже с более слабыми чипами. Снизив стоимость работы ИИ-моделей, можно будет сохранять конкурентоспособность даже в таких условиях. В прошлом месяце китайский стартап DeepSeek представил ИИ-модель V3, обеспечивающую низкие затраты на обучение и инференс в сравнении с сопоставимыми по возможностям моделями из США. DeepSeek утверждает, что Huawei успешно адаптировала V3 к Ascend. Ранее сообщалось, что Huawei охотно направляет к клиентам специалистов для помощи с переходом с NVIDIA на Ascend.
27.08.2019 [11:00], Геннадий Детинич
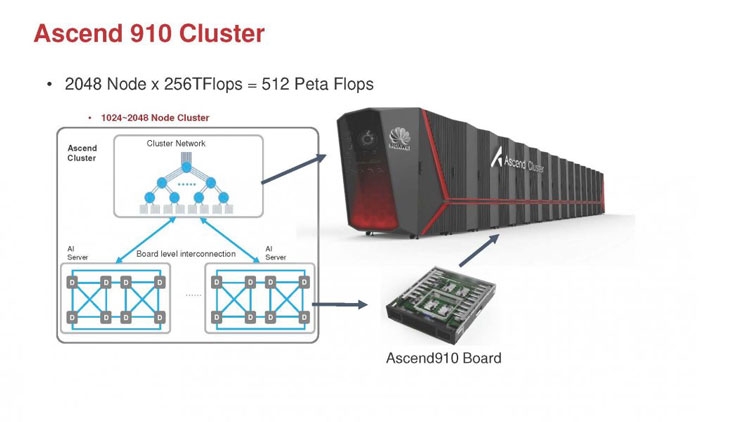
Huawei Ascend 910: китайская альтернатива ИИ-платформам NVIDIAГлубокое машинное обучение ― это сравнительно новая область приложения для вычислительных архитектур. Как всё новое, ML заставляет искать альтернативные пути решения задач. В этом поиске китайские разработчики оказались на равных и даже в привилегированных условиях, что привело к появлению в Китае мощнейших ИИ-платформ. Как всем уже известно, на конференции Hot Chips 31 компания Huawei представила самый мощный в мире ИИ-процессор Ascend 910. Процессоры для ИИ каждый разрабатывает во что горазд, но все разработчики сравнивают свои творения с ИИ-процессорами компании NVIDIA (а NVIDIA с процессорами Intel Xeon). Такова участь пионера. NVIDIA одной из первых широко начала продвигать свои модифицированные графические архитектуры в качестве ускорителей для решения задач с машинным обучением.  Гибкость GPU звездой взошла над косностью x86-совместимой архитектуры, но во время появления новых подходов и методов тренировки машинного обучения, где пока много открытых дорожек, она рискует стать одной из немногих. Компания Huawei со своими платформами вполне способна стать лучшей альтернативой решениям NVIDIA. Как минимум, это произойдёт в Китае, где Huawei готовится выпускать и надеется найти сбыт для миллионов процессоров для машинного обучения. 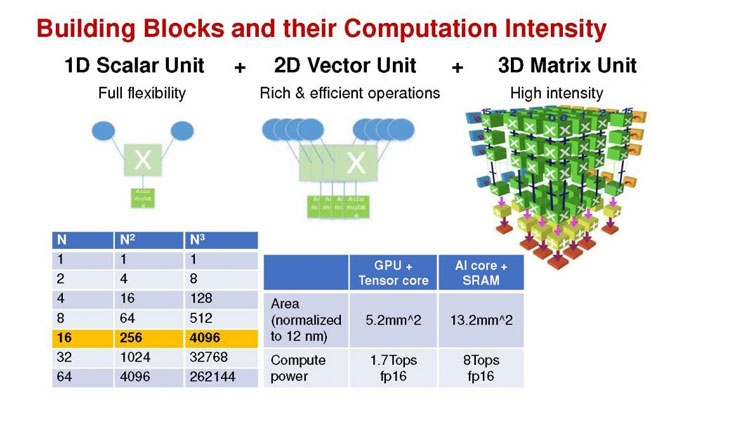 Мы уже публиковали анонс наиболее мощного ускорителя для ML чипа Huawei Ascend 910. Сейчас посмотрим на это решение чуть пристальнее. Итак, Ascend 910 выпускается компанией TSMC с использованием второго поколения 7-нм техпроцесса (7+ EUV). Это техпроцесс характеризуется использованием сканеров EUV для изготовления нескольких слоёв чипа. На конференции Huawei сравнивала Ascend 910 с ИИ-решением NVIDIA на архитектуре Volta, выпущенном TSMC с использованием 12-нм FinFET техпроцесса. Выше на картинке приводятся данные для Ascend 910 и Volta, с нормализацией к 12-нм техпроцессу. Площадь решения Huawei на кристалле в 2,5 раза больше, чем у NVIDIA, но при этом производительность Ascend 910 оказывается в 4,7 раза выше, чем у архитектуры Volta. 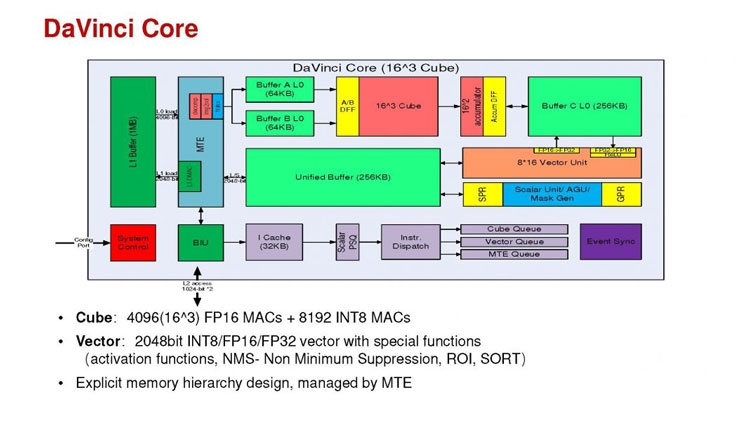 Также на схеме видно, что Huawei заявляет о крайне высокой масштабируемости архитектуры. Ядра DaVinci, лежащие в основе Ascend 910, могут выпускаться в конфигурации для оперирования скалярными величинами (16), векторными (16 × 16) и матричными (16 × 16 × 16). Это означает, что архитектура и ядра DaVinci появятся во всём спектре устройств от IoT и носимой электроники до суперкомпьютеров (от платформ с принятием решений до машинного обучения). Чип Ascend 910 несёт матричные ядра, как предназначенный для наиболее интенсивной работы. 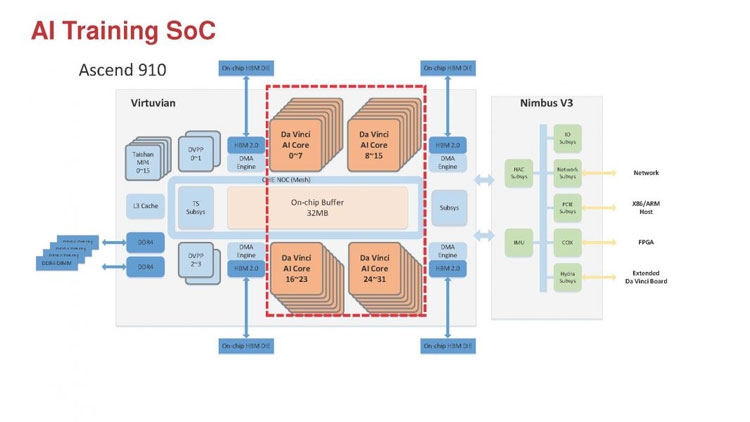 Ядро DaVinci в максимальной конфигурации (для Ascend 910) содержит 4096 блоков Cube для вычислений с половинной точностью (FP16). Также в ядро входят специализированные блоки для обработки скалярных (INT8) и векторных величин. Пиковая производительность Ascend с 32 ядрами DaVinci достигает 256 терафлопс для FP16 и 512 терафлопс для целочисленных значений. Всё это при потреблении до 350 Вт. Альтернатива от NVIDIA на тензорных ядрах способна максимум на 125 терафлопс для FP16. Для решения задач ML чип Huawei оказывается в два раза производительнее. 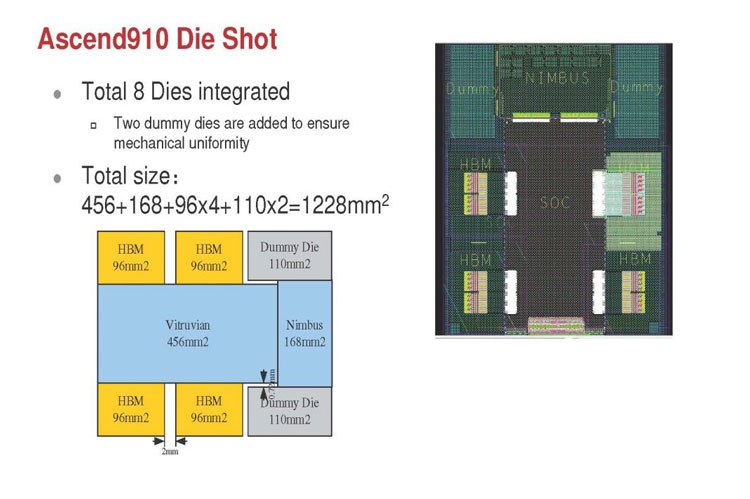 Помимо ядер DaVinci на кристалле Ascend 910 находятся несколько других блоков, включая контроллер памяти HBM2, 128-канальный движок для декодирования видеопотоков. Мощный чип для операций ввода/вывода Nimbus V3 выполнен на отдельном кристалле на той же подложке. Рядом с ним для механической прочности всей конструкции пришлось расположить два кристалла-заглушки, каждый из которых имеет площадь 110 мм2. С учётом болванок и четырёх чипов HBM2 площадь всех кристаллов достигает 1228 мм2. 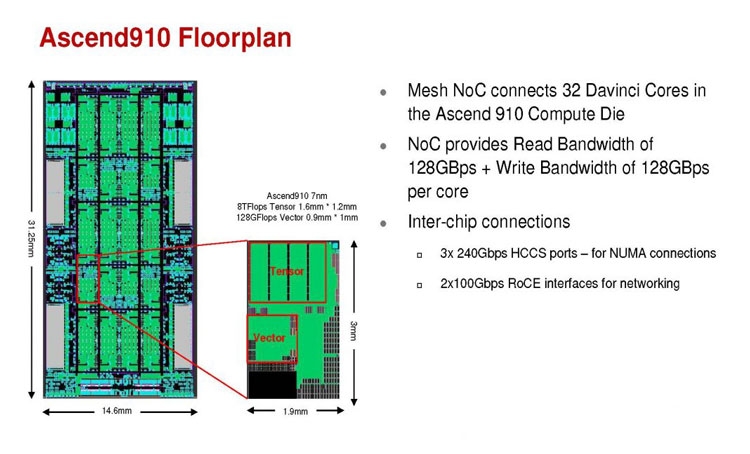 Для связи ядер и памяти на кристалле создана ячеистая сеть в конфигурации 6 строк на 4 колонки со скоростью доступа 128 Гбайт/с на каждое ядро для одновременных операций записи и чтения. Для соединения с соседними чипами предусмотрена шина со скоростью 720 Гбит/с и два линка RoCE со скоростью 100 Гбит/с. К кеш-памяти L2 ядра могут обращаться с производительностью до 4 Тбайт/с. Скорость доступа к памяти HBM2 достигает 1,2 Тбайт/с. 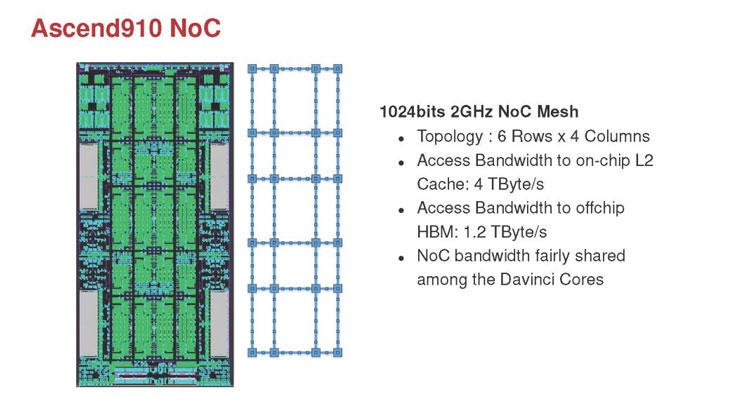 В каждый полочный корпус входят по 8 процессоров Ascend 910 и блок с двумя процессорами Intel Xeon Scalable. Спецификации полки ниже на картинке. Решения собираются в кластер из 2048 узлов суммарной производительностью 512 петафлопс для операций FP16. Кластеры NVIDIA DGX Superpod обещают производительность до 9,4 петафлопс для сборки из 96 узлов. В сравнении с предложением Huawei это выглядит бледно, но создаёт стимул рваться вперёд. 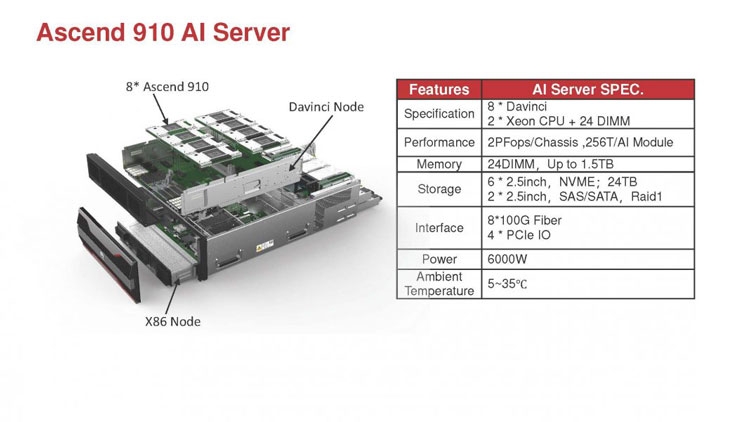
 |
|

